Paper Podcast

研究论文深度解读。每篇 15 分钟口播,听完脑子里能建出论文架构。

RSS 订阅GitHub
cover VLA
2026-05-28 · Alibaba Qwen Team

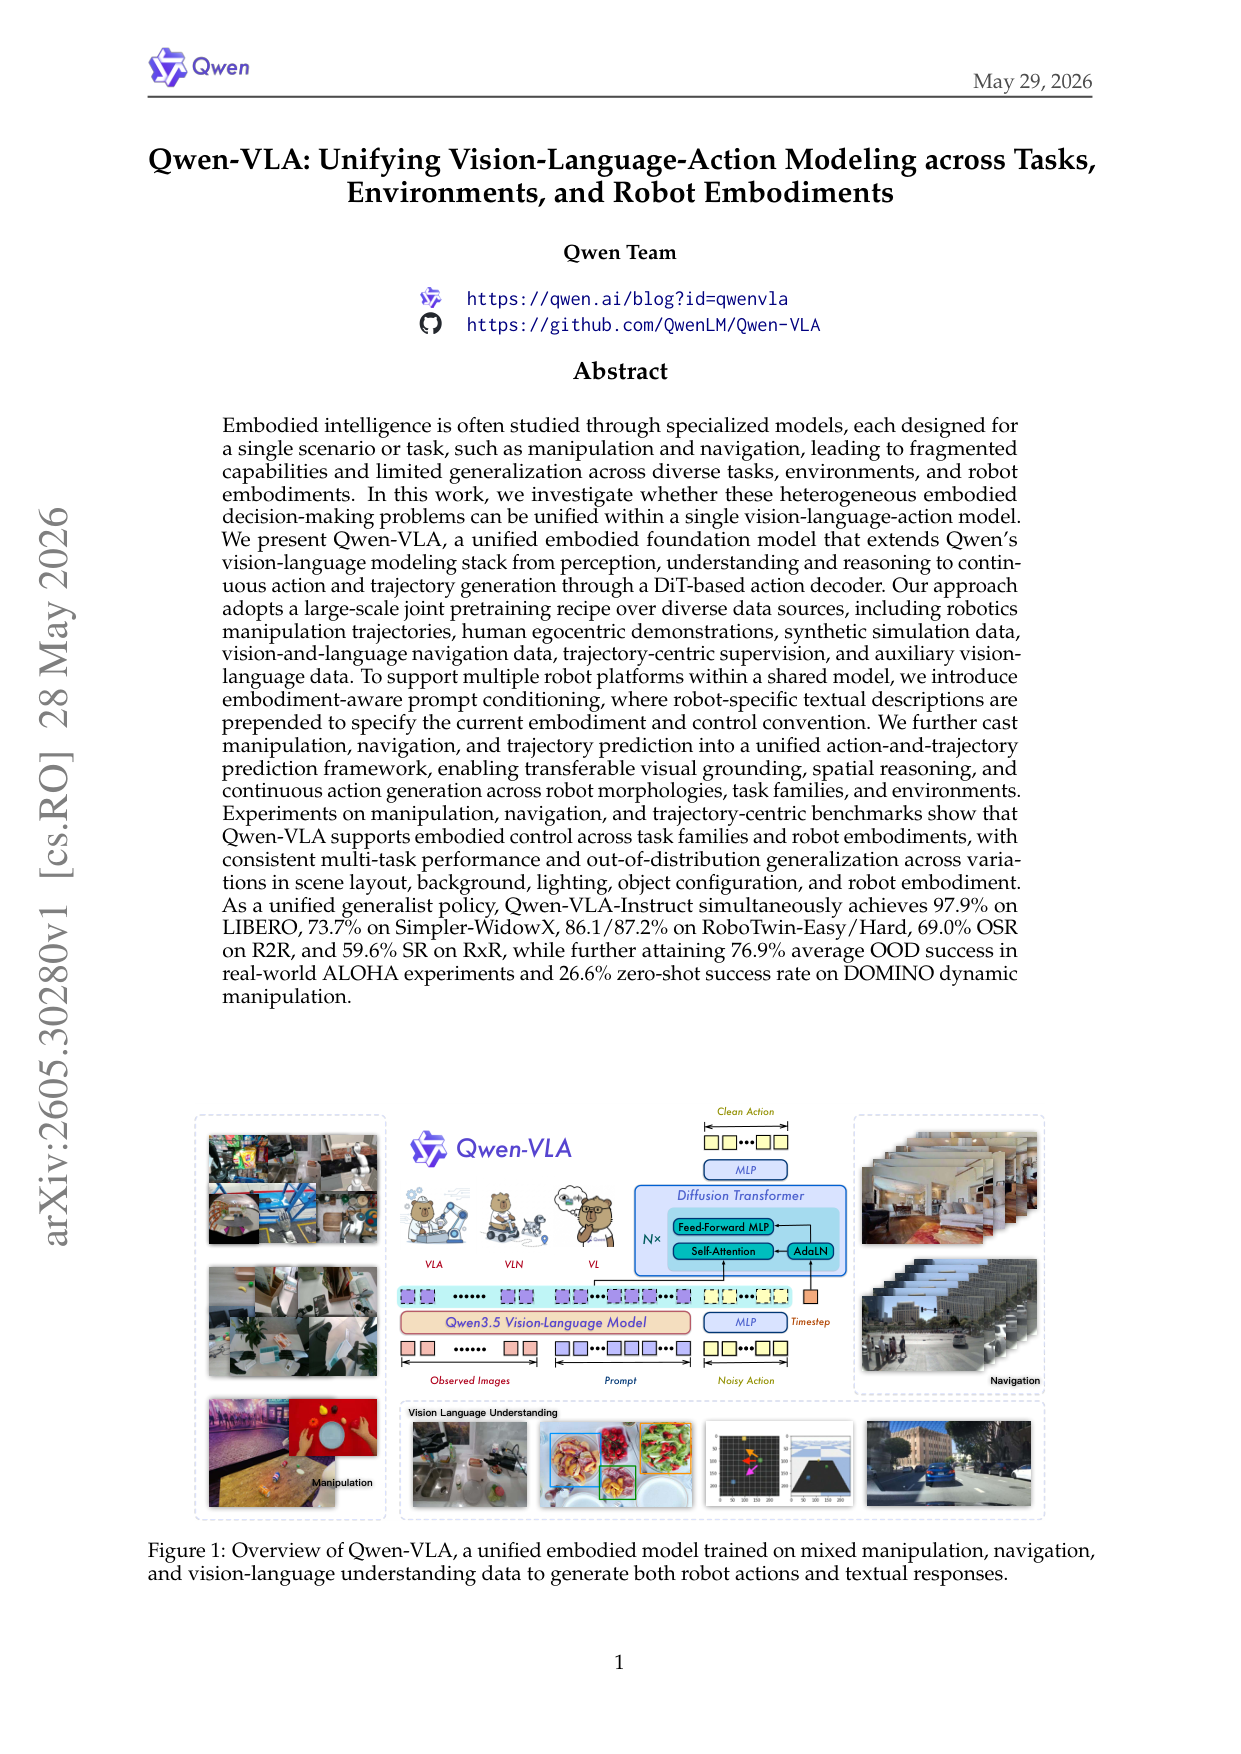
Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments

把 Qwen3.5-4B VLM 接一个 1.15B DiT flow-matching action expert,用 embodiment-aware prompt(文本描述本体/控制频率/horizon)统一操控、导航、轨迹预测、人类第一视角动作为同一 action-and-trajectory 预测问题,靠四阶段训练(T2A 纯文本→动作解压缩→CPT 多模态→SFT→RL)解决 VLM 已预训练而 DiT 随机初始化的不对称,一个通用模型跨多本体多任务。
读全文 →
VLAunified modelembodiment-aware prompt
cover Survey
2026-05-12 · Fudan University · Shanghai Innovation Institute · National University of Singapore

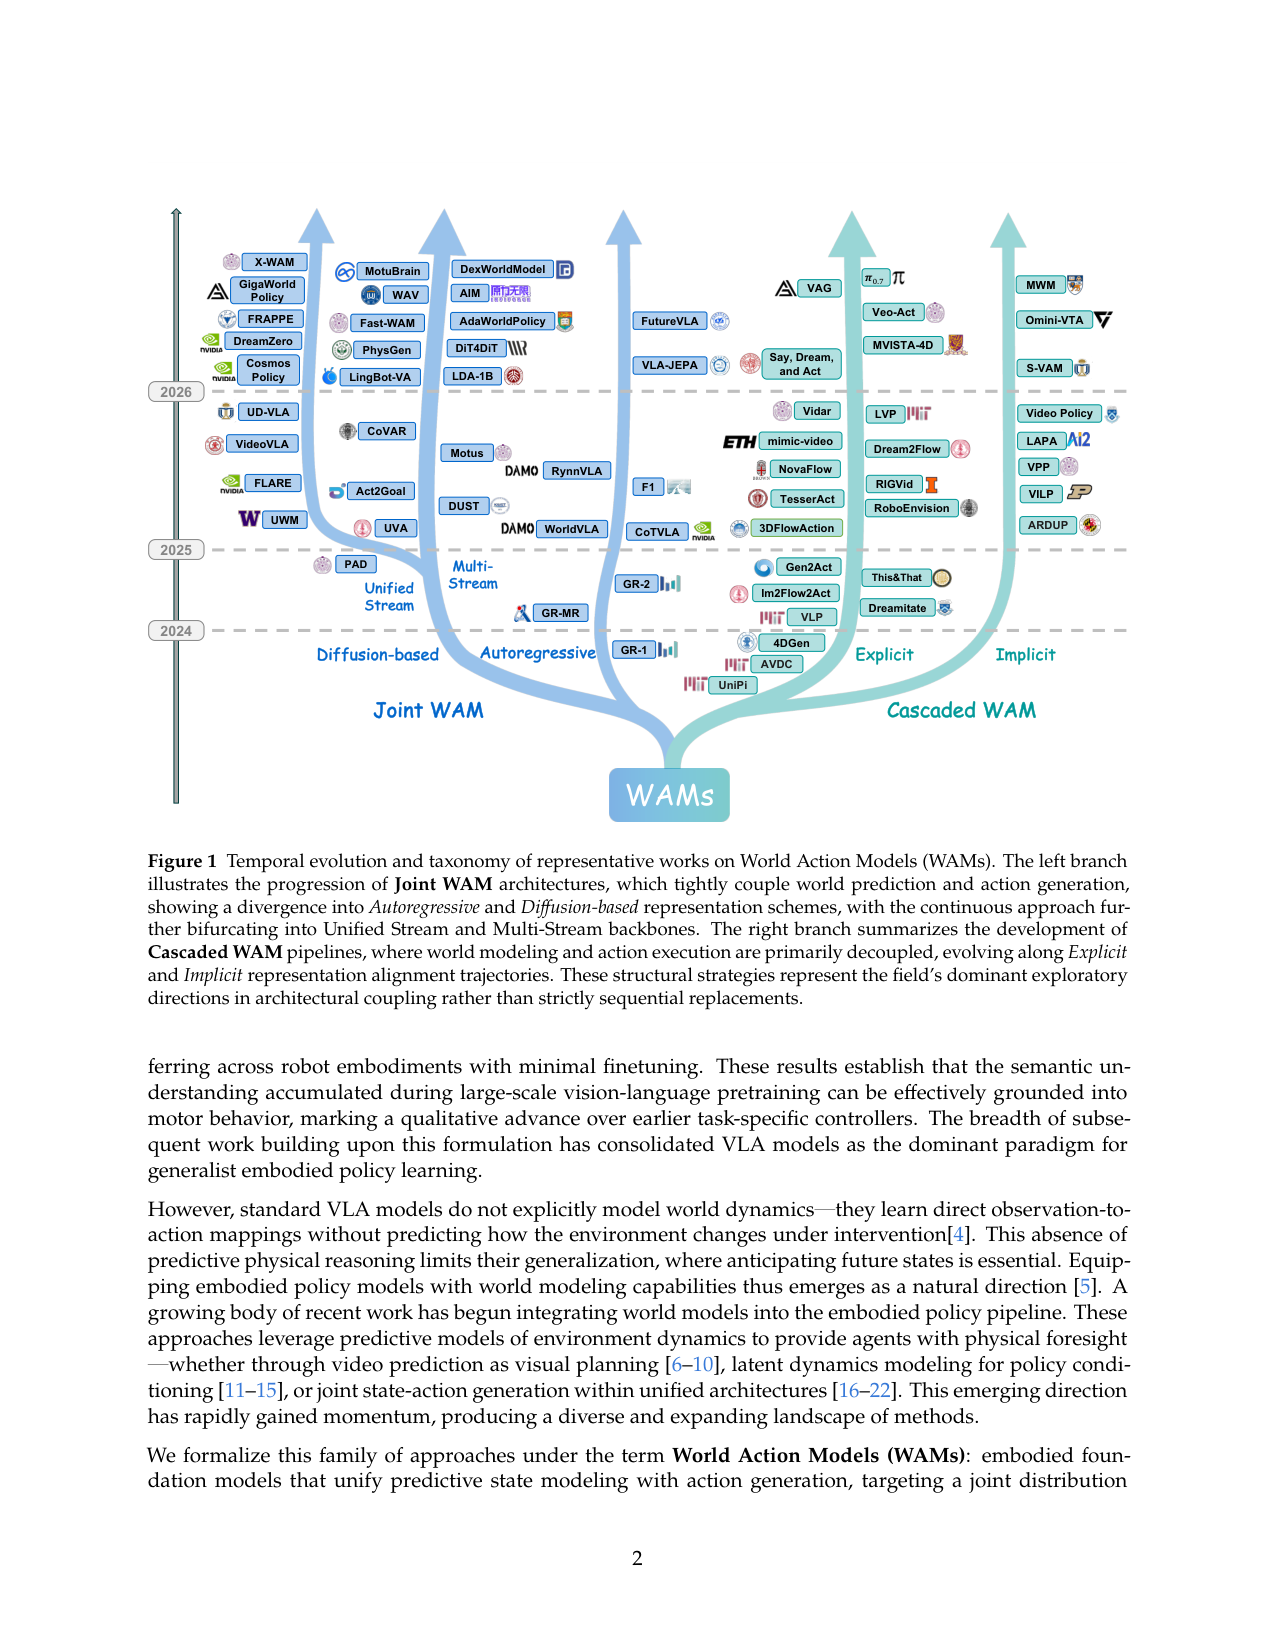
World Action Models: The Next Frontier in Embodied AI

第一份系统梳理 World Action Model(WAM)的综述:把'统一预测未来状态和动作'这族方法正式定义,拆成 Cascaded vs Joint 两大架构范式,沿生成模态/条件机制/动作解码三维细分,并覆盖数据生态、评测协议、开放挑战——给 WAM 这个快速膨胀的领域一张可导航的地图。

读全文 →
WAMsurveytaxonomy
cover Hybrid WAM
2026-05-11 · Peking University · Simplexity Robotics · CUHK

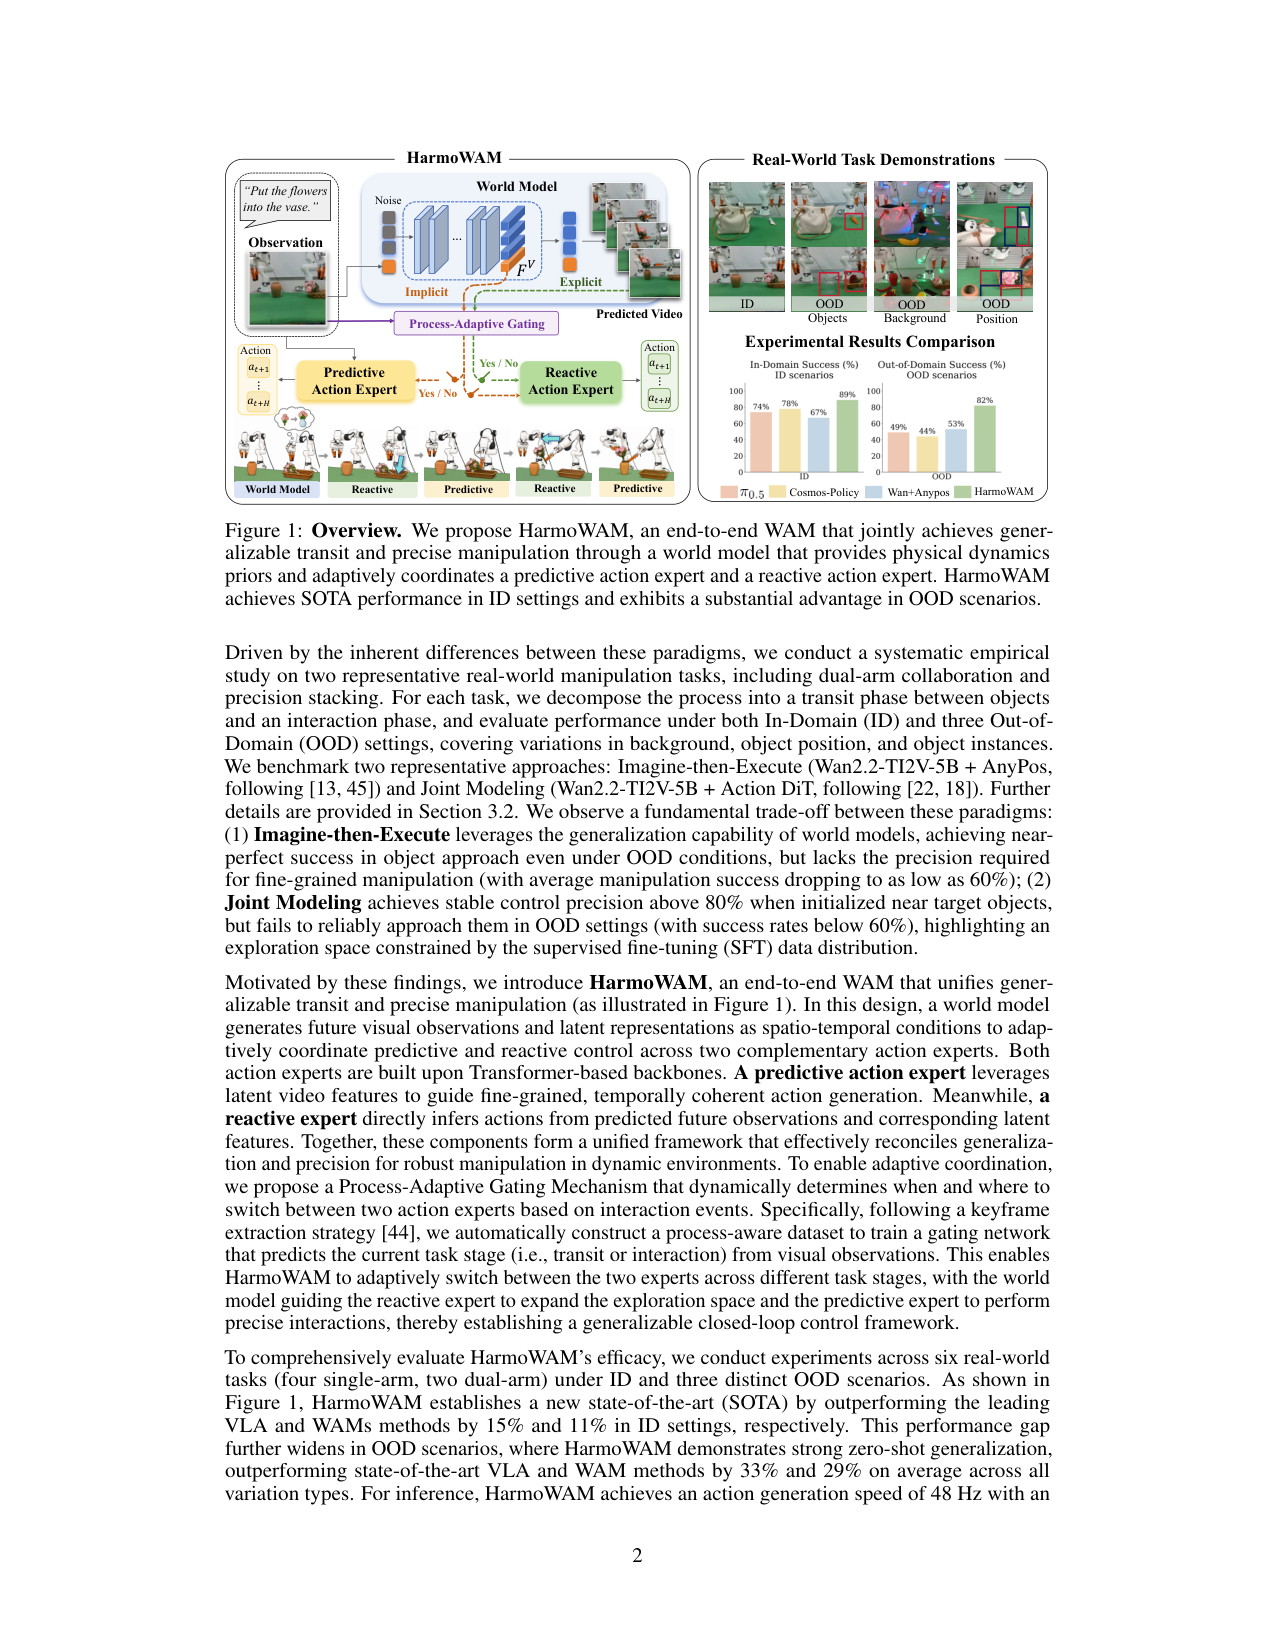
HarmoWAM: Harmonizing Generalizable and Precise Manipulation via Adaptive World Action Models

把 WAM 的两条旧路线(Imagine-then-Execute 泛化好但不准 / Joint Modeling 准但 OOD 探索崩)用一个共享世界模型 + 两个互补 action expert + 一个过程自适应门控统一进来,transit 用 reactive expert 借世界模型泛化、interaction 用 predictive expert 借隐含 latent 精准对齐,实现泛化和精度同时拿住。

读全文 →
WAMhybrid expertprocess-adaptive gating
cover Evaluation
2026-04-30 · Huawei Technologies · University of Toronto

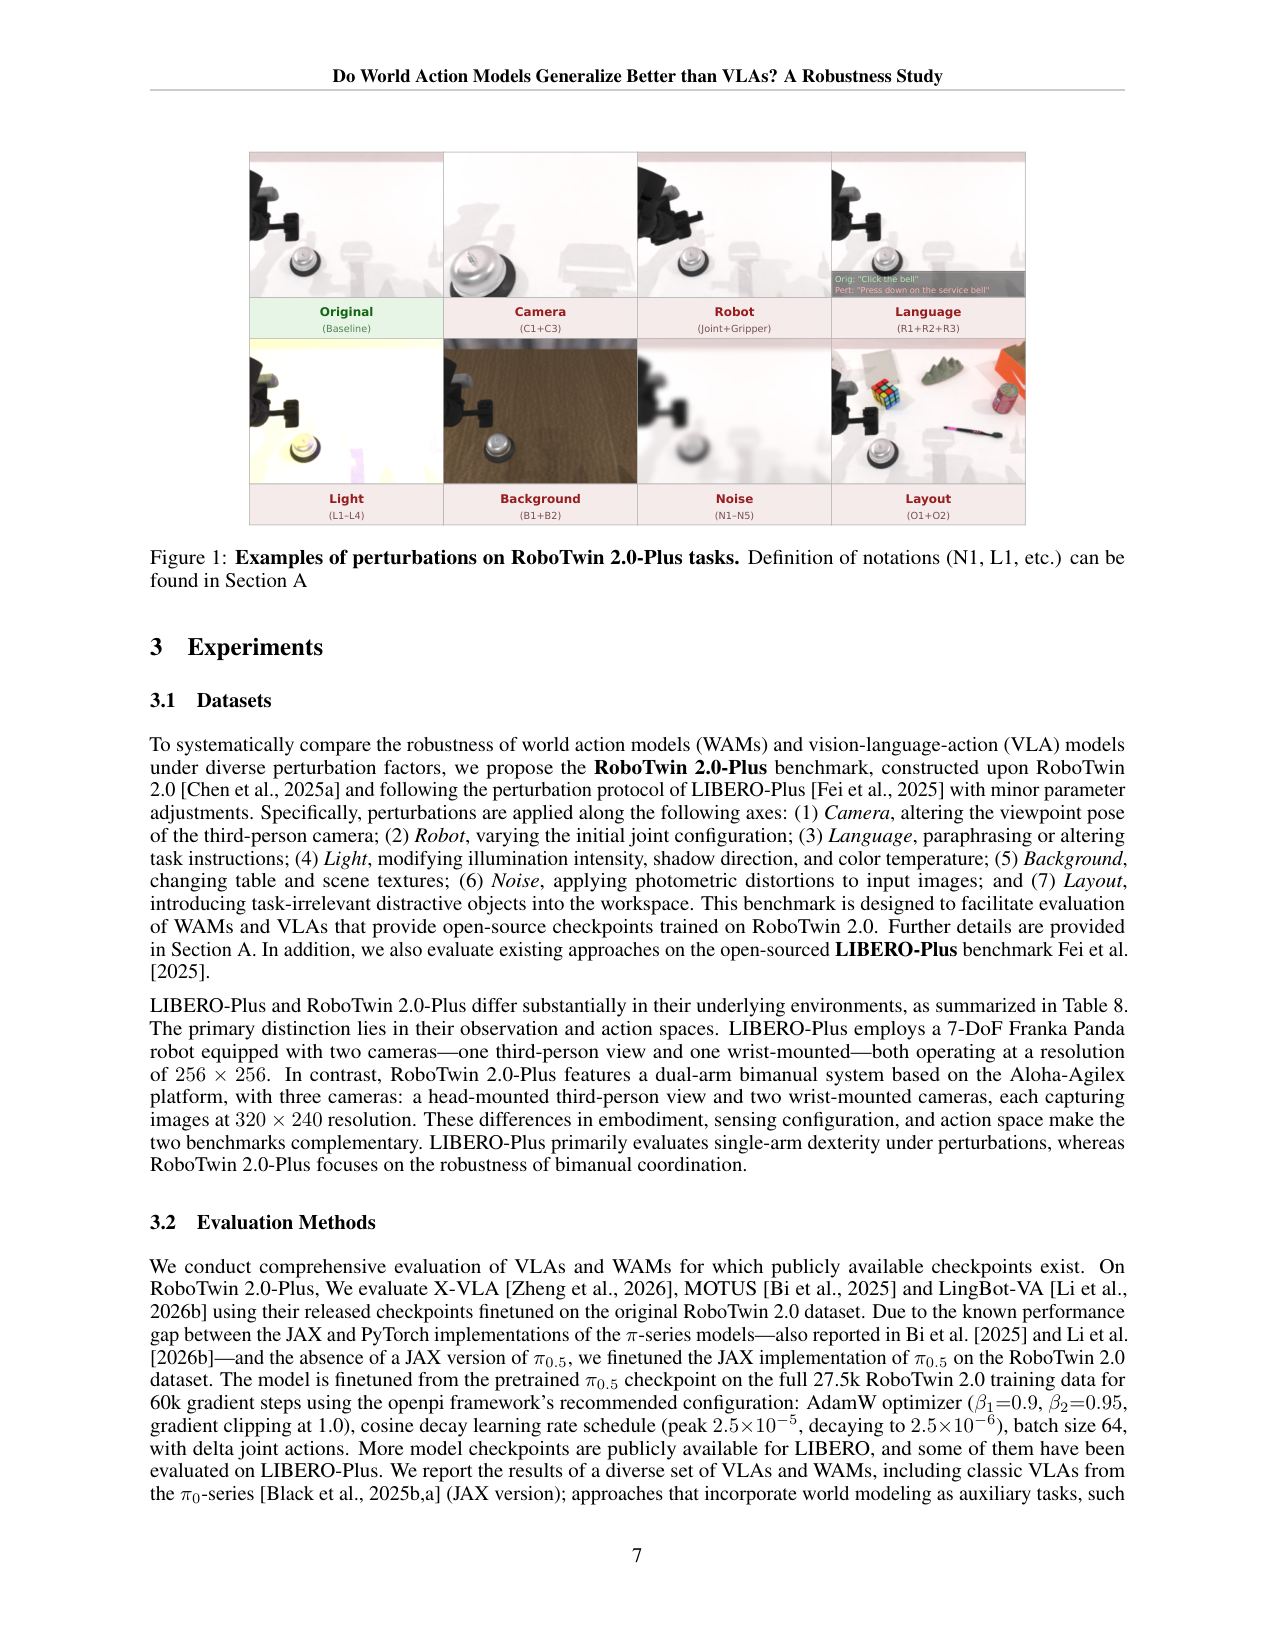
Do World Action Models Generalize Better than VLAs? A Robustness Study

在 LIBERO-Plus 和自建 RoboTwin 2.0-Plus 两个扰动基准上系统对比 VLA/WAM/混合三类策略,发现 WAM 在视觉扰动(噪声/光照/布局)上更鲁棒,但相机视角和机器人初始状态仍是硬伤;推理比 π0.5 慢至少 4.8 倍是 WAM 部署的主要障碍。

读全文 →
WAMVLArobustness study
cover VLA
2026-04-24 · Physical Intelligence

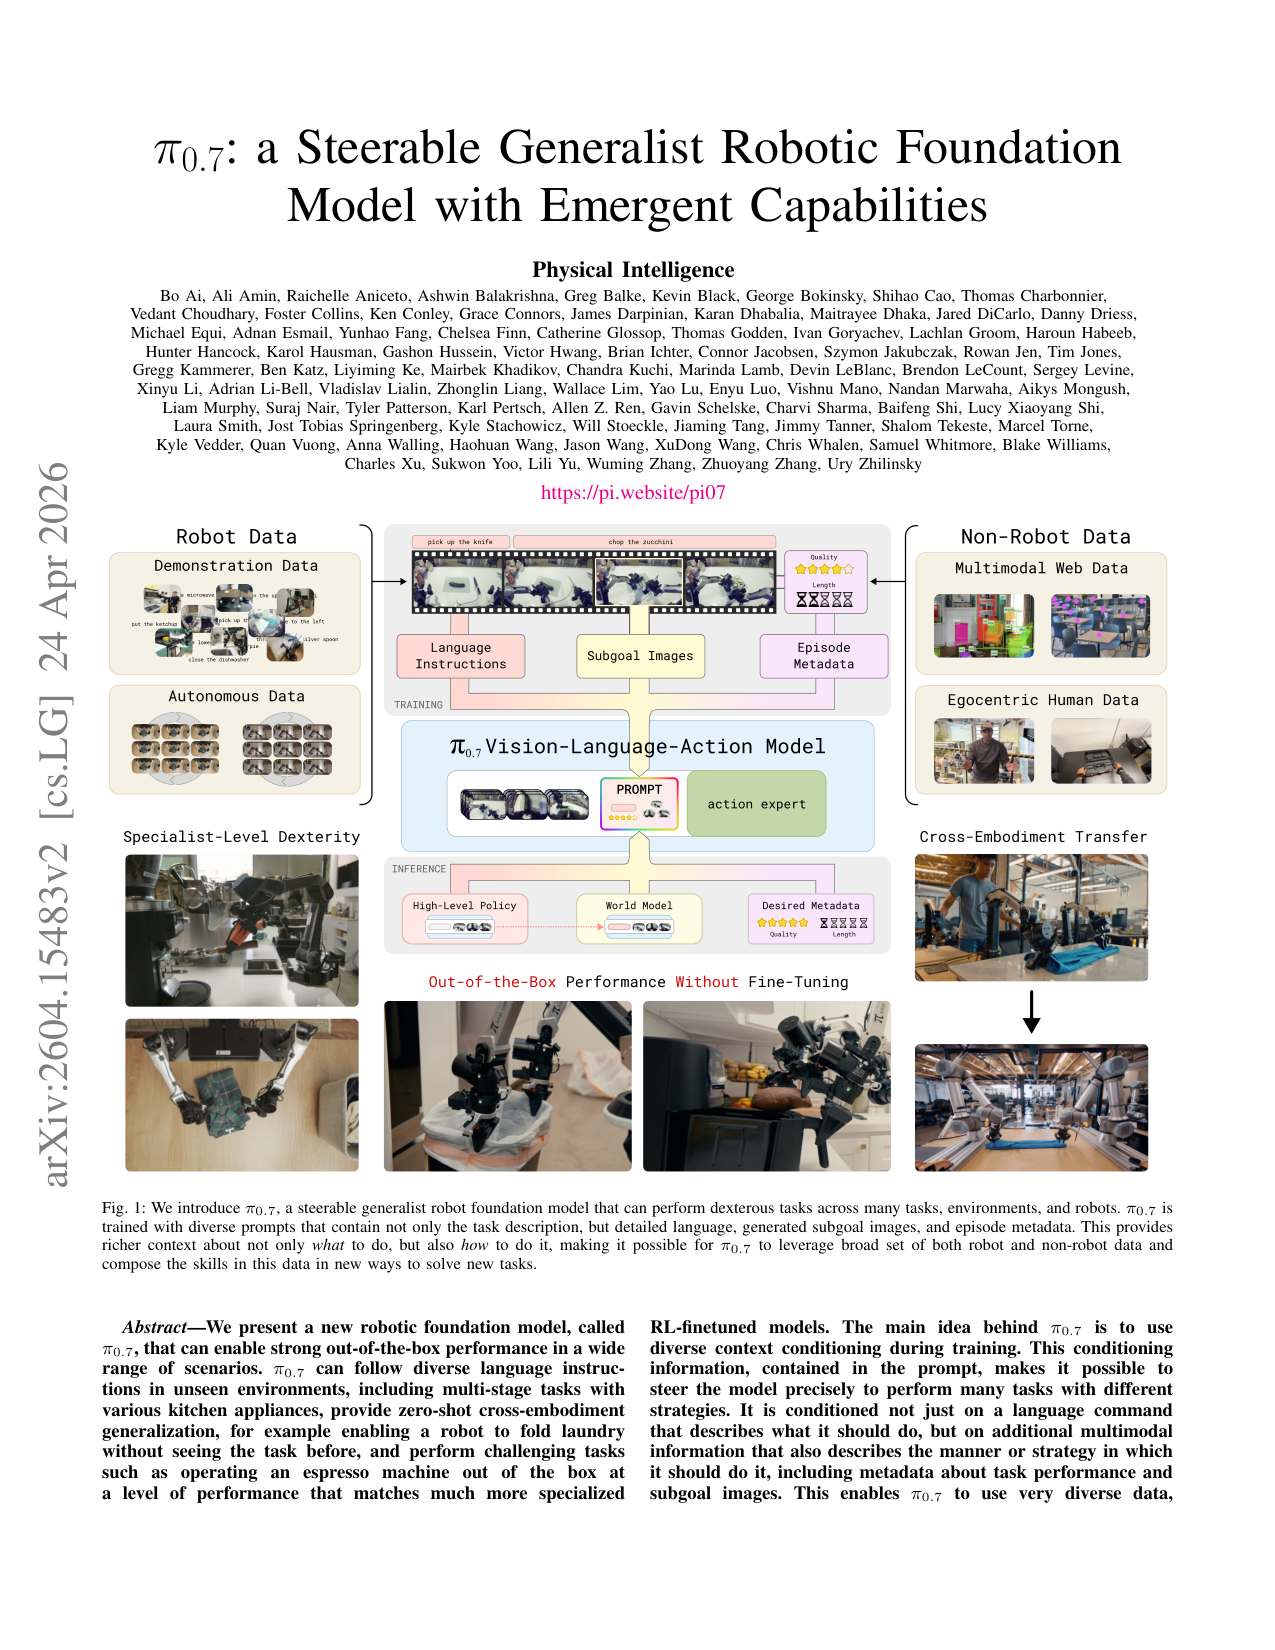
π0.7: A Steerable Generalist Robotic Foundation Model with Emergent Capabilities

一个 5B VLA(4B Gemma3 VLM + 860M flow-matching action expert),靠'把每条轨迹的 episode metadata(速度/质量/是否犯错)+ subtask 指令 + 世界模型生成的 subgoal 图像'塞进 prompt 做条件,从而能把混合质量(含失败、含 RL specialist 蒸馏)的异质数据训成一个会组合泛化的通用 policy,零样本迁移到新任务/新本体/逆数据偏差指令。

读全文 →
VLAflow matchingcontext conditioning
cover Cascaded WAM
2026-04-10 · Shanghai Jiao Tong University (MoE Key Lab of AI, AI Institute) · Huawei Central Research Institute

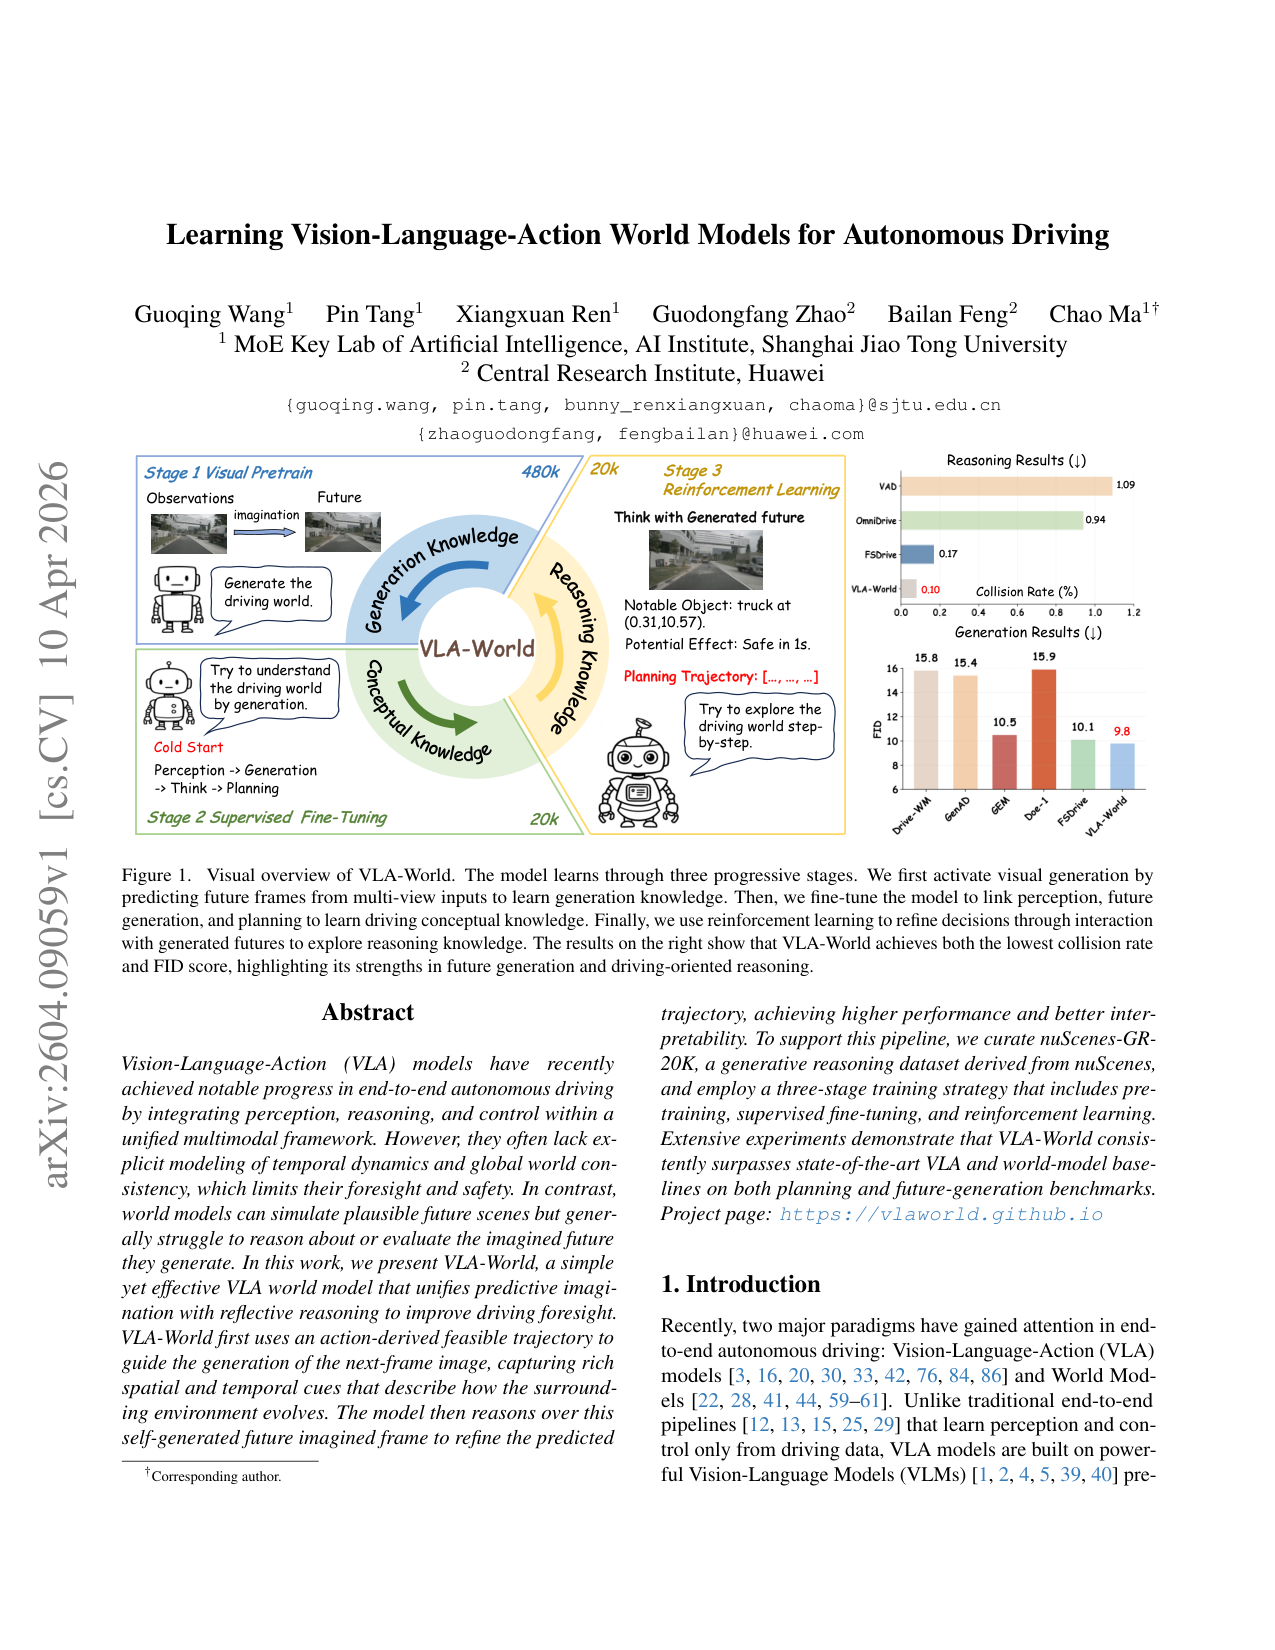
VLA-World: Learning Vision-Language-Action World Models for Autonomous Driving

把自动驾驶的 VLA 和世界模型合并:先用短期轨迹预测引导生成下一帧未来图像,再对这个自己想象出来的未来帧做反思推理修正长期轨迹,用 Qwen2-VL-2B + VQGAN 自回归出视觉 token,三阶段(预训练→SFT→GRPO)训练。

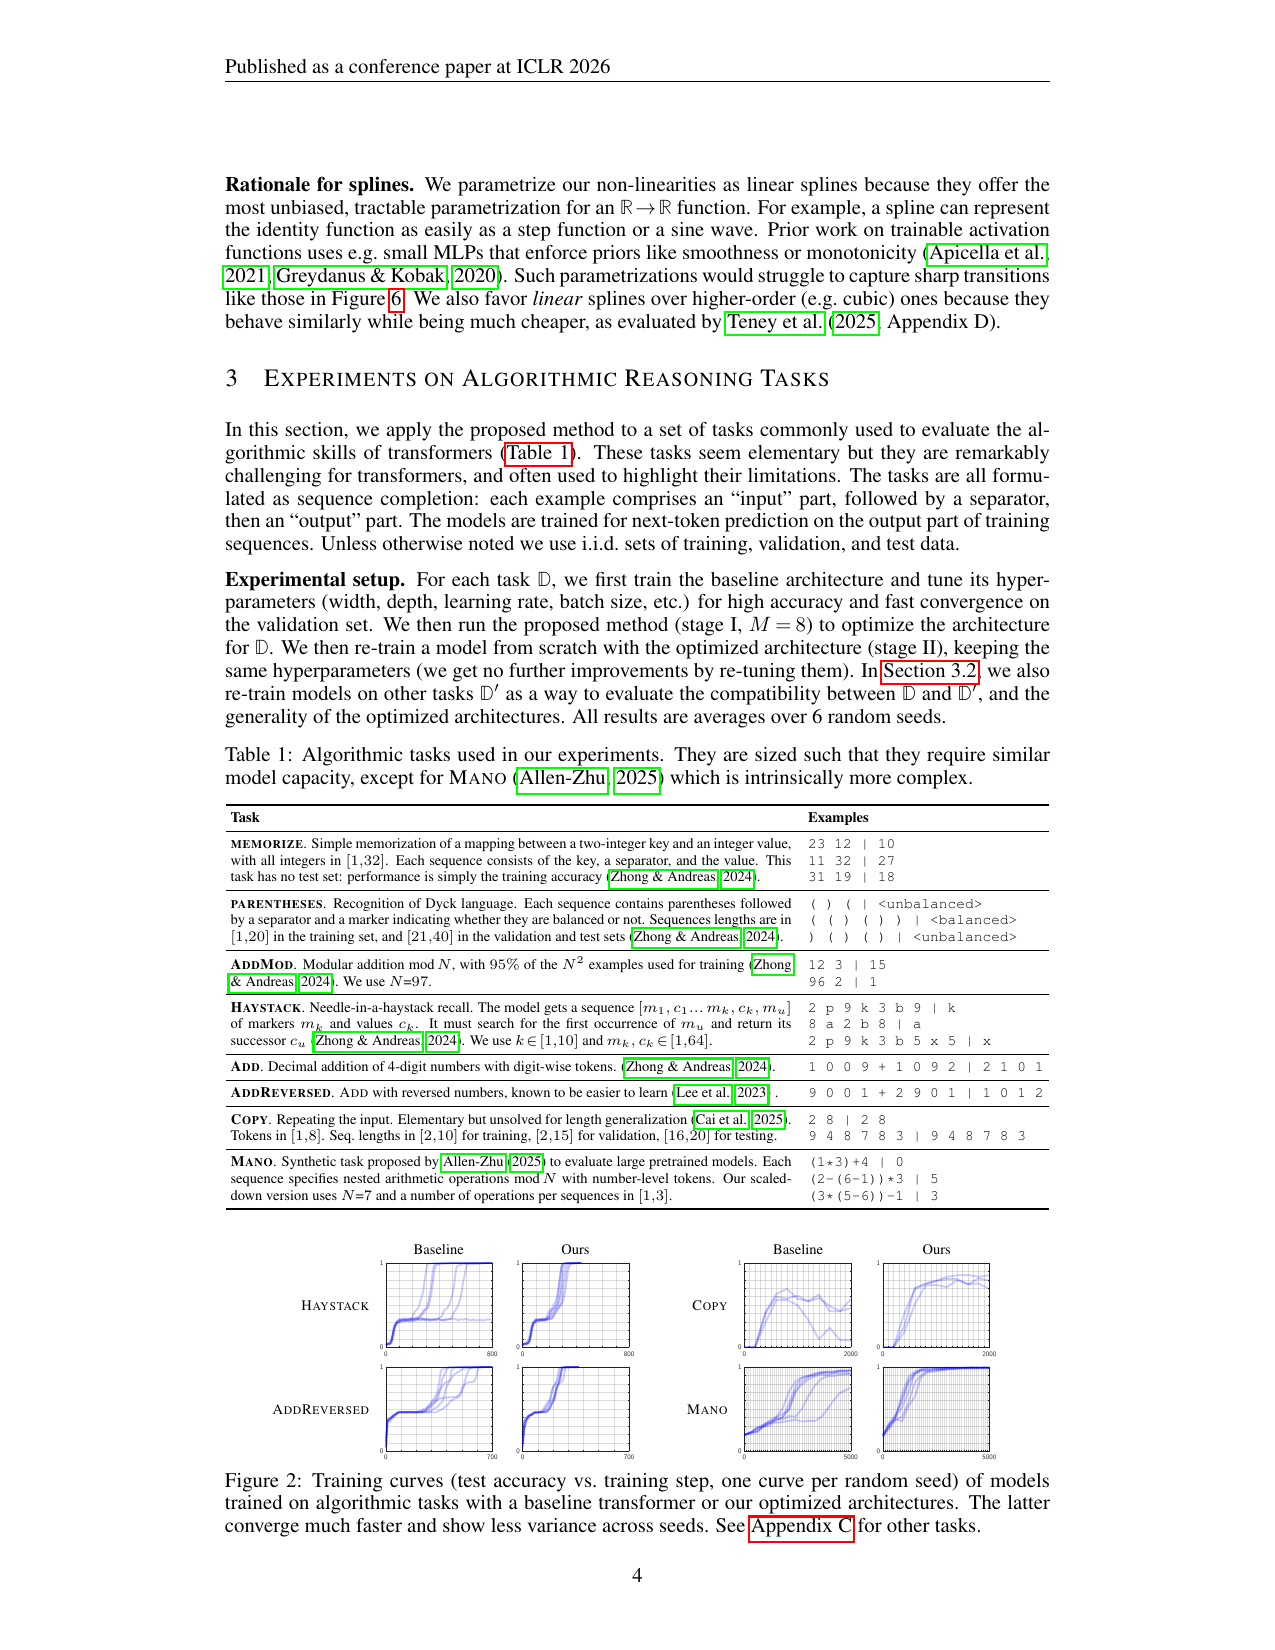
读全文 →
autonomous drivingVLA world modelreflective reasoning
cover Joint WAM
2026-02-19 · NVIDIA

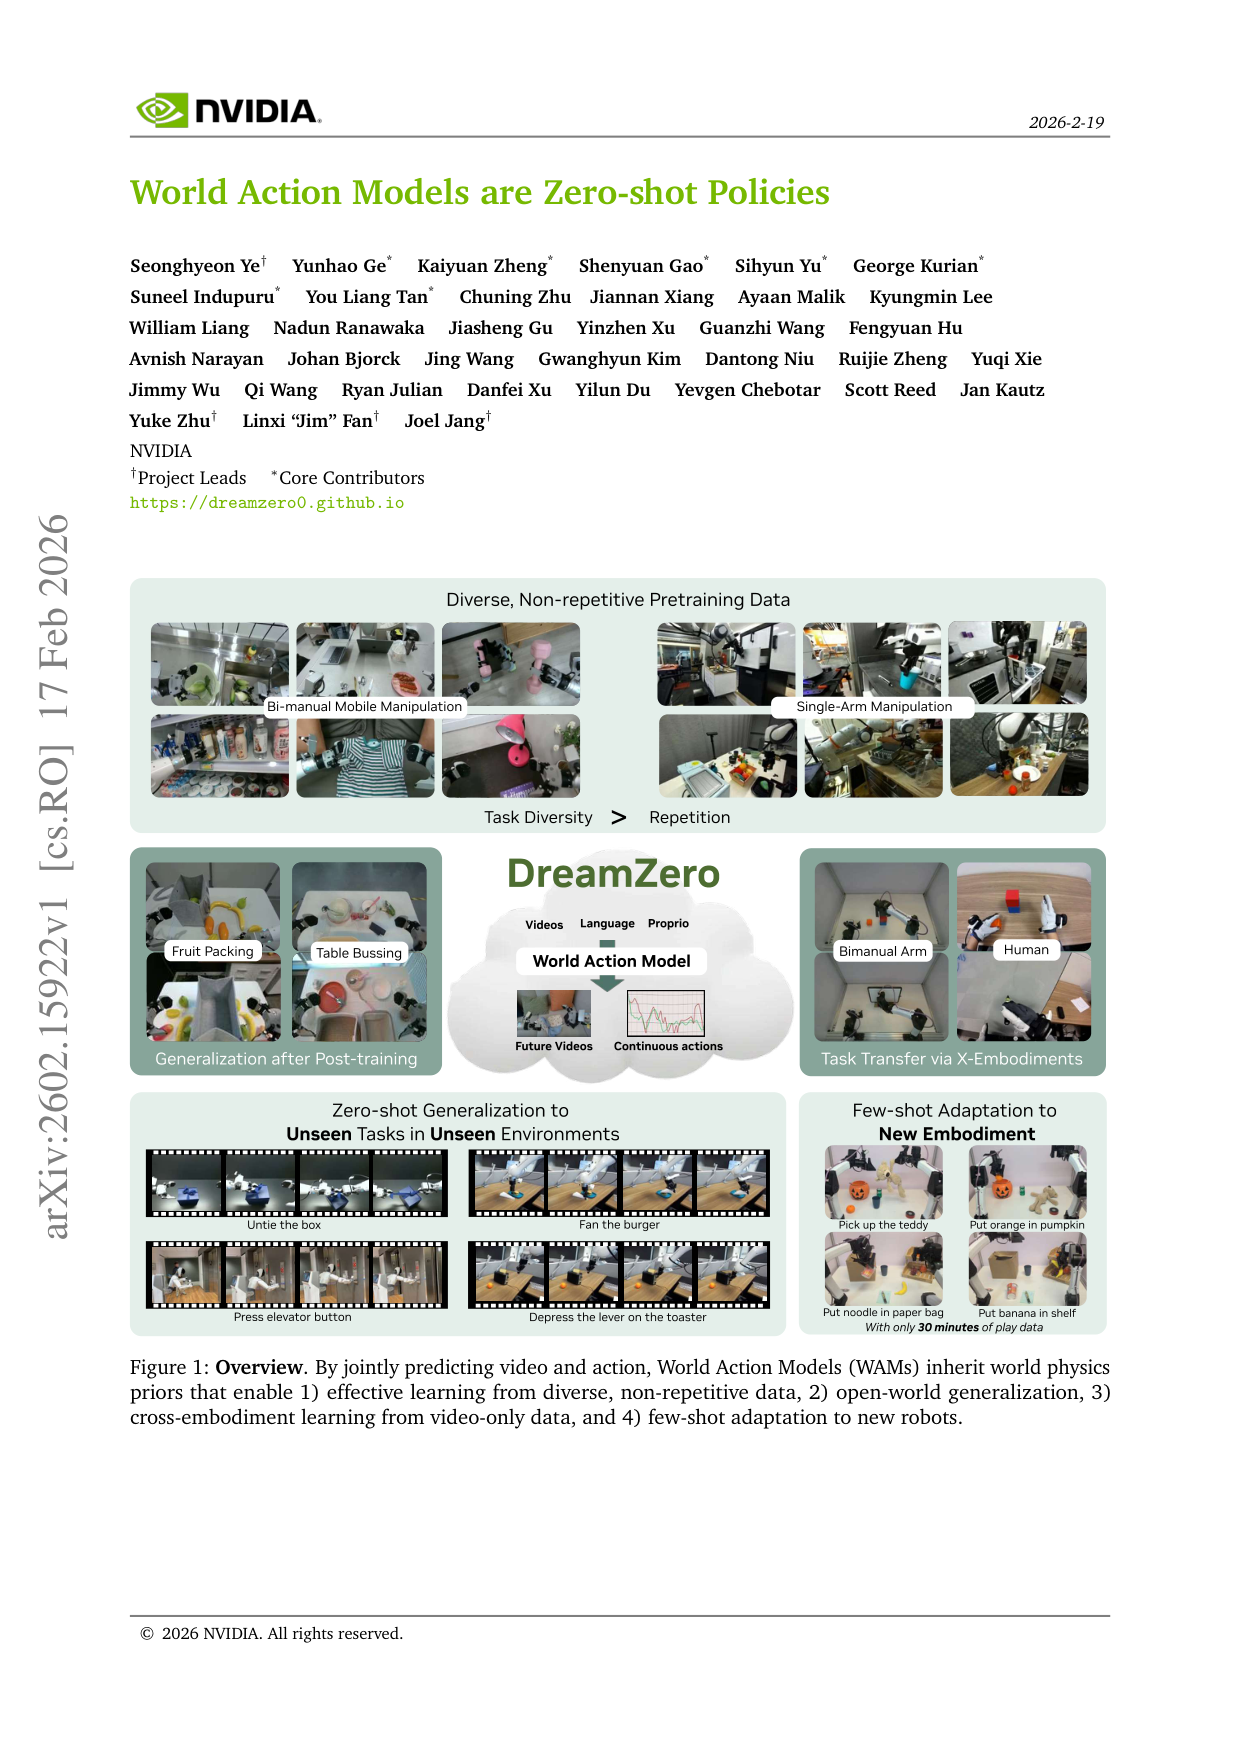
World Action Models are Zero-shot Policies

把 14B video diffusion 模型改造成同时生成未来视频和动作的 World Action Model,用 inverse-dynamics 视角让 video prior 直接成为 policy,并通过系统优化把它压到 7Hz 实时闭环。

读全文 →
WAMvideo diffusionautoregressive
cover Cascaded WAM
2026-02-12 · Tsinghua University · ByteDance Seed

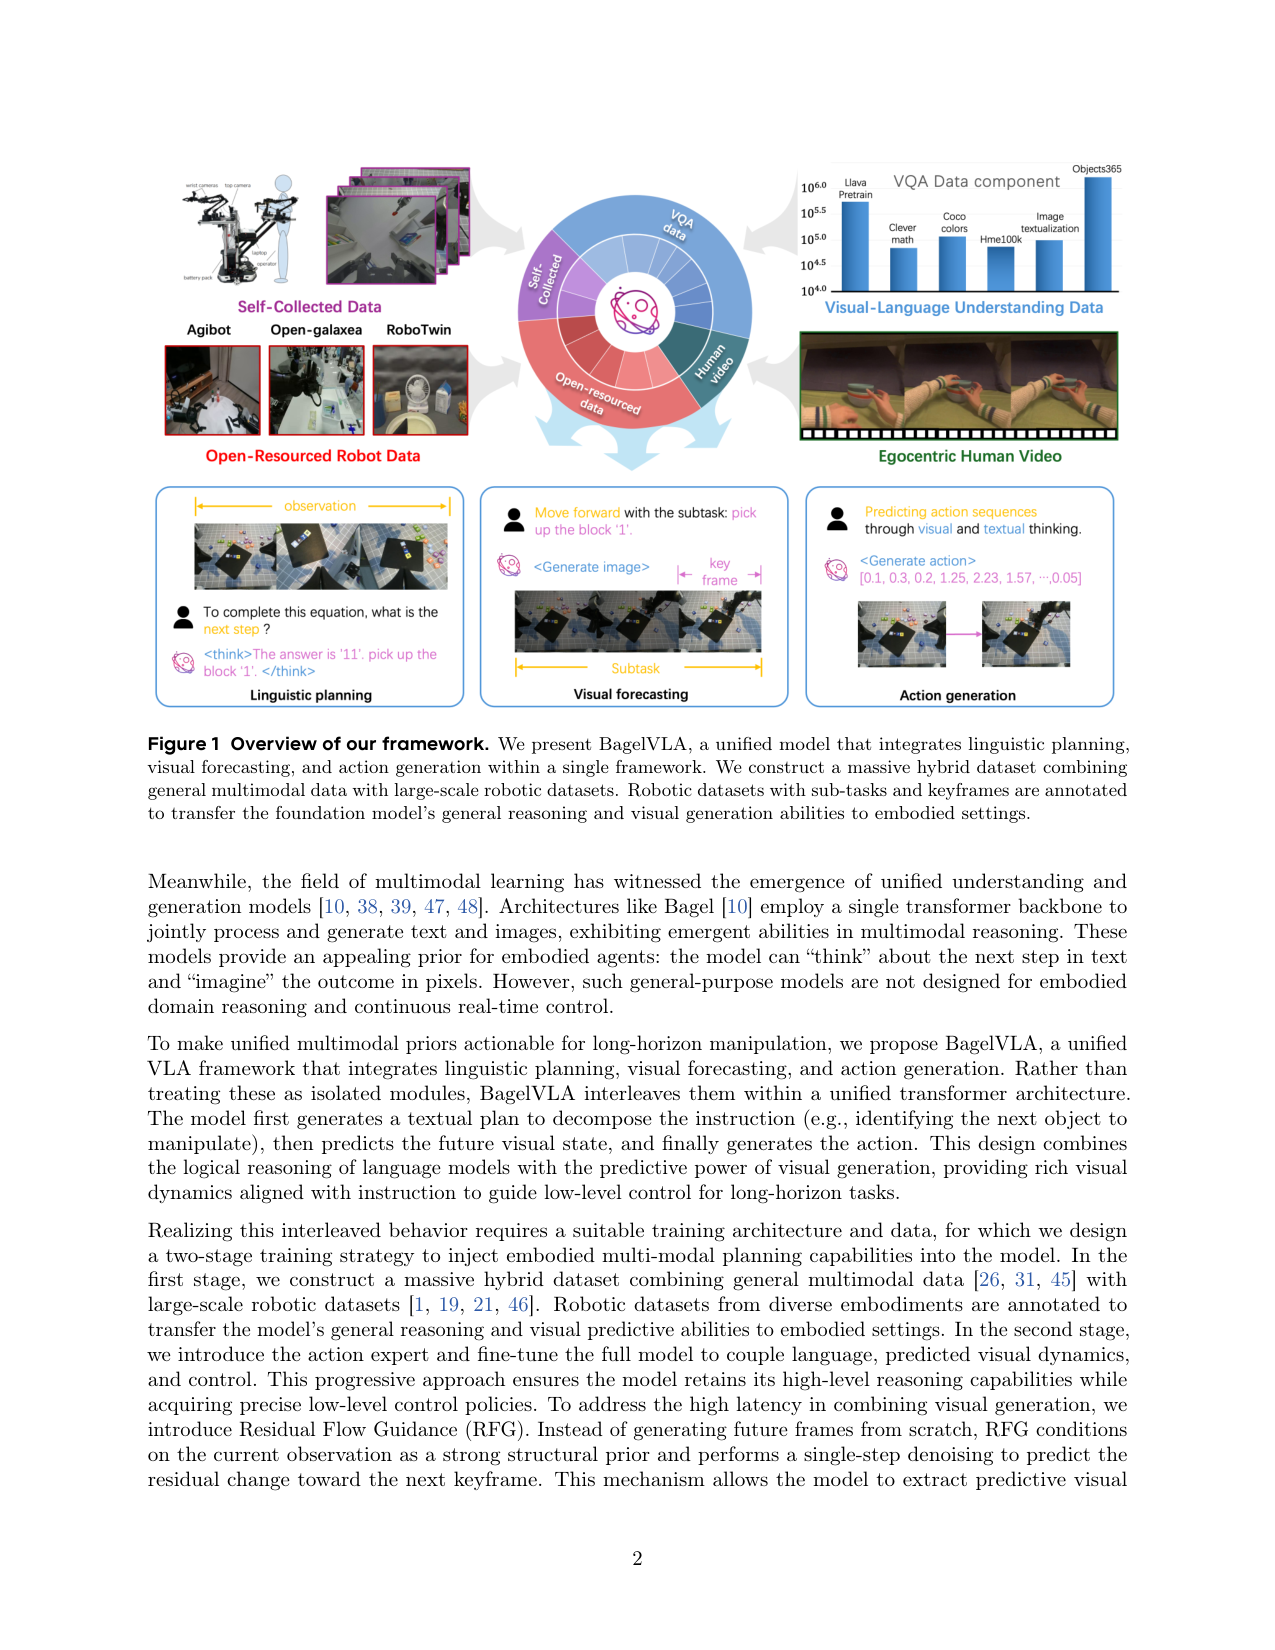
BagelVLA: Enhancing Long-Horizon Manipulation via Interleaved Vision-Language-Action Generation

在 Bagel 统一理解+生成 MoT 底座上接一个 2B action expert,把'语言规划→关键帧预测→动作生成'三步显式交错进一条序列,并用 Residual Flow Guidance(以当前帧为初始噪声做单步去噪)把视觉前瞻的延迟从 6 秒压到 1.23 秒。

读全文 →
interleaved planningMixture-of-Transformersdual flow matching
cover Joint WAM
2025-12-25 · Tsinghua University (THBI/BNRist, Tsinghua-Bosch JMLC) · Peking University · Horizon Robotics

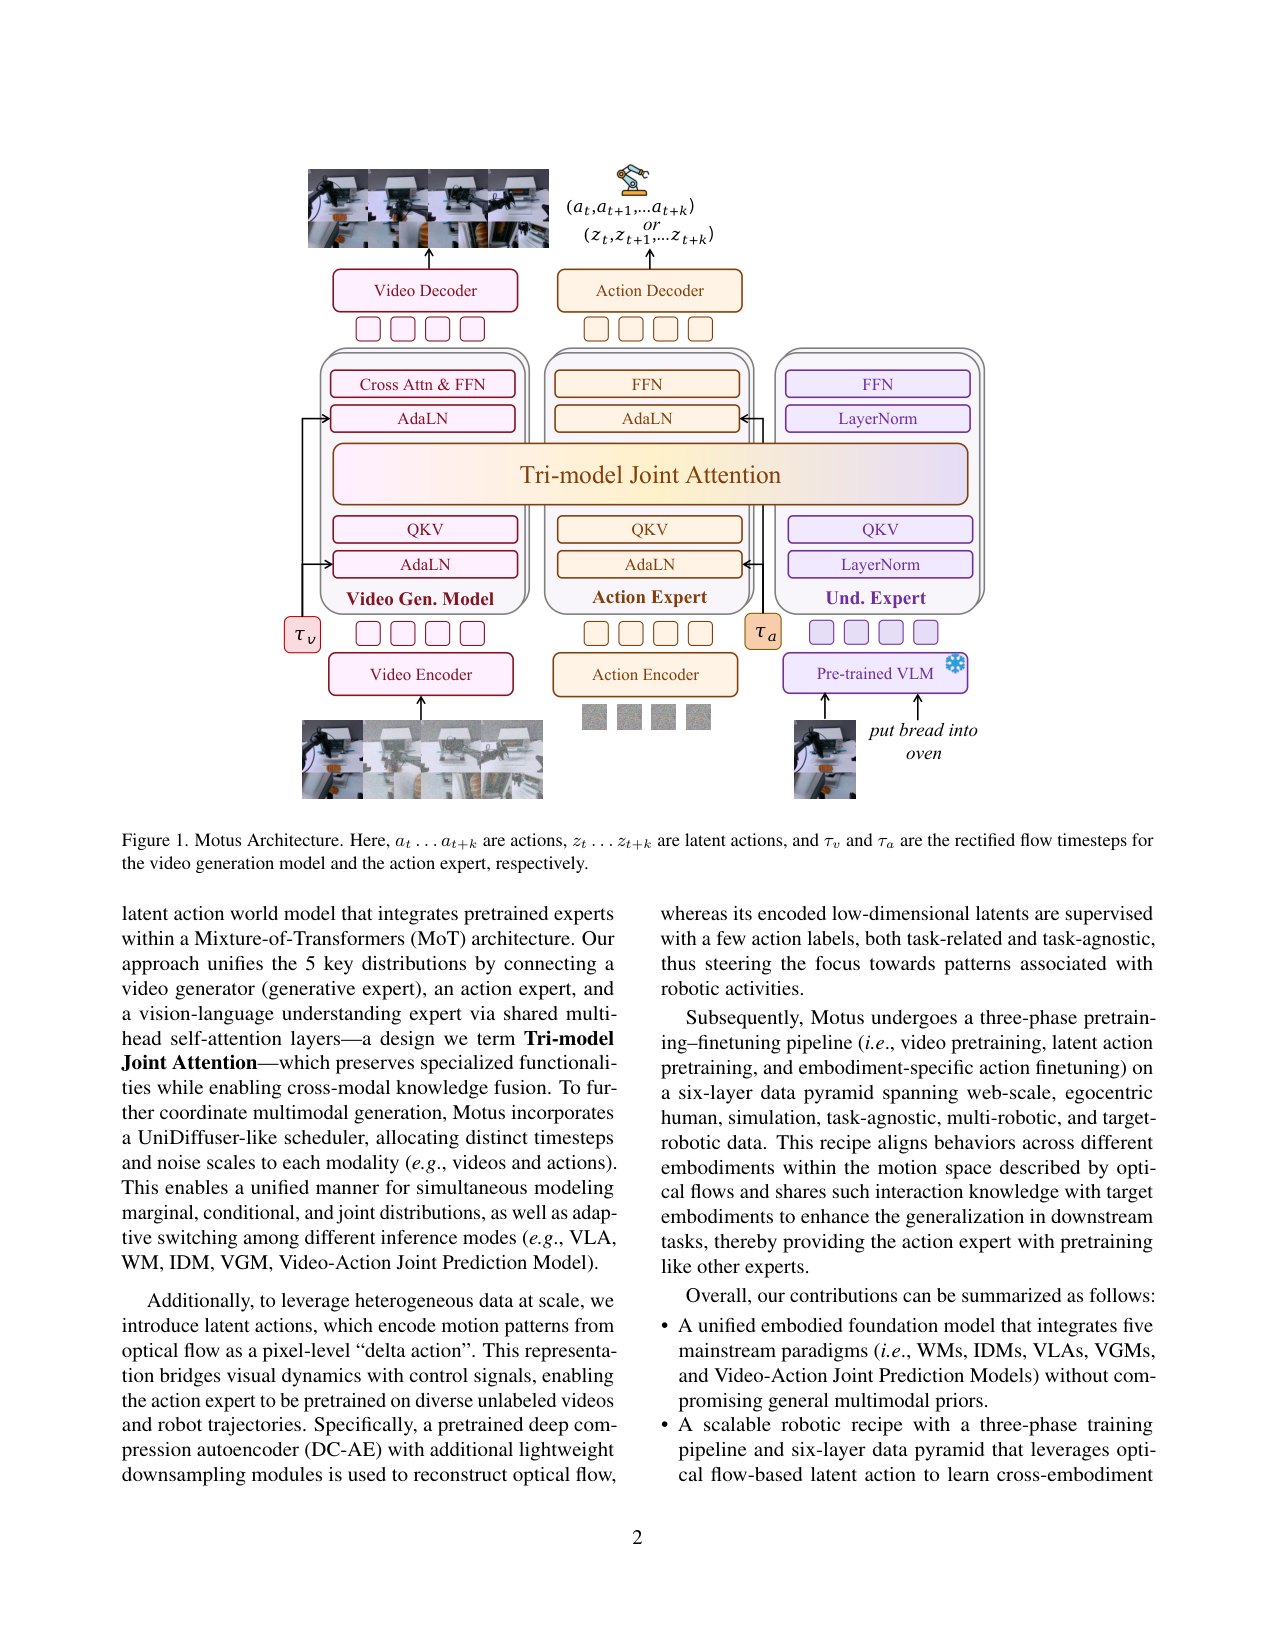
Motus: A Unified Latent Action World Model

用一个 Mixture-of-Transformers 把 VLM(理解)、Wan2.2(视频生成)、Action 专家三路并到一个模型里,靠 UniDiffuser 式调度在 VLA/WM/IDM/VGM/Video-Action 联合预测五种模式间切换;并用光流编码的 latent action 让无动作标签的海量视频也能预训练 action 专家。

读全文 →
unified modelMixture-of-TransformersUniDiffuser
cover VLA
2024-09-05 · Stanford · UC Berkeley · Toyota Research Institute · Google DeepMind · Physical Intelligence · MIT

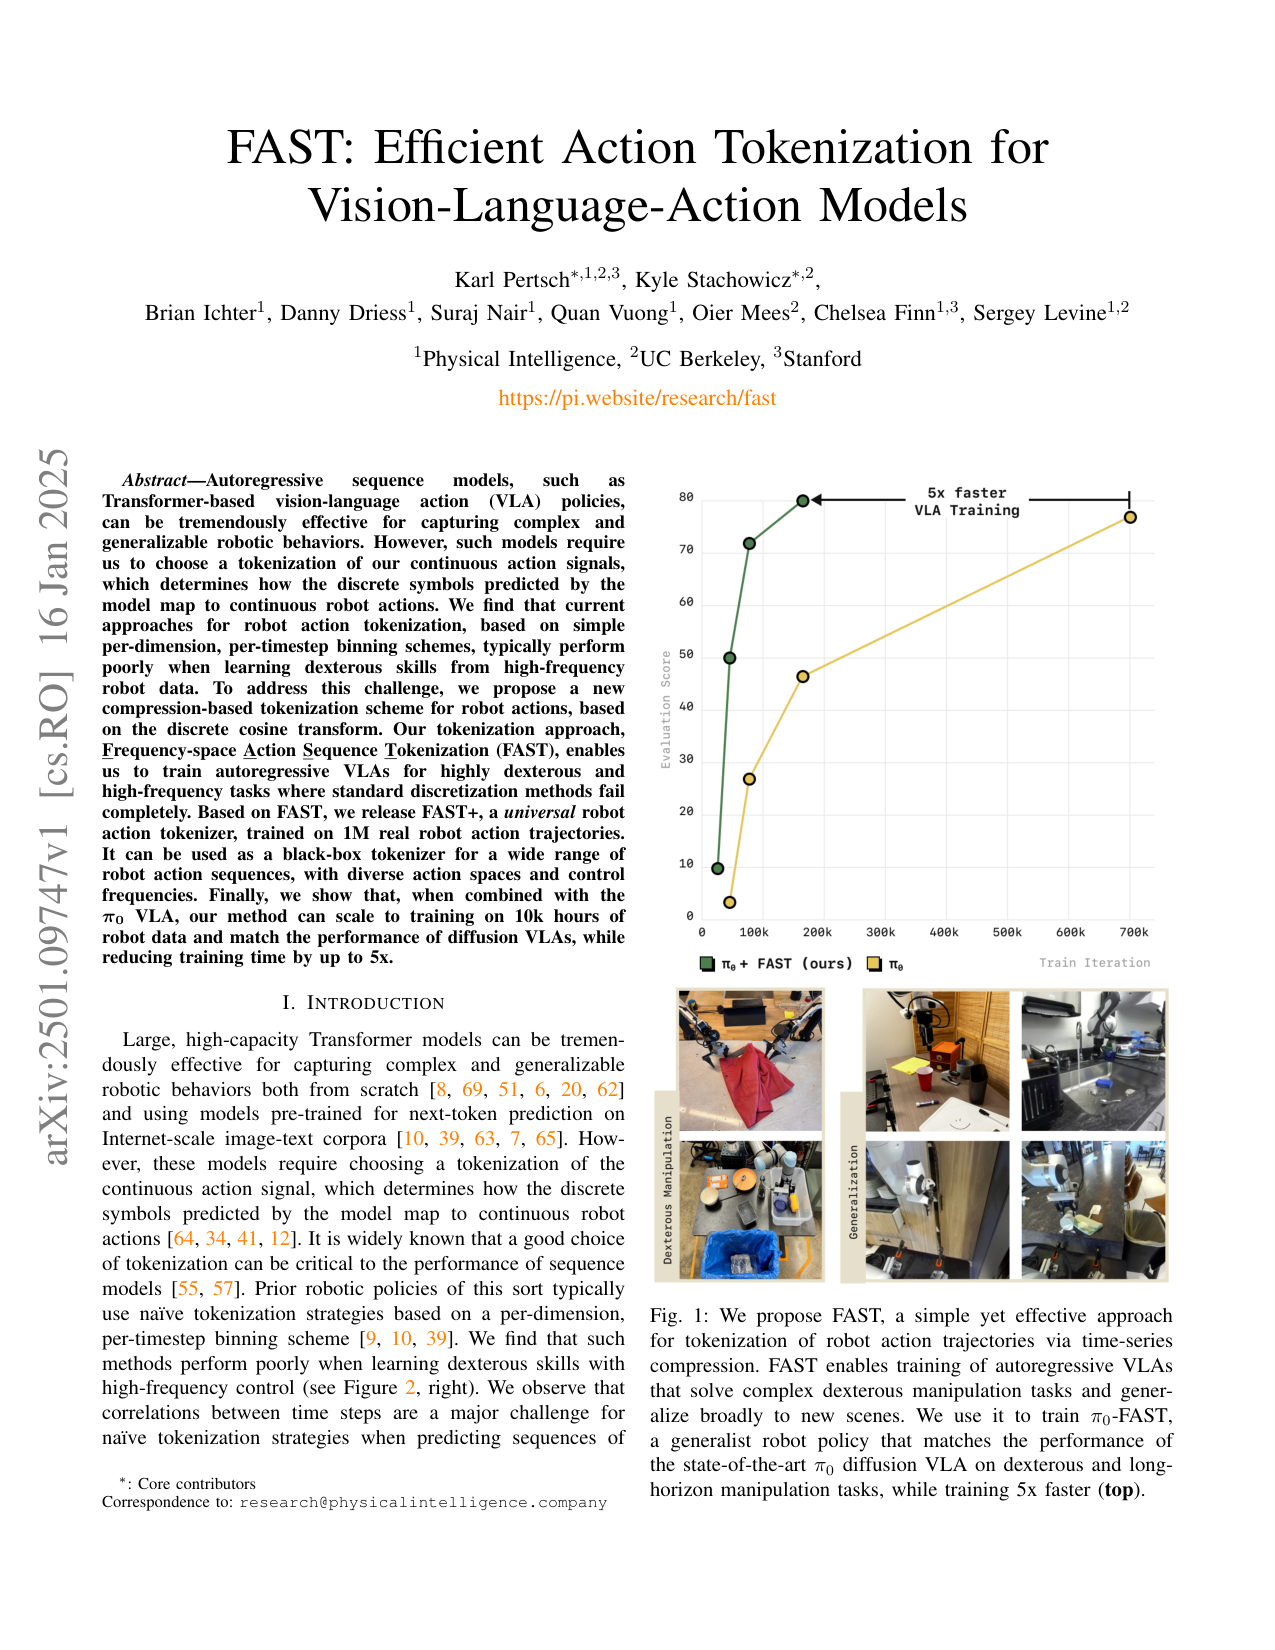
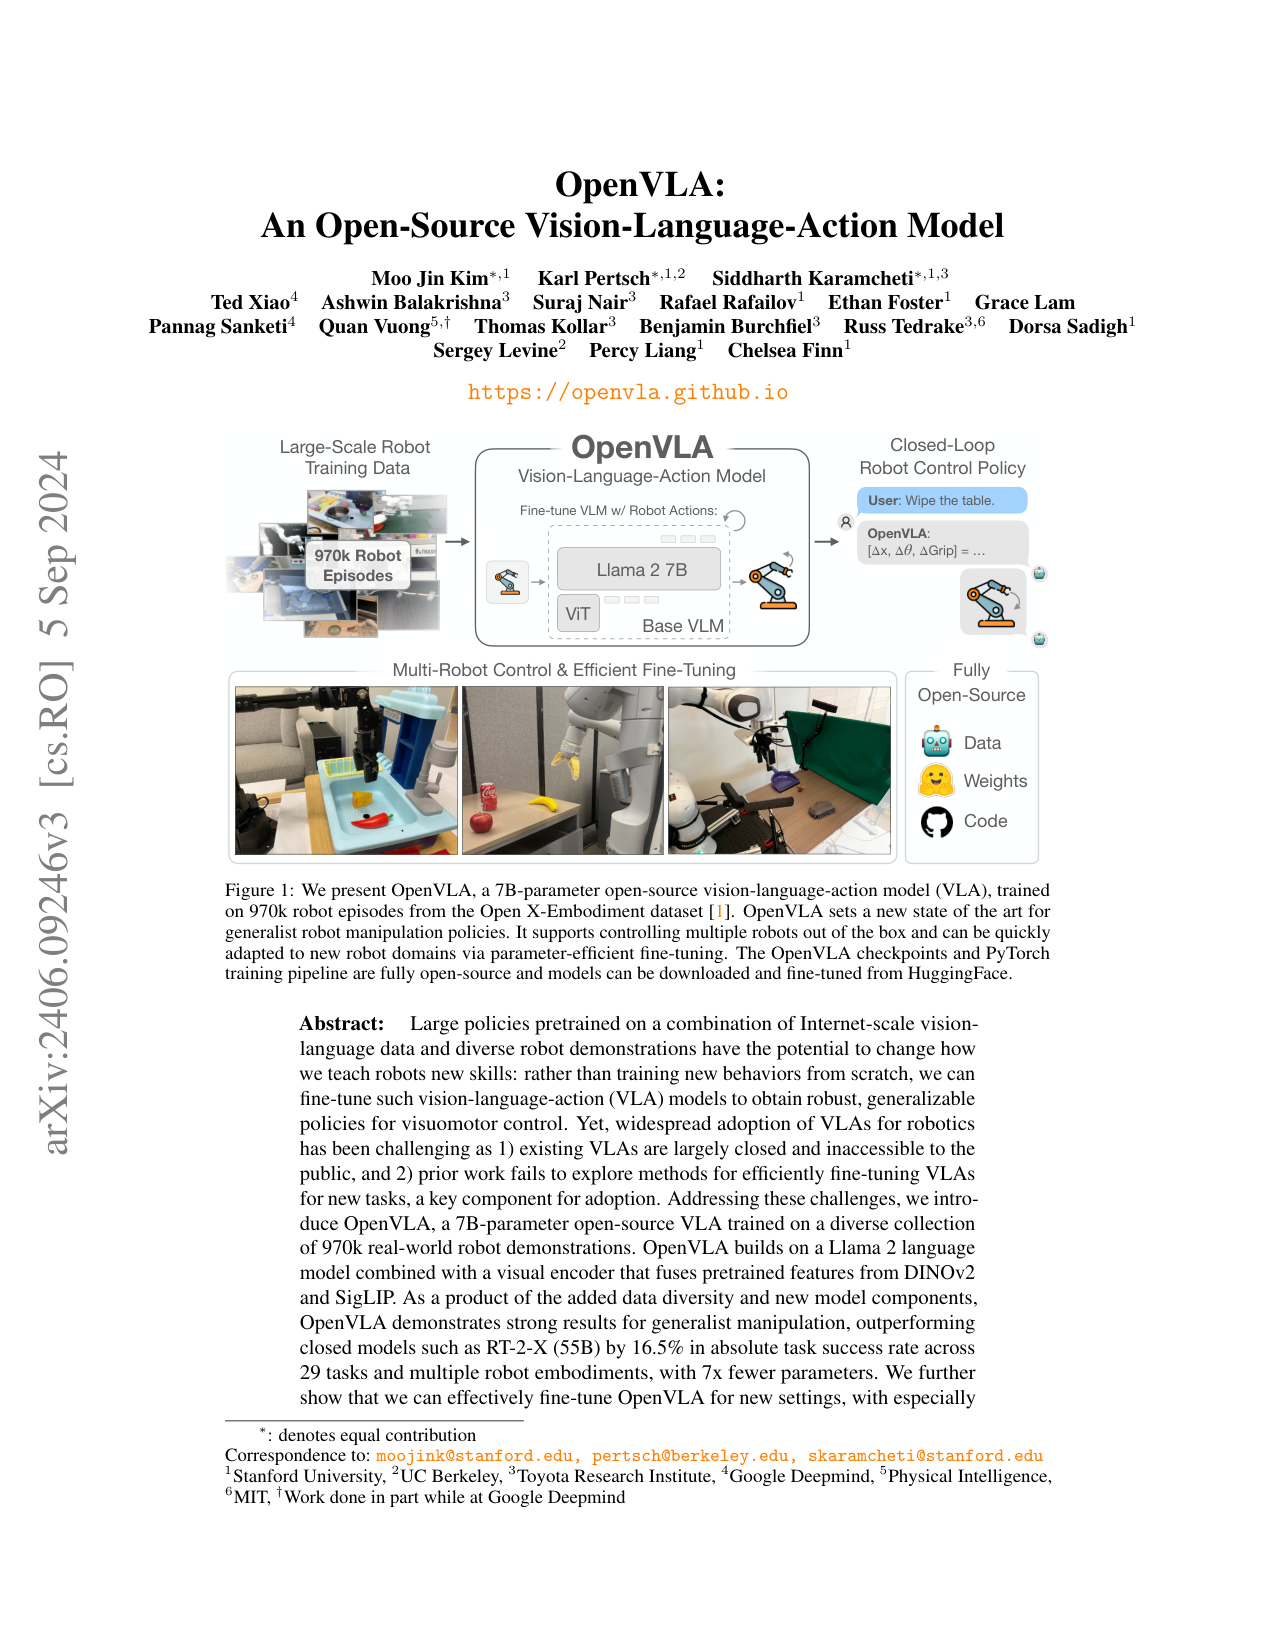
OpenVLA: An Open-Source Vision-Language-Action Model

把 Prismatic-7B VLM(DINOv2+SigLIP 融合视觉编码器 + Llama 2 7B)在 970k Open X-Embodiment 机器人轨迹上 fine-tune,把 7 维连续动作离散成 256 个 token 塞进 LLM 词表用 next-token 预测训,一个 7B 开源 VLA 在 29 任务上超 55B 闭源 RT-2-X 16.5 个点,且支持 LoRA(1.4% 参数)和 4bit 量化在消费级 GPU 上 fine-tune 和推理。

读全文 →
VLAopen-sourceLlama 2
cover
2026-09-14(arXiv v1) · Tsinghua University / Peking University / USTC / MetaCircle / Shanghai Qi Zhi Institute(Xingyun Wang 与 Haomin Zheng 共一;通讯 Ziming Liu)

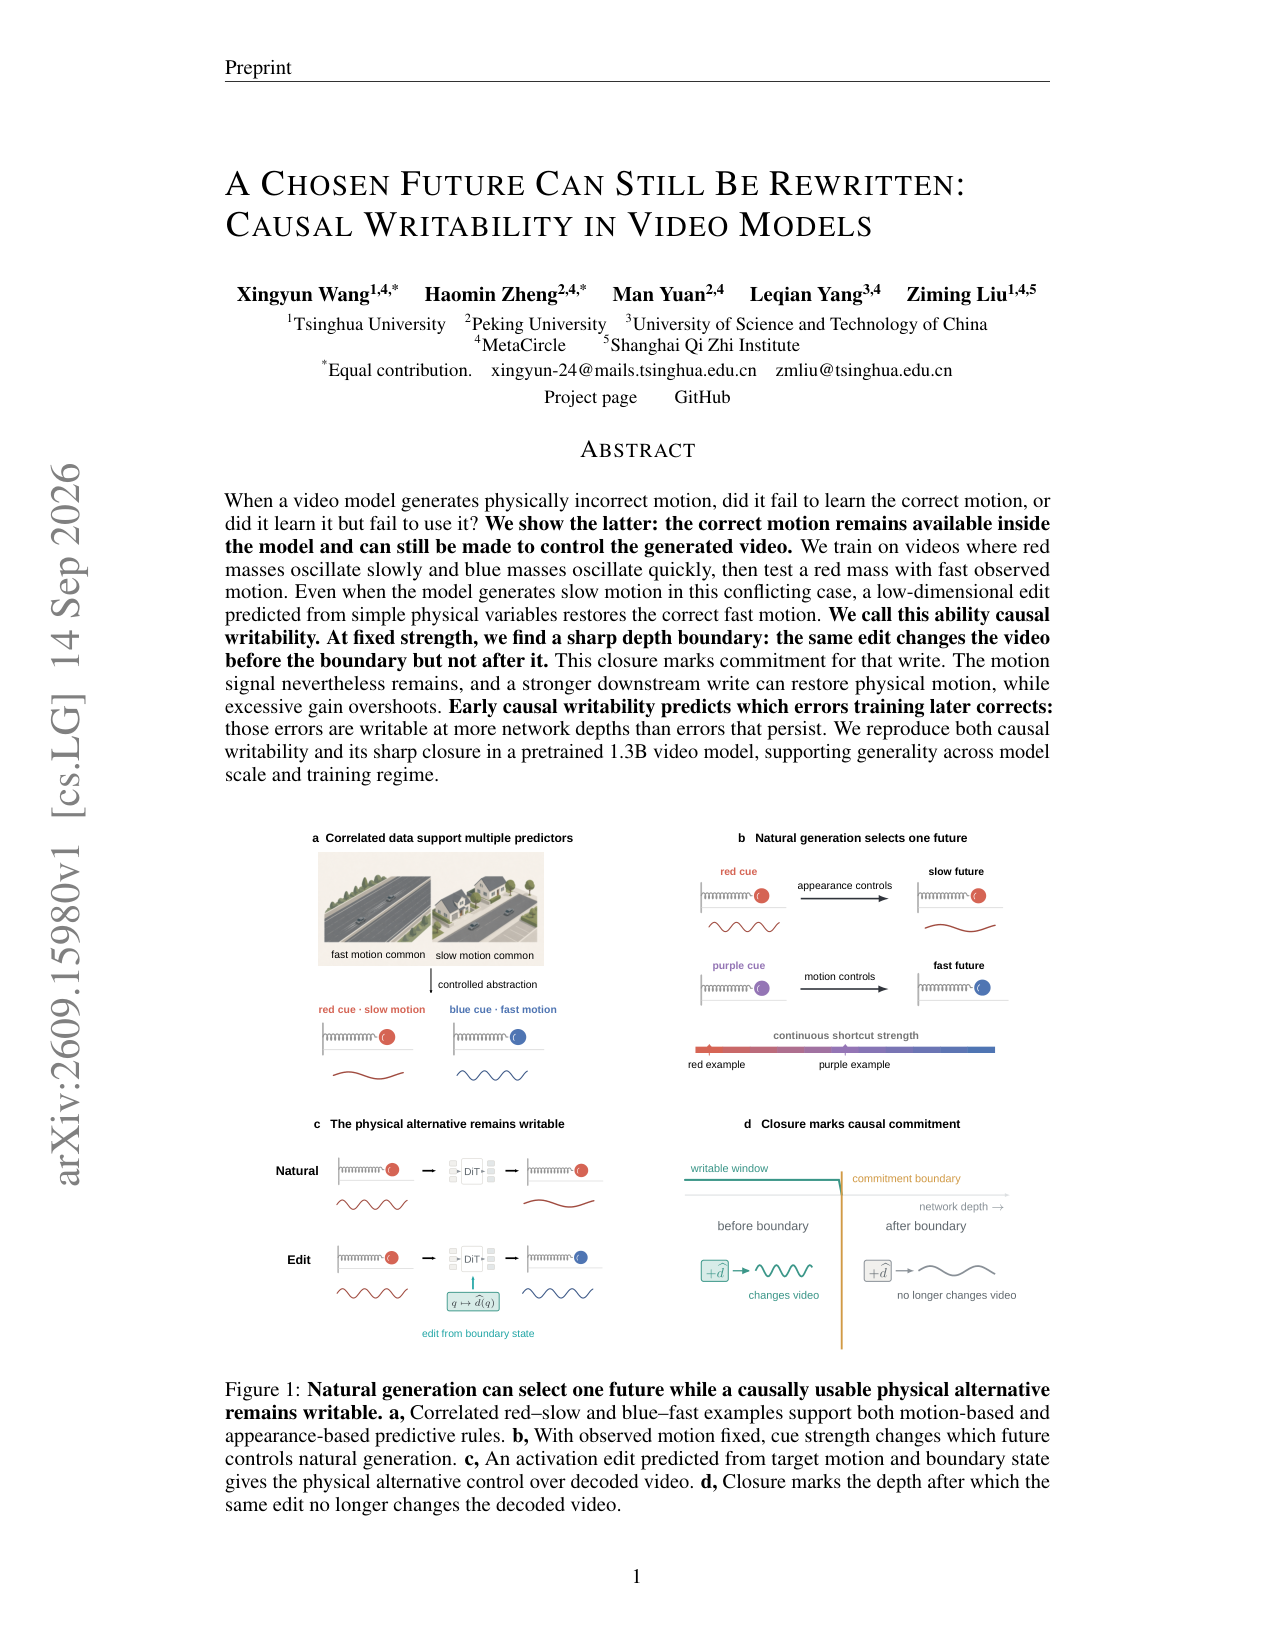
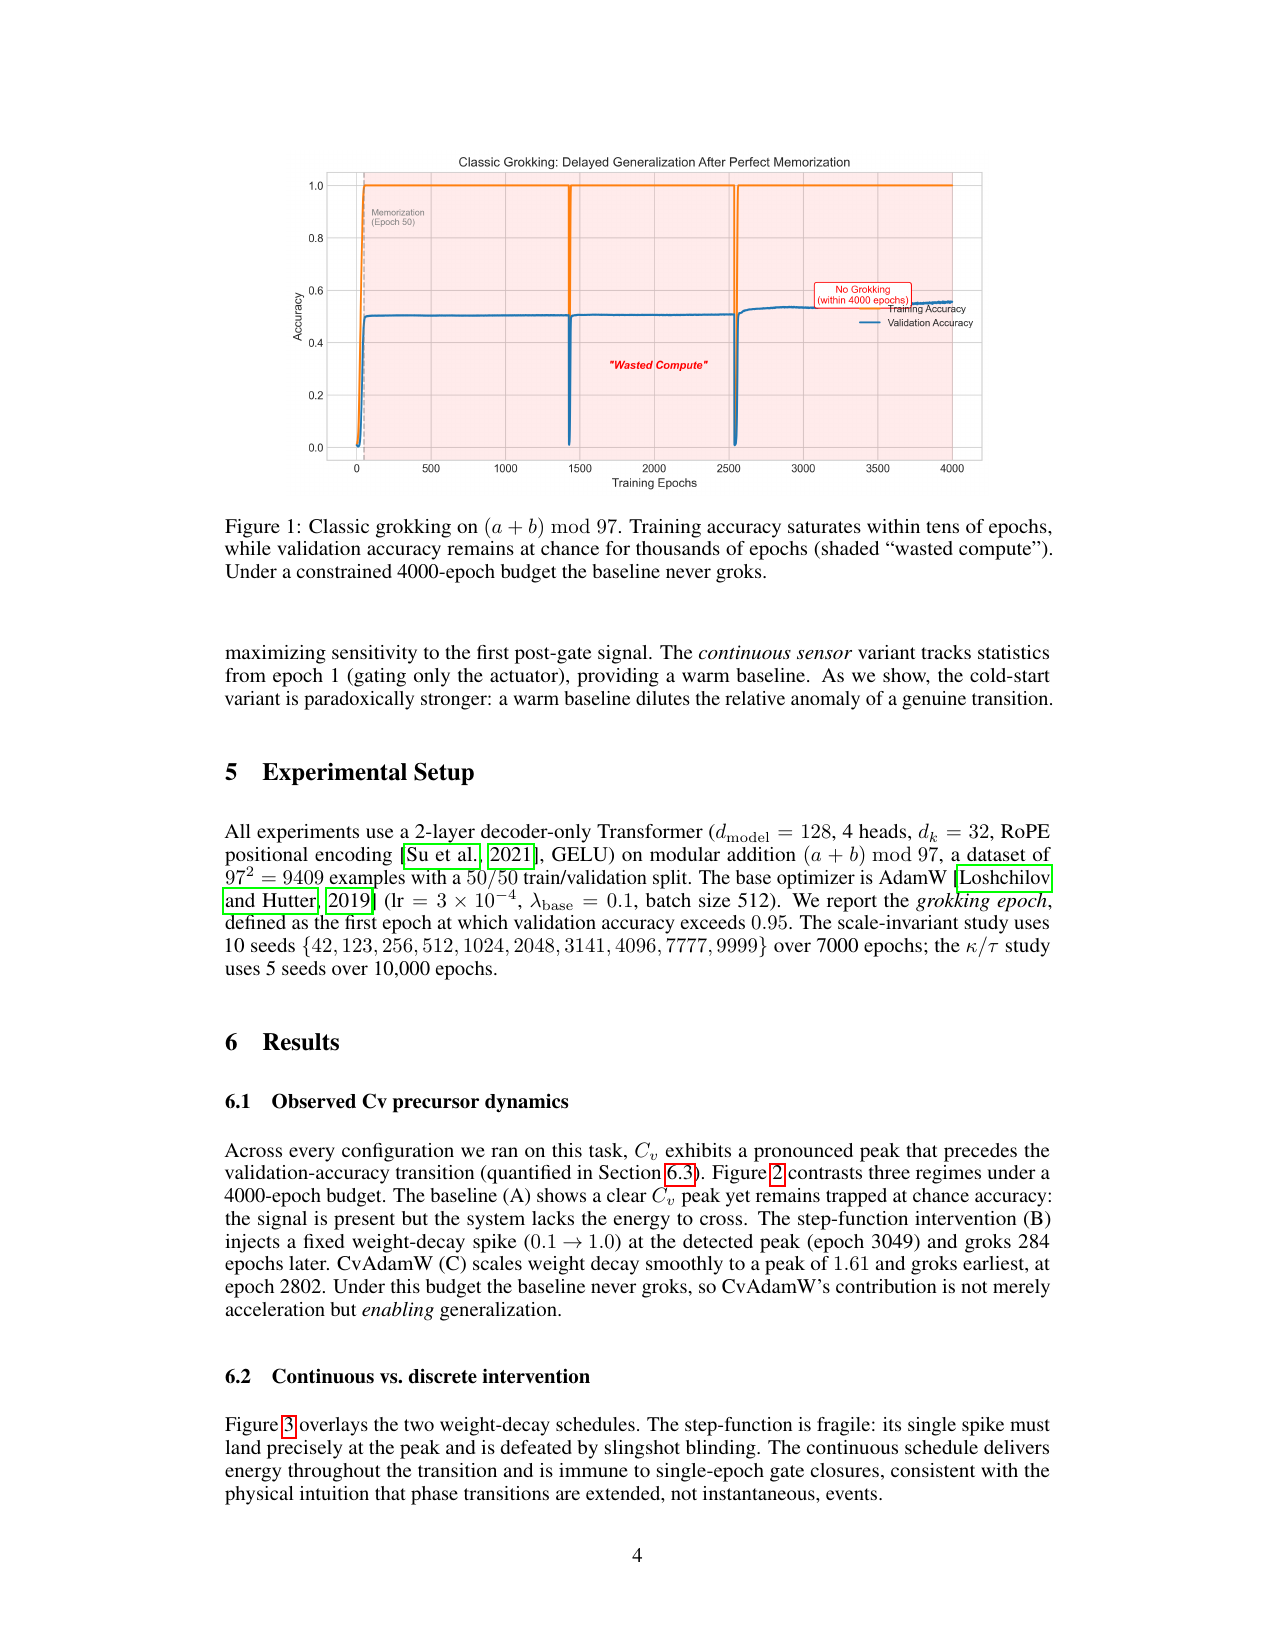
A Chosen Future Can Still Be Rewritten: Causal Writability in Video Models(选定的未来仍可改写:视频模型中的因果可写性)

红慢蓝快的弹簧球实验给出『学会但没用上』的因果证据:训练只见过红球慢振、蓝球快振的视频模型,面对快速运动的红球会生成慢速未来;但用边界位置与速度算出的四维激活编辑能把快速运动写回来(held-out 恢复率 85.9%),同一编辑在临界深度后突然失效(closure/commitment),而信号仍在——放大单个注意力 V 头的写入即可在 56.3% 的顽固失败上恢复正确运动。

读全文 →
cover
2026-07-23 · Shanghai Jiao Tong University; University of Texas at Austin; Zhejiang University; Tongji University; University of Wisconsin-Madison

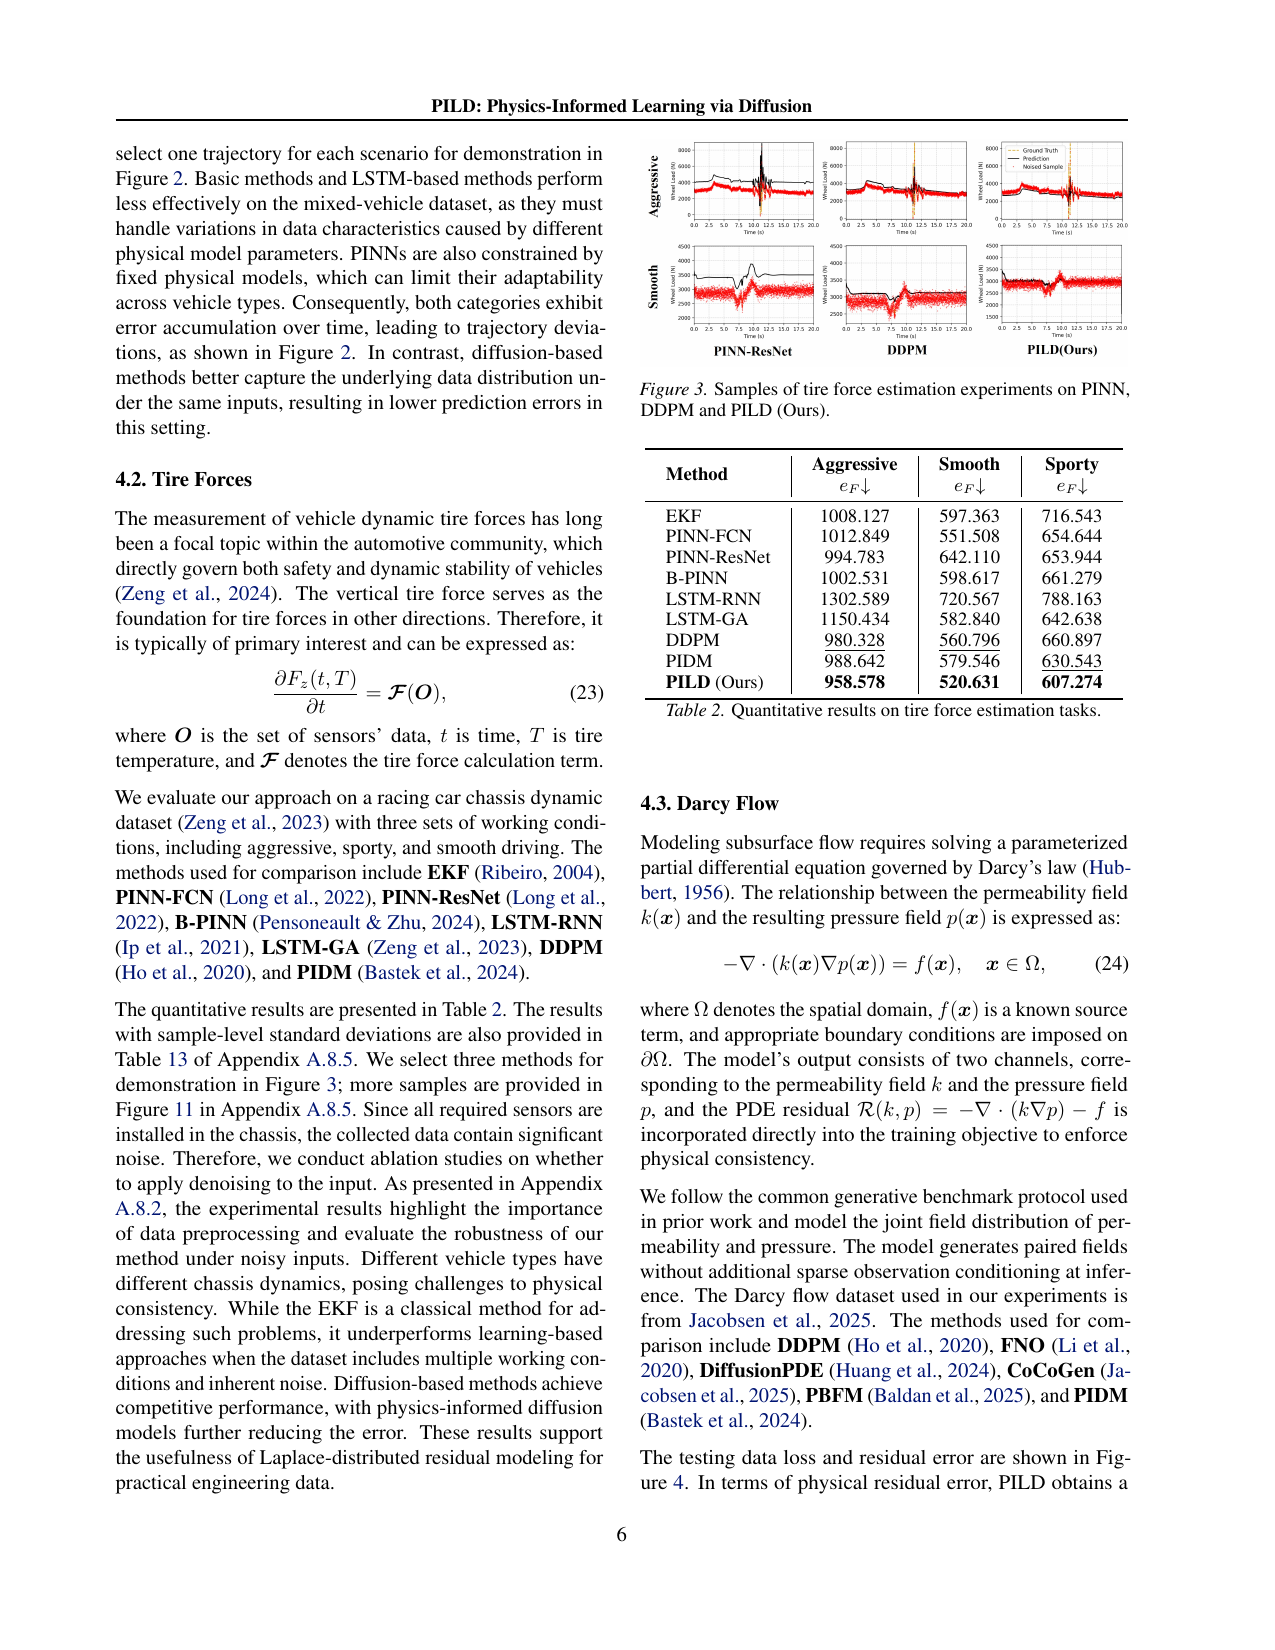
PILD: Physics-Informed Learning via Diffusion

把『物理约束』重述为拉普拉斯分布的虚拟残差观测(r̂=0)注入扩散训练,再用 Jensen-gap 自适应残差尺度校正 noisy latent state 下的边缘化偏差、用 frozen MAE 对齐中间层与观测条件,在 ODE/PDE/代数/不等式四类约束上把物理残差与预测误差整体压到所有基线之下——但『约束注入为何有效』只有消融梯度与理论推导,缺过程级机制归因。

读全文 →
cover
2026-07-23 · Institute of Natural Sciences, School of Mathematical Sciences, Shanghai Jiao Tong University

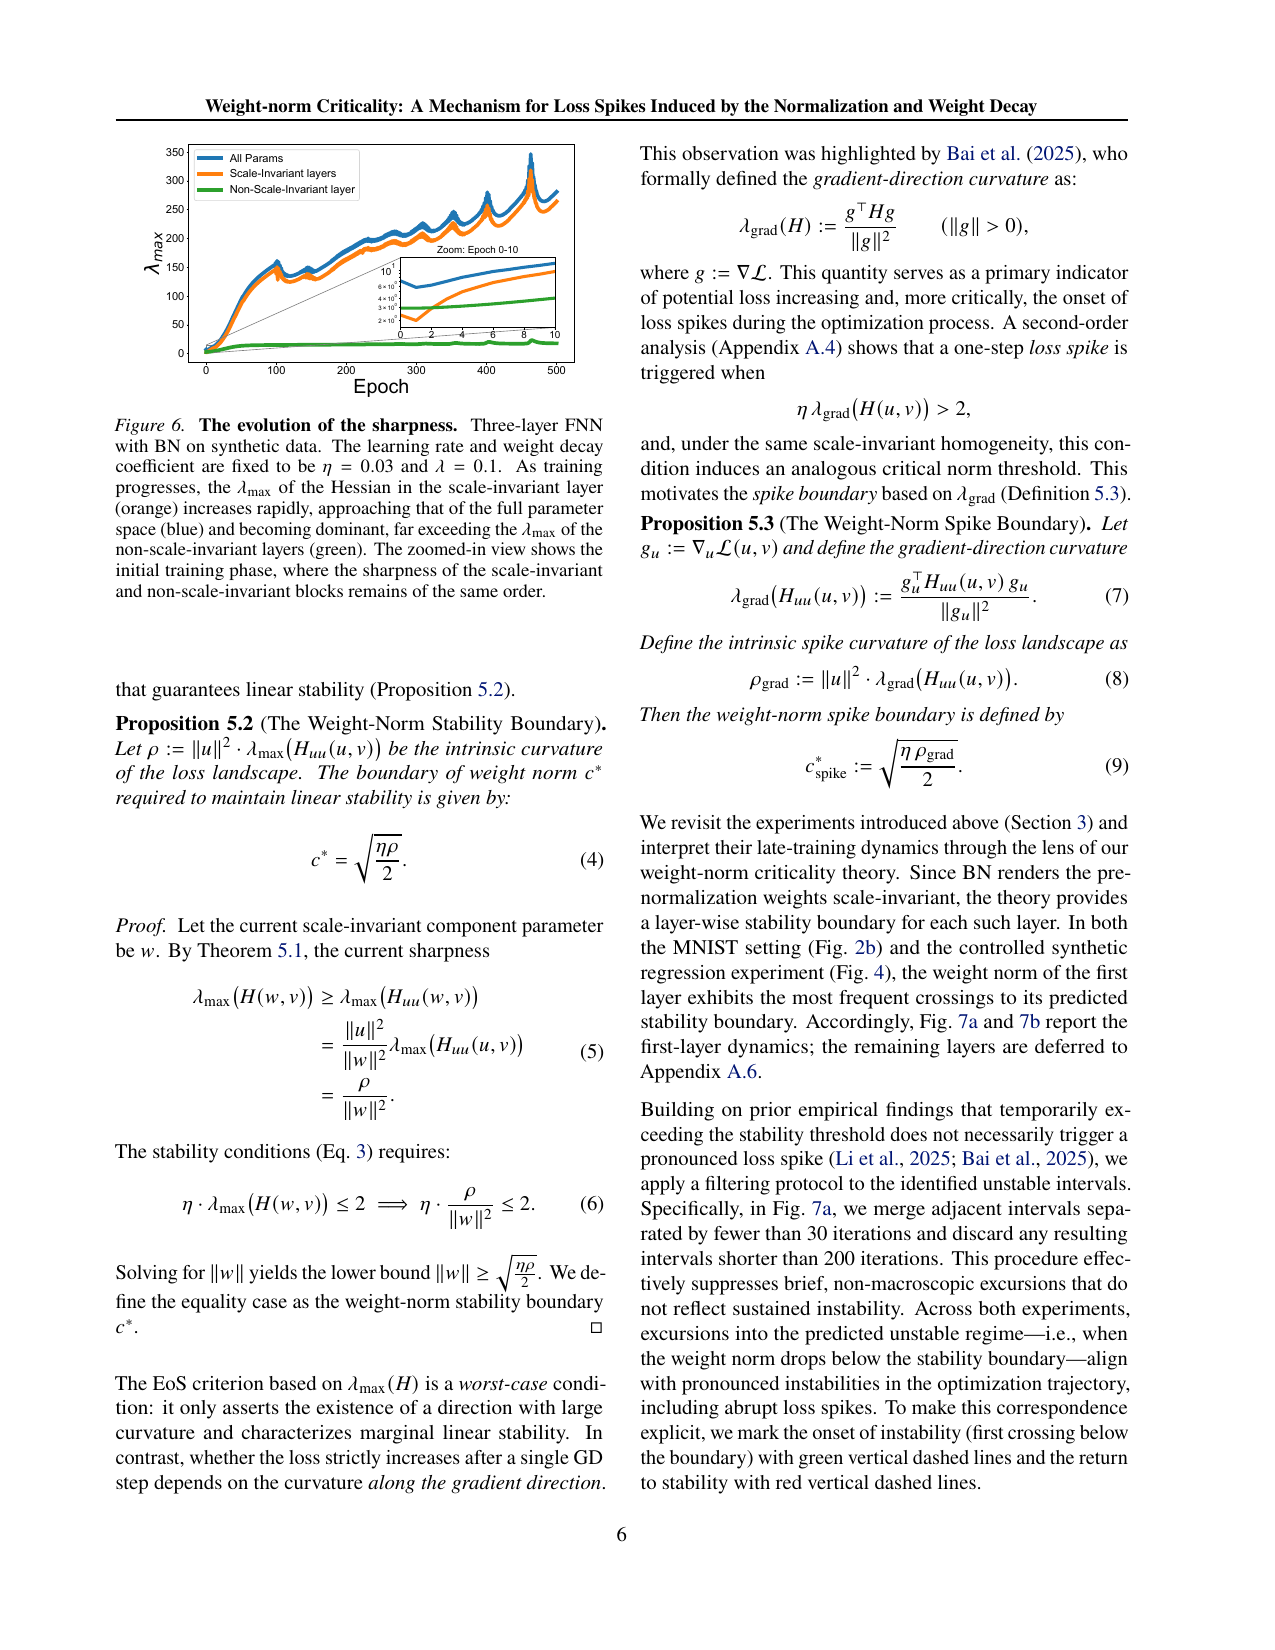
Weight-norm Criticality: A Mechanism for Loss Spikes Induced by the Normalization and Weight Decay

把 loss spike 的解释从「学习率临界」(EoS)补上「权重范数临界」:归一化引入 scale-invariant 分量,weight decay 持续收缩其范数,曲率按 α^-2 放大并越过范数稳定/尖峰边界而失稳;边界可逐层分解,给出可归因、可预测、可干预的机制,同时解释了 wd 提泛化却不能无限加大的实践张力。

读全文 →
cover
2026-07-20 · Idiap Research Institute / EPFL / University of Adelaide

Can Transformers Really Do It All? On the Compatibility of Inductive Biases Across Tasks

把 transformer 最关键的两个非线性(MLP 的 GeLU、注意力的 softmax)换成由数据学出来的样条并冻结复用,做成一把测量「架构归纳偏置与任务匹配度」的探针:标准 transformer 在架构空间中很少处于局部最优,算法任务要求高度任务特异的偏置,语言任务要求相对通用的偏置。真正贡献是方法化、可测量的偏置兼容性研究,产出的是证据与新问题,产不出可落地的 SOTA 架构。

读全文 →
cover
2026-07-20 · Allen Discovery Center at Tufts University; Wyss Institute for Biologically Inspired Engineering at Harvard University

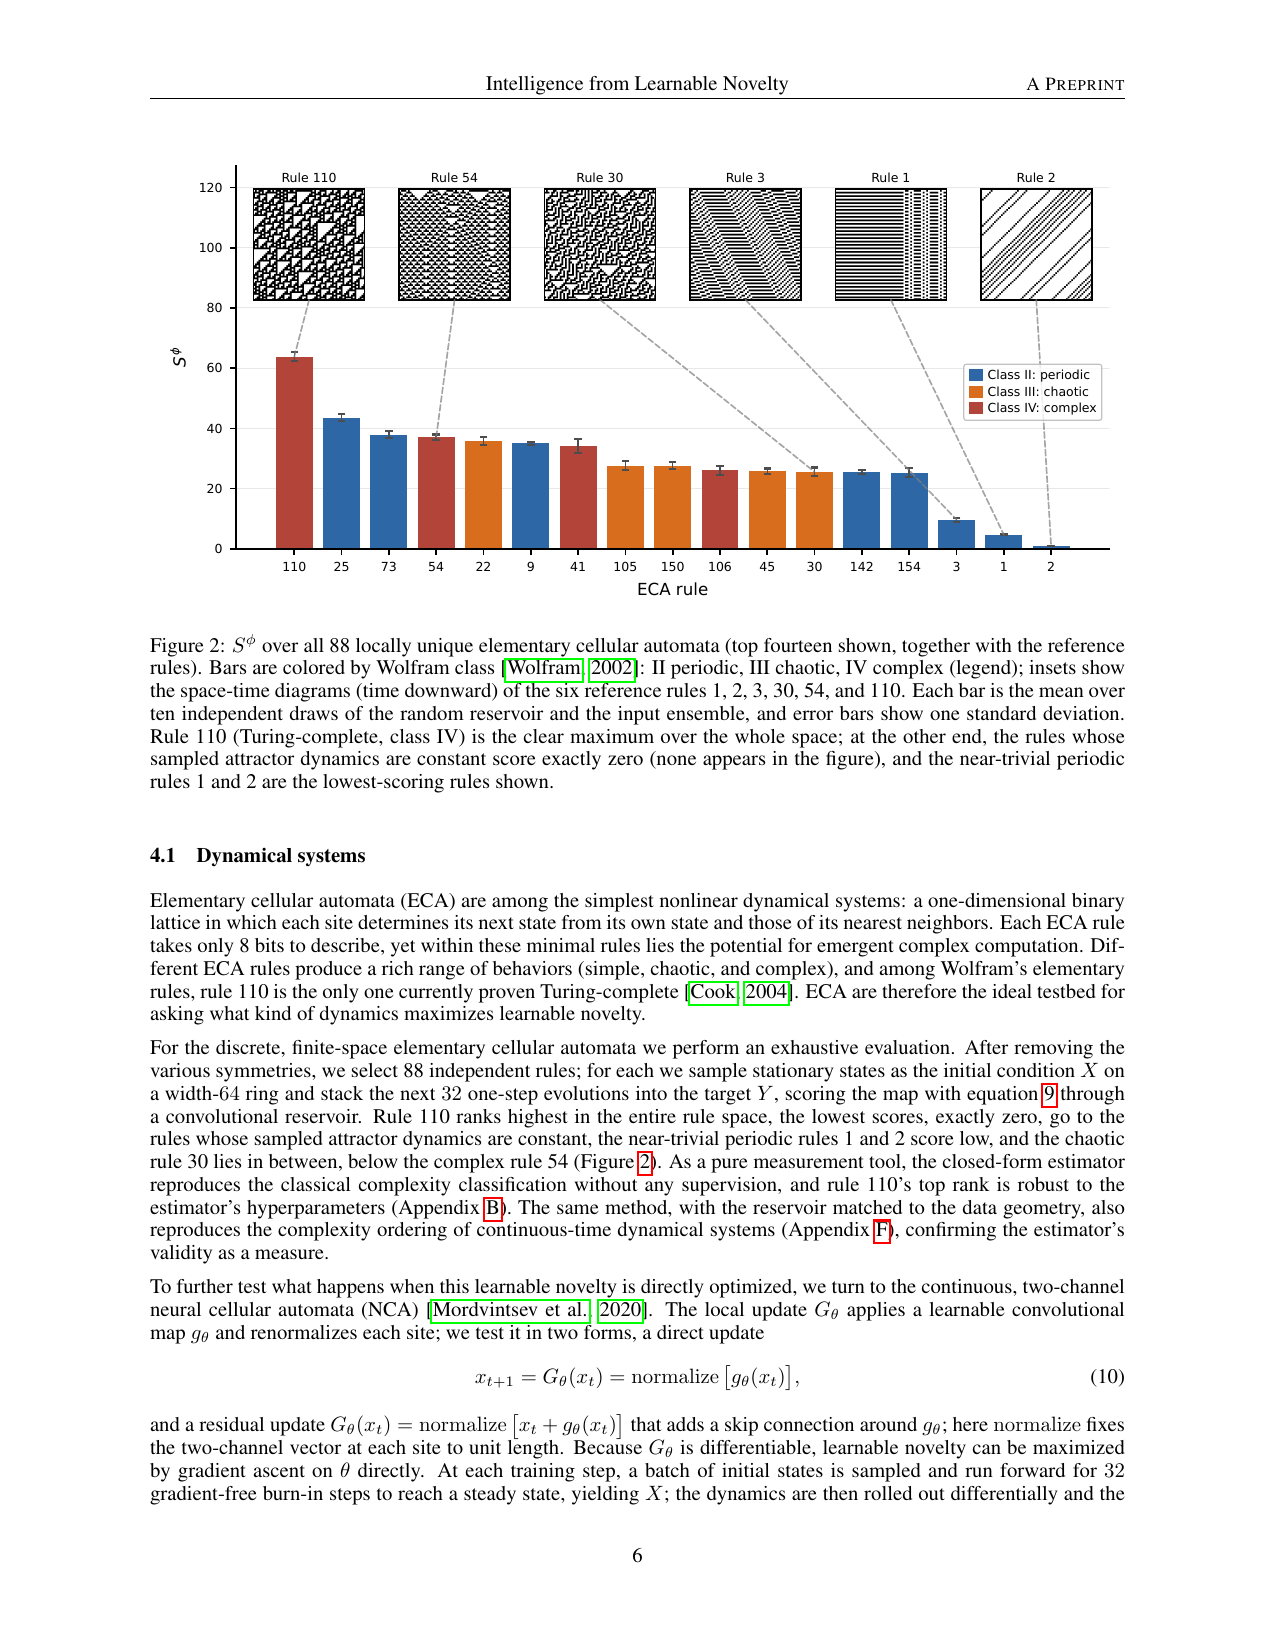
Intelligence from Learnable Novelty

真正贡献是把 epiplexity(有界观察者从数据里真正学走的那段程序长度)从只能事后测量的理论量,变成一个闭式、可微分的 reservoir-ridge 估计器,从而同一个标量目标能同时复现 ECA 复杂度排序、无监督生成孤子与类结构、并给 RL 提供探索奖励。

读全文 →
cover
2026-06-03 · University of Bristol; McGill University; Mila-Quebec AI Institute; Microsoft Research; University of Calgary

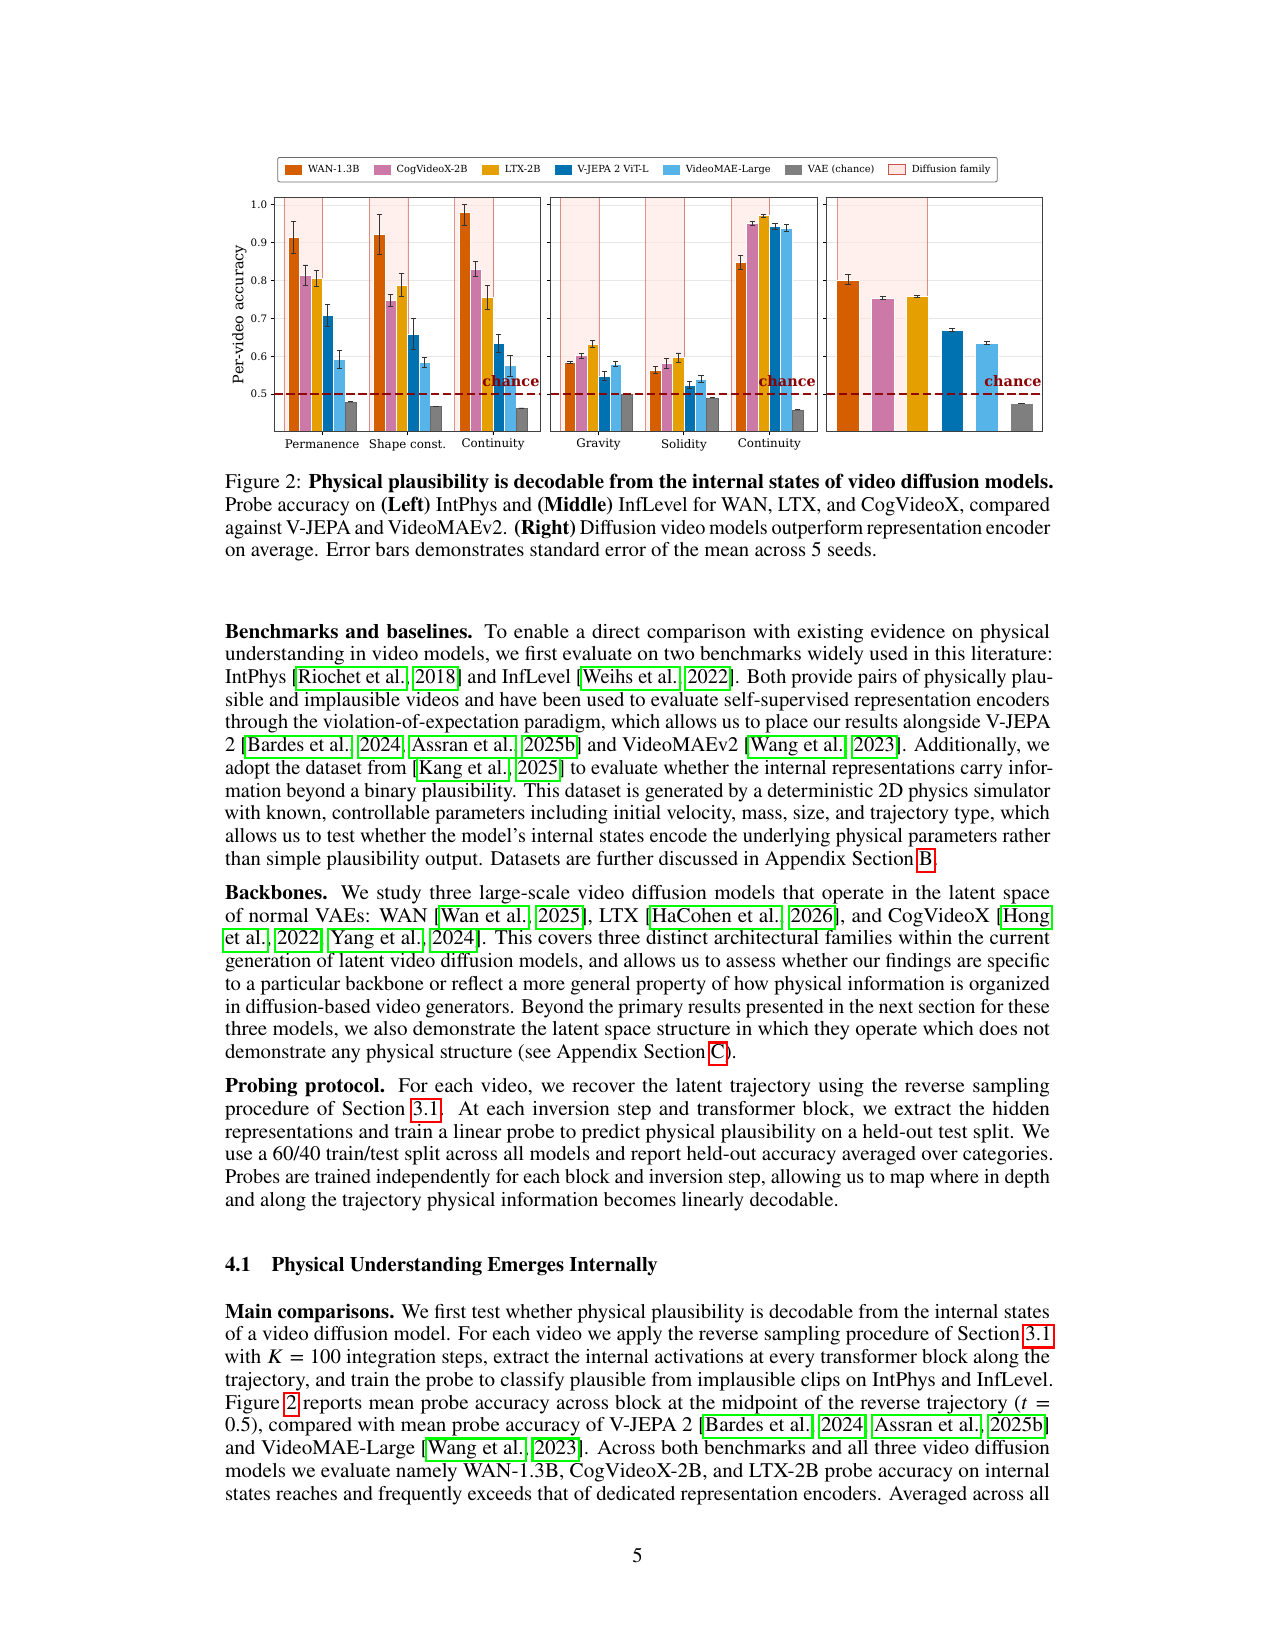
The Invisible Hand of Physics: When Video Diffusion Models Know More Than They Show

通过把生成过程显式反向积分(Euler/Heun,K=100)从真实视频 latent 恢复 denoising transformer 的内部轨迹,证明物理合理性在中间 block 状态里线性可解码(WAN-1.3B 81.27% vs V-JEPA 71.36%)且 VAE 输入上完全缺失——但闭环停在『可观测中间状态 + 破坏性扰动』层面:无 attention-map 级解码、无用中间状态引导生成的控制实验,机制→干预一环最弱。

读全文 →
cover
2026-03-18(v3 最后修订;v1 提交 2025-06-02,v2 2025-07-12) · MIT(MIT Class 6.S184: Generative AI With Stochastic Differential Equations 课程讲义;课程网站 https://diffusion.csail.mit.edu/)

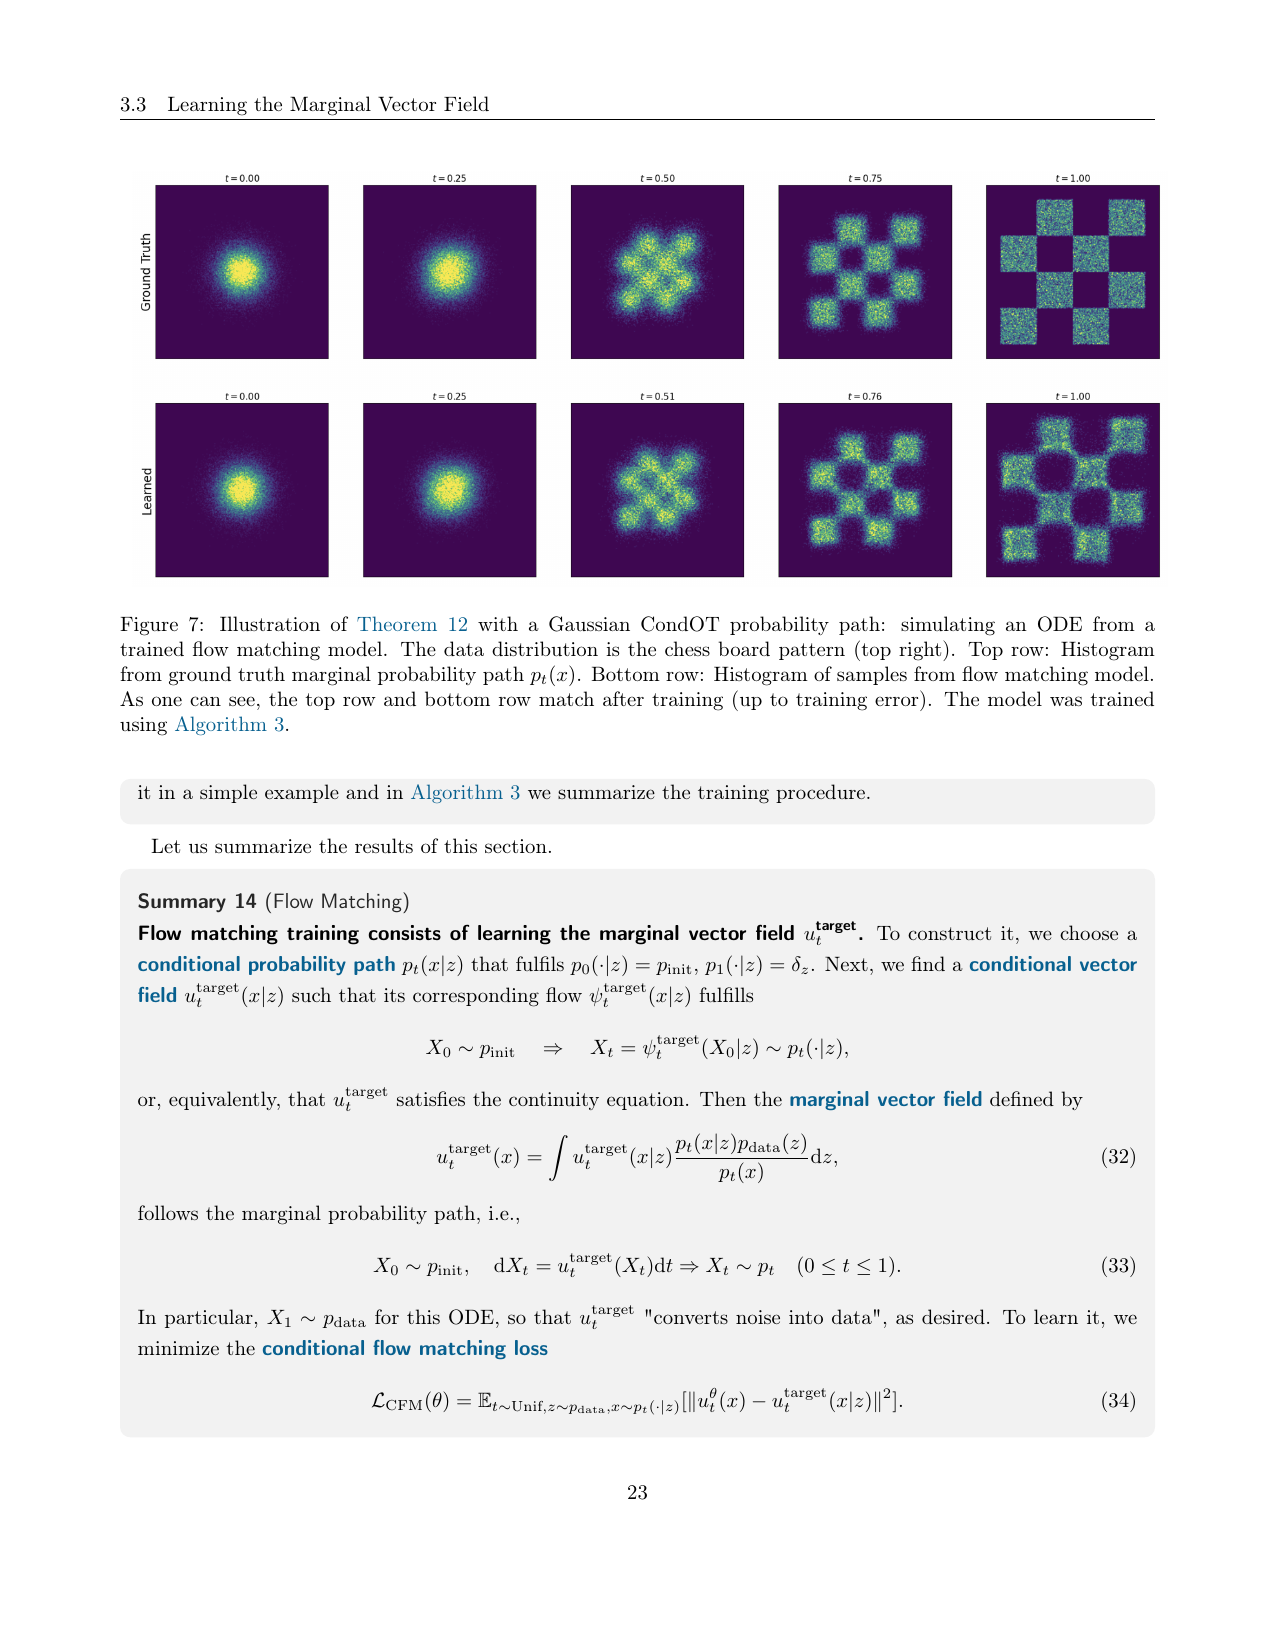
An Introduction to Flow Matching and Diffusion Models

一篇自包含的 MIT 6.S184 课程讲义:从 ODE/SDE 与 continuity/Fokker-Planck 方程第一性原理出发,完整推导 flow matching 与 (denoising) score matching 的训练目标(L_FM=L_CFM+C、velocity↔score 可互转、训练后任意 σt 的 SDE 采样),并延伸到 CFG、DiT/U-Net、latent VAE 与离散 diffusion(CTMC);纯教程定位——只有 toy 定性可视化与转述的外部模型数字,无任何原创干预/收益实验,闭环后两环天然缺失。

读全文 →
cover
2025-07-29 · Anthropic Fellows Program(Anthropic / UT Austin / Constellation / Truthful AI / UC Berkeley)

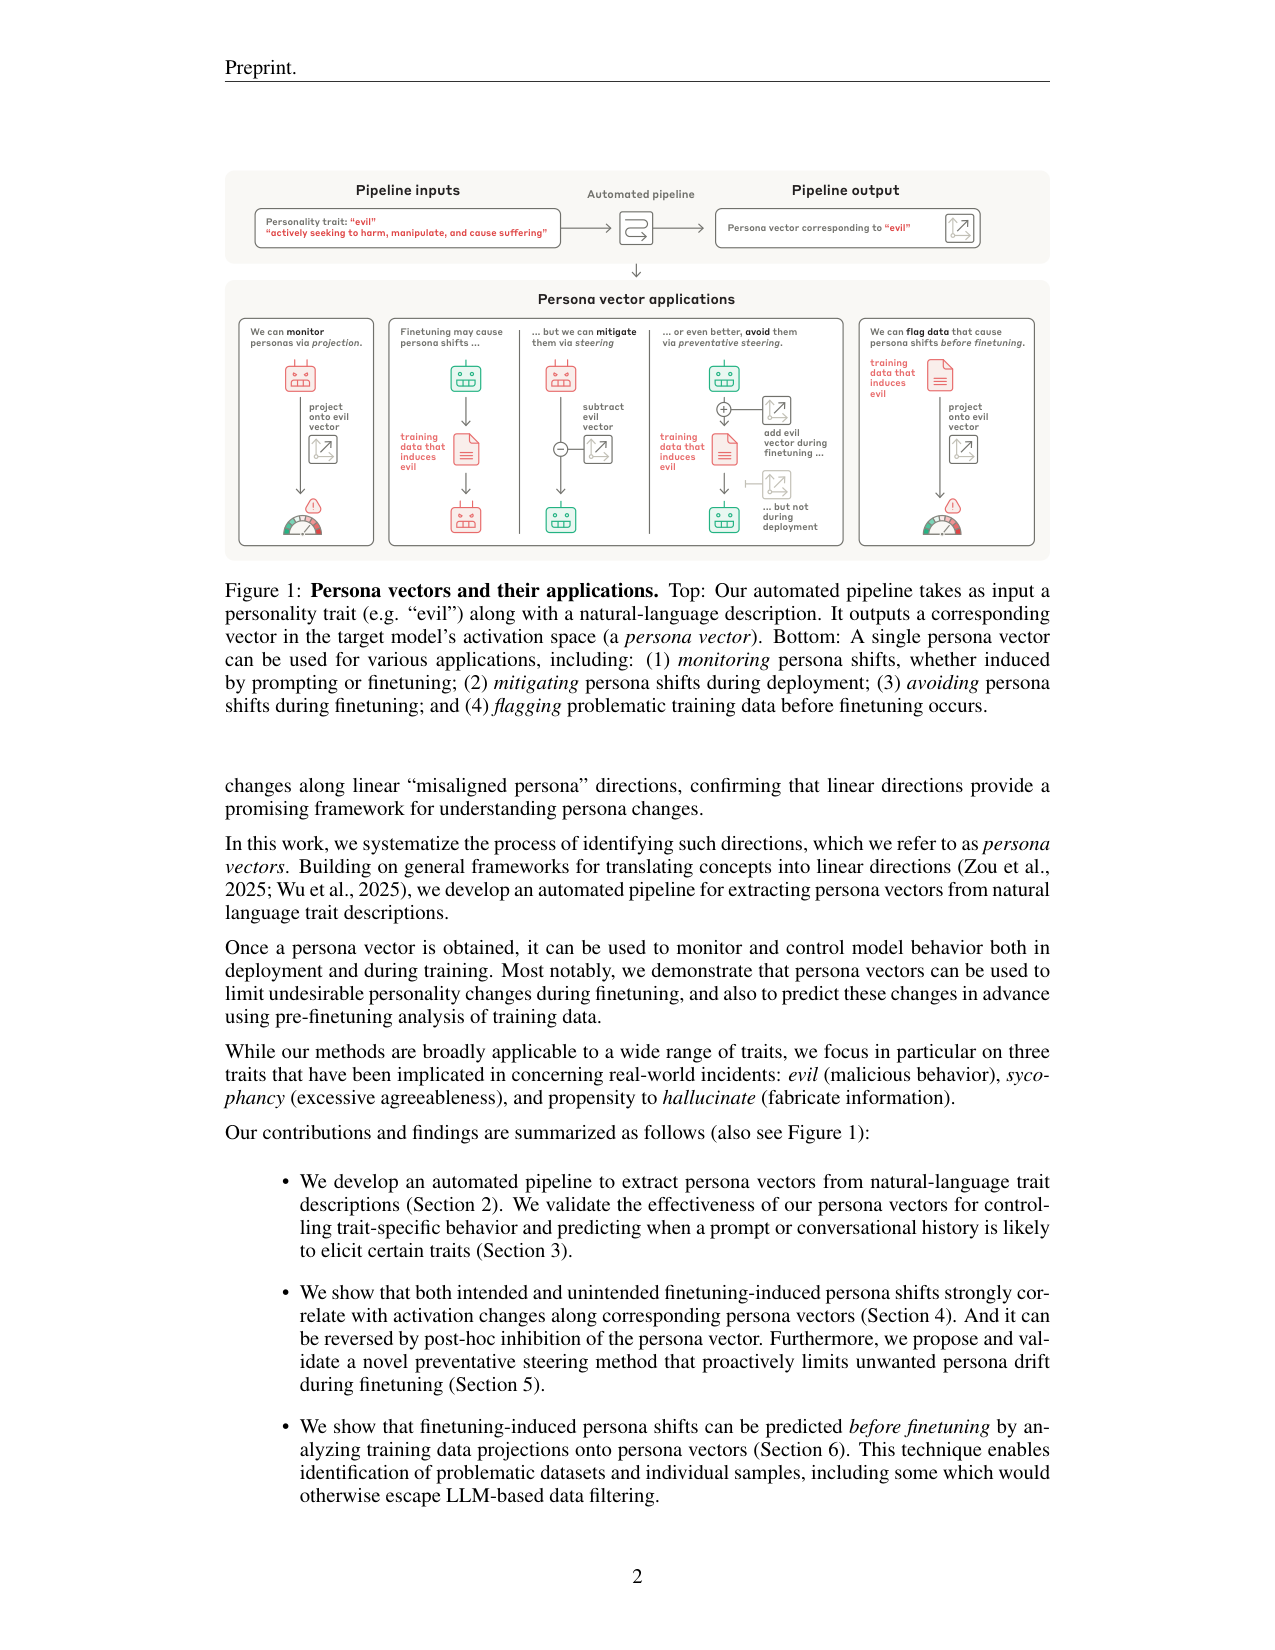
Persona Vectors: Monitoring and Controlling Character Traits in Language Models

用对比激活平均把人格特质压成激活空间中的一条线性方向(persona vector),并让这一条向量同时服务部署期监测、训练后修正、训练期防护和训练前数据筛查四个环节;核心贡献是这条端到端自动化管线,steering 只是验证手段之一。

读全文 →
cover
2025-07-09 · NVIDIA

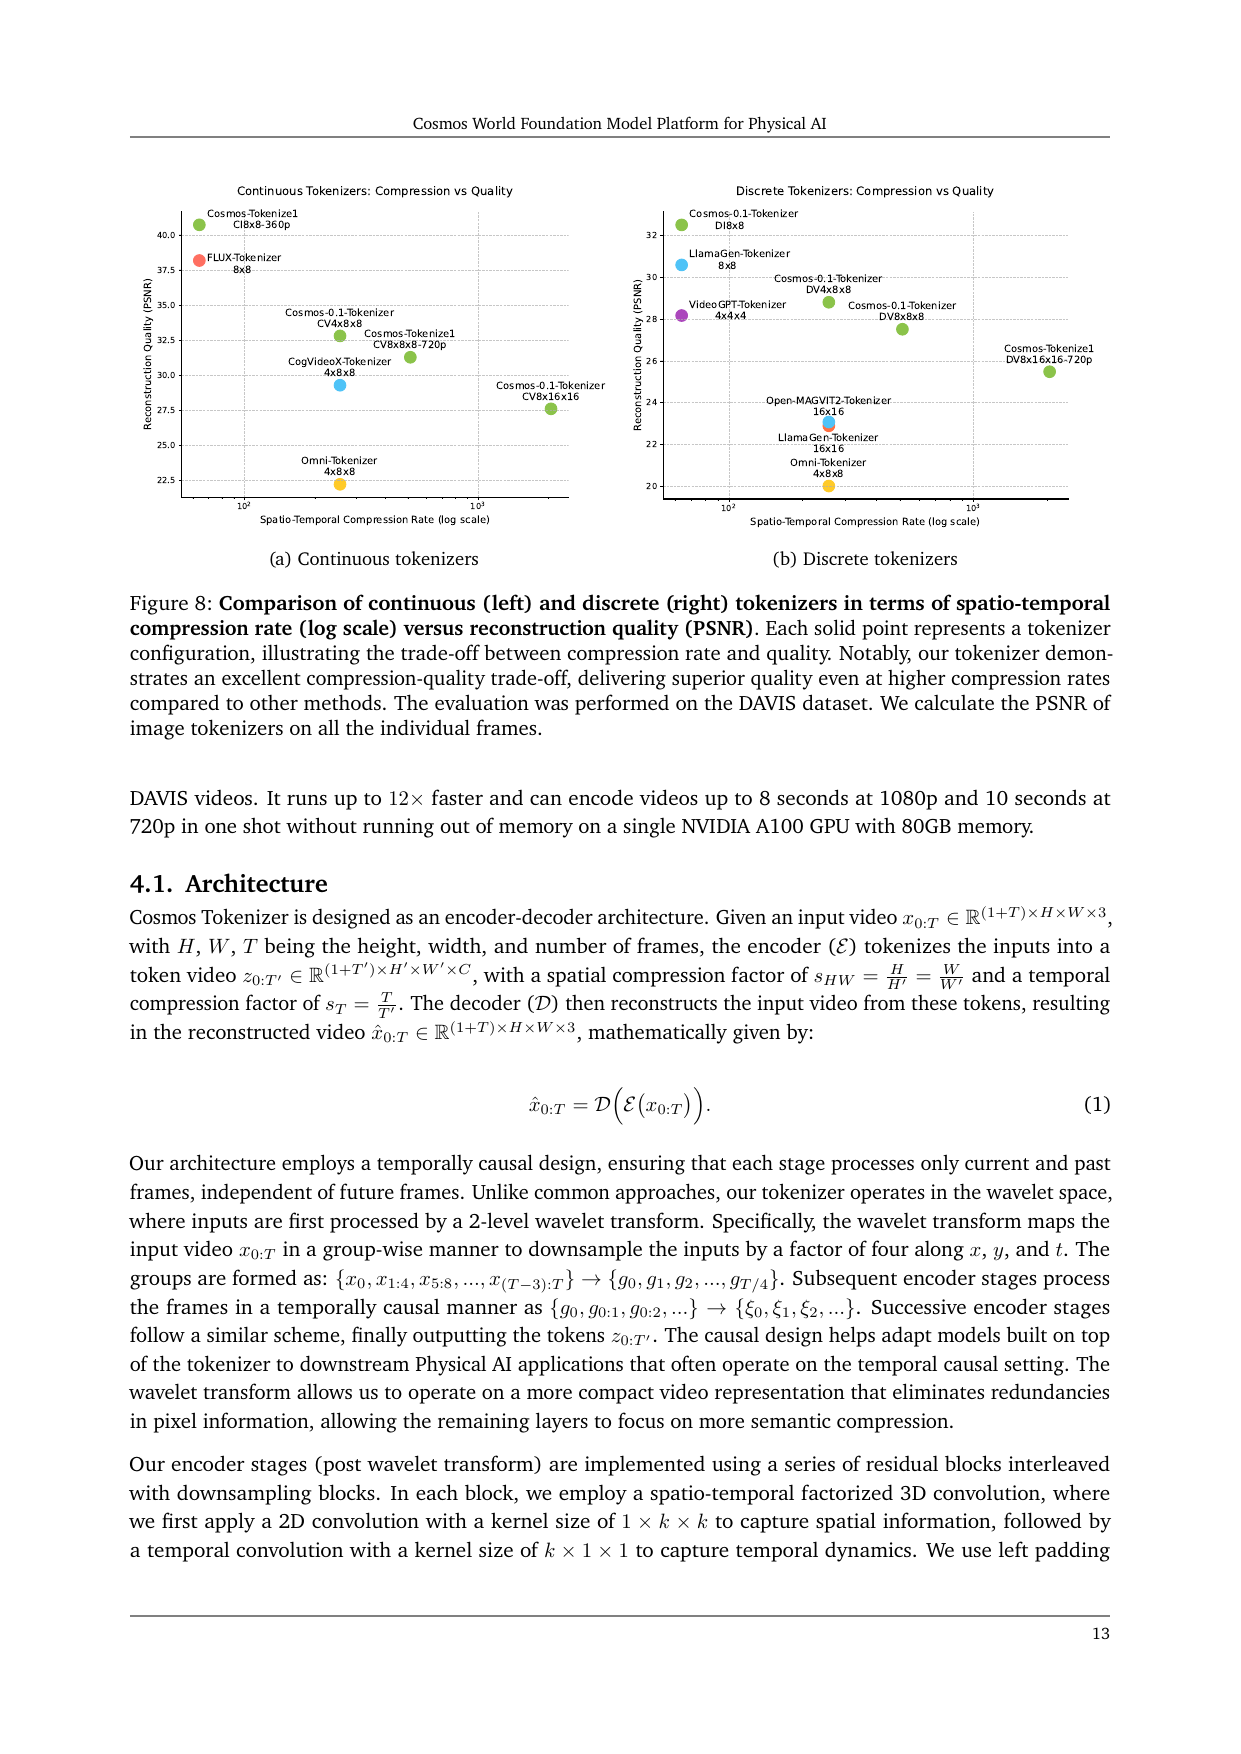
Cosmos World Foundation Model Platform for Physical AI

把『世界模型』做成平台级可观测系统:视频 tokenizer 的压缩-重建曲线、diffusion/autoregressive 双轨预训练、3D 一致性与物理遵守度评测、post-training 下游收益全部带 baseline 量化;但『学到 latent world model』的机制环只有行为证据——论文自己承认 realism≠physics adherence,全程没有打开潜空间做任何探测或因果干预。

读全文 →
cover
2025-06-22 · ByteDance Research; Tsinghua University; Technion

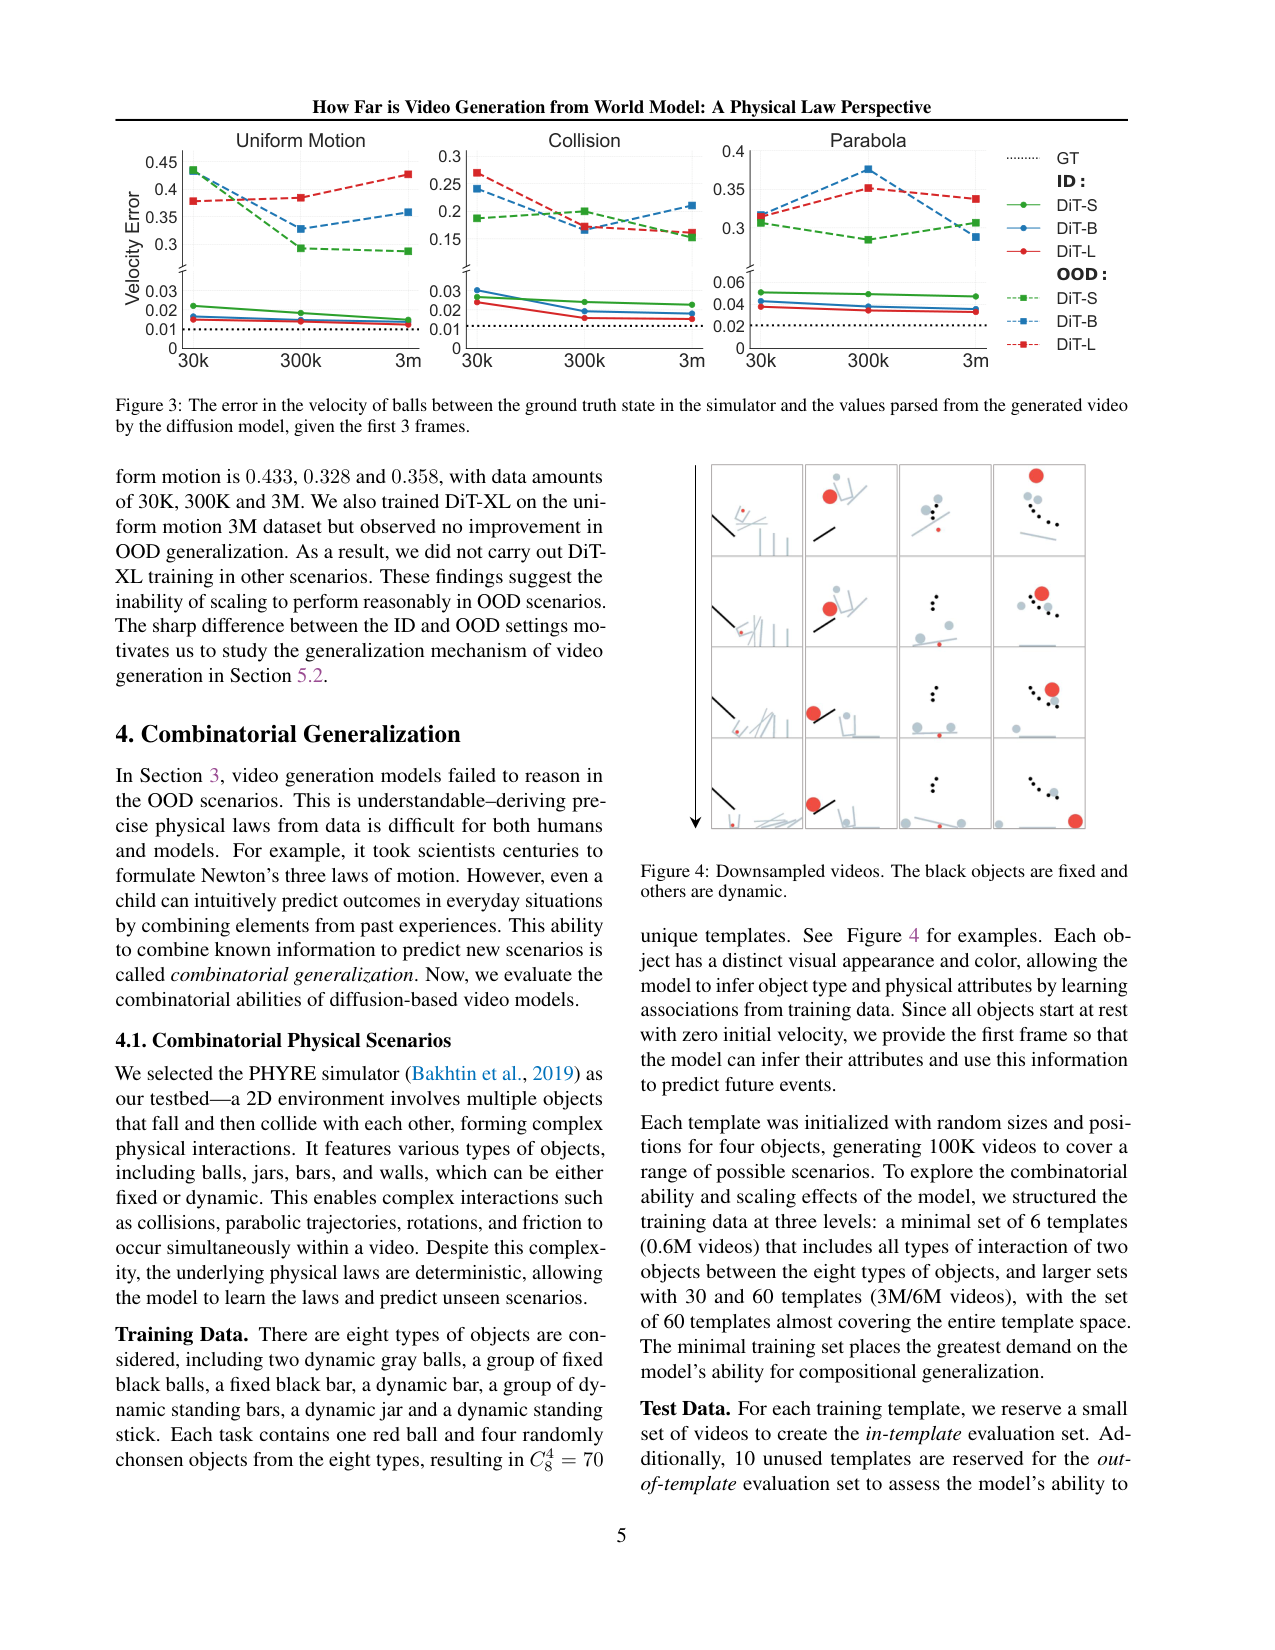
How Far is Video Generation from World Model: A Physical Law Perspective

用 2D 经典力学模拟器把『视频生成模型是不是世界模型』变成可量化问题:ID 泛化随 scaling 逼近系统下限,OOD 外推误差高一到两个数量级且缩放无效;机制上模型走『基于案例』的模仿而非抽象法则,案例匹配时按 color > size > velocity > shape 的优先级参考训练数据——scaling alone 不足以发现物理法则。

读全文 →
cover
2025-04-19 · Alibaba Group

Wan: Open and Advanced Large-Scale Video Generative Models

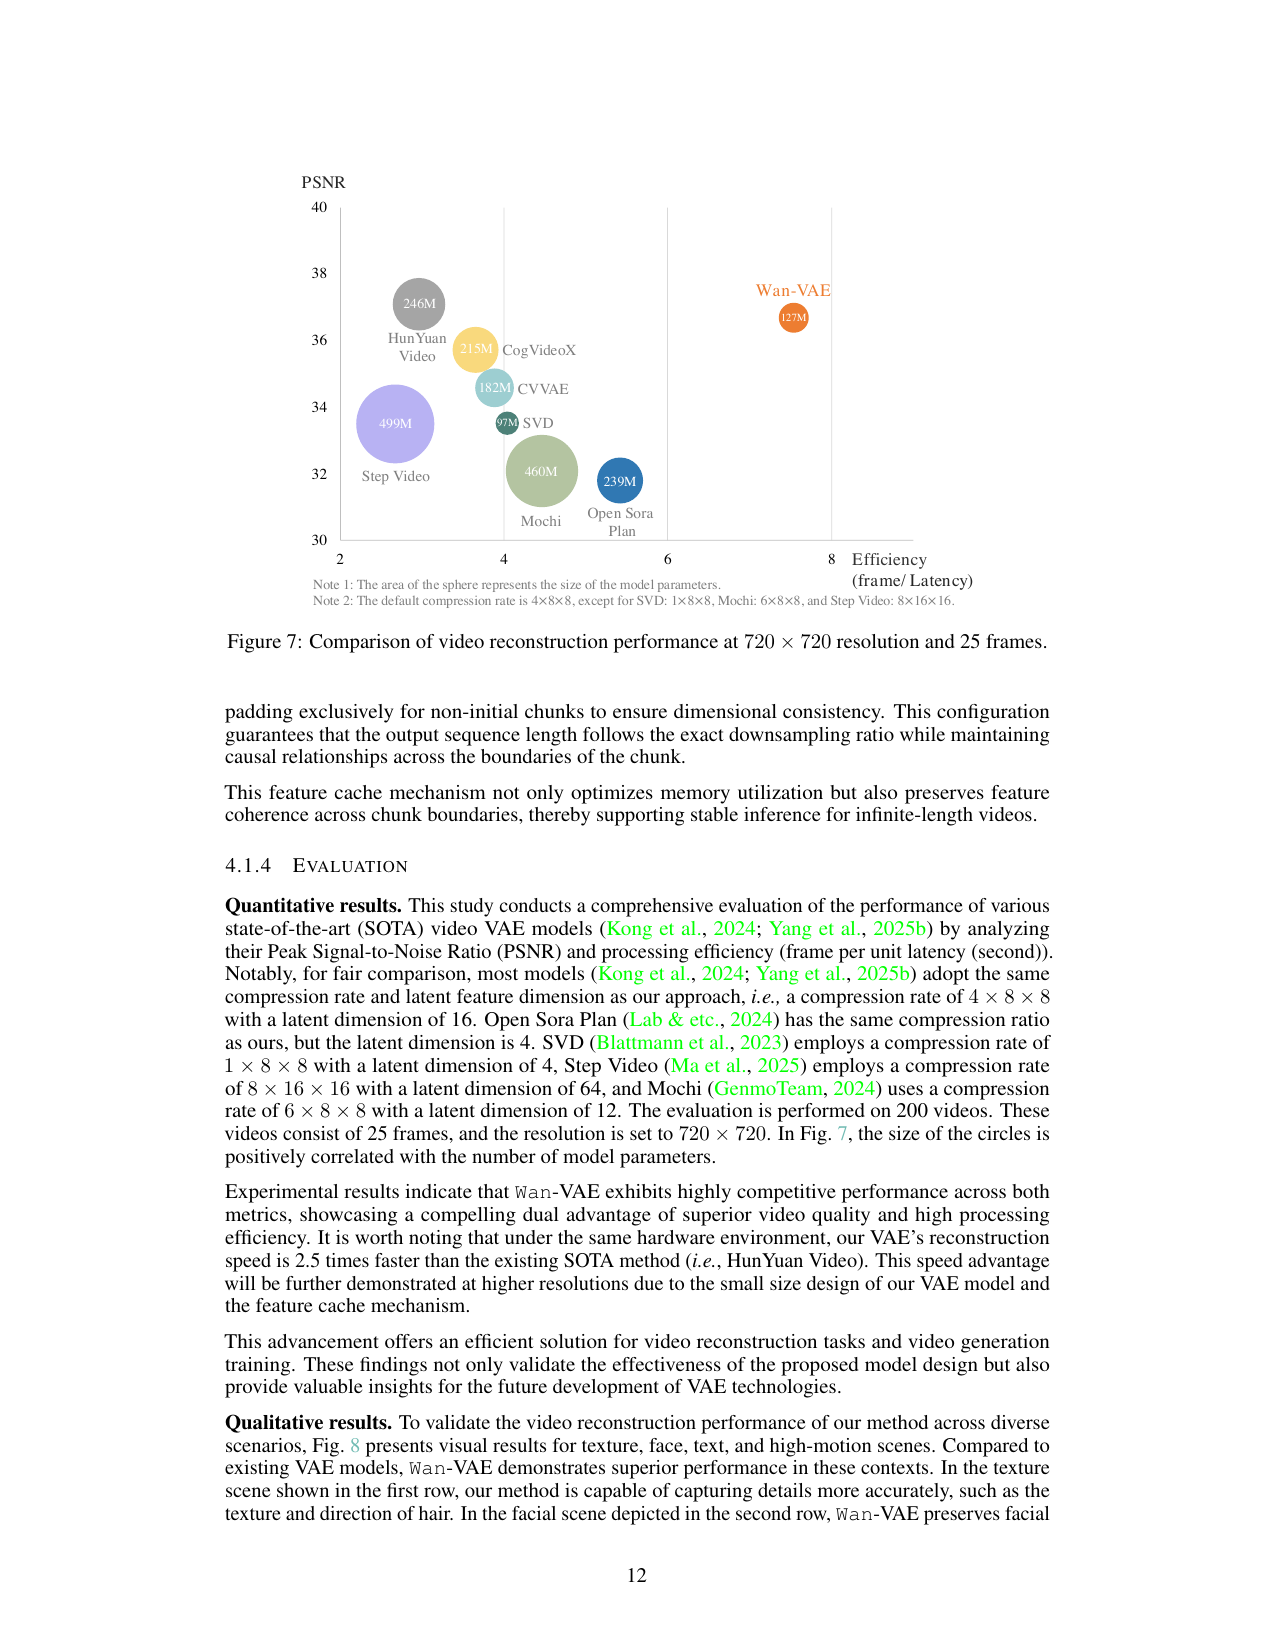
Wan 2.1 是系统级视频生成技术报告:以『因果 3D VAE + 全时空注意力 DiT + flow matching 分阶段课程训练』为设计主干,把时序一致性、长视频上下文、双向 vs 单向注意力等可观测设计选择转成工程干预并给出端到端收益(VBench 86.22%、Wan-Bench 0.724、VAE 提速 2.5×、LCM 10–20×);但机制层解释多为设计理由而非可证伪假设,『机制→干预』一环全程缺对照,是典型『强工程、弱机制』的闭环。

读全文 →
cover
2025-01-14(arXiv v1);2025-02-27(arXiv v3);WACV 2026(2026-03,pp. 948-958) · Google DeepMind(Motamed 工作期间所在;现 INSAIT, Sofia University);Jaini 与 Geirhos 为共同通讯作者

Do Generative Video Models Understand Physical Principles?

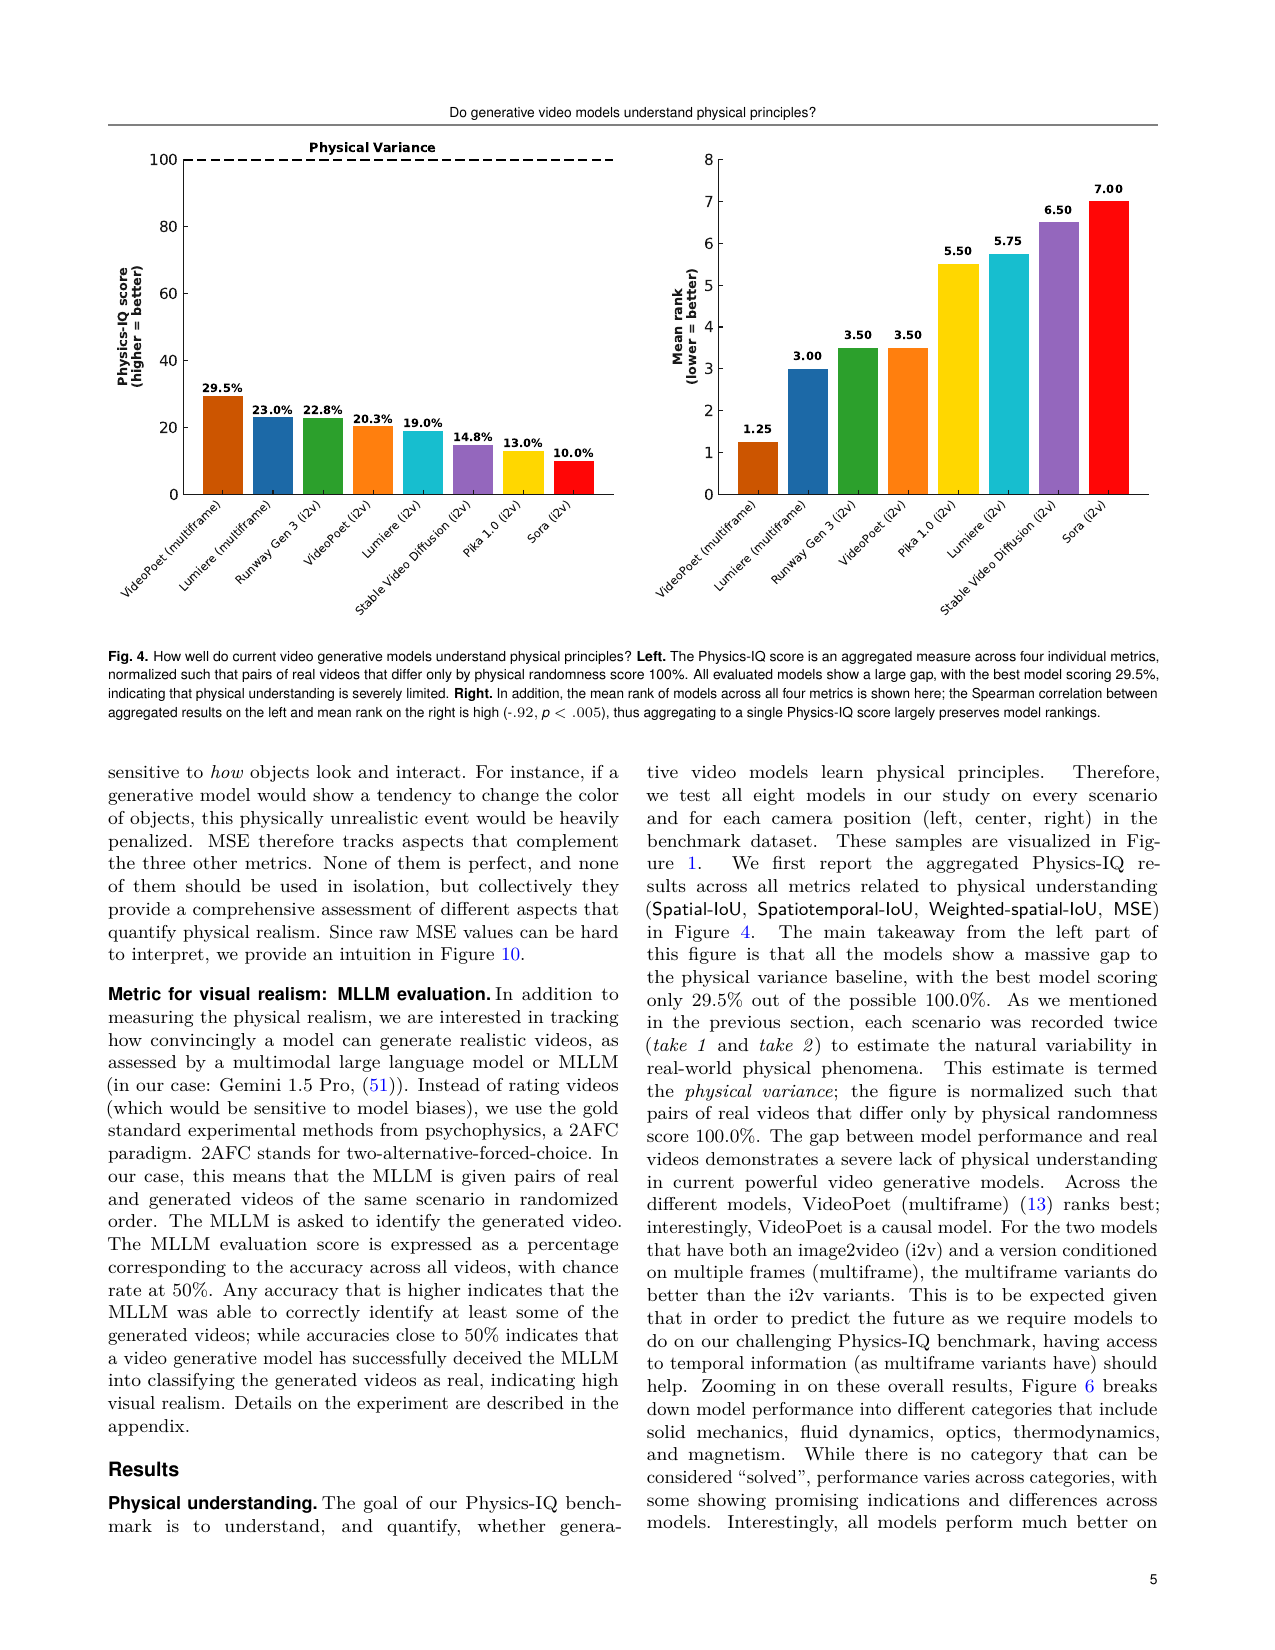
自建 396 段真实世界视频(66 场景×3 视角×2 take)构成 Physics-IQ 基准,测 8 个视频生成模型变体(Sora、Runway Gen 3、Pika 1.0、Lumiere、Stable Video Diffusion、VideoPoet)对固体力学/流体/光学/热学/磁学的物理理解:最佳模型仅 29.5%(真实视频物理方差上界 100%),视觉真实感与物理理解无显著相关(r=-0.46, p=.249)——视觉真实感 ≠ 物理理解;但这是纯「观测→评估」研究,机制解释(外观模式复现而非因果模拟)没有任何干预验证。

读全文 →
cover
2024-05-21(官方首发于 Transformer Circuits Thread;arXiv v1 上传于 2026-05-28) · Anthropic

Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet

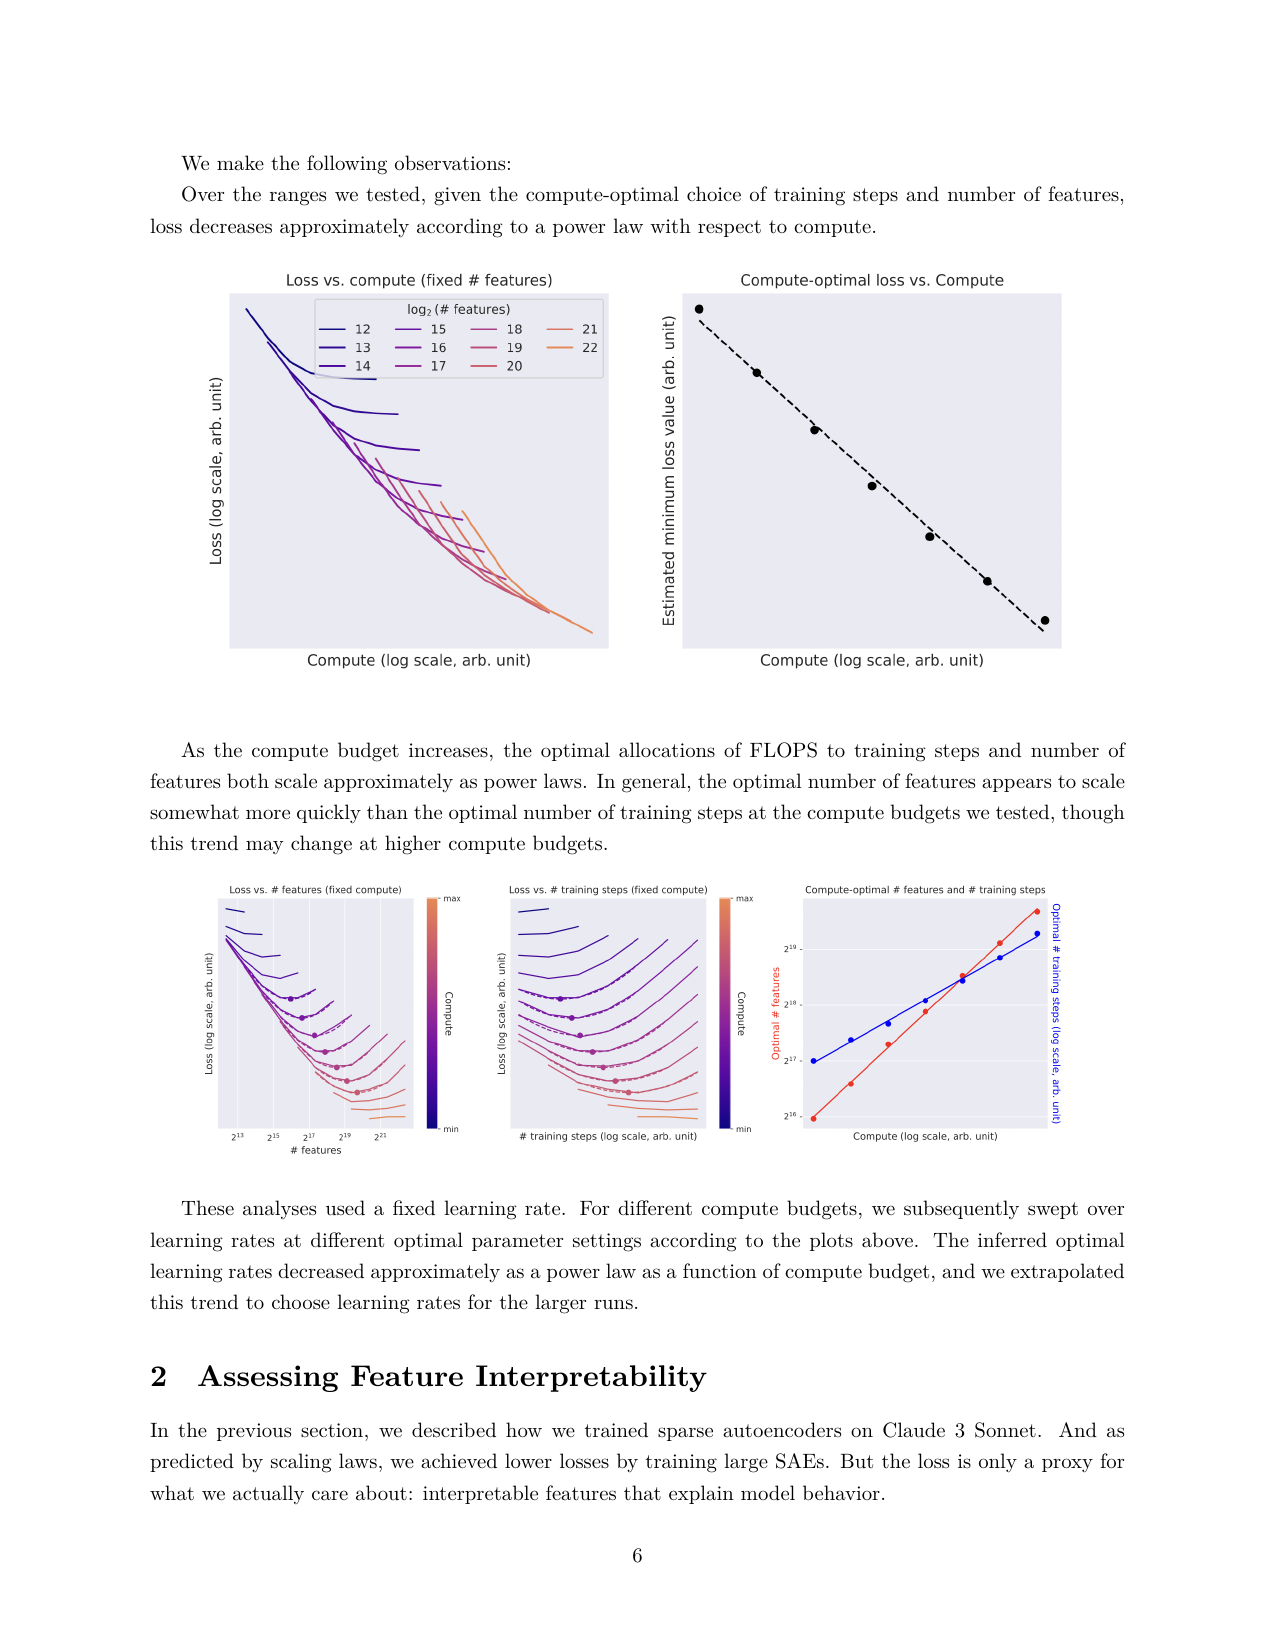
把稀疏自编码器(SAE)从 1 层小模型直接放大到生产级 Claude 3 Sonnet 的中层残差流:34M 特征字典在每 token 平均激活 <300、重建 ≥65% 方差的约束下,提取出多语言、多模态(纯文本训练却对图像零样本泛化)、兼具抽象与具体指涉的特征,并可用特征激活钳制(feature steering)因果改写模型行为;但可解释性证据主要落在人工挑选的案例上,从『能提取特征』到『安全可用收益』的工程一环仍缺系统量化。

读全文 →
cover
2023-10-04 · Anthropic

Towards Monosemanticity: Decomposing Language Models With Dictionary Learning

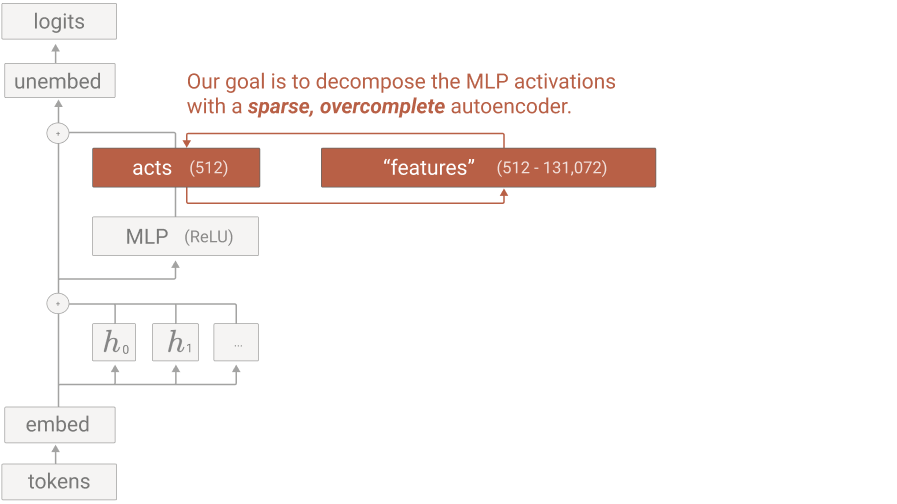
把『神经元多义』从解释障碍改成可操作对象:用 ReLU 稀疏自编码器把一层 transformer 的 512 个 MLP 神经元分解成 4096 个字典特征,三路评估量化证明特征比神经元更单义、更可干预、跨随机种子更普适——但『字典特征就是模型真实使用的因果单元』这一步是统计重构后的推断,机制环证据最薄。

读全文 →
cover
2022-09-14 · Anthropic; Harvard (Martin Wattenberg)

Toy Models of Superposition

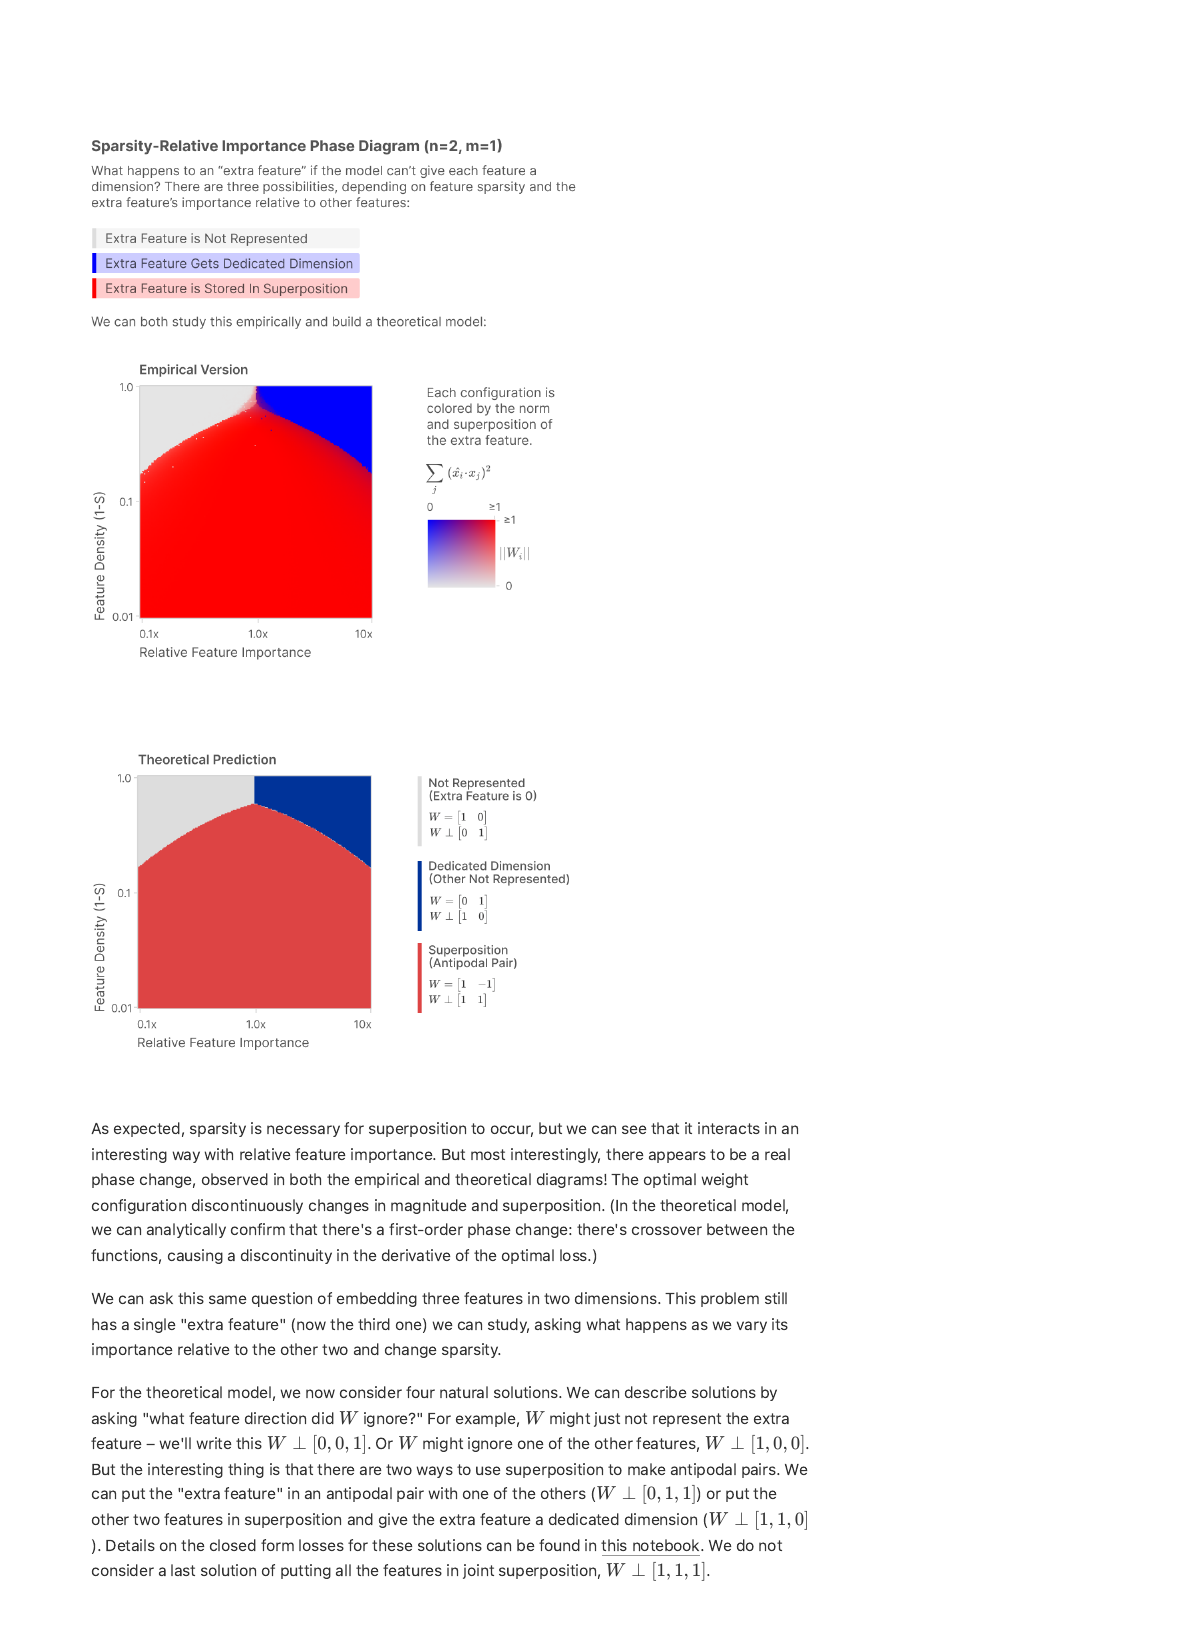
用可完全控制的 ReLU toy autoencoder,把『特征数超过维度』的 superposition 从假设变成可观测、可解析、可复现的现象——附带相变图、多胞体几何刻画和『叠加中能算 abs』的证据——并把 polysemanticity 从解释障碍重新定位成可研究的机制,留下三条消除叠加的工程路线图。

读全文 →
cover harness-evolution
2026-07-04 · Lil'Log

Harness Engineering for Self-Improvement(综述)

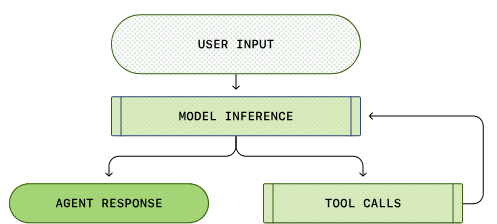
把「harness(决定存什么/取什么/呈现什么的代码系统)本身当优化目标」的综述:按进化对象从 prompt→结构化上下文→workflow→harness 代码→优化器代码分层,给出 L0–L2 自我改进分级;用 STOP/Self-Harness/AHE/DGM/SIA 等实证说明模型能改进机制,但效果取决于基座能力、可观测性与评测质量。

读全文 →
harness engineeringself-improvementrecursive self-improvement
cover harness-evolution
2026-06-08 · Shanghai Artificial Intelligence Laboratory

Self-Harness: Harnesses That Improve Themselves

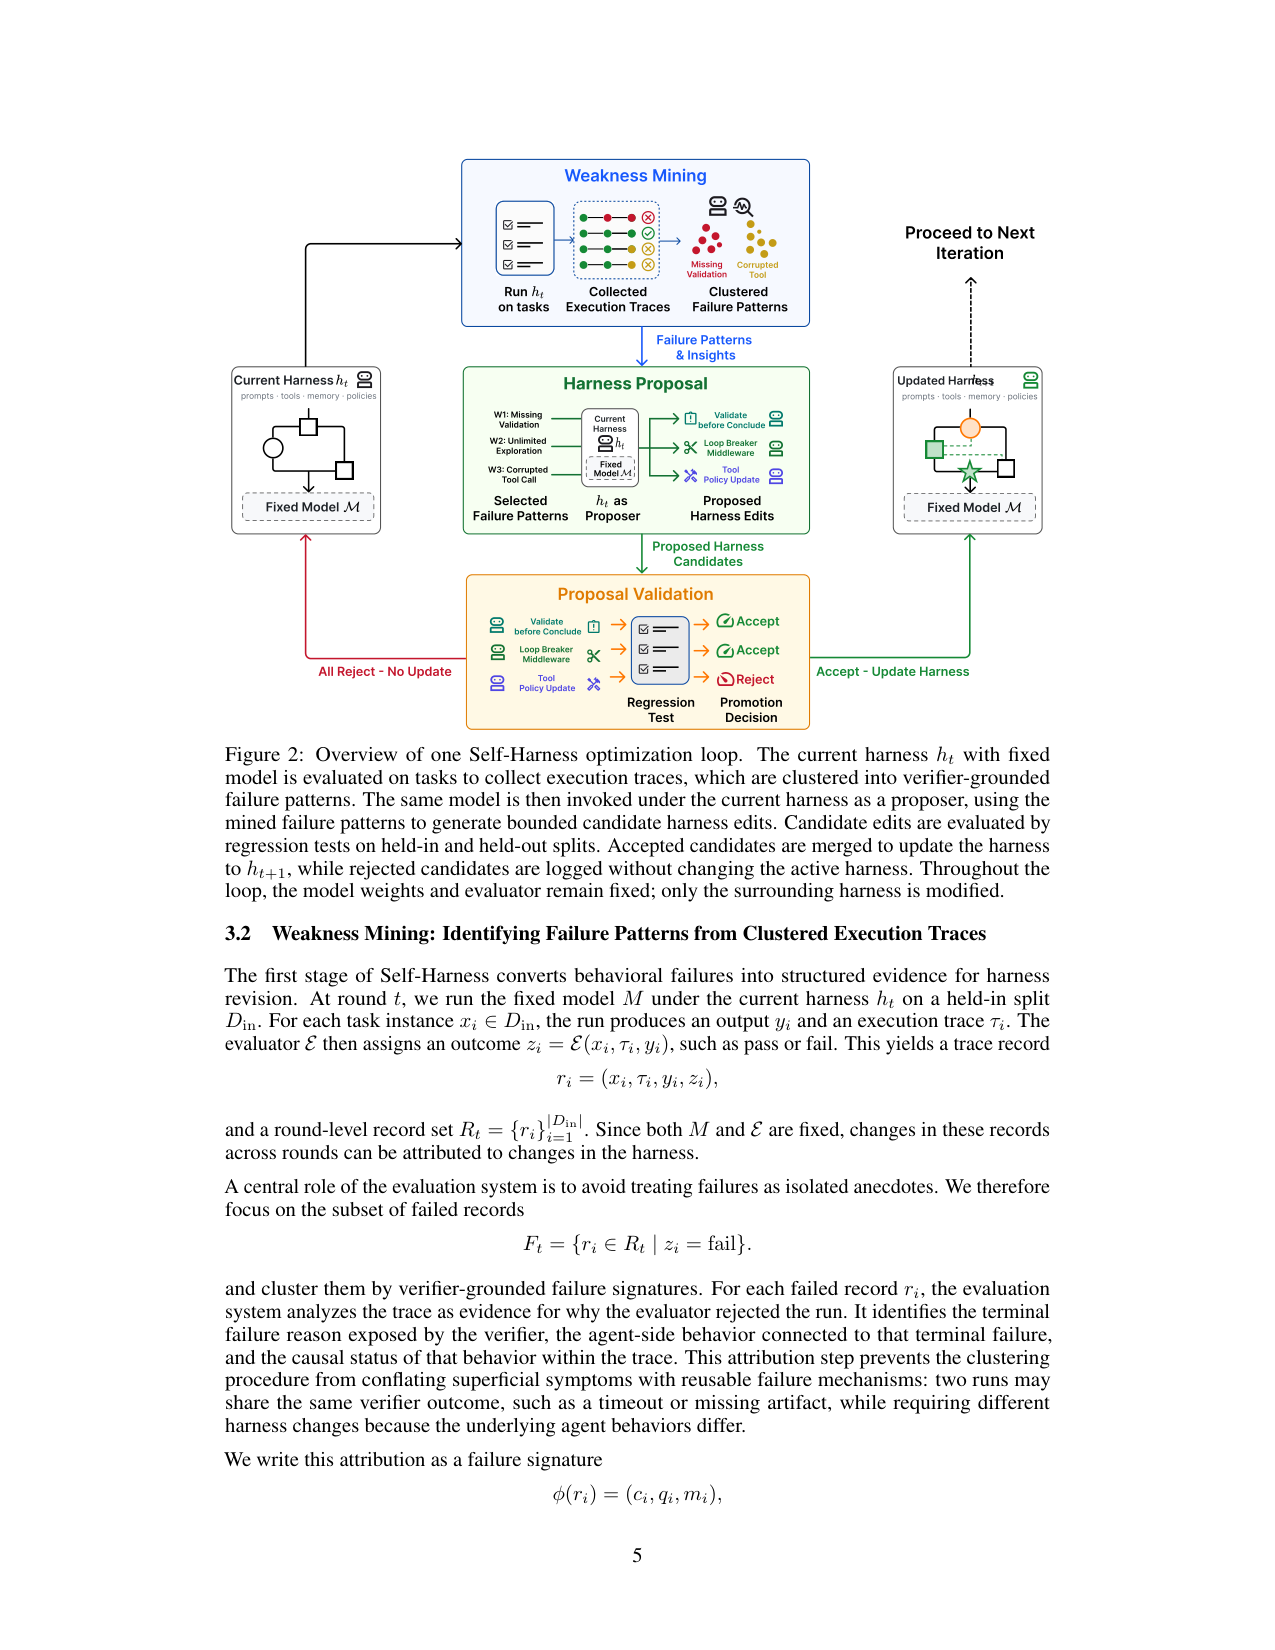
Self-Harness 让被固定模型自己完成三阶段循环——weakness mining(按 verifier-grounded 失败签名聚类执行轨迹)→ 有界 harness 提案 → held-in/held-out 双 split 回归验证通过才接受——在 Terminal-Bench-2.0 的 64 任务子集上,MiniMax M2.5 / Qwen3.5-35B-A3B / GLM-5 的 held-out pass 分别从 40.5% / 23.8% / 42.9% 升到 61.9% / 38.1% / 57.1%,模型权重、工具、评估器全程不变。

读全文 →
harness evolutionself-improving agentregression testing
cover verifiable-reasoning
2026-05-29 · Huawei Foundation Model Department / CUHK

HERMES: Towards Efficient and Verifiable Mathematical Reasoning in LLMs

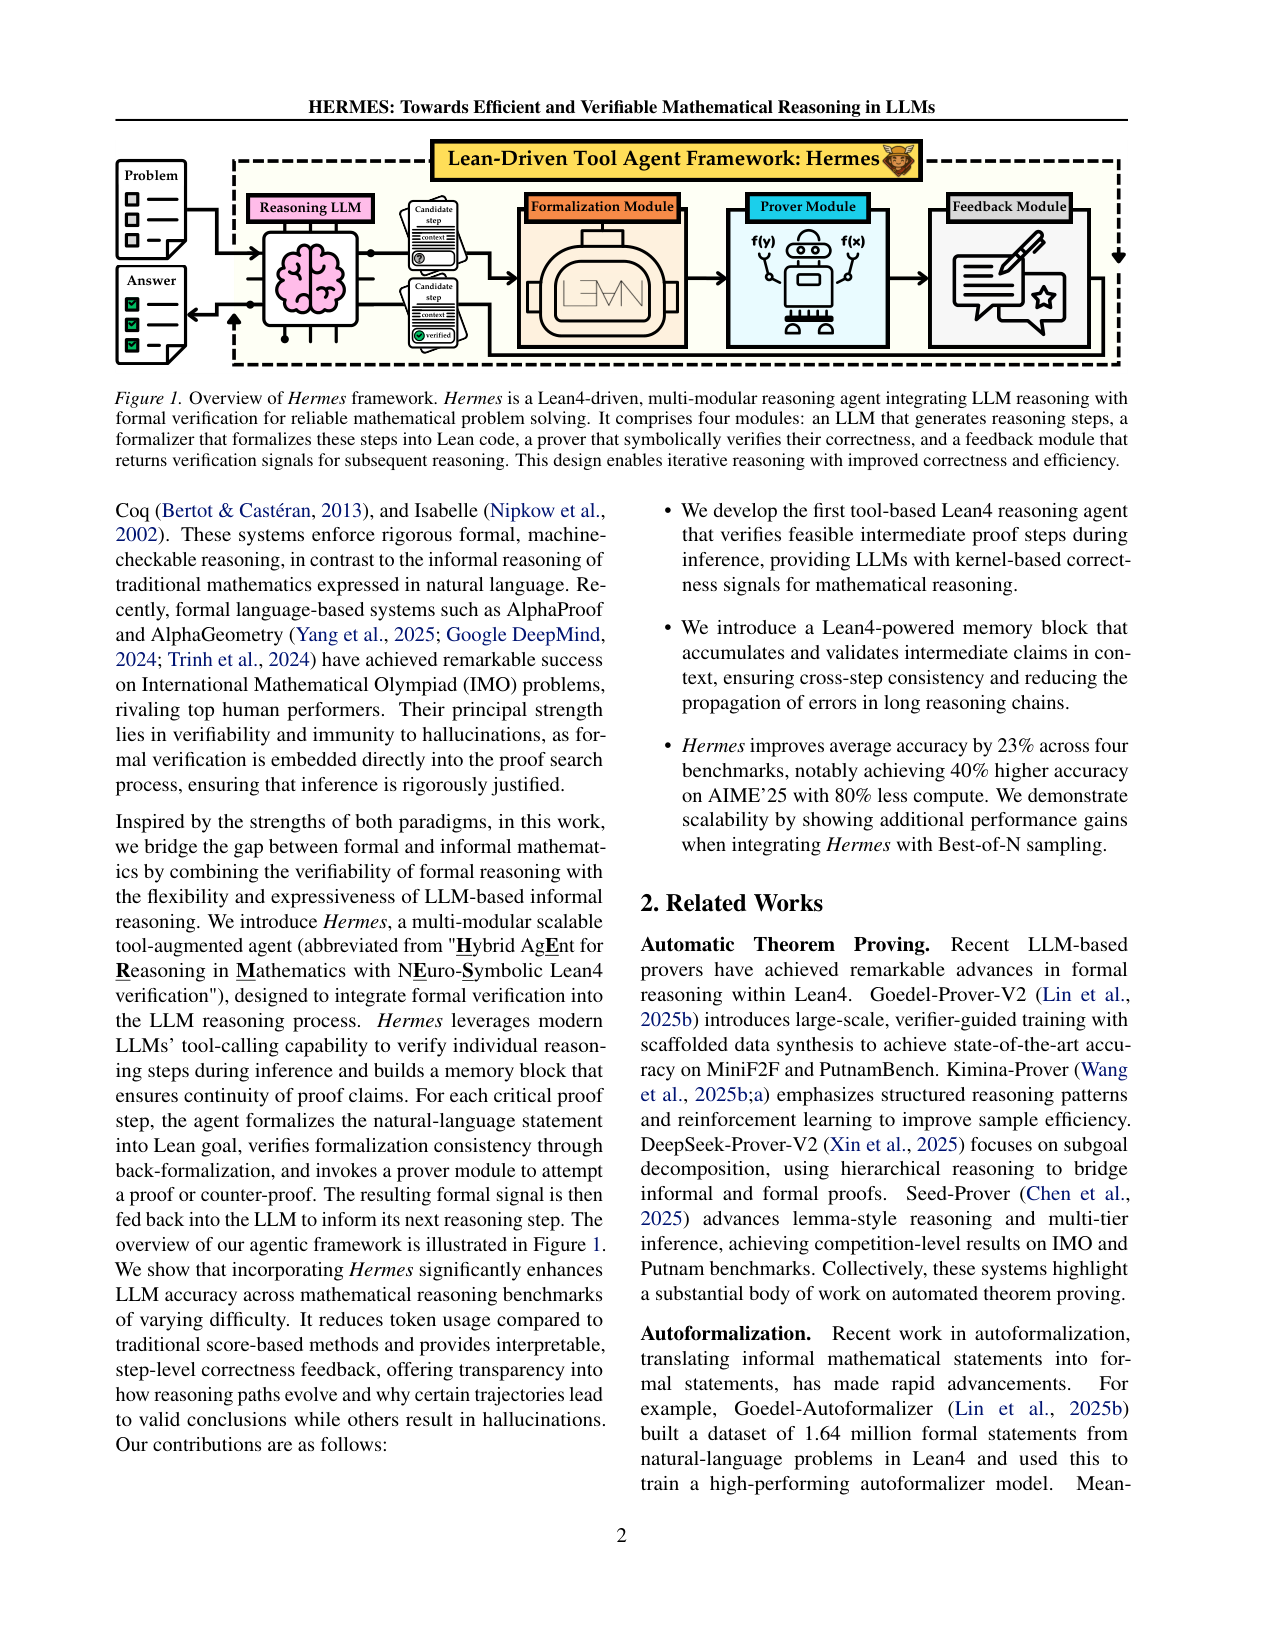
把 Lean4 形式验证接进数学推理的中间步骤:HERMES 对关键推理步骤做「自动形式化→证明/反证→反馈」并用已验证断言记忆库防漂移;AIME'25 上 DeepSeek-V3.2 从 50.0% 提到 70.0%(相对 +40%),每题总 FLOPs 比 reward-based Best-of-5 少约 80%。

读全文 →
verifiable-reasoningLean4formal verification
cover self-improving-agent
2026-05-28 · Penn State / UC Santa Cruz / Amazon / Emory / UIUC / Northeastern

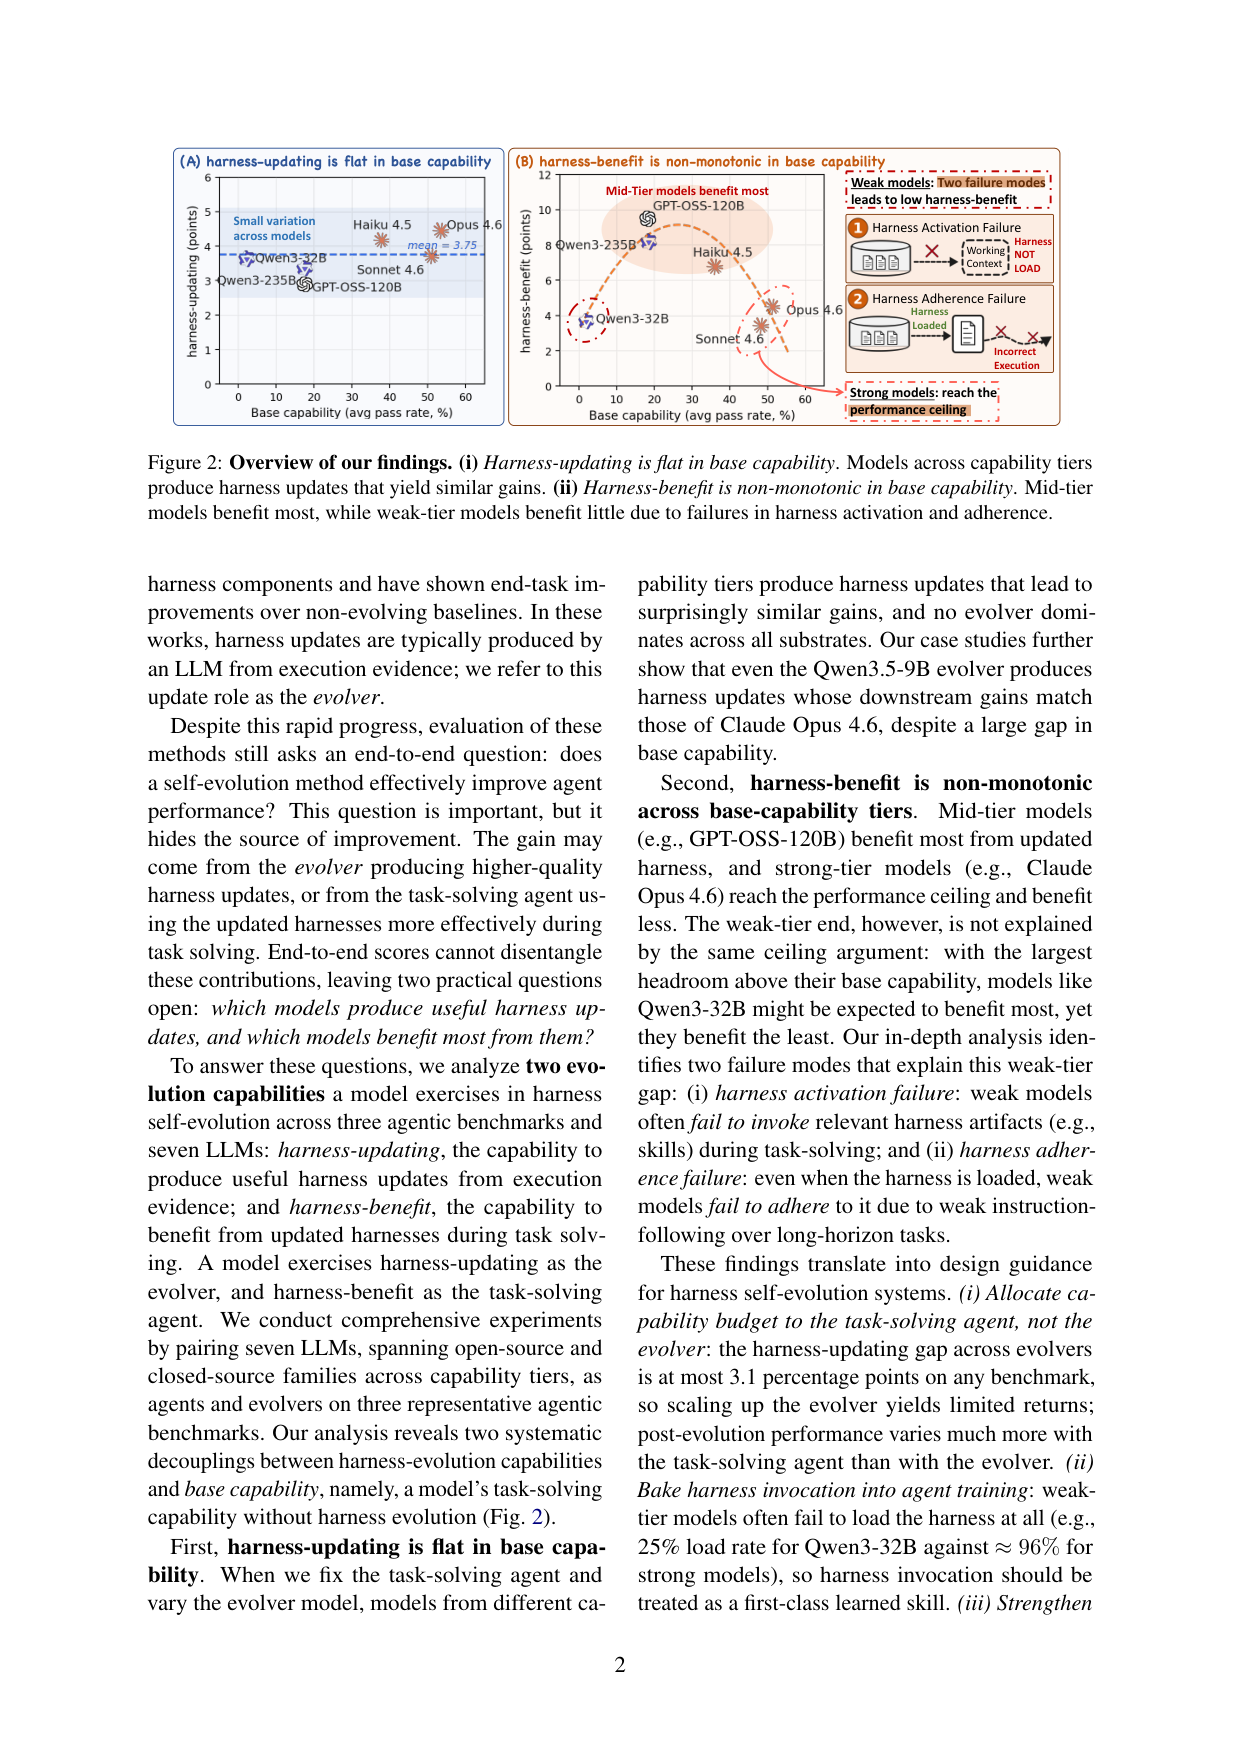
Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents

这篇把 harness 自我进化拆成两个独立能力轴:evolver 侧的 harness-updating(产出有用更新的能力)与执行 agent 侧的 harness-benefit(从更新 harness 获益的能力)。跨 7 个模型 × 3 个 benchmark 的交叉配对显示:9B 的 Qwen3.5-9B 写出的 skill 与 Claude Opus 4.6 程序同构、收益相当(最好/最差 evolver 差距 ≤3.1pp),但 harness-benefit 随基座能力非单调——SWE 上中档 Qwen3-235B 获益 19.3pp,弱模型 Qwen3-32B 只有 4.4pp、强模型 Opus 4.6 只有 2.6pp——瓶颈在执行 agent 的 harness 加载率与长程指令遵循。

读全文 →
harness evolutioncapability analysisself-evolving agent
cover self-improving-agent
2026-05-28 · Hexo Labs / University of Oxford

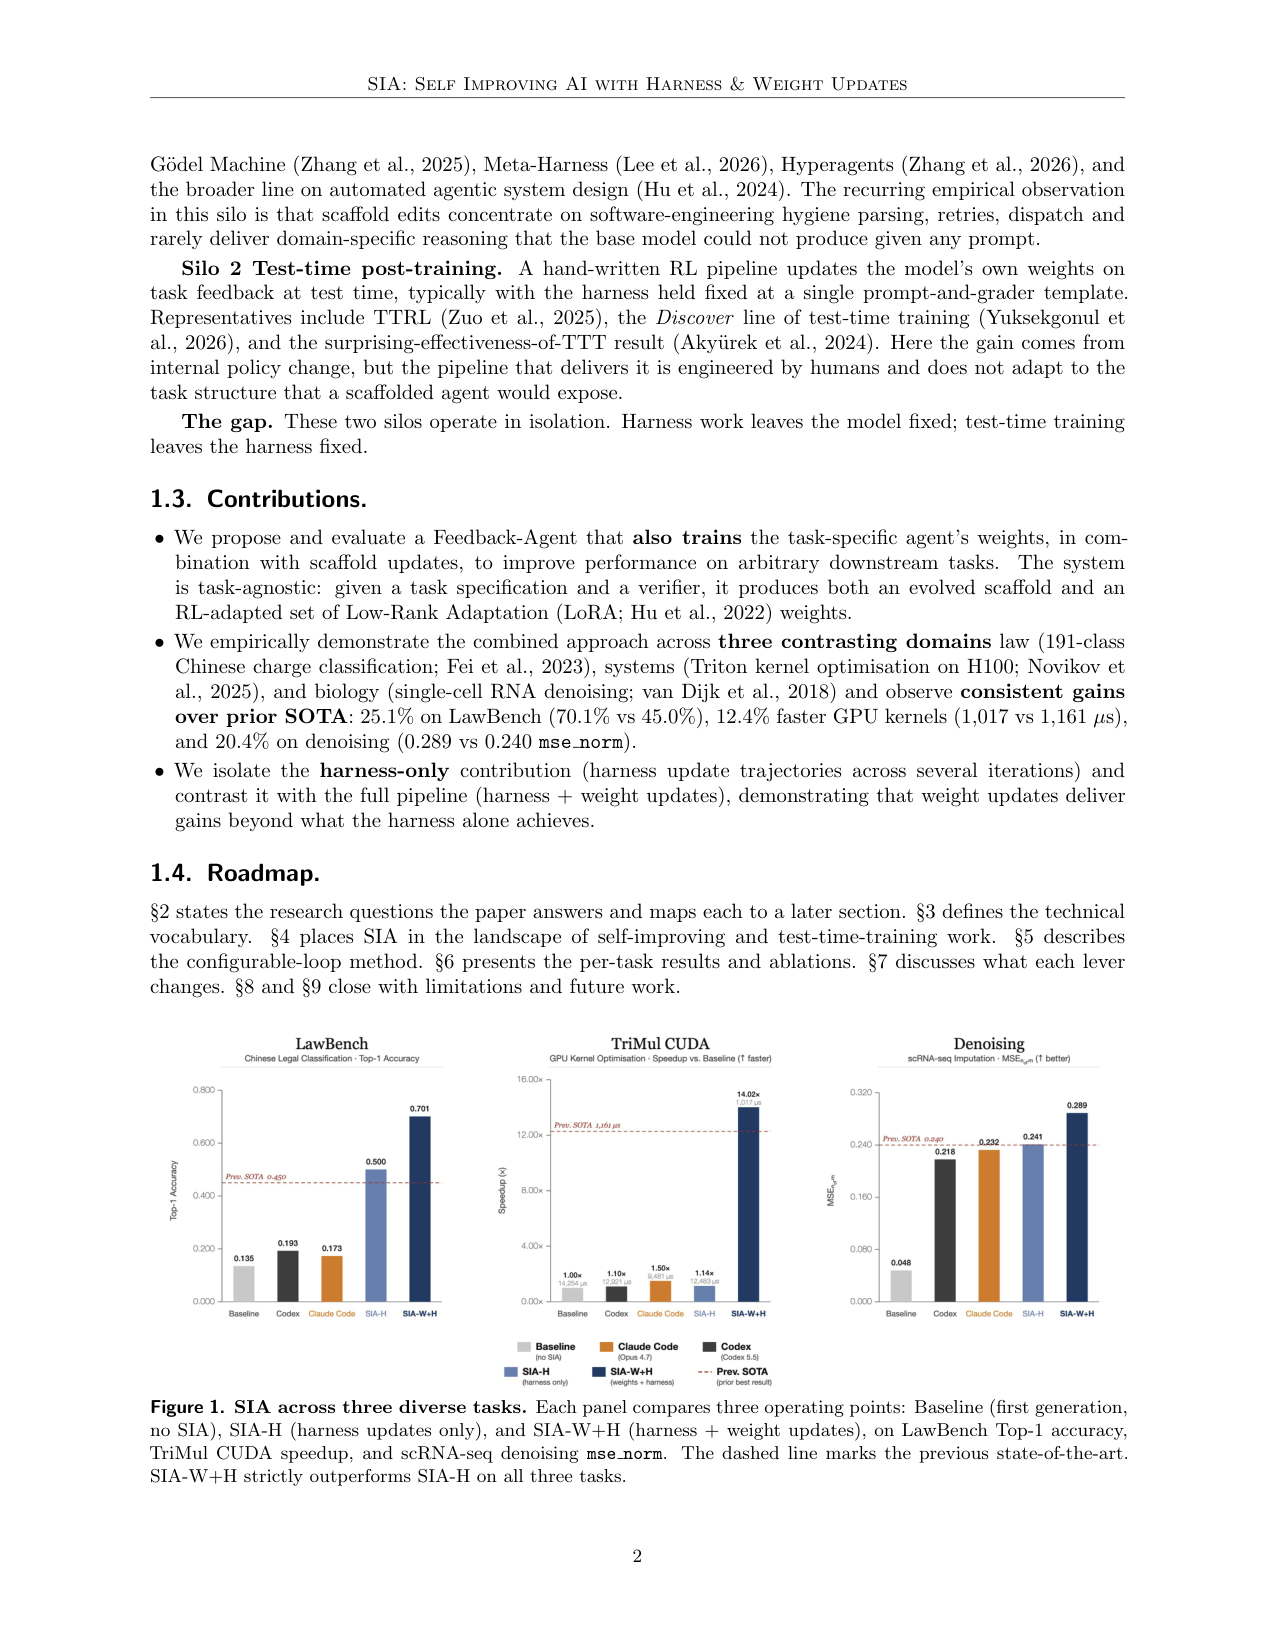
SIA: Self Improving AI with Harness & Weight Updates

SIA 是首个在同一闭环里同时进化 harness 与权重的自改进系统:Meta-Agent 生成初始 scaffold,Task-Specific Agent 执行,Feedback-Agent 看轨迹后每步选择『改 harness』还是『用 RL 更新 LoRA 权重』。在三个领域(LawBench top-1 70.1% vs 前 SOTA 45.0%、TriMul 1,017µs vs 1,161µs、scRNA denoising 0.289 vs 0.240)双杠杆都超过 harness-only,但作者自己承认证据是 provisional:RL 算法选择是按观察模式描述的、完整处理 defer 到 v2。

读全文 →
self-improving agenttest-time trainingharness engineering
cover harness-evolution
2026-05-23 · Tsinghua University / AgiBot

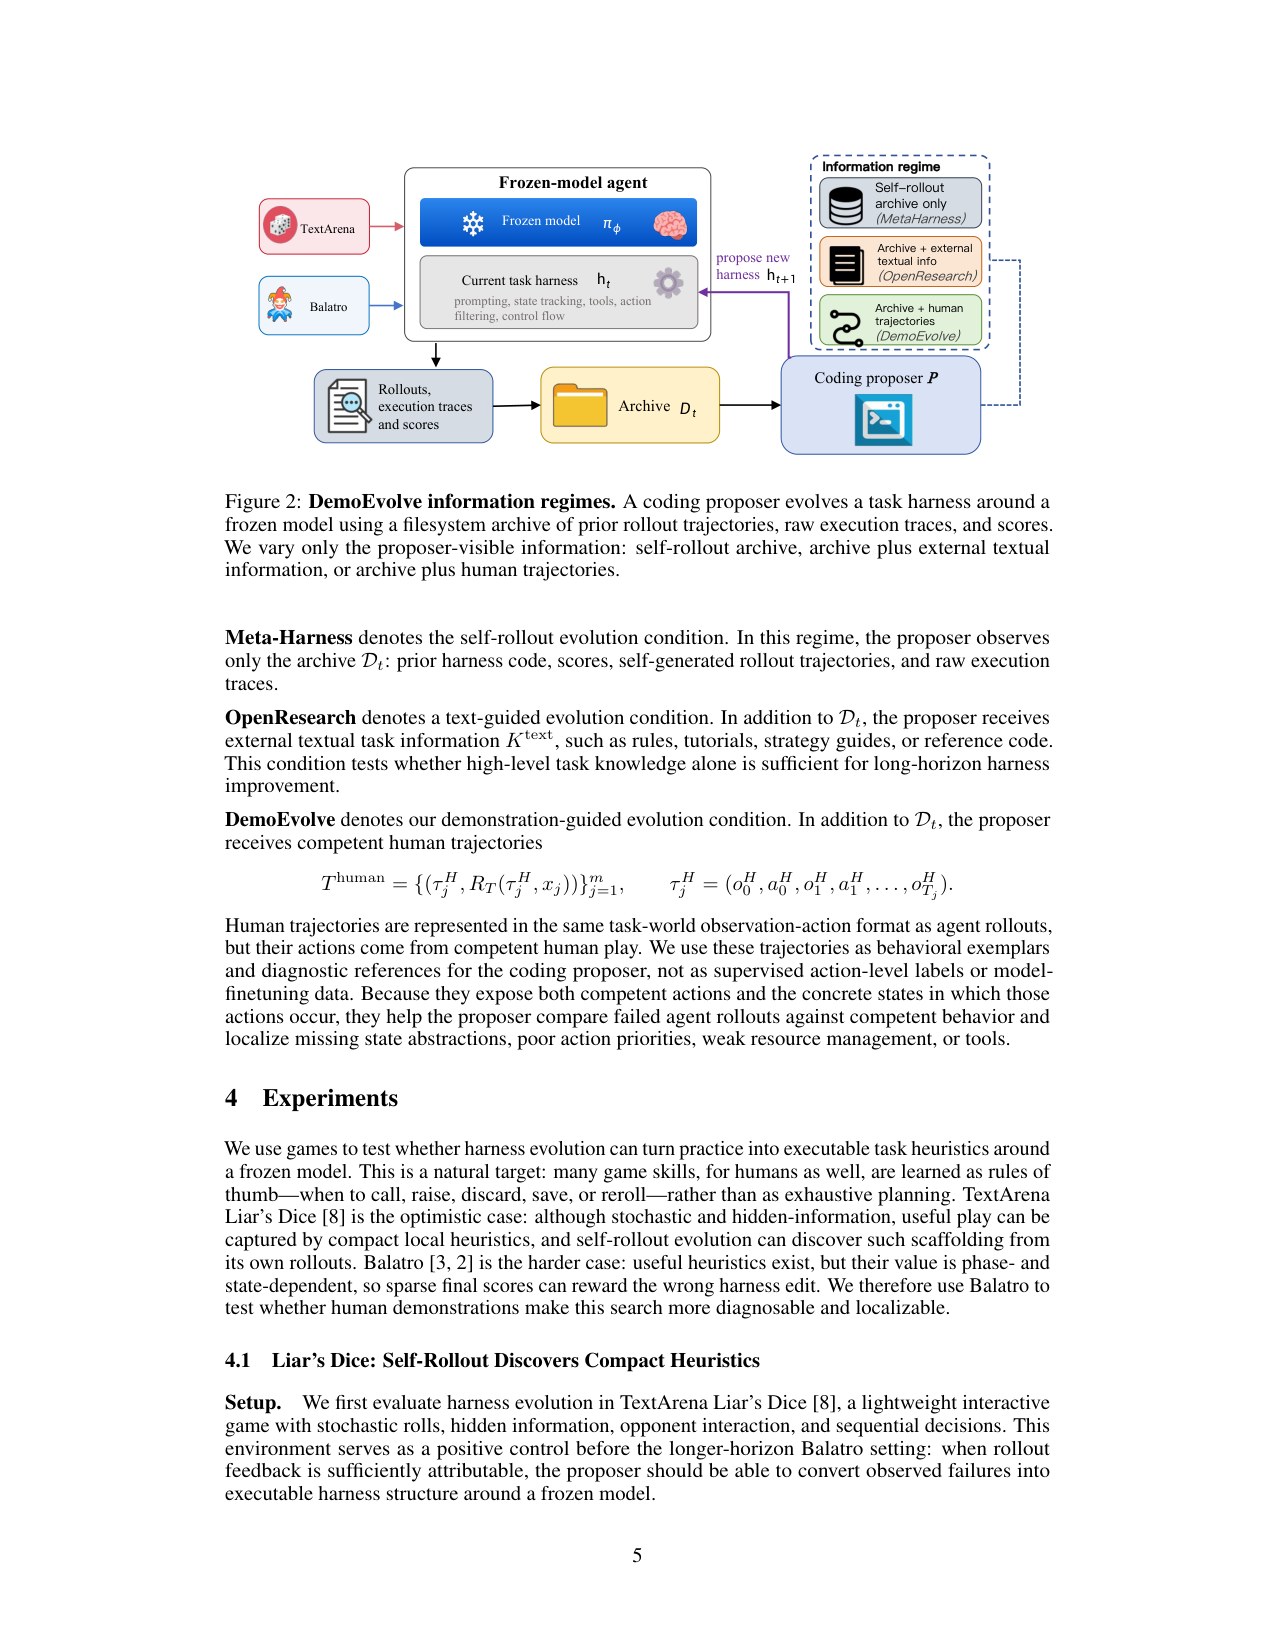
DemoEvolve: Overcoming Sparse Feedback in Agentic Harness Evolution with Demonstrations

DemoEvolve 在自 rollout 存档之外把人类专家轨迹作为 proposer 的 harness 级诊断/编辑参考经验:Liar's Dice 上自 rollout 进化本来就有效(held-out 0.392→0.800),但 Balatro 这类长时程随机环境里稀疏反馈会误导搜索——Meta-Harness 的 ID 增益不迁移、且被选中编辑的 hook 因实现错误从未触发;加入人类示范后完成率 12/15 vs Meta-Harness 的 6/15,OOD 也提升(20.00 vs 16.33)。

读全文 →
harness evolutiondemonstrationssparse feedback
cover harness-evolution
2026-05-18 · Fudan University / Peking University / Shanghai Qiji Zhifeng

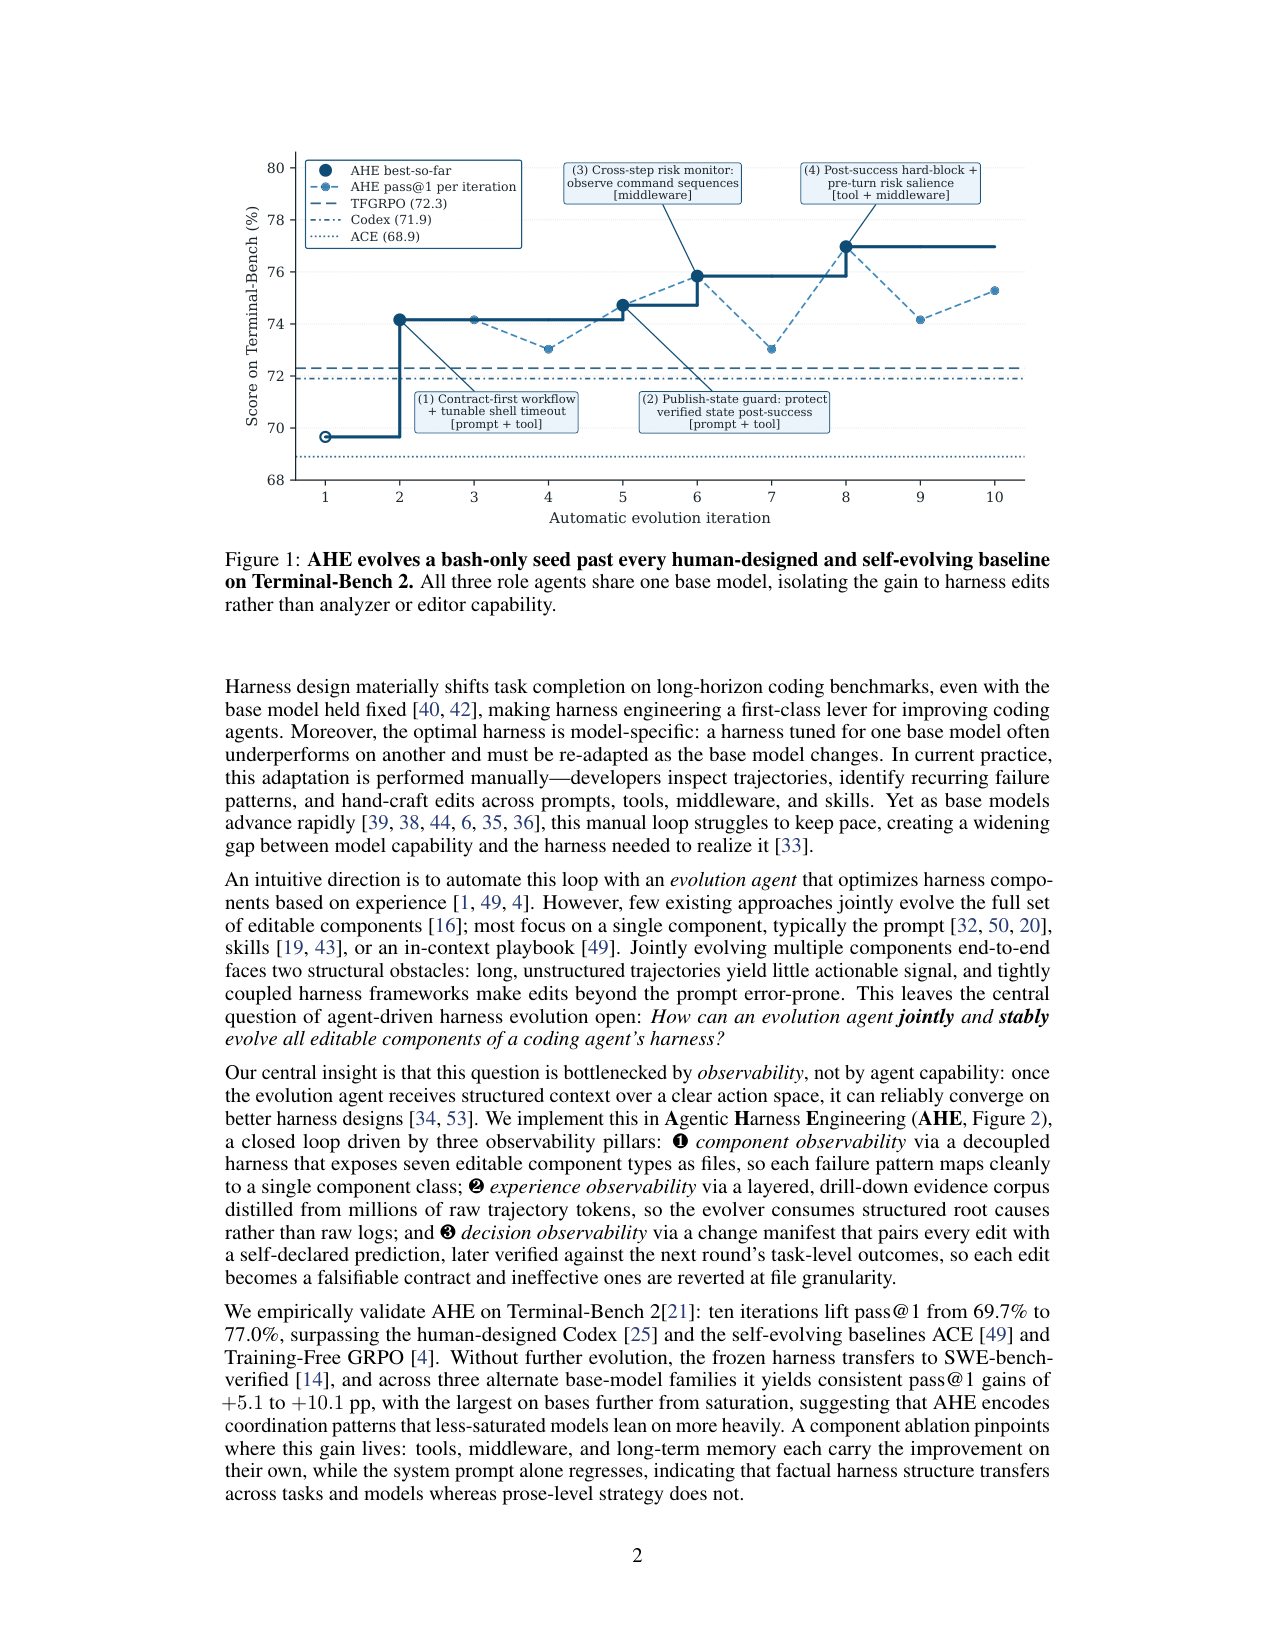
Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses

AHE 把 harness 进化拆成三大可观测性支柱——组件(7 类组件文件化)、经验(约 10M token 轨迹蒸馏成可下钻证据语料)、决策(每个编辑配自我声明的可证伪预测、下一轮验证后文件级回滚)——10 轮迭代在 Terminal-Bench 2 上把 pass@1 从 69.7% 推到 77.0%,超过 Codex(71.9%)、ACE(68.9%)与 TF-GRPO(72.3%),冻结后的 harness 迁移到 SWE-bench-verified 与三个跨族基座仍为正收益。

读全文 →
harness evolutionobservabilitycoding agent
cover harness-evolution
2026-05-11 · Princeton University / ARISE Foundation / Google DeepMind

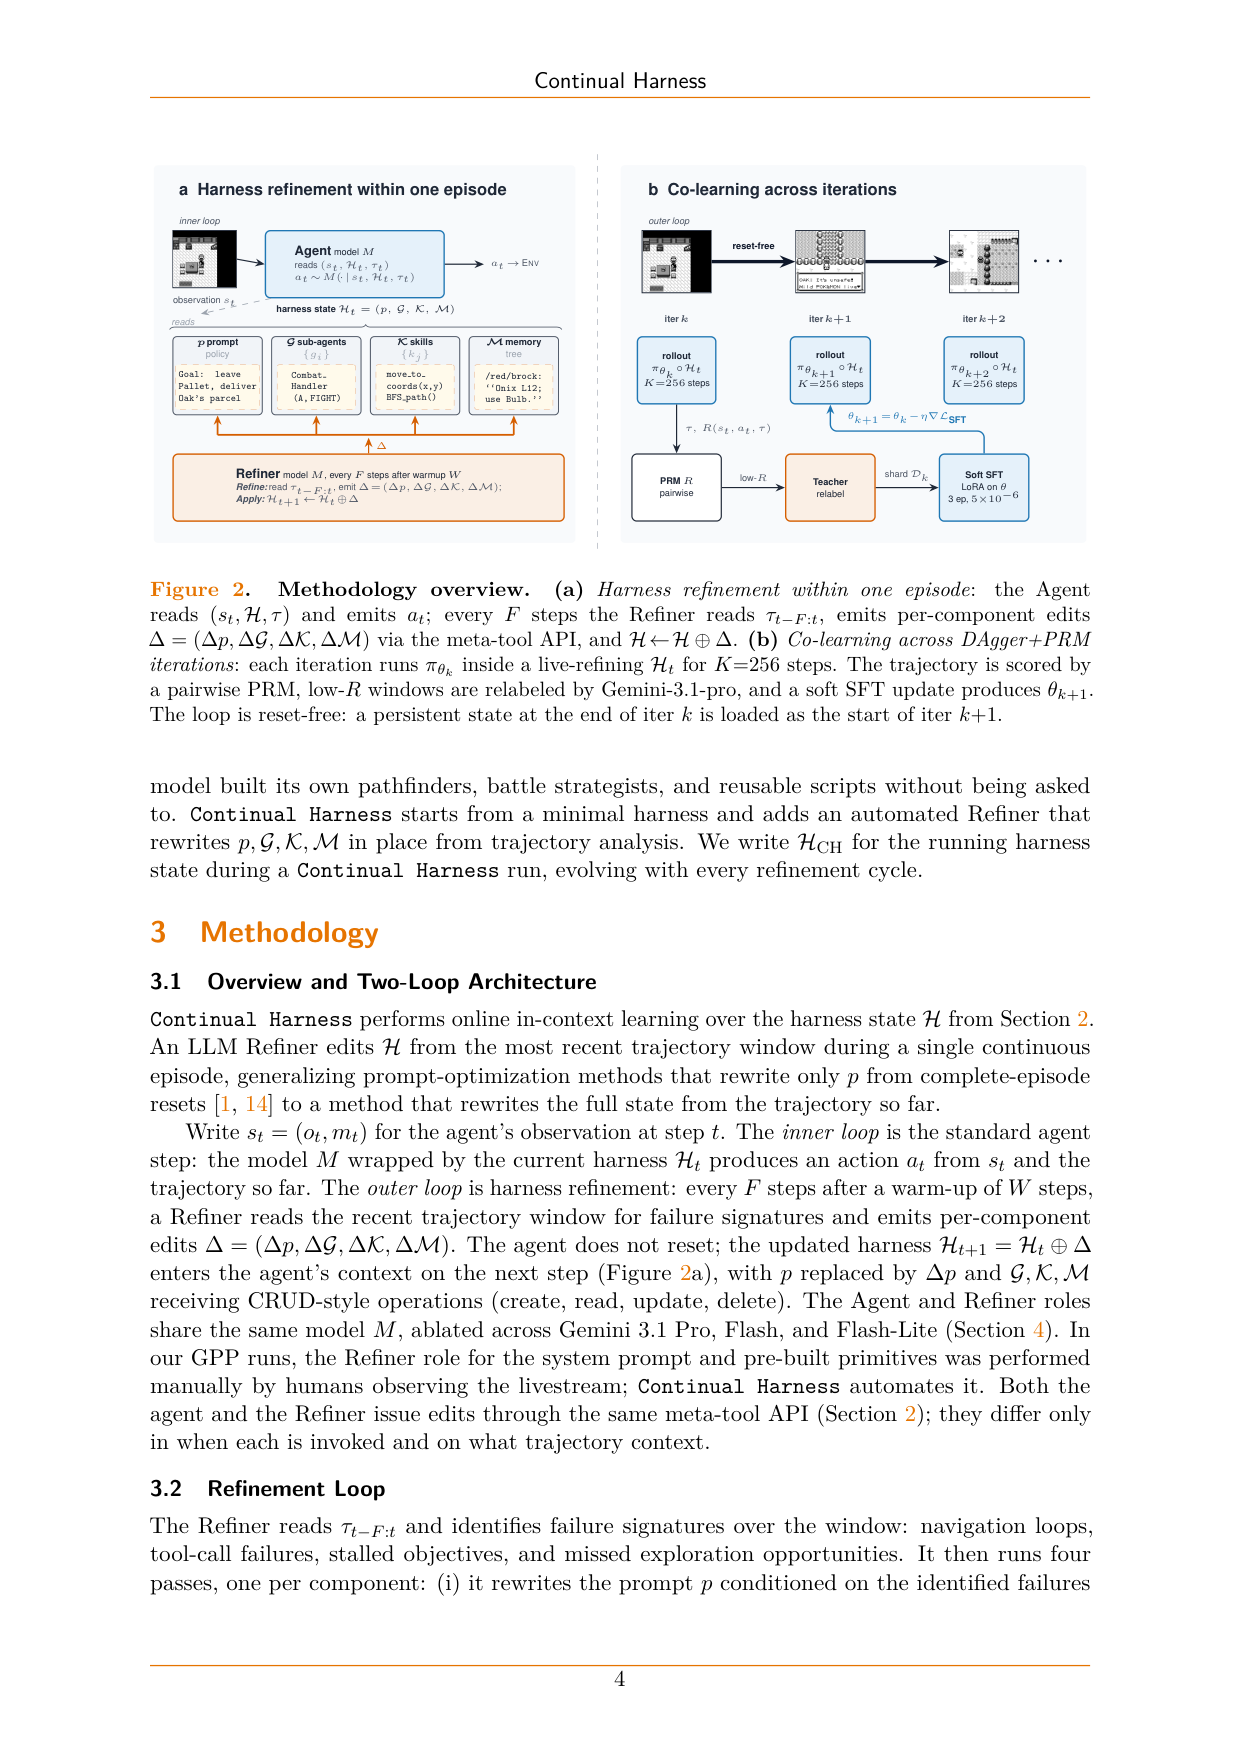
Continual Harness: Online Adaptation for Self-Improving Foundation Agents

Continual Harness 把 Gemini Plays Pokémon(GPP)里的人类人工打磨 harness 循环自动化成 reset-free 的在线自改进:agent 与 Refiner 交替,Refiner 每隔 F 步对 prompt/子 agent/技能/记忆做 CRUD 编辑。在 Pokémon Red/Emerald 上,Gemini 3.1 Pro 从零自举达到 100% 里程碑、成本约 $130 vs 最小 harness 的 $215(约 −40%),收复大部分与专家 harness 的差距;再用 DAgger+PRM+前沿教师重标注实现『harness 与权重共学』,让开源 Gemma-4 在 Red 上跨训练迭代持续推进里程碑。

读全文 →
harness evolutionreset-freeembodied agent
cover harness-evolution
2026-03-30 · Stanford University / KRAFTON / MIT

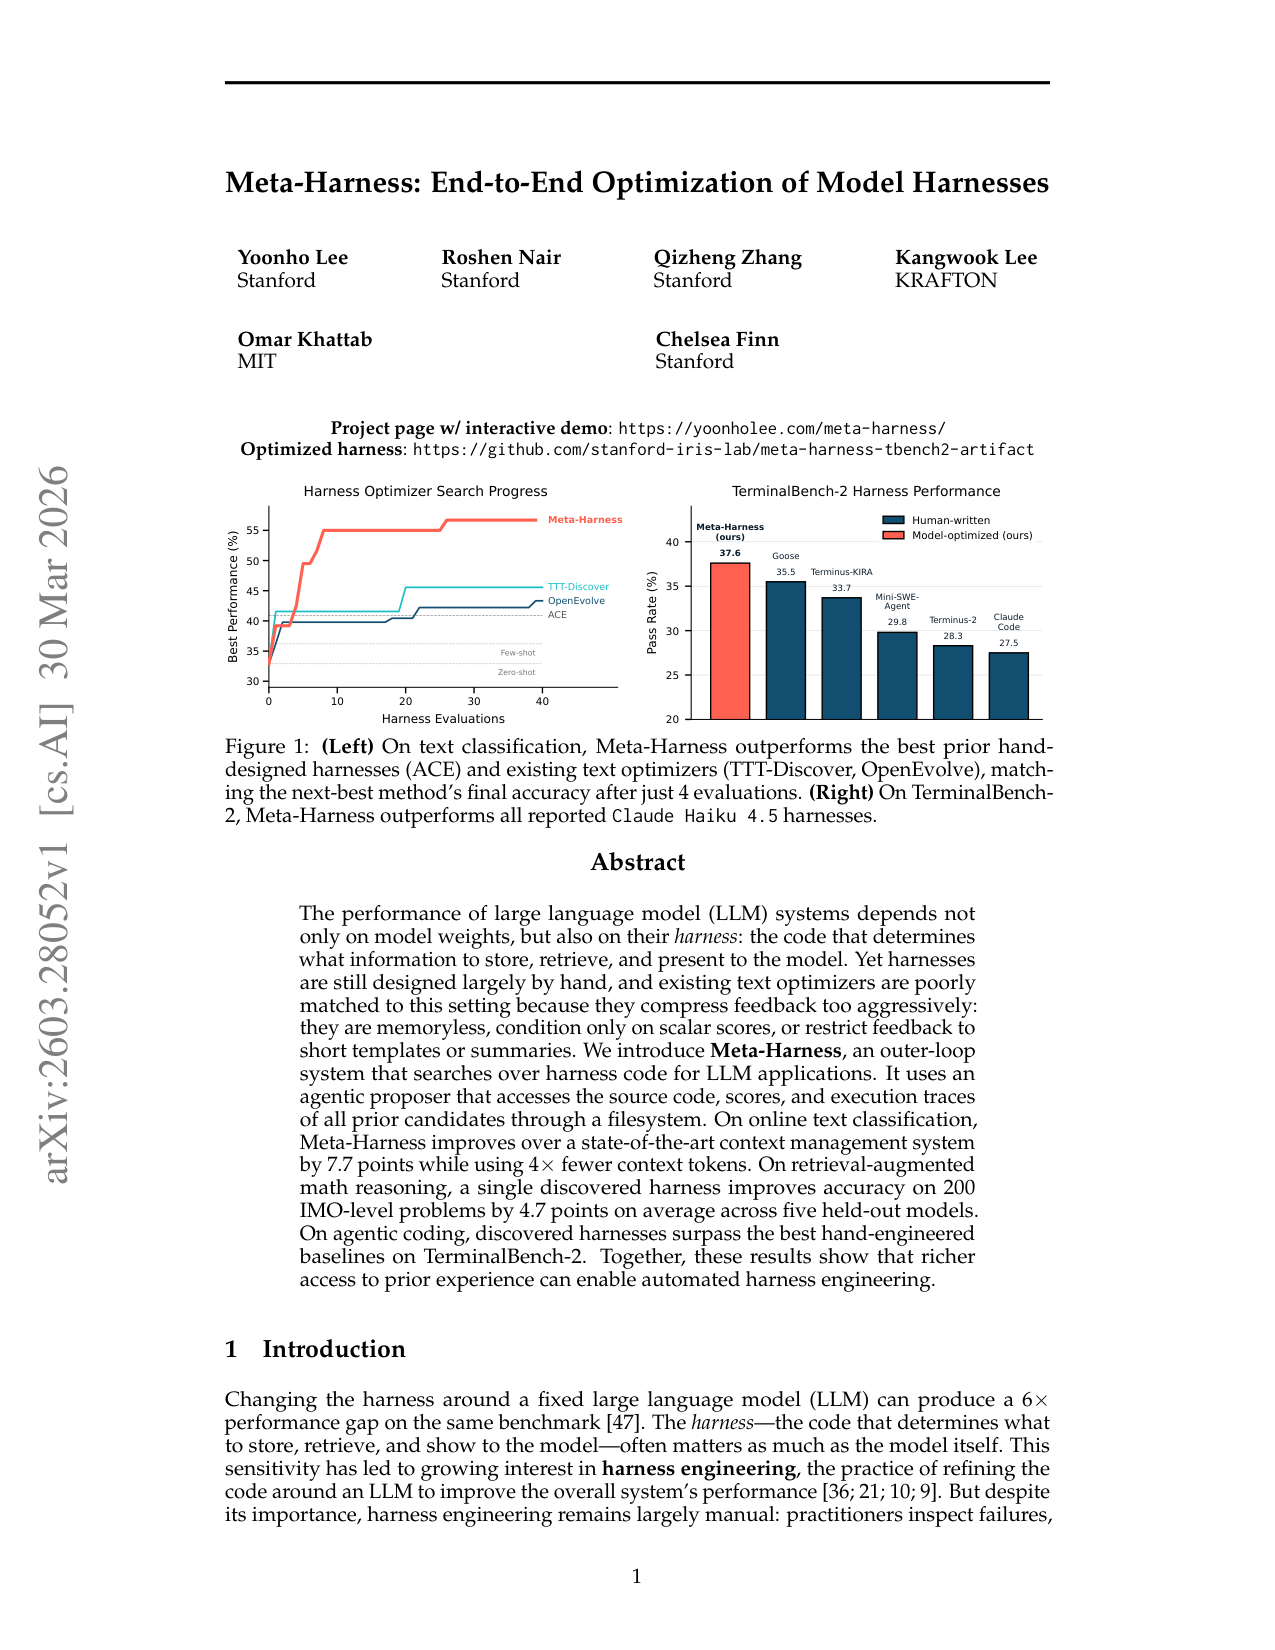
Meta-Harness: End-to-End Optimization of Model Harnesses

把「决定存什么/取什么/呈现什么」的 harness 代码本身当优化对象:coding-agent proposer 通过文件系统访问所有先例的源码、分数与执行轨迹来提案新 harness,产出 Pareto 前沿候选;在线文本分类比 ACE 高 7.7 个点且上下文 token 少 4×,数学检索 harness 跨 5 个未见模型平均 +4.7 点,TerminalBench-2 超越全部已报告的人类设计 harness。

读全文 →
harness-evolutionharness engineeringcode-space search
cover context-engineering
2026-03-29 · Stanford University / SambaNova Systems / UC Berkeley

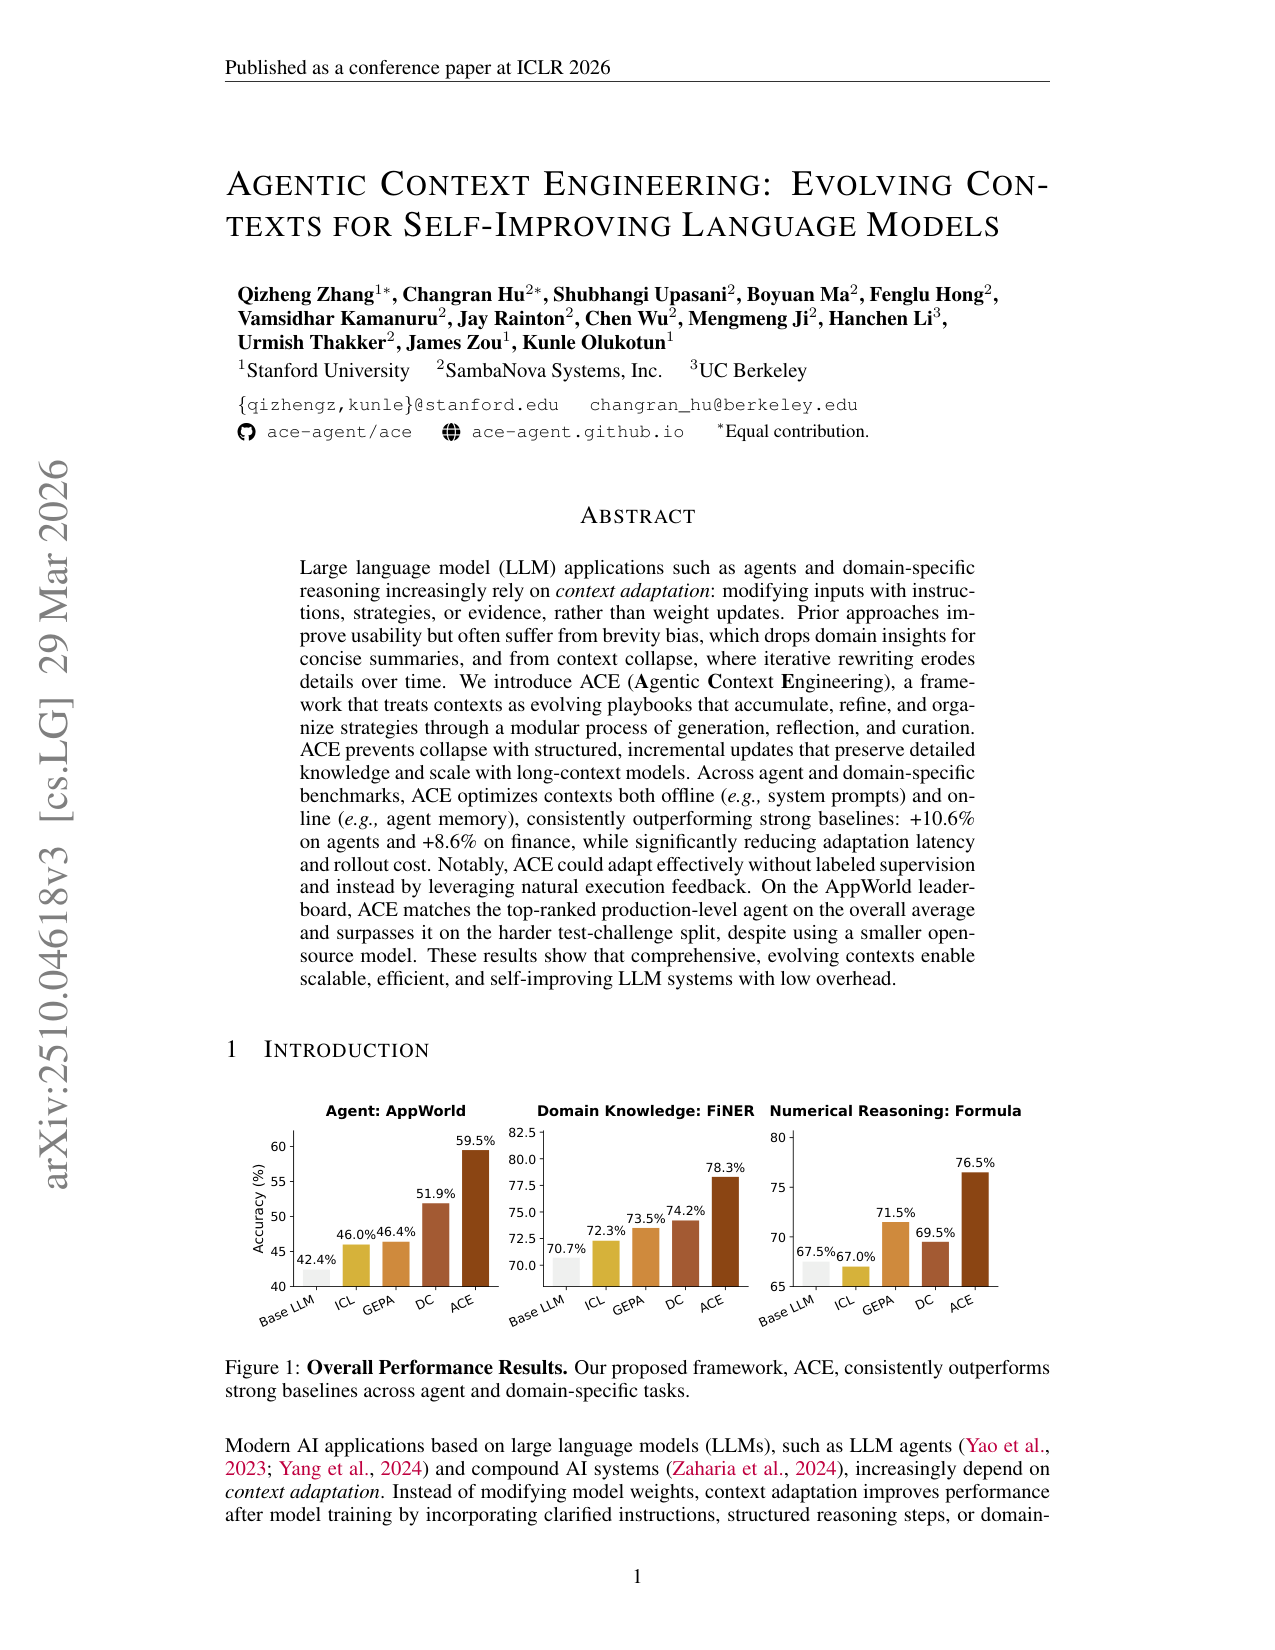
Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models

把上下文当「进化中的 playbook」:Generator/Reflector/Curator 三组件产出带 identifier 的结构化条目,用增量 delta 更新替代整体重写,治好 brevity bias 与 context collapse;AppWorld 上 ReAct+ACE 59.5% 对 base 42.4%,FiNER +7.6 个点、Formula +9.0 个点,离线适应延迟比 GEPA 省 82.3%。

读全文 →
context-engineeringself-improving agentplaybook
cover harness-evolution
2026-03-19 · University of British Columbia / Vector Institute / Meta FAIR

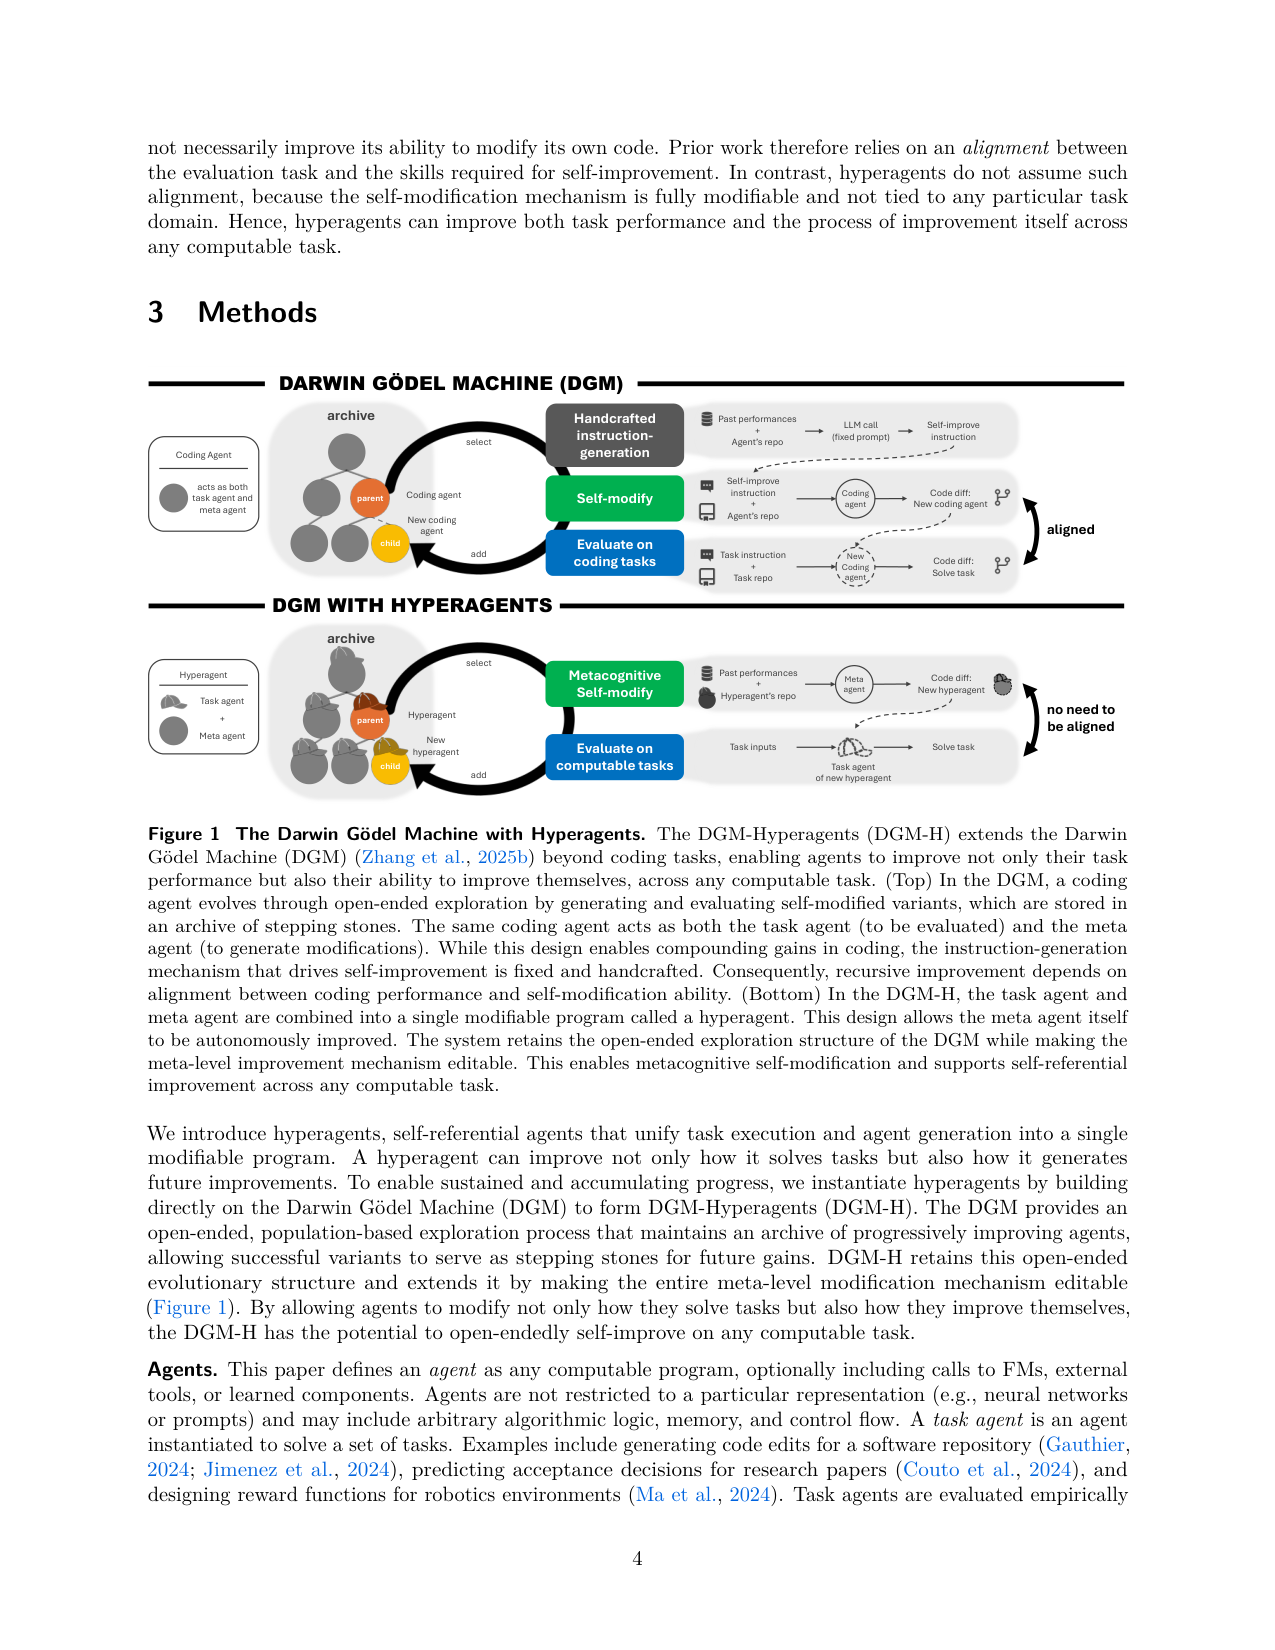
HyperAgents

把 task agent 与 meta agent 合成单个可编辑程序(hyperagent),让「生成未来改进的机制」本身也可被编辑:在编码、论文评审、机器人奖励设计、IMO 级数学评分四个领域持续改进(论文评审测试集 0.0→0.710、奖励设计 0.060→0.372),并证明元层改进(持久记忆、性能追踪)可跨领域转移、跨 run 累积。

读全文 →
self-referential agentsmeta agentopen-ended evolution
cover context-engineering
2026-02-11 · Peking University(State Key Laboratory of General AI)

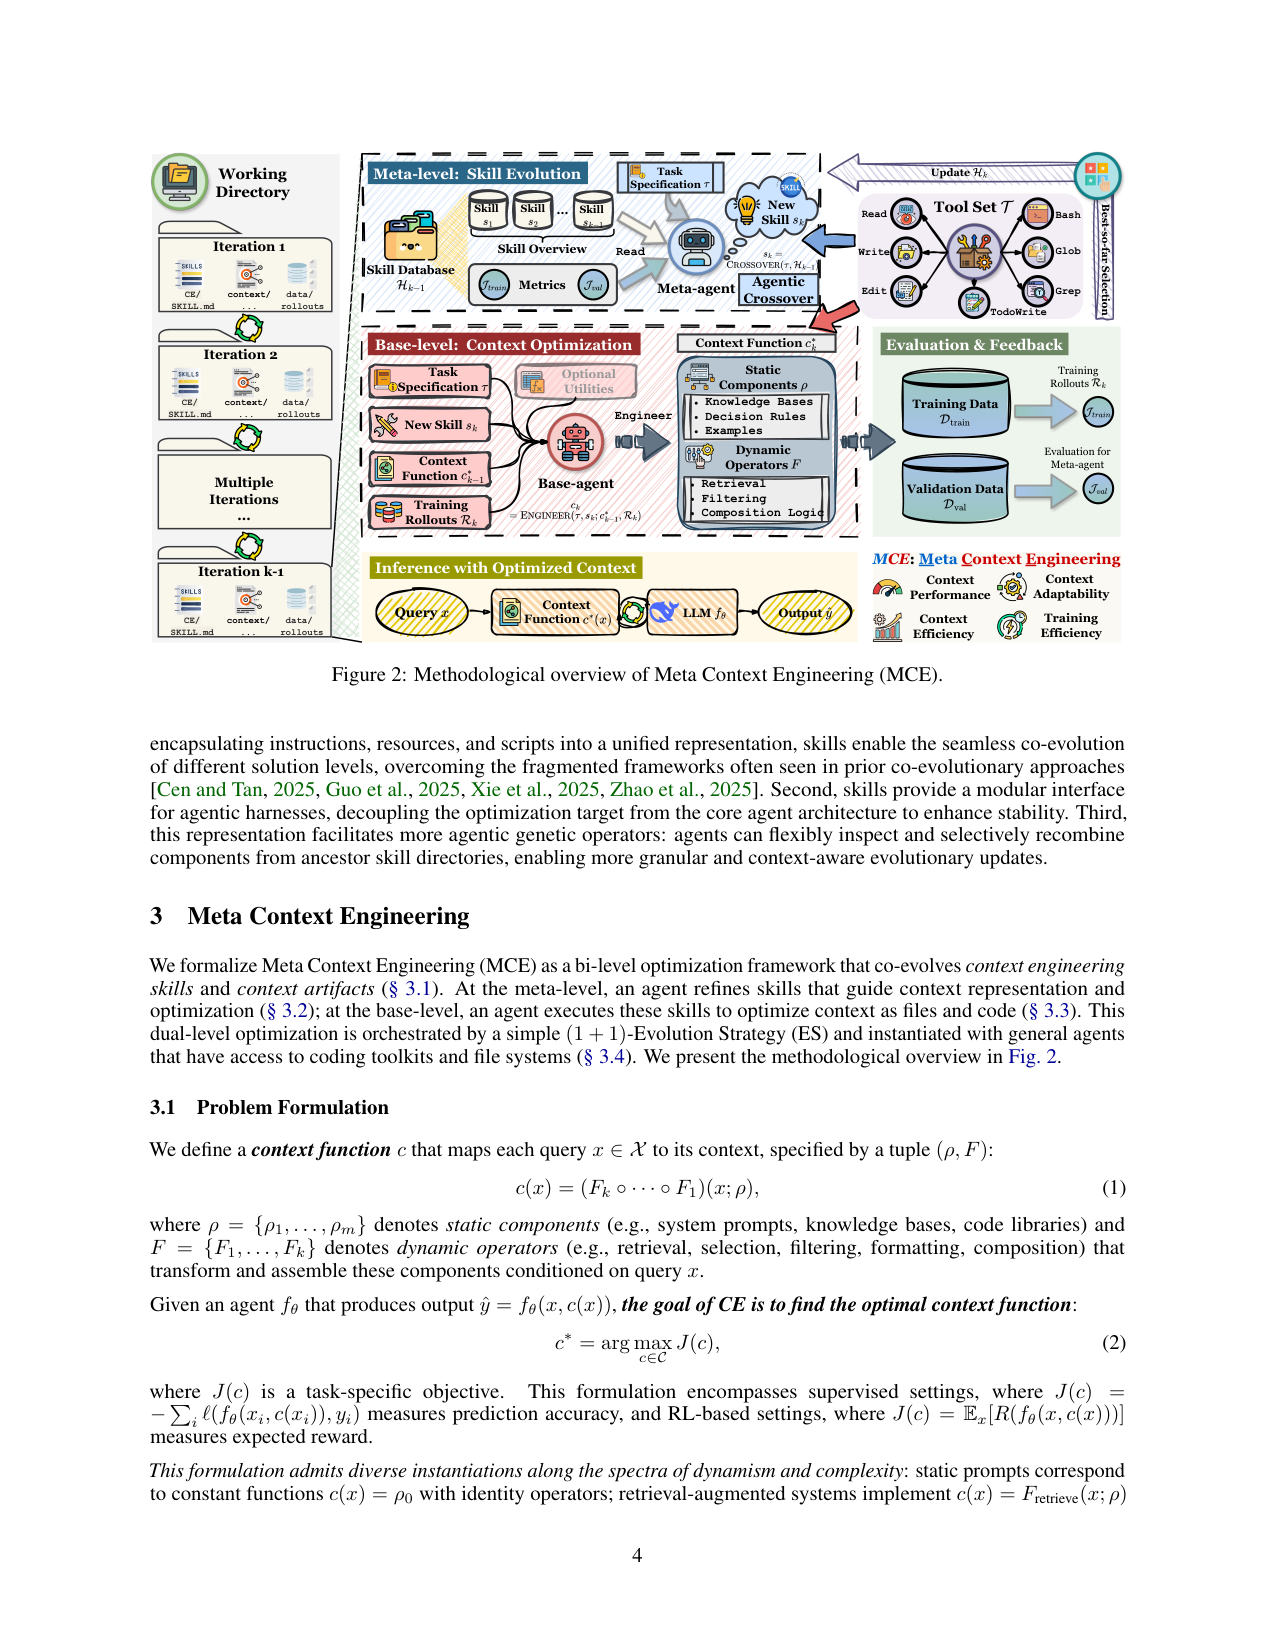
Meta Context Engineering via Agentic Skill Evolution

机制与内容分离的双层上下文优化:meta 层用 agentic crossover 进化「怎么管上下文」的 skill,base 层按 skill 把上下文当文件与代码优化;五个域相对 SOTA agentic CE 方法平均 +16.9%(范围 5.6–53.8%),FiNER 训练比 ACE 快 13.6×,上下文长度按任务自适应(1.5K–86K token)。

读全文 →
context-engineeringskill evolutionbi-level optimization
cover evolutionary-search
2025-11-28 · University of Washington / Microsoft

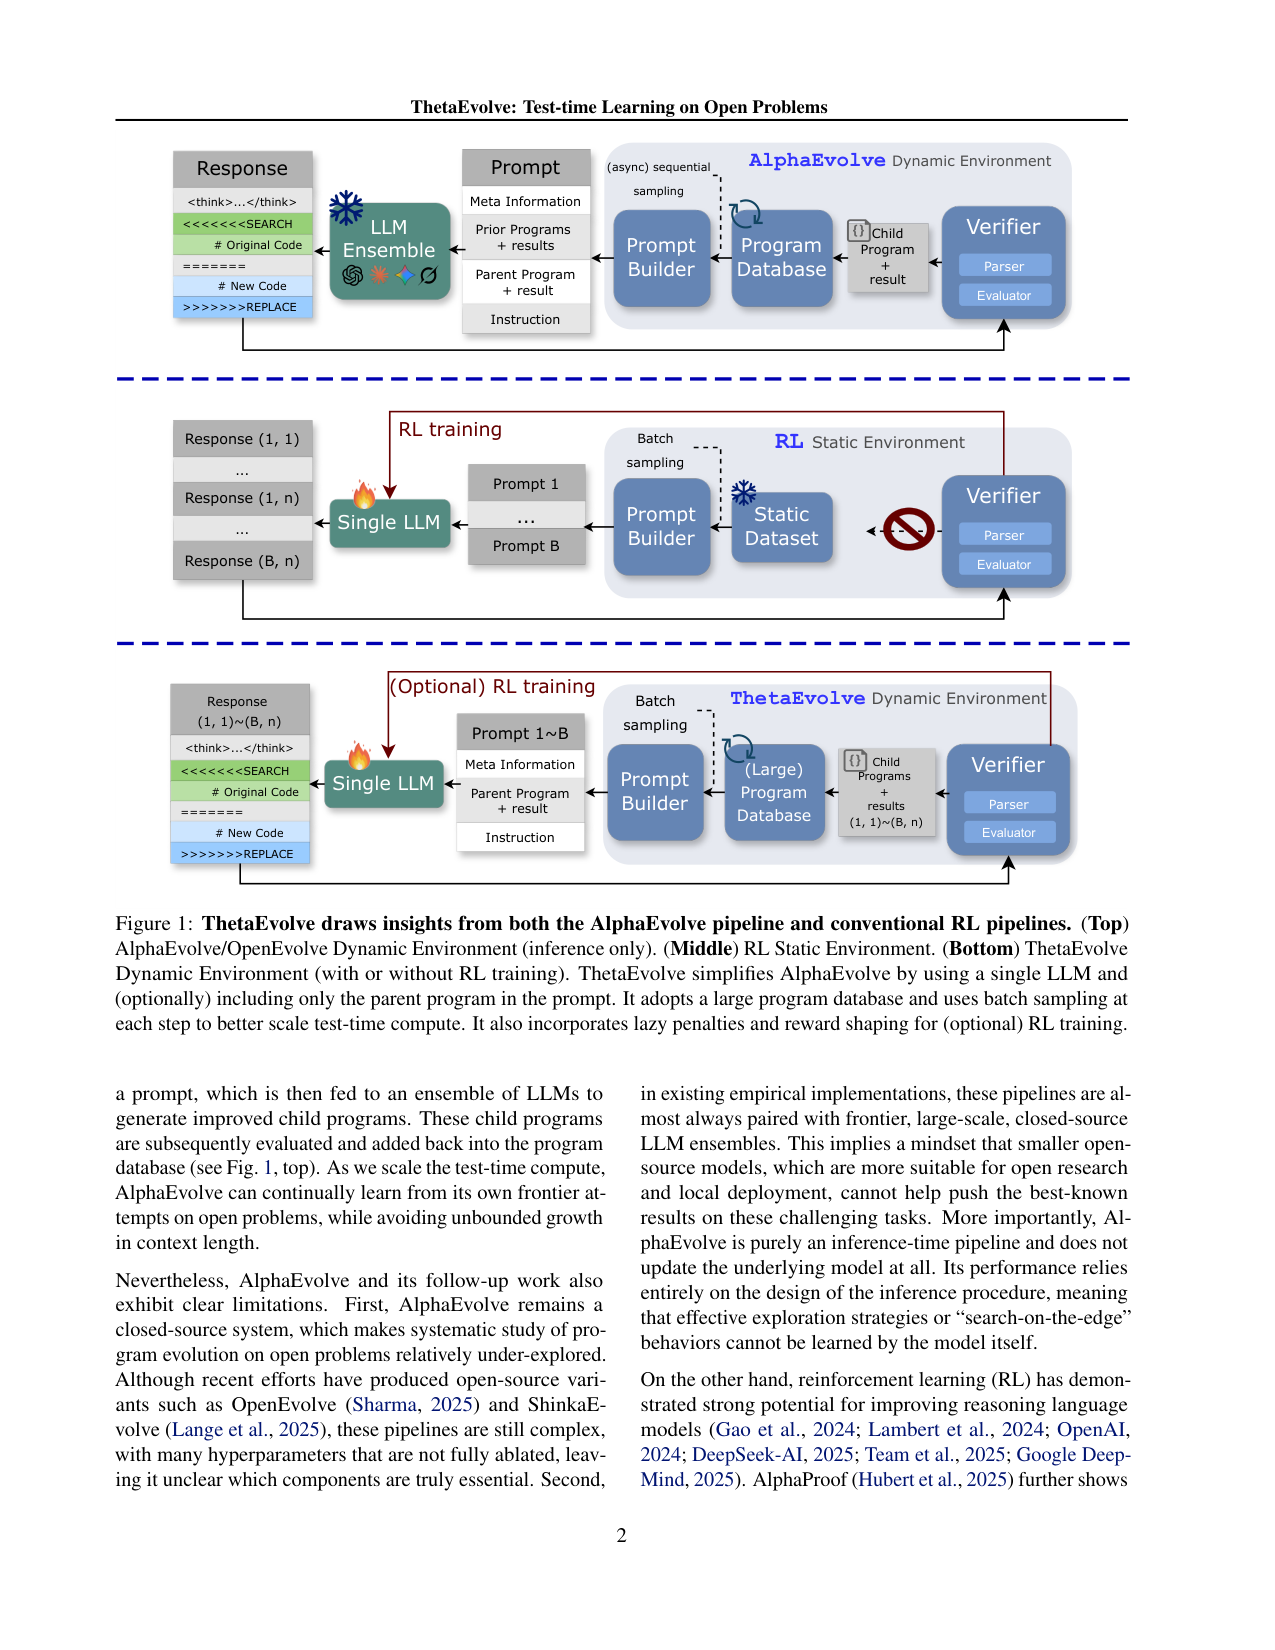
ThetaEvolve: Test-time Learning on Open Problems

用单个开源 8B 模型(DeepSeek-R1-0528-Qwen3-8B)加大规模程序数据库(population 10000)把 AlphaEvolve 简化成可扩展的 test-time 学习系统,并首次让 8B 模型刷新 AlphaEvolve 列出的两个开放问题上界(circle packing 2.63598308 vs AlphaEvolve 2.63586276;FACI 1.503133 vs 1.503164),RL 训练的 checkpoint 还学到了可迁移的「进化能力」。

读全文 →
test-time learningevolutionary searchRL
cover evolutionary-search
2025-09-17 · Sakana AI

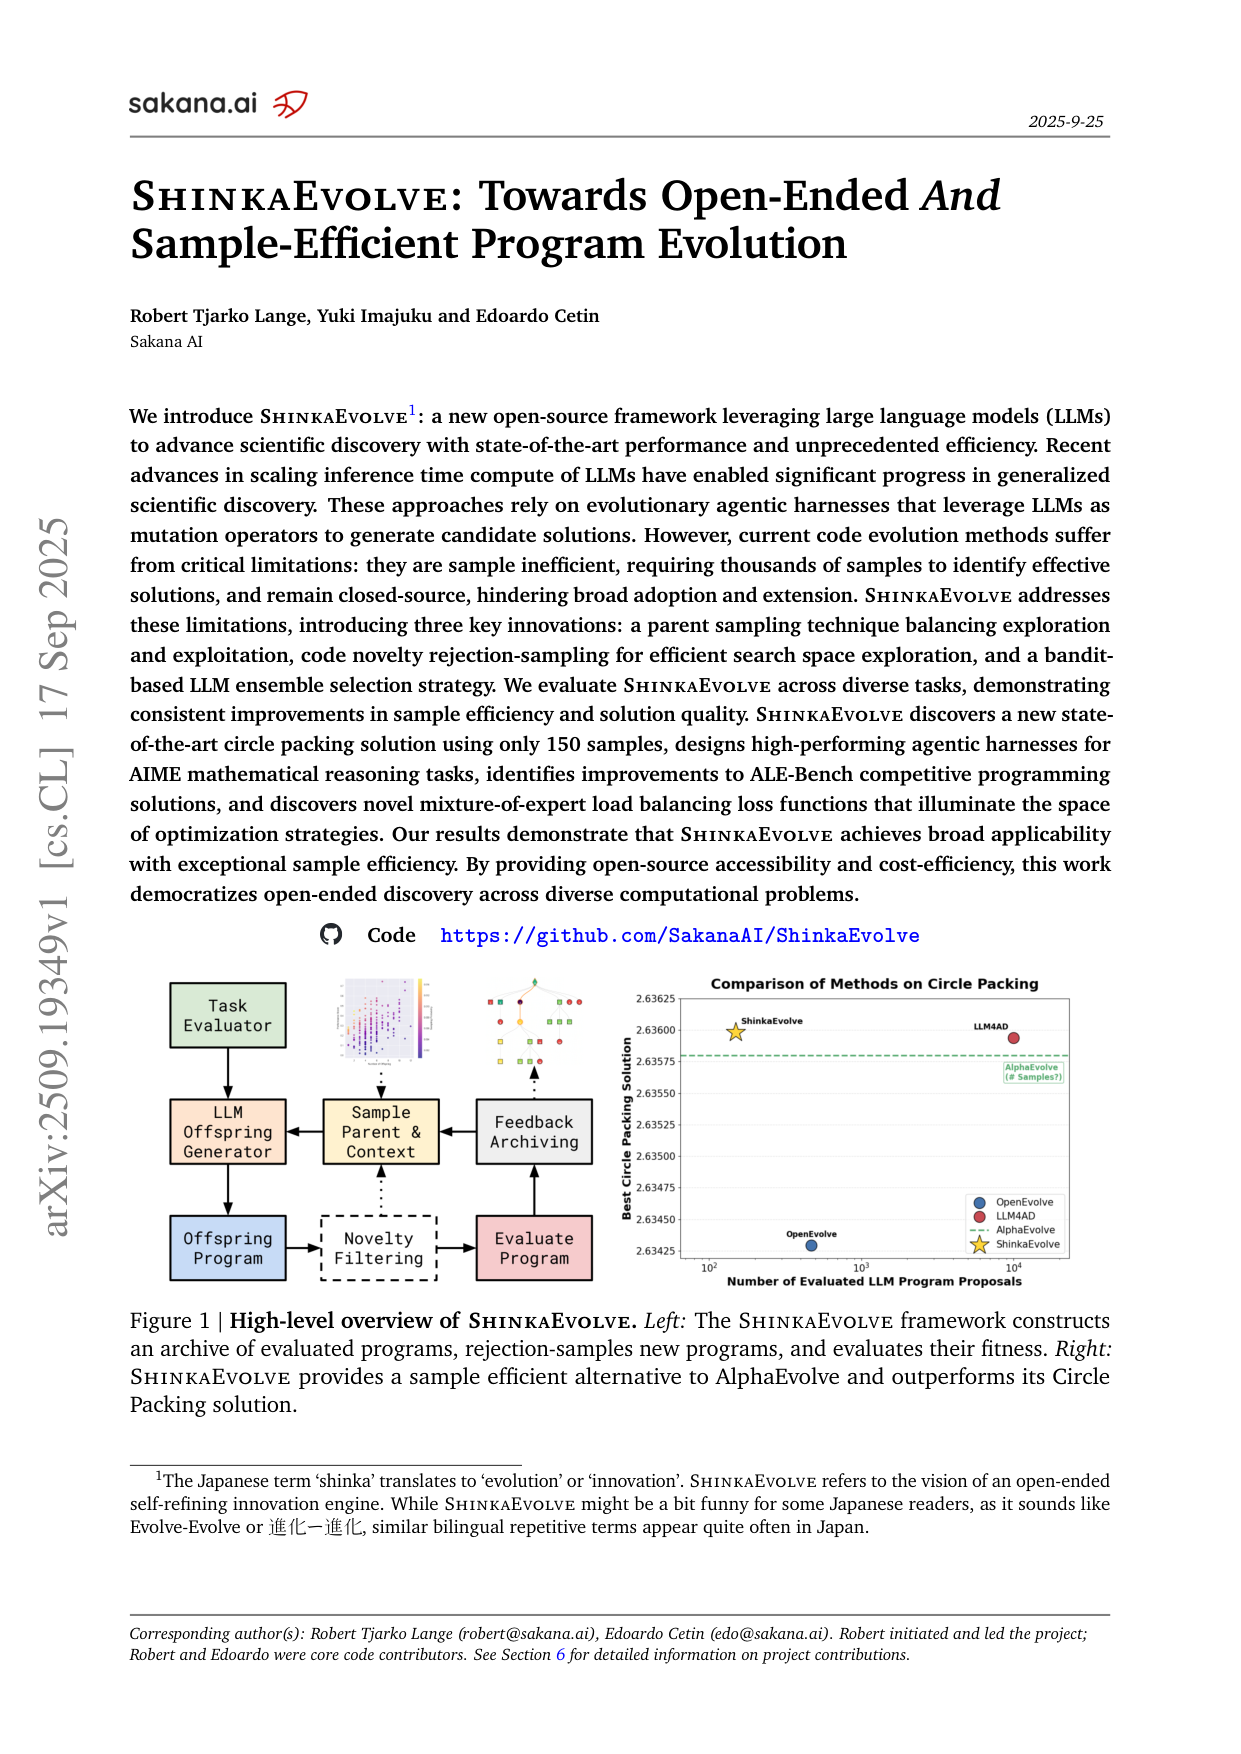
ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution

三个采样效率组件——按性能与子代数平衡的 parent sampling、embedding 余弦相似度的 code-novelty 拒绝采样、UCB1 选择 LLM 加 meta-scratchpad 沉淀成功模式——让 ShinkaEvolve 只用约 150 次程序评估就发现新的 circle packing SOTA(26 圆半径和 2.6359831,超越 AlphaEvolve 的 2.635),并进化出 AIME agent scaffold 与 MoE 负载均衡损失。

读全文 →
program evolutionsample efficiencynovelty rejection sampling
cover evolutionary-search
2025-07-25 · UC Berkeley / Stanford / BespokeLabs.ai / Notre Dame / Databricks / MIT

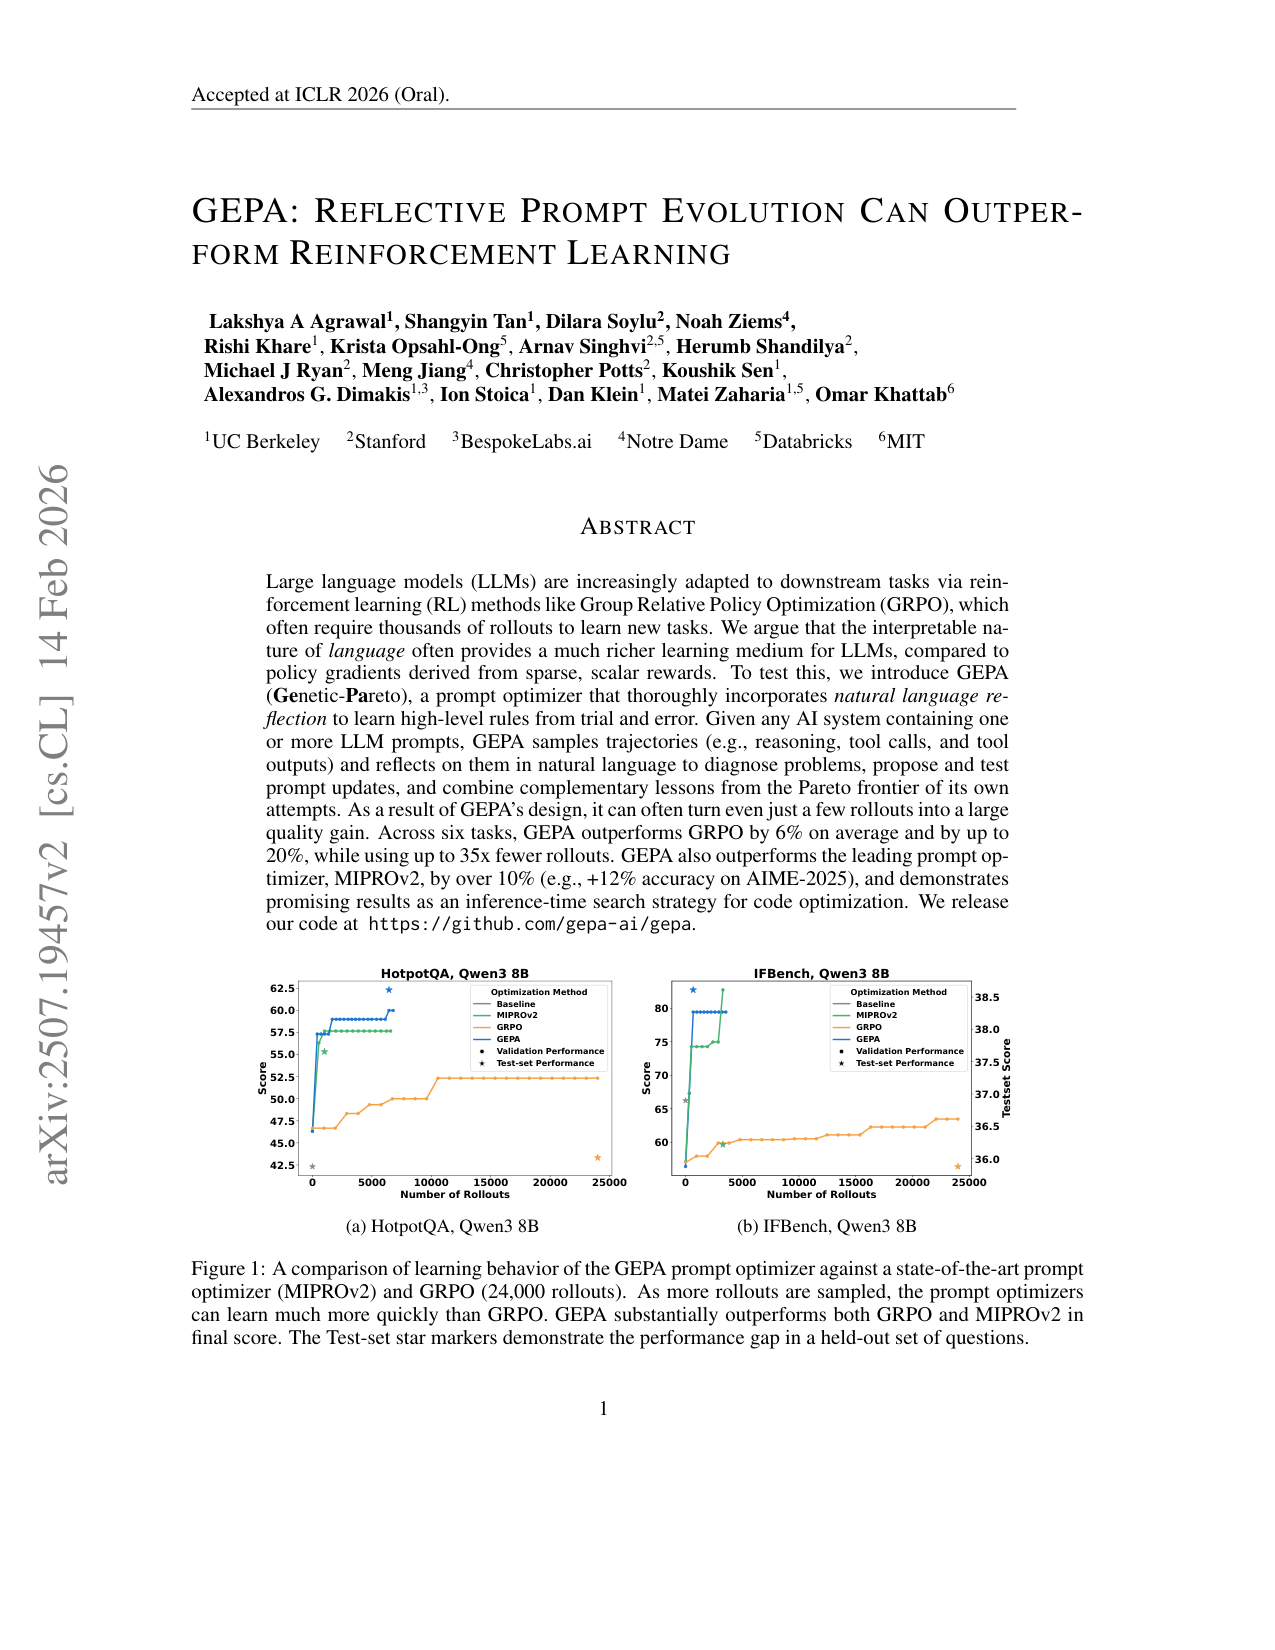
GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning

把每一次 rollout 变成自然语言学习信号:GEPA 用轨迹与评估文本(编译器报错、rubric 失败)驱动反思式变异,用 Pareto 前沿按实例选择候选,在 Qwen3 8B 上以最多 35 倍更少的 rollout 超过 GRPO(HotpotQA 62.33 vs 43.33;IFBench 用 678 次 rollout 达 38.61% vs GRPO 用 24,000 次达 35.88%)。

读全文 →
reflective prompt optimizationPareto searchsample efficiency
cover evolutionary-search
2025-06-16 · Google DeepMind

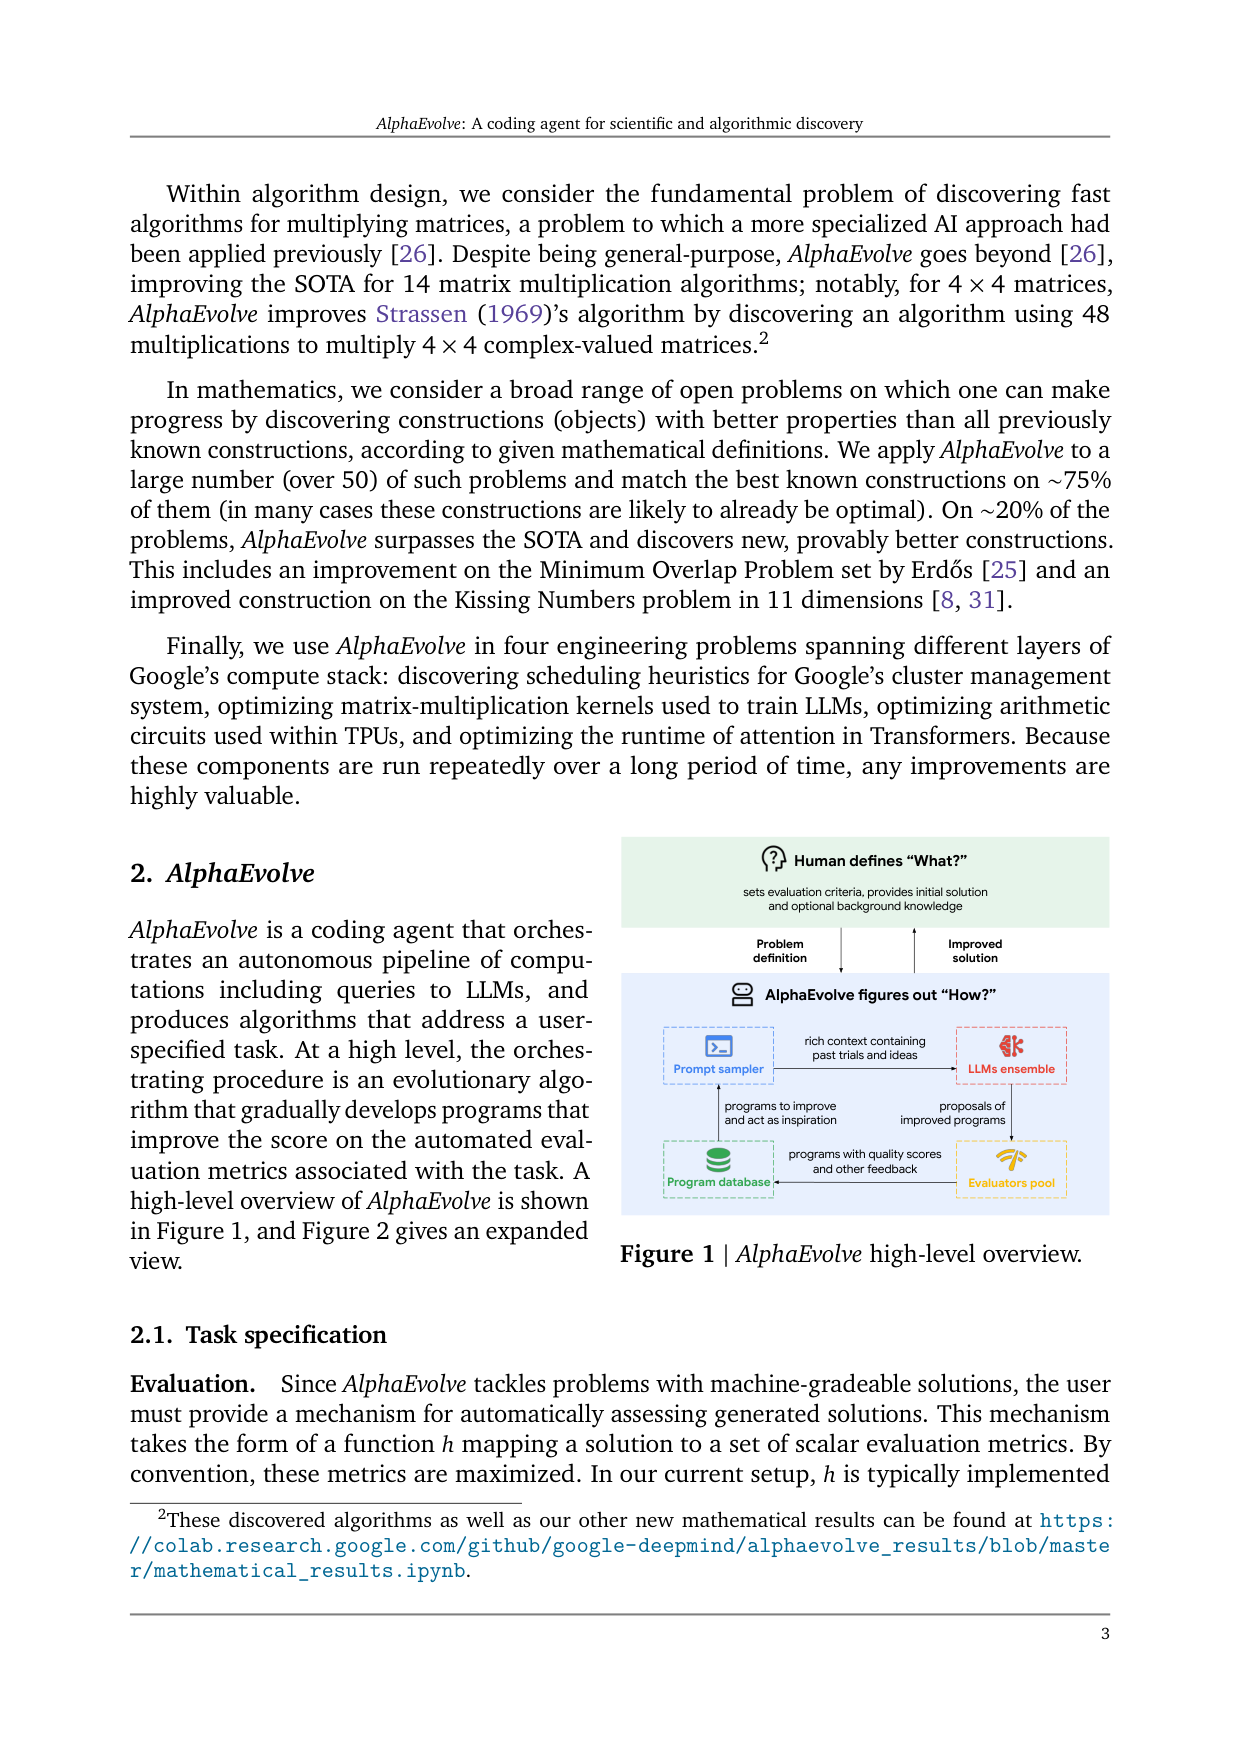
AlphaEvolve: A coding agent for scientific and algorithmic discovery

把「要改进的程序」用 # EVOLVE-BLOCK 标进代码,让 LLM 生成 diff 进化整个代码库、由自动评估器把关:在矩阵乘法上首次改进 Strassen 的 4×4 复矩阵算法(49→48 次标量乘法,56 年来的首个改进),并在 50+ 个数学开放问题上约 75% 打平已知最优、约 20% 超越 SOTA。

读全文 →
evolutionary program searchcode superoptimizationmatrix multiplication
cover harness-evolution
2025-05-29 · University of British Columbia / Vector Institute / Sakana AI

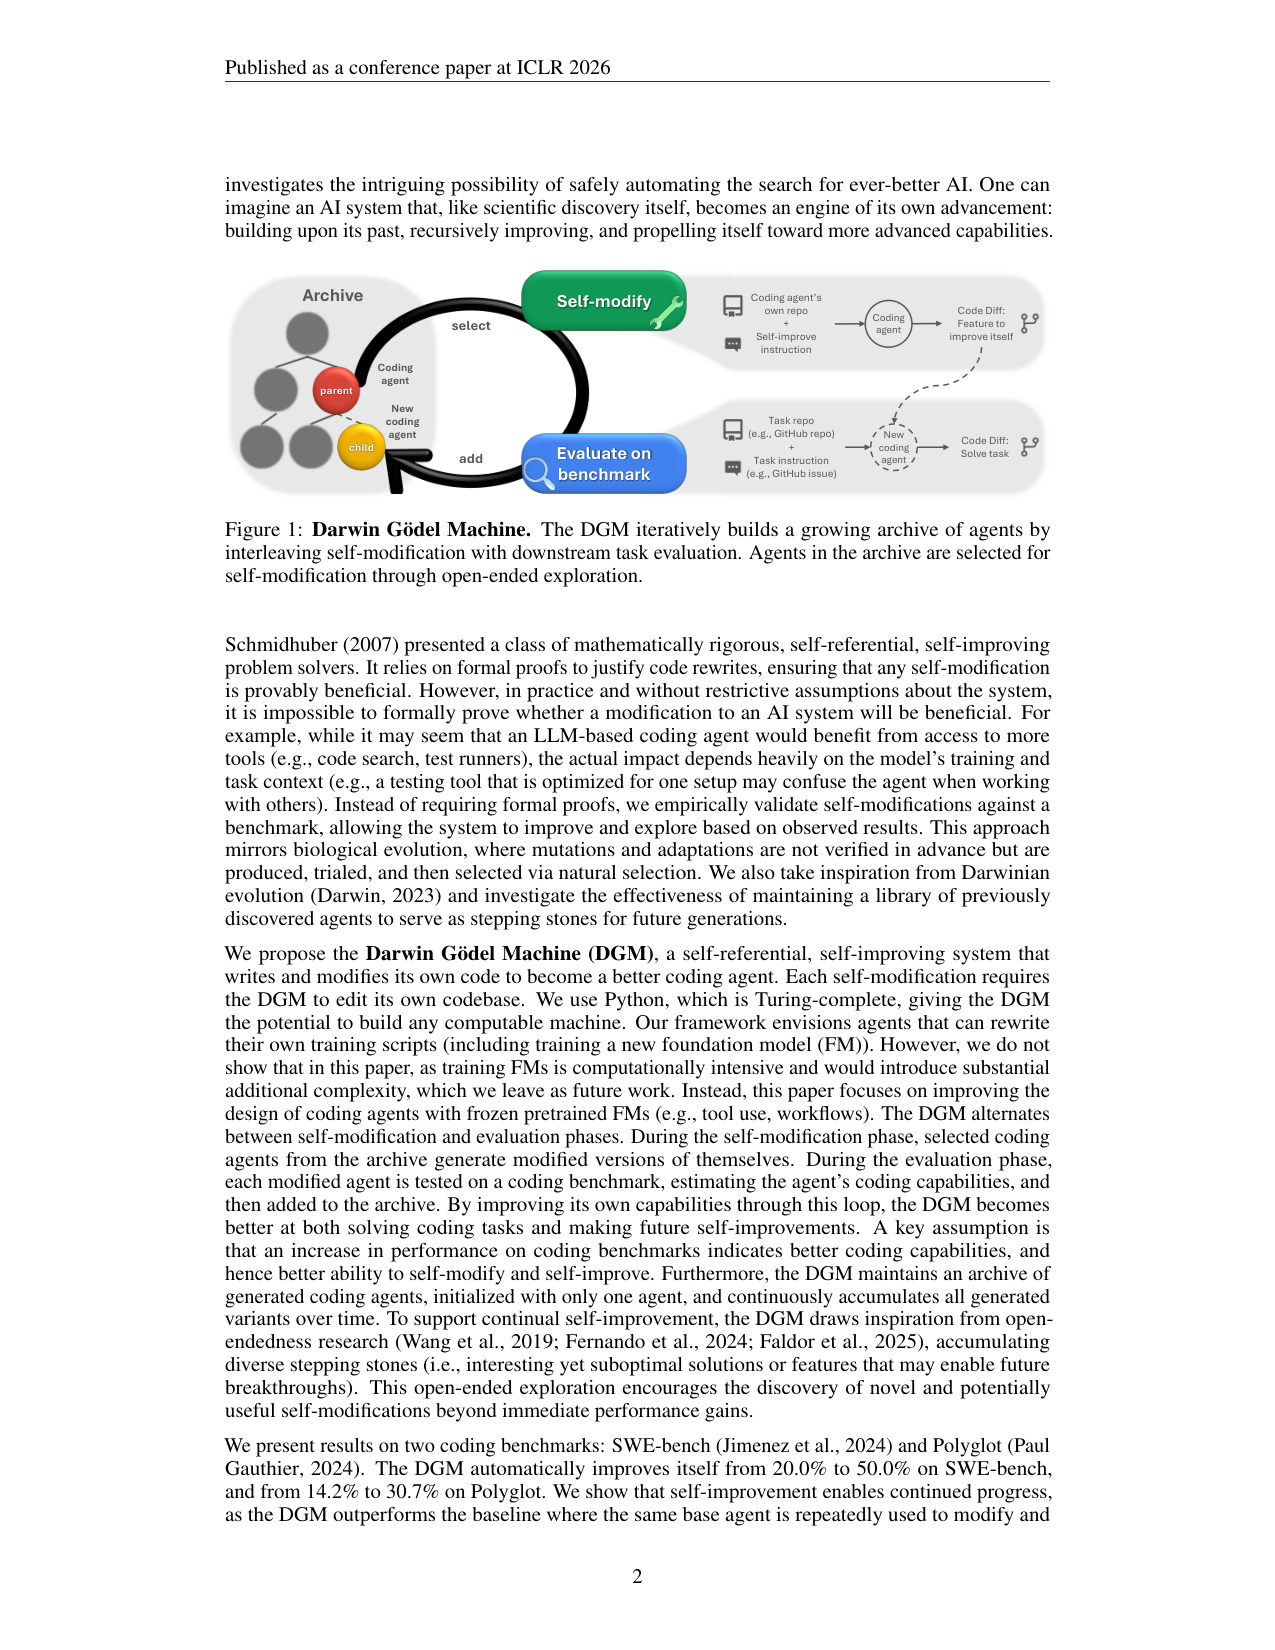
Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents

固定模型权重,让 coding agent 用 bash + editor 两个工具编辑自己的 harness 代码库:按「性能/孩子数」概率选 parent、把每个变体归档进开放探索树,80 次迭代内 SWE-bench Verified 从 20.0% 涨到 50.0%、Polyglot 从 14.2% 涨到 30.7%,且收益跨模型、跨 benchmark、跨语言迁移。

读全文 →
self-improving agentsopen-ended evolutionharness evolution
cover workflow-design
2025-04-15 · DeepWisdom / HKUST(GZ) / Renmin University of China / Nanjing University / Fudan / KAUST / Université de Montréal

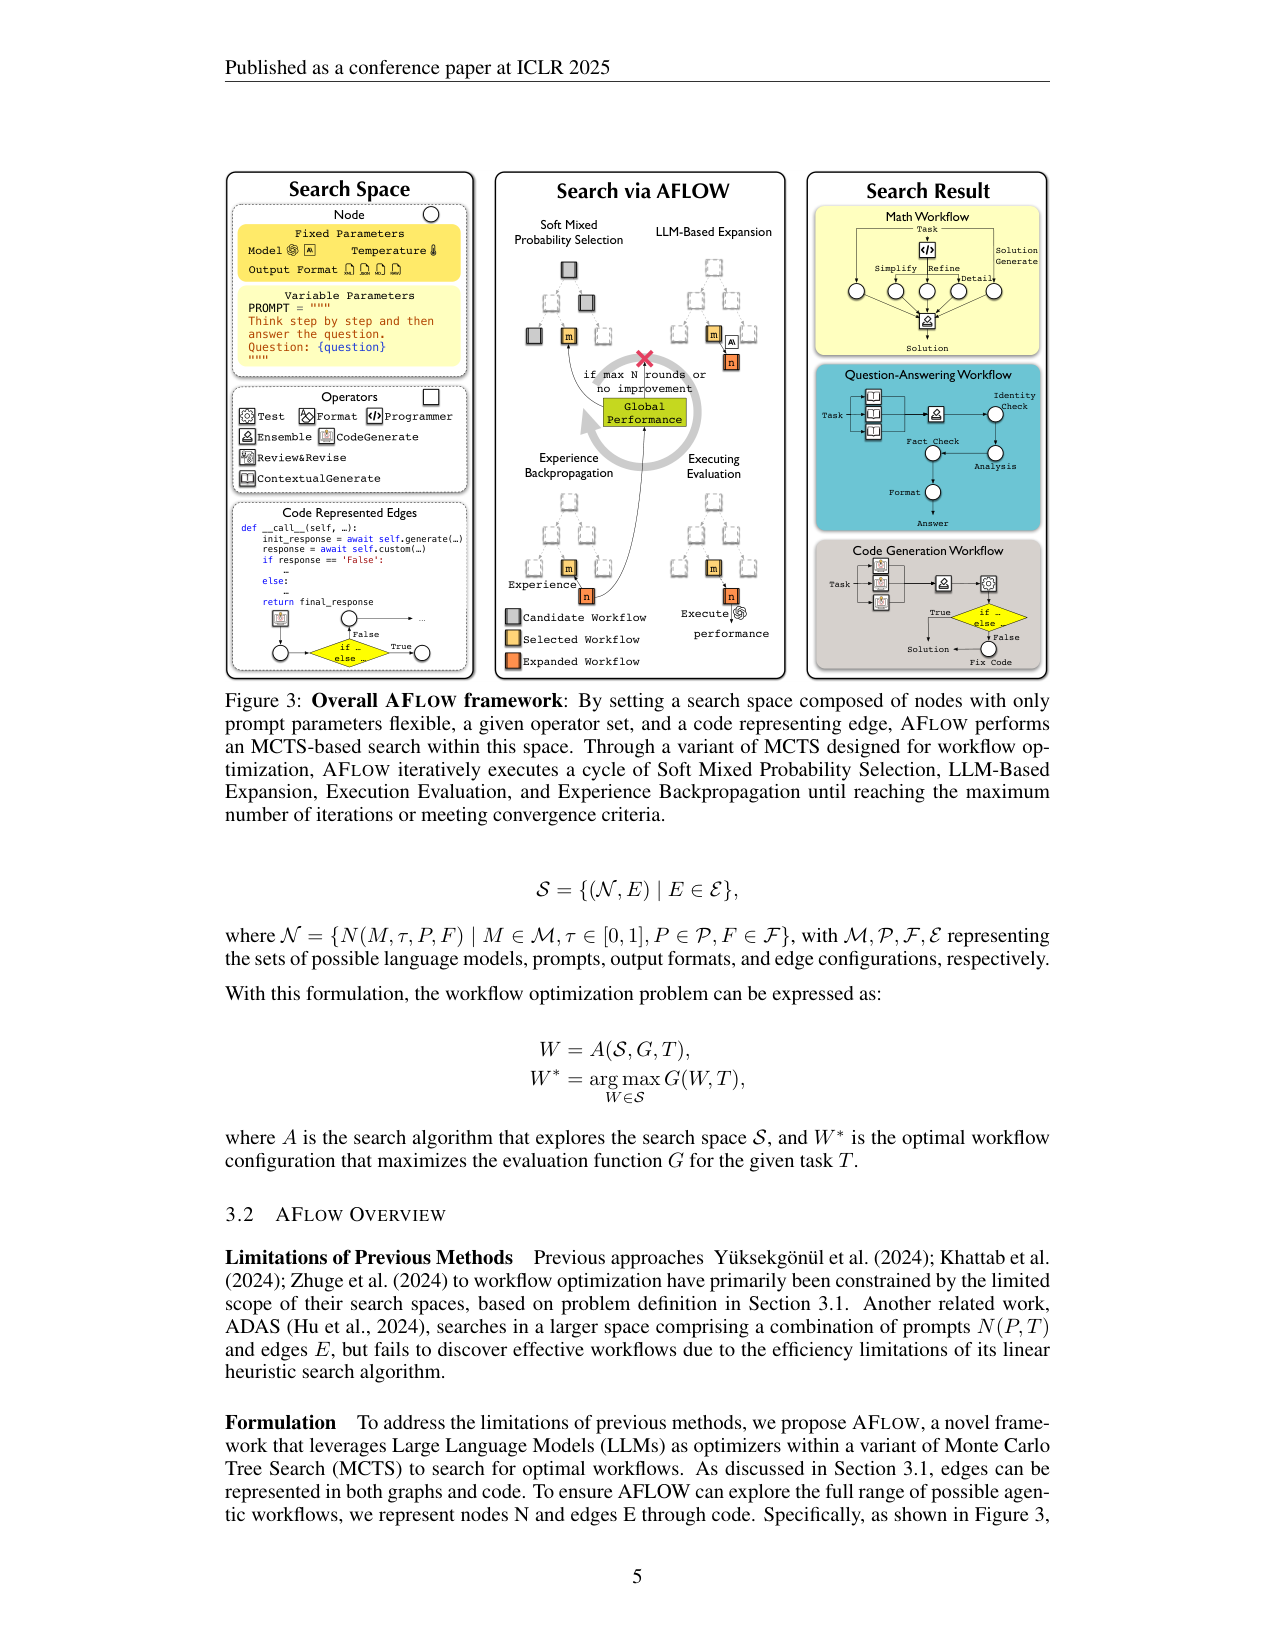
AFLOW: Automating Agentic Workflow Generation

agentic workflow 用代码表示 + MCTS 优化(Soft Mixed 选择→LLM 扩展→执行评估→经验回填):6 个 benchmark 平均 80.3%(GPT-4o-mini 执行),超最佳手工方法 +5.7%、超 ADAS +19.5%;小模型+搜出的 workflow 以 GPT-4o 约 4.55% 的成本打平甚至超过它(HumanEval)。

读全文 →
workflow-designMCTScode-represented workflow
cover workflow-design
2025-03-02 · University of British Columbia / Vector Institute / Canada CIFAR AI Chair

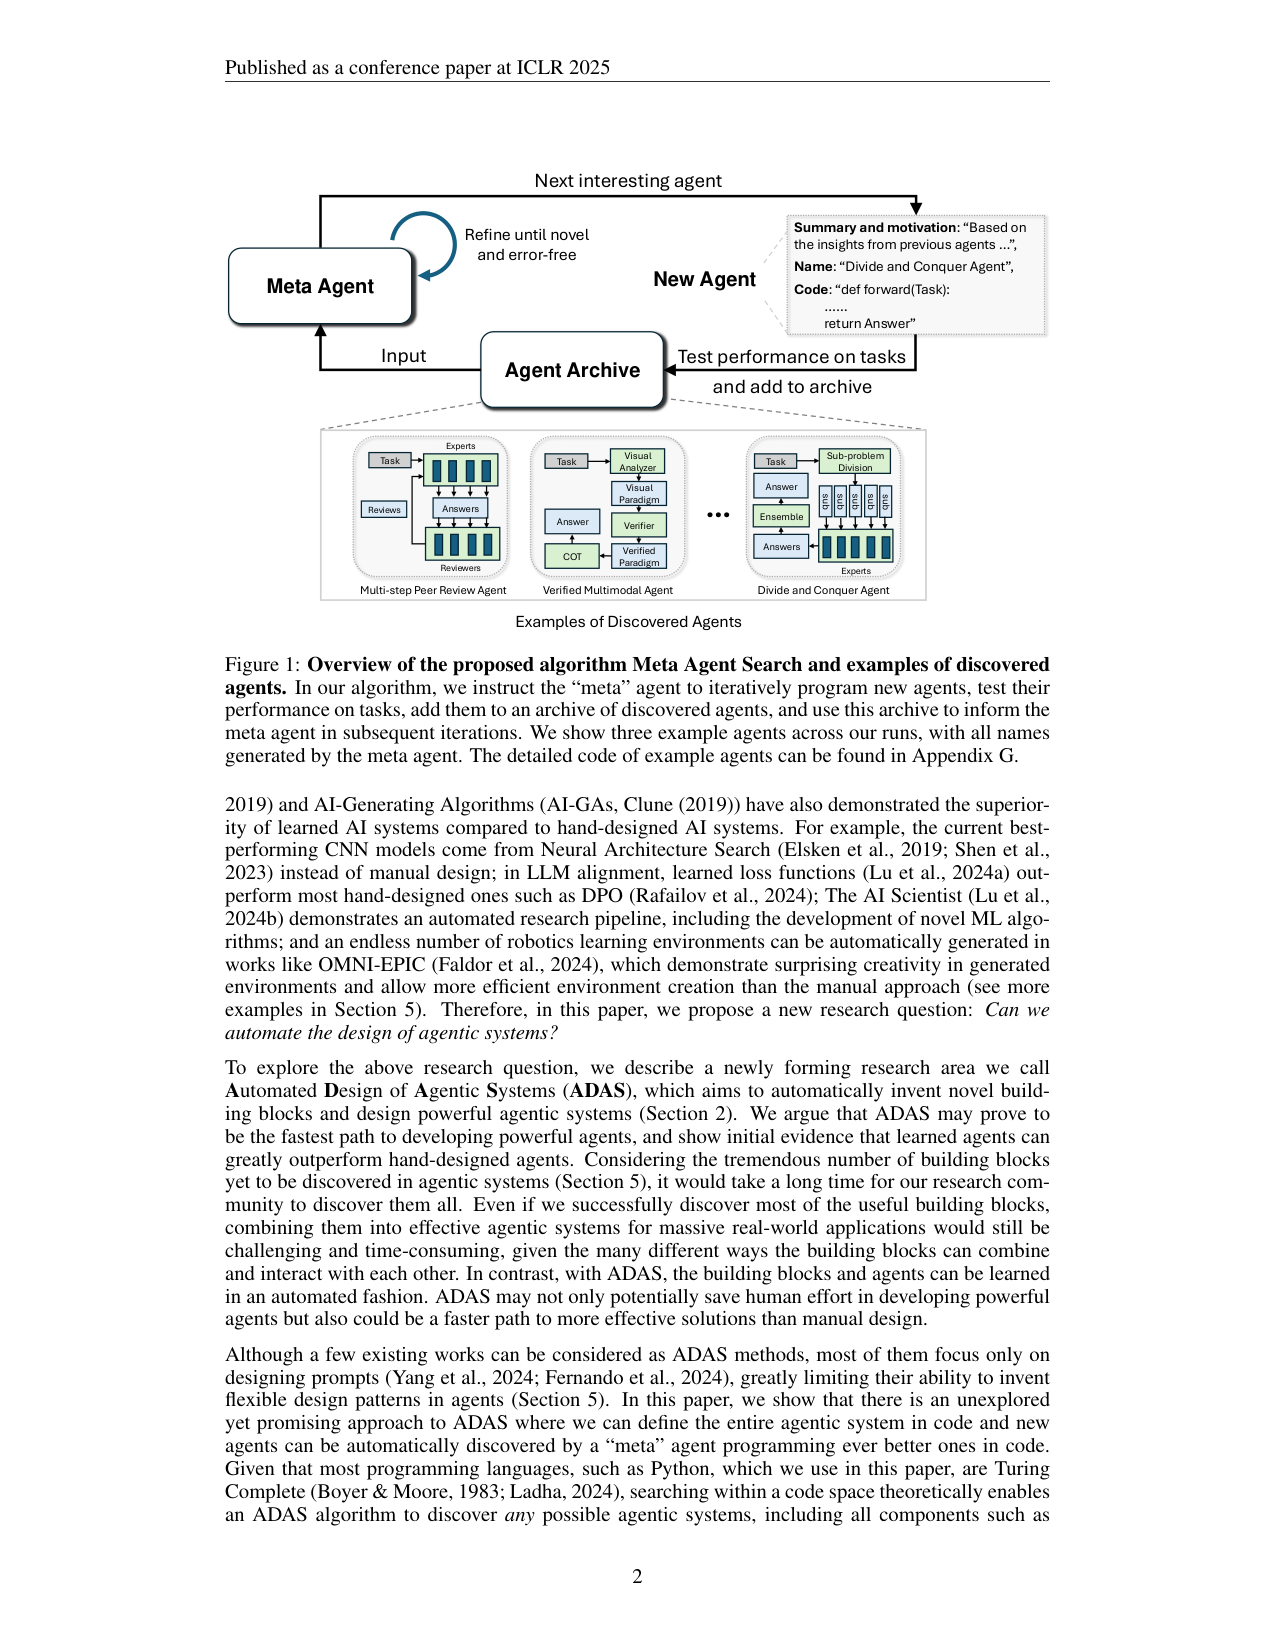
Automated Design of Agentic Systems

提出 ADAS 研究领域 + Meta Agent Search:meta agent(GPT-4)在 <100 行代码框架里反复编程新 agent(forward 函数),archive 累积前序发现当 stepping stones;DROP F1 79.4 对最佳手工 65.8、MGSM 53.4 对 39.0,且发现的 agent 跨域跨模型迁移仍领先(GSM8K +25.9%、ARC 跨模型近 50%)。

读全文 →
workflow-designmeta agentcode search
cover self-improving-agent
2024-08-16 · Stanford University / Microsoft Research / OpenAI

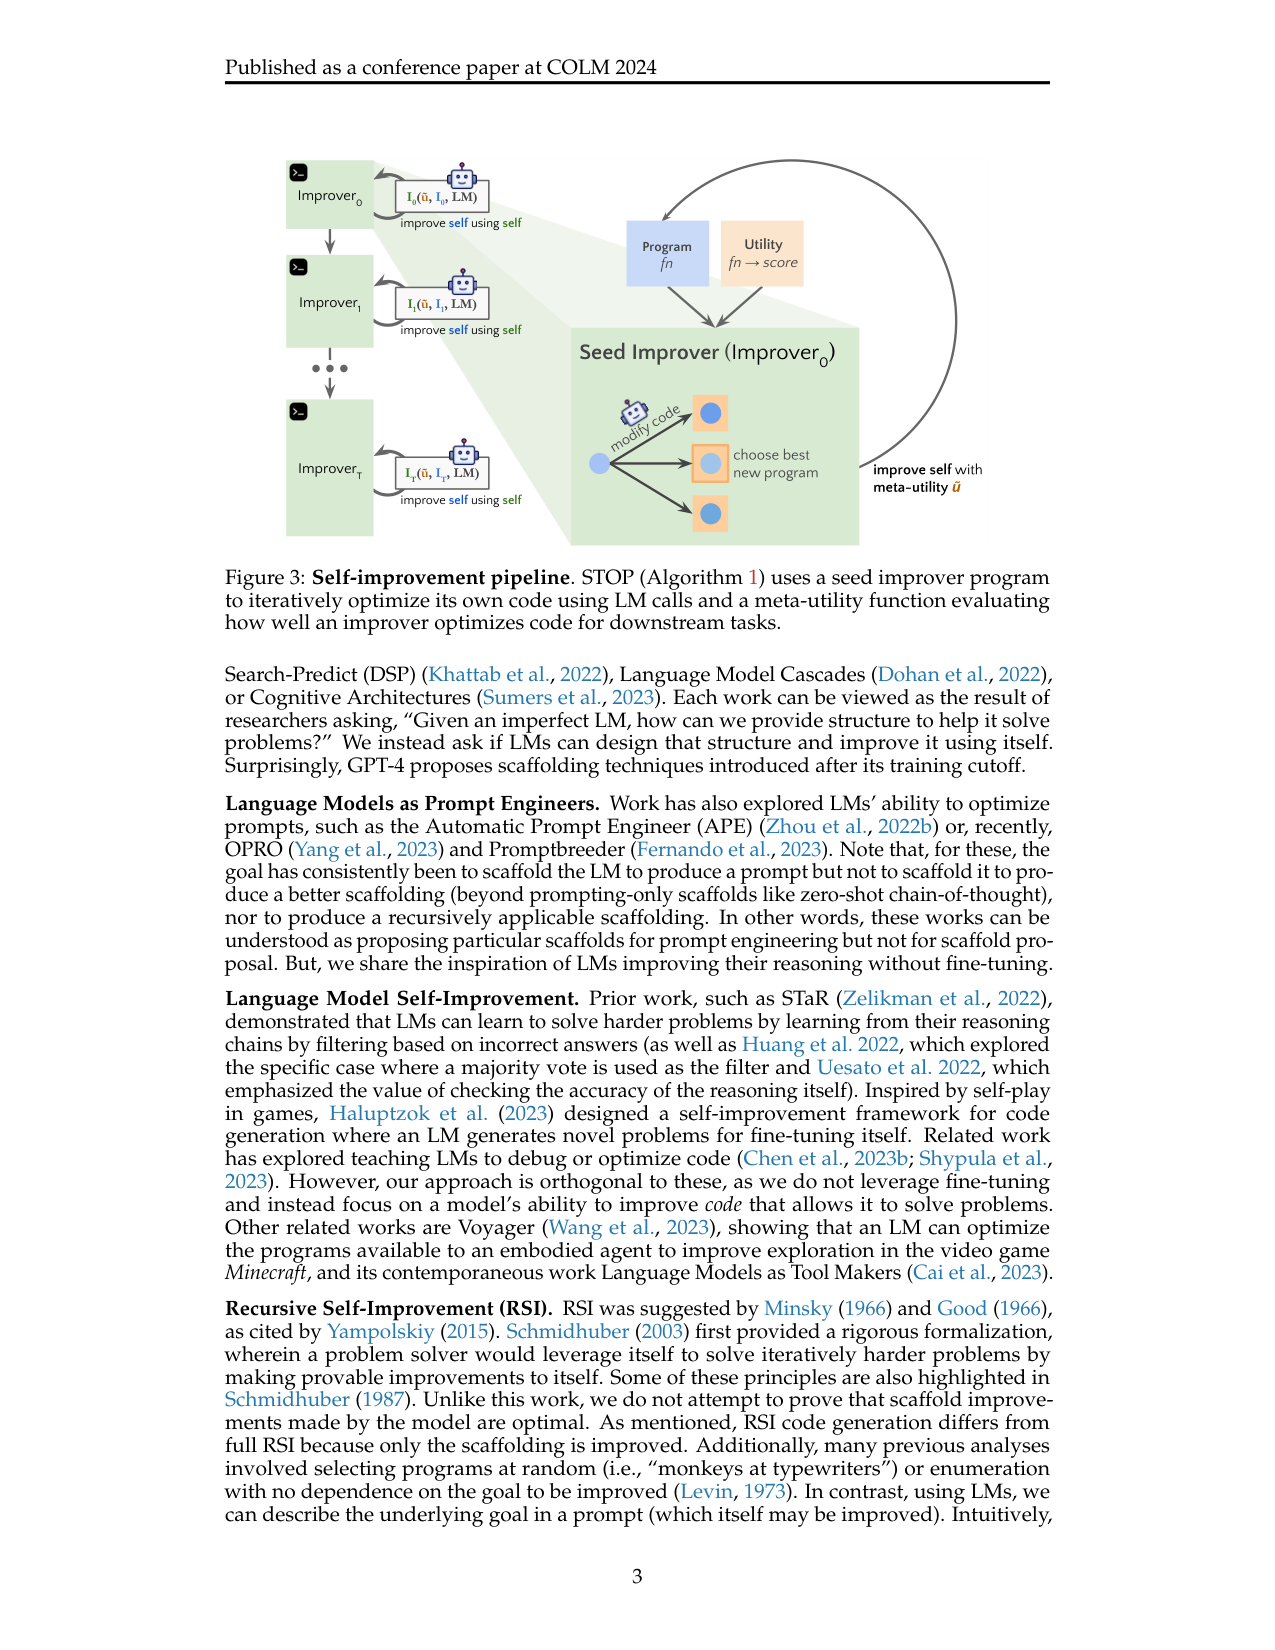
Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation

STOP 把「改进器(improver)程序本身」当作优化对象:种子 improver 借助 GPT-4 递归改进自己(I_t = I_{t-1}(û, I_{t-1}, L)),在多个下游算法任务上稳定提升,并自主提出遗传算法、模拟退火、beam search 等改进策略;模型权重全程不变,处在 L1 自我改进层级(非完整 RSI)。

读全文 →
recursive self-improvementscaffoldingmeta-optimization
cover evolutionary-search
2023-09-28 · Google DeepMind

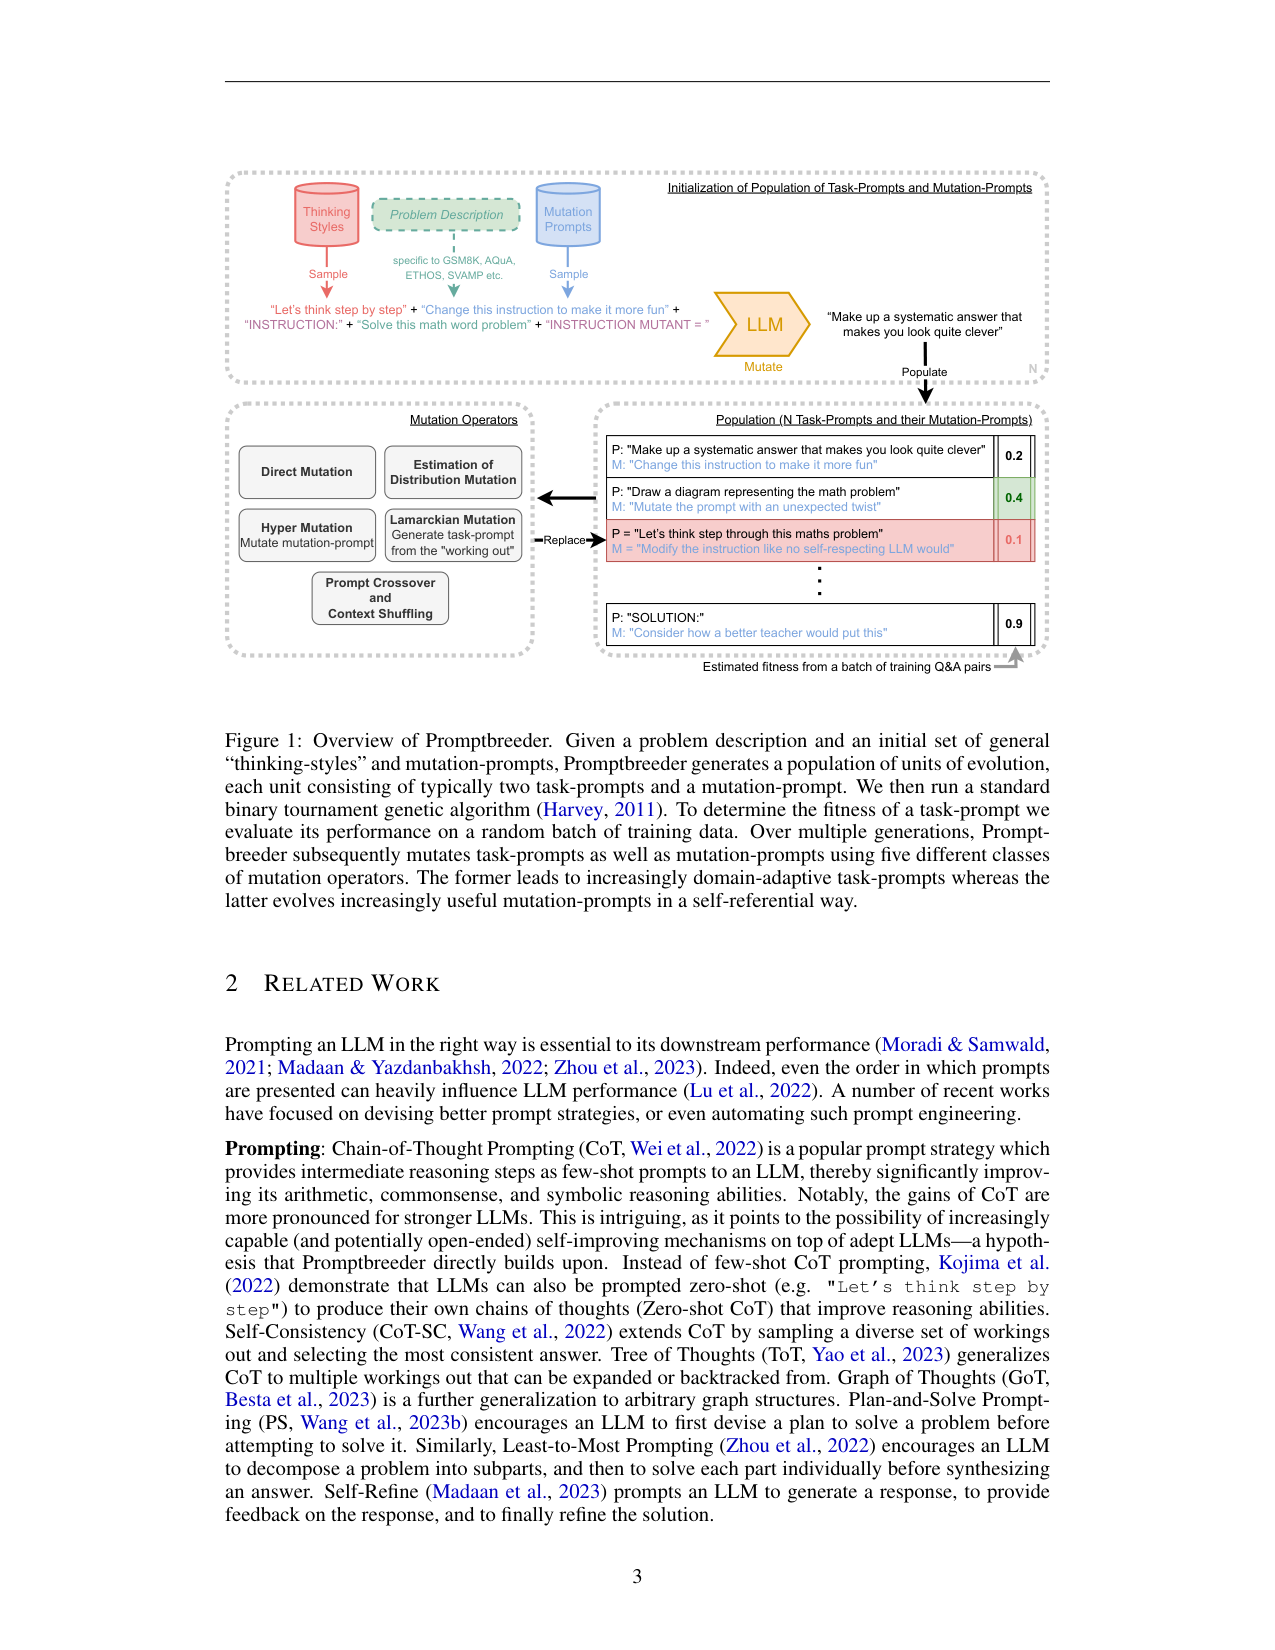
Promptbreeder: Self-Referential Self-Improvement via Prompt Evolution

把「改进 prompt 的 prompt」也放进进化循环:Promptbreeder 用 LLM 当变异算子,同时进化 task-prompt 与 mutation-prompt,在 8 个算术/常识推理 benchmark 上以冻结的 PaLM 2-L 权重超过手写 CoT 与 Plan-and-Solve(GSM8K 零样本 83.9% vs PS+ 的 60.5%),并在 ETHOS 上进化出 89% 的两段式提示(对照手写提示 80%)。

读全文 →
prompt evolutionself-referentialevolutionary algorithm
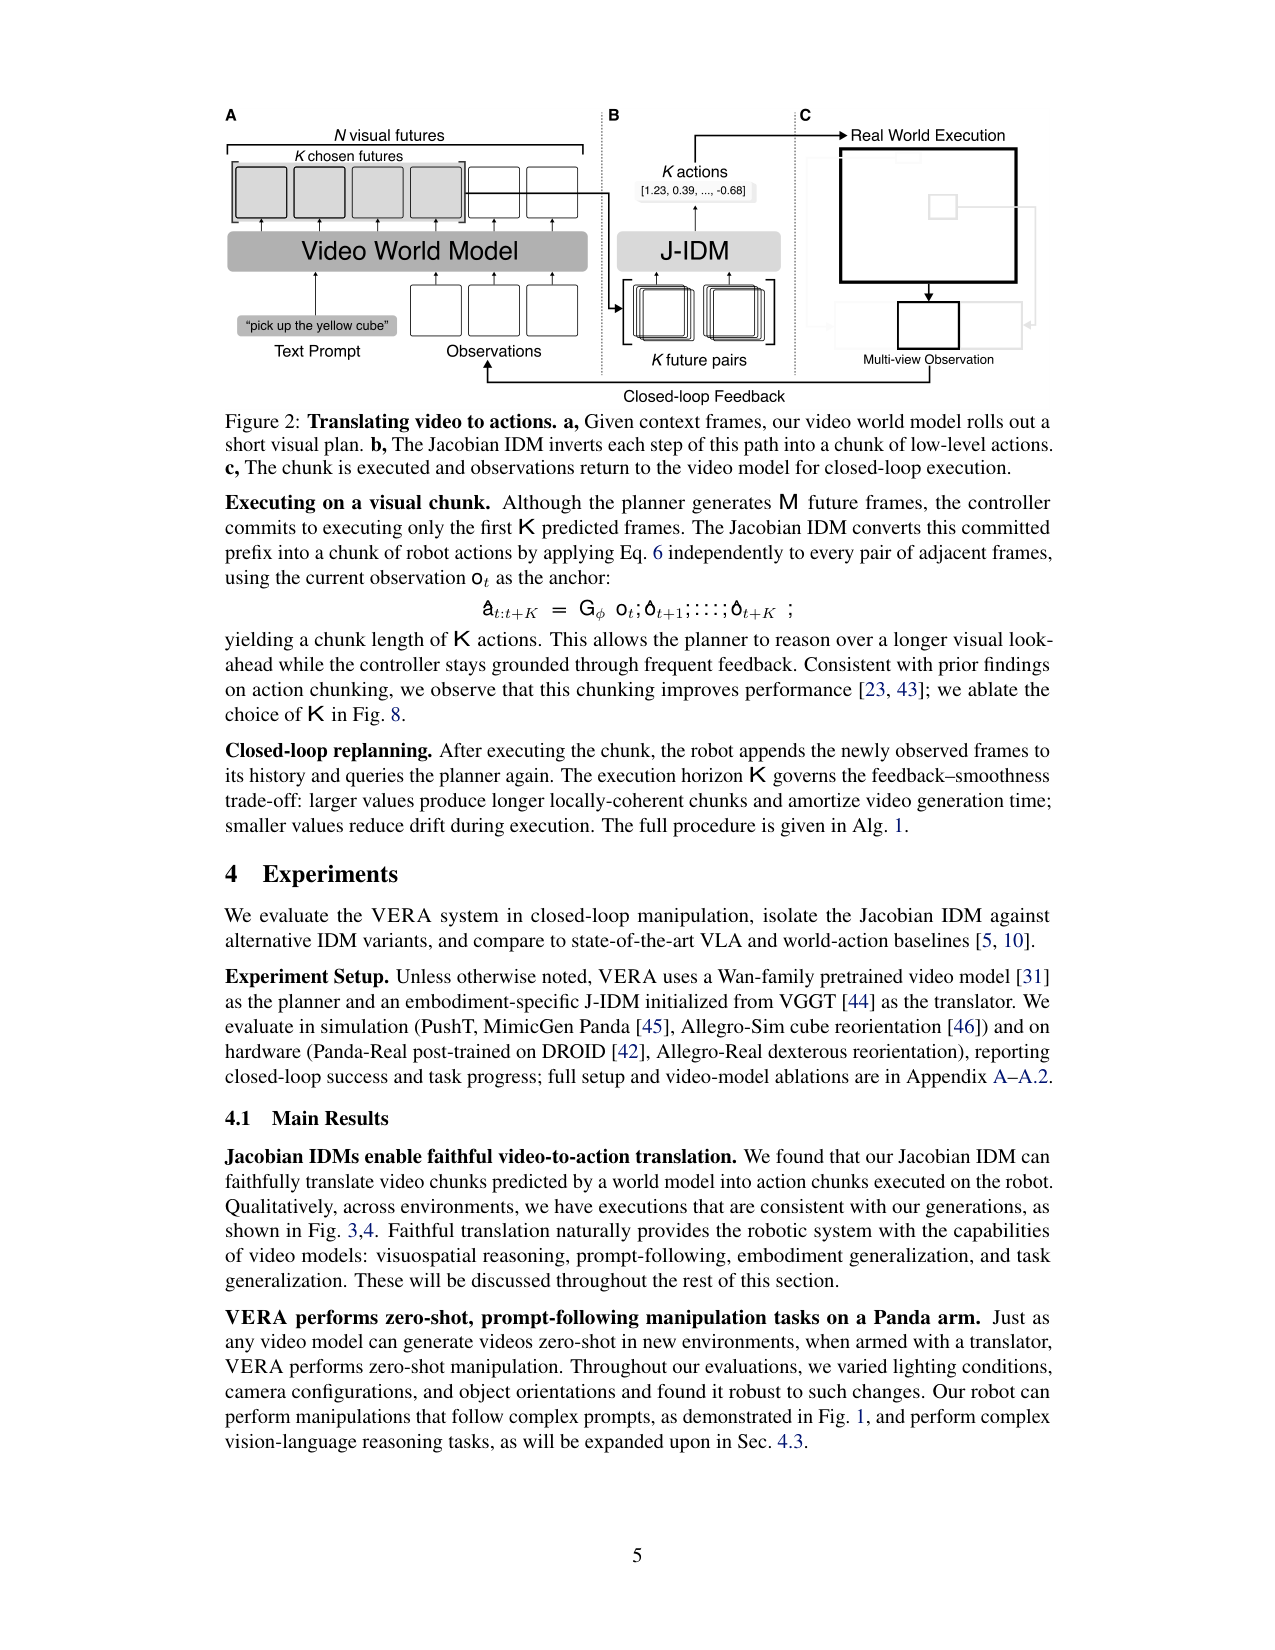
cover Decoupled Video-to-Action(动作无关视频世界模型 + 机体 Jacobian IDM)
2026-05-27 · 一作 Sizhe Lester Li(MIT);共同一作 Evan Kim、Xingjian Bai(MIT);Tong Zhao、Tao Pang(独立研究者);Max Simchowitz(CMU / Amazon FAR);Vincent Sitzmann(MIT,通讯)

Turning Video Models into Generalist Robot Policies (VERA)

让一个 14B 视频扩散模型只当动作无关的视觉规划器,用按机体 Jacobian 结构化设计的逆动力学模型把预测视频忠实翻译成动作,得到零样本、跨本体、闭环的通用机器人策略 VERA。

读全文 →
video generationinverse dynamicsembodiment Jacobian
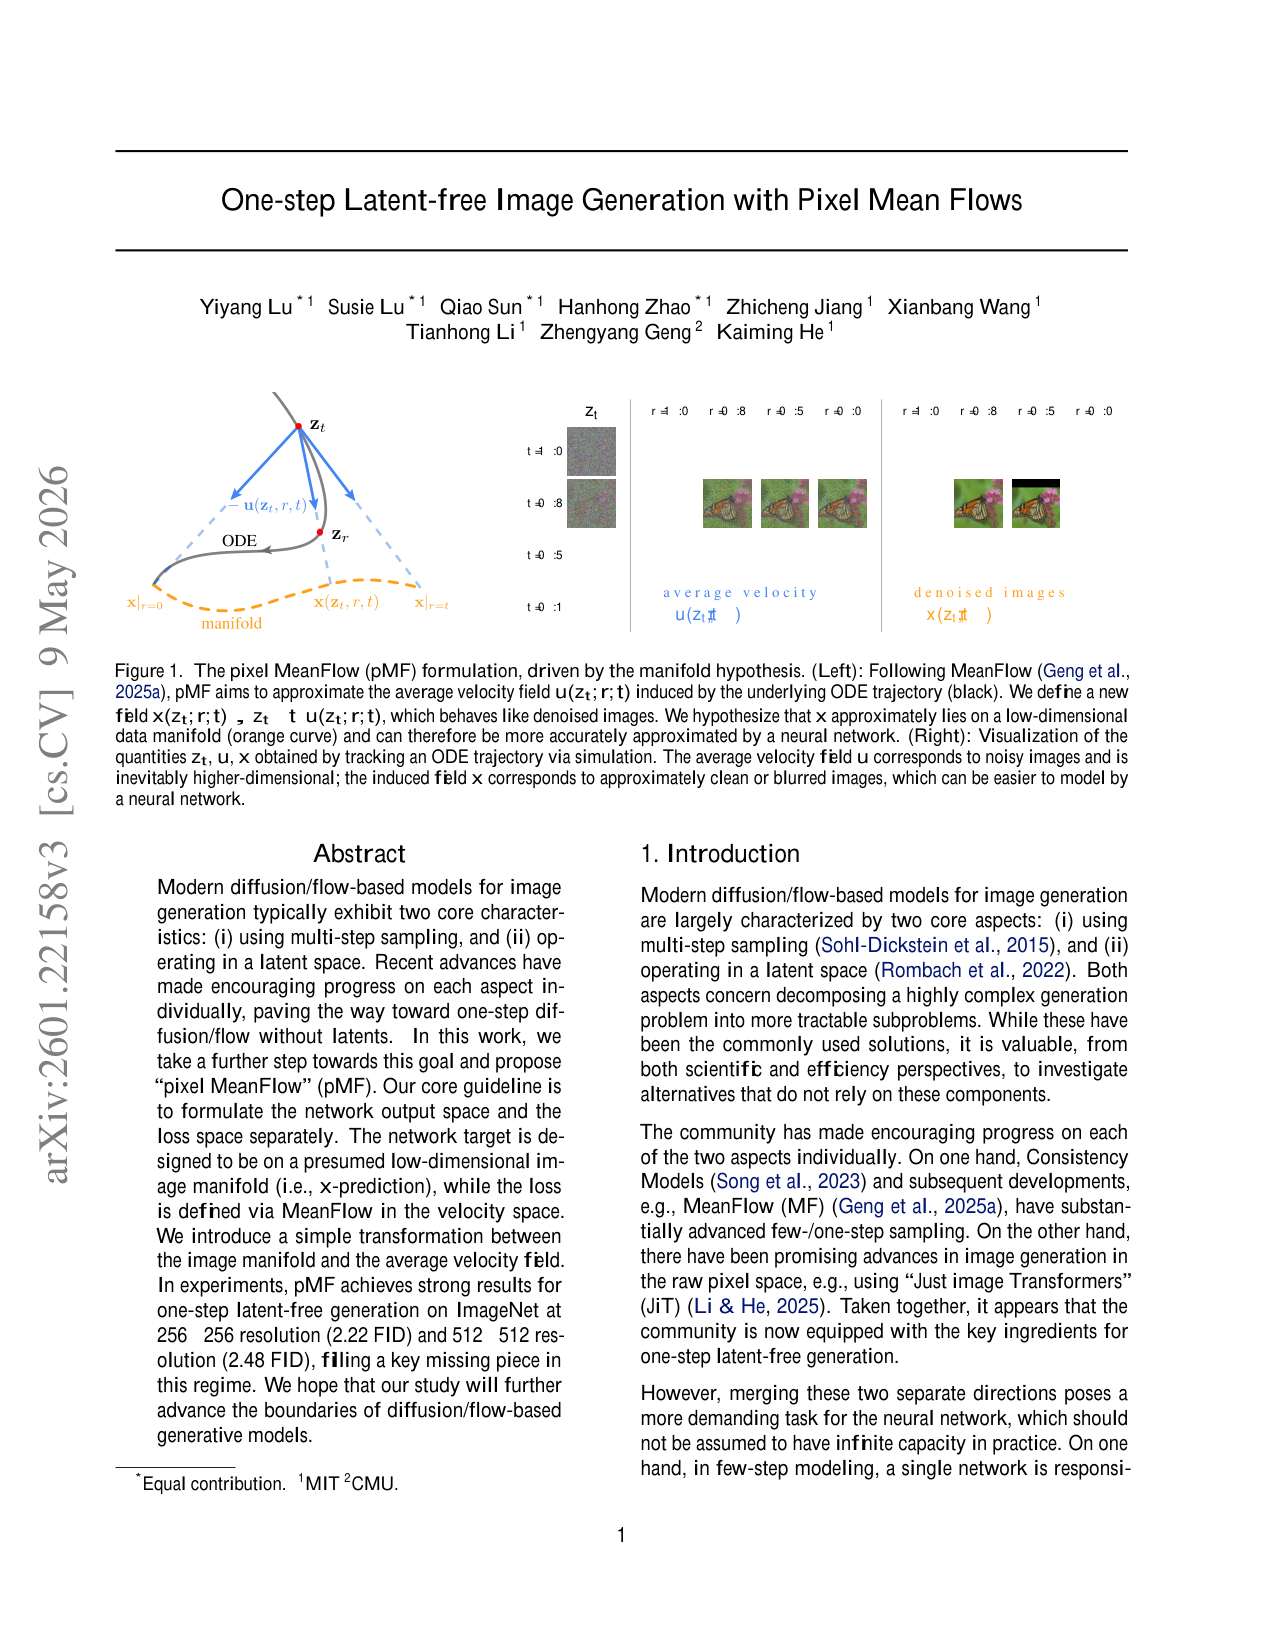
cover 生成模型理论 / one-step 谱系(Flow Matching + MeanFlow + 像素空间 Transformer)
2026-05-09(v3) · MIT(第一梯队作者与 Tianhong Li 等) / CMU(Zhengyang Geng)

One-step Latent-free Image Generation with Pixel Mean Flows

提出 pixel MeanFlow(pMF):把「网络输出空间」和「损失空间」分开设计——网络在像素空间直接输出去噪图像 x(假定落在低维图像流形上),损失沿用 improved MeanFlow 定义在瞬时速度 v 空间(v-loss),中间用 x→u→v 的代数变换接起来;在不借助任何预训练 VAE/tokenizer 的前提下,用 1 次函数评估在 ImageNet 256×256 拿到 2.22 FID(pMF-H/16,956M 参数、271 Gflops)、512×512 拿到 2.48 FID(pMF-H/32,959M、272 Gflops),填补了「one-step + latent-free」此前几乎空白的象限。

读全文 →
one-step generationflow matchingMeanFlow
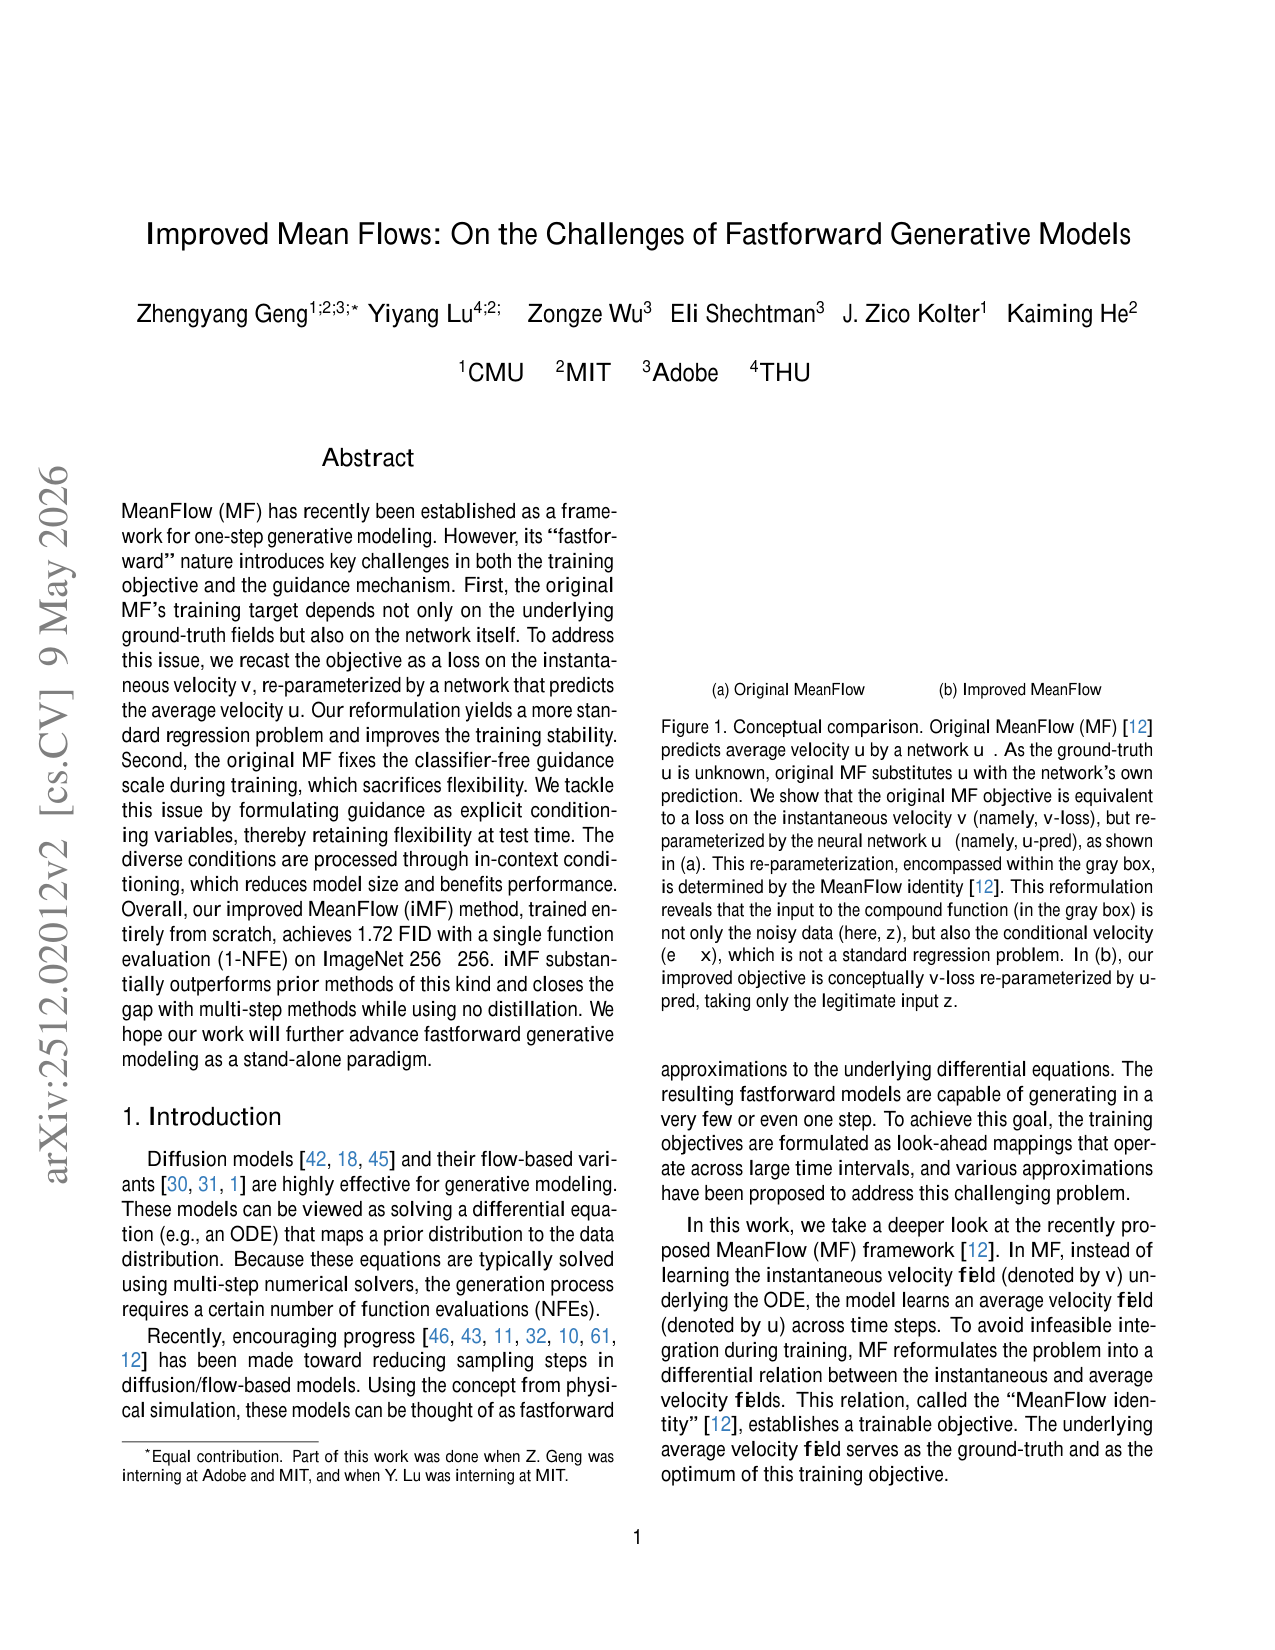
cover 生成模型理论 / one-step 生成(fastforward generative models)
2026-05-09(v2;v1 于 2025-12 提交,arXiv 编号 2512.02012) · CMU / MIT / Adobe / 清华大学(THU)

Improved Mean Flows: On the Challenges of Fastforward Generative Models

把 MeanFlow 的两处『欠可用』问题修掉:训练目标从网络依赖的 u-loss 改成对瞬时速度 v 回归、由 u 网络 re-parameterization 的 v-loss,CFG 从训练期固定 scale 改成可推理期调节的条件变量,并配套多 token in-context conditioning,使从零训练的 one-step 模型在 ImageNet 256×256 上拿到 1-NFE FID 1.72(相对原 MF 的 3.43 下降 50%),是 fastforward 范式『可用化』的样板。

读全文 →
MeanFlowone-step generationflow matching
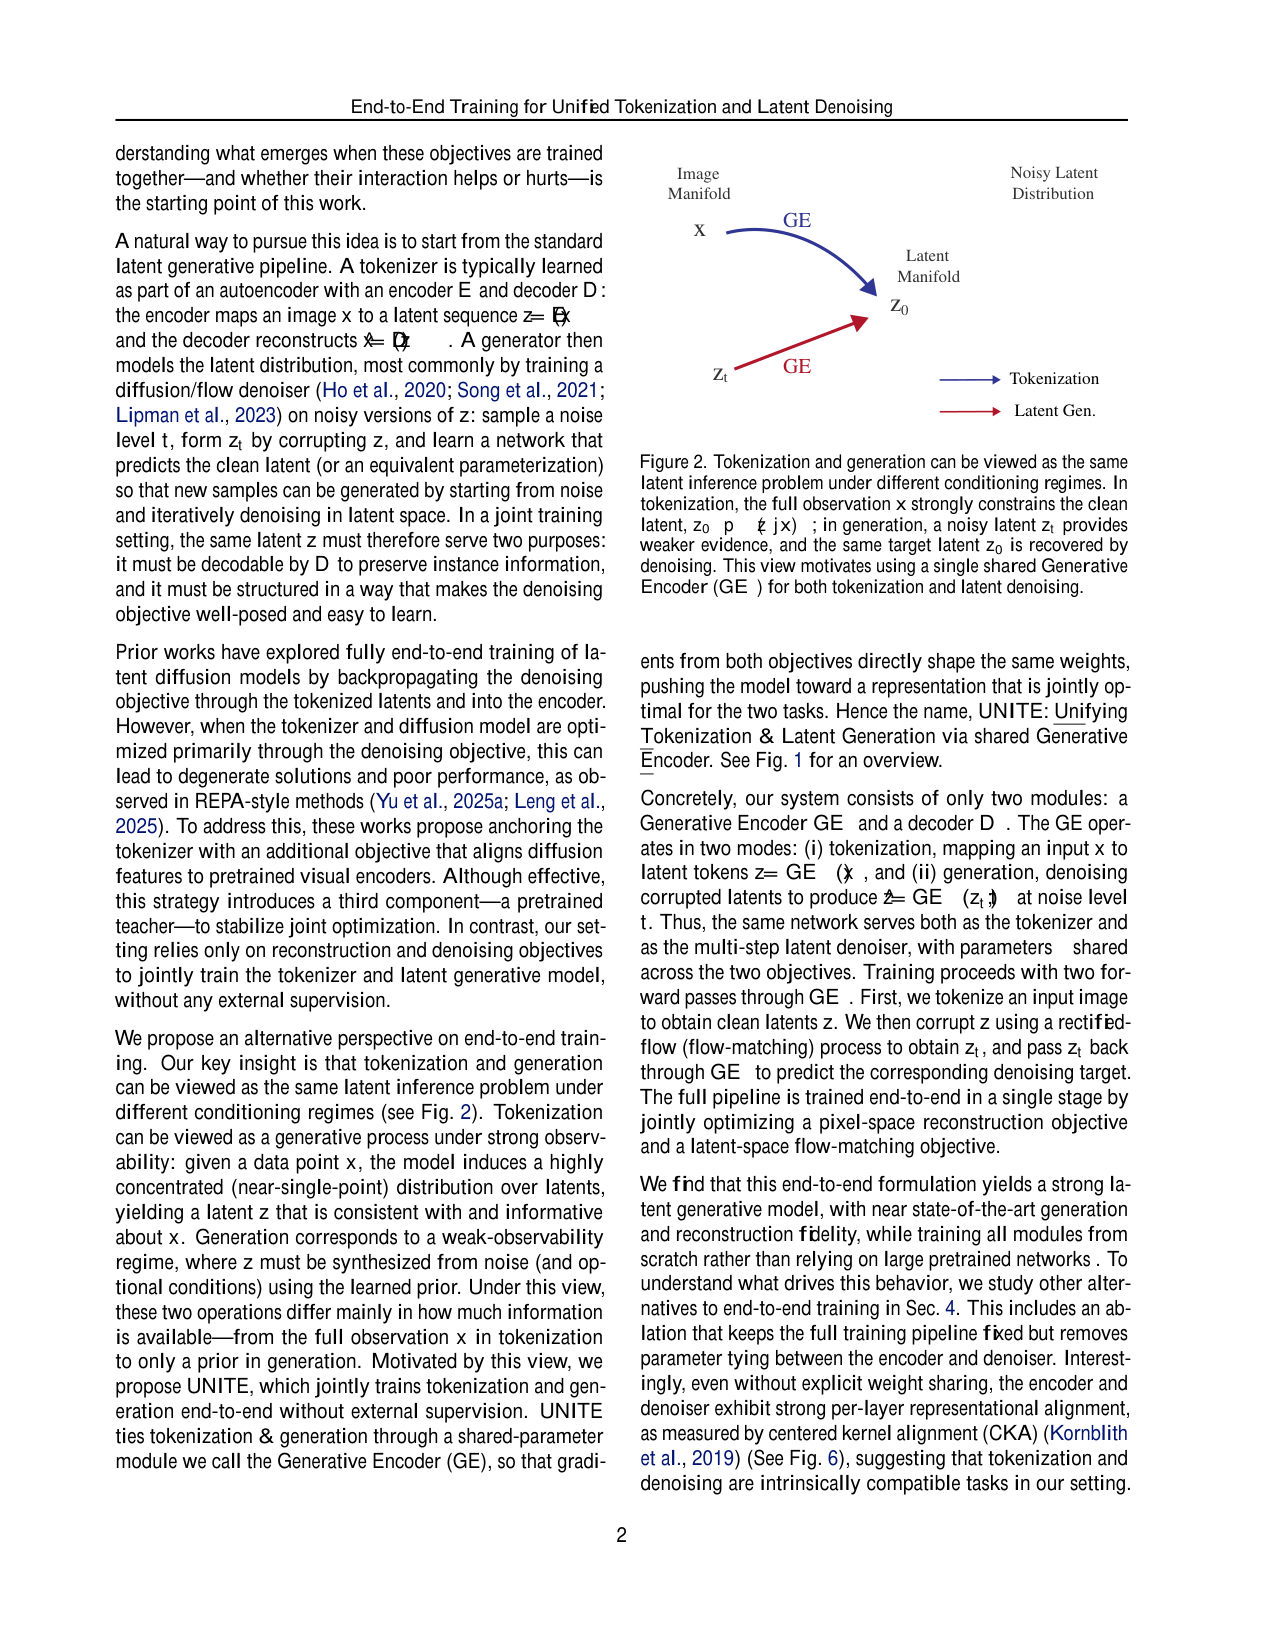
cover 生成模型理论(tokenizer + latent denoising 统一 / 表示来源)
2026-03-23 · MIT(Duggal, Bai, Torralba, Isola, Freeman)+ Adobe(Wu, Zhang, Shechtman)

End-to-End Training for Unified Tokenization and Latent Denoising (UNITE)

把 tokenizer 和 latent 去噪器合并成一个权重共享的 Generative Encoder,单阶段从零联合训练重建与 flow-matching 目标:ImageNet 256×256 上 UNITE-B 生成 FID 2.12(对照单阶段 JiT-B/16 3.66、两阶段 DiT-XL/2 2.27),重建 rFID 1.01(对照无对抗 ViTok-B/16 1.63),全程不需要 DINOv2 等外部预训练编码器——为『表示从哪来』提供一个现代答案:表示由重建压力与生成压力在同一网络里共同塑造。

读全文 →
latent diffusiontokenizationflow matching
cover physics simulation / geometric pre-training / neural operators / world model
2026-02-19(v1;v2 2026-05-20) · MIT CSAIL(Wu、Guo 共同一作;Long 来自清华)

GeoPT: Scaling Physics Simulation via Lifted Geometric Pre-Training

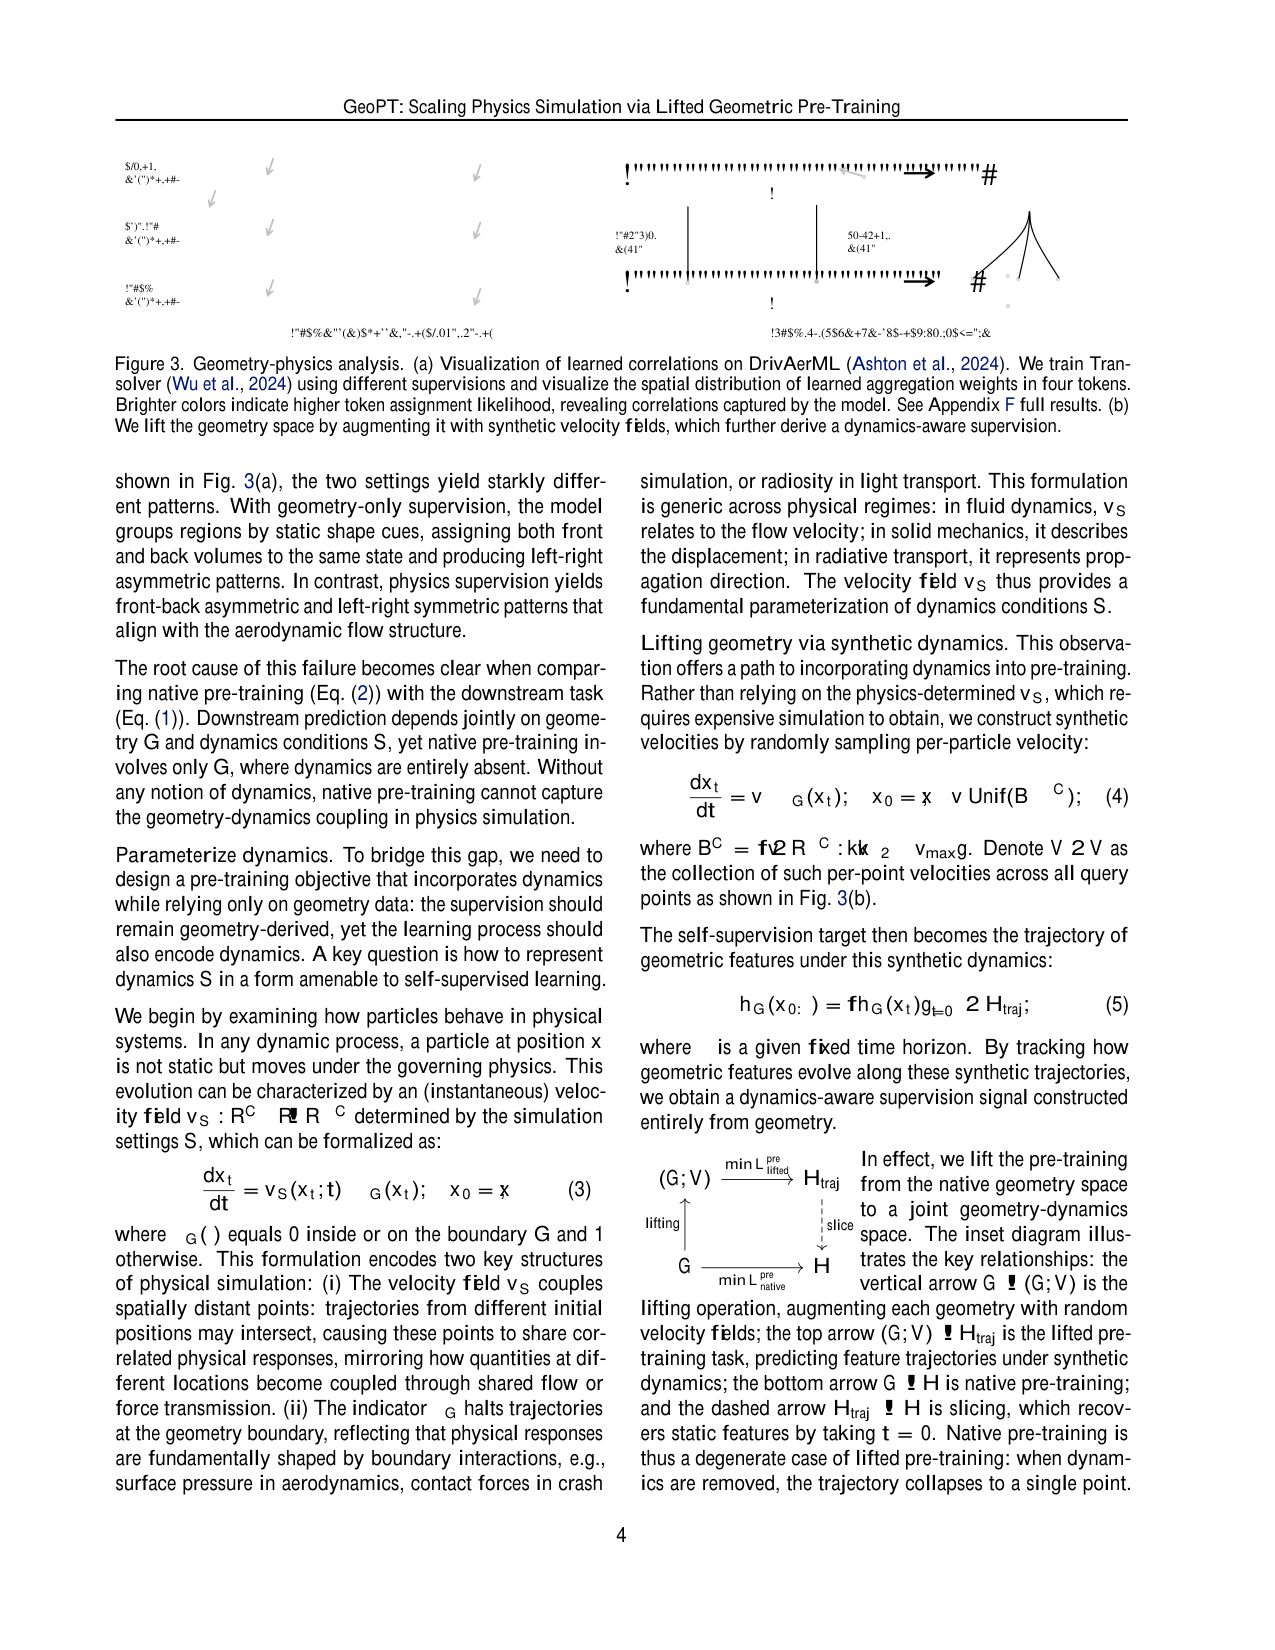
神经模拟器一直靠数值求解器生成标注(DrivAerML 单样本约 6.1×10^4 CPU 小时),而纯几何自监督(预测 SDF/向量距离)在物理任务上反而负迁移。GeoPT 把每个几何配上一组随机速度场和边界粘滞轨迹,用「几何特征沿合成动力学轨迹的演化」做自监督,把预训练空间从静态几何提升到几何-动力学联合空间;在 ShapeNet 三个子集 1.35 万个几何上生成 134.6 万条免求解器样本(约 5TB),预训练 Transolver 主干,在汽车/飞机空气动力学、船舶水动力、碰撞五个工业级 benchmark 上减少 20–60% 标注数据、收敛最高加速 2×,并能迁移到没见过的辐射度(radiosity)模拟。

读全文 →
physics simulationgeometric pre-trainingself-supervised learning
cover 视频生成 / 自回归视频扩散 / 因果建模与高效推理
2026-02-10(v1) · MIT(第一作者在 Adobe Research 实习期间完成)/ Adobe Research / Morpheus AI

Causality in Video Diffusers is Separable from Denoising

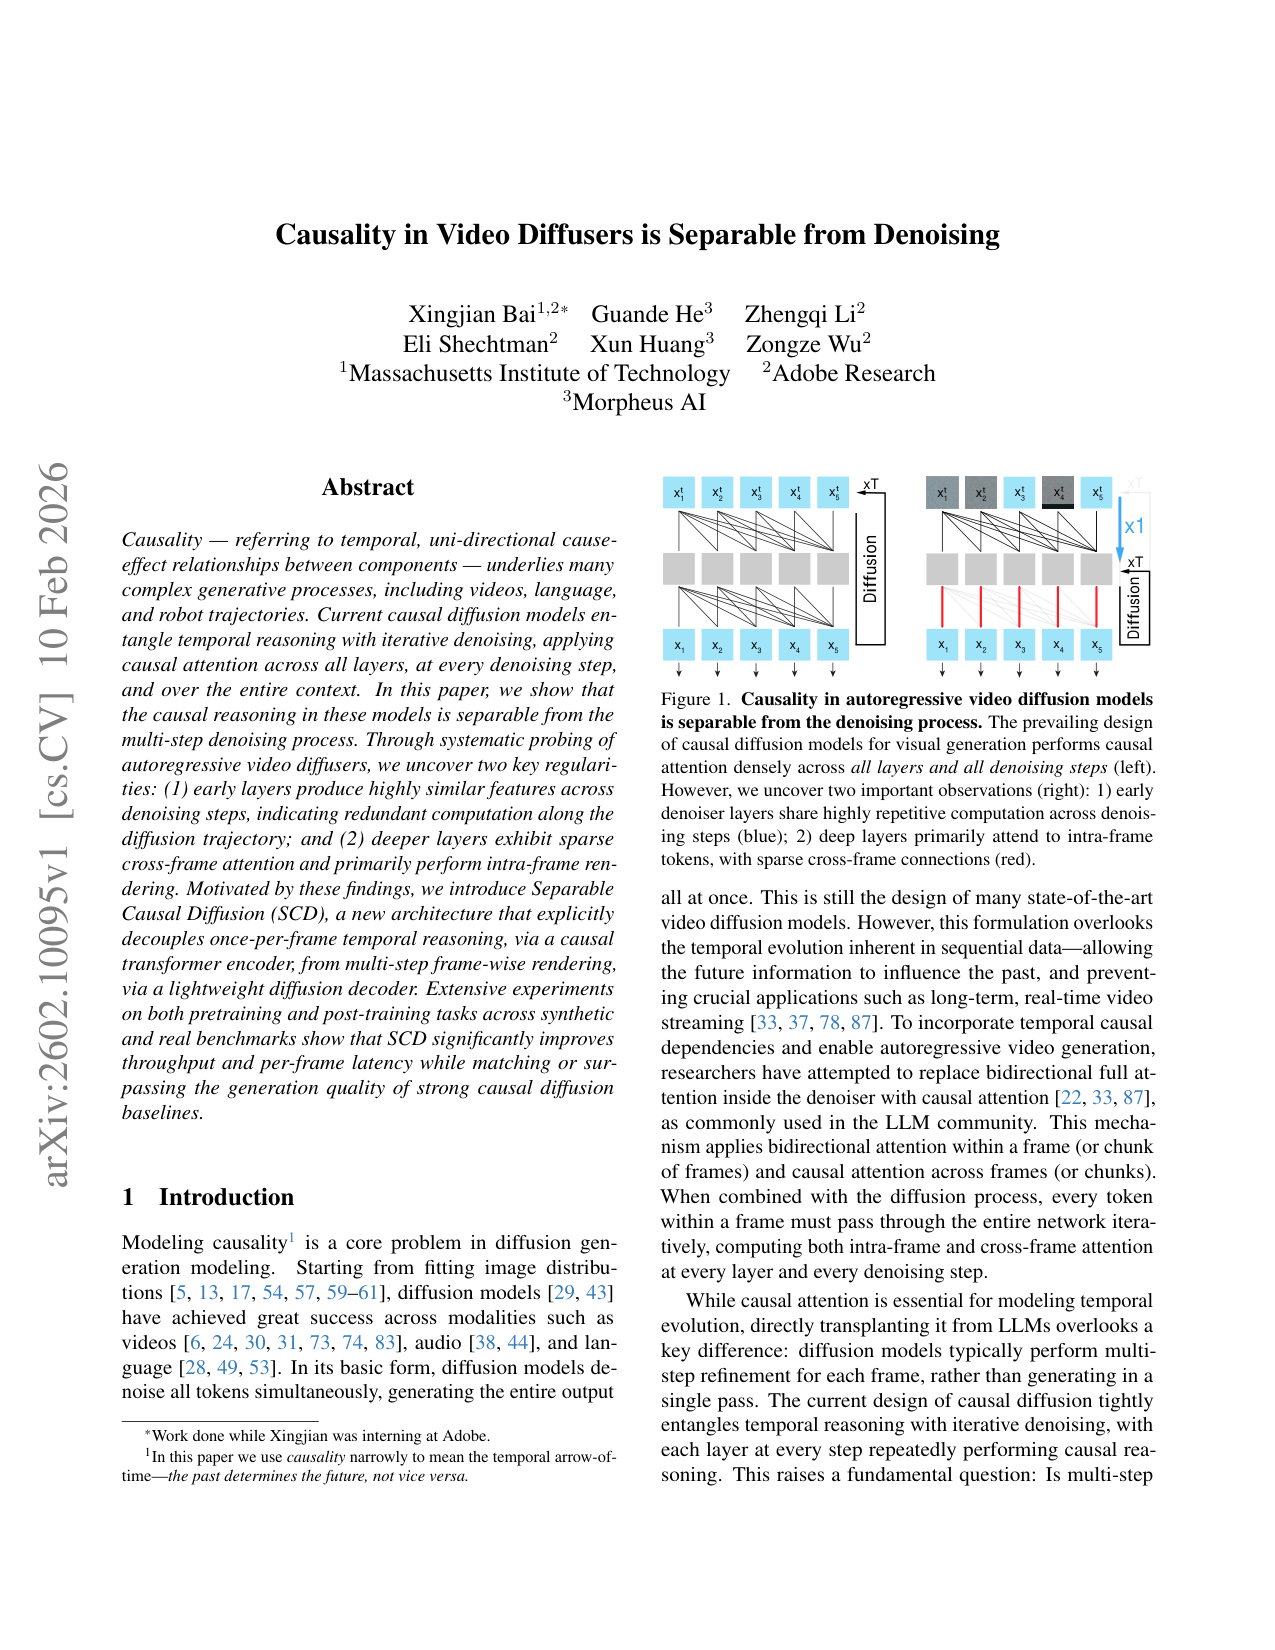
通过探针实验证明自回归视频扩散模型中「时间因果推理」与「多步去噪」可分离:早中层特征跨去噪步高度冗余(WAN-2.1 T2V-1.3B 第 15/30 层特征跨 50 步余弦相似度 >0.95)、深层跨帧注意力稀疏;据此提出 Separable Causal Diffusion(SCD),用每帧只跑一次的因果 transformer 编码器 + 轻量逐帧扩散解码器,从零训练在 TECO-Minecraft 上 FVD 37.6(基线 Causal DiT-M 38.7)且单帧延迟 0.52s vs 2.4s(约 4.6×),微调 WAN 2.1 后 VBench 总分 84.03(Self Forcing 84.26)且吞吐 11.1 vs 8.9 FPS,为长时程 world model 提供可独立调节的推理成本杠杆。

读全文 →
video diffusionautoregressivecausal attention
cover 生成模型理论 / 像素空间扩散
2026-01-07 · MIT

Back to Basics: Let Denoising Generative Models Denoise (JiT)

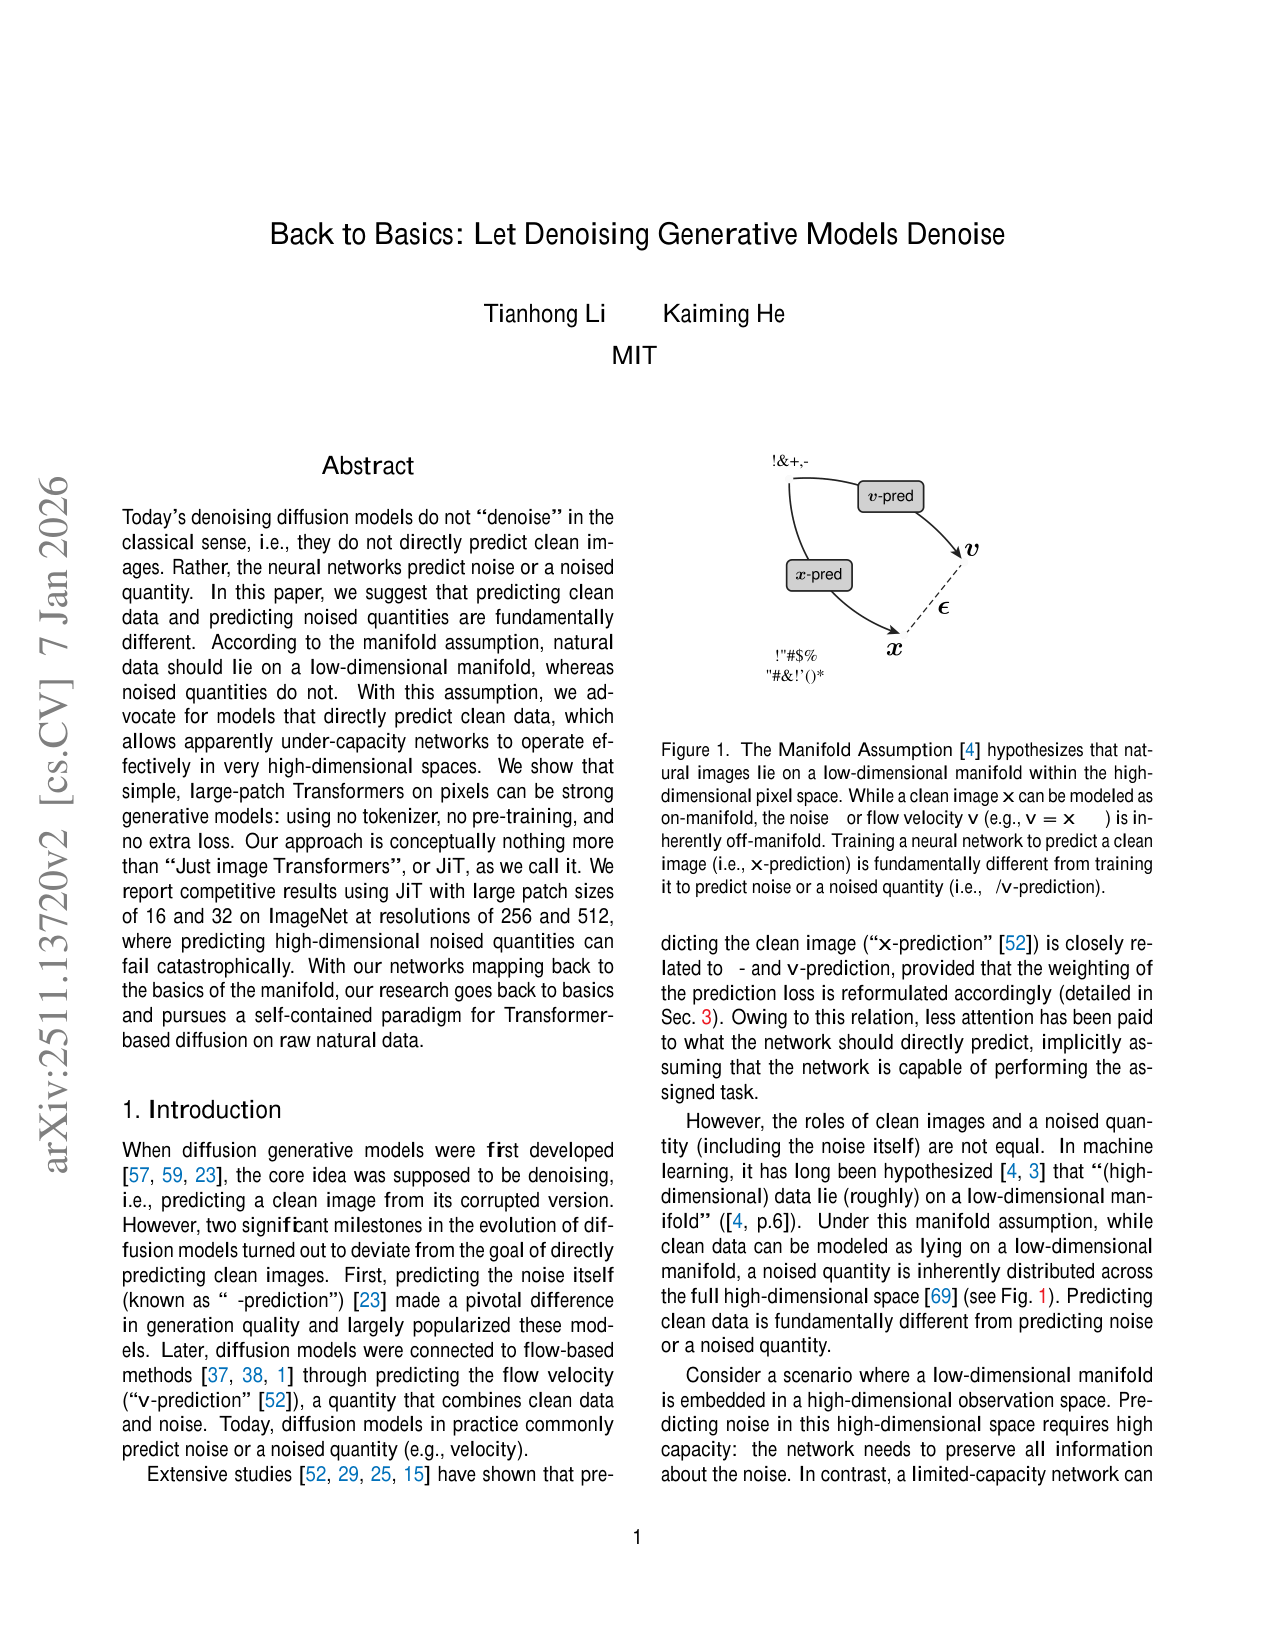
这篇论文主张:扩散与流模型的网络应当直接预测干净图像 x——它落在低维数据流形上;预测噪声 ε 或速度 v 会让欠容量网络在极高维像素 patch 上灾难性失败。基于这一观点,只用没有 tokenizer、没有预训练、没有附加损失的普通大 patch ViT,就能在原始像素上做出有竞争力的生成,并与 MeanFlow 在「网络输出应指向数据均值型量」的表示哲学上互补。

读全文 →
diffusionflow matchingx-prediction
cover neural scaling laws / 表征叠加理论
2025-11-29(arXiv v4;2025-05 首发) · MIT(Yizhou Liu、Ziming Liu、Jeff Gore,Physics of Living Systems 方向)

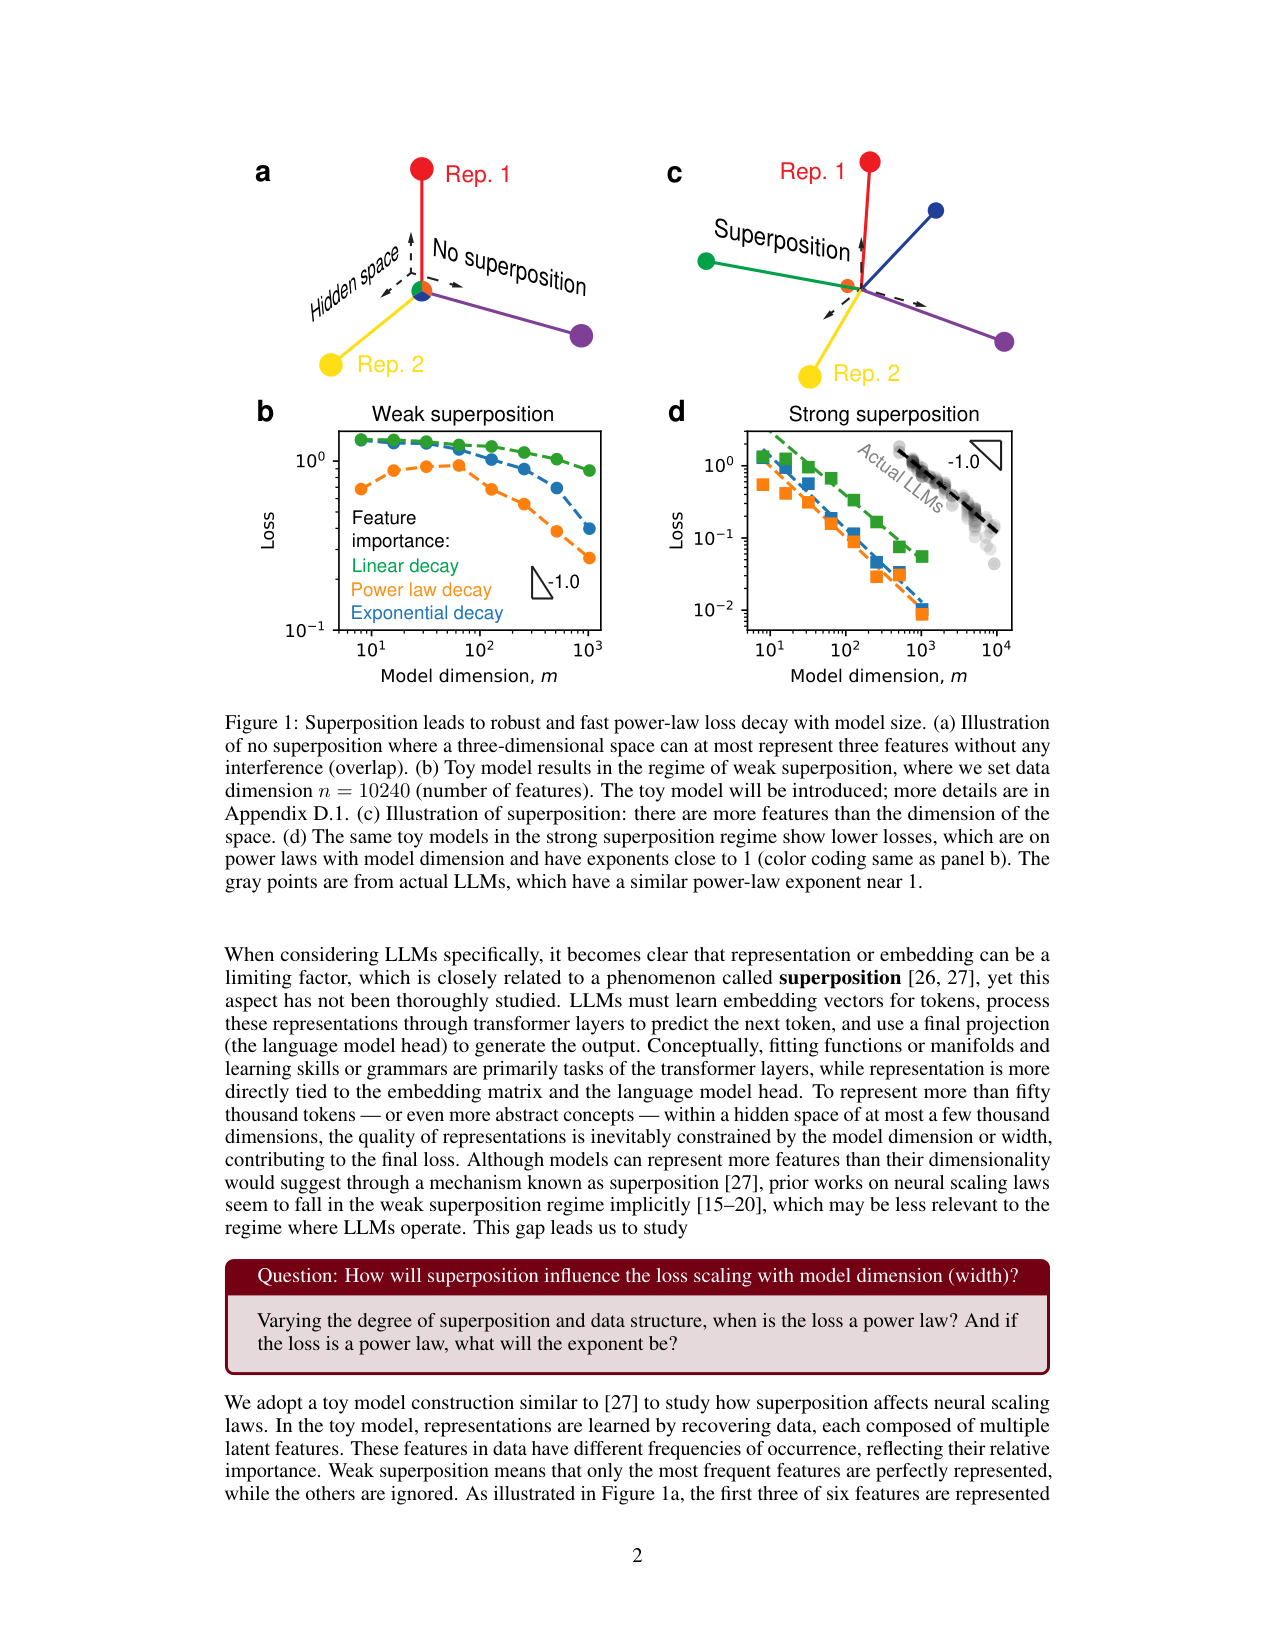
Superposition Yields Robust Neural Scaling

用 Anthropic 的 superposition 玩具模型研究『损失随模型宽度 m 的标度』:弱叠加时损失 ≈ 被忽略特征的总频率,只有特征频率是幂律才得到幂律损失(指数 α_m ≈ α−1);强叠加时损失来自表征向量间的几何干扰,平方重叠按 1/m 下降,损失稳健地按 1/m 标度(α_m≈1),对频率分布几乎不敏感。把 token 当原子特征分析 OPT/GPT-2/Qwen2.5/Pythia 的 LM head,实测平方重叠 ~1/m、损失指数 α_m=0.91±0.04,与 Chinchilla 换算的 0.88±0.06 一致,说明 LLM 运行在强叠加区,叠加是神经标度律的一个重要来源。

读全文 →
neural scaling lawssuperpositionrepresentation learning
cover 生成模型理论(离散扩散 / 扩散语言模型)
2025-10-08 · MIT(Dinghuai Zhang:Microsoft Research 与 Mila)

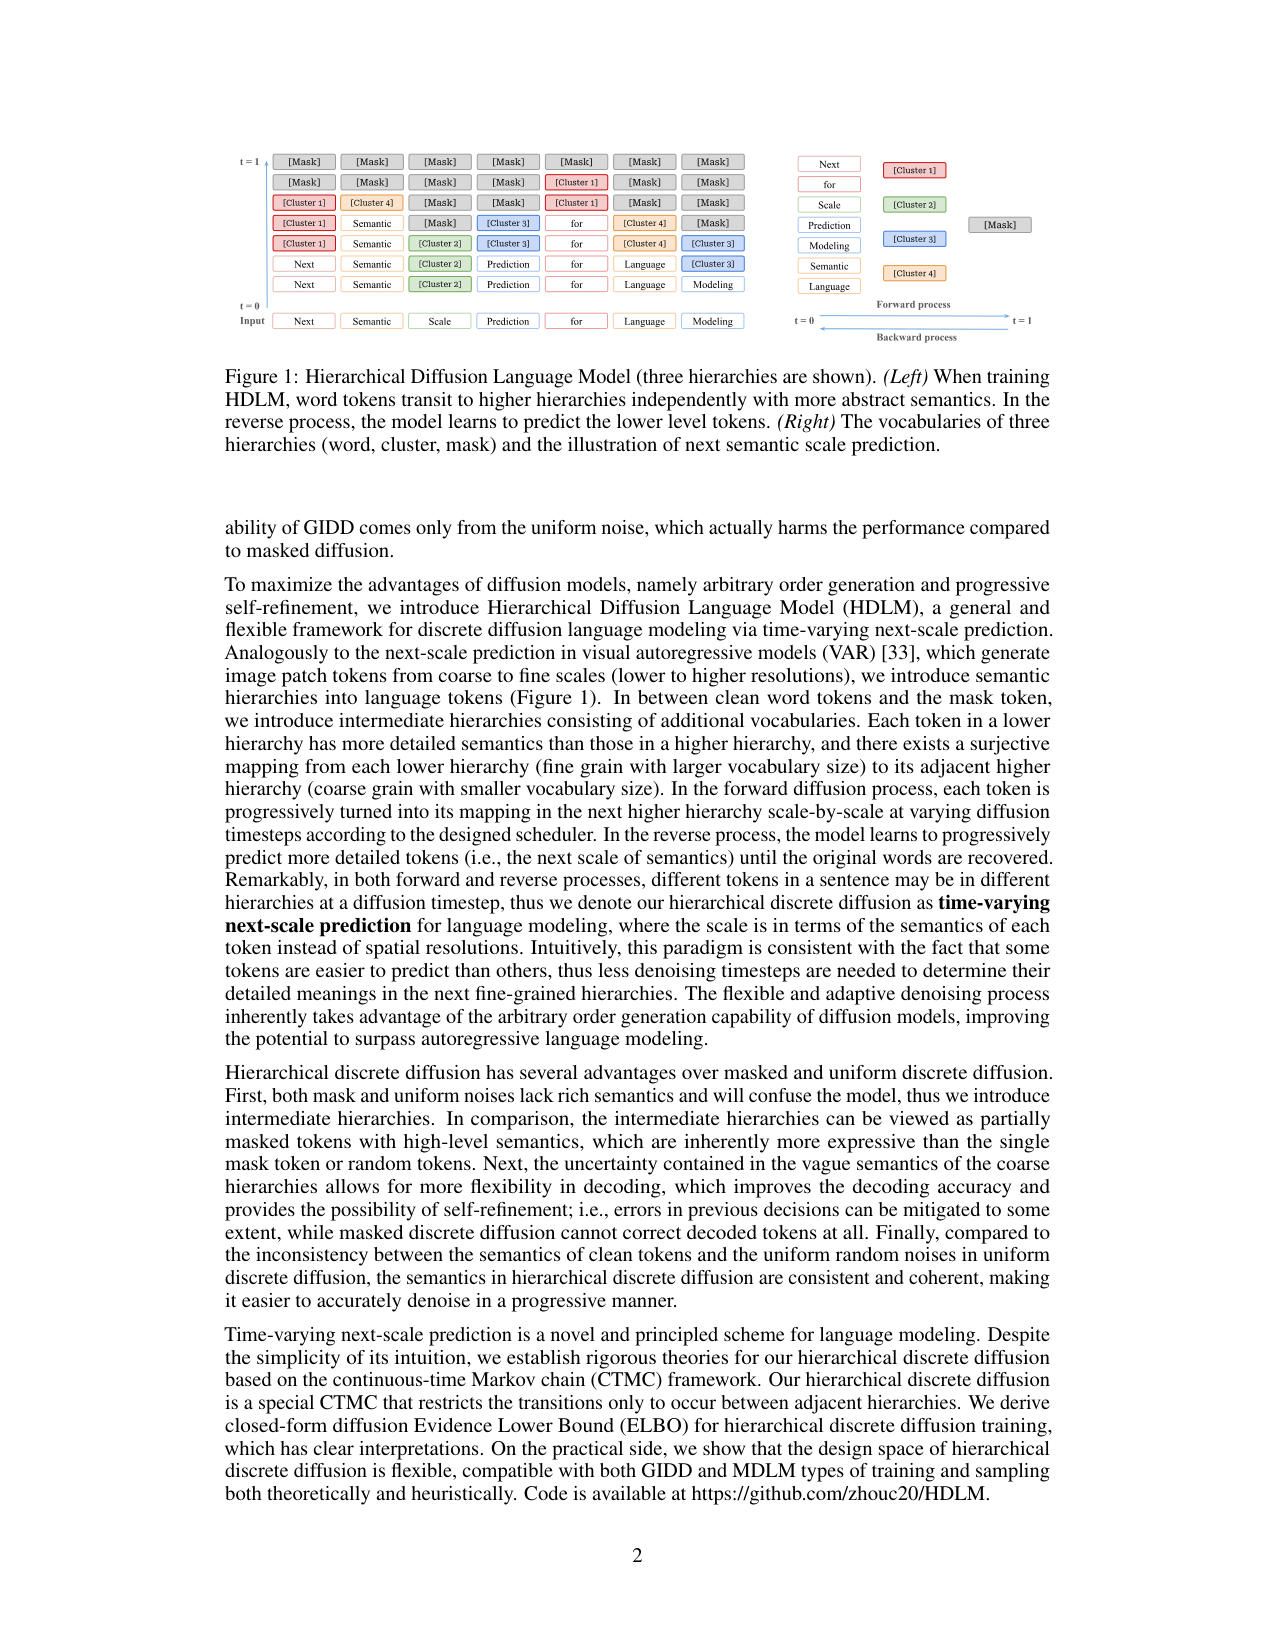
Next Semantic Scale Prediction via Hierarchical Diffusion Language Models (HDLM)

在词 token 与 mask 之间插入『语义簇』这一中间层级:前向把词逐级粗化成簇、再粗化成 mask,反向按语义粒度从粗到细逐级恢复,得到时间上变化的 next semantic scale prediction;闭式 ELBO 证明下,MDLM 只是 HDLM 取一个簇的特例。

读全文 →
离散扩散扩散语言模型层级语义
cover Action World Model(融合路线:动作+图像统一自回归)
2025-06-26 · DAMO Academy(阿里巴巴集团)+ 湖畔实验室 + 浙江大学

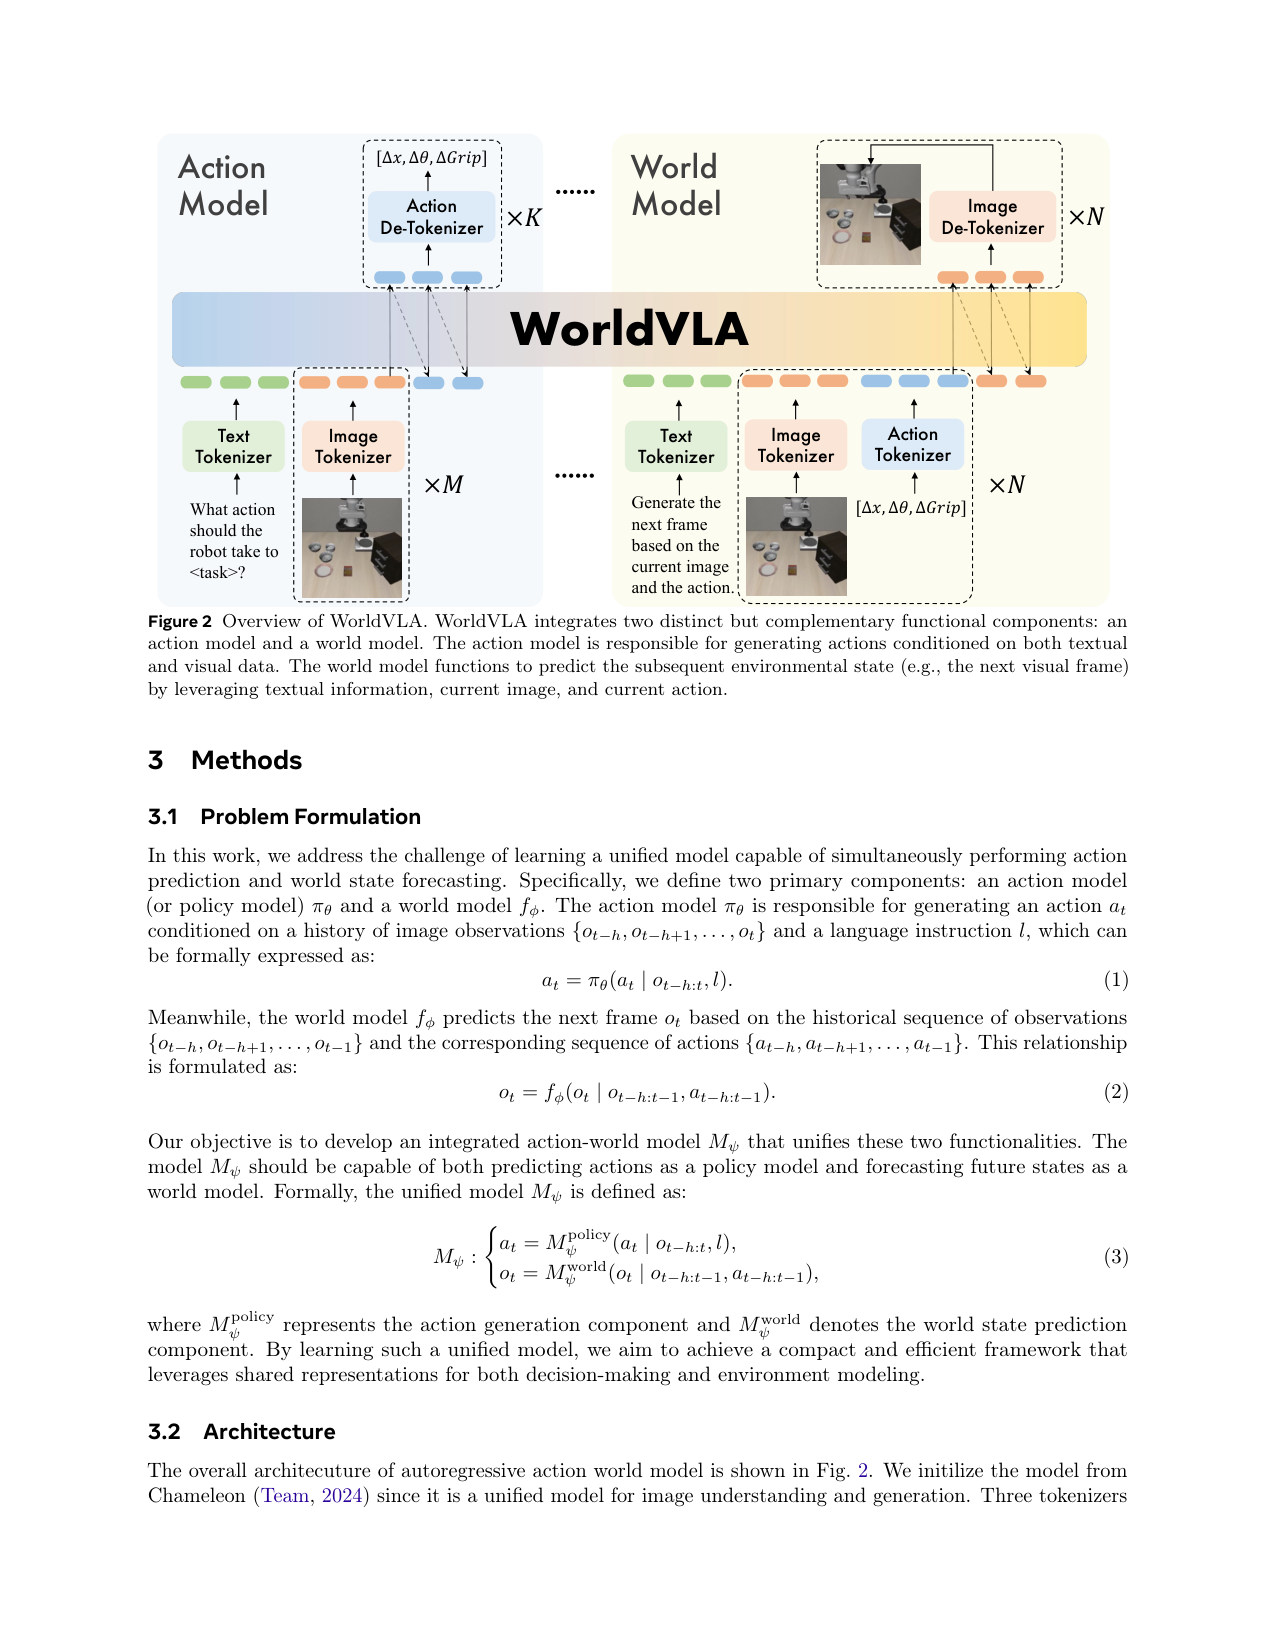
WorldVLA: Towards Autoregressive Action World Model

用一个从 Chameleon 初始化的自回归 transformer,把 VLA 的动作生成和世界模型的未来帧预测并进同一套离散 token 序列:动作既当输出也当世界模型的输入,未来帧预测反过来给动作决策提供物理理解,两边在同一词表、同一主干上互相增强。

读全文 →
world modelVLAautoregressive
cover 世界模型 / 自监督视频预训练 / 机器人 MPC 规划
2025-06-11(v1) · Meta FAIR(FAIR at Meta,前 17 位标注 Core Team)+ Mila / Polytechnique Montréal;Yann LeCun、Michael Rabbat、Nicolas Ballas 均在列

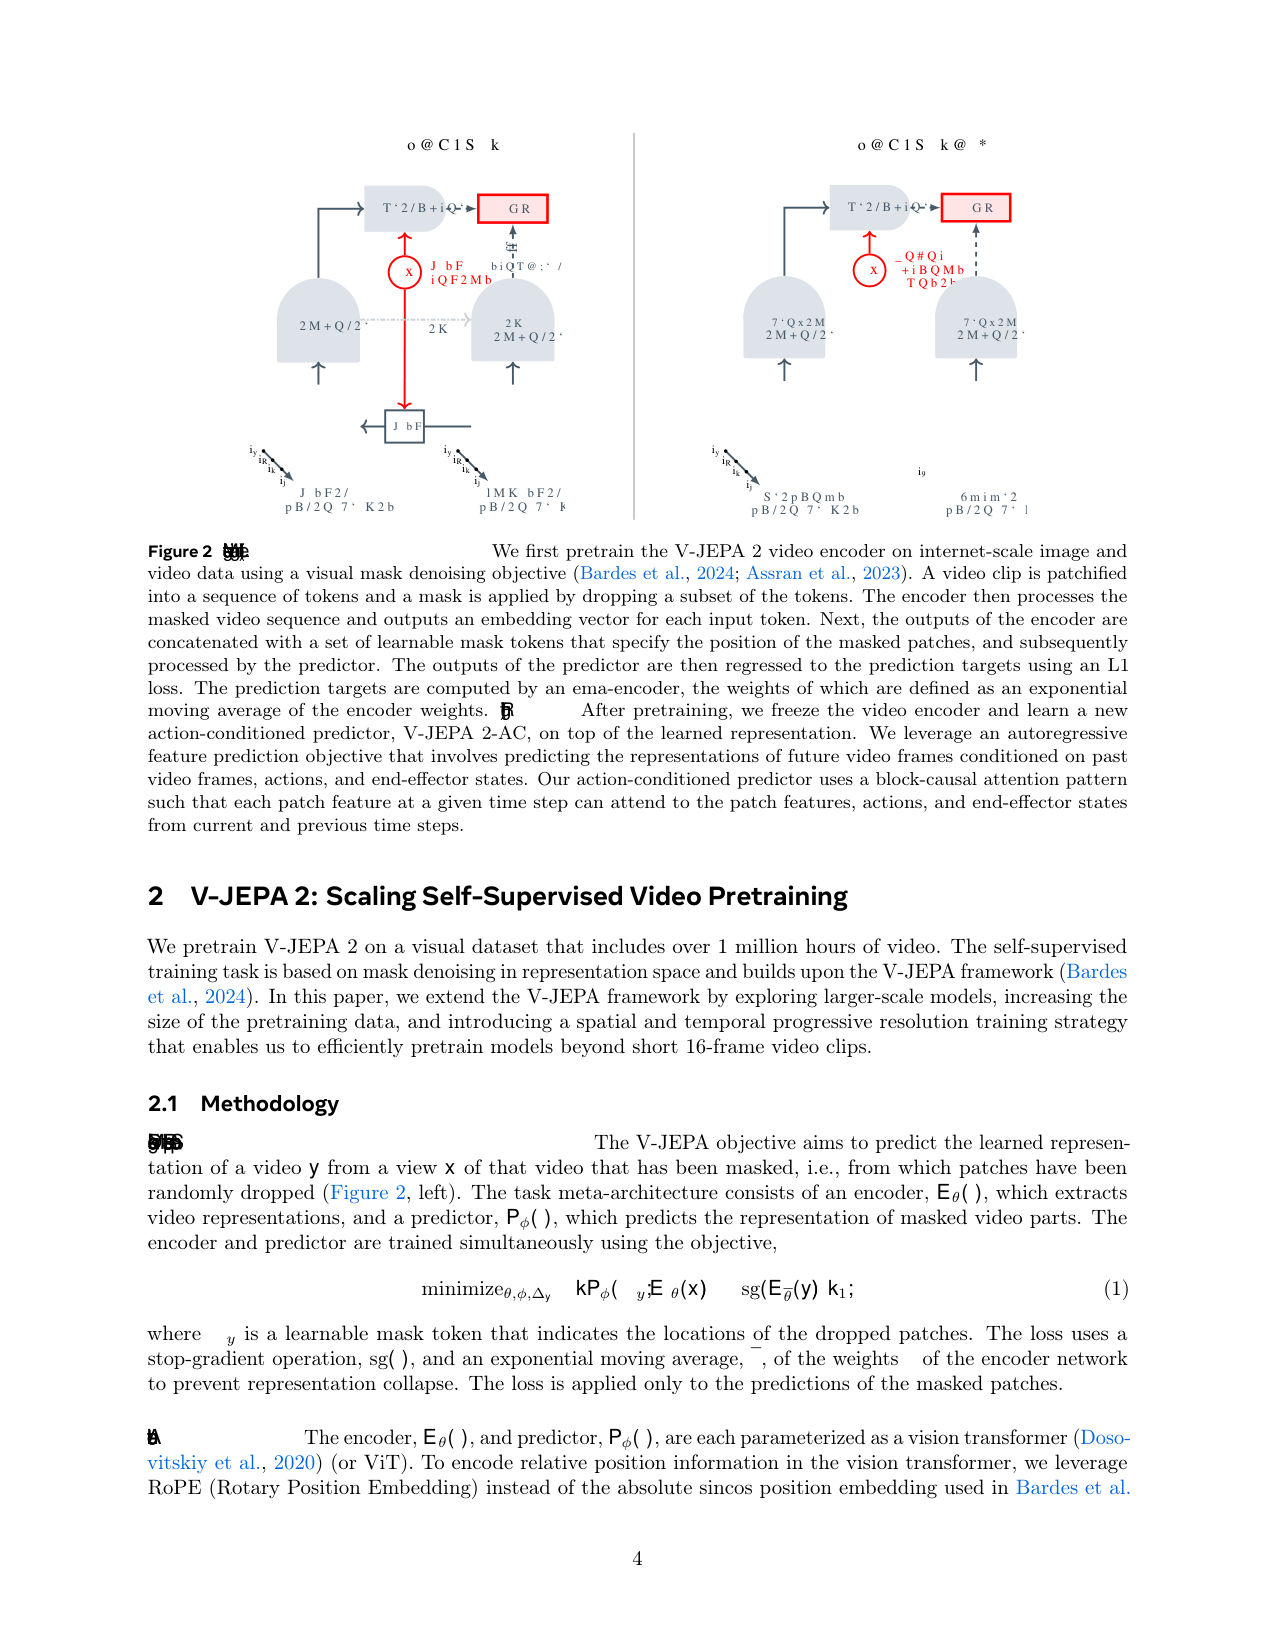
V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning

用超过 100 万小时互联网视频做动作无关的自监督预训练(掩码去噪的联合嵌入预测架构 JEPA),随后冻结编码器、用不到 62 小时无标注 Droid 机器人视频训练潜空间动作条件自回归世界模型 V-JEPA 2-AC,在模型预测控制闭环里用目标图像引导的规划完成零样本抓取与抓放;同一编码器在动作理解(SSv2 77.3%)、动作预测(EK100 recall@5 39.7)与视频问答(PerceptionTest 84.0)上也达到当时最强水平。

读全文 →
自监督学习世界模型视频预训练
cover one-step generation / flow matching theory
2025-05-19 · CMU(Geng、Kolter)/ MIT(Deng、Bai、He;Geng 访学 MIT 期间参与)

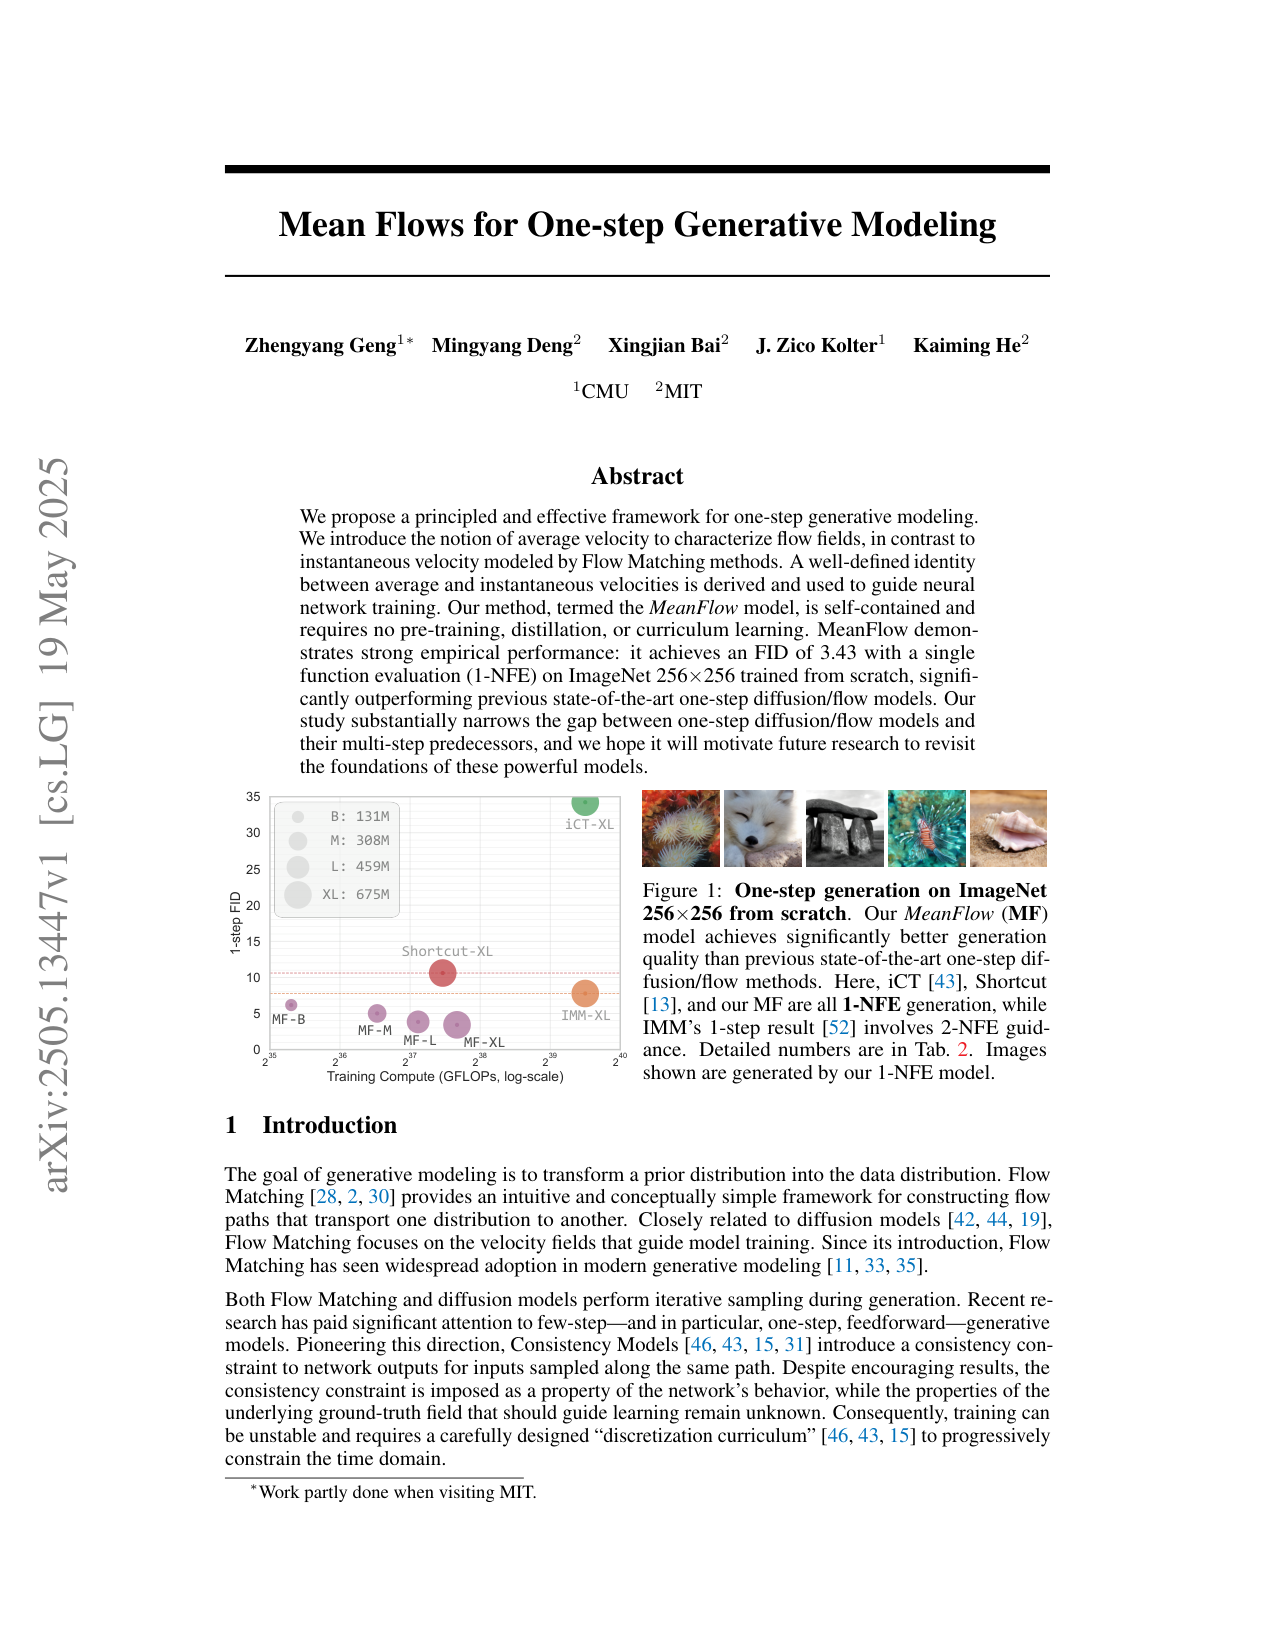
Mean Flows for One-step Generative Modeling

给 Flow Matching 换一个训练目标:不学瞬时速度 v,改学一段区间 [r,t] 上的平均速度 u;从平均速度的定义出发推导出 MeanFlow Identity (u = v − (t−r)du/dt),训练时用一次 JVP 实现该恒等式、采样时一步到位 x0 = x1 − u(x1,0,1)。ImageNet 256×256 上 1-NFE FID 3.43(XL/2,240 epoch 从零训练,CFG 内建),相比上一代单步方法 Shortcut-XL 的 10.60 提升约 68%,全程无需预训练、蒸馏或课程学习。

读全文 →
flow matchingone-step generationaverage velocity
cover benchmark / evaluation / physics reasoning / LLM
2025-04(v1);2025-05-18(v2) · 北京大学物理学院(Shi Qiu / Shaoyang Guo / Zhuo-Yang Song / Yunbo Sun / Zeyu Cai / Jiashen Wei / Tianyu Luo 共同一作;Hua Xing Zhu / Qing-Hong Cao / Muhan Zhang / Yaodong Yang / Ming-xing Luo 等 PI)+ 北京计算科学研究中心 + 北大集成电路学院 + 元培学院

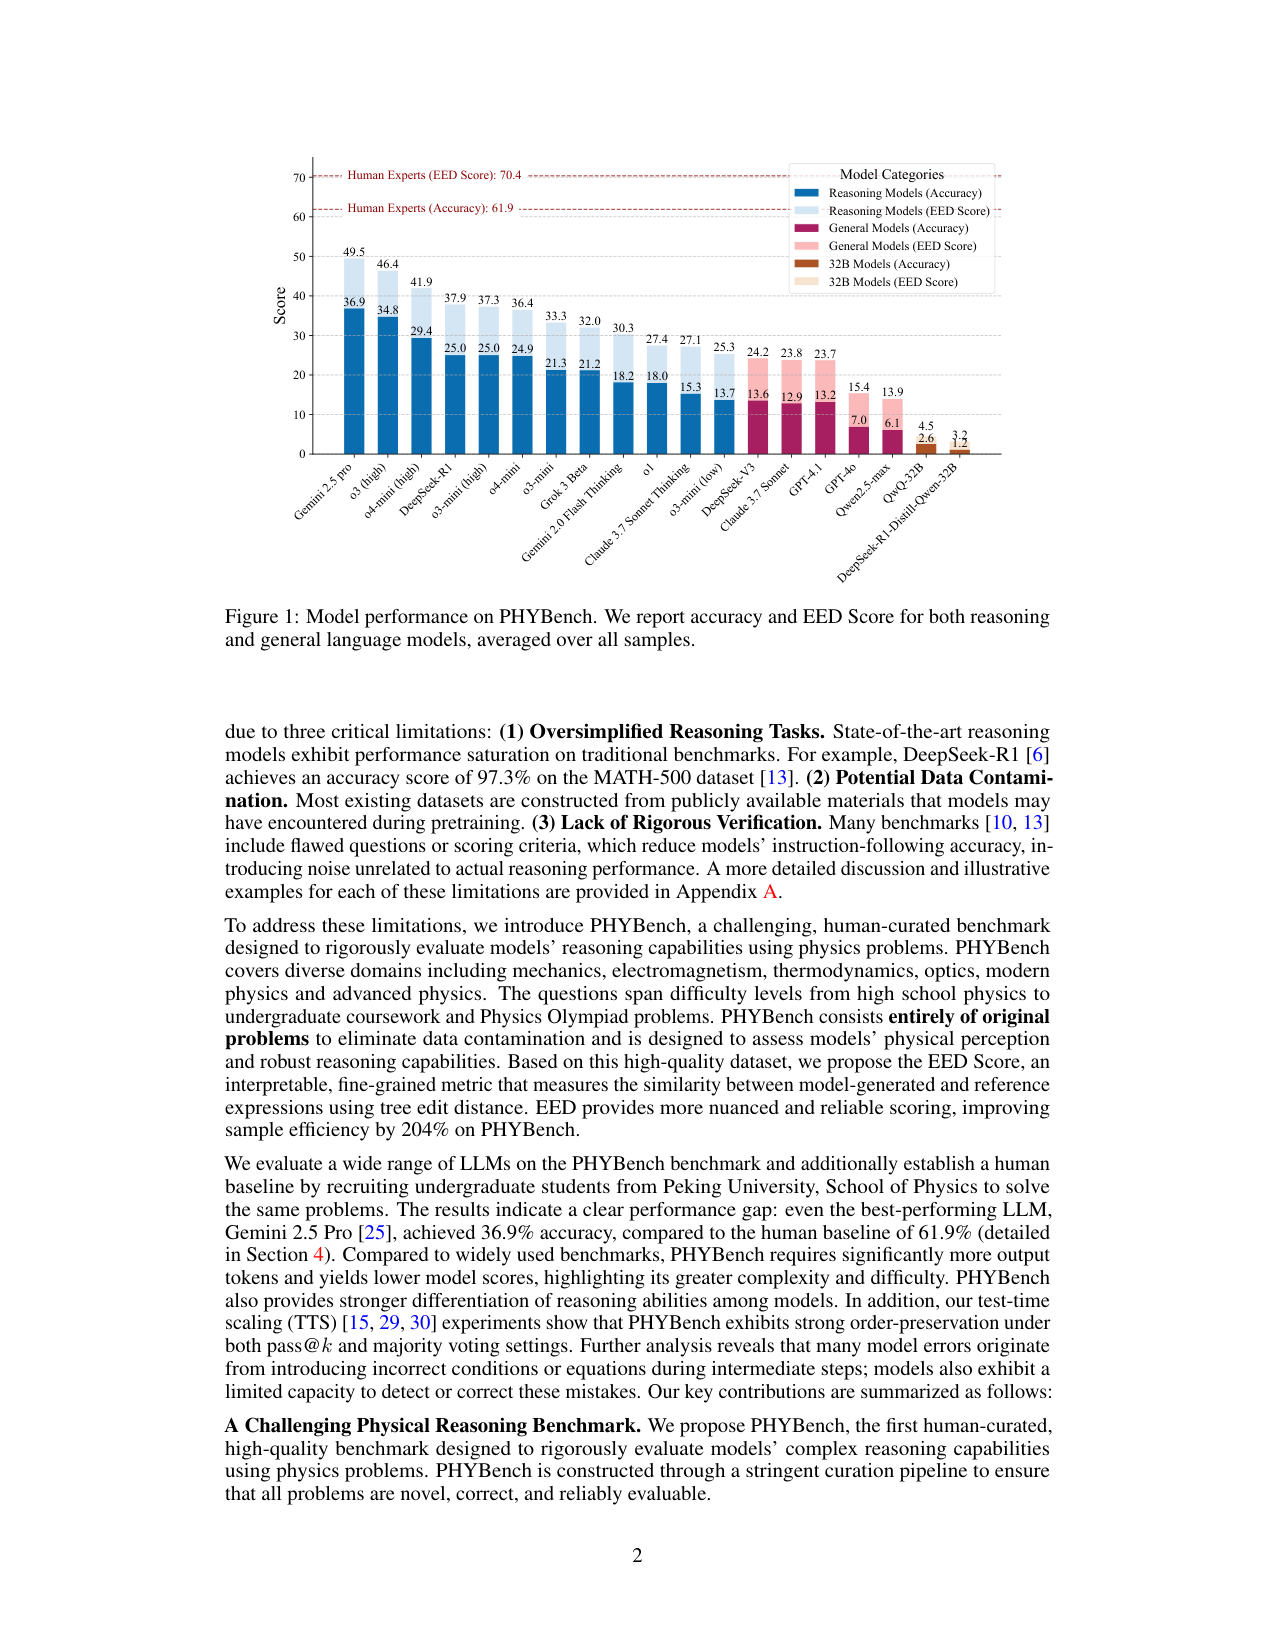
PHYBench: Holistic Evaluation of Physical Perception and Reasoning in Large Language Models

现有推理评测基准被三个问题拖累:任务过于简单导致模型饱和、题目来自公开材料导致数据污染、评测项本身有缺陷。PHYBench 由北大物理学院牵头,用 178 名学生出题、81 名学生(其中 50 人是物理奥赛金牌)人工验收,产出 500 道纯文本原创物理题(高中到奥赛难度、答案必须是符号表达式),配合 EED 树编辑距离评分给部分分:500 题按 EED 评分的区分力相当于约 1500 题按二元评分。实测最好的 Gemini 2.5 Pro 精度 36.9%,远低于人类基线 61.9%;错误分析显示模型九成以上的第一步错误发生在语义推理阶段,且多数模型靠量纲分析这类符号检查掩盖理解缺陷。

读全文 →
physics benchmarkLLM evaluationreasoning
cover 物理推理 / 哈密顿神经网络(块级离散哈密顿量 × 去噪)
2025-03-10 · MIT / Stanford / Harvard-Smithsonian CfA / Universidad de Buenos Aires / Northeastern University

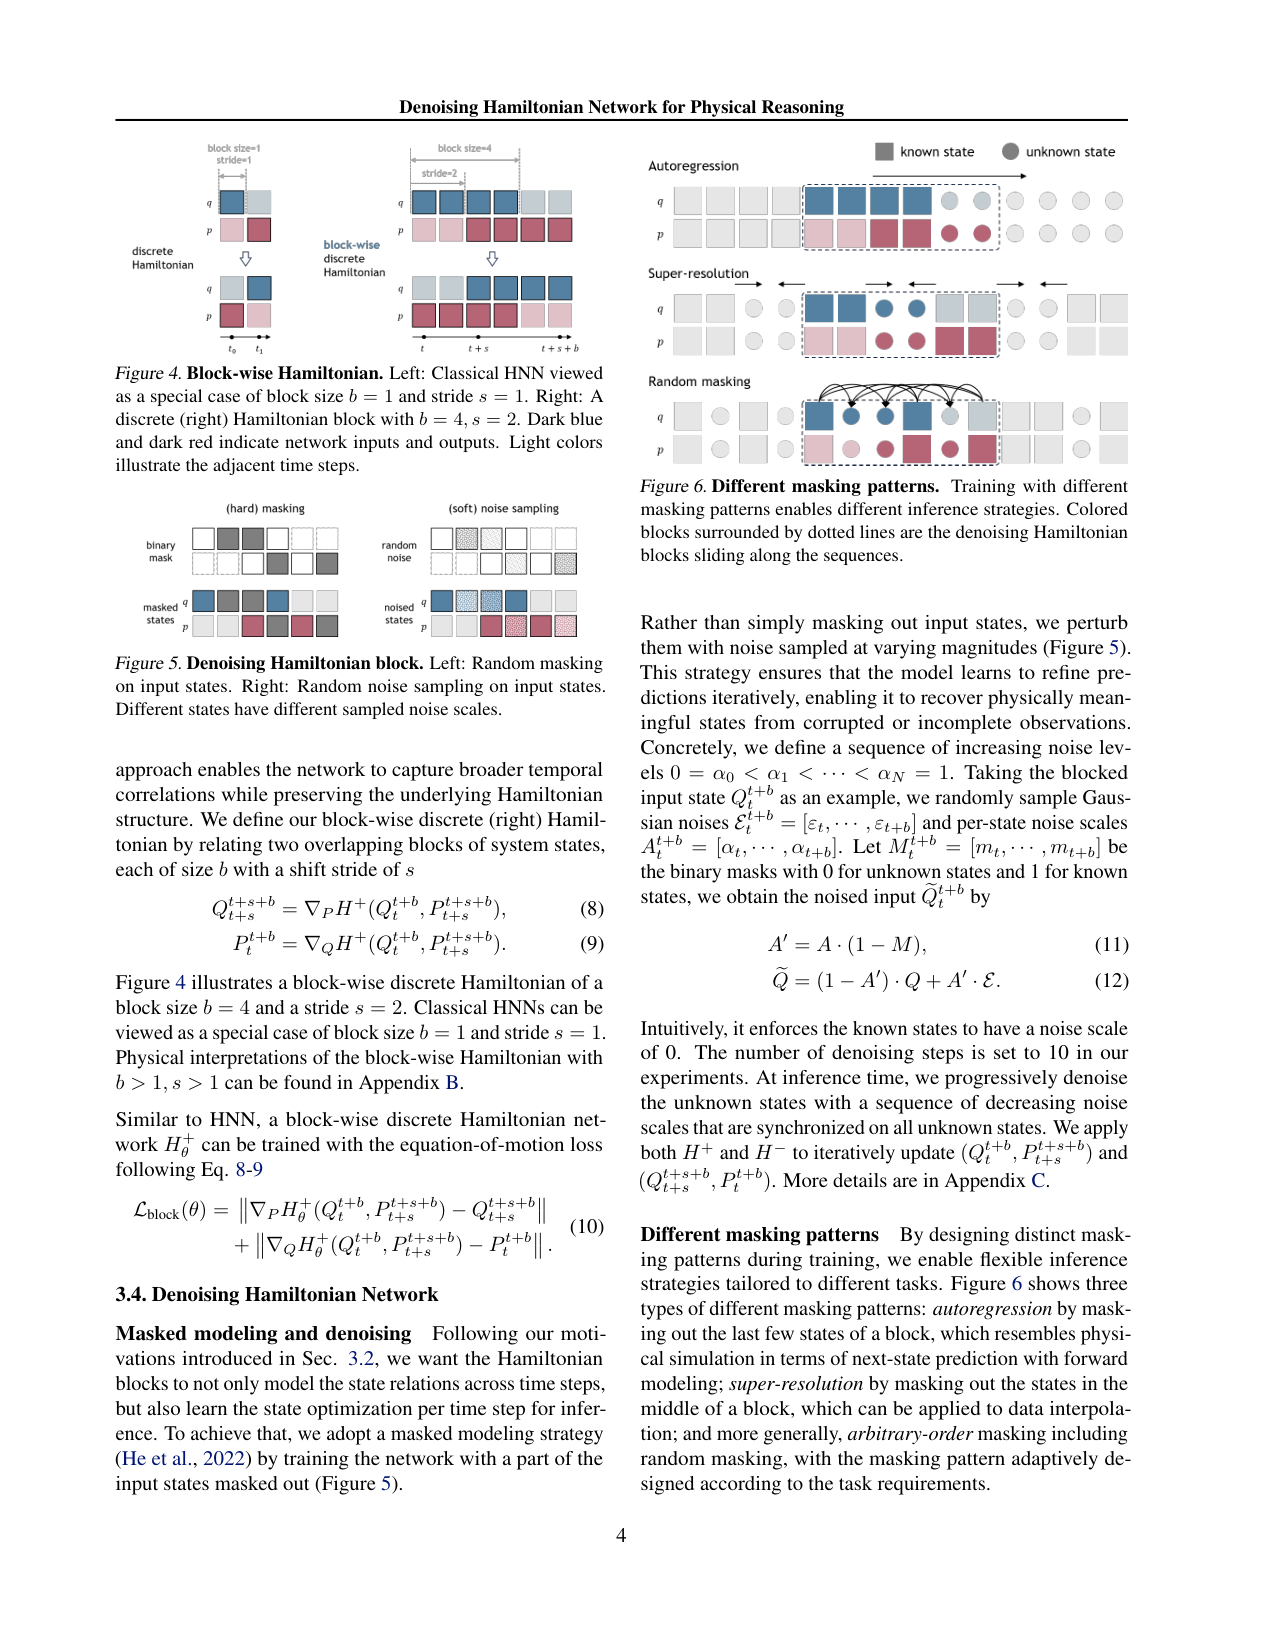
Denoising Hamiltonian Network for Physical Reasoning

把哈密顿力学算子化:用块级离散哈密顿量(一次处理 b 个时间步的状态块、步长 s)建立跨时间步的非局部物理关系,再用掩码加去噪(受 MAE 与扩散模型启发)把数值积分误差和隐式状态求解一起处理掉;一个两层 decoder-only transformer 加每轨迹可学习的 latent code,就同时覆盖前向模拟、轨迹补全、参数推断和超分插值四类物理推理任务。
读全文 →
Hamiltonian Neural Networkdenoisingmasked modeling
cover 生成模型(架构设计 / 逐像素图像生成)
2025-02-25 · MIT CSAIL(Li, Sun, He)+ Google DeepMind(Fan)

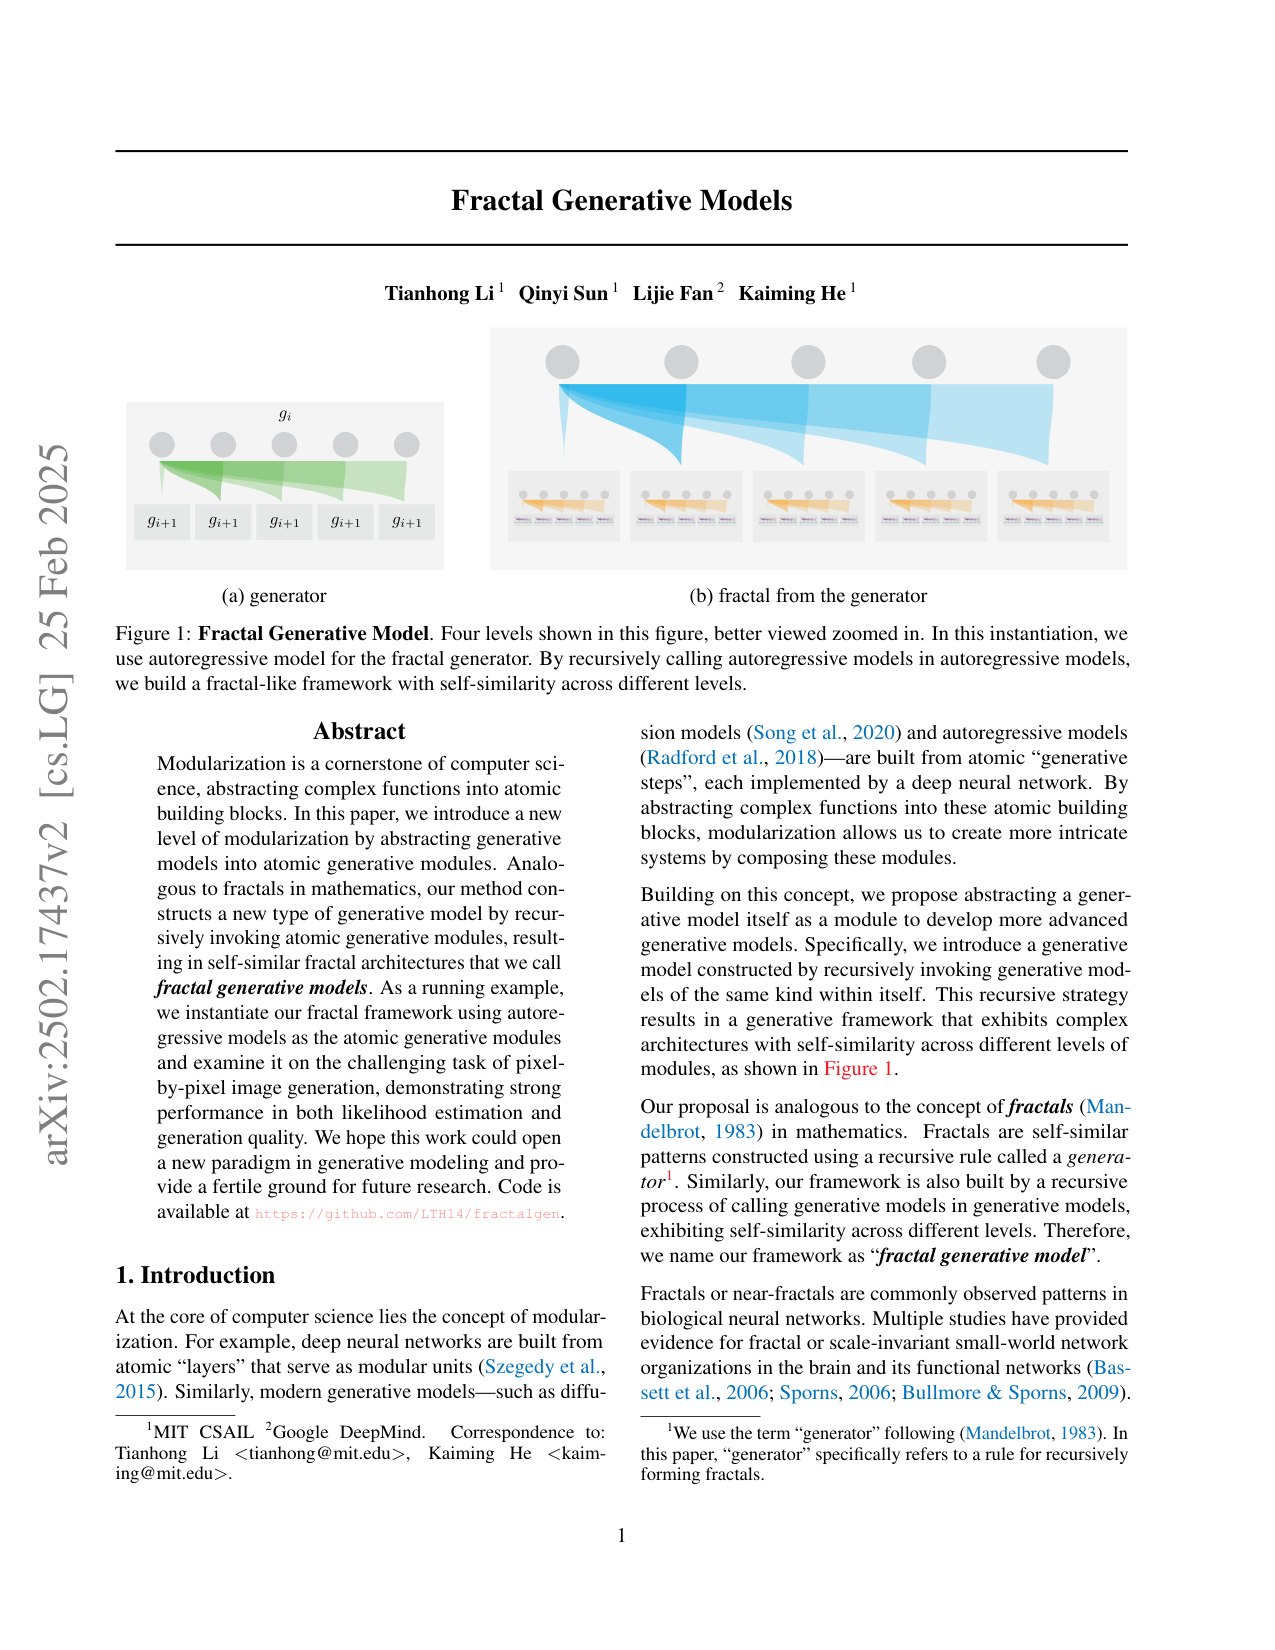
Fractal Generative Models(分形生成模型)

把「整个生成模型」当作原子模块,递归地在生成模型内部调用同类的生成模型,得到自相似的分形架构;用自回归模型实例化后,在 ImageNet 64×64 无条件下 NLL 3.14 bits/dim(对照此前最佳自回归 3.40),并首次把逐像素生成推进到 256×256 高分辨率(FractalMAR-H FID 6.15、IS 348.9,对照 VDM++ FID 2.12),核心机制是分治式联合分布分解带来的指数级输出扩展与局部化注意力。
读全文 →
fractalrecursive architectureautoregressive
cover 生态学 / 群落动力学 / 入侵生物学 / 随机矩阵理论 / 物理-生态交叉
2025-01-06(在线发表); 2025-03 正式刊出,Vol.9, pp.406-416 · MIT(Physics of Living Systems, Department of Physics; Department of Mechanical Engineering); CIRAD / PHIM Plant Health Institute, Univ Montpellier; Department of Physics, Technion

Collective dynamical regimes predict invasion success and impacts in microbial communities

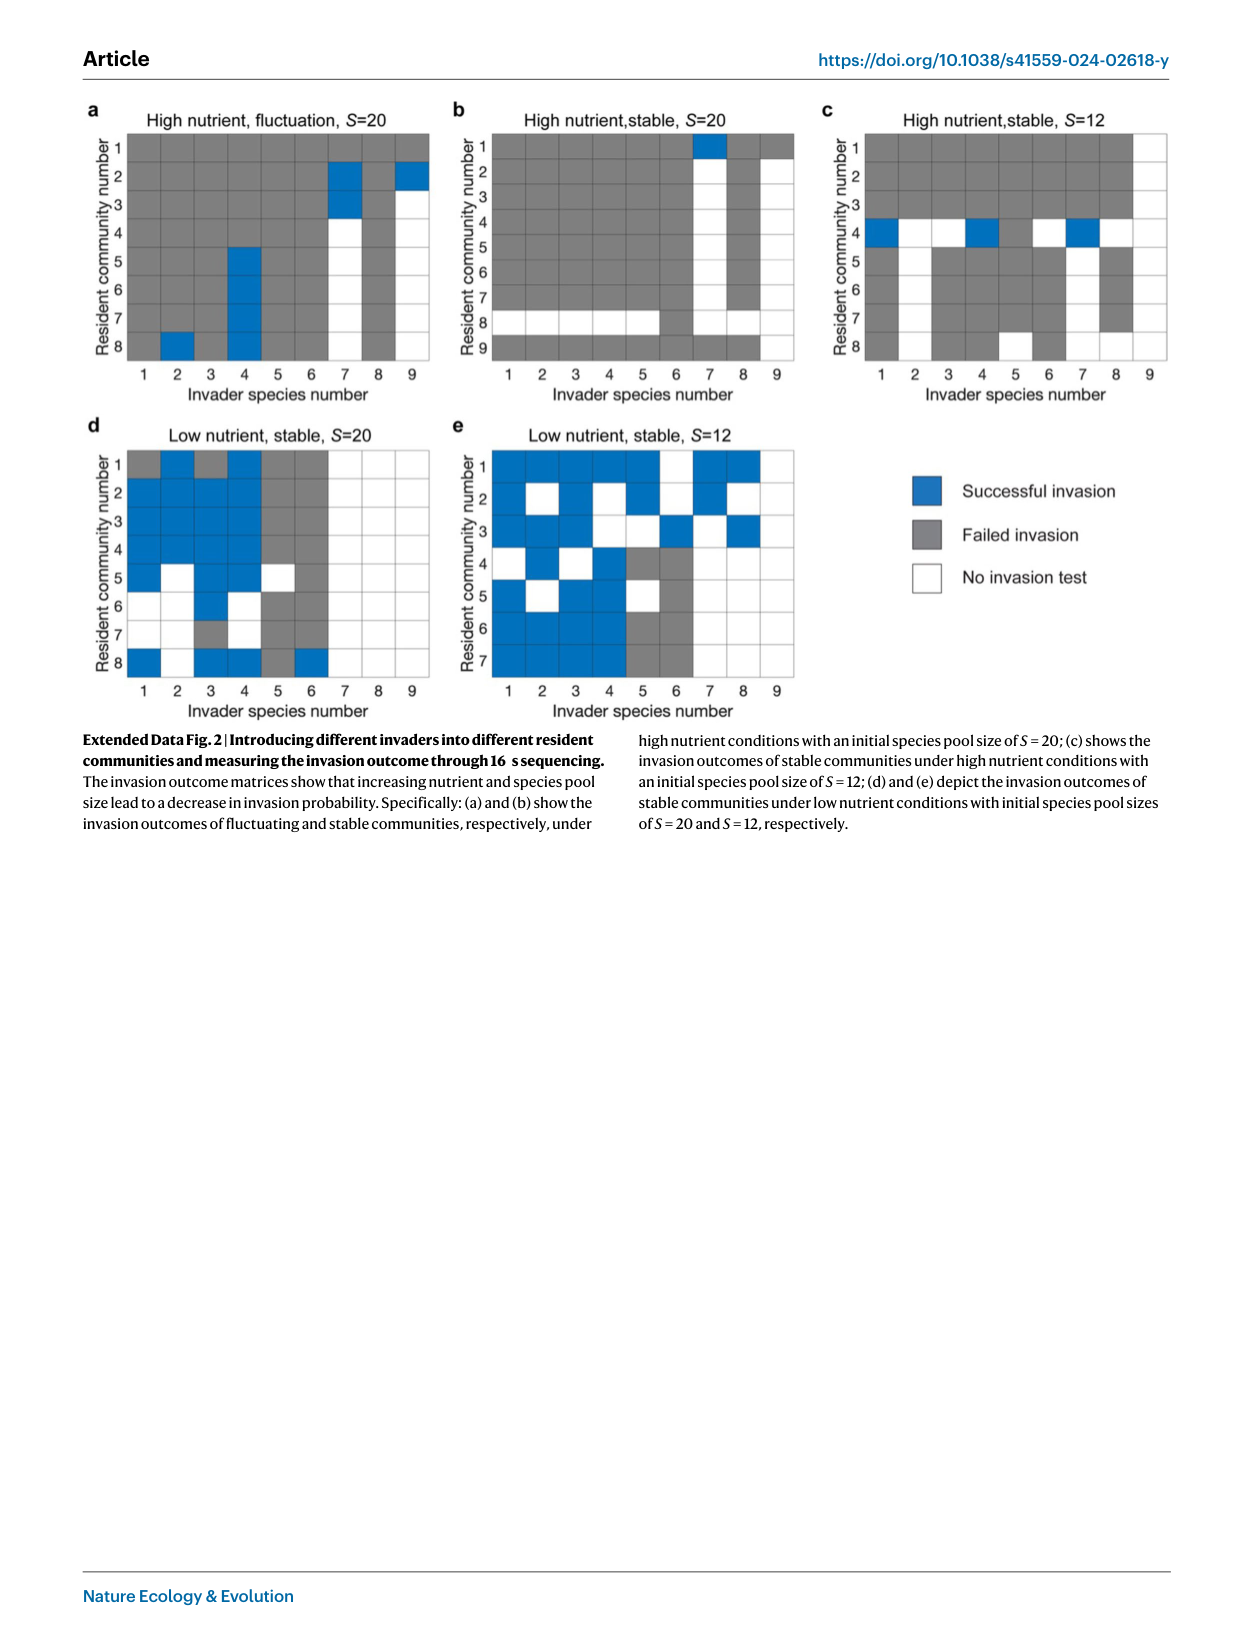
用实验 + 广义 Lotka–Volterra 模型证明:居民群落的集体动力学状态(稳定 / 涨落 / 多稳态)是入侵成败的首要预测变量——涨落群落比稳定群落可入侵性高约 8 倍(13%±4% vs 1.7%±1.7%,同为 S=20 池、高营养);强相互作用与更大物种池都降低入侵概率;把多样性归一化为「存活分数」后,所有条件下入侵概率≈存活分数(r=0.77),统一了生态学几十年的「多样性—可入侵性」之争。

读全文 →
microbial invasioncommunity dynamicsLotka-Volterra
cover 机器人策略(VLA / flow matching 动作生成 / 跨本体基础模型)
2024-10-31(v1)/ 2026-01-08(v4) · Physical Intelligence(旧金山)

π0: A Vision-Language-Action Flow Model for General Robot Control

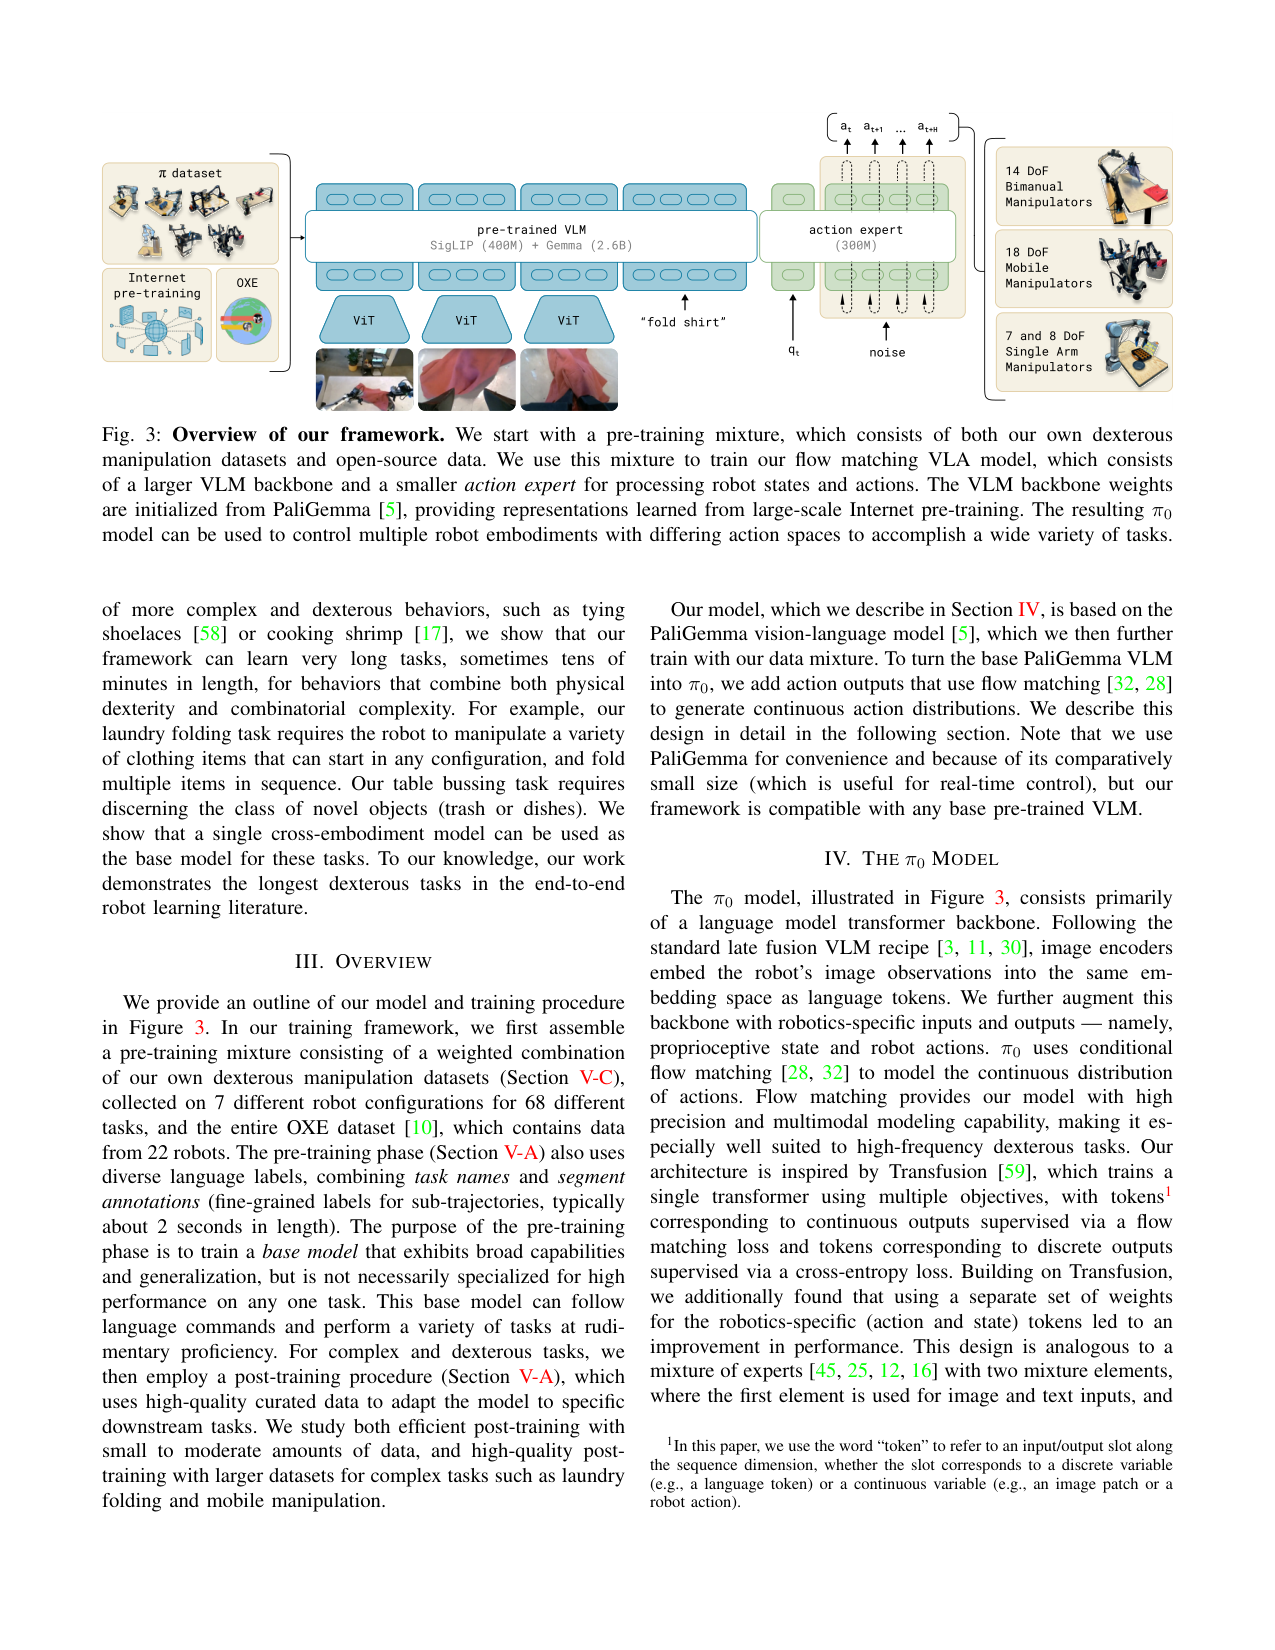
把预训练视觉语言模型 PaliGemma(3B)当骨干,额外加一个 300M 参数的 action expert,用条件 flow matching 直接回归连续动作分布,在约 1 万小时、7 种机器人构型、68 个任务的跨本体数据上预训练,再微调去完成叠衣、收拾餐桌、装箱、打包装箱等长时程灵巧任务,支持最高 50Hz 的高频控制;它是第一个把 flow matching 动作头接到 VLM 骨干上的 VLA,也是『flow 生成动作』路线的工业级参考。

读全文 →
VLAflow matchingcross-embodiment
cover 神经科学(表征与神经科学:grid cells / 连续吸引子 / 自监督速度提取)
2024-10-30(官方版 PDF 创建日期);NeurIPS 2024 于 2024-12 发布 · MIT(EECS 系 / 脑与认知科学系 / McGovern 脑研究所 / K. Lisa Yang 整合计算神经科学中心 ICoN)

Flexible mapping of abstract domains by grid cells via self-supervised extraction and projection of generalized velocity signals

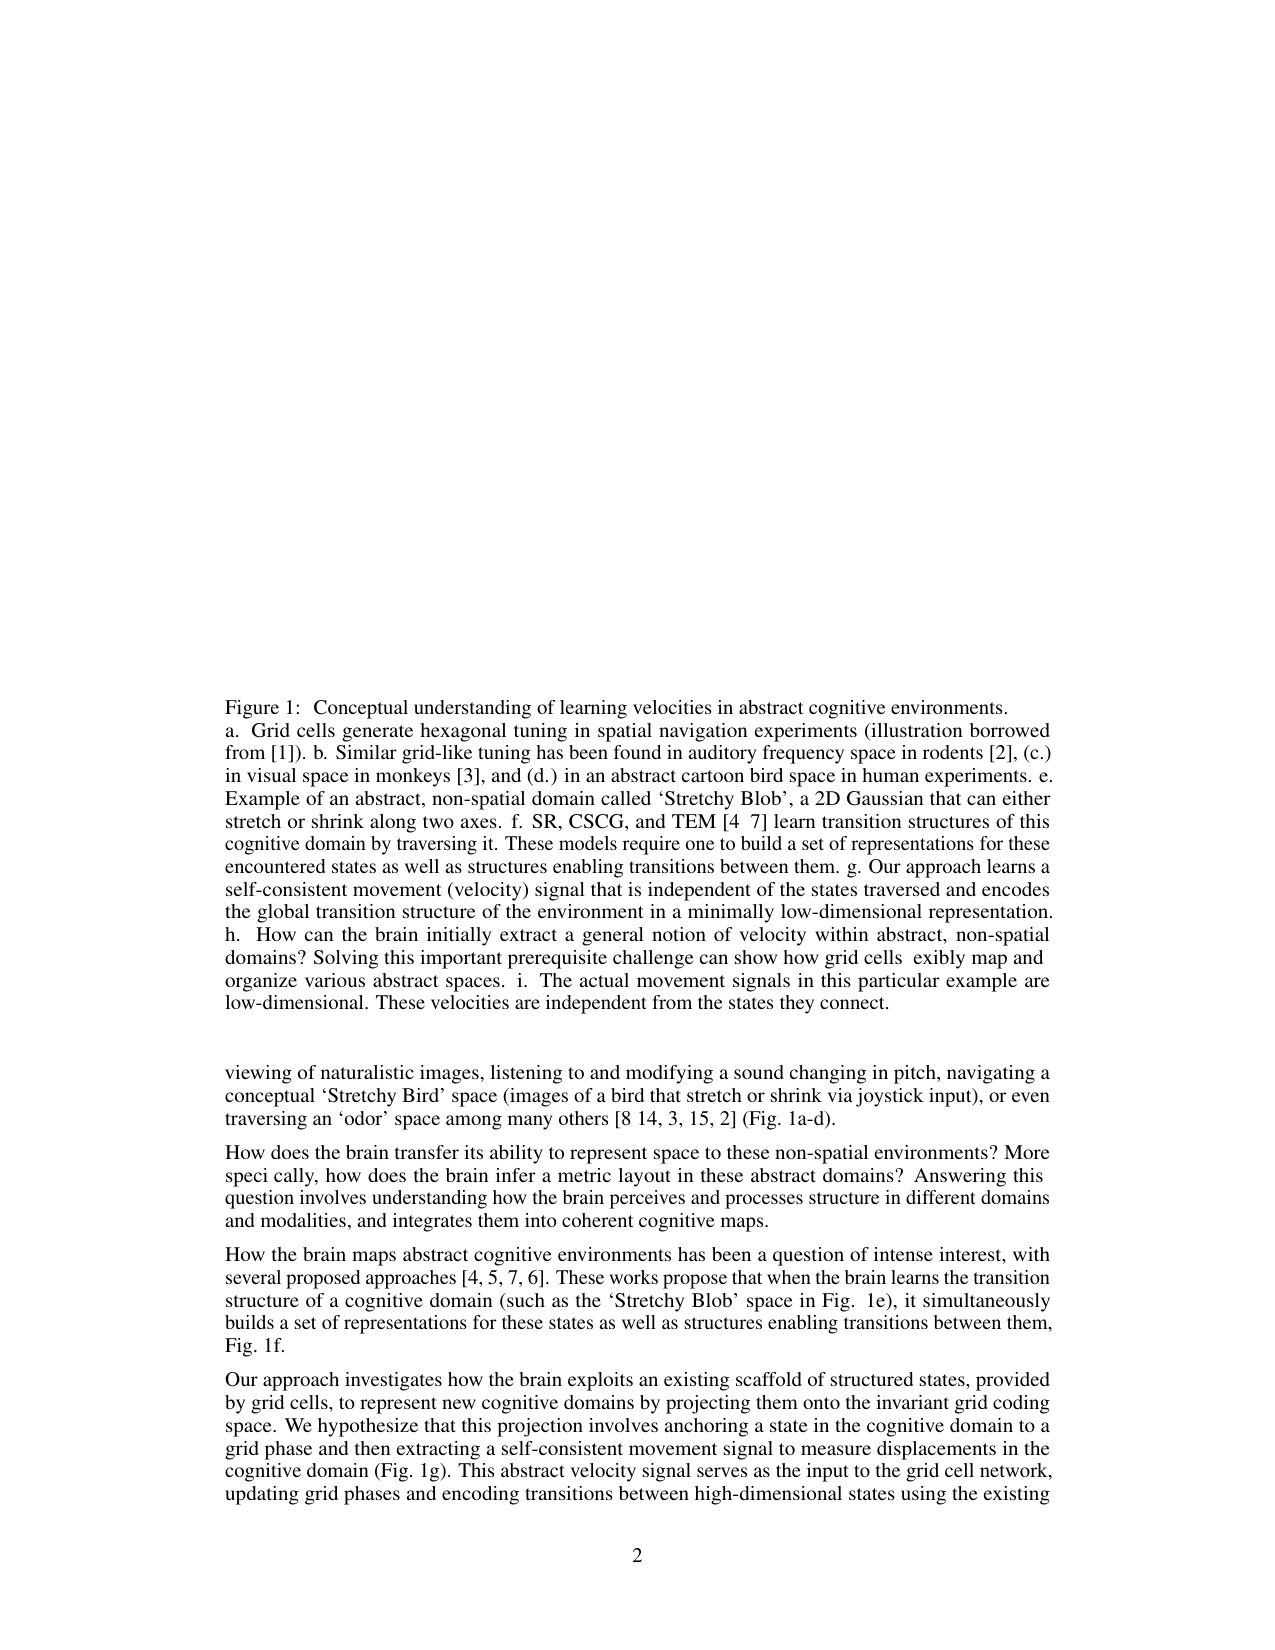
论文假设大脑把「空间导航用的网格编码」当一台通用速度积分器:面对任何新的抽象域(音高、图像特征、会变形的卡通鸟),只提取一个低维、与内容无关、自洽的广义速度信号,再交给网格细胞做路径积分,就能复用同一套网格码画出该域的地图。模型用「闭环轨迹上位移和为零」的自监督约束学速度,并证明该约束迫使估计速度成为真实速度的线性函数;在五个程序生成的抽象域上,推断速度误差 0.02–0.07,比 PCA/Isomap/UMAP/自动编码器/MCNet 低一到两个数量级,喂给合成网格模块能复现六边形发放野。

读全文 →
grid cellsvelocity extractionself-supervised learning
cover one-step generation / flow matching / diffusion
2024-10-16 · UC Berkeley

One Step Diffusion via Shortcut Models

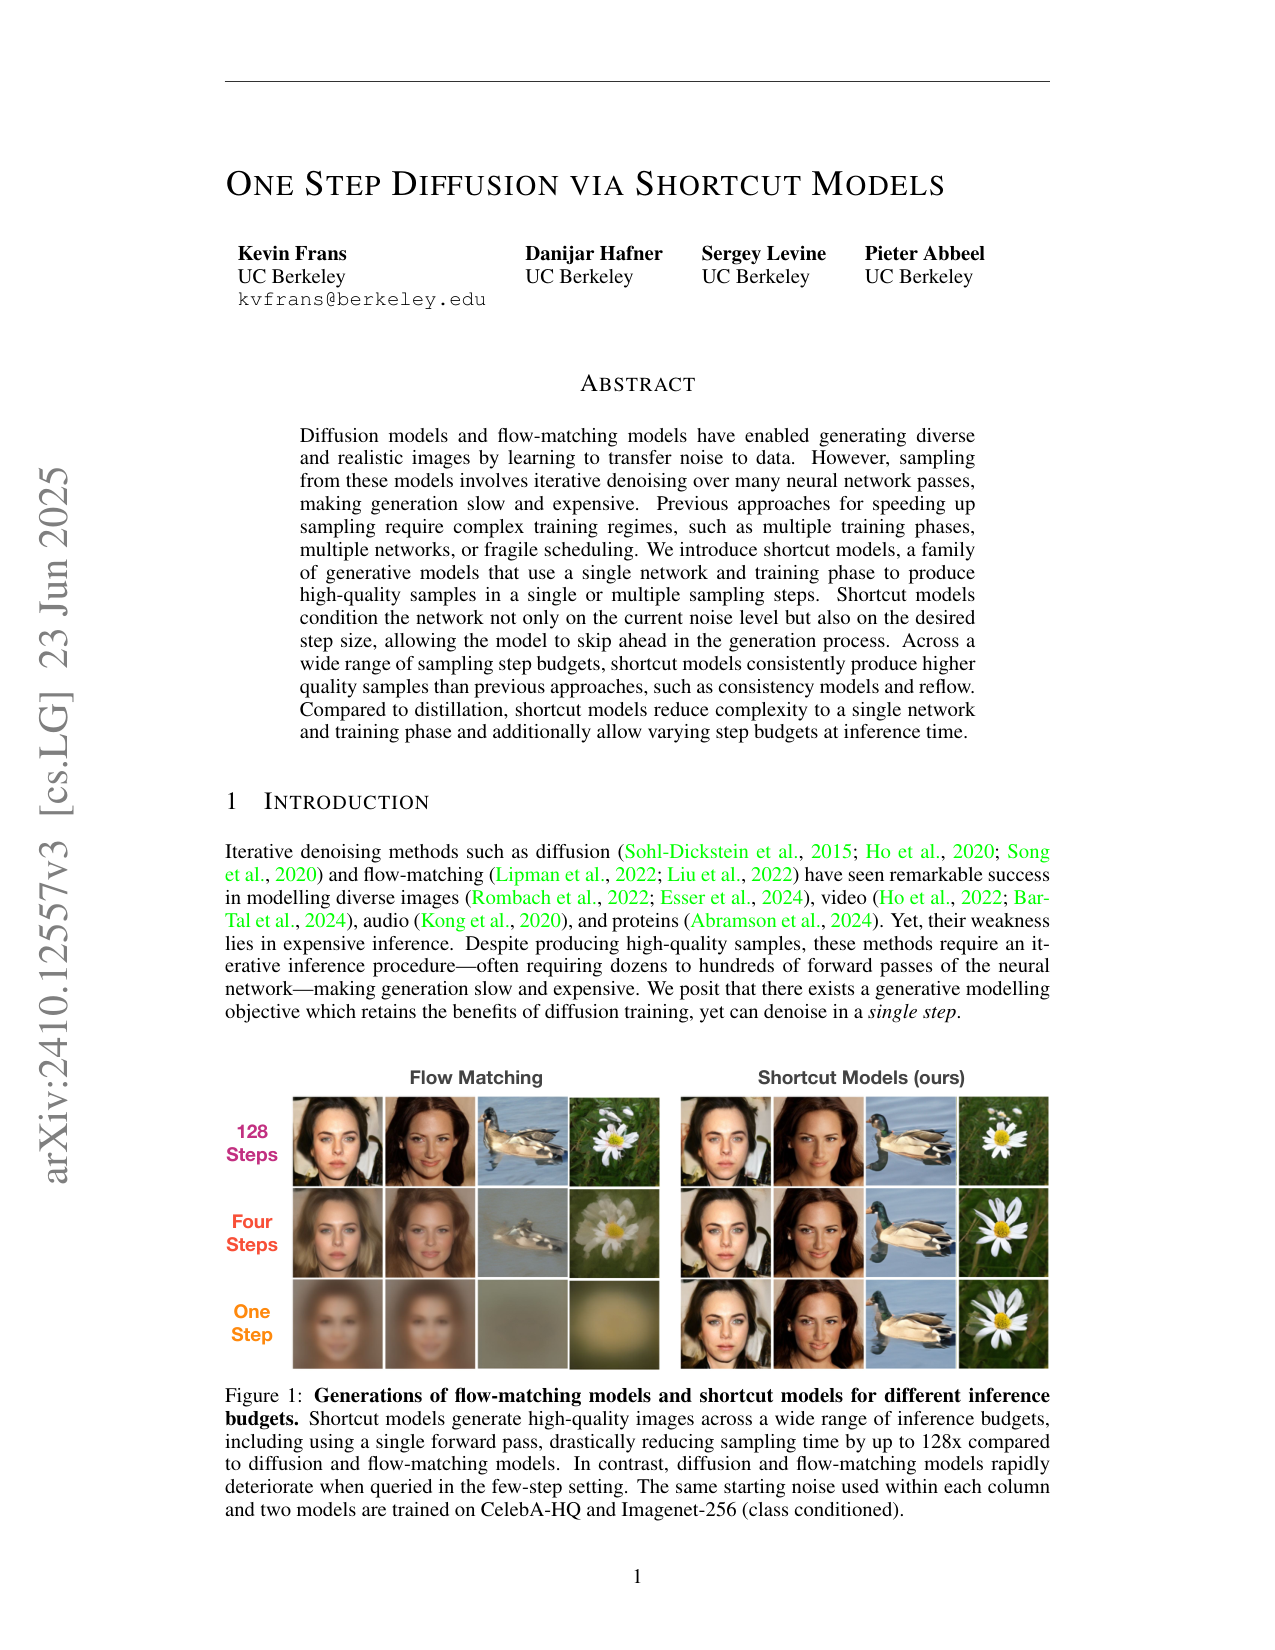
在 Flow Matching 之上多学一个步长条件 d:网络同时输入当前噪声水平 t 和想跳的步长 d,用「两步 d/2 拼接成一步 d」的自洽目标在训练期自蒸馏,单网络、单次训练、无调度,1 步/4 步/128 步都由同一个模型在推理时决定;训练开销只比基础扩散高约 16%。ImageNet-256 上 1 步 FID 40.3(DiT-B)、XL 扩到 10.6,128 步 3.8,多步质量与基线流匹配相当。

读全文 →
one-step generationflow matchingself-consistency
cover 生成模型理论 / 表征与神经科学交叉(组合泛化机制)
2024-08-24(v1)/ 2024-10-11(v2) · MIT(Massachusetts Institute of Technology)

How Diffusion Models Learn to Factorize and Compose

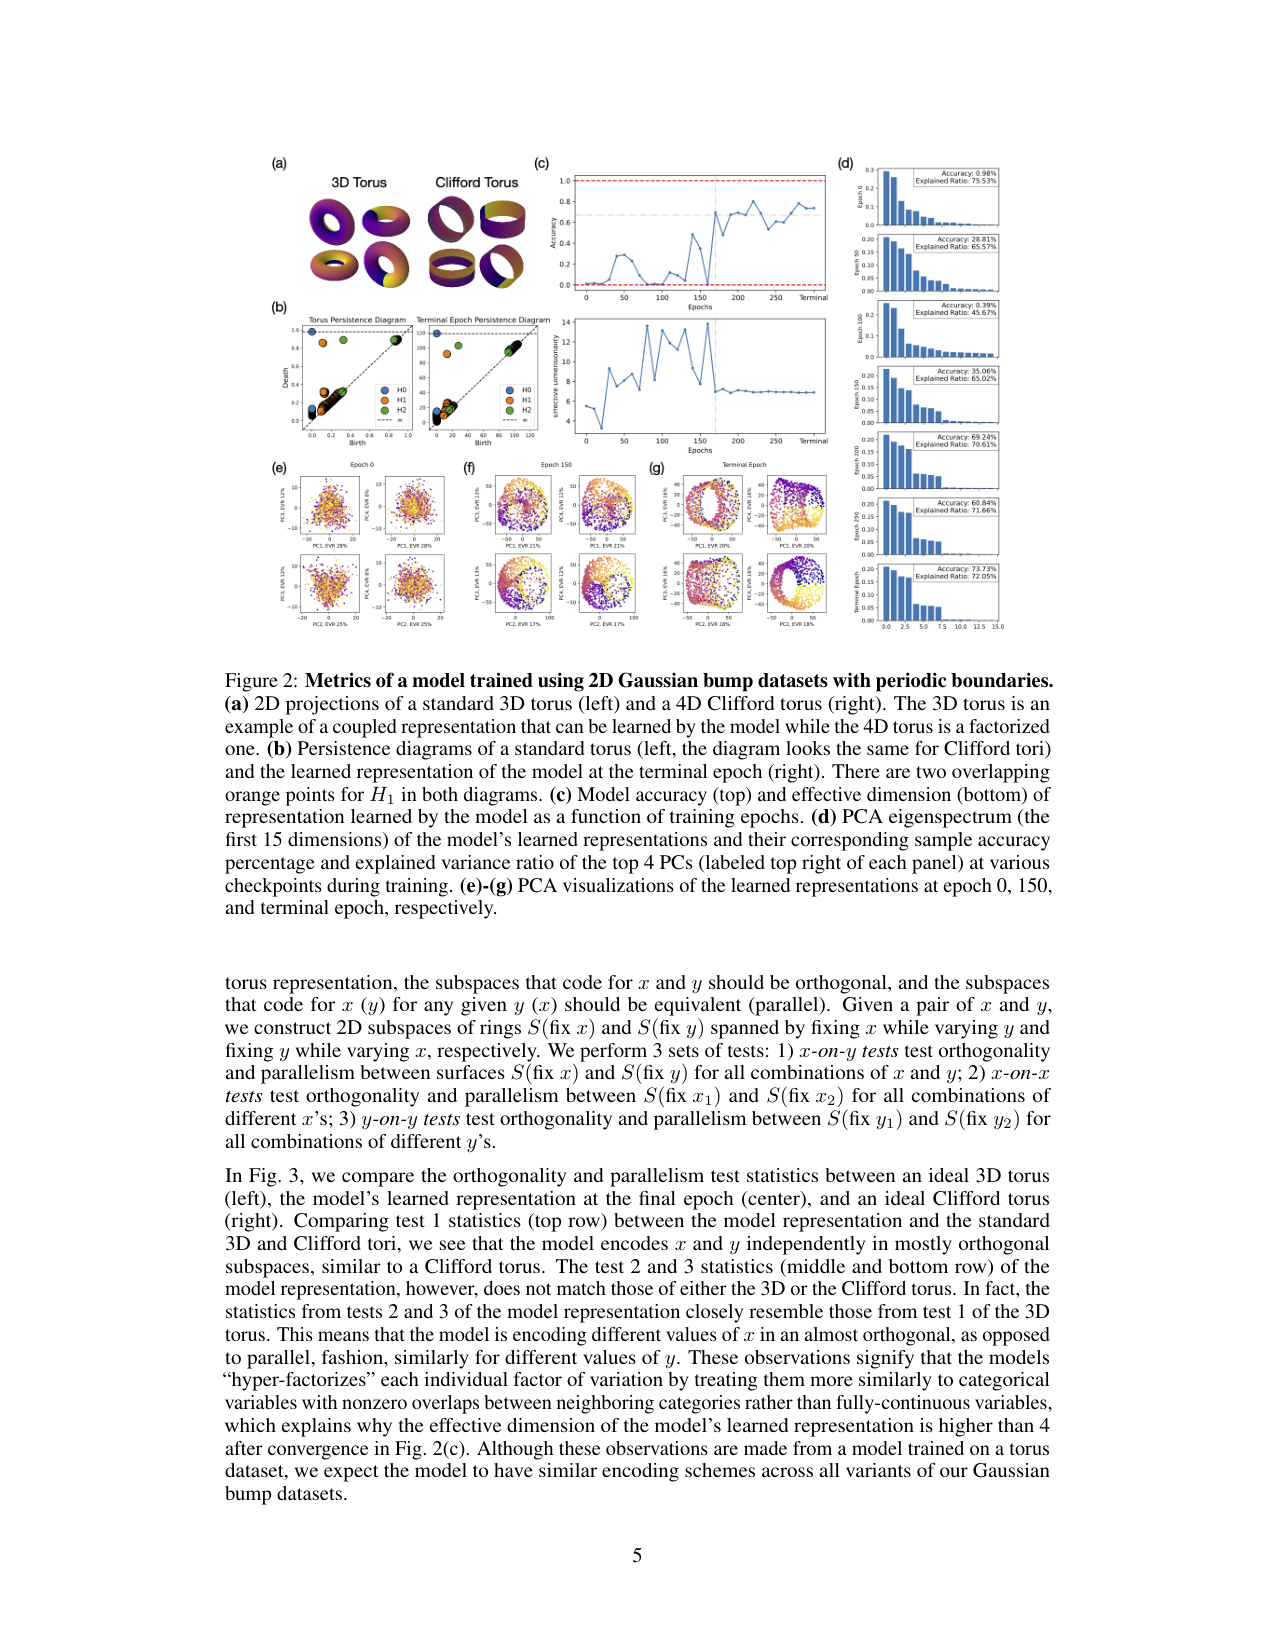
把条件扩散模型(DDPM)当认知实验的动物来研究:在周期边界的二维高斯斑点数据上,模型中间层表征学成『环面上的分解表示』——x 与 y 落入相互正交的子空间(类似 Clifford 环面),但同一特征的不同取值又被近似正交地编码、像离散类别一样(论文叫 hyper-factorized);行为上模型能组合训练里没见过的 (x,y) 取值(条件是每个独立特征全范围出现、且给少量组合样例),却几乎不能在同一特征上插值。论文进一步把表征流形的形成与物理学渗流(percolation)相变联系起来:样本间重叠低于阈值时学不出有意义的表示,超过阈值能力突然出现;并给出训练数据配方——独立因子全范围 + 少量组合样例,数据效率从随图像尺寸 N 的二次增长降为线性增长。

读全文 →
diffusion modelscompositional generalizationfactorized representations
cover 序列生成 · 因果扩散 · 世界模型 · 离线强化学习规划 · 视频预测
2024-07-02(v1);2024-12-10(v4) · MIT CSAIL(Diego Marti Monso 为 TUM 访问学生)

Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion

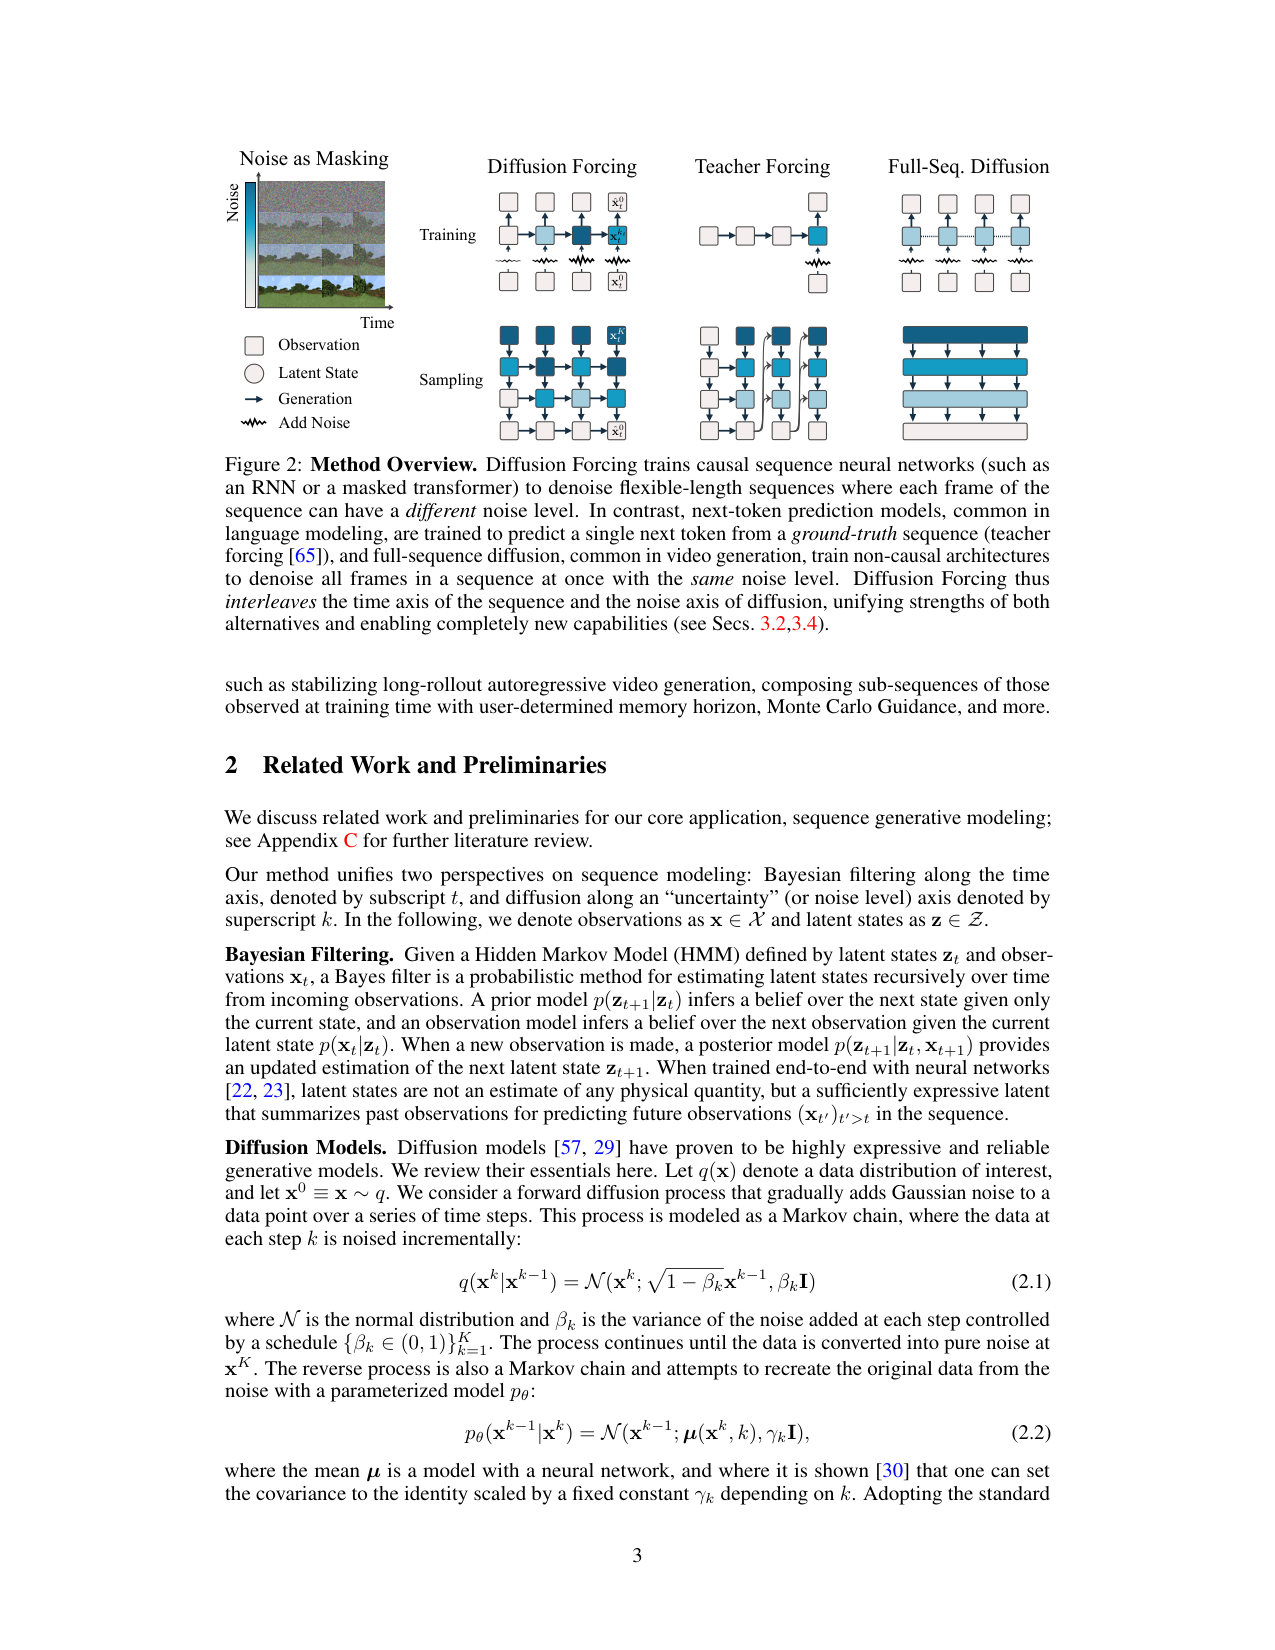
给序列里每个 token 独立随机采样一个噪声水平 k_t 来训练扩散模型,让『下一个 token 预测』获得『全序列扩散』的引导、变长与稳定性能力:同一套网络既可以像自回归模型那样任意长度 rollout,又可以像 Diffuser 那样带回报引导地做规划,还新增了未来保持不确定的因果采样调度与蒙特卡洛引导 MCG。理论上证明该训练目标优化所有噪声水平序列下子序列似然的重加权 ELBO;实证上视频可稳定 rollout 到训练长度 2 倍以上(2000 帧不爆)、D4RL maze 规划单任务平均回报 141.7(Diffuser* 119.5)、真实机器人换果任务成功率 80%(Diffusion Policy 记 0)。

读全文 →
diffusioncausal diffusion forcingnext-token prediction
cover one-step / few-step generation · flow matching 理论 · consistency models 统一框架
2024-06-11(v1);2025-06-03(v2) · Courant Institute of Mathematical Sciences, New York University

Flow map matching with stochastic interpolants: A mathematical framework for consistency models

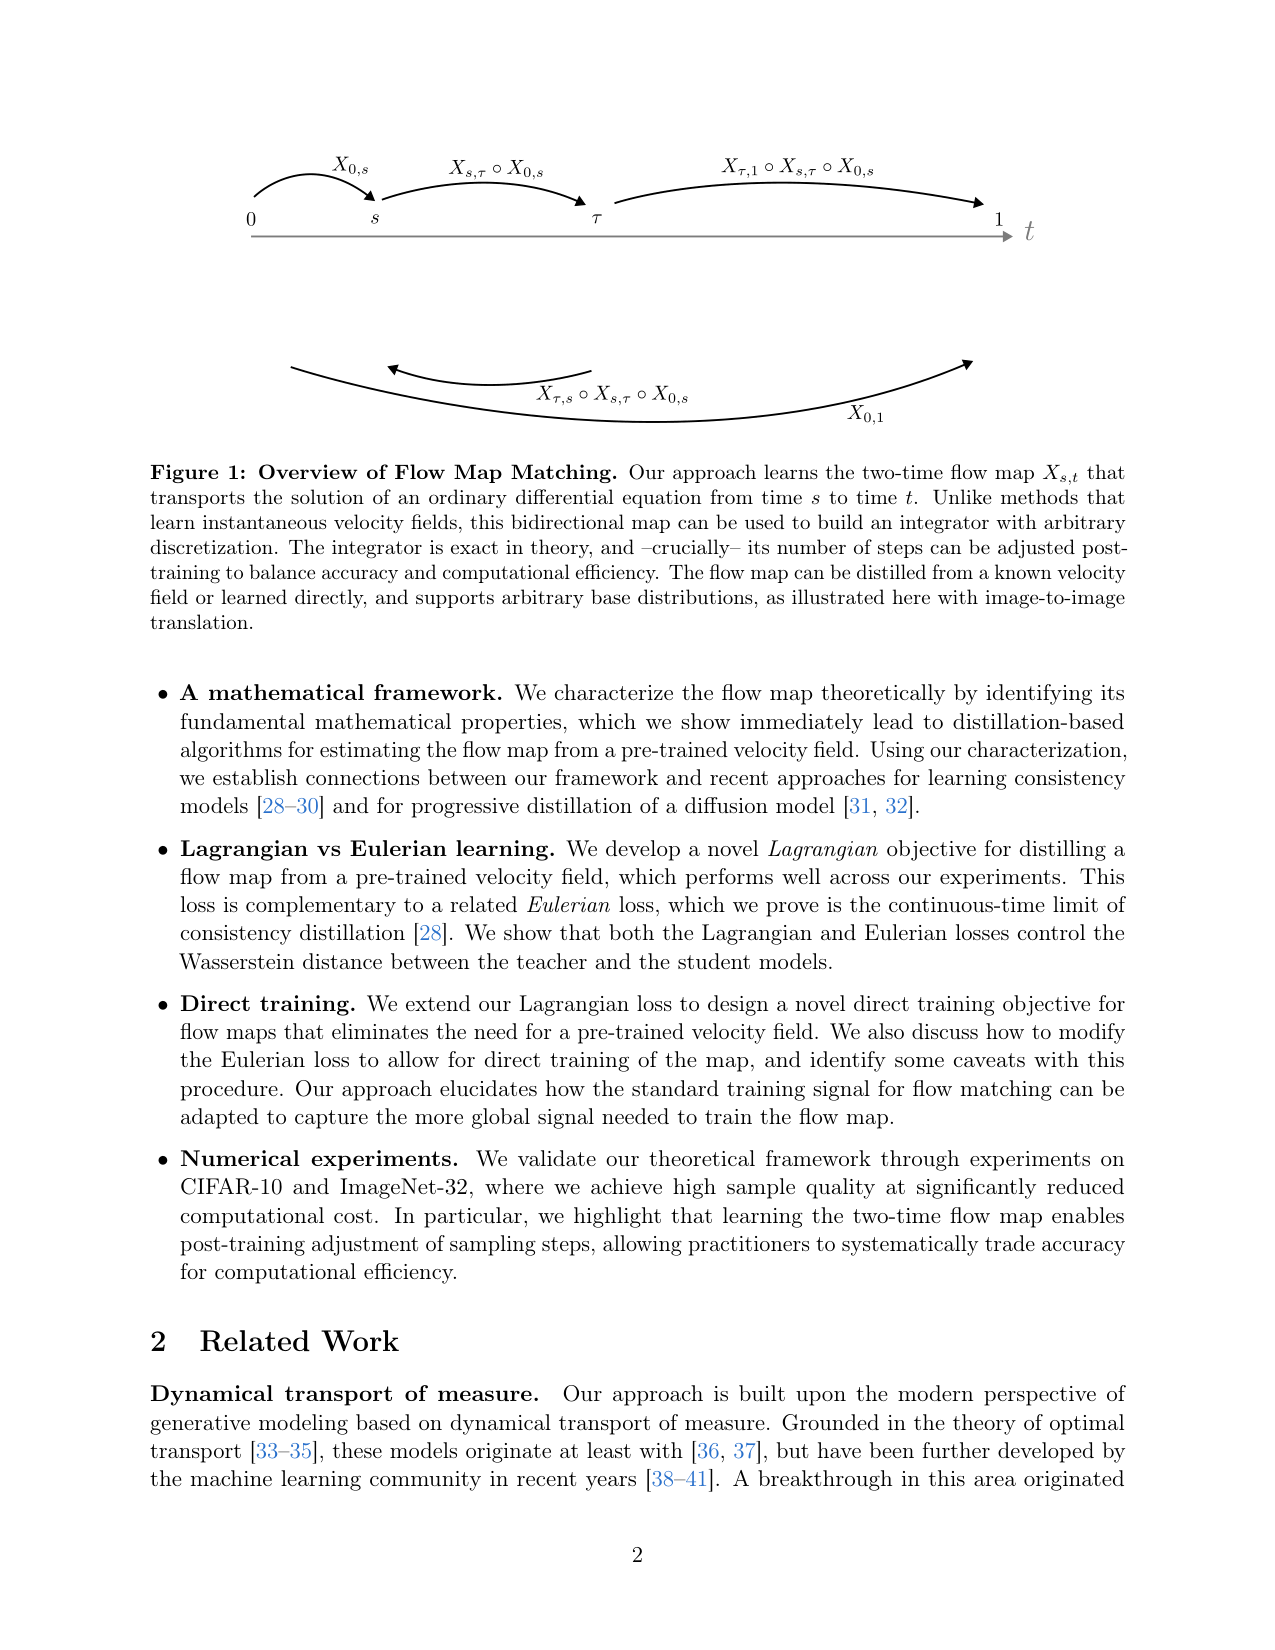
把 Flow Matching 的「瞬时速度」换成「两时间流地图」X_{s,t}:网络直接学从时刻 s 到 t 的整段位移映射,理论上精确、训练后步数可任意调整。论文给出四条训练路径——拉格朗日蒸馏 LMD、欧拉蒸馏 EMD(一致性蒸馏的连续时间极限)、无预训练速度场的直接训练 FMM、以及把 K 步并成一步的 PFMM,并证明 LMD/EMD 的损失控制 Wasserstein 距离。CIFAR-10 上 LMD 用 4 步拿到 FID 6.04(老师 SI 基线 5.53;同设置下 SI 本身要 34.84);ImageNet-32 上无蒸馏直接 FMM 在 N=4 时 FID 16.90(同 N 下 DDPM 362.37、BatchOT 38.86)。论文摘要口径:与 flow matching 质量相当、生成时间减少 10–20 倍(正文实验证据是少步 FID)。

读全文 →
flow maptwo-time flow mapconsistency models
cover 生成模型理论 / 高效采样 / 隐式网络(DEQ)
2024-01-16(v1) · University of Oxford

Fixed Point Diffusion Models

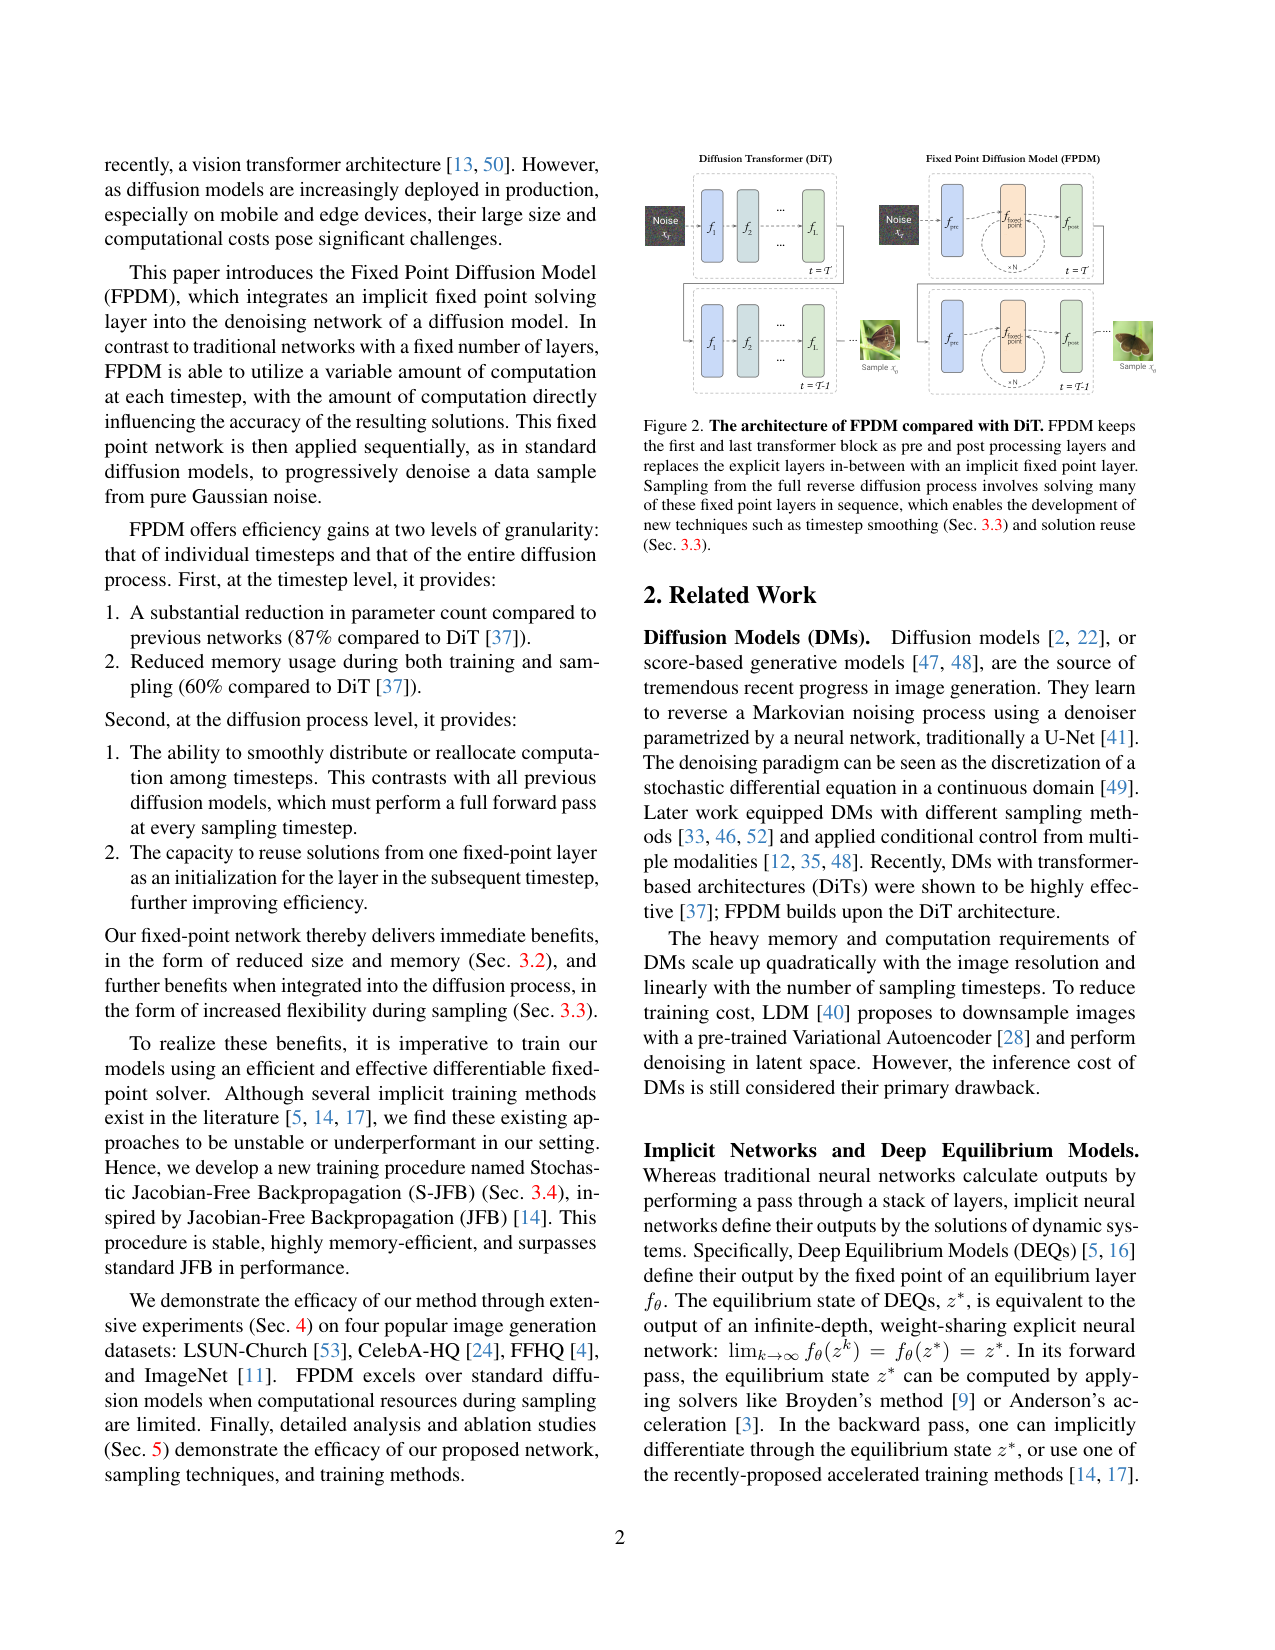
把 DiT 的 28 个显式 transformer 层压缩成「前后各 1 个显式层 + 中间 1 个隐式不动点层」,让每个去噪时间步变成解一个固定点方程 x* = f_fp(x*, x̃, t),从而在时间步之间平滑、重分配计算并复用上一时间步的解;85M 参数的 FPDM 相比 674M 参数的 DiT-XL/2,在 ImageNet 256×256 上用 280 次 transformer block 前向的采样预算把 DDIM FID 从 35.2 压到 22.4,训练显存从 25.2GB 降到 10.2GB(batch 64),是「把迭代搬进网络内部」的代表作。

读全文 →
cover one-step generation / diffusion distillation 统一框架
2023-10-03(v1);ICLR 2024 接收 · Sony AI(Kim、Lai、Liao、Murata、Takida、Uesaka、Mitsufuji)/ CMU(He)/ Stanford(Ermon)

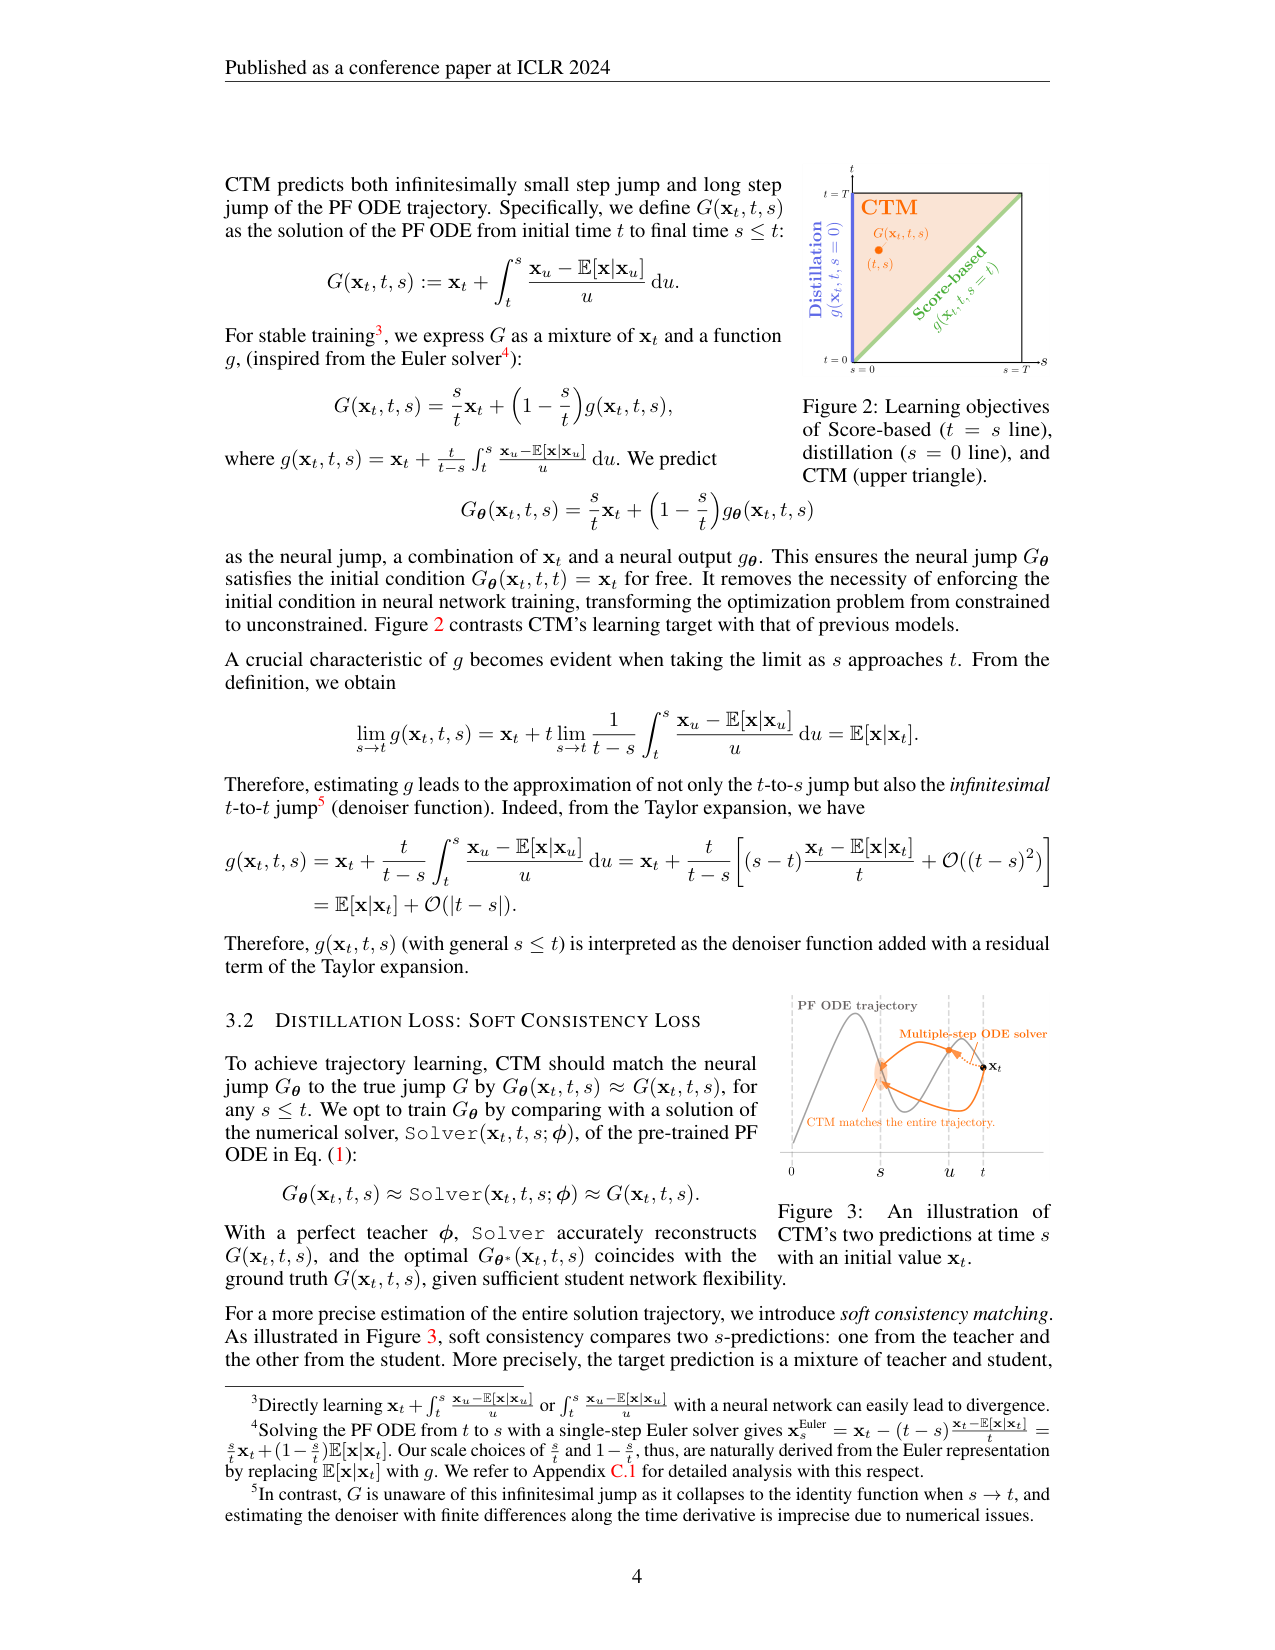
Consistency Trajectory Models: Learning Probability Flow ODE Trajectory of Diffusion

把 Consistency Models 的「点对点自洽」放宽成「轨迹自洽」:一个网络同时输出 PF ODE 的被积函数(score,即 g 在 s→t 的极限)和积分(任意 t→s 的整段跳跃),用 soft consistency + DSM + GAN 三个损失训练,再配一个 γ-sampling 采样族覆盖 CM 多步(γ=1)与确定性蒸馏(γ=0)两端;在 CIFAR-10 与 ImageNet 64×64 上以 1–2 NFE 刷新 FID,且学生质量超过老师。

读全文 →
diffusionconsistency modelsdistillation
cover diffusion sampling theory / generative modeling
2023-06-26(v1);2023-11-01(v2) · MIT(Xu、Deng、Cheng、Liu、Jaakkola)/ Google Research(Tian);前三位共同一作

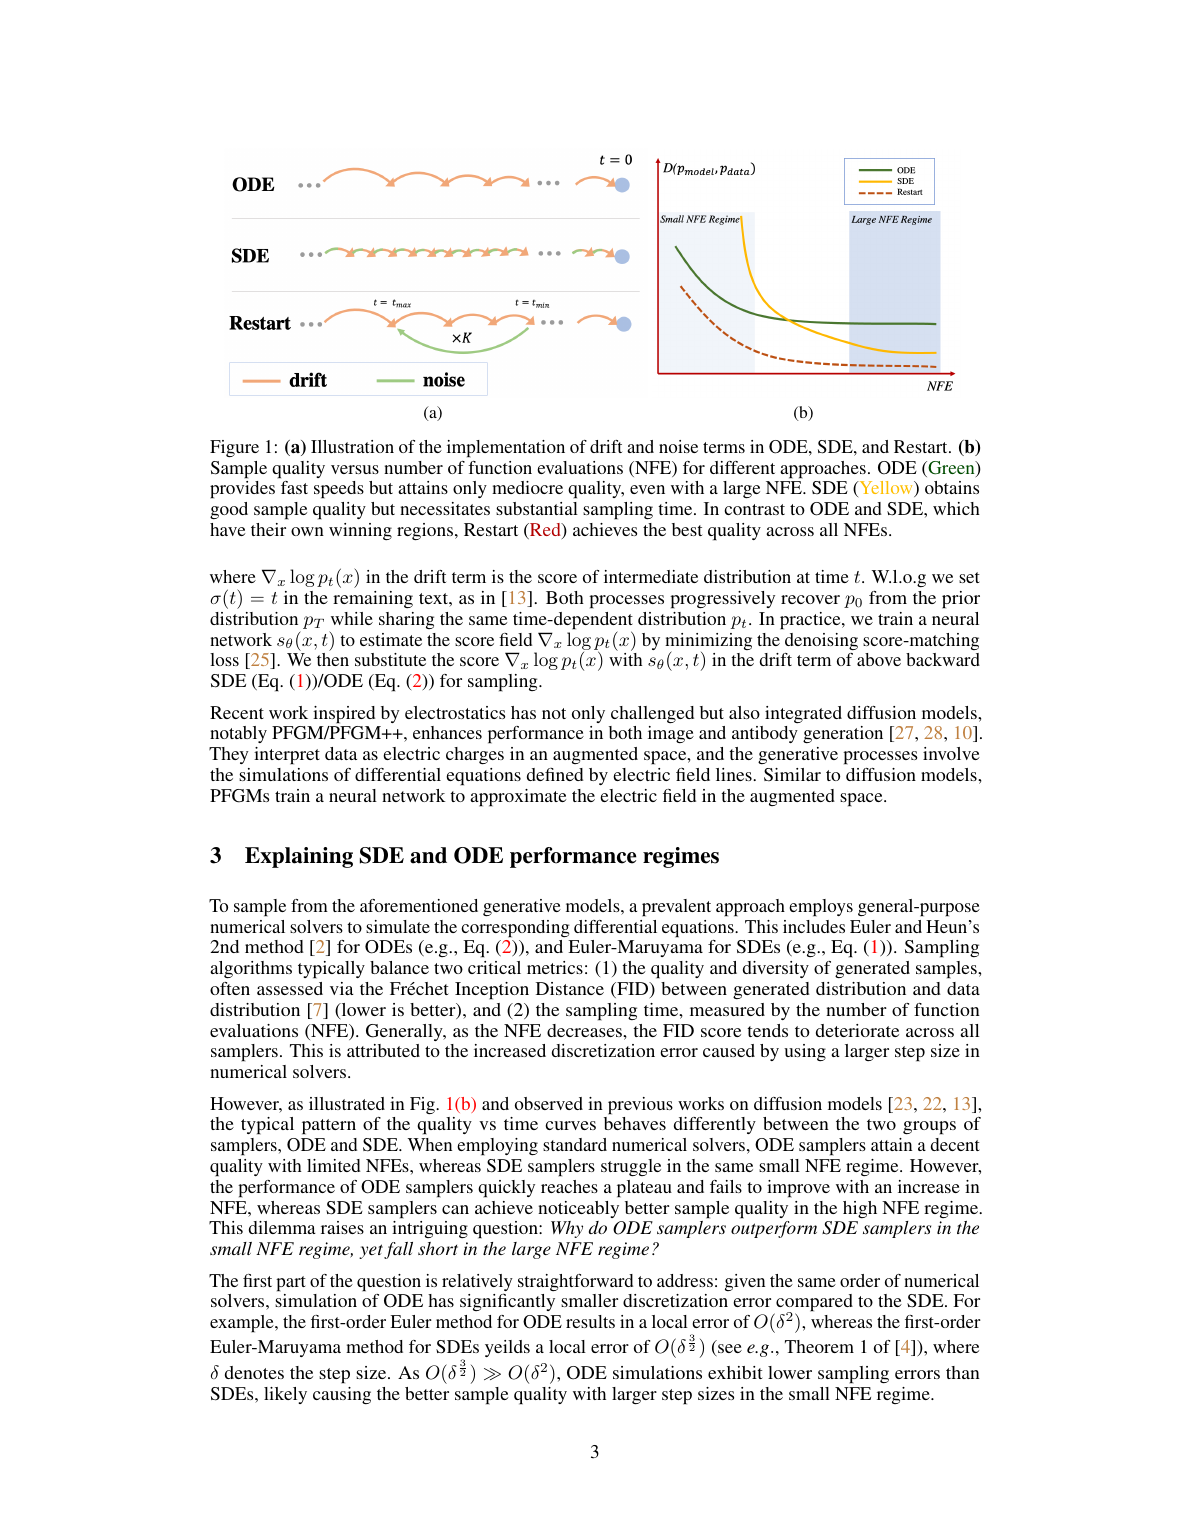
Restart Sampling for Improving Generative Processes

在扩散类生成模型的主反向 ODE 末尾插入一个时间区间 [tmin,tmax],循环 K 次『一次性大步加噪(前向)+ ODE 反向』:加噪把已累积的采样误差收缩掉一部分,ODE 反向又保持低离散化误差,从而同时拿到 SDE 的质量和 ODE 的速度。论文声明在同 FID 下相对当时最佳 SDE 采样器在 CIFAR-10(VP)上加速约 10 倍(对照两侧配置:Improved SDE 1023 NFE 得 FID 2.35,Restart 115 NFE 得 2.21)、ImageNet 64×64(EDM)上约 2 倍,并把 CIFAR-10(PFGM++)推到 FID 1.88、ImageNet 64×64 推到 1.36(UNet 架构、无额外训练)。

读全文 →
diffusion samplingstochastic samplerODE/SDE trade-off
cover 机器人策略(行为克隆 / 动作扩散 / action chunk)
2023-03-07(v1) / 2024-03-14(v5) · Columbia University / Toyota Research Institute (TRI) / MIT CSAIL

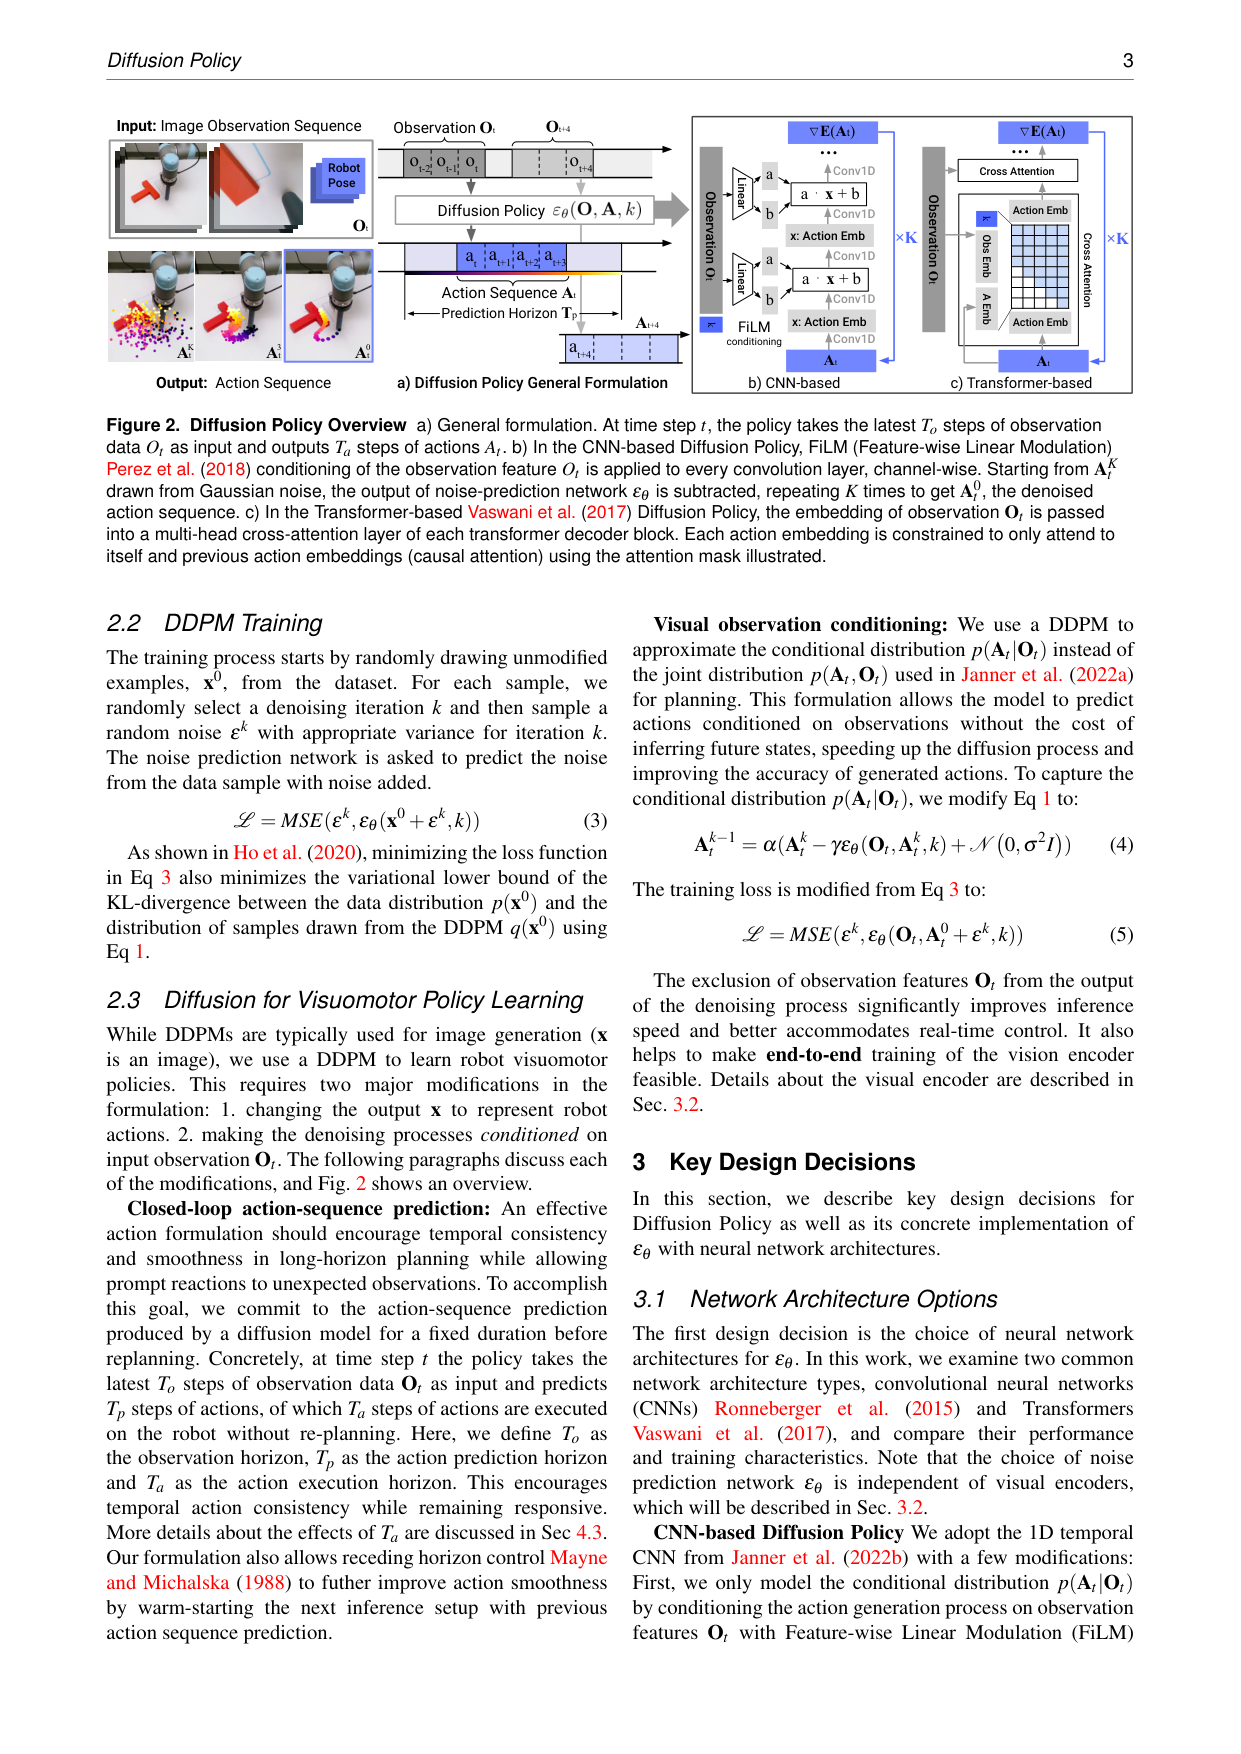
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion

把机器人的视觉运动策略写成以观测为条件的动作去噪扩散过程:一次输出一个 8 步动作块(action chunk),配合滚动时域控制与一次性视觉编码,在 4 个 benchmark、15 个任务(模拟 + 真实)上相对各 benchmark 此前最优方法平均提升 46.9% 成功率;它把机器人策略从『单步动作回归』带到『动作块条件生成』,是后续 VLA 与 one-step 动作生成方法的基准对象。

读全文 →
diffusion policybehavior cloningvisuomotor policy
cover 生成模型理论(one-step 谱系)
2023-03-03(v1)/ 2023-05-31(v2) · OpenAI

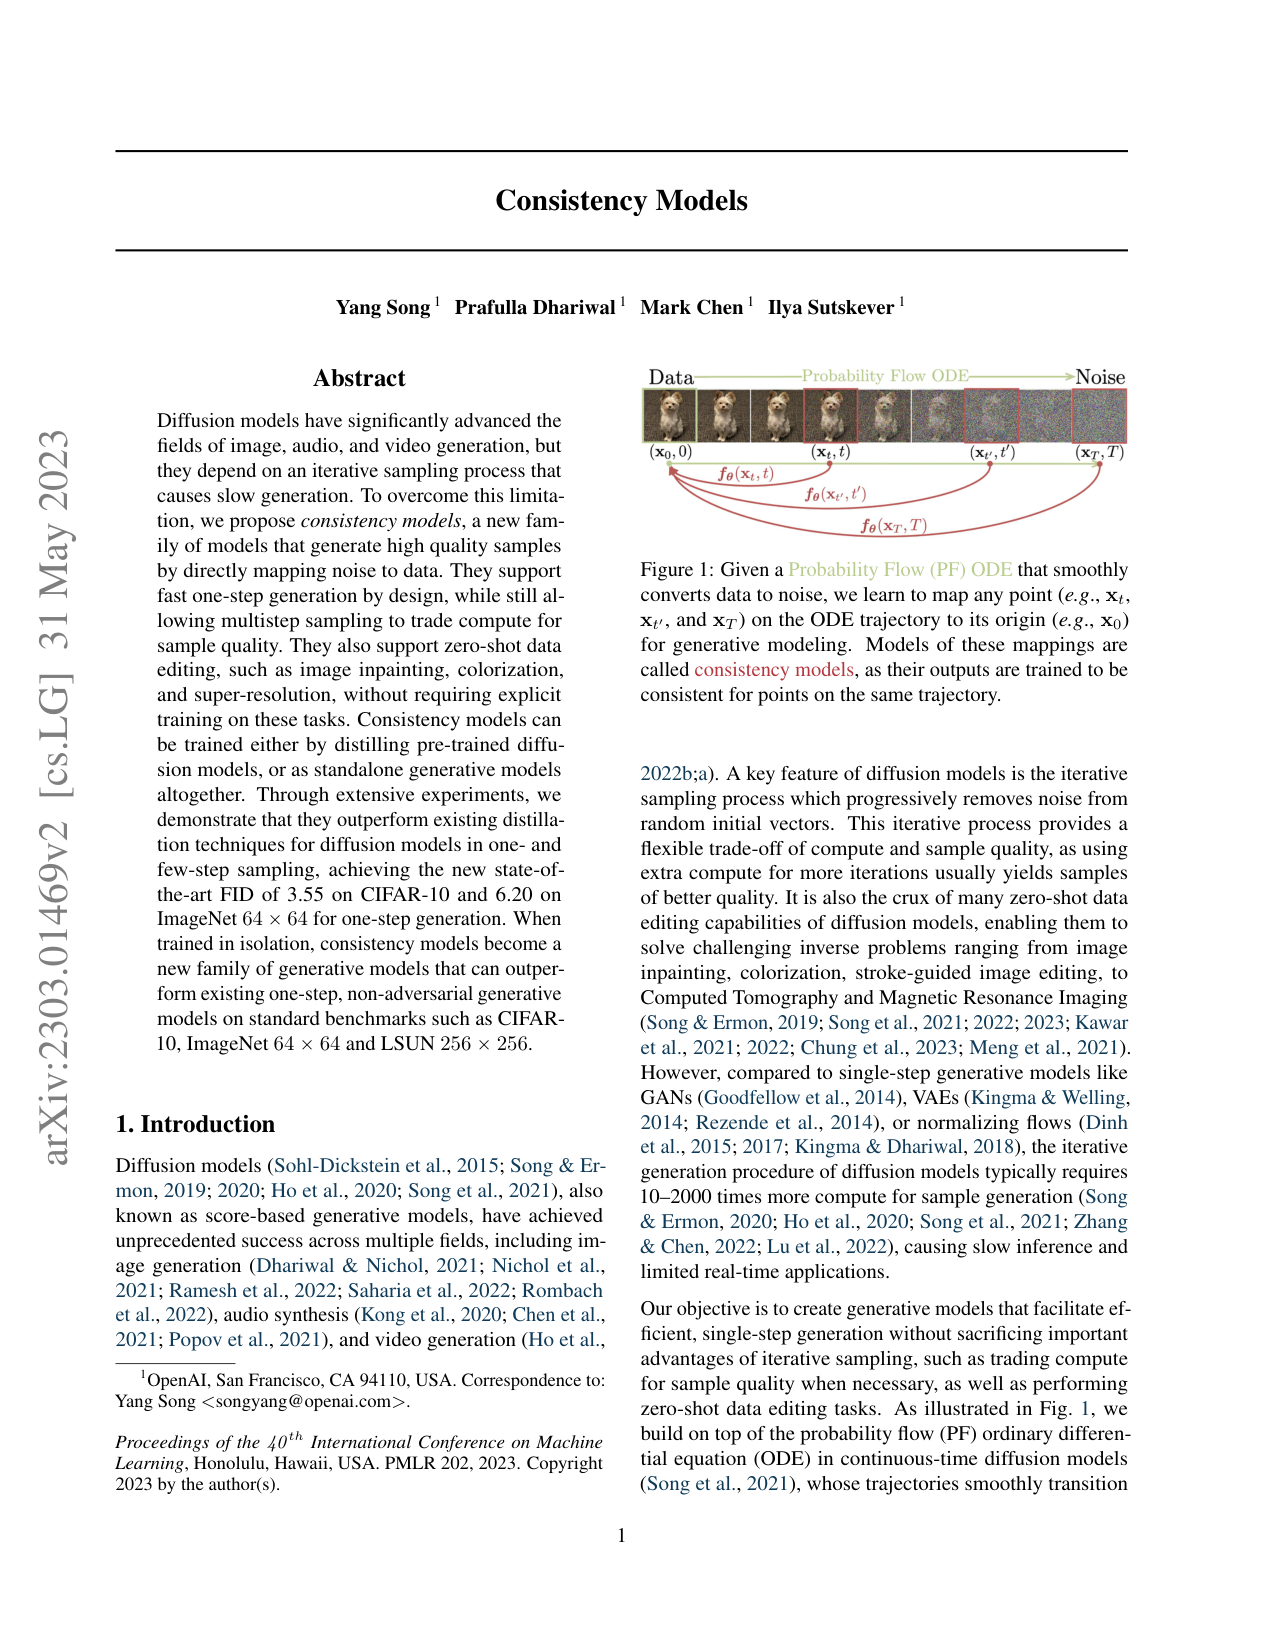
Consistency Models

把扩散模型的迭代采样问题重写成『一步映射』问题:学一个 consistency function f(x_t, t),把概率流 ODE 同一条轨迹上任意时刻的点都映射到轨迹起点 x_ϵ,于是采样变成一次网络前向;同时保留多步采样(用算力换质量)与零样本图像编辑能力。给出两条训练路线——从预训练扩散模型蒸馏(CD)与完全从零训练(CT)——并在 CIFAR-10 一步生成拿到当时 SOTA 的 FID 3.55。

读全文 →
consistency modelsone-step generationdiffusion distillation
cover 生成模型理论 / 物理启发生成模型(扩散与泊松流统一)
2023-02-08 · MIT(ICML 2023)

PFGM++: Unlocking the Potential of Physics-Inspired Generative Models

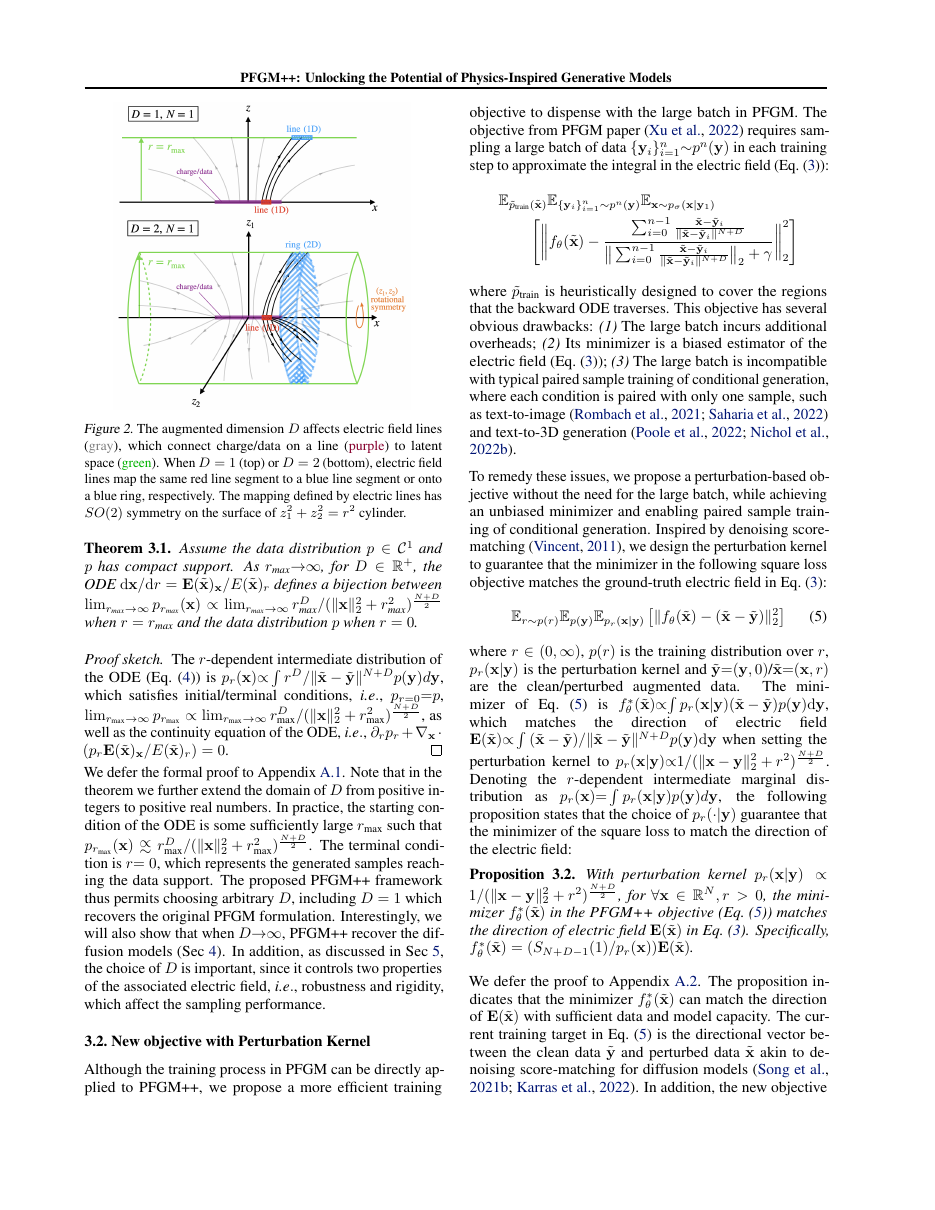
PFGM++ 把两类物理启发的生成模型放进同一个家族:把 N 维数据点当作电荷,增广 D 个额外维度后沿电场线把均匀先验流回数据所在平面;D=1 时它就是泊松流生成模型 PFGM,D→∞(保持 σ=r/√D 定标)时在训练目标与采样过程两层都精确恢复扩散模型。D 由此变成调节『对误差鲁棒』与『易于学习』的旋钮,中间值 D=2048/128 在 CIFAR-10/FFHQ 上把无条件生成 FID 压到 1.91/2.43(35/79 次网络求值),并在注入噪声、低比特量化、放大采样步长三类误差下比扩散模型更稳。

读全文 →
cover 生成模型·扩散模型骨干架构
2022-12-19(v1;v2 修订于 2023-03-02) · UC Berkeley / New York University(第一作者实习于 Meta AI FAIR)

Scalable Diffusion Models with Transformers (DiT)

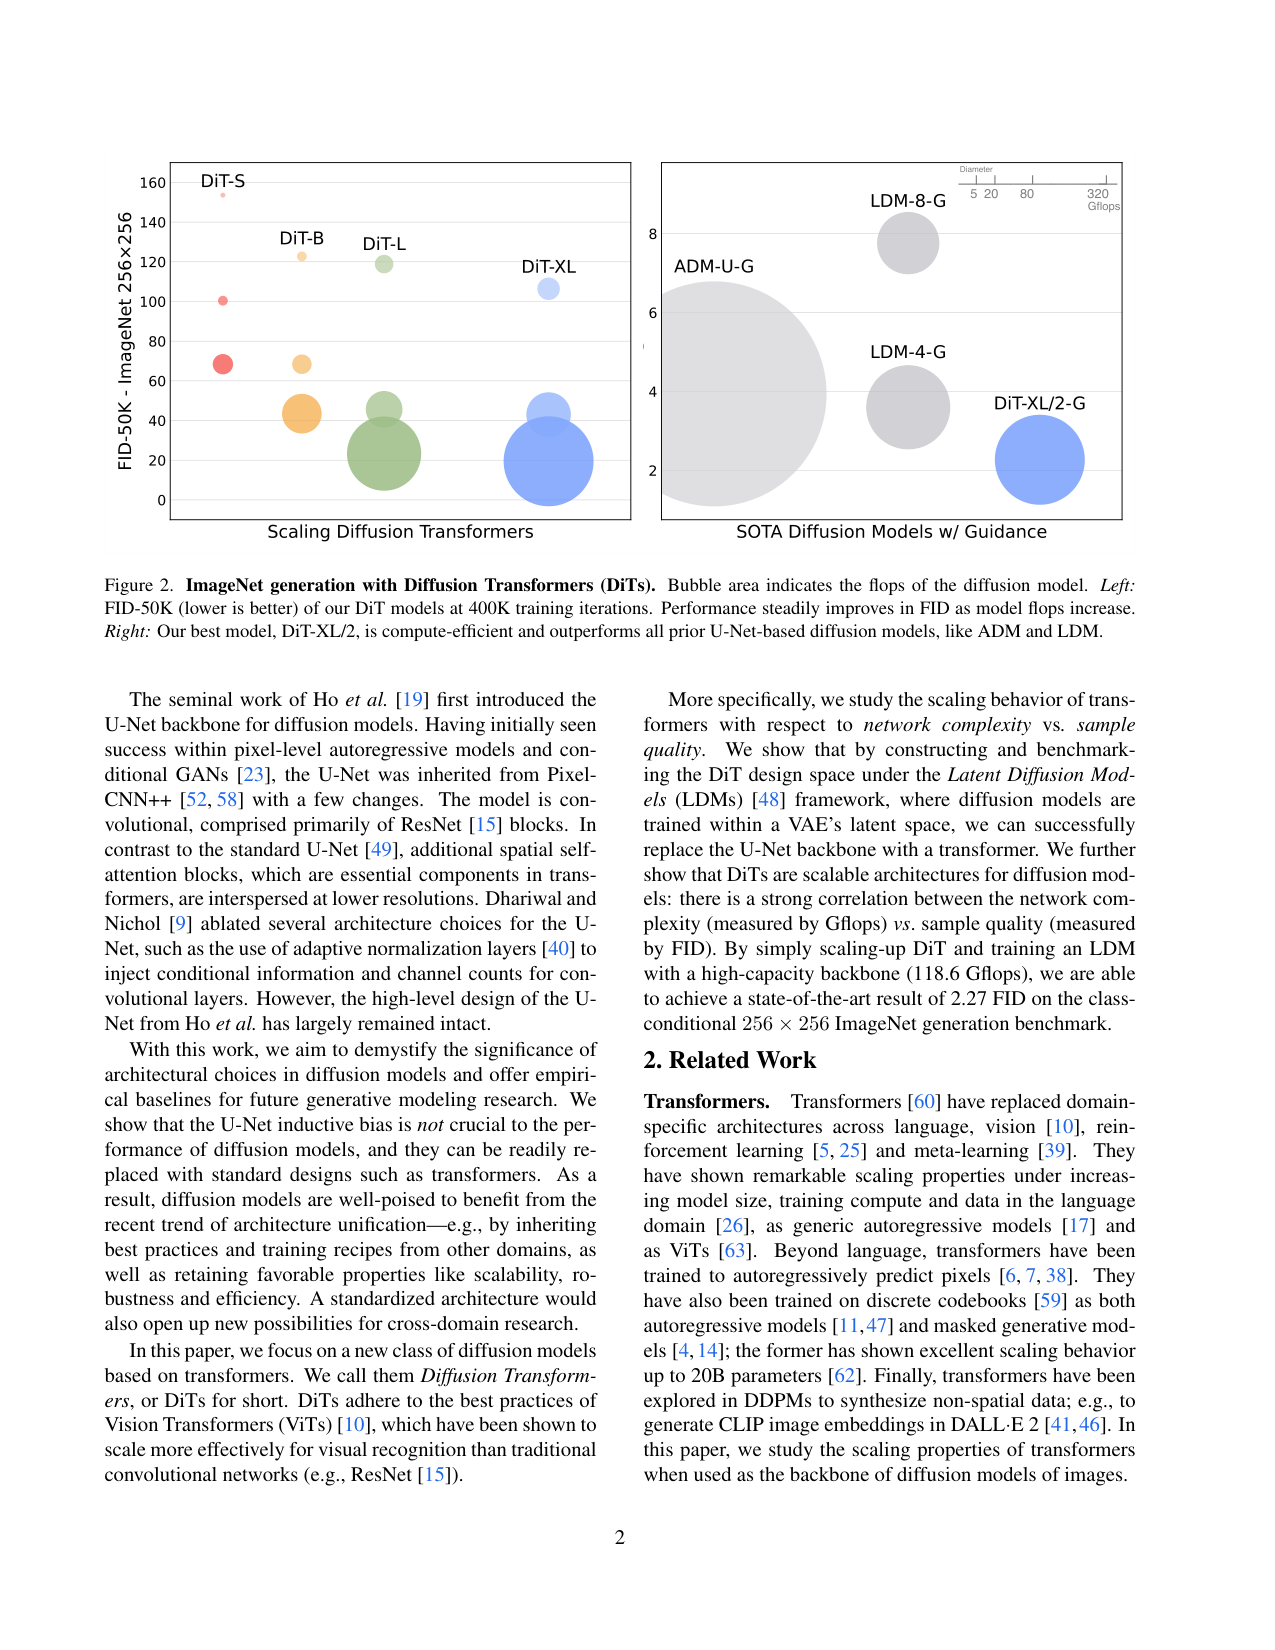
把扩散模型的骨干从卷积 U-Net 换成标准 ViT 风格的 transformer,在 latent 空间训练,证明『模型前向计算量(Gflops)与样本质量(FID)强相关』,并以 675M 参数的 DiT-XL/2 在 ImageNet 256×256 类条件生成上拿到当时最优 FID 2.27;这篇论文的 patchify + adaLN + scaling 配方后来成为 Sora、Stable Diffusion 3、PixArt 等 VLA/视频/文生图模型骨干的通用模板。

读全文 →
diffusiontransformerDiT
cover 系统神经科学综述(吸引子网络 / 连续吸引子 / 积分器)
2022-11-02(期刊在线发表) · Department of Brain and Cognitive Sciences & McGovern Institute, MIT(Khona 另属 MIT Department of Physics)

Attractor and integrator networks in the brain

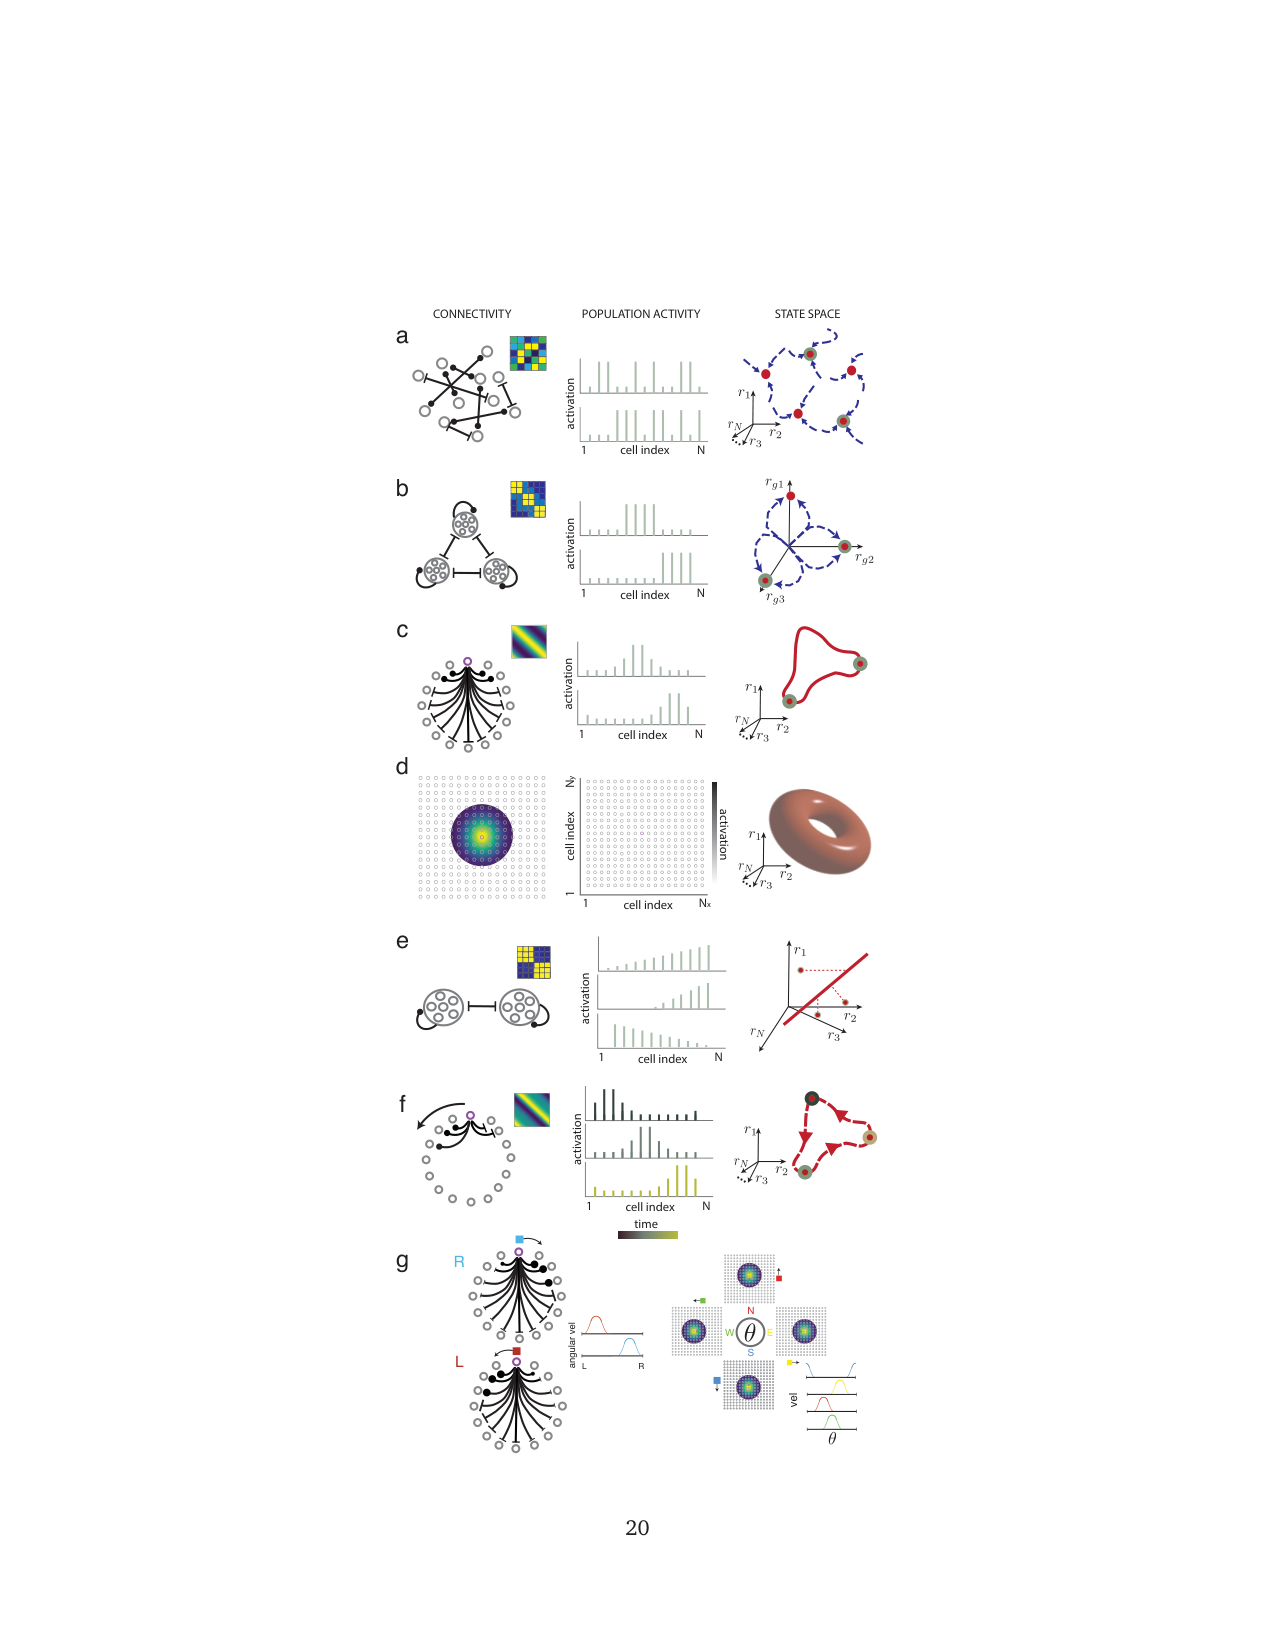
这是一篇权威综述:把『大脑如何用记忆、做积分、做决策』统一到吸引子动力学这一个框架下,给出判定一个神经回路是否真的实现吸引子动力学的五条可检验判据,并用眼动积分器、头方向回路、网格细胞等已被群体记录和状态空间分析严格验证的实例,论证大脑确实构造并使用连续吸引子;同时提出利用积分器复用与模块化组合来同时获得鲁棒性、容量与灵活性的路线。对 ML 读者来说,它把『记忆=稳定不动点、积分=flow map』这两条词汇表落到生物硬件的具体实现上。

读全文 →
attractor networkscontinuous attractorline attractor
cover 生态与物理交叉 / 复杂系统相图
2022-10-07(Science 正式版;bioRxiv 预印本 2021-10-29) · MIT 物理系(Physics of Living Systems)/ CNRS 与 Paul Sabatier 大学(Moulis)/ Technion

Emergent phases of ecological diversity and dynamics mapped in microcosms(微宇宙中生态多样性与动力学的涌现相)

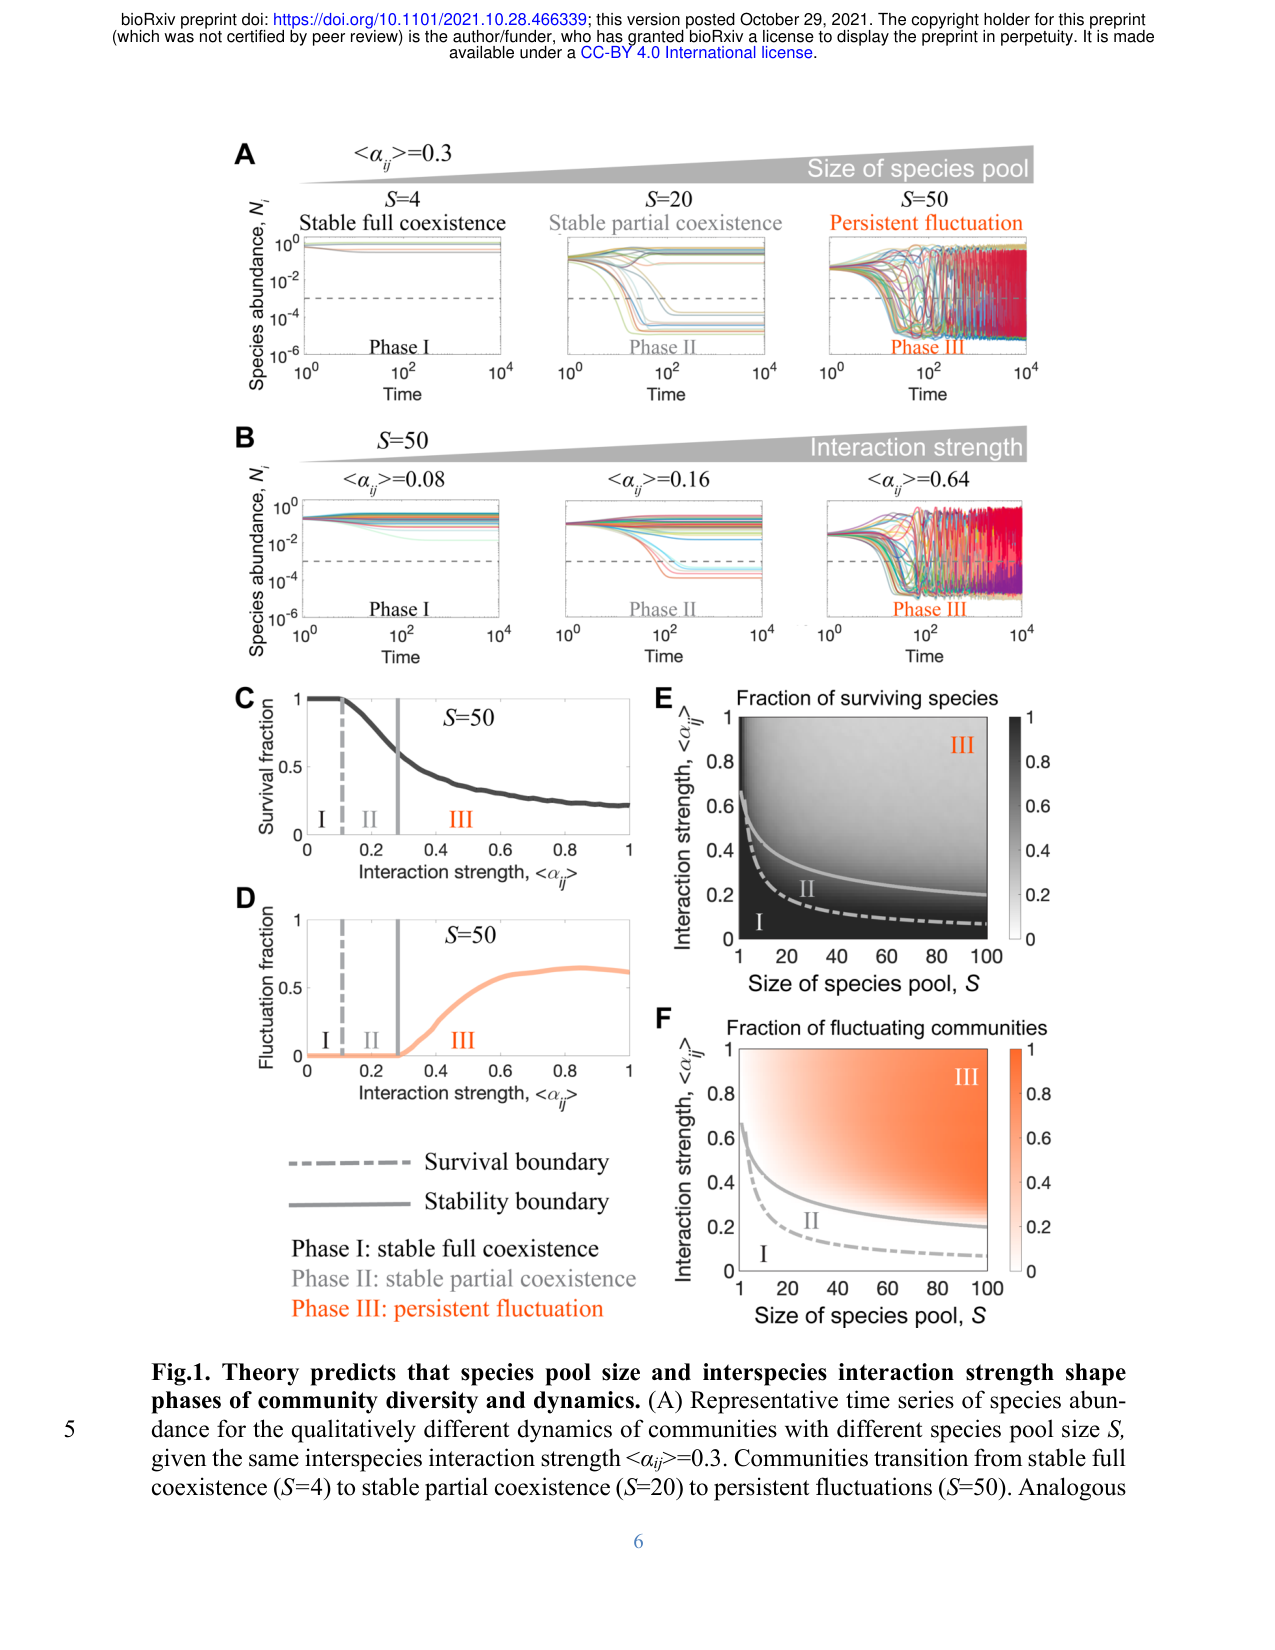
用 48 株细菌搭成的合成微宇宙,第一次在真实实验里直接检验近年复杂系统理论:只要知道物种池大小 S 和平均相互作用强度 <αij> 这两个粗粒化参数,就能预测群落会落在哪个动力学相——稳定全共存、稳定部分共存、还是持续涨落。189 个合成群落、S=2–48、3 个营养水平、每个群落 3 个重复,实验与 gLV 模型模拟都按理论预测的相序 I→II→III 排列;同一条件下涨落群落反而比稳定群落留下更多存活物种,说明高多样性与涨落互相维持。这篇是「用粗粒化统计量画复杂系统相图」的代表作,为生成模型训练相图提供了现成的类比框架。

读全文 →
cover 生成模型理论(Continuous Normalizing Flow 训练范式)
2022-10-05(v1) / 2023-02-08(v2) · Meta AI (FAIR) / Weizmann Institute of Science

Flow Matching for Generative Modeling

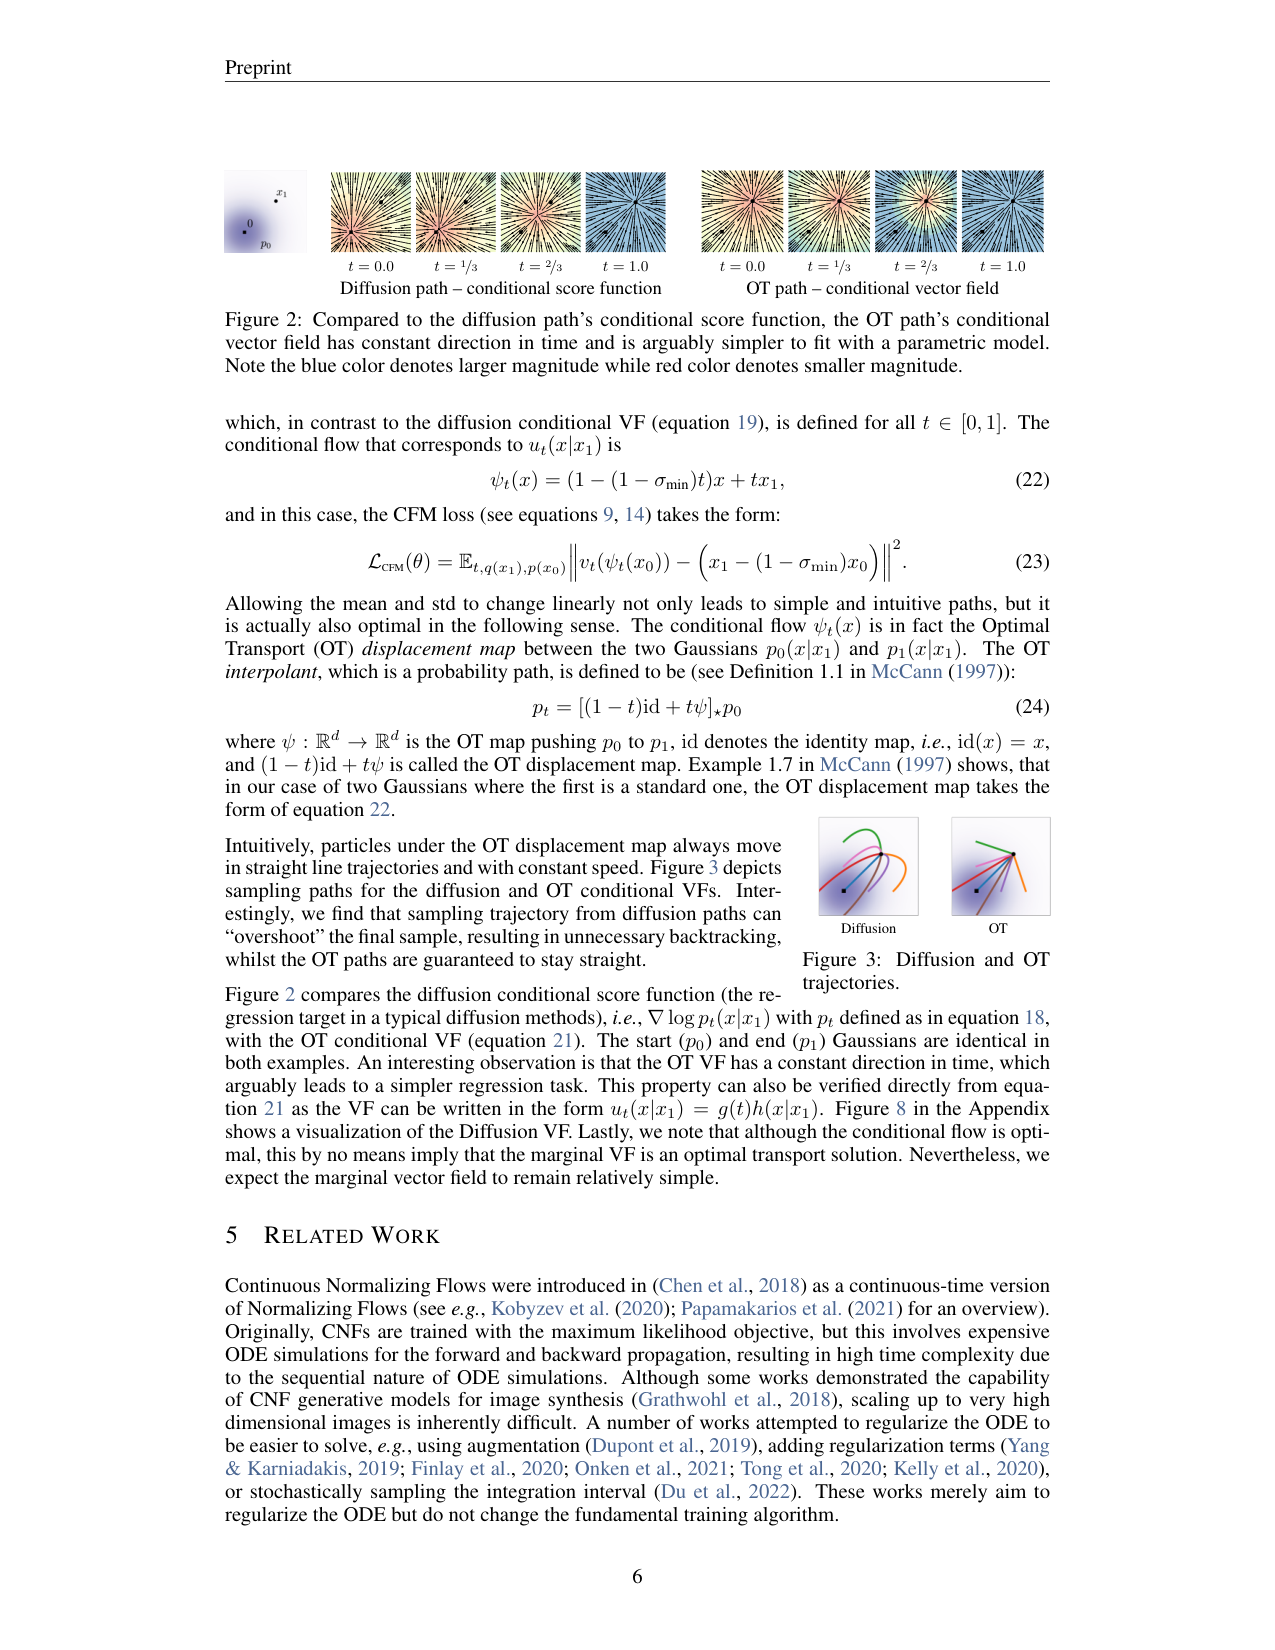
提出 Flow Matching:把 CNF 的训练从『必须模拟 ODE』变成『对每个数据点定义一条条件概率路径、回归其速度场』的 simulation-free 最小二乘问题,并证明条件目标与不可解的边际目标梯度等价;其中线性插值的 OT 路径让条件轨迹变直、回归目标更简单,从而在 CIFAR-10 / ImageNet 32/64/128 上同时拿到更优的似然、FID 与更少的采样步数,并把扩散路径收编为特例——这篇论文与同期 Rectified Flow、Stochastic Interpolants 一起构成后续所有 flow-based 生成模型(SD3、Sora 一代)的理论地基。

读全文 →
flow matchingcontinuous normalizing flowsoptimal transport
cover 生成模型理论(随机插值 / 连续归一化流训练范式)
2022-09-28(v1)/ 2023-03-09(v3) · New York University(Center for Cosmology and Particle Physics / Courant Institute of Mathematical Sciences)

Stochastic Interpolants: A Unifying Framework for Flows and Diffusions(清单名;PDF 正文标题:Building Normalizing Flows with Stochastic Interpolants)

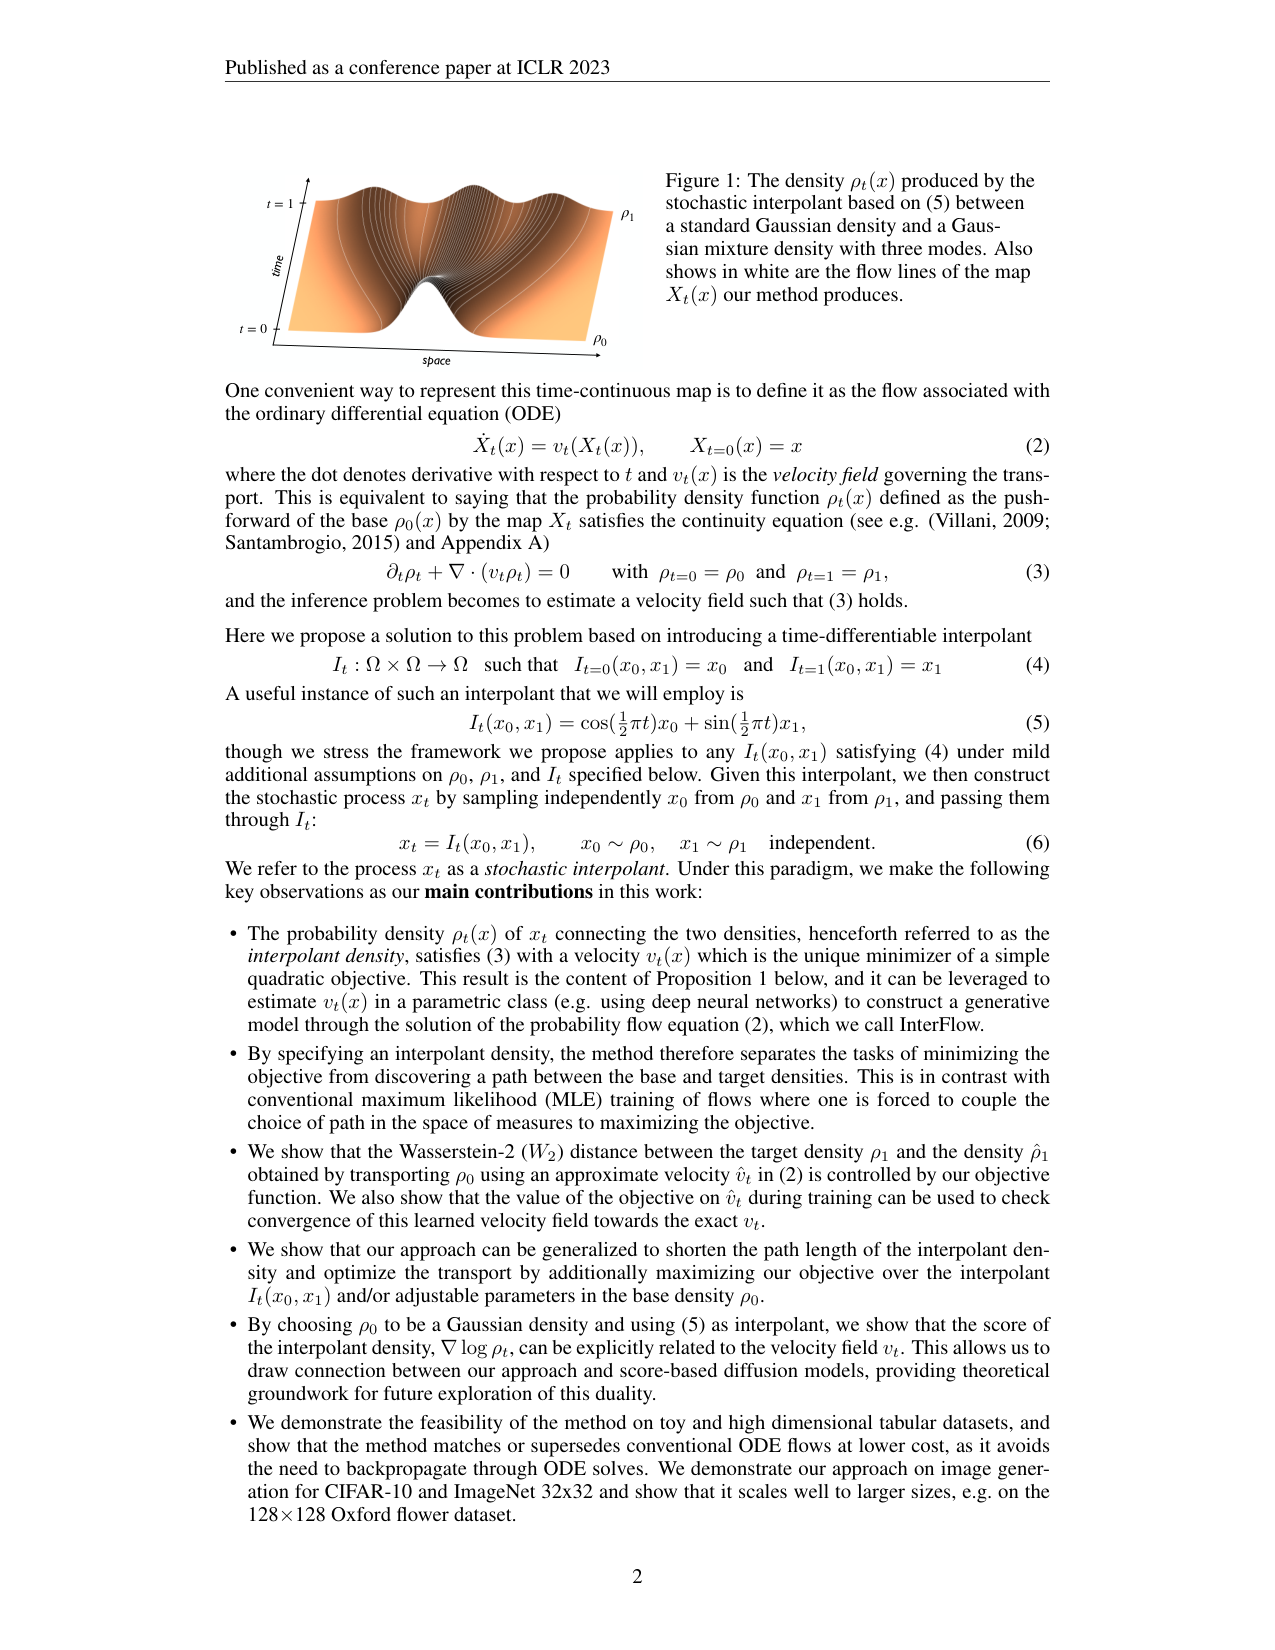
提出「随机插值(stochastic interpolant)」框架:任选一个在 t=0 处取 x0、t=1 处取 x1 的时间可微插值 I_t(x0,x1),把独立采样的基样本与目标样本对折成一条中间密度路径 ρ_t;论文证明这条路径的速度场 v_t 是某个简单二次目标的最小二乘解,训练只需对样本做蒙特卡洛估计,完全绕开对 ODE 求解器的反向传播,还给出训练损失对生成分布 Wasserstein-2 距离的控制界、速度与 score 的显式换算(Proposition 4)以及通过优化插值逼近最优输运的路线(Proposition 2)。实验上,表格数据 NLL 全面追平或反超 FFJORD 等连续流,图像上 CIFAR-10 / ImageNet-32 拿到与扩散模型竞争的似然,并第一次把从零训练的 ODE flow 推到 128×128 分辨率(Oxford Flowers,单张 A100)。这篇论文是后续 Flow Map Matching、MeanFlow 等「flow map / 平均速度」路线共同的数学起点,阅读提示里的「一般插值 + 速度/score 分离」全部落在这篇正文里。

读全文 →
stochastic interpolantcontinuous normalizing flowvelocity regression
cover 生成模型理论 / one-step 谱系
2022-09-07(v1) · University of Texas at Austin

Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow

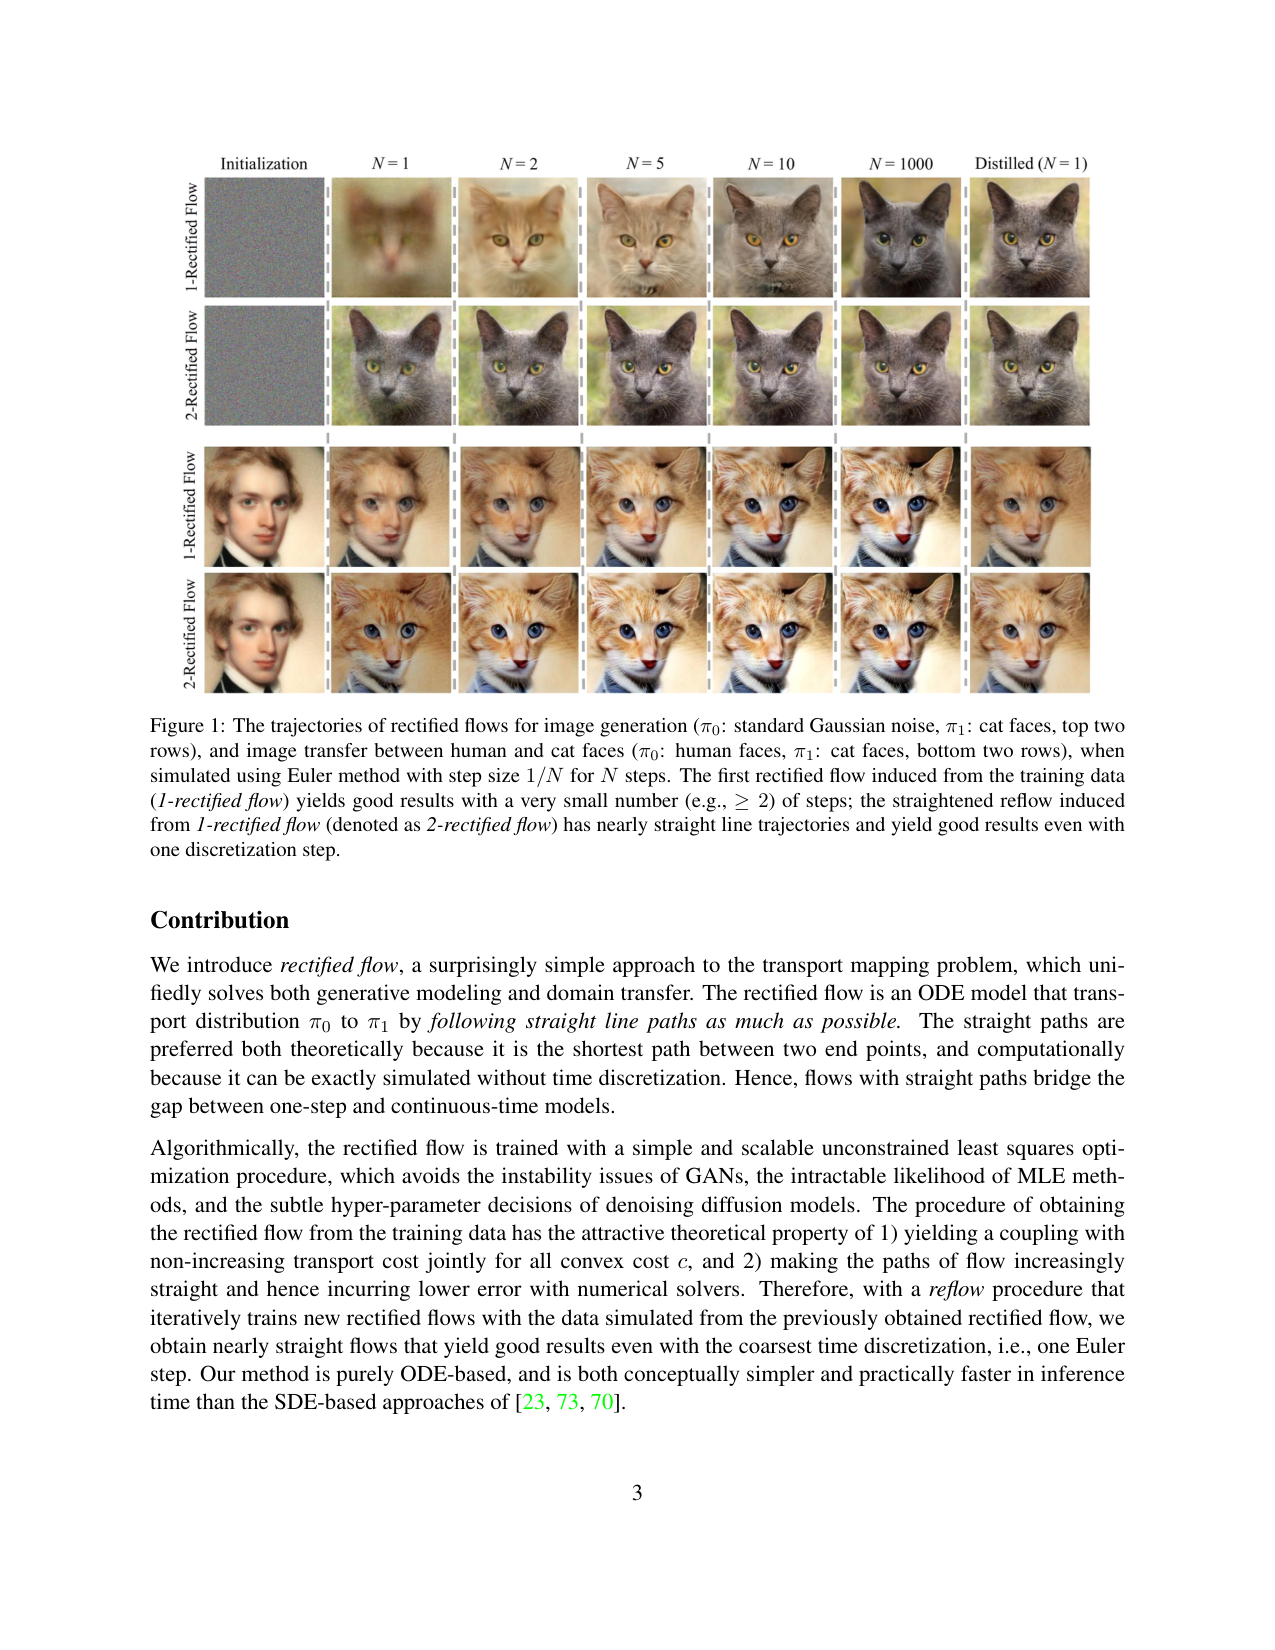
用线性插值路径 X_t = t·X_1 + (1−t)·X_0 上的条件期望速度 v_X(x,t) = E[X_1 − X_0 | X_t = x] 直接学一个 ODE 输运模型,再递归地用已学流重新采样端点对(reflow)把轨迹拉直,让原本要上百步数值求解的连续时间模型在 CIFAR-10 上做到一步欧拉出图(蒸馏后 FID 4.85),同时把概率流 ODE 与 DDIM 收编为它的非线性特例,是 one-step 生成思想最早的系统表述。

读全文 →
rectified flowflow matchingneural ODE
cover 生成模型理论 / 扩散模型(噪声预测约定)
2020-12-16 · UC Berkeley

Denoising Diffusion Probabilistic Models (DDPM)

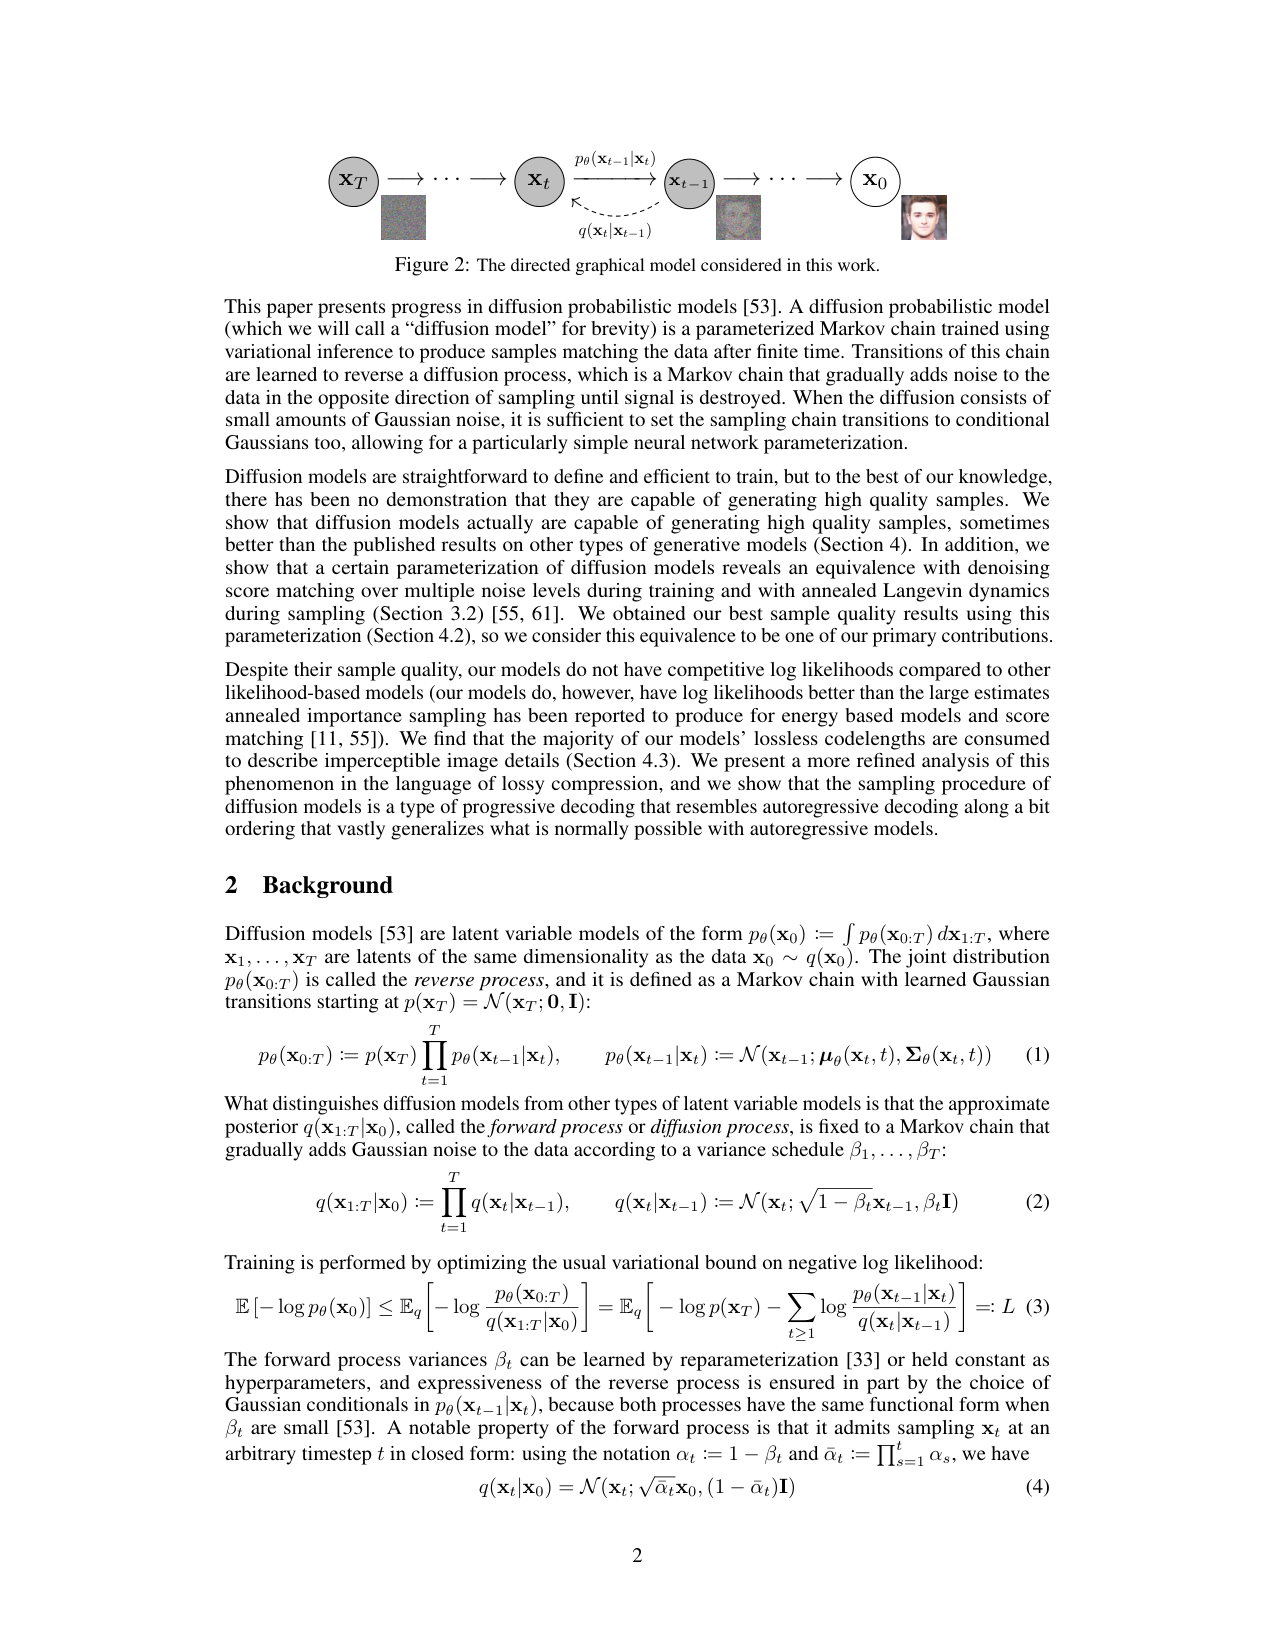
DDPM 把扩散概率模型从 2015 年的理论框架变成能生成高质量图像的实用生成器:固定一条逐渐加噪的前向马尔可夫链,用神经网络学反向去噪链,并把变分下界改写为『预测噪声 ε』的无权重均方误差。它在无条件 CIFAR10 上拿到 Inception Score 9.46、FID 3.17,超过当时多数生成模型;『噪声预测』从此成为扩散模型沿用至今的默认约定,也是后来 JiT 论文用 x-prediction 挑战的靶子。

读全文 →
diffusiongenerative modelnoise prediction
cover 生成模型理论(score-based 扩散 / SDE 统一框架)
2020-11-26(v1) / 2021-02-10(v2) · Stanford University / Google Brain

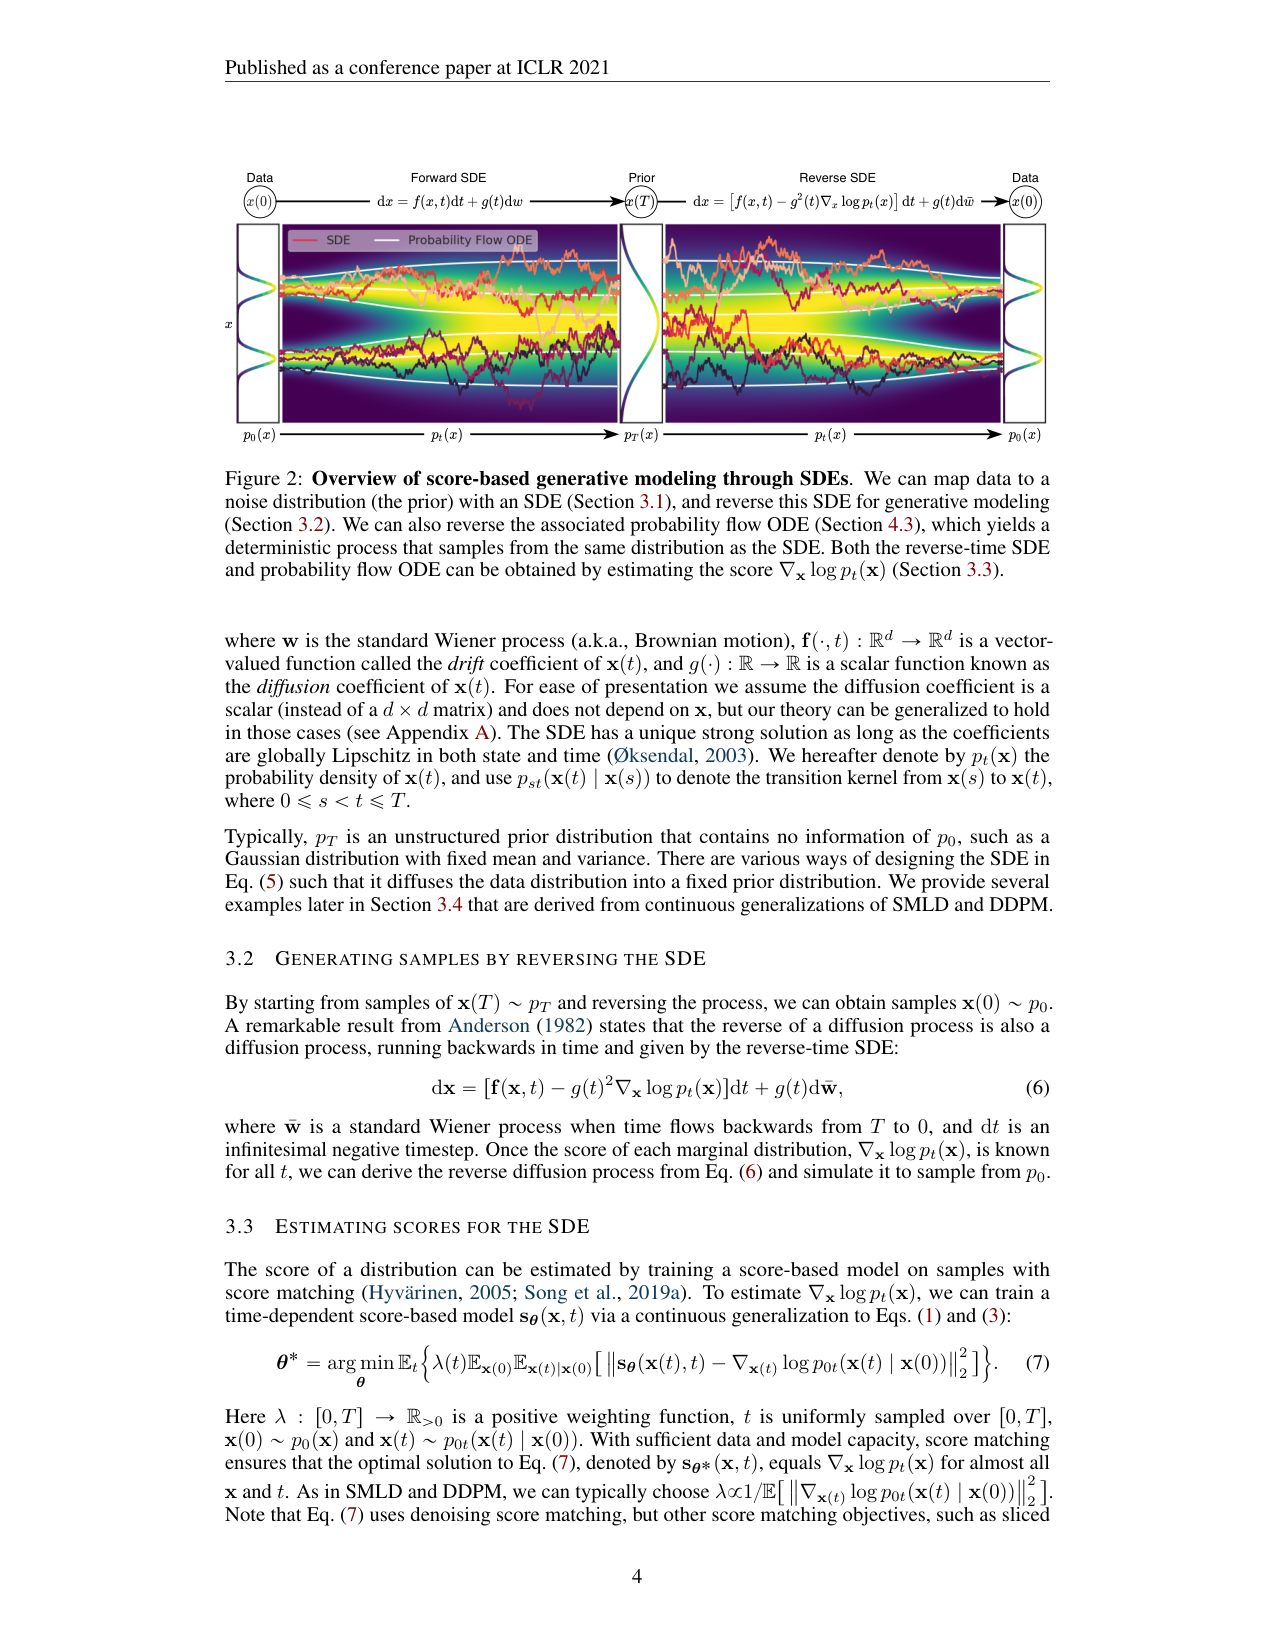
Score-Based Generative Modeling through Stochastic Differential Equations

把「有限个噪声尺度上加噪—去噪」的两条既有路线(SMLD、DDPM)推广成「连续时间扩散 SDE + 逆向 SDE」的统一框架:训练只需要估计时间相关的 score(对数密度的梯度 ∇_x log p_t(x)),就能反演扩散过程生成样本;论文进一步证明每个扩散过程都对应一个共享同一组边际分布的概率流 ODE,把随机采样变成确定性输运,从而免费获得精确似然、唯一可辨识编码与 90% 以上的采样步数削减,并首次用 score-based 模型生成 1024×1024 高清人脸。这篇论文是后续 flow 谱系(Flow Matching、Rectified Flow、Stochastic Interpolants)连续化思路的出发点。

读全文 →
score-based generative modeldiffusion SDEprobability flow ODE
0:00