One-step Latent-free Image Generation with Pixel Mean Flows(精读)
一句话定位
这篇论文(MIT/CMU,arXiv 2601.22158)要填一个此前几乎空白的象限:生成模型既做到一步采样(1 次函数评估,1-NFE),又不依赖 latent 空间(不经过预训练 VAE/tokenizer),直接在原始像素上从零训练。它给出的方法是 pixel MeanFlow(pMF),核心指南是一句话:把网络输出空间和损失空间分开设计——网络直接输出去噪图像 x(一个被假定落在低维图像流形上的量),损失却定义在瞬时速度 v 空间(一个有明确真值的回归空间),中间用两条代数式把 x、u(平均速度)、v 三个场接起来。在 ImageNet 上,pMF-H/16 用 1-NFE 在 256×256 拿到 2.22 FID(956M 参数、271 Gflops),pMF-H/32 在 512×512 拿到 2.48 FID(959M 参数、272 Gflops)。
问题背景:为什么「一步」和「无 latent」很难同时做到
现代扩散/flow 图像生成有两个约定俗成的组件。第一是多步采样:生成一张图等价于解一条从噪声到数据的常微分方程(ODE),每前进一小步都要调用一次网络前向,像 DiT-XL 在 ImageNet 256×256 上要 250 次函数评估,开 classifier-free guidance(CFG)还要翻倍到 500 次。第二是 latent 空间:像素维度太高,主流做法先用预训练 VAE 把 256×256×3 的图像压成 32×32×4 的潜变量,生成在 latent 里做,最后用解码器还原。
这两条线各自都有过进展:Consistency Models、MeanFlow 系列把采样压到 1 步;JiT 等像素空间 Transformer 拿掉了 latent。但把两个目标合到同一个网络里,负担会叠加:一步建模要求单个网络同时刻画不同起止点之间的整段轨迹,像素空间又要求网络在没有 tokenizer 的情况下自己完成压缩与抽象。更具体的技术障碍是:直接在像素空间预测速度场会失败。这篇论文的消融给出一个很刺眼的数字——ImageNet 256×256、patch 维度 768 时,网络预测平均速度 u(u-prediction)的 1-NFE FID 高达 164.89,同一架构改预测去噪图像 x(x-prediction)只有 9.56。所以问题可以收敛成一句:在像素空间一步生成,网络到底该输出什么量。
核心思想:输出空间与损失空间分离
pMF 的全部设计围绕「输出空间」与「损失空间」两个概念展开。先给预期:网络输出什么(预测目标)决定高维空间能不能学动;损失在哪个空间算决定回归问题稳不稳定。 pMF 把这两件事拆开,分别选最合适的空间,再用代数变换连接。
先看 flow matching 的标准设定。给定真实图像 x 与高斯噪声 ε,线性插值定义带噪数据
z_t = (1−t)·x + t·ε, t ∈ [0,1]
其中 t=0 时 z_0 是干净图像、t=1 时 z_1 是纯噪声;对 z_t 求导得到条件速度 v = ε − x,也就是「从图像指向噪声」的位移。flow matching 训练网络回归这个 v,推理时沿学到的速度场从 t=1 积分回 t=0。问题在于积分要切很多小段,所以 NFE 大。
MeanFlow 的思路是把「一段积分」压缩成一步:定义从时间 r 到 t 的平均速度
u(z_t; r, t) = (1/(t−r)) · ∫_r^t v(z_τ, τ) dτ
如果速度场接近直线,平均速度乘以区间长度就约等于整段位移,于是一步就能从 z_1 走到 z_0。但平均速度 u 没有可直接观测的真值,训练时要用一条恒等式(MeanFlow identity)把积分换成微分:v(z_t, t) = u(z_t; r, t) + (t−r)·(d/dt)u(z_t; r, t),其中 d/dt 用雅可比向量积(JVP)计算并做 stop-gradient。这样网络可以输出 u,再用上式合成一个「复合预测」V_θ 去回归 v——这就是 improved MeanFlow(iMF)的做法,u-prediction 加 v-loss。
pMF 的关键一步,是再引入一个与 u 线性相关的量——去噪图像场:
x(z_t; r, t) = z_t − t·u(z_t; r, t)
预期:这个式子要回答「平均速度场能不能被重参数化成一个更易学的量」。解释符号:z_t 是带噪输入,u 是平均速度,乘上 t 再被 z_t 减掉,得到的 x 把「噪声成分」从速度里剥离——u 场里噪声和图像两种成分搅在一起、在高维空间里铺满,而 x 场在视觉上表现为干净图或过度去噪后的发糊图。图 1 的右半部分把同一批 (r,t) 点上算出的 u 和 x 并排展示,u 排全是带噪图像,x 排基本是干净或发糊的图像,这正是「x 落在低维图像流形上」的直接证据。
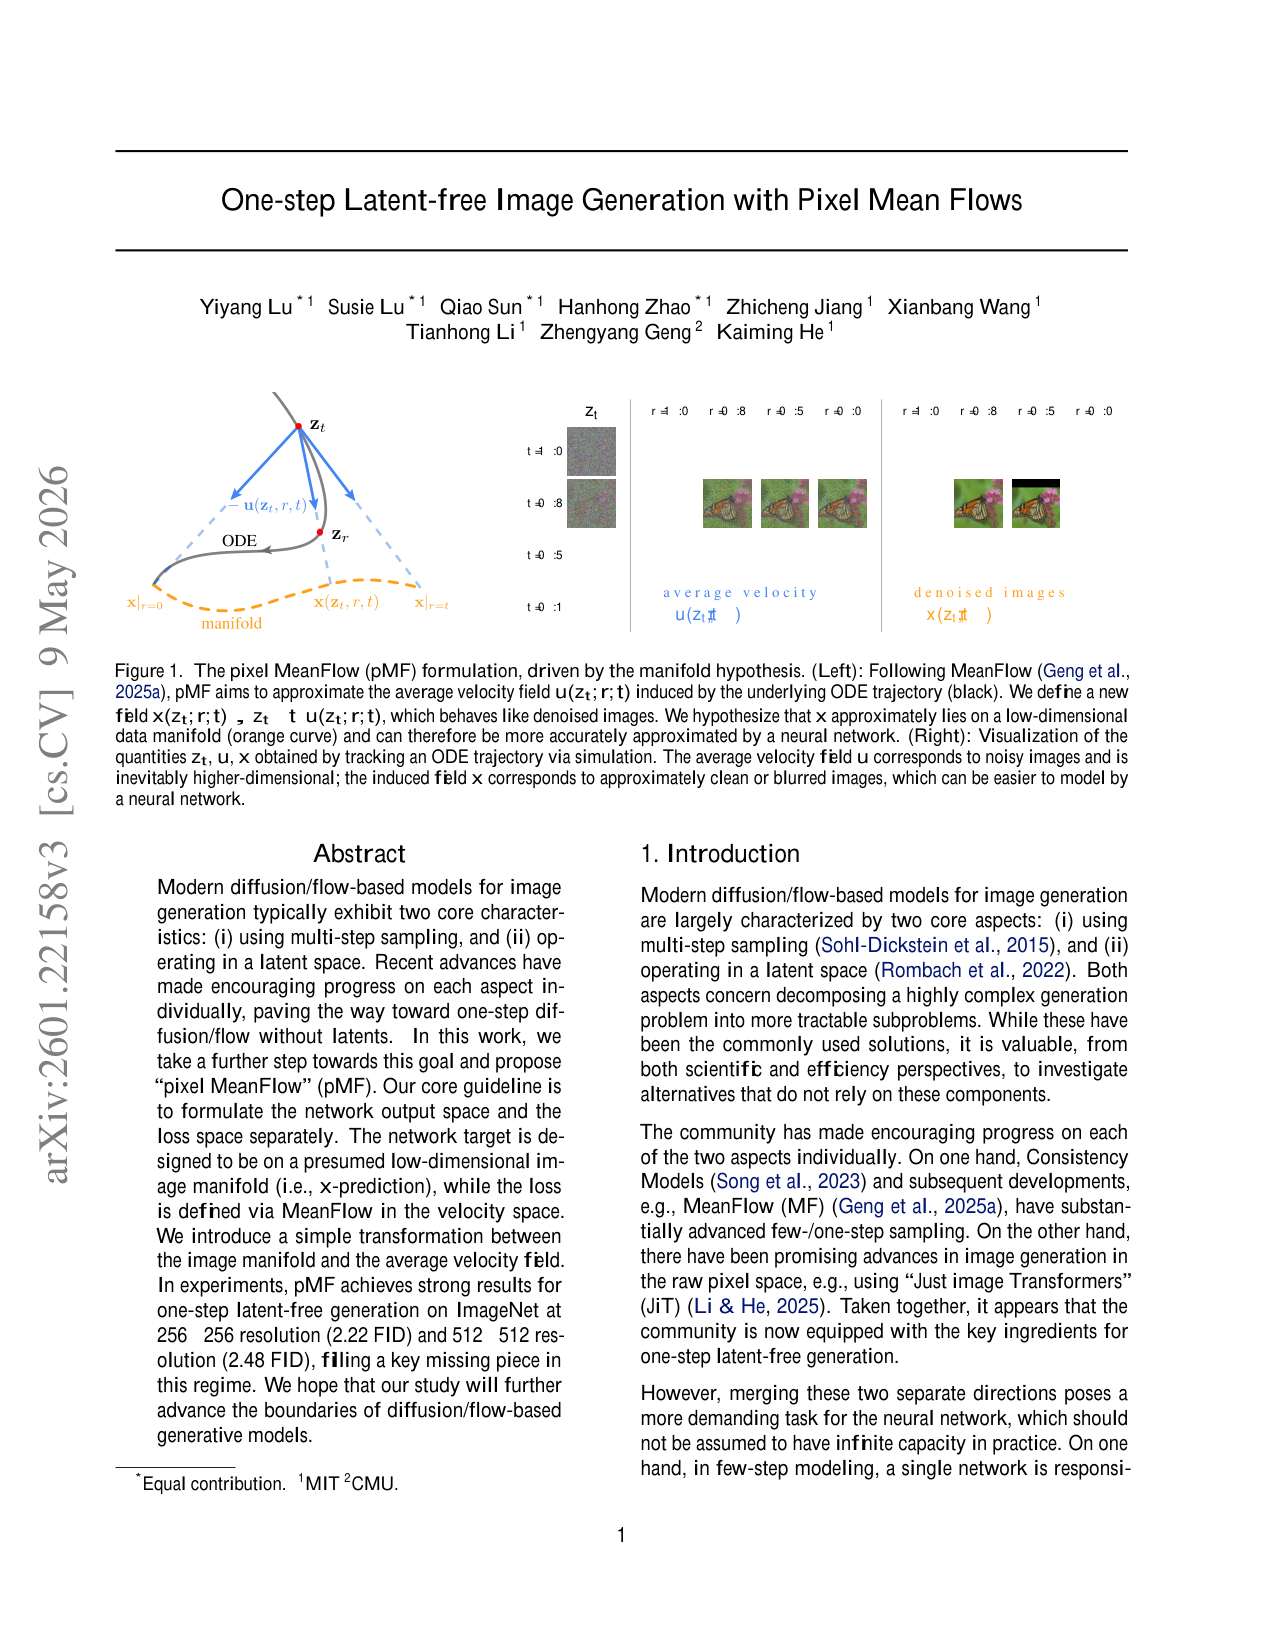
这个 x 场的三个特殊位置值得逐一看。r = t 时,平均速度退化为瞬时速度 v,x(z_t; t, t) = z_t − t·v(z_t, t),恰好就是 JiT 论文里的 x-prediction 目标——去噪图像,噪声水平高时发糊。r = 0 时,u(z_t; 0, t) = (z_t − z_0)/t,代入得 x(z_t; 0, t) = z_0,严格等于 ODE 的终点,也就是数据分布上的点。中间的 0 < r < t 没有理论保证,但仿真显示它同样呈现去噪图像样貌。论文把这套论证叫「广义流形假设」:u 是含噪的高维量,x 是低维流形上的量,网络输出 x 更容易。
训练算法把这三个场串起来:网络直接输出 x_θ(z_t; r, t),先用 u_θ = (z_t − x_θ)/t 转回平均速度,再用 MeanFlow identity 合成 V_θ = u_θ + (t−r)·JVP_sg,损失在 v 空间回归:
L_pMF = E_{t,r,x,ε} ‖V_θ − v‖²
这里的预期:损失仍然回归瞬时速度 v(回归目标标准、有明确真值 ε−x),但网络输出的是 x(流形友好)。对比表 1 里各家方法的「预测空间 → 转换 → 损失空间」:DiT 是 ε→ε,SiT 是 v→v,MF 是 u→u,iMF 是 u→v,JiT 是 x→v,pMF 是 x→u→v——只有 pMF 走了两步转换,把「好学的输出」和「好回归的损失」接到了一起。
因为网络输出就是像素图像,pMF 还获得一个附带红利:感知损失可以直接作用在输出上(what-you-see-is-what-you-get)。总损失是 L_pMF + λ·L_perc,L_perc 用 LPIPS(VGG 版权重 0.4、ConvNeXt-V2 版权重 0.1),只在噪声低于阈值 t_thr 时施加(默认 0.8,长训练改 0.6),避免让网络去预测过度发糊的图。
关键实验:x-prediction 的优势在哪些条件下成立
论文的实验分三层:玩具实验、ImageNet 消融、系统级对比。
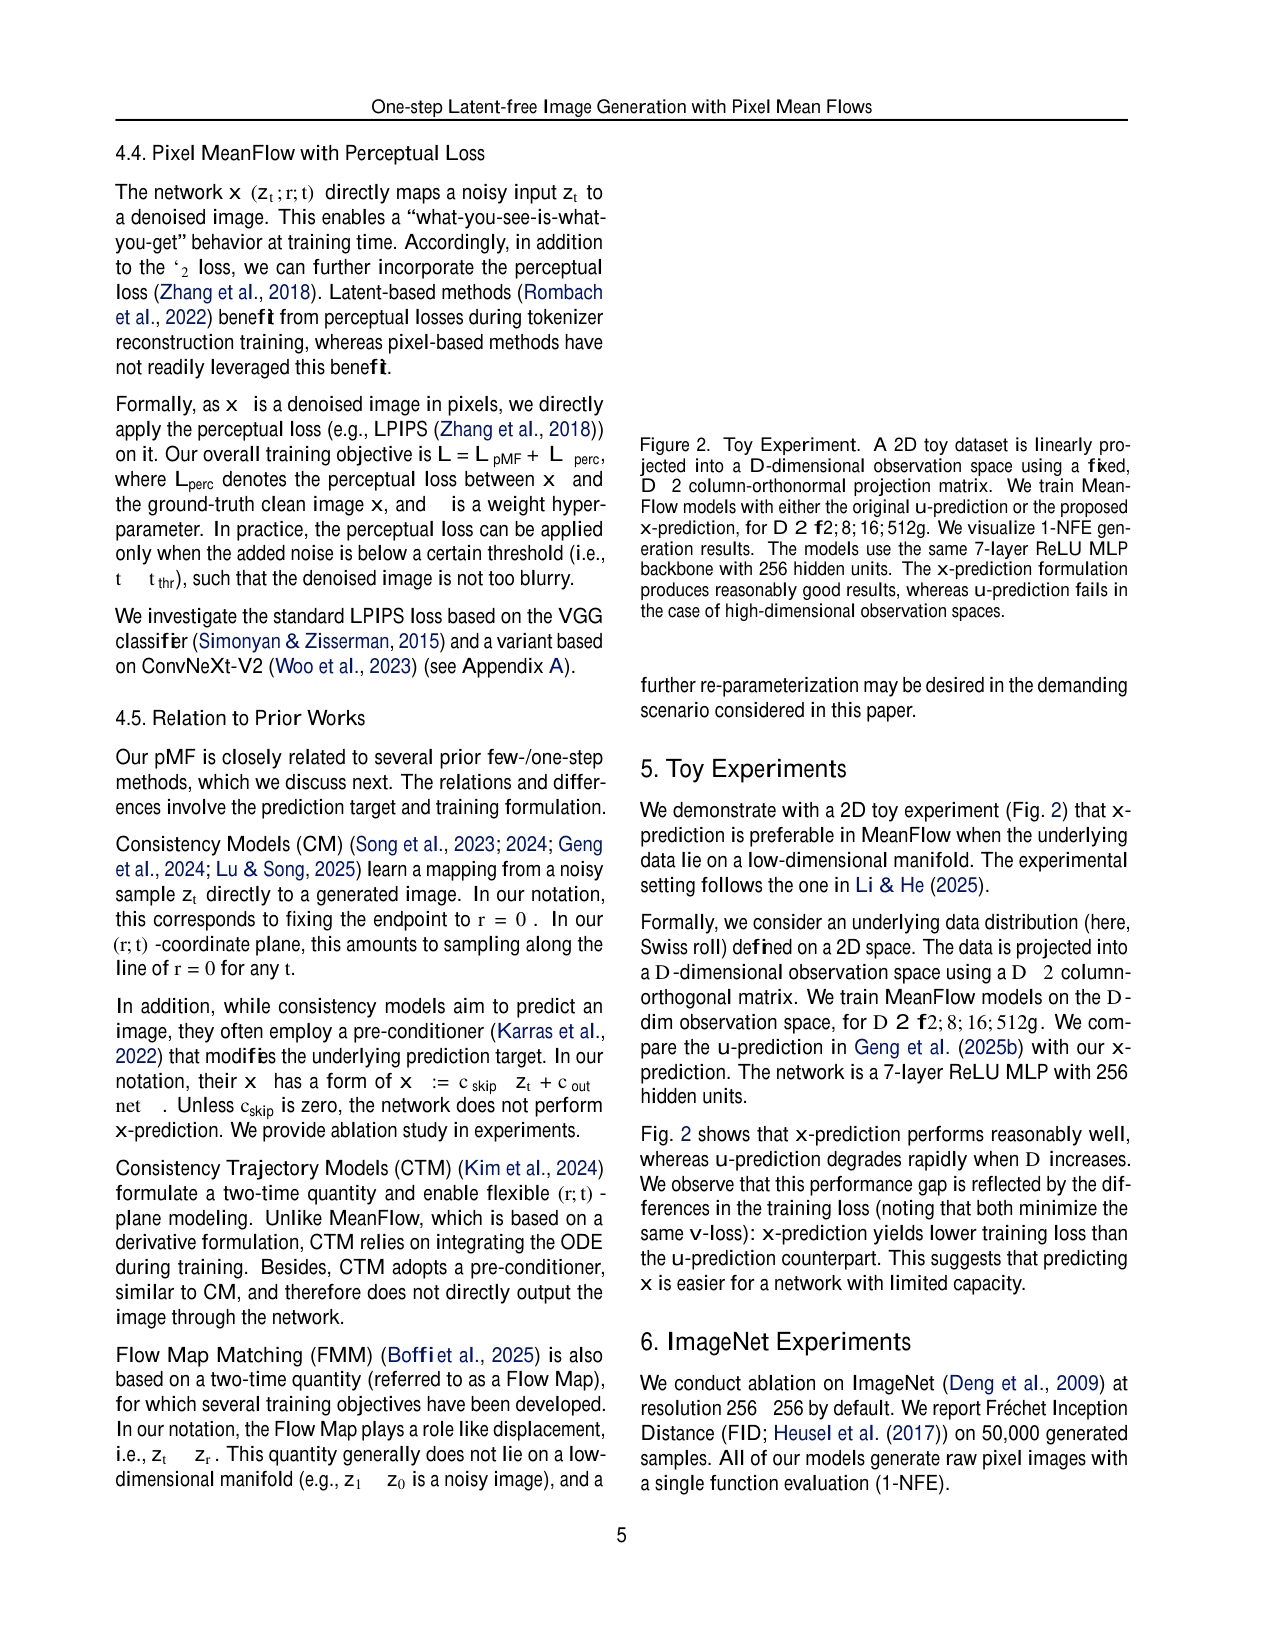
玩具实验(图 2)把问题从图像抽象到一般的高维观测。把二维 Swiss roll 数据用固定的 D×2 列正交矩阵投影进 D 维观测空间,D 取 2、8、16、512,同一个 7 层 ReLU MLP(256 隐藏单元)分别做 u-prediction 和 x-prediction,两者最小化的是同一个 v-loss。结果显示:D 小(2 维)时两者都能生成出 Swiss roll 形状;D 增大后 u-prediction 生成的点散成噪声,x-prediction 仍保持流形结构,而且 x-prediction 的训练损失更低。这张图把「高维观测空间里目标是否落在低维流形」从图像推广到一般数据,是全文论证链的第一环。
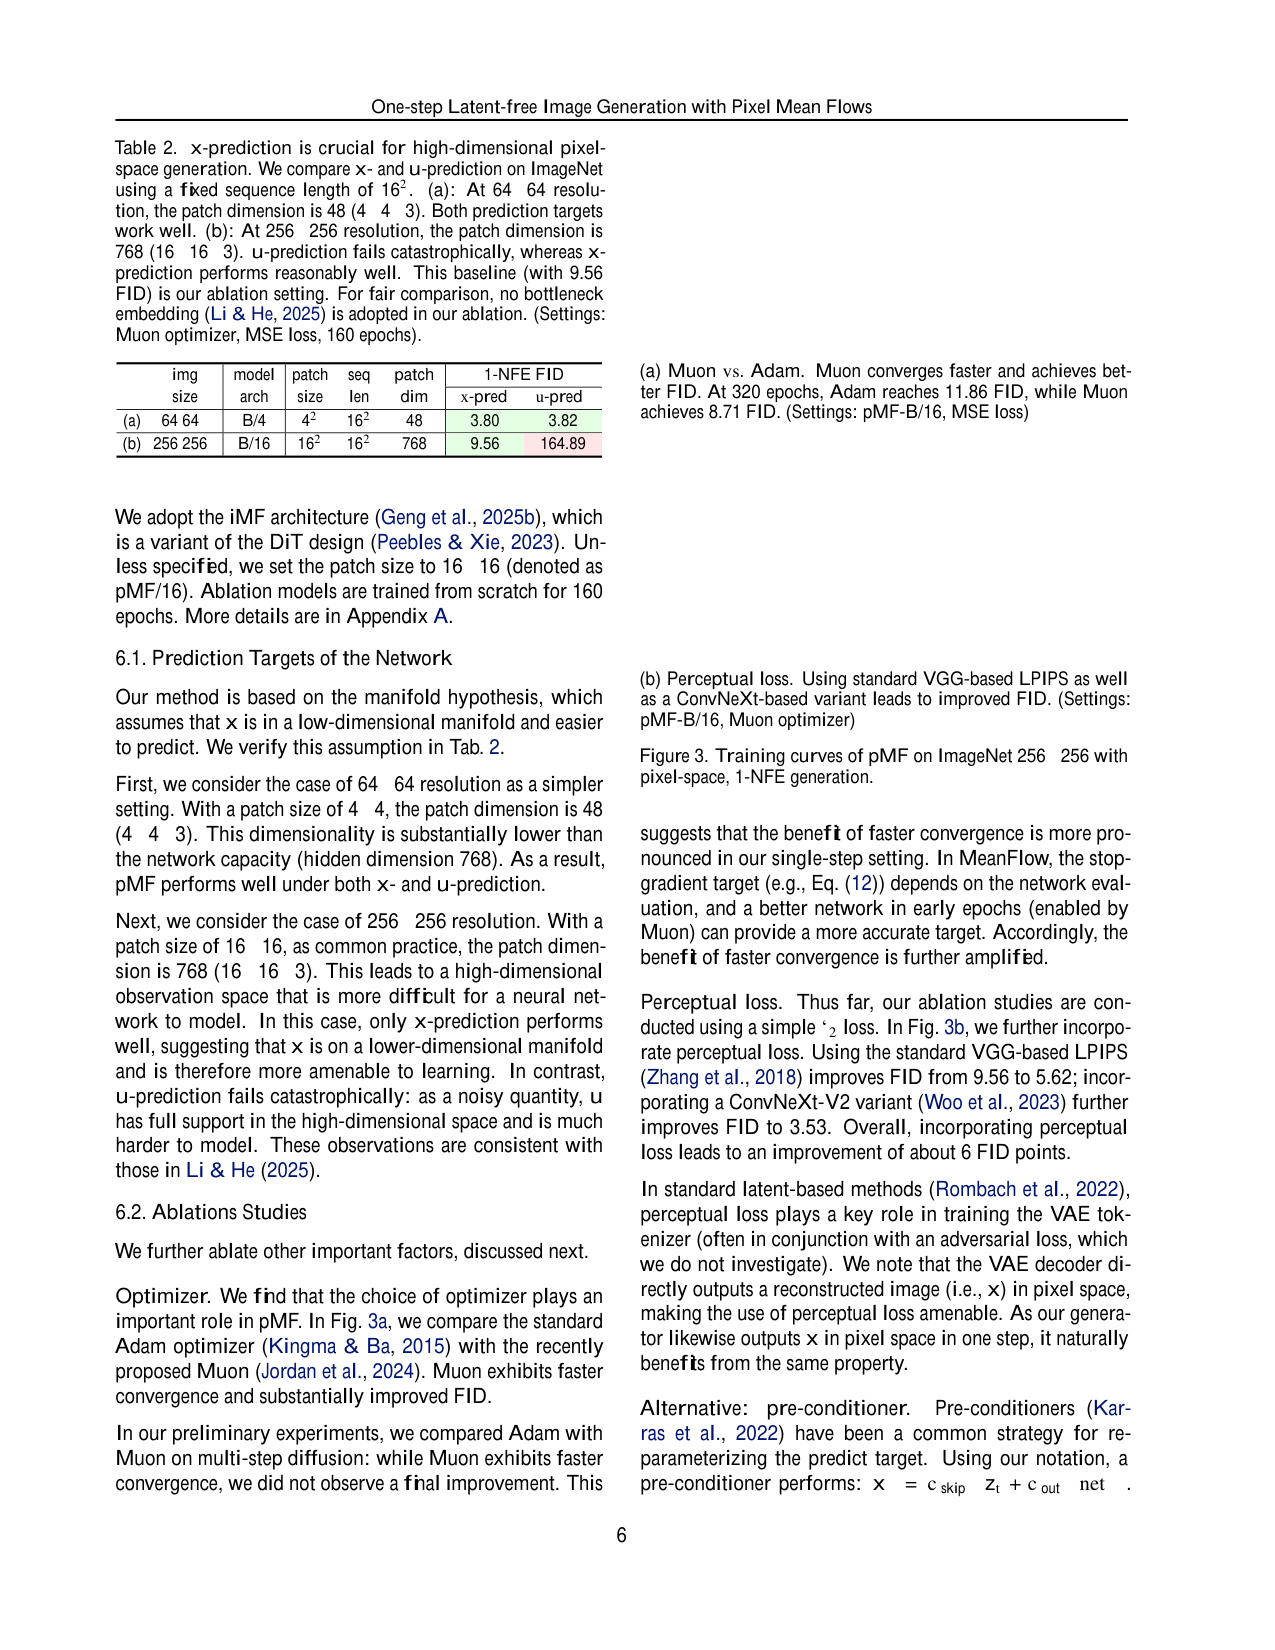
ImageNet 消融(表 2)把同一对比搬到真实图像。64×64 分辨率、patch 4×4(单 patch 维度 48)时,x-prediction 与 u-prediction 几乎打平(3.80 vs 3.82 FID)——因为 48 维远低于网络容量(hidden 768),学哪个都行。256×256、patch 16×16(维度 768)时,x-prediction 是 9.56,u-prediction 崩到 164.89。设置是 B/16 架构、Muon 优化器、MSE 损失、160 epoch、序列长度 162。分界线清楚:观测维度越高,输出目标是否落在低维流形越关键。
优化器与感知损失(图 3)。优化器消融显示 Muon 比 Adam 好:同为 320 epoch,Adam 是 11.86 FID,Muon 是 8.71。论文给出的解释是:one-step 训练的 stop-gradient 目标依赖网络自身质量,Muon 让早期网络更准,目标就更准,收益被放大;对照实验里多步 diffusion 中 Muon 只有收敛更快、没有最终提升。感知损失消融更直接:纯 ℓ2 是 9.56,加 VGG-LPIPS 降到 5.62,再加 ConvNeXt-V2 版到 3.53,总共约 6 个 FID 点。这套收益在 latent 方法里属于 tokenizer 训练阶段,pMF 靠「输出即像素」把它搬进了生成器本体。
两组合格线消融回答了「为什么非要用 pMF 这个具体设计」。第一组是 pre-conditioner:Consistency Models 常用的线性式(c_skip=1−t, c_out=t)、EDM 式、sCM 式分别只有 34.61、14.43、13.81,而 pMF 的纯 x-prediction(等价于 c_skip=0)是 3.53——因为只要 c_skip 非零,网络输出就混进 z_t 的噪声成分,偏离 x 空间,落回高维流形。第二组是时间采样:只采 r=t 一条线(flow matching 式)是 194.53,只采 r=0(consistency 式)是 389.28,两条线都采是 106.59,全区域 0≤r≤t 采样是 3.53。MeanFlow 的一步能力来自 (r,t) 平面上各点之间的平均速度关系,把采样限制到一条或两条线上,这个关系就丢了。
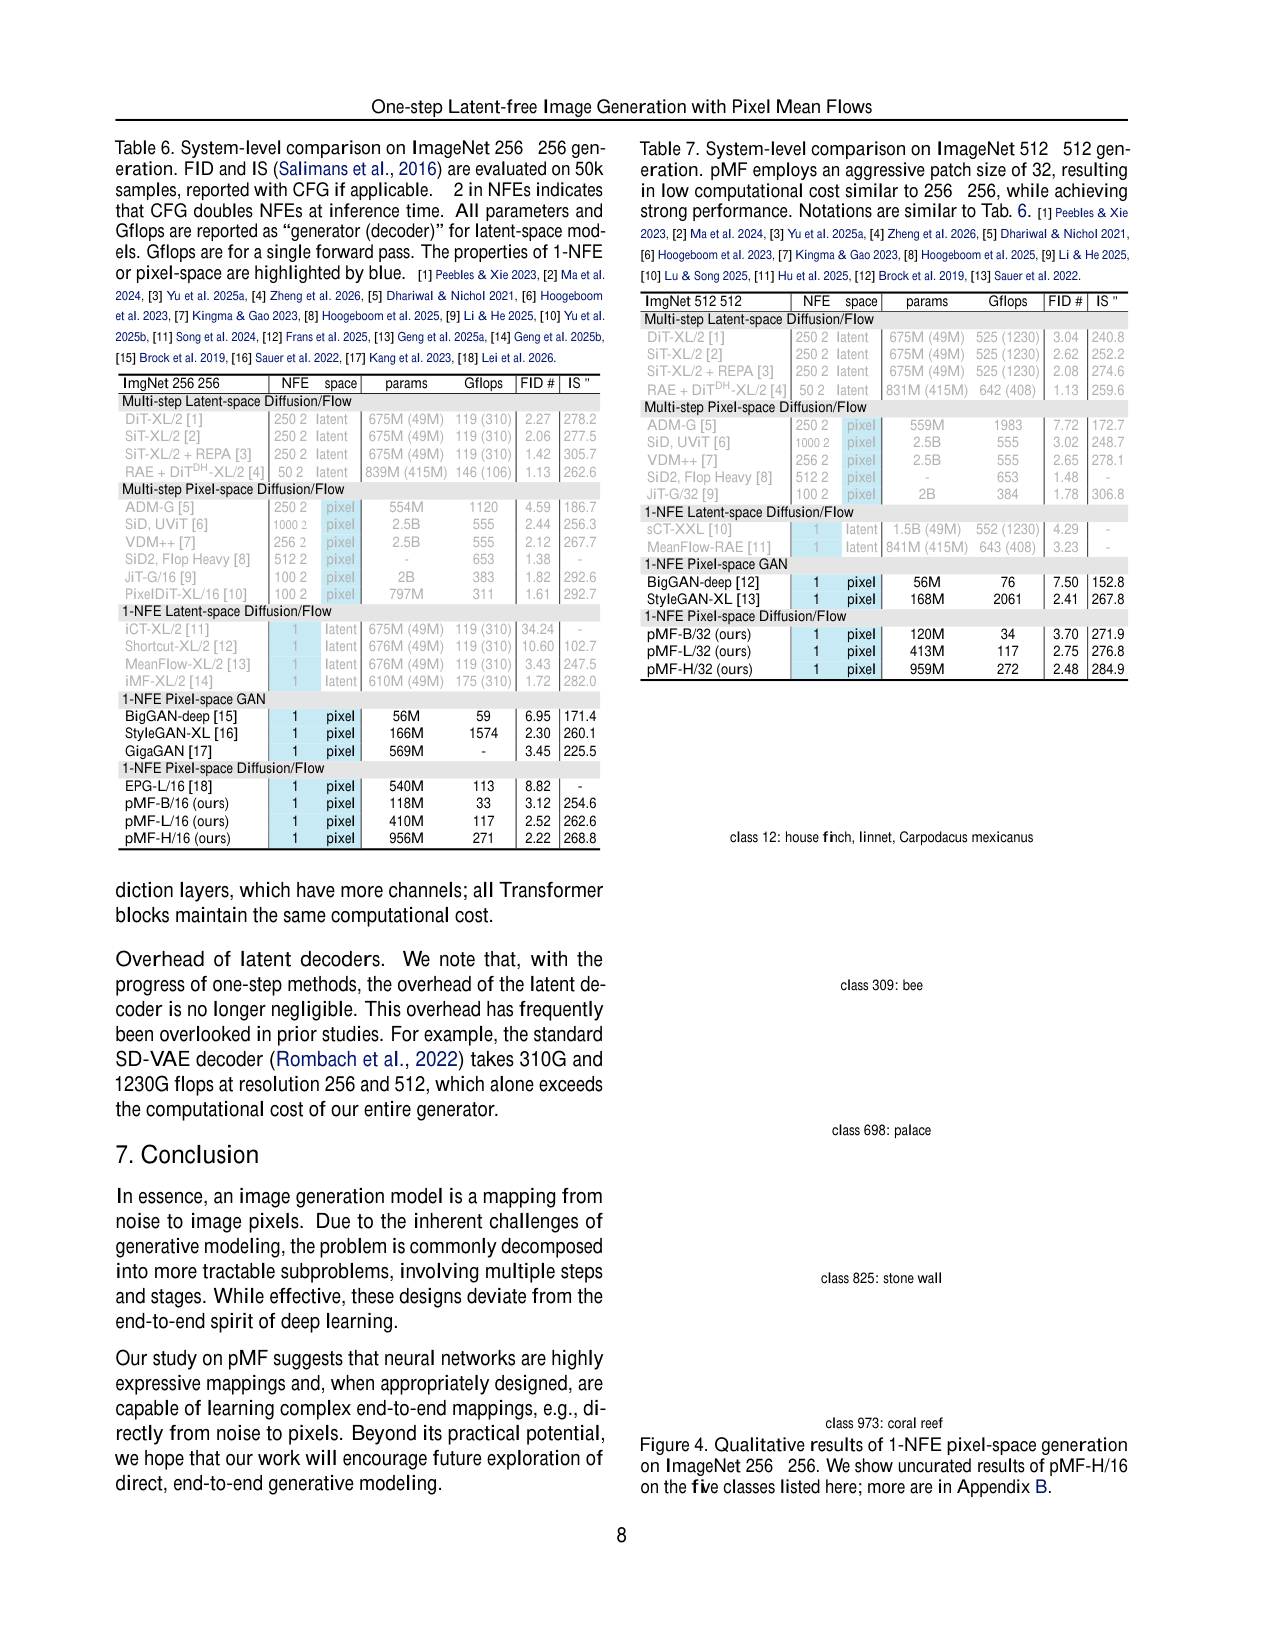
系统级对比(表 6/7)。256×256 上 pMF-H/16(360 epoch)1-NFE FID 2.22、IS 268.8,956M 参数、271 Gflops;L/16 是 2.52,B/16 是 3.12。此前唯一的同类方法 EPG-L/16(one-step、latent-free、带自监督预训练)是 8.82;one-step 但走 latent 的 iMF-XL/2 是 1.72;多步 latent 的 DiT-XL/2(250×2 步)2.27、SiT-XL/2+REPA(250×2 步)1.42;多步像素的 JiT-G/16(100×2 步)1.82。512×512 上 pMF-H/32 是 2.48,对照 one-step 像素 GAN StyleGAN-XL 的 2.41(168M 参数、2061 Gflops,pMF 的 272 Gflops 只有它的约 1/7)。论文特别强调 latent 解码器的开销:SD-VAE 解码器单独在 256 要 310 Gflops、512 要 1230 Gflops,已经超过 pMF 整个生成器;one-step 时代 tokenizer 不再是免费午餐。
谱系定位
pMF 站在三条技术线的交点。对照 iMF(one-step、latent,1.72 FID):两者损失完全相同(v-loss、JVP、CFG 全部沿用),差异只在预测目标——iMF 输出 u,pMF 输出 x,转换从 u→v 变成 x→u→v,场景从 latent 换成像素。对照 JiT(像素、多步,100×2 步 1.82 FID):JiT 已经验证了 x-prediction + v-loss 在像素空间的可行性,pMF 把它接进 MeanFlow 的 (r,t) 平面实现一步化;时间采样消融(只采 r=t 是 194.53)说明光有 JiT 的设定学不动 one-step。对照 Consistency Models 及其变体(CTM、FMM):CM 固定 r=0 线预测终点且常用 pre-conditioner,输出偏离 x 空间;CTM 训练期要积分 ODE;FMM 学位移 z_t−z_r(含噪声)。pMF 在三者的失败点上都做了针对性消融,这也是表 3 的存在意义。
局限
论文自承的局限有三条。其一,1-NFE 与最优多步方法仍有差距:256×256 的 2.22 对照 RAE+DiTDH(50×2 步)1.13、SiT+REPA(250×2 步)1.42,one-step 的分布覆盖还追不上上百步求解器。其二,实验集中在 ImageNet 类条件生成单一任务,没有文本条件、视频或其他数据域;感知损失阈值 t_thr 与两类权重是经验超参,对抗损失方向未探索。其三,高分辨率靠固定序列长度、增大 patch 实现,1024×1024 时 patch 是 64×64、单 patch 维度 12288,这种极端 patch 化对细节的影响没有单独讨论。
我们读出的局限还有三条。JVP 的 stop-gradient 与 Muon 的选择都是经验性的,论文用「早期网络更准→目标更准」解释 Muon 的收益,但多步场景没有最终提升,这个机制解释缺少直接测量,而且 JVP 训练要两次前向加一次反向,论文没有报与普通 FM 训练的 wall-clock 对比。CFG 的最优 scale/interval 是逐配置搜索的,表 6/7 的 FID 与附录展示的 FID 2.74/IS 290.0(ω=7.0、区间 [0.1,0.7])不是同一设置,读数字要带设置。最后一点关系到这篇论文对机器人的启发:x-prediction 的优势在高维观测(patch 维度 768)显著、在低维(48)消失,因此对低维动作通道(如 7 自由度关节角)「要不要 latent」的答案可能与高维图像观测不同,而论文只在图像域验证过,跨域结论应视为待检验的假设。
对「动作/观测要不要 latent」的直接启发
这篇论文给「要不要 latent」提供了一个比「空间高不高维」更细的判断标准:看预测目标是否落在低维流形上。图像观测维度高(256×256×3,patch 维度 768 起),如果网络直接回归带噪速度这类在高维空间铺满的量就会学不动(164.89 对 9.56);把目标换成落在低维图像流形上的去噪图,不借助任何预训练 tokenizer 也能一步生成。动作通道通常维度低、本身接近低维流形,u-prediction 与 x-prediction 的差距会缩小(64×64 时 3.80 对 3.82 的持平就是低维侧的参照)。所以对机器人策略:高维观测想免 latent,就要像 pMF 一样给网络一个流形友好的输出目标;低维动作要不要 latent 的收益则有限。这套结论在图像上被验证得比较扎实,动作/观测的组合还需要专门实验确认。
复现要点
论文未声明开源,实现基于 iMF 的 JAX/TPU 代码。附录给出完整配置:B/L/H 深度 16/32/48、hidden 768/1024/1280、batch 1024、Muon(β1,β2)=(0.9,0.95)、学习率恒 1e-3、时间对 (t,r) 从 logit-normal(0.8,0.8) 采样且 50% 样本 r≠t、EMA half-life {500,1000,2000} Mimg、类别/时间/guidance/区间 token 各 8/4/4/4 个、LPIPS 权重 0.4、ConvNeXt 权重 0.1;训练与 CFG 伪代码在 Alg.1/2。关键复现检查点:u-prediction 对照(表 2 的 164.89)与时间采样器消融(表 3b)是检验实现是否正确的最快信号。
提出 pixel MeanFlow(pMF):把「网络输出空间」和「损失空间」分开设计——网络在像素空间直接输出去噪图像 x(假定落在低维图像流形上),损失沿用 improved MeanFlow 定义在瞬时速度 v 空间(v-loss),中间用 x→u→v 的代数变换接起来;在不借助任何预训练 VAE/tokenizer 的前提下,用 1 次函数评估在 ImageNet 256×256 拿到 2.22 FID(pMF-H/16,956M 参数、271 Gflops)、512×512 拿到 2.48 FID(pMF-H/32,959M、272 Gflops),填补了「one-step + latent-free」此前几乎空白的象限。
阅读提示
精读深度:精读
清单提示:原文提示:输出空间与损失空间分离原则(网络直接输出 x、损失定义在速度空间 v);无 latent 的一步生成(原始像素、1-NFE);对「动作/观测要不要 latent」有直接启发(预测目标是否落在低维流形决定可学性:高维观测需要 x-prediction,低维动作差别有限)。
问题
要解决什么:主流扩散/flow 图像生成有两根支柱:多步采样(一次生成要解几十到几百步 ODE,每步一次网络前向)和 latent 空间(靠预训练 VAE/tokenizer 把高维像素压进低维潜变量)。两条线各自都有进展:Consistency Models 和 MeanFlow 把采样压到 1 步,JiT 等像素空间 Transformer 把 latent 拿掉。但把两者合并起来对网络是双重负担:一步建模要求单个网络同时刻画不同起止点之间的轨迹,像素空间又要求网络在没有 tokenizer 的情况下自己完成压缩与抽象(流形学习)。这篇论文要回答的问题就是:能不能设计一个网络,既一步生成、又直接在原始像素上工作,并且不靠蒸馏、从零训练就达到有竞争力的质量。
为什么 prior work 不够:多步 latent 方法(DiT/SiT 等,250×2 步)质量最好,但每张图要数百次网络前向;one-step latent 方法(iMF-XL/2,1-NFE FID 1.72)把步数压到了 1,仍依赖预训练 VAE 解码器,且 SD-VAE 解码器本身在 256×256 要 310 Gflops、512×512 要 1230 Gflops,已经超过 pMF 整个生成器;像素空间多步方法(JiT-G/16,100×2 步 FID 1.82)拿掉了 latent 却仍要多步;此前唯一的 one-step latent-free 方法 EPG(8.82 FID)依赖自监督预训练。更关键的是技术层面的缺口:在像素空间直接预测速度或平均速度会失败——ImageNet 256×256、patch 维度 768 时 u-prediction 的 1-NFE FID 高达 164.89,说明「网络输出什么量」这个选择决定了高维像素空间能不能学动。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 带噪像素 z_t | raw pixel RGB | ImageNet 256×256×3 原始像素直接进网络,patch 16×16 切分、序列长度 162;线性插值 z_t = (1−t)x + t·ε,t∈[0,1],t=0 是数据端、t=1 是噪声端 |
| 时间步对 (r, t) | scalar pair | 平均速度场跨过的区间起点 r 与终点 t,0≤r≤t≤1;网络用差值 t−r 做条件嵌入,训练时从 logit-normal(0.8, 0.8) 采样,50% 样本 r≠t |
| 类别条件 c | class label | ImageNet 1000 类标签,8 个类 token 拼进序列;训练时以 0.1 概率丢弃以支持 classifier-free guidance(CFG) |
| CFG 条件(scale + interval) | continuous scalars | 沿用 iMF 的 CFG 区间条件化,guidance scale 与区间端点各 4 个 token;推理期在最优 scale/interval 下评估 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 去噪图像 x_θ(z_t; r, t) | raw pixel RGB | 网络直接输出像素空间的去噪图像;1-NFE 采样时取 (r,t)=(0,1),x_θ(z_1; 0, 1) 就是最终生成图,不需要数值 ODE 求解 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet 类条件生成 256×256 | 128 万张训练图,1000 类 | 原始像素空间训练(无 VAE tokenizer);FID-50K:生成 5 万张、每类 50 张,对照训练集分布;主结果 2.22(pMF-H/16,360 epoch) |
| ImageNet 类条件生成 512×512 与 1024×1024 | 同一数据集,不同分辨率 | 固定序列长度 162,靠增大 patch 尺寸(512 用 32×32、1024 用 64×64)维持计算量;512×512 主结果 2.48(pMF-H/32) |
架构(摘要)
主干与结构
backbone:Transformer(iMF 的 DiT 变体,JAX/TPU 实现),pMF-B/L/H 三档;patch size = 图像尺寸/16,noise scale = 图像尺寸/256
参数:B/16 118M / L/16 410M / H/16 956M(256×256);512×512 的 B/32 120M / L/32 413M / H/32 959M(序列长度固定 162,仅 patch embedding 与前几层通道变多)
类型:one-step latent-free flow 生成模型:网络输出像素空间去噪图像 x,训练用 improved MeanFlow 的 v-loss
关键组件
- x-prediction 网络 net_θ(z_t, r, t, c, CFG 条件):直接输出去噪图像 x_θ
- u 转换:u_θ = (z_t − x_θ)/t,把 x 场转回平均速度场
- 复合预测 V_θ = u_θ + (t−r)·JVP_sg,其中 JVP 是雅可比向量积、sg 表示 stop-gradient(沿用 iMF 实现)
- 训练损失 L_pMF = E‖V_θ − v‖²(v-loss,回归目标是条件速度 ε−x)
- 感知损失 L = L_pMF + λ·L_perc:LPIPS(VGG 版权重 0.4 + ConvNeXt-V2 版权重 0.1),仅在 t ≤ t_thr(0.8;长训练改 0.6)时施加
- 优化器 Muon(β1,β2)=(0.9,0.95),lr 恒 1e-3,batch 1024,EMA half-life {500,1000,2000} Mimg
为什么这样设计
核心指南是输出空间与损失空间分离:输出空间选择 x,因为 x 场在流形假设下落在低维图像流形上,网络容量有限时更容易学(高维像素空间直接回归带噪速度会崩);损失空间选择 v,因为 v 有明确的条件真值 ε−x、回归问题标准。两个空间用两条代数式连接:x→u(u=(z−x)/t)和 u→v(MeanFlow identity 给出 V_θ),损失在 v 空间评估。这个设计同时拿到 JiT 的「像素直接输出」(让感知损失可用)和 MeanFlow 的「一步建模」。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 1-NFE FID-50K(ImageNet 256×256,类条件,像素空间,从零训练) | 2.22 | 此前唯一同类 one-step latent-free 方法 EPG-L/16 为 8.82(且依赖自监督预训练);同族 one-step latent 的 iMF-XL/2 为 1.72;多步 latent 的 DiT-XL/2(250×2 步)2.27、SiT-XL/2+REPA(250×2 步)1.42;多步像素 JiT-G/16(100×2 步)1.82 | pMF-H/16:956M 参数、271 Gflops、360 epoch、batch 1024、Muon、带感知损失、5 万张生成图 FID-50K,CFG 在最优 scale/interval 下评估 |
| 1-NFE FID-50K(ImageNet 512×512,类条件,像素空间,从零训练) | 2.48 | one-step 像素 GAN StyleGAN-XL 2.41(168M 参数、2061 Gflops);多步 latent SiT-XL/2(250×2 步)2.62、RAE+DiTDH 1.13;多步像素 SiD2 1.48、JiT-G/32(100×2 步)1.78 | pMF-H/32:959M 参数、272 Gflops、patch 32×32、序列长度固定 162,计算量与 256×256 版本几乎持平 |
| 预测目标消融(Tab.2,1-NFE FID,ImageNet) | 256×256:x-pred 9.56 vs u-pred 164.89;64×64:3.80 vs 3.82 | 同一 B/16 架构、同样最小化 v-loss,只换预测目标;u-prediction 在 patch 维度 768 时崩溃,patch 维度 48 时两者持平 | Muon、MSE loss、160 epoch、序列长度 162、无 bottleneck embedding;64×64 用 patch 4×4(维度 48),256×256 用 patch 16×16(维度 768) |
| 感知损失消融(Fig.3b,1-NFE FID,ImageNet 256×256) | 9.56 → 5.62 → 3.53 | 纯 ℓ2 基线 9.56;加 VGG-LPIPS 后 5.62;再加 ConvNeXt-V2 版后 3.53,共约 6 个 FID 点 | pMF-B/16、Muon、160 epoch;感知损失仅在 t ≤ 0.8 时施加,LPIPS 权重 0.4、ConvNeXt 权重 0.1 |
| 优化器消融(Fig.3a,1-NFE FID,ImageNet 256×256) | 320 epoch:Adam 11.86 vs Muon 8.71 | 同 pMF-B/16、MSE loss;Muon 收敛更快且 FID 更好;多步 diffusion 里 Muon 只有更快收敛、没有最终提升,收益在单步加 stop-gradient 目标下被放大 | pMF-B/16、160/320 epoch、batch 1024、lr 恒 1e-3 |
| pre-conditioner 消融(Tab.3a,1-NFE FID,ImageNet 256×256) | 线性 34.61 / EDM 式 14.43 / sCM 式 13.81 / 无 pre-conditioner 的纯 x-pred 3.53 | CM/CTM 常用的 pre-conditioner 在像素高维输入下反而差;除非 c_skip=0,网络输出偏离 x 空间、可能落回高维流形 | pMF-B/16、Muon、带感知损失、160 epoch;三种 pre-conditioner:线性 (c_skip=1−t, c_out=t)、EDM 式、sCM 式 |
| 时间采样器消融(Tab.3b,1-NFE FID,ImageNet 256×256) | 只采 r=t 194.53 / 只采 r=0 389.28 / 两条线 106.59 / 全区域 0≤r≤t 3.53 | FM 式(r=t 线)与 CM 式(r=0 线)单独都学不动;MF 靠 (r,t) 平面上的关系学习平均速度场 | pMF-B/16、Muon、带感知损失、160 epoch |
| 高分辨率扩展(Tab.4,1-NFE FID,ImageNet) | 256 3.53 / 512 4.06 / 1024 4.58 | 固定序列长度 162 只增大 patch:patch 维度从 768(16×16)→ 3072(32×32)→ 12288(64×64),FID 增幅温和 | pMF-B/16、Muon、带感知损失、160 epoch;512 与 1024 沿用同一训练配方 |
Insights
- 输出空间与损失空间分离是全文的方法论核心:网络输出选「落在低维流形上的量」(x),损失选「有明确真值的回归空间」(v),两个空间靠 x→u→v 两条代数式连接,同一网络、同一前向同时承担两个角色(Sec.4.1–4.3)。
- x(z_t; r, t) = z_t − t·u(z_t; r, t) 把平均速度场重参数化成去噪图像场:r=t 时退化为 JiT 的 x-prediction(去噪图,噪声大时发糊),r=0 时严格等于 ODE 终点 z_0(落在数据分布上),中间 r 值靠仿真可视化支持「也像去噪图」(Sec.4.2、Fig.1)。
- 高维观测空间是 u-prediction 的滑铁卢:patch 维度 48 时 x/u 持平(3.80/3.82),维度 768 时 u-pred 崩到 164.89 而 x-pred 9.56——目标是否落在低维流形决定可学性,这给「要不要 latent」提供了比维度本身更细的判断标准(Tab.2、Sec.6.1)。
- 免 latent 的收益在系统层被量化:pMF-H/16 整个生成器 271 Gflops,而 SD-VAE 解码器单独就要 310 Gflops(256)与 1230 Gflops(512),one-step 时代 latent 解码开销已经超过生成器本体(Sec.6.3)。
- 像素直接输出带来 what-you-see-is-what-you-get:感知损失可以直接加在输出上,9.56→3.53 约 6 个 FID 点;latent 方法在 tokenizer 训练时享有的感知损失红利,像素方法用同一个性质拿回(Sec.4.4、Fig.3b)。
vs 同类工作
- vs improved MeanFlow(one-step latent,iMF-XL/2 1.72):iMF 网络输出 u、损失在 v(u→v 一步转换);pMF 把输出换成 x,走 x→u→v 两步转换,并把场景从 latent 搬到原始像素;损失公式、JVP 实现、CFG 方案都沿用 iMF,差异集中在预测目标与空间。
- vs JiT(像素多步,100×2 步 FID 1.82):JiT 已经用 x-prediction + v-loss 的组合在像素空间多步生成,pMF 把同一个 x-prediction 接进 MeanFlow 的 (r,t) 平面一步建模;Tab.3b 说明光靠 FM 的 r=t 线(JiT 的设定)学不动 one-step。
- vs Consistency Models / CTM / FMM:CM 固定 r=0 线做终点预测,且常用 pre-conditioner(c_skip·z_t + c_out·net_θ),c_skip≠0 时网络输出偏离 x 空间;CTM 靠训练期积分 ODE;FMM 学的是位移 z_t−z_r(含噪声、不在低维流形)。pMF 在全 (r,t) 平面采样、直接输出 x,Tab.3 的消融把这三条路的失败点都对照出来。
- vs EPG(one-step latent-free,8.82 FID):EPG 用自监督预训练补足单步像素建模的难度,pMF 从零训练、无预训练,256×256 上 2.22 对 8.82。
- vs StyleGAN-XL(one-step 像素 GAN,2.30 FID):同为 1-NFE 像素空间,pMF 前向 271 Gflops 对 1574 Gflops(约 5.8 倍差距),且 pMF 是 Transformer 架构、可继续加数据加参数。
局限
- 论文自承:1-NFE 与当前最优多步方法仍有差距——256×256 的 2.22 对照 RAE+DiTDH(50×2 步)1.13、SiT+REPA(250×2 步)1.42;one-step 的分布覆盖与多样性仍追不上几十上百步的求解器。
- 论文自承:实验集中在 ImageNet 类条件图像生成单一任务,无文本条件、无视频、无其他数据域;感知损失只在噪声低于阈值时施加(t_thr 0.8、长训练 0.6),阈值是经验超参,对抗损失方向未探索。
- 论文自承:高分辨率靠固定序列长度、增大 patch 维持成本,1024×1024 时 patch 是 64×64、单 patch 维度 12288,这种极端 patch 化对细节保真的影响没有单独讨论(此前像素 Transformer 常需要 refiner head 补细节)。
- 我们读出:JVP 的 stop-gradient 与 Muon 的选择是经验性的——论文用「早期网络更准→目标更准→收益放大」解释 Muon 在单步的收益,但多步场景没有最终提升,这个机制解释缺少直接测量;JVP 使训练需要两次前向加一次反向,论文没报与普通 FM 训练的 wall-clock 对比。
- 我们读出:CFG 最优 scale/interval 仍是每配置搜索出来的,表 6/7 的 FID 与附录展示的 FID 2.74/IS 290.0(ω=7.0、区间 [0.1,0.7])不是同一设置,读者对数字要带设置看。
- 我们读出:对「动作/观测要不要 latent」的启发建立在图像单域证据上——x-prediction 的优势在高维观测(patch 维度 768)显著、在低维(48)消失;低维动作通道可能接近 u-prediction 也能学动的区间,但论文没有在机器人动作/多模态策略上验证,跨域结论应视为待检验的假设。
可复现性
- code:论文未声明开源;实现基于 iMF 的 JAX/TPU 代码
- weights:未提供
- setup_note:附录给出完整配置(Tab.8:B/L/H 深度 16/32/48、hidden 768/1024/1280、batch 1024、Muon、lr 1e-3、logit-normal(0.8,0.8) 时间采样器、EMA half-life {500,1000,2000} Mimg、感知损失权重 0.4/0.1)与训练/CFG 伪代码(Alg.1/2)
主干与结构
backbone:Transformer(iMF 的 DiT 变体,JAX/TPU 实现),pMF-B/L/H 三档;patch size = 图像尺寸/16,noise scale = 图像尺寸/256
参数:B/16 118M / L/16 410M / H/16 956M(256×256);512×512 的 B/32 120M / L/32 413M / H/32 959M(序列长度固定 162,仅 patch embedding 与前几层通道变多)
类型:one-step latent-free flow 生成模型:网络输出像素空间去噪图像 x,训练用 improved MeanFlow 的 v-loss
关键组件
- x-prediction 网络 net_θ(z_t, r, t, c, CFG 条件):直接输出去噪图像 x_θ
- u 转换:u_θ = (z_t − x_θ)/t,把 x 场转回平均速度场
- 复合预测 V_θ = u_θ + (t−r)·JVP_sg,其中 JVP 是雅可比向量积、sg 表示 stop-gradient(沿用 iMF 实现)
- 训练损失 L_pMF = E‖V_θ − v‖²(v-loss,回归目标是条件速度 ε−x)
- 感知损失 L = L_pMF + λ·L_perc:LPIPS(VGG 版权重 0.4 + ConvNeXt-V2 版权重 0.1),仅在 t ≤ t_thr(0.8;长训练改 0.6)时施加
- 优化器 Muon(β1,β2)=(0.9,0.95),lr 恒 1e-3,batch 1024,EMA half-life {500,1000,2000} Mimg
为什么这样设计
核心指南是输出空间与损失空间分离:输出空间选择 x,因为 x 场在流形假设下落在低维图像流形上,网络容量有限时更容易学(高维像素空间直接回归带噪速度会崩);损失空间选择 v,因为 v 有明确的条件真值 ε−x、回归问题标准。两个空间用两条代数式连接:x→u(u=(z−x)/t)和 u→v(MeanFlow identity 给出 V_θ),损失在 v 空间评估。这个设计同时拿到 JiT 的「像素直接输出」(让感知损失可用)和 MeanFlow 的「一步建模」。
pMF 公式化与广义流形假设的可视化
原文 caption:The pixel MeanFlow (pMF) formulation, driven by the manifold hypothesis. (Left): pMF aims to approximate the average velocity field u(zt, r, t) induced by the underlying ODE trajectory (black). We define a new field x(zt, r, t) ≜ zt − t·u(zt, r, t), which behaves like denoised images. We hypothesize that x approximately lies on a low-dimensional data manifold (orange curve). (Right): Visualization of zt, u, x obtained by tracking an ODE trajectory. The average velocity field u corresponds to noisy images and is inevitably higher-dimensional; the induced field x corresponds to approximately clean or blurred images.
左图给出全文核心假设:黑色曲线是一条真实 ODE 轨迹,pMF 学的是平均速度场 u,但网络输出的是新定义的 x = z_t − t·u,论文假设 x 落在这条橙色低维流形上,因此比 u 更好逼近。右图用预训练 JiT 模型仿真一条轨迹后逐点可视化:上面一排是不同 (r,t) 处的 u(表现为带噪图),下面一排是同样的 (r,t) 处算出的 x(表现为干净或过去噪发糊的图像)。读图重点:同样一组 (r,t),u 排和 x 排的视觉差异,就是「输出目标落在低维流形上」这一论断的直接证据。
二维玩具实验:观测维度升高时 x-prediction 的优势
原文 caption:A 2D toy dataset is linearly projected into a D-dimensional observation space using a fixed, D×2 column-orthonormal projection matrix. We train MeanFlow models with either the original u-prediction or the proposed x-prediction, for D ∈ {2, 8, 16, 512}. We visualize 1-NFE generation results. The models use the same 7-layer ReLU MLP backbone with 256 hidden units. The x-prediction formulation produces reasonably good results, whereas u-prediction fails in the case of high-dimensional observation spaces.
把二维 Swiss roll 数据用固定的 D×2 列正交矩阵投影进 D 维观测空间(D 取 2/8/16/512),同一份数据、同一个 7 层 ReLU MLP(256 隐藏单元)、同样最小化 v-loss,只改预测目标:u-prediction 还是 x-prediction。1-NFE 生成的散点图显示:D 小时两者都生成出 Swiss roll 形状;D 变大(16 以上)u-prediction 生成的点散成噪声,x-prediction 仍保持流形形状。这张图把「高维观测空间里目标是否落在低维流形」从图像推广到一般数据,是 x-prediction 优于 u-prediction 的最干净证据。
训练曲线:Muon 优化器与感知损失的影响
原文 caption:(a) Muon vs. Adam. Muon converges faster and achieves better FID. At 320 epochs, Adam reaches 11.86 FID, while Muon achieves 8.71 FID. (Settings: pMF-B/16, MSE loss). (b) Perceptual loss. Using standard VGG-based LPIPS as well as a ConvNeXt-based variant leads to improved FID. (Settings: pMF-B/16, Muon optimizer).
两张 ImageNet 256×256 的训练曲线。图 (a) 横轴 epoch、纵轴 1-NFE FID:Muon 收敛更快,320 epoch 时 8.71,Adam 同 epoch 只有 11.86;论文的解释是 one-step 场景里 stop-gradient 目标依赖网络自身质量,早期网络更准(Muon 提供)→ 目标更准 → 收益被放大。图 (b) 对比损失项:纯 ℓ2 9.56 → 加 VGG-LPIPS 5.62 → 再加 ConvNeXt-V2 版 3.53,感知损失总共带来约 6 个 FID 点。读图重点:感知损失能直接用,靠的是网络输出就是像素图像这一性质。
1-NFE 像素空间生成的定性结果
原文 caption:Qualitative results of 1-NFE pixel-space generation on ImageNet 256×256. We show uncurated results of pMF-H/16 on the five classes listed here; more are in Appendix B.
pMF-H/16 在 5 个 ImageNet 类别(house finch、bee、palace、stone wall、coral reef)上未经挑选的生成样例,验证 2.22 FID 之外的主观质量:单步、无 latent、从零训练的模型能给出与真实照片接近的纹理。同一页还排着 256×256 与 512×512 的系统对比表(Tab.6/7),pMF 的 271/272 Gflops 与 latent 解码器 310/1230 Gflops 的对照可直接从表里读出。
🎧 音频版
时长 36:33 · Edge TTS
一步生成,还能甩掉 latent?Pixel Mean Flows 精读
先给结论:这篇把「一步生成」和「像素空间」两个目标同时落地了
小播:老播,这期题目有点长,《One-step Latent-free Image Generation with Pixel Mean Flows》。我拆一下:one-step 是一步生成,latent-free 是不要 latent 空间。这两个词放在一起,好像在说一件以前没人做成的事?
老播:对,你理解得方向对了。先给一个背景坐标:现在最强的图像生成模型,比如扩散模型和 flow matching 模型,生成一张图通常要两样东西。第一,多步采样——从纯噪声出发,沿着学到的速度场一步步走回数据分布,每走一步让神经网络跑一次前向,一次前向叫一次函数评估,缩写 NFE,普通方法要走几十步甚至两百五十步。第二,latent 空间——像素维度太高,主流做法先用预训练 VAE 把图像压成低维潜变量,在潜变量里生成完,再用解码器还原成图像。这篇论文要做的,就是把这两样东西都拿掉:一次函数评估,直接在原始像素上从零训练,生成出 256×256 的图像。
小播:那它做到什么程度?直接说数字。
老播:重点数字先说一遍,后面还会反复回到。在 ImageNet 256×256 类条件生成上,pMF 最大的型号 pMF-H/16 用 1-NFE 拿到 2.22 的 FID;512×512 是 2.48。FID 是衡量生成分布和真实图片分布差距的指标,越小越好。作为对照,之前唯一一个同样是「一步加无 latent」的方法叫 EPG,它还要靠自监督预训练,分数是 8.82;而 one-step 但走 latent 的最强方法 iMF-XL/2 是 1.72,多步的 DiT-XL 走 250 步是 2.27。也就是说,pMF 把「无 latent 一步生成」这个象限从 8.82 拉到了 2.22,接近甚至部分超过走 latent 或多步的方法。这期我们就把三件事讲透:为什么网络输出什么量这么关键;输出空间和损失空间分开设计是怎么做到的;以及它对机器人里「动作和观测要不要加 latent」这个问题有什么直接启发。
背景铺垫:多步生成为什么慢,大家又为什么躲进 latent 空间
小播:从头来。你说生成是沿着速度场走,这个速度场到底是什么?我本科只学过一点概率,你给我个能抓的模型。
老播:好,我们从 flow matching 讲起,这是这篇论文的直接地基。假设一张真实图片叫 x,一个高斯噪声叫 ε。做一个线性插值:z_t = (1−t)·x + t·ε,t 从 0 走到 1。t=0 的时候 z 就是图片 x,t=1 的时候 z 就是纯噪声 ε。这个插值过程里,每个点 z_t 的移动方向是固定的,就是 ε 减 x,论文叫条件速度 v,意思是「从图片指向噪声」的位移。flow matching 训练一个网络 v_θ,输入带噪的 z_t 和时间 t,输出预测的速度,去回归这个 ε 减 x。
小播:等一下,同一张 z_t 可以由很多对不同的 (x, ε) 拼出来,那回归目标不就有歧义?
老播:问得细。flow matching 的理论关键就在这里:对任意给定的 z_t,把所有能生成它的 (x, ε) 对的 ε 减 x 取平均,得到边际速度 v(z_t),它是唯一确定的。网络收敛后学到的就是这条平均速度场。推理的时候,从 t=1 的纯噪声出发,让数值求解器沿着速度场积分回 t=0。积分要精确,就得把区间切成很多小段,每一步调用一次网络,所以 NFE 常常是几十到几百。ImageNet 上典型的 DiT-XL 模型要 250 次函数评估,开 classifier-free guidance(CFG,一种让生成更贴类别条件的技巧)还要再翻倍。
小播:那 latent 空间是干什么的?为什么大家都要躲进去?
老播:像素空间维度太高。256×256 的彩色图是 196608 个数,网络直接在这么高的空间里学生成,对容量和算力都是负担。主流做法是先用一个预训练 VAE 把图像压成 32×32×4 的潜变量,压缩了 48 倍,生成在潜变量里做,最后用解码器还原。latent 的好处是维度低、语义集中;代价是你多了一个必须训练的 tokenizer,而且生成质量的天花板受解码器限制。这篇论文里有一个很有冲击力的对照:SD-VAE 那个标准解码器,单独跑一次前向在 256×256 上要 310 Gflops,512×512 上要 1230 Gflops——这个数字已经超过了 pMF 整个生成器(271 和 272 Gflops)。所以当生成模型做到一步的时候,latent 解码器本身反而成了开销大头。
小播:那之前有没有人试过把「一步」和「像素空间」合起来?
老播:两条线分别都有人推进。一步这边,Consistency Models 和 MeanFlow 系列把采样压到了 1 次评估;像素这边,JiT 这类像素空间 Transformer 拿掉了 latent,但它要走 100 步。合起来难在哪?一步建模要求单个网络同时刻画不同起止点之间的整段轨迹,像素空间又要求网络在没有 tokenizer 的情况下自己完成压缩和抽象。更麻烦的是,直接在像素空间预测速度会失败——论文的消融里,256×256 图像、patch 维度 768 时,网络预测平均速度 u 的 1-NFE FID 是 164.89,几乎等于没生成;同一架构改预测去噪图像 x,就只有 9.56。这个对比是整篇论文的入口:在像素空间一步生成,网络到底该输出什么量,这件事以前没人认真设计过。
核心思想:网络的输出和损失各占一个空间,中间用代数式接起来
先把「分离原则」说清楚
老播:pMF 的全部设计围绕两个词:输出空间和损失空间。先给预期:网络输出什么(预测目标)决定高维空间能不能学动;损失在哪个空间算决定回归问题稳不稳定。pMF 把这两件事拆开,分别选最合适的空间,再用代数变换把它们接起来。
小播:输出空间和损失空间,这两个概念分开讲一下?
老播:输出空间就是网络最后一层直接吐出来的那个量的类型。损失空间是训练时回归目标所在的类型。两者可以一致,也可以不一致,中间用变换连接。论文画了一张表,把所有相关方法按这个维度排开:DiT 预测噪声 ε、损失也在 ε 空间;SiT 预测瞬时速度 v、损失在 v;原版 MeanFlow 预测平均速度 u、损失在 u;improved MeanFlow(iMF)预测 u、损失却转到 v,走一步转换;JiT 预测去噪图像 x、损失在 v,也是一步转换;pMF 预测 x、损失在 v,但要走两步转换 x→u→v。你看这条谱系,真正在像素空间一步生成的 pMF,是唯一走两步转换的——把「好学的输出」和「好回归的损失」接到了一起。
x 场为什么像去噪图像:三个 r 值分情况看
小播:好,那「好学的输出」x 具体是什么?为什么它就比 u 好学?
老播:这是全文最关键的一个定义。先回忆 MeanFlow 里的平均速度 u:从时间 r 到 t,把瞬时速度求平均,得到 u(z_t; r, t),它代表「这一整段轨迹的平均方向」。pMF 定义一个新的场:x(z_t; r, t) = z_t − t·u(z_t; r, t)。这个式子要回答的问题,是把平均速度场重参数化成一个更易学的量。逐符号看:z_t 是带噪输入,u 是平均速度,t 是时间,用 z_t 减去 t 倍的 u,等于把「噪声成分」从速度里剥掉。结果 x 在视觉上表现为干净图,或者过度去噪后发糊的图。图 1 的右半部分把同一批 (r,t) 点上算出的 u 和 x 并排摆在一起:上面一排 u 全是带噪图像,下面一排 x 基本是干净或发糊的图像。这就是「x 落在低维图像流形上」的直接证据——u 里噪声和图像两种成分搅在一起、在高维空间里铺满,x 集中在低维流形附近。
小播:这里有个 r,它是平均速度区间的起点。x 场的性质会随 r 变吗?
老播:会,而且论文就是按 r 分三种情况论证的。第一种,r 等于 t,平均速度退化成瞬时速度 v,这时 x = z_t − t·v,恰好就是 JiT 论文里的 x-prediction 目标——去噪图像,噪声大的时候发糊。第二种,r 等于 0,平均速度是整段轨迹的平均,算下来 x 严格等于 z_0,也就是 ODE 的终点,落在数据分布上。第三种,中间的 0 小于 r 小于 t,没有理论保证,但仿真显示它同样呈现去噪图像的样貌。三种情况合起来,论文叫它「广义流形假设」:u 是含噪的高维量,x 是低维流形上的量,网络输出 x 更容易。这个假设就是后面所有实验要验证的东西。
训练怎么做:x 转 u,u 转 v,损失压在 v 上
小播:那训练的时候,网络到底怎么把 x 和 v 对上?中间那个 u 是怎么出来的?
老播:训练分四步,每一步都是代数运算。第一步,网络 net_θ 直接输出去噪图像 x_θ(z_t; r, t),输入是带噪像素 z_t 加上时间对 (r,t)、类别条件这些。第二步,用公式 u_θ = (z_t − x_θ)/t 把 x 转回平均速度 u——这条式子就是刚才那个定义的逆运算。第三步,用一条叫 MeanFlow identity 的恒等式把 u 变成瞬时速度侧的复合预测:V_θ = u_θ + (t−r)·(d/dt)u_θ。先给预期:这条式子的意思是,平均速度等于瞬时速度再减去「平均速度随时间变化」造成的修正。其中 d/dt 用雅可比向量积算,缩写 JVP,可以理解成把速度当切向量、沿着 u 对输入 z 的雅可比矩阵传播一遍;sg 表示 stop-gradient,让修正项不参与对网络的梯度回传,这是 iMF 留下的工程选择。第四步,损失直接回归条件速度:L_pMF = E‖V_θ − v‖²,其中 v 就是 ε 减 x。所以整体是:输出在 x 空间,损失在 v 空间,x→u→v 两条代数式把两边接起来。
小播:损失回归 ε 减 x,这个目标干净明确;输出是像素图像,学起来容易。两边各取所长?
老播:对,这就是输出空间和损失空间分离的含义。顺带还有一个红利:因为网络输出就是像素图,感知损失可以直接作用在输出上,论文叫 what-you-see-is-what-you-get。总损失是 L_pMF 加 λ 倍的感知损失 L_perc,用 LPIPS,只在噪声低于阈值 t_thr 时施加,避免让网络去预测过度发糊的图。这套感知损失收益我们后面会看到数字,约 6 个 FID 点。
这对「动作/观测要不要 latent」有什么启发
小播:这个分离原则对我们做机器人的,直接有什么用?你开头说它对「动作和观测要不要 latent」有启发,具体在哪?
老播:给一个可检验的判断标准:要不要 latent,先看你的预测目标落在哪,空间本身高不高维排第二位。这篇论文最干净的一组证据在表 2:64×64 图像、patch 维度只有 48 时,x-prediction 和 u-prediction 几乎打平,3.80 对 3.82;256×256、patch 维度 768 时,x-prediction 是 9.56,u-prediction 崩到 164.89。差异全在目标是否落在低维流形上。对应到机器人:图像观测是高维的,如果网络直接回归「带噪速度」这类在高维空间铺满的量,就会学不动;把目标换成落在低维图像流形上的去噪图,不借助任何预训练 tokenizer 也能一步生成。动作通道通常维度低,比如 7 自由度关节角或者末端位姿,本身已经接近低维流形,u-prediction 和 x-prediction 的差距会缩小,加不加 latent 的收益有限。所以要设计免 latent 的策略网络,重点在给高维观测配一个流形友好的输出目标。有一点要提醒:这是图像域的证据,动作和观测的组合在论文里没有验证,应该当成待检验的假设来用,我们收尾还会再提。
实验:目标换一换,结果从崩掉到能用
小播:实验部分我们从哪个看起?
老播:从玩具实验看起,它把上面的结论从图像抽象成一般数据。把二维 Swiss roll 数据用固定的 D×2 列正交矩阵投影进 D 维观测空间,D 取 2、8、16、512,同一个 7 层 ReLU MLP、256 个隐藏单元,分别做 u-prediction 和 x-prediction,两者最小化的是同一个 v-loss。结果,D 小的时候两者都能生成出 Swiss roll 的形状;D 一大,u-prediction 生成的点散成噪声,x-prediction 还是完整的流形形状,而且 x-prediction 的训练损失更低。图 2 就是这一组散点图,读图重点看 D 从 8 增到 16、512 的那几格,u-prediction 生成的点怎么一步步散成噪声、x-prediction 怎么保持流形形状的。
小播:然后直接上 ImageNet?
老播:对,表 2 是真实图像版本,数字刚才说过:patch 维度 48 时 3.80 对 3.82,维度 768 时 9.56 对 164.89。设置是 B/16 架构、Muon 优化器、MSE 损失、160 epoch、序列长度 162。分界线说得很清楚:观测维度越高,输出目标是否落在低维流形越关键。接着是两个训练层面的改进。优化器对比,Muon 对 Adam:320 epoch 时 Adam 是 11.86 FID,Muon 是 8.71。论文的解释是,one-step 训练的目标里有 stop-gradient 项,依赖网络自身质量,Muon 让早期网络更准、目标就更准、收益被放大;多步 diffusion 的对照实验里 Muon 只有收敛更快,没有最终提升。感知损失这边,纯 ℓ2 是 9.56,加 VGG 版 LPIPS 到 5.62,再加 ConvNeXt-V2 版到 3.53,总共约 6 个 FID 点。
小播:还有两组消融我看论文里很强调,pre-conditioner 和时间采样器?
老播:这两组消融回答的是「为什么非要用 pMF 这个具体设计」。pre-conditioner 是 Consistency Models 常用的输出重参数化技巧,把网络输出改成 c_skip·z_t 加 c_out·net_θ。论文试了三种:线性式、EDM 式、sCM 式,分别是 34.61、14.43、13.81,而 pMF 的纯 x-prediction 是 3.53。原因:只要 c_skip 非零,输出就混进 z_t 的噪声成分,偏离 x 空间,落回高维流形。时间采样器这边,只采 r=t 一条线(flow matching 式)是 194.53,只采 r=0(consistency 式)是 389.28,两条线都采是 106.59,全区域 0≤r≤t 采样是 3.53。MeanFlow 的一步能力来自 (r,t) 平面上各点之间的平均速度关系,采样限制到一条或两条线上,这个关系就丢了。这两张表的对比都把「照搬别家设计」的失败点量化出来了。
小播:最后是系统级结果,就是开头那个 2.22?
老播:对。256×256 上,pMF-H/16 训练 360 epoch,1-NFE FID 2.22、IS 268.8,956M 参数、271 Gflops;L/16 是 2.52,B/16 是 3.12。对照:EPG-L/16 是 8.82,它还要自监督预训练;one-step 走 latent 的 iMF-XL/2 是 1.72;多步 latent 的 DiT-XL/2(250×2 步)2.27,SiT-XL/2 加 REPA(250×2 步)1.42;多步像素的 JiT-G/16(100×2 步)1.82。512×512 上,pMF-H/32 是 2.48,对照 one-step 像素 GAN 的 StyleGAN-XL 是 2.41,但 StyleGAN-XL 前向要 2061 Gflops,pMF 只要 272。所以 pMF 的位置是:和最强的多步方法还有距离,但已经把「无 latent 一步生成」从基本不可用拉到了有竞争力的水平,而且在算力上碾压同象限的 GAN。
架构和训练配置:从 0 到 2.22 需要哪些零件
小播:数字都出来了,最后把工程层补齐:这是什么架构、怎么训的,哪些配置是复现的关键零件?
老播:架构直接继承 iMF 那篇的骨干,本质是 DiT 的变体:输入图像切 patch,默认 16×16,256×256 的图像切成 16×16 个 patch 网格,固定序列长度 162;每个 patch 线性投影成 token 进 Transformer,最后一层把 token 解码回像素图像。隐藏维度看型号:B/16 是 768,L/16 和 H/16 更大。训练配置一张表能说清:batch size 1024,学习率恒定 1e-3、没有 warmup,权重衰减和 dropout 都是 0,EMA 半衰期按数据量设 500、1000、2000 百万张图三档,优化器用 Muon,β1=0.9、β2=0.95。时间对 (r,t) 的采样有讲究:r 严格小于 t 的点占 50%,采样器用 logit-normal(0.8,0.8),保证全平面都采到、又偏向低噪声区;类别条件按 0.1 概率随机丢弃,为后面的 CFG 服务。
小播:CFG 和感知损失这两个工程件,具体怎么配?
老播:CFG 就是 classifier-free guidance,训练时随机丢类别条件,推理时把有条件输出和无条件输出拉开距离,让生成更贴类别。论文的 CFG 配置按区间分段,逐配置搜索:比如 256×256 主结果用的是区间 [0.1,0.7] 内的 scale,附录里 FID 2.74、IS 290.0 那组用的是 ω=7.0。感知损失前面提过:总损失等于回归损失加 λ 倍的 LPIPS,只在噪声低于阈值 t_thr 时施加,避免让网络去预测过度发糊的图;两条感知损失路径——VGG 版和 ConvNeXt-V2 版——是叠着用的,加完从 9.56 到 5.62 再到 3.53。
小播:分辨率往上走的时候,架构怎么保持序列长度不变?
老播:高分辨率靠加大 patch。512×512 用 32×32 的 patch,patch 维度从 768 涨到 3072;1024×1024 用 64×64,patch 维度 12288。序列长度固定 162,模型结构和算力基本不变,只换 patch 大小。这是论文表 4 的做法,也是它能从 256 一路做到 1024 而不重新设计的原因。代价是 patch 维度过高时细节保真存疑,论文没有单独讨论,我们前面局限里也标了这条。
同象限的对手:EPG 和像素 GAN
小播:和它同象限竞争的还有谁?把账算清楚。
老播:同象限就是「一步生成、无 latent」这个格子。论文说,已知唯一同类方法是 EPG,Lei 等人 2026 年那篇,540M 参数、113 Gflops,要靠自监督预训练才能达到 8.82 的 FID。pMF 从零训练就超过它:B/16 是 118M 参数、33 Gflops、3.12,L/16 是 410M、117 Gflops、2.52,H/16 是 956M、271 Gflops、2.22。也就是说,pMF 最大的型号算力是 271 Gflops,比 EPG 的 113 高,但参数多 77%、FID 好 4 倍;更小的 pMF-B 用 33 Gflops 就拿到 3.12,比 EPG 的 8.82 好一大截。差距的来源论文归因于输出目标:EPG 没有走 x-prediction 这条流形友好的路。
小播:GAN 呢?一步生成的 GAN 也很强。
老播:像素 GAN 一直是这个象限的主力。256×256 上,BigGAN-deep 是 6.95(56M 参数、59 Gflops),StyleGAN-XL 是 2.30(166M、1574 Gflops),GigaGAN 是 3.45(569M)。pMF-H 的 2.22 已经低于 StyleGAN-XL 的 2.30,而且算力只有 271 对 1574,约六分之一;pMF-B 用 33 Gflops 拿 3.12,比 GigaGAN 的 3.45 还好,算力不到它的十六分之一。不过要注意,GAN 数字和 pMF 的口径细节有差异,比如评估方式不完全一致,直接对比要带设置。结论是:pMF 在「无 latent 一步生成」这个格子里,质量已经压过同代 GAN,算力还低一个量级;加上 Transformer 架构的可扩展性,这条路后续还能继续加数据加参数。
顺带回答:GAN 一直是这个象限的主力,为什么没守住
小播:GAN 一步生成很成熟,pMF 凭什么挤进来?
老播:GAN 在这个象限的优势是质量天花板高,StyleGAN-XL 的 2.30 一度是最强。短板有三条。第一是训练不稳定:对抗训练要平衡生成器和判别器,超参敏感、容易模式坍塌,扩到更大数据时维护成本高。第二是架构受限:表 6 里像素 GAN 都是卷积架构,没有 Transformer 那种随数据、参数平滑扩展的证据。第三是算力:StyleGAN-XL 单次前向 1574 Gflops,是 pMF 的六倍左右,同样画一张 256×256 图,成本不是一个量级。pMF 走回归式训练,损失就是均方误差加感知损失,稳定、可扩展、成本低,在质量接近的前提下把另外两项补上了。换个说法:GAN 仍有自己的价值,但「无 latent 一步生成」这个格子的竞争标准被抬高了。
把成本账算完整:为什么「无 latent」在一步时代才划算
小播:把 latent 解码器开销这笔账算完整一点,别只说一个数字。
老播:论文专门算过。以 512×512 为例,latent 路线完整链路是:VAE 编码一次前向、潜空间生成器一次前向、VAE 解码一次前向。其中 SD-VAE 解码器单次前向要 1230 Gflops,编码器还要再加一部分;pMF 整个生成器只有 272 Gflops。也就是说,one-step latent 方法里,光解码器就是生成器的四倍多。多步时代这笔开销被均摊在几十上百次生成器前向里,不明显;一旦采样只剩一步,tokenizer 的编解码就成了最大的单项开销。这是 pMF 选像素空间最实在的工程理由:像素本身不省算力,但当采样步数压到 1,latent 的固定开销开始主导,绕开它就是绕开大头。
质量指标全景:FID 之外还能看什么
小播:除了 FID,这篇还报了哪些质量指标,怎么横着比?
老播:IS(Inception Score)是另一个常用指标,越高越好,衡量生成样本的类别清晰度和多样性。256×256 上,pMF-H/16 是 IS 268.8,对照 one-step latent 的 iMF-XL/2 是 282.0,多步的 DiT-XL 是 278.2,像素 GAN 里 StyleGAN-XL 是 260.1、BigGAN-deep 是 171.4。也就是说,pMF 的 IS 落在主流方法的区间里,略低于 latent 一档,但明显高于同代 GAN。FID 和 IS 一起看,pMF 的位置是「分布距离接近 best、类别清晰度达标」,没有明显的单边短板。论文还放了非整理的样本图和 CFG scale 的 FID 曲线:样本层面,低 CFG 时图像偏糊、类别不鲜明,高 CFG 时细节增强但多样性和色彩可能失真,2.22 那组是在这个权衡里挑出来的点。
这篇之后:三个可以认真回答的问题
小播:收尾前,把论文留下的开放问题列一下。
老播:三个方向,按难度排。第一,文本条件和其他数据域:目前只有 ImageNet 类条件图像生成,文本到图像、视频、音频这些场景还没验证,x-prediction 的流形优势在非图像域是否成立是开放问题。第二,更正式的流形论证:广义流形假设目前靠可视化加消融支撑,没有 intrinsic dimension 之类的定量估计,也没有理论刻画什么条件下 x 一定落低维;这一步补上,结论才能从图像推广到任意高维数据。第三,机器人侧的组合验证:论文只给了图像域证据,动作和观测拼接后的高维空间里,x-prediction 和 u-prediction 的分界线在哪,需要专门的策略实验回答——这正好接上我们前面说的「要不要 latent」的判断标准,把它从假设变成结论。
它在清单的阅读路径里排在哪
小播:我们清单里 one-step 这条线有好几张卡,pMF 应该放在哪个位置读?
老播:按依赖顺序读。先 flow matching:条件速度匹配、路径设计、采样 ODE,这是所有后续的地基;再 rectified flow:reflow 重新配对让轨迹变直,第一次系统讨论少步采样;然后 mean-flows:平均速度场 u 的定义和 MeanFlow Identity,一步生成的理论起点;improved-mean-flows 把训练目标改成回归 v 加重参数化,解决稳定性和可用性;jit-back-to-basics 证明 x-prediction 在像素空间可行,但要走 100 步;最后才是这篇 pixel-mean-flows,把 x-prediction 接进 mean-flow 的 (r,t) 平面,同时拿到一步生成和像素空间。这条线读完,你会看到同一个问题的三次换挡:先换目标(u 到 v),再换空间(latent 到像素),最后换步数(多步到一步),每次换挡解决一个具体瓶颈。pMF 在谱系里的位置可以概括成一句话:它是 one-step 这条线上,第一个在像素空间从零训练就把 FID 打进个位数的模型。
谱系定位:它站在 iMF、JiT 和一致性模型的哪条线上
小播:如果我要跟别人转述这篇论文,它和前作们到底差在哪?
老播:可以分四个对照记。第一,对 iMF:两者损失完全相同,v-loss、JVP、CFG 全部沿用,差异只在预测目标——iMF 输出 u,pMF 输出 x,转换从 u→v 变成 x→u→v,场景从 latent 换成像素。你可以理解成 pMF 把 iMF 的「目标选择」换成了 JiT 验证过的 x-prediction。第二,对 JiT:JiT 已经证明 x-prediction 加 v-loss 在像素空间可行,但它走 100 步;pMF 把它接进 MeanFlow 的 (r,t) 平面实现一步化。时间采样消融里只采 r=t 是 194.53,说明光有 JiT 的设定学不动 one-step,这一步差距就是 MeanFlow 的价值。第三,对 Consistency Models 这一族:CM 固定 r=0 线预测终点,还常用 pre-conditioner,输出偏离 x 空间;CTM 训练期要积分 ODE;FMM 学的是位移 z_t−z_r,含噪声、不在低维流形上。pMF 在 (r,t) 全平面采样、直接输出 x,表 3 把这三条路的失败点都对照出来了。第四,对 EPG 和 GAN:EPG 靠自监督预训练补足单步像素建模的难度,pMF 从零训练就超过它;StyleGAN-XL 算力是 pMF 的约 7 倍多(2061 对 272 Gflops),pMF 是 Transformer 架构,还能继续加数据加参数。
局限:几个地方要打折扣
小播:说得这么好,哪些地方要打折扣?别替论文背书。
老播:打折扣的地方至少有五条。第一,和最优多步方法的差距还在:256×256 的 2.22,对照 RAE 加 DiTDH(50×2 步)的 1.13、SiT 加 REPA(250×2 步)的 1.42,one-step 的分布覆盖还追不上上百步的求解器。第二,实验只有 ImageNet 类条件图像生成一个任务,没有文本条件、没有视频、没有其他数据域;感知损失阈值 t_thr 和两类权重都是经验超参,对抗损失方向没做。第三,高分辨率靠固定序列长度、增大 patch 实现,1024×1024 时 patch 是 64×64、单 patch 维度 12288,这种极端 patch 化对细节保真的影响没有单独讨论,而像素 Transformer 圈子里补细节通常还要专门的 refiner 头。第四,两个工程选择是经验性的:JVP 的 stop-gradient 和 Muon 优化器,论文用「早期网络更准、目标更准」解释 Muon 的收益,但多步场景没有最终提升,这个机制解释缺少直接测量;而且 JVP 训练要两次前向加一次反向,论文没报和普通 flow matching 训练的墙钟时间对比。第五,CFG 的最优 scale 和区间是逐配置搜索出来的,表里的 2.22 和附录展示的 FID 2.74、IS 290.0(ω=7.0、区间 [0.1,0.7])不是同一设置,读者看数字要带设置。
小播:还有我们对机器人那块的应用,也要打折扣吧?
老播:对,最后这条专门说。x-prediction 的优势在高维观测显著、在低维消失,这个结论来自图像域;低维动作通道可能落在「u-prediction 也能学动」的区间,但论文没有在机器人动作或动作加观测的组合上验证过。拿它的分离原则去设计策略网络,方向我认为是对的,但数字和结论要当假设用,等专门实验确认。另外补一条口径提醒:论文报告的 FID 都在 50k 样本上评估、带 CFG 就标注带 CFG,参数和 Gflops 对 latent 模型只算「生成器加解码器」;对比任何数字前先核对这两项,这是表 6 的评测说明里明确写的。
收尾:这期记住三件事
小播:收尾了,老播帮我总结三件要带走的事。
老播:第一件,输出空间和损失空间可以分开设计:网络输出选落在低维流形上的量(去噪图像 x),损失选有明确真值的回归空间(瞬时速度 v),中间用 x→u→v 的代数变换连接;JVP 这一步让网络既能输出干净的像素图,又能在瞬时速度空间里拿到干净的回归梯度。这个「分离原则」是全文的方法论核心,也是它区别于 iMF、JiT、Consistency Models 的地方。第二件,高维观测下「预测目标是否落在低维流形」决定能不能学动:patch 维度 48 时 x 和 u 打平(3.80 对 3.82),维度 768 时 u-prediction 崩到 164.89、x-prediction 只有 9.56。这是「要不要 latent」的细粒度判断标准——对图像这类高维观测,一个流形友好的输出目标可以替代预训练 tokenizer。第三件,无 latent 一步生成已经可行且有竞争力:ImageNet 256×256 是 2.22 FID、512×512 是 2.48,都是 1-NFE、从零训练(IS 268.8,也在主流区间),而整个生成器 271 和 272 Gflops,小于 latent 解码器单独的开销(SD-VAE 解码器 256×256 要 310、512×512 要 1230)。对后续工作的意义,我想说一句:当 one-step 把采样成本压下来之后,tokenizer 的解码开销反而成了大头,pMF 证明了这条路可以绕开 latent 走通(不需要预训练 tokenizer,也不需要对抗训练),接下来「像素空间单步生成能不能追平甚至超过多步 latent」就是一个可以认真回答的问题了。往后看,one-step 像素空间这条线的下一个问题是能不能配上文本条件、能不能在视频里成立,以及机器人的动作观测组合能不能复用同一套判断标准。对读者来说,最该带走的是那组对照:patch 维度 48 时 3.80 对 3.82,维度 768 时 9.56 对 164.89——目标是否落在低维流形,直接决定能不能学动。记住这个判断标准,比记住 2.22 这个 FID 更有用,它能迁移到清单里所有高维生成问题,也包括世界模型和机器人策略这类高维输出场景。