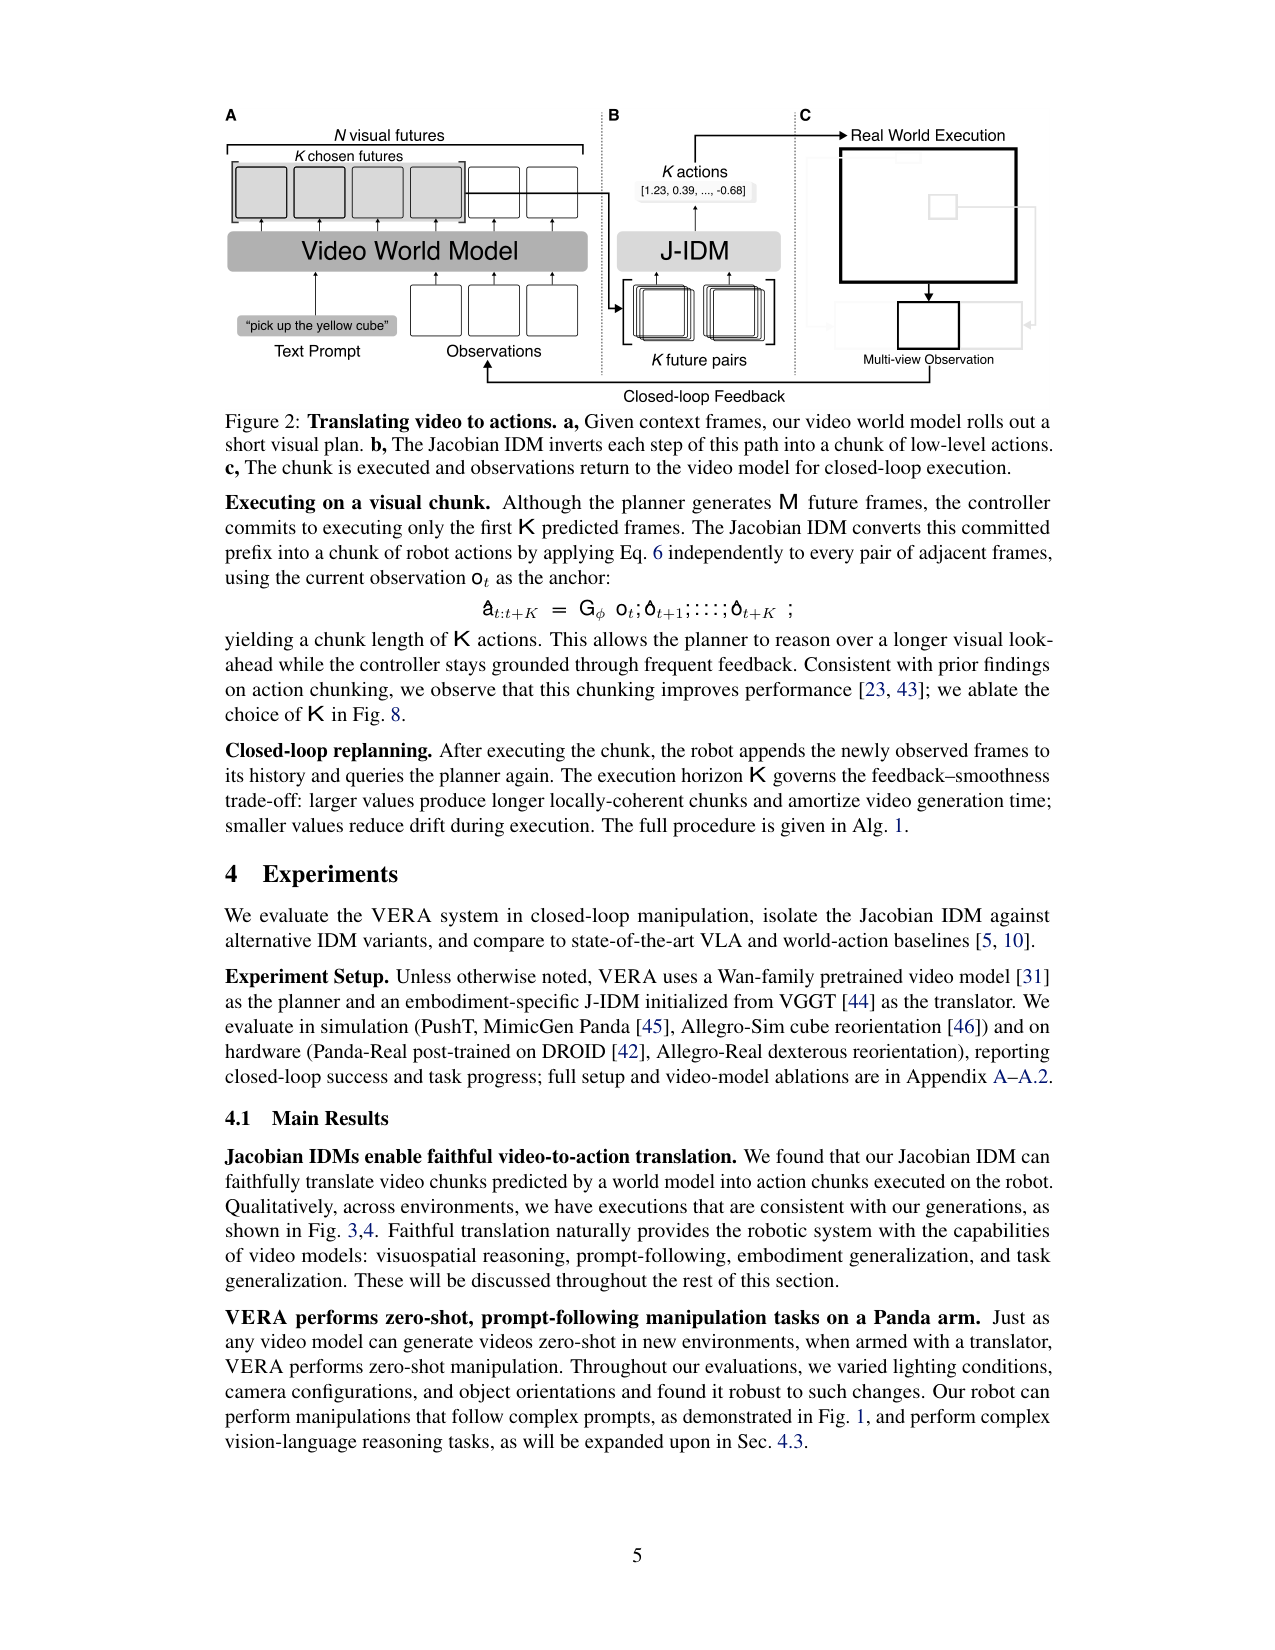
 Decoupled Video-to-Action(动作无关视频世界模型 + 机体 Jacobian IDM)
Turning Video Models into Generalist Robot Policies (VERA)
让一个 14B 视频扩散模型只当动作无关的视觉规划器,用按机体 Jacobian 结构化设计的逆动力学模型把预测视频忠实翻译成动作,得到零样本、跨本体、闭环的通用机器人策略 VERA。
优先论文清单(核心必读 + 扩展阅读)深度解读:生成模型 / one-step 谱系 / 世界模型 / 机器人 / 神经科学 / 物理交叉。播客更长、更细、更好懂。
Decoupled Video-to-Action(动作无关视频世界模型 + 机体 Jacobian IDM)
让一个 14B 视频扩散模型只当动作无关的视觉规划器,用按机体 Jacobian 结构化设计的逆动力学模型把预测视频忠实翻译成动作,得到零样本、跨本体、闭环的通用机器人策略 VERA。
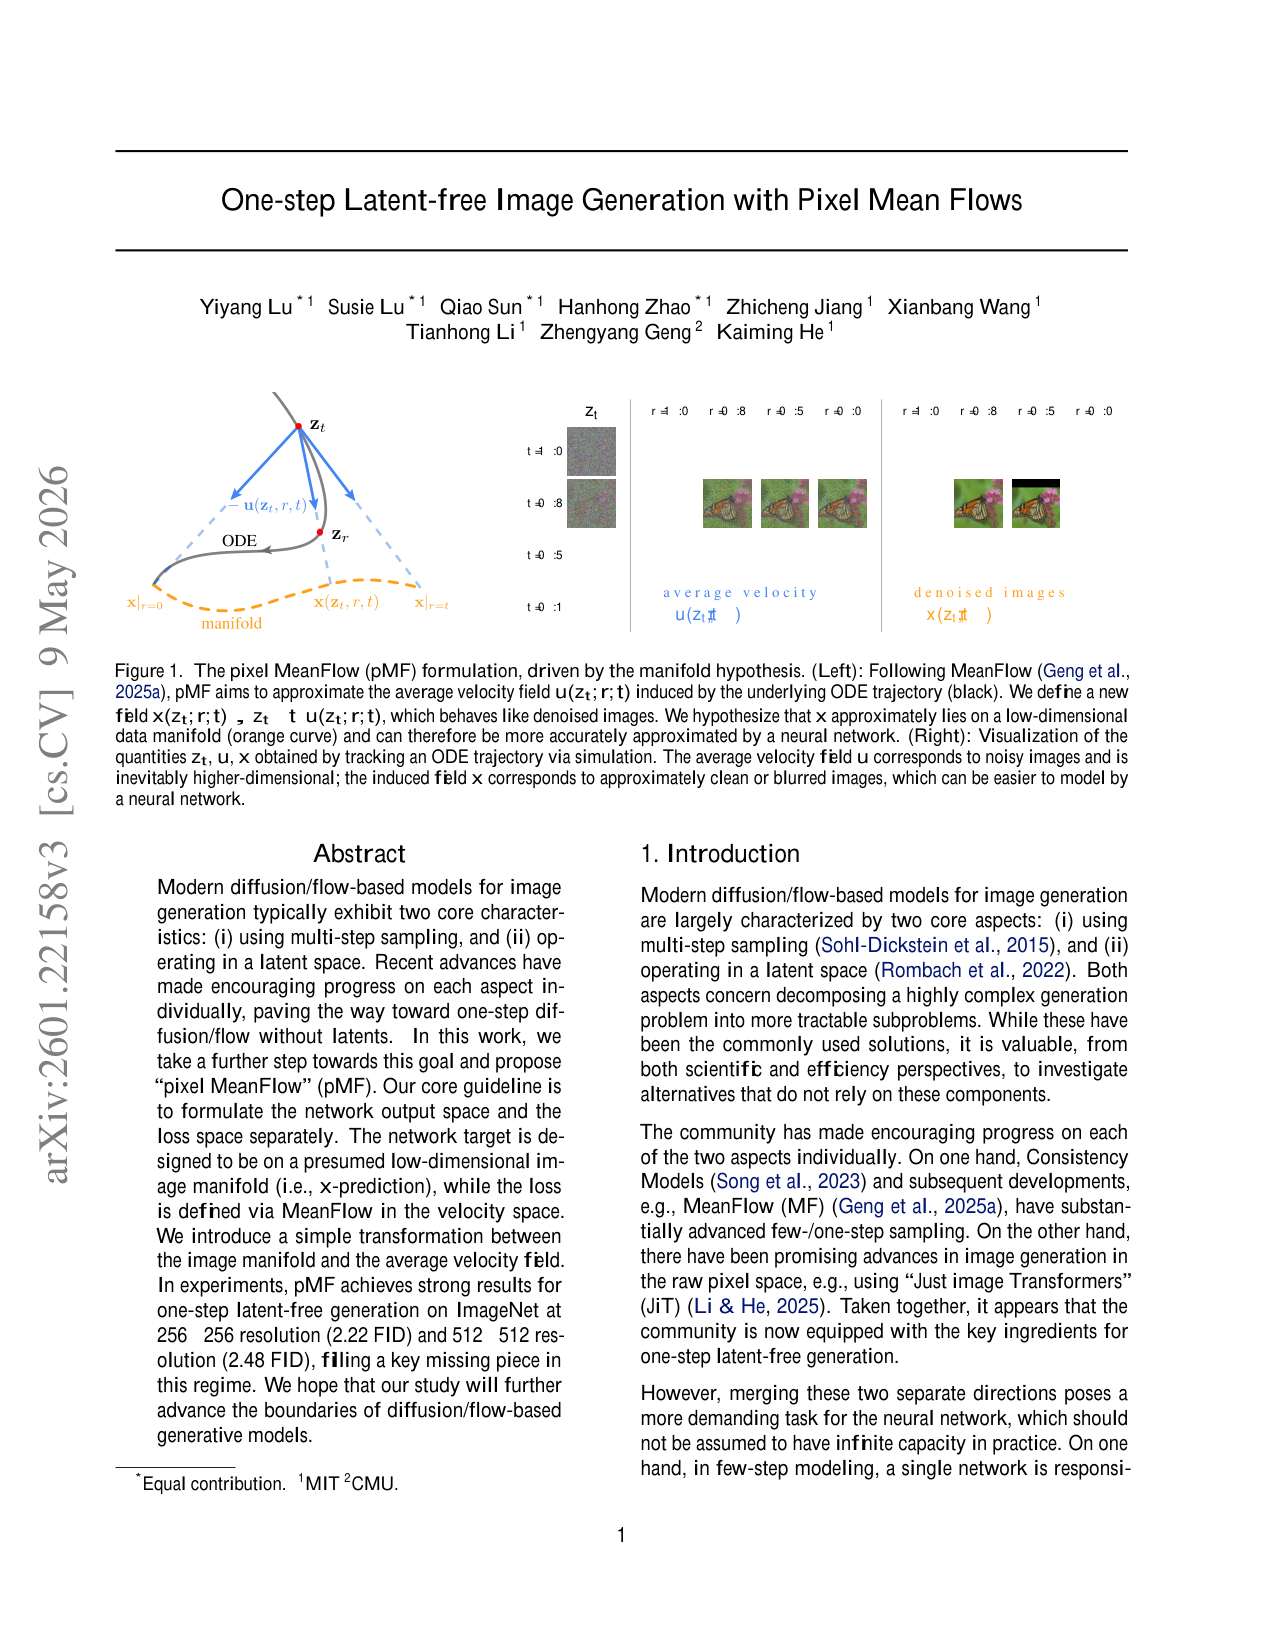 生成模型理论 / one-step 谱系(Flow Matching + MeanFlow + 像素空间 Transformer)
提出 pixel MeanFlow(pMF):把「网络输出空间」和「损失空间」分开设计——网络在像素空间直接输出去噪图像 x(假定落在低维图像流形上),损失沿用 improved MeanFlow 定义在瞬时速度 v 空间(v-loss),中间用 x→u→v 的代数变换接起来;在不借助任何预训练 VAE/tokenizer 的前提下,用 1 次函数评估在 ImageNet 256×256 拿到 2.22 FID(pMF-H/16,956M 参数、271 Gflops)、512×512 拿到 2.48 FID(pMF-H/32,959M、272 Gflops),填补了「one-step + latent-free」此前几乎空白的象限。
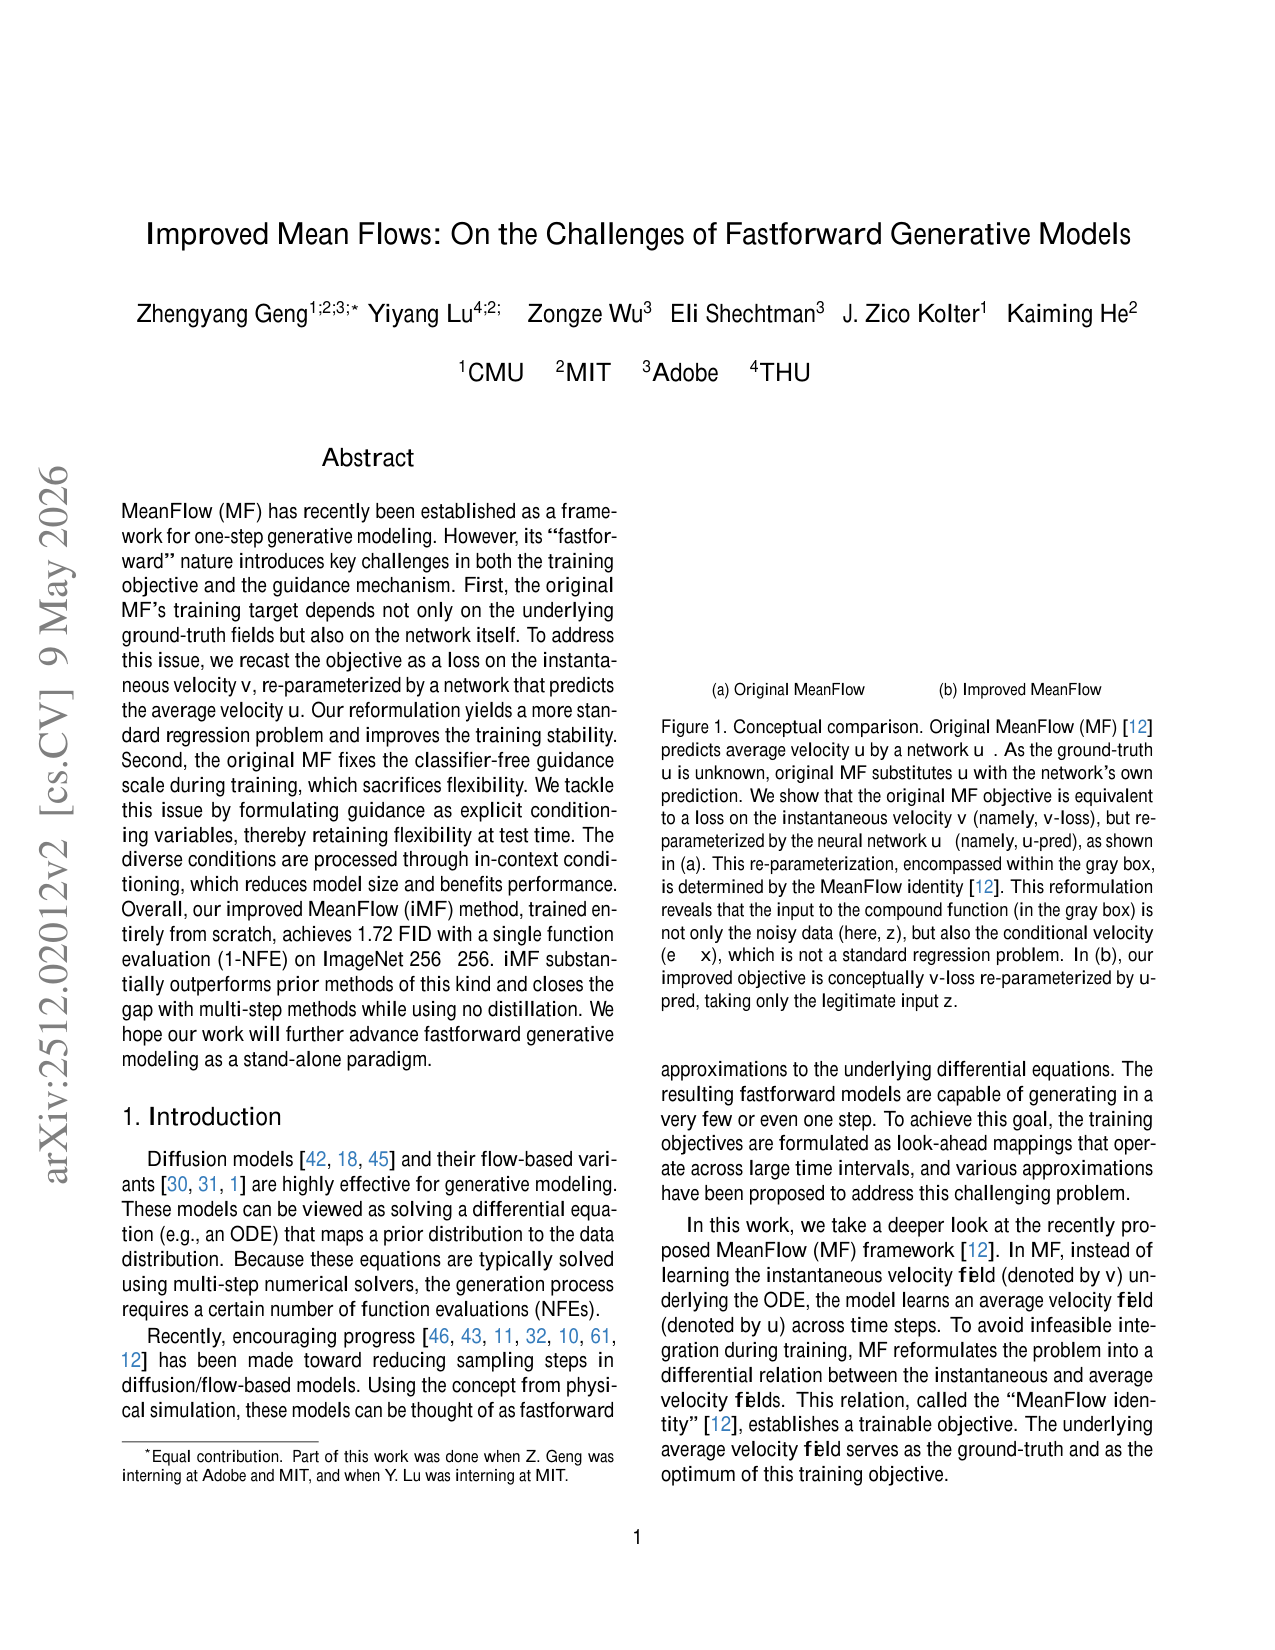 生成模型理论 / one-step 生成(fastforward generative models)
把 MeanFlow 的两处『欠可用』问题修掉:训练目标从网络依赖的 u-loss 改成对瞬时速度 v 回归、由 u 网络 re-parameterization 的 v-loss,CFG 从训练期固定 scale 改成可推理期调节的条件变量,并配套多 token in-context conditioning,使从零训练的 one-step 模型在 ImageNet 256×256 上拿到 1-NFE FID 1.72(相对原 MF 的 3.43 下降 50%),是 fastforward 范式『可用化』的样板。
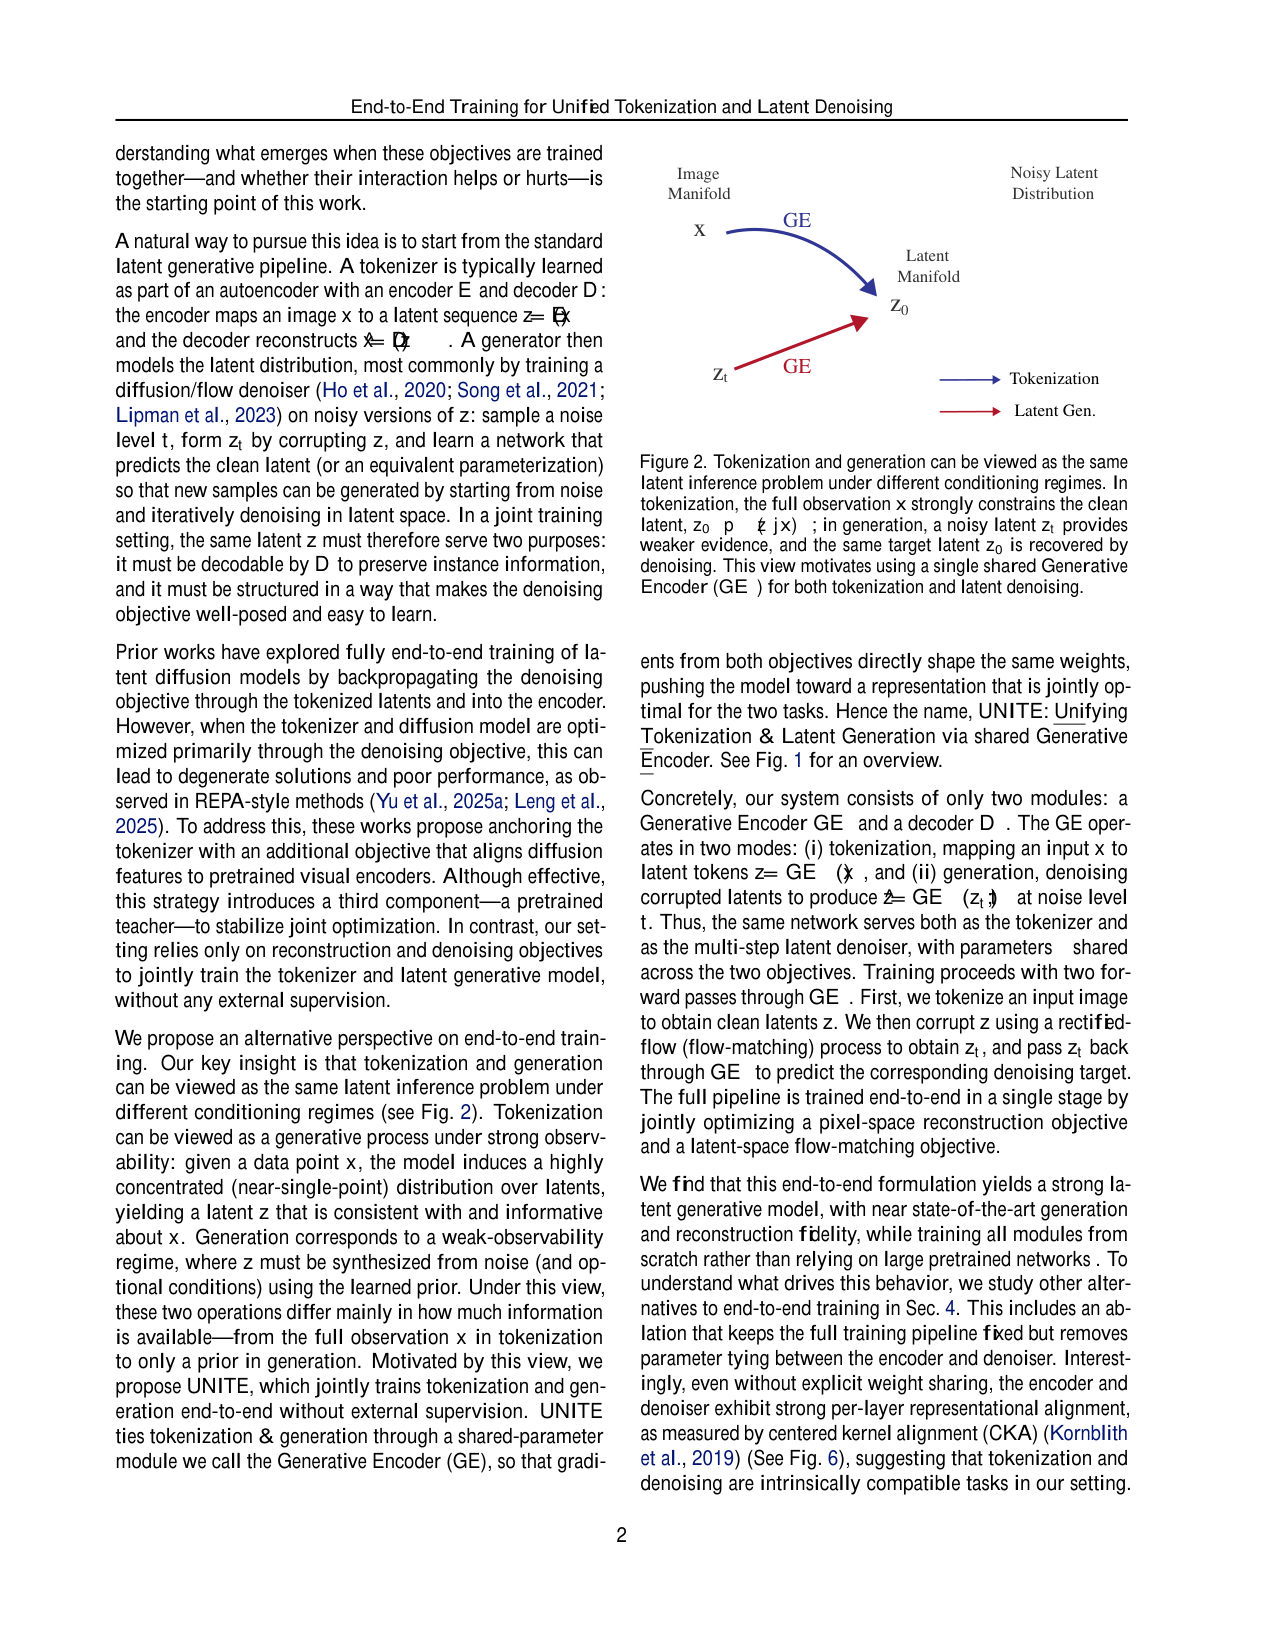 生成模型理论(tokenizer + latent denoising 统一 / 表示来源)
把 tokenizer 和 latent 去噪器合并成一个权重共享的 Generative Encoder,单阶段从零联合训练重建与 flow-matching 目标:ImageNet 256×256 上 UNITE-B 生成 FID 2.12(对照单阶段 JiT-B/16 3.66、两阶段 DiT-XL/2 2.27),重建 rFID 1.01(对照无对抗 ViTok-B/16 1.63),全程不需要 DINOv2 等外部预训练编码器——为『表示从哪来』提供一个现代答案:表示由重建压力与生成压力在同一网络里共同塑造。
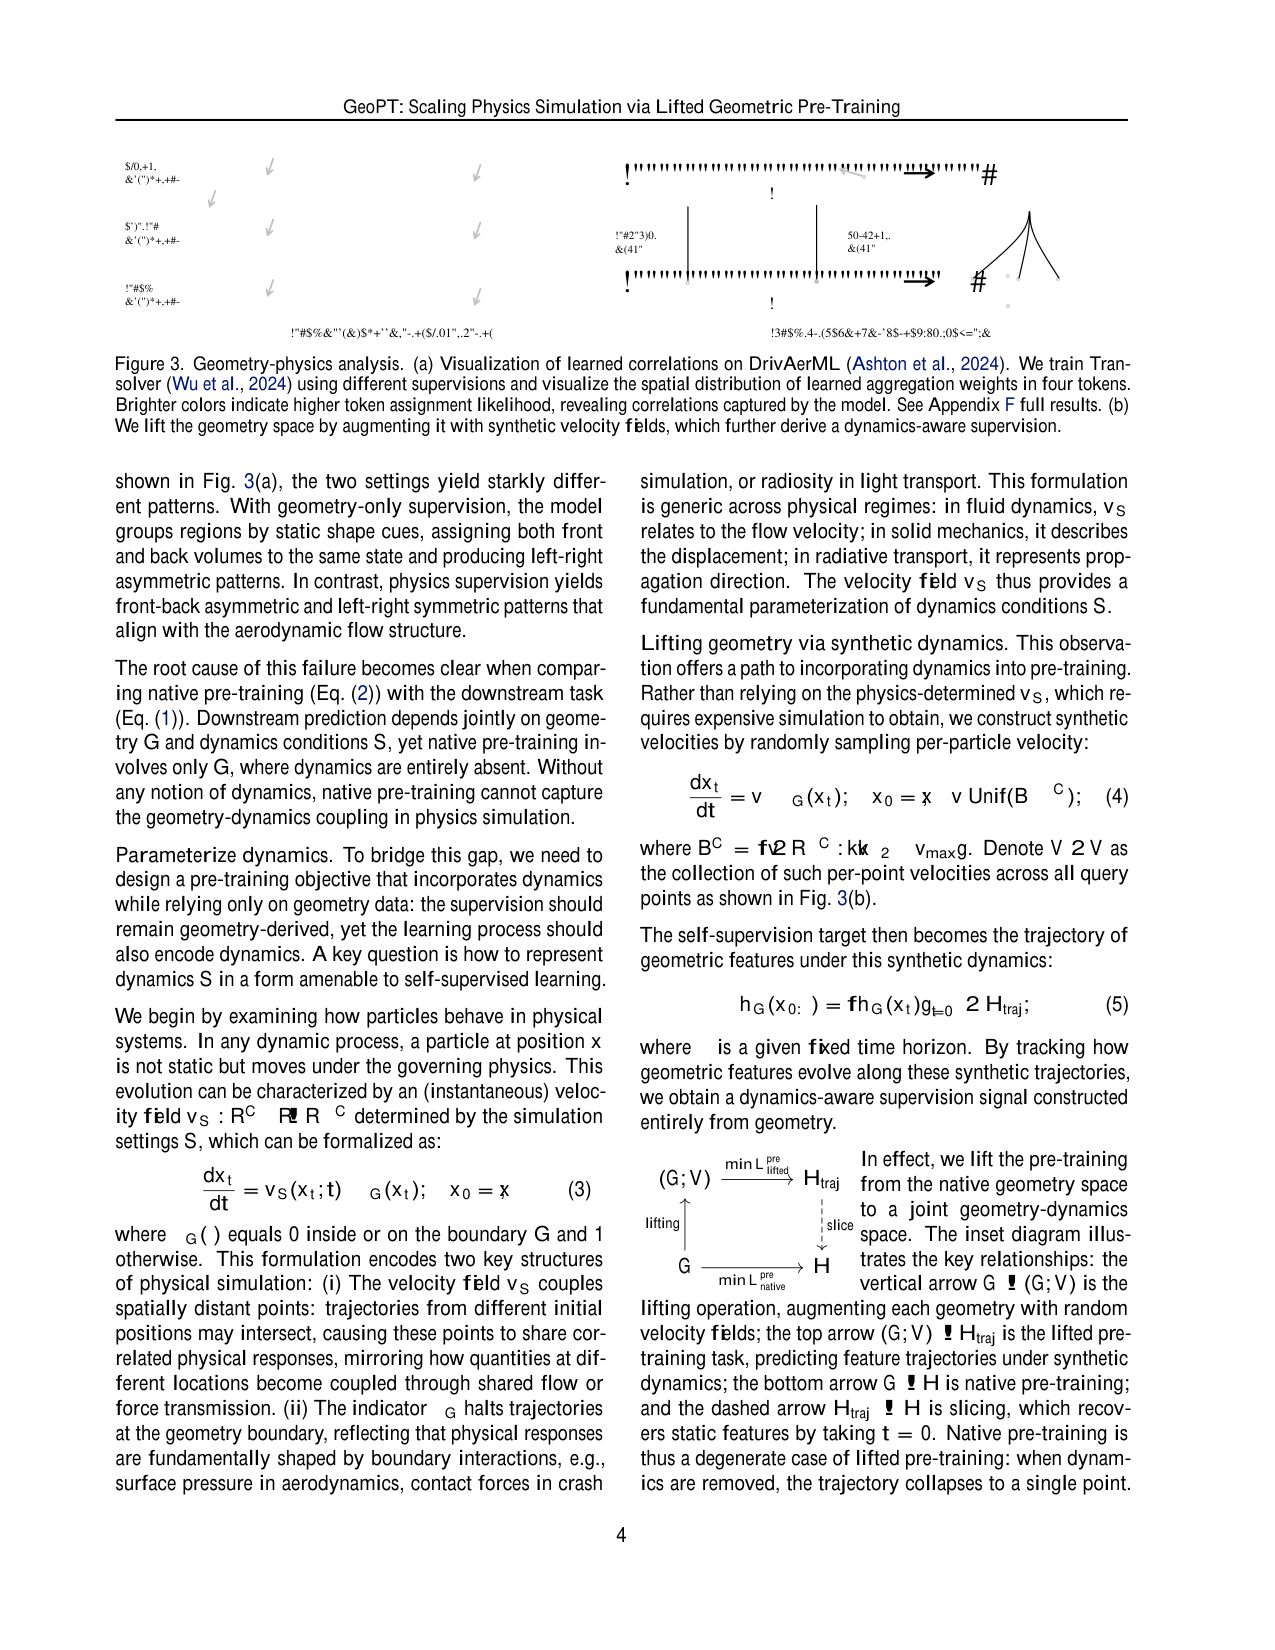 physics simulation / geometric pre-training / neural operators / world model
神经模拟器一直靠数值求解器生成标注(DrivAerML 单样本约 6.1×10^4 CPU 小时),而纯几何自监督(预测 SDF/向量距离)在物理任务上反而负迁移。GeoPT 把每个几何配上一组随机速度场和边界粘滞轨迹,用「几何特征沿合成动力学轨迹的演化」做自监督,把预训练空间从静态几何提升到几何-动力学联合空间;在 ShapeNet 三个子集 1.35 万个几何上生成 134.6 万条免求解器样本(约 5TB),预训练 Transolver 主干,在汽车/飞机空气动力学、船舶水动力、碰撞五个工业级 benchmark 上减少 20–60% 标注数据、收敛最高加速 2×,并能迁移到没见过的辐射度(radiosity)模拟。
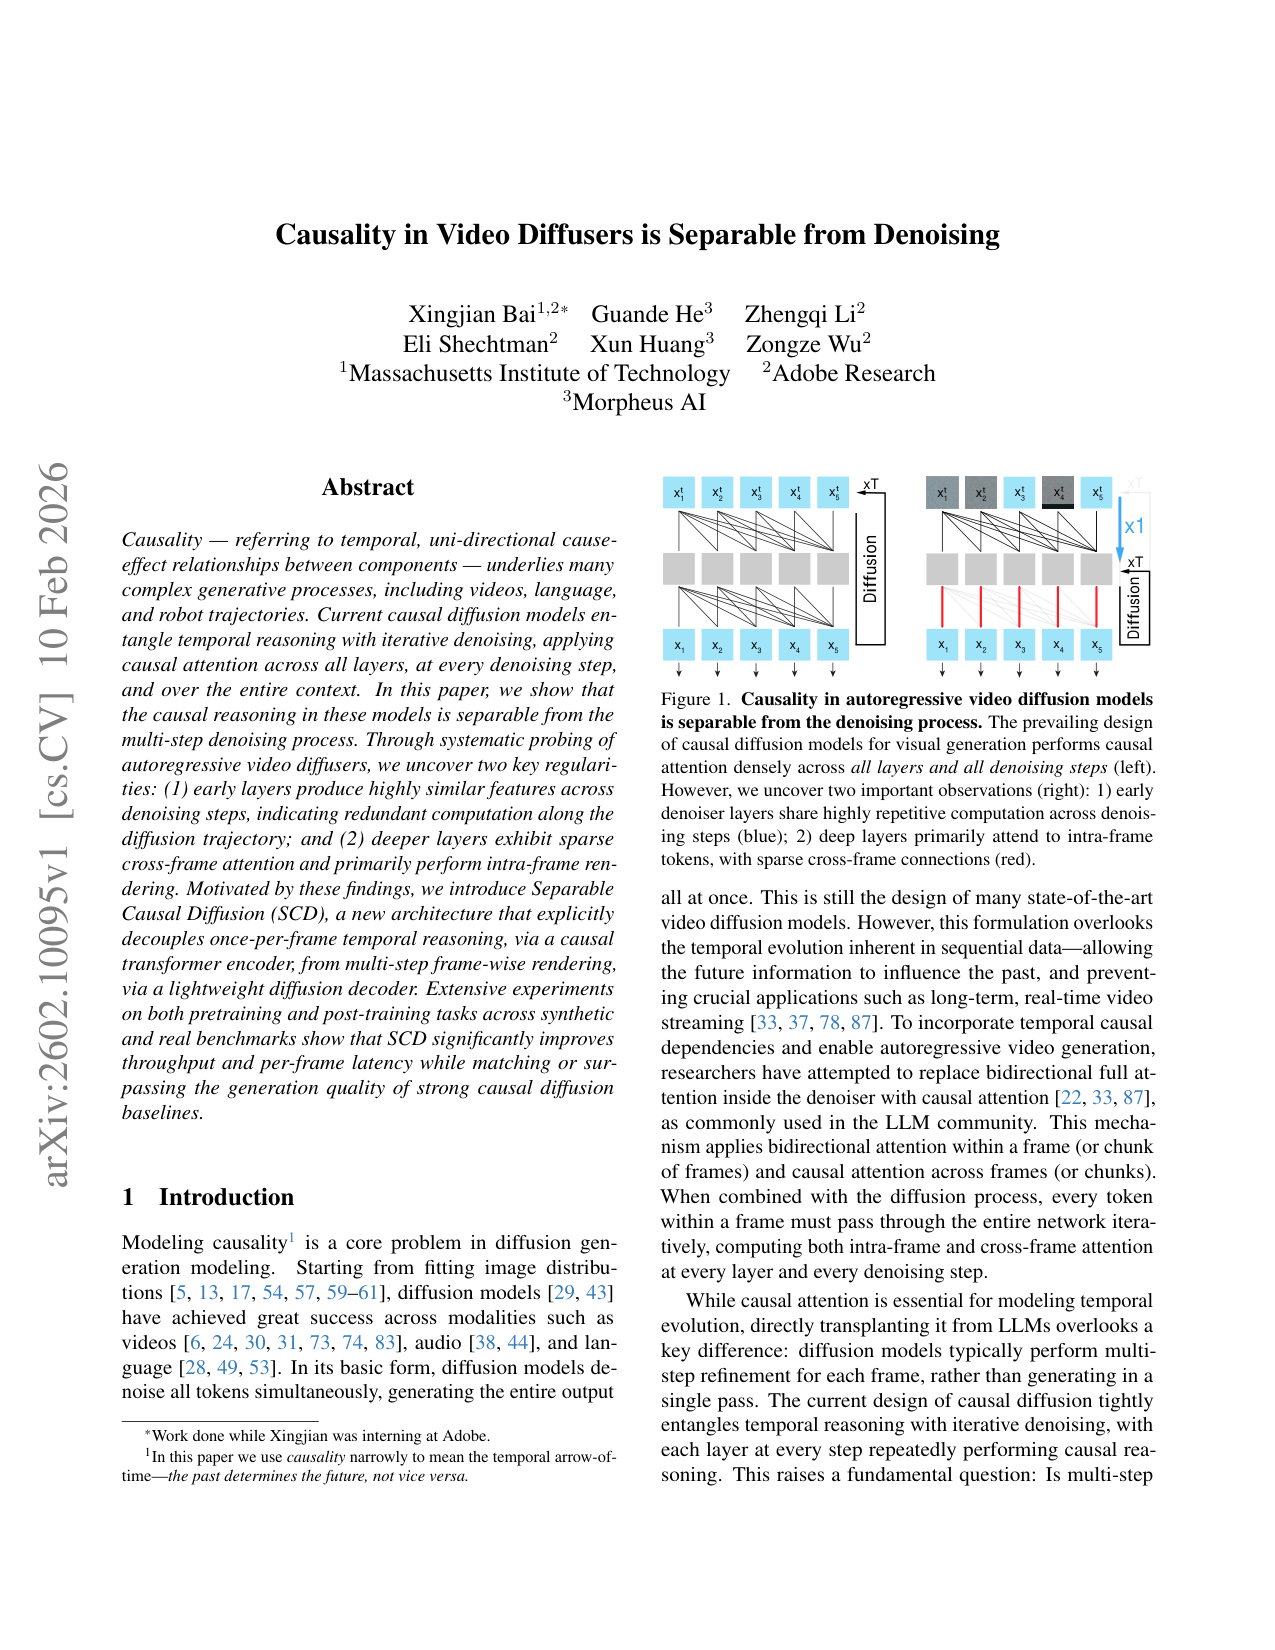 视频生成 / 自回归视频扩散 / 因果建模与高效推理
通过探针实验证明自回归视频扩散模型中「时间因果推理」与「多步去噪」可分离:早中层特征跨去噪步高度冗余(WAN-2.1 T2V-1.3B 第 15/30 层特征跨 50 步余弦相似度 >0.95)、深层跨帧注意力稀疏;据此提出 Separable Causal Diffusion(SCD),用每帧只跑一次的因果 transformer 编码器 + 轻量逐帧扩散解码器,从零训练在 TECO-Minecraft 上 FVD 37.6(基线 Causal DiT-M 38.7)且单帧延迟 0.52s vs 2.4s(约 4.6×),微调 WAN 2.1 后 VBench 总分 84.03(Self Forcing 84.26)且吞吐 11.1 vs 8.9 FPS,为长时程 world model 提供可独立调节的推理成本杠杆。
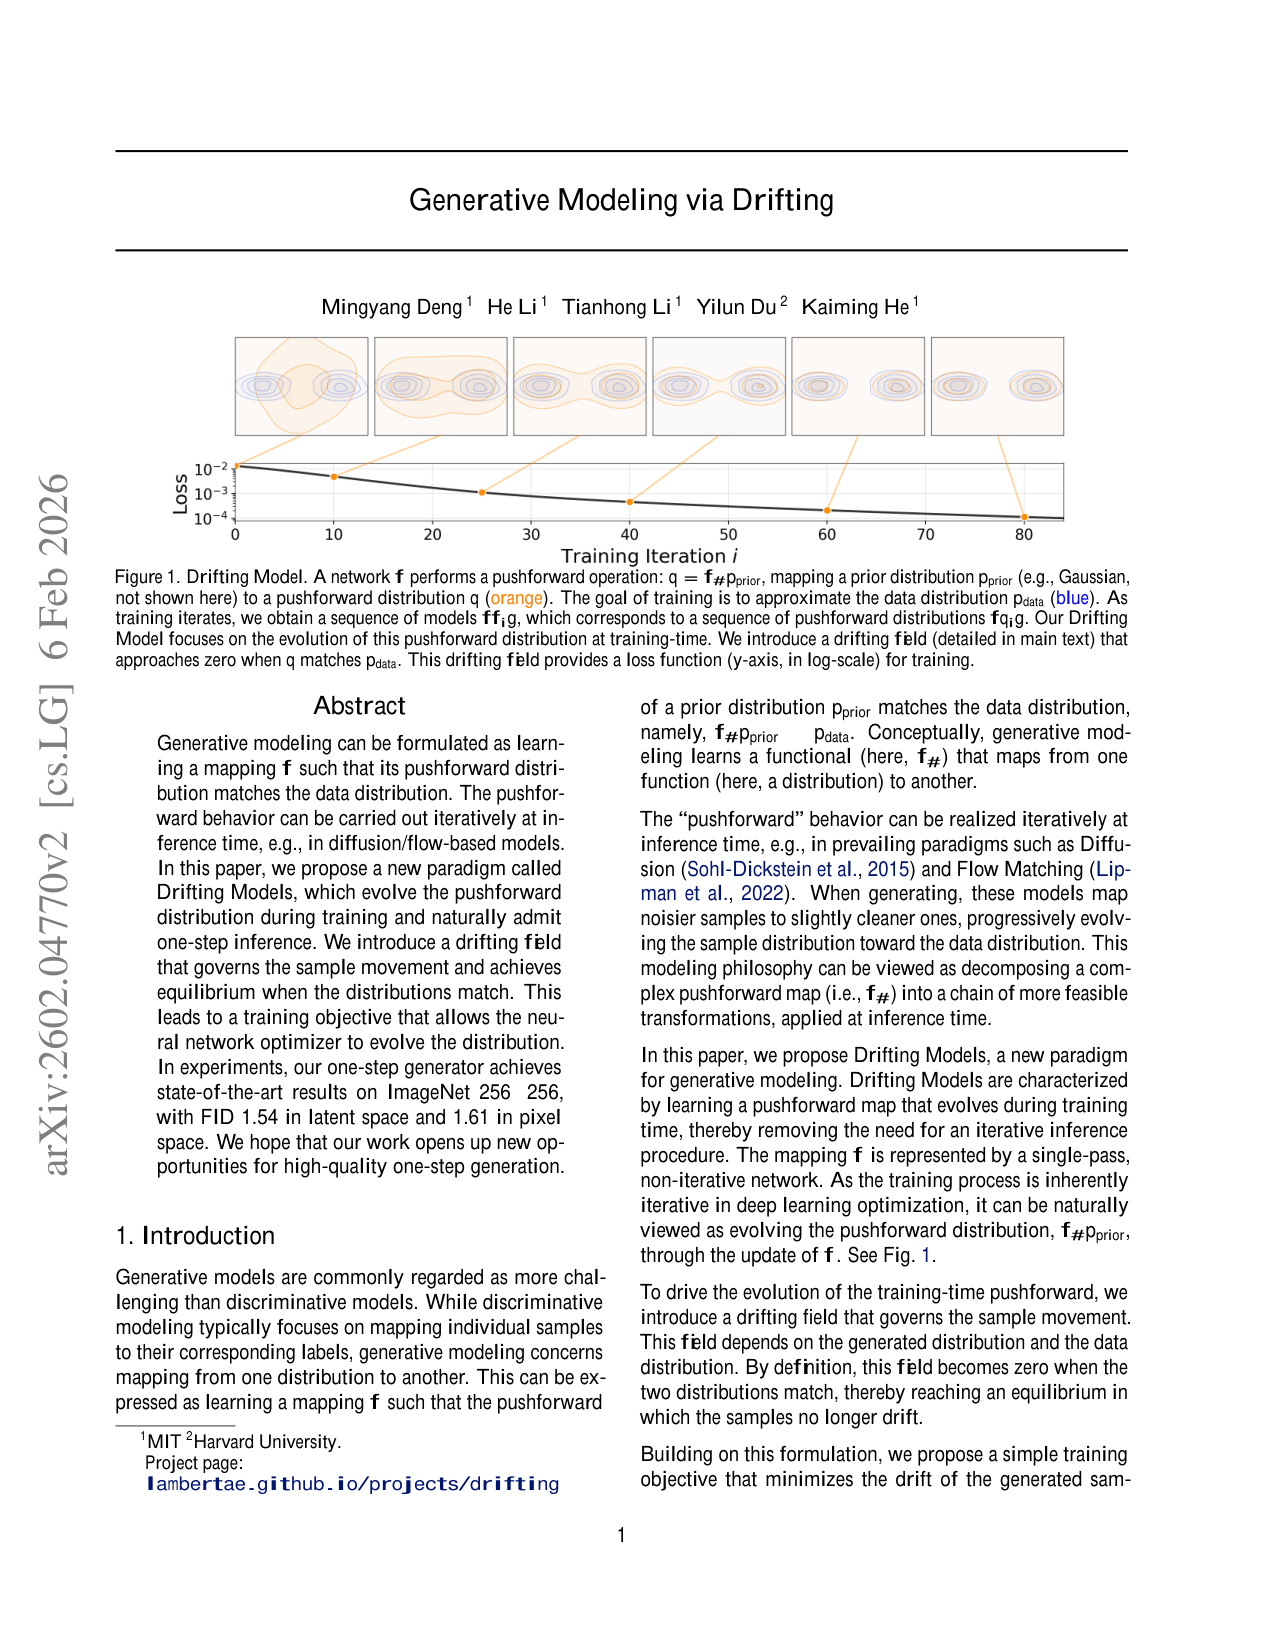 生成模型理论 / one-step 生成谱系
把扩散/流模型在推理期的迭代,整体搬到训练期:用反对称漂移场驱动 pushforward 分布在训练中演化到数据分布,推理只剩一次前向,ImageNet 256×256 潜空间 1-NFE FID 1.54。
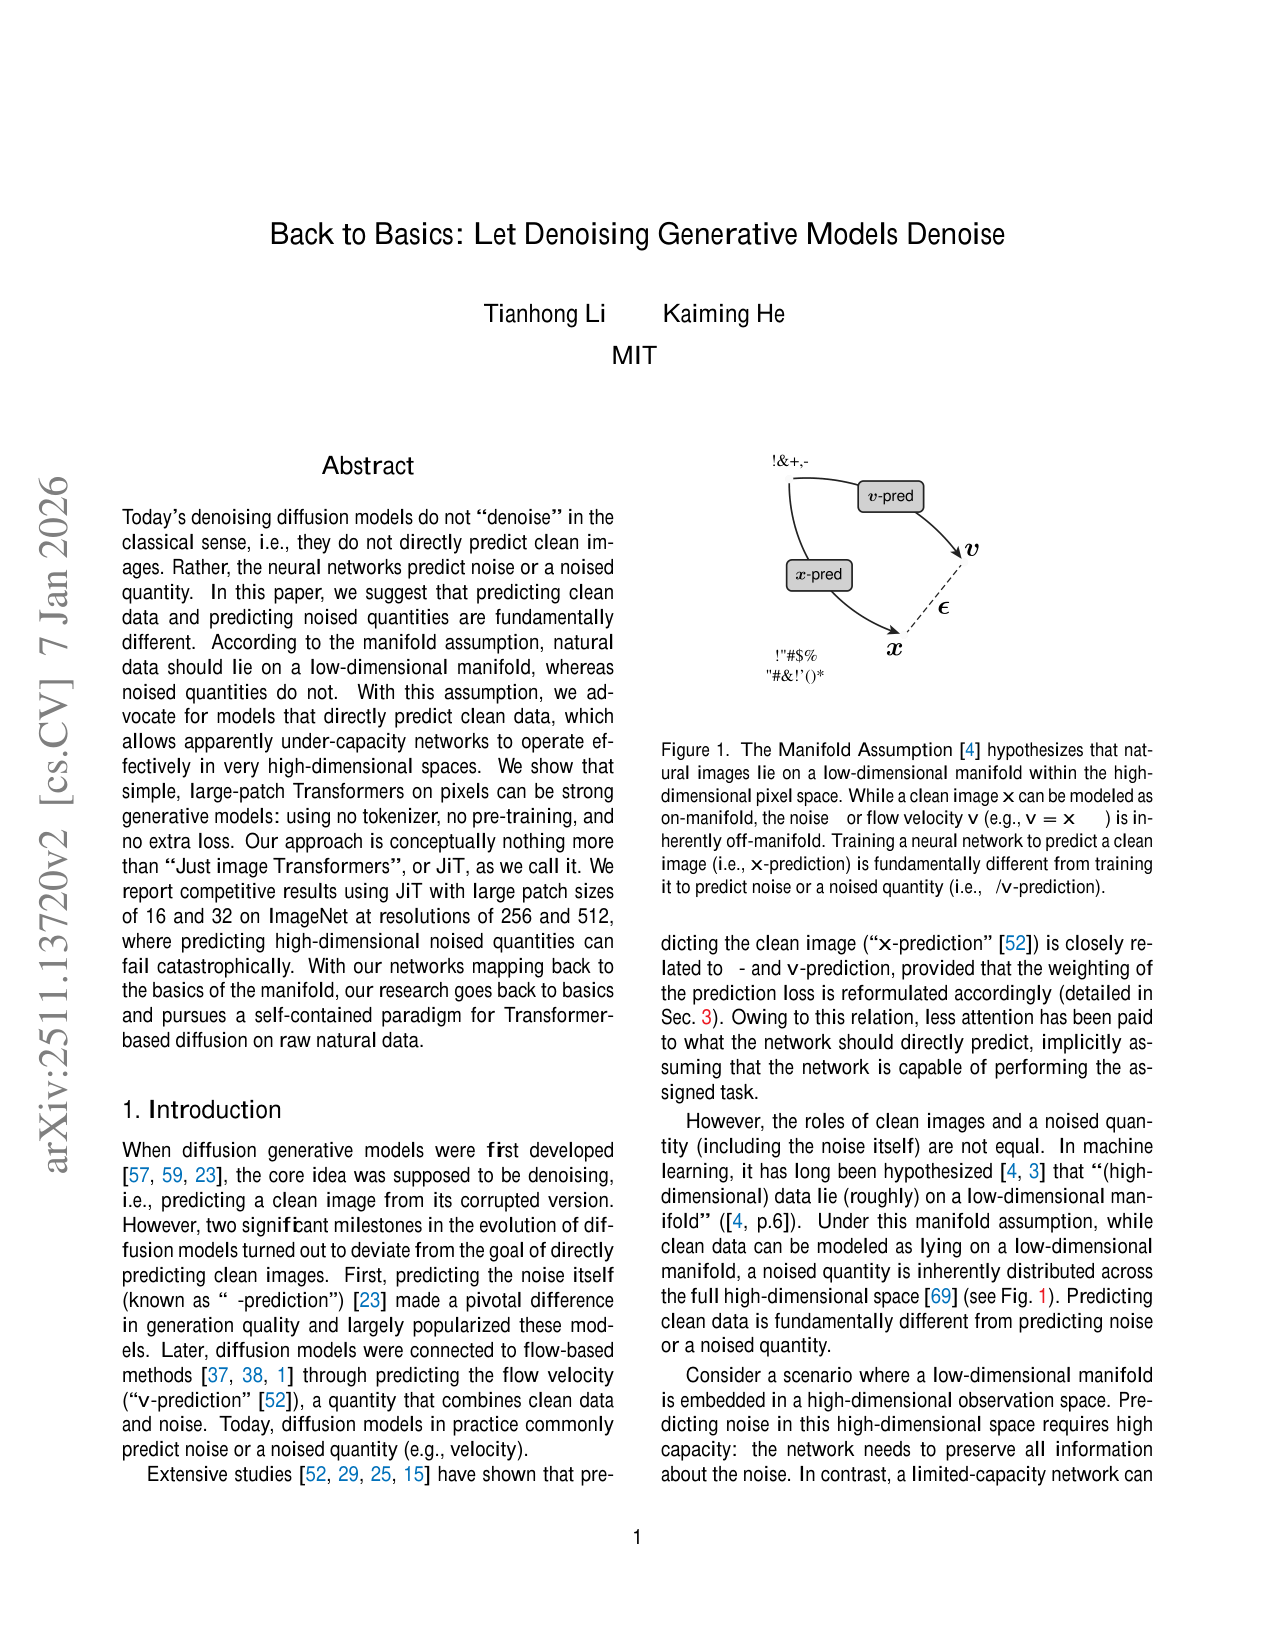 生成模型理论 / 像素空间扩散
这篇论文主张:扩散与流模型的网络应当直接预测干净图像 x——它落在低维数据流形上;预测噪声 ε 或速度 v 会让欠容量网络在极高维像素 patch 上灾难性失败。基于这一观点,只用没有 tokenizer、没有预训练、没有附加损失的普通大 patch ViT,就能在原始像素上做出有竞争力的生成,并与 MeanFlow 在「网络输出应指向数据均值型量」的表示哲学上互补。
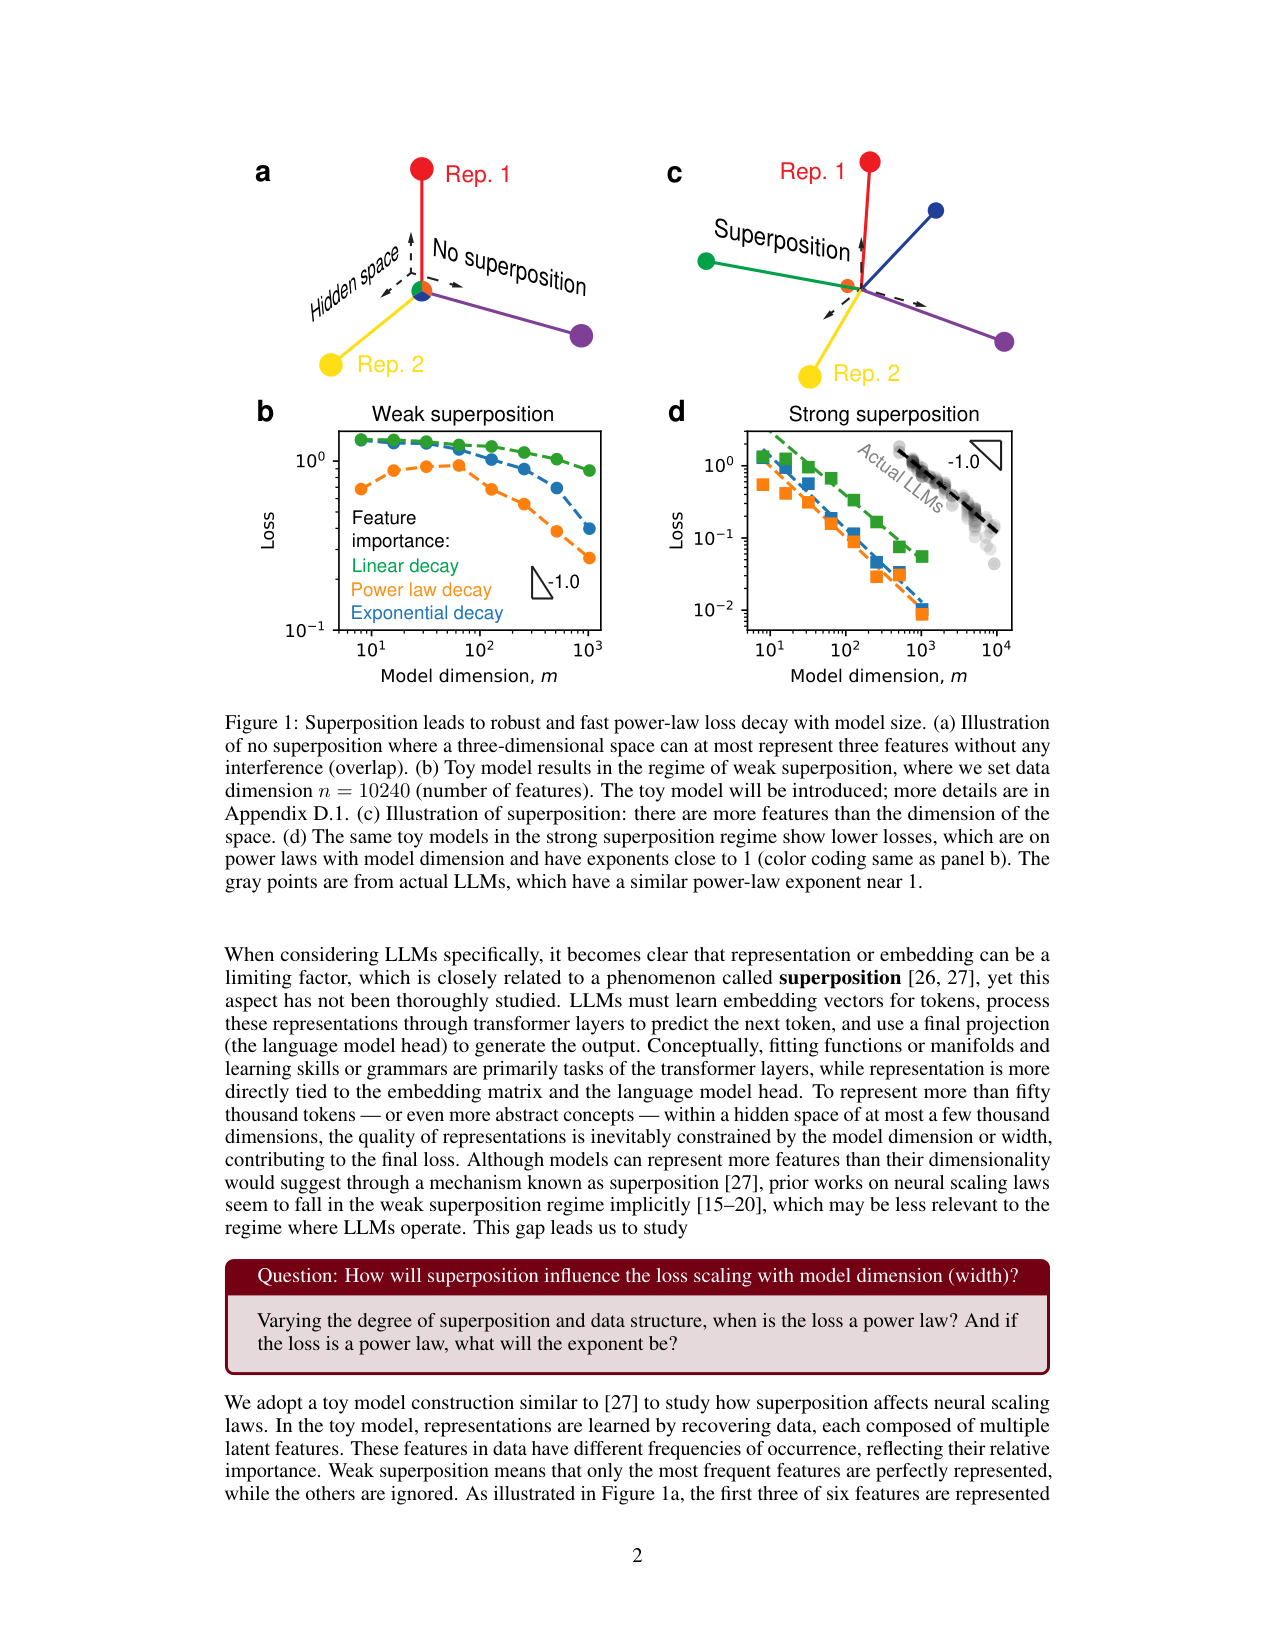 neural scaling laws / 表征叠加理论
用 Anthropic 的 superposition 玩具模型研究『损失随模型宽度 m 的标度』:弱叠加时损失 ≈ 被忽略特征的总频率,只有特征频率是幂律才得到幂律损失(指数 α_m ≈ α−1);强叠加时损失来自表征向量间的几何干扰,平方重叠按 1/m 下降,损失稳健地按 1/m 标度(α_m≈1),对频率分布几乎不敏感。把 token 当原子特征分析 OPT/GPT-2/Qwen2.5/Pythia 的 LM head,实测平方重叠 ~1/m、损失指数 α_m=0.91±0.04,与 Chinchilla 换算的 0.88±0.06 一致,说明 LLM 运行在强叠加区,叠加是神经标度律的一个重要来源。
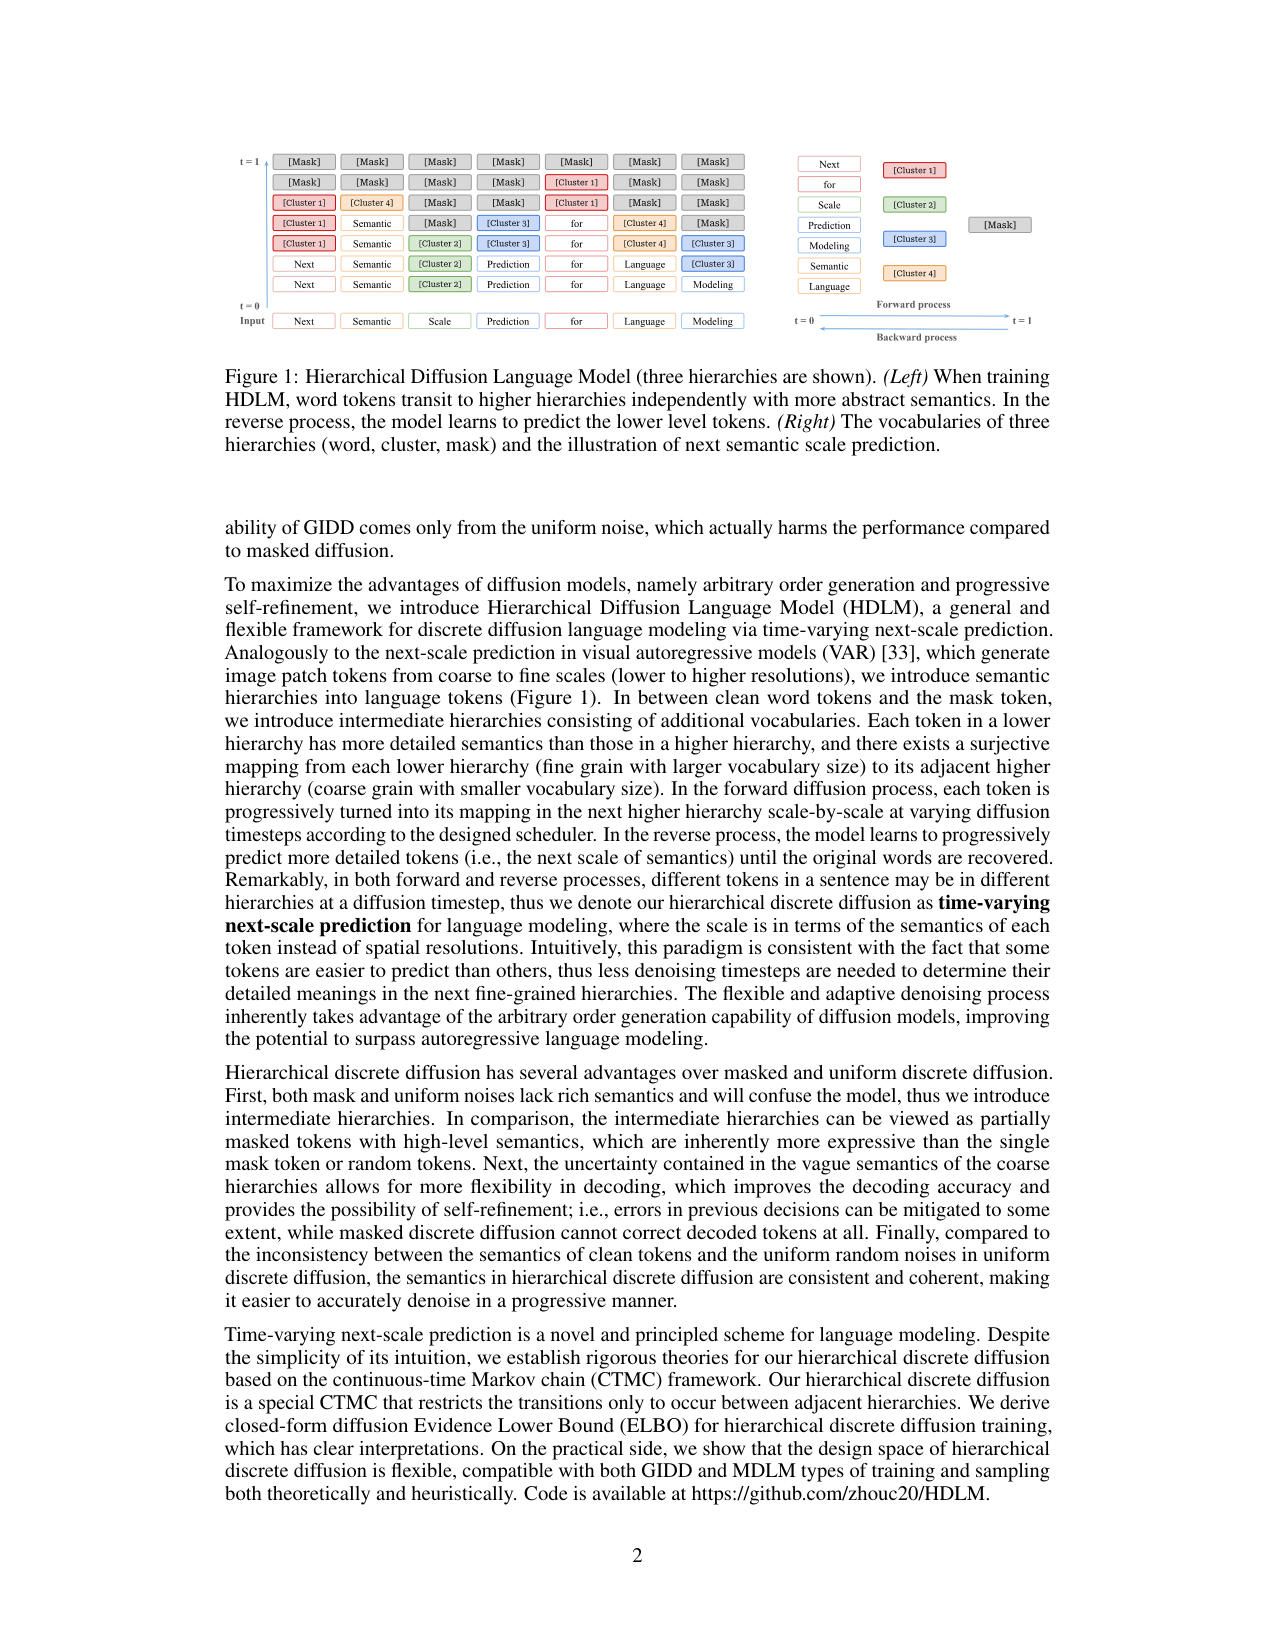 生成模型理论(离散扩散 / 扩散语言模型)
在词 token 与 mask 之间插入『语义簇』这一中间层级:前向把词逐级粗化成簇、再粗化成 mask,反向按语义粒度从粗到细逐级恢复,得到时间上变化的 next semantic scale prediction;闭式 ELBO 证明下,MDLM 只是 HDLM 取一个簇的特例。
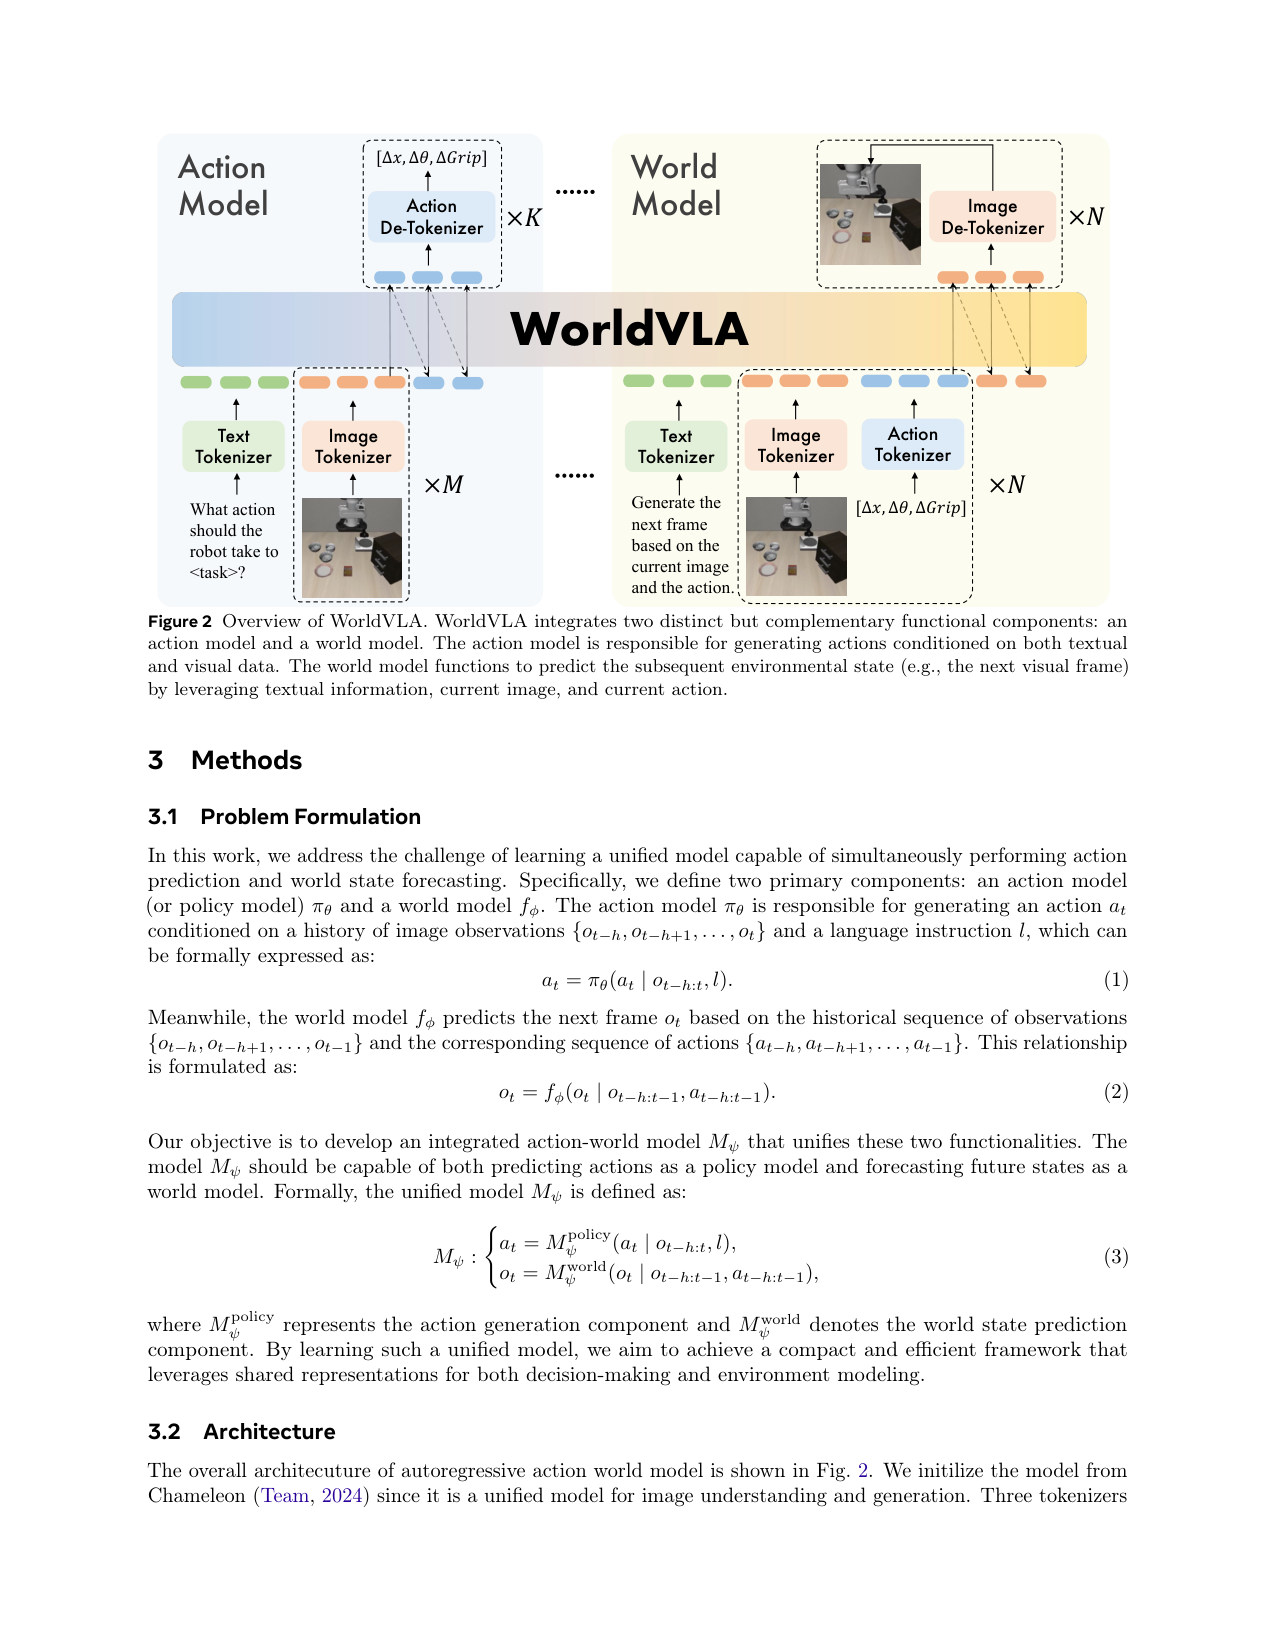 Action World Model(融合路线:动作+图像统一自回归)
用一个从 Chameleon 初始化的自回归 transformer,把 VLA 的动作生成和世界模型的未来帧预测并进同一套离散 token 序列:动作既当输出也当世界模型的输入,未来帧预测反过来给动作决策提供物理理解,两边在同一词表、同一主干上互相增强。
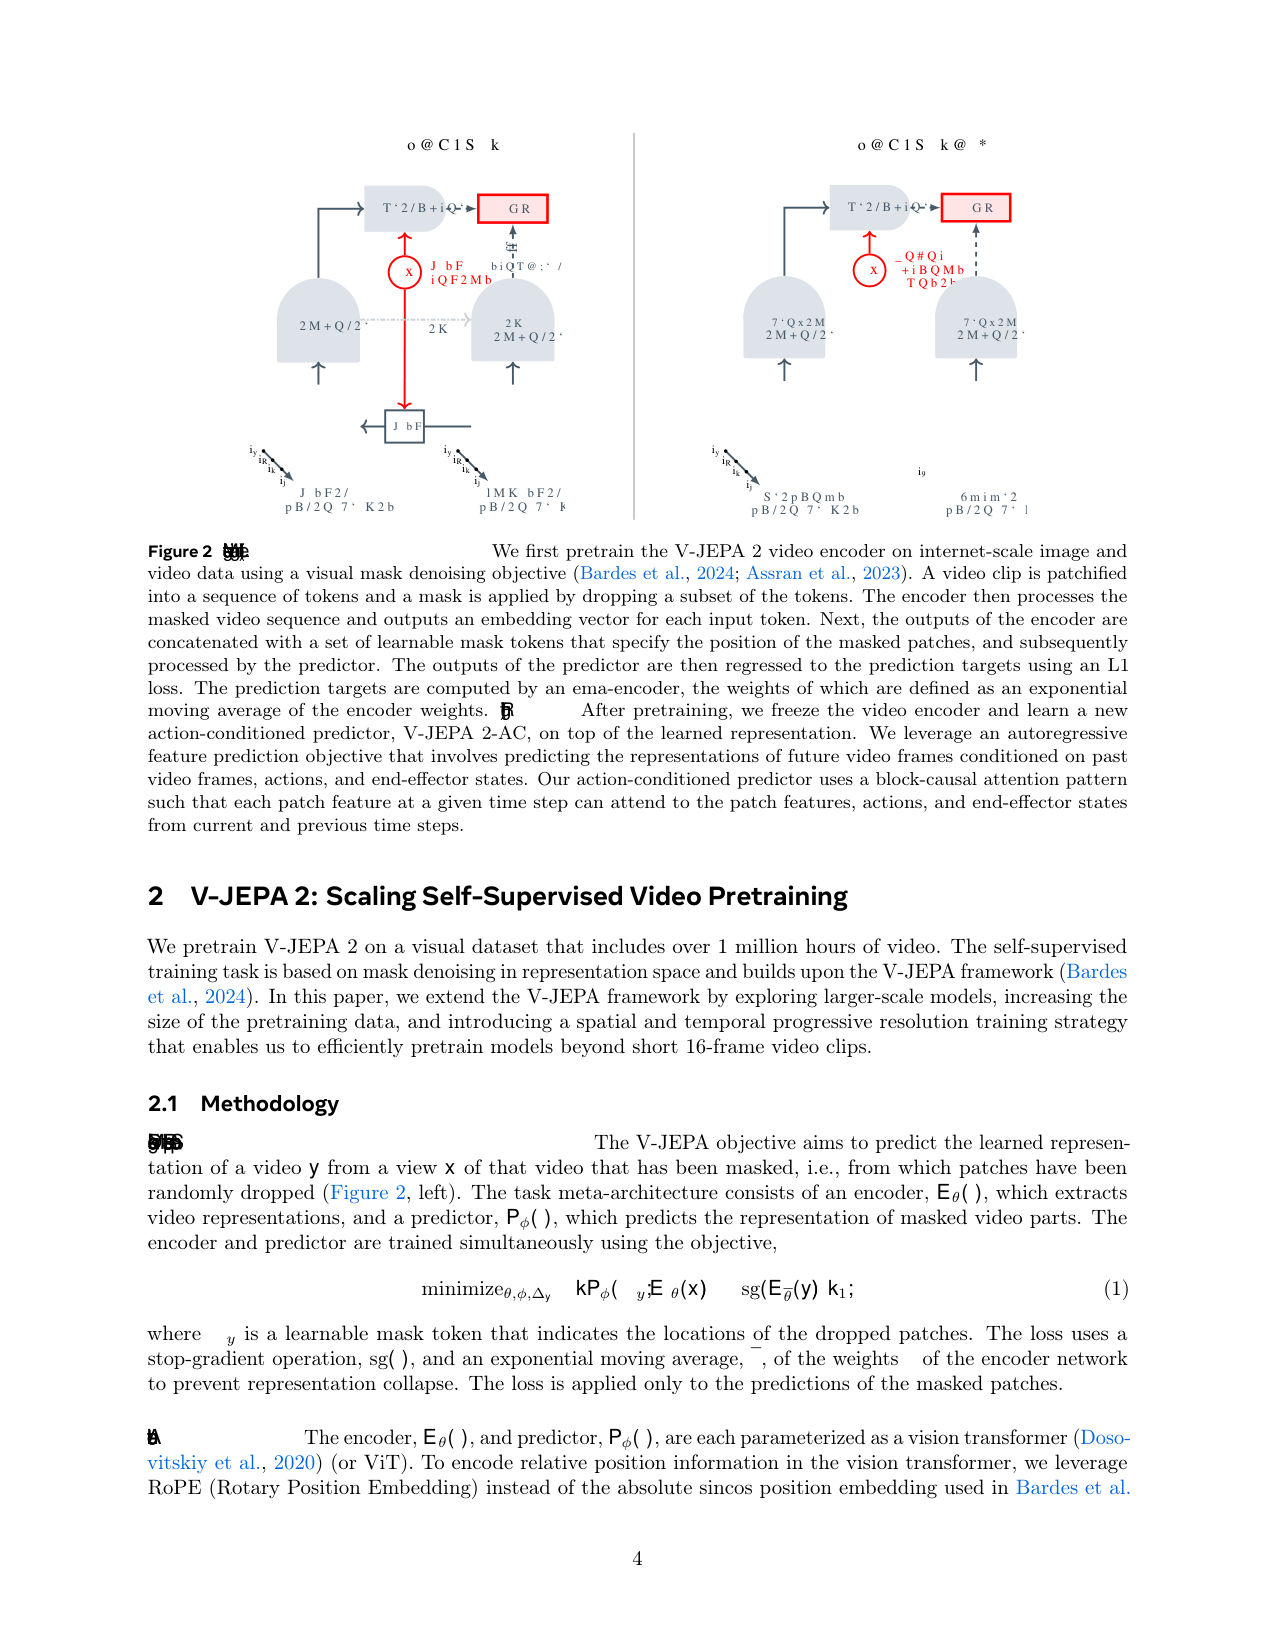 世界模型 / 自监督视频预训练 / 机器人 MPC 规划
用超过 100 万小时互联网视频做动作无关的自监督预训练(掩码去噪的联合嵌入预测架构 JEPA),随后冻结编码器、用不到 62 小时无标注 Droid 机器人视频训练潜空间动作条件自回归世界模型 V-JEPA 2-AC,在模型预测控制闭环里用目标图像引导的规划完成零样本抓取与抓放;同一编码器在动作理解(SSv2 77.3%)、动作预测(EK100 recall@5 39.7)与视频问答(PerceptionTest 84.0)上也达到当时最强水平。
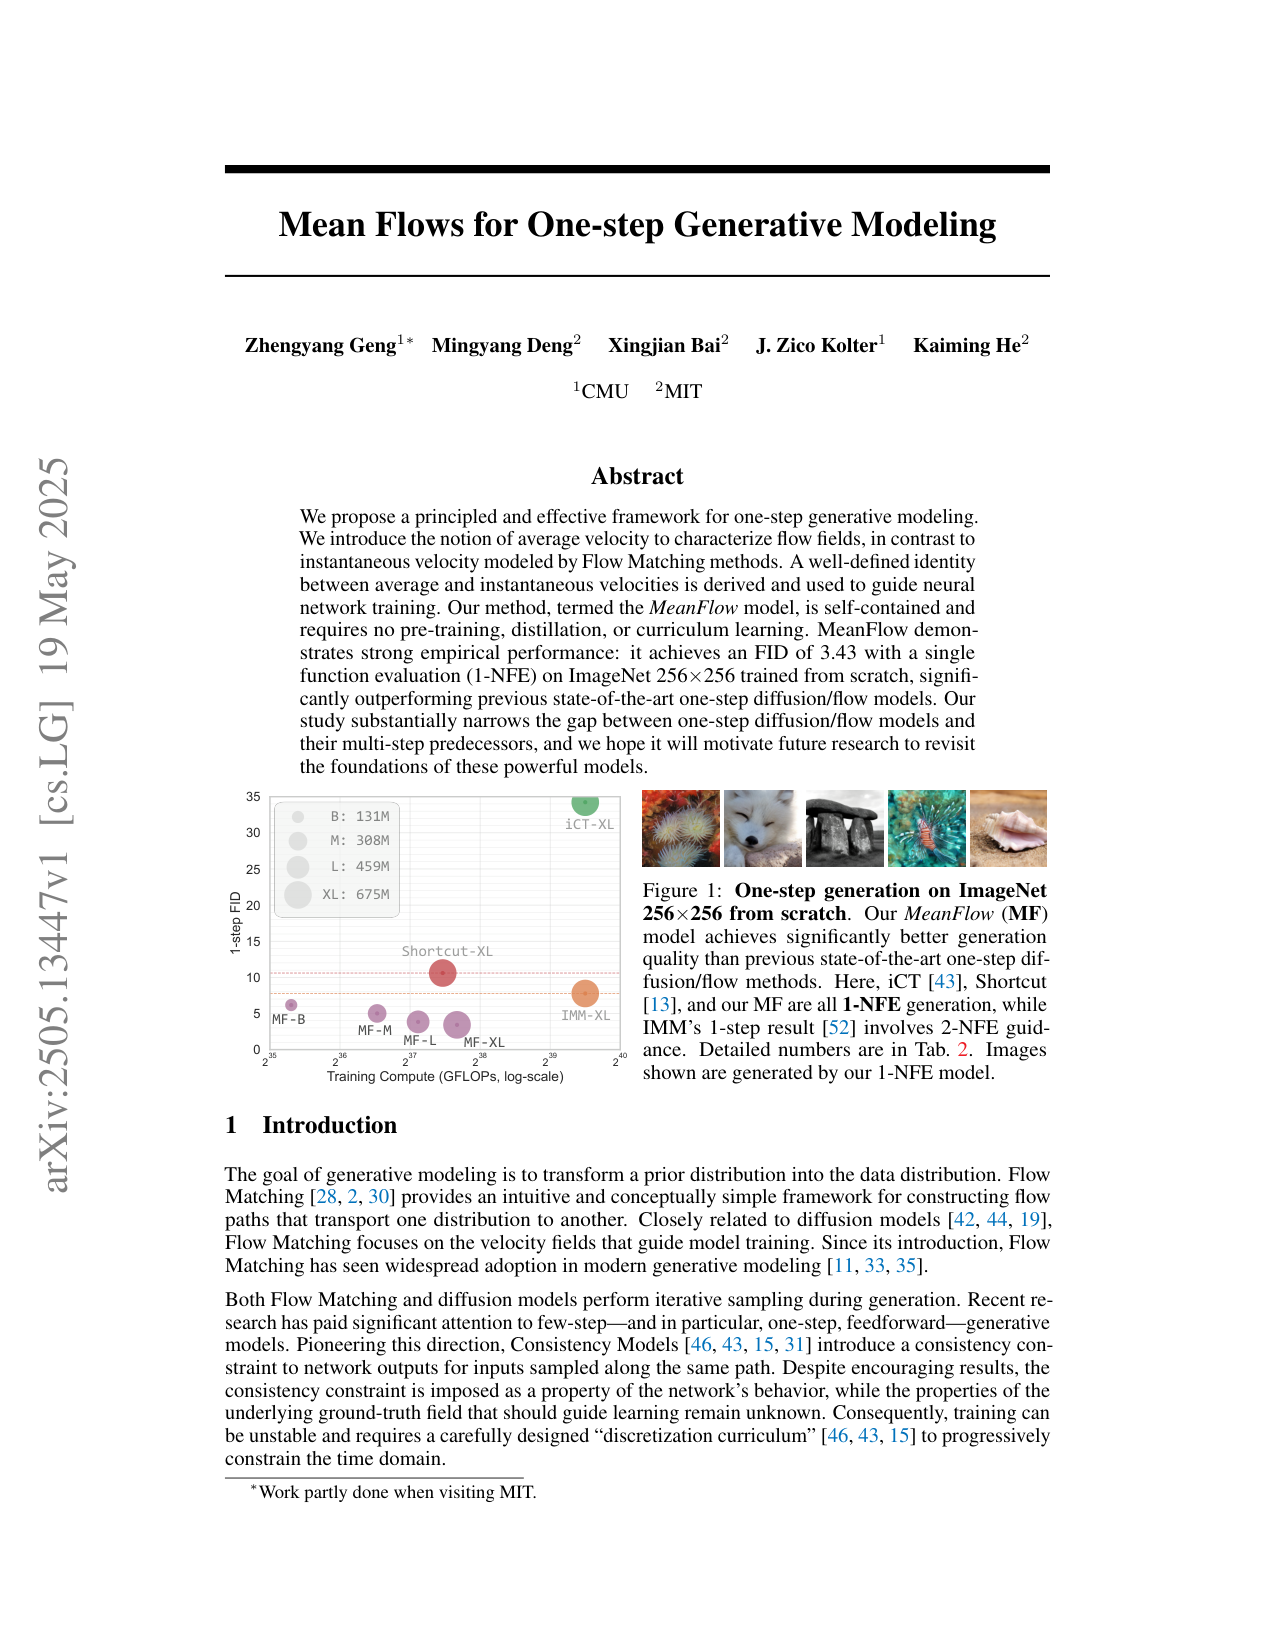 one-step generation / flow matching theory
给 Flow Matching 换一个训练目标:不学瞬时速度 v,改学一段区间 [r,t] 上的平均速度 u;从平均速度的定义出发推导出 MeanFlow Identity (u = v − (t−r)du/dt),训练时用一次 JVP 实现该恒等式、采样时一步到位 x0 = x1 − u(x1,0,1)。ImageNet 256×256 上 1-NFE FID 3.43(XL/2,240 epoch 从零训练,CFG 内建),相比上一代单步方法 Shortcut-XL 的 10.60 提升约 68%,全程无需预训练、蒸馏或课程学习。
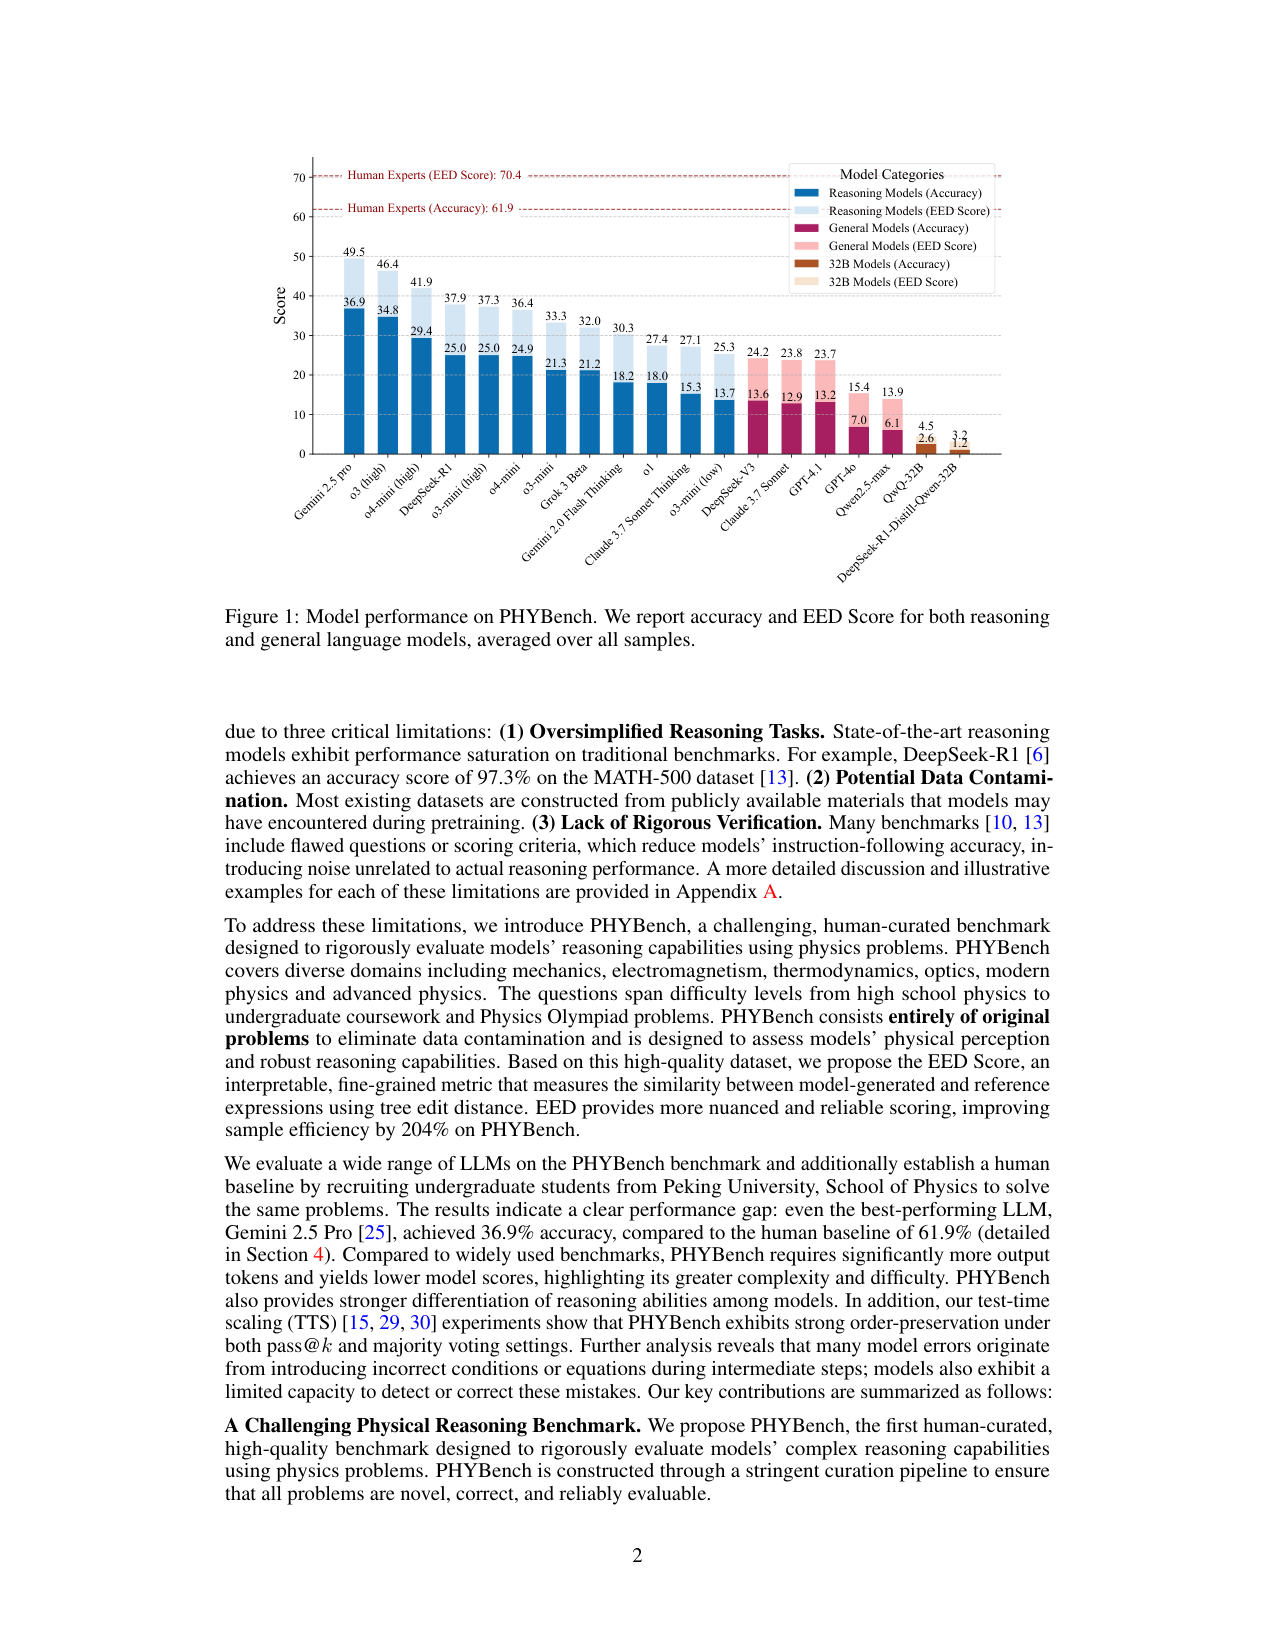 benchmark / evaluation / physics reasoning / LLM
现有推理评测基准被三个问题拖累:任务过于简单导致模型饱和、题目来自公开材料导致数据污染、评测项本身有缺陷。PHYBench 由北大物理学院牵头,用 178 名学生出题、81 名学生(其中 50 人是物理奥赛金牌)人工验收,产出 500 道纯文本原创物理题(高中到奥赛难度、答案必须是符号表达式),配合 EED 树编辑距离评分给部分分:500 题按 EED 评分的区分力相当于约 1500 题按二元评分。实测最好的 Gemini 2.5 Pro 精度 36.9%,远低于人类基线 61.9%;错误分析显示模型九成以上的第一步错误发生在语义推理阶段,且多数模型靠量纲分析这类符号检查掩盖理解缺陷。
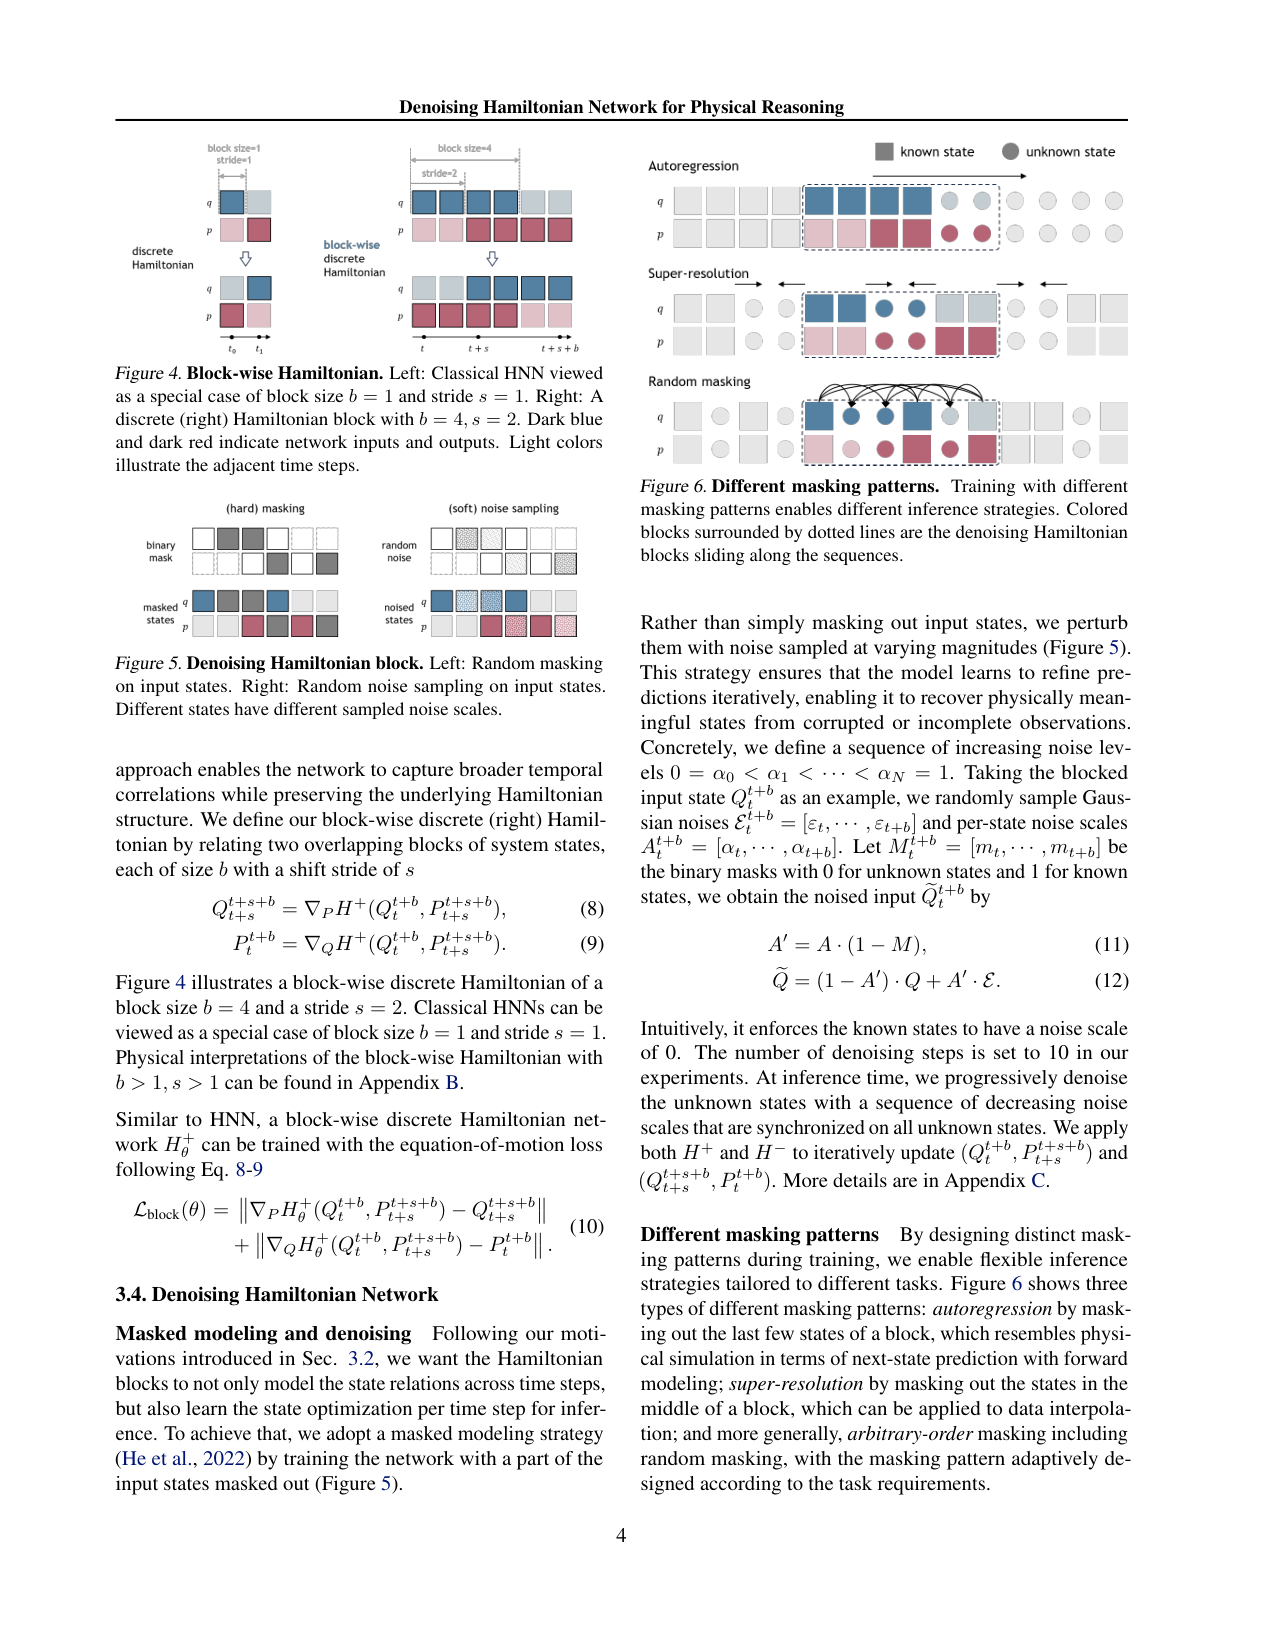 物理推理 / 哈密顿神经网络(块级离散哈密顿量 × 去噪)
把哈密顿力学算子化:用块级离散哈密顿量(一次处理 b 个时间步的状态块、步长 s)建立跨时间步的非局部物理关系,再用掩码加去噪(受 MAE 与扩散模型启发)把数值积分误差和隐式状态求解一起处理掉;一个两层 decoder-only transformer 加每轨迹可学习的 latent code,就同时覆盖前向模拟、轨迹补全、参数推断和超分插值四类物理推理任务。
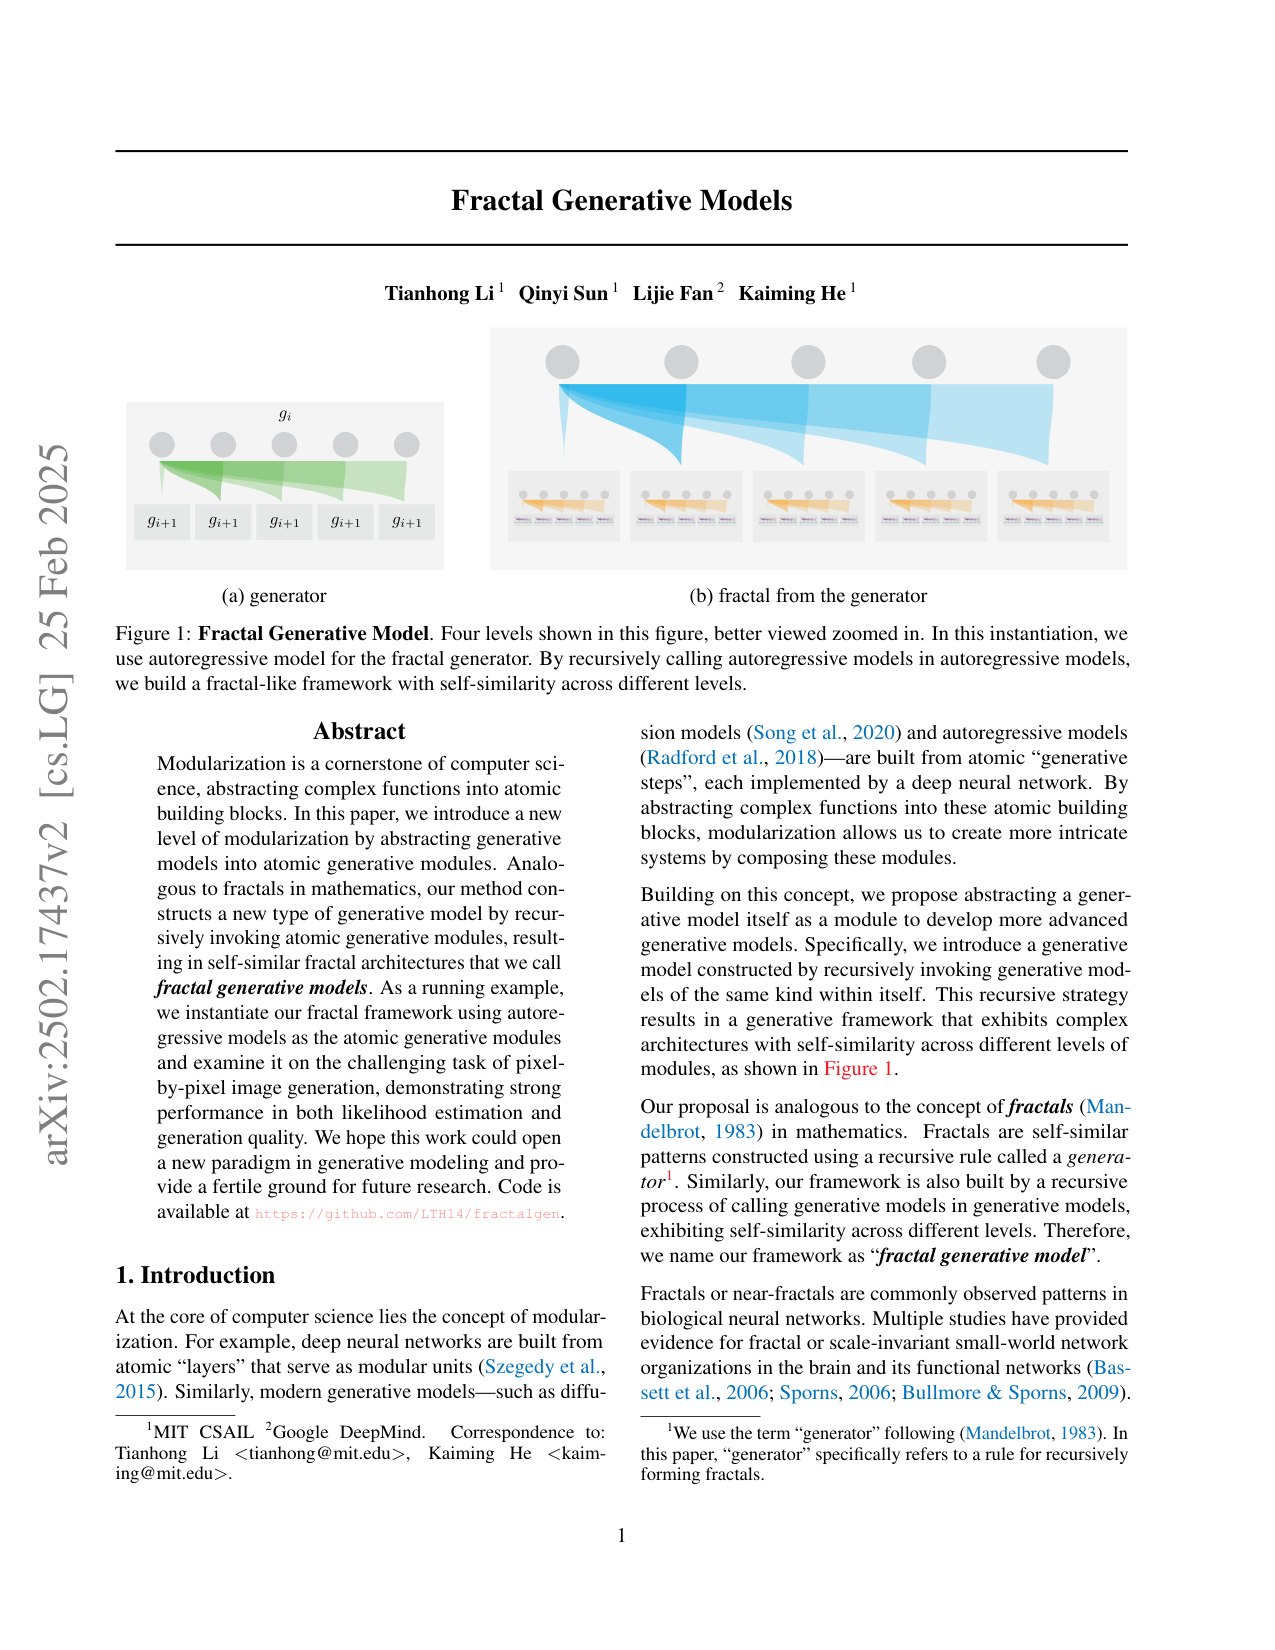 生成模型(架构设计 / 逐像素图像生成)
把「整个生成模型」当作原子模块,递归地在生成模型内部调用同类的生成模型,得到自相似的分形架构;用自回归模型实例化后,在 ImageNet 64×64 无条件下 NLL 3.14 bits/dim(对照此前最佳自回归 3.40),并首次把逐像素生成推进到 256×256 高分辨率(FractalMAR-H FID 6.15、IS 348.9,对照 VDM++ FID 2.12),核心机制是分治式联合分布分解带来的指数级输出扩展与局部化注意力。
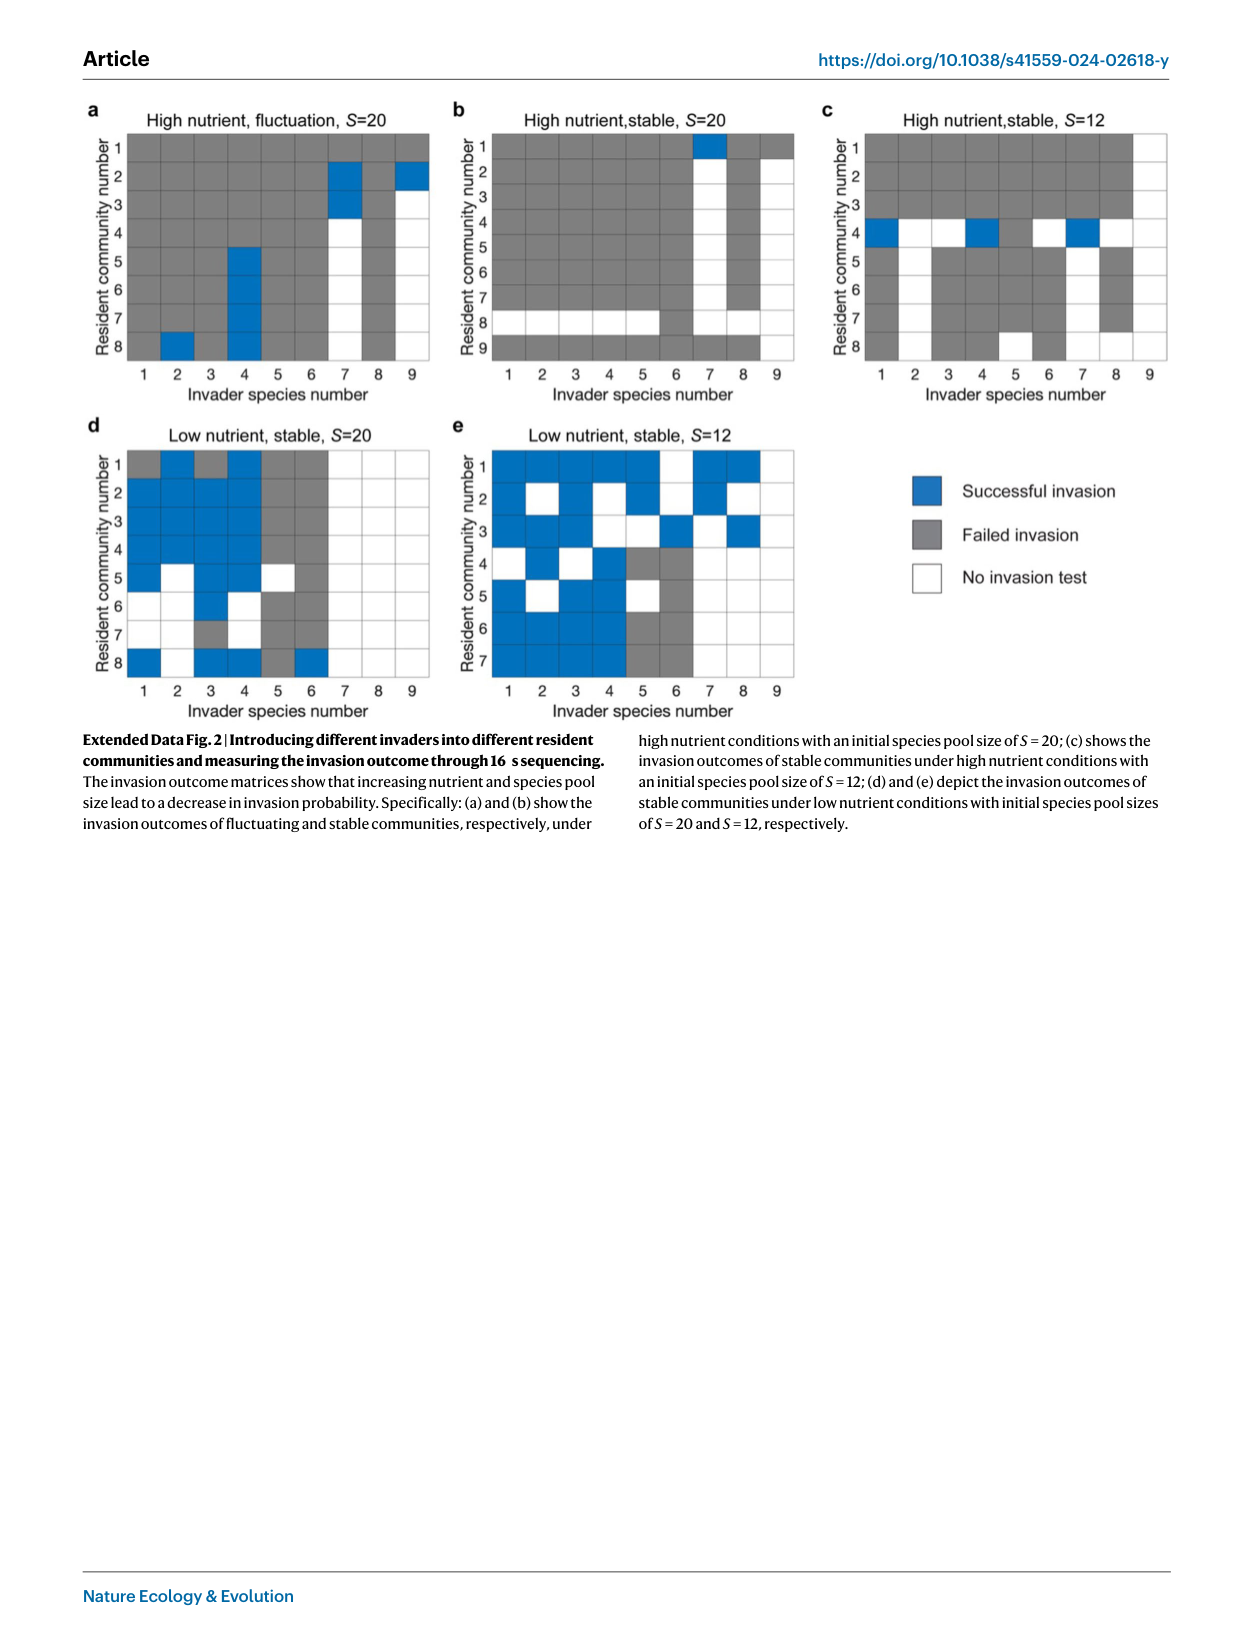 生态学 / 群落动力学 / 入侵生物学 / 随机矩阵理论 / 物理-生态交叉
用实验 + 广义 Lotka–Volterra 模型证明:居民群落的集体动力学状态(稳定 / 涨落 / 多稳态)是入侵成败的首要预测变量——涨落群落比稳定群落可入侵性高约 8 倍(13%±4% vs 1.7%±1.7%,同为 S=20 池、高营养);强相互作用与更大物种池都降低入侵概率;把多样性归一化为「存活分数」后,所有条件下入侵概率≈存活分数(r=0.77),统一了生态学几十年的「多样性—可入侵性」之争。
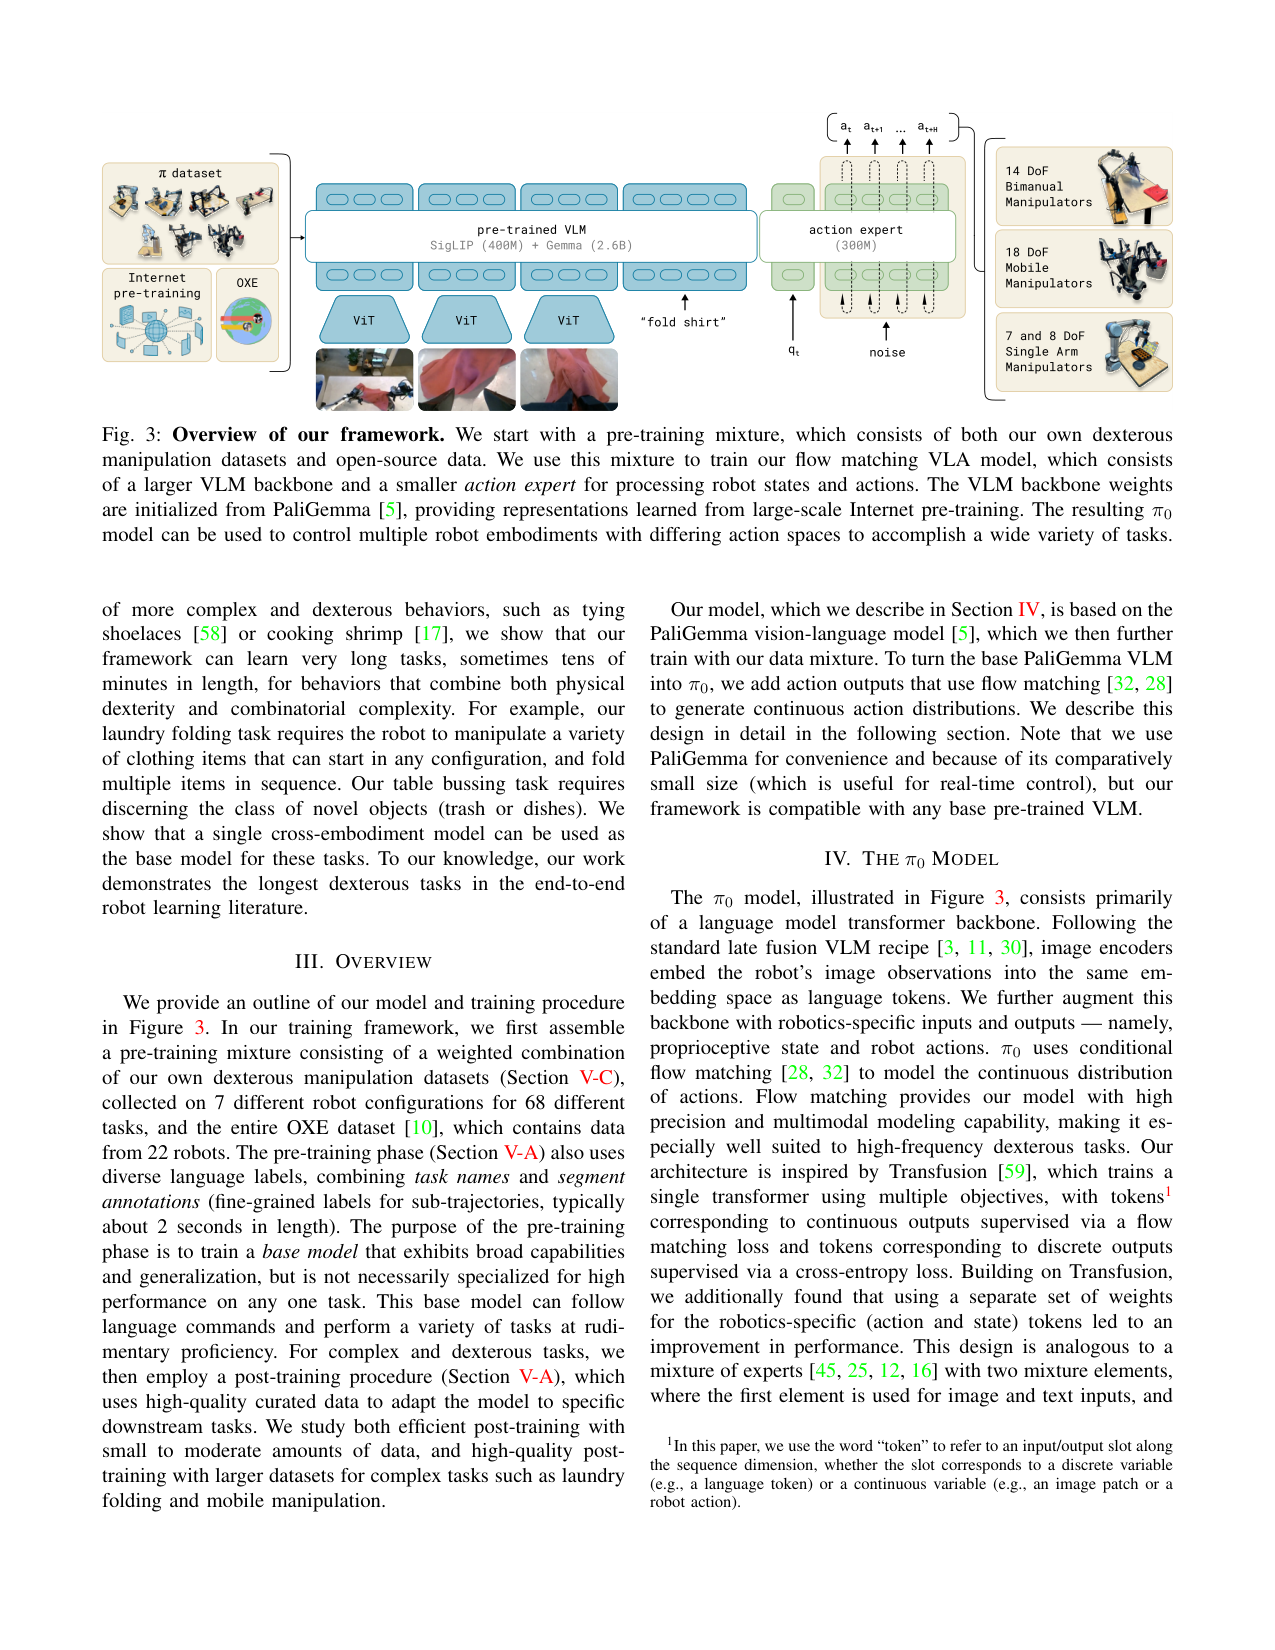 机器人策略(VLA / flow matching 动作生成 / 跨本体基础模型)
把预训练视觉语言模型 PaliGemma(3B)当骨干,额外加一个 300M 参数的 action expert,用条件 flow matching 直接回归连续动作分布,在约 1 万小时、7 种机器人构型、68 个任务的跨本体数据上预训练,再微调去完成叠衣、收拾餐桌、装箱、打包装箱等长时程灵巧任务,支持最高 50Hz 的高频控制;它是第一个把 flow matching 动作头接到 VLM 骨干上的 VLA,也是『flow 生成动作』路线的工业级参考。
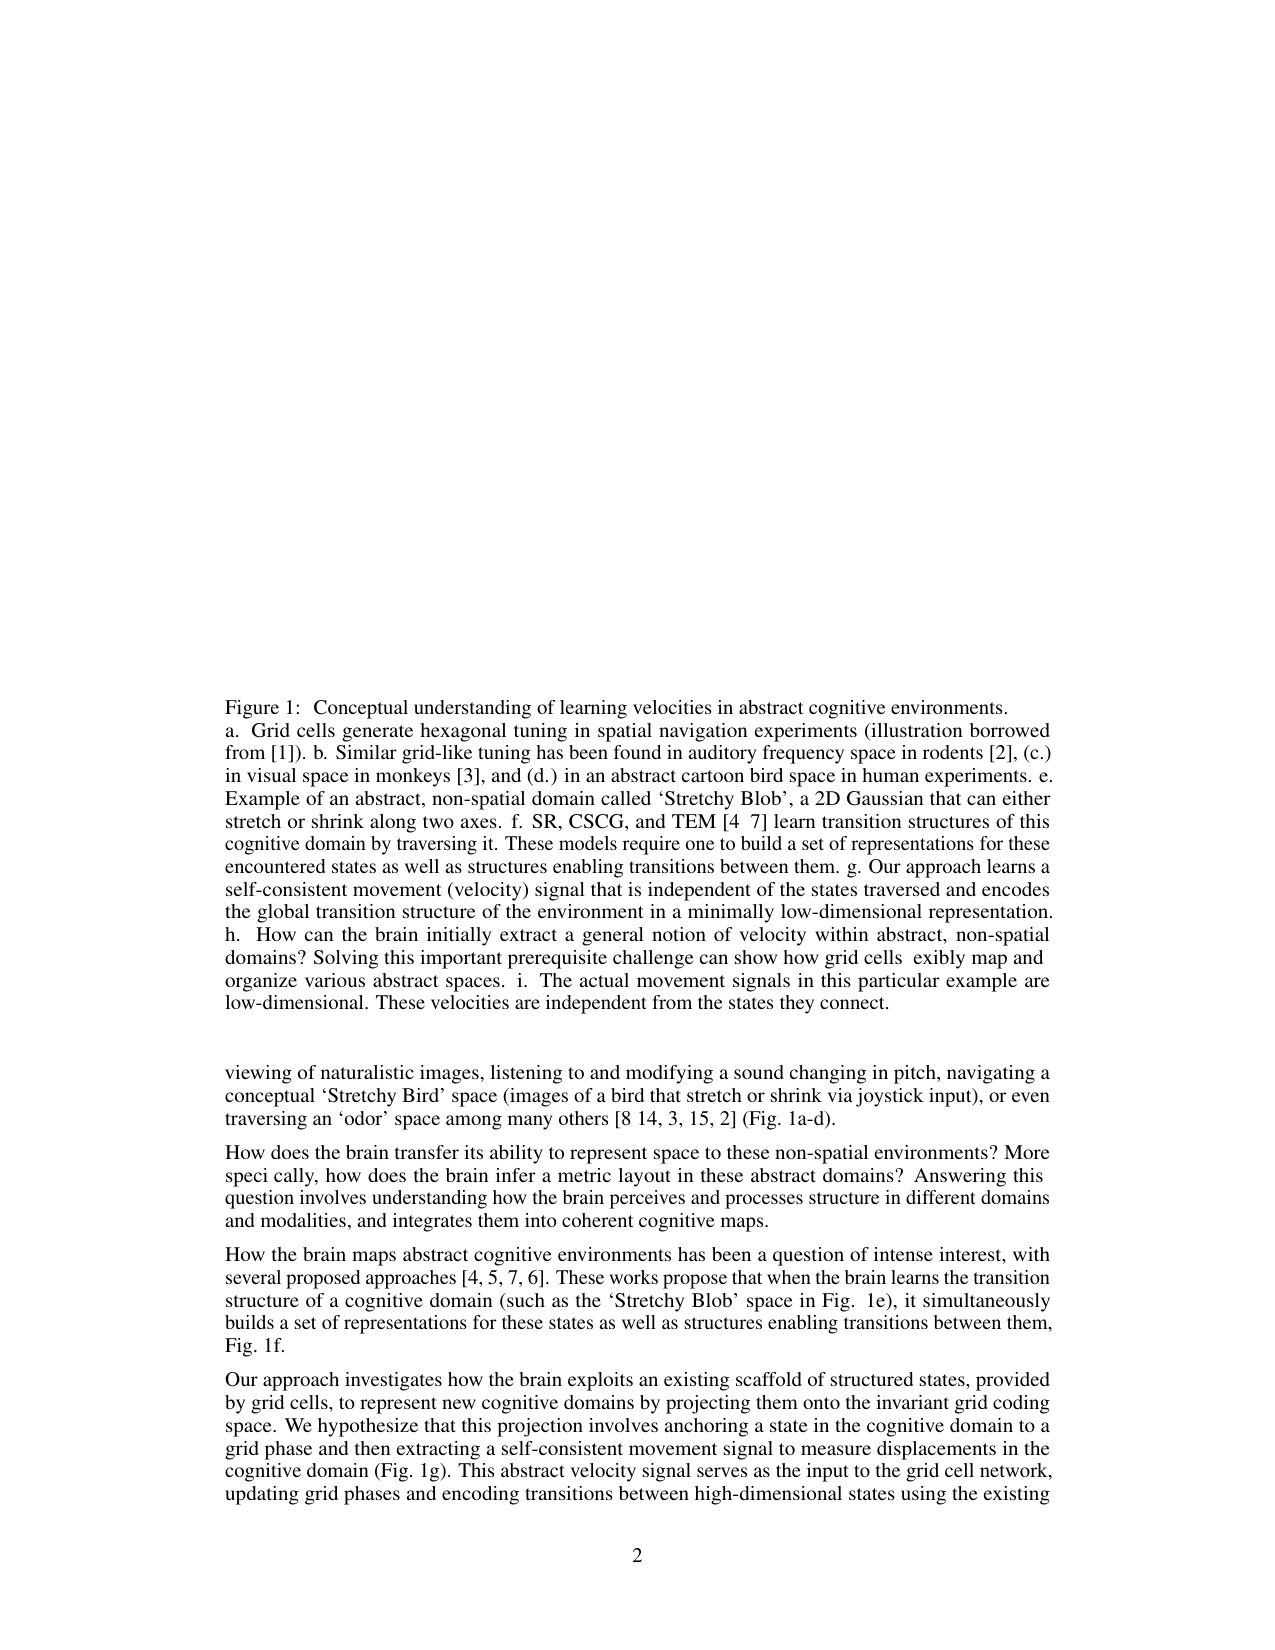 神经科学(表征与神经科学:grid cells / 连续吸引子 / 自监督速度提取)
论文假设大脑把「空间导航用的网格编码」当一台通用速度积分器:面对任何新的抽象域(音高、图像特征、会变形的卡通鸟),只提取一个低维、与内容无关、自洽的广义速度信号,再交给网格细胞做路径积分,就能复用同一套网格码画出该域的地图。模型用「闭环轨迹上位移和为零」的自监督约束学速度,并证明该约束迫使估计速度成为真实速度的线性函数;在五个程序生成的抽象域上,推断速度误差 0.02–0.07,比 PCA/Isomap/UMAP/自动编码器/MCNet 低一到两个数量级,喂给合成网格模块能复现六边形发放野。
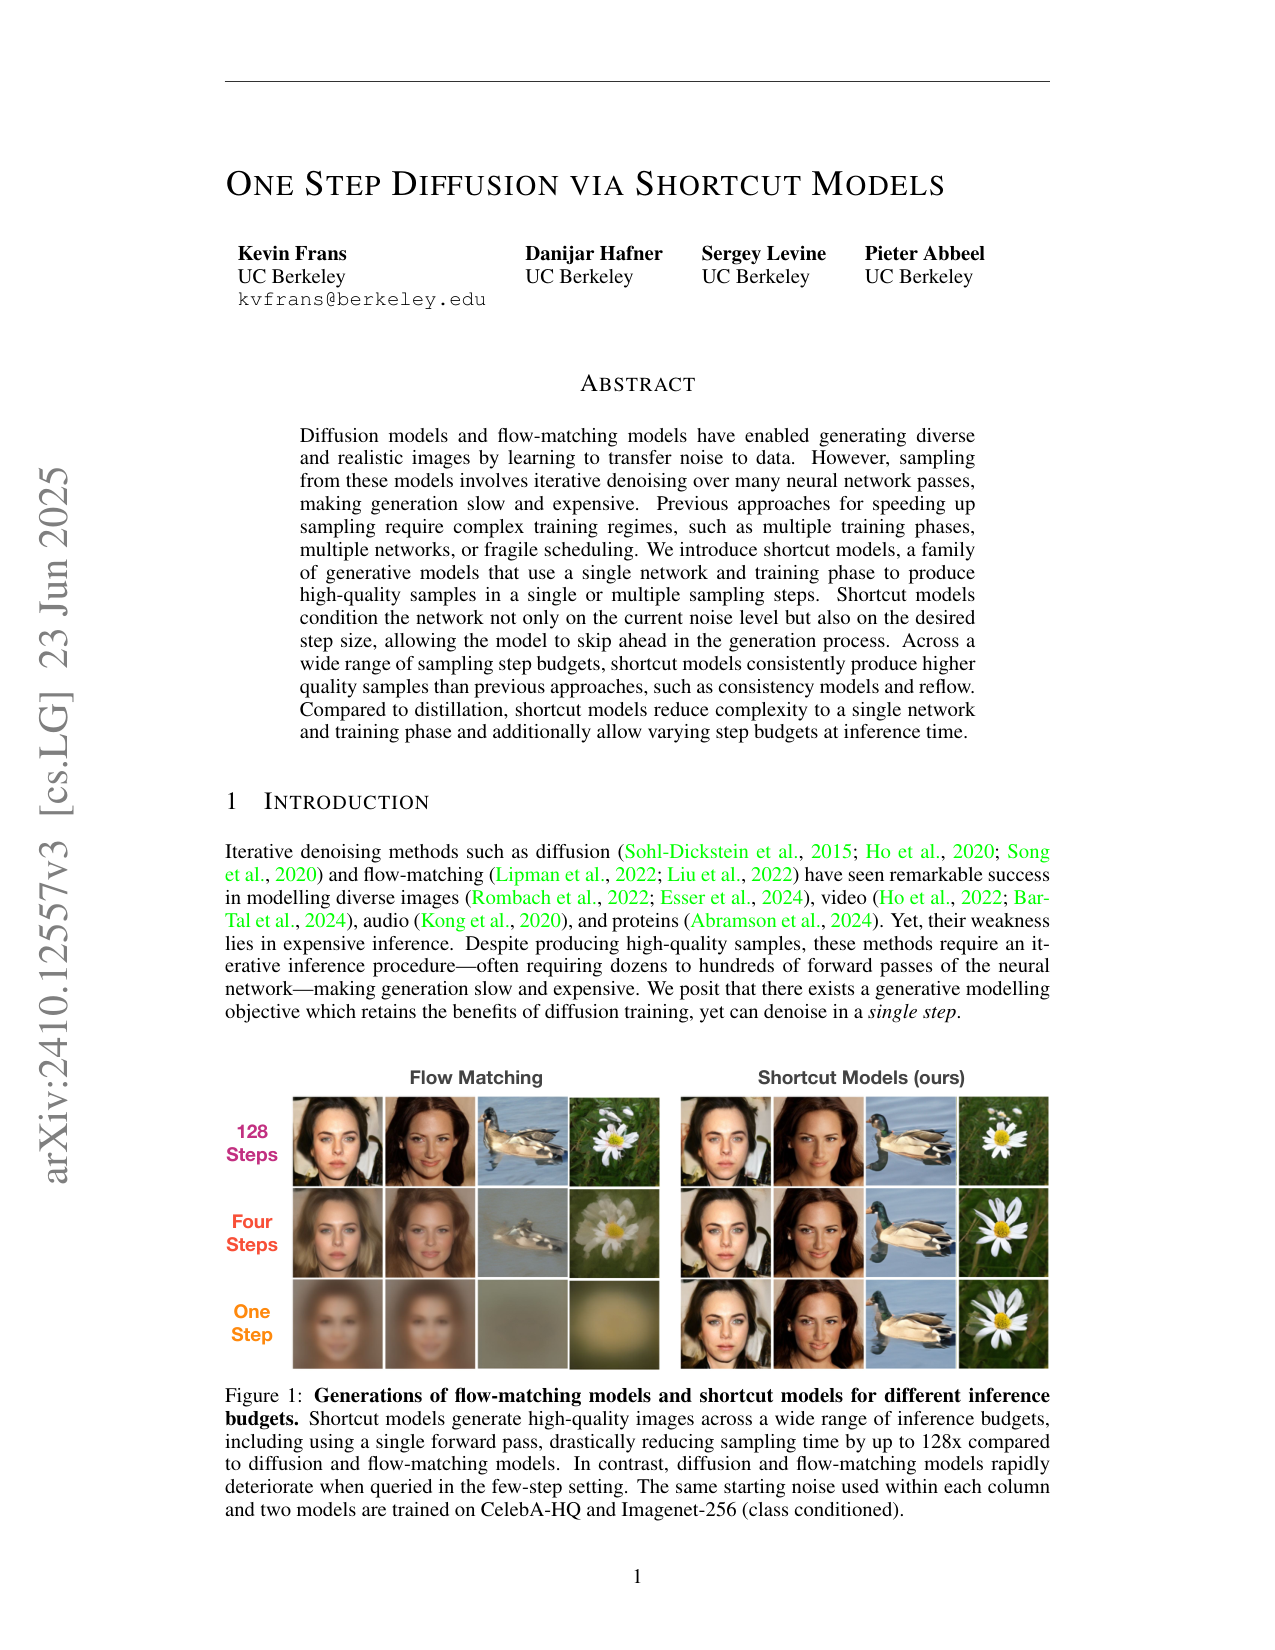 one-step generation / flow matching / diffusion
在 Flow Matching 之上多学一个步长条件 d:网络同时输入当前噪声水平 t 和想跳的步长 d,用「两步 d/2 拼接成一步 d」的自洽目标在训练期自蒸馏,单网络、单次训练、无调度,1 步/4 步/128 步都由同一个模型在推理时决定;训练开销只比基础扩散高约 16%。ImageNet-256 上 1 步 FID 40.3(DiT-B)、XL 扩到 10.6,128 步 3.8,多步质量与基线流匹配相当。
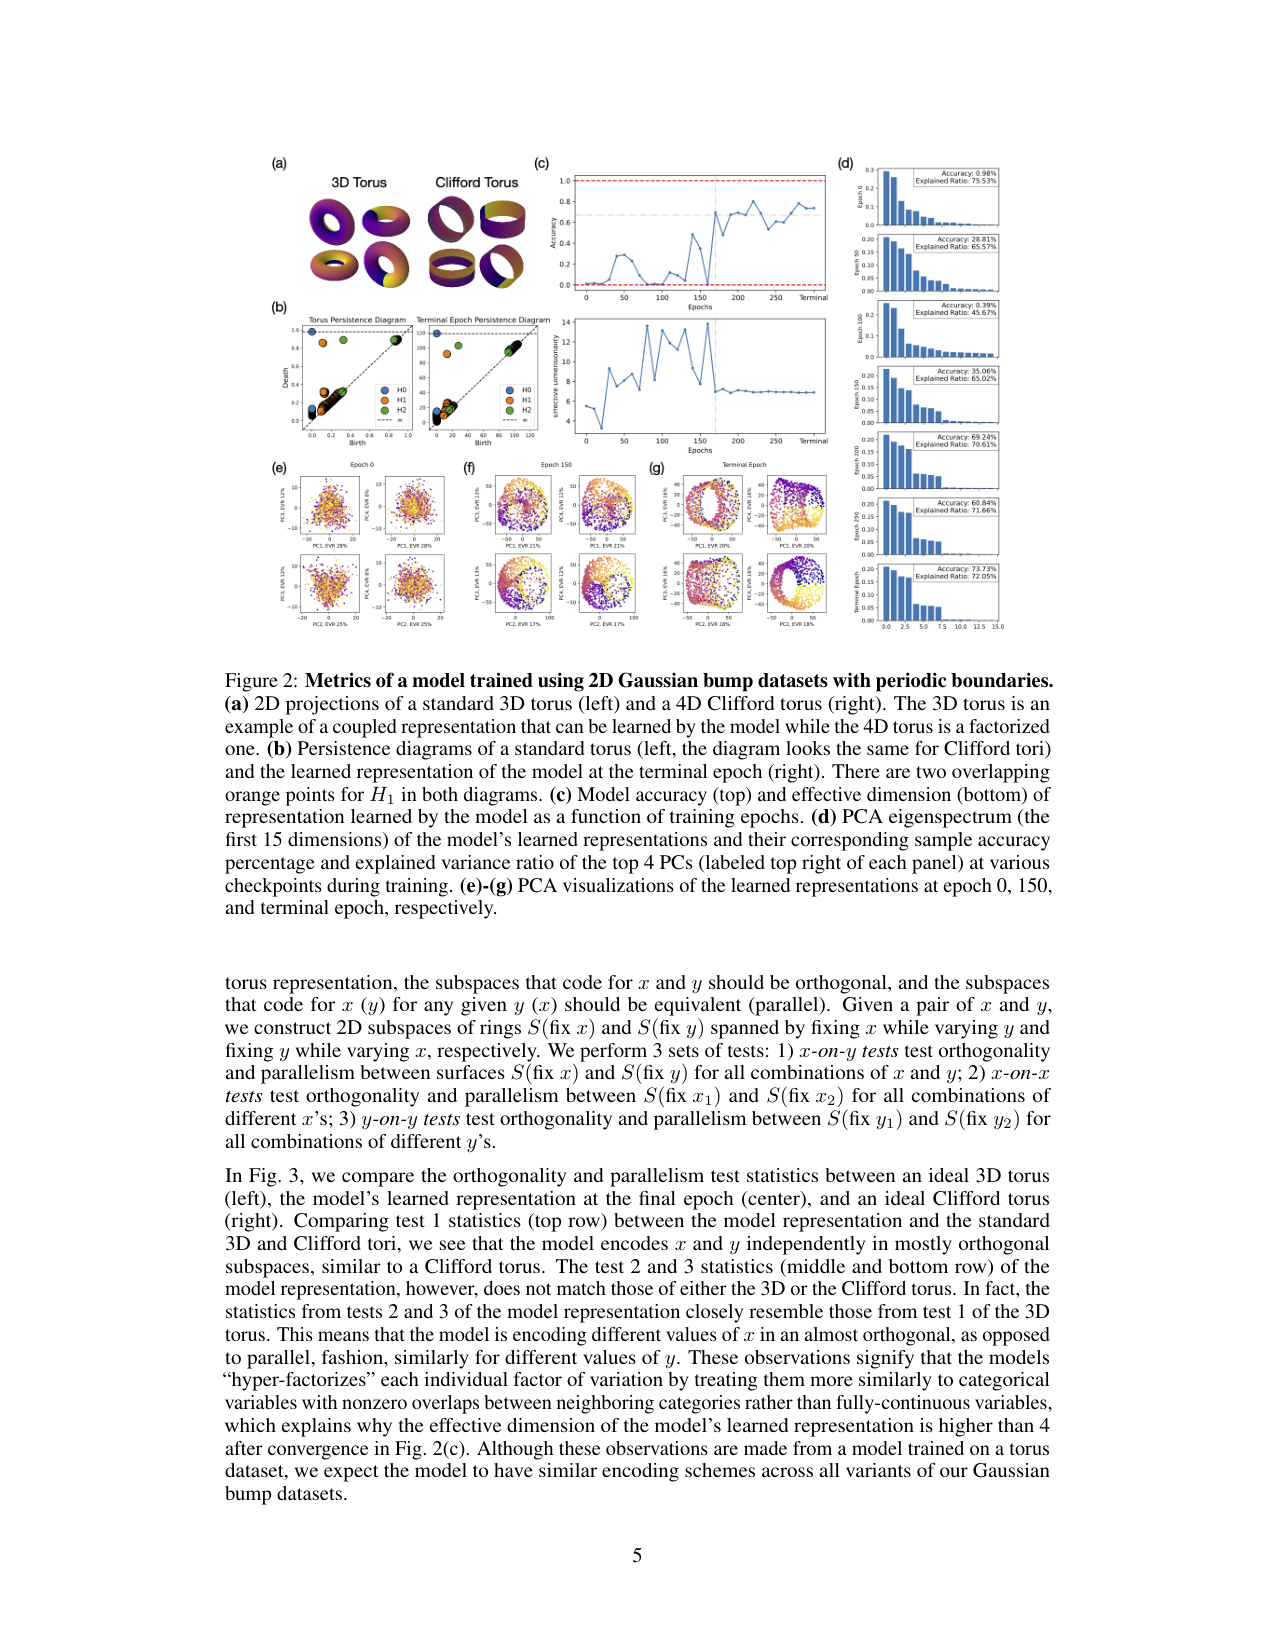 生成模型理论 / 表征与神经科学交叉(组合泛化机制)
把条件扩散模型(DDPM)当认知实验的动物来研究:在周期边界的二维高斯斑点数据上,模型中间层表征学成『环面上的分解表示』——x 与 y 落入相互正交的子空间(类似 Clifford 环面),但同一特征的不同取值又被近似正交地编码、像离散类别一样(论文叫 hyper-factorized);行为上模型能组合训练里没见过的 (x,y) 取值(条件是每个独立特征全范围出现、且给少量组合样例),却几乎不能在同一特征上插值。论文进一步把表征流形的形成与物理学渗流(percolation)相变联系起来:样本间重叠低于阈值时学不出有意义的表示,超过阈值能力突然出现;并给出训练数据配方——独立因子全范围 + 少量组合样例,数据效率从随图像尺寸 N 的二次增长降为线性增长。
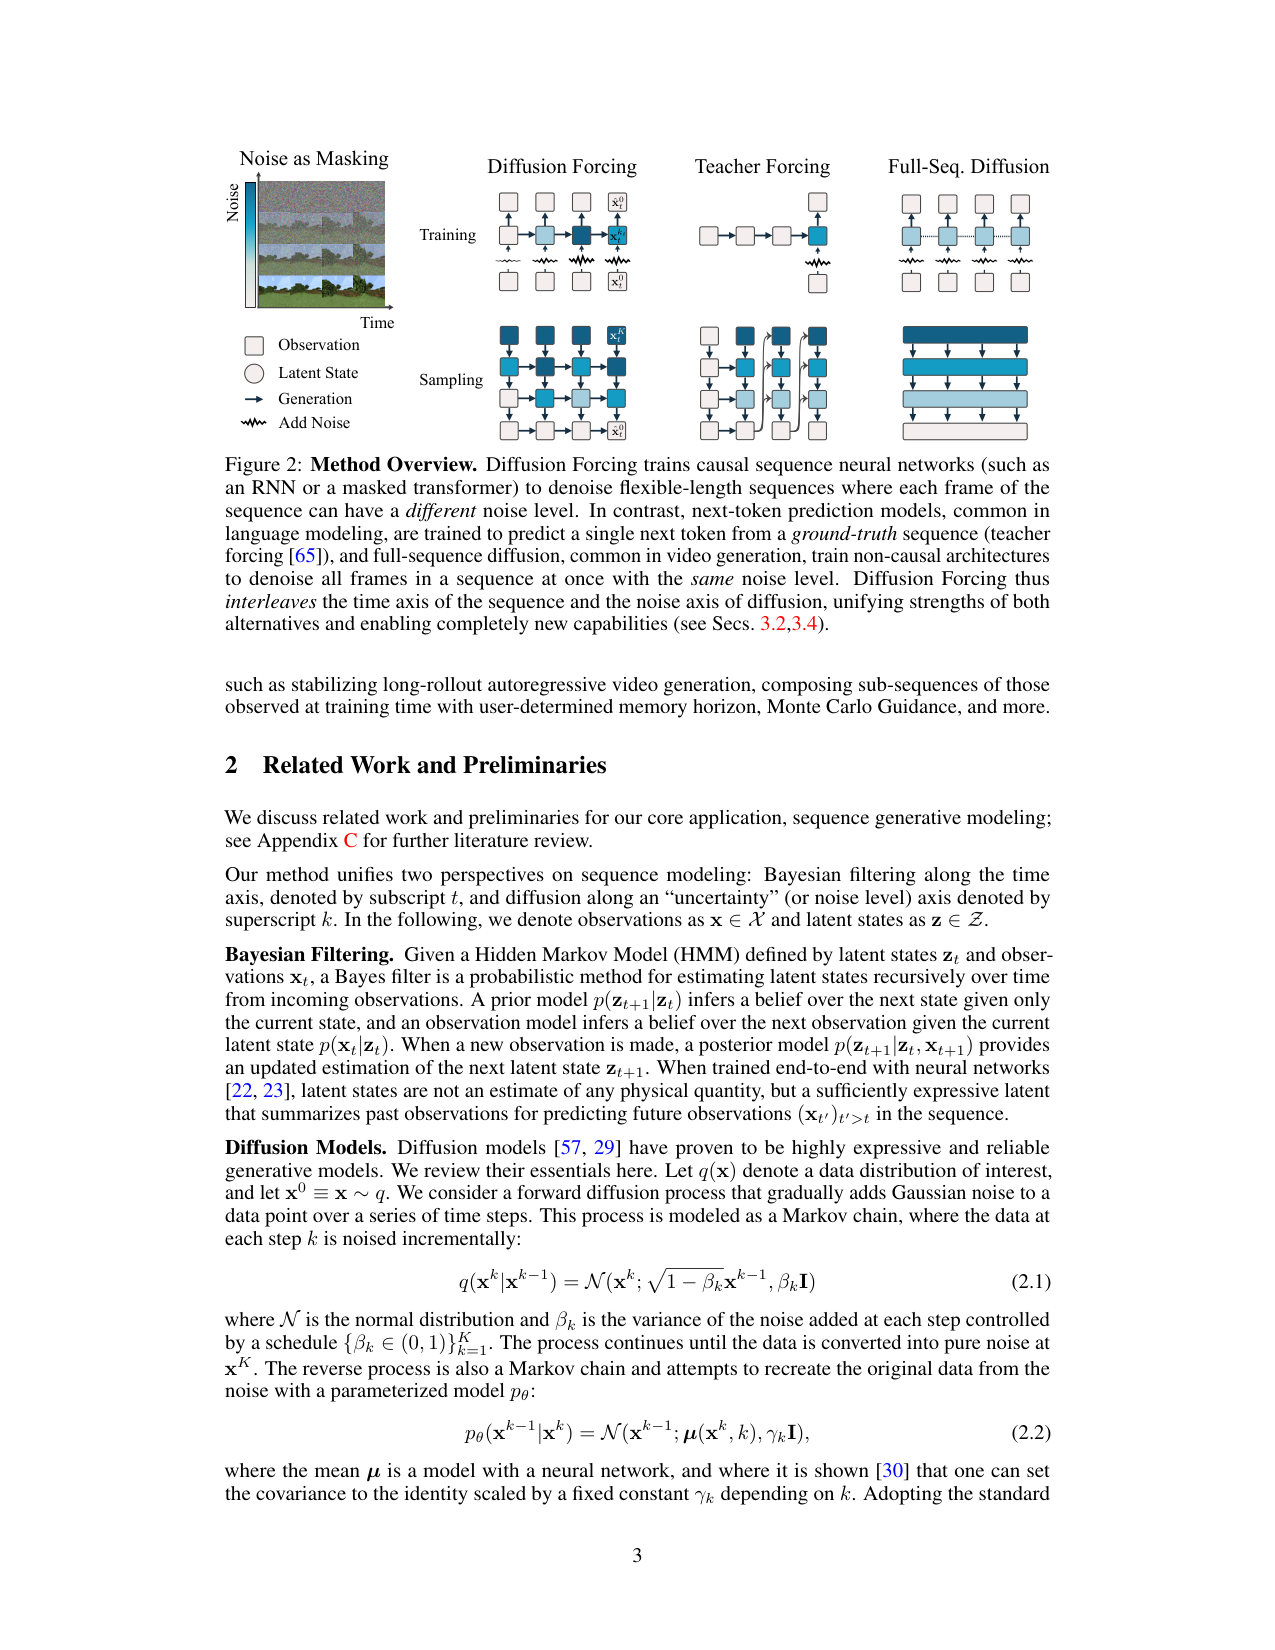 序列生成 · 因果扩散 · 世界模型 · 离线强化学习规划 · 视频预测
给序列里每个 token 独立随机采样一个噪声水平 k_t 来训练扩散模型,让『下一个 token 预测』获得『全序列扩散』的引导、变长与稳定性能力:同一套网络既可以像自回归模型那样任意长度 rollout,又可以像 Diffuser 那样带回报引导地做规划,还新增了未来保持不确定的因果采样调度与蒙特卡洛引导 MCG。理论上证明该训练目标优化所有噪声水平序列下子序列似然的重加权 ELBO;实证上视频可稳定 rollout 到训练长度 2 倍以上(2000 帧不爆)、D4RL maze 规划单任务平均回报 141.7(Diffuser* 119.5)、真实机器人换果任务成功率 80%(Diffusion Policy 记 0)。
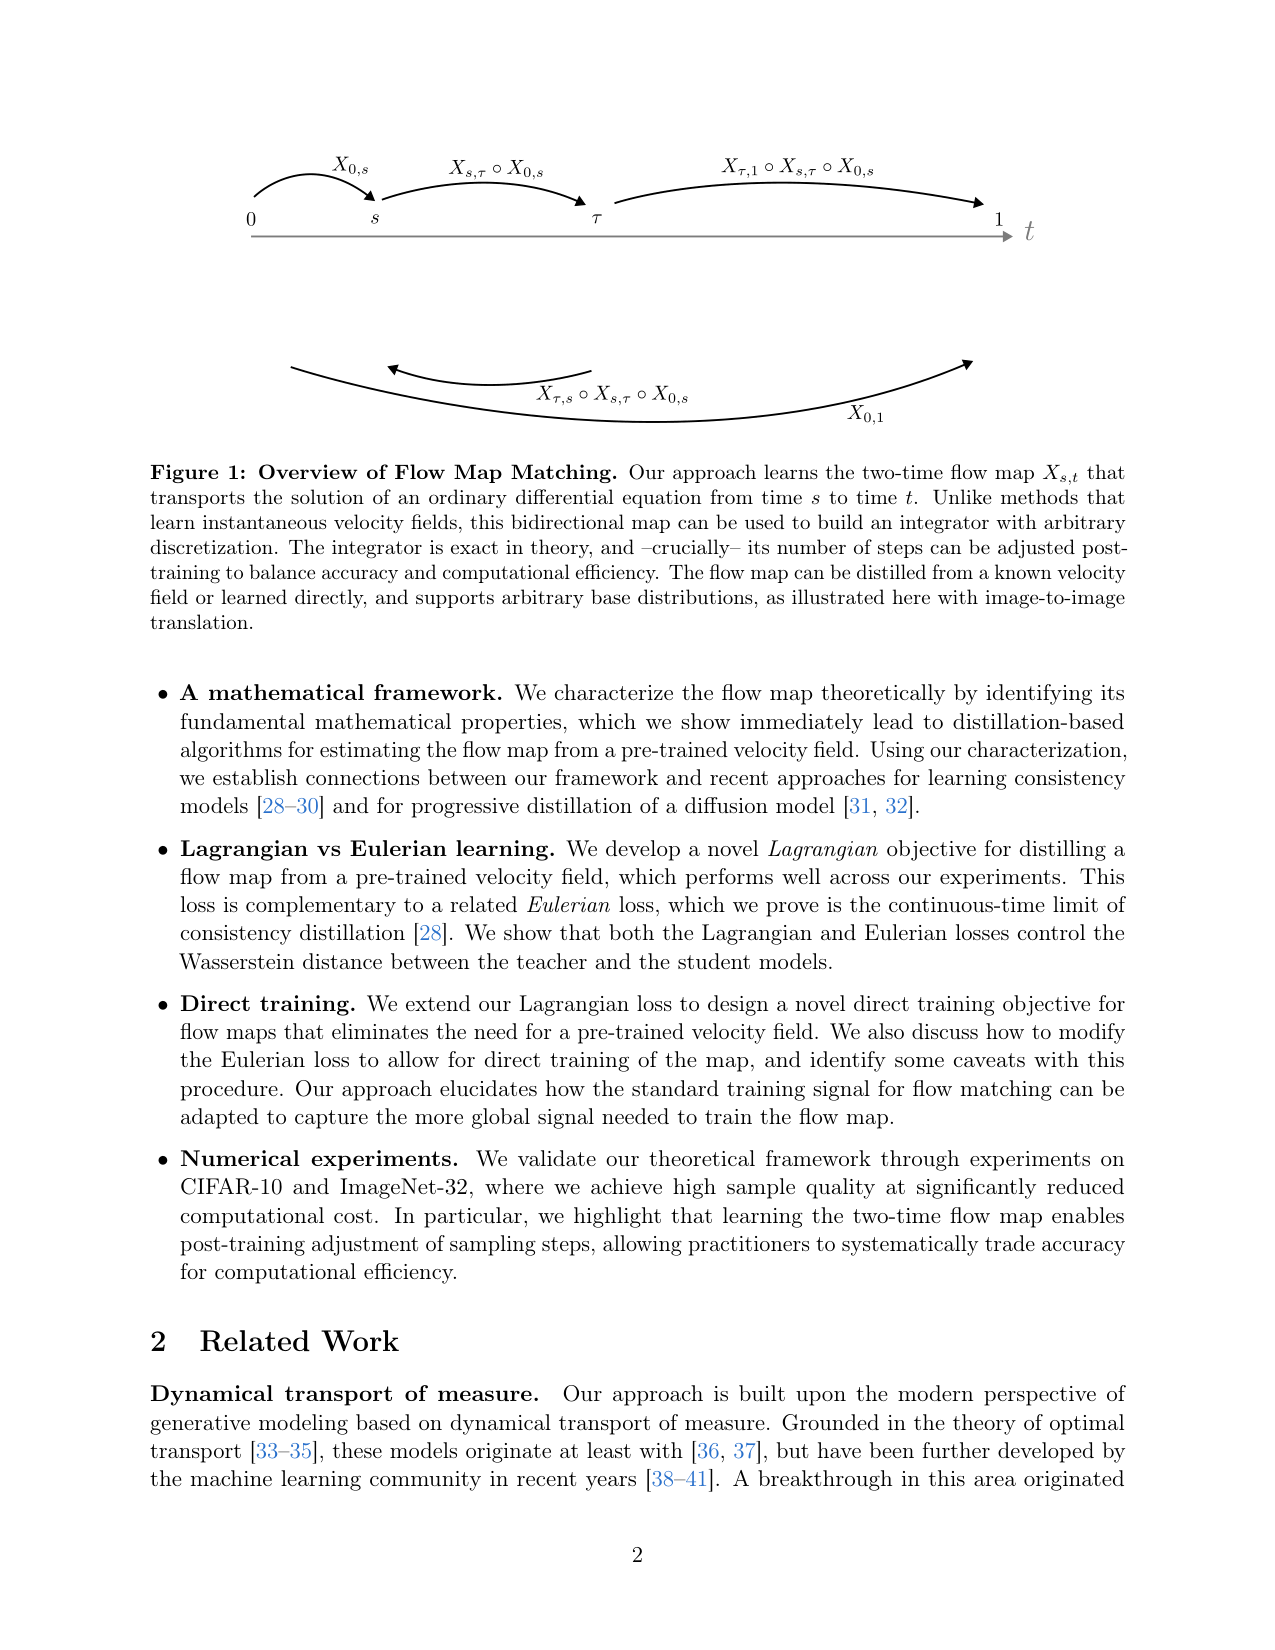 one-step / few-step generation · flow matching 理论 · consistency models 统一框架
把 Flow Matching 的「瞬时速度」换成「两时间流地图」X_{s,t}:网络直接学从时刻 s 到 t 的整段位移映射,理论上精确、训练后步数可任意调整。论文给出四条训练路径——拉格朗日蒸馏 LMD、欧拉蒸馏 EMD(一致性蒸馏的连续时间极限)、无预训练速度场的直接训练 FMM、以及把 K 步并成一步的 PFMM,并证明 LMD/EMD 的损失控制 Wasserstein 距离。CIFAR-10 上 LMD 用 4 步拿到 FID 6.04(老师 SI 基线 5.53;同设置下 SI 本身要 34.84);ImageNet-32 上无蒸馏直接 FMM 在 N=4 时 FID 16.90(同 N 下 DDPM 362.37、BatchOT 38.86)。论文摘要口径:与 flow matching 质量相当、生成时间减少 10–20 倍(正文实验证据是少步 FID)。
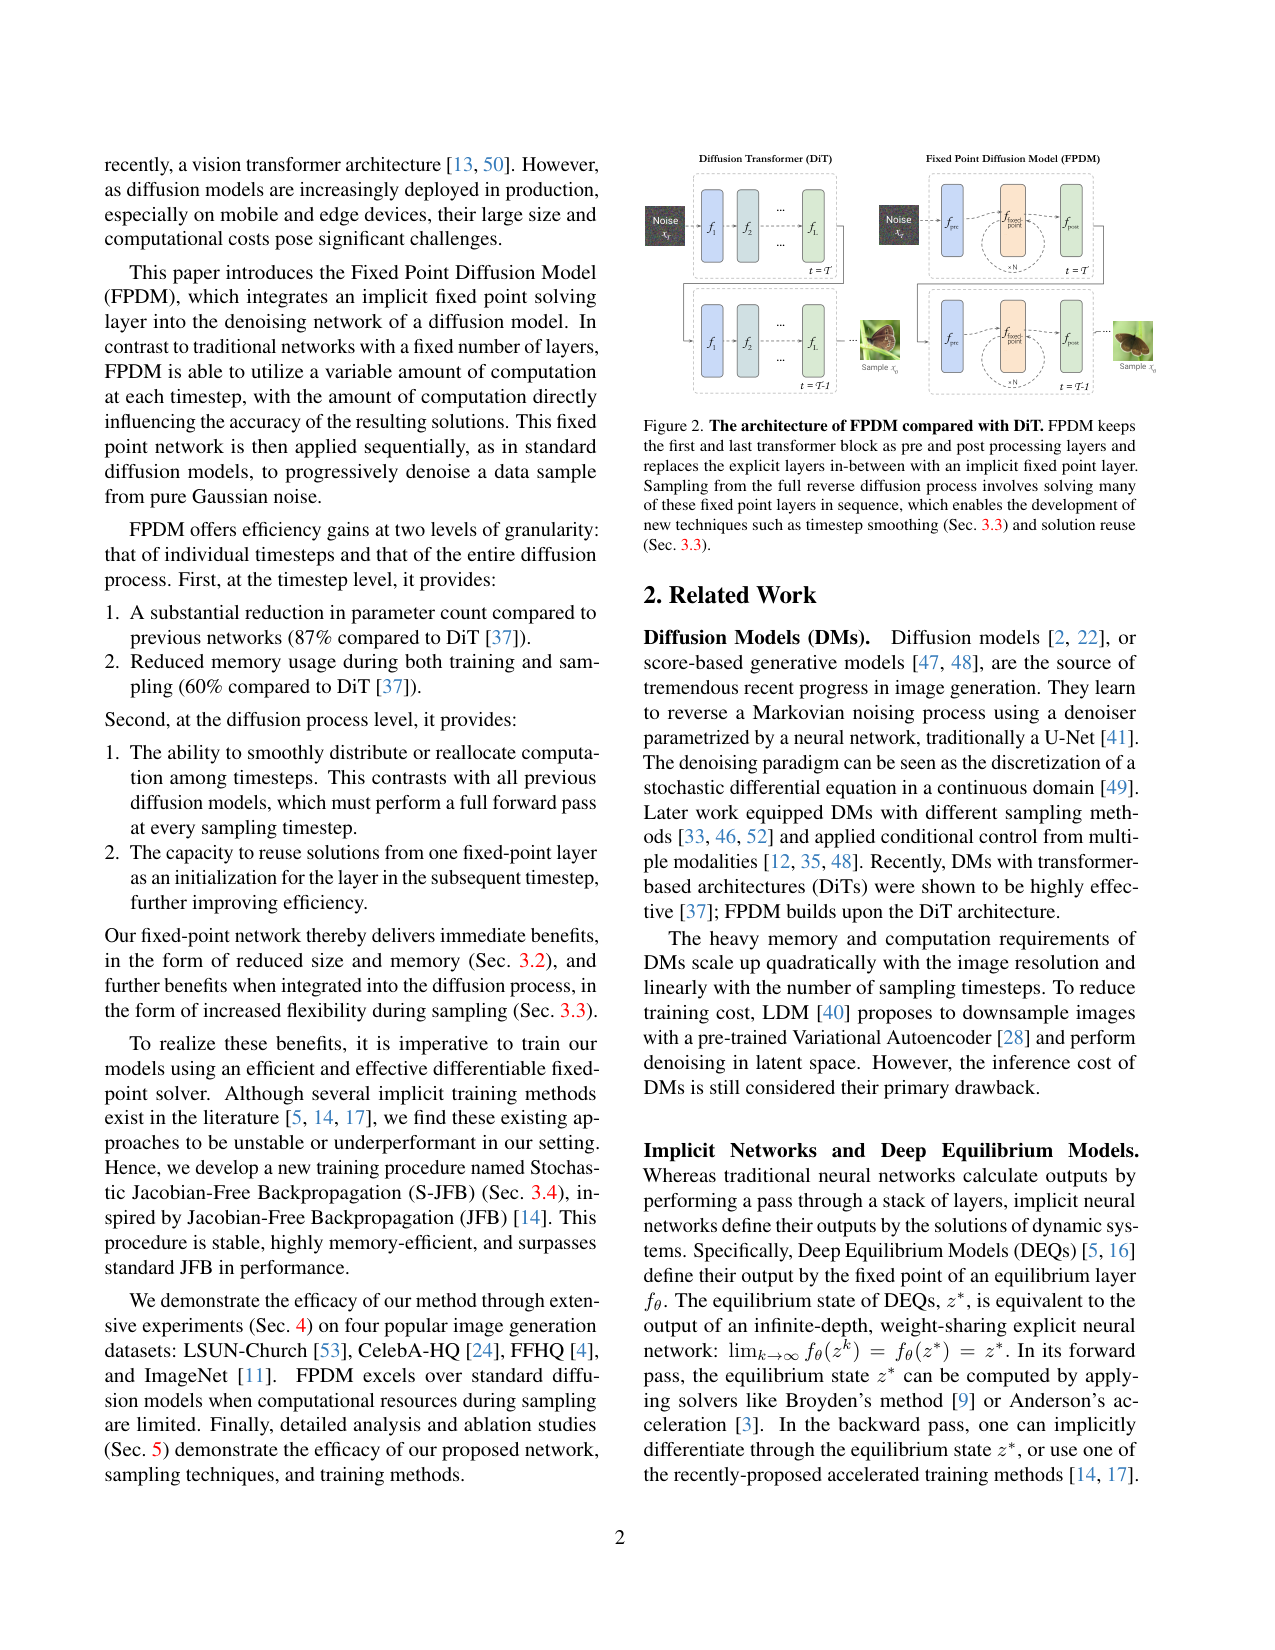 生成模型理论 / 高效采样 / 隐式网络(DEQ)
把 DiT 的 28 个显式 transformer 层压缩成「前后各 1 个显式层 + 中间 1 个隐式不动点层」,让每个去噪时间步变成解一个固定点方程 x* = f_fp(x*, x̃, t),从而在时间步之间平滑、重分配计算并复用上一时间步的解;85M 参数的 FPDM 相比 674M 参数的 DiT-XL/2,在 ImageNet 256×256 上用 280 次 transformer block 前向的采样预算把 DDIM FID 从 35.2 压到 22.4,训练显存从 25.2GB 降到 10.2GB(batch 64),是「把迭代搬进网络内部」的代表作。
 one-step generation / diffusion distillation 统一框架
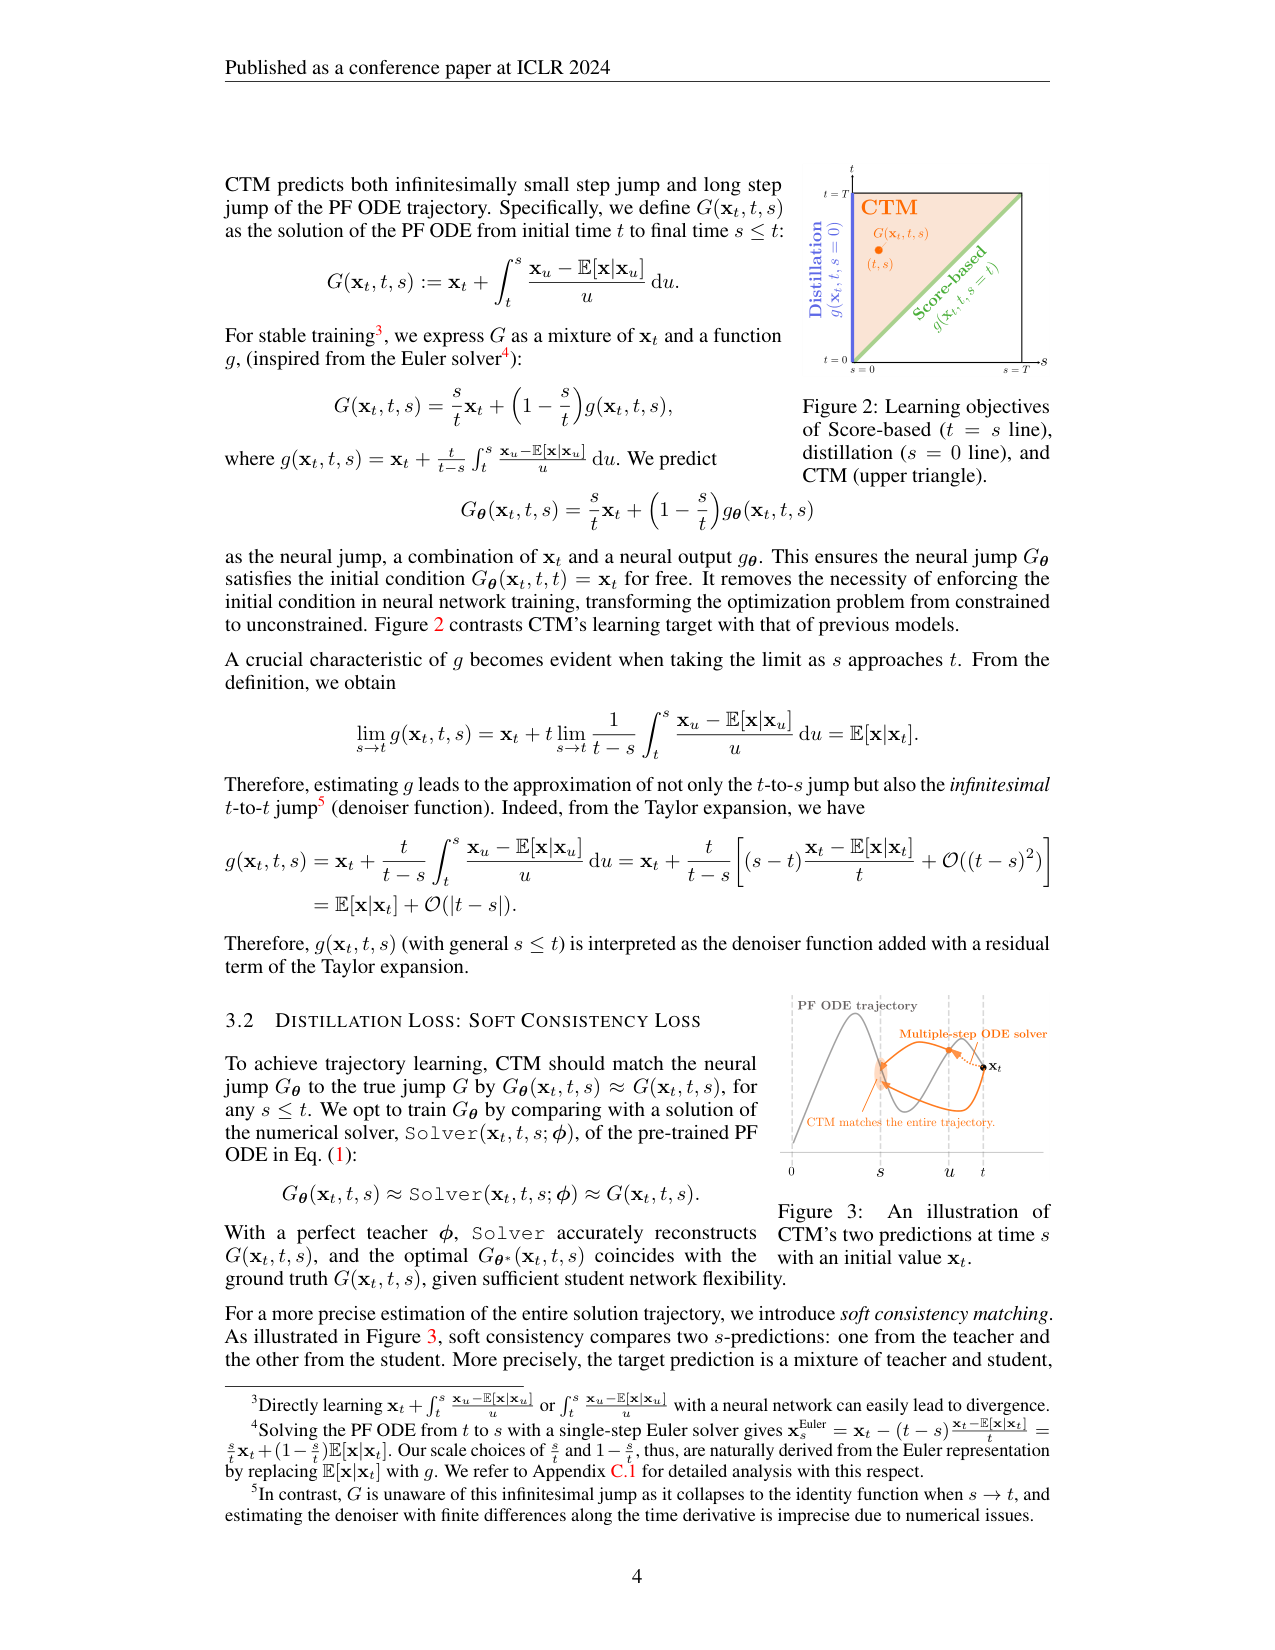
把 Consistency Models 的「点对点自洽」放宽成「轨迹自洽」:一个网络同时输出 PF ODE 的被积函数(score,即 g 在 s→t 的极限)和积分(任意 t→s 的整段跳跃),用 soft consistency + DSM + GAN 三个损失训练,再配一个 γ-sampling 采样族覆盖 CM 多步(γ=1)与确定性蒸馏(γ=0)两端;在 CIFAR-10 与 ImageNet 64×64 上以 1–2 NFE 刷新 FID,且学生质量超过老师。
 diffusion sampling theory / generative modeling
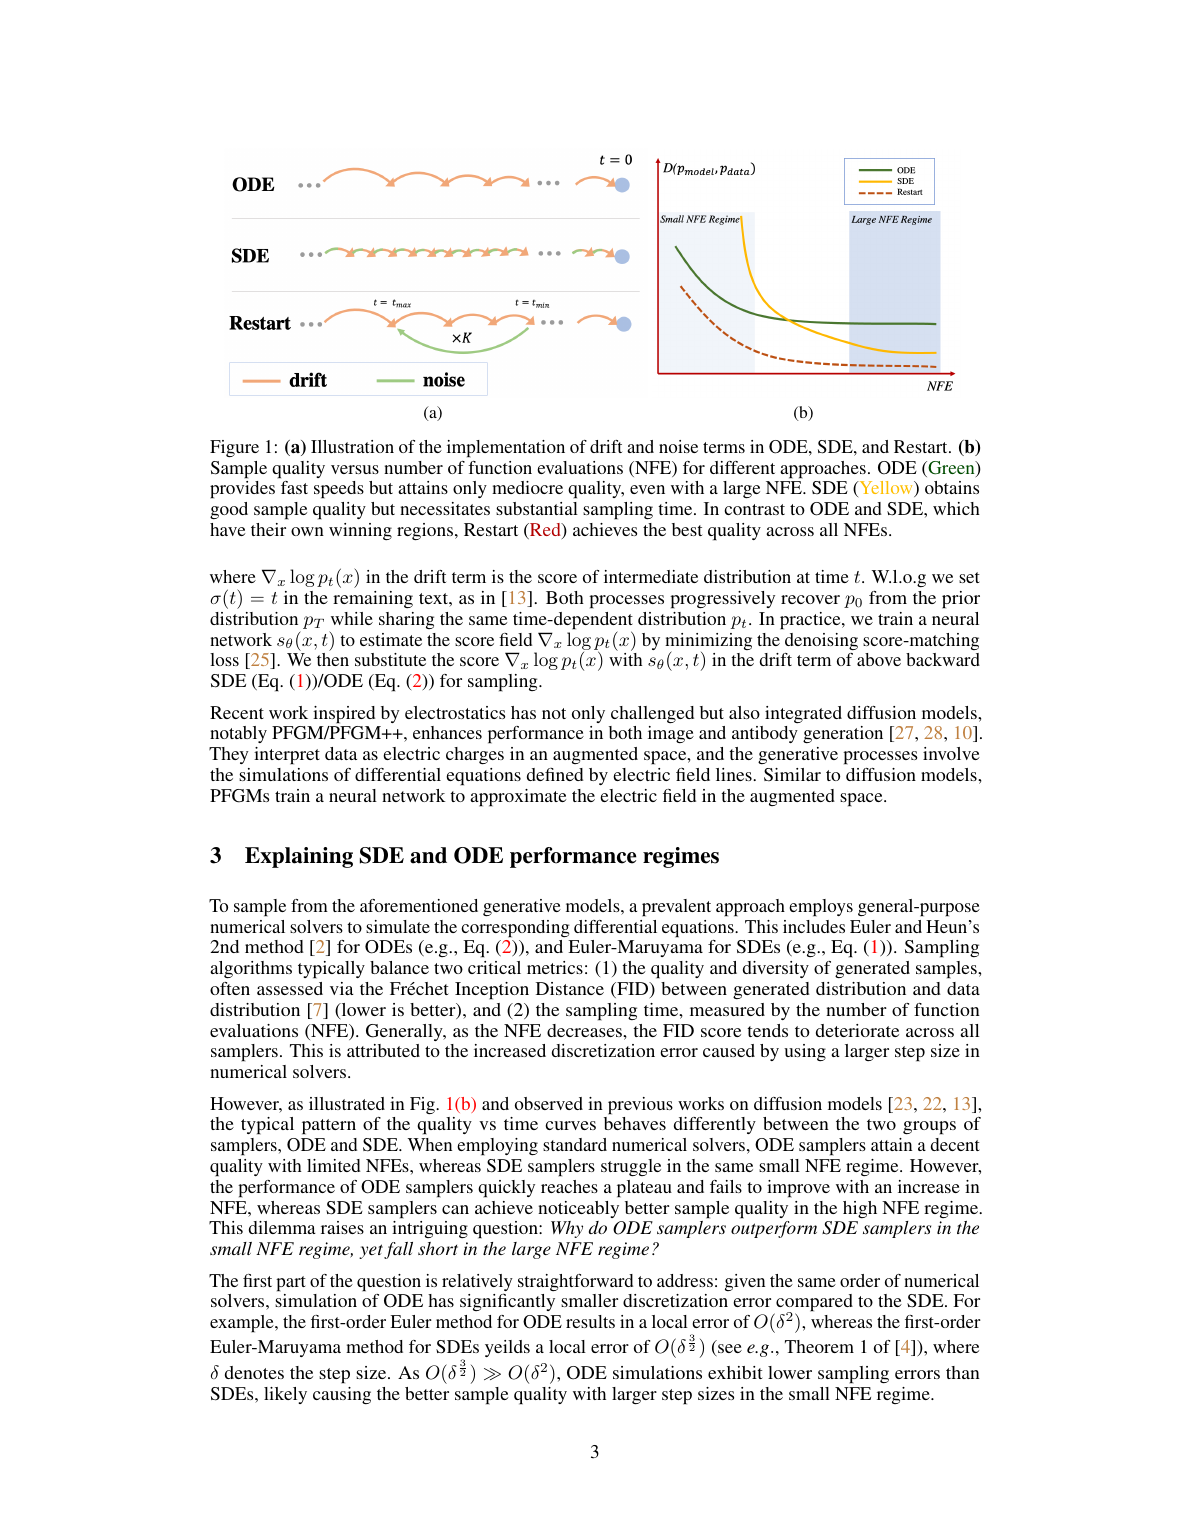
在扩散类生成模型的主反向 ODE 末尾插入一个时间区间 [tmin,tmax],循环 K 次『一次性大步加噪(前向)+ ODE 反向』:加噪把已累积的采样误差收缩掉一部分,ODE 反向又保持低离散化误差,从而同时拿到 SDE 的质量和 ODE 的速度。论文声明在同 FID 下相对当时最佳 SDE 采样器在 CIFAR-10(VP)上加速约 10 倍(对照两侧配置:Improved SDE 1023 NFE 得 FID 2.35,Restart 115 NFE 得 2.21)、ImageNet 64×64(EDM)上约 2 倍,并把 CIFAR-10(PFGM++)推到 FID 1.88、ImageNet 64×64 推到 1.36(UNet 架构、无额外训练)。
 机器人策略(行为克隆 / 动作扩散 / action chunk)
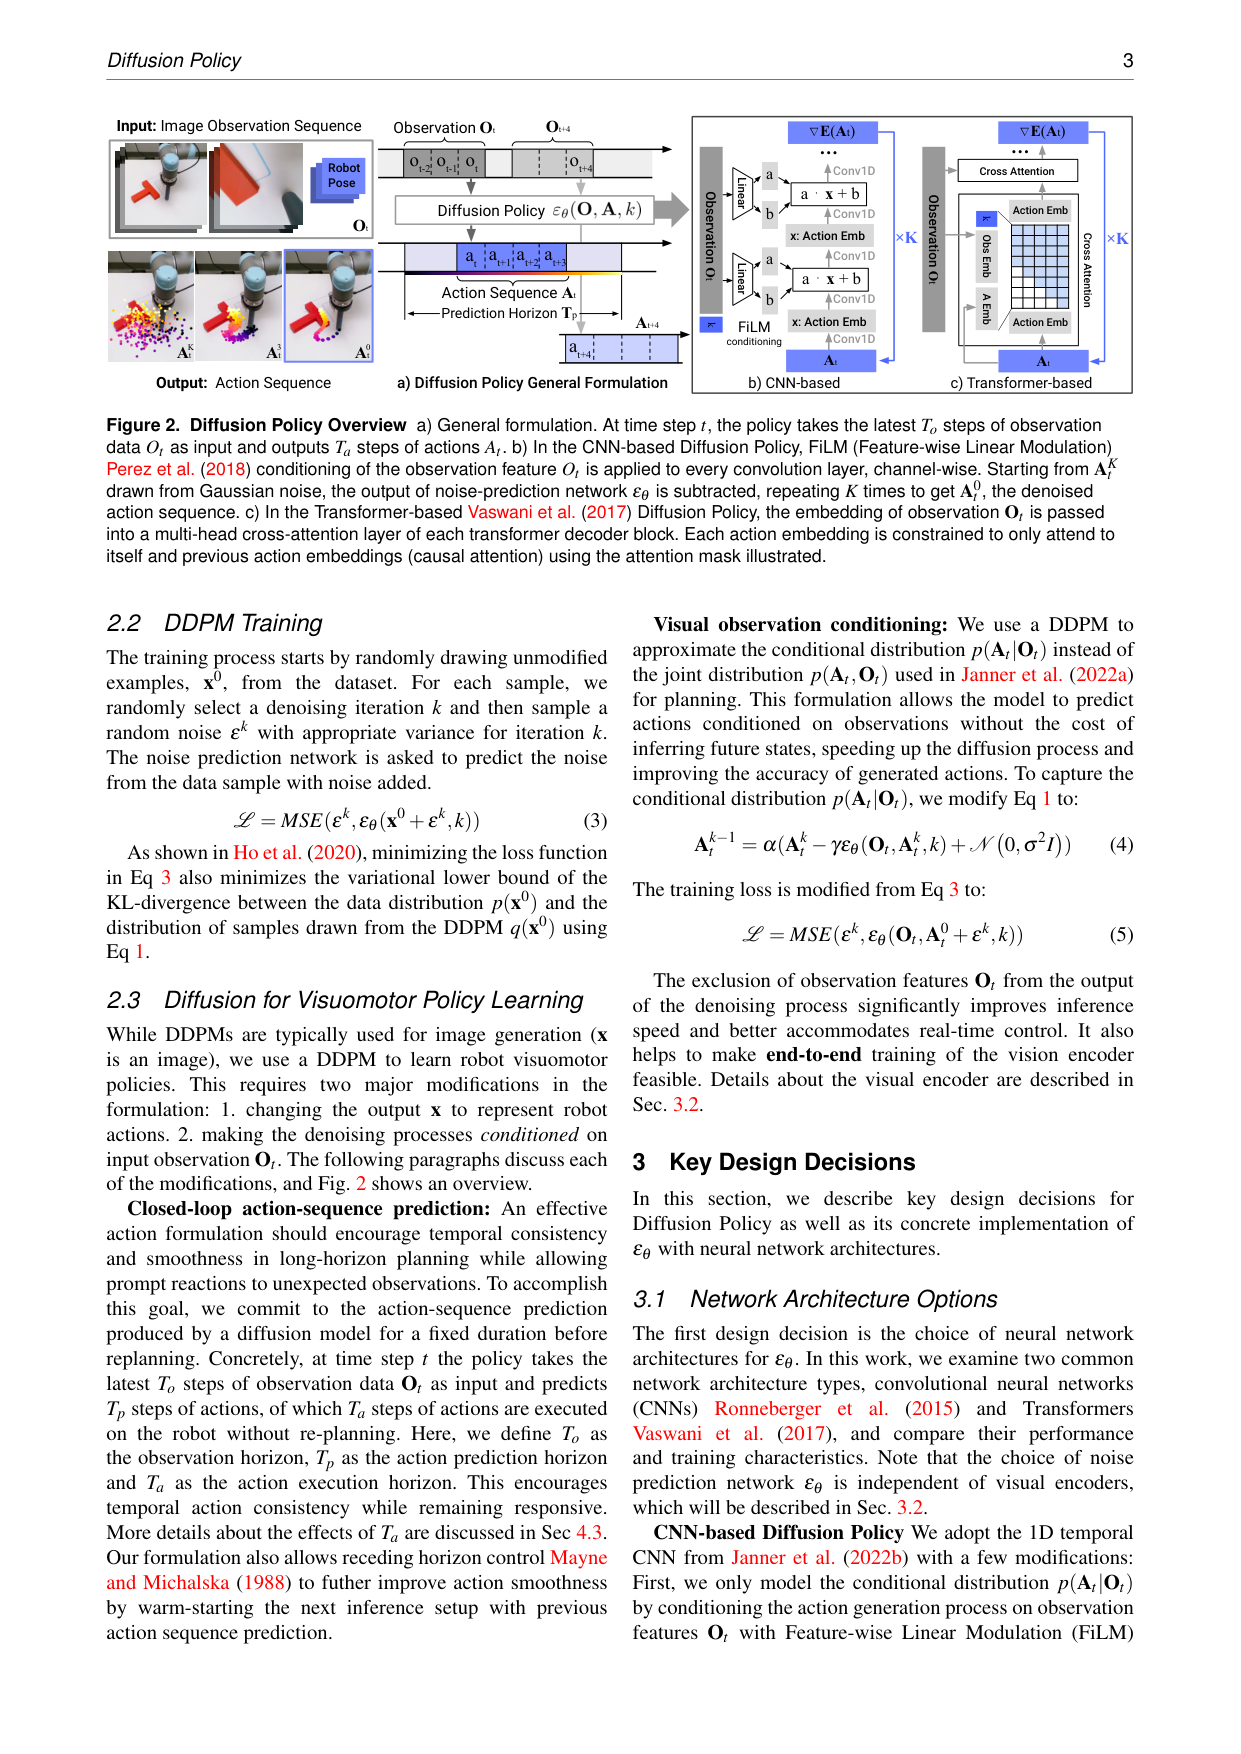
把机器人的视觉运动策略写成以观测为条件的动作去噪扩散过程:一次输出一个 8 步动作块(action chunk),配合滚动时域控制与一次性视觉编码,在 4 个 benchmark、15 个任务(模拟 + 真实)上相对各 benchmark 此前最优方法平均提升 46.9% 成功率;它把机器人策略从『单步动作回归』带到『动作块条件生成』,是后续 VLA 与 one-step 动作生成方法的基准对象。
 生成模型理论(one-step 谱系)
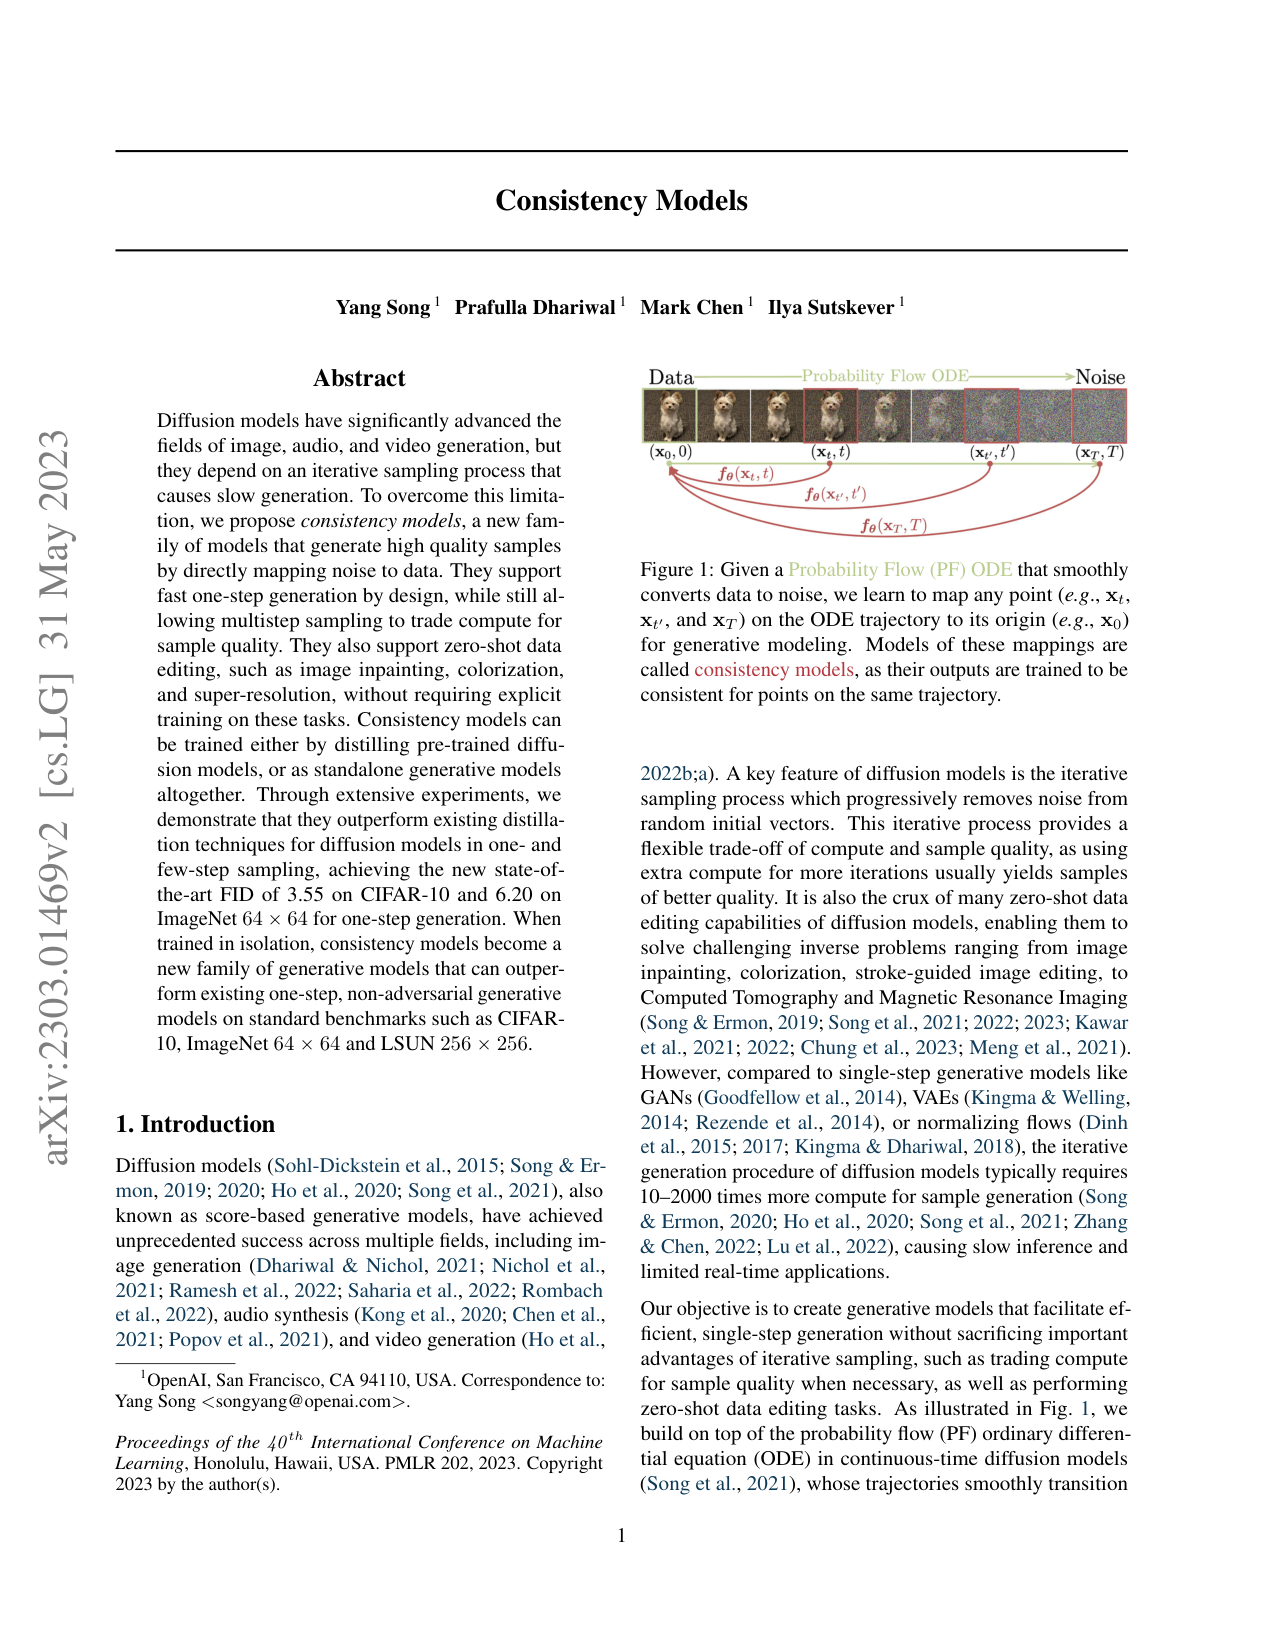
把扩散模型的迭代采样问题重写成『一步映射』问题:学一个 consistency function f(x_t, t),把概率流 ODE 同一条轨迹上任意时刻的点都映射到轨迹起点 x_ϵ,于是采样变成一次网络前向;同时保留多步采样(用算力换质量)与零样本图像编辑能力。给出两条训练路线——从预训练扩散模型蒸馏(CD)与完全从零训练(CT)——并在 CIFAR-10 一步生成拿到当时 SOTA 的 FID 3.55。
 生成模型理论 / 物理启发生成模型(扩散与泊松流统一)
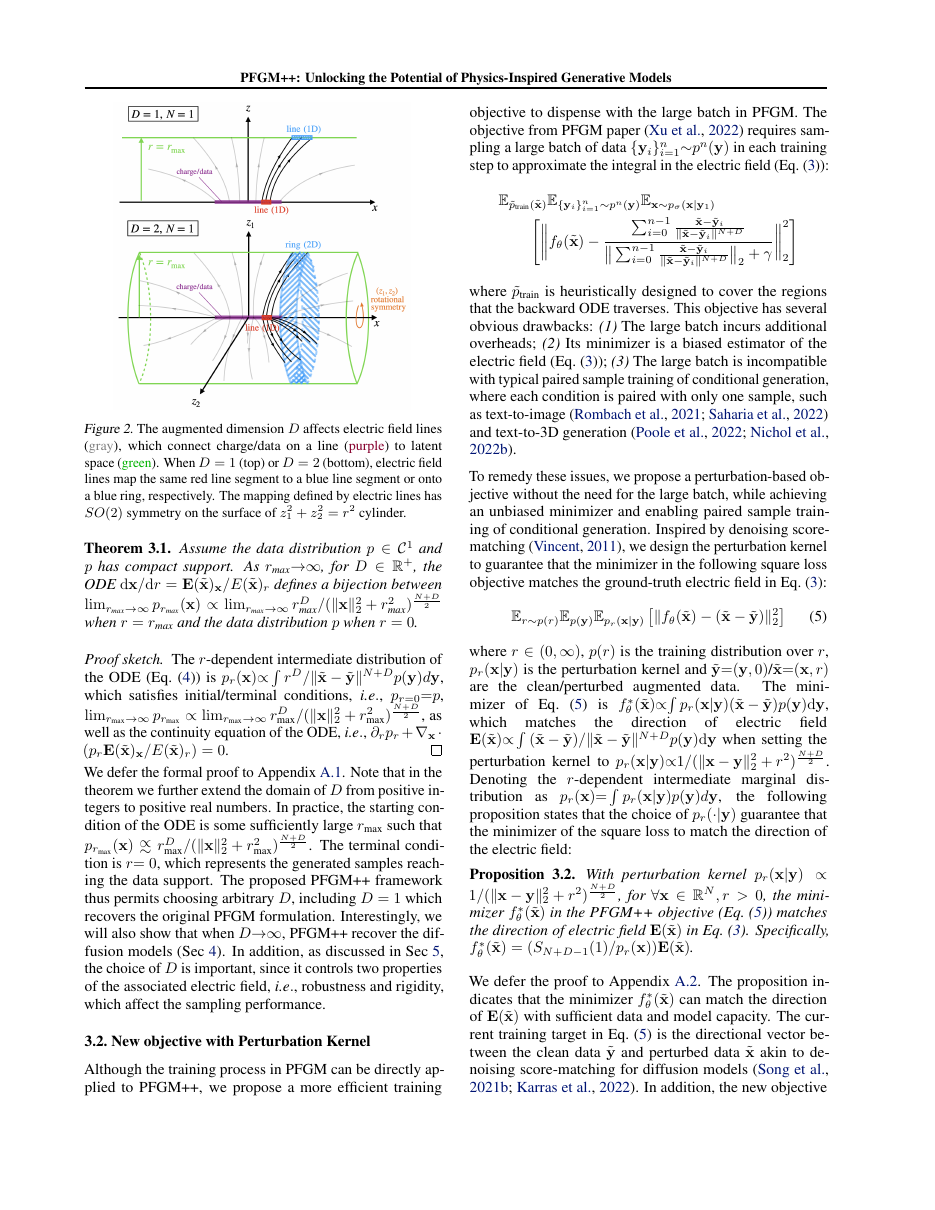
PFGM++ 把两类物理启发的生成模型放进同一个家族:把 N 维数据点当作电荷,增广 D 个额外维度后沿电场线把均匀先验流回数据所在平面;D=1 时它就是泊松流生成模型 PFGM,D→∞(保持 σ=r/√D 定标)时在训练目标与采样过程两层都精确恢复扩散模型。D 由此变成调节『对误差鲁棒』与『易于学习』的旋钮,中间值 D=2048/128 在 CIFAR-10/FFHQ 上把无条件生成 FID 压到 1.91/2.43(35/79 次网络求值),并在注入噪声、低比特量化、放大采样步长三类误差下比扩散模型更稳。
 生成模型·扩散模型骨干架构
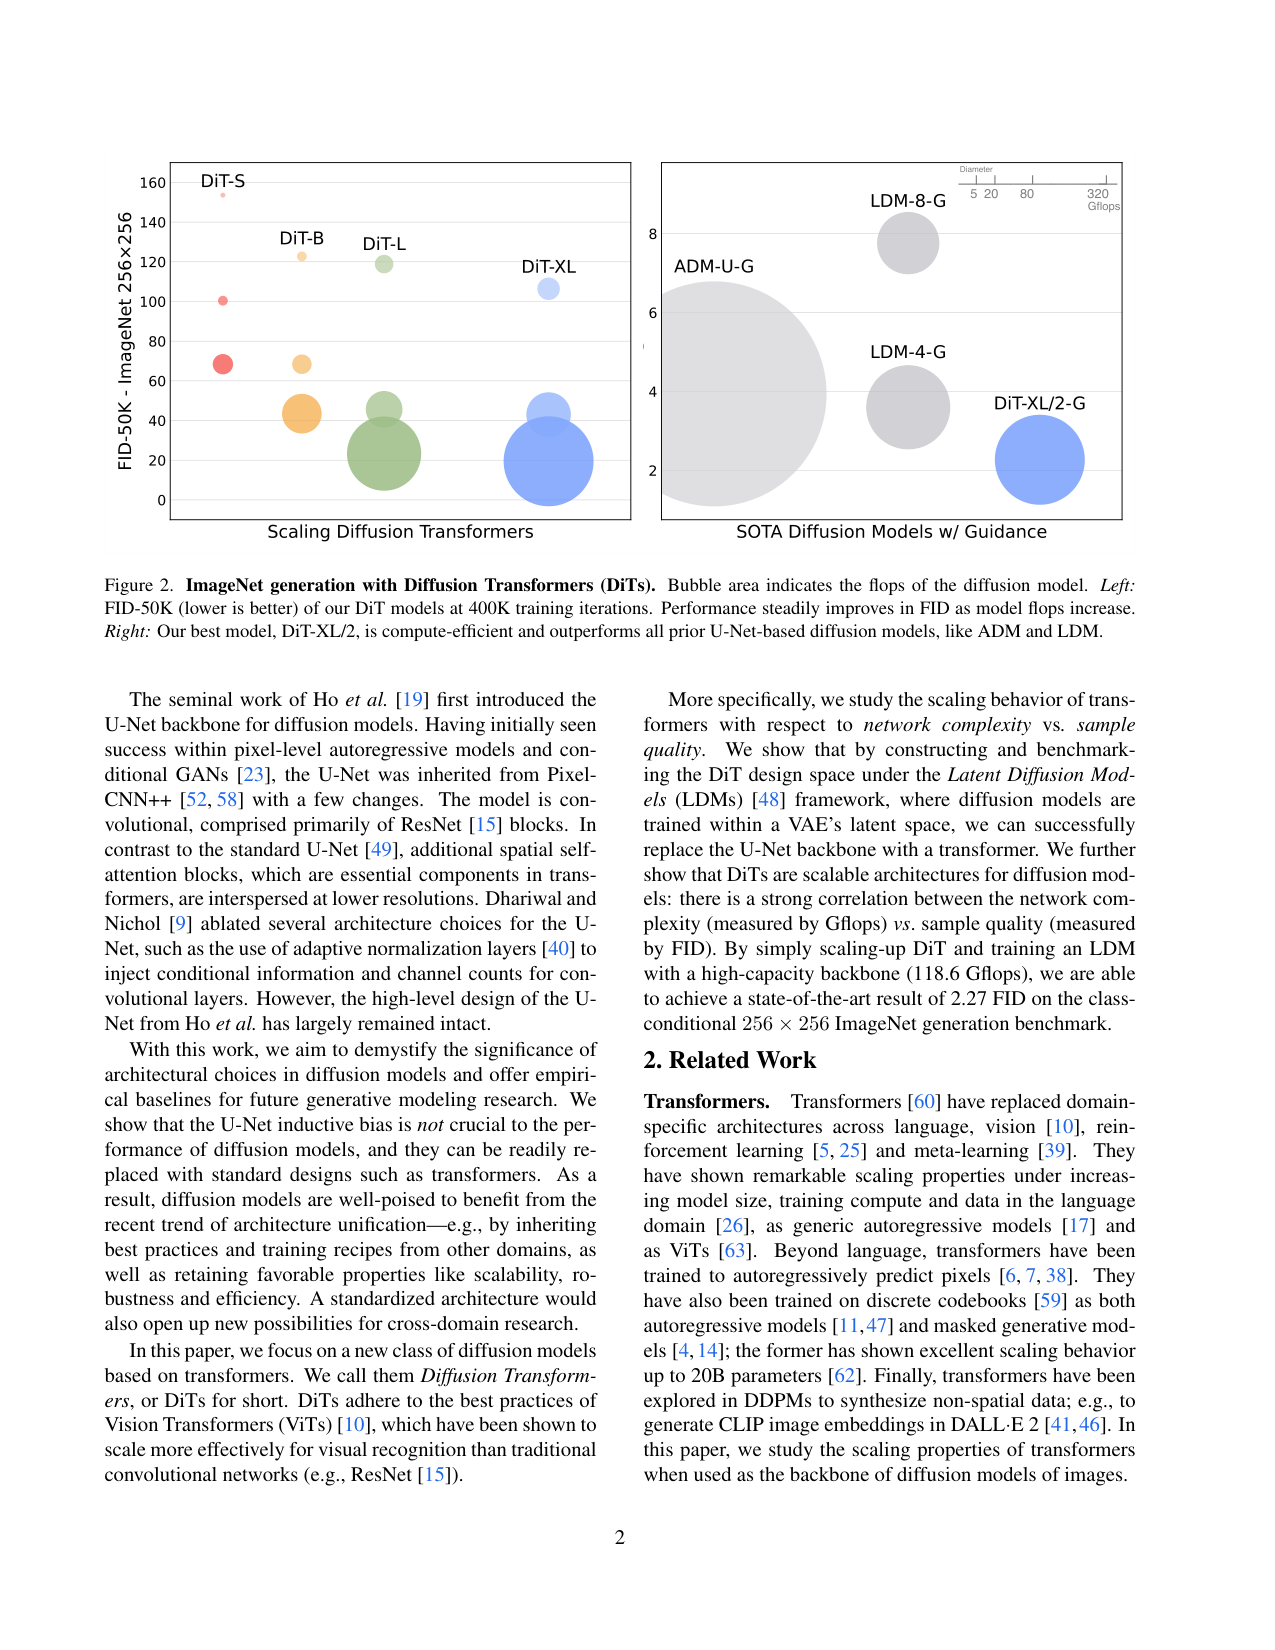
把扩散模型的骨干从卷积 U-Net 换成标准 ViT 风格的 transformer,在 latent 空间训练,证明『模型前向计算量(Gflops)与样本质量(FID)强相关』,并以 675M 参数的 DiT-XL/2 在 ImageNet 256×256 类条件生成上拿到当时最优 FID 2.27;这篇论文的 patchify + adaLN + scaling 配方后来成为 Sora、Stable Diffusion 3、PixArt 等 VLA/视频/文生图模型骨干的通用模板。
 系统神经科学综述(吸引子网络 / 连续吸引子 / 积分器)
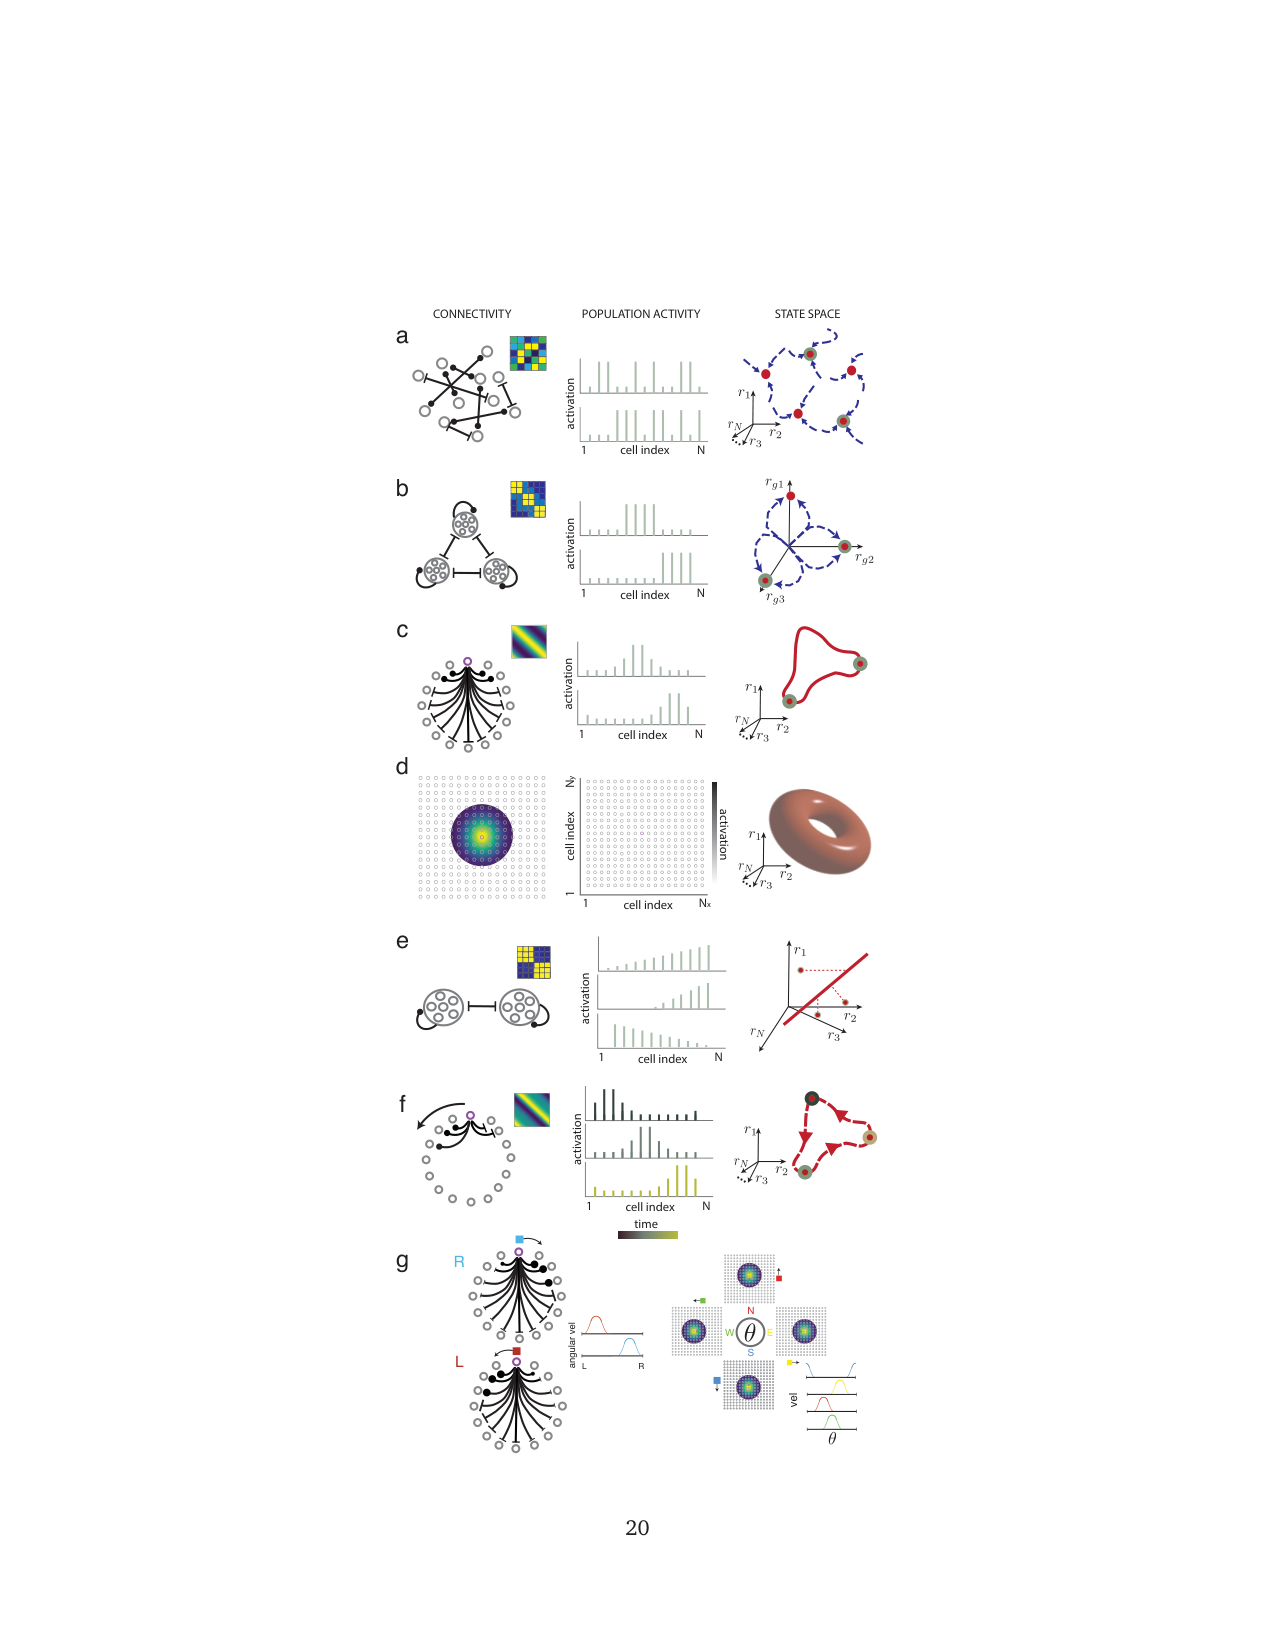
这是一篇权威综述:把『大脑如何用记忆、做积分、做决策』统一到吸引子动力学这一个框架下,给出判定一个神经回路是否真的实现吸引子动力学的五条可检验判据,并用眼动积分器、头方向回路、网格细胞等已被群体记录和状态空间分析严格验证的实例,论证大脑确实构造并使用连续吸引子;同时提出利用积分器复用与模块化组合来同时获得鲁棒性、容量与灵活性的路线。对 ML 读者来说,它把『记忆=稳定不动点、积分=flow map』这两条词汇表落到生物硬件的具体实现上。
 生态与物理交叉 / 复杂系统相图
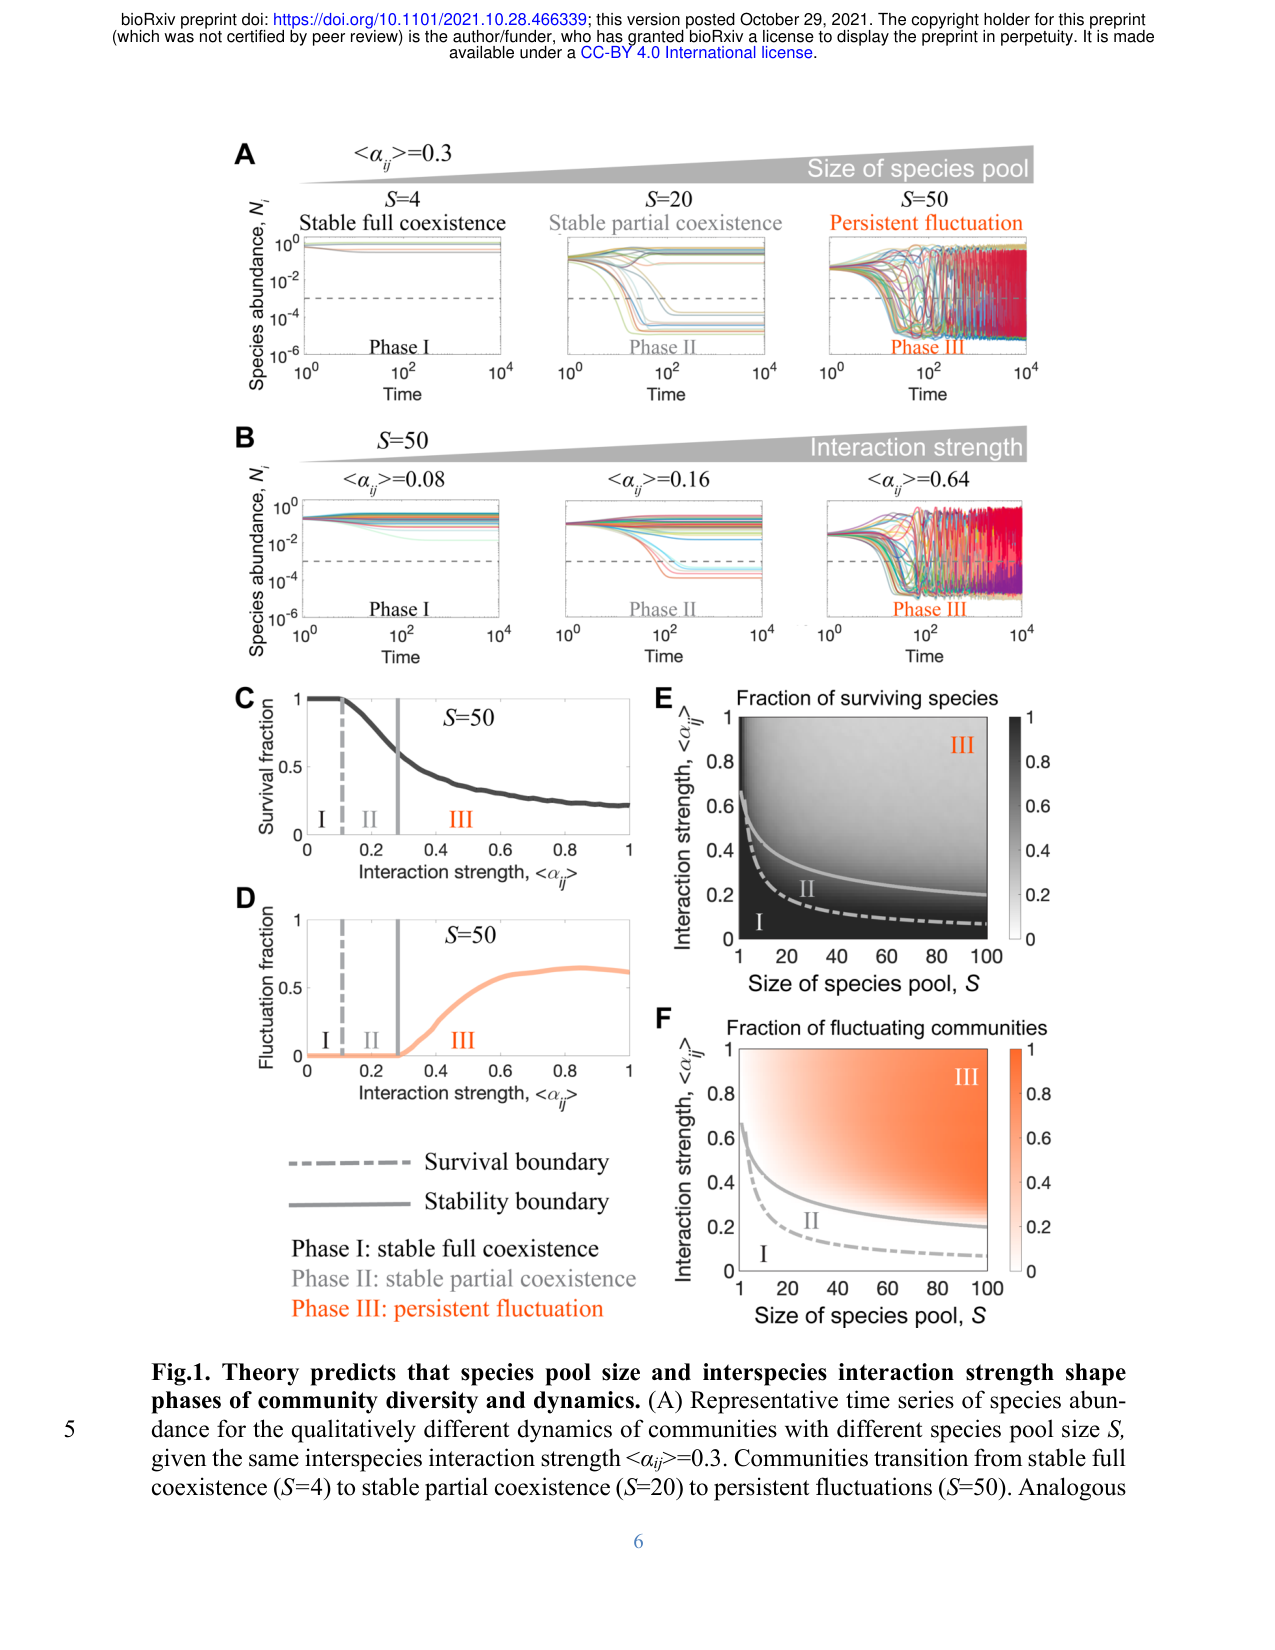
用 48 株细菌搭成的合成微宇宙,第一次在真实实验里直接检验近年复杂系统理论:只要知道物种池大小 S 和平均相互作用强度 <αij> 这两个粗粒化参数,就能预测群落会落在哪个动力学相——稳定全共存、稳定部分共存、还是持续涨落。189 个合成群落、S=2–48、3 个营养水平、每个群落 3 个重复,实验与 gLV 模型模拟都按理论预测的相序 I→II→III 排列;同一条件下涨落群落反而比稳定群落留下更多存活物种,说明高多样性与涨落互相维持。这篇是「用粗粒化统计量画复杂系统相图」的代表作,为生成模型训练相图提供了现成的类比框架。
 生成模型理论(Continuous Normalizing Flow 训练范式)
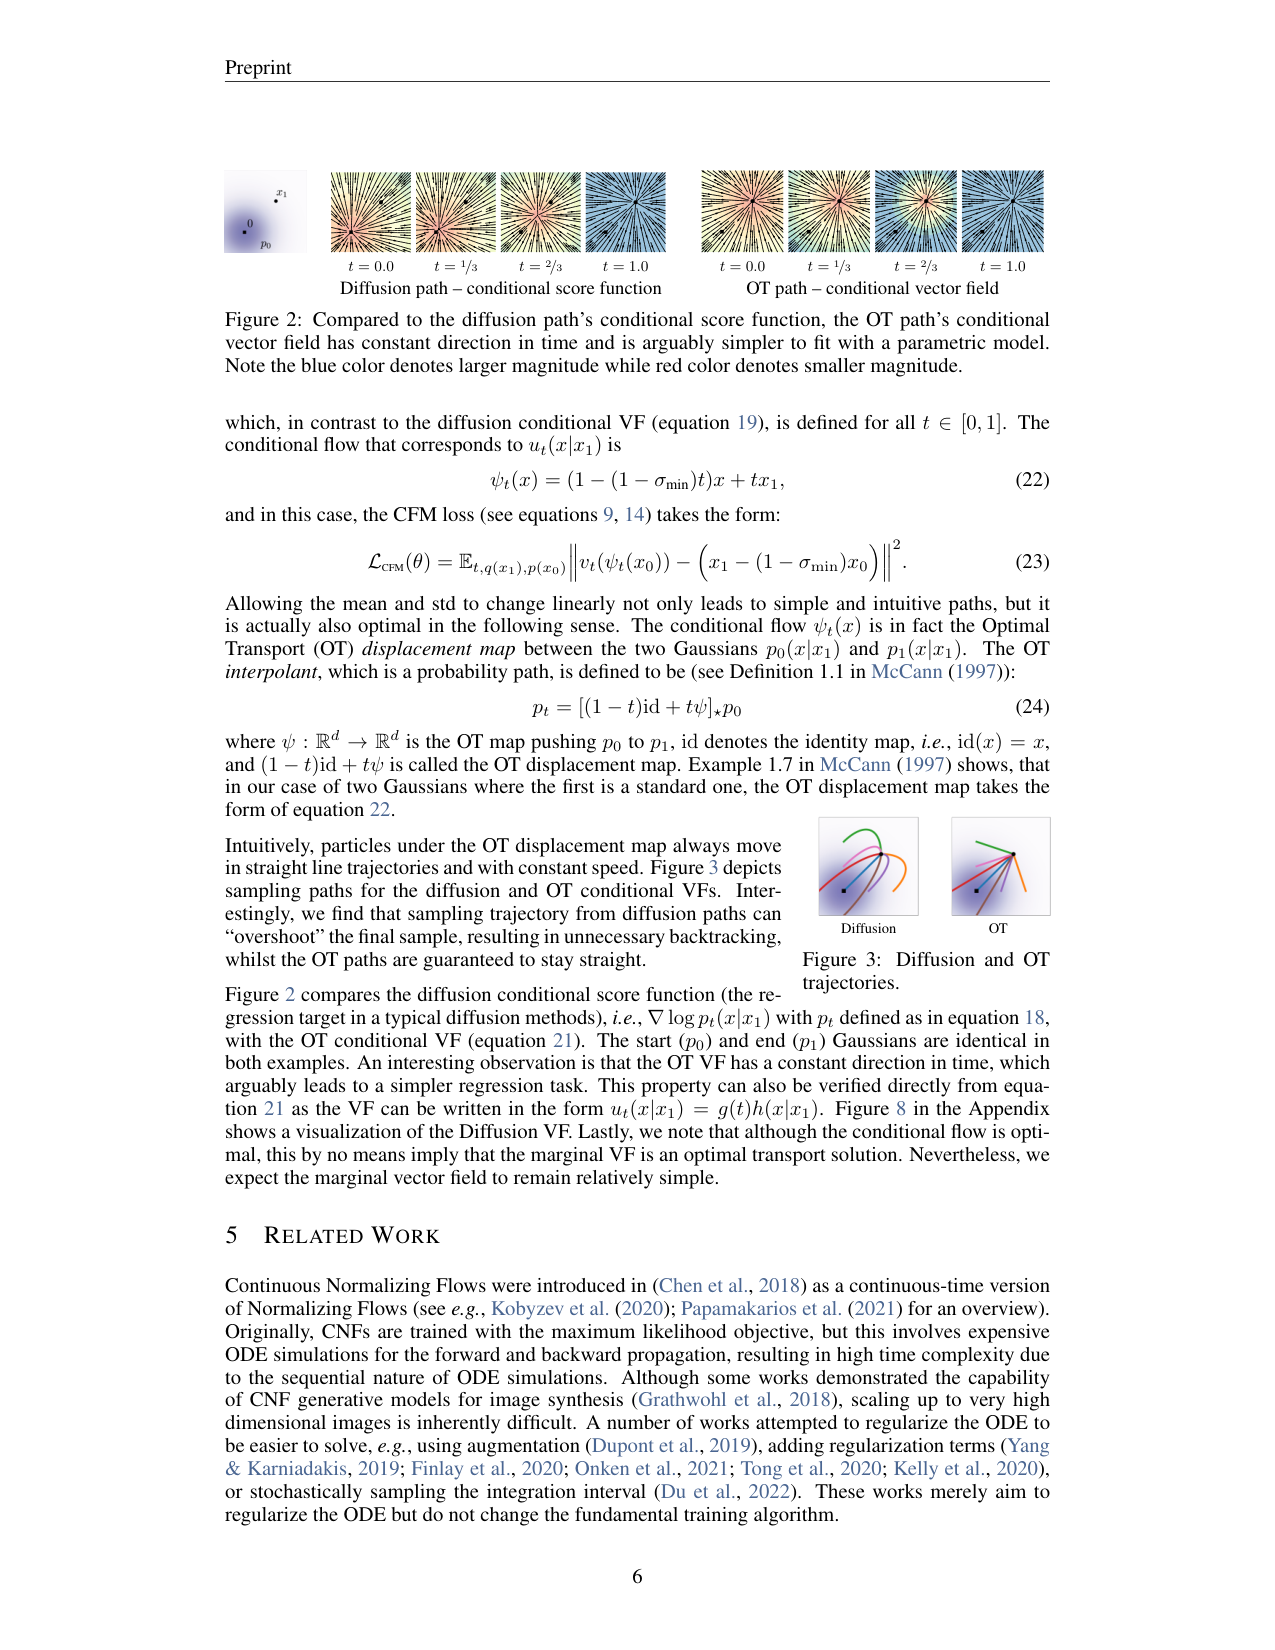
提出 Flow Matching:把 CNF 的训练从『必须模拟 ODE』变成『对每个数据点定义一条条件概率路径、回归其速度场』的 simulation-free 最小二乘问题,并证明条件目标与不可解的边际目标梯度等价;其中线性插值的 OT 路径让条件轨迹变直、回归目标更简单,从而在 CIFAR-10 / ImageNet 32/64/128 上同时拿到更优的似然、FID 与更少的采样步数,并把扩散路径收编为特例——这篇论文与同期 Rectified Flow、Stochastic Interpolants 一起构成后续所有 flow-based 生成模型(SD3、Sora 一代)的理论地基。
 生成模型理论(随机插值 / 连续归一化流训练范式)
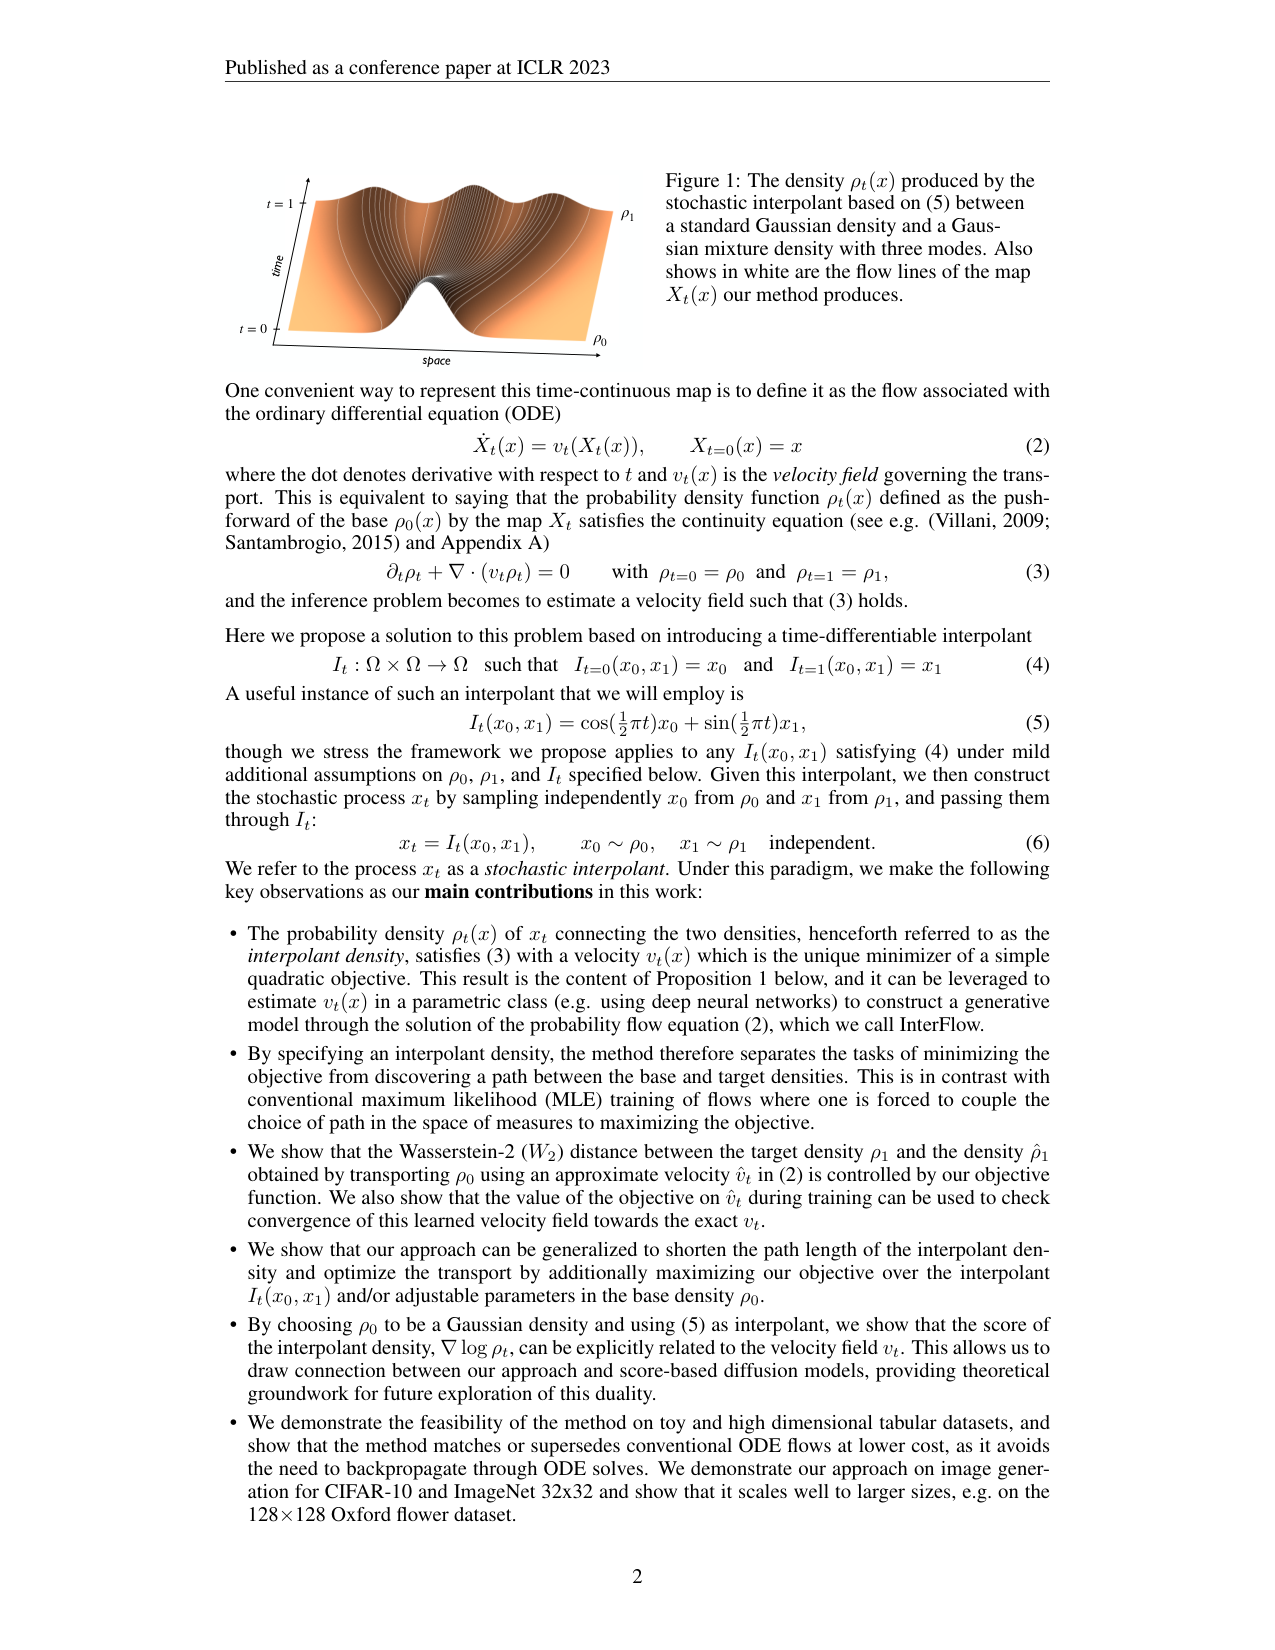
提出「随机插值(stochastic interpolant)」框架:任选一个在 t=0 处取 x0、t=1 处取 x1 的时间可微插值 I_t(x0,x1),把独立采样的基样本与目标样本对折成一条中间密度路径 ρ_t;论文证明这条路径的速度场 v_t 是某个简单二次目标的最小二乘解,训练只需对样本做蒙特卡洛估计,完全绕开对 ODE 求解器的反向传播,还给出训练损失对生成分布 Wasserstein-2 距离的控制界、速度与 score 的显式换算(Proposition 4)以及通过优化插值逼近最优输运的路线(Proposition 2)。实验上,表格数据 NLL 全面追平或反超 FFJORD 等连续流,图像上 CIFAR-10 / ImageNet-32 拿到与扩散模型竞争的似然,并第一次把从零训练的 ODE flow 推到 128×128 分辨率(Oxford Flowers,单张 A100)。这篇论文是后续 Flow Map Matching、MeanFlow 等「flow map / 平均速度」路线共同的数学起点,阅读提示里的「一般插值 + 速度/score 分离」全部落在这篇正文里。
 生成模型理论 / one-step 谱系
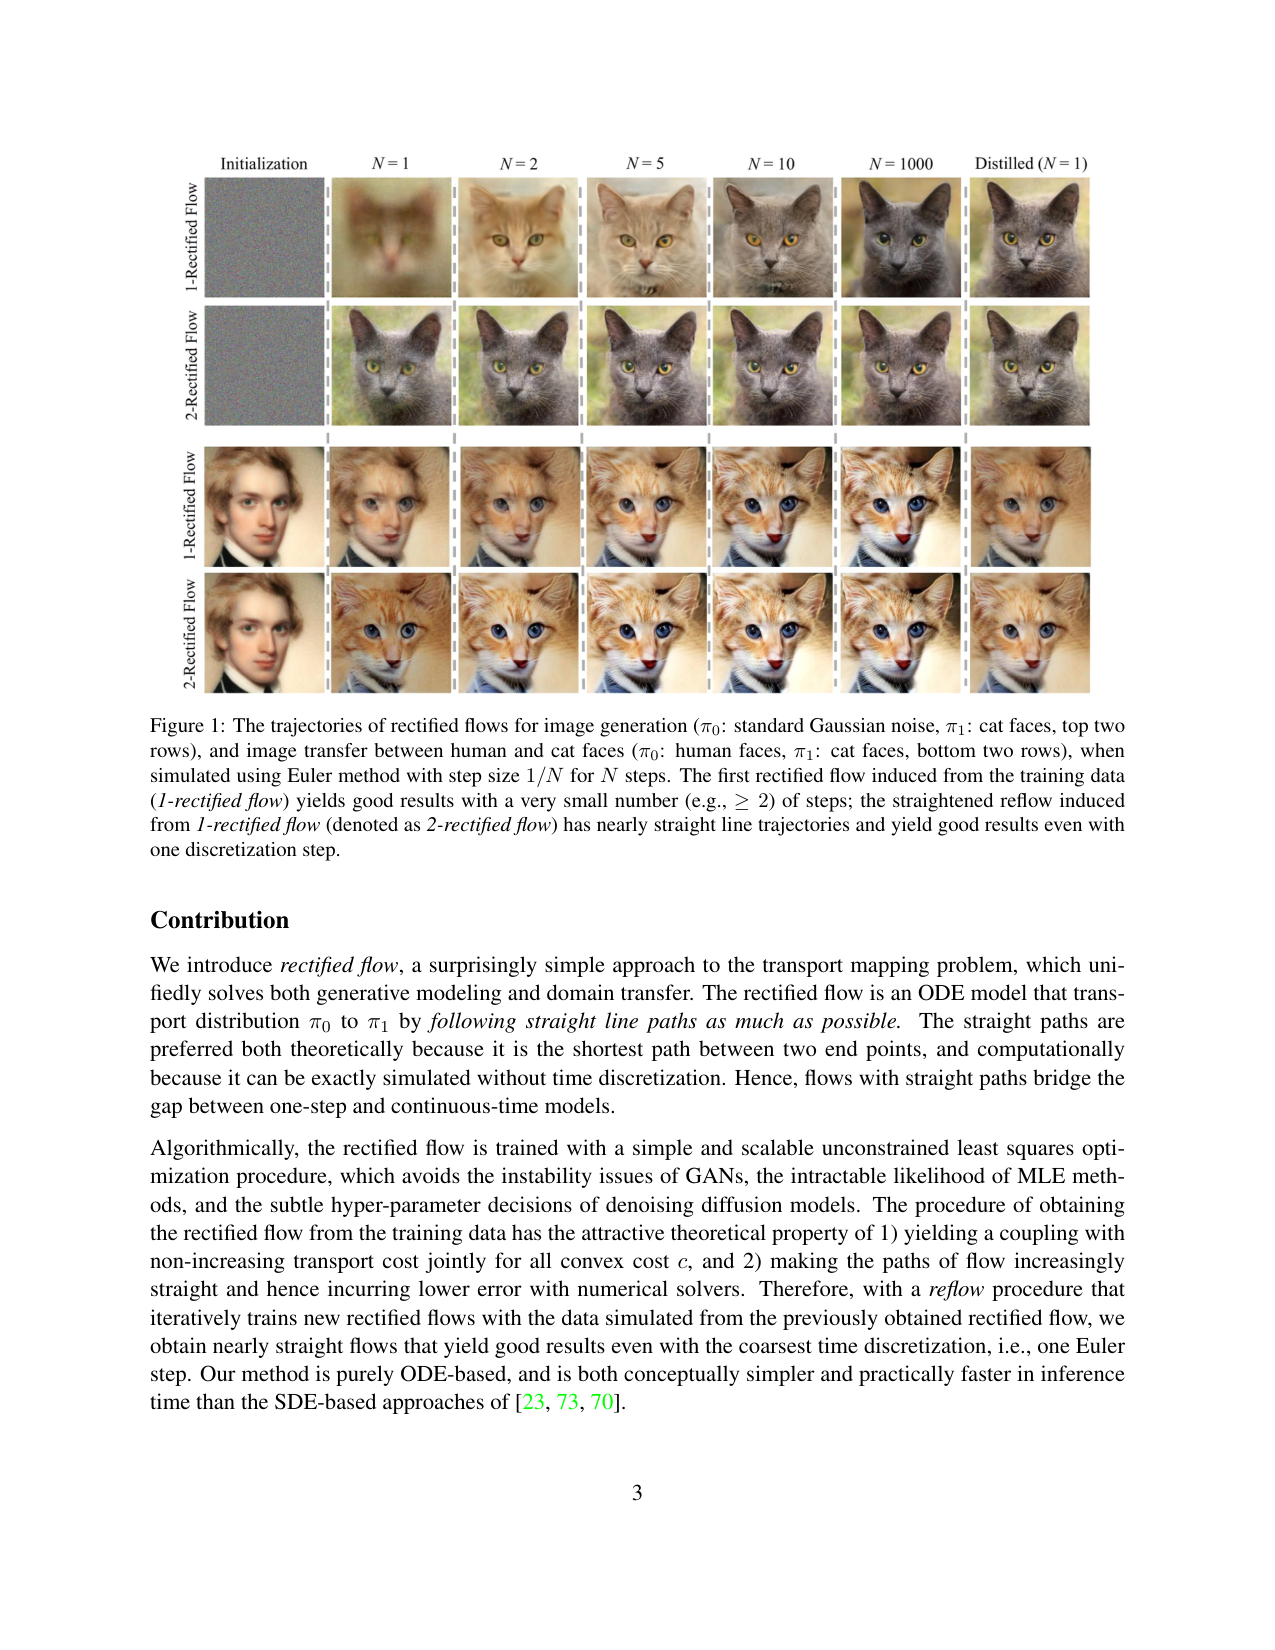
用线性插值路径 X_t = t·X_1 + (1−t)·X_0 上的条件期望速度 v_X(x,t) = E[X_1 − X_0 | X_t = x] 直接学一个 ODE 输运模型,再递归地用已学流重新采样端点对(reflow)把轨迹拉直,让原本要上百步数值求解的连续时间模型在 CIFAR-10 上做到一步欧拉出图(蒸馏后 FID 4.85),同时把概率流 ODE 与 DDIM 收编为它的非线性特例,是 one-step 生成思想最早的系统表述。
 生成模型理论 / 扩散模型(噪声预测约定)
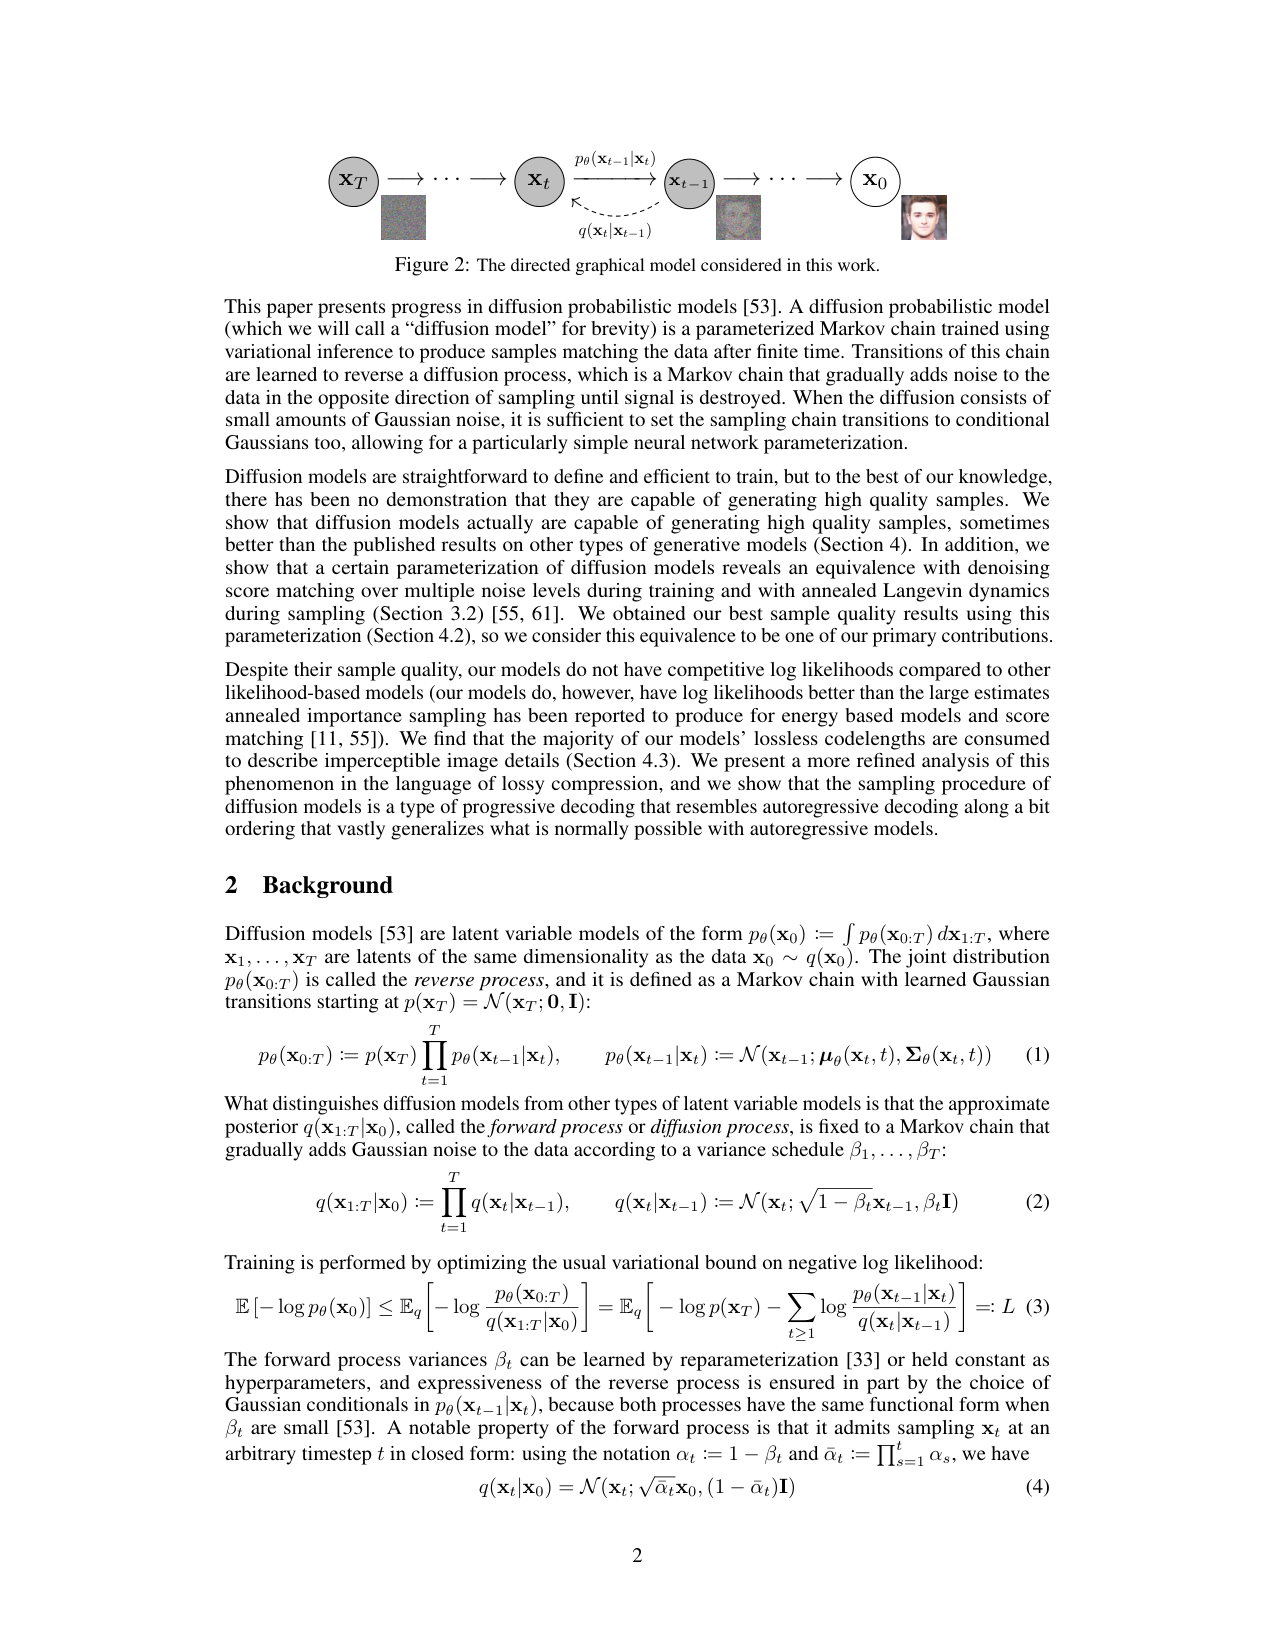
DDPM 把扩散概率模型从 2015 年的理论框架变成能生成高质量图像的实用生成器:固定一条逐渐加噪的前向马尔可夫链,用神经网络学反向去噪链,并把变分下界改写为『预测噪声 ε』的无权重均方误差。它在无条件 CIFAR10 上拿到 Inception Score 9.46、FID 3.17,超过当时多数生成模型;『噪声预测』从此成为扩散模型沿用至今的默认约定,也是后来 JiT 论文用 x-prediction 挑战的靶子。
 生成模型理论(score-based 扩散 / SDE 统一框架)
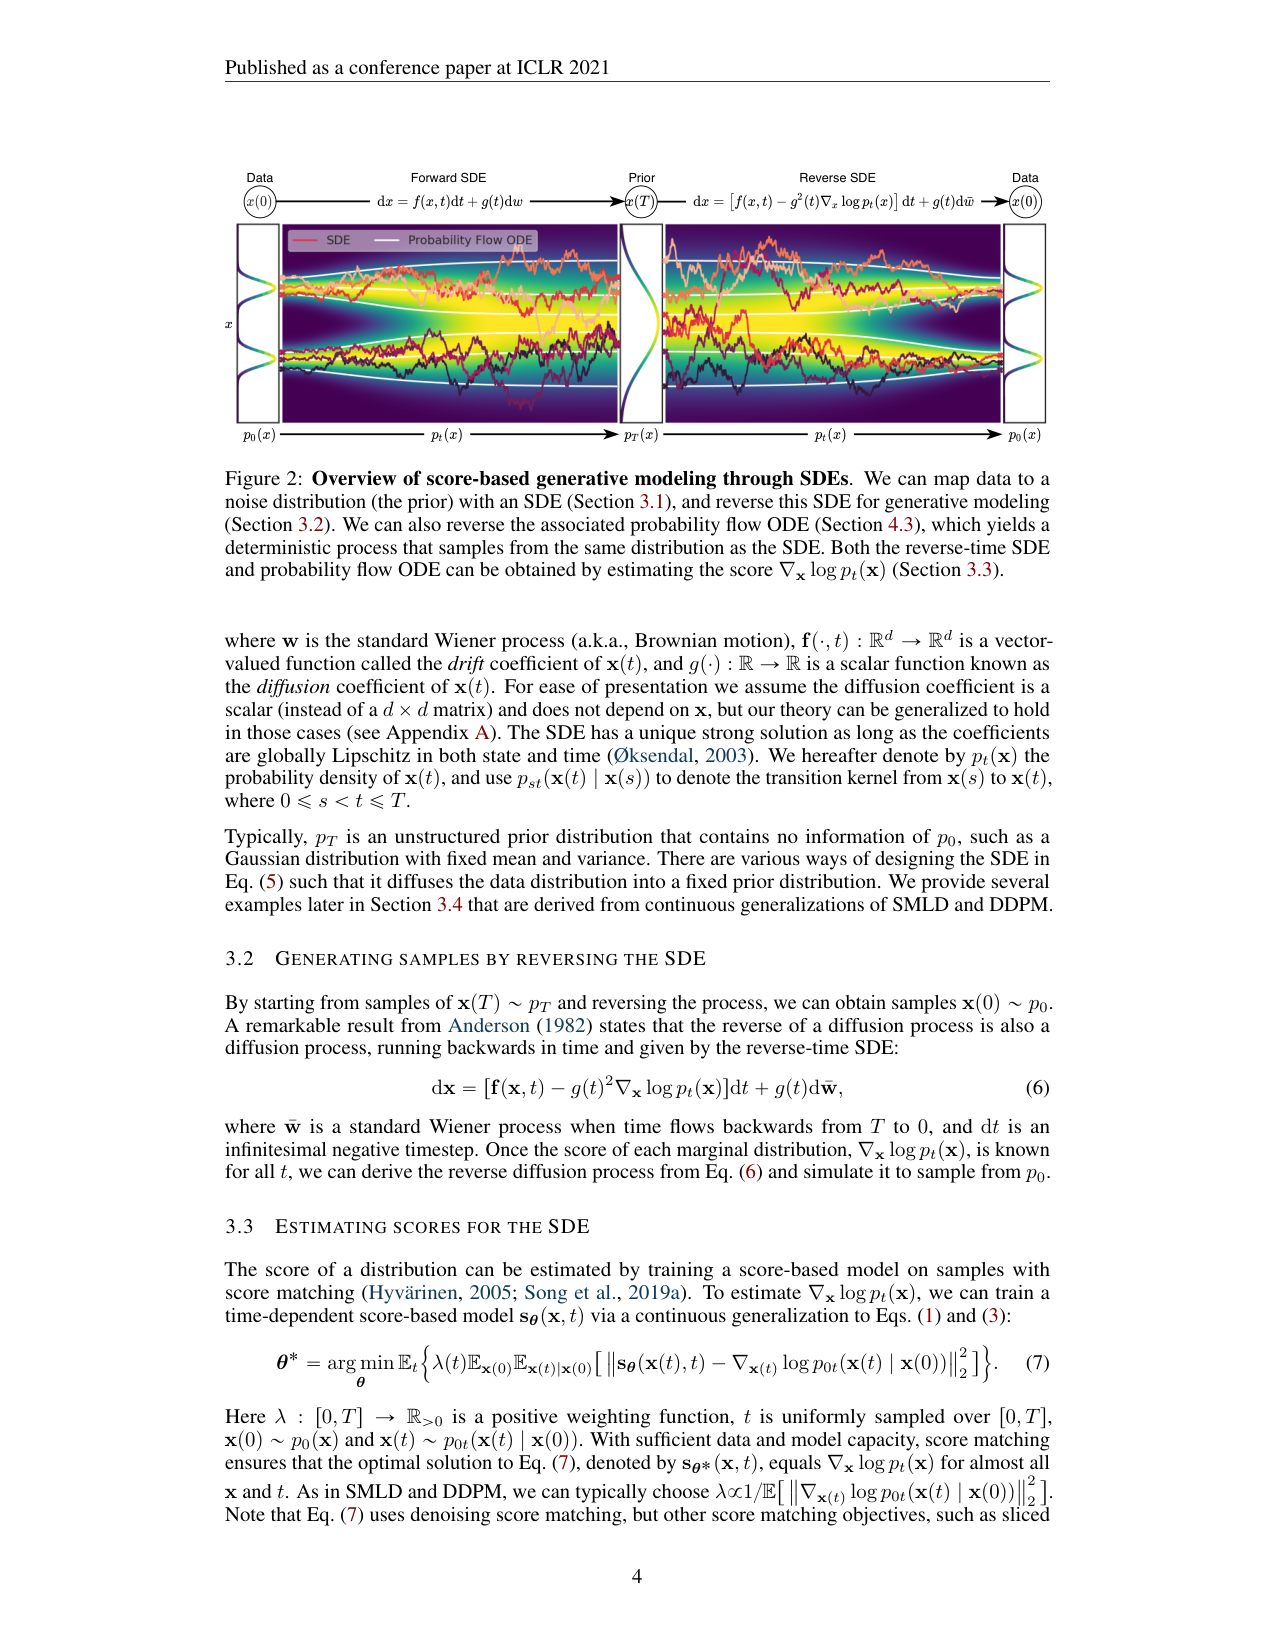
把「有限个噪声尺度上加噪—去噪」的两条既有路线(SMLD、DDPM)推广成「连续时间扩散 SDE + 逆向 SDE」的统一框架:训练只需要估计时间相关的 score(对数密度的梯度 ∇_x log p_t(x)),就能反演扩散过程生成样本;论文进一步证明每个扩散过程都对应一个共享同一组边际分布的概率流 ODE,把随机采样变成确定性输运,从而免费获得精确似然、唯一可辨识编码与 90% 以上的采样步数削减,并首次用 score-based 模型生成 1024×1024 高清人脸。这篇论文是后续 flow 谱系(Flow Matching、Rectified Flow、Stochastic Interpolants)连续化思路的出发点。