Flow Map Matching(flow-map-matching,泛读)
- 作者:Nicholas M. Boffi、Michael S. Albergo、Eric Vanden-Eijnden(纽约大学 Courant 数学研究所)
1. 要解决什么问题
扩散模型和 Flow Matching 把「生成」看成「把一个分布搬运到另一个分布」:从高斯噪声出发,沿着一条随时间变化的轨迹走到数据分布。采样时,这条轨迹由概率流常微分方程(ODE)描述,需要数值求解,通常要走几十到几百步。每走一步都要一次神经网络前向,推理成本因此居高不下。
减少步数的研究分成几条线。一条是蒸馏:先训练一个多步模型当老师,再把知识压进少步学生,代价是多一个训练阶段。另一条是 Consistency Models(一致性模型):给网络强加「同一条轨迹上不同时刻的输出指向同一个终点」的约束,直接做单步或少步生成,但它缺少系统性的数学框架,训练对离散化课程和超参很敏感。这篇 Flow Map Matching(FMM)想补上这块地基:定义一个比瞬时速度更完整的对象——两时间流地图,用它统一解释一致性、一致性轨迹模型(CTM)和渐进蒸馏,并给出直接从零训练、不需要预训练速度场的路线。
2. 背景:瞬时速度场与概率流 ODE
先交代这篇的工作基础 stochastic interpolant(随机插值)。它把数据 x1 和基分布样本 x0(对图像生成通常取高斯噪声)配成对,再定义一个随时间的插值过程:
I_t = α_t·x0 + β_t·x1 + γ_t·z
这个式子的含义是构造一条从基分布到数据的路径:系数满足 α_0 = β_1 = 1、α_1 = β_0 = 0、γ_0 = γ_1 = 0,所以 t=0 时 I_0 = x0(噪声侧),t=1 时 I_1 = x1(数据侧),中间时刻是两个样本的混合,z 是额外的标准高斯噪声。经典的 Flow Matching / rectified flow 取 α_t = 1−t、β_t = t、γ_t = 0,即直线插值 x1 和 x0。
插值过程定义了唯一的速度场 b_t(x) = E[İ_t | I_t = x]——给定中间点 x,把所有能到达它的配对 (x0, x1, z) 的瞬时导数求期望。概率流 ODE ẋ_t = b_t(x_t) 的解的分布与插值过程的分布逐时刻一致,所以采样可以换成解这个 ODE:从 x_0 ~ ρ0 出发,沿 b_t 一路推到 t=1。训练网络就是回归这个速度场,监督信号是插值路径自己的导数 İ_t,loss 是 E[|b̂_t(I_t) − İ_t|²]。
问题的根源在这里:瞬时速度 b_t 只描述「这一刻朝哪个方向走」,采样必须把它积分起来。积分步数越多越准,但每步一次前向;步数少,弯曲的轨迹就会被切线近似带偏。
3. 核心对象:两时间流地图
FMM 的关键动作是换一个建模对象。对 ODE 的解定义两时间流地图:
X_{s,t}(x_s) = x_t
即「从时刻 s 的点出发,沿 ODE 走到时刻 t 落到的点」。X_{s,t} 是一个从 s 到 t 的整段映射,反过来 X_{t,s} 是它的逆。它满足三个基本性质。第一,拉格朗日方程:∂t X_{s,t}(x) = b_t(X_{s,t}(x)),且 X_{s,s}(x) = x——把 X_{s,t} 对终点 t 求导,得到它当前所在位置的速度场;拉格朗日这个说法表示参照系跟着轨迹一起动。第二,合成律(也叫一致性性质):
X_{t,τ}(X_{s,t}(x)) = X_{s,τ}(x)
意思是先走 [s,t] 再走 [t,τ],等价于直接走 [s,τ]——任意相邻两段拼起来等于一整段。第三,由合成律推出可逆性 X_{s,t}(X_{t,s}(x)) = x。此外还有欧拉方程 ∂s X_{s,t}(x) + b_s(x)·∇X_{s,t}(x) = 0,它是固定空间点、对起点 s 求导的表述,∂s 是偏导、∇X_{s,t} 是映射对空间变量的雅可比、b_s(x)·∇X_{s,t}(x) 是一个雅可比-向量积(JVP)。
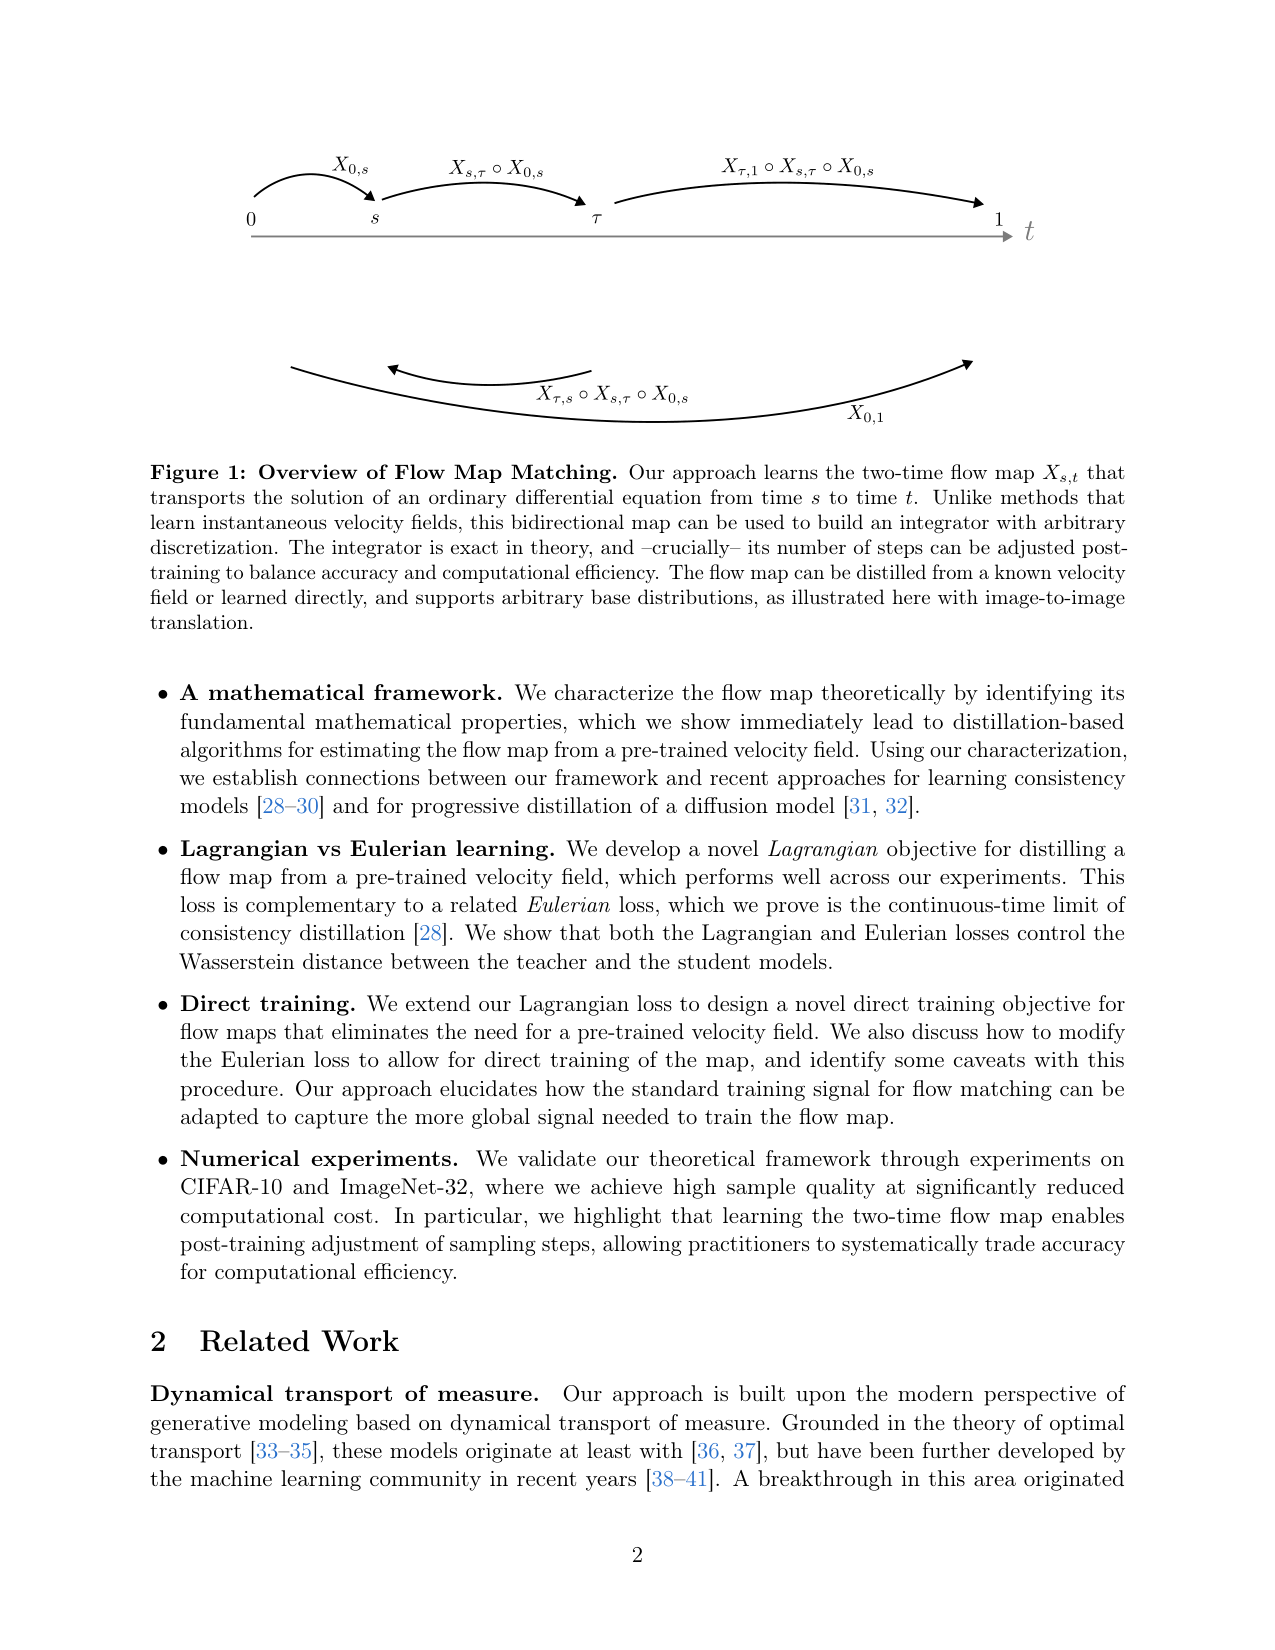
上面这张总览图画的就是这个对象:时间轴 0→s→τ→1 上,分段箭头 X_{0,s}、X_{s,τ}∘X_{0,s}、X_{τ,1}∘X_{s,τ}∘X_{0,s} 逐段复合,而下方一条大弧 X_{0,1} 表示一次性走完全程,反向箭头表示映射可逆。合成律保证这两种走法在数学上等价,所以步数可以训练后再决定:想要质量就多分几步,想要速度就少分几步甚至一步 X_{0,1}(x0),同一套网络权重直接换采样方式。
实现上,网络需要同时吃两个时间,论文用 ansatz(试凑参数化)强制边界条件:
X̂_{s,t}(x) = x + (t−s)·v^θ_{s,t}(x)
其中 v^θ_{s,t}(x) 是网络输出的速度场。t=s 时右边自动等于 x,边界条件 X̂_{s,s}(x)=x 无需额外约束;同时 (t−s)·v^θ 正是整段位移,v^θ 读作「每单位时间的位移」,这一点后面对照 MeanFlow 时会再用到。
4. 四条训练路径
论文按「有没有预训练速度场」分成蒸馏和直接训练两条主线,一共给出四个损失。
4.1 蒸馏:拉格朗日损失 LMD 与欧拉损失 EMD
先看给定预训练速度场 b 的情况。把拉格朗日方程的两边相减、平方、取期望,得到拉格朗日蒸馏损失:
L_LMD = E[|∂t X̂_{s,t}(I_s) − b_t(X̂_{s,t}(I_s))|²]
这个式子的含义是惩罚「学生映射的切向速度」和「老师速度场」在映射到达的位置上不一致;∂t X̂_{s,t} 是映射对终点 t 的偏导,I_s 是插值点,期望遍历时间对 (s,t)(按权重 w_{s,t} 采样)和所有数据/噪声配对。它要回答的问题:怎么把老师 b 的知识灌进一张整段映射?答案是让映射在任意 [s,t] 区间上都满足老师的速度场方程。拉格朗日方程的解唯一,所以损失为零当且仅当学生等于真流地图。
把欧拉方程同样平方取期望,得到欧拉蒸馏损失:
L_EMD = E[|∂s X̂_{s,t}(I_s) + b_s(I_s)·∇X̂_{s,t}(I_s)|²]
∂s X̂_{s,t} 是映射对起点 s 的偏导,∇X̂_{s,t}(I_s) 是映射在 I_s 处的雅可比,与 b_s(I_s) 做点积。附录 C 证明:当 b 来自扩散模型的概率流时,这个损失正好是一致性蒸馏(Consistency Distillation)的连续时间极限——这是论文把 Consistency Models 收进统一框架的关键。
两个损失都有理论保证:论文证明它们控制学生分布与老师分布之间的 Wasserstein 距离,W²₂(ρ1, ρ̂1) ≤ e^{1+2∫₀¹|C_t|dt}·L_LMD(C_t 是速度场满足单边 Lipschitz 假设的常数),以及 W²₂(ρ1, ρ̂1) ≤ e¹·L_EMD。后一个界不依赖 Lipschitz 常数,看起来更强,但代价是损失里含空间梯度 ∇X̂:在最优映射奇异的地方梯度没有定义,训练困难,这为后面 LMD 明显优于 EMD 的实验结果埋下伏笔。
4.2 直接训练:FMM 损失
蒸馏需要老师 b。要绕过它,直觉是用插值路径自己的导数 İ_t 代替 b_t——这正是 Flow Matching 直接训练的做法。拉格朗日版本给出 FMM 的直接训练损失:
L_FMM = E[|∂t X̂_{s,t}(X̂_{t,s}(I_t)) − İ_t|²] + E[|X̂_{s,t}(X̂_{t,s}(I_t)) − I_t|²]
读法:先把插值点 I_t 用反向映射 X̂_{t,s} 送回起点附近,再让正向映射 X̂_{s,t} 把该点送到 t 时刻;第一项要求这条合成轨迹在 t 时刻的切向速度等于 İ_t(插值路径的真实导数),第二项要求合成回来的点还原成 I_t(循环可逆)。两项都能在同一个前向里算出来,∂t X̂ 用前向模式自动微分与映射本身同批求得。权重必须对称 w_{t,s} = w_{s,t},因为要同时学正反两个方向;选 w = 1 学全区间就能单步 X_{0,1},选 |t−s| < 1/K 的 strip 只学短区间,采样时要走 K 步。
论文专门讨论了一个读者自然会问的替代方案:欧拉式直接估计,即把 EMD 里的 b_s(I_s) 直接换成 İ_s。展开期望后,交叉项是 İ_s 的线性函数,可以用 tower property(条件期望的塔性质)把 İ_s 换成它的条件期望 b_s(I_s);但最后一项是 İ_s 的二次项,E[|İ_s·∇X̂|²] 与 E[|b_s·∇X̂|²] 一般不相等,tower property 对非线性函数失效,最小化这个目标得到的映射和真流地图不一致。Consistency Models 家族的处理是给二次项加 stopgrad(切断梯度),论文证明这样得到的更新不动点是真流地图,但目标函数本身不再保证单调下降、不动点的稳定性也没有理论保证。这是论文对 CM 训练困难的一个理论解释。
4.3 渐进蒸馏:PFMM
实验里发现直接学一步映射收敛困难,论文采用渐进策略:先用 strip 权重 |t−s| < 1/K 学到 K 步映射当老师,再蒸馏成一步。渐进流地图匹配损失:
L_PFMM = E[|X̌_{s,t}(I_s) − (X̂_{t_{K−1},t_K}∘⋯∘X̂_{t_1,t_2})(I_s)|²]
其中 t_k = s + (k−1)(t−s)/(K−1) 是把 [s,t] 均匀切成 K−1 段的分点。含义:学生 X̌ 一步的输出要等于老师 X̂ 连续复合 K−1 次的输出。老师参数冻结,只对学生求梯度;可以从老师参数热启动,也可以 M < K 步递归迭代(每次少一半步数),类似 Progressive Distillation。
5. 实验
5.1 二维棋盘:直接训练可行,但一步难
先在一个合成分布上验证四种方法:把二维标准高斯搬到棋盘分布(紧支撑、边缘不连续,对映射是个苛刻测试)。网络是 512 隐单元×6 层的 MLP,Adam 优化器,训练 5×10⁴ 次迭代。以 SI(随机插值)用 N=80 步数值积分的结果为参考,各方法在图上标注了与目标分布的 KL 散度(DKL):SI N=80 参考为 0.016;直接学全区间一步的 FMM 是 0.017,学 |t−s|<0.25 的四步 FMM 降到 0.008;PFMM 把四步蒸馏成一步拿到 0.01;蒸馏路径里 LMD 一步 0.033,EMD 一步 0.082。两件事值得注意:直接学整段映射可行,四步明显优于一步,印证了「一步难学」;LMD 明显好于 EMD,而图里的黄色点(落到棋盘外的点)集中在棋盘边缘——误差主要来自最优映射在边缘的不连续。
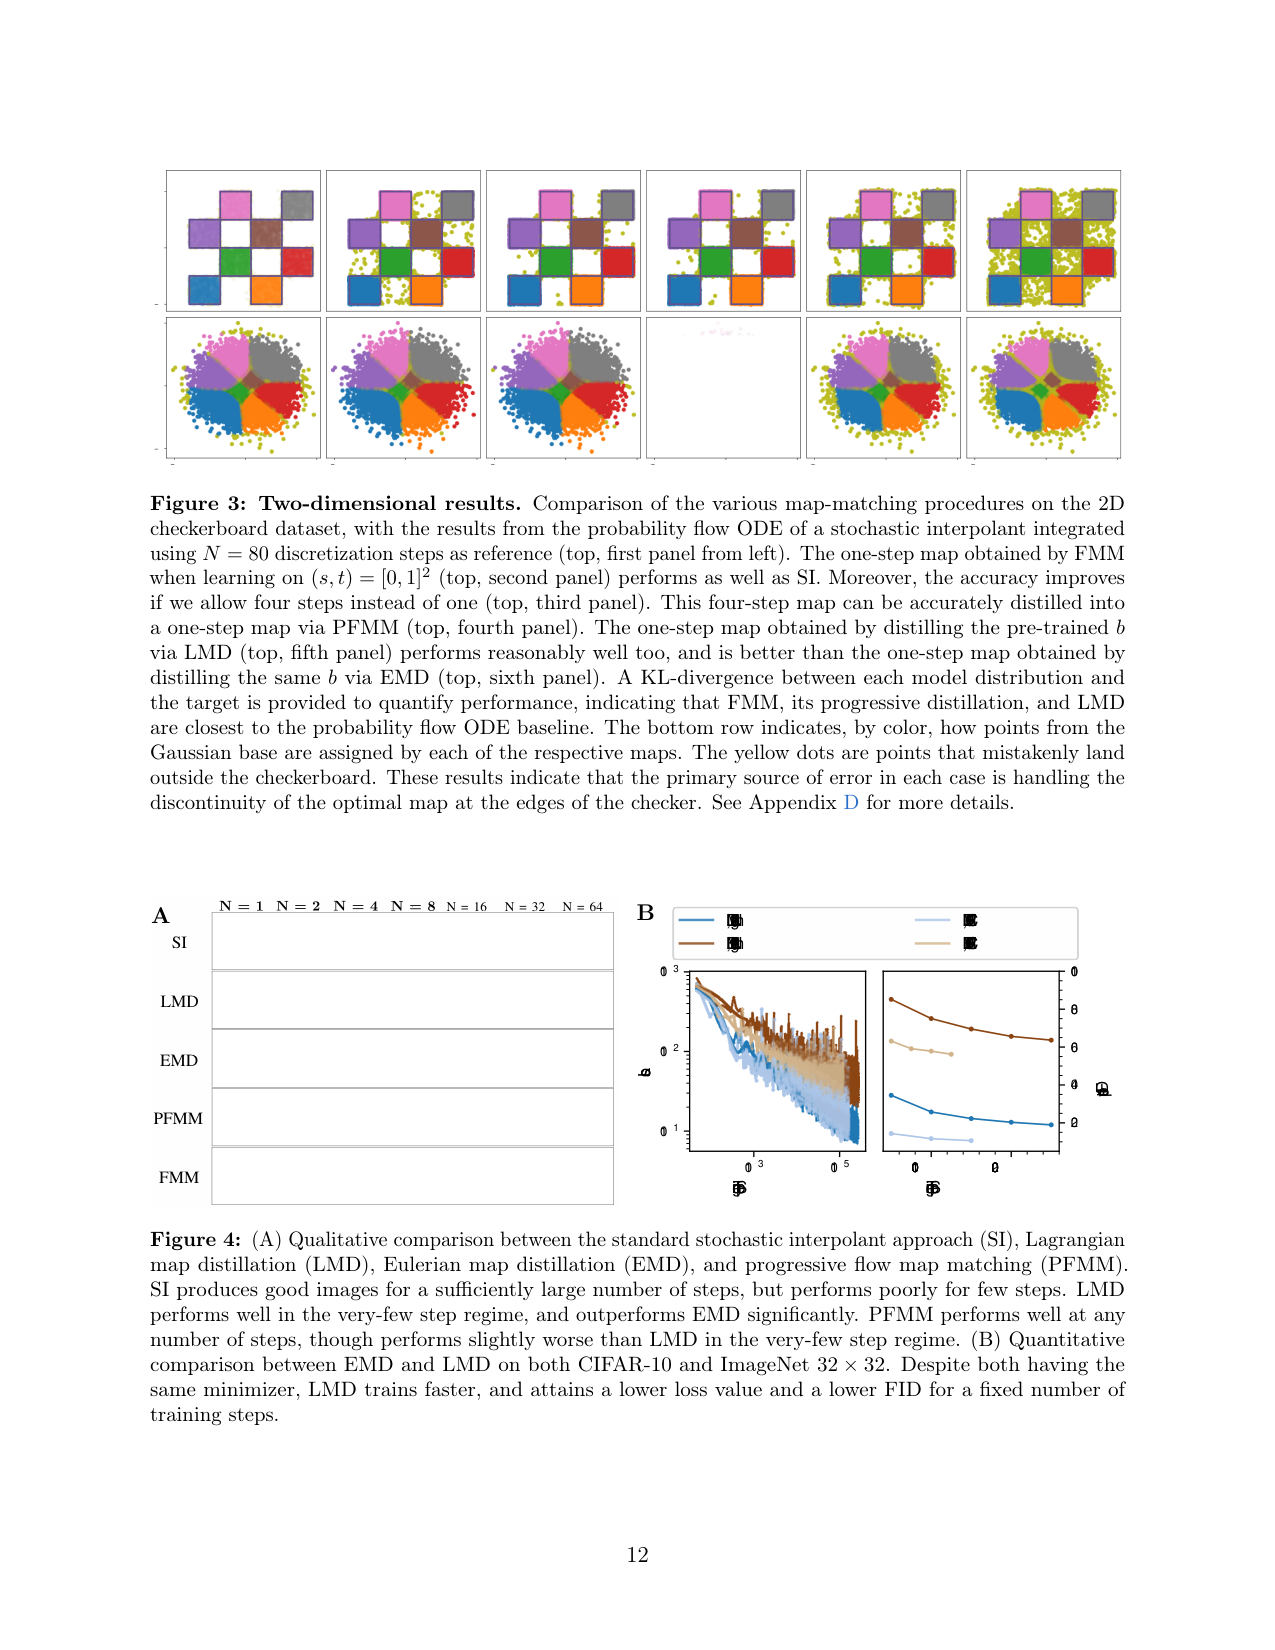
上面左半(Figure 3)就是这组 2×6 面板:上行各方法生成分布,下行颜色显示每个初始点被映射到哪、黄点是落出棋盘的样本。右半(Figure 4)进入图像实验。
5.2 CIFAR-10:LMD 几步就接近老师
图像实验用 OpenAI guided-diffusion 的 U-Net(channel 256),s、t 分别按原架构的 t 嵌入方式编码后拼接。老师在 CIFAR-10 上的基线 FID 是 5.53(自适应 RK5 求解器,对应几百次网络评估);PFMM 的老师是 |t−s|<0.25 训练的 8 步 FMM,FID 8.44。结果(表 1,FID / 括号内 T-FID):N=2 步时 SI 112.42、EMD 48.32(34.19)、LMD 7.13(1.27)、PFMM 18.35(7.02);N=4 步时 SI 34.84、EMD 44.35(30.74)、LMD 6.04(1.05)、PFMM 11.14(1.52)。T-FID 是学生样本与老师样本之间的 FID,用来剥离老师质量的影响——论文自承老师模型用有限算力训练。读法:LMD 用 4 步就把 FID 压到 6.04,逼近需要数百次评估的老师 5.53,而 SI 同样 4 步只有 34.84;EMD 加步数几乎不改善,印证了空间梯度带来的问题。
5.3 ImageNet-32:无蒸馏直接 FMM 也能打
在 ImageNet-32(128 万张 32×32 图)上,论文直接最小化 FMM 损失(无任何蒸馏)、权重取 |t−s| < 0.25、训练 1×10⁵ 步,得到少步 FID(表 2):N=4 时 16.90、N=6 时 14.48、N=8 时 12.61、N=20 时 9.68。对照是 DDPM(362.37 / 275.28 / 232.97 / 63.08)和 mini-batch OT 的 Flow Matching(38.86 / 22.08 / 15.64 / 7.71),后两列引自 Pooladian et al.。少步区(N≤8)FMM 明显低于两个对照;高步区 N=20 时 BatchOT 7.71 反超 FMM 9.68,论文注明高步区插值方法仍略优。这张表支持论文「无蒸馏也能直接学出有效少步映射」的主张。
5.4 LMD 与 EMD 的收敛差距
Figure 4B 画了两个数据集上 LMD 与 EMD 的训练 loss 和 1-step FID 随训练步数的曲线:两者有同一个全局极小(都是 0),但 LMD 的 loss 和 FID 都收敛快约一个数量级,CIFAR-10 与 ImageNet-32 一致。论文给的解释是 EMD 含空间梯度 ∇X̂,映射奇异处梯度无定义,训练信号不稳定;LMD 完全避开空间梯度。
5.5 一致性风格迁移
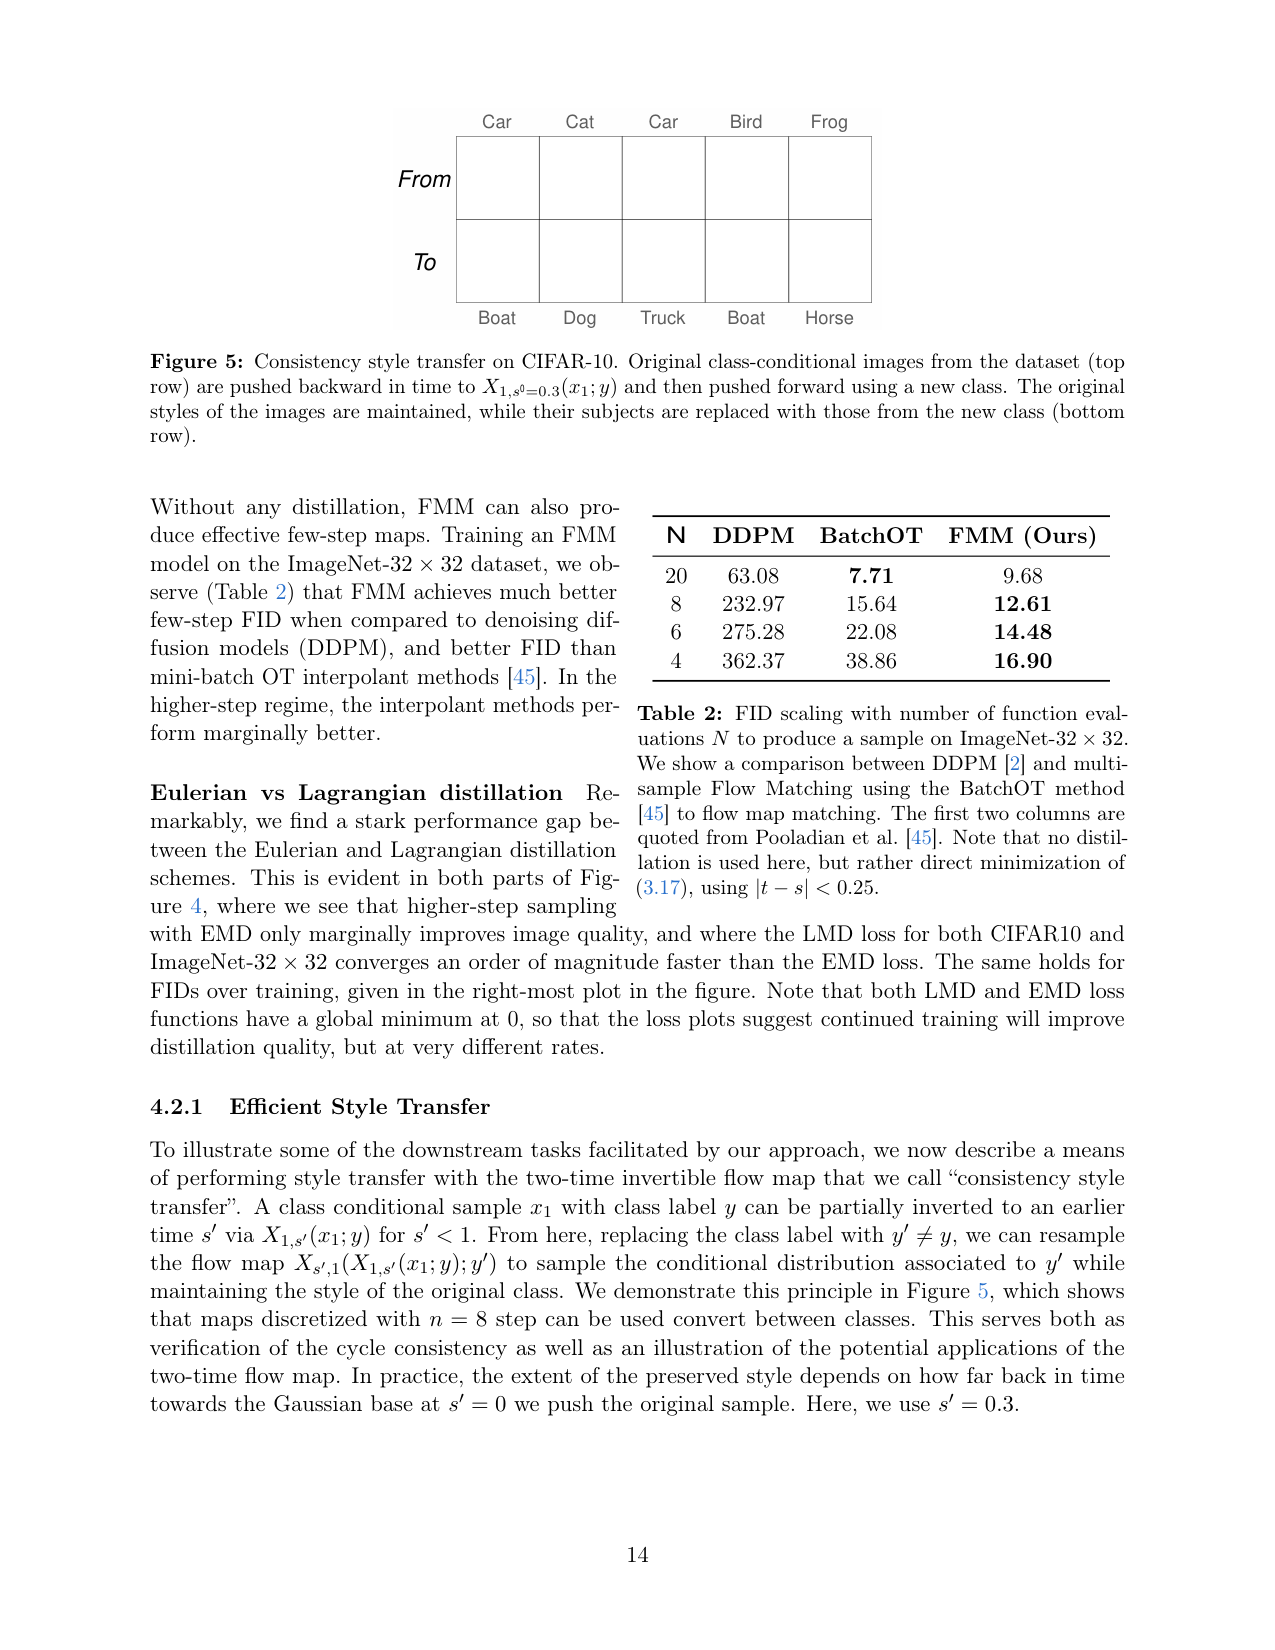
流地图的双向性带来一个附加应用:类别条件样本 x1 先沿 X_{1,s'}(x1; y) 推回噪声侧(s' = 0.3),换一个类别标签 y',再沿 X_{s',1}(·; y') 前推,n=8 步采样。Figure 5 展示 Car→Boat、Cat→Dog、Car→Truck、Bird→Boat、Frog→Horse:原图的风格(纹理、背景等)保留,主体换成新类别。保留多少风格取决于 s' 推回多远,这个演示顺带验证了循环一致性 X_{s,t}(X_{t,s}(x)) = x。
6. 与 MeanFlow 的对照
清单提示要求把 FMM 和 MeanFlow(arXiv 2505.13447)放在一起看,两者是同一想法的两种参数化。MeanFlow 的学习目标是平均速度 u(z_t, r, t),按定义是区间 [r,t] 上的位移除以区间长度:u = (X_{s,t}(x) − x)/(t−s)。FMM 学的是位移映射本身 X_{s,t},而它的参数化 X̂_{s,t}(x) = x + (t−s)·v^θ 把位移显式写成区间长度乘以网络输出 v^θ——代数上一眼可见,v^θ 正是「每单位时间的位移」,和平均速度的定义逐项对得上。换一种说法,FMM 的 v^θ 与 MeanFlow 的 u 学的是同一个量,差别在训练目标:FMM 用拉格朗日/欧拉方程加边界条件组织监督,支持 strip(|t−s| 受限)学多步、训练后自由调步数;MeanFlow 用 MeanFlow Identity(u = v − (t−r)·du/dt)把平均速度回归成瞬时速度与 JVP 的代数关系,主打一步采样。MeanFlow 论文还从边界条件角度补充了一个细节:直接参数化位移 S = (t−r)·u 需要显式约束 S|_{t=r} = 0,而参数化平均速度 u 时这个条件自动成立;FMM 的 ansatz x + (t−s)v^θ 恰好等价于后者。
7. 局限
第一,一步直接训练收敛困难,论文明确说这是实践中的挑战:全区间的一步 FMM 在棋盘上差于四步版本,实验里的单步模型几乎都来自 PFMM 蒸馏。第二,实验规模有限:只有 CIFAR-10 和 ImageNet-32 两张 32×32 小图数据集,没有高分辨率、文本到图像或视频验证,老师模型也是有限算力训练。第三,摘要里「生成时间减少 10–20 倍」是口径性表述,正文的支撑是少步 FID 与 NFE 减少,没有单独报墙钟时间。第四,欧拉式直接估计有偏,只能靠 stopgrad 拿临界点,稳定性没有保证。第五,理论的正则性假设(单边 Lipschitz)覆盖不了棋盘边缘这类不连续的最优映射,误差正集中在那里,处理靠训练技巧。最后,蒸馏路径(LMD/EMD)仍需要预训练速度场,完全自包含的 FMM 路径在 CIFAR-10 上论文没有给出无蒸馏数字(表 4 标注 N/A)。
8. 复现要点
论文未附官方代码仓库,图像实验基于 openai/guided-diffusion 的 U-Net,两时间嵌入为 s、t 分别嵌入后拼接。关键超参(表 4):两数据集均 batch 256、LR 1e-4、LR decay 0.992/1k epoch、U-Net channel 256、dim mult [1,2,2,2]、学习时间嵌入、4 GPU;训练步数 LMD 1.5×10⁵(CIFAR)/ 2.5×10⁵(ImageNet)、EMD 1.2×10⁵ / 2.5×10⁵、直接 FMM 1×10⁵(仅 ImageNet)、PFMM 1.3×10⁵(仅 CIFAR)。2D 实验是 512×6 MLP、Adam、5×10⁴ 迭代。
把 Flow Matching 的「瞬时速度」换成「两时间流地图」X_{s,t}:网络直接学从时刻 s 到 t 的整段位移映射,理论上精确、训练后步数可任意调整。论文给出四条训练路径——拉格朗日蒸馏 LMD、欧拉蒸馏 EMD(一致性蒸馏的连续时间极限)、无预训练速度场的直接训练 FMM、以及把 K 步并成一步的 PFMM,并证明 LMD/EMD 的损失控制 Wasserstein 距离。CIFAR-10 上 LMD 用 4 步拿到 FID 6.04(老师 SI 基线 5.53;同设置下 SI 本身要 34.84);ImageNet-32 上无蒸馏直接 FMM 在 N=4 时 FID 16.90(同 N 下 DDPM 362.37、BatchOT 38.86)。论文摘要口径:与 flow matching 质量相当、生成时间减少 10–20 倍(正文实验证据是少步 FID)。
阅读提示
精读深度:泛读
清单提示:原文提示:这是「直接学整段映射」的严格版;把它和 MeanFlow 的平均速度定义对照,能厘清二者是同一想法的不同参数化。
问题
要解决什么:扩散模型和 Flow Matching 采样时要数值求解概率流 ODE,通常要走几十到几百步,推理成本高;Consistency Models 用一致性约束做到单步或少步,但缺少系统性的数学框架,训练需要精细调超参和离散化课程。FMM 要补上这块地基:定义一个两时间流地图 X_{s,t},它把 ODE 从时刻 s 的任意点送到时刻 t 的点,学它会得到一台「理论上精确、步数训练后随便调」的积分器。
为什么 prior work 不够:瞬时速度场 b_t 只能描述「这一瞬间往哪走」,采样必须把无数个瞬间积分起来;Consistency Models 学的是单时间映射,天然享受不到多步采样带来的质量提升,训练还要靠精心设计的离散化课程;Consistency Trajectory Models 学了类似两时间的对象,但用了对抗训练损失,不稳定且难调;Progressive Distillation 把扩散模型的几步并一步,但对象是离散步进而非连续流地图。FMM 从拉格朗日/欧拉方程出发推导蒸馏损失,并给出不依赖预训练速度场的直接训练损失,把一致性、CTM、渐进蒸馏都收进同一个框架。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 插值点 I_t = α_t x0 + β_t x1 + γ_t z | 像素/潜向量(CIFAR-10 32×32、ImageNet-32 32×32) | stochastic interpolant:x0~ρ0 是基分布样本、x1~ρ1 是数据、z 是标准高斯噪声;系数满足 α0=β1=1、α1=β0=0、γ0=γ1=0。t=0 时 I_0=x0,t=1 时 I_1=x1。 |
| 时间对 (s, t) | 两个标量时间,t∈[0,1] | 网络要学的映射跨越任意区间 [s,t];s、t 按原 U-Net 的 t 嵌入方式各自编码后拼接。权重 w_{s,t} 决定学哪些区间:|t−s|<1/K 的 strip 只学短区间,K 步采样;w_{s,t}=1 学全区间,可单步 X_{0,1}。 |
| 类别标签 y(条件生成) | int(CIFAR-10 10 类 / ImageNet 类) | 风格迁移实验中用于「推回原类、换新类前推」。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 两时间流地图 X̂_{s,t}(x) = x + (t−s)v^θ_{s,t}(x) | 与输入同维的映射 | 网络输出速度场 v^θ,乘以区间长度 (t−s) 得到位移;ansatz 自动满足边界条件 X̂_{s,s}(x)=x。采样时 x1 = X̂_{0,1}(x0) 一步到位,或按 t0<... |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10 32×32 | 5×10⁴ 训练图 | U-Net channel 256、dim mult [1,2,2,2]、学习时间嵌入;batch 256、LR 1e-4、LR decay 0.992/1k epoch、4 GPU(表 4)。蒸馏路径:老师 SI FID 5.53(自适应 RK5 采样);PFMM 老师为 8 步 FMM(|t−s|<0.25)FID 8.44。 |
| ImageNet-32 32×32 | 1,281,167 训练图 | 同样 U-Net 配置;直接 FMM(无蒸馏)训练 1×10⁵ 步;DDPM 与 BatchOT 的 FID 数字引自 Pooladian et al.(2023)。 |
| 2D checkerboard(棋盘分布) | 合成分布 | 基分布为标准高斯、目标为紧支撑的不连续棋盘密度;MLP 512 隐单元×6 层,Adam,5×10⁴ 迭代。 |
架构(摘要)
主干与结构
backbone:U-Net(OpenAI guided-diffusion 实现)用于图像;MLP 512 隐单元×6 层用于 2D
参数:未报告总参数量
类型:两时间流地图网络:输出 v^θ_{s,t}(x),映射按 ansatz X̂_{s,t}(x)=x+(t−s)v^θ_{s,t}(x) 组装;时间条件把 s、t 分别嵌入后拼接,当作原架构的 t 使用
关键组件
- X̂_{s,t} 的 t 偏导 ∂t X̂ 用前向模式自动微分计算,与 X̂ 同一次前向求得(LMD/FMM 的监督信号)
- ∇X̂ 用 Jacobian-vector product(JVP)计算(EMD 的监督信号)
- FMM 直接训练时嵌套调用 X̂_{s,t}(X̂_{t,s}(I_t)):先逆推再前推,两项损失同一次前向得到
- 边界条件由 ansatz 自动满足:t=s 时 X̂_{s,s}(x)=x
为什么这样设计
学整段映射需要一个「任意区间」的对象,网络必须同时吃 s 和 t 两个时间;把位移显式写成 (t−s)v^θ 既保证边界条件,也让「每单位时间的位移」(即平均速度)从网络输出里直接读出来。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 2 步生成 FID(蒸馏路径) | LMD 7.13(T-FID 1.27) | 同 N=2 下 SI 112.42、EMD 48.32(T-FID 34.19)、PFMM 18.35(T-FID 7.02);老师 SI 基线 FID 5.53(自适应 RK5) | U-Net channel 256、batch 256、LR 1e-4、4 GPU;LMD/EMD 老师为 SI(FID 5.53),PFMM 老师为 8 步 FMM(FID 8.44,|t−s|<0.25);训练步数 LMD 1.5×10⁵、EMD 1.2×10⁵、PFMM 1.3×10⁵ |
| CIFAR-10 4 步生成 FID | LMD 6.04(T-FID 1.05),接近老师 5.53 | 同 N=4 下 SI 34.84、EMD 44.35(T-FID 30.74)、PFMM 11.14(T-FID 1.52) | 同上设置;LMD 用 4 步就基本追平需要自适应求解器(数百次评估)的 SI 老师 |
| ImageNet-32 少步 FID(无蒸馏直接 FMM) | N=4 时 16.90;N=8 时 12.61;N=20 时 9.68 | DDPM:362.37 / 232.97 / 63.08;BatchOT:38.86 / 15.64 / 7.71(DDPM 与 BatchOT 两列引自 Pooladian et al.,仅 FMM 为本工作训练) | 直接最小化 (3.17)、|t−s|<0.25、1×10⁵ 训练步、batch 256、4 GPU;N=20 时 BatchOT 7.71 反超 FMM 9.68,论文注明高步区插值方法略优 |
| LMD vs EMD 收敛速度 | LMD 的 loss 与 1-step FID 在 CIFAR-10 和 ImageNet-32 上都收敛快约一个数量级 | EMD 同设置同老师;两损失有同一个全局极小(0),差异在收敛速率 | 图 4B 曲线:横轴训练步(10¹–10⁵),纵轴 loss 与 1-step FID;两数据集各自独立训练 |
| 2D 棋盘分布 DKL(图上标注) | FMM(N=4) 0.008 最优;PFMM(N=1) 0.01;FMM(N=1) 0.017;LMD(N=1) 0.033;EMD(N=1) 0.082 | SI 用 N=80 步积分作为参考,图上 DKL 0.016;直接学 [0,1]² 全区间的一步 FMM(0.017)差于 |t−s|<0.25 的四步 FMM(0.008) | MLP 512 隐单元×6 层、Adam、5×10⁴ 迭代;DKL 为图上小字,论文正文未逐项重述 |
| 生成时间减少 10–20 倍(摘要口径) | 论文摘要:质量与 flow matching 相当、生成时间减少 10–20 倍 | 对比对象为 flow matching(SI)用自适应求解器的采样成本 | 该表述出现在 Abstract;正文的支撑证据是 CIFAR-10/ImageNet-32 的少步 FID 与 NFE 减少,没有单独报告墙钟时间对比 |
Insights
- 步数变成训练后的自由参数:合成律 X_{t,τ}∘X_{s,t}=X_{s,τ} 保证任何时间划分下『小步复合 = 大步』,所以同一个网络既能单步也能多步,精度与速度的权衡在推理时调,训练时不用重来。
- 拉格朗日 vs 欧拉视角的差距:两个损失有同一个全局极小(都是真流地图),但 EMD 含空间梯度 ∇X̂,在最优映射奇异(如棋盘边缘)处梯度无定义,导致收敛慢、图像发糊;LMD 避开空间梯度,实践中快约一个数量级。
- 直接训练的关键是把『整段映射』变成可仿真的回归:FMM 用 X̂_{t,s}(I_t) 把插值点逆推回起点再前推,两项监督(导数匹配 + 循环可逆)同一次前向得到;欧拉式的直接估计(用 İ 替代 b)因二次项破坏 tower property 而有偏,只能靠 stopgrad 拿到临界点。
- 一步生成的实际路线依赖蒸馏:论文明确说直接学一步映射收敛困难,实际配置是 |t−s|<0.25 的 strip 学到 K 步、再用 PFMM 蒸馏成一步——『一步』是渐进合并的产物。
- 双向映射的副产品是风格迁移:X_{1,s'}(x1;y) 把样本推回噪声侧再换标签前推,就能换主体保风格,顺带验证了循环一致性。
vs 同类工作
- vs Consistency Models(Song et al.):CM 学单时间映射,多步采样没有增益,训练要靠离散化课程;FMM 学两时间映射,多步采样自然受益。附录 C 把一致性蒸馏写成 EMD 的连续时间极限,CM/CTM 成为框架的特例。
- vs Consistency Trajectory Models(CTM):CTM 也学两时间映射,但用含对抗训练的损失;FMM 用拉格朗日/欧拉方程直接推导的回归损失,没有对抗环节。
- vs Progressive Distillation / Neural Operator:PD 把扩散模型离散的几步并一步,蒸馏对象是步进;FMM 的 PFMM 是同一思想在连续流地图上的版本,且可直接从 (3.17) 训练出的老师出发。
- vs MeanFlow(arXiv 2505.13447):MeanFlow 定义平均速度 u=(X_{s,t}(x)−x)/(t−s) 作为学习目标,FMM 直接学位移映射 X_{s,t};FMM 的参数化 X_{s,t}(x)=x+(t−s)v^θ 与平均速度定义代数同构,二者是同一想法的两种参数化。区别在训练目标:FMM 用拉格朗日/欧拉方程加边界条件、支持 strip 学多步再调步;MeanFlow 用 MeanFlow Identity(u = v − (t−r)du/dt)回归平均速度、主打一步。MeanFlow 论文另指出:直接参数化位移 S 需显式边界条件 S|_{t=r}=0,参数化平均速度 u 时该条件自动成立。
局限
- 一步直接训练收敛困难(论文自承 'directly learning a one-step map to be challenging in practice'):全区间 [0,1]² 的一步 FMM 在棋盘上差于 |t−s|<0.25 的四步版本;实验里的单步模型几乎都来自 PFMM 蒸馏,『一步生成』卖点实际依赖两阶段流程。
- 实验规模有限:只有 CIFAR-10 与 ImageNet-32(32×32 小图),没有 ≥256px 分辨率、text-to-image 或视频验证;老师模型用有限算力训练(论文自承 limited compute),因此引入 T-FID 来剥离老师质量的影响。
- 10–20 倍提速是摘要口径:正文没有直接报告墙钟时间对比,支撑证据是少步 FID 与 NFE 减少;ImageNet-32 上 N=20 时 BatchOT(7.71)反而反超 FMM(9.68),高步区插值方法仍占优。
- 欧拉式直接估计有偏(3.6 节):用 İ 替代 b 后二次项 E[|İ_s·∇X̂|²] 不满足 tower property,只能靠 stopgrad 得到临界点,论文自承难以保证该临界点稳定、损失不再单调下降;CM 系列用同样技巧也面临此问题。
- 理论依赖正则性假设(Assumption 3.3 单边 Lipschitz),而最优映射在棋盘边缘不连续:所有方法的误差都集中在边缘(Figure 3 黄点),对奇异映射的处理靠训练技巧,理论没有覆盖。
- 蒸馏路径(LMD/EMD)仍需要预训练速度场 b;完全自包含的路径只有直接训练 FMM/PFMM,而这条路径在 CIFAR-10 上论文只给出 PFMM 蒸馏结果,没有无蒸馏 FMM 的 CIFAR 数字(表 4 中 FMM 在 CIFAR 行标注 N/A)。
可复现性
- code:论文未附官方代码仓库;图像实验基于 OpenAI guided-diffusion 的 U-Net(github.com/openai/guided-diffusion),两时间嵌入为 s、t 分别嵌入后拼接
- weights:未发布
- setup:表 4 超参:CIFAR-10 5×10⁴ 图、ImageNet-32 1,281,167 图、batch 256、LR 1e-4、LR decay 0.992/1k epoch、U-Net channel 256、dim mult [1,2,2,2]、学习时间嵌入、4 GPU;训练步数:LMD 1.5×10⁵(CIFAR)/2.5×10⁵(ImageNet)、EMD 1.2×10⁵/2.5×10⁵、FMM 1×10⁵(ImageNet)、PFMM 1.3×10⁵(CIFAR);2D 实验 MLP 512×6、Adam、5×10⁴ 迭代
主干与结构
backbone:U-Net(OpenAI guided-diffusion 实现)用于图像;MLP 512 隐单元×6 层用于 2D
参数:未报告总参数量
类型:两时间流地图网络:输出 v^θ_{s,t}(x),映射按 ansatz X̂_{s,t}(x)=x+(t−s)v^θ_{s,t}(x) 组装;时间条件把 s、t 分别嵌入后拼接,当作原架构的 t 使用
关键组件
- X̂_{s,t} 的 t 偏导 ∂t X̂ 用前向模式自动微分计算,与 X̂ 同一次前向求得(LMD/FMM 的监督信号)
- ∇X̂ 用 Jacobian-vector product(JVP)计算(EMD 的监督信号)
- FMM 直接训练时嵌套调用 X̂_{s,t}(X̂_{t,s}(I_t)):先逆推再前推,两项损失同一次前向得到
- 边界条件由 ansatz 自动满足:t=s 时 X̂_{s,s}(x)=x
为什么这样设计
学整段映射需要一个「任意区间」的对象,网络必须同时吃 s 和 t 两个时间;把位移显式写成 (t−s)v^θ 既保证边界条件,也让「每单位时间的位移」(即平均速度)从网络输出里直接读出来。
方法总览:两时间流地图 X_{s,t} 与合成律
原文 caption:Our approach learns the two-time flow map Xs,t that transports the solution of an ordinary differential equation from time s to time t. Unlike methods that learn instantaneous velocity fields, this bidirectional map can be used to build an integrator with arbitrary discretization. The integrator is exact in theory, and its number of steps can be adjusted post-training to balance accuracy and computational efficiency.
时间轴 0→s→τ→1 上方标着分段复合箭头 X_{0,s}、X_{s,τ}∘X_{0,s}、X_{τ,1}∘X_{s,τ}∘X_{0,s},下方一条整体大弧箭头 X_{0,1},另配反向箭头表示可逆。读法:把「瞬时速度的数值积分」换成「一段映射」——任意相邻两段拼起来等于一整段(合成律),所以大步小步自洽,步数训练后随便调;X_{0,1} 一步就从噪声直达数据,X_{1,s} 则把样本推回噪声侧。这张图确立全文的核心对象与『训练后调步数』的卖点。
2D 棋盘对比(Figure 3)+ 图像实验定性定量(Figure 4)
原文 caption:Figure 3: Two-dimensional results. Comparison of the various map-matching procedures on the 2D checkerboard dataset, with the results from the probability flow ODE of a stochastic interpolant integrated using N=80 discretization steps as reference... Figure 4: (A) Qualitative comparison between SI, LMD, EMD, and PFMM. (B) Quantitative comparison between EMD and LMD on both CIFAR-10 and ImageNet 32×32.
Figure 3 是 2 行×6 列面板:上行依次为 SI(N=80 参考)、FMM(N=1)、FMM(N=4)、PFMM(N=1)、LMD(N=1)、EMD(N=1),各面板标注 DKL(0.016 / 0.017 / 0.008 / 0.01 / 0.033 / 0.082);下行用颜色显示每个初始点被映射到哪里,黄点代表落到棋盘外的点。读法:FMM 学 4 步(DKL 0.008)比直接学 1 步(0.017)好,PFMM 能把 4 步蒸馏成 1 步(0.01),LMD(0.033)明显优于 EMD(0.082);误差集中在棋盘边缘的不连续处。Figure 4A 是 SI/LMD/EMD/PFMM 在 N=16/32/64 步下的生成图像对比,LMD 在极少步下质量最好;4B 画 LMD 与 EMD 的训练 loss 与 1-step FID 曲线,两图都显示 LMD 收敛快约一个数量级。
一致性风格迁移(Figure 5)+ ImageNet-32 少步 FID(Table 2)
原文 caption:Figure 5: Consistency style transfer on CIFAR-10. Original class-conditional images (top row) are pushed backward in time to X1,s'=0.3(x1; y) and then pushed forward using a new class... Table 2: FID scaling with number of function evaluations N to produce a sample on ImageNet-32×32.
Figure 5 展示流地图的双向用途:把类别条件样本沿 X_{1,0.3}(·;y) 推回噪声侧再换标签 y' 沿 X_{0.3,1}(·;y') 前推(n=8 步),Car→Boat、Cat→Dog、Car→Truck、Bird→Boat、Frog→Horse,保留原图风格、替换主体,同时验证循环一致性。Table 2 列无蒸馏直接 FMM 在 N=4/6/8/20 步的 FID(16.90 / 14.48 / 12.61 / 9.68),对照 DDPM(362.37 / 275.28 / 232.97 / 63.08)与 BatchOT(38.86 / 22.08 / 15.64 / 7.71,后两列引自 Pooladian et al.)。读法:少步区(N≤8)FMM 明显优于两个对照,高步区(N=20)BatchOT 7.71 反超 FMM 9.68。
🎧 音频版
时长 26:10 · Edge TTS
Flow Map Matching:直接学整段映射(对话版·泛读)
这篇解决什么问题,为什么专门做一期
小播:老播,今天这篇论文解决什么问题?
老播:这篇是 Flow Map Matching,纽约大学 Courant 数学研究所的 Boffi、Albergo 和 Vanden-Eijnden 写的,2025 年发表在 TMLR。一句话背景:扩散模型和 Flow Matching 生成图片,要沿着一条轨迹把噪声变成数据,这条轨迹在数学上是一个常微分方程,采样等于数值求解它,通常要走几十到几百步,每步一次神经网络前向,推理成本很高。这篇的定位:给一类叫 Consistency Models 的快速生成方法补一个系统的数学框架,核心对象是一个叫「两时间流地图」的东西。它主要的贡献在理论:把一致性方法统一起来,再给出不靠老师也能直接训练的目标。
小播:所以它要回答的核心问题是什么?
老播:把「学瞬时速度」换成「学整段映射」:网络直接学从时刻 s 到时刻 t 的整段位移,理论上精确,训练完以后用几步采样可以随便调。一句话预告:CIFAR-10 上它的 LMD 方法用 4 步拿到 FID 6.04,而老师模型用自适应求解器(相当于几百次评估)是 5.53;同设置下普通 Flow Matching 4 步只有 34.84。另外,清单里特别要求对照 MeanFlow——这两篇其实是同一个想法的两种参数化,这期会把这段关系讲透,也把 FMM 到底比「学速度」强在哪讲清楚。
先补背景:采样为什么这么贵
小播:先补背景吧,为什么生成一张图要解微分方程?
老播:扩散模型和 Flow Matching 的思路,是把生成看成「把一个分布搬运到另一个分布」。数据在一边,高斯噪声在另一边,中间造一条插值路径把它们连起来。这篇用的是 stochastic interpolant(随机插值)框架:定义 I_t = α_t x0 + β_t x1 + γ_t z,其中 x0 是噪声样本、x1 是数据样本、z 是额外的标准高斯噪声,系数设计成 t=0 时 I_0 等于噪声、t=1 时 I_1 等于数据。拿最常见的直线插值举例:α_t = 1−t、β_t = t、γ_t = 0,那么 I_t = (1−t)·x0 + t·x1,对 t 求导得到 İ_t = x1 − x0,就是从数据指向噪声的向量。
小播:这个导数就是网络要学的东西?
老播:对,但要先做一步平均。同一个中间点 I_t 可以由很多不同的 (x0, x1) 配对产生,每个配对给的导数不一样;把所有可能配对的导数按概率求条件期望,得到速度场 b_t(x) = E[İ_t | I_t = x]——给定一个中间点,「这个点平均该往哪走」。Flow Matching 训练网络回归这个速度场,监督信号就是插值路径自己的导数 İ_t,采样时从纯噪声出发,沿着速度场一步一步走回数据侧。问题就在这里:速度场只描述「这一刻朝哪个方向走」,要得到整条轨迹,必须把无数个「这一刻」积分起来。步数越多越接近真实轨迹,但每步一次网络前向;步数少,弯曲的轨迹就被直线切线近似带偏。所以采样成本高,根源在「瞬时速度」这个对象本身。
小播:这跟扩散模型的 score 有什么关系?
老播:插值框架把扩散模型也收进去了:取 α_t = 0、β_t = t、γ_t = √(1−t²),就对应方差保持(VP)扩散,噪声 z 显式出现在插值里,速度场等价于对 score 的一个重参数化;取 α_t = 1−t、β_t = t、γ_t = 0,就是 rectified flow 和 Flow Matching 的标准设置。论文的理论对所有这些特例都成立,所以它能同时覆盖扩散和流两类模型,后面「EMD 是一致性蒸馏的连续时间极限」这个结论,也依赖这个统一性。
小播:Consistency Models 不是已经在做少步生成了吗?怎么还缺框架?
老播:Consistency Models(一致性模型)确实做到了单步或少步:它要求同一条轨迹上不同时刻的网络输出指向同一个终点,这个约束让一次网络输出直接跳到终点。它实践很成功,但缺一个理论框架:一致性是强加在「网络行为」上的约束,底层那条真实映射长什么样、损失为什么这样设计,缺少系统解释;训练要精细调离散化课程和超参。FMM 做的事情,就是把一致性、一致性轨迹模型、渐进蒸馏这些方法统一到一个「两时间流地图」的框架里,每一项都有明确的数学依据;一致性在这里被重新解释成流地图的合成性质,不需要额外拍脑袋加约束。
核心思想:学整段映射,步数训练后随便调
小播:核心对象「两时间流地图」是什么?
老播:对概率流 ODE 定义流地图 X_{s,t}:给定时刻 s 的任意点,沿着 ODE 走到时刻 t,落到的位置记为 X_{s,t}(x)。X_{s,t} 是一段映射,从 s 到 t 的整段位移都在里面;反过来 X_{t,s} 是它的逆。它满足拉格朗日方程:∂t X_{s,t}(x) = b_t(X_{s,t}(x)),且 X_{s,s}(x) = x,把映射对终点 t 求导,等于映射所在位置的速度场,「拉格朗日」的意思是参照系跟着轨迹一起动。还有一个合成律:X_{t,τ}(X_{s,t}(x)) = X_{s,τ}(x),先走 [s,t] 再走 [t,τ],等价于直接走 [s,τ]。
小播:这个合成律为什么重要?
老播:它保证了「大步等于小步的复合」。同一个网络,把 [0,1] 分成 K 段逐步走,和直接走一步 X_{0,1},在理论上完全等价(实际网络只是近似满足合成律,所以多步通常更准)。于是步数变成训练之后的自由参数:想要质量,多分几步;想要速度,用 X_{0,1} 一步到位,同一套权重直接换采样方式,不用重新训练。举个数:如果你训练时把权重 w_{s,t} 设成 1,学的是全区间所有映射,那采样时既可以 X_{0,1}(x0) 一步出图,也可以切成 8 步慢慢走;如果你只学 |t−s| < 0.25 的短步,采样时可以把每段再细分,步数只能往多里走。这是 FMM 相对「学瞬时速度」的核心差别:瞬时速度要积分,流地图已经把整段位移打包好了。学整段映射、训练后任意调步数,是全文的主线,后面实验里会反复看到它。
小播:网络怎么输出一个「映射」?图像维度那么高。
老播:论文用了一个很干净的参数化:X̂_{s,t}(x) = x + (t−s)·v^θ_{s,t}(x)。网络输出速度场 v^θ,乘上区间长度 (t−s) 就是位移。这个形式自动满足边界条件 X̂_{s,s}(x) = x,因为 t=s 时括号里是零;同时 v^θ 直接读作「每单位时间的位移」,这个细节到 MeanFlow 对照那里还要用。网络要同时吃两个时间 s 和 t,做法是把它们各自按原 U-Net 的时间嵌入方式编码,再拼起来。
小播:前面两次出现「拉格朗日」「欧拉」,这两个词什么意思?
老播:是描述同一张映射的两种视角。拉格朗日视角跟着轨迹走:∂t X_{s,t}(x) = b_t(X_{s,t}(x)),说的是「我这条轨迹走到哪,速度就是那一点的速度场」,参照系是移动的粒子;欧拉视角站在固定空间点上:∂s X_{s,t}(x) + b_s(x)·∇X_{s,t}(x) = 0,说的是「固定住终点 t 看,起点 s 往回调时,经过固定点 x 的轨迹怎么变」,参照系是固定的空间。两个方程各自推出一个蒸馏损失:LMD 来自拉格朗日方程,EMD 来自欧拉方程。后面的实验会看到,同一个真映射,从两个视角学,难度差得很多。
小播:那怎么训练它?总得有个监督信号。
老播:论文给了四条路径,分两类。第一类是蒸馏,前提是有预训练速度场 b。拉格朗日蒸馏损失 LMD:E[|∂t X̂_{s,t}(I_s) − b_t(X̂_{s,t}(I_s))|²],惩罚学生映射的切向速度与老师速度场不一致,∂t X̂ 是映射对终点求偏导,I_s 是插值点,期望遍历所有时间对和数据噪声配对。第二个是欧拉蒸馏损失 EMD:E[|∂s X̂_{s,t}(I_s) + b_s(I_s)·∇X̂_{s,t}(I_s)|²],固定空间点对起点求导,∇X̂ 是雅可比,用 JVP 算。论文证明 EMD 在扩散模型设置下恰好是一致性蒸馏的连续时间极限。
小播:为什么损失为零,映射就一定是正确的?
老播:因为拉格朗日方程的解唯一:给定速度场 b 和起点,ODE 的轨迹是确定的,所以同时满足方程和边界条件 X_{s,s}(x)=x 的映射,有且只有真流地图一个。损失是方程残差的平方期望,为零当且仅当学生满足方程,学生就等于真映射。这就是论文说「理论精确」的依据:正确性来自方程的唯一解,不靠启发式约束。
小播:损失有理论保证吗,还是纯经验?
老播:有。论文证明 LMD 和 EMD 都控制学生分布与老师分布之间的 Wasserstein 距离:W²₂(ρ1, ρ̂1) ≤ e^{1+2∫₀¹|C_t|dt}·L_LMD。这里 ρ1 是老师流地图从噪声推出来的目标密度,ρ̂1 是学生推出来的分布,C_t 是速度场满足单边 Lipschitz 假设的常数;EMD 那边是 W²₂(ρ1, ρ̂1) ≤ e¹·L_EMD,不依赖 Lipschitz 常数。意思是损失压到足够小,学生生成的分布就保证贴近老师,这条链路是有数学依据的。不过 EMD 的界虽然漂亮,损失里却带着空间梯度 ∇X̂,后面实验会看到它因此吃亏。
小播:第二类路径呢?
老播:第二类是直接训练,不需要老师。FMM 损失有两项:第一项 E[|∂t X̂_{s,t}(X̂_{t,s}(I_t)) − İ_t|²],把插值点 I_t 先用反向映射 X̂_{t,s} 送回起点,再让正向映射把它送到 t 时刻,要求这条合成轨迹的切向速度等于 İ_t;第二项 E[|X̂_{s,t}(X̂_{t,s}(I_t)) − I_t|²],要求合成回来的点还原成 I_t,这是循环可逆性。两项在同一次前向里算出来。这里有个关键约束:权重必须对称 w_{t,s} = w_{s,t},因为要同时学正反两个方向;选 w = 1 学全区间,就能一步 X_{0,1}。给个具体的小例子帮落地:取一对 (x0, x1),x1 是数据、x0 是噪声,t = 0.5 时 I_t 是两者的加权混合。FMM 的流程是先把 I_t 用反向映射 X̂_{0.5,0} 送回 0 附近,再让正向映射 X̂_{0,0.5} 把它推回 0.5:第二项要求推回来的点还原成 I_t,第一项要求这个来回轨迹在 0.5 处的切向速度等于 İ_t。两端点对不上或者方向不对,都会扣分,网络被迫学会整段路程怎么走。
小播:权重 w_{s,t} 除了对称,还有什么讲究?
老播:它决定你学哪些时间区间。设成 1 是学全区间,一步 X_{0,1} 就能生成;设成 |t−s| < 1/K,只在 (s,t) 平面上对角线附近的一条带子里取权重(论文 Figure 2 的示意图画的就是这条 strip),学到的每段映射都短、都好学,采样时走 K 步。带子越窄越好学,但步数越不能少——这是「训练后调步数」的另一个旋钮:调宽带子换速度,调窄换精度。
小播:为什么不能直接把 EMD 里的速度场换成 İ_t 来做直接训练?这样省事多了。
老播:问得好,论文专门讲了这个坑。把 b_s(I_s) 换成 İ_s 之后,展开期望:交叉项是 İ_s 的线性函数,可以用 tower property(条件期望的塔性质)把 İ_s 换成它的条件期望 b_s(I_s);但二次项 E[|İ_s·∇X̂|²] 没法这样处理,它和 E[|b_s·∇X̂|²] 一般不相等。条件期望对非线性函数不保真,所以这个直接目标的最小值点会对不上真流地图。Consistency Models 的做法是给二次项加 stopgrad(切断梯度),论文证明这样得到的不动点正确,但损失不再保证单调下降,稳定性没有理论保证——这算是对 CM 训练困难的一个理论解释。
小播:还有第四条路径?
老播:对,PFMM,渐进流地图匹配。实验里发现直接学一步映射收敛困难,所以先学 K 步:权重取 |t−s| < 1/K 的 strip,只学短区间,采样时走 K 步;然后再蒸馏成一步,学生一步的输出要等于老师连续复合 K−1 次的输出。可以递归做,每次步数减半,类似渐进蒸馏。这条路径在后面实验里是「单步模型」的真正来源,先记住这一点,讲局限时还会回到它。
看实验:从棋盘到 CIFAR-10 再到 ImageNet-32
小播:先看最简单的情况?
老播:2D 棋盘分布。把二维标准高斯搬到棋盘形状的目标:紧支撑、边缘不连续,对映射是个苛刻测试。网络是 512 隐单元 6 层的 MLP,Adam 优化器,训练 5×10⁴ 次迭代。参考是普通随机插值用 N=80 步数值积分的结果,图上 DKL 0.016。直接学全区间一步的 FMM 是 0.017,学四步的 FMM 降到 0.008,是所有方法里最低;PFMM 把四步蒸馏成一步拿到 0.01;蒸馏路径里 LMD 一步 0.033,EMD 一步 0.082。两个结论:直接学整段映射可行,四步明显好于一步,印证了一步难学;LMD 明显好于 EMD。读图方法说一下:Figure 3 是 2 行 6 列的面板,上行是各方法生成的棋盘密度,越接近标准棋盘越好;下行把基分布的每个初始点按它被映射到的位置着色,黄点代表落出棋盘的样本,整张图没有黄点才算干净。FMM 四步和 PFMM 一步的面板最干净,EMD 的棋盘边缘最糊。图上落出棋盘的黄点集中在边缘,误差主要来自最优映射在边缘的不连续。
小播:CIFAR-10 上的数字呢?
老播:图像实验用 U-Net,channel 256,s 和 t 分别嵌入后拼接。老师在 CIFAR-10 的基线 FID 是 5.53,用自适应 RK5 求解器采样,相当于几百次网络评估。表 1 的结果:2 步时,普通 SI 是 112.42,EMD 是 48.32,PFMM 是 18.35,LMD 是 7.13;4 步时,SI 34.84,EMD 44.35,PFMM 11.14,LMD 6.04。LMD 用 4 步就逼近老师 5.53,而 SI 4 步只有 34.84。表里还有个 T-FID,是学生样本和老师样本之间的 FID,用来剥离老师质量的影响,因为论文自承老师模型用有限算力训练。这里顺带说一个术语:NFE 指 number of function evaluations,网络评估次数,少步方法比的核心就是它。SI 老师用自适应求解器拿到 FID 5.53,代价是每张图几百次网络评估;LMD 用 4 次就逼近这个水平。补充一句 FID 是什么:它衡量生成样本分布和真实数据分布的距离,越低越好,是生成模型的标准指标。训练配置上,CIFAR-10 用 batch 256、学习率 1e-4、4 块 GPU,LMD 训练 1.5×10⁵ 步、EMD 1.2×10⁵ 步、PFMM 1.3×10⁵ 步。核心结论再强调一遍:学整段映射之后,几步就能接近老师几十几百步的水平。
小播:ImageNet-32 呢?那个是 128 万张图的数据集。
老播:ImageNet-32 上论文用的是无蒸馏的直接 FMM,权重 |t−s| < 0.25,训练 1×10⁵ 步。少步 FID:N=4 时 16.90,N=6 时 14.48,N=8 时 12.61,N=20 时 9.68。对照是 DDPM 和 mini-batch OT 的 Flow Matching,后两列引自 Pooladian et al.:N=4 时 DDPM 362.37、BatchOT 38.86;N=8 时 DDPM 232.97、BatchOT 15.64;N=20 时 DDPM 63.08、BatchOT 7.71。少步区 FMM 明显低于两个对照,但 N=20 时 BatchOT 的 7.71 反超了 FMM 的 9.68——高步区插值方法仍略优,论文自己承认这点。这张表的意义在于:无蒸馏、直接从零训练,FMM 也能拿到有效的少步生成器。
小播:LMD 和 EMD 的差距,在图像上还成立吗?
老播:成立,论文画了曲线,就是 Figure 4 的右半部分:横轴是训练步数,纵轴一个是 loss、一个是 1-step FID。左半部分是定性对比:普通 SI 在 N=16、32、64 步下,少步时图片明显发糊,步数加多才清晰;LMD 用 1 到 4 步就有可用质量;PFMM 在各步数都稳定;EMD 加步数改善很小。两个损失有同一个全局极小(都是零,对应真流地图),但 LMD 的 loss 和 1-step FID 在 CIFAR-10 和 ImageNet-32 上都收敛快约一个数量级。解释是 EMD 含空间梯度 ∇X̂:最优映射奇异的地方梯度没有定义,训练信号不稳定;LMD 完全不碰空间梯度,所以更稳。
小播:风格迁移那段是什么?好像挺有意思。
老播:那是流地图双向性的副产品,论文叫一致性风格迁移。类别条件样本 x1 先沿 X_{1,s'}(x1; y) 推回噪声侧,s' = 0.3,换一个类别标签 y',再沿 X_{s',1}(·; y') 前推,8 步采样。Figure 5 里 Car→Boat、Cat→Dog、Car→Truck、Bird→Boat、Frog→Horse,原图的纹理和背景风格保留,主体换成新类别。保留多少风格取决于 s' 推回多远,推得越深主体换得越彻底、风格保得越少。为什么能保风格?因为 X_{1,0.3} 只把图片往回推了一小段,离数据侧还近,样本里大部分结构和纹理信息都还在;换标签后再推回来,这些残留结构就作为「风格」被保留下来。这个演示也顺带验证了循环一致性:能推回去再推回来,说明正反向映射是自洽的。
谱系定位:它和 Consistency、MeanFlow 是什么关系
小播:把它放回谱系里,和谁最近?
老播:最近的是 Consistency Models:CM 学单时间映射,多步采样没有增益,训练要靠离散化课程;FMM 学两时间映射,多步采样自然受益,附录把一致性蒸馏写成 EMD 的连续时间极限。CTM 也学两时间映射,但用对抗训练损失,FMM 用回归损失。渐进蒸馏把扩散模型的离散步进并成一步,FMM 的 PFMM 是它在连续流地图上的版本。最后是清单考点 MeanFlow:MeanFlow 定义平均速度 u = (X_{s,t}(x) − x)/(t−s),也就是位移除以区间长度,作为学习目标;FMM 直接学位移映射 X_{s,t},而它的参数化 x + (t−s)v^θ 里,v^θ 恰好就是「每单位时间的位移」。两个网络学的代数对象是同一个量,区别在训练目标:FMM 用拉格朗日/欧拉方程加边界条件组织监督,支持 strip 学多步、训练后调步数;MeanFlow 用 MeanFlow Identity 把平均速度表达成瞬时速度和 JVP 的关系,主打一步。MeanFlow 论文还指出:直接参数化位移需要显式边界条件,参数化平均速度时边界条件自动成立,FMM 的 ansatz 正好落在后者上。把这段话压缩成一句结论:FMM 直接回归整段位移映射,MeanFlow 回归整段平均速度,前者除以区间长度、后者乘上区间长度,就是同一个对象——同一想法,两种参数化,区别在监督信号怎么组织。
局限:别把摘要当全部
小播:说了这么多,弱点在哪?
老播:第一,一步直接训练收敛困难,论文原话是实践中很有挑战:全区间一步 FMM 在棋盘上差于四步版本,实验里的单步模型几乎都来自 PFMM 蒸馏,「一步」卖点实际依赖两阶段流程,前面让先记住这一点,现在用上了。第二,实验规模有限:只有 CIFAR-10 和 ImageNet-32 两张 32×32 小图,没有高分辨率、文本到图像或视频验证,老师模型也是有限算力训练。第三,摘要说「生成时间减少 10–20 倍」是口径性表述,正文支撑是少步 FID 和 NFE 减少,没有单独报墙钟时间;而且 N=20 时 BatchOT 反超 FMM。第四,欧拉式直接估计有偏,只能靠 stopgrad 拿临界点,稳定性没有保证。第五,理论的正则性假设覆盖不了棋盘边缘那种不连续映射,误差正集中在那里。最后,蒸馏路径仍需要预训练速度场,完全自包含的 FMM 路径在 CIFAR-10 上没有无蒸馏数字。另外复现门槛偏高:论文没有放官方代码仓库,图像实验基于 OpenAI guided-diffusion 的 U-Net 自己改两时间嵌入,超参都在表 4,但缺少现成实现,跑起来要自己拼装。
收尾:记住这三件事
小播:总结一下,这期要记住哪三件事?
老播:第一,学习对象是整段映射,采样时不再逐步积分瞬时速度:X_{s,t} 把一段位移打包,合成律保证大步等于小步复合,训练后步数随便调,这是 FMM 的核心。第二,数字上它确实有效:CIFAR-10 上 LMD 4 步 FID 6.04,逼近老师 5.53,同设置 SI 只有 34.84;ImageNet-32 无蒸馏直接 FMM 在 N=4 时 16.90,低于 DDPM 的 362.37 和 BatchOT 的 38.86。第三,它和 MeanFlow 是同一想法的两种参数化:FMM 直接学位移映射,MeanFlow 学平均速度,代数上对应同一个量,区别在训练目标。这篇的意义在于给一致性方法一个理论地基,同时证明了直接学整段映射这条路走得通——虽然一步还要靠蒸馏,但框架本身把步数从「训练时定死」变成了「推理时选择」。