UNITE:把 tokenizer 和生成模型合并进同一个网络(泛读)
问题与背景
现代 latent diffusion(潜在扩散)图像生成走的是两段式管线。第一段训练一个 autoencoder 当 tokenizer:编码器把图像压缩成紧凑的 latent,解码器从 latent 还原图像,训练目标通常包含重建损失和对抗损失(GAN loss),后者用一个判别器逼迫还原结果更真实。第二段把这个 tokenizer 冻结,在它的 latent 空间上训练一个扩散或 flow 去噪器做生成。这个分工看起来合理:重建要求 latent 保留实例信息,生成要求 latent 分布好采样。代价是生成任务的梯度永远流不回 tokenizer,表示空间长什么样完全由重建目标说了算。
这套管线背后是一个老问题——「表示从哪来」。过去十年的主要答案有两个来源:一是重建目标,autoencoder 一路练下来,latent 里存的主要是可还原的像素级信息;二是外部自监督教师,DINOv2 这类模型用自蒸馏在几十亿张图上练出语义表示,REPA、RAE 等方法把扩散模型的中间特征往 DINOv2 上对齐,等于把表示从外部借来。两条路都有额外成本:前者把生成和表示学习切开,后者依赖昂贵的预训练组件,还加深了管线分段。VAE 本来是「一个模型同时管重建和生成」的早期答案,用 KL 项把 latent 分布拽向高斯先验,但高斯先验采样质量有限,现代做法换上学出来的去噪器当先验,却又退回了两段式。
核心思想:tokenization 和 generation 是同一个推断问题
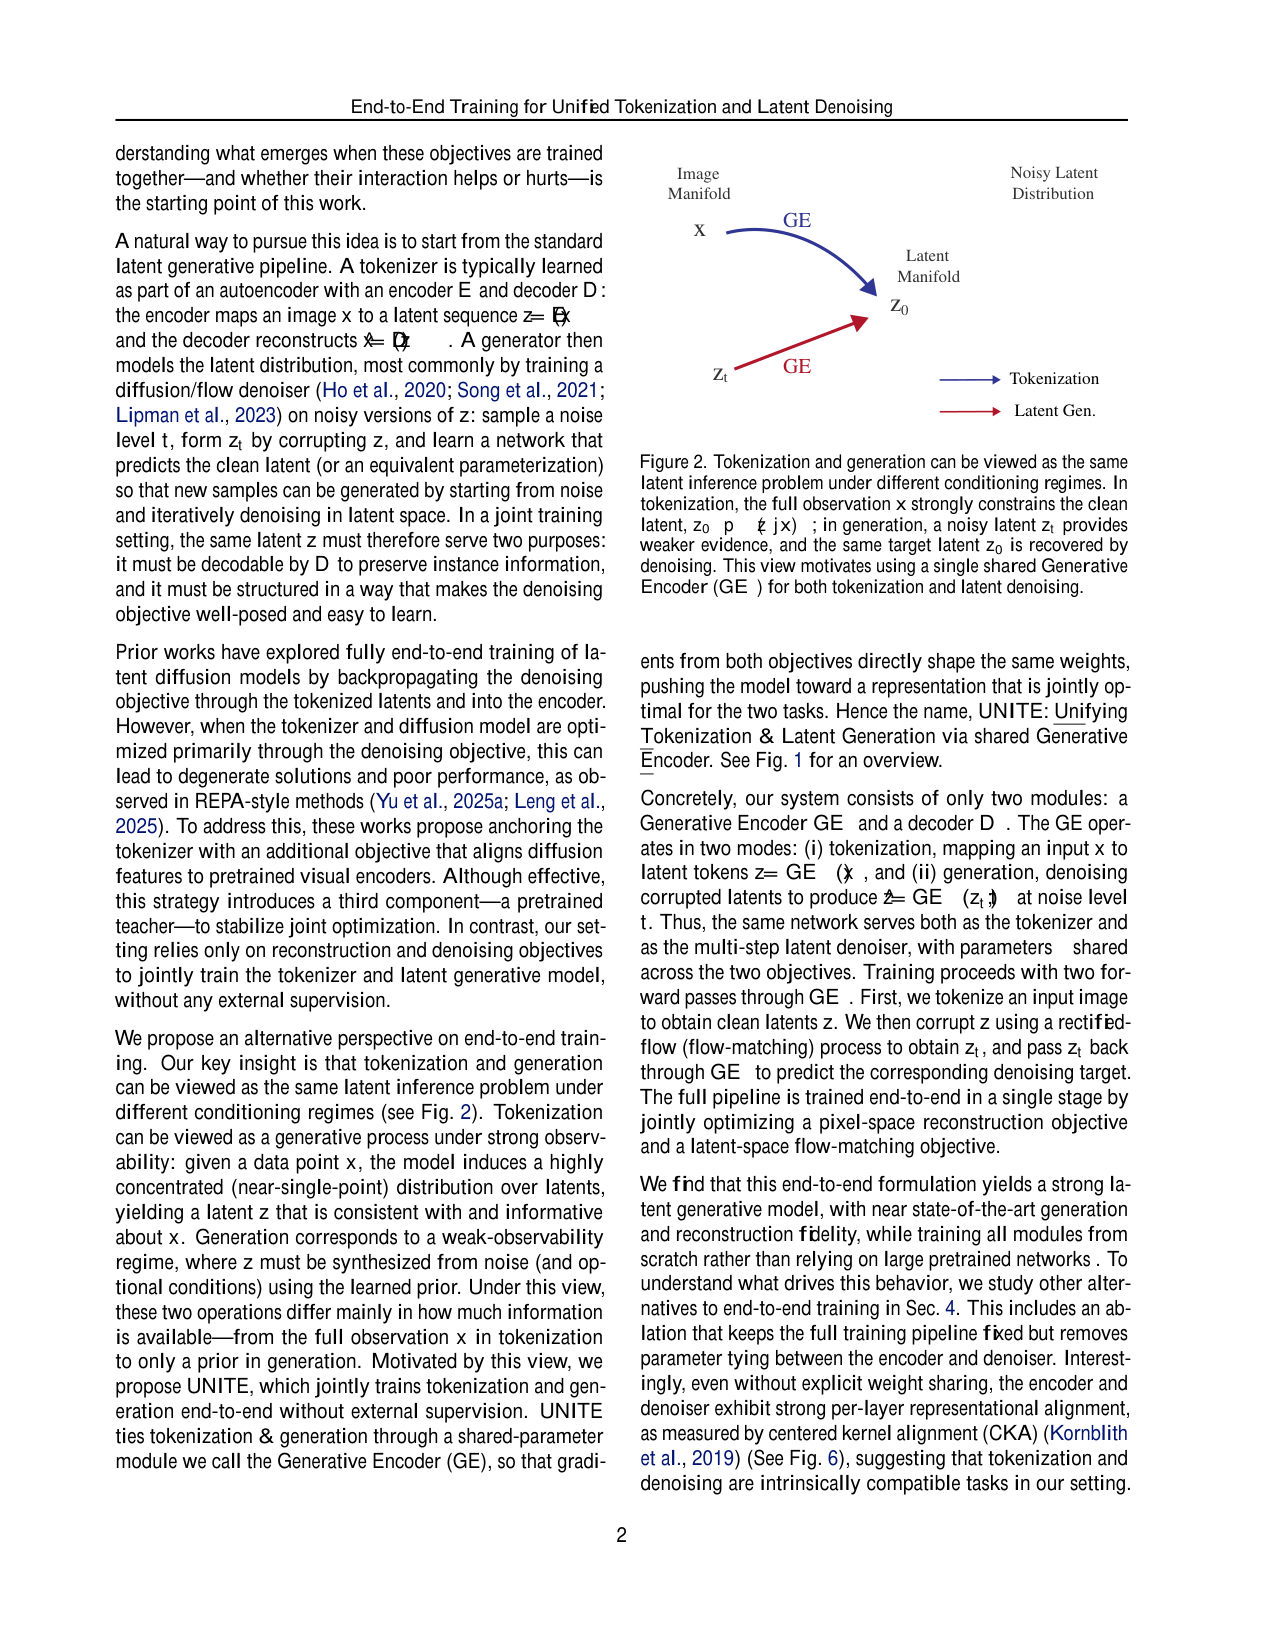
UNITE 的出发点是:tokenization 和 generation 可以看成同一个潜变量推断问题,区别只在可观测信息有多少。tokenization 是强观测:手里有完整图像 x,推断出一个集中、和 x 一致的 latent z0;generation 是弱观测:手里只有带噪 latent z_t 和时间 t,要恢复同一个目标 z0。既然追的是同一个 z0,两个角色共用一套参数就有了根据。下图是论文对这套观点的图示:两条路径指向同一个 latent 目标,区别只是观测强弱。
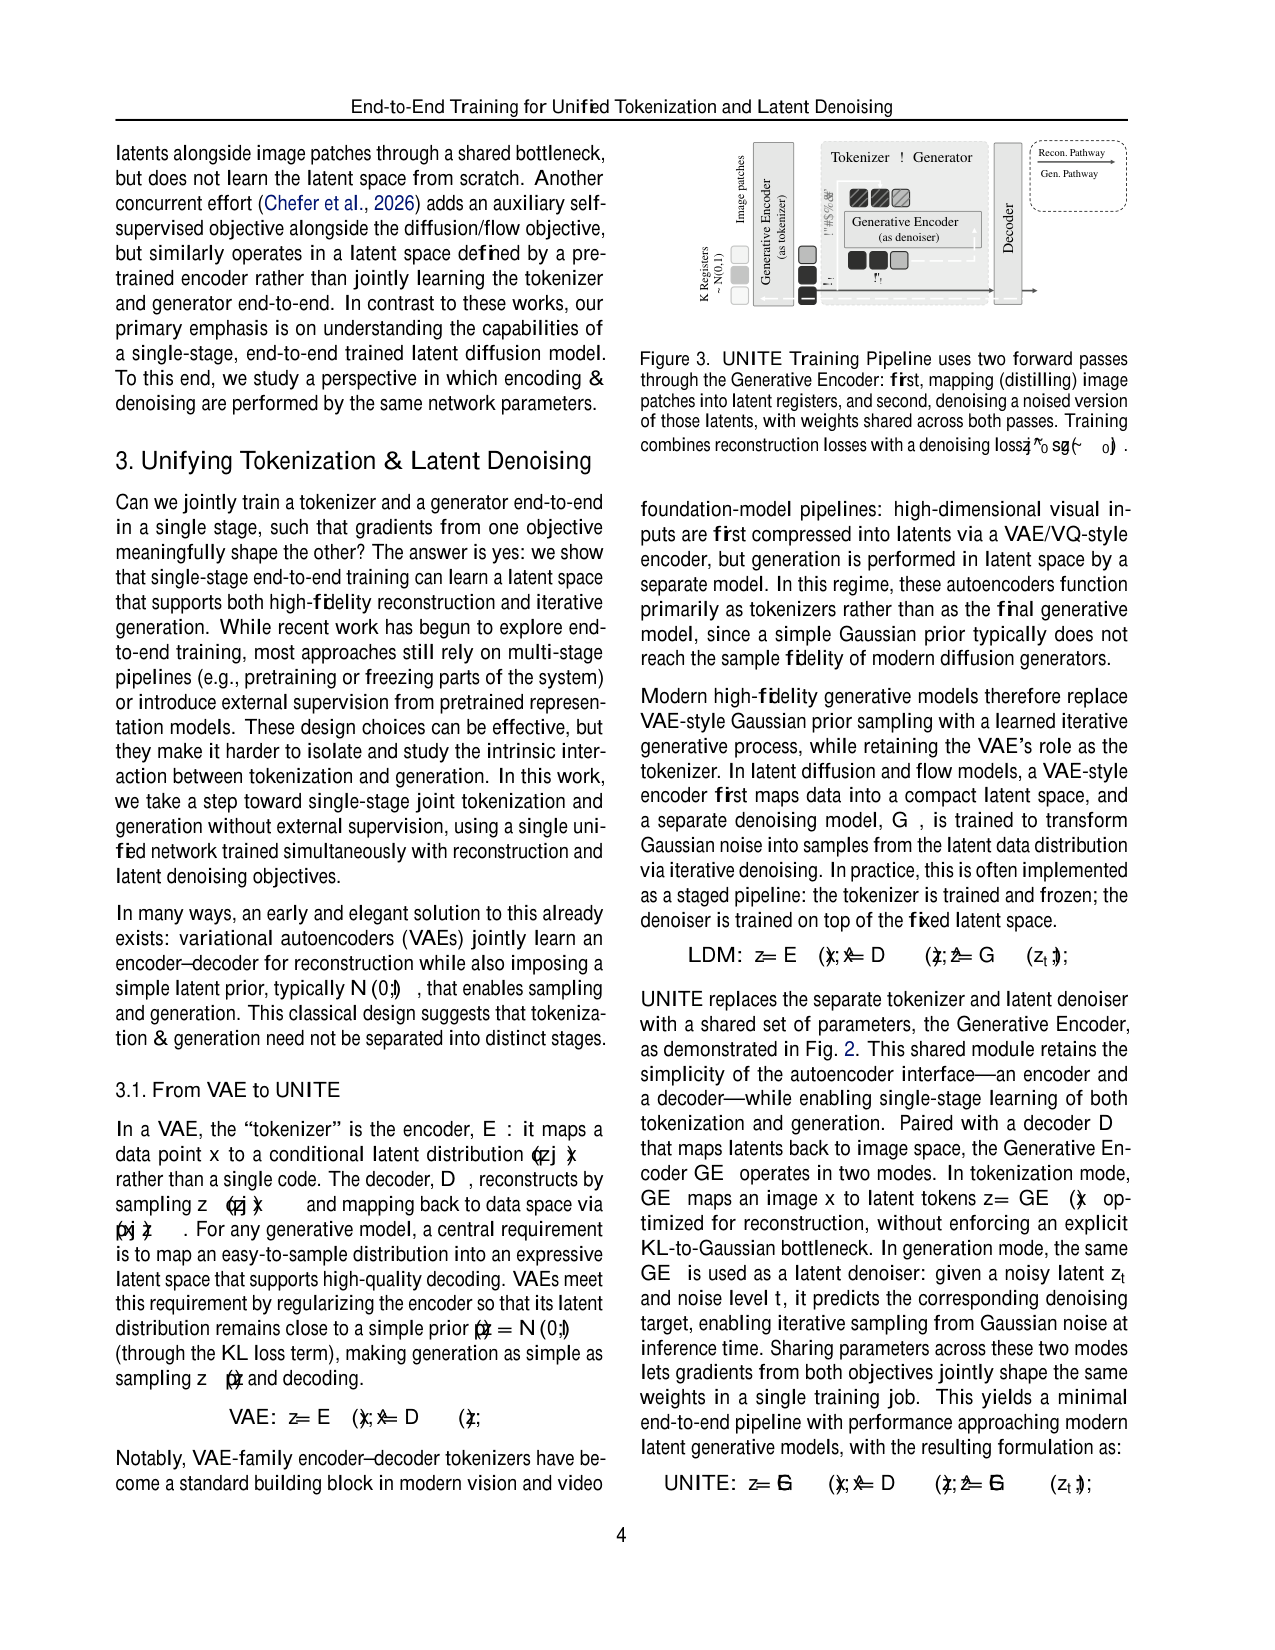
具体实现靠「register token」机制。latent 被定义成固定 K 个 register token:一组位置固定的向量,初始化为标准高斯噪声 N(0,1)。tokenization 模式下,图像切成 patch、投影成 patch token,与 K 个 register 拼起来过 self-attention(让序列里每个 token 参考其它 token 的信息更新自己),注意力让 register 吸收 patch 的信息,然后丢掉 patch,剩下的 register 就是图像的 latent z0。generation 模式下,直接把带噪 latent 塞进这 K 个 register,配合时间 t 和类别条件,预测干净 latent。register 初始化为 N(0,1) 有个讲究:它正好等于 rectified flow 在最大噪声时刻 t=0 时的输入分布,两个模式的输入域一致,网络不需要猜输入从哪条路进来。
训练是单阶段的,一次迭代做两次前向。第一次走 tokenization 路径:z0 = GE(x),解码前给 z0 注入尺度 σ=0.7 的小噪声再重建,损失 L_recon = ‖x̂ − x‖₁ + LPIPS(x̂, x),第一项是逐像素 L1 距离,第二项是用预训练 VGG 特征算的感知距离;注入噪声是为了防止解码器过拟合无噪声码,这是 RAE、REPA 验证过的正则做法。第二次走 generation 路径:先构造带噪 latent z_t = t·z0 + (1−t)·ε,其中 ε∼N(0,I)、t∼U[0,1],t=1 对应干净数据、t=0 对应纯噪声,这是 rectified flow 的标准线性插值加噪;GE(z_t, t) 预测干净 latent ẑ0,损失 L_flow = E‖ẑ0 − sg(z0)‖₂²,即预测与停梯度(stop-gradient)的干净 latent 的均方误差。总损失是两者相加,一次反向更新同一套权重。下图画的就是这条单阶段管线:上面是重建路径,下面是去噪路径,中间是共同更新的共享权重。
两个目标一起优化会出现「对抗式」的训练动力学:重建压力把 latent 往信息密集推,生成压力惩罚脆弱表示、把 latent 往抗噪推,两个方向互相拉扯。论文观察到 FID 在变好时 denoising loss 可能反而上升(Figure 4),解释是 latent 变丰富让去噪变难、但样本更真实。所以训练的目标是找到稳定平衡点,把两个损失压到零反而坏事。stop-gradient 也是一个关键设计:构造 z_t 用的 z0 不参与梯度回传。权重共享下保留它最优(gFID 2.12 / rFID 1.1),去掉会让两路径末层对齐变差;而拆开权重时去掉 stop-gradient 反而变好(gFID/rFID 2.60/1.30 → 2.24/0.85),说明「是否需要直接梯度路径」和「是否共享权重」绑在一起。
推理时,GE 当 tokenizer 用就是一次前向出 z0、解码器还原图;当生成器用就从高斯噪声初始化 register,带类别标签迭代去噪,配合 classifier-free guidance(CFG)在 [0.1, 1.0] 的时间区间解概率流 ODE,约 108 次网络评估出一张 256×256 的图——生成器就是一个迭代版本的 tokenizer。
关键结果
ImageNet 256×256 生成:UNITE-B(217M 参数)FID 2.12,压过单阶段像素基线 JiT-B/16(131M,3.66)和两阶段 DiT-XL/2(675M+49M,2.27)、SiT-XL/2(675M+49M,2.06);UNITE-L(589M)到 1.73。协议统一为:50K 生成样本、每类 50 张 class-balanced 采样、dopri5 求解器、CFG 从 1.0 扫到 4.0 取最好值。论文特别注明 class-balanced 采样比均匀随机采样低约 0.1,跨论文比绝对值要小心。
ImageNet 256×256 重建:UNITE-B 的 rFID 1.01(无对抗、无预训练编码器、120 epoch),对照同设置无对抗的 ViTok-B/16 stage-1 是 1.63;解码器单独做 16 epoch 的 GAN 微调后 rFID 0.51,超过 SD-VAE 的 0.62 和 RAE 的 0.58(VA-VAE 0.28 仍更低,它用了对抗+DINOv2)。权重共享消融:拆开权重后 rFID 恶化到 1.38。
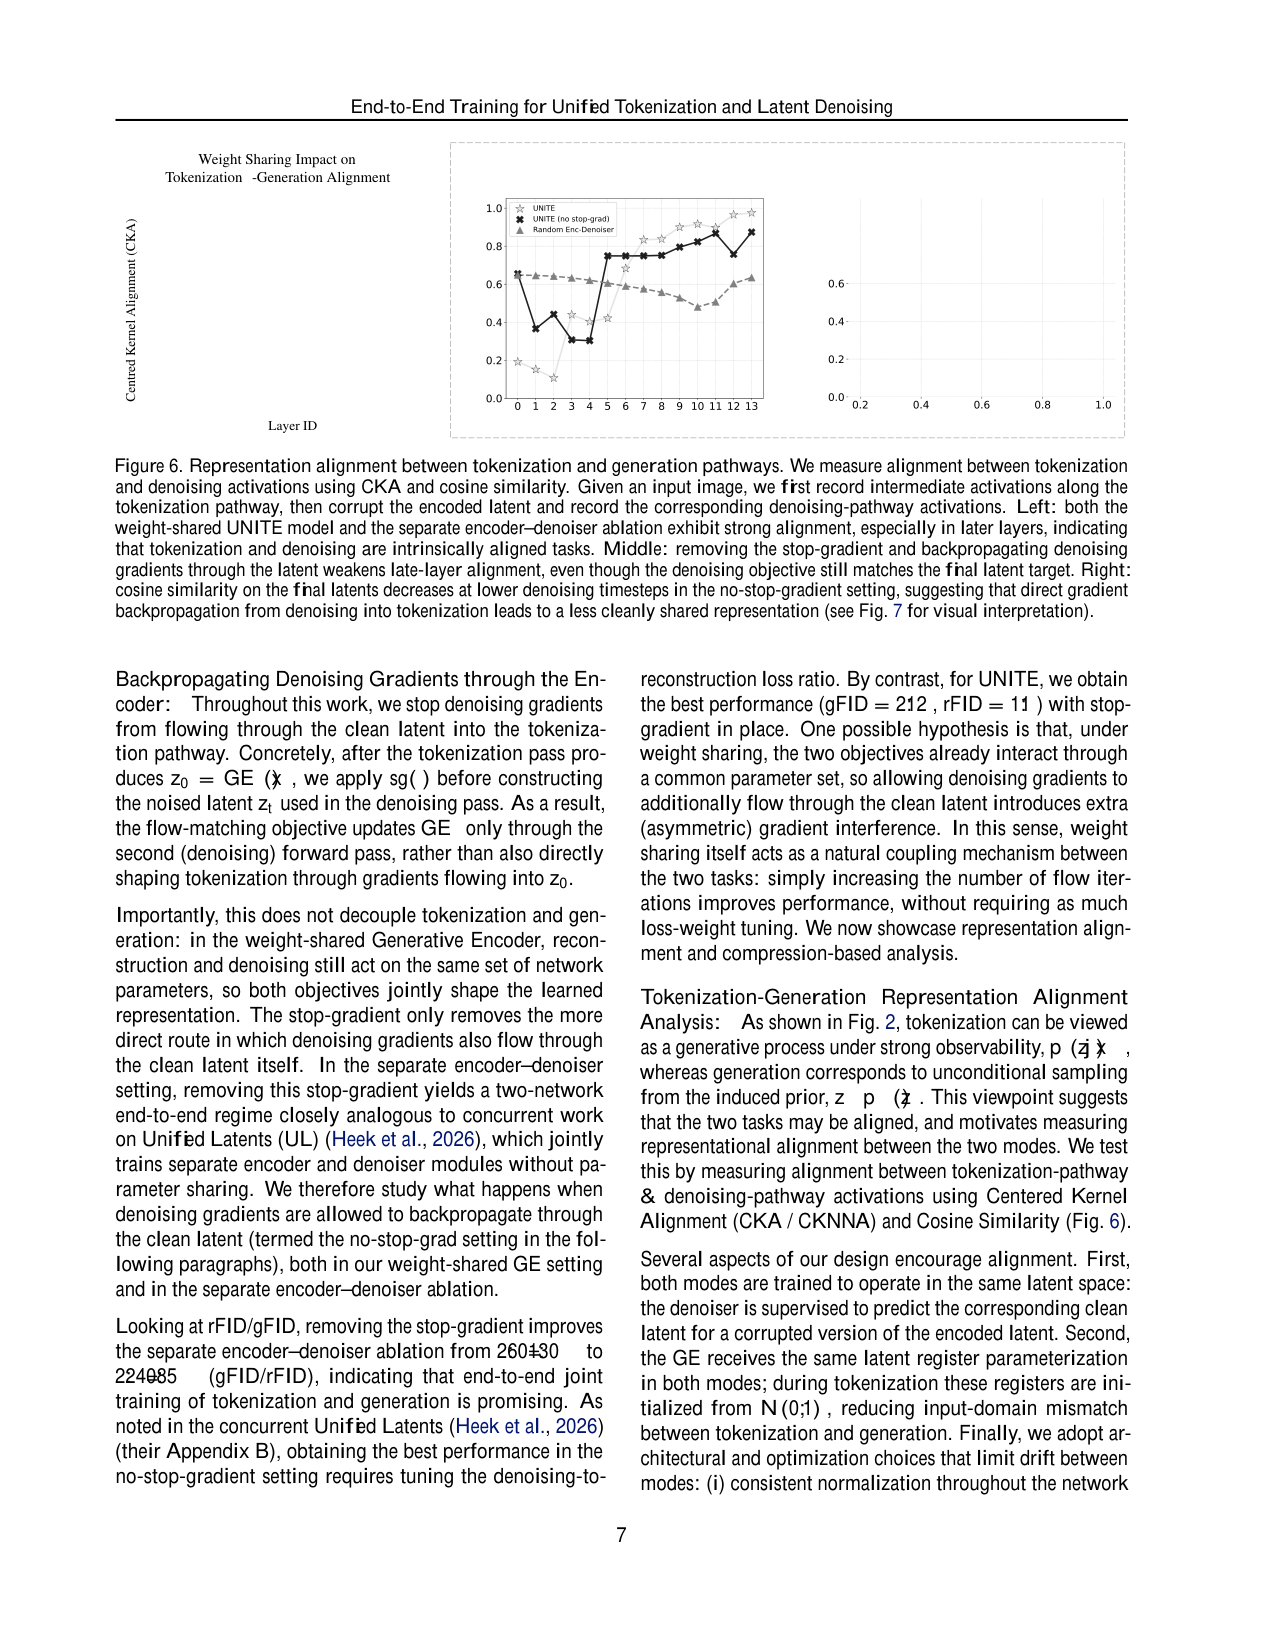
表示对齐与压缩分析:CKA(centered kernel alignment,衡量两层激活相似度的指标)显示 tokenization 与 generation 两路径靠后层对齐度很高,权重共享版和拆开版都如此;去掉 stop-gradient 会降低末层对齐。用张量直方图熵估描述长度:共享模型的 attention/MLP 功能参数熵几乎不变(拆开版 91.2 MB 对共享版 90.8 MB),差异集中在归一化参数(30.7 MB 升到 42.0 MB,正好等于拆开版去噪器的 42.0 MB)——两个模式主要靠归一化和尺度区分,主力计算被复用。下图是 CKA 对齐证据:左图两条线在高层的相似度都接近 1,中图显示去掉 stop-gradient 后末层对齐下降。
跨模态(分子/晶体):QM9 上没有 DINO 级预训练编码器,UNITE-S(DiT-S 约 33M、16 维 latent,约 20:1 压缩,单阶段 8000 epoch)重建匹配率 99.37%、RMSD 0.039 Å,对照 ADiT 两阶段 tokenizer 的 97.20%、0.075 Å;生成有效率 94.90%、唯一率 99.71%,对照 ADiT 的 96.02%、97.76%。MP20 晶体上整体有效率 87.9%,低于 ADiT 联合版的 91.9%。
效率:UNITE-B 120 epoch 约 6.7×10^20 FLOPs,与 DiT-XL/2 的 6.4×10^20 相当,参数从 724M 降到 217M;同时免掉 DINOv2 训练约 27000 个 A100-GPU 小时的固定开销。
谱系定位
UNITE 站在「表示从哪来」这条问题线上:REPA/RAE 的答案是从外部 SSL 教师借表示,Unified Latents(Heek 等 2026)是端到端训两个独立网络、最好数字还要第二阶段扩散微调,JiT 是像素空间从零单阶段但拿不出可复用 tokenizer。UNITE 的答案是从零、单阶段、权重共享:表示由重建和去噪两个压力在同一个网络里共同塑造,既要保得住实例信息、又要扛得住噪声扰动,不需要外部教师。
局限
- 判别能力有限:linear probing(在冻结 latent 上训线性分类器测表示质量)准确率约 30%,与 VAE/VQGAN 同级;作者建议改用 VLM 评测,但论文没做。
复现
代码开源在 https://github.com/ShivamDuggal4/UNITE-tokenization-generation ,项目页 https://xingjianbai.com/unite-tokenization-generation/ 。训练配置(Muon、batch 1024、240 epoch、重建噪声 0.7、调度 shift 0.5、flow mini-batch 14、CFG 扫描等)在论文附录完整给出;ImageNet 需要 LPIPS 用的 VGG,分子实验不需要。论文未明确说明是否发布预训练权重。
把 tokenizer 和 latent 去噪器合并成一个权重共享的 Generative Encoder,单阶段从零联合训练重建与 flow-matching 目标:ImageNet 256×256 上 UNITE-B 生成 FID 2.12(对照单阶段 JiT-B/16 3.66、两阶段 DiT-XL/2 2.27),重建 rFID 1.01(对照无对抗 ViTok-B/16 1.63),全程不需要 DINOv2 等外部预训练编码器——为『表示从哪来』提供一个现代答案:表示由重建压力与生成压力在同一网络里共同塑造。
阅读提示
精读深度:泛读
清单提示:原文提示:单阶段 tokenizer+生成;『表示从哪来』问题的现代答案之一。
问题
要解决什么:现代 latent diffusion 采用两段式管线:先单独训练 tokenizer(autoencoder,通常带 GAN 损失),冻结后在它的 latent 空间里训练扩散/flow 去噪器,生成梯度从不回流到 tokenizer。UNITE 要回答:能否用一个网络、一次训练,同时当 tokenizer 和 latent 去噪器,让重建与生成两个目标共同塑造同一套表示,并且从零开始,不用对抗损失、不用 DINO 这类预训练编码器。
为什么 prior work 不够:端到端联合训练 latent diffusion 此前有尝试,但纯去噪目标主导时容易退化(REPA 系观察到的现象);REPA / REPA-E / RAE 靠引入预训练视觉编码器(DINOv2)做特征对齐来稳定训练,等于增加第三个组件、加深管线分段。RAE 用 SSL 编码器替换 VAE 编码器,解码器还要在后续阶段重训。这些方案都依赖外部教师,无法迁移到没有现成编码器的领域(分子、晶体),也没有研究重建与生成如何共同塑造共享参数。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 图像 x(tokenization 模式) | RGB image | ImageNet 256×256,切成 16×16 patch 并投影成 patch token |
| K 个 register token(两种模式共用) | latent vectors | 固定 K 个位置的向量,初始化为 i.i.d. N(0,1);tokenization 时与图像 patch 拼接过 self-attention 后留存,作为 latent z0(默认 latent 32 维 × 16×16 分辨率) |
| 带噪 latent z_t 与时间 t(generation 模式) | continuous latent + scalar | z_t = t·z0 + (1−t)·ε,t∼U[0,1];t=1 干净、t=0 纯噪声;可附带类别标签 c 作为条件 |
| 噪声 ε | continuous vector | ε∼N(0,I),与 z0 同维 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| latent z0(tokenizer 输出) | K 个 register 向量 | 一次前向 z0 = GE(x) 得到,解码器 D 可据此还原图像 |
| 预测干净 latent ẑ0(生成器输出) | 与 z0 同维 | ẑ0 = GE(z_t, t),x-start 预测,与 tokenization 输出落在同一空间 |
| 重建图像 x̂ | RGB image | x̂ = D(z0 + σε),σ=0.7 为重建噪声尺度(跟随 RAE/REPA 的做法) |
控制频率:n/a(图像与分子生成;训练时每个样本两次 GE 前向 + 14 个去噪 mini-batch,推理时 tokenizer 1 次前向、生成约 108 NFE)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet-1K(256×256) | 1,281,167 张训练图 | 生成与重建两组实验;FID 用 50K 生成样本、每类 50 张 class-balanced 采样 |
| QM9 | 约 130K 个小有机分子(≤9 个重原子) | 显式氢 + 3D 笛卡尔坐标;UNITE-S 单阶段 8000 epoch,对照 ADiT 两阶段共 10000 epoch |
| MP20 | 45,231 个无机晶体结构(≤20 原子/晶胞) | 来自 Materials Project;UNITE-S 单阶段 10000 epoch |
架构(摘要)
主干与结构
backbone:DiT 风格 ViT 作为 GE(DiT-B/L/XL)+ ViT 解码器(ViT-B/L)
参数:UNITE-B 共 217M(GE 86.2M + 解码器 130.6M);UNITE-L 589M;UNITE-XL 806M;UNITE-S(QM9)约 33M
类型:ViT 编码器-解码器 + rectified flow;同一 ViT(Generative Encoder)双模式:tokenizer 与 latent denoiser,权重共享
关键组件
- Generative Encoder tokenization 模式:图像 patch token + K 个 N(0,1) register → self-attention → 丢弃 patch、保留 register 作为 z0
- Generative Encoder generation 模式:z_t 初始化 register,GE(z_t, t) 预测干净 latent ẑ0(x-start 预测)
- 解码器 D:ViT 栈 + 轻量 unpatchification 头,把 latent 还原成像素
- 末端 LayerNorm(可学习 scale/shift):两个模式主要靠归一化与尺度参数分化
- stop-gradient sg(z0):去噪梯度不流回 clean latent
- 重建噪声 σ=0.7 注入 + 噪声调度 shift 0.5(适配 32 维 latent,等价锚定维度 4096)
为什么这样设计
把 tokenization 与 generation 看成同一个潜变量推断问题的两种观测强度:tokenization 是强观测(全图 x → 集中分布 z0),generation 是弱观测(z_t + t → 恢复同一 z0)。共享权重让重建与去噪梯度共同塑造表示;register 初始化为 N(0,1) 让两个模式的输入分布一致,减少模式间漂移。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ImageNet 256×256 生成 FID(越低越好) | 2.12(UNITE-B,217M,联合 tokenizer+生成) | 单阶段 JiT-B/16 3.66(131M)、RIN 3.42(410M);两阶段 DiT-XL/2 2.27(675M+49M)、SiT-XL/2 2.06(675M+49M);带 DINOv2 监督的最优两阶段 DDT-XL/2 1.26 | ImageNet-1K 256×256,50K 生成样本、每类 50 张 class-balanced,dopri5 求解器,CFG 扫描 1.0–4.0 |
| ImageNet 256×256 生成 FID(放大模型) | 1.73(UNITE-L,589M)/ 1.75(UNITE-XL,806M,IS 309.9) | UNITE-B 2.12;JiT-L/16 2.36;PixelFlow-XL/4 1.98;JiT-H/16 1.86 | 同上(class-balanced 50K 样本、dopri5、CFG 扫描) |
| ImageNet 256×256 重建 rFID(越低越好) | 1.01(UNITE-B,120 epoch,无对抗、无预训练编码器);decoder-only GAN 微调 16 epoch 后 0.51 | 同设置无对抗 ViTok-B/16 stage-1 1.63;对照 SD-VAE 0.62、DC-AE-f32 0.69、RAE 0.58、VA-VAE 0.28(后两者用 DINOv2) | ImageNet-256,UNITE-B base backbone,120 epoch;rFID 用重建图计算 |
| 权重共享消融(重建 rFID) | 共享 1.01 vs 拆开 1.38 | UNITE-B 权重共享版 1.01;separate encoder–denoiser 版 1.38 | 同一端到端管线、保留 stop-gradient,ImageNet-256,120 epoch |
| 去噪步数缩放(gFID) | 3.33 → 2.12(flow 迭代次数从基准 1 增加到 14 倍) | 权重共享下 gFID 3.33(1×)→ 2.12(14×),重建 rFID 保持或略升 | ImageNet-256,UNITE-B,每重建迭代配 1 个 vs 14 个去噪 mini-batch |
| QM9 分子重建匹配率 / RMSD | 99.37% / 0.039 Å(UNITE-S,单阶段 8000 epoch) | ADiT 两阶段 tokenizer 97.20% / 0.075 Å(其两阶段合计 10000 epoch) | QM9,显式氢 + 3D 坐标,10K 生成样本评测;UNITE-S DiT-S 约 33M、16 维 latent(约 20:1 压缩) |
| QM9 分子生成有效率 / 唯一率 | 94.90% / 99.71% | ADiT-S 96.02% / 97.76%;GeoLDM 93.8% / 92.9%;EDM 91.9% / 90.7% | QM9,10K 生成样本;有效用化学约束判定,唯一率用 canonical SMILES 判重 |
| 训练效率(ImageNet-256) | UNITE-B 120 epoch 约 6.7×10^20 FLOPs、FID 2.18 | DiT-XL/2 约 6.4×10^20 FLOPs(FID 2.27、724M 参数);UNITE-B 217M 参数;免去 DINOv2 约 27000 A100-GPU-hour 固定成本 | ImageNet-256,梯度 checkpointing,每样本约 3.5 TFLOPs(含 LPIPS 的 VGG 前向) |
Insights
- tokenization 与 generation 是同一个潜变量推断问题的两种观测强度:tokenization 拿全图 x(强观测、分布集中),generation 拿带噪 latent z_t 与 t(弱观测、恢复同一 z0)——这是权重共享成立的概念基础(Fig. 2, p2)。
- 单阶段联合训练呈现『对抗式』动力学:重建把 latent 往信息密集推、生成把 latent 往抗噪推,FID 变好时 denoising loss 可能反而上升;目标是把两个损失带到稳定平衡点而非压到零(Fig. 4, p5)。
- stop-gradient 与权重共享绑定:权重共享下保留 sg(z0) 最优(gFID 2.12 / rFID 1.1),去掉反而降低两路径末层对齐;拆开权重时去掉 stop-gradient 反而变好(gFID/rFID 2.60/1.30 → 2.24/0.85)——直接梯度路径只在无共享时才必要(p6–7)。
- 表示对齐分析(CKA + 熵)显示两模式差异集中在归一化/scale(norm 参数熵 30.7 → 42.0 MB),attention/MLP 功能参数熵几乎不变(91.2 → 90.8 MB),说明共享权重主要复用功能子层、用归一化表达模式差异(p8)。
- 从零单阶段消除了对预训练编码器的依赖:QM9 没有 DINO 级编码器也拿到 99.37% 重建匹配率,验证『表示由重建+生成共同塑造』可迁移到没有外部教师的领域(Tab. 3)。
vs 同类工作
- vs REPA / REPA-E / RAE:这些方法把 diffusion 中间特征向 DINOv2 对齐(REPA)或替换编码器(RAE),表示来自外部 SSL 教师、管线更深;UNITE 从零单阶段、无预训练编码器,ImageNet-256 生成 FID 2.12(对照 REPA-B 2.15、RAE-B 2.08 同级),且不需要 DINOv2 约 27000 A100-GPU-hour 的前置成本(Tab. 1, p3, p11)。
- vs Unified Latents(Heek et al. 2026):同方向的端到端两模块训练,等价于 UNITE 的 separate-weights 消融;UL 最好的数字需要第二阶段扩散微调(其 Appendix B),UNITE 用权重共享单阶段(p3, p6–7)。
- vs JiT(像素空间从零单阶段):JiT-B/16 FID 3.66 对 UNITE-B 2.12,且 JiT 产出不了可复用 tokenizer;UNITE 在 latent 空间做,生成器之外附带一个重建可用的 tokenizer(Tab. 1, p11)。
- vs VAE / VQGAN:它们只当 tokenizer,独立生成能力弱(高斯先验采样质量有限);UNITE 用学出来的去噪器替代高斯先验,让同一个编码器同时承担 tokenizer 与生成器(p3)。
- vs Latent Forcing / Self-Flow:都在预训练编码器(DINO/DINOv2)定义的 latent 上做文章,不从零学表示;UNITE 全程从零(p3–4)。
局限
- 判别能力有限:linear probing 准确率约 30%,与 VAE/VQGAN 同级;作者认为线性探针对高压缩 latent 不能完全反映判别力、建议改用 VLM 评测,但论文未提供该评测(p11)。
- 生成质量仍低于带外部监督的最优两阶段方法:ImageNet-256 上 DDT-XL/2 1.26、RAE-DiTDH-XL/2 1.13,UNITE 最好 1.73——『接近 SOTA』成立,『达到 SOTA』不成立(Tab. 1)。
- 更难的数据集表现下滑:MP20 晶体整体有效率 87.9%(ADiT 联合版 91.9%)、重建匹配率 75.7%(ADiT 专用 tokenizer 84.50%),复杂结构上的重建差距明显(Tab. 5)。
- 『无外部监督』有保留:ImageNet 实验用 LPIPS 损失,依赖预训练 VGG(论文称其小且可自训、分子实验未用);最好的重建 rFID 0.51 需要 decoder-only GAN 微调 16 epoch,引入一小段第二阶段(p9, 附录 A)。
- 训练成本不低:ImageNet-256 240 epoch、全局 batch 1024、每次迭代 14 个去噪 mini-batch;论文未展示 text-to-image / 视频 / 更高分辨率扩展(Tab. 8)。
- 机制解释以相关性证据为主:『两模式主要在归一化上分化』『共享权重产生共同表示』来自 CKA 与熵分析,没有干预/因果实验直接验证(p7–8)。
- FID 协议差异需谨慎:class-balanced 采样(每类 50 张)比均匀随机采样低约 0.1,跨论文对比绝对值时需按协议对齐(附录 B)。
可复现性
- code:https://github.com/ShivamDuggal4/UNITE-tokenization-generation
- weights:论文未明确说明是否发布预训练权重(以 GitHub 仓库为准)
- project_page:https://xingjianbai.com/unite-tokenization-generation/
- note:ImageNet-256 训练配置完整给出(Muon、batch 1024、240 epoch、warmup 20、EMA 0.9978、重建噪声 0.7、调度 shift 0.5、flow mini-batch 14、CFG 扫描 1.0–4.0、积分区间 [0.1,1.0]);LPIPS 需要预训练 VGG;分子实验配置(UNITE-S 33M、16 维 latent、8000/10000 epoch、batch 512)在附录 C
主干与结构
backbone:DiT 风格 ViT 作为 GE(DiT-B/L/XL)+ ViT 解码器(ViT-B/L)
参数:UNITE-B 共 217M(GE 86.2M + 解码器 130.6M);UNITE-L 589M;UNITE-XL 806M;UNITE-S(QM9)约 33M
类型:ViT 编码器-解码器 + rectified flow;同一 ViT(Generative Encoder)双模式:tokenizer 与 latent denoiser,权重共享
关键组件
- Generative Encoder tokenization 模式:图像 patch token + K 个 N(0,1) register → self-attention → 丢弃 patch、保留 register 作为 z0
- Generative Encoder generation 模式:z_t 初始化 register,GE(z_t, t) 预测干净 latent ẑ0(x-start 预测)
- 解码器 D:ViT 栈 + 轻量 unpatchification 头,把 latent 还原成像素
- 末端 LayerNorm(可学习 scale/shift):两个模式主要靠归一化与尺度参数分化
- stop-gradient sg(z0):去噪梯度不流回 clean latent
- 重建噪声 σ=0.7 注入 + 噪声调度 shift 0.5(适配 32 维 latent,等价锚定维度 4096)
为什么这样设计
把 tokenization 与 generation 看成同一个潜变量推断问题的两种观测强度:tokenization 是强观测(全图 x → 集中分布 z0),generation 是弱观测(z_t + t → 恢复同一 z0)。共享权重让重建与去噪梯度共同塑造表示;register 初始化为 N(0,1) 让两个模式的输入分布一致,减少模式间漂移。
tokenization 与 generation:同一潜变量推断问题的强/弱观测两端
原文 caption:Tokenization and generation can be viewed as the same latent inference problem under different conditioning regimes. In tokenization, the full observation x strongly constrains the clean latent z0 ~ p(z|x); in generation, a noisy latent zt provides weaker evidence, and the same target latent z0 is recovered by denoising. This view motivates using a single shared Generative Encoder (GEθ) for both tokenization and latent denoising.
全篇的概念基石:tokenization 路径拿完整图像 x 通过 GE 得到干净 z0(强观测),generation 路径拿带噪 z_t 通过同一个 GE 恢复同一目标 z0(弱观测)。读图要点:两条路径指向同一个 latent 目标,区别只是输入观测的强弱,这正是权重共享成立的依据——记住『同一 z0、两种观测』这个画面。对应论断:tokenization 与 generation 是同一个推断问题(引言与第 3 节)。
UNITE 训练管线:同一网络两次前向 + 权重共享
原文 caption:UNITE Training Pipeline uses two forward passes through the Generative Encoder: first, mapping (distilling) image patches into latent registers, and second, denoising a noised version of those latents, with weights shared across both passes. Training combines reconstruction losses with a denoising loss |ẑ0 − sg(z0)|.
单阶段训练的完整示意图:Recon. Pathway 把图像 patch 映射进 latent register、解码器重建(recon 损失);Gen. Pathway 对 z0 加噪后让同一 GE 去噪(flow 损失,目标带 stop-gradient);中间的 Gradients 表示两个损失共同更新同一套共享权重。读图要点:一次迭代两次前向、一次反向,权重只有一套——这就是『单阶段』的具体含义。对应论断:单阶段联合训练可行且不需要外部监督(第 3.2 节)。
tokenization 与 generation 路径的表示对齐(CKA)
原文 caption:Representation alignment between tokenization and generation pathways measured using CKA and cosine similarity. Left: both the weight-shared UNITE model and the separate encoder–denoiser ablation exhibit strong alignment, especially in later layers. Middle: removing the stop-gradient weakens late-layer alignment. Right: cosine similarity on the final latents decreases at lower denoising timesteps in the no-stop-gradient setting.
支撑『两任务内在相容、共享权重有据』的证据图:左图横轴是网络层、纵轴是 CKA(两层激活相似度,0–1 越高越像),UNITE 与拆开权重版在靠后层都接近 1;中图去掉 stop-gradient 后末层对齐下降;右图显示无 stop-gradient 时最终 latent 的余弦相似度在低噪声时刻下滑。读图要点:对齐度高说明同一套参数做两件事有共享基础;stop-gradient 帮助保住干净共享表示。对应论断:表示对齐分析与权重共享的作用(第 4 节)。
🎧 音频版
时长 25:52 · Edge TTS
UNITE:把 tokenizer 和生成模型合并进同一个网络(对话版)
先讲清楚这篇要解决什么问题
小播:今天这期聊 MIT 和 Adobe 合作的论文《End-to-End Training for Unified Tokenization and Latent Denoising》,简称 UNITE,arXiv 编号 2603.22283。我听说它想把两件本来分开做的事——图像 tokenizer 和生成模型——合并成一个网络、一次训练跑完。先说说它到底解决了什么问题?
老播:一句话背景:现在主流的图像生成管线叫 latent diffusion(潜在扩散),分两段训练。第一段训练一个 autoencoder 当 tokenizer(分词器):把图像压成紧凑的 latent 向量,解码器再还原;第二段把这个 tokenizer 冻结,再训练一个扩散或 flow 去噪器在这套 latent 上做生成。两个模块各自动自己的参数,生成任务的梯度永远碰不到 tokenizer。这篇论文问的问题很直接:能不能用一个网络、一个训练任务,同时当 tokenizer 又当去噪器,让两个目标一起塑造同一套表示?他们的答案叫 Generative Encoder,可以叫生成式编码器:同一套参数跑两个模式,当 tokenizer 时把图像变成 latent,当去噪器时把带噪 latent 还原成干净 latent。结论先放这里:ImageNet 256×256 上,UNITE-Base 的生成 FID 是 2.12,同协议下单阶段像素基线 JiT-B/16 是 3.66,两阶段方案 DiT-XL/2 是 2.27——单阶段从零训练不仅可行,还压过了不少两阶段方案。今天这期要讲清楚三件事:为什么 tokenizer 和生成可以看成同一个问题、单阶段权重共享具体怎么练、以及这给「表示从哪来」这个问题提供了一个什么答案。
小播:FID 2.12 这个数字我记住了,后面会反复看到它的对照。我们从背景开始吧。
先补背景:现在的大模型为什么把分词和生成分开练
小播:先说清楚 tokenizer 到底是什么。我一直不太确定这个词的意思。
老播:tokenizer 这个词来自语言模型,指把文本切成 token、再映射成向量。图像这边沿用同样的概念:图像是 256×256×3 的像素,直接在像素上建模又慢又难,于是先训练一个压缩器,把一张图编码成几十到几百个紧凑向量,这套向量叫 latent,做压缩的模型就是 tokenizer。tokenizer 通常是一个 autoencoder:编码器把图压成 latent,解码器把 latent 还原成图,训练目标是还原得越像越好。现代 latent diffusion 的 tokenizer 大多还加对抗损失,也就是 GAN loss,让一个判别器分辨真假、反过来逼还原结果更真实,Stable Diffusion 的 SD-VAE 就是典型。
小播:那生成模型为什么要在这套 latent 上单独练?
老播:因为生成任务的要求和重建不一样。重建要求 latent 保住实例信息,还原得越像越好;生成要求 latent 的分布好采样、好去噪,结构太随意会让去噪器学不动。两段式设计把这两个压力分开处理:先练 tokenizer 只优化重建,冻住,再练去噪器只优化生成。方便是方便,代价是生成任务的梯度从来不会流回 tokenizer,表示空间长什么样完全由重建目标说了算。这背后是一个更大的问题——「表示从哪来」。过去十年,视觉表示主要有两个来源:一个来源是重建目标,autoencoder 一路练下来,latent 里存的主要是像素级可还原信息;另一个来源是外部自监督大模型,比如 DINOv2,用自蒸馏在几十亿张图上练出语义表示,近两年的 REPA、RAE 这些方法干脆把 diffusion 的特征往 DINOv2 上对齐,等于把表示从外部教师那里借来。两条路都有外部依赖:前者把生成和表示学习切开了,后者依赖一个昂贵的大教师模型。
小播:你说的「表示从哪来」,能不能再展开一点?为什么这个问题值得单独拎出来说?
老播:因为表示的质量决定了模型后面能干多少活。一套 latent 要同时服务两类下游:一类是生成,从噪声里采出新的样本;另一类是判别,比如分类、检测、图文对齐,这些任务希望 latent 里装的是语义信息。过去二十年,两个需求各自长出了一类表示:生成方向从重建目标出发,练出 VAE、VQGAN 这种 tokenizer;判别方向从对比学习、自蒸馏出发,练出 DINO、CLIP 这种编码器。两套表示经常不兼容,流水线里要么牺牲一方,要么花大价钱把两边拼起来。UNITE 的立场是:先别急着选边,把重建和生成两个目标放在同一个网络里一起优化,看看共同压力下会长出什么样的表示。它想证明一件事:不用外部教师,单靠重建加去噪,也能练出一套两头都能用的 latent。
小播:可是 VAE 早就同时练过重建和生成了,为什么还要重新做这件事?
老播:问到点子上了。变分自编码器 VAE 确实是最早的联合方案:它同时优化重建损失和一个 KL 项,把编码器输出的分布往标准高斯先验上拽,采样时从高斯分布抽一个点、解码就出图。但它有一个短板:高斯先验本身表达能力有限,直接用它采样,图像质量明显不如迭代去噪。所以后来的 latent diffusion 把「先验」换成了学出来的去噪器,却又退回两段式:tokenizer 归 tokenizer,去噪器归去噪器。UNITE 想做的,就是把 VAE 那个「一个模型同时管重建和生成」的设计,用现代的去噪器版本重新实现一遍。
小播:那为什么大家明知道两段式有这个代价,还是一直用?
老播:因为分开练省心。tokenizer 的输入输出都是图像,重建损失稳定;去噪器的输入输出都在 latent 空间,训练目标和数据分布都明确。把两段接起来,梯度要穿过 latent 往回传,容易退化、数值不稳,这正是 REPA 那批方法观察到的现象。所以过去几年,工程上宁可多训一个 tokenizer、多存一套权重,也不冒联合训练的风险。UNITE 要挑战的,就是这个「省心」的默认选择。
核心思想:tokenizer 和去噪器其实在解同一个问题
小播:那怎么把两个角色塞进一个网络?它们的输入看起来完全不一样啊。
老播:这正是这篇论文的出发点,也是它最值得记住的观点:tokenization 和 generation 可以看成同一个潜变量推断问题,区别只在可观测信息有多少。tokenization 是强观测:手里有完整图像 x,推断出一个高度集中、和 x 一致的 latent z0;generation 是弱观测:手里只有带噪 latent z_t 和时间 t,可能再加一个类别标签,要恢复同一个目标 z0。既然两个任务追的是同一个 z0,共用一套参数就有了根据——同一个网络学到的变换,两边都能用。
小播:那网络结构上怎么让两种输入共用一个接口?
老播:靠「register token」机制。latent 被定义成固定 K 个 register token 组成的序列,register token 是一组位置固定的占位向量,进入网络前初始化为标准高斯噪声 N(0,1)。tokenization 模式下,把图像切成 patch、每个 patch 投影成一个 token,和 K 个 register 拼在一起过 self-attention——self-attention 的作用是让序列里每个 token 都能参考其它所有 token 的信息来更新自己;注意力让 register 把 patch 里的信息吸收进来,然后丢掉 patch token,剩下的 K 个 register 就是图像的 latent z0。generation 模式下,直接把带噪 latent 塞进这 K 个 register,不再拼接 patch,配合时间 t 和类别条件,预测干净 latent。
小播:所以 tokenization 路径里,网络输出的其实是 K 个「读过整张图」的向量,对吗?
老播:对。可以这么想:patch token 像一篇文档的原始词,register 像一组空白的便签,self-attention 让便签把文档的关键信息抄下来,最后文档词丢掉,只留便签。生成路径反着来:便签里存的是带噪的 latent,网络要做的是把噪声一点一点清掉,直到便签内容变成能解码出图像的干净 latent。两条路径处理的是同一种对象,只是「抄写」和「清洗」的差别——这正是权重共享设计成立的地方。
小播:register 初始化成高斯噪声,这个细节有什么讲究?
老播:有讲究。register 的初始化分布 N(0,1) 正好等于 rectified flow 在最大噪声时刻的输入分布。rectified flow 是一类 flow matching 训练方式,用线性插值把数据分布连到噪声分布,学一个网络沿这条线把噪声搬回数据。这个选择让 tokenization 和 generation 两个模式看到的输入分布一致,网络不需要去猜「现在这个输入是从哪条路进来的」。这属于论文反复强调的「减少模式间漂移」的设计。
小播:那加噪和去噪具体怎么写?
老播:先说加噪,这是 rectified flow 的标准形式。给定干净 latent z0,采样一个噪声 ε,ε 服从标准高斯分布,再采样一个时间 t,t 在 0 到 1 之间均匀取值,构造 z_t = t·z0 + (1−t)·ε。这里 t=1 对应干净数据,t=0 对应纯噪声,整个式子表示从纯噪声到干净 latent 的线性插值。去噪器的任务:输入 z_t 和 t,预测干净 latent,写成 ẑ0 = GE(z_t, t)。这是 x-start 预测,输出的量纲和 tokenization 的输出一样,两边能对齐。训练时有一个 stop-gradient,也就是梯度停止,写成 sg(z0):构造 z_t 用的 z0 不参与梯度回传。这个细节后面单独讲。
小播:两个任务各自的损失怎么算?
老播:一次训练迭代做两次前向。第一次是 tokenization 路径:图像进 GE 得到 z0,在解码前给 z0 注入一个小噪声,尺度 σ=0.7,然后解码器重建图像,损失是 L_recon = ‖x̂ − x‖₁ + LPIPS(x̂, x)。‖x̂ − x‖₁ 是逐像素的 L1 距离,LPIPS 是感知距离,用预训练 VGG 网络的特征算差距,两者相加。注入 0.7 尺度的噪声是为了给重建加正则:不让解码器过拟合无噪声的干净码,这是 RAE 和 REPA 都验证过的做法。第二次是 generation 路径:用 z_t 初始化 register,GE 预测 ẑ0,损失是 L_flow = E‖ẑ0 − sg(z0)‖₂²,也就是预测和停梯度的干净 latent 之间的均方误差。总损失是两个损失相加,一次反向,两个目标的梯度同时更新同一套参数。
小播:为什么训练时要让两个模式走同一个网络?拆成两个小网络不也能各自优化吗?
老播:拆开是论文专门做的消融,结论是拆开也能打,但共享更好。原因有两层。第一层是参数效率:两个模式共享同一套注意力、MLP 计算,只靠末端归一化参数区分,等于用一套模型的存储换两套功能。第二层是隐式正则:生成目标逼 latent 抗噪,这个约束直接作用在编码器上;拆开权重后这个耦合消失,重建反而变差,rFID 从 1.01 恶化到 1.38。论文用信息论的说法总结:共享参数的联合程序,描述长度比两个独立模块更短。
小播:两个目标一起优化,会不会互相打架?
老播:会,而且论文专门研究了这个现象。重建压力把 latent 往信息多、细节足的方向推;生成压力惩罚「脆弱的表示」,也就是加一点噪声语义就崩掉的表示,逼 latent 变得抗噪。两个方向在同一个网络上拉扯,训练曲线像一场对抗游戏:FID 在变好,denoising loss 却可能同时上升,论文 Figure 4 里用带星标的红曲线展示这一点。乍看不好理解,但论文的解释是:denoising loss 上升常常意味着 latent 变得更丰富、信息更密,去噪变难了,生成出来的样本反而更真实。所以训练的目标,是找到两个损失之间的稳定平衡点,把损失压到零反而坏事。
小播:这种「越训损失越高」的现象,是不是意味着训练很难稳定?
老播:稳定反而比较容易达到。论文观察到的是:只要用上合理的优化细节——学习率 warmup、两个目标共用一套调度、末端归一化——训练会在一个平衡点上稳住,损失保持非零但不发散。这个非零的损失水平在扩散模型里本来就是常态:现代扩散模型训练完,去噪损失同样不为零。所以关键的判断标准要看生成质量,也就是 FID 和重建的 rFID,看这两条曲线是不是同时被带下去。
小播:那 stop-gradient 又是什么角色?
老播:它是一个设计选择:去噪的梯度不直接流回 tokenization 的干净输出。论文发现,在权重共享的前提下,去掉 stop-gradient 反而引入额外的梯度干扰,让两个模式的表示对齐变差;保留它,权重共享本身已经足够把两个任务耦合起来。对照实验里,拆成两个独立网络的变体去掉 stop-gradient 反而变好,说明这个选择和「是否共享权重」是绑在一起的。这些机制后面在分析部分有专门的图。
小播:推理的时候,一个模型怎么同时干两件事?
老播:当 tokenizer 用,一次前向,图像进 GE 出 latent,解码器还原图;当生成器用,从高斯噪声初始化 register,带上类别标签,迭代去噪,配合 classifier-free guidance(CFG,把有类别和无类别条件的预测加权组合、提升样本质量的技巧),在 0.1 到 1.0 的时间区间上解概率流 ODE,大约 108 次网络评估出一张 256×256 的图。生成器就是一个迭代版本的 tokenizer——每一步都在做「从带噪 latent 推断干净 latent」这件事。论文还验证过,换用固定的 50 步二阶求解器,FID 差距在 0.05 以内,说明学到的轨迹接近直线、低阶求解器也够用。
关键实验:数字上它到底站不站得住
小播:好了,看数字。ImageNet 256×256 生成,UNITE 什么水平?
老播:主表里 UNITE-Base,217M 参数,FID 2.12。FID 是衡量生成图整体分布和真实图整体分布差距的指标,越低越好。对照分两组看。单阶段像素基线:JiT-B/16,131M 参数,直接在像素上训练,FID 3.66;RIN,410M,3.42。两阶段 latent 方案:DiT-XL/2,675M 加 49M 参数,FID 2.27;SiT-XL/2,同样 675M 加 49M,2.06。UNITE-Base 的 2.12 压过 JiT 和 DiT-XL。放大模型:UNITE-Large,589M,FID 1.73;UNITE-XL,806M,FID 1.75,IS 309.9。所有 FID 都在同一套协议下算:生成 5 万张图、每类 50 张的 class-balanced 采样,dopri5 自适应求解器,CFG 从 1.0 扫到 4.0 取最好值。论文还特别提醒,class-balanced 采样比均匀随机采样低约 0.1,跨论文比绝对值要留个心。
小播:生成好,重建呢?tokenizer 本职不能丢。
老播:重建看 rFID,也就是把重建图当生成图去算的 FID,越低越好。UNITE-Base 的 rFID 是 1.01,没有对抗损失、没有预训练编码器,训练 120 epoch;对照组 ViTok-B/16 的 stage-1,同样从零、无对抗,1.63。再把解码器单独做 16 epoch 的 GAN 微调,编码器冻结,rFID 降到 0.51,超过 SD-VAE 的 0.62 和 RAE 的 0.58;不过带对抗加 DINOv2 的 VA-VAE 是 0.28,仍然更低。最有意思的消融:把权重共享拆开,编码器和去噪器各练各的,rFID 从 1.01 恶化到 1.38——共享权重本身对重建就是一种正则。
小播:拆开权重会怎样,论文还做了什么分析?
老播:论文用 CKA(centered kernel alignment,衡量两层网络激活相似度的指标,0 到 1 越高越像)测 tokenization 路径和去噪路径的表示对齐。结果:权重共享版和拆开版的对齐度都很高,尤其靠后的层,说明两个任务在表示层面本来就相容;去掉 stop-gradient 会让靠后层的对齐变差。另一个分析是压缩视角:用每个张量的直方图熵估算模型描述长度,共享模型的注意力/MLP 功能参数熵几乎没变,拆开版 91.2 MB 对共享版 90.8 MB,差别集中在归一化参数上,从 30.7 MB 升到 42.0 MB。这支持论文的一个判断:两个模式主要靠归一化和尺度区分,注意力和 MLP 这些主力计算被复用。
小播:你前面提到「去噪次数从 1 加到 14 次」,这个权衡怎么看?
老播:论文 Figure 5 画的就是这个权衡,横轴是每个重建迭代配的去噪步数,纵轴是 FID,实线是生成 FID,虚线是重建 rFID。权重共享版(UNITE)的实线随着步数增加明显下降,从 3.33 到 2.12,虚线几乎不动甚至略好;拆开权重版也随步数改善,但整体权衡点不如共享版。这张图的含义:在共享网络里,多给去噪压力一些训练预算,表示会变得更好采样,同时没有牺牲重建——两条曲线一起变好,说明两个目标在共享设置下互相促进。
小播:换到没有预训练编码器的领域呢?
老播:这是 UNITE 最实用的卖点。分子生成数据集 QM9 上,没有 DINO 这种现成编码器,UNITE-S,DiT-S 骨架约 33M 参数,单阶段 8000 epoch,重建匹配率达到 99.37%,对照 ADiT 两阶段 tokenizer 的 97.20%;RMSD 从 0.075 埃降到 0.039 埃;生成唯一率 99.71% 对 97.76%;有效率 94.90%,略低于 ADiT 的 96.02%。晶体数据集 MP20 上,UNITE-S 整体有效率 87.9%,ADiT 的两阶段联合版 91.9%,逼近但没超过。效率上,UNITE-Base 120 epoch 总计算约 6.7×10^20 FLOPs,和 DiT-XL/2 的 6.4×10^20 相当,参数从 724M 降到 217M;还省掉了 DINOv2 训练那约 27000 个 A100-GPU 小时的固定开销。
谱系定位:它站在哪条技术线上
小播:所以它跟 VAE 那条老线是什么关系?
老播:关系很近。VAE 是最早的「一个模型重建加生成」,但它的先验是固定的高斯分布;UNITE 相当于把先验升级成学出来的迭代去噪过程,同时让编码器本身也参与生成训练。把它放进更宽的谱系看:REPA 和 RAE 是「借表示」,把生成模型的中间特征往 DINOv2 对齐,表示来自外部教师,代价是多一个预训练组件;Unified Latents,Heek 等人 2026 年的工作,和 UNITE 最接近,也是端到端训 tokenizer 加生成器,但它用两个独立网络,最好的数字还依赖第二阶段的扩散微调;UNITE 用权重共享的单网络、单阶段。JiT 是像素空间的从零单阶段,质量好但拿不出可复用的 tokenizer;UNITE 在 latent 空间做,生成器之外还白得一个重建用的 tokenizer。所以 UNITE 的回答是:「表示从哪来」可以来自重建和去噪两个目标在同一个网络里的共同塑造——表示既要保得住实例信息,又要扛得住噪声扰动,两者互相约束,从零开始,不需要外部教师。这就是它作为「表示从哪来」问题的一个现代答案。
局限:哪些地方还不能替它背书
小播:听起来很完整,但有哪些不足?
老播:有,而且不止一条。第一,判别能力弱:论文自己的 linear probing(线性探针,在冻结的 latent 上训练线性分类器测表示质量)准确率约 30%,和普通 VAE、VQGAN 一个水平;作者认为线性探针对高压缩 latent 不能完全反映判别力,建议改用 VLM 评测,但论文没做。第二,生成质量还追不上带外部监督的最优两阶段方法:DDT-XL/2 是 1.26,RAE-DiTDH-XL/2 是 1.13,UNITE 最好 1.73,所以论文说的是「接近 SOTA」,「接近」两个字要保留。第三,更难的数据集掉链子:MP20 晶体上重建匹配率 75.7%,ADiT 专门训练的 tokenizer 是 84.50%。第四,「无外部监督」要打折扣:ImageNet 实验用了 LPIPS 损失,它依赖一个预训练 VGG 网络,虽然很小、论文说分子实验没用它,严格讲还有一点外部依赖。第五,最好的重建数字 rFID 0.51 要额外做 16 epoch 的解码器 GAN 微调,等于偷偷加了一小段第二训练阶段。第六,训练本身不便宜:240 epoch、全局 batch 1024、每次迭代跑 14 个去噪 mini-batch,论文也没有展示 text-to-image 或视频的扩展。最后,那些机制解释——两个模式主要在归一化上区分、共享权重产生共同表示——来自 CKA 和熵这些相关性证据,论文没有做干预实验,因果性还没有被直接验证。
收尾:这期记住这三件事
小播:我来总结,看对不对。第一,tokenization 和 generation 在 UNITE 看来是同一个潜变量推断问题,区别只是观测强弱:tokenization 拿全图,generation 拿带噪 latent,目标都是同一个 z0。第二,把编码器和去噪器合并成一个权重共享的网络、单阶段从零训练,这条路走得通:ImageNet 256×256 上 UNITE-Base FID 2.12,压过单阶段 JiT 的 3.66 和两阶段 DiT-XL/2 的 2.27,重建 rFID 1.01 也比同设置的无对抗 ViTok 的 1.63 好。第三,「表示从哪来」的现代答案多了一个:表示可以由重建压力和生成压力共同塑造,从零开始、不用 DINOv2 这类外部教师,这给分子、晶体这些没有现成编码器的领域打开了门。
老播:补一句对后续工作的意义。UNITE 把「表示从哪来」这个老问题重新摆到台面上:如果 tokenizer 和生成器可以是一个网络,下一步自然要问,这个网络学到的表示能不能直接支撑别的任务。论文讨论里提到机器人世界模型、DINO 或 JEPA 式目标、以及多轮迭代式的图像到 latent 映射。它和经典的 wake-sleep 算法也有精神上的联系:同一个网络既做判别式的编码,又做生成式的去噪。单阶段从零训练这件事,两年前听起来像冒险,现在有了一个能打平甚至超过部分两阶段方案的证据。