WorldVLA:把动作和图像并进同一个自回归世界模型(精读)
一句话定位:WorldVLA 用一个从 Chameleon 初始化的自回归 transformer,把 VLA 的动作生成和世界模型的未来帧预测统一到同一套离散 token 序列里:动作既当输出、也当世界模型的输入,未来帧预测反过来给动作决策提供物理理解,两边在同一词表、同一主干上互相增强。这是世界模型「融合路线」的代表作,与 VERA 的「解耦路线」形成两极对照。
---
要解决的问题:动作决策与环境建模为什么值得并进一个模型
机器人操作模型一直有两类能力要配齐。一类是动作决策:看到当前画面和指令,输出下一步该做的动作,典型代表是视觉-语言-动作模型(Vision-Language-Action Model,VLA),比如 OpenVLA 用预训练多模态大模型接一个动作头,把动作当成一组离散 token 自回归生成。另一类是环境建模:给定观测和动作,预测未来的画面,也就是世界模型(world model),比如 iVideoGPT。两类能力各自有短板。VLA 的问题在于动作只出现在输出端,模型学不到「这个动作会怎样改变环境」,动作域在预训练里接触又少,泛化偏弱。世界模型的问题在于它只能给未来的状态画面,给不出可执行的动作,落地还得再配一个策略模型。两者分开部署,一套机器人系统要养两个模型,表征各管各的。
更早的级联方案把两步串起来:先让视频模型预测未来画面,再根据画面出动作,GR-1、GR-2 的视频预训练走的就是这条路,UVA 则用两个独立的扩散头分别出图、出动作。论文指出这类方案有个隐患:视频预测部分的条件里通常只有任务指令、没有动作,而同一帧初始画面可以通向多种可能的未来,训练信号带歧义;动作和视频又由不同模块处理,表征不共享。WorldVLA 想直接回答一个问题:能否让一个模型同时干决策和环境建模这两件事,并且让两边互相受益。这是本期要讲透的第一条主线,对应的正是阅读提示里的「融合路线」。
核心思想:动作和图像在同一个词表里走同一条自回归路径
论文把问题形式化地拆成两个函数。动作模型 π_θ 负责从历史图像观测 o_{t-h:t} 和语言指令 l 生成动作 a_t:
a_t = π_θ(a_t | o_{t-h:t}, l)
这个式子要先给出预期:它回答「给定过去 h 帧画面和指令,下一步动作是什么」。其中 θ 是动作模型的参数,o_{t-h:t} 是从 t-h 时刻到 t 时刻的历史观测序列,l 是任务指令,a_t 是当前要生成的动作。
世界模型 f_ϕ 负责从历史观测和动作序列预测下一帧画面 o_t:
o_t = f_ϕ(o_t | o_{t-h:t-1}, a_{t-h:t-1})
这个式子回答「给定过去的画面和机器人实际执行的动作,环境下一步会变成什么样」。其中 ϕ 是世界模型的参数,o_{t-h:t-1} 是截至上一帧的观测,a_{t-h:t-1} 是同期执行过的动作序列,o_t 是要预测的下一帧。论文的关键主张是:这两个函数可以装进同一个模型 M_ψ,共享参数、共享表征,动作分支和世界分支分开计算损失,但网络只有一份。
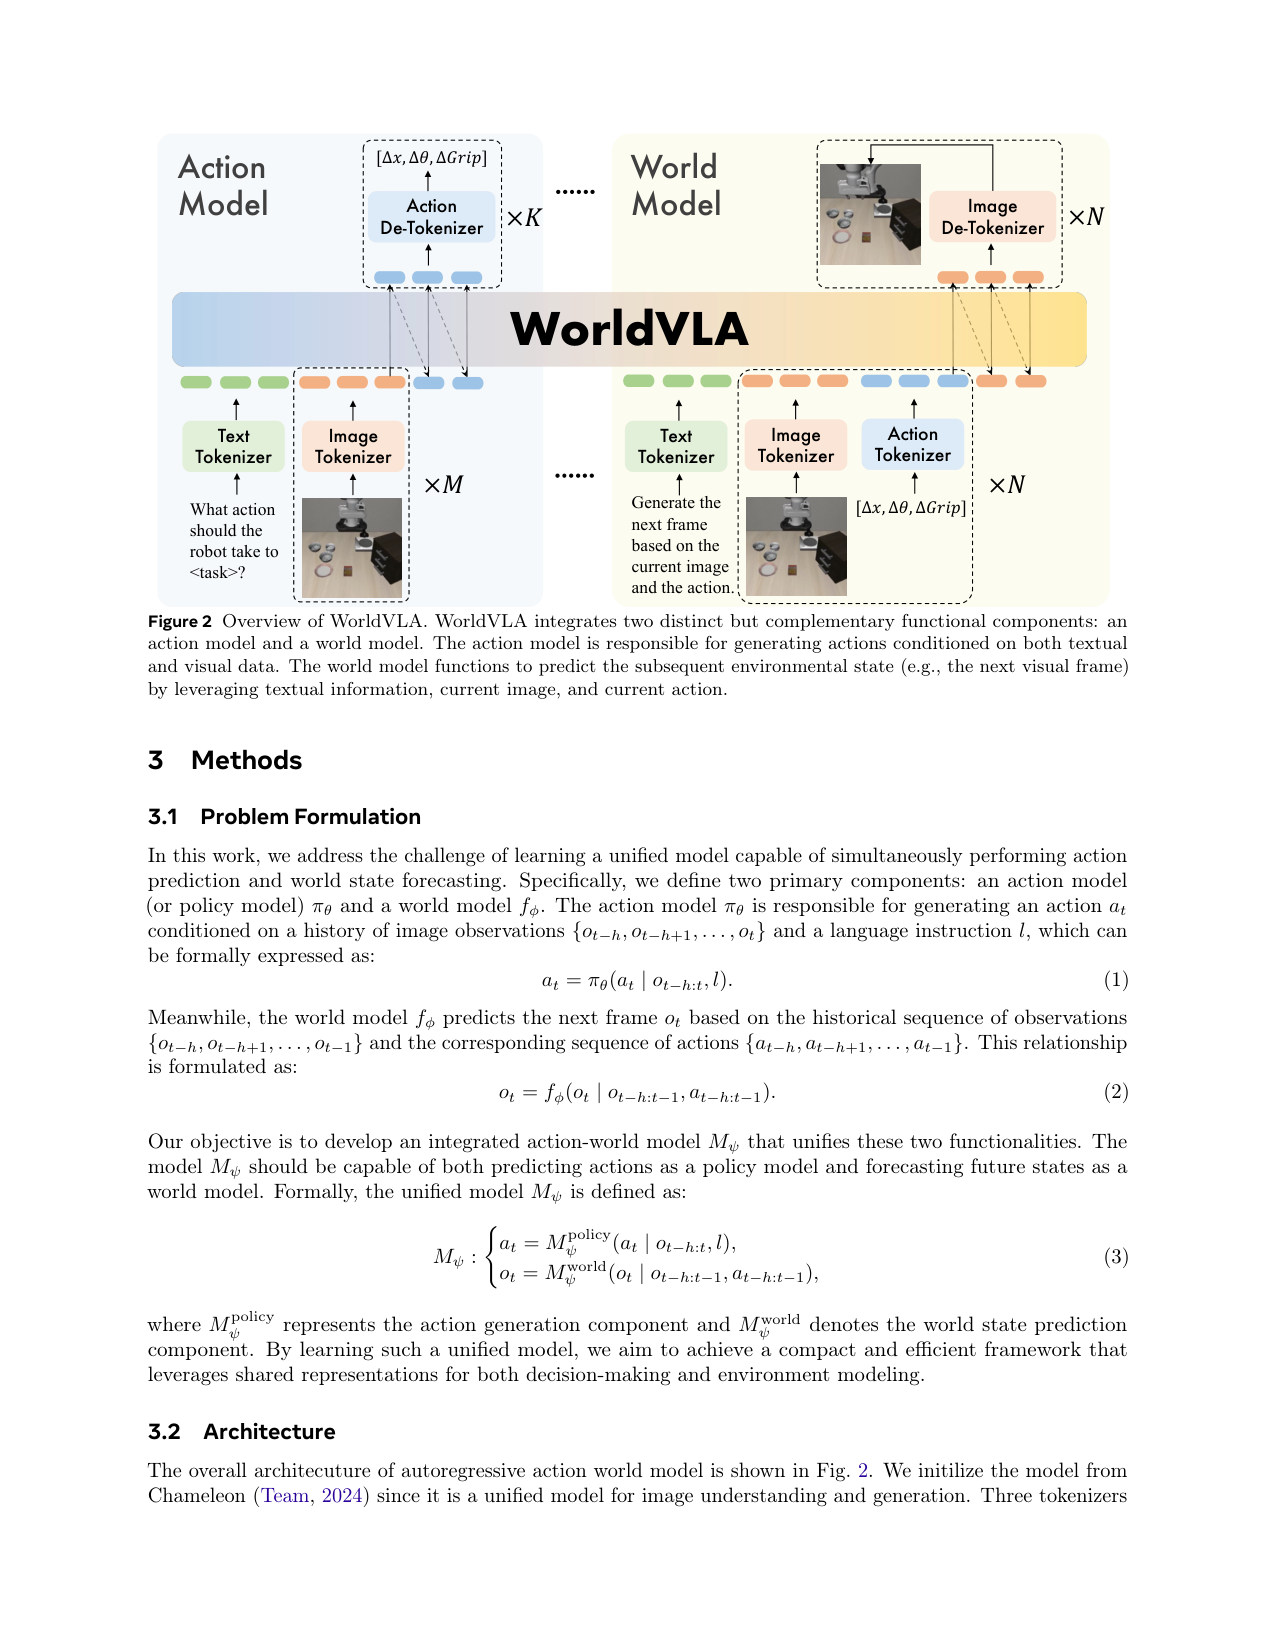
实现层面,WorldVLA 的融合靠三件事。第一,三个 tokenizer 全部离散化并放进同一个词表:图像用 VQ-GAN,压缩率 16、codebook 大小 8,192,256×256 的图变成每帧 256 个 token,512×512 变成每帧 1,024 个 token;文本用 BPE,总词表 65,536,其中已经包含 8,192 个图像 token 和 256 个动作 token;动作把 7 维连续量(3 相对位置、3 相对角、1 夹爪绝对状态)每维量化成 256 个 bin。这样动作、图像、文本在同一个自回归路径上以 token 序列的形式互相条件。第二,主干直接初始化自 Chameleon,一个少有的把图像理解和图像生成并进同一个 transformer 的模型,天然具备「视觉既当输入又当输出」的能力。第三,训练时把动作模型数据和世界模型数据混在一起喂,一个前向里既算动作分支的交叉熵损失,也算世界分支的交叉熵损失:
L = L_action + α·L_world
这个式子回答「两类任务怎么合在一个目标里」。L_action 是动作模型数据上的损失,L_world 是未来帧预测数据上的损失,α 是平衡两类损失的权重。为什么需要 α:图像 token(每帧 256 或 1,024 个)数量远多于动作 token(7 个),直接相加会让世界模型的损失主导训练,所以论文把 α 定在 0.04,压低世界模型数据的占比。下图是整篇的结构图:同一个模型里,动作分支以文本和图像为条件生成动作,世界分支以文本、当前图像和当前动作为条件预测下一帧,动作既出现在输出端、也作为世界分支的输入端,这就是融合路线和后面 VERA 解耦路线最直观的差别。
训练与推理里的关键机制:动作注意力掩码
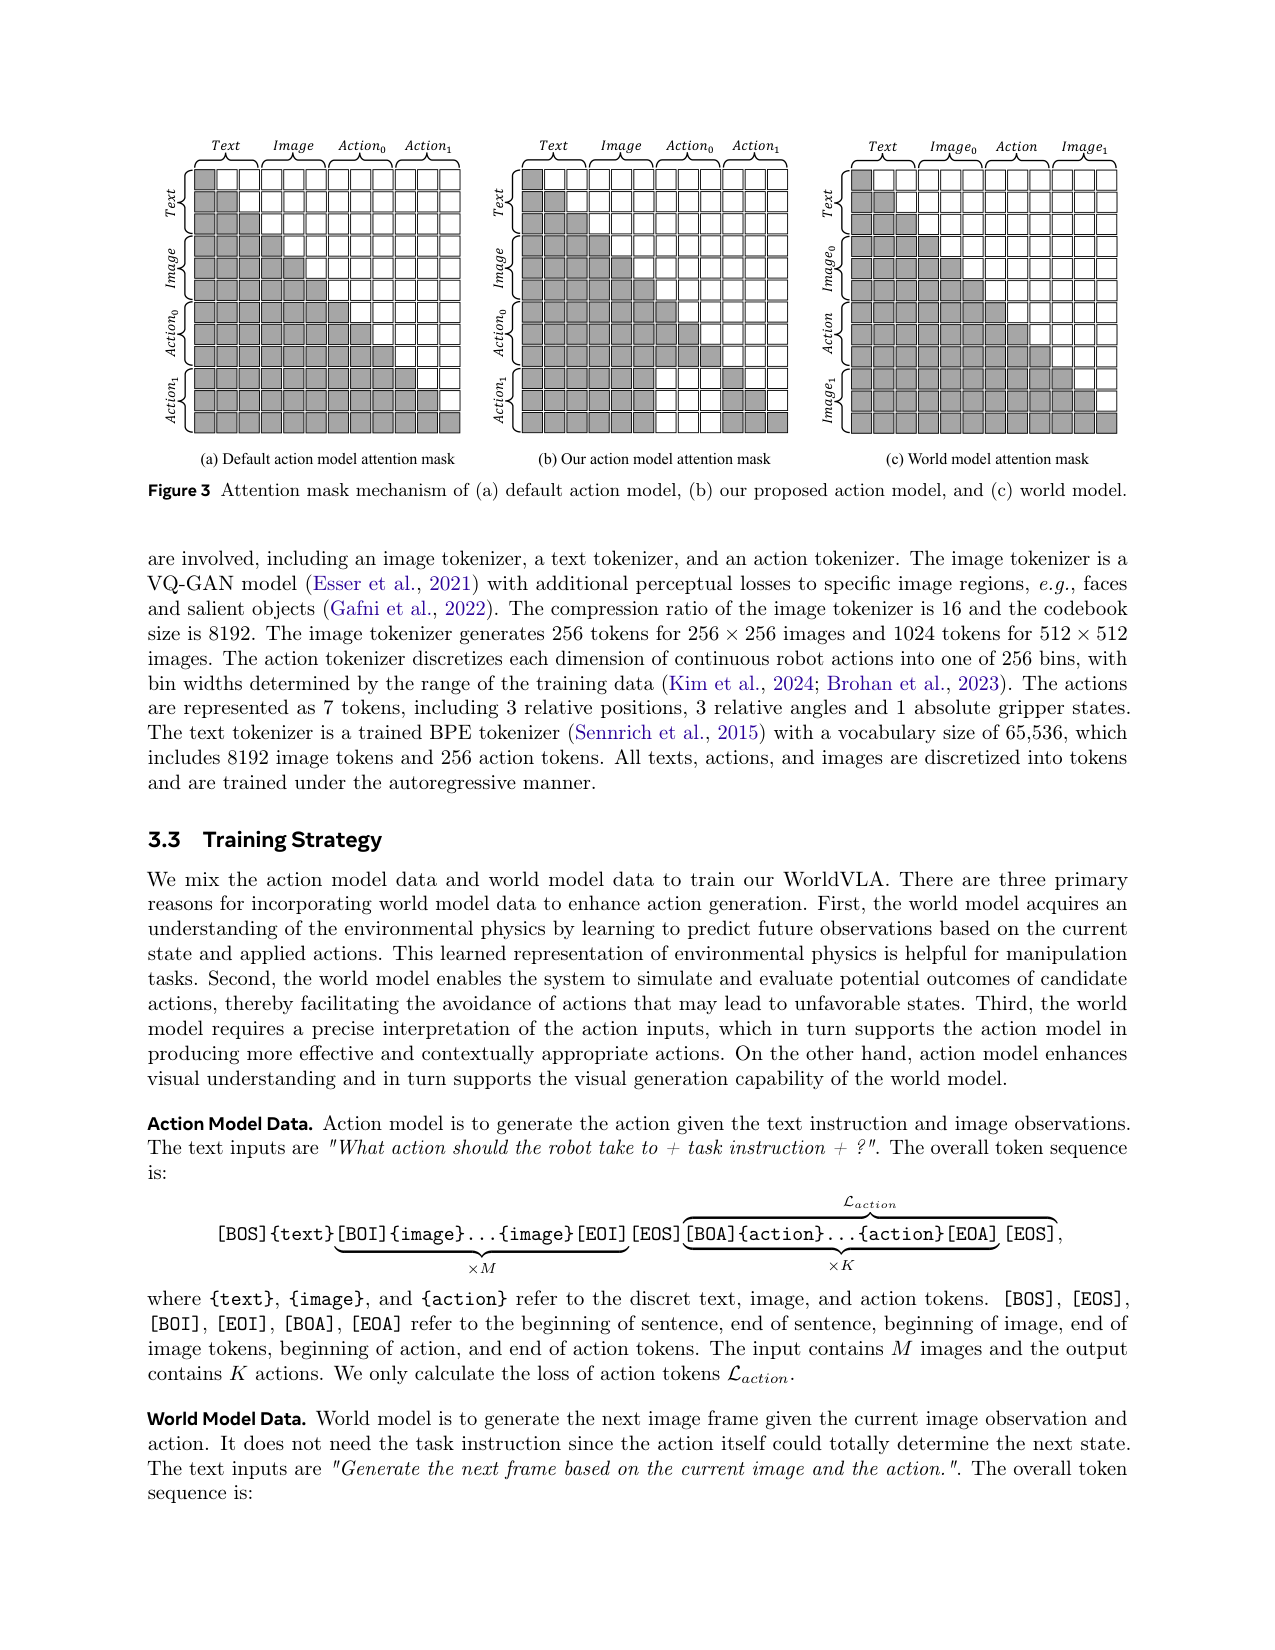
把动作放进自回归框架后,论文撞上一个具体的坑:一次生成连续 K 个动作(动作 chunk)时,如果沿用标准的因果注意力掩码,后面的动作会依赖前面已经生成的动作。动作域在预训练里接触少、泛化弱,先出的动作一旦有错,错误就顺着同一动作空间传染给后续动作,chunk 越长崩得越狠。论文的修法很直接:生成当前动作 token 时,把先前所有动作 token 从注意力范围里屏蔽掉,只允许它看文本和图像。这等于让 K 个动作各自直接由视觉和指令决定、并行解码,和 OpenVLA-OFT 的并行动作头思路一致,但保留在自回归框架内。世界模型分支继续用标准因果掩码。下图三个子图分别对应默认动作模型、本文动作模型与世界模型的注意力连接方式。
关键实验:互相增强的两个方向,以及掩码的修复效果
评测在 LIBERO 仿真基准上进行,包括 LIBERO-Spatial、Object、Goal、Long 四个子集,每任务跑 50 次 rollout 记成功率(SR),训练用 90% 轨迹、验证用 10%。先看整体战绩:Table 2 里,WorldVLA 在 256×256 分辨率下四任务平均成功率 79.1%,512×512 下 81.8%,两者都超过带大规模预训练的离散动作基线 OpenVLA 的 76.5%;不过连续动作模型 OpenVLA-OFT 仍是 95.4%,这个差距留到局限里再说。
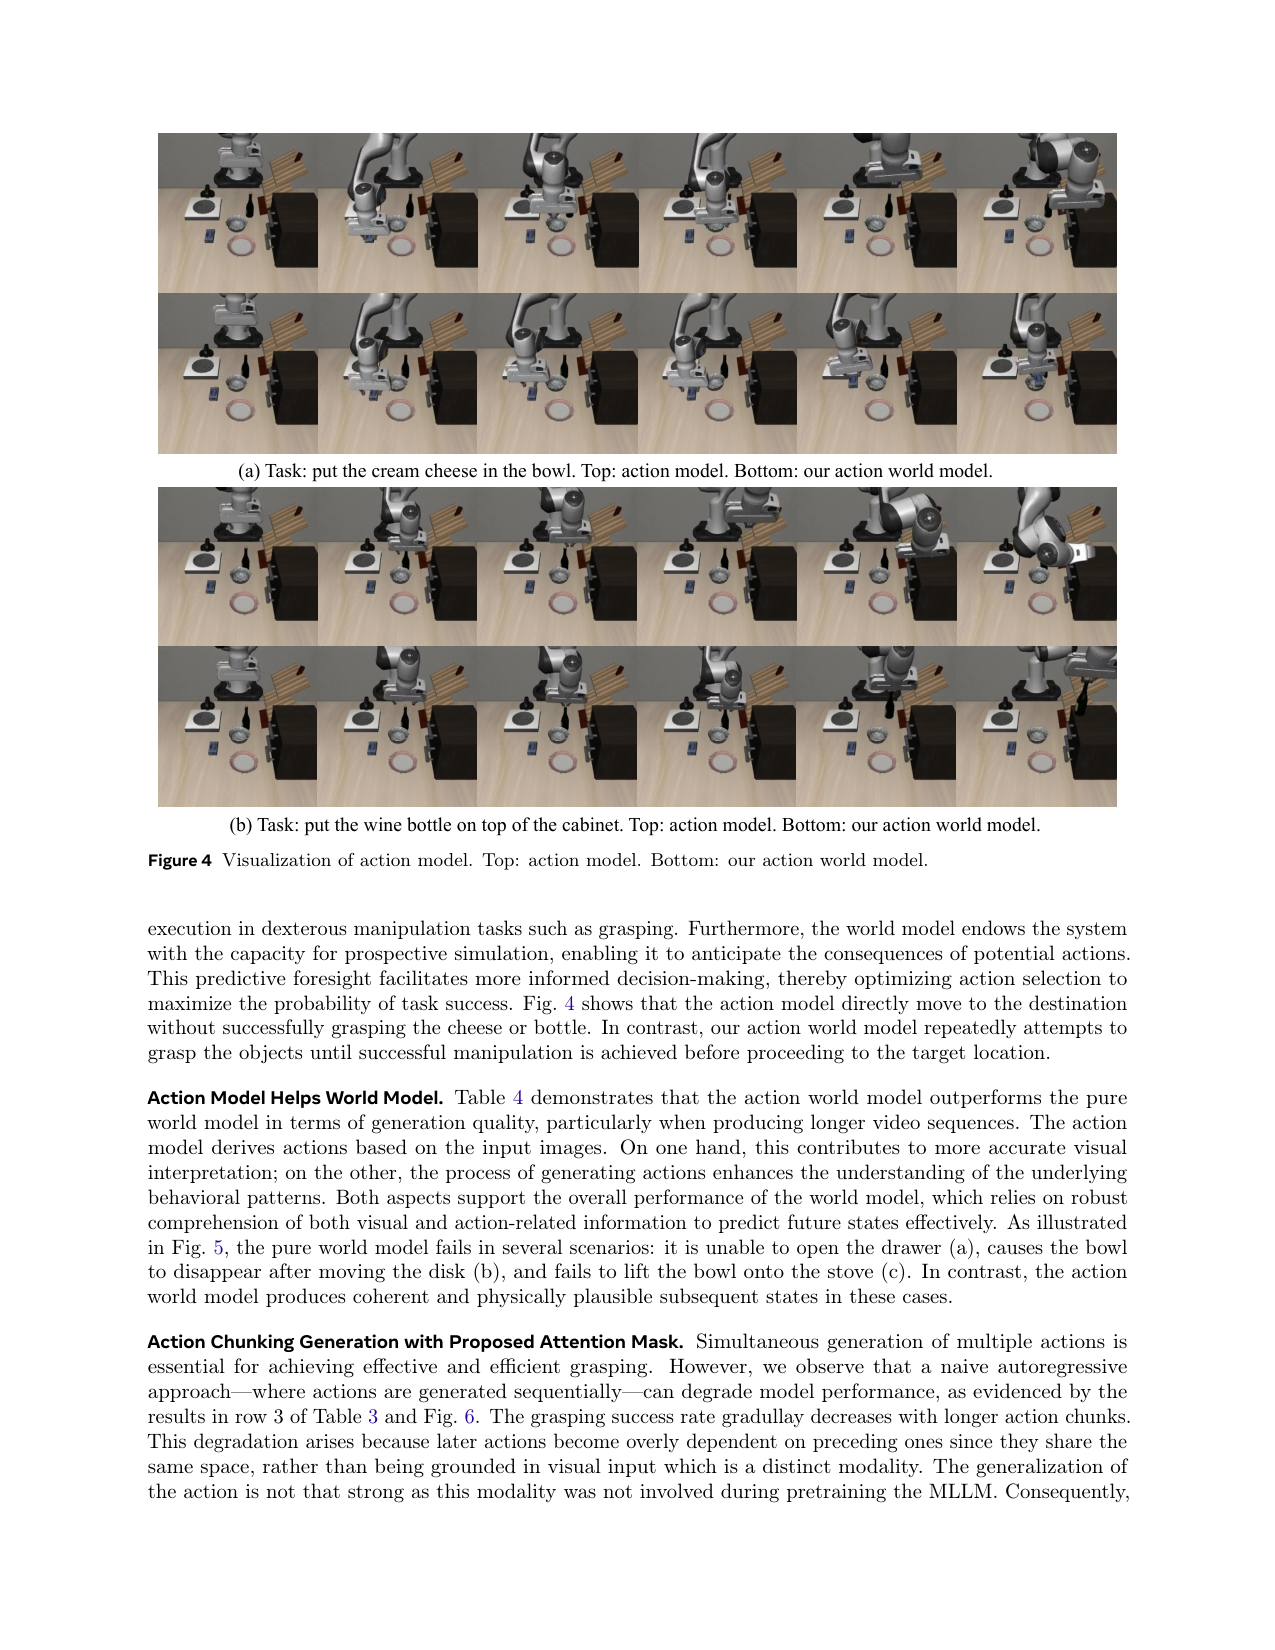
第二个问题是世界模型到底帮没帮到动作模型。Table 3 的消融显示:去掉世界模型分支、逐动作生成时平均成功率 62.8%,加进世界模型数据后到 67.2%,提升 4.4 个点;在加了动作掩码的版本上,世界模型再带来 76.6% 到 78.1% 的 1.5 个点。定性上 Figure 4 更直观:纯动作模型经常直接把手移到目标位置、却没抓住奶酪或瓶子,动作世界模型会反复尝试抓取直到成功再移动。结论在正文和消融里出现两次:世界模型通过「预测动作后果」给动作决策提供物理理解,这是第一条反复强调的重点。Figure 4 如下。
第三个问题是反过来:动作模型帮到世界模型吗?Table 4 用 FVD、PSNR、SSIM、LPIPS 四个指标评未来帧预测质量,关键差异在序列长度——10 帧时两者几乎打平(FVD 255.1 对 250.0,越低越好),预测 50 帧时动作世界模型的 FVD 674.1 明显好于纯世界模型的 718.6。论文在 Figure 5 里给的定性例子更明显:纯世界模型预测出打不开抽屉、移动盘子后碗直接消失、没能把碗放上炉子这类物理上站不住的画面,动作世界模型给出的后续状态连贯合理。这条结论的意思是:让模型学会出动作,反而提升了它预测画面的能力,因为动作生成强迫模型精确解读动作、理解行为模式。
第四个问题是掩码的修复效果,这也是全文数字最漂亮的地方。Table 3 里,朴素自回归加动作 chunk 会把平均成功率从 62.8% 打到 54.0%,其中 Spatial 从 77.8% 跌到 36.7%、Long 从 23.0% 跌到 16.9%;换成论文提出的动作掩码后,平均成功率回到 76.6%,涨了 22.6 个点,已经反超不 chunk 的版本。Figure 6 展示了四个子任务上成功率随 chunk 长度的变化,朴素掩码在长 chunk 下掉得更快,论文掩码在长 chunk 下保持平稳;两条曲线在 chunk 过长时都会回落,对应论文自承的局限——chunk 太长会限制策略及时更新。
第五个问题顺带把「世界模型」和「视频预测模型」分开:两者都预测未来视觉,但世界模型以动作为条件,视频预测模型只以任务文本为条件(对应 GR-1/GR-2 的预训练路线)。Figure 7 显示,动作世界模型在全部四个子任务上都提升动作成功率,视频预测只在两个任务有益、在一个任务上还掉点。论文给出的解释就是前面埋的伏笔:没有动作条件时,同一帧画面对应多种可能的未来,训练信号带歧义。另外两个消融作为补充说明:Table 5 显示历史图像从 1 帧加到 2 帧,chunk 版成功率从 74.0% 涨到 84.4%,2 帧到 4 帧只到 84.7%,说明离散图像 tokenizer 的语义理解有限、两帧上下文够用;Table 6 显示世界模型目标先预训练再训动作,平均成功率从 62.8% 涨到 66.8%,Long 任务从 23.0% 涨到 30.2%。
谱系定位:与 VERA 形成世界模型的两极
世界模型往机器人方向走,眼下有两条分岔路,WorldVLA 和 VERA 正好各占一极。WorldVLA 是融合路线:动作和图像在同一个自回归模型里联合生成,动作直接作为世界模型的输入,两边共享表征、双向互惠,代价是单一模型要同时服务两个任务,动作域泛化弱的问题要靠注意力掩码这类机制去补,离散动作 token 化还带来信息损失。VERA(Turning Video Models into Generalist Robot Policies,arXiv 2605.27817)是解耦路线:让一个动作无关的视频世界模型只负责输出视觉计划,另训一个按机体 Jacobian 结构化的逆动力学模型(IDM),把预测视频里的像素运动翻译成动作。解耦的收益是视频规划器可以跨本体复用、换机体只换小的 IDM,视频模型的推理能力完整保留;代价是视频到动作的翻译可能失真,每个本体都要单独采数据训 IDM。融合路线把动作请进世界模型内部,解耦路线把动作挡在世界模型外面,两条路线对「动作该放在哪」给出了相反的答案,这是理解当前世界模型机器人研究最重要的一张地图。
在更小的粒度上,WorldVLA 还和两类工作对照。UVA 同样统一视频与动作,但用两个独立扩散头分别出图、出动作,WorldVLA 用的是离散自回归加单一词表,站在 Chameleon、Emu3 的 next-token 谱系上;OpenVLA 也用离散动作 token 自回归,但没有世界模型分支和动作掩码,WorldVLA 无预训练也能超它 2.6 到 5.3 个点(79.1%/81.8% 对 76.5%),这个对比撑起了「融合设计有效」的论断。
局限
论文自承的局限有三条:离散图像 tokenizer(VQ-GAN)的感知表达力有限,统一的理解-生成 tokenizer 是明确的改进方向;数据与模型规模没有 scaling;只在 LIBERO 仿真上评测,没有真实机器人实验。我们补充几条读出来的。第一,世界模型带来的平均增益偏小:掩码版只有 76.6% 到 78.1% 的 1.5 个点,10 帧预测的 FVD 255.1 反而略差于纯世界模型 250.0,优势集中在 50 帧长序列,α=0.04 的选择依据论文没有消融。第二,离散动作 token 化的代价是实打实的:平均成功率 81.8% 对连续模型 OpenVLA-OFT 的 95.4%,差距 13.6 个点,「离散天生差」的判断部分来自 256 个 bin 的量化设计,统一框架本身的价值还需要在连续动作输出上验证。第三,评测任务类别单一,都是单臂桌面抓取/放置/开门,跨本体、真实环境、长程任务的证据缺失,论文也没报告参数量、训练步数、推理成本这些工程数字,复现门槛偏高。
结论
WorldVLA 用一份共享表征同时做动作决策和未来帧预测,动作既当输出也当输入,两条任务在同一个自回归模型里互相增强:世界模型把 62.8% 的平均成功率抬到 67.2%,动作模型把 50 帧预测的 FVD 从 718.6 降到 674.1。自回归生成动作 chunk 的退化来自同空间错误传播,一个注意力掩码就把平均成功率从 54.0% 拉回 76.6%。它是世界模型融合路线的代表,和 VERA 的解耦路线合起来,构成了当前把世界模型变成机器人策略的两种基本姿势。下一篇可以接着聊 VERA,把这条线的两端都听完。
用一个从 Chameleon 初始化的自回归 transformer,把 VLA 的动作生成和世界模型的未来帧预测并进同一套离散 token 序列:动作既当输出也当世界模型的输入,未来帧预测反过来给动作决策提供物理理解,两边在同一词表、同一主干上互相增强。
阅读提示
精读深度:精读
清单提示:原文提示:融合路线(动作+图像统一自回归);对比 VERA 的解耦路线,形成世界模型的两极。
问题
要解决什么:机器人操作模型需要同时具备两类能力:根据观测和指令生成动作(决策),以及根据观测和动作预测未来状态(环境建模)。论文要回答:能不能让一个模型同时干这两件事,并让两边互相受益,替代当前一个 VLA 加一个世界模型分开部署、表征各管各的做法。
为什么 prior work 不够:VLA 模型(如 OpenVLA)把动作当纯输出,动作从不作为输入参与更深层的推理,模型缺少对动作如何改变环境的理解,且动作域在预训练中接触少、泛化弱。世界模型(如 iVideoGPT)能预测未来视觉,但只能给状态、给不出动作,落地还要再接一个策略模型。级联方案(先出视频再出动作,如 GR-1/GR-2 的视频预训练、UVA 的双扩散头)里,视频预测部分要么缺少动作条件,同一帧图像对应多种可能的未来,训练信号带歧义;要么动作和视频由不同模块处理,表征不共享。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 文本指令 | text | BPE tokenizer,词表 65,536(含 8,192 个图像 token 和 256 个动作 token);动作模型输入模板为「What action should the robot take to {任务指令} ?」 |
| 历史图像观测 | image | 默认 M=2 帧;VQ-GAN tokenizer,压缩率 16、codebook 8,192;256×256 每帧 256 token,512×512 每帧 1,024 token |
| 动作(世界模型分支的输入) | continuous→discrete | 7 维动作:3 相对位置 + 3 相对角 + 1 夹爪绝对状态;每维按训练数据范围离散成 256 个 bin |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 动作序列 | discrete tokens | K 步动作 chunk;LIBERO-Long 用 K=10,其余三个 LIBERO 任务 K=5;只对动作 token 算交叉熵损失 |
| 未来图像帧 | image | 世界模型分支预测下一帧,训练时重复 N=1 轮;只对生成的图像 token 算损失 |
控制频率:论文未报告统一控制频率;动作 chunk 为 K=5(LIBERO-Goal/Object/Spatial)或 K=10(LIBERO-Long)步
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| LIBERO(Spatial/Object/Goal/Long/90) | 仿真桌面操作基准 | 过滤失败轨迹与 no-op 动作(同 OpenVLA);世界模型评测需要视频-动作成对 ground truth,按 90% 训练 / 10% 验证切分 |
| LIBERO-90 | 90 个短程任务 | 仅用于大规模预训练对比;Table 2 用全部数据训练保证公平 |
架构(摘要)
主干与结构
backbone:Chameleon(mixed-modal early-fusion LLM)初始化
参数:论文未报告参数量(Chameleon 有 7B 与 34B 两个规格,本文未指明用哪个)
类型:离散自回归 mixed-modal transformer(图像 token / 文本 token / 动作 token 共享同一词表)
关键组件
- VQ-GAN 图像 tokenizer:压缩率 16、codebook 8,192,带人脸/显著物体感知损失
- BPE 文本 tokenizer:词表 65,536,其中含 8,192 图像 token 与 256 动作 token
- 动作 tokenizer:7 维动作每维 256 bins
- 动作注意力掩码:生成当前动作时禁止访问先前动作,只允许看文本与图像
- 训练目标 L = L_action + 0.04·L_world,两类数据混合训练
为什么这样设计
选 Chameleon 初始化,因为它是少有的把图像理解和图像生成并进同一个 transformer 的模型,动作和图像统一路线需要这种既有输入编码又有输出生成能力的基座。三个 tokenizer 全部离散化并放进同一词表,动作、图像、文本在同一个自回归路径上以 token 序列形式互相条件,动作既当输出(动作分支)又当输入(世界分支)。世界模型数据占比用 α=0.04 压低,因为图像 token(每帧 256/1,024 个)数量远多于动作 token(7 个),直接相加会让世界模型损失主导训练。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | transformer 规格未报告(继承 Chameleon 结构) |
| 分辨率 | 输入分辨率 512×512(默认;256×256 有对比实验) |
| VAE | VQ-GAN,空间压缩率 16,codebook 8,192 |
| 每帧 latent 维 | 256×256 → 256 token/帧;512×512 → 1,024 token/帧(16×16 / 32×32 网格) |
| Chunk | 动作 chunk K=5(LIBERO-Goal/Object/Spatial)、K=10(LIBERO-Long);世界模型 N=1 轮 |
| 上下文 | 默认输入 M=2 帧历史图像 + 文本指令(动作分支);世界分支为当前图像 + 当前动作 |
| 动作 | 7 维:3 相对位置、3 相对角、1 夹爪绝对状态;每维 256 bins |
| 训练 | 动作数据与世界数据混合;α=0.04;未报告 steps/batch/优化器;未提及 LoRA(推测为全量微调 Chameleon) |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| LIBERO 四任务平均成功率(256×256 / 512×512) | 79.1% / 81.8% | 离散动作基线 OpenVLA(带 RT 预训练)76.5%;连续动作模型 OpenVLA-OFT 95.4% | LIBERO-Spatial/Object/Goal/Long,每任务 50 次 rollout;WorldVLA 用 Table 2 的全部数据训练但无预训练 |
| 加入世界模型带来的平均成功率提升 | 62.8%→67.2%(+4.4 点);掩码版 76.6%→78.1%(+1.5 点) | 同一模型去掉世界模型分支(Table 3 row 1、row 4) | LIBERO 四任务平均;M=2 帧图像、K=5/10 动作 chunk |
| 朴素自回归动作 chunk 的性能退化 | 平均 62.8%→54.0%;Spatial 77.8%→36.7%、Long 23.0%→16.9% | 不 chunk(逐动作生成)版本(Table 3 row 1) | LIBERO 四任务;K=5(Goal/Object/Spatial)/K=10(Long) |
| 动作注意力掩码对 chunk 版的修复 | 平均 54.0%→76.6%(+22.6 点) | 朴素 causal 掩码 + 动作 chunk(Table 3 row 3) | LIBERO 四任务;K=5/10;M=2 |
| 世界模型 50 帧预测质量(FVD,越低越好) | 674.1 | 纯世界模型 718.6 | LIBERO 验证集(10% 轨迹);预测 50 帧;10 帧时两者基本打平(255.1 vs 250.0) |
| 世界模型预训练对动作模型的提升 | 平均 62.8%→66.8%(+4.0 点) | 无世界模型预训练(Table 6) | LIBERO 四任务平均;Long 从 23.0%→30.2% |
Insights
- 动作与图像能在同一个自回归模型里互相增强:动作生成帮视觉理解,未来帧预测帮动作决策;定性图(Figure 4/5)和定量消融(Table 3/4)两条证据都指向同一结论
- 自回归生成动作 chunk 的退化主要来自同空间错误传播:后续动作依赖先前动作、又不接触预训练充分的视觉域,所以越长的 chunk 越容易崩;修注意力掩码比换架构更便宜,效果也立竿见影(54.0%→76.6%)
- 世界模型与视频预测模型的分界在「动作条件」:动作进条件就同时消除未来歧义、引入对动作的理解;动作不进条件,同一帧对应多种未来,训练信号带歧义
- 分辨率 512×512 比 256×256 平均高 2.7 点(81.8% vs 79.1%),原因包括 Chameleon 预训练本身按 512 优化,以及抓取任务需要更高视觉精度
- 两帧历史图像已够用(1→2 帧 74.0%→84.4%,2→4 帧只到 84.7%):离散 VQ-GAN 图像 tokenizer 的语义理解弱于 CLIP 类编码器,多帧上下文是补这个短板最便宜的手段
vs 同类工作
- vs VERA(2605.27817,解耦路线):VERA 让动作无关的视频世界模型只输出视觉计划,另训一个按机体 Jacobian 结构化的逆动力学模型把像素运动翻译成动作;WorldVLA 把动作直接并进世界模型,一个自回归模型同时生成动作与未来帧。两极对照:解耦最大化视频模型复用与跨本体换 IDM 的灵活性,代价是视频→动作翻译可能失真、每本体要单独训 IDM;融合最大化表征共享与双向互惠,代价是动作域泛化弱、离散动作 token 化有信息损失、单一模型同时服务两任务
- vs UVA(Unified Video Action Model):两者都统一视频与动作,但 UVA 用两个独立的扩散头分别出图、出动作;WorldVLA 用离散自回归加单一词表,属于 Chameleon/Emu3 的 next-token 谱系
- vs OpenVLA(离散动作 token 自回归):WorldVLA 无预训练也能超 OpenVLA(79.1%/81.8% 对 76.5%,256/512 分辨率),差异来自世界模型分支与动作掩码;但仍低于连续动作模型 OpenVLA-OFT 的 95.4%,离散动作 bin 的信息损失是明牌代价
- vs 级联路线(先视频后动作,GR-1/GR-2 视频预训练):WorldVLA 用动作条件世界模型替代动作无关视频预测,Figure 7 显示前者在全部任务上提升、后者只在部分任务有益
局限
- 论文自承:离散图像 tokenizer(VQ-GAN)感知表达力有限,设计统一的理解-生成 tokenizer 是改进方向
- 论文自承:数据与模型规模没有 scaling;动作 chunk 过长会限制策略及时更新,性能回落,掩码只是缓解手段
- 论文自承:只在 LIBERO 仿真评测,没有真实机器人实验,也没有报告参数量、训练成本等工程细节
- 我们读出:世界模型带来的平均增益偏小——Table 3 掩码版 76.6%→78.1%(+1.5 点),Table 4 的 10 帧预测 FVD 255.1 反而略差于纯世界模型 250.0,增益集中在 50 帧长序列,α=0.04 的选择依据也未消融
- 我们读出:离散化动作(每维 256 bins)造成信息损失,平均成功率显著低于连续动作模型 OpenVLA-OFT(81.8% 对 95.4%);「离散天生差」的判断部分来自 bin 设计,统一框架本身的价值还要在连续动作输出上验证
- 我们读出:评测只在 LIBERO 单臂桌面仿真,任务类别单一(抓取/放置/开门),跨本体、真实环境、长程任务的证据缺失;开源仓库的代码与权重成熟度、可复现性未验证
可复现性
- code:https://github.com/alibaba-damo-academy/WorldVLA(论文给出仓库地址)
- weights:论文未明确说明权重是否发布
- sim_benchmark:LIBERO(Spatial/Object/Goal/Long/90);每任务 50 次 rollout;M=2 帧输入、K=5/10 chunk、α=0.04
主干与结构
backbone:Chameleon(mixed-modal early-fusion LLM)初始化
参数:论文未报告参数量(Chameleon 有 7B 与 34B 两个规格,本文未指明用哪个)
类型:离散自回归 mixed-modal transformer(图像 token / 文本 token / 动作 token 共享同一词表)
关键组件
- VQ-GAN 图像 tokenizer:压缩率 16、codebook 8,192,带人脸/显著物体感知损失
- BPE 文本 tokenizer:词表 65,536,其中含 8,192 图像 token 与 256 动作 token
- 动作 tokenizer:7 维动作每维 256 bins
- 动作注意力掩码:生成当前动作时禁止访问先前动作,只允许看文本与图像
- 训练目标 L = L_action + 0.04·L_world,两类数据混合训练
为什么这样设计
选 Chameleon 初始化,因为它是少有的把图像理解和图像生成并进同一个 transformer 的模型,动作和图像统一路线需要这种既有输入编码又有输出生成能力的基座。三个 tokenizer 全部离散化并放进同一词表,动作、图像、文本在同一个自回归路径上以 token 序列形式互相条件,动作既当输出(动作分支)又当输入(世界分支)。世界模型数据占比用 α=0.04 压低,因为图像 token(每帧 256/1,024 个)数量远多于动作 token(7 个),直接相加会让世界模型损失主导训练。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | transformer 规格未报告(继承 Chameleon 结构) |
| 分辨率 | 输入分辨率 512×512(默认;256×256 有对比实验) |
| VAE | VQ-GAN,空间压缩率 16,codebook 8,192 |
| 每帧 latent 维 | 256×256 → 256 token/帧;512×512 → 1,024 token/帧(16×16 / 32×32 网格) |
| Chunk | 动作 chunk K=5(LIBERO-Goal/Object/Spatial)、K=10(LIBERO-Long);世界模型 N=1 轮 |
| 上下文 | 默认输入 M=2 帧历史图像 + 文本指令(动作分支);世界分支为当前图像 + 当前动作 |
| 动作 | 7 维:3 相对位置、3 相对角、1 夹爪绝对状态;每维 256 bins |
| 训练 | 动作数据与世界数据混合;α=0.04;未报告 steps/batch/优化器;未提及 LoRA(推测为全量微调 Chameleon) |
WorldVLA 总体架构:动作模型与世界模型共用一个主干
原文 caption:Overview of WorldVLA. WorldVLA integrates two distinct but complementary functional components: an action model and a world model. The action model is responsible for generating actions conditioned on both textual and visual data. The world model functions to predict the subsequent environmental state (e.g., the next visual frame) by leveraging textual information, current image, and current action.
融合路线的结构图。同一套模型里,动作分支以文本+图像为条件生成动作;世界分支以文本+当前图像+当前动作为条件预测下一帧。读图看输入输出箭头:动作既出现在输出端,也作为世界分支的输入端,这就是「动作既当输出又当输入」的统一设计,也是与解耦路线最直观的差别。
三种注意力掩码:(a) 默认动作模型 (b) 本文动作模型 (c) 世界模型
原文 caption:Attention mask mechanism of (a) default action model, (b) our proposed action model, and (c) world model.
论文最关键的机制图。默认 causal mask(a)下,动作 token 之间互相可见,先出的动作错误会顺着同一动作空间传给后续动作;(b) 中当前动作只允许注意文本与图像 token,看不到先前动作,等于把 K 个动作并行生成,切断错误传播链;(c) 世界模型保持标准 causal mask。这张图对应全文最强的实验结论:加掩码把 chunk 版平均成功率从 54.0% 抬到 76.6%。
动作模型可视化:动作模型 vs 动作世界模型
原文 caption:Visualization of action model. Top: action model. Bottom: our action world model.
定性展示「世界模型帮助动作模型」:上行纯动作模型经常直接把手移到目标位置、却没抓住奶酪或瓶子;下行动作世界模型会反复尝试抓取,直到成功握住物体才向目标移动。对应 Table 3 的定量趋势(加入世界模型,平均成功率 62.8%→67.2%),证明世界模型通过模拟动作后果让策略学会重试。
🎧 音频版
时长 32:14 · Edge TTS
WorldVLA:动作和图像在一个模型里互相成就(对话版)
先讲清楚这篇要解决什么问题
小播:老播,今天聊 WorldVLA,arXiv 编号 2506.21539,2025 年 6 月挂出来,阿里巴巴 DAMO 学院、湖畔实验室和浙江大学合作的工作,代码仓库在 GitHub 上公开。题目里有个词很关键,Action World Model,动作世界模型。先说说这篇到底解决什么问题,为什么值得专门做一期?
老播:一句话背景:机器人这边有两类模型一直分家过日子。一类叫 VLA,全称视觉-语言-动作模型,就是看画面、听指令、直接出动作,OpenVLA 是代表;另一类叫世界模型,就是给定画面和动作,预测下一步画面会变成什么样,iVideoGPT 这类。VLA 会干活,但动作只在输出端出现,模型学不到「这个动作会怎样改变环境」;世界模型懂环境,能预测未来画面,但给不出可执行的动作。WorldVLA 的答案:把它们并进一个模型,动作和图像用同一套离散 token 走同一条自回归路径,让两边互相增强。这篇论文是「融合路线」的代表作,我们上一期或者下一期会聊 VERA 的「解耦路线」,两篇正好构成世界模型的两极,所以今天这期值得把细节讲透。
小播:这篇对听众的价值在哪?我们之前聊过不少生成模型和世界模型,这篇有什么新东西?
老播:它把两个我们熟悉的概念第一次真正焊在了一起:之前的世界模型预测画面,动作模型出动作,各干各的;这篇让动作直接进世界模型的条件,让画面预测反过来训练动作模型。听众如果能跟着把这篇的机制捋一遍,后面再看到任何「动作世界模型」方向的工作,都能一眼看出它站在融合还是解耦这一极。
小播:先把结论预告一下,本期要讲清哪几件事?
老播:三件事。第一,融合路线具体怎么融合——三个 tokenizer、一个词表、一个 transformer,动作既当输出也当输入。第二,动作注意力掩码——自回归生成一连串动作时会出错传染,论文用一个掩码修复,这是全文机制上最有意思的部分。第三,和 VERA 的谱系对照——融合路线和解耦路线各押什么注。先放一个数字锚点:在 LIBERO 仿真基准上——LIBERO 是一个桌面机器人操作的仿真评估套件,后面实验部分会展开——加进世界模型把四任务平均成功率从 62.8% 抬到 67.2%,动作注意力掩码把动作 chunk 版本从 54.0% 拉回 76.6%。动作 chunk 先给个一句话定义:机器人一次连续执行的一小段动作序列,后面核心思想部分会细讲。
补背景:VLA 和世界模型为什么一直分开
小播:好,从背景开始。VLA 我大概知道,世界模型我也听说过名字,它们为什么合不到一起?先把术语定义清楚。
老播:先给定义。VLA,Vision-Language-Action Model,视觉-语言-动作模型。做法是拿一个预训练好的多模态大语言模型当主干,接一个动作头,把机器人该执行的动作作为输出。动作可以做成连续量,比如扩散策略、Diffusion Policy,也可以做成离散 token,比如 OpenVLA 把动作像文本一样分词,自回归地一个 token 一个 token 生成。它的问题是动作只出现在输出端:模型从没见过「执行这个动作之后,画面会变成什么样」,动作域在预训练语料里又少,所以泛化偏弱。更早的行为克隆,behavior cloning,就是直接模仿专家的观测-动作对,用视觉主干加一个动作头,问题也一样,甚至更简单。这条线的价值在于预训练多模态大模型带来了互联网规模的图文先验,这是从小数据里练出的动作头拿不到的;代价就是动作始终被当成品外挂件,模型对「动作—环境」的因果没有概念。
小播:那世界模型呢?它和视频预测模型听起来很像,我经常混。
老播:容易混,先给一个区分。视频预测模型,video prediction model,输入当前帧和任务文本,输出未来的帧,代表性的有 SVD、MAGVIT 这类视频生成模型,它从头到尾不碰动作。世界模型,world model,输入里多了动作:给定当前观测和一段动作,预测未来的观测,相当于在模型里装一个环境的物理模拟器。两者的差别就在「动作进不进条件」,这个差别后面会成为论文的一个关键实验结果,先记住。
小播:好,那世界模型本身能干什么?
老播:Ha 和 Schmidhuber 2018 年那篇《World Models》是这条线的源头,后来有 iVideoGPT 这类把视频生成当世界模型的交互式模型,也有 Cosmos 这种为具身智能准备的视频基础模型平台。它能预测未来画面,用途包括生成训练数据、做模型预测控制、在多个候选策略里挑最好的。但它有一个功能性缺口:只能输出未来的状态画面,输出不了动作。要把世界模型变成能控制机器人的东西,外面还得再接一个策略模型。再往深说一层:世界模型因为要预测「动作之后的画面」,它被迫理解动作怎样改变世界,这种理解恰恰是 VLA 缺的;而 VLA 因为要生成动作,它被迫把画面读细,这种能力又恰是世界模型缺的。两个缺口正好互补,这是 WorldVLA 整个论证的出发点。
小播:那把两者串起来不就行了吗?先预测视频,再根据视频出动作。
老播:有人这么干过,这就是级联路线。GR-1、GR-2 用视频预测来预训练动作模型;UVA,Unified Video Action Model,用一个模型配两个独立的扩散头,分别生成图像和动作。论文指出这类方案有两个隐患。第一,视频预测部分的条件里通常只有任务指令、没有动作,同一帧初始画面可以通向很多种不同的未来,训练信号带歧义——模型看到同一个开头要预测不同结局,等于被要求输出一个「平均未来」,画面容易糊。第二,动作和视频由不同模块处理,表征不共享,动作侧学到的理解传不到视频侧。WorldVLA 换了一个切口:让动作直接进世界模型的输入,也让未来帧预测的损失进动作模型的训练,两个任务在同一个模型里共享全部参数。用相关工作的话说,它站在 Chameleon、Emu3 这一支「把一切都变成 token、统一理解与生成」的谱系上。补一个背景点:把多模态理解与生成并进一个模型,2024 年 Chameleon 和 Emu3 已经证明在图文上可行,WorldVLA 做的,是把这个套路搬到「动作」这第三种模态上,并且让动作同时扮演输入和输出两个角色。
核心思想:把动作和图像并进同一个词表
小播:具体怎么做到「共享全部参数」?从模型结构开始讲。
老播:分三步。第一步,把三种模态全部变成 token,而且放进同一个词表。图像用 VQ-GAN 编码,这是一个向量量化生成模型,压缩率 16,码本大小 8,192;256×256 的图变成每帧 256 个 token,512×512 的图变成每帧 1,024 个 token。文本用 BPE 分词,总词表 65,536,注意这个数字已经包含那 8,192 个图像 token 和 256 个动作 token。动作是 7 维:3 个相对位置、3 个相对角度、1 个夹爪绝对状态,每一维按训练数据范围量化成 256 个 bin。到这一步,图像、文本、动作都是同一套词表里的符号,可以在同一个 transformer 里按 token 序列互相条件。这里可以先算一笔账,后面用得上:512×512 的一帧图是 1,024 个 token,而一个动作只有 7 个 token,图像侧的数量是动作侧的 146 倍,这个数量级差距直接决定了损失权重 α 为什么要压到 0.04。
小播:所以「统一自回归」的意思是,动作和图像在同一个序列生成框架里走?
老播:对,这就是融合路线的核心。第二步,主干直接初始化自 Chameleon,一个把图像理解和图像生成并进同一个 transformer 的模型,正好提供「视觉既当输入又当输出」的能力。第三步是训练目标。论文把问题形式化拆成两个函数:动作模型 π_θ 从历史图像观测 o_{t-h:t} 和语言指令 l 生成动作 a_t,也就是 a_t = π_θ(a_t | o_{t-h:t}, l);世界模型 f_ϕ 从历史观测和动作序列预测下一帧 o_t = f_ϕ(o_t | o_{t-h:t-1}, a_{t-h:t-1})。这两个式子要回答的问题分别是「下一步该做什么」和「环境下一步会变成什么样」,符号里 θ 和 ϕ 是两边的参数,h 是历史窗口长度,t 是当前时刻,o 是观测帧,a 是动作,l 是指令。论文的关键主张:这两个函数装进同一个模型 M_ψ,参数只有一份,动作分支和世界分支分开算损失,但网络共享。这里的「自回归」值得再解释一层:整个模型就是一个 next-token 预测器,给定前面已经生成的 token,预测下一个 token 的概率分布,图像、文本、动作都在这个统一框架里,区别只在条件段和生成段的划分。补充一个数字感受:训练时输入图像数 M 默认是 2,动作 chunk 数 K 在 Long 上是 10、其余任务上是 5,世界模型只滚 1 轮,这些是论文实验部分的默认配置。
小播:两个任务在一个模型里,损失怎么合?
老播:训练目标写成 L = L_action + α·L_world。这个式子回答「两类任务怎么合成一个损失」。L_action 是动作模型数据上的交叉熵损失,L_world 是世界模型数据上的交叉熵损失,α 是平衡权重。为什么需要 α:图像 token 每帧 256 到 1,024 个,动作 token 只有 7 个,数量差几十倍,直接相加世界模型的损失会主导训练、动作信号被淹没,所以论文把 α 定在 0.04。数据组织上,两类样本都拼成带特殊标记的 token 序列:动作模型样本的开头是一句固定模板文本「What action should the robot take to 加任务指令」,中间放 M 帧图像 token,结尾放 K 个动作 token;世界模型样本则是「Generate the next frame based on the current image and the action」加上当前图像和当前动作,输出下一帧的图像 token。序列里 [BOS]、[BOI]、[EOI]、[BOA]、[EOA] 这些特殊 token 负责把不同模态的区间切开,训练时只对输出段的 token 算损失。动作模型的数据占比被 α 压得很低,但后面会看到,这么小的占比带来的提升依然能被测出来。
小播:0.04 这么小的权重,世界模型凭什么还能帮到动作模型?
老播:论文给了三个机制层面的理由,这也是「为什么有效」的核心。第一,预测未来帧要求模型理解环境物理,也就是动作怎样改变状态,这个理解直接服务抓取这类需要精细操作的任务。第二,世界模型可以模拟候选动作的后果,帮模型提前避开会走向坏状态的动作。第三,世界模型必须精确解读动作输入,才能预测正确画面,这反过来逼动作模型把动作生成得更合理。反方向,动作生成也帮世界模型:生成动作的过程强迫模型做更细的视觉理解,理解了画面才能预测下一帧。这双向的机制,就是「动作和图像互相增强」这句话的含义,也是本期要反复强调的第一条结论。
小播:推理的时候,模型到底怎么用?动作和画面不会同时生成吗?
老播:好问题,这正好说明两个分支怎么分工。做决策时走动作分支:喂 M 帧历史图像和指令,一次生成 K 个动作,机器人执行完再拍新画面,滑窗继续。做预测时走世界分支:喂当前图像和当前动作,生成下一帧的图像 token,如果要更长地平线,就把预测出的帧再当输入滚下去。两个分支共享同一份参数,但在不同的 token 区间上做生成,这正是 Figure 2 那张结构图想表达的意思。论文训练时为了省钱,世界模型只滚 N 等于 1 轮,也就是一次只学预测一帧。
小播:融合之后,训练和推理上遇到什么具体的坑?
老播:遇到一个很具体的坑,也是这篇最有意思的机制。动作是自回归生成的,一次要连出 K 个动作,这叫动作 chunk。先补一个定义:因果注意力掩码是自回归模型的标配,规定每个 token 只能看到它前面已经生成的 token,看不到后面的,这样生成才能一个接一个进行。问题是:后面的动作 token 因此能看前面已经生成的动作 token,而动作域在预训练里接触太少、泛化弱,前面动作一旦出错,错误会顺着同一个动作空间传染给后面的动作,chunk 越长崩得越狠。论文的修法叫动作注意力掩码:生成当前动作 token 时,把先前所有动作 token 从注意力范围里屏蔽掉,只允许它看文本和图像。这样每个动作直接由视觉和指令决定,K 个动作实际上可以并行解码,不用一个等一个。世界模型分支继续用标准因果掩码。这个思路和 OpenVLA-OFT 的并行动作头一致,但人家换了输出结构,WorldVLA 只在注意力连接方式上做文章,改动更小,后面实验部分能看到效果很直接。
关键实验:世界模型帮动作、动作帮世界、掩码救 chunk
小播:数字说话。评测在哪个环境,baseline 都有谁?
老播:评测在 LIBERO 仿真基准,四个子集:LIBERO-Spatial、Object、Goal、Long,分别考空间关系、物体识别、目标变化和长程任务,另外还有个 LIBERO-90 用来做大尺度预训练对比。具体说:Spatial 是根据位置放碗,考空间关系;Object 是识别并拾取放置独特物体,考物体识别;Goal 是固定物体、不断变目标,考程序化学习;Long 包含 10 个长程任务,考多步骤执行。每个任务跑 50 次 rollout 记成功率,成功率就是完成任务的比例;世界模型评测用 FVD、PSNR、SSIM、LPIPS 四个指标,FVD 衡量生成视频与真实视频分布的距离,越低越好,PSNR、SSIM 越高越好。数据按 90% 训练、10% 验证切分,世界模型评测需要视频和动作成对的地面真值,所以单独留了验证集;Table 2 那组对比用全部数据训练,保证和基线站在同一条起跑线上,其余消融用 90% 训练集。先看整体战绩,Table 2:WorldVLA 在 256×256 分辨率下四任务平均成功率 79.1%,512×512 下 81.8%,两个都超过带大规模预训练的离散动作基线 OpenVLA 的 76.5%。512 分辨率下四个子任务的单列数字是 87.6、96.2、83.4、60.0,Spatial 和 Object 已经逼近连续模型。对照连续模型那一组更有味道:DiT Policy 带预训练平均 82.4,WorldVLA 512 不带预训练平均 81.8,几乎追平;Octo 带预训练 75.1,被 WorldVLA 反超。注意一个细节:WorldVLA 没有大规模机器人预训练,OpenVLA 有,所以这个对比撑起「融合设计本身有效」的论断。另一个细节:分辨率从 256 提到 512,平均涨 2.7 个点,论文归因于 Chameleon 预训练本身按 512 优化,以及抓取任务需要更精细的视觉信息。不过连续动作模型 OpenVLA-OFT 平均还是 95.4%,这个差距留到局限里说。
小播:「世界模型帮动作模型」具体怎么测出来的?
老播:看 Table 3 的消融,一行一行加东西,这是本期最该记住的表。第 1 行,只有动作模型、逐动作生成,四任务平均 62.8%。第 2 行,加进世界模型数据,67.2%,涨 4.4 个点。第 3 行,换成动作 chunk 但用默认因果掩码,平均掉到 54.0%,其中 Spatial 从 77.8% 跌到 36.7%,Long 从 23.0% 跌到 16.9%——这就是自回归 chunk 的退化,先出的动作错误传染给后面的。第 4 行,加论文的动作注意力掩码,平均回到 76.6%,比第 3 行涨 22.6 个点,已经反超不 chunk 的第 1 行。第 5 行,再叠世界模型,78.1%。这组数字把两个结论都钉死了:世界模型帮忙是真的,掩码修复 chunk 退化也是真的。
小播:有没有更直观的证据?
老播:有,Figure 4 是抓取场景的定性对比。纯动作模型经常直接把手移到目标位置,但没抓住奶酪或者瓶子,任务就失败了;动作世界模型会反复尝试抓取,直到成功握住物体才往目标移动。这就是世界模型在线的价值:它能模拟「这个动作会有什么后果」,模型据此知道刚才那次抓取没成功、需要重试。定性图和 Table 3 的定量数据互相印证,是第一条结论的两份证据。
小播:动作 chunk 那张图怎么读?我想知道曲线长什么样。
老播:Figure 6 是动作 chunk 长度消融,四个子任务各一张小图,横轴是 chunk 长度,纵轴是成功率,图上画两条曲线:一条朴素因果掩码,一条论文掩码。读图的关键在趋势:朴素掩码的曲线随 chunk 变长掉得很快,说明错误在动作序列里传播;论文掩码的曲线在长 chunk 下保持平稳,说明屏蔽先前动作确实切断了传播。两条曲线在 chunk 特别长的时候都会回落,论文的解释是 chunk 太长会让策略没法及时根据新观测更新,这是动作 chunk 方案的固有代价,掩码只能缓解。另外 Table 5 里有个配套数字:同样两帧输入,动作 chunk 让推理速度从每秒 1.77 个 rollout 提到 3.13,chunk 的工程价值也在这里,一次出多个动作少跑几次模型。
小播:反过来,动作模型帮世界模型,证据在哪?
老播:Table 4 评未来帧预测质量,用 FVD、PSNR、SSIM、LPIPS 四个指标,FVD 越低越好,它衡量生成视频和真实视频分布的距离。关键在预测长度:10 帧时两者几乎打平,动作世界模型 FVD 255.1 对纯世界模型 250.0,略差一点点;预测 50 帧时,动作世界模型 674.1,明显好于纯世界模型 718.6,PSNR 也从 23.98 升到 24.30。也就是说,动作带来的增益主要在长序列预测上,短预测看不出差别。Figure 5 的定性例子更醒目:纯世界模型预测出打不开抽屉、移动盘子之后碗直接消失、没能把碗放上炉子,这些画面在物理上站不住;动作世界模型给出的后续帧连贯、符合物理。论文的解释:生成动作的过程增强了视觉理解和行为模式理解,这两样都是预测未来画面需要的。这条和前面那条合起来,就是「互相增强」的完整证据链:世界模型帮动作模型有 Table 3 和 Figure 4,动作模型帮世界模型有 Table 4 和 Figure 5,两个方向都有定量和定性两套证据。
小播:还有一组成果是对比「世界模型」和「视频预测模型」,这两个名字很容易混,这个对比解决什么问题?
老播:它回答「帮动作模型的视觉生成应该以什么为条件」。两者都预测未来视觉,区别只在条件:视频预测模型只以任务文本为条件、不带动作,对应 GR-1、GR-2 的预训练路线;世界模型以动作为条件。Figure 7 是柱状图,五个栏目是 Goal、Object、Spatial、Long 和 Average,每个栏目里动作世界模型和视频预测模型并排比成功率。结果显示,动作世界模型在全部四个子任务上都提升动作成功率,视频预测只在两个任务有益、在一个任务上还掉点。原因就是背景里埋的歧义:没有动作条件时,同一帧画面可以通向多种可能的未来,训练信号带歧义;动作条件同时消除了歧义、又强迫模型理解动作。这条结论和前面的机制解释互相印证,是本期的第二条重点:世界模型和视频预测模型的分界在动作条件。
小播:有没有更工程向的消融?
老播:有两个可以提。Table 5 关于历史图像输入数量:从 1 帧加到 2 帧,动作 chunk 版本成功率从 74.0% 涨到 84.4%,2 帧到 4 帧只到 84.7%,说明两帧上下文就够,再往上收益很小。论文的解释是 VQ-GAN 这种离散图像 tokenizer 的语义理解弱于 CLIP 类编码器,多给帧是补短板最便宜的办法。Table 6 关于世界模型预训练:先用世界模型目标预训练、再训动作,平均成功率从 62.8% 涨到 66.8%,Long 任务从 23.0% 涨到 30.2%,涨得最明显的就是最需要长程推理的 Long。
和 VERA 对照:世界模型的两极怎么选
小播:现在把谱系拉远。阅读提示专门说,要和 VERA 的解耦路线对比,形成世界模型的两极。展开讲讲。
老播:这是理解这篇论文最重要的坐标系。当前把世界模型变成机器人策略,有两条路线,各占一极。WorldVLA 是融合路线:动作和图像在同一个自回归模型里联合生成,动作直接进世界模型的输入,两边共享表征、互相增强;代价是单一模型要同时服务两个任务,动作域泛化弱要靠掩码这类机制去补,离散动作 token 化还有信息损失。VERA 是解耦路线,论文全称 Turning Video Models into Generalist Robot Policies,arXiv 2605.27817。它让一个动作无关的视频世界模型只负责输出视觉计划——那个规划器是一个基于 Wan 的视频扩散模型,规模 14B——另外训练一个按机体 Jacobian 结构化的逆动力学模型,把预测视频里的像素运动翻译成动作。Jacobian 是机器人运动学里的雅可比矩阵,在这里用来建模「像素动一点、关节该动多少」的局部线性关系,逆动力学就是由画面的运动反推动作。注意 WorldVLA 把动作 token 写进世界模型的输入序列,VERA 的动作从头到尾不进视频模型,这个结构性差别就是「两极」的由来。
小播:解耦路线的好处是什么?
老播:三点。第一,视频规划器保持动作无关,可以跨本体复用,换一个机器人只换小的逆动力学模型。第二,不同视频模型可以随意替换,不用重新训练逆动力学模型。第三,逆动力学模型可以用自对弈数据单独训练,数据好找,而且按 Jacobian 结构化之后,动作自由度升高时它的精度掉得慢,数据效率也更高。代价也明显:视频到动作的翻译可能失真,每个本体都要单独采动作数据训练逆动力学模型,翻译这一步成了整条管线的瓶颈。两篇论文各自的证据:WorldVLA 靠消融证明互相增强,VERA 靠零样本 Panda 机械臂操作和 16 自由度 Allegro 灵巧手证明解耦能落地。这里也顺便交代 WorldVLA 在融合这一极里和 UVA 的差别:UVA 也是统一出图出动作,但用的是两个独立扩散头,WorldVLA 把一切都压进单一词表的自回归,属于 next-token 谱系,和 Chameleon、Emu3 一脉相承。
小播:所以一句话总结两极?
老播:融合路线把动作请进世界模型内部,解耦路线把动作挡在世界模型外面,「动作放在哪」是分水岭。融合赌共享表征的互惠收益大于相互干扰,解耦赌模块隔离的灵活性和可复用性大于表征不共享的损失。两条路线目前都有各自的证据和短板,谁对现在还难说,合在一起看才是世界模型走向机器人策略的全貌。这是本期的第三条重点,我在收尾还会再提一次。另外在更小的粒度上,WorldVLA 还对照 UVA:UVA 也统一视频和动作,但用两个独立的扩散头,WorldVLA 用离散自回归加单一词表,属于 next-token 谱系;对照 OpenVLA:WorldVLA 无预训练也能超它 2.6 到 5.3 个点,差异来自世界模型分支和动作掩码。再对照级联的 GR-1、GR-2:它们的视频预测不带动作,WorldVLA 用 Figure 7 的实验专门证明,带动作的世界模型在全部任务上都能帮动作模型,不带动作的视频预测只在部分任务有益。
泼冷水:增益有多大、证据有多窄
小播:泼冷水环节。这篇的证据有哪些短板,先说你读出来的最弱一环。
老播:最弱的一环,我会说是世界模型带来的平均增益本身。注意 Table 3:在已经加了动作掩码的版本上,世界模型只带来 76.6% 到 78.1% 的 1.5 个点;Table 4 里 10 帧预测的 FVD 255.1 反而略差于纯世界模型 250.0,优势集中在 50 帧长序列;α=0.04 这个关键权重怎么选出来的,论文没有给消融。也就是说,「世界模型帮忙」在定性图和长序列指标上很漂亮,但平均成功率的增量有限,说服力主要来自机制解释和可视化,定量证据偏薄。往深说一层:如果世界模型的核心价值是学物理、模拟后果,那它应该对长程、多步骤任务帮助最大,论文里 Long 任务从 23.0% 到 30.2% 也确实涨得多,但这个方向的证据只有一个任务族,还没铺开。
小播:还有别的短板吗?
老播:论文自承三条。第一,离散图像 tokenizer VQ-GAN 的感知表达力有限,设计统一的理解-生成 tokenizer 是改进方向。第二,数据与模型规模没有 scaling,论文结论部分自己说了,扩数据和扩模型是下一步。第三,只在 LIBERO 仿真上评测,没有真实机器人实验,也没有报告参数量、训练步数、推理成本这些工程数字。我们补充两条。第一,离散动作 token 化的代价实打实:平均成功率 81.8% 对连续动作模型 OpenVLA-OFT 的 95.4%,差 13.6 个点;「离散天生差」这个判断部分来自 256 个 bin 的量化设计,统一框架本身的价值还需要在连续动作输出上重新验证。第二,评测任务都是单臂桌面抓取、放置、开门,类别单一,跨本体、真实环境、长程任务的证据缺失,复现门槛偏高。另外还有一个没被论文正面处理的点:动作掩码让每个动作只看视觉,等于放弃了动作序列内部的时序一致性,这对平滑运动的代价论文没有量化,只给了成功率的净效果。开源方面,论文给了 GitHub 仓库地址,但权重有没有随文发布没有写明,想复现还得自己训。
收尾:这期记住这三件事
小播:收尾。这期信息量不小,记住哪三件事?
老播:第一,融合路线。WorldVLA 把动作和图像并进同一个自回归模型,三个 tokenizer 共用同一个 65,536 词表,动作既当输出也当世界模型的输入,同一份表征服务两个任务,互相增强——世界模型把平均成功率从 62.8% 抬到 67.2%,动作模型把 50 帧预测的 FVD 从 718.6 降到 674.1。第二,动作注意力掩码。自回归生成动作 chunk 的退化来自同空间错误传播,把先前动作从注意力里屏蔽掉、让每个动作只由视觉决定,平均成功率就从 54.0% 拉回 76.6%,改动只在注意力连接方式,架构没动。第三,两极地图。融合路线 WorldVLA 和解耦路线 VERA 对「动作放在哪」给出相反答案,融合赌共享表征互惠,解耦赌模块隔离复用;这两条路线合起来,才是世界模型变成机器人策略的全貌。再补一句这篇对后续工作的意义:它证明了在机器人这个动作数据稀缺的场景里,「让模型先学会预测动作的后果」是一条可行的补数据路径,后来的工作把世界模型预训练、统一 tokenizer、连续动作输出这些方向接着做下去,很多都能追溯到 WorldVLA 这三个贡献上。
小播:好,那我们下次见。
老播:下次见。