Fractal Generative Models:递归调用生成模型的生成模型(泛读)
问题与背景
计算机科学里,模块化(modularization)是把复杂函数抽象成原子构件的基本手段:深度神经网络由原子「层」堆出来,扩散模型和自回归模型由原子「生成步」组成,每一步由神经网络实现。这篇来自 MIT(Tianhong Li、Qinyi Sun、Kaiming He)和 Google DeepMind(Lijie Fan)的论文想再往上抬一级:把「整个生成模型」本身当成原子模块,递归地在生成模型内部调用同类的生成模型,构造出自相似的分形架构,命名为分形生成模型(Fractal Generative Models)。
动机来自两个观察。第一个观察是大脑:多项研究(Bassett 2006、Sporns 2006、Bullmore & Sporns 2009)发现生物神经网络存在分形或近分形的小世界组织,大脑的发育大量采用模块化,从小的网络递归构建更大的网络。第二个观察是自然数据:云、树枝、雪花、晶体、染色质、蛋白质都呈现分形或近分形模式,更宽泛地说,图像由子图组成、分子由子分子组成、生物神经网络由子网络组成。论文的立场是:如果数据本身可以按层级递归切块,生成模型也应该由「本身是生成模型」的子模块递归组成。
论文用分形几何里「generator」(生成器,即构造分形的递归规则)一词称呼这个递归规则:生成器 g_i 根据上一级生成器的一个输出 x_i,产生下一级的一组新数据 {x_{i+1}} = g_i(x_i)。分形有一个关键性质:每一层一个输入可以产生多个输出,输出数随层数指数增长,而层数只需对数增长。把这个性质装进神经网络,就是用一个参数化的生成模型当生成器,让网络从数据里学递归规则,从而把指数级输出增长用在建模高维数据上——这正是「递归调用原子生成模块的自相似架构」这条 reading_tip 考点。
核心思想:分治分解联合分布
框架落地为自回归模型时,目标是用一个可管理的序列长度 k,建模 N = k^n 个随机变量的联合分布,其中 n = log_k(N) 是递归层数。直接用一个自回归模型建模全部 N 个变量在计算上不可行,论文采用分治策略:第一级把联合分布切成 k 块,每块含 k^{n-1} 个变量,每块的条件分布交给第二级的自回归模型,如此递归。
分解写成公式就是:p(x_1, …, x_{k^n}) = Π_{i=1}^{k} p(x_{(i-1)k^{n-1}+1}, …, x_{i·k^{n-1}} | x_1, …, x_{(i-1)k^{n-1}})。先给预期:这个式子回答「联合分布怎么切成小块、每块由谁负责」。逐符号解释:左侧 p(x_1, …, x_{k^n}) 是全部 N 个变量的联合分布;右侧是 k 个条件分布的乘积,第 i 个因子负责第 i 块 k^{n-1} 个变量,条件部分是已经建模过的前面所有变量;每个因子由下一级的自回归模型负责,递归 n 层后,最底层只需处理 k=3 的像素 RGB 通道。这个分解让整个框架用 n 层、每层长度 k 的短序列模型处理 k^n 个变量,注意力从全序列平方级降到局部块内平方级,同时层级结构与图像的多尺度结构吻合。
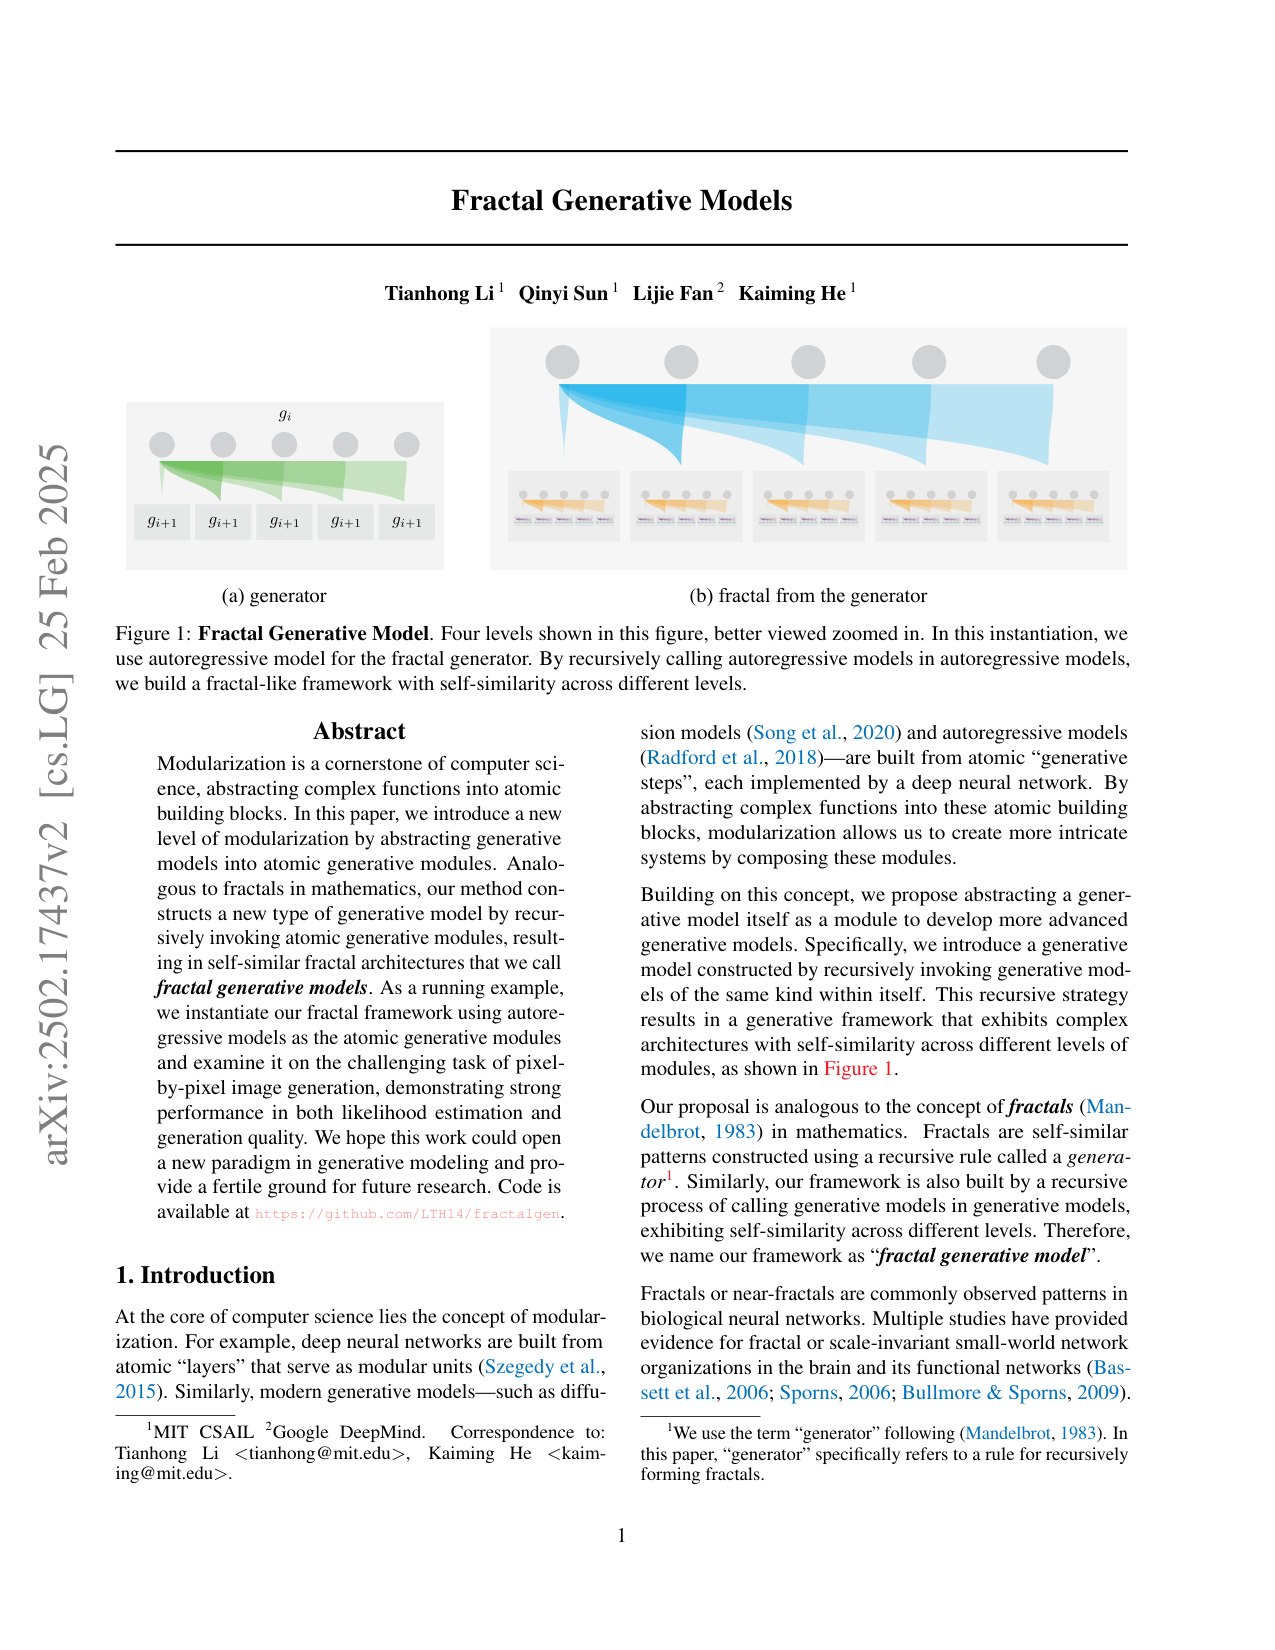
上图是论文 Figure 1 的示意图:左边是单个 generator,右边是 4 层分形展开,每个灰色盒子是一个自回归模型,父块生成多个子块,结构跨层级自相似。递归嵌套的自相似架构在这里直接可见:每层分支数固定时,输出的数量随层数指数增长,层数则只需随总变量数对数增长。
架构与训练:从 16×16 patch 到单个像素
实例化任务选在逐像素(pixel-by-pixel)图像生成上:不经过 tokenizer,直接在原始像素上建模 256×256×3 = 196,608 个变量。第一级 g1 的序列长度 256,把图像切成 16×16 个 patch;第二级 g2 把每个 16×16 patch 再切成 4×4 个 patch;第三级 g3 建模 4×4 patch 内像素间的依赖;最后一级 g4 用极轻量 transformer 对每个像素的 R/G/B 三通道做 256-way cross-entropy(RGB 值当作 0–255 的离散整数)。每一级的数据流见 Figure 3:transformer 的输入序列是「上一级 generator 的输出 token(放在最前)」加上「当前图像 patch 的嵌入」,输出交给下一级的多个子模型。
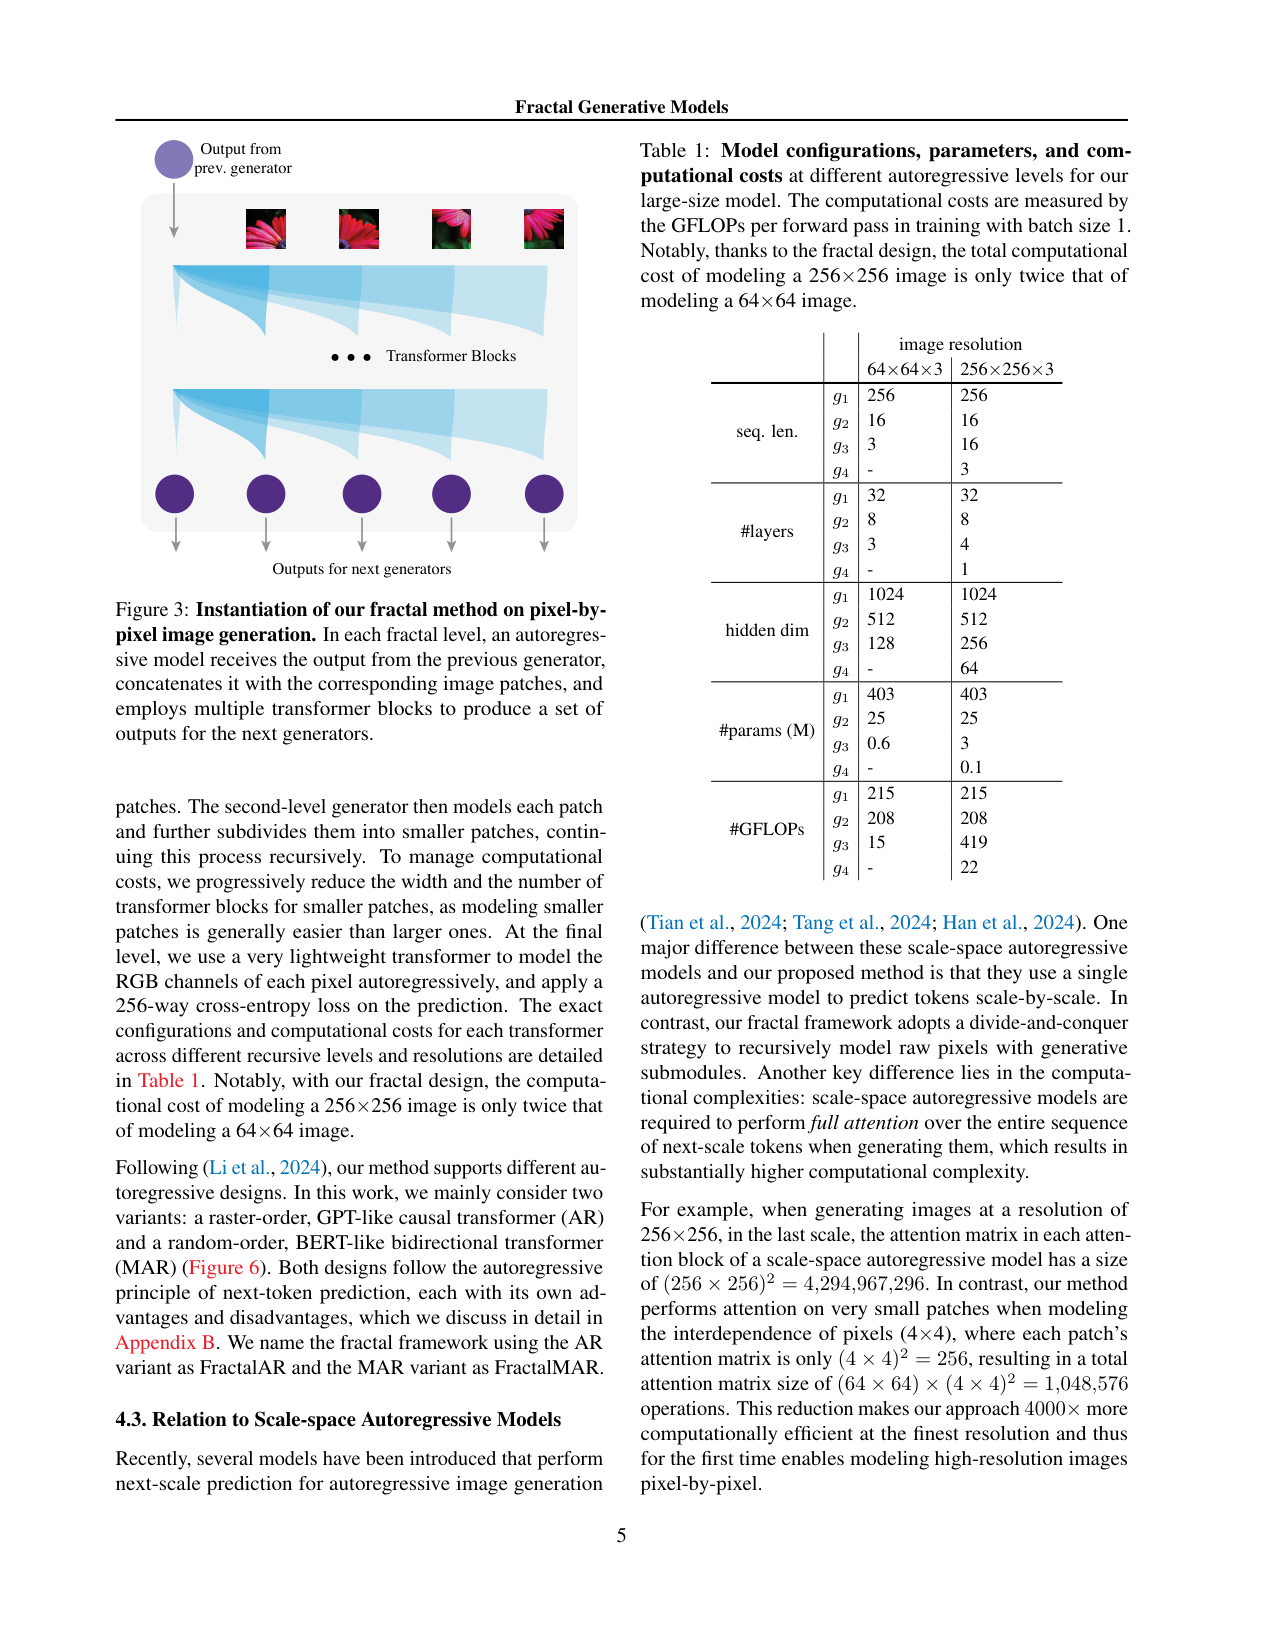
计算上有个关键数字:层级越深、patch 越小、建模越简单,所以论文逐级缩减 transformer 宽度与层数(g1 32 层 hidden 1024、403M 参数、215 GFLOPs;g2 8 层 512、25M、208 GFLOPs;g3 4 层 256、3M、419 GFLOPs;g4 1 层 64、0.1M、22 GFLOPs,256×256 配置),结果是建模 256×256 图像的总计算量约 864 GFLOPs,只有建模 64×64(约 438 GFLOPs)的约 2 倍。
框架支持两种自回归 generator 变体:AR 是 raster 顺序的 GPT 式因果 transformer,支持 KV-cache 加速;MAR 是随机顺序的 BERT 式双向 transformer,来自 Li et al. 2024 的 MAR 工作,可并行预测多个 patch。对应命名 FractalAR 与 FractalMAR。训练端到端进行,按广度优先遍历整棵分形结构:每级接收上一级输出、向下传导,损失在最底层的像素级 cross-entropy 上计算并回传经过所有层级。生成按深度优先遍历:第一级建模 16×16 patch 间依赖,逐级往下,最后一级采样 RGB 值。256×256 实验里额外加了两个工程细节:guiding pixel(每级先预测当前 patch 的平均像素值作为全局条件)和邻接 patch 上下文(给下一级提供当前 patch 周围 4 个 patch 的输出,缓解 patch 边界不一致)。
关键结果
似然估计(无条件 ImageNet 64×64):分形层数越多越好。单层 full-length 模型(序列长度 12,288)需要 29,845 GFLOPs 且训练不可行;2 层框架(4,096+3)要 5,516 GFLOPs、NLL 3.34 bits/dim;3 层 FractalAR 只要 438 GFLOPs、NLL 3.14 bits/dim,FractalMAR 3.15。对照其它似然模型:此前最佳自回归方法(Perceiver AR、MegaByte)3.40,扩散方法 NFDM 3.20、flow matching 3.31,PixelCNN 3.57。3.14 的绝对值压过所有自回归基线约 0.26 bits/dim,与扩散方法同级——这组消融同时展示「更深的递归层级更省算力 + 似然更好」,是论文最有力的机制证据。
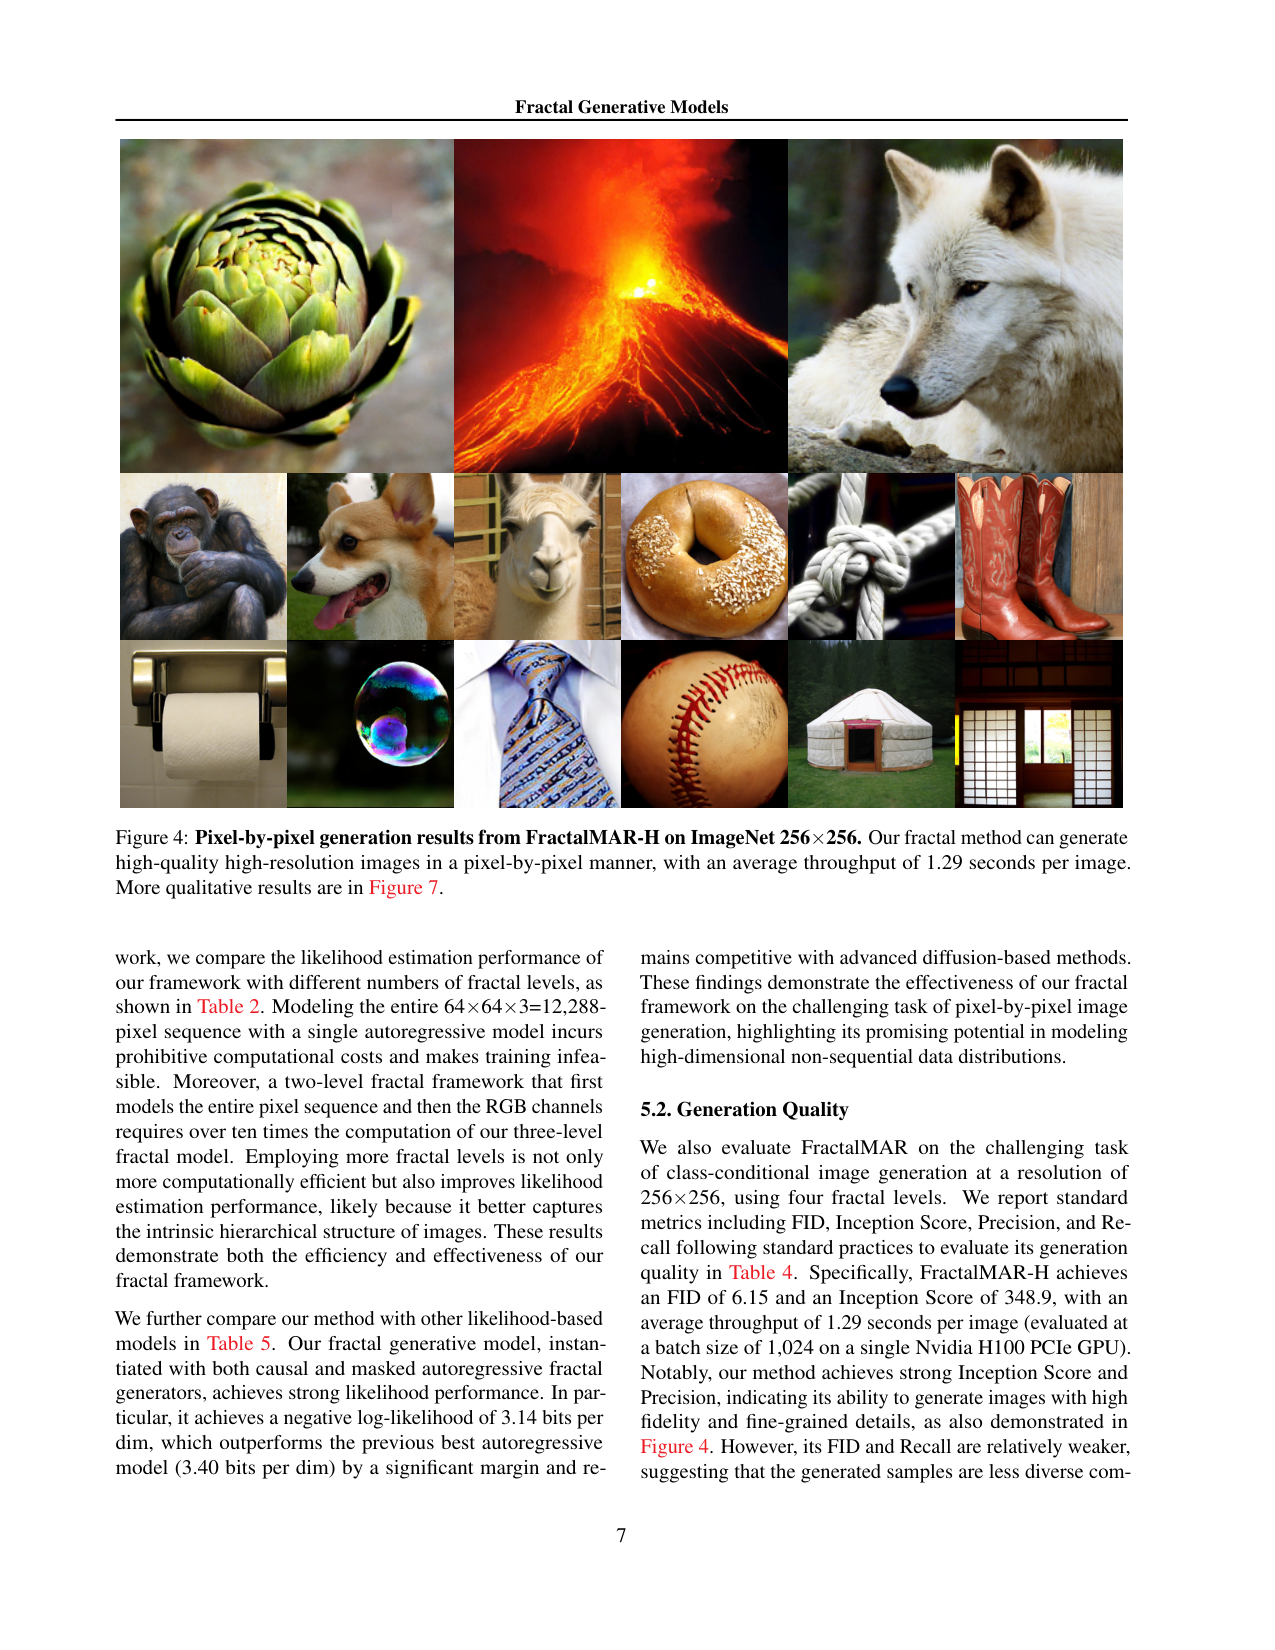
生成质量(类条件 ImageNet 256×256):FractalMAR-H(848M 参数,4 级)FID 6.15、Inception Score 348.9、Precision 0.81、Recall 0.46,平均吞吐 1.29 秒/张(batch 1024、单张 Nvidia H100 PCIe)。对照同一张 Table 4:VDM++(2B)FID 2.12、StyleGAN-XL(166M)2.30、ADM(554M)4.59、GigaGAN(569M)3.45。FractalMAR-H 的 IS 348.9 和 Precision 0.81 高于全部对照(StyleGAN-XL 265.1 / 0.78),说明保真度高、细节丰富,见 Figure 4 的生成样本;但 FID 6.15 与 Recall 0.46 偏低,说明多样性弱于扩散与 GAN,作者归因于逐像素建模近 20 万像素的难度。缩放趋势明确:参数从 186M 涨到 848M,FID 从 11.80 降到 6.15、Recall 从 0.29 涨到 0.46,论文预期更大模型能继续缩小差距,且因为没有 tokenizer,不存在重建误差对生成质量的天花板。
条件逐像素预测(Figure 5,定性):inpainting(补洞)、outpainting(外扩)、uncropping(大掩码外扩)、class-conditional editing(用类别标签把猫脸换成狗脸)都能在掩码条件下准确预测未知像素。逐像素生成让过程人类可读可控,这既是可控生成能力,也顺带解释了为什么这个方法天然适配图像编辑类任务。
效率对比(理论 GFLOPs):与尺度级自回归(VAR、HART、Infinity)比,后者用单个模型逐尺度预测、生成下一尺度 token 时要做整条序列的全注意力;256×256 图像最后尺度上,单个注意力矩阵有 (256×256)² ≈ 4.29×10⁹ 项。本文在 4×4 patch 内做注意力,每块矩阵 (4×4)² = 256 项,全图共 (64×64)×256 ≈ 1.05×10⁶ 项,约 4000 倍差距。这是论文「首次让逐像素建模高分辨率图像可行」的主要依据。
谱系定位
与 FractalNet(Larsson et al. 2016)同源——它用递归调用卷积块构成分形网络,但模块粒度是卷积小块、任务是分类;本文把模块粒度抬到「整个生成模型」,任务输出是百万像素。与尺度级自回归(VAR/HART/Infinity)的差别在「单模型逐尺度」对「分治递归子模型」;与长序列建模(MegaByte、Perceiver AR)的差别在「图像当一维序列」对「图像当集合、递归切块」;与级联扩散、tokenizer+latent 两级范式的差别在「分层但不递归」对「递归 + 自相似」。放在 He 组的脉络里看,这是「极简结构」风格的又一例:ResNet 用残差块反复堆叠,MAR 把扩散模型模块化,这篇把「分治递归」当成唯一规则,用一个可复用模块构造整棵架构。
局限
- 多样性偏弱:FractalMAR-H FID 6.15 / Recall 0.46,低于 VDM++(2.12)与 StyleGAN-XL(2.30,Recall 0.53);「更大模型补差距」是作者的预期,论文只验证到 848M。
复现
代码已开源:https://github.com/LTH14/fractalgen 。训练配置完整:AdamW(weight decay 0.05、momentum 0.9/0.95),batch 2048(64×64)/1024(256×256),base learning rate 5e-5 按 batch/256 缩放,40 epochs 线性 warmup 加 cosine 调度,总 400 epochs;256×256 额外使用 guiding pixel 与邻接 patch 上下文;CFG 在训练时用 10% dummy class,推理时线性 CFG 调度加 top-p 0.0001 截断。论文未明确说明是否发布预训练权重。
把「整个生成模型」当作原子模块,递归地在生成模型内部调用同类的生成模型,得到自相似的分形架构;用自回归模型实例化后,在 ImageNet 64×64 无条件下 NLL 3.14 bits/dim(对照此前最佳自回归 3.40),并首次把逐像素生成推进到 256×256 高分辨率(FractalMAR-H FID 6.15、IS 348.9,对照 VDM++ FID 2.12),核心机制是分治式联合分布分解带来的指数级输出扩展与局部化注意力。
阅读提示
精读深度:泛读
清单提示:原文提示:递归调用原子生成模块的自相似架构;He 组「极简结构」风格的又一例。
问题
要解决什么:生成模型的高维建模成本问题:直接用一个自回归模型对 256×256×3=196,608 个像素的联合分布做全序列建模,注意力矩阵大到无法训练;而逐像素(pixel-by-pixel)生成恰恰是检验生成模型能否处理高维非序列数据(图像、分子、蛋白质)的代表性任务。论文用分治思想把联合分布递归切块,每层只处理长度 k 的短序列,层数 n=log_k(N) 随总变量数 N 对数增长。
为什么 prior work 不够:此前逐像素方法把图像当一维长序列,靠稀疏注意力或压缩表示降成本(Sparse Transformer、Routing Transformer、Perceiver AR、MegaByte),多数只做到似然估计、生成质量差;尺度级自回归(VAR、HART、Infinity)用单个模型逐尺度预测 token,最后一个尺度仍要对整条序列做全注意力;两级 tokenizer+生成器范式(VQ-VAE、cascaded diffusion)分层但缺少递归与自相似。这些方法都没有利用图像「子图仍是图」的递归结构,也没有把生成模型本身当成可复用的原子模块。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 原始图像(或上一级 generator 的输出 token) | RGB image / latent token | 第一级 g1 输入整图 256×256,切成 16×16 patch 嵌入成序列;后续各级输入对应 patch 的图像块与上一级 generator 的输出 token,token 放在图像 token 序列之前 |
| guiding pixel(256×256 实验) | scalar | 每级先用上一级输出预测当前输入图像块的平均像素值,作为额外条件注入 transformer,提供全局上下文 |
| 类别标签 c(class-conditional) | discrete class | ImageNet 类别;训练时 10% 样本替换为 dummy class token 以支持 classifier-free guidance |
| 当前 patch 周围 4 个 patch 的上一级输出 | latent token | 生成时提供给下一级 generator,缓解 patch 边界不一致 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 下一级 generator 的输入 token 集合 | latent token | 每级 transformer 基于(上一级输出 + 图像 patch token)预测一组输出,作为下一级各子模型的条件 |
| 逐像素 RGB logits(最后一级) | discrete distribution over 256 values | 最后一层轻量 transformer 对每个像素的 R/G/B 三通道各自做 256-way cross-entropy,RGB 值当作 0-255 的离散整数 |
| 生成图像 | RGB image | 深度优先遍历分形架构逐像素采样,256×256 图像约 1.29 秒/张(batch 1024、单张 Nvidia H100 PCIe) |
控制频率:n/a(图像生成;无机器人控制。推理为深度优先逐像素采样,采样数 = 像素数 ≈196,608 步的逐通道预测)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet-1K(64×64) | 约 128 万张训练图 | 无条件似然估计(NLL bits/dim)+ 条件生成(FID);层数消融、通道顺序实验都在此分辨率 |
| ImageNet-1K(256×256) | 约 128 万张训练图 | 类条件生成(FID/IS/Precision/Recall)+ 条件逐像素预测(inpainting/outpainting/uncropping/class editing);4 个分形层级 |
架构(摘要)
主干与结构
backbone:ViT 风格 transformer(每级层数/宽度随 patch 变小而递减,见 Table 1:g1 32 层 hidden 1024 → g2 8 层 512 → g3 4 层 256 → g4 1 层 64)
参数:FractalMAR 全套(256×256 4 级):H 版 848M 参数;64×64 3 级共约 428M(403+25+0.6)
类型:递归嵌套的自回归模型(fractal framework):每级是一个独立的 transformer 自回归模型,接收上一级输出 + 当前图像 patch,输出下一级子模型的输入;最后一级逐像素预测 RGB
关键组件
- 原子模块抽象:把 p(x|c) 的自回归模型当作模块单元,模块内部递归调用同类的模块
- 分治分解:p(x_1..x_N) = Π_i p(第 i 块 | 前面的块),每块交给下一级自回归模型
- 两种 generator 变体:AR(raster 顺序 GPT 式因果 transformer)与 MAR(随机顺序 BERT 式双向 transformer,源自 MAR/Li et al. 2024)
- 宽度逐级缩减 + guiding pixel + 邻接 patch 上下文,保证多级训练/生成稳定
为什么这样设计
图像天然是「子图仍是图」的近分形对象,把整图联合分布按分治递归切成小块,每级只需建模长度 k 的短序列与局部 patch 内依赖,注意力从整图平方级降到 4×4 局部平方级;层级越深 patch 越小、建模越简单,所以逐级缩减 transformer 规模,使得 256×256 的总计算量只有 64×64 的约 2 倍(864 vs 438 GFLOPs)
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 无条件似然 NLL(bits/dim) | 3.14(FractalAR) | 此前最佳自回归模型 3.40(Perceiver AR、MegaByte);扩散方法 NFDM 3.20、flow matching 3.31 | unconditional ImageNet 64×64 test set,论文 Table 3 |
| 分形层数消融(NLL / 计算量) | 3 层:3.14、438 GFLOPs | 2 层:3.34、5516 GFLOPs;单层 full-length(12288 序列):29845 GFLOPs 且训练不可行 | unconditional ImageNet 64×64,g1/g2/g3 配置同 Table 1,GFLOPs 为 batch 1 前向 |
| 生成质量 FID(越低越好) | 6.15(FractalMAR-H,848M 参数) | VDM++ 2.12(2B)、StyleGAN-XL 2.30(166M)、ADM 4.59(554M) | class-conditional ImageNet 256×256,50K 生成样本,Table 4 |
| 生成质量 Inception Score(越高越好) | 348.9(FractalMAR-H) | StyleGAN-XL 265.1、GigaGAN 225.5、ADM 186.7、BigGAN-deep 198.2 | class-conditional ImageNet 256×256,Table 4 |
| 缩放趋势(模型从小到大) | 186M→848M 时 FID 11.80→6.15、Recall 0.29→0.46 | 自身 B/L/H 三档:B 186M FID 11.80、L 438M FID 7.30、H 848M FID 6.15 | class-conditional ImageNet 256×256,FractalMAR-B/L/H |
| 生成吞吐 | 1.29 秒/张 | 论文未给出其它逐像素方法的同协议吞吐对照(对照是理论 GFLOPs:4×4 patch 注意力总操作约 1.05×10^6 vs 整图全注意力 4.29×10^9,约 4000 倍差距) | ImageNet 256×256,batch 1024,单张 Nvidia H100 PCIe |
| 条件生成 FID(ImageNet 64×64) | 2.72(FractalMAR) | MAR 2.93、iDDPM 2.92、Consistency Model 4.70;GAN 对照 StyleGAN-XL 1.51 仍更低 | class-conditional ImageNet 64×64,附录 Table 5 |
Insights
- 模块化层次可以再抬一级:把「生成模型整体」当原子模块,递归调用同类模块即可构造更复杂的生成模型;分形几何保证输出数随层数指数增长(每层分支 k、n 层得 k^n 个输出),层数只需 log_k(N)(N 为总变量数)(Sec 3.1, p3–4)。
- 联合分布的分治分解把计算从全序列平方注意力变成局部 patch 注意力:256×256 图像最后尺度上,单级全注意力矩阵 4,294,967,296 项,本文 4×4 patch 内注意力总操作 1,048,576 项,约 4000 倍差距(Sec 4.3, p5)。
- 更深的递归层级同时带来更低计算与更好似然:3 层 438 GFLOPs / NLL 3.14,2 层 5516 GFLOPs / 3.34,单层 full-length 29845 GFLOPs 训练不可行(Table 2)——层级本身贴合图像多尺度结构,是一组白赚的收益。
- 逐像素生成提供可解释、可控的生成过程:inpainting、outpainting、uncropping、class-conditional editing(把猫脸按类别标签换成狗脸)都能靠条件预测实现,且没有 tokenizer 的重建误差(Sec 5.3, Figure 5)。
- He 组极简结构风格的又一例:一条递归规则(分治分解)+ 一个可复用模块(自回归模型)= 整个架构;这与 ResNet 的残差块堆叠、MAR 把扩散模型模块化是同一思路,用简单规则生成复杂结构(p1, p3)。
vs 同类工作
- vs FractalNet(Larsson et al. 2016):同源思想——递归调用模块构成分形结构;差异在模块粒度(小卷积块 vs 完整生成模型)与输出规模(分类 logits vs 百万像素)。
- vs 尺度级自回归(VAR、HART、Infinity):单模型逐尺度预测 vs 分治递归子模型;后者最后尺度全注意力(256×256)^2≈4.29×10^9 项,本文 4×4 patch 局部注意力总操作约 1.05×10^6 项,约 4000 倍差距(Sec 4.3)。
- vs 长序列自回归(MegaByte、Perceiver AR):把图像当一维长序列、用局部/稀疏注意力处理 vs 把图像当集合、按分治递归切块,且这些方法多数只报似然、生成质量有限(MegaByte 3.40 vs 本文 3.14 bits/dim,Table 3)。
- vs 层级/级联生成(VQ-VAE-2、cascaded diffusion):分层但每层独立训练或由 tokenizer 先压缩 vs 单一递归规则的自相似架构、端到端一次训练、无 tokenizer(p3)。
- vs MAR(Li et al. 2024):MAR 把扩散模型模块化为连续 token 的 AR 建模单元,本文把 AR 模型本身模块化并递归嵌套,MAR 顺理成章成为本框架的一个 generator 变体(FractalMAR)(Sec 4.2)。
局限
- 多样性偏弱:FractalMAR-H 的 FID 6.15 与 Recall 0.46 低于 VDM++(2.12)、StyleGAN-XL(2.30)、GigaGAN(Recall 0.61),作者归因于逐像素建模近 20 万像素难度大;「加大模型能补齐差距」属于作者的预期,论文只验证到 848M。
- 模态单一:动机里提到的分子构型、蛋白质、生物神经网络等非序列高维数据没有实验,框架跨模态迁移(如何定义每级的『块』)未验证。
- 训练成本与对照不完整:端到端多级训练(256×256 需 4 级、batch 1024、400 epochs)的总训练开销未与 SOTA 对比;论文的 4000 倍效率是最后尺度注意力的理论 GFLOPs 对比,没有与 VAR/HART 的端到端推理吞吐实测对比。
- 评估范围窄:只在 ImageNet 上评测,没有 text-to-image、真实照片分布或其它数据集的验证;FID 协议(50K 样本、CFG 扫描取最优)跨论文对比时需对齐。
- 分治假设的适用范围不明:框架要求数据能按层级切块、每块的分布交给子模型,patch 结构是手工定的(16×16→4×4→像素),哪些数据适合这种结构、如何自动学习分块,论文没有讨论。
可复现性
- code:https://github.com/LTH14/fractalgen(论文已开源)
- weights:论文未明确说明是否发布预训练权重(以 GitHub 仓库为准)
- note:训练配置完整:AdamW(weight decay 0.05,momentum 0.9/0.95),batch 2048(64×64)/1024(256×256),base lr 5e-5 按 batch/256 缩放,40 epochs 线性 warmup + cosine 调度,总 400 epochs;256×256 额外用 guiding pixel 与邻接 patch 上下文;CFG 用 10% dummy class 训练、推理时线性 CFG 调度 + top-p 0.0001
主干与结构
backbone:ViT 风格 transformer(每级层数/宽度随 patch 变小而递减,见 Table 1:g1 32 层 hidden 1024 → g2 8 层 512 → g3 4 层 256 → g4 1 层 64)
参数:FractalMAR 全套(256×256 4 级):H 版 848M 参数;64×64 3 级共约 428M(403+25+0.6)
类型:递归嵌套的自回归模型(fractal framework):每级是一个独立的 transformer 自回归模型,接收上一级输出 + 当前图像 patch,输出下一级子模型的输入;最后一级逐像素预测 RGB
关键组件
- 原子模块抽象:把 p(x|c) 的自回归模型当作模块单元,模块内部递归调用同类的模块
- 分治分解:p(x_1..x_N) = Π_i p(第 i 块 | 前面的块),每块交给下一级自回归模型
- 两种 generator 变体:AR(raster 顺序 GPT 式因果 transformer)与 MAR(随机顺序 BERT 式双向 transformer,源自 MAR/Li et al. 2024)
- 宽度逐级缩减 + guiding pixel + 邻接 patch 上下文,保证多级训练/生成稳定
为什么这样设计
图像天然是「子图仍是图」的近分形对象,把整图联合分布按分治递归切成小块,每级只需建模长度 k 的短序列与局部 patch 内依赖,注意力从整图平方级降到 4×4 局部平方级;层级越深 patch 越小、建模越简单,所以逐级缩减 transformer 规模,使得 256×256 的总计算量只有 64×64 的约 2 倍(864 vs 438 GFLOPs)
分形生成模型总览:自回归模型里递归套自回归模型
原文 caption:Fractal Generative Model. Four levels shown in this figure, better viewed zoomed in. In this instantiation, we use autoregressive model for the fractal generator. By recursively calling autoregressive models in autoregressive models, we build a fractal-like framework with self-similarity across different levels.
论文核心论断的示意图:左边是一个 generator(生成器,即原子生成模块),右边展示 4 个层级的分形展开——每个灰色盒子代表一个自回归模型,父块生成多个子块、子块再生成孙块,结构在不同层级间自相似。读法:把「一个 AR 模型」当模块,模块的输出分支成多个下一级模块的输入,分支数固定时输出数随层数指数增长。重要性:这是「递归调用原子生成模块的自相似架构」这一 reading_tip 考点的直接证据。
逐像素图像生成实例化:每级 transformer 的输入输出接线
原文 caption:Instantiation of our fractal method on pixel-by-pixel image generation. In each fractal level, an autoregressive model receives the output from the previous generator, concatenates it with the corresponding image patches, and employs multiple transformer blocks to produce a set of outputs for the next generators.
展示具体网络怎么接:每级 transformer 的输入序列 =「上一级 generator 的输出 token(放在最前)」+「当前图像 patch 的嵌入」;若干 transformer block 处理后,为下一级的多个 generator 各产出一个输出。读法:把上一级输出当成条件 token 与图像 token 一起过 attention。重要性:说明分形框架落地为像素生成时的最小数据流,对应 Table 1 中 g1→g4 的层级配置。
FractalMAR-H 在 ImageNet 256×256 的逐像素生成结果
原文 caption:Pixel-by-pixel generation results from FractalMAR-H on ImageNet 256×256. Our fractal method can generate high-quality high-resolution images in a pixel-by-pixel manner, with an average throughput of 1.29 seconds per image.
定性证据:848M 参数的 FractalMAR-H 在 256×256 分辨率、不经过 tokenizer 的情况下逐像素生成出清晰的类别图像,平均 1.29 秒/张(batch 1024、单张 Nvidia H100 PCIe)。读法:看生成样本的纹理与形状细节,对应 Table 4 中 IS 348.9、Precision 0.81 的高保真读数。重要性:证明分治递归架构把逐像素生成从「只能做似然估计」推进到「能出高分辨率图」。
🎧 音频版
时长 24:07 · Edge TTS
Fractal Generative Models:让生成模型递归地调用自己(对话版)
先讲清楚这篇要解决什么问题
小播:今天这期聊的是 MIT 和 Google DeepMind 合作的一篇论文,《Fractal Generative Models》,分形生成模型,arXiv 编号 2502.17437,作者里有 Kaiming He。名字听着就很特别,先说说它到底解决了什么问题?
老播:一句话背景:现在主流的图像生成模型,无论是扩散模型还是自回归模型,内部都是「一层层神经网络堆起来」,每层网络负责一次原子化的生成步骤,论文把这套做法叫做模块化。这篇论文想做一个更激进的事:把「整个生成模型」本身当成一个原子模块,然后在生成模型的内部,递归地调用同类的生成模型——生成模型里套生成模型,再套生成模型,形成一种自相似、像分形一样的架构。一句话结论:用这个递归框架做逐像素图像生成,在 ImageNet 64×64 的无条件下,负对数似然做到 3.14 bits/dim,压过此前最好的自回归方法 3.40;同时第一次把逐像素生成推进到了 256×256 高分辨率,FractalMAR-H 的生成质量指标里,Inception Score 348.9 是那批对照模型里最高的。今天这期要讲清楚三件事:为什么要把生成模型递归地套起来、这个自相似架构具体怎么落地成网络、以及它在 Kaiming He 那条「极简结构」技术路线里的位置。
小播:分形、递归、自相似,这些词听起来偏数学,但 3.14 对 3.40 这个数字我记住了。我理解这期的卖点有三层:模块化的新层次、递归自相似的架构、以及一个能落地的逐像素图像实验,我们一层一层过。先从背景开始吧。
先补背景:像素级生成为什么难,之前的人卡在哪
小播:先定义一下「逐像素生成」。这个词我大概知道意思,就是把一张图的每个像素一个一个地生成出来,对吗?
老播:对。逐像素生成的意思是:不经过 tokenizer 压缩,直接对原始像素建模。一张 256×256 的彩色图有 256×256×3 等于 196,608 个像素值,每一个像素值还要考虑它和周围像素的依赖关系。难点有两个:第一是维度高,近二十万个变量;第二是这些变量有很强的空间结构,远处像素相关、近处像素更相关,顺序该怎么定都不清楚。所以逐像素生成一直是生成模型里出了名的硬骨头,过去大多数方法只能做到把似然估计做出来,生成的图质量上不了台面。这里先解释一下似然和 bits/dim:生成模型要估计训练数据的概率密度,负对数似然就是把「模型认为数据有多可能」转成损失,单位 bits/dim 表示平均每个维度、每个像素通道要花多少 bit 来编码,数字越低说明模型对数据分布拟合得越准,这是无 tokenizer 模型的主要评测手段。这里有个背景要知道:似然和样本质量在生成模型里经常脱钩,一个模型可以把数据分布拟合得很好,但采样出来的图未必好看;过去逐像素方法大多只能把似然做出来,样本质量一直上不去。这篇论文把两边都报了,这也是它敢直接和扩散模型比生成质量的原因。
小播:那之前的自回归方法是怎么做的?为什么做不好?
老播:主流做法是把图像摊成一维长序列,然后借用语言模型的技术。比如 Sparse Transformer、Routing Transformer、Perceiver AR、MegaByte 这些,都用稀疏注意力或者压缩表示来降低长序列的成本。这条路的问题在于:图像的结构是多尺度的,一维摊平之后,序列里任意两个位置都可能需要互相看,全序列注意力要么贵得离谱,要么得靠各种技巧省算力。举个具体的量级感受:注意力成本随序列长度平方增长,12,288 个像素摊成序列,注意力矩阵就已经接近 1.5 亿项,再往上到 256×256 的 196,608 个像素,直接是 380 多亿项,训练根本放不进显存。另一个方向是尺度级自回归,代表是 VAR、HART、Infinity 这些模型,它们用单个自回归模型一级一级地预测 token,分辨率从低到高。这条路的问题在最后一级:生成高分辨率 token 的时候,还是要对整条序列做全注意力。还有一个老办法是两级管线:先训练一个 tokenizer 把图像压成 latent,再在 latent 上训练生成模型,代价是引入重建误差、训练被拆成两段。这篇论文挑的切口是:图像本身有「子图还是图」的递归结构,那就干脆把生成模型本身也做成递归的,用分治去绕开长序列注意力。
小播:所以它的切入点是利用图像的多尺度结构,在「怎么处理长序列」这条技术线之外另开了一条路。这个角度我理解了,接着讲核心思想吧。
核心思想:把生成模型当积木,递归地套自己
小播:你说的「生成模型里套生成模型」,具体是什么样子的?
老播:可以这样想。自回归模型的核心能力,是建模一个条件概率 p(x|c):给定已知信息 c,预测下一个东西 x 的分布。这篇论文把「建模 p(x|c) 的自回归模型」当成一个原子积木,然后用分治的策略递归地使用它。假设我们要建模 N 个变量的联合分布,每个自回归模型只处理固定长度 k 的序列,N = k 的 n 次方,n 就是递归层数。第一级自回归模型把联合分布切成 k 块,每块交给第二级的一个子模型,第二级再切、再往下交,切到最底层,每个子模型只处理 k 个变量。这就是一个标准的 divide-and-conquer,分而治之。拿论文的实例来感受一下层级:ImageNet 64×64 的一张图有 12,288 个像素值,等于 256 乘 16 再乘 3,正好对应三层——第一层管 256 个 4×4 的 patch 块,第二层管每个 patch 里的 16 个像素位置,第三层管每个像素的 RGB 三个通道。
小播:切成块之后,块和块之间怎么保证依赖关系还在?毕竟图像里远处像素也有相关性。
老播:关键在条件。切块的时候,第 i 块的分布,要条件在它前面的所有块上。写成公式:p(x_1 到 x_{k^n} 的联合分布),等于 i 从 1 到 k 的连乘,每个因子是 p(第 i 块的 k^{n-1} 个变量 | x_1 到 x_{(i-1)k^{n-1}})。先给个预期:这个式子回答的是「联合分布怎么被一级一级切开,每块由谁负责」。逐符号看:左边是全部 N 个变量的联合分布;右边的连乘符号 Π 表示切成 k 个因子;第 i 个因子的前一半是这一块要建模的 k^{n-1} 个变量,竖线后面是条件,也就是前面已经处理过的 (i-1) 乘以 k^{n-1} 个变量;每个因子对应一个下一级的自回归模型,子模型之间靠这个条件保持全局依赖,所以远处像素的信息会通过逐级的条件传递进来,块切得再小,全局结构也丢不掉。这样一路递归下去,最底层的模型只需要处理 k 等于 3 的 RGB 三个通道,而每一级的注意力都只发生在一个小块的内部。这就是论文 Figure 1 画的东西:左边是一个 generator 积木,右边展开四层,每个灰色盒子是一个自回归模型,父块长出子块,子块再长孙块,跨层级结构自相似,这正是任务提示里说的「递归调用原子生成模块的自相似架构」。
小播:为什么递归层数越多反而越便宜?多套几层不是应该更贵吗?
老播:这里恰恰是分形的数学性质在起作用:每一层从一个输入产生多个输出,输出数量随层数指数增长,而层数只需要随总变量数对数增长。算力上,注意力成本从「全序列长度的平方」变成「小块长度的平方再乘以块数」。论文给了一个具体的对比数字:256×256 图像的最后一级,单个全注意力矩阵是 43 亿项,分形方法在 4×4 小块内做注意力,全图加起来大约 105 万项,差了约 4000 倍,这个对比的设置是逐像素建模 256×256 的最后一个尺度。我们留在实验部分细说。举个数量级的例子:假设每层固定产生 16 个分支,四层下来输出位置就是 16 的 4 次方等于 65,536 个,层数只需要 4;对应到图像上,196,608 个像素值用三到四层就覆盖完了。输出规模指数增长、层数对数增长,这个性质正是分形几何里「用简单规则生成复杂结构」的来源,也是论文把它命名为分形生成模型的原因。先记住结论:递归层数多,每个子模型反而更小、更简单,总计算量在下降。
具体怎么搭:从 16×16 的 patch 一路到单个像素
小播:那落地到图像上,这一级一级具体切的是什么?
老播:用 256×256 的图像举例,一共四层。第一级 g1 的序列长度是 256,把整张图切成 16×16 个 patch,建模 patch 之间的依赖;第二级 g2 把每个 16×16 的 patch 再切成 4×4 个 patch,建模 patch 内部的依赖;第三级 g3 建模每个 4×4 patch 里像素和像素之间的依赖;最后一级 g4 用一层很轻的 transformer,对每个像素的 R、G、B 三个通道各自做 256 类的交叉熵预测,RGB 值被当成 0 到 255 的离散整数。每一级的数据流是:把上一级 generator 的输出 token 放在序列最前面,后面接当前图像 patch 的嵌入,一起过 transformer,输出交给下一级的子模型们。也就是说,上一级的输出在下一级眼里就是一种「关于这块区域先验信息」的条件 token。
小播:每一级都用一个独立的 transformer?那参数和算力加起来不会爆炸吗?
老播:论文有一个出人意料的设计:patch 越小、建模越容易,所以越往下的 transformer 越轻。第一级 g1 是 32 层、hidden 维 1024,403M 参数,前向 215 GFLOPs;第二级 g2 缩到 8 层、512 维,25M 参数,前向 208 GFLOPs;第三级 g3 在 256×256 配置下是 4 层、256 维,3M 参数,前向 419 GFLOPs;最后一级 g4 只有 1 层、64 维,0.1M 参数,前向 22 GFLOPs。这些数字都来自论文 Table 1,GFLOPs 是 batch 1 训练前向的测量口径。算下来,建模一张 256×256 图的总计算量大约 864 GFLOPs,只有建模一张 64×64 图(大约 438 GFLOPs)的 2 倍。分辨率大了 16 倍,算力只多一倍,这是分治递归带来的直接收益。
小播:训练和生成分别怎么走这棵树?
老播:训练是广度优先,端到端一次跑完:从第一级往下,每级接收上一级的输出继续往下传,损失在最底层的像素交叉熵上计算,然后一路回传更新所有层级的参数。生成是深度优先:第一级先建模 16×16 patch 之间的依赖,每生成一个 patch 就往下进到第二级处理 patch 内部的 4×4 小块,一路钻到像素,采样出 RGB 值,再回头处理下一个 patch。论文还加了两个工程细节:256×256 时每级先预测当前 patch 的平均像素值,当作一个全局条件 token,叫 guiding pixel,让每个子模型在预测细节之前先有一点全局上下文;另外生成时把当前 patch 周围四个 patch 的上一级输出也传给下一级,缓解 patch 边界接不上的问题。这两个细节都针对高分辨率实验,完整描述在论文附录 A,复现时可以对着核对。
实验里看到的:似然、质量、效率
小播:好,现在到数字环节。第一个数字,3.14 bits/dim,是在什么设置下拿到的?
老播:无条件 ImageNet 64×64 的测试集,指标是负对数似然 NLL,单位 bits/dim,越低越好。FractalAR 拿到 3.14,FractalMAR 是 3.15。对照的基线:此前最好的自回归方法是 Perceiver AR 和 MegaByte,都是 3.40;扩散方法里 NFDM 是 3.20,flow matching 是 3.31,PixelCNN 是 3.57。也就是说,3.14 比最好的自回归方法低了大约 0.26,还和扩散方法打平。这组实验里最说明问题的是一张层数消融表:单层 full-length 模型要处理 12,288 长度的序列,需要 29,845 GFLOPs,训练直接不可行;2 层框架要 5,516 GFLOPs,NLL 3.34;3 层分形只要 438 GFLOPs,NLL 反而更好,3.14。层数越多,算力越低、似然越好,这两个方向一起改善,这是论文最有力的机制证据,也印证了「递归层级贴合图像多尺度结构」这个判断。
小播:那生成质量呢?逐像素生成历史上一直出不了好图,这里到 256×256 表现如何?
老播:用的是类条件 ImageNet 256×256,四层分形,模型叫 FractalMAR-H,848M 参数,报告 FID、Inception Score、Precision、Recall 四个指标。结果是 FID 6.15、IS 348.9、Precision 0.81、Recall 0.46,平均吞吐 1.29 秒一张图,这个吞吐的测量设置是 batch 1024、单张 Nvidia H100 PCIe。对照同表:VDM++ 2B 参数 FID 2.12,StyleGAN-XL 166M 参数 FID 2.30,ADM 554M 参数 FID 4.59。FractalMAR-H 的 IS 348.9 和 Precision 0.81 比所有对照都高,StyleGAN-XL 是 265.1 和 0.78,这说明它生成的单张图保真度高、细节足,Figure 4 里的样本也支持这一点:横着扫过去是一排排 256×256 的类别图像,纹理和轮廓都比较清楚,这是没有 tokenizer、纯粹逐像素生成出来的。但 FID 6.15 和 Recall 0.46 偏低,说明多样性弱于扩散和 GAN。作者把这个归因于逐像素建模近二十万个像素本身就很难。缩放趋势是清楚的:参数从 186M 涨到 848M,FID 从 11.80 降到 6.15,Recall 从 0.29 涨到 0.46,论文预期继续加大模型还能补齐多样性差距,而且因为没有 tokenizer,理论上不受重建误差的天花板限制。
小播:刚才你提到 4000 倍的计算差距,这个数字又是怎么来的?
老播:这是和尺度级自回归方法比的理论算力。VAR、HART、Infinity 这类模型用单个自回归模型逐尺度预测,生成下一尺度 token 时要做整条序列的全注意力。在 256×256 图像的最后一级,一个注意力矩阵的大小是 256×256 的平方,大约 4.29×10⁹ 项,也就是 43 亿项。分形方法只在 4×4 的 patch 内部做注意力,每个 patch 的矩阵是 16 的平方等于 256 项,全图 64×64 个 patch 加起来大约 1.05×10⁶ 项,也就是 105 万项。43 亿对 105 万,大约 4000 倍的差距。这个对比的设置是 256×256 图像逐像素建模的最后一个尺度,它说明分治递归把最贵的那一级注意力彻底局部化了,这也是论文说「首次让逐像素建模高分辨率图像可行」的依据。顺带说明,论文的似然数字全部来自 64×64,256×256 的评估走类条件生成质量指标,两组实验是互补的:64×64 证明拟合能力,256×256 证明生成能力和工程可行性。
小播:除了似然和生成,还有别的数字可以佐证框架的普适性吗?
老播:还有两组。第一组是类条件 ImageNet 64×64 的 FID,FractalMAR 是 2.72,对照 MAR 是 2.93、iDDPM 是 2.92、Consistency Model 是 4.70,GAN 对照 StyleGAN-XL 的 1.51 仍然更低,这说明在 64×64 上分形已经能和经典方法竞争。第二组是像素通道顺序的鲁棒性:RGB、GRB、BGR 三种顺序的 NLL 都是 3.17,FID 在 3.14 到 3.32 之间小幅波动,都训练 400 个 epoch,说明框架对通道顺序不敏感。另外论文还展示了条件逐像素预测:inpainting 补洞、outpainting 外扩、uncropping 大范围外扩,还有类别编辑——用类别标签把猫脸换成狗脸,都是靠掩码条件下的逐像素预测完成的。逐像素生成的好处在这里体现出来:生成过程是人类可读、可干预的,给定已知区域就能推未知区域,天然适配图像编辑,而且全程没有 tokenizer 的重建损失。
它在技术谱系里的位置
老播:把这条线捋一下。最接近的前作是 FractalNet,2016 年的工作,它也递归调用模块构成分形网络,但模块是一小块卷积、任务做分类,输出低维 logits;这篇把模块粒度抬到「整个生成模型」,输出是百万级像素。尺度级自回归 VAR、HART 是单模型逐尺度,分形是分治递归子模型;长序列方法 MegaByte、Perceiver AR 把图像当一维序列,分形把图像当集合递归切块;级联扩散和 tokenizer 加 latent 的两级范式是分层但每层独立,分形是一套规则递归到底。放到 Kaiming He 的脉络里看,这是「极简结构」风格的又一例:ResNet 用残差块反复堆叠,MAR 把扩散模型模块化成连续 token 的自回归单元,这篇把「分治递归」当成唯一规则,一个可复用的生成模型积木,构造出整棵自相似架构——规则简单、结构复杂,这个风格贯穿了他从 ResNet 到现在的几乎所有工作,和任务提示里点名的「He 组极简结构风格」是同一件事。
局限:先泼点冷水
小播:按惯例,我们也要看看它哪里还没做到。
老播:至少五条。第一,多样性偏弱,FractalMAR-H 的 FID 6.15、Recall 0.46,低于 VDM++ 的 2.12 和 StyleGAN-XL 的 2.30、Recall 0.53,「加大模型能补差距」是作者的预期,论文只验证到 848M 参数。第二,模态单一,动机里提到的分子构型、蛋白质、生物神经网络都没有实验,跨模态时每一级该切什么块、怎么定义层级,论文没有答案。第三,效率对照是理论口径,4000 倍是最后尺度注意力的 GFLOPs 对比,论文没有给和 VAR、HART 的端到端推理吞吐实测对比;训练侧的总开销,多级端到端、batch 1024、400 个 epoch,也没有和别的模型对齐比较。第四,评估范围窄,只在 ImageNet 上做生成和编辑,没有 text-to-image 或者更多数据集的验证,而且 FID 的测量协议,比如 50K 样本、CFG 扫描取最优,跨论文对比时要小心。第五,分块结构是手工定的,16×16 到 4×4 到像素这个层级由人设计,什么数据适合这种递归结构、能不能自动学出分块,都没有展开。第六,论文把「开启新范式」写在结论里,但证据目前只有图像一类任务、自回归这一种原子模块,扩散模型当 generator 的分形版本没有实验,框架的通用性还要靠后续工作来证明。
收尾:记住这三件事
小播:好,最后帮听众把重点收一收。我记住的第一件事:这篇论文把「整个生成模型」当成原子模块,递归地在生成模型里调用生成模型,构造自相似的分形架构,这是它最核心的贡献。第二件事:更深的递归层级同时带来更低的算力和更好的似然,ImageNet 64×64 上 3 层分形 438 GFLOPs、NLL 3.14,对照 2 层的 5,516 GFLOPs、3.34,以及此前最佳自回归的 3.40。第三件事:它把逐像素生成推到 256×256,FractalMAR-H 的 IS 348.9、Precision 0.81 全场最高,FID 6.15 和 Recall 0.46 还有差距,但缩放趋势指向模型越大越接近扩散水平。
老播:我补充一句它对后续的意义。分形框架把一个看似矛盾的组合变成了现实:既没有 tokenizer,又能生成高分辨率图像,代价是多样性还要补。它提示的后续方向很具体:把递归规则用到分子、蛋白质这类同样有层级结构的非序列数据上,以及把分块方式从手工设计变成自动学习。对一个提出新范式的论文来说,3.14 和 6.15 这两个数字说明递归自相似架构起步就能打,剩下的空间留给后续工作去填。今天的三个数字,3.14 对 3.40 的似然优势、4000 倍的注意力差距、2 倍的 256 对 64 算力比,你可以带走反复对照。