π0: A Vision-Language-Action Flow Model for General Robot Control(精读)
一句话定位:把预训练视觉语言模型 PaliGemma(3B)当骨干,额外加一个 300M 参数的 action expert,用条件 flow matching 直接回归连续动作分布;在约 1 万小时、7 种机器人构型、68 个任务的跨本体数据上预训练,再微调去完成叠衣、收拾餐桌、装箱等长时程灵巧任务,支持最高 50Hz 的高频控制。这是第一个把 flow matching 动作头接到 VLM 骨干上的 VLA,也是「flow 生成动作」路线的工业级参考。
1. 要解决什么问题
机器人策略的通用性有两个来源:一是互联网规模的语义与视觉先验(来自 VLM),二是足够多样、足够大的行为数据。前一代 VLA(RT-2、OpenVLA)沿用了语言模型的自回归范式,把动作量化成离散 token 用交叉熵训练。这条路线有两个结构性问题:动作被离散化后损失了连续与多模态信息;逐 token 生成无法一次输出未来一整段动作(action chunk),而灵巧操作恰恰需要高频、连续、提前规划的动作序列。另一条线(Diffusion Policy、ACT)用扩散/动作 chunk 建模连续动作分布,但模型小、没有互联网语义先验,也不做跨本体预训练。数据侧,最灵巧的任务此前通常只有 10 小时以内的演示,没有人系统回答过「该混什么数据、按什么权重、先训什么后训什么」。
本文的核心主张是:把 VLM 预训练、跨本体数据、flow matching 动作头、预训练/后训练配方四件事组合成一个完整框架,机器人基础模型就能同时具备语义通用性(听懂语言、识别未见物体)、鲁棒性(从错误中恢复)与灵巧性(50Hz 高频、精细多阶段操作)。这个判断在文中被反复验证:开箱评测、语言跟随、微调数据量实验、复杂多阶段任务四组实验全部指向同一结论——组合优于任何单点改进。
2. 背景:VLA 谱系与三个卡点
先给三个概念定位。VLA(vision-language-action model)指把预训练 VLM 微调到机器人动作输出上的模型;RT-2 把它变成语言模型式的 token 预测,OpenVLA 用 7B 模型在 OXE 上开源复现。action chunk 指一次输出未来 H 步动作的序列,最早由 ACT 引入,能降低执行抖动、改善开环稳定性。flow matching 是扩散的一个变体:扩散学「噪声→数据」的去噪过程,flow matching 直接学「噪声→数据」的速度场,用一条可设计的插值路径(通常是直线)把两个分布连起来。
三个卡点。第一,动作表示:自回归离散化把动作压进词表,OpenVLA 在需要高频灵巧控制的评测里接近失效;第二,数据:单任务数据量小,需要跨本体、跨任务的大规模混合,还要处理动作空间不一致(单臂 7 维到移动双臂 17 维);第三,配方:预训练与后训练数据的作用不同,混比和阶段划分直接影响最终策略是「熟练但脆弱」还是「能恢复但不熟练」。
π0 的切入点是同时改架构与配方:架构上用 flow matching 动作头替换交叉熵,配方上先大规模跨本体预训练、再用高质量数据微调。
3. 核心思想
3.1 模型结构:VLM 骨干 + action expert,两套权重一个 transformer
模型主体是一个 decoder-only transformer,装了两套权重。图像 token 与语言 token 走大的 VLM 骨干(PaliGemma 3B,图像编码器加 Gemma 2B 语言模型,权重继承互联网预训练);机器人状态 q_t 与动作 token 走 action expert(300M 参数,width 1024、mlp 4096,从零初始化)。两套权重在 self-attention 层交互,其余各算各的。这个设计与混合专家(MoE)同构:两个专家,按 token 类型路由,只是没有门控网络。作用有两个:动作分支只占 300M,10 步 flow 积分每次前向都只过小网络,推理快;VLM 骨干尽量保持贴近 PaliGemma 的表示,减少机器人专用 token 带来的分布漂移。
输入序列按注意力 mask 分成三块:[图像+语言] → [状态 q_t] → [噪声动作 A_τ 共 H=50 个]。块内双向注意力,块间因果;状态单独成块,因为它在 10 步 flow 积分里不变,单独成块后它的 key/value 只需计算一次。推理时先编码图像、语言、状态并缓存 K/V,然后 10 步积分只重算动作 token 后缀,这就是 50Hz 控制能跑起来的关键工程点。
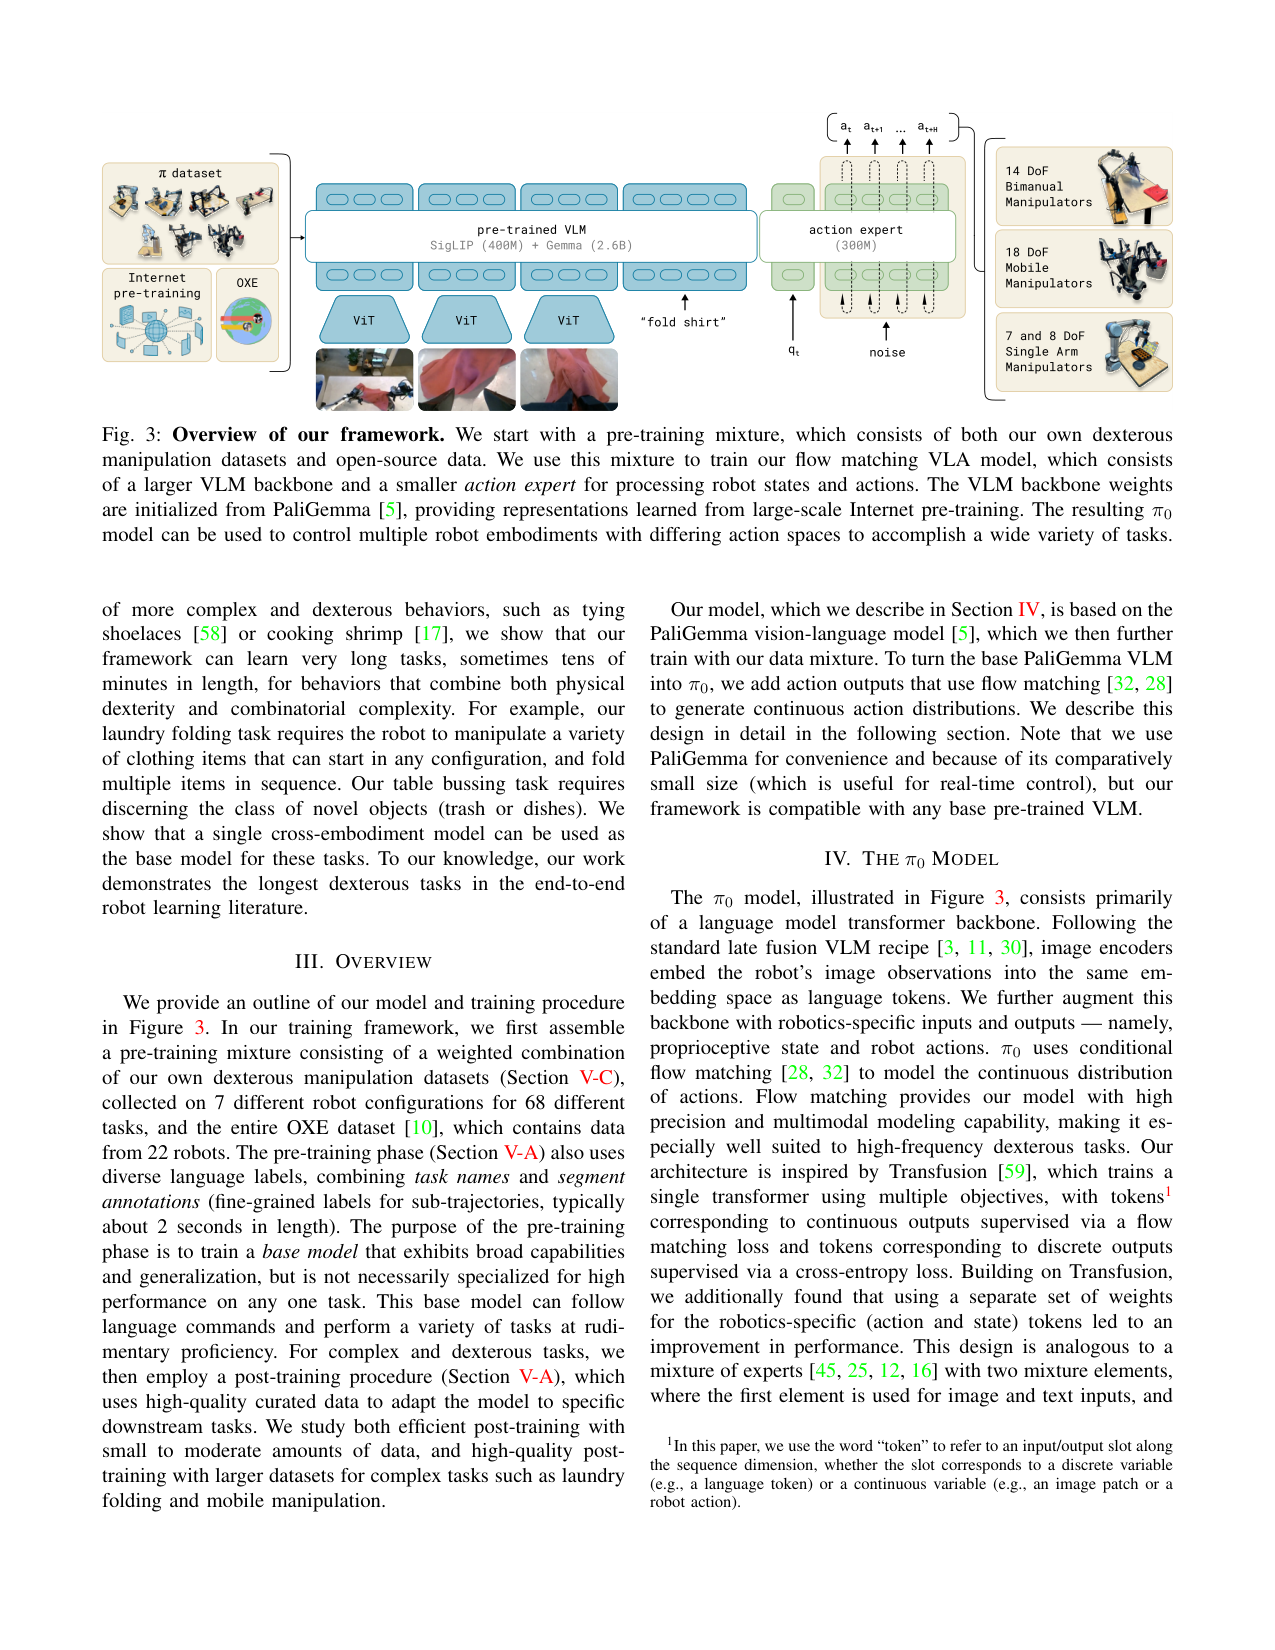
▲ Figure 3:π0 框架总览。左侧是预训练数据混合(自有灵巧数据 + 开源数据),中间是模型本体——大的 VLM 骨干处理图像与语言,小的 action expert 处理状态与动作,两者只在 self-attention 层交互;右侧是多种机器人本体共用同一模型。
3.2 Flow matching 动作头:怎么把「预测动作」变成「回归速度场」
先给预期:下面的损失函数要回答的问题是——给定观测 o_t,网络在每个噪声动作 token 上预测的速度场,与把该噪声动作搬回真实动作所需的速度差多远。这个式子把「生成动作分布」变成逐 token 的回归,训练时一次前向就是一次普通回归,不需要模拟采样过程。
对动作块 A_t = [a_t, …, a_{t+H−1}](H=50),论文用线性高斯(最优传输)插值路径定义噪声动作:
A_τ = τ A_t + (1 − τ) ε,其中 ε ~ N(0, I),τ ∈ [0, 1]。
逐符号解释:A_t 是 t 时刻起未来 50 步的真实动作;ε 是标准高斯噪声;τ 是 flow 时间,τ=0 时 A_0 是纯噪声,τ=1 时 A_1 回到真实动作;这个式子意味着「噪声动作」是真实动作与噪声的线性混合,随时间从噪声端走到数据端。条件 flow matching 损失写成:
L_τ(θ) = E_{p(A_t|o_t), q(A_τ|A_t)} ‖ v_θ(A_τ; o_t) − u(A_τ | A_t) ‖²。
逐符号解释:期望对两个分布取——观测-动作对来自数据集分布 p(A_t|o_t),噪声动作来自插值路径 q(A_τ|A_t) = N(τA_t, (1−τ)I);v_θ(A_τ; o_t) 是网络在噪声动作和观测条件下预测的速度场;u(A_τ|A_t) = A_t − ε 是条件速度——把 A_τ 沿直线搬向 A_t 所需的瞬时速度。网络学的就是「给定观测,把噪声动作沿直线拉向真实动作」的速度场,即 u = A_t − ε 这个常数方向。
训练时 τ 从一个偏态 Beta 分布采样:p(τ) = Beta((s−τ)/s; 1.5, 1),s=0.999。这里有个与图像生成不同的设计:图像生成(如 SD3)倾向于从中间时间步采样,因为低噪声端只需学恒等、高噪声端只需学均值;π0 认为动作预测里「给定观测求平均动作 E[A_t|o_t]」本身很难,观测对动作的约束远强于文本标签对图像的约束,所以训练火力应集中在高噪声端(低 τ),且 τ > s 完全不采。s=0.999 还允许积分步长大于 0.1,最多可到 1000 步,给推理步数留出余量。
推理时从 A_0 ~ N(0, I) 出发,做 10 步前向 Euler 积分:A_{τ+δ} = A_τ + δ·v_θ(A_τ; o_t),δ=0.1。10 步后得到整块 50 步动作,开环执行。论文试过 temporal ensembling(把多次推理的动作加权聚合,ACT 的做法),发现反而降低性能,最终放弃。
3.3 数据与配方:跨本体混合 + 预训练/后训练
数据混合按 timestep 计:开源数据(OXE 的 Magic Soup 子集、Bridge v2、DROID)占 9.1%,低频(2–10Hz)、1–2 个相机,提供物体与场景多样性;自采数据 903M timesteps(单臂 106M + 双臂 797M),覆盖 68 个任务、7 种机器人构型,包括叠衣这类高难度任务。跨本体统一方案:配置与动作向量 zero-pad 到 18 维(容纳双臂 6-DoF×2、两个夹爪、移动底盘、升降躯干),图像槽不足 3 张的本体把缺失槽 mask 掉;每个任务-本体组合按 n^0.43 降权,压住叠衣这类过采样数据。
预训练阶段跑 700k 步,产出能直接提示调用的基础模型;后训练用高质量任务数据微调(最简单任务约 5 小时,最复杂 100+ 小时)。论文的配方假设是:多样但质量参差的数据教策略「从错误中恢复」,高质量数据教「熟练流畅」;只训高质量数据得到脆弱策略,只训预训练数据则缺少熟练度。
4. 关键实验
4.1 开箱评测(Figure 7)
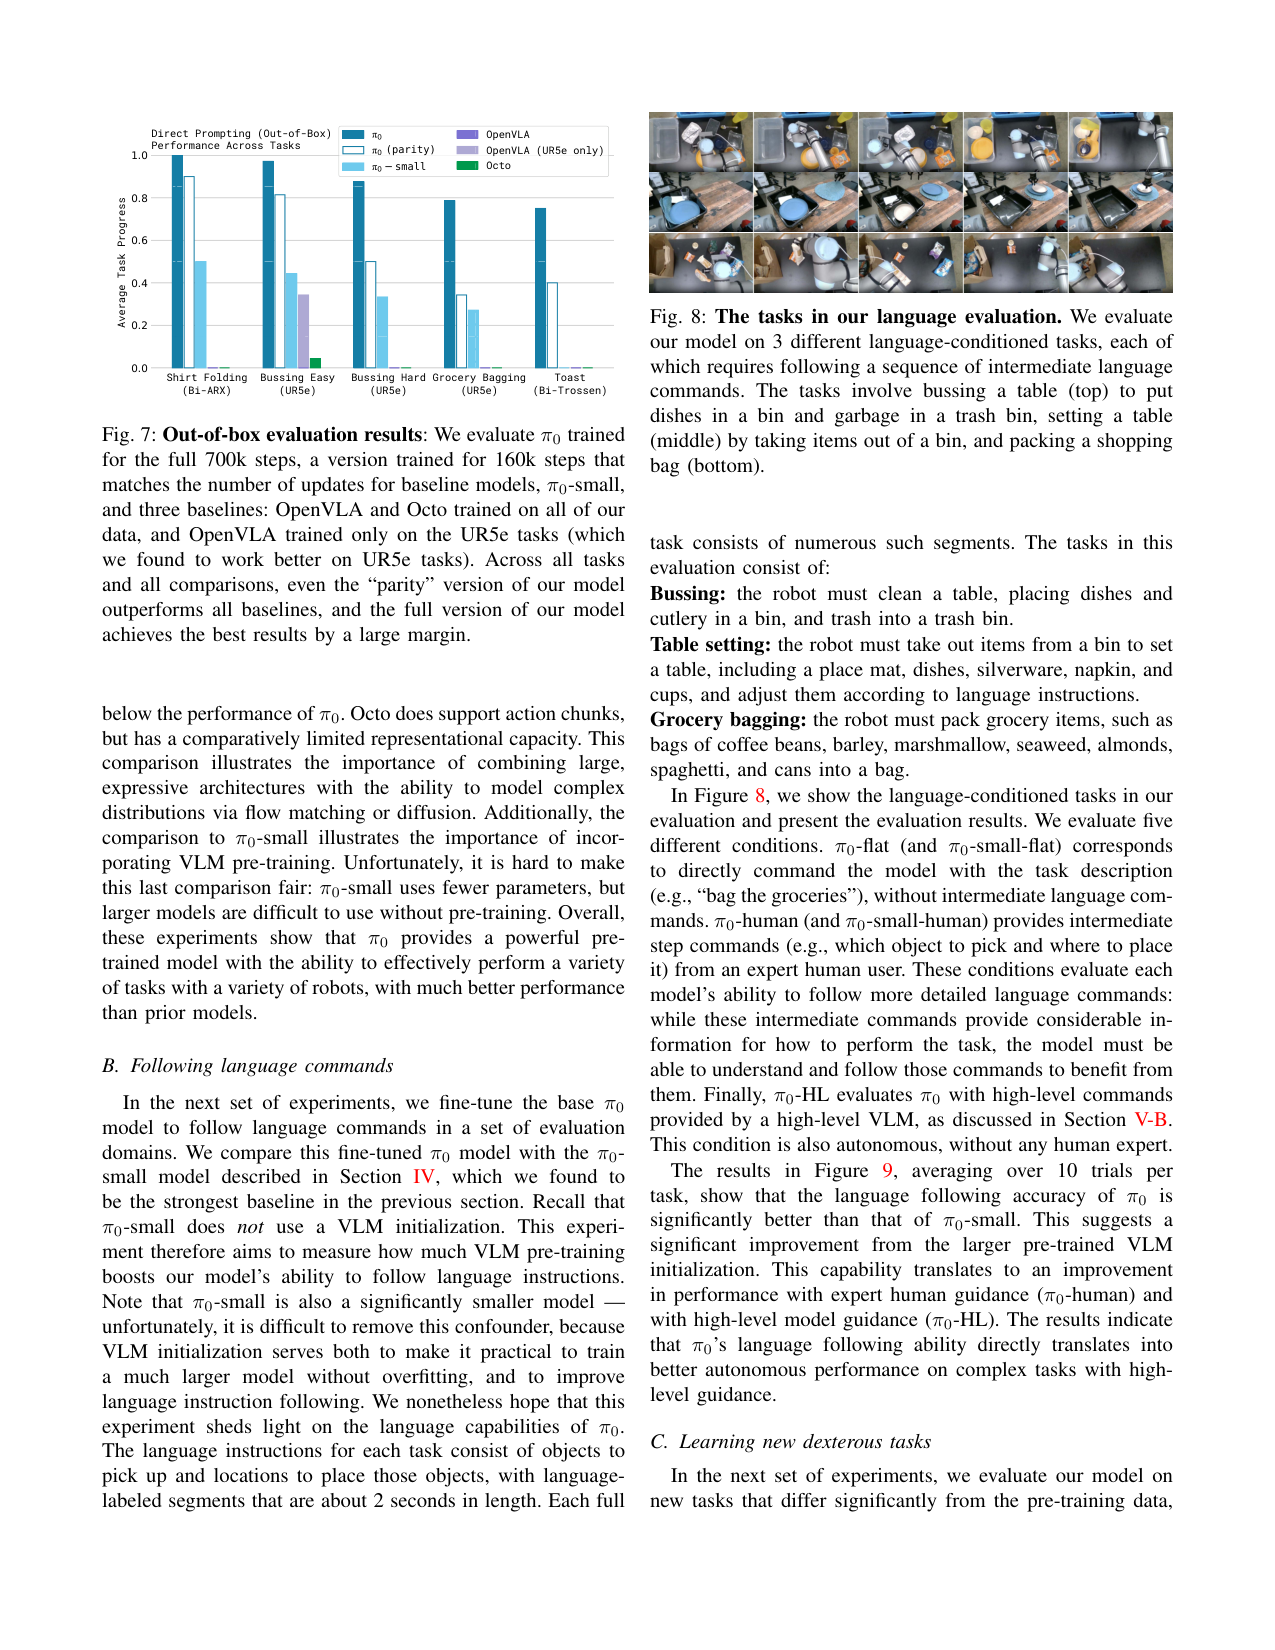
▲ Figure 7:开箱评测结果。横轴 5 个直接提示任务,纵轴归一化任务进度(0–1);深青柱为 π0(700k 步),白框柱为 parity 版(160k 步),浅青柱为 π0-small,其余为 OpenVLA/Octo。
直接提示基础模型做 5 个任务:shirt folding、bussing easy/hard、grocery bagging、toast out of toaster,每任务 10 条 episode,按归一化任务进度打分(0–1)。全量 π0(700k 步)在 5 个任务上约为 1.00 / 0.97 / 0.88 / 0.79 / 0.75;训练步数与 baseline 对齐的 parity 版(160k 步)仍有 0.90 / 0.81 / 0.50 / 0.34 / 0.40;π0-small(470M,无 VLM 初始化)有 0.50 / 0.44 / 0.34 / 0.27 / ≈0;同数据训练的 OpenVLA(7B)与 Octo(93M)基本贴地(≈0–0.05),OpenVLA-UR5e-only 仅在 bussing easy 到 ≈0.34。这个结果说明两件事:优势大部分来自架构+数据+初始化(parity 版照样全面胜出);flow 动作表示与 action chunk 本身贡献巨大(π0-small 也赢 OpenVLA 与 Octo)。
4.2 语言跟随(Figure 9)
对比 π0 与 π0-small 的语言指令跟随准确率:bussing ≈0.94 vs 0.70,table setting ≈0.90 vs 0.31,grocery bagging ≈0.70 vs 0.31。更重要的现象是高层指令的价值:table setting 任务里,直接提示(flat)π0 只有 ≈0.38,专家分步指令(human)升到 ≈0.72,由另一个 VLM 策略给出的中间指令(HL)≈0.84——语言跟随能力直接转化为任务成功率,且高层 VLM 策略可以当「规划器」用。
4.3 微调数据量实验(Figure 11)
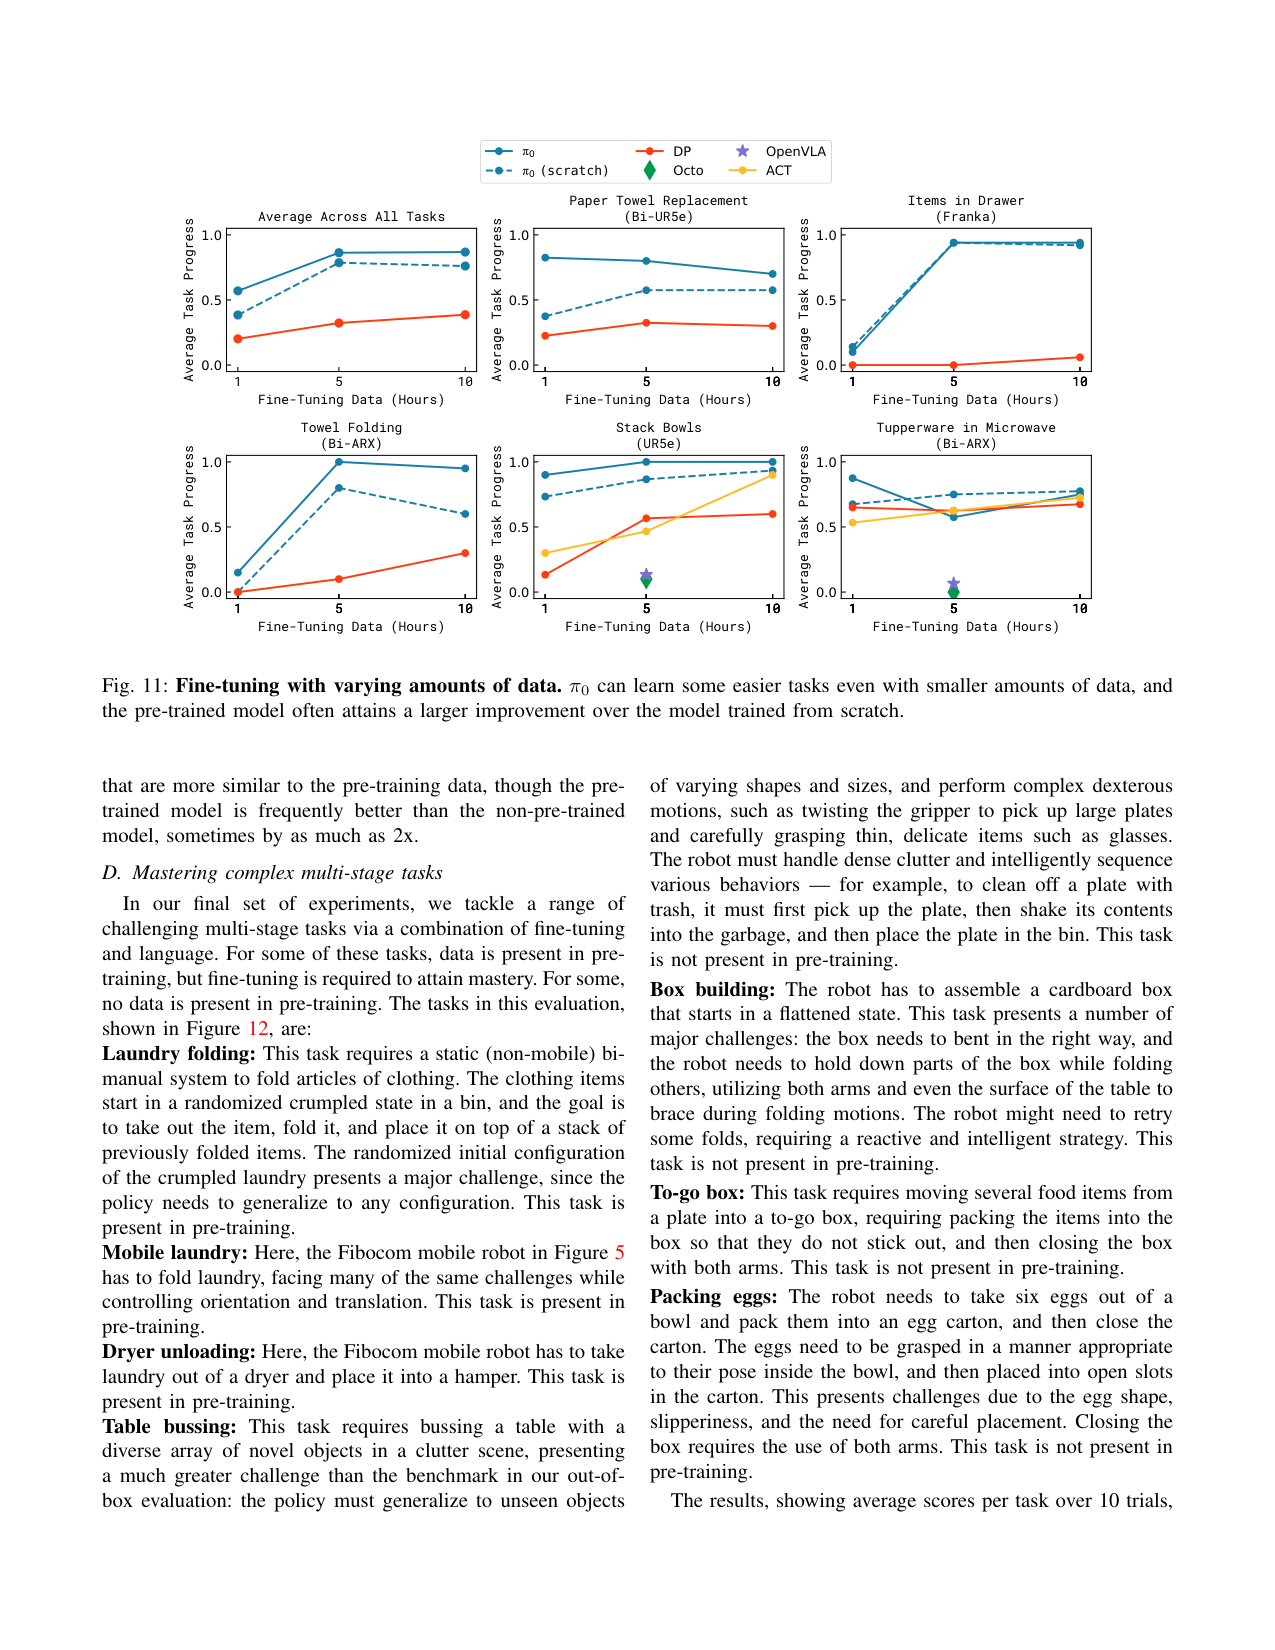
▲ Figure 11:微调数据量实验。六个面板的横轴都是微调数据量(1/5/10 小时),纵轴平均任务进度;「Average Across All Tasks」面板里,深青实线(预训练 π0)在 1h 时约 0.57,5h 与 10h 约 0.87。
6 个下游任务(stack bowls、towel folding、tupperware in microwave、paper towel replacement、items in drawer),微调数据 1/5/10 小时。平均值上:预训练 π0 为 ≈0.57 / 0.87 / 0.87;π0 scratch 为 ≈0.38 / 0.79 / 0.76;最强 prior(论文指出是纯 scratch 训练的 ACT/DP 类方法)≈0.20 / 0.33 / 0.39。1 小时数据时预训练收益最大;与预训练相似的任务(stack bowls、towel folding)提升可达约 2 倍,预训练里没有的新任务(paper towel replacement、Franka drawer)提升较小。
4.4 复杂多阶段任务(Figure 12 + 13)
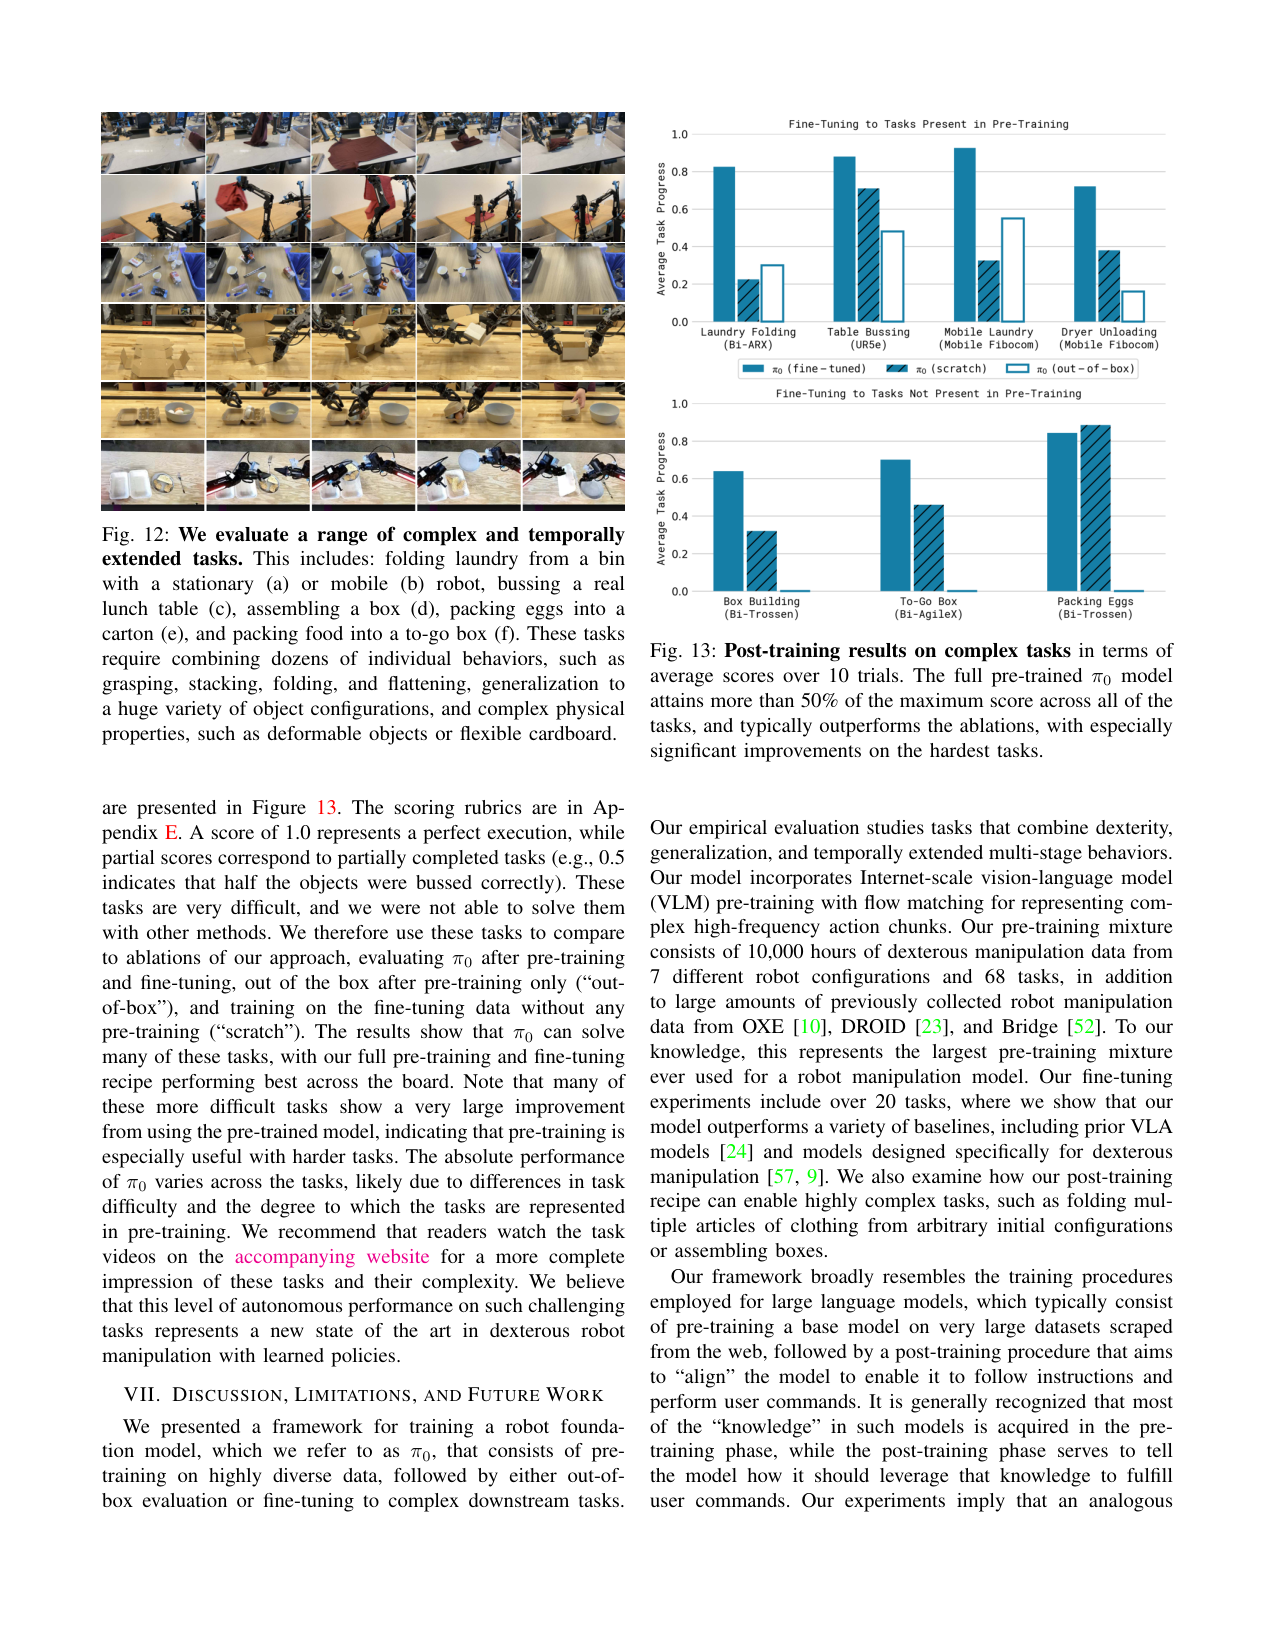
▲ Figure 12 与 Figure 13:上半是 6 个复杂任务的场景,下半是柱状图——预训练+微调 π0 在全部 7 个任务上超过最大分的一半。
7 个 5–20 分钟的长任务(叠衣、移动叠衣、烘干机取衣、收拾餐桌、装纸箱、to-go box、packing eggs)。预训练+微调的 π0 在全部 7 个任务上超过最大分的 50%:≈0.83 / 0.93 / 0.72 / 0.88 / 0.64 / 0.70 / 0.84;只预训练开箱版在预训练外的任务(装纸箱、to-go box、packing eggs)接近 0,微调后大幅拉起;scratch 版多数任务明显更低(最难的 table bussing 12 物体:0.88 vs 0.48 vs 0.71)。这组实验同时展示了配方的价值与边界:预训练教恢复与多样、后训练教熟练;但预训练外任务的「通用性」要靠微调才能兑现。
4.5 推理时延
RTX 4090 上 onboard 推理 ≈73ms(图像编码 14ms + 观测前向 32ms + 10 步动作前向 27ms),offboard(Wi-Fi)86ms。对应 50Hz 本体每 0.5s 推理一次,推理只占控制周期约 4%;20Hz 本体(UR5e、Franka)每 0.8s 推理一次。
5. 谱系定位
与 RT-2 / OpenVLA 比,π0 用 flow matching 输出连续动作并支持 action chunk,开箱任务上差距巨大(OpenVLA ≈0 vs π0 parity 0.34–0.90),说明自回归离散化是灵巧高频任务的主要瓶颈。与 Diffusion Policy / ACT 比,π0 在动作扩散之上叠加了 VLM 语义先验与跨本体预训练;微调实验里纯 scratch 的 ACT/DP 仍是除 π0 外最强的方法,但 1 小时数据下被预训练 π0 大幅拉开。与 Transfusion、MARS、Playground v3 比,π0 把「语言走一套权重、扩散走另一套权重」的混合设计搬进机器人控制,并首次把它接到 VLM 骨干上。
它的位置可以这样概括:这是「flow 生成动作」的工业级参考——证明了 flow matching 动作头能稳定接在 3B VLM 上、10 步积分加 KV cache 能支撑 50Hz 实机控制、跨本体数据配方能训练出可微调的通用策略。后续 openpi(π0.5 系)与 MeanFlow 系(one-step flow 动作模型)都以它为起点,把 10 步积分往 1 步压缩。
6. 局限
论文自承四条:预训练数据「该混什么、按什么权重」没有系统理解,n^0.43 是启发式;无法预测某个任务需要多少、什么类型的数据才能接近完美,部分任务不稳定;跨域正迁移(自动驾驶、导航、腿足)没有验证;复杂任务绝对分数随难度与预训练覆盖度变化。我们读出四条:baseline 对比有不对称性(OpenVLA 步数少且不支持 action chunk,Octo 只有 93M 参数,π0-small 与 π0 的对比混杂了规模与初始化);开箱通用性有限(预训练外任务接近 0,更准确的说法是「覆盖度 + 微调可达性」);Fig 13 里 packing eggs 上 scratch 与微调版接近,预训练收益因任务而异;每任务 10 条 episode、rubric 人工打分、无显著性检验,且代码权重未开源,外部复现门槛极高。
7. 复现与延伸
代码与权重未随论文发布(Physical Intelligence 公司论文,官网有演示视频);后续 openpi 项目(2025-10 的 π0.5 系)以开源形式延续了同一架构路线。评估全部在真实机器人上完成,无仿真基准;推理时延数据(RTX 4090)是复现高频控制可行性最直接的参考。
8. 一句话收束
π0 把「VLM 语义先验 + flow matching 连续动作 + 跨本体大数据 + 预训练/后训练配方」四件事合成一个能跑 50Hz 实机的通用策略框架;对读生成模型的人,它是把 flow matching 从图像搬到动作空间、并处理好与 LLM 骨干接口的完整样例。
把预训练视觉语言模型 PaliGemma(3B)当骨干,额外加一个 300M 参数的 action expert,用条件 flow matching 直接回归连续动作分布,在约 1 万小时、7 种机器人构型、68 个任务的跨本体数据上预训练,再微调去完成叠衣、收拾餐桌、装箱、打包装箱等长时程灵巧任务,支持最高 50Hz 的高频控制;它是第一个把 flow matching 动作头接到 VLM 骨干上的 VLA,也是『flow 生成动作』路线的工业级参考。
阅读提示
精读深度:精读
清单提示:原文提示:注意 flow matching action head 与 VLM 骨干的接口设计、专家混合、cross-embodiment 数据;这是『flow 生成动作』的工业级参考,也是把 MeanFlow 系迁移到动作空间的现实起点。
问题
要解决什么:机器人策略要同时做到通用(跨任务、跨本体、能听懂语言)、鲁棒(能从错误中恢复)和灵巧(高频、精细、多阶段操作)。单任务模仿学习的数据只有几十到几百条轨迹(10 小时以内),学出的策略脆弱且不通用;通用机器人基础模型缺的是把这些组件组合起来的完整框架:大规模语义先验、跨本体数据、能表达连续多模态动作分布的架构、以及预训练/后训练配方,四者缺一不可。
为什么 prior work 不够:前一代 VLA(RT-2、OpenVLA)沿用语言模型的自回归范式,把动作离散成文本 token 用交叉熵训练,采样时逐 token 生成:动作被量化、无法表达连续多模态分布、不能一次输出动作块(action chunk),在高频灵巧任务上明显吃力(OpenVLA 不支持 action chunking)。动作扩散路线(Diffusion Policy、ACT)能建模连续动作分布,但模型小、没有互联网规模语义先验,也不做跨本体预训练。更大的问题在数据与配方:此前最灵巧的任务实验通常只有 10 小时以内的数据,没有人回答过『该用什么数据、按什么比例混合、先训什么后训什么』。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| RGB 图像序列 | image | 每本体 2–3 张:腕部相机、肩部/基座相机等;不同本体相机数量不同,不足 3 张的图像槽在训练时 mask 掉 |
| 语言指令 | text tokens | 任务描述或高层策略给出的中间指令,例如『把杯子放进碗篮』 |
| 本体状态 q_t | continuous vector | 关节角向量,维度统一 padding 到 18(容纳双臂 6-DoF×2、2 个夹爪、移动底盘、升降躯干) |
| 噪声动作 A_τ(训练/推理) | continuous vector | H=50 步动作块的加噪版本;训练时 A_τ = τA_t + (1−τ)ε,推理时从标准高斯采样作为 Euler 积分起点 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 动作块 A_t = [a_t, ..., a_{t+H-1}] | continuous action chunk | 未来 H=50 步连续动作,维度 18(padded,零填充到最大本体维度);由 flow matching 向量场 10 步 Euler 积分生成,开环执行 |
| 速度场 v_θ(A_τ; o_t) | continuous vector | 网络在每个噪声动作 token 位置的输出,训练时回归 u = A_t − ε,推理时作为 ODE 右端项 |
控制频率:20Hz(UR5e、Franka;每 0.8s 推理一次,执行 16 步)/ 50Hz(其余本体;每 0.5s 推理一次,执行 25 步)
输入拼接 protocol
输入序列按 3 个注意力块拼接:<块1>[图像 token I1..In | 语言 token l_t]<块2>[状态 q_t]<块3>[噪声动作 token A_τ 共 H=50 个]。块内双向注意力,块间因果:块1 只能看自己,块2 只能看块1,块3 可看全部。状态单独成块是为了让它的 KV 在 10 步 flow 积分中只算一次。语言走 VLM 骨干,状态与动作 token 走 action expert。数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| 开源数据(OXE Magic Soup 子集 + Bridge v2 + DROID) | 占混合比例的 9.1%(按 timestep 计) | 1–2 个相机、2–10Hz 低频控制;覆盖大量物体与场景,提供语义与视觉多样性 |
| 自采灵巧操作数据 | 903M timesteps(单臂 106M + 双臂 797M) | 68 个任务(每个任务含大量子行为,如 bussing 包含多种餐具与垃圾)、7 种机器人构型;任务权重按 n^0.43 降权过采样 |
| 后训练(微调)数据 | 简单任务约 5 小时,复杂任务 100+ 小时 | 高质、策略一致的演示;用于把基础模型变成熟练策略 |
| 评测协议 | 每个任务 10 条 episode | 归一化任务进度打分(0–1,可部分成功);rubric 见附录 E |
架构(摘要)
主干与结构
backbone:PaliGemma 3B(Gemma 2B 语言模型 + ViT 图像编码器,late-fusion)
参数:3.3B 总参(PaliGemma 3B + action expert 300M,专家从零初始化)
类型:decoder-only 混合专家式 transformer + 条件 flow matching 动作头
关键组件
- VLM 骨干:图像与语言 token,权重继承 PaliGemma 预训练,训练中继续更新
- action expert:300M 参数(width 1024 / mlp 4096),专门处理状态与动作 token,权重从零初始化
- flow matching 动作头:每个动作 token 经 MLP 嵌入(含 flow timestep 的正弦编码 φ(τ)),输出线性投影为速度场
- 块级因果注意力 mask:<图像+语言> → <状态> → <动作> 三块,块内双向,块间因果
- 条件 flow matching 损失:动作 token 回归 u = A_t − ε,替代语言模型的交叉熵
- KV cache 推理:图像/语言/状态只前向一次,10 步 flow 积分只重算动作 token 后缀
为什么这样设计
VLM 骨干提供互联网规模的语义、视觉与推理先验(零样本语言跟随、识别未见物体);flow matching 提供连续、多模态、高频的动作分布建模;action expert 隔离机器人专用 token 的更新路径,让 VLM 骨干尽量贴近预训练分布(减少分布漂移),同时把 flow 积分限定在小网络里以压低推理时延;块级 mask 允许 10 次动作前向共享前缀 KV,把 onboard 推理压到 73ms。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | VLM 骨干:width 2048、depth 18、mlp 16384、18 头、1 个 KV 头、head dim 256(Gemma 2B 配置) |
| 分辨率 | PaliGemma 默认输入分辨率(224×224 图像块序列) |
| VAE | 无 VAE;图像直接走 PaliGemma 的 ViT 图像编码器 |
| 每帧 latent 维 | 动作 token:H=50 个,每个 token 是 18 维动作向量加噪声 |
| Chunk | H=50 步动作块:20Hz 本体覆盖 2.5 秒,50Hz 本体覆盖 1 秒 |
| 上下文 | 上下文 = 2–3 张图像 + 语言指令 + 状态 + 50 个动作 token |
| 动作 | 动作空间 18 维(padded):双臂 6-DoF×2 + 2 夹爪 + 底盘 2–3 维 + 升降躯干 |
| 训练 | 预训练 700k 步(compute-parity 版 160k 步);flow timestep 从 Beta((s−τ)/s; 1.5, 1) 采样,s=0.999;10 步 Euler 积分(δ=0.1) |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 开箱评测平均任务进度(直接语言提示,5 任务) | π0(700k 步):shirt folding ≈1.00 / bussing easy ≈0.97 / bussing hard ≈0.88 / grocery bagging ≈0.79 / toast ≈0.75 | π0 parity(160k 步)0.90/0.81/0.50/0.34/0.40;π0-small(470M,无 VLM 初始化)0.50/0.44/0.34/0.27/≈0;OpenVLA(7B,同数据训练)≈0–0.05;Octo(93M,同数据训练)≈0–0.05;OpenVLA-UR5e-only 仅在 bussing easy 达 ≈0.34 | 每个任务 10 条 episode,归一化任务进度(0–1,部分成功给分数);训练步数:π0 全量 700k、parity 160k、OpenVLA 160k、Octo 320k;数值为从论文图 7 读取的近似值 |
| 语言指令跟随准确率(bussing / table setting / grocery bagging) | π0:≈0.94 / ≈0.90 / ≈0.70 | π0-small(无 VLM 初始化):≈0.70 / ≈0.31 / ≈0.31 | 微调后评测,语言片段约 2 秒一条;表内为 Fig 9 读取值;同任务任务成功率:table setting 在 flat/human/HL 三种指令下 π0 为 ≈0.38/0.72/0.84(高层 VLM 策略给出的中间指令收益最大) |
| 微调数据量实验:平均任务进度(1h / 5h / 10h 数据) | π0(预训练后微调):≈0.57 / 0.87 / 0.87 | π0 scratch:≈0.38 / 0.79 / 0.76;最强 prior(论文指出是纯 scratch 训练的 ACT/DP 类方法):≈0.20 / 0.33 / 0.39 | 6 个下游任务平均(stack bowls、towel folding、tupperware in microwave、paper towel replacement、items in drawer、average across all);1/5/10 小时微调数据,每任务 10 条 episode;1 小时时预训练收益最大,与预训练相似任务(stack bowls)可达约 2 倍提升 |
| 复杂多阶段任务平均分(7 任务,满分 1.0) | 预训练+微调 π0:laundry folding ≈0.83 / mobile laundry ≈0.93 / dryer unloading ≈0.72 / table bussing ≈0.88 / box building ≈0.64 / to-go box ≈0.70 / packing eggs ≈0.84 | 只预训练开箱:与预训练相似任务 ≈0.16–0.55,预训练外任务(box building / to-go box / packing eggs)≈0.01;scratch:≈0.22–0.89(多数任务明显低于微调版,packing eggs 接近) | 任务时长 5–20 分钟,每任务 10 条 episode;rubric 打分(如 table bussing 12 个物体);论文结论:全配方在全部任务上超过最大分 50% 并普遍优于两个消融 |
| 推理时延(NVIDIA RTX 4090) | onboard 总计 ≈73ms(图像编码 14ms + 观测前向 32ms + 10 步动作前向 27ms),offboard 86ms(含 Wi-Fi 网络 13ms) | 对应 50Hz 本体每 0.5s 推理一次,推理只占控制周期约 4% | 3 相机、H=50 动作块、10 步 Euler;20Hz 本体每 0.8s 推理(执行 16 步),50Hz 每 0.5s(执行 25 步) |
Insights
- 动作预测与图像生成的目标分布不同:给定观测后 E[A|o] 本身难学,所以 flow timestep 采样要偏向高噪声端(Beta 分布,s=0.999),这与图像生成偏中间采样的 logit-normal 经验相反(论文 Sec. IV / 附录 B 的 Figure 14)
- VLM 预训练的价值主要体现在语言跟随与开箱可用性:同架构的 π0-small(470M,无 VLM 初始化)在开箱任务上仍赢过 OpenVLA 与 Octo,说明『flow 动作表示 + action chunk』本身就有大贡献(Fig 7)
- 预训练-后训练配方:多样但低质量的数据教策略『恢复与纠错』,高质量数据教『熟练与流畅』;只训高质量数据得到的是脆弱策略,零样本跑预训练模型又没有微调数据的熟练度(Sec. VII)
- 开环执行动作块优于 temporal ensembling:照搬 ACT 的 ensembling 反而伤害性能,作者选择直接执行整块 50 步动作(Sec. V-A / 附录 D)
- 跨本体训练能把低频开源数据(9.1%)与高频自采数据(903M timesteps)揉进一个模型:统一 padding 到 18 维动作空间 + 图像槽掩码是工程上的关键简化(Sec. V-A)
vs 同类工作
- vs RT-2 / OpenVLA(自回归离散动作 VLA):π0 用 flow matching 输出连续动作 + H=50 action chunk + 最高 50Hz 控制;开箱任务上 OpenVLA(7B)在 5 个任务全部接近 0,而 π0 parity 版(160k 步)全面胜出,说明自回归离散化是灵巧高频任务的主要瓶颈
- vs Diffusion Policy / ACT(动作扩散/动作 chunk,无 VLM):π0 在他们之上叠加了互联网规模语义先验与跨本体预训练;微调实验中纯 scratch 的 ACT/DP 仍是除 π0 外最强的方法,但 1 小时数据下被预训练 π0 大幅拉开
- vs Transfusion(Zhou et al. 2024):同样在单一 transformer 里混合交叉熵与逐元素 flow loss;π0 的增量是给机器人专用 token 加了一组独立权重(action expert),并把它接到 VLM 骨干上
- vs MARS / Playground v3(扩散-自回归混合权重):把『语言走一套权重、扩散走另一套权重』的思路首次搬进机器人控制,且权重只在 self-attention 交互
- 定位:π0 是『flow 生成动作』的工业级参考——它证明了 flow matching 动作头可以稳定接在 3B VLM 上、10 步积分 + KV cache 能支撑 50Hz 实机控制、跨本体数据配方能训练出可微调的通用策略;后续 openpi(π0.5 系)与 MeanFlow 系(one-step flow 动作模型)都以它为起点
局限
- 论文自承:预训练数据『该混什么、按什么权重混』没有系统理解,n^0.43 权重是启发式;作者把当时能拿到的数据全混进去了
- 论文自承:无法预测某个任务需要多少、什么类型的数据才能接近完美;部分任务在评测里并不稳定
- 论文自承:跨域正迁移(自动驾驶、导航、腿足运动)是否成立没有验证,universal 基础模型的设想超出当前证据
- 论文自承:复杂任务的绝对分数因任务难度与预训练覆盖度而异,个别任务仍有明显失败模式
- 我们读出:baseline 对比有不对称性——OpenVLA 训练步数少且不支持 action chunk,Octo 只有 93M 参数;论文用 compute-parity(160k 步)缓解,但 π0-small(470M)与 π0(3.3B)的对比仍混杂了模型规模与 VLM 初始化两个变量
- 我们读出:out-of-box 通用性有限——预训练数据里没有的任务(box building、to-go box、packing eggs)开箱分接近 0,『通用性』更准确的说法是『预训练任务的覆盖度 + 微调可达性』
- 我们读出:Fig 13 显示 packing eggs 上 scratch 与微调版接近,预训练收益在不同任务上差异很大,论文『全配方最好』的表述需要按任务拆开看
- 我们读出:评测为每个任务 10 条 episode、分数由 rubric 人工设计,无误差线显著性检验;实验成本(1 万小时数据、700k 步训练、7 种真实机器人)使外部复现门槛极高,代码与权重也未开源
可复现性
- code:未开源(Physical Intelligence 公司论文;官网 blog 提供演示视频与部分细节)
- weights:未随论文发布权重;后续 openpi 项目(π0.5 系,2025-10)以开源形式延续了该架构路线
- sim_benchmark:无仿真基准;全部为真实机器人评测(UR5e、Franka、Trossen/ARX/AgileX、Mobile ALOHA 类、Fibocom),推理时延在 RTX 4090 上给出
主干与结构
backbone:PaliGemma 3B(Gemma 2B 语言模型 + ViT 图像编码器,late-fusion)
参数:3.3B 总参(PaliGemma 3B + action expert 300M,专家从零初始化)
类型:decoder-only 混合专家式 transformer + 条件 flow matching 动作头
关键组件
- VLM 骨干:图像与语言 token,权重继承 PaliGemma 预训练,训练中继续更新
- action expert:300M 参数(width 1024 / mlp 4096),专门处理状态与动作 token,权重从零初始化
- flow matching 动作头:每个动作 token 经 MLP 嵌入(含 flow timestep 的正弦编码 φ(τ)),输出线性投影为速度场
- 块级因果注意力 mask:<图像+语言> → <状态> → <动作> 三块,块内双向,块间因果
- 条件 flow matching 损失:动作 token 回归 u = A_t − ε,替代语言模型的交叉熵
- KV cache 推理:图像/语言/状态只前向一次,10 步 flow 积分只重算动作 token 后缀
为什么这样设计
VLM 骨干提供互联网规模的语义、视觉与推理先验(零样本语言跟随、识别未见物体);flow matching 提供连续、多模态、高频的动作分布建模;action expert 隔离机器人专用 token 的更新路径,让 VLM 骨干尽量贴近预训练分布(减少分布漂移),同时把 flow 积分限定在小网络里以压低推理时延;块级 mask 允许 10 次动作前向共享前缀 KV,把 onboard 推理压到 73ms。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | VLM 骨干:width 2048、depth 18、mlp 16384、18 头、1 个 KV 头、head dim 256(Gemma 2B 配置) |
| 分辨率 | PaliGemma 默认输入分辨率(224×224 图像块序列) |
| VAE | 无 VAE;图像直接走 PaliGemma 的 ViT 图像编码器 |
| 每帧 latent 维 | 动作 token:H=50 个,每个 token 是 18 维动作向量加噪声 |
| Chunk | H=50 步动作块:20Hz 本体覆盖 2.5 秒,50Hz 本体覆盖 1 秒 |
| 上下文 | 上下文 = 2–3 张图像 + 语言指令 + 状态 + 50 个动作 token |
| 动作 | 动作空间 18 维(padded):双臂 6-DoF×2 + 2 夹爪 + 底盘 2–3 维 + 升降躯干 |
| 训练 | 预训练 700k 步(compute-parity 版 160k 步);flow timestep 从 Beta((s−τ)/s; 1.5, 1) 采样,s=0.999;10 步 Euler 积分(δ=0.1) |
π0 框架总览:VLM 骨干 + action expert + flow matching 动作头,多本体多任务预训练
原文 caption:Overview of our framework. We start with a pre-training mixture, which consists of both our own dexterous manipulation datasets and open-source data. We use this mixture to train our flow matching VLA model, which consists of a larger VLM backbone and a smaller action expert for processing robot states and actions. The VLM backbone weights are initialized from PaliGemma.
全篇架构图:左边是预训练数据混合(自有灵巧数据 + OXE 等开源数据),中间是模型本体——大 VLM 骨干处理图像和语言,小 action expert 处理状态和动作,两者只在 self-attention 里交互;右边是多种机器人本体(单臂、双臂、移动操作)共用同一模型。读法:先看『什么 token 进哪个专家』——图像/语言进 VLM 骨干,状态/动作进 action expert,这是 flow 动作头与 VLM 接口设计的关键;再看推理路径——观测编码一次、动作块 flow 积分多次。这张图支撑全文的方法主张:跨本体数据 + VLM 先验 + flow 动作头三者组合。
开箱评测:π0 全 700k 步在 5 个任务上全面领先,160k 步 parity 版也赢过所有 baseline
原文 caption:Out-of-box evaluation results: We evaluate π0 trained for the full 700k steps, a version trained for 160k steps that matches the number of updates for baseline models, π0-small, and three baselines: OpenVLA and Octo trained on all of our data, and OpenVLA trained only on the UR5e tasks.
分组柱状图:横轴 5 个直接提示任务(shirt folding / bussing easy / bussing hard / grocery bagging / toast),纵轴归一化任务进度 0–1,图例 6 个模型。读法:每条任务组里比各柱高度——深青(π0 700k)几乎顶满,白框(π0 parity 160k)次之,浅青(π0-small)再次,OpenVLA/Octo 基本贴地。结论:即使训练步数与 baseline 对齐(160k),π0 仍全面胜出,说明优势来自架构+数据+初始化,而少部分是训练步数;π0-small 也能赢 OpenVLA/Octo,说明动作表示与架构本身(flow + chunk)贡献很大。
微调数据量实验:预训练 π0 在 1/5/10 小时数据下都领先,1 小时时差距最大
原文 caption:Fine-tuning with varying amounts of data. π0 can learn some easier tasks even with smaller amounts of data, and the pre-trained model often attains a larger improvement over the model trained from scratch.
六面板折线/点图:横轴微调数据量(1/5/10 小时),纵轴平均任务进度,对比 π0(预训练后微调)、π0 scratch、Diffusion Policy、Octo、OpenVLA、ACT。读法:看『Average Across All Tasks』面板——深青实线(预训练 π0)在 1h 时约 0.57,5h 与 10h 约 0.87;虚线(π0 scratch)1h 约 0.38;其余 baseline 最高约 0.2–0.39。结论:预训练在小数据时收益最大,与预训练数据相似的任务(stack bowls、towel folding)提升可达约 2 倍;新物体/新手法的任务(paper towel、Franka drawer)提升较小。
复杂多阶段任务:微调后 π0 在 7 个任务上全部超过最大分的一半
原文 caption:Fig. 12: We evaluate a range of complex and temporally extended tasks... Fig. 13: Post-training results on complex tasks in terms of average scores over 10 trials. The full pre-trained π0 model attains more than 50% of the maximum score across all of the tasks, and typically outperforms the ablations, with especially significant improvements on the hardest tasks.
上半页是 6 个任务的场景图(静止叠衣、移动叠衣、烘干机取衣、收拾餐桌、装纸箱、打包装鸡蛋/外卖盒),下半页是 Fig 13 柱状图:横轴 7 个任务,纵轴 0–1 平均分,三组柱对比『预训练+微调』『只预训练开箱』『scratch』。读法:微调后的 π0 各任务约 0.64–0.93;预训练里没有的任务(装纸箱、to-go box、packing eggs)开箱分接近 0,微调后大幅拉起;最难的 table bussing(12 个物体、未见物体)预训练收益最大。结论:预训练-后训练配方是这套系统能做好长时程灵巧任务的原因,也展示了『预训练教恢复与多样、后训练教熟练』的假设。
🎧 音频版
时长 32:33 · Edge TTS
π0 精读:一个会叠衣服的 33 亿参数模型,怎么把「生成动作」做成了工业级参考(对话版)
先讲清楚这篇要解决什么问题
小播:今天这期聊的是《π0: A Vision-Language-Action Flow Model for General Robot Control》,arXiv 编号 2410.24164,作者是 Physical Intelligence 公司的团队,里面有好几位我们熟悉的机器人学习大佬。我听说它是机器人领域的大事件,模型会自己叠衣服、收拾餐桌、装外卖盒,还能连续干二十分钟。它到底解决了什么问题,值得单独做一期?
老播:一句话背景:机器人在真实世界里干活,需要同时做到三件事——听懂语言和看懂没见过的东西(语义通用性)、从错误里恢复(鲁棒性)、高频精细地操作物体(灵巧性)。之前的方法在这三件事上各占一头:OpenVLA 这类 VLA 模型有语言和视觉先验,但把动作当成文字来生成,做不了高频灵巧操作;Diffusion Policy 这类动作扩散模型能生成连续动作,但模型小、没有互联网语义先验。π0 做的事,是把四样东西组合成一个完整框架:预训练好的视觉语言模型当骨干、一个 300M 参数的 action expert 用 flow matching 生成连续动作、约 1 万小时的跨本体数据、以及先预训练再微调的训练配方。今天这一期,我们把它的核心机制讲透:flow matching 动作头怎么接到 VLM 骨干上、那个专家混合设计到底在干嘛、跨本体数据怎么混,最后用四组实验的数字验证它的成色。它值得单独做一期,因为它是「flow 生成动作」这条路的工业级参考——后面 openpi、MeanFlow 系的一步流动作模型,都以它当起点。
小播:我听说它每秒能出 50 个动作指令,这个数字先记下。我们从哪开始?
老播:从它要解决的问题开始:动作为什么这么难生成。
先补背景:VLA 卡在哪,动作为什么难生成
小播:先给我把术语铺一下。VLA 是什么?flow matching 又是什么?
老播:VLA 是 vision-language-action model 的缩写,意思是把预训练好的视觉语言模型微调到输出机器人动作上。flow matching 是扩散模型的一个变体:扩散模型学的是「从噪声一步步去噪还原数据」,flow matching 学的是「把噪声直接搬到数据」的速度场,中间那条搬运路径可以自己设计,通常设计成直线,所以生成时几步就能走完。π0 里生成的是动作,不是图片。动作生成难在哪?先看前一代 VLA 的做法。
小播:前一代 VLA,比如 RT-2 和 OpenVLA,它们怎么输出动作?
老播:它们把动作量化成离散的数字,当成文字 token 一样,用语言模型的交叉熵损失训练,采样时逐个 token 生成。OpenVLA 是 7B 参数的模型,在 OXE 开源数据集上训练,是当时最主流的 VLA 基线。这套做法有两个结构性问题。第一,动作被离散化了,真实动作是连续的,连续分布还常常是多模态的——同一个场景可能有几种都算对的抓法,离散化会把这些可能性抹掉。第二,逐 token 生成做不了 action chunk,也就是没法一次输出未来一整段动作。灵巧操作恰恰需要提前规划一段动作,OpenVLA 自己也不支持 action chunk。论文里做了对比:OpenVLA 在叠衬衫、收桌子这类开箱任务上,得分基本贴着 0。
小播:那 Diffusion Policy、ACT 那条线呢?它们不是已经能生成连续动作了吗?
老播:能,但它们的问题在另一头。Diffusion Policy 用扩散模型生成动作,ACT 用动作 chunk 加 CVAE,都擅长从几十到几百条轨迹里学单个灵巧任务。它们没有 VLM 那种互联网规模的语言和视觉先验,认不出「没见过但语义上该放这儿」的物体,也不做跨本体预训练。而且它们的数据规模小:此前最灵巧的任务,训练数据通常只有 10 小时以内的演示,折算下来就是几十到几百条轨迹。π0 的观察是,通用机器人策略缺的单一组件已经有人做过了,缺的是把它们组合起来的框架,尤其是数据配方——该混什么数据、按什么权重、先训什么后训什么,没有人系统回答过。
小播:还有一个词,跨本体。cross-embodiment 是什么意思?
老播:意思是把不同机器人采集的数据混进同一个模型训练。不同机器人有不同数量的手臂、相机和自由度,动作空间从单臂的 7 维到移动双臂的 17 维。跨本体的价值在于数据池子变大:单任务数据不够,但把几十个任务、几种机器人的数据合在一起,模型能学到通用的操作语义,而不是某一个本体的肌肉记忆。π0 的数据是 7 种机器人构型、68 个任务,开源数据里还有 OXE、Bridge v2、DROID 这些别人的数据,都混进同一个预训练。 比例上,开源数据占混合的 9.1%,看起来不多,但它们的价值在覆盖度:预训练模型要认识「这个世界有什么」,单靠自家机器人数据是不够的,开源数据的物体和场景多样性补上了这一块。这也是跨本体思想的一部分——本体不只是机器人,还包括别人家机器人采的数据。
小播:还有个问题想先问清楚:为什么高频控制这么重要?50Hz 和以前的 5Hz 差在哪?
老播:差在动作的细腻程度。机器人抓取、折叠、放置这些操作,低速控制意味着两次指令之间机器人要盲走很长一段,碰到软物体、衣服这种形变对象,几毫秒的偏差就会让动作失败。50Hz 的意思是每 0.02 秒出一个新动作指令,动作轨迹连续平滑。前一代自回归 VLA 生成一个 token 就要一次采样,高频场景根本跑不动;这也是为什么 action chunk 和 flow 积分这种「一次算出一段」的设计在灵巧操作里是刚需。50 步动作块在 50Hz 本体上覆盖 1 秒,在 20Hz 的 UR5e、Franka 上覆盖 2.5 秒,机器人先把这一段执行完再重新推理。
小播:所以 π0 的回答是:VLM 先验加 flow matching 动作头加跨本体大数据,再加一个预训练/后训练的配方。
老播:对,这就是全篇主线。下面进核心思想,把三块机制逐个拆开。
核心思想:flow matching 动作头怎么接到 VLM 骨干上
小播:先说最关键的接口设计:一个生成文字和图像的 VLM,怎么让它输出连续动作?
老播:思路是给每个动作一步一个 token,但训练目标换成 flow matching。具体说,模型每次输出未来 H 步动作的动作块 A_t = [a_t, a_{t+1}, …, a_{t+H-1}],论文取 H=50。输入序列里就放 50 个「动作 token」,每个 token 对应动作块里的一步。训练时,这 50 个 token 的训练目标换成回归损失:预测一个速度场,把「加了噪声的动作」沿直线拉回「真实动作」。在 transformer 里,动作 token 的嵌入也不查表,直接过一个 MLP:把这一步的动作向量 a 和 flow 时间 τ 的正弦编码 φ(τ) 拼在一起,过两层带 swish 激活的全连接,再投影到 transformer 宽度。时间信息从这里进入模型,网络才知道当前噪声程度。
小播:这个速度场怎么定义?把公式讲一下,我先听预期再听符号。
老播:好,预期是:下面这条损失衡量的是——给定观测,网络预测的搬运速度,和把噪声动作直线搬回真实动作所需要的速度,差多远。训练时一步前向就是一次普通回归,全程不用模拟采样过程,这是 flow matching 相比扩散训练的最大便利。噪声动作的定义是线性插值:
A_τ = τ · A_t + (1 − τ) · ε,其中 ε 采样自标准高斯分布 N(0, I)。
逐项解释:A_t 是未来 50 步的真实动作;ε 是标准高斯噪声;τ 是 flow 时间,取 0 到 1;τ=0 时 A_0 是纯噪声,τ=1 时 A_1 回到真实动作。这个式子的意思是:噪声动作是「真实动作和噪声的线性混合」,时间从 0 走到 1,就是从纯噪声平滑过渡到真实动作。注意这种线性插值路径也叫最优传输路径,它的好处是每个「噪声-动作」对的轨迹是直线,网络回归的目标方向恒定,10 步积分就能走完;扩散模型的路径是弯曲的,往往要几十上百步。
小播:那损失函数呢?
老播:条件 flow matching 损失写成:
L_τ(θ) = E[ ‖ v_θ(A_τ; o_t) − u(A_τ | A_t) ‖² ]。
逐项解释:θ 是网络参数,v_θ(A_τ; o_t) 是网络在观测 o_t 下对噪声动作 A_τ 预测的速度场;u(A_τ | A_t) = A_t − ε 是条件速度,就是「把 A_τ 沿直线拉向 A_t」这个方向上需要的瞬时速度;期望对数据集里的观测-动作对和随机采样的 τ 取。网络学的就是把噪声动作沿直线拉向真实动作的速度场。整块 50 步动作的分布就这样被建模出来,而且不需要任何动作离散化。
小播:这个目标确实简单。那训练时 τ 怎么取?图像生成里好像有讲究。
老播:有,而且 π0 在这里做了一个和图像生成相反的设计。图像生成的经验是从中间时间步多采样,比如 Stable Diffusion 3 用 logit-normal 分布偏重中间,因为低噪声端只要学会恒等映射、高噪声端只要学会均值,中间才是信息量最大的地方。π0 认为动作预测不同:给定机器人观测后,E[A_t|o_t]——观测条件下的平均动作——本身就很难学,因为观测对动作的约束比文本标签对图像的约束强得多。所以他们用偏态 Beta 分布采样:p(τ) = Beta((s−τ)/s; 1.5, 1),s=0.999。这个分布把采样火力集中在高噪声端,也就是低 τ 那边,而且 τ 超过 0.999 的完全不采。顺带,s=0.999 还意味着积分步长可以大于 0.1,最多能到 1000 步,给推理步数留了调节空间。
小播:推理的时候呢?从噪声开始怎么得到动作?
老播:推理时从标准高斯采样 A_0,然后做 10 步前向 Euler 积分:A_{τ+δ} = A_τ + δ·v_θ(A_τ; o_t),步长 δ=0.1。10 步之后得到一整块 50 步动作,开环执行。这里有个反直觉的工程结论:论文试过 temporal ensembling——把多次推理的动作加权平均,这是 ACT 的做法——发现反而让策略变差,最后放弃,直接开环执行整块动作。50 步动作块在 20Hz 的 UR5e 和 Franka 上覆盖 2.5 秒,在 50Hz 的其它本体上覆盖 1 秒。 这里可以给一个具体的感觉:如果某一步动作的真实值是 0.5,初始噪声是 0.1,τ 从 0 走到 1 的过程里,噪声动作会从 0.1 平滑走到 0.5,10 步 Euler 每步走十分之一段,方向始终由条件速度 u = A_t − ε 指过去。因为路径是直线,方向不拐弯,10 步就足够;换成扩散那种弯曲路径,同样的精度往往要几十上百步。这也是 flow matching 相比扩散在实机上的直接好处——步数少,推理快。
核心思想:那个 300M 的 action expert,到底在干嘛
小播:接下来是那个 300M 参数的 action expert。为什么不能直接在 PaliGemma 上微调,非要单独加一套权重?
老播:先看模型本体。骨干是 PaliGemma,3B 参数的开源 VLM,图像编码器加 Gemma 2B 语言模型,权重继承互联网预训练。图像 token 和语言 token 走这套骨干。机器人状态 q_t 和 50 个动作 token 走另外一套 300M 的 action expert,宽度 1024、MLP 4096,从零初始化。两套权重在同一个 transformer 里,只在 self-attention 层交互。这个设计和混合专家 MoE 同构:两个专家,按 token 类型路由,区别是这里没有门控网络,路由规则是写死的——图像语言进大专家,机器人专用 token 进小专家。
小播:这么做的好处是什么?
老播:两个。第一,推理速度:flow 积分要跑 10 步,每步都是一次 transformer 前向。如果每步都过 3B 骨干,50Hz 控制想都别想。动作分支只有 300M,10 次前向每次只过小网络。实测在 RTX 4090 上,图像编码 14 毫秒、观测前向 32 毫秒、10 步动作前向 27 毫秒,onboard 总推理约 73 毫秒,offboard 带 Wi-Fi 86 毫秒。对照一下控制周期:50Hz 本体每 0.5 秒推理一次,推理只占周期的 4% 左右。第二,训练稳定性:机器人专用 token 的训练信号和语言图像不同,直接更新全部权重会把 VLM 骨干推离 PaliGemma 学到的表示;单独一套权重把更新隔离在 300M 的小专家里,作者消融发现这个设计带来稳定提升。
小播:这套「一套权重给语言图像、另一套给动作」的架构,之前有没有先例?
老播:有,血缘很清楚。Transfusion 先在单一 transformer 里混合两种训练目标:离散 token 用交叉熵、连续 token 用 flow 损失;MARS 和 Playground v3 更进一步,给扩散部分单独分配一套权重。π0 的增量是把这两样搬进机器人控制:它自称是第一个「flow matching VLA」,也就是第一个用 flow 生成高频动作块的视觉语言动作模型。接口设计上最容易被忽略的一点是注意力 mask:序列分三块,块间因果、块内双向——第一块图像加语言只能看自己,第二块状态 q_t 能看第一块,第三块 50 个噪声动作 token 能看前面全部。块内双向意味着 50 个动作 token 互相注意,输出整块动作时内部协调一致,比如夹爪要不要配合手腕一起动。状态单独成块有工程原因:它在 10 步 flow 积分里一直不变,单独成块后它的 key/value 只算一次并缓存,每步积分只重算动作 token 后缀的注意力。这就是 KV cache 推理,是 50Hz 能跑起来的关键。 还有一层细节值得说:两套专家不是完全隔离的,它们只在 self-attention 层交互。也就是说,动作 token 的 query 会去注意图像和语言 token 的 key、value,反之亦然,但每个 token 的线性变换用的权重属于各自的专家。这样的好处是语义信息能流进动作生成,而动作分支的更新不会污染图像语言表示,两者的分工和交互各取所需。
核心思想:1 万小时跨本体数据,怎么混出来
小播:数据侧的数字很吓人:7 种机器人构型、68 个任务、约 1 万小时。不同机器人动作空间都不一样,怎么塞进一个模型?
老播:统一动作空间。7 种构型里,UR5e 单臂是 7 维配置空间,Franka 是 8 维,双 Trossen 是 14 维,移动 Fibocom 配置 14 维、动作 17 维。π0 的解法是把所有配置向量和动作向量 zero-pad 到 18 维——这个数字正好容纳双臂 6-DoF 乘 2、两个夹爪、移动底盘、升降躯干。图像槽同理:相机数量从 2 张到 3 张不等,不足 3 张的把缺失槽 mask 掉。数据混合按 timestep 计:开源数据占 9.1%,包括 OXE 的 Magic Soup 子集、Bridge v2、DROID,这些数据低频(2 到 10Hz)、一到两个相机,但物体和场景极其多样;自采数据 903M timesteps,其中单臂 106M、双臂 797M,覆盖 68 个任务。每个任务-本体组合按 n 的 0.43 次方降权,把叠衣这种被过度采样的任务压下去。
小播:为什么预训练要用「质量参差」的数据?直接全用高质量演示不是更好?
老播:论文的核心配方假设就在这:预训练数据要多样性,后训练数据要高质量。多样但质量参差的数据教模型「从错误里恢复」——模型见过大量失败和纠正过程,出了岔子知道怎么救回来;高质量数据教「熟练和流畅」——动作干净利落。只训高质量数据,得到的策略一旦偏离轨迹就崩;只训预训练数据,动作不熟练。预训练阶段跑 700k 步,产出能直接提示调用的基础模型;后训练用任务数据微调,最简单的任务约 5 小时数据,最复杂的要 100 小时以上。这个「先预训练、再微调」的配方,正是从大语言模型训练里搬过来的,论文把它当作和架构同等重要的贡献。
关键实验:四组结果,逐个看数字
小播:数字部分来了。第一组是开箱评测,直接提示基础模型干活,不给微调。结果怎么样?
老播:Figure 7 那张图:5 个任务——叠衬衫、收拾桌子简单版、收拾桌子困难版、杂货装袋、从烤面包机取吐司。每任务 10 条 episode,按归一化任务进度打分,0 到 1,部分成功也给分数。 具体 rubric:收拾桌子简单版按 7 个物体计分,困难版按 12 个物体计分,每个放对位置的物体得 1 分;杂货装袋按 7 件商品计分;取吐司按 4 步计分;叠衬衫只有成功或失败两种结果。困难版比简单版多了一些刁钻摆法,比如筷子压在垃圾上、物体互相遮挡,还有预训练数据里没见过的物体——这些才是拉开差距的地方。
全量 π0 训练 700k 步,五个任务得分约为 1.00、0.97、0.88、0.79、0.75。为了公平,论文训了一个训练步数跟 baseline 对齐的 parity 版,只有 160k 步,得分仍有 0.90、0.81、0.50、0.34、0.40——照样赢过所有 baseline。同数据训练的 OpenVLA(7B)和 Octo(93M)基本贴地,约 0 到 0.05;OpenVLA 只训 UR5e 数据的版本好一些,但也就收拾桌子简单版到约 0.34。还有个细节:π0-small,470M 参数、没有 VLM 初始化,得分 0.50、0.44、0.34、0.27、约 0,也赢过 OpenVLA 和 Octo。这一组得出两个结论:优势大部分来自架构加数据加初始化,因为步数对齐的 parity 版照样全面胜出;flow 动作表示和 action chunk 本身贡献巨大,因为连没有 VLM 的 π0-small 都能赢。
小播:第二组,语言指令跟随。VLM 先验在这里应该最有用吧?
老播:对,Figure 9。对比 π0 和 π0-small 的语言跟随准确率:bussing 任务约 0.94 对 0.70,table setting 约 0.90 对 0.31,杂货装袋约 0.70 对 0.31。差距在需要语义理解的任务上尤其大。更值得记住的是高层指令的价值:table setting 任务里,直接一句「把桌子摆好」(flat)π0 只有约 0.38;专家分步下指令(human)升到约 0.72;由另一个 VLM 策略给出的中间指令(HL)约 0.84。HL 的原理是:让一个高层 VLM 看着当前画面,输出「下一步该拿起哪个物体、放到哪里」这样的短指令,π0 负责执行。意思是语言跟随能力直接转化为任务成功率,而且高层 VLM 可以当规划器用,把「收拾桌子」拆成「把餐巾纸放进垃圾桶」这样的子步骤。
小播:第三组,微调数据量。这是我最关心的:预训练到底值多少钱?
老播:Figure 11,6 个下游任务——叠碗、叠毛巾、微波炉放保鲜盒、换纸巾筒、Franka 抽屉放东西,外加一个所有任务的平均面板——微调数据分 1、5、10 小时三档。看「所有任务平均」:预训练 π0 是约 0.57、0.87、0.87;π0 scratch(从头训)是约 0.38、0.79、0.76;最强的 prior 方法,论文指出是纯 scratch 训练的 ACT、Diffusion Policy 这类,约 0.20、0.33、0.39。注意 1 小时这一档,预训练 π0 0.57,比 scratch 的 0.38 高出近一半,比 prior 的 0.20 高出近两倍——数据越少,预训练收益越大。分任务看,跟预训练数据相似的任务(叠碗、叠毛巾)提升可达约 2 倍,预训练里完全没有的新任务(换纸巾、Franka 抽屉)提升就小。微波炉那个任务还有个有意思的现象:π0 用 1 小时数据就明显好过 baseline,但训到 5 小时反而跟 baseline 拉平,论文把它归因于任务与预训练数据的相似度。 单任务面板还能读出更多:叠碗任务里,预训练 π0 在 1 小时数据下就接近满分的两倍于 scratch 版,是「预训练相似任务收益最大」的例证;换纸巾筒这种完全没见过的任务,预训练 π0 依然好于 scratch 和 prior,但差距小很多。论文给出的概括是:预训练在相似任务上带来最大提升,但对新任务也有正迁移,只是幅度小。
这组实验同时解释了为什么 π0 是「flow 生成动作」的工业级参考:预训练给了它一个起点,微调只需要把起点拉向任务。
小播:第四组,最难的复杂多阶段任务,5 到 20 分钟那种。
老播:Figure 12 和 13。七个任务:叠衣、移动叠衣、烘干机取衣、收拾餐桌、装纸箱、to-go 外卖盒、打包鸡蛋。 评分也是分段式的:叠衣满分 4 分,从篮子里取出一件得 1 分、摊平得 1 分、折叠得 1 分、放进叠好的堆里得 1 分;装纸箱满分 5 分;to-go 外卖盒满分 5 分;打包鸡蛋满分 7 分,每颗蛋进槽得 1 分。这样部分成功也能量化,比如叠了一半拿 2 分。
这些任务要求几十个行为的组合——抓取、叠、堆、压平——还有变形物体和硬纸板这类难处理的对象。预训练加微调的 π0 在全部七个任务上超过最大分的一半:约 0.83、0.93、0.72、0.88、0.64、0.70、0.84。对比两个消融:只预训练开箱版,在预训练里没有的任务上——装纸箱、to-go 盒、打包鸡蛋——得分接近 0.01,微调之后被大幅拉起;scratch 版多数任务明显更低,最难的收拾餐桌(12 个物体、还有没见过的物体)是 0.88 对 0.71 对开箱的 0.48。这组实验把配方的价值和边界都展示出来了:预训练教恢复和多样,后训练教熟练;但预训练外任务的「通用性」要靠微调兑现,开箱直接可用只发生在预训练覆盖过的任务上。还要补一个数字:推理时延。RTX 4090 上 onboard 约 73 毫秒,图像编码 14 毫秒、观测前向 32 毫秒、10 步动作前向 27 毫秒;offboard 带网络 86 毫秒。对照 50Hz 控制周期 0.5 秒,推理只占 4% 左右,这个数字决定了「flow 生成动作」能不能上实机。
它在技术谱系里的位置
小播:把它放回技术谱系,它跟谁比、好在哪、差在哪?
老播:三组对比。对 RT-2、OpenVLA 这代自回归 VLA,π0 用 flow matching 输出连续动作、支持 50 步动作块、最高 50Hz 控制;开箱任务上 OpenVLA 接近 0,而步数对齐的 parity 版还有 0.34 到 0.90,这说明自回归离散化是高频灵巧任务的主要瓶颈。对 Diffusion Policy、ACT 这代动作扩散方法,π0 在它们之上叠加了 VLM 语义先验和跨本体预训练;微调实验里,纯 scratch 的 ACT、DP 依然是除 π0 外最强的方法,但 1 小时数据下被预训练 π0 大幅拉开。再往上是架构血缘:Transfusion 先在单一 transformer 里混合交叉熵和逐元素 flow 损失,MARS 和 Playground v3 做了「语言一套权重、扩散另一套权重」,π0 把这两样搬进机器人控制,并第一次接在 VLM 骨干上。
小播:那它和 MeanFlow 那条线是什么关系?清单里提到它俩连着。
老播:关系是起点和后续。MeanFlow 系的目标是让 flow 模型一步走完——直接从噪声映射到数据,省掉 10 步积分;π0 证明了在动作空间里 flow 这套框架能跑通、能上实机,但它的 10 步 Euler 积分、Beta 采样、动作头接口,正是 MeanFlow 系要压缩和接管的起点。用一句话概括,π0 是「flow 生成动作」的工业级参考:flow 动作头怎么接 VLM、专家混合怎么路由、KV cache 怎么省、Beta 采样为什么偏噪声端,这些设计细节都被后续 openpi 的 π0.5 系和 MeanFlow 系的一步流动作模型当成出发点。它处在那条从「多步扩散」到「一步流」的技术路线上,位置在中间靠前。 具体到开源生态,π0 论文本身没有放代码和权重,但 2025 年 10 月发布的 openpi 项目(π0.5 系列)把这条架构路线开源了,社区因此能在自己的机器人上复现「VLM 骨干加 flow 动作头」的组合。MeanFlow 这条线则代表另一个方向:把 10 步积分换成一步映射,用 rectified flow 的 reflow 或蒸馏把轨迹拉直,目标是把动作生成的延迟从几十毫秒再压一个量级。读这篇论文时带着这两条后续线,会更容易看清哪些设计是地基、哪些设计是可以替换的零件。
局限要讲清楚
小播:论文自己承认的局限,加上你读出来的,都说说。
老播:先论文自承四条。第一,预训练数据「该混什么、按什么权重」没有系统理解,n 的 0.43 次方降权是启发式,作者是把当时能拿到的数据全混了。第二,没法预测某个任务需要多少、什么类型的数据才能接近完美,部分任务评测里并不稳定。第三,跨域正迁移没验证——自动驾驶、导航、腿足运动这些更远的领域能不能共享这套预训练,论文没有证据。第四,复杂任务的绝对分数随难度和预训练覆盖度变化,个别任务仍有明显失败模式,作者建议看官网视频感受任务复杂度。
小播:你读出来的呢?
老播:四条。第一,baseline 对比有不对称性:OpenVLA 训练步数少、不支持 action chunk,Octo 只有 93M 参数;论文用 parity 版缓解,但 π0-small 和 π0 的对比仍然混杂了模型规模与 VLM 初始化两个变量,作者自己也承认这个对比很难做得公平。第二,开箱通用性有限:预训练外任务开箱接近 0,「通用」更准确的说法是「预训练覆盖度加微调可达性」。第三,Figure 13 里打包鸡蛋这个任务,scratch 和微调版接近,预训练收益在不同任务上差异很大,论文「全配方最好」的表述要按任务拆开看。第四,评测每任务 10 条 episode、分数是人工设计的 rubric、没有显著性检验,而且代码和权重没有开源,1 万小时数据和 700k 步训练让外部复现门槛极高,这也是它和 openpi 后续开源版本口碑差异的来源之一。 还有一个容易被忽略的点:论文评估里「开箱」指预训练后直接提示,但预训练数据本身是按任务采样的,68 个任务覆盖了什么,模型才擅长什么;把「开箱可用」理解成「任意新任务都能零样本搞定」会高估它,论文自己也没有这样宣称。
收尾:记住这三件事
小播:收个尾。本期记住的三件事,我用我的话复述一遍。第一,π0 把动作生成从「离散 token 的自回归」换成了「连续动作的 flow matching 回归」:50 步动作块、10 步 Euler 积分、50Hz 控制,这套接口设计让它既保住了 VLM 的语义先验,又拿到了连续多模态的动作分布。第二,那个 300M 的 action expert 是工程灵魂:两套权重一个 transformer,只在 self-attention 交互,机器人专用 token 的更新被隔离在小网络里,10 步 flow 积分每步只过小网络,KV cache 复用前缀,才把推理压到 73 毫秒、占到控制周期的 4%。第三,1 万小时跨本体数据的配方:zero-pad 到 18 维统一动作空间、按 n 的 0.43 次方降权、预训练教恢复、后训练教熟练,四组实验里最扎眼的数字是 1 小时微调数据下预训练 π0 的 0.57 对 prior 的 0.20。
老播:补一句它对后续工作的意义。π0 的价值在于把「flow 生成动作」从论文变成了能上实机的工业级参考:flow 动作头怎么接 VLM、专家混合怎么路由、KV cache 怎么省、Beta 采样为什么偏噪声端,这些设计细节都被后续 openpi 和 MeanFlow 系的一步流动作模型当成起点。下一个值得追问的问题是:10 步积分能不能压到 1 步,以及预训练覆盖度之外的任务,能不能靠更聪明的数据配方直接开箱可用。