How Diffusion Models Learn to Factorize and Compose(MIT,NeurIPS 2024,精读)
一句话定位:这篇论文把扩散模型当成认知实验里的动物来研究——用完全可控的二维高斯斑点数据,回答「模型内部怎么表示独立变化的因子、组合泛化能力从哪来、什么训练数据才够」。核心结论有三个:模型学到分解但半连续的环面表征(x 与 y 正交、同一特征的不同取值却像离散类别);行为上能组合、几乎不能插值;表征流形的形成与物理学渗流相变对应,数据重叠超过阈值后能力突然出现。这套「病变数据集 + 区域化准确率 + 独立因子/组合样例混合」的实验范式,可以直接迁移到组合物理推理的研究里。
---
要解决的问题:组合泛化的机制没有共识
大型文生图模型能生成训练集里从没一起出现过的元素组合,论文举的例子是「astronaut riding a horse on the moon」——宇航员、骑马、月球各自常见,三者同框的照片训练集里几乎没有。这种组合泛化能力存在,但机制不清楚:模型是把元素拆成独立因子分别编码(分解表示),还是整个塞进一个联合表示(耦合表示)?此前研究没有共识。β-VAE 一族的解耦表征工作(Higgins 2017、Burgess 2018 等)认为分解促进泛化,Montero 2021、Xu 2022 等却发现解耦分数与组合泛化相关性很弱;Okawa et al. 2023 在 toy 扩散模型上观察到乘法式组合行为,但没有分析内部表征。
论文先给出一个样本效率层面的动机。设数据由 K 个独立 1D 因子组成,每维有 N 个状态。若模型学联合表示 P(x1,…,xK),约需要 N^K 量级的样本才能覆盖;若能识别因子独立、学分解表示 P(x1)…P(xK),约 KN 个样本就够。两个方案差出数量级,所以「模型到底学哪种、为什么」值得拆开验证。
实验范式:把扩散模型当认知实验的动物
论文的套路借鉴认知心理学与神经科学:给模型设计简单的认知任务,同时看两个层面的证据——生成输出(「行为」)和中间层激活(「神经活动」)。数据是 N×N 灰度图(默认 32×32),每张一个 2D 高斯斑点(bump,垂直与水平 1D 条纹的乘法)或 2D 高斯 SOS(条纹的加法),中心位置 (µx,µy) 在 [0,32]² 连续变化,σx=σy=1.0、dx=dy=0.1 为默认,一套默认数据有 102,400 张图。模型是条件 DDPM,UNet 带 3 个下/上采样块,条件线索就是 ground-truth 位置标签 (µx,µy),以位置编码形式在每个块注入。训练损失是标准 DDPM 的噪声预测 MSE:
L = E_{t, x0, ϵ} ‖ϵ − ϵθ(x_t, t, c)‖²
这个式子回答「网络要学什么」:在扩散时间步 t、给定条件 c 时,准确预测注入的噪声 ϵ。其中 x_t 是加噪图像、ϵθ 是 UNet 输出、c=(µx,µy) 是位置条件、期望对时间步、数据与噪声取。表征分析取 layer 4 的激活(跳过 bottleneck,因为 skip connection 让那里的信号衰减),用 PCA/UMAP 降到 2D/3D 观察。
核心发现一:分解但半连续的环面表征
怎么判断模型学的是分解还是耦合表示?平面上做不了——两条线做笛卡尔积 L1×L1 拓扑等价于平面 R²,形状一样。论文的招数是给图像空间加周期边界(左右、上下相接),把数据所在的流形从平面变成环面。环面有两种标准实现:3D 环面把两个圆耦合嵌进 R³(耦合表示),Clifford 环面把两个圆各自嵌进 R²、整体在 R⁴(分解表示),它们的 2D 投影形状不同,于是可以区分。
三个证据说明模型学到的是 Clifford 型环面。第一,持久同调:模型终端表征的持久图与标准环面一致——H0 秩 1、H1 秩 2、H2 秩 1,确认了环面拓扑。第二,有效维度轨迹:训练中参与率
PR = (Σλi)² / Σλi²
这个式子回答「激活空间实际占用了几个维度」,λi 是第 i 个主成分的特征值,分子是总方差的平方、分母是方差平方和;若所有方差集中在一个方向,PR=1,若均分在 d 个方向,PR=d。随着训练推进,PR 先升后降,200 epochs 后收敛到约 7;前 4 个主成分的特征值明显突出,说明 4 维结构(两个环方向各 2 维)占主导,对应分解的 Clifford 环面。第三,正交性/平行性测试(来自 Cueva et al. 2021):固定 x 扫 y 得到的环与固定 y 扫 x 得到的环相互正交,接近 Clifford 环面。图 2 把这几条证据放在一起。
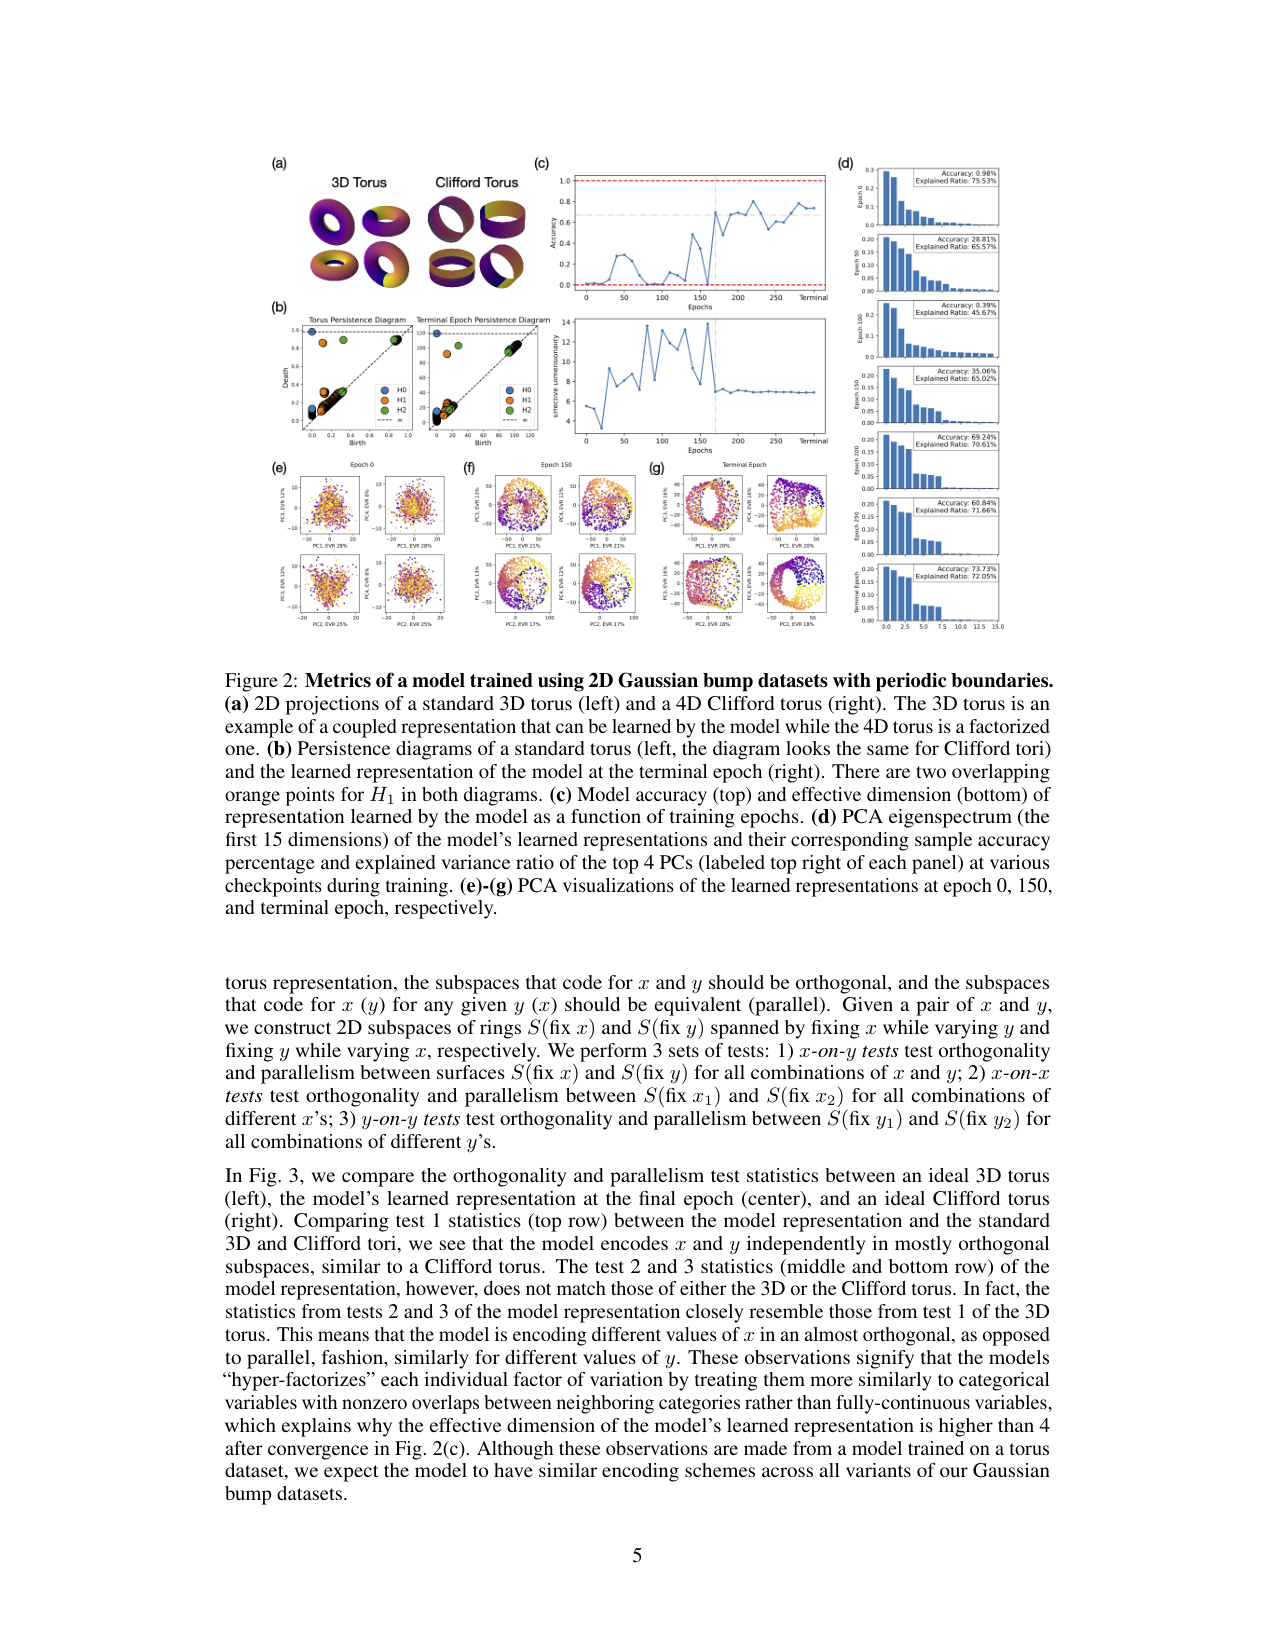
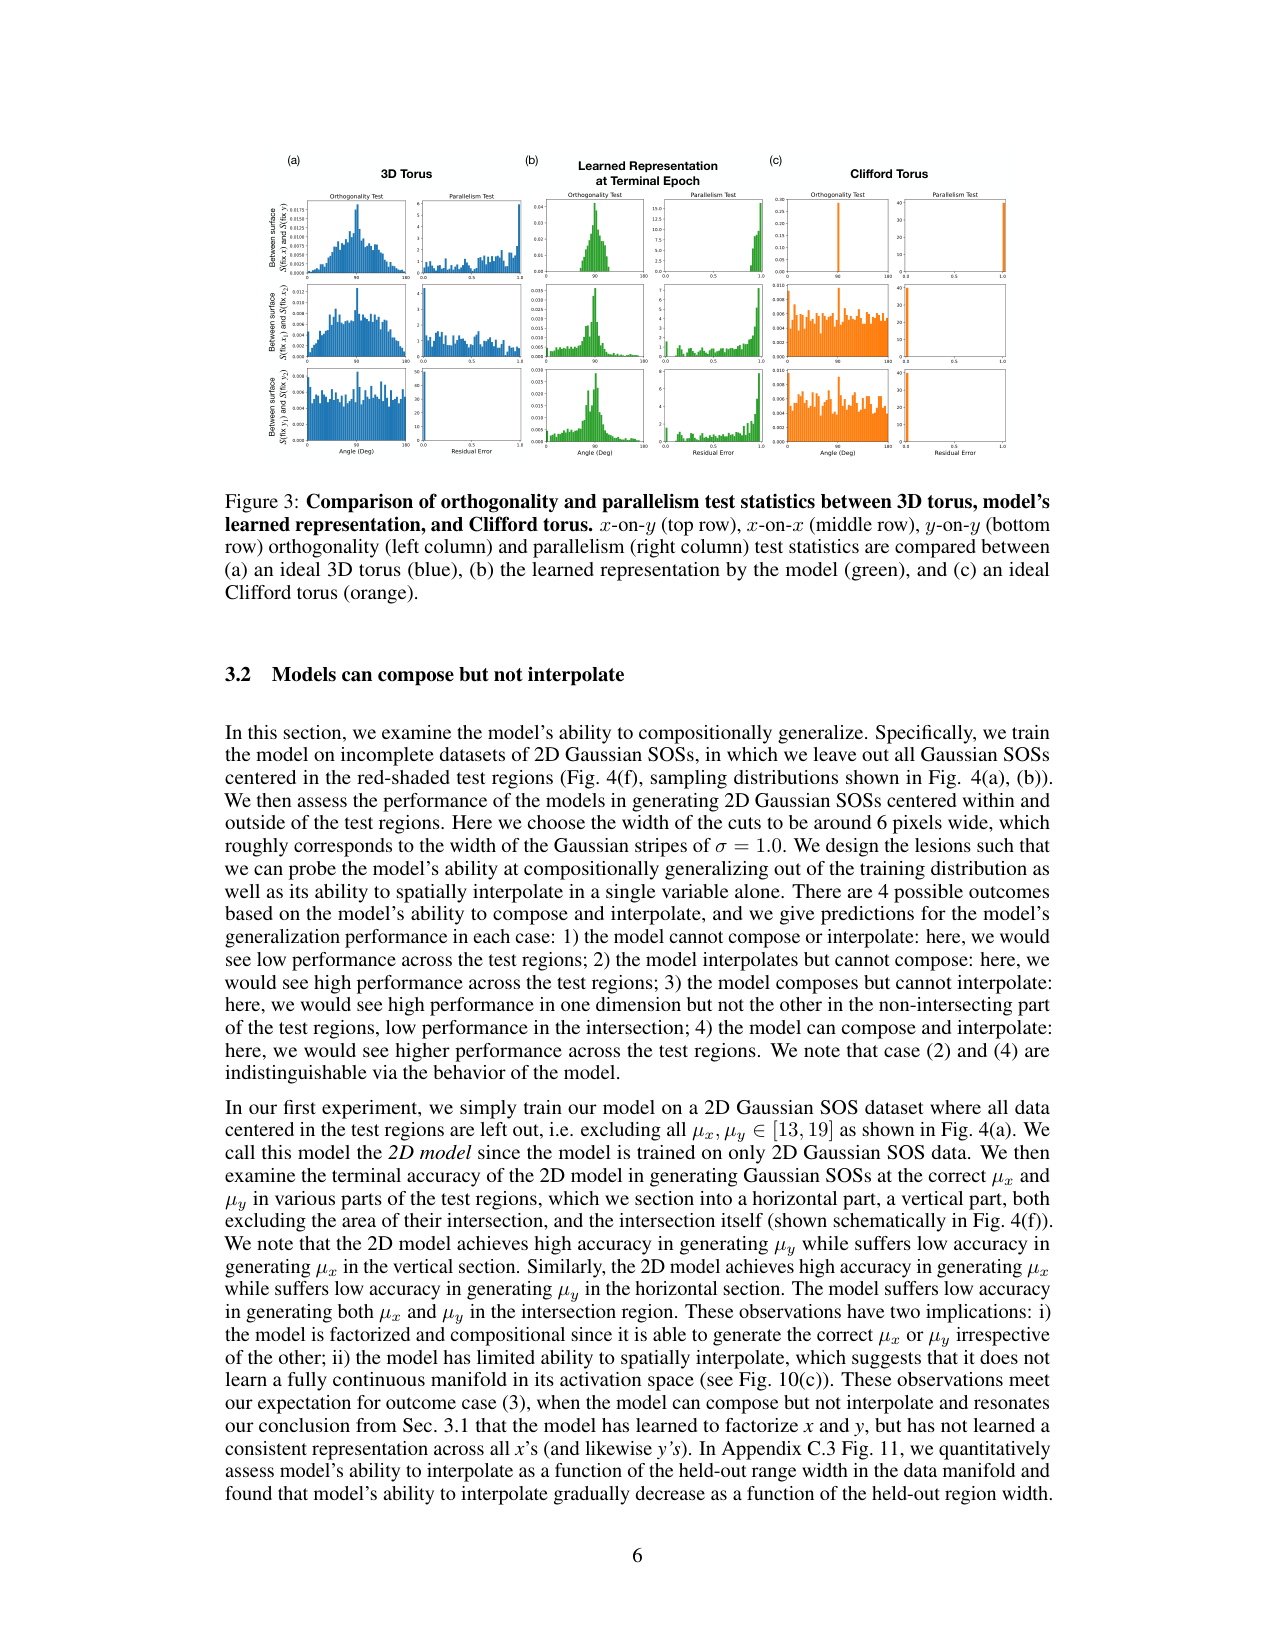
但分解有一个重要尾巴:同一特征的不同取值之间,统计量也接近正交——x-on-x、y-on-y 测试与理想 Clifford 环面(要求平行)不符,与 3D 环面也不符。这说明模型把每个连续特征进一步「超分解」成类似离散类别的编码,相邻取值只靠非零重叠连接(图 3)。这就是为什么有效维度会高于 4,也预告了插值能力差的后果。
核心发现二:能组合、不能插值
行为实验用 2D Gaussian SOS 数据,挖掉十字形测试区 µx,µy∈[13,19](约 6 像素宽,等于 σ=1.0 的条纹宽),然后按测试区的垂直段、水平段、交叉段分别统计生成正确率(图 4)。
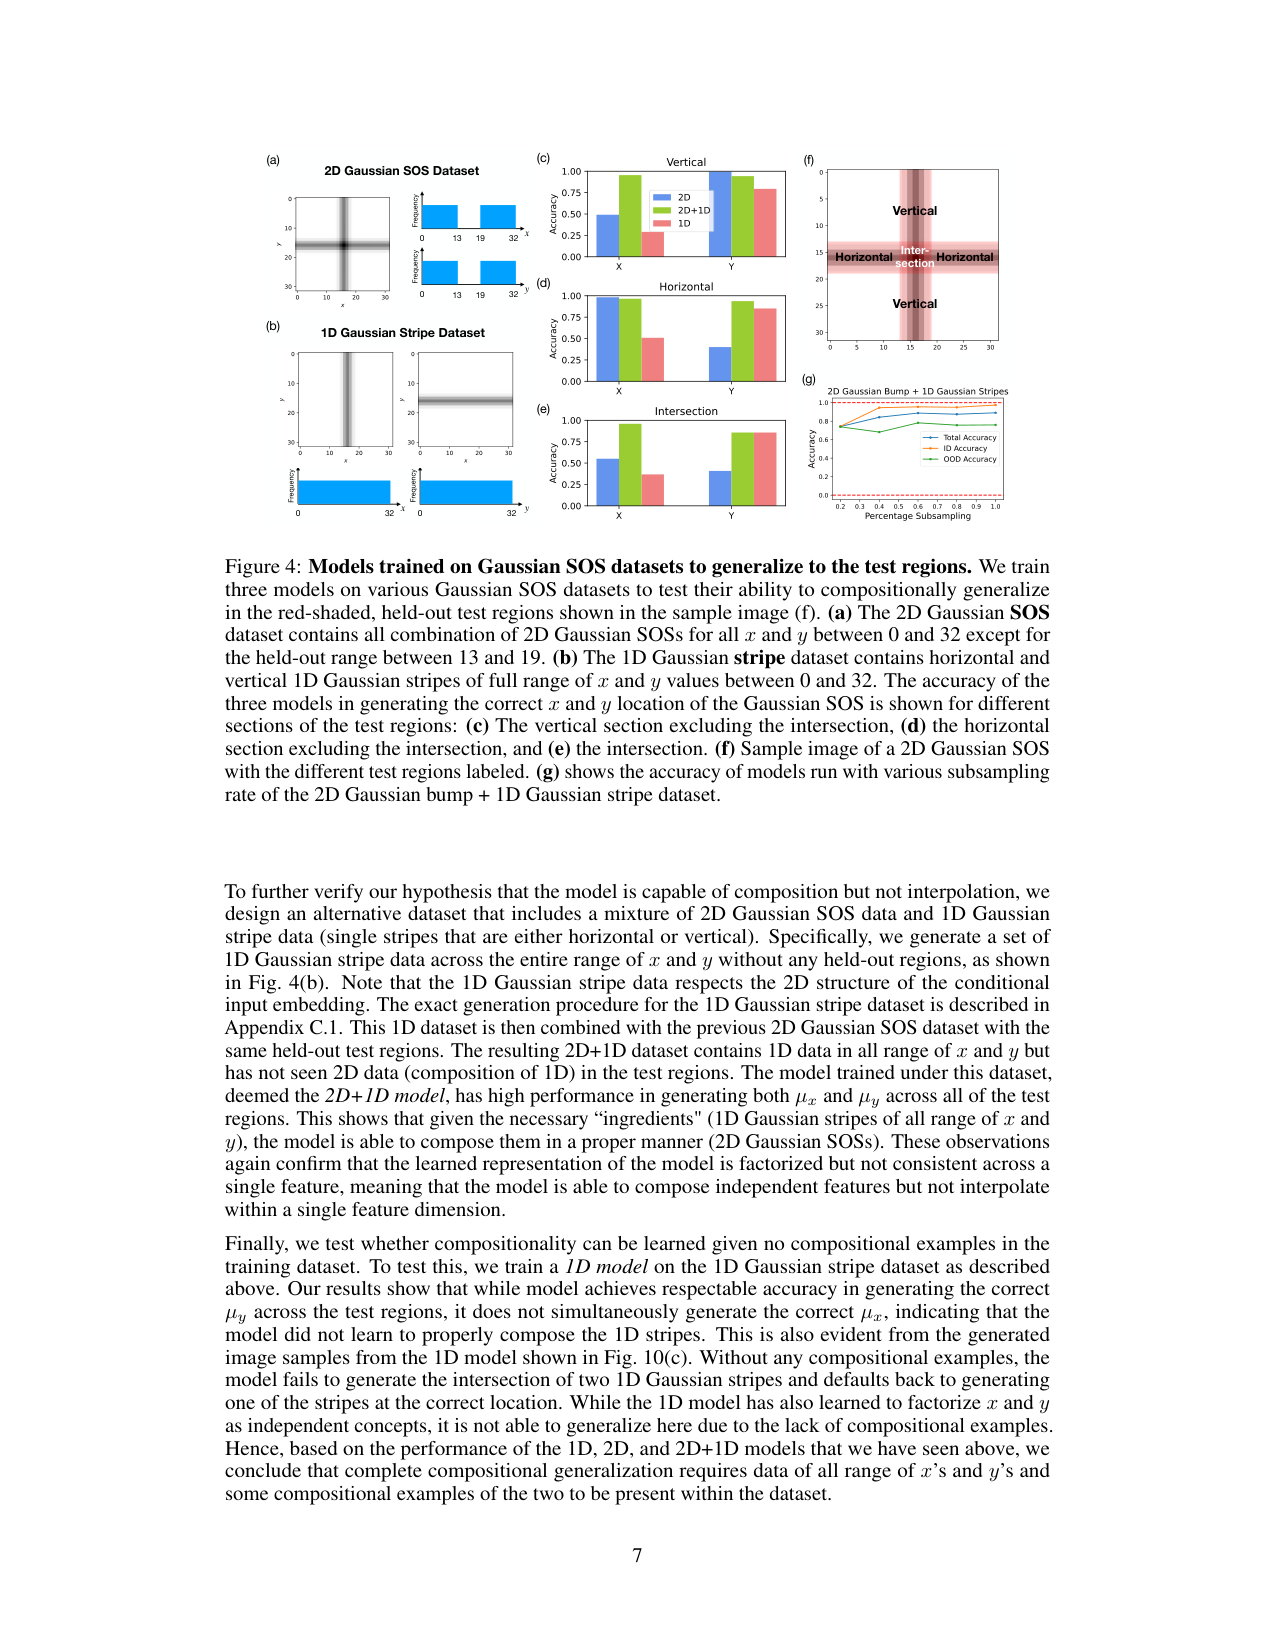
结果分三层。第一层,只训 2D SOS 的模型(2D 模型):垂直段 µy 准确、µx 不准确,水平段反过来,交叉段两个都差。这说明模型能组合——正确给出训练里见过的那个维度,且不受另一个维度影响;同时几乎不能插值——给不出测试区里没见过的取值。第二层,补上全范围 1D 条纹的模型(2D+1D 模型):三段全部高准确率,说明只要每个独立因子在训练里全范围出现过,少量组合样例就足以让模型把两个条纹正确组合成 SOS。第三层,只训 1D 条纹的模型(1D 模型):µy 准、µx 给不出,交叉段默认生成单条纹——没有组合样例时,模型学不会「把两条条纹乘/加起来」这个组合动作。三个模型合起来的结论:完整的组合泛化需要每个因子全范围出现,加上一些组合样例。这个结论在图 2、图 3 的表征层面与图 4 的行为层面相互印证:分解是真的,但半连续的分类式编码让插值失败。
核心发现三:渗流 onset——表征在数据阈值处突然成形
论文进一步问:分解表征(或者说流形本身)是什么条件下才学得出来?答案联系到物理学渗流理论。高斯斑点数据集可以被近似成 Poisson Boolean(Gilbert 圆盘)模型:每个斑点是一个圆盘,落在 32×32 格上,相邻圆盘有重叠就视为连通。渗流理论关心临界占比:系统里出现一个贯穿的最大连通集团,需要多大比例的节点重叠,超过临界值会发生相变。
论文把「重叠」量化为相邻斑点图像的归一化 L2 乘积,即 ‖√(a·b)‖₂/‖a‖₂,其中 a、b 是两张相邻的斑点图,· 是逐元素乘。这个式子回答「两张图有多像」,分子是乘积图能量的平方根、分母是单张图的范数,自身重叠归一为 1。模拟显示,最大连通集团质量占比随数据占比 λ 上升,存在阈值式突增;σ 越小(斑点越窄、重叠越少),阈值越高,σ=0.1 时永远不连通。
实验与模拟对照(图 6):固定 1024 个中心点(d=1.0),按 λ 取嵌套子集(λ=0.2 是 λ=0.1 的超集),不同 σ 共用同一批格点,训练批数按数据量反比补偿。模型终端准确率随 λ 的变化与渗流预测一致:σ=1.0 时低 λ 就能学,σ=0.3/0.5 需要更高 λ 且方差大,σ=0.1 要到 λ=0.8/0.9 才学会。σ=0.1 是个值得注意的例外——模拟里它永远不渗流,但实验里模型仍然学会,论文的解释是扩散加噪过程把单像素宽的斑点抹宽,等效增大了重叠。
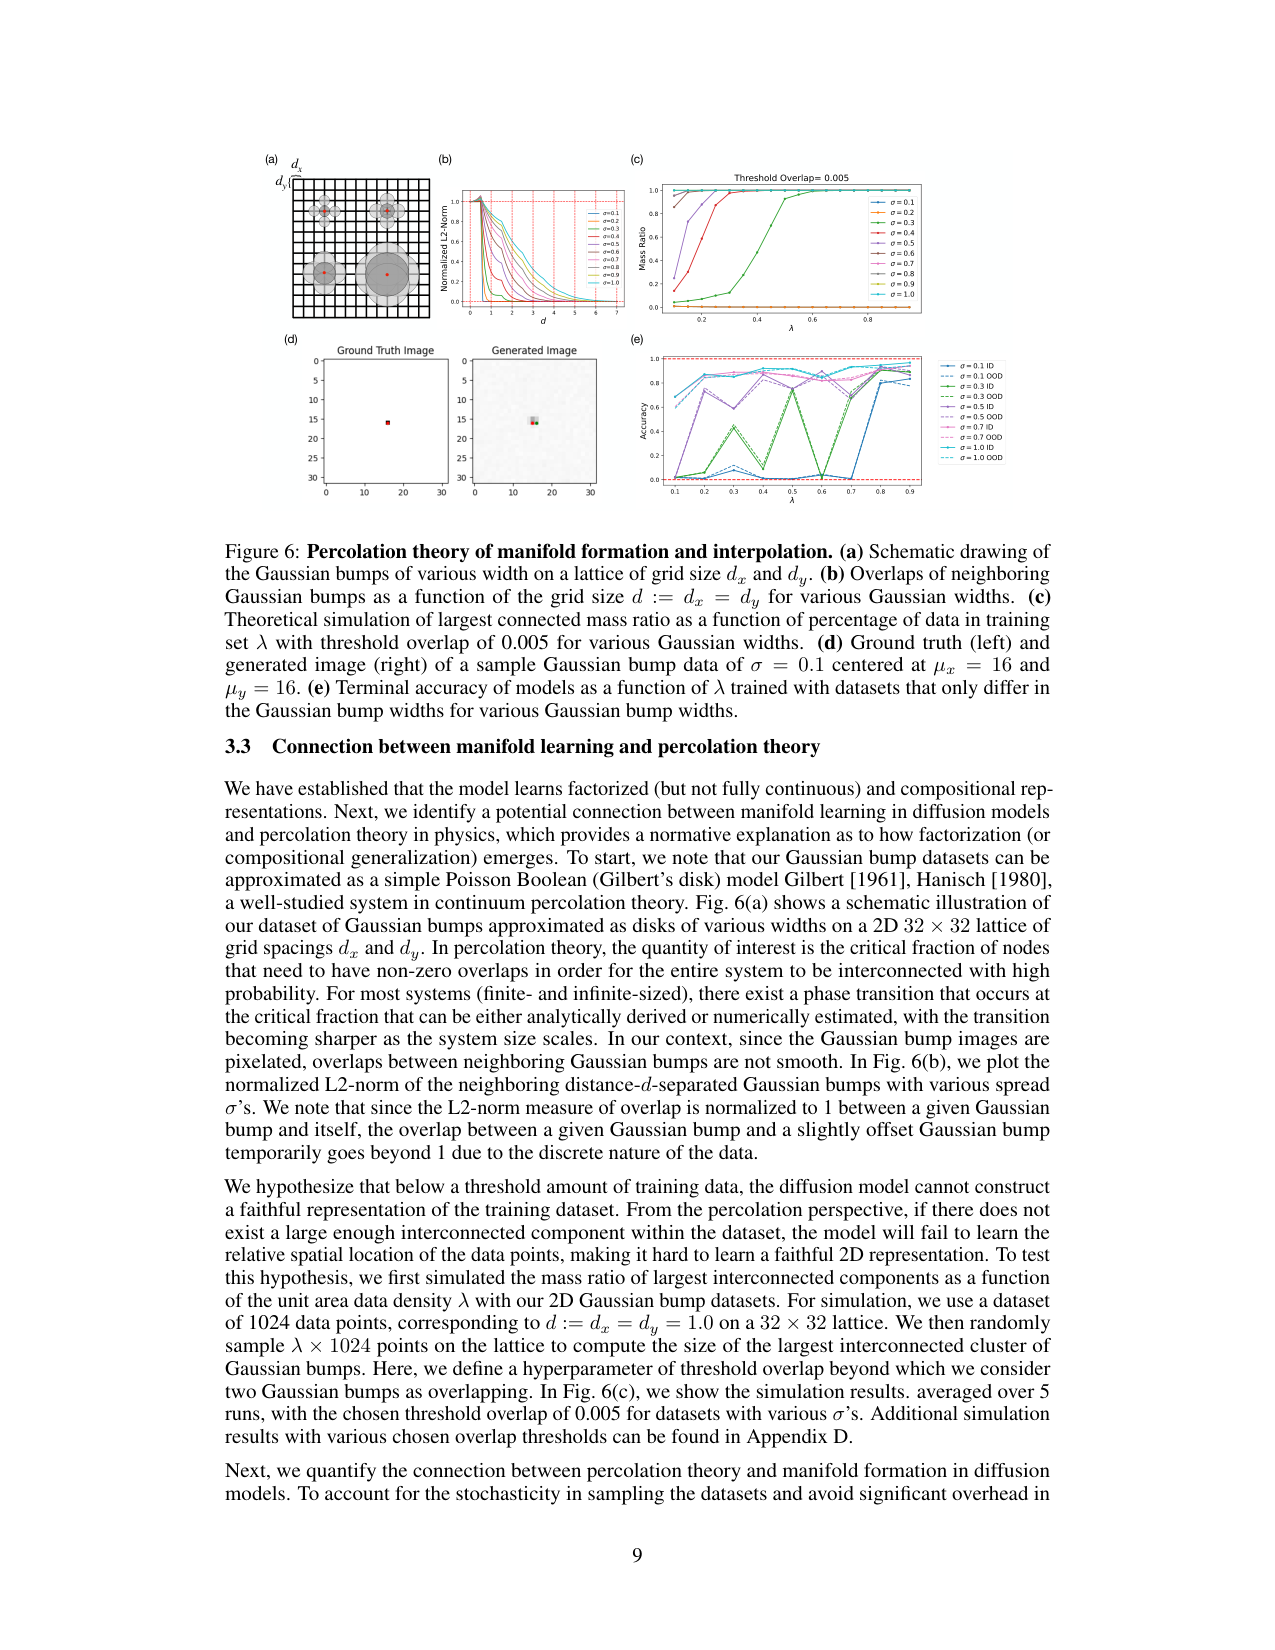
渗流视角的实质:样本间的重叠是流形学习的「胶水」。重叠低于阈值时,模型学不出数据点之间的相对位置关系,表征是散的;超过阈值,连通集团形成,表征与能力一起突然出现。论文把这一点与扩散模型能力随数据量突现的经验现象联系起来,并提出在真实数据上可以用互信息或余弦相似度充当抽象的「重叠」。
数据配方与样本效率
3.2 节的另一个实验把配方推到数据效率层面:2D bump + 全范围 1D 条纹的增强集,与纯 2D bump 基线对比,都挖掉中心 20% 做 OOD 评估,按画布尺寸 N 缩放数据量。结果:达到 60% 准确率阈值所需的数据,基线随 N 二次增长,增强集随 N 线性增长(log-log 图上的二次与线性参考线)。单独看组合任务,bump 测试区准确率最高到 70%;把训练里的 2D bump 子采样到 20%,准确率基本不变。图 10 还显示,只在图像边缘放少量部分重叠的 2D 样例(2D rim),模型就恢复了组合能力,与大量组合样例的效果相当。这些结果支持一个可操作的建议:训练扩散模型时,让每个独立因子全范围出现、再配少量组合样例,比盲目堆组合数据更省。
谱系定位
论文处在两条线的交叉点。一条是生成模型的组合泛化:对 Okawa et al. 2023(乘法式组合)做了机制层面的补全——那篇只看行为,这篇加了表征几何、插值测试与数据配方,并把组合形式扩到加法。另一条是解耦表征与组合泛化的老争论:对 β-VAE 一族(Higgins 2017 等)与 Montero 2021、Xu 2022 的矛盾结论给出一个解释——分解确实帮助组合泛化,但必须配合「全范围因子 + 组合样例」的数据条件,而且分解本身是半连续的,单看解耦分数会漏掉这些结构。理论上它与 Wiedemer et al. 2023(组合泛化的 first principles 条件)互补:那篇给充分条件,这篇给扩散模型里的实证机制。方法上,它把神经科学的流形分析工具(持久同调、环面正交/平行测试)与物理学的渗流理论带进生成模型表征研究。
局限
第一,全部结论建立在 toy 域上:二维高斯斑点/SOS、单目标、32×32 灰度图,组合形式只有加法与乘法两种,真实图像里多种组合并存,迁移性没有验证。第二,渗流连接是类比加事后拟合:论文承认模拟的重叠阈值 0.005 是「为了最好匹配实验数据而选」,没有从扩散训练动力学推导出相变,σ=0.1 的例外要靠加噪抹宽补充解释。第三,行为实验有不可区分性:论文自己指出「会插值但不会组合」与「既能组合又能插值」在行为上无法区分,插值结论主要靠 layer 4 表征分析支撑,而架构只测了一种(单 UNet、固定取层)。第四,条件线索就是 ground-truth 位置标签,等于直接把答案告诉模型,无标签设置没有测。第五,渗流实验方差大(σ=0.3/0.5 抖动明显),模拟只做 5 次平均,论文把部分方差归因于训练随机性。另外正文没有给代码或权重链接。
尽管如此,这套范式对组合物理推理研究有直接参考价值:把物理量(位置、朝向、速度、材质等)当作独立因子,物理推理的新场景就对应因子的新组合;论文的「全范围独立因子 + 少量组合样例 + 病变区域测试」恰好给出训练数据怎么设计、能力怎么评估的现成模板,渗流视角还提示了数据重叠与能力突现之间的定量关系。
把条件扩散模型(DDPM)当认知实验的动物来研究:在周期边界的二维高斯斑点数据上,模型中间层表征学成『环面上的分解表示』——x 与 y 落入相互正交的子空间(类似 Clifford 环面),但同一特征的不同取值又被近似正交地编码、像离散类别一样(论文叫 hyper-factorized);行为上模型能组合训练里没见过的 (x,y) 取值(条件是每个独立特征全范围出现、且给少量组合样例),却几乎不能在同一特征上插值。论文进一步把表征流形的形成与物理学渗流(percolation)相变联系起来:样本间重叠低于阈值时学不出有意义的表示,超过阈值能力突然出现;并给出训练数据配方——独立因子全范围 + 少量组合样例,数据效率从随图像尺寸 N 的二次增长降为线性增长。
阅读提示
精读深度:精读
清单提示:原文提示:分解/组合表征 + 渗流 onset;直接为「组合物理推理」研究提供实验范式。
问题
要解决什么:大型文生图扩散模型能生成训练集里从没一起出现过的元素组合(论文举『astronaut riding a horse on the moon』为例),即组合泛化;但组合能力的内部机制——模型如何表示独立变化因子、这种表示何时随训练出现、什么训练数据足以支撑组合泛化——此前没有共识。已有分解表征研究(β-VAE 一族、Montero 2021、Xu 2022 等)对『分解表征是否促进组合泛化』给出互相矛盾的结论;针对扩散模型,Okawa et al. 2023 观察到乘法式组合行为,但没有分析内部表征。论文用认知神经科学式的小规模对照实验回答三个问题:扩散模型是否学到分解表示、什么时候出现;模型能否泛化出训练分布、需要什么数据;加入少量显式分解样例能否提升样本效率。
为什么 prior work 不够:此前工作要么在复杂真实数据上只算解耦分数(disentanglement score),看不清表示的具体几何;要么只测生成行为、不查机制。论文给出先验直觉:K 个独立 1D 因子组成的数据分布 P(x1)P(x2)…P(xK),若模型学联合表示(每维 N 个状态),约需 N^K 个样本;若能识别因子独立、学分解表示,约 KN 个样本就够。耦合表示与分解表示在样本效率上差出数量级,所以『模型到底学哪种、为什么』值得在完全可控的数据上拆开看。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 噪声图 x_T | 32×32 灰度图像同维向量 | 标准 DDPM 前向加噪的采样起点;训练时从数据样本 x0 按转移分布取 x_t |
| 扩散时间步 t | 标量(离散 0..T) | 条件 DDPM 的标准去噪步;生成终端时刻的 layer 4 激活用于表征分析 |
| 条件线索 c = (µx, µy) | 两个连续标量(位置标签) | 每张训练图像带 ground-truth 中心坐标;时间步、x、y 三份等长位置编码拼接后,在每个 down/up 块注入 UNet;默认坐标连续分布于 [0,32]²,图像左上角为 (1,1) |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 生成图像 x0 | 32×32 灰度图像 | 应显示中心在 (µx,µy) 的 2D 高斯斑点(bump,乘法合成)或 2D 高斯 SOS(加法合成);评估指标是生成图像中心位置正确率 |
控制频率:n/a(图像生成;按生成图中心正确率评估,见 Appendix A.3)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| 2D Gaussian Bump | 默认 32×32、d=0.1 时 102,400 张 | 每张一个 2D 高斯斑点,即垂直与水平 1D 高斯条纹的乘法;默认 σx=σy=1.0、dx=dy=0.1;σ 越大相邻斑点重叠越多,d 越大网格越稀、数据越少 |
| 2D Gaussian SOS | 同规模(d=0.1 时 102,400 张) | 垂直与水平 1D 条纹的加法(sum of stripes);组合/插值实验挖掉测试区 µx,µy∈[13,19](约 6 像素宽,≈σ=1.0 的条纹宽) |
| 1D Gaussian Stripe | 全 x、全 y 范围的水平/垂直单条纹 | 把 32×32 潜在空间嵌入 44×44 后裁剪可见部分,使 1D/0D 数据与 2D 条件编码结构兼容;1D 模型只用此数据训练 |
| 2D+1D 混合集 | 2D SOS(挖测试区)+ 全范围 1D 条纹;或 2D bump(挖中心 20%)+ 1D 条纹 | 验证『独立因子全范围 + 少量组合样例』的数据配方;Fig 5 数据效率实验按 N×N 画布缩放数据集 |
| 渗流实验集 | 32×32 格上固定 1024 个中心(d=1.0) | 按 λ 取子集且逐级嵌套(λ=0.2 是 λ=0.1 的超集,依此类推);不同 σ 共用同一批格点;训练批数按数据量反比补偿,保证总批数一致 |
架构(摘要)
主干与结构
backbone:UNet;每个 down/up 块 = max pooling/upsampling + 两个双卷积层(卷积 + group norm + GELU)
参数:论文未公布参数量
类型:条件 DDPM,标准 UNet(3 个下采样/上采样块 + 交错自注意力 + skip connection)
关键组件
- 条件嵌入:时间步、x 位置、y 位置三份等长位置编码拼接,在每个 down/up 块注入
- 表征分析取 layer 4 激活(选 layer 4 而非 bottleneck,因为 skip connection 使 bottleneck 信号衰减)
- 损失:标准 DDPM 噪声预测 MSE,L = E_{t,x0,ϵ} ‖ϵ − ϵθ(x_t, t, c)‖²
- 训练:A100,单次约 6 小时;AdamW + 学习率调度,未做超参调优
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 表征几何:环面分解 | 模型学到 Clifford 型(分解)环面:持久同调 H1 秩 2、H2 秩 1;x 与 y 编码在正交子空间 | 对照理想 3D 环面(耦合)与理想 Clifford 环面(分解):x-on-y 测试统计量接近 Clifford;持久同调与标准环面一致 | 周期边界 2D Gaussian bump 数据集(32×32,σ=1.0,d=0.1,102,400 张);条件 DDPM UNet 的 layer 4 激活;训练 200 epochs |
| 表征几何:超分解(分类式编码) | 同一特征不同取值之间近似正交(x-on-x / y-on-y 测试),相邻取值只有非零重叠;有效维度收敛约 7,前 4 个 PC 突出 | 对照两种理想环面:x-on-x/y-on-y 统计量不属于任何一方,最接近 3D 环面的 x-on-y 分布;Wasserstein 距离见 Appendix Fig 8 | 同上;正交性/平行性测试按 Cueva et al. 2021 实现,32 个固定 x 各扫 32 个 y 点(反之亦然) |
| 行为:组合 vs 插值 | 2D 模型在测试区垂直段 µy 准、µx 不准(水平段相反)、交叉段两者都差;2D+1D 模型三段全准;1D 模型 µy 准但给不出 µx | 1D 模型(无组合样例)对照 2D+1D 模型(全范围 1D + 组合样例):前者交叉段失败、默认生成单条纹,后者成功;结论是组合泛化需要每个因子全范围加少量组合样例 | 2D SOS 数据集挖掉 µx,µy∈[13,19](约 6 像素宽,≈σ=1.0 条纹宽),32×32;生成正确率按测试区垂直段/水平段/交叉段分别统计 |
| 数据效率缩放 | 达到 60% 准确率阈值所需数据:2D bump + 1D 条纹增强集随图像尺寸 N 线性增长,纯 2D bump 基线随 N 二次增长 | 纯 2D bump 基线(log-log 图二次参考线)vs 增强集(线性参考线);bump 组合任务测试区准确率最高 70%;bump 子采样到 20% 时准确率基本不变 | N×N 画布,挖中心 20% 区域做 OOD 评估;按 N 缩放数据量并画 log-log 图;增强集含全范围 1D 条纹 |
| 渗流 onset(相变) | 模型能力随数据占比 λ 阈值式出现:σ=1.0 低 λ 即可学,σ=0.3/0.5 需更高 λ 且方差大,σ=0.1 到 λ=0.8/0.9 才学会 | 对照渗流模拟(阈值重叠 0.005,5 次平均):σ=0.1 永不渗流,但实验里扩散加噪把斑点抹宽、λ≥0.8 仍学会——趋势一致,σ=0.1 例外由加噪效应解释 | 32×32 格上固定 1024 个中心(d=1.0),λ=0.1…1.0 嵌套子集(λ=0.2 含 λ=0.1,依此类推),不同 σ 共用格点;训练批数按数据量反比补偿使总批数一致 |
Insights
- 扩散模型有分解的归纳偏置:独立变化因子落入正交子空间(Clifford 型环面),这与神经科学里 grid cells / head direction cells 分解编码空间的方式一致(论文引 Lindsey & Issa 2023、Moser 等)。
- 分解伴随『分类式离散化』:同一特征的不同取值近似正交、相邻取值靠非零重叠连接——表示是半连续的,这同时解释了插值能力差与有效维度高于 4。
- 组合泛化的数据配方:每个因子全范围出现 + 少量组合样例(2D+1D 混合),数据效率从随 N 二次增长降为线性;图 10 显示只在图像边缘给少量部分重叠的 2D 样例,组合能力就恢复。
- 渗流视角:样本间重叠(论文用相邻图归一化 L2 乘积度量)低于阈值时流形学不出来,超过阈值能力涌现——把表征形成看作物理相变,可解释扩散模型能力随数据量突然出现。
- 实验范式可迁移:病变区域 + 按区域分解的准确率 + 独立因子/组合样例混合数据集,是研究组合物理推理(把位置、朝向、速度等物理量当独立因子组合)的直接模板。
vs 同类工作
- vs Okawa et al. 2023(扩散模型乘法式组合泛化):那篇在 toy 扩散模型上观察到乘法组合行为,没分析内部表征;这篇补上表征几何(环面分解)、插值测试与数据配方,并把组合形式扩到加法(SOS)。
- vs 解耦表征文献(β-VAE、Montero 2021、Xu 2022):此前对『分解是否促进组合泛化』结论分裂;这篇用完全可控数据给出:分解 + 全范围因子 + 少量组合样例才成立,且分解是半连续(分类式)的,解释了为何简单解耦分数会给出矛盾结论。
- vs Wiedemer et al. 2023(组合泛化 first principles 理论):那篇给理论充分条件,这篇给扩散模型的实证机制与训练数据层面的可操作建议。
- 方法论:把神经科学流形分析工具(持久同调、Cueva et al. 环面正交/平行测试)系统性用于扩散模型内部表征;把物理学渗流理论引入表征形成研究。
局限
- 玩具域局限:二维高斯斑点/SOS、单目标、32×32 灰度图,组合形式只有加法与乘法两种;真实图像中多种组合形式并存(论文讨论中承认),结论能否迁移到文生图模型没有验证。
- 渗流连接是类比加事后拟合:论文承认模拟用的重叠阈值 0.005 是『为了最好匹配实验数据而选』;没有从扩散训练动力学推导出渗流相变的理论;σ=0.1 的例外要靠『加噪把斑点抹宽』补充解释。
- 行为实验存在不可区分性:论文自己指出『能插值但不会组合』与『既能组合又能插值』两种情形在生成行为上无法区分,插值结论主要依赖 layer 4 表征分析;架构选择(单 UNet、取 layer 4 而非 bottleneck)影响结论稳健性。
- 条件线索是 ground-truth 标签 (µx,µy),相当于直接把位置告诉模型;无标签或自监督条件设置没有测,组合能力可能被显式标签放大。
- 渗流实验方差大(σ=0.3/0.5 准确率抖动明显),模拟只 5 次平均;论文自己把部分方差归因于训练与采样的随机性。
- 可复现性缺口:正文没有代码或权重链接;插值测试只做了单一变量的一维挖除,交互作用(如两维同时挖除)没有系统测。
可复现性
- code:论文正文未提供代码/权重链接
- weights:无公开权重(自训条件 DDPM UNet,A100 约 6 小时/模型)
- datasets:合成 2D 高斯 bump/SOS/1D 条纹,按 σ、d、λ 参数可精确复现
- note:复现要点:周期边界、44×44 扩展嵌入裁剪出 1D/0D 数据、嵌套子集采样、总训练批数一致;渗流模拟的重叠阈值是超参数
主干与结构
backbone:UNet;每个 down/up 块 = max pooling/upsampling + 两个双卷积层(卷积 + group norm + GELU)
参数:论文未公布参数量
类型:条件 DDPM,标准 UNet(3 个下采样/上采样块 + 交错自注意力 + skip connection)
关键组件
- 条件嵌入:时间步、x 位置、y 位置三份等长位置编码拼接,在每个 down/up 块注入
- 表征分析取 layer 4 激活(选 layer 4 而非 bottleneck,因为 skip connection 使 bottleneck 信号衰减)
- 损失:标准 DDPM 噪声预测 MSE,L = E_{t,x0,ϵ} ‖ϵ − ϵθ(x_t, t, c)‖²
- 训练:A100,单次约 6 小时;AdamW + 学习率调度,未做超参调优
模型学到环面形分解表征:持久同调、有效维度与 PCA 投影
原文 caption:Metrics of a model trained using 2D Gaussian bump datasets with periodic boundaries. (a) 2D projections of a standard 3D torus (left) and a 4D Clifford torus (right). (b) Persistence diagrams of a standard torus and the learned representation at the terminal epoch. (c) Model accuracy (top) and effective dimension (bottom) as functions of training epochs. (d) PCA eigenspectrum (first 15 dims) and sample accuracy / explained variance ratio of top 4 PCs at various checkpoints. (e)-(g) PCA visualizations of the learned representations at epoch 0, 150, and terminal epoch.
这张图回答『模型学到的是耦合表示还是分解表示』。(a) 给出两种理想几何作对照:3D 环面把两个圆耦合嵌入 R³,Clifford 环面把两个圆各自嵌入 R²(整体 R⁴),2D 投影形状不同,这是能区分两者的前提。(b) 持久同调证明模型终端表征确实是环面:H0 秩 1、H1 秩 2(两个重叠橙色点)、H2 秩 1,与标准环面一致。(c) 有效维度(participation ratio,=(Σλi)²/Σλi²)随训练先升后降,200 epoch 后收敛到约 7,说明流形先铺开再定型。(d) 前 4 个主成分的特征值在收敛时明显突出——4 维结构(两个环方向各 2 维)占主导。(e)-(g) PCA 投影从 epoch 0 弥散到终端近似 Clifford 环面的正交十字结构。结论:模型学到分解的 Clifford 型环面;但有效维度 7 高于 4,提示分解带冗余,为 Figure 3 的『超分解』留下伏笔。
正交性与平行性测试:模型把同一特征的不同取值也编码成近似正交
原文 caption:Comparison of orthogonality and parallelism test statistics between 3D torus, model's learned representation, and Clifford torus. x-on-y (top row), x-on-x (middle row), y-on-y (bottom row) orthogonality (left column) and parallelism (right column) test statistics.
这张图回答『分解到底做到什么程度』。三行分别是不同特征之间(x-on-y)、同一特征不同取值之间(x-on-x、y-on-y)的测试;左列正交性(两子空间夹角)、右列平行性(一个子空间对另一个的投影重建误差)。对比蓝色 3D 环面、绿色模型表征、橙色 Clifford 环面:第一行 x-on-y 上模型接近 Clifford——x、y 落在正交子空间,验证了分解;但第二、三行同一特征不同取值之间,模型统计量接近正交而非平行,两种理想环面都给不出这个模式。结论:模型把每个连续特征进一步『超分解』成类似离散类别的编码,相邻类别只有非零重叠;这解释了 Figure 2 里有效维度高于 4,也预告了行为上插值能力差的后果。
行为实验:能组合、不能插值;独立因子全范围 + 组合样例才够
原文 caption:Models trained on Gaussian SOS datasets to generalize to the test regions. (a) 2D Gaussian SOS dataset with held-out range µx, µy ∈ [13,19]. (b) 1D Gaussian stripe dataset of full x and y range. (c) vertical section, (d) horizontal section, (e) intersection accuracy of the three models. (f) Sample image with test regions labeled. (g) Accuracy of models trained with various subsampling rates of the 2D bump + 1D stripe dataset.
行为实验的核心证据,把『组合』和『插值』两种能力分开测。数据集 (a) 挖掉 µx,µy∈[13,19] 的十字测试区(红),(b) 是全范围 1D 条纹。三个模型的生成正确率按测试区三段分别统计(c 垂直段、d 水平段、e 交叉段):2D 模型(只训 SOS)在垂直段 µy 准、µx 不准,水平段反过来,交叉段两者都差——说明它能组合(正确给出见过的那个维度)但不能插值(给不出没见过的取值);2D+1D 模型(补全范围 1D 条纹)三段全准;1D 模型(只有条纹、无组合样例)在交叉段失败,默认生成单条纹。结论:完整组合泛化需要每个因子全范围出现加少量组合样例;两张图合起来也把『模型失败在插值、组合本身没问题』从行为层面坐实。
渗流理论:数据重叠过阈值,表征流形才突然成形
原文 caption:Percolation theory of manifold formation and interpolation. (a) Schematic of Gaussian bumps of various width on a lattice of grid size dx, dy. (b) Overlaps of neighboring Gaussian bumps as a function of grid size d for various Gaussian widths. (c) Simulation of largest connected mass ratio as a function of percentage of data λ with threshold overlap 0.005 for various Gaussian widths. (d) Ground truth and generated image of a σ=0.1 bump. (e) Terminal accuracy of models as a function of λ trained with datasets of various Gaussian bump widths.
渗流 onset 的证据。数据集被近似成 Poisson Boolean(Gilbert 圆盘)模型:(a) 不同宽度高斯斑点铺在 dx×dy 格上;(b) 相邻斑点归一化 L2 重叠随格距 d 变化(σ 越大重叠越多);(c) 模拟里最大连通集团质量占比随数据占比 λ 上升,呈阈值式突增,σ 越小阈值越高,σ=0.1 永不连通;(d) σ=0.1 的地面真值(单像素宽)与模型生成(加噪过程把斑点抹宽);(e) 模型终端准确率随 λ 变化:σ=1.0 低 λ 就能学,σ=0.3/0.5 需要更高 λ 且方差大,σ=0.1 到 λ=0.8/0.9 才学会——与 (c) 的渗流预测在趋势上一致。结论:样本间重叠低于阈值时模型学不出忠实表征,超过阈值能力突然涌现,表征流形形成呈现相变特征;σ=0.1 的例外由扩散加噪的抹宽效应解释。
🎧 音频版
时长 27:57 · Edge TTS
How Diffusion Models Learn to Factorize and Compose(对话版·深度版)
先讲清楚这篇要解决什么问题
小播:老播,这篇论文标题挺直白——扩散模型是怎么学会分解和组合的。先说说它到底想解决什么?
老播:背景是这样的:现在的大型文生图模型,比如你让它画「宇航员骑在月球上的马上」,它能画出来。宇航员、骑马、月球,每个元素单独都很常见,但「三者同框」的照片在训练集里几乎不存在,模型却能把它们组合出来。这个能力叫组合泛化——用见过的元素,生成没见过的组合。问题是:模型内部到底是怎么做到这一点的?它是不是把「宇航员」「马」「月球」拆成独立的部分分别编码?这种拆分什么时候学会?训练数据要满足什么条件才够?这三个问题,之前没有人系统地回答过。
小播:听起来是「知道它能做到,但不知道它怎么做到的」。而且这个问题好像不只是学术八卦,训练数据怎么设计、模型能力怎么评估,都跟它有关。
老播:对,这就是值得专门做一期的原因。它把「组合泛化」从现象变成了可测量的科学问题:给出表征几何的判据、把组合和插值两种能力分开测的行为实验、还有数据配方的定量结论。这套东西可以直接指导后续研究和训练数据设计,也是我们做这期的原因。
小播:那这篇论文的答案是什么?
老播:一句话结论:这篇用极度简化的实验发现,扩散模型内部确实会把独立的因素拆开编码——x 和 y 落进相互正交的子空间,类似神经科学里网格细胞和头方向细胞分开编码的方式;但拆得过头了,连同一个因素的不同取值都被当成近似正交的离散类别,所以模型能组合、却几乎不能插值。还有一个更宏观的发现:表征流形的形成像物理里的渗流相变,数据重叠过了某个阈值,能力才突然出现。本期我们把这三点一层层讲透:分解表征的几何证据、组合与插值的分离、渗流的 onset,最后说它对组合物理推理研究有什么直接用处。
把实验台搭起来:数据、模型、还有怎么看它的内部
小播:先别急,把背景补上。为什么组合泛化的机制之前没搞清楚?
老播:主要因为真实数据太复杂。之前的解耦表征研究,比如 β-VAE 那一族,在真实图像上算一个「解耦分数」,结论互相打架:有的说分解表征促进泛化,有的说两者没相关性。直接相关的先例是 Okawa 等人在 2023 年的工作,他们在 toy 扩散模型上观察到乘法式组合行为,但只看了生成结果,没看内部表征。所以机制问题一直悬着。这篇的切入点来自认知神经科学:动物实验研究大脑时,既看行为,也看神经元活动——比如把电极插进海马体,记录位置细胞、网格细胞怎么放电。论文照搬了这个套路,把扩散模型当动物,既看生成输出(行为),也看中间层的激活(神经活动)。
小播:为什么要从神经科学借方法?分解编码在大脑里有先例吗?
老播:有,而且很明确。哺乳动物大脑把空间信息分解编码:位置细胞管「我在哪」,网格细胞管二维空间的度量,头方向细胞管朝向,各用各的细胞群,互不混叠。论文引用了这一批神经科学结果,动机很朴素:如果生物神经系统都倾向于把独立变化的特征分开编码,那人工生成模型很可能也有类似倾向,值得去验证。当然,这只是动机,验证还得靠自己的实验。
小播:那实验台具体怎么搭?数据长什么样?
老播:数据是 32×32 的灰度图,每张图里一个二维高斯斑点,中心位置用 (µx, µy) 表示,在 0 到 32 的范围内连续变化。默认的斑点宽度 σ 是 1.0,网格间距 d 是 0.1,这样一套默认数据有 102,400 张图。这两个参数很重要:σ 控制相邻斑点重叠多少,d 控制网格多密、数据总量多少。斑点有两种合成方式:一种叫 bump,是垂直和水平两条一维高斯条纹的乘法;另一种叫 SOS,是两条条纹的加法。为什么要两种?因为真实世界里的组合既有乘法式的(比如两个条件同时为真),也有加法式的(比如两股信号叠加),论文想证明结论对两种组合形式都成立。
小播:模型呢?条件扩散模型是什么意思?
老播:扩散模型 DDPM 是这么工作的:训练时往真实图片上逐步加噪声,直到图片变成纯噪声;然后学一个反向过程,从噪声一步步去噪还原图片。条件扩散模型就是多给一个条件线索,告诉模型「我要生成什么样的图」。这篇里条件线索直接就是位置标签 (µx, µy)——每张训练图都带着自己的真实中心坐标,模型生成时也拿到这个坐标。条件信息用位置编码表示:时间步、x、y 三份等长向量拼起来,喂进 UNet 的每一个下采样和上采样块。选择用位置编码而不是可学习的嵌入,是为了保持位置标签的连续性——x 等于 10 和 x 等于 11 的编码得是平滑相关的。
小播:训练目标是什么?还是扩散模型那套噪声预测损失?
老播:对,标准 DDPM 的噪声预测损失:L 等于期望 ‖ϵ 减 ϵθ(x_t, t, c)‖ 的平方。拆开看:ϵ 是训练时注入的高斯噪声,ϵθ 是 UNet 预测的噪声,x_t 是加了 t 步噪声的图像,c 是位置条件,期望对时间步、数据样本和噪声取。网络的任务就是准确说出「这步噪声长什么样」。这个损失本身没有任何组合相关的项——组合能力是训练过程自己长出来的,这一点很关键。评估行为时,看生成图像的中心位置对不对;看内部时,取 UNet 第 4 层的激活,用 PCA 和 UMAP 降维观察。选第 4 层而不是最深的 bottleneck,是因为 skip connection 让 bottleneck 的信号衰减,第 4 层的信息更丰富。这套「行为加神经活动」的双层证据,贯穿整篇论文。
小播:数据里两个维度都是独立的,这是不是让问题变简单了?
老播:是故意变简单的。论文自己算了一笔账:如果数据由 K 个独立因子组成、每维有 N 个状态,模型学耦合表示大约需要 N 的 K 次方个样本;如果它能识别因子独立、学分解表示,大约只要 K 乘 N 个。拿这篇的数据举例:N 取 32、K 取 2,耦合表示要覆盖大约 32 的平方、也就是上千个组合,分解表示只需要两个方向各自覆盖 32 个取值、加起来 64 个就够了。差出数量级。所以「模型到底学哪种表示」直接决定数据效率,值得在一个完全可控、能看清内部结构的场景里拆开验证。
核心机制:模型把 x 和 y 拆进了两套互不相干的空间
小播:现在进入正题。怎么判断模型内部是分解表示还是耦合表示?两个词先定义清楚。
老播:好。分解表示的意思是,模型把 x 单独用一组维度编码,y 单独用另一组维度编码,两组互不干扰;耦合表示的意思是,x 和 y 合起来编在一个联合的结构里。难点在于:怎么从激活空间里看出区别?直接看形状分不出来——两条线做笛卡尔积,得到的拓扑等价于一个平面,和二维平面长得一样。所以论文要换一个流形:给图像加周期边界,左右相接、上下相接,数据所在的流形就从平面变成了环面。
小播:环面有什么特别?为什么环面就能区分了?
老播:因为环面有两种标准实现,形状不同。第一种是 3D 环面,把两个圆耦合地嵌进三维空间,像一个甜甜圈,这是耦合表示;第二种叫 Clifford 环面,把两个圆各自嵌进二维空间、整体在四维,投影到二维看,两个圆呈现互相正交的十字结构,这是分解表示。两者的二维投影明显不同,于是「分解还是耦合」变成一道可以检验的几何题:模型激活空间里如果出现 Clifford 型的正交十字,就是分解;如果出现甜甜圈,就是耦合。
小播:检验结果是什么?模型选了哪种?
老播:三个证据都指向分解。第一,持久同调——一种判断流形拓扑的工具,它统计流形上有多少个「洞」。结果:模型终端的表征,H0 群的秩是 1、H1 群的秩是 2、H2 群的秩是 1,和标准环面的拓扑特征完全一致。简单说,H1 秩 2 就是环面上有两个独立的环绕路径,这是「这是个环面」的铁证。第二,看有效维度随训练的变化,用参与率来量。先给预期:这个数回答「激活空间实际占用了几维」。公式是 PR 等于 (Σλi)² 除以 Σλi²,其中 λi 是第 i 个主成分的特征值,分子是总方差的平方、分母是各方差平方的和。如果方差全集中在一个方向,PR 等于 1;如果均分在 d 个方向,PR 等于 d。结果很有意思:训练过程中 PR 先升后降,200 个 epoch 后收敛到大约 7;同时前 4 个主成分的特征值明显突出——4 维结构占主导,正好对应 Clifford 环面需要的两个正交二维环。第三,正交性测试:固定 x 扫 y 得到的环,和固定 y 扫 x 得到的环,落在正交的子空间里——这正是 Clifford 环面的特征。这里还有个具体的对应关系:论文在附录里发现,环形成之后,前 4 个主成分正好被两个环瓜分——第 1 和第 3 个主成分张成 x 方向的环,第 2 和第 4 个张成 y 方向的环,两个子空间互相正交。也就是说,模型在激活空间里明确地划了两块区域,一块专管 x,一块专管 y。
小播:等一下,有效维度收敛到 7,可 Clifford 环面只有 4 维,多出来的 3 维是哪来的?
老播:问得好,这正是论文最细的一个发现。他们做了更精细的正交性、平行性测试,方法是 Cueva 等人 2021 年给循环神经网络工作记忆用的那套:固定 x 的取值,扫一遍 y,得到一组子空间;再固定 y 扫 x,得到另一组。测试分三类:x 和 y 之间、不同 x 之间、不同 y 之间。结果:不同特征之间确实正交,符合 Clifford 环面;但「同一个特征的不同取值之间」也近乎正交。想象完全连续的编码:x 取 5 和取 6 时,对应的环应该互相平行、有规律地平移。模型的表现完全相反——相邻取值的环接近正交,像一组互相倾斜的环,只靠一点点非零重叠连接。论文管这叫超分解:模型把连续的 x 当成一堆离散类别来编,类别之间有一点点重叠。你可以想象 32 个取值对应 32 个近乎正交的环,像一把扇子一样互相倾斜;如果它是完全连续的编码,这些环应该排成一排互相平行,可模型给出的形状明显偏向前者。
小播:所以多出来的维度被用来把相邻取值分开了?
老播:对,这就是为什么有效维度是 7 而不是 4:模型额外花维度把同一个特征的不同取值拉开,让它们互相接近正交。这也同时解释了为什么模型插值能力差——取值之间没有连续的「路」可走,生成没见过的取值就变成了一件需要猜的事。记住这个结论:分解是真的,但拆过头了,拆成了半连续的分类式编码。这个机制层面的结论,马上会在行为实验里得到印证。
小播:这个测试本身可靠吗?模型表征在训练早期还不是环面,测试有意义吗?
老播:论文在附录里做了 Wasserstein 距离的量化对比,把模型各训练阶段的测试统计量和理想 Clifford 环面、理想 3D 环面分别比,也承认早期阶段表征还不是环面、那时的对比意义有限。所以严格说,正交性测试的强结论适用于训练后期的成熟表征,这一点要带着看。
关键实验:能组合、不能插值,还差一层渗流阈值
小播:行为实验怎么做的?怎么把「组合」和「插值」这两种能力分开测?
老播:先设计一个预测框架:把模型的能力分成组合和插值两维,两两组合有四种可能。如果都不会,测试区应该全线低准确率;如果会插值但不会组合,测试区应该全线高准确率;如果会组合但不会插值,应该出现「一个维度准、另一个不准」的模式;如果都会,全线高。论文特别指出,第二种和第四种在行为上分不开,所以这个框架能确认的强结论集中在「会组合但不会插值」这一格。实验数据用 SOS,训练时挖掉一块十字形测试区:所有中心落在 µx 和 µy 都属于 13 到 19 之间的图全部拿掉,这个宽度大约 6 个像素,正好等于 σ 等于 1.0 的条纹宽度。然后按测试区三段分别统计生成准确率:垂直段、水平段、还有两者交叉的正方形。
小播:结果落在哪一格?
老播:先看只训二维 SOS 的模型,论文叫它 2D 模型:垂直段里 µy 准确、µx 不准确,水平段反过来,交叉段两个都差。这个模式正好落在「会组合、不会插值」那一格——模型能正确给出训练里见过的那个维度,而且不受另一个维度影响,这是组合能力;但它给不出测试区里没见过的取值,这是插值失败。行为结论和前面表征分析完全对上:分解是真的,分类式编码让插值失败。
小播:那什么样的训练数据能让它把测试区也生成对?
老播:论文试了两种补充。第一种是给训练集加上全范围的一维条纹——横条纹和竖条纹,x 和 y 的所有取值都有,但测试区里没有二维组合样例。结果这个 2D+1D 模型在垂直段、水平段、交叉段全部高准确率:只要每个独立因子全范围出现过,模型就能把两条条纹正确组合成 SOS。第二种是只训一维条纹、一个二维样例都不给,论文叫它 1D 模型:能给出 µy,却给不出 µx,交叉段直接退化成生成一条单条纹——没有组合样例,模型学不会「把两条条纹加起来」这个动作。三个模型对照,结论很明确:完整的组合泛化需要两个条件同时满足——每个独立因子在训练里全范围出现,再加一些组合样例。每个数字都有对照:2D 模型是基线,2D+1D 是加分项,1D 模型是缺组合样例的负例。
小播:那乘法式的 bump 呢?前面的结论只对加法成立吗?
老播:论文专门做了乘法版的对照:用 2D bump 替换 SOS,加同样的全范围一维条纹,测试区是同样的十字。结果模型能生成测试区里的 bump,准确率最高到 70%,说明乘法式组合也能学会。更有意思的是,把训练里的二维 bump 子采样到原来的 20%,测试区准确率基本不掉——组合泛化对「组合样例的数量」很不敏感,敏感的其实是「每个独立因子的覆盖范围」。附录里还试了只给图像边缘少量部分重叠的二维样例,模型就恢复了组合能力,效果和给大量组合样例相当。这说明配方里「少量组合样例」是真的可以很少。
小播:好,前面讲的是「要什么数据」。有没有量化「这样有多省数据」?
老播:有,这是数据效率那一节,也是一个很漂亮的结果。做法:把训练数据里的二维斑点按比例子采样,同时让画布尺寸 N 变大,看要达到 60% 准确率阈值需要多少数据。结果画成 log-log 图:只训二维斑点的基线,需要的数据随 N 二次增长——因为要覆盖 N 乘 N 个位置组合;加上全范围一维条纹的增强集,需要的数据随 N 线性增长——因为只需要覆盖每个方向 N 个取值。参考线一条二次、一条线性,区别非常清楚。这句话可以换个说法记:分解表征把样本复杂度从「组合数的平方」降成「因子数的和」,这是全文最有操作价值的一个数字结论。
小播:到这里我先把实验串一下:三个模型的对照证明了数据条件,数据效率那节证明了省多少数据。最后那个渗流是怎么回事?听起来像是物理概念。
老播:对,这是论文最有野心的部分,回答「表征流形在什么条件下才学得出来」。他们注意到,斑点数据集可以近似成物理里研究得很透的 Poisson Boolean 模型,也叫 Gilbert 圆盘模型:每个斑点是一个圆盘,铺在格点上,相邻圆盘有重叠就算连通。渗流理论关心的是:要出现一个贯穿整个系统的大连通集团,需要多大比例的节点有重叠;超过临界占比会发生相变,小碎块突然连成一片。论文把「重叠」具体量化成相邻两张斑点图的归一化 L2 乘积:‖√(a·b)‖₂ 除以 ‖a‖₂,a 和 b 是相邻的两张图,· 是逐元素乘,一张图和自己的重叠归一为 1。先给预期:这个数衡量「相邻样本有多像」,它决定了模型能不能从样本之间读出相对位置关系,相当于流形学习的胶水。
小播:模拟和实验对得上吗?
老播:对得上,趋势很一致。模拟里,最大连通集团的质量占比随数据占比 λ 上升,存在阈值式突增;斑点越窄、重叠越少,阈值越高。实验里,他们固定 1024 个中心点,按 λ 取嵌套子集——λ 等于 0.2 的数据集包含 λ 等于 0.1 的全部数据,依此类推,不同斑点宽度共用同一批格点;训练批数按数据量反比补偿,保证每个模型见过的训练批次总量一致,这样 λ 之间的差异就只来自数据量本身。结果:σ 等于 1.0 时,很低的数据占比就能学会;σ 等于 0.3 和 0.5 时,需要更高占比,而且准确率方差很大;σ 等于 0.1 时,到 λ 等于 0.8、0.9 才学会。σ 等于 0.1 是一个诚实的例外:渗流模拟预测它永不连通,因为单像素宽的斑点之间没有重叠,但实验里模型还是学会了,论文的解释是扩散加噪过程把斑点抹宽,等效增大了重叠。这个例外说明理论框架覆盖了大部分现象,边缘情形要靠加噪效应补上,论文没有把它硬塞进理论框架。
还有两个技术细节值得说。一个是重叠测量:像素化的图像让重叠曲线在网格间距大约 0.5 处出现一个尖峰,那是离散化造成的假象,论文特别做了说明;另一个是相变的陡峭程度:σ 等于 0.3 和 0.5 的准确率方差大,一部分来自训练本身的不稳定,一部分来自渗流过渡本身是渐进的——模拟曲线显示 σ 越小、过渡越平缓,所以实验里看不到一刀切的突变。附录里还有一组更细的对照:把 OOD 区域设成方形、放在数据流形中间或者角落,bump 数据上内部区域的组合泛化随宽度缓慢衰减、外部区域快速衰减,而 SOS 数据在两种位置、各种宽度下都保持高准确率——加法式组合对 OOD 位置更稳健,也再次说明 SOS 是更适合学组合的数据形态。
小播:所以「渗流 onset」指的就是这个阈值现象——数据重叠没过阈值,表征出不来,一过阈值,能力突然出现?
老播:对,这是本期的第二个关键结论:表征流形形成有相变特征,样本间的重叠是控制参数,低于阈值时模型学不出数据点之间的相对位置,超过阈值连通集团形成,表征和能力一起突然出现。论文在讨论里也提出,真实数据上可以用互信息或者余弦相似度充当抽象的「重叠」。这个视角对组合物理推理研究特别直接:如果把物理量——位置、朝向、速度、材质——都看成独立因子,物理推理的新场景就对应因子的新组合;这篇给的「全范围独立因子加少量组合样例」的数据配方、病变区域加分段准确率的评估方式,就是现成的实验范式;渗流视角还提示,数据重叠和模型能力突现之间可能存在一条可量化的分界线,这对设计物理推理训练集有直接参考价值。
它在文献里站在哪
小播:把它放回文献里,和最重要的几个邻居比,差在哪、好在哪?
老播:三个对照。对 Okawa 等人 2023 年那篇:那篇证明了 toy 扩散模型能做乘法式组合,但只看了行为,没分析内部表征;这篇补上了机制层面的东西——环面几何、超分解、插值测试,还把组合形式从乘法扩到加法。对 β-VAE 那批解耦表征工作:之前「分解到底促不促进泛化」结论分裂,这篇给出了一个解释——分解确实有用,但要在「全范围因子加组合样例」的数据条件下才兑现,而且分解本身是半连续的,单看解耦分数会漏掉这个结构,这可能就是之前矛盾结论的来源。对 Wiedemer 等人 2023 年的组合泛化理论:那篇给的是理论上的充分条件,这篇给的是扩散模型里的实证机制和可操作的数据配方,两者互补。方法上,持久同调和环面正交性测试都是从神经科学流形分析里借来的,属于跨领域工具的搬运,这也让这篇在「生成模型表征」这个方向上有了方法论的独特性。在生成模型谱系里,它处在「扩散模型组合泛化机制」这条线的源头位置:后面研究组合泛化数据配方、或者把解耦分析用到扩散模型内部表征上的工作,很多都能追溯到这篇的实验范式。
局限:这篇论文没底气说的话
小播:诚实评估一下,哪些地方证据最弱?
老播:至少五条,我按严重程度排。第一,一切结论建立在 toy 域上——二维高斯斑点、单目标、32×32 灰度图,组合形式只有加法和乘法两种;真实图像里多种组合形式同时存在,结论能不能迁移到文生图模型,没有验证,论文自己在讨论里也承认这一点。第二,渗流那条线有事后拟合的成分:论文自己承认,模拟里用的重叠阈值 0.005 是为了最好地匹配实验数据才选的,并没有从扩散训练动力学推导出相变;σ 等于 0.1 的例外也得靠加噪抹宽来补。第三,行为实验存在不可区分性:论文自己指出,「会插值但不会组合」和「既能组合又能插值」两种情形在生成行为上无法分辨,所以插值结论主要靠第 4 层表征分析支撑,而架构只测了一种 UNet、固定取一层,换个架构或换一层结论稳不稳,没有测。第四,条件线索就是 ground-truth 位置标签,等于训练时把正确答案直接告诉模型;无标签或者自监督的条件设置没有测过,组合能力可能被显式标签放大。第五,渗流实验方差很大——σ 等于 0.3 和 0.5 的准确率抖动明显,模拟只平均了 5 次;另外正文没有给代码或权重链接,复现要自己按参数搭。还有一个小的缺口:插值测试只做了单一方向的一维挖除,两个维度同时挖掉的情况没有系统测,而真实世界的数据不完整覆盖往往同时发生在多个因子上。
小播:这些局限不影响核心结论,但确实提醒我们,它在真实场景的迁移性还要靠后续工作补。
老播:对,把它当成「受控条件下的机制证明」来读最合适:它把组合泛化的机制问题拆成了可测量的几何量、可复现的行为模式和可设计的数据条件,这本身就是贡献。
收尾:记住这三件事
小播:最后帮我收拢一下,本期最该记住的三件事?
老播:第一,扩散模型内部学到的是分解但半连续的表示:x 和 y 落在正交子空间,符合 Clifford 环面的几何;可同一特征的不同取值被编码得像离散类别,所以模型能组合、不能插值。第二,组合泛化有明确的数据条件:每个独立因子全范围出现、再加少量组合样例,数据效率就能从随 N 二次增长降到线性增长;组合样例可以少到只有图像边缘的零星几个。第三,表征形成像渗流相变:样本间重叠低于阈值时流形学不出来,超过阈值能力突然出现;斑点越窄,需要的数据越多。三句话换个说法就是:分解是真的,但拆过头了;数据配方是「全范围加少量样例」;能力突现有个阈值。
老播:这篇对后续工作的意义在于,它把组合泛化从「现象」变成了「可分解、可测量、可设计数据」的问题。对组合物理推理研究尤其如此——把物理量当独立因子、用病变区域测能力、用渗流看数据重叠,这套范式可以直接搬过去用。下期可以接着聊:把这些实验从二维斑点搬到真实物理模拟器,哪些结论还站得住,哪些会塌。
小播:好,那我先把这三件事记下来,下次就拿它当检查清单去读别的生成模型论文。