Restart Sampling for Improving Generative Processes
- 作者:Yilun Xu、Mingyang Deng、Xiang Cheng(共同一作)、Yonglong Tian、Ziming Liu、Tommi Jaakkola
这篇论文做了什么
扩散类生成模型(diffusion model)以及 PFGM/PFGM++ 这类基于微分方程的生成模型,采样时都要数值求解一个反向过程:从噪声分布出发,沿着网络预测的向量场逐步回到数据分布。这里有一个一直存在的两难:用确定性 ODE 采样,步数少时质量不错,但 FID 随步数增加很快平台化;用随机 SDE 采样,步数足够多时质量更高,但要花很多时间。这篇论文把两种采样器的差异拆成两类误差,然后提出一个叫做 Restart 的采样算法:在主反向 ODE 的末尾插入一个时间区间,循环 K 次「一次性加足噪声(前向)+ ODE 反向(去噪)」。加噪把前面累积的误差收缩掉一块,ODE 反向又把步长误差控制在 ODE 水平,于是同时拿到 SDE 的质量和 ODE 的速度。论文的核心结果是:在同 FID 下相对当时最佳 SDE 采样器,CIFAR-10(VP)上约快 10 倍、ImageNet 64×64 上约快 2 倍,并把 CIFAR-10(PFGM++)推到 FID 1.88、ImageNet 64×64 推到 1.36,均无需任何额外训练。
背景:为什么 ODE 快而 SDE 好
扩散模型的反向过程可以用两条方程描述。反向 SDE 为
$$
dx = -2\dot\sigma(t)\sigma(t)\nabla_x\log p_t(x)\,dt + \sqrt{2\dot\sigma(t)\sigma(t)}\,dW_t
$$
反向 ODE(概率流 ODE)为
$$
dx = -\dot\sigma(t)\sigma(t)\nabla_x\log p_t(x)\,dt
$$
先给预期:这两个式子共享同一个漂移项,区别只在最后那个随机项——SDE 每步额外注入小噪声($dW_t$ 是标准维纳过程),ODE 全程确定。$\sigma(t)$ 是预定义的噪声调度,随 t 增大;$\nabla_x\log p_t(x)$ 是中间分布 $p_t$ 的 score(对数密度梯度),实际由神经网络 $s_\theta(x,t)$ 近似。两个过程共享同一族中间分布 $p_t$,所以可以只换采样器、不换模型。
两类采样器的差距来自两类误差。第一类是离散化误差:数值求解器用有限步长 δ 逼近连续方程。一阶 Euler ODE 的局部误差是 O(δ²),而一阶 Euler-Maruyama(SDE 的标准格式)是 O(δ^{3/2}),δ<1 时后者明显更大——所以大步长(小 NFE)下 ODE 更准。第二类是近似误差:神经网络对 score 场 $\nabla_x\log p_t$ 的估计不可能完全准,NFE 很大、步长很小时,离散化误差被压下去,近似误差开始主导。此时 SDE 每步的小噪声发挥了一个 ODE 没有的作用:把前面累积的误差「收缩」掉一部分。论文用一个 Wasserstein-1 上界把这两类影响写进同一条公式(定理 1):
$$
W_1(p^{\mathrm{ODE}_\theta}_{t_{\min}}, p_{t_{\min}}) \le B\cdot TV(p^{\mathrm{ODE}_\theta}_{t_{\max}}, p_{t_{\max}}) + O(\delta+\epsilon_{\mathrm{approx}})(t_{\max}-t_{\min})
$$
$$
W_1(p^{\mathrm{SDE}_\theta}_{t_{\min}}, p_{t_{\min}}) \le \left(1-\lambda e^{-U}\right)B\cdot TV(p^{\mathrm{SDE}_\theta}_{t_{\max}}, p_{t_{\max}}) + O(\sqrt{\delta t_{\max}}+\epsilon_{\mathrm{approx}})(t_{\max}-t_{\min})
$$
这里的读法是:总误差 = 收缩后的初始误差 + 附加采样误差。$W_1(\cdot,\cdot)$ 是 Wasserstein-1 距离;$TV$ 是总变差距离,衡量进入区间时生成分布与真实分布的差距;$B$ 是一个常数上界;收缩因子里 $\lambda<1$,$U = BL_1/t_{\min} + L_1^2 t_{\max}^2/t_{\min}^2$,其中 $L_1$ 是网络输出的 Lipschitz 常数上界、$\epsilon_{\mathrm{approx}}$ 是近似误差上界。ODE 的上界没有收缩因子,所以初始误差被完整保留;SDE 的上界多了一个小于 1 的因子 $(1-\lambda e^{-U})$,代价是附加误差项多出一个 $\sqrt{\delta t_{\max}}$。在 NFE 大(δ 小)时,收缩项占主导,SDE 上界更低——这解释了高 NFE 区 SDE 胜出。这个分解是全文的理论支点:如果能把「收缩」和「低离散化误差」同时拿到,两条曲线的优点就都能保留。
核心思想:Restart 循环
Restart 的做法分四步(对应图 1(a)):
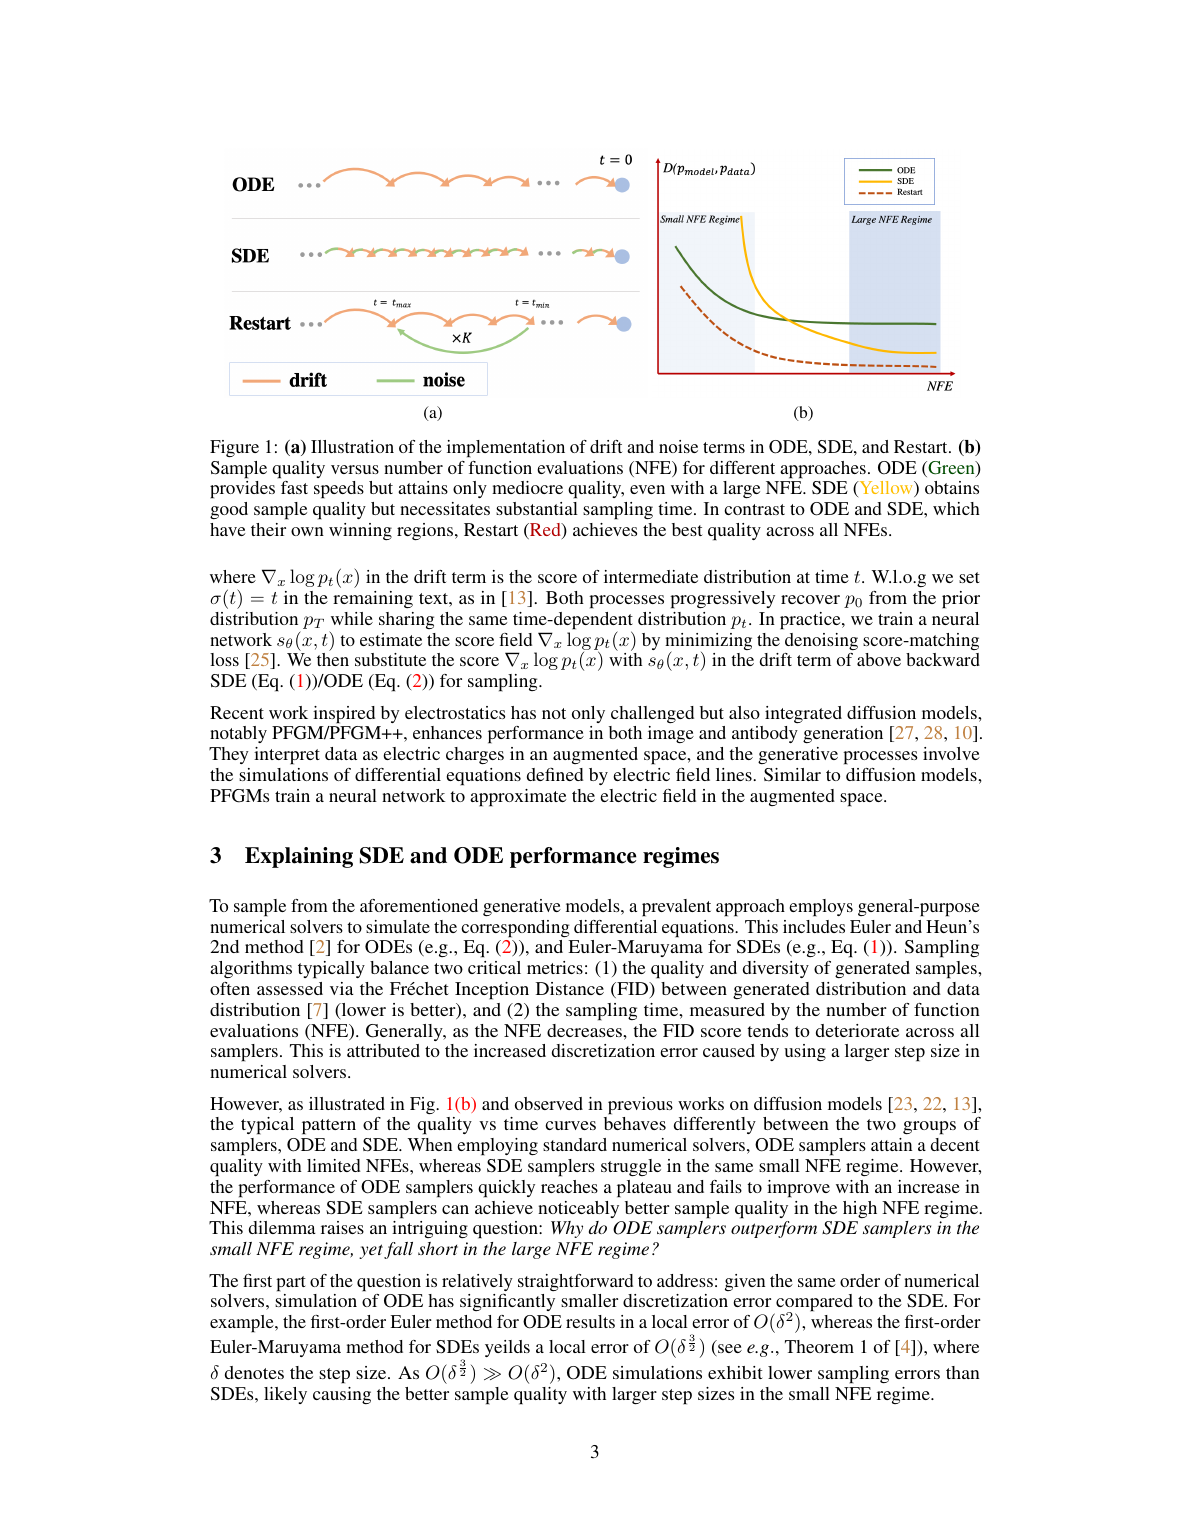
1. 主反向 ODE 从 T 跑到 $t_{\min}$,得到起点 $x^0_{t_{\min}} = \mathrm{ODE}_\theta(x_T, T\to t_{\min})$;
2. Restart forward:一次性加大量噪声,$x^{i+1}_{t_{\max}} = x^i_{t_{\min}} + \varepsilon_{t_{\min}\to t_{\max}}$。这里 $\varepsilon$ 服从解析扰动核 $N(0, (\sigma(t_{\max})^2-\sigma(t_{\min})^2)I)$,由扩散前向过程直接给出,不需要任何网络前向,所以加噪几乎不花时间;
3. Restart backward:从 $t_{\max}$ 沿 ODE 跑回 $t_{\min}$,$x^{i+1}_{t_{\min}} = \mathrm{ODE}_\theta(x^{i+1}_{t_{\max}}, t_{\max}\to t_{\min})$;
4. 循环 2–3 步 K 次,最后从 $t_{\min}$ 继续主反向到 0。
先给预期:为什么「把噪声加回去再重新跑一遍」能改善质量?每次加噪相当于把采样状态推回到一个更「高噪声」的时间点,这一步把前面累积的离散化与近似误差混进新噪声里;随后 ODE 反向再去噪时,这部分误差被重新生成过程覆盖掉,相当于一次局部重启。区间 [tmin,tmax] 通常放在主反向过程的末尾,因为越靠近数据(t 越小)累积误差越大,收缩收益最高。CIFAR-10(VP)上的示例配置是 [0.06, 0.30]、K=10、NFE=75。
定理 2 给出了 Restart 的上界:
$$
W_1(p^{\mathrm{Restart}_\theta(K)}_{t_{\min}}, p_{t_{\min}}) \le B(1-\lambda)^K TV(p^{\mathrm{Restart}_\theta(0)}_{t_{\max}}, p_{t_{\max}}) + (K+1)\,O(\delta+\epsilon_{\mathrm{approx}})(t_{\max}-t_{\min})
$$
先给预期:这个式子把「K 越大越好」和「K 不能无限大」同时说清楚了。收缩项带 $(1-\lambda)^K$:每循环一次,初始误差乘以一个小于 1 的因子,K 次后随 K 指数下降。附加项带 $(K+1)$:每多循环一次,就多跑一段 ODE,离散化与近似误差线性累积。两者一降一升,所以 K 存在一个最优甜点,FID 随 K 先降后升(图 5)。符号上,$\lambda<1$ 是收缩因子,$B$ 是常数,$TV$ 是进入区间时的初始误差,$\delta$ 是步长,$\epsilon_{\mathrm{approx}}$ 是近似误差上界。相比定理 1 里 SDE 的 $(1-\lambda e^{-U})$,Restart 的 $(1-\lambda)^K$ 收缩更强,原因是噪声被从 drift 中剥离、单次加噪更大,而反向段保持纯 ODE 所以离散化误差仍是 ODE 水平。
关键实验与结果
标准基准:CIFAR-10 与 ImageNet 64
图 3 是全文的主结果图,横轴 NFE、纵轴 FID(50K 采样)。

CIFAR-10(无条件,VP 模型)上,Restart 用 NFE=75 达到 FID 2.27(配置 tmin=0.06、tmax=0.30、K=10),NFE=115 到 2.21,NFE=519 到 2.11。对照当时最佳 SDE(Improved SDE):1023 NFE 才到 2.35,63 NFE 只有 2.88;ODE(Heun) 在 1023 NFE 时停在 2.90 的平台,63 NFE 是 2.89。也就是说 Restart 在更少的步数上拿到比两者都低的 FID。论文据此声明同 FID 下相对最佳 SDE 加速约 10 倍——两侧配置大致是 Improved SDE 1023 NFE(FID 2.35)对 Restart 115 NFE(FID 2.21)。在更难的 ImageNet 64×64(类别条件,EDM)上,Restart 用多级区间(5 个区间各配 K)在 NFE=623 拿到 FID 1.36,好过 Improved SDE 1023 NFE 的 1.40;而 Heun ODE 停在 2.24。另一个值得注意的对照组:Vanilla SDE 在 ImageNet 上 128 NFE 时 FID 崩到 59.71,说明小步数下 SDE 的离散化误差确实致命。Restart 配 DPM-Solver-3 还能进一步压低 NFE:CIFAR-10 上 NFE=27 就拿到 FID 2.11,比单独用 DPM-Solver 在 16–36 NFE 区间都低(图 4)。
更强模型:EDM 与 PFGM++
把 Restart 套到更强的预训练模型上,收益依然存在:CIFAR-10 上 EDM 用 NFE=43 到 FID 1.90,PFGM++ 用同样的 43 步到 1.88;对照 Heun ODE 63 步只有 1.97(EDM)/1.91(PFGM++),Improved SDE 63 步只有 2.27。1.88 是论文报告的 CIFAR-10 无条件 UNet 架构最佳 FID,全程没有额外训练。这里有个细节:模型越强,最优 K 越小——EDM 只允许较少的 Restart 迭代,因为它的累积误差本来就小(图 5)。
大规模 text-to-image:Stable Diffusion v1.5
论文还把 Restart 用到真实管线:Stable Diffusion v1.5(LAION-5B 预训练,512×512),COCO 验证集随机 5K 条 caption,guidance 权重 w∈{2,3,5,8},每步 2 次函数评估(条件+无条件)。Restart 只用 66 步=132 NFE(主反向 DDIM 30 步、Restart 反向 Heun),对照 DDIM 50/100 步和 DDPM 100/200 步。图 6 横轴是 CLIP 分数(文本-图像对齐)或 Aesthetic 分数(视觉质量),纵轴是 FID。
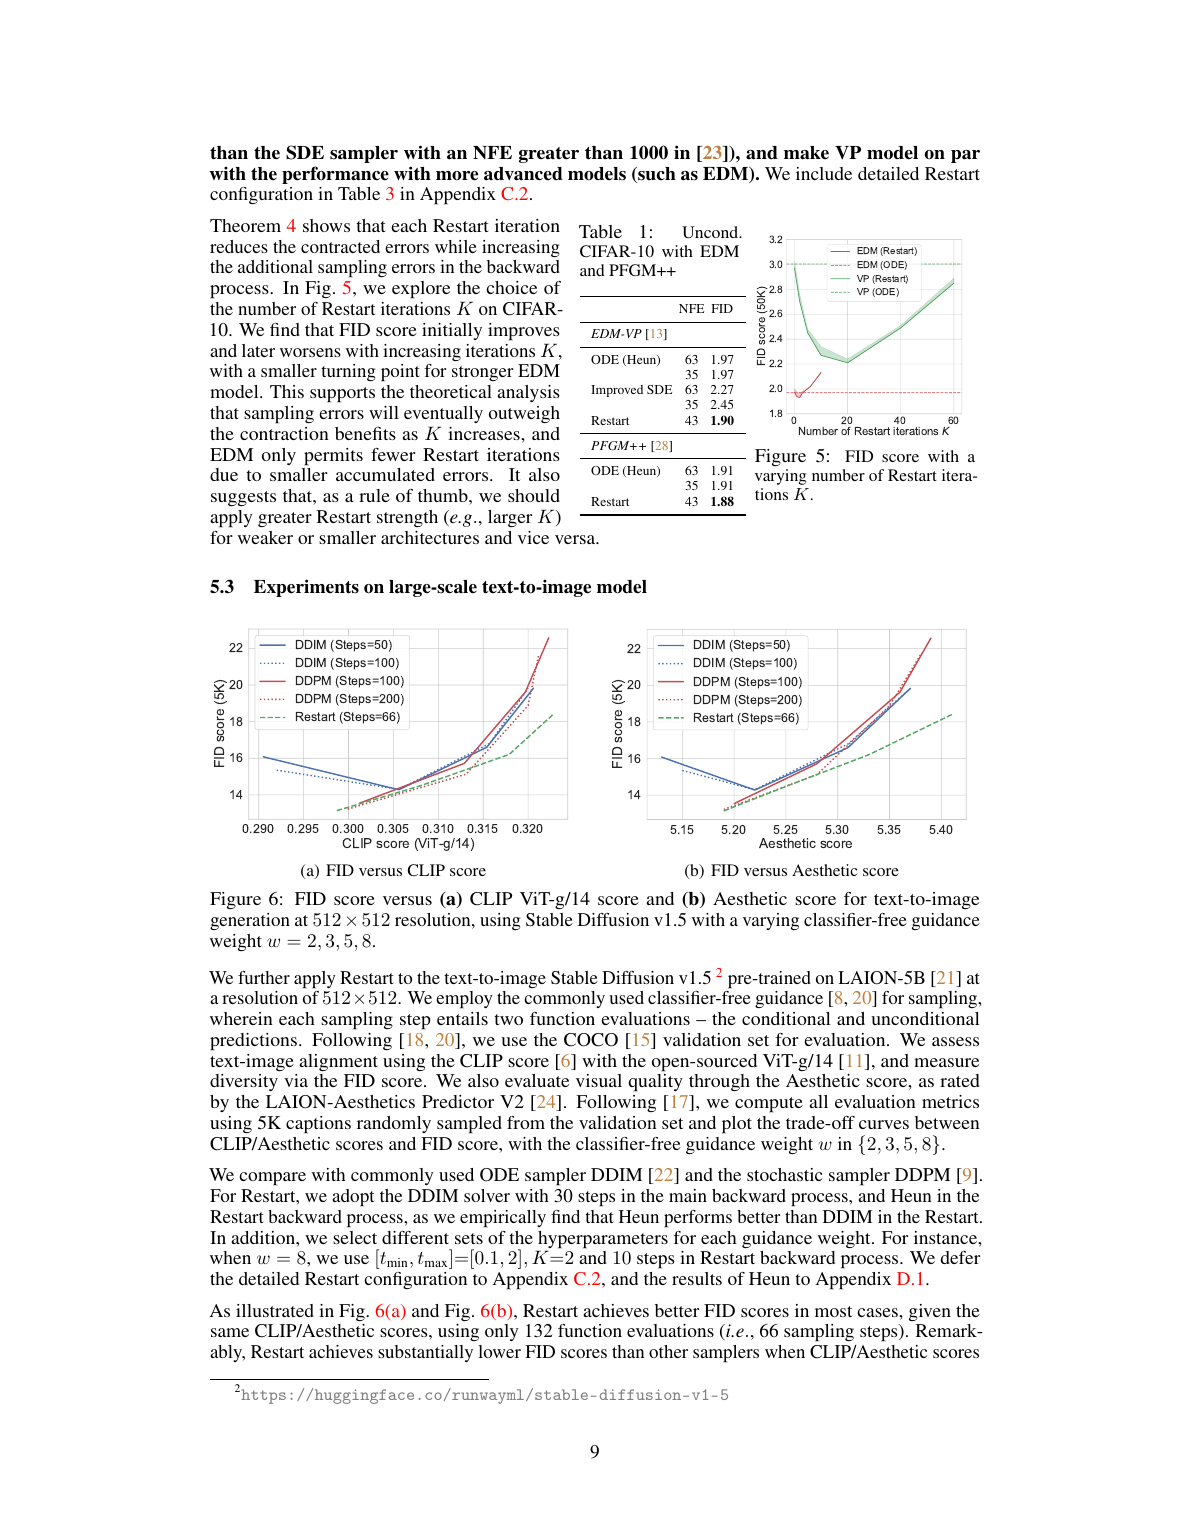
结果:在相同 CLIP/Aesthetic 分数下,Restart 多数情况 FID 更低;w 越大(对齐分数越高)优势越明显,w=8 时配置 [tmin,tmax]=[0.1,2]、K=2。低 w 区 DDPM 的 FID 和 Restart 接近,但 Restart 用一半的步数。论文结论:Restart 在多样性(FID)与对齐/视觉质量(CLIP/Aesthetic)之间取得了比既有采样器更均衡的权衡。
谱系定位:采样期改造的延续
Restart 属于「采样期改造」这条路线:模型训练完之后不再动任何权重,只改写求解器或采样流程来换取质量与速度。它和同一组的后续工作是一条线——本文的共同一作 Mingyang Deng 出自 Jaakkola 组,之后还有 Mean Flows(NeurIPS 2025)等论文,共同话题是在推理/采样期改造生成过程;Deng 后来参与的另一支工作 Generative Drifting 也把「改动采样期」的思路往更广的生成框架上推。放在谱系里看:Improved SDE 和 Gonna Go Fast 在「逐步小噪声」里优化 SDE,Restart 把随机性集中成离散的前向加噪步;DDIM/DPM-Solver 只优化 ODE 的离散化误差,Restart 以 ODE 为主干再加收缩层。Restart 的位置是「把 SDE 的随机性按需取用」:要收缩就加一次大噪声,要精度就纯 ODE。
局限
论文自己承认最明显的短板:K 和 [tmin,tmax] 没有原则性的选择方法,靠「模型越弱/任务越难就用越强 Restart」的启发式,自动选参被列为 future direction。由此带来几个现实问题:第一,「同 FID 下 10 倍加速」的两侧精确配置没有逐表列出,正文只给了 FID-NFE 曲线,复现时要自己从表 2/3 插值。第二,Stable Diffusion 的超参按 w 手动挑(正文给了 w=8 的配置,其余在附录分 5 组),换模型、换分辨率就要重调。第三,理论是 Wasserstein-1 上界,隐藏常数含 Lipschitz 常数与维度的多项式依赖,只能解释趋势、给不出最优 K 的闭式解。第四,合成验证是 20 维高斯混合,能直接测误差但规模小;高维图像只能看 FID。第五,多级 Restart 让超参空间更大(ImageNet 623 NFE 配置含 5 个区间、每级独立 K),手工调参成本高,论文也没有给每级区间的消融。
一句话记住
Restart 采样把扩散模型的采样拆成「主反向 ODE + 末尾区间内循环 K 次的大加噪-ODE 反向」,让收缩误差随 K 指数下降、附加误差随 K 线性上升,在最优 K 处同时拿到 SDE 的质量与 ODE 的速度;它属于采样期改造路线,与 Deng/Jaakkola 组后续的 Mean Flows、Generative Drifting 共享「不改权重、只改采样过程」的议题。
在扩散类生成模型的主反向 ODE 末尾插入一个时间区间 [tmin,tmax],循环 K 次『一次性大步加噪(前向)+ ODE 反向』:加噪把已累积的采样误差收缩掉一部分,ODE 反向又保持低离散化误差,从而同时拿到 SDE 的质量和 ODE 的速度。论文声明在同 FID 下相对当时最佳 SDE 采样器在 CIFAR-10(VP)上加速约 10 倍(对照两侧配置:Improved SDE 1023 NFE 得 FID 2.35,Restart 115 NFE 得 2.21)、ImageNet 64×64(EDM)上约 2 倍,并把 CIFAR-10(PFGM++)推到 FID 1.88、ImageNet 64×64 推到 1.36(UNet 架构、无额外训练)。
阅读提示
精读深度:泛读
清单提示:原文提示:采样期改造;与 Deng/Jaakkola 的共同话题
问题
要解决什么:扩散类生成模型(diffusion、PFGM/PFGM++)的采样要在质量与速度之间权衡:质量常用 FID(越低越好),速度用网络函数评估次数 NFE(越低越快)。同一个模型换不同采样器,曲线形态相反——ODE 采样器小 NFE 时表现不错,但 FID 随 NFE 增大很快平台化;SDE 采样器高 NFE 时质量明显更高,却要很多步。论文要回答的问题:为什么会出现这两种相反的行为,以及能否设计一个采样算法,同时拿到 ODE 的快和 SDE 的好。
为什么 prior work 不够:此前的工作把 ODE 与 SDE 当成两条平行路线:要快就选确定性 ODE 求解器(DDIM、DPM-Solver、Heun),要好就选随机 SDE 采样器(EDM 的 Improved SDE、Gonna Go Fast)。这些工作各自改进求解精度或步长选择,但没有把两类采样器的误差来源拆开分析,也没有人提出把 SDE 的随机性『单独取出来、一次加足』的方案。论文指出两者差异来自两类误差:离散化误差(步长大的损失)与近似误差(神经网络对 score 场的估计误差,NFE 大时占主导),并观察到 SDE 每步的小噪声能把已累积误差『收缩』掉一部分——这是此前没人显式利用的机制。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 预训练 score 网络 sθ(x,t) | 神经网络(VP/EDM/PFGM++ 的 UNet,或 Stable Diffusion v1.5) | 训练好的模型权重,采样期不更新参数;对应扩散模型的 ∇x log pt(x) 或 PFGM 的电场。 |
| Restart 超参 | K + [tmin,tmax] + 各段步数 | K 为循环次数,[tmin,tmax]⊂[0,T] 为加噪区间;主反向步数 Nmain、Restart 反向步数 NRestart。例如 CIFAR-10 VP 用 NFE=75 时取 tmin=0.06、tmax=0.30、K=10(0.30/0.06 对应 EDM 18 步离散化方案的第 12/14 个时间步)。 |
| 初始噪声 x_T | 高维向量 | 从标准高斯先验采样,作为主反向过程的起点。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 生成样本 x_0 | 与数据同维(图像像素或 SD 的 512×512 图像) | 主反向 ODE 从 x_T 跑到 tmin,再经 K 轮 Restart 循环,最后继续 ODE 到 t=0。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10(无条件生成) | 5 万张 32×32 训练图 | 用公开预训练 VP、EDM、PFGM++ 模型([13,28]),FID 在 50K 采样上评估;采样用 EDM 离散化方案。 |
| ImageNet 64×64(类别条件) | 128 万张 64×64 训练图 | 用公开预训练 EDM 模型,1000 类条件;FID 在 50K 采样上评估。 |
| Stable Diffusion v1.5(text-to-image) | LAION-5B 预训练,512×512 | 评估用 COCO 验证集随机抽 5K 条 caption;指标为 CLIP ViT-g/14 分数、LAION-Aesthetics V2 分数与 FID(5K)。每个采样步 2 次函数评估(条件+无条件预测)。 |
| 合成数据(实验 5.1) | 20 维、2000 个点 | 高斯混合分布,4 层 MLP 拟合 score,时间区间 [tmin,tmax]=[1.0,1.5];用来直接测量收缩误差与附加采样误差。 |
架构(摘要)
主干与结构
backbone:复用预训练 score 网络(VP/EDM/PFGM++ 的 UNet;SD v1.5 UNet),不训练、不改参数
参数:n/a(采样期算法,无新增参数)
类型:采样算法:主反向 ODE + K 轮 Restart 循环(加噪前向 + ODE 反向)
关键组件
- 主反向过程:确定性 ODE 从 T 跑到 tmin(Heun 2 阶;SD 上用 DDIM 30 步),tmin 取在累积误差较多的时间附近
- Restart forward(加噪):x_{tmax}^{i+1} = x_{tmin}^i + ε_{tmin→tmax},ε 服从解析扰动核 N(0, (σ(tmax)²−σ(tmin)²)I),不需要任何网络前向
- Restart backward(去噪):x_{tmin}^{i+1} = ODE_θ(x_{tmax}^{i+1}, tmax→tmin),用 Heun 求解
- 重复上述循环 K 次;循环 i=0..K−1
- 多级 Restart(multi-level):在 ImageNet 64 上叠 5 个区间 [19.35,40.79],[1.09,1.92],[0.59,1.09],[0.30,0.59],[0.06,0.30],各配不同 K
为什么这样设计
把随机性从 drift 里剥离、一次性加大量噪声,收缩效果比 SDE 逐步骤混入小噪声更强(定理 2 的 (1−λ)^K 因子);反向段保持纯 ODE,步长可以取到和 ODE 求解器一样大,离散化误差停留在 ODE 水平。区间放在主反向末尾,因为那里累积误差最大、收缩收益最高。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 无条件,VP 模型:FID vs NFE | Restart NFE=75 时 FID 2.27(tmin=0.06、tmax=0.30、K=10);NFE=115 时 2.21;NFE=519 时 2.11 | Improved SDE(当时最佳 SDE):1023 NFE 得 2.35、63 NFE 得 2.88、35 NFE 得 3.45;ODE(Heun):1023 NFE 得 2.90、63 NFE 得 2.89(平台);Vanilla SDE 1024 NFE 2.79;Gonna Go Fast 1000 NFE 2.55 | 50K 采样评估 FID;VP 预训练模型,EDM 离散化方案,Heun 2 阶用于主/反向 ODE;Restart 区间 [0.06,0.30],K=10(NFE=75 行)。论文声明同 FID 下相对最佳 SDE 加速约 10 倍:对照表 2/3,Improved SDE 1023 NFE 2.35 对 Restart 115 NFE 2.21(更低的 FID、更少步数);严格同 FID 点的两侧配置论文未逐表列出。 |
| CIFAR-10 无条件,VP + DPM-Solver-3:低 NFE 区间 | Restart NFE=27 时 FID 2.11(配置 (8,3,1,0.06,0.3));NFE=18 时 2.40 | DPM-Solver 单独使用:图 4 中 NFE 16–36 区间 FID 均高于 Restart(如 NFE≈30 时约 3.0 量级) | 50K 采样评估;主反向用 DPM-Solver-3 加速,Restart 反向用 Heun;区间 [0.06,0.3] 附近。说明 Restart 连快速 ODE 求解器的领域也能再压一档。 |
| CIFAR-10 无条件,EDM / PFGM++:最佳 FID | Restart NFE=43 时 FID 1.90(EDM)/ 1.88(PFGM++),配置 (18,3,2,0.14,0.30) | ODE(Heun):63 NFE 得 1.97(EDM)/ 1.91(PFGM++);Improved SDE:63 NFE 得 2.27 | 50K 采样评估;预训练 EDM/PFGM++ 模型;区间 [0.14,0.30]、K=2。1.88 是论文当时在 CIFAR-10 无条件 UNet 架构上的最佳 FID(无额外训练)。 |
| ImageNet 64×64 类别条件,EDM:FID vs NFE | Restart NFE=623 时 FID 1.36(多级 Restart,5 个区间) | Improved SDE:1023 NFE 得 1.40、63 NFE 得 2.24;ODE(Heun):1023 NFE 得 2.24、63 NFE 得 2.30;Vanilla SDE 128 NFE 崩到 59.71 | 50K 采样评估;预训练 EDM 模型;多级配置示例 623 NFE = 主反向 36 步 + {(10,3,19.35,40.79),(10,3,1.09,1.92),(7,6,0.59,1.09),(7,6,0.30,0.59),(7,25,0.06,0.30)}。论文称同 FID 相对最佳 SDE 加速约 2 倍。 |
| Stable Diffusion v1.5 text-to-image:CLIP/Aesthetic vs FID | Restart 用 66 步=132 NFE(每步 2 次函数评估),在相同 CLIP ViT-g/14 或 Aesthetic 分数下多数情况 FID 更低,w 大(如 w=8)时优势明显;w=8 配置 [tmin,tmax]=[0.1,2]、K=2、Restart 反向 10 步 | DDIM 50/100 步、DDPM 100/200 步(均为常用采样器),guidance 权重 w∈{2,3,5,8} | SD v1.5(LAION-5B 预训练,512×512),COCO 验证集随机 5K caption;CLIP 用 ViT-g/14,Aesthetic 用 LAION-Aesthetics Predictor V2;主反向 DDIM 30 步、Restart 反向 Heun;超参按 w 手动挑选。 |
| 合成实验:收缩误差 vs 附加采样误差(Pareto) | 相同附加采样误差水平下,Restart 的收缩误差始终低于 ODE 与 SDE;附加采样误差区间 [0.8,0.85] 内总误差也更小 | 同一设置下的 ODE 与 SDE(一阶 ODE 求解) | 20 维高斯混合、2000 点、4 层 MLP 拟合 score,区间 [tmin,tmax]=[1.0,1.5];总误差 = W1(生成分布, 数据分布),分解为收缩误差与附加采样误差(图 2)。 |
Insights
- ODE 与 SDE 的差异来自两类误差的此消彼长:一阶 Euler ODE 局部误差 O(δ²) 小于 Euler-Maruyama SDE 的 O(δ^{3/2}),所以小 NFE 时 ODE 更准;NFE 大时离散化误差变小,神经网络对 score 场的近似误差占主导,此时 SDE 每步的小噪声能把已累积误差收缩掉一部分,于是 SDE 在高 NFE 区胜出。
- 加噪的关键在『位置、大小、频次』:把噪声从 drift 步骤里剥离出来、一次性加足、循环 K 次,收缩因子从 SDE 的 (1−λe^{−U}) 变成 (1−λ)^K,随 K 指数下降;反向段保持 ODE 则离散化误差不随噪声变大。
- K 存在最优甜点:收缩随 K 指数下降、附加采样误差随 K 线性增长,FID 随 K 先降后升;模型越弱或任务越难,最优 K 越大(图 5:VP 的转折点比 EDM 更大)。
- 区间放末尾收益最大:累积误差在 t 小的地方(接近数据)最大,把 Restart 区间放在主反向末尾(如 CIFAR-10 的 [0.06,0.30])能让每次收缩作用于最多的误差。
vs 同类工作
- vs Improved SDE(Karras et al., EDM, 2022):SDE 在每个反向小步的 drift 里混入小噪声;Restart 把噪声独立成一个前向步骤、一次性加大量,收缩更强且反向仍用 ODE。
- vs Gonna Go Fast(Dockhorn et al., 2022):自适应步长的 SDE 采样器,减少高 NFE 区的浪费;仍属于逐步小噪声路线,没有显式的『加噪-去噪循环』。
- vs 快速确定性求解器(DDIM、DPM-Solver、Heun):只降低离散化误差,没有收缩机制,FID 随 NFE 平台化;Restart 以 ODE 为主干,把求解器当反向子过程用(Heun 或 DPM-Solver-3),再加收缩。
- vs PFGM/PFGM++:PFGM 家族换的是『场』(电场而非 score),采样仍是 ODE/SDE 二选一;Restart 作为采样层可直接叠加,论文用 PFGM++ 验证出 FID 1.88。
局限
- 超参没有原则性选择方法(论文自承):K 与 [tmin,tmax] 靠『模型越弱/任务越难就用越强 Restart』的启发式;不同 NFE、不同模型要重新扫描,自动选择是论文自己列的 future direction。
- 『同 FID 下 10 倍加速』的精确对照配置没有逐表列出:正文声明来自 FID-NFE 曲线,从表 2/3 可推断是 Improved SDE 1023 NFE(FID 2.35)对 Restart 115 NFE(FID 2.21)附近的交叉,但论文没有给出严格等 FID 的两侧配置表,复现时需要自己插值(我们读出的)。
- Stable Diffusion 的超参按 guidance 权重手动挑:正文给出 w=8 的配置,其余 w 的配置在附录 C.2 分 5 组列出;换模型或换分辨率后这些区间和 K 需要重新调,泛化性没有自动化保障。
- 理论是上界分析而非精确刻画:定理 1/2 是 Wasserstein-1 上界,隐藏常数含 Lipschitz 常数与维数的多项式依赖,只能解释『为什么收缩有效、K 有甜点』的趋势,不能直接给出最优 K 的闭式解。
- 合成验证维度低:实验 5.1 用 20 维高斯混合,能直接测量误差但规模小;高维图像上只能看 FID 等指标,无法逐点验证收缩误差的数值。
- 多级 Restart 使超参空间变大:ImageNet 64 的 623 NFE 配置含 5 个区间、每个区间独立 K 与步数(如 (7,25,0.06,0.30)),手工调参成本高,论文也没有给出每级区间对最终 FID 的消融。
可复现性
- code:https://github.com/Newbeeer/diffusion_restart_sampling
- weights:使用公开预训练模型:VP/EDM/PFGM++ 的 CIFAR-10 与 ImageNet 64 检查点([13,28]),Stable Diffusion v1.5(runwayml,LAION-5B 预训练)
- setup:采样用 EDM 离散化方案;主/Restart 反向用 Heun 2 阶(SD 主反向用 DDIM 30 步);Restart 配置记作 (Nmain, NRestart,i, Ki, tmin,i, tmax,i),CIFAR-10 各 NFE 行、ImageNet 多级配置、SD 各 w 配置分别见附录 C.2 表 3/5/10。
主干与结构
backbone:复用预训练 score 网络(VP/EDM/PFGM++ 的 UNet;SD v1.5 UNet),不训练、不改参数
参数:n/a(采样期算法,无新增参数)
类型:采样算法:主反向 ODE + K 轮 Restart 循环(加噪前向 + ODE 反向)
关键组件
- 主反向过程:确定性 ODE 从 T 跑到 tmin(Heun 2 阶;SD 上用 DDIM 30 步),tmin 取在累积误差较多的时间附近
- Restart forward(加噪):x_{tmax}^{i+1} = x_{tmin}^i + ε_{tmin→tmax},ε 服从解析扰动核 N(0, (σ(tmax)²−σ(tmin)²)I),不需要任何网络前向
- Restart backward(去噪):x_{tmin}^{i+1} = ODE_θ(x_{tmax}^{i+1}, tmax→tmin),用 Heun 求解
- 重复上述循环 K 次;循环 i=0..K−1
- 多级 Restart(multi-level):在 ImageNet 64 上叠 5 个区间 [19.35,40.79],[1.09,1.92],[0.59,1.09],[0.30,0.59],[0.06,0.30],各配不同 K
为什么这样设计
把随机性从 drift 里剥离、一次性加大量噪声,收缩效果比 SDE 逐步骤混入小噪声更强(定理 2 的 (1−λ)^K 因子);反向段保持纯 ODE,步长可以取到和 ODE 求解器一样大,离散化误差停留在 ODE 水平。区间放在主反向末尾,因为那里累积误差最大、收缩收益最高。
Restart 的加噪-去噪结构与 FID vs NFE 曲线
原文 caption:(a) Illustration of the implementation of drift and noise terms in ODE, SDE, and Restart. (b) Sample quality versus number of function evaluations (NFE) for different approaches.
左侧子图对比三种采样器如何实现 drift 与 noise 项:ODE 全程无噪声;SDE 在每个小步里混入小噪声;Restart 把噪声集中成一步前向(粗箭头),再整段反向 ODE。右侧子图横轴 NFE、纵轴 FID:ODE(绿)小 NFE 就可用但很快平台化,SDE(黄)高 NFE 才追上来,Restart(红)在各 NFE 都取到最低 FID。这张图是全文的路线图,直接给出『两类误差拆开处理』的设计动机。
FID vs NFE:CIFAR-10 VP 与 ImageNet 64 EDM
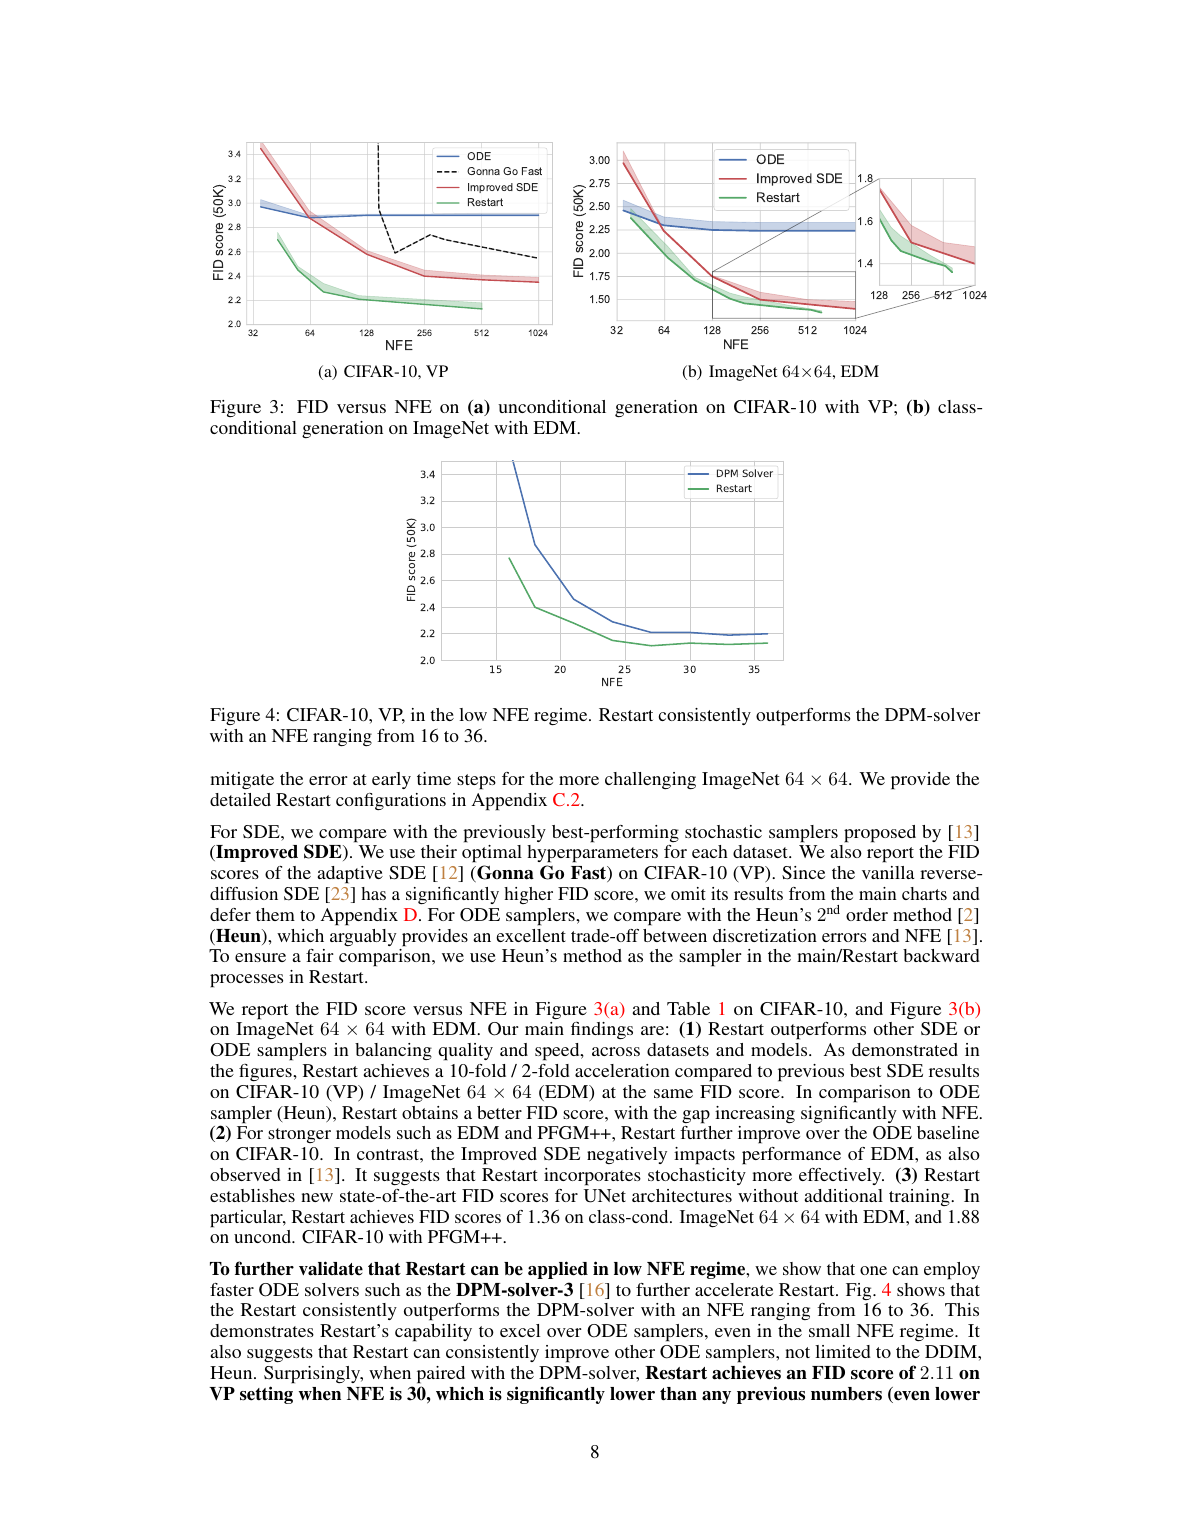
原文 caption:FID versus NFE on (a) unconditional generation on CIFAR-10 with VP; (b) class-conditional generation on ImageNet with EDM.
两条子图横轴都是 NFE、纵轴 FID(50K)。CIFAR-10 VP:Restart 曲线整体在 Improved SDE、ODE(Heun) 下方,NFE=43 时 FID 2.70、75 时 2.27、115 时 2.21、519 时 2.11,而 Improved SDE 要到 1023 NFE 才到 2.35、ODE(Heun) 停在 2.90 平台。ImageNet 64 EDM:Restart 623 NFE 达 1.36,好过 Improved SDE 1023 NFE 的 1.40。这张图支撑『Restart 在质量与速度上都胜过两类既有采样器』的核心论断。
Stable Diffusion 的 CLIP/Aesthetic 分数与 FID 权衡曲线
原文 caption:FID score versus (a) CLIP ViT-g/14 score and (b) Aesthetic score for text-to-image generation at 512×512 resolution, using Stable Diffusion v1.5 with a varying classifier-free guidance weight w = 2, 3, 5, 8.
横轴分别是 CLIP 分数(文本-图像对齐)与 Aesthetic 分数(视觉质量),纵轴是 FID(多样性/保真)。Restart 用 66 步=132 NFE(每步 2 次评估),对照 DDIM 50/100 步与 DDPM 100/200 步;同一条曲线上的点对应 guidance 权重 w=2,3,5,8。Restart 在相同 CLIP/Aesthetic 分数下多数情况 FID 更低,w 越大(对齐分数越高)优势越明显。它说明 Restart 不只在像素级基准有效,在真实 text-to-image 管线里同样能改善多样性-对齐权衡。
🎧 音频版
时长 25:33 · Edge TTS
往采样里加回噪声,为什么反而又快又好?(对话版)
先讲清楚:这篇到底在解决什么问题
小播:老播,今天这篇论文叫 Restart Sampling,翻译过来是"重启采样"。采样还能重启?听起来像是把生成到一半的图丢掉重来,那不是更慢吗?而且它的影响面不小,只要是扩散模型采样都能套这套思路,连 Stable Diffusion 这种文生图管线都验证过。这期值得听。
老播:你猜对了一半。它确实会把走到一半的样本"加回一大笔噪声、推回高噪声的时间点",然后重新往下跑。但关键有两点:第一,加噪声这一步几乎不花时间,它用的是扩散前向过程的解析公式,不需要调用神经网络;第二,重新往下跑的这段 ODE,会把前面累积的误差收缩掉一块。论文来自 MIT 的 Yilun Xu、Mingyang Deng、Xiang Cheng、Ziming Liu 和 Tommi Jaakkola,其中 Tian Yonglong 在 Google Research,前三位共同一作,发表在 NeurIPS 2023,代码开源。它要解决的是扩散模型采样的老矛盾:确定性 ODE 采样器快,但质量很快到顶;随机 SDE 采样器质量上限高,但要很多步。这篇的答案可以一句话说清:把随机性从求解器里拆出来,在采样末尾的区间里循环 K 次"一次性加足噪声,再用 ODE 反向去噪",同时拿到 SDE 的质量和 ODE 的速度。这句话我后面会反复说,它是全文的记忆锚点。
小播:好,那我先记下这句:加回噪声是为了收缩误差,相当于把一小段采样局部重来,而且加噪声本身不花时间。
老播:对。而且它还有一个更大的背景:这篇属于"采样期改造"这条路线——模型训练完就不动了,只改采样过程来换质量和速度。这条线上还有它同组后来的工作,比如 Mean Flows,和本文的共同一作 Mingyang Deng、以及 Jaakkola 组都有直接关联,这点我们放到谱系段再展开。
背景:为什么 ODE 快、SDE 好,两边各卡在哪
小播:先把概念对齐一下。扩散模型我是知道的:训练时给图片逐步加噪声直到变成纯高斯,采样时反向操作,从噪声里一步步去噪还原出图片。但 ODE 和 SDE 具体指什么?
老播:扩散模型的反向过程是一条微分方程,可以写成两种版本。SDE 版本每走一小步会额外注入一点随机噪声,轨迹是随机的;ODE 版本完全确定,同样的起点永远走出同一条路。两者共享同一个"漂移"场,由神经网络预测,预测的是当前中间分布的 score——score 这个词你可以理解成对数概率密度关于输入 x 的梯度,它告诉我们"往哪个方向走,图片更像真实数据"。训练时我们用去噪得分匹配让网络拟合这个场,采样时就把网络预测塞进方程当向量场用。补充一句:不同论文里这个网络预测的东西叫法不同,有的叫 score,有的叫速度场,有的叫 epsilon,核心都是同一个反向向量场的不同参数化。这里要先给出两个衡量指标:快慢用 NFE,number of function evaluations,网络函数评估次数,可以近似理解成采样步数;质量用 FID,越低越好,它比较生成图片分布和真实图片分布的差距。
小播:那 ODE 和 SDE 的表现差在哪?
老播:同样一个预训练模型,现象是:用 ODE 采样,30 步、60 步已经挺像样,但再加步数,FID 几乎不动了。论文里 CIFAR-10 上用 Heun 二阶 ODE 采样器,63 步 FID 2.89,加到 1023 步还是 2.90,完全平台化。反过来,SDE 采样 60 步左右质量还不行,但加到上千步能到 2.35——这是 Improved SDE 在 CIFAR-10 VP 模型上 1023 NFE 的结果——比 ODE 的天花板低不少。所以 ODE 的强项在小步数,SDE 的强项在大步数。
小播:那两边各卡在哪?为什么会有这种相反的曲线?
老播:论文把误差拆成两类,这是全文的理论支点。第一类叫离散化误差:数值求解器用有限步长去近似连续方程,步长越大误差越大。一阶 Euler 方法解 ODE,局部误差是步长的平方量级;一阶 Euler-Maruyama 方法解 SDE,局部误差是步长的 3/2 次方量级。步长小于 1 时,3/2 次方远大于平方,所以大步长下 ODE 明显更准,这是 ODE 在小 NFE 区胜出的原因。第二类叫近似误差:神经网络拟合 score 场总有偏差,当步数很多、离散化误差被压下去以后,近似误差变成主要矛盾。此时 SDE 每步注入的小噪声反而派上用场:它能带动生成分布和真实分布互相靠近,把前面累积的误差"收缩"掉一部分。论文给了一个定理,用 Wasserstein-1 距离把总误差写成两项:收缩后的初始误差,加上附加采样误差。ODE 的上界没有收缩因子,初始误差原样保留;SDE 的上界多一个小于 1 的收缩因子,代价是附加项里多一个根号步长的项。所以在 NFE 大时 SDE 占优,NFE 小时 ODE 占优。
小播:这个收缩,在公式里是怎么写出来的?我只看结论有点不踏实。
老播:定理 1 把总误差写成两项之和:总误差 ≤ 收缩因子 × 初始误差 + 附加采样误差。先给预期,这个式子想回答的问题,是为什么 SDE 在高步数时上界更低。ODE 那一行没有收缩因子,初始误差前面直接乘一个常数 B;SDE 那一行,初始误差前面多乘了一个小于 1 的因子,具体是 1 − λ·e^(−U),U 是 B·L1/t_min 加上 L1²·t_max²/t_min² 这样一个量,L1 是网络输出关于输入的 Lipschitz 常数上界,λ 是收缩常数。代价在第二项:SDE 的附加误差里多了一个根号 δ·t_max 的项,δ 是步长,步长越小这项越小。当 NFE 很大、δ 很小时,收缩项占主导,SDE 的上界就比 ODE 低。这里用到的 Wasserstein-1 和 TV 都是衡量分布差距的度量:Wasserstein-1 也叫推土机距离,衡量把分布 A 变成分布 B 的最小搬运代价;TV 距离衡量两个分布的重叠程度,两者都是越小越好。
小播:懂了,一个输在步长大的精度,一个赢在能忘掉一部分错误。那自然的想法就是:能不能把 SDE 的收缩拿来用,又别让它的离散化误差拖后腿?
老播:这正是论文提出的 Restart 要干的事。
核心思想:把噪声一次加足,再让 ODE 重新跑一遍
小播:那 Restart 具体怎么操作?
老播:操作分四步。第一步,主反向 ODE 照常从噪声时间 T 一路跑到一个较早的时间 t_min,比如 CIFAR-10 上取 0.06。第二步,Restart 前向:给样本一次性加一笔大噪声,把它从 t_min 推到较晚的时间 t_max,比如 0.30。这笔噪声服从一个解析的高斯核,方差是 t_max 和 t_min 两个时刻噪声水平的平方差,这是扩散前向过程直接给出的公式,不需要调用网络,所以几乎零成本。
小播:加噪声不用网络,这个我不太信。平时去噪不是每一步都要算网络吗?
老播:去噪要算网络,加噪不用。扩散模型的前向过程是纯解析的:训练时给图片加噪声,用一个高斯核,给定当前图像和噪声水平 σ(t),一步就能采样出加噪结果。Restart 前向用的就是同一个核:从 t_min 推到 t_max,等于在原有噪声水平上再叠一层方差为 σ(t_max)² − σ(t_min)² 的高斯噪声。σ(t) 是噪声调度函数,随 t 单调递增;CIFAR-10 的 VP 模型上,σ(0.30)² 减 σ(0.06)² 就是这一步要加的高斯噪声方差。所以这一步的成本只是一次随机数采样,跟网络计算无关。第三步,Restart 反向:从 t_max 沿着 ODE 一路去噪回到 t_min,这一步和普通 ODE 采样完全一样。第四步,把第二、三步循环 K 次,最后从 t_min 继续跑到 t=0 出图。主反向和 Restart 反向都用 Heun 二阶求解器,论文认为它是在离散化误差和步数之间最均衡的 ODE 求解器;到了 Stable Diffusion 上,主反向改用 DDIM 30 步,因为文生图场景里它更快。
小播:我复述一下:先跑到 0.06,加一大笔噪声跳回 0.30,再从 0.30 跑回 0.06,如此反复 K 次。加噪声把样本推回高噪声状态,等于把前面走的那段路部分作废、重新走。那为什么重新走一遍会更准?
老播:这里的关键是"收缩"到底收缩的是什么。采样越往后,前面所有步的离散化误差和网络近似误差累积得越多。加一笔大噪声后,样本被推回高噪声状态,分布重新变宽,前面积累的偏差被新噪声覆盖掉相当一部分;随后 ODE 反向去噪时,生成分布会向真实分布收缩回去,这就是定理里那个收缩因子在起作用。而且每一轮循环,收缩作用的都是上一轮结束时新累积的误差,多轮循环层层叠加,最终误差会显著小于只做一次加噪。论文的定理 2 把 Restart 的总误差上界写成这样的形式:收缩项是常数 B 乘 (1−λ) 的 K 次方,再乘初始误差;附加项是 (K+1) 倍的附加采样误差。先给预期:这个式子要回答的问题是"K 到底该取多大"。式子里的 B 是一个常数上界,λ 是小于 1 的收缩因子,初始误差用 TV 距离衡量,是进入区间时生成分布和真实分布的差距;附加采样误差里包含步长 δ 和近似误差,再乘上区间长度 (t_max−t_min)。因为 (1−λ) 小于 1,K 每加一,收缩项就乘一次 (1−λ),指数级下降;而附加项随 K+1 线性增长。一个指数降、一个线性涨,加起来就存在最优 K:太小收缩不够,太大附加误差反超。给你一个抓手的数字:如果每个循环的收缩因子是 0.9(示意值),K=10 次后初始误差被乘上 0.9 的 10 次方,约 0.35,剩三成;K=25 次约 0.07,剩不到一成。实际收缩因子由模型和区间决定,但趋势就是:循环越多,初始误差压得越狠,附加误差也在同步累积。CIFAR-10 VP 上这个最优值大约在 K=10 附近,FID 随 K 的曲线先降后升。
小播:那为什么比 SDE 那种"每步都加小噪声"更强?SDE 不也靠噪声收缩吗?
老播:区别在两点。第一,SDE 的噪声混在 drift 每一步里,幅度被限制在步长量级;Restart 把噪声独立成一个前向步骤,一次性加足,方差可以远大于单步噪声,收缩更猛。第二,SDE 加噪声的同时,离散化误差也被拖累——Euler-Maruyama 的误差是步长的 3/2 次方,而 Restart 的反向段是纯 ODE,离散化误差保持 ODE 的平方量级。所以 Restart 拿到的是 SDE 的收缩加 ODE 的精度,两边的好处都不丢。
小播:我还有个担心:加回噪声,会不会把已经生成好的结构也毁掉?
老播:答案在区间的位置。t 越小代表噪声越少、越接近成图;t 越大噪声越多、越接近纯噪声。Restart 的区间放在一个较早但还没到终点的位置,比如 CIFAR-10 的 [0.06, 0.30]:0.06 时刻图像已经相当清晰,0.30 时刻还有明显噪声,但也不是纯噪声。把样本从 0.06 推回 0.30,等于退回到图像轮廓还在、细节还没定型的阶段,重新走一遍这一小段,把前面累积的误差洗掉。它没有把样本推回 t 很大的纯噪声区,所以整体结构还在,只是细节阶段被重新生成一次。这也是为什么论文强调区间要放在主反向的末尾:越靠近成图,累积误差越多,这一段收缩的收益最高。对更难的 ImageNet 64,他们用多级 Restart,从晚到早叠五个区间,每级各配一个 K,相当于在不同时间尺度上各做几轮局部重来。
小播:机制我基本理清了:加噪是免费的、收缩是强力的、去噪是精确的,三件事凑一起,理论上同时拿到两边的好处。接下来看实验怎么验证。
实验:同样的质量,步数能少多少
老播:先说主基准 CIFAR-10,无条件生成,VP 模型。图 3 的横轴是 NFE,纵轴是 FID,50K 采样评估。Restart 用 75 步拿到 FID 2.27,115 步拿到 2.21,519 步拿到 2.11。论文把每个配置记成一个五元组 (Nmain, NRestart, K, tmin, tmax),依次是主反向步数、Restart 反向步数、循环次数、区间起点和终点;75 步那一行的配置是主反向 18 步、Restart 反向 3 步、K=10、区间 [0.06, 0.30]。对照当时的最佳 SDE 采样器 Improved SDE:1023 步才到 2.35,63 步只有 2.88;对照 Heun ODE:1023 步停在 2.90。也就是说,Restart 用比 ODE 多一点的步数,拿到了比 SDE 上千步还低的 FID。论文据此声明同 FID 下相对最佳 SDE 加速约 10 倍,两侧配置大致是 Improved SDE 1023 步 FID 2.35 对比 Restart 115 步 FID 2.21。我提醒一句:这个 10 倍是论文从 FID-NFE 曲线上读出来的,两侧的精确配置没有逐表列出,属于证据偏弱的地方,我们放到局限段再讲。
小播:那低步数区呢?那本来是 ODE 的强项,Restart 能不能打?
老播:能。他们拿 Restart 配 DPM-Solver-3,这是当时最快的 ODE 求解器之一:CIFAR-10 上 27 步就拿到 FID 2.11,18 步拿到 2.40;而单独用 DPM-Solver 在 16 到 36 步这个区间,FID 全程比 Restart 高。所以 Restart 把快速求解器也往下压了一档。更强的预训练模型上效果一样:CIFAR-10 的 EDM 模型,Restart 43 步 FID 1.90;PFGM++ 模型,同样 43 步拿到 1.88。说明一下,PFGM++ 是扩散模型的近亲,它把噪声换成电场来定义生成过程,但采样仍然是求解微分方程,所以 Restart 能直接套用。对照 Heun ODE 63 步是 1.97(EDM)和 1.91(PFGM++),Improved SDE 63 步只有 2.27。1.88 是论文当时报告的 CIFAR-10 无条件 UNet 架构最佳 FID,全程没有额外训练。这里有个有意思的规律(图 5):FID 随 K 先降后升,模型越强,转折点越靠左——EDM 只允许较少的 Restart 迭代,因为强模型自己的累积误差本来就小;反过来,越弱的模型越需要大 K。
小播:CIFAR-10 是 32×32 的小图。到 ImageNet 64 呢?
老播:ImageNet 64×64,类别条件,EDM 模型,难度上一个台阶。Restart 用多级区间:主反向 36 步,再叠五个区间,从晚到早分别是 [19.35, 40.79] 配 K=3、[1.09, 1.92] 配 K=3、[0.59, 1.09] 配 K=6、[0.30, 0.59] 配 K=6、[0.06, 0.30] 配 K=25,合计 623 步拿到 FID 1.36,比 Improved SDE 1023 步的 1.40 还好,Heun ODE 停在 2.24。同 FID 下相对最佳 SDE 加速约 2 倍。对照组里还有个很说明问题的数字:Vanilla SDE 在 128 步时 FID 崩到 59.71,说明小步数下纯 SDE 的离散化误差确实致命,这反过来衬托出 Restart 去噪段保持 ODE 的价值。除了图像,论文还做了个 20 维的合成实验,直接验证"收缩"这个机制:2000 个点的高斯混合,4 层 MLP 拟合 score,区间取 [1.0, 1.5]。他们把总误差拆成收缩误差和附加采样误差分别测量,画出帕累托前沿(图 2):在相同的附加采样误差水平上,Restart 的收缩误差始终低于 ODE 和 SDE。这个实验规模小,但它是论文里把理论的两个量直接测出来的地方,值得留意。
小播:最后一个问题:这套方法在真实产品管线里有用吗?比如 Stable Diffusion 那种文生图。
老播:论文在 Stable Diffusion v1.5 上验证了:LAION-5B 预训练、512×512,用 COCO 验证集随机抽 5K 条 caption 评估。注意这里每个采样步要算两次网络(条件和无条件各一次),所以 66 步等于 132 次函数评估。他们对照 DDIM 50 步、100 步和 DDPM 100 步、200 步,guidance 权重取 2、3、5、8。这里 DDIM 是确定性 ODE 采样器,DDPM 是随机 SDE 采样器,正好对应前面讲的两类路线。图 6 的横轴是 CLIP 分数(文本-图像对齐)或 Aesthetic 分数(视觉质量),纵轴是 FID。结果:相同 CLIP 或 Aesthetic 分数下,Restart 多数情况 FID 更低;权重越大,优势越明显,w=8 时配置是区间 [0.1, 2]、K=2。
小播:那个 guidance 权重 w 是什么意思?为什么 w 越大 Restart 优势越明显?
老播:classifier-free guidance 是文生图常用的技巧:让模型同时预测有条件和无条件的输出,再按权重组合,w 越大越强调文本对齐,图像越锐利、细节越夸张,但多样性下降、FID 变差。图 6 里每条曲线从左到右大致对应 w 从 2 到 8:w 越大,CLIP 分数越高、FID 越差。Restart 在 w 大的区域优势更明显,说明它在细节阶段处理得更好,能压住高引导带来的伪影,图 7 的对比图里它比 DDIM 的细节更准,从图上能直接看出来。低权重时 DDPM 的 FID 和 Restart 接近,但 Restart 用一半的步数。所以这套采样期改造不只在像素级基准有效,在真实文生图管线里同样改善"多样性-对齐"的权衡。
它在哪条路线上:采样期改造
老播:放到谱系里看,Restart 属于"采样期改造"这条技术路线:模型训练完,权重不再动,只改采样流程来换质量和速度。之前的 Improved SDE 和 Gonna Go Fast 是在逐步小噪声里优化 SDE;DDIM、DPM-Solver 只优化 ODE 的离散化误差;Restart 的位置是把两者拆开、按需组合。更值得注意的是同组的人:本文共同一作 Mingyang Deng 出自 Jaakkola 组,之后还有 Mean Flows(NeurIPS 2025)等论文,以及 Generative Drifting 这条线,共同话题都是"在推理/采样期改造生成过程"——不重训模型、纯改写求解器。把 Restart 和这些放在一起,能看到一条连贯的研究脉络:先搞清楚采样误差从哪来,再想办法在采样期把它压下去。
局限:哪些地方论文自己也说不清
老播:先说论文自己承认的。第一,K 和区间 [tmin, tmax] 没有原则性的选择方法,靠"模型越弱、任务越难就用越强的 Restart"这条启发式,自动选参被他们列为未来方向。这意味着换一个数据集或模型,超参要重新扫。第二,同 FID 下 10 倍加速的两侧精确配置没有逐表列出,正文只有 FID-NFE 曲线,复现时要从表格里自己插值。第三,Stable Diffusion 的超参是按 guidance 权重手动挑的,正文给了 w=8 的配置,其余几组放在附录;换模型、换分辨率,这套区间和 K 大概率要重调。
小播:这些是论文自承的。你们读出来还有什么?
老播:还有两条。第四,理论分析是 Wasserstein-1 上界,隐藏常数里含 Lipschitz 常数和维度的多项式依赖,它能解释"为什么 K 有甜点"的趋势,但给不出最优 K 的闭式解,离可预测的最优配置还有距离。第五,合成验证用的是 20 维高斯混合,规模小、能直接测误差,但高维图像上只能看 FID 这类指标,收缩误差的数值无法逐点验证。另外,多级 Restart 让超参空间更大了——ImageNet 那个 623 步的配置有五个区间、每级独立 K——手工调参成本很高,论文也没有逐级消融。
收尾:这期记住三件事
小播:那我来总结三件事。第一,扩散模型采样有两个误差来源:离散化误差让 ODE 在小步数占优,近似误差让 SDE 靠收缩在高步数占优。第二,Restart 把随机性从求解器里拆出来,在末尾区间循环"免费加足噪声加 ODE 反向",收缩随 K 指数增强、附加误差随 K 线性增长,所以 K 有最优值,同时拿到 SDE 的质量和 ODE 的速度。第三,它属于采样期改造路线,和 Deng、Jaakkola 组后续的 Mean Flows、Generative Drifting 一脉相承——训练不动,只改采样。老播,还有要补的吗?
老播:补一句意义。Restart 的价值在于证明了采样期改造的潜力可以很大:不训练、不改参数,一个纯采样算法就能在 CIFAR-10 上把 FID 从 Improved SDE 1023 步的 2.35 压到 Restart 519 步的 2.11,甚至 115 步的 2.21,还能搬到 Stable Diffusion 这种真实管线里用。还有个值得记住的细节:Restart 的加噪是免费的,因为它用的是解析前向核,这一步不消耗网络评估,这正是它能在不显著增加 NFE 的情况下拿到收益的结构性原因。它给后续工作留下的开放问题是:怎么自动选 K 和区间,让这套重启不再靠人工调参。想看代码,GitHub 仓库是 Newbeeer/diffusion_restart_sampling,论文是 arXiv 2306.14878。