V-JEPA 2:自监督视频模型让理解、预测与规划成为同一件事
一句话定位:Meta FAIR 的 V-JEPA 2 先把自监督视频预训练从 200 万视频推到 2200 万样本、从 3 亿参数推到 10 亿,再用不到 62 小时无标注机器人视频训练一个潜空间动作条件世界模型 V-JEPA 2-AC,在模型预测控制闭环里零样本完成真实机械臂的抓取与抓放。这篇论文把「理解、预测、规划」三条线放进同一个表征空间:同一个冻结编码器,既在 Something-Something v2 上拿到 77.3% 的动作理解准确率,又在两个陌生实验室的 Franka 机械臂上做到 80% 的抓放成功率。
问题与背景
世界模型的经典做法分两支。一支在像素空间做视频预测,扩散式世界模型(Genie、UniSim、Cosmos、Diffusion Forcing 一系)把未来帧当生成问题:给定条件,采样出看起来合理的视频。这支的优势是输出天然可解释,代价是每次预测都要跑昂贵的扩散采样,且像素重建把算力花在了不可预测的纹理上。另一支在表征空间做预测,JEPA(联合嵌入预测架构)路线只预测场景中「可预测的结构」,比如物体的运动轨迹,而主动忽略叶片的摆动这类不可预测细节。V-JEPA 2 走的是后一条路,它把这条路的规模做大了两个数量级,再补上最关键的一块拼图:动作条件化。
阶段一:动作无关的自监督预训练
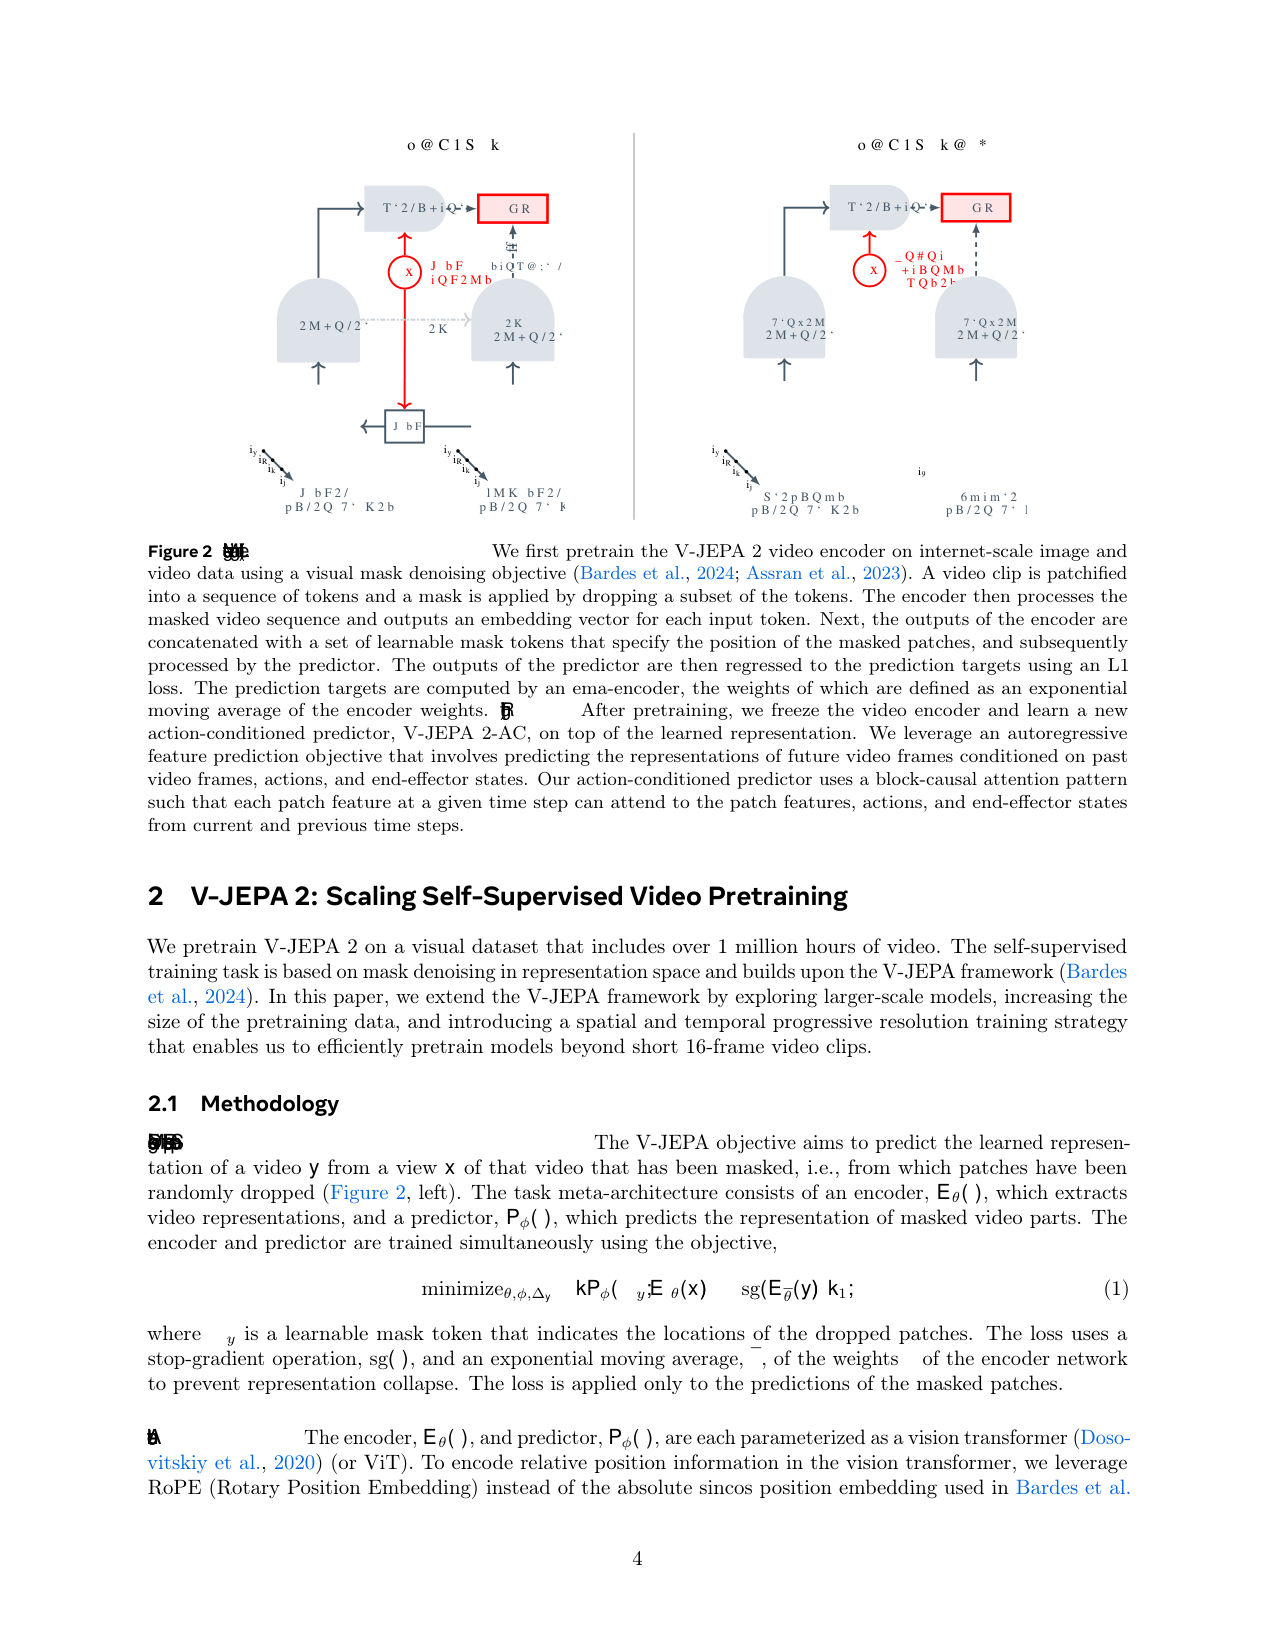
预训练目标是「表征空间掩码去噪」:把视频切成 2×16×16 的 tubelet patch token,随机丢弃一部分,编码器只处理可见 token,预测器用可学习 mask token 定位被掩位置,去回归 EMA 教师编码器对掩码 patch 的表征。
对应的目标函数是
minimize_{θ,ϕ,Δ_y} ‖ P_ϕ(Δ_y; E_θ(x)) − sg(E_θ̄(y)) ‖₁
这个式子回答的问题是「预测什么才算学会了视频」。符号逐项解释:E_θ 是学生编码器,处理被掩码的视图 x;P_ϕ 是预测器,输入可学习 mask token Δ_y(它标记被丢 patch 的位置)和可见 token 的表征,输出对掩码 patch 的预测;E_θ̄ 是教师编码器,处理完整视频 y,权重 θ̄ 是学生权重 θ 的指数滑动平均(EMA);sg 是 stop-gradient,让教师侧不回传梯度;损失取 L1,且只作用在被掩 patch 上。EMA + stop-gradient 的作用是防止表征坍缩:没有它们,网络会学到把所有输入都编码成同一个常数。
规模上,论文报告了四个叠加的配方,全部用 6 个分类任务(SSv2、Diving-48、Jester 三个动作类 + Kinetics-400、COIN、ImageNet 三个外观类)的冻结探针平均准确率衡量,基线是 200 万视频的 VideoMix2M 上训练的 ViT-L/16,得分 84.2%:数据从 200 万扩到 2200 万(VideoMix22M,含 SSv2、Kinetics、HowTo100M、YT1B 与 ImageNet,总计超过 100 万小时)加 1.0 分;模型从 3 亿扩到 10 亿参数加 1.5 分;训练从 9 万迭代加长到 25.2 万迭代加 0.8 分;分辨率从 256² 提到 384²、时长从 16 帧提到 64 帧,再加 0.7 分。累计 4.0 分,把平均准确率推到 88.2%。其中数据 curation 单独也值 1.4 分:YT1B 有约 140 万小时且未筛选,论文用检索式聚类把它的分布对齐到 Kinetics、SSv2、COIN、EpicKitchen 的目标分布,过滤掉卡通等噪声内容。
这组实验里一个重要的工程技巧是渐进式分辨率训练:全分辨率直接训练 64 帧 384² 的 ViT-g 约需 60 GPU-years,论文改用 warmup(1.2 万迭代,16 帧 256²)— 常数(22.8 万迭代)— cooldown(1.2 万迭代,期间升到 64 帧 384²)三段式调度,把成本压到约七分之一(8.4 倍加速),性能保持。3D-RoPE 位置编码(把特征维分成时间、高、宽三段分别旋转)替代绝对位置编码,是稳定 10 亿参数训练的关键细节。
阶段二:动作条件化的潜空间世界模型 V-JEPA 2-AC
预训练模型能补全视频缺失部分,但不知道动作对未来的因果影响。V-JEPA 2-AC 要解决的就是这个问题:把「给定动作,未来表征往哪走」学出来。做法分三步。第一步,编码器冻结,逐帧独立编码 Droid 视频片段,得到 16×16×1408 的特征图序列 z_k = E(x_k)。第二步,把动作 a_k(7 维,相邻帧末端执行器状态的差分:3 位置 + 3 朝向 + 1 夹爪)、末端状态 s_k(7 维,相对基座的位置、欧拉角与夹爪开合)与帧表征 z_k 按时间交错成 (a_k; s_k; z_k) 序列,喂给 24 层 block-causal transformer 预测器(16 头、hidden 1024、约 3 亿参数)。block-causal 意味着当前时刻的 patch 只能注意同时刻与更早时刻的信息,保证因果。第三步,用两段损失训练。
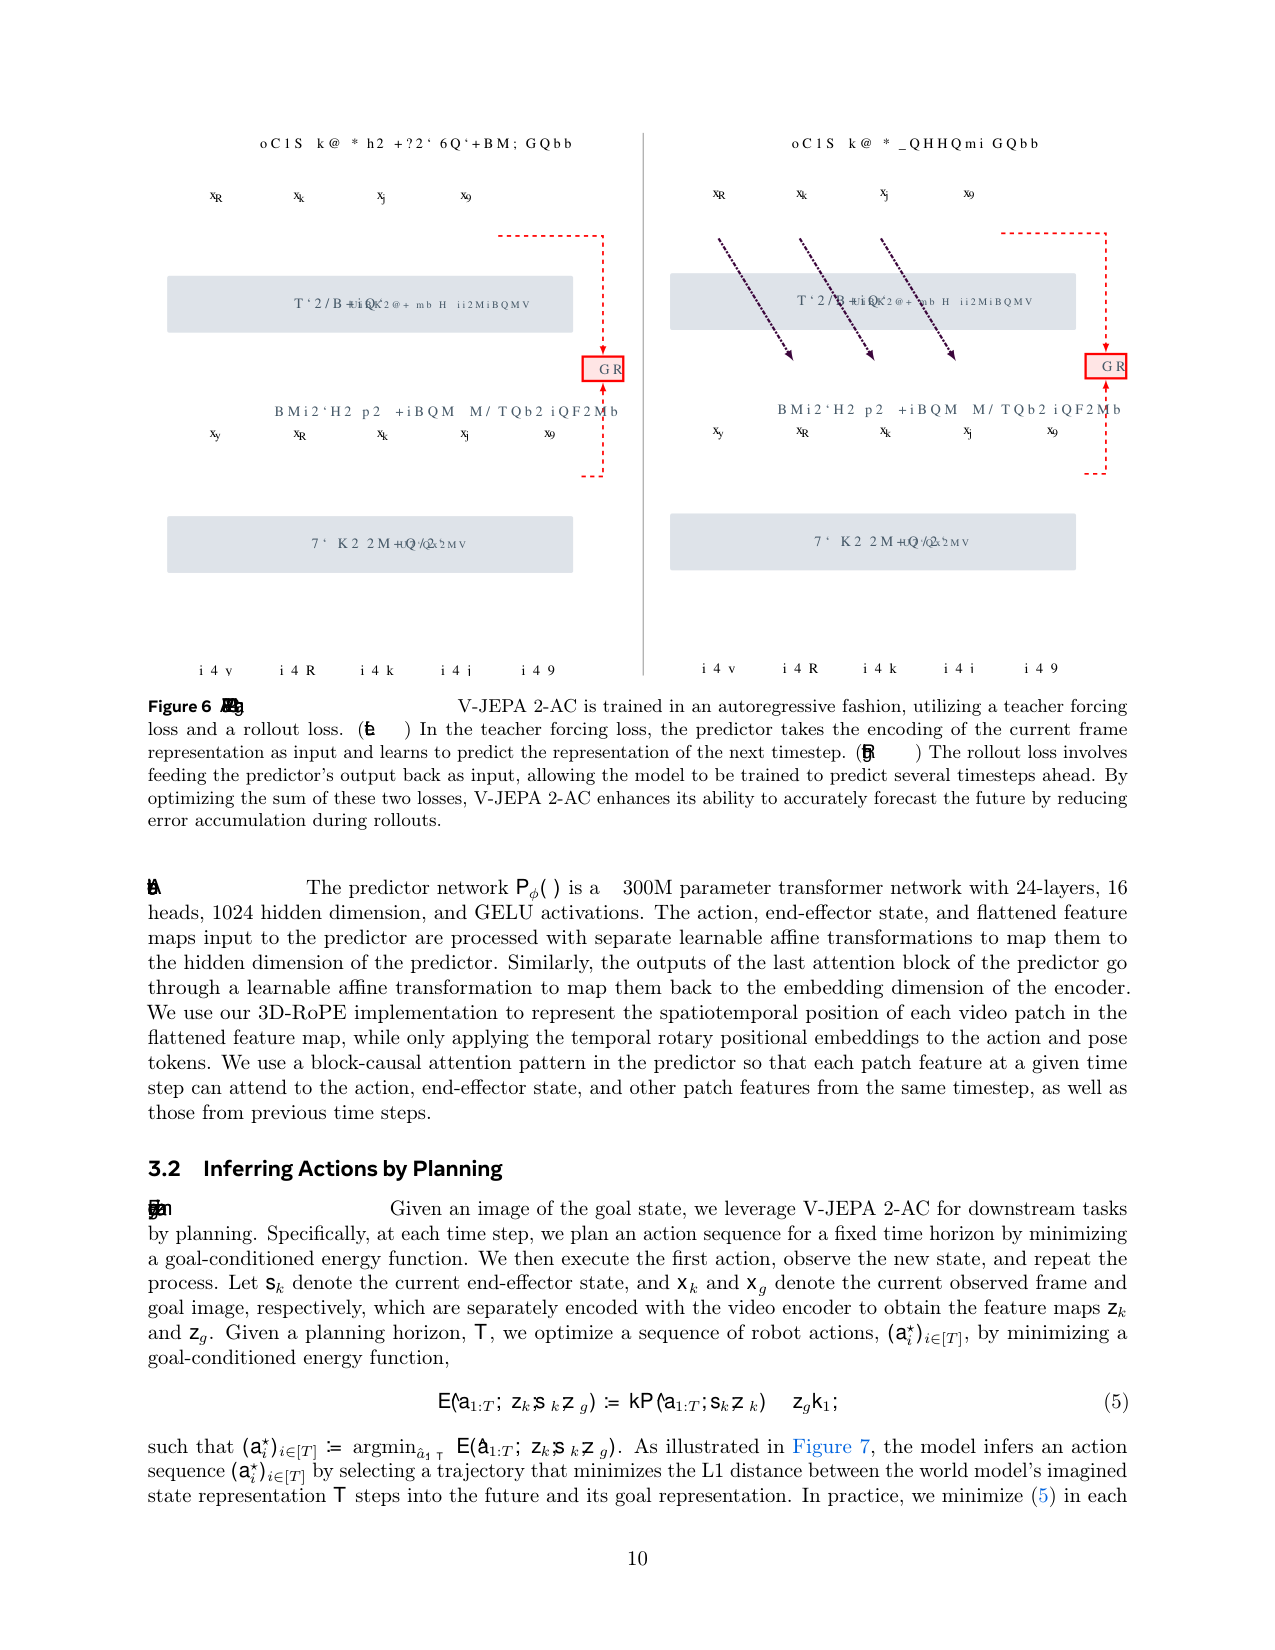
teacher-forcing 损失回答「单步预测准不准」:
L_teacher-forcing(ϕ) = (1/T) Σ_{k=1..T} ‖ ẑ_{k+1} − z_{k+1} ‖₁ = (1/T) Σ_{k=1..T} ‖ P_ϕ((a_t, s_t, E(x_t))_{t≤k}) − E(x_{k+1}) ‖₁
逐符号解释:T=15(16 帧片段产生 15 步预测);ẑ_{k+1} 是预测器用截至第 k 帧的动作、状态、表征预测出的第 k+1 帧表征;z_{k+1} = E(x_{k+1}) 是冻结编码器对真实下一帧的编码,当监督;L1 距离逐元素求和取平均。这个损失让每一步预测都贴着真实表征走。
光有 teacher-forcing 还不够:推理时模型要拿自己的输出当输入,误差会一路累积。所以加了 rollout 损失,回答「自己滚起来稳不稳」:
L_rollout(ϕ) = ‖ P_ϕ(a_{1:T}; s_1, z_1) − z_{T+1} ‖₁
这里 P_ϕ(a_{1:T}; s_1, z_1) 表示把动作序列 a_1..a_T 全部喂进去、让模型自回归滚 T 步得到的最终表征;实际实现 T=2,只反传一个循环步,控制梯度复杂度。总损失是两者之和:L(ϕ) = L_teacher-forcing(ϕ) + L_rollout(ϕ)。两个损失一起训练,模型既会单步贴紧真实表征,又能在自回归滚动时少漂移。
训练数据只有约 62 小时、约 2.3 万条 Droid 轨迹,且全部无标注:没有奖励、没有任务标签、不知道演示成功还是失败,只用原始视频加末端执行器状态。这正是论文想强调的:互联网视频预训练承担了绝大部分表征学习,机器人阶段只需要极少交互数据。
规划:目标图像 + CEM 的闭环 MPC
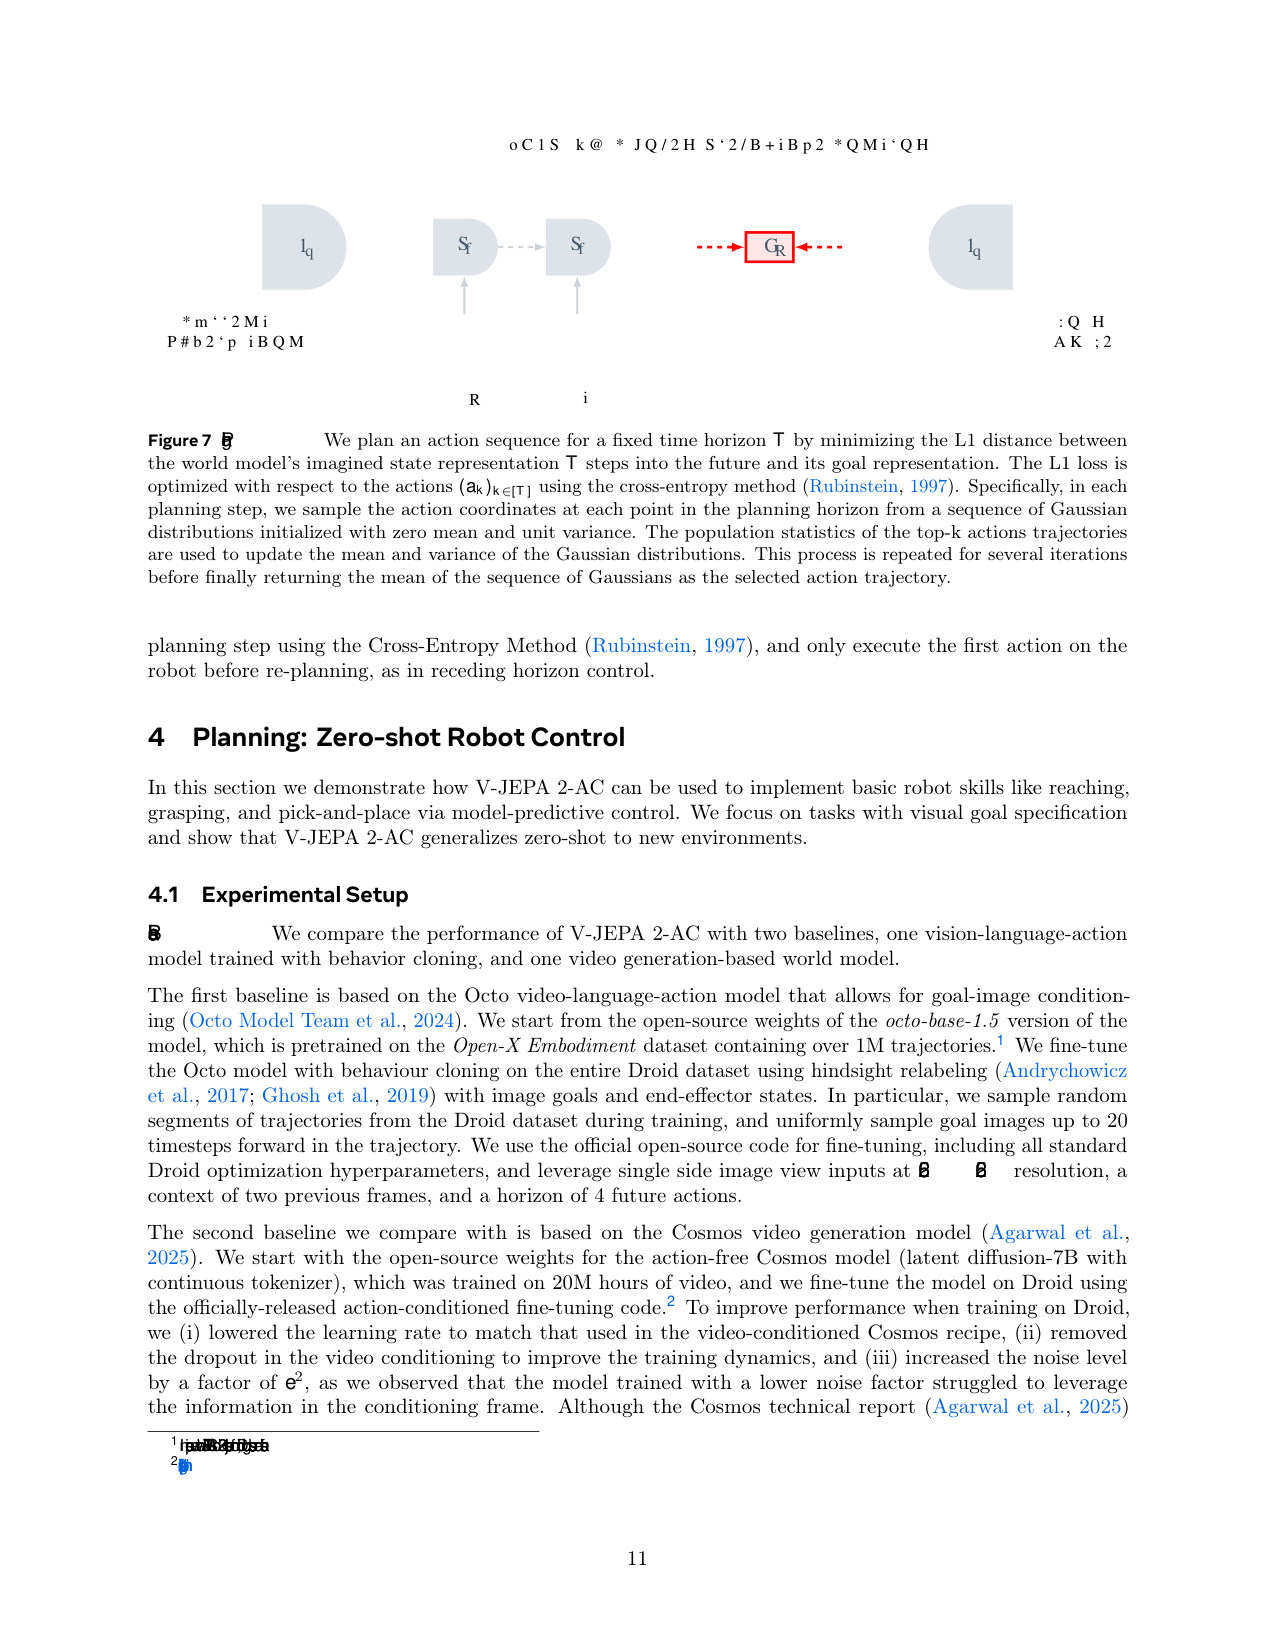
有了世界模型,怎么把「到达目标图像」翻译成动作?论文沿用经典的能量最小化框架。给定当前帧表征 z_k、末端状态 s_k 和目标图像编码 z_g,规划一个 horizon T 的动作序列,使能量最小:
E(â_{1:T}; z_k, s_k, z_g) = ‖ P_ϕ(â_{1:T}; s_k, z_k) − z_g ‖₁
这个式子回答「哪条动作轨迹会让想象出来的未来离目标最近」。符号逐项解释:â_{1:T} 是候选动作序列;P_ϕ(â_{1:T}; s_k, z_k) 是世界模型想象 T 步后的未来表征;z_g = E(x_g) 是目标图像经同一冻结编码器得到的表征;L1 距离衡量两者差距。最小化用交叉熵方法(CEM)完成:从 N(0,1) 高斯分布采样一批候选动作轨迹,把能量最低的 top-k 当作精英,用精英更新高斯均值和方差,迭代 10 轮,最后取高斯均值作为要执行的动作。实际配置是 800 个样本、10 轮迭代、horizon 1,动作限制在半径 0.075 的 L1 球内(单步最大距离下降 0.13),执行第一步后重新规划,即 receding horizon 控制。
抓放任务用 3 张子目标图像分段切换:先以「物体被抓持」为目标规划 4 步,再以「物体接近目标位」规划 10 步,最后以「物体放到位」规划 4 步。这暴露出一个诚实的边界:长时程无子目标的规划还做不了,后面局限里细说。
关键实验
理解:6 任务冻结探针评测里,V-JEPA 2 ViT-g 平均 87.5%,超过 V-JEPA ViT-H 的 85.2%、InternVideo2s2-1B 的 87.0%、DINOv2 的 81.1%、SigLIP2 的 81.1% 与 PECoreG 的 82.3%;动作类任务优势最明显,SSv2 上 75.3% 对 InternVideo 的 69.7% 和 PECoreG 的 55.4%。升到 384² 分辨率、64 帧的 ViT-g384 平均到 88.2%,SSv2 77.3%。需要说明的是,各 baseline 编码器的预训练数据不同(DINOv2 用 LVD-142M、PE 用 MetaCLIP),论文只能做系统级比较。
预测:EK100 动作预测,mean-class recall@5,上下文在动作开始前 1 秒截断。V-JEPA 2 ViT-g384 拿到 39.7,比此前最强的 PlausiVL(8B 参数)27.6 高 12.1 分、约 44% 相对提升,而且 3 亿参数的 ViT-L 就有 32.7,已经超过所有专门做该任务的 baseline;recall@5 随模型规模从 32.7(ViT-L)线性升到 39.7(ViT-g384)。
规划:两台不同实验室的 Franka + RobotiQ 机械臂、每任务 10 次试验、随机物体位置与起始位姿,全程零样本(部署环境无任何数据)。V-JEPA 2-AC 平均成功率:reach 100%、抓杯 65%、抓盒 25%、持物前进杯 75%/盒 75%、抓放杯 80%/盒 65%;对照 Octo(Open-X 上预训练、全量 Droid 行为克隆微调)对应是 100%、15%、0%、15%/70%、15%/10%。与扩散式世界模型 Cosmos(潜扩散 7B、2000 万小时视频预训练)的对比更直接:同样 CEM + 目标图像规划、同一张 RTX 4090,Cosmos 80 样本要 4 分钟一个动作,reach 80% 但抓杯 0%、抓盒 20%、抓放全 0%;V-JEPA 2-AC 用 10 倍样本(800)只要 16 秒一个动作,各任务成功率全面更高。
鲁棒性(干扰、分布偏移):论文做了两组值得注意的方法论测试。一组是相机位置扰动:把相机从机器人基座方向顺时针扫到左侧(约 35°–85°),采集 201 步随机运动轨迹,对每对相邻帧用 1 步 rollout 推断最优动作,再解最小二乘 W* 把推断动作映射到真实动作。结果是 W* 条件数约 1.5(说明它近似一个旋转矩阵),平均绝对误差约 1.6 cm(对照真实单步位移约 5 cm,属于系统性误差),且推断坐标轴的旋转误差随相机角度近似线性增长。含义很明确:模型在隐式地从单目 RGB 推断动作坐标轴,相机一偏,动作方向就系统性偏转,所以论文部署前要手动试相机位置、全程未做标定。另一组是分布偏移:零样本部署到两个新实验室本身就是最严格的分布偏移测试——不同环境、不同桌面、杂乱场景、未见过的物体摆放,模型全都没见过。此外,解码可视化里的夹爪开合消融可以看作物理扰动测试:同样的动作序列,夹爪闭合时杯子跟着手臂移动,夹爪张开时杯子保持不动(物体恒常性、重力),说明世界模型学到了动作-物理后果的对应关系。
谱系定位
这条技术路线的主线是 JEPA 家族:I-JEPA 证明图像上预测表征可行,V-JEPA 把它搬到视频,V-JEPA 2 把规模推上去并首次给出「动作条件化 + 真实机器人 MPC」的完整闭环。与之对照的三条线:扩散式视频生成世界模型(Diffusion Forcing 是最有代表性的一个:逐 token 变噪声水平、自回归生成视频且自带误差修正),输出像素、能表达多模态未来,但单步规划成本高到做不了闭环;行为克隆 VLA(Octo、π0 一系),直接回归动作、推理快,但要专家轨迹、只用成功示范,没有推理时规划;以及强化学习世界模型(Dreamer 一系),要环境交互与奖励,规模受限。V-JEPA 2-AC 的选择是:预测目标在表征空间、单步是确定性回归,换取 16 秒/动作的规划延迟,把 MPC 变成真实机械臂上能跑的东西;代价是丢掉了扩散模型的多模态未来表达与逐 token 误差修正。VidQA 部分它还有一个额外贡献:第一次用完全没有语言监督的视频编码器做 MLLM 主干,18M 对齐数据、Qwen2-7B 的冻结对比里平均 52.3,高于 PE 49.1、SigLIP2 48.1、DINOv2 45.7;扩到 88.5M 数据、Llama 3.1 8B 后平均 59.5,在 PerceptionTest(84.0 vs 82.7)、MVP、TempCompass、TemporalBench、TOMATO 五个基准上超过 PerceptionLM 8B,但 TVBench、MVBench 落后。
局限
论文自承的局限和我们的读法合在一起至少六条。第一,相机位置敏感:无标定、隐式推断动作坐标轴,相机角度一变旋转误差近似线性增长,部署要先手动挑相机位置。第二,长时程规划:自回归误差累积加搜索空间指数增长,预测只覆盖约 16 秒,抓放要拆子目标。第三,目标表达单一:只接受图像目标,语言指令没有支持。第四,EK100 评估面窄:厨房 + 固定词表,预测时距从 1 秒拉到 10 秒性能快速下降,词表外动作无法泛化。第五,对比公平性:baseline 预训练数据各不相同,只能系统级比较;VidQA 的 TVBench、MVBench 仍低于 PerceptionLM。第六,我们的读法:JEPA 主动丢弃不可预测细节,对亚厘米级精确控制可能信息不足(相机误差约 1.6 cm 提示了天花板),且编码器只到 1B 参数,20B 级收益尚无证据。
复现
代码官方开源在 facebookresearch/vjepa2,预训练数据全部来自公开数据源(SSv2、Kinetics、HowTo100M、YT1B、ImageNet、Droid),理论上可复现;全分辨率 64 帧 384² 训练约 60 GPU-years 是主要门槛,渐进式训练可压到约七分之一;机器人规划阶段单卡 RTX 4090 即可。
用超过 100 万小时互联网视频做动作无关的自监督预训练(掩码去噪的联合嵌入预测架构 JEPA),随后冻结编码器、用不到 62 小时无标注 Droid 机器人视频训练潜空间动作条件自回归世界模型 V-JEPA 2-AC,在模型预测控制闭环里用目标图像引导的规划完成零样本抓取与抓放;同一编码器在动作理解(SSv2 77.3%)、动作预测(EK100 recall@5 39.7)与视频问答(PerceptionTest 84.0)上也达到当时最强水平。
阅读提示
精读深度:精读
清单提示:原文提示:理解「潜空间自回归预测 + 动作条件化」与扩散式世界模型(Diffusion Forcing)的对比;注意其鲁棒性测试(干扰、分布偏移)方法论。
问题
要解决什么:从观察中学习能理解、预测并在物理世界行动的世界模型:先用互联网规模的视频(动作无关)学通用视觉表征与动力学,再用少量交互数据把它变成动作条件化的潜空间世界模型,最后通过 MPC 规划在真实机器人上完成目标图像引导的任务,全程不依赖部署环境的任何数据、任务标签或奖励。
为什么 prior work 不够:像素级视频生成式世界模型(Genie、UniSim、Cosmos 等)能生成看起来合理的未来帧,但多数只评估视觉质量、没有闭环控制机器人,且单步规划要跑昂贵的扩散采样;从交互数据学习的任务专用世界模型需要部署环境的交互数据,难以迁移;行为克隆的 VLA 策略(Octo、π0 等)需要高质量专家轨迹、只用成功示范,推理时没有显式规划。JEPA 路线把预测目标放在表征空间而非像素,只预测场景中可预测的结构,从而让理解、预测、规划共享同一套表征。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 视频片段 (x_k)_{k=1..16} | video | 动作条件阶段:4 秒、4 fps、256×256 的 16 帧 Droid 视频片段(随机缩放裁剪增广,长宽比 0.75–1.35);预训练阶段:16–64 帧、256²–384² 的互联网视频与图像 |
| 末端执行器状态 (s_k) | proprioception | 7 维实值向量,相对机器人基座:前 3 维笛卡尔位置、中 3 维外部欧拉角朝向、最后 1 维夹爪开合状态 |
| 动作序列 (a_k)_{k=1..15} | control action | 7 维向量,由相邻两帧末端执行器状态差分得到(位置差 + 朝向差 + 夹爪差) |
| 目标图像 x_g(规划时) | goal image | 期望状态的单帧图像,用冻结编码器 E 编码为 z_g 作为规划目标;抓放任务使用 3 张子目标图像分 4+10+4 步切换 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 下一帧表征预测 ẑ_{k+1} = P_ϕ((a_t, s_t, E(x_t))_{t≤k}) | latent feature map | 与编码器输出同形状(16×16×1408)的潜表征预测,L1 回归到冻结编码器对真实下一帧的编码 z_{k+1} |
| 动作序列 â_{1:T}(规划时) | action plan | CEM 在动作空间采样使能量函数 E=||P_ϕ(â_1:T; s_k, z_k) − z_g||_1 最小的最优动作序列;只执行第一个动作后重新规划(receding horizon) |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| VideoMix22M(VM22M,预训练) | 22M 样本 / 超过 100 万小时视频 + 100 万张图像 | SSv2 168K(权重 0.056)、Kinetics 733K(0.188)、HowTo100M 1.1M(0.318)、YT1B 19M(0.188,检索式筛选)、ImageNet 100 万张图(0.250);全部公开数据源;curation 相对未筛选 YT1B 平均 +1.4 分 |
| Droid(V-JEPA 2-AC 后训练) | 约 62 小时 / 约 2.3 万条轨迹(含成功与失败) | 7-DoF Franka Panda + 两指夹爪的桌面遥操作数据;只使用原始视频 + 末端执行器状态,无奖励、无任务标签、无成败标注;丢弃短于 4 秒的片段 |
| EK100(动作预测) | 100 小时 / 45 个厨房环境 / 3568 个动作标签(97 动词 + 300 名词) | mean-class recall@5,默认 1 秒预测时距 |
| 6 任务分类探针(理解) | SSv2、Diving-48、Jester(动作类)+ Kinetics-400、COIN、ImageNet(外观类) | 冻结编码器 + 4 层 attentive probe;V-JEPA 2 ViT-g384 用 384² 分辨率与 64 帧 |
| VidQA 对齐数据 | 88.5M 图像/视频-文本对(受控对比用 18M 子集) | 与 PerceptionLM 同源配方;冻结编码器对比时统一用 Qwen2-7B-Instruct,缩放实验用 Llama 3.1 8B |
架构(摘要)
主干与结构
backbone:编码器 E:ViT(300M ViT-L – 1B ViT-g),tubelet 2×16×16 patchify,3D-RoPE(特征维分三段分别做时间/高/宽旋转编码),多块掩码;V-JEPA 2-AC 预测器 P_ϕ:24 层 transformer、16 头、hidden 1024、GELU、约 300M 参数
参数:编码器 300M(ViT-L)– 1B(ViT-g);预测器约 300M;MLLM 阶段 LLM 为 Qwen2-7B / Llama 3.1 8B
类型:两阶段:动作无关的自监督视频预训练(JEPA 掩码去噪)+ 动作条件化潜空间自回归世界模型(V-JEPA 2-AC);规划阶段外加 MPC 闭环
关键组件
- 掩码去噪目标:随机丢弃一部分视频 patch,编码器只处理可见 patch,预测器用可学习 mask token 定位被掩位置并回归 EMA 教师编码器的表征,L1 损失只作用于掩码 patch,stop-gradient + EMA 防表征坍缩
- V-JEPA 2-AC 输入拼接:(a_k; s_k; z_k) 按时间交错,动作/状态/展平特征图分别用可学习仿射变换投影到预测器 hidden 维
- block-causal attention:当前时刻的 patch 可注意同时刻与更早时刻的 patch、动作、末端状态,保证因果性
- 两段式损失:teacher-forcing(T=15,逐帧预测下一帧表征)+ rollout(T=2,把预测输出当输入回环,只反传一个循环步)
- 规划:CEM(800 样本 × 10 轮迭代,horizon 1,动作限制在半径 0.075 的 L1 球内),目标条件能量 E=||P_ϕ(â_1:T; s_k, z_k) − z_g||_1
- LLM 对齐:LLaVA 式三阶段视觉指令微调(投影器图像字幕 → 全模型图像 QA → 视频字幕+QA),ViT-g384 每帧 288 个视觉 token
为什么这样设计
预测目标选在表征空间而非像素,让模型只学习场景中可预测的结构(物体轨迹、形状恒常),把注意力留给对控制有用的信息;冻结编码器使 62 小时的小数据量后训练不会破坏互联网视频学到的通用表征;teacher-forcing 保证逐帧准确、rollout 损失压低推理时误差累积;block-causal attention 保证规划时只用过去与当前信息。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| SSv2 top-1 准确率(动作理解) | 77.3%(V-JEPA 2 ViT-g384) | 同协议下 InternVideo2s2-1B 69.7%、PECoreG 55.4%;上一代 V-JEPA ViT-H 74.3%(256² 协议) | 冻结编码器 + 4 层 attentive probe,384² 分辨率、64 帧 × 2 时间裁剪 × 3 空间裁剪 |
| 6 任务(3 动作 + 3 外观)平均准确率 | 87.5%(ViT-g)/ 88.2%(ViT-g384) | V-JEPA ViT-H 85.2%、InternVideo2s2-1B 87.0%、DINOv2 81.1%、SigLIP2 81.1%、PECoreG 82.3% | SSv2/Diving-48/Jester/K400/COIN/ImageNet,冻结编码器 + attentive probe;baseline 编码器预训练数据不同,只能做系统级比较 |
| EK100 动作预测 mean-class recall@5 | 39.7(V-JEPA 2 ViT-g384) | 此前最强 PlausiVL 8B 27.6(+12.1,约 +44% 相对提升);InAViT 160M 25.8、Video-LaMA 7B 26.0 | 上下文在动作开始前 1 秒截断,32 帧 @ 8fps @ 384²,attentive probe 三 query token(动词/名词/动作)各自分类 + focal loss |
| 机器人零样本抓放成功率(10 次试验平均) | 抓杯 65%、抓盒 25%、抓放杯 80%、抓放盒 65%;reach 100% | Octo(Open-X 预训练 + Droid 行为克隆微调):抓杯 15%、抓盒 0%、抓放杯 15%、抓放盒 10%、reach 100% | 两台不同实验室的 Franka + RobotiQ 夹爪,零样本部署(部署环境无任何数据),图像目标 + MPC,每任务 10 次试验、随机物体位置与起始位姿 |
| MPC 单步规划延迟 | 16 秒/动作(V-JEPA 2-AC,800 样本 × 10 迭代,horizon 1) | Cosmos 潜扩散世界模型 4 分钟/动作(80 样本 × 10 迭代,horizon 1),Lab2 上 reach 80% 但抓杯 0%、抓盒 20%、抓放 0%/0% | 同一台 NVIDIA RTX 4090,同为 CEM + 目标图像编码进模型潜空间;V-JEPA 2-AC 样本数是 Cosmos 的 10 倍 |
| VidQA(8B 级模型) | PerceptionTest 84.0、TempCompass 76.9、MVP 44.5、TemporalBench 36.7、TOMATO 40.3;平均 59.5 | PerceptionLM 8B:82.7、72.7、39.7、28.3、32.0、平均 56.7;TVBench 60.6 vs 63.5、MVBench 73.5 vs 77.1 落后 | V-JEPA 2 ViT-g384 + Llama 3.1 8B,88.5M 图像/视频-文本对齐样本,PerceptionTest 为 SFT 后测试集、其余 zero-shot |
| 四个 scaling 配方的累计收益 | +1.0(数据)+1.5(模型)+0.8(训练)+0.7(分辨率/时长)= +4.0,84.2%→88.2% | 基线 ViT-L/16 在 2M 视频的 VideoMix2M 上 6 任务平均 84.2% | 6 分类任务冻结探针平均;模型 300M→1B、训练 90K→252K 迭代、256²/16 帧→384²/64 帧 |
Insights
- 预测目标放哪决定了世界模型能干什么:JEPA 在表征空间回归『可预测结构』,避开了像素重建对不可预测纹理的算力浪费,所以同一套表征能同时做理解、预测、规划(6 任务平均 87.5% 时机器人任务仍可用同一编码器)。
- 四件套 scaling 每个都独立贡献正收益:数据 +1.0、模型 +1.5、训练 +0.8、分辨率/时长 +0.7(84.2→88.2),说明视频自监督预训练的收益来自数据、模型、算力、输入规格四者的合力,渐进式训练把 60 GPU-years 的需求压到约 1/8.4。
- 小数据 + 冻结编码器足够迁移出控制能力:只用 62 小时无标注 Droid 视频(含失败轨迹、无奖励无任务标签),V-JEPA 2-AC 在陌生实验室零样本达到抓杯 65%、抓放 80% 的成功率,说明互联网视频预训练替机器人阶段承担了大部分表征学习。
- 世界模型做 MPC 的可行性由单步规划延迟决定:V-JEPA 2-AC 16 秒/动作、Cosmos 4 分钟/动作(同为单卡 4090、horizon 1),延迟差一个数量级直接决定闭环能否跑起来;扩散式世界模型若想用于真实 MPC,必须解决推理成本。
- 无语言监督的编码器可以作为 MLLM 视觉主干:ViT-g512 冻结对比平均 52.3,高于 PE 49.1、SigLIP2 48.1、DINOv2 45.7(同 LLM 同数据),且扩数据后 VidQA 平均 59.5 超过 PerceptionLM 8B 的 56.7,动摇了『语言监督是视频编码器必须品』的假设。
vs 同类工作
- vs V-JEPA(Bardes 2024):数据 2M→22M、模型 300M→1B、训练 90K→252K 迭代、分辨率/时长 256²/16 帧→384²/64 帧;SSv2 从 74.3% 升到 77.3%(g384),ImageNet 从 80.0% 升到 84.6%。
- vs 视频生成式世界模型(Genie/UniSim/Cosmos/Diffusion Forcing 一系):预测目标在表征空间而非像素,单步是确定性回归而非扩散采样;Cosmos 在真实闭环里 reach 80% 但抓取/抓放接近 0%,且单步规划 4 分钟;本文同评测里成功率更高且 16 秒/动作。
- vs 行为克隆 VLA(Octo/π0 一系):无需专家轨迹、可吸收失败数据、推理时显式规划;Octo 用 100 万+ 轨迹预训练 + 全量 Droid 微调,抓杯仍只有 15%,低于 V-JEPA 2-AC 的 65%。
- vs I-JEPA/V-JEPA 的技术细节:3D-RoPE 替代绝对位置编码稳定大模型训练;warmup-constant-cooldown 调度替代 EMA/weight decay ramp-up,简化配方且多 checkpoint 可复用。
局限
- 相机位置敏感(论文自承并定量):模型从单目 RGB 隐式推断动作坐标轴、无相机标定;相机角度从约 35° 扫到 85°,推断坐标轴旋转误差近似线性增长,平均绝对误差约 1.6 cm(对照真实单步位移约 5 cm,属于系统性误差);论文因此部署前要手动试相机位置,且未用任何标定。
- 长时程规划受限(论文自承):自回归滚动误差累积 + 动作轨迹搜索空间随 horizon 指数增长;预测能力只覆盖约 16 秒,抓放必须拆成 3 张子目标图,无子目标的端到端长任务仍做不了。
- 目标表达单一(论文自承):只能接受图像目标,野外部署更自然的语言指令没有支持;语言目标嵌入潜空间留作未来工作。
- EK100 泛化未知(论文自承):厨房场景 + 固定动词/名词词表,无法覆盖训练词表外的动作;预测时距从 1 秒拉长到 10 秒 recall@5 快速下降。
- 对比公平性受限(我们的读法):baseline 编码器预训练数据互不相同(DINOv2 用 LVD-142M、PE 用 MetaCLIP),论文只能做系统级比较;VidQA 里 TVBench 60.6、MVBench 73.5 仍低于 PerceptionLM 的 63.5、77.1。
- 表征丢弃不可预测细节(我们的读法):JEPA 主动忽略纹理等不可预测像素,对需要亚厘米级精确控制的场景可能信息不足;相机误差约 1.6 cm 的平均绝对值也提示精细控制存在天花板,且编码器只到 1B 参数,未见 20B 级视频编码器的收益证据。
可复现性
- code:https://github.com/facebookresearch/vjepa2(官方开源)
- weights:文中未明确列出预训练权重下载地址;博客与仓库为官方入口
- setup:预训练数据全部来自公开数据源(SSv2/Kinetics/HowTo100M/YT1B/ImageNet/Droid),便于复现;全分辨率 64 帧 384² ViT-g 约需 60 GPU-years,渐进式训练降至约 1/8.4;机器人规划单卡 RTX 4090 即可
- note:本批次任务限定只写 card.json/card.md/podcast.md/figures,未产出 source.pdf 副本
主干与结构
backbone:编码器 E:ViT(300M ViT-L – 1B ViT-g),tubelet 2×16×16 patchify,3D-RoPE(特征维分三段分别做时间/高/宽旋转编码),多块掩码;V-JEPA 2-AC 预测器 P_ϕ:24 层 transformer、16 头、hidden 1024、GELU、约 300M 参数
参数:编码器 300M(ViT-L)– 1B(ViT-g);预测器约 300M;MLLM 阶段 LLM 为 Qwen2-7B / Llama 3.1 8B
类型:两阶段:动作无关的自监督视频预训练(JEPA 掩码去噪)+ 动作条件化潜空间自回归世界模型(V-JEPA 2-AC);规划阶段外加 MPC 闭环
关键组件
- 掩码去噪目标:随机丢弃一部分视频 patch,编码器只处理可见 patch,预测器用可学习 mask token 定位被掩位置并回归 EMA 教师编码器的表征,L1 损失只作用于掩码 patch,stop-gradient + EMA 防表征坍缩
- V-JEPA 2-AC 输入拼接:(a_k; s_k; z_k) 按时间交错,动作/状态/展平特征图分别用可学习仿射变换投影到预测器 hidden 维
- block-causal attention:当前时刻的 patch 可注意同时刻与更早时刻的 patch、动作、末端状态,保证因果性
- 两段式损失:teacher-forcing(T=15,逐帧预测下一帧表征)+ rollout(T=2,把预测输出当输入回环,只反传一个循环步)
- 规划:CEM(800 样本 × 10 轮迭代,horizon 1,动作限制在半径 0.075 的 L1 球内),目标条件能量 E=||P_ϕ(â_1:T; s_k, z_k) − z_g||_1
- LLM 对齐:LLaVA 式三阶段视觉指令微调(投影器图像字幕 → 全模型图像 QA → 视频字幕+QA),ViT-g384 每帧 288 个视觉 token
为什么这样设计
预测目标选在表征空间而非像素,让模型只学习场景中可预测的结构(物体轨迹、形状恒常),把注意力留给对控制有用的信息;冻结编码器使 62 小时的小数据量后训练不会破坏互联网视频学到的通用表征;teacher-forcing 保证逐帧准确、rollout 损失压低推理时误差累积;block-causal attention 保证规划时只用过去与当前信息。
两阶段训练:掩码去噪预训练 + 动作条件世界模型
原文 caption:Figure 2 Multistage training. (Left) We first pretrain the V-JEPA 2 video encoder on internet-scale image and video data using a visual mask denoising objective. ... (Right) After pretraining, we freeze the video encoder and learn a new action-conditioned predictor, V-JEPA 2-AC, on top of the learned representation. ... Our action-conditioned predictor uses a block-causal attention pattern ...
一张图概括整篇论文的结构。左半边是预训练:视频被切成 patch token、随机丢一部分,编码器只看可见 token,预测器配合可学习 mask token 回归 EMA 教师编码器对掩码 patch 的表征。右半边是后训练:冻结编码器,预测器接收 (动作、末端状态、当前帧表征) 交错序列,用 block-causal attention 预测未来帧表征。读图重点在『预测发生在表征空间』:左右两侧预测的都是 z 而不是像素,这正是与扩散式视频生成的根本分界。
V-JEPA 2-AC 训练:teacher-forcing + rollout 双损失
原文 caption:Figure 6 V-JEPA 2-AC training. V-JEPA 2-AC is trained in an autoregressive fashion, utilizing a teacher forcing loss and a rollout loss. (Left) In the teacher forcing loss, the predictor takes the encoding of the current frame representation as input and learns to predict the representation of the next timestep. (Right) The rollout loss involves feeding the predictor's output back as input, allowing the model to be trained to predict several timesteps ahead.
展示动作条件自回归预测的具体训练方式。左图 teacher-forcing:每个时间步都用真实的下一帧编码 z_{k+1} 当监督(T=15),让模型先学会单步预测准;右图 rollout:把预测的 ẑ 当输入再预测一步(T=2),模型提前适应推理时『用自己的输出当输入』的循环,压低误差累积。这张图对应 podcast 里『潜空间自回归预测 + 动作条件化』的核心机制。
目标条件规划:CEM 最小化想象表征与目标表征的距离
原文 caption:Figure 7 Planing. We plan an action sequence for a fixed time horizon T by minimizing the L1 distance between the world model's imagined state representation T steps into the future and its goal representation. The L1 loss is optimized with respect to the actions using the cross-entropy method.
规划阶段的完整闭环。给定当前帧表征 z_k、末端状态 s_k 和目标图像表征 z_g,模型用 CEM 在动作空间采样一批候选动作轨迹,把每条轨迹『想象』出来的未来表征和 z_g 比 L1 距离,用 top-k 精英样本更新高斯分布的均值方差,迭代多轮后取均值作为要执行的动作,执行第一步后重新规划。关键点:规划全程只需要预测器的一次前向,所以单步规划只要 16 秒,这是它比视频生成式世界模型快一个量级的原因。
相机位置敏感性:推断动作坐标轴的旋转误差
原文 caption:Figure 16 Sensitivity to camera position. Rotation error (in the x-y plane) of the action coordinate axis inferred by V-JEPA 2-AC as a function of camera position, with 0 degrees corresponding to a camera located at the robot base, and 90 degrees corresponding to a camera located left of the robot base.
鲁棒性测试的核心图:把相机从机器人基座方向顺时针扫到左侧(约 35°–85°),用 201 步随机轨迹收集『真实动作 vs 模型推断动作』配对,最小二乘解出变换矩阵 W*,其条件数约 1.5(说明 W* 近似旋转矩阵),从而算出推断坐标轴的旋转误差。结论是旋转误差随相机角度近似线性增长——模型从单目 RGB 隐式推断动作坐标轴,相机一偏就会系统性偏转动作方向,论文因此要在部署前手动试相机位置,且全程未做任何标定。
🎧 音频版
时长 34:23 · Edge TTS
V-JEPA 2:在表征空间里做世界模型,机器人只要 62 小时视频(对话版·深度版)
先讲清楚这篇要解决什么问题
小播:老播,这期要聊的 V-JEPA 2,光看标题就把我绕晕了——自监督视频模型,怎么就能同时理解、预测、规划三件事?这篇到底要解决什么问题,值得专门做一期?
老播:一句话背景:现在做机器人世界模型,主流是两条路,一条是拿海量视频训练视频生成器,在像素或潜空间里把未来帧画出来;另一条是拿专家示范直接学动作策略。这篇论文走的是第三条路——先用超过 100 万小时的互联网视频做动作无关的自监督预训练,再用不到 62 小时的机器人视频补一个动作条件化的潜空间世界模型,最后用模型预测控制(MPC)在真实机械臂上零样本完成抓取和抓放。一句话结论先放这:它证明理解、预测、规划可以共用同一套视觉表征,机器人阶段的数据需求小到可以忽略;同时它的鲁棒性测试把边界画得很清楚——相机位置一变,模型推断的动作坐标轴就偏,长时程规划也还做不了。这一期会把潜空间自回归预测和动作条件化讲透,拿它和 Diffusion Forcing 这类扩散式世界模型正面比一比,最后专门讲它的鲁棒性测试方法。
小播:那我先把问题记下来:为什么在表征空间里预测,比在像素空间里生成视频,更适合做机器人规划?
老播:这个问题问得准,整篇论文的核心就是回答它,我们最后会给你一个带数字的答案。
先把世界模型的两条路线摆出来
小播:那从最基础的来,什么叫世界模型?
老播:世界模型就是让智能体在脑子里预演未来的模型:给定现在的状态和将要执行的动作,预测下一个状态会变成什么样。预测准了,就能在动手之前比较不同动作方案的好坏。这个概念最早能追溯到 Sutton 和 Barto 的强化学习框架,后来 Ha 和 Schmidhuber 的 World Models、Dreamer 系列都在做这件事。真正的分岔点在于预测什么。
小播:预测什么?不就是预测下一帧画面吗?
老播:画面只是一层皮。主流分成两支。一支是扩散式的视频生成:以 Diffusion Forcing 为代表性工作,把未来视频当成生成问题,逐步去噪、采样出未来帧,好处是输出直接是视频、能表达多种可能的未来,代价是每一步预测都要跑很多轮扩散采样,很慢。另一支是表征空间预测,也就是 JEPA,全称联合嵌入预测架构:I-JEPA 先在图像上证明预测表征可行,V-JEPA 把它搬到视频,V-JEPA 2 把规模做大了两个数量级。它只预测场景里可预测的结构,比如物体的运动轨迹和形状恒常,主动忽略叶片晃动这类猜不准的像素细节。
小播:忽略细节会不会是偷懒?做机器人控制,细节难道不重要?
老播:论文的论证是反过来的:像素重建会把大量算力花在永远猜不准的纹理上,而对控制有用的信息恰恰是那部分可预测的结构,而且同一套表征能同时服务理解、预测、规划三个任务。当然,忽略细节有没有代价,我们放到局限部分说,先记住这个悬念。
小播:那先把 JEPA 这个名字拆开,它跟对比学习有什么不同?
老播:JEPA 的全称是联合嵌入预测架构:联合指输入视图和预测目标放进同一个嵌入空间比,嵌入指学表征,预测指直接回归目标视图的表征。它和对比学习的区别在于,对比学习靠拉近正样本对、推开负样本学表征,JEPA 靠预测目标视图的表征,根本不需要负样本。I-JEPA 在图像上证明这套做法能学出接近 DINO 的表征,V-JEPA 把它扩展到视频并验证动作理解,V-JEPA 2 接的就是这两步,把数据和模型都放大。评估设计上还有一个细节:论文刻意挑了 3 个必须靠多帧才能分类的动作类任务和 3 个单帧基本够用的外观类任务,避免只测动作或只测外观的偏科,后面所有 scaling 数字都建立在这 6 个任务的平均上。
小播:那能不能先剧透一下,表征空间里的距离到底可不可靠?
老播:先卖个关子:规划那一段你会看到,他们直接拿两个表征之间的 L1 距离当规划代价,能不能用,看机器人实验结果就知道。
小播:那之前的世界模型到底卡在哪,这篇的切口是什么?
老播:卡在两个地方。第一,像素级视频生成的世界模型,像 Genie、UniSim、Cosmos 这些,大多只被评估生成得够不够像,真正闭环控制真实机器人的很少,而且单步规划要几分钟;第二,从交互数据学的任务专用世界模型,需要部署环境自己的数据,换个实验室就得重新收集。V-JEPA 2 的切法是:用动作无关的互联网视频把表征和动力学先学出来,机器人阶段只补一个轻量的动作条件化层,然后零样本换环境。这里还要先把 MPC 说清楚:模型预测控制就是每步规划一小段动作、只执行第一个动作、再重新规划,滚动往前走,机器人论文里也叫 receding horizon 控制,后面核心思想部分会反复用到它。
核心思想:先在互联网视频上预训练,再补动作条件化
小播:好,核心思想从哪开始讲?
老播:分两个阶段。阶段一是动作无关的自监督预训练,产出通用视频编码器;阶段二冻结编码器,训练动作条件化的世界模型 V-JEPA 2-AC。先讲阶段一。
阶段一:表征空间里的掩码去噪
老播:阶段一的训练任务叫表征空间掩码去噪。做法是:把视频切成小 patch token,随机丢掉一部分,编码器只看剩下的 token,预测器负责猜被丢掉的那部分 patch 的表征应该是什么,监督信号来自一个 EMA 教师编码器对完整视频的编码。这里有一个公式,先给预期:这个式子回答预测什么才算真正学会了视频。
minimize ‖ P_ϕ(Δ_y; E_θ(x)) − sg(E_θ̄(y)) ‖₁
逐符号解释:x 是被掩码的视图;E_θ 是学生编码器,只处理可见 token;Δ_y 是可学习的 mask token,它告诉预测器被丢掉的 patch 在哪些位置;P_ϕ 是预测器,输入 mask token 和可见 token 的表征,输出对掩码 patch 表征的预测;y 是完整视频;E_θ̄ 是教师编码器,权重 θ̄ 是学生权重 θ 的指数滑动平均;sg 是 stop-gradient,让教师侧不回传梯度;损失取 L1,只作用在被掩 patch 上。EMA 加 stop-gradient 是这一族方法防表征坍缩的标配:没有它们,网络很快学会把所有输入编码成同一个常数,预测就作弊了。
小播:预测表征而不是像素,具体省了什么、赚了什么?
老播:先看赚了什么,用论文的 scaling 数据说话。预训练数据从 200 万视频扩到 2200 万样本,也就是 VideoMix22M,包含 SSv2、Kinetics、HowTo100M、YT1B 和 ImageNet,总时长超过 100 万小时;6 个分类任务的平均准确率从 84.2% 涨到 85.2%,这是数据项的收益,基线是 200 万视频上训练的 ViT-L/16。模型从 3 亿参数(ViT-L)扩到 10 亿(ViT-g),再加 1.5 分到 86.7%;训练从 9 万迭代加长到 25.2 万迭代,再加 0.8 分到 87.5%;分辨率从 256² 提到 384²、时长从 16 帧提到 64 帧,最后加 0.7 分到 88.2%。四项一共 4 分。这套数字说明视频自监督学习的收益来自数据、模型、算力、输入规格四件套的合力,每一项单独都有正贡献。
小播:那 2200 万样本里,数据本身干不干净?
老播:论文专门有一段讲数据筛选。YT1B 是最大的来源,约 140 万小时、基本没筛过,里面混着卡通、剪辑这类对理解物理世界没帮助的内容。做法是从视频里抽场景,每个场景算一个嵌入向量,再用检索式聚类,按 Kinetics、SSv2、COIN、EpicKitchen 的目标分布挑选场景,把噪声过滤掉。光 curation 这一步,6 任务平均分就值 1.4 分;筛选后的 YT1B 单独训练,在 ViT-L 规模上已经接近完整 VM22M 的效果,说明数据质量可以在一定程度上替代数据量。图像数据还有一个技巧:把一张图在时间维复制 16 份当视频喂进去,让预训练同时吃到图像和视频两种信号。
小播:那 64 帧、384² 的视频训练起来得多贵?
老播:论文给了一个估算:如果从头到尾全分辨率训练这种输入的 ViT-g,大约要 60 GPU-years。对策是渐进式分辨率训练:warmup 阶段 1.2 万迭代用 16 帧、256²,主训练阶段 22.8 万迭代保持常数学习率,最后 cooldown 阶段 1.2 万迭代才把分辨率和时长升上去,成本压到原来的约八分之一,也就是 8.4 倍加速。另外还有个细节:位置编码换成了 3D-RoPE,把特征维分成时间、高、宽三段分别做旋转编码,论文说这是 10 亿参数模型训练稳定的关键。
阶段二:动作条件化的潜空间自回归世界模型
小播:阶段一学会了世界大概怎么动,但动作怎么进去?
老播:这正是阶段二补的东西,模型叫 V-JEPA 2-AC,AC 是 action-conditioned 的缩写。它的输入输出可以这样建出来:一段 4 秒、4 帧每秒、256×256 的 Droid 机器人视频,一共 16 帧;每一帧单独过冻结的编码器,得到 16×16×1408 的特征图 z_k;再配上第 k 帧的末端执行器状态 s_k,7 维,包括 3 个位置、3 个欧拉角朝向、1 个夹爪开合;以及第 k 到 k+1 帧之间的动作 a_k,7 维差分向量,由相邻两帧的末端状态相减得到。三者按时间交错成 (a_k; s_k; z_k) 序列,喂给一个 24 层、16 头、hidden 1024、约 3 亿参数的 transformer 预测器。它用 block-causal 注意力,当前时刻只能看同时刻和更早时刻的信息,保证预测只依赖过去和现在。
小播:那这个预测器本身有什么工程细节?
老播:有几个值得记的。第一,动作、末端状态、展平后的特征图分别用独立的可学习仿射变换投影到 hidden 维,再拼成 token 序列,输出端再仿射映射回编码器的 1408 维。第二,位置编码用 3D-RoPE,帧表征的空间 patch 用完整的三维旋转编码,动作和姿态 token 只加时间维的旋转编码。第三,block-causal 的注意力掩码保证每一帧的 patch 只能看同时刻和更早时刻的信息,规划时不会偷看未来。第四,训练时对视频片段做随机缩放裁剪,长宽比在 0.75 到 1.35 之间采样,相当于数据增广,让模型对相机视角和构图有一定容忍度——注意这个增广和后面相机敏感性的局限是呼应的,增广只能覆盖训练分布内的小扰动,相机大幅换位就出了分布。
小播:那训练损失怎么设计?直接让预测贴着真实表征走就行吗?
老播:光那样不够。论文用了两段损失。第一段叫 teacher-forcing,先给预期:它回答单步预测准不准。公式是
L_tf(ϕ) = (1/T) Σ_{k=1..15} ‖ P_ϕ((a_t, s_t, E(x_t))_{t≤k}) − E(x_{k+1}) ‖₁
逐符号解释:T 取 15,因为 16 帧有 15 个相邻预测;P_ϕ 的输入是截至第 k 帧的动作、末端状态、帧表征;E(x_{k+1}) 是冻结编码器对真实下一帧的编码,当监督;L1 距离逐元素求和取平均。每个时间步都拿真实下一帧的表征来纠错,模型先学会单步预测准。但推理时模型只能拿自己的输出当输入,误差会累积,所以第二段叫 rollout 损失:
L_rollout(ϕ) = ‖ P_ϕ(a_{1:T}; s_1, z_1) − z_{T+1} ‖₁
这里的 P_ϕ(a_{1:T}; s_1, z_1) 表示把整串动作喂进去、让模型自回归滚动 T 步后得到的最终表征;实现里 T=2,只反传一个循环步,控制梯度开销。总损失是两个相加。两段损失的用意:teacher-forcing 保单步精度,rollout 保自回归稳定性,推理时漂移才压得住。
小播:那动作条件化具体是怎么进到预测里的?
老播:动作和末端状态作为独立的 token,和帧表征一起进注意力:要预测第 k+1 帧的表征,模型就得同时消化第 k 帧长什么样、手在哪、我给了什么动作指令,于是它被迫学会从动作到未来表征的映射。注意整个阶段编码器是冻结的,只有预测器约 3 亿参数在训练,数据只有约 62 小时、约 2.3 万条 Droid 轨迹,而且全部无标注——没有奖励、没有任务标签、甚至不知道演示成功还是失败,只用原始视频加末端执行器状态。这一点是论文最想强调的:互联网预训练替机器人阶段承担了绝大部分表征学习,后面实验会证明这个判断。
规划:目标图像加 CEM 的闭环
小播:世界模型有了,怎么把到达目标翻译成动作?
老播:用能量最小化加模型预测控制。先给预期:下面这个式子回答哪条动作轨迹会让想象出来的未来离目标最近。给定当前帧表征 z_k、末端状态 s_k、目标图像编码 z_g,目标图像用同一个冻结编码器编码,规划 horizon T 的动作序列,让
E(â_{1:T}; z_k, s_k, z_g) = ‖ P_ϕ(â_{1:T}; s_k, z_k) − z_g ‖₁
最小。逐符号解释:â_{1:T} 是候选动作序列;P_ϕ(â_{1:T}; s_k, z_k) 是世界模型想象 T 步后的未来表征;z_g 是目标;L1 距离衡量两者差距。最小化不用梯度,用交叉熵方法 CEM:从零均值单位方差的高斯分布采样一批候选动作轨迹,算每条的能量,取能量最低的 top-k 当精英,用精英更新高斯分布的均值和方差,迭代 10 轮,最后取高斯均值当要执行的动作。实际配置:800 个样本、10 轮迭代、horizon 取 1,动作限制在半径 0.075 的 L1 球内,单步最大能让手到目标的距离下降 0.13。执行第一个动作后重新规划,这就是前面说的 receding horizon。
小播:这里插一句,为什么 horizon 只取 1?
老播:好问题。horizon 取 1 意味着每一轮只规划一个动作、只优化一步,靠高频重规划逼近目标。这样绕开了长 horizon 搜索空间爆炸的问题,也让每个动作的规划延迟可控。论文里 16 秒一个动作、800 个样本,就是这个配置下测出来的。抓放任务更复杂,用 3 张子目标图像分段:先以物体被抓持为目标规划 4 步,再以物体接近目标位规划 10 步,最后以物体放到位规划 4 步,模型每到一个子目标自动切换下一张。
小播:那 3 张子目标图这个设计,模型知道先抓再放的规则吗?
老播:子目标分割是通用的做法,类似把任务拆步骤;关键在论文没有给模型任何任务规则,只是顺序喂 3 张图、每张规划固定步数,模型按能量最小化自动切换。为了验证世界模型真的在想象物理、背动作,他们训练了一个轻量帧解码器,把预测的表征解码回画面:用真实动作序列滚动,夹爪闭合时杯子跟着手臂走,但最后一帧杯子的位置比真实轨迹略低,这是自回归误差累积的直接可视化;换成夹爪张开的动作序列,杯子保持不动。两个对照说明模型学到了物体恒常和重力,同时也把误差累积的量级摆在了眼前。
和扩散式世界模型正面比一比
小播:现在把开头那个问题正式对上:为什么在表征空间预测比在像素空间生成更适合机器人规划?
老播:拿 Diffusion Forcing 代表的扩散式世界模型做四个维度的对比,答案就清楚了。第一,预测目标:扩散式模型生成像素或潜空间视频,必须把画面里每样东西都画出来,包括不可预测的纹理;V-JEPA 2-AC 预测的是表征,只保留可预测的结构。第二,输出分布:扩散式采样天然能表达多种可能的未来,V-JEPA 2-AC 是确定性回归,只给一个未来,多模态要靠 CEM 在动作空间采样来补,这算它一个局限。第三,推理成本:扩散式每步都要多轮去噪,Diffusion Forcing 还得逐 token 处理不同的噪声水平;V-JEPA 2-AC 单步就是一次前向回归。第四,误差修正:扩散去噪本身有能力修正上一轮引入的误差,自回归模型没有这个机制,只能靠 rollout 损失缓解漂移。论文里最硬的对照是 Cosmos,一个 70 亿参数的潜扩散动作条件视频生成模型:同样用 CEM、同样单卡 RTX 4090,Cosmos 80 个样本要 4 分钟规划一个动作,V-JEPA 2-AC 用 800 个样本只要 16 秒。这个延迟差直接决定 MPC 闭环在真实机械臂上能不能跑起来。
四组实验,一路看到边界
小播:好,那四组实验逐个来。第一组是理解?
老播:对,动作理解。评测方式是冻结编码器,在表征上接一个 4 层 attentive probe 分类器。6 个任务里,SSv2、Diving-48、Jester 是动作类,必须看多帧才能分类;Kinetics-400、COIN、ImageNet 是外观类,单帧信息基本够。结果:V-JEPA 2 ViT-g 六任务平均 87.5%,对照是 V-JEPA ViT-H 85.2%、InternVideo2s2-1B 87.0%、DINOv2 81.1%、SigLIP2 81.1%、PECoreG 82.3%;动作类优势最明显,SSv2 上 75.3% 对 InternVideo 的 69.7% 和 PECoreG 的 55.4%。升到 384²、64 帧的 ViT-g384 平均到 88.2%,SSv2 77.3%。如果你看论文的 Figure 3,那根柱子从左到右就是数据、模型、训练、分辨率四项的累加,每一项都是正贡献,这就是四件套 scaling 的直接证据。这里要提醒一句:这些 baseline 编码器的预训练数据各不相同,DINOv2 用 LVD-142M、PE 用 MetaCLIP,所以只能做系统级比较,分数差异里混着数据差异。
小播:那和语言模型接起来的那部分呢,视频问答算理解吗?
老播:算,而且它回答了一个更普遍的问题:没有语言监督的视频编码器,能不能当多模态大模型的主干。受控对比里,所有模型用同一个 LLM、同一批 1800 万对齐样本,只换视觉编码器:V-JEPA 2 ViT-g512 平均 52.3,高于 PE 49.1、SigLIP2 48.1、DINOv2 45.7,差距集中在 MVP、TemporalBench、TVBench 这些强调时序理解的基准上。端到端训练下,把编码器从 300M 扩到 1B,PerceptionTest 加 0.9、TVBench 加 3.3、MVBench 加 1.2;输入分辨率从 256 提到 512,PerceptionTest 再加 2.2、TemporalBench 加 4.0、TVBench 加 3.3。最后把对齐数据从 1800 万扩到 8850 万、换成 Llama 3.1 8B,平均 59.5,在 PerceptionTest、MVP、TempCompass、TemporalBench、TOMATO 五个基准上超过 PerceptionLM 8B,其中 TemporalBench 36.7 对 28.3、TOMATO 40.3 对 32.0 差距最大,TVBench 和 MVBench 落后。
小播:第二组是预测,预测什么?
老播:预测人接下来要做什么动作,基准是 EK100 动作预测:100 小时第一人称厨房视频,度量是 mean-class recall@5,也就是模型给出 5 个候选,正确的动作落进前 5 个就算对。上下文在动作开始前 1 秒截断。V-JEPA 2 ViT-g384 拿到 39.7,此前最强的是 PlausiVL,80 亿参数,27.6,高出 12.1 分、约 44% 相对提升;而且 3 亿参数的 ViT-L 就有 32.7,已经超过所有专门做这个任务的 baseline。还能看到随规模线性增长:32.7(ViT-L)、36.5(ViT-H)、38.0(ViT-g)、39.7(ViT-g384)。
小播:那它预测失败的时候,是怎么个失败法?
老播:论文在附录里做了失败分析:动词、名词、动作三路分类器各自独立,最常见的失败配置是动词和名词都对、动作错了,也就是两个部件没对上;完全成功的配置占大多数。他们还做了协议消融:上下文从 8 帧加到 32 帧、帧率提到 8、分辨率升到 384²,性能一路涨到饱和,这也解释了为什么预测实验最终用 32 帧、8 帧率、384² 的配置。
小播:第三组是机器人本体,这个怎么测的?
老播:两台不同实验室的 Franka 机械臂加 RobotiQ 夹爪,每任务 10 次试验,随机物体位置和起始位姿,全程零样本,部署环境没有任何训练数据。先报 V-JEPA 2-AC 的平均成功率:reach 100%、抓杯 65%、抓盒 25%、持物前进杯 75% 盒 75%、抓放杯 80% 盒 65%。对照是 Octo,一个在 Open-X 上预训练、用全量 Droid 做行为克隆微调的视觉语言动作模型:reach 也是 100%,但抓杯 15%、抓盒 0%、持物 15% 和 70%、抓放 15% 和 10%。注意最关键的一点:Octo 的预训练数据超过 100 万条轨迹,再全量微调 Droid,V-JEPA 2-AC 只有 62 小时无标注视频,交互任务反而全面领先。和 Cosmos 的对照前面说过:reach 80%,抓取抓放接近 0%,还慢一个数量级。读 Table 2 的时候,抓杯和抓放这两列差距最大,因为杯子抓法特殊,要把手指伸进杯口卡住边缘,动作精度要求高,最能拉开模型差距。
小播:第四组,鲁棒性测试,这个考点你专门提醒过我。
老播:对,这是这篇论文方法论上值得单独讲的地方,它把干扰和分布偏移分开测。先说干扰测试:相机位置。模型从单目 RGB 隐式推断动作坐标轴,没有相机标定。论文把相机从机器人基座方向顺时针扫到左侧,大约 35° 到 85°,采集 201 步随机运动轨迹,对每对相邻帧用 1 步 rollout 推断最优动作,再解一个最小二乘问题,找把推断动作映射到真实动作的线性变换 W*。结果:W* 的条件数约 1.5,说明它近似一个旋转矩阵,于是能算出推断坐标轴的旋转误差;平均绝对误差约 1.6 厘米,对照真实单步位移约 5 厘米,误差是系统性的,而且旋转误差随相机角度近似线性增长。含义很直接:相机一偏,动作方向就系统性偏转,所以论文部署前要手动试相机位置、全程不做标定。这既是它的测试方法,也是它的软肋。配套的还有一个物理扰动测试:同样的动作序列,夹爪闭合时杯子跟着手臂移动,夹爪张开时杯子原地不动,说明世界模型学到了物体恒常和重力这类物理后果。再说分布偏移测试:零样本部署到两个新实验室本身就是最严格的分布偏移测试,不同环境、不同桌面、杂乱场景、没见过的摆放,模型全都没见过;预训练数据侧也有分布问题,YT1B 约 140 万小时未筛选视频,论文用检索式聚类把它的分布对齐到目标任务分布,光这一项就值 1.4 分。另外预测时距也算压力测试:EK100 上从 1 秒拉到 2 秒、4 秒、10 秒,recall 快速下降,未来本身是多模态的,越远越难猜。
它站在哪条线上,和谁差在哪
小播:除了相机,他们还测过别的干扰吗?
老播:动作层面有一个隐含约束:规划时把动作限制在半径 0.075 的 L1 球内,因为太大的动作对模型属于分布外输入,预测会不可靠,这是训练分布对规划空间的隐性限制。物理层面有夹爪开合对照,前面说过了。预测时距也算压力测试:EK100 上把预测时距从 1 秒依次拉到 2、4、10 秒,recall@5 快速下降,说明表征预测的可靠性随距离衰减,这和机器人长时程规划的局限是同一条根。
小播:那现在把地图画全,V-JEPA 2 到底站在哪条线上?
老播:它属于 JEPA 表征空间预测这条线,是 I-JEPA、V-JEPA 的规模升级版,也是第一条把这条线完整走到真实机器人闭环规划的工作。对照的三条线各有各的取舍。扩散式视频生成世界模型,代表是 Diffusion Forcing 和 Cosmos:输出像素、能表达多模态未来、自带去噪式误差修正,但单步规划成本高到闭环跑不动。行为克隆 VLA,代表是 Octo、π0:直接回归动作、推理快,但需要专家轨迹、只用成功示范、推理时没有显式规划,学不会训练数据里没出现过的行为。强化学习世界模型,代表是 Dreamer 一系:有奖励信号、能优化策略,但要环境交互,规模上不去。V-JEPA 2-AC 的取舍:预测目标放表征空间、单步确定性回归,换来 16 秒一个动作的规划延迟,让 MPC 在真实机械臂上可行;代价是丢掉扩散模型的多模态未来表达。VidQA 部分它还有一条独立贡献:第一次拿完全没有语言监督的视频编码器当多模态大模型主干,受控对比里 ViT-g512 平均 52.3,高于 PE 49.1、SigLIP2 48.1、DINOv2 45.7,用的是同一个 LLM、同一批 1800 万对齐样本;对齐数据扩到 8850 万、换成 Llama 3.1 8B 后平均 59.5,在 PerceptionTest、MVP、TempCompass、TemporalBench、TOMATO 五个基准上超过 PerceptionLM 8B,但 TVBench 和 MVBench 落后。
六条局限,先听论文自己说的
小播:现在听你泼冷水,这条线最虚的地方在哪?
老播:至少六条。第一,相机位置敏感,前面已经量化:无标定、隐式推断坐标轴,旋转误差随相机角近似线性涨,部署前要手动挑相机位置,这直接限制它换环境的鲁棒性。第二,长时程规划做不了:自回归误差累积,加动作轨迹搜索空间随 horizon 指数增长,预测能力只覆盖约 16 秒,抓放必须拆成 3 张子目标图,无子目标的端到端长任务没戏。第三,目标表达单一:只能吃图像目标,野外更自然的语言指令没有支持,论文把语言目标嵌入潜空间列为未来工作。第四,EK100 评估面窄:厨房场景加固定动词名词词表,词表外动作无法泛化,预测时距拉长性能掉得很快。第五,对比公平性:各 baseline 编码器预训练数据各不相同,只能做系统级比较;VidQA 的 TVBench 60.6、MVBench 73.5 还低于 PerceptionLM 的 63.5、77.1。第六是我们的读法:JEPA 主动丢弃不可预测细节,对需要亚厘米级精确控制的场景,信息可能不够,1.6 厘米的相机误差已经提示精细控制的天花板;编码器也只到 10 亿参数,20B 级视频编码器的收益没有证据。
小播:那复现难度呢,代码和数据都公开吗?
老播:代码在 facebookresearch/vjepa2 官方仓库公开,预训练数据全部来自公开数据源,SSv2、Kinetics、HowTo100M、YT1B、ImageNet、Droid,理论上可以复现;主要门槛是算力,全分辨率 64 帧 384² 的 ViT-g 约 60 GPU-years,渐进式训练能压到八分之一左右;机器人规划阶段单卡 RTX 4090 就够了。预训练权重的下载入口论文里没有写死,要从官方仓库和博客找。
小播:所以零样本很强和换相机就偏,这两句话得放一起听。
老播:对,这正是把它当考点的原因:论文最强的证据和最诚实的边界是同一枚硬币的两面。
记住三件事
小播:最后总结,本期记住三件事。第一,V-JEPA 2 用超过 100 万小时互联网视频做动作无关预训练,再用 62 小时无标注机器人视频训练动作条件化潜空间世界模型,机器人阶段的数据需求小到可以忽略,零样本部署到两个陌生实验室还能做到抓放 80% 和 65%。第二,潜空间单步回归把 MPC 单步规划压到 16 秒,对比扩散式世界模型的 4 分钟,这个延迟差决定闭环能不能跑,这是它选表征空间预测的直接理由。第三,它的鲁棒性测试把边界画得很清楚:跨实验室的分布偏移测试通过了,相机位置这一项干扰测试却暴露了隐式坐标轴推断的弱点,长时程规划也还靠子目标撑着。
老播:我再补一句这篇对后续工作的意义。它把 JEPA 路线从表征学习推进到可用于控制的世界模型,后面值得跟进的方向论文自己也列了:语言目标嵌入潜空间、分层多尺度预测解决长时程、更大规模编码器。如果你把它和 Diffusion Forcing 那期连着听,两条路线各自的取舍会更立体:一条用速度换闭环可行性,一条用生成能力换表达丰富度,下一代机器人世界模型很可能在它们交汇的地方出现。
小播:那这期就到这里,下期见。