Consistency Models(OpenAI,ICML 2023,泛读)
一句话定位:把扩散模型「迭代去噪 10–2000 步」的采样过程,重写成「一次网络前向就把噪声映射成图片」的一步映射问题;关键是学一个自洽的 consistency function——同一条概率流 ODE 轨迹上的任意点都映射到同一个起点。这张卡覆盖:自洽性目标与 NFE 灵活性(一步是设计目标,多步只是用算力换质量的可选项)、两种训练路线(从预训练扩散模型蒸馏 CD / 完全从零训练 CT),以及这篇论文作为 one-step 训练目标鼻祖之一的谱系位置。
---
要解决的问题:扩散模型质量好,但采样太慢
扩散模型是 2022 年前后图像、音频、视频生成的主流。它的采样机制是迭代的:从高斯噪声出发,逐步去噪,每步都要过一次网络。论文引言里给出的量级是,相对 GAN、VAE、normalizing flow 这类单步模型,扩散采样通常要多花 10–2000 倍的计算量;例如 score SDE 采样 2000 步,DDPM 1000 步,即便用当时的加速求解器(DDIM、DPM-Solver、DEIS),也要 10 步以上才能出有竞争力的样本。这让实时应用(比如交互式编辑、低延迟生成)很难落地。
当时的两条加速路线各有短板。数值 ODE 求解器只是把步数压到 10–20,仍然要多次网络评估。蒸馏路线里,knowledge distillation(Luhman & Luhman 2021)和 DFNO(Zheng et al. 2022)要先让扩散模型大量采样、构造一个合成数据集,再在这个数据集上训练学生模型,数据准备本身就很贵;唯一不依赖合成数据的是 progressive distillation(PD, Salimans & Ho 2022),但它一步生成的质量有限——CIFAR-10 上一步 FID 8.34,DFNO 用合成数据做到 4.12。更根本的问题是,这些方法都是「先训一个慢模型,再事后加速」;这篇论文想换一个思路:把「一步生成」直接写进训练目标。
核心思想:学一个自洽的「轨迹→起点」映射
论文建立在连续时间扩散模型的理论上。扩散模型定义了一个随机微分方程(SDE),把数据分布平滑地扩散成高斯噪声;Song et al. 2021 证明,这个 SDE 对应一个等价的常微分方程,叫概率流 ODE(Probability Flow ODE,PF ODE),它的每条解轨迹从数据点 x₀ 出发、平滑演化到噪声点 x_T,且任意时刻的粒子分布与 SDE 一致。也就是说,生成问题可以看成:从噪声端 x_T 出发,沿着轨迹走回数据端 x₀。
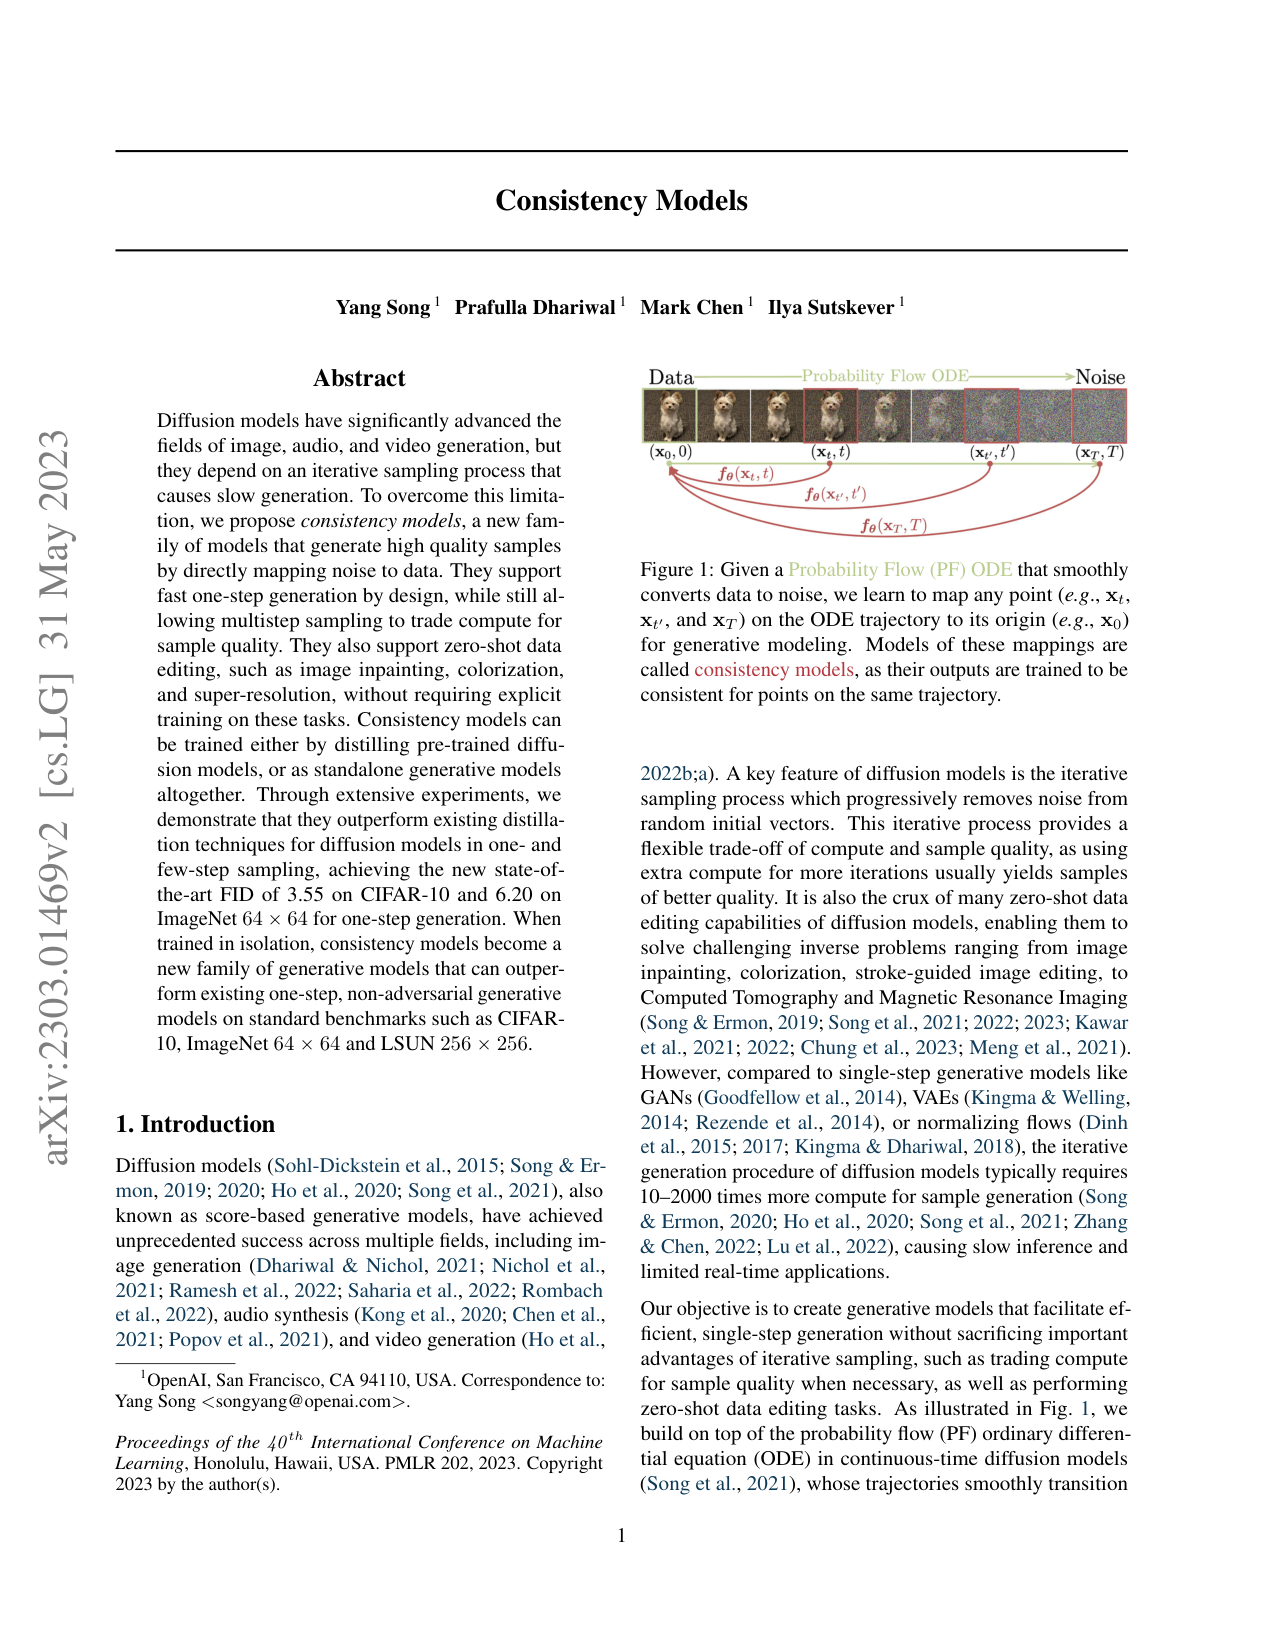
Consistency Models 的核心定义很简单:对 PF ODE 的每条轨迹,定义一个 consistency function f(x_t, t) = x_ε,把轨迹上任意时刻的点映射回轨迹起点(ε=0.002 是数值稳定下限,论文沿用 Karras et al. 2022 的 EDM 设定,T=80)。这个函数要满足自洽性:同一条轨迹上的任意两个点,映射结果必须相同,即 f(x_t, t) = f(x_t', t')。下图就是论文的 Figure 1:轨迹上 x_t、x_t1、x_T 三个不同噪声程度的点,都被箭头指向同一个 x₀。
训练好的 consistency model 采样只需要一步:从噪声分布 N(0, T²I) 采一个 x_T,前向一次得 x_ε = f_θ(x_T, T),这就是生成结果。但论文同时保留了多步选项(Algorithm 1):先一步得到样本,再注入噪声、再映射、反复若干轮,用算力换质量;中间时间点用贪心三元搜索按 FID 逐点选定。后面会看到,2 步就能把 CIFAR-10 的 FID 从 3.55 降到 2.93。
自洽性这个约束本身不够,还需要边界条件。 如果只要求「处处输出一致」,网络可以输出全零——f≡0 也满足「所有点映射到同一点」,但它没有任何生成意义。论文的解法是把边界条件写进模型结构:f_θ(x_ε, ε) = x_ε 必须恒成立,即时间在 ε 时输出等于输入。实现上用了带 skip 连接的参数化:
f_θ(x, t) = c_skip(t)·x + c_out(t)·F_θ(x, t)
这个式子要回答的问题是:怎么让网络在 t=ε 处自动变成恒等映射。其中 F_θ 是一个自由形式的 U-Net,c_skip 和 c_out 是时间相关的标量系数,要求 c_skip(ε)=1、c_out(ε)=0。这样当 t=ε 时,c_out 项消失,输出恒等于输入 x;当 t>ε 时,网络输出是「保留一部分输入 + 网络修正」的加权组合。论文 p5 明确说这条约束对训练成败起关键作用,它从结构上排除了平凡解 f≡0,同时这个参数化与主流扩散模型同构,可以复用现成 U-Net 架构。
两种训练方式:蒸馏(CD)与从零(CT)
Consistency Distillation(CD):假设手里有一个训练好的扩散模型(score model s_φ),怎么把它蒸馏成一个一步生成器,而且不用先造合成数据集?做法是:从数据点 x 出发,按扩散的转移密度采 x_{t_{n+1}} ~ N(x, t²_{n+1}I),再用一步 ODE 求解器(Euler 或 Heun)从 x_{t_{n+1}} 推算出相邻时刻的估计点 x̂_{t_n};这两个点在同一段轨迹上,consistency model 对它们的输出应当一致。损失写出来是:
L_CD = E[ λ(t_n) · d( f_θ(x_{t_{n+1}}, t_{n+1}), f_{θ⁻}(x̂_{t_n}, t_n) ) ]
这个式子要回答的问题是:网络怎么知道两个相邻轨迹点该映射到哪里。E 表示对所有随机量求期望:x 采自数据集,n 均匀取自 {1,…,N−1},x_{t_{n+1}} 采自 N(x, t²_{n+1}I)。λ(t_n) 是时间权重,论文实验里取 1 就够;d 是度量函数,实验里对比了 ℓ2、ℓ1 和 LPIPS,LPIPS 最好。f_θ 是当前在优化的「在线网络」,f_θ⁻ 是「目标网络」——θ⁻ 是 θ 过去值的指数滑动平均(EMA),更新时对 θ⁻ 用 stopgrad。这套 EMA + stopgrad 的做法直接来自深度 Q-learning(Mnih et al. 2015)和动量对比学习(MoCo/SimCLR),论文结论里也点名了这种跨领域相似。训练时把时间区间 [ε, T] 分成 N−1 段,边界按 Karras 公式 t_i = (ε^{1/ρ} + (i−1)/(N−1)(T^{1/ρ}−ε^{1/ρ}))^ρ 取,ρ=7,实验最优 N=18、Heun 二阶求解器。Theorem 1 给出理论保证:若求解器局部误差是 O(Δt^{p+1}),蒸馏损失为零时模型误差是 O(Δt^p)——步长越小,学到的映射越接近真实的 consistency function。
Consistency Training(CT):没有预训练扩散模型怎么办?论文用一个关键观察把 CD 里的「score 模型 + ODE 求解器」整个替换掉。分数函数 ∇log p_t(x_t) 有一个无偏估计:-(x_t − x)/t²,其中 x 是数据点、x_t ~ N(x, t²I)。这个估计的意思是,给定一个带噪点 x_t,把它向「离它最近的数据点」方向推,再除以噪声方差,就是 score 的一个无偏估计。于是 CD 里的相邻点对 (x_{t_{n+1}}, x̂_{t_n}) 可以直接换成 (x + t_{n+1}z, x + t_n z),z ~ N(0, I)——同一份数据点 x 加两个不同级别的噪声:
L_CT = E[ λ(t_n) · d( f_θ(x + t_{n+1}z, t_{n+1}), f_{θ⁻}(x + t_n z, t_n) ) ]
这个式子回答的问题是:不用 score 模型,怎么构造「同一轨迹上的两个点」。Theorem 2 证明,当用 Euler 求解器且 score 模型完美时,CD 损失与 CT 损失之差是 o(Δt),Δt→0 时两者等价。也就是说,从零训练与蒸馏是同一个自洽性目标在极限下的两种实现,前者的质量损耗来自缺少预训练模型提供的先验。CT 的实现细节是:N(离散段数)和 EMA 衰减 μ 用自适应调度,训练早期 N 小、收敛快但样本差,后期 N 大、质量好但收敛慢;自适应增长显著提速(Figure 3d,CIFAR-10 上)。
关键实验与结果
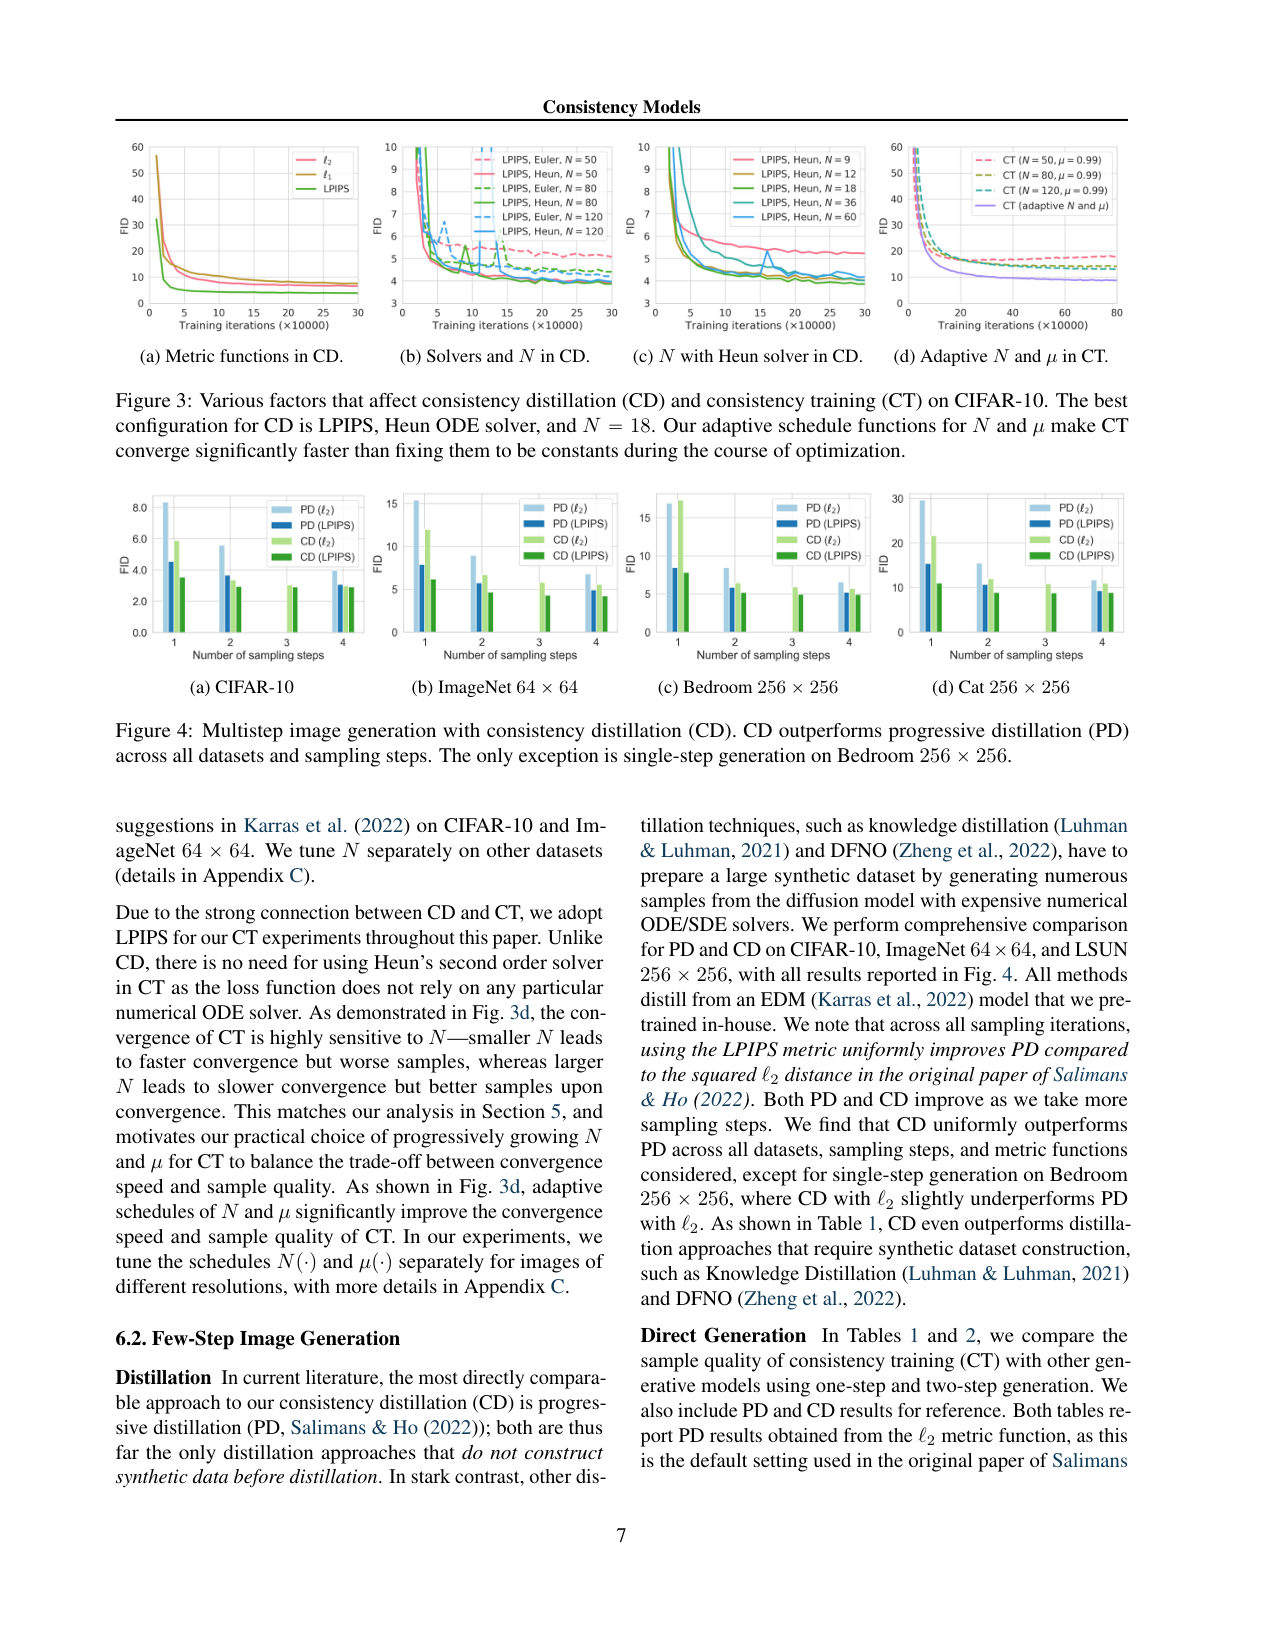
蒸馏版(CD)对少步采样的提升是全数据集、全步数的一致碾压。 所有方法蒸馏同一个 in-house 预训练 EDM 模型。CIFAR-10(32×32)上:CD 一步 FID 3.55(IS 9.48),对照 PD 一步 8.34、DFNO 一步 4.12、10 步 DPM-Solver-fast 4.70;CD 两步 2.93,对照 PD 两步 5.58。ImageNet 64×64 上:CD 一步 6.20(precision 0.68 / recall 0.63),PD 一步 15.39;两步 4.70 vs 8.95。LSUN Bedroom 256 上:CD 一步 7.80、两步 5.22,PD 一步 16.92、两步 8.47;LSUN Cat 256 上:CD 一步 11.0、两步 8.84,PD 一步 29.6、两步 15.5。Figure 4(下图)把四个数据集的「步数—FID」曲线画在一起,CD 在从 1 步到几十步的整个区间都低于 PD;唯一例外是 Bedroom 256 单步且都用 ℓ2 度量时 PD 略好,论文 p7 原文承认了这一点。
从零训练(CT)的定位是:单步、非对抗、不依赖蒸馏的独立生成模型家族。 CIFAR-10 上 CT 一步 FID 8.70、两步 5.83,与 PD 一步 8.34 同量级,但 CT 完全随机初始化、没有任何预训练模型参与;对照当时单步非对抗模型,DC-VAE 17.9、Glow 48.9、Residual Flow 46.4、DenseFlow 34.9,CT 显著更好。不过 CT 与 GAN 仍有距离:StyleGAN2-ADA 在 CIFAR-10 单步 FID 2.92,BigGAN 14.7。ImageNet-64 上 CT 一步 13.0,LSUN Bedroom 一步 16.0、Cat 一步 20.7。Figure 5 还有一个有意思的观察:同一份初始噪声喂给 EDM(多步)、CT 单步、CT 两步,三行样本结构相似,说明 CT 学到的映射与扩散多步路径落在相近的解上,也提示无对抗训练的 CT 不容易塌缩。
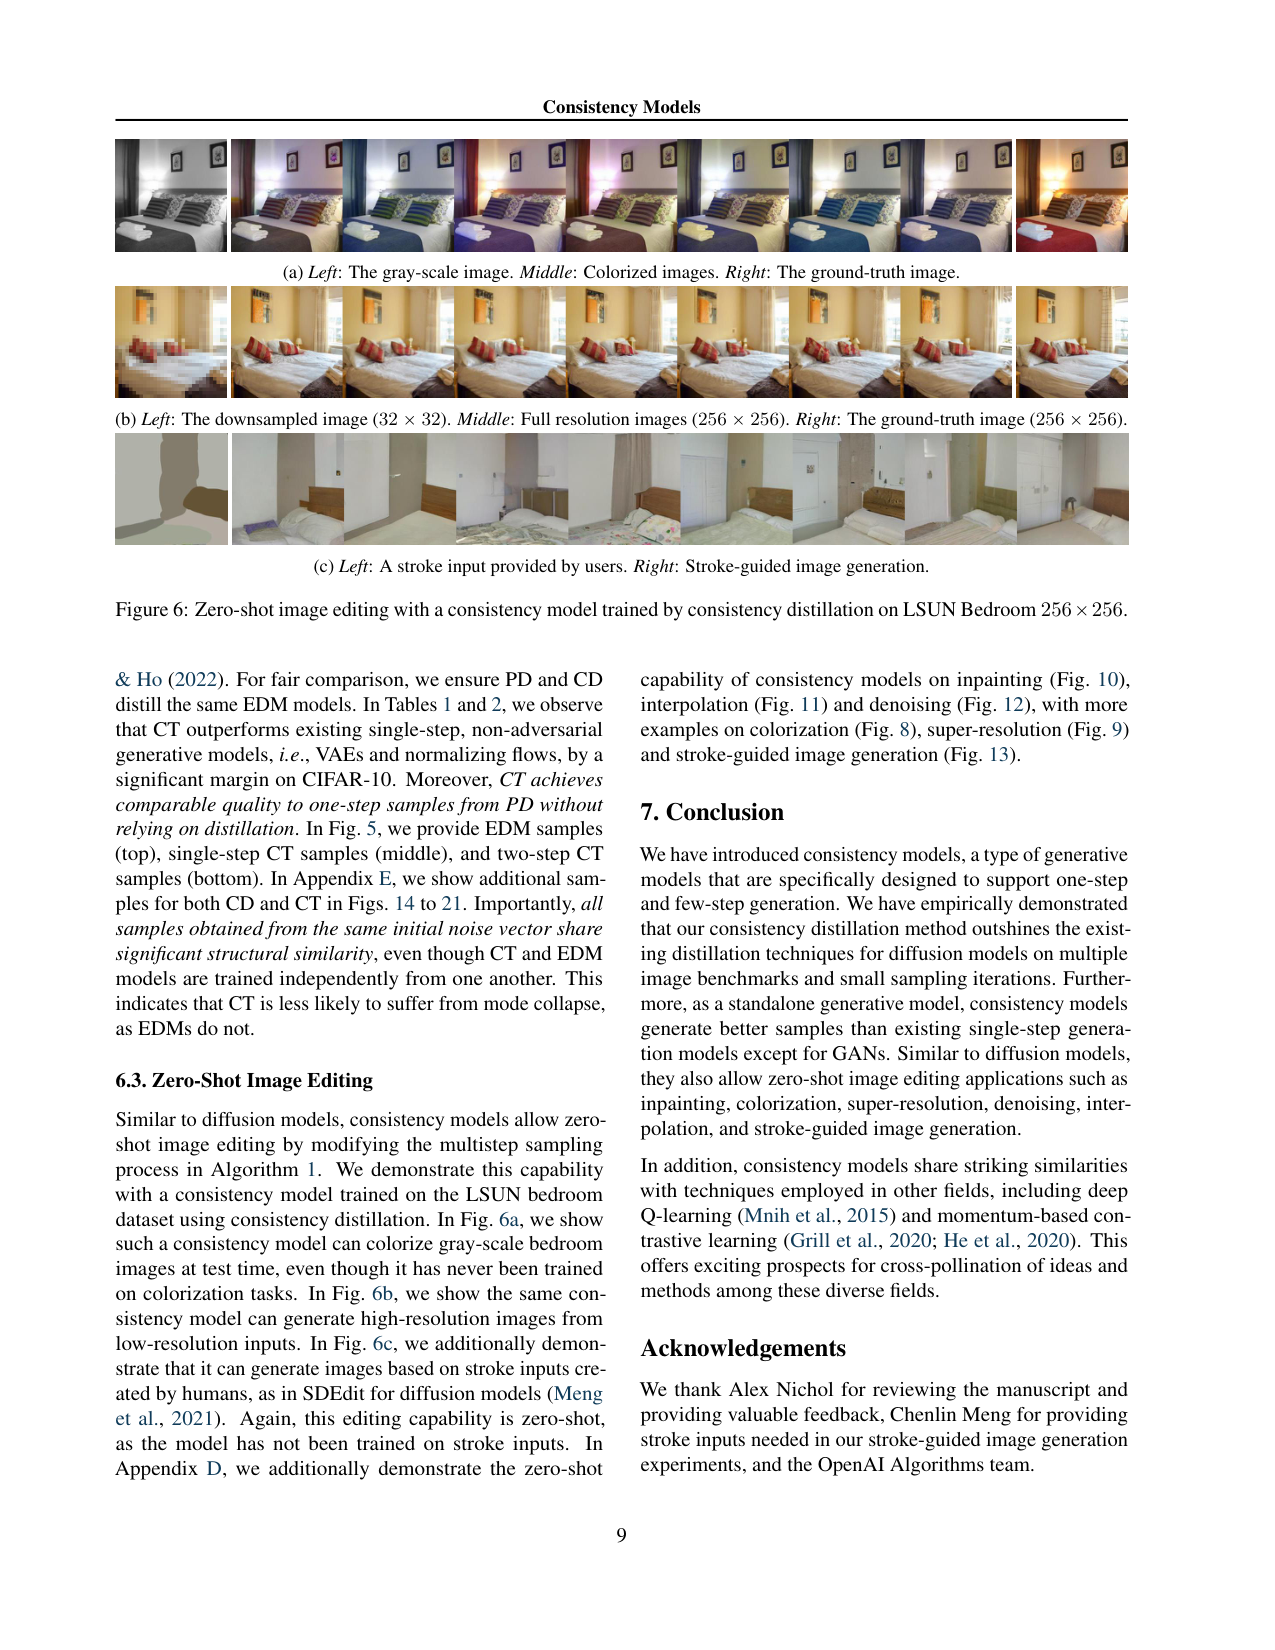
零样本编辑(Figure 6,下图):同一个只在 LSUN Bedroom 上训练过的 CD 模型,测试时直接做灰度图上色、32×32→256×256 超分、笔画引导生成(SDEdit 式),以及附录里的 inpainting、去噪、插值——这些任务训练时一次都没见过。机制是多步采样 + 迭代替换:在部分观测条件下跑一致性采样,未约束区域自由生成。需要说明,这些展示只有定性图、没有定量指标和基线对照。
谱系定位
Consistency Models 处在「one-step 扩散」这条线的源头位置:此前的一步加速要么靠 ODE 求解器压步数、要么靠蒸馏造数据,它第一次把「任意噪声级别 → 数据」的自洽映射直接作为训练目标。与同期工作对照:vs progressive distillation——两者都不造合成数据,CD 全面更好;vs rectified flow 的 1-step(表 1 里 1-Rectified Flow +distill 一步 FID 6.18)——rectified flow 靠重复整流把轨迹拉直,consistency 靠自洽性约束直接学一步映射,两条路线后来被大量工作结合(比如 consistency 目标 + 直线轨迹)。它启发了后续 consistency trajectory models、iCT(improved consistency training)、consistency-ICM 以及把 consistency 目标用于大模型一步推理的一系列工作,是 2023 年后「一步生成 / few-step 生成」研究的重要参照点。
局限
论文自承和我们可以读出的局限有六条。第一,CT 从零训练的单步质量明显落后蒸馏版:CIFAR-10 上 8.70 vs 3.55,ImageNet-64 上 13.0 vs 6.20,LSUN Bedroom 上 16.0 vs 7.80;没有扩散模型可借力时,一步质量离 SOTA 还差一截。第二,多步采样的天花板低于扩散模型本身:CIFAR-10 上 CD 两步 2.93 仍高于 EDM 35 步的 2.04,ImageNet-64 上两步 4.70 vs ADM 250 步的 2.07;「去噪→加噪→再映射」的回环与真实轨迹不完全一致。第三,零样本编辑只有定性展示,没有定量指标,编辑的适用范围与失败模式没有系统分析。第四,训练对超参调度敏感:CT 的 N、μ 调度要按分辨率单独调(附录 C),没有通用法则;连续时间损失(Theorem 3–5)需要 forward-mode 自动微分,主流框架支持有限,实际只用离散版本。第五,多步采样的时间点用贪心三元搜索逐点优化 FID,依赖「FID 对下一个时间点单峰」的假设,论文自承只是经验成立。第六,验证范围限于无条件图像生成,没有条件生成(text-to-image)、视频、音频或更高分辨率的实验。
复现
官方代码仓库 github.com/openai/consistency_models(论文发表后公开);数据集 CIFAR-10 / ImageNet-64 / LSUN 均公开;注意论文蒸馏的是 in-house 预训练 EDM 底座,复现蒸馏路线需要先拿到或训练对应的 EDM。
记住的三件事
1. 自洽性目标:consistency function 把同一条 PF ODE 轨迹上的所有点映射到同一个起点,一步采样 = 一次前向。
2. 两种训练路线统一在同一个目标下:CD 用预训练扩散模型造相邻轨迹点对,CT 用无偏 score 估计(-(x_t−x)/t²)从零训练,Theorem 2 证明两者在 Δt→0 时等价。
3. NFE 灵活性:一步是设计目标,多步只是可选项;CIFAR-10 上 CD 一步 FID 3.55、两步 2.93,而 PD 一步 8.34、两步 5.58——它是 one-step 训练目标这条技术线的鼻祖之一。
把扩散模型的迭代采样问题重写成『一步映射』问题:学一个 consistency function f(x_t, t),把概率流 ODE 同一条轨迹上任意时刻的点都映射到轨迹起点 x_ϵ,于是采样变成一次网络前向;同时保留多步采样(用算力换质量)与零样本图像编辑能力。给出两条训练路线——从预训练扩散模型蒸馏(CD)与完全从零训练(CT)——并在 CIFAR-10 一步生成拿到当时 SOTA 的 FID 3.55。
阅读提示
精读深度:泛读
清单提示:原文提示:理解自洽性目标(consistency function:同一条 PF ODE 轨迹上的点映射到同一个起点)与 NFE 灵活性(一步生成是设计目标,多步采样只是可选的用算力换质量选项);这是 one-step 训练目标的鼻祖之一——一步生成直接写在训练目标里,多步采样只是用算力换质量的可选项。
问题
要解决什么:扩散模型质量高但采样慢:生成一张图要迭代去噪 10–2000 步(论文引 DDIM/DPM-Solver 等仍需 10 步以上才出有竞争力的样本,原始 score SDE 采样 2000 步)。作者想要一种把『一步生成』写进训练目标本身的模型:一次网络前向就把噪声直接映射成图片,同时保留扩散模型的两个优点——多步采样用算力换质量,以及零样本图像编辑(上色、超分、inpainting、笔画引导生成)。
为什么 prior work 不够:当时的两条加速路线各有限制:数值 ODE 求解器(DDIM、DPM-Solver、DEIS 等)只是把 1000 步压到 10–20 步,仍要多次网络评估;蒸馏方法里,knowledge distillation(Luhman & Luhman 2021)和 DFNO(Zheng 2022)要先让扩散模型大量采样构造合成数据集再蒸馏,成本很高;唯一不造数据的 progressive distillation(PD, Salimans & Ho 2022)一步质量有限(CIFAR-10 one-step FID 8.34,DFNO 为 4.12)。更重要的是,这些方法都先训扩散模型再事后加速,没有把『一步生成』作为模型本身的训练目标。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 噪声向量 x_T | continuous vector(图像同维) | 采样时从 π(x) = N(0, T²I) 取,T=80(Karras EDM 设定);训练时用数据样本 x 加噪得到 x_t ~ N(x, t²I) |
| 时间 t | scalar in [ε, T] | ε=0.002 为数值稳定下限,T=80;训练时按 Karras 公式 t_i = (ε^{1/ρ} + (i−1)/(N−1)(T^{1/ρ} − ε^{1/ρ}))^ρ 离散化,ρ=7 |
| 数据样本 x(仅训练) | continuous vector(图像同维) | CD 用来生成相邻轨迹点对,CT 直接用 x 加噪 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 生成样本 x_ϵ ≈ 数据样本 | continuous vector(图像同维) | f_θ(x_t, t) 输出轨迹起点 x_ϵ;一步采样即 x_ϵ = f_θ(x_T, T) |
控制频率:n/a(图像生成;NFE 从 1 到几十自由选择,见 Algorithm 1 多步采样)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10 | 50K 训练 / 10K 测试,32×32 | CD 一步 FID 3.55(IS 9.48),两步 2.93;CT 一步 8.70、两步 5.83;对照 EDM 35 步 2.04、PD 一步 8.34 |
| ImageNet 64×64 | downsampled ImageNet | CD 一步 FID 6.20(precision 0.68/recall 0.63),两步 4.70;PD 一步 15.39;EDM 79 步 2.44 |
| LSUN Bedroom 256×256 | 标准 LSUN 子集 | CD 一步 7.80、两步 5.22;PD 一步 16.92、两步 8.47;EDM 79 步 3.57;零样本编辑实验在此数据集上做 |
| LSUN Cat 256×256 | 标准 LSUN 子集 | CD 一步 11.0、两步 8.84;PD 一步 29.6、两步 15.5 |
架构(摘要)
主干与结构
backbone:EDM(Karras et al. 2022)风格 U-Net;CD 用预训练 EDM 模型初始化权重,CT 随机初始化
参数:论文未单独公布参数量(沿用各分辨率 EDM 的 U-Net 配置)
类型:一致性函数回归:U-Net 直接预测轨迹起点,无迭代去噪头、无对抗判别器
关键组件
- 边界条件参数化 f_θ(x,t) = c_skip(t)·x + c_out(t)·F_θ(x,t),其中 c_skip(ε)=1、c_out(ε)=0,保证 f_θ(x_ε, ε)=x_ε
- EMA target network θ⁻:θ⁻ ← stopgrad(μθ⁻ + (1−μ)θ),μ 用调度(CT 中自适应增长)
- 多步采样(Algorithm 1):x ← f_θ(x̂_{τ_n}, τ_n),τ_n 由贪心三元搜索按 FID 选定
- 训练目标两种:CD(配预训练 score 模型 + ODE 求解器)与 CT(配无偏 score 估计)
为什么这样设计
自洽性是核心归纳偏置:同一条轨迹上的点共享同一个起点,所以只需让网络在相邻轨迹点上输出一致,逐段传播即可学出全局映射。边界条件把『t=ε 处输出必须是输入本身』编码进结构,从架构上排除平凡解 f≡0;skip 参数化与扩散模型一致,方便直接复用现成 U-Net。EMA 目标网络沿用 Q-learning 与对比学习的成熟做法,稳定训练。
数值 sense
| 项 | 值 |
|---|---|
| dimension | CIFAR-10: d=3×32×32=3072;ImageNet-64: d=3×64×64=12288;LSUN 256: d=3×256×256=196608 |
| noise_scale | T=80、ε=0.002(Karras EDM 设定),像素值归一化到 [−1,1] |
| discretization | CD 用 N=18 段(t_i 按 ρ=7 的 Karras 公式),Heun 二阶求解器,LPIPS 度量 |
| 训练 | CD 从预训练 EDM 初始化;CT 随机初始化,N 与 EMA 衰减 μ 用自适应调度(按分辨率单独调,附录 C) |
| sampling | NFE=1(一步)到 NFE=2/若干步;多步采样在一步输出上反复『加噪→再映射』 |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 one-step FID | CD 3.55(IS 9.48) | PD 8.34;DFNO 4.12;EDM 35 步 2.04 | CIFAR-10 32×32,CD/PD/DFNO 均蒸馏同一预训练 EDM 模型,NFE=1 |
| CIFAR-10 two-step FID | CD 2.93(IS 9.75) | PD 5.58 | 同上,NFE=2 |
| ImageNet 64×64 one-step FID | CD 6.20(precision 0.68 / recall 0.63) | PD 15.39;DFNO 8.35;EDM 79 步 2.44 | ImageNet 64×64,同一 EDM 底座,NFE=1 |
| ImageNet 64×64 two-step FID | CD 4.70 | PD 8.95 | 同上,NFE=2 |
| LSUN Bedroom 256×256 FID(1 步 / 2 步) | CD 7.80 / 5.22 | PD 16.92 / 8.47;EDM 79 步 3.57 | LSUN Bedroom,NFE=1 / NFE=2;单步 ℓ2 度量下 CD 略低于 PD 是唯一例外(论文 p7) |
| LSUN Cat 256×256 FID(1 步 / 2 步) | CD 11.0 / 8.84 | PD 29.6 / 15.5 | LSUN Cat,NFE=1 / NFE=2 |
| CT 从零训练 one-step FID | CIFAR-10 8.70;ImageNet-64 13.0;LSUN Bedroom 16.0;LSUN Cat 20.7 | PD one-step(蒸馏)CIFAR-10 8.34;CT 与之同量级且不需要预训练模型;对照 StyleGAN2-ADA(GAN)CIFAR-10 2.92 | 随机初始化、无蒸馏、无对抗训练,NFE=1 |
| CT vs 单步非对抗生成模型(CIFAR-10) | CT 8.70 | DC-VAE 17.9;Glow 48.9;Residual Flow 46.4;DenseFlow 34.9 | CIFAR-10,NFE=1,无蒸馏无对抗训练 |
| 零样本图像编辑(定性) | 上色、超分(32→256)、inpainting、SDEdit 笔画引导、去噪、插值均成功 | 无定量 baseline(论文仅给示例图) | LSUN Bedroom 上训练的 CD 模型,测试时直接处理未见过的任务输入 |
Insights
- 一步生成可以写进训练目标本身:consistency model 直接以『任意噪声级别都映射到同一数据点』的自洽映射为训练目标,一步生成是这个目标顺带产生的属性(p1–2 引言 + p3 定义)。
- 边界条件 f_θ(x_ε, ε)=x_ε 是训练成败的关键:它从结构上排除平凡解 f≡0,论文 p5 明确写出这一条(Theorem 1 之后)。
- 蒸馏和从零可以统一:Theorem 2 说明 CD 与 CT 损失相差 o(Δt),当 Euler 求解器 + 完美 score 模型时两者等价;『从零』版本只需要数据点和两个噪声级别,连预训练扩散模型都不需要(p5–6)。
- 训练技巧直接借了强化学习与对比学习的地基:EMA 目标网络 + stopgrad(Q-learning、MoCo/SimCLR 的做法),论文结论里也点名了 deep Q-learning 与 momentum contrastive learning 的相似性(p9)。
- 相同噪声在 EDM(多步)与 CT(一步)下产生结构相似的样本(Figure 5),提示 CT 学到的一步映射与扩散的多步路径落在相近的解上,且无对抗训练下塌缩风险低(p9 正文)。
vs 同类工作
- vs progressive distillation(PD, Salimans & Ho 2022):两者都无需先造合成数据集;CD 在 CIFAR-10、ImageNet-64、LSUN Cat/Bedroom 的全部采样步数上一致更优,唯一例外是 Bedroom 256 单步且用 ℓ2 度量(CD 7.80 vs PD 16.92 是 LPIPS 度量;ℓ2 下 PD 略好,p7)。
- vs knowledge distillation(Luhman & Luhman 2021)/ DFNO(Zheng et al. 2022):这些要先跑扩散模型生成海量合成样本再蒸馏,训练成本高;CD 直接从轨迹相邻点对学,不需要合成数据集。
- vs 加速 ODE 求解器(DDIM/DPM-Solver/DEIS):求解器压缩到 10 步左右就到极限,CD 一步即达 3.55,比 10 步 DPM-Solver-fast 的 4.70 更好(表 1)。
- vs GAN 系单步模型:CT 不需要对抗训练、训练稳定,但 CIFAR-10 一步 FID 8.70 仍明显高于 StyleGAN2-ADA 的 2.92——论文也承认 GAN 仍是单步质量天花板(表 1 对照)。
- vs Neural Flows(Biloš et al. 2021):同样定义『沿 ODE 轨迹映射』,但 consistency models 不要求可逆,架构约束更少(p3 脚注对比)。
局限
- 从零训练(CT)的单步质量明显落后于蒸馏版:CIFAR-10 上 CT 8.70 vs CD 3.55,ImageNet-64 上 13.0 vs 6.20,LSUN Bedroom 上 16.0 vs 7.80(表 1/2)。没有预训练扩散模型可借力时,一步质量离 SOTA 蒸馏还有一截。
- 多步采样的天花板低于扩散模型本身:CIFAR-10 上 CD 两步 2.93 仍高于 EDM 35 步的 2.04,ImageNet-64 上 CD 两步 4.70 vs ADM 250 步 2.07。一致性模型的『去噪→加噪→再映射』回环与真实轨迹并不完全一致,多步质量上不去(表 1/2)。
- 零样本编辑只有定性示例、没有定量指标与基线对照;同一 latent(噪声)空间下的编辑适用范围、失败模式没有系统分析(第 6.3 节)。
- 训练对超参调度敏感:CT 的 N、μ 自适应调度要按数据集分辨率单独调(附录 C),论文没有给出通用法则;连续时间损失(Theorem 3–5)需要 forward-mode 自动微分,主流框架支持有限,实际只用离散版本(p5)。
- 多步采样的中间时间点用贪心三元搜索逐点优化 FID,依赖『FID 对下一个时间点单峰』这一假设,论文自承只是经验成立,更优策略留作未来工作(p4)。
- 验证范围限于无条件图像生成(CIFAR-10 / ImageNet-64 / LSUN 256),没有条件生成(如 text-to-image)、视频、音频或更高分辨率的实验。
可复现性
- code:OpenAI 官方仓库 github.com/openai/consistency_models(论文发表后公开)
- weights:EDM 底座需自行训练或获取(论文蒸馏的是 in-house 预训练 EDM)
- datasets:CIFAR-10 / ImageNet-64 / LSUN Bedroom & Cat,均公开
- note:论文 p5 自承连续时间损失需要 forward-mode AD,框架支持差,实际采用离散损失;多步时间点选择为贪心启发式
主干与结构
backbone:EDM(Karras et al. 2022)风格 U-Net;CD 用预训练 EDM 模型初始化权重,CT 随机初始化
参数:论文未单独公布参数量(沿用各分辨率 EDM 的 U-Net 配置)
类型:一致性函数回归:U-Net 直接预测轨迹起点,无迭代去噪头、无对抗判别器
关键组件
- 边界条件参数化 f_θ(x,t) = c_skip(t)·x + c_out(t)·F_θ(x,t),其中 c_skip(ε)=1、c_out(ε)=0,保证 f_θ(x_ε, ε)=x_ε
- EMA target network θ⁻:θ⁻ ← stopgrad(μθ⁻ + (1−μ)θ),μ 用调度(CT 中自适应增长)
- 多步采样(Algorithm 1):x ← f_θ(x̂_{τ_n}, τ_n),τ_n 由贪心三元搜索按 FID 选定
- 训练目标两种:CD(配预训练 score 模型 + ODE 求解器)与 CT(配无偏 score 估计)
为什么这样设计
自洽性是核心归纳偏置:同一条轨迹上的点共享同一个起点,所以只需让网络在相邻轨迹点上输出一致,逐段传播即可学出全局映射。边界条件把『t=ε 处输出必须是输入本身』编码进结构,从架构上排除平凡解 f≡0;skip 参数化与扩散模型一致,方便直接复用现成 U-Net。EMA 目标网络沿用 Q-learning 与对比学习的成熟做法,稳定训练。
数值 sense
| 项 | 值 |
|---|---|
| dimension | CIFAR-10: d=3×32×32=3072;ImageNet-64: d=3×64×64=12288;LSUN 256: d=3×256×256=196608 |
| noise_scale | T=80、ε=0.002(Karras EDM 设定),像素值归一化到 [−1,1] |
| discretization | CD 用 N=18 段(t_i 按 ρ=7 的 Karras 公式),Heun 二阶求解器,LPIPS 度量 |
| 训练 | CD 从预训练 EDM 初始化;CT 随机初始化,N 与 EMA 衰减 μ 用自适应调度(按分辨率单独调,附录 C) |
| sampling | NFE=1(一步)到 NFE=2/若干步;多步采样在一步输出上反复『加噪→再映射』 |
PF ODE 轨迹上的任意点都被映射到同一起点 x0
原文 caption:Given a Probability Flow (PF) ODE that smoothly converts data to noise, we learn to map any point (e.g., x_t, x_t1, and x_T) on the ODE trajectory to its origin (e.g., x_0) for generative modeling. Models of these mappings are called consistency models, as their outputs are trained to be consistent for points on the same trajectory.
全文最核心的概念图:横着看是一条概率流 ODE 轨迹,从数据端 x_0 平滑演化到噪声端 x_T;图里三个不同时刻的点(x_t、x_t1、x_T)都画了箭头指向同一个 x_0,表示 consistency function 把它们映射到同一处。读图要点:同一个轨迹上不同的噪声程度共享同一个目的地,这就是 self-consistency。重要性:它把『一步生成』翻译成一个明确的映射目标——采样时只需要从噪声端 x_T 出发做一次映射。对应论文 1–3 节的定义。
多步采样:CD 在四个数据集上全面超过 progressive distillation
原文 caption:Multistep image generation with consistency distillation (CD). CD outperforms progressive distillation (PD) across all datasets and sampling steps. The only exception is single-step generation on Bedroom 256×256.
四张子图(a)CIFAR-10、(b)ImageNet 64×64、(c)Bedroom 256、(d)Cat 256,横轴是采样步数(1 到几十步),纵轴是 FID(越低越好),每条曲线是一个方法。读法:看 CD(实线)与 PD(虚线)在相同步数下的 FID 差距——从 1 步到多步 CD 一致更低,唯一例外是 Bedroom 256 单步且都用 ℓ2 度量时 PD 略好(论文 p7 原文)。它支撑『蒸馏版一致性模型是当时最强的少步采样器』这一核心结论。
从零训练 CT 的样本质量 + 零样本图像编辑展示
原文 caption:Figure 5: Samples generated by EDM (top), CT + single-step generation (middle), and CT + 2-step generation (bottom). All corresponding images are generated from the same initial noise. Figure 6: Zero-shot image editing with a consistency model trained by consistency distillation on LSUN Bedroom 256×256. (a) gray-scale → colorized; (b) 32×32 → 256×256 super-resolution; (c) stroke input → stroke-guided generation.
上半页 Figure 5:同一份初始噪声分别喂给 EDM(多步)、CT 单步、CT 两步,三行样本结构相似,说明 CT 学到的一步映射与扩散模型的多步采样落在相近的解上,也说明无对抗训练的 CT 不容易塌缩到少数模式。下半页 Figure 6:同一个只在 LSUN Bedroom 上训练过的 CD 模型,直接做灰度图上色(a)、32×32→256×256 超分(b)、笔画引导生成(c),全部零样本——训练时没碰过这些任务。它支撑『一步生成与零样本编辑可以同时保留』的论断,但只有定性图、没有定量指标。
🎧 音频版
时长 24:21 · Edge TTS
Consistency Models:把扩散的千百步压缩成一步(对话版)
先讲清楚这篇要解决什么问题
小播:今天这期聊 OpenAI 的《Consistency Models》,arXiv 编号 2303.01469,ICML 2023 的论文,作者是 Yang Song、Prafulla Dhariwal、Mark Chen 和 Ilya Sutskever。我听说它是「一步生成」这条技术线的开山之作,先说说它到底解决了什么问题?
老播:一句话背景:2022 年,扩散模型是图像生成效果最好的方法,但采样很慢,从纯噪声到一张图片要迭代去噪成百上千步。这篇论文想把「一步生成」直接写进训练目标:训练一个模型,一次网络前向就把噪声映射成图片。当时的加速路线有两条,一边是更聪明的 ODE 求解器,把 1000 步压到 10–20 步;一边是蒸馏,把慢模型的输出教给快模型。Consistency Models 走的是第三条路,把「一步生成」本身当成目标来学。也正因为这一步生成是训练目标本身、多步采样反而成了可选项,这篇论文常被看作 one-step 训练目标的鼻祖之一。今天这期要讲清楚三件事:自洽性目标是什么、两种训练方式(蒸馏和从零)怎么统一、一步和多步的灵活性从哪来。结论先放这里:CIFAR-10 上它一步生成的 FID 是 3.55,同设置下 progressive distillation 是 8.34,双方蒸馏的是同一个预训练 EDM 模型。
小播:一步就能出图,这个承诺很猛。我们从背景开始吧。
先补背景:扩散模型为什么慢,加速路子卡在哪
小播:扩散模型我大致知道,加噪再学去噪。慢在哪里?它在图像、音频、视频生成上全面开花,代价是什么?
老播:扩散模型把生成当成一个迭代过程。前向:给真实图片逐步加噪,一直加到变成纯高斯噪声;反向:训练一个网络,每次只剥掉一小层噪声。采样的时候从纯噪声出发,要剥一千层、两千层噪声才能看到图。为什么要剥这么多次?因为网络只在相邻噪声级别之间被训练,每一步只被教着去除当前这一小层噪声;一步跨度过大的跳跃会让去噪误差累积、出现伪影。步数越多,每步的误差越小,但计算量线性上升。质量和速度之间的这种张力,就是扩散模型从诞生起一直背着的老问题。它的直接代价是推理速度:实时交互场景,比如画布上改图、对话里生成图,动辄要等好几秒。一步生成对这类场景的意义就在这里。论文引言给的量级是:相比 GAN、VAE、normalizing flow 这类单步模型,扩散采样通常要多花 10–2000 倍的计算量;score SDE 采样 2000 步,DDPM 1000 步,DDIM 也要 10 步以上才出有竞争力的样本。
小播:那当时的加速方案都卡在哪?
老播:两条主线各自有短板。第一条是数值 ODE 求解器,DDIM、DPM-Solver、DEIS 这些,靠更聪明的离散化把步数压到 10 步左右,但步数再少质量就崩。第二条是蒸馏,训练一个学生网络模仿老师扩散模型。这条线里大部分方法要先让老师模型大量采样、造一个合成数据集,再在这个数据集上训练学生,合成数据的成本本身很高;当时唯一不依赖合成数据的是 progressive distillation,简称 PD,它直接逐步减半采样步数去教学生,但一步质量有限,CIFAR-10 上一步 FID 只有 8.34。更根本的问题是,这两条线都是先训练一个慢模型,再想办法让它变快。这篇论文换了一个问法:能不能从一开始就训练一个天生一步的模型?
小播:天生一步,听起来是把目标函数改了?
老播:对,这就是核心。先补一个理论背景。扩散模型有两套表述:一套是 DDPM 那种离散的逐步加噪去噪,另一套是 Song 等人把 score matching 写成连续时间的随机微分方程,也就是 score-based 生成模型;score 指的是对数密度的梯度,模型先学它,再沿着这个梯度场把噪声搬回数据。这篇论文站在连续时间这一支上,因为只有连续时间才有下面要说的概率流 ODE。它有一个等价形式叫概率流 ODE,英文是 Probability Flow ODE,缩写 PF ODE。扩散过程对应的随机微分方程,可以改写成这个常微分方程,它的每条解轨迹从数据端 x_0 平滑演化到噪声端 x_T,而且任意时刻的粒子分布和原来的扩散过程完全一致。这条轨迹为什么有用:因为轨迹上每个时刻的粒子分布正好等于扩散过程在该时刻的分布,所以沿着轨迹走,分布就从噪声平滑地变成数据,生成问题就变成一个沿轨迹走回去的问题。这篇论文就是围绕这条轨迹做文章。
核心思想:让轨迹上每个点都指向同一个起点
小播:好,那核心定义是什么?
老播:论文定义了一个叫 consistency function 的对象,中文可以叫一致性函数。先给直觉:PF ODE 的每一条轨迹,对应一张具体的图片(起点 x_0)和一堆噪声程度不同的中间点。一致性函数的作用是:给定轨迹上任意时刻的点 (x_t, t),直接返回这条轨迹的起点 x_ε。这里 ε 是数值稳定下限,论文沿用 Karras 等人的 EDM 设定取 0.002,最大噪声时刻 T 取 80。这个函数必须满足自洽性:同一条轨迹上的两个点,映射结果必须完全一样,写成公式就是 f(x_t, t) = f(x_t', t'),对同一条轨迹上任意两个时刻 t、t' 都成立。这个式子回答的问题是:网络怎么知道两个噪声程度不同的点该去向同一个地方。f 是映射函数,x_t 是 t 时刻的带噪点,x_t' 是另一个时刻的带噪点,两个输入不同,但输出必须相同。这里的语义也很直白:同一条轨迹上的中间点,本来就是同一张图片在不同噪声程度下的样子,它们当然应该还原到同一个起点。这就是全文最核心的约束,名字里的 consistency 就从这来。另外注意一个细节:这个映射不需要可逆。normalizing flow 为了保证能算密度,网络必须可逆,架构选择很受限;consistency function 只要求正向映射,自由度大得多。论文第 3 页专门拿它和 neural flows 对比,说可逆性这条约束在这里被去掉了。
小播:那训练好之后,采样就是一次前向?
老播:对。从噪声分布 N(0, T²I) 采一个 x_T,前向一次得到 x_ε = f_θ(x_T, T),就是生成的图片,一步完成。这里 f_θ 表示带参数 θ 的网络,θ 是训练出来的权重。但有个坑:如果只要求处处输出一致,网络可以学成恒零函数,f≡0 也满足所有点映射到同一点,但没有任何生成意义。论文的解法叫边界条件:强制 f_θ(x_ε, ε) = x_ε,也就是在时间 ε 处,输出必须等于输入。实现方式是把边界条件写进网络结构,用带 skip 连接的参数化:f_θ(x, t) = c_skip(t)·x + c_out(t)·F_θ(x, t)。这个式子要回答的问题是:怎么让网络在 t=ε 时自动退化成恒等映射。其中 F_θ 是一个自由形式的 U-Net,c_skip 和 c_out 是时间相关的标量系数,要求 c_skip(ε)=1、c_out(ε)=0,这样 t=ε 时第二项消失,输出自动等于输入 x。论文第 5 页明确说这条约束对训练成败起关键作用,它从结构上排除了平凡解;这个参数化还和主流扩散模型同构,所以可以直接复用现成的 U-Net 架构。
小播:还有一个问题:训练时网络只看到相邻的两个时间点,凭什么最后整条轨迹都一致?
老播:问得好,这是理解「为什么有效」的关键。训练时确实只看到相邻点对,但相邻点的约束会沿着轨迹传播:把每一段的误差压下去,整条轨迹的累积误差也压下去了。Theorem 1 给的就是这个误差传播论证:假设 ODE 求解器每步的局部误差是 O(Δt 的 p+1 次方),蒸馏损失为零时,模型对轨迹上任意点的误差是 O(Δt 的 p 次方),时间步长 Δt 越小,逼近越准。这套论证和数值 ODE 求解器的全局误差分析是同一个套路,论文的证明也直接参考了数值分析教材里的经典结果。换句话说,逐段一致推全局一致,这是有理论兜底的。
小播:那「同一个起点」的约束具体怎么学?你前面说有两种训练方式。
老播:对,这是论文的另一半贡献。第一种叫 Consistency Distillation,一致性蒸馏,缩写 CD,适合手里有预训练扩散模型的情况。做法是:从数据点 x 出发,按扩散过程的转移分布加噪得到 x_{t_{n+1}},再用一步 ODE 求解器(Euler 或 Heun)从它推算出相邻时刻的估计点 x̂_{t_n}。这两个点在轨迹上挨得很近,一致性模型对它们的输出应当一致,于是损失写成 L_CD = E[ λ(t_n) · d( f_θ(x_{t_{n+1}}, t_{n+1}), f_{θ⁻}(x̂_{t_n}, t_n) ) ]。这个式子回答的问题是:网络拿什么当训练信号。E 表示对所有随机量求期望:x 采自数据集,n 在 1 到 N−1 里均匀取,x_{t_{n+1}} 采自以 x 为中心、方差 t²_{n+1} 的高斯。λ 是时间权重,实验里取 1 就够;d 是度量函数,论文对比了 ℓ2、ℓ1 和 LPIPS,LPIPS 效果最好。LPIPS 好在哪里:它在一个预训练好的图像特征空间里算感知距离,比较接近人眼对图像相似度的感受;ℓ2 在原始像素空间算,容易把低频的大误差当成主要矛盾。f_θ 是正在优化的在线网络,f_θ⁻ 是目标网络,它的参数 θ⁻ 是 θ 历史值的指数滑动平均(EMA),更新时对 θ⁻ 冻结梯度。为什么要一个冻结梯度的目标网络?如果让在线网络和自己直接对比,两个输出可以一起漂移来互相将就,训练会不稳;目标网络拿着参数的历史均值,给在线网络一个相对稳定的参照系。这个 EMA 加 stopgrad 的组合,是直接从深度 Q-learning 和动量对比学习(MoCo 那一类工作)借来的,论文结论里自己也点名了这种跨领域相似。另外,所有 CD 实验都用预训练 EDM 的权重来初始化一致性模型,CT 则随机初始化,这个差别后面解释结果时会用到。时间区间 [ε, T] 被分成 N−1 段,边界按 Karras 公式 t_i = (ε^{1/ρ} + (i−1)/(N−1)·(T^{1/ρ} − ε^{1/ρ}))^ρ 取,ρ=7;这个公式的作用是让时间点在小噪声一端更密,因为那个区域的变化更剧烈。实验里 CD 的最优配置是 N=18、Heun 二阶求解器、LPIPS 度量。
小播:那第二种呢?没有预训练模型怎么办?
老播:第二种叫 Consistency Training,一致性训练,缩写 CT,完全不需要预训练扩散模型。关键是一个数学观察:分数函数 ∇log p_t(x_t) 有一个无偏估计:-(x_t − x)/t²。先解释分数函数:它表示对数概率密度的梯度,是扩散模型要学的东西。这个估计的意思是:给定一个带噪点 x_t,把它朝最近的干净数据点 x 的方向推,再除以噪声方差 t²,结果就是分数的一个无偏估计。利用这个估计,CD 里那对相邻点可以换成 (x + t_{n+1}z, x + t_n z),z 是标准高斯噪声,也就是同一份干净数据 x 加两个不同级别的噪声。CT 损失写成 L_CT = E[ λ(t_n) · d( f_θ(x + t_{n+1}z, t_{n+1}), f_{θ⁻}(x + t_n z, t_n) ) ],它和 CD 损失的差别只在于:CD 用预训练模型加 ODE 求解器产生相邻点,CT 直接在同一份数据上加两个噪声级别。Theorem 2 证明:用 Euler 求解器且分数模型完美时,CD 损失与 CT 损失之差是 o(Δt),时间步长 Δt 趋向零时两者等价。所以从零训练和蒸馏在极限下是同一个目标,蒸馏里的扩散模型知识被这个无偏估计替代了。CT 和 CD 还有一个实际操作上的差别:CT 的损失里根本没有 ODE 求解器,连 Heun 都不需要,训练管线更简单;代价是收敛更慢,最终单步质量低一些,这个后面看数字就有感觉。CT 实操上有个细节:离散段数 N 和 EMA 衰减 μ 要用自适应调度,前期 N 小、收敛快但样本质量差,后期 N 大、质量好但收敛慢;论文在 CIFAR-10 上对比了自适应和固定参数的版本,同样的训练轮数下自适应调度的 FID 明显更低,收敛速度显著加快。
小播:那一步生成质量不够的时候怎么办?
老播:论文保留了扩散模型的灵活性:多步采样。做法在论文的 Algorithm 1 里:先一步得到样本 x,再对 x 注入噪声 x̂_{τ_n} = x + √(τ_n² − ε²)·z,然后再次映射回起点,反复若干轮,每轮都修正一点。走一遍两步流程感受一下:第一步,从 N(0, T²I) 采噪声,映射一次得到初稿;第二步,在某个中间时刻 τ 注入噪声,把初稿变回一个带噪点,再映射一次得到精修稿。这里注入噪声的幅度由 √(τ² − ε²) 控制,τ 越大噪声越强。中间时间点 τ_n 用贪心三元搜索逐点按 FID 选定:先固定前面选好的时间点,把下一个时间点在区间里三分查找 FID 最低的位置,逐个确定下来。这个设计让 NFE,也就是网络评估次数,可以从 1 自由调到几十:想要快就一步,想要质量就多走两步。这里和扩散的迭代采样有个区别:扩散每一步都沿着同一条轨迹往前挪,一致性模型每轮是「跳到起点、再被噪声拉回中间、再跳」,每多一轮就多一次精修,NFE 灵活性就来自这个可重复的映射。后面你会看到两步就能把 CIFAR-10 的 FID 从 3.55 降到 2.93。这条「加噪、再映射」的回环,也正好是后面零样本编辑的基础。
关键实验:一步有多强,多步能换多少质量
小播:数字说话。一步生成到底什么水平?
老播:先说蒸馏版 CD,最直接的对照是 progressive distillation(PD),两者都不需要造合成数据集,而且蒸馏的是同一个 in-house 预训练 EDM 模型,对比公平。CIFAR-10 32×32 上,CD 一步 FID 3.55、IS 9.48;对照 PD 一步 8.34,DFNO 一步 4.12,10 步的 DPM-Solver-fast 4.70。这里两个指标先解释一下:FID 衡量生成分布和真实分布在特征空间里的距离,越低越好;IS 是 Inception Score,衡量生成图像的类别清晰度和多样性,越高越好。CD 两步 FID 2.93,PD 两步 5.58。再对照求解器一族:DDIM 10 步 8.23、20 步 6.84、50 步 4.67,CD 一步 3.55 已经低于 50 步的 DDIM,这是「一步超过十几步到几十步」的直接证据。同一张表里还有一个对照很能说明问题:1-Rectified Flow 不蒸馏、直接一步采样时 FID 是 378,加上蒸馏才到 6.18,说明在这条线上,一步目标和蒸馏配合起来才有意义。ImageNet 64×64 上,CD 一步 FID 6.20(precision 0.68、recall 0.63),PD 一步 15.39;两步 4.70 对 8.95。256 分辨率:LSUN Bedroom 上 CD 一步 7.80、两步 5.22,PD 一步 16.92、两步 8.47;LSUN Cat 上 CD 一步 11.0、两步 8.84,PD 一步 29.6、两步 15.5。论文 Figure 4 把四个数据集的「步数—FID」曲线画在一起,横轴是采样步数,从 1 步到几十步,纵轴是 FID,越低越好;CD 的曲线在 PD 下方,说明同样的计算量下质量更高,从 1 步到几十步全程如此。唯一例外是 Bedroom 256 单步且都用 ℓ2 度量时 PD 略好,论文第 7 页原文承认了这个例外。
小播:那从零训练的 CT 呢?
老播:CT 的定位是单步、非对抗、独立的生成模型家族。CIFAR-10 上 CT 一步 FID 8.70、两步 5.83,和 PD 一步 8.34 同量级,但 CT 完全随机初始化,没有借任何预训练模型的光。对比当时的单步非对抗模型:DC-VAE 17.9、Glow 48.9、Residual Flow 46.4、DenseFlow 34.9,CT 明显更好;不过离 GAN 还有距离,StyleGAN2-ADA 在 CIFAR-10 单步 FID 2.92。另外论文里有个值得记住的细节:同一份初始噪声喂给 EDM(多步)、CT 单步、CT 两步,三行样本结构相似,说明 CT 学到的一步映射和扩散多步路径落在相近的解上,也提示无对抗训练下塌缩风险低。还有零样本编辑:同一个在 LSUN Bedroom 上训练过的 CD 模型,测试时直接做灰度图上色、32×32 到 256×256 超分、笔画引导生成,附录里还有 inpainting、去噪和样本插值,训练时一次都没见过这些任务;机制就是前面说的多步采样加迭代替换:把输入(比如一张灰度图)当成带噪观测,每一轮采样后,把已知区域(亮度通道)强制替换回观测值,未知区域(颜色通道)交给模型自由生成,迭代几轮后条件信息就逐渐传播到整张图。这块只有定性示例,没有定量指标,讲局限时我们再提。
它在一步生成这条线上排什么位置
小播:那这篇在整个谱系里算什么?
老播:它是 one-step 训练目标这条线的源头之一。它之前的加速,要么靠求解器压步数,要么靠蒸馏造数据,都是事后优化;它第一次把「任意噪声级别都映射到同一个数据点」的自洽约束直接当训练目标。和 rectified flow 的 1-step 版本比:表 1 里 1-Rectified Flow 蒸馏后一步 FID 6.18,低于 CD 的 3.55;rectified flow 靠重复整流把轨迹拉直,consistency 靠自洽性约束直接学一步映射,两条路线后来常被结合使用。这篇之后,consistency trajectory models、improved consistency training(iCT)、consistency-ICM,以及把 consistency 目标用于大模型一步推理的一系列工作都从这出发,它是 2023 年后 few-step 生成研究的重要参照。它还提供了一条对抗训练之外的单步生成路线:GAN 靠判别器博弈做到单步,consistency 靠自洽性约束做到单步,后者的训练稳定性明显更好,这为后来很多生产环境里的加速方案埋了伏笔。
局限:还有哪些坑要记住
小播:那有哪些问题需要泼冷水?
老播:至少六条。第一,CT 从零训练的单步质量明显落后蒸馏版:CIFAR-10 上 8.70 对 3.55,ImageNet-64 上 13.0 对 6.20,LSUN Bedroom 上 16.0 对 7.80,没有扩散模型可借力时一步质量还差一截。第二,多步采样的天花板低于扩散模型本身:CIFAR-10 上 CD 两步 2.93,EDM 35 步能到 2.04;ImageNet-64 上 CD 两步 4.70,ADM 250 步 2.07。多步回环是「去噪、加噪、再映射」,和真实轨迹有偏差,步数多了质量也上不去。第三,零样本编辑只有定性图,没有定量指标,编辑的适用范围和失败模式没有系统分析。第四,训练对超参调度敏感:CT 的 N 和 μ 调度要按数据集分辨率单独调,论文放在附录 C,没有给出通用法则;连续时间损失版本需要 forward-mode 自动微分,主流框架支持差,实际只能用离散版本。第五,多步采样的中间时间点是贪心三元搜索按 FID 逐点选的,依赖「FID 对下一个时间点单峰」这个假设,论文自承只是经验上成立。第六,验证范围只有无条件图像生成,没有条件生成(比如文字到图)、视频、音频或更高分辨率的实验。
收尾:这期记住这三件事
小播:那我们收个尾,这期该记住什么?
老播:三件事。第一,自洽性目标:一致性函数把同一条概率流 ODE 轨迹上的所有点映射到同一个起点,一步采样就是一次前向。第二,蒸馏和从零是同一个目标的两种实现:CD 用预训练扩散模型造相邻轨迹点对,CT 用无偏分数估计 -(x_t − x)/t² 从零训练,Theorem 2 说两者在步长趋向零时等价。第三,NFE 灵活性:一步是设计目标,多步只是可选项——CIFAR-10 上 CD 一步 FID 3.55、两步 2.93,PD 一步 8.34、两步 5.58。这篇论文把「一步生成」从工程技巧变成了训练目标本身,后面的 consistency 家族和一大片一步扩散工作都从这里出发。这期信息量不小,我们下次见。