Scalable Diffusion Models with Transformers (DiT)
一句话定位:把扩散模型的骨干从卷积 U-Net 换成标准 ViT 风格的 transformer,在 latent 空间训练,系统研究「模型前向计算量(Gflops)→ 样本质量(FID)」的 scaling 关系,并以 DiT-XL/2(675M 参数)在 ImageNet 256×256 类条件生成上拿到当时最优 FID 2.27。这篇论文的 patchify + adaLN 条件注入 + scaling 配方,后来成了 Sora、Stable Diffusion 3、PixArt 这些文生图/视频/VLA 模型骨干的通用模板。
1. 要解决什么问题
扩散模型在 2022 年已经是图像生成的主流,但几乎所有实现都把卷积 U-Net 当作默认骨干。U-Net 从 DDPM(Ho et al., 2020)沿用至今,中间 ADM(Dhariwal & Nichol, 2021)只消融过层数、通道数、归一化方式这些细节,没人系统验证过骨干本身能不能换。与此同时,语言模型和视觉识别已经证明 transformer 有更好的 scaling 特性——算力、数据、参数一起涨时,性能几乎可以预测地变好。
论文要回答的是一个具体的架构问题:把 U-Net 换成标准 transformer 之后,扩散模型的生成质量随计算量怎么增长?能不能像语言模型那样得到一条干净的 scaling 曲线,并且用足够的计算反超当时的 GAN 路线(StyleGAN-XL)?
之前的工作还留下一个度量上的坑:评价架构复杂度习惯用参数量,但参数量反映不了分辨率、token 数这些明显影响生成质量的因素。作者改用理论 Gflops 作为复杂度标尺,这贯穿了全篇的分析。
2. 输入输出与整体数据流
DiT 工作在 latent 空间。预训练的 VAE 编码器把 256×256×3 的图像压缩成 32×32×4 的 latent(8× 下采样),扩散模型就在这个 latent 上加噪、去噪,采样完成后用 VAE 解码器还原成图像。
输入有三样:加噪后的 latent z_t(32×32×4,512×512 图像对应 64×64×4)、噪声时间步 t(1 到 1000)、类别标签 c。输出两样:预测噪声 ϵ_θ(z_t, t, c) 和预测协方差 Σ_θ,形状都和输入 latent 相同。
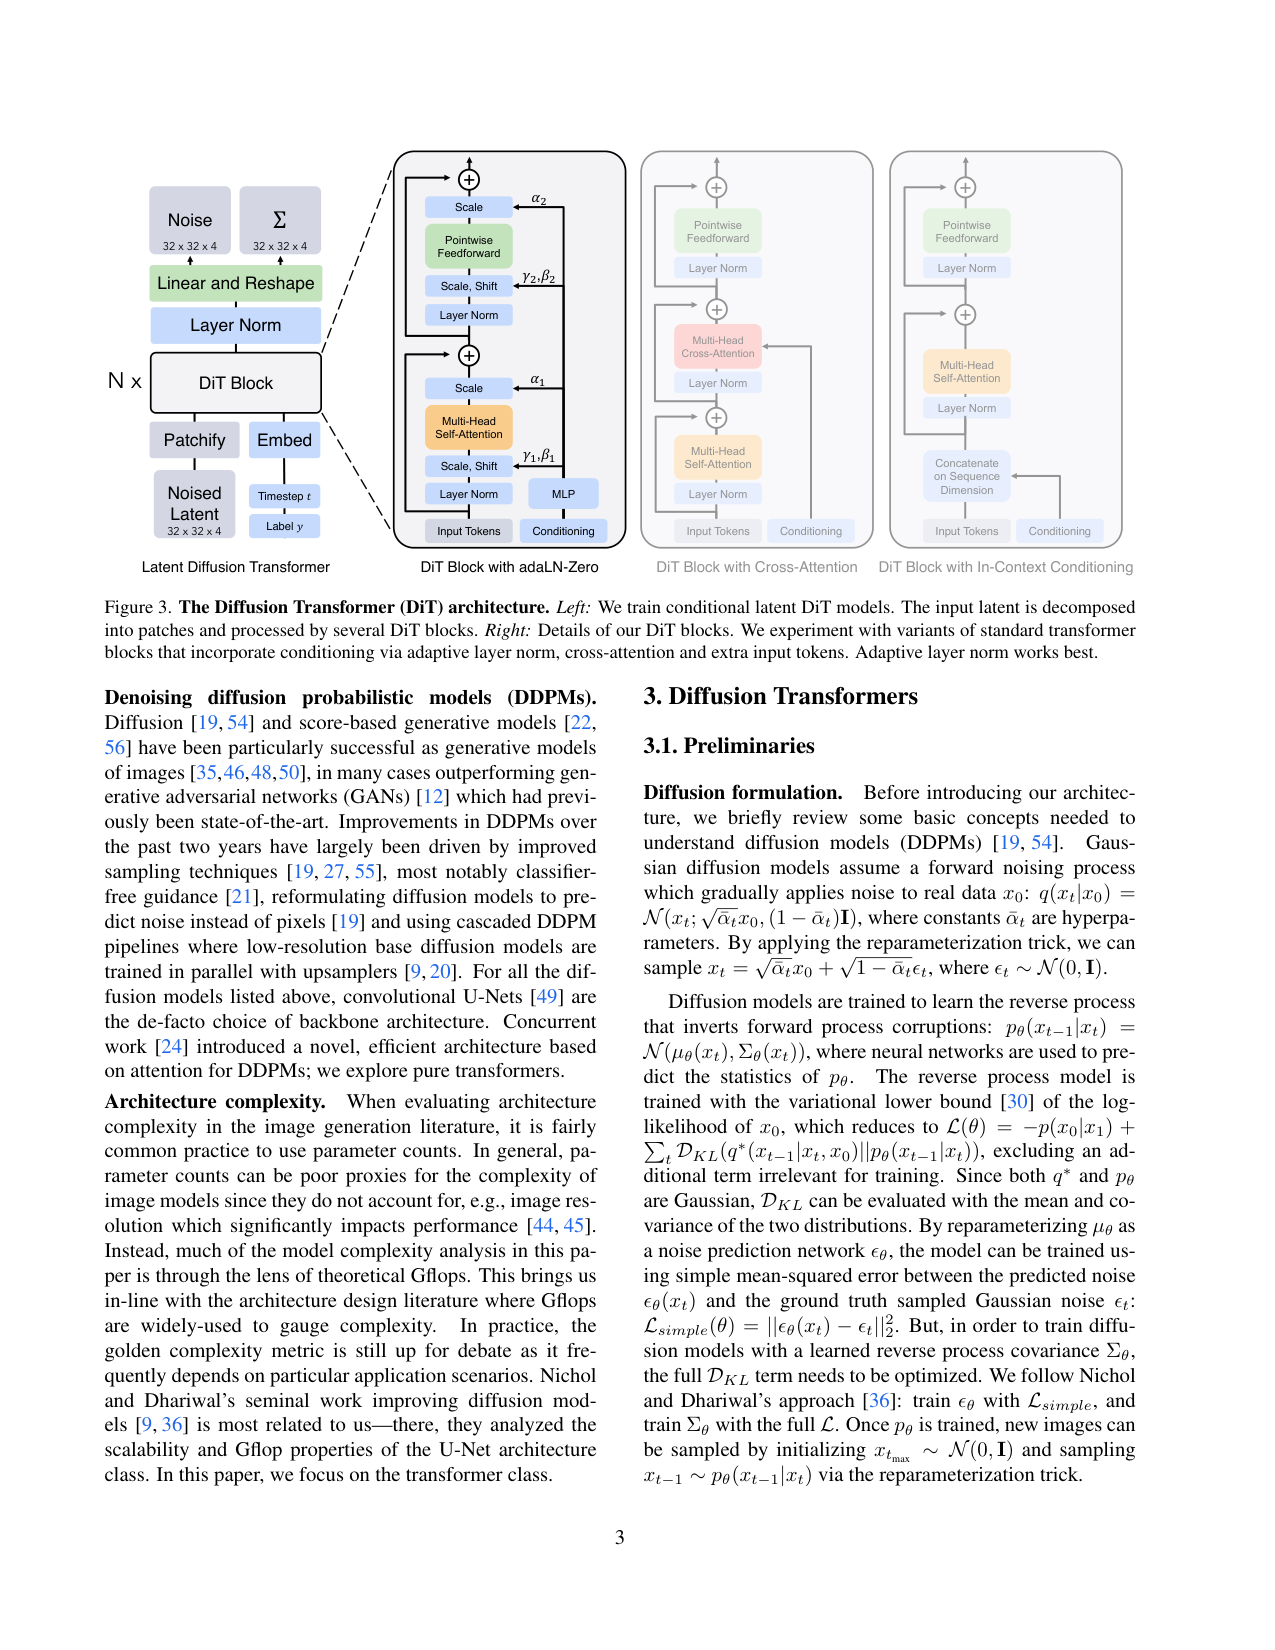
DiT 的完整前向:patchify 把 latent 切成 token → 叠 N 个 DiT block → 线性解码器把每个 token 映射回 p×p×2C 的空间块 → 重排成噪声和协方差预测。整体结构与 ViT 几乎一一对应,唯一加进来的条件是时间步和类别。
3. 架构:patchify、条件注入与 adaLN-Zero
3.1 Patchify:怎么把 latent 变成序列
第一步把 32×32×4 的 latent 切成 p×p 的 patch(p 取 2、4、8),每个 patch 线性嵌入成一个 d 维 token,序列长度 T = (32/p)²。p=2 时 T=256 个 token,p=8 时只有 16 个。嵌入后加 ViT 标准的 sine-cosine 位置编码。
这个设计的关键在于 patch 大小成了一个隔离变量的开关:p 减半,token 数变 4 倍,注意力计算量至少翻 4 倍,而参数量几乎不变(patchify 是共享的线性层)。所以「变计算量、不变参数」和「变参数、不变计算量」两组对照都能做,后面 scaling 实验全靠它。论文明确写了:halving p 会让总 transformer Gflops 至少翻 4 倍,但对参数量没有实质影响。
3.2 条件注入:时间步和类别怎么进网络
标准 ViT block 没有条件入口,作者比较了三种注入方式:
- in-context:把 t、c 的 embedding 当作两个额外 token 拼进序列,网络照常跑,最后丢掉。几乎不增加计算。
选择 adaLN-Zero 的原因在消融里非常清楚:400K 步时它的 FID-50K 是 19.47,接近 in-context 变体 35.24 的一半,同时它的计算量(118.6 Gflops)比 cross-attention(137.6 Gflops)更低。恒等初始化(α 置零)这个细节贡献了可观的收益——和 ResNet 把残差块初始化为恒等、扩散 U-Net 零初始化最后一个卷积层是同一套思想。论文从这里得到的核心结论:条件注入的结构选择是影响生成质量的第一位因素,甚至比模型规模更敏感。
3.3 模型规模与解码
模型配置完全照搬 ViT 的四档:DiT-S(12 层、384 维、1.4 Gflops@p=4)、DiT-B(12 层、768 维、5.6)、DiT-L(24 层、1024 维、19.7)、DiT-XL(28 层、1152 维、29.1)。乘以 3 档 patch 大小,构成 12 个模型的设计空间,Gflops 覆盖 0.36(S/8)到 118.64(XL/2)。训练时全部使用 ADM 的配方:AdamW、常数学习率 1e-4、batch 256、无 weight decay、仅水平翻转、EMA(decay 0.9999),不加 warmup 和正则化也全程稳定。
4. 关键实验与结果
4.1 条件注入消融(图 5)
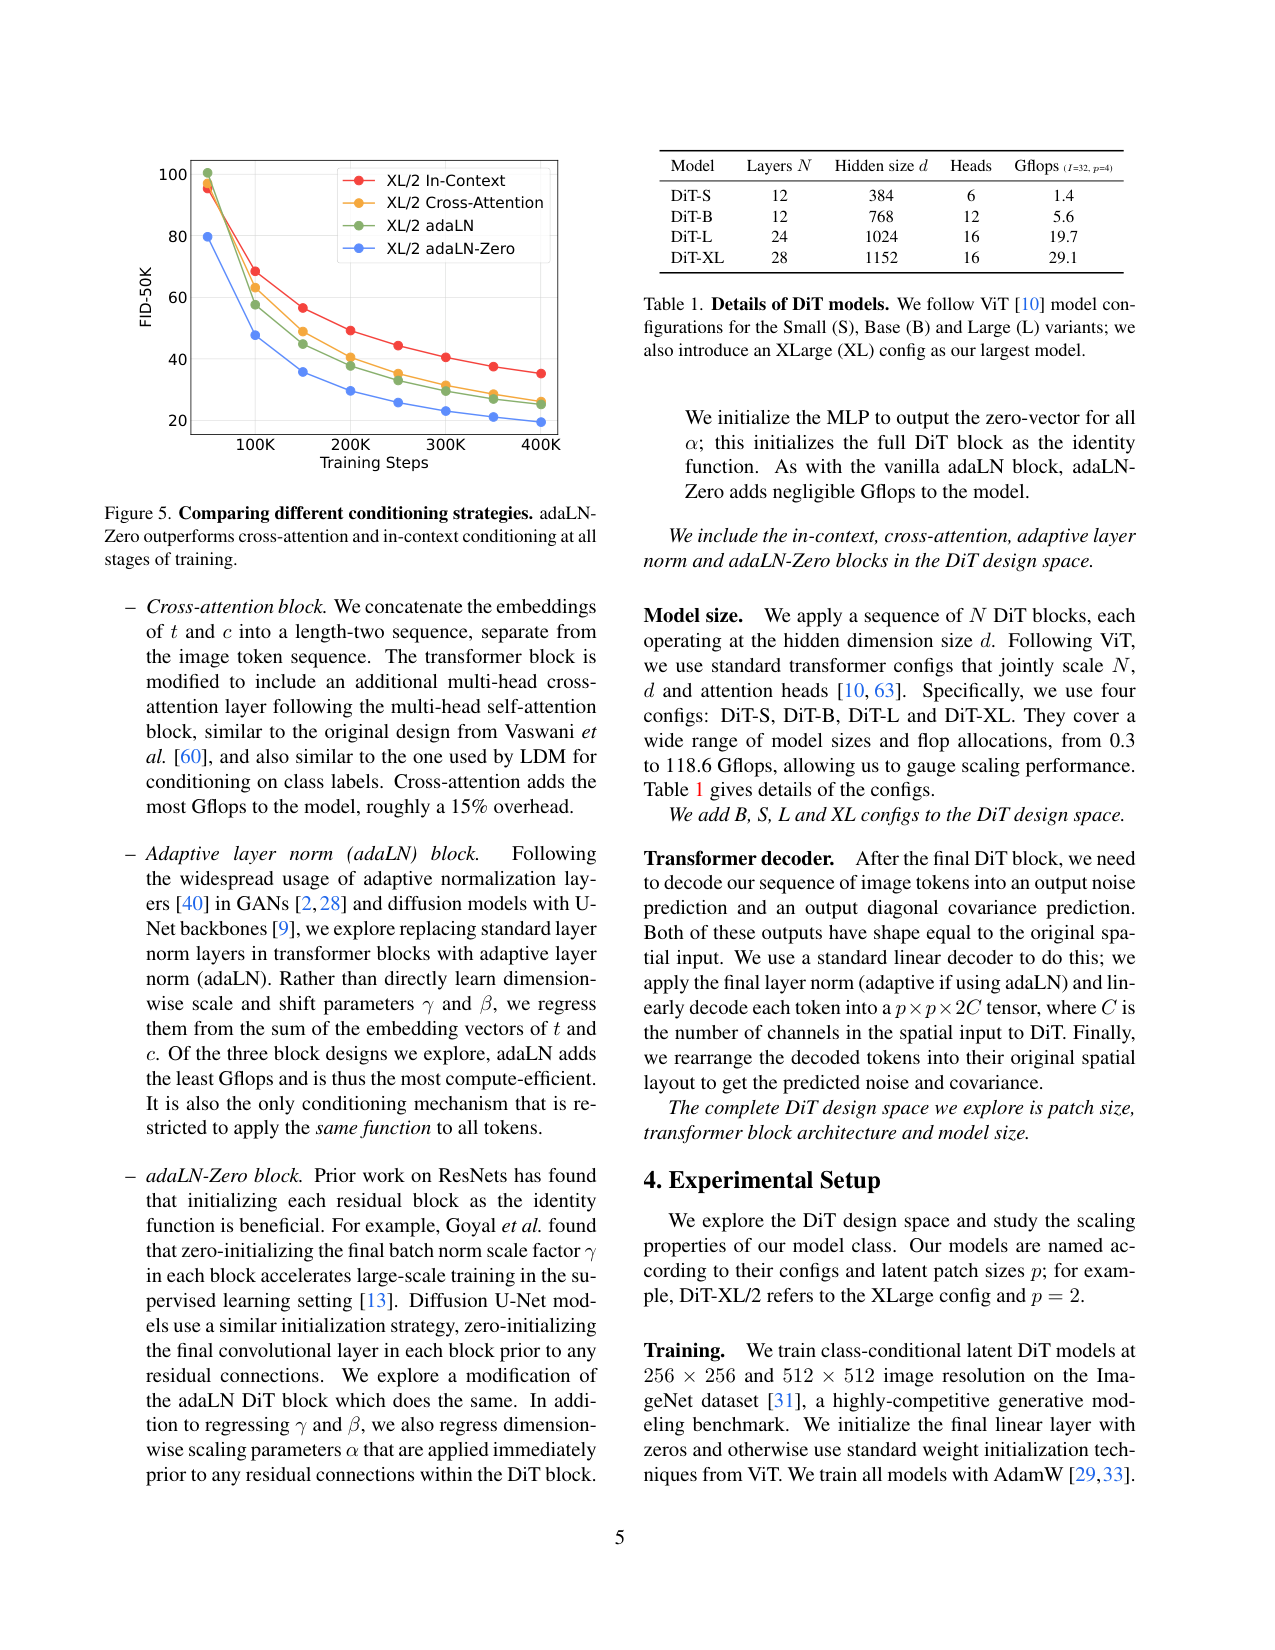
横轴是训练步数(100K 到 400K),纵轴是 FID-50K。四个 DiT-XL/2 变体除了条件注入方式不同,其他一切相同。400K 步终点:in-context 35.24、cross-attention 26.14、adaLN 25.21、adaLN-Zero 19.47。结论:adaLN-Zero 用最少的计算拿到最好的质量,质量差距接近一倍。
4.2 Scaling 曲线(图 2、图 6、图 8)
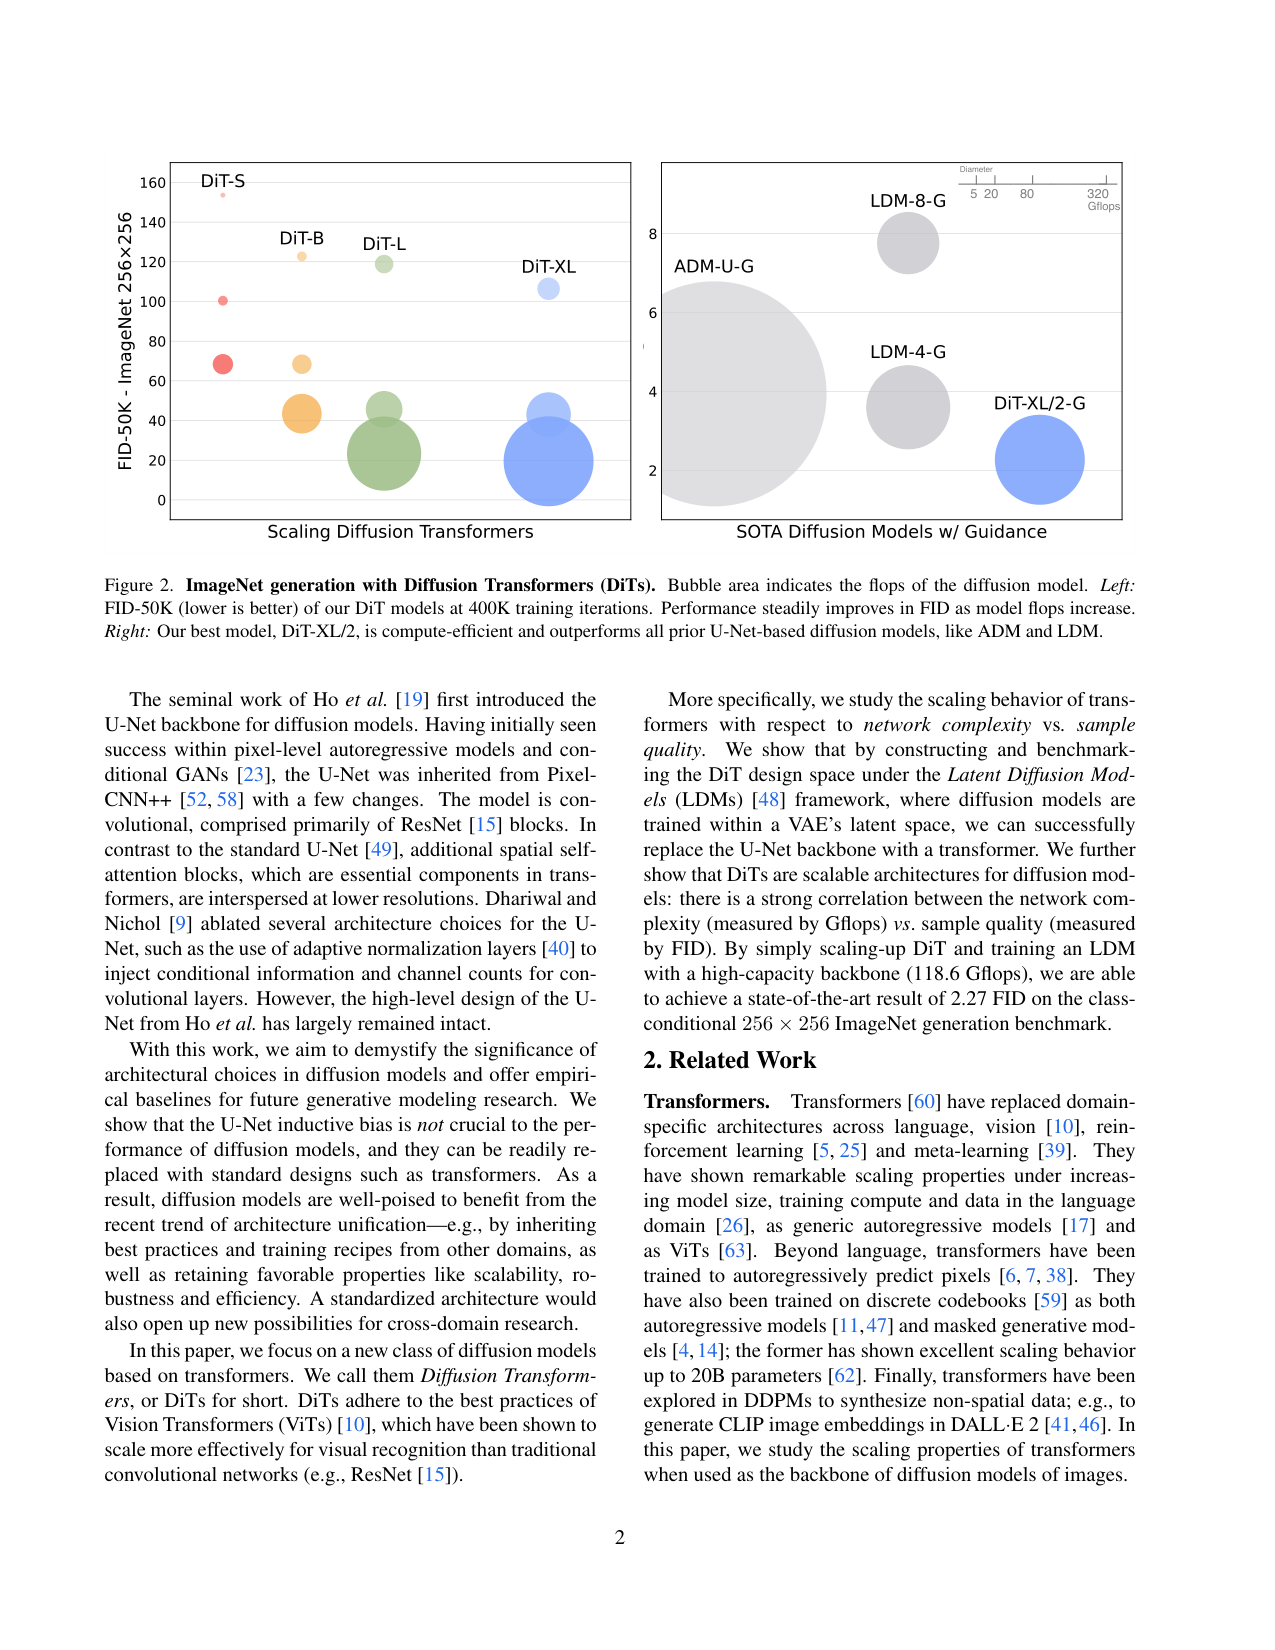
12 个模型训到 400K 步,FID-50K 从 153.60(S/8)单调降到 19.47(XL/2)。两条规律:固定 patch 变大模型,FID 全程下降;固定模型减小 patch(增加 token 数),FID 也全程下降,而参数几乎不变——后者直接说明参数数不是关键,计算量才是。
图 8 把 12 个模型画在 log-log 坐标里,对数尺度相关系数 -0.93。最有力的一对数据:S/2(6.06 Gflops,FID 68.40)与 B/4(5.56 Gflops,FID 68.38),Gflops 相近则 FID 几乎相同,尽管参数从 33M 涨到 130M。
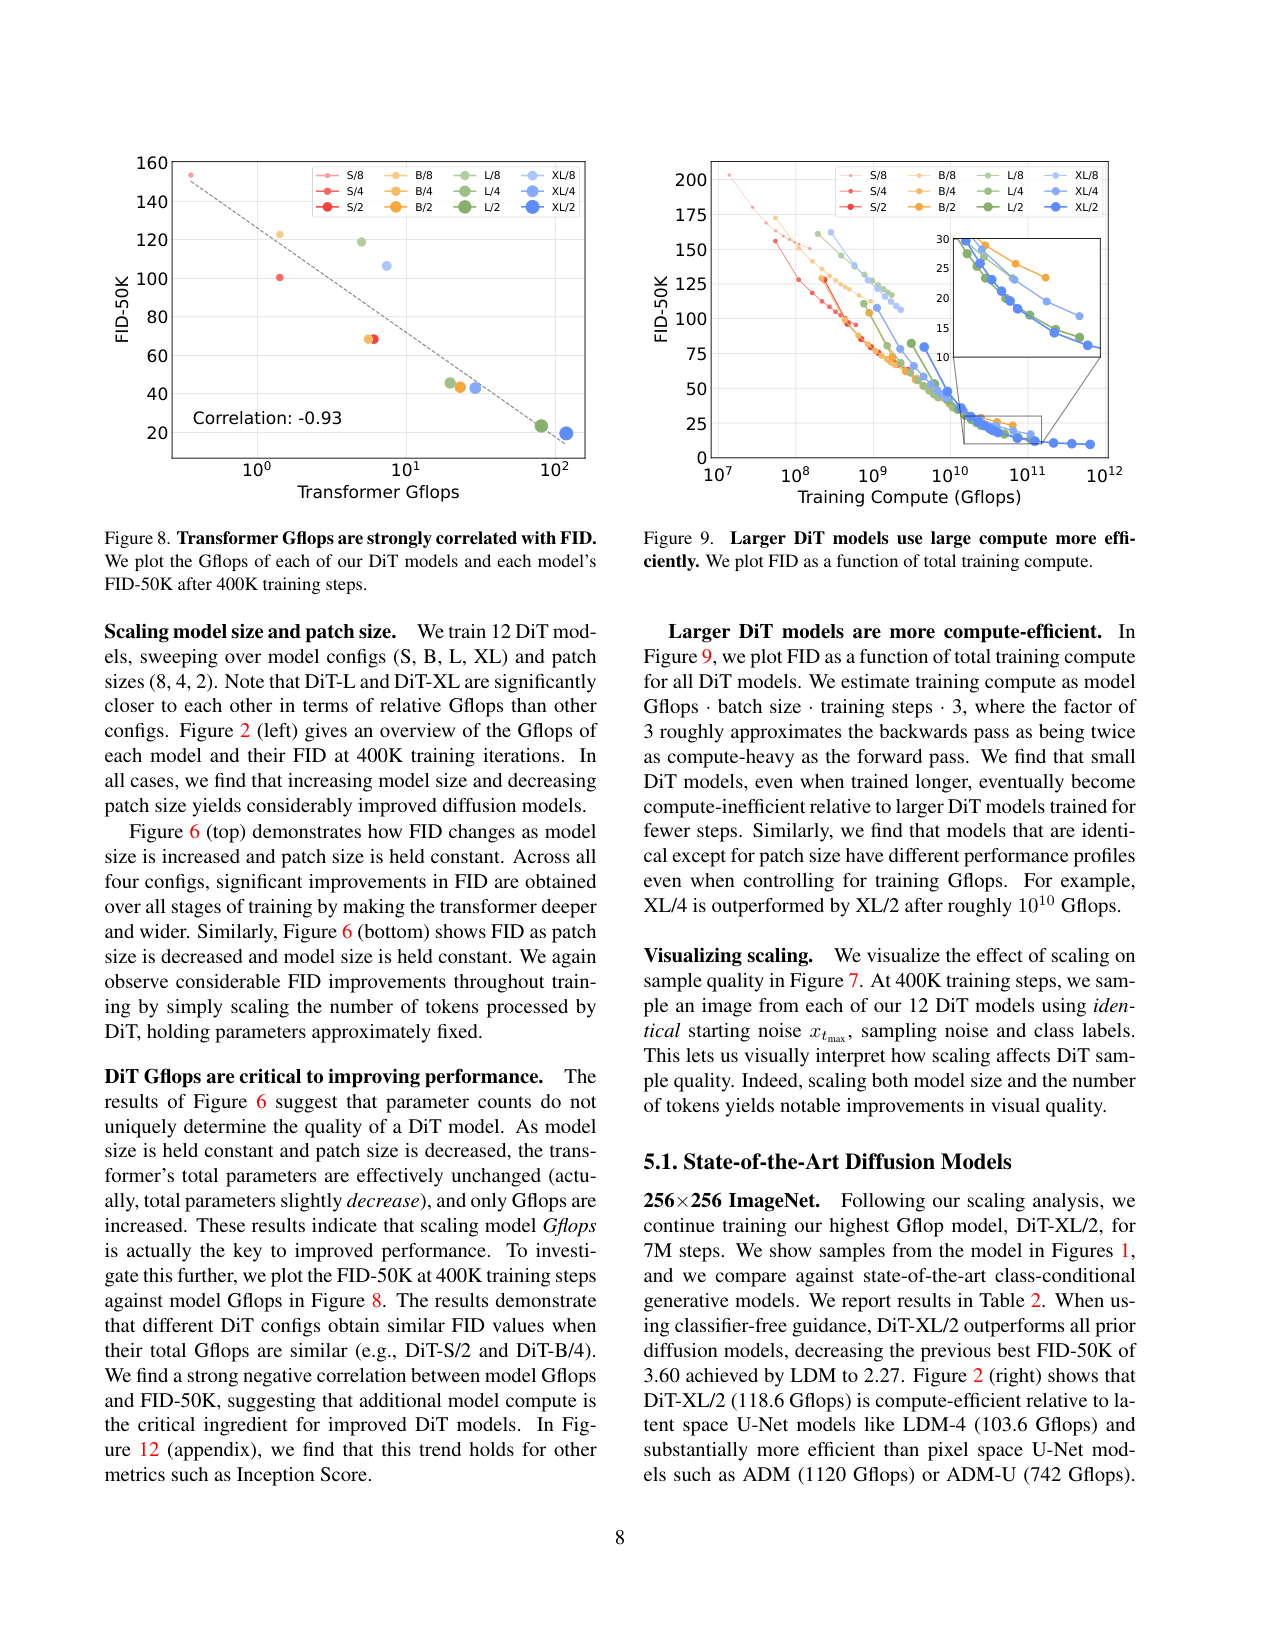
训练总计算(估计为 Gflops×batch×steps×3)的视角给出第二个结论:大模型在同预算下更高效,XL/4 与 XL/2 在约 1e10 Gflops 处交叉;小模型就算多训很多步也追不上大模型。第三个结论来自图 10:增大采样步数(测试时计算)补偿不了模型计算不足——L/2 用 1000 步(80.7 Tflops/图)FID-10K 是 25.9,XL/2 只用 128 步(15.2 Tflops/图)就有 23.7。
4.3 对 SOTA 的结果(表 2、表 3)
DiT-XL/2 续训到 7M 步(256×256),配合 classifier-free guidance(s=1.5,作用于 latent 前 3 通道),FID-50K 达到 2.27,超过此前所有扩散模型,也超过 StyleGAN-XL 的 2.30——扩散模型在这个基准上首次全面反超 GAN。512×512 上训 3M 步的模型 FID 3.04,超过 ADM-G+U 的 3.85。计算效率同样突出:256×256 下 DiT-XL/2 前向 118.6 Gflops,ADM 是 1120、ADM-U 是 742;512×512 下 524.6 Gflops 对比 ADM 的 1983 和 ADM-U 的 2813。
5. 谱系定位
DiT 处在两条技术路线的交汇处。一条是 LDM 开创的 latent diffusion:先用 VAE 压缩,再在小得多的空间上做扩散,DiT 直接沿用这套框架和预训练 VAE。另一条是 ViT 的架构统一趋势:识别任务已经证明 transformer 能取代卷积并随规模变强,DiT 把这个结论搬到生成侧。
和 ADM 比,DiT 证明骨干本身可以换,且换完之后 scaling 更好;和 LDM 比,在同一个 latent 空间里骨干替换本身就带来了收益(FID 3.60→2.27);和 StyleGAN-XL 比,它终结了 GAN 在类条件 ImageNet 上的领先。后续的 PixArt、SD3、Sora 基本沿用了 patchify + adaLN(或其变体 adaLN-Zero)+ Gflops scaling 分析这套配方,视频和 VLA 模型的骨干也大量以 DiT 为模板——这正是清单提示里说的「通用模板」的含义。
6. 局限
论文自承的局限有三条:训练配方全部继承 ADM 没有调优,架构收益之外可能存在配方红利;256×256 训到 7M 步、512×512 训到 3M 步时 FID 仍未饱和,绝对数字受算力预算限制;guidance 只作用于 latent 前 3 个通道就有接近全通道引导的效果,这个现象论文自己都觉得意外。
我们读出的局限:生成质量上限被 frozen VAE 卡住,latent 是 8× 下采样压缩的,高频细节在编码时就丢了,论文也没做像素空间 DiT 的对照实验;论文只系统测了 ε-prediction 一种参数化,没有比较 ε/v/x 三种预测目标,而后续 flow matching(SD3、Sora 用 v-prediction)和 He 组 JiT 的 x-prediction 都表明参数化选择影响很大——预测 ε 意味着网络输出不落在数据流形上,预测 x₀ 则相反,这是 DiT 留白的部分;评测只在类条件 ImageNet,未覆盖文生图、视频等更接近应用的设定。
7. 复现
官方开源了 JAX 实现(github.com/facebookresearch/DiT)与权重(HuggingFace)。训练在 TPU v3-256 pod 上,全局 batch 256,DiT-XL/2 约 5.7 步/秒。所有模型的超参和 FID 都列在论文 Table 4;VAE 用现成的 sd-vae-ft-mse / ft-ema;评估用 ADM 的 TensorFlow 套件、250 步 DDPM 采样、FID-50K 口径。
把扩散模型的骨干从卷积 U-Net 换成标准 ViT 风格的 transformer,在 latent 空间训练,证明『模型前向计算量(Gflops)与样本质量(FID)强相关』,并以 675M 参数的 DiT-XL/2 在 ImageNet 256×256 类条件生成上拿到当时最优 FID 2.27;这篇论文的 patchify + adaLN + scaling 配方后来成为 Sora、Stable Diffusion 3、PixArt 等 VLA/视频/文生图模型骨干的通用模板。
阅读提示
精读深度:精读
清单提示:原文提示:重点看 patchify、adaLN 条件注入与 scaling 曲线;这是 VLA/视频模型骨干的通用模板;同时注意它仍是 latent 空间 + ε/v-prediction,与 He 组 JiT 形成对比。
问题
要解决什么:扩散模型在图像生成上已经很强,但所有主流实现都默认用卷积 U-Net 做骨干;而语言模型和视觉识别领域已经证明 transformer 有更好的 scaling 特性。论文要回答一个具体的架构问题:把 U-Net 换成标准 transformer 之后,扩散模型的质量随计算量怎么增长,能不能借此获得 transformer 的 scaling 红利。
为什么 prior work 不够:Dhariwal & Nichol(ADM,2021)对 U-Net 做过架构消融,但没系统验证骨干本身是否可以替换;主流评价架构复杂度用参数量,而参数量反映不了分辨率、patch 数这些影响生成质量的因素;此外 GAN 路线(StyleGAN-XL)在同一基准上仍占优,扩散模型缺少一个能持续 scale 的骨干来反超。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| noised latent z_t | latent | VAE 编码器的输出加噪后的空间表征;256×256 图像对应 32×32×4,512×512 图像对应 64×64×4,通道数 C=4 |
| timestep t | scalar | 扩散过程的噪声步,t∈{1,…,1000},用 256 维频率编码 + 两层 MLP 嵌入 |
| class label c | categorical | ImageNet 类别标签,训练时按一定概率丢弃为 ∅ 以支持 classifier-free guidance |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 预测噪声 ϵ_θ(z_t, t, c) | latent | 与输入同形状 32×32×4(或 64×64×4)的噪声预测,DDPM 的 ε-prediction 参数化,逐像素 MSE 训练 |
| 对角协方差 Σ_θ(z_t, t, c) | latent | 同样形状的协方差预测,用完整 DKL 项单独训练(沿用 ADM 的做法) |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet(类条件)256×256 | 128 万张训练图 / 1000 类 | 生成模型标准基准;主表 FID-50K 用 250 步 DDPM 采样、ADM 的 TensorFlow 评估套件 |
| ImageNet(类条件)512×512 | 同 256×256 数据 | DiT-XL/2 训 3M 步;precision/recall 沿用 ADM 的 1000 张真实样本口径 |
架构(摘要)
主干与结构
backbone:DiT:在 latent patch 上运行的 ViT 风格 transformer(纯 transformer,无卷积下采样/上采样)
参数:33M(DiT-S)– 675M(DiT-XL),不含 84M 参数的 frozen VAE
类型:latent diffusion + transformer(DDPM,ε-prediction + 学习 Σ_θ,t_max=1000 线性噪声调度)
关键组件
- patchify:把 32×32×4 的 noised latent 切成 p×p patch(p∈{2,4,8}),线性嵌入成 T=(32/p)² 个 d 维 token,加 sine-cosine 位置编码
- DiT block(adaLN-Zero):用时间步+类别的 embedding 之和回归每层的 γ、β(调制 LayerNorm)和 α(调制残差前缩放);α 全零初始化,让每个 block 初始为恒等映射
- 线性解码器:每个 token 线性映射成 p×p×2C 张量,重排回空间布局,输出噪声预测和协方差预测
- frozen VAE:Stable Diffusion 的预训练 VAE,编码器 8× 下采样;解码器可选原版 / ft-MSE / ft-EMA 三种权重
- 训练配方:AdamW、常数学习率 1e-4、batch 256、无 weight decay、仅水平翻转增广、EMA(decay 0.9999),全部继承 ADM
为什么这样设计
设计目标是『尽量忠实标准 transformer』以继承其在语言和视觉识别里被反复验证的 scaling 特性,所以采用 ViT 的 patchify + 位置编码 + 标准 block + 线性解码;同时把扩散模型搬到 latent 空间(256×256 图像压成 32×32×4),让大规模架构探索的计算成本可控,这也是 LDM 验证过的做法。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| FID-50K(ImageNet 256×256 类条件,classifier-free guidance s=1.5) | 2.27 | 此前最优 3.60(LDM-4-G,cfg=1.5,latent U-Net 骨干);同表 StyleGAN-XL 2.30、ADM-G+U 3.94 | DiT-XL/2 训练 7M 步(EMA),250 步 DDPM 采样,ft-EMA VAE decoder,ADM 的 TensorFlow 评估套件 |
| FID-50K(ImageNet 512×512 类条件,cfg=1.5) | 3.04 | 此前最优 3.85(ADM-G+U,像素空间 U-Net);StyleGAN-XL 2.41 | DiT-XL/2 训练 3M 步,patch=2 时处理 1024 个 token,524.6 Gflops,250 步采样 |
| 条件注入方式消融 FID-50K(400K 步,无 guidance) | 19.47(adaLN-Zero) | in-context 35.24、cross-attention 26.14、adaLN 25.21,均为同规模 DiT-XL/2 | 四个 XL/2 变体各训 400K 步,ImageNet 256×256,超参完全相同;Gflops:in-context 119.4 / cross-attention 137.6 / adaLN 118.6 / adaLN-Zero 118.6 |
| Gflops 与 FID-50K 的对数相关系数(12 个模型) | -0.93 | 自比:S/2 与 B/4 的 Gflops 相近(6.06 vs 5.56)时 FID 也几乎相同(68.40 vs 68.38) | S/B/L/XL × patch 8/4/2,400K 步后 FID-50K vs transformer Gflops(0.36–118.64 G) |
| 256×256 单次前向 Gflops 对比 | 118.6(DiT-XL/2) | ADM 1120、ADM-U 742(像素空间 U-Net);LDM-4 103.6、LDM-8 57(latent U-Net) | DiT-XL/2 在 32×32×4 latent、p=2 下的 forward 计算量(不含 VAE) |
| 采样计算能否补偿模型计算(FID-10K) | 23.7(XL/2,128 步,15.2 Tflops/图) | 25.9(L/2,1000 步,80.7 Tflops/图);小模型用约 5 倍采样计算仍落后 | 12 个模型 400K 步后,采样步数 ∈ {16,32,64,128,256,1000},FID-10K |
| 无 guidance 的 FID-50K 随训练步数(XL/2,256×256) | 9.62(7M 步) | 同模型 400K 步 19.47、2.35M 步 10.67;加 guidance(s=1.5)后 2.27 | DiT-XL/2 续训至 7M 步,FID 全程未饱和 |
Insights
- 决定扩散模型生成质量的关键代理是模型前向计算量 Gflops,参数数只起次要作用:S/2 与 B/4 的 Gflops 相近(6.06 vs 5.56)则 FID 几乎相同(68.40 vs 68.38);同一模型把 patch 从 8 减到 2,参数从 33M 基本不变,FID 却从 153.60 降到 68.40(400K 步,无 guidance)。
- 条件注入方式是第一位的架构选择:adaLN-Zero 在 400K 步的 FID 19.47,接近 in-context 变体 35.24 的一半,且计算量最低;把每个 block 零初始化成恒等映射贡献了其中相当一部分收益。
- scaling 行为与语言模型一致:在相同训练计算预算下,大模型比小模型更高效(图 9 中 XL/4 与 XL/2 在约 1e10 Gflops 训练计算处交叉);增大测试时采样计算补偿不了模型计算不足(图 10)。
- 架构统一是可行的:标准 ViT 配方(patchify + 位置编码 + 标准 block + 线性解码)可以无缝替换 U-Net 拿到更好质量,扩散模型由此接入 transformer 生态的 scaling 红利,为后续 Sora/SD3/PixArt 等骨干统一铺路。
vs 同类工作
- vs ADM(Dhariwal & Nichol 2021):同一代扩散模型标杆,像素空间 U-Net;DiT 换到 latent 空间 + transformer 骨干后,256×256 前向计算从 1120 Gflops 降到 118.6 Gflops,无 guidance 的 FID 从 10.94 降到 9.62(DiT 多训了 7M 步),加 guidance 后 2.27 对 ADM-G 的 4.59。
- vs LDM(Rombach et al. 2022):同样用 frozen VAE 的 latent 空间,骨干仍保留 U-Net;DiT 把 256×256 的 SOTA FID 从 3.60(LDM-4-G cfg=1.5)压到 2.27,计算量同量级(118.6 vs 103.6 Gflops),说明在同一 latent 框架下骨干替换本身带来收益。
- vs ViT / Scaling ViT(Dosovitskiy et al. 2020;Zhai et al. 2022):把视觉识别里验证过的 ViT 配方原样搬到生成任务,验证 transformer scaling 在扩散模型里同样成立;DiT 的贡献在于『生成侧也需要这样的系统 scaling 研究』。
- vs StyleGAN-XL(Sauer et al. 2022):GAN 路线在 ImageNet 256×256 的最优 FID 2.30 被 DiT-XL/2-G 的 2.27 反超,扩散模型在类条件图像生成基准上首次全面领先 GAN。
- vs 同期工作(Jabri et al. 2022,Scalable Adaptive Computation for Iterative Generation):那个工作做注意力式的高效迭代生成,会改动标准结构;DiT 坚持纯标准 transformer,把『忠实 ViT、不加定制』当作卖点,差异在结构保真度与 scaling 分析的系统性。
局限
- 论文自承:训练配方几乎全部继承 ADM(学习率、Adam 参数、weight decay 都没调优),且 FID 对实现细节敏感(因此统一用 ADM 的 TF 评估套件);架构收益之外可能还有没被探索的配方红利。
- 论文自承:256×256 训到 7M 步、512×512 训到 3M 步时 FID 仍未饱和,继续训练会继续变好,所以表里的绝对数字受训练预算限制,代表的是『给定算力的成绩』,上界未知。
- 论文自承:classifier-free guidance 只作用于 latent 的前 3 个通道就能达到接近全通道引导的效果,这个现象论文自己都觉得意外,只留待未来研究,说明对 latent 通道语义的理解还不完整。
- 我们读出:生成质量上限被 frozen VAE 卡住——latent 是 8× 下采样压缩出来的,高频细节在编码时就丢了,DiT 只能修复 latent 里的信息;论文没做像素空间 DiT 的对照实验,『可以无修改应用于像素空间』只是声称。
- 我们读出:论文只系统测了 ε-prediction 一种参数化(预测噪声,噪声本身不落在数据流形上),没比较 ε/v/x 三种预测目标;后续 flow matching / v-prediction 工作(SD3、Sora)和 He 组 JiT 的 x-prediction 表明,参数化选择对训练效率和少步采样影响很大,这是 DiT 没覆盖的空白。
- 我们读出:评测只在类条件 ImageNet 上,未覆盖 text-to-image、视频、跨模态等更接近真实应用的设定;guidance scale(1.25/1.5/6.0)是手工选的,没有自适应策略;论文也没讨论模型泛化与鲁棒性。
可复现性
- code:https://github.com/facebookresearch/DiT(官方开源,JAX 实现)
- weights:DiT-XL/2 权重公开(HuggingFace facebookresearch/dit)
- setup:TPU v3-256 pod,全局 batch 256,DiT-XL/2 约 5.7 it/s;所有模型超参与 FID 完整列在 Table 4;VAE 用现成 sd-vae-ft-mse / ft-ema;采样 250 步 DDPM、ADM TF 评估套件
- note:本批次未产出 source.pdf 副本(任务限定只写 card.json/card.md/podcast.md/figures)
主干与结构
backbone:DiT:在 latent patch 上运行的 ViT 风格 transformer(纯 transformer,无卷积下采样/上采样)
参数:33M(DiT-S)– 675M(DiT-XL),不含 84M 参数的 frozen VAE
类型:latent diffusion + transformer(DDPM,ε-prediction + 学习 Σ_θ,t_max=1000 线性噪声调度)
关键组件
- patchify:把 32×32×4 的 noised latent 切成 p×p patch(p∈{2,4,8}),线性嵌入成 T=(32/p)² 个 d 维 token,加 sine-cosine 位置编码
- DiT block(adaLN-Zero):用时间步+类别的 embedding 之和回归每层的 γ、β(调制 LayerNorm)和 α(调制残差前缩放);α 全零初始化,让每个 block 初始为恒等映射
- 线性解码器:每个 token 线性映射成 p×p×2C 张量,重排回空间布局,输出噪声预测和协方差预测
- frozen VAE:Stable Diffusion 的预训练 VAE,编码器 8× 下采样;解码器可选原版 / ft-MSE / ft-EMA 三种权重
- 训练配方:AdamW、常数学习率 1e-4、batch 256、无 weight decay、仅水平翻转增广、EMA(decay 0.9999),全部继承 ADM
为什么这样设计
设计目标是『尽量忠实标准 transformer』以继承其在语言和视觉识别里被反复验证的 scaling 特性,所以采用 ViT 的 patchify + 位置编码 + 标准 block + 线性解码;同时把扩散模型搬到 latent 空间(256×256 图像压成 32×32×4),让大规模架构探索的计算成本可控,这也是 LDM 验证过的做法。
DiT 的 Gflops 与 FID 关系总览 + 与 U-Net 扩散模型的对比
原文 caption:ImageNet generation with Diffusion Transformers (DiTs). Bubble area indicates the flops of the diffusion model. Left: FID-50K of our DiT models at 400K training iterations. Performance steadily improves in FID as model flops increase. Right: Our best model, DiT-XL/2, is compute-efficient and outperforms all prior U-Net-based diffusion models, like ADM and LDM.
左边是 12 个 DiT 模型(S/B/L/XL × patch 8/4/2)在 400K 步时的 FID-50K 随 Gflops 下降的散点总览,气泡面积表示计算量,直接给出『计算量越大质量越好』的主结论;右边把 DiT-XL/2(118.6 Gflops)与像素空间 U-Net(ADM 1120 Gflops)和 latent U-Net(LDM-4 103.6 Gflops)放在同一张图上,说明换掉 U-Net 之后可以用低一个量级的计算拿到更好的 FID。
DiT 整体架构:patchify + 三类条件注入 block
原文 caption:The Diffusion Transformer (DiT) architecture. Left: We train conditional latent DiT models. The input latent is decomposed into patches and processed by several DiT blocks. Right: Details of our DiT blocks. We experiment with variants of standard transformer blocks that incorporate conditioning via adaptive layer norm, cross-attention and extra input tokens. Adaptive layer norm works best.
全篇最关键的一张结构图。左半是数据流:VAE 的 32×32×4 latent 先被 patchify 切成 token 序列,叠 N 个 DiT block,最后线性解码成噪声与协方差预测;右半给出三种条件注入方式的 block 细节——adaLN-Zero(γ/β 调制 LayerNorm + α 调制残差,代价几乎为零)、cross-attention(多一层交叉注意力,约 15% 额外计算)、in-context(把 t、c 当两个额外 token 拼进序列)。读图重点是:条件信息从哪进、每类设计多花多少计算,这决定了后面消融为什么选 adaLN-Zero。
条件注入方式消融:adaLN-Zero 全程领先
原文 caption:Comparing different conditioning strategies. adaLN-Zero outperforms cross-attention and in-context conditioning at all stages of training.
四个 DiT-XL/2 变体(in-context、cross-attention、adaLN、adaLN-Zero)在训练 100K–400K 步期间的 FID-50K 曲线。横轴是训练步数,纵轴是 FID(越低越好);关键对比在 400K 步终点:adaLN-Zero 的 19.47 接近 in-context 的 35.24 的一半,而且它的 Gflops(118.6)还低于 cross-attention(137.6)。这张图支撑论文最重要的工程结论:条件注入的方式本身对质量影响巨大,adaLN-Zero 用最省的计算拿到最好的质量。
log-log 尺度下 Gflops 与 FID 的相关性 -0.93
原文 caption:Transformer Gflops are strongly correlated with FID. We plot the Gflops of each of our DiT models and each model's FID-50K after 400K training steps.
把 12 个 DiT 模型按 transformer Gflops(横轴,对数坐标,0.36–118.64)与 FID-50K(纵轴)画成散点,算出对数尺度相关系数 -0.93。图中 S/2 与 B/4 的 Gflops 相近(6.06 vs 5.56)、FID 也几乎相同(68.40 vs 68.38),这正是『决定质量的是计算量、参数数只起次要作用』的直接证据;同一页下方还有图 9,用训练总计算(Gflops×batch×steps×3)说明大模型在相同训练预算下更高效。
🎧 音频版
时长 35:17 · Edge TTS
扩散模型的骨干,为什么要换成 Transformer?(DiT 精读)
先讲清楚这篇要解决什么问题
小播:今天要聊的这篇,标题叫《Scalable Diffusion Models with Transformers》,大家习惯叫它 DiT。我听说它特别重要,做视频生成、做机器人策略的人都拿它当基础。这篇到底解决了什么问题?
老播:一句话背景:2022 年前后,扩散模型已经是图像生成的主流方法,但几乎所有模型的骨干都固定用同一种卷积网络,叫 U-Net。DiT 这篇论文做的事情,是把 U-Net 换成视觉 transformer,也就是 ViT,然后系统性地研究一个问题——换掉骨干之后,模型的计算量越大,生成的图片质量是不是越好。结论是:是的,而且关系非常干净。论文用 675M 参数的 DiT-XL/2 在 ImageNet 256×256 类条件生成上拿到当时最好的 FID 2.27,第一次让扩散模型全面超过 GAN 路线。
小播:那它跟视频生成、机器人有什么关系?我听说这些领域都引用它。
老播:因为 DiT 的配方后来成了通用模板:先在 latent 上把输入切成 patch 变成 token,用 adaLN-Zero 注入条件信息,叠一堆标准 transformer block,最后线性解码。Sora 的视频模型、Stable Diffusion 3、PixArt 的文生图骨干,基本都沿这条路线;机器人那边的 VLA 和视频预测模型也大量以 DiT 为骨干。所以今天这期把 DiT 读透,等于把后面一大片工作的地基读透了。我会重点讲三件事:patchify 怎么把图片变成 token、adaLN 怎么把条件信息送进网络、以及那条著名的 scaling 曲线是怎么画出来的。
先补背景:U-Net 是什么,为什么有人想换掉它
小播:好,那我们从头开始。先定义一下,扩散模型到底是什么?
老播:扩散模型是一种生成模型,思路是分两步:第一步,把真实图片一步步加噪声,加到彻底变成纯噪声;第二步,训练一个网络学会反过来,从纯噪声一步步把图片还原出来。加噪的过程是固定的、不需要学的,真正要学的是反向去噪那一步。这个框架最早来自 2015 年 Sohl-Dickstein 等人的工作,2020 年 Ho 等人用 DDPM 这个名字把它做成能出图的实用方法。U-Net 就是从那会儿开始,成为扩散模型的标准骨干。
小播:U-Net 具体长什么样?
老播:U-Net 是一种卷积网络,形状像字母 U:先一层层下采样,把特征图变小变深,再一层层上采样,把特征图恢复原尺寸,中间在低分辨率的地方穿插空间注意力,让不同位置的信息能互相交换。它擅长处理图片这种规则网格结构,而且参数共享、计算高效。ADM 那篇论文,就是 Dhariwal 和 Nichol 在 2021 年发的《Diffusion Models Beat GANs》,对 U-Net 做过很多细节消融,比如通道数、归一化方式、条件信息怎么注入,但从来没有人问过一个更基本的问题:骨干本身能不能换成别的结构?
小播:为什么突然想换?U-Net 明明用得挺好。
老播:因为另一条路在快速证明自己。语言模型那边,GPT 系列用 transformer,规模越大、数据越多,性能几乎可以预测地变好,这叫 scaling 特性,Kaplan 等人还专门总结过 scaling law;视觉识别那边,ViT 也证明了 transformer 能取代卷积网络,而且在大规模设定下更划算。生成模型这边反而一直停在专用架构上,作者觉得这一步该补上了。他们站的位置是两条前人的工作之上:LDM,也就是后来 Stable Diffusion 前身那批人做的 latent diffusion,证明了可以在 VAE 压缩过的 latent 空间里训练扩散模型,计算省很多;DiT 在这套框架里把骨干换成 transformer,验证 transformer 的 scaling 红利能不能在生成任务上复现。
小播:那 U-Net 的归纳偏置呢?卷积的局部性、下采样上采样,不是对图像天然友好吗?
老播:这正是论文要检验的假设。U-Net 的归纳偏置——卷积的局部连接、跨尺度的跳跃连接、下采样上采样的多分辨率结构——一直被当成扩散模型高质量生成的关键。作者把这些偏置全部拿掉,换成对空间结构没有先验假设的 transformer,然后看结果。他们的答案相当直接:这些偏置对高质量生成贡献有限,标准结构就够用了,而且还能拿到更好的 scaling 曲线。这是一个有争议的论断,所以后面所有实验都尽量控制变量,让结论站得住。
小播:顺便问一句,2022 年的时候,扩散模型凭什么已经是主流?之前好像是 GAN 更强?
老播:转折点在 2021 年的 ADM:Dhariwal 和 Nichol 用改进的 U-Net 让扩散模型在图像生成质量上第一次超过当时的 GAN,再加上扩散模型训练稳定、不容易模式坍缩,很快成了主流方法。但主流也有代价:U-Net 这个骨干从 DDPM 开始就一直没人真正质疑过,相当于所有人在同一栋房子里装修,没人检查地基。DiT 就是那个把地基问题摆上台面的工作——先问"骨干能不能换",再回答"换了之后 scaling 好不好"。
小播:那用什么来衡量"规模"?参数数量行不行?
老播:论文明确反对用参数量。原因很具体:参数量反映不了分辨率、token 数这些明显影响生成质量的因素。你想想,同一个模型喂 256×256 还是 512×512,参数一模一样,但计算量和质量差很远。所以他们改用理论 Gflops——模型跑一次前向传播需要的十亿次浮点运算数——当作复杂度标尺,全部 12 个模型都用这个横轴。这个选择是后面 scaling 曲线的地基。作者也承认,度量指标本身没有绝对最优,不同场景看重的开销不同,但 Gflops 至少能同时反映分辨率和模型大小,比参数数可靠得多。
核心思想第一步:patchify,把 latent 变成一串 token
小播:好,那 DiT 到底长什么样?从头讲一遍。
老播:先说整体数据流。DiT 在 latent 空间里工作:一个预训练好的 VAE 编码器把 256×256×3 的图片压缩成 32×32×4 的小张量,横向纵向各缩 8 倍,通道变成 4 个。这个 VAE 就是 Stable Diffusion 用的那个,作者直接拿来用、冻结住不训练。扩散模型就在这 32×32×4 的 latent 上加噪、去噪,最后用 VAE 解码器还原成图片。这样做的直接收益是计算量:在 32×32 的空间上跑 transformer,和在 256×256 像素上跑,不是一个量级。像素空间跑扩散模型的 ADM 在 256×256 下前向要 1120 Gflops,DiT 只要 118.6 Gflops,差了将近一个数量级。
小播:那 32×32×4 的格子怎么喂给 transformer?transformer 吃的是序列。
老播:这就是第一个关键词,patchify,直译叫"打补丁"。做法是:把 32×32 的 latent 切成 p×p 的小块,每个小块线性映射成一个向量,也就是一个 token。patch 大小 p 可以取 2、4、8。token 总数 T 等于 (32/p)²:p=2 的时候是 16×16 等于 256 个 token,p=8 的时候只有 4×4 等于 16 个 token。每个 token 再配上 ViT 标准的 sine-cosine 位置编码,告诉网络它在空间上原来在哪个位置。这套东西和 ViT 对图片的做法一一对应,作者刻意保持忠实,为的是继承 transformer 的 scaling 特性。最后一个 block 之后,每个 token 会被线性解码成 p×p×2C 的空间块,一半输出噪声预测、一半输出协方差预测,再重排回 32×32×4 的布局。
小播:那位置信息怎么办?patch 被压平成一维序列,空间关系不就丢了吗?
老播:这就是位置编码的作用,和 ViT 一模一样:每个 token 按它在序列里的位置得到一个用固定公式算出的编码向量,加进 token 表示里。因为是固定公式,没有额外参数,也几乎不增加计算。DiT 的定位是尽量忠实标准 transformer,所以这类细节都直接沿用,不发明新东西——新东西集中在条件注入上。后面讲 adaLN 的时候你会看到,作者把设计空间压缩得很小,刻意只动该动的地方。
小播:patch 大小这个选择有什么讲究?
老播:讲究大了,它是全篇实验设计的关键旋钮。p 减半,token 数变 4 倍,注意力计算量至少翻 4 倍,但参数量几乎不变,因为 patchify 本身是一个共享的小线性层。这就给了你一个干净的开关:单独拨动"计算量"这个变量,把参数量按住不动,来做对照实验。后面 12 个模型的 scaling 曲线,横轴上的跨度全靠它铺出来。这个设计后来被几乎所有 DiT 类模型继承,包括视频生成里对时空做 patchify 的做法——本质上就是把"颗粒度"变成一个可调的旋钮。
核心思想第二步:adaLN,把时间步和类别送进网络
小播:token 有了,那扩散模型特有的条件信息怎么进去?比如噪声时间步 t 和类别标签 c。
老播:这是第二个关键词,也是论文里最值得抄的设计。标准 ViT block 没有条件入口,作者试了三种方式。第一种叫 in-context:把 t 和 c 的 embedding 当成两个额外 token 直接拼进输入序列,网络照常跑,最后把这两个 token 丢掉,几乎不增加计算。第二种叫 cross-attention:在 block 里加一层交叉注意力,让图像 token 去关注条件 token,这是代价最大的方案,约 15% 的 Gflops 开销。第三种叫自适应 LayerNorm,简称 adaLN:把 block 里的标准 LayerNorm 换成自适应版本,用 t 和 c 的 embedding 之和回归出逐维的缩放 γ 和偏移 β,再作用到归一化输出上。
小播:等一下,LayerNorm 的作用我大概知道,是给特征做归一化。那"自适应"是什么意思?
老播:普通 LayerNorm 的 γ 和 β 是网络自己学的一组固定参数,所有输入共享;adaLN 的 γ 和 β 则是根据条件动态算出来的——时间步不同、类别不同,缩放和偏移就不同,等于让条件信息直接调控每一层的特征幅度。实现上,时间步 t 先过一个 256 维的频率编码,再和类别 embedding 相加,过一个 SiLU 激活加一个线性层,输出的维度是隐藏维的 6 倍,用来拆成 γ、β、α 三组参数。
小播:那 adaLN-Zero 又是什么?
老播:是 adaLN 的一个改进。在 adaLN 的基础上,残差连接之前再回归一个逐维的缩放 α,并且把 α 全零初始化。这样每个 DiT block 在训练最开始就是恒等映射——输入是什么,输出就是什么。这个技巧在 ResNet 和扩散 U-Net 里都出现过:把残差块初始化为恒等,大规模训练更稳定。作者把它移植到 transformer 上,效果出乎意料地好。你可以这样理解:网络一开始相当于什么都没做,从"复制输入"这个最保守的起点出发,随着训练逐步放开残差,比从随机初始化的复杂函数出发更容易收敛到好解。
小播:为什么条件注入方式的差距能这么大?能给个解释吗?
老播:论文给的解释比较克制,我们加上自己的理解:in-context 把条件当成普通 token,条件信息要在几十层注意力里慢慢传播,噪声时间步这种对每一步都关键的信息容易被稀释;cross-attention 的信息路径直接,但多一层注意力增加约 15% 的计算;adaLN 把条件直接调制每一层的特征分布,信息零距离到达每个 block,代价又几乎为零。而 α 零初始化的恒等起点,让网络从最平稳的状态开始学,大规模训练更稳。这两点——条件信息的直达程度、训练的起始条件——合在一起,就解释了为什么 adaLN-Zero 同时拿到最低的 FID 和最低的额外计算。
小播:对了,adaLN-Zero 里的 block 内部结构是标准的吗?
老播:标准。每个 DiT block 就是 ViT 那套:LayerNorm、多头自注意力、残差,再 LayerNorm、逐点前馈 MLP、残差。adaLN 改动的是把两个 LayerNorm 换成自适应版本,adaLN-Zero 再多一个 α 作用在残差前面。除了条件注入,没有其他定制。这恰恰是论文的策略:主干保持普通,把设计空间压缩到三个维度——patch 大小、block 的条件注入方式、模型规模——这样每个维度的贡献都能单独度量,不会互相纠缠。
小播:好到什么程度?给数字。
老播:这是全篇最有力的一个消融。四个 DiT-XL/2 变体,除了条件注入方式不同,其他一切相同,都训练 400K 步、都在 ImageNet 256×256 上、超参完全一样。结果:in-context 的 FID-50K 是 35.24,cross-attention 是 26.14,adaLN 是 25.21,adaLN-Zero 是 19.47。FID 是衡量生成质量的指标,越低越好,用 5 万张生成图和真实图算分布距离。adaLN-Zero 的分数接近 in-context 的一半,而且它的计算量 118.6 Gflops 比 cross-attention 的 137.6 还低。这个消融说明:条件注入怎么设计,对质量的影响比模型规模本身还敏感,这是全篇最重要的工程结论之一,后面讲 scaling 曲线的时候你会看到,同样的计算量差距,靠换条件注入方式能拿到的收益相当可观。
核心思想第三步:训练公式还是老一套
小播:换了骨干,训练目标是不是也要改?公式还是原来那套吗?
老播:完全一样,这也是论文的卖点之一——架构换了,训练配方原样照搬,连超参都没调。这里有个公式,先给预期:它说的是,训练时给干净数据加噪,然后让网络预测我们加进去的噪声,用最简单的均方误差当损失。式子这样写:L = ‖ε_θ(z_t, t, c) − ε‖²。每个符号的意思:z_t 是加了 t 步噪声之后的 latent,ε 是我们加的、已知的标准高斯噪声,ε_θ 是网络的预测,t 和 c 是条件。为什么这么简单的目标能成立?因为 DDPM 那套理论证明,学会预测噪声,就等价于学会逆转加噪过程;采样时从纯噪声出发,按学到的反向过程一步步走 1000 步,就得到图片的 latent,再解码成图。
小播:那噪声具体怎么加?也说一下。
老播:加噪过程一句话:x_t = √ᾱ_t · x₀ + √(1−ᾱ_t) · ε。先给预期,这个式子回答"中间时刻的带噪样本长什么样"。x₀ 是干净 latent,ε 是标准高斯噪声,ᾱ_t 是一个随 t 递减的常数调度,决定噪声占比。t 小的时候 √ᾱ_t 接近 1,样本基本是干净的;t 大的时候噪声项主导,样本接近纯噪声。训练时每个样本随机抽一个 t,加一次噪,让网络去猜 ε。DiT 沿用 ADM 的配置:时间步上限 1000,线性噪声调度从 1e-4 到 2e-2,另外用完整的 DKL 项单独训练协方差预测 Σ_θ——协方差决定每一步采样时加多少随机性,这块继承 ADM 的参数化,作者明确说一个超参都没调,为的是让架构对比干净。
小播:还有一个细节,训练稳定性。transformer 训练不是经常要 warmup 吗?
老播:对,很多 ViT 训练都需要学习率预热和正则化,否则训练会炸。DiT 的作者报告了一个反常规的现象:他们用常数学习率 1e-4、batch 256、AdamW、无 weight decay、只用水平翻转做增广,所有规模的模型训练都稳定,没有出现 loss spike。EMA 权重衰减设 0.9999,所有报告的指标都用 EMA 模型算。作者把训练配方固定下来,全部继承 ADM,这样 12 个模型之间的差异就只来自架构和计算量,scaling 结论更干净。
小播:采样的时候怎么用类别条件?不是直接喂进去就行吗?
老播:直接喂类别可以,但质量差一截。作者用 classifier-free guidance,公式是 ϵ̂ = ϵ_θ(z_t, ∅) + s·(ϵ_θ(z_t, c) − ϵ_θ(z_t, ∅))。先给预期:这个式子让采样结果偏向类别 c,s 越大越像 c、多样性越低。ϵ_θ(z_t, ∅) 是无条件预测,来自训练时随机把类别丢弃、替换成空标签 ∅ 的那条通路;s 是引导强度,论文主实验取 1.5。有个细节:guidance 只作用在 latent 的前 3 个通道上,效果和全部 4 个通道差不多,作者自己都说这个现象有点意外,留给未来研究。guidance 的收益非常大,后面讲成绩表的时候你会看到,同一个模型加不加强度 1.5 的引导,FID 从 9.62 掉到 2.27。
关键实验一:条件注入的消融
小播:实验部分从哪张图开始看?
老播:先看条件注入消融,也就是论文的图 5。横轴是训练步数,从 100K 到 400K,纵轴是 FID-50K,越低越好。四条曲线对应四种注入方式,全程 adaLN-Zero 压在最下面,也就是一直最好,100K、200K、300K、400K 每个阶段都是。400K 步终点我们刚说过:35.24、26.14、25.21、19.47。这张图的含义:模型规模、patch 大小、训练配方完全相同的条件下,只改条件注入方式,FID 就能差接近一倍。如果你想抄 DiT 的配方,adaLN-Zero 这一项必须抄,它同时是最省计算和最好用的方案。
关键实验二:那条 scaling 曲线
小播:接下来是著名的 scaling 曲线?
老播:对,这是全篇的核心证据。作者训练了 12 个模型:模型规模四档 S、B、L、XL,patch 三档 8、4、2,两两组合。模型配置照搬 ViT:S 是 12 层、隐藏维 384,B 是 12 层、768 维,L 是 24 层、1024 维,XL 是 28 层、1152 维。全部 12 个模型训练 400K 步,超参完全相同。图 8 把 12 个点画在 log-log 坐标里,横轴是 transformer Gflops,从 0.36 到 118.64,纵轴是 FID-50K,算出的对数相关系数是 -0.93,几乎就是一条直线。
小播:-0.93 意味着什么?
老播:意味着计算量和质量之间有很强的单调关系,你可以拿它当预测工具。最有力的一对数据是 S/2 和 B/4:S/2 是 6.06 Gflops,FID 68.40;B/4 是 5.56 Gflops,FID 68.38。这俩计算量差不多,FID 几乎一样,但参数一个 33M、一个 130M,差将近 4 倍。反过来看同一模型减 patch:XL 从 p=8 换到 p=2,参数基本不变,FID 从 106.41 一路降到 19.47。这两组对照合起来就一句话:决定质量的是前向计算量 Gflops,参数数只起次要作用。这是全篇最想让你记住的结论,我们收尾还会再说一遍。
小播:图 6 那张分上下两排的图呢?也是 scaling 证据吗?
老播:对,图 6 展示的是训练过程中的 FID 曲线,横轴是训练步数,纵轴是 FID。上排固定 patch 大小、模型从 S 变到 XL,能看到更大的模型全程压着更小的模型;下排固定模型、patch 从 8 变到 2,同样一路改善。这张图的重点在"全程"两个字:不是只有 400K 步终点有效,从训练一开始,更大计算量的模型就领先,说明这是稳定的规律,而不是某个随机种子或某个训练阶段的偶然。论文里还配了一张同种子对比图,图 7:12 个模型用完全相同的初始噪声、完全相同的类别标签去采样,排成网格,从左到右模型变大、从上到下 patch 变小,肉眼就能看到画面从模糊色块变成清晰物体,比数字更有说服力。
小播:除了模型本身的计算量,训练总计算量有没有类似规律?
老播:有,论文的图 9 画的是训练总计算,估计方法是模型 Gflops 乘 batch 256 乘训练步数再乘 3,那个 3 是近似把反向传播算成两倍前向、再加一些边角开销。结论:大模型在相同训练预算下更高效。XL/4 和 XL/2 的曲线在约 1e10 Gflops 的地方交叉,之后 XL/2 一直领先;小模型就算多训很多步也追不上大模型。这跟语言模型的 scaling law 是一致的:把算力花在更大的模型上,比花在更长的训练上划算。作者还在附录里确认,同样的规律对 Inception Score、Precision 这些其他指标也成立,其中 IS 和 Precision 受益甚至更多。
小播:这条 -0.93 的曲线能叫 scaling law 吗?
老播:作者很克制,全篇只用 scaling properties,没用 scaling law 这个词。原因也实在:只有 12 个点、最大到 675M 参数和 118.6 Gflops,样本量撑不起一条"定律";而且 FID 这种分布距离指标在低值区会变平,对数直线未必能外推。后来确实有工作发现,计算量再往上走,FID 的改善会放缓甚至出现弯曲。所以把它当成"强相关的经验规律"来用,把它当成"定律"去外推,要慎重。这个克制是好事,说明作者清楚自己证据的边界在哪。
小播:那采样的时候多花计算,能不能补救小模型?
老播:论文专门做了这个实验,图 10:把采样步数从 16 加到 1000,发现小模型用更多的采样计算也补不上模型计算的差距。具体数字:L/2 用 1000 步采样,每张图花 80.7 Tflops,FID-10K 是 25.9;XL/2 只用 128 步,每张图花 15.2 Tflops,反而是 23.7。XL/2 用不到五分之一的采样计算,质量还更好。测试时加计算替代不了训练时加规模,这个结论后来被反复引用。
关键实验三:对 SOTA 的最终成绩
小播:最后那张成绩表呢?FID 2.27 是怎么来的?
老播:表 2 是 ImageNet 256×256 类条件生成的全家福。DiT-XL/2 在 400K 步的基础上继续训练到 7M 步,配合 classifier-free guidance,s 取 1.5、作用在 latent 前 3 通道,FID-50K 是 2.27。对比组:此前最优的扩散模型 LDM-4-G 在 cfg=1.5 时是 3.60,GAN 路线的 StyleGAN-XL 是 2.30,像素空间 U-Net 的 ADM-G 是 4.59。所以 2.27 同时破了扩散模型和 GAN 的记录。注意一个细节:DiT-XL/2 不加 guidance、训 7M 步的 FID 是 9.62,2.27 是加 guidance 之后的数,两者要分清楚;只训 2.35M 步、和 ADM 训练量相当的版本,FID 也有 2.55,仍然超过所有旧方法。
小播:512×512 呢?
老播:512 那边训 3M 步的 XL/2 拿到 3.04,超过了所有此前的扩散模型,上一任扩散最优 ADM-G+U 是 3.85;不过 GAN 路线的 StyleGAN-XL 在 512 上是 2.41,仍然排第一,所以论文在 512 上的措辞是"超过所有此前扩散模型",没有说全面超过。计算效率依然亮眼:512 下 DiT 是 524.6 Gflops,ADM 是 1983,ADM-U 是 2813,只有五分之一左右。作者还测了 recall 指标,DiT 在多个 guidance 强度下都比 LDM-4 和 LDM-8 高,说明提升 FID 的同时没有牺牲多样性。
小播:guidance 强度怎么选?越大越好吗?
老播:要谨慎。guidance 强度 s 越大,样本越贴着类别走、细节越锐利,但多样性下降,FID 也不是一直变好。256×256 下 s=1.25 时 FID 是 3.22,s=1.5 时是 2.27,再往上会回升;附录展示样本时,256 的模型用了 s=4.0,512 的用了 s=6.0,为的是突出清晰度。所以 2.27 这个数依赖一个手工选的强度,这也是论文局限的一部分。作者对评估细节很谨慎,所有 FID 都用 ADM 的 TensorFlow 评估套件、250 步 DDPM 采样,还专门在附录里测了三种 VAE 解码器权重——同一个模型换解码器,FID 从 2.46 变到 2.30、再到 2.27,说明最终数字对 VAE 这一环也敏感。
谱系定位:它处在哪条路线上,JiT 怎么跟它对着干
小播:那它在整个生成模型谱系里是什么位置?
老播:两条线的交汇。第一条线是 latent diffusion:LDM 证明在 VAE 压缩过的空间里训练扩散模型,计算省一个量级,DiT 直接继承这套框架和现成的预训练 VAE。第二条线是架构统一:ViT 在识别任务里取代了卷积,DiT 把同样的结论搬到生成任务。和 ADM 比,DiT 证明了骨干可以替换,而且换完之后计算量低一个量级、质量更好;和 LDM 比,在同一个 latent 空间里,把 U-Net 换成 transformer 本身就把 256×256 的最优 FID 从 3.60 压到 2.27;和 StyleGAN-XL 比,它终结了 GAN 在类条件 ImageNet 256 分辨率上的领先。后续的 PixArt、Stable Diffusion 3、Sora,骨干基本就是 patchify 加 adaLN 这个配方,视频生成和 VLA 模型的骨干也大量以 DiT 为模板。
小播:能不能举几个具体的下游例子,说明这个模板怎么被套用?
老播:可以。PixArt 直接把 DiT 的 patchify 和 adaLN 拿去做文生图,把类别条件换成文本条件;Stable Diffusion 3 用 MM-DiT,把文本和图像两路 token 放进同一个 transformer 里联合处理;Sora 把视频 latent 切成时空 patch,条件注入也是 adaLN 那一套的变体;机器人这边,很多视频预测模型和策略模型直接把 DiT 当骨干,输入从图像 token 扩展到动作加观测。它们共享的正是 DiT 验证过的那件事:标准 transformer 加合理的条件注入,在扩散目标下能稳定 scaling。清单里说它是通用模板,就是这个意思——先在 latent 上 patchify 成 token,用 adaLN-Zero 注入条件,叠一堆 block,最后线性解码,这套流程从图片到视频到机器人动作序列都能套。
小播:但提示里还说,它和 He 组的 JiT 形成对比?
老播:对,这点值得展开。DiT 有两个隐含设定:latent 空间加 ε-prediction,也就是让网络预测噪声。预测 ε 有个数学上的麻烦:噪声本身落在数据分布之外,网络每一步的输出都不在数据流形上,等于让网络不断去猜一个结构上"乱"的目标。后来 flow matching 那一派改用 v-prediction,预测速度场,训练更稳、少步采样更好,SD3 和 Sora 都走这条路。而 Kaiming He 组的 JiT,全名《Back to Basics: Let Denoising Generative Models Denoise》,arXiv 编号 2511.13720,走得更远:直接预测干净数据 x₀,也就是 x-prediction。他们的理由是 x₀ 在数据流形上,目标本身是合理图像,网络更容易学;他们还去掉了 VAE tokenizer,在像素空间直接用大 patch 做,认为 tokenizer 的压缩瓶颈反而限制表达。所以对比很清楚:DiT 是 latent 空间加 ε-prediction 的代表,JiT 是像素空间加 x-prediction 的代表,两条路线在视频生成和一步生成的研究里长期并存。
小播:也就是说,DiT 的配方也不是终点?
老播:它是一块里程碑,但留下了参数化的空白:论文只系统测了 ε-prediction 一种,没比较 ε、v、x 三种预测目标。这个空白正好被后面的工作填上,我们马上讲局限。
局限:论文自承的,和我们读出来的
小播:那这篇论文有什么短板?别只说好话。
老播:先说论文自己承认的三条。第一条,训练配方全部继承 ADM,学习率、Adam 参数、weight decay 一个都没调,所以架构收益之外可能还有配方红利没被挖出来。第二条,256×256 训到 7M 步、512×512 训到 3M 步,FID 曲线还没饱和,继续训还会更好,所以 2.27 和 3.04 代表的是给定算力下的成绩,不是架构上限。第三条,guidance 只作用在 latent 前 3 个通道就有接近全通道的效果,作者自己说这现象有点意外,留给未来工作。
小播:你们自己读出来还有什么问题?
老播:四条。第一,生成质量的天花板被 frozen VAE 卡住:latent 是 8× 下采样压缩出来的,高频细节在编码时就丢了,DiT 只能在 latent 里修补;论文声称能无修改搬到像素空间,但没有做对照实验,所以"骨干无关空间"这个说法没有直接证据。第二,评测只在类条件 ImageNet 上,没覆盖文生图、视频、跨模态这些更接近真实应用的设定,guidance 强度 1.25、1.5、6.0 都是手工选的,没有自适应策略。第三,scaling 曲线只到 675M 参数和 118.6 Gflops,更大规模的 extrapolation 没有验证,后来的工作发现 scaling law 在高计算区会有弯曲,不能直接外推。第四,就是刚才说的参数化问题:只测了 ε-prediction,而后续工作证明预测目标的选择影响训练效率和少步采样能力,这正是 JiT 后来发难的切入点。
收尾:记住这三件事
小播:最后总结一下,这期该记住哪三件事?
老播:第一,patchify 是 DiT 的入口设计:把 latent 切成 patch 当 token,patch 大小是控制计算量的旋钮,p 减半 token 数翻 4 倍、参数不变。第二,条件注入用 adaLN-Zero:用时间步和类别的 embedding 回归每层的 γ、β、α,α 零初始化让 block 从恒等开始,400K 步时 FID 19.47,接近 in-context 变体 35.24 的一半。第三,scaling 曲线:12 个模型在 log-log 坐标里 Gflops 和 FID 的相关是 -0.93,S/2 和 B/4 用相近的计算量拿到几乎相同的 FID,说明决定质量的是前向计算量而不是参数数。把这三件事串起来,你就理解为什么 DiT 成了视频和 VLA 模型的通用骨干模板。
老播:最后补一句它对后续的意义。DiT 证明了扩散模型可以接入 transformer 的 scaling 红利,这条路线直接通到 Stable Diffusion 3 和 Sora;同时它留下的参数化问题和 latent 瓶颈问题,催生了 flow matching 的 v-prediction 和 He 组 JiT 的 x-prediction 两条新路线。读 DiT,读到的是一块地基:它把"骨干"这个变量从扩散模型里解放了出来,后续所有架构创新都是在这块地基上盖楼。