Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion
- arXiv: 2407.01392(v4, 2024-12-10),NeurIPS 2024
这篇论文解决什么问题
概率序列建模长期被两条路线分割。下一个 token 预测模型(以 teacher forcing 训练)擅长变长生成:可以只生成一个 token,也可以自回归地生成"无穷多"个;可以条件在任意长度的历史上;还支持树搜索和在线闭环控制。但它在连续数据上有两个硬伤:采样时没有机制把序列往某个目标(比如高回报)引导;自回归 rollout 超过训练长度时,帧间小误差不断累积,模型发散——视频预测尤其明显。另一条路线是全序列扩散:把一段固定长度的序列拼起来整体扩散,所有 token 用同一个噪声水平。它能做分类器引导,也擅长生成连续信号(视频),但被非因果、无掩码的结构锁死:只能生成固定长度整段序列,做不了变长生成,也做不了逐 token 的因果条件。
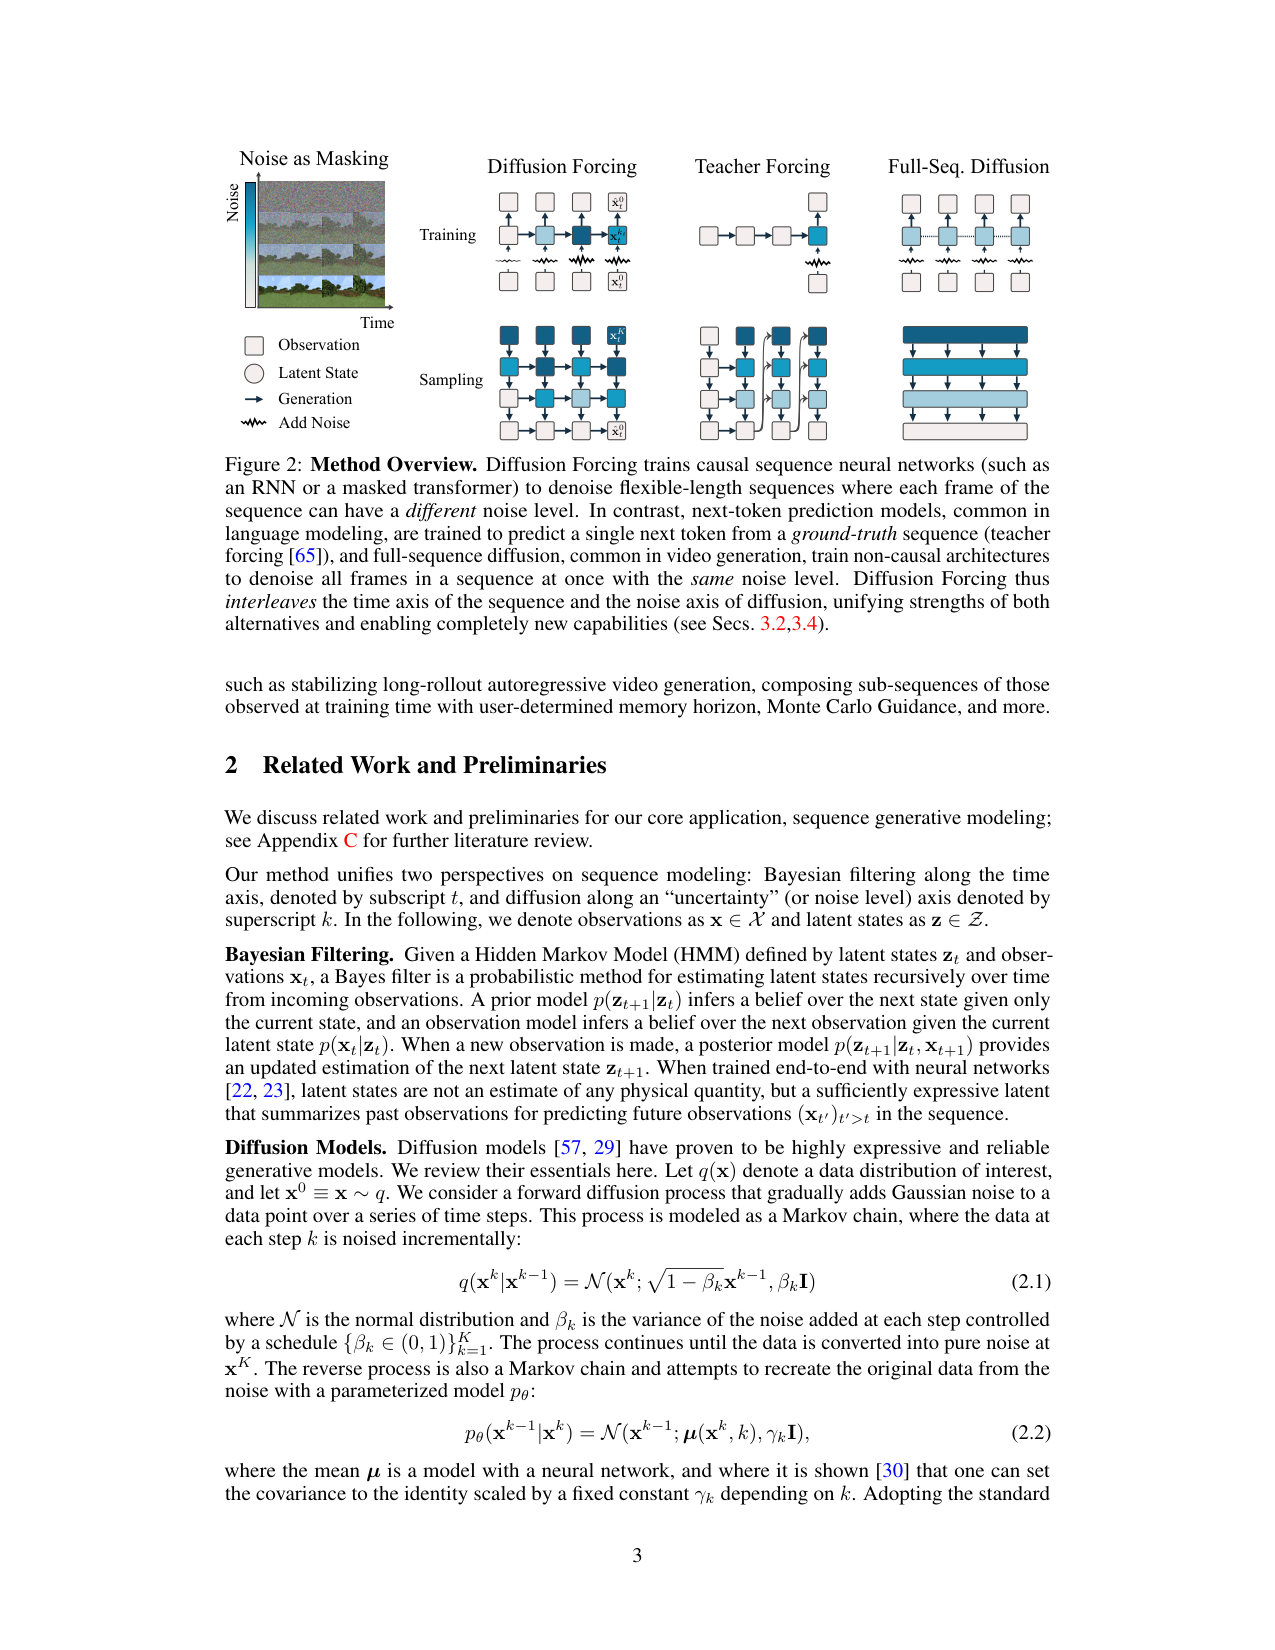
论文的关键观察是:这两条路线可以统一在"掩码"的视角下。teacher forcing 是沿时间轴掩码——只让你看过去、预测下一个 token;扩散加噪是沿噪声轴掩码——把 token 加噪到不同程度,等价于部分遮挡它。那么为什么不把两条轴同时打开:每个 token 独立随机采样一个噪声水平 k_t,训练一个因果模型去同时"解开"任意组合的噪声 token?这就是 Diffusion Forcing(DF):一个用独立 per-token 噪声水平训练的因果 next-token 扩散模型。它在推理时把"噪声水平"当作自由旋钮——同一个模型既可以像自回归模型那样任意长度 rollout,又可以像全序列扩散那样带引导地规划,还新增了全序列扩散做不了的两件事:未来保持不确定的因果采样调度,以及蒙特卡洛引导(MCG)。
一句话结论:DF 让 next-token 预测获得全序列扩散的引导能力,同时保留变长生成,并用"小噪声条件"解决自回归误差累积;理论上是所有子序列似然的重加权 ELBO,实证上视频 2000 帧不爆、D4RL maze 规划全面超过 Diffuser、真实机器人换果任务 80% 成功率。
方法:噪声即掩码,两个轴一起打开
第一步:把加噪看成部分掩码
对任意 token 集合,训练"从被掩码的部分恢复完整内容"都是同一个模板。加噪前向过程把数据 x₀ 逐级变成噪声 x_K:
x_k = √ᾱ_k · x₀ + √(1−ᾱ_k) · ϵ_k,ϵ_k ~ N(0, I)。
这个式子要回答的问题是:给定一个干净 token,它在噪声水平 k 下长什么样。其中 ᾱ_k 是累计信号保持比例(前 k 步的 α 连乘),√ᾱ_k 乘在数据上、√(1−ᾱ_k) 乘在标准高斯噪声上;k=0 时 ᾱ₀=1,得到的就是干净数据本身,k=K 时 x_K 近似纯白噪声。加噪程度越高,掩码程度越高:k=0 完全可见,k=K 完全掩码。于是"噪声水平"与"掩码程度"一一对应,这就是噪声轴上的掩码。
第二步:每 token 独立噪声水平的训练目标
DF 的训练目标是让模型学会去噪"任意 token 任意噪声水平"的组合。每个时间步 t 独立均匀采样 k_t∈{0,…,K},分别对 x_t 加噪得到 x_{k_t}^t;一个因果 RNN 维护隐状态 z_{t-1}(过去 token 的压缩),每个时间步的单元是一个条件扩散模型,输入 (z_{t-1}, x_{k_t}^t, k_t),输出噪声预测 ϵ̂_t。损失是标准的 DDPM 式均方误差:
L = E_{k,x,ϵ}[ Σ_{t=1..T} ‖ϵ_t − ϵ_θ(z_{t-1}, x_{k_t}^t, k_t)‖² ]。
这个式子要回答的问题是:用什么样的监督,网络才能学会所有噪声组合下的去噪。ϵ_t 是第 t 个 token 的真实加噪噪声,ϵ_θ 是网络对它的预测,差值平方再对随机噪声水平、数据、噪声取期望。z_{t-1} 是 RNN 隐状态,编码过去全部 token 的信息;k_t 作为条件告诉模型"当前观测有多可信"。论文证明(Theorem 3.1,附录 A):这个目标优化所有噪声水平序列下、子序列似然的重加权 ELBO;在表达充分的网络下,权重项不影响最优点,可以放心去掉。特别地,k_t 只取 {0, K} 时就是"掩掉任意先前 token"的特例,所以模型学到的是训练集所有子序列的条件分布——这就是"一个模型、所有子序列"的理论来源。
第三步:采样 = 在 M×T 网格上随意走
采样时,DF 先在二维噪声网格 K∈[K]^{M×T} 上定义路径:列是时间步 t,行是去噪轮次 m,K_{m,t} 是第 t 个 token 在第 m 轮的目标噪声水平。从全部白噪声出发,逐行、行内从左到右(因果)去噪,直到最后一行全部为 0。由于训练覆盖了任意噪声组合,这个网格可以训练后任意设计,对应不同的能力:
- 全序列扩散式:所有 token 同步去噪,等价于 Diffuser 的采样。
新的采样能力:引导、因果不确定性与 MCG
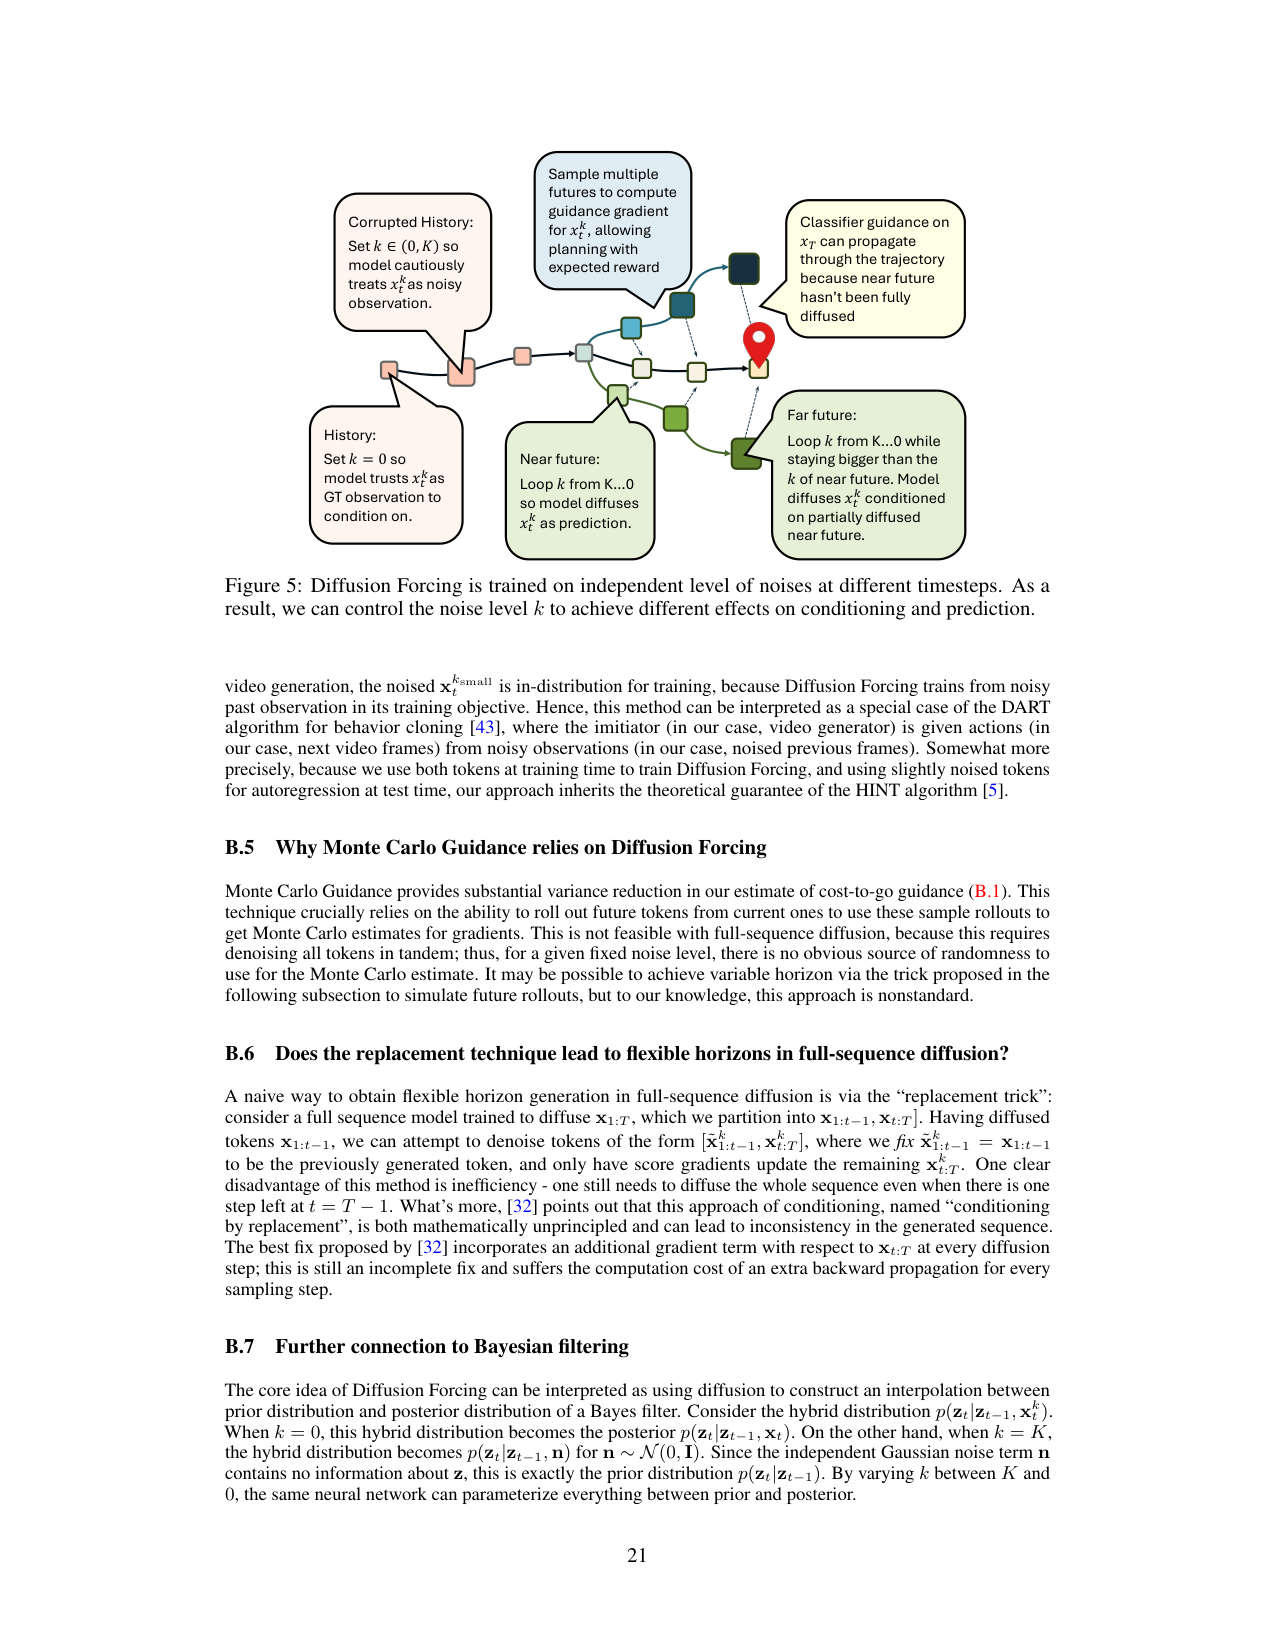
全序列扩散的引导方式是分类器引导:采样时把噪声预测改成 ϵ_θ − √(1−ᾱ_k)·∇_x log c(y|x),把生成往目标 y 推。DF 的独特之处在于未来 token 没有完全去噪,所以引导梯度可以沿因果链从未来反传到过去,同时尊重"过去已经确定"的因果结构。这带来三个新能力:
- 长时程引导:对未来多个时间步的奖励做引导,梯度会修改当前与近期的 token,而 Diffuser 的引导只能作用在整段同步去噪上,无法体现"近处动作更重要"。
关键实验与结果
视频:超过训练长度 2 倍以上的稳定 rollout
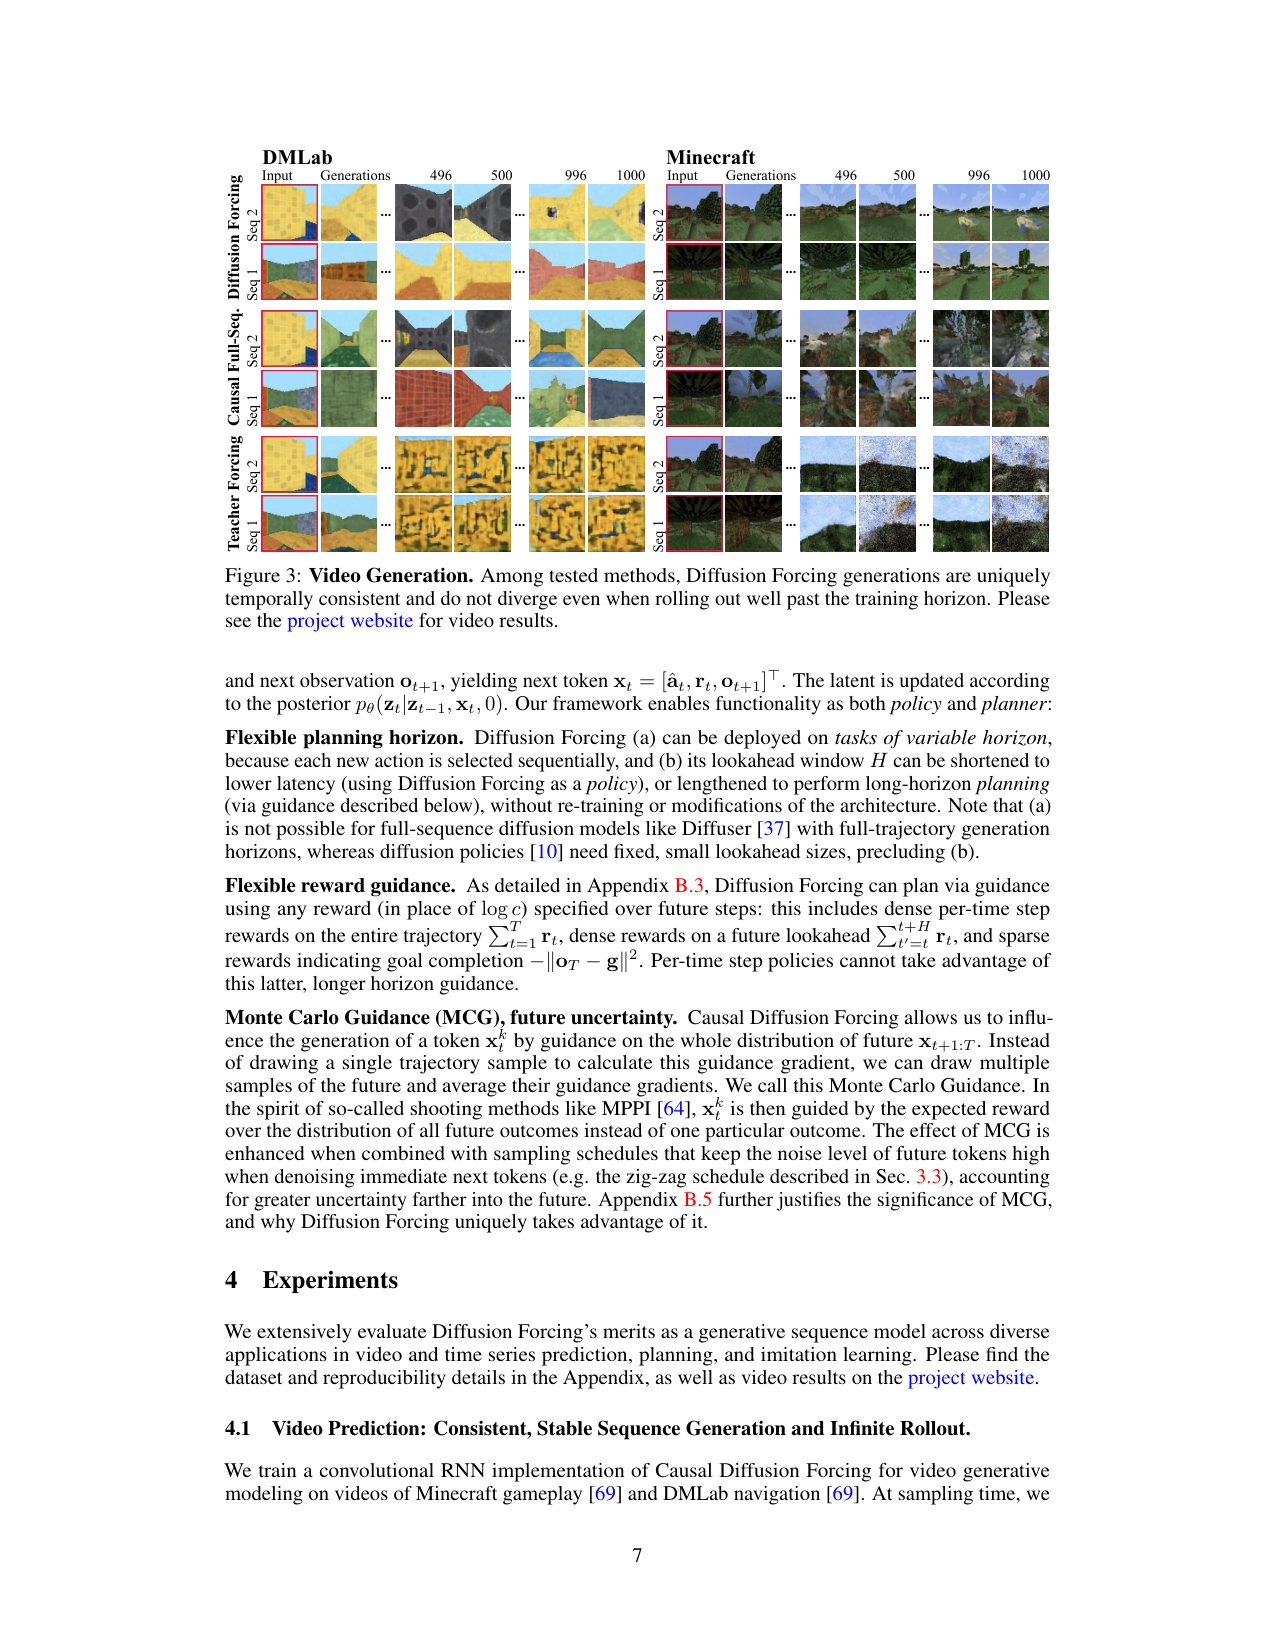
视频预测用 conv-RNN 实现(U-Net + GRU,Minecraft 36M 参数、DMLab 24M 参数),在 TECO 的 Minecraft(128px、训练 72 帧)与 DMLab(64px、训练 36 帧)上训练,只用了约 10% 的子序列。对照是同一 RNN 架构的两种基线:teacher-forcing 的 next-frame 扩散与因果全序列扩散。Figure 3 显示:DF 从测试集起始帧 rollout 到第 496–1000 帧仍保持时间一致性;两种基线很快发散,全序列扩散在训练长度内还有帧间跳跃。附录 E.3 补充:不加滑窗、不重置隐状态,DF 可以生成 180 帧(2–5 倍训练长度),测试到 2000 帧也没有爆炸。注意这是可视化观测,论文没有给 FVD 等标准定量指标。
D4RL maze 规划:动作自洽 + 因果不确定性 + MCG
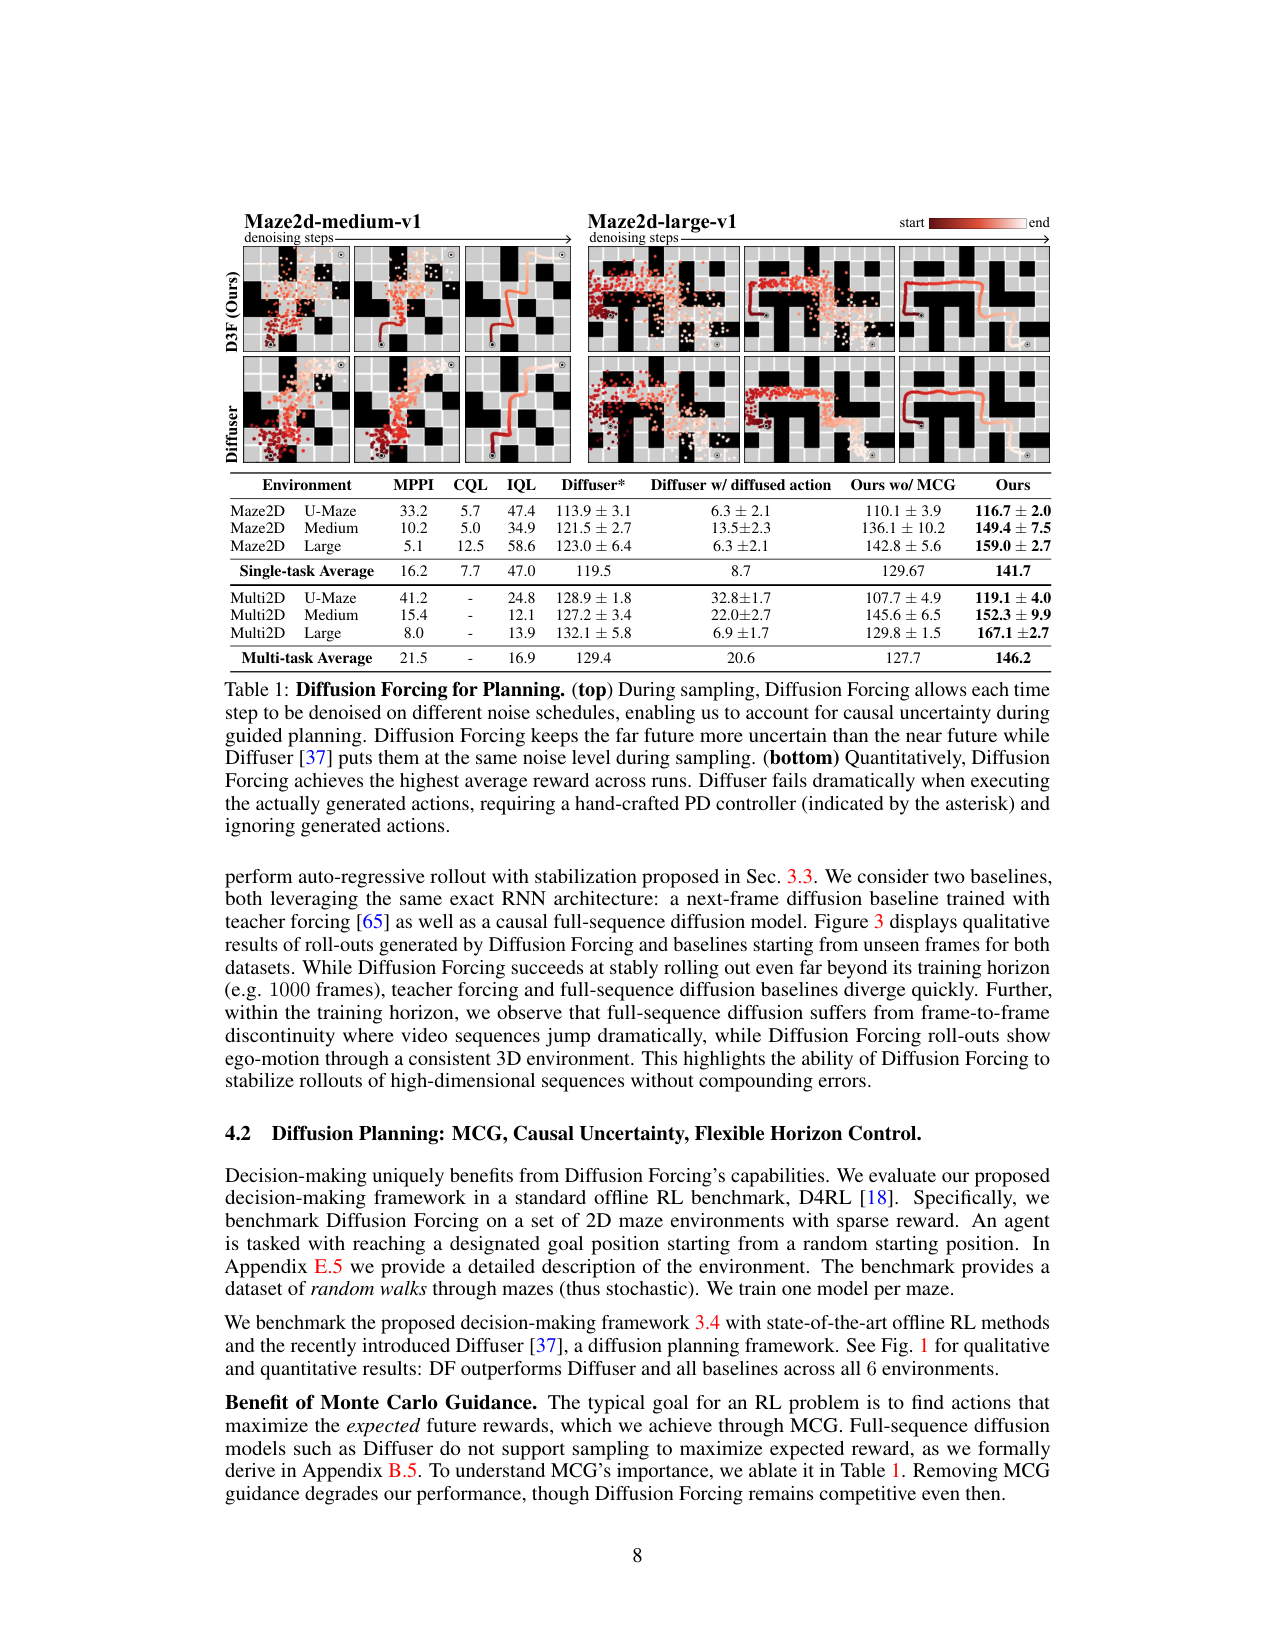
决策实验在 D4RL maze2d 的三个环境(umaze/medium/large)及多目标变体上做,观测 4 维(2D 位置+速度)、动作 2 维加速度、稀疏奖励(进入目标半径 0.5 内得 1)。每时间步 token 打包 [a_t, r_t, o_{t+1}],训练同 Algorithm 1。结果(Table 1):单任务平均回报 Ours 141.7,Diffuser*(手写 PD 控制器从生成状态反推动作)119.5,Diffuser 直接执行生成动作只有 8.7,IQL 47.0,MPPI 16.2;多目标变体 Ours 146.2 vs Diffuser* 129.4。三个要点:第一,DF 生成的动作与状态自洽,直接执行不崩溃,Diffuser 需要外部 PD 控制器;第二,金字塔调度编码因果不确定性(近处确定、远处不确定),是超越 Diffuser 的关键;第三,MCG 提供额外增益(141.7 vs 去 MCG 的 129.7)。论文同时承认评测指标有争议(附录 D.8):episode reward 有利于慢走到达目标的生成,Diffuser 可能因此受益,建议用首次到达时间。
真实机器人:带记忆的模仿学习与遮挡鲁棒性
换果任务:苹果和橙子放在 A/B 两个槽,用第三个槽周转互换;初始位置随机导致两种可能的目标态,单帧观测无法决定下一步,必须记住初始配置(非马尔可夫)。150 条 VR 遥操作演示,视频下采样到 40 帧、每帧捆绑 15 个 6-DoF 动作。DF 用隐状态天然携带记忆,成功率 80%;无记忆的 Diffusion Policy 失败。测试时加入视觉干扰物并全遮挡相机,DF 把污染观测标成 k>0 走先验,成功率只降 4 个百分点到 76%;next-frame 扩散基线把污染观测当 ground truth,只有 48%。
时间序列:作为通用序列模型不退化
GluonTS 六数据集(维度 8–2000)、pytorch-ts 设置、CRPSsum 评测(越低越好):Exchange 0.003±0.001(最佳先前方法 0.006)、Traffic 0.040、Taxi 0.075;但 Wikipedia 上排第四(0.085,ScoreGrad 0.043 第一)。论文的定位是"没有明显性能代价",卖点仍在引导与稳定性。
谱系定位:与 flow map 长时程路线互为对手
在"稳定长时程生成"这个目标上,存在两条对立路线,DF 是 flow map 谱系(FMM、MeanFlow、Consistency Models,本清单同批)的主要对手方法。
flow map 路线的做法是把时间当作显式对象:直接学习两时间流映射 X_{s,t}(把时刻 s 的任意点送到时刻 t),用合成律 X_{t,τ}∘X_{s,t}=X_{s,τ} 保证任意步数划分下小步复合等于大步,从数学上控制多步采样的一致性与误差。它给出的保证是"映射本身精确",代价是要学一个覆盖所有时间区间的映射族,且一步直接训练收敛困难(FMM 论文自承)。
DF 路线的做法是把时间当作噪声调度的对象:模型只学"给定任意噪声组合的下一步",稳定性来自"条件 token 保持小噪声、误差留在训练分布内",以及"近处确定、远处不确定"的因果调度。它给出的保证是"任意噪声组合下都能去噪"(所有子序列的 ELBO),代价是单步预测本身的误差没有被显式约束,稳定性靠分布内化而非映射精度。
两条路线在应用上互补:flow map 适合需要"步数随意但单次映射精确"的场景(one-step 生成、蒸馏),DF 适合需要"超长 rollout + 引导 + 变长 + 记忆"的场景(世界模型、规划、机器人)。在长时程世界模型这个交叉点上,它们是彼此最主要的对照:一个用显式映射锁误差,一个用噪声调度容错。
局限
- 论文自承:当前因果实现基于 RNN;高分辨率视频与更复杂分布大概率需要大规模 transformer(附录 B.1 给出实现思路但未做),没有研究到互联网规模数据的扩展行为。
可复现性
- 代码:正文未附官方仓库链接,项目网站 https://boyuan.space/diffusion-forcing 提供视频演示。
记住的三件事
1. 噪声水平 = 掩码程度:每个 token 独立随机加噪训练,让一个因果模型学会任意噪声组合的去噪,采样调度变成训练后的自由旋钮。
2. 稳定 rollout 靠"小噪声条件":把预测帧当带小噪声的观测喂回,误差留在训练分布内,视频可 rollout 到训练长度 2 倍以上不爆。
3. 因果不确定性与 MCG 让规划超过 Diffuser:近处确定、远处不确定的金字塔调度 + 多条未来轨迹平均引导,D4RL maze2d 单任务平均 141.7 vs Diffuser* 119.5。
给序列里每个 token 独立随机采样一个噪声水平 k_t 来训练扩散模型,让『下一个 token 预测』获得『全序列扩散』的引导、变长与稳定性能力:同一套网络既可以像自回归模型那样任意长度 rollout,又可以像 Diffuser 那样带回报引导地做规划,还新增了未来保持不确定的因果采样调度与蒙特卡洛引导 MCG。理论上证明该训练目标优化所有噪声水平序列下子序列似然的重加权 ELBO;实证上视频可稳定 rollout 到训练长度 2 倍以上(2000 帧不爆)、D4RL maze 规划单任务平均回报 141.7(Diffuser* 119.5)、真实机器人换果任务成功率 80%(Diffusion Policy 记 0)。
阅读提示
精读深度:精读
清单提示:原文提示:每 token 独立噪声水平实现因果去噪;长时程 rollout 稳定性与动作规划实验;是『flow map 长时程』讨论的主要对手方法。
问题
要解决什么:概率序列建模的两大范式各缺一块能力。下一个 token 预测(teacher forcing)支持变长生成、变长历史条件、树搜索和在线闭环控制,但训练时喂的是真实历史、推理时喂的是自己的预测,两者分布不一致;在连续数据(视频)上自回归 rollout 超过训练长度时,帧间小误差不断累积,模型发散。全序列扩散(Diffuser、Video Diffusion)把所有 token 拼起来用同一个噪声水平扩散,能做分类器引导、擅长连续信号,但只能生成固定长度整段序列,非因果、无法变长,也无法做逐 token 的因果条件。论文要造一个模型,同时拿到两边的优点:可变长度生成 + 长时程引导 + 连续信号稳定 rollout。
为什么 prior work 不够:第一,naive 组合行不通:论文明确实验了『把 next-token 模型按全序列扩散方式训练』,生成质量差,原因是它没有建模『早期 token 的小不确定性要求后期 token 的大不确定性』这一因果结构。第二,AR-Diffusion 与 Rolling Diffusion 让噪声水平沿时间轴线性变化,采样时的噪声调度被训练锁死,换一种调度(比如想让近未来更确定)必须重训模型,而且它们只做了语言建模、没有引导。第三,Diffuser 类全序列扩散在 D4RL 规划里直接执行生成的 action 会崩溃,实现上靠手写 PD 控制器从生成状态反推动作(论文 Table 1 用星号标注);它把近未来和远未来放在同一噪声水平,忽略了因果不确定性。第四,teacher forcing 的 next-token 扩散(TimeGrad)只能单步去噪、不能多步引导,也没有稳定超长 rollout 的机制。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| x_{k_t}^t:每个时间步 t 的噪声 token | 视频帧 128×128×3(Minecraft)/ 64×64×3(DMLab);maze 状态 4 维(2D 位置+速度);机器人帧+动作 | 训练时每个 token 独立采样噪声水平 k_t∈{0,1,…,K}(均匀采样),经前向扩散 x_k=√ᾱ_k x_0+√(1−ᾱ_k)ϵ 加噪;k=0 表示干净 token,k=K 表示近似纯白噪声。不同时间步的 k_t 互不影响。 |
| k_t:当前 token 的噪声水平 | 整数标量 0..K | 作为条件告诉模型『这个观测有多可信』:k=0 表示完全可信的真实观测(对应 Bayes 滤波的后验更新),k=K 表示无信息的纯噪声(对应先验采样)。 |
| z_{t-1}:RNN 隐状态(过去 token 的压缩) | 向量(视频为 16/32 通道 2D 张量,maze 为 256 维) | 由 GRU 维护,对过去所有 token 的马尔可夫充分统计量;训练时沿时间反向传播(deterministic latent),采样时逐 token 顺序更新。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| ϵ̂_t = ϵ_θ(z_{t-1}, x_{k_t}^t, k_t):噪声预测 | 与输入 token 同维 | 等价于预测干净 token x̂_t^0(仿射重参数化);训练目标 Σ‖ϵ_t−ϵ̂_t‖²。采样时用 DDPM 反向步 x_{k−1}←(1/√α_k)(x_k−(1−α_k)/√(1−ᾱ_k)ϵ̂)+σ_k w 逐步去噪。 |
| 规划时的 token 元组 [a_t, r_t, o_{t+1}] | 动作+奖励+下一观测 | 决策任务里每个时间步的 token 打包动作、奖励与下一状态观测,一次去噪同时预测三者,动作与状态自洽。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| Minecraft navigation 视频(TECO 数据集) | 仅用约 10% 子序列训练 | 第一视角随机游走,128×128 像素,训练子序列 72 帧;配对动作被丢弃以增加随机性。模型 36M 参数。 |
| DMLab navigation 视频(TECO 数据集) | 仅用约 10% 子序列训练 | 3D 迷宫随机游走,64×64 像素,训练子序列 48 帧(正文 Figure 3 表述为 36 帧,附录 E.3 说明 36 帧为最大训练长度之一)。模型 24M 参数。 |
| D4RL maze2d(umaze/medium/large + multi-goal 变体) | 每环境 1 个模型,离线随机游走数据集 | 观测 4 维(2D 位置+速度)、动作 2 维加速度、稀疏奖励(进入以目标为中心半径 0.5 的圆内得 1,否则 0);数据集由 waypoint 间的随机无碰撞游走生成,与 Diffuser 同约定:丢弃奖励、只用目标位置引导;multi 变体目标与起点都随机。 |
| Franka 换果任务(自采,VR 遥操作) | 150 条专家演示,每条 500–600 帧 | 苹果与橙子在 A/B 槽互换、用第三个空槽周转;初始位置随机导致两种目标态,任务非马尔可夫(需记住初始配置);视频下采样到 40 帧、每帧捆绑 15 个 6-DoF 动作;双相机(腕部+正面)。 |
| GluonTS 多变量时序(Exchange/Solar/Electricity/Traffic/Taxi/Wikipedia) | 维度 8/137/370/963/1214/2000 | 上下文与预测窗口等长(预测长度 24 或 30),pytorch-ts 实验设置;评测 CRPSsum(越低越好),100 条采样轨迹、19 个分位点。 |
架构(摘要)
主干与结构
backbone:conv-RNN(视频:扩散 U-Net + GRU;非视频:ResMLP + GRU)
参数:Minecraft 视频 36M;DMLab 视频 24M;maze 规划 4.33M
类型:条件扩散单元组成的因果循环网络(Causal Diffusion Forcing, CDF);每个时间步 = 一个标准条件扩散模型
关键组件
- dynamics model p_θ(z_t|z_{t-1}, x_{k_t}^t, k_t):U-Net/ResMLP 输出喂给 GRU,GRU 隐状态即 z_t
- observation model p_θ(x_t^0|z_t):视频为 1 层 ResNet+conv,非视频为另一个 ResMLP
- 噪声预测头 ϵ_θ(z_{t-1}, x_{k_t}^t, k_t),训练损失 Σ_t‖ϵ_t−ϵ_θ‖²(DDPM 式)
- deterministic latent:z_t 是信念分布的确定函数而非采样,保证 BPTT 可反向传播
- v-parameterization(视频与时序)、x0-parameterization(规划与模仿学习)、ϵ-parameterization(理论推导)
- Fused SNR reweighting:用历史信噪比的运行均值与当前 token 信噪比做联合加权(视频训练,min-SNR 基础)
- 噪声调度:sigmoid(视频)、linear(maze)、cosine(其余)
为什么这样设计
把序列生成拆成『一个共享的条件扩散单元沿时间复用』:z_{t-1} 携带过去全部信息,x_{k_t}^t 是当前观测,k_t 告诉模型观测可信度。这样每个时间步的输入输出与标准条件扩散模型同构,可以直接套 DDPM 损失;RNN 比 transformer 在线决策更省,训练时 deterministic latent 允许沿时间反向传播。论文指出 transformer 实现只需给序列扩散模型加独立噪声水平 + 因果注意力掩码(附录 B.1),主实验出于效率选了 RNN。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| D4RL maze2d 单任务平均回报 | 141.7(Ours) | Diffuser*(手写 PD 控制器)119.5;Diffuser 直接执行生成动作 8.7;IQL 47.0;MPPI 16.2;CQL 7.7 | D4RL maze2d umaze/medium/large 三环境平均,离线随机游走数据集,稀疏奖励,每环境 1 个模型(4.33M 参数) |
| maze2d-large 单环境回报 | 159.0 ± 2.7(Ours) | Diffuser* 123.0 ± 6.4;Diffuser w/ diffused action 6.3 ± 2.1;IQL 58.6 | D4RL maze2d-large-v1,目标固定,同样稀疏奖励与离线设置 |
| 多目标(multi-goal)三环境平均回报 | 146.2(Ours) | Diffuser* 129.4;IQL 16.9;MPPI 21.5;去掉 MCG 的 Ours 127.7 | maze2d multi 变体:目标与起点都随机,其余设置同单任务 |
| MCG 消融(单任务平均) | 141.7(完整)vs 129.7(去掉 MCG) | 去 MCG 后仍高于 Diffuser* 119.5 | 同一 maze2d 三环境,仅移除 MCG 引导,其余采样设置不变 |
| 视频超长 rollout | 稳定生成 1000+ 帧(DMLab)且 2000 帧不爆 | 同一 RNN 架构的 teacher-forcing next-frame 扩散与因果全序列扩散均快速发散(定性,Figure 3) | Minecraft 128px 训练 72 帧、DMLab 64px 训练 36 帧,conv-RNN 24–36M 参数,8×A100 训练 50k 步;附录 E.3 非挑帧可视化 |
| 真实机器人换果任务成功率 | 80%(50 次评估口径见附录) | Diffusion Policy(无记忆,10 节)失败,成功率为 0 量级 | Franka 臂,150 条 VR 遥操作演示,三槽换果(非马尔可夫:需记住初始配置),40 帧视频×每帧 15 个 6-DoF 动作 |
| 遮挡/污染观测下成功率 | 76%(相比干净观测降 4 个百分点) | next-frame 扩散基线 48%(把污染观测当 ground truth) | 同一换果任务,测试时加入视觉干扰物并全遮挡相机,DF 通过把观测标为 k>0 走先验;数据集采集时无目标袋、测试时零样本加入 |
| 时序预测 CRPSsum(越低越好) | Exchange 0.003±0.001;Traffic 0.040±0.004;Taxi 0.075±0.002;Wikipedia 0.085±0.007 | Exchange 上最佳先前方法 TimeGrad/ScoreGrad 0.006;Wikipedia 上 ScoreGrad 0.043 第一、TimeGrad 0.049 第二、Transformer-MAF 0.063 第三、Ours 第四 | GluonTS 六数据集、pytorch-ts 设置、上下文=预测窗口、5 个随机种子取均值±标准差 |
Insights
- 噪声水平就是『部分掩码』程度:k=0 对应完全可见(Bayes 滤波的后验更新),k=K 对应完全掩码(先验采样),一个网络参数化先验与后验之间的整个插值(3.1 节、附录 B.7)。
- 训练目标天然覆盖所有子序列:k_t∈{0,K} 的特例等价于掩掉任意先前 token,因此 DF 学到的是『所有子序列的联合分布』,采样时可以在任意位置截断、组合、条件化(3.2 节、Theorem 3.1)。
- 稳定 rollout 的机制是『把预测帧降级为带小噪声的观测』:这使累积误差落在训练分布内,与行为克隆加噪(DART/HINT)同源,是 teacher forcing 发散问题的分布内解法(附录 B.4)。
- 因果不确定性与引导互为条件:远未来保持高噪声,既编码了『近未来更确定』的结构,又给引导梯度留了从未来反传回过去的通路,两者同一机制(3.3–3.4 节、Figure 5)。
- MCG 是 DF 独有的引导方式:部分噪声提供随机源,多次采样平均引导梯度得到期望回报的估计,全序列扩散在同一噪声水平下没有这种随机性(3.4 节、附录 B.5)。
vs 同类工作
- vs Diffuser(Janner et al., ICML 2022):全序列扩散规划。Diffuser 把整条轨迹同一噪声水平扩散,直接执行生成动作会崩溃(maze2d 平均 8.7 vs DF 141.7),实现上靠手写 PD 控制器从生成状态反推动作(星号标注版本 119.5);DF 的动作与状态自洽,还能变长规划。
- vs AR-Diffusion(Wu et al., NeurIPS 2023):噪声水平沿位置线性依赖,采样调度被训练锁死,换调度必须重训;只做语言建模、无引导。DF 的独立噪声水平让『调度变成训练后的自由参数』,并引入 MCG。
- vs Rolling Diffusion(2023):近未来更确定、远未来更不确定的采样思想与 DF 的金字塔调度相似,但 Rolling Diffusion 的训练噪声水平与位置线性绑定,采样必须用同一方案,改调度要重训。
- vs TimeGrad(next-token diffusion,teacher forcing):单步去噪、无多步引导、长序列易发散;DF 保留 next-token 的变长与在线能力,补上引导与稳定 rollout。
- vs flow map 长时程谱系(FMM / MeanFlow / Consistency,本清单同批):两条对立路线。flow map 把『长时程』当显式对象——直接学两时间映射 X_{s,t},用合成律 X_{t,τ}∘X_{s,t}=X_{s,τ} 保证任意步数划分下采样一致,靠映射的数学性质控制误差;DF 把『长时程』当噪声调度问题——保持条件 token 在小噪声水平,让误差留在训练分布内。flow map 给的是可证明的多步一致合成,DF 给的是任意噪声组合的鲁棒性、引导与变长能力;在『稳定超长 rollout』这一目标上互为最主要对手。
局限
- 论文自承:当前因果实现基于 RNN;高分辨率视频与更复杂分布大概率需要大规模 transformer(附录 B.1),论文没有研究 DF 到互联网规模数据与任务的扩展行为(5 节 Discussion)。
- 视频实验规模有限且以定性为主:只用了 TECO 数据集的约 10% 子序列,训练长度仅 36–72 帧,模型 24–36M 参数;Figure 3 与附录可视化没有 FVD 等标准定量指标,『2000 帧不爆』是可视化观测而非指标统计。
- maze 评测指标本身有争议(论文附录 D.8 自承):episode reward 奖励『慢走到达并停在目标附近』,而数据集没有『停在目标』的行为,生成慢轨道的 Diffuser 可能因此占便宜;论文建议改用『首次到达目标时间』。另外 Diffuser* 依赖手写 PD 控制器,DF 与其对比的公平性受限。
- MCG 的增量贡献有限:去掉 MCG 后单任务平均 129.7,仍高于 Diffuser* 119.5,说明主要增益来自因果结构本身;MCG 只在 maze 这种低成本环境验证,没有在真实机器人上单独消融。
- 机器人验证窄:单一换果任务、150 条演示;对 Diffusion Policy 的『失败』对比没有给中间档基线或完整成功率曲线;对遮挡的鲁棒性依赖『把观测标成 noisy』这一人工开关,需要事先知道观测被污染。
- 时间序列只是『不退化』验证:Wikipedia 上 DF 排第四(CRPSsum 0.085 vs ScoreGrad 0.043),六数据集没有全面领先,说明 DF 在通用序列建模上没有明显优势,卖点集中在引导与稳定性。
可复现性
- code:论文正文未附官方代码仓库链接;项目网站 https://boyuan.space/diffusion-forcing 提供视频演示(正文多次引用)
- weights:未发布
- setup:视频:8×A100、fp16、50k 步、batch 8×16、约 12 小时(40k 步收敛);Minecraft 36M 参数 / DMLab 24M 参数 / maze 4.33M 参数。maze/时序/机器人:单张 2080Ti 11GB,maze batch 2048、机器人 batch 32,50k–100k 步收敛、4–8 小时。参数化:视频与时序 v-prediction、规划与模仿 x0-prediction。噪声调度:视频 sigmoid、maze linear、其余 cosine。Fused SNR 仅视频使用。采样:pyramid 调度 K(附录 D.7 式 D.1),重采样处理同噪声水平角点情况(附录 D.5)。
主干与结构
backbone:conv-RNN(视频:扩散 U-Net + GRU;非视频:ResMLP + GRU)
参数:Minecraft 视频 36M;DMLab 视频 24M;maze 规划 4.33M
类型:条件扩散单元组成的因果循环网络(Causal Diffusion Forcing, CDF);每个时间步 = 一个标准条件扩散模型
关键组件
- dynamics model p_θ(z_t|z_{t-1}, x_{k_t}^t, k_t):U-Net/ResMLP 输出喂给 GRU,GRU 隐状态即 z_t
- observation model p_θ(x_t^0|z_t):视频为 1 层 ResNet+conv,非视频为另一个 ResMLP
- 噪声预测头 ϵ_θ(z_{t-1}, x_{k_t}^t, k_t),训练损失 Σ_t‖ϵ_t−ϵ_θ‖²(DDPM 式)
- deterministic latent:z_t 是信念分布的确定函数而非采样,保证 BPTT 可反向传播
- v-parameterization(视频与时序)、x0-parameterization(规划与模仿学习)、ϵ-parameterization(理论推导)
- Fused SNR reweighting:用历史信噪比的运行均值与当前 token 信噪比做联合加权(视频训练,min-SNR 基础)
- 噪声调度:sigmoid(视频)、linear(maze)、cosine(其余)
为什么这样设计
把序列生成拆成『一个共享的条件扩散单元沿时间复用』:z_{t-1} 携带过去全部信息,x_{k_t}^t 是当前观测,k_t 告诉模型观测可信度。这样每个时间步的输入输出与标准条件扩散模型同构,可以直接套 DDPM 损失;RNN 比 transformer 在线决策更省,训练时 deterministic latent 允许沿时间反向传播。论文指出 transformer 实现只需给序列扩散模型加独立噪声水平 + 因果注意力掩码(附录 B.1),主实验出于效率选了 RNN。
方法总览:噪声即掩码,训练与采样的 2D 去噪网格
原文 caption:Method Overview. Diffusion Forcing trains causal sequence neural networks (such as an RNN or a masked transformer) to denoise flexible-length sequences where each frame of the sequence can have a different noise level. In contrast, next-token prediction models, common in language modeling, are trained to predict a single next token from a ground-truth sequence (teacher forcing).
并排对比三种训练/采样方式:teacher forcing 沿时间轴掩码(只预测下一个 token)、全序列扩散沿噪声轴掩码(所有 token 同一噪声水平)、Diffusion Forcing 同时在两轴上做部分掩码(每个 token 独立噪声水平,采样时按 M×T 网格从左到右、从上到下逐步去噪)。这张图回答『因果去噪怎么实现』:把噪声水平当掩码程度,模型在训练中见过任意噪声组合,采样时就能按任意调度去噪。对应核心思想第 3.1–3.2 节。
独立噪声水平的四个用法:条件与预测的控制旋钮
原文 caption:Diffusion Forcing is trained on independent level of noises at different timesteps. As a result, we can control the noise level k to achieve different effects on conditioning and prediction.
把历史、近未来、远未来分别设成不同噪声水平得到的四种行为:历史 token 设 k=0 表示当作可信 ground truth 条件;设 k∈(0,K) 表示当作可能被污染的观测(对遮挡鲁棒);近未来逐级去噪得到预测;远未来始终保持比近未来更高的噪声水平,让引导梯度能从未完全扩散的未来反传到过去,实现长时程引导。这张图把『每 token 独立噪声水平』从训练细节变成采样时的功能开关,是理解 Causal Uncertainty 与 MCG 的钥匙。
视频生成:超过训练长度的稳定 rollout
原文 caption:Video Generation. Among tested methods, Diffusion Forcing generations are uniquely temporally consistent and do not diverge even when rolling out well past the training horizon.
DMLab 与 Minecraft 两个数据集上,从未见过的起始帧开始 rollout 到第 496–1000 帧的定性对比:Diffusion Forcing 的序列保持时间一致性、没有发散;Causal Full-Seq.(同一 RNN 架构的全序列扩散)与 Teacher Forcing 的 next-frame 扩散很快发散。注意横轴是帧号而非时间:训练只见过 36–72 帧,这里展示了 2 倍以上的外推。它对应长时程 rollout 稳定性实验(4.1 节),也是『靠小噪声条件稳定自回归』论断的视觉证据。
maze2d 规划:因果不确定性与 MCG 的定量收益
原文 caption:Diffusion Forcing for Planning. (top) During sampling, Diffusion Forcing allows each time step to be denoised on different noise schedules, enabling us to account for causal uncertainty during guided planning. (bottom) Diffusion Forcing achieves the highest average reward across runs.
上半部分是调度对比:Diffuser 在采样时把所有时间步放在同一噪声水平,DF 用金字塔式调度让远未来保持更高噪声(更不确定)。下半部分是 D4RL maze2d 三环境的平均回报表:单任务平均 Ours 141.7 vs Diffuser*(手写 PD 控制器从生成状态反推动作)119.5 vs Diffuser 直接执行生成动作 8.7 vs IQL 47.0;去掉 MCG 仍有 129.7。这张图是动作规划实验(4.2 节)的定量核心,同时暴露评测指标本身的争议(附录 D.8)。
🎧 音频版
时长 31:35 · Edge TTS
Diffusion Forcing(对话版·精读)
先说说这篇论文要解决什么问题
小播:欢迎回来。今天这篇是《Diffusion Forcing: Next-token Prediction Meets Full-Sequence Diffusion》,NeurIPS 2024 的论文,来自 MIT CSAIL,一作 Boyuan Chen。老规矩,先给我一句话定位:这篇要解决什么问题,为什么值得专门做一期?
老播:一句话背景:生成模型的序列建模长期被两条路线瓜分,一条是语言模型式的下一个 token 预测,一条是视频生成式的全序列扩散,各有一身优点也各有一堆短板。这篇的定位,是把两条路线合成一个训练范式:给序列里每个 token 独立随机采样一个噪声水平,让同一个因果模型既拿到 next-token 预测的变长生成能力,又拿到全序列扩散的引导能力,还顺带解决了自回归模型在连续数据上 rollout 会发散的老毛病。一句话结论先放这儿:它在视频上能稳定生成超出训练长度两倍以上的帧数,在 D4RL 的迷宫规划任务上平均回报超过最强的扩散规划基线 Diffuser,在真实机器人上做到了 80% 成功率。这一期我们就把"独立噪声水平"这四个字为什么有这么大能量讲透。
小播:听起来是个把两个流派缝在一起的工作。那它和"缝合怪"有什么区别?我记得以前也有人试过把 next-token 模型拿去做全序列扩散。
老播:问得好。论文里明确做了那个朴素组合,结果生成质量很差,原因我们后面展开。它的出发点恰恰是解释"为什么朴素组合会失败":早期 token 只要有一点点不确定性,后期 token 的不确定性就必须跟着放大,而全序列扩散把所有 token 放在同一个噪声水平上,这个因果结构被抹掉了。所以这一期的核心线索就一条:噪声水平等于掩码程度,每个 token 独立随机加噪训练,采样调度就变成训练后的自由旋钮。这个结论开场先说一遍,后面我们会反复回到它。
把问题放进谱系:两条路线各缺什么
小播:好,那我先把基础概念对齐一下。下一个 token 预测模型,比如 GPT 这类,它训练的时候是怎么做的?"teacher forcing"这个词我听过,但细节记不清了。
老播:teacher forcing 的意思是:训练时喂给模型真实的过去序列,让它预测紧挨着的下一个 token,算完误差就更新参数。推理时把模型自己的预测当成"过去"继续往下走。这个流程在语言上非常好用:可以只生成一个词,也可以无限生成下去;可以条件在任意长度的历史上;还可以做树搜索。但是有两个问题。第一,没有机制把采样往某个目标引导,比如"这段视频最后要达成某个任务",它只能顺着学到的分布往下走。第二,在连续数据上,训练时喂的是真实帧、推理时喂的是自己的预测帧,两边分布不一样,误差会一步一步累积,视频预测超过训练长度基本就花了。这是它最疼的伤。
小播:那全序列扩散呢?视频扩散模型应该能生成挺连贯的短片吧?
老播:全序列扩散的做法,是把一段固定长度的序列整个拼起来,当成一个高维对象,所有 token 用同一个噪声水平加噪、一起去噪。它有两个明确的优点:采样时可以加分类器引导,把生成往"高回报"或者"指定类别"推,这在规划任务里很值钱;处理连续信号也比较稳。但代价也很清楚:长度是训练时就定死的,做不了变长生成;结构是非因果的,做不了"只条件在过去"的逐 token 生成。最要命的是,我们前面说的那个朴素组合——用 next-token 模型做全序列扩散——论文实测生成质量差,因为早期的 token 一旦被完全去噪定了型,后期 token 的不确定性就没有地方表达了。
小播:那我先补一个概念:全序列扩散的"引导",具体是改采样还是改训练?
老播:采样时改。扩散采样每走一步都在预测噪声,引导的做法是在噪声预测上减掉一个指向目标的梯度项,意思是"这段轨迹往高回报方向偏",相当于每一步都被目标推一把。Diffuser 就是用这个做规划:在离线轨迹数据上学分布,采样时引导到高回报轨迹。但这个引导是整段序列一起作用的,它没法表达"越靠前的动作越要当心"这种因果权重,这正是后面金字塔调度要补的东西。
老播:全序列扩散的做法,是把一段固定长度的序列整个拼起来,当成一个高维对象,所有 token 用同一个噪声水平加噪、一起去噪。它有两个明确的优点:采样时可以加分类器引导,把生成往"高回报"或者"指定类别"推,这在规划任务里很值钱;处理连续信号也比较稳。但代价也很清楚:长度是训练时就定死的,做不了变长生成;结构是非因果的,做不了"只条件在过去"的逐 token 生成。最要命的是,我们前面说的那个朴素组合——用 next-token 模型做全序列扩散——论文实测生成质量差,因为早期的 token 一旦被完全去噪定了型,后期 token 的不确定性就没有地方表达了。
小播:等等,我再确认一下:全序列扩散把所有 token 放同一个噪声水平,到底为什么和因果性冲突?
老播:你把噪声水平理解成"这个 token 还有多少不确定性"就行。真实世界的序列是有方向的:时间靠前的 token 影响靠后的,所以"过去的 token 应该更确定、未来的 token 可以更不确定"才是符合因果结构的分布。全序列扩散强制所有 token 同步去噪,等于把未来和过去塞进同一个不确定性水平,因果结构就被抹掉了。同期相关工作 AR-Diffusion 和 Rolling Diffusion 也意识到了这一点,但它们让噪声水平沿时间位置线性变化,等于把调度方案写死进训练里,换一种调度就必须重训,而且它们没做引导。这些就是这篇论文的切口:把每个 token 的噪声水平解耦,调度问题训练后再说。
核心思想:给每个 token 独立噪声水平
小播:好,进入正题。它的训练到底怎么改?"每个 token 独立噪声水平"具体怎么操作?
老播:分三步讲。第一步,把"加噪"重新理解成"部分掩码"。标准的扩散前向过程是这样的:给定一个干净 token x₀,在噪声水平 k 下它变成 x_k,公式是 x_k = √ᾱ_k·x₀ + √(1−ᾱ_k)·ϵ_k。这个式子要回答的问题是:一个干净 token 被加噪到第 k 级之后长什么样。其中 ᾱ_k 是前 k 步的信号保持比例的连乘,√ᾱ_k 乘在干净数据上,√(1−ᾱ_k) 乘在标准高斯噪声 ϵ_k 上。k 等于 0 的时候 ᾱ₀ 等于 1,x₀ 原样保留;k 越大,噪声占比越大,k 取到最大值 K 的时候,x_K 基本就是纯白噪声。所以你完全可以把噪声水平当成掩码程度:k 等于 0 就是完全可见,k 等于 K 就是完全掩码。加噪这条路,做的就是沿"噪声轴"掩码。
小播:这个视角挺有用的。那 teacher forcing 的掩码在哪条轴上?
老播:在时间轴上:它让你只看过去,把未来整个掩掉,然后预测下一个 token。所以你看,两条路线其实各掩了一条轴。这篇论文的关键动作,是把两条轴同时打开:训练时,序列里每一个时间步 t 独立地、均匀随机地采样一个噪声水平 k_t,从 0 到 K 都有可能;每个 token 按自己的 k_t 加噪,互不干扰。于是模型见到的训练样本是"任意 token 处于任意噪声水平"的组合,它被迫学会同时解开所有组合。这就是核心思想,也就是"噪声即掩码":噪声水平就是掩码程度,独立采样就是沿两条轴同时做部分掩码。
小播:那模型架构上怎么处理?一个 token 一个噪声水平,听起来每个时间步都要单独处理一遍。
老播:对,论文的实现是一个因果循环网络,每个时间步就是一个标准条件扩散模型。网络维护一个隐状态 z,记作 z_{t-1},它把过去所有 token 的信息压缩起来;当前时间步的输入是带噪 token x_{k_t}^t 和它的噪声水平 k_t,输出是对噪声 ϵ_t 的预测。损失写成这样:
L = E[ Σ_t ‖ϵ_t − ϵ_θ(z_{t-1}, x_{k_t}^t, k_t)‖² ]。
这个式子要回答的问题是:用什么样的监督,才能让网络学会所有噪声组合下的去噪。ϵ_t 是第 t 个 token 真实加进去的噪声,ϵ_θ 是网络对这个噪声的预测,两者差平方求和;外面的期望是对随机噪声水平、数据和噪声取的。z_{t-1} 是隐状态,携带历史信息,k_t 是条件变量,告诉模型"当前这个观测有多可信"。它和标准 DDPM 的损失长得一样,差别只在每个 token 的噪声水平是独立采样的,而且多了隐状态这个条件。隐状态在训练时是确定性更新的,梯度可以沿时间反传回去,所以整个东西能端到端训练。
小播:能不能给一个具体的训练样本,让我具体感受"独立噪声水平"是什么意思?
老播:拿长度 3 的序列举例。训练时模型可能看到第一个 token 被加噪到最高水平 K,等于完全掩掉;第二个 token 加到一半 K/2;第三个 token 保持干净 0。下一次采样训练样本,三个水平又换一组,比如 0、K、K/2。模型被迫学会:无论历史上哪些 token 可信、哪些被污染、哪些完全没有信息,都要给出合理的下一步预测。这就是"所有子序列的条件分布"的意思——k 取 0 或 K 的组合,覆盖了"只掩中间"、"只留开头"等等各种子序列。
小播:这个损失看起来就是多个扩散损失的叠加,凭什么它就"对了"?我担心的点是:这么训,模型会不会只学会某个噪声水平分布下的去噪,换个分布就露馅?
老播:这正是论文花了一整个附录去证明的事情。Theorem 3.1 说:这个训练目标优化的是所有噪声水平序列下、子序列似然的重加权证据下界 ELBO;在模型表达力足够的情况下,重加权项不影响最优点,可以直接忽略。更具体一点:k_t 只取 0 或者 K 这个特例,就等价于把任意先前 token 完全掩掉,所以模型学到的是训练集所有子序列的条件分布。也就是说,它见过的"掩码模式"覆盖了你能想到的几乎所有组合,采样时的调度方案自然就可以随便换了。这里再把核心结论说一遍:独立噪声水平训练,把"用什么调度去噪"从训练时决定,挪到了采样时决定,调度变成一个自由旋钮。
小播:回到开头那个问题:朴素组合为什么会失败,你现在能用一句话讲清楚了吗?
老播:可以。朴素组合用 next-token 模型做全序列扩散,所有 token 同步去噪,早期 token 一旦被确定下来,后期 token 的不确定性就无处安放,模型必须假装后面的 token 已经确定,生成的序列自然失真。DF 的独立噪声水平让"早期确定、后期不确定"的因果结构直接体现在训练数据里,模型从数据里学到了这个结构。这也再次回到我们的核心结论:噪声水平等于掩码程度,独立采样是关键,这句话在开场说过一遍,这里说第二遍。
小播:那采样时这个旋钮具体怎么拧?比如我想要它像语言模型一样自回归地一步步生成,怎么办?
老播:采样时,论文在一张二维网格上走:列是时间步,行是去噪轮次,每个格子写着"这个 token 在这一轮的目标噪声水平"。从全部白噪声出发,逐行、行内从左到右地去噪。因为训练覆盖了任意组合,这张网格可以任意画。你想要自回归,就让历史 token 保持干净、每次只把下一个 token 完全去噪;你想要全序列扩散,就让所有 token 同步去噪。最有意思的是两种新画法。第一种叫金字塔调度:近未来的 token 先去噪到低噪声,远未来的 token 始终保持高噪声,这就在采样过程里编码了"近处确定、远处不确定"的因果不确定性,远未来比近未来更不确定。第二种画法直接解决自回归的发散问题:把上一帧的预测结果,以略大于 0 的小噪声水平喂回模型,让模型把它当成"带小噪声的观测",而不必当成 ground truth。
小播:采样网格里,如果某个 token 这一轮和上一轮的目标噪声水平一样,怎么办?
老播:这是论文在附录里专门处理的角点情况。比如一个 token 已经去噪到 0 了,下一轮还是 0,那就直接把旧值抄过来;如果它要保持纯噪声 K,也直接沿用。但有一种情况论文选择重采样:在 MCG 里要对同一个 token 生成多条未来样本,做法是把 token 先反向往回加噪、再正向去噪回原水平,相当于在扩散过程内部重新抽一次样,这样多条样本之间才有随机性。这里还能再补一层理解,把整件事和经典滤波联系起来:k 等于 0 时,隐状态的更新等价于 Bayes 滤波里的后验更新;k 等于 K 时,纯噪声没有携带任何关于当前 token 的信息,等价于只靠先验;中间的所有 k 值就是先验到后验的插值。一个网络把这条插值曲线整个参数化了,这是论文里一个很省事的设计。
小播:这个"小噪声条件"是这篇我最想弄明白的点。为什么把预测帧稍微加一点噪声,就能让 rollout 稳定?
老播:关键在分布。teacher forcing 发散的原因,是推理时喂的预测帧在训练分布之外——训练时它只见过真实帧。而 Diffusion Forcing 训练目标本来就覆盖"各种噪声水平的观测",带小噪声的帧对模型来说就在训练分布内。累积误差还是会产生,但模型把它当成分布内的噪声来处理,不再当成一个没见过的东西硬着头皮预测。论文把这个联系到行为克隆里的 DART 加噪技巧,并指出它继承了 HINT 的稳定性保证。再直白一点:误差没办法消除,但可以把它"降级"成模型熟悉的噪声,这就是视频能超长 rollout 的机制。我们下一段就去看这个机制在实验里表现怎么样。
关键实验:视频、规划、机器人、时序各看到了什么
小播:先看视频。论文说 rollout 到训练长度两倍以上不爆,具体实验怎么做的?
老播:视频预测在 TECO 数据集的两个环境上做:Minecraft 的沼泽地形第一视角,128 像素,训练子序列 72 帧;DMLab 的 3D 迷宫,64 像素,训练子序列 36 帧。模型是卷积 RNN,Minecraft 版 36M 参数、DMLab 版 24M 参数,只用了数据集大约 10% 的子序列。对照基线用的是同一个 RNN 架构:一个 teacher forcing 训练的 next-frame 扩散模型,一个因果全序列扩散模型。结果看 Figure 3:从测试集起始帧开始,Diffusion Forcing 生成到第 1000 帧仍然时间一致;两个基线很快发散,全序列扩散在训练长度以内就有帧间跳跃。附录里补充了一个更狠的数字:不重置隐状态、不加滑窗,模型能稳定生成 180 帧,是训练长度的 2 到 5 倍,测试到 2000 帧也没有爆炸。注意这里要加个限定:这是可视化观测,论文没有给 FVD 这类标准定量指标,这一点我们在局限里还会说。
小播:那视频模型是怎么训的?训练成本高不高?
老播:训练用 8 张 A100,50k 步,batch 是 8 乘 16,fp16 混合精度,大约 40k 步收敛,全程约 12 小时。论文还报告了一个训练技巧叫 Fused SNR 重加权:标准 min-SNR 加权只考虑当前 token 的信噪比,这里把历史信噪比的运行均值也考虑进来,两个信息源按独立事件概率组合,显著加速了视频收敛;它对非图像域没有增益,所以只在视频上用。参数化也有讲究:视频用 v-prediction,规划与模仿学习用 x0 预测,时序又用回 v-prediction,三种写法在扩散文献里是等价的,选择取决于应用更在意什么。
小播:1000 帧对短视频生成已经很夸张了。接下来是规划实验,这是它对比 Diffuser 的主战场吧?
老播:对,这是这篇论文最有分量的数字来源。任务用 D4RL 的 maze2d 三个环境:umaze、medium、large,观测是 4 维(2D 位置加速度),动作是 2 维加速度,奖励很稀疏——进入以目标为中心、半径 0.5 的圆内得 1,否则得 0。每个时间步的 token 打包成动作、奖励和下一观测三元组,训练方式和 Algorithm 1 完全一样。结果看 Table 1:单任务平均回报,Diffusion Forcing 是 141.7;最强的基线是 Diffuser 的一个带星号版本,119.5,注意这个版本靠手写 PD 控制器从生成的状态反推动作,因为它直接执行自己生成的动作会崩溃,直接执行版只有 8.7;再往下是 IQL 的 47.0,MPPI 的 16.2,CQL 的 7.7。多目标变体里 Diffusion Forcing 是 146.2,Diffuser 带星号版本 129.4。所以它和带 PD 控制器的 Diffuser 相比领先约两成;和直接执行自己生成动作的 Diffuser 相比,是 141.7 对 8.7,超过 16 倍。而且动作是自己生成、自己执行,不需要外部控制器。
小播:引导具体怎么算?我记得 Diffuser 是用目标位置做条件,DF 也这样吗?
老播:沿用同一约定:丢弃数据集里的奖励,用目标位置引导。具体引导能量取轨迹上每个时间步到目标距离之和,也就是 Σ||p_t − g||,这样任何时间步都可以是"到达目标的最后一步",规划视界就不用预先指定。论文提到迷宫是强非凸的,这个目标很容易让规划撞墙,但 DF 仍然能稳定找到不碰墙的路径。这里也透露出灵活视界的价值:全序列模型必须先指定总长度 T,DF 可以随时让某一步成为终点,这在任务长度不确定的机器人场景里很实用。
小播:那这个增益到底来自哪三块?我记得你提过因果不确定性、MCG,还有动作自洽。
老播:三块都有实验支撑。第一块,动作自洽:Diffuser 生成的状态和动作互相不一致,直接执行动作就崩,只能靠 PD 控制器补救;Diffusion Forcing 的 token 是动作、奖励、状态一起预测的,自洽,所以能直接闭环。第二块,因果不确定性:金字塔调度让近未来更确定、远未来保持不确定,这正好匹配决策问题的结构——越靠前的动作越重要。第三块,MCG,全称蒙特卡洛引导:对同一个 token 采样多条未来轨迹,把它们的引导梯度平均,得到"期望回报"梯度的低方差估计,类似 MPPI 那种 shooting 的思想。消融实验显示,去掉 MCG 之后单任务平均从 141.7 降到 129.7,仍然高于 Diffuser 的 119.5,说明主要增益来自因果结构本身,MCG 是额外加成。还有一个值得说的点:论文自己承认评测指标有毛病,episode reward 会奖励"慢悠悠走到目标附近"的生成,附录里建议以后改用首次到达时间,我们局限部分细说。
小播:机器人实验呢?80% 成功率那个,和前面的规划是一套方法吗?
老播:是同一套框架换了个任务。真实场景是 Franka 机械臂换果:苹果和橙子放在 A、B 两个槽,要用第三个空槽周转互换。初始位置随机,所以目标态有两种可能,单看某一帧照片判断不出该往哪动,必须记住初始配置才能决定——这个任务是非马尔可夫的。数据集是 150 条 VR 遥操作演示,每条 500 到 600 帧,下采样到 40 帧、每帧捆绑 15 个六自由度动作。Diffusion Forcing 用隐状态天然携带记忆,成功率 80%;对照的 Diffusion Policy 是当时主流的模仿学习算法,没有记忆机制,在这个任务上失败。更有意思的是遮挡鲁棒性:测试时往桌上扔一个目标袋当视觉干扰,甚至把相机整个挡住,模型只要把污染观测标成高噪声水平 k 大于 0,就会更多地依赖先验来推动作,成功率只从 80% 降到 76%;而 next-frame 扩散基线必须把污染观测当 ground truth 用,只有 48%。最后还有一个副产物:同一个模型只给一帧就能生成机器人做任务的视频,为以后用无标注视频预训练铺路。
小播:时间序列那部分我快速过一下。它是否也像很多生成模型论文一样,顺手在时序上刷了个榜?
老播:恰恰相反,这是我最欣赏它诚实的地方。论文在 GluonTS 的六个时序数据集上按 pytorch-ts 的标准设置评测,指标是 CRPSsum,越低越好。结果:Exchange 上 0.003,最佳先前方法是 0.006;Traffic 上 0.040,Taxi 上 0.075,都和最好的方法打平或者略好。但 Wikipedia 数据集上它排第四,0.085,第一名 ScoreGrad 是 0.043。论文自己的措辞是"没有明显的性能代价",把时序当作通用性验证,卖点还是引导和稳定性。这个结果我们也会放进局限里——它说明了这篇论文的方法在"纯生成质量"上优势有限,优势集中在我们前面讲的那几个能力上。
谱系定位:它和 flow map 长时程路线互为对手
小播:现在放到谱系里看。这篇论文的对手,除了 Diffuser 和 AR-Diffusion,还有谁?
老播:在"稳定长时程生成"这个目标上,它和 flow map 谱系是两条对立路线,彼此是对方最主要的对照方法。flow map 谱系包括本清单里的 Flow Map Matching、Mean Flows、Consistency Models。那条路线的做法,是把时间当作显式的对象来学:直接学习一个两时间流映射 X_{s,t},把时刻 s 的任意点送到时刻 t,再用合成律 X_{t,τ}∘X_{s,t}=X_{s,τ} 保证小步复合等于大步,从数学上锁住多步采样的一致性。它给出的保证是"映射本身精确",代价是覆盖所有时间区间的映射族很难直接学,一步训练收敛困难,FMM 论文自己承认这一点。
小播:这两条路线的"保证"听起来不对称,一个数学上严格,一个实证上稳定?
老播:对,这个不对称值得记住。flow map 的合成律在数学上是严格的:任意步数划分下,小步复合都等于大步,所以多步采样的一致性有定理兜底;它的短板在"学映射"这一步,一步直接训练收敛困难,实际靠蒸馏或者只学短区间。DF 这边,训练目标有 ELBO 保证,但单步预测误差没有显式上界,稳定性来自"误差被降级成分布内噪声"这个机制,属于经验性质。两家都不轻松:一个把难度押在训练时学映射,一个把难度押在误差的分布内化。这也解释了为什么后续工作会尝试把两条路线往一起凑,各取所长。
小播:那 Diffusion Forcing 这边呢?
老播:它把时间当作噪声调度的对象:模型只学"给定任意噪声组合,下一步怎么去噪",稳定性来自小噪声条件和因果调度,让误差留在训练分布内。它给出的保证是"任意噪声组合都能去噪",对应所有子序列似然的 ELBO,代价是单步预测的误差没有被显式约束,稳定性靠分布内化,而 flow map 靠映射精度。所以在长时程世界模型这个交叉点上,两家是彼此最主要的对手:flow map 用显式映射锁误差,Diffusion Forcing 用噪声调度容错。再往回看这篇论文在序列生成内部的对手:对 Diffuser,它赢在动作自洽和因果不确定性;对 AR-Diffusion 和 Rolling Diffusion,它赢在独立噪声水平把采样调度解耦出来,改调度不用重训;对 TimeGrad 这种 teacher forcing 的 next-token 扩散,它补上了多步引导和长 rollout 稳定。
局限:论文自己承认的,和我们读出来的
小播:按惯例,泼冷水环节。先说论文自己承认的。
老播:第一,当前因果实现基于 RNN,高分辨率视频和更复杂的数据分布大概率需要大规模 transformer,论文给了实现思路但没有做,也没有研究到互联网规模数据的扩展行为。第二,视频实验的规模有限:只用了大约 10% 的数据、训练长度只有 36 到 72 帧、模型最大 36M 参数,而且评测以可视化为主,没有 FVD 这类标准定量指标,"2000 帧不爆"是观测出来的现象,我们对它要有保留。
小播:那评测指标本身呢?你刚才提到 maze 的 episode reward 有问题。
老播:对,这条是论文自己承认的:episode reward 会奖励"慢走到达目标附近并停留"的轨迹,而数据集里根本没有"停在目标"的行为数据,所以生成慢轨迹的方法可能因此占便宜,Diffuser 或许受益于此。论文建议改用"首次到达目标的时间"这种更合理的指标。另外 Diffuser 的带星号版本依赖手写 PD 控制器,和 Diffusion Forcing 直接执行自己动作的对比,公平性要打折扣。还有几条是我们读出来的:MCG 的增量贡献有限,去掉它还有 129.7,高于 Diffuser 的 119.5,说明增益主体在因果结构本身;机器人验证只有一个任务、150 条演示,对 Diffusion Policy 的"失败"没有给完整成功率曲线;遮挡鲁棒性依赖"把观测标成 noisy"这个人工开关,需要事先知道观测被污染了才有效。最后,时间序列上的 Wikipedia 第四名说明它在纯生成质量上没有全面领先,这篇论文的定位是能力型方法,看它要挑对场景。
小播:那它和同期工作 AR-Diffusion、Rolling Diffusion 的边界,除了"调度能不能换",还有别的吗?
老播:还有两点。第一,AR-Diffusion 只做了语言建模,没有探索引导,也没有决策实验;Rolling Diffusion 和 DF 的"近处确定、远处不确定"采样思想很像,但它的噪声水平训练时就按位置绑定,采样必须用同一套方案,改调度等于重训。第二,DF 把调度解耦之后,换调度不用重训,工程上很值钱:你可以先训一个模型,再针对应用试各种采样方案,找到最好的一种直接用。计算开销论文也有交代:独立噪声水平在时间维度上增加复杂度,他们用图像预训练先把像素层面的复杂度解决掉,第二阶段视频训练步数更少,采样质量就已经超过全序列扩散收敛时的水平。
收尾:记住这三件事
小播:好,最后帮我收一下。这期要记住的三件事?
老播:第一,噪声水平就是掩码程度,每个 token 独立随机加噪训练,让一个因果模型学会任意噪声组合的去噪,采样调度因此在训练后可以随便换——这是整个方法的支点。第二,稳定长 rollout 靠小噪声条件:把预测帧当带小噪声的观测喂回,误差留在训练分布内,视频能生成到训练长度两倍以上,2000 帧不爆;对比之下 teacher forcing 和全序列扩散基线很快就发散。第三,因果不确定性与 MCG 让规划全面超过 Diffuser:近处确定、远处不确定的金字塔调度,加上多条未来轨迹平均引导,D4RL maze2d 单任务平均回报 141.7,对照 Diffuser 带 PD 控制器的版本 119.5,直接执行生成动作的版本只有 8.7。
小播:那它和 flow map 那条线的对峙,你最后怎么总结?
老播:一句话:长时程生成有两条路,一条把时间当显式映射来锁误差,一条把时间当噪声调度来容错,Diffusion Forcing 是后一条路线上最重要的代表。它对后续工作的意义在于,给世界模型和机器人策略提供了一个"既可变长、又可引导、还自带记忆"的训练范式,后来像 π0、WorldVLA 这些工作都在同一张谱系里接着往前推。下一期我们就把它的对手 Flow Map Matching 摊开讲,两边对着看会更有意思。