Consistency Trajectory Models: Learning Probability Flow ODE Trajectory of Diffusion
- 作者:Dongjun Kim、Chieh-Hsin Lai(共同一作,Sony AI)、Wei-Hsiang Liao、Naoki Murata、Yuhta Takida、Toshimitsu Uesaka、Yutong He(CMU)、Yuki Mitsufuji、Stefano Ermon(Stanford)
1. 要解决什么问题
扩散模型生成图像的方式,是沿一条「概率流 ODE」把噪声逐渐变成数据。这里的关键矛盾在采样步数:score-based 方法用数值求解器(DDIM、EDM 的 Heun 等)沿轨迹积分,步数少时离散化误差明显;蒸馏方法(以 Consistency Models 为代表)让神经网络一次性估计整段积分、一步出图,但多步采样时质量反而随步数下降,而且拿不到 score、算不了似然。CTM 想同时解决这两端的问题。
为什么之前的方法都不够?score-based 求解器绕不开离散化误差。论文用 Taylor 展开指出,积分余项 O(Δt) 没有被任何有限步求解器估计,这就是 NFE 小的时候质量损失的结构性来源(附录 B.1)。CM 把任意时刻的带噪样本都映射回 0 时刻,等价于每次采样都做一次「长跳到 0」;多步采样时相邻两步的跳跃区间互相重叠,Theorem 1 与 Theorem 8 证明误差累积到 O(Σ√(t_n − √(1−γ²)t_{n+1})),所以 Figure 7 里 CM 风格多步采样的 FID 随 NFE 增加而变差。CM 还缺少一个在速度与质量之间调节的旋钮。
2. 输入与输出
训练输入是三个量:带噪样本 x_t(由 x_t = x_0 + t·ε 前向扩散得到,x_0 是干净图像、ε 是标准高斯噪声)、当前时间 t、目标时间 s(s ≤ t);类别条件生成时再加类别标签 c。时间尺度沿 EDM 的表(σ_min=0.002、σ_max=80、ρ=7)。网络输出是跳跃端点 G_θ(x_t, t, s),即 PF ODE 从 t 走到 s 的解的估计;其内部函数 g_θ 在 s→t 的极限退化为去噪器 E[x|x_t],这就是 score 的另一种表达。
3. 核心思想:从「点对点自洽」到「轨迹自洽」
CM 的一致性要求是:从任何时间 t 出发的带噪样本,经过网络映射后都落到同一个 0 时刻干净点。这可以叫「点对点自洽」。CTM 的改动是:改学一族映射 G(·, t, s),覆盖所有 s ≤ t,并要求任意 t→s 的单段跳跃,与先跳到中间时刻 u 再跳回 s 的分段跳跃结果一致。一致性从「所有路径汇到同一个终点」放宽成「任何一段轨迹都与其他段拼接起来一致」,也就是「轨迹自洽」。
先给公式预期:下面这个式子回答「PF ODE 从 t 到 s 的精确解长什么样」,它把解写成起点 x_t 加上一段积分。理解起来,这一段积分就是整段轨迹的位移。
G(x_t, t, s) := x_t + ∫_t^s (x_u − E[x|x_u]) / u du
逐符号解释:x_u 是轨迹上 u 时刻的状态;E[x|x_u] 是给定带噪样本 x_u 时对原始干净数据的条件期望,也就是去噪器;分子 x_u − E[x|x_u] 除以 u 正是瞬时速度(score 的另一种写法,因为 PF ODE 的漂移是 −u·∇log p_u(x_u) = (x_u − E[x|x_u])/u);整个积分就是把从 t 到 s 的每一小段速度加起来,得到总位移。当 s=t 时 G 退化为恒等,边界条件 G(x_t, t, t) = x_t 自动成立。
直接让神经网络学这个积分会发散(论文 3.1 节注 3)。CTM 采用 Euler 求解器启发的参数化:
G_θ(x_t, t, s) = (s/t)·x_t + (1 − s/t)·g_θ(x_t, t, s)
这里的预期是:用一个带权重的混合形式,把边界条件直接写进系数。系数 s/t 与 1 − s/t 来自 Euler 一步解:x_s ≈ (s/t)x_t + (1 − s/t)E[x|x_t],把其中的去噪器换成网络输出 g_θ 即可。这个形式的好处有两层:一是 s=t 时第二个系数归零,G_θ(x_t,t,t)=x_t 无需显式约束,带约束优化变成无约束优化;二是取 s→t 极限,g_θ(x_t,t,s) 趋向 E[x|x_t],所以同一个网络既给出长跳跃(积分),又给出 score(被积函数)。Figure 2 把三家方法画在 (t,s) 平面上:score-based 只学 t=s 这条对角线,蒸馏只学 s=0 这条边,CTM 学整个 s≤t 的上半三角。
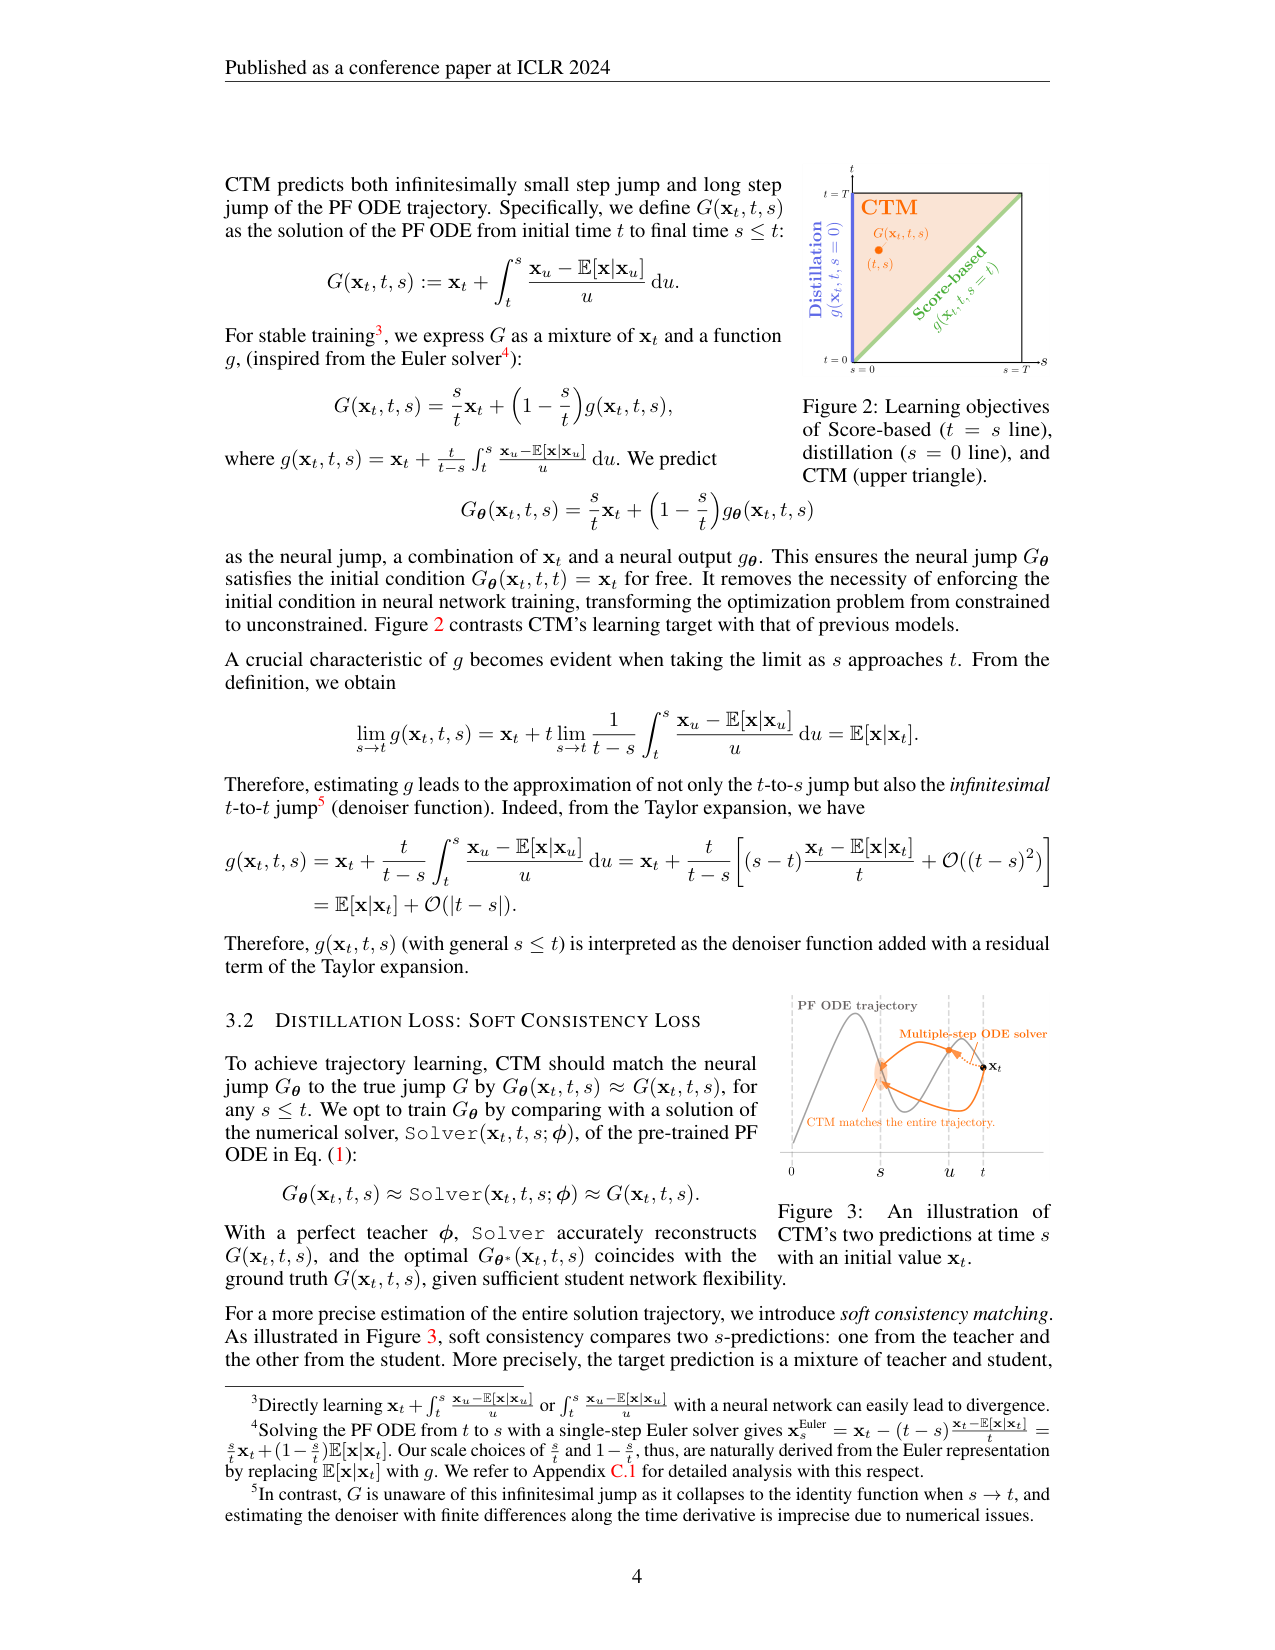
轨迹自洽靠什么训练出来?论文设计了一个 soft consistency loss。它的做法是:随机采一个中间时刻 u ∈ [s, t),让学生跳跃 G_θ(x_t, t, s) 去对齐「老师先解 ODE 从 t 到 u、学生再从 u 跳到 s」的结果。这里的预期是:通过随机化 u,老师的信息可以在任意子区间上显式到达学生。当 u=s 时,老师覆盖整段 [s,t],等价 global consistency;当 u=t−Δt 时只覆盖单步,等价 local consistency(再令 s=0 就是 CM 的蒸馏目标)。随机 u 的好处是:local 的一致性需要学生把零散的单步信息外推到长跳,global 每步都解整段 ODE、训练贵 3 倍;soft 版本让学生直接拿到任意子区间的显式监督,CIFAR-10 上比 global 快 2 倍且质量相当(Figure 10)。
为了让学生超过老师,CTM 还加了两个辅助损失。第一个是去噪分数匹配(DSM):L_DSM = E‖x_0 − g_θ(x_t, t, t)‖²,它给 g_θ(x_t,t,t) 一个带真值的目标(最优时等于 E[x|x_t]),同时缓解 s→t 时系数 (1−s/t) 缩到 0 导致的梯度消失。第二个是 GAN 损失:用 StyleGAN-XL 风格的判别器(8 个判别器,EfficientNet×4 + DeiT-base×4)修高频细节。总损失 L = L_CTM + λ_DSM·L_DSM + λ_GAN·L_GAN,λ 按末层梯度范数比自适应设定。论文把这三项解释为蒸馏距离 + 数据分布 KL + 数据分布 f-散度的组合(3.3 节注 7)。
4. γ-sampling:一个采样族覆盖两种采样
CTM 把「怎么采样」也统一了。γ-sampling 的每一轮是:先用网络去噪到中间时间 √(1−γ²)·t_{n+1},再加 γ·t_{n+1}·ε 的噪声回到 t_{n+1}。γ 是唯一的旋钮:
- γ=1:每步都加回满噪声,等价 CM 的多步采样,样本方差最大,语义随 NFE 漂移;
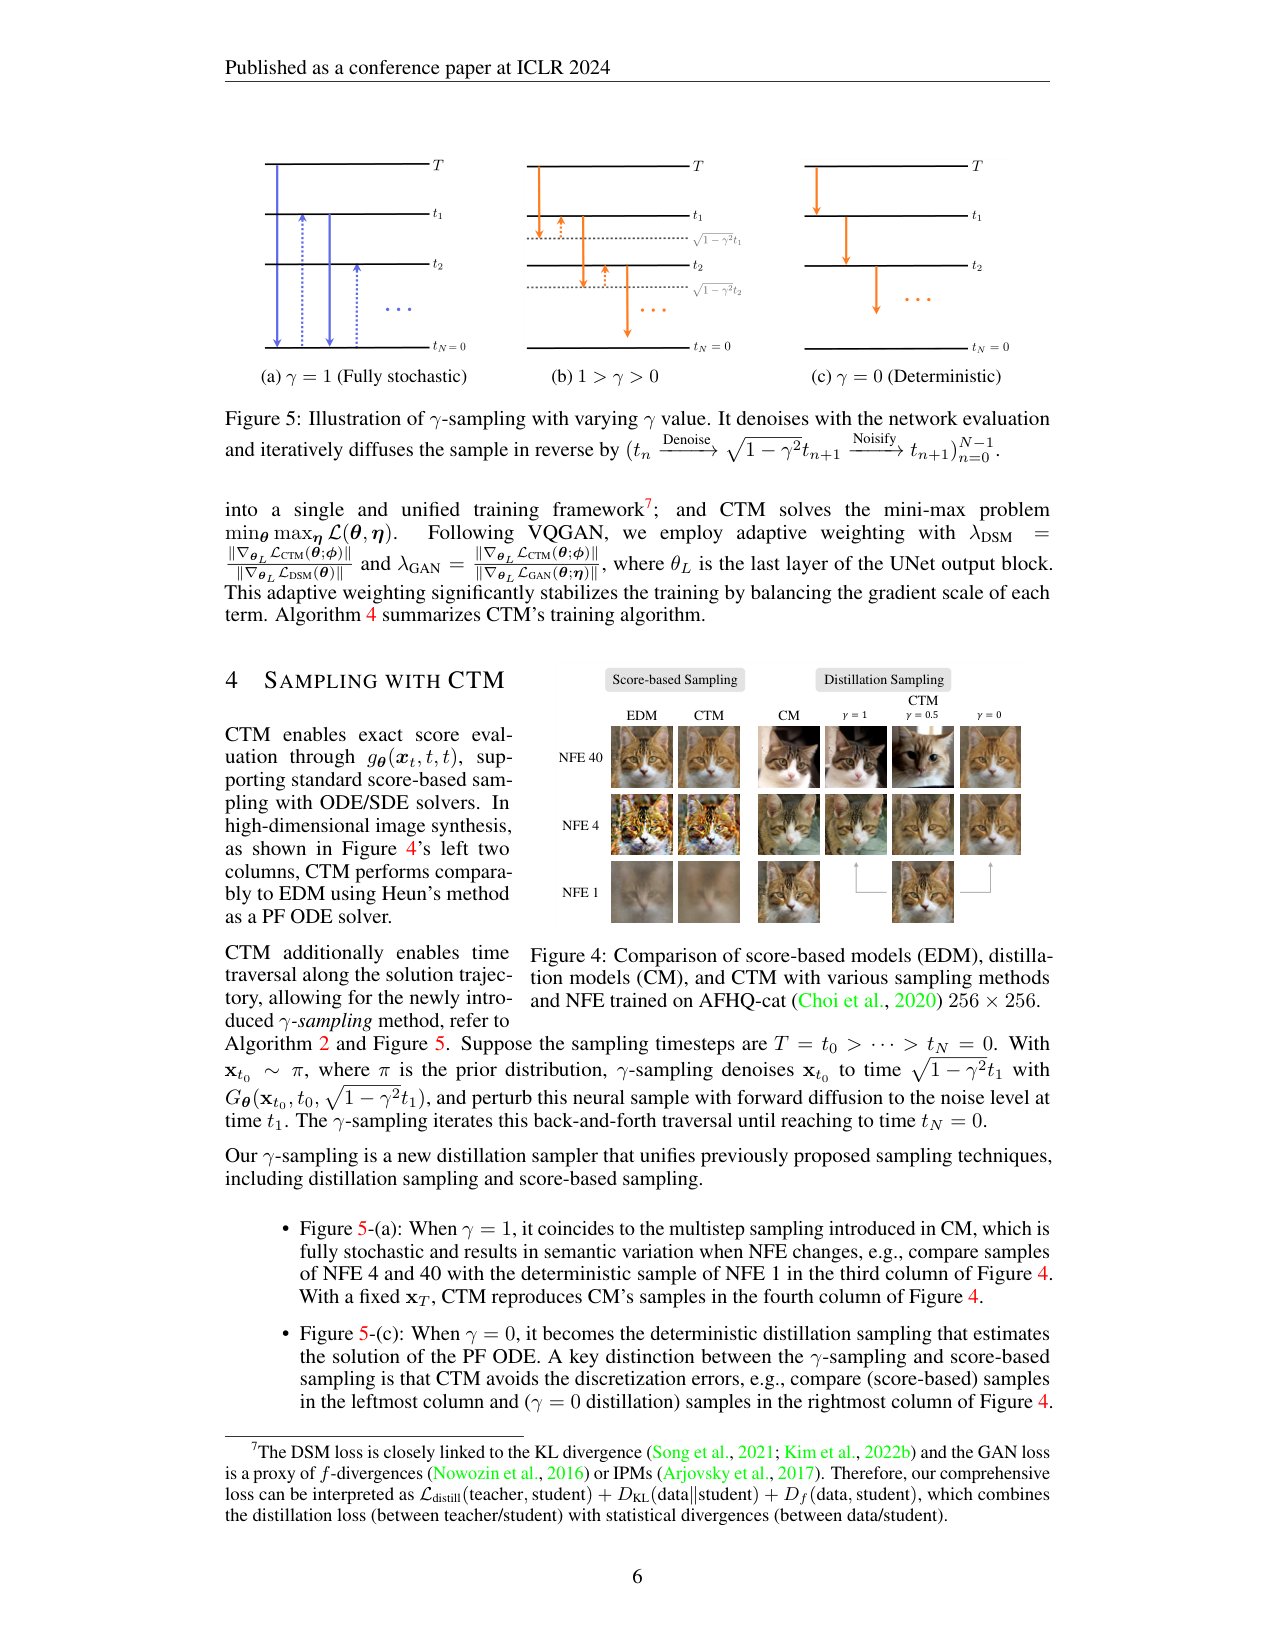
Figure 5 用三张小图画了这个循环:γ=1 时箭头在每层时间之间来回加噪,γ=0 时只有向下的去噪箭头。Figure 4 在 AFHQ-cat 256 上展示了结果:NFE=1 时 EDM 与 CTM 的 score-based 采样明显模糊,CTM γ=0 的蒸馏采样保持清晰。
5. 关键实验与结果
所有数字都带 baseline 和 setup。CIFAR-10(32×32,EDM 老师 + DDPM++ 学生,100K 迭代):
- 无条件 NFE 1 FID 1.98,低于老师 EDM 的 2.01(35 NFE)和 CD 的 3.55(NFE 1,官方报告);论文还提到用官方 CM 代码重训 CD 只能到 10.53;
ImageNet 64×64(类别条件,CM 老师 + ADM 学生,30K 迭代):NFE 1 无引导 FID 1.92,低于 CM 的 6.20、StyleGAN-XL 的 2.09 和 ADM 的 2.07(250 NFE);NFE 2 到 1.73。学生超过老师这一点在两份数据上都成立:CIFAR-10 的 1.98 对老师 EDM 的 2.01,ImageNet 的 1.92 对老师 CM 的 6.20。
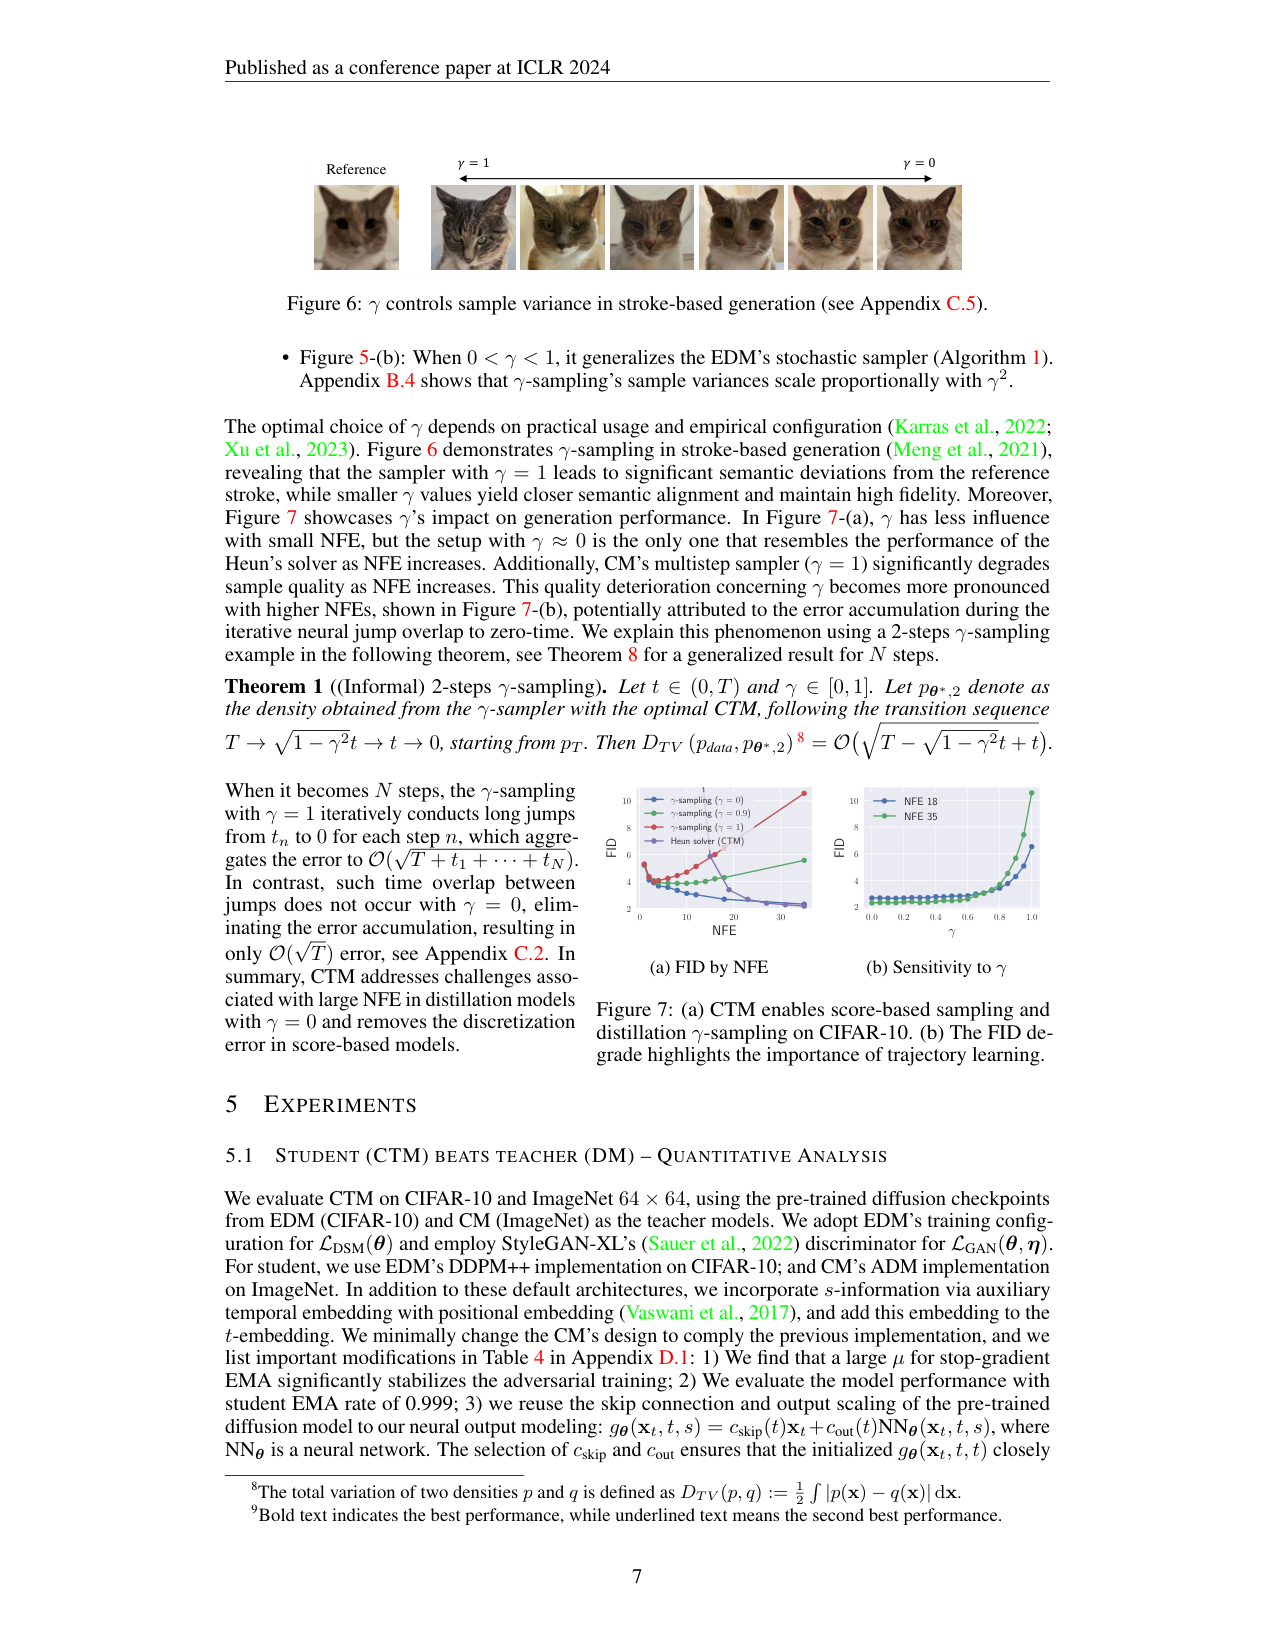
Figure 7(a) 是这篇最有信息量的图:横轴 NFE、纵轴 FID(CIFAR-10),四条曲线分别是 γ=0、γ=0.9、γ=1 和 Heun 求解器。随 NFE 增加,γ=1 的 FID 一路上涨到 10–11,γ=0 一路降到 2 出头并接近 Heun 求解器——这正是「轨迹学习避免区间重叠误差累积」的直接证据。Figure 7(b) 固定 NFE 18/35 扫 γ:γ<0.6 时 FID 平坦在 2–3,接近 1 时急剧恶化。
消融方面:GAN 损失把 CIFAR-10 无条件 NFE 1 的 FID 从 5.19 压到 2.28、NFE 18 从 3.00 压到 2.23(同一超参);soft consistency 优于 local、与 global 相当且训练快 2 倍(Figure 10)。训练效率:CIFAR-10 100K 迭代、ImageNet 30K 迭代达到报告质量,论文称相对对应基线快约 10 倍与 20 倍。无预训练老师时,CIFAR-10 无条件从零训练 NFE 1 FID 2.39,对比 CM 从零训练的 CT 基线 8.70。
6. 与相关工作对比
CTM 处在「one-step 谱系」里 score-based 与蒸馏之间:score-based 学被积函数但受离散化误差限制,CM 学积分但只锚定 0 时刻、多步退化;CTM 用 (t,s) 平面的整块三角覆盖两者。与 MeanFlow(后续工作,arXiv 2505.13447)的呼应值得单独说:MeanFlow 学的是整段平均速度 u(x, r, t),位移等于 (t−r)·u,一步采样 x_0 = x_1 − u(x_1, 0, 1);CTM 的 G(x_t,t,s) 等价于 x_t 加上「平均速度 × (s−t)」,同样把整段积分当网络目标。区别在自洽的来源:CTM 靠 soft consistency 损失把轨迹自洽逼出来,MeanFlow 靠平均速度的定义与积分可加性直接推出恒等式、自洽自动满足。两条路线共享同一个判断——学整段积分量,才能绕开 CM 式多步退化。
7. 局限
第一,主结果依赖预训练老师。CIFAR-10 与 ImageNet 64×64 的 SOTA 数字都从 EDM/CM checkpoint 蒸馏而来;无预训练老师版只在 CIFAR-10 无条件上验证,FID 2.39 明显差于蒸馏版 1.98。第二,实验规模有限:只有 CIFAR-10 32×32 与 ImageNet 64×64 定量,高分辨率只有 AFHQ-cat 256 定性展示,没有 text-to-image、latent 空间、视频或音频,ImageNet 未报 NLL。第三,GAN 组件带来复杂性与不稳定风险:需要 warm-up、高 EMA(µ=0.999/0.9999)、8 个判别器加 LPIPS,自适应权重依赖末层梯度,换数据集要重新调参。第四,γ 的选取依赖任务与经验,γ 接近 1 时质量急剧下滑,采样族可用但需要按任务挑 γ。第五,理论保证(收敛性、γ-sampling 误差界)都假设最优 CTM(G_θ* ≡ G),实际学生与老师的近似差距没有量化上界;γ-sampler 在路径意义上使用了未来信息,没有对应的 Itô SDE,随机采样的理论支撑空缺。第六,classifier-rejection sampling 每类要先生成 50/(1−r) 张候选再挑前 50,平均 NFE 随拒绝率上升。
8. 复现
官方代码在 https://github.com/sony/ctm。关键配置:CIFAR-10 用 4×V100(16G)、100K 迭代、batch 256、N=18、最大 ODE 步数 17;ImageNet 用 8×A100(40G)、30K 迭代、batch 2048、N=40、最大 ODE 步数 20;时间表 σ_min=0.002、σ_max=80、ρ=7、σ_data=0.5;求解器 Heun;EMA µ=0.999(CIFAR-10 条件 / ImageNet)或 0.9999(CIFAR-10 无条件)。
记住三件事:一是点对点自洽放宽成轨迹自洽,一个网络同时给 score 与跳跃;二是 γ-sampling 的 γ=0 消除区间重叠误差,γ=1 复现 CM 的多步退化;三是学生超过老师,靠 soft consistency + DSM + GAN 三损失合流。
把 Consistency Models 的「点对点自洽」放宽成「轨迹自洽」:一个网络同时输出 PF ODE 的被积函数(score,即 g 在 s→t 的极限)和积分(任意 t→s 的整段跳跃),用 soft consistency + DSM + GAN 三个损失训练,再配一个 γ-sampling 采样族覆盖 CM 多步(γ=1)与确定性蒸馏(γ=0)两端;在 CIFAR-10 与 ImageNet 64×64 上以 1–2 NFE 刷新 FID,且学生质量超过老师。
阅读提示
精读深度:泛读
清单提示:清单提示:看它如何把「点对点自洽」放宽为「轨迹自洽」,与 MeanFlow 的「整段平均速度」呼应。
问题
要解决什么:扩散模型采样要沿概率流 ODE 做数值积分,步数少(NFE 小)时离散化误差明显;蒸馏类方法(以 Consistency Models 为代表)把积分直接交给神经网络、一步出图,但多步采样时每步都往 0 时刻做长跳,时间区间互相重叠,误差随 NFE 累积、样本质量反而下降,还拿不到 score、算不了似然。CTM 想用一个框架同时解决这两类问题:既能像 score-based 那样任意步数采样且质量随预算提升,又能像蒸馏那样少步出图。
为什么 prior work 不够:score-based 采样(DDIM/EDM 等数值求解器)受制于所有求解器都有的离散化误差,论文用 Taylor 展开指出误差来源是积分残差项 O(Δt) 未被估计(第 2 节、附录 B.1);CM 的多步采样把每一步都映射回 0 时刻,Theorem 1 和 Theorem 8 表明相邻长跳的时间区间重叠导致误差累积到 O(Σ√(t_n − √(1−γ²)t_{n+1})),因此 NFE 增加时 FID 变差(Figure 7 红曲线)。CM 只条件化单个时间、锚定 s=0,没有质量-速度之间的调节旋钮,也缺少 score 访问。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 带噪样本 x_t | 图像像素(CIFAR-10 32×32 / ImageNet 64×64) | 由 x_t = x_0 + t·ε 前向扩散得到,x_0 是干净数据、ε 是标准高斯噪声,时间尺度沿 EDM 的 σ 时间表(σ_min=0.002、σ_max=80、ρ=7)。 |
| 时间对 (t, s) | 两个标量(s ≤ t) | t 是当前所在时间,s 是想跳到的目标时间;网络以 t 嵌入 + 额外 s 位置嵌入(positional embedding)条件化,两者加和进 U-Net。 |
| 类别标签 c(仅条件生成) | int | CIFAR-10 条件版与 ImageNet 64×64 使用类别条件;无条件版无此项。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 跳跃端点 G_θ(x_t, t, s) | 与输入同维图像向量 | PF ODE 从时间 t 到 s 的解的估计,等价于 x_s ≈ G_θ(x_t, t, s);其内部函数 g_θ(x_t, t, s) 在 s→t 的极限退化为去噪器 E[x|x_t],即 score 的另一种表达。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10 32×32 | 5 万训练图(10 类) | 无条件与类别条件两种设置;学生用 EDM 的 DDPM++,老师用 EDM 预训练 checkpoint;100K 迭代、batch 256、4×V100。 |
| ImageNet 64×64 | 128 万训练图(1000 类) | 类别条件;学生用 CM 的 ADM,老师用 CM 预训练 checkpoint;30K 迭代、batch 2048、8×A100(40G)。 |
| AFHQ-cat 256×256 | 定性展示 | 仅用于 Figure 4 的采样质量对比,无 FID 报告。 |
架构(摘要)
主干与结构
backbone:U-Net:CIFAR-10 用 EDM 的 DDPM++,ImageNet 64 用 CM 的 ADM;两者均加一个 s 时间嵌入(positional embedding,加进 t 嵌入)
参数:论文未直接报告总参数量(沿用 EDM/CM 的 U-Net 配置)
类型:score/跳跃 双用途网络:g_θ(x_t, t, s) = c_skip(t)·x_t + c_out(t)·NN_θ(x_t, t, s),c_skip(t)=σ²_data/(t²+σ²_data)、c_out(t)=t·σ_data/√(t²+σ²_data)(EDM 风格),σ_data=0.5
关键组件
- 跳跃表示 G_θ(x_t, t, s) = (s/t)·x_t + (1 − s/t)·g_θ(x_t, t, s):Euler 求解器启发,s=t 时自动满足初始条件 G_θ(x_t,t,t)=x_t,训练从带约束问题变成无约束问题
- s 条件嵌入:把目标时间 s 的位置编码加到 t 嵌入上,让同一网络区分不同跳跃长度
- soft consistency 蒸馏损失(主损失,LPIPS 特征距离)
- DSM 辅助损失:‖x_0 − g_θ(x_t, t, t)‖²,最优时 g_θ(x_t,t,t)=E[x|x_t],弥补 s→t 时 (1−s/t) 缩放因子导致的梯度消失
- GAN 辅助损失:StyleGAN-XL 风格判别器(EfficientNet×4 + DeiT-base×4 共 8 个,特征金字塔 + 跨尺度混合),自适应权重 λ 按末层梯度范数比调节
- EMA 学生:sg(θ) ← stopgrad(µ·sg(θ) + (1−µ)·θ),µ=0.999(CIFAR-10)/0.9999
为什么这样设计
直接学 x_t + ∫ 或 ∫ 本身容易发散(论文 3.1 节注 3),用 Euler 形式 G = (s/t)x_t + (1−s/t)g 既保证边界条件自动满足,又让 g 在 s→t 时自然退化为去噪器,因此同一个 g 能同时承担 score 与跳跃两种角色;EDM 风格的 c_skip/c_out 让学生初始化时 g_θ(x_t,t,t) 就接近老师去噪器,是 30K–100K 迭代快速收敛的结构性原因。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 无条件 FID(NFE 1) | 1.98 | 老师 EDM 2.01(35 NFE);CD 3.55(NFE 1,官方报告);用官方 CM 代码重训的 CD 10.53(NFE 1) | CIFAR-10 32×32 无条件,EDM 老师 + DDPM++ 学生,100K 迭代、batch 256 |
| CIFAR-10 条件 FID(NFE 1) | 1.73 | StyleGAN-XL 1.85(1 NFE)、EDM 1.82(35 NFE) | CIFAR-10 类别条件,同架构配置 |
| CIFAR-10 FID(NFE 2) | 1.63 | CD 2.93(NFE 2)、EDM 2.01(35 NFE);论文称当时所有生成模型中的最优 | CIFAR-10,γ=0 两段采样 |
| CIFAR-10 NLL(bits/dim) | 2.43 | EDM 2.56、DDPM 3.75(1000 步);当时 SOTA | 用 g_θ(x_t,t,t) 当 score 解 PF ODE,RK45、tol=1e−3 |
| ImageNet 64×64 FID(NFE 1,无引导) | 1.92 | CM 6.20(NFE 1)、StyleGAN-XL 2.09(1 NFE)、ADM 2.07(250 NFE)、EDM 2.44(79 NFE) | ImageNet 64×64 类别条件,CM/ADM 老师 + ADM 学生,30K 迭代、batch 2048 |
| ImageNet 64×64 FID(NFE 2) | 1.73 | PD 8.95(NFE 2)、CD 4.70(NFE 2) | 同上,γ=0 两段采样 |
| 从零训练(无预训练老师)CIFAR-10 无条件 FID(NFE 1) | 2.39 | CT(Consistency Training)8.70(NFE 1,无预训练老师设置) | CIFAR-10 无条件,300K 迭代、batch 128,学生用自己的 g_θ 当 score 构造目标 |
| GAN 损失消融(CIFAR-10 无条件) | NFE 1:5.19 → 2.28;NFE 18:3.00 → 2.23 | 同一超参下关闭 GAN 的 CTM 5.19 / 3.00 | CIFAR-10 无条件,λ_GAN=0 与自适应 λ_GAN 对照 |
| 训练迭代量 | CIFAR-10 100K 迭代、ImageNet 30K 迭代达到报告质量 | 论文称相对对应基线快约 10 倍(CIFAR-10)与 20 倍(ImageNet) | Figure 10/11 中以 CM 10×iter 曲线作对照 |
Insights
- 把 CM 的『点对点自洽』放宽为『轨迹自洽』:CM 强制任意 (x_t, t) 都映射到同一个 0 时刻点,CTM 改学一族映射 G(·, t, s)(所有 s≤t),并要求 t→s 的单段跳跃与 t→u→s 的分段跳跃一致;g 在 s→t 的极限又回到去噪器,所以自洽性覆盖了从无穷小跳跃到任意长跳跃的整条轨迹(Lemma 2、3.1 节)。
- 一个网络两个角色:g_θ(x_t,t,s) 同时是被积函数(s→t 极限 = E[x|x_t])与积分(长跳跃),因此 CTM 把 score-based 采样(t=s 线)和蒸馏采样(s=0 线)统一成 (t,s) 平面上的一个学习目标(Figure 2)。
- soft consistency 随机化 u 是关键工程决策:老师信息在任意子区间显式可达,比 local 的外推更准、比 global 便宜 2 倍;这是 1 步质量超老师的基础之一(3.2 节、附录 C.3、Figure 10)。
- γ-sampling 是质量-速度旋钮:γ=0 消除区间重叠、误差 O(√T),γ=1 复现 CM 多步的误差累积 O(Σ√(t_n−√(1−γ²)t_{n+1})),方差按 γ² 增长;这从结构上解释了 CM 多步退化(Theorem 1/8、Proposition 7)。
- 学生超过老师:soft consistency + DSM + GAN 三损失合流后,CIFAR-10 NFE 1 的 1.98 低于老师 EDM 的 2.01,ImageNet NFE 1 的 1.92 远低于老师 CM 的 6.20(5.1 节)。
- score 访问带来 CM 没有的下游能力:g_θ(x_t,t,t) 可算 NLL(CIFAR-10 2.43)、支持 classifier-rejection sampling,以及把现有扩散社区的条件生成/引导方法直接搬过来(摘要、5.1 节)。
vs 同类工作
- vs Consistency Models:CM 锚定 s=0,只学『任意时刻 → 0 时刻』的点对点映射,多步采样每步长跳到 0、时间区间重叠导致误差累积(Theorem 1/8 的 γ=1 情形);CTM 学任意 (t,s) 对,γ-sampling 让它在 NFE 增加时质量继续上升,还能拿 score、算似然。
- vs score-based diffusion(EDM/DDIM):数值求解器有 Taylor 残差带来的离散化误差 O(Δt);CTM 的 γ=0 直接把整段积分交给网络,离散化误差不出现,且 NFE 1 就达到甚至超过老师 EDM 35 NFE 的质量(CIFAR-10 1.98 vs 2.01)。
- vs 其他蒸馏(PD、BOOT、DFNO、2-Rectified Flow、CD+GAN):CTM 用 soft consistency 显式蒸馏任意子区间 + DSM/GAN 双辅助损失,收敛快(30K–100K 迭代)且学生质量超过老师;CD+GAN 的 CIFAR-10 NFE 1 FID 2.65 低于 CTM 的 1.98。
- vs MeanFlow(后续工作,2505.13447):MeanFlow 学整段平均速度 u(x, r, t),由定义推出恒等式 u = v − (t−r)du/dt,跨区间自洽自动满足、无需一致性损失;CTM 的 G(x_t,t,s) 等价于 x_t 加上『平均速度 × (s−t)』,也把整段积分当网络目标,但自洽靠 soft consistency 损失强加。两者共享『学整段积分量而非点速度』的路线,呼应关系:CTM 用损失逼出来的轨迹自洽,在 MeanFlow 里由积分可加性直接保证。
- vs Flow Map Matching / Shortcut 类:FMM 直接参数化位移需显式边界条件,CTM 的 Euler 式混合把边界条件做进系数里自动满足(附录 C.1);Shortcut 在 flow matching 损失上额外加两时间点一致性,CTM 的一致性覆盖任意区间对。
局限
- 主结果依赖预训练老师:CIFAR-10 与 ImageNet 64×64 的 SOTA 数字都从 EDM/CM checkpoint 蒸馏而来;无预训练老师的从零训练版只在 CIFAR-10 无条件上验证,FID 2.39 明显差于蒸馏版 1.98(Table 1)。
- 实验规模有限:只有 CIFAR-10 32×32 与 ImageNet 64×64 两类定量设置;高分辨率仅有 AFHQ-cat 256 的定性展示,没有 text-to-image、latent 空间、视频或音频验证,ImageNet 也没有报告 NLL。
- GAN 组件带来复杂性与不稳定风险:需要 warm-up(CIFAR-10 前 50K 迭代 λ_GAN=0)、高 EMA(µ=0.999/0.9999)、8 个判别器(EfficientNet×4 + DeiT×4)+ LPIPS 特征距离,自适应权重按梯度范数比调节;训练稳定依赖这些细节,换数据集要重新调参。
- γ 的选取依赖任务与经验:γ=1 在高 NFE 时 FID 明显退化(CIFAR-10 NFE 35 时约 10–11,对比 γ≈0 的 2–3),图 (b) 显示 γ 接近 1 时质量急剧下滑,采样族可用但需要按任务挑 γ。
- 理论保证针对最优 CTM:收敛性(Proposition 3/5)与 γ-sampling 误差界(Theorem 1/8)都假设 G_θ* ≡ G,实际学生与老师之间的近似差距没有量化上界;γ-sampler 在路径意义上使用了未来信息、没有对应的 Itô SDE,随机采样器的 SDE 层理论支撑空缺(附录 C.2)。
- classifier-rejection sampling 成本高:每类要先生成 50/(1−r) 张候选再按分类概率挑前 50,平均 NFE 随拒绝率上升(5.1 节)。
可复现性
- code:https://github.com/sony/ctm
- weights:论文未明确给出预训练权重链接(以官方仓库为准)
- setup:CIFAR-10:4×V100 16G、100K 迭代、batch 256、N=18、最大 ODE 步数 17、Heun 求解器;ImageNet:8×A100 40G、30K 迭代、batch 2048、N=40、最大 ODE 步数 20;σ_min=0.002、σ_max=80、ρ=7、σ_data=0.5;EMA µ=0.999(CIFAR-10 条件/ImageNet)/0.9999(CIFAR-10 无条件)
主干与结构
backbone:U-Net:CIFAR-10 用 EDM 的 DDPM++,ImageNet 64 用 CM 的 ADM;两者均加一个 s 时间嵌入(positional embedding,加进 t 嵌入)
参数:论文未直接报告总参数量(沿用 EDM/CM 的 U-Net 配置)
类型:score/跳跃 双用途网络:g_θ(x_t, t, s) = c_skip(t)·x_t + c_out(t)·NN_θ(x_t, t, s),c_skip(t)=σ²_data/(t²+σ²_data)、c_out(t)=t·σ_data/√(t²+σ²_data)(EDM 风格),σ_data=0.5
关键组件
- 跳跃表示 G_θ(x_t, t, s) = (s/t)·x_t + (1 − s/t)·g_θ(x_t, t, s):Euler 求解器启发,s=t 时自动满足初始条件 G_θ(x_t,t,t)=x_t,训练从带约束问题变成无约束问题
- s 条件嵌入:把目标时间 s 的位置编码加到 t 嵌入上,让同一网络区分不同跳跃长度
- soft consistency 蒸馏损失(主损失,LPIPS 特征距离)
- DSM 辅助损失:‖x_0 − g_θ(x_t, t, t)‖²,最优时 g_θ(x_t,t,t)=E[x|x_t],弥补 s→t 时 (1−s/t) 缩放因子导致的梯度消失
- GAN 辅助损失:StyleGAN-XL 风格判别器(EfficientNet×4 + DeiT-base×4 共 8 个,特征金字塔 + 跨尺度混合),自适应权重 λ 按末层梯度范数比调节
- EMA 学生:sg(θ) ← stopgrad(µ·sg(θ) + (1−µ)·θ),µ=0.999(CIFAR-10)/0.9999
为什么这样设计
直接学 x_t + ∫ 或 ∫ 本身容易发散(论文 3.1 节注 3),用 Euler 形式 G = (s/t)x_t + (1−s/t)g 既保证边界条件自动满足,又让 g 在 s→t 时自然退化为去噪器,因此同一个 g 能同时承担 score 与跳跃两种角色;EDM 风格的 c_skip/c_out 让学生初始化时 g_θ(x_t,t,t) 就接近老师去噪器,是 30K–100K 迭代快速收敛的结构性原因。
CTM 的学习目标:score 线、蒸馏线、CTM 三角形 + soft consistency 示意图
原文 caption:Figure 2: Learning objectives of Score-based (t = s line), distillation (s = 0 line), and CTM (upper triangle). Figure 3: An illustration of CTM's two predictions at time s with an initial value x_t.
Figure 2 用 (t, s) 平面画出三家方法的覆盖范围:score-based 只学 t=s 这条对角线(无穷小跳跃,即被积函数),CM 式蒸馏只学 s=0 这条边(长跳到 0 时刻的积分),CTM 学整个 s≤t 上半三角(任意时刻到任意时刻的跳跃)。Figure 3 展示 soft consistency 的训练方式:学生从 x_t 出发的两条预测路径(直接从 t 跳到 s,以及老师先解 ODE 到中间时刻 u 再跳回 s)要在 s 处对齐,也就是『轨迹级』的自洽。这张图直接对应阅读提示里的『点对点自洽 → 轨迹自洽』。
AFHQ-cat 256 采样对比(EDM/CM/CTM × NFE 40/4/1)+ γ-sampling 图解
原文 caption:Figure 4: Comparison of score-based models (EDM), distillation models (CM), and CTM with various sampling methods and NFE trained on AFHQ-cat 256×256. Figure 5: Illustration of γ-sampling with varying γ value.
Figure 4 是采样网格:横轴方法(EDM、CTM score-based、CM、CTM γ=1/0.5/0),纵轴 NFE(40/4/1)。肉眼可见 NFE=1 时 EDM 与 CTM score-based 糊成一团,蒸馏类仍可辨认;CTM γ=0 在 NFE 1 时最清晰。Figure 5 画 γ-sampling 三步循环:去噪到 √(1−γ²)t_{n+1} 再加噪回 t_{n+1};γ=1 全随机(等价 CM 多步)、γ=0 纯确定(无上箭头)。它说明 CTM 用一个采样族同时覆盖 score-based 与蒸馏两类方法。
CIFAR-10 上 FID-NFE 曲线与 γ 敏感度
原文 caption:Figure 7: (a) CTM enables score-based sampling and distillation γ-sampling on CIFAR-10. (b) The FID degrade highlights the importance of trajectory learning.
图 (a) 横轴 NFE、纵轴 FID,四条曲线:γ=0(蓝)、γ=0.9(绿)、γ=1(红)、Heun 求解器(紫)。随 NFE 增加,γ=1 的 FID 一路上涨到 10–11,γ=0 一路降到 2 出头并接近 Heun 求解器——直接证据表明 CM 式多步(γ=1)的时间区间重叠造成误差累积,而 γ=0 的轨迹式学习没有这个问题。图 (b) 固定 NFE 18/35 扫 γ:γ<0.6 时 FID 平坦在 2–3,接近 1 时急剧恶化,说明确定性端点才是质量稳定的区域。
🎧 音频版
时长 25:26 · Edge TTS
Consistency Trajectory Models(对话版·泛读)
这期要讲的,是扩散模型采样慢的问题
小播:老播,这期讲什么论文?
老播:讲 Consistency Trajectory Model,缩写 CTM,一致性轨迹模型,ICLR 2024 的论文,作者来自索尼 AI、卡内基梅隆和斯坦福。它解决的是扩散模型生成图像太慢的问题。扩散模型在文本转图像、图像生成这些场景里质量很好,慢是它最明显的短板。
小播:慢在哪?
老播:扩散模型去噪,要沿着一条叫「概率流 ODE」的曲线,把噪声一步步推成图像。普通做法要几十次到上千次网络调用,业界管这个次数叫 NFE,就是 Number of Function Evaluations,生成一张图需要调用几次网络。每调用一次就是一次前向计算,NFE 大,生成就慢。为了快,有人做蒸馏,让一个网络一步出图,代表方法是 Consistency Model,一致性模型,CM。但 CM 有个毛病:一步出图质量不错,多走几步质量反而变差,这在当时是公认的怪现象。
小播:为什么多走几步反而变差?
老播:这正是 CTM 要回答的问题之一。CTM 这篇把 score-based 和蒸馏两类方法统一成一个框架,一步出图能超过老师,多步采样质量还继续涨。它在 CIFAR-10 和 ImageNet 64×64 上都刷了新纪录,CIFAR-10 上 1 次网络调用的 FID 是 1.98,比老师 EDM 35 次调用的 2.01 还好。FID 是 Fréchet Inception Distance,衡量生成图和真实图分布差距的指标,越低越好,这个数字的含义后面会展开。
小播:那这期适合什么人来听?
老播:适合有机器学习基础、但平时不搞生成模型的人。你只需要知道扩散模型是「加噪再学去噪」,不需要会推随机微分方程。我尽量把每个术语第一次出现都解释一遍,公式给出来之前先说它要回答什么问题。
小播:那「统一」具体怎么做?
老播:核心就一句话——把一致性模型的「点对点自洽」要求,放宽成「轨迹自洽」。后面我会把这句话拆开讲,也会讲它和后续 MeanFlow 那篇「整段平均速度」的呼应。听完这期,你能回答三个问题:为什么 CM 多步退化,CTM 怎么同时拿到 score 和整段跳跃,以及它和 MeanFlow 那条路线的关系。
先补点背景:扩散采样到底慢在哪
小播:先补课。扩散采样为什么慢?
老播:训练时我们给图像逐渐加噪声,学一个网络,看到带噪图像能预测原始干净图像,这个网络叫去噪器。扩散过程在数学上写成一个前向随机微分方程,时间从 0 到 T,0 是干净数据,T 是纯噪声。CTM 用的是 EDM 的时间表,噪声尺度从 0.002 到 80。这里补一个概念:score,中文常译作分数。它是概率密度的梯度,方向指向样本密度更高的区域。扩散模型学去噪器,本质上就是在学 score 的另一种写法,两者只差一个常数变换。score-based 采样器的每一步,都靠这个梯度把带噪样本往高密度区推,推一步、再看、再推。采样就是反过来:从纯噪声出发,靠去噪器一步步把噪声变成图像。整个过程可以写成一个确定性方程,就是概率流 ODE,Probability Flow ODE。沿着它从噪声时间 T 走到 0 时刻,就得到一张图。
小播:那一步直接走到 0 不行吗?
老播:一步走,就是让网络估计整段积分。整段轨迹是弯的,网络一步估计会有误差。正统做法是数值求解器:把轨迹切成小段,一小段一小段走,DDIM、EDM 的 Heun 求解器都是干这个的。步数越多越准,但每步都调用一次网络,NFE 就上去了。而且求解器有本质的离散化误差:任何有限步的数值积分,都会丢掉积分余项那一小块,论文用 Taylor 展开把这部分误差写成 O(Δt) 量级。这是第一类方法,叫 score-based 采样,卡在「步数少误差大」。
小播:第二类方法呢?
老播:第二类叫蒸馏。用训好的扩散模型当老师,训练一个学生网络,让它直接输出整段轨迹的结果,一步出图。代表是 Consistency Model,一致性模型,CM。CM 的做法是:不管从哪个时间出发,网络都把它映射到 0 时刻的干净图像。为保证这一点,它要求「点对点自洽」:同一张图在不同噪声程度的版本,经过网络后必须落到同一个干净图。训练时用损失把这一点强加给网络,网络就学会了一步从噪声到图像的映射。这里的「老师-学生」结构说一下:老师是已经训好的扩散模型,学生是新的网络,学生拿老师输出的结果当训练目标,学老师的本领,这个过程叫蒸馏。蒸馏的常见问题是学生最多追平老师、很难超过,CTM 后面打破了这一点。
小播:这听起来合理,问题出在哪?
老播:出在多步采样。CM 想多走几步提高质量,但每一步都是「长跳到 0 时刻」,相邻两步的跳跃区间重叠。打个比方,CM 的多步像每次跑步都从终点重新量起,前一步量过的路后一步又量一遍,误差一层层叠上去。论文用 Theorem 1 和 Theorem 8 证明了误差累积的量级是 O(Σ√(t_n − √(1−γ²)t_{n+1}))。这里 γ 是采样时加回噪声的比例,后面会专门讲;先记住这个式子告诉我们,误差和跳跃区间长度的平方根成正比,相邻跳跃的区间重叠越多,误差累积越大。CIFAR-10 上实验直接可见:CM 风格多步采样,NFE 从 4 加到 35,FID 不降反升,后面讲实验时会有具体的图。
小播:那 CTM 打算怎么改?
老播:把「点对点自洽」放宽成「轨迹自洽」。这是全篇最核心的改动,下一段细讲。
自洽从「一个点」放宽到「整条轨迹」
小播:点对点自洽和轨迹自洽,差别在哪?
老播:CM 的一致性,说的是所有时刻的带噪版本都映射到同一个 0 时刻点。CTM 改成学一族映射:从任意时间 t 出发,跳到任意更早的时间 s,都给出这一段轨迹的终点。它要求的是,从 t 直接跳到 s 的结果,和先跳到中间时刻 u、再从 u 跳到 s 的结果一致。也就是说,任何一段轨迹都要和别的段拼接起来一致。这就是轨迹自洽。放宽之后,一致性从「所有路径汇到同一个终点」变成「任何一段轨迹都和其他段拼接吻合」,约束从点变成整条曲线。
小播:网络怎么同时处理所有的时间对?
老播:这是 CTM 的关键设计。先看一个式子,它回答「概率流 ODE 从 t 到 s 的精确解长什么样」,把解写成起点加上一段积分:
G(x_t, t, s) = x_t + ∫_t^s (x_u − E[x|x_u]) / u du
逐项看:x_t 是出发点;x_u 是轨迹上 u 时刻的状态;E[x|x_u] 是去噪器,给定带噪样本预测干净数据;分子 x_u 减去 E[x|x_u] 再除以 u,正是这个时刻的瞬时速度,也就是 score,对数概率密度的梯度。整个积分把从 t 到 s 每一点的速度加起来,得到总位移。s 越接近 t,积分越短;s=t 时 G 就是恒等映射,边界条件自动满足。这个式子本身是 ODE 解的积分形式,把它看成网络要逼近的目标就行。给个数字建立量级感:ImageNet 64 上,网络要在 64×64×3 的图像空间里一次前向覆盖从噪声尺度 80 到 0.002 的整段轨迹,等于让网络一次回答「这张纯噪声图去噪到最后应该长什么样」。
小播:直接让网络学这个积分不行吗?
老播:论文试过,直接学会发散。所以它用 Euler 一步求解器的形式做参数化:
G_θ(x_t, t, s) = (s/t)·x_t + (1 − s/t)·g_θ(x_t, t, s)
这里的预期是:把边界条件直接写进系数。Euler 一步解长这样:x_s ≈ (s/t)·x_t + (1 − s/t)·E[x|x_t],CTM 把其中的去噪器换成网络输出 g_θ。系数 s/t 和 1 − s/t 加起来等于 1,s=t 时第二个系数归零,G_θ(x_t,t,t)=x_t 自动成立,训练从带约束变成无约束。更关键的是极限行为:s 越来越接近 t 时,g_θ 趋向去噪器 E[x|x_t]。同一个网络,长跳跃时给出整段积分,短跳跃时给出 score。score 和跳跃,一个是方程的被积函数,一个是方程的解,被同一个函数 g 承接了。这个双用途是 CTM 叫「一致性轨迹模型」的原因:它学的是整条轨迹,而不只是轨迹的终点。对比一下:CM 的网络只输出终点,轨迹内部的信息完全看不到;CTM 的 g 对任意 s 都有意义,等于把整条轨迹折叠进了同一个函数。
小播:这结构听起来有点绕,有没有图能一眼看懂?
老播:有,Figure 2。它把三类方法画在一个平面上:横轴是目标时间 s,纵轴是起始时间 t。score-based 只学 t=s 这条对角线,因为它的每一步都是无穷小的跳跃;CM 式蒸馏只学 s=0 这条边,因为它的所有跳跃都指向 0 时刻;CTM 学整个 s≤t 的上半三角,任意一对时间都能跳。一个网络覆盖全部,这是「统一」的几何含义。有了这个图,再看「点对点自洽放宽成轨迹自洽」就清楚:CM 只在一条边上做文章,CTM 在整块区域里要求自洽。
小播:轨迹自洽靠什么训练出来?
老播:靠一个叫 soft consistency loss 的损失,软一致性损失。做法是随机采一个中间时刻 u,让学生从 t 跳到 s,去对齐「老师先从 t 解 ODE 到 u,学生再从 u 跳到 s」的结果。随机化 u 的好处,是老师的信息能在任意子区间上显式传给学生。u 取到 s 那边,就是全局一致性,老师覆盖整段区间;u 取到 t 附近,就是局部一致性,只覆盖单步,CM 的蒸馏目标就是它的特例。局部一致性的问题是老师信息零散,学生得靠外推把各段拼起来,长跳的精度受影响;全局一致性每步都解整段 ODE,训练贵 3 倍。soft 版本折中,CIFAR-10 上比全局快 2 倍,质量不降,Figure 10 里它的曲线压着 local 走、和 global 相当。具体走一遍训练:采样一个带噪点 x_t,老师先解 ODE 走一段到 u,学生从 u 跳到 s,再把「学生直接从 t 跳到 s」和「老师到 u 再跳回 s」两条路的结果都送到 0 时刻比较,比较用的距离是 LPIPS,一种感知特征距离,比像素距离更接近人眼判断。
小播:光靠蒸馏,学生一般打不过老师吧?
老播:所以它又加了两个辅助损失。一个是去噪分数匹配,缩写 DSM,直接让 g_θ(x_t,t,t) 预测干净图像,给网络一个带真值的目标,还能缓解 s 接近 t 时系数 (1−s/t) 缩到零造成的梯度消失;另一个是 GAN 损失,用判别器修图像细节,判别器用的是 StyleGAN-XL 那套,8 个判别器在特征空间里打分。三个损失一起训,学生反而超过老师,实验部分有数字。论文把这套组合解释成蒸馏距离加上数据分布 KL 散度再加上 f-散度,三个信号各管一段。
小播:采样的时候怎么用这个网络?
老播:这是 CTM 的另一个卖点,γ-sampling。每轮做两步:先用网络去噪到中间时间 √(1−γ²)·t_{n+1},再加回 γ·t_{n+1} 倍的高斯噪声,回到时间 t_{n+1}。γ 是从 0 到 1 的旋钮。γ=1 时加回满噪声,完全随机,等价 CM 的多步采样;γ=0 时纯确定性,直接走轨迹;中间值推广了 EDM 的随机采样器。方差随 γ² 增长,γ 从 0.5 提到 1,方差放大 4 倍。关键在误差:γ=0 时跳跃区间不重叠,误差只有 O(√T);γ=1 时每步都长跳到 0,区间重叠,误差按刚才那个 O(Σ√(...)) 累积。再看一遍这个循环怎么和 EDM 对上:EDM 的随机采样器先加噪到更大的噪声尺度、再用 Heun 求解器去噪回来;γ-sampling 顺序反过来,先去噪、再加噪。两个循环交替执行后走向一致,所以 0<γ<1 可以看成 EDM 随机采样器的推广,差别是 CTM 的去噪一步直接给整段结果,没有离散化误差。这个分析顺带解释了 CM 多步采样为什么退化,也给了用户一个质量-速度的调节旋钮。γ 还连着可复现性:γ=1 时每一步都重新加满噪声,同一张初始噪声图,多步采样的结果会漂移,语义都可能变;γ=0 时固定初始噪声就得到固定结果,适合需要一致输出的场景。
关键实验:学生怎么超过老师
小播:数字呢?
老播:先记两个设置。CIFAR-10 是 32×32 的小图,老师用 EDM 的预训练模型,学生是 DDPM++,训 10 万迭代,4 张 V100;ImageNet 64×64 是 1000 类的大规模,老师用 CM 的预训练模型,学生是 ADM,只训 3 万迭代,8 张 A100。所有 FID 都在这两个设置下对比,标准做法。
小播:结果如何?
老播:CIFAR-10 无条件,NFE 1,FID 是 1.98。老师 EDM 要 35 次调用才到 2.01,学生一步比老师 35 步更好。条件生成 NFE 1 是 1.73,低于 StyleGAN-XL 的 1.85 和 EDM 35 步的 1.82。NFE 2 到 1.63,同一步数下 CD 是 2.93,论文说这是当时所有生成模型里最好的。它还能算似然,NLL 是 2.43,EDM 是 2.56。这里要强调一下设置:NLL 是拿 g_θ(x_t,t,t) 当 score 去解概率流 ODE 得到的,CM 没有这个能力,因为它拿不到 score。
小播:ImageNet 那边呢?
老播:ImageNet 64×64,NFE 1 无引导 FID 1.92,CM 同样一步是 6.20,StyleGAN-XL 是 2.09,ADM 250 步是 2.07。NFE 2 到 1.73。这两组数字共同说明一件事:学生超过老师。CIFAR-10 的 1.98 对老师 EDM 的 2.01,ImageNet 的 1.92 对老师 CM 的 6.20。对蒸馏方法来说,学生超过老师算少见的结果,靠的是 soft consistency 加 DSM 加 GAN 三个损失合流。
小播:多步不退化有直接证据吗?
老播:有,Figure 7(a),这是全篇信息量最大的一张图。横轴 NFE,纵轴 FID,CIFAR-10 上四条曲线:γ=0、γ=0.9、γ=1 和 Heun 求解器。γ=1 那条,也就是 CM 风格多步,NFE 增加时 FID 一路涨,在 NFE 10 附近到 10 到 11;γ=0 那条一路降到 2 出头,和 Heun 求解器的曲线几乎重合。这就是轨迹自洽和点对点自洽在实验上的分水岭。Figure 7(b) 固定 NFE 18 和 35 扫 γ,γ 小于 0.6 时 FID 稳在 2 到 3,接近 1 时急剧恶化,γ 越小越安全。除了主结果,还有一组消融值得看:Figure 10 对比 local、global、soft 三种一致性损失,NFE 1 和 NFE 18 两张子图里 soft 都好于 local、追平 global;Figure 11 扫 DSM 权重,λ_DSM 取 0.1、1.0、5.0,1.0 最优;Figure 12 说明 GAN 在 NFE 1 和 NFE 18 两个设置下都带来稳定下降。
小播:定性图呢?
老播:Figure 4 在 AFHQ-cat 256 上排了一张对比网格,横轴方法、纵轴 NFE 40、4、1。NFE 1 那一行,EDM 和 CTM 的 score-based 采样糊成一团,蒸馏类的图还能认出猫,CTM γ=0 的图最清晰。Figure 5 用三张小图画 γ-sampling 的循环:γ=1 时箭头在时间层之间来回加噪,γ=0 时只有向下走,一眼能看出随机和确定的区别。
小播:GAN 损失帮了多少?
老播:消融数字在同一设置下:CIFAR-10 无条件,关掉 GAN 时 NFE 1 的 FID 是 5.19,打开后 2.28;NFE 18 从 3.00 降到 2.23。幅度很大,也说明这套系统对 GAN 训练依赖不小。训练速度上,CIFAR-10 10 万迭代、ImageNet 3 万迭代就达到报告质量,论文说相对对应基线快约 10 倍和 20 倍,对比图里 CM 画的是乘了 10 倍迭代的曲线。还有一个无老师版本:不依赖任何预训练扩散模型,CIFAR-10 无条件从零训,NFE 1 FID 2.39,同设置下 CM 的从零训练基线 CT 是 8.70。论文还报了两个细节:一是多样性,ImageNet 上它的 IS 是 70.38,验证集本身是 64.10,StyleGAN-XL 是 82.35,CTM 的类别可分性贴近真实数据,StyleGAN-XL 偏高,说明后者可能过度迎合分类器;二是 classifier-rejection sampling,每类先生成 50/(1−r) 张候选、按分类概率挑前 50,平均 NFE 是 1/(1−r),这个采样的 FID-IS 曲线能比肩用 250 步分类器引导的效果。
谱系定位:它站在 one-step 谱系的中间
小播:这篇和之前的工作比,位置怎么摆?
老播:它处在 score-based 采样和蒸馏之间。score-based 学被积函数,受离散化误差限制;CM 学积分,只锚定 0 时刻、多步退化;CTM 用整个 (t,s) 平面把两者盖住。和后续 MeanFlow 的呼应最值得说:MeanFlow 学的是整段平均速度 u,一步采样 x_0 = x_1 − u(x_1, 0, 1),位移等于平均速度乘区间长度;CTM 的 G(x_t,t,s) 等价于 x_t 加上「平均速度 × (s−t)」,同样把整段积分当网络目标。区别在自洽的来源:CTM 靠 soft consistency 损失把轨迹自洽逼出来,MeanFlow 靠平均速度的定义和积分可加性直接推出恒等式,自洽自动满足。两条路线共享同一个判断——学整段积分量,才能绕开 CM 式多步退化;CTM 是这条路线里先把它做成完整框架的工作,MeanFlow 把自洽从损失变成了定义。放回 2023 年的时间坐标:当时 one-step 的主流是 CM 和它的变体,CTM 的贡献是在 CM 的框架里塞进 score 能力、给出 γ 这个调节旋钮;后来的 flow 类工作(Rectified Flow、MeanFlow)把「学整段量」这条路进一步理论化,但 CTM 已经把这个判断完整演示过了。
局限:别把这篇想得太完美
小播:这篇有什么问题?
老播:第一,主结果依赖预训练老师。CIFAR-10 和 ImageNet 的数字都从 EDM、CM 的 checkpoint 蒸馏,无老师版本只在 CIFAR-10 无条件验证过,FID 2.39 比蒸馏版 1.98 差不少。第二,实验规模有限。定量只有 CIFAR-10 32×32 和 ImageNet 64×64,高分辨率只有 AFHQ-cat 256 的定性展示,没有文生图、没有 latent 空间、没有视频音频,ImageNet 也没报似然,扩展性要打问号。第三,GAN 组件让系统变复杂。要 warm-up,前 5 万迭代不开 GAN;要很高的 EMA 系数,EMA 就是指数滑动平均,用来维护学生网络的平滑版本;要 8 个判别器和 LPIPS 感知特征距离,判别器在特征空间打分,输入要先放大到 224×224,自适应权重按梯度范数调。这套东西换数据集基本要重新调参,训练稳定性靠经验保证,理论支撑薄弱;而且系统里有两个互相博弈的网络要同时调好,Table 3 显示 GAN 收益明显,但这份收益的代价是训练复杂度。第四,γ 的选取靠任务和经验,γ 接近 1 时质量急降,采样族可用但每个任务要重新挑 γ。第五,理论保证都假设最优 CTM,也就是学生已经完美复刻了老师的跳跃;实际训练里学生和老师差多少,论文没有给量化上界;γ-sampler 路径上用了未来信息,没有对应的 Itô 随机微分方程,随机采样那套的理论支撑是空缺的。第六,演示的 classifier-rejection sampling 每类要先出 50/(1−r) 张候选再挑前 50,平均 NFE 随拒绝率上升,快采样省下的成本被这部分吃回去一些。
收尾:记住这三件事
小播:我总结这期要记住的三件事。第一,CM 要求点对点自洽,所有时刻都映射到 0 时刻;CTM 放宽成轨迹自洽,任意 t 到 s 的跳跃和分段跳跃一致,一个网络同时给 score 和整段积分。第二,γ-sampling 里 γ=0 消除区间重叠误差、多步质量继续涨,γ=1 复现 CM 的多步退化,这解释了 CM 退化问题的来源。第三,soft consistency 加 DSM 加 GAN,让学生一步出图就超过老师,CIFAR-10 的 1.98 对老师 EDM 35 步的 2.01。
老播:补充一句这篇对后续的意义。CTM 是 one-step 谱系里较早把「学整段积分量」这条路线做完整的:它证明了用损失强加轨迹自洽可行,后面的 MeanFlow 又证明这条自洽可以从定义里自动涌现。两条线合起来,奠定了 flow 类一步生成模型的基本范式——网络直接输出覆盖整段区间的量,采样不再依赖数值积分。你在今天的生成模型里看到的一步生成、速度质量可调,源头都能追到这条轨迹。
小播:那这期就到这,我去把 CTM 和 MeanFlow 两条路线对照着再听一遍。老播:对照着听效果最好,谢谢收听,下期见。