Causality in Video Diffusers is Separable from Denoising(泛读)
一句话定位:论文用探针实验证明,自回归视频扩散模型里的「时间因果推理」和「多步去噪」可以拆开——时间推理每帧只需做一次,逐帧渲染才需要多步迭代。基于这个发现,它提出 Separable Causal Diffusion(SCD):一个每帧只跑一次的因果 transformer 编码器负责时间推理,一个轻量逐帧扩散解码器负责渲染。在从零训练与微调预训练模型两种场景下,SCD 的生成质量持平或超过强基线,同时单帧延迟明显下降,为长时程 world model 提供了一条可独立调节推理成本的路径。核心结论反复出现三次:开场这一句、正文探针部分的证据、结尾对后续工作的意义。
1. 要解决什么问题
现在的视频生成模型有两条路线。双向扩散(Wan 2.1、LTX-Video 等)把整段视频同时加噪同时去噪,所有帧互相可见,全局一致性好,但必须把整段视频生成完才能看到第一帧,延迟按秒算,也没法做实时流式生成。自回归视频扩散把语言模型「预测下一个 token」的思路搬过来:一帧一帧往外生成,每一帧只依赖过去的帧。这类模型叫因果视频扩散(CausalWan、FAR、Self Forcing、Pyramid Flow 都是代表),它的关键机制是因果注意力——给注意力加一个掩码,当前帧只能看自己帧内部和自己之前的帧,不能看未来。
问题出在实现方式上。这些模型把 LLM 的因果注意力整建制移植进扩散去噪器:扩散生成一帧要走几十步去噪,每一步、每一层,都要把帧内注意力和跨帧注意力重新算一遍,整条历史上下文被反复查阅。语言模型是单遍生成一个 token,视频扩散是多步精修同一帧,两者的计算结构本来不同,但没人问过这个差异。论文提出的问题非常直接:多步去噪,真的是时间推理的必要条件吗?还是说,因果推理可以被单独抽出来、每帧只做一次?
2. 两个探针发现:因果性与去噪可分离
回答这个问题,论文先做探针实验。主试床是 WAN-2.1 T2V-1.3B,一个开源的文生视频扩散模型,1.3B 参数、30 层 Transformer。作者把它改造成逐帧自回归生成器,固定提示词和随机种子,逐层、逐去噪步记录中间激活和注意力图。
2.1 发现一:跨去噪步冗余
同一帧在 50 步去噪里,第 15 层(共 30 层)的中间特征,任意两步之间的余弦相似度都超过 0.95。数字背景:特征向量是 1536 维,两个高维向量余弦相似度能稳定超过 0.95,说明它们几乎就是同一个向量。PCA 可视化进一步确认:主成分从第 1 步就和后面 49 步高度对齐,能抓住物体的全局形状、姿态,甚至最后一帧里弯曲的钩状尾巴这种细节。这个现象从最早的去噪步就可见,说明内容、布局、运动在第 1 步去噪就定型了,后面几十步主要在做低层像素细节和渲染质量的精修。
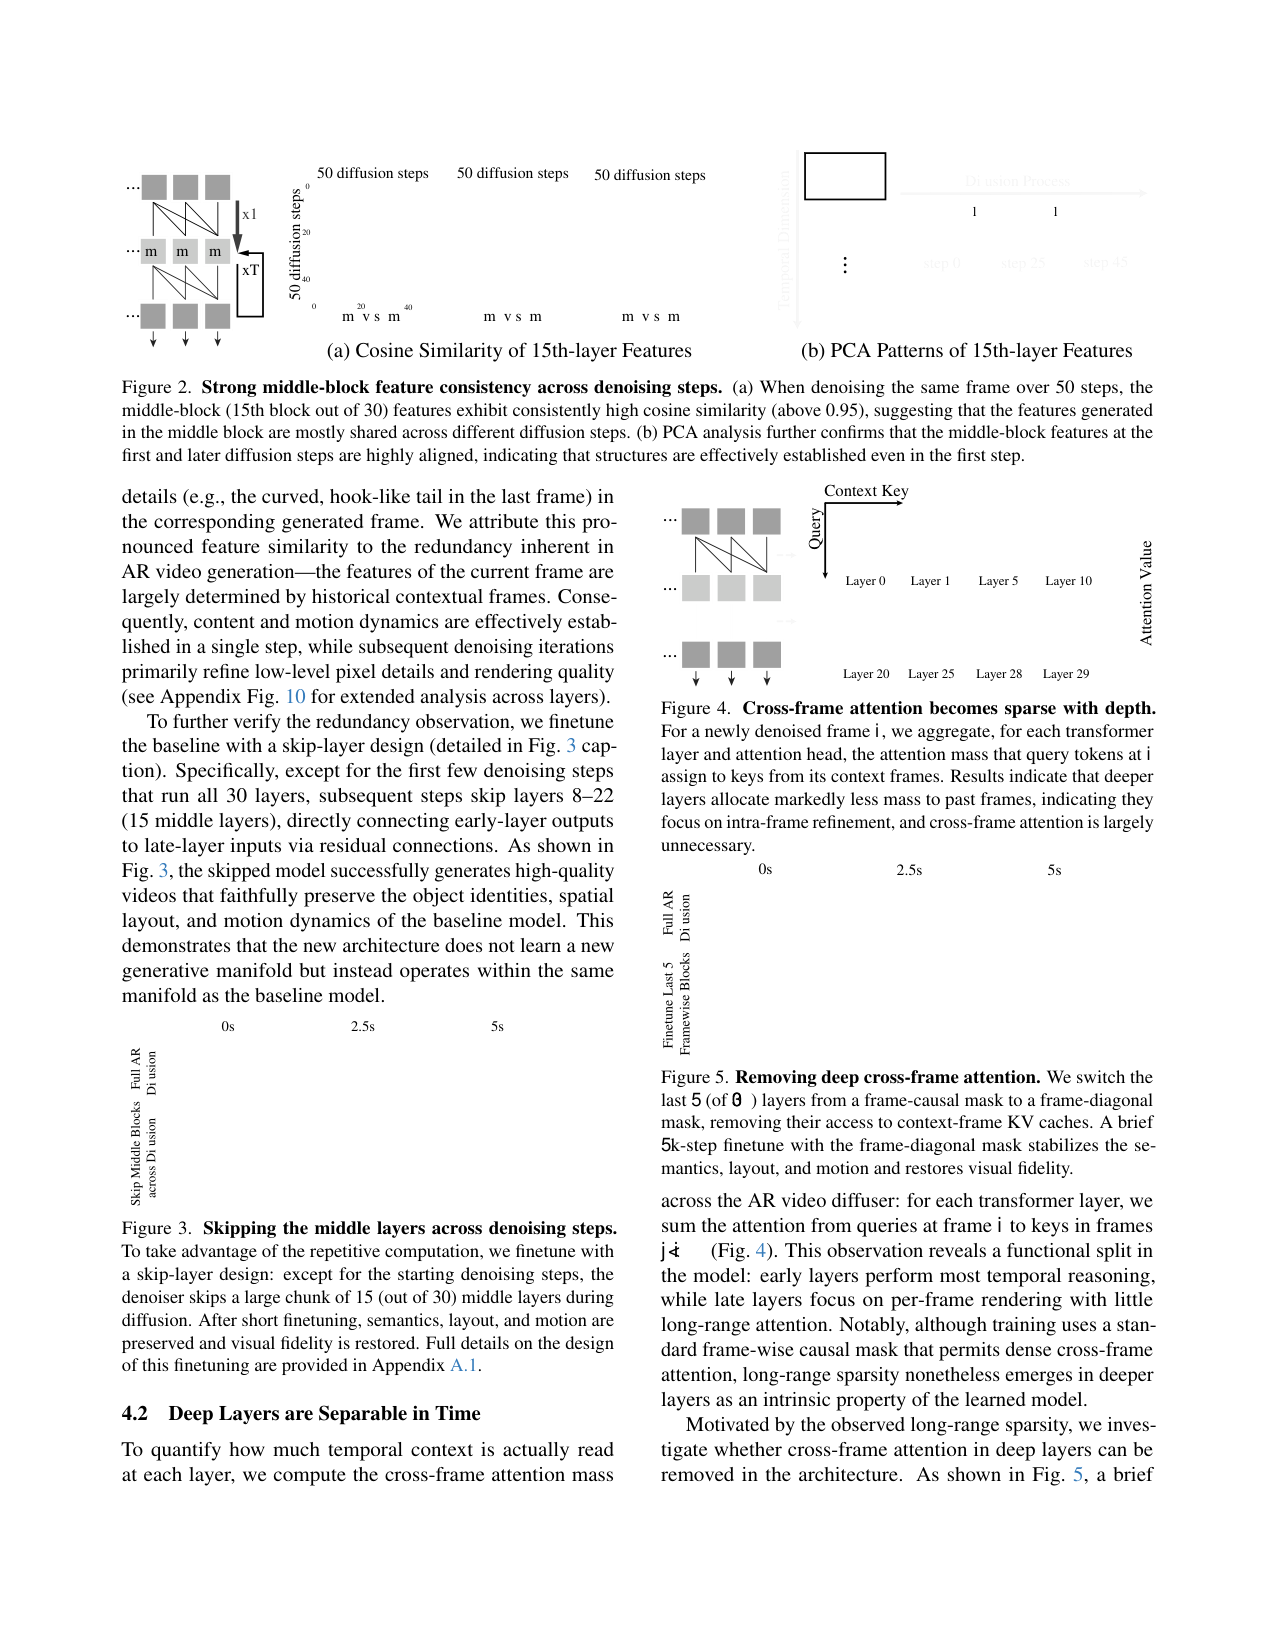
怎么证明这段计算真的冗余、去掉不会塌?论文做了 skip-layer 微调:除了最开始几步跑全部 30 层,后续去噪步跳过中间第 8 到第 22 层(15 层),让早期输出通过残差连接直接接到晚期输入。短时间微调之后,跳过中间层的模型生成的视频,物体身份、空间布局、运动动态都和基线一致,视觉保真度也恢复。这说明那 15 层在绝大多数去噪步里做的事基本可以共享。
2.2 发现二:深层跨帧注意力稀疏
第二组探针统计每一层里,当前帧的 query token 把多少注意力质量分配给了历史帧的 key。query 和 key 是注意力的两个角色:query 负责「问」,key 负责「被查」。结果随深度单调变化:浅层分配大量注意力给历史帧,越到深层越少,第 25 层以后基本全在看本帧内部。论文用「帧对角掩码」做验证:把最后 5 层换成只允许帧内注意力的掩码,彻底切断它们对历史 KV 缓存的访问,5k 步微调后生成质量就恢复。这里有个关键点:训练用的掩码本来就允许稠密跨帧注意力,稀疏是模型自己学出来的结构性质,所以可以直接在架构上移除。
论文把这两条规律在另外两类模型上做了复验:一个 4 步 block-自回归的 Self-Forcing 学生模型(每次预测 3 个 latent 帧),一个用 Diffusion Forcing 训练、3D UNet 主干的 Minecraft 模型。两者给出定性一致的趋势,支撑「可分离是因果视频扩散的普遍性质」这个论断。
3. 方法:把时间推理和渲染拆成两个模块
3.1 先看因果扩散的数学形式
要理解 SCD 的设计,先看因果扩散模型在学什么。一个因果生成器把视频序列 x_1:N 的联合分布分解成条件概率的乘积:
p_θ(x_1:N | a_1:N) = ∏_{i=1}^{N} p_θ(x_i | C_i = (x_ 这个式子要回答的问题是:整个视频的联合分布怎么拆成能逐帧生成的形式。其中每个未来帧 x_i 只条件于它之前的帧 x_
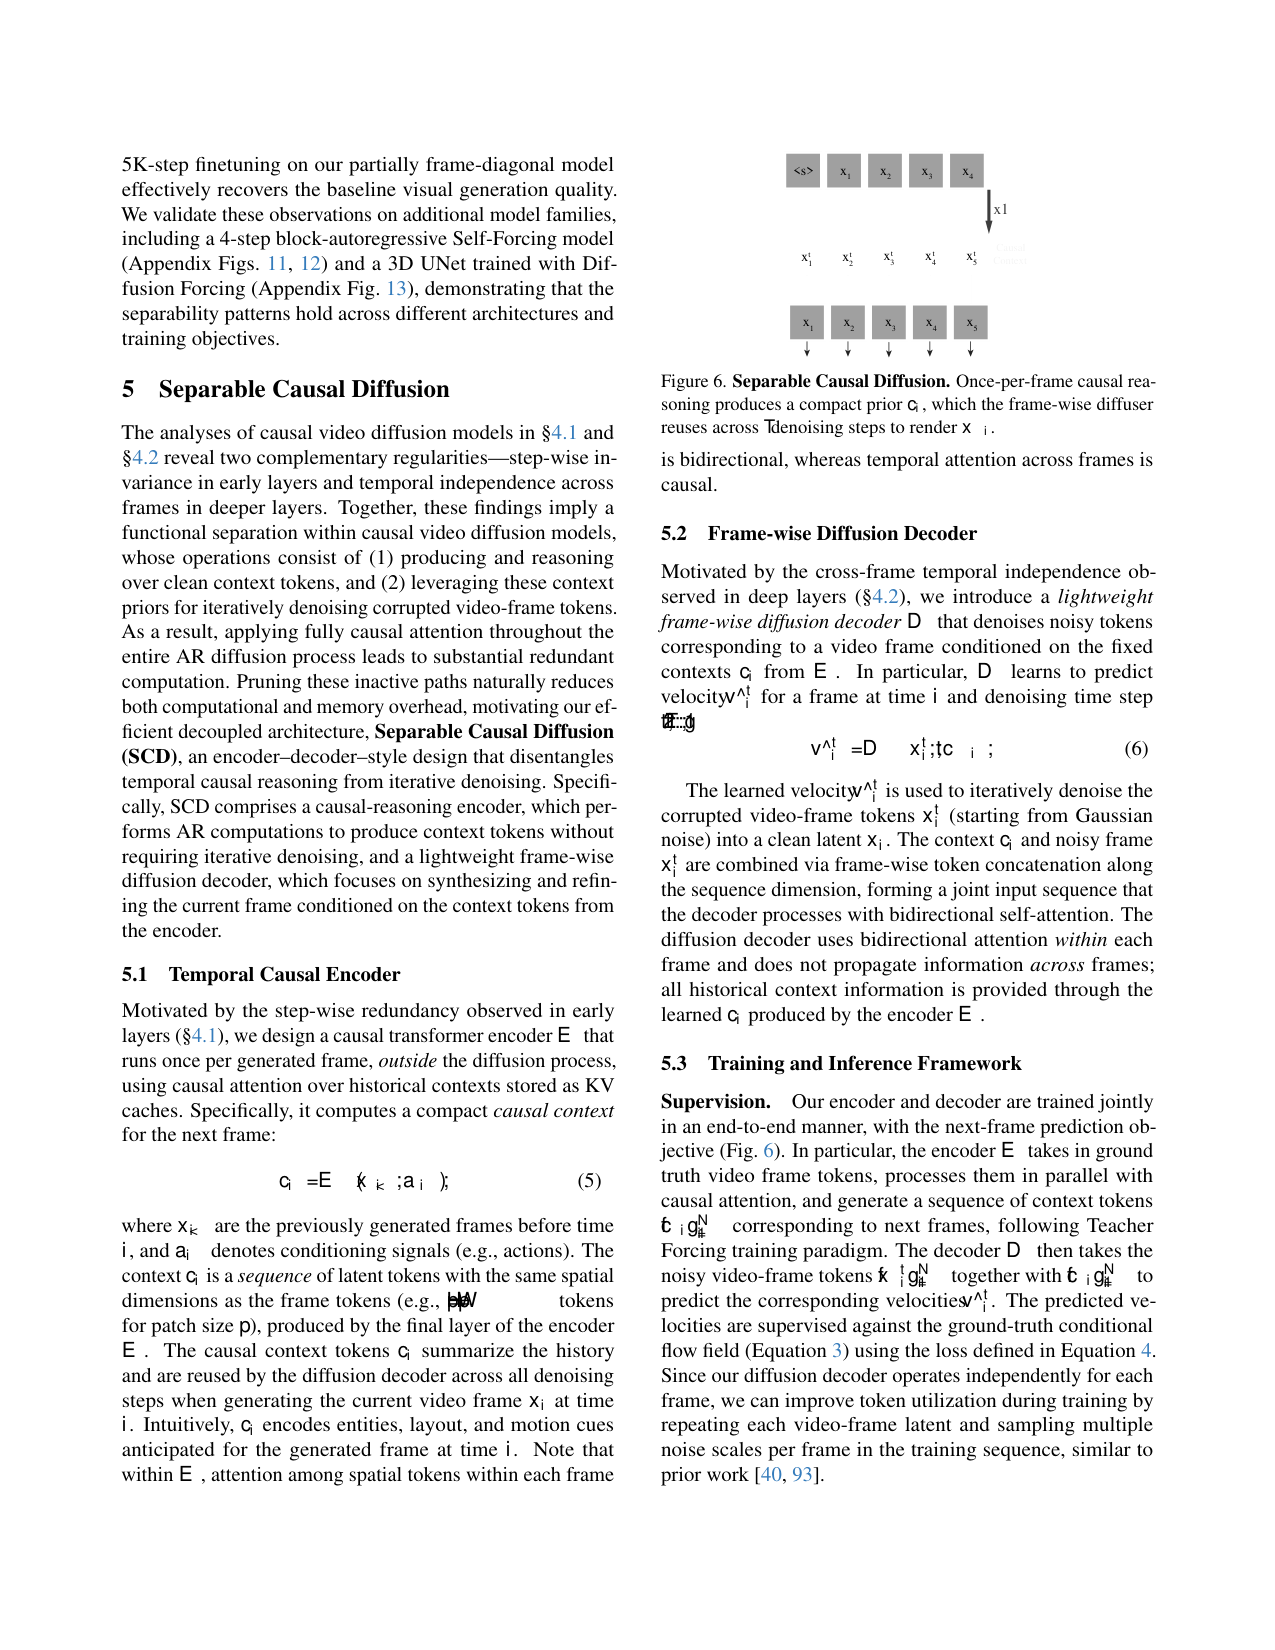
u(x_i^t, t | x_i) = d/dt x_i^t = ε_i − x_i 速度等于噪声减数据,这是条件流匹配的监督目标。训练损失是预测速度与真实速度之差的加权期望: L(θ) = E_{x,i,t,ε}[ w(t) || u(x_i^t, t | x_i) − v_θ(x_i^t, t, C_i) ||² ] w(t) 是时间权重。关键在最后一项:网络 v_θ 对每一个 t ∈ [0,1] 都要以历史上下文 C_i 为条件,而损失对 t 积分,所以模型在整条去噪轨迹上每一步都要反复 consult 上下文——因果推理就这样被绑死在整个扩散路径上。SCD 要做的就是把这项依赖抽出来。 两条探针规律刚好对应两个模块。跨步冗余说明时间推理可以每帧只做一次;跨帧稀疏说明深层渲染可以完全不看历史。于是 SCD 把模型拆成两部分: 推理的摊销复杂度从「每帧 × 每层 × 每步的全量因果注意力」变成: O(E_θ)(每帧一次)+ T × O(D_φ)(每步一次) 而且因为走 next-frame 范式(编码器直接读上一帧的干净输出),还省掉了其它 AR 模型生成后额外跑一次前向做 KV 缓存的那一步。两个模块的规模可以独立调:编码器加重(SCD-ME)改善运动与布局跟随、只增一点点延迟;解码器加重(SCD-MD)提升帧内细节、但延迟按 T 倍层数涨。这就是论文说的「时间推理预算与渲染预算可独立调节」——它对长时程 world model 的价值正在于此:推理成本有了可分别拧的旋钮。 训练效率。编码器每帧只算一次、与噪声无关,训练时可以把同一个帧的 latent 重复 K 次、采样 K 组不同噪声/时间步,让解码器一次学 K 个目标。K=4 时 TECO-Minecraft 上 FVD 23.1(K=1 是 23.9),且按墙钟训练时间对比,K=2 和 K=4 在相同时间内 LPIPS 更低,说明摊销不只是多看噪声样本,优化轨迹本身更好。 上下文扰动。训练用干净历史、推理用自回归 rollout 的误差历史,存在暴露偏差。因为时间推理被单独抽出,扰动可以直接加在接口 c_i 上:~c_i = c_i + η ε。训练时 η_t≈0.05,推理时再加 CFG 权重 η_cfg≈1.5 做负引导,TECO-Minecraft 上 FVD 从 24.8(无扰动)降到 22.3。扰动不需要重跑网络、不需要重缓存 KV。 微调适配。把开源的 WAN 2.1 T2V-1.3B 双向扩散模型改造成 SCD,有两个障碍:双向模型吃「噪声当前帧」,SCD 编码器吃「上一帧的干净输出」;直接按层拆分有 domain gap。解法:训练时给编码器喂 top 20% 高噪声的当前帧、推理时换纯高斯,把输入分布对齐;再做 leave-one-out 分析——逐层删掉某一层、看验证扩散损失(5 个噪声级平均),发现最前和最后几层最重要、中间层影响小,于是把前 25 层做编码器、解码器用前 5 层加后 5 层拼成,总共 35 层。 TECO-Minecraft(128×128,256 段视频,36 帧上下文生成 264 帧算 FVD):SCD-M(230M 参数,8+4 层)FVD 37.6,低于全因果基线 Causal DiT-M 的 38.7 和此前最优 FAR-M-Long 的 39.0;单帧延迟 0.52 秒,对比 Causal DiT-M 的 2.4 秒快了约 4.6 倍。UCF-101(64×64,真实动作视频,256 段 × 100 条轨迹):SCD-B(132M)FVD 174.7,低于 Causal DiT-B 的 187.6 和 FAR-B 的 194.1;延迟 1.1 秒对比 3.9 秒,约 3.5 倍。RealEstate10K(256×256,16→48 帧)是一个反例:SCD-B 的 FVD 102.83 略差于 Causal DiT-B 的 101.64,说明分离假设存在质量代价边界,长程质量并不总是免费。 在 VBench 上(832×480、81 帧、batch 1、单卡 H100 80GB),从 WAN 2.1 T2V-1.3B 微调出的 SCD(1.6B)总评分 84.03,对比最强自回归基线 Self Forcing 的 84.26,基本持平;吞吐 11.1 FPS 对比 8.9 FPS,单帧延迟 0.29 秒对比 0.45 秒,低约 35%。对比双向的原生 Wan 2.1(0.78 FPS),吞吐提升 10 倍以上,总评分 84.03 对 84.26 也基本相当。微调版语义对齐分数略低(79.60 对 80.30),论文把这归因于双向到解耦的架构失配。训练效率上,SCD 在单步 rollout 训练中比 Self Forcing 高约 20% 的每迭代效率。 扰动消融(TECO-Minecraft,400k 步,144→156 帧口径):只变训练噪声强度 η_t ∈ {0, 0.05, 0.10, 0.20, 0.50}、推理不加 CFG,η_t=0.05 时 FVD 最优(23.8,基线 24.8);固定 η_t=0.05、扫推理 CFG 权重 η_cfg ∈ {0, 1.0, 1.5, 2.0},η_cfg=1.5 时 FVD 22.3 最低。因为扰动只作用在因果接口上,全程不需要重新编码或重新缓存。 这篇论文站在三条技术路线的交汇处。第一条是「LLM 因果注意力进视频扩散」的自回归路线(CausalWan、FAR、Self Forcing、Pyramid Flow),本文的增量是追问因果注意力是否必须每层每步都做,并用探针证据回答。第二条是扩散加速采样的「早期结构复用」思路(图像侧的 DeepCache、BlockDance),本文把同样的现象在 AR 视频扩散里识别成两条互补规律,加速来自结构解耦而非采样技巧。第三条是 AR 模块 + 扩散模块的混合架构(MarDini、VideoMAR 已用 AR 模块产上下文、扩散模块画图),本文从证据出发推导出同类解耦结构,并补上了从预训练双向模型迁移的适配方法。 论文自承三条。第一,跨步不变性在去噪轨迹末端变弱:最后 10 步与最初 40 步的中层特征相似度降到约 0.8,单次因果前向替代不了轨迹末端的动态。第二,深层残留少量非零跨帧注意力,高分辨率下 SCD 相对全因果基线的质量差距(VBench 84.03 vs 84.26)很可能来自这些残余耦合。第三,从双向教师迁移有架构失配,语义对齐分数下降。 我们补充三条。核心量化证据(余弦相似度 >0.95)只在 WAN-2.1 T2V-1.3B 一个主试床上测量,Self-Forcing 和 3D UNet 两个验证模型只给定性一致,跨模型、跨分辨率的系统量化是缺的。从零训练只在低分辨率小数据集上验证,真实场景长视频未测,且 RealEstate10K 上出现质量回退。「延迟降 2–3 倍」依赖基线:对 Causal DiT 是 3.5–4.6 倍,对高分辨率 Self Forcing 只有约 1.25 倍,读数字时要看对照对象。 记住三件事。第一,因果推理与去噪在自回归视频扩散里可分离:内容、布局、运动在第 1 步去噪就定型(1536 维特征跨步余弦相似度 >0.95),深层渲染基本不读历史。第二,证据链完整:skip-layer 微调(跳过中间 15/30 层)和帧对角掩码(最后 5 层切断跨帧)都证明去掉重复计算质量不塌。第三,SCD 把推理成本从「每帧每步全量因果注意力」变成「每帧一次因果推理 + T 次轻量渲染」,单帧延迟在 Minecraft 上从 2.4 秒降到 0.52 秒、在 VBench 上从 0.45 秒降到 0.29 秒——时间推理预算与渲染预算从此可以分开拧,这正是它对长时程 world model 的意义。3.2 SCD:编码器管因果,解码器管渲染
3.3 三个工程细节
4. 关键实验与结果
4.1 从零训练:小分辨率数据集
4.2 微调预训练模型:VBench 文生视频
4.3 上下文扰动消融
5. 谱系定位
6. 局限
7. 收尾
通过探针实验证明自回归视频扩散模型中「时间因果推理」与「多步去噪」可分离:早中层特征跨去噪步高度冗余(WAN-2.1 T2V-1.3B 第 15/30 层特征跨 50 步余弦相似度 >0.95)、深层跨帧注意力稀疏;据此提出 Separable Causal Diffusion(SCD),用每帧只跑一次的因果 transformer 编码器 + 轻量逐帧扩散解码器,从零训练在 TECO-Minecraft 上 FVD 37.6(基线 Causal DiT-M 38.7)且单帧延迟 0.52s vs 2.4s(约 4.6×),微调 WAN 2.1 后 VBench 总分 84.03(Self Forcing 84.26)且吞吐 11.1 vs 8.9 FPS,为长时程 world model 提供可独立调节的推理成本杠杆。
阅读提示
精读深度:泛读
清单提示:原文提示:因果性与去噪可分离;稀疏因果注意力;为长时程 world model 提供推理成本杠杆。
问题
要解决什么:自回归(AR)视频扩散模型把 LLM 的因果注意力搬进扩散去噪器:每个去噪步、每一层、对整条历史上下文都重做一遍跨帧因果注意力。论文要回答:多步去噪精修真的是时间推理的必要条件吗,还是时间推理可以单独抽出来、每帧只做一次?
为什么 prior work 不够:LLM 是单遍生成一个 token,视频扩散是多步精修同一帧,两者计算结构不同;直接把 causal attention 移植进去噪器会让时间推理与多步去噪在每个 token、每层、每步上完全绑死。已有工作(CausalWan / FAR / Self Forcing / Pyramid Flow 等)都默认这种绑定,没人问过跨帧因果推理是否需要在整条去噪轨迹上重复做。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 历史干净帧 token 序列 x_<i | latent token 序列 | 已生成帧的 latent 通过 KV cache 提供给因果编码器;连同条件信号 a_≤i(文本 prompt 或动作),每帧只读一次 |
| 当前帧噪声 latent x_i^t | latent | 第 i 帧在去噪步 t 的带噪表示,从高斯噪声出发,进入逐帧扩散解码器 |
| 去噪步 t 与条件信号 | scalar + conditioning | t ∈ [T,…,1],与上下文 latent c_i 一起输入解码器 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 因果上下文 latent c_i | latent token 序列 | 编码器最后一层输出,与帧 token 同空间尺寸(H/p × W/p 个 token),打包该帧的实体、布局、预期运动,被解码器在所有去噪步复用 |
| 当前帧干净 latent x_i 与预测速度 ^v | latent + velocity | 解码器逐帧迭代去噪 T 步得到干净帧;训练监督目标是条件流匹配的 ground-truth 速度 u = ε − x |
控制频率:视频生成无控制频率;推理按帧计费:每帧 1 次编码器前向 + T 次解码器前向(微调版 T=4 步自蒸馏,从零训练版 T=50 步)
输入拼接 protocol
core domain 不要求数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| TECO-Minecraft(动作条件长程预测) | 300 帧 / 视频,128×128;评估 256 段视频 | FVD 用 36 上下文帧 → 264 生成帧;像素指标(LPIPS/SSIM/PSNR)用 144 → 156 帧;400k 训练步 |
| UCF-101(真实动作视频) | 约 13K 段,64×64;随机抽 256 段、每段 100 条随机轨迹 | 像素指标 best-of-100,FVD 对 100 条轨迹平均;与 MCVD/ExtDM/FAR 同口径 |
| RealEstate10K(真实室内场景) | 256×256;16 上下文帧 → 48 生成帧 | 无条件生成;400k 步、50 去噪步;tokenizer 用 E2E-VAE(REPA-E 微调自 VA-VAE) |
| VBench(文生视频基准,微调评估) | 832×480、81 帧;1M 条 VidProM 提示子集 | 70k 条 WAN 2.1 T2V-14B 合成数据做扩散损失微调,1M 提示做自 rollout 训练;吞吐/延迟在 1×H100 80GB、batch 1 测量,首帧额外开销计入 |
架构(摘要)
主干与结构
backbone:DiT(Peebles & Xie 2023)宽度/头配置;从零训练变体按 DiT-B/M 规格;微调版从 WAN 2.1 T2V-1.3B(30 层)移植权重
参数:SCD-B 132M / SCD-M 230M / SCD-ME 306M / SCD-MD 383M / 微调版 SCD 1.6B(前 25 层编码器 + 前 5+后 5 层解码器,共 35 层)
类型:encoder–decoder 解耦:因果 transformer 编码器(时间推理,每帧一次)+ 轻量逐帧扩散解码器(渲染,每帧 T 次)
关键组件
- 因果编码器 E_θ:帧内双向、帧间因果注意力,KV cache 读历史;每帧一次前向,输出上下文 token 序列 c_i
- 逐帧扩散解码器 D_φ:帧内双向注意力,输入为噪声帧 token 与 c_i 沿序列维拼接;逐帧独立去噪,全程无跨帧计算
- 条件流匹配训练:速度预测目标 u = ε − x,时间加权损失;训练时每帧重复 latent 并采样多个噪声尺度(K 路摊销解码,K=4 时 FVD 23.1 vs K=1 的 23.9)
- 上下文扰动:c_i 加高斯噪声 ~c_i = c_i + ηε;训练 η_t≈0.05、推理 CFG η_cfg≈1.5,用于暴露偏差缓解与负引导
- 双向教师 → SCD 微调适配:编码器输入重参数化(训练喂 top 20% 高噪声当前帧、推理换纯高斯)+ leave-one-out 层分配
为什么这样设计
两个探针规律直接映射到两个模块:早中层特征跨去噪步冗余 → 把时间推理抽出来每帧只做一次(编码器,成本被 T 步摊销);深层跨帧注意力稀疏、主要做帧内渲染 → 解码器做成逐帧独立、只依赖上下文 latent。推理复杂度从「每帧每层每步全量因果注意力」降为 O(E)+T·O(D),且 next-frame 范式省掉一次额外的 KV cache 前向。时间推理预算与渲染预算由此变成两个可独立调节的维度。
数值 sense
| 项 | 值 |
|---|---|
| 分辨率 | 从零训练 128×128(Minecraft)/ 64×64(UCF)/ 256×256(RealEstate10K);微调 832×480、81 帧 |
| depth | SCD-B = 8 编码 + 4 解码;SCD-M = 8+4(hidden 1024、16 heads);SCD-ME = 12+4;SCD-MD = 8+12;微调版 = 25 +(5+5) |
| 每帧 latent 维 | 论文未公布 latent 精确通道数;帧 token 数为 H/p × W/p(patch 尺寸 p),上下文 c_i 与帧 token 同空间尺寸 |
| inference_cost | BP/frame(S=50):SCD-B/M 208 vs DiT-B/FAR-M 600(约 2.9× 下降);微调版每帧 0.29s vs Self Forcing 0.45s |
| 训练 | 从零 400k 步;微调 batch 64、lr 2e-5、AdamW、EMA 0.99;自 rollout 学生 lr 2e-6、critic 4e-7 |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 单帧推理延迟(Sec/F,越低越好) | 0.52 | 2.4(Causal DiT-M,同规模全因果基线)/ 2.2(FAR-M-Long,此前最优) | TECO-Minecraft 128×128,256 段视频,单卡 H100;SCD-M(230M,8+4 层拆分),50 去噪步 |
| FVD(越低越好) | 37.6 | 38.7(Causal DiT-M)/ 39.0(FAR-M-Long) | TECO-Minecraft 128×128,36 上下文帧 → 264 生成帧,400k 训练步 |
| 单帧推理延迟(Sec/F) | 1.1 | 3.9(Causal DiT-B)/ 3.2(FAR-B) | UCF-101 64×64,256 段 × 100 条随机轨迹,单卡 H100;SCD-B(132M) |
| FVD | 174.7 | 187.6(Causal DiT-B)/ 194.1(FAR-B) | UCF-101 64×64,100 条轨迹 FVD 平均,400k 步 |
| VBench 总分(越高越好) | 84.03 | 84.26(Self Forcing 1.3B,同分辨率同量级参数)/ Wan 2.1 双向 84.26 | 832×480、81 帧、batch 1、1×H100 80GB;SCD 1.6B 从 WAN 2.1 T2V-1.3B 微调 |
| 吞吐(FPS,越高越好) | 11.1 | 8.9(Self Forcing)/ 6.7(Pyramid Flow 2B)/ 0.78(Wan 2.1 双向) | 同上;首帧额外开销计入吞吐核算 |
| 单帧延迟(秒,越低越好) | 0.29 | 0.45(Self Forcing) | VBench 832×480、batch 1、1×H100 80GB |
| 上下文扰动消融 FVD(越低越好) | 22.3 | 24.8(无扰动 η=0) | TECO-Minecraft 400k 步、144→156 帧评估;η_t=0.05 + 推理 CFG η_cfg=1.5 |
| RealEstate10K FVD(反例:质量代价边界) | 102.83 | 101.64(Causal DiT-B,略优) | 256×256、16→48 帧、400k 步、50 去噪步;SCD-B |
Insights
- 时间推理在 AR 视频扩散器里第 1 步就基本完成:第 15/30 层特征跨 50 个去噪步余弦相似度 >0.95(1536 维),后续步主要是帧内像素精修,论文第 4.1 节。
- 深层跨帧注意力稀疏是学出来的结构性质:训练掩码允许稠密跨帧注意力,模型自己选择了稀疏,所以可以直接在架构上移除而不伤质量,论文第 4.2 节与 Fig 5。
- 推理成本从「每帧每层每步全量因果注意力」变成「每帧一次因果推理 + T 次轻量渲染」:复杂度 O(E)+T·O(D),时间推理预算与渲染预算可独立调节,这是 SCD 对长时程 world model 的推理成本杠杆,论文第 5.3 节与 E.3 节。
vs 同类工作
- vs 直接移植 LLM causal attention 的自回归视频扩散(CausalWan / FAR / Self Forcing / Pyramid Flow):它们让每层每步都做跨帧因果注意力;本文用探针证据证明因果推理只需每帧一次,其余跨帧计算是冗余。
- vs 扩散加速采样(DeepCache、BlockDance 等图像侧 early-step 结构复用):本文在 AR 视频扩散中识别出「跨步冗余 + 跨帧稀疏」两条互补规律,并用 skip-layer 与帧对角掩码微调做了因果验证,加速来自结构解耦而非采样技巧。
- vs AR + 扩散混合架构(MarDini / VideoMAR:AR 模块产上下文表征、扩散模块生成视觉 token):本文从探针证据出发独立推导出同类解耦结构,并补上从预训练双向教师迁移的适配方法(输入重参数化 + leave-one-out 层分配);上下文 latent 作为唯一接口可被扰动,额外获得鲁棒化与 CFG 引导能力。
局限
- (论文自承)跨步不变性在去噪轨迹末端减弱:最后 10 步与最初 40 步的中层特征相似度降到约 0.8,单次因果前向无法完全替代轨迹末端的演化动态。
- (论文自承)深层仍残留少量非零跨帧注意力质量,高分辨率下 SCD 相对全因果基线的质量差距(VBench 84.03 vs 84.26、语义 79.60 vs 80.30)可能来自这些残余耦合。
- (论文自承)从 decoder-only 双向教师迁移存在架构失配,语义对齐分数略降(79.60 vs 80.30),作者将之归因于不可避免的架构差异。
- (我们读出)核心量化证据(余弦相似度 >0.95)只在 WAN-2.1 T2V-1.3B 一个主试床上测量;Self-Forcing 与 3D UNet 两个验证模型只给出定性一致,缺跨模型、跨分辨率的系统量化。
- (我们读出)从零训练只在低分辨率小数据集(TECO-Minecraft / UCF-101 / RealEstate10K)上验证,真实场景长视频未测;RealEstate10K 上 SCD-B 的 FVD 102.83 略差于 Causal DiT-B 的 101.64,说明分离假设存在质量代价边界。
- (我们读出)「延迟降 2–3×」依赖基线选择:对 Causal DiT 基线是 3.5–4.6×,对高分辨率 Self Forcing 只有约 1.25×(0.29s vs 0.45s),杠杆随模型与分辨率变化。
可复现性
- code:论文未提供代码链接(arXiv v1)
- weights:未开源;微调基于开源 WAN 2.1 T2V-1.3B 权重移植
- datasets:全部公开:TECO-Minecraft、UCF-101、RealEstate10K、VBench、VidProM 提示
主干与结构
backbone:DiT(Peebles & Xie 2023)宽度/头配置;从零训练变体按 DiT-B/M 规格;微调版从 WAN 2.1 T2V-1.3B(30 层)移植权重
参数:SCD-B 132M / SCD-M 230M / SCD-ME 306M / SCD-MD 383M / 微调版 SCD 1.6B(前 25 层编码器 + 前 5+后 5 层解码器,共 35 层)
类型:encoder–decoder 解耦:因果 transformer 编码器(时间推理,每帧一次)+ 轻量逐帧扩散解码器(渲染,每帧 T 次)
关键组件
- 因果编码器 E_θ:帧内双向、帧间因果注意力,KV cache 读历史;每帧一次前向,输出上下文 token 序列 c_i
- 逐帧扩散解码器 D_φ:帧内双向注意力,输入为噪声帧 token 与 c_i 沿序列维拼接;逐帧独立去噪,全程无跨帧计算
- 条件流匹配训练:速度预测目标 u = ε − x,时间加权损失;训练时每帧重复 latent 并采样多个噪声尺度(K 路摊销解码,K=4 时 FVD 23.1 vs K=1 的 23.9)
- 上下文扰动:c_i 加高斯噪声 ~c_i = c_i + ηε;训练 η_t≈0.05、推理 CFG η_cfg≈1.5,用于暴露偏差缓解与负引导
- 双向教师 → SCD 微调适配:编码器输入重参数化(训练喂 top 20% 高噪声当前帧、推理换纯高斯)+ leave-one-out 层分配
为什么这样设计
两个探针规律直接映射到两个模块:早中层特征跨去噪步冗余 → 把时间推理抽出来每帧只做一次(编码器,成本被 T 步摊销);深层跨帧注意力稀疏、主要做帧内渲染 → 解码器做成逐帧独立、只依赖上下文 latent。推理复杂度从「每帧每层每步全量因果注意力」降为 O(E)+T·O(D),且 next-frame 范式省掉一次额外的 KV cache 前向。时间推理预算与渲染预算由此变成两个可独立调节的维度。
数值 sense
| 项 | 值 |
|---|---|
| 分辨率 | 从零训练 128×128(Minecraft)/ 64×64(UCF)/ 256×256(RealEstate10K);微调 832×480、81 帧 |
| depth | SCD-B = 8 编码 + 4 解码;SCD-M = 8+4(hidden 1024、16 heads);SCD-ME = 12+4;SCD-MD = 8+12;微调版 = 25 +(5+5) |
| 每帧 latent 维 | 论文未公布 latent 精确通道数;帧 token 数为 H/p × W/p(patch 尺寸 p),上下文 c_i 与帧 token 同空间尺寸 |
| inference_cost | BP/frame(S=50):SCD-B/M 208 vs DiT-B/FAR-M 600(约 2.9× 下降);微调版每帧 0.29s vs Self Forcing 0.45s |
| 训练 | 从零 400k 步;微调 batch 64、lr 2e-5、AdamW、EMA 0.99;自 rollout 学生 lr 2e-6、critic 4e-7 |
因果性与去噪可分离:常规稠密因果扩散 vs 解耦设计
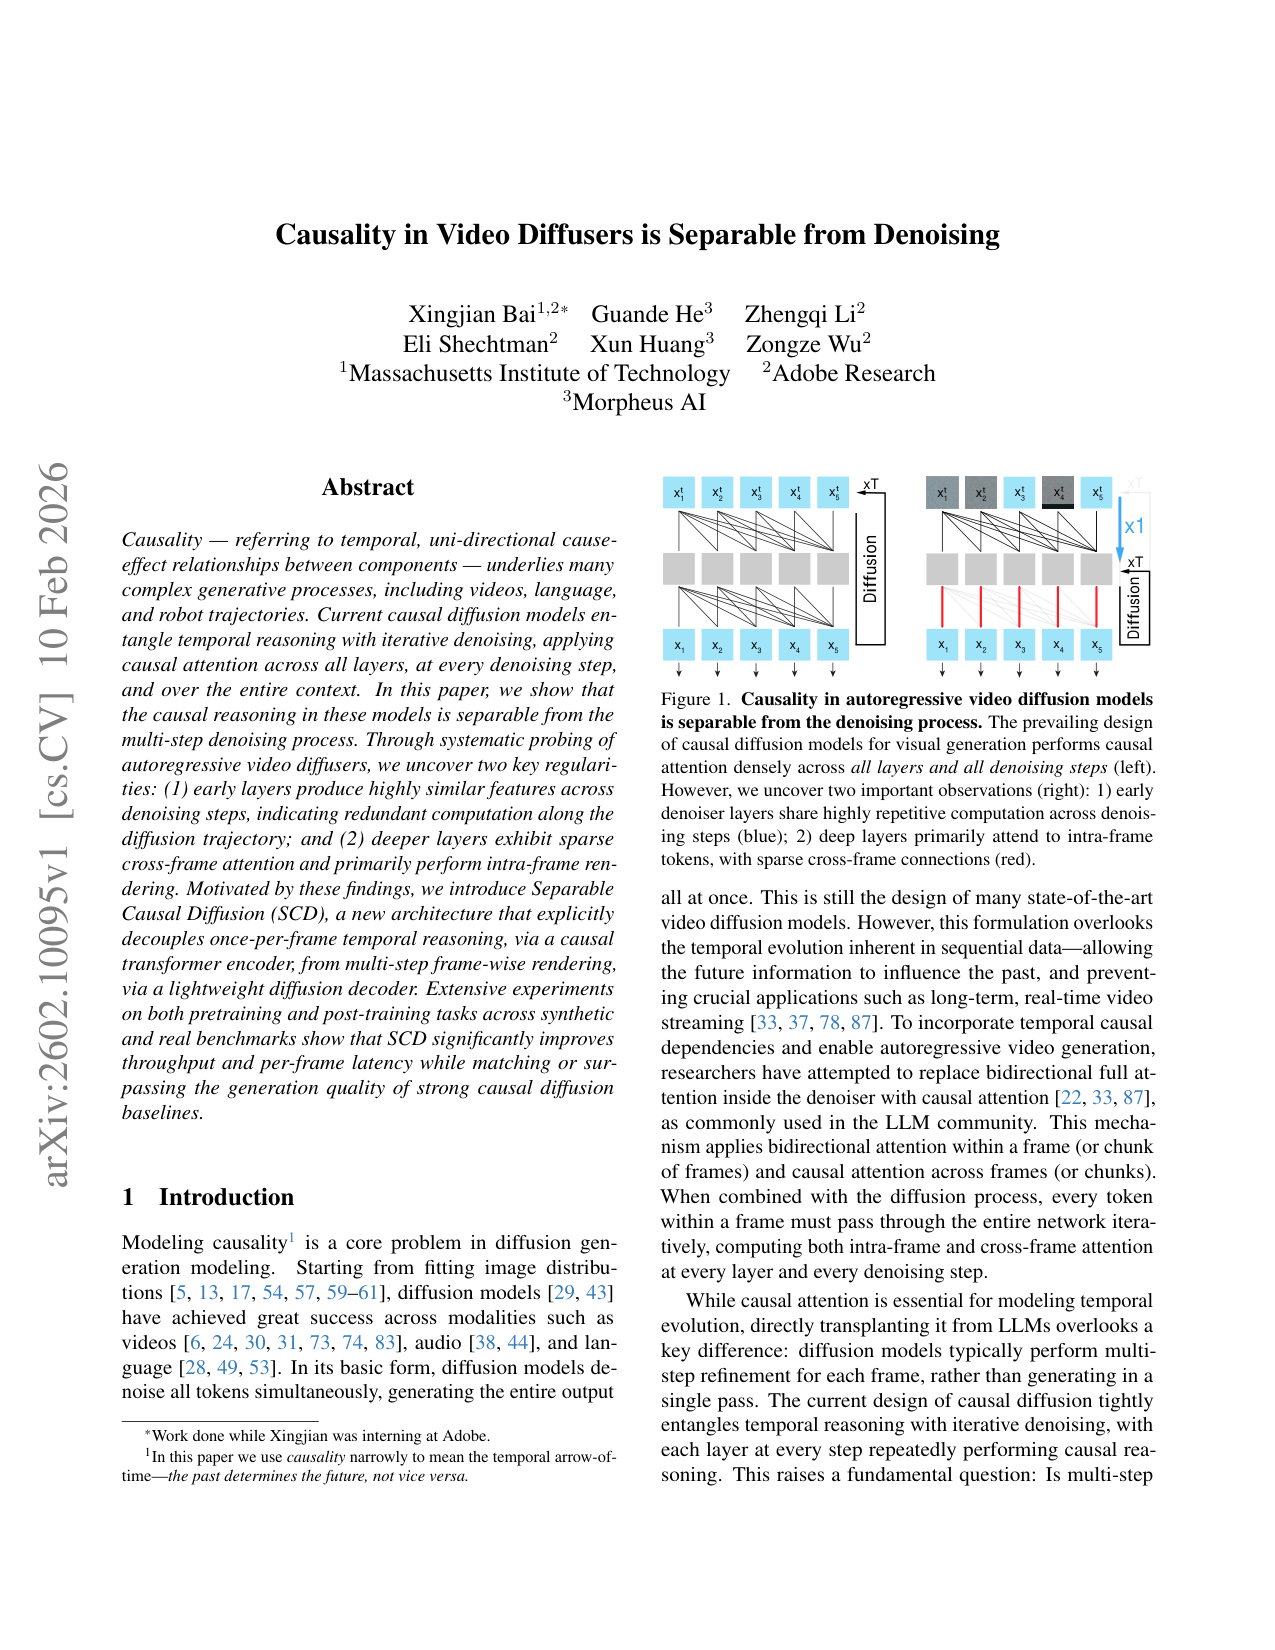
原文 caption:Causality in autoregressive video diffusion models is separable from the denoising process. The prevailing design performs causal attention densely across all layers and all denoising steps (left). Two observations (right): 1) early denoiser layers share highly repetitive computation across denoising steps (blue); 2) deep layers primarily attend to intra-frame tokens, with sparse cross-frame connections (red).
全篇论断的路线图。左图是现状:去噪器每层每步对整条历史做稠密因果注意力(蓝箭头表示跨步重复计算)。右图是解耦后的目标结构:蓝色箭头表示帧内多步渲染,红色稀疏连接表示跨帧因果推理。读法:先看左图的重复性,再看右图把「时间推理」和「渲染」拆成两条独立计算路径。它把待验证的两个规律(跨步冗余、跨帧稀疏)和最终架构放在同一张图上,是理解全文的第一张地图。
探针证据:跨去噪步冗余(Fig 2/3)+ 深层跨帧注意力稀疏(Fig 4/5)
原文 caption:Figure 2. Strong middle-block feature consistency across denoising steps. (a) 15th-block (of 30) features over 50 steps show cosine similarity above 0.95. (b) PCA shows first-step and later-step features align highly. Figure 3. Skipping middle layers: except for starting steps, the denoiser skips 15 of 30 middle layers; semantics, layout, motion preserved after short finetuning. Figure 4. Cross-frame attention becomes sparse with depth. Figure 5. Switching the last 5 of 30 layers to frame-diagonal mask; a 5k-step finetune stabilizes quality.
支撑「可分离」论断的四件套证据。Fig 2a 是 50×50 的相似度矩阵(横轴纵轴都是 50 个去噪步,颜色越暖相似度越高),第 15 层任意两步之间都超过 0.95,说明同一帧在去噪过程中间层特征几乎不变;Fig 2b 的 PCA 显示第一步的主成分就能捕捉物体全局形状、姿态与细节结构(如弯曲的钩状尾巴)。Fig 3 是因果验证:除起始几步外跳过中间 15 层(8–22 层),短微调后语义/布局/运动全部保住,证明这段计算冗余。Fig 4 横轴是层、纵轴是各层 query 分配给历史帧 key 的注意力质量,越深越低;Fig 5 把最后 5 层换成帧对角掩码、5k 步微调后质量恢复,证明深层跨帧注意力可以整段移除。这张页是全文证据链的核心。
SCD 架构:每帧一次因果编码 + 多步逐帧渲染
原文 caption:Separable Causal Diffusion. Once-per-frame causal reasoning produces a compact prior c_i, which the frame-wise diffuser reuses across T denoising steps to render x_i.
架构图。上半部分:因果编码器读 与历史帧 x1…x4,产出紧凑上下文 c_i;下半部分:逐帧扩散解码器把 c_i 与各帧噪声 token 拼起来,逐帧独立去噪 T 步得到干净帧。帧内注意力双向、帧间注意力因果。读法:把「时间推理」与「渲染」在计算图上彻底分开——编码器每帧只付一次成本,解码器按帧并行做多步精修。它直接对应推理复杂度 O(E)+T·O(D),也是「时间推理预算 vs 渲染预算可独立调节」这一成本杠杆的来源。
🎧 音频版
时长 22:51 · Edge TTS
视频扩散里的因果推理,其实可以跟去噪拆开(对话版)
一开场就说结论:这篇要讲「可分离」
小播:老播,这期论文的标题读起来像绕口令:Causality in Video Diffusers is Separable from Denoising,翻译过来是「视频扩散模型里的因果性,和去噪过程可以分离」。它到底在解决什么问题?
老播:先给一句话背景。现在的视频生成主流是扩散模型,最新的一条路线叫自回归视频扩散:像语言模型预测下一个词那样,一帧一帧往外生成视频,每帧只依赖过去的帧,代表作有 CausalWan、FAR、Self Forcing。这类模型把语言模型里的因果注意力整建制搬进了扩散去噪器,每个去噪步、每一层都要把跨帧的因果推理重做一遍。这篇论文问了一个很直接的问题:多步去噪,真的是时间推理必需的吗?
小播:答案呢?
老播:答案就是标题,也是这期要反复强调的核心结论:时间因果推理和去噪在自回归视频扩散里可以分离。时间推理每帧只需做一次,逐帧渲染才需要多步迭代。论文先做探针实验把这个结论证明出来,再设计了一个叫 Separable Causal Diffusion、简称 SCD 的新架构,在多个基准上把单帧延迟降下来,生成质量还持平甚至更好。预告一下,本期会讲清两件事:探针怎么证明「可分离」,以及这套架构怎么变成推理成本的杠杆。
先把背景铺开:因果视频扩散和普通视频扩散差在哪
小播:在进探针之前,把背景讲透。自回归视频扩散和普通视频扩散的差别到底在哪?
老播:先补一个最基础的定义。扩散模型先把数据逐步加噪到纯噪声,再学一个网络把噪声一步步还原成数据,这里面的每一步还原就叫一个去噪步,视频扩散就是把数据换成视频。普通双向视频扩散,比如 Wan 2.1、LTX-Video,把整段视频同时加噪、同时去噪,所有帧互相可见,好处是全局一致性好,代价是必须生成完整个视频才能看到第一帧,延迟按秒算。自回归版把联合分布拆成条件概率的乘积:p(x_1:N | a_1:N) = ∏ p(x_i | x_ 小播:那因果注意力具体指什么? 老播:注意力是 Transformer 里让每个 token 查看其它 token 的机制,token 可以粗略理解成「一个小格子」。因果注意力就是加一个掩码:当前帧的 token 只能看自己帧内部和自己之前的帧,不能看未来。语言模型靠这个保证词的先后顺序。因果视频扩散把同一套掩码用在去噪器里,于是每一帧的每个 token,在每一个去噪步、每一层,都要先算帧内注意力、再算跨帧注意力,把整条历史重新查一遍。扩散生成一帧要走几十步,这个成本就随视频长度和去噪步数一起涨。 小播:也就是说,因果推理被绑在了每个去噪步上,论文怀疑这种绑定是浪费。 老播:对,这就是它的切口。上一代方法,比如 Teacher Forcing 和 Diffusion Forcing,忙的是训练时历史该加多少噪声,好让训练和推理的自回归误差对齐。Teacher Forcing 训练时给模型看真实的历史帧,推理时模型却要拿自己生成的、带误差的历史当条件,两边对不上,误差会一路累积;Diffusion Forcing 干脆训练时给历史帧随机加噪,让模型适应各种水平的污染。这两条路都默认一件事:时间推理必须嵌在去噪器里、跟着每一步走。这篇换了个问题问:时间推理本身,到底需不需要在每个去噪步重复做?顺带一提,自回归视频扩散之所以值得做,是因为只有逐帧生成才能支持实时流式播放、人机交互、还有机器人 rollout 这类要边生成边用的场景,双向扩散在这类场景下延迟扛不住。这篇论文的受众也就在这:世界模型、机器人策略这类要长期滚动生成的工作,推理成本是按帧累积的,省下每一帧的成本都是直接的收益。 小播:探针是怎么做的?在什么模型上? 老播:主试床是 WAN-2.1 T2V-1.3B,一个开源的文生视频扩散模型,1.3B 参数、30 层 Transformer。作者把它改造成逐帧自回归生成器,固定提示词和随机种子,然后逐层、逐去噪步记录中间激活和注意力图。第一条发现叫跨步冗余:同一个帧在 50 步去噪里,第 15 层(一共 30 层)的中间特征,任意两步之间算余弦相似度,数值都超过 0.95。这里给数字背景:特征向量是 1536 维,两个高维向量余弦相似度能稳定超过 0.95,说明它们几乎就是同一个向量。再配合 PCA 主成分分析看,主成分从第 1 步就和后面 49 步高度对齐,能抓住物体的全局形状、姿态、甚至最后一帧里弯曲的钩状尾巴这种细节。论文里那张 50 乘 50 的相似度热力图很好读:横轴纵轴都是 50 个去噪步,颜色代表两步特征之间的相似度,除了对角线,整片区域都是高亮的,意思就是任意两步算出来的特征都差不多。结论是:内容、布局、运动在第 1 步去噪就定型了,后面几十步只是在打磨像素级的渲染质量。 小播:特征几乎相同,那这段计算确实浪费。但怎么证明去掉它不会塌? 老播:验证环节叫 skip-layer 微调。除了最开始几步跑全部 30 层,后面的去噪步跳过中间第 8 到第 22 层,一共 15 层,让早期输出通过残差连接直接接到晚期输入。短时间微调之后,跳过中间层的模型生成的视频,物体身份、空间布局、运动动态都跟基线一致,视觉保真度也恢复。这说明那 15 层在绝大多数去噪步里做的事基本可以共享,这组对照实验就是「冗余」这个词的证据。 小播:第二条发现呢? 老播:第二条叫跨帧稀疏。作者统计每一层里,当前帧的 query token 把多少注意力质量分配给了历史帧的 key。query 和 key 是注意力的两个角色,query 负责「问」,key 负责「被查」。结果随深度单调变化:浅层分配很多注意力给历史帧,越到深层越少,第 25 层以后基本全在看本帧内部。这里有个重要的点:训练用的掩码本来就允许稠密跨帧注意力,稀疏是模型自己学出来的结构性质。验证方式是对称的:把最后 5 层从帧因果掩码换成帧对角掩码,彻底切断它们对历史 KV 缓存的访问,5k 步微调后生成质量就恢复。KV 缓存是自回归模型里缓存历史特征、避免重复计算的机制,这里被直接关掉也不影响质量。为了说明这两条规律不挑模型,作者还在另外两类模型上做了复验:一个 4 步 block 自回归的 Self-Forcing 学生模型,一个用 Diffusion Forcing 训练、3D UNet 主干的 Minecraft 模型,都观察到同样的趋势;3D UNet 那个实验还对比了去噪步 t=50 和 t=9 两个时刻,趋势一致,说明这条规律跟 Transformer 还是 UNet、跟哪种训练目标都没关系。 小播:这两条合起来,就是「可分离」的完整证据链。接下来怎么把它变成架构? 老播:两条规律刚好对应两个模块。跨步冗余说明时间推理可以每帧只做一次,跨帧稀疏说明深层渲染可以完全不看历史。于是 SCD 把模型拆成两部分:一个因果 transformer 编码器 E,每生成一帧只跑一次,用 KV 缓存读历史干净帧,输出一个紧凑的上下文向量序列 c_i;一个轻量的逐帧扩散解码器 D,把 c_i 和当前帧的噪声 token 沿序列维拼起来,做帧内双向注意力,逐帧独立去噪 T 步,全程没有跨帧计算。c_i 打包的是这一帧该有的实体、布局、预期运动,相当于把「这一帧该有什么」的结论交给渲染器,渲染器只负责把它画出来。推理成本从「每帧 × 每层 × 每步的全量因果注意力」变成 O(E) 加 T 倍的 O(D):O(E) 是编码器一次前向的开销,每帧只付一次,O(D) 是解码器一步去噪的开销,每帧要付 T 次,因为编码器要做跨帧因果注意力、解码器只在单帧里算,所以两者的量级相当。而且因为走的是 next-frame 范式,还省掉了别的自回归模型生成后额外跑一次前向做 KV 缓存的那一步。换个角度理解它的价值:视频生成里时间推理的成本跟着帧数走,渲染的成本跟着去噪步数和分辨率走,SCD 把这两笔账分开记,长时程生成时就可以只付时间推理的账、把渲染的账留在当前帧内部。用式子看更清楚。编码器做的事是 c_i = E_θ(x_ 小播:数字说话。论文在两种场景下评估,先看从零训练。 老播:从零训练在三个小分辨率数据集上:TECO-Minecraft、UCF-101、RealEstate10K。先说 TECO-Minecraft,128×128 分辨率,256 段视频,评估时用 36 帧上下文生成 264 帧,算长时程质量;像素指标用 144 帧上下文生成 156 帧。SCD-M 模型 230M 参数,8 层编码器加 4 层解码器。结果:FVD 37.6,低于全因果基线 Causal DiT-M 的 38.7,也低于此前的 SOTA FAR-M-Long 的 39.0,生成质量最好;像素指标 LPIPS 0.179、SSIM 0.524、PSNR 19.3,对比 Causal DiT-M 的 0.196、0.512、18.9,也是最好或并列最好;单帧延迟 0.52 秒,对比 Causal DiT-M 的 2.4 秒,快了大约 4.6 倍。FVD 是衡量生成视频和真实视频分布差距的指标,越低越好。UCF-101 是真实动作视频,64×64,256 段视频每段抽 100 条轨迹,SCD-B(132M 参数)的 FVD 174.7,低于 Causal DiT-B 的 187.6 和 FAR-B 的 194.1,延迟 1.1 秒对比 3.9 秒,约 3.5 倍。所以「质量持平或更好、延迟降 2 到 3 倍以上」这句话,在从零训练场景站得住。这里顺带说两张探针图怎么读。跨帧注意力那张图,每个层是一个注意力热力图小面板,从第 0 层排到第 29 层,颜色越亮代表当前帧把越多注意力质量投给历史帧:浅层面板里横跨历史帧的区域是亮的,越到深层,亮区收缩到本帧内部,第 28、29 层几乎见底。leave-one-out 那张图反过来,横轴是删掉哪一层、纵轴是验证扩散损失,最前和最后几层删掉时损失明显上涨,中间层删掉损失几乎不动。两张图互相印证:中间层既没在做时间推理、也没在做关键的帧内渲染。另外两个变体值得看:SCD-ME 把编码器从 8 层加到 12 层,延迟还是 0.52 秒,FVD 进一步降到 36.1;SCD-MD 把解码器加到 12 层,FVD 降到 34.9 最好,延迟却涨到 1.6 秒——这就是刚才说的两个旋钮的代价对比。 小播:那微调预训练大模型呢?这是更贴近实际部署的场景。 老播:微调的目标是把开源的 WAN 2.1 T2V-1.3B 双向扩散模型改造成 SCD。这个场景在术语上叫 post-training:拿一个已经会生成完整视频的大模型,改造蒸馏成能逐帧生成的高效模型,工业界常靠这步把大模型已学到的能力榨出来,比从零训练省钱得多。这里有两个工程问题:双向模型吃的是「噪声当前帧」,SCD 编码器吃的是「上一帧的干净输出」;另外直接按层拆分会掉质量。作者的解法:训练时给编码器喂高噪声水平的当前帧,取噪声最大的 20% 区间,推理时换成纯高斯噪声,把输入分布对齐;再用 leave-one-out 分析,逐层删掉某一层、看验证扩散损失的变化,发现最前和最后几层最重要、中间层删掉影响小,于是把前 25 层当编码器,解码器用前 5 层加后 5 层拼成,总共 35 层,模型 1.6B 参数。结果在 VBench 文生视频基准上,832×480、81 帧、单卡 H100 80GB、batch 1:SCD 总评分 84.03,对比最强自回归基线 Self Forcing 的 84.26,基本持平;吞吐 11.1 FPS 对比 8.9 FPS,单帧延迟 0.29 秒对比 0.45 秒,低了约 35%。对比双向的原生 Wan 2.1,吞吐是 0.78 FPS,SCD 快了 10 倍以上,总评分 84.03 对 84.26 也基本相当。注意微调版本的语义对齐分数略低,79.60 对 80.30,作者把差距归因于双向到解耦的架构失配。 小播:还有一个数字我想单独记一下,上下文扰动那个消融。 老播:对,这是第三个值得说的实验。SCD 把时间推理抽出来之后,历史上「给上下文帧加噪」的鲁棒化手段可以简化为只扰动接口 c_i:c_i 加高斯噪声,训练时噪声强度 0.05,推理时再加一个小的 CFG 权重 1.5 做负引导。CFG 是 classifier-free guidance,用带条件和不带条件的预测组合来增强引导,这里引导的对象是扰动过的因果先验。在 TECO-Minecraft 上,400k 训练步、144 到 156 帧的评估口径下,FVD 从无扰动的 24.8 降到 22.3。好处是扰动只发生在因果接口上,不需要重跑网络,也不需要重新缓存历史。另外在训练效率上,因为编码器每帧只算一次、和噪声无关,训练时可以把同一个帧的 latent 重复 K 次、采样 K 组不同的噪声和时间步,一次喂给解码器学。K=4 时,TECO-Minecraft 上 FVD 23.1,比 K=1 的 23.9 还好,按墙钟训练时间比更是省时间,说明摊销不只是在偷看更多噪声样本。论文报告 SCD 在单步 rollout 训练里比 Self Forcing 高约 20% 的每迭代效率。 小播:最后一小段,把它放在谱系里定位。 老播:它处在三条线的交汇处。一条是把语言模型因果注意力搬进视频扩散的自回归路线,CausalWan、FAR、Self Forcing、Pyramid Flow 都在做,这篇的增量是追问「因果注意力真的需要每层每步都做吗」,并用探针证据回答;一条是扩散加速采样里「早期结构可以提前建立、后续步只精修」的思路,图像侧的 DeepCache、BlockDance 是代表,这篇把同样的现象在视频扩散里识别成两条互补规律;还有一条是 AR 模块加扩散模块的混合架构,MarDini、VideoMAR 已经用 AR 模块产上下文、扩散模块画图,这篇从证据出发推导出同样的解耦结构,并补上了从预训练双向模型迁移的适配方法。一句话概括它的位置:它给「时间推理预算」和「渲染预算」装了两个独立调节的维度,这是它对长时程 world model 的价值所在。 小播:最后说局限,包括论文自己承认的,和我们读出来的。 老播:论文自承三条。第一,跨步不变性在去噪轨迹末端会变弱:最后 10 步和最初 40 步的中层特征相似度掉到大约 0.8,说明单次因果前向替代不了轨迹末端的动态。第二,深层还残留少量非零跨帧注意力,高分辨率下 SCD 相对全因果基线的那一点点质量差,VBench 84.03 对 84.26,很可能就来自这些残余耦合。第三,从双向教师迁移有架构失配,语义对齐分数下降。我们补充三条。核心的量化证据,余弦相似度超过 0.95 这个数字,只在 WAN 2.1 一个主试床上测过,Self Forcing 和 3D UNet 这两个验证模型只给了定性一致,跨模型、跨分辨率的系统量化是缺的。从零训练只在低分辨率小数据集上做,真实场景长视频没测;而且 RealEstate10K 上 SCD-B 的 FVD 102.83 略差于 Causal DiT-B 的 101.64,说明分离假设是有代价边界的,会牺牲一点长程质量,设置是 16 帧上下文生成 48 帧、50 去噪步。另外「延迟降 2 到 3 倍」这个说法依赖基线:对 Causal DiT 是 3.5 到 4.6 倍,对高分辨率 Self Forcing 只有约 1.25 倍,杠杆随模型和分辨率变化,泛读时别把倍数记死。 小播:好,我总结本期要记住的三件事。第一,因果推理和去噪在自回归视频扩散里可以分离:内容、布局、运动在第 1 步去噪就定型,1536 维特征跨 50 步的余弦相似度超过 0.95,深层渲染基本不读历史。第二,探针证据链是完整的:除了相似度数字,skip-layer 微调跳过中间 15 层、帧对角掩码切断最后 5 层的跨帧访问,去掉重复计算质量都不塌。第三,SCD 把时间推理做成每帧一次的编码器、渲染做成逐帧多步的解码器,推理成本从每帧每步全量因果注意力变成每帧一次加 T 次轻量渲染,单帧延迟在 TECO-Minecraft 上从 2.4 秒降到 0.52 秒,在 VBench 上从 Self Forcing 的 0.45 秒降到 0.29 秒。 老播:我补一句它对后续工作的意义。长时程 world model 的关键瓶颈是推理成本随帧数线性上涨,SCD 提供了一条把成本杠杆化的路径:时间推理按帧计费、渲染按步计费,两个预算可以独立调。这篇没有回答的问题,比如分离假设的边界在哪里、编码器怎么按语言模型的缩放规律长大,留给后面的人。论文自己列的后续方向有三条:研究 next-frame 去噪编码器相对语言模型的缩放规律、把 SCD 的效率用在 rollout 训练框架里、把预训练好的推理器和去噪器接到不同的隐空间里。核心思想:两条探针发现,把「可分离」钉死
关键实验:从零训练和微调预训练模型,两个场景都验证
放到谱系里看:它站在哪条技术路线上
局限:不替论文背书的部分
收尾:记住这三件事