Fixed Point Diffusion Models(泛读卡片)
> 一句话定位:把 DiT 的一整段显式 transformer 层换成「前后各 1 个显式层 + 中间 1 个隐式不动点层」,让每个去噪时间步变成解一个固定点方程,采样时就可以把固定的计算预算在时间步之间平滑、重分配,并复用上一时间步的解。85M 参数的 FPDM 在 ImageNet 256×256 上以 280 次 transformer block 前向的预算把 DDIM FID 从 DiT 的 35.2 压到 22.4,训练显存从 25.2GB 降到 10.2GB。它代表「把迭代搬进网络内部」这一条技术路线,与把迭代搬进训练期的 Drifting 正好互补。
问题:扩散模型又大又慢
扩散模型质量好、训练稳,但推理要反复跑网络。DDPM 按 1000 步训练,采样时为了省时间通常只取 5、10 或 20 个时间步,每步都完整跑一遍去噪网络。骨干网络本身也很重:DiT-XL/2 有 28 个显式 transformer 层、674M 参数,单卡训练要 25.2GB 显存(batch 64)。对移动端和边缘设备来说,模型太大、采样太慢是两道硬门槛。
过去的改进大多在「网络外部」做文章:DDIM 把随机去噪变成确定性采样,蒸馏和 Consistency 模型把时间步从上千压到几步甚至一步,整流流把轨迹拉直让大步长更准。这些方法都没有动网络本身的结构——每个时间步照样要完整前向一次,层数固定、消耗固定。本文的切口在网络内部:把一段显式层换成可以反复迭代的隐式不动点层,让「一次前向」变成「N 次迭代」,N 可大可小,预算就能自由分配。
方法一:把去噪网络变成可迭代的不动点层
先解释两个基础概念。固定点(fixed point)是指满足 x* = f(x*) 的那个点 x*:把 f 作用在它上面,结果还是它自己。求固定点最简单的办法是固定点迭代,从某个初值出发反复套用 f,x_{k+1} = f(x_k),在 f 满足压缩条件下会线性收敛到唯一解——这个结论的根源是巴拿赫不动点定理。DEQ(Deep Equilibrium Model)就是把网络层本身定义成这样的隐式方程,前向过程靠迭代求解,计算量由迭代次数决定。
FPDM 的去噪网络分三段:显式预处理层 f_pre、隐式不动点层 f_fp、显式后处理层 f_post,中间的不动点层要解的是
x* = f_fp(x*, x̃, t)。
先给预期:这个式子回答「在当前去噪状态上,网络反复作用多次之后稳定在哪个点」。左边 x* 是解,右边同一个 x* 又出现在 f_fp 的参数里,所以它是隐式方程,要靠迭代逼近。逐项看符号:f_fp 是带时间步条件 t 的 transformer 层;x̃ 叫输入注入(input injection),是前层输出经过投影层的结果,它把「当前含噪输入」的信息固定地喂给迭代过程;t 是扩散时间步。求解时从初值出发反复迭代,直到相邻两次迭代的差足够小。网络最后的输出是
x_post = f_post(x*)。
整体流程是:输入 x_input 先过 f_pre 得到 x_pre,投影成 x̃,解固定点得到 x*,再过 f_post 得到输出;训练时输出算损失,采样时输出作为下一时间步的输入。
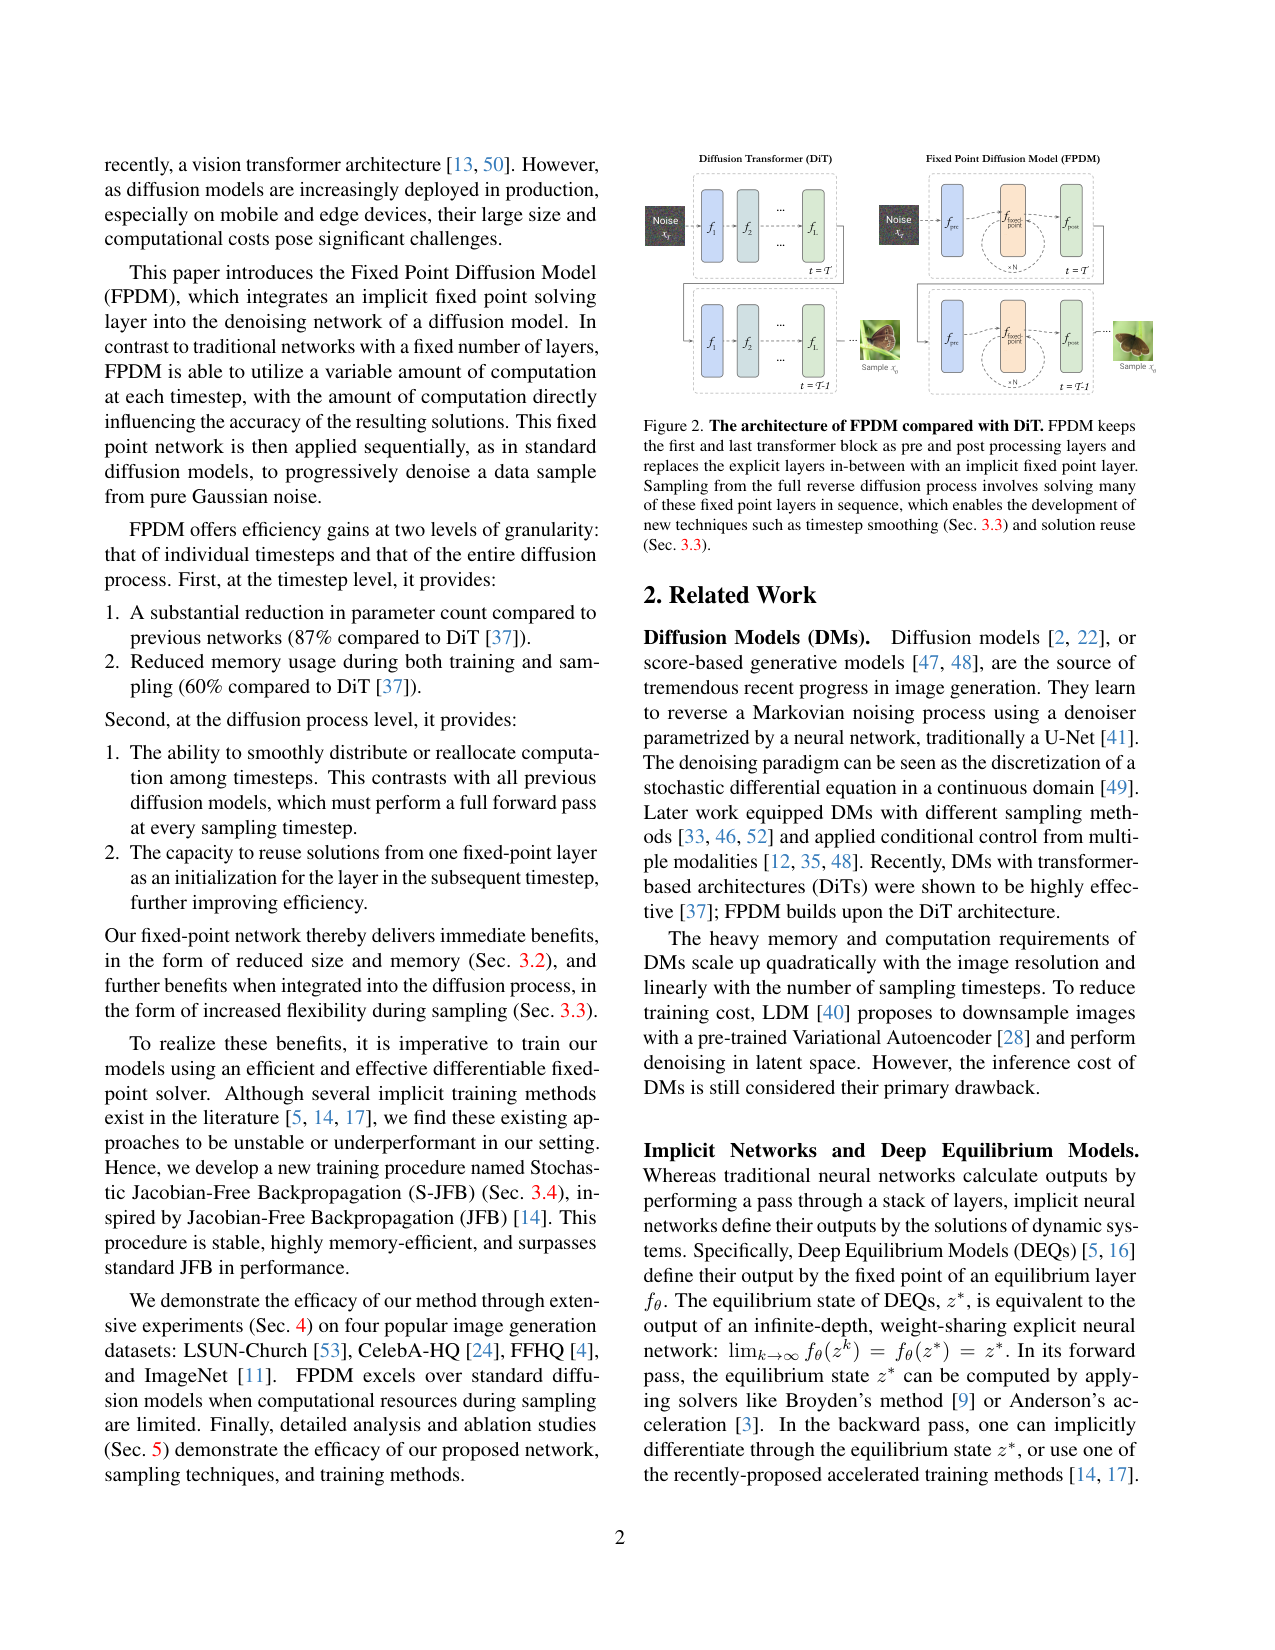
Figure 2 把两种网络并排画出来:左边 DiT 每个时间步完整跑 L 层,右边 FPDM 只跑 f_pre、不动点层(×N 次迭代)、f_post。读图的关键是那个 ×N 循环:层数少了,但每步可以迭代多次,迭代次数就是新的自由度。显式层从 28 层压到 2 层后,参数量从 674M 降到 85M,训练显存从 25.2GB 降到 10.2GB(batch 64,降 60%)。
方法二:S-JFB——怎么给隐式层算梯度
隐式层训练的关键问题:前向是迭代求出来的,反向怎么传梯度?DEQ 的标准做法是隐式微分,要算并求逆 Jacobian,内存和时间都很贵;后来有人提出 JFB(Jacobian-Free Backpropagation),思路是丢掉 Jacobian 逆那一项。论文先说明这个近似的由来:由隐函数定理,损失对参数的梯度本来可以写成
∂L/∂θ ≈ (∂L/∂x*)·(I − ∂f_fp/∂x*)^(−1)·(∂f_fp/∂θ)。
这个式子要回答「梯度如何穿过隐式层」:第一项是损失对解的梯度,中间的 (I − ∂f_fp/∂x*)^(−1) 是 Jacobian 逆项,最后一项是层对参数的导数。JFB 直接把中间的逆项扔掉,只反传最后一步。代价是梯度有偏,论文实测 1-step 梯度在 ImageNet 上几乎训不动:FID 高达 567.6(N=6 组)。
论文的解法是随机化多步展开,叫 S-JFB。训练时前向先跑 n 次无梯度迭代(n 从 0 到 N 均匀采样,不存中间量),再跑 m 次有梯度迭代(m 从 1 到 M 均匀采样),反传只展开最后 m 次。M、N 是超参数,最优值很低:论文消融显示 (M,N)=3 时 FID 43.0、=6 时 43.2、=12 时 61.5、=24 时直接崩到 567.6。S-JFB 在 N=6 时把 FID 从 JFB 的 567.6 压到 43.2,比多步 JFB 的 48.2 还低。多展开几步、加随机化,隐式网络在大规模上就训得动了。
方法三:采样期的计算平滑、重分配与解复用
固定点网络给采样带来三个显式网络给不了的自由度。
第一是平滑(smoothing)。固定一笔采样预算(用 transformer block 前向总次数衡量),DiT 每步必须完整前向,预算直接决定时间步数;FPDM 可以把每步迭代数砍小,用更多时间步去铺满去噪过程。Figure 3 画的就是这个对比:同样预算下 DiT 只能在大间隔的少数时间步去噪,FPDM 可以把计算摊匀。
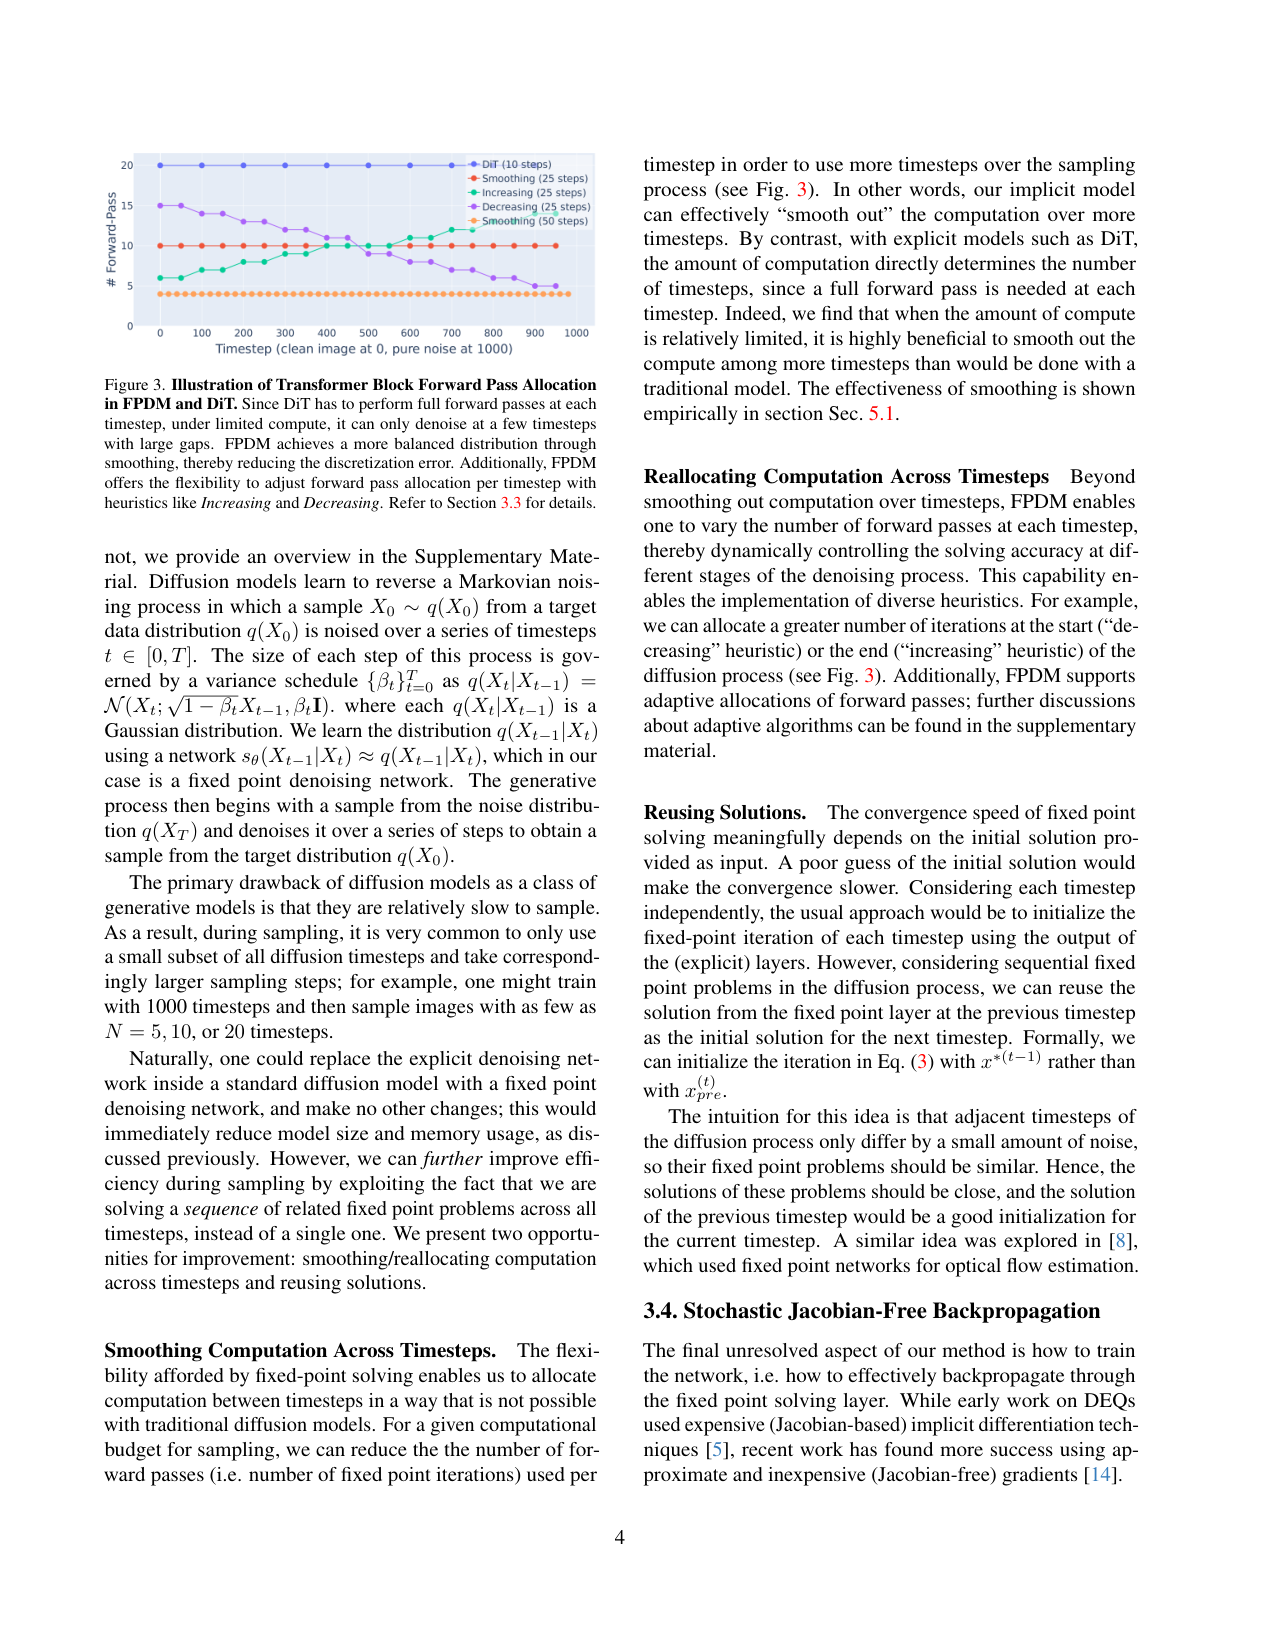
第二是重分配(reallocating)。迭代次数可以按时间步动态调整,把算力集中到去噪前期(decreasing)或后期(increasing),甚至用误差阈值自适应分配(论文在补充材料里给了阈值 + 二分探测的示例算法)。消融里 increasing 优于 constant 和 decreasing:5 次迭代/步时,increasing 的 FID 是 44.8,constant 45.8,decreasing 46.3(1000 张生成图)。
第三是解复用(reusing)。相邻时间步的固定点问题只差少量噪声,解应该很接近,所以用上一时间步的解 x*^(t−1) 初始化当前步的迭代,替代从零开始。Figure 6 显示复用在小迭代预算时收益最大(每步迭代次数越少越明显),且在低噪声时间步上收敛提升最大,跟「相邻步越来越相似」一致。
这三招合起来回答同一个问题:一笔固定的采样计算,怎么切分最划算?Figure 4 给出了定量答案。
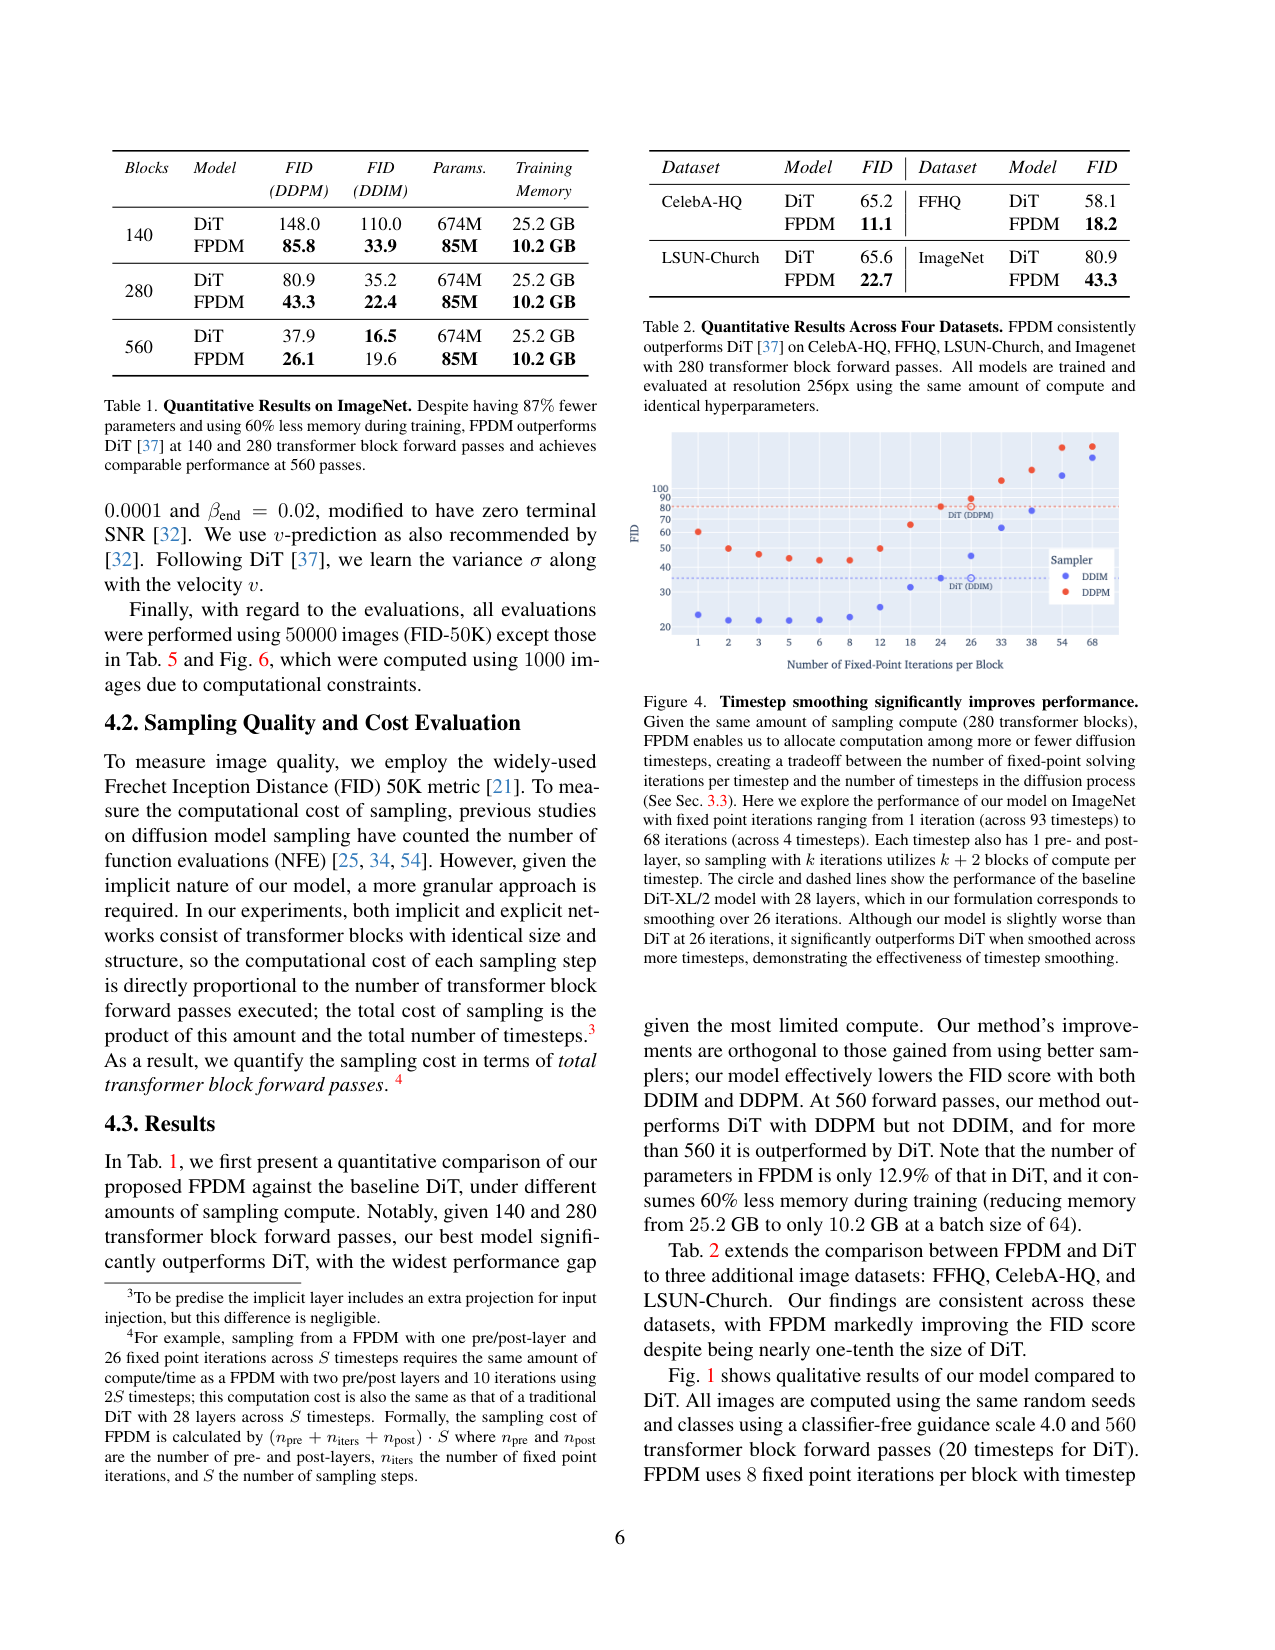
Figure 4 的横轴是每步迭代次数,纵轴是 FID-50K,总预算固定 280 个 block,所以迭代数 × 时间步数约等于 280/每步固定开销。曲线呈 U 形:1 次迭代时每步解没收敛,误差累积;68 次迭代时只剩 4 个时间步,离散化误差变大。最优区间在 4–8 次迭代。图中圆圈虚线是 DiT-XL/2 的参考线(28 层 ≈ 26 次迭代):FPDM 在 26 次附近略差于 DiT,但把迭代降到 4–8 次、铺满更多时间步后,显著低于 DiT。结论是:在受限计算下,迭代不收敛的损失小于时间步太稀的离散化损失。
实验:受限计算下的全面占优
主实验是 ImageNet 256×256 类条件生成,与 DiT-XL/2 用相同算力(8×V100、ImageNet 4 天 ≈ 400K DiT 步、batch 512、lr 1e-4)、相同超参(线性调度、zero terminal SNR、v-prediction)训练,FID-50K 评估。采样成本统一按 transformer block 前向总次数算:FPDM 每时间步是 (1 个 pre + k 次迭代 + 1 个 post) 次前向,DiT 每时间步是 28 次。
280 块预算下,FPDM 的 DDPM FID 是 43.3,DiT 是 80.9;DDIM 口径 FPDM 22.4,DiT 35.2。140 块预算下差距更大:DDIM 口径 FPDM 33.9 vs DiT 110.0。到 560 块(相当于 DiT 20 个时间步)时,DDPM 口径 FPDM 26.1 仍优于 DiT 37.9,但 DDIM 口径 DiT 16.5 反超 FPDM 19.6;论文明确说预算更多时差距继续扩大。跨数据集验证在 280 块预算下同样占优:CelebA-HQ 11.1 vs 65.2、FFHQ 18.2 vs 58.1、LSUN-Church 22.7 vs 65.6、ImageNet 43.3 vs 80.9(均 DDPM 采样)。注意这些 FID 的对比方都是同一篇论文里的 DiT 复现,参数量是 674M vs 85M。
谱系:迭代放在哪
把近几年的高效扩散工作放在一条线上看:标准扩散把迭代放在采样轨迹上(上千个时间步);DDIM、整流流、Consistency 和蒸馏在减少时间步或拉直轨迹;DEQ 扩散的两个先例想把整条轨迹压成单个固定点(Pokle 等)或蒸馏成一步 DEQ(Geng 等,止步 CIFAR-10)。FPDM 的位置是「把迭代放进网络内部」:采样期每个时间步都解一个固定点,迭代次数按预算伸缩。同一根轴上还有个镜像:Drifting 把迭代搬进训练期,让 pushforward 分布在训练中演化到数据分布,训练终点对应映射 x → x + V(x) 的不动点,推理只剩 1 次前向。两条路线共享「生成过程 = 求平衡态」的视角:FPDM 在推理期、逐时间步求平衡,Drifting 在训练期求全局平衡。这篇论文也坦承一个代价——无限计算下,FPDM 退化成权重共享 transformer,追不上 8 倍参数的 DiT。
局限
第一,计算不受限时性能下降(论文自承):560 块预算下 DDIM FID 19.6 vs DiT 16.5,预算更多时 FPDM 只能靠权重共享一条路,与 DiT 的差距拉大。第二,收益依赖平滑与复用两个技巧(论文自承):时间步数和迭代数都饱和后,这两个机制失效。第三,规模与任务范围有限:实验止于 256×256,只有 ImageNet 类条件加三个无条件数据集,没有 text-to-image 或视频验证,移动端部署这个动机没有直接测量延迟。第四,部分消融用 1000 张图算 FID(FID-50K 的 1/50),统计功效偏弱,4–8 次迭代的最优区间和 increasing 的优势幅度需要更大规模复核。第五,自适应分配算法只给了示例,没有系统研究。读完可以记住的核心结论重复一遍:把迭代次数变成采样期的可调旋钮,让固定预算在时间步之间平滑分配,是 FPDM 在受限计算下压过 DiT 的主要原因;这个自由度来自隐式不动点层,与 Drifting 把迭代挪进训练期的做法正好构成一条线上的两端。
把 DiT 的 28 个显式 transformer 层压缩成「前后各 1 个显式层 + 中间 1 个隐式不动点层」,让每个去噪时间步变成解一个固定点方程 x* = f_fp(x*, x̃, t),从而在时间步之间平滑、重分配计算并复用上一时间步的解;85M 参数的 FPDM 相比 674M 参数的 DiT-XL/2,在 ImageNet 256×256 上用 280 次 transformer block 前向的采样预算把 DDIM FID 从 35.2 压到 22.4,训练显存从 25.2GB 降到 10.2GB(batch 64),是「把迭代搬进网络内部」的代表作。
阅读提示
精读深度:泛读
清单提示:原文提示:固定点求解与扩散的结合——把去噪网络里的一整段显式层换成可迭代的不动点层,让采样变成一串相关的固定点问题;与 Drifting 的「平衡」思想串成一条线——两边都把生成过程看成求平衡态/不动点,区别在迭代放在推理期还是训练期。
问题
要解决什么:扩散模型采样慢、模型大。主流扩散骨干(DiT-XL/2 等)由固定层数的显式网络构成,采样时每个时间步都必须完整跑一遍全部 28 层,推理预算直接决定时间步数;训练常按 1000 步调度,采样却往往只取 5、10 或 20 个时间步,粗步长带来的离散化误差由网络容量硬扛。本文想同时解决两个问题:把参数量和训练显存降一个量级,并把「计算预算 vs 采样精度」的权衡从网络外打开到网络内——让同一个网络能用不同次数的迭代换取不同精度,进而把固定的采样计算在时间步之间自由分配。
为什么 prior work 不够:显式网络(DiT、U-Net)每时间步固定消耗一次完整前向,无法把算力在时间步之间搬运,采样步数少时只能靠加大单步误差;DEQ 这类隐式网络此前在扩散上只有两个先例,且都试图把整条扩散轨迹压成单个固定点方程——Pokle 等的 DEQ-Diffusion 是纯推理期技术,把顺序采样变成并行但内存消耗比标准祖先采样高;Geng 等的 one-step DEQ 蒸馏需要预训练扩散模型,且实验没超过 CIFAR-10。训练侧也有缺口:隐式网络常用的 1-step 梯度(JFB)在 ImageNet 这种大规模任务上几乎不收敛。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 隐变量 x_input^(t) | SD-VAE 潜空间张量(32×32×4 量级) | 采样起始点是标准高斯噪声;每个时间步输入当前去噪中的隐变量,配合时间步 t 一起进网络 |
| 时间步 t | 标量 | 训练用线性噪声调度(β_start=1e-4、β_end=0.02、zero terminal SNR),训练 1000 步,采样时间步数可自由选择 |
| 输入注入 x̃ | d 维向量 | x̃ = projection(x_pre),即显式前层输出经过一个投影层,作为固定点层的条件输入(input injection) |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 固定点解 x*^(t) | d 维向量 | 满足 x* = f_fp(x*, x̃, t) 的平衡解,由固定点迭代求得;经后层输出 x_post,用于计算损失或作为下一时间步的输入 |
| 去噪后的隐变量 / 生成图像 | SD-VAE 隐变量 → 图像 | 最后一个时间步的输出经 VAE 解码得到 256×256 图像 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet 256×256(类条件) | ImageNet 分类数据,分辨率 256 | 主定量基准(FID-50K),8×V100 训练 4 天 ≈ 400K DiT 步;batch 512、lr 1e-4;类条件,定量结果不用 CFG |
| CelebA-HQ / FFHQ / LSUN-Church 256×256(无条件) | 三套 256×256 图像数据集 | 验证跨数据集一致性,1 天 ≈ 100K DiT 步;与 DiT 用相同算力、相同超参训练 |
架构(摘要)
主干与结构
backbone:DiT-XL/2 结构(28 个显式层),改为 1 个 pre 层 + 1 个隐式不动点层 + 1 个 post 层
参数:85M(DiT-XL/2 为 674M;每层 24M,不动点层额外带一个投影)
类型:隐式不动点网络(DEQ 风格)+ DiT 骨架,在 SD-VAE 潜空间运行
关键组件
- 隐式不动点层 f_fp:x* = f_fp(x*, x̃, t),用固定点迭代 x_{k+1} = f_fp(x_k, x̃, t) 求解,迭代次数在采样时按预算自由选(论文示例 1–68 次)
- 显式 pre/post 层:各 1 个 transformer 层,负责与时间无关的特征提取/输出;消融显示至少 1 层优于 0 层
- S-JFB 训练:前向先跑 n ~ U[0,N] 次无梯度迭代、再跑 m ~ U[1,M] 次有梯度迭代,反传只穿过最后 m 次;M=N=12(最优 M,N 为 3–6)
- 时间步平滑:固定总前向预算,把每步迭代数降到 4–8、把时间步数拉满(280 块预算下最多 93 个时间步)
- 解复用(warm start):用上一时间步的固定点解初始化当前时间步的迭代
- 计算重分配启发式:increasing / decreasing 按时间步线性增减迭代次数
为什么这样设计
隐式层用多次迭代换精度,把「计算–精度」权衡从网络层数搬到迭代次数,采样时可按预算实时调节;一个不动点层替代一整段显式层,参数量与训练显存大幅下降;扩散过程相邻时间步只差少量噪声,对应的固定点问题高度相似,解可复用,这是显式网络给不了的特性。论文特意在 DiT 上加 v-prediction 与 zero terminal SNR 两项近期改进,说明收益与采样器、调度改进正交。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ImageNet 256×256 FID-50K,140 次 transformer block 前向(越低越好) | FPDM 85.8(DDPM)/ 33.9(DDIM) | DiT-XL/2 148.0(DDPM)/ 110.0(DDIM),参数 674M vs 85M | 类条件,8×V100 训练 4 天 ≈ 400K DiT 步,batch 512、lr 1e-4,线性调度 β_start=1e-4、β_end=0.02、zero terminal SNR,v-prediction,FID-50K 无 CFG |
| ImageNet 256×256 FID-50K,280 次 transformer block 前向 | FPDM 43.3(DDPM)/ 22.4(DDIM) | DiT-XL/2 80.9(DDPM)/ 35.2(DDIM);训练显存 10.2GB vs 25.2GB(batch 64,降 60%) | 同上;这是四个数据集对比的统一预算 |
| ImageNet 256×256 FID-50K,560 次 transformer block 前向 | FPDM 26.1(DDPM)/ 19.6(DDIM) | DiT-XL/2 37.9(DDPM)/ 16.5(DDIM);超过 560 次后 DiT(DDIM)反超 | 同上;560 块 = DiT 20 个时间步 × 28 层,FPDM 为 8 次迭代/步 × 较多时间步(配 CFG 4.0 用于定性对比) |
| 四数据集 FID,280 次前向(DDPM 采样) | CelebA-HQ 11.1 / FFHQ 18.2 / LSUN-Church 22.7 / ImageNet 43.3 | DiT 同预算:CelebA-HQ 65.2 / FFHQ 58.1 / LSUN-Church 65.6 / ImageNet 80.9 | 全部 256×256,同一算力同一超参训练(非 ImageNet 数据集 1 天 ≈ 100K DiT 步,无条件;ImageNet 类条件) |
| 训练方法消融(ImageNet FID-50K,N=6 组) | Stochastic JFB 43.2 | JFB(1-step 梯度)567.6、Multi-Step JFB 48.2;M,N 最优区间 3–6((M,N)=3 时 43.0、=6 时 43.2、=12 时 61.5、=24 时 567.6) | M、N 为训练时无梯度/有梯度迭代数上界,ImageNet 类条件,其余训练设置同上 |
| 迭代分配启发式(ImageNet FID,1000 张生成图) | increasing 5 次迭代/步 44.8(最优) | constant 45.8、decreasing 46.3(同为 5 次迭代/步);预算更大时 8 次迭代/步 increasing 45.6 仍优于 constant 47.3 | 受算力限制该表用 1000 张图算 FID,固定 280 块总前向预算,把迭代集中到去噪后期 |
Insights
- 把「计算–精度」权衡从网络层数搬到迭代次数:隐式不动点层用 N 次迭代换取可调精度,采样预算与图像质量直接挂钩,这是显式 DiT 给不了的自由度。
- 时间步平滑的收益来自减少离散化误差:固定 280 块预算时,4–8 次迭代/步、铺满时间步的方案,比 26 次迭代/步(等价于 DiT 28 层 × 10 步)的 FID 更低;迭代不收敛的误差小于大步长的离散化误差。
- 相邻时间步的固定点问题高度相似,解可复用:warm start 在小迭代预算时收益最大,且在低噪声(去噪后期)时间步上收敛提升最明显,与「相邻步只差少量噪声」一致。
- 训练方法决定成败:1-step 梯度(JFB)在 ImageNet 上 FID 高达 567.6,随机多步反传 S-JFB 压到 43.2;隐式网络的大规模训练需要多步展开加随机化。
- 谱系定位:FPDM 把迭代放进采样期网络内部(推理期多步迭代换精度);Drifting 把迭代放进训练期(训练到平衡态、推理 1 次前向);Consistency/蒸馏则减少时间步本身。三条路都在回答同一个问题——把扩散的多次前向省下来或重新分配。
vs 同类工作
- 相比 DiT(同骨架 674M、28 层):参数量只剩 12.9%(85M),训练显存降 60%(25.2GB→10.2GB,batch 64),140/280 块预算下 FID 全面占优,560 块及以后被 DiT(DDIM) 反超。
- 相比 Pokle 等的 DEQ-Diffusion(整条轨迹一个固定点、并行采样):FPDM 按时间步逐个解固定点问题,是顺序采样,训练显存与推理内存都更低,且从头训练无需预训练模型。
- 相比 Geng 等的 one-step DEQ 蒸馏:FPDM 保留多步采样,把每步内部迭代可变,直接在大规模(ImageNet 等四数据集、256×256)上训练,无需教师模型。
- 相比 Drifting(训练期迭代、1-NFE 推理):FPDM 是推理期迭代,两者在「迭代放哪」这一维上互补,共享「生成过程=求平衡态」的视角。
- 相比 JFB 原版(1-step 梯度):S-JFB 用随机多步展开,训练稳定且 FID 从 567.6 降到 43.2(N=6 组)。
局限
- 计算不受限时打不过 DiT(论文自承):无资源约束时 FPDM 退化为权重共享 transformer,无法匹配 8 倍参数的 DiT;560 块预算下 DDIM FID 19.6 vs DiT 16.5,更多预算时差距扩大。
- 收益依赖平滑与复用两个技巧(论文自承):时间步数与迭代数都饱和后,这两个机制失效,模型只剩权重共享这一条路。
- 规模与任务范围有限:实验止于 256×256,仅 ImageNet 类条件 + 三个无条件数据集,没有 text-to-image、视频或更高分辨率验证,移动端部署这一动机没有直接延迟/能耗测量。
- 部分消融统计功效弱:Tab 5 与 Fig 6 用 1000 张生成图算 FID(FID-50K 的 1/50),噪声大,最优迭代数 4–8 与 increasing 的优势幅度需要 50K 规模复核。
- 自适应分配算法只给了可行性示例(阈值 + 二分探测),没有系统性研究,能否自动适配不同预算尚未证实。
可复现性
代码与预训练模型公开(https://lukemelas.github.io/fixed-point-diffusion-models/);训练设置明确(8×V100,ImageNet 4 天 ≈ 400K 步,batch 512,lr 1e-4,线性调度 zero terminal SNR + v-prediction);采样成本按 (n_pre + n_iter + n_post) × 时间步数 计算 transformer block 前向,与 DiT 口径统一;S-JFB 的随机性只来自 n、m 的均匀采样,可复现。
主干与结构
backbone:DiT-XL/2 结构(28 个显式层),改为 1 个 pre 层 + 1 个隐式不动点层 + 1 个 post 层
参数:85M(DiT-XL/2 为 674M;每层 24M,不动点层额外带一个投影)
类型:隐式不动点网络(DEQ 风格)+ DiT 骨架,在 SD-VAE 潜空间运行
关键组件
- 隐式不动点层 f_fp:x* = f_fp(x*, x̃, t),用固定点迭代 x_{k+1} = f_fp(x_k, x̃, t) 求解,迭代次数在采样时按预算自由选(论文示例 1–68 次)
- 显式 pre/post 层:各 1 个 transformer 层,负责与时间无关的特征提取/输出;消融显示至少 1 层优于 0 层
- S-JFB 训练:前向先跑 n ~ U[0,N] 次无梯度迭代、再跑 m ~ U[1,M] 次有梯度迭代,反传只穿过最后 m 次;M=N=12(最优 M,N 为 3–6)
- 时间步平滑:固定总前向预算,把每步迭代数降到 4–8、把时间步数拉满(280 块预算下最多 93 个时间步)
- 解复用(warm start):用上一时间步的固定点解初始化当前时间步的迭代
- 计算重分配启发式:increasing / decreasing 按时间步线性增减迭代次数
为什么这样设计
隐式层用多次迭代换精度,把「计算–精度」权衡从网络层数搬到迭代次数,采样时可按预算实时调节;一个不动点层替代一整段显式层,参数量与训练显存大幅下降;扩散过程相邻时间步只差少量噪声,对应的固定点问题高度相似,解可复用,这是显式网络给不了的特性。论文特意在 DiT 上加 v-prediction 与 zero terminal SNR 两项近期改进,说明收益与采样器、调度改进正交。
FPDM 与 DiT 的架构对比
原文 caption:FPDM 与 DiT 结构对比:DiT 每个时间步完整跑 L 层,FPDM 每步跑 f_pre + 不动点层(×N 次迭代)+ f_post
左图是 DiT:每个去噪时间步都要完整跑一遍全部 L 个 transformer 层,层数固定、消耗固定。右图是 FPDM:显式层压到前后各一小段,中间是一个被反复调用 N 次的不动点层。读图要点是「×N」这个循环:它把一次前向变成 N 次迭代,N 可变,采样预算因此可以在时间步之间搬运;同时这一层替代了大部分显式层,参数量从 674M 降到 85M。这是全文机制的核心图。
前向计算在时间步之间的分配示意
原文 caption:FPDM 与 DiT 的 transformer block 前向分配:DiT 受限计算下只能在大间隔的少数时间步去噪;FPDM 通过平滑得到更均衡的分配,并可用 increasing/decreasing 启发式调节
这张图解释「平滑」:同样一笔采样预算,DiT 因为每步必须完整前向,只能选少数几个时间步、步与步之间间隔很大(离散化误差大);FPDM 把每步的迭代数砍小,就能铺到更多时间步上,间隔变小。图里还展示了 increasing 与 decreasing 两种把迭代集中在后期或前期的分配方式。它说明固定点网络带来的自由度:计算可以按时间步任意切分。
时间步平滑的定量结果(ImageNet)
原文 caption:固定 280 个 transformer block 的采样预算,FPDM 从 1 次迭代×93 个时间步到 68 次迭代×4 个时间步;圆圈虚线是 DiT-XL/2(28 层 ≈ 26 次迭代)
横轴是每个时间步的固定点迭代次数,纵轴是 FID-50K(越低越好),总前向预算固定在 280 个 block。曲线说明存在最优区间:迭代太少(1 次)每步解没收敛,误差累积;迭代太多(68 次)时间步只剩 4 个,离散化误差变大。DiT 对应 26 迭代这条参考线:FPDM 在 26 次附近略差,但在 4–8 次迭代、更多时间步的区域显著更低,这正是平滑带来的收益。读图时注意对角关系:迭代数×时间步数≈总预算。
🎧 音频版
时长 23:35 · Edge TTS
Fixed Point Diffusion Models(对话版·泛读)
这篇论文解决什么问题
小播:今天这篇叫《Fixed Point Diffusion Models》,固定点扩散模型,牛津大学做的,发表在 CVPR 2024。先问个直白的:它解决什么问题?
老播:一句话背景:扩散模型出图质量高,但模型又大又慢,放到手机、边缘设备这类资源受限的场景里很吃力。这篇论文的做法,是把去噪网络里的一整段 transformer 层,换成一块可以反复迭代的「不动点层」,让每个去噪时间步变成解一个固定点方程。先说结论,后面我们会一步步拆开:85M 参数的模型,在 ImageNet 256×256 上,用 280 次前向计算的采样预算,把 DDIM 的 FID 从 674M 参数 DiT 的 35.2 压到了 22.4,训练显存从 25.2GB 降到 10.2GB。
小播:这篇跟咱们之前聊的 Consistency、整流流,还有 Drifting 都沾边,为什么值得单独做一期?
老播:三个理由。第一,它是 DEQ 这类隐式网络和扩散模型结合的代表作,之前两个结合的先例一个只做推理期、一个只做到 CIFAR-10,它是第一个在 ImageNet 这种规模上从头训练成功的。第二,它给出了显式网络没有的新自由度:迭代次数可调,这让「采样预算」第一次可以精细切分。第三,它跟 Drifting 正好是同一根轴的两端,把两篇放一起读,能看清高效生成这条技术线在怎么演变。另外它的结论本身有点反常识:85M 参数的小模型,在受限预算下赢了 674M 参数的大模型。
小播:这数字挺能打。但「固定点」这个词听着像数学课,跟生成图片有什么关系?
老播:关系就是这篇论文的全部内容。我们先把需要的概念讲清楚,再回到这个结论。你记一条主线就行:它把「采样时一次前向」变成了「N 次迭代」,N 可以按预算调,这一小步改变带来了一连串好处。
先讲清楚扩散模型为什么又大又慢
小播:好,从扩散模型讲起。它到底怎么生成图片?
老播:扩散模型分两步。训练时,拿一张干净图片,按一个噪声调度表逐步加噪,论文和基线都按 1000 步训练,加到最后图片变成纯高斯噪声;同时训练一个网络学会反向操作,从任意噪声程度的图上把噪声去掉。采样时,从纯噪声出发,沿着时间步倒着走,一步步去噪,最后得到图片。这里的时间步对应加噪程度,t 越大噪声越多,跟真实时间没有关系。
小播:为什么训练要 1000 步,采样却只敢用 20 步?
老播:训练时用密集的小步,是为了让网络在每个噪声档位上都见过足够多的样本,学得细;采样时步数越少越省时间,所以常见做法是训练 1000 步、采样取 5、10 或 20 个时间步,相当于跳档走。少取步数的代价叫离散化误差:去噪在数学上对应一个连续过程,切成 20 大段,每段用一次网络输出代替整段的变化,段切得越粗,误差越大。这里先定义一下计算单位:一次 transformer block 前向,就是让输入完整穿过一个 transformer 层块。
小播:那 DiT 这个基线又是什么?
老播:DiT 是扩散模型用 transformer 做骨干的代表作,也是这篇论文的对照对象。它把去噪网络做成 28 层 transformer,674M 参数,单卡训练显存 25.2GB,batch 64。还要补充一个背景:FPDM 和 DiT 走同一套流程——图像先被编码器压成 32×32×4 的隐变量,网络在 SD-VAE 潜空间里低维去噪,最后解码回 256×256 图像,两家都避开直接处理像素,计算量小很多,口径一致。
小播:之前大家怎么提速的?
老播:基本都在时间步层面做文章。DDIM 把随机采样变成确定性采样,同样步数下更稳;蒸馏和 Consistency 模型把上千步压到几步甚至一步,Consistency 的思路是让网络把任意噪声档直接映射到干净图;整流流把采样轨迹学直,让大步长更准。这些方法都没动网络内部结构——每个时间步照样必须完整前向一次,层数固定、消耗固定。这篇论文的切口就在这:网络内部能不能动?
小播:为什么网络非要一次前向走到底?改成数值积分那种不行吗?
老播:扩散采样确实能写成概率流 ODE,用欧拉法或者 DPM-Solver 那种数值积分器求解,但那是把网络当速度场、在采样轨迹层面做显式展开。FPDM 换了个层面:把网络本身定义成一个映射,在单个时间步内部做固定点迭代。这里的分野是「显式」和「隐式」:显式网络把计算写在层结构里,一次前向走完所有层;隐式网络把计算留给求解过程,走多少步由求解器决定。神经 ODE、DEQ 都属于后者,FPDM 用的是固定点求解这一支。
核心:把一段网络变成可以反复迭代的不动点层
小播:先给「固定点」一个定义,我怕后面跟不上。
老播:固定点就是满足 x* 等于 f(x*) 的那个点:把函数 f 作用到它身上,结果还是它自己。最朴素的求法叫固定点迭代:随便给个初值 x₀,反复套用 f,x_{k+1} = f(x_k),在 f 满足压缩条件时——大意是 f 每作用一次,两点之间的距离都按固定比例缩小——它会线性收敛到唯一解,这个结论的根源是巴拿赫不动点定理。粗略算一笔:如果压缩常数是 0.5,误差每迭代一次减半,10 次迭代后只剩初始误差的大约千分之一,所以迭代次数够用就行。DEQ 这类隐式网络,就是把一整层网络定义成这个隐式方程,前向过程靠迭代求解,迭代次数就是它的计算量。
小播:迭代到什么时候停?总得有个判据吧。
老播:最简单的判据是看相邻两次迭代的差,论文里记作 δ:连续两次迭代的输出几乎不变,就认为收敛了,可以停。论文 Figure 6 就是用这个 δ 来衡量每个时间步的收敛情况:复用上一时间步的解之后,δ 明显下降,尤其低噪声、也就是去噪后期的那些时间步,说明热启动让迭代更快到达稳定点。这个判据也是补充材料里自适应分配算法的基础——设定一个 δ 阈值,达不到就继续迭代。
小播:所以 FPDM 是把去噪网络变成 DEQ?
老播:对,但结构上有讲究。它的去噪网络分三段:显式预处理层、隐式不动点层、显式后处理层。中间那层要解的是
x* = f_fp(x*, x̃, t)。
这个式子在回答:「在当前去噪状态上,网络反复作用很多次之后,稳定在哪个点?」先给预期再逐符号看:x* 是我们要的解,它同时出现在等号两边,所以这是个隐式方程,要靠迭代逼近;f_fp 是带时间步条件 t 的 transformer 层,t 告诉网络当前噪声有多大;x̃ 叫输入注入,是前层输出经过投影层得到的,投影的作用是把前层输出压到和隐层状态同维度,这样每一次迭代都能把「当前含噪输入」的信息加回去,迭代始终盯着同一个输入。求解时从初值出发反复迭代,直到相邻两次结果足够接近,得到的 x* 再过后处理层输出。完整流程是:输入先过预处理层,投影成 x̃,解固定点得到 x*,再过后处理层,输出作为下一时间步的输入。
小播:论文里那张架构对比图,具体怎么读?
老播:Figure 2 左右并排画了两个网络。左边是 DiT:从上到下一条直线串起 L 个 transformer 层块,每个时间步完整走一遍,消耗固定。右边是 FPDM:先是 f_pre 预处理,中间一个不动点层被反复调用 N 次,图上画成带 ×N 标记的循环,最后 f_post 输出。读图的关键就在那个 ×N 的循环:它把「一次前向」变成「N 次迭代」,N 可变,采样预算因此可以在时间步之间搬运;同时这一个隐式层顶替了大部分显式层,参数量从 674M 掉到 85M。这张图把全文机制浓缩在一处。
小播:等一下,为什么要解固定点,直接跑一层不行吗?
老播:直接跑一层也行,但那就回到显式网络了。解固定点的好处有两层。第一层直接来自参数量:28 个各自带参数的显式层,换成 1 个反复使用的隐式层加前后各 1 个显式层,参数量从 674M 降到 85M,训练显存从 25.2GB 降到 10.2GB,batch 64。从另一个角度看,这相当于把 28 层变成了共享同一组参数的循环,权重共享省参数,这一点后面局限部分还会再提。第二层更重要:迭代次数变成一个可调旋钮,采样预算紧就少迭代几次,预算松就多迭代几次,计算和精度直接挂钩,这是显式网络给不了的自由度。
小播:训练这样的隐式层,梯度怎么传?听起来很麻烦。
老播:这正是论文的第二个贡献,叫 S-JFB,随机无 Jacobian 反传。先讲背景:给隐式层传梯度,标准做法是隐式微分,利用隐函数定理算出梯度,但中间要构造并求逆一个 Jacobian 矩阵,维度和隐层一样大,内存和时间都很贵。后来有人提出 JFB,把梯度公式里那个 Jacobian 逆项直接丢掉,只反传最后一步,省掉大部分开销。但论文实测,1-step 梯度在 ImageNet 上几乎训不动:FID 高达 567.6,这是 N 等于 6 的设置。FID 我们稍后解释,先记住越低越好。
小播:那 S-JFB 改了什么?
老播:改成随机多步展开。前向先随机跑 n 次无梯度迭代,n 从 0 到 N 均匀采样,这 n 次不存中间量,所以内存省;再随机跑 m 次有梯度迭代,m 从 1 到 M 均匀采样,反传只展开最后这 m 次。随机化的作用,是让网络不要只针对某一个展开长度过拟合,多步展开则让梯度信息更完整。M 和 N 是超参数,最优值很低:论文消融里 M、N 都取 3 时 FID 是 43.0,取 6 时 43.2,取 12 时掉到 61.5,取 24 直接崩回 567.6。用 N=6 那一组横向对比:1-step 梯度 JFB 是 567.6,多步 JFB 是 48.2,S-JFB 是 43.2。多展开几步、加随机化,隐式网络在大规模任务上就训得动了。
小播:训练解决了。采样的时候,85M 参数的小网络怎么赢 674M 的大网络?
老播:靠三个采样期技巧,这是论文的第三个贡献。第一个叫平滑:固定一笔采样预算,DiT 每步必须完整前向,预算直接决定时间步数;FPDM 可以把每步迭代数砍小,把计算铺到更多时间步上,时间步间距变小,离散化误差变小。论文 Figure 3 画的就是这个对比,同样预算下 DiT 只能在大间隔的少数时间步去噪,FPDM 能把计算摊匀。第二个叫重分配:迭代次数可以按时间步动态调,集中到去噪前期叫 decreasing,集中到后期叫 increasing,还可以用误差阈值做自适应分配,论文在补充材料里给了阈值加二分探测的示例算法。第三个叫解复用:相邻时间步的固定点问题只差少量噪声,解应该很接近,所以直接用上一时间步的解当初始值,省掉从零开始的收敛过程,这个思路在 DEQ 做光流估计的工作里也出现过。这三招合起来,把一笔固定计算切成最优的形状。
小播:那怎么切最优?有没有个定量答案?
老播:论文的 Figure 4 给了,这是全篇最该看的一张图。ImageNet 上,总预算固定 280 次 transformer block 前向,横轴是每步迭代次数,纵轴是 FID,越低越好。因为预算固定,迭代次数乘时间步数近似恒定,这张图的每个点都对应一种「迭代数对时间步数」的切分。曲线是 U 形:每步只迭代 1 次时,解没收敛,误差累积;每步迭代 68 次时,只剩 4 个时间步,离散化误差变大。最优区间在每步 4 到 8 次迭代。图上那条参考线是 DiT,28 层对应约 26 次迭代:FPDM 在 26 次附近还略差,但把迭代降到 4 到 8 次、铺满时间步之后,FID 显著更低。读出来的结论:在受限计算下,迭代不收敛的损失,小于时间步太稀带来的离散化损失。这也是全文最重要的一个平衡——每步迭代次数和时间步数之间的平衡。
看数字:受限计算下它怎么赢
小播:刚才说的 FID 对比,我们把数字摊开看。
老播:好,先交代 setup,不然数字没意义。主实验是 ImageNet 256×256 类条件生成,和 DiT-XL/2 用相同算力、相同时间训练:8 张 V100,ImageNet 训练 4 天、约 40 万步,batch 512,学习率 1e-4,噪声调度是 zero terminal SNR,预测目标用 v-prediction,没有占 DiT 的便宜。FID 是 Fréchet Inception Distance,拿 5 万张生成图和真实图,在 Inception 网络的特征空间里比较两组分布的均值和协方差,FID-50K,越低越好。采样成本统一按 transformer block 前向总次数算:FPDM 每步是 1 个前层加 k 次迭代加 1 个后层,共 k 加 2 次;DiT 每步是 28 次,两边口径一样。
训练开销也值得对齐口径:论文里 FPDM 和 DiT 用相同算力、相同训练时间,ImageNet 都是 4 天,FPDM 每步平均迭代次数还略多,所以省的主要是显存和参数量——同一块显卡能塞更大的 batch、更小的模型更容易部署。论文说的「加速训练」,指的是这个意义上的资源效率,读的时候别理解成单步更快。
小播:280 块预算那组,具体差多少?
老播:280 块下,FPDM 的 DDPM 口径 FID 是 43.3,DiT 是 80.9;DDIM 口径 FPDM 22.4,DiT 35.2。DDPM 和 DDIM 是两种采样器,DDIM 是确定性的,通常同样步数下更好,论文两个都报了,说明收益和采样器选择无关。预算更紧时差距更大:140 块下,DDIM 口径 FPDM 33.9,DiT 110.0。预算放宽到 560 块,相当于 DiT 20 个时间步乘 28 层,DDPM 口径 FPDM 26.1 还是赢 DiT 的 37.9,但 DDIM 口径 DiT 16.5 反超 FPDM 的 19.6。论文明确说预算再往上,DiT 的优势会继续扩大,这条我们局限部分细说。
小播:一个数据集可能运气好,换数据集呢?
老播:论文在另外三个数据集上做了同样的 280 块对比,全部用 DDPM 采样:CelebA-HQ 上 FPDM 是 11.1,DiT 是 65.2;FFHQ 上 18.2 对 58.1;LSUN-Church 上 22.7 对 65.6。这些数据集是无条件生成,ImageNet 是类条件的,参数量始终是 85M 对 674M,也就是对手的八分之一左右。定性结果也配套:Figure 1 里用 classifier-free guidance 4.0、560 块预算采样,DiT 对应 20 个时间步,FPDM 用每步 8 次迭代,同一随机种子下 FPDM 的图更清晰,论文归因于计算被摊到了更多时间步。所谓 classifier-free guidance,就是生成时把「带类别条件」和「不带条件」两种输出拉开,让图像更贴合类别,两边用了同样的 4.0。
小播:复用解这个技巧,效果怎么验证的?
老播:论文 Figure 6 做的消融:每步迭代次数很少时,用上一时间步的解做初始化,FID 明显更低;迭代次数多了以后,复不复用差别不大,因为迭代本身就收敛够了。细分到时间步看,复用在低噪声、也就是去噪后期的时间步上收敛提升最大,和「相邻步越来越相似」的预期一致。这和 Figure 4 的结论互相印证:预算紧张时,把迭代省下来换时间步,再用复用把省下来的迭代捡回来一部分。
小播:我复述一遍,你看我理解对不对:固定 280 块预算,FPDM 选每步 4 到 8 次迭代,铺到几十个时间步,再用上一时间步的解热启动,所以小网络反超大网络。
老播:对,这就是全文的核心机制,记住这句就够了。再补两个结构上的消融数字:前后显式层用 1 层最省参数,消融里 0 层、1 层、2 层、4 层对比,至少 1 层优于 0 层,小预算下 1 层最优、大预算下 2 到 4 层更好;迭代分配启发式里,把迭代集中到去噪后期最划算,5 次迭代每步时 increasing 的 FID 是 44.8,constant 是 45.8,decreasing 是 46.3,这组用 1000 张图评估。
它在高效扩散这条线上站在哪
老播:放进谱系里看,有一条线索特别清楚:迭代放在哪里?标准扩散把迭代放在采样轨迹上,上千个时间步;DDIM、整流流、Consistency 和蒸馏,方向是减少时间步或拉直轨迹;DEQ 和扩散结合的两个先例,Pokle 那篇想整条轨迹压成单个固定点、做成并行采样但内存更高,Geng 那篇把预训练模型蒸馏成一步 DEQ、只做到 CIFAR-10。FPDM 站在「把迭代放进网络内部」这个位置,采样期逐时间步解固定点,迭代次数可伸缩。这条线的另一端是 Drifting:它把迭代搬进训练期,让分布演化到平衡态,推理只剩一次前向,ImageNet 256 潜空间上 1 次函数评估做到 FID 1.54。两篇论文共享同一个视角:生成过程就是求平衡态。FPDM 在推理期、逐时间步求平衡,Drifting 在训练期求全局平衡,正好是一根轴的两端,连起来看,高效生成的历史就是不断在重新分配迭代的位置。
它也有明显短板
小播:听下来全是好处,短板在哪?
老播:论文自己承认的最重要一条:计算不受限时,它打不过 DiT。560 块预算下 DDIM 口径已经落后,预算再多,FPDM 只剩权重共享这一条路,可以类比 ALBERT 那种层间共享参数的 transformer,容量上限比 8 倍参数的 DiT 低,差距会继续拉大。第二个短板:收益依赖平滑和复用这两个技巧,时间步数和迭代数都饱和之后,技巧失效,模型没有别的招了。第三个短板:实验规模有限,只做到 256×256,只有 ImageNet 类条件加三个无条件数据集,没有 text-to-image 或视频验证,论文开头说的移动端部署场景也没有直接测延迟或能耗。
小播:还有别的吗?
老播:两个细节要提醒。分配启发式那组消融只用 1000 张生成图算 FID,是 FID-50K 的五十分之一,统计功效偏弱,4 到 8 次迭代的最优区间和 increasing 的优势幅度,值得用 5 万张规模复核。自适应分配算法只给了示例,没有系统研究,能不能自动适配不同预算还没有结论。另外采样成本的口径是 block 前向次数,投影层那点额外开销论文说可忽略,但真实的墙钟时间差异没有单独报告。另外还有个口径要提醒:定性对比那张 Figure 1 用了 classifier-free guidance 4.0 和 560 块预算,而定量 FID 表格都是无 guidance 的,两套设置不完全同口径,所以「图更清晰」这个定性结论,说服力比 FID 数字弱一些。
总的判断:这篇在「预算受限」这个条件下是实打实的赢,但把它当成全能方案,会误读它的适用范围。
记住这三件事
小播:最后我复述三件事。第一,FPDM 把去噪网络中间的一段换成了不动点层,迭代次数成了采样期可调的旋钮,85M 参数在 280 块预算下把 ImageNet 的 DDIM FID 从 DiT 的 35.2 压到 22.4。第二,采样时把固定预算平滑分配到更多时间步、每步 4 到 8 次迭代,再复用上一时间步的解,比堆迭代次数更划算,这是全文最重要的平衡。第三,训练靠 S-JFB 随机多步展开,FID 从 1-step 梯度的 567.6 拉到 43.2,隐式网络在大规模任务上才跑得动。
老播:补一句对后续工作的意义:这篇告诉我们,扩散模型省算力的空间,除了时间步和轨迹,还有网络内部——把一次前向变成可伸缩的迭代。它和 Drifting 连成一条线:一个把迭代留在推理期、逐时间步求平衡,一个把迭代搬进训练期、换一步出图。后续谁能在两者之间找到更好的分配,谁就离「又快又好的生成」更近一步。