GeoPT:用「提升式几何预训练」扩展物理模拟
> 泛读卡片 · ICML 2026(PMLR 306)· arXiv 2602.20399 · MIT CSAIL + 清华
> 阅读提示:几何预训练→物理模拟;世界模型「预训练化」的最新例。
一句话定位
神经模拟器(用一次神经网络前向代替昂贵数值求解的代理模型)长期靠数值求解器生成的标注训练,扩展被标注成本卡死:DrivAerML 空气动力学数据集里,单个工业级样本约需 6.1×10^4 CPU 小时。GeoPT 换一条路——只用公开三维几何(ShapeNet 三个子集共 13,463 个形状)和随机合成的速度场做免物理标签的自监督预训练,预训练数据规模做到 134.6 万条,再在 5 个工业级 benchmark(汽车/客机/飞行器空气动力学、船舶水动力、汽车碰撞)上微调,能减少 20–60% 的标注数据并保持全量精度、收敛最高加速 2×,还能迁移到预训练完全没见过的辐射度(radiosity)模拟。这篇文章把视觉领域的「自监督预训练 + 少量标注微调」配方搬进了物理模拟,是物理世界模型「预训练化」的最新例子。
问题:物理模拟的标注太贵
物理仿真的解场由两样东西共同决定:几何 G(空间区域和边界)和动力学条件 S(如何驱动系统,比如来流速度、撞击角)。数值求解器算出解场 u(x),但每个样本都要完整跑一次仿真。论文引言给出的参照:DrivAerML 一个样本约 6.1×10^4 CPU 小时。相比之下,几何本身在公开仓库里取之不尽。自然的想法是学视觉 MAE/SimCLR 那样,先用几何做自监督预训练,再在少量物理标注上微调。
这条看似顺理成章的路线实测会翻车。论文用 Transolver(一种把网格点聚合成潜在物理状态的 Transformer 模拟器)在 DrivAerML 上做了实验:先用静态几何监督(预测点到曲面的向量距离)预训练,再微调到物理标注,精度明显差于直接从头训练——出现了负迁移(Fig.1)。
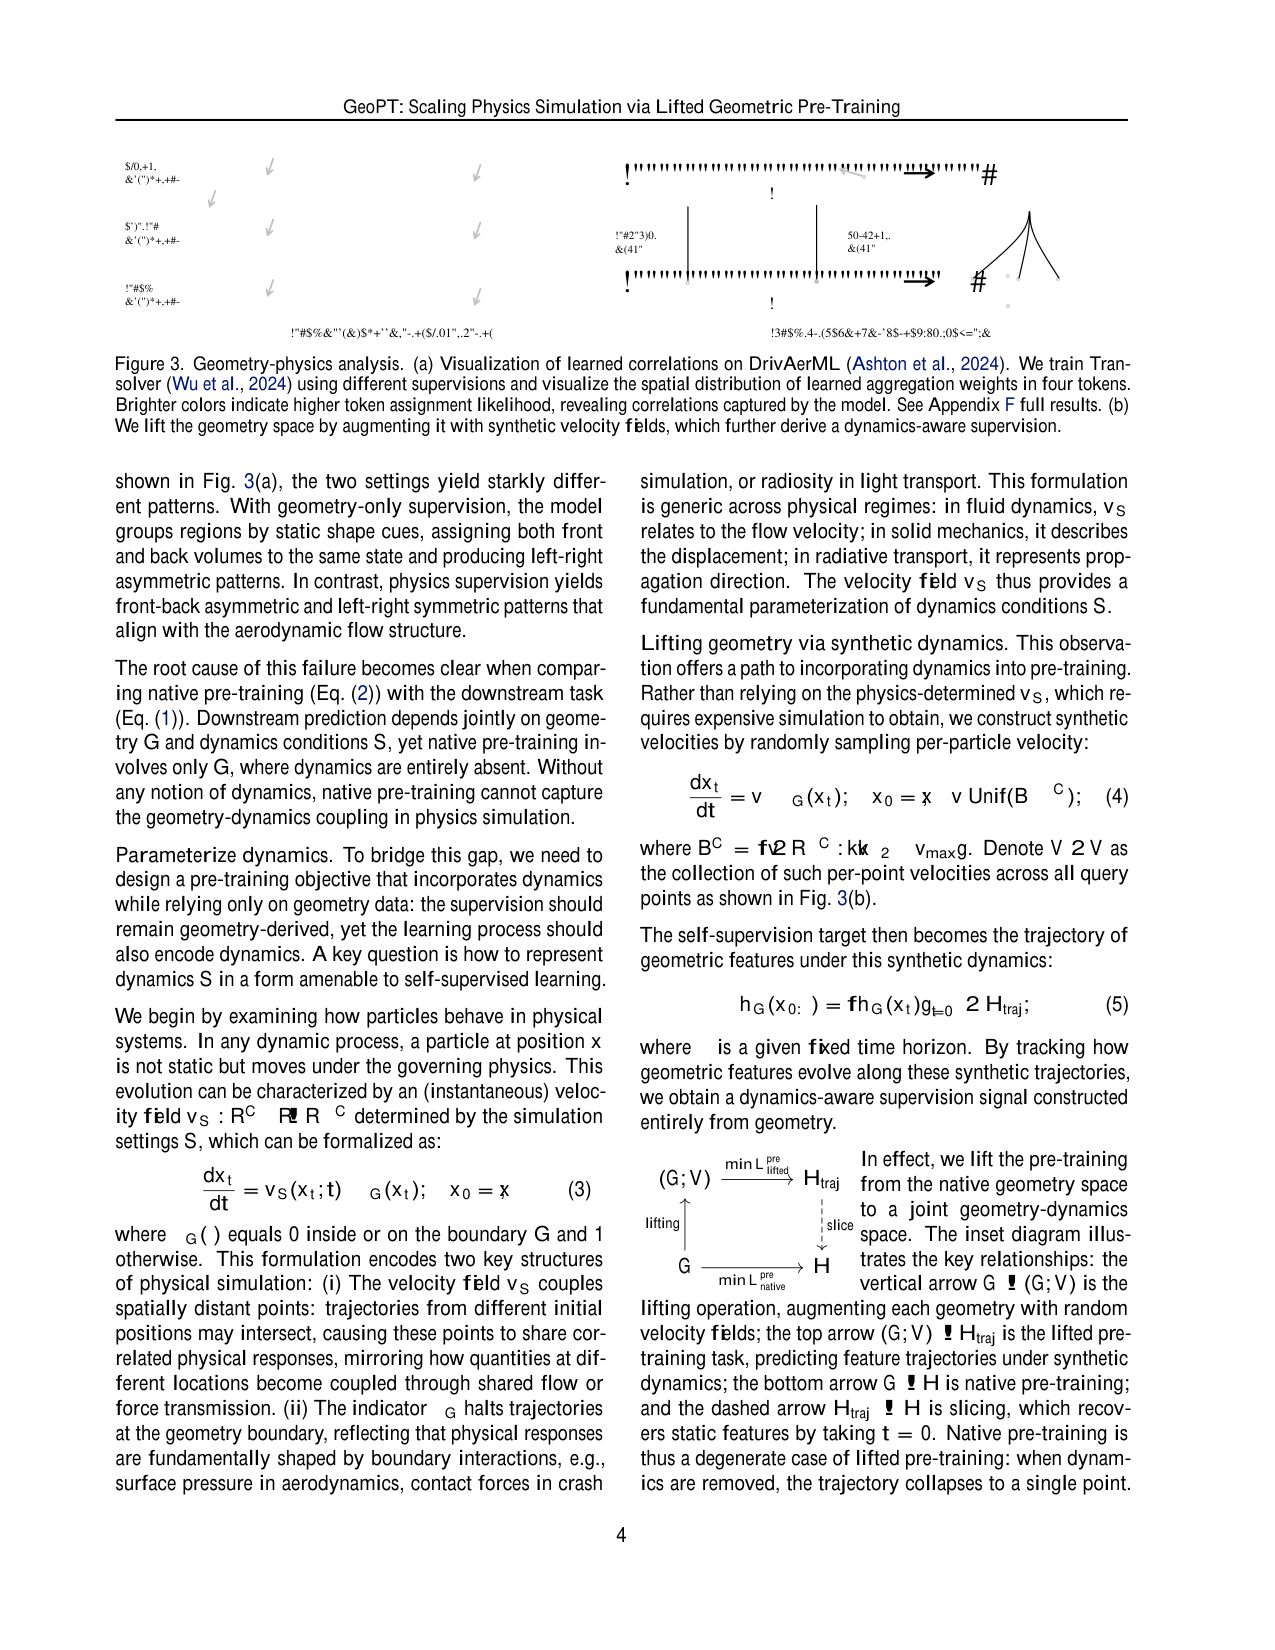
原因藏在学到的相关性里。Figure 3(a) 把两种训练方式学到的聚合权重画出来:几何监督把车头和车尾卷进同一个状态 token、还学出左右不对称的相关性;物理监督学出的是前-后不对称、左右对称、贴合空气动力学流场结构的模式。差别有清晰的来源:下游任务要求几何与动力学的耦合,原生几何预训练的信号里动力学完全缺席,模型只能学到静态几何的相关性,与物理结构对不上。这解释了一个反直觉现象:几何监督「看起来有用」,实际却拖后腿。
方法:把预训练空间「提升」到几何-动力学联合空间
GeoPT 的核心动作,是把预训练的信号空间从静态几何 G 提升(lift)到联合空间 (G, V),其中 V 是逐点速度场。先看物理系统里的粒子怎么动:粒子位置 x 在动力学条件 S 下按瞬时速度场运动,但一碰到几何边界就停下来。写成公式:
$$\frac{dx_t}{dt} = v_S(x_t, t) \cdot \mathbb{1}_G(x_t), \quad x_0 = x$$
这个式子的作用是回答「动力学如何进入预训练信号」。v_S 是仿真设置决定的瞬时速度场;1_G(x_t) 是指示函数,在几何内部或边界上取 0、其余取 1,它把轨迹在边界截停,编码了表面压力、接触力这类边界交互。公式包含物理模拟的两条结构性性质:速度场把空间上远离的点耦合起来(不同初始位置的轨迹会相交、共享相关响应),指示函数让边界决定物理响应。
真实动力学 v_S 要跑仿真才拿得到,预训练不能用。GeoPT 的替代方案:随机采样逐点速度,v 从半径为 v_max 的球里均匀抽取:
$$\frac{dx_t}{dt} = v \cdot \mathbb{1}_G(x_t), \quad v \sim \text{Unif}(\mathcal{B}^C)$$
自监督目标就是几何特征(向量距离)沿这条合成轨迹的演化序列:
$$h_G(x_{0:\tau}) = \{h_G(x_t)\}_{t=0}^{\tau} \in \mathcal{H}^{\text{traj}}$$
τ 是固定时间步数(默认 τ=2,即 3 个时间步)。模型输入 (x, G, V),回归预测未来的向量距离序列,预训练损失:
$$\mathcal{L}^{\text{pre}}_{\text{lifted}} = \mathbb{E}_{x;G;V} \left[ \left\| \hat{F}_\theta(x; G, V) - h_G(x_{0:\tau}) \right\|_2^2 \right]$$
期望遍历三个随机源:几何 G(类别平衡采样)、查询点 x(体积与表面)、逐点速度 v(均匀球)。对同一几何,组合数几乎是无限的,所以 13,463 个形状就能造出 134.6 万条样本。原生几何预训练是这套框架的退化情形:动力学去掉、轨迹缩成一个点,取 t=0 切片并对 V 求期望,正好得到原生监督的模型(论文 Eq.8)。也就是说,静态几何预训练学的只是提升式预训练在动力学方向上的平均值,信息有损。
为什么随机速度场也能教出对真实物理有用的东西?论文给了一个理论解读(Remark 4.1、附录 A):粒子轨迹的系综对应相空间里的无碰撞输运方程 ∂_t f + v·∇_x f = 0,其中 f(x, v, t) 是相空间密度,边界处粒子粘滞(flux (v·n)_+ f 进入边界密度)。这套系统满足质量守恒:粒子总量不变,只是从内部转移到边界。预训练随机遍历各种速度场,等于让模型在所有动力学下都遵守这条守恒律,从而给下游物理学习一个与几何-动力学耦合对齐的起点。论文自己也谨慎说明:这提供的是归纳偏置,不能保证通用泛化(Remark A.3)。
数据生成成本被压得很低:用 FCPW 光线-三角求交加速,单样本(36,864 个跟踪点、τ=2)约 0.2 秒(80 CPU 核),比工业级 CFD 快约 107 倍;全套约 5TB,3 天生成完。
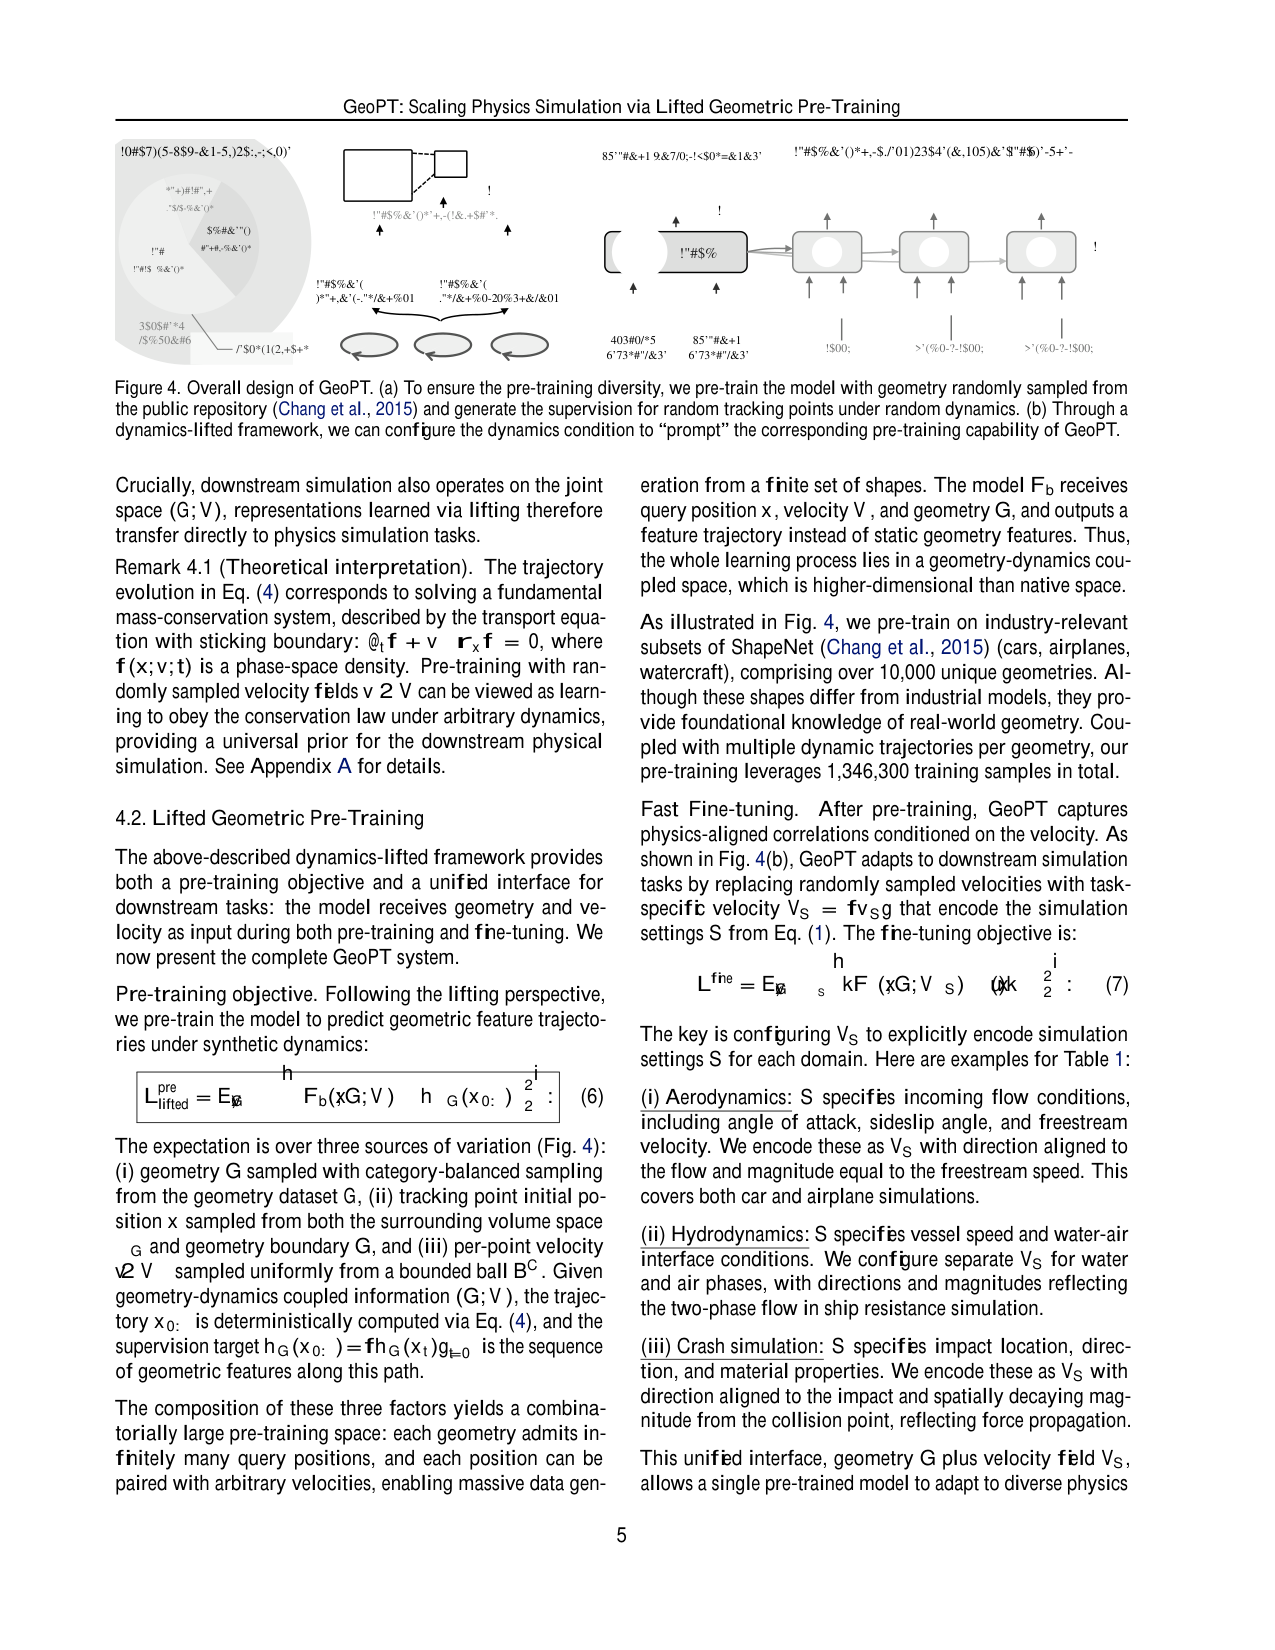
统一接口:动力学条件当「提示键」
预训练和微调共用同一个 (G, V) 输入接口。微调时,把仿真设置 S 参数化为逐点速度场 V_S:方向取来流方向或撞击方向(比如 DTCHull 的偏航角、AirCraft 的攻角和侧滑角、Car-Crash 的撞击角),范数按论文给的 recipe 配置——低速场景(车速/船速低于 100 m/s)取 [0.1, 1.0],高速任务(NASA-CRM、AirCraft)取 [1.0, 2.0];具体实验里低俗场景统一取 0.3,NASA-CRM 归一化到 [1.0, 1.4],AirCraft 到 [1.4, 1.8]。预训练时随机采过各种方向和速度,微调时把 V_S 配到目标设置上,等于检索预训练阶段学到的对应相关性模式:不同方向激活不同相关性(横风下的斜向相关),速度变大相关性更集中,速度为零退化为静态几何。
实验与结果
五个 benchmark 都按工业实践配置:约 100 个训练样本、20–50 个测试样本,全数据全训练设置下比较 relative L2 或 MSE。三个观察:
其一,数据效率。GeoPT 全任务减少 20–60% 标注数据并保持与全量数据训练相当的精度。收益大小和几何多样性相关:DTCHull 船体曲率、长宽比变化大,降幅最高 60%;NASA-CRM 只有内外襟翼角变化,降幅最低。预训练在 AirCraft 这类训练-测试几何差异大的任务上同样成立(Aligned 设置 140 样本:relative L2 0.062,对照 Transolver++ 0.064、GINO 0.133)。
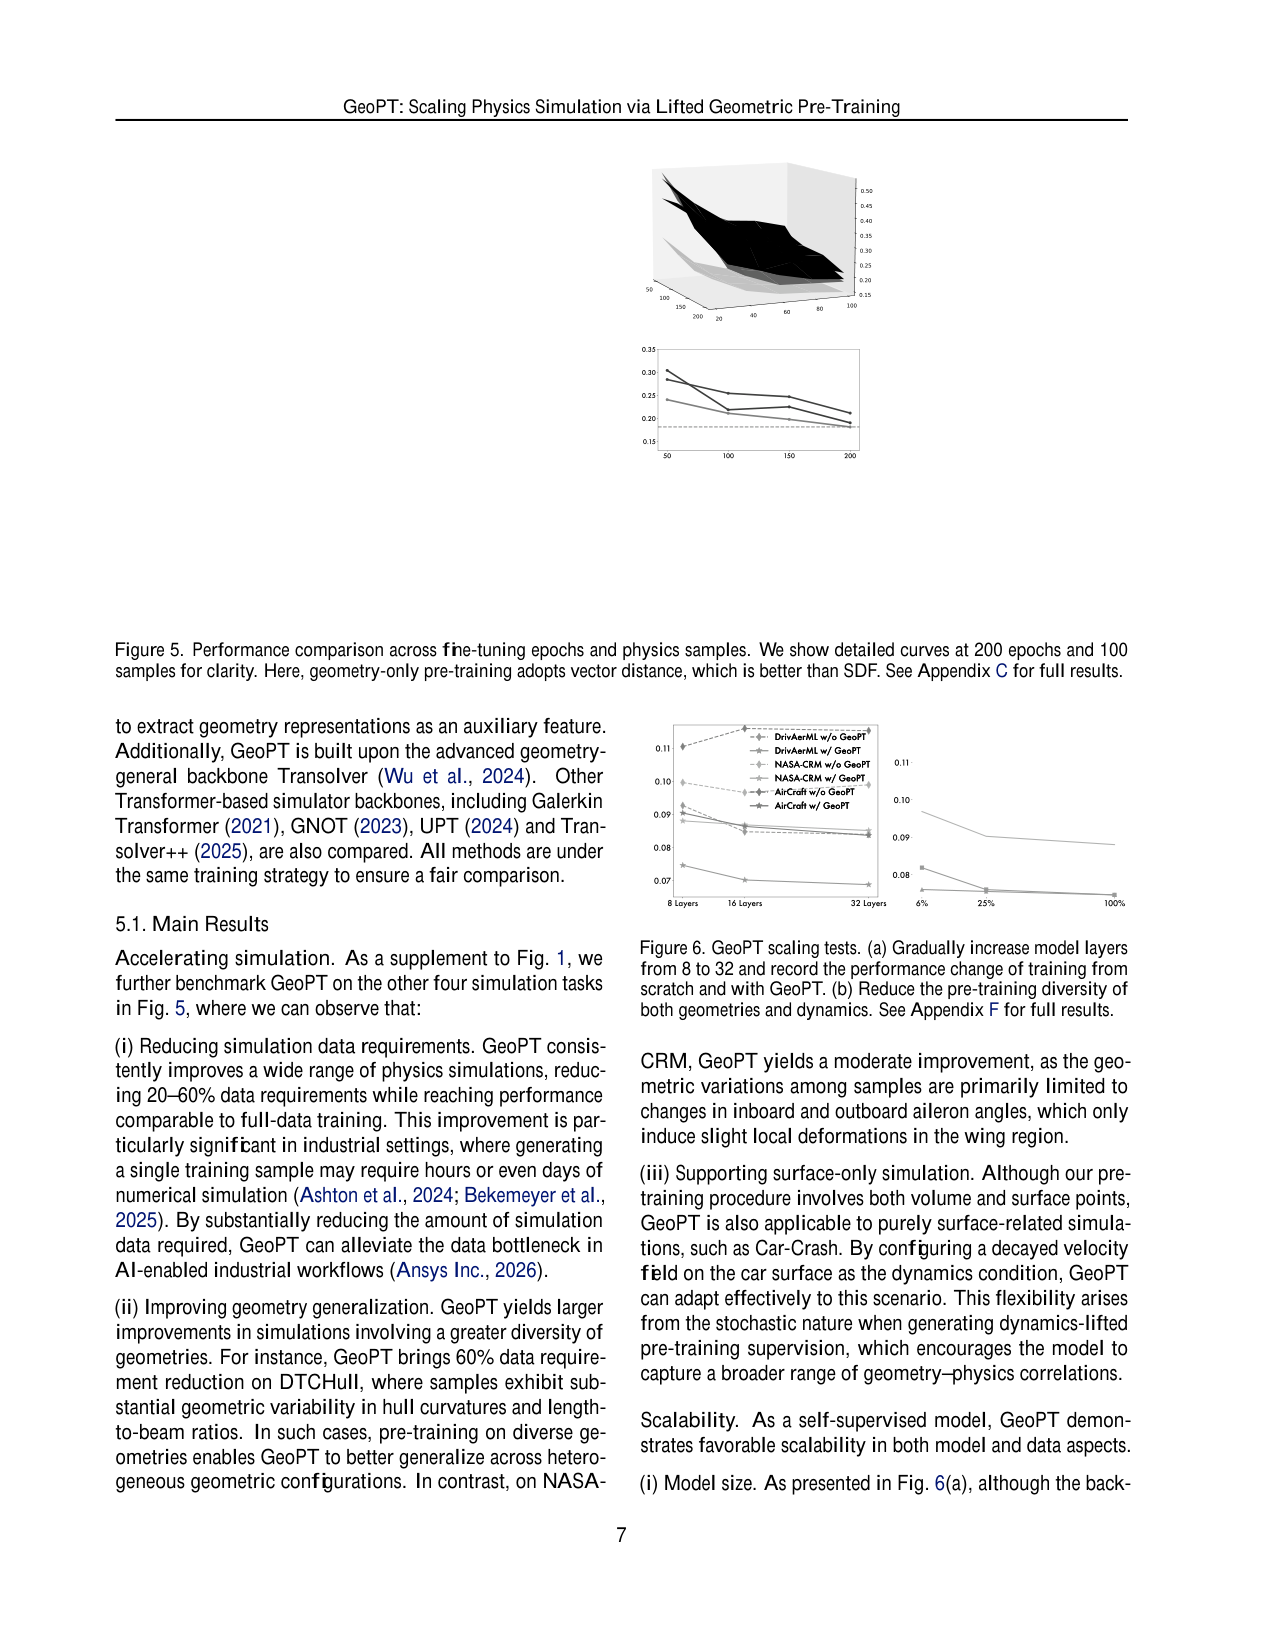
其二,缩放性。Figure 6(a) 和表 6 显示,层数从 8 加到 32,从零训练在部分任务上停滞甚至变差(AirCraft 从零 32 层 relative L2 0.1104→0.1153、Car-Crash 0.1977→0.1905,过拟合),GeoPT 则持续受益(DrivAerML 0.0746→0.0687)。预训练大几何库起到了正则化作用,让扩模型真正换来精度。多样性消融(Fig.6b)说明:几何多样性比动力学轨迹多样性更关键,而动力学多样性的价值依任务而定——DrivAerML 来流固定,6% 的轨迹采样就接近 100% 的效果;AirCraft 速度/攻角/侧滑都在变,动力学多样性越多越好。
其三,跨域泛化。预训练后直接微调到辐射度(光输运)任务:Cornell box、预训练从未见过的 Stanford bunny 几何,160 训练 / 40 测试样本,MAE 9.0×10^-2,对照从零训练 9.7×10^-2,对高频阴影边界的还原更准。把预训练几何库从 ShapeNet 子集扩到 ShapeNet 全量再加 Hunyuan3D 生成的约 30 万几何,下游精度还能再涨(Fig.10)。瞬态 DTCHull(预测下一时刻场)把 V_S 范数缩到稳态的 1/5,relative L2 从 0.06189 降到 0.05402。
谱系定位
GeoPT 处在「神经模拟器」与「自监督预训练」两条线的交叉点。物理基础模型这一路(Poseidon 预训练 2D 流体、DPOT 自回归多物理、Unisolver 用 PDE 条件架构、P3D 做 3D 流体)都还在求解器生成的仿真数据上预训练、且局限于规则网格;GeoPT 把预训练数据源换成 off-the-shelf 几何 + 合成动力学,预训练阶段完全免求解器。离它最近的对照是「几何条件化」路线(Zhang et al. 2026、Hunyuan3D 特征):用冻结的几何编码器当辅助特征接进物理网络,实测帮助有限,因为静态表示不含动力学;GeoPT 直接预训练物理主干本身,消融(Fig.8a)显示预训练主干比加条件特征收益更大。放在世界模型语境里看:视频世界模型已经在靠无标注视频预训练(如 V-JEPA 一脉),GeoPT 把同样的「先自监督预训练、再少量标注适配」逻辑搬进物理仿真,用几何库存当无标注语料,用合成动力学当自监督任务——这是世界模型「预训练化」进程的最新例子。
局限
论文自承的限制有三类。第一,逐点速度场参数化有损:碰撞模拟同时涉及弹性和强度两类材料属性时,压成单一速度值会丢失区分度(作者提出后续用 ControlNet 式零初始化扩输入通道)。第二,方法面向复杂几何的任务设计,规则网格上的 3D 湍流这类没有复杂几何边界的仿真没被覆盖,各向同性动力学没有进入预训练。第三,理论部分(输运方程、质量守恒)是归纳偏置层面的论证,论文明确写不能保证通用泛化。
我们读出来的补充限制:其一,「合成动力学学到的东西具体靠哪些成分迁移到真实物理」缺少定量归因,Fig.3/7 的相关性可视化是定性的;其二,微调要小心配置 V_S,方向偏移 0–40° 会掉精度、高速任务更敏感,范数 recipe 仍属需要调的超参;其三,部分任务收益有限(radiosity MAE 9.0 vs 9.7×10^-2,相对改善约 7%),AirCraft 微调过程仍不稳定;其四,预训练数据默认只来自 ShapeNet 三个类别 1.35 万个几何,工业级几何多样性上限未测,且预训练本身要 5TB 存储和约 3 天 CPU 生成。
复现要点
官方代码仓库在 github.com/Physics-Scaling/GeoPT(Transolver 主干 + 数据管线)。预训练 200 epoch、AdamW lr 1e-3 + cosine、batch 8/24/20(base/large/huge)、A100 40GB 上 144/360/576 GPU 小时;微调 200 epoch、AdamW lr 1e-3 + OneCycleLR、batch 1、relative L2。数据配置:τ=2、v_max=2、每几何 100 个动力学场、32,768 体积点 + 4,096 表面点。主要结论有 5 次运行的标准差和 95% 置信区间支撑(等价边界 0.001)。
神经模拟器一直靠数值求解器生成标注(DrivAerML 单样本约 6.1×10^4 CPU 小时),而纯几何自监督(预测 SDF/向量距离)在物理任务上反而负迁移。GeoPT 把每个几何配上一组随机速度场和边界粘滞轨迹,用「几何特征沿合成动力学轨迹的演化」做自监督,把预训练空间从静态几何提升到几何-动力学联合空间;在 ShapeNet 三个子集 1.35 万个几何上生成 134.6 万条免求解器样本(约 5TB),预训练 Transolver 主干,在汽车/飞机空气动力学、船舶水动力、碰撞五个工业级 benchmark 上减少 20–60% 标注数据、收敛最高加速 2×,并能迁移到没见过的辐射度(radiosity)模拟。
阅读提示
精读深度:泛读
清单提示:原文提示:几何预训练→物理模拟;世界模型「预训练化」的最新例。播客覆盖:为什么纯几何预训练会负迁移;如何用合成动力学把预训练空间从静态几何提升(lift)到几何-动力学联合空间;百万级免求解器预训练数据与 5 个工业级 benchmark 的收益;与 Poseidon/DPOT/Unisolver 等物理基础模型的区别。
问题
要解决什么:神经模拟器(用一次前向代替昂贵数值求解的代理模型)的扩展被标注生成卡住:每个训练样本都要完整跑一次 CFD/CSM 数值求解,成本随几何与物理复杂度急剧上升,工业级样本动辄上万 CPU 小时。论文想复制视觉/语言「海量无标注自监督预训练 + 少量标注微调」的路线,让模拟器只靠取之不尽的三维几何(ShapeNet 这类公开几何库)做预训练,再在少量物理标注上微调。
为什么 prior work 不够:直接把视觉的自监督搬到几何上会失败:在 DrivAerML 空气动力学上,用静态几何监督(预测 SDF 或向量距离)预训练再微调,精度明显差于从零训练(负迁移,论文 Fig.1)。论文用 Transolver 学到的聚合权重可视化定位原因(Fig.3a):几何监督把车头和车尾卷进同一个 token、学出左右不对称的相关性;物理监督学出的是前-后不对称、左右对称、与流场结构一致的相关性。下游任务要求几何 G 与动力学条件 S 的耦合,而原生几何预训练只有 G,动力学完全缺失,这就是负迁移的根源。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 查询点位置 x | 3D 坐标向量(体积点或表面点) | 每样本 32,768 个体积点 + 4,096 个表面点,从几何包围盒和表面采样,剔除落在几何内部的点。 |
| 逐点速度场 V | 3D 向量场(每点一个速度向量) | 预训练时 v~Unif(B^C),B^C 是半径 v_max=2 的球;微调时换成仿真设置参数化的 V_S(方向取来流/撞击方向,范数按速度 recipe)。 |
| 几何 G | 网格(mesh),归一化到 x 轴长度 5、统一朝向 | 预训练来自 ShapeNet-V1 汽车/飞机/船舶子集;下游是工业级网格(DrivAerML 约 1.6 亿网格点)。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 几何特征轨迹 h_G(x_{0:τ}) | τ+1 个向量距离值(逐时间步) | 预训练输出:查询点在未来 τ 步的向量距离序列(默认 τ=2,即 3 个时间步);微调时替换为物理量场(压力、速度、应力等)。 |
| 物理量场 u(x) | 逐点标量/向量场 | 下游输出:表面压力系数、周围流场速度、船体阻力和兴波、最大二维 Von Mises 应力等。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ShapeNet-V1 汽车/飞机/船舶子集(预训练) | 13,463 个几何(7,479 车 + 4,045 飞机 + 1,939 船) | 每几何 100 个随机动力学场 × 36,864 个跟踪点 × τ=2 → 1,346,300 条样本(约 5TB);80 CPU 核约 3 天生成完。附录消融:ShapeNet-V2(9,515 个,质量更高但多样性低)效果反而差。 |
| ShapeNet 全量 / ShapeNet+Hunyuan3D(扩展预训练) | 约 5 万 / 约 30 万几何 | Fig.10:扩大多样性进一步提升下游精度,尤其是 AirCraft 这类少见光滑几何。 |
| DrivAerML(空气动力学,汽车) | 约 160M 网格点/样本,约 6TB | RANS 高保真;表面压力 + 周围风速;每个样本 CFD 成本约 6.1×10^4 CPU 小时。 |
| NASA-CRM(空气动力学,客机) | 约 450K 网格点,约 3GB | 几何 + 速度 + 攻角(AOA)变化。 |
| AirCraft(空气动力学,飞行器) | 约 330K 网格点,约 7GB | 几何 + 速度 + 攻角 + 侧滑角变化;训练-测试几何分布差异大,最具挑战。 |
| DTCHull(船舶水动力) | 约 240K 网格点,约 2GB | OpenFOAM RANS 生成;几何参数化 + 偏航角;预测时均表面压力和水流速度;另有瞬态版本。 |
| Car-Crash(碰撞,固体力学) | 约 1M 网格点,约 8GB | OpenRadioss 模拟;不同撞击角;记录各单元最大二维 Von Mises 应力;表面速度场用线性衰减配置。 |
| Cornell box 辐射度(泛化验证) | 160 训练 / 40 测试样本 | 光输运问题,预训练完全没见过;测试用未见于预训练的 Stanford bunny 几何;动力学条件参数化为光传播方向。 |
架构(摘要)
主干与结构
backbone:Transolver(Transformer 神经模拟器,学习潜在物理状态 token)
参数:base 8 层 3M;large 16 层 7M;huge 32 层 15M(均 256 隐藏通道、32 个状态 token)
类型:预训练范式(方法不绑定结构):在 (G, V) 联合空间做免物理标签自监督,再按任务微调;主干可为任意 Transformer 神经模拟器
关键组件
- 动力学提升(lifting):几何 + 随机逐点速度场 → 边界粘滞轨迹 x_t = x + t·v·1_G(x),1_G 在几何内部/边界为 0
- 监督目标:几何特征(向量距离)沿轨迹的序列 h_G(x_{0:τ}),默认 τ=2(3 步),回归用 L2
- 统一接口:预训练与微调同用 (G, V) 输入;微调把仿真设置 S 参数化为逐点速度场 V_S(方向 = 来流/撞击方向,范数按低速 [0.1,1.0]/高速 [1.0,2.0] recipe)
- 数据管线:FCPW 光线-三角求交加速,单样本约 0.2 秒(80 CPU 核),比工业级 CFD 快约 107 倍
- 质量守恒先验:随机速度场遍历 = 在相空间输运方程 ∂_t f + v·∇_x f = 0 下学习遵守质量守恒(附录 A)
为什么这样设计
物理模拟的解场由几何与动力学共同决定,自监督信号必须同时包含两者。真实动力学 v_S 要仿真才拿得到,于是用随机速度场代替:它保留了物理的两条结构性性质(跨点耦合、边界交互),又完全免求解器。参数化为逐点速度场让预训练和微调共享同一个接口,动力学条件 V 相当于检索键,配置不同的 V_S 就能『提示』出预训练时对应的相关性模式。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 标注数据需求降幅(5 个 benchmark 汇总) | 20–60%,且达到全量数据训练相当的精度 | 对比对象:Transolver 从零训练 + 100% 标注数据(论文 Fig.1/5) | 每 benchmark 约 100 个训练样本、20–50 个测试样本;DTCHull 几何多样性强,降幅最高 60%;NASA-CRM 只变襟翼角,降幅最低 |
| 收敛加速 | 最高 2×(同样本量下提前到达从零训练的最终精度) | Transolver 从零训练 200 epoch | 5 个 benchmark,微调 200 epoch、batch 1、relative L2 损失;曲线见 Fig.5,逐任务加速幅度不同 |
| Aligned 设置:DrivAerML 表面压力 MSE(归一化) | 0.003370(GeoPT) | Transolver 自实现 0.004223;GAOT(2025) 0.051729;GINO(2023B) 0.088124 | 450 个训练样本(附录表 5a),数值直接来自 GAOT/论文 |
| Aligned 设置:NASA-CRM 压力 MSE(归一化) | 0.010722(GeoPT) | Transolver 自实现 0.011246;GAOT(2025) 0.077170;GINO(2023B) 0.105688 | 105 个训练样本(附录表 5b) |
| Aligned 设置:AirCraft 气动系数 relative L2 | 0.062(GeoPT) | Transolver++(2025) 0.064;Transolver 自实现 0.083;GINO(2023B) 0.133 | 140 个训练样本(附录表 5c) |
| 模型规模扩展(DrivAerML relative L2,8→32 层) | GeoPT:0.0746 → 0.0687,越深越好 | 从零训练:0.0927 → 0.0839(16 层后停滞);AirCraft 从零训练 32 层反而变差(0.1104→0.1153),Car-Crash 同样(0.1977→0.1905) | Transolver backbone,base/large/huge(3M/7M/15M 参数),全数据全训练(表 6) |
| 预训练数据生成成本 | 单样本约 0.2 秒(80 CPU 核),全套约 5TB、3 天 | 对照:DrivAerML 单个工业级 CFD 样本约 6.1×10^4 CPU 小时 | FCPW 光线-三角求交;36,864 跟踪点/样本、τ=2、每几何 100 个动力学场 |
| 辐射度(radiosity)跨域泛化 MAE | 9.0×10^-2(GeoPT) | 从零训练 9.7×10^-2 | Cornell box + 未见过的 Stanford bunny 几何;160 训练 / 40 测试样本(附录 E.1);动力学条件参数化为光传播方向 |
| 瞬态(time-dependent)DTCHull relative L2 | 0.05402(GeoPT) | 从零训练 0.06189 | 全数据全训练;V_S 范数取稳态配置的 1/5(附录表 4a) |
Insights
- 原生几何预训练是提升式预训练的退化情形:取 t=0 切片并关于 V 求期望,Eq.(8) 给出 E_V[F*_lifted(x;G,V)] = F*_native(x;G)——静态监督只能学几何-几何相关性,学不到几何-动力学耦合,这就是 Fig.1 负迁移的理论对应(第 4.2 节 Remark 4.2)。
- 随机合成动力学就能把『动力学』装进自监督:不需要任何物理标签或求解器,靠随机速度场 + 边界粘滞轨迹 + 几何特征序列,一个有限几何库就能生成 134.6 万条多样样本;多样性主要来自几何本身,而动力学轨迹多样性是任务相关的(Fig.6b)。
- 动力学条件 V 是检索键:同一套预训练参数,配置不同 V_S(方向/速度)会激活不同的相关性模式(Fig.7c 跨风/高速集中/零速退化为静态),微调时按仿真设置『提示』对应能力,形成统一接口。
- 预训练的收益随模型变大而变大:Table 6 中从零训练在 32 层时 AirCraft/Car-Crash 反而变差(过拟合),GeoPT 预训练起到正则化作用,让扩大模型持续带来增益。
vs 同类工作
- vs Poseidon / DPOT / Unisolver / P3D(物理基础模型):这些工作仍在求解器生成的仿真数据上预训练,局限于规则网格和特定物理族,扩展仍需昂贵仿真;GeoPT 的预训练完全免求解器,只用 off-the-shelf 几何 + 合成动力学(第 2.1 节)。
- vs Zhang et al. 2026(From cheap geometry to expensive physics)与 Hunyuan3D 几何条件化:它们把预训练几何编码器当冻结辅助特征接入物理网络,不缩放物理主干、表示仍是静态的;GeoPT 直接预训练物理主干本身,且消融显示预训练主干比加条件特征收益大(Fig.8a)。
- vs 原生几何自监督(SDF / vector distance):实测负迁移(DrivAerML 精度下降),说明静态几何监督的信号空间与下游任务错位;GeoPT 通过提升空间修复这一错位(Fig.1、Eq.2 vs Eq.6)。
- vs MAE / SimCLR 等通用自监督:它们把学习限制在预训练数据的本征空间(输入信息不超出预训练数据);GeoPT 面临下游空间严格比预训练数据空间『更丰富』的情况,用 lifting 主动扩展监督空间来弥合(第 2.2 节)。
局限
- 动力学参数化有损:把所有仿真设置压成逐点速度场,无法精确刻画所有物理设置;论文自承碰撞模拟同时涉及弹性和强度两类材料属性时,压成单一速度值会因降维丢失区分度(附录 G,作者提出后续可用 ControlNet 式零初始化扩通道)。
- 覆盖范围偏『复杂几何』任务:对无复杂几何边界的仿真(如规则网格上的 3D 湍流)没有覆盖,各向同性/无边界动力学没有进入预训练(附录 G 自承)。
- 『合成动力学迁移到真实物理』的证据以定性为主:Fig.3/Fig.7 的相关性可视化说明模式对上了,但缺少定量归因实验说明『合成轨迹里学到的东西』具体是哪些成分在迁移;理论部分(输运方程 + 质量守恒,附录 A)的 Remark A.3 自己也写明这只提供归纳偏置、不能保证通用泛化。
- 微调依赖仔细配置 V_S:方向偏移 0–40° 会掉精度,高速任务(NASA-CRM/AirCraft)对方向错配更敏感(Fig.13);范数虽有 recipe(低速 [0.1,1.0]、高速 [1.0,2.0]),仍属于需要按任务调的超参,不同配置下收益幅度可能收窄。
- 部分任务收益幅度有限:radiosity MAE 9.0 vs 9.7×10^-2,相对改善约 7%;AirCraft 这类训练-测试几何差异大的任务微调过程仍不稳定(Fig.15c,10× 小学习率也无法完全压平)。
- 预训练数据仍有限制:默认只用 ShapeNet 三个类别 1.35 万个几何,虽然扩展实验(ShapeNet 全量 + Hunyuan3D 生成几何到约 30 万)有效,但工业级几何的多样性上限未测;且预训练监督是合成的向量距离轨迹,与真实物理场之间存在 gap,预训练本身也要 5TB 存储与约 3 天 CPU 生成。
可复现性
- code:https://github.com/Physics-Scaling/GeoPT(论文给出)
- weights:论文未明确说明是否发布预训练权重(截至本卡阅读时)
- setup:A100 40GB;预训练 200 epoch、AdamW lr 1e-3 + cosine、warmup 10 epoch、batch 8/24/20(B/L/H)、GPU 小时 144/360/576;微调 200 epoch、AdamW lr 1e-3 + OneCycleLR、batch 1、relative L2、GPU 小时 3/6/10;自监督数据配置见附录表 3a(τ=2、v_max=2、每几何 100 动力学场、32,768 体积点 + 4,096 表面点);统计检验:5 次运行标准差(表 7),数据节省声明由 95% 置信区间支撑(等价边界 0.001)
主干与结构
backbone:Transolver(Transformer 神经模拟器,学习潜在物理状态 token)
参数:base 8 层 3M;large 16 层 7M;huge 32 层 15M(均 256 隐藏通道、32 个状态 token)
类型:预训练范式(方法不绑定结构):在 (G, V) 联合空间做免物理标签自监督,再按任务微调;主干可为任意 Transformer 神经模拟器
关键组件
- 动力学提升(lifting):几何 + 随机逐点速度场 → 边界粘滞轨迹 x_t = x + t·v·1_G(x),1_G 在几何内部/边界为 0
- 监督目标:几何特征(向量距离)沿轨迹的序列 h_G(x_{0:τ}),默认 τ=2(3 步),回归用 L2
- 统一接口:预训练与微调同用 (G, V) 输入;微调把仿真设置 S 参数化为逐点速度场 V_S(方向 = 来流/撞击方向,范数按低速 [0.1,1.0]/高速 [1.0,2.0] recipe)
- 数据管线:FCPW 光线-三角求交加速,单样本约 0.2 秒(80 CPU 核),比工业级 CFD 快约 107 倍
- 质量守恒先验:随机速度场遍历 = 在相空间输运方程 ∂_t f + v·∇_x f = 0 下学习遵守质量守恒(附录 A)
为什么这样设计
物理模拟的解场由几何与动力学共同决定,自监督信号必须同时包含两者。真实动力学 v_S 要仿真才拿得到,于是用随机速度场代替:它保留了物理的两条结构性性质(跨点耦合、边界交互),又完全免求解器。参数化为逐点速度场让预训练和微调共享同一个接口,动力学条件 V 相当于检索键,配置不同的 V_S 就能『提示』出预训练时对应的相关性模式。
几何-物理分析:原生几何监督为什么负迁移
原文 caption:Geometry-physics analysis. (a) Visualization of learned correlations on DrivAerML. We train Transolver using different supervisions and visualize the spatial distribution of learned aggregation weights in four tokens. Brighter colors indicate higher token assignment likelihood. (b) We lift the geometry space by augmenting it with synthetic velocity fields, which further derive a dynamics-aware supervision.
(a) 用三种监督各训一个 Transolver,看学到的聚合权重分布:几何监督把车头车尾分到同一 token 且左右不对称,物理监督则前-后不对称、左右对称、贴合流场结构——直观说明静态几何监督学不到几何-动力学耦合,这是 Fig.1 负迁移的成因。(b) 提出解法:给几何叠上随机合成速度场,监督目标变成几何特征沿动力学轨迹的演化。这张图支撑全文最核心的论断『动力学缺失导致负迁移,合成动力学可以补齐』。
GeoPT 整体设计:预训练多样性 + 动力学提示
原文 caption:Overall design of GeoPT. (a) To ensure the pre-training diversity, we pre-train the model with geometry randomly sampled from the public repository and generate the supervision for random tracking points under random dynamics. (b) Through a dynamics-lifted framework, we can configure the dynamics condition to 'prompt' the corresponding pre-training capability of GeoPT.
(a) 预训练数据怎么造:随机取几何 + 随机取跟踪点 + 随机速度场,三层随机叠出百万级多样样本。(b) 统一接口怎么用:预训练和微调都吃 (G, V),下游把仿真设置塞进 V_S,等于用动力学条件『提示』预训练阶段学到的对应能力。这是理解 GeoPT 方法全貌的入口图,配合 Eq.(4)-(6) 看。
主结果:微调轮数与样本量下的精度曲线
原文 caption:Performance comparison across fine-tuning epochs and physics samples. We show detailed curves at 200 epochs and 100 samples for clarity. Here, geometry-only pre-training adopts vector distance, which is better than SDF. See Appendix C for full results.
四个 benchmark(NASA-CRM/AirCraft/DTCHull/Car-Crash)上,GeoPT(红)、从零训练(黑)、纯几何预训练(蓝)的精度随微调 epoch 和样本量变化的曲线:GeoPT 在同 epoch 更早收敛、同精度用更少样本,几何预训练明显掉队。图下方同一页还有 Fig.6 缩放实验(层数 8→32 与预训练多样性消融)。泛读观众看这张图就能抓住『预训练到底带来多少收益』。
🎧 音频版
时长 21:46 · Edge TTS
GeoPT:给物理模拟做「免标注」的预训练(对话版·泛读)
先讲清楚这篇要解决什么问题
小播:欢迎回来。今天这篇是《GeoPT: Scaling Physics Simulation via Lifted Geometric Pre-Training》,ICML 2026 的论文,来自 MIT CSAIL 和清华,共同一作是吴海旭和郭铭昊,作者名单里有何恺明。老规矩,先给一句话定位:它要解决什么问题,为什么值得做一期?
老播:一句话背景:现在做物理模拟,主力手段是神经模拟器——用神经网络的一次前向代替传统数值求解器,跑得极快,但训练它需要海量带标注数据,而每一份标注都要完整跑一次仿真,贵得吓人。论文给的例子:DrivAerML 这个汽车空气动力学数据集,生成单个工业级样本大约要 6.1×10^4 个 CPU 小时。GeoPT 的做法,是学视觉和语言那套「海量无标注自监督预训练 + 少量标注微调」的配方,只靠公开的三维几何模型和随机生成的速度场做预训练,全程不碰求解器。一句话结论:在汽车、客机、飞行器空气动力学、船舶水动力、汽车碰撞五个工业级任务上,它能减少 20% 到 60% 的标注数据、收敛最高加速 2 倍,还能迁移到预训练完全没见过的光线模拟。今天这期把三件事讲透:为什么纯几何预训练会翻车、随机合成动力学怎么把「动力学」装进自监督信号、以及这为什么是世界模型「预训练化」的最新例子。
小播:三个问题我记下了。先说第一个吧,几何预训练为什么会翻车?听起来几何和物理应该挺有关系。
先补背景:模拟器的扩展为什么被标注卡住
老播:先把概念对齐。神经模拟器这个词的意思:传统做法是拿计算流体力学、固体力学这类数值求解器,对一个几何模型算出压力场、流场、应力场,一算就是几小时甚至几天;神经模拟器学一个函数,输入几何和仿真设置,直接输出这些物理量,推理只要一次前向。它的价值在做迭代设计——工程师改一次汽车外形,就要重新算一遍风阻,神经网络能把这份账单省下来。但训练它需要标注,标注就是求解器的输出,每一个样本都是完整仿真的账单。
小播:那到底贵到什么程度?除了 CPU 小时,还有别的维度吗?
老播:贵在几何和物理复杂度一起涨。网格越密、物理越精细,求解时间涨得越快;工业级样本还要长时间收敛。论文给了一个具体参照:DrivAerML 单样本约 6.1×10^4 CPU 小时,这还只是空气动力学一个数据集。数据集规模上,DrivAerML 全套约 6TB,NASA-CRM 约 3GB,AirCraft 约 7GB,Car-Crash 约 8GB——每一份都是仿真时间堆出来的。所以「扩展神经模拟器」这件事,瓶颈在造标注,造标注的瓶颈在求解器,这条路越走越贵。
小播:那视觉和语言是怎么绕开这个瓶颈的?我记得它们也是先有大量数据才有大模型。
老播:视觉和语言靠自监督预训练。拿 MAE 来说,它把图片随机遮一块、让模型补全,全程不需要人标;拿 GPT 系列来说,预测下一个 token 就是监督信号。这类方法的前提是原始数据本身量大又便宜。物理模拟这边,解法场贵,但几何模型便宜——ShapeNet 这类公开三维模型库有几万个现成形状,零标注。顺理成章的想法:先拿几何做自监督预训练,再在少量物理标注上微调,省掉大部分仿真钱。三维几何的自监督之前也有人做过,像 Point-BERT 用掩码重建,但那是为了几何理解本身,做完就停了,没有接着往物理任务上接。
小播:这个思路听着很自然,为什么论文说它不行?
老播:因为物理解场由几何和动力学两件事共同决定:几何划定空间区域和边界,动力学决定系统怎么被驱动,比如来流速度、攻角、撞击角。纯几何预训练只见过静态形状,信号里完全没有动力学。论文做了个直接实验:用预测「点到曲面的向量距离」这种几何监督预训练 Transolver,再到 DrivAerML 上微调,精度比从头训练还差,出现负迁移。它还把两种训练学到的聚合权重画了出来:几何监督把车头和车尾卷进同一个状态 token、学出左右不对称的相关性;物理监督学出的模式前-后不对称、左右对称、贴合流场结构。两组可视化放在一起看,原因就清楚了——模型学到的「相关性」和真实物理结构对不上。这里先记住第一个核心结论:几何预训练会负迁移,根源是动力学缺失——这个结论后面我们还会从机制上再确认一遍。
核心思想:把预训练空间「提升」到几何加动力学的联合空间
小播:先停一下,Transolver 是什么?
老播:一个 Transformer 结构的神经模拟器,它不直接对网格点做注意力,而是把成千上万的网格点聚合成几十个「物理状态」token,再做全局交互,处理不规则几何比较强。GeoPT 拿它当主干,但方法本身不挑结构,实验里换到别的 Transformer 求解器上也成立。
小播:好,回到正题。负迁移的原因找到了,那怎么把动力学装进预训练?又没有真实物理标签。
老播:这是全文最核心的一步,叫「提升」——英文 lifted。物理系统的粒子怎么动?位置 x 随时间按速度场运动,但一旦碰到几何边界就停下来、粘在边界上。把这句话写成公式:
$$\frac{dx_t}{dt} = v_S(x_t, t) \cdot \mathbb{1}_G(x_t), \quad x_0 = x$$
先给预期:这个式子回答「动力学怎么进入预训练信号」。左边 dx_t/dt 是粒子在时刻 t 的瞬时速度;右边 v_S 是仿真设置决定的瞬时速度场,下标 S 表示它由来流、撞击角这些条件决定;1_G 是指示函数,在几何内部或边界上取 0、在外面取 1,它把轨迹在边界处截停,对应表面压力、接触力这类边界交互。这个式子里藏着物理模拟的两条结构性性质:速度场会把空间上离得很远的点耦合起来——不同起点出发的轨迹可能相交,于是这些位置共享相关的物理响应;边界指示函数让几何决定物理响应在哪里停。
小播:明白了,这是真实物理的速度场。可预训练拿不到它,怎么换成合成的?
老播:换成随机速度。真实 v_S 要跑仿真才知道,GeoPT 直接对每个查询点从半径为 v_max 的球里均匀抽一个速度向量,轨迹就变成自由飞行加边界粘滞:先沿直线飞,撞到几何就停下。自监督目标变成几何特征沿这条合成轨迹的演化序列——每个时间步算一次该点到曲面的向量距离,把 3 个时间步的距离序列当预测目标,默认把轨迹切成 3 步来离散。向量距离这个词先解释一下:它指查询点到几何表面的最近距离向量,带方向信息,比如在车头外侧和车尾外侧,指向会相反;论文专门和符号距离函数做了对照,向量距离信息更全、预训练效果更好。轨迹步数也消融过:只取 1 步就退化成静态几何、没有收益,取 2 步效果最好,再多步数收益不再增加、离散误差反而累积。训练损失就是回归这个序列,期望遍历三个随机源:随机几何、随机查询点、随机速度场。查询点也分两类,从几何包围盒里采体积点、从表面上采表面点,预训练两种都见。
小播:随机速度场和真实物理差得那么远,凭什么学到的东西能用?这一点是我最怀疑的。
老播:论文给了两层回答。第一层是结构:随机速度虽然乱,但保留了真实物理那两条性质——速度场耦合远点、边界截停轨迹。第二层是理论:把大量粒子的轨迹放进相空间看,这套动力学对应无碰撞输运方程,速度场随便怎么采,粒子总数都守恒,只从空间内部往边界转移。预训练随机遍历各种速度场,等于让模型在所有动力学下遵守同一条质量守恒律,这给下游物理学习提供了一个和几何-动力学耦合对齐的起点。再补一个对称性的观察:原生几何预训练其实是这套框架的退化情形——把动力学去掉、轨迹缩成一个点,取 t=0 并对速度场求期望,正好得到原生监督学的东西。换个角度说,静态几何预训练学的只是提升式预训练在动力学方向上的平均值,信息被平均掉了,所以它翻车。这是第二个核心结论:提升空间之后,动力学以自监督的形式进了预训练,原生几何预训练只是它的一个切片。
小播:那造数据贵不贵?预训练得先算这么多轨迹吧。
老播:这是另一个卖点:便宜。用光线-三角形求交加速,单条样本大约 0.2 秒就能算完,80 个 CPU 核三天能生成全套 134.6 万条样本、约 5TB 数据,成本比跑一次工业级 CFD 低约 107 倍。拿这个数和开头那个对照:6.1×10^4 CPU 小时是求解器一条样本的价钱,0.2 秒是预训练一条样本的价钱,差两个数量级以上。几何库本身有限,但同一几何可以配无穷多种速度场和查询点,多样性是组合出来的,论文专门消融过:预训练多样性主要靠几何撑起来,轨迹数量次要。
小播:那预训练和微调怎么衔接?学的东西怎么用到具体任务上?
老播:靠同一个输入接口。预训练和微调都吃「几何加逐点速度场」。微调时把仿真设置参数化成速度场 V_S:方向直接取来流方向或撞击方向,比如 DTCHull 的偏航角、AirCraft 的攻角和侧滑角、Car-Crash 的撞击角;范数按论文给的配方——低速场景取 0.1 到 1.0,高速场景取 1.0 到 2.0,具体实验里低速统一取 0.3,NASA-CRM 归一化到 1.0 到 1.4,AirCraft 到 1.4 到 1.8。配置好 V_S,等于用动力学条件当「提示键」,检索预训练阶段学过的对应相关性:换个风向,模型激活横风下的斜向相关;速度变大,相关性更集中;速度设成零,就退化成静态几何。这样预训练的一身能力,靠一个速度场就能按需调出来。
关键实验:数据、缩放、迁移各看到了什么
小播:好,机制讲完了。现在看数字,先从最重要的数据效率开始。
老播:五个任务统一按工业实践配置:每个约 100 个训练样本、20 到 50 个测试样本。结果论文总结为减少 20% 到 60% 的标注数据,同时达到全量数据训练的精度。收益大小和几何多样性直接挂钩:DTCHull 船体,曲率和长宽比变化很大,降幅最高、到 60%;NASA-CRM 客机,样本间只差内外襟翼角,降幅最低。这组数字的意思是:预训练对「几何花样多」的任务最值钱,几何本来就很单调的任务,预训练帮不上太多。
小播:那它和最强基线比呢?有没有对等设置下的直接对比?
老播:附录里给了对等设置。DrivAerML 表面压力,450 个训练样本,GeoPT 的归一化 MSE 是 0.003370;同样自己实现的 Transolver 从零训练是 0.004223;之前的最强基线 GAOT 是 0.051729。NASA-CRM 用 105 个样本,GeoPT 是 0.010722,Transolver 从零是 0.011246,GAOT 是 0.077170。AirCraft 用 140 个样本,GeoPT 的 relative L2 是 0.062,Transolver++ 是 0.064。注意这个对比的含义:GeoPT 的收益在和同架构从零训练比时是几成到一倍左右的误差下降,和上一代方法比是数量级的差距——上一代方法的差距主要来自骨干网络本身,GeoPT 是在最强骨干上再叠加预训练的收益。
小播:另一个让我意外的是「模型越大越好」这个说法,从零训练的模型不也越深越好吗?
老播:这里有个有意思的反差。把层数从 8 加到 32,从零训练的 Transolver 在部分任务上停滞甚至变差——AirCraft 从零训练 32 层的 relative L2 是 0.1153,比 16 层的 0.1160 还略高;Car-Crash 从 0.1779 涨到 0.1905,这是过拟合。而 GeoPT 32 层在 DrivAerML 上是 0.0687,比 8 层的 0.0746 还好。原因可以这样理解:工业任务只有约 100 个样本,参数一多就记住训练集,而大几何库预训练把模型的假设空间规整过,过拟合被压下去,扩大模型才真正换来精度。多样性消融还有个反直觉的结论:几何多样性比动力学轨迹多样性更重要,而动力学多样性的价值依任务而定——DrivAerML 来流固定,只用 6% 的轨迹采样就接近 100% 的效果;AirCraft 速度、攻角、侧滑都在变,轨迹多样性越多越好。
小播:那几何多样性的极限在哪里?是不是预训练数据越多就越好?
老播:论文做了个扩展实验,把预训练几何从 ShapeNet 三个子集(约 1.35 万个)扩到 ShapeNet 全量(约 5 万个),再加 Hunyuan3D 生成的约 30 万几何,下游精度还能再涨,尤其是 AirCraft 这种少见光滑几何。顺着这个结果往远处想:三维生成模型可以当几何数据源,预训练数据的供给侧就打开了。另外论文还做了一个质量对照:ShapeNet 第一版网格质量差但数量多、多样性高,第二版手工修过质量但只有九千多个,实测第一版预训练效果反而更好,说明这个阶段多样性比干净更重要。
小播:最后说跨域迁移。辐射度模拟那个实验,怎么设计的不公平?
老播:设计得挺苛刻。辐射度是光输运问题,预训练只见过空气动力学相关的汽车、飞机、船几何,测试用了一个预训练从未见过的 Stanford bunny 几何,房间是 Cornell box。160 个训练样本、40 个测试样本,动力学条件参数化成光传播方向。结果 GeoPT 的 MAE 是 9.0×10^-2,从零训练是 9.7×10^-2,对高频阴影边界的还原更准。幅度谈不上巨大,但注意这是个完全没见过的物理域加完全没见过的几何。瞬态任务也试了:预测 DTCHull 下一时刻的场,把速度范数缩到稳态的 1/5,relative L2 从 0.06189 降到 0.05402。论文还画了最差案例:即便模型预测得最差的那个空气动力学样本,尾流区域的误差也比从零训练小。这些实验合起来支撑一个判断:预训练给的先验跨物理域也大致成立——这是第三个核心结论。
它在哪条路线上:世界模型「预训练化」的最新例
小播:把镜头拉远,这篇在整体版图里站在什么位置?
老播:物理基础模型这条线,之前的工作都还在求解器生成的仿真数据上预训练:Poseidon 预训练 2D 流体,DPOT 做多物理自回归,Unisolver 用 PDE 条件架构,P3D 做 3D 流体,都限制在规则网格和特定物理族,扩展还是得靠仿真。离 GeoPT 最近的是「几何条件化」路线:拿预训练好的几何编码器(比如 Hunyuan3D 的特征)当冻结辅助特征接进物理网络,实测帮助有限,因为静态表示不含动力学。GeoPT 的差别有两处:预训练阶段完全免求解器,只用几何加随机速度;预训练直接作用于物理主干本身,让动力学以自监督形式进入表示。放到世界模型语境里看:视频世界模型这一脉已经在用无标注视频做自监督预训练,GeoPT 把同样的逻辑搬进物理仿真,几何库存当无标注语料、合成动力学当自监督任务。这正是一系列世界模型「预训练化」里最新的一步,回答的是同一个问题:能不能让模型先把物理的普遍规律学到手,再为具体任务补少量标注。
局限:论文自承的,和我们读出来的
小播:挑刺时间。先听论文自己承认的。
老播:三条。第一,把所有仿真设置压成一个逐点速度场,有信息损失:碰撞模拟同时涉及弹性和强度两类材料属性,压成单一速度值会丢区分度,作者设想以后用 ControlNet 那种零初始化扩输入通道来补。第二,方法面向「复杂几何」设计,规则网格上的 3D 湍流这类没有复杂边界的仿真没覆盖,各向同性动力学根本没进预训练。第三,理论部分——输运方程、质量守恒——提供的是归纳偏置,论文自己写明不能保证通用泛化。
小播:我们这边再补几条吧。
老播:我读出来的四条。其一,「合成动力学学到的东西,具体靠哪些成分迁移到真实物理」缺定量归因,论文给的相关性可视化是定性的,相关性模式对上了,但没说清是哪部分在起作用。其二,微调要小心配置速度场,论文专门测过方向偏移:把速度场方向从正确配置偏 0 到 40 度,精度逐步下降,NASA-CRM 和 AirCraft 这类高速任务更敏感,因为高速下方向错配的影响被放大;范数也要按速度区间选,低速任务偏爱小范数,高速任务需要大范数才能提示出对应的集中相关性。这套配方仍属于需要按任务调的超参。其三,部分任务收益幅度有限,辐射度那个 MAE 9.0 对 9.7×10^-2,相对改善大约 7%,AirCraft 这类训练-测试几何差异大的任务,微调过程本身也不稳定。其四,预训练数据默认只有 ShapeNet 三个类别、1.35 万个几何,工业级几何多样性上限没测过,而且预训练自己也要 5TB 存储和三天 CPU 时间——比仿真便宜,但也不是零成本。
收尾:记住这三件事
小播:按惯例收个尾,本期记住的三件事。
老播:第一,纯几何预训练会负迁移,根源是动力学缺席;把预训练空间提升到几何加动力学的联合空间,用随机速度场加边界粘滞造出自监督,静态几何预训练只是它的退化切片。第二,免求解器预训练真的可行:134.6 万条样本、约 5TB、三天生成完,换来工业任务减少 20% 到 60% 标注数据、收敛最高加速 2 倍、模型越大收益越大。第三,这是世界模型「预训练化」的最新一步——先让模型从无标注几何和合成动力学里学到物理的普遍结构,再为具体任务补少量标注,物理模拟终于搭上了视觉语言那趟自监督预训练的顺风车。
老播:最后补一句对后续工作的意义:这篇把「数据瓶颈」从求解器成本挪到了几何素材加随机动力学,等于把扩展模拟器的抓手从算力转回了数据工程和自监督设计。后续值得盯的方向:能不能把更多物理设置(多材料、多场耦合)干净地参数化进输入通道,以及几何多样性继续放大之后,预训练先验的收益会到哪里封顶。这期就到这里,下期见。