Denoising Hamiltonian Network for Physical Reasoning(精读)
> arXiv 2503.07596 · MIT / Stanford / Harvard-Smithsonian CfA / UBA / Northeastern · 2025-03-10 · Preliminary work(under review)
> 一句话:把哈密顿力学算子化——用块级离散哈密顿量建立跨时间步的非局部关系,用掩码加去噪(MAE 与扩散模型的思路)替代数值积分器并完成四类物理推理任务;作者阵容里就有 Kaiming He,是理解「He 组工具箱 × 物理动力学」的最佳入口。
这篇要解决什么问题
物理推理要求模型尊重物理定律:能量和力的关系要成立,长期演化要稳定。做法上,主流是 HNN 这类把物理算子嵌进网络的科学机器学习。这套路线有两个共同短板。第一,它们主要建模相邻时间步之间的局部关系,网络学的是 (q_t, p_t) 到 (q_{t+1}, p_{t+1}) 的一步更新,长程的、系统级的相互作用被丢在视野之外。第二,它们几乎只做前向模拟——给定初始条件往后推,轨迹补全、稀疏观测下的参数推断、超分插值这类任务基本没人做。
论文的动机从 Figure 2 的三种求解方式说起:简单系统有解析解;复杂系统靠 PDE 加数值求解器一步步积分(最通用、误差会累积);某些系统里,时间上离得很远的两个状态可以用全局守恒律直接关联,比如机械能守恒 ½mv² = mgΔh,高中题里不用跑整条轨迹就能算出速度。DHN 想做的事,是把第三种「全局守恒律直接关联远距离状态」的能力装进神经网络,同时保留第二种的通用性。
方法:从哈密顿量到去噪神经算子
哈密顿力学与 HNN 的短板
先给定义。系统的状态用相空间坐标 (q, p) 表示:q 是广义坐标,p 是广义动量;单摆里 q 是角度 θ、p 是角动量,多质点系统里 q 是位置、p 是动量。哈密顿量 H(q, p) 是标量函数,多数情况下等于系统总能量。动力学由哈密顿方程给出:
dq/dt = ∇_p H,dp/dt = −∇_q H。
这条式子回答的问题是「状态怎么随时间运动」:状态沿哈密顿量的梯度方向演化,而 H 本身在运动过程中保持不变,这就是能量守恒的来源。HNN(Greydanus 2019)把 H(q, p; θ) 当黑盒函数用网络拟合,损失是
L_HNN = ||∇_p H − dq/dt|| + ||∇_q H + dp/dt||,
符号逐个看:∇_p H 是网络对动量求偏导,应等于坐标的变化率 dq/dt;−∇_q H 应等于动量的变化率 dp/dt。网络学的是「能量的形状」,守恒性质写在结构里。但推理时要沿辛梯度做数值积分,积分器本身的近似会带来能量漂移;而且 HNN 一次只建模一个系统、只看相邻步,做不了补全和稀疏插值。
块级离散哈密顿量:把「相邻两步」变成「一整块」
预期:把 b 个连续时间步的状态拼成块,让网络一次处理一整块状态,从而建立跨时间步的非局部关系。先看离散哈密顿量——连续版本给微分方程,离散版本直接给相邻状态的关系(右哈密顿量 H+):
q_{t+1} = ∇_p H+(q_t, p_{t+1}),p_t = ∇_q H+(q_t, p_{t+1})。
「右」的意思是 q 向前、p 向后;它是连续哈密顿量的一阶离散近似,比显式欧拉更保辛,但更新是隐式的,推理时要解优化才能算出新状态。块级版本把 b 个状态拼成块 Q_t^{t+b} = [q_t, ..., q_{t+b}]、P 同理,引入步长 s,两个错开 s 步的块互为输入输出:
Q_{t+s}^{t+s+b} = ∇_P H+(Q_t^{t+b}, P_{t+s}^{t+s+b}),
P_t^{t+b} = ∇_Q H+(Q_t^{t+b}, P_{t+s}^{t+s+b})。
逐个符号解释:Q_t^{t+b} 是输入块的 q 序列,P_{t+s}^{t+s+b} 是输出块的 p 序列,网络 H+θ 对这两块求梯度,得到另一侧的两个块;整条式子说左侧块和右侧块通过同一个哈密顿量的梯度互相决定。块大小 b 和步长 s 是自由参数,经典 HNN 就是 b=1、s=1 的特例(Figure 4 左),一次只看一个状态;b=4、s=2 的块(Figure 4 右)一次看四个状态、错开两步,网络能在更宽的窗口里发现关系。
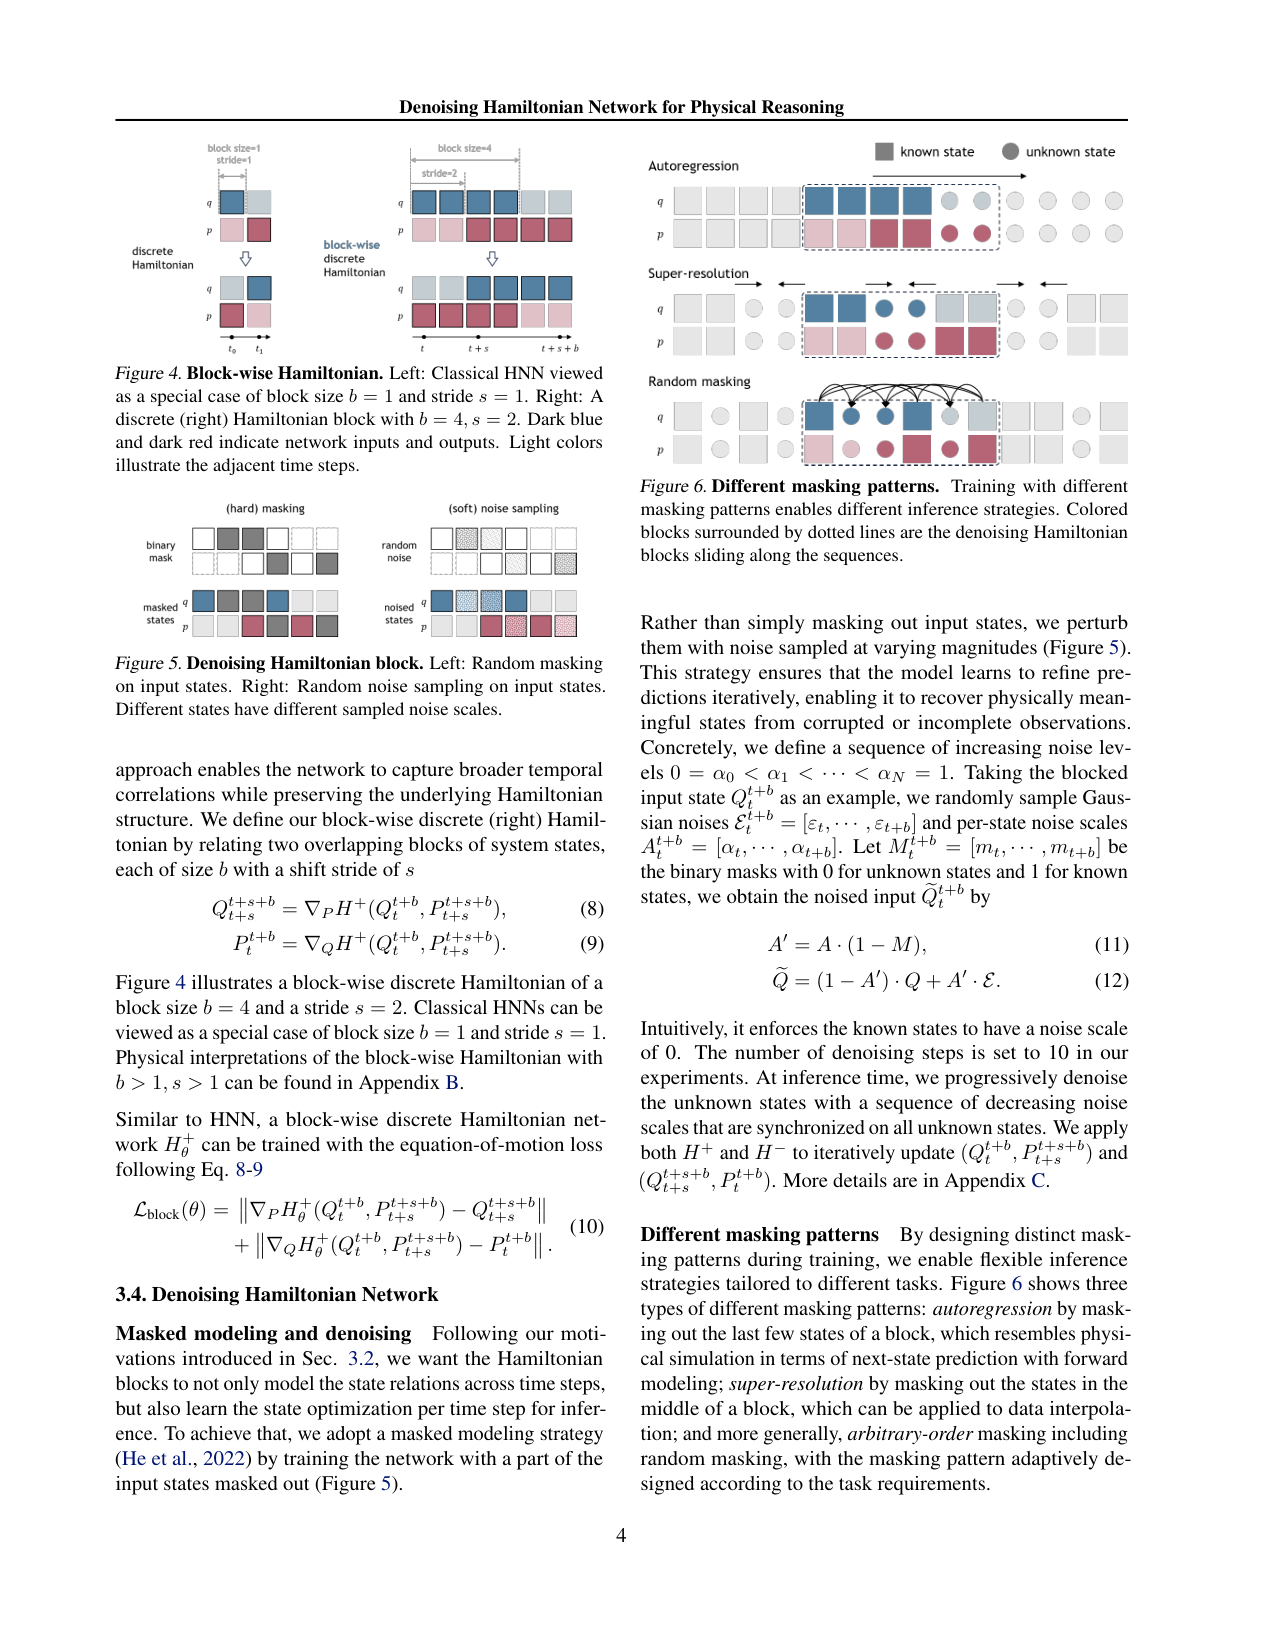
守恒量怎么变?附录 B 给出的解释:块里 b 个状态可以看成 b 个完全相同的物理系统、各自从不同起始时刻开始演化,到某个共同时刻把状态摞在一起,正好拼出横跨 b 个时间步的块;这些系统互不作用,所以守恒的是它们的总能量。由此带来两个松弛:约束从逐状态守恒变成块内总能量守恒(允许块内能量分布不同);当 s < b 时输入输出有 b−s 步重叠,严格守恒要求重叠区状态一致,但自洽损失很少归零。约束变弱,换来的是跨时间步的非局部关系和更强的表达力。
去噪:把隐式求解装进网络,顺带修掉积分误差
预期:用「掩码 + 不同幅度噪声 + 渐进去噪」替代推理期的隐式求解,同时修正数值积分误差。训练时随机把块里部分状态遮掉——硬掩码直接挖空,软掩码注入不同幅度的高斯噪声:
A′ = A·(1−M),Q̃ = (1−A′)·Q + A′·E。
M 是二值掩码(未知状态 0、已知状态 1),A 是逐状态噪声尺度,E 是高斯噪声;已知状态的噪声尺度被乘成 0,未知状态按各自随机尺度加噪。网络的任务是把带噪、缺位的状态块还原成物理有效状态。推理时用扩散式的渐进去噪:噪声水平序列 0 = α_0 < α_1 < ... < α_N = 1,从纯噪声出发,每一步
(q̂_0, p̂_0) = DHN(q_n, p_n),
(q_{n−1}, p_{n−1}) = (1−α_{n−1})(q̂_0, p̂_0) + α_{n−1}·ε。
先给预期:这个式子回答「已知当前噪声水平 α_n 的状态,怎么迈向更干净的一步」。符号逐一看:DHN 先预测干净状态 (q̂_0, p̂_0);(1−α_{n−1}) 决定保留多少预测结果,α_{n−1} 决定掺回多少新采样的高斯噪声 ε;α 从 1 递降到 0,状态就从纯噪声平滑地落到物理有效轨迹上。这套采样和 DDPM 几乎同构(论文明确引了 Ho 2020 和 Song 2020)。训练时 H+ 与 H− 成对交替应用,去噪步数固定为 10。
这一步同时解决两个问题:每时间步的状态求解被建模成去噪,推理时一次网络前向就得到物理自洽的状态,不再需要优化器;积分误差的累积也被当作噪声逐步消掉。训练时随机采样噪声尺度,模型适应各种噪声条件,推理时统一用递减尺度,训练/推理的灵活性来自这里。这正是「哈密顿结构 + 去噪」结合的点:哈密顿量提供跨时间步的结构约束,去噪提供求解能力和误差修正。
掩码模式决定任务(Figure 6):自回归模式遮块末段,推理时用已知历史推未来,对应物理模拟;超分模式遮块中间,两侧已知推中间,对应插值;随机掩码任意位置混合,对应表征学习。三种模式训练时混合,推理时按任务选择,架构不动。
架构与多系统建模
架构是一个去掉因果 mask 的 decoder-only transformer(Figure 7):Q 块、P 块、全局 latent code z 拼成 2b+1 个 token,做全自注意力,每个状态都能看到块内所有状态;逐状态噪声尺度编码后加进位置嵌入,告诉网络每个状态脏到什么程度;z 作为 query token 输出哈密顿量值。实验实现只有两层,单 GPU 可训练。
z 的第二个角色是 autodecoder(Figure 8):不用 encoder,直接给整个数据集维护一个 codebook,每条轨迹一个可学习 z;训练时网络权重和所有 z 一起优化,测试时冻结网络、只优化新轨迹的 z。这样 z 承担系统识别——不同绳长的摆对应不同的 z,一个模型就能跨系统泛化,这是多系统建模的关键。
实验:三场考试
数据是两个模拟系统(Figure 18):单摆变化绳长 l∈[0.5,1.0](m=1,θ=π/2 固定),双摆变化第二段绳长 l2∈[0.5,1.5](l1=1,m1=m2=1,初始角固定),g=0.981;1000 条训练、200 条测试,每条 128 步。变化的是系统参数而不是初始状态,与 Toth 2019 固定参数、变初始条件的做法相反,用来测对参数化系统族的泛化。单摆能量可解析计算,用于测能量守恒;双摆是混沌系统,用于测长程稳定性。
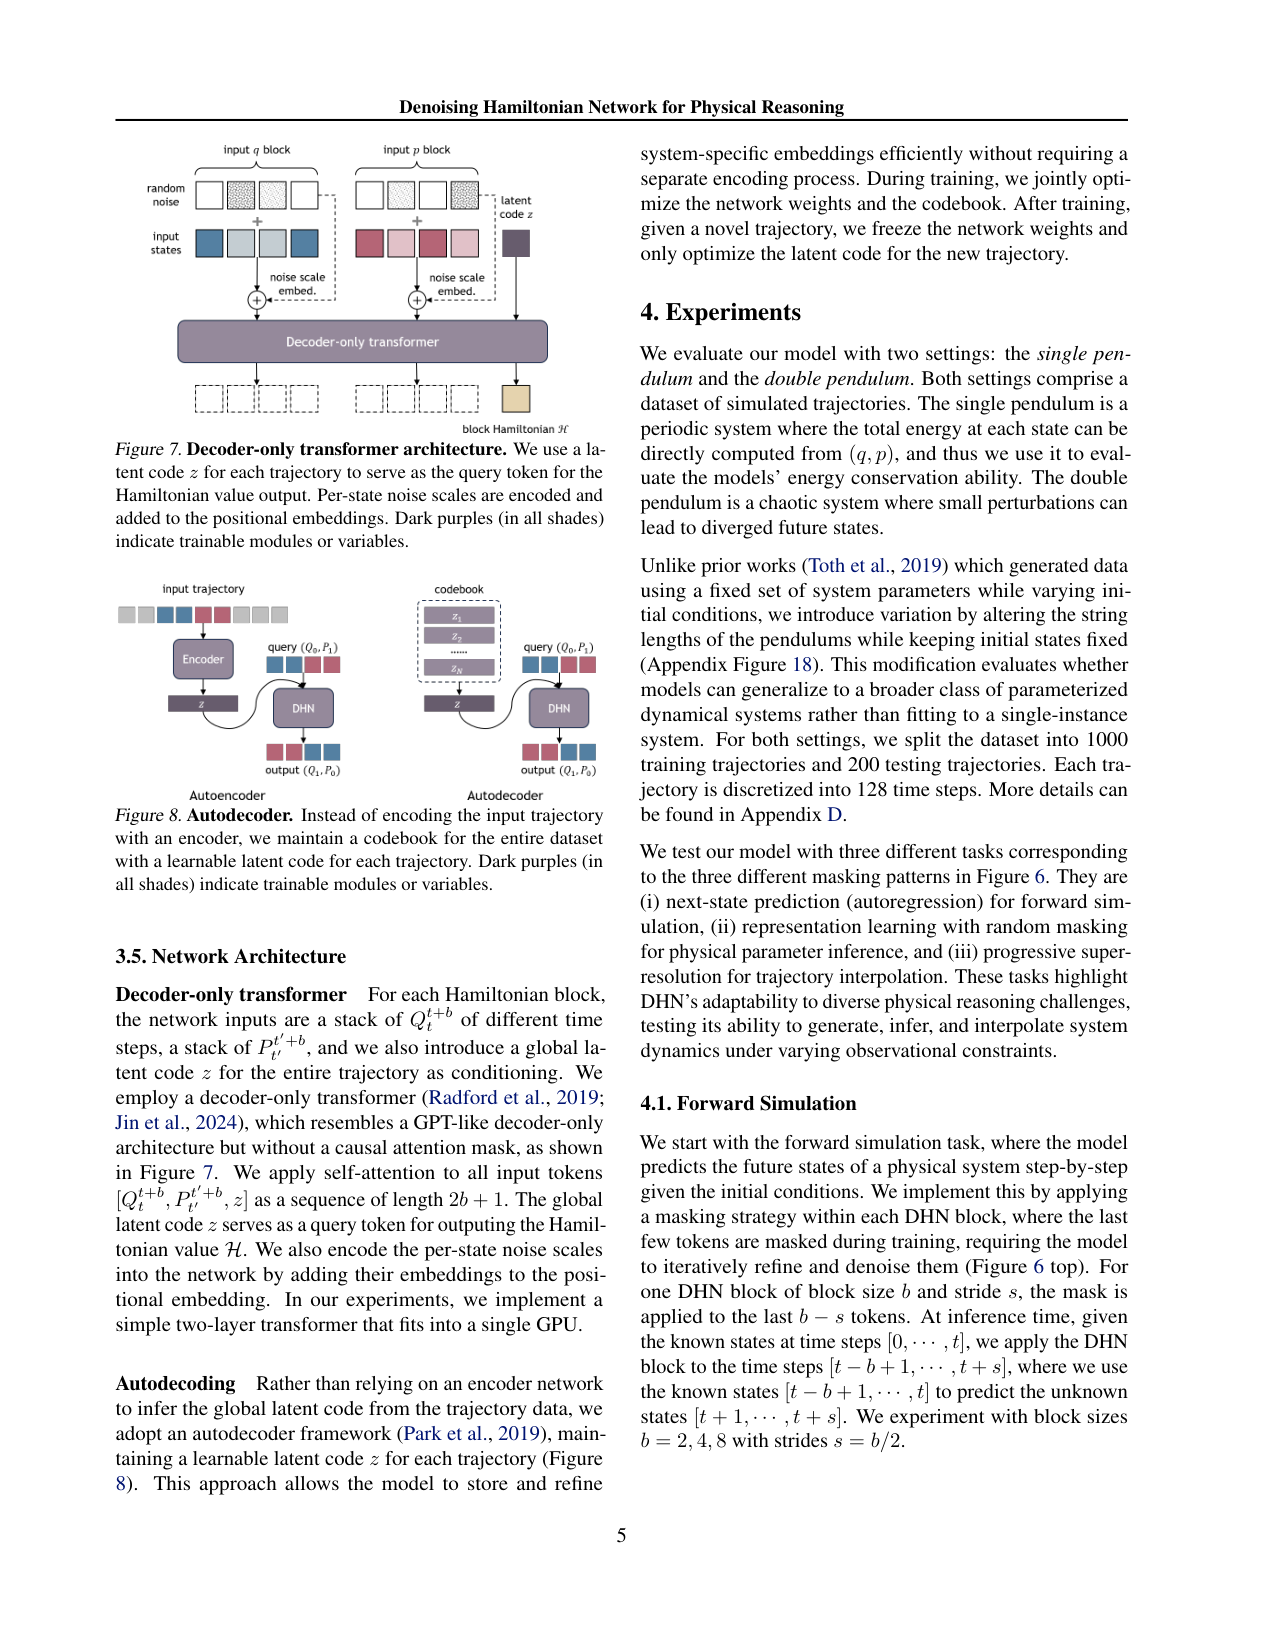
前向模拟分两个子实验。拟合已知轨迹:给前 8 步,预测后 120 步(Figure 9)。DHN 的 q 误差全程更低,总能量误差贴近零、只有小幅波动;HNN 某个积分器组合在单条轨迹上的能量误差出现多单位量级的尖峰。补全新轨迹:给前 16 步,冻结网络只优化 z,再预测后 112 步(Figure 10,上排 vs HNN、下排 vs vanilla ResNet/Transformer,注意上下两排 y 轴刻度不同)。小 block 的 DHN 在误差与能量稳定性上同时胜出;但 b=8 长程误差爆炸,论文的解释是两层 transformer 拟合不了太复杂的多状态关系。
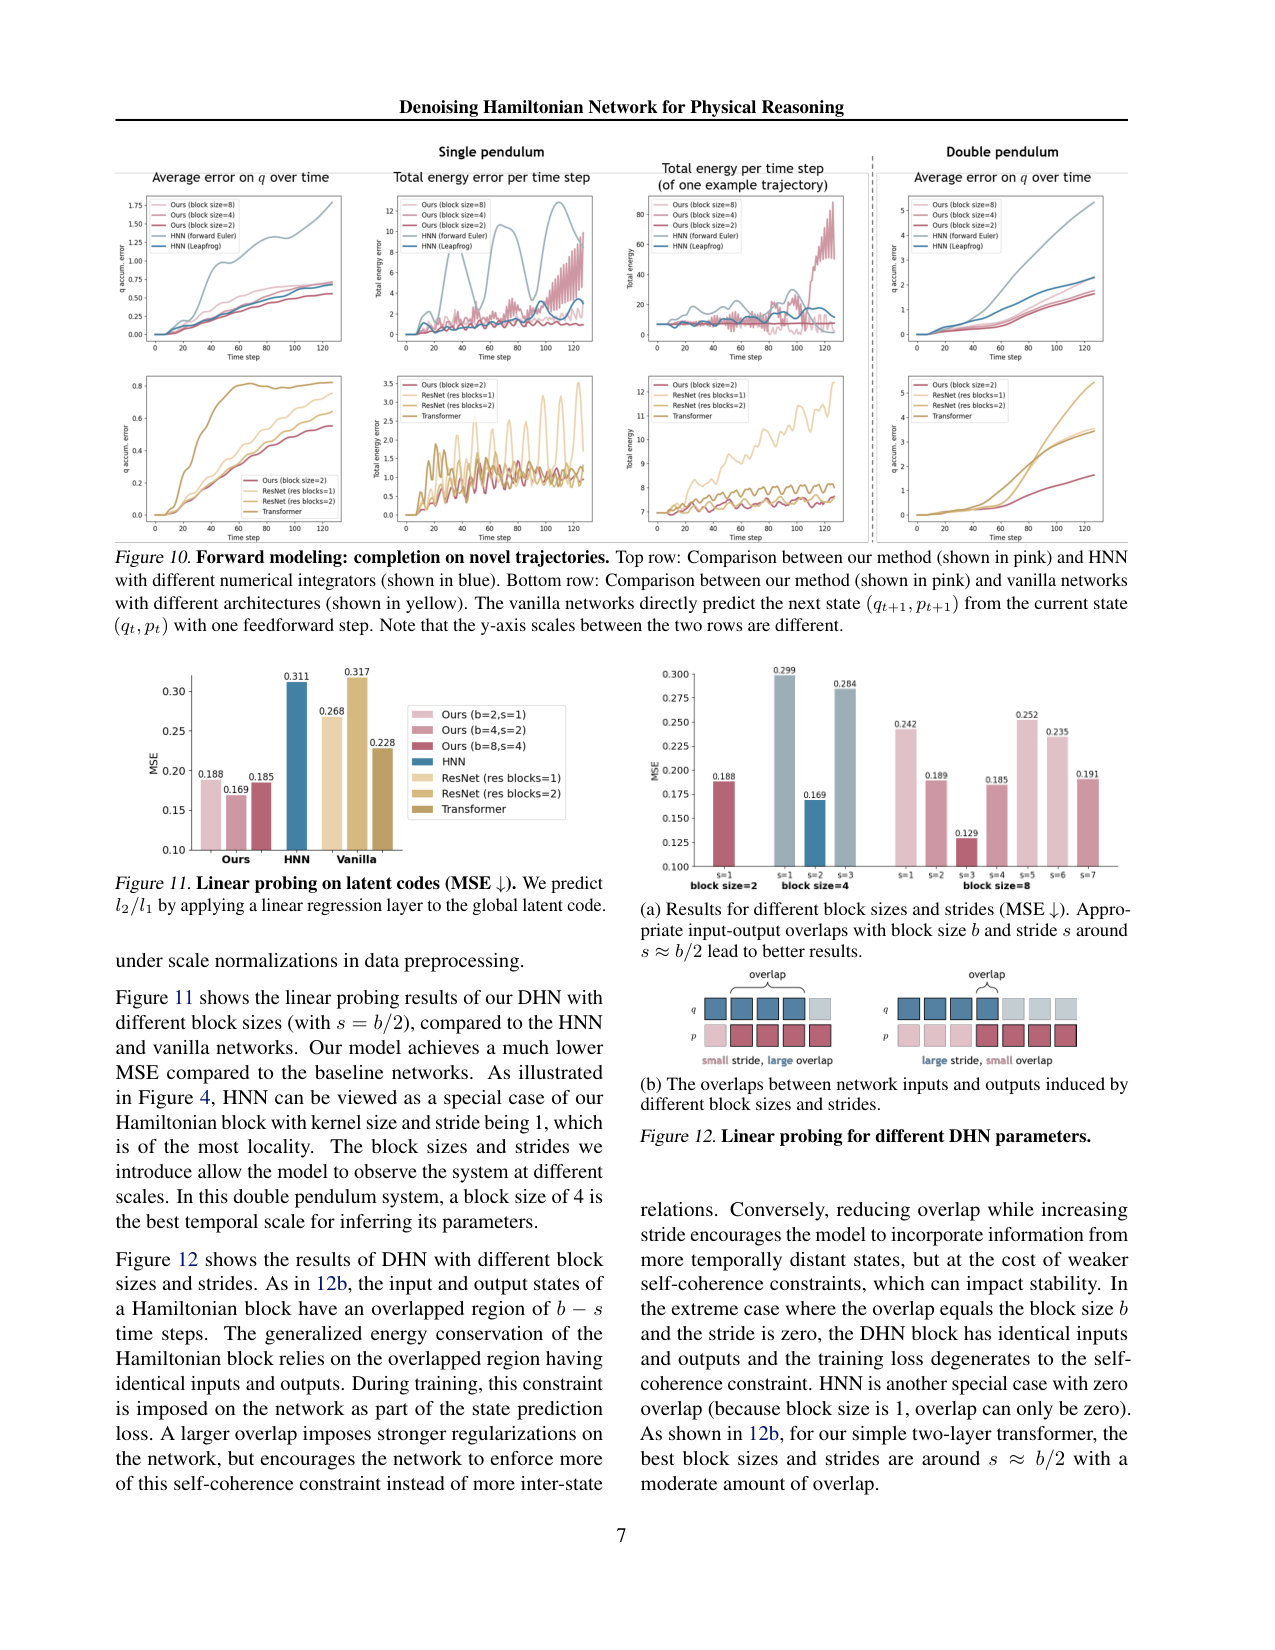
参数推断用双摆猜长度比 l2/l1(无量纲,不受归一化影响)。冻结表征后,在全局 latent code z 上接线性回归层(Figure 11):DHN 三种块大小在 0.17–0.19,最好的 b=4 为 0.169;HNN 为 0.311;vanilla ResNet/Transformer 在 0.228–0.317。块参数扫描(Figure 12)显示 s≈b/2 时最好:重叠太多,网络只顾自洽约束、关系学得少;重叠太少,信息传得远但稳定性差。
超分插值做 4×(连续两次 2×,b=2、s=1,三个阶段共享 z,Figure 13)。结果(Figure 14,数值×100):同初始条件的测试段,CNN 略好(能过拟合训练轨迹);不同初始条件,CNN 误差大幅上升(单摆 0.680、双摆 25.020),DHN 基本持平(单摆 0.035、双摆 6.801)。物理约束带来的泛化收益在分布偏移下才真正显出来。
谱系定位
三条线交汇。哈密顿/拉格朗日神经网络线:HNN(Greydanus 2019)学连续哈密顿量加数值积分,HGN(Toth 2019)从图像序列学哈密顿动力学,后续有 Finzi 2020 的显式约束、SymODEN 的耗散项;DHN 把 HNN 当 b=1、s=1 的特例,用块大小/步长把「局部—全局」变成连续谱。PDE 线:PINN、FNO、Neural ODE 面向连续时空与规则采样,对离散、不规则采样的哈密顿动力学并不顺手,论文在 Related Work 里明确了这个区别。生成模型/自监督线:掩码来自 MAE(He 2022)、去噪来自 DDPM(Ho 2020)、autodecoder 来自 DeepSDF(Park 2019)、整段序列去噪重建来自视频生成模型(论文引了 Diffusion Policy 等)。DHN 的独特点是第三条线完整接到第一条线上:用生成式去噪的目标训练物理算子,把物理推理重构成整段状态序列的去噪重建。
局限
计算成本更高(论文自认需要比 baseline transformer 更密集的梯度计算);实验只有单摆、双摆这类简单时域动力学,扩展到复杂时空系统未验证;大 block 长程误差爆炸说明当前两层架构容量有限;能量守恒是松弛近似——守恒的是块内总能量,重叠区自洽损失很少归零,守恒程度依赖网络容量与 b、s 选择,论文没有给定量数字;Figure 9/10 多数结果只有曲线没有表格数值,去噪步数固定 10 没有消融,代码与权重未发布;推理期每条新轨迹还要先优化 z,含噪声观测下的鲁棒性没有讨论。
收尾
记住这一句:DHN 把物理模拟重构成对整段状态序列的去噪重建,哈密顿量提供守恒结构,去噪提供求解与误差修正;它是和 He 组「对上话」的一篇——MAE 的掩码、扩散的去噪、DeepSDF 的 autodecoder 都在,作用对象从图像换成了哈密顿结构约束下的物理状态。
把哈密顿力学算子化:用块级离散哈密顿量(一次处理 b 个时间步的状态块、步长 s)建立跨时间步的非局部物理关系,再用掩码加去噪(受 MAE 与扩散模型启发)把数值积分误差和隐式状态求解一起处理掉;一个两层 decoder-only transformer 加每轨迹可学习的 latent code,就同时覆盖前向模拟、轨迹补全、参数推断和超分插值四类物理推理任务。
阅读提示
精读深度:精读
清单提示:原文提示:Hamiltonian 神经算子 + 去噪;最容易和 He 组'对上话'的一篇。
问题
要解决什么:现有的物理约束神经网络把物理算子嵌入网络,但有共同短板:一是主要建模相邻时间步之间的局部关系,预测 (q_{t+1},p_{t+1}) 只依赖 (q_t,p_t),抓不到长程或系统级相互作用;二是只做前向模拟,从初始条件往后推,做不了轨迹补全、稀疏观测下的参数推断、超分插值这类互补任务。本文要把『物理关系』从『相邻步更新』推广成『任意距离状态之间的块级关系』,并统一成一套去噪框架。
为什么 prior work 不够:HNN(Greydanus 2019)用网络拟合哈密顿量 H(q,p;θ),再沿辛梯度做数值积分,理论上有守恒结构,但依赖积分器本身会引入累积误差和能量漂移;标准 HNN 一次只建模一个系统、要求均匀时间步,做不了补全和稀疏插值。离散哈密顿量(Gonzalez 1996)的隐式更新更保辛,但推理时要解优化问题,而单条轨迹数据没有额外参考点,优化难以收敛。PDE 路线的 PINN、FNO、Neural ODE 面向连续时空与规则采样,对离散、不规则采样的哈密顿动力学并不顺手。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| Q 块(b 个连续时间步的广义坐标) | 序列,长度 b | Q_t^{t+b}=[q_t,...,q_{t+b}],作为哈密顿块输入;训练时按掩码模式部分已知、部分加噪 |
| P 块(b 个连续时间步的广义动量) | 序列,长度 b | P_{t+s}^{t+s+b}=[p_{t+s},...,p_{t+s+b}],与 Q 块错开 s 步 |
| 逐状态噪声尺度 | 标量序列,长度 b | 已知状态为 0,未知状态按 A′=A·(1−M) 随机采样;编码后加入位置嵌入 |
| 全局 latent code z | 向量(每轨迹一个) | 承担系统识别(如绳长、质量);作为 query token,输出哈密顿量值;测试新轨迹时冻结网络只优化 z |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 去噪/补全后的状态块 | 序列,长度 b | 网络对 Q、P 块求梯度得到另一侧块(块级离散哈密顿量的左右两侧),推理时按递减噪声水平渐进去噪到 α=0 |
| 哈密顿量值 H | 标量 | 由 z 作为 query token 读出 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| 单摆模拟轨迹 | 1000 训练 / 200 测试,每条 128 时间步 | 变化参数:绳长 l∈[0.5,1.0],质量 m=1,初始角 θ=π/2 全部固定;g=0.981;能量可由 (q,p) 解析计算,用于能量守恒评测(Appendix D) |
| 双摆模拟轨迹 | 1000 训练 / 200 测试,每条 128 时间步 | 变化参数:第二段绳长 l2∈[0.5,1.5],l1=1、m1=m2=1、θ1=θ2=π/2 固定;混沌系统,用于参数推断与超分插值;与 Toth 2019 固定参数、变初始条件的数据生成方式相反 |
架构(摘要)
主干与结构
backbone:decoder-only Transformer(去掉因果 mask 的 GPT 式结构)
参数:论文未给出精确参数量;实验实现为两层 transformer,单 GPU 可训练
类型:块级离散哈密顿神经算子 + 去噪自解码器
关键组件
- 状态块 Q_t^{t+b}=[q_t,...,q_{t+b}]、P_t^{t+b}=[p_t,...,p_{t+b}];块大小 b 与步长 s 可调,HNN 是 b=1,s=1 的特例
- 块级离散右哈密顿量:Q_{t+s}^{t+s+b}=∇_P H+(Q_t^{t+b}, P_{t+s}^{t+s+b}),P_t^{t+b}=∇_Q H+(Q_t^{t+b}, P_{t+s}^{t+s+b});用方程损失 L_block 训练
- 掩码建模 + 变幅度噪声:A′=A·(1−M),Q̃=(1−A′)·Q+A′·E,已知状态噪声尺度为 0
- 训练时 10 步去噪;推理时按递减噪声水平 0=α0<α1<...<αN=1 渐进去噪,H+ 与 H− 成对交替应用
- 掩码模式→任务:自回归(遮块末段)做前向模拟,超分(遮中间)做插值,随机掩码做表征学习
- 全局 latent code z 与 Q/P 块拼成 2b+1 个 token 送入全自注意力;逐状态噪声尺度嵌入加进位置编码
- autodecoder:每轨迹一个可学习 z 组成 codebook,训练联合优化网络与 codebook;测试时冻结网络只优化新轨迹的 z
为什么这样设计
离散右哈密顿量本身比显式前向欧拉更保辛,但隐式更新在推理期要解优化;把『求解』改成『去噪』后,网络一次前向就给出物理自洽的状态,同时把积分误差的累积当噪声逐步消掉。块大小 b 让网络同时看到 b 个时间步,建立非局部关系;全局 z 承担系统识别,让一个模型服务多个系统。
数值 sense
| 项 | 值 |
|---|---|
| tokens_per_block | 2b+1(Q 块 b 个 + P 块 b 个 + z) |
| block_size | b∈{2,4,8},stride s=b/2;超分阶段用 b=2,s=1 |
| overlap | 输入输出重叠 b−s 个时间步 |
| denoising_steps | 训练固定 10 步;推理噪声水平从 α=1 递降到 α=0 |
| trajectory | 每条 128 步;1000 训练/200 测试;单摆 l∈[0.5,1.0]、双摆 l2∈[0.5,1.5] |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 前向模拟·拟合已知轨迹(单摆/双摆 q 误差与能量误差) | DHN 的 q 误差全程低于 HNN 各积分器组合;b=2 时总能量稳定、无漂移趋势 | HNN+数值积分器:误差随时间累积,某积分器在单条轨迹上能量误差出现多单位量级尖峰 | 前 8 步→预测后 120 步;单摆 l∈[0.5,1.0]、双摆 l2∈[0.5,1.5];b∈{2,4,8}, s=b/2;1000 训练/200 测试(Figure 9) |
| 前向模拟·新轨迹补全(q 误差与能量误差) | 小 block 的 DHN 在 q 误差与能量稳定性上同时压过两组基线;b=8 长程误差爆炸 | HNN 误差最大的积分器曲线末端接近 1.8(MSE,图读近似);vanilla Transformer 接近 0.8;y 轴刻度上下两排不同 | 前 16 步→冻结网络只优化 z→预测后 112 步;上排 vs HNN、下排 vs ResNet/Transformer(Figure 10) |
| 参数推断·linear probing 预测 l2/l1(MSE) | DHN b=4 最低 0.169;b=2 为 0.188、b=8 约 0.185 | HNN 0.311;vanilla(ResNet/Transformer)0.228–0.317 | 双摆;冻结表征后在线性回归层上预测长度比 l2/l1(无量纲量,不受数据归一化影响) |
| 块参数扫描(b、s 对 probing MSE 的影响) | s≈b/2 附近最好(b=4,s=2 → 0.169 为全局最低) | 极端重叠(s 小)或重叠过小(s 大)的设置在 0.24–0.30 档 | 双摆 probing,同一两层 transformer,b∈{2,4,8} 配多档 s(Figure 12) |
| 4× 超分插值 MSE(图中数值×100) | 不同初始条件:单摆 0.035、双摆 6.801;同初始条件:单摆 0.039、双摆 1.055 | CNN 同初始条件略好(数值接近 0,能过拟合训练轨迹);不同初始条件大幅变差(单摆 0.680、双摆 25.020) | 两次 2× 超分(b=2,s=1),三个阶段共享 latent code;测试段 [0,64] 同初始、[65,128] 不同初始(Figure 14) |
Insights
- 把『物理模拟』重构成『全局重建』:不去逐帧预测,而是像视频生成模型那样对整段状态序列去噪,这是论文 Sec 5 的核心主张,也是它和 MAE/扩散谱系的接缝。
- 去噪在 DHN 里同时干两件事:修正数值积分误差的累积 + 把离散哈密顿量的隐式求解变成一次网络前向(Sec 3.2/3.4)。
- 块级哈密顿量的守恒量从『单个状态的能量』松弛为『b 个独立系统(不同起始时刻)的总能量』,换来跨时间步的非局部关系;约束变弱,但长期能量漂移反而比 HNN+积分器可控(附录 B + Figure 9/10)。
- 一个两层 transformer 加每轨迹可学习 z,就同时做前向、补全、参数推断、超分:z 里可线性读出物理参数 l2/l1,说明系统识别被压缩进了全局条件(Figure 11)。
- 论文把 HNN 当作自身特例(b=1,s=1),用块大小/步长统一『局部 vs 全局』的连续谱,给后续工作留了直接扩展点。
vs 同类工作
- vs HNN(Greydanus 2019):HNN 学连续哈密顿量并依赖数值积分器,只建模相邻步、单系统;DHN 用块级离散哈密顿量直接关联跨时间步状态,去噪替代积分器修正,autodecoder 支持多系统。
- vs HGN(Toth 2019):HGN 从图像序列学哈密顿动力学,仍以均匀步长前向推演为主;DHN 直接处理离散/稀疏状态,覆盖补全与插值。
- vs PINN / FNO / Neural ODE:三者面向连续 PDE 与规则时空网格;DHN 面向离散哈密顿结构,对不规则采样与离散动力学更直接(论文 Related Work)。
- vs MAE(He 2022)/ DDPM(Ho 2020):掩码与去噪目标来自自监督/扩散谱系,但 DHN 把它们作用在物理状态上,结构约束来自块级哈密顿量,重建目标从像素换成了物理状态。
局限
- 计算成本更高:论文自认 DHN 比 baseline transformer 需要更密集的梯度计算(Sec 5)。
- 实验规模小:只有单摆、双摆两类简单时域动力学;扩展到复杂时空系统需要层级或注意力结构,论文未验证(Sec 5)。
- 大 block 长程误差爆炸:b=8 时两层 transformer 拟合不了复杂多状态关系,补全误差随时间放大(Sec 4.1 Figure 10)。
- 能量守恒是松弛近似:守恒的是块内总能量,重叠区(b−s 步)自洽损失几乎不会归零,守恒程度依赖网络容量与 b、s 选择(附录 B)。
- 证据链不完整:Figure 9/10 多数结果只有曲线没有表格数值;去噪步数固定 10 无消融;代码与权重未发布(preliminary work, under review)。
- 推理期仍需逐轨迹优化 z(autodecoding),对含噪声观测的鲁棒性以及优化不收敛的影响没有讨论。
可复现性
- code:未提供(preliminary work,under review)
- weights:未开源
- sim_benchmark:模拟单摆/双摆:g=0.981,l∈[0.5,1.0] / l2∈[0.5,1.5],1000 训练/200 测试,128 步(Appendix D)
主干与结构
backbone:decoder-only Transformer(去掉因果 mask 的 GPT 式结构)
参数:论文未给出精确参数量;实验实现为两层 transformer,单 GPU 可训练
类型:块级离散哈密顿神经算子 + 去噪自解码器
关键组件
- 状态块 Q_t^{t+b}=[q_t,...,q_{t+b}]、P_t^{t+b}=[p_t,...,p_{t+b}];块大小 b 与步长 s 可调,HNN 是 b=1,s=1 的特例
- 块级离散右哈密顿量:Q_{t+s}^{t+s+b}=∇_P H+(Q_t^{t+b}, P_{t+s}^{t+s+b}),P_t^{t+b}=∇_Q H+(Q_t^{t+b}, P_{t+s}^{t+s+b});用方程损失 L_block 训练
- 掩码建模 + 变幅度噪声:A′=A·(1−M),Q̃=(1−A′)·Q+A′·E,已知状态噪声尺度为 0
- 训练时 10 步去噪;推理时按递减噪声水平 0=α0<α1<...<αN=1 渐进去噪,H+ 与 H− 成对交替应用
- 掩码模式→任务:自回归(遮块末段)做前向模拟,超分(遮中间)做插值,随机掩码做表征学习
- 全局 latent code z 与 Q/P 块拼成 2b+1 个 token 送入全自注意力;逐状态噪声尺度嵌入加进位置编码
- autodecoder:每轨迹一个可学习 z 组成 codebook,训练联合优化网络与 codebook;测试时冻结网络只优化新轨迹的 z
为什么这样设计
离散右哈密顿量本身比显式前向欧拉更保辛,但隐式更新在推理期要解优化;把『求解』改成『去噪』后,网络一次前向就给出物理自洽的状态,同时把积分误差的累积当噪声逐步消掉。块大小 b 让网络同时看到 b 个时间步,建立非局部关系;全局 z 承担系统识别,让一个模型服务多个系统。
数值 sense
| 项 | 值 |
|---|---|
| tokens_per_block | 2b+1(Q 块 b 个 + P 块 b 个 + z) |
| block_size | b∈{2,4,8},stride s=b/2;超分阶段用 b=2,s=1 |
| overlap | 输入输出重叠 b−s 个时间步 |
| denoising_steps | 训练固定 10 步;推理噪声水平从 α=1 递降到 α=0 |
| trajectory | 每条 128 步;1000 训练/200 测试;单摆 l∈[0.5,1.0]、双摆 l2∈[0.5,1.5] |
块级哈密顿量:HNN 是 b=1,s=1 的特例,b=4,s=2 建立跨时间步关系
原文 caption:Block-wise Hamiltonian. Left: Classical HNN viewed as a special case of block size b = 1 and stride s = 1. Right: A discrete (right) Hamiltonian block with b = 4, s = 2. Dark blue and dark red indicate network inputs and outputs.
左图是经典 HNN 的离散右哈密顿量块,只看相邻两个时间步;右图把 4 个 q 状态(蓝)和 4 个 p 状态(红)拼成块,两个错开 2 步的块互为输入输出。它证明 DHN 用块大小 b 和步长 s 统一了『局部—全局』连续谱,是全文结构约束的起点。
去噪哈密顿块:硬掩码挖空 + 软噪声注入
原文 caption:Denoising Hamiltonian block. Left: Random masking on input states. Right: Random noise sampling on input states. Different states have different sampled noise scales.
左半是二值掩码把部分状态标为未知(灰/白格),右半是给不同状态注入不同幅度的高斯噪声(深浅不同的格子)。它说明 DHN 训练输入同时包含缺失与带噪状态,网络要学会把残缺输入还原成物理有效状态,这是去噪机制的直接图示。
三种掩码模式对应三类任务
原文 caption:Different masking patterns. Training with different masking patterns enables different inference strategies.
三行分别演示自回归(遮块末段、向右预测)、超分(遮中间、两侧已知推中间)、随机掩码(任意位置混合)三种模式,灰方块为已知状态、灰圆圈为未知状态。它说明同一个 DHN 块通过换掩码就能切换任务,架构不用改。
decoder-only transformer:Q/P 块加 z 组成 2b+1 个 token
原文 caption:Decoder-only transformer architecture. We use a latent code z for each trajectory to serve as the query token for the Hamiltonian value output. Per-state noise scales are encoded and added to the positional embeddings.
输入 Q 块、P 块与每状态噪声尺度(noise scale embed)一起进入 decoder-only transformer(无因果 mask),z 作为 query 输出哈密顿量值。它说明 DHN 用全自注意力让每个状态看到块内所有状态,噪声尺度嵌入让网络知道每个状态脏到什么程度。
autodecoder:用 codebook 代替 encoder
原文 caption:Autodecoder. Instead of encoding the input trajectory with an encoder, we maintain a codebook for the entire dataset with a learnable latent code for each trajectory.
左边是常规 autoencoder 路线(encoder 推断 z),右边是 DHN 的 codebook 路线:每条轨迹一个可学习 z,训练时直接优化。它说明多系统建模靠的是每轨迹 latent code 承担系统识别,省掉独立编码器。
新轨迹补全:DHN 同时压过 HNN 与 vanilla 网络
原文 caption:Forward modeling: completion on novel trajectories. Top row: Comparison between our method (pink) and HNN with different numerical integrators (blue). Bottom row: Comparison between our method (pink) and vanilla networks (yellow).
2×4 网格,横轴都是时间步:第 1、4 列是单摆/双摆的 q 误差,第 2、3 列是平均与单条轨迹的能量误差。上排 vs HNN(蓝)、下排 vs vanilla ResNet/Transformer(黄);注意上下两排 y 轴刻度不同。DHN 曲线在误差与能量稳定性上都更低,而大 block(b=8)长程误差爆炸。
线性探针:z 里能读出 l2/l1
原文 caption:Linear probing on latent codes (MSE ↓). We predict l2/l1 by applying a linear regression layer to the global latent code.
柱状图,纵轴是预测长度比 l2/l1 的 MSE(越低越好):DHN 三种块大小约 0.17–0.19,最好的 b=4 为 0.169;HNN 0.311;vanilla ResNet/Transformer 在 0.228–0.317。它证明全局 latent code 编码了物理参数,块大小 b 决定表征质量。
块参数扫描:s≈b/2 的重叠量最合适
原文 caption:(a) Results for different block sizes and strides (MSE ↓). (b) The overlaps between network inputs and outputs induced by different block sizes and strides.
(a) 是不同 b、s 组合下的 probing MSE 柱状图,s≈b/2 附近最低(b=4,s=2 → 0.169),极端重叠或重叠过小都更差;(b) 示意输入输出重叠区 b−s。它说明重叠是正则化的来源:太多重叠让网络只顾自洽约束,太少则跨状态关系弱、稳定性差。
推理期渐进去噪:H+ 与 H− 成对交替
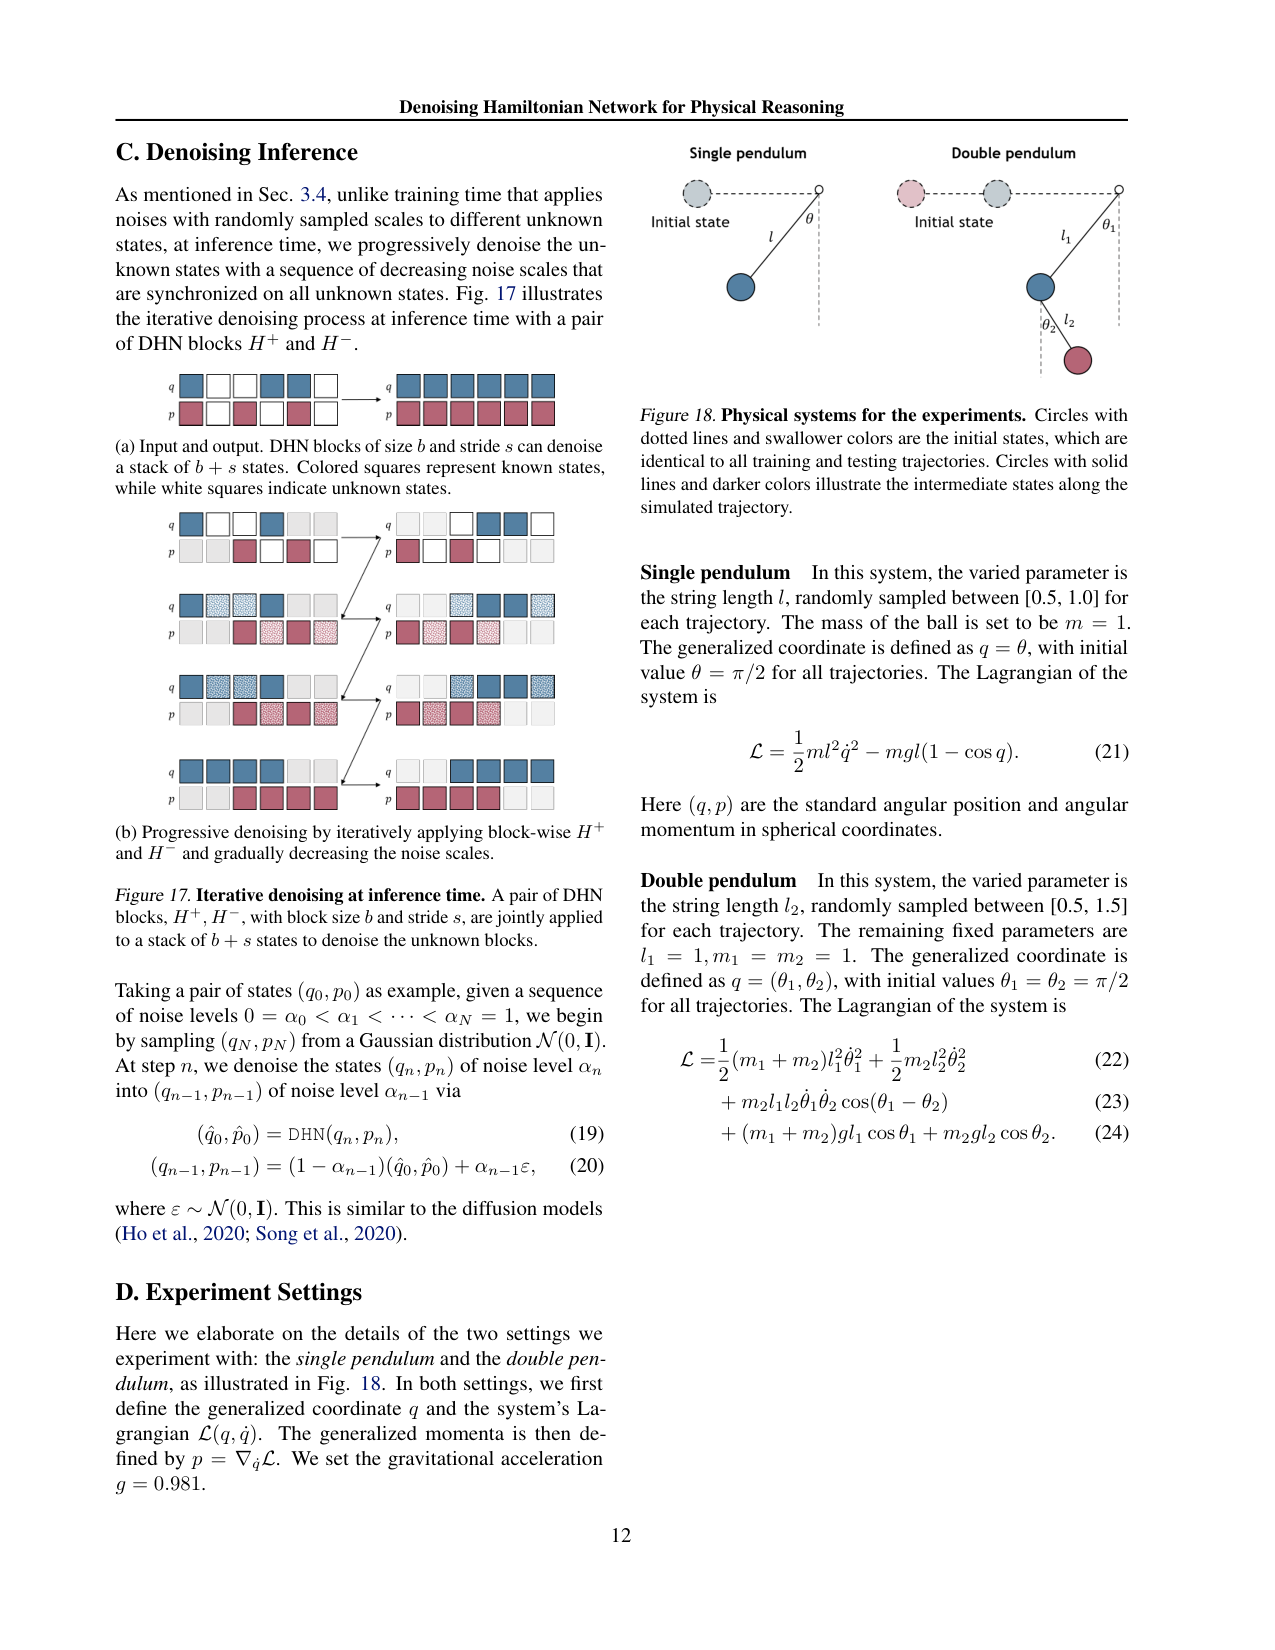
原文 caption:Iterative denoising at inference time. A pair of DHN blocks, H+, H−, with block size b and stride s, are jointly applied to a stack of b + s states to denoise the unknown blocks.
(a) 一个 DHN 块可以处理 b+s 个状态,彩色格为已知、白格为未知;(b) 三行示意把 H+ 与 H− 交替应用、噪声水平逐渐下降的迭代过程。它直接对应采样公式 (q̂0,p̂0)=DHN(qn,pn)、(qn−1,pn−1)=(1−αn−1)(q̂0,p̂0)+αn−1ε,说明去噪是扩散式的多步精修,会逐步逼近物理有效状态。
实验系统:单摆与双摆,固定初始状态、变化系统参数
原文 caption:Physical systems for the experiments.
左右分别是单摆(绳长 l∈[0.5,1.0],角 θ)与双摆(l1=1、l2∈[0.5,1.5]);虚线浅色圆是初始状态(训练测试全部相同),实线深色圆是模拟轨迹上的中间状态。它说明数据生成方式是变化系统参数而非初始条件,用来测对参数化系统族的泛化。
🎧 音频版
时长 33:09 · Edge TTS
Denoising Hamiltonian Network for Physical Reasoning(对话版·精读)
先说说为什么这篇值得专门做一期
小播:老播,今天这篇《Denoising Hamiltonian Network for Physical Reasoning》,标题里有哈密顿网络、物理推理,听着像理论物理课。先问一句,这篇论文解决什么问题?为什么值得专门做一期?
老播:先给一句话背景。这是 Kaiming He 参与署名的一篇论文,作者阵容里有 MIT 的 William Freeman、斯坦福的 Leonidas Guibas,第一作者 Congyue Deng 现在是斯坦福博士生。论文做的事,是把经典力学里的哈密顿方程改造成一种神经网络算子,再用去噪的思路去训练它,让一个两层的小 transformer 同时完成预测轨迹、补全轨迹、猜系统参数、给稀疏轨迹插值四类任务。论文自己标注是 preliminary work,还在审稿,但方法上的想法很完整,值得单独拆开讲。顺便说个彩蛋:论文致谢里专门感谢了猫 Rell 提供 Figure 1 的照片,团队氛围挺轻松。
小播:等等,你说 Kaiming He 参与?那就跟 MAE、跟视觉自监督是同一个谱系了。
老播:对,这正是这期最重要的线索。DHN 的三大件——掩码建模、去噪、每轨迹一个可学习的 latent code——全是 He 组和视觉自监督、生成模型圈子用熟的工具,这篇把它们搬到了哈密顿力学上。本期要把「哈密顿神经算子 + 去噪」这个结合讲透:哈密顿结构给了什么,去噪又补了什么,最后说清楚为什么它是跟 He 组「对上话」的最好入口。
小播:好,那先把结论放这儿:这期最后要记住什么?
老播:记住一句话:这篇把「物理模拟」从「一步一步往前积分」重构成「对整段状态序列做去噪重建」,哈密顿量提供守恒结构,去噪负责修正数值误差、完成各种推理任务。这个视角跟视频生成模型整段去噪是同一个思路,区别在于作用对象从像素换成了物理状态。
小播:那这期的路线图是什么?
老播:四步。第一步铺垫,把哈密顿力学和 HNN 讲清楚,说它们卡在哪;第二步是核心,块级哈密顿量怎么建立跨时间步的关系,去噪怎么解决求解和误差问题;第三步看三场实验;第四步讲局限。公式不多,但每一条都会先给预期再逐符号拆开。
先把背景铺开:哈密顿力学和 HNN 卡在哪
小播:先从最基础的问起:哈密顿力学是什么?为什么做物理推理的人要用它?
老播:先给定义。一个物理系统的状态用相空间里的点表示,相空间坐标是 (q, p):q 是广义坐标,p 是广义动量。单摆里 q 就是角度 θ,p 是角动量;多质点系统里 q 是位置,p 是动量。系统还有一个标量函数叫哈密顿量 H(q, p),大多数情况下它等于系统的总能量。动力学由哈密顿方程决定:dq/dt = ∇_p H,dp/dt = −∇_q H。这条式子回答「状态怎么随时间运动」:状态沿着哈密顿量的梯度方向演化,而 H 本身在运动过程中保持不变——这就是能量守恒。
小播:所以哈密顿方程的好处是,只要把 H 学准,能量结构就被尊重了?
老播:对,2019 年 Greydanus 那篇 HNN 就是这个思路。它用一个神经网络去拟合 H(q, p; θ),训练损失直接拿哈密顿方程当监督:L_HNN = ||∇_p H − dq/dt|| + ||∇_q H + dp/dt||。逐项看:∇_p H 是网络对动量求偏导,应该等于坐标的变化率 dq/dt;−∇_q H 应该等于动量的变化率 dp/dt。网络学的是「能量的形状」而不是「下一步去哪」,所以守恒性质写在结构里。推理时从初始状态出发,沿网络给出的梯度做数值积分,推整条轨迹。论文里的 HNN 基线配了好几种数值积分器,显式欧拉、四阶龙格库塔、辛积分器都有,不同组合的累积误差不一样,这正是 DHN 想绕开的部分。
小播:数值积分器的差别有这么关键吗?
老播:关键在长期行为。显式欧拉每步都有局部误差,误差随步数累积;辛积分器能保住相空间的体积结构,但不同的辛积分器误差行为也不一样。HNN 的梯度本身是对的,可只要积分器有近似,长期预报就会偏;论文实验里 HNN 配不同积分器,能量误差曲线差得非常多,正好说明问题出在积分这一步。
小播:那 HNN 的短板在哪?
老播:两个。第一,它只建模相邻时间步之间的局部关系:网络做的是 (q_t, p_t) 到 (q_{t+1}, p_{t+1}) 的一步更新,一次只看两步,长程的、系统级的相互作用看不到。第二,它只擅长前向模拟,给定初始条件往后推,轨迹补全、稀疏观测下的参数推断、超分插值这些「反过来」的任务做不了。举三个具体的例子:轨迹补全是轨迹中间缺了一段,要拿前后信息把缺口补上;参数推断是只看几帧观测,猜出摆长或者质量;超分插值是稀疏采样了几个点,要把中间的状态加密出来。这些任务在科学场景里都很常见,但 HNN 这条路线基本不覆盖。还有一个技术细节:HNN 必须跑数值积分器,积分器本身的近似会引入误差,长期预报时能量会漂移,这是 HNN 家族的普遍毛病。
小播:那为什么不直接用解析解?物理题不是都能算吗?
老播:论文里 Figure 2 把求解物理状态的路数分成三种,这个图值得仔细读。第一种是解析解,只有很规则的系统才有,比如自由落体 v = v0 + at,一个式子算到底,省事但适用范围窄。第二种是 PDE 加数值求解器,最通用,f = m·ẍ 这类局部关系一步一步积分,代价是误差累积。第三种是直接的非局部关系:某些系统里,时间上离得很远的状态能用全局守恒律直接连起来,比如机械能守恒 ½mv² = mgΔh,高中题里不用解整条轨迹就能算出速度。HNN 走的是第二种的路,DHN 想做的,是把第三种「用全局守恒律直接关联远距离状态」的能力装进黑盒神经网络,同时不丢掉第二种的通用性。这就是全文动机的核心。
小播:懂了,DHN 是冲着「局部 vs 全局」这个缺口去的。
老播:还有一层铺垫要交代。DHN 用到的两样工具,掩码建模和去噪,分别来自 MAE 和扩散模型。MAE 是 He 组 2022 年那篇,把图像随机遮掉 75% 的 patch,只留四分之一给网络看,让它从残缺像素重建整张图;扩散模型是 Ho 那篇 DDPM,把真实数据用 1000 步逐步加噪成纯噪声,再学一条反向链把它一步步还原。两件事的共同点:都让模型从「不完整的输入」里恢复「完整的输出」。记住这条线,一会儿看 DHN 怎么把它用到物理上——同样是遮掉一部分、加噪再还原,只不过对象从像素换成了物理状态。
核心思想:哈密顿神经算子怎么去噪
小播:好,进入正题。第一步,它怎么把哈密顿量变成能跨时间步的神经算子?
老播:这一步叫块级离散哈密顿量。预期是:把 b 个连续时间步的状态拼成一个块,让网络一次处理一整块,而不是只处理一对相邻状态。先铺垫一个概念:离散哈密顿量。连续哈密顿量给的是微分方程,离散版本直接给出两个相邻状态之间的关系,论文用「右哈密顿量」H+ 的写法:q_{t+1} = ∇_p H+(q_t, p_{t+1}),p_t = ∇_q H+(q_t, p_{t+1})。「右」的意思是 q 向前、p 向后。它比朴素的显式欧拉更保辛,也就是更接近真实系统的几何结构,但它是隐式的:新状态出现在等号两边,推理时要解一个优化问题才能算出来。
小播:隐式求解很麻烦吗?
老播:论文点破了这个难点:如果手里只有一条模拟轨迹、没有额外参考点,这个优化很难收敛。记住这个伏笔,去噪机制就是来替代这个求解过程的。现在写块级版本。把 b 个连续状态拼成块:Q_t^{t+b} = [q_t, ..., q_{t+b}],P 同理,再引入步长 s,块级右哈密顿量把两个错开 s 步的块联系起来:
Q_{t+s}^{t+s+b} = ∇_P H+(Q_t^{t+b}, P_{t+s}^{t+s+b}),
P_t^{t+b} = ∇_Q H+(Q_t^{t+b}, P_{t+s}^{t+s+b})。
逐个符号解释:Q_t^{t+b} 是输入块里的 q 序列,P_{t+s}^{t+s+b} 是输出块里的 p 序列,网络 H+θ 对这两个块求梯度,得到另一侧的两个块。整条式子说:左侧块和右侧块通过同一个哈密顿量的梯度互相决定。块大小 b 和步长 s 是两个自由参数,经典 HNN 就是 b=1、s=1 的特例——一次只看一个状态,对应最局部的模型;b=4、s=2 的块一次看四个状态、错开两步,网络能在更宽的窗口里发现关系。论文里 Figure 4 左图就是 HNN 的块,右图就是 b=4、s=2 的块,可以对照着看。训练损失就是方程损失:L_block = ||∇_P H+θ 的输出 − 真实输出块|| + ||∇_Q H+θ 的输出 − 真实输入块||,也就是让网络梯度预测的块尽量贴近真实轨迹里的块。
小播:这个块级式子训练的时候怎么用?
老播:直接把真实轨迹切块当监督:取一段轨迹,把 Q 块和 P 块喂进去,网络对它们求梯度,预测出另一侧的两个块,损失就是预测块和真实块的均方误差。训练时滑动窗口扫过整条轨迹,所以网络见过的都是真实块之间的关系,推理时它才能反过来从部分状态推完整状态。注意一个细节:输入输出有 b−s 步重叠,重叠区的状态既当输入又当输出,这个自洽约束是能量守恒能在块里成立的条件,也是后面 b、s 选择的关键。
小播:那问题来了:b 大于 1 的时候,它还叫哈密顿量吗?能量守恒还在吗?
老播:这是附录 B 专门回答的问题,也是全文最需要耐心的一段。答案:守恒量还在,但从「单个状态的能量」变成了「b 个独立系统的总能量」。怎么理解:一个大小为 b 的块里 b 个状态,可以看成 b 个一模一样的物理系统、各自从不同的起始时刻开始演化;到了某个共同时刻,把这 b 个系统的状态摞在一起,正好拼出一个横跨 b 个时间步的块。这 b 个系统互不作用,所以守恒的是它们的总能量。这样做带来两个松弛:第一,约束从逐状态守恒变成块内总能量守恒,允许块内能量分布不同,约束变弱;第二,当步长 s 小于块大小 b 时,输入输出有 b−s 个时间步的重叠,比如 b=4、s=2 就有 2 步重叠,严格守恒要求重叠区状态完全一致,但训练时这个自洽损失很少能压到零。所以守恒是近似保证,代价是物理约束变弱,收益是网络能一次看到 b 个状态、建立跨时间步的关系。
小播:这一步解决了「局部 vs 全局」。那去噪解决什么?
老播:去噪同时解决两个问题,这是全文第二个关键设计。第一个是前面说的隐式求解:离散哈密顿量的更新推理时要解优化,手里只有一条轨迹的话很难收敛。第二个是数值积分误差的累积。做法是掩码加噪声一起上:训练时随机把块里一部分状态遮掉,硬掩码直接挖空,软掩码注入不同幅度的高斯噪声。公式是 A′ = A·(1−M),Q̃ = (1−A′)·Q + A′·E。逐个符号看:M 是二值掩码,未知状态记 0、已知状态记 1;A 是每个状态各自的噪声尺度;已知状态的噪声尺度被乘成 0,未知状态按各自随机尺度加噪;E 是采样的高斯噪声。网络的任务,是把带噪、缺位的状态块还原成物理上有效的状态。
小播:这跟扩散模型的去噪是一回事吗?
老播:论文明确说受扩散模型启发,推理时用的就是一套扩散式的渐进去噪。噪声水平序列取 0 = α_0 < α_1 < ... < α_N = 1,从纯噪声出发,每一步让网络先预测干净状态,再往干净方向走一步:
(q̂_0, p̂_0) = DHN(q_n, p_n),
(q_{n−1}, p_{n−1}) = (1−α_{n−1})(q̂_0, p̂_0) + α_{n−1}·ε。
先给预期:这条式子回答「已知当前噪声水平 α_n 的状态,怎么迈向更干净的一步」。逐符号看:DHN 先预测干净状态 (q̂_0, p̂_0);(1−α_{n−1}) 决定保留多少预测结果,α_{n−1} 决定掺回多少重新采样的高斯噪声 ε;α 从 1 递降到 0,状态就从纯噪声平滑地落到物理有效轨迹上。举个具体的刻度:α=1 表示纯噪声,α=0 表示完全干净的状态,推理时从 1 出发,每步把噪声水平降一档,一路走到 0,中间经过多少个档位就是多少步去噪。这套采样和 DDPM 几乎同构,论文直接引了 Ho 2020 和 Song 2020。训练时 H+ 和 H− 成对交替应用:H+ 从 (Q_t, P_{t+s}) 推 (Q_{t+s}, P_t),H− 反着推,两者互相吃对方的输出,交替作用让整块状态从两头往中间收敛;去噪步数在实验里固定为 10。
小播:所以去噪把「解优化」换成了「一次网络前向」?
老播:对,这就是它的作用:每时间步的状态求解被建模成去噪,推理时不用跑优化器,网络前向就把状态修到物理自洽;积分误差的累积也被当成噪声逐步消掉。训练时随机采样噪声尺度,让模型适应各种噪声条件;推理时用递减尺度统一去噪,训练和推理的灵活性都来自这里。这一段就是「哈密顿结构 + 去噪」结合的核心:哈密顿量提供跨时间步的结构约束,去噪提供求解能力和误差修正。用一句话概括:没有去噪,块级哈密顿量在推理时是解不动的;没有哈密顿结构,去噪出来的轨迹不保证守恒。两者缺一不可。
小播:为什么训练时要随机采样噪声尺度,而不是固定用一个?
老播:因为推理时的任务千差万别:前向预测是从干净的已知状态推未来,补全是从部分干净、部分缺失的状态恢复,超分是从稀疏采样加密。如果训练只见过一种噪声水平,推理时换个任务就懵了;随机尺度让模型在从纯噪声到几乎干净的整条轴上都能干活。噪声水平序列从 0 排到 1,0 是完全干净、1 是纯噪声,训练时每个状态独立采样尺度,已知状态强制归 0,未知状态随机取——这样一个模型天然覆盖三种任务的输入分布。
小播:那一个模型怎么同时干前向预测、插值、参数推断三件事?
老播:靠掩码模式,论文设计了三种。自回归模式:遮掉块末尾的几个状态,推理时用已知历史推未来,对应物理模拟;超分模式:遮掉块中间的状态,两边已知推中间,对应插值;随机掩码:任意位置随机遮,对应表征学习——网络被迫从残缺输入里提炼整个系统的信息。训练时按需混合这些模式,推理时选对应掩码就行,架构完全不用换。Figure 6 三行分别画了这三种模式,灰方块是已知状态、灰圆圈是未知状态,虚线框是滑动的哈密顿块。
小播:架构本身长什么样?
老播:一个去掉因果掩码的 decoder-only transformer。把 Q 块、P 块、全局 latent code z 拼在一起,得到 2b+1 个 token,做全自注意力——没有因果掩码,所以每个状态都能看到块内所有状态。每个状态的噪声尺度被编码后加进位置嵌入,让网络知道这个状态脏到什么程度;z 作为 query token,负责输出哈密顿量的值。实验里只有两层,单 GPU 就能训。z 还有一个更重要的角色,autodecoder:它不用 encoder 去编码轨迹,而是给整个数据集维护一个 codebook,每条轨迹分配一个可学习的 z;训练时网络权重和所有 z 一起优化,测试时冻结网络权重、只优化新轨迹的 z。这样 z 就承担了系统识别:不同绳长的摆对应不同的 z,一个模型就能跨系统泛化。这个做法来自 DeepSDF,2019 年 Park 那篇,是隐式表征的成熟范式。
小播:z 一开始是随机初始化的,它怎么学到绳长这种物理量?
老播:靠训练时和网络一起优化。每条轨迹只有一个 z,网络权重是共享的,所以 z 必须把这条轨迹独有的信息都装下:绳长、质量这些系统参数,只能从 z 里来。测试时给新轨迹几个已知状态,冻结网络只调 z,等于在 latent 空间里搜索这个系统对应的编码,搜到之后整条轨迹的补全、加密就都能做了。实验里线性探针能从 z 直接读出 l2/l1,说明这个编码确实装的是物理参数,装对了。
小播:好,核心思想我理一遍:块级哈密顿量给结构,去噪给求解和修正,latent code 管多系统。对?
老播:对,而且记住一句话——物理推理在这里被重构成了对整段状态序列的去噪重建,一步一步积分变成了整段重建。这个说法后面还会再出现,它是全篇最值得带走的主张。
三场考试:前向模拟、参数推断、超分插值
小播:方法讲完,我有个疑问:三场考试的输入输出完全不同,怎么确保是同一套模型在干活?
老播:这正是掩码模式的意义,也是这个设计最妙的地方。三场考试对应三种掩码:自回归掩码考前向模拟,随机掩码考参数推断,中间掩码考插值。训练时三种掩码混合出现,模型学的是同一个从残缺物理状态恢复完整状态的能力,测试时只是换掩码,权重完全一样。所以实验里只有一套模型,换掩码考三次。
小播:实验怎么设计的?先报数据设置。
老播:两个系统:单摆和双摆。单摆变化参数是绳长 l,均匀随机取 [0.5, 1.0],质量 m=1,初始角 θ=π/2 对所有轨迹都一样;双摆变化参数是第二段绳长 l2,取 [0.5, 1.5],l1=1、m1=m2=1,初始角也都固定。重力加速度取 g=0.981。数据是模拟轨迹,1000 条训练、200 条测试,每条 128 个时间步。重点:变化的是系统参数,初始状态全部固定——这跟 Toth 那篇固定参数、变初始条件的做法正好相反,用来测模型能不能泛化到参数化的系统族,而不只是拟合一条具体轨迹。单摆能量可以从状态解析算出来,所以拿它测能量守恒;双摆是混沌系统,初始条件差一点点,未来轨迹就会彻底分岔,所以长程预报本身是更难的任务。
小播:第一场考试,前向模拟,考什么?
老播:两个子实验。第一个是拟合已知轨迹:给每条轨迹前 8 步,预测后面 120 步。看 Figure 9,粉红色是 DHN,蓝色是 HNN 配不同数值积分器,四列分别是单摆的 q 误差、平均能量误差、单条轨迹能量误差、双摆的 q 误差,横轴都是时间步。DHN 的 q 误差全程更低,总能量误差贴近零、只有小幅波动;HNN 某个积分器在单条轨迹上的能量误差会出现几个单位量级的尖峰,这就是积分器误差的累积。块大小也有讲究:b=2 时能量最稳,b 加大后长程会有波动,但论文说看不出明显的漂移趋势。第二个子实验是补全新轨迹:给前 16 步,先冻结网络权重、只优化这条轨迹的 z,再预测后 112 步。看 Figure 10,上排对比 HNN,下排对比没有任何物理约束的 vanilla ResNet 和 Transformer,注意上下两排 y 轴刻度不一样,别直接比数值。小 block 的 DHN 在 q 误差和能量误差上都更稳;但 b=8 的大 block 在长程会误差爆炸,论文的解释是两层 transformer 拟合不了太复杂的多状态关系。
小播:能量误差为什么单独拿出来看?
老播:因为 q 误差小可能只是轨迹恰好贴近,能量误差才是守恒性的直接证据。单摆能量能从 (q, p) 解析算出来,拿网络预测的状态算出能量,再跟真实能量比,误差小说明模型没有偷偷让能量漂走。DHN 的能量误差曲线贴着零走,HNN 的某些积分器在单条轨迹上能冲出几个单位的尖峰——同样是把哈密顿量学对了,积分器的选择把结果拉开了。
小播:第二场考试,参数推断,怎么考的?
老播:用双摆,目标是猜长度比 l2/l1。选这个量是因为它无量纲,数据预处理做了缩放归一化也保持不变。做法是标准的自监督评测套路:冻结学好的表征,在全局 latent code z 上接一个线性回归层,看能从 z 里读出多少物理参数。看 Figure 11,纵轴是探针 MSE,越低越好:DHN 三种块大小在 0.17 到 0.19,最好的 b=4 是 0.169;HNN 是 0.311;vanilla ResNet 和 Transformer 在 0.228 到 0.317。差距的来源就是块大小——b 让网络同时看多个时间步,z 里就攒下了系统级信息,而 HNN 只看相邻步,表征里缺这块信息。论文还扫了块参数,Figure 12:步长大约等于块大小一半,也就是 s≈b/2 时最好;重叠太多,网络只顾着自洽约束、跨状态关系学得少;重叠太少,信息传得远但稳定性差。b=4、s=2 正好落在最优点上。
小播:第三场考试,超分插值?
老播:把稀疏轨迹加密,做 4 倍超分:连续做两次 2 倍超分,每次用一个 b=2、s=1 的块,遮中间状态、用两侧已知状态推。三个阶段共享同一条轨迹的 z,形成结构化的 codebook。看 Figure 14,纵轴是乘了 100 的 MSE:同初始条件的测试段,CNN 基线略好一点,数值接近零,原因是 CNN 没有正则化、能直接过拟合训练轨迹;换到不同初始条件的测试段,CNN 的插值误差大幅上升,单摆到 0.680、双摆到 25.020,而 DHN 基本持平,单摆 0.035、双摆 6.801。这说明物理约束带来的泛化能力,在分布偏移下才真正显出来。三场考试正好对应三种掩码模式:自回归掩码考前向模拟,随机掩码考参数推断,中间掩码考插值,一套架构全部拿下。
小播:等一下,同初始条件 CNN 反而更好,这不算是论文的软肋吗?
老播:算,我们把它记进局限里。论文自己的解释是 CNN 能过拟合训练分布,所以同分布测试占便宜;这恰好反过来说明 DHN 的收益主要来自分布外泛化,分布内拟合它没有优势。后面讲局限时再展开。
它在哪条谱系上:和谁比、好在哪里
小播:把 DHN 放进谱系里,它站在哪?
老播:三条线交汇。第一条是哈密顿和拉格朗日神经网络线:HNN 是 Greydanus 2019 那篇,学连续哈密顿量加数值积分;HGN 是 Toth 2019 那篇,从图像序列学哈密顿动力学;后面还有 Finzi 2020 的显式约束版本、SymODEN 加耗散项的版本。DHN 的改进是把 HNN 当成 b=1、s=1 的特例,用块大小和步长把「局部到全局」变成连续谱,顺手解决积分器和隐式求解的问题。第二条是 PDE 线:PINN 把 PDE 损失嵌进网络,FNO 用傅里叶变换学函数空间映射,Neural ODE 参数化连续时间动力学;它们面向连续时空和规则采样,对离散、不规则采样的哈密顿动力学并不顺手,论文在 Related Work 里明确说了这个区别。第三条是生成模型和自监督线:掩码建模来自 MAE,去噪来自 DDPM,autodecoder 来自 DeepSDF,整段序列去噪重建来自视频生成模型的思路,论文引了 Diffusion Policy 那批工作。
小播:所以它跟 He 组的对话,具体对在哪几个点?
老播:三个点。第一,MAE 的随机掩码被改造成物理版的掩码加噪声;第二,MAE 用 encoder 重建像素,DHN 用去噪重建物理状态,重建目标从像素换成了哈密顿结构约束下的状态;第三,autodecoder 的每样本可学习编码,对应 MAE 和 DeepSDF 的 latent 范式。加上 Kaiming He 本人就在作者名单里,这篇几乎是 He 组工具箱在物理动力学上的直接演示。它处的位置:把生成式去噪的目标完整接到物理算子上,物理推理作为重建问题,这是它和同批物理学习论文拉开距离的地方。
小播:整段序列去噪重建,这个说法跟视频生成有什么关系?
老播:直接关系。论文在结论里说,模拟被重新定义成一个全局、时间一致的重建过程,这明显借了视频生成模型的思路——扩散视频模型也是一整段序列一起去噪,而不是逐帧预测。DHN 等于把逐帧预测的模拟改成整段去噪的模拟,任务定义一变,补全、插值、参数推断这些从局部观测推全局的问题就自然落入同一框架。这也是它和 Diffusion Policy 那批工作被引在同一处的原因。还有一个差异值得说:系统参数被放进了 latent code 而不是显式条件输入,测试时通过优化 z 适配新系统,相当于把 test-time adaptation 也揉进了物理模型。
局限:哪些地方它自己都说没做好
小播:现在说局限,哪些是论文自己承认的?
老播:第一条,计算成本。论文在结论里直接说,DHN 比 baseline transformer 需要更密集的梯度计算。第二条,规模。实验只有单摆、双摆这类简单时域动力学,扩展到复杂时空系统需要层级或注意力结构,论文没做。第三条,大块不 work:b=8 长程误差爆炸,说明当前两层架构的容量撑不起太大的块。
小播:那哪些是我们读出来的?
老播:第四条,能量守恒是松弛过的近似:守恒的是块内总能量,而且重叠区的自洽损失很少真正归零,守恒程度取决于网络容量和 b、s 的选择,论文附录 B 自己承认了这一点,但没有给定量数字。第五条,证据链不完整:Figure 9 和 Figure 10 大部分结果只有曲线没有表格数值,去噪步数固定 10 也没有消融,代码和权重没发布,论文标注还在审稿。第六条,推理期每条新轨迹都要先优化 z,这个优化本身有成本,遇到含噪声观测或者优化不收敛时表现会怎样,论文没有讨论。另外同初始条件的超分实验 CNN 反而更好,说明分布内拟合它没有优势,卖点全押在分布外泛化上。
小播:这些局限里,哪一条最影响实用性?
老播:如果只挑一条,我选计算成本加推理优化这一对。训练时梯度更密,推理时每条新轨迹还要先优化 z,两者叠加,跟 HNN 那种训完直接积分的用法比,部署成本明显更高。加上能量守恒是近似保证,真要拿去给科学实验当可信工具,还需要更严格的误差控制。
收尾:这期记住三件事
小播:好,最后请老播把三件事钉死。第一件?
老播:哈密顿量被神经算子化,而且从「相邻两步」推广成「一块 b 个状态」:块级离散哈密顿量让网络建立跨时间步的关系,守恒量变成块内总能量,HNN 只是 b=1、s=1 的特例。这是「结构」那一半。
小播:第二件?
老播:去噪是「灵活」那一半:掩码加变幅度噪声训练,推理时渐进去噪,一次前向替代了隐式求解的优化过程,也修正了数值积分误差;一个目标同时支撑前向模拟、插值、参数推断。再重复一遍核心结论:DHN 把物理推理重构成对整段状态序列的去噪重建,一步一步积分变成了整段重建,这是它区别于所有逐步积分方法的地方。
小播:第三件?
老播:它是跟 He 组对上话的好入口:MAE 的掩码、扩散的去噪、DeepSDF 的 autodecoder,三件套都在,只是作用对象从图像变成了哈密顿结构约束下的物理状态。对后续工作的意义:物理推理作为重建问题这个视角,加上「一个 latent code 管一个系统」的多系统建模,值得在更大规模、更复杂系统上验证。
小播:好,这期我们记住:哈密顿结构给守恒,去噪给求解和修正,整段重建给任务泛化。下期见。
老播:下期见。