网格细胞如何给抽象空间画地图:先提速度,再走积分(MIT,NeurIPS 2024,泛读)
一句话定位:论文把「网格编码 = 通用速度积分器」这个主张落成一个可训练的自监督模型——面对任何一个新的抽象认知域,大脑只需要提取一个低维、与内容无关、自洽的广义速度信号,再交给网格细胞做路径积分,就能复用同一套网格码画出该域的地图。这张卡覆盖:速度优先的认知映射思路、闭环自监督约束(以及它如何从数学上推出速度映射的线性性)、五个程序化抽象域上的定量结果,以及它如何支撑「latent flow integration」的类比论证。
---
要解决的问题:同一群网格细胞,怎么给完全不同的抽象空间画地图
内侧内嗅皮层的网格细胞是空间导航的核心元件:动物在房间里移动时,每个网格细胞会在多个位置发放,发放点连成规则的三角形网格,构成六边形对称的周期性地图。这套机制的关键运算叫路径积分——细胞群的活动状态(网格相位)随速度线性更新,位置等于速度对时间的累加。近年实验发现,同一群细胞在抽象空间里也出现网格样发放:大鼠听音调连续变化的纯音时(Aronov et al. 2017)、猕猴看自然图像时(Killian et al. 2012)、人类用摇杆连续改变一只卡通鸟的腿和脖子长度时(fMRI),都能观察到类似的结构。这些域的共同点是都有一两个连续可变的低维轴,但感官观测本身是高维的——一张 16×16 的图像就有 256 个像素值。
论文提出的核心假说是:大脑把「画空间地图」的机制整体迁移到抽象域,迁移的关键在于先提取「广义速度」。地图生成被拆成两步:第一步,从高维连续感官流里提取一个低维位移信号,即从一帧到下一帧的变化量;第二步,把这个速度信号喂给现成的网格积分器,由它把速度累加成地图。相比之前的工作,这个切口的优势在于换域成本。Tolman-Eichenbaum Machine(TEM)用循环网络基于预定义动作预测观测,换一个环境就要连同网格样表征一起重学;后继表示(successor representation,SR)依赖离散动作空间;克隆结构认知图(CSCG)只处理离散域。它们都要为每个新域同时学「状态表示 + 转移结构」。论文把状态表示外包给已经存在的网格码,新域只需要补一块速度提取器,这就是「速度优先」的含义。
核心思想:网格编码是一台通用速度积分器
要支撑这个主张,提取出的速度必须满足两条性质。其一是内容无关:同一段位移,无论发生在哪两个具体画面之间,编码出的速度向量应当一致,这样速度才对域的「内容」无感。其二是自洽:沿任意一条闭合路径走一圈,累加的位移必须回到起点,否则积分出的地图会自相矛盾,同一个位置落到不同的网格相位上。这两条性质指向一个自监督设定:没有速度标签,也没有预先给定的坐标轴和速度维度。
图 1 是全文的概念图:a–d 展示网格样发放如何从空间推广到音高、视觉与卡通鸟空间;e 定义本文最常用的抽象域 Stretchy Blob——画面中央一个二维高斯斑块,可以沿高、宽两轴拉伸或收缩;f 画 TEM/SR/CSCG 的路线(边遍历边学状态表示加转移结构);g 画本文路线(只学一个与状态无关的自洽速度,用最小维度编码全局转移结构);h 点出前置问题——大脑怎么先提取出广义速度;i 说明本例的真实速度只有 2 维,与它连接的具体状态无关。
实现:编码器-解码器加四条损失,闭环损失是题眼
模型是编码器-解码器结构:编码器 f 吃相邻两帧 i_t、i_{t+1},输出低维速度 v̂;解码器 g 用 i_{t+1} 和 v̂ 重建下一帧 î_{t+2}。编码器与解码器都是多层感知机,每域参数量 53.6 万到 62.2 万(Table 2);训练用 Adam、学习率 5e-4、800 到 1200 轮、batch 192 到 256,单张 Titan RTX 上每个实验一到五小时。潜变量维度与域流形维度一致(1D 域 1 维、2D 域 2 维、3D 鸟 3 维),但训练时模型并不知道这个数字是答案。训练数据是程序化生成的轨迹:轨迹长 81 步、训练集 80 万样本、测试集 20 万样本,关键设定是轨迹首尾相接成闭环。
训练有四条损失。下一状态预测损失最小化 ‖i_{t+2} − î_{t+2}‖²,保证速度可解码。闭环损失(loop-closure)要求整条闭环轨迹上估计速度之和为零向量,权重是下一状态预测损失的 10 倍,是全文的题眼。捷径损失用两段速度相加去预测两步后的帧(从 i_{t+2} 加 v̂₂→₃ + v̂₃→₄ 预测 i_{t+4}),检验解码器对组合速度的泛化。各向同性损失在小位移附近(用 1 减余弦相似度做距离度量、小于阈值 θ)最小化速度范数的方差,消除不同方向上的尺度差。
闭环损失还附带一个重要的数学结论。论文附录 B.1 证明:把闭环约束施加在「真实速度 → 估计速度」的映射 e 上,可以推出齐次性 e(αv) = αe(v) 和可加性 e(v₁+v₂) = e(v₁)+e(v₂),因此 e 是线性函数。也就是说,模型学到的速度表示必须是真实速度的线性变换,任何非线性扭曲都会被闭环约束排除。这对网格细胞至关重要,因为路径积分就是线性累加——相位更新的每一步都只是把一个速度向量加进来,只有速度表示是线性的,积分结果才正确。消融实验给出量级感受:在 Moving Blobs 域上只开下一状态预测损失,误差 0.134;加上闭环损失降到 0.044;再加两个辅助损失降到 0.02。并且只有闭环损失在场时,喂给合成网格模块才出现六边形发放野。
自监督的程度值得强调:没有任何损失告诉模型真实速度是多少、坐标轴怎么摆、速度该有几维,尺度与方向全部自学。论文还验证了训练数据不必全由闭环构成:把 50% 闭环轨迹与 50% 随机游走混在一起,闭环损失只作用在闭环段上,误差 0.035,与全闭环训练基本持平。
关键实验:五个抽象域上误差低一到两个数量级
度量方式需要先讲清楚,因为它直接决定结论的含义。模型输出的速度没有固定坐标系,只要它是真实速度的线性变换就算合格,所以论文把估计速度经一个最佳线性变换对齐到真实速度(用伪逆求解),再计算归一化均方误差;先用 DBSCAN 聚类去掉少量离群点再拟合变换,但误差按全部数据(含离群点)计算。每个实验跑 6 个随机种子,报告均值±标准差。表 1 的基线有四个降维方法(PCA、Isomap、UMAP、自动编码器)和一个视频预测网络 MCNet。
逐域看数字(均为 6 种子均值±标准差):Stretchy Blob(2D)本文 0.05 ± 0.01,MCNet 1.95 ± 0.14、PCA 0.63、Isomap 0.42、UMAP 0.79、自动编码器 (1.59–3.40)×10³;Stretchy Bird(2D)本文 0.07 ± 0.03,MCNet 2.01 ± 0.01、PCA 0.21、Isomap 0.36、UMAP 0.46、自动编码器 20.90 ± 38.04;Stretchy Bird(3D)本文 0.07 ± 0.02,MCNet 2.96 ± 0.10、PCA 0.31、Isomap 0.64、UMAP 1.05、自动编码器 (2.66–5.08)×10²;Moving Blobs(2D)本文 0.02 ± 0.01,MCNet 2.00、PCA 1.94、Isomap 0.66、UMAP 0.62、自动编码器 2.03;Frequency Modulation(1D)本文 0.02 ± 0.02,MCNet 2.01、PCA 1.97、Isomap 2.00、UMAP 2.00、自动编码器 2.00。最刺眼的对比出现在最简单的 1D 任务上:五个基线误差全部在 2.0 附近,本文是 0.02,差两个数量级;Stretchy Blob 上自动编码器比本文高四到五个数量级。基线里表现最好的是 Stretchy Bird(2D)上的 PCA(0.21),仍比本文高 3 倍。
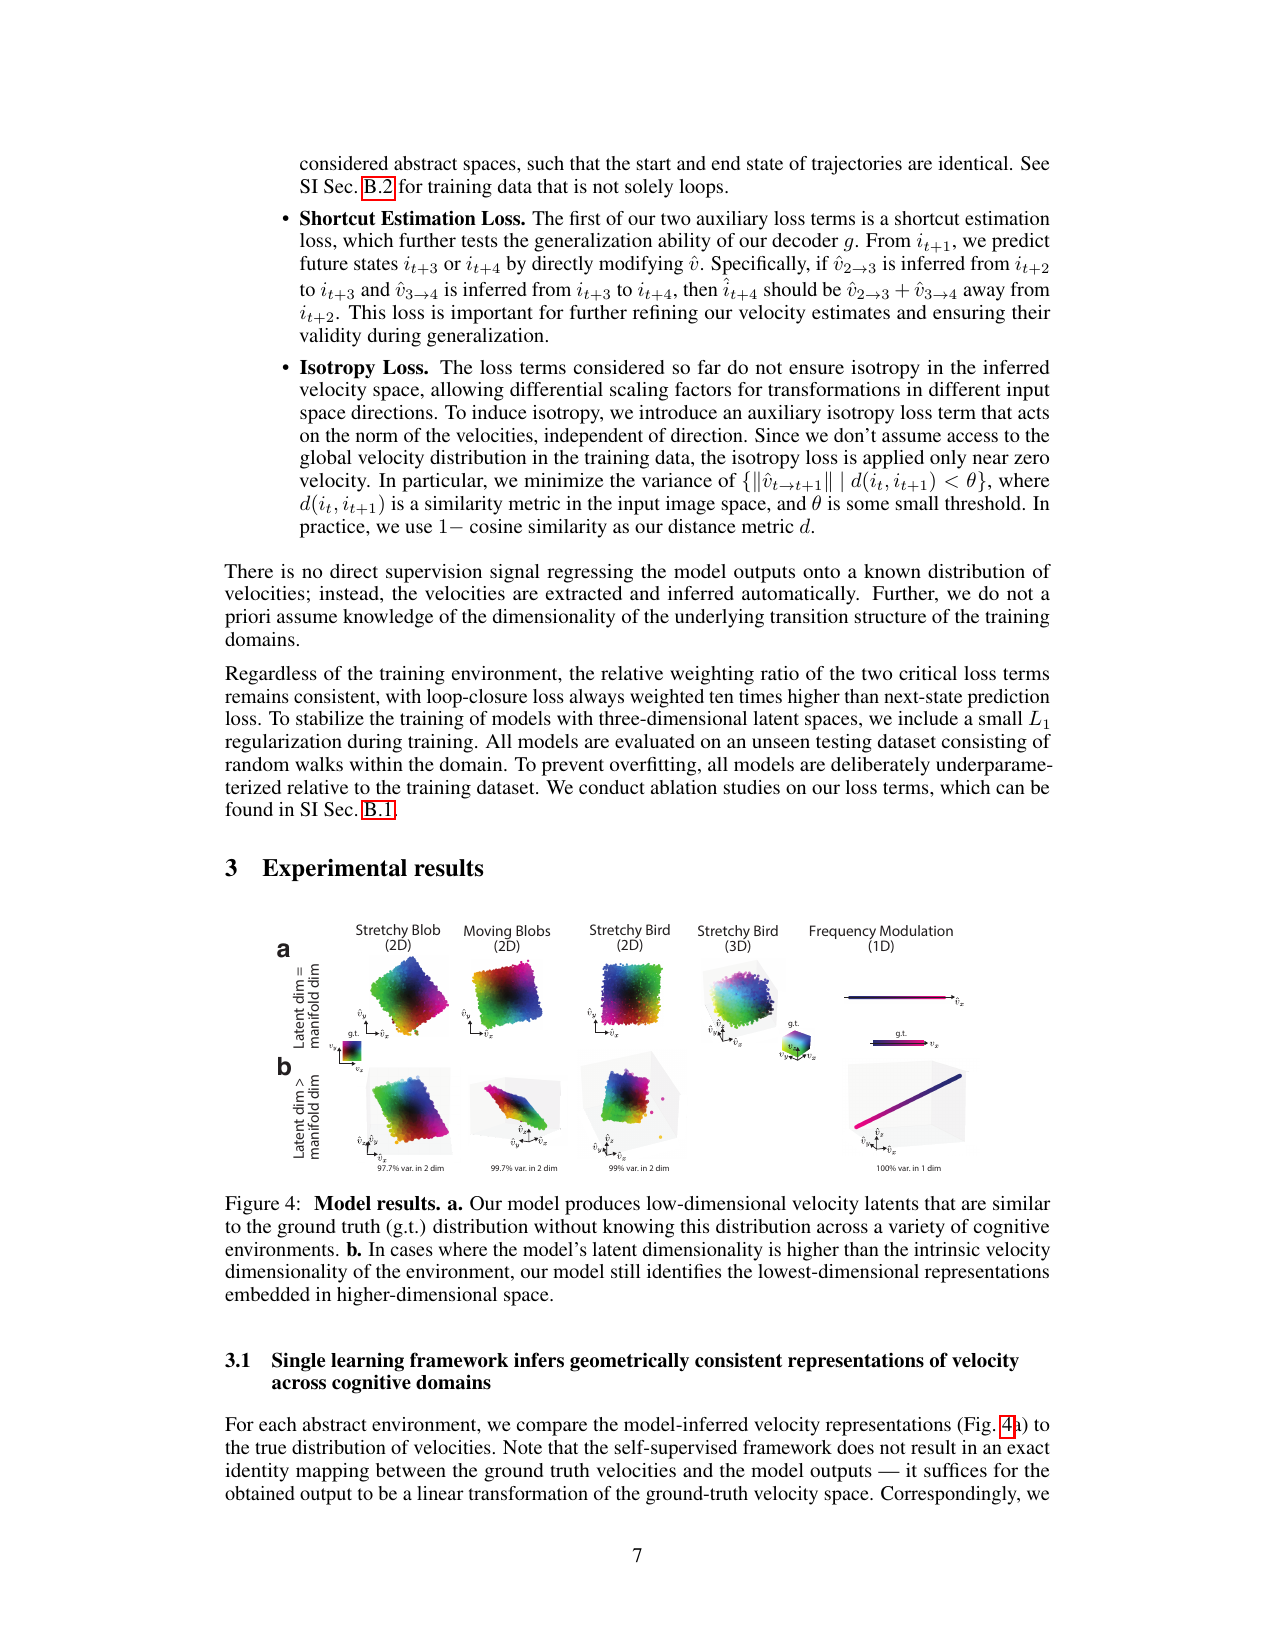
图 4 回答两个问题。a 逐域对比模型推断速度分布与真实速度分布:没有速度标签也能重建正确的分布形态。b 处理「潜变量维度给高了」的情况——把潜变量设成 3 维而真实流形只有 2 维,模型自动把表示压缩回二维子空间:对推断速度做 PCA,Stretchy Blob 上前两维捕获 97.7% 的方差,Moving Blobs 99.7%,Stretchy Bird(2D)99%,1D 的 Frequency Modulation 上 100% 的方差落在 1 维。对照是图 6 里的 PCA:对 Moving Blobs 的 256 维原始输入直接降维,需要约 24 个主成分才能覆盖 95% 的方差。结论是本文模型等于一种顺着过渡结构做的降维:它学的状态附近的切空间(速度方向),状态点之间的欧氏距离。
网格积分:估计速度接进合成网格模块出现六边形发放野
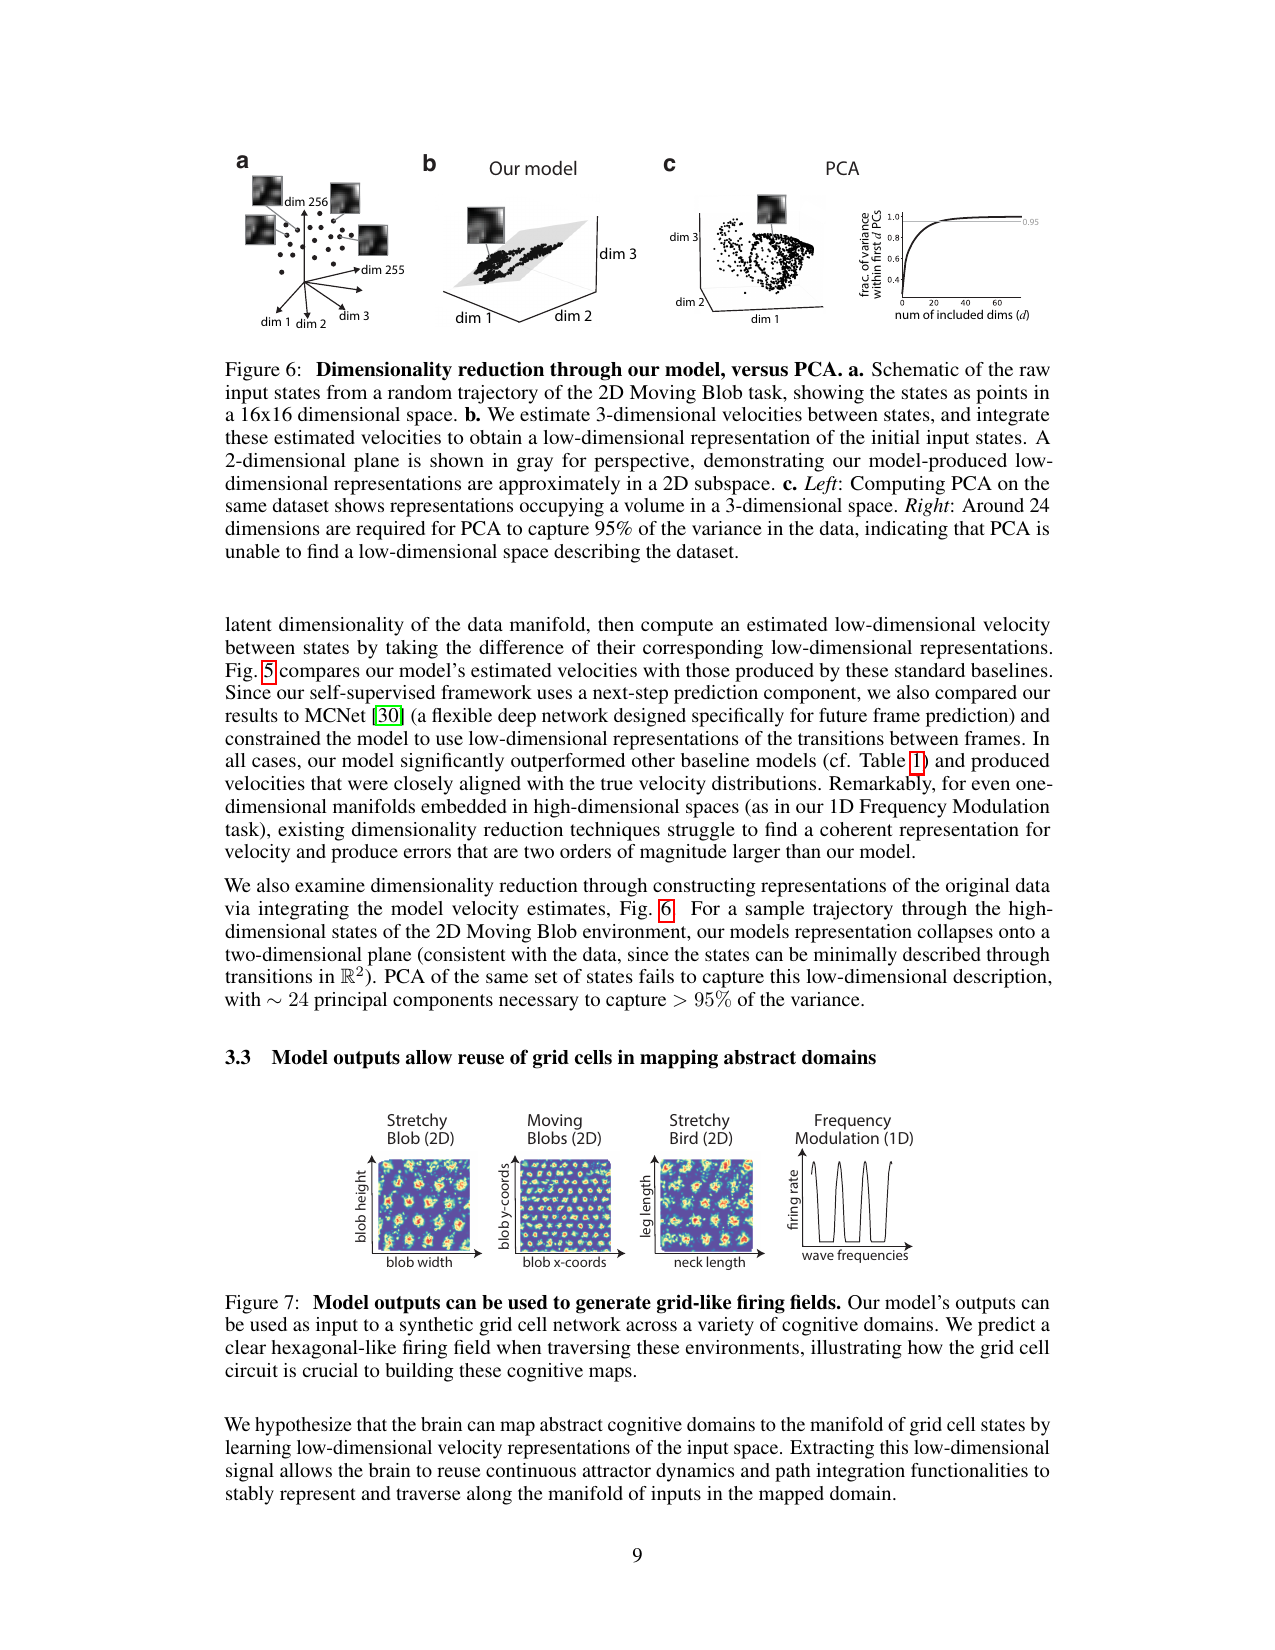
最后一个关键实验把速度提取与网格细胞直接接起来(图 7):把估计速度(允许一个最佳线性变换对齐)喂给三层平面波叠加模拟的合成网格模块,速度用来更新平面波相位,再让模型遍历四个抽象域。单个神经元的发放野呈现清晰的六边形图案——横轴是各域的连续状态参数(blob 高/宽、腿长/脖长、斑块坐标、波频率),色标是发放率。这张图直接演示标题主张:同一个网格积分器,只要喂入正确的速度,就能在多个抽象域上画出网格地图。由此论文给出一个可证伪的跨域预测:同一网格模块跨域积分时,细胞间共同发放关系(谁和谁共发放)应保持不变;这与睡眠期、跨环境表征不变性的已有观测(Gardner 2019、Trettel 2019、Gardner 2021 的环面拓扑)方向一致,但尚未被直接实验验证。
谱系定位:与认知地图模型、降维方法,以及 latent flow integration 的类比
这篇论文处在「速度提取优先」这个新切口上。与 TEM、SR、CSCG 对照:它们同时学状态表示加转移结构,换域成本高,本文把状态表示外包给固定网格码,只需补速度提取器。与 PCA、Isomap、UMAP、自动编码器对照:它们保持状态间近邻距离,忽略切空间结构,在低维流形任务上系统性失败。与 MCNet 这类视频预测网络对照:它们预测像素级未来帧,得不到最小低维速度,表示无法直接给网格细胞积分。再往外接一条生成模型的类比,也就是这份解读清单特意提示的「latent flow integration」论证:只要能在高维观测流形上提取一个自洽、低维、与内容解耦的速度场,一台固定的积分器就能把速度累加、映射出整个域的结构。这与潜在流积分类方法的核心论点同构——那里用学到的速度场把噪声或隐变量积分成数据,这里用网格相位积分把抽象域状态积分成认知地图。论文自身没有使用 latent flow integration 这个词,这个连接来自解读清单的提示;它把「闭环一致性」这条生物约束摆到台面上,恰好可以作为潜在流模型设计一致性目标的一个参照。
局限
论文自承与我们可以读出的局限共五条,另附一条信息来源说明。第一,两个核心损失(下一状态预测、闭环)在生物学上对应感官预测误差与神经积分,但两个辅助损失(捷径、各向同性)的生物支持较弱,更像为训练稳定性补的工程手段。第二,论文假设潜空间速度向量可交换,即速度相加的顺序不影响结果,这使它无法直接表示非欧空间(如球面)上的切向量;论文给出的出路是把非欧空间嵌入更高维的欧氏空间。第三,验证范围全部是程序生成、低维过渡结构的人工域(轨迹长 81、图像 16×16 或 32×12),没有自然图像、真实神经数据或大尺度环境,论文把扩展到自然环境和学习非欧结构(如家谱)列为未来工作。第四,模型假设域内状态唯一、相邻帧过渡可由单一速度刻画,真实刺激流里同一观测可能对应多种移动解释,这种观测歧义超出模型处理范围。第五,核心跨域预测(细胞间共同发放关系跨域保持)目前只有理论论证与间接观测支持,尚无直接实验证据。信息来源说明:随任务提供的 PDF 是残缺导出(第 3–26 页全白、无嵌入图片),本卡正文、实验数字与图选页依据 NeurIPS 2024 官方 Proceedings 版 PDF(papers.nips.cc,hash 9b333cc1c9eb36e479b27f8c19f0873c)与作者公开代码库(github.com/abhi-iyer/velocity_extraction)补足。
复现
作者公开了代码库 github.com/abhi-iyer/velocity_extraction;数据全部程序生成(五个抽象域,训练集 80 万、测试集 20 万样本,轨迹长 81),超参见论文 Table 2(Adam 学习率 5e-4、800–1200 轮、batch 192–256、各损失权重);硬件为单张 NVIDIA Titan RTX,单实验一到五小时;6 个随机种子跨实验复用。
记住的三件事
1. 网格编码是一台通用速度积分器:给同一套网格相位状态喂不同域的广义速度,它就能积分出不同域的地图,前提是速度与内容解耦且自洽。
2. 自洽靠闭环损失实现,且闭环约束在数学上推出速度映射必须是线性的——消融里闭环损失把 Moving Blobs 域的误差从 0.134 压到 0.044,再加辅助损失到 0.02。
3. 「内容无关速度 + 闭环一致性 + 固定积分器」构成 latent flow integration 类方法的类比论证:高维观测流形上的位移,可以由一个自洽可积的速度场变成潜在空间里的线性流动。
论文假设大脑把「空间导航用的网格编码」当一台通用速度积分器:面对任何新的抽象域(音高、图像特征、会变形的卡通鸟),只提取一个低维、与内容无关、自洽的广义速度信号,再交给网格细胞做路径积分,就能复用同一套网格码画出该域的地图。模型用「闭环轨迹上位移和为零」的自监督约束学速度,并证明该约束迫使估计速度成为真实速度的线性函数;在五个程序生成的抽象域上,推断速度误差 0.02–0.07,比 PCA/Isomap/UMAP/自动编码器/MCNet 低一到两个数量级,喂给合成网格模块能复现六边形发放野。
阅读提示
精读深度:泛读
清单提示:原文提示:网格编码 = 通用速度积分器;用于构建「latent flow integration」的类比论证
问题
要解决什么:内侧内嗅皮层的网格细胞在空间导航中生成规则的周期性地图;近年实验发现,同一群细胞在音调连续变化(大鼠,Aronov et al. 2017)、视觉特征(猕猴,Killian et al. 2012)、可变形卡通鸟(人,fMRI)等抽象空间里也出现网格样发放。大脑如何把「画空间地图」的能力迁移到这些非空间域?论文聚焦前置问题:大脑如何在不知道任何坐标、也没有速度标签的情况下,从高维连续感官流里提取出可用的「广义速度」信号。
为什么 prior work 不够:TEM(Tolman-Eichenbaum Machine)用 RNN 基于预定义动作预测观测,换环境要重学动作与网格样表征;后继表示(SR)依赖离散动作空间;CSCG(克隆结构认知图)只处理离散域。这些方法都要为每个新域同时学「状态表示 + 转移结构」,换域成本高,也无法复用网格细胞的预结构化状态。经典降维(PCA/Isomap/UMAP/自动编码器)保持状态间距离,忽略状态附近的切空间(速度)结构,在低维流形嵌入高维的任务上系统性失败;视频预测网络(MCNet)预测像素级未来帧,但得不到最小低维速度,表示无法直接给网格细胞做积分。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 相邻两帧 i_t, i_{t+1} | 高维图像/频谱(Stretchy Blob 16×16、Stretchy Bird 32×12、Moving Blobs 16×16、Frequency Modulation 1×100) | 来自程序化生成的轨迹;轨迹长 81 步,训练集 80 万样本、测试集 20 万样本;速度分布随域不同(如 Blob 用 U²(0.05,0.6),Bird 用 U²(−1.5,1.5),Moving Blobs 用 U²(−20,20),FM 用 U(0.1,10)) |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 低维广义速度 v̂_{t→t+1} | 连续向量,维度 = 域流形维度(1D 域 1 维、2D 域 2 维、3D Bird 3 维) | 编码器 f 的输出;要求内容无关、自洽(闭环和为 0);训练时无任何速度标签,维度也不事先给定 |
| 预测帧 î_{t+2}(仅训练/验证解码器) | 与输入同尺寸图像 | 解码器 g 用 i_{t+1} 与 v̂ 重建的下一帧,用于下一状态预测、捷径损失 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| Stretchy Blob (2D) | 16×16 帧;训练 800k / 测试 200k | 画面中央高斯斑块沿高、宽两轴拉伸/收缩;速度 U²(0.05,0.6),最大速度步 0.08 |
| Stretchy Bird (2D) | 32×12 帧;训练 800k / 测试 200k | 鸟的脖子、腿两个自由度,对应人脑实验 [15];速度 U²(−1.5,1.5),最大步 1.5 |
| Stretchy Bird (3D) | 32×12 帧;训练 800k / 测试 200k | 两条腿独立变化;速度 U³(−1.5,1.5) |
| Moving Blobs (2D) | 16×16 帧;训练 800k / 测试 200k | 一组高斯斑块平移、进出视野;速度 U²(−20,20),最大速度步 1.0 |
| Frequency Modulation (1D) | 1×100 频谱;训练 800k / 测试 200k | 一组正弦波频率连续变化,模拟 Aronov et al. 2017 的声音调制实验;速度 U(0.1,10),最大步 0.05 |
架构(摘要)
主干与结构
backbone:编码器 f:相邻两帧 → 低维速度;解码器 g:状态 + 速度 → 下一帧;均为 MLP
参数:每域 536k–622k 可学习参数(Table 2:Blob/Moving Blobs 536e3,Bird 2D/3D 622e3,FM 544e3)
类型:编码器-解码器 MLP + 连续吸引子网格积分器(积分器只在生成发放野时使用)
关键组件
- 编码器 f(i_t, i_{t+1}) → v̂_{t→t+1}:把高维相邻帧压缩为低维速度,内容与位移解耦
- 解码器 g(i_{t+1}, v̂) → î_{t+2}:保证速度可解码,参与下一状态预测与捷径损失
- 积分器:三层平面波叠加模拟的网格模块,速度更新平面波相位,仅在评估时用来画发放野
- 潜变量维度 = 流形维度(1–3);给定更高维度时模型自动塌缩到真实子空间(Fig. 4b)
为什么这样设计
状态表示交给现成的网格码,新域只需补速度提取器;编码器-解码器把「内容」与「位移」分开,使速度对域内容无关;闭环损失要求绕圈相位复位,保证速度自洽且线性可积——这两条正是网格细胞做线性路径积分的前提。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 推断速度 vs 真实速度的归一化均方误差(最佳线性变换对齐后计算;DBSCAN 去离群拟合、全数据评估) | 0.05 ± 0.01 | MCNet 1.95 ± 0.14;PCA 0.63;Isomap 0.42;UMAP 0.79;Autoencoder (1.59–3.40)×10³ | Stretchy Blob (2D);16×16 帧,潜变量 2 维;6 个随机种子各跑 1 次取均值±标准差(Table 1) |
| 推断速度 vs 真实速度的归一化均方误差(同上度量) | 0.07 ± 0.03(2D)/ 0.07 ± 0.02(3D) | 2D:MCNet 2.01 ± 0.01、Autoencoder 20.90 ± 38.04、PCA 0.21、Isomap 0.36、UMAP 0.46;3D:MCNet 2.96 ± 0.10、Autoencoder (2.66–5.08)×10²、PCA 0.31、Isomap 0.64、UMAP 1.05 | Stretchy Bird 2D / 3D;32×12 帧,潜变量 2 维 / 3 维;6 种子(Table 1) |
| 推断速度 vs 真实速度的归一化均方误差(同上度量) | 0.02 ± 0.01 | MCNet 2.00 ± 0.01;Autoencoder 2.03 ± 0.05;PCA 1.94;Isomap 0.66;UMAP 0.62 | Moving Blobs (2D);16×16 帧,潜变量 2 维;6 种子(Table 1) |
| 推断速度 vs 真实速度的归一化均方误差(同上度量) | 0.02 ± 0.02 | MCNet 2.01 ± 0.01;PCA 1.97;Isomap 2.00;UMAP 2.00;Autoencoder 2.00 ± 0.01(基线误差约为本文 100 倍) | Frequency Modulation (1D);1×100 频谱,潜变量 1 维;6 种子(Table 1) |
| 潜变量高于流形维度时,推断速度 PCA 前 d 维捕获的方差占比 | 97.7%(Blob)/ 99.7%(Moving Blobs)/ 99%(Bird 2D)落在 2 维;100% 落在 1 维(FM) | PCA 直接对 Moving Blobs 的 256 维原始输入需要约 24 个主成分才覆盖 95% 方差 | Fig. 4b / Fig. 6;潜变量设 3 维而真实流形 2 维(FM 设 2 维而真实 1 维) |
| 损失消融(Moving Blobs)与数据消融(Stretchy Bird 2D) | 只开下一状态预测 0.134;+闭环 0.044;+两个辅助损失 0.02;50% 闭环+50% 随机游走 0.035 | 全闭环训练(Table 1 设定)下 Moving Blobs 0.02、Bird 2D 0.07 | 附录 B;误差度量同 Table 1;数据消融中闭环损失只作用在闭环轨迹上 |
Insights
- 网格编码 = 通用速度积分器:同一套周期性的网格相位状态,只要喂入内容无关且自洽的广义速度,就能积分出任意抽象域的地图;「画地图」被拆成「速度提取 + 速度积分」两步,前者是新域唯一要学的部分(对应 Figure 1 g/h)。
- 闭环约束在数学上等价于要求速度映射线性:附录 B.1 从「闭环位移和为零」推出齐次性与可加性,e(αv)=αe(v)、e(v₁+v₂)=e(v₁)+e(v₂),所以估计速度必为真实速度的线性函数——这正是网格细胞线性路径积分能工作的前提。
- 跨域预测:同一网格模块跨域积分时,细胞间共同发放关系(谁和谁共发放)应保持不变;这是可证伪的实验假说,与 Gardner 2019、Trettel 2019、Gardner 2021(环面拓扑)等睡眠期/跨环境表征不变性观测一致。
- 从降维视角看:与其在状态集合上算距离(PCA 等),不如学每个状态附近的切空间(速度);连续变化输入的低维流形任务上,后者误差低一到两个数量级。
vs 同类工作
- vs TEM:TEM 用 RNN 预测观测、依赖预定义动作,换环境要重学 affordance 与网格样表征;本文先提速度,换域只需把速度投影到固定网格码。
- vs SR / CSCG:SR 依赖离散动作空间,CSCG 仅限离散域;本文面向连续抽象域且完全无监督(无动作标签、无速度标签)。
- vs PCA / Isomap / UMAP / Autoencoder:它们保持状态间距离,忽略切空间(速度)结构;本文学全局速度算子,1D Frequency Modulation 上误差低两个数量级。
- vs MCNet:MCNet 做视频未来帧预测,不追求最小低维速度,表示无法直接给网格细胞积分。
- 「latent flow integration」类比:本文的「内容无关速度 + 闭环一致性 + 固定积分器」机制,与潜在流积分类方法的核心论点同构——高维观测流形上的位移,可由一个自洽可积的速度场变成潜在空间里的线性流动;论文自身未用该词,此连接来自解读清单提示。
局限
- 论文自承:两个核心损失(下一状态预测、闭环)在生物学上对应感官预测误差与神经积分,但两个辅助损失(捷径、各向同性)的生物支持较弱,更像为训练稳定性补的工程手段。
- 论文自承:假设潜空间速度向量可交换(加法顺序无关),因此无法直接表示非欧空间(如球面)的切向量;论文给出的出路是把非欧空间嵌入更高维欧氏空间。
- 验证范围全部是程序生成、低维过渡结构的人工域(轨迹长 81、图像 16×16 / 32×12),没有自然图像、真实神经数据或大尺度环境;论文把扩展到自然环境和学习非欧结构(如家谱)列为未来工作。
- 我们读出:模型假设域内状态唯一、相邻帧过渡可由单一速度刻画;真实刺激流里同一观测可对应多种移动解释(观测歧义),超出模型处理范围。
- 我们读出:核心跨域预测(细胞间共同发放关系跨域保持)目前只有理论论证与睡眠期/跨环境不变性观测的间接支持,尚无直接实验验证,属于可证伪的待检验假说。
- 信息来源备注:随任务提供的 PDF 为残缺导出(仅第 1–2 页有文本,第 3–26 页全白、无嵌入图片);本卡正文、实验数字、图选页与说明依据 NeurIPS 2024 官方 Proceedings 版 PDF(papers.nips.cc,hash 9b333cc1c9eb36e479b27f8c19f0873c)与作者公开代码库 github.com/abhi-iyer/velocity_extraction 补足;figures/p02.png 来自本地 extracted 整页图,figures/p07.png、p09.png 由官方 PDF 同分辨率(150 dpi)渲染。
可复现性
- code:https://github.com/abhi-iyer/velocity_extraction
- hardware:单张 NVIDIA Titan RTX,单实验 1–5 小时
- data:程序生成五个抽象域;训练集 80 万、测试集 20 万样本,轨迹长 81;全部超参见论文 Table 2(Adam lr 5e-4、800–1200 epoch、batch 192–256、各损失权重)
- seeds:6 个随机种子,跨实验复用同一批种子
主干与结构
backbone:编码器 f:相邻两帧 → 低维速度;解码器 g:状态 + 速度 → 下一帧;均为 MLP
参数:每域 536k–622k 可学习参数(Table 2:Blob/Moving Blobs 536e3,Bird 2D/3D 622e3,FM 544e3)
类型:编码器-解码器 MLP + 连续吸引子网格积分器(积分器只在生成发放野时使用)
关键组件
- 编码器 f(i_t, i_{t+1}) → v̂_{t→t+1}:把高维相邻帧压缩为低维速度,内容与位移解耦
- 解码器 g(i_{t+1}, v̂) → î_{t+2}:保证速度可解码,参与下一状态预测与捷径损失
- 积分器:三层平面波叠加模拟的网格模块,速度更新平面波相位,仅在评估时用来画发放野
- 潜变量维度 = 流形维度(1–3);给定更高维度时模型自动塌缩到真实子空间(Fig. 4b)
为什么这样设计
状态表示交给现成的网格码,新域只需补速度提取器;编码器-解码器把「内容」与「位移」分开,使速度对域内容无关;闭环损失要求绕圈相位复位,保证速度自洽且线性可积——这两条正是网格细胞做线性路径积分的前提。
概念图:学习抽象认知环境中的速度
原文 caption:Conceptual understanding of learning velocities in abstract cognitive environments. a. Grid cells generate hexagonal tuning in spatial navigation. b. Similar grid-like tuning in auditory frequency space in rodents. c. in visual space in monkeys. d. in an abstract cartoon bird space in human experiments. e. Abstract domain 'Stretchy Blob', a 2D Gaussian that stretches/shrinks along two axes. f. SR, CSCG, and TEM learn transition structures by traversing the domain, building state representations plus transition structures. g. Our approach learns a self-consistent movement (velocity) signal independent of the traversed states, encoding global transition structure in a minimally low-dimensional representation. h. How can the brain extract a general notion of velocity in abstract, non-spatial domains? i. Actual movement signals in this example are low-dimensional and independent of the states they connect.
a–d 用四个实验把「网格样发放」从空间推广到音高/视觉/卡通鸟空间,是全文的动机来源;e 定义 Stretchy Blob 抽象域(2D 高斯,两轴伸缩);f 画 TEM/SR/CSCG 的路线——边遍历边学状态表示加转移结构;g 画本文路线——只学一个与状态无关的自洽速度;h 点出前置问题(如何先提取广义速度);i 说明本例真实速度只有 2 维、与连接的状态无关。读图顺序:先看 a–d 建立「网格能跨域出现」,再看 f 与 g 的对照理解「速度优先」这个切口。重要性:key。
模型结果:推断速度与真实速度分布一致,且自动找到正确维度
原文 caption:Model results. a. Our model produces low-dimensional velocity latents that are similar to the ground truth (g.t.) distribution without knowing this distribution across a variety of cognitive environments. b. In cases where the model's latent dimensionality is higher than the intrinsic velocity dimensionality of the environment, our model still identifies the lowest-dimensional representations embedded in higher-dimensional space.
a 逐域对比模型推断速度分布与真实速度分布(每列一个抽象域,横轴纵轴是速度分量,g.t. 为真实分布):没有速度标签也能重建正确的分布形态;b 处理「潜变量维度给高了」的情况:横轴是推断速度的前两个主成分,标注了前 2 维(或 1 维)捕获的方差占比——Stretchy Blob 97.7%、Moving Blobs 99.7%、Stretchy Bird 2D 99%、Frequency Modulation 1D 100%,证明模型自动压缩到真实流形维度。重要性:key。
模型输出接入合成网格细胞网络后出现六边形发放野
原文 caption:Model outputs can be used to generate grid-like firing fields. Our model's outputs can be used as input to a synthetic grid cell network across a variety of cognitive domains. We predict a clear hexagonal-like firing field when traversing these environments, illustrating how the grid cell circuit is crucial to building these cognitive maps.
把模型估计速度(允许最佳线性变换对齐)喂给三层平面波模拟的合成网格模块,遍历四个域时单个神经元发放野呈现清晰六边形图案:横轴是域状态参数(blob 高/宽、腿长/脖长、斑块坐标、波频率),色标是发放率。这张图直接演示标题主张——同一个网格积分器只要拿到正确速度就能给不同抽象域画网格地图。重要性:key。
🎧 音频版
时长 21:56 · Edge TTS
网格细胞如何给抽象空间画地图:先提速度,再走积分(对话版)
这篇要解决什么问题,为什么值得单独做一期
小播:老播,今天这篇标题特别长,叫《Flexible mapping of abstract domains by grid cells via self-supervised extraction and projection of generalized velocity signals》,MIT Fiete 组的 NeurIPS 2024 论文。先用人话讲:它到底要解决什么问题?
老播:一句话背景:大脑内侧内嗅皮层里有一类网格细胞,动物在房间里走动时,它们的发放会在空间里铺成规则的六边形图案,等于给二维空间画了一张周期性地图。近几年实验发现,同样这群细胞在听连续变化的音调、看图像、操作一个会变形的卡通鸟时,也会出现类似的网格状发放。这篇论文想解释一个前置问题:大脑怎么做到换一个完全不同的抽象空间,还沿用同一套网格细胞来画地图?它给出的答案可以概括成八个字:先提速度,再走积分。动物在某个抽象空间里连续移动时,大脑先提取一个低维的广义速度信号,再把它喂给网格细胞,由网格细胞靠路径积分把速度累加成地图。今天这期要讲清楚三件事:第一,为什么说网格编码等于一台通用速度积分器;第二,这个速度信号怎么在没有任何标签的情况下自学出来;第三,这套机制怎么用来支撑 latent flow integration 的类比论证。结论先放这里:在五个程序生成的抽象域上,论文方法推断速度的误差在 0.02 到 0.07 之间,而 PCA、UMAP、Isomap、自动编码器和视频预测网络 MCNet 的误差普遍高一到两个数量级。
小播:误差低一到两个数量级,这个差距不小。我们先把背景铺开。
先补背景:网格细胞本来在干嘛,为什么能管抽象空间
小播:网格细胞我大概知道是定位用的,它怎么还跟听声音、看图片扯上关系?
老播:先给定义。网格细胞是内侧内嗅皮层里的神经元,动物移动时,每个网格细胞会在空间里的多个位置发放,这些发放点连起来形成规则的三角形网格,也就是六边形对称的发放野。整个细胞群的活动状态构成一张周期性地图:细胞群活动的相位代表当前位置,动物移动时相位沿网格平移,移动越快相位更新越快。这套机制叫路径积分,网格细胞做的运算可以看成把速度随时间累加。空间导航里,位置等于初始位置加上速度对时间的积分,网格细胞恰好实现了这个积分运算。
小播:那抽象空间里怎么也有网格?
老播:实验上,2017 年 Aronov 等人让大鼠听音调连续变化的纯音,在内侧内嗅皮层观察到一维的网格样发放;Killian 等人在猕猴看自然图像时看到视觉空间里的网格样结构;人的实验里,用摇杆连续改变一只卡通鸟腿和脖子的长度,fMRI 同样看到网格样表征。这些域的共同点:都有一个连续可变的低维轴,比如音高、图像特征、鸟的腿长。注意它们各自只有一两个自由度,但观测本身是高维的——一张 16×16 的图就有 256 个像素值。大脑若为每个域重新造一套状态表示,代价很高。论文的核心假说是:大脑只提取位移,也就是从一帧到下一帧的变化量,这个变化量是低维的、与具体图像内容无关的;拿到它,就能用现成的网格积分器画地图。
小播:也就是说,画地图这件事被拆成了速度提取和速度积分两步?
老播:对,这个拆分正是全文的骨架。先解释为什么网格状态可以复用。网格细胞群的活动被约束在一个连续吸引子上:整个细胞群的活动状态只能待在一个低维的环面流形上,局部的移动对应相位沿某个方向的平移。这套结构天生适合做积分,动物无论走到哪里,相位都能平滑地跟着速度走。空间导航里它积分的是移动速度;抽象域里只要把广义速度换成域内的位移,同一个结构就能继续工作。这也是论文和之前工作最根本的分歧:TEM 那条路线假设大脑为每个域重建一套稳定状态,论文假设大脑复用一套稳定状态,只补一块速度提取器。
小播:那之前的工作具体卡在哪?
老播:Tolman-Eichenbaum Machine,简称 TEM,用循环网络基于预定义动作预测观测,换一个环境就得把动作和网格样表征一起重学;后继表示,英文 successor representation,简称 SR,依赖离散动作空间;克隆结构认知图,简称 CSCG,只能处理离散域。它们都要为每个新域同时学状态的表示和状态之间的转移结构,换域成本很高。论文换了一个切口:状态表示交给已经存在的网格码,新域只需要补一块速度提取器。这个思路能成立,前提是速度满足两条性质:内容无关,以及自洽。先记住这两条,下面讲怎么实现。
核心思想:从高维画面里抽出与内容无关的速度
小播:那这个速度提取器怎么设计?为什么可以不要监督信号?
老播:先讲数据长什么样。论文程序化生成了五个抽象域。Stretchy Blob,2D:画面中央一个高斯斑块,可以沿高、宽两个方向拉伸或收缩。Stretchy Bird,2D:鸟的脖子和腿两个自由度,对应上面说的人脑实验。Stretchy Bird,3D:两条腿独立变化。Moving Blobs,2D:一组高斯斑块平移。Frequency Modulation,1D:一组正弦波的频率连续变化,对应大鼠听声音的实验。每个域的轨迹长 81 步,训练集 80 万条样本、测试集 20 万条,输入是相邻两帧。每个域的速度分布也写进了论文 Table 2:比如 Stretchy Blob 的速度均匀分布在 0.05 到 0.6 之间,Moving Blobs 在正负 20 之间,这些数字保证轨迹的多样性和不同域之间对比的公平性。关键设定:轨迹首尾相接成闭环,也就是说沿轨迹走一圈,位移总和必须为零。
小播:闭环这个设定很关键,但它怎么变成训练信号?
老播:模型是一个编码器-解码器结构,编码器和解码器都是多层感知机,参数量 53.6 万到 62.2 万,训练用 Adam、学习率 5e-4、800 到 1200 轮,单张 Titan RTX 上每个实验一到五小时。编码器吃相邻两帧,吐出一个低维速度;解码器拿后一帧和这个速度去预测再下一帧。潜变量维度先设成和域流形维度一致:2D 域取 2、1D 域取 1。然后有四条损失。第一条是下一状态预测损失:预测出的帧要和真实下一帧尽量接近,它保证速度可解码,也就是说速度里确实装着从一帧到下一帧的位移。第二条是闭环损失,英文 loop-closure:在整条闭环轨迹上,所有估计速度相加必须等于零向量。这条损失的权重是下一状态预测损失的 10 倍,是全文的题眼。第三条是捷径损失:用两段速度相加去预测两步后的帧,检验解码器能不能组合速度做泛化。第四条是各向同性损失:在小位移附近,让速度的范数方差尽量小,消除不同方向上的尺度差。
小播:为什么训练要一次看三帧?直接拿两帧预测下一帧不行吗?
老播:模型看的是 i_t 和 i_{t+1},预测的是 i_{t+2},也就是用前两帧推第三帧。论文特意用三帧,是为了防止编码器把要预测的图像的细节直接抄进速度表示里——速度必须装的是位移,帧的内容。论文在附录里做了对照:改成两帧训练,结果不变。内容无关这条性质还有一个具体的例子:在 Stretchy Blob 里,从高度 5 变到 6 的位移,和从高度 8 变到 9 的位移,编码出的速度向量应当一样。速度只回答变了多少,不管从哪变到哪。另外,各向同性损失有个实现细节:距离度量用 1 减余弦相似度,阈值 θ 按域设在 1e-4 到 1e-2 之间,只有小位移附近的样本才参与这项损失,因为全局的速度分布事先并不知道。
小播:闭环损失为什么权重最高?它到底在强制什么?
老播:它在强制自洽,而且附带一个数学上更深的结论。设想大脑记录轨迹时不知道任何坐标,只知道一连串位移;如果这些位移本身不一致,比如绕一圈回来位移总和不为零,那么累加出来的地图会自相矛盾,同一个位置会落到不同的格子相位上。闭环损失要求绕圈回来相位必须复位,地图才自洽。论文附录 B.1 给出证明:把闭环约束施加到从真实速度到估计速度的映射 e 上,可以推出 e 满足齐次性和可加性,也就是 e(αv) 等于 α 乘 e(v),e(v₁ 加 v₂) 等于 e(v₁) 加 e(v₂),所以 e 是线性函数。这句话的意思:模型学到的速度表示必须是真实速度的线性变换,任何非线性扭曲都会被排除。为什么线性如此重要?因为网格细胞做路径积分就是线性累加,一步一个速度向量,加出来的相位才正确。这里给一个量级感受:在 Moving Blobs 域上只开下一状态预测损失,误差 0.134;加上闭环损失,降到 0.044;再加两个辅助损失,降到 0.02。而且只开下一状态预测损失时,喂给网格模块得到的发放野不成六边形,加上闭环损失后才出现六边形。
小播:这个求和运算本身,是谁在做的?
老播:论文特别强调,闭环求和这一步在生物学上由下游的网格细胞电路完成——闭环损失模拟的正是网格积分器的工作,所以速度提取和网格积分在论文里是一体的:速度要在闭环上自洽,靠的是网格电路能做路径积分这个前提。这也是为什么说网格编码是这台机制的底座:没有积分器,速度就只是一堆向量;有了积分器,速度才变成地图。
小播:这个证明把几何约束和线性性连起来了,难怪权重最高。
老播:还要强调,这一切都没有任何监督。没有哪个损失告诉模型真实速度是多少、坐标轴怎么摆,速度的尺度、方向全部自学出来。论文还验证了训练数据不一定全是闭环:把 50% 闭环轨迹和 50% 随机游走混在一起,闭环损失只作用在闭环段上,误差 0.035,和全闭环训练基本持平。这降低了方法对数据形态的要求。
关键实验:五个抽象域、误差小一到两个数量级
小播:好,现在看结果。论文怎么度量速度学得准不准?
老播:度量方式值得先讲清楚,因为结论的含义都挂在它上面。模型输出的速度没有固定坐标系,只要它是真实速度的线性变换就算成功,所以论文把估计速度经一个最佳线性变换对齐到真实速度,再算归一化均方误差;先按 DBSCAN 聚类去掉少量离群点再拟合变换,但误差按全部数据、包括离群点计算。每个实验跑 6 个随机种子,报告均值加减标准差。对比对象有四个降维方法,PCA、Isomap、UMAP、自动编码器,外加一个视频预测网络 MCNet。
小播:数字呢?
老播:逐域看。Stretchy Blob,2D:论文模型 0.05 加减 0.01,MCNet 是 1.95 加减 0.14,PCA 0.63,Isomap 0.42,UMAP 0.79,自动编码器最离谱,误差在一千五到三千四之间。Stretchy Bird,2D:论文 0.07 加减 0.03,MCNet 2.01,PCA 0.21,Isomap 0.36,UMAP 0.46,自动编码器 20.90 加减 38.04。Stretchy Bird,3D:论文 0.07 加减 0.02,MCNet 2.96 加减 0.10,PCA 0.31,Isomap 0.64,UMAP 1.05,自动编码器在两百六到五百零八之间。Moving Blobs,2D:论文 0.02 加减 0.01,MCNet 2.00,PCA 1.94,Isomap 0.66,UMAP 0.62,自动编码器 2.03。Frequency Modulation,1D:论文 0.02 加减 0.02,MCNet 2.01,PCA 1.97,Isomap 和 UMAP 都是 2.00,自动编码器 2.00。也就是说,在最简单的 1D 任务上,五个基线的误差全部在 2.0 附近,论文模型是 0.02,差了两个数量级;在 Stretchy Blob 上,自动编码器的误差比论文模型大四到五个数量级。基线并非完全没出力:PCA 在 Stretchy Bird 2D 上做到 0.21,是基线里最好的,仍比论文模型高 3 倍。
小播:那潜变量维度给高了会怎样?模型会不会把维度用满?
老播:这正是图 4 的第二个面板回答的问题。把潜变量维度设成 3,而真实流形只有 2 维,模型自己会把表示压缩回二维子空间:对推断速度做 PCA,Stretchy Blob 上 97.7% 的方差落在前两维,Moving Blobs 是 99.7%,Stretchy Bird 2D 是 99%,1D 的 Frequency Modulation 上 100% 的方差落在 1 维。对照实验:对 Moving Blobs 的原始 256 维输入直接做 PCA,需要大约 24 个主成分才能覆盖 95% 的方差。所以论文模型是一种顺着过渡结构做的降维:它找的各个状态附近的移动方向,也就是切空间,状态点之间的欧氏距离。
小播:那这些误差数字,主要是哪条损失在起作用?
老播:论文在 Moving Blobs 域上做了损失消融。只开下一状态预测损失,误差 0.134,这时速度表示可以做任意非线性扭曲,喂给网格模块时发放野也不成六边形;加上闭环损失,误差降到 0.044,发放野出现六边形;再加捷径和各向同性两个辅助损失,误差进一步到 0.02,发放野更干净。数据形态也有消融:在 Stretchy Bird 2D 域上,把 50% 闭环轨迹和 50% 随机游走混在一起训练,闭环损失只作用在闭环段上,误差 0.035,和全闭环训练的 0.07 同一量级,说明方法不依赖训练数据恰好全是闭环。还有一个支持性观察:解码器隐式学到了训练数据流形的边界。在 Stretchy Bird 2D 里固定一个速度反复应用,当腿和脖子缩到训练数据里出现过的极限时,解码器输出进入不动点,继续加同一个速度,画面不再变化。解码器理解域的边界,它机械地外推。
小播:最后那个六边形发放野,是怎么做出来的?
老播:把估计速度,允许一个最佳线性变换对齐,喂给一个合成的网格模块。这个模块用三个平面波的叠加模拟连续吸引子,速度用来更新平面波的相位。遍历这些抽象域时,单个神经元的发放野呈现清晰的六边形图案;而把基线模型的速度输出接进同一个模块,六边形发放野明显更模糊。这直接演示了论文的标题:同一个网格积分器,只要喂正确的速度,就能在多个抽象域上画出网格地图。
它在整个谱系里的位置,这段讲快一点
小播:这段讲快一点:这篇论文在认知地图这条线里排什么位置?
老播:它处在速度提取优先这个新切口上,和三类工作形成对照。对照 TEM、SR、CSCG:它们都要同时学状态表示加转移结构,换域成本高,这篇把状态表示外包给固定网格码,只需补速度提取器。对照 PCA、Isomap、UMAP、自动编码器:它们保持状态之间的近邻距离,忽略了切空间也就是速度方向的结构,所以在低维流形任务上系统性失败。对照 MCNet 这类视频预测网络:它们预测像素级未来帧,不追求最小低维速度,输出没法直接给网格细胞积分。再往外接一条生成模型的类比,也就是这份解读清单特意提示的 latent flow integration 论证:只要能在高维观测流形上提取一个自洽、低维、与内容解耦的速度场,一台固定的积分器就能把速度累加、映射出整个域的结构。这和潜在流积分类方法的核心论点是同构的——那边用学到的速度场把噪声或隐变量积分成数据,这边用网格相位积分把抽象域状态积分成认知地图。论文自身没有使用 latent flow integration 这个词,这个连接来自清单提示的跨领域类比;它把闭环一致性这条生物约束摆出来,恰好可以作为潜在流模型设计一致性目标的一个参照。
局限:泼三盆冷水
小播:听完优点,说说问题。
老播:至少三条,前两条是论文自承的。第一,两个核心损失,下一状态预测和闭环,在生物学上说得通,分别对应感官预测误差和神经积分;但两个辅助损失,捷径和各向同性,生物支持要弱得多,更像为训练稳定性补的工程手段。第二,论文假设潜空间里的速度向量可交换,也就是速度相加的顺序不影响结果,这使它无法直接表示非欧空间、比如球面上的切向量;论文给的出路是把非欧空间嵌入更高维的欧氏空间再处理。第三,验证范围全部是程序生成、低维过渡结构的人工域,轨迹长 81、图像 16×16 或 32×12,距离真实感官输入和自然环境还很远,论文自己把扩展到自然图像、学习非欧结构比如家谱,列为未来工作。再补两条我们读出来的。其一,模型假设域内每个状态唯一、相邻帧的过渡能用单一速度刻画,真实刺激流里同一个画面可以对应多种移动解释,这种歧义不在处理范围内。其二,论文最核心的预测,同一网格模块跨域积分时细胞间共同发放关系保持不变,目前只有理论论证和睡眠期、跨环境表征不变性的间接观测支持,还没有直接实验证据。
小播:对了,我们这期的数字和图,是从哪份材料来的?
老播:补一句信息来源。我们手头的 PDF 是残缺导出,只有前两页有文字,正文和图表都缺失,所以这期的实验数字和图都依据 NeurIPS 2024 官方会议版本补全,作者也公开了代码仓库,数字都可以对照核对。这一点也写进了卡片资产的局限说明。
收尾:记住这三件事
小播:收尾,这期该记住什么?
老播:三件事。第一,网格编码等于一台通用速度积分器:给同一套网格相位状态喂不同域的广义速度,它就能积分出不同域的地图,前提是速度与内容解耦且自洽。第二,自洽靠闭环损失实现,而且闭环约束在数学上推出速度映射必须是线性的,正好对齐网格细胞做线性路径积分——单看数字,闭环损失把 Moving Blobs 域的误差从 0.134 压到 0.044,再加辅助损失到 0.02。第三,这套内容无关速度加闭环一致性加固定积分器的机制,正好构成 latent flow integration 类方法的类比论证:高维观测流形上的位移,可以由一个自洽可积的速度场变成潜在空间里的线性流动。这篇论文把认知灵活性从一个口号变成了一个可以验证的机制问题,也为跨域迁移、数据高效泛化提供了一个自监督设计的参考点。这期就到这里,下次见。