Generative Modeling via Drifting(漂移生成模型)
> MIT 与 Harvard University(Kaiming He 组)· arXiv:2602.04770 · 精读
一句话定位
这篇论文提出一类新的生成模型范式 Drifting Model:把扩散/流模型放在推理期的迭代,整体搬到训练期。训练中 SGD 每次更新参数,等价于生成分布(噪声先验的 pushforward 分布)在训练时间轴上一步步演化;论文设计一个反对称的「漂移场」驱动这个演化,当生成分布与数据分布一致时漂移场归零,系统到达平衡态(不动点)。推理时网络只做一次前向(1-NFE),不需要 ODE/SDE、不需要预训练教师、也没有判别器。在 ImageNet 256×256 上,潜空间单步 FID 1.54、像素空间单步 FID 1.61,均为当时单步方法的最高水平。
问题与谱系:迭代到底该放在哪一端
生成建模的标准写法是学一个映射 f,使噪声先验 p_eps 经过 f 之后的分布逼近数据分布。记 q = f#p_eps,这里的 f# 叫 pushforward(推前)算子,含义是:对每个噪声 ε 取 x = f(ε),噪声分布就被 f「推」成了 x 的分布。生成的目标就是找到 f 使得 q ≈ p_data。
扩散模型和流匹配模型把这一步拆成推理期的迭代:从一个噪声样本出发,反复执行 x_{i+1} = x_i + Δx_i(例如 Euler 解 ODE/SDE),每一次更新都要调用一次网络,所以「步数」等于网络前向次数 NFE,出图要几十到几百次。单步化研究分两条路:蒸馏路线需要一个现成的多步教师(progressive distillation、DMD、iCT);从头训练路线(Shortcut、MeanFlow、iMF、AdvFlow)仍锚定在扩散/流模型的轨迹或速度场上。这篇论文的切口在于:训练本身就有成千上万步迭代,为什么不用训练期的迭代去完成「分布演化」,让推理只剩一次前向?
核心思想:训练期演化 pushforward 分布
训练即演化
网络训练天然迭代。把第 i 轮迭代的模型记为 f_i,其输出分布记为 q_i = [f_i]#p_eps。训练过程就对应一条分布序列 {q_i}。对同一个噪声 ε,参数更新前后输出从 x_i = f_i(ε) 变到 x_{i+1} = f_{i+1}(ε),可以写成:
x_{i+1} = x_i + V_{p;q_i}(x_i)
这里的 V_{p;q} 就是漂移场(drifting field),下标 p、q 表示它同时依赖数据分布 p 和当前生成分布 q。它回答的问题很直接:一个生成样本 x 下一步该往哪挪,才能让 q 整体朝 p 走。下面先给结论再展开:当 q = p 时 V 必须为零,样本不再漂移,训练到达一个平衡态;训练目标就是让 V 的范数尽可能小。
反对称性给出平衡态,训练目标是范数平方
要让「q = p ⇒ V = 0」对任何样本都成立,最简单充分的条件是反对称性:
V_{p;q}(x) = −V_{q;p}(x)
逐符号看:这个式子说把 p 和 q 对调,漂移方向就反向。如果真有 q = p,那么 V_{p;p} = −V_{p;p},两边同时满足只能 V = 0。这就是平衡态(equilibrium)的由来:训练终点对应映射 x → x + V(x) 的一个不动点,样本停在原地,分布不再演化。
把平衡条件变成训练目标,论文用了一个 stop-grad(停止梯度)技巧。设网络参数为 θ、输出 x = f_θ(ε),在平衡点成立不动点关系 f(ε) = f(ε) + V(f(ε))。把这个等式当成回归目标:
L = E_ε ‖ f_θ(ε) − stopgrad( f_θ(ε) + V_{p;q_θ}(f_θ(ε)) ) ‖²
逐项解释:括号里是冻结的上一步输出加上漂移,构成一个不参与梯度回传的目标;网络预测要朝这个冻结目标靠拢。stopgrad 的作用是避免梯度穿过 V 反传到分布 q_θ 上——V 依赖 q_θ,穿过分布求导很难处理,冻结目标把这条路径切断。BYOL 和一致性模型也用同样的 stop-grad 思路。这个损失的值恰好等于 E‖V‖²,所以训练过程就是不断压低漂移场的范数。
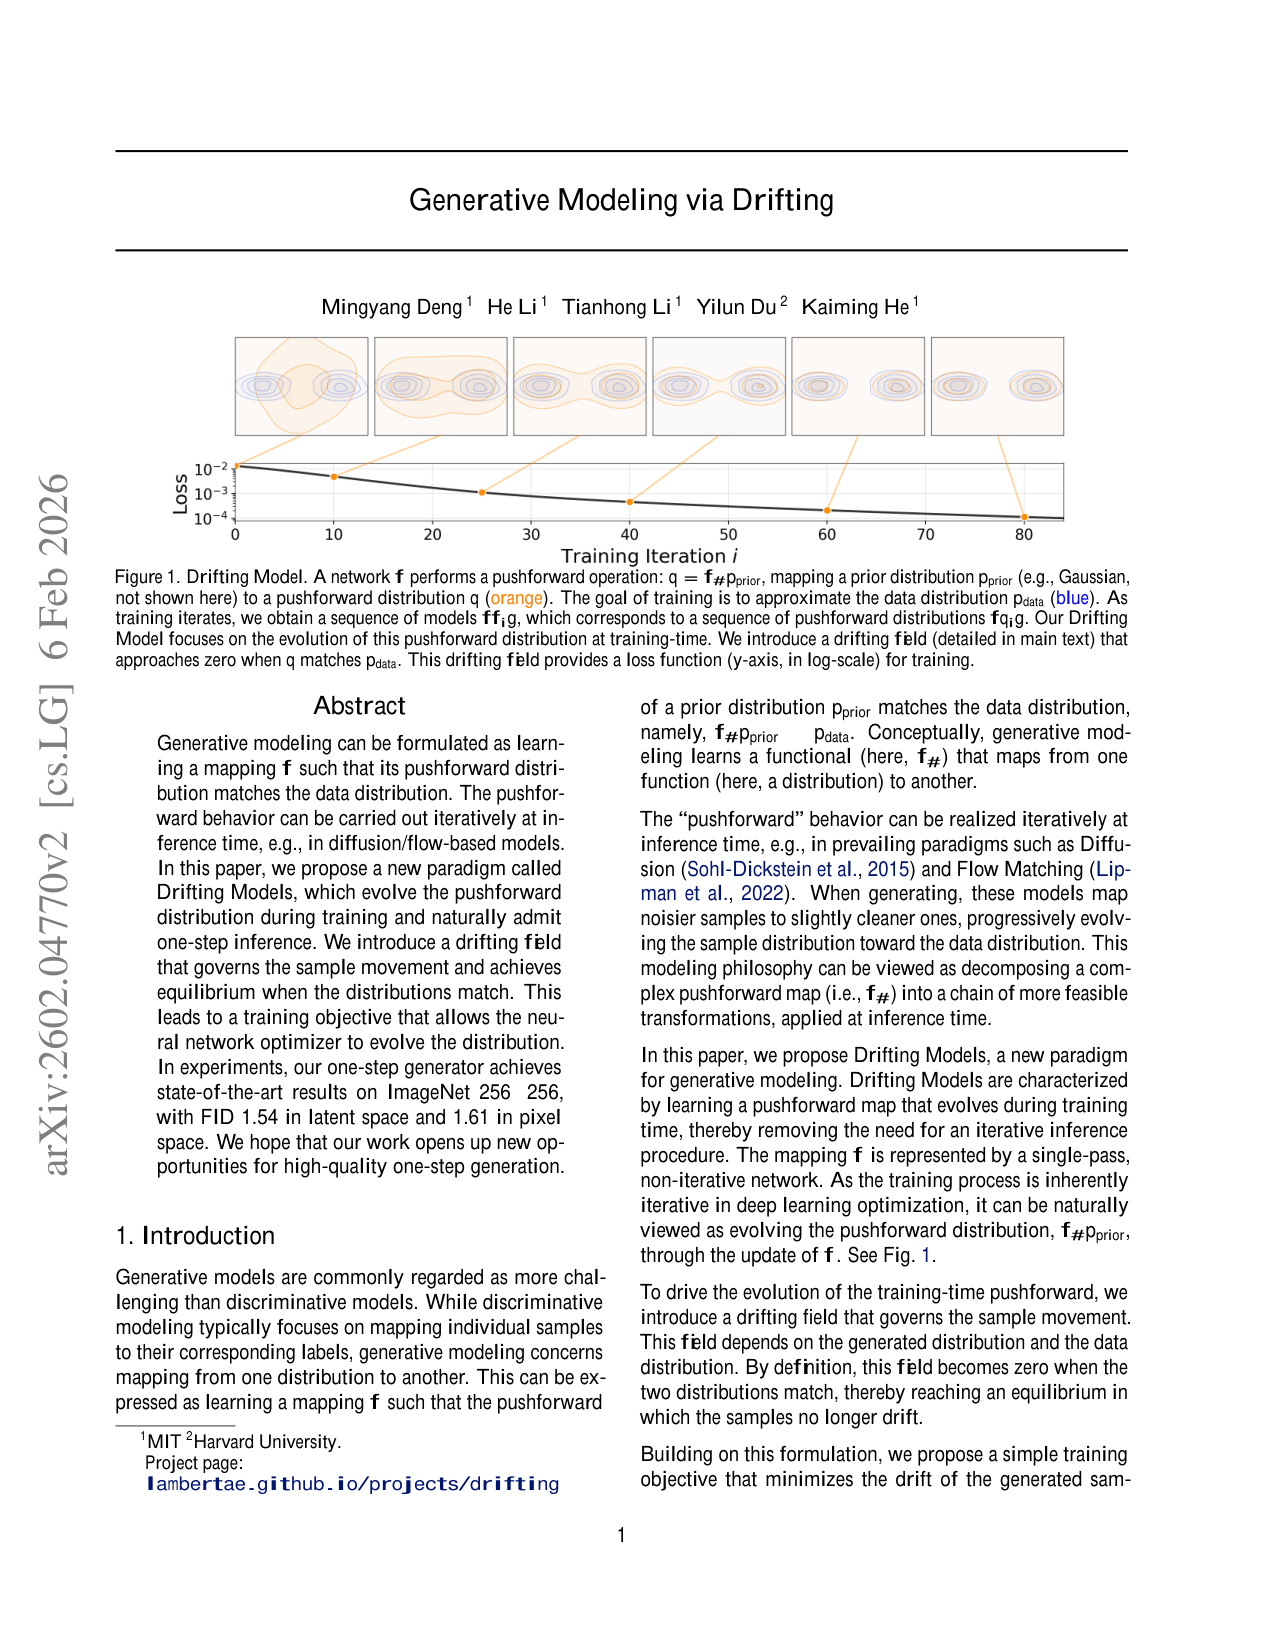
图 1 是这篇论文的概念图:横轴是训练迭代,橙色是 pushforward 分布 q,蓝色是数据分布 p_data,纵轴(对数刻度)是漂移场损失。随着训练推进,q 逐步逼近 p,损失随之下降。读图的要点在于:演化发生在训练期,推理期只剩一次前向。
反向蕴含与平衡唯一性
一个必须问的问题是:V ≈ 0 是否反过来推出 q ≈ p?一般情形下论文明确说不行——任意向量场都可能有非数据分布的零点。论文给出的是核化构造下的可辨识性论证(附录 C.1):把 p、q 用一组线性无关的基函数展开成系数 a、b,零漂移条件 V(x) ≡ 0 在足够多探针点(N ≫ m²)上变成一组双线性方程 a_i b_j − a_j b_i = 0;在交互向量线性无关的非退化假设下,这组方程推出 a 与 b 平行,再结合概率密度归一条件(∫p = ∫q = 1)得到 a = b,即 p = q。要注意这仍是启发式论证:唯一性依赖非退化假设,收敛条件(什么样的优化轨迹保证到达平衡)在论文里明确列为开放问题。
漂移场怎么算:均值偏移吸引 + 负样本排斥
漂移场依赖两个分布,必须变成可计算的蒙特卡洛估计。论文从经典 mean shift(均值偏移,Cheng 1995)出发,定义两项:
V⁺_p(x) = (1/Z_p) E_{y⁺~p}[ k(x, y⁺) (y⁺ − x) ],V⁻_q(x) = (1/Z_q) E_{y⁻~q}[ k(x, y⁻) (y⁻ − x) ]
逐符号解释:y⁺ 是从数据分布抽的正样本,y⁻ 是从当前生成分布抽的负样本;k 是相似度核;Z_p、Z_q 是归一化因子(对核权重做归一)。V⁺_p 是「数据对 x 的均值偏移」:把 x 拉向数据密集的方向;V⁻_q 是「生成样本对 x 的均值偏移」:把 x 从生成样本扎堆的方向推开。最终漂移场取两者之差:
V_{p;q}(x) = V⁺_p(x) − V⁻_q(x)
把两项合并,漂移方向简化为正负样本之差:
V_{p;q}(x) = (1/(Z_p Z_q)) E_{p,q}[ k(x, y⁺) k(x, y⁻) (y⁺ − y⁻) ]
核取 k(x, y) = exp(−‖x − y‖ / τ),τ 是温度。实践里用 softmax 近似归一化(对 y 轴,再对 x 轴各做一次,类似 InfoNCE),负样本直接复用本批生成样本。这个「吸引减排斥」的结构解释了方法对模式坍缩的稳健性:某处生成样本过多时排斥项变大把样本推走,未被覆盖的模式持续提供吸引,生成分布因此被摊开。
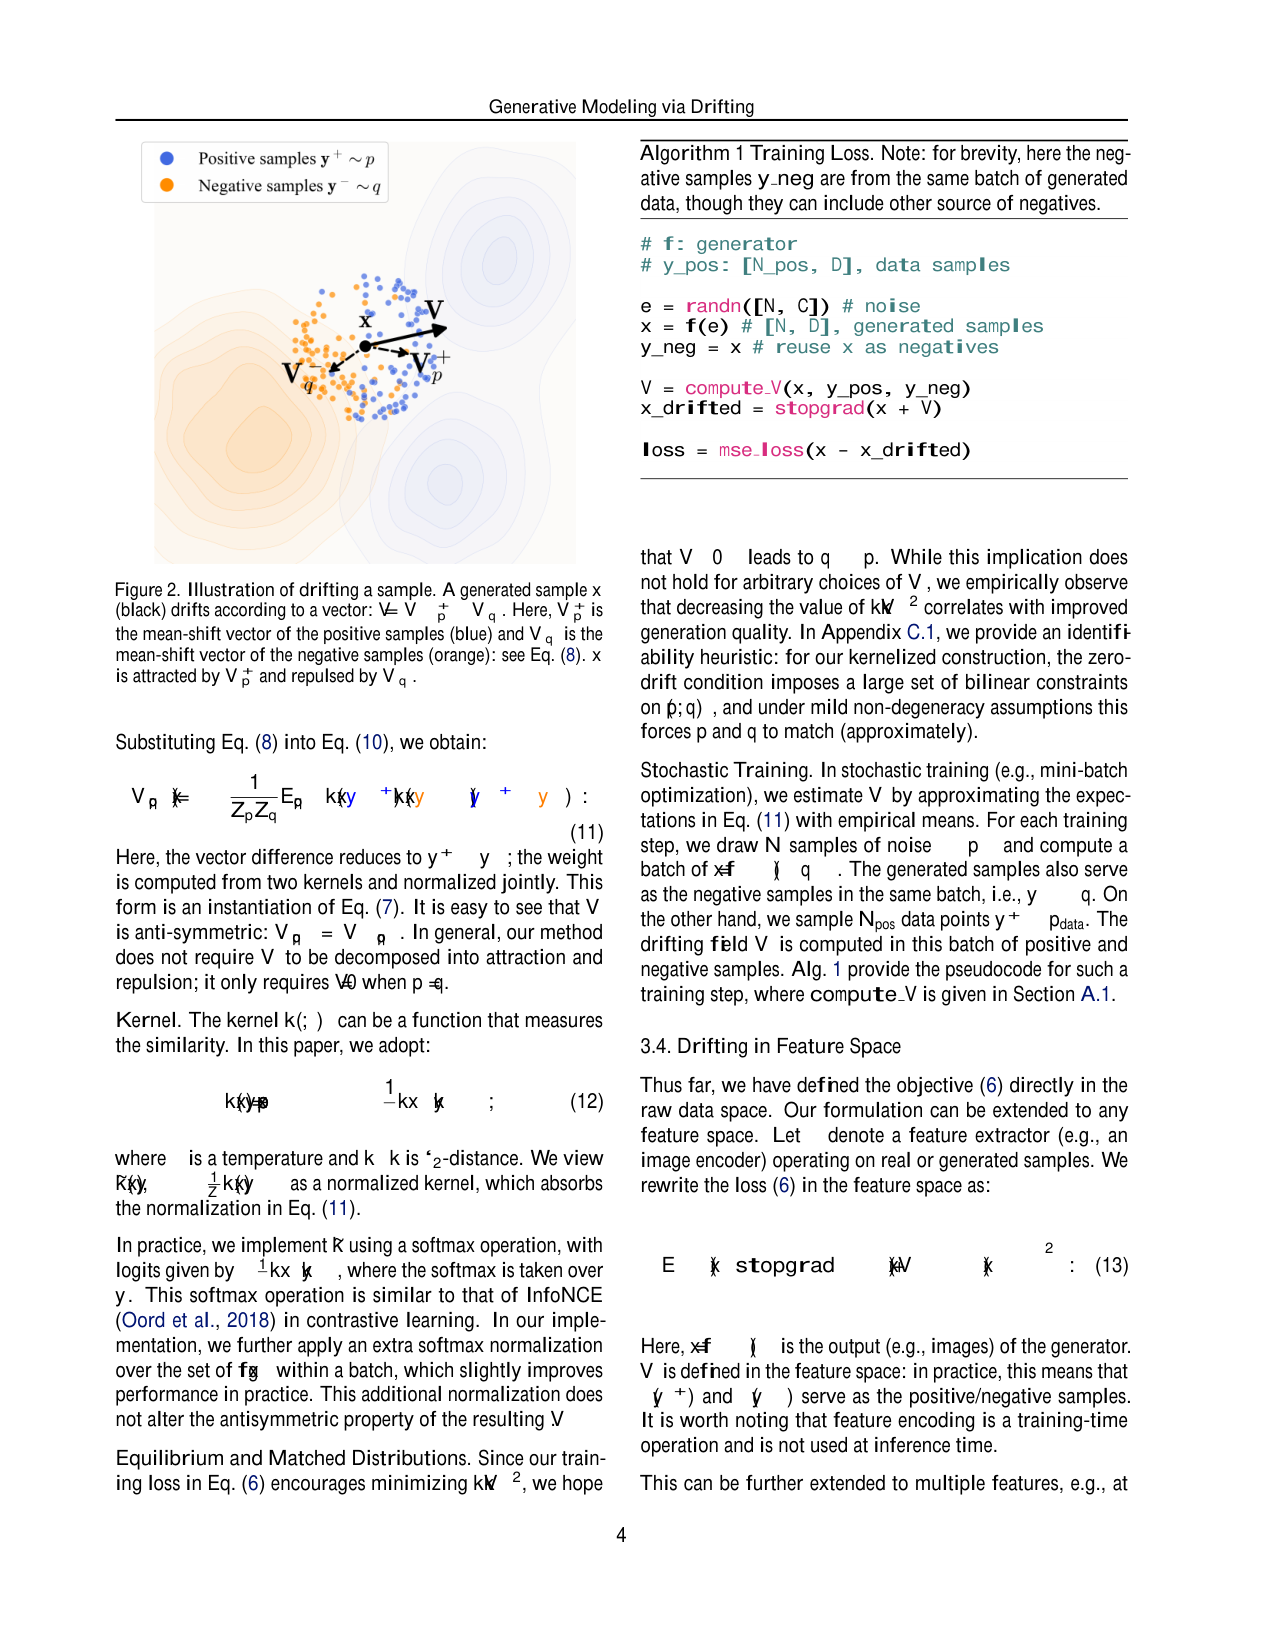
图 2 画的就是这一项:黑点 x 被蓝色正样本的均值偏移吸引、被橙色负样本的均值偏移排斥,合成 V 的方向。注意这张图的物理含义:吸引与排斥互相抵消的时刻,恰好是 q 与 p 对齐的时刻,对应平衡态。
特征空间与 CFG
在原始像素或 latent 空间直接算核相似度很难:高维空间里距离普遍偏大,核函数会「平」掉,所有样本之间都差不多远。论文的解法是把漂移损失搬到预训练自监督编码器 ϕ 的特征空间:
L = Σ_j E ‖ ϕ_j(x) − stopgrad( ϕ_j(x) + V(ϕ_j(x)) ) ‖²
这里 ϕ_j 是第 j 个尺度/位置的 Ci 维特征向量(ResNet 四个 stage 的多尺度特征 + 局部统计量)。训练时梯度穿过特征编码器和 VAE 解码器回传,推理时 ϕ 完全不参与。特征空间是否合适直接决定成败:表 3 里同样预算下 SimCLR 编码器 FID 11.05,自研 latent-MAE(加宽、加长预训练、分类微调)降到 3.36;论文自述在 ImageNet 上无法让方法在没有特征编码器时工作。
类条件生成用训练期 CFG:把无条件真实样本按比例 γ 混进负样本分布,平衡时网络学到的是 q_θ(·|c) ≈ α p_data(·|c) − (α−1) p_data(·|?),其中 α = 1/(1−γ)。这和原始 CFG 外推条件/无条件分布的精神一致,区别在于混合发生在训练期的负样本里,推理时只需指定 α 且保持 1-NFE。
关键实验
玩具实验与反对称消融
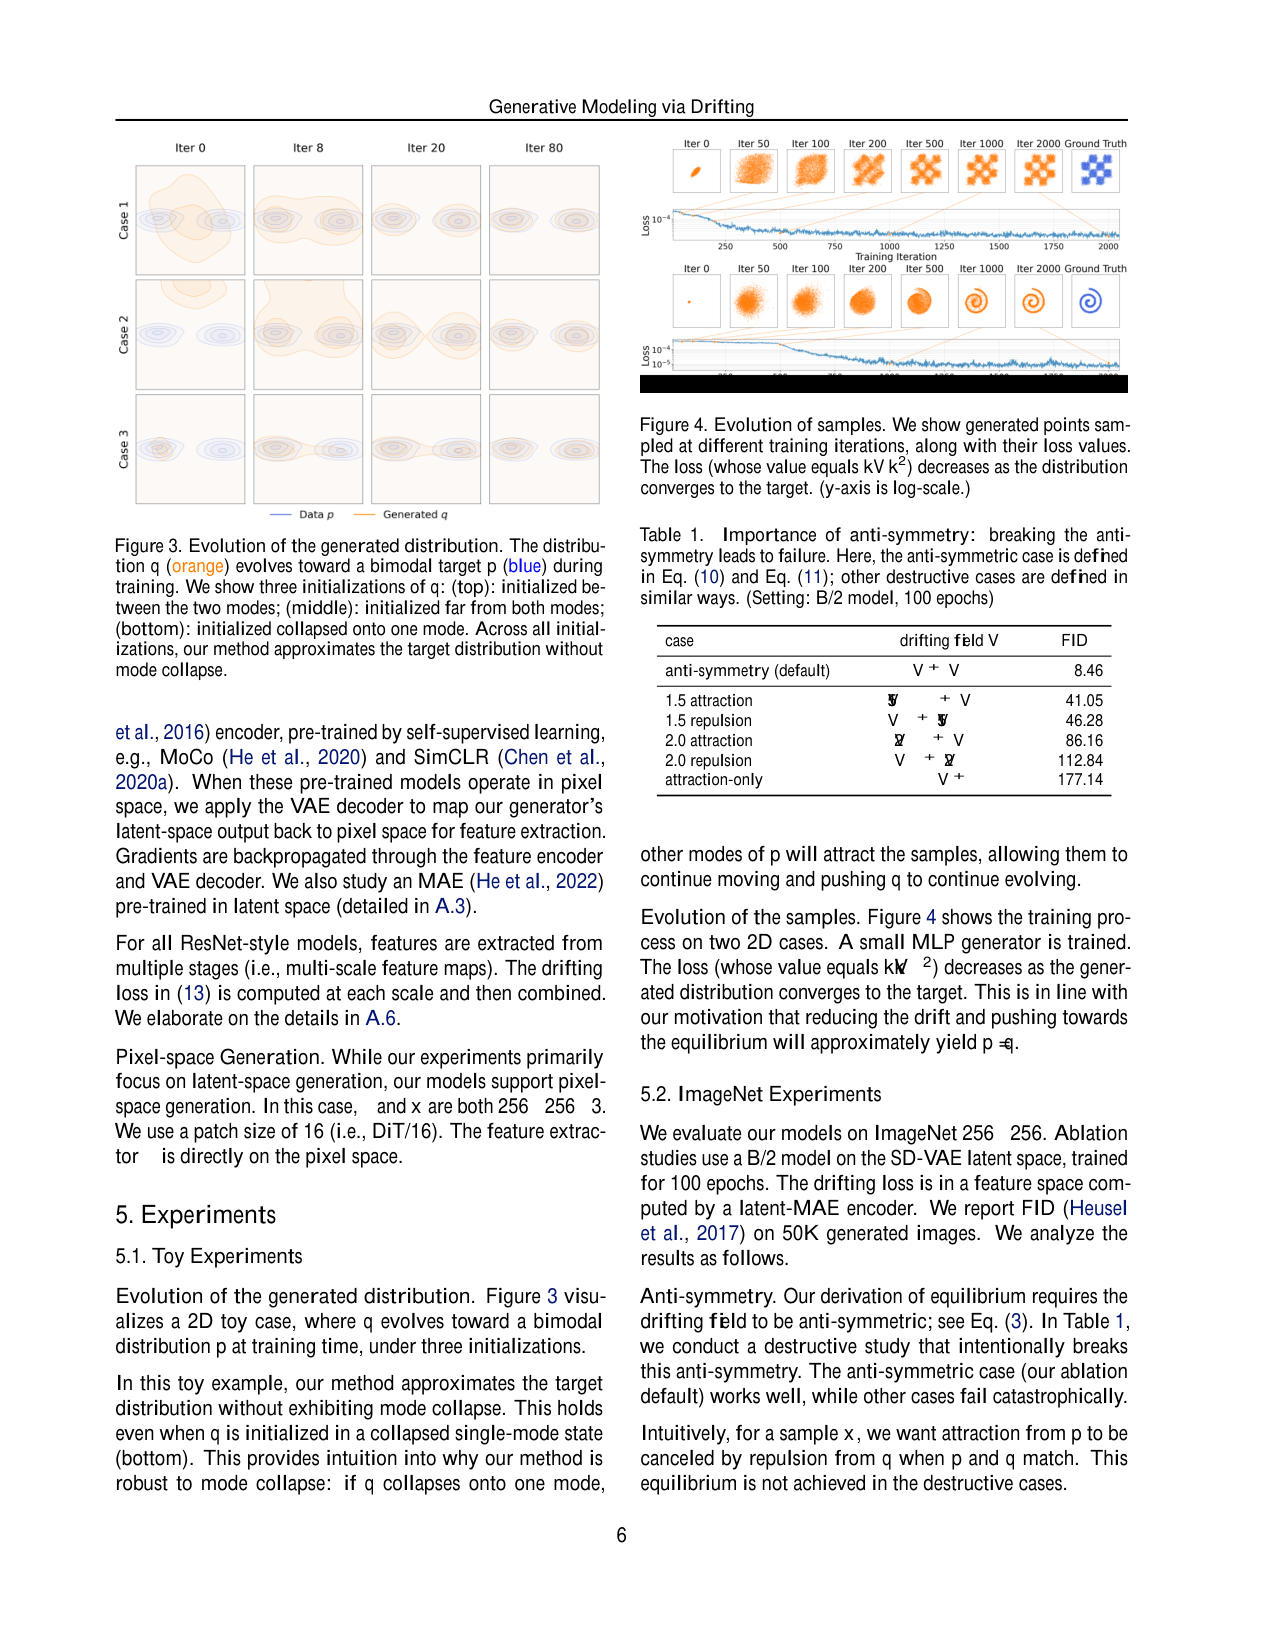
图 3 是 2D 双峰目标的训练演化,三种初始化(初始在两峰中间、离峰很远、塌缩在单个峰上)最终都铺满两个峰,没有模式坍缩。同一页的图 4 显示损失(= ‖V‖²)随训练单调下降,与「压低漂移即逼近数据分布」的动机一致。表 1 是破坏性消融:把吸引或排斥项放大到 1.5×、2×,FID 从默认的 8.46 恶化到 41.05–177.14(DiT-B/2、100 epochs、ImageNet latent 设定),说明反对称的分量比例是平衡态的硬约束。
ImageNet 256×256
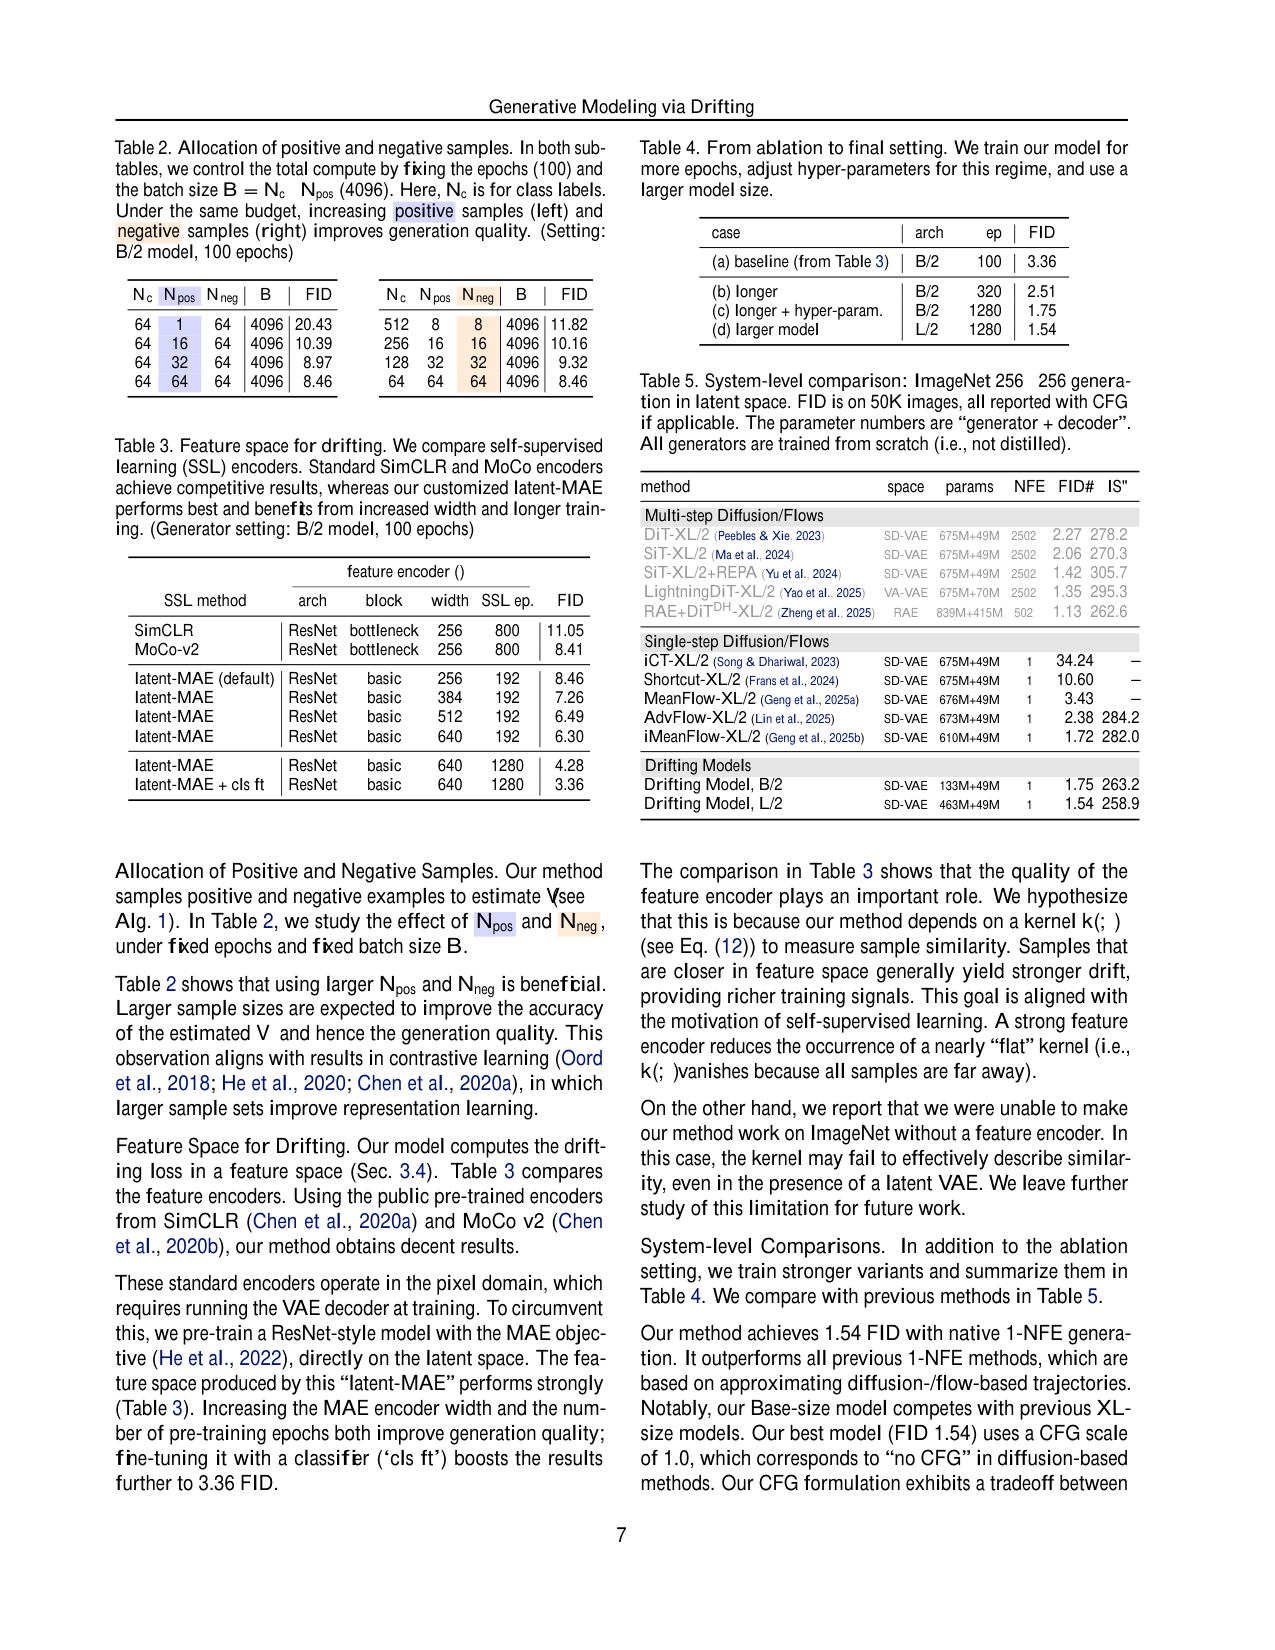
表 5(潜空间)是主打结果:Drifting L/2 单步 FID 1.54(463M 参数 + 49M VAE 解码器,CFG α=1.0),低于 iMeanFlow-XL/2 的 1.72(610M 参数)、AdvFlow-XL/2 的 2.38、MeanFlow-XL/2 的 3.43、Shortcut-XL/2 的 10.60、iCT-XL/2 的 34.24,且全部从头训练、非蒸馏;B/2 的 1.75 也追平了 XL 规模的对手。像素空间(表 6)单步 FID 1.61(L/16,87G FLOPs),对照 StyleGAN-XL 的 2.30(1574G FLOPs)和 GigaGAN 的 3.45。扩展路径(表 4)显示 FID 1.54 是加长训练与放大模型的递进结果:B/2 100 epochs 3.36 → 320 epochs 2.51 → 1280 epochs 1.75 → L/2 1280 epochs 1.54。
机器人控制
机器人实验沿用 Diffusion Policy 协议,把多步扩散生成器换成单步 Drifting 生成器(1-NFE,漂移损失直接在原始表示上算)。成功率(最后 10 个 checkpoint 平均)方面,ToolHang state 从 Diffusion Policy(100 NFE)的 0.30 提到 0.38,BlockPush phase1 从 0.36 提到 0.56、phase2 从 0.11 提到 0.16;Lift、Can 双方都接近 1.0,PushT 略有互有胜负(state 0.91 vs 0.86,visual 0.84 vs 0.86)。
与 Consistency / MeanFlow 的目标差异
把这篇放进单步谱系,最值得对比的是两个相邻工作。Consistency Models 学的是一个一致性函数 f(x_t, t) = f(x_T, T):同一 ODE 轨迹上的所有点映射到同一个终点。它的训练目标里轨迹和边界条件是主角,蒸馏变体还要预训练教师。Drifting 没有轨迹概念:平衡条件 q = p 是分布的(分布层面的不动点),训练目标只有漂移范数,逐点轨迹约束完全不存在。MeanFlow / improved MeanFlow 学的是流 ODE 的「快进」传输映射,目标围绕速度场和轨迹设计,仍然属于 flow 谱系;Drifting 的目标不包含速度场,只由数据正样本与生成负样本的均值偏移差驱动。数字对照(潜空间、1-NFE、从头训练):Drifting L/2(463M)FID 1.54 对 iMeanFlow-XL/2(610M)1.72。三条路线的分水岭可以用一句话概括:Consistency 约束沿轨迹自洽,MeanFlow 学传输映射,Drifting 学的是分布层面的不动点。
局限
1. 理论缺口:V ≈ 0 ⇒ q ≈ p 一般不成,唯一性只建立了核化构造 + 非退化假设下的启发式论证;收敛条件(什么样的训练动力学保证到达平衡)论文明确列为开放问题。
2. 强依赖特征编码器:无特征空间时 ImageNet 上训不动;编码器质量直接决定上限(同预算 SimCLR 11.05 vs latent-MAE + 分类微调 3.36),这给方法引入一个论文之外的强依赖。
3. 训练开销与工程敏感:每步要跑特征编码器与 VAE 解码器并回传梯度,还要在几十个尺度/位置特征上分别算漂移损失;正负样本分配、核温度、归一化方式都显著影响 FID(表 2、表 11)。
4. 评估面窄:主实验只有 ImageNet 256×256 和 Diffusion Policy 机器人协议;像素空间只训到 640 epochs(潜空间 1280),作者预期更长训练仍有提升;未覆盖更大分辨率、文本条件与视频。
5. 框架通用性存疑:论文在 C.2 节把 MMD 归约为漂移场的特例,但按 MMD 框架实现拿不到合理结果,说明「可归约」与「可训练」之间还有距离。
复现与延伸
项目页在 lambertae.github.io/projects/drifting,代码细节(含漂移场计算的伪代码、多尺度特征、样本队列、CFG 权重公式)都在附录;权重是否开源论文未提及。对后续工作最有价值的延伸方向是漂移场的其他构造(论文只验证了均值偏移 + 指数核这一种)、特征编码器的选择,以及把平衡态理论从启发式升级为有收敛保证的定理。
把扩散/流模型在推理期的迭代,整体搬到训练期:用反对称漂移场驱动 pushforward 分布在训练中演化到数据分布,推理只剩一次前向,ImageNet 256×256 潜空间 1-NFE FID 1.54。
阅读提示
精读深度:精读
清单提示:原文提示:把「训练中演化 pushforward 分布」与不动点/平衡态对应;思考平衡唯一性与收敛条件;对比它与 Consistency/MeanFlow 的目标差异。
问题
要解决什么:生成建模被写成学一个映射 f,使噪声先验的 pushforward 分布 q=f#p_eps 逼近数据分布 p_data。扩散/流模型把这一步拆成推理期几十上百次迭代(ODE/SDE 求解),每一步都要一次网络前向(NFE),单步(1-NFE)生成长期质量差或依赖蒸馏教师。论文想把迭代从推理期挪到训练期,让推理变成一次前向、且从头训练(不需要预训练多步教师)。
为什么 prior work 不够:蒸馏路线(progressive distillation、DMD、iCT 等)需要现成的高质量多步教师,训练流程重;从头训单步的路线(Shortcut、MeanFlow、iMF、AdvFlow)仍锚定在扩散/流模型的 ODE 轨迹或速度场上,目标设计受轨迹概念约束。GAN 需要判别器与对抗优化,训练不稳定;MMD/矩匹配在小样本和 ImageNet 高维设定下质量不足。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 噪声 z | continuous + discrete | Gaussian 噪声(latent 设定为 32×32×4 的 SD-VAE latent;像素设定为 256×256×3)加上 32 个随机 style token(64 个可学习 embedding 的随机索引),两者联合作为先验 p_eps |
| 条件 c | class label | ImageNet 类别标签;机器人设定不用类别 |
| CFG 强度 alpha | scalar | 训练时随机采样(表 8 分布),作为网络条件输入;推理时可任意指定 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 生成样本 x | image latent / image / action | latent 设定输出 32×32×4 latent(VAE 解码到 256×256×3);像素设定直接输出 256×256×3;机器人设定输出动作 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet 256×256 类条件生成 | 1.28M 张训练图 / 1000 类 | FID 在 50K 张生成图上评估;潜空间用 SD-VAE tokenizer(32×32×4) |
| 机器人任务(Diffusion Policy 协议) | 4 个单阶段 + 2 个多阶段任务 | Lift / Can / ToolHang / PushT 与 BlockPush / Kitchen,state 与 visual 两种观测,成功率取最后 10 个 checkpoint 平均 |
架构(摘要)
主干与结构
backbone:DiT-style transformer 生成器 + 预训练 SSL 特征编码器(MoCo-v2 / SimCLR / 自研 latent-MAE)
参数:L/2 latent 463M(+49M VAE decoder);B/2 133M;L/16 像素 464M
类型:单步(1-NFE)生成器,非迭代;训练期用漂移损失
关键组件
- DiT 生成器:SwiGLU、RoPE、RMSNorm、QK-Norm、adaLN-Zero + in-context conditioning tokens(16 个)+ register tokens + 32 个 style embedding tokens
- latent 设定 patch=2(256 token),像素设定 patch=16
- 特征编码器 phi:ResNet 结构(GroupNorm),在 latent(32×32×4)或像素(256×256×3)上预训练 MAE,4 个 stage 提供多尺度特征;像素设定额外加 ConvNeXt-V2
- 漂移损失:对每个尺度/位置的 Ci 维特征向量各算一个漂移损失后求和
- 样本队列:每类 128 个真实正样本 + 1000 个无条件样本(MoCo 式队列,训练时抽样)
为什么这样设计
生成器是标准的可扩展 DiT 骨架,好对比同规模基线;漂移损失需要'语义相近的样本在特征空间靠近',所以特征编码器必须用自监督预训练(MoCo/SimCLR/latent-MAE)而非随机初始化;多尺度多位置特征是为了给高维数据足够丰富的梯度信号(表 3 从 8.46 一路改进到 3.36 的路径就是加宽编码器、加长预训练、加分类微调)
数值 sense
| 项 | 值 |
|---|---|
| latent | 32×32×4(VAE 空间压缩 8×,通道 4) |
| tokens | latent 设定 256 个 token;像素设定 256 个 token |
| batch | 有效 batch B = Nc×Nneg,消融默认 4096、最终 8192 |
| 训练 | 消融 B/2 训 100 epochs(30K 步);最终 L/2 训 1280 epochs(200K 步) |
| feature | ResNet 4 个 stage,特征图分辨率 32²/16²/8²/4²,通道 C/2C/4C/8C |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ImageNet 256×256 潜空间 FID-50K(越低越好) | 1.54(Drifting L/2,1-NFE) | 同表 1-NFE 方法:iMeanFlow-XL/2 1.72(610M+49M)、AdvFlow-XL/2 2.38、MeanFlow-XL/2 3.43、Shortcut-XL/2 10.60、iCT-XL/2 34.24;多步参考:SiT-XL/2+REPA 1.42(250×2 步)、DiT-XL/2 2.27(250×2 步) | SD-VAE latent 32×32×4,DiT-L/2 463M+49M 参数,1280 epochs(200K 步),CFG α=1.0,50K 张生成图,全部从头训练非蒸馏;同表 Drifting B/2 为 1.75(133M+49M) |
| ImageNet 256×256 像素空间 FID-50K(越低越好) | 1.61(Drifting L/16,1-NFE) | 单步 GAN:StyleGAN-XL 2.30(166M,1574G FLOPs)、GigaGAN 3.45、BigGAN 6.95;多步像素:SiD2 UViT/1 1.38(512×2 步)、PixelDiT/16 1.61(200×2 步)、JiT-G/16 1.82(100×2 步)、ADM-G 4.59(250×2 步) | 无 VAE,直接生成 256×256×3,DiT-L/16 464M 参数,640 epochs(100K 步),87G FLOPs,50K 张生成图 |
| 反对称破坏消融 FID-50K(B/2、100 epochs 基线设定) | 8.46(默认反对称 V=V⁺−V⁻) | 1.5× 吸引 41.05、1.5× 排斥 46.28、2× 吸引 86.16、2× 排斥 112.84、纯吸引 177.14 | DiT-B/2,SD-VAE latent,100 epochs(30K 步),batch 4096,特征编码器为 latent-MAE(宽 256、预训练 192 epochs) |
| 正负样本分配消融 FID-50K(固定 B=4096、100 epochs) | 8.46(Nc=64,Npos=64,Nneg=64) | Npos=1 时 20.43、Npos=16 时 10.39、Npos=32 时 8.97;另一组 Nc/Npos/Nneg=512/8/8 为 11.82、256/16/16 为 10.16、128/32/32 为 9.32 | DiT-B/2 潜空间,每类独立跑算法 1,有效 batch=Nc×Npos=4096,100 epochs |
| 特征编码器消融 FID-50K(B/2、100 epochs) | 3.36(latent-MAE 宽 640、预训练 1280 epochs + 分类微调) | SimCLR(ResNet-50)11.05、MoCo-v2 8.41、latent-MAE 宽 256/192ep 8.46、宽 640/192ep 6.30、宽 640/1280ep 4.28 | DiT-B/2 潜空间生成,漂移损失在各编码器特征空间计算;同批正负样本、同训练预算 |
| 从消融到最终设定 FID-50K(潜空间) | 1.54(L/2、1280 epochs) | 同表递进:B/2 100ep 3.36 → B/2 320ep 2.51 → B/2 1280ep 1.75 → L/2 1280ep 1.54 | 加长训练、按长训调超参、放大模型;特征编码器 latent-MAE 宽 640 + 分类微调 |
| 机器人成功率(Diffusion Policy 协议,取最后 10 个 checkpoint 平均) | ToolHang state 0.38 / BlockPush phase1 0.56 / phase2 0.16(Drifting Policy,1-NFE) | Diffusion Policy(100 NFE):ToolHang state 0.30 / BlockPush phase1 0.36 / phase2 0.11;Lift 0.98 vs 1.00(state)、Can 0.96 vs 0.98、PushT state 0.91 vs 0.86、Kitchen 各 phase 双方均接近 1.0 | 把 Diffusion Policy 的多步扩散生成器换成 Drifting 单步生成器(1-NFE,state 与 visual 两种观测),漂移损失直接在原始表示上算、不用特征空间 |
Insights
- 训练过程本身就是生成过程:SGD 的每次参数更新等价于 pushforward 分布的演化,因此『迭代』可以从推理期搬到训练期,推理只剩一次前向(论文 3.1 节)。
- 平衡态由反对称性保证:V_{p;q}(x)=−V_{q;p}(x) 推出 q=p ⇒ V=0,训练目标就是最小化 E‖V‖²,训练终点对应映射 x→x+V(x) 的不动点(3.2 节)。
- 反向蕴含(V≈0 ⇒ q≈p)在一般情形不成立;论文用核化构造 + 基函数展开给出可辨识性启发式:零漂移约束化为双线性方程 a_i b_j − a_j b_i=0,在非退化假设与足够多探针点(N≫m²)下推出 a∝b,再由概率归一得 p=q(C.1 节)。
- 方法在谱系上同时避开三条路:不依赖 ODE/SDE 轨迹(对比扩散/流与 MeanFlow)、不需要预训练教师(对比蒸馏与 Consistency 的蒸馏变体)、没有判别器与对抗优化(对比 GAN)。
- CFG 变成训练期行为:把无条件真实样本混进负样本,平衡解等价于 αp_data(·|c)−(α−1)p_data(·|?) 的外推,推理保持 1-NFE(3.5 节)。
vs 同类工作
- vs 扩散/流匹配(DDPM、Score SDE、Flow Matching):它们把复杂 pushforward 分解成推理期迭代的链式变换(x_{i+1}=x_i+Δx_i,Euler 求解 ODE/SDE),多步 NFE;Drifting 把同样的更新结构搬到训练期,推理 1-NFE,且完全不使用 ODE/SDE 公式。
- vs 蒸馏类单步(progressive distillation、DMD、iCT):需要高质量预训练多步教师 + 轨迹对齐;Drifting 从头训练,教师为零。iCT-XL/2 在表 5 同设定下 FID 34.24,远高于 Drifting L/2 的 1.54。
- vs Consistency Models:Consistency 的目标是学一致性函数 f(x_t,t)=f(x_T,T),要求同一 ODE 轨迹上的所有点映射到同一终点,轨迹/边界条件是训练目标的一部分;Drifting 没有轨迹概念,平衡条件 q=p 是分布的(非逐点轨迹的)不动点,训练目标只有漂移范数。
- vs MeanFlow / improved MeanFlow:iMF 学的是流 ODE 的『快进』传输映射(Geng et al. 2025a/b),目标围绕速度场/轨迹设计,仍属于 flow 谱系;Drifting 目标不含速度场,只由正样本(数据)与负样本(生成样本)的均值偏移差驱动。数字对照:潜空间 1-NFE,Drifting L/2(463M)FID 1.54 优于 iMeanFlow-XL/2(610M)的 1.72。
- vs GAN:单生成器 + 无判别器 + 无对抗 min-max;损失只作用于生成样本本身(把 x 推向冻结的 x+V)。
- vs MMD/矩匹配:论文在 C.2 节证明 MMD 的梯度可以诱导一个漂移场,但 Drifting 的 V-centric 公式更一般:支持归一化核(MMD 的核无法自然导出归一化)、灵活步长与 V 归一化、并把平衡概念扩展到 CFG;论文自述用 MMD 框架在实验里拿不到合理结果。
局限
- 理论缺口:V≈0 ⇒ q≈p 一般不成;论文只给出核化构造下的可辨识性启发式(基函数展开 + 非退化假设 + 探针点 N≫m²),平衡唯一性与收敛条件仍是开放问题(Discussion 明说 it remains unclear under what conditions V→0 leads to q→p)。
- 强依赖特征编码器:论文自述在 ImageNet 上无法让方法在无特征空间时工作(kernel 全平、相似度失效);编码器质量直接决定上限(同预算下 SimCLR 11.05 vs latent-MAE+cls ft 3.36)。
- 训练开销与工程敏感:每步都要跑特征编码器和 VAE 解码器并回传梯度,还要在几十个尺度/位置特征上分别算漂移损失;batch 构成(Npos/Nneg 分配)与核温度、归一化都对 FID 影响显著(表 2、表 11)。
- 评估面窄:主实验只有 ImageNet 256×256 与 Diffusion Policy 机器人协议;像素空间仅训 640 epochs(潜空间 1280),作者预期更长训练还有提升;未覆盖更大分辨率、文本条件与视频。
- CFG 语义与扩散不同:L/2 最优 FID 出现在 α=1.0(扩散语境相当于无 CFG),说明它的 guidance 权衡由训练期负样本混合决定,FID/IS 曲线(图 5)与标准 CFG 相似但机制不同。
- 框架通用性存疑:虽然 C.2 节把 MMD 归约为 V 的特例,论文承认按 MMD 框架实现得不到合理结果,说明『任意可归约的场』与实际可训练的场之间还有很大距离。
可复现性
- code:project page: lambertae.github.io/projects/drifting(论文脚注)
- weights:论文未提及权重开源
- compute:Google TPU(TPU Research Cloud 提供),模型全从头训练
- eval:ImageNet 256×256 FID-50K 标准协议(50K 生成图);机器人按 Diffusion Policy 协议(成功率取最后 10 个 checkpoint 平均)
主干与结构
backbone:DiT-style transformer 生成器 + 预训练 SSL 特征编码器(MoCo-v2 / SimCLR / 自研 latent-MAE)
参数:L/2 latent 463M(+49M VAE decoder);B/2 133M;L/16 像素 464M
类型:单步(1-NFE)生成器,非迭代;训练期用漂移损失
关键组件
- DiT 生成器:SwiGLU、RoPE、RMSNorm、QK-Norm、adaLN-Zero + in-context conditioning tokens(16 个)+ register tokens + 32 个 style embedding tokens
- latent 设定 patch=2(256 token),像素设定 patch=16
- 特征编码器 phi:ResNet 结构(GroupNorm),在 latent(32×32×4)或像素(256×256×3)上预训练 MAE,4 个 stage 提供多尺度特征;像素设定额外加 ConvNeXt-V2
- 漂移损失:对每个尺度/位置的 Ci 维特征向量各算一个漂移损失后求和
- 样本队列:每类 128 个真实正样本 + 1000 个无条件样本(MoCo 式队列,训练时抽样)
为什么这样设计
生成器是标准的可扩展 DiT 骨架,好对比同规模基线;漂移损失需要'语义相近的样本在特征空间靠近',所以特征编码器必须用自监督预训练(MoCo/SimCLR/latent-MAE)而非随机初始化;多尺度多位置特征是为了给高维数据足够丰富的梯度信号(表 3 从 8.46 一路改进到 3.36 的路径就是加宽编码器、加长预训练、加分类微调)
数值 sense
| 项 | 值 |
|---|---|
| latent | 32×32×4(VAE 空间压缩 8×,通道 4) |
| tokens | latent 设定 256 个 token;像素设定 256 个 token |
| batch | 有效 batch B = Nc×Nneg,消融默认 4096、最终 8192 |
| 训练 | 消融 B/2 训 100 epochs(30K 步);最终 L/2 训 1280 epochs(200K 步) |
| feature | ResNet 4 个 stage,特征图分辨率 32²/16²/8²/4²,通道 C/2C/4C/8C |
Drifting Model 总览:训练期演化 pushforward 分布
原文 caption:A network f performs a pushforward operation: q = f#p_prior, mapping a prior distribution p_prior to a pushforward distribution q (orange). The goal of training is to approximate the data distribution p_data (blue). As training iterates, we obtain a sequence of models {f_i}, corresponding to a sequence of pushforward distributions {q_i}. Our Drifting Model focuses on the evolution of this pushforward distribution at training-time. A drifting field approaches zero when q matches p_data, providing a loss function (y-axis, log-scale) for training.
全篇概念图:横轴是训练迭代,纵轴(对数刻度)是漂移场损失的下降曲线;橙色是网络输出的 pushforward 分布 q,蓝色是数据分布 p_data。随着 SGD 一步步行进,模型序列 {f_i} 对应的 q_i 不断逼近 p_data,损失(等于漂移场范数平方)随之走低。读图要点:迭代发生在训练期,推理时 f 只跑一次前向;这张图把『训练=分布演化』这个核心设定可视化,是全篇论证的起点。
单个样本的漂移:数据吸引 + 生成分布排斥
原文 caption:Illustration of drifting a sample. A generated sample x (black) drifts according to a vector: V = V⁺_p − V⁻_q. Here, V⁺_p is the mean-shift vector of the positive samples (blue) and V⁻_q is the mean-shift vector of the negative samples (orange): see Eq. (8). x is attracted by V⁺_p and repulsed by V⁻_q.
漂移场的机制图:对一个生成样本 x(黑点),数据分布抽出的正样本(蓝)给出均值偏移向量 V⁺_p,把 x 拉向数据密集区;生成分布抽出的负样本(橙)给出 V⁻_q,把 x 从生成样本扎堆处推开;最终漂移方向 V = V⁺_p − V⁻_q。对应 Eq.(8)–(11):合并后漂移正比于 E[k(x,y⁺)k(x,y⁻)(y⁺−y⁻)],向量差简化为正负样本差。这张图解释为什么方法对模式坍缩稳健:某处生成样本过多时排斥项把样本推走,而未被覆盖的模式持续提供吸引。
2D 玩具:三种初始化下 q 都演化到双峰目标 p
原文 caption:The distribution q (orange) evolves toward a bimodal target p (blue) during training. We show three initializations of q: (top) initialized between the two modes; (middle) initialized far from both modes; (bottom) initialized collapsed onto one mode. Across all initializations, our method approximates the target distribution without mode collapse.
同一页还含图 4(生成样本随训练演化、损失=‖V‖² 单调下降)和表 1(破坏反对称的消融)。图 3 是三种初始化:q 初始落在两峰中间、离两峰都远、塌缩在单峰上,训练后都能铺满双峰目标 p。读图重点:第三种情形下,未被覆盖的峰通过正样本吸引把样本从聚集处拉走,所以不会锁死在单峰。表 1 进一步说明反对称的分量比例是硬约束——把吸引或排斥项放大到 1.5×/2×,FID 从默认 8.46 恶化到 41.05–177.14(DiT-B/2、100 epochs、ImageNet latent 设定)。
ImageNet 256×256 潜空间系统级对比:1-NFE 新 SOTA
原文 caption:System-level comparison: ImageNet 256×256 generation in latent space. FID is on 50K images, all reported with CFG if applicable. The parameter numbers are 'generator + decoder'. All generators are trained from scratch (i.e., not distilled).
此页还含表 2(正负样本分配消融)与表 3(特征编码器消融)。表 5 是主打结果:1-NFE 一栏中 Drifting L/2 的 FID 1.54(463M+49M)低于 iMeanFlow-XL/2 的 1.72(610M+49M)、AdvFlow-XL/2 的 2.38、MeanFlow-XL/2 的 3.43、Shortcut-XL/2 的 10.60、iCT-XL/2 的 34.24,全部从头训练、非蒸馏;B/2(133M)的 1.75 也追平 XL 规模对手。对照多步方法:DiT-XL/2 跑 250×2 步 FID 2.27、SiT-XL/2+REPA 250×2 步 1.42。读表要点:同为 1-NFE,比拼的是训练目标设计的质量。
🎧 音频版
时长 34:04 · Edge TTS
把迭代搬进训练期:单步生成的 Drifting Model(精读)
开场:这篇要解决什么问题
小播:今天这篇叫《Generative Modeling via Drifting》,作者里有 Kaiming He。我听说它能让生成模型只跑一步就出图,质量还特别好。先说说它到底做了什么?
老播:一句话背景:现在主流的扩散模型、流匹配模型,出图都要迭代几十上百步,每一步都让神经网络算一次,这个「一次网络前向」叫一个 NFE。这篇论文想把这个迭代整个搬到训练期:训练时网络参数一直在更新,生成分布跟着演化,推理时网络只算一次前向,1-NFE 直接出图。他们给这个演化配了一个「漂移场」,生成分布和数据分布对上时漂移场归零,系统到平衡态。结论先放在这里:ImageNet 256×256 上,潜空间单步 FID 1.54、像素空间单步 FID 1.61,是当时单步方法里的最好成绩,同表对照 improved MeanFlow 的 XL 模型是 1.72。先定义两个指标,后面全程要用:FID 衡量生成分布和真实分布在特征空间的距离,越低越好,在 50K 张生成图上评估;IS 衡量单张图的质量,越高越好。这期要讲清楚三件事:训练期的分布演化怎么对应不动点、平衡的唯一性靠什么保证、以及它和 Consistency、MeanFlow 这两类单步方法的目标差在哪。
先补背景:生成模型为什么非要跑很多步
小播:先从最基础的问:为什么扩散模型要跑那么多步?一步出图难在哪里?
老播:生成建模的目标可以写成一个映射问题:找一个网络 f,把噪声变成长得像数据的样本。噪声的分布经过 f 之后会变成一个样本分布,这个变换在概率论里叫 pushforward,中文叫推前分布,记作 q = f#p。理想情况是 q 恰好等于数据分布 p_data。扩散模型和流匹配模型怎么逼近这个目标?它们把「从噪声到数据」拆成一条很长的链:样本每一步只动一点点,x_{i+1} = x_i + Δx_i,相当于在解一个微分方程,每一步都要网络算一次。所以步数基本等于网络前向次数,也就是 NFE,出图成本随步数线性上涨。拿 2022 年的 DiT-XL 举例:ImageNet 256 上要跑 250×2 步,才拿到 FID 2.27;跑得步数少,质量就掉。推理迭代这件事,天然是单步生成的第一个障碍。
小播:那单步化不是早就有人在做了吗?蒸馏、还有 MeanFlow 那些。
老播:对,单步化有两条现成的路,两条都绕不开一个词:轨迹。轨迹就是每个样本从噪声到数据走的那条路径。蒸馏路线,比如 progressive distillation、DMD、iCT,先训练一个高质量多步教师,再让学生模仿教师沿轨迹的输出,把多步压成一步,问题在于多了一个教师训练阶段,流程重、成本高。从头训练路线,比如 Shortcut、MeanFlow、iMF、AdvFlow,目标仍然建立在轨迹或速度场上:要么学轨迹上的传输映射,要么直接学流的速度场。这篇论文的位置就在这两条路之外:它完全不用轨迹,把迭代挪到训练期,用漂移场直接驱动生成分布演化。这个定位在后面讲谱系对比的时候会反复出现,先记住一个关键词:它拒绝轨迹。
小播:那这个「轨迹」具体指什么?为什么两条路都绕不开它?
老播:轨迹是每个样本从噪声到数据走过的路径,扩散模型的推理就是在轨迹上取点:从纯噪声出发,一步步走回数据。蒸馏想让学生一步复现教师的终点,但「把整条轨迹压成一步」的映射,本身要靠轨迹上的点对点对齐来训练:progressive distillation 是一步步把步数减半,DMD 用分布匹配对齐教师和学生,iCT 用轨迹上相邻点的自洽性约束。从头训的 MeanFlow 也一样,它学的是把轨迹「快进」的传输映射,目标函数里写着轨迹上的速度和时间区间。这些方法的目标都带着时间维度和轨迹概念。Drifting 把这两个概念都删掉了:目标里没有时间步 t,没有轨迹采样,只有一批真实样本和一批生成样本之间的漂移。这个差异到谱系部分还要细讲。
小播:那为什么非要在意 NFE?多跑几步,质量更好不行吗?
老播:要看应用场景。离线批量出图,多跑几步无所谓;但实时场景,比如机器人控制、交互式图像编辑、视频流生成,推理延迟直接决定能不能用。Diffusion Policy 在机器人上要跑 100 步才出一次动作,单步模型把延迟压掉两个数量级。ImageNet 上多步模型的天花板确实更高,表里 SiT-XL/2 加 REPA 能到 FID 1.42,但那是 250×2 步换来的;单步路线追求的是在一次前向的预算里把质量推到极限。Drifting 的 1.54 离 1.42 已经不远,这就是这篇的分量。
核心思想第一步:训练过程本身就是分布演化
小播:那「把迭代搬到训练期」具体是什么意思?
老播:想想训练是怎么进行的:SGD 更新成千上万次参数,网络从 f_0 变成 f_1、f_2,一直到 f_T。每一步参数变了,同一个噪声喂进去,出来的样本就变了。把第 i 轮的输出分布记为 q_i = [f_i]#p,训练过程就对应一长串分布 q_0、q_1、q_2……这就是「训练期演化 pushforward 分布」的字面意思:训练在演化一个分布,而这个分布的终点应该落在数据分布上。
小播:那每一步样本具体怎么动?
老播:把第 i 轮和第 i+1 轮对同一个噪声的输出相减,x_{i+1} = x_i + Δx_i,这个 Δx_i 来自参数更新。论文把 Δx 的规则显式写成一个场:x_{i+1} = x_i + V_{p;q_i}(x_i)。这里 V 叫漂移场(drifting field),下标 p、q 表示它依赖数据分布 p 和当前生成分布 q。它回答的问题很直接:一个生成样本下一步该往哪挪,整批样本才会朝数据分布移动。先给结论:当 q 等于 p 的时候,所有样本都应该停下不动,也就是 V 必须等于零;训练目标就是把这个场的范数压到零。
小播:为什么训练期的演化能替代推理期的迭代?训练步数够用吗?
老播:可以算一笔账:扩散模型推理要跑 50 到 1000 次网络前向,训练却有几十万步参数更新。把「演化分布」这件事交给参数更新完成,步数预算充裕得多。更关键的是方向:训练目标直接衡量当前分布离数据分布有多远,每一步更新都朝缩短这个距离的方向走,推理期的迭代自然就省掉了。这也解释了方法为什么叫「漂移」:样本在训练过程中的移动方式,就是被 V 这个场推着走,训练结束,漂移归零。
核心思想第二步:反对称的漂移场给出平衡态
小播:怎么保证「q 等于 p 时 V 一定为零」?
老播:论文用一个很干净的条件:反对称性(anti-symmetry)。写成公式:V_{p;q}(x) = −V_{q;p}(x)。这个式子说,把 p 和 q 对调,漂移方向就反号。如果真的有 q = p,那么左边 V_{p;p} 和右边 −V_{p;p} 是同一个量,一个量等于自己的相反数,只能等于零。所以只要 V 反对称,q = p 就必然推出 V = 0,平衡态成立。这里的平衡态就是不动点:把样本更新看成映射 x → x + V(x),训练终点恰好是这个映射的不动点,样本原地不动,分布停止演化。
小播:那训练目标长什么样?
老播:把平衡条件变成损失。在平衡点成立不动点关系 f(ε) = f(ε) + V(f(ε)),把这个关系当回归目标:L = E_ε ‖ f_θ(ε) − stopgrad( f_θ(ε) + V(f_θ(ε)) ) ‖²。逐项看:θ 是网络参数;f_θ(ε) 是网络输出;stopgrad 表示括号里这一整块不参与梯度回传,是一个冻结目标;网络要朝「上一步输出加漂移」这个冻结目标靠拢。这个损失的值恰好等于 E‖V‖²,所以训练就是不断压低漂移范数。为什么用 stopgrad?因为 V 依赖当前生成分布 q_θ,梯度要是穿过 V 反传,就要对分布求导,很难处理;把目标冻结在上一步,就绕开了这条路径。BYOL 和一致性模型里也有同样的 stopgrad 技巧。还有一个值得点破的视角:第 i 轮的网络更新 f_{i+1} ← f_i + V 本身就是在做不动点迭代,损失只是把这个迭代转写成回归形式。所以「训练期演化」和「不动点」是一体两面:训练更新在迭代求解 x → x + V(x) 的不动点,V 归零时求解完成。
小播:那这个损失训练出来的模型,推理的时候怎么用?
老播:推理时只需要一次前向:采样一个噪声 ε,跑一遍 f,直接得到样本,1-NFE。这也是它和扩散模型最明显的差别,扩散的迭代在推理期,它的迭代在训练期。这句话值得记住:训练里本来就有的那些步,被重新利用来演化生成分布,推理因此只剩一步。
核心思想第三步:平衡唯一性,反着走成不成立
小播:等一下,V 等于零能反推 q 等于 p 吗?万一有个奇奇怪怪的分布也让 V 为零呢?
老播:这个问题问到了理论最薄的地方。一般情形下,论文明确说反着走不成立:随便构造一个向量场,都可能存在非数据分布的零点。论文给的是一个在特定构造下成立的可辨识性论证,放在附录 C.1。大意是:把 p 和 q 都用一组线性无关的基函数展开成系数 a 和 b,漂移场 V 对每个探针点 x 的值就可以写成基函数交互项的线性组合,Σ a_i b_j U_ij,这里 U_ij 是基函数 i、j 相互作用产生的向量。零漂移条件 V(x) ≡ 0 在足够多探针点上变成一组方程,论文的核心观察是:这组方程在反对称性(U_ij = −U_ji)和「交互向量线性无关」的非退化假设下,等价于 a_i b_j − a_j b_i = 0 对所有的 i、j 成立。逐符号看:i、j 是基函数下标,这个式子等于说系数向量 a 和 b 平行。再补上概率密度归一条件 ∫p = ∫q = 1,平行的两个概率分布只能相等,于是 p = q。整个论证有三个前提:探针点个数要远大于基函数对数的平方、交互向量要线性无关、基展开要足够逼近。所以它是个启发式论证,给的是设计指导;论文在讨论部分明确说,什么样的条件下 V 趋于零能推出 q 趋于 p,这个问题仍然开放,训练动力学能不能保证到达平衡也没有定理。
小播:那实验上呢?损失和生成质量有关系吗?
老播:有关系。图 4 里,2D 玩具上损失(= ‖V‖²)随训练单调下降,分布同步收敛到目标;ImageNet 上他们也观察到压低漂移和改善 FID 相关。这层「理论有缺口、实验相关」的组合,恰恰是这篇论文最容易被挑战的地方,我们放到局限部分再展开。
小播:那这个可辨识性论证,实际指导了什么设计?
老播:它把几条工程选择串起来了:核要归一化,因为归一化保证 p=q 时正负项成对抵消;正负样本要同批采样,因为只有同批统计,抵消性质才在期望意义上成立;反对称必须严格保持,因为零漂移约束能真正约束分布。这套论证虽然没给出收敛定理,但把设计的约束讲清楚了,这也是附录存在的价值。
核心思想第四步:漂移场具体怎么算
小播:理论说完了,那 V 到底是个什么函数?总不能解析地算两个分布吧?
老播:两个分布当然算不动,论文把它做成蒙特卡洛估计,用一批样本近似。构造分两步,先定义两个均值偏移(mean shift)向量:V⁺_p(x) = E_{y⁺~p}[k(x,y⁺)(y⁺−x)] / Z_p,V⁻_q(x) = E_{y⁻~q}[k(x,y⁻)(y⁻−x)] / Z_q。逐符号解释:y⁺ 是从数据分布抽的正样本,y⁻ 是从当前生成分布抽的负样本;k 是相似度核函数,衡量两个样本有多像;Z_p、Z_q 是归一化因子,把核权重归一;括号里的 y⁺−x 是向量差。V⁺_p 的意思是「数据对 x 的均值偏移」:x 附近的数据样本会把 x 拉向数据密集区;V⁻_q 的意思是「生成样本对 x 的均值偏移」:x 附近的生成样本会把 x 从扎堆处推开。漂移场取两者之差:V = V⁺_p − V⁻_q。均值偏移是 1995 年 Cheng 提出来的经典聚类工具,论文借它的壳,但用场论的方式重新组织。
小播:所以是数据拉一把、生成样本推一把?
老播:对,这个结构是抗模式坍缩的关键。把两项合并,V 正比于 E[k(x,y⁺)k(x,y⁻)(y⁺−y⁻)],漂移方向简化成正负样本之差,权重由两个核共同决定。核取 k(x,y) = exp(−‖x−y‖/τ),τ 是温度,控制多大范围算「附近」。实践里用 softmax 近似归一化,跟对比学习 InfoNCE 的写法很像;负样本直接复用本批生成样本,不用额外生成。图 2 画的就是这个机制:黑点 x 被蓝点代表的真实数据吸引、被橙点代表的生成样本排斥,合出 V 的方向。为什么这样能防坍缩?某个区域生成样本一多,排斥项变大,样本被推走;没被覆盖的模式没有排斥,只有吸引,样本会持续流过去。2D 玩具图 3 里,q 初始塌缩在单峰上,训练后照样铺满双峰目标,就是直接证据。实现上还有两个工程细节:正样本从每类 128 个样本的队列里抽,无条件样本从 1000 个的全局队列里抽,每步推新退旧,保证抽样统计稳定;温度设了 0.02、0.05、0.2 三档,每个温度各算一个漂移场再求和,比单温度略好——单用 0.05 是 FID 8.67,三个合起来是 8.46(B/2、100 epochs 设定)。
小播:softmax 归一化具体做了什么?为什么要做两次?
老播:归一化解决尺度问题。k(x,y) 的绝对值随距离尺度变化很大,直接当权重用,不同特征空间的量纲会干扰漂移大小。论文用 softmax 把「对一批 y 的权重」归一成和为 1,这步和 InfoNCE 一样;再对 x 方向也做一次 softmax,两个方向各归一次再几何平均,消融里这样是 FID 8.46,只对 y 做是 8.92,都不做是 10.54(B/2、100 epochs)。还有一层值得点破的性质:当 p 等于 q 时,正样本和负样本来自同一个分布,y⁺−y⁻ 这一项会成对抵消,V 自动归零。这个「分布匹配即自动平衡」是构造保证的,网络不用学,靠的是反对称结构,这也是整个方法最省心的地方。
核心思想第五步:特征空间和 CFG
小播:这个核要在什么空间里算?直接在像素上算距离行不行?
老播:高维空间里直接算有困难:像素或 latent 空间维数高,样本间距离普遍偏大,指数核会「平」掉,所有样本看起来都差不多远,漂移信号就没了。论文的做法是把损失搬到预训练自监督编码器 ϕ 的特征空间:L = Σ_j E ‖ ϕ_j(x) − stopgrad( ϕ_j(x) + V(ϕ_j(x)) ) ‖²。这里 ϕ_j 是第 j 个尺度/位置的特征向量,ResNet 四个 stage 能给出 32²、16²、8²、4² 四档分辨率的多尺度特征,一个尺度一个位置算一个损失再求和,论文说多尺度多位置的损失加在一起,比单看全局统计好——消融里只加全局特征 FID 9.58,加全 8.46。编码器用自监督预训练:MoCo、SimCLR,还有他们自研的 latent-MAE。为什么要自监督?因为漂移场靠核相似度工作,只有语义相近的样本在特征空间彼此靠近,核才有区分度,这正好是 MoCo、MAE 这批方法擅长的事。训练时梯度穿过编码器和 VAE 解码器回传,推理时编码器完全不参与,不影响 1-NFE。特征编码器的质量直接决定上限,这个我们到实验部分用数字说。
小播:类条件生成呢?ImageNet 有 1000 个类,怎么保证生成的图片是「这一类的」?
老播:他们做了一套训练期 CFG。原始 CFG 是 Ho 和 Salimans 在 2022 年提出的,思路是在推理时把条件分布和无条件分布做外推,让样本更贴类别。这里把同样的事搬进训练期:把无条件真实样本按比例 γ 混进负样本分布,平衡时网络学到的是 α p_data(·|c) − (α−1) p_data(·|?),α = 1/(1−γ) 就是 CFG 强度,也作为条件输入网络。逐项看:c 是类别,问号表示无条件数据分布;式子说明网络在条件分布和无条件分布之间外推,和原始 CFG 的精神一致。训练时 α 按预定义分布随机采样,推理时指定一个值,仍然只有一次前向,1-NFE 不被破坏。细节上:L/2 模型最优 FID 在 α=1.0,相当于扩散语境里的「无 CFG」;B/2 的最优在 α=1.1。
实验一:玩具实验和反对称消融
小播:从实验开始讲。先看 2D 玩具,它证明什么?
老播:图 3 的设定是双峰目标分布,三种初始化的 q:一开始在两峰中间、离两峰都远、塌缩在单峰上,训练后都收敛到双峰目标,没有模式坍缩。2D 玩具还有一个细节:q 的初始位置影响收敛路径,但终点一致,这正好对应图 1 里「演化」的概念。这个实验的价值在于展示漂移场的动力学:排斥项让样本离开聚集处,吸引项让样本流向空模式,两者平衡时停下来。同一页的图 4 显示损失随训练下降,支撑「压低漂移约等于逼近数据」的动机。紧接着的表 1 是破坏性消融,设定是 DiT-B/2、ImageNet latent、100 epochs:默认反对称的 V 是 FID 8.46;把吸引项放大到 1.5 倍,FID 跳到 41.05,放大到 2 倍是 86.16,纯吸引是 177.14;把排斥项放大到 1.5 倍是 46.28,2 倍是 112.84。这个表把反对称的分量比例变成硬约束:吸引和排斥必须等比例,平衡才成立。注意幅度:8.46 到 177.14,同一套训练预算、同一个模型骨架,只改一个系数,质量崩了二十倍,说明平衡结构对方法来说是地基级别的设计,消融里少见的干净。
实验二:正负样本、特征编码器和扩展
小播:消融里还有两个表值得讲,正负样本分配和特征编码器。
老播:表 2 控制总预算:固定有效 batch 4096、100 epochs,看正样本数量。Npos 从 1 提到 64,FID 从 20.43 一路降到 8.46。正样本多了,漂移场的蒙特卡洛估计更准,这和对比学习里「样本集越大表征越好」的观察一致。表 3 是特征编码器:同样预算下,SimCLR 编码器 11.05,MoCo-v2 是 8.41,自研的 latent-MAE 宽度 256 是 8.46;把编码器加宽到 640、预训练拉到 1280 epochs,FID 到 4.28,再加分类微调到 3.36。MoCo 和 SimCLR 是在像素空间预训练的,用在潜空间生成上还要先过一遍 VAE 解码器;latent-MAE 直接在 latent 上预训练,省掉这一步,这也是它被选为默认的原因。这两个表合起来说明:方法的质量高度依赖批量统计的准确度和特征空间的语义质量。论文还自述:没有特征编码器时,ImageNet 上完全训不动,这个问题我们放局限里细说。
小播:那从消融到最终成绩是怎么走过来的?
老播:表 4 是扩展路径:B/2 100 epochs 是 3.36,训到 320 epochs 变 2.51,1280 epochs 加调超参变 1.75,换 L/2 训 1280 epochs,FID 1.54。这里每个数字都对着同一个设定:SD-VAE 潜空间、50K 张生成图评估、从头训练。
实验三:ImageNet 系统级对比和像素空间
小播:重点来了,系统级对比。1.54 在单步方法里排第几?
老播:表 5 是潜空间对比,所有方法 1-NFE、从头训练、FID 用 50K 张生成图评估。Drifting L/2(463M 参数加 49M VAE 解码器)FID 1.54,低于 iMeanFlow-XL/2 的 1.72(610M 参数)、AdvFlow-XL/2 的 2.38、MeanFlow-XL/2 的 3.43、Shortcut-XL/2 的 10.60、iCT-XL/2 的 34.24。注意 iMeanFlow 用了更大的 XL 模型,参数 610M 比 463M 多,FID 反而更高,说明差距主要来自训练目标的设计,模型规模解释不了。对照多步方法,DiT-XL/2 跑 250×2 步是 2.27,SiT-XL/2+REPA 是 1.42,单步的 1.54 已经压过一部分多步基线,这是单步方法第一次在标准潜空间协议下全面逼近甚至超过多步。像素空间表 6:Drifting L/16 单步 FID 1.61,87G FLOPs;对照 GAN 路线,StyleGAN-XL 是 2.30 但要 1574G FLOPs,GigaGAN 3.45,BigGAN 6.95。87G 对 1574G 差了约 18 倍计算量,FID 还更好。论文还做了定性对比:和 iMF 逐类并排出图,iMF 那组是 DiT-XL/2、CFG 6.0,FID 3.92、IS 348.2;把 Drifting 的 CFG 调到 IS 对齐到 354.4 时,FID 是 3.01,低一截。
小播:那 CFG 呢?他们用 CFG 了吗?
老播:表 5 里 Drifting 的 1.54 是 α=1.0,也就是没用 guidance;iMF 那批数字普遍带高 CFG。图 5 的 FID 对 α 曲线显示:α 增大时 IS 升高,FID 先降后升,权衡和标准 CFG 类似,只是机制发生在训练期。这里有个有意思的点:L/2 的最优 FID 出现在 α=1.0,意味着它的最强成绩其实没有靠 guidance 撑起来,这在单步方法里很少见。公平起见也要报一组数字:IS 方面 Drifting L/2 是 258.9,iMeanFlow-XL/2 是 282.0,单图质量还有差距,这也解释了论文做定性对比时要调高 CFG 去对齐 IS,而不是直接比默认设定。
实验四:机器人控制
小播:图像之外还有机器人实验,这个跨领域验证挺关键的。
老播:实验协议完全沿用 Diffusion Policy:把多步扩散生成器换成单步 Drifting 生成器,1-NFE,漂移损失直接在原始表示上算,不用特征空间。成功率取最后 10 个 checkpoint 平均。ToolHang state 从 Diffusion Policy(100 NFE)的 0.30 提到 0.38;BlockPush phase1 从 0.36 提到 0.56,phase2 从 0.11 提到 0.16;Lift 从 0.98 到 1.00,Can 从 0.96 到 0.98;PushT 稍弱,state 是 0.91 对 0.86,visual 是 0.84 对 0.86;Kitchen 各 phase 双方都接近 1.0。用 1/100 的推理步数拿到相近或更好的成功率,说明这个目标设计对低维动作分布也成立,方法跨领域。还有个细节:机器人这里完全没用特征编码器,直接在原始表示上算漂移,效果仍然成立,说明特征空间只是高维视觉下的工程选择,场论本身在低维也能工作。
谱系定位:它和 Consistency、MeanFlow 差在哪
小播:现在回答最关键的谱系问题:同样是单步,它和 Consistency、MeanFlow 的目标有什么不同?
老播:三条路线并排看。Consistency Models 的目标是学一致性函数:f(x_t, t) = f(x_T, T),意思是同一条 ODE 轨迹上的所有点,映射到同一个终点。它的训练目标里轨迹、时间步、边界条件是主角,蒸馏变体还需要预训练教师,从头训的 iCT 也要从轨迹和边界条件出发。MeanFlow 和 improved MeanFlow 学的是流 ODE 的「快进」传输映射,目标围绕速度场和轨迹设计,仍然在 flow 谱系内部。Drifting 的差别在于:目标里没有轨迹、没有时间步、没有速度场,只有一个分布层面的不动点条件 q = p。Consistency 约束的是沿着轨迹自洽,Drifting 约束的是分布停在数据分布上,两种平衡发生在不同的空间:一个是逐样本的轨迹终点一致,一个是整批样本的分布一致。数字对照最有说服力:潜空间 1-NFE、从头训练,Drifting L/2 的 1.54 对 iMeanFlow-XL/2 的 1.72。另外两条相邻路线:和 GAN 比,没有判别器、没有对抗 min-max;和 MMD 矩匹配比,论文在附录 C.2 证明 MMD 的梯度可以诱导出一个漂移场,但他们的 V 中心公式更一般,支持归一化核、灵活步长,还能把平衡概念扩展成 CFG;论文也坦白,按 MMD 框架实现,实验里拿不到合理结果。C.2 还给了个更一般的观察:任何以 p=q 为最小值的分布差异损失,其梯度都能诱导出一个漂移场,所以漂移场框架可以把一批分布层面的方法统一起来看。
小播:Consistency 和 MeanFlow 内部还能再拆细一点吗?它们的变体差在哪?
老播:Consistency 有两个版本:consistency distillation 用预训练教师生成轨迹来训练,consistency training 从零开始,靠边界条件 f(x_T, T) = x_T 加上相邻时间点的一致性约束;iCT 是后者的改进版,重点处理训练稳定性。不管哪个版本,目标里都写着时间步 t 和轨迹上的点。MeanFlow 这边,原版学的是把整条流轨迹一步「快进」到终点的映射,iMF 改进了训练目标和正则化,ImageNet 潜空间 1-NFE 做到 FID 1.72(XL、610M 参数)。Drifting 和这两家的共同点只有一个:都做单步、都从头训练;差异在目标结构:它只需要三样东西,一批真实样本当正样本、一批生成样本当负样本、一个反对称的漂移场。对比学习、MMD 这些分布层面的工具和它同源,但把「平衡态」显式写进训练目标,是这篇独有的设计。
局限:理论缺口和工程依赖
小播:批评的部分来了。这篇论文的软肋在哪?
老播:至少八条,挑重点说。第一,理论缺口:V ≈ 0 推出 q ≈ p 只在核化构造加非退化假设下成立,是启发式论证;什么样的优化动力学保证收敛到平衡,论文明确说是开放问题。第二,特征编码器依赖:没有特征空间 ImageNet 上训不动,编码器质量直接决定上限,同预算下 SimCLR 11.05 对 latent-MAE 加分类微调 3.36,这等于把一部分成败押在论文之外的预训练模型上。第三,训练开销:每一步都要跑特征编码器、VAE 解码器并回传梯度,几十个尺度位置的损失求和,batch 构成(正负样本数量)和核温度、归一化都显著影响 FID,工程调参面很大。第四,评估面窄:主实验只有 ImageNet 256×256 和 Diffusion Policy 机器人协议,像素空间只训了 640 epochs,潜空间是 1280,作者自己预期更长训练还有提升;更大分辨率、文本条件、视频都没有覆盖。第五,框架通用性还要打问号:MMD 在理论上可以归约成它的特例,实践却跑不出合理结果,说明「能写成的公式」和「能训练的方法」之间还有距离。第六,模式坍缩的论证只在 2D 玩具上直接做过,高维 ImageNet 上只能间接看 FID 和最近邻分析,图 6 显示生成图和最近的真实图在 CLIP 特征下差异明显,说明模型没有背训练集,但「绝不坍缩」这种强结论还撑不住。第七,CFG 的增益有限:L/2 最优 FID 在 α=1.0,等于没开 guidance,这套训练期 CFG 更像一个可选开关,和扩散模型里 CFG 的收益不可比。第八,可辨识性论证要求 p、q 在整个空间都有支撑,论文用无限小高斯平滑绕开边界问题,这又多加了一层假设。
收尾:记住这三件事
小播:好,最后帮我收一下。这期最该记住的三件事?
老播:第一,迭代的位置变了:扩散/流把迭代放在推理期,所以多步 NFE;Drifting 把迭代放进训练期,利用 SGD 本身的步数演化生成分布,推理只剩一次前向。第二,平衡态来自反对称:V_{p;q} = −V_{q;p} 保证 q = p 时 V = 0,训练目标就是压低 ‖V‖²;唯一性只有核化构造下的启发式论证,收敛条件开放。第三,目标谱系的位置:Consistency 沿轨迹约束自洽,MeanFlow 学流映射,Drifting 只约束分布层面的不动点,没有轨迹和速度场,ImageNet 潜空间 1-NFE FID 1.54 是这个设计交出的成绩。这篇工作的意义在于给单步生成开了一条独立的路线,和 MeanFlow、iMF 属于同一代「从零开始做单步」的尝试,但走的是分布平衡这条路。后续可以沿着三个方向继续做:漂移场的其他构造、特征编码器的选择、把平衡理论从启发式补成有收敛保证的定理。这期就到这,想深入了解的话,对照着读 MeanFlow、improved MeanFlow 和 Consistency 三篇,会把这条谱系看得更清楚。