Superposition Yields Robust Neural Scaling(深度解读卡片)
- 作者:Yizhou Liu、Ziming Liu、Jeff Gore(MIT)
1. 这篇论文解决什么问题
大语言模型有一条被反复验证的经验规律:模型参数越多、宽度越宽,损失越低,而且损失随模型尺寸按幂律下降。这条「神经标度律」支撑了今天整个大模型的工程路线,但它的来源一直没有定论。此前的主流解释分两类:一类把损失归因于模型对函数或流形的近似能力,一类归因于网络学到的离散技能的重要性分布,它们在无穷数据极限下都能推出幂律,但都要求数据分布本身是幂律,而且与真实 LLM 的运行状态对不上。
本文换了一个切口:把目光放在表征(representation)上。LLM 的词表有几万到十几万个 token,隐藏层只有几千维,embedding 矩阵和语言模型头(LM head)必须用远少于特征数的维度去表示这些 token。这里就出现了一个被称为 superposition(叠加) 的现象:模型用同一个维度空间同时表示比维度多得多的特征,特征之间靠重叠和纠错来共存。论文的核心论点是:损失随模型宽度 m 的标度行为,取决于叠加的强弱——弱叠加下只有数据频率是幂律才有幂律损失;强叠加下损失来自表征向量之间的几何重叠,稳健地按 1/m 走,和数据的频率分布几乎无关。 这个「1/宽度」标度,恰好就是真实 LLM 测出来的样子。
2. 玩具模型:数据、架构、怎么控制叠加
论文沿用 Anthropic 的 superposition 玩具模型(Elhage et al. 2022),做的是「用表征重建数据」的任务。先看数据。输入是 n 维向量 x,n 是原子特征数。每个分量 x_i 表示样本里特征 i 的激活程度,采样方式写成
$$x_i = u_i v_i, \quad u_i \sim \text{Bernoulli}(p_i),\ v_i \sim U(0, 2)$$
这个式子要回答的问题是「一个特征在单个样本里出现得多频繁、有多强」。其中 $u_i$ 是伯努利随机变量,以概率 $p_i$ 取 1,否则取 0,$p_i$ 就是特征 i 的出现频率;$v_i$ 在 0 到 2 之间均匀采样,控制特征激活后的强度。$p_i$ 按 i 递减排列,所以下标 i 就是特征的频率排名;$\sum_i p_i$ 是每个样本里平均激活的特征数,叫激活密度 E,主实验中固定为 1。特征在数据里是稀疏的:n 有几千上万,E 只有 1。
模型端非常简单。权重矩阵 $W \in \mathbb{R}^{n\times m}$ 把 x 投影进 m 维隐藏空间:$h = W^\top x$,再用 $y = \text{ReLU}(Wh + b)$ 读回 n 维重建向量。这里 $m \ll n$,所以模型必然学不全所有特征。损失是重建误差 $L = \langle \|y - x\|^2 \rangle$,角括号表示对 x 的分布求平均。关键概念:特征 i 被表征,当且仅当 W 的第 i 行 $W_i$ 非零。 无叠加的理想情况是前 m 个最频繁特征用正交基完美表示、其余行全零;叠加则意味着非零行多于 m 个,特征之间共享维度、互相干扰。
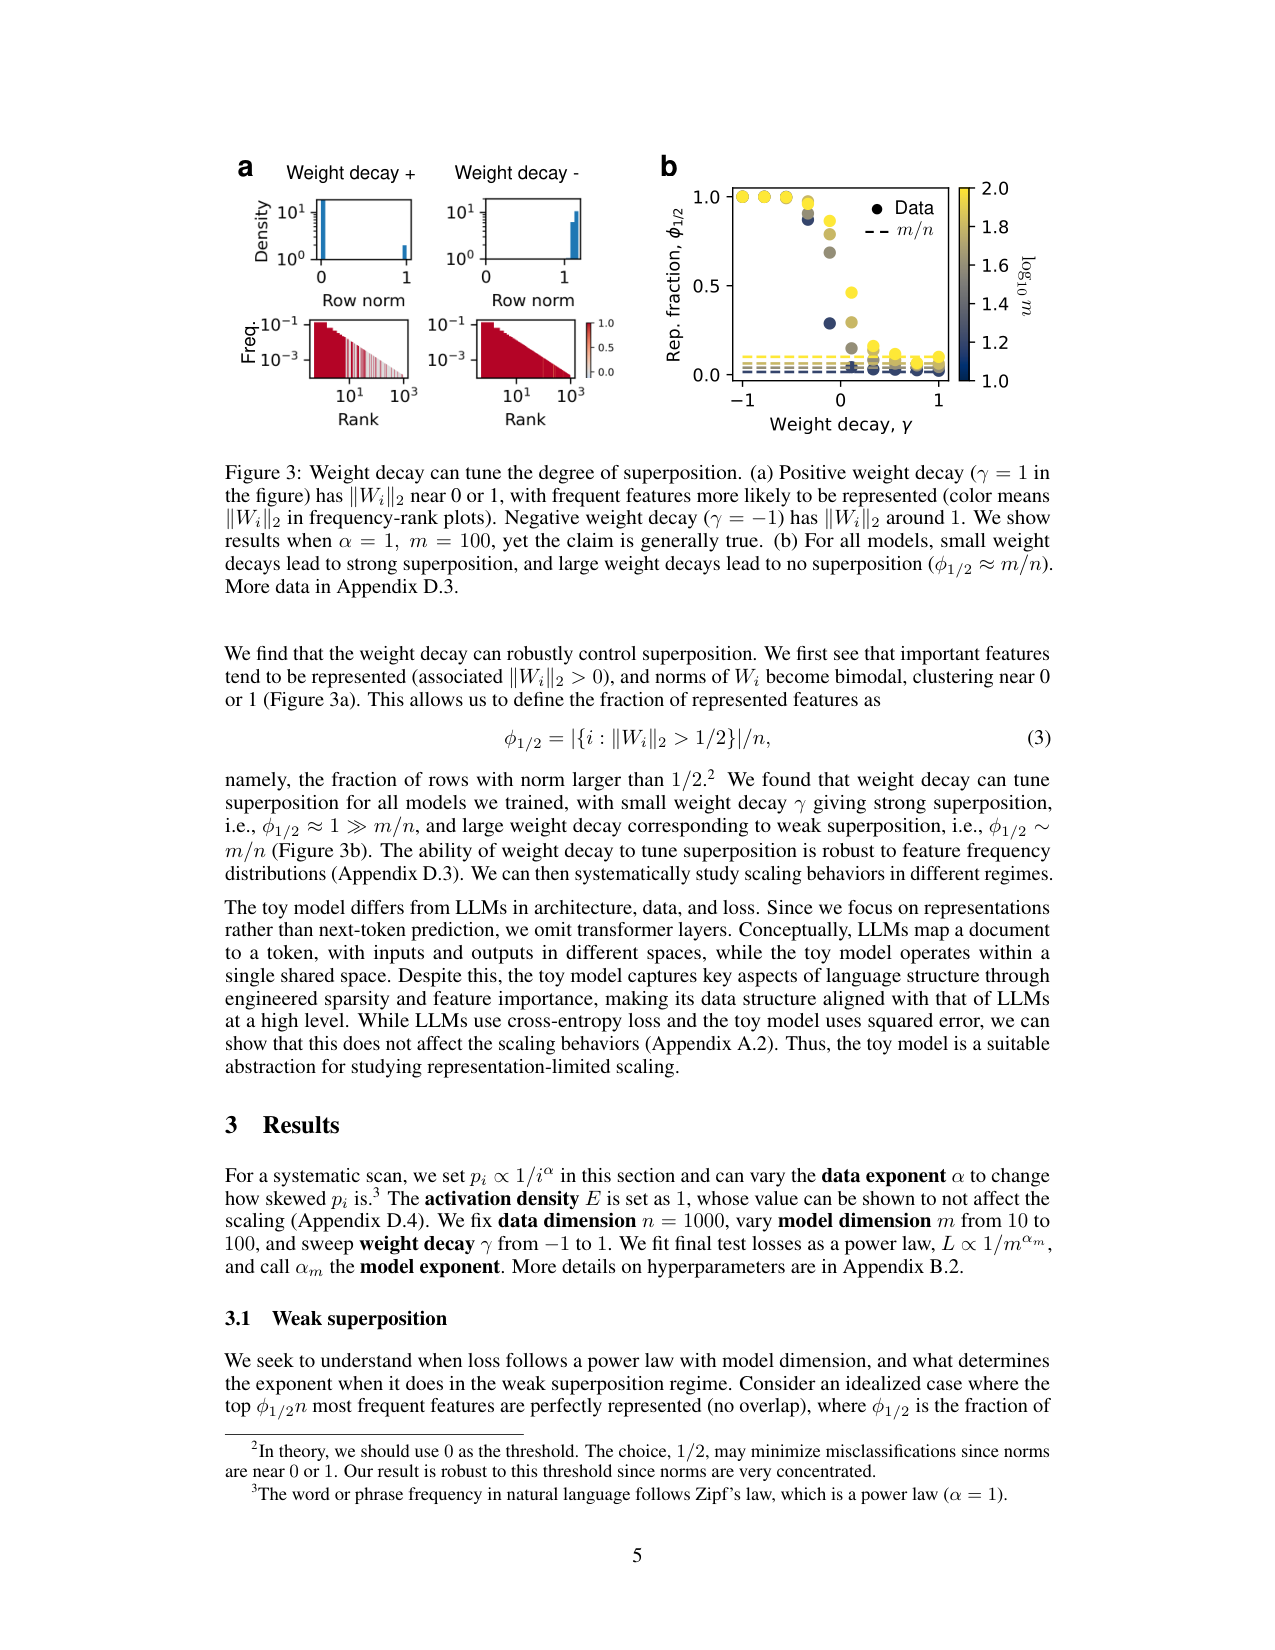
Figure 3(p05):权重衰减把叠加程度变成可调的连续旋钮。面板 a 是行范数在频率-秩图上的分布:正权重衰减下范数双峰分布在 0 和 1 附近,高频特征范数趋近 1、低频趋近 0;负权重衰减下所有行范数都贴在 1 附近。面板 b 是被表征比例 $\phi_{1/2}$(范数大于 $1/2$ 的行占全体的比例)随 $\gamma$ 的变化:$\gamma$ 小(负)时 $\phi_{1/2}\approx 1$(强叠加),$\gamma$ 大(正)时 $\phi_{1/2}\sim m/n$(弱叠加)。
怎么做到连续调节?论文在 AdamW 里加了一项解耦权重衰减/增长。对权重矩阵的第 i 行,更新规则是
$$W_{i,t+1} = \begin{cases} W_{i,t} - \eta_t \gamma W_{i,t}, & \gamma \ge 0 \\ W_{i,t} - \eta_t \gamma W_{i,t}(1/\|W_{i,t}\|^2 - 1), & \gamma < 0 \end{cases}$$
这里 $\gamma\ge 0$ 的更新就是普通的权重衰减:把行向量往零收缩,越不重要的特征越先被压没。$\gamma<0$ 时式子对应在 $(\|W_i\|^2 - 1)^2$ 上做梯度下降,把行范数往 1 拉,于是所有特征都留在隐藏空间里,只能靠重叠共存。$\eta_t$ 是学习率,训练采用 warm-up 加 cosine 衰减,每步采样新数据。用这个旋钮,论文就能在同一套数据上系统扫描「弱叠加区」和「强叠加区」两个世界的标度行为。这里要记住的结论是:叠加程度是可控的,弱/强叠加是两个可以分开研究的区间——这是全篇所有实验的前提。
3. 弱叠加:损失是被忽略特征的频率和
先看弱叠加区。理想情况下,前 $\phi_{1/2} n$ 个最频繁的特征被完美表征,对应的偏置 $b_i = 0$;其余特征完全没学,偏置取 $\langle x_i \rangle$(即用均值去猜)。这时损失只来自那些被忽略的特征,写成
$$L = \sum_{i > \phi_{1/2} n} \langle (x_i - \langle x_i\rangle)^2\rangle \approx \langle v^2 \rangle \sum_{i > \phi_{1/2} n} p_i$$
这个式子的意思是:损失约等于「所有没学到的特征」的出现频率之和。第一项 $\langle (x_i-\langle x_i\rangle)^2\rangle$ 是特征 i 的方差;代入 $x_i = u_i v_i$ 展开后,主项是 $\langle v^2\rangle p_i$,其中 $\langle v^2\rangle = 4/3$(因为 $v \sim U(0,2)$),$p_i^2$ 这类高阶项在 $p_i \ll 1$ 时被扔掉,所以求和只剩下 $\sum p_i$。这个预测和实测吻合(Figure 4a)。
接下来是关键的一步:当频率本身是幂律 $p_i \propto 1/i^\alpha$ 且 $n \gg m$ 时,把求和换成积分 $\int_m^n p_i\, di \propto m^{-\alpha+1}$,于是损失 $L \propto 1/m^{\alpha_m}$ 里的指数是
$$\alpha_m = \alpha - 1$$
逐个符号解释:$\alpha$ 是数据频率的幂律指数(Zipf 律对应 $\alpha=1$),$m$ 是模型宽度,$\alpha_m$ 是损失随宽度的标度指数。结论是:弱叠加区里,只有数据频率本身是幂律,损失才会是幂律;指数比数据的指数小 1。 如果频率是指数衰减或线性衰减,损失曲线就会弯曲、不成幂律(Figure 1b)。这对自然语言是个坏消息:token 频率是 Zipf 律、$\alpha\approx 1$,弱叠加下 $\alpha_m = \alpha - 1 \approx 0$,损失几乎不随宽度下降——这显然和真实 LLM 不符,说明 LLM 应该跑在另一个区间。
4. 强叠加:几何重叠给出 1/宽度
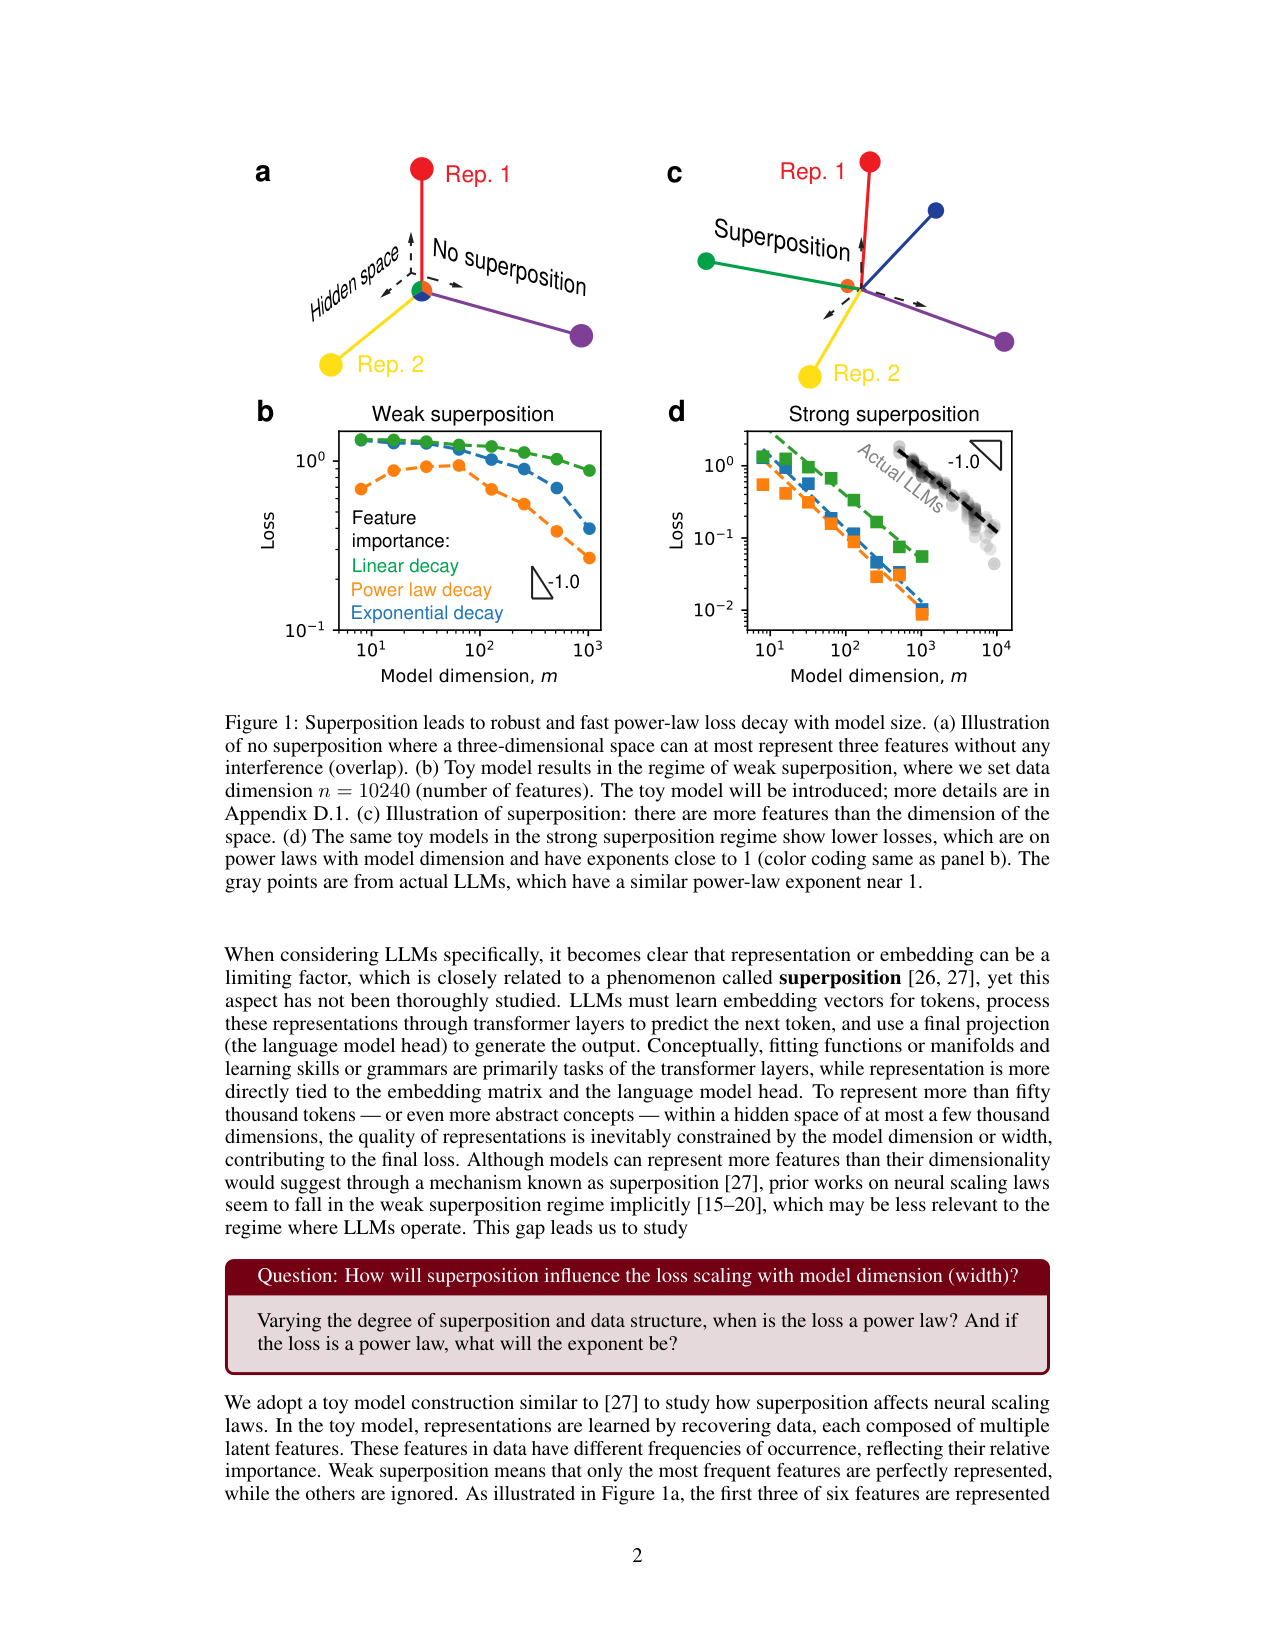
Figure 1(p02):全篇的总览图。面板 b 是弱叠加下三种频率(指数/幂律/线性,n=10240,$\gamma=0.1$)的损失-宽度双对数图,只有幂律频率成直线;面板 d 是同样的模型换到强叠加($\gamma=-1$),三条线都变成近似平行、斜率在 −1 附近的直线,灰色点是真实 LLM 的损失,斜率 −0.91±0.04。一句话:换到强叠加,幂律损失对数据分布变稳健了。
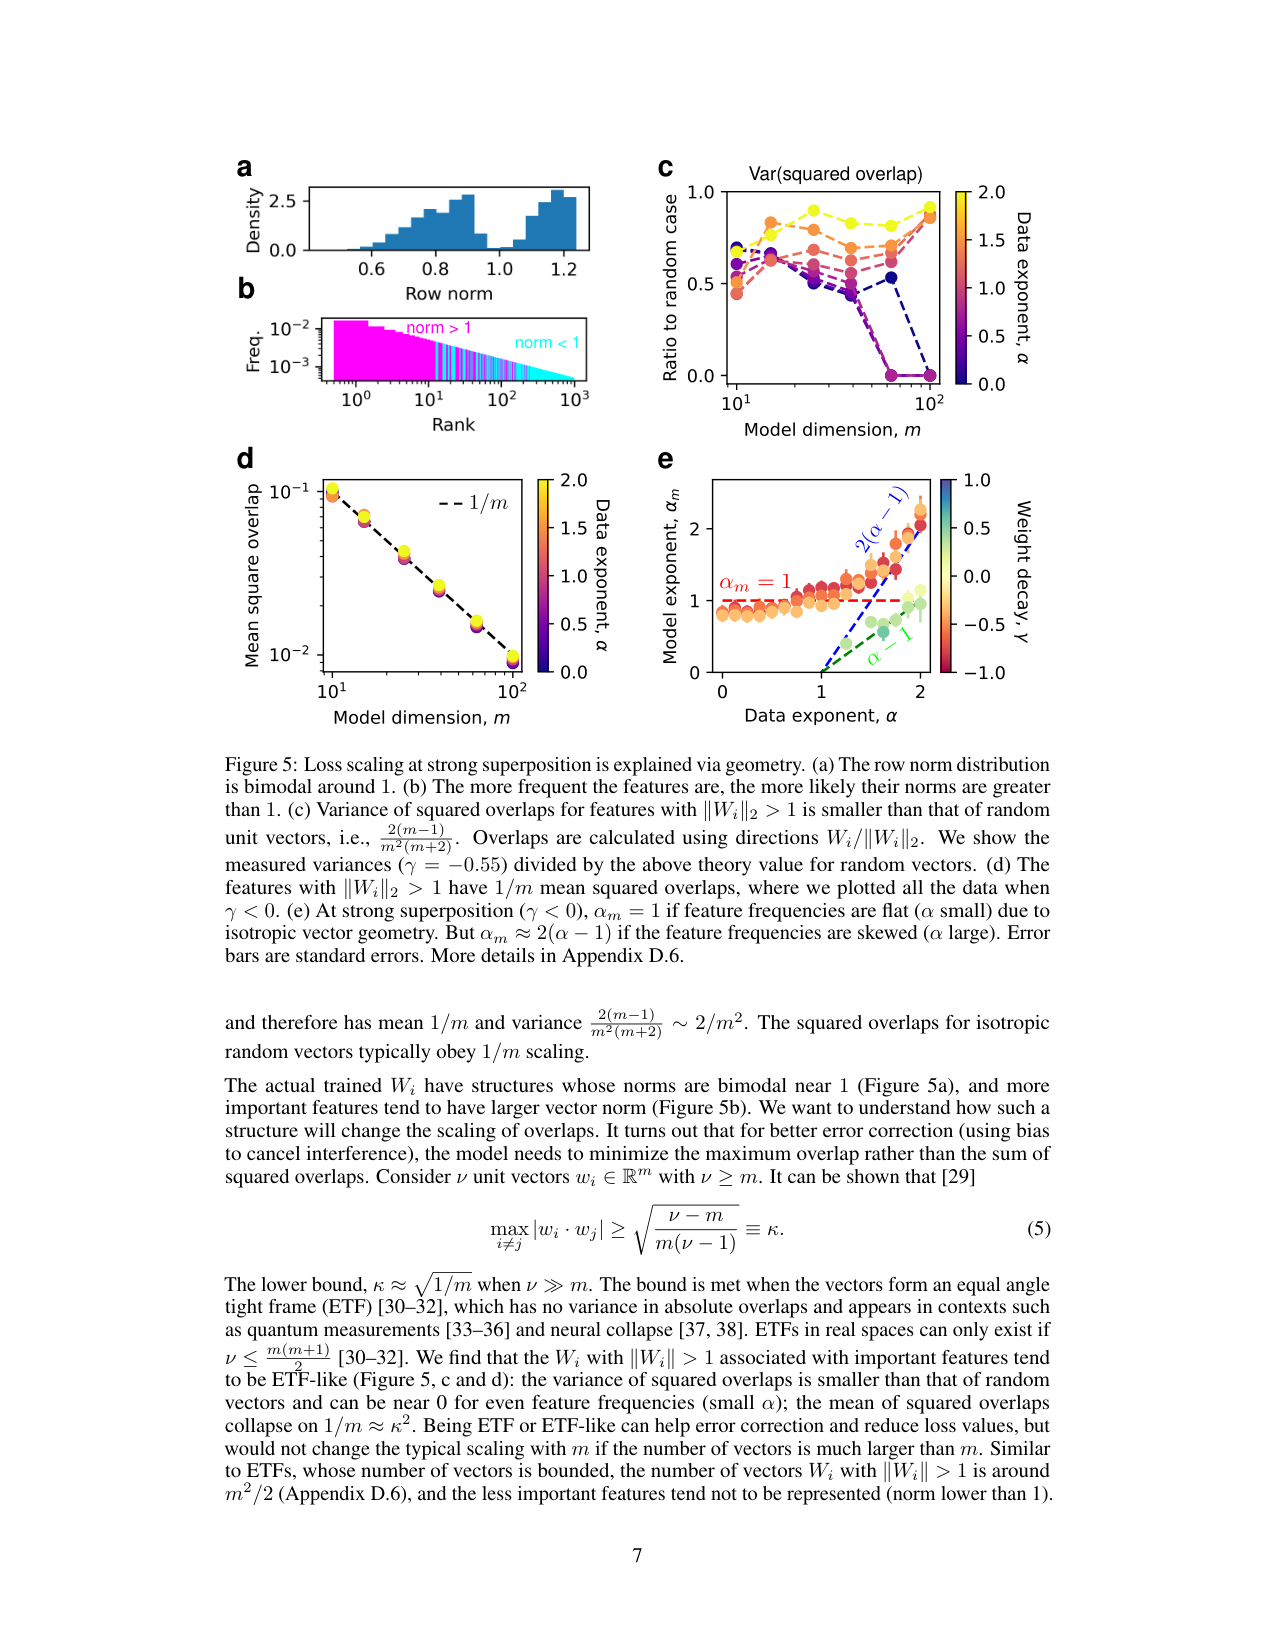
Figure 5(p07):强叠加下 1/m 标度的几何来源。机制是这样的。强叠加下所有特征都被表征,损失主要来自表征向量之间的干扰(interference):读出某个特征时,其它特征的重叠信号会混进来。两个 m 维空间里的随机各向同性单位向量,其平方重叠(squared overlap)的均值是 1/m、方差约 $2/m^2$——这是高维几何的「自然刻度」,向量越多、空间越宽,两两越接近正交。这里要用到第二个几何事实:为了用偏置做纠错,模型需要压低的是最大重叠,而 Welch 下界说,$\nu$ 个单位向量里必然存在一对重叠至少
$$\max_{i\neq j} |w_i \cdot w_j| \ge \sqrt{\frac{\nu - m}{m(\nu-1)}} \approx \frac{1}{\sqrt{m}},\quad \nu \gg m$$
等式由等角紧框架(ETF)达到:一组两两夹角相等、重叠完全均匀的向量。$\nu$ 是向量个数,$m$ 是空间维数;ETF 在实空间最多只能有 $m(m+1)/2$ 个向量。论文实测(Figure 5c、5d):范数大于 1 的强表征向量确实是 ETF-like——平方重叠的方差比随机向量小、平坦频率下接近 0,均值落在 $1/m \approx \kappa^2$ 上;强表征特征数约 $m^2/2$,远超 $m$ 但远小于 $n$。
于是干扰损失按平方重叠之和走,平坦频率($\alpha$ 小)下就是 $\sim 1/m$,得到 $\alpha_m = 1$。这是全篇最核心的机制链条:强叠加 → 所有特征共享 m 维空间 → 两两重叠按 1/m 衰减 → 干扰损失按 1/m 标度,与数据频率分布无关。 当频率偏斜($\alpha$ 大)时,高频特征占据「好角度」、低频特征被挤进小角度互相纠缠,损失对频率变敏感;论文用一个极端配置猜想(前 $m^2/2$ 个特征 ETF-like、贡献可忽略,其余特征损失 $\sim \sum_{i=m^2/2}^n p_i \sim m^{-2(\alpha-1)}$)得到 $\alpha_m = 2(\alpha-1)$,与观测接近但这是猜想、没有严格解。
5. 真实 LLM 的验证
论文把「token 当作原子特征」做朴素映射:数据维 n 取词表大小,模型宽 m 取隐藏维,分析对象是语言模型头 W 的行向量。四个开源模型族(OPT、GPT-2、Qwen2.5、Pythia,约 100M 到 70B)在四个数据集(Wikitext-103、Pile-10k、C4、BookCorpus)上做评估。三类观测:
1. 强叠加判据:LM head 行范数全部非零且 $n \gg m$,说明所有 token 都被表征——LLM 处在强叠加区。
2. 几何预测:归一化行向量的平均平方重叠沿 1/m 参考线下降(Figure 6a,数据较噪、论文未拟合直线)。
3. 损失标度:对每个模型-数据集拟合 $L = C_m/m^{\alpha_m} + L_{\backslash m}$,其中 $C_m/m^{\alpha_m}$ 是宽度相关项、$L_{\backslash m}$ 是与宽度无关的常数(语言固有不确定性,拟合得到非零截距),联合拟合得 $\alpha_m = 0.91 \pm 0.04$。
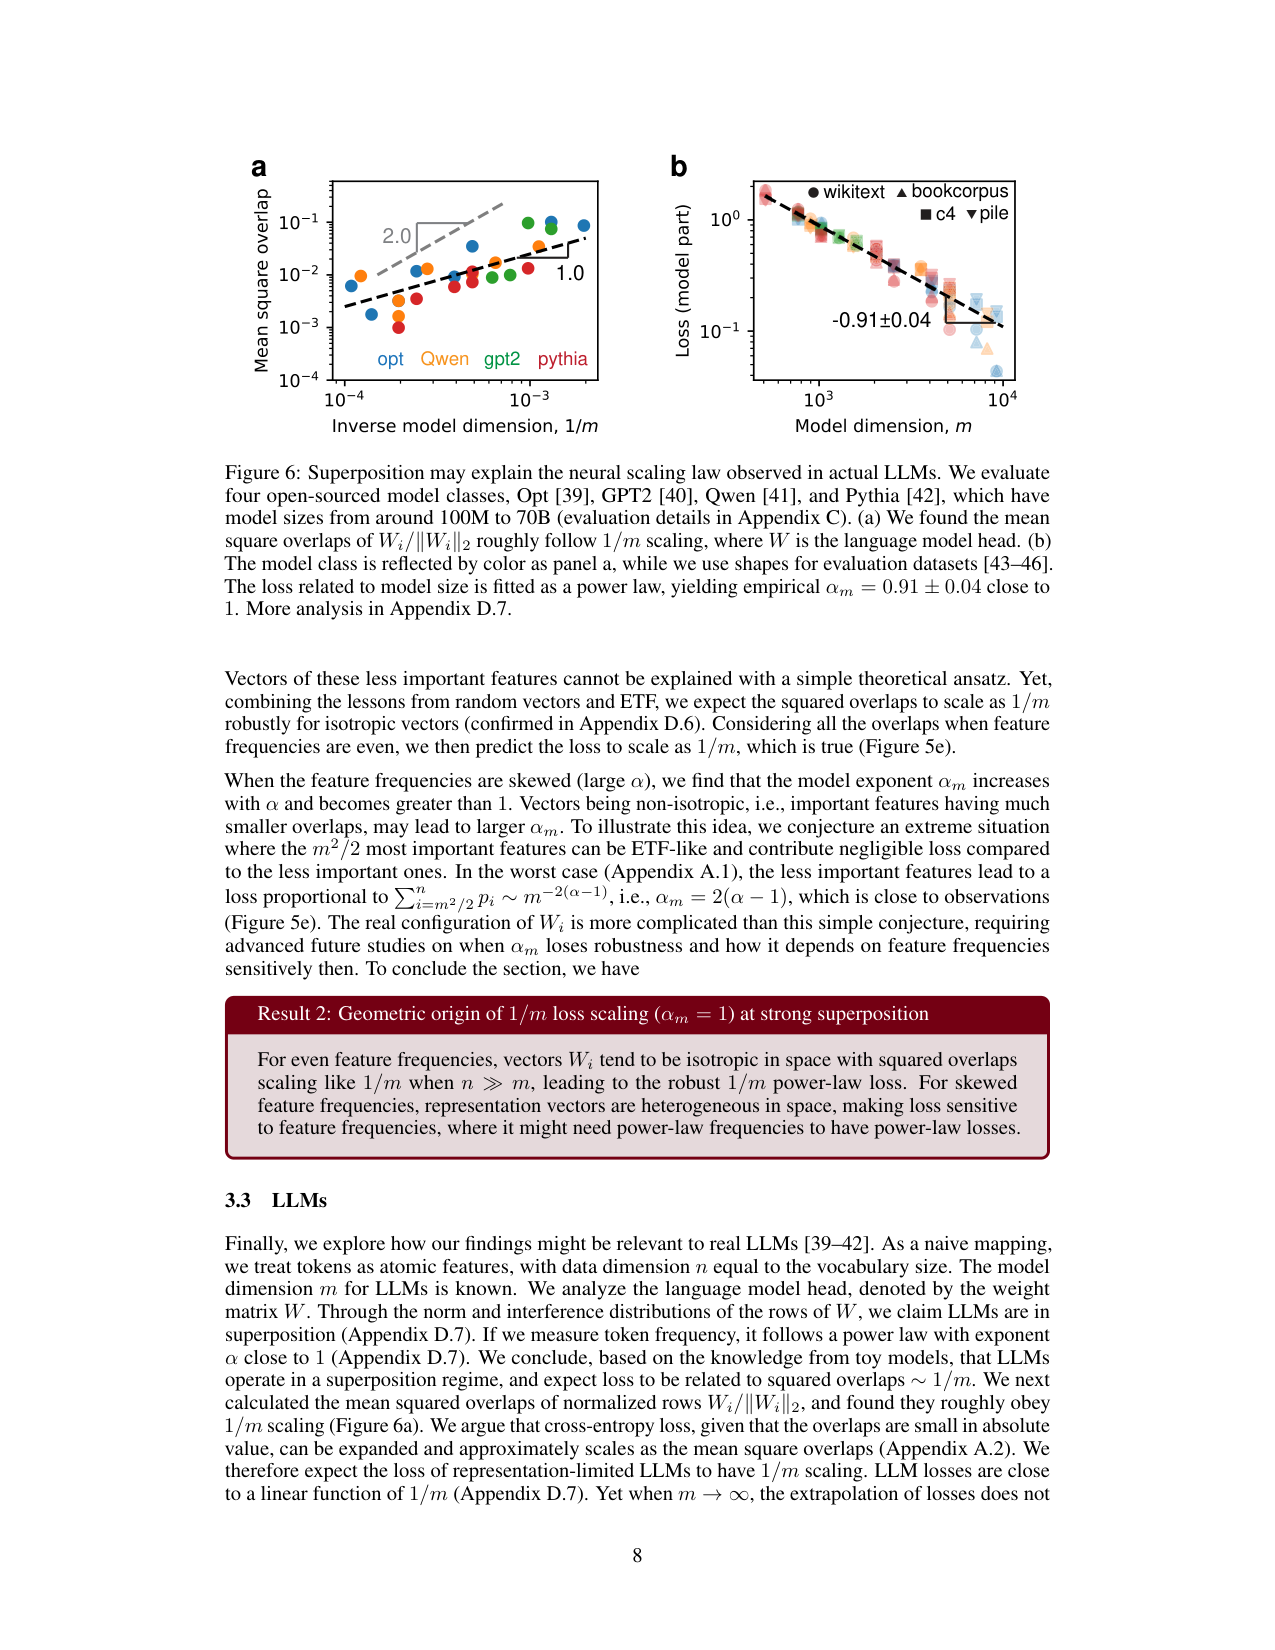
Figure 6(p08):面板 a 是四个模型族的 LM head 平均平方重叠随宽度 m 的变化,散点贴着 1/m 参考线;面板 b 是损失-尺寸幂律拟合,标出 $\alpha_m = 0.91\pm0.04$。交叉验证来自 Chinchilla:$N \propto m^{2.52\pm 0.03}$,乘以 $N$ 方向的标度指数 $\alpha_N = 0.35 \pm 0.02$,换算得 $\alpha_m = 0.88 \pm 0.06$——两条独立路径都逼近 1。所以论文的结论是:LLM 运行在强叠加区,其宽度方向的标度律可以被叠加几何解释。
交叉熵损失为什么也能套平方重叠的论证?附录 A.2 给了展开:把归一化隐藏态看成 $W_i/\|W_i\|$,交叉熵损失展开后与模型尺寸有关的最低阶项是
$$L_m = \frac{1}{2}\sum_{j\neq i} \left(\frac{W_i \cdot W_j}{\|W_i\|}\right)^2 e^{-\|W_i\|}$$
这个式子回答的问题是「哪些项随 m 变化」。其中 $W_i \cdot W_j/\|W_i\|$ 是特征 i 与 j 的重叠,一阶项 $\sum_{j\neq i} W_i\cdot W_j$ 因为语言数据的相关性只贡献一个与 m 无关的小常数(同一前缀能接不同 token,会把向量拉近),所以真正随 m 变化的最低阶就是平方重叠之和;cosine 相似度 ~ $1/\sqrt{m}$,平方后得到 1/m。行范数 $\|W_i\|$ 被语言内在不确定性钉住、不随 m 明显变化(附录 D.7 的观测),所以标度来自重叠而非范数。
6. 谱系定位
论文处在「解释神经标度律」这条技术路线上,和几条相关线路的关系是:
- 经验标度律(Kaplan 2020、Chinchilla 2022):它们给出幂律是经验事实;本文补上宽度方向的机制解释,并把实测指数 0.91 与理论 1 对齐。
7. 局限
1. 玩具模型没有被严格求解(论文自承)。强叠加下偏斜频率的 $\alpha_m = 2(\alpha-1)$ 依赖一个极端配置猜想——前 $m^2/2$ 个高频特征 ETF-like、低频特征挤在小角度——指数形式有观测支撑,但从优化动力学的严格推导缺位,这是证据最弱的一环。
2. 只研究宽度方向的标度。数据量、训练步数方向的标度没有做;强叠加下这些标度与表征夹角演化有关,论文明确说需要严格求解才能解释。
3. 只处理表征损失。transformer 层的解析/语法损失 $f_\ell(\ell)$ 没有建模,总损失分解 $C_m/m^{\alpha_m} = f_m(m) + f_\ell(\ell)$ 建立在 $N\propto m^2\ell$ 和最优 m-ℓ 平衡的经验假设上。
4. LLM 证据是相关性。四个开源模型族、每个模型-数据集只评估一次,没有干预实验证明因果;LLM 为什么处于强叠加只有稀疏性加 softmax 纠错的猜测。
5. 展开与拟合假设。交叉熵→平方重叠要求重叠远小于 1、行范数不随 m 变化;联合拟合用了 18 个参数(16 个 $L_{\backslash m}$ + $C_m$ + $\alpha_m$),误差棒不含结构假设的不确定性。
6. 可解释性代价:鼓励叠加可能让小模型追平大模型,但会让机制可解释与 AI safety 分析更困难,论文对此有自承。
8. 可复现性
代码开源在 github.com/liuyz0/SuperpositionScaling:大玩具模型 exp-17.py、小玩具模型超参在附录 B.2、重叠计算 overlap-0.py、评估 cali-1.py、token 频率 token-freq-0.py、损失拟合 nonlinearfit-3.ipynb。玩具模型用 V100 GPU、FP32,batch 2048、20000 步(8192/80000 验证不影响结果)。LLM 权重从 HuggingFace 下载,评估每模型-数据集 1 次、每数据集 10000 段×2048 token,重叠计算批量 8192。一句话收尾:叠加把「损失随宽度怎么降」这个问题的答案从数据分布手里,交到了高维几何手里——强叠加区里 1/m 是几何给定的,这是本文最值得记住的结论。
用 Anthropic 的 superposition 玩具模型研究『损失随模型宽度 m 的标度』:弱叠加时损失 ≈ 被忽略特征的总频率,只有特征频率是幂律才得到幂律损失(指数 α_m ≈ α−1);强叠加时损失来自表征向量间的几何干扰,平方重叠按 1/m 下降,损失稳健地按 1/m 标度(α_m≈1),对频率分布几乎不敏感。把 token 当原子特征分析 OPT/GPT-2/Qwen2.5/Pythia 的 LM head,实测平方重叠 ~1/m、损失指数 α_m=0.91±0.04,与 Chinchilla 换算的 0.88±0.06 一致,说明 LLM 运行在强叠加区,叠加是神经标度律的一个重要来源。
阅读提示
精读深度:精读
清单提示:原文提示:叠加驱动的 scaling 机制——弱叠加时损失由被忽略特征的频率和决定(只有特征频率本身是幂律时损失才是幂律);强叠加时损失来自表征向量之间的几何重叠,得到稳健的『1/宽度』标度。播客要覆盖两个可复用样板:高维几何样板(随机各向同性向量的平方重叠 ~1/m、ETF 最大重叠下界 κ≈1/√m、强表征特征数上界 m²/2)与标度论证样板(频率和→积分→幂律指数 α_m)。
问题
要解决什么:大语言模型越宽越好,损失随模型尺寸按幂律下降(神经标度律),但这条规律的来源没有定论。论文把注意力放到表征瓶颈上:LLM 的词表有数万 token,隐藏层只有几千维,embedding 和 LM head 必须用远少于特征数的维度表示特征,这种表示层面的限制与 superposition 现象直接相关,而此前多数标度律解释隐式假设了弱叠加。论文想回答:叠加程度和数据特征频率结构如何决定损失随宽度 m 的标度?什么条件下损失是幂律?幂律的指数是多少?
为什么 prior work 不够:Kaplan 等(2020)与 Chinchilla(2022)只是经验拟合,没解释指数从哪来;Bahri 等、Bordelon 等用核/流形近似推导出 resolution-limited 区的指数 α_m = α′−1(α′ 是核特征值衰减指数),这个结果对应弱叠加区,但 LLM 实际运行的强叠加区没有被处理;Hutter 的 learning curve、Michaud 等的 quantization model 假设技能/特征重要性是幂律分布,得到与本文弱叠加区相同的频率和结论,却同样默认了弱叠加;Song 等的 resource model 用中心极限定理给出 1/m,只适用于过参数化场景,与 LLM 关联较弱。此前没有任何工作把叠加程度当连续变量控制,系统地扫两个区间的标度行为。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 稀疏特征向量 x∈R^n | n 维向量(n=数据维/原子特征数) | x_i = u_i v_i,u_i~Bernoulli(p_i) 控制特征 i 是否激活,v_i~U(0,2) 控制激活强度;p_i 是特征 i 的出现频率,按 i 递减排序;激活密度 E=Σp_i 在主实验中取 1。 |
| 模型宽度 m(隐藏维数) | 标量 | m≪n;小玩具模型 n=1000、m∈{10,15,25,39,63,100};大玩具模型 n=10240、m 从 2^3=8 到 2^10=1024。 |
| 权重衰减/增长 γ | 标量(连续控制叠加程度) | γ∈[−1,1];γ>0 收缩行范数到 0(弱叠加),γ<0 把行范数拉向 1(强叠加)。 |
| 特征频率分布(数据指数 α) | p_i∝1/i^α 的 α | α∈[0,2] 扫描;另用指数分布 p_i∝e^{−i/400} 与线性分布 p_i∝n−i 对照(大玩具模型)。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 重建输出 y=ReLU(Wh+b)∈R^n | n 维向量 | h=W^T x 把 x 投影进 m 维隐藏空间,W∈R^{n×m} 的每一行 W_i 是特征 i 的表征;损失 L=⟨‖y−x‖²⟩ 为重建均方误差。 |
| 损失随 m 的幂律指数 α_m | 标量(L∝1/m^{α_m}) | 强叠加下对多种频率分布 α_m≈1;弱叠加下 α_m≈α−1。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| 大玩具模型合成数据(Figure 1/8/9) | n=10240 特征 | 三种特征频率:指数 p_i∝e^{−i/400}、幂律 p_i∝i^{−1.2}、线性 p_i∝n−i;激活密度 E=1;每步新采样,batch 2048,训练 20000 步(均验证不影响结果);V100 GPU、FP32。 |
| 小玩具模型合成数据(Figure 3/4/5/14) | n=1000 特征 | p_i∝1/i^α,α∈[0,2] 扫 17 个值;m 取 6 档;γ∈[−1,1];用于系统扫描标度指数 α_m。 |
| LLM 评估数据集 | 4 个公开语料 | Wikitext-103、Pile-10k、C4、BookCorpus;每个模型-数据集各跑 1 次评估,每数据集流式采样 10000 段、最长 2048 token(约 2×10^7 token)。 |
| LLM 模型族 | OPT、GPT-2、Qwen2.5、Pythia(约 100M–70B 参数) | 权重从 HuggingFace 下载;分析 LM head W 的行范数与行向量重叠;另用 Chinchilla(2022)的参数-宽度关系 N∝m^{2.52±0.03} 做交叉验证。 |
架构(摘要)
主干与结构
backbone:两层 ReLU 自编码器(Anthropic superposition 玩具模型,Elhage et al. 2022)
参数:W∈R^{n×m}、b∈R^n;n=1000 或 10240,m=10–1024;不含 transformer 层
类型:表征重建玩具模型:h=W^T x → y=ReLU(Wh+b),L=⟨‖y−x‖²⟩;LLM 分析对象是语言模型头 W(n=词表大小、m=隐藏维)
关键组件
- 特征激活模型 x_i=u_i v_i(Bernoulli×Uniform)
- 解耦权重衰减/增长更新:γ≥0 时 W_i←W_i−η_t γ W_i(收缩),γ<0 时 W_i←W_i−η_t γ W_i(1/‖W_i‖²−1)(梯度下降 (‖W_i‖²−1)²,拉向单位范数);AdamW 实现,warm-up+cosine 衰减
- 表征判据:特征 i 被表征 ⇔ 行范数 ‖W_i‖≠0;ϕ_{1/2}=#{i:‖W_i‖²>1/2}/n 为被表征特征比例
- ReLU+负偏置纠错:用偏置抵消行间干扰,是叠加能降低损失的来源(线性模型无此能力)
为什么这样设计
论文要回答的是『表征层面的标度』:LLM 中拟合函数/流形主要由 transformer 层完成,而表征质量直接由 embedding 与 LM head 的宽度 m 限制;去掉 transformer 层、只留编码-重建回路,可以把表征限制造成的损失单独拿出来,配合权重衰减连续调节叠加程度,系统地扫弱/强叠加两个区间的标度行为。玩具模型与 LLM 的差异(架构、损失函数)论文在附录 A.2 论证不影响标度指数:交叉熵损失在重叠很小时展开后正比于平方重叠,与平方误差同阶。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 弱叠加下模型指数 α_m(损失 L∝1/m^{α_m}) | α_m≈α−1(幂律频率时);非幂律频率时损失曲线不成直线 | 理论预测 ∫_m^n p_i di∝m^{−α+1}(α>1);实测值在 α>1 时贴近 α−1(Figure 4b,9 个最接近理想无叠加的 γ 情形) | 小玩具模型 n=1000,m∈{10,15,25,39,63,100},γ>0(弱叠加),p_i∝1/i^α,α∈[0,2],激活密度 E=1,每步新采样、AdamW、warm-up+cosine |
| 强叠加下模型指数 α_m(大玩具模型) | 指数频率 1.01±0.05、幂律频率(i^{−1.2}) 1.0±0.1、线性频率 0.89±0.05 | 对照弱叠加:同三种频率下弱叠加只有幂律频率成幂律;强叠加下三种都成幂律且指数≈1 | 大玩具模型 n=10240,m 从 2^3=8 到 2^10=1024,γ=−1(强叠加),E=1,batch 2048、20000 步、V100 GPU;误差为 100 个 batch 损失的标准差 |
| 强叠加下强表征向量(‖W_i‖²>1)的平均平方重叠 | 均值≈1/m,即 ≈κ²(Welch 下界平方) | 随机各向同性单位向量理论均值 1/m、方差 2(m−1)/(m²(m+2))≈2/m²;训练后向量方差更小(平坦频率下接近 0),均值贴 1/m 线 | 小玩具模型 n=1000、γ<0,行归一化后两两计算重叠;强表征特征数约 m²/2(Figure 16),m∈{10..100} |
| LLM 损失随宽度 m 的标度指数 α_m | 0.91±0.04(4 模型族 × 4 数据集联合拟合) | Chinchilla 交叉验证:N∝m^{2.52±0.03} 与 α_N=0.35±0.02 换算得 α_m=0.88±0.06;理论预测 1(强叠加平方重叠 1/m) | OPT、GPT-2、Qwen2.5、Pythia(约 100M–70B),在 Wikitext-103、Pile-10k、C4、BookCorpus 上各 1 次评估(每数据集 10000 段×2048 token);拟合 L=C_m/m^{α_m}+L_{∖m},共 18 参数(16 个 L_{∖m}+C_m+α_m) |
| LLM LM head 行向量平均平方重叠 | 散点沿 1/m 参考线下降(论文未拟合直线,数据较噪) | 对照线 1/m(强叠加预测);token 频率幂律指数 α≈1 与玩具模型强叠加条件一致 | 四个开源模型族 LM head W 的归一化行向量,批量 pairwise |cos|(batch 8192),n=词表大小、m=隐藏维;另测 4 个 tokenizer×4 数据集各 100 万 token 的频率-秩分布 |
| 激活密度 E 对标度指数的影响 | 损失∝E 线性增长,α_m 不变(强叠加下约 1.1±0.1) | 理论预期:E 只进系数不进指数;实测 α_m≈1.12±0.06/1.12±0.08/1.1±0.1/1.1±0.1/1.1±0.2(m=63,不同 E) | 小玩具模型 α=1、m=63、n=1000,E∈[0.5,7.5] 扫描,各 γ 下指数稳健(Figure 14/15) |
Insights
- 叠加程度决定标度行为的定性性质:弱叠加下幂律损失依赖数据频率本身是幂律(α_m=α−1);强叠加下损失来自表征向量间的几何干扰,稳健地按 1/m 标度(α_m≈1),对频率分布几乎免疫。这是全篇最重要的对照,Figure 1 一张图讲完。
- 可复用的高维几何样板:m 维空间中随机各向同性单位向量的平方重叠均值为 1/m;若向量数 ν≫m,最大重叠被 Welch 下界压住(≈1/√m),等角紧框架(ETF)达到该下界且在实空间最多容纳 m(m+1)/2 个向量。叠加表征的干扰损失因此按平方重叠 1/m 走。
- 可复用的标度论证样板:把『损失=Σ 被忽略特征频率』的求和用积分 ∫p_i di 近似,p_i∝1/i^α 时得到 m^{−α+1}(弱叠加)或 m^{−2(α−1)}(强叠加偏斜频率的极端配置);频率和→积分→指数,是这类标度推导的标准三步。
- LLM 实测与玩具模型定量吻合:LM head 行范数全非零且 n≫m(强叠加),平均平方重叠~1/m,token 频率 α≈1,损失指数 α_m=0.91±0.04 与 1 接近;与 Chinchilla 的 0.88±0.06 互相印证。截距 L_{∖m}>0 说明语言存在宽度无关的固有不确定性,加宽模型只能减少错误干扰、无法消掉这部分损失。
- 标度何时停止:按 token=原子特征的朴素映射,当宽度 m 接近词表大小时宽度限制的损失会偏离幂律并消失;若词表大小低于语言中真正独立要素的数目,幂律可能延续更久。
- 实用含义:鼓励叠加可能让小模型追平大模型(nGPT 归一化到单位球面等架构、无权重衰减的优化器已有正向结果);但更强的叠加会让机制可解释性与 AI safety 分析更困难,且这些改进可能只改标度律的系数、不改指数。
vs 同类工作
- vs Kaplan et al. 2020 / Hoffmann et al. 2022(Chinchilla):后者是经验幂律拟合,本文第一次给出『宽度方向』标度的机制解释——叠加几何给出 1/m,并把实测指数 0.91 与理论 1 对齐。
- vs Bahri et al. 2024、Bordelon et al. 2020(核特征值/流形理论):resolution-limited 区的 α_m=α′−1 对应本文弱叠加区(α′=α,即数据本身指数);强叠加区 α′ 被几何改写成与数据无关的 1/m 标度,这是新增部分。
- vs Hutter 2021 / Michaud et al. 2023(learning curve / quantization model):两者都假设技能重要性幂律分布、得到『被忽略项频率和』的结论,与本文弱叠加区结果相同,但隐式默认弱叠加;本文把同一数据结构放到强叠加区得到不同指数。
- vs Song et al. 2024(resource model):用中心极限定理给出 1/m,适用于过参数化、每个参数独立做同一任务的情形;本文的 1/m 来自有限宽度下表征重叠的几何,机制与适用区都不同。
- vs Elhage et al. 2022(Anthropic toy models of superposition):沿用其自编码器构造,但原始工作只研究『数据结构何时导致叠加』,没有控制叠加程度,也没有连接标度律;本文加了解耦权重衰减旋钮、系统扫描两个区间的标度,并做了 LLM 验证。
局限
- 玩具模型没有被严格求解(论文自承 'without rigorously solving the toy model'):强叠加下偏斜频率的 α_m=2(α−1) 依赖一个极端配置猜想(前 m²/2 个高频特征是 ETF-like、贡献可忽略,低频特征互相挤在小角度),该猜想支撑了指数形式但缺少从优化动力学的严格推导,是证据最弱的一环。
- 只研究宽度 m 方向的标度:数据量/训练步数方向的标度没有做,论文只在弱叠加区引用了既有结论,强叠加区与表征夹角如何演化需要严格求解,论文明确表示目前无法解释。
- 只处理表征(representation)损失:transformer 层的解析/语法损失 f_ℓ(ℓ) 没有建模;总损失分解 C_m/m^{α_m}=f_m(m)+f_ℓ(ℓ) 建立在 N∝m²ℓ 与『最优 m-ℓ 关系下两项平衡』的经验假设上,f_ℓ 与 1/m 同阶只是推测。
- LLM 证据是相关性而非因果:只分析了 4 个开源模型族的 LM head 权重和评估损失(每个模型-数据集 1 次评估),没有干预实验证明『去掉叠加就会改变指数』;为什么 LLM 会处于强叠加只有稀疏性与 softmax 纠错的猜测,没有机制验证。
- 交叉熵→平方重叠的推导假设重叠远小于 1 且行范数不随 m 变化;后一条只有观测支持(Figure 20),前一条在极低频/高频 token 之间未必成立。联合拟合用了 18 个参数(16 个 L_{∖m}+C_m+α_m)拟合 4 模型族×4 数据集的损失,存在过拟合风险,α_m 的误差棒只反映拟合不确定性、没包含这些结构假设。
- 对可解释性与 AI safety 的潜在代价(论文自承):鼓励叠加的训练方法会让机制解释更困难;论文还提示同预训练损失下叠加程度不同的模型可能在推理、RL 可训练性等涌现能力上有差异,这点未研究。
可复现性
- code:https://github.com/liuyz0/SuperpositionScaling(官方仓库;大玩具模型 exp-17.py、小玩具模型见 Appendix B.2、重叠计算 overlap-0.py、评估 cali-1.py、token 频率 token-freq-0.py、损失拟合 nonlinearfit-3.ipynb)
- weights:LLM 权重从 HuggingFace 官方仓库下载(OPT、GPT-2、Qwen2.5、Pythia 系列);玩具模型权重训练后存储为 PyTorch 格式
- setup:玩具模型:V100 GPU、FP32,batch 2048(8192 验证无影响)、20000 步(80000 验证无影响),lr 0.02 起步并按 (8/m)^{0.25} 缩放,bias 用 lr 2.0/m、无权重衰减,5% warm-up+cosine;LLM 评估每模型-数据集 1 次、流式采样 10000 段×2048 token;重叠计算批量 8192、归一化加 ε=10^{-9} 防除零
主干与结构
backbone:两层 ReLU 自编码器(Anthropic superposition 玩具模型,Elhage et al. 2022)
参数:W∈R^{n×m}、b∈R^n;n=1000 或 10240,m=10–1024;不含 transformer 层
类型:表征重建玩具模型:h=W^T x → y=ReLU(Wh+b),L=⟨‖y−x‖²⟩;LLM 分析对象是语言模型头 W(n=词表大小、m=隐藏维)
关键组件
- 特征激活模型 x_i=u_i v_i(Bernoulli×Uniform)
- 解耦权重衰减/增长更新:γ≥0 时 W_i←W_i−η_t γ W_i(收缩),γ<0 时 W_i←W_i−η_t γ W_i(1/‖W_i‖²−1)(梯度下降 (‖W_i‖²−1)²,拉向单位范数);AdamW 实现,warm-up+cosine 衰减
- 表征判据:特征 i 被表征 ⇔ 行范数 ‖W_i‖≠0;ϕ_{1/2}=#{i:‖W_i‖²>1/2}/n 为被表征特征比例
- ReLU+负偏置纠错:用偏置抵消行间干扰,是叠加能降低损失的来源(线性模型无此能力)
为什么这样设计
论文要回答的是『表征层面的标度』:LLM 中拟合函数/流形主要由 transformer 层完成,而表征质量直接由 embedding 与 LM head 的宽度 m 限制;去掉 transformer 层、只留编码-重建回路,可以把表征限制造成的损失单独拿出来,配合权重衰减连续调节叠加程度,系统地扫弱/强叠加两个区间的标度行为。玩具模型与 LLM 的差异(架构、损失函数)论文在附录 A.2 论证不影响标度指数:交叉熵损失在重叠很小时展开后正比于平方重叠,与平方误差同阶。
叠加带来稳健且快速的幂律损失下降
原文 caption:Superposition leads to robust and fast power-law loss decay with model size. (a) Illustration of no superposition where a three-dimensional space can at most represent three features without any interference. (b) Toy model results in weak superposition (n=10240). (c) Illustration of superposition: more features than dimensions. (d) Same toy models in strong superposition show lower losses, power laws in model dimension with exponents close to 1; gray points are actual LLMs with similar exponent.
全篇总览图。面板 b 是弱叠加下三种特征频率(指数/幂律/线性,n=10240,γ=0.1)的损失-宽度双对数图:只有幂律频率那条线成直线(指数 α_m≈α−1),另外两条明显弯曲——说明弱叠加下幂律损失依赖数据本身是幂律。面板 d 是同样模型换到强叠加(γ=−1):三条线都变成近似平行的直线,斜率都在 −1 附近(指数/幂律/线性分别 1.01±0.05、1.0±0.1、0.89±0.05),灰色点是真实 LLM(斜率 −0.91±0.04)。这张图给出全篇核心对照:叠加程度改变标度行为的『定性性质』——从依赖数据分布变为对数据分布稳健。
权重衰减可以连续调节叠加程度
原文 caption:Weight decay can tune the degree of superposition. (a) Positive weight decay (γ=1) has ‖W_i‖² near 0 or 1, frequent features more likely represented; negative weight decay (γ=−1) has ‖W_i‖² around 1. (b) Small weight decays lead to strong superposition, large weight decays to no superposition (ϕ_{1/2}≈m/n).
方法图,证明『叠加程度可调』这个前提成立。面板 a 是频率-秩图上行的范数着色:γ>0 时行范数双峰分布在 0 和 1 附近(高频率特征范数趋近 1、低频率趋近 0),γ<0 时所有行范数都在 1 附近(所有特征都被表征、互相重叠)。面板 b 画被表征比例 ϕ_{1/2} 随权重衰减 γ 的变化:γ 小(负)时 ϕ_{1/2}≈1≫m/n(强叠加),γ 大(正)时 ϕ_{1/2}~m/n(只有最频繁的 m 个特征被完美表征)。它把『叠加程度』从定性概念变成可连续调节的实验旋钮,是后面系统性扫描标度指数的基础。
强叠加下的 1/m 标度来自表征向量的几何
原文 caption:Loss scaling at strong superposition is explained via geometry. (a) Row norm distribution is bimodal around 1. (b) More frequent features more likely have norms greater than 1. (c) Variance of squared overlaps for ‖W_i‖²>1 features is smaller than random unit vectors. (d) Features with ‖W_i‖²>1 have 1/m mean squared overlaps. (e) At strong superposition α_m=1 if frequencies flat (small α); α_m≈2(α−1) if skewed (large α).
全篇机制核心图,回答『为什么强叠加下损失按 1/m 走』。面板 c、d 是关键:把范数>1 的强表征特征的方向(W_i/‖W_i‖)两两求平方重叠,其均值落在 1/m 的理论线上(面板 d),方差比随机单位向量小、平坦频率下接近 0(面板 c)——说明训练出的向量接近等角紧框架(ETF),最大重叠达到 Welch 下界 κ≈1/√m。面板 e 总结标度指数:α 小时 α_m=1(损失 1/m),α 大时 α_m 上升、接近 2(α−1)(依赖频率分布)。这张图给出可复用的几何论证样板:重叠均值 1/m ⇒ 干扰损失 1/m。
真实 LLM 的损失标度与叠加预测一致
原文 caption:Superposition may explain the neural scaling law observed in actual LLMs. (a) Mean square overlaps of W_i/‖W_i‖₂ roughly follow 1/m scaling, W is the language model head. (b) Loss related to model size fitted as a power law, empirical α_m=0.91±0.04 close to 1.
LLM 验证图,把玩具模型的预测搬到真实模型上。面板 a:OPT、GPT-2、Qwen2.5、Pythia 四个模型族(约 100M–70B)的 LM head 行向量平均平方重叠,横轴是隐藏维 m,双对数下散点贴着 1/m 参考线(数据较噪,论文没有拟合直线,只对照斜率)。面板 b:四个模型族在四个数据集(Wikitext-103/Pile-10k/C4/BookCorpus)上的评估损失减去各自常数项后按 L=C_m/m^{α_m} 拟合,得 α_m=0.91±0.04;用 Chinchilla 的 N∝m^{2.52±0.03} 换算得到 α_m=0.88±0.06,互相印证。这张图说明『LLM 运行在强叠加区、损失按 1/m 标度』有直接观测支撑。
🎧 音频版
时长 29:58 · Edge TTS
Superposition Yields Robust Neural Scaling(对话版·深度版)
先讲清楚这篇要解决什么问题
小播:这期聊哪篇论文?一上来先说它解决了什么,别急着报菜名。
老播:这篇叫《Superposition Yields Robust Neural Scaling》,中文可以叫《叠加带来稳健的神经标度律》,MIT 的 Yizhou Liu、Ziming Liu 和 Jeff Gore 写的,发表在 NeurIPS 2025。它想回答一个特别基础的问题:大语言模型为什么越大越好?我们常说损失随模型规模按幂律下降,但这条规律从哪来,一直没有人讲清楚。这篇论文给的答案是:损失随宽度怎么降,取决于表征的叠加程度;真实 LLM 处在强叠加区,损失按 1/宽度 下降,而这个 1/宽度 是高维几何给定的,跟数据长什么样几乎没关系。
小播:等一下,「叠加」这个词我在别的语境里见过,这里指的是什么?
老播:这里的 superposition 是一个专门术语,中文译作叠加,意思是:模型用 m 维的隐藏空间,去表示远多于 m 个的特征。举个例子,词表有十万个 token,隐藏层只有几千维,那必然有很多特征挤在同一个维度区域里,互相重叠、共享维度。这个概念来自 Anthropic 的 superposition 研究,属于机制可解释性那条线。这篇论文做的事情,是把这个现象和神经标度律焊在一起:先造一个能控制叠加程度的玩具模型,把弱叠加和强叠加两个区间的标度行为分别测出来,再拿真实 LLM 对质,看谁的预测赢。
小播:预告一下,听完这期我该记住哪三件事?
老播:第一,叠加的强弱决定标度律的定性行为——弱叠加下只有数据频率本身是幂律,损失才是幂律;强叠加下损失稳健地按 1/宽度 走。第二,强叠加的 1/宽度 来自高维几何:表征向量两两之间的重叠按 1/m 衰减,干扰损失就按 1/m 走,这里有可以拿去复用的论证样板。第三,真实 LLM 的实测和强叠加预测定量吻合,宽度方向的标度指数是 0.91 上下,接近理论值 1。
先把神经标度律和之前的解释摆一摆
小播:那先补背景。神经标度律具体是什么?我知道越大越好,但数字上是什么样?
老播:经验规律是这样:模型参数量 N、数据集大小、算力这三样东西,每一项单独往上加,损失都会按幂律下降。经典数字来自 OpenAI 的 Kaplan 2020 和 DeepMind 的 Chinchilla 2022:在算力最优的配置附近,损失随参数量大致按 N 的 0.35 次方下降,参数翻十倍,损失按幂律走一个固定的比例。这篇论文处理的是这条规律里的一个具体维度:模型宽度 m,也就是隐藏维数。
小播:为什么单独挑宽度出来研究?参数量不是更直接吗?
老播:因为参数量 N 和宽度 m、深度ℓ之间有约束关系,粗略地说 N 正比于 m 的平方乘ℓ。同参数量下可以有不同的宽深配比,到底哪个在贡献损失,经验拟合分不出来。论文只动宽度、把宽度方向的标度单独拿出来,这是它和一堆「拟合 N 的幂律」的工作在问题设定上的差别。而且表征这个瓶颈,跟宽度绑得最紧:embedding 和语言模型头都是宽度乘词表大小的矩阵,宽度直接决定每个 token 有多少个维度可以用。
小播:那之前的人怎么解释这条幂律?
老播:主流解释分两拨。一拨说模型在近似数据所在的流形或者函数,指数取决于数据的结构,代表工作是 Bahri 他们 2024 年发表在 PNAS 的《Explaining neural scaling laws》;另一拨说网络在学一堆离散的技能或者特征,这些技能的重要性按幂律分布,代表工作是 Hutter 的 learning curve 理论,和 Michaud 他们的 quantization model。这两拨解释有一个共同点:都要数据本身是幂律的,才能推出损失是幂律。
小播:那卡在哪了?要求数据是幂律,听着也没那么离谱,语言频率本来就是 Zipf 律啊。
老播:卡在两点。第一,这些理论推导的设定,基本都对应「弱叠加」——只有最频繁的一小撮特征被完美表示,其余全部丢掉。第二,把 Zipf 律代进去,指数对不上。语言里 token 频率的幂律指数大约是 1,弱叠加理论给出损失指数是 α 减 1,约等于 0——那损失几乎不随宽度下降。可真实 LLM 明明宽度越大损失越低,而且降得不慢。这就是论文的切入点:LLM 大概率跑在弱叠加理论覆盖不到的那个区间,也就是强叠加区。
小播:所以它要做的第一件事,是造一个能把叠加程度掰开揉碎控制的玩具模型?
老播:对。而且它没有另起炉灶,直接用了 Anthropic 2022 年的 superposition 玩具模型——那个模型本来就是研究「特征在维度不够时怎么挤在一起」的。Anthropic 原工作已经发现了两件事:线性模型里叠加只会增加干扰,因为干扰没有机制抵消;一旦有了 ReLU 加负偏置,模型可以把重叠信号抵消掉,当特征稀疏、频率又比较平均的时候,叠加反而比丢掉特征划算。这篇论文在它上面加了一个关键的旋钮,后面细讲。先记住这个大框架:数据是稀疏特征,模型用窄的隐藏空间去重建数据,重建误差就是损失。
核心思想分四步走:玩具模型、叠加旋钮、弱叠加、强叠加
小播:好,进核心。第一步,玩具模型具体长什么样?
老播:输入是 n 维向量,n 是原子特征数,比如 n 等于一千,或者一万。每个分量 x_i 是这个样本里特征 i 的激活程度,采样写成 x_i 等于 u_i 乘 v_i。这里 u_i 是伯努利随机变量,以概率 p_i 取 1、否则取 0,p_i 就是特征 i 的出现频率;v_i 在 0 到 2 之间均匀采样,决定激活之后的强度。特征按频率从高到低排序,下标 i 越小越频繁。所有特征出现频率的总和叫激活密度 E,主实验里固定为 1,意思是每个样本平均只激活一个特征——数据非常稀疏。
老播:模型端更简单:一个权重矩阵 W 把 x 投影进 m 维隐藏空间,得到 h 等于 W 的转置乘 x;再用 W 和偏置 b 把 h 读回 n 维,中间过一层 ReLU,得到重建 y。损失是 y 和 x 的均方误差。这里 m 远小于 n,模型肯定学不全。有一个贯穿全文的定义:特征 i 被表征,当且仅当 W 的第 i 行非零。无叠加,就是前 m 个最频繁的特征用正交方向完美表示、其余行全零;叠加,就是非零行比 m 多得多,大家共享维度。给你一组具体数字,后面所有实验都在这两套配置上跑:小玩具模型 n 等于 1000,宽度 m 取 10、15、25、39、63、100 六档,权重衰减 γ 从负 1 到正 1 扫描,数据指数 α 从 0 到 2 取 17 个值;大玩具模型 n 等于 10240,宽度 m 从 8 到 1024,覆盖大约两个数量级。
小播:为什么叠加居然能降低损失?多挤几个特征进去,不是互相干扰吗?
老播:关键在 ReLU 加负偏置。读出某个特征的时候,其它特征在它方向上的重叠信号会被负偏置消掉一部分,模型等于在做纠错。Anthropic 原工作就证明过:线性模型里叠加只会添乱,因为干扰没有机制抵消;有了非线性,当特征稀疏、频率又比较平均的时候,叠加反而比丢掉特征划算。这篇论文的实验里,强叠加区的损失确实比弱叠加区低一截。这里还埋着一个伏笔:因为纠错把一阶干扰抵消掉了,最后剩下来、跟模型宽度挂钩的,是抵消不干净的二阶残差——也就是平方重叠,这个在讲交叉熵那一节会用到。
小播:第二步,那个「叠加旋钮」是怎么做的?
老播:它加了一项解耦的权重衰减,或者叫权重增长。对 W 的每一行:γ 大于等于 0 的时候,更新就是普通的权重衰减,把行向量往零压,越不重要的特征越先被压没,这叫弱叠加;γ 小于 0 的时候,更新变成把行范数往 1 拉,等价于对「范数平方减 1 的平方」做梯度下降,所有特征都留在空间里,只能靠重叠共存,这叫强叠加。训练之后行范数呈现双峰分布:正 γ 下集中在 0 和 1 附近,负 γ 下全贴在 1 附近。于是论文定义了一个量叫被表征比例,写作 ϕ 下标 1/2,就是范数大于 1/2 的行占全体的比例:小 γ 时这个比例约等于 1,大 γ 时约等于 m 除以 n。用这一个旋钮,就能在完全相同的玩具模型上,系统扫描弱叠加和强叠加两个区间。
小播:第三步,弱叠加区里发生了什么?
老播:弱叠加区里,模型只完美表示最频繁的一小撮特征,其余特征的偏置取它们的均值——等于用平均值去猜。于是损失就只剩下「没学到的特征」的贡献,可以写成一个求和式:L 约等于 ⟨v²⟩ 乘上所有被忽略特征的概率之和。⟨v²⟩ 是激活强度平方的期望,因为 v 在 0 到 2 之间均匀分布,等于 4/3。这个式子的意思是:损失约等于被丢弃特征的总出现频率,谁没被学到,谁就按它的频率给损失添乱。
小播:然后呢?这个求和怎么变成幂律?
老播:这就是全篇第一个可以复用的标度论证样板:频率和换积分。当频率本身是幂律,也就是 p_i 正比于 1 除以 i 的 α 次方,而且 n 远大于 m 的时候,把从 m 到 n 的求和近似成积分,积出来正比于 m 的负 α 加 1 次方。所以损失随宽度 m 的指数是 α 减 1。逐个符号解释:α 是数据频率的幂律指数,m 是模型宽度,α_m 是损失随宽度的标度指数。结论:弱叠加下,只有数据本身是幂律,损失才是幂律;Zipf 律 α 约等于 1,损失指数约等于 0,损失几乎不随宽度下降。指数衰减、线性衰减的频率分布,损失曲线直接弯掉、不成幂律。这个结论和传统「数据驱动标度」的解释是一路的,论文用实测验证了它,但它显然解释不了真实 LLM。
小播:所以重头戏在第四步,强叠加区。
老播:对,这是全篇的核心。强叠加下所有特征都被表征,损失主要来自表征向量之间的干扰:读特征 i 的时候,别的特征在 i 方向上的重叠分量会混进重建。要算这个干扰有多大,需要两个高维几何事实。
老播:第一个事实,随机向量重叠的自然刻度。在 m 维空间里随便取两个各向同性单位向量,它们的平方重叠——就是夹角余弦的平方——均值是 1/m,方差大约 2 除以 m 的平方。意思是空间越宽,任意两个随机向量越接近正交,重叠按 1/m 衰减。第二个事实,Welch 下界:如果你有 ν 个单位向量,而且 ν 远大于 m,那它们两两之间必然存在一对,重叠至少是根号下 ν 减 m 除以 m 乘 ν 减 1,ν 很大时约等于 1 除以根号 m。这个下界会被一组叫等角紧框架的向量达到——所有夹角完全相等的极端配置,它最多只能容纳 m 乘 m 加 1 除以 2 个向量。
小播:这两个事实怎么凑出 1/宽度?
老播:论文实测,训练出来的强表征向量——范数大于 1 的那一批——确实接近等角紧框架:平方重叠的方差比随机向量小,平坦频率下接近零,均值落在 1/m 上。强表征特征的数量大约在 m 的平方除以 2,比 m 多得多,又比 n 小。于是干扰损失约等于平方重叠之和,按 1/m 走,得到损失指数 α_m 等于 1。这就是全篇的机制主干:强叠加 → 所有特征共享 m 维空间 → 两两重叠按 1/m 衰减 → 干扰损失按 1/m 标度,和数据频率分布基本无关。 给你一个抓手的数字:宽度从 100 翻到 10000,一百倍,随机向量的平均平方重叠从 1/100 降到 1/10000,也降一百倍,干扰损失跟着降一百倍。这就是 1/宽度 标度的意思:宽度乘十,损失除十。
小播:这套几何论证能不能总结成模板,以后读别的论文直接套?
老播:可以,这是全篇最值钱的副产品之一。第二个样板叫重叠归约:先把损失拆成干扰项,再论证干扰项正比于表征向量两两之间的平方重叠,然后引用「m 维随机向量的平方重叠均值是 1/m」这个几何事实,得到损失按 1/m 走。第三个样板叫下界卡指数:当向量数量远超维度的时候,Welch 下界保证最大重叠至少是 1 除以根号 m,等角紧框架达到这个下界、且数量有上界 m 平方除以 2——用这些事实说明模型把向量排成了近似等角的结构。三步走完,1/宽度 就出来了。这套样板比单独记住结论有用,因为结论只属于这篇论文,样板可以迁移。
小播:那强叠加是不是对所有频率分布都稳健?
老播:大部分稳健,有一个例外要讲清楚。频率平坦的时候,α_m 稳稳等于 1;频率非常偏斜、少数高频特征占大头的时候,高频特征会抢走「好角度」,低频特征被挤进很小的角度互相纠缠,损失又重新对频率敏感。论文给了一个极端配置的猜想:前 m 平方除以 2 个高频特征是等角紧框架、贡献可以忽略,剩下低频特征在坏配置下损失正比于从 m 平方除以 2 到 n 的频率和,约等于 m 的负 2(α−1) 次方,也就是 α_m 约等于 2(α−1)。这个式子跟观测接近,但它是猜想,没有严格推导——这个我们放到局限里再讲。
关键实验:四张图把机制钉住
小播:进实验部分。挑几个关键图讲,第一个肯定是总览图。
老播:Figure 1 是全文的总览,一张图讲完「叠加程度改变标度行为的性质」。面板 b 是弱叠加,面板 d 是强叠加。数据是大玩具模型,n 等于 10240,宽度 m 从 8 到 1024;三种特征频率:指数衰减、幂律(i 的 1.2 次方)、线性衰减。弱叠加下,三种频率里只有幂律那一条在双对数图上是直线,指数约等于 α 减 1;另外两条明显弯曲。同一批模型换到强叠加,三条线都变成近似平行的直线,斜率都在负 1 附近:指数频率 1.01 加减 0.05,幂律频率 1.0 加减 0.1,线性频率 0.89 加减 0.05。注意这里的对照:同样三种数据,弱叠加下幂律损失依赖数据是幂律,强叠加下三条线全成幂律、指数全在 1 附近。图里还有灰色点,是真实 LLM 的损失,斜率负 0.91 加减 0.04,跟玩具模型贴在一起。
小播:弱叠加的理论预测,除了这个总览,还有更细的验证吗?
老播:有,Figure 4 专门验证弱叠加的「频率和」理论。面板 a 把实测损失和被忽略特征频率和的理论预测放在一起,横轴是被表征的特征数,也就是 ϕ1/2 乘 n,正权重衰减下两者贴得很近。面板 b 选了 9 个最接近理想无叠加的模型配置,实测的 α_m 和理论值 α 减 1 基本一致。这张图的作用是把弱叠加区的结论坐实:损失确实等于被丢弃特征的频率和,指数确实由数据决定。
小播:第二张图,就是那个旋钮的图?
老播:对,Figure 3 证明「叠加程度可控」这个前提成立。面板 a 是行范数在频率-秩图上的着色:正权重衰减下,范数双峰分布在 0 和 1 附近,高频特征范数趋近 1、低频趋近 0;负权重衰减下所有行范数都贴在 1 附近。面板 b 是被表征比例 ϕ1/2 随 γ 的变化:γ 小的时候这个比例约等于 1,γ 大的时候掉到 m/n 附近。这张图的意义在于,把叠加从定性概念变成连续可调的实验变量,后面所有扫描都建立在它上面。
小播:第三张图应该是几何那张。
老播:Figure 5 是机制核心,四个子图回答「为什么强叠加下损失按 1/m 走」。面板 c 看平方重叠的方差:训练出的强表征向量,方差比随机单位向量小,平坦频率下接近 0,这是等角紧框架的特征;面板 d 看均值:强表征向量的平均平方重叠落在 1/m 的线上,也就是 Welch 下界 κ 的平方。面板 e 是标度指数总结:α 小的时候 α_m 等于 1,α 大的时候 α_m 爬上去、接近 2(α−1)。这张图给出的论证样板是:把损失的标度归约成重叠的标度——重叠均值是 1/m,损失就是 1/m。
小播:第四张,LLM 那张,怎么读?
老播:Figure 6 把玩具模型搬到真实模型。做法是把 token 当原子特征,数据维取词表大小,宽度取隐藏维,分析语言模型头 W 的行向量。四个开源模型族:OPT、GPT-2、Qwen2.5、Pythia,规模从大约 1 亿到 700 亿参数,在四个数据集上评估:Wikitext-103、Pile-10k、C4、BookCorpus。面板 a 是归一化行向量的平均平方重叠,散点贴着 1/m 参考线下降——注意数据比较噪,论文没有硬拟合直线,只是对照斜率。面板 b 是损失拟合:对每个模型和数据集,把损失拆成宽度相关项,也就是 C_m 除以 m 的 α_m 次方,再加上一个与宽度无关的常数,联合拟合得到 α_m 等于 0.91 加减 0.04。这里的基线是 Chinchilla 的交叉验证:Chinchilla 的参数 N 正比于 m 的 2.52 次方,参数方向的标度指数是 0.35 加减 0.02,两者相乘换算到宽度方向,得到 0.88 加减 0.06——两条独立路径都逼近 1。
小播:除了这四张主图,LLM 的分析还有没有补充证据?
老播:有三条,都在附录里,但都值得知道。第一条是强叠加判据:语言模型头的行范数全部非零,而且词表大小远大于宽度,说明所有 token 都被表征了——这符合强叠加、不符合弱叠加。第二条是 token 频率:四个 tokenizer 配四个数据集,每个组合各采 100 万 token,测出来的频率-秩分布在双对数下都是直线,指数 α 都在 1 附近——和玩具模型里「强叠加加平坦频率给 1/m」的条件一致。第三条是损失形态:固定一个模型族和一个数据集,评估损失对 1/m 画出来近似一条直线,斜率似乎跨模型族通用,截距随数据集和模型族不同——这正是「宽度相关项加常数项」这种分解的观测依据。
小播:那个非零截距是什么?损失拟合出来到不了零?
老播:对,这是论文的一个附加观察:把损失按 1/m 外推到 m 无穷大,损失不会归零,有一个正的截距。解释是语言本身有固有不确定性——同一句话可以有多种合理的续写,这部分损失加宽模型也消不掉。所以损失分解成宽度相关项加常数项,加宽只能减少「错误的干扰」,减不了数据内在的不确定性。
小播:还有一个疑问:玩具模型用均方误差,LLM 用交叉熵,凭什么指数能对齐?
老播:附录 A.2 专门做了这个。把归一化后的隐藏态看成 W_i 除以它的范数,单个数据点的交叉熵损失展开之后,与模型尺寸有关的最低阶项是二分之一乘上所有 j 不等于 i 的平方重叠,再乘一个指数因子。展开里的一阶项——重叠的一次方求和——因为语言数据有相关性,只贡献一个与宽度无关的小常数:同一前缀可以接不同的 token,比如「I like」后面接 cats 接 dogs 都合理,数据会把这些向量往一起拉。真正随宽度变化的最低阶就是平方重叠项。余弦相似度按 1 除以根号 m 走,平方之后就是 1/m。所以交叉熵在重叠很小时,标度行为跟平方误差同阶,对齐是成立的——前提是重叠确实小,这个前提本身也是它的局限之一。
小播:还有一个稳健性实验值得提吗?我记得有激活密度的扫描。
老播:值得提,它堵住了一个可能的质疑。有人会说:损失标度会不会取决于稀疏程度?论文把激活密度 E 从 0.5 扫到 7.5,固定 α 等于 1、m 等于 63、n 等于 1000,发现损失约等于 E 乘一个常数,也就是 E 只进系数、不进指数,强叠加下 α_m 始终在 1.1 上下。所以「1/宽度」这个结论不依赖稀疏程度的取值,这是支撑结论稳健性的一个补充。
它在标度律研究里站在什么位置
小播:谱系定位。它跟最重要的几个相关工作比,差在哪、好在哪?
老播:四个对照。第一,对 Kaplan 2020 和 Chinchilla 2022 这些经验标度律,它们是观察、是拟合,本文补上了宽度方向的机制解释,把实测指数 0.91 和理论值 1 对齐。第二,对核特征值那一路——Bahri 2024、Bordelon 2020——它们推的 resolution-limited 指数 α′ 减 1,对应本文的弱叠加区,那里的 α′ 就是数据自身的指数;本文的新增点是,强叠加区里这个指数被几何改写成与数据无关的 1/m。第三,对技能模型那一路——Hutter、Michaud——它们的「损失等于被忽略技能频率和」,跟本文弱叠加区是同构的,差别在于它们隐式假定弱叠加,没有覆盖强叠加区。第四,对 Song 等人的 resource model,它用中心极限定理给出 1/m,适用于过参数化场景;本文的 1/m 来自有限宽度下的重叠几何,机制不同。
老播:还有一个直接的前作:Anthropic 2022 年的 superposition 玩具模型。本文的构造几乎原样沿用,但原工作只研究数据结构什么时候导致叠加,没有旋钮去控制叠加,更没有连上标度律。论文的增量正好是三样东西:控制叠加的旋钮、两个区间的系统扫描、真实 LLM 的验证。整体看,这条技术路线从「数据谱系决定指数」慢慢走向「几何结构决定指数」:弱叠加区里数据说了算,强叠加区里几何说了算,这篇论文正好站在两条路线交界的位置。
局限要讲透:证据最弱的地方在哪
小播:好,按惯例讲局限。先说论文自己承认的,再说我们读出来的。
老播:最重要的一条:玩具模型没有被严格求解。 论文自己写明,工作建立在玩具模型的观测和分析上,没有严格求解。强叠加下偏斜频率的 α_m 等于 2(α−1),依赖一个极端配置猜想——前 m 平方除以 2 个高频特征是等角紧框架、贡献可以忽略,低频特征挤在小角度里互相纠缠。指数形式有观测支撑,但从优化动力学的严格推导是缺位的。这是全篇证据最弱的一环,也是后续研究最该补的地方。
小播:还有哪几条?
老播:第二条,它只研究了宽度这一个方向的标度。数据量、训练步数方向的标度没有做;强叠加区里,这些标度跟表征夹角的演化有关,论文明确说目前解释不了。第三条,它只处理表征损失。transformer 层的解析、语法损失没有建模,总损失分解成宽度项加常数项,建立在「参数量正比于 m 平方乘层数」和最优宽深关系下两项平衡的经验假设上,解析项随宽度的行为是推测。第四条,LLM 的证据是相关性、不是因果:四个开源模型族,每个模型每个数据集只评估一次,没有干预实验证明去掉叠加就会改变指数;LLM 为什么处在强叠加区,只有「语言特征稀疏、softmax 擅长纠错」两个猜测。第五条,技术细节:交叉熵到平方重叠的展开,要求重叠远小于 1,行范数不随宽度变化只有观测支持;联合拟合用了 18 个参数——16 个常数项加一个系数加一个指数——去拟合 4 乘 4 的损失面,存在过拟合风险,误差棒只反映拟合的不确定性,没有包含结构假设的不确定性。
小播:有没有我们对这篇论文自己的顾虑?
老播:有几条我们读出来的。第六条:LLM 分析只用了语言模型头,embedding 和中间层都没有看,表征瓶颈到底集中在哪一层,论文没法判断——如果瓶颈在别处,仅凭头的分析下结论就有点早。第七条:论文在结尾给出了工程建议,比如用 nGPT 这类把表征归一化到单位球面的架构来鼓励叠加,让小模型追平大模型。这个方向很有意思,但论文也自己承认,这些改进可能只是改变了标度律的系数、没有改变指数,而且鼓励叠加会让机制可解释性和 AI safety 分析更困难。我们读的时候还要注意,整篇的「token 当作原子特征」是一个朴素映射,词表大小未必等于语言里真正独立要素的数目——论文自己也说,如果真实数目比词表大,幂律可能延续得更久。
收尾:记住三件事
小播:最后收个尾。这期该记住的三件事?
老播:第一,叠加的强弱决定标度律的定性行为:弱叠加下只有数据频率是幂律,损失才是幂律,指数是 α 减 1;强叠加下损失稳健地按 1/宽度 走,指数是 1,几乎不依赖数据分布。第二,强叠加的 1/宽度 来自高维几何:m 维空间里随机向量平方重叠的自然刻度是 1/m,等角紧框架把最大重叠压到 1 除以根号 m,强表征特征最多 m 平方除以 2 个,干扰损失于是按 1/m 标度——这个「把损失归约成重叠标度」的论证样板,可以拿去读别的表征类论文。第三,真实 LLM 实测和强叠加预测吻合:四个开源家族、四个数据集,损失指数 0.91 加减 0.04,Chinchilla 换算 0.88 加减 0.06,都在理论值 1 附近;非零截距说明语言固有不确定性是加宽模型消不掉的。
小播:那这篇对后续工作的意义是什么?
老播:它把「损失随宽度怎么降」这个问题的答案,从数据分布手里交到了高维几何手里:强叠加区里,1/m 是几何给定的。沿着它走下去,下一步是严格求解玩具模型、把 2(α−1) 的猜想变成定理,再往上是把表征损失和解析损失两块拼成完整的宽度标度。对工程的影响也很直接:如果叠加是标度的来源,那么鼓励叠加的训练方法就可能改变系数甚至指数——论文提示,在频率极度偏斜的领域任务上,指数有可能变得更快。