One Step Diffusion via Shortcut Models
- 作者:Kevin Frans、Danijar Hafner、Sergey Levine、Pieter Abbeel(UC Berkeley)
1. 要解决什么问题
扩散模型和 Flow Matching 生成一张图,等价于从纯噪声出发、沿着学到的速度场数值求解一个 ODE,通常要几十到几百次网络前向。论文给出的参照:DiT-XL 在 ImageNet-256 上跑 500 步拿到 FID 2.27,ADM-G 要 250 步拿到 4.59。推理成本直接卡住了生成模型在实时场景(机器人、交互应用)的使用。
少走几步、甚至只走一步,此前的路线分两类。一类是两阶段蒸馏:先训练一个多步模型当老师,再把它压成少步学生。Reflow 的做法是让老师全量模拟 ODE,在 CelebA-HQ 生成 5 万个、ImageNet 生成 100 万个 (x0, x1) 合成配对,每个配对要 128 次前向;Progressive Distillation 则把蒸馏拆成 log2(T) 个师生阶段,逐步减半步长。两类做法都要先有老师,还要决定「什么时候停止训练、开始蒸馏」。另一类是 Consistency Models:给网络强加「同一条轨迹上不同时刻的输出一致」的行为约束,从零训练。它省掉了老师,但一致性是加在网络输出上的软约束,需要严格设计的离散化课程(时间分箱随训练逐步变粗)和大规模 bootstrap。
Shortcut Models 的切口是:把「这次想走多大步」也变成网络的条件输入。同一个网络同时学会 128 步、4 步、1 步三种走法,推理时按预算选步数,训练只需要一次、不需要老师也不需要调度。
2. 背景:少步采样为什么难
Flow Matching 把数据 x1 和噪声 x0 线性插值成中间点 x_t = (1−t)x0 + t·x1,条件速度是 v_t = x1 − x0。给定一对 (x0, x1) 速度唯一,但只给定 x_t 时,它可能来自很多不同的配对,所以网络实际学的是条件平均速度 v̄_θ(x_t, t) ≈ E[v_t | x_t],损失为 L_CF(θ) = E[‖v̄_θ(x_t, t) − (x1 − x0)‖²]。
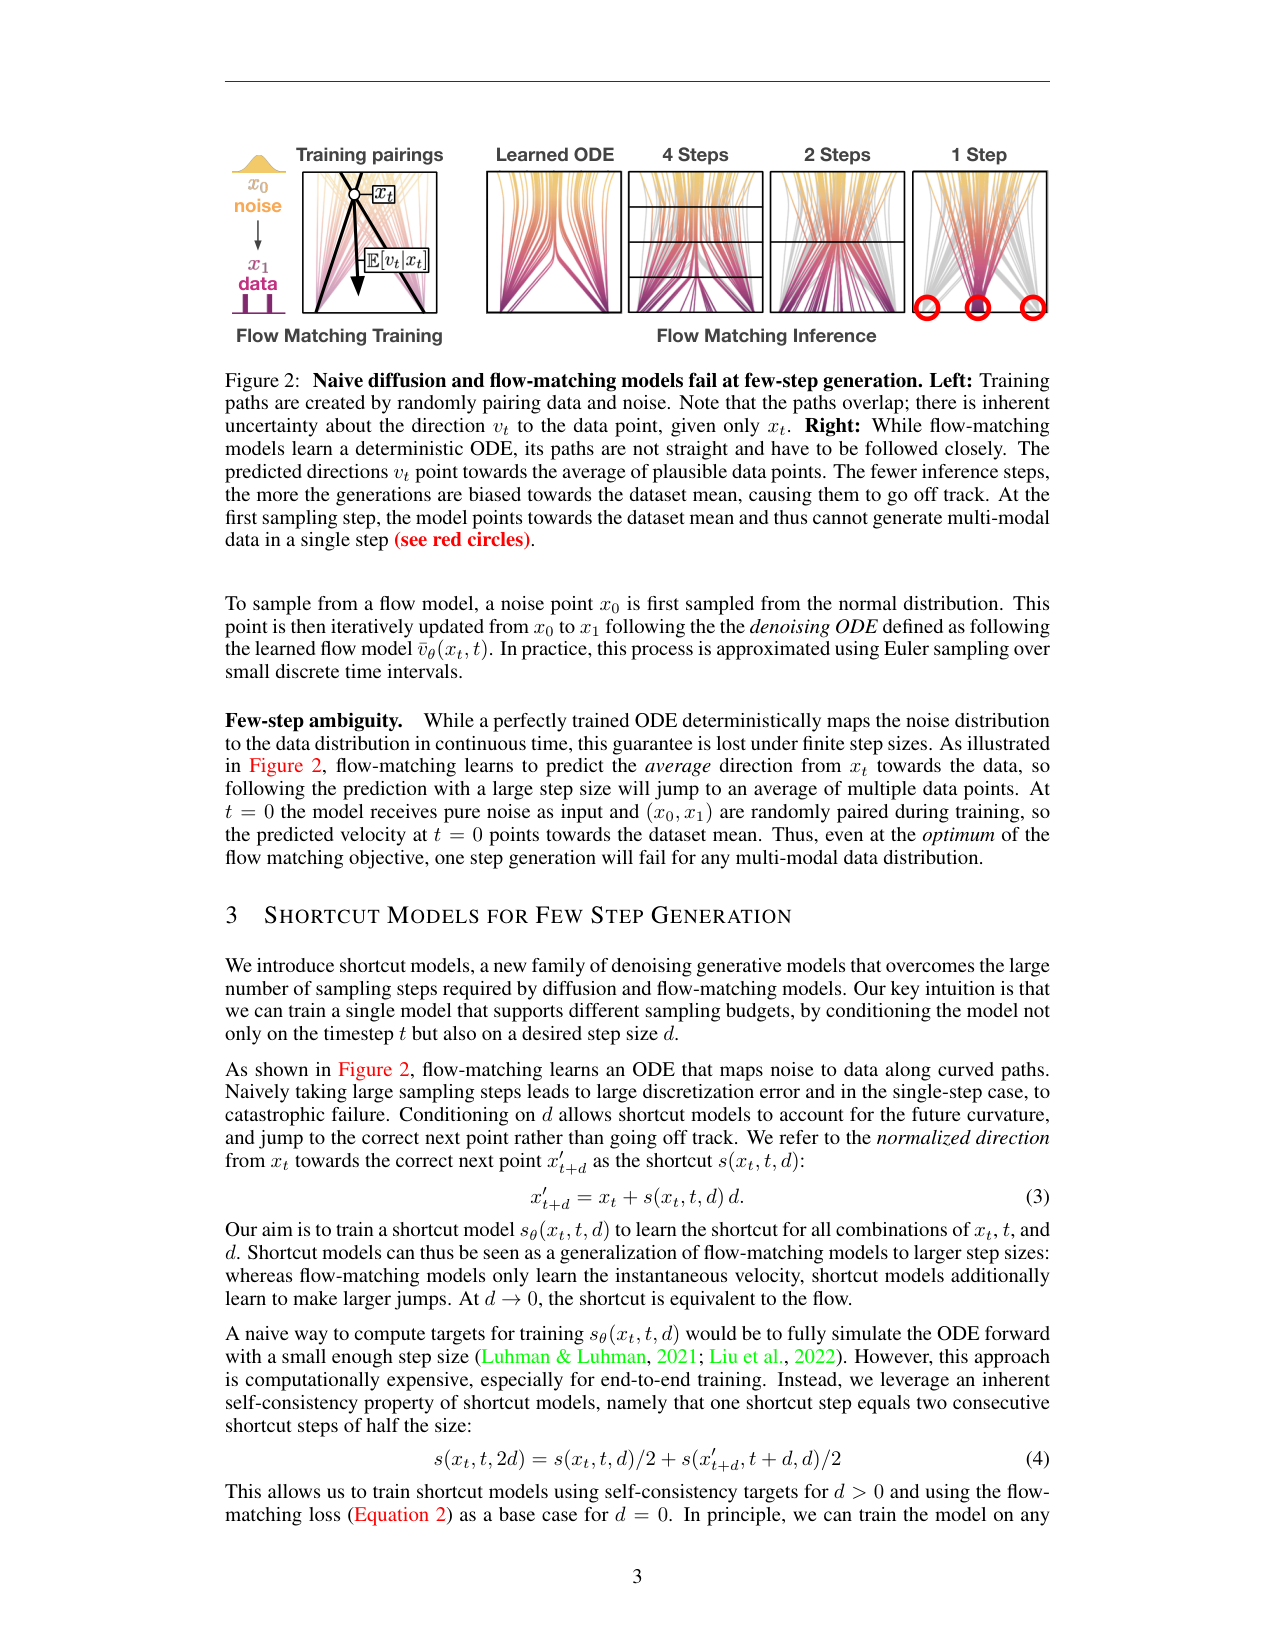
这个目标的隐患在于:少步采样时,网络沿当前点的切线方向大步跳,相当于用一条直线代替弯曲的轨迹。图 2 把问题画清楚了:左半显示训练时同一中间点对应多条互相交叉的路径,方向有内在不确定性;右半显示学到的 ODE 轨迹弯曲,步数越少,生成的样本越偏向数据集均值,1 步时红圈直接指向平均位置——对任何多峰分布,单步生成都会得到「平均脸」式的失败样本。这是 naive 流匹配在少步下必然退化的结构性原因。
3. 核心思想:学一条跨大步长的「捷径」
3.1 步长条件的 shortcut
Shortcut Models 定义了一个带步长条件的映射。从当前点 x_t 出发、跨步长 d 到达下一个点 x′_{t+d},更新式为:
x′_{t+d} = x_t + s(x_t, t, d)·d
这个式子要回答的问题是:网络如何在不知道未来轨迹的情况下直接跳到正确的下一点。s(x_t, t, d) 是网络输出的 shortcut 向量,表示「从 x_t 出发、走 d 这么长一步的平均移动方向」;乘以 d 之后得到实际位移。当 d 趋向 0 时,s 退化为瞬时速度,shortcut 模型就变成普通 Flow Matching——所以 shortcut 是流匹配在「大步长」上的推广,d=0 是多步生成的天然基座。
采样时(Algorithm 2)从纯噪声 x_0 出发,用固定步长 d 迭代:x ← x + s_θ(x, t, d)·d,t ← t + d,直到 t=1。推理时把 d 设成 1/128、1/4、1 分别对应 128 步、4 步、1 步——同一个模型、同一套权重,步数在推理时动态决定。
3.2 自洽目标:两小步拼接成一大步
大步长的 target 没有地面真值,全量模拟 ODE 又太贵。论文利用 shortcut 的自洽性质:一步 2d 的位移,等于两步 d 的位移的平均拼接:
s(x_t, t, 2d) = s(x_t, t, d)/2 + s(x′_{t+d}, t+d, d)/2
这个式子的读法:左边是「一次跳 2d」的方向,右边是「先跳一个 d、再跳一个 d」的方向的平均。如果模型学好了,两边应该相等。训练时先用模型自己走两个 d 小步(第一小步从 x_t 出发,第二小步从 x′_{t+d} 出发,第二个点由第一个预测构造,用 stop-gradient 切断梯度),把拼接结果当成 2d 步的回归目标。这就是训练期的自蒸馏:大步长的老师,就是小步长时的模型自己。
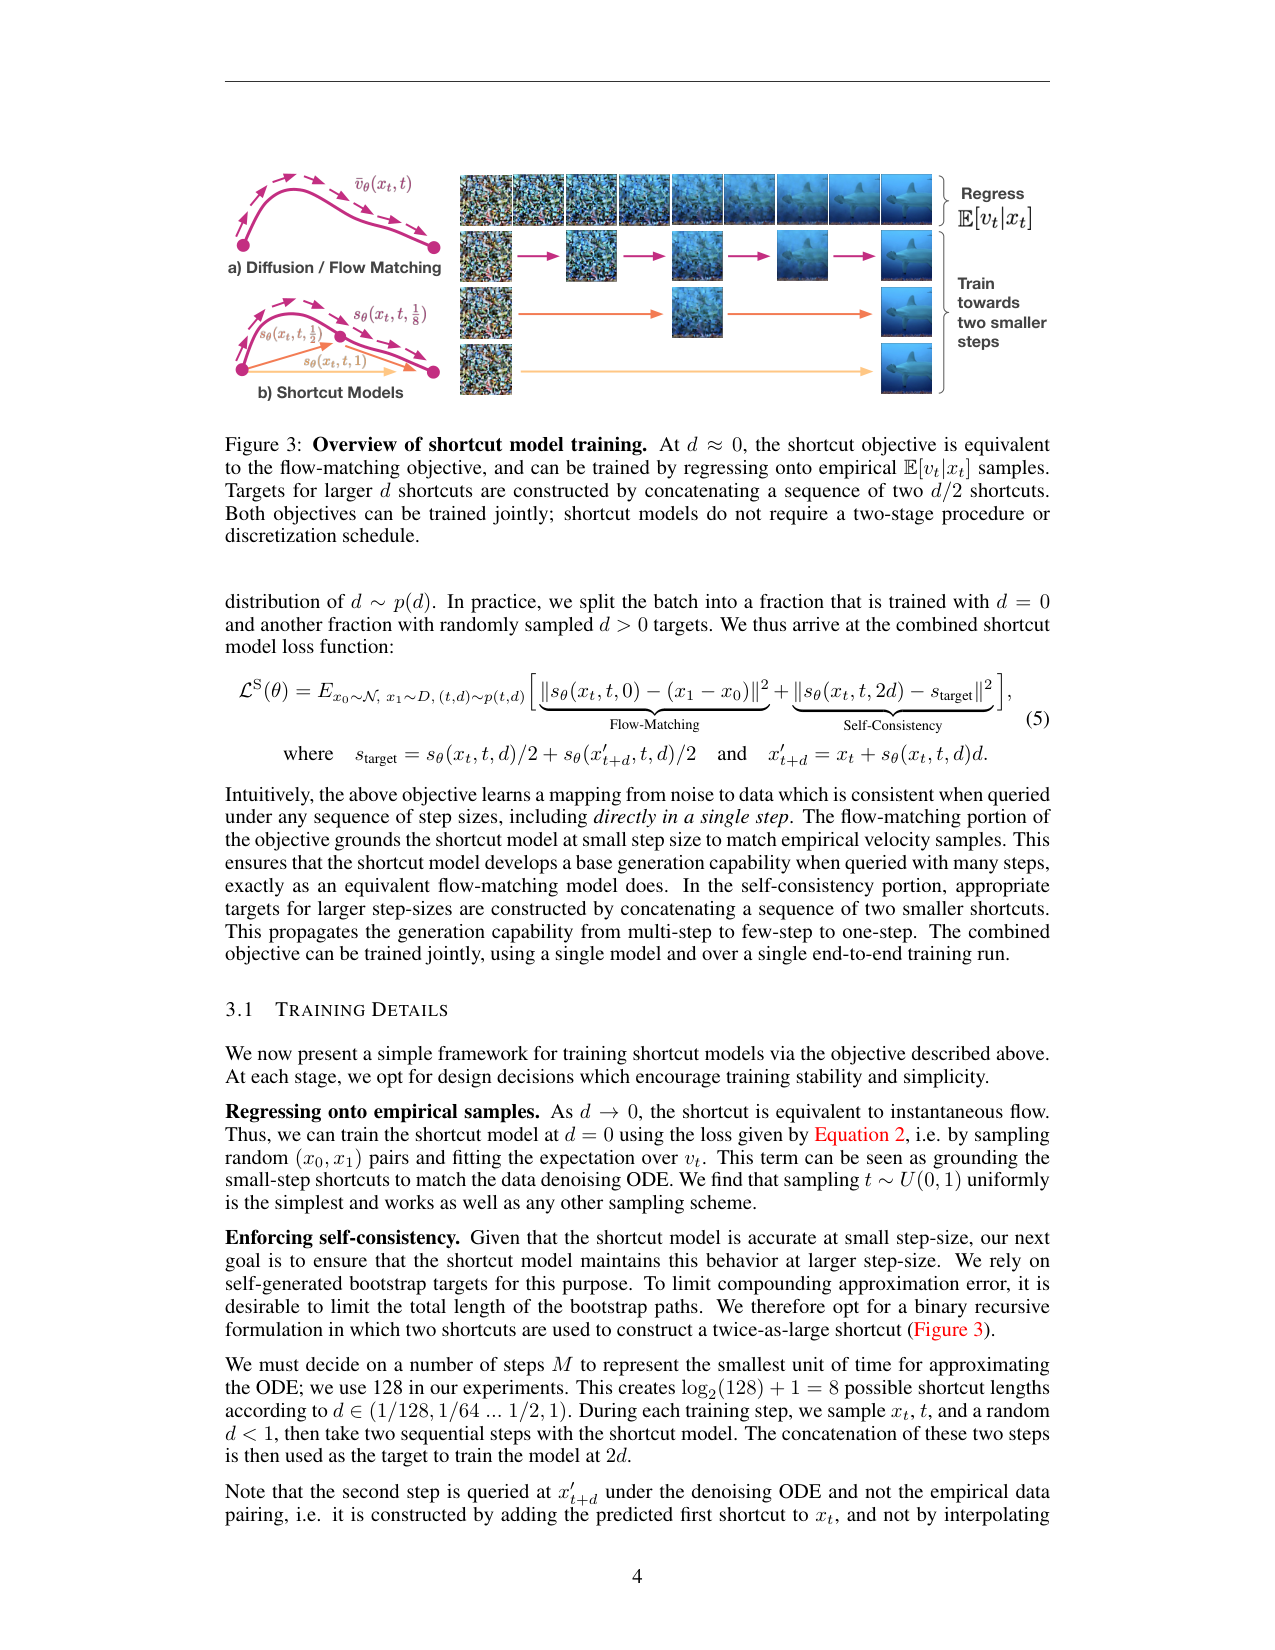
实现细节:论文把最短细分设成 M=128,于是 d 只有 8 档:1/128、1/64、…、1/2、1(log2(128)+1)。自举链固定为 2 步,误差不会沿着长链累积。图 3 展示了整体训练机制:a) 传统扩散/流匹配只在 d≈0 处回归经验速度 E[v_t|x_t];b) shortcut 把两个 d/2 小步串起来当一步 d 的目标,两个目标联合训练。
3.3 联合损失与训练细节
总损失把两项合在一起:
L_S(θ) = E[‖s_θ(x_t, t, 0) − (x1 − x0)‖²] + E[‖s_θ(x_t, t, 2d) − s_target‖²]
其中 s_target = s_θ(x_t, t, d)/2 + s_θ(x′_{t+d}, t+d, d)/2,x′_{t+d} = x_t + s_θ(x_t, t, d)·d。
第一项是 Flow Matching 损失(d=0 分支),用真实数据配对把模型锚定在数据分布上,保证多步生成能力与基线一致;第二项是自洽损失(d>0 分支),把多步能力逐级传播到单步。批次里 75% 的样本走第一项、25% 走第二项。整个训练单次完成,没有调度。每个更新约 1 前向 + 2 反向 + 0.5 自洽 target 计算单元,相比基础扩散的 3 单元,训练开销约 +16%。
4. 关键实验
主实验在 CelebA-HQ(无条件)和 ImageNet-256(类别条件)上,所有方法用同一个 DiT-B 架构、同一套代码库、相近算力训练,评估 FID-50k(越低越好)。
- CelebA-HQ 256 无条件:Shortcut 1 步 20.5、4 步 13.8、128 步 6.9。对照:Flow Matching 128 步 7.3,但 4 步 (63.3)、1 步 (280.5);Diffusion 128 步 23.0;Consistency Training 1 步 33.2;Reflow 1 步 23.2;Live Reflow 1 步 43.3(括号表示该目标本不支持的场景)。
5. 谱系定位
相比 Consistency Models,shortcut 把一致性约束换成自洽目标:CM 需要离散化课程、T 次 bootstrap、常配感知损失,shortcut 只要 L2、log2(T)=8 次 bootstrap、无课程,多步生成是天然的 d=0 基座。相比两阶段蒸馏,shortcut 省掉合成数据集和师生阶段。相比后发的 MeanFlow(NeurIPS 2025),两条路线的分工正好相反:shortcut 的加速发生在推理端——训练期学所有步长的捷径,推理时按预算动态选步数,但一步质量有限(ImageNet 1 步 10.6);MeanFlow 把「平均速度」(一步位移)直接写进训练目标,训练时即一步、无自举链,ImageNet 1-NFE FID 3.43 明显更低,代价是步数不是它的条件变量,动态预算灵活性弱于 shortcut。两条路线共同回答了「怎么让生成模型少步或一步」,也共同把 one-step 从「先训慢模型再蒸馏」推向「单次训练直接学快模型」。
6. 局限
- 论文自承:噪声到数据的映射完全由数据期望决定,模型没有自由度去调整这个映射,少了 GAN/VAE 可以简化学习问题的空间。
在 Flow Matching 之上多学一个步长条件 d:网络同时输入当前噪声水平 t 和想跳的步长 d,用「两步 d/2 拼接成一步 d」的自洽目标在训练期自蒸馏,单网络、单次训练、无调度,1 步/4 步/128 步都由同一个模型在推理时决定;训练开销只比基础扩散高约 16%。ImageNet-256 上 1 步 FID 40.3(DiT-B)、XL 扩到 10.6,128 步 3.8,多步质量与基线流匹配相当。
阅读提示
精读深度:泛读
清单提示:原文提示:学习「捷径」轨迹支持动态步数;注意其推理时加速机制与 MeanFlow 的「训练时即一步」路线差异。
问题
要解决什么:扩散和流匹配模型的采样要数值求解概率流 ODE,通常要几十到几百次网络前向,生成慢且贵;现有加速路线(两阶段蒸馏、Consistency 类)要么多一个训练阶段、要么依赖精心设计的离散化课程。Shortcut Models 想让『一个网络、一次训练』同时支持任意推理预算:128 步、4 步、1 步都由推理时自己选。
为什么 prior work 不够:Flow Matching 学的是瞬时速度 v_t,少步采样等于用切线近似整条弯曲轨迹,粗步长离散化误差大,1 步时预测方向指向数据集均值、对任何多峰分布都失效(论文第 2 节 Fig.2)。两阶段蒸馏(Reflow、知识蒸馏)要先让老师模型全量模拟 ODE 生成合成数据集:Reflow 在 CelebA-HQ 生成 5 万、ImageNet 生成 100 万个 (x0,x1) 对,每对要 128 次前向;Progressive Distillation 分成 log2(T) 个师生阶段,蒸馏完还丢掉多步能力。Consistency Models 端到端、无老师,但一致性是强加在网络行为上的约束,需要严格离散化课程和大量 bootstrap,且每个步数都依赖自举。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 带噪潜变量 x_t | latent (32×32×4) | 256×256×3 图像经 sd-vae-ft-mse 8× 下采样到 32×32×4;x_t = (1−t)x_0 + t·x_1,t 是噪声水平,x_0 是噪声、x_1 是数据。 |
| 噪声水平 t | 标量 | 采样时只在 d 的整数倍时刻查询(t ∈ {0, d, 2d, …, 1});训练时从这些离散点采样。 |
| 期望步长 d | 标量(8 档) | d ∈ {1/128, 1/64, …, 1/2, 1},由 M=128 的基础细分决定,log2(128)+1=8 档;d=0 是训练专用分支(退化回 Flow Matching)。 |
| 类别标签 c | int(仅 ImageNet) | 1000 类,10% 概率 dropout 以支持 CFG 1.5(只在训练目标里用,采样时不额外跑一次)。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| shortcut 向量 s_θ(x_t, t, d) | latent 同维向量场 | 表示『从 x_t 出发、跨步长 d 的平均移动方向』;采样更新 x_{t+d} = x_t + s·d;d→0 时退化为瞬时速度。 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CelebA-HQ 256×256(无条件) | 约 3 万张 | latent 32×32×4;400k 训练步、batch 64、无 CFG;评估 FID-50k。 |
| ImageNet 256×256(类别条件) | 128 万张 | 800k 训练步、batch 256、CFG 1.5(训练用)、类别 dropout 0.1;评估 FID-50k。 |
| 机器人 Push-T / Transport(仿真) | 2 个任务 | 沿用 Diffusion Policy(Chi et al. 2023)的演示数据集与网络结构;观测条件化动作生成,1 步采样。 |
架构(摘要)
主干与结构
backbone:DiT-B(Peebles & Xie 2023):hidden 768、patch 2、12 层、12 heads、MLP ratio 4;XL 实验为 DiT-XL/2(676M)
参数:DiT-B 约 130M;DiT-XL 676M
类型:flow matching 变体:在标准 DiT 上把『步长 d』作为额外条件(与 t 一起嵌入),输出 shortcut 向量场
关键组件
- 步长条件 d:与时间 t 一同做位置编码嵌入,使同一网络支持 8 档步长
- d=0 分支:回归经验速度 x_1 − x_0(Flow Matching 损失),锚定少步能力
- d>0 分支:自洽目标,把两个 d/2 小步拼接成一步 d 的 target(stop-gradient)
- 批次内 75% 样本走 d=0、25% 走 d>0 自举目标
- EMA(0.999)参数用于生成自举 target 与评估
- 离散时间采样:训练只在 d 的整数倍时刻取 t
为什么这样设计
瞬时速度只描述『这一瞬间』的方向,大步长会沿切线冲出弯曲轨迹;把步长 d 变成条件输入后,网络可以直接预测『跨 d 的平均方向』(捷径),等于把 ODE 的积分工作内化到一次前向里。大步长没有地面真值,论文用自洽性质构造目标:两小步拼接成一大步,自举链固定为 2 步以限制误差累积,d=0 分支用真实数据配对锚定、防止纯自举漂移。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CelebA-HQ 256 无条件 FID-50k(1 步 / 4 步 / 128 步) | 20.5 / 13.8 / 6.9 | Flow Matching 128 步 7.3、4 步 (63.3)、1 步 (280.5);Diffusion 128 步 23.0、1 步 (132.2);Consistency Training 1 步 33.2;Live Reflow 1 步 43.3(括号=该目标不支持的场景) | DiT-B、sd-vae-ft-mse 潜空间、400k 步、batch 64、无 CFG;所有方法同架构同代码库、算力相当 |
| ImageNet-256 类别条件 FID-50k(1 步 / 4 步 / 128 步) | 40.3 / 28.3 / 15.5 | Flow Matching 128 步 17.3、4 步 (108.2)、1 步 (324.8);Diffusion 1 步 (467.2);Consistency Training 1 步 69.7;Consistency Distillation 1 步 136.5;Reflow 1 步 44.8;Progressive Distillation 1 步 35.6(但 128/4 步退化为 (201.9)/(142.5));Live Reflow 1 步 58.1 | DiT-B、800k 步、batch 256、CFG 1.5 仅用于训练目标(采样不额外评估) |
| ImageNet-256 规模扩展(XL/2,1 步 / 4 步 / 128 步) | 10.6 / 7.8 / 3.8 | DiT-XL 500 步 2.27(675M、640 epoch);ADM-G 250 步 4.59;LDM-4-G 500 步 3.6;StyleGAN-XL 1 步 2.3;BigGAN-deep 1 步 6.96(论文注明其算力低于这些多步 SOTA) | DiT-XL/2 676M、250 epoch、ImageNet-256 类别条件 |
| 机器人 Push-T / Transport 成功率(1 步) | 0.87 / 0.80 | Diffusion Policy 100 步 0.95 / 1.00,但 1 步崩到 0.12 / 0.00;IBC 100 步 0.90 / 0.00;LSTM-GMM 1 步 0.67 / 0.76;BET 1 步 0.79 / 0.38 | Diffusion Policy(Chi et al. 2023)演示集与网络结构,仅改 weight decay 0.001→0.1 并加 d 条件;flow matching 目标;2 个仿真任务 |
| 训练开销 | 约 +16% 计算量 | 对比对象:同架构基础扩散训练(每更新 3 计算单元) | 每个 shortcut 更新 = 1 前向 + 2 反向 + (1/4)×2 自洽 target ≈ 3.5 单元(论文脚注 2) |
Insights
- 把步长 d 变成条件输入后,『推理预算』从训练时就内化进网络:同一个模型在 1/4/128 步之间任意切换,动态步数支持是方法最直接的卖点(论文第 3 节、Fig.1)。
- 大步长 target 由自洽性质构造:一步 2d 等于两步 d 的平均拼接,自举链固定为 2 步,把『全量 ODE 模拟』的蒸馏成本换成训练期廉价的自蒸馏(论文 Eq.4、Fig.3)。
- naive 流匹配单步必然失效的结构性原因:训练时随机配对使 t=0 处预测方向指向数据集均值,任何多峰分布在 1 步下都只能得到平均样貌(论文第 2 节、Fig.2)。
- 多步质量没有牺牲:Shortcut 128 步 CelebA 6.9 略优于 Flow Matching 的 7.3,作者猜测自洽损失起了隐式正则作用,留给未来工作(论文第 5.1 节)。
- 自举类方法(如 Q-learning 路线)常随规模失去扩展性,shortcut 保留了扩展性:XL 1 步 10.6 相对 B 的 40.3 持续下降(论文 Fig.5、表 2)。
vs 同类工作
- vs 两阶段蒸馏(Reflow / 知识蒸馏):它们先生成合成数据集(Reflow:CelebA 5 万、ImageNet 100 万个样本,每个 128 次前向)再训学生,多一个阶段;shortcut 单次训练,没有合成数据集,也没有『何时结束训练、何时开始蒸馏』的接口问题。
- vs Progressive Distillation:同样用二分思想(逐步减半步长),但 PD 分成 log2(T) 个师生阶段,且蒸馏后多步能力退化(表 1 括号值 128 步 (201.9));shortcut 一次跑完且保留多步能力。
- vs Consistency Models:CM 需要严格离散化课程(时间分箱随训练扩大)、T 次 bootstrap,常用感知损失;shortcut 只用 L2、log2(T)=8 次 bootstrap、无课程,且多步生成是天然的 d=0 基座、不需要自举。
- vs Live Reflow(论文自提端到端基线):它每步用 8 步全 ODE 模拟造 target,计算量是其它方法 4 倍以上;shortcut 自举链只有 2 步,训练开销仅 +16%。
- vs MeanFlow(后发,NeurIPS 2025):Shortcut 的加速发生在推理端——训练期学所有步长的捷径,推理时按预算选步数;MeanFlow 把『一步位移』(平均速度)直接写进训练目标,训练时即一步、无自举链,ImageNet 1-NFE FID 3.43 明显低于 Shortcut-XL 的 10.6,但步数不是它的条件变量,动态预算灵活性弱于 shortcut。
局限
- 论文自承:噪声到数据的映射完全由数据集上的期望决定,模型没有自由度去调整这个映射,少了一步生成模型(如 GAN、VAE)可以简化学习问题的空间(论文第 6 节 Limitations)。
- 论文自承:多步与一步之间仍有质量差距,ImageNet-XL 128 步 3.8 vs 1 步 10.6,CelebA-B 128 步 6.9 vs 1 步 20.5(表 1、表 2)。
- 自举目标依赖模型自身输出:论文只有经验证据、没有收敛性定理,target 用 EMA 缓解但仍沿 8 档 d 传播近似误差,这是证据最弱的一环(我们读出的)。
- 我们读出:一步质量仍落后后发的 MeanFlow(ImageNet 1-NFE 3.43 vs 10.6)与对抗式蒸馏路线;表 2 也注明其训练算力低于 DiT-XL 等 SOTA 多步模型,横向对比不完全公平。
- 我们读出:实验规模有限——只覆盖 256 分辨率 latent DiT、无条件+类别条件两类图像设置和 2 个仿真机器人任务,没有 text-to-image、视频、更高分辨率;机器人实验只有两任务、成功率评估噪声较大。
可复现性
- code:https://github.com/kvfrans/shortcut-models(官方开源实现与检查点)
- weights:官方仓库提供模型检查点
- setup:DiT-B 配置见附录表 3:sd-vae-ft-mse 潜空间、M=128、75% d=0、EMA 0.999、AdamW lr 1e-4 wd 0.1、400k(CelebA)/800k(ImageNet)步;TPUv3/JAX,单次训练约 1–2 天
主干与结构
backbone:DiT-B(Peebles & Xie 2023):hidden 768、patch 2、12 层、12 heads、MLP ratio 4;XL 实验为 DiT-XL/2(676M)
参数:DiT-B 约 130M;DiT-XL 676M
类型:flow matching 变体:在标准 DiT 上把『步长 d』作为额外条件(与 t 一起嵌入),输出 shortcut 向量场
关键组件
- 步长条件 d:与时间 t 一同做位置编码嵌入,使同一网络支持 8 档步长
- d=0 分支:回归经验速度 x_1 − x_0(Flow Matching 损失),锚定少步能力
- d>0 分支:自洽目标,把两个 d/2 小步拼接成一步 d 的 target(stop-gradient)
- 批次内 75% 样本走 d=0、25% 走 d>0 自举目标
- EMA(0.999)参数用于生成自举 target 与评估
- 离散时间采样:训练只在 d 的整数倍时刻取 t
为什么这样设计
瞬时速度只描述『这一瞬间』的方向,大步长会沿切线冲出弯曲轨迹;把步长 d 变成条件输入后,网络可以直接预测『跨 d 的平均方向』(捷径),等于把 ODE 的积分工作内化到一次前向里。大步长没有地面真值,论文用自洽性质构造目标:两小步拼接成一大步,自举链固定为 2 步以限制误差累积,d=0 分支用真实数据配对锚定、防止纯自举漂移。
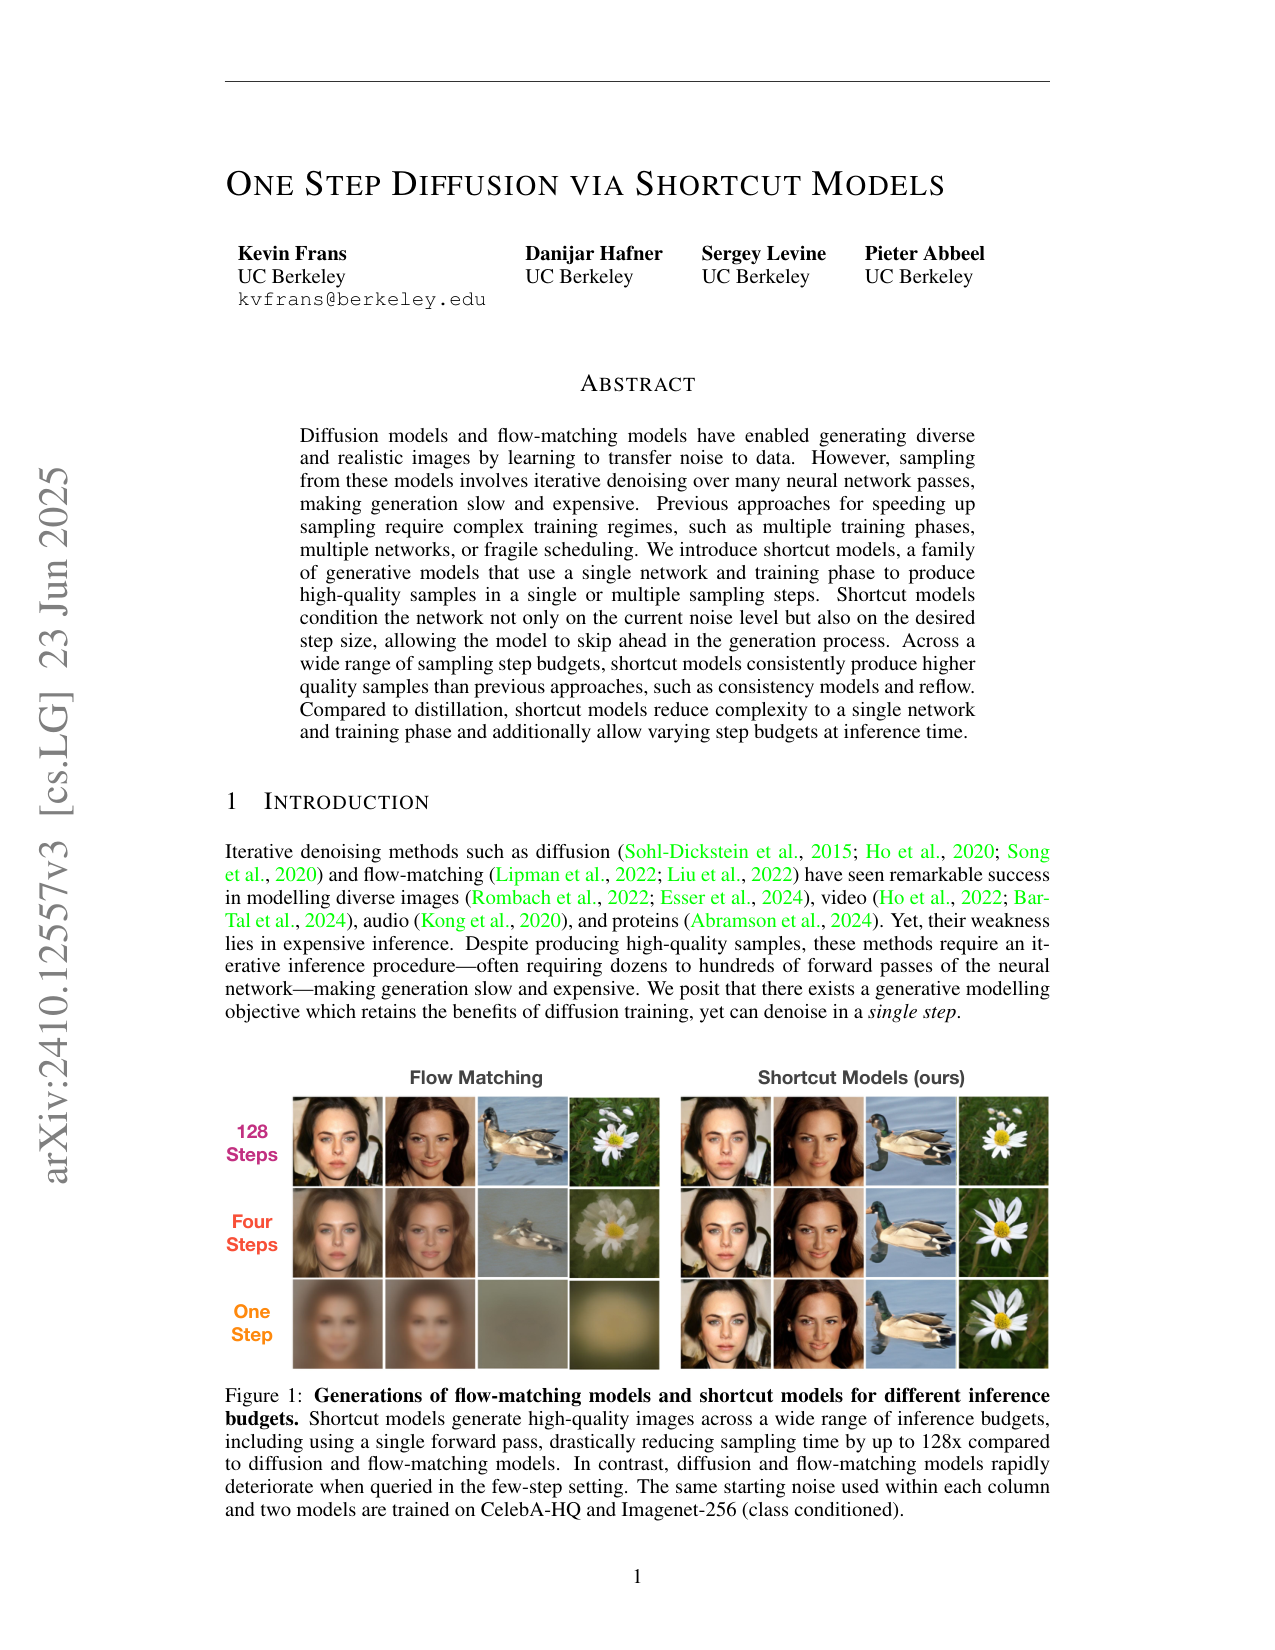
不同推理预算下的生成对比:Flow Matching vs Shortcut Models
原文 caption:Generations of flow-matching models and shortcut models for different inference budgets. Shortcut models generate high-quality images across a wide range of inference budgets, including using a single forward pass, drastically reducing sampling time by up to 128x compared to diffusion and flow-matching models. In contrast, diffusion and flow-matching models rapidly deteriorate when queried in the few-step setting. The same starting noise used within each column and two models are trained on CelebA-HQ and Imagenet-256 (class conditioned).
全文头号定性图。三行分别是 128 步、4 步、1 步,每列使用同一个初始噪声,两模型在 CelebA-HQ 与 ImageNet-256 上训练。左列 Flow Matching 在 4 步时开始模糊、1 步时退化成接近数据集的平均样貌(模式坍缩);右列 Shortcut 在三档步数下都保持清晰可辨。读法:横向对比同一步数下两个模型的差异,纵向看同一模型随步数减少的退化程度。它支撑全文核心主张——一个网络覆盖任意推理预算、单次前向也能出高质量图,相比扩散/流匹配采样最多省 128 倍时间。
少步生成为什么失败:训练配对的歧义 + 一步指向数据集均值
原文 caption:Naive diffusion and flow-matching models fail at few-step generation. Left: Training paths are created by randomly pairing data and noise. Note that the paths overlap; there is inherent uncertainty about the direction vt to the data point, given only xt. Right: While flow-matching models learn a deterministic ODE, its paths are not straight and have to be followed closely. The predicted directions vt point towards the average of plausible data points. The fewer inference steps, the more the generations are biased towards the dataset mean, causing them to go off track. At the first sampling step, the model points towards the dataset mean and thus cannot generate multi-modal data in a single step (see red circles).
问题诊断图,支撑『为什么 naive 流匹配少步必然退化』。左半:训练时随机配对噪声 x0 与数据 x1,同一中间点 x_t 对应多条互相交叉的路径,只知道 x_t 时去往哪个数据点的方向有内在不确定性。右半:学到的 ODE 轨迹弯曲,少步采样按切线方向大步走,步数越少越偏向数据集均值,红圈标出 1 步时直接指向平均位置、无法表达多峰分布。读法:注意右图从 4 步到 1 步时路径逐渐偏离真实轨迹、终点落在分布中心。它引出解法——学一个能『跳过弯曲轨迹』的跨大步长捷径。
Shortcut 训练机制总览:d≈0 回归经验速度,大步长由两个半程捷径拼接
原文 caption:Overview of shortcut model training. At d ≈ 0, the shortcut objective is equivalent to the flow-matching objective, and can be trained by regressing onto empirical E[vt|xt] samples. Targets for larger d shortcuts are constructed by concatenating a sequence of two d/2 shortcuts. Both objectives can be trained jointly; shortcut models do not require a two-stage procedure or discretization schedule.
方法图,分 a/b 两半。a) 传统扩散/流匹配:只在 d≈0 处对经验速度 E[v_t|x_t] 回归,所以模型只会小步走;b) Shortcut:把两个 d/2 小步串起来得到一步 d 的目标(自洽),d≈0 的 Flow Matching 项与 d>0 的自洽项在同一个训练里联合优化,箭头展示『两小步 → 一大步』的拼接。读法:看 b 里 self-consistency 的箭头方向,理解自蒸馏如何在训练期把多步能力一步步搬到单步。它支撑『单次训练、无两阶段、无调度』的核心卖点,也是与 Consistency Models 课程式训练的关键区别。
🎧 音频版
时长 25:04 · Edge TTS
One Step Diffusion via Shortcut Models:一个网络,想跑几步跑几步(对话版)
先讲清楚这篇要解决什么问题
小播:今天聊 UC Berkeley 的《One Step Diffusion via Shortcut Models》,arXiv 编号 2410.12557,ICLR 2025 的 Oral 论文,作者是 Frans、Hafner、Levine 和 Abbeel。标题里的 Shortcut 就是「捷径」的意思。它解决什么问题,值得单独做一期?
老播:一句话背景:扩散模型和 Flow Matching 生成一张图,要从纯噪声出发,沿着学到的速度场一步一步走回数据侧,通常要走几十到几百次网络前向,生成慢、推理贵。这篇论文想解决的是:能不能让同一个网络、同一次训练,同时支持 128 步、4 步、1 步三种采样,推理时想用几步就用几步,1 步也能出像样的图。做法是把「这次想跳多大步」也变成网络的输入条件,训练时用「两小步拼成一大步」的自洽目标自己教自己,不需要额外的老师模型,也不需要精心调训练调度。这期要讲清楚三件事:捷径轨迹怎么定义、动态步数怎么从训练里长出来、以及它和后发的 MeanFlow 那条「训练时即一步」的路线差在哪。结论先放这里:ImageNet-256 上同一个 DiT-B 模型,128 步 FID 15.5、4 步 28.3、1 步 40.3;而基线 Flow Matching 1 步直接到 324.8,差距是数量级的。这个「一个模型吃下所有步数」的能力,是本期反复要回到的核心。
小播:为什么值得单独做一期?它和之前讲过的 Consistency Models 关系近吗?
老播:关系很近,但位置不同。Consistency Models 是这条线的开山之作,Shortcut 是第一个把「单网络、单次训练、任意步数」同时做到的方法;后来 NeurIPS 2025 的 MeanFlow 直接拿它当对照基线,还有一篇专门的改进工作《Improved Training Technique for Shortcut Models》在修它暴露出来的五个训练问题。理解这一篇,等于摸清 one-step 这条技术线的底座,后面几期讲 MeanFlow、Flow Map Matching 都能接得上。
小播:一步就差出这么多,那先把背景铺开讲吧。
先补背景:扩散模型为什么慢,之前的加速路子卡在哪
小播:扩散模型慢,我知道要迭代去噪。慢到什么程度?
老播:论文给的参照是:DiT-XL 在 ImageNet-256 上要 500 步拿到 FID 2.27,ADM-G 要 250 步拿到 4.59,LDM-4-G 要 500 步拿到 3.6。这里先给一个术语定义:FID 是 Fréchet Inception Distance 的缩写,越低越好,衡量生成图片和真实图片的特征分布差多远。跑几百次几十亿参数的神经网络才出一张图,在机器人这类实时场景里直接不可用。
小播:那之前的方法是怎么加速的,卡在哪?
老播:之前的加速可以分成三类,各有各的代价。第一类是更聪明的 ODE 求解器,DDIM、DPM-Solver 这类,能把 1000 步压到 10 到 20 步,但步数再少质量就崩,因为它没有改变模型学的东西。第二类是两阶段蒸馏:先训练一个多步模型当老师,再把它压成少步学生。Reflow 要让老师全量模拟 ODE 造合成数据集,在 CelebA-HQ 造 5 万个、ImageNet 造 100 万个 (x0, x1) 配对,每个配对要 128 次前向,光是造数据就贵;Progressive Distillation 把蒸馏拆成 8 个师生阶段,逐步减半步长,而且蒸馏完多步能力会退化,表里它 128 步的 FID 只剩括号里的 201.9。第三类是 Consistency Models 这条线:给网络强加「同一条轨迹上不同时刻的输出要指向同一个终点」的一致性约束,从零训练、没有老师。问题在训练需要精心设计的离散化课程,时间分箱要随训练逐步变粗,还要做大量自举。
小播:那「端到端」这个词是什么意思?我在论文里老看到。
老播:端到端指的是单次训练从头学到尾、没有老师阶段,老师是蒸馏方法才有东西。论文把所有方法分成两类对照:两阶段方法(先训多步模型再蒸馏)和端到端方法(单次训练直接得到少步模型),Shortcut 属于后者,跟 Consistency Training 同组。
小播:所以求解器不改变学的东西,蒸馏要老师,一致性要课程。这篇想绕开这些代价?
老播:对,它的切口是把步长本身变成网络输入。这里补一段 Flow Matching 的基本框架,后面用得着:模型把数据 x1 和噪声 x0 线性插值成中间点 x_t = (1−t)x0 + t·x1,速度定义为 v_t = x1 − x0;给定一对数据噪声,速度唯一,但同一个中间点 x_t 可能来自很多不同的配对,所以网络实际学的是条件平均速度,损失是 E[‖v̄_θ(x_t, t) − (x1 − x0)‖²]。问题出在少步采样:网络学的是瞬时速度,也就是每个时刻「往哪走」的切线方向,采样时大步走,等于用一条直线去代替弯曲的轨迹,步数越少偏差越大;1 步的时候,网络在纯噪声处预测的方向指向数据集的平均位置,任何多峰分布都会得到「平均脸」式的失败样本。图 2 里红圈标的就是这个现象:一步的箭头直接指向分布中心。要把一步做好,网络得学会「跳过弯曲轨迹、直接落到正确的下一点」——这就是捷径的动机。
核心思想:把步长变成条件,训练时学一条跨大步长的捷径
小播:捷径具体怎么定义?公式先给预期,再慢慢拆。
老播:好,核心更新式是 x′_{t+d} = x_t + s(x_t, t, d)·d。这个式子要回答的问题:网络怎么在不知道未来轨迹的情况下,直接预测跨 d 步之后该落在哪。逐符号看:x_t 是当前带噪的中间点,t 是噪声水平,d 是这次想跳的步长,s(x_t, t, d) 是网络输出的 shortcut 向量,代表「从 x_t 出发、跨 d 的平均移动方向」,乘上 d 才是实际位移。最关键的性质:d 趋向 0 时,s 退化成瞬时速度,模型变回普通 Flow Matching。所以 shortcut 是流匹配在大步长上的推广,d=0 这个分支天然保证多步生成能力和基线一致——多步能力是白送的基座。拿 4 步生成举个例子:d=1/4,t 只在 0、1/4、1/2、3/4、1 这五个时刻被查询,每次网络预测的是「接下来四分之一段轨迹的平均方向」,相当于把这段弧线拉成一条弦;瞬时速度是贴着曲线的切线,shortcut 是连接两端的弦,步长越大、弦越能绕过曲线的弯曲。网络在训练里见过所有 (t, d) 组合,学会的是「在该步长下沿这条轨迹的正确平均方向」,等于把 ODE 的数值积分工作内化进一次前向——这就是它与求解器加速的差别所在:求解器只改离散化,shortcut 改的是模型学的东西。
小播:那一大步的正确答案从哪来?总不能让网络凭空猜。
老播:这就是全文最巧的部分,用自洽性质构造目标。式子:s(x_t, t, 2d) = s(x_t, t, d)/2 + s(x′_{t+d}, t+d, d)/2。预期是:一次跳 2d 的方向,应该等于先跳一个 d、再跳一个 d 的方向的平均。左边 s(x_t, t, 2d) 是一次大步,右边第一项 s(x_t, t, d)/2 是第一小步的方向减半,第二项 s(x′_{t+d}, t+d, d)/2 是从第一小步落点再走一小步的方向减半。训练时先用模型自己走两个 d 小步,第二小步从第一小步预测出的 x′_{t+d} 出发,把两次小步的平均当成 2d 大步的回归目标,目标端切断梯度。这一步就是训练期自蒸馏:大步长的老师,就是小步长时的模型自己,不需要额外老师、不需要合成数据集。
小播:等等,前面说 1 步时网络会指向数据集均值,那 shortcut 为什么就绕开了这个问题?
老播:差别就在目标本身。naive 流匹配在纯噪声处的目标永远是瞬时速度,指向均值;shortcut 在 d=1 时的目标,是经过两半程拼接出来的「一步直达的正确方向」,网络被反复教过「大步长下该朝哪跳」,所以它学到的 1 步方向会绕过弯曲轨迹、落在具体的多峰分支上,图 1 里右侧 1 步那一行就是证据。换一种说法,它把「怎么大步跳」直接写进了训练目标,这就是捷径轨迹的含义。
小播:这里说的自蒸馏,和传统的蒸馏有什么差别?
老播:差别在老师和学生是不是同一个网络。传统蒸馏先训好一个固定的老师,再让另一个学生模仿,两个网络、两个阶段;shortcut 的老师和学生是同一个网络——训练中用 EMA 版本的权重去造自洽目标,模型一边学、一边当自己的老师,所以单次训练就完成了。为什么不用「直接全量模拟 ODE 造 target」这个更直接的办法?因为那是 Reflow 和知识蒸馏的做法,造一个 target 要跑完 128 次前向,端到端训练的每一步都这么干,成本受不了;二分递归把成本压到两次小步前向,这是它能单次训练的关键。
小播:自举不会越滚越偏吗?误差会累积吧。
老播:论文用两个手段控制。第一,自举链固定为 2 步:把最短细分设成 M=128,d 只有 8 档,从 1/128、1/64 一直到 1/2、1,目标永远只由两小步拼出来,误差不会沿长链累积。对比一下,Consistency Models 需要 T 次自举,这里只要 log2(T)=8 次。第二,批次里 75% 的样本走 d=0 分支,用真实数据配对回归经验速度,把模型钉在数据分布上;剩下 25% 走自洽分支。总损失就是两项相加:第一项 ‖s_θ(x_t,t,0) − (x1−x0)‖² 负责多步能力,第二项 ‖s_θ(x_t,t,2d) − s_target‖² 负责把多步能力逐级传播到单步,其中 s_target 就是上面两个半程的平均。整个训练单次跑完、没有调度,开销只比基础扩散多约 16%——每个更新约 3.5 个计算单元,基础扩散是 3 个,多出来的部分主要是自洽目标那两次额外小步前向。图 3 把机制画成两半:上半是传统做法,只在 d 趋近 0 的地方对经验速度回归;下半是 Shortcut 的做法,把两个半程捷径拼成一个大步目标,两个目标同一个训练里联合优化,箭头方向就是「两小步变成一大步」的拼接过程。
小播:两个损失共享同一个网络,不会打架吗?
老播:设计上是有意的。d=0 分支给出「小步时该往哪走」的真值锚点,d>0 分支给出「大步时该往哪走」的拼接目标,两条分支共用一套权重,参数共享正是传播的载体——小步学到的能力,通过权重直接流进大步分支。论文还做了个设计简化:t 只在 d 的整数倍离散点采样,进一步减少两个分支的冲突。没有额外的权重、没有课程,这也是它和 Consistency Models 最直观的差别。
小播:训练细节再给点具体的?比如超参。
老播:给。模型主干是 DiT-B,AdamW 优化器、学习率 1e-4、weight decay 0.1;EMA 系数 0.999,自举目标和最终评估都用 EMA 权重;CelebA-HQ 训 400k 步、batch 64,ImageNet 训 800k 步、batch 256。图像先过一个预训练自编码器 sd-vae-ft-mse,把 256×256×3 的图压成 32×32×4 的潜变量,模型在潜空间里生成,最后再解码回图像。ImageNet 那边用类别条件,类别标签 10% 概率丢弃以支持无分类器引导 CFG 1.5,不过引导只在训练目标里用,采样时不额外跑一次网络。
小播:所以动态步数是训练的自然产物?推理时怎么用?
老播:对,这就是今天第一个考点:捷径轨迹支持动态步数。推理时从纯噪声出发,把 d 固定成 1/128、1/4 或 1,迭代 x ← x + s_θ(x,t,d)·d、t ← t + d,直到 t=1。同一个网络、同一套权重,想 128 步就 128 步,想 1 步就 1 步,预算在推理时决定、随时能换,不用重新训练。还有个实现细节:训练时 t 只在 d 的整数倍时刻采样,比如 d=1/4 时只查 t=0、1/4、1/2、3/4、1 这五个点,省得网络去学不会用到的中间时刻。图 1 是直接证据:同一列是同一个初始噪声,三行分别是 128 步、4 步、1 步,左边 Flow Matching 到 4 步开始糊、1 步变成平均脸,右边 Shortcut 三档都清楚。读图口诀:横向比方法,纵向看步数退化。这也是论文「相比扩散和流匹配,采样最多省 128 倍」那句话的出处——128 步压到 1 步,同一个模型完成。
关键实验:一个模型吃下所有步数,质量还守得住
小播:数字怎么样?先看主表。
老播:主实验是 CelebA-HQ 无条件生成和 ImageNet-256 类别条件生成,所有方法用同一个 DiT-B 架构、同一套代码库、相近算力训练,评估 FID-50k,越低越好;评估用 EMA 权重,图像统一缩到 299×299 后算特征分布距离,跟领域标准协议一致。CelebA 上,Shortcut 1 步 20.5、4 步 13.8、128 步 6.9;对照 Flow Matching 128 步 7.3,但 4 步只有括号里的 63.3、1 步 280.5;Diffusion 128 步 23.0、1 步 (132.2);Consistency Training 1 步 33.2;Reflow 1 步 23.2。括号表示这个目标本不支持的场景,把多步模型硬拉到少步的分数。ImageNet 上更极端:Shortcut 1 步 40.3、4 步 28.3、128 步 15.5;Flow Matching 128 步 17.3、1 步 (324.8);Diffusion 1 步 (467.2);Consistency Distillation 1 步 136.5;Consistency Training 1 步 69.7;Reflow 1 步 44.8。唯一在 1 步上超过它的是 Progressive Distillation 的 35.6,代价是 128 步退化成 (201.9),多步能力没了。端到端方法里,Shortcut 在 4 步和 1 步全面领先。
小播:论文自己还提了个端到端基线 Live Reflow,它怎么样?
老播:Live Reflow 是把 Reflow 改成单次训练:一部分 batch 走流匹配损失,另一部分每步用 8 步全 ODE 模拟造自蒸馏目标,所以它的计算量是其它方法的 4 倍以上。结果在 CelebA 上 1 步 FID 43.3,比 Shortcut 的 20.5 差一倍,ImageNet 上 1 步 58.1 也比 40.3 差。这个对照说明:自举造目标的方式本身不新鲜,shortcut 的价值在于把自举链压到 2 步、把成本降下来,效率高了一个量级。 顺带一提训练稳定性:自举类方法在社区里常被认为难训,论文特意强调 shortcut 不需要任何 warmup 或调度,直接用标准 AdamW 从头训到尾就能收敛,这一点在复现时很加分。
小播:多步能力守住了,那结论是「少步变好、多步不变」?
老播:图 4 把这条曲线讲清楚了:横轴是去噪步数,纵轴是 FID。Flow Matching 的曲线在步数下降时急剧抬升,Shortcut 的曲线平缓得多,128 步处两者几乎重合,CelebA 上 Shortcut 128 步 6.9 甚至比 Flow Matching 的 7.3 还低一点。作者猜测自洽损失起了隐式正则作用,这个解释他们自己也没完全敲实,算留给未来的开放问题。少步时 Flow Matching 的失败样貌是模糊和模式坍缩,Shortcut 的瑕疵集中在高频细节,主体内容是对的——所以论文给了个实用建议:先用 1 步快速出一版,想细化就用同一个初始噪声多跑几步重新生成。附录里的三联图就是给这个用的:每组三张是同一个噪声分别用 128、4、1 步生成的,方便肉眼对比退化模式。另一个值得看的点是规模:自举类方法有个前科,Q-learning 那类方法模型变大反而退化;Shortcut 保留了扩展性,DiT-XL/2(676M 参数)在 ImageNet 上 1 步 10.6、4 步 7.8、128 步 3.8,对照 DiT-XL 500 步 2.27、ADM-G 250 步 4.59、StyleGAN-XL 1 步 2.3。训练代价上,Shortcut-XL 只训 250 epoch,DiT-XL 训了 640 epoch,参数规模 676M 对 675M,基本同级。注意论文注明它的训练算力低于这些多步 SOTA,横比不完全公平,但趋势说明自举没有把模型带偏,一步质量随参数规模稳步下降。
小播:图像之外呢,机器人那边验证了吗?
老播:验证了,这是论文的加分项。它把 Diffusion Policy 框架(原文要 100 步去噪)的目标换成 shortcut,只改 weight decay 和加 d 条件,网络结构和超参基本不动。Push-T 和 Transport 两个仿真任务上:Shortcut 1 步成功率 0.87 和 0.80;Diffusion Policy 100 步 0.95 和 1.00,但 1 步直接崩到 0.12 和 0.00;单步基线 BET 是 0.79 和 0.38,LSTM-GMM 是 0.67 和 0.76。多模态动作策略用一次前向就接近 100 步扩散策略的水平,对实时机器人决策是实打实的收益。这里再重复一遍核心结论:一个模型、一次训练,128 步的质量守住,1 步的质量从「平均脸」拉到可用的水平,这就是 shortcut 三个字的分量。
它和 MeanFlow 差在哪:推理时加速 vs 训练时即一步
小播:清单提示里专门点了一句,它和 MeanFlow 是两条路线。展开讲讲?
老播:一句话概括:Shortcut 把加速放在推理端,MeanFlow 把一步写死在训练目标里。Shortcut 训练期学的是「任意步长的捷径」,推理时才决定用 1 步还是 128 步,动态预算是它独有的能力;代价是一步质量有限,ImageNet 1 步 10.6。MeanFlow 是 NeurIPS 2025 的后发工作,学的是「平均速度」,把一步位移直接作为训练目标,训练时即一步、没有自举链,ImageNet 1-NFE FID 3.43,明显低于 Shortcut-XL 的 10.6;但步数在 MeanFlow 里属于求解器的事,它把步长当区间条件,动态预算的灵活性弱于 shortcut。对照 Consistency Models,Shortcut 的区别在:CM 把一致性当网络行为约束、要离散化课程,Shortcut 把自洽写进目标、无课程、只用 L2 损失、自举次数从 T 降到 log2(T)。对照两阶段蒸馏,Shortcut 省掉老师、合成数据集和「何时开始蒸馏」的决策。所以它在谱系里的位置:第一个把「单网络、单次训练、任意步数」同时做到的方法,给后发的 MeanFlow 和 Flow Map Matching 铺了路。Flow Map Matching 直接建模整段位移,思路和 shortcut 的「跨大步长位移」同源;MeanFlow 则把它从经验自举升级成有定义可推导的目标场。
局限也得说清楚,我们读出来的也算
小播:这篇有什么短板?你自己读出来的也算。
老播:先论文自承的两条。第一,噪声到数据的映射完全由数据集上的期望决定,模型没有自由度去调整这个映射,GAN、VAE 那种「主动改映射来简化学习」的空间它没有。第二,多步和一步之间仍有质量差距:ImageNet-XL 128 步 3.8、1 步 10.6,CelebA-B 128 步 6.9、1 步 20.5,ImageNet-B 128 步 15.5、1 步 40.3,一步还是不如多步,这个 gap 是论文明说的开放问题。
小播:那自举那条呢?我觉得这是证据最弱的地方。
老播:你点到关键了。自洽目标依赖模型自己的输出,论文给了大量经验证据,但没有收敛性定理——为什么「两小步拼接」的 target 一路传下去能收敛,没有理论保证,只是用 EMA 缓解误差,近似误差仍沿 8 档 d 传播。这是我们读出的第一条。第二条:一步质量至今仍落后后发的 MeanFlow(3.43 对 10.6)和对抗式蒸馏路线,方法上限当时没封顶。第三条:实验规模有限,只有 256 分辨率、latent DiT、两类图像设置加两个仿真机器人任务,没有 text-to-image、视频、更高分辨率;机器人那两列成功率本身噪声也不小。另外自洽损失和 CFG 的交互、d 条件在更大模型上的表现,论文也没有展开。这些都不影响它作为「单网络任意步数」概念验证的价值,但横向结论别过度外推。
收尾:记住三件事,外加这条线后来的走向
小播:好,我总结这期要记住的三件事。第一,Shortcut Models 把步长 d 变成网络条件,同一个模型 128 步、4 步、1 步随便选,动态步数是它区别于所有前作的标志。第二,大步长目标来自自洽性质——两小步拼成一大步,训练期自蒸馏、无老师无课程,开销只多 16%。第三,它和后发 MeanFlow 是互补的两条路线:Shortcut 推理时加速、MeanFlow 训练时即一步;论一步质量 MeanFlow 的 3.43 领先它的 10.6,论步数灵活性它领先。
老播:补一句这篇对后续工作的意义。它把 one-step 生成从「先训慢模型再蒸馏」的套路里解放出来,证明单次训练、自蒸馏就能同时拿到多步和单步能力;这条线接下来最扎眼的问题,就是那个明摆着的差距——多步 3.8 对一步 10.6,怎么让一步追平多步。MeanFlow 用平均速度接住了这个问号,Shortcut 的 d 条件、自洽目标这些零件,后来被 Flow Map Matching 和不少改进版继续沿用。对一个想快速摸清 one-step 谱系的人来说,这篇是绕不开的坐标点。