Next Semantic Scale Prediction via Hierarchical Diffusion Language Models (HDLM)
一句话定位:这篇 NeurIPS 2025 论文给文本离散扩散模型加了一层「语义中间尺度」——在干净词 token 与无语义的 mask 之间插入「语义簇」,让加噪变成词→簇→mask 的逐级粗化,去噪变成 mask→簇→词的逐级细化。视觉生成里的 VAR 按分辨率(物理尺度)从粗到细生成图像,HDLM 把同一个 coarse-to-fine 思想搬进语言,尺度轴换成每个 token 的语义粒度,并给出闭式 ELBO 证明:MDLM 只是它取一个簇的特例。
1. 要解决什么问题
自回归语言模型按 next-token prediction 逐词生成,每生成一个 token 就定型,之后无法回头修改。扩散语言模型想绕过这个限制:先给整句加噪声,再通过多步去噪逐步还原,理论上支持任意顺序生成与自我精修。问题出在「噪声」本身。masked 扩散(MDLM、MD4)把所有被掩码的位置压成同一个 mask embedding,这个符号没有语义;而且它的生成方式是逐步揭开 mask,揭开的 token 同样无法再改,等于把自回归的不可修改限制又带回来了。uniform 扩散用随机 token 当噪声,同一个 token 在加噪阶段是纯噪声、解码阶段却要有含义,前后语义自相矛盾,经验上效果也明显落后。GIDD 用混合速率把两类噪声统一进一个框架,但被扰动的 token 依然没有语义,且它的自我修正能力只来自 uniform 成分——实验里这个成分在推理时反而帮倒忙(OWT 上 GIDD+-small 的 Gen PPL 170.2,比 MDLM-small 的 163.7 更差)。
2. 核心思想:分层离散扩散
HDL 的做法是在词与 mask 之间插入一层「语义簇」词表。先说明三个层级:最细的是 word 层,即 GPT-2 的 50,257 个词 token,语义最具体;中间是 cluster 层,n 个语义簇 token(论文实验 n=2 到 256),每个簇聚合一批语义相近的词,语义更抽象;最粗的是 mask,一个符号,没有语义。三者之间有一个满射映射 Γ:每个词映射到它所属的簇(Γ(i,j)=1 当且仅当词 j 属于簇 i),簇再映射到 mask。映射由「语义聚类」预定义:在预训练 GIDD 模型的词向量上做带尺寸约束的 K-means++,让各簇规模均衡、簇内语义相关。
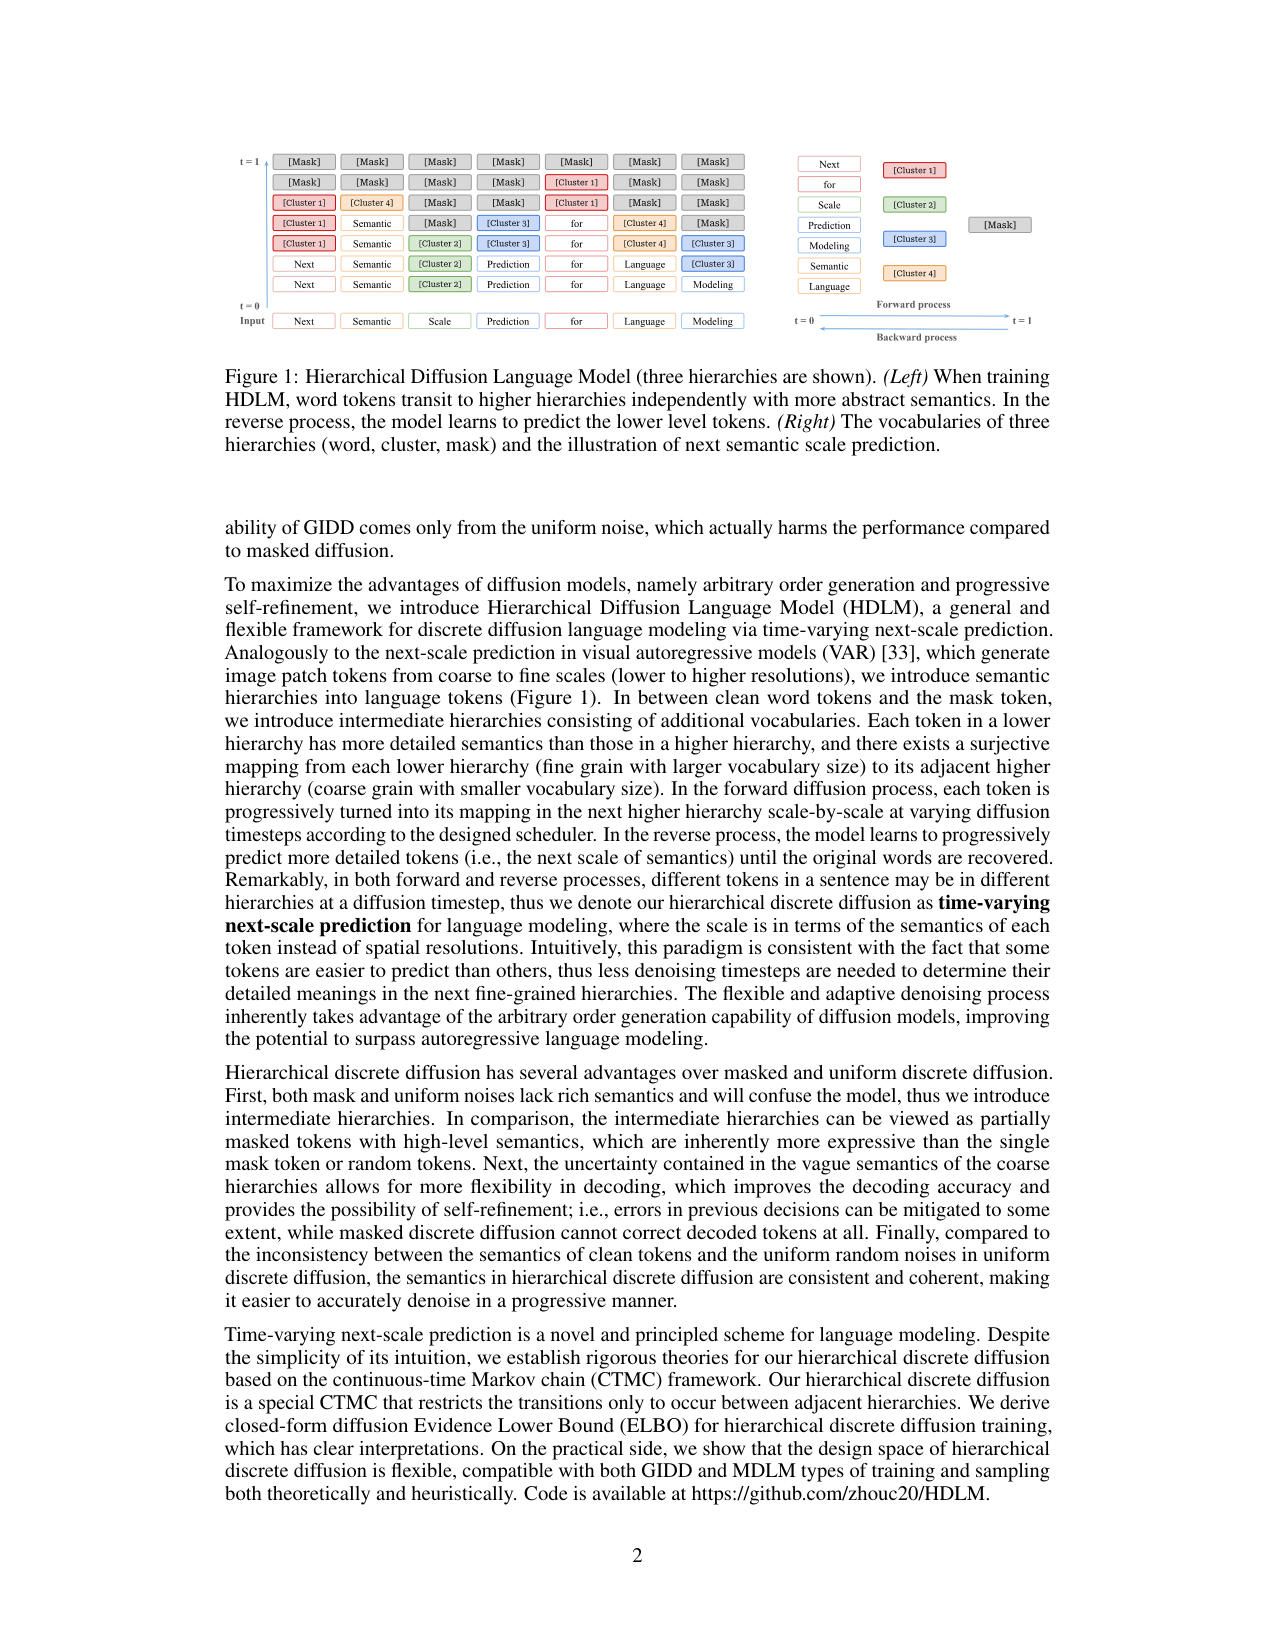
图 1 是全文的概念总览。左半张是七个词的句子在扩散过程中的纵向切片:最下方 t=0 是干净词序列;越往上,每个词独立地变化——有的保持词形,有的变成 [Cluster 1..4] 这样的簇 token,有的变成 [Mask];同一行的不同位置可以同时处于不同层级,直到最上方 t=1 全部变成 mask。右半张展示三个层级的词表与 next semantic scale prediction 的含义。读这张图的关键:噪声是按语义粒度逐级加上去的,每一行都是「部分有语义、部分被抽象」的中间态,反向过程就是把这些中间态逐步细化回原词。
前向过程用连续时间马尔可夫链(CTMC)描述,总扩散时间归一化为 1。给定干净词 x,t 时刻该位置的边际分布是
$$q_t(z_t|x) = \mathrm{Cat}(z_t;\, \alpha_t x + \beta_{t,c}\,c(x) + \beta_{t,m}\,m)$$
这个式子回答的问题是:t 时刻一个位置处于三种状态(还是原词 / 变成簇 / 变成 mask)的概率各是多少。$\mathrm{Cat}$ 是分类分布;$\alpha_t$ 是保留原词的概率,随 t 从 1 衰减到 0;$\beta_{t,c}$ 是变成正确簇 $c(x)$ 的概率;$\beta_{t,m}$ 是变成 mask 的概率,且 $\beta_{t,c}+\beta_{t,m}=1-\alpha_t$。与 GIDD 相比,关键的差别在这里的「噪声分布」是干净数据 x 的函数——簇是 x 自己的簇,mask 是全局符号,语义始终与数据一致。scheduler 取 $\alpha_t=(1-t)^\gamma$,γ 控制加噪快慢(γ=1、2、3 的边际概率曲线见图 2)。
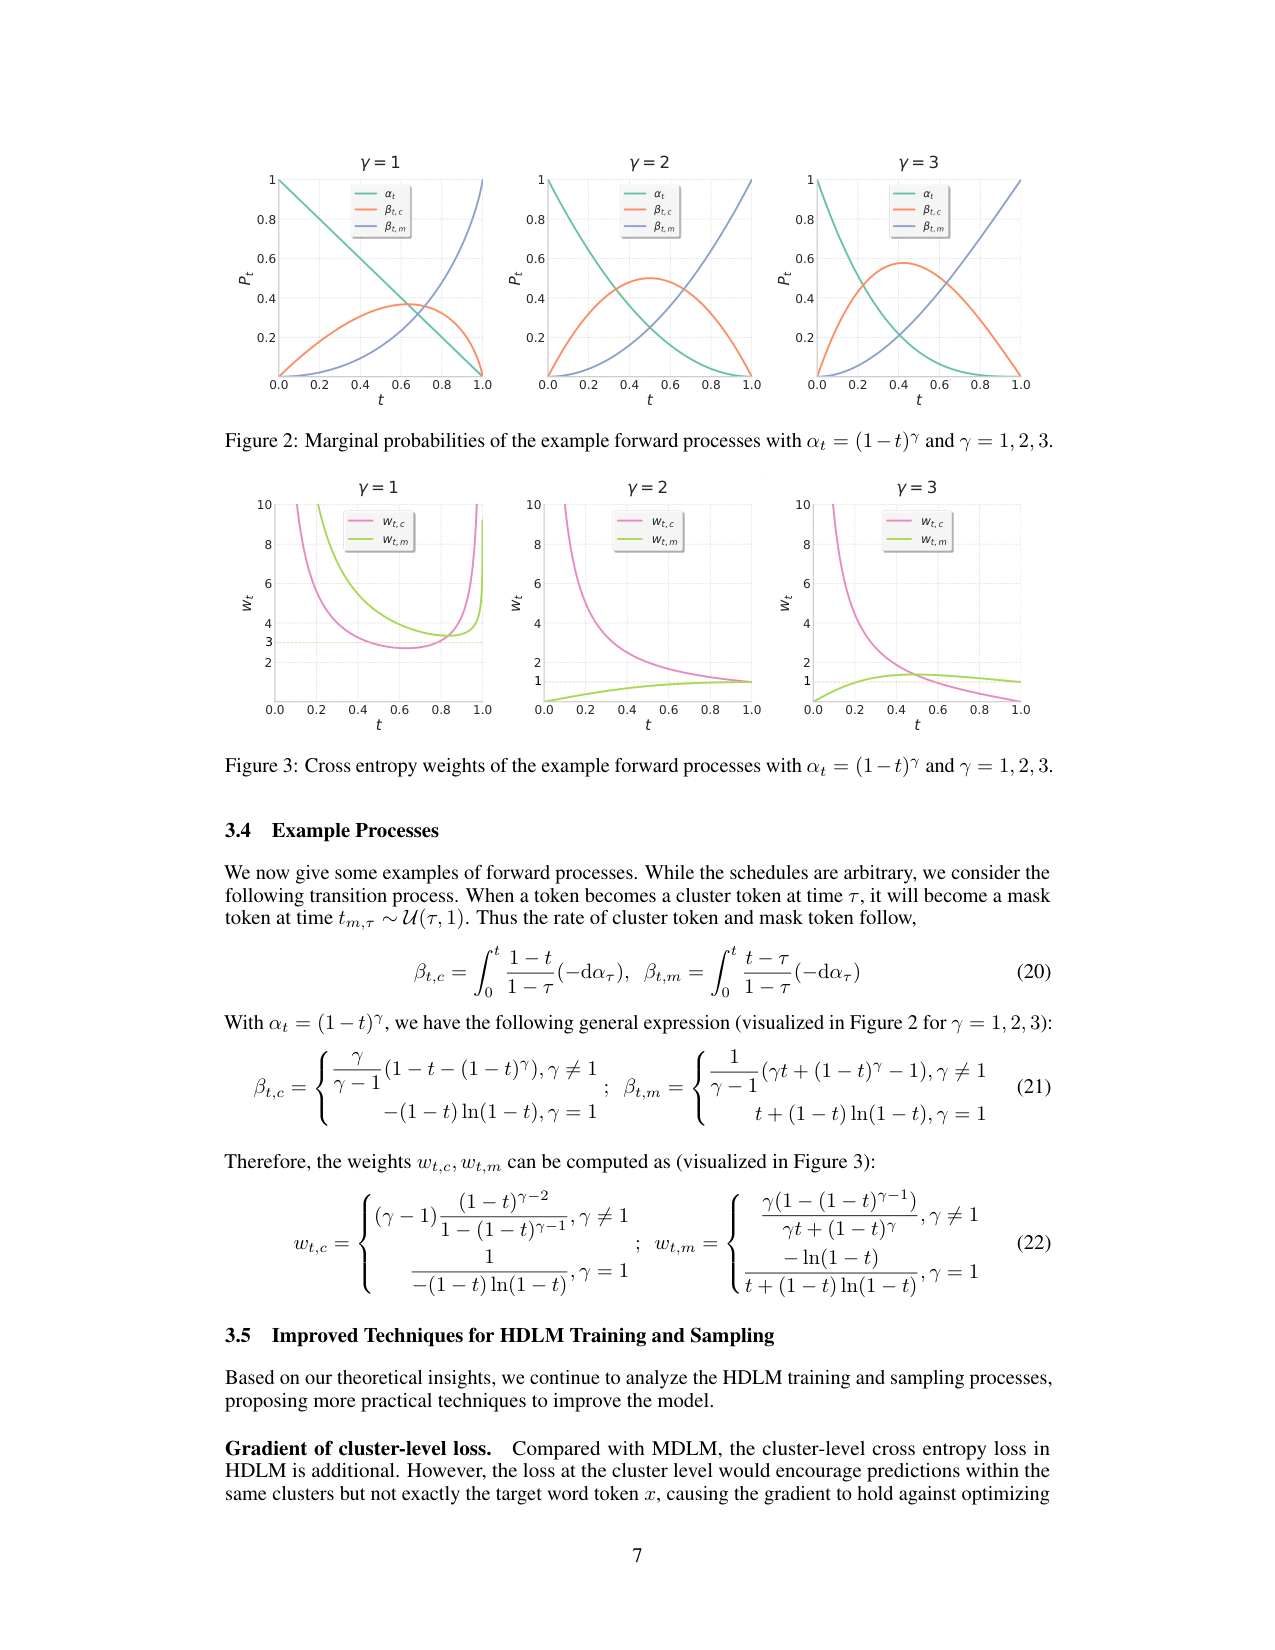
图 2 的横轴是时间 t,纵轴是各状态概率,三组子图对应 γ=1、2、3:γ 越大,词态越早离开、簇态峰越靠后、mask 主导的时间越长。图 3 画的是闭式 ELBO 里两个损失项的权重 $w_{t,c}$ 与 $w_{t,m}$ 随时间的变化——权重会变,但它们的期望恒为 1 且与 schedule 无关(论文 Proposition 4),所以换 γ 只重新分配各阶段的训练侧重,总预算不变。
3. 训练目标:闭式 ELBO
有了分层前向过程,训练目标需要严格推导。论文在 CTMC 框架里写出前向速率矩阵 Q_t(块结构,只允许相邻层级间转移,mask 是吸收态),代入通用的连续时间 ELBO,化简得到两层交叉熵的和:
$$\mathcal{L} = \mathbb{E}_{t,z_t}\Big[\delta_{z_t=c}\,w_{t,c}\,\mathrm{CE}\big(x,\ \tfrac{x_\theta \odot (\Gamma^\top\Gamma x)}{x_\theta^\top\Gamma^\top\Gamma x}\big) + \delta_{z_t=m}\,w_{t,m}\,\mathrm{CE}(\Gamma x,\, \Gamma x_\theta)\Big]$$
这个式子要回答的问题是:模型对任意噪声状态该学什么。$z_t$ 是 t 时刻的噪声 token;$\delta_{z_t=c}$ 是指示函数,$z_t$ 是簇时取 1;第一项发生在簇态——模型只需在已知簇内区分是哪个词,所以预测分布 $x_\theta$(模型对 word 词表的输出)先按 $\Gamma^\top\Gamma x$ 限制在簇内、再归一化,损失是簇内词级交叉熵;第二项发生在 mask 态——此时只需预测正确簇,损失对簇分布 $\Gamma x$ 与 $\Gamma x_\theta$ 做交叉熵。权重 $w_{t,c}=-\alpha'_t/\beta_{t,c}$、$w_{t,m}=\beta'_{t,m}/\beta_{t,m}$ 由 schedule 决定,控制各阶段侧重。结论:训练损失就是「簇内选词」与「猜对簇」两个任务的分阶段加权,对应先粗后细的两段式解码。论文还证明 MDLM 是 HDLM 取一个簇(簇 embedding 等于 mask)的特例,说明新框架包含旧方法。
4. 训练与解码的实用技巧
论文从 ELBO 出发提出几项工程技巧。其一,簇级损失的梯度会把概率推向簇内所有词,模型被允许在 mask→簇阶段犯中等程度的错,再由簇→词阶段纠正——形成 easy-to-hard 的课程分解;把簇级损失换成更「难」的全词表交叉熵(hard 模式)反而变差(Valid PPL ≤25.38 vs ≤23.36、Gen PPL 151.9 vs 144.2,HDLM-small-64、131B tokens)。其二,随机扰动 ξ:前向时以概率 1−ξ 把词粗化成错误的簇,让训练见过「上下文里的簇错了」的样本,显式练自我修正;ξ=1 是标准版。其三,force transition 解码:从簇 token 选词时只在该簇的词集合内归一化,保证与前向一致,默认开启。其四,把损失权重裁剪到 2.0/10.0 稳定优化。
5. 实验结果
实验在 OpenWebText 上做(8,013,769 条,验证集取 100,000 条,context 512 token 无 packing,131B training tokens;DiT-small 92.1M 与 DiT-base 321.2M 非嵌入参数)。指标有两个:Valid PPL(验证集困惑度)和 Gen PPL(生成 256 个 length-512 样本、512 去噪步、以 gpt2-large 为参考模型的生成困惑度)。
主结果(Table 1):小模型全面超过离散扩散基线——HDLM-small-128 的 Valid PPL ≤23.25,MDLM-small 是 ≤27.39、GIDD+-small 是 ≤25.82(三者都训 131B tokens);Gen PPL 144.2(HDLM-small-64)对 MDLM 的 163.7、GIDD+ 的 170.2。base 模型 HDLM-base-128 的 Valid PPL ≤19.22,低于 GPT-2 的 23.40,接近 Llama-110M 重训的 16.11(但 Llama 用了 262B tokens,是 HDLM 的两倍)。也就是说,扩散语言模型第一次在同等规模下追平了自回归基线。
消融揭示了三个规律。簇数 n:n=1 时 Valid PPL ≤25.72、Gen PPL 163.9,几乎复现 MDLM-small 的 163.7,验证了「MDLM 是特例」;n=64/128 最优(≤23.36/≤23.25),256 开始回落——最优簇数大约在词表大小的平方根量级,把生成分成复杂度相近的两段。随机扰动 ξ(Table 3,HDLM-small-64):Gen PPL 从 ξ=1 的 144.2 降到 ξ=0.9 的 69.76、ξ=0.8 的 54.15,降幅 51.6% 与 62.5%;但去掉 force transition 后 ξ=0.9 的 Gen PPL 恶化到 184.0,说明扰动训练与受限解码要配合使用。噪声 schedule γ:γ 从 1 增到 3 时 Valid PPL 恶化(≤23.36→≤130.32)而 Gen PPL 略好(144.2→135.9),即更硬的训练前向换来更好的推理解码节奏。
辅助实验:LM1B(33B tokens)上 HDLM-64 的 Valid PPL ≤26.95,低于 MDLM ≤27.04、SEDD ≤32.79(AR Transformer 是 22.32)。零样本下游六项(ARC-e/ARC-c/BoolQ/PIQA/OBQA/WinoGrande)小模型平均 39.62(HDLM-4),超过 MDLM 的 39.44(262B tokens 训练)与 GIDD 的 38.53(131B tokens),接近 GPT-2 的 40.41;base 模型 HDLM-256 平均 39.59,全面超过 GIDD-base 的 37.66。
6. 谱系定位
HDL 处在离散扩散语言模型这条技术路线上:它把 GIDD 的「任意混合噪声分布」进一步推广为「随数据变化的语义层级噪声」,并把 MDLM 收编为特例;与走 concrete score 路线的 SEDD 相比,它的训练目标就是两个带权重的交叉熵,实现更直接。更大的背景里,掩码扩散的大规模路线(LLaDA、Dream)证明了扩散语言模型可以 scaling,但都保留 mask 无语义与不可修正的问题,HDLM 是这条线上把「噪声语义化」做完整的一步。
7. 局限
论文自承与我们可以读出的局限:其一,聚类质量对性能影响显著,而语义聚类只是 K-means 近似,coherence 只有 0.3–0.4,可学习/隐式/多层级映射都未实验。其二,Valid PPL 在跨模型对比时失真——HDL 的词表含 word+cluster,更大的词表天然摊薄概率质量、推高困惑度;ELBO 只是似然上界,复杂前向可能让界变松。其三,实验只做了一层中间层级,任意多层级的理论都给了但实现留作未来工作。其四,规模有限:最大 321.2M 非嵌入参数、131B tokens 预训练,未到大模型尺度,下游只测似然型选择题,开放生成质量没有验证。其五,ξ 的收益依赖 force transition 等推理设置,且 Gen PPL 衡量的是与 gpt2-large 的对齐度,简单重复文本也会得到低值,不能完全代表生成质量。
复现信息
代码仓库 https://github.com/zhouc20/HDLM(论文公开)。训练设置完整:8×A100/H100 80GB、bf16、Adam lr 5e−4 余弦衰减到 10%、weight decay 0.02、grad clip 1.0、500k steps × batch 512。权重下载链接论文未明确给出。
在词 token 与 mask 之间插入『语义簇』这一中间层级:前向把词逐级粗化成簇、再粗化成 mask,反向按语义粒度从粗到细逐级恢复,得到时间上变化的 next semantic scale prediction;闭式 ELBO 证明下,MDLM 只是 HDLM 取一个簇的特例。
阅读提示
精读深度:泛读
清单提示:原文提示:分层离散扩散——每个 token 独立地按 scheduler 粗化到更抽象的祖先层级(word→cluster→mask),反向逐步预测更细的语义,同一时刻不同 token 可处于不同层级,因此叫时间变化的 next semantic scale prediction;语义尺度 vs 物理尺度的粗粒化类比——VAR 在图像上按分辨率(物理尺度)从粗到细生成 patch,HDLM 在语言上按语义粒度从粗到细恢复 token,两者共享 coarse-to-fine 的 next-scale 思想,区别在粗化轴从空间分辨率换成了语义。
问题
要解决什么:自回归语言模型按 next-token prediction 生成,无法回头修改已经生成的 token;扩散语言模型具备渐进去噪与自我精修的能力,但主流两类离散扩散的前向过程都有缺陷:masked 扩散把所有被掩码的 token 压成同一个无语义的 mask embedding,而且一旦解码就再也无法修正,重新带回自回归的『不可修改』限制;uniform 扩散把 token 均匀扰动成随机 token,同一个 token 在加噪阶段是噪声、解码阶段却要有语义,前后语义不自洽,经验上也明显落后于 masked 扩散。HDLM 要在这两条路之外,把『噪声』本身做成有语义的中间层级,让去噪变成逐级细化语义的过程。
为什么 prior work 不够:GIDD(von Rütte et al., 2025)用混合速率把 uniform 与 masked 统一进一个框架,部分缓解了上述问题,但被扰动的 token(mask 与随机 token)仍然缺少丰富语义;它的自我修正能力只来自 uniform 噪声部分,而实验显示均匀噪声成分实际会拖累性能——OWT 上 GIDD+-small 在 131B tokens 下的 Gen PPL 170.2,比 MDLM-small 的 163.7 还差(Valid PPL 则分别是 ≤25.82 与 ≤27.39),说明均匀噪声在推理时帮倒忙。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 噪声序列 z_t | 离散 token 序列(序列长度 512,每个位置 ∈ word 词表 ∪ cluster 词表 ∪ {mask}) | 前向从干净词序列 x 出发,随时间 t∈(0,1) 逐 token 独立粗化:先以概率 β_t,c 变成该词所属簇 c(x),再以概率 β_t,m 变成 mask;同一时刻不同位置可处于不同层级 |
| 时间 t | scalar ∈ (0,1) | 连续时间 CTMC 设定,总扩散时间归一化为 1;scheduler α_t=(1−t)^γ,γ=1/2/3 都在实验中出现 |
| 层级映射 Γ(预定义) | surjective 映射 word→cluster | 用预训练 GIDD 的 word embedding 做带尺寸约束的 K-means++(语义聚类),簇数 n∈{2,4,…,256};簇质心作为 cluster token embedding 初始化 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| word 级预测分布 x_θ(z_t,t) | |V| 维分布 | 模型对任意噪声状态输出整个 word 词表的分布;cluster 预测用贝叶斯后验 Γx_θ 导出,不需要单独分类头;解码时 force transition 把簇内解码限制在对应簇的词集合里 |
| 生成序列 | word token 序列(长度 512) | 从全 mask 序列出发反向采样 512 步(Gen PPL 评测设置),逐步把 mask→簇→词细化,最终得到干净文本 |
控制频率:n/a(文本生成任务,无控制频率;『尺度』指每个 token 的语义粒度,随时间逐 token 变化)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| OpenWebText (OWT) | 8,013,769 条,验证集取 100,000 条;context 512 token,无 sentence packing | 主实验:131B training tokens(500k steps × batch 512);GPT-2 tokenizer;指标 Valid PPL 与 Gen PPL(256 个 length-512 样本、512 去噪步、gpt2-large 作参考模型) |
| LM1B | sequence length 128,无 packing;33B tokens(1M steps) | 辅助实验:HDLM-64 Valid PPL ≤26.95,低于 MDLM ≤27.04 与 SEDD ≤32.79(均 33B tokens);AR Transformer 22.32 |
| Zero-shot 下游套件(lm-eval) | ARC-e / ARC-c / BoolQ / PIQA / OpenBookQA / WinoGrande 六项 | 沿用 GIDD 的评测套件与按 token 似然(ELBO 估算)的评估方式;Small 平均 39.62(HDLM-4),Base 平均 39.59(HDLM-256) |
架构(摘要)
主干与结构
backbone:DiT(Transformer);GPT-2 tokenizer(词表 50257)
参数:SMALL:92.1M 非嵌入参数(12 层/12 heads/hidden 768);BASE:321.2M 非嵌入参数(24 层/16 heads/hidden 1024)
类型:分层离散扩散语言模型(CTMC 框架,一层中间层级 word→cluster→mask;mask 为吸收态)
关键组件
- 分层词表:word 词表 |V|=50257;cluster 词表 |C|=n(2–256);mask 1 个;簇 token embedding 用 K-means 质心初始化
- surjective 映射 Γ∈R^{|C|×|V|}:Γ(i,j)=1 当且仅当词 j 属于簇 i;前向过程限制只在相邻层级间转移
- 前向 CTMC:x→c(x)→m,mask 为吸收态;边际 q_t(z_t|x)=Cat(α_t x + β_t,c c(x) + β_t,m m),β_t,c+β_t,m=1−α_t
- 闭式 CT-ELBO:两个加权交叉熵——簇态时在已知簇内做 word 分类(x_θ 先按 Γ⊤Γx 限制在簇内再归一化),mask 态时做 cluster 分类(对 Γx_θ);权重 w_t,c、w_t,m 的期望恒为 1,与 schedule 无关
- 随机扰动 ξ:训练时以概率 1−ξ 把词粗化成错误簇(在其余 n−1 个簇上均匀),模拟推理时的错误上下文;ξ=1 回到标准 HDLM
- 实用技巧:force transition(簇内受限解码,默认开启)、loss 权重裁剪(w_t 截到 2.0/10.0)、分母裁剪 1e−4
为什么这样设计
让中间噪声态携带语义:簇 token 相当于带高层语义的『部分掩码』,比单一 mask 或随机 token 信息量更大,也保持了噪声与干净语义的一致性;粗层级的模糊性给解码留出修正空间,配合 ξ<1 的扰动训练,让模型学会在错误上下文里自我修正。簇级交叉熵还形成 easy-to-hard 的课程分解,训练时允许先错簇再纠词。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| OWT Valid PPL(小模型) | HDLM-small-128 ≤23.25(HDLM-small-64 ≤23.36) | MDLM-small ≤27.39、GIDD+-small ≤25.82、SEDD ≤24.10(262B tokens) | OpenWebText,DiT-small 92.1M 非嵌入参数,GPT-2 tokenizer,context 512,131B training tokens |
| OWT Valid PPL(base 模型) | HDLM-base-128 ≤19.22 | GPT-2 23.40(训练 token 数未知);Llama-110M 重训 16.11(但用了 262B tokens,是 HDLM 的 2 倍) | OpenWebText,DiT-base 321.2M 非嵌入参数,131B training tokens |
| OWT Gen PPL | HDLM-base-128 139.9(HDLM-small-64 144.2) | MDLM-small 163.7、GIDD+-small 170.2 | 256 个 length-512 样本、512 去噪步、gpt2-large 为参考模型;131B tokens |
| ξ 扰动消融的 Gen PPL(HDLM-small-64) | ξ=0.9 时 69.76、ξ=0.8 时 54.15 | ξ=1.0 时 144.2(相对降 51.6% 与 62.5%);ξ=0.9 但不用 force transition 时 184.0 | OWT,131B tokens,其余设置同主实验 |
| 簇数 n 消融的 Valid PPL(HDLM-small) | n=64 时 ≤23.36、n=128 时 ≤23.25 最优;n=1 时 ≤25.72 | n=1 恢复 MDLM 性能(≤25.72 / Gen 163.9,与 MDLM-small reimpl 的 163.7 一致) | OWT,131B tokens,ξ=1,γ=1,标准训练模式 |
| LM1B Valid PPL | HDLM-64 ≤26.95 | MDLM ≤27.04、SEDD ≤32.79(均 33B tokens);AR Transformer 22.32 | LM1B,sequence length 128 无 packing,1M steps = 33B tokens,lr 3e−4 恒定 + 2500 warmup |
| Zero-shot 六项平均准确率(lm-eval) | Small:HDLM-4 39.62%;Base:HDLM-256 39.59% | Small:MDLM(262B tokens)39.44%、GIDD(131B)38.53%、GPT-2 40.41%;Base:GIDD(131B)37.66% | ARC-e/ARC-c/BoolQ/PIQA/OBQA/WinoGrande,按 ELBO 估算的 per-token 似然评估 |
Insights
- 语言的粗化轴可以选语义本身:把『噪声』做成 word→cluster→mask 的语义阶梯,扩散去噪就变成逐级精化语义,每个 token 独立决定自己需要多少步——好预测的词先定型,难预测的词留在粗层级更久(论文第 1 节)
- MDLM 是 HDLM 取一个簇的特例(Remark 1):当只有一个簇且其 embedding 等于 mask 时,闭式 ELBO 退化为 MDLM 的损失,说明 HDLM 是更一般的框架且兼容旧方法
- 两个损失的期望权重恒为 1 且与 schedule 无关(Proposition 4):换噪声 schedule 只重新分配 mask 阶段与簇阶段的训练侧重,总预算不变,这是 MDLM 不变性结果的推广
- 多阶段分解胜过一步到位的 hard 目标:hard 训练模式(mask 态直接做全词表 CE)性能反而更差(Valid PPL ≤25.38 vs ≤23.36、Gen PPL 151.9 vs 144.2,HDLM-small-64,131B tokens),说明允许先错簇再纠词的课程设计有收益
- 用扰动模拟推理错误买到最多的 Gen PPL 收益:ξ<1 让训练见过错误簇上下文,OWT Gen PPL 相对 ξ=1 降低 51.6%–62.5%(144.2→69.76/54.15),但依赖 force transition 解码
vs 同类工作
- vs MDLM/MD4(masked 扩散):MDLM 把 mask 当作唯一噪声态,解码后无法修正;HDLM 在 mask 与词之间插入语义簇层级,前向噪声态带语义、反向可逐级修正,且 MDLM 是 HDLM 的 n=1 特例
- vs GIDD(uniform+mask 混合):GIDD 的噪声态(mask 与随机 token)仍无语义,self-correction 只来自拖后腿的 uniform 成分;HDLM 的混合分布 π_t 是干净数据 x 的函数(π_t∝β_t,c·c(x)+β_t,m·m),语义与数据一致,理论性质与 ELBO 都不同
- vs SEDD(学习数据分布比值):SEDD 走 concrete score 路线,HDLM 直接给出闭式 ELBO 与两段式 CE 损失,实现更简单;OWT 上 131B tokens 的 HDLM-small ≤23.25 低于 262B tokens 的 SEDD ≤24.10
- vs VAR(视觉自回归):VAR 在图像上按分辨率(物理尺度/空间粒度)逐级生成 patch token,HDLM 把同一 coarse-to-fine 思想移植到语言,尺度轴换成每个 token 的语义粒度;两者都做 next-scale prediction,区别在粗化轴是物理分辨率还是语义
局限
- 聚类质量显著影响性能(论文自承,Section C.3):预定义映射用 K-means 近似,语义 coherence 只有 0.3–0.4,更精确或可学习的层级(DeepSets、随机/隐式映射、多层)都未实验验证
- Valid PPL 在跨模型对比时失真(论文自承,Section B.1):HDL 词表含 word+cluster,更大词表会摊薄概率质量推高 PPL;ELBO 只是似然上界,复杂前向可能让界变松,直接比较需谨慎
- 只实验了一层中间层级:任意多层级的理论(ELBO、条件转移矩阵)都给了,但实现留作未来工作;采样算法随层级增加需要更精细设计
- 规模与评测有限:模型最大 321.2M 非嵌入参数、131B tokens(OWT)预训练,未到大模型尺度(对比 LLaDA/Dream 7B 级);下游只用似然型选择题,未验证开放生成质量;论文还观察到增大模型未必提升下游准确率(部分归因于预训练过拟合)
- ξ 的收益依赖 force transition 与推理设置:没有 force transition 时 ξ=0.9 的 Gen PPL 从 69.76 恶化到 184.0;Gen PPL 本身衡量与参考模型 gpt2-large 的对齐度,简单重复文本也会得到低值,不能完全代表生成质量
可复现性
- code:https://github.com/zhouc20/HDLM(论文公开仓库)
- weights:论文未明确给出权重下载链接(正文只给代码仓库)
- datasets:OpenWebText / LM1B / lm-eval 套件均公开
- note:训练设置完整:8×A100/H100 80GB、bf16 混合精度、Adam(β=0.9/0.99, ε=1e−9)、lr 5e−4 余弦衰减到 10%、warmup 10k、weight decay 0.02、grad clip 1.0;loss 权重裁剪到 2.0/10.0,分母裁剪 1e−4
主干与结构
backbone:DiT(Transformer);GPT-2 tokenizer(词表 50257)
参数:SMALL:92.1M 非嵌入参数(12 层/12 heads/hidden 768);BASE:321.2M 非嵌入参数(24 层/16 heads/hidden 1024)
类型:分层离散扩散语言模型(CTMC 框架,一层中间层级 word→cluster→mask;mask 为吸收态)
关键组件
- 分层词表:word 词表 |V|=50257;cluster 词表 |C|=n(2–256);mask 1 个;簇 token embedding 用 K-means 质心初始化
- surjective 映射 Γ∈R^{|C|×|V|}:Γ(i,j)=1 当且仅当词 j 属于簇 i;前向过程限制只在相邻层级间转移
- 前向 CTMC:x→c(x)→m,mask 为吸收态;边际 q_t(z_t|x)=Cat(α_t x + β_t,c c(x) + β_t,m m),β_t,c+β_t,m=1−α_t
- 闭式 CT-ELBO:两个加权交叉熵——簇态时在已知簇内做 word 分类(x_θ 先按 Γ⊤Γx 限制在簇内再归一化),mask 态时做 cluster 分类(对 Γx_θ);权重 w_t,c、w_t,m 的期望恒为 1,与 schedule 无关
- 随机扰动 ξ:训练时以概率 1−ξ 把词粗化成错误簇(在其余 n−1 个簇上均匀),模拟推理时的错误上下文;ξ=1 回到标准 HDLM
- 实用技巧:force transition(簇内受限解码,默认开启)、loss 权重裁剪(w_t 截到 2.0/10.0)、分母裁剪 1e−4
为什么这样设计
让中间噪声态携带语义:簇 token 相当于带高层语义的『部分掩码』,比单一 mask 或随机 token 信息量更大,也保持了噪声与干净语义的一致性;粗层级的模糊性给解码留出修正空间,配合 ξ<1 的扰动训练,让模型学会在错误上下文里自我修正。簇级交叉熵还形成 easy-to-hard 的课程分解,训练时允许先错簇再纠词。
HDLM 总览:word→cluster→mask 三级层级与前向/反向过程
原文 caption:Hierarchical Diffusion Language Model (three hierarchies are shown). (Left) When training HDLM, word tokens transit to higher hierarchies independently with more abstract semantics. In the reverse process, the model learns to predict the lower level tokens. (Right) The vocabularies of three hierarchies (word, cluster, mask) and the illustration of next semantic scale prediction.
全文核心概念图。左半是七词句『Next Semantic Scale Prediction for Language Modeling』的纵向扩散示意:最下方 t=0 是干净词序列,向上每个词独立变化——有的保持词形,有的变成 [Cluster 1..4] 这样的簇 token,有的变成 [Mask];同一行的不同位置可以处于不同层级(例如一行里同时有词、簇、mask),直到最上方 t=1 全部变成 mask。右半是三个层级词表(word、cluster、mask)与 next semantic scale prediction 的示意。读图要点:噪声按语义粒度逐级加上,每一行都对应『部分有语义、部分被抽象』的中间态;反向过程就是从顶到底把语义逐级细化。对应正文第 1 节对 HDLM 的定义与第 3.1 节前向过程。
示例前向过程的边际概率(α_t=(1−t)^γ,γ=1/2/3)
原文 caption:Marginal probabilities of the example forward processes with α_t = (1−t)^γ and γ = 1, 2, 3.
横轴是时间 t,纵轴是各类状态的边际概率 P_t;三条曲线分别对应词态保留概率 α_t、簇态概率 β_t,c、mask 态概率 β_t,m。γ=1、2、3 三个子图对比 schedule 硬度:γ 越大,词态离开得越早,簇态峰越靠后,mask 态主导的时间更长。读法:给定任意时刻 t,一个位置处于三个层级之一的概率之和恒为 1;中间层级(簇)的存在让『半噪声』状态带语义。对应第 3.4 节示例 process 的公式(20)(21)。
两类交叉熵损失的权重曲线(γ=1/2/3)
原文 caption:Cross entropy weights of the example forward processes with α_t = (1−t)^γ and γ = 1, 2, 3.
横轴是时间 t,纵轴是损失权重 w_t(w_t,c 与 w_t,m 两条曲线);三个子图对应 γ=1/2/3。这两条曲线是闭式 ELBO 里簇态 word 分类损失与 mask 态 cluster 分类损失的系数:权重随时间变化(早期偏 mask 任务、晚期偏簇内细化),但 Proposition 4 证明其期望恒为 1,与 schedule 无关,所以 γ 只是重新分配不同阶段的训练侧重,总权重预算不变。对应第 3.4 节公式(22)与第 3.3 节 Proposition 4。
🎧 音频版
时长 23:42 · Edge TTS
Next Semantic Scale Prediction via Hierarchical Diffusion Language Models(对话版)
先讲清楚,这篇论文到底解决了什么问题
小播:老播,这期讲什么论文?
老播:讲一篇 NeurIPS 2025 的工作,来自 MIT 和微软研究院,叫 HDLM,全称 Hierarchical Diffusion Language Model,分层扩散语言模型。一句话背景:现在最强的语言模型都是自回归的,一个字接一个字往后生成,但每个词生成完就定型,没法回头改。扩散语言模型想换一种生成方式——先生成一份带噪声的草稿,再通过多步去噪逐步精修。这篇的定位:把扩散过程里的「噪声」本身做成有语义的中间层级,让去噪变成从粗语义到细语义的逐级细化。
小播:等等,「噪声带语义」这句话我就没听懂。噪声不就是乱的吗?
老播:正常,这正是这篇论文的出发点。先记住一句话结论:在 OpenWebText 上 131B tokens 训练量下,HDLM 小模型的验证困惑度做到 ≤23.25,比同一训练量的 MDLM ≤27.39 明显更低,第一次让扩散语言模型在同等规模下追平了自回归基线。这期我们会把三件事讲清楚:噪声为什么能分级、每级带语义;「语义尺度」这个说法到底是什么意思;它和图像生成里 VAR 的「物理尺度」粗到细有什么关系。
小播:这期值得专门听的点在哪?
老播:扩散语言模型这几年有个尴尬:能力上限不差,但实际生成质量总被自回归压一头。这篇把差距第一次缩到「同等规模基本追平」,还打开了一个新设计空间——噪声可以有语义、可以分尺度。理解了它,再去看 LLaDA、Dream 这些大规模扩散语言模型,会更容易跟上它们的做法。
背景铺垫:自回归和掩码扩散各自卡在哪
小播:先把问题放回谱系里,自回归模型为什么需要替代方案?
老播:自回归模型比如 GPT,生成方式叫 next-token prediction——每一步只看已经写好的词,预测下一个词,写出去就定死了。好处是简单、能大规模训练;坏处是没法回头改。比如先写了「苹果」,后面发现整句应该是「苹果公司发布新机」,前面那个词已经改不了了。语言生成里这种「先粗后改」的能力很重要,所以研究者一直在找替代范式。
小播:扩散模型是怎么做的?
老播:扩散模型反过来。训练时给句子加噪声,让模型学会从噪声还原原句;生成时从全噪声状态出发,一步步去噪,每一步都在修改整句,理论上前面错了后面还能救回来。语言是离散的,所以用离散扩散。主流有两类:masked 扩散,把一部分位置盖成一个专门的「掩码符号」让模型填;uniform 扩散,把位置替换成随机 token。
小播:为什么语言不能直接用图像那套连续扩散?
老播:图像是连续数值,可以直接加高斯噪声、做平滑插值;文本是离散符号,从「好」到「坏」没有中间值可以插。所以文本扩散必须设计离散状态之间的转移规则,这也让噪声态的选择变得特别关键——噪声态选得越合理,去噪越容易。masked 和 uniform 就是两种最朴素的选择。
小播:这两类各自有什么问题?
老播:masked 的问题有两个。第一,mask 符号本身没有语义——模型看到 mask,只知道「这里缺了个词」,不知道缺的是哪一类词,信息量太少;第二,它的生成方式是逐步揭开 mask,揭开一个就定型一个,自回归「不能回头改」的老毛病又回来了。uniform 的问题:同一个 token,加噪阶段它是纯噪声,解码阶段却要有含义,前后语义对不上,模型去噪时很困惑,效果也差。后来 GIDD 用混合速率把两类噪声统一进一个框架,但被扰动的 token 依然没有语义,而且 uniform 成分在推理时反而拖后腿——OWT 上 131B tokens 训练,GIDD+-small 的生成困惑度 170.2,比 MDLM-small 的 163.7 还差。
小播:所以核心矛盾是:噪声态没有语义,去噪就没有抓手。
老播:对。这就是这篇论文的切口:能不能让「噪声」本身分成几级,每一级都带一点语义?答案是分层离散扩散,这也是它的名字来源。
小播:那他们为什么选择「加一层簇」这条路?
老播:论文的论证分三步。第一步,中间层级的簇 token 相当于「带高层语义的部分掩码」——模型看到簇 token,至少知道这个词大概属于哪一类,比只看 mask 信息量大得多。第二步,簇的模糊性给解码留了修正空间,前面猜错了簇,后面还能在正确的簇里重新选词。第三步,噪声态和干净态语义一致,模型不用在「噪声语义」和「内容语义」之间来回切换。这三步合起来,就是分层离散扩散有效的原因。
核心思想:在词和 mask 之间加一层「语义簇」
老播:做法是在词和 mask 之间插入一层「语义簇」。先定义三个层级。最细的是 word 层:GPT-2 的 50257 个词 token,语义最具体。中间是 cluster 层:几百个语义簇,每个簇装一批意思相近的词。最粗的是 mask:一个符号,没有语义。层级之间有一个满射映射:每个词都映射到它所属的簇,簇再映射到 mask。映射是预定义的,做法叫语义聚类——拿预训练模型的词向量做聚类,把「北京、上海、广州、深圳」这类词聚进同一个簇,把「高兴、开心、愉悦」聚进另一个簇,同时控制各簇规模尽量均衡。
小播:实际聚类效果好吗?
老播:论文附录展示了 32 个簇的结果:一个簇里装的是纽约、伦敦、芝加哥这类城市名,另一个簇装的是 2016、2015、2014 这类年份,还有一个簇是中国、日本、俄罗斯这些国家名。聚类质量谈不上完美,但方向是对的——这正是簇 token 能携带「高一层语义」的原因。
小播:那前向加噪和反向去噪具体怎么走?
老播:前向过程里,每个词独立地按一个时间表逐步粗化。设 t 从 0 走到 1,t=0 是干净句子;随着 t 增大,每个位置有三种可能的去向——保留原词、变成它所属的簇、变成 mask。关键在「独立」两个字:同一个时刻,句子里的不同位置可以处于不同层级。比如「我们 明天 去 爬山」这句话,也许「我们」和「去」已经变成 mask,「明天」变成了簇 token,「爬山」还是原词。所以论文管这个叫 time-varying next semantic scale prediction——随时间变化的「下一个语义尺度预测」,这里的 scale 指每个 token 的语义粗细,跟图像里的分辨率没关系。
小播:论文的图 1 具体画了什么?
老播:一句七个词的句子,从下往上排 t=0 到 t=1 的切片:最下面一行全是干净词;越往上,每个词独立变化——有的保持词形,有的变成带编号的 [Cluster 1]、[Cluster 2] 这种簇 token,有的变成 [Mask];同一行里三种状态混在一起,最上面一行全部是 mask。反向过程就是从上往下,先把 mask 填成簇,再把簇细化成词。
小播:这个「独立」为什么重要?
老播:因为不同词预测难度不同。好预测的词,比如冠词、常见搭配,模型很快就能定下来;难预测的词,比如一个生僻名词,需要更多上下文,就让它留在粗层级更久。masked 扩散对所有位置一视同仁,这里每个 token 按自己独立的时间粗化,越难预测的词在粗层级停留越久——这是扩散模型「任意顺序生成」能力的直接体现,也是它能反超自回归的潜在来源。补充一点:自回归每一步只能用一边的信息——左侧已经生成的词;扩散模型每一步都能看到整句的所有位置,虽然部分还是粗的,但方向是全局的。分层设计让模型在最需要上下文的地方多花几步,正好补上自回归「信息只用一边」的短板。
小播:那和图像生成里的 VAR 有什么关系?你开场提了「物理尺度」。
老播:关系在「粗到细」这条主线上,这是本期最重要的类比,而且它来自真实的相关工作。视觉自回归模型 VAR 生成图像时,把整张图按分辨率分成几级,先生成 16×16 的模糊版,再逐级生成 32×32、64×64,补上细节——这是按物理尺度粗到细,物理尺度就是空间分辨率。HDLM 把同一个 next-scale prediction 思想搬进语言:先把整句变成 mask,再逐级细化成语义簇,最后细化成具体词。两者共享 coarse-to-fine 的骨架,区别只在粗化轴——图像粗化的是物理尺度,语言粗化的是语义尺度。这句话会在这期里出现三次,因为它是理解整篇论文的钥匙。
小播:训练目标怎么定?加了中间层,损失函数还能推出来吗?
老播:能,而且论文给了闭式解。整套推导建立在连续时间马尔可夫链框架上:每个 token 的状态随时间按转移速率变化,总扩散时间归一化为 1,好处是训练时 t 可以连续采样,不需要固定离散步数。先给预期:训练损失应该拆成两个任务——「mask 变簇」时,模型只要猜对这个位置属于哪个簇;「簇变词」时,模型在这个簇内部猜是哪个词,一层比一层细。写成式子,连续时间的证据下界 ELBO 化简成:
L = E[ δ(c)·w_c·CE(簇内选词) + δ(m)·w_m·CE(猜簇) ]
逐项解释:E 表示对扩散时间 t 和噪声状态求期望,训练时随机采样;δ(c) 是指示函数,当前噪声状态是簇时取 1;w_c 和 w_m 是两个由噪声时间表决定的权重,控制两个任务的相对侧重;CE 是交叉熵损失,衡量预测分布和真实标签的差距。第一项要求模型在已知簇内区分具体词,第二项只要求预测对簇。结论有两条。第一条:两个权重的期望恒为 1,跟时间表无关——换时间表只是重新分配「先猜簇、后选词」两个阶段的训练量,总预算不变。第二条:如果只取一个簇、让这个簇等于 mask,整个损失就退化成 MDLM 的损失——MDLM 是它取一个簇的特例,新框架把旧方法收编了。
小播:论文里的图 2、图 3 画的是什么?
老播:图 2 画前向过程的边际概率:横轴是时间 t,纵轴是一个位置处于三种状态(原词、簇、mask)的概率,三组子图对应时间表参数 γ=1、2、3。γ 越大,词态概率掉得越早,mask 态主导的时间越长,也就是噪声加得更快更猛。图 3 画的是两个损失权重 w_c、w_m 的曲线,同样三组子图:权重随 t 变化,但期望恒为 1。读这两张图的核心:时间表只决定「先猜簇、后选词」两个阶段的节奏,不改变总训练预算。
小播:理论挺完整,实际操作上还有什么技巧?
老播:有三个值得说。第一,随机扰动:训练时故意以概率 1−ξ 把词粗化成「错误的簇」——「爬山」本该进「户外活动」簇,却给它配一个「金融」簇。原因:推理时多步去噪会累积错误,模型必须见过「上下文里簇错了、但词还能救回来」的样本,才能真正学会自我修正。ξ=1 是标准版,ξ=0.9 就是扰动训练。第二,force transition 解码:从簇 token 选词时,只在簇内的词里选,不把概率分给簇外的词,保证前向和反向自洽,默认开启。第三,把损失权重裁剪到一个范围,稳定优化。另外,簇级损失的梯度会把概率推向簇内所有词,训练时允许先错簇再纠词,形成一种由易到难的课程安排。
小播:我复述一遍核心:噪声从单级变成三级,每级带语义;去噪变成逐级细化;MDLM 只是它的特例。对吗?
老播:对。这个结论后面会用实验数字再验证一次。
关键实验:数字怎么验证这套想法
老播:实验主战场是 OpenWebText,约 801 万条,验证集取 10 万条,context 512 token,训练量 131B tokens,模型是 DiT 结构——小模型 92.1M 非嵌入参数,base 模型 321.2M。指标两个。验证困惑度 Valid PPL:在验证集上算,越低代表模型对下一词的预测越有把握。生成困惑度 Gen PPL:生成 256 个长度 512 的样本、512 步去噪,用 gpt2-large 当参考模型计算。
小播:评测设置里有没有要留意的坑?
老播:有两点。验证困惑度是用 ELBO 估计的,而 ELBO 只是真实似然的上界,复杂前向可能让这个界偏松;生成困惑度衡量的是生成文本和参考模型 gpt2-large 的对齐程度,简单重复的文本也能拿到低值。这两点我们到局限部分再展开。
小播:数字呢?
老播:同一训练量 131B tokens 下,MDLM-small 验证困惑度 ≤27.39,GIDD+-small ≤25.82,HDLM-small-128 是 ≤23.25,两个扩散基线都被压住。生成困惑度差距更大:HDLM-small-64 是 144.2,MDLM 是 163.7,GIDD+ 是 170.2。base 模型 HDLM-base-128 验证困惑度 ≤19.22,低于 GPT-2 的 23.40,接近 Llama-110M 的 16.11——注意 Llama 训了 262B tokens,是它两倍。这个结果的意义:扩散语言模型第一次在同等规模、同等待遇下追平自回归模型。
小播:消融里哪个数字最让你信服?
老播:三个消融各说明一件事。第一,簇数 n:n=1 时验证困惑度 ≤25.72、生成困惑度 163.9,几乎就是 MDLM 的 163.7——直接验证了「MDLM 是特例」的理论;n=64 和 128 最优(≤23.36、≤23.25),n=256 开始回落,论文给的解释是最优簇数大约在词表大小的平方根量级,把生成分成复杂度相近的两段。第二,扰动概率 ξ:生成困惑度从 ξ=1 的 144.2 降到 ξ=0.9 的 69.76、ξ=0.8 的 54.15,降幅 51.6% 和 62.5%——这是全篇最大的单点收益;但去掉 force transition,ξ=0.9 反而恶化到 184.0,说明扰动训练必须和受限解码配合。第三,时间表参数 γ:从 1 加到 3,验证困惑度从 ≤23.36 恶化到 ≤130.32,生成困惑度反而从 144.2 略降到 135.9——更硬的前向换来更好的推理解码节奏,也印证了「换时间表只是重新分配训练侧重」的理论。
小播:泛化能力呢?只在 OWT 上练过,下游任务表现怎么样?
老播:两个补充实验。LM1B 上 33B tokens 训练,HDLM-64 验证困惑度 ≤26.95,MDLM ≤27.04、SEDD ≤32.79。零样本六项评测(ARC-e、ARC-c、BoolQ、PIQA、OBQA、WinoGrande)平均,小模型 HDLM-4 是 39.62%,MDLM 是 39.44%(但训练了 262B tokens,两倍于它)、GIDD 38.53%、GPT-2 40.41%;base 的 HDLM-256 是 39.59%,超过 GIDD-base 的 37.66%。基本结论:对扩散基线全面领先,对自回归还差一点,但训练量只有别人的一半。六项平均赢过两倍训练量的 MDLM,这是泛化能力的一个证据。单项上也值得看一眼:HDLM-4 在 ARC-challenge 上 26.62%,小模型里最高,还超过 Llama 重训版的 25.51%;但在 PIQA 物理常识题上 52.50%,低于 GPT-2 的 62.89%——需要世界知识的任务和自回归仍有差距。平均数字好看,单项分化也明显。
小播:到这里我把关键结论再确认一遍:噪声带语义的分层设计,让去噪变成逐级细化;同等规模下追平自回归;扰动训练加受限解码买到最多的收益。
谱系定位:它站在哪条线上
老播:把它放进谱系看。离散扩散语言模型这条线上,SEDD 走估计数据分布比值的 concrete score 路线,实现复杂;MDLM 把训练目标简化成掩码预测,但噪声无语义;GIDD 把 uniform 和 mask 统一成混合框架,噪声态仍然无语义。HDLM 的独特点在于:混合噪声分布变成了干净数据的函数——噪声态是「这个位置自己的簇」或 mask,语义始终和内容一致,并且把 MDLM 收编成 n=1 的特例。往大模型方向看,LLaDA、Dream 证明了掩码扩散能扩展到 7B 参数规模,但它们保留的仍然是单级 mask;HDLM 是这条线上把「噪声语义化、分尺度生成」做完整的一步,而视觉那边 VAR 的分尺度路线已经能出最好的生成效果,这也是这篇论文想让语言侧追上的方向。
局限:哪些地方还不能太乐观
小播:那有什么要泼冷水的?
老播:至少五条。第一,语义聚类是整条链子的地基,论文自承聚类质量对性能影响显著,而它的 K-means 近似语义一致性只有 0.3–0.4——簇里会混进不相关的词,可学习的、隐式的、多层的映射都没有实验。第二,验证困惑度在跨模型对比时会失真:HDL 的词表比 MDLM 多出整层簇 token,更大的词表天然把概率质量摊薄、推高困惑度;ELBO 又只是似然的上界,复杂前向可能让界变松。第三,实验只做了一层中间层级,任意多层级的理论都证了,但实现留作未来工作,多层会显著增加采样设计的难度。
小播:聚类这个地基,具体差在哪?
老播:一致性只有 0.3–0.4,意味着簇里相当一部分词和簇主题无关;而且映射在训练前就定死,训练中不能改,某个簇里混进几个完全无关的词,模型每次从那个簇选词都会被带偏。多层会显著增加采样设计的难度。第四,规模有限:最大 321.2M 非嵌入参数、131B tokens,没到大模型尺度,下游只测似然型选择题,开放生成质量没人验证。第五,ξ 的收益高度依赖 force transition 和推理设置,而且 Gen PPL 衡量的是与 gpt2-large 的对齐度——简单重复的文本也能拿到低值,它不能完全代表生成质量。
小播:还有,论文说增大模型未必提升下游准确率?
老播:对,base 的 HDLM-256 平均 39.59%,小模型 HDLM-4 是 39.62%,几乎没有提升;论文把一部分原因归到在预训练数据上过拟合。这提醒我们,它下游的竞争力目前来自训练效率,模型变大本身带来的增益还没有体现。
小播:最强的数字,恰恰依赖最脆的假设?
老播:对,ξ 那组 51.6% 的降幅来自一个明确的配置组合,换掉 force transition 就倒挂。读这篇论文要记住:它的理论贡献和工程技巧绑定得很紧。
收尾:这期记住三件事
小播:收尾,我总结三件记住的事。第一,噪声可以分级带语义:word→cluster→mask,去噪就是逐级细化语义,每个 token 按自己的难度决定在哪一层停留。第二,语义尺度对标物理尺度:VAR 按图像分辨率从粗到细,HDLM 按 token 的语义粒度从粗到细,同一套 next-scale prediction 思想换了个粗化轴。第三,理论收编旧方法、工程买到收益:MDLM 是 HDLM 取一个簇的特例;扰动训练加 force transition 把生成困惑度从 144.2 拉到 54.15。
老播:我补一句这篇对后续的意义。它把「扩散模型的噪声应该长什么样」这个问题重新打开了——mask 和随机 token 只是最简单的一档噪声,语义分层给了语言扩散一个更自然的去噪阶梯。后续工作大概率会沿两个方向走:把聚类换成可学习的层级,把中间层级从一层加到多层。到那时候,本期讲的这套 ELBO 和采样框架还是地基。如果后面有人把语义层级做成可学习的,或者把语言的分尺度思路和图像的多分辨率生成结合起来,这套框架可以直接套用。