PHYBench:给 LLM 的物理推理能力做一次严格体检
> 泛读卡片 · arXiv 2504.16074(Under review)· 北京大学物理学院 + 北大 AI 研究院等
> 阅读提示:这是用户自己的工作——500 道原创物理题、EED 评分体系、Gemini 2.5 Pro 36.9% vs 人类 61.9%;面向研究者介绍评测经验。
一句话定位
当前推理评测基准有三个公认的毛病:题目太简单导致模型饱和(DeepSeek-R1 在 MATH-500 上精度 97.3%,分数挤成一团)、题目来自公开材料导致数据污染(Gemini 2.5 Flash 在公开的 AIME 2024 上平均分超过 99%)、评测项本身有缺陷(抽查 OlympiadBench 36 道物理符号题就有 14 道有问题)。PHYBench 由北大物理学院牵头,用 178 名学生出题、81 名学生(其中 50 人是中国物理奥赛金牌)人工验收,产出 500 道纯文本原创物理题,答案统一要求为单一符号表达式,并配套 EED 树编辑距离评分给部分分。实测最好的 Gemini 2.5 Pro 精度 36.9%,人类基线 61.9% ± 2.1%,两者之间隔着当前推理模型够不到的鸿沟;错误分析进一步表明,模型九成以上的第一步错误发生在语义推理阶段。这篇论文值得研究者读,因为它把评测里最容易被糊弄的三件事——防污染、把关质量、给部分分——都做成了可复制的流程。
问题:评测基准的三个坑
做推理评测的人都会遇到同一个困境:想区分模型能力,得先有难且可信的题。论文把现有基准的毛病归成三类。第一类是饱和。DeepSeek-R1 在 MATH-500 上精度 97.3%,剩下的差距既小又受格式影响——模型有时只是没按格式写答案,不算推理失败。第二类是污染。AIME 2024、OlympiadBench 这类题集来自公开考试与公开材料,极可能进了预训练语料;论文给了一个实测:Gemini 2.5 Flash 在 AIME 2024 上 16 次运行平均超过 99%,同一模型在 PHYBench 上只有 34.25%(pass@1),同一个人背过题和没背过题,分数差一倍以上。第三类是错题。抽查 OlympiadBench 36 道答案要求符号表达式的物理题,14 道存在歧义或标准答案抽取错误,其中 Problem 1015 的答案里出现了题干从未定义的变量 γ,Problem 1216 的标准答案本身抽错、导致所有模型被误判。
这些坑共同指向一个结论:跑分数字的可信度取决于题目的原创性、正确性和评分粒度。PHYBench 从这三个方向同时下手。
方法:原创题怎么造,EED 怎么给分
500 道题的制造流水线
题源来自两条线:非公开习题与公开材料,但全部经过改编,作者声称直接网络搜索或标准参考找不到原题。出题阶段由 178 名北大物理学院学生完成,每道题被要求做成一个具体的物理场景,答案必须是单一符号表达式(比如三球问题里的绳子张力 T2 = 2mg + 4mv0²/l),并且拒绝方程形式(比如 T/m − 2g = v0²/l)和浮点近似,这样正确性就能靠符号等价判定。接下来是评审轮:评审员逐题把关,同时把 o1、DeepSeek-R1 的零样本输出贴在旁边当歧义探测器,模型答得飘忽的题目就回炉改题干。最后是大规模人类实测:81 名学生每人做 8 题,反馈清晰度和答案唯一性。757 道题走完三道关,只留下 500 道,保留率 66.1%。这 81 人里 50 人是物理奥赛金牌,他们同时也构成人类基线——先证明题对真人可解(61.9%),模型 36.9% 的分数才有意义。
EED Score:给表达式打连续分
二元评分下,47 分和 0 分的答案都算错,信息量被压成一位。PHYBench 的答案恰好是符号表达式,可以用树结构来度量相似度。EED 的做法分三步:先用 SymPy 把模型答案和标准答案从 LaTeX 正则化成标准形式,再各自建成正则化表达式树,最后算两棵树之间的归一化编辑距离。核心公式是这个相对编辑距离:
$$r = \frac{\text{Distance}(T_{\text{gt}}, T_{\text{gen}})}{\text{Size}(T_{\text{gt}})}$$
先给预期:这个式子回答的问题是,模型答案和标准答案在结构上差多远。分子 Distance 是把标准答案树 T_gt 改成模型答案树 T_gen 所需的最小节点级操作数——插入、删除、替换都算一次;分母 Size(T_gt) 是标准答案树的节点数,用节点数归一化,让大树和小树的距离可比。r 越小越接近。拿到 r 之后分段给分:
$$\text{score} = \begin{cases} 100, & r = 0 \\ 60 - 100r, & 0 < r < 0.6 \\ 0, & r \geq 0.6 \end{cases}$$
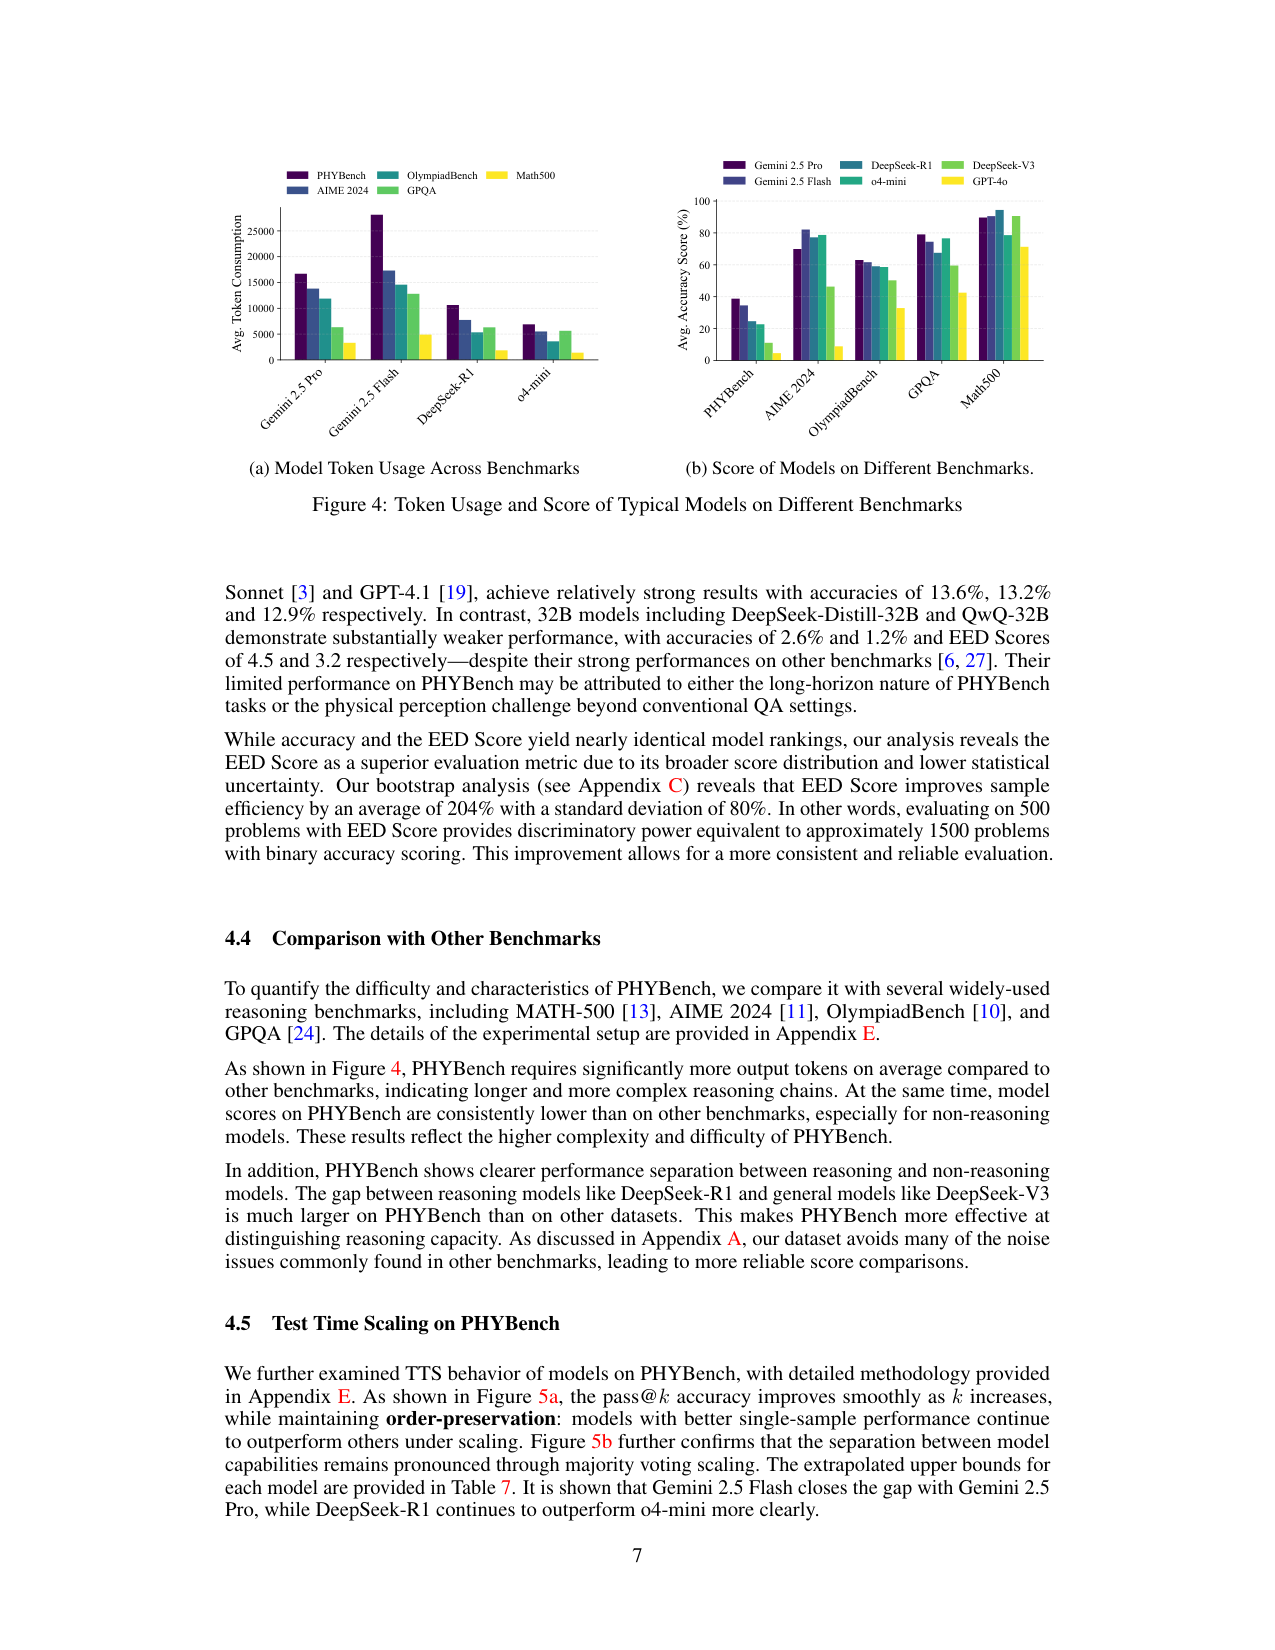
意思是:完全等价得满分 100;有点小结构误差或系数误差时,从 60 分起按距离线性扣,最坏扣到 0;差太远直接 0 分。图 2 里 DeepSeek-R1 的答案 T2 = 2mg + 2mv0²/l(系数错了一半)得 EED 47,GPT-4o 的答案差得更远得 EED 13,而二元评分里两个都是 0。另外对超过 5 个节点的子树,插入和删除操作打 6 折(成本 min(x, 0.6(x−5)+5)),让整块物理成分的增删不必按单节点累加,算法用扩展 Zhang-Shasha 树编辑距离实现。
EED 的收益可以用一个公式量化。bootstrap 重采样算出每个模型在 EED 和 Accuracy 上的相对不确定度 CV_EED 与 CV_ACC,样本效率定义为:
$$\text{Sample Efficiency} = \left(\frac{\text{CV}_{\text{ACC}}}{\text{CV}_{\text{EED}}}\right)^2$$
相对不确定度小的一方,等价于用更少的样本达到同样的区分力。19 个模型逐项算下来平均提升 204%(标准差 80%),也就是说 500 题用 EED 评分的区分力,相当于约 1500 题用二元评分。评分本身的参数(基线 60、惩罚 100)在 50 到 70、100 到 140 范围内扫过,模型排名基本不动(±1 位以内),说明这个度量不是调出来的。
实验与结果
主结果:最好的模型也够不到人类基线
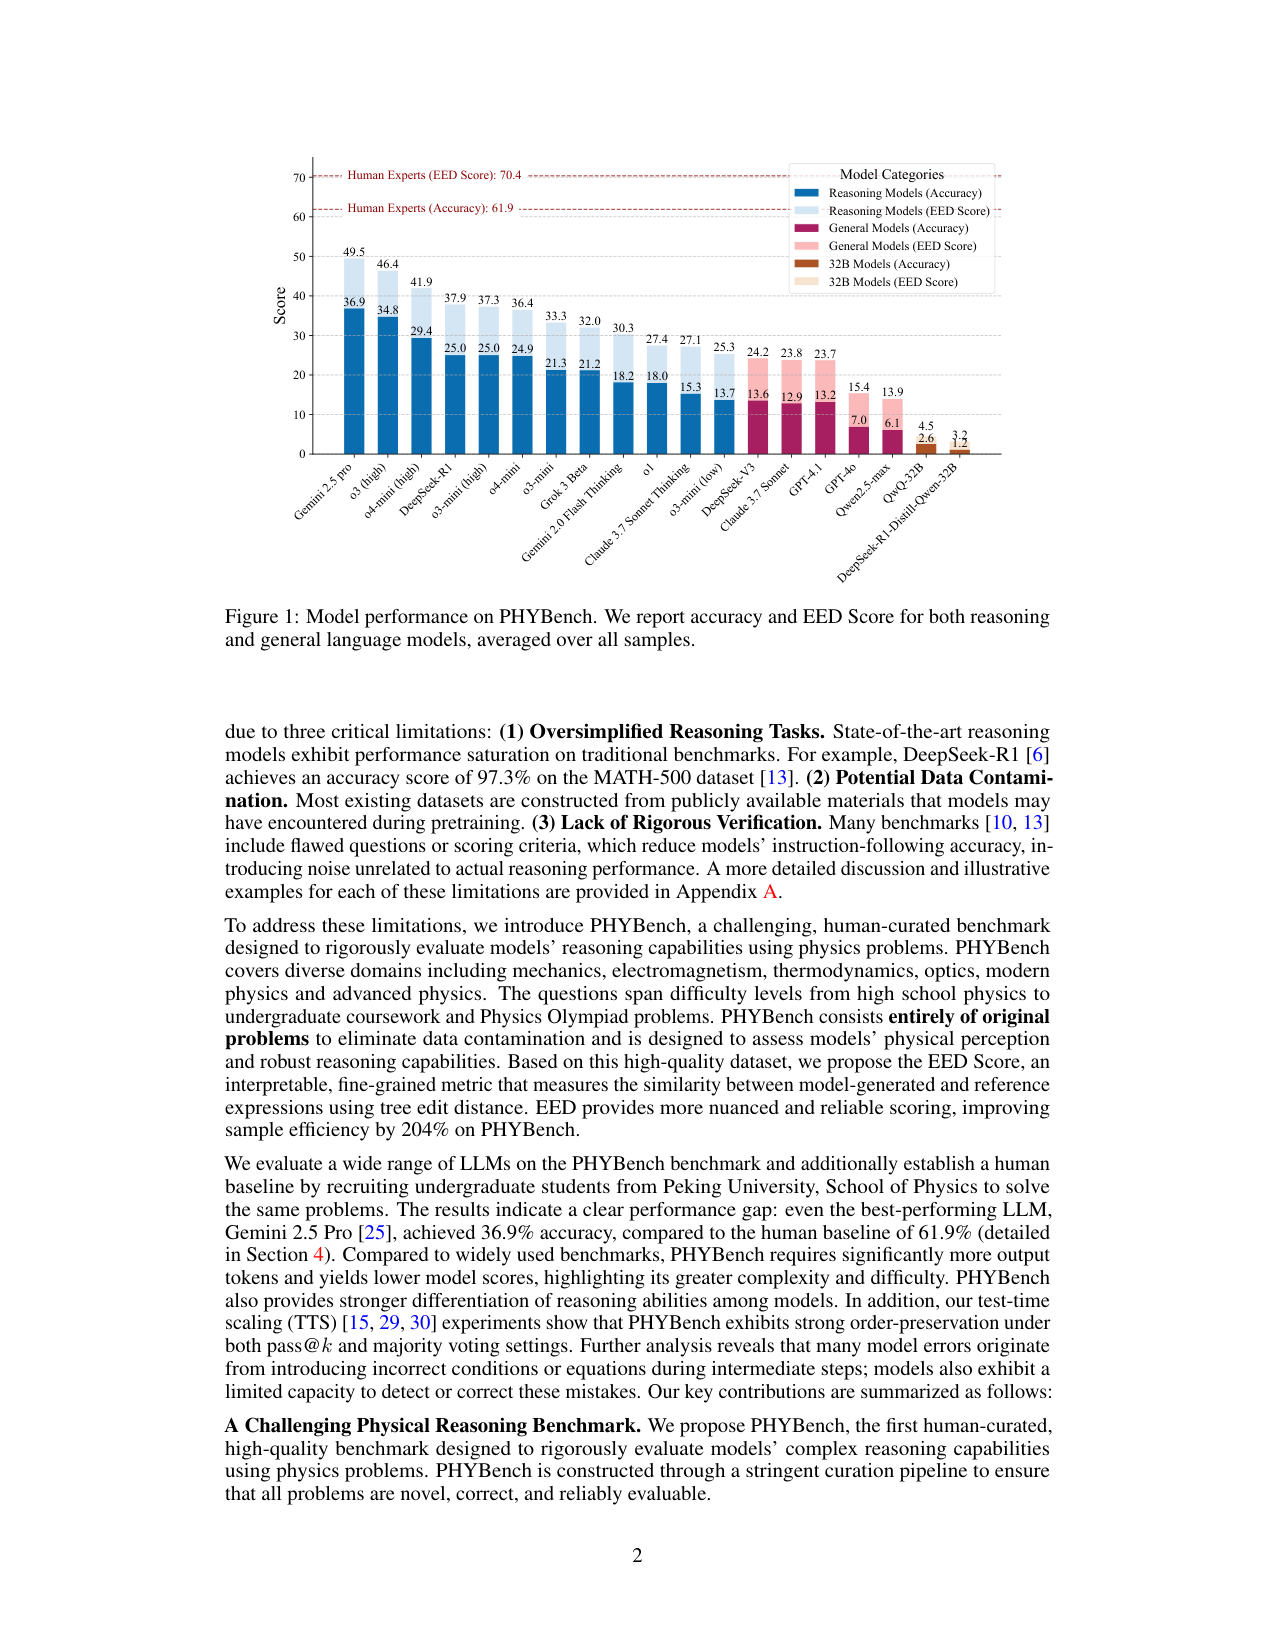
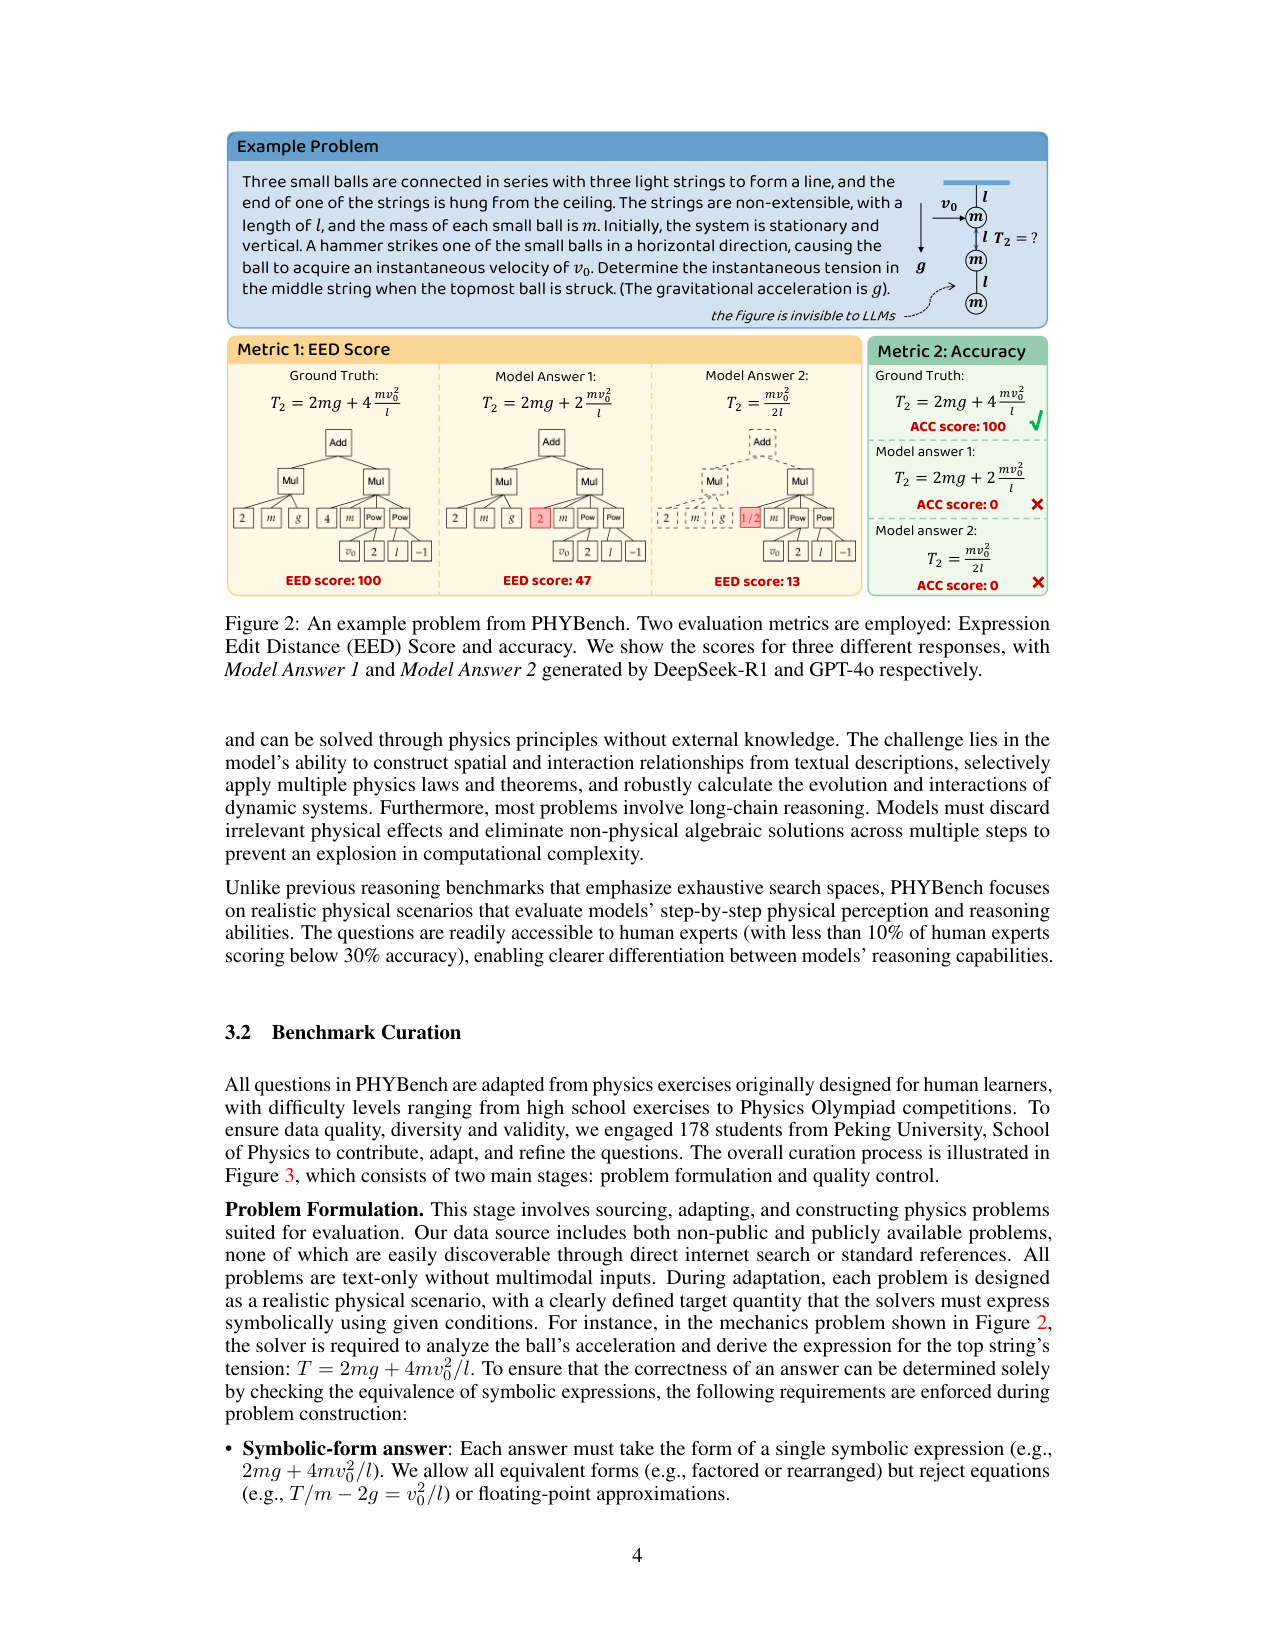
图 1 是论文的核心证据:横轴 19 个模型按成绩排序,纵轴分数,每个模型两根柱子(EED 与 Accuracy),两条虚线是人类基线(精度 61.9%、EED 70.4)。要点有三个。第一,差距大:最好的 Gemini 2.5 Pro 精度 36.9%、EED 49.5,人类基线 61.9% ± 2.1%,99% 置信水平下人类显著高于全部模型。第二,有区分度:推理模型(o3 34.8%、o4-mini 29.4%、DeepSeek-R1 24.9%)整体明显高于普通模型(DeepSeek-V3 13.5%、Claude 3.7 Sonnet 13.2%、GPT-4.1 12.9%),而 32B 开源小模型(QwQ-32B、DeepSeek-R1-Distill-Qwen-32B)精度只有 1% 到 3%、EED 3 到 4.5 分,几乎贴地——这些模型在其他基准上成绩不错,说明 PHYBench 测出了别的基准测不出的东西。第三,题确实难:DeepSeek-R1 在 PHYBench 上平均输出 10,636 个 token,对比 MATH-500 的 1,857、GPQA 的 6,308、OlympiadBench 的 5,372、AIME 2024 的 7,741(表 1 同一模型统一 prompt),解题链最长、分数最低(25.0% 对 97.3%/71.5%/58.7%/79.8%)。
错误定位:模型卡在语义推理
模型整体分低,那错在哪一步?论文选 7 个模型、50 道代表题,人工逐条推理链定位第一个错误,分两个轴。第一轴是物理感知 PP(漏变量、误解物理量关系、错误建模)对稳健推理 RR(公式选错、条件没组合对):7 个模型里 PP 只占 4% 到 21%,RR 占 79% 到 96%。第二轴把 RR 再拆成语义推理(从物理背景生成先前步骤没有的新方程)和符号推理(对既有方程做化简、代入):RR 里的错误 87% 到 99% 落在语义这一侧。合起来看,模型读题、列已有方程、做代数都靠得住,真正翻车的是从物理语境凭空生成新方程这一步——比如明明磁场存在外力矩,模型还假定角动量守恒。
扰动实验:鲁棒不一定等于理解
为了区分鲁棒和真懂,论文做了链式思维投毒:把参考解答截断到中途,注入 6 类系统性错误让模型继续(扰动目标统一是万有引力里的 (Rm+h)²:T1 去掉平方、T2 变号成 (Rm−h)²、T3 组合、T4 删掉 h 项、T5 组合 T2 和 T4、T6 把流体静力学方程翻成倒数的形式)。按反应把模型分成三类:表层推理照错往下推;真推理靠语义理解发现并修复错误;伪真推理靠量纲分析、极限检验这类符号一致性检查抓错。结果很说明问题:DeepSeek-R1 原始精度 97%,遇到 T1/T3 这类能靠量纲检查暴露的错误还能维持 64%/99%,遇到 T2/T4 这种量纲上没破绽的错误直接掉到 39%/37%;Gemini 2.5 Pro 则靠把语义推理转成形式化推导,六个扰动都维持在 78% 到 100%。两者都做到了表面鲁棒,但用的都是绕开语义理解的办法——这是论文最值得记住的发现之一:当前模型的鲁棒性来源,常常不是物理理解。
测试时扩展:采样空间里有答案,模型认不出
pass@k 和多数投票是两种测试时扩展策略。pass@k 随着 k 增大一路涨:Gemini 2.5 Pro 从 pass@1 的 38.7% 涨到 pass@32 的 65.9%(外推上界 74.9),DeepSeek-R1 从 25.1% 涨到 50.9%(上界 81.3),且排序保持稳定。多数投票却几乎不动:Gemini 2.5 Pro 投 32 票也只有 42.0%。这个对比直接指向一个结论:正确答案其实在模型的采样空间里,模型缺的是把正确答案挑出来的自我校验能力。
谱系定位
PHYBench 处在推理评测这条线的后段。MATH-500/GSM-8K 代表第一代,已经被打到饱和;AIME 2024 和 OlympiadBench 代表第二代,难度上来了但题源公开、把关不足;HLE 走前沿知识路线,侧重覆盖面而非推理过程。PHYBench 和它们的区别落在三处:全部原创加三道人工关防污染;答案限符号表达式,让等价判定自动化;EED 给部分分,把二元评测升级成连续评测。和 GPQA 相比,GPQA 是知识型选择题,模型输出 token 少(DeepSeek-R1 平均 6,308),PHYBench 逼模型走 10,636 个 token 的多步符号推导,因此推理模型和普通模型的差距在 PHYBench 上被拉得更大。它承认的代价是:过程级人工评测(精度更高、能查中间步骤)通常覆盖不到 10 道题,EED 用最终表达式质量做代理,换来 500 题可自动化。
局限
论文自承的限制有两条:题目集中在奥赛级难度、各物理领域分布不均,向科研级推理的泛化有限;EED 只看最终答案,不检查推理过程,中间步骤的错误可能被最终表达式掩盖,树节点也一视同仁、不做量纲合理性校验。我们补读出的限制:人类基线是 81 名北大物理学生(一半奥赛金牌),每人只做 8 题共 559 份答卷,代表顶尖本科生而非一般人群,61.9% 这个绝对数字有选择偏倚;题目图对模型不可见,模型只能从文字重建空间关系,评测的是文本物理推理,多模态看图建模被排除,这也部分解释了物理感知错误占比低;正文写 32B 模型精度 2.6% 和 1.2%,表 4 给的是 1.58% 和 0.70%,两处数字对不上;原创性靠流程保证,模型是否真没见过这些改编题,只能靠低分和保留率反推,缺少直接污染审计实验。
复现要点
数据集与结果公开在 phybench.cn,TTS 实验使用开源 100 题子集。评测配置:统一 prompt(以物理专家身份逐步求解、最终答案放进 boxed 环境),自动抽取框内唯一 LaTeX 表达式,每模型每题 16 次运行;EED 用 SymPy 正则化加扩展 Zhang-Shasha 算法,子树折扣 0.6,默认参数基线 60、惩罚 100;模型结果 1,000 次 bootstrap、人类结果 10,000 次 bootstrap,成对优势置信度用高斯估计。想复刻这套评测经验,最值得抄的三件事是:用符号表达式约束答案格式、用树编辑距离给部分分、用投毒协议把鲁棒性拆成表层与真理解。
现有推理评测基准被三个问题拖累:任务过于简单导致模型饱和、题目来自公开材料导致数据污染、评测项本身有缺陷。PHYBench 由北大物理学院牵头,用 178 名学生出题、81 名学生(其中 50 人是物理奥赛金牌)人工验收,产出 500 道纯文本原创物理题(高中到奥赛难度、答案必须是符号表达式),配合 EED 树编辑距离评分给部分分:500 题按 EED 评分的区分力相当于约 1500 题按二元评分。实测最好的 Gemini 2.5 Pro 精度 36.9%,远低于人类基线 61.9%;错误分析显示模型九成以上的第一步错误发生在语义推理阶段,且多数模型靠量纲分析这类符号检查掩盖理解缺陷。
阅读提示
精读深度:泛读
清单提示:原文提示:这是用户自己的工作——500 道原创物理题、EED 评分体系、Gemini 2.5 Pro 36.9% vs 人类 61.9%;面向研究者介绍评测经验。播客覆盖:500 道原创题怎么造出来并防污染;EED 树编辑距离评分怎么给部分分、为什么样本效率 +204%;主结果 Gemini 2.5 Pro 36.9% 对人类 61.9%;以及做 LLM 评测的可迁移经验——防数据污染、质量把关、细粒度评分、错误定位与推理鲁棒性分析。
问题
要解决什么:评测 LLM 的推理能力缺一个严格、可信的基准。论文点名三个坑:一是任务过简导致饱和,DeepSeek-R1 在 MATH-500 上精度 97.3%,分数挤在一起分不出模型高下;二是数据污染,AIME 2024 这类公开题集很可能进了预训练语料,实测 Gemini 2.5 Flash 在 AIME 2024 上 16 次运行平均超过 99%、单次 100%;三是评测项本身有缺陷,抽查 OlympiadBench 36 道符号表达式的物理题,14 道存在歧义或答案抽取错误。论文要造一个模型没见过的、题目严格把关的、还能给过程性部分分的物理推理基准。
为什么 prior work 不够:MATH-500/GSM-8K 已饱和,失去区分度;AIME 2024 公开且模型可能背过题;GPQA 侧重前沿知识覆盖面而非多步推理(模型解题输出 token 少);OlympiadBench 体量大但质量把控不足,抽查 36 道就有 14 道有问题,其中 Problem 1015 答案里出现题干没定义的变量 γ,Problem 1216 标准答案抽取错误导致模型被误判。另外所有主流基准都用二元评分,答案全对或全错,区分力和统计效率都低。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 物理题干(纯文本) | text(无图、无多模态) | 每道题描述一个具体物理场景,要求对给定条件求某个关键量的符号表达式;变量全部在题干定义,不需要外部知识或未言明的假设,答案唯一(允许全部等价形式)。 |
| 模型解答(逐步推导文本) | text + LaTeX | 统一 prompt:以物理专家身份逐步求解,最终答案放入 boxed 环境;抽取器只保留框内恰好一个 LaTeX 表达式,忽略框外内容。 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 符号表达式答案 | LaTeX symbolic expression | 单一符号表达式,例如三球问题 T2 = 2mg + 4mv0^2/l;接受因式分解、重排等所有等价形式,拒绝方程形式(如 T/m − 2g = v0^2/l)和浮点近似。 |
| 评分 | 0 到 100 连续分(EED)或 0/1(Accuracy) | EED:gt 与 gen 表达式正则化后转树,相对编辑距离 r 归一化到 gt 树大小,r=0 得 100,0 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| PHYBench 500 题 | 500 道原创题 | 6 大领域(力学/电磁学/热学/光学/近代物理/高等物理),高中到本科与物理奥赛难度;纯文本;平均参考解约 3000 字符、人类通常几十步中间式;TTS 实验用开源 100 题子集。 |
| PHYBench 人类基线 | 81 人 / 559 份有效答卷 | 北大物理学院学生,其中 50 人为中国物理奥赛金牌;每人 8 题;精度 61.9% ± 2.1%、EED 70.4 ± 1.8(10,000 次 bootstrap)。 |
| 出题与评审队伍 | 178 名贡献者 + 评审 | 北大物理学院 178 名学生出题/改编/打磨;评审阶段展示 o1、DeepSeek-R1 输出辅助查歧义;Reviewer's Library 757 题,最终保留 500 题(保留率 66.1%)。 |
| 对比基准 | MATH-500 / GPQA / OlympiadBench / AIME 2024 | 表 1 用 DeepSeek-R1 测:平均输出 token 分别 1,857 / 6,308 / 5,372 / 7,741,PHYBench 10,636;平均精度 97.3% / 71.5% / 58.7% / 79.8%,PHYBench 25.0%。 |
架构(摘要)
主干与结构
backbone:
参数:
类型:n/a
关键组件
- 三道关的 curation pipeline:出题与改编(178 名学生、非公开加公开来源、全部原创化)到评审轮(评审员加 LLM 输出辅助查歧义,迭代打磨)到大规模人类实测(81 人、757 题淘汰到 500 题)
- EED 评分器:LaTeX 到 SymPy 正则化到正则化表达式树到扩展 Zhang-Shasha 树编辑距离(含大于 5 节点的子树插入/删除 60% 折扣)到 0 到 100 部分分
- 统一评测 harness:统一 prompt 加 boxed 最终答案抽取加每模型每题 16 次运行加 1,000 次 bootstrap 不确定性估计
为什么这样设计
这是一篇基准论文而非模型论文,所以没有神经网络架构。设计上把评测对象压缩成单一符号表达式答案:既能让等价判定自动化(SymPy 正则化),又让树编辑距离给出连续部分分;把难题把关完全交给人工三道关,用 66.1% 的淘汰率换正确性与无歧义。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Accuracy(500 题平均) | Gemini 2.5 Pro 36.9% | 人类基线 61.9% ± 2.1%(99% 置信水平显著高于所有模型) | 19 个模型乘每模型每题 16 次运行;人类:81 名北大物理学生(50 名奥赛金牌)每人 8 题、559 份有效答卷、10,000 次 bootstrap |
| EED Score 样本效率 | +204%(σ=80%) | 二元 Accuracy 评分(500 题 EED 区分力约等于 1500 题二元) | 1,000 次 bootstrap;样本效率 = (CV_ACC/CV_EED)^2,按表 4 的 19 个模型逐项计算取平均 |
| 平均输出 token(DeepSeek-R1) | 10,636 token | MATH-500 1,857(97.3% 精度)/GPQA 6,308(71.5%)/OlympiadBench 5,372(58.7%)/AIME 2024 7,741(79.8%) | 表 1 统一配置:同模型同 prompt,PHYBench 精度 25.0% |
| 第一步错误分布 | RR 占 79% 到 96%(7 模型),其中语义错误占 87% 到 99% | PP(物理感知)只占 4% 到 21% | 7 个模型乘 50 道代表题,人工定位每条推理链中的第一个错误 |
| 扰动鲁棒性(精度) | DeepSeek-R1:原始 97% 到 T2 39% / T4 37%;Gemini 2.5 Pro:原始 97% 到各扰动 78% 到 100% | GPT-4o 原始 4%、各扰动 0 到 1%;o1-preview 原始 94%、T1 9% / T2 15% | 注入 6 类 CoT 错误后要求继续推导;正确部分解基线 F2 下多数模型 89% 到 100% |
| TTS:pass@32 与多数投票 | Gemini 2.5 Pro pass@1 38.7% 到 pass@32 65.9%(外推上界 74.9);DeepSeek-R1 25.1% 到 50.9%(上界 81.3) | 多数投票只涨几个点(Gemini 2.5 Pro vote32 42.0) | 开源 100 题子集,每模型每题最多 32 个样本、每个数据点要求超 90% 题目采样数够 k;指数衰减拟合 Acc = Boundary − Gain·exp(−x/x0),x = log k |
Insights
- 模型的失败主战场在语义推理:7 个模型第一步错误中物理感知只占 4% 到 21%,稳健推理占 79% 到 96%,而推理类错误里 87% 到 99% 属于从物理语境生成新方程(语义),纯符号化简/代入几乎不犯错(第 5.1 节、表 2)。
- 表面鲁棒和语义理解可以分离:DeepSeek-R1 靠量纲分析、极限检验这类符号检查抓错,遇到没有符号提示的扰动(T2 变号、T4 丢项)精度从 97% 掉到 39%/37%;Gemini 2.5 Pro 靠把语义推理换成形式化推导维持 8 个百分点以内波动,两类策略都躲开了语义理解这道坎(第 5.2 节、表 3)。
- 多数投票几乎没用而 pass@k 一路涨:pass@32 把 Gemini 2.5 Pro 从 38.7% 抬到 65.9%,多数投票只到 42.0%,正确答案存在于模型采样空间,但模型没有可靠的自我校验机制去认出它(第 4.5 节、表 7)。
- 污染是能测出来的:Gemini 2.5 Flash 在公开的 AIME 2024 上平均超 99%,在全部原创的 PHYBench 上只有 34.25%(pass@1),同一模型两套数字之间的落差就是记忆和泛化的分界(第 4.4 节、附录 A.2)。
- EED 的价值在信息量:二元评分下 47 分和 13 分的答案都被判 0,EED 把它们拉成连续梯度;500 题 EED 的区分力相当于约 1500 题二元评分,评测成本是评测质量的一部分(第 3.3 节、附录 C.1)。
vs 同类工作
- vs MATH-500 / AIME 2024(题目公开、二元评分):PHYBench 全部题目原创、经三道人工关,答案限单一符号表达式并用 EED 给部分分;MATH-500 已被 DeepSeek-R1 打到 97.3%,AIME 2024 上 Gemini 2.5 Flash 平均超 99%。
- vs GPQA(知识覆盖导向):GPQA 的物理题主要是知识型选择,模型输出 token 少、推理链短;PHYBench 要求多步符号推导,DeepSeek-R1 平均输出 10,636 token 对比 GPQA 6,308,且 PHYBench 上推理模型与普通模型的差距更大(DeepSeek-R1 24.9% vs DeepSeek-V3 13.5%)。
- vs OlympiadBench(体量大、把关弱):抽查 36 道符号表达式物理题有 14 道存在歧义或答案抽取错误;PHYBench 用 66.1% 的淘汰率换题面正确性,并把评审员配了 LLM 输出当歧义探测器。
- vs HLE(前沿知识难度导向):HLE 强调知识覆盖面、偏离推理评测;PHYBench 定位在有明确答案可判定的多步物理推理,人类基线 61.9% 保证题目可解、模型 36.9% 保证有区分空间。
- vs 过程级人工评测(如 PRM 相关工作):过程级评测精度高但通常只能覆盖不到 10 道题、无法规模化;EED 牺牲过程信息换取 500 题可自动化、可复现的评测,论文明确把它定位成最终答案质量的代理。
局限
- 难度定位与覆盖面:论文自承题目集中在奥赛级难度、各物理领域分布不均,向科研级推理的泛化有限;未来要扩规模与覆盖面(第 6 节)。
- EED 只看最终答案:评分不检查推理过程,中间步骤的错误可能被最终表达式掩盖;所有树节点一视同仁,不做量纲合理性这类物理校验(附录 B.3 自承)。
- 人类基线的构成与覆盖:81 名受试全是北大物理学生且一半是奥赛金牌,每人只做 8 题(559 份答卷),单题人类表现波动大;这个基线代表顶尖本科生,代表不了科研人员或一般人群,61.9% 的绝对水平有选择偏倚。
- 纯文本格式的代价:题目图对模型不可见,模型只能从文字重建空间关系;评测的是文本物理推理,多模态物理感知(看图建场景)被排除,这也部分解释了物理感知错误少这个结论。
- 正文与附录表有出入:正文写 32B 模型精度 2.6% 和 1.2%,表 4 给的是 1.58% 和 0.70%,两处不一致(我们的核对)。
- 原创性靠流程保证、无法形式化证明:题目改编自非公开加公开来源,作者声称无法靠直接搜索或标准参考找到,但模型是否真没见过这些变体,只能靠保留率 66.1% 和低分反推,缺少像擦除后重训这类直接的污染审计实验。
可复现性
- code:数据集与结果公开:https://www.phybench.cn/(TTS 实验使用开源 100 题子集)
- weights:n/a(基准论文)
- setup:评测:统一 prompt(以物理专家身份逐步求解、答案放 boxed),自动抽取框内唯一 LaTeX 表达式;每模型每题 16 次运行;EED 用 SymPy 正则化加扩展 Zhang-Shasha 算法(子树折扣 0.6),默认参数基线 60、惩罚 100;统计:模型结果 1,000 次 bootstrap、人类结果 10,000 次 bootstrap、成对优势置信度用高斯估计 CL = Φ((ŝi−ŝj)/√(σi²+σj²));扰动协议与 6 类扰动定义见附录 G.2,TTS 拟合 Acc = Boundary − Gain·exp(−x/x0)
主干与结构
backbone:
参数:
类型:n/a
关键组件
- 三道关的 curation pipeline:出题与改编(178 名学生、非公开加公开来源、全部原创化)到评审轮(评审员加 LLM 输出辅助查歧义,迭代打磨)到大规模人类实测(81 人、757 题淘汰到 500 题)
- EED 评分器:LaTeX 到 SymPy 正则化到正则化表达式树到扩展 Zhang-Shasha 树编辑距离(含大于 5 节点的子树插入/删除 60% 折扣)到 0 到 100 部分分
- 统一评测 harness:统一 prompt 加 boxed 最终答案抽取加每模型每题 16 次运行加 1,000 次 bootstrap 不确定性估计
为什么这样设计
这是一篇基准论文而非模型论文,所以没有神经网络架构。设计上把评测对象压缩成单一符号表达式答案:既能让等价判定自动化(SymPy 正则化),又让树编辑距离给出连续部分分;把难题把关完全交给人工三道关,用 66.1% 的淘汰率换正确性与无歧义。
PHYBench 主结果:19 个模型 vs 人类
原文 caption:Model performance on PHYBench. We report accuracy and EED Score for both reasoning and general language models, averaged over all samples.
论文最核心的一张图,回答这篇工作的核心论断:模型离人类物理推理差多远、推理模型和普通模型的差距在哪。横轴是 19 个模型按表现排序,纵轴是分数(0 到 70),每个模型一对柱子:左柱 EED Score、右柱 Accuracy;两条虚线是人类基线(精度 61.9%、EED 70.4)。读图要点:最好的 Gemini 2.5 Pro 精度柱只有 36.9%,柱顶远够不到人类虚线;推理模型(o3、o4-mini、DeepSeek-R1 等)整体柱高明显超过普通模型(GPT-4o、DeepSeek-V3 等),区分度比 MATH-500 这类饱和基准强得多;右端 32B 小模型(QwQ-32B、DeepSeek-R1-Distill-Qwen-32B)精度柱几乎贴地(1% 到 3%)。
示例题 + EED 评分演示
原文 caption:An example problem from PHYBench. Two evaluation metrics are employed: Expression Edit Distance (EED) Score and accuracy. We show the scores for three different responses, with Model Answer 1 and Model Answer 2 generated by DeepSeek-R1 and GPT-4o respectively.
这道题是理解 PHYBench 和 EED 的钥匙:三球三绳悬挂系统,锤击使最上方球获得水平瞬时速度 v0,求中间绳子的瞬时张力 T2,标准答案是 T2 = 2mg + 4mv0^2/l。页面上半是物理示意图(标注图对模型不可见,模型只读文本);下半是表达式树对比:标准答案得 EED 100、ACC 100,DeepSeek-R1 的答案(T2 = 2mg + 2mv0^2/l)得 EED 47、ACC 0,GPT-4o 的答案(T2 = mv0^2/l 这类)得 EED 13、ACC 0。读图要点:二元评分把 47 分和 13 分都打成 0,EED 保留了部分正确的梯度,这正是样本效率提升的来源。
跨基准的 token 消耗与分数对比
原文 caption:Token Usage and Score of Typical Models on Different Benchmarks
支持 PHYBench 难度与复杂度的论断。面板 (a):几个代表模型(Gemini 2.5 Pro/Flash、DeepSeek-R1、o4-mini)在五个基准上的平均输出 token,PHYBench 的柱子明显最高(DeepSeek-R1 平均 10,636 token,Gemini 2.5 Flash 甚至到约 2 万),说明解题链最长。面板 (b):同一批模型在五个基准上的平均精度,PHYBench 上全线最低(约 20% 到 40% 区间),MATH-500 上冲到 70% 到 95%。读图要点:用同一批模型做对照,PHYBench 同时满足输出链更长加分数更低,这两个证据合起来支撑题目更复杂、更不容易背的论断。
🎧 音频版
时长 23:24 · Edge TTS
PHYBench:给大模型的物理推理能力做个体检(对话版·泛读)
先讲清楚这篇要解决什么问题
小播:大家好,我是小播,负责替大家提问,把听不懂的地方问出来。今天这期聊的是《PHYBench: Holistic Evaluation of Physical Perception and Reasoning in Large Language Models》,给大语言模型做物理感知和物理推理的全面评测,来自北京大学物理学院牵头、北大人工智能研究院参与的团队,作者名单里还有几十位北大学生,是篇典型的师生合作大工程。老播,先给我一句话定位:这篇论文解决什么问题,为什么值得专门做一期?
老播:大家好,我是老播。一句话背景:现在测大模型推理能力的主流基准,要么被模型刷到接近满分、分不出高下,要么题目是公开的、模型可能早就背过,要么题本身就有错。PHYBench 的做法,是用 500 道全部原创的物理题,配一套能打部分分的评分系统,把这三个坑一起填上。一句话结论先放这儿:当前最好的模型 Gemini 2.5 Pro,精度 36.9%,而人类基线是 61.9%,中间隔着一道现在所有模型都够不到的差距。这期我们把三件事讲透:500 道原创题是怎么造出来防污染的、EED 评分是怎么给部分分的、以及从评测结果看模型到底卡在哪一步。
小播:三件事我记下了。先从头说起,为什么已有的基准不够用?
先补背景:跑分基准的三个坑
老播:评测推理能力的前提,是题得能区分模型。论文把现有基准的问题归成三类。第一类是饱和。MATH-500 是 500 道数学题的常用基准,DeepSeek-R1 在它上面精度 97.3%,分数挤在顶端,模型之间那点差距还经常是答案格式问题,跟推理能力关系不大。论文提到,像 Gemini 2.5 Pro、o4-mini-high、DeepSeek-R1 这些模型,在 MATH-500 上只要把答案格式修正一下就能全对,说明这类基准已经测不出推理的上限了。第二类是数据污染。AIME 2024 是美国数学邀请赛的公开题,OlympiadBench 是奥赛题集,这类公开材料大概率进过大模型的预训练语料。论文给了一个很直接的实测:Gemini 2.5 Flash 在公开的 AIME 2024 上,16 次运行平均分超过 99%,同一个模型在全部原创的 PHYBench 上,pass@1 只有 34% 左右。同一个模型,背过题和没背过题,分数差出一倍多,这个落差就是记忆和泛化的分界。这也提醒我们,看任何跑分先问一句:题是不是公开的。第三类是错题。论文抽查了 OlympiadBench 36 道要求答案写成符号表达式的物理题,14 道有歧义或者标准答案抽取错误,比如有一道题,标准答案里出现了题干从没定义过的变量;另一道题标准答案本身抽取错了,导致所有模型都被误判。另外还有一类基准走知识路线,比如 GPQA 测研究生级科学知识,题目以选择题为主,模型输出 token 很少,测的是知道什么,推理链根本撑不起来。
小播:第三个坑听起来最离谱,基准题自己都是错的,那跑出来的分还有什么可信度。
老播:对,所以基准建设的重点就落在这三件事上:题目要原创、要正确、评分要能拉开差距。这里也可以问一句,为什么偏偏选物理题当试金石?数学竞赛题现成的一大堆。原因是物理题的结构特别适合评测:一道题先给你一个具体场景,要求从文字里重建空间和相互作用关系,再挑适用的物理定律,多个条件组合推导,最后落成一个符号表达式。场景描述、定律选择、多步推导三件事都齐,正好把感知和推理都覆盖进去,而且每一步都有可以核对的表达式,这为后面做投毒实验埋了伏笔。论文的应对是一套组合拳,接下来进核心思想。先记住一个数字锚点:最好的模型 36.9%,人类 61.9%,后面所有实验都围着这个差距展开。
核心思想:500 道原创题加一套会打部分分的评分器
小播:先从造题开始。500 道原创物理题,怎么保证原创、怎么保证题没有错?
老播:流程是三道关。第一关,178 名北大物理学院的学生从非公开习题和公开材料里出题、改编,所有题目都被要求改写成模型在网上搜不到的样子,而且答案必须是单一符号表达式。举论文里的例子:三个小球用三根轻绳串起来挂在天花板上,锤击最上面的球让它获得水平瞬时速度 v0,求中间绳子的瞬时张力 T2,答案写成 T2 等于 2mg 加 4mv0 平方除以 l 这种符号形式。题目覆盖力学、电磁学、热学、光学、近代物理、高等物理六大领域,难度从高中一直排到本科课程和物理奥赛。出题还有几条硬性要求:题干里的变量全部定义清楚,不需要外部知识或者没写明的假设,答案唯一。把答案限制成符号表达式有个大好处:正确与否可以用符号等价来判断,两个长得不一样的式子,化简完一样就算对,评分可以全自动。第二关,评审员逐题把关,同时把 o1、DeepSeek-R1 这些模型的零样本输出贴在旁边当歧义探测器,模型答得前后矛盾、飘忽不定的题就回炉改题干,一直改到模型输出稳定反映题意。第三关,81 名学生每人做 8 题实测,反馈题面是否清晰、答案是否唯一,其中 50 人是中国物理奥赛金牌。757 道题走完三道关,只留下 500 道,保留率 66.1%。这些人类受试的成绩就是人类基线:精度 61.9%、EED 分 70.4,波动分别是正负 2.1 和正负 1.8 个百分点。
小播:我算了一下,人类做这些题也只有六成多?那说明题是真的难,模型菜得有理有据。
老播:对,这一点很关键。人类 61.9% 说明题对真人可解但不容易,模型 36.9% 说明模型确实差一截,两头都有区分空间。要是人类 100 分、模型 99 分,这基准就废了。论文还给了个人类分布的数据:受试里成绩最好的一批人,也就是上四分位,能做到 71.4% 的精度,而低于 30% 的人类受试不到一成,说明题目难度对真人来说处在合理区间。另外这些题全部是纯文本,题里的示意图对模型不可见,模型只能靠文字重建空间关系,这是基准的一个设计选择,讲局限的时候我们回头再说它。
小播:接下来是评分。二元评分就是答对满分答错零分,EED 这个部分分是怎么打的?
老播:EED 全称是表达式编辑距离。打个比方:标准答案是棵树,模型答案也是棵树,树上的每个节点是一个运算或者一个符号,EED 在数的是,要把标准答案这棵树改成模型答案那棵树,最少要动几个节点,插入、删除、替换各算一次,动得越少说明越接近。用树而不是字符串来比,是因为表达式天然是树状结构,乘法交换律、合并同类项这类等价变形会被 SymPy 正则化先吸收掉,剩下的差异才是真正的结构差异。归一化之后就是论文的核心公式:r 等于两棵树的编辑距离除以标准答案树的节点数,r 越小越接近。然后分段给分:r 等于 0,也就是完全等价,得 100 分;r 在 0 到 0.6 之间,得 60 减 100r;r 超过 0.6,得 0 分。论文给了一个很直白的例子:还是三球那道题,DeepSeek-R1 算出 T2 等于 2mg 加 2mv0 平方除以 l,系数错了一半,EED 给 47 分;GPT-4o 算得差得更远,EED 给 13 分;但二元评分下,这两个答案都是 0 分。这里还有个实现细节:对超过 5 个节点的子树,插入和删除的成本打 6 折,因为一整块物理成分的增删应该比逐节点累加便宜,算法用扩展 Zhang-Shasha 树编辑距离实现,复杂度跟标准算法保持一致。
小播:47 分和 0 分,同样是错,EED 保留了一个梯度。这个梯度具体有什么用?
老播:用处就是论文说的样本效率。用 bootstrap 重采样,也就是对样本反复有放回抽样的方法,估计每个模型分数的波动程度,相对波动小的评分方式,就相当于用更少的题达到同样的区分力。公式是样本效率等于精度波动除以 EED 波动的平方,19 个模型平均下来,EED 比二元评分提升 204%,标准差 80%。换算一下:500 道题用 EED 评分,区分力和约 1500 道题用二元评分相当。做评测的人都知道,出高质量原创题是最贵的环节,评分方式能省下三分之二的工作量,这是实打实的贡献。而且论文做了参数鲁棒性测试:给分的基线从 50 扫到 70、扣分斜率从 100 扫到 140、子树折扣开关各试一遍,模型排名几乎不动,只在个别本来就分不开的相邻模型上有正负一名的波动,说明这个部分分和具体参数选择关系不大。顺带提一句,EED 的目标是给研究者一个可解释、规则驱动、不需要任何模型参与打分的度量,这和后来自动化判分的大模型裁判是两条不同的路线。论文还从理论上解释了为什么部分分有用:二元评分是阶跃函数,模型能力只要略低于题目难度阈值就整题得零分,低分段的区分力被压没了;EED 的分数随能力近似线性下降,低分段也能把模型按能力摊开。
小播:好,核心思想我复述一遍:原创题三道关防污染防错题,符号表达式答案让等价判断自动化,EED 给部分分把评测样本效率提升 204%。对吧?
老播:完全对。36.9% 对 61.9% 的差距、样本效率加 204%、66.1% 的淘汰率,这三个数字是这期的记忆锚点。接下来看实验,看模型到底错在哪。
关键实验:模型到底卡在哪一步
小播:先看主结果。36.9% 对 61.9% 这个差距,具体是哪些模型贡献的?
老播:论文的图 1 把 19 个模型的分数画成柱状图,横轴是模型、纵轴是分数,每个模型一对柱子,分别记 EED 分和精度分,两条虚线是人类基线。三个看点。第一,最好的 Gemini 2.5 Pro 精度 36.9%、EED 49.5,人类是 61.9% 和 70.4,99% 置信水平下人类显著高于所有模型。第二,推理模型整体拉开普通模型:o3 精度 34.8%、o4-mini 29.4%、DeepSeek-R1 24.9%,而 DeepSeek-V3 只有 13.5%、Claude 3.7 Sonnet 13.2%、GPT-4.1 12.9%,早期推理模型 o1 也只有 10.7%。第三,32B 的开源小模型 QwQ-32B 和 DeepSeek-R1-Distill-Qwen-32B 精度只有 1% 到 3%,几乎贴地,这些模型在其他基准上成绩并不差,说明 PHYBench 确实测出了别处测不到的东西。再看解题长度:DeepSeek-R1 在 PHYBench 上平均输出 10,636 个 token,同一个模型在 MATH-500 上只要 1,857 个、GPQA 6,308 个、AIME 2024 7,741 个,解题链长一个量级,分数却全线最低。论文还专门用 bootstrap 验证了 EED 和精度两种评分的模型排名几乎一致,但 EED 的统计波动更小,所以同样 500 道题,EED 能给更可信的排序。
小播:分数最低、链最长,那这些长链错在哪一环?开头说的语义推理,就是这里吗?
老播:对,这是论文信息量最大的一块。他们选 7 个模型、50 道代表题,人工逐条推理链找第一个错误,分两个维度。第一个维度是物理感知对稳健推理:物理感知指漏掉关键变量、误解物理量关系、场景建模建错,稳健推理指公式选错、条件没组合对。结果 7 个模型里,第一步错误落在物理感知的只占 4% 到 21%,落在稳健推理的占 79% 到 96%,比如 GPT-4o 的物理感知错误占比最高也只有 21%,Gemini 2.5 Pro 是 9%、DeepSeek-R1 只有 4%。第二个维度把稳健推理再拆开:语义推理是从物理背景里生成之前步骤没有的新方程,符号推理是对已有方程做化简和代入。结果稳健推理里的错误,87% 到 99% 是语义型的,o3-mini 和 o4-mini 甚至到了 99%。合起来就是论文的主结论:模型读题、列已有方程、做代数都靠得住,真正卡死它们的是从物理语境凭空造出新方程这一步,比如磁场存在外力矩的时候还默认角动量守恒。
小播:错误分类是人工标的,这个结论怎么验证它靠谱?
老播:所以他们又加了一个投毒实验,这是我最喜欢的设计。做法是把参考解答截断到中间,人为注入 6 类错误,让模型接着往下推。错误都动在万有引力公式里 Rm 加 h 的平方上:T1 把平方去掉、T2 把加号改成减号、T4 把 h 项整个删掉、T6 把流体静力学方程翻成倒数形式,等等。对照组里,给一个正确的部分解答时,多数模型能答到 89% 到 100%,说明模型顺着正确思路走没问题。注入错误之后,看模型能不能发现并纠正。结果把模型分成三类:表层推理是照错往下推,完全不验证;真推理是靠语义理解发现错误并修复,比如意识到高度定义里半径加海拔的几何关系,把减号纠正回加号;伪真推理是靠量纲分析、极限检验这类一致性检查抓错,能做对一部分但换一种错误类型就失效。数字很有意思:DeepSeek-R1 原始精度 97%,遇到 T1、T3 这种能靠量纲检查暴露的错误,还能维持 64% 和 99%,T3 是组合扰动反而成绩回升,因为两个互相冲突的线索更容易触发模型的检查机制;但遇到 T2、T4 这种量纲上没破绽的错误,直接掉到 39% 和 37%;Gemini 2.5 Pro 则靠把语义推理转成形式化推导,六个扰动全部维持在 78% 到 100%;而早期的 o1-preview 原始 94%,遇到 T1 只剩 9%、T2 只剩 15%,普通模型 GPT-4o 原始就只有 4%,扰动下基本归零。这个实验说明:模型表现出的鲁棒性,来源常常是符号层面的检查策略,绕开了语义理解本身。再回到那个差距:36.9% 对 61.9%,差的这部分主要就在语义推理上。
小播:单个样本不行,多采样几次呢?测试时扩展有用吗?
老播:论文做了 pass@k 和多数投票两个对照。pass@k 是采样 k 次取最高分,多数投票是采样 k 次投票选出现最多的答案。结果 pass@k 一路涨:Gemini 2.5 Pro 从 pass@1 的 38.7% 涨到 pass@32 的 65.9%,外推上界 74.9;DeepSeek-R1 从 25.1% 涨到 50.9%,上界 81.3。多数投票几乎不动,投 32 票也只有 42.0%。这个对比指向一个结论:正确答案其实存在于模型的采样空间里,模型缺的是把正确答案挑出来的自我校验能力。论文用指数衰减曲线去拟合 pass@k 的上界,模型名次在扩展过程中保持稳定,说明 PHYBench 在测试时扩展下也守得住排序。需要说明,这里的 pass@k 用的是开源 100 题子集,全量 500 题的数字会不一样,但趋势是论文论证的重点。另外 DeepSeek-V3、GPT-4o 这类普通模型连上界曲线都拟合不出来,说明多采样对它们没有明确的天花板效应,提升空间还看不到头。
它在评测基准这条线上处在哪
小播:好,把它放回谱系里。和 MATH-500、AIME、GPQA 这些比,PHYBench 的位置在哪?
老播:可以分三代看。第一代 MATH-500、GSM-8K,被模型刷到饱和,DeepSeek-R1 97.3% 就是例证。第二代 AIME 2024、OlympiadBench,难度上来了,但题源公开、把关不足,AIME 2024 上 Gemini 2.5 Flash 平均超 99%,OlympiadBench 抽查 36 道有 14 道有问题。还有一条知识路线 GPQA、HLE,侧重前沿知识覆盖面,以选择题为主,模型输出 token 少、推理链短,测的是知道什么,测不出多步推理。论文引言还引了 MathArena 的结论:前沿模型在公开的奥赛难度题上已经能答得不错,但那恰恰说明公开题集被刷透了,回到全部原创的 PHYBench 才现出原形。PHYBench 和它们的区别在三点:题目全部原创加三道人工关,解决污染和错题;答案限制成符号表达式,等价判断全自动;EED 给部分分,把评测从二元升级成连续。论文自己也承认,它的体量只有 500 道题,和 OlympiadBench 的八千道相比小很多,但换来的是每题都经过人验、答案可自动判定。代价也明确:过程级人工评测能查中间步骤,但通常只能覆盖不到 10 道题,EED 用最终表达式的质量做代理,换来 500 道题全自动评分。
局限:别把 61.9% 当成不可动摇的线
小播:最后说说局限,我猜不止论文自己写的那两条。
老播:论文自承的有两条:题目集中在奥赛级难度、物理领域分布不均,向科研级推理的泛化有限;EED 只看最终答案,不查推理过程,中间步骤的错误可能被最终表达式掩盖,甚至出现中间推理全错、最终式子碰巧和标准答案等价就给 100 分的情况,而且树节点一视同仁,不做量纲合理性这类物理校验。我们补读出四条。第一,人类基线是 81 名北大物理学生、一半是奥赛金牌,每人只做 8 题共 559 份答卷,这个群体代表顶尖本科生,61.9% 这个绝对数字有选择偏倚,换成一般人群或者科研人员,基线会不一样;论文自己也报告了受试分布很宽,上四分位精度到 71.4%,说明平均值背后个体差异很大。第二,题目图对模型不可见,模型只能靠文字重建空间关系,这测的是文本物理推理,看图建模这类多模态感知被排除,所以论文得出物理感知错误少的结论,要在这个设定下理解。第三,正文写 32B 模型精度 2.6% 和 1.2%,附录表 4 给的是 1.58% 和 0.70%,两处数字对不上。第四,原创性靠流程保证,模型到底有没有见过这些改编题,只能靠低分和 66.1% 的淘汰率反推,没有做数据擦除重训这类直接的污染审计。
收尾:记住这三件事
小播:好,收尾,我总结这期记住的三件事。第一,PHYBench 是 500 道原创物理题加三道人工关,保留率 66.1%,从源头防污染防错题。第二,EED 评分把二元判断升级成树编辑距离的部分分,样本效率提升 204%,500 道题的区分力约等于 1500 道题用二元评分。第三,最好的 Gemini 2.5 Pro 精度 36.9%,人类基线 61.9%,差距主要落在语义推理:模型能读题、能算代数,卡在从物理语境生成新方程,而且多数模型的鲁棒性来自符号检查这类策略,绕开了语义理解。
老播:补一句这篇对后续工作的意义。它给评测立了一个范式:符号表达式答案、自动等价判定、细粒度评分,这条路线能省下约三分之二的出题量;它给的投毒协议,可以拿来当衡量模型推理鲁棒性的标准测试。对做评测的人,最值得抄的三件事是约束答案格式、用树编辑距离给部分分、用投毒协议拆鲁棒性。对做模型的人,语义推理这道坎还横在那里,36.9% 和 61.9% 之间的空间,就是下一轮工作的起点。