Improved Mean Flows:把 one-step 生成模型做成可用范式
一句话定位:原版 MeanFlow 能一次函数评估(1-NFE)生成图像,但它的训练目标依赖网络自身、CFG scale 训练期就定死。本文(iMF)把训练目标重写成「对瞬时速度 v 回归、由平均速度网络 re-parameterization」的标准回归问题,把 CFG scale 变成推理期可调的条件变量,再配多 token in-context conditioning,让从零训练的 one-step 模型在 ImageNet 256×256 上拿到 1-NFE FID 1.72,相对原版 MF-XL/2 的 3.43 下降约 50%,是 fastforward 范式「可用化」的样板。
背景:生成模型为什么需要很多步
扩散与 flow matching 模型的生成过程是解一条 ODE:从噪声分布出发,沿着学到的速度场走回数据分布。Flow Matching(FM)学的是瞬时速度场 v:对线性插值 z_t = (1−t)x + t·e(t 是时间步,x 是数据样本,e 是高斯噪声),训练网络 v_θ 去回归条件速度 e−x,损失是
E[ ‖ v_θ(z_t) − (e−x) ‖² ]。
这个式子回答的问题是「在 z_t 这个位置、这个时刻,流应该往哪个方向走」。符号逐个看:z_t 是加噪样本,e−x 是「从数据到噪声」的位移方向(也叫条件速度),v_θ 是网络预测。同一张 z_t 可以由很多对 (x, e) 生成,所以真正唯一的回归目标是边际速度 v(z_t) = E[e−x | z_t],即对所有满足 z_t 的 (x, e) 取期望。推理时用数值求解器从 t=1 积分到 t=0,每一步都要调用一次网络,通常几十到几百次函数评估(NFE)。
MeanFlow(MF)换了个思路:学平均速度场 u,即两个时间步 r 到 t 之间瞬时速度的平均:u(z_t) = (1/(t−r))·∫_r^t v(z_τ)dτ。直觉上,如果速度场接近直线,平均速度 u 就能代替整条积分,一步从 z_1 走到 z_0:z_0 = z_1 − u_θ(z_1)。训练时积分不可做,MF 用 MeanFlow identity 把积分换成微分关系:u(z_t) = v(z_t) − (t−r)·(d/dt)u(z_t),其中 (d/dt)u = JVP(u; v) 是 Jacobian-vector product,把速度 v 当作切向量沿着 u 的雅可比传播。
问题出在训练目标的实现上。原版 MF 的回归目标是
u_tgt = (e−x) − (t−r)·JVP(u_θ; e−x),
然后最小化 ‖u_θ − sg(u_tgt)‖²(sg 是 stop-gradient)。这里做了两个近似:把边际速度 v 换成条件速度 e−x,把 JVP 里的真值 u 换成网络预测 u_θ。这两个近似埋下两个隐患:目标依赖网络(u_θ 出现在目标里,目标随网络漂移),回归输入混入未知量(复合函数除了 z_t 还吃了 e−x)。本文要解决的就是这两点。
核心方案一:对 v 回归,用 u 网络 re-parameterization
先给预期:既然 FM 对 v 回归很稳定,MF 能不能也回归 v?可以——把 MeanFlow identity 反过来用,v(z_t) = u(z_t) + (t−r)·(d/dt)u(z_t),左边当回归目标,右边用 u_θ 参数化,得到复合函数
V_θ(z_t) = u_θ(z_t) + (t−r)·JVP_sg(u_θ; v_θ),
训练损失 E[ ‖ V_θ(z_t) − (e−x) ‖² ]。符号解释:u_θ 是平均速度预测,JVP_sg 是对 (d/dt)u 的 Jacobian-vector product(sg 表示对这项的输出 stop-gradient),v_θ 是网络自己预测的瞬时速度,只吃 z_t。原版 MF 的 JVP 输入是 e−x,本文改成 v_θ(z_t),于是复合函数的输入只剩 z_t,回归问题「正宗」了。论文证明这个目标和原版目标完全等价——原版 MF 表面学 u,实际就是对 v 回归,只是被 u 网络 re-parameterization 了。
v_θ 从哪来:两种实现。一是边界条件 v_θ(z_t, t) = u_θ(z_t, t, t),因为按定义 v 就是 u 在 r→t 的极限,零额外参数;二是辅助 v-head,在 u_θ 主干上挂一个 8 层子网络专门预测 v,训练期用 FM 辅助损失 ‖v_θ − (e−x)‖² 兜住,推理期不用这个头。
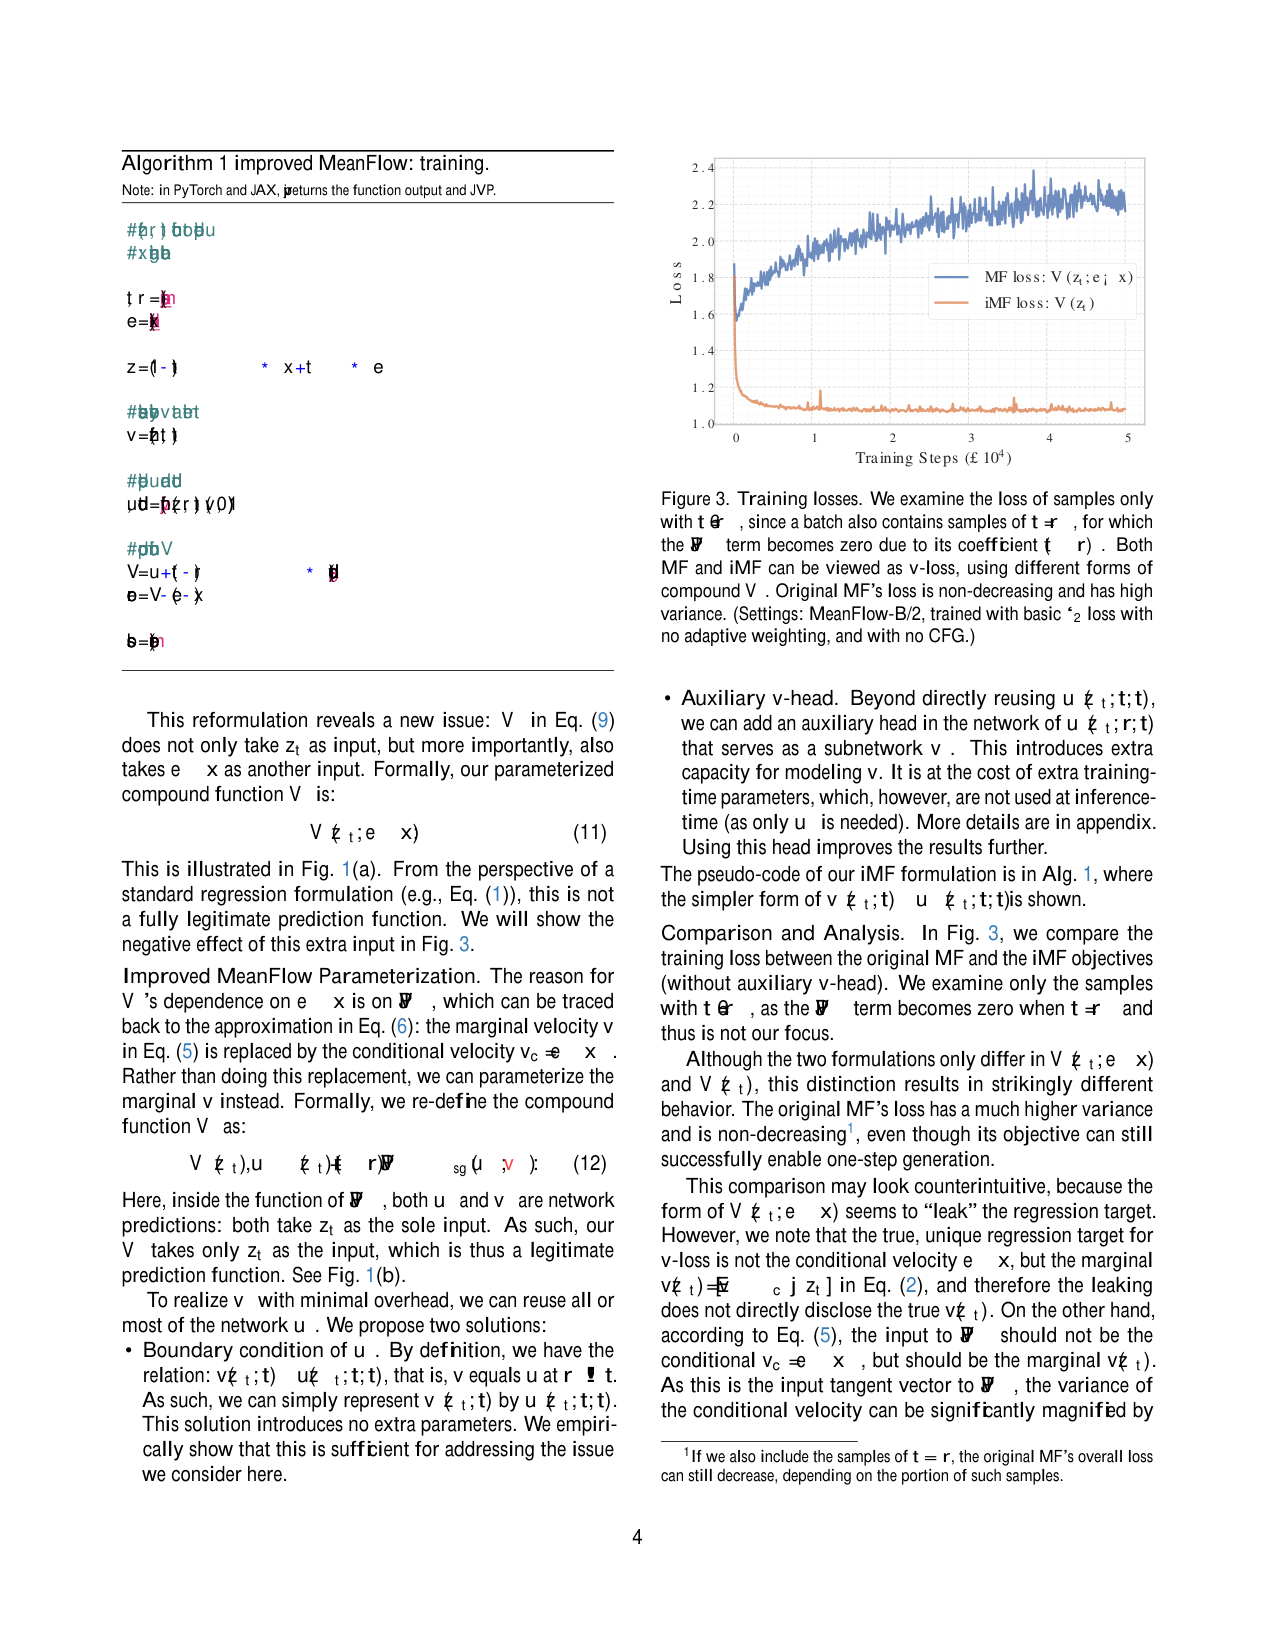
为什么更稳:JVP 的切向量本该是边际速度 v(z_t),方差比条件速度 e−x 小;原版 MF 把 e−x 直接塞进 JVP,条件速度的高方差被 JVP 放大,损失又高又不降。Fig.3 是直接证据:同样在 MeanFlow-B/2、基本 ℓ2 损失、无 CFG 的设置下,原版 MF 的损失从约 1.6 一路升到约 2.3 且剧烈抖动,iMF 的损失从约 1.8 快速降到约 1.1 后平稳。两版只差 JVP 输入这一处,行为完全不同。
stop-gradient 的位置:本文保留了 sg,但位置变了。原版 MF 的 sg 在回归目标里(目标才「像」常数);iMF 的 sg 在预测函数 V_θ 内部,目标是干净的 e−x。论文承认理论上的 JVP 目标并不严格需要它,去掉会引入对 θ 的高阶梯度、优化更难,所以实践上保留。
消融结果(Tab.1a,MF-B/2、240 epoch、ImageNet 256×256、FID-50K):无 CFG 时原版 MF 是 32.69,边界条件版 29.42(改善 3.27)、辅助头版 30.76(改善 1.93);有 CFG(固定 ω 训练)时原版 6.17,边界条件版 5.97、辅助头版 5.68(约 10% 相对提升)。换到更大的 MF-XL/2,有 CFG 时原版 3.43,边界条件版 2.99——模型越大,受益越明显。
核心方案二:CFG scale 从固定超参变成条件变量
先给预期:CFG 是扩散模型里「按类别引导」的标准技巧,采样时把条件与无条件的速度按比例混合。原版 MF 在训练期就把比例 ω 定死,本文把 ω 也变成网络的条件输入,让一个模型覆盖所有 ω。
先看原版 MF 的固定引导场:v_cfg(z_t|c) = ω·v(z_t|c) + (1−ω)·v(z_t),c 是类别标签。本文把 ω 加进条件:V_θ(·|c, ω) = u_θ(z_t|c, ω) + (t−r)·JVP_sg。训练时 ω 从 [1.0, 8.0] 里按幂分布 p(ω) ∝ ω^β(β=1 或 2,偏向小 ω)随机采样;ω=1 就退化成无 CFG。再进一步,CFG 区间 [t_min, t_max](多步方法里提升多样性的技巧)也做成条件,区间外的训练样本 ω 置 1。
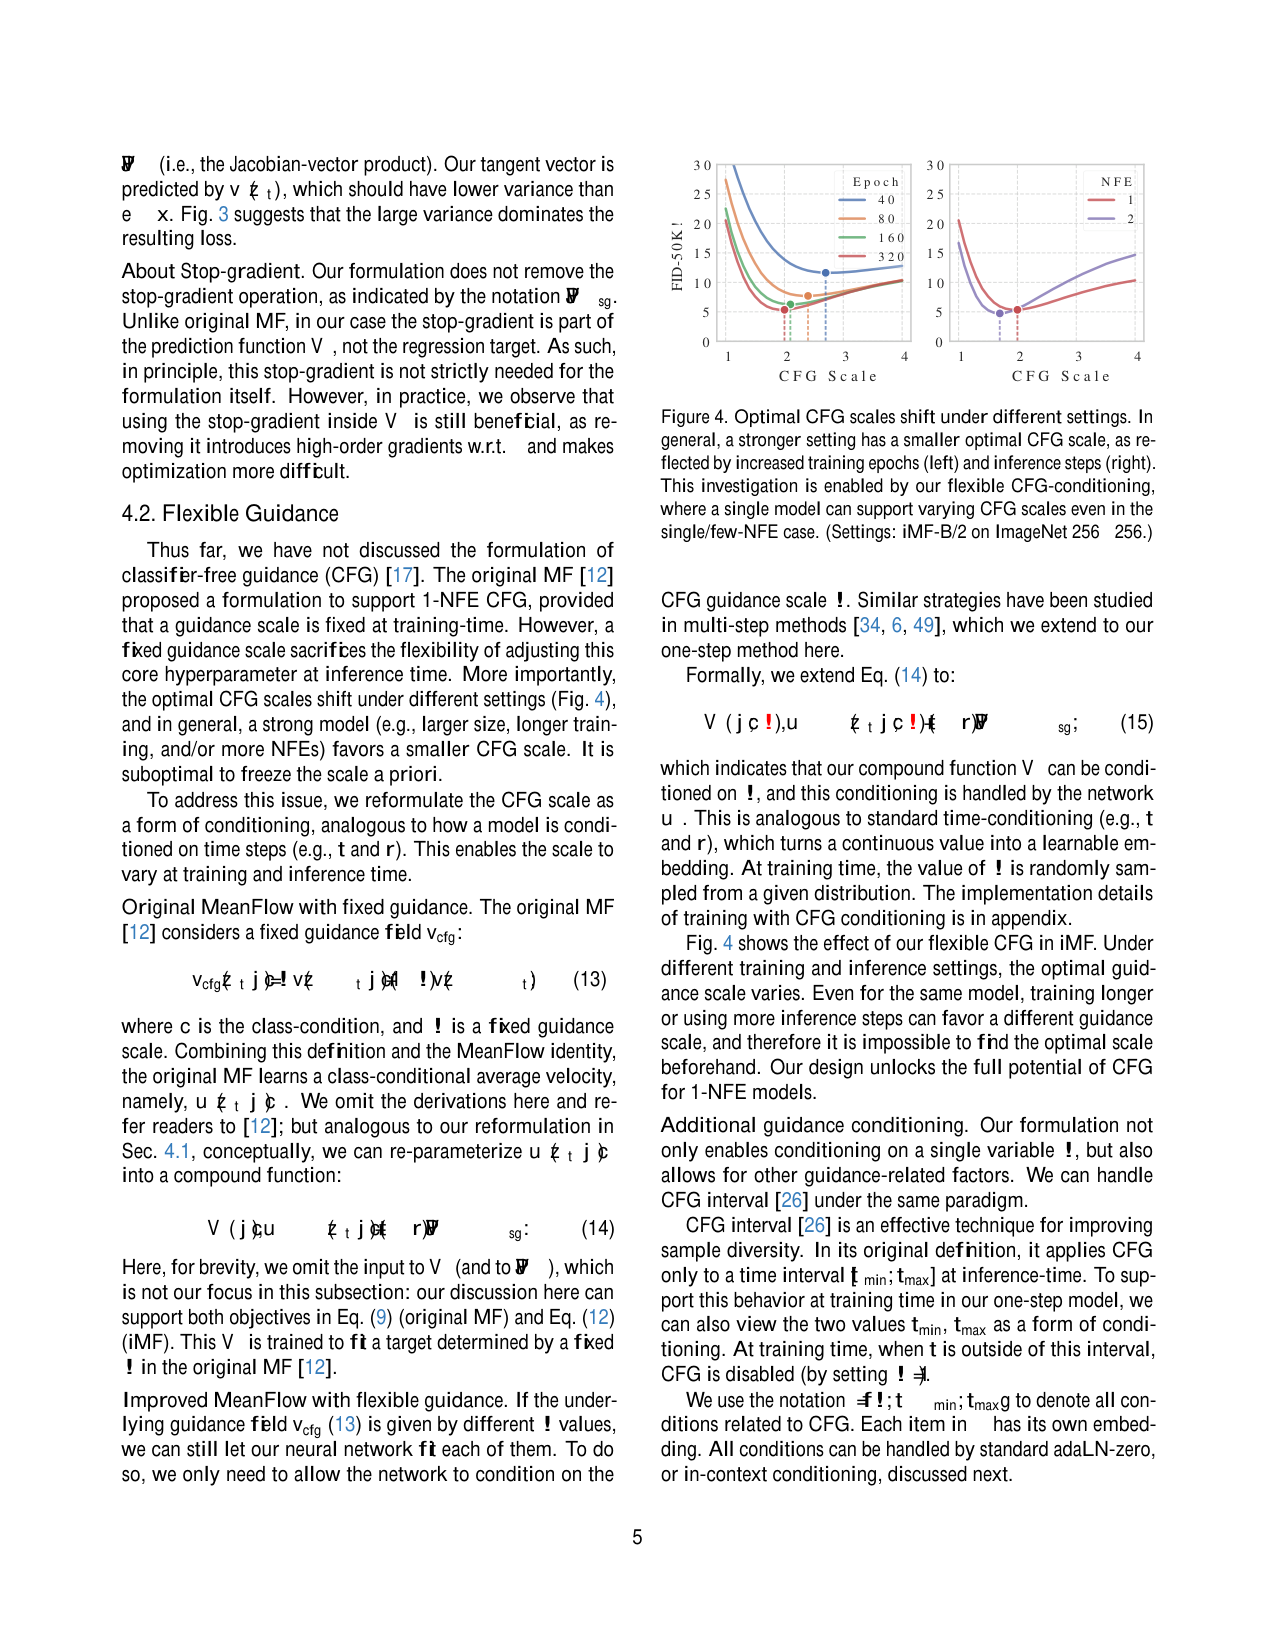
为什么有必要:Fig.4 显示最优 ω 随模型变强而变小——同一模型训 40/80/160/320 epoch,或推理 1/2 步,最低 FID 对应的 ω 都不同,训练期根本没法提前选对一个固定值。条件化之后,推理期随便调 ω 都在训练分布内;ω=1 也成了模型见过的情况,Ω-条件下 ω=1 的 FID 从 30.76 降到 20.95,跨 scale 训练本身还改善了泛化。
消融(Tab.1b,从辅助头模型出发):固定 ω 基线 w/ CFG 5.68;只加 ω 条件 5.52;再加区间条件到 4.57。区间条件带来的收益来自 CFG interval 本身——它在多步方法里就有效,本文把它搬进了 one-step。
核心方案三:多 token in-context conditioning
先给预期:现在模型要同时吃六类条件(r、t、类别 c、ω、t_min、t_max),常见做法 adaLN-zero 把所有条件嵌入求和进一个向量,条件多了会过载;而且 adaLN-zero 本身参数很重。本文把每种条件拆成多个可学习 token,沿序列轴和图像 latent token 拼接,交给 Transformer 注意力统一处理。
实现上:类别 8 个 token,时间步/guidance/区间各 4 个 token,所有 token 加类型位置嵌入后拼进序列。移除 adaLN-zero 后残差块用零初始化(γ 初值 0,残差块从恒等映射起步,和 adaLN-zero 的初始化同源),其余线性层用 σ²=0.1/fan_in 的高斯初始化。
效果(Tab.1c,MF-B/2 规模、ImageNet 256×256、1-NFE):adaLN-zero 版 133M 参数、FID 4.57;换成 in-context 后 89M 参数(省约 1/3)、FID 4.09——又小又好。再加 SwiGLU/RMSNorm/RoPE 到 3.82,训练延长到 640 epoch 到 3.39。DiT 当年评测 in-context 条件劣于 adaLN-zero,本文发现每个条件给多个 token 后差距消失。
实验:系统结果与谱系定位
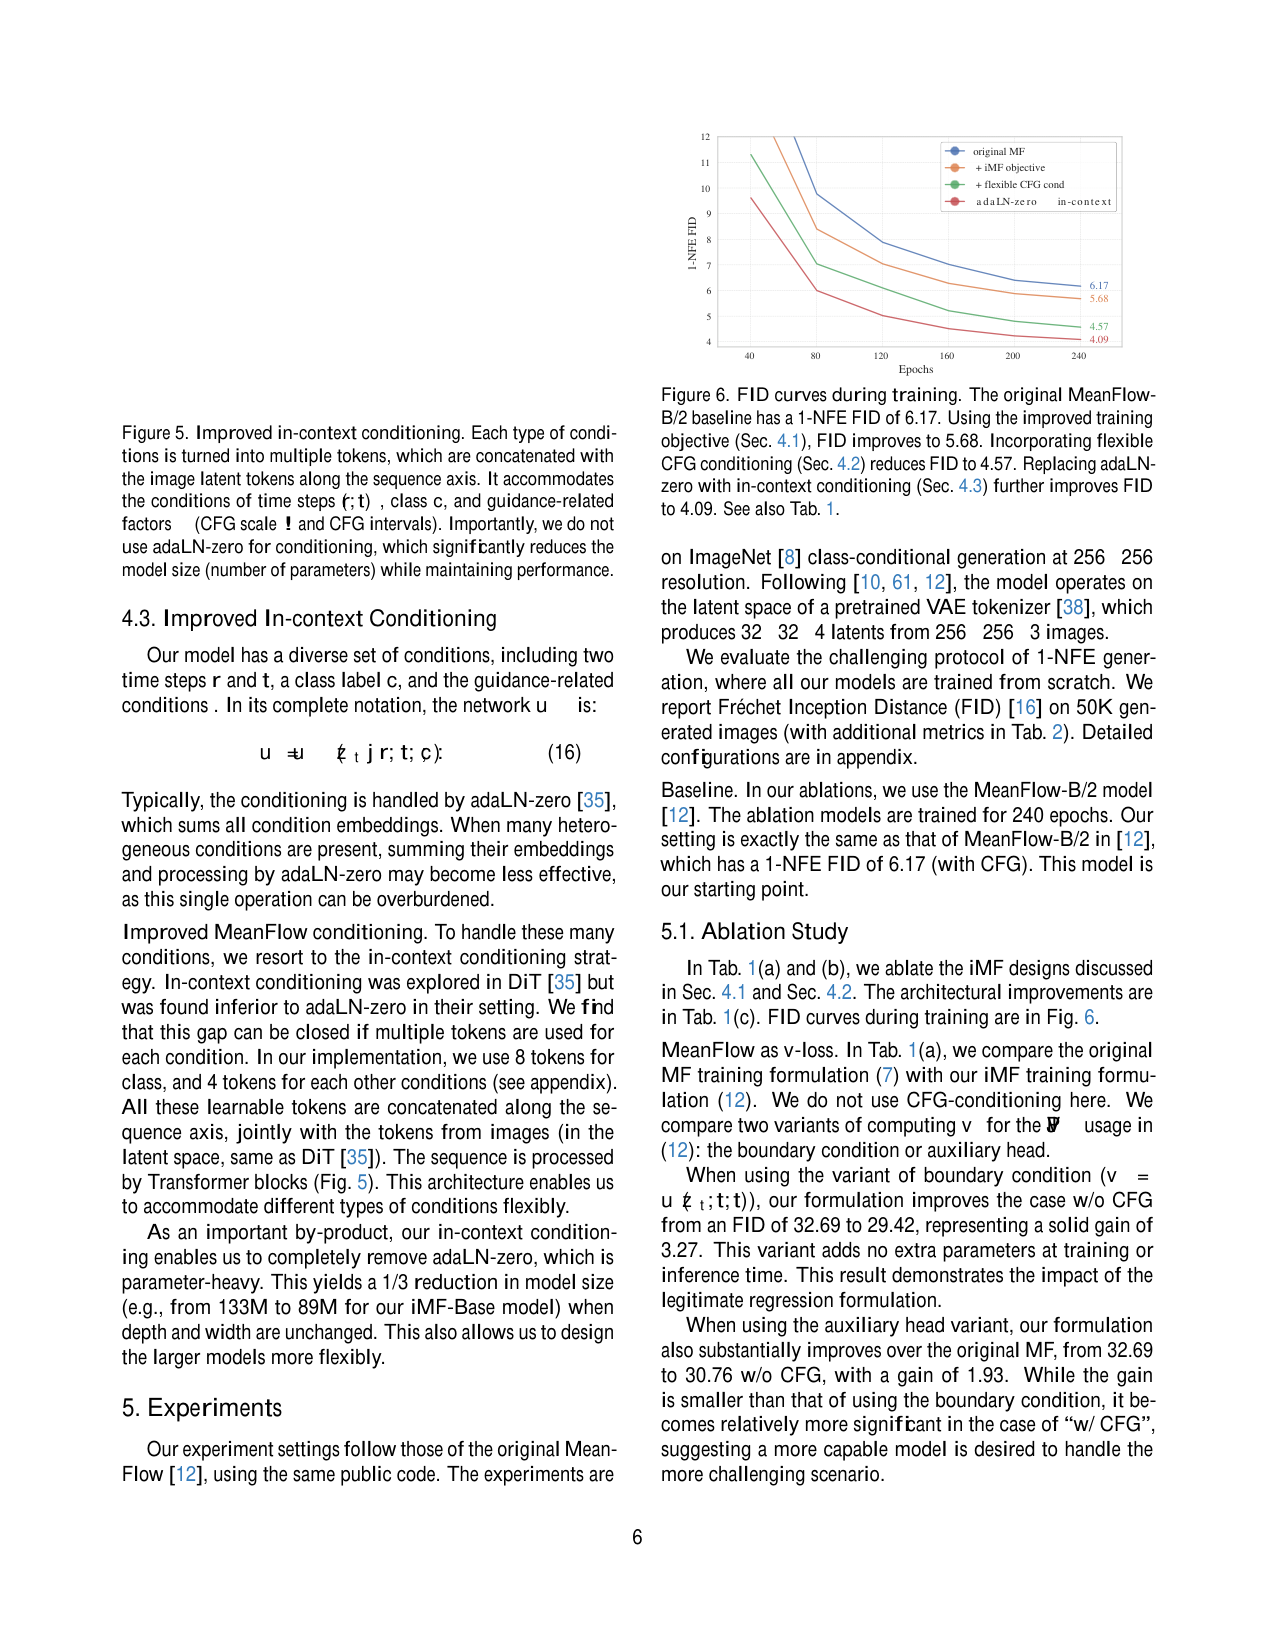
Fig.6 是三项改进的累计曲线(MF-B/2、ImageNet 256×256、1-NFE FID、240 epoch):原版 MF 终点 6.17 → 加 iMF 目标 5.68 → 加柔性 CFG 条件 4.57 → 加 in-context conditioning 4.09,每段间隔就是每项设计的独立贡献。
系统对比(Tab.2):iMF-B/2 89M 参数 FID 3.39,已经超过 676M 的原版 MF-XL/2(3.43);iMF-XL/2 610M 参数 FID 1.72,相对 MF-XL/2 的 3.43 降约 50%。跨方法对比(Tab.3):1-NFE 从零训练的方法里,iCT-XL/2 34.24、Shortcut-XL/2 10.60、TiM-XL/2 3.26、α-Flow-XL/2+ 2.58,iMF-XL/2 1.72 全部超过;1-NFE 蒸馏系方法 π-Flow-XL/2 2.85、DMF-XL/2+ 2.16、FACM-XL/2 1.76,也被从零训练的 iMF 超过。放宽到 2-NFE,iMF-XL/2 到 1.54,进一步逼近多步方法(DiT-XL/2 250×2 步 2.27、SiT-XL/2 2.06、LightningDiT 1.35、DDT 1.26、RAE+DiTDH 1.13)。
谱系上,它和 α-Flow(分解 MF 目标 + FM→MF 调度)、Decoupled MeanFlow / CMT(用预训练 FM 当老师)都不同:iMF 不动调度、无预训练对齐,直接修目标结构和 CFG,与这些并行改进正交。
局限
论文自承的:其一,1-NFE 把采样成本压到接近 tokenizer 时,预训练 VAE 的解码开始占不可忽略的推理开销,需要后续高效 tokenizer 或像素空间生成;其二,移除 adaLN-zero 后 MF 与 iMF 的参数/算力无法严格对齐,B/M/L/XL 代号只作参照;其三,展示质量用的 CFG 设置(ω=6.0、区间 [0.2,0.8],FID 3.92 / IS 348.2)偏向 IS 牺牲 FID,和最优 FID 1.72 的评估设置不同。
我们读出的:柔性 CFG 多了 ω 采样分布(幂分布 β)和区间端点采样两个超参,最优 β 可能随模型/数据集变,论文只在 ImageNet 上验证;stop-gradient 的去留仍是经验结论,缺形式化收敛分析;one-step 的 1.72 与多步最优 1.13 之间还有差距,多样性覆盖仍是 open question。
把 MeanFlow 的两处『欠可用』问题修掉:训练目标从网络依赖的 u-loss 改成对瞬时速度 v 回归、由 u 网络 re-parameterization 的 v-loss,CFG 从训练期固定 scale 改成可推理期调节的条件变量,并配套多 token in-context conditioning,使从零训练的 one-step 模型在 ImageNet 256×256 上拿到 1-NFE FID 1.72(相对原 MF 的 3.43 下降 50%),是 fastforward 范式『可用化』的样板。
阅读提示
精读深度:精读
清单提示:原文提示:对比两版训练目标——为什么「对 v 回归 + re-parameterization」更稳定;理解 in-context conditioning 与显式条件变量的设计;这是把 one-step 方法做「可用化」的样板。
问题
要解决什么:原版 MeanFlow(MF)是 one-step 生成框架:学习两个时间步之间的平均速度场 u,从而一次函数评估(1-NFE)完成采样。但它有两个结构性问题:其一,训练目标里用网络自己的预测 u_θ 去替代未知的平均速度真值,目标随网络变化,回归问题『不正宗』,且 JVP 的输入混入了条件速度 e-x 这个额外量;其二,classifier-free guidance(CFG)的 scale ω 在训练期就固定,推理期无法调节,而最优 ω 随模型变强而变小,固定一个值损失灵活性。
为什么 prior work 不够:Flow Matching 回归的是瞬时速度 v,训练稳定但要多步数值求解 ODE(NFE 数十到数百);Consistency Models 做单步但依赖学习到端点的映射、常需蒸馏或对步数敏感;Shortcut / IMM / α-Flow 等 fastforward 方法各修各的近似,但没动 MF 的目标结构本身。原版 MF 已经能 1-NFE 生成,但其 u-loss 的目标里有 JVP(u_θ; e-x) 这一项,回归目标与输入都依赖网络和条件样本,训练损失方差高、甚至不下降(论文 Fig.3 原 MF 曲线非递减);同时 MF 的 CFG 在训练期固定 scale,论文 Fig.4 显示更强的模型(更多 epoch、更多 NFE)偏好更小的 ω,固定值难提前选对。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 带噪 latent z_t | latent | ImageNet 256×256 图像经预训练 VAE tokenizer 压缩为 32×32×4 latent,线性插值 z_t = (1-t)x + t·e,t 为时间步 |
| 时间步条件 (r, t) | scalar pair | 平均速度场跨过的区间起点 r 与终点 t,网络用差值 t-r 做条件嵌入 |
| 类别条件 c | class label | ImageNet 1000 类标签,训练时以 0.1 概率丢弃(cls drop)以支持 CFG |
| CFG 条件 Ω = {ω, t_min, t_max} | continuous scalars | 推理期可变的 guidance scale ω 与 CFG 区间端点,作为条件变量喂给网络 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 平均速度场 u_θ(z_t | r, t, c, Ω) | latent 向量 | 与输入 latent 同维度的速度预测;1-NFE 采样直接 z_0 = z_1 - u_θ(z_1),(r,t)=(0,1),不需要多步 ODE 求解 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet 类条件生成 256×256 | 128 万张训练图,1000 类 | 在预训练 VAE tokenizer 的 latent 空间(32×32×4)上训练;评估 FID-50K:生成 5 万张、每类 50 张,对照训练集分布 |
架构(摘要)
主干与结构
backbone:Transformer(DiT 式 patch 化 latent 扩散主干,patch size 2×2),JAX/TPU 实现,基于原版 MF 公开代码
参数:iMF-B 89M / iMF-M 174M / iMF-L 409M / iMF-XL 610M(因移除 adaLN-zero,与 MF 的 131M/308M/459M/676M 只能近似对应)
类型:fastforward flow 模型:预测平均速度 u,单步采样
关键组件
- 主网络 u_θ(z_t | r, t, c, Ω):预测平均速度场
- v_θ 的两种实现:边界条件 v_θ(z_t, t) = u_θ(z_t, t, t)(零额外参数)或辅助 v-head(训练期 8 层共享主干,仅用于 JVP 输入,推理期不用,附 FM 辅助损失)
- 多 token in-context conditioning:类别 8 个 token,时间步/guidance/区间各 4 个 token,与图像 latent token 沿序列轴拼接
- CFG 条件:ω 与区间端点经位置编码 + 2 层 MLP 成嵌入,训练时按分布采样
- 通用 Transformer 改进:SwiGLU、RMSNorm、RoPE、零初始化残差块(替代 adaLN-zero 的初始化策略)
为什么这样设计
目标是把『回归目标依赖网络、回归输入混入未知量』的 MF 目标改回标准回归:让复合函数 V_θ(z_t) = u_θ(z_t) + (t-r)·JVP_sg(u_θ; v_θ) 只吃 z_t 一个合法输入,v_θ 由网络自己预测(边际速度的估计,方差低于条件速度 e-x)。条件多了(r、t、c、ω、区间),单次 adaLN-zero 求和会过载,改成每类条件多个 token 拼接进序列,交给注意力自己处理,顺带把参数重的 adaLN-zero 整个拿掉,参数减少 1/3。
数值 sense
| 项 | 值 |
|---|---|
| latent | VAE 把 256×256×3 图像压成 32×32×4 的 latent(约 4096 个图像 token) |
| model | iMF-XL:48 层、hidden 1024、16 头、610M 参数;推理单步 FLOPs 174.6 G(不含 tokenizer 解码) |
| tokens | 类别 8 token、时间步 4 token、guidance 4 token、区间 4 token,与图像 token 沿序列拼接 |
| 训练 | iMF-XL 训 800 epoch、batch 1024、lr 1e-4 恒定、Adam(0.9,0.95)、EMA decay 0.9999;(t,r) 采样 logit-normal(-0.4,1.0),50% 样本 r≠t;ω 从 [1,8] 按 p(ω)∝ω^β 采样(β=1 或 2) |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 1-NFE FID-50K(ImageNet 256×256,类条件,从零训练) | 1.72 | 原版 MF-XL/2 3.43(同族 baseline,相对降 50%);此前同类最强 α-Flow-XL/2+ 2.58;蒸馏系 1-NFE 最强 FACM-XL/2 1.76 | iMF-XL/2:610M 参数、48 层、800 epoch、batch 1024、5 万张生成图 FID-50K |
| 训练目标消融(Tab.1a,MF-B/2,240 epoch,ImageNet 256×256) | w/o CFG 29.42 / w/ CFG 5.97 | 原版 MF 同规模 w/o CFG 32.69、w/ CFG 6.17 | 边界条件 v_θ = u_θ(z_t,t,t),零额外参数;无 CFG 与有 CFG 各训一个模型(沿用原 MF 协议) |
| 辅助 v-head 消融(Tab.1a) | w/o CFG 30.76 / w/ CFG 5.68 | 同规模原版 MF w/o CFG 32.69、w/ CFG 6.17(约 10% 相对提升) | v_θ 用 8 层辅助头 + FM 辅助损失;推理期不用该头 |
| 柔性 CFG 消融(Tab.1b,从辅助头模型 5.68/30.76 出发) | ω-条件 w/ CFG 5.52、ω=1 时 25.15;Ω-条件 w/ CFG 4.57、ω=1 时 20.95 | 固定 ω 的模型 w/ CFG 5.68、ω=1 行为 30.76(Ω-条件把无 CFG FID 降了约 10 个点) | ω 从 [1,8] 采样、β=1;Ω 增加区间端点条件,t_min~U[0,0.5]、t_max~U[0.5,1.0] |
| in-context conditioning + 工程改进(Tab.1c,MF-B/2 规模) | FID 4.09 → 3.82 → 3.39 | adaLN-zero 版 4.57(参数 133M);替换后 89M 参数 FID 4.09;加 SwiGLU/RMSNorm/RoPE 后 3.82;训 640 epoch 后 3.39 | ImageNet 256×256、1-NFE、240 epoch 起步、batch 1024 |
| 2-NFE FID(Tab.3) | 1.54 | α-Flow-XL/2+ 1.95、MeanFlow-XL/2+ 2.20、iCT-XL/2 20.30(同为 2 步) | iMF-XL/2 同模型放宽到 2 次函数评估 |
| 与多步扩散的差距(Tab.3,多 NFE 参考) | 1.72(1-NFE) | DiT-XL/2 250×2 步 FID 2.27、SiT-XL/2 250×2 步 2.06、LightningDiT-XL/2 250×2 步 1.35、DDT-XL/2 1.26、RAE+DiTDH-XL 1.13 | iMF 单步 vs 多步方法 250 次 ODE 步长(×2 表示 CFG 使计算翻倍) |
Insights
- 原版 MF 表面学的是『平均速度 u』,实际回归目标等价于瞬时速度 v;u 只是对 v 的 re-parameterization(MeanFlow identity 双向可用),所谓『u-loss』的稳定性问题出在回归输入与目标都依赖网络,修的是回归问题的『正宗性』(Fig.1/Fig.3)。
- 把 CFG scale 当条件变量训练,推理期自由调节,还能把『无 CFG』也纳入训练分布:同一模型 ω=1 时的 FID 比单独训的无 CFG 模型好 10 个点(30.76 → 20.95,Tab.1b),跨 scale 训练本身是正则。
- 条件多了以后,把每种条件拆成多个 token 放进序列让注意力自己处理,效果超过把所有条件嵌入求和进 adaLN-zero,参数还省 1/3(133M → 89M)——条件建模的粒度比『一个全局条件向量』更匹配 Transformer。
- 从零训练(无蒸馏、无预训练对齐)的 one-step 模型 1-NFE FID 1.72,追平并超过多篇蒸馏系 1-NFE 方法(FACM 1.76、DMF 2.16、π-Flow 2.85),说明 fastforward 可以作为独立范式而非蒸馏的副产品。
vs 同类工作
- vs 原版 MeanFlow:目标从网络依赖的 u-loss 改成 v-loss + u-pred re-parameterization,CFG 从固定 scale 改成条件变量,架构从 adaLN-zero 改成多 token in-context;MF-XL 3.43 → iMF-XL 1.72(相对降 50%)。
- vs α-Flow:α-Flow 分解 MF 目标并用 FM→MF 的插值调度训练,iMF 不动调度、直接修目标与 CFG;同 1-NFE 从零训练下 iMF-XL/2 1.72 低于 α-Flow-XL/2+ 2.58。
- vs Decoupled MeanFlow / CMT:两者靠预训练 FM 模型做初始化或固定回归目标(需要多步模型当老师),iMF 完全从零训练,不需要预训练对齐。
- vs Consistency Models / Shortcut / IMM:这些方法各自定义单步映射或矩匹配目标,iMF 保持平均速度场的数学框架,把『对 v 回归 + 条件化』做到底。
局限
- 论文自承:1-NFE 把采样成本压到接近 tokenizer 时,预训练 VAE tokenizer 的解码开始占不可忽略的推理开销,本文专注 fastforward 模型本身、与 tokenizer 设计正交,需要后续高效 tokenizer 或像素空间生成(Conclusion 段)。
- 论文自承:移除 adaLN-zero 后 MF 与 iMF 的参数/算力无法严格对齐,B/M/L/XL 代号只作参照(iMF-L/XL 比同代号 MF 小约 10%),跨模型比的『每参数效率』要谨慎。
- 论文自承:CFG 区间推理设置会偏向 IS(单张质量)牺牲 FID(多样性),论文在 ω=6.0、区间 [0.2,0.8] 下 FID 3.92 / IS 348.2 展示质量,与最优 FID 的 1.72 不是同一设置,读者看数字要带设置。
- 我们读出:柔性 CFG 引入 ω 采样分布 p(ω)∝ω^β(β=1 或 2 的幂分布)与区间端点采样作为额外超参,最优 β 可能与模型规模/数据集相关,论文只在 ImageNet 上验证。
- 我们读出:stop-gradient 保留在 V_θ 内部属于经验选择,论文承认理论上 JVP 目标并不严格需要它;实践中去掉会引入对 θ 的高阶梯度、优化更难,稳定性收益的机制解释(条件速度的高方差被 JVP 放大)由 Fig.3 支撑,缺少形式化的收敛证明。
- 我们读出:实验只在 ImageNet 256×256 类条件生成一个任务上做;1.72 与多步方法最优(RAE+DiTDH 1.13、DDT 1.26)仍有差距,one-step 的分布覆盖与多样性与 250 步求解器还有距离。
可复现性
- code:基于原版 MF 公开代码库(https://github.com/Gsunshine/meanflow),JAX/TPU
- weights:论文未明确承诺开源权重
- eval:FID-50K / IS,ImageNet 256×256,类条件,CFG 时报告最优 ω 与区间设置
主干与结构
backbone:Transformer(DiT 式 patch 化 latent 扩散主干,patch size 2×2),JAX/TPU 实现,基于原版 MF 公开代码
参数:iMF-B 89M / iMF-M 174M / iMF-L 409M / iMF-XL 610M(因移除 adaLN-zero,与 MF 的 131M/308M/459M/676M 只能近似对应)
类型:fastforward flow 模型:预测平均速度 u,单步采样
关键组件
- 主网络 u_θ(z_t | r, t, c, Ω):预测平均速度场
- v_θ 的两种实现:边界条件 v_θ(z_t, t) = u_θ(z_t, t, t)(零额外参数)或辅助 v-head(训练期 8 层共享主干,仅用于 JVP 输入,推理期不用,附 FM 辅助损失)
- 多 token in-context conditioning:类别 8 个 token,时间步/guidance/区间各 4 个 token,与图像 latent token 沿序列轴拼接
- CFG 条件:ω 与区间端点经位置编码 + 2 层 MLP 成嵌入,训练时按分布采样
- 通用 Transformer 改进:SwiGLU、RMSNorm、RoPE、零初始化残差块(替代 adaLN-zero 的初始化策略)
为什么这样设计
目标是把『回归目标依赖网络、回归输入混入未知量』的 MF 目标改回标准回归:让复合函数 V_θ(z_t) = u_θ(z_t) + (t-r)·JVP_sg(u_θ; v_θ) 只吃 z_t 一个合法输入,v_θ 由网络自己预测(边际速度的估计,方差低于条件速度 e-x)。条件多了(r、t、c、ω、区间),单次 adaLN-zero 求和会过载,改成每类条件多个 token 拼接进序列,交给注意力自己处理,顺带把参数重的 adaLN-zero 整个拿掉,参数减少 1/3。
数值 sense
| 项 | 值 |
|---|---|
| latent | VAE 把 256×256×3 图像压成 32×32×4 的 latent(约 4096 个图像 token) |
| model | iMF-XL:48 层、hidden 1024、16 头、610M 参数;推理单步 FLOPs 174.6 G(不含 tokenizer 解码) |
| tokens | 类别 8 token、时间步 4 token、guidance 4 token、区间 4 token,与图像 token 沿序列拼接 |
| 训练 | iMF-XL 训 800 epoch、batch 1024、lr 1e-4 恒定、Adam(0.9,0.95)、EMA decay 0.9999;(t,r) 采样 logit-normal(-0.4,1.0),50% 样本 r≠t;ω 从 [1,8] 按 p(ω)∝ω^β 采样(β=1 或 2) |
原版 MF 与 iMF 的目标结构对比
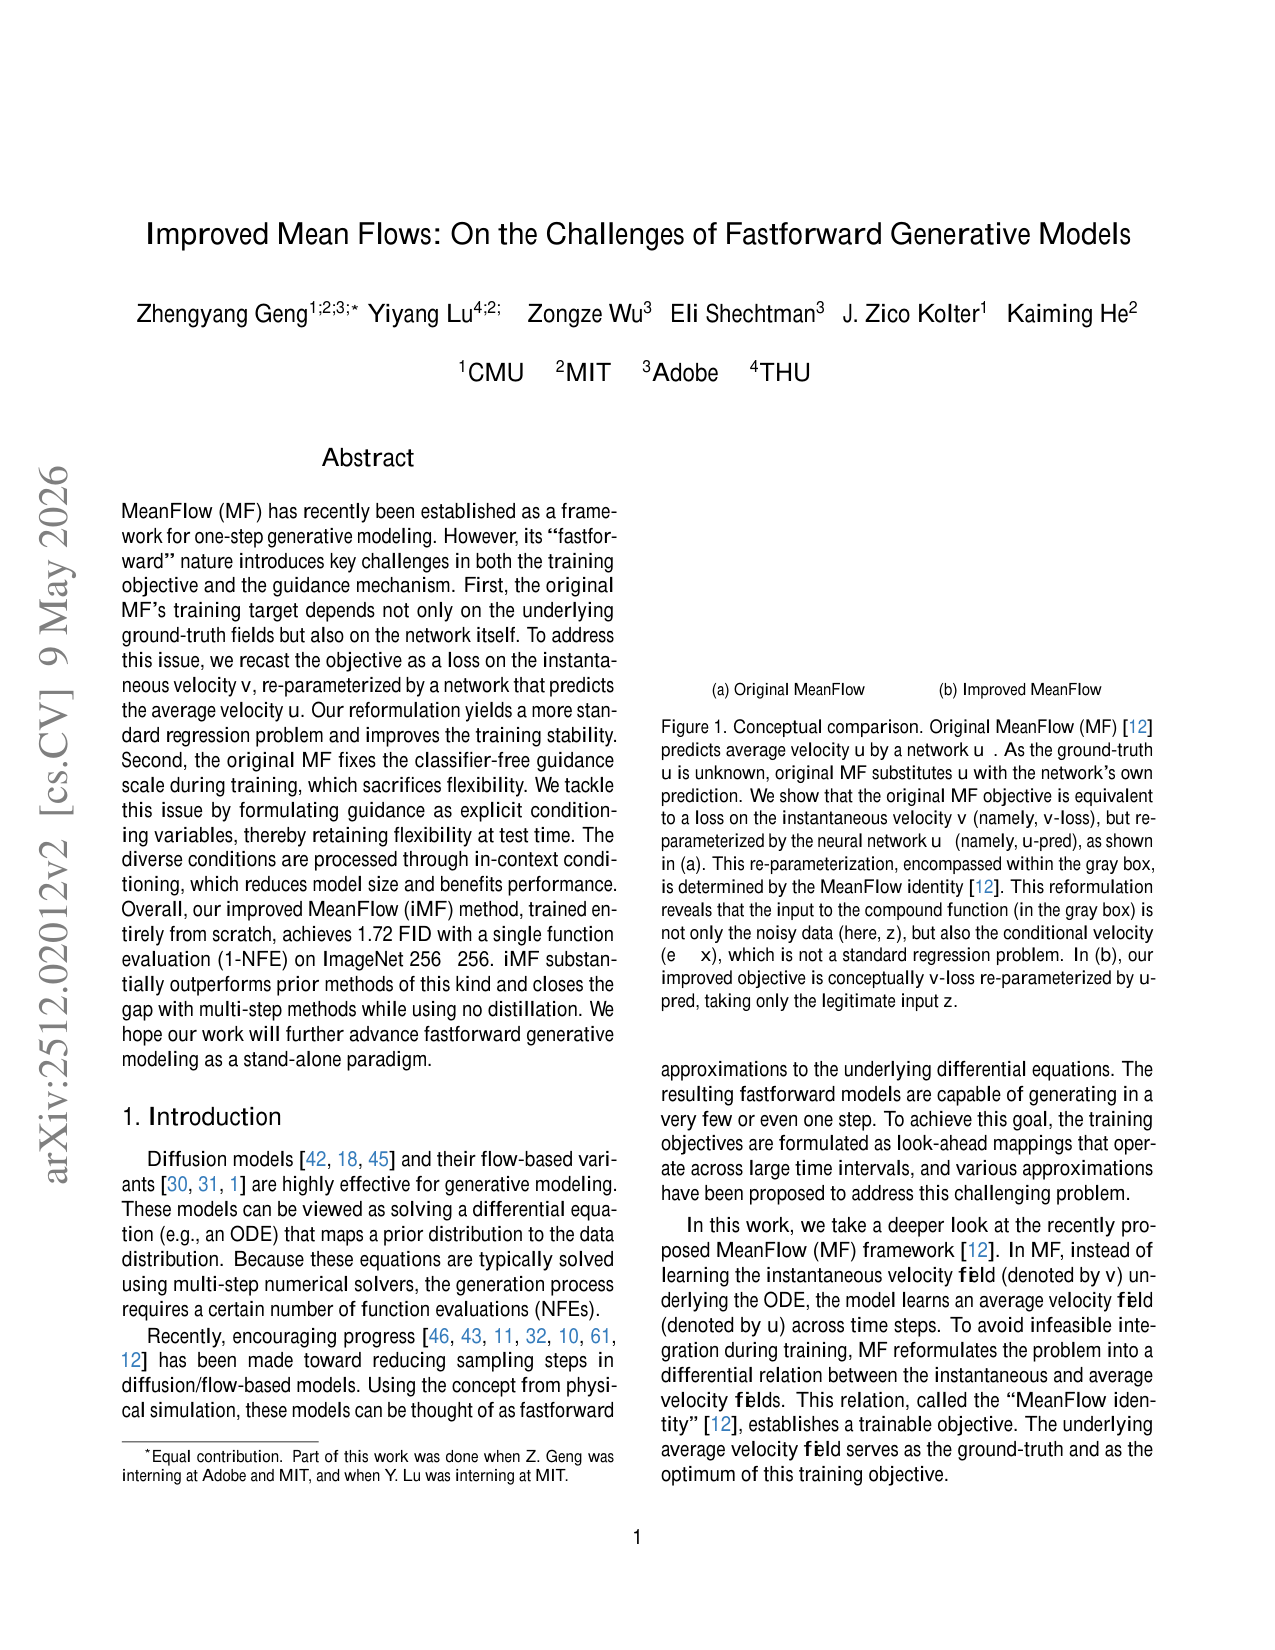
原文 caption:Conceptual comparison. Original MeanFlow (MF) predicts average velocity u by a network u_θ. As the ground-truth u is unknown, original MF substitutes u with the network's own prediction. We show that the original MF objective is equivalent to a loss on the instantaneous velocity v (namely, v-loss), but re-parameterized by the neural network u_θ (namely, u-pred)... In (b), our improved objective is conceptually v-loss re-parameterized by u-pred, taking only the legitimate input z.
图 (a) 画原版 MF:复合函数 V_θ 的输入除了带噪数据 z,还混进了条件速度 e-x(图里灰色框表示由 MeanFlow identity 决定的 re-parameterization),所以回归输入『泄』进了未知量;(b) 画 iMF:V_θ 只吃 z 一个合法输入。这张图对应全文最核心的论断——原版 MF 的训练目标等价于 v-loss 但被 u_θ re-parameterization,且输入不正宗,iMF 把输入收回到 z。读图重点看灰色框里喂给 JVP 的量是 e-x 还是网络预测 v_θ。
原版 MF 与 iMF 的训练损失曲线
原文 caption:Training losses. We examine the loss of samples only with t ≠ r ... Both MF and iMF can be viewed as v-loss, using different forms of compound V_θ. Original MF's loss is non-decreasing and has high variance. (Settings: MeanFlow-B/2, trained with basic ℓ2 loss with no adaptive weighting, and with no CFG.)
横轴训练步数(1e4 量级)、纵轴 loss:蓝线(原版 MF,V_θ(z_t, e-x))从约 1.6 升到约 2.3 且剧烈抖动、整体不下降;橙线(iMF,V_θ(z_t))从约 1.8 快速降到约 1.1 后平稳。同样是被视为 v-loss 的两个目标,只差在 JVP 的输入是条件速度 e-x 还是网络预测 v_θ,损失行为就完全不同。这是『对 v 回归 + re-parameterization 更稳』的直接证据。
不同设置下最优 CFG scale 会移动
原文 caption:Optimal CFG scales shift under different settings. In general, a stronger setting has a smaller optimal CFG scale, as reflected by increased training epochs (left) and inference steps (right). This investigation is enabled by our flexible CFG-conditioning, where a single model can support varying CFG scales even in the single/few-NFE case. (Settings: iMF-B/2 on ImageNet 256×256.)
左右两个面板都是横轴 CFG scale、纵轴 FID-50K;左面板画不同训练 epoch(40/80/160/320)的曲线,右面板画不同推理步数(NFE 1 与 2)。每条曲线的最低点(最优 ω)用虚线标出:模型越强(epoch 越多、NFE 越多),最优 ω 越小。这说明把一个 ω 固定到训练期必然对一部分设置次优,是『显式条件变量取代固定 scale』的动机图。
三项改进叠加的 1-NFE FID 曲线
原文 caption:FID curves during training. The original MeanFlow-B/2 baseline has a 1-NFE FID of 6.17. Using the improved training objective (Sec. 4.1), FID improves to 5.68. Incorporating flexible CFG conditioning (Sec. 4.2) reduces FID to 4.57. Replacing adaLN-zero with in-context conditioning (Sec. 4.3) further improves FID to 4.09. See also Tab. 1.
横轴训练 epoch(40 到 240)、纵轴 1-NFE FID,四条曲线依次叠加:原版 MF-B/2 终点 6.17,加 iMF 目标到 5.68,加柔性 CFG 条件到 4.57,再用 in-context 替换 adaLN-zero 到 4.09(B/2 规模、240 epoch、ImageNet 256×256、FID-50K)。每条曲线的间隔就是每项设计的独立贡献,读图时按颜色从上往下看即可。
🎧 音频版
时长 34:11 · Edge TTS
一步生成的可用化:Improved Mean Flows 精读
先说结论,这篇解决什么问题
小播:老播,这期论文讲什么?我先看了标题,叫《Improved Mean Flows: On the Challenges of Fastforward Generative Models》,后半句我完全没概念,什么是 fastforward?
老播:先给你一个背景坐标。现在最强的图像生成模型,比如扩散模型或者 flow matching 模型,生成一张图的过程是解一条微分方程:从纯噪声出发,沿着学到的「速度场」一步步走回数据分布。每走一步都要让神经网络跑一次前向,这叫一次函数评估,英文缩写 NFE。普通方法要走几十步甚至两百五十步,所以生成慢、算力贵。大家一直想做的事,就是让模型一步就走到头,NFE 等于 1,这就是 fastforward,直译是「快进」——把多步积分压成一个大步。这篇论文就是在这个方向里,把前人的一步生成方法 MeanFlow 修到能用的程度。
小播:那它修完之后效果如何?你直接说数字,我记一下。
老播:好,重点数字先说一遍:在 ImageNet 256×256 类条件生成上,它从零训练,一次函数评估的 FID 是 1.72。FID 是衡量生成分布和真实图片分布差距的指标,越小越好。作为对比,原版 MeanFlow 的 XL 型号是 3.43,也就是相对下降了大概 50%。后面我们还会反复回到这个数字,它是这期的主线。
小播:也就是说,同样是 XL 规模,把目标函数和条件方式改一改,一步生成的分数就砍了一半?
老播:对,而且它完全从零训练,没有用任何多步模型来蒸馏。这期我们就把三件事讲透:第一,训练目标为什么从「回归平均速度」改成「回归瞬时速度、再用平均速度网络重新参数化」之后会稳定这么多;第二,classifier-free guidance 的强度从训练期定死改成推理期可调的条件变量,这一步为什么是一步生成「可用化」的关键;第三,条件变量变多以后,它怎么用多 token 的 in-context conditioning 把模型做小、做准。
先把背景讲清楚:多步生成为什么慢
小播:我们从头来。你刚才说生成是沿着速度场走,能不能把这个「速度场」讲得具体一点,我本科只学过一点概率。
老播:可以,我们从 flow matching 讲起,这是这篇论文的直接前身。假设一张真实图片叫 x,一个高斯噪声叫 e。我们做一个线性插值 z_t = (1−t)x + t·e,t 从 1 走到 0:t 等于 1 的时候 z 全是噪声,t 等于 0 的时候 z 就是图片。这个插值过程里,每个时刻点 z_t 的移动方向是固定的,叫条件速度,就是 e 减 x,也就是「从图片指向噪声」的位移。flow matching 训练一个网络 v_θ,输入 z_t 和时间 t,输出预测的速度,去回归这个 e−x。
小播:这里有个细节我要确认:e−x 是配对好的那一个噪声和图片算出来的方向,可同一张 z_t 可以由很多对不同的 (x, e) 拼出来,那回归目标不就有歧义了吗?
老播:问得好,这正是 flow matching 理论里关键的一步。对任意给定的 z_t,把所有能生成它的 (x, e) 对的 e−x 取平均,得到的就是边际速度 v(z_t),它才是唯一确定的回归目标。训练收敛后,网络学到的就是这条平均速度场。推理的时候,你从 t=1 的纯噪声出发,让数值求解器沿着 v_θ 积分回 t=0。积分要精确,就得把区间切很多小段,每一步调用一次网络,所以 NFE 常常是几十到几百。ImageNet 上典型的 DiT-XL 模型要 250 次函数评估,CFG 一开还要再翻一倍。
小播:我先复述一下刚才这层:flow matching 学的是每一点的瞬时方向,推理时要把这些方向串起来积分,所以步数多;MeanFlow 想学的是两个时间点之间的平均方向,一步顶一段积分。理解对吗?
老播:对,而且「平均方向」这个说法有个很要紧的数学前提:只有当速度场接近直线的时候,平均速度乘以区间长度才严格等于积分位移。真实数据的速度场肯定有弯曲,所以 MeanFlow 严格说是在学「最佳直线近似」。这个前提也解释了为什么后面要把目标摆回瞬时速度——平均速度本身没有可以直接观测的真值,它只能从瞬时速度的积分关系里推出来。
小播:那一步生成的思路,就是想跳过这段积分?一步怎么跳过?
老播:对,这就是 MeanFlow 的核心想法。它不学瞬时速度 v,改学平均速度 u:也就是从时间 r 到时间 t 之间,把瞬时速度场求平均,得到 u(z_t) = (1/(t−r))·∫从 r 到 t v(z_τ)dτ。如果速度场接近直线,那么「平均速度乘以时间」就约等于「整个积分位移」,于是一步就能从 z_1 走到 z_0,公式就是 z_0 = z_1 − u_θ(z_1)。
小播:但训练的时候,这个积分没法算啊,网络里总不能真的去积一条连续的场。
老播:对,训练期积分不可行,所以 MeanFlow 用了一条叫 MeanFlow identity 的恒等式,把积分换成微分:u(z_t) = v(z_t) − (t−r)·(d/dt)u(z_t)。这个式子的意思是,平均速度 u 等于当前瞬时速度 v,再减去「平均速度随时间变化」造成的修正。其中 (d/dt)u 是用雅可比向量积算的,缩写 JVP——你可以粗浅理解成把速度 v 当切向量,沿着 u 对输入 z 的雅可比矩阵传播一遍,得到 u 沿着流方向的变化率。
小播:这里我想停下来确认一个细节。MeanFlow identity 里 u 和 v 是互相推导的,那为什么训练的时候非要 v 不可,直接用 u 做目标不行吗?
老播:问题就在 u 没有真值。你手里只有成对的 (x, e) 和插值出来的 z_t,能直接算出来的只有条件速度 e−x。u 是「一段区间里 v 的平均」,你得先有整条 v 才能算 u,而整条 v 恰恰是你要学的东西。所以原版 MF 只能拿网络自己的预测 u_θ 去填这个空,目标里就长出了网络自己。这个循环如果不处理,回归目标就一直在漂。
小播:听起来数学很干净,那原版 MeanFlow 的问题出在哪?
老播:出在把恒等式变成训练目标的时候,做了两个近似。第一个近似,把边际速度 v(z_t) 用条件速度 e−x 替代,和 flow matching 的做法一样;第二个近似,JVP 里真正的平均速度 u,用网络自己的预测 u_θ 替代。于是回归目标写成 u_tgt = (e−x) − (t−r)·JVP(u_θ; e−x),再最小化 ‖u_θ − u_tgt‖²。你看这里的问题:网络要拟合的目标里,包含网络自己,目标会跟着网络漂移。而且 JVP 的输入是 e−x,也就是说整个复合函数除了带噪样本 z_t,还混进了条件速度这个额外输入。这两个毛病叠加,训练损失就很不稳定——论文里 Figure 3 画出来,原版 MeanFlow 的损失曲线几乎不下降,还抖得厉害。但它居然还是能一步生成,这就是原版方法神奇的地方,也是这篇论文要解剖的地方。
小播:那这个领域除了 MeanFlow,还有别的「一步生成」路线吗?我想有个全景。
老播:有一整族,论文把他们都叫 fastforward generative models。Consistency Models 学的是从中间任意时刻直接跳到终点的映射,最早把一步生成带火;Consistency Trajectory Models 想学任意两个时刻之间的轨迹,但训练时要真的做积分;Shortcut Models 从两个时刻和它们中点的关系入手;IMM 用不同时刻的矩匹配来做;MeanFlow 就是学两个时刻之间的平均速度。这批方法里有的靠蒸馏起步,有的从零训练,MeanFlow 属于从零训练这一支。iMF 这篇文章站的位置,就是把这一支里 MeanFlow 的目标和条件方式修到能打。
核心思想第一步:把目标改成对瞬时速度回归
小播:好,现在到了正题。你说要把目标改成对瞬时速度 v 回归,具体怎么改?
老播:先给预期。flow matching 对 v 回归,训练一直很稳定,那 MeanFlow 能不能也回归 v?可以,把 MeanFlow identity 倒过来用:v(z_t) = u(z_t) + (t−r)·(d/dt)u(z_t)。左边 v 是回归目标,右边这个复合函数用网络参数化。这样定义一个新的复合函数 V_θ(z_t) = u_θ(z_t) + (t−r)·JVP_sg(u_θ; v_θ),训练损失写成 E[‖V_θ(z_t) − (e−x)‖²]。
小播:这个式子我试着拆一下:u_θ(z_t) 是网络预测的平均速度,JVP_sg 是算平均速度沿流方向的变化率,乘上区间长度 t−r 是修正项,两项加起来就是瞬时速度 v 的估计,最后拿它和条件速度 e−x 比。我理解对了吗?
老播:完全正确,你拆得很准。注意两个细节。第一,JVP 里面的输入换成了 v_θ——网络自己预测的瞬时速度,它只吃 z_t 一个输入。这样整个复合函数 V_θ 的输入只剩 z_t,回归问题就「正宗」了,和 flow matching 一个形状。第二,论文证明这个新目标和原版目标在数学上完全等价。这句话值得说两遍:原版 MeanFlow 表面上学平均速度 u,它的目标实际上就是对瞬时速度 v 回归,只是被平均速度网络重新参数化了一遍。所以这篇改动触及的,是藏在网络里的回归问题本身。
小播:那 v_θ 这个网络从哪来?总不能凭空多一个网络吧。
老播:两个办法。第一个办法叫边界条件,零额外参数:因为按定义,v 就是平均速度 u 在 r 趋近 t 时的极限,所以直接让 v_θ(z_t, t) 等于 u_θ(z_t, t, t),同一个网络换个时间输入就行。第二个办法是加一个辅助头:在 u_θ 主干后面挂一个八层的小子网络专门预测 v,训练时再给它配一个 flow matching 辅助损失,保证它学到的是瞬时速度;这个头推理的时候完全不用,只服务训练。
小播:那为什么换了这个输入,训练就稳定了?你得给我一个讲得通的原因。
老播:原因在方差。JVP 的切向量,理论上应该是边际速度 v(z_t),它是把条件速度 e−x 对 z_t 取平均之后的结果,方差小。原版 MF 直接把 e−x 塞进 JVP,条件速度的方差很大,而雅可比向量积会把这个大方差放大,放大之后损失就又被方差主导了,曲线自然又高又抖。换成网络预测的 v_θ 之后,输入只跟 z_t 有关,方差降下来,损失就正常下降了。论文的 Figure 3 就是直接证据:同一个 MeanFlow-B/2 模型、同样的基本 ℓ2 损失、都不开 CFG,原版损失从大约 1.6 一路涨到 2.3 还剧烈抖动,iMF 的损失从大约 1.8 快速降到 1.1 然后平稳。两个目标只差 JVP 输入这一处,行为完全不同。
小播:这个方差的解释,你能不能再具体一点?放大倍数总得有个感觉。
老播:我们做个量级感。边际速度 v(z_t) 是对条件速度 e−x 做条件平均,条件平均天然压缩方差,直觉上如果某个 z_t 对应十几种不同的 (x, e),平均之后波动小得多;而单个样本的 e−x 方差是它的好几倍。JVP 相当于把切向量乘以一个雅可比矩阵,矩阵的谱范数可以远大于 1,等于把输入方差再乘一个放大系数。原版 MF 两个放大叠一起,损失的方差就压不住,曲线像心电图。换成网络预测的 v_θ 之后,输入只剩 z_t 决定的量,方差回到正常水平。论文用 Figure 3 的曲线直接佐证,但方差放大的具体系数是多少,论文没有逐项量化,这一点我们记在局限里。
小播:这里有个地方我觉得反直觉,想让你再讲讲。原版 MF 的复合函数明明把 e−x 塞进去了,e−x 就是回归目标本身,这看起来像直接泄题,怎么反而有害?
老播:这正是论文里专门解释的一个「假象」。看起来泄题,但 v-loss 的真正回归目标,我们前面说过,是边际速度 v(z_t),也就是对 e−x 的条件期望,单个样本的 e−x 只相当于一次带噪声的观测。把带噪声的观测塞进预测函数的输入端,拿到的分数里噪声被 JVP 放大,损失表面变陡、变糙,梯度信号就被淹没了。所以泄进来的那点「目标信息」抵不过被放大的方差,整体效果是训练变坏。这个解释在论文里靠 Figure 3 的曲线支撑,属于经验证据加机制分析,我们读的时候留了一分余地。
小播:还有个 stop-gradient,论文里反复提,它在哪、为什么留?
老播:留,但是位置变了。原版 MF 的 stop-gradient 放在回归目标上,让目标看起来像个常数;iMF 的 stop-gradient 放在预测函数 V_θ 内部,目标是干净的 e−x。论文承认,理论上的 JVP 目标并不严格需要这个 stop-gradient,去掉它引入对网络参数的高阶梯度,优化变难,所以实践中保留。这个选择本身有点工程味道,后面讲局限时我们还会回来。
小播:那数字上,这个目标重写到底值多少分?
老播:消融实验在 Tab.1a,设置是 MeanFlow-B/2 骨干、ImageNet 256×256、240 epoch、FID-50K。不开 CFG 时,原版 MF 是 32.69,换成边界条件的版本是 29.42,降了 3.27;辅助头版本是 30.76,降了 1.93。开 CFG 时原版 6.17,边界条件版 5.97,辅助头版 5.68,约 10% 的相对提升。换到大一号的 MF-XL/2,开 CFG 时原版 3.43,边界条件版 2.99。注意一个规律:模型越大,这个目标重写带来的收益越明显,说明网络容量大了以后能更好地把 v_θ 从 u_θ 里学出来。
核心思想第二步:把 CFG 强度变成条件变量
小播:目标讲完了,下一个是 classifier-free guidance,这词我听过但一直没吃透,先给个定义?
老播:classifier-free guidance,缩写 CFG,是扩散模型里最常用的「按类别引导」技巧。采样的时候,除了算带类别条件的速度 v(z_t|c),再算一个不带类别的速度 v(z_t),然后把两者按比例混合:v_cfg = ω·v(z_t|c) + (1−ω)·v(z_t)。ω 叫引导强度,大于 1 的时候,模型会更忠实于类别、单张更清晰,代价是多样性下降。标准做法里,ω 是推理期的一个超参,用户想调随时调。
小播:那原版 MeanFlow 在这上面有什么毛病?
老播:原版 MeanFlow 为了支持一步生成的 CFG,把 ω 在训练期就定死了,推理期不能改。这带来一个实际问题:最优 ω 会随着模型变强而变小。论文的 Figure 4 画得很清楚:同一个 iMF-B/2 模型,训练 40、80、160、320 个 epoch,或者推理用 1 步、2 步,每种设置下最低 FID 对应的 ω 都不一样,训练越久、步数越多,最优 ω 越小。训练期根本没法提前知道该定哪个值,定错就是次优。
小播:所以它把 ω 也变成网络的条件输入,对吧?就像时间步 t 一样。
老播:对,这就是显式条件变量的思路。网络写成 V_θ(·|c, ω),ω 和 t、r 一样通过嵌入喂给网络;训练时 ω 从 1 到 8 的区间里按幂分布采样,偏向小值,ω 等于 1 就退化成无 CFG。这样推理期你想用 2.5 就用 2.5,想用 5 就用 5,全都在训练分布里。更进一步,它把 CFG 区间 [t_min, t_max] 也做成条件——这是多步方法里提升多样性的技巧,原本只在推理期起作用,现在训练期就把它参数化进网络,区间外的样本 ω 置 1。
小播:效果数字呢?这步值多少?
老播:从 Tab.1b 看,起点是辅助头版本的固定 ω 模型,开 CFG 时 FID 5.68。只加 ω 条件变成 5.52,进步不大——因为小模型上原版已经接近最优固定值了。但把 CFG 区间条件也加上,直接降到 4.57。还有个更漂亮的副产物:同一模型推理时把 ω 设成 1,就还原成无 CFG 行为,此时 FID 从固定模型的 30.76 降到 20.95,降了差不多 10 个点。说明跨强度训练本身成了正则,连「不带引导」这件事都学得更好了。
小播:这个设计我觉得特别值得记一笔:它把一个推理期要反复调的旋钮,变成了模型自己理解的一个维度。
老播:对,这也是我开头说的「可用化」。一步生成之前是能跑通,但 ω 定死在训练期,用户想调节奏没门。现在推理期可以随便调 ω 和区间,一步生成才真正变成了可用的工具。这句话我们在收尾还会再重复一次。
核心思想第三步:多 token 的 in-context conditioning
小播:到这里,核心思想的前两步讲完了:目标改回对 v 回归,CFG 强度变成条件变量。接下来该讲条件本身怎么喂进模型了吧?
老播:对,你接得很好。现在模型手里的条件清单是:两个时间步 r 和 t、类别 c、引导强度 ω、区间端点 t_min 和 t_max,六个标量加一个类别,类型还很不一样。怎么把它们高效地喂给 Transformer,就是第三步。
小播:条件变量变多了,模型怎么消化?r、t、类别 c、ω、区间端点,加起来一堆。
老播:常见的做法是 adaLN-zero:把每个条件算一个嵌入,全部加和,再用这个和去调制 Transformer 残差块的归一化参数。条件少的时候很好用,DiT 就是用这个拿的效果。但本文的条件类型多,而且类别和引导这些条件性质差别很大,把它们的嵌入挤在一个求和向量里,一个操作扛太多信息,容易过载。另外 adaLN-zero 本身参数很重。
小播:那它换成什么?
老播:换成 in-context conditioning,中文可以叫上下文条件化。做法是把每种条件复制成多个可学习的 token,类别用 8 个,时间步、引导强度、区间各用 4 个,然后这些 token 和图像的 latent token 沿序列轴拼在一起,直接交给 Transformer 的注意力层处理。图像本身在预训练 VAE 的 latent 空间里,256×256 的图压成 32×32×4 的 latent,token 序列里大概有四千多个图像 token,条件 token 就混在其中。
小播:in-context 这个词在 DiT 论文里我记得是被否定过的,说它不如 adaLN-zero。
老播:记得准。DiT 当年对比过,单 token 的 in-context 条件化效果不如 adaLN-zero,所以后来大家默认用 adaLN-zero。这篇的发现是:每个条件给多个 token 之后,这个差距就消失了,效果反而更好。这个点值得记:条件建模的粒度,比「一个全局条件向量」更匹配 Transformer——注意力本来就会自己决定在序列的哪些位置取信息。
小播:那参数上省了多少?
老播:adaLN-zero 被整个拿掉之后,iMF-Base 从 133M 参数降到 89M,少了大概三分之一,而 FID 从 4.57 变成 4.09,又小又好。在此基础上把 SwiGLU、RMSNorm、RoPE 这些通用 Transformer 改进加进去,FID 到 3.82;训练从 240 个 epoch 延长到 640,到 3.39。这个 89M 的 B 号模型,比 676M 的原版 MF-XL 的 3.43 还低。
关键实验:每一步改进各值多少,以及最终榜单
小播:现在我们把它串起来,看整体的实验图景。论文里有没有一张图把三个改进的贡献一次画出来?
老播:有,先教你怎么读它。横轴是训练轮数 epoch,从 40 到 240,纵轴是 1-NFE 的 FID,越低越好,四根曲线从下到上分别是四个配置,每根曲线的终点就是那个配置的最终分数。图里没有置信区间,但四根曲线的间距远大于曲线的抖动,所以结论是稳的。
老播:有,Figure 6,我建议你盯住它。横轴是训练 epoch,纵轴是 1-NFE FID,四根曲线:原版 MeanFlow-B/2 终点在 6.17;加上改进目标,到 5.68;再加上柔性 CFG 条件,到 4.57;最后把 adaLN-zero 换成 in-context conditioning,到 4.09。每两根曲线之间的垂直距离,就是每项设计的独立贡献。这个图也把主线重复了一遍:目标重写打底,条件化提效,架构瘦身提速。
小播:那和原版 MeanFlow 的完整系统对比呢?
老播:Tab.2 是逐型号对比,全部是 ImageNet 256×256、1-NFE、FID-50K。原版 MF-XL/2 是 676M 参数、3.43;iMF-XL/2 是 610M 参数、1.72,相对降 50%。iMF-M/2 是 174M、2.27,iMF-L/2 是 409M、1.86。注意一个有趣的对照:89M 的 iMF-B/2 得分 3.39,已经压过 676M 的原版 MF-XL 的 3.43——同样的分数,参数少了一个量级。
小播:跟其它一步生成方法比呢?我记得你说它没有蒸馏。
老播:对,这是它最亮的一点。Tab.3 分了几栏。从零训练的一步方法里:iCT-XL/2 是 34.24,Shortcut-XL/2 是 10.60,TiM-XL/2 是 3.26,α-Flow-XL/2+ 是 2.58,iMF-XL/2 的 1.72 是全部最低。再看蒸馏系的一步方法——它们拿多步模型当老师:π-Flow-XL/2 是 2.85,DMF-XL/2+ 是 2.16,FACM-XL/2 是 1.76。iMF 从零训练,把蒸馏系也超过了。放宽到两步,iMF-XL/2 到 1.54,对比同样是两步的 α-Flow-XL/2+ 是 1.95、MeanFlow-XL/2+ 是 2.20。最后给一个多步方法的参照系:DiT-XL/2 用 250 步,FID 是 2.27,SiT-XL/2 是 2.06,更强的 LightningDiT 是 1.35,DDT 是 1.26,最强的 RAE+DiTDH-XL 是 1.13。可以看到,一步和两百五十步之间的差距被压到很小了,但还没有抹平。
小播:我注意到 Tab.2 里 B/M/L/XL 的参数差异挺大,训练设置一样吗?
老播:不完全一样,说几个关键的。B 号模型在消融里训 240 epoch,系统版训 640;M 和 L 号训 640,XL 号训 800。batch size 系统版统一 1024,学习率恒定 1e-4,优化器是 Adam,EMA 衰减 0.9999。时间步 (r, t) 从 logit-normal 分布采样,50% 的样本满足 r 不等于 t。这些设置都在附录的 Tab.4 里。另外,因为移除了 adaLN-zero,MF 和 iMF 同代号模型的参数不能严格对齐,论文明说 B/M/L/XL 只作参照。
小播:除了 FID,论文还报了一个叫 IS 的指标,这两个指标有什么区别?
老播:IS 是 Inception Score,衡量单张图片的清晰度和类别可分性,越高越好;FID 衡量生成分布和真实分布的整体重合度,越低越好。两个指标经常打架:IS 偏好又清晰又「典型」的图,FID 偏好覆盖全部真实分布。论文里 iMF-XL 的 IS 是 282.0,原版 MF-XL 是 247.5,两个指标都涨了。论文还放了三个类别的生成样例,类名是 house finch、pot、lakeside 这类 ImageNet 类,样例没有刻意挑选。另外有个细节:展示样例用的 CFG 设置和最优 FID 的设置不同,这一点放进局限里说。
小播:评价口径确认一下,这些数字都是怎么算的?
老播:统一是 ImageNet 256×256 类条件生成,FID 在生成的 5 万张图上算,每类 50 张,对照训练集分布,也就是 FID-50K。模型都工作在预训练 VAE 的 latent 空间里。CFG 相关的数字,论文报告的是各自最优引导强度下的结果——这在原版 MF 里没法做到,也算「可用化」的一部分。
谱系定位:它站在哪条技术路线上
小播:最后把它放回地图里。它和别的 MeanFlow 改进工作什么关系?
老播:MeanFlow 出来后有一批改进,方向各不相同。α-Flow 把 MF 的目标拆开,设计了一个从 flow matching 逐步过渡到 MeanFlow 的训练调度;Decoupled MeanFlow 拿预训练好的 flow matching 模型,在最后几层加第二个时间步条件微调成一步模型;CMT 用预训练模型生成固定的回归目标做中期训练。它们的共同点,多半需要多步模型当老师。iMF 走了另一条路:调度不动、老师不要,直接修目标的结构和 CFG 的处理方式,所以它和这些工作可以叠加,论文里用「正交」这个词。
小播:那它跟这些同样在改进 MeanFlow 的工作,是不是竞争关系?
老播:竞争和互补都有。α-Flow 的调度、Decoupled MeanFlow 的预训练初始化、CMT 的固定目标,跟 iMF 改的目标结构和 CFG 处理,动的是不同的螺丝。论文自己的态度很明确:这些改进相互独立,可以叠在一起用,所以它把「回归目标和条件方式」这条线单独补上,没有去和 α-Flow 争调度。也正因为如此,它和这批工作比的是最终 FID:同样从零训练、同样 1-NFE,iMF-XL/2 的 1.72 比 α-Flow-XL/2+ 的 2.58 低,这就是同台竞技的结果。
小播:那跟蒸馏路线比,谁更有前途?
老播:这张榜单给出一个很强的信号:从零训练的一步模型已经追平并超过了蒸馏系方法,FACM 的 1.76 被 1.72 反超。蒸馏的代价是先要有一个好的多步模型,训练管线长一倍;从零训练直接训一步模型,管线短。这篇论文想说的事情,是 fastforward 有资格作为独立范式单独研究,可以脱离多步模型的附属地位。这是它作为「样板」的含义。
局限:哪些话我们替它说
小播:夸了这么多,说点不好的。你自己读的时候觉得哪几条限制最重要?
老播:分两类,论文自己承认的,和我们读出来的。论文自承的第一条:一步生成把采样成本压到很低之后,预训练 VAE tokenizer 的解码反而开始占不可忽略的开销,等于瓶颈从「生成步数」转移到「编解码」,所以后续需要高效 tokenizer 或者直接在像素空间生成。第二条:移除 adaLN-zero 之后,MF 和 iMF 的参数、算力没法严格对齐,B/M/L/XL 这些代号只作参照,跨模型的「每参数效率」要谨慎解读。第三条:展示质量用的 CFG 设置,ω 等于 6、区间 [0.2, 0.8],这个设置下 FID 是 3.92、IS 是 348.2,它偏向单张质量、牺牲多样性,跟最优 FID 的 1.72 不是同一个评估设置,看数字要带设置。
小播:那复现的难度怎么样?代码是公开的吗?
老播:论文基于原版 MeanFlow 的公开代码库改的,原版代码在 GitHub 上,JAX 加 TPU 的实现,作者致谢里也提到用了 Google 的 TPU 研究云。权重论文没有明确承诺开源,所以严格复现需要自己训练——XL 号训 800 epoch、batch 1024,算力门槛不低。我们读出来的时候把这一条也归进复现相关的顾虑。
小播:那你读出来的呢?
老播:四条。其一,柔性 CFG 引入了新的超参:ω 的幂分布指数 β,以及区间端点的采样范围,论文只在 ImageNet 上验证过,最优 β 会不会随数据集或模型规模漂移,没证据。其二,stop-gradient 的去留是经验结论,论文自己也承认理论上并不严格需要它,缺一个形式化的收敛分析来证明方差解释。其三,实验只有 ImageNet 256×256 一个任务,一步生成的泛化、在更大分辨率或者视频上的表现是空白。其四,也是最实在的:1.72 和最强多步方法 RAE+DiTDH 的 1.13 之间还有距离,一步生成在分布覆盖上还有进步空间,论文没有回避这一点。
收尾:记住三件事
小播:那我们收尾。这期内容多,我试着复述三件最重要的事,你看我抓得准不准。第一,原版 MeanFlow 表面回归平均速度,实际目标等价于对瞬时速度回归,问题出在回归输入混进了条件速度 e−x;改成网络预测 v_θ 之后,方差降下来,训练损失从不下降到正常收敛,这是「对 v 回归加重新参数化更稳定」的含义。
老播:准。第二件?
小播:第二,CFG 强度从训练期定死的超参,变成推理期可调的条件变量,同一个模型可以自由选 ω,还能还原无 CFG 行为,这一步是一步生成「可用化」的开关。第三,条件多了之后用多 token in-context conditioning,参数省三分之一,分数反而更好,89M 的 B 号模型 3.39 压过 676M 的原版 XL 的 3.43。
老播:三件都抓对了。我再补一句给后续工作的话:这篇把一步生成的目标问题摆正、把 CFG 变灵活、把条件架构做轻,让从零训练的一步模型在 ImageNet 上拿到 1.72 的 FID,追平并超过蒸馏系方法。它对后续的意义,是把「一步生成」从演示变成了可以继续往上堆的独立平台——谁能在 tokenizer、更大数据、更多任务上把这条线推下去,谁就接住了这个样板。
小播:那这期就到这,下次见。
老播:下次见。