PFGM++:用一个维度旋钮,把扩散模型和泊松流生成模型串成一个家族
一句话定位:PFGM++(arXiv 2302.04265,ICML 2023,MIT 团队)把数据点看作 N 维空间里的正电荷,增广 D 个额外维度后沿电场线把均匀先验流回数据所在平面,得到一个以 D 为旋钮的生成模型家族:D=1 是泊松流生成模型 PFGM,D→∞(保持 σ=r/√D 定标)在训练与采样两层都精确恢复扩散模型。中间值 D=2048/128 在 CIFAR-10/FFHQ 上把无条件 FID 压到 1.91/2.43(35/79 次网络求值),并对注入噪声、低比特量化、放大采样步长三类误差都更稳。
1. 这篇要解决什么问题
扩散模型已经是高质量图像生成的主流:DDPM、score-SDE、EDM 一脉把生成过程写成「加噪—去噪」,网络学的是噪声水平相关的分数函数(score,即加噪数据分布的对数密度梯度),采样沿概率流 ODE 从纯噪声走回数据。这条路线质量高,但有一个公开的弱点:对估计误差敏感。分数函数稍微学偏,采样轨迹就容易跑飞,模型对采样步长、网络压缩、数值误差的容忍度都不高。
2022 年的 PFGM 换了个物理视角:把数据点当成静电学里的正电荷,生成就是沿着电场线从远处走回电荷。它的鲁棒性更好,但训练要在一个训练步里采样一大批数据来近似电场积分,目标有偏、开销大,还做不了需要一对一配对的文本条件生成。PFGM 和扩散模型各占一个端点,中间区域没人系统探索,也缺一个统一的训练目标。本文一次解决两件事:把增广维度从 1 推广成可调参数 D,让 PFGM 与扩散模型成为同一个家族的两个端点;再给出一个无偏、单样本的扰动训练目标,让整个家族训练起来和扩散模型一样顺手。
2. 物理类比:静电学怎么变成生成模型(教科书案例)
先给预期:静电学里,正电荷会在周围空间产生电场,从远处出发的粒子沿电场线走,最后会落到某个电荷上。把每个数据点看成放在 z=0 平面上的正电荷,那么「从均匀先验出发、沿电场线走回电荷」就成了一条生成路径。模型要学的,是空间中每一点的电场方向。
PFGM 中电场定义为(公式先出现前的预期:这个积分要回答「空间中某一点的电场指向哪里、多强」):
$$E(\tilde{x}) = \frac{1}{S_N(1)} \int \frac{\tilde{x}-\tilde{y}}{\|\tilde{x}-\tilde{y}\|^{N+1}} p(y)\,dy$$
逐符号解释:$\tilde{x}$ 是空间中的位置(数据坐标 $x$ 加上增广坐标),$\tilde{y}$ 是某个数据电荷的位置,$p(y)$ 是数据分布,$\|\tilde{x}-\tilde{y}\|$ 是两点距离,$N$ 是数据维度,$S_N(1)$ 是单位 N 维球面的表面积——一个只跟维度有关的常数,用来把积分归一化。整体意思是:某点的电场,等于它到所有电荷的「带方向距离」按数据分布加权求和,电荷越近、贡献越大。PFGM 用 D=1(只加一维 z)做了这件事,采样就是沿电场线积分。
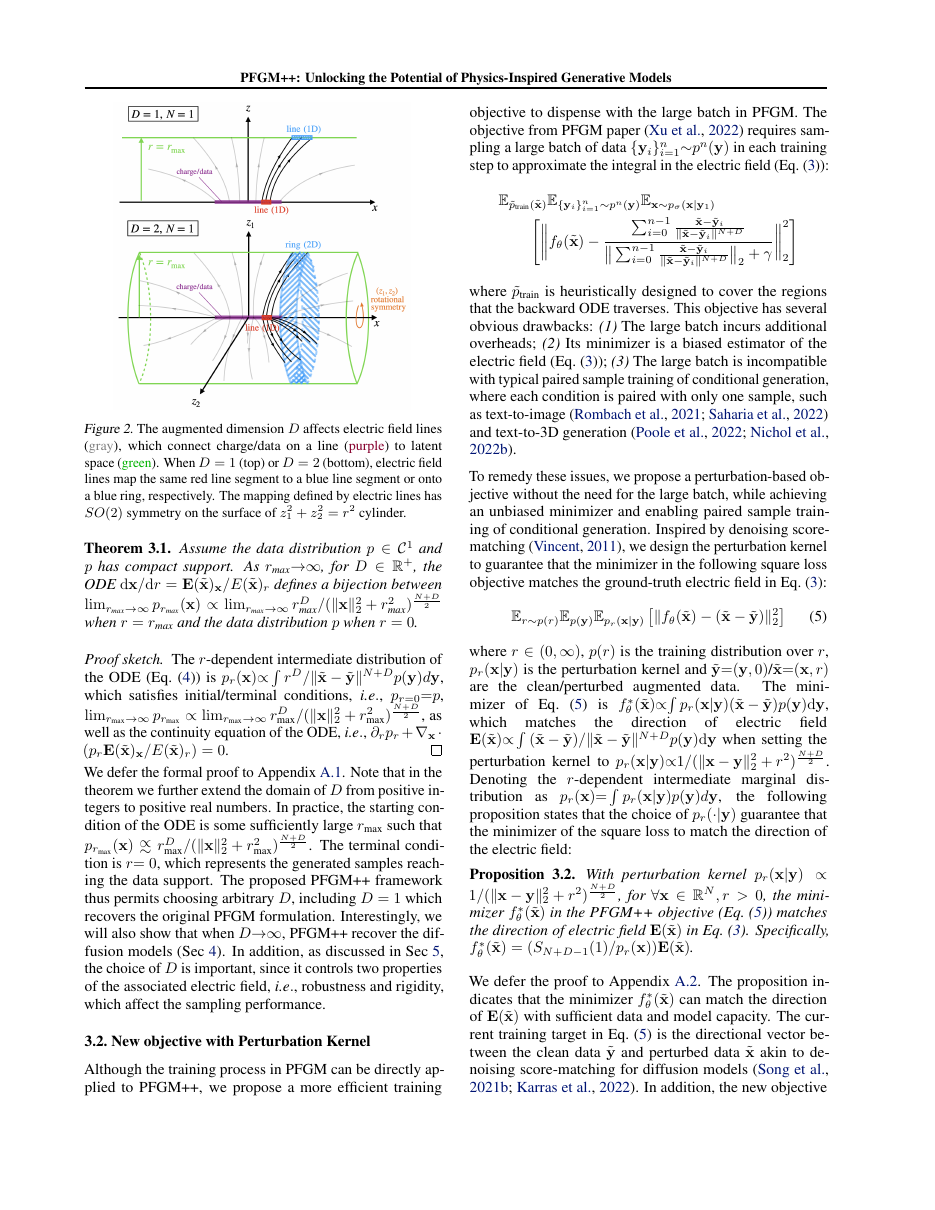
下图是本文的教科书案例:同一份一维数据(红色线段),D=1 时电场线把它映到先验平面上的同一条线段;D=2 时同样这份数据被映到圆柱面 $z_1^2+z_2^2=r^2$ 上的一个环(蓝色)。关键在第二行:电场线绕环有 SO(2) 旋转对称,意味着我们跟踪增广变量的长度 r=||z||₂ 就足够了,不需要逐个建模 D 个分量。
3. 核心机制:D 维增广、对称约简、无偏训练目标
第一步:把增广维度从 1 变成 D,再用对称性压回标量
把增广变量从一维 z 换成 D 维向量 z=(z₁,…,z_D),数据点 $\tilde{x}=(x,z)$ 落在 N+D 维空间,电场变为(预期:和式 (2) 同构,只是维度从 N+1 换成 N+D):
$$E(\tilde{x}) = \frac{1}{S_{N+D-1}(1)} \int \frac{\tilde{x}-\tilde{y}}{\|\tilde{x}-\tilde{y}\|^{N+D}} p(y)\,dy$$
符号变化只有两处:距离的幂次从 N+1 变成 N+D(空间的维度变了),归一化常数换成 N+D−1 维单位球面面积。这个电场在圆柱面 ||z||₂=r 上有旋转对称性,因为电荷所在的 z=0 平面在增广方向上是「无标记」的,旋转 z 不改变物理图景。于是 D 个分量对生成轨迹的影响全部浓缩成半径 r,生成 ODE 写成(预期:把时间参数换成半径 r,得到以 r 为锚的常微分方程):
$$\frac{dx}{dr} = \frac{E(\tilde{x})_x}{E(\tilde{x})_r}$$
其中 E_x 是电场在数据方向的分量,E_r 是电场在半径方向的分量。推导 r 的动力学 dr/dt = Σ_i (z_i/r)·dz_i/dt,把电场公式代进去,恰好得到 E_r 的积分形式。这一步的价值在于:网络永远只处理 (x, r),计算量与 D 无关,D 变成一个可以随便拧的旋钮,而增广的「物理」深度随 D 改变。
第二步:无偏扰动训练目标
预期:要学比值 E_x/E_r,但积分式无法直接当监督信号。PFGM 的做法是每个训练步采样一大批数据去近似电场(有偏、慢、不能配对条件训练)。本文要一个单样本目标,让它的最小化者恰好等于目标场。
$$E_{r\sim p(r)}\,E_{p(y)}\,E_{p_r(\tilde{x}|y)}\left\|\, f_\theta(\tilde{x}) - \frac{x-y}{r/\sqrt{D}}\,\right\|^2$$
逐符号解释:r 是扰动半径,p(r) 是训练时的半径分布(由扩散模型的 p(σ) 迁移而来);p_r(x̃|y) 是扰动核,具体形式 $p_r(x|y)\propto 1/(\|x-y\|^2+r^2)^{(N+D)/2}$——可以理解成 N+D 维空间里「柯西型」的加噪分布,半径 r 控制扰动幅度;x 是从扰动核里采出的加噪样本,y 是干净数据;分母 r/√D 是归一化尺度,让目标向量的大小与 D 无关。这个平方损失的最小化者,在每个点 x̃ 处等于条件期望 √D·E[(x−y)|x̃]/r,恰好是归一化电场 E_x/E_r 的 √D 倍——所以最小化者无偏,且每个训练步只需要一个配对样本 (x̃, y),天然支持文本条件生成。
第三步:为什么 D→∞ 就退化成扩散模型
预期:扩散模型的分数函数 ∇_x log p_σ(x) 告诉网络「从加噪样本往干净数据方向走」,PFGM++ 的电场方向在 D 很大时应该趋近同一个方向——前提是两种「噪声水平」的标定对得上,这个标定就是 σ=r/√D。
定理 4.1 说:固定 σ=r/√D,令 D→∞,则 √D·E_x/E_r 收敛到 σ∇_x log p_{σ=r/√D}(x),两边的采样 ODE 轨迹重合。符号含义:σ 是扩散模型的高斯噪声标准差,r 是 PFGM++ 的扰动半径,√D 是两者之间的换算因子。命题 4.2 补上训练层:D→∞ 时式 (6) 的最小化者,等于加权去噪分数匹配目标 $E_{\sigma\sim p(\sigma)}\lambda(\sigma)E\left\|f_\theta(x,\sigma)-(x-y)/\sigma\right\|^2$ 的最小化者。连扰动核都收敛:半径分布 $p_r(R)\propto R^{N-1}/(R^2+r^2)^{(N+D)/2}$ 在 D→∞、σ=r/√D 固定时变成高斯核 exp(−||x−y||²/2σ²),也就是扩散模型的标准加噪分布。图 4(a) 实测了这一点:横轴 D(2² 到 2²⁰),纵轴电场与分数函数的平均 L2 距离,曲线随 D 单调下降到 0。
4. D 是鲁棒性与刚性的旋钮
预期:D 同时决定加噪样本范数的集中程度,而集中程度决定模型对误差的敏感度。
半径分布 $p_r(R)$ 的均值约为 r√(N/D)。D 越大,分布越集中:加噪样本的范数被钉在球面半径 r√(N/D) 附近,网络输入分布「窄而规律」,训练容易(论文叫 rigid,刚性);代价是采样轨迹一旦偏离训练数据里的范数—半径关系就会崩溃,对估计误差敏感。D 越小,范数分布越重尾:图 4(b) 显示 D<2⁵=32 时半径方差可以超过 2¹⁰,网络输入覆盖极宽的范围,对误差的容忍度反而高(鲁棒),但分布难学,对有限容量网络有压力。两端都不理想,中间存在甜点。
为了让有限 D 用上扩散模型精心调过的超参,本文提出相位对齐:令 r=σ√D,中间分布 p_r 的相位(加噪数据被哪些模式影响的程度)对所有 D 近似一致,于是把 EDM 调好的 σ_max=80、σ_min=0.002、训练分布 p(σ) 按 r_max=σ_max√D、p(r)=p(σ=r/√D)/√D 零样本迁移到任意 D。图 3 用平均 TVD(全变差距离)验证:对齐后 D=2⁴ 到 2²⁰ 的相位曲线几乎重合。
5. 关键实验:甜点 D 的 FID 与鲁棒性证据
实验设定:CIFAR-10 32×32(improved NCSN++,批大小 512)与 FFHQ 64×64(improved DDPM++,批大小 256),超参全部从 EDM 迁移,采样用 Heun 二阶 ODE 求解器,CIFAR-10 35 次网络求值(NFE)、FFHQ 79 NFE。
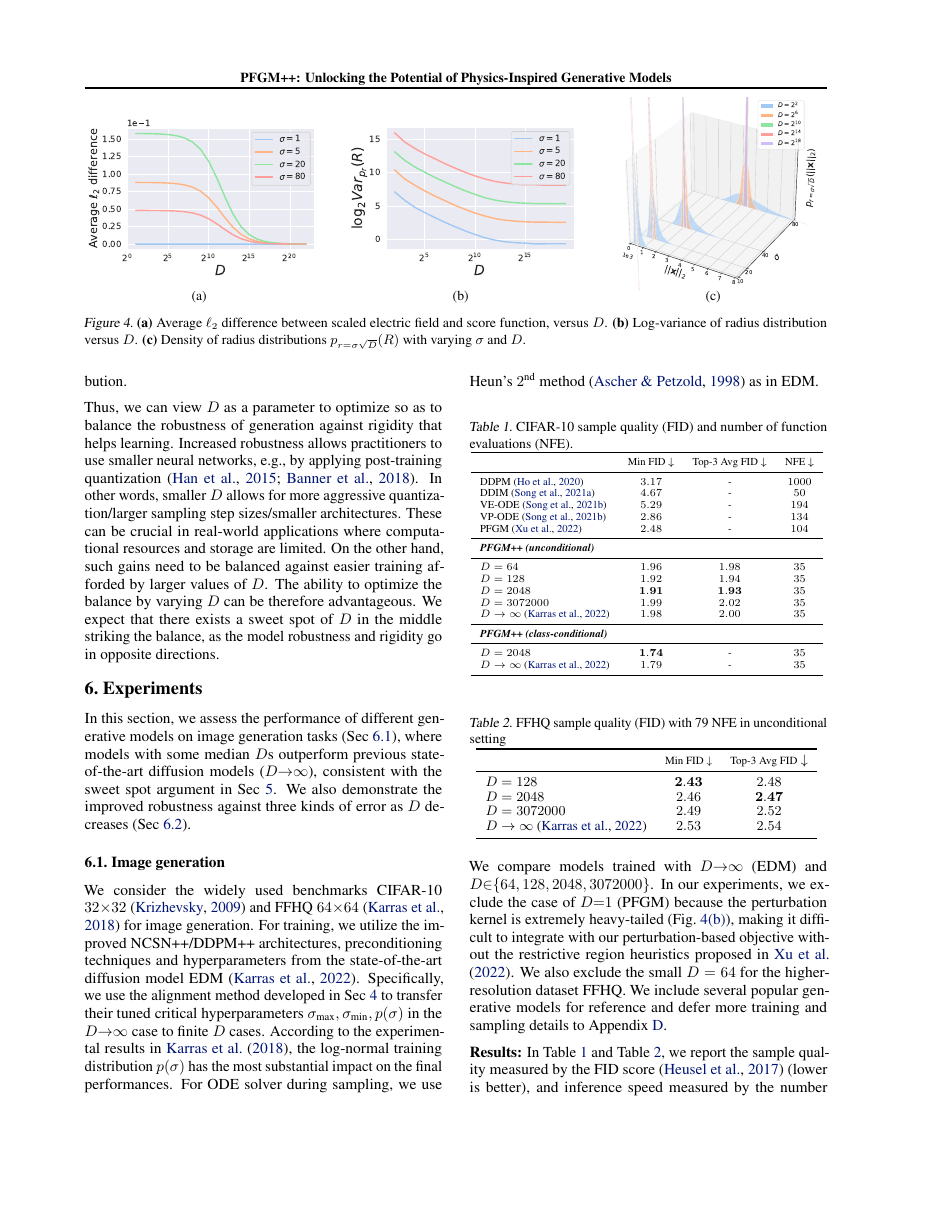
CIFAR-10 无条件生成,D=2048 拿到 min FID 1.91,对比同框架下 D→∞(EDM 重跑)1.98、PFGM(D=1)2.48、VP-ODE 2.86、DDPM 3.17(1000 NFE)。FFHQ 64×64 上 D=128 拿到 2.43,EDM 是 2.53。类条件 CIFAR-10 上 D=2048 的 1.74 也压过 EDM 的 1.79。三个数字的共同点:最好的 D 落在中间(64~2048),两端都没有最优,与「甜点」预期一致;而 D=3072000 的 1.99 与扩散的 1.98 几乎相同,验证 D≫N 时退化为扩散模型。
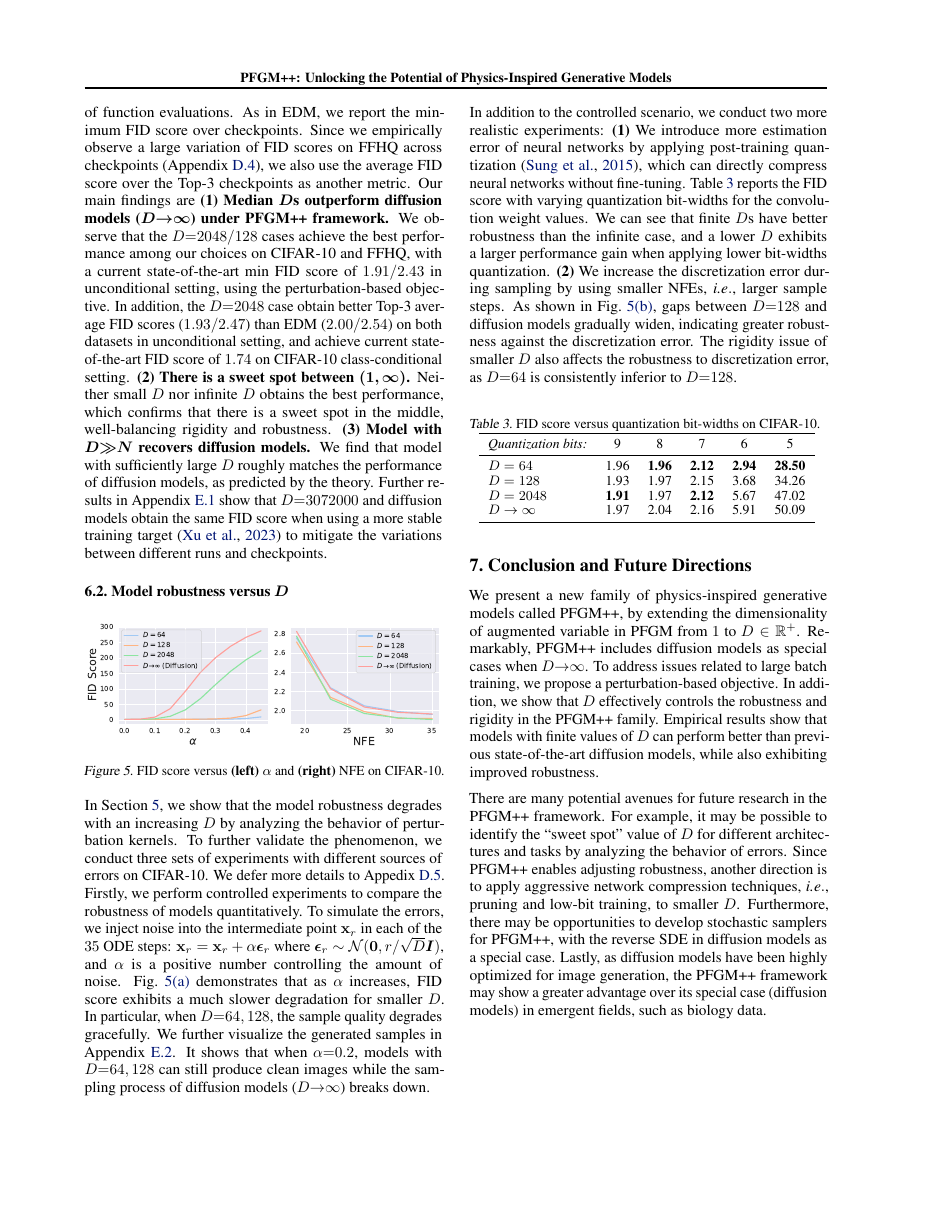
鲁棒性三组实验(CIFAR-10):第一组在每个采样步注入高斯噪声,x_r←x_r+α·ε_r,ε_r 标准差取 r/√D;α=0.2 时 D=64/128 仍能生成干净图,扩散模型的采样直接崩坏,图 5 左图里小 D 的 FID 曲线随 α 上升缓慢。第二组对卷积权重做 5~9 bit 训练后量化:5 bit 时 D=64 的 FID 是 28.50,D→∞ 是 50.09,量化越狠小 D 优势越大。第三组减少 NFE(采样步长变大):D=128 与扩散的差距随步长增大而拉大,但 D=64 反而比 D=128 差——重尾的刚性代价在这一组里体现出来。
6. 谱系定位
PFGM++ 处在「物理启发生成模型」这条线上,把两个端点焊进同一家族:PFGM(D=1,NeurIPS 2022)提供静电场视角,扩散模型(EDM/VE/VP,D→∞)提供分数匹配的成熟训练与调参体系。相比 PFGM,它把训练目标换成无偏扰动目标并解锁配对条件训练;相比扩散模型,它在 σ=r/√D 标定下证明三层等价,又用有限 D 拿到更好的 FID 与鲁棒性。设计上它借用了 score 场相位分析(Xu et al. 2023 的 Stable Target Field)里的「相位」概念做超参对齐。整篇文章的贡献可以概括为:用一维旋钮 D 连接两种看似不同的生成机制,并给出统一的训练目标。
7. 局限与复现
局限方面,首先要承认 D=1(PFGM 本身)被排除在实验外:它的扰动核重尾到无法直接配本文的无偏目标,仍需 PFGM 的区域启发式,谱系端点并未被真正统一。其次,FID 在 checkpoint 间波动约 ±0.2(总训练预算 2 亿张图),论文靠 min FID 或 Top-3 平均报告,EDM 基线也是作者重跑值,与原论文数字存在出入,比较精度有限。第三,只在 32×32 与 64×64 两个低分辨率基准上验证,没有更高分辨率或文本条件生成实验,条件生成的潜力仅在目标层面论证。第四,甜点 D 没有理论预测公式,需要逐数据集逐架构扫描;鲁棒性收益是经验现象,缺少误差预算层面的定量刻画。最后,小 D 的鲁棒性以训练难度为代价,D=64 在采样大步长下反而输给 D=128。
复现条件:代码在 github.com/Newbeeer/pfgmpp,数据 CIFAR-10 与 FFHQ 公开,训练用 4×A100 或 8×V100,超参沿用 EDM(Adam lr 1e-4、EMA、ln σ~N(−1.2,1.2²)、σ_data=0.5)并经 r=σ√D 迁移。需要说明的是,仓库里 tasks/core/pdfs/pfgmpp.pdf 当时下载成了另一篇论文(arXiv 2302.10878 格码论文),本卡片内容以 arXiv 2302.04265 的原文为准。
PFGM++ 把两类物理启发的生成模型放进同一个家族:把 N 维数据点当作电荷,增广 D 个额外维度后沿电场线把均匀先验流回数据所在平面;D=1 时它就是泊松流生成模型 PFGM,D→∞(保持 σ=r/√D 定标)时在训练目标与采样过程两层都精确恢复扩散模型。D 由此变成调节『对误差鲁棒』与『易于学习』的旋钮,中间值 D=2048/128 在 CIFAR-10/FFHQ 上把无条件生成 FID 压到 1.91/2.43(35/79 次网络求值),并在注入噪声、低比特量化、放大采样步长三类误差下比扩散模型更稳。
阅读提示
精读深度:泛读
清单提示:原文提示:静电学→生成模型;物理类比的教科书案例。播客必须讲清:把数据点看作电荷、沿电场线生成样本;增广维度 D 是连接 PFGM(D=1)与扩散模型(D→∞)的旋钮;为什么 D 维极限退化为扩散模型(在 σ=r/√D 定标下,电场方向收敛到分数函数、训练目标收敛到去噪分数匹配、采样 ODE 与扩散 ODE 一致)。
问题
要解决什么:扩散模型(DDPM、score-SDE、EDM 一脉)已是高质量图像生成的主流,但对估计误差敏感:训练出的分数函数一旦有偏差,采样轨迹容易跑偏。2022 年的 PFGM 从静电学出发,用 N+1 维空间的电场线做生成,鲁棒性更好,却要依赖大 batch 估计电场,训练目标有偏、开销大,也难以做条件生成。本文要解决两个问题:把『静电场生成』从 D=1 推广成一个连续谱系,让 PFGM 与扩散模型成为两个端点;同时给出一个无偏、单样本的扰动训练目标,让整个谱系训练起来和扩散模型一样简单,并支持配对的条件生成训练。
为什么 prior work 不够:扩散模型(D→∞ 端)把加噪样本的范数与噪声水平 σ 强耦合,估计误差会直接放大到采样路径上;PFGM(D=1 端)的扰动分布在固定半径处重尾严重,训练目标要用大 batch 近似积分式电场(最小化者有偏),并且只能靠区域启发式限制训练与采样范围,无法直接用于需要一对一配对的文本条件生成。两条路线各占一个端点,中间区域无人系统性探索,也缺少统一的训练目标。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 数据点 x(电荷) | N 维向量;图像为 32×32×3 / 64×64×3 像素 | 放在 z=0 超平面上的正电荷,决定 N+D 维空间里的电场分布 |
| 增广变量 z∈R^D | D 维向量 | 训练时按扰动核采样;因 SO(D) 旋转对称性,模型只需标量 r=||z||_2 而不需要逐个分量 |
| 扰动半径 r | 正标量 | ODE 的锚变量:从 r_max=σ_max·√D(按 EDM 的 σ_max=80 迁移)走到 r=0 的数据平面 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 生成样本 x_0 | N 维图像像素 | 从先验 p_rmax 出发,沿 dx/dr=E_x/E_r 积分回 r=0 的数据平面 |
| 预测场 f_θ(x̃) | N 维向量 | 网络在增广点 x̃=(x,r) 处预测(归一化后的)电场方向,采样时直接用作 ODE 速度场 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10(32×32) | 5 万张训练图 / 1 万张测试图 | 无条件与类条件生成主基准;报告 min FID(每个 checkpoint 3 个种子取最小) |
| FFHQ(64×64) | 7 万张人脸图(训练子集) | 无条件生成;因 checkpoint 间 FID 波动大,报告 Top-3 checkpoint 平均 FID |
架构(摘要)
主干与结构
backbone:improved NCSN++(CIFAR-10)/ improved DDPM++(FFHQ),沿用 EDM 的网络与预处理
参数:正文未给出参数量(直接复用 EDM 架构)
类型:卷积 U-Net + 电场预测头(时间/半径条件)
关键组件
- 状态表示:增广点 x̃=(x,r),r=||z||_2;网络输入 (c_in·x, c_noise(σ)),σ=r/√D
- 预测头:f_θ(x̃)≈√D·E_x/E_r,即归一化电场的 x 分量
- 预处理:EDM 的 c_in/c_out/c_skip,σ_data=0.5;训练分布 ln σ~N(−1.2, 1.2²)
- 采样器:Heun 二阶 ODE 求解器,步长调度 ρ=7,35 NFE(CIFAR-10)/ 79 NFE(FFHQ)
为什么这样设计
静电场在圆柱面 ||z||_2=r 上有 SO(D) 旋转对称性,D 个增广分量对生成轨迹的影响只通过范数 r 体现,网络输入从 (x,z) 约简到 (x,r),计算量与 D 无关,D 因此变成可自由调节的维度旋钮。训练目标仿照去噪分数匹配构造,使 D→∞ 时与扩散模型共用同一套优化目标与超参,有限 D 时也能直接迁移 EDM 调好的超参。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 无条件生成 min FID | 1.91 | EDM(D→∞) 1.98、PFGM(D=1) 2.48、VP-ODE 2.86、DDPM 3.17(1000 NFE) | 32×32 图像,D=2048,35 次网络求值(NFE),improved NCSN++,训练超参从 EDM 按 r=σ√D 迁移 |
| FFHQ 64×64 无条件生成 min FID | 2.43 | EDM(D→∞) 2.53(本文重跑值) | 64×64 人脸,D=128,79 NFE,improved DDPM++ |
| CIFAR-10 类条件生成 min FID | 1.74 | EDM(D→∞) 1.79 | 32×32,D=2048,35 NFE;论文称该数值为当时 CIFAR-10 类条件 SOTA |
| 5-bit 训练后量化 FID(CIFAR-10) | 28.50(D=64) | 50.09(D→∞,同一量化设置) | 对卷积权重做 5-bit 量化且不微调,35 NFE;量化越狠小 D 相对优势越大(9 bit 时两者均为约 1.96~1.97) |
| D 足够大时恢复扩散模型(min FID) | 1.99(D=3072000) | EDM(D→∞) 1.98 | CIFAR-10 无条件,35 NFE;验证 D≫N 时退化为扩散模型的理论预测 |
Insights
- 扩散模型是泊松流/静电场生成模型在增广维度 D→∞ 的极限,PFGM 是 D=1 端点,中间存在连续谱与性能甜点——『物理启发生成模型』与『分数匹配』在数学上同族(定理 4.1 + 命题 4.2)。
- D 越小,加噪样本范数分布越重尾,对估计误差越鲁棒,但网络输入分布越难学;D 越大范数越集中,训练越容易,采样却对误差越敏感。鲁棒与刚性在 D 上此消彼长。
- 把大 batch 场估计换成单样本扰动目标(类似去噪分数匹配),最小化者仍然无偏,还天然支持一对一配对的文本条件生成——这是 PFGM 时代做不到的。
- 物理类比的价值在于给出可解释的生成机制:生成 = 沿电场线把均匀先验流回电荷(数据)所在平面,对称性分析告诉我们只需要跟踪半径标量。
vs 同类工作
- vs PFGM(D=1,NeurIPS 2022):增广维度从 1 推广到任意 D,训练目标从有偏的大 batch 场估计换成无偏扰动目标,解锁配对条件训练;PFGM 成为本家族的一个端点。
- vs 扩散模型(EDM/VE/VP,D→∞):在 σ=r/√D 定标下,电场方向、采样 ODE、训练目标三层等价都被证明,扩散模型成为本家族的另一端点;有限 D 在 FID 与鲁棒性上都更好。
- vs score 场相位分析(Xu et al. 2023, Stable Target Field):借用『相位』概念设计 r=σ√D 对齐,把扩散模型调好的超参零样本迁移到任意 D,省去逐 D 调参。
局限
- D=1(PFGM 本身)被排除在实验外:扰动核重尾到无法直接配本文的无偏目标,仍需 PFGM 的区域启发式,说明谱系端点并未被本文真正统一。
- FID 波动大:checkpoint 间约 ±0.2(总训练预算 2 亿张图),论文靠 min FID 或 Top-3 平均报告,且 EDM 基线是作者重跑值、与原论文数字存在出入,比较精度有限。
- 只在 CIFAR-10 32×32 与 FFHQ 64×64 两个低分辨率基准上验证,没有更高分辨率或文本条件生成实验;条件生成的潜力仅在训练目标层面论证。
- 甜点 D 没有理论预测公式,需要逐数据集逐架构扫描;鲁棒性收益是经验现象,缺少『误差预算』层面的定量刻画。
- 小 D 的鲁棒性以训练难度为代价:重尾输入对有限容量网络有压力,D=64 在采样大步长下反而比 D=128 差(刚性端受限)。
可复现性
- code:https://github.com/Newbeeer/pfgmpp
- data:CIFAR-10 与 FFHQ(均为公开数据集)
- hardware:4×A100 或 8×V100
- training:沿用 EDM 的超参:Adam lr 1e-4、EMA、log-normal 训练分布 p(σ)(ln σ~N(−1.2,1.2²))、σ_data=0.5、批大小 512(CIFAR-10)/256(FFHQ);超参经 r=σ√D 迁移到有限 D
- sampling:Heun 二阶 ODE,ρ=7 步长调度,r_max=80√D、r_min=0.002√D;35 NFE(CIFAR-10)/79 NFE(FFHQ);FID 用 5 万张生成样本与预计算统计量比对
- notes:卡源论文原文 arXiv 2302.04265;仓库 tasks/core/pdfs/pfgmpp.pdf 当时下载为另一篇 arXiv 2302.10878(格码论文),本卡片内容以 arXiv 2302.04265 为准
主干与结构
backbone:improved NCSN++(CIFAR-10)/ improved DDPM++(FFHQ),沿用 EDM 的网络与预处理
参数:正文未给出参数量(直接复用 EDM 架构)
类型:卷积 U-Net + 电场预测头(时间/半径条件)
关键组件
- 状态表示:增广点 x̃=(x,r),r=||z||_2;网络输入 (c_in·x, c_noise(σ)),σ=r/√D
- 预测头:f_θ(x̃)≈√D·E_x/E_r,即归一化电场的 x 分量
- 预处理:EDM 的 c_in/c_out/c_skip,σ_data=0.5;训练分布 ln σ~N(−1.2, 1.2²)
- 采样器:Heun 二阶 ODE 求解器,步长调度 ρ=7,35 NFE(CIFAR-10)/ 79 NFE(FFHQ)
为什么这样设计
静电场在圆柱面 ||z||_2=r 上有 SO(D) 旋转对称性,D 个增广分量对生成轨迹的影响只通过范数 r 体现,网络输入从 (x,z) 约简到 (x,r),计算量与 D 无关,D 因此变成可自由调节的维度旋钮。训练目标仿照去噪分数匹配构造,使 D→∞ 时与扩散模型共用同一套优化目标与超参,有限 D 时也能直接迁移 EDM 调好的超参。
增广维度 D 如何改变电场线(D=1 与 D=2 的静电场图)
原文 caption:The augmented dimension D affects electric field lines (gray), which connect charge/data on a line (purple) to latent space (green). When D=1 (top) or D=2 (bottom), electric field lines map the same red line segment to a blue line segment or onto a blue ring, respectively. The mapping defined by electric lines has SO(2) symmetry on the surface of z_1^2+z_2^2=r^2 cylinder.
全篇的物理教科书案例图:上半 D=1 时,一维数据线段(红)的电场线把先验平面映到同一条线段;下半 D=2 时,同样的数据线段被映到圆柱面 z_1²+z_2²=r² 上的一个环(蓝),并且电场线绕环有 SO(2) 旋转对称。读图要点:D 从 1 变到 2,先验→数据的映射从『线段到线段』变成『线段到环』,而对称性保证我们只需要跟踪半径 r=||z||,D 个增广分量不需要逐个建模。它对应『数据点=电荷、生成=沿电场线走回电荷』的核心设定。
电场与分数函数的距离、扰动范数方差随 D 变化 + CIFAR-10/FFHQ 结果表
原文 caption:Figure 4. (a) Average l2 difference between scaled electric field and score function, versus D. (b) Log-variance of radius distribution versus D. (c) Density of radius distributions p_{r=σ√D}(R) with varying σ and D. Table 1. CIFAR-10 sample quality (FID) and number of function evaluations (NFE). Table 2. FFHQ sample quality (FID) with 79 NFE in unconditional setting.
一页装下两个核心证据。图 4(a) 横轴是 D(2² 到 2²⁰),纵轴是电场与分数函数的平均 L2 距离,曲线随 D 单调下降到 0,验证『D→∞ 电场=分数函数』的理论极限;图 4(b) 纵轴是扰动半径的 log 方差,随 D 增大急剧收窄,说明大 D 把加噪样本范数钉在 r·√(N/D) 附近、小 D 则重尾。表 1/表 2 是招牌数字:CIFAR-10 无条件 min FID 1.91(D=2048,35 NFE)与 FFHQ 2.43(D=128,79 NFE),都低于 EDM(D→∞) 的 1.98/2.53。
鲁棒性证据:注入噪声 α、采样步数 NFE、量化位宽下的 FID
原文 caption:Figure 5. FID score versus (left) α and (right) NFE on CIFAR-10. Table 3. FID score versus quantization bit-widths on CIFAR-10.
图 5 左右两格:左图横轴是每步注入噪声的强度 α(0 到 0.4)、右图横轴是采样网络求值次数 NFE(20 到 35),纵轴都是 FID。左图里 D=64/128 的曲线随 α 增大上升缓慢,扩散模型(D→∞)急剧恶化,对应正文『α=0.2 时 D=64/128 仍能出干净图、扩散采样崩溃』;右图里随 NFE 减小(步长变大)D=128 与扩散的差距拉大。表 3 是 9/8/7/6/5 bit 训练后量化下的 FID:5 bit 时 D=64 为 28.50,扩散为 50.09,量化越狠小 D 的优势越大。这张页支撑『D 是鲁棒性旋钮』的核心论断。
🎧 音频版
时长 26:28 · Edge TTS
PFGM++:把扩散模型和泊松流生成模型拧成一个旋钮(播客对话版·泛读)
1. 先讲清楚这篇要解决什么问题
小播:老播,这期讲什么论文?先说清楚它解决什么问题,值不值得专门做一期。
老播:这篇是 2023 年 ICML 的 PFGM++,作者来自 MIT,第一作者是 Yilun Xu,合作的还有 Max Tegmark 和 Tommi Jaakkola。一句话背景:最近几年图像生成的主流是扩散模型,先给数据加噪再学去噪,生成质量很高,但它有一个出了名的弱点——对估计误差敏感,网络稍微学偏一点,采样就容易跑飞。这篇论文的定位,是把扩散模型和另一条物理路线——泊松流生成模型 PFGM——放进同一个家族,中间用一个叫 D 的维度旋钮连着。一句话预告结论:在这个家族里,选一个不大不小的 D,生成质量能超过扩散模型,而且对误差更抗造。我们这期会把三件事讲透:静电场怎么变成生成模型、D 这个旋钮怎么拧、为什么 D 很大时它就变回扩散模型。
小播:这个预告我记住了:中间值 D 比两端都好。我还有个疑问先放着——「扩散是 D→∞ 的极限」这句话听起来像数学命题,我们后面慢慢验证。先从背景开始,扩散和 PFGM 各自是怎么回事?
2. 先把两条线铺开:扩散模型和静电场生成
小播:先给我把扩散模型讲清楚,假设我只知道它是现在画图的主流。
老播:扩散模型的全名是去噪扩散概率模型,工作机制拆成两步。第一步叫加噪过程:拿一张干净图像,逐步往里掺高斯噪声,掺到上千步,图像基本变成纯噪声;这一步是固定的,不需要训练。第二步叫去噪过程:训练一个神经网络,给它一张被噪声污染到某个程度的图像,让它预测原来的干净图像或者当时注入的噪声,然后从纯噪声出发,一步一步把噪声剥掉,就得到一张新图。网络学到的核心对象叫分数函数,写出来是加噪数据分布的对数密度梯度 ∇ₓlog p_σ(x),一句话理解:它指向「从当前加噪状态往更可能是数据的方向走」。采样就是在概率流 ODE 里沿着这个方向积分。这里 σ 是噪声标准差,它既是训练时加噪强度的刻度,也是采样时「现在走到哪一步」的时间变量。为什么说它怕误差:采样是沿着一个方向场走很多步,每步的方向都有估计误差,误差会随着步数累积放大,最后一步偏差就变成整张图的偏差。这个背景很重要,后面鲁棒性实验就是直接往采样过程里注入误差来对比。
小播:那 FID 和 NFE 是什么?一会儿会反复出现。
老播:FID 是衡量生成质量的指标,把生成图的特征分布和真实图的特征分布做比较,数值越低越好;NFE 是生成一张图要调用多少次网络,等于采样步数,越低越快。举个具体的例子:经典的 DDPM 生成一张图要一千次网络求值,而这篇论文的实验里只要 35 次。
小播:好,那 PFGM 呢?泊松流是什么?
老播:PFGM 的全称是 Poisson Flow Generative Models,泊松流生成模型,2022 年发表在 NeurIPS。名字里的泊松来自静电学:电荷产生的电场的势函数满足泊松方程,所以这条路线叫「泊松流」。它把每个数据点看成静电学里的一个正电荷,电荷会在周围空间产生电场,从远处出发的粒子沿电场线走,最后会落到某个电荷上。生成过程就变成:从先验分布出发,沿着电场线走回数据所在的平面。数据是 N 维的,PFGM 在数据之外额外加一个维度 z,整个空间变成 N+1 维,先验放在一个很大的 N+1 维半球上。
小播:所以「静电学→生成模型」就是:数据点当电荷,生成就是沿电场线流回电荷。我理解这个类比了。那 PFGM 卡在哪?
老播:卡在训练上。电场是一个积分式:空间某点的电场,等于它到所有数据电荷的带方向距离按数据分布加权求和。PFGM 用一个训练步采样一大批数据(比如上千个样本)来近似这个积分,两个问题跟着来:近似有偏,训练开销大;而且这种「一批样本凑一个目标」的方式做不了文本条件生成——文本生成要求每个文本提示只配一张图,一对一配对训练,大 batch 近似插不进去。另外它只有 D=1 这一个设定,没有参数可以调。
小播:那扩散模型是不是也逃不开这个传输框架?两套语言里其实在干同一件事?
老播:可以这么看。扩散模型也可以理解成沿 ODE 传输:它的「力场」是分数函数,时间变量是噪声水平 σ;PFGM 的「力场」是电场,时间变量是半径。网络的工作在每个中间状态都一样——预测「下一步往数据方向怎么走」。这个共同结构,正是后面 PFGM++ 能统一它们的原因,记住这一点,第三段的定理就好理解了。
小播:我试着把两条线并排看:扩散模型用 σ 当时间变量,PFGM 用半径当时间变量,两者都是「把简单分布流到数据分布」的传输过程。这个并排是对的,对吧?
老播:对,这个并排理解很重要,后面会看到它俩共享同一个数学结构。还有一个概念先埋在这里:论文里反复提到「相位」,指的是加噪数据在不同噪声水平下受数据分布里哪些模式影响的程度。近处主要受单一数据点影响,远处被所有模式平均影响,这个演化过程就是相位变化。相位对齐是后面超参迁移的关键。
3. 核心思想三步走:加维度、做对称约简、换训练目标
小播:这应该是全篇最重的部分,你分步讲,我慢慢消化。
老播:好,三步。第一步,把增广维度从 1 推广到 D。PFGM 只加一维 z,PFGM++ 加一个 D 维向量 z=(z₁,…,z_D),数据点变成 N+D 维空间里的点 x̃=(x,z)。先给预期:下面这个式子回答「N+D 维空间里某一点的电场指向哪里」,它和 PFGM 的电场公式长得一样,只是把维度 N+1 换成 N+D:
E(x̃) = (1/S_{N+D−1}(1)) ∫ (x̃−ỹ)/‖x̃−ỹ‖^{N+D} p(y) dy
逐项说:x̃ 是空间中任意一点,ỹ 是一个数据电荷的位置,p(y) 是数据分布,‖x̃−ỹ‖ 是两点距离,幂次 N+D 来自空间维度,S_{N+D−1}(1) 是单位球面面积,一个只跟维度有关的归一化常数。整体意思:某点的电场,是它到所有电荷的带方向距离按数据分布加权求和,电荷越近贡献越大。
小播:式子没问题,但 D 个分量怎么算得动?D 可以很大,比如论文里用了 2048。
老播:这就是关键的一步——对称约简。注意电场在圆柱面 ‖z‖₂=r 上是旋转对称的:数据电荷都躺在 z=0 平面,在增广方向旋转 z 不改变物理图景,这种对称叫 SO(D) 对称。既然 D 个分量在对称意义下等价,我们只需要跟踪它们的长度 r=‖z‖₂,一个标量就够了。论文里有一张教科书级别的示意图:同样的一个一维数据线段,D=1 时电场线把它映到先验平面上的同一条线段;D=2 时同样这份数据被映到圆柱面 z₁²+z₂²=r² 上的一个环,电场线绕环转一圈都指向同一个数据。这张图直接说明两件事:增广维度变了、映到的先验几何就变;而旋转对称保证我们只跟踪半径 r。把生成 ODE 的变量从时间换成 r,就得到 dx/dr=E_x/E_r,E_x 是电场在数据方向的分量,E_r 是电场在半径方向的分量。推导很直接:r 对时间的导数,等于每个分量 z_i 的贡献按 z_i/r 加权求和,把电场公式代进去,恰好就得到 E_r 的积分形式。给个具体数字感受一下量级:CIFAR-10 的像素维度 N=3×32×32=3072,论文用的 D=2048,模型工作在一个 N+D≈5120 维的空间里,但网络真正看到的输入只有 3072 个像素加一个半径标量。
小播:所以 D=1 是 PFGM,D 很大是扩散,中间每个 D 都是一套生成模型,但网络结构完全不用改。那训练目标怎么改?刚才说 PFGM 的大 batch 有偏。
老播:第二步,换训练目标。PFGM 想学电场积分,PFGM++ 换了个思路:定义一张「加噪分布」——扰动核 p_r(x|y)∝1/(‖x−y‖²+r²)^{(N+D)/2},可以理解成 N+D 维空间里的柯西型加噪分布,r 控制扰动幅度。训练目标写成下面这个平方损失,先给预期:这个式子的最小化者正好等于我们要的电场方向,而且每个训练步只需要一个配对样本:
E_{r~p(r)} E_{p(y)} E_{p_r(x̃|y)} ‖f_θ(x̃) − (x−y)/(r/√D)‖²
逐项解释:r 是扰动半径,p(r) 是训练时半径的抽样分布——具体做法是沿用扩散模型的 log-normal 分布 ln σ~N(−1.2,1.2²),再按 r=σ√D 换算出 r;x 是从扰动核里采出来的加噪样本,y 是干净数据;网络 f_θ 在增广点 x̃ 处预测一个向量,目标是 (x−y)/(r/√D),也就是「从加噪样本指向干净数据的位移」除以归一化尺度。分母里的 √D 不是随便放的,它保证目标向量的尺度不随 D 漂移。为什么这个目标靠谱:把平方损失对 f_θ 求最小,最小化者等于条件期望 √D·E[(x−y)|x̃]/r,数学上正好等于归一化电场 E_x/E_r 的 √D 倍,所以无偏。代价是一点不付:单样本更新、不需要大 batch、天然支持文本条件这种一对一配对训练。这一步直接对标去噪分数匹配——扩散模型就是用类似的目标训练的,这为第三步的「统一」埋下伏笔。
小播:这个设计我理解为:用一个扰动核把「电场」翻译成「去噪位移」,训练就变得和扩散一样简单。第三步呢?为什么 D→∞ 就变回扩散模型?
老播:第三步是理论收口,先要对齐两边的「噪声水平」。扩散模型用 σ 表示噪声标准差,PFGM++ 用 r 表示扰动半径,两边要对上,标定关系是 σ=r/√D。先给预期:在这个标定下,D 趋于无穷时,PFGM++ 的电场方向会变成扩散模型的分数函数,采样轨迹和训练目标也都会变成扩散模型的。论文给了两个结果。定理 4.1:固定 σ=r/√D,D→∞ 时 √D·E_x/E_r 收敛到 σ∇ₓlog p_{σ=r/√D}(x),也就是电场方向等于分数函数方向;采样时 dx/dr 这条 ODE 和扩散模型的概率流 ODE 是同一个东西。命题 4.2:训练层也收敛,刚才那个平方损失的最小化者,变成去噪分数匹配目标 E‖f_θ(x,σ)−(x−y)/σ‖² 的最小化者。连加噪分布都对上了:扰动核的半径分布 p_r(R)∝R^{N−1}/(R²+r²)^{(N+D)/2},在 D→∞、σ=r/√D 固定时收敛成高斯核 exp(−‖x−y‖²/2σ²),这就是扩散模型的标准加噪分布。
小播:我追问一下标定关系 σ=r/√D 是怎么来的,这个式子看着像天上掉下来的。
老播:可以给个量级上的解释,论文在第五节也讨论了这件事:扰动半径分布的均值大约是 r√(N/D),也就是加噪位移的典型尺度;扩散模型加噪位移的典型尺度是 √N·σ。让两个尺度相等,就得到 r√(N/D)=√N·σ,两边一化简正好是 σ=r/√D。也就是说,这条标定保证两种模型在每一步加噪的「力度」一样,这样中间分布才能对齐。
小播:我复述一遍确认理解:扩散模型的加噪、训练、采样,在数学上都是 PFGM++ 在 D→∞ 的极限;PFGM 是 D=1 的端点;中间的 D 是同一个家族的成员。这个「统一」是等式意义上的,对吗?
老播:对。论文里还有两个实测图把这个等式关系直接验证到位。图 4(a):横轴 D 从 2² 到 2²⁰,纵轴是电场方向和分数函数方向的平均距离,曲线随 D 单调下降、最终归零。相位对齐的验证在图 3:论文用平均全变差距离衡量中间分布离均匀分布有多远,对齐之前不同 D 的曲线明显分开,做了 r=σ√D 的对齐之后,D 从 2⁴ 到 2²⁰ 的曲线几乎重合,说明这个标定在实验上也把中间分布对齐了。验证的是定理本身,实验证据落在等式层面。接下来是这个旋钮能干什么。
小播:还有第四步?
老播:对,第四步是 D 的物理含义——它同时决定加噪样本范数的集中程度。半径分布 p_r(R) 的均值大约在 r√(N/D)。D 大,分布集中,加噪样本的范数被钉在一个确定值附近,网络输入分布整齐,训练容易,论文叫「刚性」;代价是采样轨迹一旦偏离训练数据里的范数—半径关系,就会崩,所以对误差敏感。D 小,分布重尾,论文里测到 D 小于 32 时半径方差可以超过 2¹⁰,输入覆盖极宽,对误差的容忍度高,论文叫「鲁棒」;代价是重尾分布难学,对网络容量有压力。所以鲁棒和刚性在 D 上此消彼长,中间存在甜点。为了让有限 D 直接享用扩散模型调好的超参,论文还给出相位对齐:令 r=σ√D,中间分布对所有 D 近似同相位,于是把 EDM 调好的 σ_max=80、σ_min=0.002 和训练分布直接按比例搬过去,D=2048 的实验就是这么做的。
4. 关键实验:甜点 FID 和三组鲁棒性证据
小播:理论说完了,上数字。实验设定先说清楚。
老播:两个基准:CIFAR-10 32×32,用 improved NCSN++ 网络,批大小 512;FFHQ 64×64 人脸,用 improved DDPM++,批大小 256。超参全部从 EDM 迁移,采样用 Heun 二阶求解器,CIFAR-10 是 35 次网络求值,FFHQ 是 79 次。评测上,生成 5 万张图去和真实图统计量比 FID;CIFAR-10 每个 checkpoint 跑三个种子取最小,FFHQ 因为波动大报 Top-3 的平均。
小播:先说质量,把甜点坐实。
老播:先提醒一句读表的背景:EDM 原论文在 CIFAR-10 报的 min FID 是 1.98,作者重跑也在同一量级,但 checkpoint 之间能波动 ±0.2,所以「1.91 对 1.98」这种差距要放在波动背景里看,论文自己也是靠 Top-3 平均来降低运气成分。回到数字:CIFAR-10 无条件生成,D=2048 拿到 min FID 1.91;同设置下 D→∞(就是 EDM,作者自己重跑)是 1.98,PFGM(D=1)是 2.48,更早的 VP-ODE 是 2.86,DDPM 是 3.17——注意 DDPM 要用 1000 次网络求值,PFGM++ 只要 35 次。Top-3 平均 FID 也一致:D=2048 是 1.93,EDM 是 2.00。表 1 的结构也顺便说一下:上半部分是 DDPM、DDIM、VE-ODE、VP-ODE、PFGM 这些历史方法,下半部分是 D=64、128、2048、3072000 和无穷大的 PFGM++,看 min FID 这一列,数字从左往右先降后升,甜点就在中间。FFHQ 上 D=128 拿到 min FID 2.43,Top-3 平均 2.48,EDM 分别是 2.53 和 2.54。类条件 CIFAR-10 上 D=2048 是 1.74,EDM 是 1.79。三个数据集设定下,最好的 D 都落在中间:CIFAR-10 是 2048,FFHQ 是 128,两端都没有最优。
小播:D=2048 和 D=128 都赢过两端,这就是甜点。那 D 极大呢?理论说会退化回扩散。
老播:对,D=3072000 在 CIFAR-10 上是 1.99,和 EDM 的 1.98 基本一致,验证了 D≫N 时退化的预测。这条一致性很重要,它把「扩散是特例」从理论坐实到实验。然后是鲁棒性三组实验,都在 CIFAR-10 上。第一组,采样时每一步注入高斯噪声,强度用 α 控制,注入噪声的标准差取 r/√D,和加噪尺度同量级:α=0.2 时,D=64 和 D=128 还能出干净图,扩散模型(D→∞)的采样直接崩坏;整条 FID 曲线看,小 D 随 α 上升得慢,扩散上升得快。第二组,对网络权重做训练后量化,位宽从 9 bit 降到 5 bit:9 bit 时大家 FID 都在 1.96 到 1.97,几乎没损失;5 bit 时 D=64 是 28.50,D→∞ 是 50.09——量化越狠,小 D 优势越大。第三组,把 NFE 从 35 往下减,模拟更大的采样步长误差:D=128 和扩散模型的差距随步长增大而拉大,但 D=64 反而比 D=128 差,重尾的刚性代价在这里现形。
小播:三组实验对应三种误差源:数值噪声、权重压缩、步长离散化。结论是同一个:D 越小越抗造,但太小也不行。那图怎么读?我如果在论文里翻到这几张图,该看什么?
老播:看图 4 的三联图最直观。图 4(a) 横轴是 D,纵轴是电场方向和分数函数方向的平均距离,看它单调下降归零,对应「D→∞ 等于扩散」的定理;图 4(b) 横轴也是 D,纵轴是半径分布的 log 方差,看它随 D 陡降,对应「大 D 范数集中、小 D 重尾」;图 4(c) 是不同 σ 和 D 下加噪样本范数的密度,看高密度区域随 D 增大越收越窄。图 5 两格:左图横轴 α、右图横轴 NFE,纵轴都是 FID,看四条曲线(D=64、128、2048、扩散)的分离程度,分离越大说明小 D 的鲁棒优势越明显。表 3 按位宽列 FID,横着看每一列里 D=64 和 D→∞ 的差距随位宽变低而拉大。
5. 它在生成模型的谱系里站在哪
小播:把它放回谱系里,一句话总结它的位置?
老播:它处在「物理启发生成模型」这条线上,干的事是把两个端点焊进同一个家族:PFGM 提供静电场视角,扩散模型提供成熟的训练和调参体系,PFGM++ 证明两者是同一个东西的两个极限,并给出统一的训练目标。相比 PFGM,它把有偏的大 batch 目标换成无偏扰动目标,解锁了配对条件训练;相比扩散模型,它在 σ=r/√D 标定下给出三层等价证明,又用中间 D 拿到更好的 FID 和鲁棒性。放到更大的谱系里看,score-SDE 那套 VE/VP 统一框架和 EDM 属于「分数匹配」这一支,PFGM++ 属于「物理场」这一支,而本文的价值在于证明两支在数学上相交,交集就是 D 取极限的那条边。家族里还有一个隐藏福利:扩散模型社区调好的超参,通过相位对齐 r=σ√D 可以零样本搬到任意 D,这让它在工程上可以直接继承扩散模型多年积累的经验。
6. 局限也要讲清楚
小播:这篇论文的局限,你挑几条实在的。
老播:四条。第一,D=1,也就是 PFGM 本身,被排除在实验外:它的扰动核重尾到没法直接配本文的新目标,还得用 PFGM 原来的区域启发式,所以「统一」并没有覆盖到端点本身。第二,FID 波动大:训练 2 亿张图的预算里,checkpoint 之间 FID 能差 ±0.2,论文报的是 min FID 或 Top-3 平均,而且 EDM 基线是作者自己重跑的数字,和原论文报告值有出入,比较的精度有限。第三,实验只在 32×32 和 64×64 两个低分辨率图像上做,没有更高分辨率,也没有文本条件生成实验——条件生成的能力只体现在训练目标的设计上,没有跑出来。第四,甜点 D 没有理论预测公式,每个数据集、每个架构都要自己扫;鲁棒性收益是经验现象,缺少「误差预算」层面的定量刻画——比如给一个具体问题,多少分数误差对应多少 FID 损失、D 应该怎么选,论文给不出这样的账本。我补两条。第五,小 D 的鲁棒性是用训练难度换的,重尾输入对网络容量有要求,工程上压缩网络、加量化在小 D 上更划算,但训练时并不省事。第六,论文证明的是「同一个 EDM 架构下 D 可调」,甜点 D 会不会随架构变化——比如换成分层 transformer,或者用于单步蒸馏这类场景——论文没有回答;后续主流的加速方法大多仍以扩散模型为基座,PFGM++ 这个旋钮在这些场景里的价值还没被验证。
7. 收尾:记住这三件事
小播:我总结本期记住的三件事。第一,扩散模型是 PFGM++ 这个家族在 D→∞ 的极限,PFGM 是 D=1 的端点,σ=r/√D 这个标定把两者在训练和采样上精确对齐。第二,D 是鲁棒性和刚性的旋钮:小 D 抗误差但难训,大 D 好学但脆弱,中间值最好,实验上 CIFAR-10 的 D=2048 和 FFHQ 的 D=128 都压过了扩散模型。第三,训练目标从大 batch 场估计换成了单样本扰动目标,无偏、便宜、能配对训练,这是把整个家族落到实处的关键。
老播:补一句这篇对后续工作的意义。它把「静电学→生成模型」从一条单独的路线变成一个带旋钮的家族,也是物理类比进生成模型的一个教科书案例——先给物理设定,再让对称性帮你砍掉冗余维度,最后用一个标定把新方法和老方法对齐。它把「静电场→生成模型」从一条单独的路线变成一个有旋钮的家族,给生成模型社区留下一个可以沿着维度轴继续探索的空间:找甜点的理论、低比特训练、随机采样器,都是论文自己点名的下一步。核心结论再强调一遍:扩散模型是泊松流生成家族的一个端点,中间值 D 质量更好、也更稳。这篇物理类比的教科书案例,值得记住的是它用一维旋钮 D 连接了两种看似不同的生成机制。