VERA:把视频模型改造成通用机器人策略
- 论文:Turning Video Models into Generalist Robot Policies(VERA)
问题:机器人的泛化缺在哪
机器人智能的核心难题是泛化:让一个系统控制多种本体、在陌生环境里完成没见过的任务。语言模型和视觉语言模型的通用性来自「模型和数据一起放大」,但机器人没有这个条件——web 上有海量图文数据,却没有 web 规模的动作数据。VLA(Vision-Language-Action,视觉语言动作模型,代表工作是 RT-2、OpenVLA、π0.5)把动作输出接到预训练的视觉语言主干上,想借用图文模型的泛化能力;可机器人动作空间高度异构(不同手臂的自由度、控制频率、坐标约定都不同),在相对小规模的动作数据上微调,泛化到新任务、新本体、新环境始终困难。
视频生成模型提供了另一条路。视频数据充足,视频模型能生成「视觉计划」——想象一个机器人完成任务该是什么样子,而且它和任何具体机器人的动作空间都无关。困难随之转移到下一环:怎么把像素空间里的视频计划翻译成机器人能执行的动作。一种做法是把动作直接整合进视频主干,联合预测视频和动作,这类工作叫 WAM(World Action Model,世界动作模型,代表工作是 GR-2、DreamZero、LingBot-VA);另一种做法是动作条件世界模型加推理时搜索。两条路线都需要 video、action、text 三方配对的稀有数据,而且动作头一旦接进视频主干,会稀释视频模型自己的视觉推理能力。
VERA 走第三条路,也是本文要讲透的路线:把视频模型完全留在「规划」这一侧,另训一个按机体结构设计的逆动力学模型(IDM,Inverse Dynamics Model,逆动力学模型:从视觉转移反推出产生它的动作)当「翻译器」。视频规划器保持动作无关,IDM 负责把像素运动变成动作。这条路线在论文里被总结成一句话:解耦的视频规划加忠实的视频到动作翻译,是通往零样本、跨本体、可泛化机器人控制的一条可行路线。
核心思想:机体 Jacobian 与视频规划器解耦
第一步:把「视频到动作」定义成反演问题
视频世界模型 π_vid 给定观测历史 o_{≤t} 和任务目标 g,采样出未来 M 帧:
(π_vid) (ô_{t+1}, …, ô_{t+M}) ~ π_vid(· | o_{≤t}, g)
这个式子回答的问题是:视频模型输出的是一段像素空间的「未来」,而机器人执行的是关节位置、末端速度这类本体专属指令。要让这条管线成立,需要一个忠实(faithful)的翻译器:执行翻译出的动作,要能复现视频模型预测的视觉转移。除此之外,翻译器还要省数据(最好只用自博弈数据就能训),并且能随动作维度(DoF,Degrees of Freedom,自由度)扩展——16 自由度的手比 7 自由度的手臂难得多。
论文把现有的 IDM 分成两类。一类是手工设计,靠重定向或 3D 表示;另一类是 Direct IDM(D-IDM,直接逆动力学模型),用无结构神经网络直接从图像对 (ô_t, ô_{t+1}) 端到端回归动作,UniPi 就是代表。D-IDM 简单,但在数据少、动作维度高时忠实性会崩——这正是 VERA 要解决的。
第二步:机体 Jacobian 结构化的 IDM
经典机器人学里,无限小动作和运动之间的关系由机体 Jacobian 描述。设 a ∈ R^n 是机器人的动作向量,x_i ∈ R^3 是身体点 i 的三维位置,那么在状态 o 下:
J_i(o) = ∂x_i / ∂a ∈ R^{3×n}
这个式子的含义:J_i(o) 是一个局部线性映射,动作扰动 δa 会引起身体点的小位移 δx_i ≈ J_i(o) δa。预期是「知道动作怎么动,就能知道像素怎么动」。但三维点位置观测不到,所以论文直接在图像空间学这个 Jacobian:给定一张图 o ∈ R^{H×W×3},图像条件 transformer J_θ 输出一个稠密场:
J_θ(·, o):每个像素 p 对应一个 2×n 矩阵,满足 δp = J_θ(p, o) δa
这里 δp 是像素 p 的二维位移,n 是动作维数。逐符号看:p 是像素坐标,δa 是动作增量,J_θ(p,o) 把动作增量线性映射成该像素的移动——一个像素一行,整张图就是「动作空间的每个通道分别推着哪些像素往哪动」的稠密描述。训练时用的 δp 来自现成光流估计器(RAFT、TAPIR、AllTracker、MegaFlow 之一)在相邻帧 (o_t, o_{t+1}) 上算出的运动场 v_t。相比前作(Li 等人在 Nature 2025 的工作)把像素运动提升到 3D、用 NeRF 式体渲染学 3D Jacobian 场,VERA 直接丢掉 3D 场景表示,把 J_θ 做成单个大图像 transformer,这样既能扩到 14B 视频模型的搭档规模,也更容易覆盖高维动作空间。
训练目标把前向和反向两个方向同时监督。预期:既要保证「给动作能预测出正确的像素运动」,也要保证「给像素运动能反推出正确的动作」,两个方向互为正则。损失写为:
L = Σ_p ρ(J_θ(p, o_t) δa_t − v_t(p)) + w_a Σ_p ‖δa_t − J†,λ_θ(p, o_t) v_t(p)‖²
第一项是前向(像素流)项:用 Charbonnier 函数 ρ(x)=√(x²+ε²) 度量预测像素运动 J_θ(p,o_t)δa_t 与真实光流 v_t(p) 的差距,Charbonnier 比 MSE 对大误差更稳。第二项是反向(动作重建)项:先把预测的 Jacobian 场做 λ 正则伪逆 J†,λ_θ,再拿真实光流 v_t(p) 反推动作,和真实动作 δa_t 比 L2 距离;权重 w_a=0.3。两个项共享同一个 J_θ,所以模型既要正向一致,也要反向一致。
推理时反过来用:给定视频规划器输出的相邻预测帧 (ô_t, ô_{t+1}),先用同一个光流估计器算出 v_t,再解一个带 λ 正则的最小二乘:
δâ_t = argmin_δa Σ_p ‖J_θ(p, ô_t) δa − v_t(p)‖² + λ ‖δa‖²
这个式子回答「哪条动作最可能产生了这段像素运动」:像素多而动作维数少,系统超定又可能病态,λ‖δa‖² 是 ridge 惩罚,压制过大的动作解。闭式解是 (J_θ J_θᵀ + λI)⁻¹ J_θᵀ v_t,部署时一次矩阵运算出动作,不需要迭代优化。
第三步:闭环:看得远,走得近
规划器每轮生成 M 帧未来(主实验 M=4 个 latent 帧,对应 16 张 RGB 帧),但控制器只提交前 K=1 帧:J-IDM 以当前观测 o_t 为锚,对每个相邻帧对独立套用上面的反演式,得到 K 个动作组成 chunk,执行后把新观测追加进历史再查一次规划器。动作 chunking(一次执行多步、减少重规划频率)沿用 ACT 和 Zhang 等人的先验发现,能提升性能;论文在 Figure 8 里消融了 chunk 长度——适中最好,太长会让接触任务里的误差积累、反馈变稀。
主实验的 14B 规划器是 Wan 家族的视频扩散 transformer,用 LVP(Large Video Planner)权重初始化,用 Diffusion Forcing 后训练:给定 N=6 个 latent 上下文帧(Wan tokenizer 的因果压缩下对应 4×6−3=21 张 RGB 帧),预测 M=4 个未来 latent 帧,损失只对未来的线性 flow 扩散目标算 MSE。多视角处理很简单:相机在像素空间直接拼成一个宽画布(DROID 是两外置加 wrist 拼成 128×576),跨本体训练时统一视角布局、缺的槽位补空白帧。机器人动作从头到尾不进视频模型的输入和损失——这条「动作隔离」是解耦设计的地基。
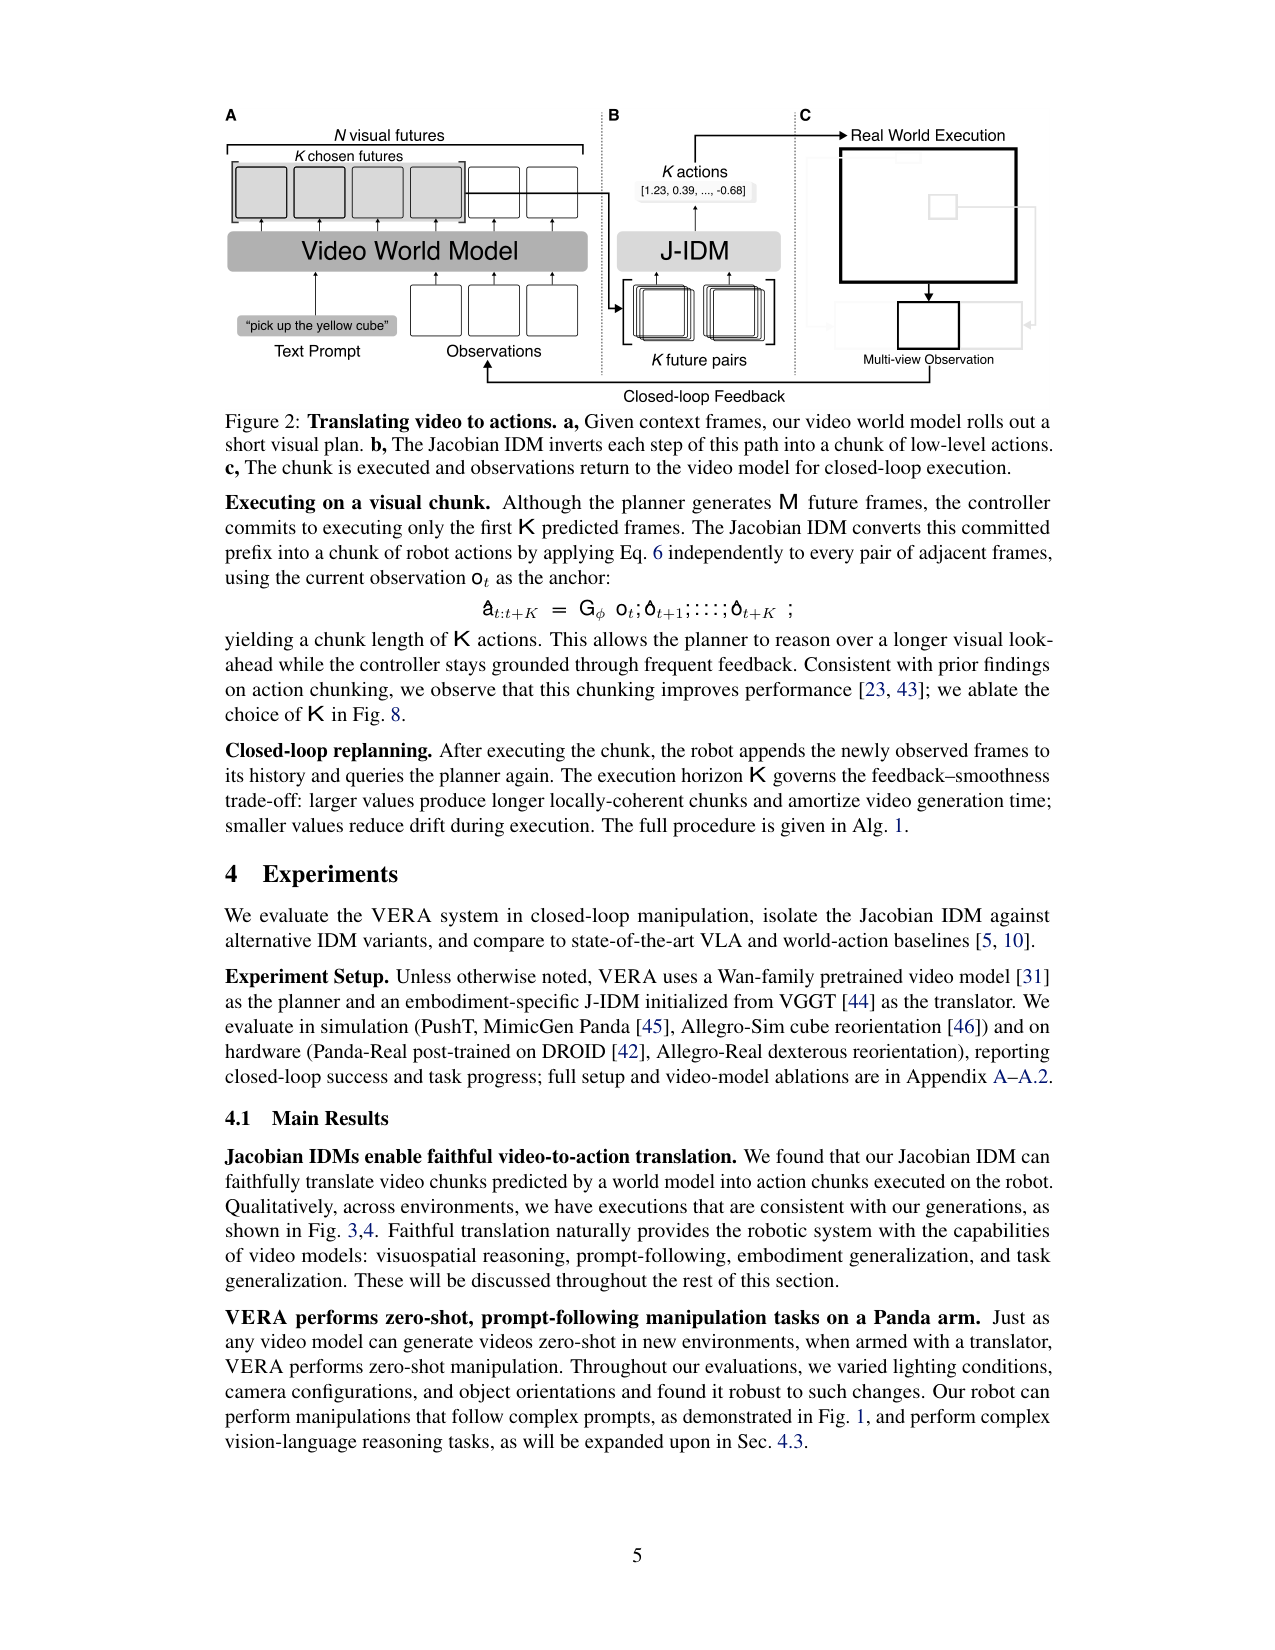
*图:视频到动作的翻译闭环(Figure 2)——a 视频世界模型生成视觉计划,b J-IDM 逐对反演成动作 chunk,c 执行后重规划。*
「视频规划器本身是 flow/world model」,IDM 怎么衔接
这是 reading_tip 里点名要讲透的一点。视频规划器用 Diffusion Forcing 训练,目标是对每个未来 latent 帧预测线性 flow 速度场 v_i,它扮演的正是 flow/world model 的角色:在 latent 空间里生成一条「未来轨迹」。世界模型的输出是 latent 速度,机器人执行的是动作增量,两者之间隔着一条链:latent 流解码成 RGB 帧 → 相邻帧之间有像素光流 → 光流由动作增量经机体 Jacobian 产生。IDM 的衔接点就在最后两环:它学的 J_θ 是「动作增量 → 像素运动」的局部线性映射,部署时把它反演,就把世界模型给出的像素流翻译成了动作流。视频模型的 latent 流和图像空间的像素流,就在解码后的相邻帧处相遇,而 J-IDM 是这个交汇处的翻译器。
这个衔接方式同时解释了论文的一个自承局限:如果视频规划器预测出的相邻帧几乎没有可观测像素运动(物体静止、接触饱和),反演就会病态,忠实恢复动作就很困难。这也是为什么 Allegro-Sim 训练要额外加 401 条随机运动辅助轨迹——它们给 J-IDM 提供局部运动模式的覆盖,让衔接处有足够的「流」可学。
关键实验与结果
控制变量研究:Jacobian 结构带来什么
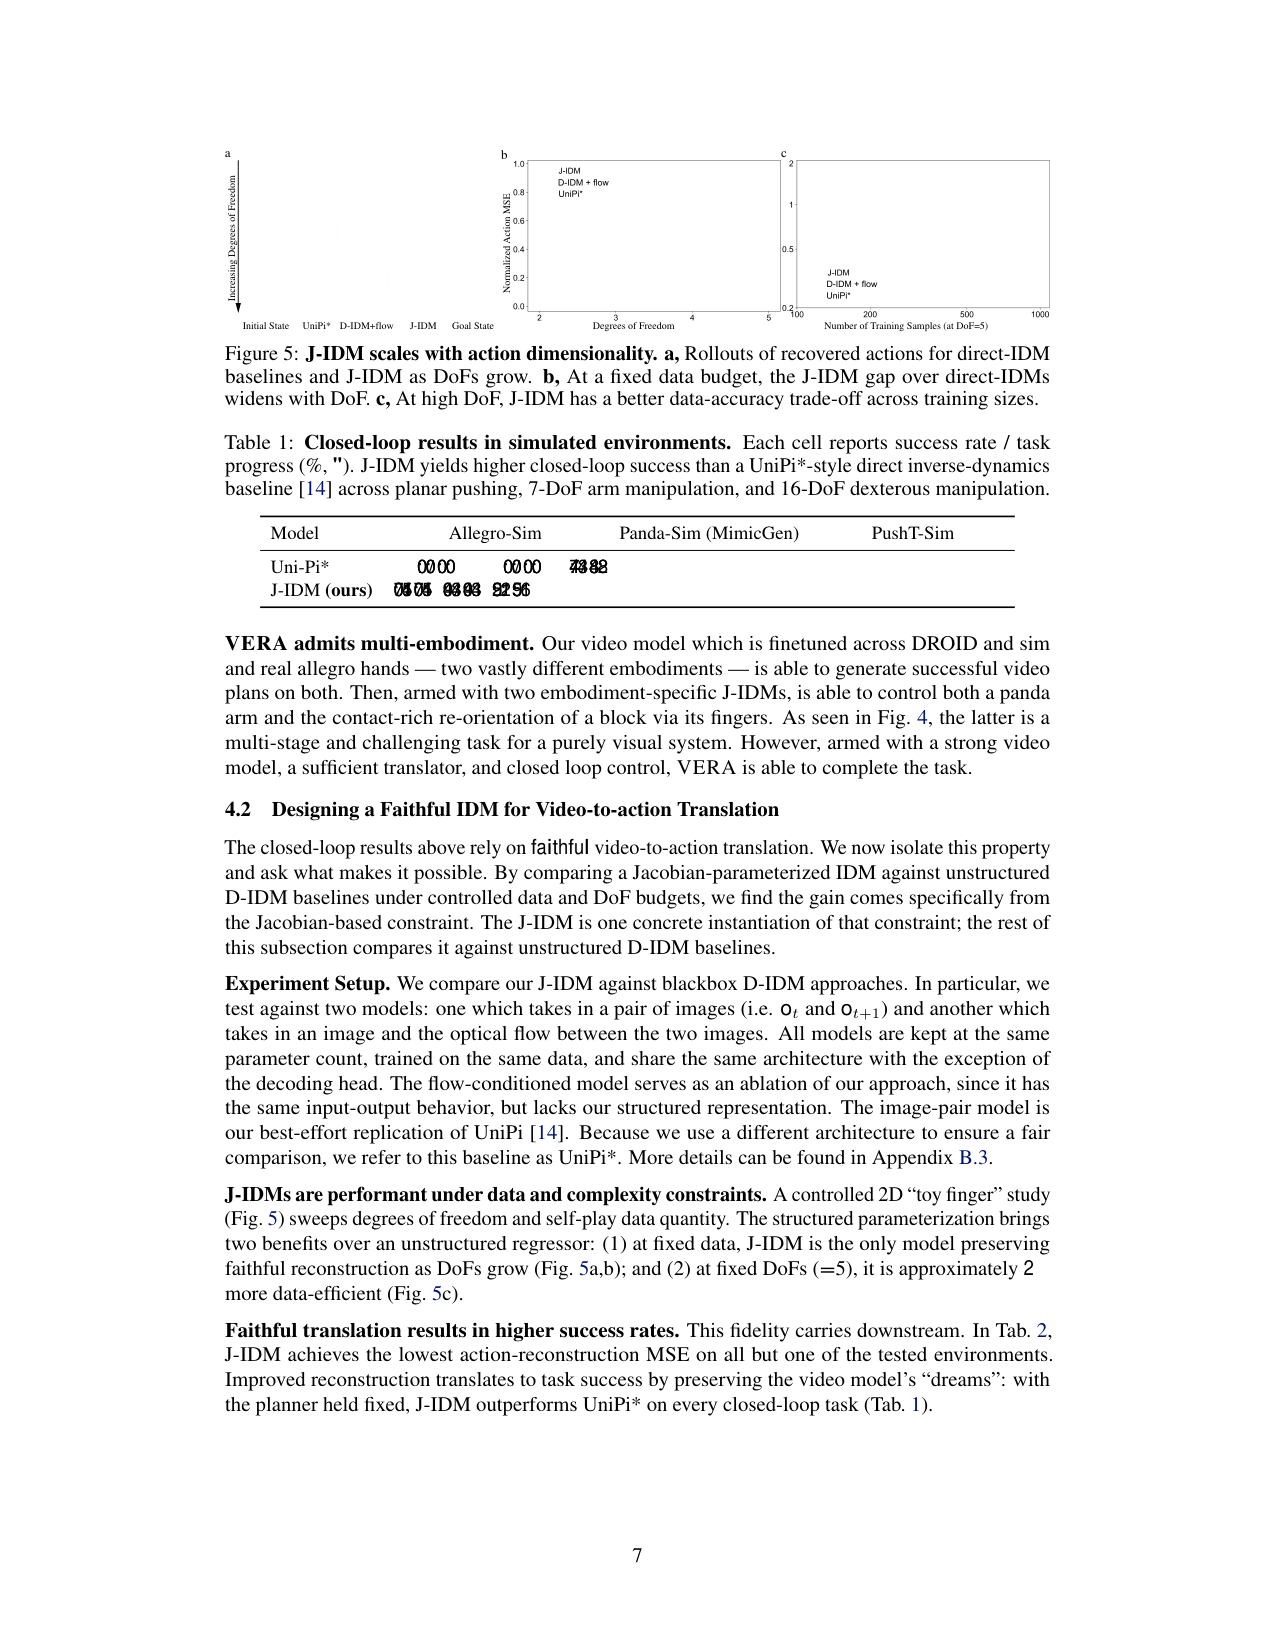
*图:J-IDM 随自由度扩展(Figure 5)——b 固定数据下随 DoF 增大只有 J-IDM 保持忠实,c 固定 DoF=5 时约 2× 数据效率。*
论文用 2D toy finger 研究把「结构」和「数据」分开看(Figure 5):同样的 DINOv2 编码器、同样的 DPT neck、同样的数据,只换解码头——一个输出稠密 Jacobian 场,另两个分别输出动作回归(无结构 D-IDM 基线,复刻 UniPi 的输入输出行为)或光流条件下的动作回归(D-IDM+Flow)。结果是两条:固定数据预算时,随自由度升高只有 J-IDM 保持忠实重建,无结构基线的动作 rollout 走形;固定 DoF=5 时,J-IDM 达到同等重建精度约只需一半样本(约 2× 数据效率)。这个结果支撑「结构约束替代数据」的论点。
仿真闭环:成功率的差距
闭环结果放在 Table 1。Allegro-Sim(16-DoF 手内立方体旋转)上,J-IDM 成功率和任务进度都是 70.0%±14.5,UniPi* 基线是 0.0%±0.0;Panda-Sim(MimicGen,7-DoF,9000 条轨迹)上 J-IDM 94.0%±3.4,UniPi* 0.0%;PushT-Sim(2-DoF 平面推块,206 条轨迹)上 J-IDM 成功率 92.5%±2.1、任务进度 95.5%±1.6,UniPi* 74.4%±3.4、84.8%±2.8。规划器固定不变,只换翻译器,闭环成功率就从零/低水平跳到 70% 以上——忠实翻译是整条管线的命门。
翻译忠实性:动作重建误差
Table 2 在 held-out 视觉转移上量动作重建 MSE。J-IDM 在 4 个环境里 3 个最低:Allegro-Sim 0.031(对比 D-IDM+Flow 0.044、UniPi* 0.063)、PushT-Sim 0.046(0.059 / 0.071)、5 关节手指 0.017(0.030 / 0.047)。唯一例外是 Panda-Sim:J-IDM 0.19,高于 D-IDM+Flow 的 0.09(UniPi* 0.38 仍垫底)。这个例外值得记住:结构约束的收益与数据分布、动作参数化有关,并非处处最强。
真实世界:零样本、推理型 prompt、跨本体
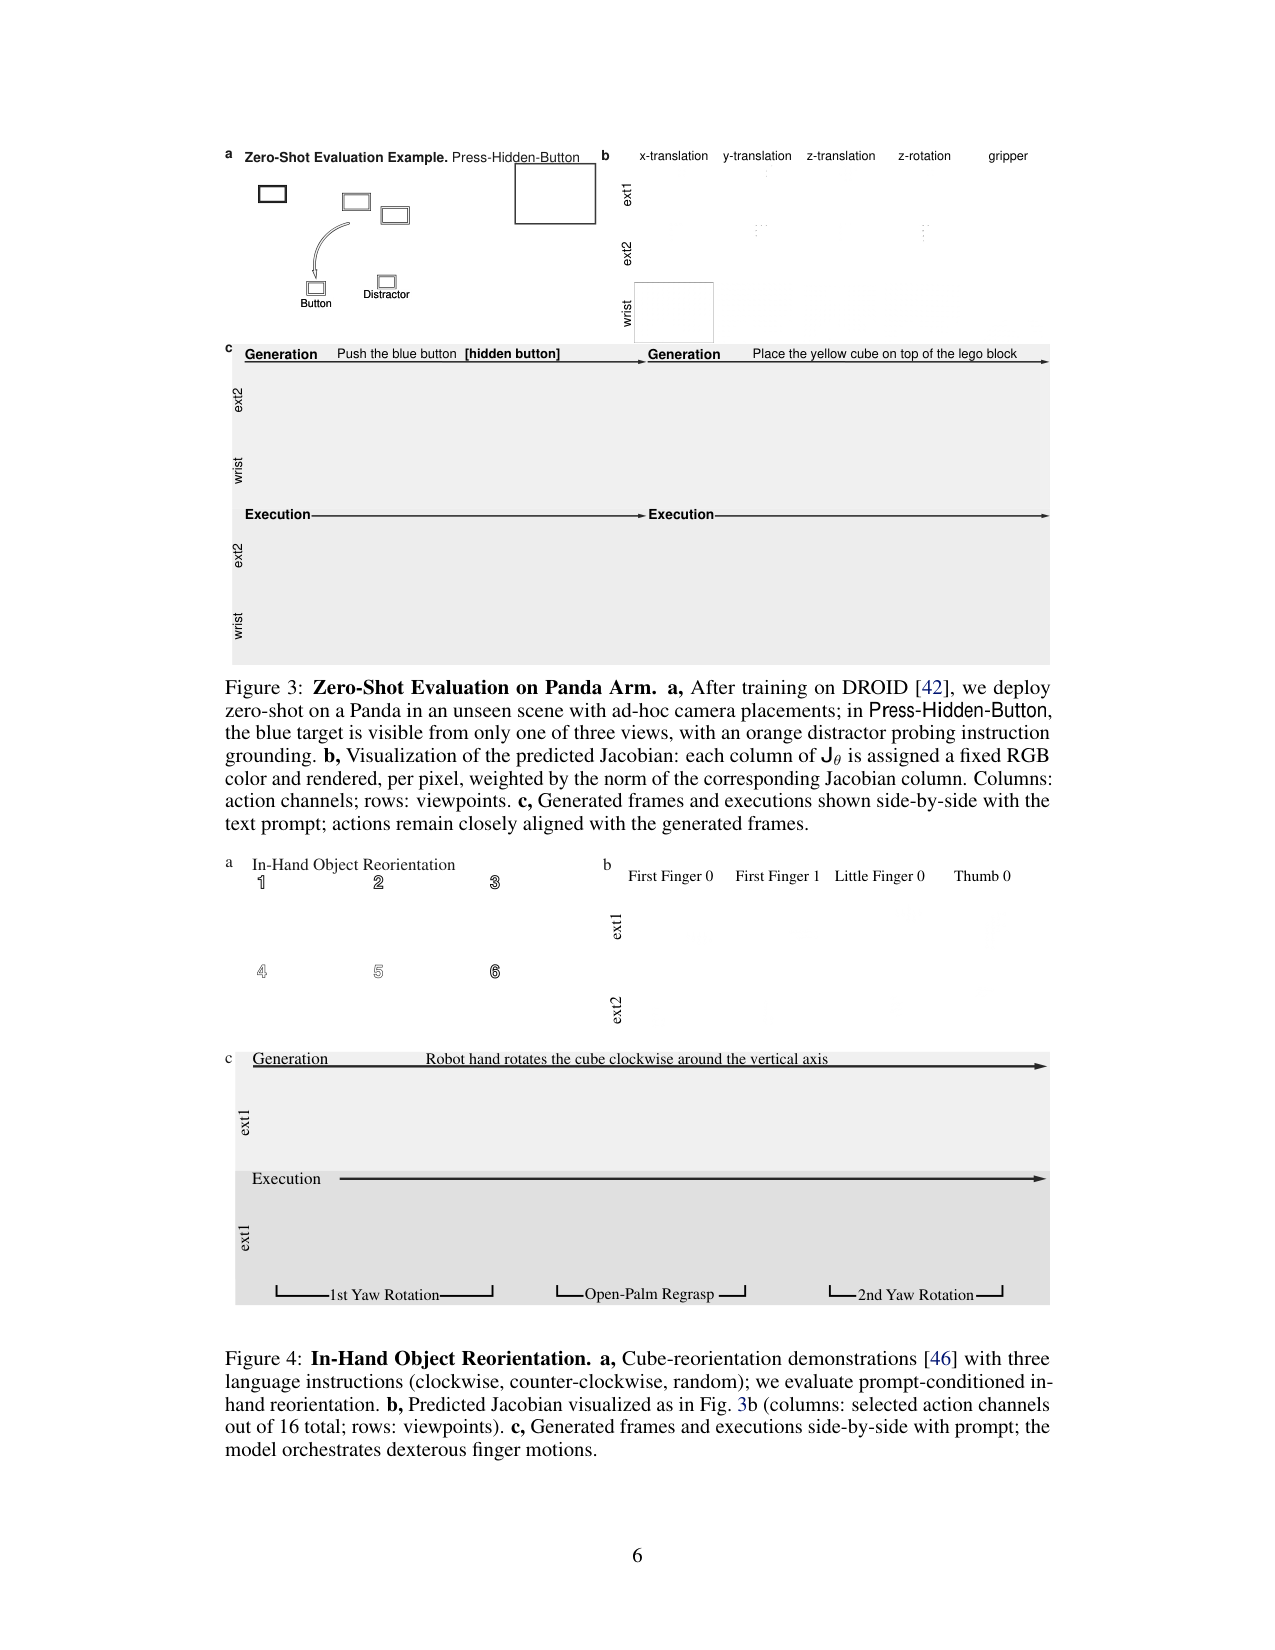
*图:真实零样本(Figure 3+4)——上为 Panda 隐藏按钮任务与预测 Jacobian 场可视化,下为 Allegro 16-DoF 手内旋转的生成与执行对比。*
真实 Panda 臂在 DROID 后训练后零样本部署到陌生场景、临时相机摆放,能完成「把绿色网球放进碗里」这类语言条件任务,也能做推理型任务:Press-Hidden-Button 里蓝色按钮只有三视角之一能看到,旁边放橙色干扰物考验指令接地,VERA 能绕过墙找到并按下按钮(Figure 3、Figure 7)。
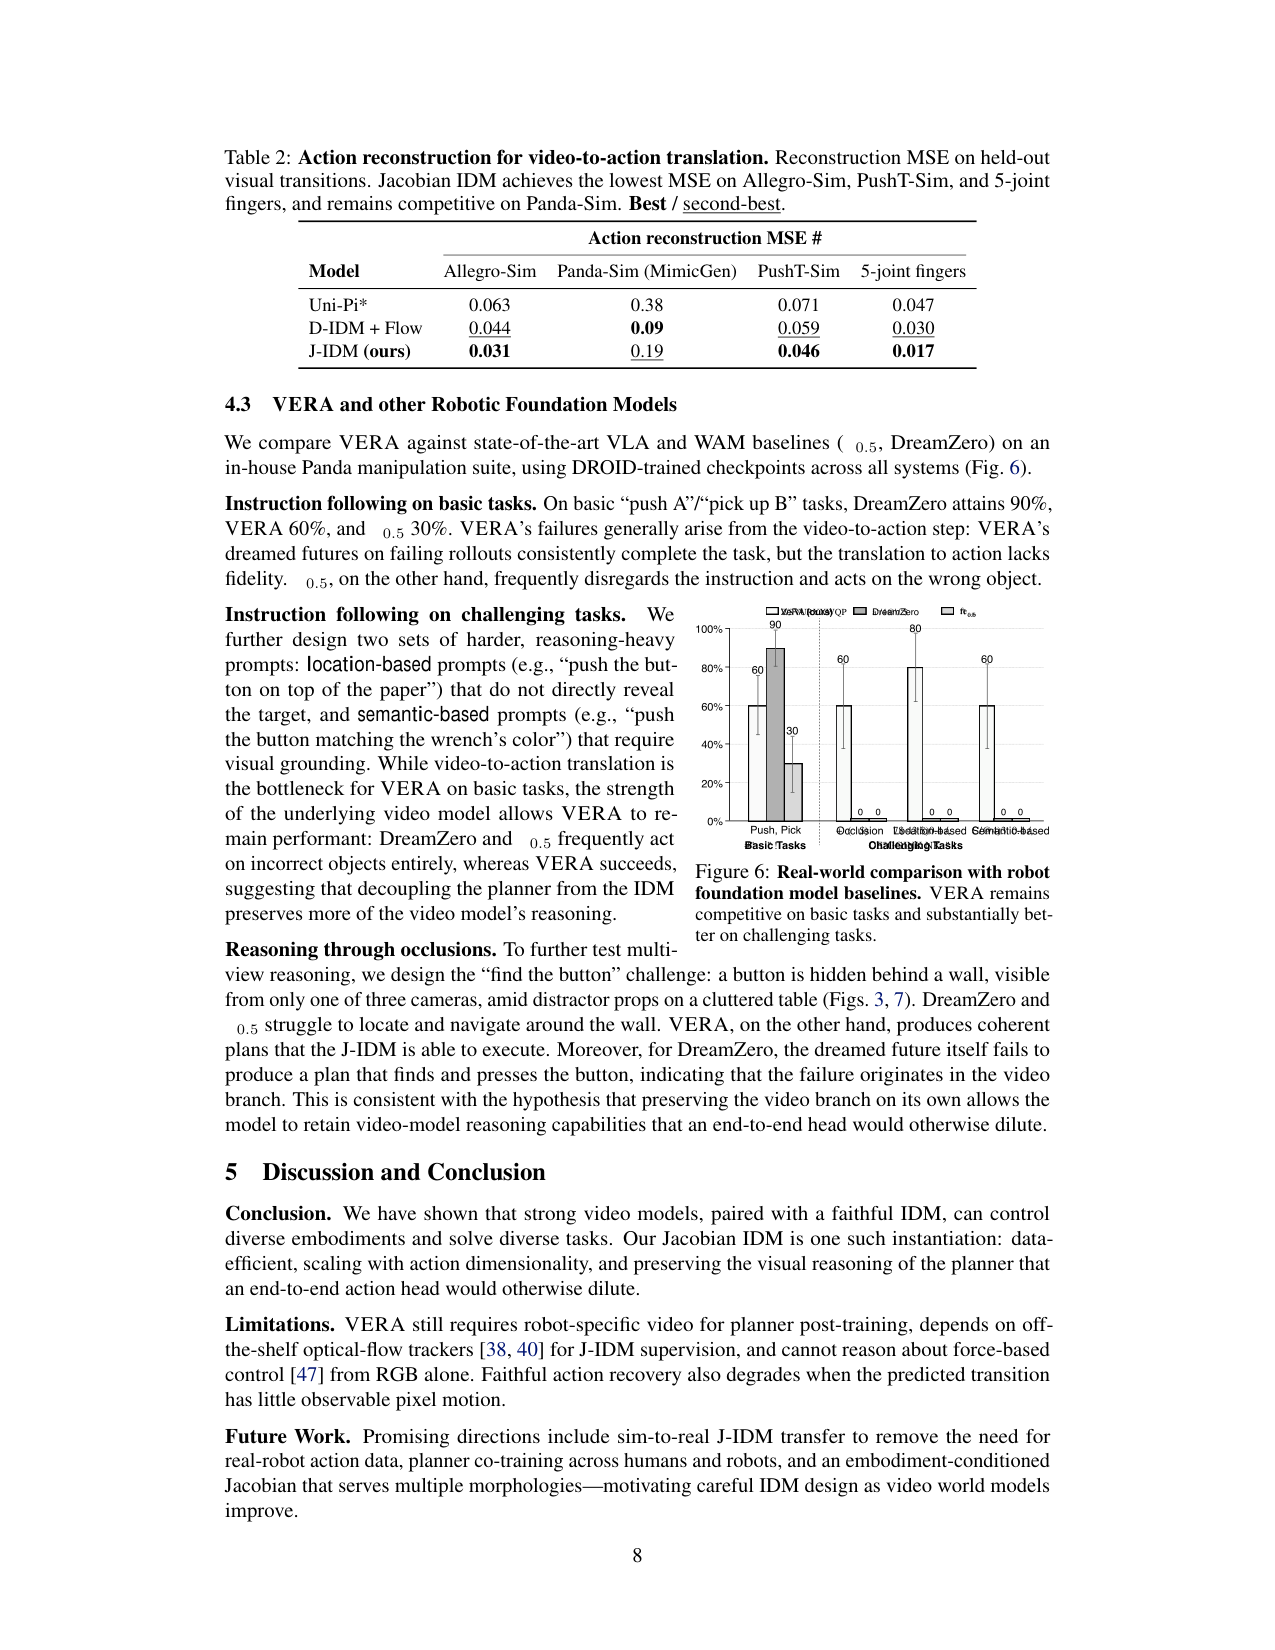
*图:真实世界基线对比(Figure 6)——基本任务 DreamZero 90% / VERA 60% / π0.5 30%,推理型难任务上 VERA 保持表现。*
Figure 6 是同台架、同 DROID 数据下与 π0.5、DreamZero 的三方对比:基本任务(push A / pick up B)DreamZero 90%、VERA 60%、π0.5 30%;难任务(「推纸上那个按钮」这类基于位置的、「推与扳手同色的按钮」这类基于语义的)VERA 保持表现,两个基线频繁对错误物体动手。失败来源也被分开:VERA 在基本任务上的失败 rollout,dream 视频都是对的,卡在视频到动作的翻译缺忠实;DreamZero 在 hidden button 里连 dream 都没找到按钮——失败发生在视频分支本身。
跨本体是解耦的招牌能力:同一个视频规划器在 DROID 和模拟/真实 Allegro 数据上混合后训练,配两个本体专属的 J-IDM,就能同时控制 Panda 臂和 16-DoF 的 Allegro 手做接触密集的手内旋转(Figure 4,含张开手掌重新抓取、两次 yaw 旋转的多阶段操作)。视频模型侧还有一组消融:随机初始化验证 MSE 0.40、Wan 初始化 0.13、LVP 初始化 0.10(DROID triview,N=8/M=6),预训练初始化对机器人视频预测的帮助很大;视角消融里 wrist-only 归一化 MSE 0.61、triview 0.13、双外置 0.10,全局场景上下文对视频预测最重要。
谱系定位
VERA 处在「解耦」这条技术路线上,和另外两条路线对照着看。VLA(RT-2、OpenVLA、π0.5)把感知和控制耦合在一个本体特定模型里,动作空间异构限制了泛化;VERA 把基础模型留在视频空间,每本体只加一个小 IDM,跨本体靠换 IDM。WAM(GR-2、DreamZero)把动作接进视频主干联合预测,动作头会稀释视频推理;hidden button 实验里 DreamZero 的 dream 失败、VERA 成功,就是「保住视频模型」的实际证据。同是解耦路线的 UniPi 用无结构回归,J-IDM 的 Jacobian 结构在数据效率和自由度扩展上胜过它。往前看,Jacobian 场这条线来自一作 Sizhe Lester Li 在 Nature 2025 的工作,那篇用 3D NeRF 场,这篇把 3D 表示去掉、直接做图像空间的大 transformer,并和 14B 视频模型配对成完整系统;同期 Rhoda AI 的 Direct Video-Action 系统也走解耦路线,佐证这条路线在真实部署里可行。
局限
论文自承四点:视频规划器后训练仍需机器人专属视频数据(Panda-Real 用了 39,816 条 DROID 轨迹、Allegro-Real 60–217 条);J-IDM 监督依赖现成光流估计器,光流误差会传导到动作;纯 RGB 无法处理基于力的控制;预测转移几乎没有像素运动时,忠实动作恢复退化。
我们另外读出四点。第一,翻译在基本任务上仍是瓶颈:同台架对比 VERA 60% 对 DreamZero 90%,差距还没被 Jacobian 结构消除。第二,J-IDM 的优势并非处处成立:Panda-Sim 重建 MSE 0.19 高于 D-IDM+Flow 的 0.09。第三,真实评估规模有限:Allegro-Real 只有 60–217 条轨迹,Panda 对比用自家台架,论文 v1 没提供统一控制频率,也没提开源代码或权重。第四,每个本体都要单独采集动作数据训 IDM,本体越多累加成本越高;论文把 sim-to-real J-IDM 转移、人类与机器人联合规划、本体条件化 Jacobian 列为 future work,等于承认当前结构尚未消除真实本体动作数据的依赖。
一句话收尾
VERA 验证了一个值得记住的组合:一个动作无关的 14B 视频世界模型当规划器,一个按机体 Jacobian 结构化的 IDM 当忠实翻译器,加上闭环重规划,就能零样本、跨本体地完成真实机器人任务;解耦的代价是翻译必须忠实,而 Jacobian 结构是让翻译在数据少、自由度高的条件下依然忠实的关键。
让一个 14B 视频扩散模型只当动作无关的视觉规划器,用按机体 Jacobian 结构化设计的逆动力学模型把预测视频忠实翻译成动作,得到零样本、跨本体、闭环的通用机器人策略 VERA。
阅读提示
精读深度:精读
清单提示:原文提示:一作 Sizhe Lester Li(MIT,Vincent Sitzmann 组);核心是 embodiment Jacobian IDM 与视频规划器解耦——视频模型只输出动作无关的视觉计划,动作由按机体 Jacobian 结构化的 IDM 从像素运动反演。请思考「视频规划器本身是 flow/world model(用 diffusion forcing 在 latent 速度场上生成未来轨迹)」时 IDM 如何衔接:它把相邻预测帧之间的像素光流,经机体 Jacobian 的 λ 正则伪逆,反演成动作增量;两层 flow(视频模型的 latent 速度、图像空间的像素光流)在解码后的相邻帧处相遇。
问题
要解决什么:机器人智能的核心是泛化:控制多种本体、在陌生环境完成未见任务。视频生成模型能生成「视觉计划」(完成任务的样子),且与任何机器人的动作空间无关、训练数据(视频)充足;缺的一环是把像素空间的视觉计划翻译成可执行的动作。
为什么 prior work 不够:VLA 路线(RT-2/OpenVLA/π0.5)把动作接到视觉语言主干上,但 web 规模的图文数据存在,web 规模的动作数据不存在,动作空间又高度异构,小数据微调难以继承图文模型的泛化。WAM 路线(GR-2/DreamZero)把动作接进视频主干联合预测,需要 video+action+text 三方配对的稀有数据,且动作头会稀释视频模型的推理。解耦路线(UniPi 等)用无结构网络直接从两帧图像回归动作,在数据少时 OOD 泛化差、随动作维度升高精度显著下降,成为整条管线的瓶颈。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 观测历史 o_{t-N+1:t} | RGB 视频帧(多视角像素拼接) | Wan tokenizer 因果压缩后为 N 个 latent 上下文帧(N=6,对应 21 张 RGB 帧);DROID 为双外置+wrist 三视角拼成 128×576 单画布,MimicGen 双视角 128×256,Allegro 三视角 128×384 |
| 任务条件 c(可选) | 语言指令 / 任务标识 | 真实场景用自然语言 prompt(如 Pick up the green tennis ball and place it inside the bowl);无条件时退化为纯 video-to-video 预测 |
| 相邻预测帧对 (ô_t, ô_{t+1})(J-IDM 输入) | RGB 图像对 + 光流 v_t | 来自视频规划器解码后的相邻提交帧;光流用现成估计器(RAFT/TAPIR/AllTracker/MegaFlow)提取 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 未来视频 latent ẑ_{t+1:t+M} | latent 视频 token(M=4,对应 16 张 RGB 帧) | 视频规划器输出,仅解码提交前缀 K=1 帧给控制器 |
| 动作 chunk δâ_{t:t+rK-1} | 连续动作增量 | J-IDM 对每个相邻帧对经 λ 正则伪逆反演出一个动作增量;Panda 为 7-DoF 末端增量+夹爪,Allegro 为 16-DoF 关节位置目标 |
控制频率:论文未报告统一控制频率;动作为相邻观测之间的增量命令,每个 committed latent transition 对应的底层指令数依任务控制率与视频帧 stride 设定
输入拼接 protocol
多视角在像素空间直接拼接成一个宽画布(如 128×576=两外置+wrist);跨本体训练时各本体统一到同一视角布局,视角不足的槽位用空白帧填充;动作从不进入视频模型输入,只在 J-IDM 训练时使用数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| PushT-Sim | 206 episodes | 2-DoF 平面推块,T 形块推到目标位姿;128×128 顶视 resize 后填充进 128×384 画布;成功按 target-overlap 判定,评测 rollout 上限 200 环境步 |
| Panda-Sim (MimicGen) | 9,000 episodes | square 3000 / coffee 2000 / stack 2000 / stack_three 2000;7-DoF 末端命令+夹爪;agent-view 外置+eye-in-hand 双视角 128×256 |
| Allegro-Sim | 2,126 主任务 + 401 辅助 episodes | 16-DoF Allegro 手相对位姿立方体旋转;401 条随机运动轨迹只提供 J-IDM 局部运动覆盖,非目标导向演示;三视角 128×384 |
| Panda-Real | 39,816 条 DROID 成功轨迹 | Franka 族双臂+平行夹爪真实数据;视频规划器只用 RGB(双外置+wrist 拼成 128×576);J-IDM 用对应动作流+RGB 光流 |
| Allegro-Real | 60(Phase 1)~217(Phase 2)episodes | 水平安装的 Allegro 手做顺时针/逆时针立方体旋转;双视角 128×256;评测在真实硬件上跑 held-out 条件 |
架构(摘要)
主干与结构
backbone:视频规划器:Wan 家族 14B 视频扩散 transformer,LVP(Large Video Planner)初始化,Diffusion Forcing 训练,无动作头;J-IDM:冻结 DINOv2 编码器+DPT neck/head(sim 小规模)/ VGGT 初始化(真实规模)的逐像素 Jacobian 场
参数:视频规划器 14B(Wan-14B);J-IDM 未单独公布参数量,与 D-IDM 基线同参数量 fair comparison
类型:解耦双模块:动作无关视频扩散世界模型(规划器)+ 图像空间 Jacobian 场 IDM(翻译器)
关键组件
- 视频规划器:video-to-video 格式(N 上下文 latent → M 未来 latent),diffusion forcing 线性 flow 目标,只对未来帧算 MSE 损失
- 多视角拼接:相机在像素空间拼成一个宽帧,同一 backbone 吃单/双/三视角,跨本体共享画布布局
- J-IDM:图像条件 transformer 输出稠密 Jacobian 场 J_θ(o) ∈ R^{K×2×H×W}(每像素 2×K 矩阵,把动作增量映射为该像素的 2D 位移)
- 联合正逆训练损失:前向像素流项(Charbonnier)+ 反向动作重建项(λ 正则伪逆),w_a=0.3
- 推理反演:对相邻预测帧对提取光流 v_t,经 (J J^T + λI)^{-1} J^T 的闭式 ridge 解恢复动作增量
- 闭环重规划:一次生成 M=4 帧,只提交 K=1 帧,执行后拿新观测再查一次规划器
为什么这样设计
视频模型与动作空间天然解耦:视频数据充足、生成的是与本体无关的视觉计划,所以把「规划」留在视频空间,把「控制」交给每本体一个小 IDM。IDM 用 Jacobian 结构约束代替对大量动作数据的依赖:动作增量与像素运动之间的局部线性映射是经典机器人学的先验,学这个结构比直接学「图像对→动作」的端到端回归更省数据、更随自由度扩展。
数值 sense
| 项 | 值 |
|---|---|
| 分辨率 | DROID triview 128×576(ext1+ext2+wrist);MimicGen dual 128×256;Allegro-Sim triview 128×384;Allegro-Real dual 128×256;PushT 128×384(128×128 顶视填充) |
| 上下文 | N=6 个 latent 上下文帧 = 4N−3 = 21 张 RGB 帧(Wan tokenizer 因果时序压缩,1 latent ≈ 4 RGB 帧) |
| lookahead | M=4 个 latent 未来帧 = 16 张 RGB 帧;提交前缀 K=1 个 latent 转移 |
| sampling | 每次规划调用 40 步 UniPC 去噪;只去噪未来 latent,上下文 latent 固定 |
| 动作 | Panda 7-DoF 末端增量+夹爪;Allegro 16-DoF 关节位置目标;PushT 2-DoF 推子位置增量;toy finger 2D 研究中 DoF 从低到高扫描 |
| jacobian | 每像素 2×n 矩阵(2=像素 dx/dy 两个方向,n=动作通道数);整图 J_θ(o) ∈ R^{n×2×H×W} |
| 训练 | Wan-14B:1 节点 8×H200;Wan-1.3B:1×H100(正文一处写 1.4B,表 3 标 1.3B);J-IDM 联合正逆损失(Charbonnier ρ=√(x²+ε²),w_a=0.3) |
| data | PushT 206 / MimicGen 9000 / Allegro-Sim 2126+401 / Panda-Real 39,816 / Allegro-Real 60–217 episodes |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Allegro-Sim 闭环成功率 / 任务进度 | 70.0% ± 14.5 / 70.0% ± 14.5 | UniPi*(同数据同参数量无结构 IDM):0.0% ± 0.0 / 0.0 ± 0.0 | 16-DoF Allegro 模拟手内立方体旋转,14B 视频规划器,triview 128×384 |
| Panda-Sim (MimicGen) 闭环成功率 | 94.0% ± 3.4 | UniPi*:0.0% ± 0.0 | 7-DoF Franka 模拟,9,000 episodes,双视角 128×256 |
| PushT-Sim 闭环成功率 / 任务进度 | 92.5% ± 2.1 / 95.5% ± 1.6 | UniPi*:74.4% ± 3.4 / 84.8% ± 2.8 | 2-DoF 平面推块,206 episodes,rollout 上限 200 环境步 |
| 动作重建 MSE(Allegro-Sim) | 0.031 | D-IDM+Flow 0.044;UniPi* 0.063 | held-out 视觉转移上重建动作,同参数量同数据 |
| 动作重建 MSE(Panda-Sim) | 0.19(第二,未最优) | D-IDM+Flow 0.09;UniPi* 0.38 | MimicGen held-out 视觉转移;这是 4 个环境里 J-IDM 唯一没有拿第一的 |
| 动作重建 MSE(PushT-Sim / 5 关节手指) | 0.046 / 0.017 | PushT:D-IDM+Flow 0.059、UniPi* 0.071;5 关节:D-IDM+Flow 0.030、UniPi* 0.047 | held-out 视觉转移,同为同参数量对比 |
| 数据效率(2D toy finger,DoF=5) | 约 2× | 无结构 D-IDM 基线达到同等重建精度需约 2 倍样本 | 2D toy finger 研究,DoF=5,固定数据预算下扫样本量;固定数据时随 DoF 增长只有 J-IDM 保持忠实重建 |
| 真实 Panda 基本任务成功率 | 60% | DreamZero 90%;π0.5 30% | in-house Panda 台架,push A / pick up B 基本指令,各系统均用 DROID 训练 checkpoint;难任务(位置/语义推理 prompt)上 VERA 保持表现,两个基线常抓错物体 |
| 视频规划器初始化消融(验证 MSE) | LVP 初始化 0.10 | Wan 初始化 0.13;随机初始化 0.40 | DROID triview,N=8 上下文 / M=6 预测,held-out latent 未来帧预测 |
| 相机视角消融(归一化验证 MSE) | triview 0.13;wrist-only 0.61 | 双外置视角 0.10 最低;外置+wrist 0.21;单外置 0.21 | DROID,归一化到 128×576 像素预算,N=8/M=6 |
Insights
- 视频模型的推理能力可以完整保留到机器人策略里,前提是配一个忠实的翻译器:解耦把「规划错」与「翻译错」两个错误源分开——hidden button 实验里 DreamZero 连 dream 都失败(视频分支本身错),而 VERA 的 dream 对、卡在翻译,两处失败有各自可修的环节
- Jacobian 结构约束替代数据:固定数据预算下,随自由度升高只有 J-IDM 保持忠实重建;DoF=5 时达到同等精度约省一半数据。学「动作→像素运动」的局部线性映射比学「图像对→动作」的黑箱回归更省样本、更随 DoF 扩展
- 像素运动是视频世界模型与动作空间的共同接口:视频规划器输出的相邻帧光流是 J-IDM 的唯一输入信号,像素运动越少(静止、接触饱和)反演越病态——这同时解释了为什么需要随机运动辅助数据,也是论文自承局限的根源
- 视频规划器本身就是 flow/world model:diffusion forcing 用线性 flow 目标在 latent 速度场上生成未来轨迹;IDM 把这段「latent 流」解码后的像素光流,经机体 Jacobian 反演成「动作流」,两层 flow 在解码后的相邻帧处衔接
- 同一个视频规划器可跨本体复用:在 DROID 与模拟/真实 Allegro 数据上混合后训练后,一个 planner 配两个 J-IDM 就能同时控 Panda 与 16-DoF 手
vs 同类工作
- vs VLA(RT-2/OpenVLA/π0.5):VLA 把感知与控制耦合在单一本体特定模型里,动作空间异构让泛化受限;VERA 把基础模型留在视频空间,每本体只加一个小 IDM,跨本体靠换 IDM 实现
- vs WAM(GR-2/DreamZero/LingBot-VA):联合预测视频+动作需要在视频主干上接动作头并要三方配对数据;VERA 完全分离动作,保住视频模型推理(hidden button 中 DreamZero 的 dream 失败、VERA 成功即证据)
- vs UniPi / Direct IDM:UniPi 用无结构网络从两帧回归动作;J-IDM 用 Jacobian 结构+联合正逆损失,换来 2× 数据效率与随 DoF 的忠实扩展(toy finger 研究)
- vs 前作 Jacobian 场(Li et al., Nature 2025):前作把像素运动提升到 3D 再用 NeRF 式体渲染学 3D Jacobian 场;VERA 丢掉 3D 场景表示,直接在图像空间用单一大 transformer,可配对 14B 视频模型并扩展到大动作空间
- vs 同期解耦系统(Rhoda Direct Video-Action):同为「视频规划+翻译」路线,佐证解耦架构可部署到真实双手机器人;VERA 的贡献在 IDM 的 Jacobian 结构化设计与系统化消融
局限
- 论文自承:视频规划器后训练仍需机器人专属视频数据(Panda-Real 用 39,816 条 DROID 轨迹、Allegro-Real 用 60–217 条),跨本体零样本依赖已训练好的各本体 J-IDM 集合
- 论文自承:J-IDM 监督依赖现成光流估计器(RAFT/TAPIR/AllTracker/MegaFlow),光流本身的错误会传导到动作
- 论文自承:纯 RGB 无法推理基于力的控制(如力控抓取);faithful 动作恢复在预测转移几乎没有像素运动时退化
- 我们读出:基本任务上翻译仍是瓶颈——同台架对比中 VERA 60% 对 DreamZero 90%,失败 rollouts 的 dream 均正确但动作缺忠实;这部分差距尚未被 Jacobian 结构消除
- 我们读出:J-IDM 的优势并非处处成立——Panda-Sim 动作重建 MSE 0.19 高于 D-IDM+Flow 的 0.09(仍是 4 环境中唯一没拿第一的),说明结构约束的收益与数据分布、动作参数化有关
- 我们读出:真实评估规模有限——Allegro-Real 仅 60–217 条轨迹、Panda 对比用自家台架与临时相机摆放;论文 v1 未提供统一控制频率、未提及开源代码/权重,复现成本高
- 我们读出:每本体都要单独采集动作数据训 IDM,本体越多累加成本越高;论文把 sim-to-real J-IDM 转移列为 future work,说明当前结构尚未消除真实本体动作数据依赖
- 我们读出:video-to-action 反演对「像素可见运动量」敏感,纹理稀少/静止区域(如深色物体、桌面上不动的部分)贡献的约束少,λ 正则只能缓解而不能消除病态
可复现性
- code:论文 v1 未提及开源仓库;项目主页 https://vera.csail.mit.edu 提供更多结果
- weights:未随文发布;视频规划器基于开源 Wan 权重与 LVP 初始化,J-IDM 真实规模用 VGGT 初始化
- sim_benchmark:PushT-Sim / MimicGen Panda-Sim / Allegro-Sim;真实评测为自建 Panda 台架与 Allegro 手;光流用 RAFT/TAPIR/AllTracker/MegaFlow,采样用 40 步 UniPC
主干与结构
backbone:视频规划器:Wan 家族 14B 视频扩散 transformer,LVP(Large Video Planner)初始化,Diffusion Forcing 训练,无动作头;J-IDM:冻结 DINOv2 编码器+DPT neck/head(sim 小规模)/ VGGT 初始化(真实规模)的逐像素 Jacobian 场
参数:视频规划器 14B(Wan-14B);J-IDM 未单独公布参数量,与 D-IDM 基线同参数量 fair comparison
类型:解耦双模块:动作无关视频扩散世界模型(规划器)+ 图像空间 Jacobian 场 IDM(翻译器)
关键组件
- 视频规划器:video-to-video 格式(N 上下文 latent → M 未来 latent),diffusion forcing 线性 flow 目标,只对未来帧算 MSE 损失
- 多视角拼接:相机在像素空间拼成一个宽帧,同一 backbone 吃单/双/三视角,跨本体共享画布布局
- J-IDM:图像条件 transformer 输出稠密 Jacobian 场 J_θ(o) ∈ R^{K×2×H×W}(每像素 2×K 矩阵,把动作增量映射为该像素的 2D 位移)
- 联合正逆训练损失:前向像素流项(Charbonnier)+ 反向动作重建项(λ 正则伪逆),w_a=0.3
- 推理反演:对相邻预测帧对提取光流 v_t,经 (J J^T + λI)^{-1} J^T 的闭式 ridge 解恢复动作增量
- 闭环重规划:一次生成 M=4 帧,只提交 K=1 帧,执行后拿新观测再查一次规划器
为什么这样设计
视频模型与动作空间天然解耦:视频数据充足、生成的是与本体无关的视觉计划,所以把「规划」留在视频空间,把「控制」交给每本体一个小 IDM。IDM 用 Jacobian 结构约束代替对大量动作数据的依赖:动作增量与像素运动之间的局部线性映射是经典机器人学的先验,学这个结构比直接学「图像对→动作」的端到端回归更省数据、更随自由度扩展。
数值 sense
| 项 | 值 |
|---|---|
| 分辨率 | DROID triview 128×576(ext1+ext2+wrist);MimicGen dual 128×256;Allegro-Sim triview 128×384;Allegro-Real dual 128×256;PushT 128×384(128×128 顶视填充) |
| 上下文 | N=6 个 latent 上下文帧 = 4N−3 = 21 张 RGB 帧(Wan tokenizer 因果时序压缩,1 latent ≈ 4 RGB 帧) |
| lookahead | M=4 个 latent 未来帧 = 16 张 RGB 帧;提交前缀 K=1 个 latent 转移 |
| sampling | 每次规划调用 40 步 UniPC 去噪;只去噪未来 latent,上下文 latent 固定 |
| 动作 | Panda 7-DoF 末端增量+夹爪;Allegro 16-DoF 关节位置目标;PushT 2-DoF 推子位置增量;toy finger 2D 研究中 DoF 从低到高扫描 |
| jacobian | 每像素 2×n 矩阵(2=像素 dx/dy 两个方向,n=动作通道数);整图 J_θ(o) ∈ R^{n×2×H×W} |
| 训练 | Wan-14B:1 节点 8×H200;Wan-1.3B:1×H100(正文一处写 1.4B,表 3 标 1.3B);J-IDM 联合正逆损失(Charbonnier ρ=√(x²+ε²),w_a=0.3) |
| data | PushT 206 / MimicGen 9000 / Allegro-Sim 2126+401 / Panda-Real 39,816 / Allegro-Real 60–217 episodes |
视频到动作的翻译闭环:上下文→视觉计划→J-IDM 反演→执行→重规划
原文 caption:Figure 2: Translating video to actions. a, Given context frames, our video world model rolls out a short visual plan. b, The Jacobian IDM inverts each step of this path into a chunk of low-level actions. c, The chunk is executed and observations return to the video model for closed-loop execution.
整篇系统的骨架图,对应 3.3 节的闭环流程:a 是视频世界模型吃上下文帧输出 M 帧视觉计划;b 是 J-IDM 把计划里相邻帧的像素运动逐对反演成 K 步动作 chunk;c 是执行后把新观测送回规划器。读法:关注「生成 M 帧、只提交 K 帧」的分工——规划器看得远,控制器靠频繁反馈保持贴地。这张图支撑全文核心论断:视频规划与动作翻译完全解耦,中间只隔一层像素运动。
真实零样本:Panda 找隐藏按钮 + Allegro 16-DoF 手内旋转
原文 caption:Figure 3: Zero-Shot Evaluation on Panda Arm. a, After training on DROID, we deploy zero-shot on a Panda in an unseen scene with ad-hoc camera placements; in Press-Hidden-Button, the blue target is visible from only one of three views, with an orange distractor probing instruction grounding. b, Visualization of the predicted Jacobian: each column of J_θ is assigned a fixed RGB color and rendered, per pixel, weighted by the norm of the corresponding Jacobian column. c, Generated frames and executions shown side-by-side with the text prompt. Figure 4: In-Hand Object Reorientation. a, Cube-reorientation demonstrations with three language instructions. b, Predicted Jacobian visualized as in Fig. 3b. c, Generated frames and executions side-by-side with prompt.
本页两张真实机器人图。上页(Figure 3):DROID 后训练后零样本部署到陌生场景、临时相机摆放;Press-Hidden-Button 任务里蓝色按钮只有三视角之一能看到、橙色干扰物考验指令接地;b 是 J-IDM 预测的 Jacobian 场可视化——每一列(对应一个动作通道)固定一种 RGB 颜色,按列范数加权渲染,能看到不同动作通道影响哪些像素区域。下页(Figure 4):Allegro 手 RGB-only 的 16-DoF 手内立方体旋转,含张开手掌重新抓取、两次 yaw 旋转的多阶段操作;c 把生成帧与真实执行并排,说明 J-IDM 的翻译与视频计划一致。
J-IDM 随自由度扩展:唯一保持忠实的结构,DoF=5 时约 2× 数据效率
原文 caption:Figure 5: J-IDM scales with action dimensionality. a, Rollouts of recovered actions for direct-IDM baselines and J-IDM as DoFs grow. b, At a fixed data budget, the J-IDM gap over direct-IDMs widens with DoF. c, At high DoF, J-IDM has a better data-accuracy trade-off across training sizes.
控制变量研究(2D toy finger):a 展示随 DoF 增加,无结构 D-IDM 基线恢复的动作 rollout 走形,J-IDM 仍忠实;b 横轴是自由度、纵轴是归一化动作 MSE,固定数据量下 J-IDM 与直接回归基线的差距随 DoF 拉大;c 横轴是训练样本数,固定 DoF=5 时 J-IDM 用约一半数据达到同等精度(约 2× 数据效率)。这张图是「Jacobian 结构约束代替数据」的直接证据,支撑 3.1 节对 IDM 三特质(忠实、省数据、随 DoF 扩展)的论证。
真实世界对比 π0.5 / DreamZero:基本任务 90/60/30,难任务 VERA 反超
原文 caption:Figure 6: Real-world comparison with robot foundation model baselines. VERA remains competitive on basic tasks and substantially better on challenging tasks.
同数据(DROID 训练 checkpoint)、同自家 Panda 台架上的三方对比。基本任务(push A / pick up B):DreamZero 90%、VERA 60%、π0.5 30%——VERA 的失败来自视频到动作的翻译缺忠实(dream 是对的,动作没跟上),π0.5 则常抓错物体。难任务(基于位置的「推纸上那个按钮」、基于语义的「推与扳手同色的按钮」):VERA 保住性能,两个基线常对错误物体动手。这张图支撑「解耦保住视频模型推理」的论断,也诚实暴露翻译环节仍是基本任务上的瓶颈。
🎧 音频版
时长 34:09 · Edge TTS
VERA:把视频模型改造成通用机器人策略(对话版·深度版)
先讲清楚这篇论文解决了什么问题
小播:老播,今天这篇是讲机器人的?标题里又是 video 又是 robot 的。
老播:对,这篇叫 Turning Video Models into Generalist Robot Policies,把视频模型改造成通用机器人策略,系统的名字叫 VERA,全称 Video-to-Embodied Robot Action Model,视频到具身机器人动作模型。一作是 MIT 的 Sizhe Lester Li,共同一作 Evan Kim 和 Xingjian Bai,通讯作者 Vincent Sitzmann,也在 MIT;另外还有独立研究者和 CMU、Amazon 的成员。arXiv 编号 2605.27817,2026 年 5 月底挂出来,项目主页是 vera.csail.mit.edu。
小播:为什么值得专门做一期?
老播:三个理由。第一,它代表了一条和主流 VLA 完全不一样的路线,讨论的是机器人智能的核心问题:怎么让一个系统控制多种机器人、在陌生环境里完成没见过的任务。第二,它把「视频生成模型怎么变成机器人控制器」拆成了两个可以分开研究的模块,这个拆法本身有方法论价值。第三,它在真实机器人上做出了零样本、跨本体的结果。一句话预告本期要讲透的内容:一个 14B 参数的视频扩散模型只负责想象未来长什么样,另配一个按机体 Jacobian 结构设计的逆动力学模型,把想象出来的视频翻译成机器人动作,这套「规划与翻译解耦」的组合,在真实 Panda 机械臂和 16 自由度的 Allegro 机械手上都跑通了。
小播:Jacobian、逆动力学,这些词我现在都不懂,后面能听懂吗?
老播:每个词第一次出现我都会给一句定义。今天核心要讲透两件事:一是为什么把「规划」和「翻译」拆开是对的;二是当你把视频规划器本身理解成一个 flow/world model 的时候,翻译器是怎么接上去的。最后还会讲它没解决的问题。
先把背景铺开:为什么绕开 VLA 这条路
小播:先说背景。之前几期讲过 VLA,视觉语言动作模型,为什么这篇要绕开它?
老播:VLA 的代表工作有 RT-2、OpenVLA、π0.5,做法是把预训练的视觉语言模型接一个动作输出头,直接输出关节指令或者末端指令。这个路线的基本逻辑是:语言模型和视觉语言模型的通用性来自「模型和数据一起放大」,把动作接上去,希望动作也能继承这份通用性。问题在于,web 上有海量的图文配对数据,却没有 web 规模的动作配对数据。机器人动作数据要靠一台台机器人慢慢采,规模差了好几个数量级。加上动作空间高度异构:7 自由度的手臂、16 自由度的灵巧手、不同的控制频率和坐标约定,模型在小规模动作数据上微调,泛化到新任务、新本体、新环境就一直吃力。这是论文开篇的论点,也解释了为什么机器人领域一直缺一个「基础模型时刻」。
小播:那视频生成模型为什么是替代选项?
老播:视频数据充足,视频生成模型能生成「视觉计划」——想象一个机器人完成任务该是什么样子,比如手把立方体转过去、机械臂把球放进碗里。它跟任何具体机器人的动作空间无关,一个视频模型能想象很多种机器人的行为。但这里出现一个新问题:视频模型输出的是像素,机器人执行的是动作,中间这层怎么翻译?有人把动作直接接进视频主干,联合预测视频和动作,这类模型叫 WAM,World Action Model,世界动作模型,代表工作有 GR-2、DreamZero、LingBot-VA。这条路要 video、action、text 三方配对的稀有数据,而且动作头接进去之后,可能会稀释视频模型自己的视觉推理能力。
小播:VERA 走的是哪条?
老播:第三条路,解耦。视频模型只做规划,动作交给另一个模块翻译。这个翻译模块叫 IDM,逆动力学模型,英文 Inverse Dynamics Model。先给定义:逆动力学,就是从结果反推原因——给它两帧画面之间的视觉转移,它反推出产生这个转移的机器人动作。它对应的是机器人学里的正动力学和逆动力学这对概念,这里特指「视觉→动作」的反演。这条路 VERA 算不上第一个走,UniPi 是著名的先例,但 UniPi 的翻译器是一个无结构神经网络,直接从两帧图像回归动作。论文在实验部分会证明,这种无结构回归在数据少、动作维度高的时候忠实性会崩。
小播:忠实性这个词你说了两次了,到底什么意思?
老播:忠实性(faithfulness)是这条管线的第一要求:执行翻译出来的动作,要能复现视频模型预测的那段视觉转移。视频里手把立方体顺时针转了三十度,翻译出的动作执行出来真的转了三十度,这就是忠实;转了但转歪了,就是不忠实。视频计划再完美,翻译错了就全错,所以 IDM 是整条管线的命门。论文对好的 IDM 提了三个要求:忠实、省数据(最好只靠自博弈数据就能训练)、能随动作维度扩展。动作维度就是自由度,DoF,能独立控制的运动通道数:7 自由度的机械臂大概是位置三个、姿态三个、夹爪一个,16 自由度的 Allegro 手就是十六个关节各算一个。自由度越高,翻译越难。
小播:等等,我得先补个基础。视频扩散模型到底是什么?我们听众有 ML 基础,但生成模型这块可能不太熟。
老播:扩散模型的基本思想是:训练时把真实数据逐步加噪,直到变成纯噪声;再学一个网络,一步步把噪声还原成数据。视频版本就是同时处理一列帧,生成一小段连续的未来视频。这类模型先在海量视频上预训练,会学到物体运动、遮挡、光照变化这些视觉物理常识。VERA 用的就是 Wan 家族的 14B 视频扩散 transformer,再用 LVP 的机器人视频权重初始化。关键一点:它生成的始终是未来画面,和动作完全无关,这正是解耦的前提。
小播:那解耦除了刚才说的,还有工程上的好处吗?
老播:论文在摘要里列了三样。第一,IDM 可以用自博弈等更容易获得的数据独立训练,动作标注可以后补。第二,同一个视频模型配不同本体各自的 IDM,就能服务不同机器人,跨本体复用。第三,以后更强的视频模型出来了,直接换进来就行,IDM 不用重训。这三条都是模块化的直接收益:规划器的改进和翻译器的改进可以分别发生、分别验收。
小播:背景到这里,我觉得框架清楚了。进入核心思想。
核心思想:Jacobian 结构化的翻译器,和视频规划器解耦
小播:好,现在进核心。VERA 的翻译器具体长什么样?
老播:关键设计叫机体 Jacobian。先拆词:Jacobian 就是微积分里的雅可比矩阵,一个多变量函数的偏导数矩阵。在这里,机体 Jacobian 描述的是「动作增量怎么影响身体上每个点的运动」。经典机器人学里这个工具存在很久了:设 a 是机器人的动作向量,n 维;x_i 是身体上第 i 个点的三维位置;那么在状态 o 下,J_i(o) = ∂x_i / ∂a,一个 3 乘 n 的矩阵。
小播:这个公式想回答什么问题?
老播:想回答「动一个动作通道,身体上的点往哪动、动多少」。动作扰动 δa 引起的点位移约等于 J_i(o) 乘 δa,δx_i 约等于 J_i(o) δa。这个矩阵由机器人的运动学结构决定,是局部线性的近似——动作增量小的时候很准。但有个麻烦:三维点的位置观测不到,机器人只有相机,看到的是像素。所以论文把 Jacobian 直接搬到图像空间:训练一个图像条件的 transformer,叫 Jθ,输入一张图 o,输出一个稠密场,每个像素 p 配一个 2 乘 n 的矩阵,满足 δp = Jθ(p, o) δa。
小播:逐符号讲一遍?
老播:好。δp 是这个像素在画面里的位移,横纵两个方向,所以矩阵是 2 行;n 是动作通道数,所以是 n 列;Jθ(p, o) 就是那个 2 乘 n 的矩阵,把 n 维动作增量线性映射成这个像素的二维位移。整张图跑一遍,就得到「每个动作通道分别推着哪些像素往哪动」的稠密描述。论文里这个场记为 Jθ(o),形状是 n 乘 2 乘 H 乘 W,H、W 是图像高宽。可以理解为每个像素位置都放了一个小线性模型,告诉你说:这个关节动一下,这个像素会怎么挪。
小播:训练的时候拿什么当监督?机器人又没有标好的像素运动。
老播:用现成光流估计器。先给定义:光流(optical flow)是相邻两帧之间每个像素的二维位移场,就是「哪些点动了、往哪个方向动、动了多少」。RAF T、TAPIR、AllTracker、MegaFlow 这些现成模型都能直接从两帧 RGB 图算出来,不用人工标注。训练时对每个数据三元组(当前帧 o_t、动作增量 δa_t、下一帧 o_{t+1}),先用光流估计器算出 o_t 到 o_{t+1} 的运动场 v_t,然后监督 Jθ 同时满足两个方向。
小播:两个方向?一个是前向一个是反向?
老播:对,这是这篇训练损失设计的重点。先讲预期:既要保证「给动作,能预测出正确的像素运动」,也要保证「给像素运动,能反推出正确的动作」,两个方向共享同一个 Jθ,互相正则。损失写出来是:L 等于两项求和。第一项是前向像素流项:把真实动作 δa_t 乘进预测的 Jacobian,得到预测像素运动,和真实光流 v_t 比,度量函数用 Charbonnier,ρ(x) 等于根号下 x 平方加 ε 平方,这个函数比 L2 距离对大误差更稳,抗离群点。第二项是反向动作重建项:先把预测的 Jacobian 场做 λ 正则伪逆,记作 J†,λ,拿真实光流反推动作,再和真实动作 δa_t 比 L2 距离,这一项前面乘了权重 w_a 等于 0.3。
小播:伪逆又是什么?听起来很数学。
老播:J 不是方阵,像素数量远大于动作维数,没法直接求逆,所以取 Moore–Penrose 伪逆,它是最小二乘意义下的解;再加 λ 正则项就是 ridge 回归,防止解过大、防止病态。这个动作重建项的意义在于:它把训练目标直接对准部署时的用法——部署时你就是拿光流反推动作。两个方向都学,Jθ 才既是好的正模型,也是好的逆模型。
小播:部署的时候怎么用?
老播:给定视频规划器输出的相邻预测帧,先提光流,再解一个带 λ 正则的最小二乘:求一个动作增量 δâ,让 Jθ 乘 δâ 尽可能接近光流 v,同时 δâ 的范数不要太大。这个问题的闭式解是 (Jθ Jθᵀ 加 λI) 的逆,再乘 Jθᵀ 再乘 v,一次矩阵运算就出动作,不需要迭代优化。这就是 inference 时整条翻译链:两帧像素 → 光流 → 伪逆 → 动作。
小播:那整套系统跑起来是什么流程?
老播:闭环,receding-horizon 滚动时域控制。每轮规划器生成 M 个未来帧,主实验 M 等于 4 个 latent 帧,对应 16 张 RGB 帧;但控制器只提交前 K 等于 1 帧。J-IDM 以当前观测为锚,对每个相邻帧对独立反演,得到动作 chunk,执行,然后把新观测追加进历史,再查一次规划器。生成 4 帧、执行 1 帧,这个分工可以叫「看得远、走得近」:规划器在远距离上保持一致性,控制器靠频繁反馈贴近现实。动作 chunking,一次执行多步再重规划,这个设计沿用了 ACT 和 Zhang 等人关于行为克隆的先验发现,能提升性能;论文在附录图八里消融了 chunk 长度,结论是适中最好——太长会让接触任务里的误差积累、反馈变稀。
小播:把这个闭环按步骤再走一遍,像念操作流程一样。
老播:论文算法一。第一步,把最近 N 个观测编码成 latent 上下文,主实验 N 等于 6。第二步,规划器采样 M 个未来 latent 帧,M 等于 4,用 40 步 UniPC 去噪,上下文保持固定不动。第三步,只把提交前缀 K 帧解码回 RGB,K 等于 1。第四步,把当前观测和这些预测帧串成一条视觉轨迹。第五步,J-IDM 对轨迹里每个相邻帧对做反演,得到 K 个动作组成的 chunk。第六步,执行 chunk,把新观测追加进历史,回到第一步。整套流程里规划器的「远见」是 M 等于 4,控制器的「接地」是 K 等于 1,这两个数字的不对称就是闭环稳定性的来源。
小播:规划器这边呢?它是什么模型?
老播:主实验是 Wan 家族的 14B 视频扩散 transformer,用 LVP,Large Video Planner,的权重初始化,训练用 Diffusion Forcing。上下文是 6 个 latent 帧,Wan 的 tokenizer 做因果时序压缩,6 个 latent 帧对应 21 张 RGB 帧,4 乘 6 减 3;每次规划调用 40 步 UniPC 去噪。训练规模:14B 模型在一个 8 张 H200 的节点上,消融用的小模型一张 H100 就够,论文表三里标 1.3B,正文一处写 1.4B,两个数字并存。多视角处理很简单:相机在像素空间直接拼成一个宽画布,DROID 数据是两外置加 wrist 三个视角拼成 128 乘 576;跨本体训练时统一视角布局,缺的槽位补空白帧。
小播:视频模型见过动作吗?
老播:从头到尾不见。机器人动作不进视频模型的输入,也不进它的训练损失,这是解耦设计的地基。视频模型只学一件事:给定历史观测和任务指令,预测未来观测。所以它还能继续用纯视频数据后训练,通用性不被任何机器人的动作空间绑住。Diffusion Forcing 这个训练目标也值得多讲一句:它对每个未来 latent 帧预测一个线性 flow 速度场,这是 flow matching 一族的方法,允许不同帧用不同的噪声水平。
小播:这正好接上你说的考点——「视频规划器本身是 flow/world model」。
老播:对,这就是 reading_tip 里点名要想透的一点。先给定义:world model,世界模型,指从观测预测未来观测的模型,直接输出未来画面,动作。视频规划器用 Diffusion Forcing 训练,目标是对每个未来 latent 帧预测速度场,在 latent 空间里生成一条未来轨迹——它就是一个世界模型,一个 flow 模型:输入历史观测,输出未来观测的轨迹。而机器人执行的是动作增量,两边隔着一条链:latent 流解码成 RGB 帧,相邻帧之间有像素光流,像素光流由动作增量经机体 Jacobian 产生。J-IDM 的衔接点就在最后两环:它学的是「动作增量到像素运动」的映射,部署时反演它,就把世界模型给出的像素流翻译成了动作流。
小播:所以是两个「flow」在图像空间接上了?
老播:正是。一层是 latent 空间的速度流,视频模型的生成目标;一层是图像空间的像素光流,光流估计器从相邻帧算出来的;中间靠解码器和光流估计器接起来。J-IDM 是交汇处的翻译器:视频模型负责「未来会怎么动」,IDM 负责「动成这个样子要发什么指令」。这个衔接方式还解释了一个现象:如果规划器预测的相邻帧几乎没有可观测像素运动,反演就会病态,忠实恢复动作就很困难。所以 Allegro 模拟训练时额外加了 401 条随机运动辅助轨迹,就是在给衔接处补充局部运动模式的覆盖。这个点记住,它是后面局限段的伏笔。
小播:这个衔接框架,和忠实性的定义有什么关系?
老播:关系很直接。忠实性的定义是「执行动作能复现预测的视觉转移」。放到这个框架里看,整条链是这样的:视频模型给出未来帧,光流估计器给出像素流,J-IDM 反演出动作,真实世界执行后应该产生同样的像素流。忠实性检验的其实是这条链能不能闭合:预测的流、反演的动作、真实执行的流,三者一致才算忠实。论文里把生成帧和执行帧并排展示的那些图,演示的就是这条链闭合。这也解释了为什么 IDM 必须学 Jacobian 而不是直接回归动作:动作和像素之间的映射是这条链的物理内核,把它学对,链才能闭合。
小播:这套结构设计,原理上为什么比无结构回归强?
老播:结构约束的意思是:模型被限制去学「动作增量到像素运动的局部线性映射」,这个线性结构是经典机器人学两百年的先验,比学「图像对到动作」的黑箱映射约束强得多。约束强意味着同样的数据能学到更可靠的东西,也意味着动作维数升高时,每列 Jacobian 仍然各有各的物理含义,扩展起来自然。这部分结论靠实验验证,下面就是实验。
关键实验:结构带来什么,系统能做什么
小播:进实验之前,先把图二这张系统骨架图读一遍?
老播:图二横着分三块。a 块,视频世界模型吃上下文帧,吐出 M 帧视觉计划,计划里是想象出来的未来画面。b 块,J-IDM 把计划里相邻帧的像素运动逐对反演成动作 chunk,这是翻译环节。c 块,执行 chunk 后把新观测送回规划器,闭环闭合。读这张图的重点:生成 M 帧、只提交 K 帧这个分工画在最显眼的位置,它提醒你规划器的计划可以长,控制器只取前一小段,靠频繁重规划贴住现实。
小播:先看最直接的问题:Jacobian 结构比无结构回归强在哪?
老播:论文做了一个 2D toy finger 控制变量研究,对应图五。做法是:同一个 DINOv2 编码器、同一个 DPT 解码颈部、同一批数据,只换解码头。一组输出稠密 Jacobian 场,就是 J-IDM;一组直接回归动作,输入输出行为复刻 UniPi,论文叫它 UniPi 星号基线;还有一组在光流条件下回归动作,叫 D-IDM 加 Flow,它是 J-IDM 的消融对照——输入输出一样,只是少了 Jacobian 结构。三个模型参数量一致。
小播:结果呢?
老播:两个结论。第一,固定数据预算时,自由度从低扫到高,只有 J-IDM 保持忠实重建,无结构基线的动作 rollout 越走越歪,图五 a 图直接展示了 rollout 走形;图五 b 图横轴是自由度、纵轴是归一化动作误差,J-IDM 和基线的差距随自由度拉大。第二,固定 5 个自由度时,J-IDM 达到同等重建精度约只需一半样本,约 2 倍数据效率,图五 c 图横轴是训练样本数。注意这个 2 倍是在 2D 手指、5 自由度的设定下测的,论文没有声称所有场景都是这个倍数。
小播:完整系统在仿真里什么水平?
老播:看表一,闭环成功率加任务进度。Allegro-Sim 是 16 自由度手内立方体旋转,J-IDM 成功率和任务进度都是 70.0% 正负 14.5,UniPi 风格基线是 0.0% 正负 0.0;Panda-Sim 用 MimicGen 生成的 9000 条轨迹、7 自由度,J-IDM 94.0% 正负 3.4,基线 0.0%;PushT-Sim 是 2 自由度平面推块、206 条演示,J-IDM 成功率 92.5% 正负 2.1、任务进度 95.5% 正负 1.6,基线是 74.4% 正负 3.4、84.8% 正负 2.8。这三个环境里规划器完全一样,只换翻译器,成功率就从零或者低水平跳到 70% 以上。这一步很关键:它把功劳记在了翻译器头上,也坐实了「忠实翻译是命门」。
小播:翻译的忠实性本身怎么量化?
老播:表二在 held-out 视觉转移上量动作重建 MSE,越低越好。J-IDM 在四个环境里三个最低:Allegro-Sim 0.031,对比光流条件基线的 0.044 和无结构的 0.063;PushT-Sim 0.046,对比 0.059 和 0.071;5 关节手指 0.017,对比 0.030 和 0.047。唯一例外是 Panda-Sim:J-IDM 是 0.19,反而高于光流条件基线的 0.09,无结构基线 0.38 仍然垫底。这个例外请记住,它是结构优势并非处处成立的直接证据,我们局限段会回来。
小播:真实机器人上的表现呢?
老播:分三块。第一块,零样本 Panda。真实 Panda 臂用 DROID 的 39,816 条轨迹后训练视频规划器,然后零样本部署到陌生场景、临时相机摆放、光照和物体朝向都变化的环境。语言指令包括「把绿色网球拿起来放进碗里」「把紫色立方体从盘子里拿出来放到一边」「把黄色方块放到乐高块上面」这类。第二块,三方对比。图六,同台架、同数据口径:各家都用 DROID 训练的 checkpoint。基本任务,推 A、拿 B 这类,DreamZero 90%、VERA 60%、π0.5 30%。失败原因分得很清楚:VERA 失败的 rollout,dream 视频都是对的,卡在视频到动作的翻译缺忠实;π0.5 则经常无视指令、抓错物体。
小播:60% 对 90%,这不落后吗?
老播:看下一组就明白为什么值得注意。第三块,难任务和遮挡推理。基于位置的 prompt,比如「推纸上那个按钮」,目标不直接出现在指令里;基于语义的 prompt,比如「推与扳手同色的按钮」,需要视觉接地。这两类上 VERA 保持表现,DreamZero 和 π0.5 频繁对错误物体动手。还有 hidden button 挑战:蓝色按钮被墙挡住,只有三个相机视角之一能看到,桌上还放了橙色干扰物考验指令接地。VERA 能绕过墙找到按钮并按下;DreamZero 连 dream 视频都没找到按钮,失败出在视频分支本身。这个对照很有价值:解耦把失败源分开了,一个系统的失败到底来自规划还是翻译,可以分别诊断、分别修。
小播:零样本这个词,在这里的准确含义是什么?
老播:指没有在这个场景、这个相机配置、这个 prompt 上做过任何示范采集或者微调,直接部署。Panda 的评测里,场景是没见过的,相机是临时摆的,光照变了,物体朝向变了,规划器只在 DROID 的 39,816 条轨迹上后训练过,IDM 也只见过 DROID 分布里的动作。能在这种条件下完成「把绿色网球放进碗里」这类指令,是视频模型视觉泛化能力的直接继承——视频模型见过的世界足够多,翻译器忠实,这份泛化就传到了机器人身上。
小播:跨本体呢?这是解耦的招牌能力。
老播:同一个视频规划器在 DROID 和模拟、真实 Allegro 数据上混合后训练,配两个本体专属的 J-IDM,就能同时控制 Panda 臂和 16 自由度的 Allegro 手,做接触密集的手内立方体旋转,包括张开手掌重新抓取、两次 yaw 旋转的多阶段操作,全程只靠 RGB,任务成功率由真实硬件上的 held-out 评测报告。图三 b 和图四 b 还展示了 J-IDM 预测的 Jacobian 场可视化:每个动作通道固定一种颜色,按列范数加权渲染到每个像素,能直接看到不同通道影响哪些像素区域——比如手指关节的通道在指尖附近亮,末端平移的通道在整只手上均匀分布。
小播:视频模型侧还有什么值得说的?
老播:两组消融。初始化消融:随机初始化验证误差 0.40,Wan 预训练初始化 0.13,LVP 初始化 0.10,设定是 DROID 三视角、8 上下文 6 预测——预训练初始化对机器人视频预测的帮助很大。视角消融:只有 wrist 视角归一化误差 0.61,三视角 0.13,双外置视角 0.10——全局场景上下文对视频预测最重要,wrist 视角单独用基本不行。这些数字也解释了为什么主实验坚持用多视角。
谱系定位:它站在哪条线上,和谁比
小播:现在把三条路线摆在一起看。
老播:VLA 把感知和控制耦合在一个本体特定模型里,动作空间异构限制了泛化;WAM 把动作头接进视频主干,需要三方配对数据,动作头还可能稀释视频模型的推理;VERA 走解耦,基础模型留在视频空间,每个本体只加一个小翻译器。hidden button 是最有力的对照:DreamZero 的失败在视频分支,VERA 的失败如果出现,在翻译分支,两个错误源可以分别定位、分别修。这是解耦相对端到端最实在的好处。
小播:和 UniPi、和以前的 Jacobian 工作比呢?
老播:UniPi 的翻译器是无结构回归,J-IDM 的 Jacobian 结构换来 2 倍数据效率和随自由度的忠实扩展。Jacobian 场这条线要提一作 Sizhe Lester Li 在 Nature 2025 发表的工作,那篇用 3D 场景表示加 NeRF 式体渲染学 3D Jacobian 场;VERA 把 3D 表示去掉,直接在图像空间做单个大 transformer,才能配得上 14B 视频模型、覆盖 16 自由度动作空间。同期 Rhoda AI 的 Direct Video-Action 系统也走「视频规划加翻译」的解耦路线,在真实双手机器人上做了闭环长程操作,说明这条路线能落地。可以说 VERA 的位置是:视频规划加忠实翻译,第三条路线,和 VLA、WAM 并行,互相竞争也互相启发。
小播:你刚才说动作头会稀释视频模型的推理,这个说法有证据吗?
老播:论文给的是行为层面的间接证据,注意区分:这是一个假说,不是已经被逐环节证明的定理。证据有三条线:hidden button 里 DreamZero 连 dream 视频都没找到按钮;π0.5 在推理型 prompt 上经常对错误物体动手;而 VERA 的 dream 正确、翻译也执行成功。端到端模型失败时很难定位是规划错了还是执行错了,解耦模型把两个环节分开,等于给了诊断工具。论文的解读是:把视频分支单独保留,能保住视频模型的推理能力,而端到端的动作头会把这份能力稀释掉。这个假说值得后续专门做干预实验去验证,目前它和证据一致,但证据还不是因果性的。
局限:论文自承的,和我们读出来的
小播:论文自己承认了哪些局限?
老播:四条。第一,视频规划器后训练仍然需要机器人专属视频数据:Panda 用了 DROID 的 39,816 条轨迹,Allegro 真实数据只有 60 到 217 条,跨本体零样本依赖已经训好的各本体 IDM。第二,J-IDM 的监督依赖现成光流估计器,光流错,动作就跟着错。第三,纯 RGB 无法处理基于力的控制,比如靠力反馈的抓取。第四,预测转移几乎没有可观测像素运动时,忠实动作恢复退化——这就是前面说的病态反演,像素不动,约束就没有了。
小播:你们读出了什么?
老播:四条。第一,翻译在基本任务上还是瓶颈:同台架 60% 对 DreamZero 的 90%,这个差距还没有被 Jacobian 结构抹平,论文自己也说 VERA 在基本任务上的失败来自翻译缺忠实。第二,结构优势处处成立:Panda-Sim 重建误差 0.19 高于光流条件基线的 0.09,说明收益跟数据分布、动作参数化方式有关,哪里适用、哪里不适用还需要更多分析。第三,真实评估规模有限:Allegro 真实只有几十到两百多条轨迹,Panda 对比是自家台架加临时相机摆放,论文没有给统一控制频率,v1 也没有提开源代码或权重,复现门槛不低。第四,每个本体都要单独采动作数据训 IDM,本体越多累加成本越高;论文把 sim-to-real 的 IDM 转移、人类与机器人联合规划、本体条件化 Jacobian 都列为 future work,等于承认当前结构还没有消除真实本体动作数据的依赖。
小播:局限听完,会不会觉得这条路被卡住了?
老播:倒是换个角度看:论文自己列的三条 future work,sim-to-real 的 IDM 转移、人类和机器人视频联合规划、本体条件化 Jacobian,每一条都对应一个当前局限的出口。这条路的骨架已经跑通,剩下的是把「每个本体都要重新采数据」这个成本降下来。前面讲过,像素运动少就病态,λ 正则只能缓解、消除不了,所以「预测出有足够像素运动的视觉计划」也成了对视频模型的一种新要求——规划器和翻译器互相提要求,这正是解耦系统有意思的地方。
收尾:这期记住的三件事
小播:最后总结,这期记住哪三件事?
老播:一,视频生成模型可以当零样本的规划器,前提是配一个忠实的翻译器;规划错和翻译错是两个可以分别诊断、分别修的失败源,这是解耦最实在的收益。二,翻译器用机体 Jacobian 结构化,比无结构回归省数据、能随自由度扩展——2D 手指研究里,5 自由度下达到同等重建精度约省一半样本。三,解耦让同一个视频模型换一个 IDM 就能换一个本体,同时保住视频模型的视觉推理:hidden button 里 WAM 连 dream 都失败,VERA 能绕过墙找到按钮。记住开头那句话:解耦的视频规划加忠实的视频到动作翻译,是通向零样本、跨本体、可泛化机器人控制的一条可行路线。
小播:这篇对后续工作意味着什么?
老播:它把「视频模型是世界模型」这条生成界的思路正式接到了机器人界:规划器只管出未来的像素流,IDM 负责在像素流和动作流之间做忠实翻译。后续值得盯三件事:sim-to-real 的 IDM 转移能不能省掉真实本体动作数据;人类和机器人视频联合训练能不能扩大规划器的通用性;本体条件化的 Jacobian 能不能让一个模型覆盖多种形态。等视频世界模型越来越强,翻译器的设计会越来越重要——这篇论文的标题值得再念一遍:把视频模型改造成通用机器人策略。