Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(精读)
一句话定位:把机器人的视觉运动策略写成以观测为条件的动作去噪扩散过程。策略不再一次输出一个动作,而是一次输出一个 8 步动作块(action chunk),执行完再重新规划;在 4 个 benchmark、15 个任务(模拟 + 真实)上,相对各 benchmark 此前最优方法平均提升 46.9% 成功率。这篇论文把机器人策略从「one-step 动作回归」带到「action-chunk 条件生成」,是后续 VLA 与 one-step 动作生成方法的基准对象。
1. 要解决什么问题
行为克隆(behavior cloning)最简单形式是监督回归:学一个函数把观测映射到动作。机器人动作预测有三点特殊。第一,演示数据里同一个状态可以有多种合法动作——比如把 T 形块推到目标,可以绕左边走,也可以绕右边走——这叫多模态动作分布,单峰回归学出来的是两种轨迹的平均,两头都不对。第二,动作在时间上强相关,逐帧独立预测会在两条合法轨迹之间来回横跳,产生抖动。第三,抓取、推箱、倒液体这类任务要求亚厘米级精度,回归到均值的行为在高精度任务上直接失败。
之前的方法分两类。显式策略(regression / LSTM-GMM / BET)直接把动作当标量或类别输出:单高斯回归只能拟合单模态;GMM 要预设模态数、对超参数敏感、容易模态坍缩;BET 把连续动作离散成类别,分箱数量随动作维度指数膨胀。隐式策略(IBC,基于能量模型 EBM)理论上能表达任意多模态分布,但训练要用负采样近似一个不可解的归一化常数,训练不稳定,论文里的评估曲线振荡得厉害。两类方法大多预测单步动作,遇到演示里的停顿段(idle actions,比如倒液体时勺子要停住接酱汁)容易过拟合卡死。这篇论文要回答:用什么样的策略表示,能同时表达多模态动作分布、输出时间一致的连续动作序列、训练稳定、而且推理快到能闭环控制真实机器人。
2. 方法:把策略写成条件去噪过程
2.1 条件 DDPM 做策略
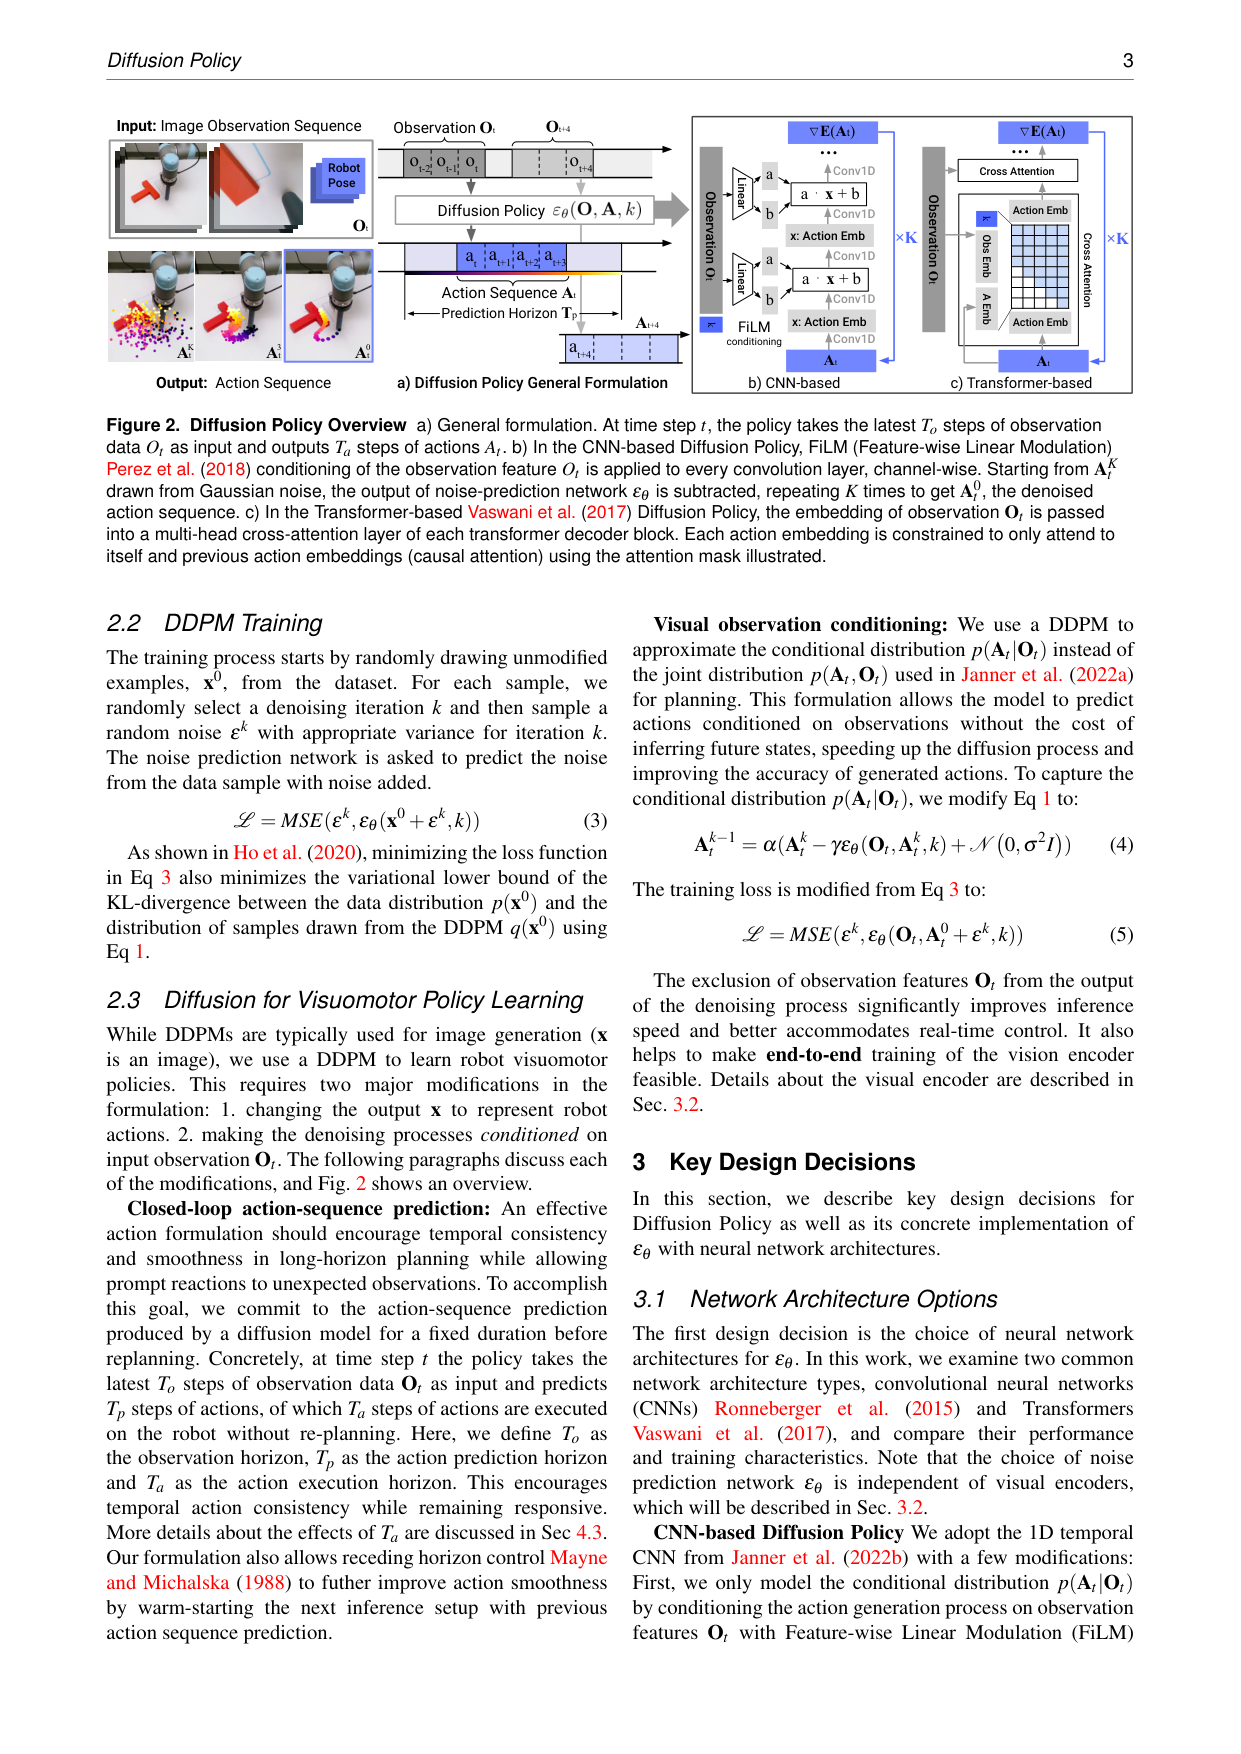
论文沿用 DDPM(Ho et al. 2020)的框架,但把生成对象从图像换成动作。给定最近 To 步观测块 Ot,策略要逼近条件分布 p(At | Ot),其中 At 是 Ta 步的动作块。推理时从一个高斯噪声样本 AK_t 出发,迭代 K 步去噪:
x_{k−1} = α(x_k − γ εθ(Ot, x_k, k) + N(0, σ²I))
这个式子要回答的问题:怎么把一段纯噪声逐步变成一段干净动作。其中 εθ 是噪声预测网络(参数 θ),输入是观测 Ot、当前噪声动作 x_k、去噪步数 k;α、γ、σ 是随 k 变化的系数,合称噪声调度(论文用 iDDPM 的 square cosine 调度),相当于梯度下降里的学习率调度;N(0, σ²I) 是每步加的少量高斯噪声。整条式子可以读成一步带噪声的梯度下降:εθ 预测的是动作分布 score 函数 ∇_a log p(a|o) 的负值,减去它就是在朝概率增大的方向走。
训练损失同样很直接:给真实动作 A0_t 加噪,让网络回归加进去的噪声。
L = MSE(ε_k, εθ(Ot, A0_t + ε_k, k))
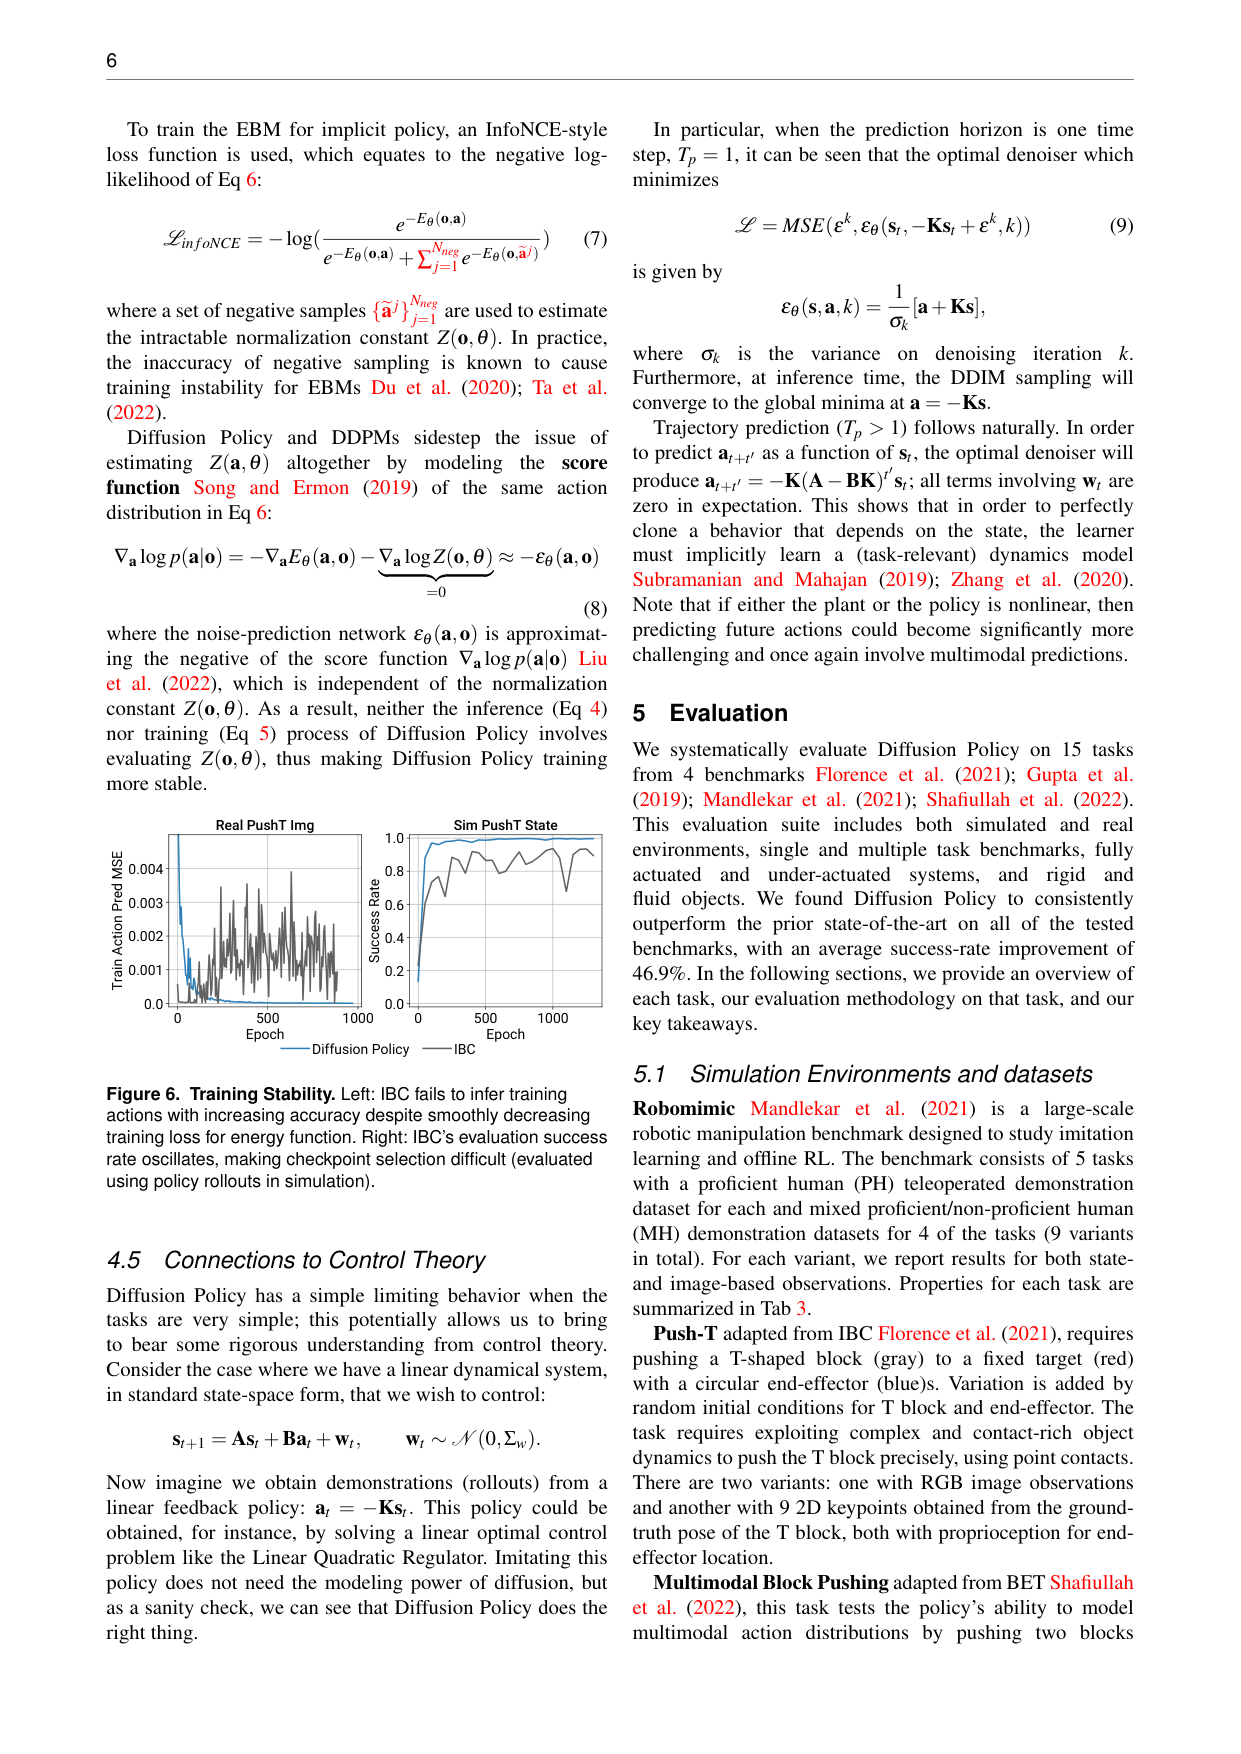
每一步训练随机抽一个去噪步数 k,加对应方差的高斯噪声 ε_k,要求网络还原它。这个 MSE 目标等价于最小化模型分布与数据分布的 KL 散度下界。关键性质:εθ 学的是 score 函数,score 与归一化常数无关,所以训练绕开了 IBC 必须面对的负采样问题,训练曲线平稳。
2.2 三个支撑性的设计决定
动作块 + 滚动时域控制。 策略输入最近 To=2 步观测,预测 Tp=16 步动作,但只执行 Ta=8 步,然后带着新的观测重新规划;下一次推理还用上一次的预测序列做 warm start。整块联合去噪保证了块内动作的时间一致性(对比逐帧独立采样的 BET,BET 会在两条模态轨迹间反复横跳),执行 8 步再重规划保留了对意外观测的响应能力。消融显示 8 步是最优点:太长(128 步)响应慢,太短(1 步)退化成单步策略。
观测条件化。 论文建模条件分布 p(At|Ot),把观测特征从去噪循环里拿出来:视觉编码器(ResNet-18,无预训练,spatial softmax pooling 保留空间信息,GroupNorm 配合 EMA 稳定训练)把图像块编码成 Ot,K 步去噪全程只编码一次,推理速度接近单步网络 K 倍的节省。CNN 版用 FiLM 把 Ot 逐通道调制进每个卷积层;Transformer 版把 Ot 经共享 MLP 变成观测嵌入序列,进 decoder 的 cross-attention。
Time-series diffusion transformer。 CNN 版 1D 时间卷积对低频信号有偏好,动作快速锐利变化(比如速度命令)时过平滑。Transformer 版(minGPT 风格 decoder,8 层、embedding 256)把噪声动作块作为 token 序列,扩散步数 k 的正弦 embedding 作为首 token,观测嵌入进 cross-attention,causal attention mask 让每个 action token 只看自己和之前的 token。注意力没有卷积的平滑归纳偏置,能表达高频动作变化,代价是超参(attention dropout、weight decay)跨任务差异大。
2.3 推理:DDIM 加速 + 位置控制
DDPM 训练用 100 个去噪步。真机上 100 步太慢,论文用 DDIM(Song et al. 2021)解耦训练与推理步数:真实任务推理只走 16 步,延迟实验里 10 步 DDIM 在 Nvidia 3080 上推理延迟 0.1 秒,加上一次性视觉编码,策略能 10Hz 闭环输出(UR5 上线性插值到 125Hz 执行)。
动作空间上,论文默认用位置控制(预测末端执行器期望位姿,旋转用 6D 连续表示),速度控制仅在消融里用。位置控制下多模态更明显(同一目标位置有多种可达姿态),扩散策略正好擅长表达多模态;位置命令的累积误差比速度命令小,更适合 8 步动作块预测。消融里 LSTM-GMM、BET 换成位置控制成功率下降,Diffusion Policy 反而上升。
3. 关键实验与结果
评估横跨 4 个 benchmark 的 15 个任务:Robomimic 5 任务(proficient-human 演示,其中 4 个任务另有 multi-human 变体)、Push-T、Multimodal Block Pushing、Franka Kitchen,加上 4 组真实世界任务(Push-T、倒/摊酱汁、马克杯翻转)和 3 个双机械臂任务。模拟任务状态版 4500 epochs、图像版 3000 epochs,成功率按 max checkpoint 与最后 10 个 checkpoint 平均两种口径报告(3 seeds × 50 初始条件)。
主结论:全部 15 个任务上相对各自此前最优方法平均提升 46.9%。简单任务上大家差距不大(Lift/Can 都接近 1.0),差距集中在高维、长程、多模态任务:Robomimic ToolHang(视觉)从 LSTM-GMM 的 0.68 提到 0.95,Transport(视觉)从 0.88 提到 1.00,IBC 在这两个任务上都是 0.00;Push-T(图像)从 IBC 的 0.75 提到 0.91;Kitchen 交互 ≥4 个物体的频率从 BET 的 0.44 提到 0.99;Block Push 推入 2 个方块的频率从 0.71 提到 0.94(相对提升约 32%)。
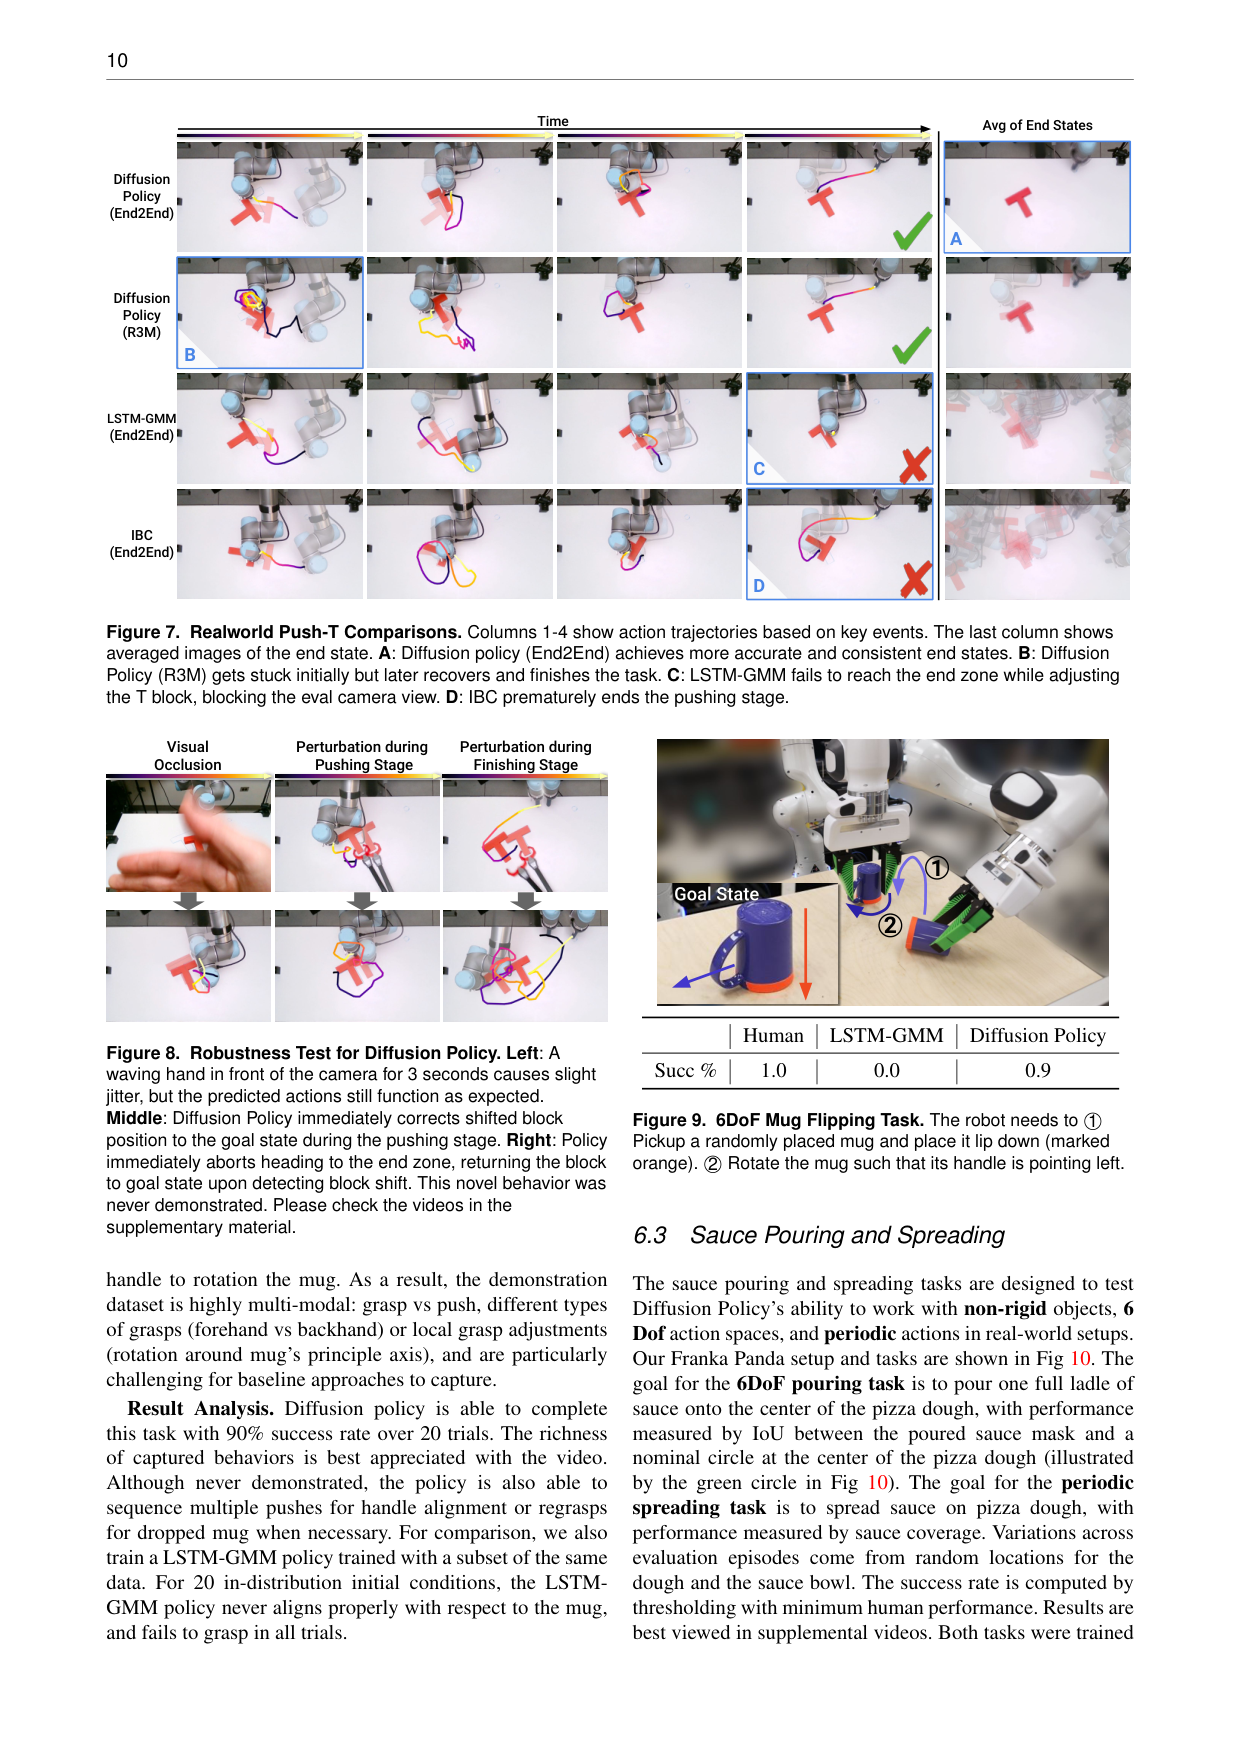
真实世界最典型的是两阶段 Push-T:需要先把 T 块推进目标区,再把末端执行器移到 end-zone。Diffusion Policy(端到端 CNN)成功率 95%、平均 IoU 0.80,人类是 100% / 0.84;LSTM-GMM 最佳变体 20%,IBC 两个变体都 0%。失败模式集中在阶段切换:LSTM-GMM 在 20 次评估里 8 次卡在 T 块附近,IBC 6 次提前离开 T 块。鲁棒性实验里,手掌遮挡相机 3 秒、推块阶段移位、收尾阶段挪走 T 块,策略都立即重规划;第三组场景里它放弃了去 end-zone、回头把 T 块推回目标再继续,这个行为从未在演示里出现过。6DoF 马克杯翻转(演示里同时存在抓取与推把手两种做法)20 次试验成功率 90%,LSTM-GMM 0%。倒酱汁 IoU 0.74(人类 0.79)、摊酱汁覆盖 0.77(人类 0.79),LSTM-GMM 两项都接近 0。
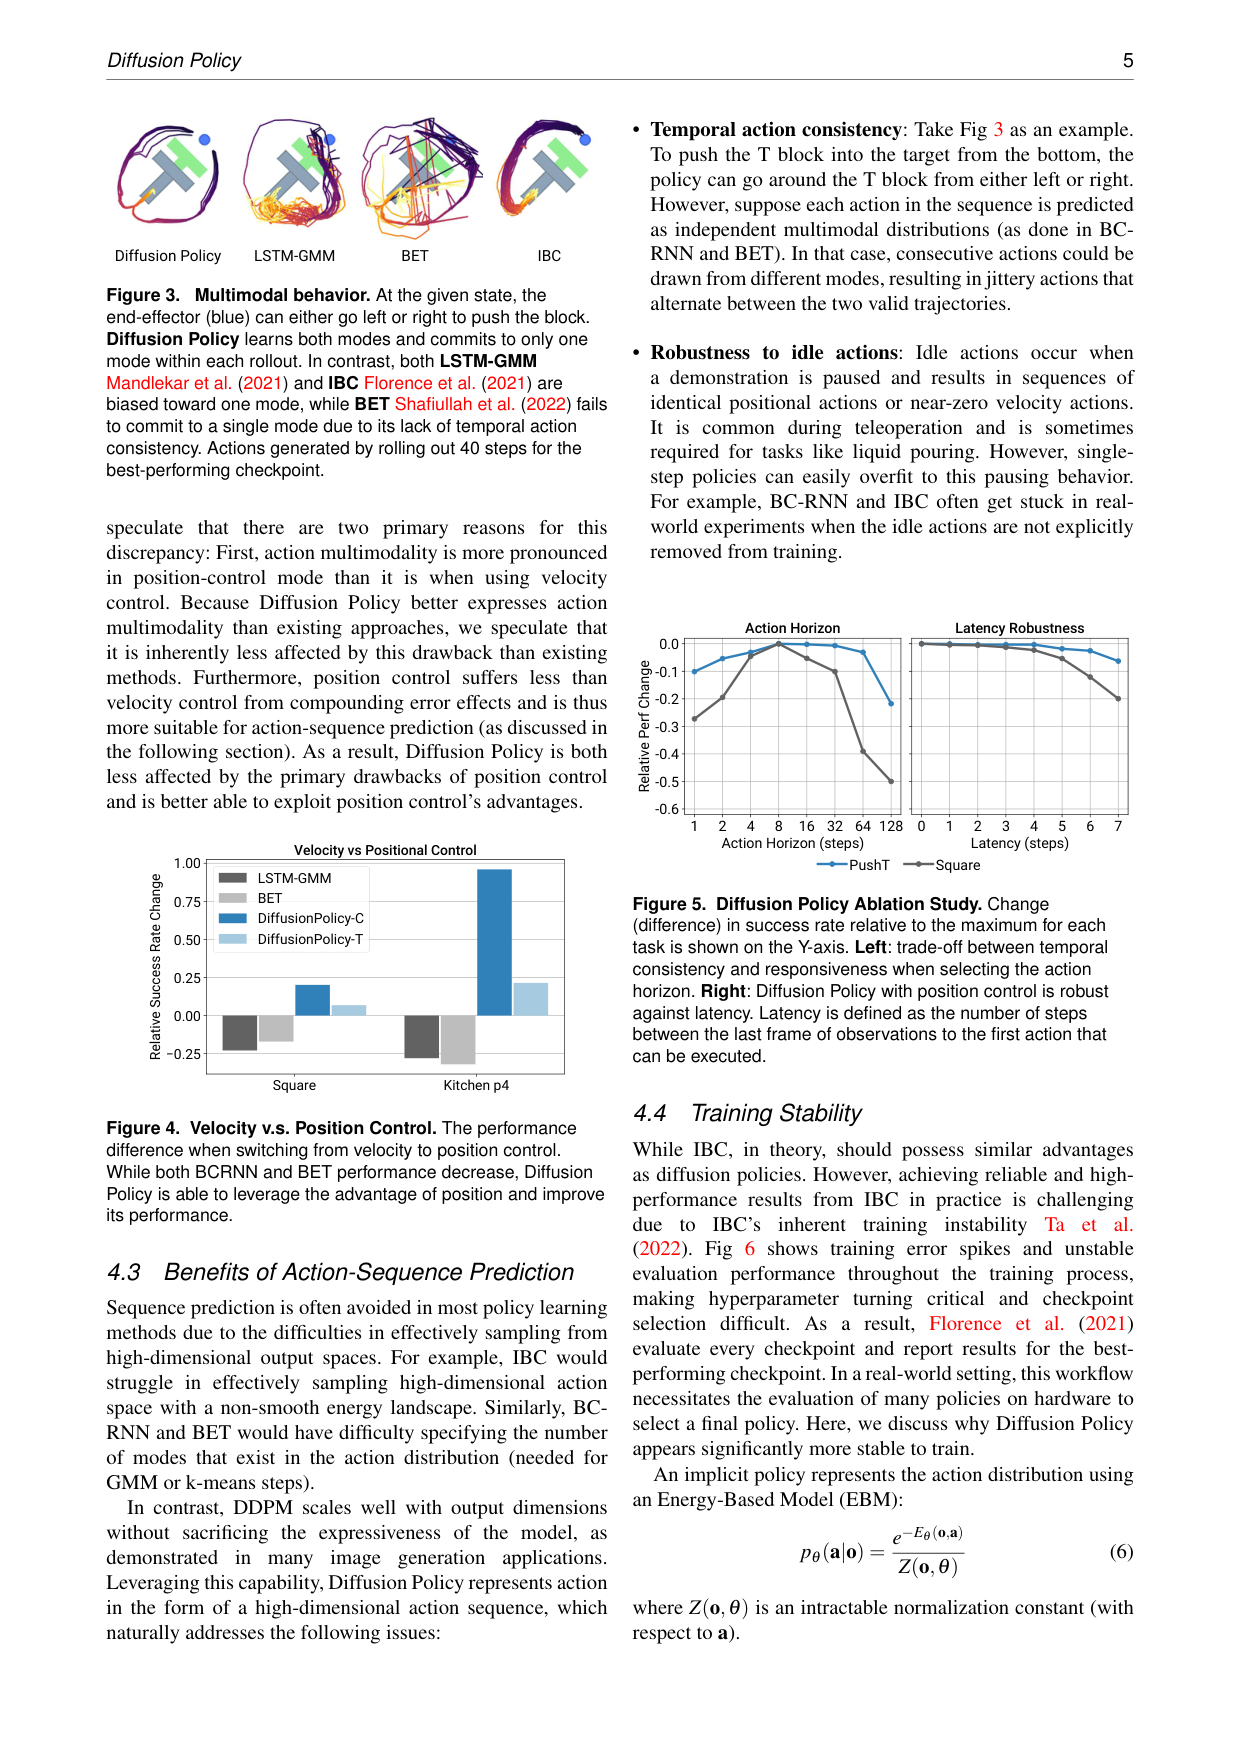
两个机制层面的发现值得记住。第一,训练稳定性来自 score 函数:IBC 的能量损失在下降,但训练动作预测误差停在 0.003 附近下不去,评估成功率大幅振荡;Diffusion Policy 曲线平稳,拿最后 10 个 checkpoint 平均就够了,IBC 却要逐个 checkpoint 挑最优。第二,延迟鲁棒性来自动作块 + 滚动时域:模拟延迟注入下,位置控制的 Diffusion Policy 在延迟 4 步内保持峰值性能,速度控制受影响更大。
4. 谱系定位
和 IBC(隐式 EBM 策略)相比,两者都做隐式分布建模,但 IBC 用 InfoNCE + 负采样近似归一化常数,负采样不准直接体现为训练振荡;Diffusion Policy 学 score 函数,归一化常数对梯度没有贡献。和 LSTM-GMM / BET(显式策略)相比,GMM 要预设模态数、BET 要聚类,动作离散化随维度指数膨胀;扩散无需指定模态数。和 Diffusion Planning(Janner et al. 2022)相比,后者建模联合分布 p(At, Ot)、推理还要预测未来观测,适合 MPC/planning;本文建模条件分布 p(At|Ot) 直接做闭环行为克隆,滚动时域 + 一次性视觉编码就是为实时闭环设计的。同期 Pearce et al. 2023、Reuss et al. 2023、Hansen-Estruch et al. 2023 侧重采样策略、classifier-free guidance 与 RL 应用,且以模拟实验为主;本文的增量在动作空间选择、滚动时域预测、实时推理工程与大量真实世界实验。论文第 4.5 节还有一个控制论视角的 sanity check:对线性系统 s_{t+1} = As_t + Ba_t + w_t、专家策略 a_t = −Ks_t,Tp=1 时最优去噪器是 εθ(s,a,k) = (1/σ_k)(a + Ks),DDIM 收敛到全局最优 a = −Ks;Tp>1 时最优预测是 a_{t+t'} = −K(A−BK)^{t'} s_t——要完美克隆依赖状态的行为,策略必须隐式学会任务相关的动力学模型。
5. 局限
论文自承四条:继承行为克隆的局限,演示数据不足或质量差时性能次优;相比 LSTM-GMM 这类单次前向方法,扩散推理计算成本与延迟更高,100→10 步的 DDIM 缓解了问题,但高频控制任务可能仍不够;Transformer 版对超参敏感、更难训练,CNN 版对速度控制这类高频变化动作表现差;真实实验评估规模小(每任务约 20 次试验),成功率区间宽。
我们读出三条:46.9% 的平均提升是 15 个任务相对各自最优基线的平均,任务间差异很大,Lift/Can 上所有方法都接近 1.0,差距集中在复杂任务,跨物体、跨场景、跨本体泛化没有被系统性压力测试;马克杯翻转的 LSTM-GMM 基线只用演示数据子集训练,对比口径略偏宽松;双机械臂任务成功率(55%-75%)明显低于单臂任务,论文未做数据量消融,任务难度和演示数量之间的关系没有被量化。
6. 复现
官方项目页 diffusion-policy.cs.columbia.edu 与开源实现 github.com/real-stanford/diffusion_policy 提供代码、训练配置与预训练 checkpoint。默认配方:CNN 版 lr 1e-4 / weight decay 1e-6,Transformer 版 lr 1e-4 / weight decay 1e-3;动作按逐维 min-max 归一化到 [-1,1](旋转分量不动),与 DDPM 的 [-1,1] clip 兼容;噪声调度用 iDDPM square cosine;训练 100 去噪步,DDIM 推理 16 步(真实)或 100 步(模拟)。
把机器人的视觉运动策略写成以观测为条件的动作去噪扩散过程:一次输出一个 8 步动作块(action chunk),配合滚动时域控制与一次性视觉编码,在 4 个 benchmark、15 个任务(模拟 + 真实)上相对各 benchmark 此前最优方法平均提升 46.9% 成功率;它把机器人策略从『单步动作回归』带到『动作块条件生成』,是后续 VLA 与 one-step 动作生成方法的基准对象。
阅读提示
精读深度:精读
清单提示:原文提示:理解 action-chunk 条件生成范式、训练/推理细节(动作空间、DDPM vs DDIM 采样、观测条件化);这是「one-step → action chunk」的基准对象。
问题
要解决什么:行为克隆(imitation learning / behavior cloning)最简单形式是把观测到动作的映射当监督回归学。机器人动作预测有三点特殊:演示数据里同一个状态可以有多种合法动作(多模态动作分布,比如绕障碍左边走还是右边走);动作在时间上强相关,逐帧独立预测会抖动;抓取/推箱这类任务对精度要求极高。这篇论文要回答:用一个什么样的策略表示,能同时表达多模态动作分布、输出时间上一致的连续动作序列、并且训练稳定、推理快到能闭环控制真实机器人。
为什么 prior work 不够:显式策略(regression / LSTM-GMM / BET)把动作当标量或类别回归:单高斯回归只能拟合单模态;GMM 要预设模态数、对超参敏感、容易 mode collapse;把连续动作离散成类别的 BET 要 k-means 聚类,分箱数量随动作维度指数膨胀。隐式策略(IBC,基于 Energy-Based Model)理论上能表达任意多模态分布,但训练要负采样近似不可解的归一化常数,训练不稳定、checkpoint 选择困难。而且这些方法大多预测单步动作,遇到演示里的停顿段(idle actions)容易过拟合卡死,短视(myopic)缺时间一致性。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 观测块 Ot(observation chunk) | image + 本体感受 | 最近 To 步观测(默认 To=2):每帧 1-2 个相机视角的图像(模拟 84×84,真实 320×240,10Hz 降采样)+ 末端执行器位姿/夹爪宽度;多相机各用独立视觉编码器,逐帧编码后拼接 |
| 噪声动作块 Ak_t(推理输入) | continuous (Ta × action_dim) | Ta 步高斯噪声(默认 Ta=8),作为去噪过程的起点;训练时是真实动作加噪 A0_t + εk |
| 去噪步数 k | scalar | 训练随机采 1..K,推理从 K 递减到 1;K_train=100(DDIM 推理可降到 10-16) |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 动作块 At(action chunk) | continuous (Ta × action_dim) | Ta 步连续动作:位置控制下为末端执行器期望位姿(位置 + 6D 旋转表示),默认 Ta=8 步;执行前 Ta_执行 = 全部 8 步中执行的动作步数,执行完才重新规划 |
| 去噪过程的中间动作块 A1_t ... AK_t | continuous | K 次迭代的中间产物,噪声逐步减少(Stochastic Langevin Dynamics 形式) |
控制频率:策略 10Hz 输出,UR5 上线性插值到 125Hz 执行;真实任务推理 16 步 DDIM,模拟任务 100 步;3080 GPU 上 10 步 DDIM 延迟 0.1s
输入拼接 protocol
输入拼接:<image1_t-1, image1_t, image2_t-1, image2_t, proprio_t-1, proprio_t> → 视觉编码器(ResNet-18,每帧独立编码后拼接成 Ot)→ εθ(Ot, Ak_t, k)。CNN 版:Ot 通过 FiLM 逐通道调制每个卷积层;Transformer 版:Ot 经共享 MLP 变成观测嵌入序列,进 decoder 的 cross-attention;Ak_t 作为 action token 序列(噪声动作序列),扩散步数 k 的正弦 embedding 作为首 token。输出为 εθ 对每个 action token 预测的噪声/梯度。数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| Robomimic(Lift / Can / Square / Transport / ToolHang) | 5 任务,proficient-human(PH)+ 4 个任务的 multi-human(MH)变体,每任务 200-700 个演示 | 状态 + 图像两种观测;成功率(max / 最后 10 个 checkpoint 平均),3 seeds × 50 初始条件(robomimic 因评估 bug 用 22 个,所有方法同口径) |
| Push-T(来自 IBC) | 模拟 200 演示 / 真实 136 演示 | 把 T 形块推进目标区,2D 动作;模拟用 9 个关键点 + 本体感受或 RGB 图像;指标为目标区覆盖(IoU),真实版为两阶段任务 |
| Multimodal Block Pushing(来自 BET) | 1000 episodes 脚本专家演示 | 推两个方块进两个目标格,顺序任意,长程多模态;指标为推入 1/2 个方块频率(p1/p2) |
| Franka Kitchen(来自 Relay Policy Learning) | 566 个人类演示,每段完成 4 个任务 | 7 个可交互物体,任务顺序任意,长程多模态;指标为交互 ≥x 个物体频率(p1-p4) |
| 真实世界:6DoF Pour / Peri Spread / Mug Flip | 每任务 90-250 演示(Franka Panda) | 倒酱汁、摊酱汁、翻转马克杯;非刚体 + 周期动作 + 6DoF 动作空间;成功率按人类最小性能阈值 |
| 真实双机械臂:Egg Beater / Mat Unrolling / Shirt Folding | 210 / 162 / 284 演示(Franka 双臂) | 遥操作用 VR(Quest Pro)或力反馈(Haption);无超参调整直接训练,成功率 55% / 75% / 75% |
架构(摘要)
主干与结构
backbone:两种主干:1D 时间 CNN(源自 Janner et al. 2022 的 diffusion planning U-Net,用 FiLM 做观测条件化);Time-series Diffusion Transformer(minGPT 风格 decoder,8 层、embedding 256、action token + k embedding 首 token + 观测 cross-attention,causal attention mask)
参数:CNN 扩散网络约 0.06-0.26M 参数(真实/模拟任务不同),视觉 ResNet-18 约 22M;Transformer 扩散网络约 9M 参数(模拟任务)
类型:条件去噪扩散概率模型(conditional DDPM)作为视觉运动策略:εθ 预测动作噪声/score 梯度,推理从高斯噪声迭代去噪 K 步得到动作块
关键组件
- 视觉编码器:ResNet-18(无预训练),spatial softmax pooling 保空间信息,GroupNorm 配合 DDPM 常用的 EMA 稳定训练;多相机各自编码后拼接
- 观测条件化:CNN 用 FiLM 逐通道调制每个卷积层;Transformer 用观测嵌入的 cross-attention;视觉特征 Ot 在 K 步去噪中只编码一次
- 时间序列扩散 Transformer:噪声动作块作为 token 序列,扩散步数 k 的正弦 embedding 作为首 token,causal attention 约束每个 action token 只看自己和之前的 token
- 滚动时域控制(receding horizon):预测 Tp=16 步、执行 Ta=8 步后重新规划;用上一次的预测做 warm start
- DDIM 推理加速:训练 100 步、推理 10-16 步
- iDDPM square cosine 噪声调度;动作归一化到 [-1,1](min-max 逐维),旋转分量不归一化
为什么这样设计
策略要满足三个互相冲突的要求:表达多模态动作分布(显式回归做不到)、输出时间一致的动作序列(单步预测做不到)、训练稳定且推理快到能上真机(EBM 的负采样不稳定,纯联合扩散规划要预测未来状态、太慢)。扩散模型恰好同时满足前两条,第三条靠三个工程决策补齐:观测只编码一次(K 步去噪复用同一 Ot)、用 DDIM 把推理从 100 步降到 10-16 步、动作块 + 滚动时域把序列预测变成闭环。Transformer 主干是为解决 CNN 对高频动作变化的过平滑倾向;位置控制 + 动作块组合能规避累积误差,是多模态最明显的动作空间。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 15 任务(4 benchmark)平均成功率提升 | +46.9% | 各 benchmark 此前最优方法(LSTM-GMM / BET / IBC 中每任务最优者) | 行为克隆配方,覆盖模拟 + 真实、2DoF-6DoF 动作、状态 + 图像观测、单/多任务、全驱动/欠驱动、刚体/流体对象;成功率(状态与图像任务分别 4500/3000 epochs) |
| Robomimic ToolHang(视觉,PH)成功率 | 0.95(DiffusionPolicy-C,max checkpoint) | LSTM-GMM 0.68、BET 0.58、IBC 0.00(max checkpoint) | Robomimic 视觉策略,proficient-human 演示,3 seeds × 22 初始条件,3000 epochs |
| Robomimic Transport(视觉,PH)成功率 | 1.00(DiffusionPolicy-C / T,max checkpoint) | LSTM-GMM 0.88、BET 0.71、IBC 0.00 | Robomimic 视觉策略,双机械臂运输任务,14 维动作,proficient-human 演示,3000 epochs |
| Push-T(模拟,图像观测)目标覆盖 | 0.91(DiffusionPolicy-C,max checkpoint) | IBC 0.75、BET 0.69、LSTM-GMM 0.69 | Push-T 模拟图像版(1×96×96),200 演示,300 epochs,指标为目标区覆盖(IoU)而非成功率 |
| Kitchen p4(交互 ≥4 个物体的频率,状态) | 0.99(DiffusionPolicy-C) | BET 0.44、LSTM-GMM 0.34、IBC 0.24(三者中最高 0.44) | Franka Kitchen,566 个人类演示、每段 4 个任意顺序任务,4500 epochs,多任务长程多模态 |
| Block Push p2(推入 2 个方块频率,状态) | 0.94(DiffusionPolicy-T) | BET 0.71、LSTM-GMM 0.01、IBC 0.00 | Multimodal Block Pushing,1000 episodes 脚本专家演示,Ta=1(脚本专家为马尔可夫),p2 相对最优 baseline 提升约 32% |
| 真实 Push-T 成功率 / 平均 IoU | 95% / 0.80(DiffusionPolicy 端到端 CNN) | 人类 100% / 0.84;LSTM-GMM 最佳变体 20% / 0.24-0.25;IBC 两个变体均 0% | UR5 单臂,136 个人类演示,10Hz 策略输出线性插值到 125Hz;成功率以人类演示最小 IoU 为阈值;IoU 取最后一步而非全程最大 |
| 6DoF 马克杯翻转成功率 | 90%(20 次试验) | LSTM-GMM 0%(20 次分布内初始条件,用同数据子集训练) | Franka 单臂真实任务,250 演示,含抓取 vs 推把手等多模态;策略还能泛化出未演示的多次推挤对齐、掉杯重抓 |
| 倒酱汁 IoU / 摊酱汁覆盖 | 倒 0.74(成功 79%)/ 摊 0.77(成功 100%) | 人类 0.79 / 1.00 与 0.79 / 1.00;LSTM-GMM 倒 0.06 / 0%、摊 0.27 / 0% | Franka 单臂真实任务,90 演示,非刚体 + 周期动作 + 6DoF;成功率按人类最小性能阈值;与 Push-T 同一套超参直接训练 |
Insights
- 策略表示本身就是行为克隆的性能瓶颈:同一个数据、同一个训练管线,只把策略从显式回归/隐式 EBM 换成动作扩散,就在全部 15 个任务上平均提升 46.9%,其中 Lift/Can 等简单任务大家都能到 1.0,差距集中在 Transport、ToolHang、Kitchen 这类高维/长程/多模态任务(Sec 5.3)
- 位置控制 + 动作块是一对互相放大的组合:位置控制下动作多模态更明显(扩散擅长表达),位置命令的累积误差更小(适合 8 步序列预测);LSTM-GMM 和 BET 换成位置控制成功率下降,Diffusion Policy 反而上升(Fig 4)
- 多模态来自采样过程的随机性,这一点比显式指定模态数更省事:随机初始化决定去噪收敛到哪个模态盆地,Langevin 随机扰动允许样本在模态间移动(Sec 4.1、Fig 3)
- 观测条件化把『联合生成』拆成『条件编码 + 生成』:视觉特征 K 步去噪只编码一次,是实时性的主要来源;端到端训练的视觉特征优于 ImageNet/R3M 冻结特征(真实 Push-T 95% vs 80% vs 15%)
- 控制论视角的 sanity check:对线性系统 st+1 = Ast + Bat + wt、专家策略 at = −Kst,Tp=1 时最优去噪器是 εθ(s,a,k) = (1/σk)(a + Ks),DDIM 收敛到全局最优 a = −Ks;Tp>1 时最优预测是 at+t′ = −K(A−BK)^t′ st——要完美克隆依赖状态的行为,策略必须隐式学会任务相关的动力学模型(Sec 4.5)
vs 同类工作
- vs IBC(Florence et al. 2021,隐式 EBM 策略):两者都做隐式分布建模,但 IBC 用 InfoNCE + 负采样近似归一化常数,负采样不准导致训练振荡、要逐 checkpoint 挑最优;Diffusion Policy 学 score 函数(∇_a log p(a|o)),归一化常数对梯度无贡献,训练曲线平稳(Fig 6)
- vs LSTM-GMM / BET(显式策略):GMM 要预设模态数、BET 要 k-means 聚类且动作离散化随维度指数膨胀;Diffusion Policy 无需指定模态数,任意可归一化分布都能表达,且整块动作联合去噪带来时间一致性(Fig 3 里 BET 模态间横跳、DP 每条轨迹只认一个模态)
- vs Diffusion Planning(Janner et al. 2022):DP 建模条件分布 p(At|Ot) 并直接做闭环行为克隆;Diffusion Planning 建模联合分布 p(At,Ot)、推理还要预测未来观测,适合 MPC/planning 但不适合实时闭环;本文的滚动时域 + 一次性视觉编码正是针对闭环实时性设计
- vs 同期扩散策略(Pearce et al. 2023、Reuss et al. 2023、Hansen-Estruch et al. 2023):他们侧重采样策略、classifier-free guidance、RL 应用,且以模拟实验为主;本文的增量在动作空间选择(位置 vs 速度)、滚动时域预测、实时推理工程与大量真实世界实验(含双机械臂)
- 作为基准对象:后续 one-step 动作生成(如 flow matching / consistency 类的单步策略)与 VLA 的 action expert(如 π0)普遍以 Diffusion Policy 的 action-chunk 公式为参照,用本文的 8 步 chunk、观测条件化、DDIM/DDPM 取舍作为对比基线
局限
- 论文自承:继承行为克隆的局限,演示数据不足或质量差时性能次优;作者建议用 RL 范式(如 Wang et al. 2023、Hansen-Estruch et al. 2023)利用次优与负数据
- 论文自承:相比 LSTM-GMM 这类单次前向方法,扩散推理的计算成本与延迟更高;100→10 步的 DDIM 缓解了问题,但对需要高频率控制的任务可能仍不够
- 论文自承:Transformer 版对超参敏感(attention dropout、weight decay 跨任务差异明显),训练难度更高;CNN 版虽开箱即用,但对速度控制这类快速锐利变化的动作表现差(时间卷积偏好低频)
- 论文自承:真实世界实验里,4 个单臂任务用了与 Push-T 相同的超参并首次尝试成功,但评估规模小(每任务 20 次试验左右),成功率区间宽
- 我们读出:46.9% 的平均提升是 15 个任务相对各自最优基线的平均,任务间差异很大——Lift/Can 上所有方法都接近 1.0,差距集中在复杂任务;跨物体、跨场景、跨本体泛化没有被系统性压力测试
- 我们读出:马克杯翻转的 LSTM-GMM 基线只用演示数据子集训练(论文自述),对比口径略偏宽松;双机械臂任务的成功率(55%-75%)明显低于单臂任务,任务难度和演示数量之间存在强相关,论文未做数据量消融
可复现性
- code:https://diffusion-policy.cs.columbia.edu(论文标注的项目页);官方开源实现 https://github.com/real-stanford/diffusion_policy
- weights:开源代码与训练配置(CNN 版与 Transformer 版、Robomimic/Push-T 等预训练 checkpoint 公开),真实世界演示数据部分随项目页发布
- sim_benchmark:Robomimic(PH/MH,状态+图像)、Push-T(模拟+真实)、Multimodal Block Pushing、Franka Kitchen;评估口径:max checkpoint 与最后 10 个 checkpoint 平均,3 seeds × 50 初始条件(robomimic 22 个)
主干与结构
backbone:两种主干:1D 时间 CNN(源自 Janner et al. 2022 的 diffusion planning U-Net,用 FiLM 做观测条件化);Time-series Diffusion Transformer(minGPT 风格 decoder,8 层、embedding 256、action token + k embedding 首 token + 观测 cross-attention,causal attention mask)
参数:CNN 扩散网络约 0.06-0.26M 参数(真实/模拟任务不同),视觉 ResNet-18 约 22M;Transformer 扩散网络约 9M 参数(模拟任务)
类型:条件去噪扩散概率模型(conditional DDPM)作为视觉运动策略:εθ 预测动作噪声/score 梯度,推理从高斯噪声迭代去噪 K 步得到动作块
关键组件
- 视觉编码器:ResNet-18(无预训练),spatial softmax pooling 保空间信息,GroupNorm 配合 DDPM 常用的 EMA 稳定训练;多相机各自编码后拼接
- 观测条件化:CNN 用 FiLM 逐通道调制每个卷积层;Transformer 用观测嵌入的 cross-attention;视觉特征 Ot 在 K 步去噪中只编码一次
- 时间序列扩散 Transformer:噪声动作块作为 token 序列,扩散步数 k 的正弦 embedding 作为首 token,causal attention 约束每个 action token 只看自己和之前的 token
- 滚动时域控制(receding horizon):预测 Tp=16 步、执行 Ta=8 步后重新规划;用上一次的预测做 warm start
- DDIM 推理加速:训练 100 步、推理 10-16 步
- iDDPM square cosine 噪声调度;动作归一化到 [-1,1](min-max 逐维),旋转分量不归一化
为什么这样设计
策略要满足三个互相冲突的要求:表达多模态动作分布(显式回归做不到)、输出时间一致的动作序列(单步预测做不到)、训练稳定且推理快到能上真机(EBM 的负采样不稳定,纯联合扩散规划要预测未来状态、太慢)。扩散模型恰好同时满足前两条,第三条靠三个工程决策补齐:观测只编码一次(K 步去噪复用同一 Ot)、用 DDIM 把推理从 100 步降到 10-16 步、动作块 + 滚动时域把序列预测变成闭环。Transformer 主干是为解决 CNN 对高频动作变化的过平滑倾向;位置控制 + 动作块组合能规避累积误差,是多模态最明显的动作空间。
Diffusion Policy 总览:条件去噪框架与 CNN / Transformer 两种实现
原文 caption:Figure 2. Diffusion Policy Overview. a) General formulation. At time step t, the policy takes the latest To steps of observation data Ot as input and outputs Ta steps of actions At. b) CNN-based Diffusion Policy: FiLM conditioning applied to every convolution layer; starting from AKt drawn from Gaussian noise, the output of noise-prediction network εθ is subtracted, repeating K times to get A0t. c) Transformer-based Diffusion Policy: the embedding of observation Ot is passed into a multi-head cross-attention layer of each transformer decoder block; each action embedding attends only to itself and previous action embeddings (causal attention).
全篇方法骨架。a) 说明输入是 To 步观测块、输出是 Ta 步动作块(action chunk),这是『one-step → action chunk』的范式切换:策略不再输出一个动作,而是一段动作。b) CNN 版用 FiLM 把观测特征调制进每一层卷积,从高斯噪声 AKt 减去 εθ 的预测,重复 K 次得到干净动作 A0t。c) Transformer 版把观测嵌入通过 cross-attention 注入每个 decoder block,action token 之间用 causal mask 保证时间因果。读法:注意视觉特征只在编码时算一次、K 步去噪全程复用,这是实时性的关键设计。
多模态行为、速度 vs 位置控制、动作块长度与延迟鲁棒性消融
原文 caption:Figure 3. Multimodal behavior: at the given state, the end-effector can either go left or right to push the block; Diffusion Policy learns both modes and commits to only one mode within each rollout, while LSTM-GMM and IBC are biased toward one mode and BET fails to commit. Figure 4. Velocity v.s. Position Control: performance difference when switching from velocity to position control. Figure 5. Ablation Study: change in success rate relative to the maximum for each task (left: action horizon trade-off; right: robustness against latency).
三张图对应三个核心论断。Figure 3:同一状态下手部可以向左或向右绕过去推 T 形块,40 步 rollout 里 Diffusion Policy 每条轨迹只认一个模态且两种模态都能到达目标,LSTM-GMM 和 IBC 偏向单侧,BET 在两条轨迹间反复横跳——对应『能表达短程多模态 + 时间一致性』。Figure 4:横轴是方法,纵轴是从速度控制切到位置控制的相对成功率变化(Push-T 与 Square 两个任务),BCRNN/LSTM-GMM 和 BET 换成位置控制后成功率下降,Diffusion Policy 反而上升——对应『位置控制 + 动作块是组合拳』。Figure 5:左图横轴是动作块长度 1-128 步,纵轴是相对峰值成功率的相对变化,8 步最优、太长响应慢、太短时间一致性差;右图横轴是延迟步数 0-7 步,位置控制的 Diffusion Policy 在延迟 4 步内保持峰值性能。
训练稳定性:IBC 的评估曲线振荡 vs Diffusion Policy 平稳
原文 caption:Figure 6. Training Stability. Left: IBC fails to infer training actions with increasing accuracy despite smoothly decreasing training loss for energy function. Right: IBC's evaluation success rate oscillates, making checkpoint selection difficult (evaluated using policy rollouts in simulation).
支撑『训练稳定、少调参』论断的证据。左图:真实 Push-T 图像任务上,IBC 的能量函数训练损失平滑下降,但训练动作预测 MSE 停在 0.003 附近下不去,说明损失降了、动作没学对;右图:模拟 Push-T 状态任务上 IBC 的成功率曲线在 0 到接近 1 之间大幅振荡,换 Diffusion Policy 后曲线平稳。读法:隐式策略用 InfoNCE + 负采样近似归一化常数,负采样不准直接体现在评估振荡上;扩散策略学 score 函数、完全绕开归一化常数,所以曲线平稳。这也解释了为什么 IBC 论文要『每 50 epoch 评估一次、挑最好的 checkpoint』,而 Diffusion Policy 拿最后 10 个 checkpoint 的平均就够。
真实世界 Push-T 对比、抗视觉/物理扰动、6DoF 马克杯翻转
原文 caption:Figure 7. Realworld Push-T Comparisons: action trajectories based on key events and averaged images of the end state for Diffusion Policy (R3M / End2End), LSTM-GMM, IBC. Figure 8. Robustness Test: visual occlusion (waving hand 3s), perturbation during pushing stage, perturbation during finishing stage. Figure 9. 6DoF Mug Flipping Task: pick up a randomly placed mug, place it lip down, rotate so the handle points left.
真实世界的三组证据。Figure 7:同一初始条件下四类方法的端状态平均图,Diffusion Policy (End2End) 的端状态最接近人类且集中;LSTM-GMM 卡在 T 块附近(20 次评估里 8 次)、IBC 提前离开 T 块(6/20)。Figure 8:三组扰动——手掌遮挡前相机 3 秒、推块阶段把 T 块移位、收尾阶段把 T 块挪走——策略都立即重规划并完成任务,第三组的『放弃去 end-zone、回头把 T 块推回目标再继续』属于从未演示过的新行为,对应论文论断『扩散策略能对未见观测合成新行为』。Figure 9:马克杯翻转任务要求随机放置的杯子杯口朝下、把手朝左,演示数据里存在『抓取 vs 推把手』等多模态,Diffusion Policy 20 次试验成功率 90%,LSTM-GMM 0%。
🎧 音频版
时长 31:38 · Edge TTS
Diffusion Policy 精读:机器人怎么用「去噪」来生成一整段动作(对话版)
先讲清楚这篇要解决什么问题
小播:今天这篇是《Diffusion Policy: Visuomotor Policy Learning via Action Diffusion》,arXiv 编号 2303.04137,哥伦比亚大学、丰田研究院和 MIT 合作的,Cheng Chi 和 Zhenjia Xu 是共同一作。我听说它几乎是现在机器人操作领域人人都要读的论文,后面很多视觉语言动作模型都拿它当基线。它到底解决了什么问题?
老播:一句话背景:机器人学操作,最常见的路子是行为克隆,也就是拿人类遥操作录下来的演示数据,训练一个「看到什么观测、输出什么动作」的策略。这条路子的难点在于,同一个状态下可能有多种合法动作,动作序列又强相关,而且精度要求很高。这篇论文的做法,是把策略定义成一个以观测为条件的去噪扩散过程:从一段纯噪声出发,迭代几十步,把噪声慢慢变成一整段干净的动作序列,一次输出 8 步动作,执行完再重新规划。一句话结论:它在 4 个 benchmark、15 个任务上,相对各 benchmark 此前的最优方法平均提升了 46.9% 的成功率,而且训练比上一代的隐式策略稳定得多。今天这期把三件事讲透:动作块(action chunk)这套条件生成范式怎么运作、训练和推理里动作空间和 DDPM/DDIM 采样的细节、以及观测条件化怎么做才能快到上真机。
小播:三个关键词,动作块、DDPM、DDIM,我都只听过名字。我们从哪开始?
老播:从行为克隆这个老问题开始。把背景铺开,你就知道为什么之前的做法都卡在同一个地方。
先补背景:行为克隆卡在多模态、时间相关和高精度上
小播:行为克隆我大概知道,就是拿演示数据做监督学习,输入观测、输出动作。问题出在哪?
老播:问题出在机器人动作和普通监督任务的差异上。第一个差异是多模态:同一个状态可以有多种合法动作。论文里的 Push-T 任务,一个圆形末端执行器要把 T 形块推进目标区,T 块挡在中间,你可以绕左边走,也可以绕右边走,两条路都能成功。演示数据里两种都有。如果策略学的是一个单峰回归,输出的是两条轨迹的平均,那条平均轨迹两边都不靠,直接失败。第二个差异是时间相关:动作在时间上强相关,逐帧独立预测会在两条合法轨迹之间来回横跳,产生抖动。第三个差异是高精度:抓取、推箱、倒液体这类任务要求很高的精度,回归到均值的行为在高精度任务上就废了。
小播:那之前的人怎么处理这三个问题?
老播:分成显式和隐式两派。显式策略直接把观测映射成动作,区别只在动作表示:单高斯回归只能表达单模态;LSTM-GMM 用高斯混合模型,要提前预设模态数,对超参数敏感,容易模态坍缩;BET 把连续动作离散成类别,再用聚类,但分箱数量随动作维度指数膨胀,动作是 14 维的时候这个表示就撑不住了。隐式策略走另一条路,代表是 IBC:用一个能量函数给每个动作打分,动作预测变成找能量最低的动作。能量函数理论上能表达任意多模态分布,但训练要负采样去近似一个不可解的归一化常数,负采样不准直接导致训练振荡。论文里 IBC 的能量损失在下降,训练动作预测误差却停在 0.003 附近下不去,评估成功率大幅振荡,作者要每 50 个 epoch 评估一次、挑最好的 checkpoint 才能用。
小播:所以显式派表达不了多模态,隐式派训练不稳。那扩散模型在这里面扮演什么角色?
老播:扩散模型在图像生成里已经证明了自己能生成高维输出、能表达任意可归一化的分布。这篇论文的切口很直接:把图像换成动作,把图像生成换成动作生成,同时解决三个问题——多模态让扩散去表达,时间相关性靠一次生成一整段动作来解决,训练稳定性来自扩散学的是 score 函数、绕开了归一化常数。下面进核心思想。
核心思想第一步:把策略写成以观测为条件的去噪过程
小播:好,那「以观测为条件的去噪过程」具体是什么?
老播:先交代两个术语。DDPM 是去噪扩散概率模型(Denoising Diffusion Probabilistic Models),一套 2020 年 Ho 等人提出的生成框架:训练时给数据逐步加噪声,推理时从纯噪声出发一步步把噪声去掉。策略就是套用这个框架:给定最近 To 步的观测块 Ot,策略要逼近条件分布 p(At | Ot),这里 At 是一段 Ta 步的动作块。推理时从一个高斯噪声样本 AK_t 出发,迭代 K 步去噪,每一步写成:
x_{k−1} = α(x_k − γ εθ(Ot, x_k, k) + N(0, σ²I))
这个式子要回答的问题:怎么把一段纯噪声逐步变成一段干净动作。逐项解释:x_k 是第 k 步的动作块,还带着噪声;εθ 是噪声预测网络,参数 θ,输入是观测 Ot、当前的噪声动作 x_k、去噪步数 k,输出预测的噪声;α、γ、σ 是随 k 变化的系数,合称噪声调度,论文用 iDDPM 的 square cosine 调度,可以理解成梯度下降里的学习率调度;N(0, σ²I) 是每步加进去的少量高斯噪声。整条式子等于一步带噪声的梯度下降:εθ 预测的是动作分布 score 函数的负值,减去它就是在朝概率密度上升最快的方向走。
小播:那训练的时候怎么教这个网络预测噪声?
老播:训练目标很简单,就是一个回归。给真实动作块 A0_t 加上噪声 ε_k,让网络把加进去的噪声还原出来:
L = MSE(ε_k, εθ(Ot, A0_t + ε_k, k))
每一步训练随机抽一个去噪步数 k,加对应方差的高斯噪声 ε_k,网络要预测出 ε_k,损失就是两者的均方误差。这个目标等价于最小化模型分布和数据分布的 KL 散度下界。这里有个关键点值得重复一遍:εθ 学的是 score 函数,也就是对数概率密度的梯度 ∇_a log p(a|o),而 score 函数和归一化常数无关。IBC 训练不稳,根子就在那个归一化常数要负采样近似;扩散策略完全绕开它,所以训练曲线平稳,这也是它能少调超参、开箱即用的原因。
小播:这个「一次输出一整段动作」的做法,就是 action chunk 吧?
老播:对,action chunk,动作块,这是全篇最核心的范式切换。之前的策略大多一次输出一个动作,论文把它改成一次输出一段。具体参数:输入最近 To=2 步观测,预测 Tp=16 步动作,但只执行 Ta=8 步,然后带着新观测重新规划;下一次推理还用上一次的预测序列做 warm start,让相邻决策窗口的动作衔接得更平滑。这套机制叫滚动时域控制(receding horizon control)。为什么这么设计?整块动作在同一个去噪样本里被联合决定,块内的时间一致性天然成立。对比逐帧独立采样的 BET:它在两条模态轨迹之间反复横跳,因为每一帧都可能换一个模态;动作块策略每条 rollout 只认一个模态。执行 8 步再重规划又保留了对意外观测的响应能力。消融实验显示 8 步是最优点:动作块太长,比如 128 步,响应慢;太短,比如 1 步,就退化成单步策略,失去全部优势。
核心思想第二步:观测只编码一次,去噪循环里不出现视觉前向
小播:那视觉信息怎么进去?图像也要参与每一步去噪吗?
老播:这恰恰是论文一个关键工程决定:观测条件化,把视觉从去噪循环里拿出来。论文建模条件分布 p(At | Ot),视觉编码器把图像块编码成特征 Ot,然后在 K 步去噪里全程复用,只编码一次。如果像之前的 Diffusion Planning 那样建模联合分布 p(At, Ot),去噪时要同时预测未来观测,每一步都要走视觉前向,速度根本跟不上闭环控制。视觉编码器用的是 ResNet-18,不做预训练、端到端训练,两个改动:用 spatial softmax pooling 代替全局平均池化,保留空间信息;用 GroupNorm 代替 BatchNorm,配合扩散模型常用的 EMA 能稳定训练。观测注入的方式分两种:CNN 版用 FiLM,把观测特征逐通道地调制进每个卷积层;Transformer 版把观测经共享 MLP 变成嵌入序列,进 decoder 的 cross-attention。多相机各自用独立编码器,逐帧编码后拼接。
小播:为什么 CNN 和 Transformer 要做两个版本?
老播:因为 CNN 版有个毛病:1D 时间卷积对低频信号有偏好,动作快速、锐利变化的时候会过平滑,速度控制这类动作空间尤其明显。论文因此提了 time-series diffusion transformer:minGPT 风格的 decoder,8 层、embedding 维度 256,噪声动作块作为 token 序列,扩散步数 k 的正弦 embedding 作为首 token,每个 block 都做观测的 cross-attention,causal attention mask 让每个动作 token 只看自己和之前的 token。注意力没有卷积的平滑归纳偏置,能表达高频动作变化。论文的建议是:新任务先试 CNN 版,开箱即用;任务复杂或者动作变化快,再换 Transformer 版,代价是超参更敏感、更难调。
小播:这两步合起来,训练和推理的完整流程是什么样的?
老播:完整流程是这样。训练:从数据集抽一个真实动作块,随机抽去噪步数 k,加噪,让网络预测噪声,回归误差,训练 100 个去噪步对应的噪声调度,模拟任务训 4500 epochs(图像版 3000)。推理:从高斯噪声出发,迭代 K 步去噪得到动作块,执行前 8 步,再取新观测重新规划。这里有一个关键加速:DDIM。DDIM 是去噪扩散隐式模型(Denoising Diffusion Implicit Models),Song 等人 2021 年提出,它的作用是把训练步数和推理步数解耦——训练用 100 步,推理可以只走 10 到 16 步。论文在 Nvidia 3080 上,100 步训练、10 步推理,单次动作推理延迟 0.1 秒,配合视觉只编码一次,策略能在真实机器人上以 10Hz 闭环输出,UR5 上再线性插值到 125Hz 执行。模拟任务推理保持 100 步,真实任务用 16 步。
小播:还有一个细节你没提,动作空间。我记得你说过位置控制和速度控制。
老播:对,这是论文里一个反常识的发现。大多数行为克隆方法用速度控制,论文默认用位置控制:直接预测末端执行器的期望位姿,旋转用 6D 连续表示,速度控制只出现在消融里。原因有两条:位置控制下动作多模态更明显,同一个目标位置可以有多种可达姿态,而扩散策略正好擅长表达多模态;位置命令的累积误差比速度命令小,更适合 8 步动作块预测。消融里 LSTM-GMM 和 BET 换成位置控制,成功率下降;Diffusion Policy 反过来,换到位置控制成功率上升。这个「位置控制 + 动作块」的组合,和「多模态表达」一起,是整篇论文反复出现的三条主线。
三组消融,把「8 步、2 帧、位置控制」逐个钉死
小播:你前面反复说 8 步动作块、位置控制,这些选择都是消融过的吗?
老播:都是,而且每组消融都讲一个权衡。第一组是动作块长度,从 1、2、4、8 一直试到 16、32、64、128。结果是一条 U 形曲线:块太短,比如 1 步,动作之间缺时间一致性,策略会在两条合法轨迹之间反复横跳、产生抖动;块太长,比如 64、128 步,策略对新的观测反应慢,追不上环境变化。8 步附近是两个方向的平衡点,在大多数任务上最优。这对应正文里那句:动作块大于 1 能预测一致动作、补偿演示里的停顿段,但太长会因反应慢而掉性能。
小播:观测块长度呢?之前说视觉偏好 2 步。
老播:第二组就是观测块长度,论文附录的图 14。纯状态输入对观测长度几乎不敏感;视觉输入偏好短但大于 1 的观测块,2 步是大多数任务的折中。理由是:观测超过 2 帧,相机视角和物体位置都变了,条件信息反而过时;只给 1 帧又缺了运动信息——两帧能给出位移,网络可以推断物体往哪个方向动。所以「To 等于 2」是消融出来的,不是拍脑袋。
小播:第三组是延迟?我记得论文对位置控制的稳健性专门做了实验。
老播:对,第三组是延迟稳健性,图 5 右。延迟定义为「观测最后一帧到首个可执行动作之间的步数」,从 0 拉到 7。位置控制版本的成功率几乎不随延迟下降;论文的解释是位置指令的误差容忍度高,动作块内部的平滑插值也吸收了一部分延迟。这个实验回答的是闭环控制里最现实的问题:传感器到执行器之间总有延迟,策略扛不扛得住。另外还有一组数据效率实验(图 15):演示数据从 40 段加到 200 段,Diffusion Policy 的成功率曲线全程在 LSTM-GMM 上方,说明多模态建模的优势在小数据上也成立,不用等数据堆够才见效。
小播:这些消融里有没有出乎意料的结论?
老播:有一个:动作空间选位置控制,方向是反直觉的。主流行为克隆用速度控制,因为速度指令平滑、好执行;但论文发现速度控制会抹平动作的多模态,位置控制保留多模态,扩散策略反而受益。配套的旋转表示也有讲究:速度控制空间用 3D 轴角表示,速度接近零时奇点不触发,这是 Mandlekar 等人的标准做法;位置控制空间用 6D 旋转表示,来自 Zhou 等人 2019 年的工作,把旋转矩阵的前两列拼成六维向量,连续、无歧义,神经网络好回归。这个「位置控制 + 6D 表示」是整套配方里容易被忽略、但真机上很关键的零件。
关键实验:15 个任务平均提升 46.9%,差距集中在复杂任务
小播:数字来了。46.9% 这个平均提升是怎么测出来的?
老播:评估横跨 4 个 benchmark 的 15 个任务:Robomimic 的 5 个任务(Lift、Can、Square、Transport、ToolHang,其中 4 个任务还带 multi-human 变体)、Push-T、Multimodal Block Pushing、Franka Kitchen,再加上 4 组真实世界任务和 3 个双机械臂任务。模拟任务状态版训 4500 epochs、图像版训 3000 epochs,成功率按两种口径报告:历史最佳 checkpoint,和最后 10 个 checkpoint 的平均,3 个随机种子乘 50 个环境初始条件。46.9% 就是 15 个任务相对各 benchmark 此前最优方法的平均提升。要注意任务间差异很大:Lift、Can 这种简单任务,所有方法都接近 1.0;差距集中在高维、长程、多模态任务上。
小播:挑几个最典型的数字说说。
老播:Robomimic 的 ToolHang,视觉输入版,Diffusion Policy 用 CNN 版到 0.95,LSTM-GMM 是 0.68,BET 0.58,IBC 直接 0.00;Transport 视觉版,Diffusion Policy 到 1.00,LSTM-GMM 0.88,IBC 0.00。Push-T 图像版,Diffusion Policy 0.91,此前最优的 IBC 0.75。长程多模态任务上差距更明显:Franka Kitchen 要求 566 段演示里每段完成任意顺序的 4 个任务,交互 ≥4 个物体的频率,Diffusion Policy 0.99,最好的基线 BET 0.44;Multimodal Block Pushing 推入 2 个方块的频率,0.94 对 BET 的 0.71,相对提升约 32%。
小播:多模态和时间一致性,有没有直接的图能看?
老播:论文的 Figure 3 就是为这个做的。Push-T 任务里同一状态,末端执行器可以向左或向右绕过去推 T 形块,图里 roll out 40 步看轨迹:Diffusion Policy 两种模态都学会了,而且每条 rollout 只认一个模态;LSTM-GMM 和 IBC 偏向单侧,只能走一边;BET 更糟,在两条轨迹之间反复横跳,因为它的动作缺乏时间一致性。这张图对应的是「能表达短程多模态 + 整块动作保证时间一致」这条论断。另外 Figure 4 是动作空间对比:从速度控制切到位置控制,LSTM-GMM 和 BET 成功率下降,Diffusion Policy 上升,支撑「位置控制 + 动作块」的组合拳结论。
小播:视觉编码器这块有消融吗?
老播:有,Robomimic Square 任务上,CLIP 预训练的 ViT-B/16 微调后到 0.98,ResNet-18 从零训 0.94;但冻结预训练特征很差,说明扩散策略要的是端到端训出来的视觉特征,这一点在真实世界实验里再次确认:端到端 95%、R3M 预训练 80%、ImageNet 预训练 15%。
复现这套东西,有哪些容易翻车的点
小播:真机效果这么好,复现的时候最容易在哪里翻车?
老播:论文附录里写了几个,都是血泪经验。第一是数据归一化:动作数据要按维度标准化到零均值单位方差;方差特别小、接近常数的维度,只平移不缩放,不然数值上会出问题;旋转表示的维度(比如四元数)保持原样不缩放。归一化做不好,一部分动作空间直接不可达,这是最常见的第一坑。第二是数据增强:训练用随机裁剪,每个任务的裁剪窗口大小不一样,推理时用同尺寸的静态中心裁剪。随机裁剪对视觉策略的效果很关键,它相当于免费的视角扰动。第三是 EMA 和 GroupNorm 的搭配:视觉编码器用 GroupNorm 代替 BatchNorm,配合 EMA 参数更新,训练才稳定;BatchNorm 在扩散这种小 batch、噪声输入的场景下会拖后腿。第四是超参的迁移性:CNN 版最优超参跨任务一致,加参数几乎总是变好;Transformer 版的最优 dropout 和权重衰减随任务漂移,加层数有时反而变差。所以论文建议新任务先跑 CNN 版,稳定、好调,再考虑 Transformer 版。
小播:这些细节对读论文的人有什么提醒?
老播:提醒一点:这篇的成功率数字高度依赖「位置控制 + 动作块 + 端到端视觉」三件套一起用,单独拆开一项复现,效果都会打折。另外报告口径要看清楚:历史最佳 checkpoint 和最后 10 个 checkpoint 平均是两套数字,论文两种都报,对比时别拿最佳对人家平均。
真实世界实验:95% 成功率接近人类,还扛住了三组扰动
小播:模拟结果这么好,上真机之后怎么样?
老播:真实世界四组任务。最有代表性的是两阶段 Push-T:先精确把 T 块推进目标区,再把末端执行器移到 end-zone 避免遮挡,成功率以人类演示的最小 IoU 为阈值。用 136 段人类演示训练,Diffusion Policy 端到端 CNN 版成功率 95%、平均 IoU 0.80,人类是 100% 和 0.84;LSTM-GMM 最佳变体只有 20%,IBC 两个变体都是 0%。失败模式集中在阶段切换:LSTM-GMM 在 20 次评估里 8 次卡在 T 块附近,IBC 6 次提前离开 T 块。视觉编码器对比也在这组实验里:端到端训练 95%,用 R3M 预训练特征 80%,用 ImageNet 预训练特征 15%,端到端完胜。
小播:抗扰动那组实验我印象很深,论文里说它生成了没见过的新行为。
老播:对,Figure 8 那组。三种扰动:手掌挡住前相机 3 秒,策略有些抖动但没跑偏;推块阶段把 T 块移位,策略立刻重规划从反方向推;收尾阶段正要去 end-zone 时把 T 块挪走,策略马上放弃去 end-zone、回头把 T 块推回目标、再继续去 end-zone——这个「回头修正」的行为在演示里从未出现过。这组实验支撑的结论是:扩散策略能对未见过的观测合成新行为。另外两组:6DoF 马克杯翻转,演示里同时存在抓取和推把手两种做法,20 次试验成功率 90%,LSTM-GMM 用同数据子集训练,20 次全部失败;倒酱汁 IoU 0.74(人类 0.79)、摊酱汁覆盖 0.77(人类 0.79),LSTM-GMM 两项都接近 0,倒酱汁任务要求勺子停住接酱汁、再精确浇到面饼中心,演示里的停顿段正是单步策略最容易卡死的地方。双机械臂三个任务(打蛋器、摊垫子、叠衬衫)成功率 55% 到 75%,用的是 210、162、284 段演示,无超参调整直接训练。
放在谱系里看:它和 IBC、Diffusion Planning 差在哪
小播:最后把这个方法放在谱系里。它和之前的 IBC 都是隐式建模,为什么一个稳一个不稳?
老播:两者的差别就在归一化常数上。IBC 用能量函数表达分布,训练时用 InfoNCE 损失加负采样去近似那个不可解的归一化常数,负采样不准,训练就振荡。Diffusion Policy 学 score 函数,score 和归一化常数无关,训练和推理都不需要算它,稳定性就是这么来的。和 Diffusion Planning(Janner 等人 2022)比:后者建模联合分布 p(At, Ot),去噪时连未来观测一起预测,适合做规划,但推理慢;本文建模条件分布 p(At | Ot),只生成动作,配合滚动时域和一次性视觉编码,直接闭环。和同期三篇扩散策略(Pearce、Reuss、Hansen-Estruch 的 2023 年工作)比:他们侧重采样策略、classifier-free guidance 和强化学习,且以模拟实验为主;本文的增量在动作空间选择、滚动时域预测、实时推理工程和大量真实世界实验。这篇论文在谱系里的位置,可以概括成一句话,也是这期要记住的核心结论之一:它把机器人策略从「one-step 动作回归」带到了「action-chunk 条件生成」,8 步动作块、观测条件化、DDPM/DDIM 取舍这套配方,成了后面 π0、VLA 和 one-step 动作生成方法对照的基准对象。
命名与定位:为什么叫 policy,不叫 planner
小播:命名上为什么叫 Diffusion Policy,不叫 Diffusion Planner?
老播:因为它做的是策略:给定观测直接出动作,中间没有显式的规划搜索、没有代价函数、没有 rollout 评估;动作序列的时间结构靠一次性生成保证。Diffusion Planning 那篇连未来观测一起生成、用于规划,属于 planner 一侧。这个区分在后续文献里被沿用,读到「action diffusion」一类工作时可以按这个标准分类。另外标题里的 Visuomotor 强调视觉输入直接到运动输出的端到端通路,不经过显式状态估计,这也解释了为什么视觉编码器必须端到端训练——中间任何冻结的特征都会切断这条通路。这条判断标准对后面读 VLA 论文同样适用:看它有没有引入显式规划循环,有,就是 planner 系;没有,就是 policy 系。本清单里 π0 和 worldvla 都在 policy 系。
从这篇到 π0 和 VLA:动作专家这条线怎么走
小播:这篇是后面 π0、VLA 的基准对象,具体是怎么被继承的?
老播:可以分三层看。第一层是公式层:π0 和很多 VLA 的动作专家直接沿用了「条件去噪生成动作块」这个框架,只是把观测条件从单模态图像换成视觉语言大模型输出的 embedding。第二层是执行层:「位置控制 + 动作块 + 滚动执行」这套真机配方原样保留,改的是生成器本身——π0 用 flow matching 替代 DDPM,用专家混合网络处理不同机器人本体。第三层是优化方向:后期工作把 16 步 DDIM 压到 1 步,靠的正是这篇定义的「多步到少步」的减步数问题——先证明多步生成能干活,再去减步数。所以读这篇时记住:它给的是一套坐标系——「动作块生成」的零点,后面所有工作都在这个坐标系里做加减法,最终成品模型由后续工作补上。
局限:论文自己承认的,和我们读出来的
小播:说点不替论文背书的话。它有哪些局限?
老播:论文自承四条。第一,继承行为克隆的局限:演示数据不足或质量差时性能次优,作者建议后续用强化学习范式利用次优数据和负数据。第二,计算成本:相比 LSTM-GMM 这种单次前向的方法,扩散推理延迟更高,100 步到 10 步的 DDIM 缓解了问题,但高频控制任务可能仍不够。第三,架构取舍:Transformer 版对超参敏感、更难训练,CNN 版对速度控制这类高频变化动作表现差。第四,真实实验规模小:每任务约 20 次试验,成功率区间比较宽。
小播:你们自己读下来,还有什么补充?
老播:三条。46.9% 是 15 个任务相对各自最优基线的平均,任务间方差很大,简单任务上所有方法都接近 1.0,跨物体、跨场景、跨本体的泛化没有被系统性压力测试,真实任务也都是单任务单策略。马克杯翻转的 LSTM-GMM 基线只用演示数据子集训练,对比口径略偏宽松。双机械臂任务成功率 55% 到 75%,明显低于单臂任务,论文没做数据量消融,任务难度和演示数量之间的关系没有量化。还有一点,整篇论文的动作块都绑定在行为克隆配方里,扩散策略怎么和数据规模一起扩展,这篇没有回答。
小播:数字解读上还有什么要小心的?
老播:两条。46.9% 是相对各任务最优基线的平均相对提升,不是绝对成功率;15 个任务里有的基线本来就很弱,平均相对提升会被弱基线拉高,真实世界任务的成功率绝对值(55% 到 95%)更能反映水平。另外,模拟任务的评估用成功率这类汇总指标,论文只对真实世界那组做了失败模式分析;模拟任务失败到底来自轨迹抖动还是环境交互错误,没有系统拆解,这些信息对迁移到新任务很有用,论文没展开。
收尾:记住这三件事
小播:好,最后我来总结这期要记住的三件事。第一,策略表示本身就是行为克隆的性能瓶颈:同一个数据、同一个训练管线,只把策略从显式回归或隐式 EBM 换成动作扩散,15 个任务平均提升 46.9%,差距集中在高维、长程、多模态任务。第二,action chunk 加滚动时域是整套范式的核心:一次输出 8 步动作块保证时间一致性,执行完再重新规划保证响应性,warm start 保证衔接平滑,位置控制加 6D 旋转表示是配套的动作空间选择。第三,实时闭环靠三个工程决定撑起来:观测只编码一次、DDIM 把推理从 100 步降到 10 到 16 步、视觉特征端到端训练。
老播:我再补一句这篇对后续工作的意义。它把「机器人策略 = 条件去噪生成」这套公式立成了行业标准写法,后面所有 VLA 的动作专家、one-step 生成方法,都在这张表上做减法:怎么把 16 步 DDIM 减到 1 步,怎么把 ResNet-18 换成更大的视觉主干,怎么把 8 步动作块变得更长更灵活。读这篇论文,你手里拿的不只是一篇 RSS 2023 的扩展版论文,而是整个机器人扩散策略谱系的起点。