Back to Basics:让去噪生成模型真正去噪(JiT)
- 论文:Back to Basics: Let Denoising Generative Models Denoise
这篇要解决什么问题
扩散模型历史上经历过两次预测目标迁移。最早的 DDPM 把预测目标定成噪声 ε(epsilon-prediction),生成质量因此大幅提升;后来 flow 系方法把目标换成速度 v(velocity-prediction),v 是干净数据与噪声的组合量。社区随后证明,在损失函数上做相应的重加权,ε、v、x 三种预测彼此等价,于是默认网络有能力完成任意一种预测任务,注意力都放在噪声调度和损失权重上。
这篇论文的起点是流形假设:自然图像位于高维像素空间里一个低维流形上。干净图像 x 可以认为落在流形上;噪声 ε 铺满整个高维空间;速度 v=x−ε 同时包含数据和噪声,同样散布在整个空间里。既然预测对象不同,网络的任务难度就不同:预测 ε 或 v 需要把高维噪声的每一个分量都保留下来,网络容量要跟观测维度匹配;预测 x 只需要滤掉噪声、保留低维结构,容量比维度小得多也能完成。
这个区别在低维 latent 空间被隐藏了。latent diffusion 先用 tokenizer 把图像压进几十维的 latent,再在上面扩散,此时预测 ε 的难度被大幅缓解;但作者认为这相当于把问题藏起来,像素等真正高维的空间里问题仍然存在。现有像素空间方法(SiD2、PixelFlow、PixNerd 等)要么用层次化小 patch、要么加 NeRF head 和表示对齐,而且普遍从 L/XL 规模起步;另一条线(RAE、DDT、LightningDiT)靠自监督预训练救高维扩散。这些方案的共同点是把困难归给结构或额外训练,这篇论文的切口是直接换预测目标。
核心论证:预测空间与损失空间可以分开选
先给结论:论文把「网络输出哪个量」和「损失在哪个空间算」拆成两个独立选择,共 9 种组合;其中只有让网络直接输出干净图像(x-prediction)的组合在极高维像素 patch 下全部可用。下面用公式展开。
论文采用线性插值加噪:z_t = t·x + (1−t)·ε。这里 z_t 是 t 时刻的加噪样本,x 是干净图像,ε 是标准高斯噪声,t 在 [0,1] 之间;t=1 时 z_t 就是干净数据,t=0 时是纯噪声。对应的流速度是 z_t 对 t 的导数:v = x − ε,即「干净图像减噪声」。
给定加噪样本 z_t 之后,x、ε、v 三个量里只有一个是独立的:z_t = t·x + (1−t)·ε 和 v = x − ε 这两个约束,加上网络预测出的任何一个量,就能把另外两个解出来。论文用 Table 1 列出全部 3×3 组合,例如网络输出 x̂ 时,ε̂=(z_t−t·x̂)/(1−t),v̂=(x̂−z_t)/(1−t)。这些转换在数学上都是现成的,早前工作(EDM、v-prediction 的推导)都可以看成 Table 1 的特例。
最终算法选择 x-prediction 配 v-loss:网络直接输出 x̂,速度由 v̂=(x̂−z_t)/(1−t) 得到,损失是 E‖v̂−v‖²。计算 1/(1−t) 时把分母 clip 到 0.05,防止除零。换个角度看,这个损失等价于对 x-loss 乘以权重 1/(1−t)²,在 t 接近 0(噪声大)的样本上放更大的权重。这个等价关系说明「换预测目标只换损失权重」的旧结论在低维空间成立,但在高维像素空间里,决定性因素是预测目标本身是否在流形上。
为什么有效,可以回到容量视角:网络把 z_t 变成 x̂,理想输出 x 的内在维度很低,欠容量网络过滤掉噪声就能逼近;而 ε̂ 或 v̂ 的理想输出铺满高维空间,网络必须把噪声的每个分量都编码出来,隐藏单元不足就失败。这个论证后面会在 toy 实验和 ImageNet 上分别验证。
JiT:普通 ViT + 大 patch + 无 tokenizer
设计上,JiT 就是「把 DiT 直接套在像素 patch 上」:输入加噪图像 z_t 切成不重叠的 p×p 像素块,每个块是 p×p×3 维的 token,线性嵌入加位置编码后过标准 Transformer block,输出层线性投影回 patch,直接给出 x̂。256 分辨率用 patch 16(每 token 768 维),512 用 patch 32(3072 维),1024 用 patch 64(12288 维),三种分辨率下序列长度都恒为 256。
「无 tokenizer」的含义有三层。第一层,输入侧不再需要任何学习过的压缩器:latent diffusion 的 VAE tokenizer 必须额外训练、还依赖对抗和感知损失,JiT 把这一步整个去掉,模型自包含。第二层,token 维度可以远高于网络隐藏维度:patch 3072 维时,768 维隐藏的 B 模型照样工作,输入维度与网络容量解耦。第三层,可迁移性:很多领域(蛋白质、分子、天气)很难设计 tokenizer,无 tokenizer 的「扩散+Transformer」范式更容易推广过去,这正是论文提出的长期目标。
普通结构还有一个附带收益:当结构与任务解耦,就能直接继承语言模型领域的通用改进。论文实验了 SwiGLU、RMSNorm、RoPE、qk-norm,以及把类别信息以 32 个 in-context class token 的形式送入 Transformer,这些改动把 JiT-B/16 的 FID 从 7.48 逐步压到 4.37(带 CFG interval)。结构与任务的解耦让扩散模型能直接继承 NLP 的架构进步。
真正出人意料的发现在网络侧的瓶颈上。论文把 patch 嵌入换成两个线性层:先降到 d′ 维、再升回隐藏维度,整体是一个低秩参数化。结果压到 d′=64 时 FID 从 8.62(无瓶颈的原始 768 维嵌入)降到 7.35,压到 16 也只有 9.40,仍然可用。网络侧的瓶颈强制模型只保留流形上的有效信息,这与输入侧 tokenizer 压缩形成对照:输入侧压缩是在掩盖问题,网络侧压缩是在利用流形的低维结构。bottleneck 有益这一点,也呼应了流形学习里「压窄通道只让有用信息通过」的经典做法。
实验证据
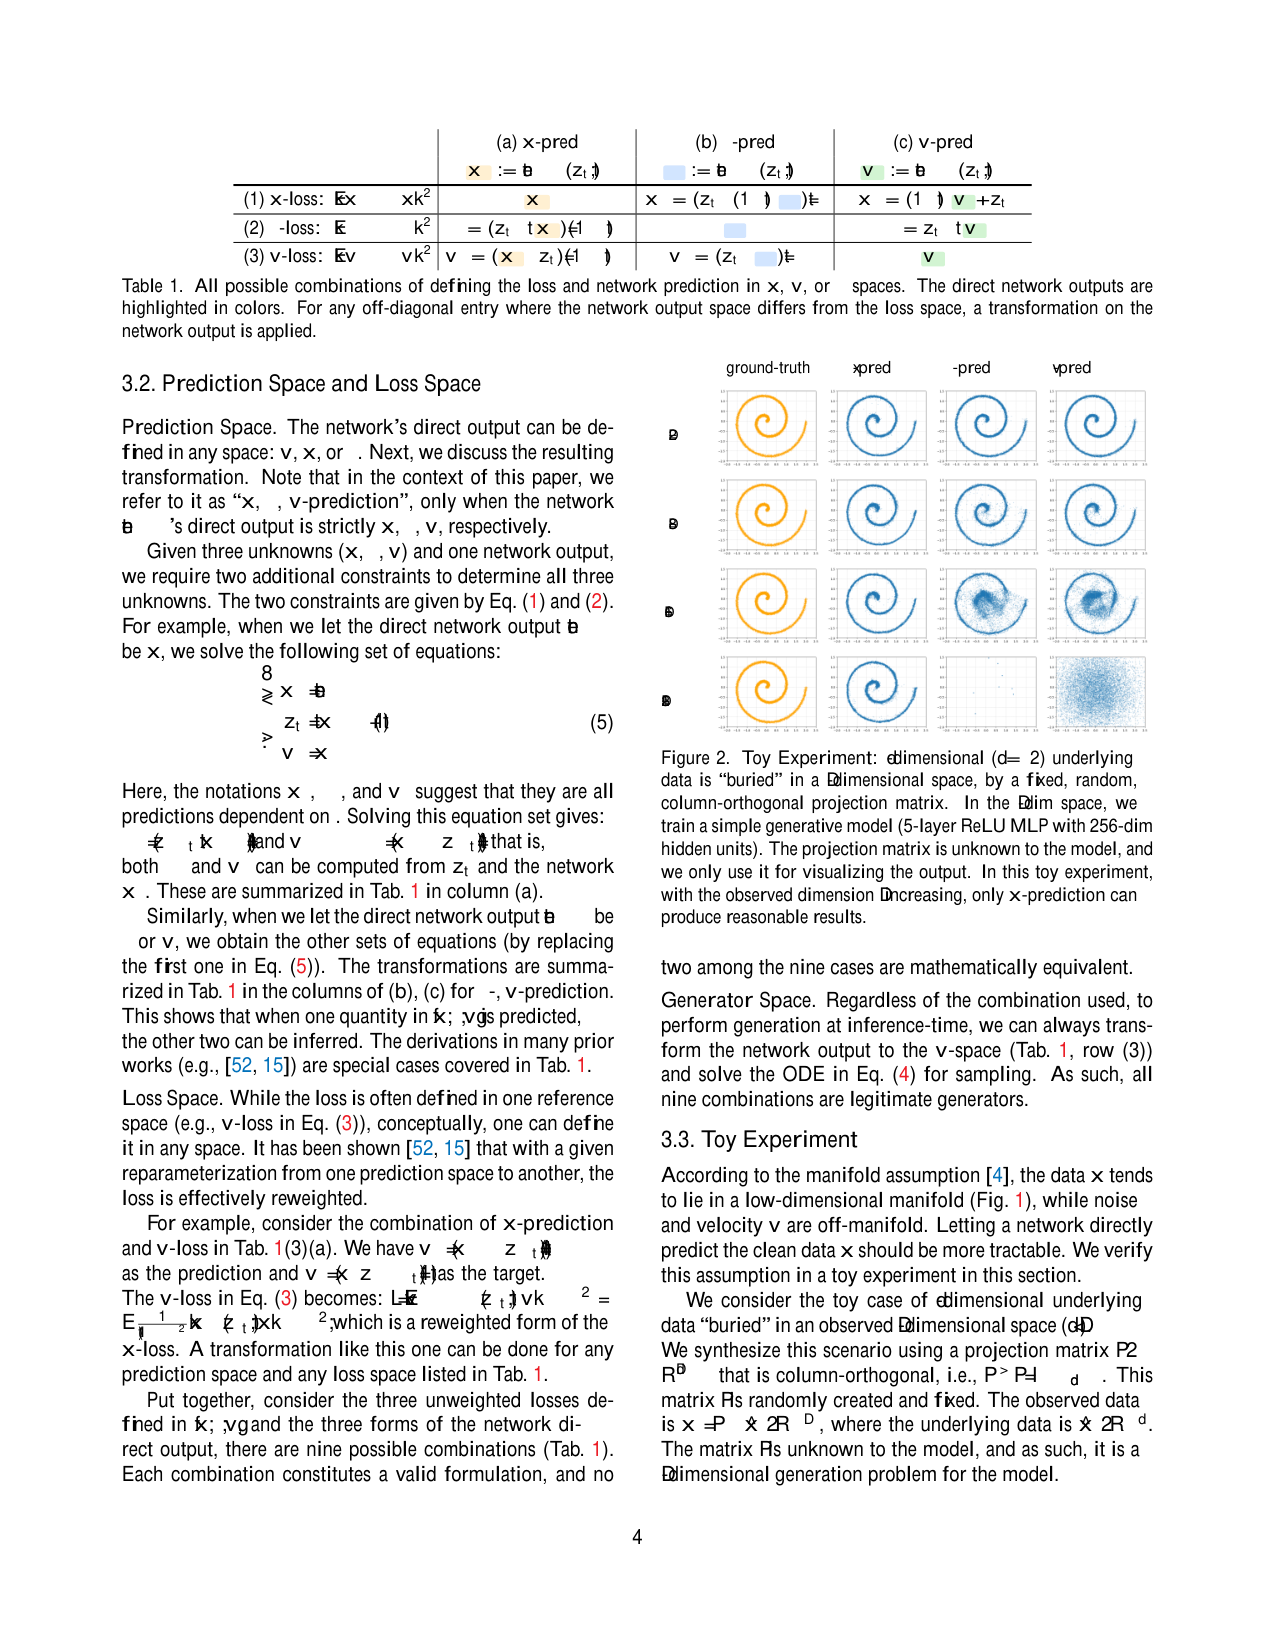
第一个关键实验是 toy 实验(Figure 2):把 d=2 维的螺旋数据用固定随机列正交投影矩阵 P 埋进 D 维空间,用 5 层、256 宽度的 ReLU MLP 学生成模型,分别试 x/ε/v 三种预测(都用 v-loss)。D=512 时 256 宽 MLP 明显欠容量:ε 和 v 预测出来的点云散成一团,只有 x-prediction 还原出螺旋结构。这个最小实验直接支持「预测流形上的 x 对容量要求低」的论断。
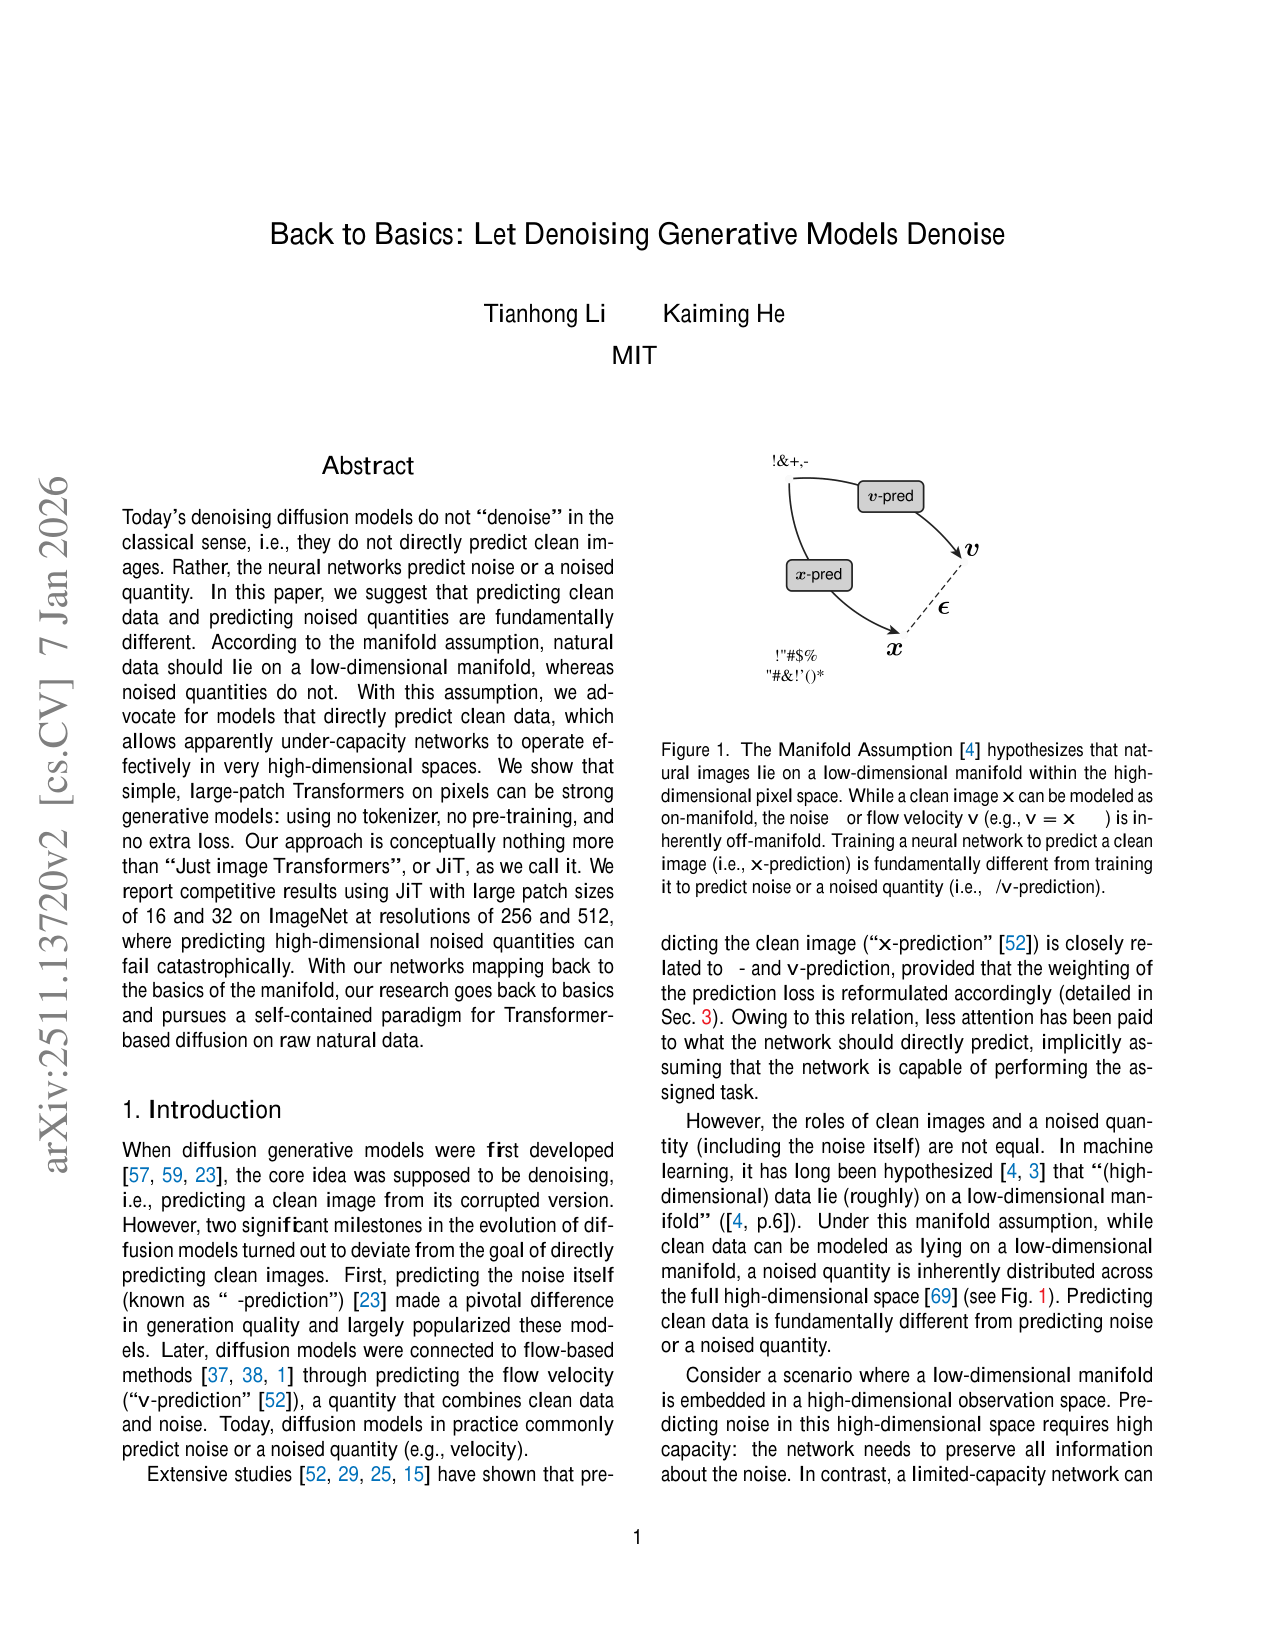
Figure 1 是流形假设的示意图:高维像素空间里,自然图像集中在低维流形上,x 落在曲面上,ε 和 v=x−ε 散布在整个空间。这张图是整个论证的起点,后面所有实验都在检验它的推论。
第二个关键实验是预测空间×损失空间的全组合(Table 2)。JiT-B/16 在 ImageNet 256 上跑 200 epoch:x-prediction 配三种损失得到 FID 8.62–10.45,而 ε-prediction 全线 372–395、v-prediction 96–127,属于灾难性失败。对照实验把 patch 换成 4×4(48 维 token、64×64 分辨率),九种组合的 FID 都在 3.46–6.20 之间,差距很小。两组数据并排看,结论很清楚:token 维度一高,预测目标的选择就决定成败。
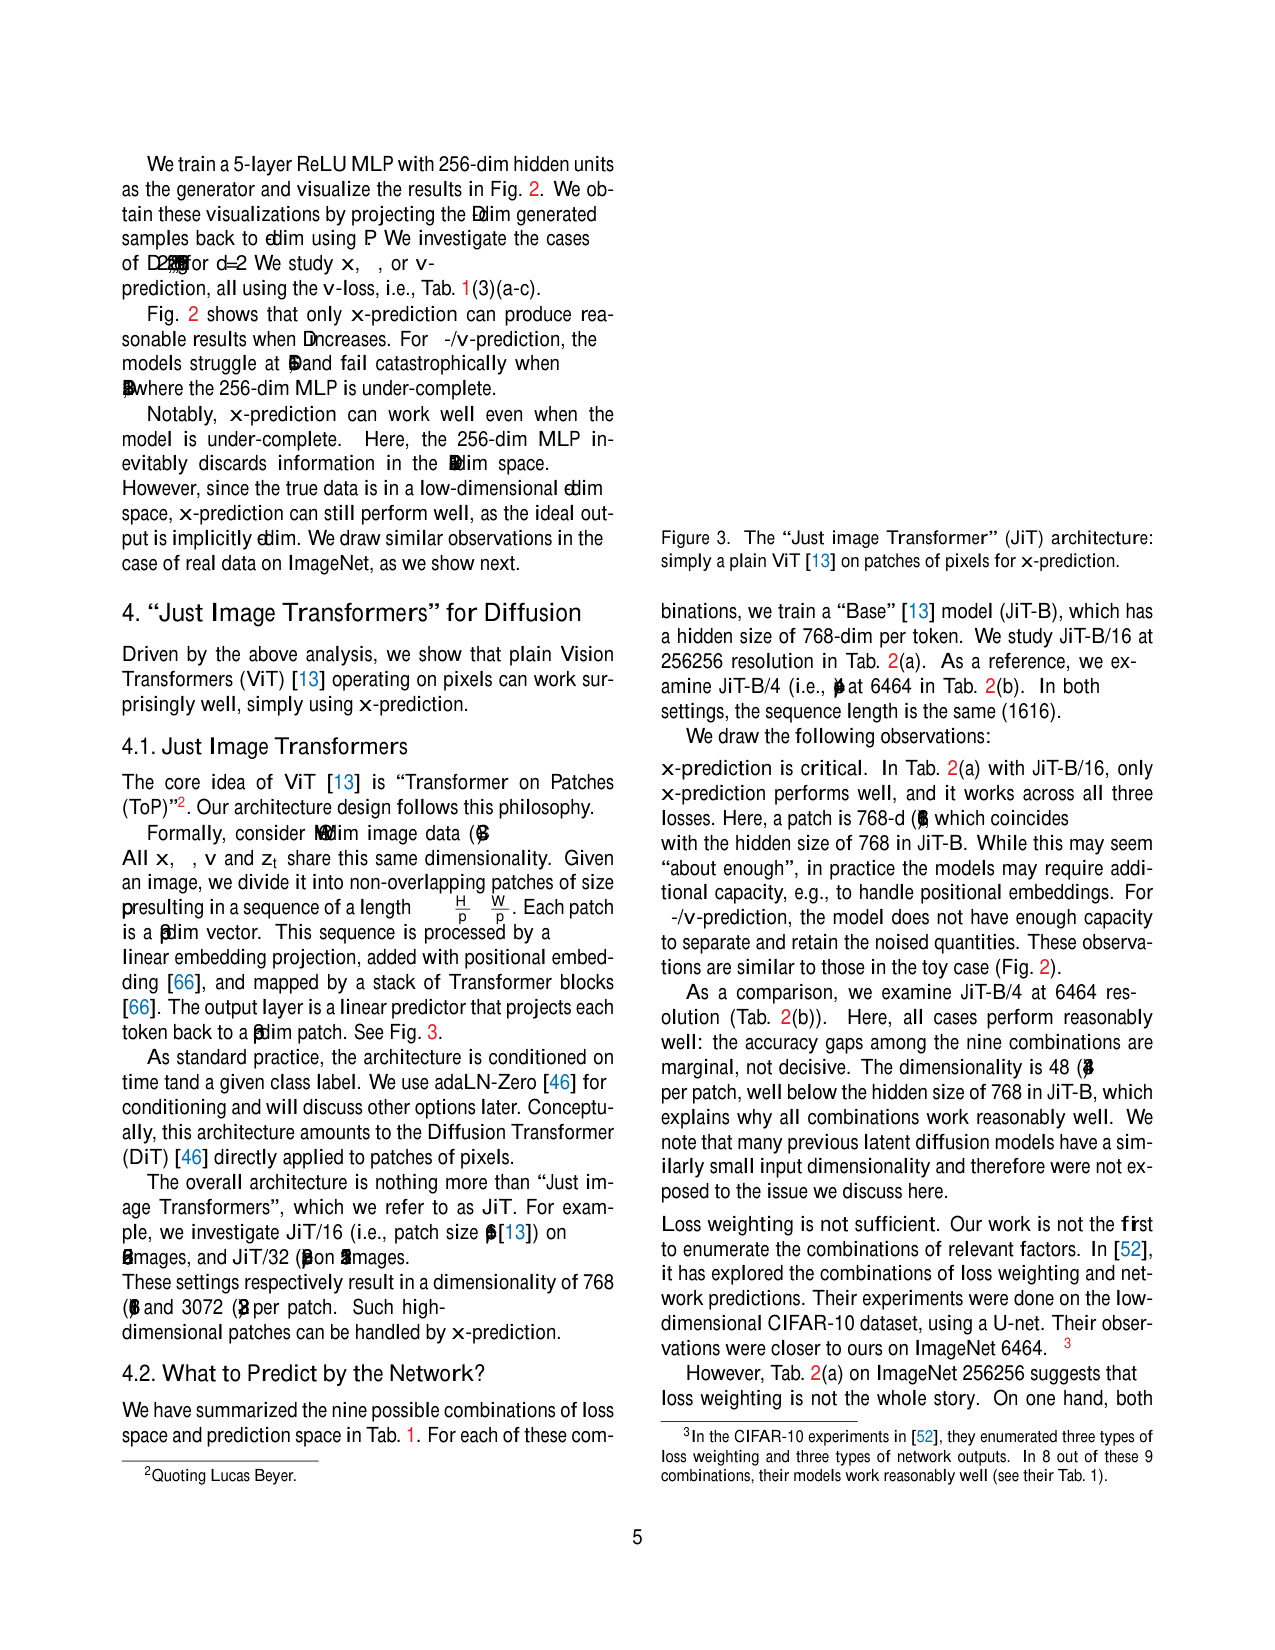
Figure 3 展示 JiT 架构本身:加噪像素 patch 进标准 Transformer,输出直接是干净图像预测。这张图说明「结构最小化」的主张——把难题留给预测目标,而不是靠结构复杂度解决。
噪声水平移位(Table 3)验证了另一个反例:把 logit-normal 采样的均值从 −0.0 移到 −1.2,相当于整体加大噪声,x-prediction 的 FID 从 14.44 先降到 8.62 再回升到 8.99,但 ε-/v-prediction 始终在 96–464 区间,调噪声水平救不回来。损失加权(Table 1 推导)同样救不了,附录里 EDM 式预条件化在 v-loss 下给出 35.49 的 FID,比纯 x-prediction 的 8.62 差一截,因为预条件化的网络输出混入了 z_t,偏离了纯 x-prediction。
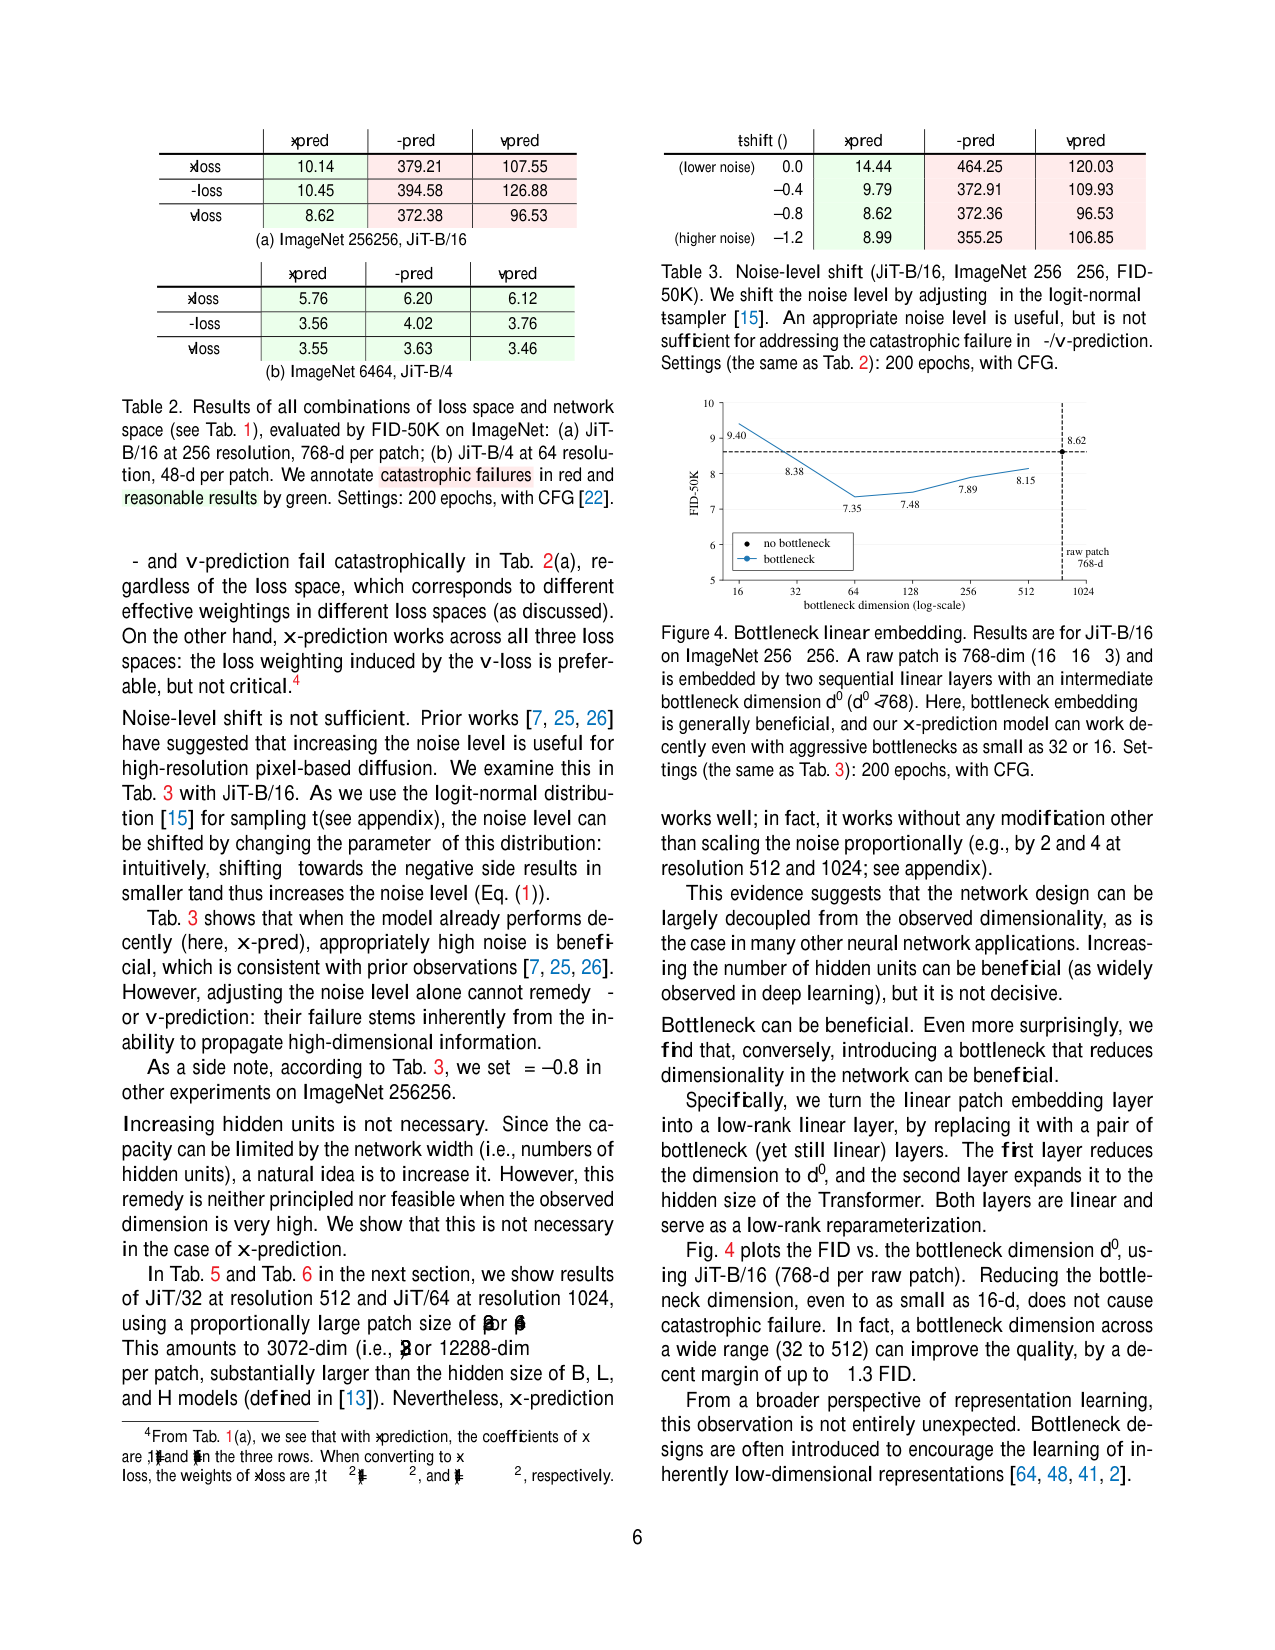
Figure 4 是 bottleneck 消融:横轴是瓶颈维度(16–1024,log 刻度),纵轴 FID-50K。曲线在 d′=64 处取到 7.35,低于无瓶颈的 8.62,压到 16 也才回到 9.40。bottleneck 有益这件事,是流形论证在网络结构上的直接推论。
规模实验(Table 4–6)把模型推到 2B:JiT-G/16 在 ImageNet 256 拿到 1.82 FID,JiT-G/32 在 512 拿到 1.78,JiT-B/64 在 1024 拿到 4.82(只有 133M 参数、30 Gflops,与 256 版本算力几乎相同)。与既有方法对比(Table 7/8):512 分辨率下,ADM-G 用 554M 参数、1983 Gflops 拿到 7.72,JiT-G/32 用 2B 参数、384 Gflops 拿到 1.78;latent 系最强的 RAE(带自监督预训练)是 1.13,JiT 的 1.82 没有超过它,但 JiT 完全没有预训练和 tokenizer。附录 Fig. 7 还给出训练损失曲线:同一 v-loss 下,v-prediction 的损失比 x-prediction 高约 25%,ε-prediction 约高 3 倍且不稳定——高维输出的失败在训练早期就注定了。
谱系定位
与 MeanFlow 的互补关系值得单独说。MeanFlow 提出用平均速度做 one-step 生成,平均速度与条件均值 E[x|z_t] 对应,并推导了平均速度与瞬时速度之间的恒等式;JiT 做的是 50 步多步流采样,走 x-prediction。两者有一条共同的表示哲学:网络输出应指向「数据均值/干净数据」这类落在流形上的量,而不是噪声或瞬时速度。区别在于用途:MeanFlow 用这个哲学实现一步生成,JiT 用同一个哲学让高维像素扩散在普通 ViT 上变得可行。所以 JiT 论文虽然把 one-step 谱系当作背景,它自己的贡献在多步流框架里。
与预训练派(RAE、DDT、LightningDiT、REPA)对照:这些方法用自监督预训练或表示对齐缓解高维扩散退化,JiT 证明纯 Transformer 加 x-prediction 无需任何预训练就能工作,代价是同 2B 量级下 FID 略逊。与像素空间方法(SiD2、PixelFlow、PixNerd)对照:它们用层次化小 patch、NeRF head、表示对齐,从 L/XL 起步;JiT 用标准 ViT、B 起步、无特殊组件。与经典流形学习/DAE 对照:DAE 本来就靠预测干净数据学表示,score matching 把目标换成了噪声;JiT 把「预测干净数据」搬回生成模型,并在极高维观测下论证了它的必要性。
局限
论文自己承认的局限包括:FID 尚未超过最强 latent 方法,同 2B 量级下 RAE 的 1.13 低于 JiT-G/16 的 1.82,precision/recall 里 recall 偏低(0.62 vs 0.67);大模型过拟合明显,G 需要 dropout 加约 320 epoch 的早停,600 epoch 的收益有相当一部分来自正则化。我们另外读出的问题有:流形假设本身没有被直接验证,toy 实验是合成投影,ImageNet 上只有「x-pred 在欠容量网络下成功」的相关性证据,论文没有测量真实数据的流形维度,也没有验证预测值确实落在流形上;结果依赖推理期超参搜索(CFG scale 1.0–4.0 步长 0.1、三个 EMA decay 候选,先 8K 样本选优再评估 50K),固定超参可能得到误导性结论;实验面只有类条件 ImageNet,文本到图像、视频、蛋白质等方向都没有验证;采样是 50 步 Heun,没有蒸馏也没有 one-step;高分辨率还需要手动按分辨率放大噪声幅度(512 用 2×、1024 用 4×)来维持信噪比。
结论
把核心结论再说一遍:在极高维像素空间里,扩散/流模型的网络应当直接预测干净图像 x,因为 x 落在低维数据流形上,而 ε 和 v 铺满高维空间;预测目标决定了网络容量需求,也决定了普通大 patch ViT 能否在无 tokenizer、无预训练、无附加损失的条件下工作。bottleneck 在网络侧有益、在输入侧非必需,是这个流形论证的直接推论。它与 MeanFlow 的关系是互补的:两者都主张网络输出指向数据均值型量,一个用于 one-step、一个用于高维像素多步扩散。JiT 的完整配置在论文 Table 9 中给出,实现基于 DiT 与 SiT 的公开代码库,具备较好的复现条件。
这篇论文主张:扩散与流模型的网络应当直接预测干净图像 x——它落在低维数据流形上;预测噪声 ε 或速度 v 会让欠容量网络在极高维像素 patch 上灾难性失败。基于这一观点,只用没有 tokenizer、没有预训练、没有附加损失的普通大 patch ViT,就能在原始像素上做出有竞争力的生成,并与 MeanFlow 在「网络输出应指向数据均值型量」的表示哲学上互补。
阅读提示
精读深度:精读
清单提示:原文提示:抓住流形论证——预测「在流形上」的 x0 vs 「不在流形上」的 ε/v;大 patch + 无 tokenizer 意味着什么;bottleneck 为什么有益。它不是 one-step,但给出了与 MeanFlow 互补的表示哲学。
问题
要解决什么:现代扩散/流模型的网络预测目标(噪声 ε 或速度 v)铺满整个高维像素空间、远离数据流形;当 patch 维度(768 甚至 3072/12288)接近或超过网络隐藏维度时,预测这些量需要网络保留全部高维信息,容量不足就灾难性失败。本文要解决的是:把网络输出换回流形上的干净图像 x,让普通 ViT + 大 patch 在原始像素上直接可用。
为什么 prior work 不够:DDPM 起 ε-prediction 成为主流,flow 系方法用 v-prediction;文献普遍认为三者经重参数化彼此等价、只差损失权重([52]、EDM [29]),默认网络有能力完成任意预测任务。这个默认在 latent 低维空间勉强成立,但一到像素空间就不成立:现有补救措施(层次化小 patch 的 SiD2/PixelFlow、NeRF head 的 PixNerd、自监督预训练的 RAE/DDT/LightningDiT)都从 L/XL 规模起步或引入外部组件,绕开了预测目标本身的问题。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| noisy image z_t | pixel (H×W×3) | 训练时 z_t = t·x + (1−t)·ε,线性插值噪声;采样时从纯噪声出发 |
| timestep t | scalar [0,1] | 训练用 logit-normal 分布采样(μ=−0.8, σ=0.8),默认 50 步 Heun 求解 ODE |
| class label c | 1000 类 | adaLN-Zero 条件 + 32 个 in-context class tokens(可选),推理时 CFG |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| clean image estimate x̂ | pixel (H×W×3) | 网络直接输出干净图像(x-prediction);v̂=(x̂−z_t)/(1−t) 用于 v-loss 与 ODE 积分 |
| generated image | pixel (H×W×3) | 由 50 步 Heun 求解 dz_t/dt = v̂(z_t,t) 从 z_0~N(0,σ²I) 积分到 t=1 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| ImageNet-1K (256×256) | 128 万张 / 1000 类 | FID-50K 与 IS 评估;JiT/16 用 patch=16 |
| ImageNet-1K (512×512) | 同上 | JiT/32,patch=32(3072-d/token),噪声幅度放大 2× |
| ImageNet-1K (1024×1024) | 同上 | JiT/64,patch=64(12288-d/token),噪声幅度放大 4× |
架构(摘要)
主干与结构
backbone:普通 ViT-B/L/H/G(无 tokenizer、无预训练、无附加损失)
参数:131M / 459M / 953M / 2B(B/L/H/G)
类型:plain ViT on raw pixel patches + x-prediction(flow matching 框架)
关键组件
- 非重叠像素 patch(16×16×3=768-d 或 32×32×3=3072-d 或 64×64×3=12288-d),序列长度恒为 256
- 线性 patch 嵌入:可选 bottleneck 版(两层线性,中间 d'=128 对 B/L、256 对 H/G)
- adaLN-Zero 时间/类别条件;可选 32 个 in-context class tokens(从第 4/8/10 层开始插入)
- 通用 Transformer 改进:SwiGLU、RMSNorm、RoPE、qk-norm
- 输出层线性投影回 p×p×3 patch;x-prediction 直接输出干净图像
- 训练:x-pred + v-loss,v̂=(x̂−z_t)/(1−t),分母 clip 0.05;EMA + CFG
为什么这样设计
既然预测目标换到流形上的 x,输入侧不再需要 latent tokenizer 压缩维度,网络侧也不需要把隐藏维度加宽到匹配 patch 维度;普通 ViT 的结构与任务解耦,可以直接继承 NLP 领域的通用改进,并保持不同分辨率下序列长度一致(256),实现跨分辨率同算力。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | B: 12 层/768 维/12 head;L: 24 层/1024 维;H: 32 层/1280 维;G: 40 层/1664 维 |
| 分辨率 | 256×256 / 512×512 / 1024×1024 |
| patch_dim | 768-d(16×16×3)/ 3072-d(32×32×3)/ 12288-d(64×64×3) |
| sequence_length | 恒 256(16×16 patches,所有分辨率) |
| bottleneck | patch embedding 低秩化:B/L 用 d'=128,H/G 用 d'=256 |
| 训练 | 200 epoch(消融)/ 600 epoch(最终);batch 1024;lr 2e-4 常数;EMA decay ∈ {0.9996, 0.9998, 0.9999};dropout 0.2(H/G 中间一半 block);G 早停约 320 epoch |
| sampling | 50 步 Heun ODE 求解;CFG scale 推理时 1.0–4.0 步长 0.1 搜索;可选 CFG interval [0.1, 1] |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ImageNet 256 FID-50K(JiT-B/16, 200ep, CFG) | x-pred 8.62(v-loss) | 同设置 ε-pred 372.36、v-pred 96.53(灾难性失败) | JiT-B/16,768-d patch,200 epoch,CFG |
| ImageNet 256 FID-50K(600ep) | JiT-G/16 1.82 | 像素空间最强 ADM-G 4.59(554M/1120 Gflops);latent+预训练 SOTA RAE 1.13 | JiT-G/16(2B, 383 Gflops),600 epoch,CFG interval,FID-50K |
| ImageNet 512 FID-50K | JiT-G/32 1.78 | ADM-G 7.72(559M/1983 Gflops)、DiT-XL/2 3.04(675+49M latent) | JiT-G/32(2B, 384 Gflops,3072-d patch),600 epoch,CFG |
| ImageNet 1024 FID-50K | JiT-B/64 4.82 | 无像素 baseline 参考;B 规模下与 256 版本算力相当(30 Gflops) | JiT-B/64(133M, 12288-d patch),200 epoch,CFG |
| Bottleneck 消融 FID-50K | d′=64 时 7.35 | 无 bottleneck(原始 768-d 嵌入)8.62 | JiT-B/16,ImageNet 256,200 epoch,CFG |
| Toy 实验(D=512, d=2) | 仅 x-prediction 还原出二维螺旋 | ε-/v-prediction 在 D=16 已退化、D=512 完全失效 | 5 层 ReLU MLP(256 宽),固定随机列正交投影 P∈R^{512×2},v-loss |
| 训练损失对比(附录 Fig.7, 同一 v-loss) | v-pred 损失比 x-pred 高约 25% | ϵ-pred 约 3× 更高且不稳定 | JiT-B/16,ImageNet 256,200 epoch |
Insights
- 网络容量要匹配的是预测目标的维度:预测 ε/v 需要保留高维噪声的全部分量,预测 x 只需低维流形信息,因此欠容量网络也能工作(Fig. 2 + Tab. 2a)。
- 输入侧与网络侧可以解耦:patch 维度 3072 甚至 12288 时,768 维 hidden 的 B 模型仍然可用,关键在把预测目标换到流形上的 x(Tab. 5)。
- Bottleneck 有益:patch 嵌入低秩化到 d′=64 时 FID 7.35 优于无瓶颈 8.62,呼应流形学习『压窄通道只保留有用信息』的传统(Fig. 4)。
- 高维像素扩散可以不需要预训练:RAE/DDT/LightningDiT 依赖自监督预训练,JiT 用 2B 的 G 模型在 256 分辨率拿到 1.82 FID,全程无预训练、无 tokenizer、无附加损失(Tab. 7)。
- 损失加权只能调权重、改变不了目标维度:噪声水平移位(Tab. 3)与 EDM 式预条件化(Tab. 10)都救不了 ε/v-prediction,失败来自预测目标本身不在流形上。
vs 同类工作
- vs MeanFlow:MeanFlow 用平均速度(与条件均值 E[x|z_t] 对应)实现 one-step 生成并推导平均/瞬时速度恒等式;JiT 用 x-prediction 做 50 步多步流采样。两者都把网络输出指向『数据均值/干净数据』这类流形上的量,一个服务一步生成、一个解决高维像素扩散,表示哲学互补(JiT 论文明确以 one-step 谱系为背景)。
- vs 预训练派(RAE/DDT/LightningDiT/REPA):这些方法靠自监督预训练或额外损失缓解高维扩散退化;JiT 证明纯 Transformer + x-prediction 无需任何预训练即可工作,同 2B 量级下 FID 略逊(1.82 vs 1.13/1.26/1.35 @256)。
- vs 像素空间方法(SiD2/PixelFlow/PixNerd):它们用层次化小 patch、NeRF head、表示对齐,且从 L/XL 起步;JiT 用标准 ViT、B 起步、无特殊组件,靠预测目标而不是结构复杂度解决问题。
- vs 经典流形学习/DAE:DAE 本就用去噪预测干净数据做表示学习;score matching 把目标换成噪声(ε-prediction)。JiT 把『预测干净数据』搬回生成模型,指出在极高维观测下这才是关键。
- vs 并发工作 [18]:x-prediction 也被用于条件世界模型,方向一致,JiT 侧重无条件/类条件图像生成与高维 patch 场景。
局限
- 论文自承:FID 未超过最强 latent 方法——同 2B 量级下 RAE 1.13 vs JiT-G/16 1.82(256 分辨率),precision/recall 中 recall 偏低(JiT-G 0.62 vs RAE 0.67),保真度与多样性仍有差距(Tab. 7/13)。
- 论文自承:大模型过拟合明显,G 需要 dropout(0.2)加早停(约 320 epoch),600 epoch 的收益部分来自正则化而非纯 scaling(附录 A)。
- 流形假设本身未被直接验证:toy 实验用随机列正交投影合成『低维流形埋在高维空间』;真实 ImageNet 上只有 x-pred 在欠容量网络下成功的相关性证据,没有直接测量数据流形维度,也没有验证预测值确实落在流形上。
- 结果依赖推理期超参搜索:CFG scale 在 1.0–4.0 以 0.1 步长扫描、EMA decay 从三个候选中选优,先以 8K 样本定参再评估 50K;论文自己承认固定超参会得到误导性观察(附录 A)。
- 实验面窄:只有类条件 ImageNet(256/512/1024),没有文本到图像、视频或其它自然数据域;对蛋白质/分子/天气等无 tokenizer 领域的推广属于展望,未做实验验证。
- 采样是 50 步 Heun 多步 ODE,未做蒸馏或 one-step;高分辨率还要手动按分辨率放大噪声幅度(512 用 2×、1024 用 4×)以维持 SNR,属于工程启发式。
可复现性
- code:论文未提供官方代码仓库;实现基于 DiT [46] 与 SiT [40] 公开代码库
- weights:未提供预训练权重
- setup_note:Table 9 给出完整配置:batch 1024、lr 2e-4 常数、warmup 5 epoch、EMA decay {0.9996,0.9998,0.9999}、logit-normal t 采样(μ=−0.8, σ=0.8)、噪声幅度=图像尺寸/256、50 步 Heun、CFG scale 1.0–4.0 搜索
主干与结构
backbone:普通 ViT-B/L/H/G(无 tokenizer、无预训练、无附加损失)
参数:131M / 459M / 953M / 2B(B/L/H/G)
类型:plain ViT on raw pixel patches + x-prediction(flow matching 框架)
关键组件
- 非重叠像素 patch(16×16×3=768-d 或 32×32×3=3072-d 或 64×64×3=12288-d),序列长度恒为 256
- 线性 patch 嵌入:可选 bottleneck 版(两层线性,中间 d'=128 对 B/L、256 对 H/G)
- adaLN-Zero 时间/类别条件;可选 32 个 in-context class tokens(从第 4/8/10 层开始插入)
- 通用 Transformer 改进:SwiGLU、RMSNorm、RoPE、qk-norm
- 输出层线性投影回 p×p×3 patch;x-prediction 直接输出干净图像
- 训练:x-pred + v-loss,v̂=(x̂−z_t)/(1−t),分母 clip 0.05;EMA + CFG
为什么这样设计
既然预测目标换到流形上的 x,输入侧不再需要 latent tokenizer 压缩维度,网络侧也不需要把隐藏维度加宽到匹配 patch 维度;普通 ViT 的结构与任务解耦,可以直接继承 NLP 领域的通用改进,并保持不同分辨率下序列长度一致(256),实现跨分辨率同算力。
数值 sense
| 项 | 值 |
|---|---|
| DiT 规格 | B: 12 层/768 维/12 head;L: 24 层/1024 维;H: 32 层/1280 维;G: 40 层/1664 维 |
| 分辨率 | 256×256 / 512×512 / 1024×1024 |
| patch_dim | 768-d(16×16×3)/ 3072-d(32×32×3)/ 12288-d(64×64×3) |
| sequence_length | 恒 256(16×16 patches,所有分辨率) |
| bottleneck | patch embedding 低秩化:B/L 用 d'=128,H/G 用 d'=256 |
| 训练 | 200 epoch(消融)/ 600 epoch(最终);batch 1024;lr 2e-4 常数;EMA decay ∈ {0.9996, 0.9998, 0.9999};dropout 0.2(H/G 中间一半 block);G 早停约 320 epoch |
| sampling | 50 步 Heun ODE 求解;CFG scale 推理时 1.0–4.0 步长 0.1 搜索;可选 CFG interval [0.1, 1] |
流形假设:x 在流形上,ε/v 在流形外
原文 caption:The Manifold Assumption hypothesizes that natural images lie on a low-dimensional manifold within the high-dimensional pixel space. While a clean image x can be modeled as on-manifold, the noise ϵ or flow velocity v (e.g., v = x − ϵ) is inherently off-manifold.
全篇论证的起点:高维像素空间里,自然图像集中在一个低维流形上(图中弯曲曲面);干净图像 x 落在曲面上,噪声 ε 与速度 v=x−ε 散布在整个高维空间中。这张图说明预测目标的选择决定了网络要拟合的量是否低维,直接支撑『x-prediction 与 ε/v-prediction 有根本区别』的核心论断。
Toy 实验:只有 x-prediction 扛得住高维观测
原文 caption:Toy Experiment: d-dimensional (d=2) underlying data is buried in a D-dimensional space, by a fixed, random, column-orthogonal projection matrix. In the D-dim space, we train a simple generative model (5-layer ReLU MLP, 256-dim hidden).
四行对应观测维度 D=2/8/16/512,底层数据恒为 d=2 维螺旋;列分别是 ground-truth、x-pred、ε-pred、v-pred(都用 v-loss)。D=512 时 256 宽 MLP 明显欠容量,ε/v 预测出的点云散成一团、结构全失,只有 x-prediction 还原出螺旋。它用最小代价证明了『预测流形上的 x 对网络容量要求低』,是后面 ImageNet 实验的先行证据。
JiT 架构:普通 ViT 直接吃像素 patch
原文 caption:The Just image Transformer (JiT) architecture: simply a plain ViT on patches of pixels for x-prediction.
架构图:输入加噪图像 z_t 切成分辨率无关的像素 patch → 线性嵌入 + 位置编码 → 标准 Transformer block 栈(adaLN-Zero 注入时间/类别条件)→ 线性输出层投影回 patch,直接给出干净图像预测 x̂。整条链路没有 tokenizer、没有卷积偏置、没有附加损失,传达『结构最小化、把难题留给预测目标』的设计。
Bottleneck 线性嵌入反而有益
原文 caption:Bottleneck linear embedding. Results are for JiT-B/16 on ImageNet 256×256. A raw patch is 768-dim and is embedded by two sequential linear layers with an intermediate bottleneck dimension d′ (d′ < 768). Bottleneck embedding is generally beneficial, and our x-prediction model can work decently even with aggressive bottlenecks as small as 32 or 16.
横轴是瓶颈维度 d′(16–1024,log 刻度),纵轴是 FID-50K(越低越好),模型为 JiT-B/16(200 epoch + CFG)。曲线显示:无瓶颈的原始 768-d 嵌入是 8.62 FID;压到 d′=64 反而最好(7.35),即使压到 16 也只有 9.40。它证明网络侧的瓶颈压缩会强制模型只保留流形上的有效信息,与输入侧 tokenizer 压缩形成对照。
🎧 音频版
时长 34:19 · Edge TTS
JiT:让去噪生成模型真正去噪(对话版·深度版)
开场先讲清楚,这篇论文在争什么
小播:老播,今天这篇论文叫《Back to Basics: Let Denoising Generative Models Denoise》,标题里就有两个关键词,back to basics 和 denoise。它到底在争什么?
老播:一句话背景:现在所有扩散生成模型,训练时让网络预测的其实大多是噪声,或者一个跟噪声混在一起的量,跟"去噪"这个名字的本意正好反过来了。这篇论文来自 MIT 的 Kaiming He 和 Tianhong Li,他们主张把网络输出换回干净图像本身,并且证明只要这么做,一个非常普通的 Transformer,不需要 tokenizer、不需要预训练、不需要附加损失,就能在原始像素上做出很强的生成效果。
小播:听起来像一个"回到第一性原理"的论证。为什么值得专门做一期?
老播:因为这个问题一直没有被认真对待过。过去十几年,扩散模型社区把注意力放在噪声调度、损失权重、网络结构上,默认"预测什么都一样,反正能换算";这篇论文用流形假设把这个默认拆掉,并且在 ImageNet 上拿出了硬结果。先把 FID 说清楚:它是衡量生成图像分布和真实图像分布距离的指标,越低越好,ImageNet 上通常报告 5 万张生成图的 FID-50K。论文的招牌结果是:纯像素、无预训练的 2B 模型在 ImageNet 256 上拿到 FID 1.82,512 分辨率上 1.78。
小播:那我们这期会讲哪几件事?
老播:三件事:第一,为什么预测干净图像和预测噪声在极高维空间里差别很大;第二,大 patch 加无 tokenizer 的普通 ViT 为什么能成立,网络侧加 bottleneck 为什么反而有好处;第三,它跟上一期 MeanFlow 的"预测数据均值"哲学是什么关系。核心结论先放这儿:预测目标决定了网络容量需求,x 在流形上,ε 和 v 不在,所以欠容量网络做 x-prediction 可以,做 ε/v-prediction 就会灾难性失败。我们这期是精读,每个环节都会放慢讲。
背景:去噪模型当年把"去噪"这两个字弄丢了
小播:先补个背景。扩散模型最早的时候,"去噪"应该就是字面意思吧?
老播:对。最早的扩散模型,比如 Sohl-Dickstein 2015 年的工作,学的是逆转的加噪过程:先把图像一步步加噪直到变成纯噪声,再学一个反过来把噪声一步步去掉的过程,网络要预测的是加噪分布里的参数。到了 2020 年 DDPM 翻身成为主流,关键转折是把预测目标改成噪声本身,这就是 epsilon-prediction:给网络一张加噪图,让它说出我加进去的那份噪声长什么样,然后用"加噪图减噪声"把干净图还原出来。这个改动让生成质量大幅提升,之后业界一直沿用。
小播:那 flow matching 又是怎么回事?
老播:flow matching 是 2022 到 2023 年流行起来的另一套框架,把生成过程看成一条从噪声到数据的连续路径,网络预测的是这条路径在每一点的切线方向,也就是速度 v-prediction,v 是干净图和噪声的一个组合量。这套框架跟扩散模型可以统一起来看。EDM 那篇论文证明过:预测噪声、预测速度、预测干净图像,三者可以互相换算,只差一个损失权重,所以在数学上等价。
小播:既然等价,那大家默认"预测哪个都行"也很合理啊?
老播:合理的前提是网络足够强、观测维度足够低。论文质疑的正是这个前提。它搬出流形假设:自然图像在像素空间里集中在一个低维流形上,这个假设最早出现在半监督学习的经典教材里。简单理解,你可以把高维像素空间想成一个巨大无比的仓库,里面绝大部分位置都是纯随机的色块,而自然图像只占其中一张很薄的曲面,这个曲面就是流形。干净图像 x 在这张曲面上,噪声 ε 是随机撒满整个仓库的,速度 v 是 x 减 ε,同样不会贴在曲面上。
小播:那现在主流的做法不是都先在 latent 空间里扩散吗?latent 维度低,这个问题是不是就没了?
老播:latent diffusion 先用一个自编码器把图像压进几十维的 latent,再在这个低维空间里扩散,预测 ε 的难度确实被大幅缓解。但作者认为这是把问题藏起来:tokenizer 本身就是个巨大的领域依赖,它靠额外训练和一堆对抗、感知损失换来了压缩,一旦回到像素或者其他真正高维的空间,问题原样还在。论文里有句很直接的话:用低维空间时,预测噪声的困难被缓解,同时被隐藏,而没有被解决。这也是为什么这篇论文坚持做像素空间——它想验证的是没有 tokenizer 帮忙时,问题本身能不能被化解。
小播:那目标在不在流形上,差别体现在哪?
老播:体现在网络容量需求上。预测 ε 或 v,网络得把高维噪声的每一个分量都记下来,容量必须跟观测维度匹配;预测 x,网络只要滤掉噪声、保留低维结构。论文里有个很直接的对照:patch 是 768 维时,B 模型的隐藏维度也正好是 768,看起来"刚好够",实际上一换到预测 ε,FID 从 8.62 直接崩到 372。这个设置是 JiT-B/16、ImageNet 256、200 epoch 加 CFG,同一个网络、同一个训练时长,只改预测目标。这一段先把结论记住:目标在不在流形上,决定了网络需要多大的容量。
小播:你说的低维结构,大概低到什么程度?给个具体数量级?
老播:256 分辨率一张图在像素空间是 256×256×3,约 19.7 万维,而自然图像的内在维度一般认为只有几十到几百,这个落差正是流形假设的核心。回到刚才的例子:patch 768 维、B 模型隐藏维度 768,看起来"刚好够",一换到预测 ε,FID 从 8.62 崩到 372,这个设置是 JiT-B/16、ImageNet 256、200 epoch 加 CFG。目标在不在流形上,决定了网络需要多大的容量,这句话先记下,后面还会反复出现。
核心思想:预测目标决定网络容量需求
小播:好,那我们把核心论证展开。论文说预测空间和损失空间是两个独立的旋钮,具体怎么拆?
老播:它从一条线性插值公式出发。先给预期:这条公式要回答"加噪样本、干净图像、噪声三者什么关系",它是后面所有换算的根基。公式是 z_t = t·x + (1−t)·ε。z_t 是 t 时刻的加噪样本,x 是干净图像,ε 是标准高斯噪声,t 从 0 到 1 表示噪声强度。t 等于 1 时 z_t 就是干净图,t 等于 0 时就是纯噪声,中间是两者的加权平均。这条路径是直线,所以叫线性调度,论文的分析对其他调度也适用。
小播:那速度 v 是怎么出来的?
老播:速度是 z_t 对 t 的导数,就是这条直线上每一点的切线方向,算出来恰好是 v = x − ε,干净图减噪声。现在看三个量 x、ε、v:它们之间有两个固定约束,一个是 z_t = t·x + (1−t)·ε,一个是 v = x − ε。所以网络只要预测出其中一个,另外两个就能解出来,不需要额外信息。
小播:能不能举个例子,比如网络预测 x̂ 之后,另外两个怎么算?
老播:可以,这是 Table 1 里的第一种情况。网络输出干净图像估计 x̂,那么把 z_t = t·x̂ + (1−t)·ε̂ 移项,就得到 ε̂ = (z_t − t·x̂)/(1−t),再把 ε̂ 代入 v = x − ε,得到 v̂ = (x̂ − z_t)/(1−t)。反过来,如果网络预测的是 ε̂,那么 x̂ = (z_t − (1−t)·ε̂)/t。三种预测、三种损失,一共九种组合,论文用一张表全部列出来,历史上 EDM、v-prediction 的各种推导都可以看成这张表的特例。这里想强调的是:表里每一格都合法,问题在于让网络去拟合哪一个,高维场景下选择不同,结果天差地别。
小播:九种组合里,它挑了哪一种?
老播:x-prediction 配 v-loss。网络直接输出 x̂,速度按 v̂ = (x̂ − z_t)/(1−t) 算,损失是 ‖v̂ − v‖ 的平方,就是预测速度和真实速度的均方误差。除法的分母会 clip 到 0.05,防止 t 接近 1 的时候除零。你注意到没有,这个 v̂ 的算法,跟 MeanFlow 那套"从预测的均值推出速度"是同一个形状,这层关系我们放到谱系那一段讲。
小播:那为什么选 v-loss 而不选 x-loss?
老播:因为 v-loss 对 x̂ 来说,等于给 x-loss 乘上权重 1/(1−t)²。举个例子,t 等于 0.5 时权重是 4,t 等于 0.1 时权重约 1.23,t 越接近 0、噪声越大,权重越大,等于在训练时更强调"把高噪声样本还原干净"这个任务。论文实验下来发现这个加权更好,但关键结论是:对 x-prediction 来说,用哪个损失都行,FID 都在 8.62 到 10.45 之间;对 ε 和 v-prediction 来说,用哪个损失都救不回来。所以损失权重是次要的,预测目标才是决定性的,这句话后面实验里会反复验证。
小播:等一下,我理一下算法流程:网络吃加噪图、输出干净图,但损失却算在速度上,中间还要除以 (1−t),这不绕吗?
老播:绕,但这是故意的。论文想强调一个点:网络输出空间和损失空间是两回事,可以分开选。训练时只做一次前向,拿到 x̂ 后立刻算 v̂,然后跟真实速度 v 比;采样时反过来,还是前向拿 x̂、算 v̂,把 v̂ 当作 ODE 的切线方向,从纯噪声出发沿路径积分 50 步,最后得到干净图。所以"输出 x̂"和"用 v-loss"两件事不冲突,前者决定网络要拟合的目标,后者决定误差怎么加权。这也是 Table 1 那张表存在的意义:九个格子全合法,挑哪个才是问题。
小播:容量那段,能不能用实验说话?
老播:可以,论文先做了一个极简的 toy 实验。把二维螺旋数据用固定随机投影矩阵埋进 D 维空间,让一个 5 层、256 个隐藏单元的 MLP 去学生成,分别试三种预测。投影矩阵是随机生成后固定下来的,模型看不到它,所以对模型来说这就是一个 D 维生成问题,只有研究者知道数据实际只有 2 维。D 等于 2、8 的时候大家都还行;D 等于 16 时 ε 和 v 预测开始退化;D 等于 512 时,256 宽的网络明显欠容量,ε 和 v 预测出来的点云完全散掉,只有 x-prediction 还原出螺旋。
小播:这个实验妙在哪?
老播:妙在观测维度可以随便改,数据的内在维度始终只有 2,而只有 x-prediction 利用了这一点。它直接演示了那句话:网络容量要匹配的是预测目标的维度,观测维度高没关系。后面 ImageNet 上的实验,就是把 toy 实验的结论搬到真实数据上验证。到这里核心论证就闭环了:目标在流形上,容量需求就低;目标在流形外,容量需求就跟维度成正比。
小播:那为什么历史上大家用 ε-prediction 用得好好的,x-prediction 当年反而被放弃?
老播:原始 DDPM 的代码里其实试过 x-prediction,当时在 CIFAR 这种低分辨率、低维度数据上,ε-prediction 明显更好,于是成了主流。后来 latent 扩散把维度压低了,ε-prediction 的问题就一直没暴露。这篇论文的贡献在于指出:维度一旦拉高,比如像素 patch 768 维甚至 3072 维,ε-prediction 的容量需求就会爆炸。这也是论文标题"回到基础"的由来——把预测目标换回它本该预测的东西。
小播:好,核心论证讲完了,接下来看它怎么落地成模型。JiT 的架构到底有多朴素?
老播:朴素到可以直接说"就是 DiT 套在像素 patch 上"。先补一个术语:patch 就是把图像切成的小方块,每个 patch 当作 Transformer 的一个 token,token 可以理解成序列里的一个元素。具体流程是:加噪图像切成不重叠的 p×p 像素块,每个块是一个 p×p×3 的 token,线性嵌入加位置编码,过标准 Transformer block,输出层线性投影回 patch,直接给干净图像预测。256 分辨率用 16 的 patch,每 token 768 维;512 用 32 的 patch,3072 维;1024 用 64 的 patch,12288 维。三种分辨率下序列长度都是 256。
小播:768、3072、12288,这些 token 维度都超过 B 模型的隐藏维度了,为什么还能训?
老播:这就是"无 tokenizer"的第一层含义:输入维度可以和网络容量解耦。B 模型隐藏维度 768,patch 3072 维、12288 维它照样处理,因为网络输出的目标是流形上的 x,内在维度低,不需要把输入的全部信息都记住。第二层含义是自包含:latent diffusion 的 tokenizer 是一个学习过的压缩器,要额外训练,还依赖对抗损失和感知损失,JiT 把这些全部去掉,整条管线只剩一个 Transformer 加一个扩散目标。第三层含义是可迁移:蛋白质、分子、天气这些领域很难设计 tokenizer,无 tokenizer 的范式更容易推广过去,这是论文反复强调的长期目标。
小播:那"无预训练"这一条呢?
老播:论文在 256 分辨率上对比过:RAE、DDT、LightningDiT 这些方法都靠自监督预训练来缓解高维扩散的退化,JiT 从头训、不预训练,还能拿到接近的水平。这也是"回到基础"的一部分——把外部依赖一个个摘掉,看看剩下什么。
小播:你说输入维度可以和网络容量解耦,最直接的证据是什么?
老播:Table 5 里有个极端的例子:JiT-B/64 在 1024 分辨率上,patch 是 12288 维,B 模型隐藏维度只有 768,差了 16 倍,模型依然拿到 4.82 FID,参数 133M、算力 30 Gflops,跟 256 分辨率的版本几乎一样。如果是预测 ε,这个规模的网络早该崩了。这组数字把"解耦"落实到了具体数量级上,也再次呼应那句话:预测目标在流形上,容量需求就跟观测维度脱钩。
小播:普通 ViT 还有别的好处吗?
老播:有,结构跟任务解耦之后,可以直接继承语言模型的架构进步。论文把 SwiGLU、RMSNorm、RoPE、qk-norm 这些从 NLP 搬过来,再实验了把类别信息做成 32 个 in-context token 送进 Transformer,JiT-B/16 的 FID 从 7.48 一路压到 4.37,这是带 CFG interval 的设置。这里 CFG 是 classifier-free guidance,生成时同时用有条件和无条件的预测拉大类别差异,是扩散模型的标准技巧。它不需要发明任何新的结构件,改的是预测目标。
小播:那 32 个 in-context token 具体怎么用?
老播:做法是把同一个类别信息重复 32 份,每份配不同的位置编码,插进 Transformer 靠后的 block,从第 4 层开始,效果比只加一个类别 token 好。这个技巧是从 MAR 那篇论文借来的,属于直接借用别人验证过的组件。你看,JiT 里几乎每个组件都能找到出处,真正原创的部分就是"预测目标"这一个决定。
小播:那为什么之前做像素扩散的人不敢用这么大的 patch?小 patch 不是更常见吗?
老播:因为大 patch 直接制造出高维 token。之前有论文反复报告:ViT 式扩散在 per-token 维度升到几百的时候就急剧退化,所以 SiD2、PixelFlow 都反过来用层次化小 patch,或者像 PixNerd 加一个 NeRF head 把 token 信息融合出来,这些设计都在给网络找"信息通道"。JiT 的立场是:问题出在预测目标,token 维度高本身不可怕。所以它特意用最大的 patch 做实验,把 token 维度推到 768、3072、12288,证明 x-prediction 下这些都行。这也是"大 patch 意味着什么"的答案:大 patch 是压力测试,也是自包含的代价——没有 tokenizer 帮你降维,你就得直面高维。
小播:那 bottleneck 呢?网络里加瓶颈压缩,听起来是自废武功。
老播:恰恰相反,这是论文里最出人意料的结果。它把 patch 嵌入换成两个线性层,先降到 d′ 维再升回隐藏维度,整体是个低秩参数化,低秩的意思就是信息先被压扁、再展开,中间只剩一个很窄的通道。JiT-B/16、ImageNet 256、200 epoch 的设置下,无瓶颈的原始 768 维嵌入是 8.62 FID;压到 d′ 等于 64 反而最好,7.35;压到 16 也只有 9.40,照样能用。为什么有益?瓶颈强制信息压缩,模型被迫只保留流形上的有效结构,噪声细节在进入主干之前就被丢掉。这跟输入侧的 tokenizer 压缩形成对照:tokenizer 是在输入侧掩盖问题,bottleneck 是在网络侧利用流形的低维结构。
小播:那高分辨率怎么办?256 的配方直接搬到 512 吗?
老播:几乎可以直接搬。patch 按图像尺寸等比放大,16 变 32 变 64,序列长度保持 256,算力几乎不变;唯一要改的是把噪声幅度放大:512 用 2 倍、1024 用 4 倍,维持信号噪声比,也就是让噪声和信号的相对大小跟 256 分辨率时保持一致。结果 JiT-B/64 在 1024 分辨率拿到 4.82 FID,只有 133M 参数、30 Gflops,跟 256 版本的算力是同一个量级。论文把完整配置列在 Table 9:batch 1024、学习率 2e-4、EMA 在三个衰减系数里选、logit-normal 时间采样,复现条件比较完整。
实验:九种组合里只有 x-prediction 全线存活
小播:架构部分讲完了,接下来看实验怎么验证。论文最有冲击力的是哪张表?
老播:Table 2。先说清楚评估设置:ImageNet 有 1000 个类别,FID-50K 是从每个类别生成 50 张、共 5 万张图,再和真实图算分布距离。JiT-B/16 在 ImageNet 256 上跑 200 epoch 加 CFG,x-prediction 配三种损失,FID 是 8.62 到 10.45;同样设置下 ε-prediction 是 372 到 395,v-prediction 是 96 到 127,属于灾难性失败。对照实验把 patch 换成 4×4,token 只有 48 维,分辨率 64,九种组合的 FID 全在 3.46 到 6.20 之间,差距很小。两张表放一起,结论就出来了:token 维度一旦高过隐藏维度,预测目标的选择就是生死问题。
小播:有没有人会说,调大噪声水平也许能救 ε 预测?
老播:论文专门做了这个实验。同样是 JiT-B/16、ImageNet 256、200 epoch,把 logit-normal 采样均值从 −0.0 调到 −1.2,等于整体加大噪声。x-prediction 的 FID 从 14.44 先降到 8.62 再微升到 8.99,符合"适当的噪声水平有益"的旧观察;但 ε-prediction 始终在 355 到 464 之间,v-prediction 在 96 到 120 之间,怎么调都回不来。损失加权也救不了:附录里试了 EDM 式预条件化,v-loss 下 FID 是 35.49,比纯 x-prediction 的 8.62 差一大截,因为预条件化的网络输出混进了 z_t 本身,偏离了纯 x-prediction。到这里,"调超参救不了 ε/v 预测"这个结论已经验证了三遍:损失权重、噪声水平、预条件化,全都无效。
小播:大模型的表现呢?
老播:把模型推大之后,JiT-G/16 在 ImageNet 256 拿到 1.82 FID,JiT-G/32 在 512 拿到 1.78,都是 2B 参数、约 383 到 384 Gflops、600 epoch 加 CFG interval 的设置。scaling 曲线值得看一组完整数字:256 分辨率、600 epoch 下,B、L、H、G 四个规模的 FID 依次是 3.66、2.36、1.86、1.82,从 L 到 H 那一下降了 0.5,收益明显。对比一下同分辨率的像素方法:ADM-G 在 512 上 554M 参数、1983 Gflops,只有 7.72 FID;DiT-XL 走 latent 路线、525 Gflops,是 3.04。JiT 用接近零的领域设计逼近了 latent 方法的水平。latent 系目前最强的 RAE 是 1.13,JiT 的 1.82 没超过它,但 RAE 带自监督预训练,这个差距我们在局限里再谈。
小播:还有一个我感兴趣的点:一个分辨率训练的模型,能直接用到别的分辨率吗?
老播:附录做了交叉分辨率实验。JiT-G/32 在 512 训练,生成的图缩小到 256,FID 是 1.84,跟专门的 256 模型 1.82 几乎一样;反过来,256 训练的模型放大到 512,FID 只有 2.45,明显差于专门的 512 模型 1.78,因为上采样丢高频细节。这组数字说明:下采样兼容好,上采样不兼容,行为跟预期一致。
小播:还有一个细节,论文说 512 的模型参数和 256 几乎一样,FID 反而更低?
老播:对,JiT-G 在 256 是 1.82、在 512 是 1.78。作者的解释是:大模型在 256 上更容易过拟合,512 的任务更难,反而不容易过拟合。这也引出了论文自己承认的一个问题,我们局限里细说。
小播:训练过程本身有没有证据?
老播:附录给了训练损失曲线,很能说明问题。JiT-B/16 在 ImageNet 256 上,同一个 v-loss 空间里,v-prediction 的损失比 x-prediction 高约 25%,ε-prediction 高约 3 倍而且不稳定。注意损失是在同一个空间算的,只是网络参数化不同,所以可以直接比。高维输出的困难在训练早期就写在损失曲线里了,多步 ODE 采样只是把这个误差一步步放大成 FID 上的灾难。
小播:那 Table 2a 里 x-prediction 三个损失都能用,是不是说明损失选择完全无所谓?
老播:也不是。x-prediction 下三个损失的 FID 是 8.62、10.14、10.45,v-loss 最好,比 x-loss 好约 1.5。原因就是前面说的重加权:v-loss 在高噪声样本上权重更大,跟 logit-normal 采样配合得更好。论文的结论是:加权有帮助,但属于锦上添花;预测目标错了,加权救不了。这两个层次要分开记。
小播:还有一个采样细节,论文老提 CFG interval,这是什么?
老播:CFG 是分类器无关引导,生成时把有条件的预测和无条件的预测做差值外推,让结果更贴类别。CFG interval 是说只在 t 从 0.1 到 1 这一段用 CFG,t 小于 0.1 的接近纯噪声区间不用,因为那一段的预测太不可靠,强行引导容易引入伪影。论文里还有一张图专门画 CFG scale 对 FID 的影响,曲线不是单调的,所以要按模型在 1.0 到 4.0 之间以 0.1 步长搜。EMA,指数滑动平均,是训练时维护参数的滑动平均、用平均后的参数做推理,论文在三个衰减系数里给每个模型选一个。这两样都是推理期决定的事,处理得细致,但代价是超参搜索空间不小,这也是我们局限里要提的一条。
谱系定位:它和 MeanFlow 是一对互补的哲学
小播:进入谱系定位。论文跟 MeanFlow 的关系,是不是你开头说的"互补"?
老播:对,这是本期的重点关系。MeanFlow 是 MIT 和 CMU 合作的工作,提出用平均速度做 one-step 生成:平均速度对应条件均值 E[x|z_t],也就是"给定加噪样本,干净图像的期望",他们推导了平均速度和瞬时速度的恒等式,用一次函数评估在 ImageNet 256 拿到 3.43 FID。one-step 这条线上前面还有 Consistency Models、Rectified Flow 这些名字,MeanFlow 是其中把"平均速度"这个概念讲得最清楚的。JiT 做的是 50 步多步流采样,走 x-prediction。两条线共享同一个表示哲学:网络输出应该指向数据均值、干净图像这类落在流形上的量,指向噪声和瞬时速度都会把任务难度抬到维度级别。
小播:那区别呢?
老播:区别在用途和机制。MeanFlow 用平均速度实现一步生成,JiT 用 x-prediction 让高维像素扩散在普通 ViT 上可行;MeanFlow 有严格推导的平均速度恒等式,JiT 有"目标在流形上"的容量论证和整张 Table 1 的换算表。所以一篇说"预测均值可以一步到位",一篇说"预测干净数据让欠容量网络也能做像素扩散",合起来是同一哲学的两半。顺带一提,x-prediction 本身有很长的历史,原始 DDPM 的代码里就试过,只是当时效果不如 ε-prediction 被放弃了,JiT 相当于把这个选项重新翻出来,论证它在高维场景下才站得住。
小播:跟其它像素方法比呢?
老播:SiD2、PixelFlow、PixNerd 这些像素空间方法,用层次化小 patch、NeRF head、表示对齐,从 L/XL 规模起步;JiT 用标准 ViT、从 B 起步、没有任何特殊组件。预训练派 RAE、DDT、LightningDiT 靠自监督预训练救高维扩散;JiT 证明没有预训练也能工作。对照下来,JiT 的主张集中在"预测目标"这一个旋钮上,其余全部保持朴素。
小播:我记得同期还有工作把 x-prediction 用在世界模型上?
老播:对,论文里提到并发工作 [18],把 x-prediction 用在条件世界模型上,就是给定前几帧预测未来帧。这说明"预测干净数据"这个方向的合理性正在被多方验证。JiT 侧重无条件加类条件图像生成,以及把流形论证讲清楚;世界模型那边则是在实际应用中独立得出了同样的选择。两条线索汇到一起,x-prediction 的适用面比论文本身展示的还要宽。
小播:那它算不算给 one-step 方法提供了理论支持?
老播:间接支持。它论证了"预测均值型量"能让网络任务变简单,而 MeanFlow 的 one-step 平均速度正是条件均值。JiT 没有直接做 one-step,它把"网络应该预测均值"这个前提在极高维像素空间里立住了,等于给 one-step 路线清了一块地基。这也是我们说两篇互补的原因:一个证明均值型预测是 one-step 的关键,一个证明它是高维像素扩散的前提。
局限:哪些地方别替论文背书
小播:该泼冷水了。论文自己承认的局限有哪些?
老播:第一条,FID 没超过最强 latent 方法。同是 2B 量级、256 分辨率,RAE 是 1.13,JiT-G/16 是 1.82;precision 和 recall 里 recall 偏低,JiT-G 是 0.62,RAE 是 0.67。recall 衡量生成结果覆盖真实分布的多少,偏低说明它在保留数据多样性上还有差距。第二条,大模型过拟合明显:G 模型需要 dropout 0.2,还要在约 320 epoch 早停,600 epoch 的收益有相当一部分来自正则化而不是纯 scaling。
小播:我们还能读出哪些问题?
老播:流形假设本身没有被直接验证。toy 实验是合成投影,真实 ImageNet 上只有"x-pred 在欠容量网络下成功"这种相关性证据,论文没有测量数据的流形维度,也没有验证预测值真的落在流形上。第三,结果依赖推理期超参搜索:CFG scale 在 1.0 到 4.0 之间按 0.1 步长扫,EMA decay 从三个候选中选,先用 8K 样本定参再评估 50K,论文自己都承认固定超参会得到误导性的观察。第四,实验面窄:只有类条件 ImageNet,文本到图像、视频、蛋白质都没有验证,跨领域推广是展望。第五,采样是 50 步 Heun,没有蒸馏也没有 one-step,高分辨率还得手动把噪声放大 2 倍或 4 倍,属于工程启发式。第六,论文没有公开官方代码仓库,复现要靠自己对照 DiT 和 SiT 的代码库改,虽然配置表给得很全,工程量不小。
收尾:这期记住三件事
小播:最后让我来总结三件事。第一,预测目标决定容量需求:干净图像 x 落在低维流形上,噪声 ε 和速度 v 铺满高维空间,所以欠容量网络能做 x-prediction,做 ε/v-prediction 就灾难性失败,ImageNet 256 上同一网络 FID 从 8.62 崩到 372。第二,大 patch 加无 tokenizer 的普通 ViT 可以成立:输入维度跟网络容量解耦、模型自包含、便于迁移,网络侧 bottleneck 压缩到 64 维反而把 FID 从 8.62 降到 7.35。第三,它跟 MeanFlow 是互补的:都主张网络输出指向数据均值型量,MeanFlow 用平均速度做 one-step,JiT 用 x-prediction 做高维像素多步扩散。
老播:补一句对后续工作的意义。这篇论文把"扩散加 Transformer"这个范式重新拉回到原始数据上,去掉 tokenizer 这个最大的领域依赖,等于给扩散模型铺了一条通往蛋白质、分子、天气这些没有 tokenizer 的领域的路。它的局限也指明了下一步:流形假设需要更直接的验证,one-step 和蒸馏还没有做,而这些恰好是 MeanFlow 那条线的领地。两篇合在一起读,你就能看到一个完整的图景:预测数据均值型量,既是 one-step 的关键,也是高维像素扩散的钥匙。我们这期就到这里,下期见。
老播:如果这期只带走一个数字,记住 372:同一个 768 维 patch 的网络,把预测目标从 x 换成 ε,FID 从 8.62 崩到 372,这就是预测目标维度决定容量需求的代价。