Flow Straight and Fast:学习生成与迁移数据的 Rectified Flow(精读卡片)
> 一句话定位:用线性插值路径上的条件期望速度直接学一个 ODE 输运模型,再递归地用已学流重新采样端点对(reflow)把轨迹拉直,让原本要上百步数值求解的连续时间模型做到一步欧拉出图,同时把概率流 ODE 与 DDIM 收编为它的非线性特例。这是 one-step 生成思想最早的系统表述。
问题:两个分布之间的输运
生成建模、图像到图像迁移、风格迁移、域适应可以放进同一个框架:给定两个经验分布 π₀ 与 π₁,找一个输运映射 T,使 T(Z₀) 服从 π₁。这个任务难在没有配对的输入输出数据,而监督学习恰恰依赖配对样本。过去有几条技术线:GAN 用 minimax 训练,数值不稳定、有 mode collapse;VAE 和标准化流走最大似然路线,似然难算,要靠结构约束换取可解性;扩散模型(DDPM 1000 步、VP SDE 在 CIFAR-10 上完整模拟 2000 次函数评估)训练稳定、质量好,但推理成本高,而且其概率流 ODE(VP ODE 约 140 步)路径弯曲、速度非均匀,粗步长下误差大。本文的做法:不绕开连续时间模型,而是把轨迹本身学直。
方法:先画路,再让粒子自己走
线性插值与回归目标
核心观察:欧氏空间里两点之间最自然的路径是直线。给一对样本 (X₀, X₁),定义线性插值
X_t = t·X₁ + (1 − t)·X₀,t ∈ [0, 1]。
这个式子要回答的问题是「在起点 X₀ 与终点 X₁ 之间,时刻 t 该停在哪个位置」:t = 0 回到 X₀,t = 1 到达 X₁,中间按比例线性移动。它的速度是常数 X₁ − X₀。问题是这条路径需要知道终点 X₁ 才能走(非因果),而且不同样本对的直线会在中间交叉——交叉处该往哪边走没有一致答案。rectified flow 的思路:把「方向」学成一个只依赖当前位置 x 与时间 t 的速度场 v,训练目标是
min_v ∫₀¹ E[ || (X₁ − X₀) − v(t·X₁ + (1 − t)·X₀, t) ||² ] dt,t ~ Uniform([0, 1])。
出现公式前先给预期:这个式子要回答「在插值点 (X_t, t) 上,粒子该朝哪个方向走」。括号里 X₁ − X₀ 是这条直线本来的方向,v 是网络要预测的方向,平方范数度量两者的偏差,期望是对样本配对与随机时间 t 取的。最优解有闭式:
v_X(x, t) = E[ X₁ − X₀ | X_t = x ],
即「所有在时刻 t 恰好经过位置 x 的直线,它们方向的平均」,论文里叫期望条件速度(expected conditional velocity)。逐符号读:x 是当前插值位置,t 是时间,X₁ − X₀ 是配对样本的连线方向,条件 X_t = x 表示只统计经过 x 的路径。这个平均方向是唯一的、确定性的,因此用它驱动的 ODE
dZ_t = v_X(Z_t, t) dt
可以只凭当前状态与时间向前积分,把非因果的插值过程变成可模拟的因果过程。
三个性质:保边缘、降代价、拉直
第一,边缘保持(定理 3.3):Z_t 的分布与 X_t 的分布在每个时刻都相同,所以 (Z₀, Z₁) 仍然是 π₀ × π₁ 的一个耦合。第二,输运代价不增(定理 3.5):对任意凸代价函数 c,都有 E[c(Z₁ − Z₀)] ≤ E[c(X₁ − X₀)]。也就是说,reflow 一次之后,端点配对变得更「省路程」——对所有凸代价同时成立,像 Pareto 下降,这区别于针对单个代价 c 求最优耦合的最优传输。第三,拉直(定理 3.7):递归应用 RectFlow 算子 Z^{k+1} = RectFlow((Z^k₀, Z^k₁)),轨迹的弯曲度以 O(1/K) 速率下降,其中弯曲度用 straightness 度量
S(Z) = ∫₀¹ E[ || (Z₁ − Z₀) − Ż_t ||² ] dt。
这个式子的含义:如果轨迹是直线且匀速,那么每时每刻的速度 Ż_t 都应该等于总位移 Z₁ − Z₀,差为 0,S(Z) = 0 就是完全直线。直线流有一个直接红利:一步欧拉 Z₁ = Z₀ + v(Z₀, 0) 就是精确解,等于把连续时间模型变成了 one-step 模型。
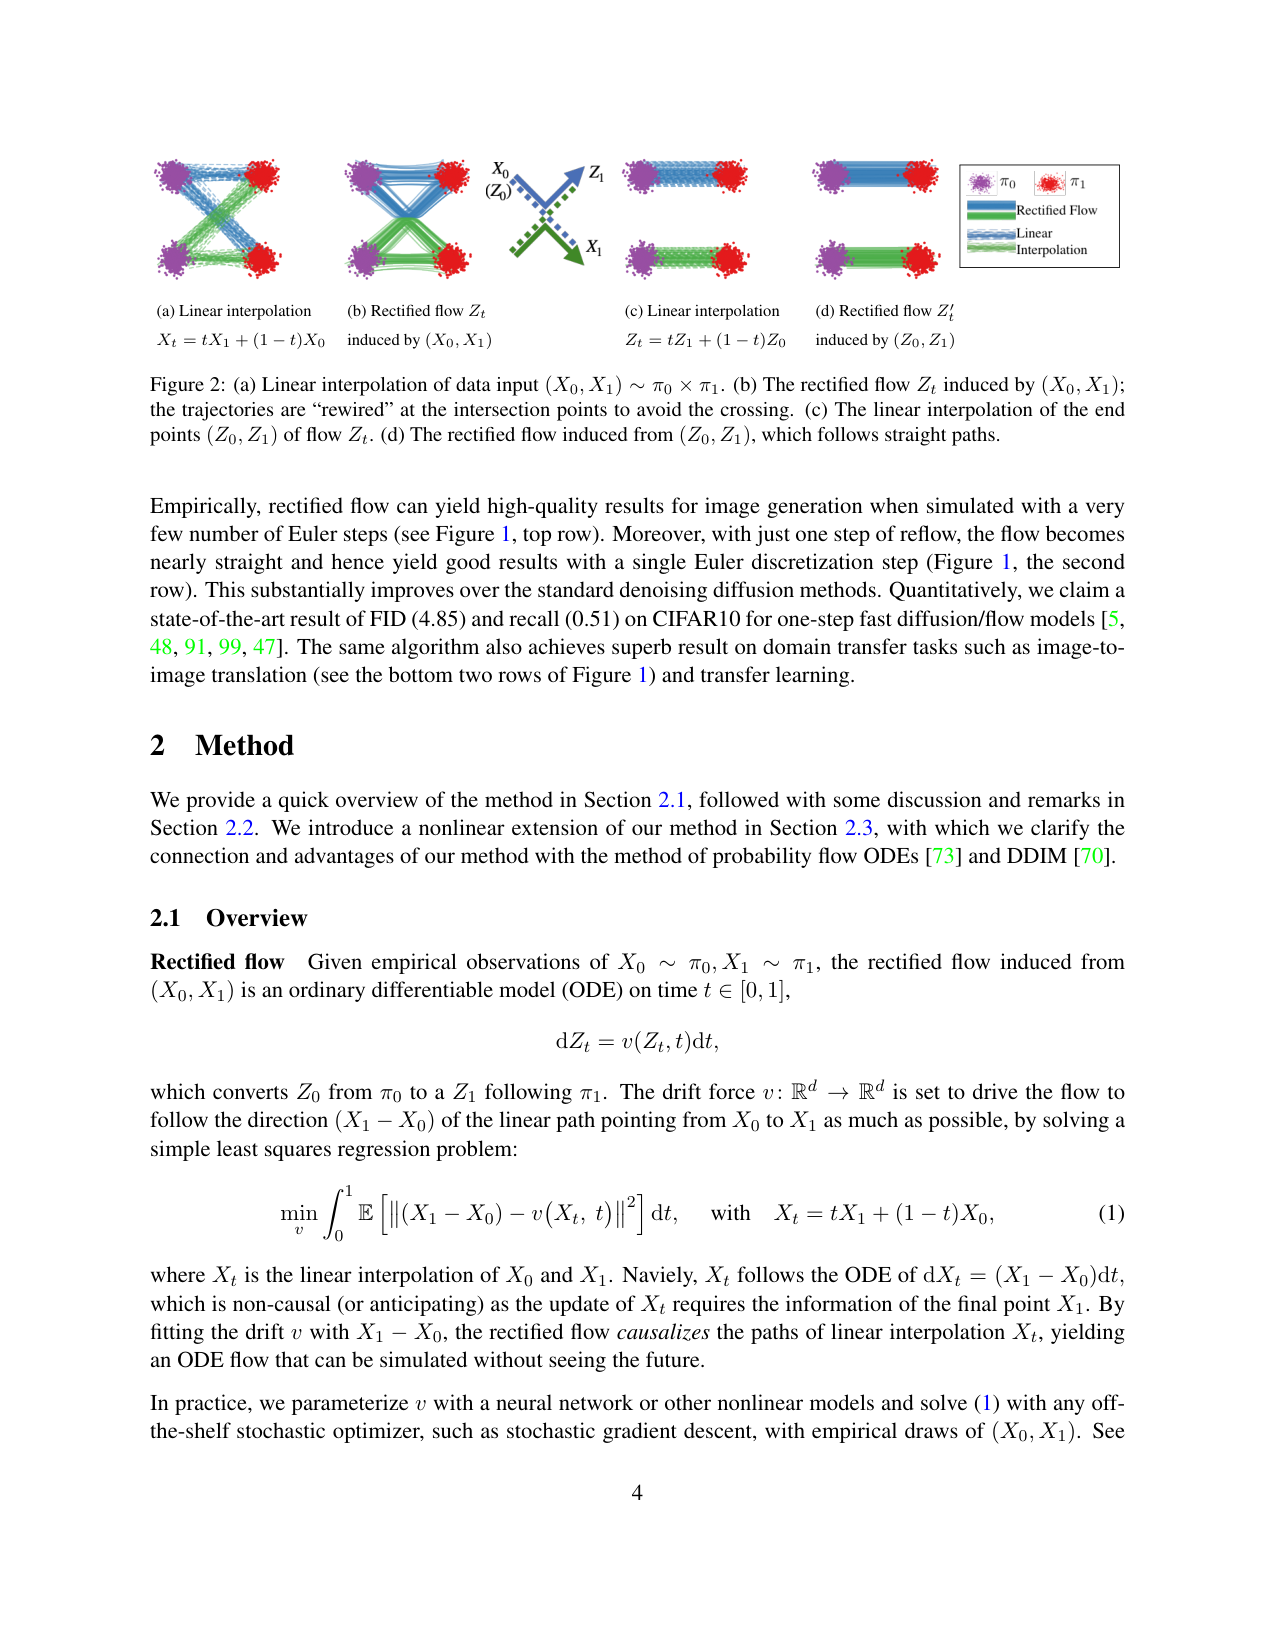
Figure 2 把机制画清楚了:(a) 独立配对 (X₀, X₁) 的直线插值在中间交叉;(b) rectified flow 在每个交叉点取「所有穿过该点的方向的平均」,轨迹被重排、不再相交,边缘分布不变;(c) 把 (b) 的端点再连直线,交叉已经大幅减少;(d) 再 rectified 一次,轨迹基本是直线。
reflow 与蒸馏
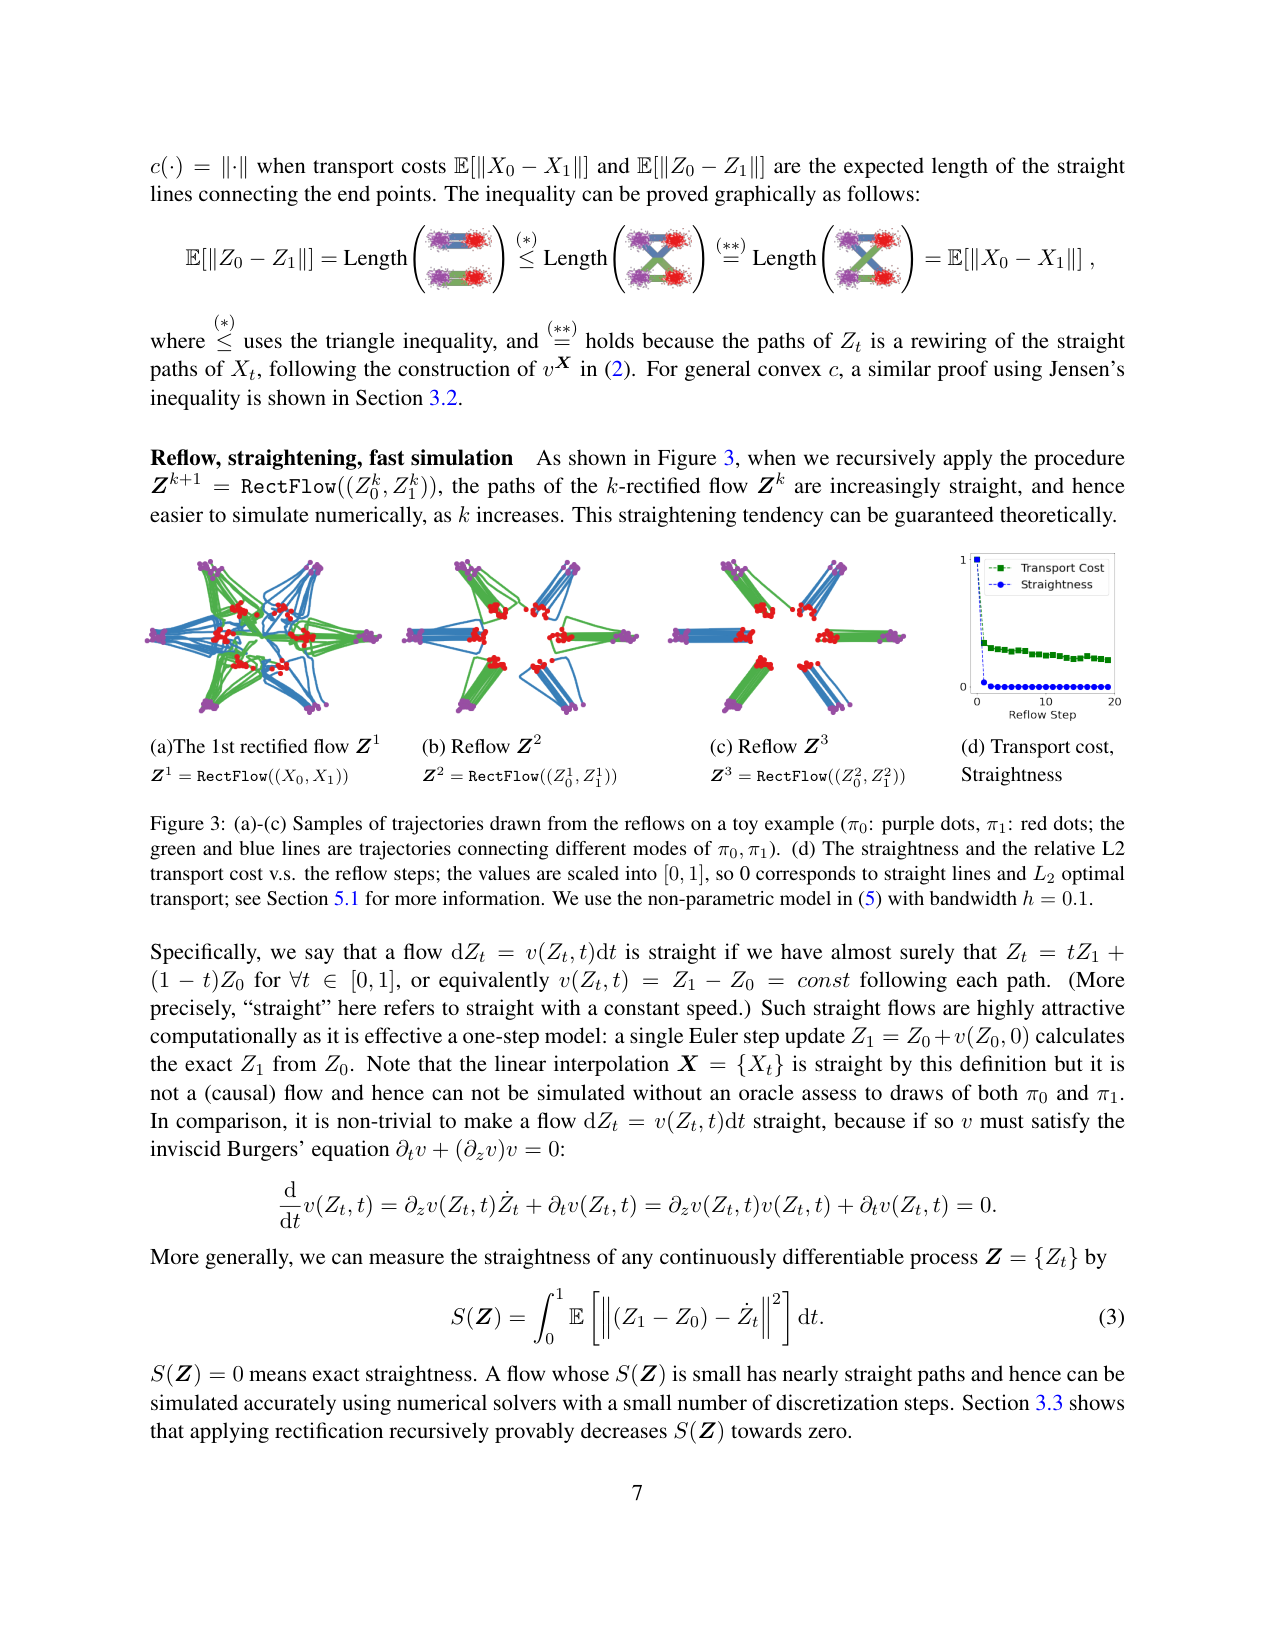
reflow 的完整流程:先按独立配对训练出 1-rectified flow;用它从 Z₀ ~ π₀ 模拟生成新的端点对 (Z₀, Z₁),拿这些「由流自己产生的配对」重新训练,得到 2-rectified flow,递归重复。论文的玩具实验(Figure 3)显示,第一次 reflow 后 straightness 就掉到接近 0,相对 L2 输运代价从约 1 降到约 0.3(归一化到 [0,1])。reflow 与蒸馏要分清:reflow 换耦合(代价更低、更直),蒸馏忠实逼近当前耦合——在最后阶段学一步映射 z₁ ≈ z₀ + v(z₀, 0),CIFAR-10 上 k=1 时改用 LPIPS 感知损失。1-rectified flow 直接蒸馏几乎无效(N=1 FID 378),说明蒸馏的收益依赖 reflow 先把轨迹拉直。
关键实验
CIFAR-10 无条件生成
定量基准:FID(越低越好,衡量生成分布与真实分布的差异)、recall(衡量多样性)、NFE(推理时调用网络的次数)。完整求解(RK45)时,1-rectified flow 用 127 次函数评估拿到 FID 2.58、recall 0.57,优于 VP ODE(140 步,3.93 / 0.51)与 sub-VP ODE(146 步,3.16 / 0.55),逼近 VP SDE(2000 步,2.55 / 0.58)。一步生成(N=1 欧拉)时,蒸馏后的 2-rectified flow 拿 FID 4.85、recall 0.50,超过此前 U-Net 架构最佳一步模型 TDPM(8.91 / 0.46)与 DDIM Distillation(9.36 / 0.51);不蒸馏的 2-rectified flow 是 12.21 / 0.34,而 VP ODE 在 N=1 时 FID 约 451、recall 0.0——轨迹没拉直的话,一步欧拉基本全糊。
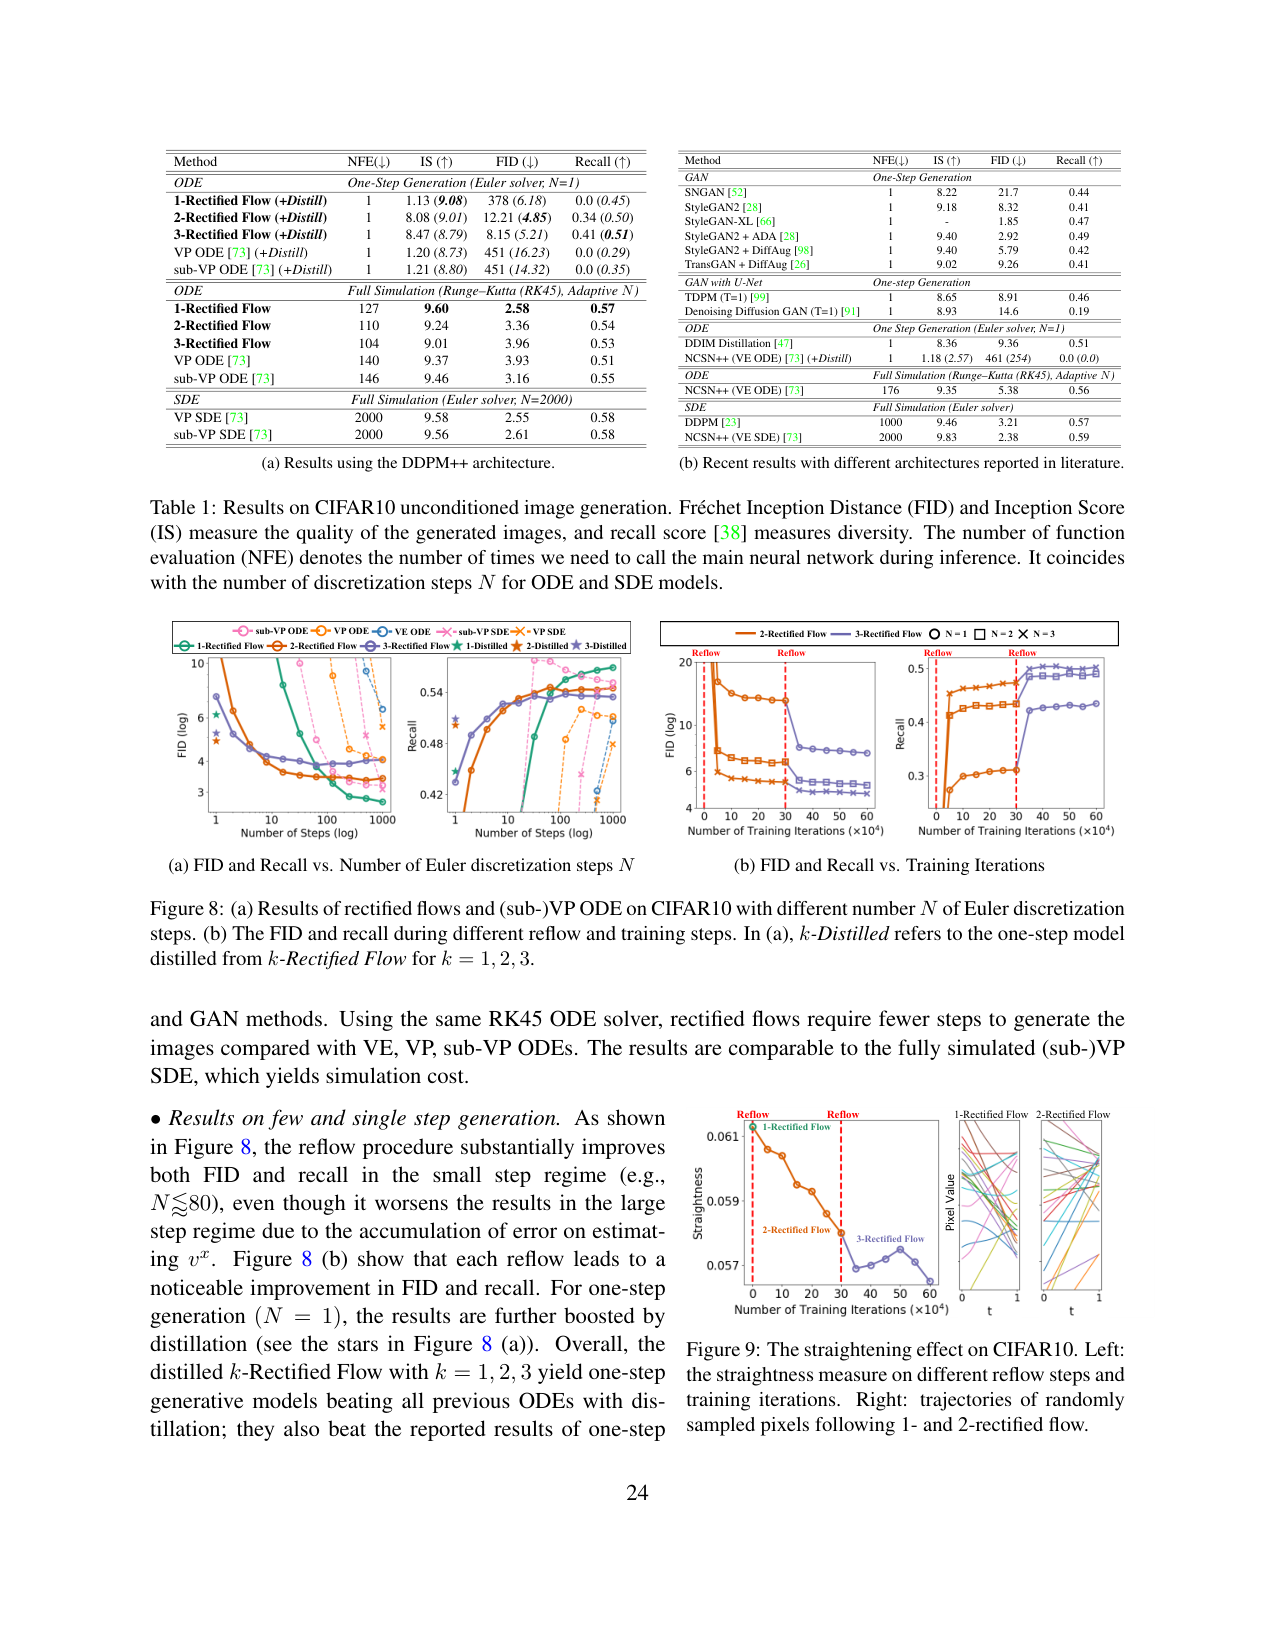
Figure 8(a) 横轴是欧拉步数 N、纵轴是 FID:在小步数区间(N ≲ 80),reflow 逐次改善 FID 与 recall;大步数区间(N ≳ 80)反而略差,因为估计 v 的误差逐轮累积。星标是蒸馏后的一步模型。
高分辨率生成、图像迁移与域适应
256×256 的 LSUN Bedroom / LSUN Church / CelebA-HQ / AFHQ Cat 上,1-rectified flow 一步到少数几步就能生成清晰图像。无配对图像迁移(AFHQ 的猫/狗/野生动物、MetFace、CelebA-HQ,512×512)里,同一个训练目标把 π₀ 设成源域、π₁ 设成目标域即可,2-rectified flow 在 N=1 时也能迁移成功;为了让主体身份保持,损失改成 ∇h(X_t)ᵀ(X₁ − X₀ − v) 的加权形式,h 是区分两域的预训练分类器的潜在表征。域适应在 Office-Home 与 DomainNet 上,把预训练模型末层特征当分布,1-rectified flow 迁移后分类准确率 Office-Home 69.2 ± 0.5(CORAL 68.7 ± 0.3)、DomainNet 41.4 ± 0.1(CORAL 41.5 ± 0.2),与最佳基线持平或略好。
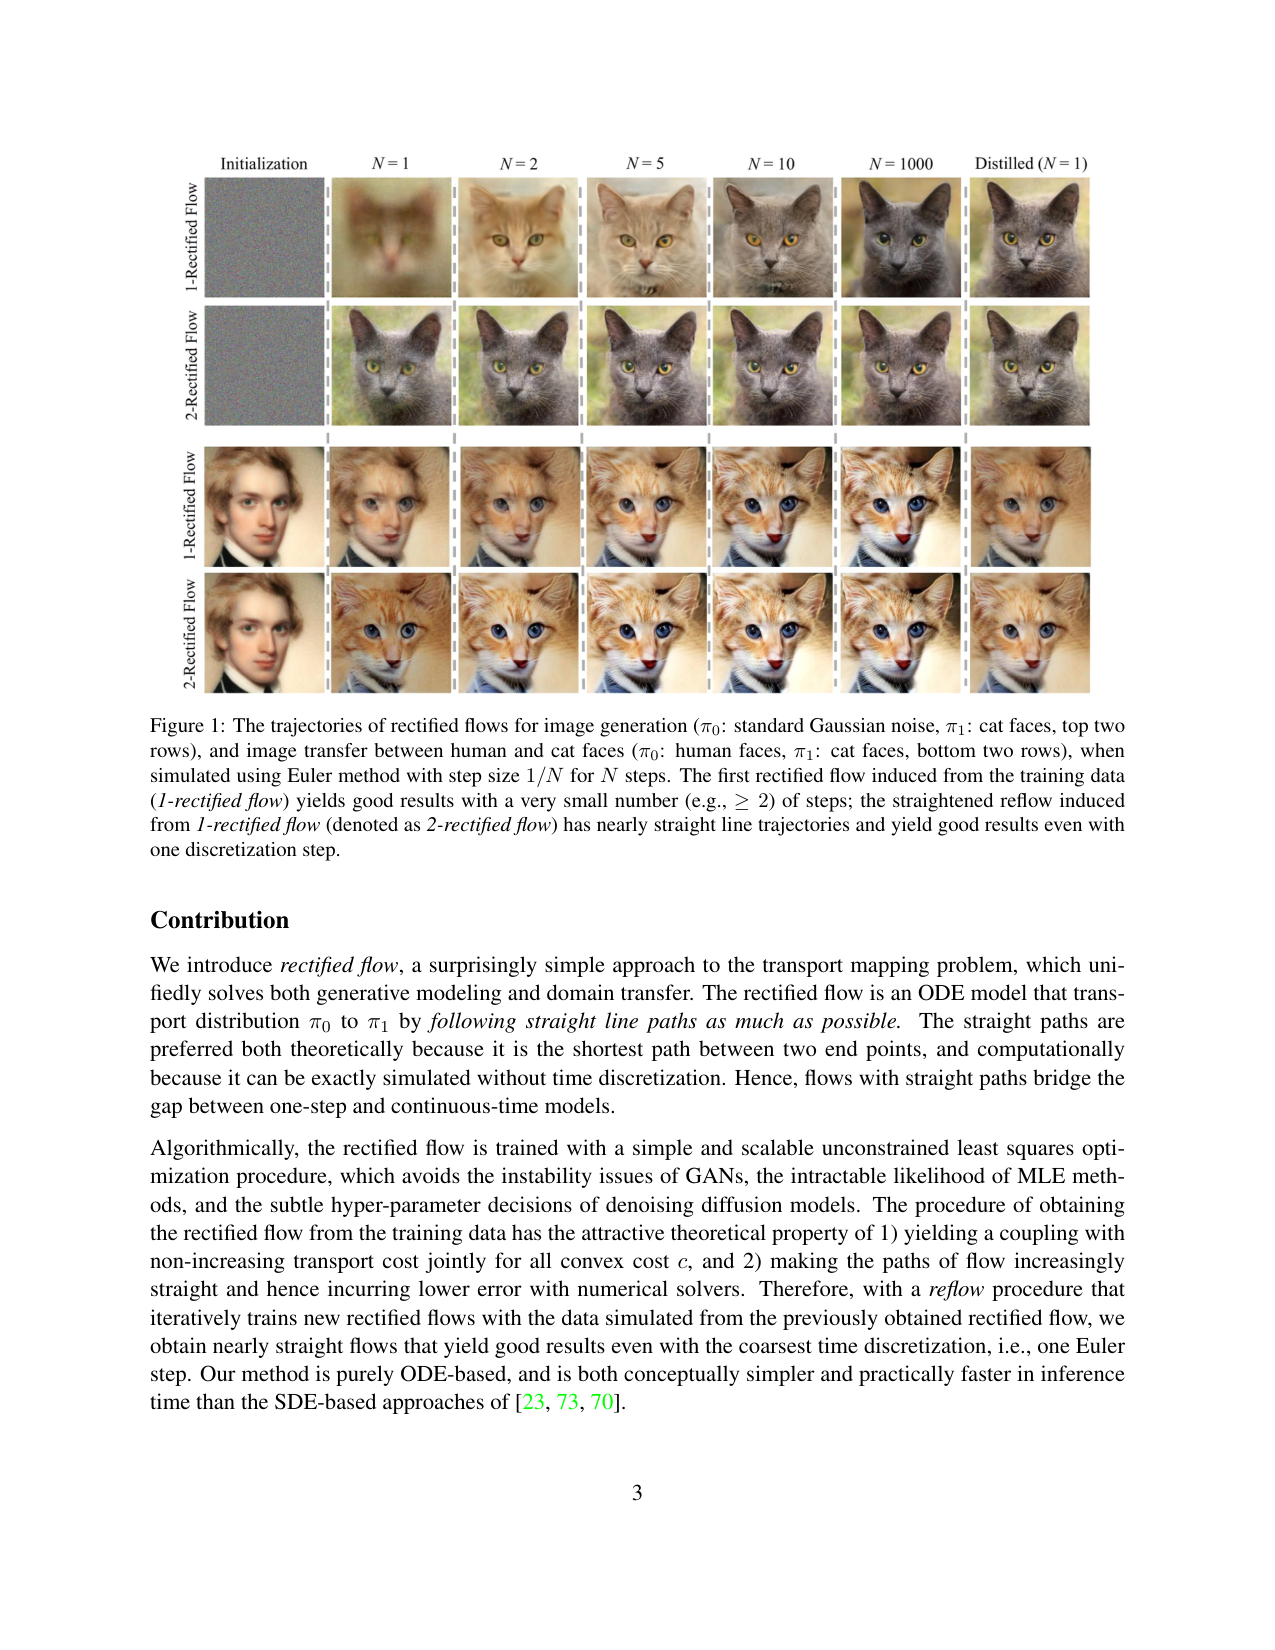
Figure 1 是最直观的定性证据:同一任务在不同欧拉步数 N=1/2/5/10/1000 下的输出。1-rectified flow 在 N=1 模糊、N=2 开始清晰;2-rectified flow 在 N=1 就清晰,加步数几乎不变。这正是「轨迹直 → 少步采样」的直接演示。
谱系定位
与概率流 ODE / DDIM 的关系:论文证明 VP/sub-VP/VE ODE 都是非线性 rectified flow 的特例(X_t = α_t·X₁ + β_t·ξ,ξ 是标准高斯),它们的弯曲来自 β_t ≠ 1 − α_t、非匀速来自指数 α_t,两者都源自 SDE 推导而非任务需要。与最优传输的关系:reflow 对所有凸代价同时不增代价,但一般达不到 c-最优(直线耦合 ≠ 最优耦合);一维情形例外,直线耦合 = 单调确定耦合 = 所有凸代价的共同最优。与后续工作的关系:流匹配(flow matching)与 rectified flow 共享同一个回归目标;MeanFlow 的平均速度 u 是「区间平均」版本——它把 (r, t) 整段的平均速度直接预测出来做 fastforward 一步采样,而 rectified flow 用 reflow 把瞬时速度场沿路径变成恒定值,两者在「直线流」这一极限下重合。这是 one-step 思想最早的系统表述,后续蒸馏扩散、一致性模型、MeanFlow 都在这一谱系上。
局限
- 论文自承:reflow 次数不宜过多,估计 v_X 的误差会逐轮累积;实验上大步数区间(N ≳ 80)reflow 反而让 FID 变差。
记住什么
一句话版本:rectified flow 用「期望条件速度」学一个 ODE,用 reflow 重排耦合把轨迹拉直,直线轨迹让一步欧拉成为精确解,于是在不引入对抗训练与似然计算的条件下逼近 one-step 生成;概率流 ODE 与 DDIM 是它的特例,这是 one-step 谱系的起点。
用线性插值路径 X_t = t·X_1 + (1−t)·X_0 上的条件期望速度 v_X(x,t) = E[X_1 − X_0 | X_t = x] 直接学一个 ODE 输运模型,再递归地用已学流重新采样端点对(reflow)把轨迹拉直,让原本要上百步数值求解的连续时间模型在 CIFAR-10 上做到一步欧拉出图(蒸馏后 FID 4.85),同时把概率流 ODE 与 DDIM 收编为它的非线性特例,是 one-step 生成思想最早的系统表述。
阅读提示
精读深度:精读
清单提示:原文提示:reflow 的核心是「用已生成轨迹重新构造耦合」从而让轨迹变直;理解为什么直线轨迹支持少步甚至一步采样;对比「期望条件速度」与 MeanFlow 平均速度的关系。这是 one-step 思想最早的系统表述。
问题
要解决什么:统一的「分布输运」问题:给定两个经验分布 π0 和 π1(生成建模里是高斯噪声与数据分布,域迁移里是两个图像域),找一个输运映射 T 使 T(Z0) 服从 π1。现有连续时间模型(扩散 SDE、概率流 ODE)推理时要反复调用网络数值求解 ODE/SDE,代价高(CIFAR-10 上 VP SDE 完整模拟要 2000 次函数评估,VP ODE 也要约 140 步);本文想直接学一个轨迹尽可能直的 ODE,让少步甚至单步欧拉就能精确模拟,同时用一个算法覆盖生成与迁移两类任务。
为什么 prior work 不够:GAN 用 minimax 训练,数值不稳定、有 mode collapse,工程调参重;VAE 与标准化流走最大似然,似然难算,要牺牲表达力或加结构约束换可解性;扩散模型训练稳定、图像质量好(CIFAR-10 上 VP SDE 的 FID 2.55、DDPM 要 1000 步),但推理要几十到上千次网络调用,且其 α_t 指数时间表导致路径弯曲、速度非均匀,粗步长下误差大;最优传输框架统一了生成与迁移,但高维大数据上求最优耦合很慢,且输运代价与学习性能并不严格对齐;已有图像迁移方法(如 CycleGAN)把生成与迁移分开处理,需要对抗损失与循环一致性正则。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| 初始样本 X_0 | d 维向量 | 生成任务里是标准高斯噪声,迁移任务里是源域图像;与 X_1 配对构成一个耦合,训练时通常独立采样 (X_0, X_1) ~ π0 × π1 |
| 目标样本 X_1 | d 维向量 | 数据分布或目标域图像;reflow 后换成由已学流模拟产生的确定性配对 (Z_0, Z_1) |
| 时间 t | 标量 ∈ [0,1] | 线性插值点 X_t = t·X_1 + (1−t)·X_0,训练时 t ~ Uniform([0,1]) |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| 速度场 v(Z_t, t) | d 维向量 | ODE dZ_t = v(Z_t, t)dt 的漂移;从 Z_0 ~ π0 积分到 Z_1,得到确定性耦合;reflow 后轨迹近直线,一步欧拉 Z_1 = Z_0 + v(Z_0, 0) 即可 |
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10 | 5 万张 32×32 训练图,无条件生成 | 主定量基准:FID / IS / recall,与 VP/sub-VP ODE、GAN 家族对比 |
| LSUN Bedroom / LSUN Church / CelebA-HQ / AFHQ Cat | 256×256 高分辨率生成 | 验证 1-rectified flow 在 256×256 上也能高质量生成(Figure 11) |
| AFHQ(cat/dog/wild)+ MetFace + CelebA-HQ | AFHQ 1.5 万张 512×512;MetFace 1336 张;CelebA-HQ 3 万张 | 无配对图像迁移,80% 训练 / 20% 测试,迁移后图像 resize 到 512×512 |
| Office-Home / DomainNet | Office-Home 4 域 65 类;DomainNet 6 域 345 类 | 域适应:在预训练模型末层特征上训练 rectified flow,用分类准确率评估 |
架构(摘要)
主干与结构
backbone:DDPM++ U-Net(沿用 Score-SDE 开源实现的结构)
参数:论文未单独报告参数量,直接复用 DDPM++ 的 U-Net 结构
类型:神经 ODE 输运模型(连续时间,速度场回归,训练期一次网络前向即可,无需 ODE 反传)
关键组件
- 速度网络 v_θ(z, t):输入插值点与时间,输出 d 维速度
- 回归目标:min E[||(X_1 − X_0) − v_θ(t·X_1 + (1−t)·X_0, t)||²],t ~ U[0,1],普通最小二乘 + 随机优化
- reflow 数据管线:用已学流模拟生成 400 万对 (z_0, z_1),微调 30 万步得到下一阶 rectified flow
- 蒸馏:一步模型 z_1 = z_0 + v(z_0, 0),k=1 时把 L2 换成 LPIPS 损失
为什么这样设计
直线插值 X_t 是欧氏空间连接两端的测地线,方向 X_1 − X_0 是唯一要预测的量;把速度场学成「穿过该点的所有直线方向的期望」后,得到一个可因果模拟、且每个时刻边缘分布与插值过程一致的 ODE。流的不相交性保证重排后的配对确定化,reflow 再把端点配对换成流自己产生的确定性配对,逐次把轨迹拉直。选择线性插值(α_t = t, β_t = 1−t)同时保证直线与匀速,这是与 VP/sub-VP ODE(弯曲 + 非匀速)的关键区别。
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 无条件生成,完整求解 ODE(RK45)的 FID | 2.58(1-rectified flow,NFE 127),recall 0.57 | VP ODE 3.93(140 步)、sub-VP ODE 3.16(146 步)、VP SDE 2.55(2000 步)、sub-VP SDE 2.61(2000 步) | CIFAR-10 32×32,DDPM++ U-Net,Adam lr 2e-4、dropout 0.15、EMA;RK45 自适应求解 |
| CIFAR-10 一步生成(N=1 欧拉 + 蒸馏)FID | 4.85(distilled 2-rectified flow),recall 0.50 | TDPM 8.91 / 0.46、DDIM Distillation 9.36 / 0.51(此前 U-Net 架构最佳一步模型);StyleGAN2+ADA 2.92 / 0.49、StyleGAN-XL 1.85 / 0.47(GAN,非 U-Net 架构);VP ODE + distill 16.23 / 0.29 | CIFAR-10,单次函数评估;论文称当时 U-Net 架构 one-step 生成模型的 SOTA(FID 4.85、recall 0.51 来自 3-rectified flow 的 0.51) |
| CIFAR-10 一步生成、不蒸馏(N=1 欧拉)FID | 12.21(2-rectified flow,recall 0.34);8.15(3-rectified flow,recall 0.41) | VP ODE 与 sub-VP ODE 在 N=1 时 FID 均约 451、1-rectified flow 378(recall 全为 0.0,即完全糊掉) | CIFAR-10,直接单步欧拉,无蒸馏;说明 reflow 本身(未经蒸馏)就能把 N=1 从完全失败救回可用 |
| reflow 对小步数区间的提升 | N ≲ 80 时 FID 与 recall 随 reflow 逐次改善;大步数区间(N ≳ 80)因 v 估计误差累积反而略变差 | 1-rectified flow 在 N=1 欧拉 FID 378 → 2-rectified 12.21 → 3-rectified 8.15;大步数时 1-rectified flow 仍最优(完整求解 FID 2.58) | CIFAR-10,Figure 8(a),欧拉步数 N 从 1 到 1000 |
| 域适应分类准确率 | Office-Home 69.2 ± 0.5;DomainNet 41.4 ± 0.1 | Deep CORAL 68.7 ± 0.3 / 41.5 ± 0.2(此前最佳或相当);ERM 66.5 ± 0.3 / 40.9 ± 0.1;Mixup 68.1 ± 0.3 / 39.2 ± 0.1 | 预训练模型末层特征上训练 1-rectified flow(DDPM++ 结构),推理 100 步欧拉,把测试集迁到训练域后送分类器 |
| 玩具例:straightness 与相对 L2 输运代价随 reflow 下降 | 一次 reflow 后 straightness 降到接近 0,相对 L2 输运代价从约 1 降到约 0.3(两者归一化到 [0,1]) | reflow 前(1-rectified flow)straightness ≈ 1、相对 L2 代价 ≈ 1 | 二维玩具分布,非参数核估计 v_{X,h}(近邻 m=100,带宽 h 在 0.1 量级),欧拉 100 步 |
Insights
- one-step 思想的系统起点:把「轨迹直」定义成 Z_t = t·Z_1 + (1−t)·Z_0(速度沿路径恒定),直线流用一步欧拉 Z_1 = Z_0 + v(Z_0, 0) 就得到精确解;reflow 让轨迹变直,等于在不引入对抗训练、不要求似然可算的前提下逼近一步模型。
- 速度场 v_X(x,t) = E[X_1 − X_0 | X_t = x] 是「期望条件速度」:每个位置时刻上所有穿过它的直线方向的平均。它与 MeanFlow 的区间平均速度是同一族对象——reflow 后速度沿路径恒定,瞬时速度等于区间平均速度,两边在这一极限下收敛到同一个量。
- 流的不相交性是全部理论的支点:ODE 解唯一 ⇒ 轨迹不能相交 ⇒ 交叉点处必须重排配对;重排把任意耦合变成确定化耦合,并且所有凸输运代价同时不增(Pareto 下降),这是针对单个代价 c 的最优传输方法做不到的。
- 扩散模型里的噪声与指数时间表并非必需:PF-ODE/DDIM 对应 X_t = α_t·X_1 + β_t·ξ 的特例,弯曲来自 β_t ≠ 1−α_t、非匀速来自指数 α_t;换成线性 α_t = t 后轨迹既直又匀速,训练目标仍是同一个最小二乘。
- reflow 与蒸馏是两个不同操作:reflow 换耦合(输运代价更低、轨迹更直),蒸馏忠实逼近当前耦合;蒸馏只该在最后阶段做,1-rectified flow 直接蒸馏在 N=1 时 FID 378 近乎无效,说明蒸馏的收益依赖 reflow 先把轨迹拉直。
vs 同类工作
- vs 概率流 ODE / DDIM:后者从 SDE 用随机分析工具推导而来,路径弯曲、需设计噪声时间表;本文直接写线性插值回归目标,并证明 VP/sub-VP/VE ODE 是同一框架的特例,默认取 α_t = t、β_t = 1−t。
- vs GAN 一步生成:无 minimax 训练、无 mode collapse 问题;CIFAR-10 一步蒸馏 FID 4.85 超过同架构 U-Net GAN(TDPM 8.91),recall 0.50 超过 StyleGAN2+ADA 的 0.49,但绝对值仍高于不同架构的 StyleGAN-XL(FID 1.85)。
- vs 最优传输:OT 对给定代价 c 求最优耦合;reflow 对所有凸代价同时不增代价、但一般达不到 c-最优(直线耦合 ≠ 最优耦合),一维情形例外:直线耦合 = 单调确定耦合 = 所有凸代价的共同最优。
- vs 后续快速采样与 one-step 工作(DPM-solver、蒸馏扩散、MeanFlow 等):本文确立了「把路径拉直再少步采样」这条路线,后续流匹配方法(含 Stable Diffusion 3 的 rectified flow 变体)与 MeanFlow 的 fastforward 范式都在这条线上延伸。
局限
- 论文自承:reflow 次数不宜过多,估计 v_X 的误差会逐轮累积(原文建议不要做太多 reflow steps);实验上 reflow 在大步数区间(N ≳ 80)反而让 FID 变差,完整求解时 1-rectified flow(2.58)优于 2/3-rectified flow(3.36/3.96)。
- 论文自承:在 d ≥ 2 时直线耦合一般达不到给定代价 c 的最优耦合,Rectify(·) 不针对任何特定代价;论文后续工作 [42] 才给出把 v 限制为梯度场(v = ∇f)来逼近二次代价最优耦合的改法。
- 论文自承:v_X 良定义需要条件密度存在且光滑;否则要往 X_0 加高斯噪声 σ²I 平滑,输运会退化为随机映射 T(X_0 + ξ)。
- 我们读出:拉直与代价下降的定理假设每轮都解出精确 v_X(或逐层 rectifiable);实际用神经网络近似,reflow 每轮要重新生成 400 万对样本并微调 30 万步,训练管线开销可观,一步采样的「便宜」建立在多轮训练的「贵」之上。
- 我们读出:一步质量仍有明显差距——CIFAR-10 一步蒸馏 FID 4.85 差于完整求解的 1-rectified flow(2.58)与 VP SDE(2.55);图像迁移实验只给视觉效果与样例,没有 FID 等定量指标。
- 我们读出:实验规模以 32×32 与 256×256 图像为主,CIFAR-10 之外没有系统的大规模文本条件生成验证;reflow 需要从已学流采样训练数据,这一自举过程的理论分析(如误差如何在 reflow 间传播)论文没有给出。
可复现性
- code:未官方开源;实现基于 Score-SDE 开源库的 DDPM++ 结构,附录给出 Algorithm 2–4 伪代码
- weights:未发布
- eval:CIFAR-10 FID/IS/recall;高分辨率数据集视觉样例;Office-Home/DomainNet 分类准确率;无配对图像迁移视觉样例
主干与结构
backbone:DDPM++ U-Net(沿用 Score-SDE 开源实现的结构)
参数:论文未单独报告参数量,直接复用 DDPM++ 的 U-Net 结构
类型:神经 ODE 输运模型(连续时间,速度场回归,训练期一次网络前向即可,无需 ODE 反传)
关键组件
- 速度网络 v_θ(z, t):输入插值点与时间,输出 d 维速度
- 回归目标:min E[||(X_1 − X_0) − v_θ(t·X_1 + (1−t)·X_0, t)||²],t ~ U[0,1],普通最小二乘 + 随机优化
- reflow 数据管线:用已学流模拟生成 400 万对 (z_0, z_1),微调 30 万步得到下一阶 rectified flow
- 蒸馏:一步模型 z_1 = z_0 + v(z_0, 0),k=1 时把 L2 换成 LPIPS 损失
为什么这样设计
直线插值 X_t 是欧氏空间连接两端的测地线,方向 X_1 − X_0 是唯一要预测的量;把速度场学成「穿过该点的所有直线方向的期望」后,得到一个可因果模拟、且每个时刻边缘分布与插值过程一致的 ODE。流的不相交性保证重排后的配对确定化,reflow 再把端点配对换成流自己产生的确定性配对,逐次把轨迹拉直。选择线性插值(α_t = t, β_t = 1−t)同时保证直线与匀速,这是与 VP/sub-VP ODE(弯曲 + 非匀速)的关键区别。
一步 vs 多步:1-rectified flow 与 2-rectified flow 的图像生成与迁移
原文 caption:The trajectories of rectified flows for image generation (π0: standard Gaussian noise, π1: cat faces, top two rows), and image transfer between human and cat faces (π0: human faces, π1: cat faces, bottom two rows), when simulated using Euler method with step size 1/N for N steps. The first rectified flow yields good results with a very small number (e.g., ≥2) of steps; the straightened reflow (2-rectified flow) has nearly straight line trajectories and yields good results even with one discretization step.
全篇最直观的一张图:每行是同一个任务在不同欧拉步数 N=1/2/5/10/1000 下的输出。1-rectified flow 在 N=1 时模糊,N=2 开始清晰;2-rectified flow 在 N=1 就已清晰,增加步数几乎不再变化。结论:reflow 一次之后轨迹接近直线,直线轨迹让一步欧拉就够用。
重排耦合:交叉的线性插值如何被 rectified flow 拉直
原文 caption:(a) Linear interpolation of data input (X0, X1) ~ π0 × π1. (b) The rectified flow Zt induced by (X0, X1); the trajectories are rewired at the intersection points to avoid the crossing. (c) The linear interpolation of the end points (Z0, Z1) of flow Zt. (d) The rectified flow induced from (Z0, Z1), which follows straight paths.
理解 reflow 的机制图。(a) 独立配对 (X0,X1) 的直线插值轨迹在中间交叉,交叉处方向信息不一致,无法因果模拟;(b) rectified flow 在每个位置取「所有穿过该点的方向的平均」,轨迹在交叉点被重排、不再相交,边缘分布与 (a) 相同;(c) 把 (b) 的端点 (Z0,Z1) 再连直线,交叉已经大幅减少;(d) 对 (Z0,Z1) 再 rectified 一次,轨迹基本是直线。
reflow 的拉直效果与输运代价下降(玩具例)
原文 caption:(a)-(c) Samples of trajectories drawn from the reflows on a toy example (π0: purple dots, π1: red dots). (d) The straightness and the relative L2 transport cost v.s. the reflow steps; the values are scaled into [0, 1], so 0 corresponds to straight lines and L2 optimal transport. Non-parametric model in (5) with bandwidth h = 0.1.
证明「reflow 让轨迹变直、同时降低输运代价」的玩具实验。(a)→(c) 第 1/2/3 次 rectified flow 的轨迹从大量交叉绕行逐步变成近乎平行的直线;(d) 横轴是 reflow 次数,纵轴是归一化到 [0,1] 的两个指标:straightness(蓝)第一次 reflow 就掉到接近 0,相对 L2 输运代价(绿)从约 1 降到约 0.3 后继续缓慢下降。
CIFAR-10 定量结果:FID/recall 随欧拉步数与训练迭代的变化
原文 caption:(a) FID and Recall vs. Number of Euler discretization steps N. (b) FID and recall during different reflow and training steps. In (a), k-Distilled refers to the one-step model distilled from k-Rectified Flow for k = 1, 2, 3. Table 1: Results on CIFAR10 unconditioned image generation.
核心定量证据。(a) 横轴欧拉步数 N、纵轴 FID:在小步数区间(N ≲ 80)reflow 逐次改善 FID 与 recall,2/3-rectified flow 在 N=1 的 FID 远低于 VP/sub-VP ODE(后者 N=1 时 FID 约 451,几乎全糊);星标是蒸馏后的一步模型。完整求解(RK45,Table 1)时 1-rectified flow 用 127 次函数评估拿 FID 2.58 / recall 0.57,优于 VP ODE(140 步,3.93 / 0.51)与 sub-VP ODE(146 步,3.16 / 0.55),逼近 VP SDE(2000 步,2.55 / 0.58)。
🎧 音频版
时长 35:41 · Edge TTS
Flow Straight and Fast:让生成模型的轨迹变直,一步出图(对话版·精读)
开场:这篇论文解决什么问题,为什么值得专门做一期
小播:老播,今天这篇论文讲什么?我先说下我的感受——现在生成一张图,模型要一步步调几十次甚至几百次网络,我一直好奇,能不能一步就出图?
老播:今天这篇叫《Flow Straight and Fast》,作者是德州大学奥斯汀分校的刘兴超、龚程越和刘强,2022 年 9 月挂到 arXiv,后来发表在 ICLR 2023。一句话背景:扩散模型能生成高质量图像,但推理时要反复求解一个随机微分方程,代价很高;一句话定位:这篇用「把轨迹学直」的办法,让连续时间模型能少步甚至一步采样;一句话结论:它通过一个叫 reflow 的操作,用已生成的轨迹重新构造样本配对,把轨迹逐次拉直,而直线轨迹用一步欧拉就能精确求解,在 CIFAR-10 上做到了蒸馏后一步生成 FID 4.85。
小播:为什么值得专门做一期?同类方法不是很多吗?
老播:因为这篇是「one-step 生成」这条思路最早的系统表述。你回头看生成模型的编年史:GAN 是一步出图,但对抗训练不稳定;扩散模型训练稳定、质量高,但推理要上百步;中间一直缺一个框架,能把「连续时间模型」和「一步采样」统一起来。这篇给出的答案是把路径学直,而且给出了可证明的拉直速率,还把概率流 ODE 和 DDIM 收编成自己的特例。后来的 flow matching、蒸馏系方法、MeanFlow,都能追溯到这篇。这期我们要把「为什么直线轨迹能一步采样」和「reflow 到底在重排什么」讲透,最后对比它和 MeanFlow 的平均速度。
小播:那我们这期大概怎么走?
老播:四步。第一步讲背景:扩散模型为什么慢,欧拉离散化为什么怕弯轨迹。第二步讲方法的第一块:线性插值加期望条件速度,这是 rectified flow 的训练目标。第三步讲 reflow:用已生成的轨迹重新构造耦合,把轨迹拉直,然后说清楚为什么直线等于一步采样。第四步用实验数字收口,再把它放进谱系——和概率流 ODE、最优传输、MeanFlow 各是什么关系。
小播:好,那先把背景铺开——扩散模型到底卡在哪?
背景:为什么生成一张图要调几百次网络
老播:生成模型有三条老路。第一条是 GAN,2014 年提出,让生成器和判别器对抗训练,图像质量高,但训练不稳定、容易 mode collapse——生成器只学会少数几种模式,多样性差。第二条是 VAE 和标准化流,走最大似然路线,理论干净,但似然要么要变分近似、要么要可逆结构,表达力受限。第三条就是扩散模型,2020 年 DDPM 为代表:先往数据里逐步加噪,把数据变成高斯噪声,再学一个网络逐步去噪。它的训练目标是一个稳定的回归问题,没有对抗训练,图像质量反超 GAN。
小播:那扩散模型的问题出在哪?
老播:出在推理。去噪要一步步来:DDPM 原文要 1000 步;Score-SDE 那套的 VP SDE 在 CIFAR-10 上完整模拟要 2000 次函数评估。函数评估就是推理时调用神经网络主干的次数,每次都要跑一遍 U-Net。后来概率流 ODE 和 DDIM 把 SDE 转成 ODE,步数降到一两百步——VP ODE 在 CIFAR-10 上约 140 步,sub-VP ODE 约 146 步——但还是要上百次调用。对比一下:GAN 这类模型一次前向就出图,连续时间模型却要反复调用,这是它最大的短板。
老播:还有个视角值得先立起来:生成、迁移、风格转换、域适应,都可以统一看成「在两个分布之间找一个输运映射」。这个框架来自最优传输,一个经典的数学分支,它把「起点终点怎么配对」抽象成代价函数 E[c(Z₁ − Z₀)],比如距离平方。但传统最优传输方法在高维大数据上算起来很慢,而且输运代价和学习性能并不严格对齐——代价最小不代表生成质量最好。这篇的立场很明确:别追求代价最优,追求路径够直,直本身就带来推理上的大便宜。回到扩散模型的问题——
小播:那为什么扩散模型还有这么多人用?
老播:因为质量好、训练稳。扩散模型在 CIFAR-10 上完整模拟的 FID 是 2.55(VP SDE),而 2020 年之前最强的 GAN 也要面对训练不稳定的问题。所以当时的格局是:一步模型(GAN)快但不稳,稳定模型(扩散)好但慢。中间地带,比如 DDIM 把 SDE 变成 ODE,省掉随机噪声那部分,步数降到一两百步,但轨迹是弯的,粗步长下误差大。这里有个背景知识:数值求解 ODE 时,离散化步数越多误差越小;如果轨迹本身是直线,一步欧拉就是精确解,根本不需要细分。论文的切口就在这里:与其在弯曲的轨迹上精打细算怎么离散,不如先把轨迹学直。直线是欧氏空间里连接两点的最短路径,既省路程又好模拟。小播:你说的欧拉步具体是什么?为什么轨迹弯了就必须多走几步?
老播:欧拉法是最简单的数值积分:从一个点出发,顺着速度场的方向迈一小步,到新位置再读一次速度、再迈一步,反复进行,一共 N 步。每步都假设速度在这一小段里恒定;如果轨迹是弯的,这个假设就失真,必须把步长缩得很小、步数加得很多才能跟上。如果轨迹本身是直线而且匀速,一步欧拉的结果和精确解完全一样,误差是零。所以「轨迹直不直」直接决定了「要几步才够」,这是贯穿全文的一条主线。
下面我们进方法。
核心思想第一步:先画一条路,再让粒子自己走
老播:先定义问题。我们要找的是一个输运映射:给定两个经验分布 π₀ 和 π₁,找一个映射 T,让 T(Z₀) 服从 π₁,其中 Z₀ 服从 π₀。生成任务里,π₀ 是标准高斯噪声、π₁ 是数据;迁移任务里,π₀ 是源域、π₁ 是目标域。这俩样本对之间没有真实的对应关系,训练时配对是随机的:从 π₀ 抽一个 X₀,从 π₁ 抽一个 X₁。起点和终点之间这个随机的对应关系,术语叫耦合,也就是 transport plan。整个生成模型的历史,都可以看成在找各种各样的耦合。
小播:没有对应关系,怎么知道该把 X₀ 送去哪?
老播:这就是线性插值的作用。定义 X_t = t·X₁ + (1 − t)·X₀,t 从 0 到 1 变化。t = 0 时 X_t 等于 X₀,t = 1 时等于 X₁,中间就是两点连线上按比例移动的位置。这条直线每个时刻的移动方向是常数 X₁ − X₀。问题来了:这条路径要先知道终点才能走,术语叫非因果或者预期性的——dX_t = (X₁ − X₀)dt 这个方程里,更新方向依赖未来的 X₁;而且不同样本对的直线会在中间交叉,交叉点处来自不同配对的方向互相冲突,不知道该听谁的。
小播:所以线性插值本身当不了生成模型。
老播:对。rectified flow 的做法是训练一个速度网络 v,让它学会「在每个位置、每个时刻,穿过这里的那些直线的平均方向」。训练目标写成:
min_v ∫₀¹ E[ || (X₁ − X₀) − v(t·X₁ + (1 − t)·X₀, t) ||² ] dt
先给预期:这个式子问的是「网络在每个插值点预测的方向,和这条直线本来的方向差多远」,把这个差压到最小。逐符号解释:X₁ − X₀ 是这条直线本来的方向;v(·, t) 是网络在插值点 X_t、时间 t 处预测的速度;两者相减取平方范数,再对随机配对 (X₀, X₁) 和随机时间 t(在 [0,1] 上均匀采样)取期望。它就是一个普通的最小二乘回归,随机梯度下降就能训,不需要对抗训练,也不需要算似然,连扩散模型那套噪声调度超参都不用调。
小播:这个回归的最优解长什么样?
老播:有闭式解:v_X(x, t) = E[ X₁ − X₀ | X_t = x ]。读出来就是:给定「时刻 t 恰好经过位置 x」这件事,把所有经过这里的直线方向取平均。论文管它叫期望条件速度——注意这个词,后面对比 MeanFlow 还要用到。它是唯一的、确定性的函数,只依赖当前位置和时间,不依赖终点。所以用它驱动的 ODE,dZ_t = v_X(Z_t, t) dt,可以只凭当前状态往前积分,把非因果的插值过程变成因果的、可模拟的过程。顺便说,最优解 v_X 的存在需要点数学条件——条件密度存在且光滑,否则这个条件期望可能没定义;论文的应对是往 X₀ 加一点高斯噪声做平滑。
小播:那这个平均方向会不会把信息磨没了?两条方向相反的线在同一点相遇,平均下来不是互相抵消了?
老播:这个问题问到点子上了。一个良定义的 ODE,解是唯一的,所以轨迹永远不能相交——两条轨迹如果同一时刻经过同一点,之后就分不清谁是谁了。线性插值里那些交叉的线,必须在交叉点重排:两条线相遇,就交换各自的终点继续走。论文的 Figure 2 画的就是这个过程:图 (a) 里直线交叉,图 (b) 里 rectified flow 在交叉点重新接线,轨迹不再相交,但每个时刻的密度分布和 (a) 完全一样。这条重排性质是整个方法的地基。它还有一个配套定理,叫边缘保持:Z_t 的分布和 X_t 的分布在每个时刻都相同。用论文的话说,质量怎么从每个小体积里流进流出,两个过程在每个位置每个时刻都相等,所以密度图完全一样;区别在联合分布——插值过程是非因果的随机配对,rectified flow 把配对确定化、马尔可夫化了。小播:为什么条件期望就是最优解?它有没有可能是别的函数?
老播:换个角度看:回归目标其实是在找「所有只依赖当前位置 x 和时间 t 的函数里,最接近直线方向 X₁ − X₀ 的那个」。最小二乘的最优解正是条件期望——它把 X₁ − X₀ 投影到「由 (x, t) 决定」的函数空间上。这也解释了为什么不同配对在同一点会平均:网络只能看到当前位置,没法区分两条不同配对的线,只能给出平均方向。这个平均是在信息约束下的最优选择;reflow 的使命,就是通过重排配对,让每个位置上只剩下一个方向,让平均退化成确定值。
小播:那这个速度场在实现上怎么算?不可能真的去求条件密度吧?
老播:对,精确的 v_X 需要知道条件密度,而且会完全过拟合——它能把训练点原封不动地送回去,等于记住数据。实用做法是函数近似:低维玩具实验用核估计,对当前位置的近邻样本做加权平均,它的每一项都是指向 π₁ 支撑集内某个点的线性函数,加权平均之后仍然是这类函数的混合,效果很好;高维图像用神经网络,训练就是一个回归。论文还发现神经网络的平滑性本身有帮助:Figure 7 里增大 L2 正则让网络更光滑,轨迹反而更直,等于平滑正则和 reflow 在往同一个方向使劲。
重排之后,端点配对 (Z₀, Z₁) 已经和原来随机配的 (X₀, X₁) 不一样了。
核心思想第二步:reflow,用已生成的轨迹重新构造耦合
老播:现在讲 reflow,这是全文的心脏。刚才说 rectified flow 的端点对 (Z₀, Z₁) 已经是被重排过的、确定性的配对。reflow 的操作就是把这个配对再当训练数据:用当前流从 Z₀ ~ π₀ 模拟出一大批新的 (Z₀, Z₁),拿这批由模型自己产生的配对重新训练一个新流,它叫 2-rectified flow;再递归一次得到 3-rectified flow。每一步都在做同一件事:用已生成的轨迹重新构造耦合。这就是阅读提示里说的 reflow 的核心。
小播:重新构造耦合,就是把起点和终点重新配对吧?为什么这样能让轨迹变直?
老播:对,耦合就是起点终点之间的对应关系。第一次 rectified flow 之后,配对从随机独立变成了按流重排,配对更省路程。数学上有个定理:对任意凸代价函数 c,都有 E[c(Z₁ − Z₀)] ≤ E[c(X₁ − X₀)],也就是输运代价对所有凸代价同时不增。凸代价函数包括欧氏距离、距离平方这些常见选择,证明只用到了詹森不等式:先把整段积分塞进代价函数,再用凸性把它拆开,最后用条件期望的性质消掉。交叉的线被重新接线后,每条线都更接近就近接送,总路程变短;路程越短、交叉越少,下一次再学「平均方向」时,每个位置上的方向就越一致,轨迹就越接近直线。Figure 3 的玩具例子里,两次 reflow 之后轨迹已经几乎是平行直线了。
这里补一个论文自己的框架,方便你记忆:线性插值相当于修路——把 π₀ 的每个点和 π₁ 的每个点用直线连起来,修出一张路网;rectified flow 相当于车流——粒子在路口做无记忆、不交叉的选择,遇到路口就按平均方向走,最后自然重排出新的配对。路是固定的,也就是插值几何不变;车流是可变的,也就是配对由流决定。reflow 改的是车流的配对规则,路本身没动。
小播:那「直线」到底好在哪里?为什么直线就能一步采样?
老播:这是全篇最重要的考点,我把定义说精确。论文把「直」定义成:Z_t = t·Z₁ + (1 − t)·Z₀ 对所有的 t 都成立,也就是速度沿路径恒定,恒等于 Z₁ − Z₀。这样的流,一步欧拉 Z₁ = Z₀ + v(Z₀, 0) 就是精确解——速度从头到尾不变,从 0 积分到 1,位移就是 v(Z₀, 0)×1。所以直线流天然是一个 one-step 模型。论文还定义了弯曲度度量 S(Z) = ∫₀¹ E[||(Z₁ − Z₀) − Ż_t||²] dt,含义是「每个时刻的实际速度偏离总位移的程度」,S = 0 就是完全直线。定理 3.7 保证:递归 reflow K 次之后,这些流里弯曲度最小的那个以 O(1/K) 的速率趋向 0。翻译成人话:reflow 的次数越多,轨迹越直,离散化误差越小,一步采样越接近精确。
小播:有没有更明确的刻画?什么情况下一个耦合是「直的」?
老播:论文给了四条等价刻画(定理 3.6),最直观的一条是:直线插值的路径互不相交。想一下,如果两条路径不相交,那么每个位置每个时刻只有一个方向,期望条件速度就等于这条线自己的方向,方程就退化成了插值方程本身,流自然就是直的。还有一个一维的特例很有意思:一维情形下,直线耦合恰好等于单调确定耦合,也就是把 π₀ 里小的点送到 π₁ 里小的点,它是所有凸代价函数的共同最优解。高维里没有这么好的事——直线耦合一般达不到某个代价的最优输运,这个我们放到谱系部分再说。
小播:懂了,直线到一步是几何事实,reflow 是让轨迹逼近直线的算法。
老播:还要区分 reflow 和蒸馏。reflow 换耦合——它产生新的、代价更低的配对和更直的轨迹;蒸馏是忠实逼近当前的配对——在最后阶段学一个一步网络 z₁ ≈ z₀ + v(z₀, 0),损失就是 E[||(Z₁ − Z₀) − v(Z₀, 0)||²]。蒸馏只在最后做。有个实验证据:1-rectified flow 直接蒸馏,CIFAR-10 上一步 FID 是 378,几乎全糊;reflow 之后再蒸馏才有 4.85。说明蒸馏的收益依赖 reflow 先把轨迹拉直,小播:能不能给个具体数字感受一下「弯 + 非匀速」的代价?
老播:看 Figure 5 的对比。VP ODE 和 sub-VP ODE 的轨迹前期几乎不动——t 小于 0.5 时位移很少,大部分更新挤在后期;用大步长(N=1 或 N=2)时,一步就把前期那段整个跳过去,结果完全偏离目标。rectified flow 是直线匀速,每一步均匀推进,粗步长下也不会漏掉一大段。这个机制直接解释了为什么 N=1 时 VP ODE 的 FID 是 451:轨迹弯加上速度不均匀,一步根本覆盖不了整个路径。论文在玩具例子里还专门给 VP ODE 换了匀速时间表(α_t = t),轨迹立刻变直变匀——说明弯和慢是时间表设计造成的,和任务本身无关。
两个操作各干各的活。CIFAR-10 上蒸馏 k=1 时还做了一点工程:把 L2 损失换成 LPIPS 感知损失,效果更好。
关键实验:玩具、CIFAR-10 的数字、迁移和域适应
老播:先看玩具例子。二维分布上,论文用非参数核估计直接算期望条件速度(近邻数 m = 100,带宽 h 在 0.1 到 1 之间),不引入神经网络误差,专门验证理论。Figure 3 的 (a)(b)(c) 三列分别是第 1、2、3 次 rectified flow 的轨迹:从大量交叉绕行,到基本平行的直线。图 (d) 横轴是 reflow 次数,纵轴是两个归一化到 [0,1] 的指标:straightness 在第一次 reflow 后就掉到接近 0;相对 L2 输运代价从约 1 降到约 0.3,之后继续缓慢下降。玩具实验直接演示了「reflow 拉直轨迹、同时降低输运代价」。
小播:真实图像上的数字呢?
老播:主基准是 CIFAR-10,32×32 分辨率,5 万张训练图,无条件生成,网络用 DDPM++ 的 U-Net,Adam 学习率 2e-4,dropout 0.15,EMA 平滑。第一个数字是完整求解:1-rectified flow 用 RK45 自适应求解器,127 次函数评估,FID 2.58、recall 0.57。FID 衡量生成分布和真实分布的差异,越低越好;recall 衡量多样性,越高越好。对照:VP ODE 140 步,FID 3.93、recall 0.51;sub-VP ODE 146 步,3.16、0.55;完整模拟的 VP SDE 要 2000 步才到 2.55、0.58。所以 1-rectified flow 用不到一半的步数就追平了扩散模型,recall 还略高。
小播:那一步采样呢?这是招牌。
老播:一步采样就是 N=1 欧拉步。不蒸馏时,2-rectified flow 的 FID 是 12.21、recall 0.34;3-rectified flow 是 8.15、0.41,图像已经能看了。而 VP ODE 和 sub-VP ODE 在 N=1 时 FID 都在 451 左右、recall 0.0,等于完全糊掉。这个对比很说明问题:同样一次网络调用,轨迹直的模型出的是能看的图,轨迹弯的模型出的是噪声。蒸馏之后,distilled 2-rectified flow 一步 FID 4.85、recall 0.50,超过此前 U-Net 架构最好的 one-step 模型 TDPM(8.91、0.46)和 DDIM Distillation(9.36、0.51)。GAN 家族里 StyleGAN2+ADA 是 2.92、0.49,StyleGAN-XL 是 1.85、0.47,但那是不同架构、还用了大量专门的训练技巧。小播:除了数字,有没有更直观的「轨迹变直」的证据?
老播:有,Figure 9 和 Figure 10 专门做这个。做法叫外推:在轨迹上任取一点 z_t,用公式 ẑ₁ = z_t + (1 − t)·v(z_t, t) 预测它最终会到哪。如果轨迹是直线,这个预测应该和取点位置无关——不管从 t=0.2 还是 t=0.8 处外推,终点都是同一个。Figure 10 在 AFHQ 猫脸上做:2-rectified flow 的 ẑ₁ 几乎不随 t 变,说明路径接近直线;1-rectified flow 的 ẑ₁ 会漂移,但 t≈0.1 时就已经能看出清晰图像,而 sub-VP ODE 要到 t≈0.6 才出清晰图像。Figure 9 右侧还画了 CIFAR-10 上随机像素值的轨迹,2-rectified flow 的像素轨迹基本就是直线,1-rectified flow 的还带弯曲。这些图把「reflow 拉直」从理论变成了看得见的现象。
论文当时声称,FID 4.85 和 recall 0.51(来自 3-rectified flow)是 CIFAR-10 上一步快速生成模型的 SOTA。
小播:那 reflow 是不是做得越多越好?
老播:论文自己说:别做太多轮。Figure 8(a) 里,横轴是欧拉步数 N、纵轴是 FID:在小步数区间(N 大概小于 80),reflow 逐次改善 FID 和 recall;但大步数区间 reflow 反而变差,因为每轮用模型自己生成的配对训练,估计速度场的误差会累积。完整求解时,1-rectified flow 的 FID 2.58 反而最好,2-rectified 是 3.36,3-rectified 是 3.96。所以 reflow 的定位是:拿一点完整求解的质量,换小步数区间的巨大提升。Figure 1 也直观展示了这个效果:同样的猫脸生成任务,1-rectified flow 在 N=1 模糊、N=2 开始清晰;2-rectified flow 在 N=1 就清晰,加到 1000 步几乎不变。
小播:高分辨率和迁移呢?它说这是统一框架。
老播:高分辨率上,1-rectified flow 在 256×256 的 LSUN Bedroom、LSUN Church、CelebA-HQ、AFHQ Cat 上都能生成清晰图像。迁移就是把 π₀ 设成源域、π₁ 设成目标域,同一个训练目标:AFHQ 的猫、狗、野生动物,MetFace,CelebA-HQ,512×512 分辨率,80% 训练、20% 测试,1-rectified flow 用 100 步欧拉迁移质量很好,2-rectified flow 一步就能迁移。为了保持主体身份,损失改成用区分两域的预训练分类器特征加权,让速度误差在影响身份的方向上被重点惩罚。域适应在 Office-Home 和 DomainNet 上:把预训练模型末层特征当分布,1-rectified flow 迁移后,Office-Home 分类准确率 69.2 ± 0.5,对照 Deep CORAL 的 68.7 ± 0.3;DomainNet 是 41.4 ± 0.1,对照 CORAL 的 41.5 ± 0.2,持平或略好。一个算法同时覆盖生成、迁移、域适应,这是它想证明的事。论文还演示了 latent 空间的性质:2-rectified flow 用一个反向步就能拿到有意义的潜码,线性插值两个潜码能平滑过渡,还能把两张拼起来的怪图先反解到潜空间、推向 π₀ 的高概率区再解回来,做图像编辑。
小播:这些潜空间操作具体怎么走?
老播:分三步。第一步,把一张真实图像 z₁ 用反向 ODE 解回潜码 z₀——2-rectified flow 只用一个反向步就能拿到有意义的潜码,1-rectified flow 要多走几步,这就是拉直的又一重收益。第二步,在潜空间里做操作:把两张图的潜码按 √α·z₀ + √(1−α)·z₀′ 线性插值,生成的图像会平滑过渡,论文的 Figure 17 和 18 展示了猫脸渐变。第三步是 Figure 12 的编辑例子:把白猫和黑猫的上半身、下半身拼成一张怪图,反向解到潜码;因为怪图在 π₀ 下的似然很低,把潜码往高概率区推——缩放到 α 倍,或者用 Langevin 动力学——再正向解回去,就得到自然的融合图像。这些操作全是 ODE 可逆性的直接应用,也是确定性潜空间带来的便利。
谱系:它和扩散、最优传输、MeanFlow 各是什么关系
老播:这篇最讨巧的一点,是把概率流 ODE 和 DDIM 收编成了自己的特例。论文证明,VP、sub-VP、VE 这些 ODE 都可以写成 X_t = α_t·X₁ + β_t·ξ 的插值形式,ξ 是标准高斯,这正是非线性 rectified flow 框架。它们的轨迹为什么弯?因为 β_t 不等于 1 − α_t,插值不沿直线走;速度为什么不均匀?因为 α_t 是指数形式,前期走得慢、后期加速。这两个特征都来自 SDE 推导的中间产物,对任务本身没有帮助。换成 α_t = t、β_t = 1 − t 的线性插值,轨迹又直又匀速,回归目标还是同一个最小二乘。论文还有一个更大的主张:扩散方法里的噪声可能本身就不必要,它成功的部分可能来自稳定、可扩展的回归训练,而不是噪声的数学结构。
小播:它和最优传输有什么关系?
老播:最优传输要找「给定代价函数下总代价最小的配对」,代价函数 c 是凸的,比如距离平方。reflow 不针对任何特定的代价,但它保证所有凸代价同时不增,相当于 Pareto 改进。要注意,维度 d ≥ 2 时,直线耦合一般达不到某个代价的最优耦合——直线是「够直」,最优是「够省」,两者有交集但不重合。论文专门证明了一维情形的特例:一维里直线耦合恰好等于单调确定耦合,是所有凸代价的共同最优。所以 reflow 的目标是「够直、能一步采样」,和「求最优输运」是两回事,别混。另外,论文还讨论过 MLE 路线训神经 ODE(2018 年那篇 Neural ODE)的问题:要沿时间反传,容易梯度消失爆炸,而且似然只约束终点分布、路径完全欠定,得靠正则项才能选出「短路径」——小播:扩散那批加速方法,比如 DPM-solver,和它是什么关系?
老播:DPM-solver 那类是「不改轨迹,改进求解器」——用高阶指数积分器在弯曲轨迹上少走几步;rectified flow 是「改轨迹」——让轨迹直到不需要高阶技巧。两条路线后来合流了:flow matching 采用线性插值,回归目标和 rectified flow 相同,再配更好的求解器,Stable Diffusion 3 的 backbone 就是这种形式。论文还系统对比了 ODE 和 SDE 的取舍:ODE 时间可逆,正反向求解一样简单;它的潜空间是确定性的,可以直接做插值和编辑,而 DDPM 的隐变量带噪声、当不了潜空间用;SDE 的优势要在需要捕捉丰富时间相关性,或者建模金融、物理模拟这类高噪声数据时才体现出来。论文的立场很鲜明:对生成和迁移这类「只看边缘分布」的任务,ODE 够用且更省。
相比之下,rectified flow 直接把路画好,再让网络去拟合路,一步到位。
小播:那扩散桥、Schrödinger 桥那类方法,又和它是什么关系?
老播:那类方法把「设计扩散模型」变成「构造桥过程」——桥就是两端都钉死的随机过程。它们理论上有吸引力,但要么要解 Schrödinger 桥问题、计算挑战很大,要么设计空间很大、缺乏一个明确的偏好准则。论文的贡献之一是给出了一个准则:在去掉噪声的 ODE 世界里,直线路径应该被优先;它预期这个想法能推广,给桥过程的设计提供指引。好,最后到最绕的那个对比——
小播:最后,阅读提示里说对比期望条件速度和 MeanFlow 的平均速度,这个怎么讲?
老播:这是今天最容易绕晕的一点,我放慢讲。rectified flow 学的 v_X(x, t) = E[X₁ − X₀ | X_t = x],是「时刻 t、位置 x 处,穿过此处的直线方向的期望」,它估计的是瞬时速度场在每个位置时刻的条件期望,每个时刻单独算。MeanFlow 是 2025 年的工作,它学的是 u(x, r, t) = E[(Z_t − Z_r) / (t − r) | Z_r = x],也就是「从时刻 r 到时刻 t 整段路程的平均速度」,直接把整个区间的平均速度预测出来,一次函数评估就从 Z_r 跳到 Z_t,这叫 fastforward 一步采样。两者是同一族对象:当轨迹是直线且匀速时,瞬时速度等于区间平均速度,等于常数 Z₁ − Z₀,两个框架在这一极限下收敛到同一个量。区别在路线:rectified flow 用 reflow 把轨迹拉直,让瞬时速度场沿路径变恒定;MeanFlow 不拉直轨迹,直接学区间平均。一个靠把路修直,一个靠直接算全程平均,回答的是同一个问题——一步采样怎么成为可能。
小播:这么一讲就通了:直线轨迹是两者共同的极限,也是 one-step 的几何基础。
局限:一步采样不是免费的
老播:讲局限,先说论文自己承认的。第一,reflow 不能无限做:估计速度场的误差会逐轮累积,实验上大步数区间 reflow 反而变差。而且少步采样的便宜,建立在多轮训练的贵之上——每轮 reflow 要重新生成 400 万对样本、再微调 30 万步。第二,维度 d ≥ 2 时直线耦合一般达不到给定代价的最优耦合,论文自己承认要在后续工作里把速度场限制成梯度场,才能逼近二次代价的最优输运。第三,期望条件速度要良定义,需要条件密度存在且光滑;否则要往起点加高斯噪声平滑,输运会变成随机映射。第四,理论保证(拉直速率、代价下降)假设每轮都解出精确的速度场,实际是神经网络近似,误差怎么在 reflow 轮次之间传播,论文没有分析。
小播:你自己读下来,觉得哪里证据最弱?
老播:图像迁移这块最弱:论文只给了视觉样例,没有 FID 之类的定量指标,好不好看靠肉眼判断。另外是规模:实验以 32×32 和 256×256 图像为主,没有大规模文本条件生成的系统验证——后来真正大规模落地,比如 Stable Diffusion 3 用 rectified flow 的插值形式,是别的团队在更大规模上做的。还有一步质量本身:CIFAR-10 一步蒸馏 FID 4.85,明显差于完整求解的 1-rectified flow 的 2.58 和 VP SDE 的 2.55,一步和完整求解之间还有差距。最后一点:reflow 的训练数据来自模型自己,这种自举过程在理论上没有收敛到某个唯一解的保证——一维之外,不同轮次的 reflow 可能停在不同的直线耦合上。
收尾:记住这三件事
小播:我来总结本期记住的三件事。第一,reflow 的核心是用已生成的轨迹重新构造耦合:把随机配对的起点终点,换成流自己产生的新配对,交叉越少、轨迹越直。第二,直线轨迹支持一步采样是一条几何事实:轨迹满足 Z_t = t·Z₁ + (1 − t)·Z₀ 时,一步欧拉 Z₁ = Z₀ + v(Z₀, 0) 就是精确解,所以把轨迹学直就等于逼近 one-step。第三,期望条件速度 v_X(x, t) = E[X₁ − X₀ | X_t = x] 和 MeanFlow 的区间平均速度是同一族对象,直线匀速流里它们重合:rectified flow 靠 reflow 修路,MeanFlow 靠直接算全程平均。这三件事其实是一件事——one-step 生成的可能性来自速度沿路径恒定。
老播:补一句这篇对后续的意义。它是 one-step 思想最早的系统表述:给了一个能证明拉直速率、能一步采样的干净框架,把扩散的概率流 ODE 收编成特例,还统一了生成与迁移。后来的 flow matching、蒸馏系 one-step 方法、MeanFlow 的 fastforward 范式,都能在这篇里找到源头。如果你只记住一个数字,就记住这个:CIFAR-10 上,reflow 一次之后,一步欧拉从 FID 378(全糊)变成 12.21(能看),再蒸馏变成 4.85。轨迹直不直,差的就是这一步。