Flow Matching for Generative Modeling(精读)
一句话定位:把生成模型的训练从「扩散过程的去噪」推广成「任意概率路径的速度场回归」——对每个数据点定义一条从噪声到它的条件路径,回归这条路径的速度,再证明这个逐样本目标与不可解的全局目标梯度等价;其中线性插值的 OT 路径让轨迹变直,换来更快训练、更少采样步、更好的似然与 FID。这篇论文与同期 Rectified Flow(Liu et al. 2022)、Stochastic Interpolants(Albergo & Vanden-Eijnden 2022)一起构成后续所有 flow-based 生成模型(Stable Diffusion 3、Sora 一代)的理论地基。
1. 要解决什么问题
生成模型要做的事,是把一个简单的已知分布(标准高斯噪声)输运成一个复杂的数据分布。扩散模型做到了这一步:先给数据逐步加噪到纯噪声,再学一个网络反过来去噪。它在 2022 年已经是图像生成的主流,训练稳定、能大规模扩展,但代价是采样路径被限制在扩散随机过程定义的那一小类里:路径是弯曲的,生成时要走很多步,还得配专门的加速采样器(DDIM、DPM-Solver 一类)。
另一条理论上的更一般路线是连续归一化流(CNF,Chen et al. 2018):用一个神经网络参数化一个时间相关的向量场 v_t,从噪声出发积分常微分方程(ODE)dφ_t/dt = v_t(φ_t),把粒子输运到数据分布。CNF 理论上能表达任意概率路径,但缺一个可扩展的训练算法。极大似然训练要一遍遍模拟 ODE、用伴随方法反传,成本高、不稳定,FFJORD 那批工作很难把分辨率推上去;已有的 simulation-free 尝试,要么带高维不可积积分(Rozen et al. 2021),要么在随机小批量下有偏梯度(Ben-Hamu et al. 2022)。
本文的问题可以压缩成一句:能不能让 CNF 像扩散模型一样容易训练,同时保留任意选择概率路径的自由?
2. 背景:概率路径、向量场与连续性方程
先把三个对象定义清楚。概率密度路径 p_t 是随时间变化的密度(t 从 0 到 1,任意时刻积分都等于 1);向量场 v_t 给每个时空点 (x, t) 一个速度;把向量场积分起来就得到流 φ_t,即一条条粒子的轨迹。它们的关系是:速度场 v_t 生成密度路径 p_t,当且仅当连续性方程 ∂p_t/∂t + div(p_t v_t) = 0 成立——这就是物理里质量守恒的写法:密度随时间的变化,等于粒子通量散度的负值。整篇论文的证明都挂在这条方程上。
3. 核心思想:条件速度匹配 → 边际速度匹配
3.1 第一步:用条件路径搭出边际路径
FM 的出发点是一个看似不可解的目标:设 p_t 是一条把噪声 p_0 = N(0,I) 输运到数据分布 p_1 ≈ q 的路径,u_t 是生成它的向量场,Flow Matching 损失定义为
L_FM(θ) = E_{t~U[0,1], x~p_t(x)} ‖v_t(x) − u_t(x)‖²
这个式子要回答的问题:让网络 v_t 去拟合目标速度场 u_t,学完从噪声积分就能得到数据分布。问题在于我们既不知道 p_t 也不知道 u_t。
解法是把全局对象拆成逐样本对象。对每个数据点 x_1,定义一个条件概率路径 p_t(x|x_1):t=0 时它是标准高斯(μ_0 = 0, σ_0 = 1),t=1 时它集中在 x_1 附近(μ_1 = x_1, σ_1 = σ_min,σ_min 取足够小)。把全体条件路径按数据分布 q(x_1) 积分,就得到边际路径 p_t(x) = ∫ p_t(x|x_1) q(x_1) dx_1——这是「条件概率路径 → 边际概率路径」的对应。
同样地,边际向量场定义为条件向量场的加权平均:
u_t(x) = ∫ u_t(x|x_1) · p_t(x|x_1) q(x_1) / p_t(x) dx_1
这里的权重 p_t(x|x_1)q(x_1)/p_t(x) 是贝叶斯后验:给定 t 时刻粒子在 x,它来自数据点 x_1 的概率。也就是说,边际速度场 = 各条件速度场按后验置信度加权平均。定理 1 用连续性方程的线性性质证明:这个加权平均确实生成边际路径。这是全文第一个关键结论,也是「条件速度匹配 → 边际速度匹配」推导的地基:全局不可解的输运场,被拆成了每个样本上都能解析写出的局部场。
3.2 第二步:条件目标与边际目标梯度等价
边际向量场仍然不可算——分母里有 p_t(x) 这个积分。但训练不需要它。Conditional Flow Matching(CFM)损失只回归条件速度:
L_CFM(θ) = E_{t~U[0,1], x_1~q(x_1), x~p_t(x|x_1)} ‖v_t(x) − u_t(x|x_1)‖²
这个式子要回答的问题:能不能用一个只依赖单个数据点的目标替代全局目标?把平方范数展开看:交叉项 E⟨v_t(x), u_t(x)⟩ 在双重期望下正好等于 E⟨v_t(x), u_t(x|x_1)⟩——因为 u_t(x) 就是 u_t(x|x_1) 的后验期望;‖u_t(x|x_1)‖² 这一项与网络参数 θ 无关。所以两个损失只差一个常数,定理 2 给出:∇_θ L_FM = ∇_θ L_CFM,逐点成立。
结论很干净:训练全程不需要边际向量场,只要「抽一个数据点、抽一个时间、从条件路径采样一个带噪样本、回归它的条件速度」。这就是 flow matching 训练就是一行均方误差的原因,也是后面所有 flow-based 模型(SD3 等)照抄的公式。
3.3 第三步:高斯条件路径与闭式速度场
条件路径取高斯族 p_t(x|x_1) = N(x | μ_t(x_1), σ_t(x_1)² I),其中 μ_t 是均值(中心位置),σ_t 是标准差(扩散宽度)。条件流取仿射映射 ψ_t(x) = σ_t(x_1) x + μ_t(x_1):把一个标准高斯噪声粒子线性搬到以 μ_t 为中心、宽度 σ_t 的位置。对 ψ_t 求时间导数(定理 3)得到闭式条件速度场:
u_t(x|x_1) = σ'_t(x_1)/σ_t(x_1) · (x − μ_t(x_1)) + μ'_t(x_1)
逐符号看:第一项是「相对收缩率」σ'_t/σ_t 乘以到均值中心的偏移,描述粒子随宽度变化被压缩或拉伸的速度;第二项 μ'_t 是均值整体移动的速度。只要 μ_t、σ_t 可微且满足边界条件,这就是生成该高斯路径的速度场。VE、VP 扩散路径只是这个通式在特定 (μ, σ) 下的两个实例——扩散被收编成 FM 的特例,而且论文在附录 D 验证了这些条件向量场与扩散模型的概率流 ODE 完全一致。
3.4 插值路径的选择:线性(OT)为什么更好
路径是设计自由度,选法直接影响轨迹形状。扩散路径(VP)取 μ_t = α_{1−t} x_1、σ_t = √(1−α²_{1−t}),速度场是时间 t 的复杂函数,条件轨迹弯曲,甚至会过冲再折返,而且有限时间到不了纯噪声(p_0 只能近似)。
OT 路径取最朴素的线性插值:μ_t(x_1) = t·x_1(均值匀速走向数据点),σ_t(x_1) = 1 − (1−σ_min)t(宽度匀速收窄)。条件流变成 ψ_t(x) = (1−(1−σ_min)t)x + t·x_1;当 σ_min → 0,这正是阅读提示里的 x_t = (1−t)x_0 + t·x_1——两个分布之间的线性插值。把它对应到物理中的输运:每个粒子从自己的起点 x_0 出发,沿直线、以恒定速度 (x_1 − x_0) 走到终点,整个密度像一缸流体一样被整体搬运。对应地,条件速度场退化成常数方向 u_t = x_1 − x_0(不依赖 t),回归目标简单到极致。
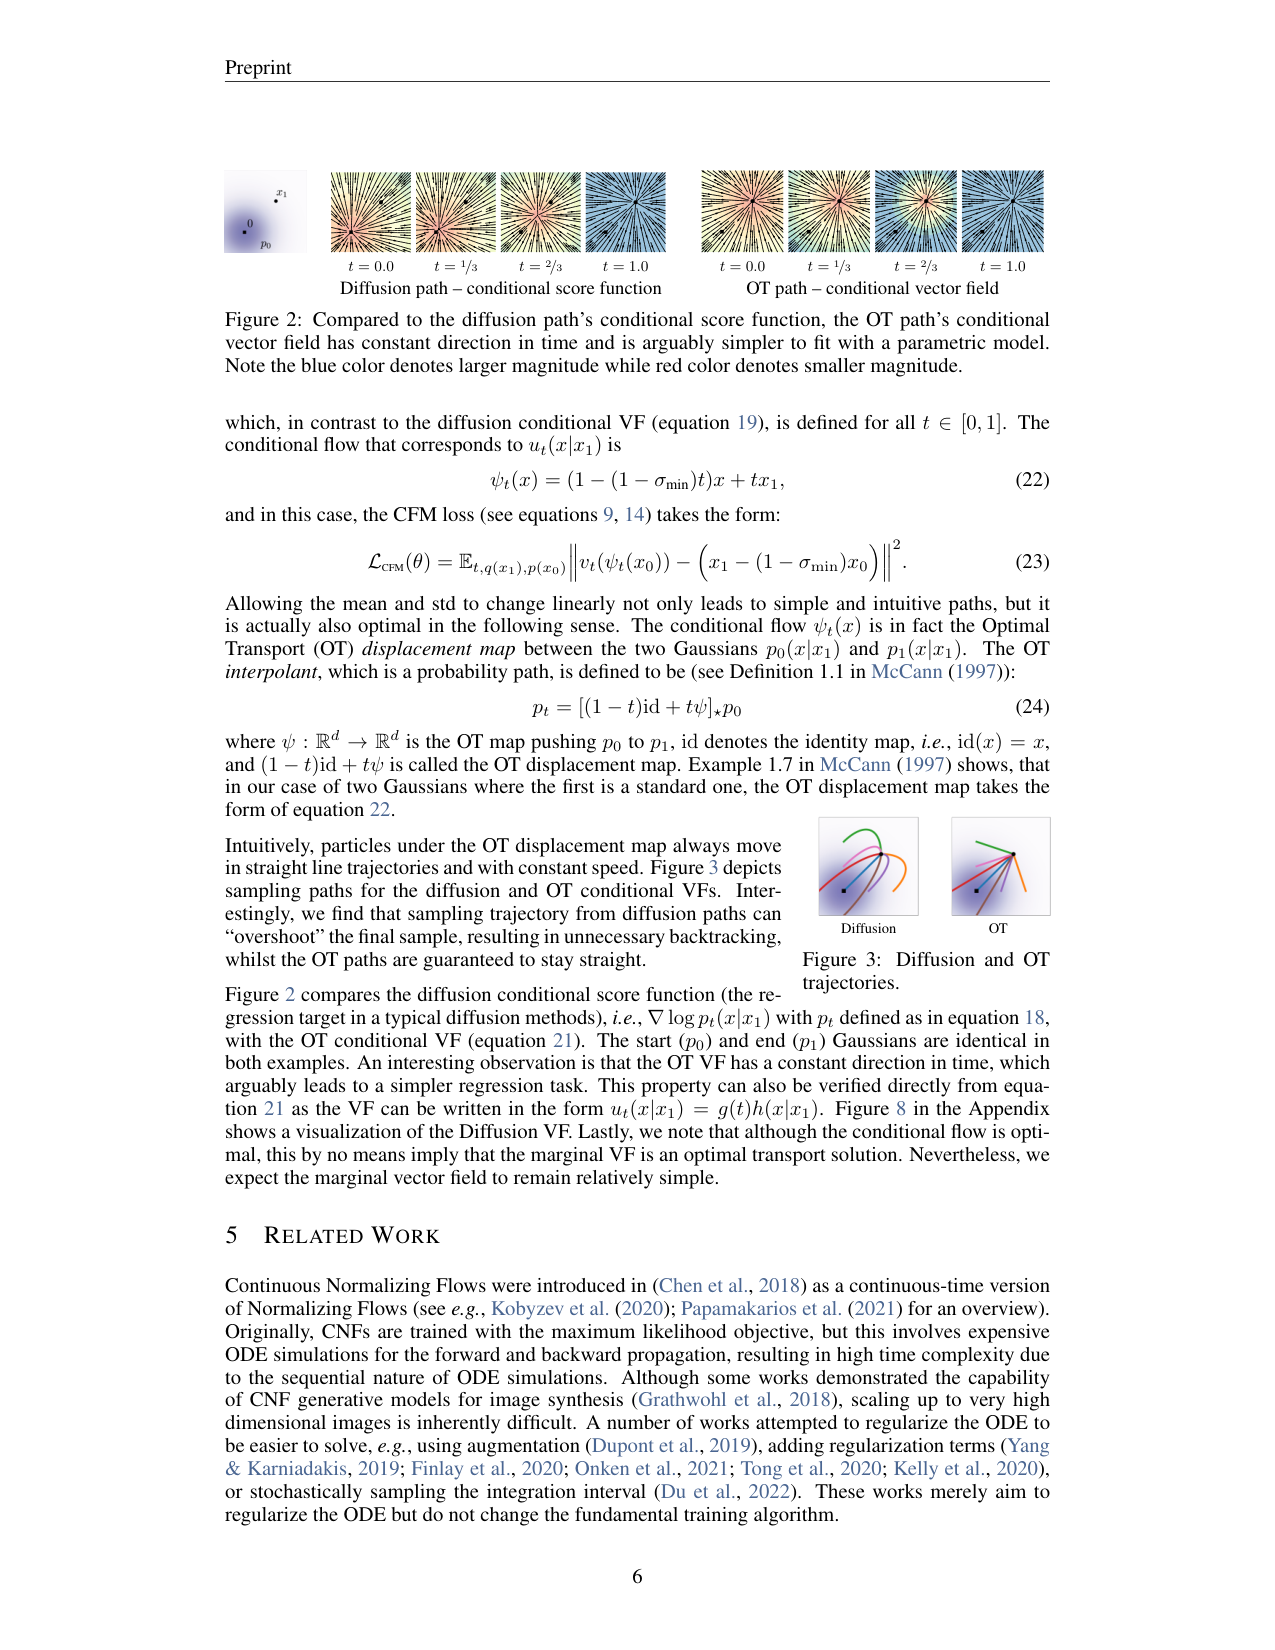
这个线性路径还带着一个最优性:它是两个高斯分布之间的 Wasserstein-2 最优传输位移映射(McCann 1997),在所以搬运方式里路径最短。图 2 把两种路径的回归目标画出来:扩散的 score 场箭头方向随时间旋转、长度缩放;OT 的速度场方向恒定、只改大小(可写成 g(t)·h(x|x_1) 的分离形式),网络拟合起来容易得多。图 3 展示同一对起终点:扩散轨迹绕大弯,OT 轨迹是直线。
论文在这里给了一句诚实的限定:条件流最优,不意味着边际流最优——不同数据点的条件轨迹在边际化后可能交叉,直线性只对单个条件对成立。但经验上边际路径仍然足够简单,这是后面实验的伏笔。
4. 训练与采样:一行损失 + 一条 ODE
训练目标(OT 路径、σ_min→0)最终长这样:
L_CFM(θ) = E_{t, x_1, x_0} ‖v_θ((1−t)x_0 + t·x_1) − (x_1 − x_0)‖²
采样时不再有任何随机性:从 x_0 ~ N(0,I) 出发,解 ODE dx_t/dt = v_θ(x_t, t),从 t=0 积分到 t=1,终点 x_1 = φ_1(x_0) 就近似服从数据分布。这就是「自己推导采样 ODE」的完整链条:训练让 v_θ 逼近生成边际路径的速度场 → 连续性方程保证沿这个场积分,密度按预期路径输运 → ODE 终点分布等于 p_1 ≈ q。似然也能算:用瞬时换元公式 log p_1(x_1) = log p_0(x_0) − ∫₀¹ div(v_t)dt,散度用 Hutchinson 迹估计,这就是 BPD 数字的来源。
5. 关键实验与结果
主实验是「同一架构、同一超参、同样训练轮数」下换训练目标(Figure 4 的 checkerboard toy 先做了定性铺垫,OT 路径更早引入结构、FM 训练更稳定):
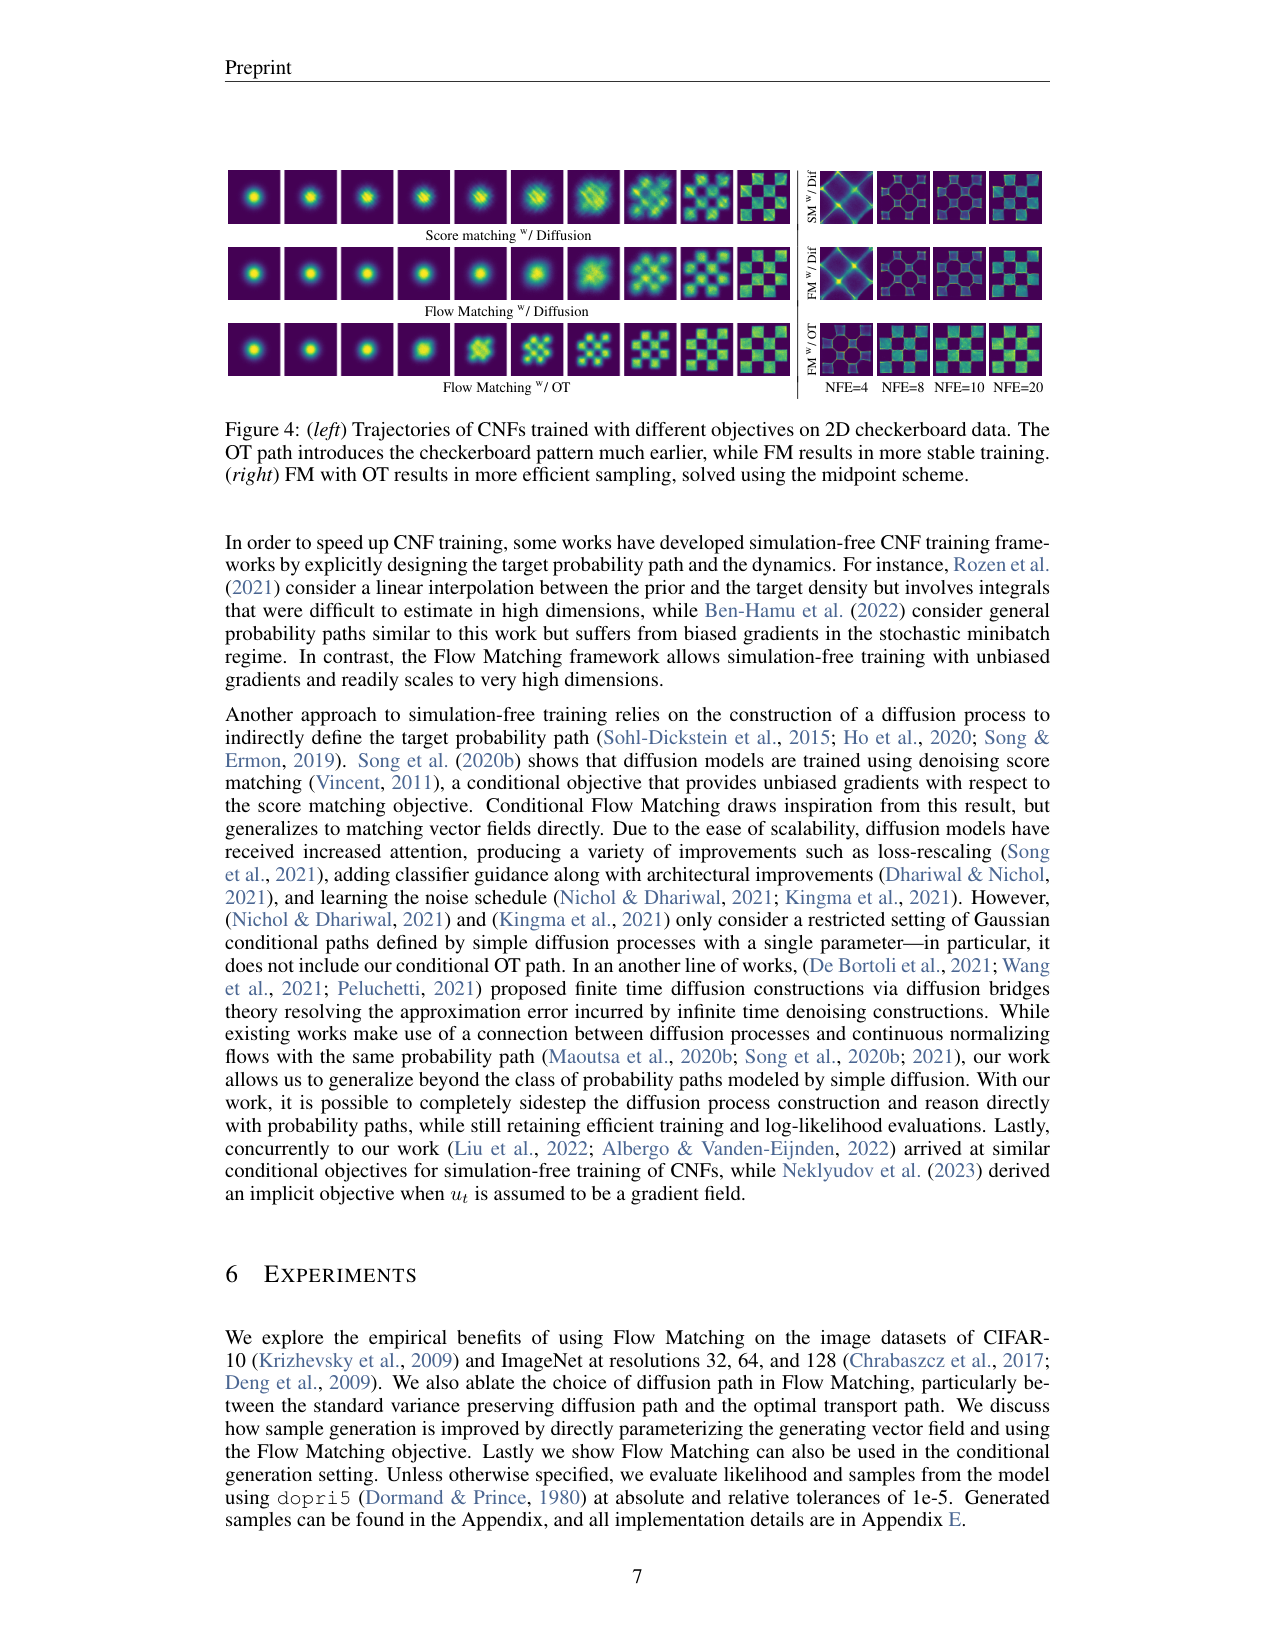
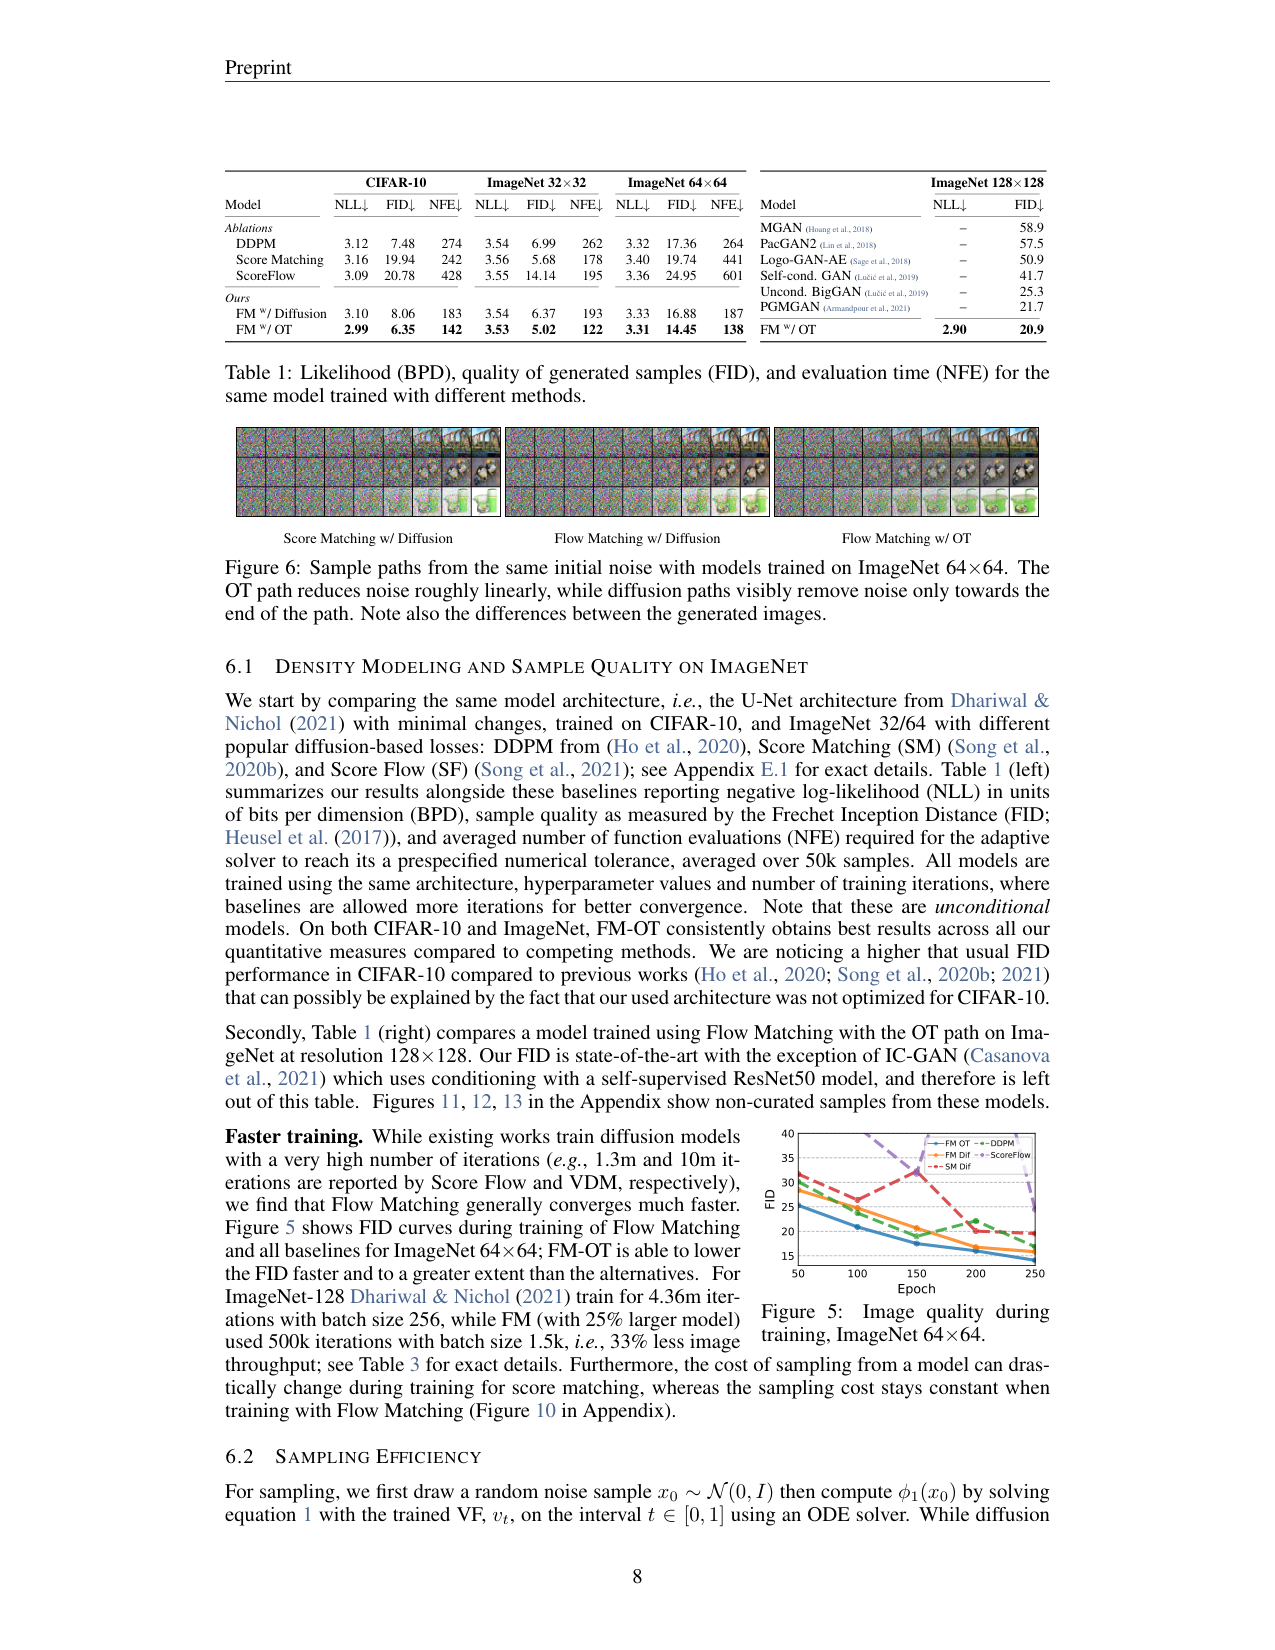
表 1(图 5 是训练过程 FID 曲线,图 6 是同种子采样轨迹)在三个数据集上的核心数字:CIFAR-10 上 FM-OT 的 NLL/FID/NFE 是 2.99/6.35/142,对照 DDPM 3.12/7.48/274、Score Matching 3.16/19.94/242、ScoreFlow 3.09/20.78/428;ImageNet-32 上 3.53/5.02/122,ImageNet-64 上 3.31/14.45/138——三项指标全部同时刷新。注意一个对照组:即使沿用扩散路径,FM-Dif(IN-64 FID 16.88)也明显好于 SM(19.74)和 SF(24.95),说明「用 FM 目标训扩散路径」本身就更稳。ImageNet-128 无条件生成上 FM-OT 拿到 NLL 2.90 BPD、FID 20.9,超过当时所有无条件 GAN(PGMGAN 21.7、Uncond. BigGAN 25.3)。训练吞吐也省:ImageNet-128 上 FM 用 500K iterations × batch 1500(比 D&N 模型大 25%),相对 Dhariwal & Nichol 的 4.36M iterations × batch 256,图像吞吐少 33%。
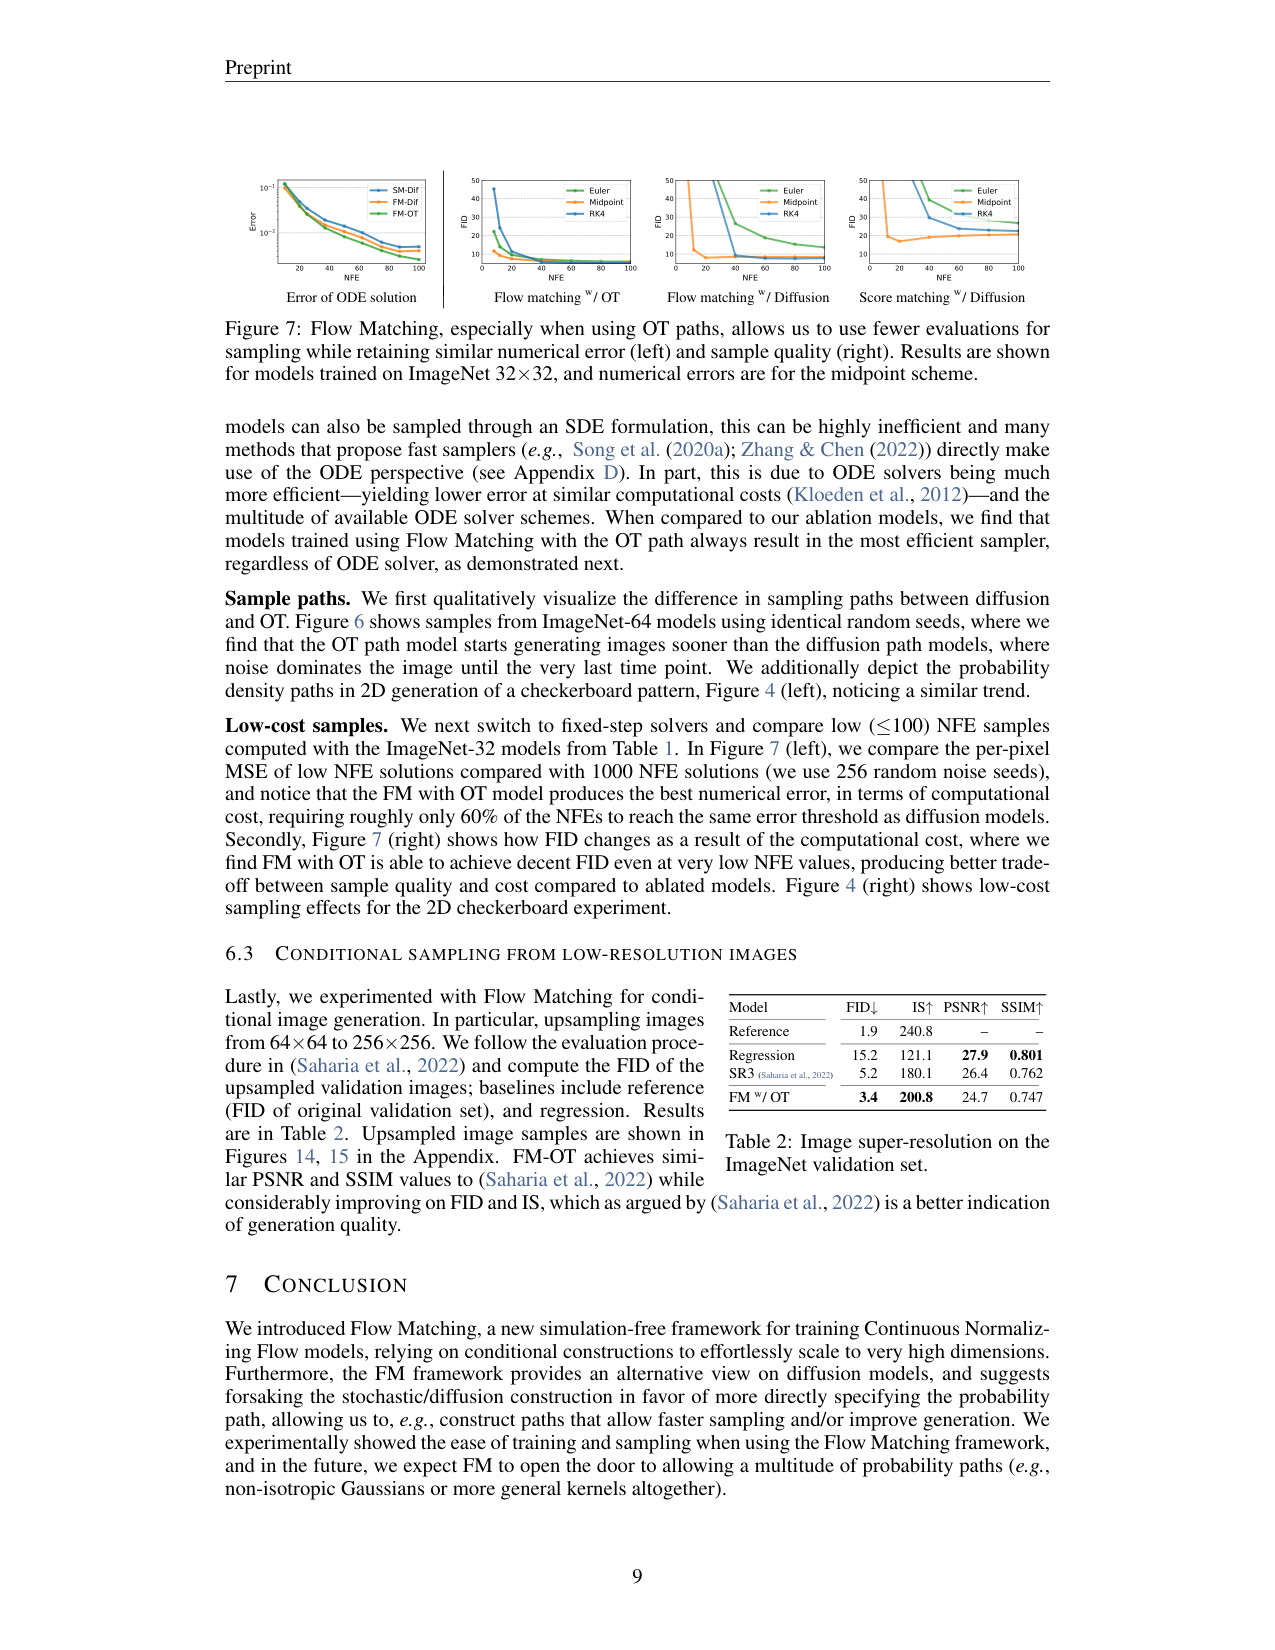
采样效率是第二个卖点(图 7):固定步数求解器下,FM-OT 达到与扩散模型相同的 ODE 数值误差,只需要约 60% 的 NFE;FID-vs-NFE 曲线上,FM-OT 在 Euler/Midpoint/RK4 三种求解器下都是最低的,低 NFE(几十步)就能拿到不错的质量。超分任务(64→256,ImageNet 验证集)验证框架的通用性:FM-OT 的 FID 3.4、IS 200.8,优于 SR3 的 5.2/180.1(参考原图 FID 1.9/IS 240.8),PSNR/SSIM(24.7/0.747)与 SR3(26.4/0.762)接近。
6. 谱系定位
这篇站在两条线的交叉点。一条是扩散模型的线:DDPM(Ho et al. 2020)、score matching(Song et al. 2020b)、ScoreFlow(Song et al. 2021)——FM 证明这些只是高斯条件路径族里的特例,并把训练目标从「匹配 score」换成「匹配速度」。另一条是 CNF 训练的线:FFJORD 的极大似然、Rozen 的线性插值密度、Ben-Hamu 的一般概率路径——FM 给出无不可积积分、梯度无偏的 simulation-free 方案。同期 Liu et al. 2022(Rectified Flow)与 Albergo & Vanden-Eijnden 2022(Stochastic Interpolants)独立得到类似的条件目标,三篇合起来定义了「flow-based 生成模型」这个范式;后续 Stable Diffusion 3 的 CFM + MM-DiT、以及 Sora 一代视频模型的 velocity prediction,用的都是本文 OT 路径这一套公式。
7. 局限
论文自承三条:条件流的最优性不传递给边际流,边际轨迹仍可能弯曲;扩散路径有限时间到不了纯噪声,而 OT 路径靠 σ_min > 0 收尾,σ_min 的大小本身是权衡(太小退化、太大偏离数据点);CIFAR-10 的 FID 高于此前专门调优的工作,架构没针对该数据集优化。
我们读出三条:生成仍然要数值积分 ODE,FM-OT 把 NFE 从上千降到几十到一百,但离单步还远——「让轨迹真正变成一条直线」的目标由后续 Rectified Flow 的 reflow 与 Consistency 模型完成;OT 路径的噪声-数据配对是随机独立耦合,没有学习最优配对,这是后续 minibatch OT、Schrödinger bridge 等工作的改进空间;实验面局限在无条件图像与单一超分任务,没有 guidance、文本条件、类条件的规模评测,也没有系统 scaling 分析,似然数字还依赖 uniform dequantization 与重要性加权(K=1 与 K=50 的结果差 0.1 BPD 量级),对比时口径要看清。
8. 复现
官方 PyTorch 库 facebookresearch/flow_matching 提供实现与示例。训练配方:Adam(β1=0.9, β2=0.999,无 weight decay),学习率 1e-4(CIFAR-10/IN-128 用多项式衰减 + warmup),CIFAR-10 与 IN-32 用 32 位精度、IN-64/128 用 16 位混合精度;似然评估用 dopri5(atol=rtol=1e-5)+ uniform dequantization + 重要性加权(K 取 1/20/50 等),FID 用 TensorFlow GAN 库,IN-128 用 Dhariwal & Nichol 的评估脚本保持一致。
提出 Flow Matching:把 CNF 的训练从『必须模拟 ODE』变成『对每个数据点定义一条条件概率路径、回归其速度场』的 simulation-free 最小二乘问题,并证明条件目标与不可解的边际目标梯度等价;其中线性插值的 OT 路径让条件轨迹变直、回归目标更简单,从而在 CIFAR-10 / ImageNet 32/64/128 上同时拿到更优的似然、FID 与更少的采样步数,并把扩散路径收编为特例——这篇论文与同期 Rectified Flow、Stochastic Interpolants 一起构成后续所有 flow-based 生成模型(SD3、Sora 一代)的理论地基。
阅读提示
精读深度:精读
清单提示:原文提示:理解「条件速度匹配 → 边际速度匹配」的推导,这是所有后续工作的地基;注意插值路径选择(线性/OT)对轨迹直线性的影响;把 x_t=(1−t)x0+tε 与「两个分布之间的线性插值」对应到物理中的输运。读完应能自己推导出采样 ODE。
问题
要解决什么:生成模型需要把一个简单分布(标准高斯噪声)输运成数据分布。扩散模型靠加噪-去噪的随机过程实现,训练稳定可扩展,但路径形式被限制在扩散过程定义的窄类里,采样路径弯曲、需要大量步数;CNF(连续归一化流)理论上能表达任意概率路径,但可扩展的训练算法缺失——极大似然训练要模拟 ODE、反向传播要走伴随方程,成本高且不稳定。
为什么 prior work 不够:扩散模型:采样概率路径必须来自某个扩散 SDE,路径弯曲(扩散路径会『过冲』再折返),训练很久还要专门设计加速采样器(如 DDIM、DPM-Solver)。CNF 的极大似然训练(FFJORD 等)逐次模拟 ODE,无法扩展到高分辨率图像;已有 simulation-free 尝试要么带高维不可积积分(Rozen et al. 2021),要么在小批量下有偏梯度(Ben-Hamu et al. 2022)。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|---|---|
| noise sample x0 | continuous vector (Rd) | 标准高斯 N(0, I) 采样,训练和推理共用,d = 图像像素数(3×H×W,训练时先做 [−1,1]→[0,256] 的变换) |
| time t | scalar in [0,1] | 训练时 t ~ U[0,1],推理时作为 ODE 积分变量 |
| data sample x1(仅训练) | continuous vector (Rd) | 训练 batch 里抽的真实图像;条件生成(超分)时额外输入 64×64 低分辨率图 |
输出
| 名称 | 类型 | 说明 |
|---|---|---|
| velocity v_t(x) | continuous vector (Rd) | 网络输出与输入同维的速度场预测;训练时回归条件速度 u_t(x|x1),推理时作为 ODE 右端项从 t=0 积分到 t=1 |
| generated sample x1 | continuous vector (Rd) | φ_1(x0),即 ODE 终点;无条件图像/超分图像 |
控制频率:n/a(图像生成;采样步数可自由选择,论文用 dopri5 自适应或固定 NFE)
数据集
| 数据 | 规模 | 备注 |
|---|---|---|
| CIFAR-10 | 50K train / 10K test,32×32 | FM-OT NLL 2.99 BPD / FID 6.35;论文自承该架构未针对 CIFAR-10 调优 |
| ImageNet 32×32 / 64×64 | downsampled ImageNet(Chrabaszcz et al. 2017 预处理) | FM-OT:IN-32 NLL 3.53/FID 5.02;IN-64 NLL 3.31/FID 14.45 |
| ImageNet 128×128 | 无条件训练,500K iterations × batch 1500 | FM-OT NLL 2.90 BPD / FID 20.9,超过当时所有无条件 GAN(PGMGAN 21.7) |
| ImageNet validation(超分) | 64×64→256×256 上采样 | FM-OT FID 3.4 / IS 200.8,参考值(原图)FID 1.9 / IS 240.8 |
| 2D checkerboard(定性 toy) | 训练一个 5 层 × 512 神经元 MLP | 演示 OT 路径更早引入结构、FM 训练更稳定(Figure 4) |
架构(摘要)
主干与结构
backbone:Dhariwal & Nichol (2021) 的 U-Net,最小改动(ImageNet-128 时比原模型大约 25% 参数)
参数:未公布总数;ImageNet-128 用比 D&N 大 25% 的模型,训练 500K iterations × batch 1500
类型:CNF 向量场回归:U-Net v_t(x,t) 直接预测速度场,无离散扩散过程、无 score 头
关键组件
- U-Net 输入 (x_t, t)(t 用 embedding 注入),输出同维速度预测 v_θ(x_t, t)
- 训练:t ~ U[0,1],x1 ~ q(x1),x0 ~ N(0,I),回归目标 u_t(x|x1)(OT 路径下即 x1 − x0)
- 推理:从 x0 ~ N(0,I) 出发解 ODE dφ_t/dt = v_θ(φ_t, t),t∈[0,1]
- 似然计算:瞬时换元(log p1 = log p0 − ∫div(v_t)dt),用 Hutchinson trace 估计散度
- 超分条件生成:低分辨率图作为额外输入,回归同一速度目标
为什么这样设计
生成模型在这里被还原成一件具体的事:给定一个可微的输运向量场,积分它就能把噪声变成数据;网络只需学会每个 (x,t) 处粒子该往哪走。把路径定义与网络参数解耦:路径由 μ_t、σ_t 显式指定(设计自由度),网络只负责回归。
数值 sense
| 项 | 值 |
|---|---|
| dimension | CIFAR-10: d = 3×32×32 = 3072;ImageNet-128: d = 3×128×128 = 49152 |
| 训练 | CIFAR-10: 1000 epochs / 391K iterations × batch 256(2 GPU);IN-32: 200 epochs / 250K × 1024(4 GPU);IN-64: 250 epochs / 157K × 2048(16 GPU);IN-128: 571 epochs / 500K × 1536(32 GPU) |
| sampling | dopri5 自适应(atol=rtol=1e-5,50K 样本平均 NFE);固定步数实验 NFE ∈ {4,8,10,20,…,100} |
| sigma_min | OT 路径终点方差 σ_min 取足够小(论文称 sufficiently small),保证 p1 集中在 x1 附近且似然有界 |
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| CIFAR-10 无条件:NLL(BPD)/ FID / NFE | 2.99 / 6.35 / 142(FM-OT) | DDPM 3.12/7.48/274,Score Matching 3.16/19.94/242,ScoreFlow 3.09/20.78/428,FM-Dif 3.10/8.06/183(同架构同超参) | U-Net(D&N 2021 架构),1000 epochs / 391K iterations × batch 256,dopri5 atol=rtol=1e-5,50K 样本平均 NFE,uniform dequantization + K=50 importance weighting |
| ImageNet 32×32:NLL / FID / NFE | 3.53 / 5.02 / 122(FM-OT) | DDPM 3.54/6.99/262,SM 3.56/5.68/178,SF 3.55/14.14/195,FM-Dif 3.54/6.37/193 | 同架构同超参,200 epochs / 250K iterations × batch 1024(4 GPU),其余同上 |
| ImageNet 64×64:NLL / FID / NFE | 3.31 / 14.45 / 138(FM-OT) | DDPM 3.32/17.36/264,SM 3.40/19.74/441,SF 3.36/24.95/601,FM-Dif 3.33/16.88/187 | 250 epochs / 157K iterations × batch 2048(16 GPU),16-bit mixed precision |
| ImageNet 128×128 无条件:NLL / FID | 2.90 / 20.9(FM-OT) | 此前无条件 GAN 最优 PGMGAN FID 21.7、Uncond. BigGAN 25.3;唯一更高的是用了自监督 ResNet50 条件化的 IC-GAN(论文从对比表剔除) | 比 D&N 大 25% 的 U-Net,571 epochs / 500K iterations × batch 1536(32 GPU),对比表里旧 GAN 数据来自各自原文 |
| 低步数采样数值误差(IN-32,midpoint) | FM-OT 达到同等误差只需扩散模型约 60% 的 NFE | SM-Dif / FM-Dif 在相同 NFE 下误差更高;FM-OT 在 Euler/Midpoint/RK4 三种求解器下 FID-vs-NFE 权衡均最优 | 固定步数求解器 NFE∈[4,100],相对 1000 NFE 参考解的逐像素 MSE,256 个随机噪声种子,模型为 Table 1 的 IN-32 三件套 |
| ImageNet 验证集超分 64→256:FID / IS / PSNR / SSIM | 3.4 / 200.8 / 24.7 / 0.747(FM-OT) | SR3 5.2/180.1/26.4/0.762;Regression 15.2/121.1/27.9/0.801;参考(原图)1.9/240.8/—/— | 评估流程照抄 Saharia et al. 2022,ImageNet validation 上采样,baseline 数字来自 SR3 原文 |
Insights
- 训练时从头到尾不需要边际向量场:条件目标与边际目标梯度相等(Theorem 2),『每样本回归』就够了——这是 flow matching 能落地成一行 MSE 损失的原因
- 边际向量场 = 条件向量场的后验加权平均(Theorem 1):把『整个分布往哪流』分解成『每个粒子自己的路往哪流』再按置信度加权
- 路径是设计自由度,扩散只是其中一种:扩散路径弯曲、过冲、有限时间到不了纯噪声;线性插值的 OT 路径让条件轨迹笔直、回归目标方向恒定,直接换来更快训练、更少采样步、更好 FID/NLL
- 『插值路径』就是物理里的输运:x_t = (1−t)x0 + t·x1 描述每个粒子从起点位置匀速直线走到终点位置,整条轨迹是密度场的输运过程;网络学的是每个时空点 (x,t) 处的速度
- FM 同时是更稳的扩散训练器:即使沿用扩散路径,FM-Dif 的 NLL/FID/NFE 也全面优于 score matching 对应的 SM/SF 基线(如 IN-64:FID 16.88 vs 19.74/24.95)
- 无条件 ImageNet-128 上 FID 20.9 超过当时所有无条件 GAN(PGMGAN 21.7),把『流模型也能 scale』写成了实验事实
vs 同类工作
- vs 扩散模型(DDPM/SM/SF):扩散是 FM 框架在特定 (μ,σ) 下的特例;FM 直接定义概率路径,绕开 SDE 构造,路径选择从『受扩散过程约束』变成『任意设计』
- vs CNF 极大似然训练(FFJORD 等):训练期零 ODE 模拟,一个 batch 就是一次普通回归,scale 到 128×128 无压力;似然评估仍可用瞬时换元
- vs Rozen et al. 2021(线性插值密度):他们要在高维估计难算的积分;FM 的 CFM 只回归逐样本目标,无不可积项
- vs Ben-Hamu et al. 2022(一般概率路径):FM 在随机小批量下有 unbiased 梯度,前者梯度有偏
- vs 同期工作:Liu et al. 2022(Rectified Flow)、Albergo & Vanden-Eijnden 2022(Stochastic Interpolants)独立得到类似的条件目标;三者构成同一范式,本篇以『高斯条件路径族 + 定理化证明 + ImageNet 规模实验』取胜,后续 SD3 的 CFM 公式直接沿用本文 OT 路径
局限
- 论文自承:条件流是最优 OT 映射,但边际向量场并没有 OT 最优性保证——不同数据点的条件轨迹在边际化后会交叉,边际路径仍可能弯曲,直线性只对单个条件对成立
- 论文自承:扩散路径在有限时间内到不了纯噪声,p0 只能用高斯近似;论文的 OT 路径靠 σ_min>0 收尾,σ_min 取太小会让终点分布退化、似然失去良好定义,取太大又偏离数据点
- 论文自承:CIFAR-10 的 FID(FM-OT 6.35)高于此前一些专门调优的工作,作者解释为所用 U-Net 架构没有针对 CIFAR-10 优化
- 我们读出:生成仍需数值积分 ODE,FM-OT 把 NFE 从上千降到几十到一百,但到不了单步;『一条直线走到底』的完整实现(reflow、单步模型)留给 Rectified Flow 与 Consistency 系列后续解决
- 我们读出:OT 路径的噪声-数据配对是随机独立的,没有学习配对的过程;配对方式本身是后续改进空间(minibatch OT、Schrödinger bridge、学习传输计划)
- 我们读出:实验局限在无条件图像与单一超分任务,没有 guidance、文本条件、类条件大规模评测,也没有系统 scaling 分析;似然数字依赖 uniform dequantization 与重要性加权(K 越大越好,如 CIFAR-10 从 K=1 的 3.11 到 K=50 的 2.99),对比口径需要看清
可复现性
- code:https://github.com/facebookresearch/flow_matching(官方 PyTorch 库,论文发表后开源)
- weights:论文未随文发布权重;官方库提供复现代码与训练配置(Adam,β1=0.9/β2=0.999,lr 1e-4,无 weight decay)
- sim_benchmark:2D checkerboard toy(5 层 512 神经元 MLP)+ CIFAR-10 / ImageNet 32/64/128 + ImageNet 超分;评估用 torchdiffeq dopri5(atol=rtol=1e-5)、TensorFlow GAN 库(FID)
主干与结构
backbone:Dhariwal & Nichol (2021) 的 U-Net,最小改动(ImageNet-128 时比原模型大约 25% 参数)
参数:未公布总数;ImageNet-128 用比 D&N 大 25% 的模型,训练 500K iterations × batch 1500
类型:CNF 向量场回归:U-Net v_t(x,t) 直接预测速度场,无离散扩散过程、无 score 头
关键组件
- U-Net 输入 (x_t, t)(t 用 embedding 注入),输出同维速度预测 v_θ(x_t, t)
- 训练:t ~ U[0,1],x1 ~ q(x1),x0 ~ N(0,I),回归目标 u_t(x|x1)(OT 路径下即 x1 − x0)
- 推理:从 x0 ~ N(0,I) 出发解 ODE dφ_t/dt = v_θ(φ_t, t),t∈[0,1]
- 似然计算:瞬时换元(log p1 = log p0 − ∫div(v_t)dt),用 Hutchinson trace 估计散度
- 超分条件生成:低分辨率图作为额外输入,回归同一速度目标
为什么这样设计
生成模型在这里被还原成一件具体的事:给定一个可微的输运向量场,积分它就能把噪声变成数据;网络只需学会每个 (x,t) 处粒子该往哪走。把路径定义与网络参数解耦:路径由 μ_t、σ_t 显式指定(设计自由度),网络只负责回归。
数值 sense
| 项 | 值 |
|---|---|
| dimension | CIFAR-10: d = 3×32×32 = 3072;ImageNet-128: d = 3×128×128 = 49152 |
| 训练 | CIFAR-10: 1000 epochs / 391K iterations × batch 256(2 GPU);IN-32: 200 epochs / 250K × 1024(4 GPU);IN-64: 250 epochs / 157K × 2048(16 GPU);IN-128: 571 epochs / 500K × 1536(32 GPU) |
| sampling | dopri5 自适应(atol=rtol=1e-5,50K 样本平均 NFE);固定步数实验 NFE ∈ {4,8,10,20,…,100} |
| sigma_min | OT 路径终点方差 σ_min 取足够小(论文称 sufficiently small),保证 p1 集中在 x1 附近且似然有界 |
OT 条件向量场方向恒定,扩散条件 score 场随时间扭动;OT 轨迹是直线,扩散轨迹过冲折返
原文 caption:Figure 2: Compared to the diffusion path's conditional score function, the OT path's conditional vector field has constant direction in time and is arguably simpler to fit with a parametric model. Note the blue color denotes larger magnitude while red color denotes smaller magnitude. Figure 3: Diffusion and OT trajectories.
上半页两组四宫格:左组是 VP 扩散路径的条件 score 场 ∇log p_t(x|x1),右组是 OT 路径的条件向量场 u_t(x|x1),起点 p0 与终点 p1 完全相同。读法:看每个时间片箭头的方向是否稳定——扩散组的箭头方向和长度随时间明显旋转、缩放(回归目标复杂);OT 组箭头方向全程一致,只改大小(可以写成 u_t = g(t)·h(x|x1) 的分离形式)。右小图 Figure 3 是两条从同一点出发的轨迹:扩散轨迹绕弯、明显过冲再折回,OT 轨迹笔直匀速。这张图支撑全文核心论点:插值路径的选择直接决定回归任务难度与采样轨迹形状。
2D checkerboard:OT 路径更早引入结构、FM 训练更稳定;低步数采样(NFE=4/8/10/20)
原文 caption:Figure 4: (left) Trajectories of CNFs trained with different objectives on 2D checkerboard data. The OT path introduces the checkerboard pattern much earlier, while FM results in more stable training. (right) FM with OT results in more efficient sampling, solved using the midpoint scheme.
左半三行轨迹快照,对应三种训练目标(Score Matching w/ Diffusion、FM w/ Diffusion、FM w/ OT)在 2D checkerboard 上的采样过程:FM-OT 一行在很早期就能看到棋盘结构,扩散路径的样本直到后期还是一团噪声,说明路径直线性让信息传递更快。右半 3×4 网格是同一模型固定步数采样(NFE=4/8/10/20,midpoint 求解器):FM-OT 在 NFE=10 左右已出清晰棋盘,而 FM-Dif/对应方法在相同步数下仍模糊。这是『少步数采样』论点的第一块证据。
主结果表:NLL/FID/NFE 全面对比;训练 FID 曲线;同种子采样轨迹
原文 caption:Table 1: Likelihood (BPD), quality of generated samples (FID), and evaluation time (NFE) for the same model trained with different methods. Figure 5: Image quality during training, ImageNet 64×64. Figure 6: Sample paths from the same initial noise with models trained on ImageNet 64×64.
全页是论文的定量核心。上部 Table 1:同一 U-Net 架构、同一超参、同样训练轮数下,FM-OT 在 CIFAR-10(NLL 2.99/FID 6.35/NFE 142)、IN-32(3.53/5.02/122)、IN-64(3.31/14.45/138)三个数据集上同时刷新三项指标(对照 DDPM 3.12/7.48/274、Score Matching 3.16/19.94/242、ScoreFlow 3.09/20.78/428 等);右侧 IN-128 对比无条件 GAN:FM-OT FID 20.9 超过 PGMGAN 21.7。左下 Figure 5:横轴 epoch、纵轴 FID,FM-OT 曲线下降最快最低。右下 Figure 6:同一初始噪声下三模型的采样过程,OT 模型噪声近似线性消退,扩散模型直到末期才出图。
低步数采样:FM-OT 数值误差与 FID 权衡最好;超分结果表
原文 caption:Figure 7: Flow Matching, especially when using OT paths, allows us to use fewer evaluations for sampling while retaining similar numerical error (left) and sample quality (right). Results are shown for models trained on ImageNet 32×32, and numerical errors are for the midpoint scheme. Table 2: Image super-resolution on the ImageNet validation set.
左上图横轴 NFE(≤100)、纵轴 ODE 数值误差(相对 1000 NFE 参考解的逐像素 MSE,256 个噪声种子,midpoint 方案):FM-OT(绿)曲线最低,达到同等误差只需扩散模型约 60% 的 NFE。右侧三张 FID-vs-NFE 图(Euler/Midpoint/RK4 三种求解器):FM-OT 在所有求解器下都能在低 NFE 处拿到低 FID,FM-Dif 次之,SM-Dif 最差——说明直线路径不挑求解器。下方 Table 2 是 64→256 超分:FM-OT FID 3.4 / IS 200.8,优于 SR3 的 5.2 / 180.1(参考原图 FID 1.9 / IS 240.8),PSNR/SSIM(24.7/0.747)与 SR3(26.4/0.762)接近,证明同一框架可直接做条件生成。
🎧 音频版
时长 34:51 · Edge TTS
Flow Matching 精读:一行回归损失,怎么把噪声搬成图片(对话版)
先讲清楚这篇要解决什么问题
小播:今天聊的这篇叫《Flow Matching for Generative Modeling》,arXiv 编号 2210.02747,作者是 Meta AI 的 Lipman、Chen 他们。我听说这是生成模型方向人人都要读的论文,Stable Diffusion 3 的底层公式就来自它。它到底解决了什么问题?
老播:一句话背景:2022 年,扩散模型已经是图像生成的主流,训练稳定、效果最好,但它的采样路径被锁死在扩散过程定义的那一类里,路径弯曲,生成一张图要跑很多步。另一边有一个理论更一般的框架,叫连续归一化流(CNF),理论上能表达任意概率路径,却一直缺一个能大规模训练它的算法。这篇论文补上了这个缺口:它提出 flow matching,一个训练 CNF 的新目标,训练时完全不用模拟生成过程,一个 batch 就是一次普通回归。结论是:用这个目标配合一条直线插值路径,训练更快、采样步数更少、似然和图片质量都更好。今天这期我们把这套推导完整走一遍,重点讲三件事:条件速度匹配怎么一步步变成边际速度匹配、插值路径的选择怎么影响轨迹的直与弯、以及采样用的 ODE 是怎么从训练目标里推出来的。听完你就能自己把采样过程写出来。
小播:这个承诺有点大,我们从哪开始?
老播:从生成模型的共同骨架开始:把一个简单分布,标准高斯噪声,输运成数据分布。输运这个词在这里就是字面意思,像搬一缸流体一样,把一堆粒子从噪声位置搬到图片位置。所有生成方法都在做这件事,区别只在怎么定义这条搬运路线、怎么学它。
先补背景:扩散、score matching 和连续归一化流
小播:先说扩散模型吧,它现在这么主流,问题出在哪?
老播:扩散模型分两步。前向:给一张真实图片逐步加噪声,加到最后变成纯噪声;反向:训练一个网络学会一步步把噪声还原成图片。前向加噪是固定的,不用学,真正要学的是反向去噪。这套框架 2015 年由 Sohl-Dickstein 提出,2020 年 Ho 等人用 DDPM 做成实用方法,之后 score matching 那条线,Song 等人 2020、2021 的工作,又把它写成连续时间的随机微分方程。在 ImageNet 这种大规模数据集上,扩散是 2022 年最能打的方法,这一点没有争议。
小播:那 CNF 是什么?为什么说它理论上更一般?
老播:连续归一化流来自 Chen 等人 2018 年的 Neural ODE 那篇。思路是:用一个神经网络参数化一个随时间变化的速度场 v_t,从噪声出发,解一个常微分方程 dφ_t/dt = v_t(φ_t),t 从 0 走到 1,把每个粒子从起点送到终点。这里的 φ_t 是粒子的位置轨迹,v_t 是每个时空点 (x,t) 上的速度。速度场不同,粒子走的路线就不同,对应的密度路径也就不同。扩散模型可以看成 CNF 的一个特例,Song 等人 2021 年证明了扩散的概率路径也能被某个速度场生成,但这个速度场只能在扩散过程定义的那一小类路径里选。
小播:所以 CNF 的问题出在训练?
老播:对,这是卡了四年的瓶颈。CNF 最自然的训练方法是极大似然:让模型给训练数据一个高概率。但似然要用对数密度,而密度要跟着 ODE 一起积分,等于每训练一步都要模拟一次完整的生成过程,再用伴随方法反传梯度。FFJORD 那批工作把这个做到了能用,分辨率一高就撑不住。中间也有人试过别的路:Rozen 等人 2021 年直接在线性插值的密度上做回归,但涉及高维不可积的积分;Ben-Hamu 等人 2022 年用一般概率路径,但随机小批量下梯度有偏。三拨人各自卡在一个地方:要么要模拟 ODE,要么要算难积的积分,要么梯度不干净。
小播:听下来,理想的训练应该长什么样?
老播:理想状态是,训练时完全不用模拟生成过程,论文里叫 simulation-free,一个 batch 就是一次普通回归,跟监督学习一样便宜;同时路径可以随便设计,想直就直。这篇论文同时做到了这两点。做到的关键,是把一个看起来不可解的全局目标,拆成每个数据点上都能解析计算的条件目标。下面我们一步步走。
核心思想第一步:给每个数据点单独定一条路
小播:好,那第一步是什么?
老播:先立一个目标。我们想要一条从噪声分布 p_0 到数据分布 p_1 的概率路径 p_t,以及生成这条路径的速度场 u_t,然后让网络 v_t 去回归它。Flow Matching 的目标函数长这样:L_FM 等于期望 ‖v_t(x) − u_t(x)‖²,期望对随机时间 t 和从 p_t 采样的 x 取。这个式子要回答的问题是:网络在 (x,t) 处预测的速度,和真正搬运分布的速度差多远。问题在于,p_t 和 u_t 我们都不知道——数据分布我们只有样本,没有密度,路径的速度场更无从谈起。
小播:那怎么绕过去?
老播:把全局对象换成逐样本对象。对每一个数据点 x_1,单独定义一条条件概率路径 p_t(x|x_1):t 等于 0 的时候是标准高斯,t 等于 1 的时候集中在 x_1 附近,像一个以 x_1 为中心、方差很小的高斯。每个数据点都有自己的这条路,路是我们可以随便设计的,写出来就是一个均值和标准差随时间变化的式子。
小播:那全体数据点合起来呢?
老播:把每个数据点的条件路径按数据分布加权求平均,就得到边际路径:p_t(x) 等于 ∫ p_t(x|x_1) q(x_1) dx_1。这个式子里的 q(x_1) 是数据分布,积分就是把所有数据点各自的路叠在一起。速度场也有同样的构造:边际速度场 u_t(x) 等于 ∫ u_t(x|x_1) 乘以后验权重 p_t(x|x_1)q(x_1)/p_t(x) 再积分。
小播:这个权重为什么是后验?
老播:因为要回答的问题是:t 时刻有个粒子出现在位置 x,它最可能从哪个数据点出发?后验概率 p_t(x|x_1)q(x_1)/p_t(x) 就是给定位置 x 时、来自数据点 x_1 的置信度。把每个条件速度场按这个置信度加权平均,得到的就是整个分布在该点的平均速度。定理 1 用连续性方程证明了这个加权平均确实生成边际路径。连续性方程就是物理里的质量守恒:密度随时间的变化率,等于粒子通量散度的负值。这一步是整个推导的第一块基石:全局的输运场,被拆成了逐样本的局部场。
核心思想第二步:条件速度匹配就够了,边际目标不用碰
小播:等一下,边际速度场还是要算后验权重,分母里有个 p_t(x) 积分,还是不可算啊。
老播:问到点子上了。边际目标确实算不了,但训练可以完全绕开它。论文的关键定理 2:条件目标 L_CFM 等于期望 ‖v_t(x) − u_t(x|x_1)‖²,这里的期望换成对 x_1 采数据、对 x 采条件路径——它和边际目标 L_FM 只差一个不依赖网络参数的常数,所以两个目标对参数 θ 的梯度完全相等。注意这个结论的强度:两个目标差的是一个常数,梯度逐点相等。
小播:凭什么?展开看看。
老播:把平方范数展开成三项。第一项 ‖v_t‖² 在两种期望下完全一样。第二项是交叉项 2⟨v_t(x), u_t(x)⟩:把 u_t(x) 换成它作为后验期望的定义,双重积分一交换顺序,这一项正好等于 2⟨v_t(x), u_t(x|x_1)⟩ 的期望。第三项 ‖u_t‖² 或 ‖u_t(x|x_1)‖² 都不含网络参数 θ,对梯度没有贡献。所以差的只是常数,梯度相同。两边的交叉项在边际化意义下是同一个东西,这就是等价的来源。
小播:这很关键,等于说训练时永远不用碰那个分母。
老播:对,这就是 flow matching 能落地成一行损失的原因,也是后面所有 flow-based 模型直接照抄的公式。训练循环就是:抽一个数据点 x_1,抽一个时间 t,从条件路径采一个带噪样本 x,让网络预测的速度和解析给定的条件速度尽量一致。三个采样全部是平凡操作,一个 batch 的代价就是一次普通的前向加回归。到这里,我们把推导的地基立起来了:条件速度匹配 → 边际速度匹配,先证明后验加权平均生成边际路径,再证明条件回归与边际回归梯度等价。
核心思想第三步:路径怎么选,弯的和直的差在哪
小播:现在条件路径可以随便设计了,那具体怎么选?
老播:论文把条件路径限定在高斯族:p_t(x|x_1) = N(x | μ_t(x_1), σ_t(x_1)²I)。μ_t 是均值,决定分布中心在哪;σ_t 是标准差,决定分布多宽。边界条件固定:t=0 时 μ_0=0、σ_0=1,大家从同一个标准高斯出发;t=1 时 μ_1=x_1、σ_1=σ_min,σ_min 取一个很小的正数,让终点集中到数据点附近。只要 μ_t、σ_t 可微,就有闭式的条件速度场,论文的定理 3:u_t(x|x_1) = (σ'_t/σ_t)(x − μ_t) + μ'_t。第一个因子 σ'_t/σ_t 是标准差的相对变化率,乘上粒子到均值中心的偏移,描述分布被压缩或拉伸的速度;第二项 μ'_t 是均值移动的速度。整个式子可以这样读:粒子速度等于宽度收缩带来的漂移,加上中心移动带来的拖拽。
小播:那扩散路径对应哪个选法?
老播:扩散对应两种特殊选法。VE 路径:均值固定在数据点 x_1 不动,宽度 σ_{1−t} 随时间从很大收窄到 0;VP 路径:均值 α_{1−t}x_1 从接近 0 走向 x_1、宽度 √(1−α²_{1−t}) 相应收窄,α_t 来自噪声调度的积分。把这两组 μ、σ 代进定理 3,得到的就是扩散模型概率流 ODE 用的速度场,附录 D 里逐项验证过。但扩散路径有两个毛病:路径是弯的,条件轨迹会过冲再折返;而且有限时间到不了纯噪声,p_0 只能近似。
小播:那这篇论文推荐的选法呢?
老播:最朴素的一种:让均值线性走、方差线性收。μ_t(x_1) = t·x_1,σ_t(x_1) = 1 − (1−σ_min)t。代入定理 3,条件流变成 ψ_t(x) = (1−(1−σ_min)t)x + t·x_1;σ_min 取到很小,就是 x_t = (1−t)x_0 + t·x_1,也就是阅读提示里那个式子。这个式子要回答的问题是:t 时刻的带噪样本,是起点噪声 x_0 和终点数据 x_1 的线性混合,权重按时间均匀切换。对应到物理里的输运:每个粒子从自己的起点出发,沿直线、以恒定速度走到自己的终点,整缸流体被整体搬过去。而回归目标呢?对这条路径求时间导数,条件速度恰好退化成常数 x_1 − x_0,方向和大小都不依赖时间 t,简单到极致。
小播:为什么管它叫 OT 路径?
老播:因为它带着最优传输的性质:这个线性映射是两个高斯分布之间的 Wasserstein-2 最优传输位移映射,McCann 1997 年的经典结论。在所有能把这团高斯搬到数据点的搬运方式里,这条路的距离最短、粒子全程直线匀速。论文图 2 把两类回归目标画在一起:扩散的 score 场,箭头方向随时间旋转、长度缩放;OT 的速度场,方向全程恒定,只改大小,可以写成 g(t) 乘 h(x) 的分离形式。回归目标越简单,网络越好学,这是全文最核心的设计论点:目标场的复杂度直接决定拟合难度。
小播:那个闭式条件速度 u_t(x|x_1) 是怎么推出来的?我自己想验证一下。
老播:可以,只用连续性方程。对条件高斯路径 p_t(x|x_1),它的密度随时间变化;连续性方程说,密度的时间变化率等于粒子通量散度的负值:∂p/∂t 加 ∇·(p u) 等于 0。把高斯密度的解析形式代进去,高斯族的流是线性流,速度是位置的仿射函数,整理之后闭式就出来了:u_t(x|x_1) 等于 σ'_t/σ_t 乘以 (x − μ_t),再加 μ'_t。这个推导任何一本讲最优传输的书都有类似版本,McCann 1997 那篇也用过同一套技巧。整条链路的依赖关系值得再说一遍:先有路径(μ_t、σ_t 怎么走),路径决定条件速度(定理 3),条件速度决定回归目标,回归目标决定网络好不好学。所以「路径设计」是 flow matching 唯一的实质自由度,后面所有变体,包括引导、噪声调度、插值改进,改的都是这一层。
采样 ODE 是怎么推出来的
小播:好,训练目标有了,那采样那一步呢?你开场说听完能自己推出来。
老播:可以,现在推。训练结束,网络 v_θ 已经逼近边际速度场 u_t。采样要做的是:从 x_0 采一个标准高斯噪声,然后解常微分方程 dφ_t/dt = v_θ(φ_t, t),从 t=0 积分到 t=1,终点 x_1 = φ_1(x_0) 就是生成的样本。把这条 ODE 翻译成好懂的记号:令 x_t = φ_t(x_0),它表示粒子在 t 时刻的位置,那么 dx_t/dt = v_θ(x_t, t),初始位置 x_0 是噪声。数值上最朴素的解法是欧拉法:x_{t+h} = x_t + h·v_θ(x_t, t),h 是步长,一步就是当前位置加上速度乘时间。为什么终点分布就是数据分布?因为连续性方程保证,沿 v_θ 积分,密度就沿训练时指定的边际路径输运,t=1 时的密度就是 p_1 约等于 q。这就是从训练目标到采样 ODE 的完整链条。似然也顺手能算:log p_1(x_1) = log p_0(x_0) − ∫₀¹ div(v_t)dt,散度用 Hutchinson 迹估计,这就是论文里 BPD 数字的来源。
小播:那如果路径是直的,欧拉法是不是特别准?
老播:对,这就是直线路径的价值。路径直,意味着速度场沿轨迹几乎不变,固定步长求解器误差小;路径弯,速度场变化快,同样的步数误差大。所以 OT 路径直接换来了采样步数的大幅下降,这是下一节实验要验证的。这里有个限定条件要说清楚:直线性只对单条条件轨迹成立,把全体数据点的条件轨迹按后验叠成边际流之后,边际流本身没有直线或最优的保证,这一点论文自己写得很清楚,我们到局限部分再展开。
训练在实现层面长什么样
小播:理论链条走完了,实际训练起来,代码里到底在做什么?
老播:训练循环就是三行采样加一行回归。每个 batch:从数据里抽一批 x_1,从 [0,1] 均匀分布抽一个时间 t,再从条件路径采带噪样本 x,然后最小化 ‖v_θ(x,t) − u_t(x|x_1)‖²。均匀时间采样和回归本身都不依赖其他时间步,所以 batch 之间完全独立,训练可以随便并行。论文里所有方法共用同一套超参:Adam,β1=0.9、β2=0.999,权重衰减 0,ϵ=1e-8;CIFAR-10 和 ImageNet-32 用 32 位全精度,ImageNet-64/128/256 用 16 位混合精度;学习率要么恒定、要么多项式衰减,衰减前有一段从 1e-8 线性升到峰值的 warmup。
小播:收敛速度呢?你开场说训练更快。
老播:这是论文里单独用一张图强调的点。图 5 是 ImageNet-64 训练过程中的 FID 曲线:FM-OT 下降最快、到得最低,三个扩散基线都更慢。对比现有扩散工作的迭代量:Score Flow 报了 130 万次迭代、VDM 报了 1000 万次;ImageNet-128 上,Dhariwal 和 Nichol 的扩散模型训了 436 万次迭代、batch size 256,而 FM-OT 只用了 50 万次迭代、batch size 1500,模型大了 25%,图像吞吐量反而少了 33%。附录里还有一张图(图 10)讲采样成本:score matching 模型在训练过程中,采样所需的函数调用次数会剧烈变化;flow matching 模型全程基本恒定,因为它的目标场复杂度不随时间漂移。训练更快、采样成本更稳,这两点加在一起,是后面工业界愿意换公式的直接原因。
关键实验:同一个骨架,换三种训练目标
小播:实验部分,论文是怎么设计的?
老播:设计很干净,方便归因:同一套 U-Net 架构,沿用 Dhariwal 和 Nichol 2021 那篇的模型只做最小改动;同一批超参数、同样的训练轮数,只换训练目标。三个主角:FM 加 OT 路径、FM 加扩散路径、score matching 加扩散路径;对照组是 DDPM、Score Flow 这些原版方法。先看 2D checkerboard toy,图 4 左:三行轨迹,FM-OT 那一行在很早期就出现棋盘结构,扩散路径的样本要到很后期才出现清晰结构,说明路径的直线性让信息传递更快,网络更早学会结构。图 4 右是固定步数采样对比,NFE 取 4、8、10、20,midpoint 求解器:FM-OT 在 10 步左右棋盘已经相当清晰,FM-Dif 相同步数还模糊。
小播:到了 ImageNet 这种大规模呢?
老播:表 1 是主结果。CIFAR-10 上,FM-OT 的 NLL、FID、NFE 三个指标分别是 2.99、6.35、142,对照 DDPM 是 3.12、7.48、274,Score Matching 是 3.16、19.94、242,ScoreFlow 是 3.09、20.78、428。ImageNet-32 上 FM-OT 是 3.53、5.02、122;ImageNet-64 上是 3.31、14.45、138。三个数据集上,FM-OT 三项指标全部同时刷新。这里有个容易忽略的对照组:就算沿用扩散路径,FM-Dif 在 ImageNet-64 的 FID 是 16.88,也好于 Score Matching 的 19.74 和 ScoreFlow 的 24.95,说明换成 FM 目标本身就让训练更稳,路径直线性是叠加在上面的额外收益。ImageNet-128 无条件生成,FM-OT 拿到 NLL 2.90、FID 20.9,超过当时所有无条件 GAN,最好的一家 PGMGAN 是 21.7,Uncond. BigGAN 是 25.3。训练吞吐也省:ImageNet-128 上 FM 用 500K 步、batch 1500,模型比 Dhariwal 和 Nichol 的大 25%,对照他们 4.36M 步、batch 256,图像吞吐少 33%,训练却更快收敛,图 5 的 FID 曲线就是这个趋势。
小播:采样效率那边的数字呢?
老播:图 7 是采样效率的证据。横轴是 NFE,函数调用次数,大致等于步数;左边那张图纵轴是 ODE 数值误差,相对 1000 步参考解的逐像素误差,用 256 个随机噪声种子、midpoint 求解器。三条线,SM-Dif、FM-Dif、FM-OT,FM-OT 最低。达到同样的误差阈值,FM-OT 只需要扩散模型约 60% 的 NFE。右边三张图是 FID 随 NFE 的变化,Euler、Midpoint、RK4 三种求解器各一张:FM-OT 在低步数区间都能拿到低 FID,说明它不挑求解器。FM-OT 在 NFE 二三十步的区间里 FID 已经比较低,而扩散模型要达到相近质量需要明显更多的步数。这些数字全部带 setup:模型是表 1 里的 ImageNet-32 三件套,固定步数求解器,误差对照 1000 步参考解。
小播:除了无条件生成,有没有条件任务的验证?
老播:有一项:超分,把 64×64 图放大到 256×256,ImageNet 验证集,评估流程照抄 Saharia 等人 2022 的 SR3。FM-OT 的 FID 是 3.4、IS 200.8,SR3 是 5.2 和 180.1;参考值,直接拿原图评估,是 FID 1.9、IS 240.8。PSNR 和 SSIM 上 FM-OT 是 24.7 和 0.747,SR3 是 26.4 和 0.762,略低但接近。FID 明显更好,说明同一套 flow matching 公式直接搬到条件生成也能打。
小播:除了采样效率,论文还报了似然数字,这部分怎么读?
老播:似然用负对数似然(NLL)衡量,单位是每维比特数(bits per dimension,BPD),数值越小越好。注意数字的 setup:评测前先做均匀去量化(uniform dequantization),再用重要性加权估计,权重系数 K 越大估计越准。CIFAR-10 上,K=50 时 FM-OT 是 2.99,DDPM 是 3.12、score matching 3.16、score flow 3.09、FM-扩散路径 3.10;K=1 时 FM-OT 是 3.11,三个基线分别是 3.24、3.28、3.21。不管 K 取多少,FM-OT 的似然都最好,差距在 CIFAR-10 上最明显;ImageNet-32 上大家接近,K=15 时 FM-OT 是 3.53,DDPM 是 3.54。计算这些数字用 dopri5 自适应步长求解器、容差 atol=rtol=1e-5,解到 t=1。这张表回答的是「采样快之外,密度建模质量过不过硬」,结论是过硬:同一架构下换目标,FM-OT 在似然、FID、采样代价三个指标上同时占优。
谱系定位:它站在哪条线上
小播:这篇论文在技术谱系里处在什么位置?
老播:两条线的交叉点。一条是扩散线:DDPM、score matching、ScoreFlow,FM 证明了扩散路径只是高斯条件路径族的特例,把训练目标从匹配 score 换成匹配速度。另一条是 CNF 训练线:FFJORD 的极大似然、Rozen 的线性插值、Ben-Hamu 的一般路径,FM 给出无不可积积分、梯度无偏的 simulation-free 方案。同期还有两篇独立工作拿到了类似的条件目标:Liu 等人 2022 的 Rectified Flow,和 Albergo 与 Vanden-Eijnden 2022 的 Stochastic Interpolants。三篇合在一起,定义了 flow-based 生成模型这个范式。后续影响可以直接看工业界:Stable Diffusion 3 用的 CFM 公式加 MM-DiT 架构,就是这个 OT 路径的版本;Sora 一代的视频模型也大量用 velocity prediction,也就是回归 x_1 − x_0 这个目标。所以这篇被称为后续所有工作的地基,公式被直接复用,原因就在这里。
小播:你说它和 Rectified Flow、Stochastic Interpolants 同期独立拿到类似目标,三篇之间怎么分工?
老播:三篇出发点不同,后续走向也不同。Rectified Flow 的起点是「噪声和数据随机配对做线性插值,再拿学到的轨迹重新配对(reflow)让轨迹逐步变直」,重心在少步采样和配对重构,就是清单里的下一张卡;Stochastic Interpolants 用两个分布端点的任意组合构造路径,把扩散和 flow 收进同一个框架,理论更一般,ImageNet 规模的实验出现得晚一些;Flow Matching 这篇把条件高斯路径族完整写下来,证明条件目标与边际目标梯度等价,并直接用同一套 U-Net 在 CIFAR-10、ImageNet 上把三种目标做完对比,是同期三篇里实验面最完整的。后面大家互相吸收:SD3 用 FM 的 OT 路径配 MM-DiT;很多方法改用 minibatch OT 改进配对质量——在每个 batch 内部重新匹配噪声和数据,让条件轨迹在 batch 内更接近全局最优传输。这正好接上我们局限里说的「随机独立配对是改进空间」这条线索。
局限:论文自承的,和我们读出的
小播:这篇有没有明显的短板?
老播:有,而且论文自己承认了几条。第一条:条件流是最优传输映射,但边际流没有这个保证,不同数据点的条件轨迹叠在一起会交叉,直线性只对单条轨迹成立,边际轨迹仍可能弯。第二条:扩散路径有限时间到不了纯噪声,只能近似;OT 路径靠 σ_min 收尾,σ_min 取太大偏离数据点、取太小分布退化,本身是个权衡。第三条:CIFAR-10 的 FID 比此前专门调优的工作高,论文解释是所用 U-Net 没有针对这个数据集优化。
小播:你自己读出来的是什么?
老播:三条。第一,生成仍然要数值积分,FM-OT 把 NFE 从上千降到几十到一百,但离单步还远,真正把轨迹压成一条直线的 reflow 和一步生成,是 Rectified Flow 和 Consistency 系列后续完成的。第二,OT 路径的噪声-数据配对是随机独立的,没有学习配对,配对本身是后续改进空间,后来的 minibatch OT、Schrödinger bridge 都从这切入。第三,实验面偏窄:没有 guidance、没有文本条件、没有类条件的大规模评测,也没有系统 scaling 分析;似然数字依赖 uniform dequantization 和重要性加权,K 从 1 提到 50,CIFAR-10 的 NLL 能从 3.11 降到 2.99,对比时口径要看清楚。另外提醒一句:这篇论文的 ImageNet-128 是无条件生成,FID 20.9 超过的是无条件 GAN,别和加了类别条件的个位数 FID 混在一起,那是后面 DiT 那篇的事。
把整条链再走一遍,顺便扫三个雷
小播:把整条链再完整走一遍,方便我记笔记。
老播:好,一共五环。第一环,选路径:给每个数据点 x_1 定义条件高斯路径 p_t(x|x_1),μ_t 和 σ_t 定边界,t=0 是标准高斯、t=1 集中在 x_1。第二环,推速度:路径经连续性方程推出条件速度 u_t(x|x_1) 等于 σ'_t/σ_t 乘 (x − μ_t) 再加 μ'_t,线性插值路径下就是常数 x_1 − x_0。第三环,定义目标:条件目标 L_CFM 等于期望 ‖v_θ 减 u_t(x|x_1)‖²,只回归每个数据点自己的条件速度。第四环,等价证明:把条件目标对边际分布展开,和全局目标 L_FM 只差一个常数,梯度相等,所以训练永远不用算边际速度那个带分母的积分。第五环,采样:训练完用 v_θ 解 ODE dx_t/dt = v_θ(x_t,t),从 x_0 积分到 x_1,终点就是生成样本;路径越直,固定步长求解器越准。五环里,第二环和第四环是这篇的原创贡献,第一、三、五环是框架的必选件。把这张五环图记住,读后面所有 flow-based 工作,你都能一眼定位它改的是哪一环。比如 Rectified Flow 改的是第一环的配对方式,Consistency Models 改的是第五环的步数,SD3 改的是第一环的路径形状和时间采样——骨架没动,动的都是环上的零件。这也是为什么这篇被叫地基:立住了框架,后面全是换零件。
小播:最后补一个追问:条件路径限定在高斯族,这个假设会不会太强?
老播:高斯族的好处是解析:条件速度有闭式、回归目标干净,这是能大规模训练的前提。代价是插值结构被限制在线性混合这一档,表达不了带旋转或非线性弯曲的运输方式。后续工作确实往这个方向扩:minibatch OT 在采样端改进配对质量,Stochastic Interpolants 允许任意端点分布,Schrödinger bridge 那一族引入熵正则、允许路径弯曲。但注意,这些扩展大多保留了「条件目标与边际目标等价」这个骨架,换的只是路径族本身。所以高斯假设是便利性选择,框架的价值在等价性上,读后续工作时要把这两层分开看。换句话说,框架的普适性和高斯族的便利性是两件事。
小播:读这篇有没有常见的坑?
老播:三个坑值得标一下。第一,别把「OT 路径」理解成真的求解了最优传输:条件层面的线性插值是两个高斯分布之间 Wasserstein-2 最优的,但数据分布和噪声分布之间的全局 OT 并没有求解,噪声和数据仍是随机配对,所以叫 OT 路径更多是沿用最优传输的构造,全局直线性是靠 reflow 那一族后续工作补的。第二,NLL 数字口径多:去量化方式、重要性加权系数 K、求解器容差都会改数字,对比前先对齐这些设置,我们前面 NLL 那段把配置列全了。第三,FID 要分清无条件与有条件:ImageNet-128 的 20.9 是无条件生成,跟加了类别条件的个位数 FID 是两套口径,别直接比。第四,训练时的时间采样默认是均匀分布,这是论文的配置;后续 SD3 改用 logit-normal 分布采样时间,感知质量更好,读后续工作数字时要注意训练配置已经换了。
收尾:记住这三件事
小播:最后,给我们总结一下这期该记住什么?
老播:三件事。第一,flow matching 的训练可以完全绕开边际向量场:条件速度匹配和边际速度匹配只差一个常数,梯度相等,所以训练就是一行均方误差,回归每个数据点的条件速度。第二,插值路径是设计自由度,扩散只是特例;线性插值的 OT 路径让条件轨迹笔直、回归目标退化成常数 x_1 − x_0,换来更快的训练、更少的采样步和更好的质量。第三,采样就是解一条 ODE:从噪声 x_0 出发,沿学到的速度场 dx_t/dt = v_θ(x_t, t) 积分到 t=1,终点就是生成样本;路径越直,固定步数求解器越准。这条从条件路径到采样 ODE 的链条,就是后面 SD3、Sora 那一大批工作共用的地基。论文里最该记住的数字是 60%:ImageNet-32 上,FM-OT 达到与扩散模型相同的采样误差,只需要约 60% 的 NFE。