Toy Models of Superposition:一个神经元为什么能同时代表好几个概念?
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
你盯着一个训练好的神经网络,想搞清楚某个神经元到底在检测什么,结果发现它同时对一堆不相干的东西有反应——你问它"你在找猫吗",它说"我在找猫,也找狗,还找半张椅子"。这种一神经元多义的现象叫 polysemanticity,长期被当作解释模型的黑障区。
2022 年 Anthropic 的《Toy Models of Superposition》把这个问题翻了个面:不再把它当成解释障碍,而是当成可以研究的机制。核心结论一句话:神经网络把特征存在"方向"上,当特征足够稀疏,一个 m 维空间可以装下远超 m 个特征——代价是容忍一点点干扰。我们从头拆。
玩具模型:把问题压到能算清楚的最小形式
作者没有直接研究真实网络,而是造了一个完全可控的玩具:输入是一组稀疏特征 $\mathbf{x}$,经过一层 ReLU 网络之后尽量还原出来:
$$\mathbf{x}' = \text{ReLU}(W^T W \mathbf{x} + b)$$
逐项看:$\mathbf{x}$ 是输入特征向量,每个特征大多数时候是 0(这就是"稀疏");$W$ 是权重矩阵,$W^T W$ 把它变成"编码再解码"的结构——先投影到隐藏空间,再投影回来;$\text{ReLU}$ 是激活函数;$b$ 是偏置。训练目标是最小化重建误差:
$$L = \mathbb{E}\left[\|\mathbf{x} - \text{ReLU}(W^T W \mathbf{x} + b)\|^2\right]$$
先给预期:这个式子在问"给定一个 m 维的隐藏空间,模型怎么把特征放进去最划算"。注意这里只有一个隐藏层,m 维——特征数可以超过 m,这正是全文的关键。
核心机制:特征存在方向上,稀疏让叠加划算
这里要铺垫一个核心假设:神经网络把特征存在"方向"上,而不是"格子"里。一旦特征是一个方向,事情就不同了——一个 m 维空间里可以放远超过 m 个方向,代价是它们不能完全正交,读数的时候会互相沾一点。
那为什么平时不这么做?因为方向之间会互相干扰。Saxe 等此前的工作把这种权衡拆成了两项:多表示特征带来的"特征收益",和特征互相干扰带来的"干扰损失"。当特征足够稀疏,干扰的期望成本急剧下降——大多数时候你读一个方向,其他方向都是 0,噪声被 ReLU 一过滤就没了。
于是模型做了一道算术题:多存几个特征、偶尔付出一点干扰代价,还是少存几个、浪费维度? 当稀疏度越过临界点,答案是前者。这就是 superposition(叠加)。
关键证据:相变图,叠加是表示策略的突变
机制给的预测是:叠加的出现应该是突变的,不是渐变的。论文用两套图验证了这一点——经验图(实际训练出来的最优权重)和理论图(解析推导的最优解):
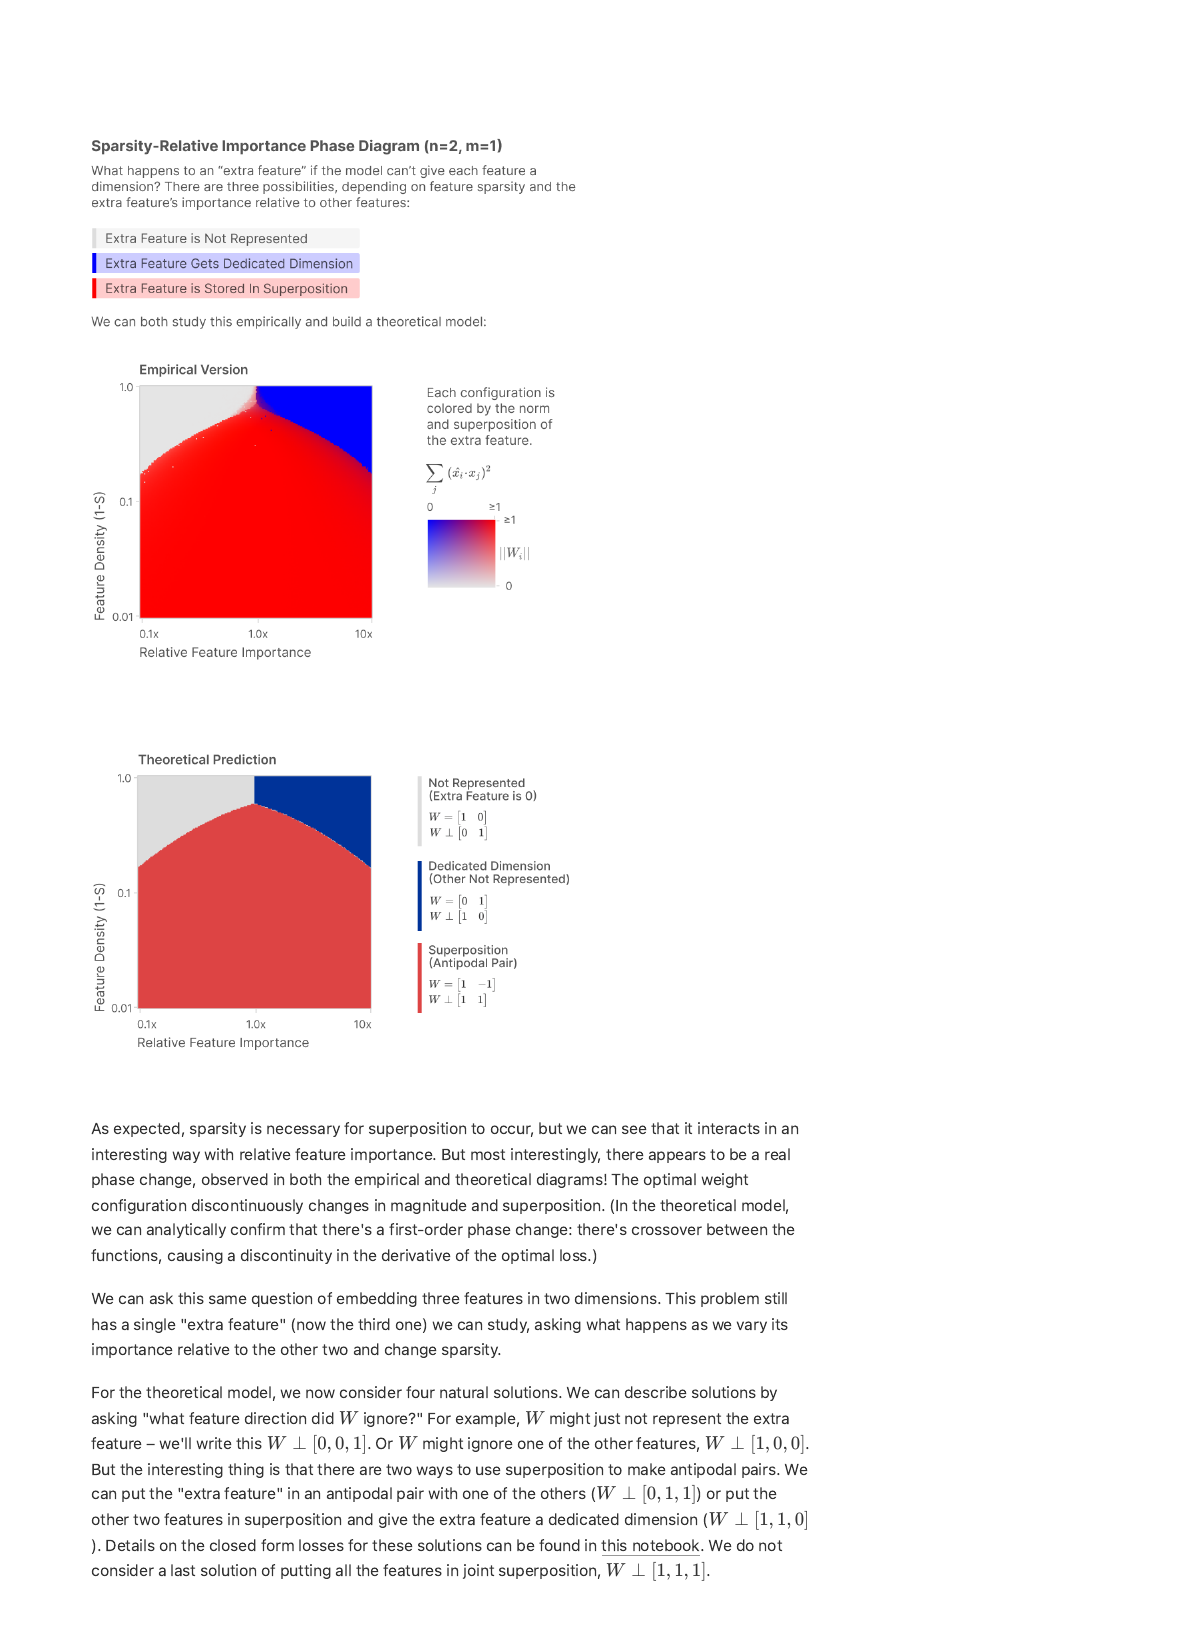
先给预期:这张图回答"什么时候叠加会出现、出现得多突然"。坐标是特征稀疏度和相对重要性,颜色/深浅表示最优编码方式。读图时注意两点:第一,稀疏度越高,叠加越激进——一个方向上塞的特征越多;第二,经验图和理论图都出现不连续跳变:稀疏度越过临界点,最优权重配置在大小和叠加方式上直接切换到另一套方案,这是一阶相变的特征。
这就把"神经元说不清楚"变成了一个可计算的问题:polysemantic 是稀疏表示下的理性选择,是模型面对维度压力给出的最优解。
延伸:叠加还连着对抗脆弱性
机制还有意外的工程含义。论文专门有一节讨论叠加和对抗鲁棒性的关系:无叠加时,第一个特征的端到端权重是标准基 $(W^TW) = (1, 0, 0, 0, \dots)$——读特征不掺杂质;叠加形成后,特征方向不再正交,微小的输入扰动可以在不同特征之间被放大。
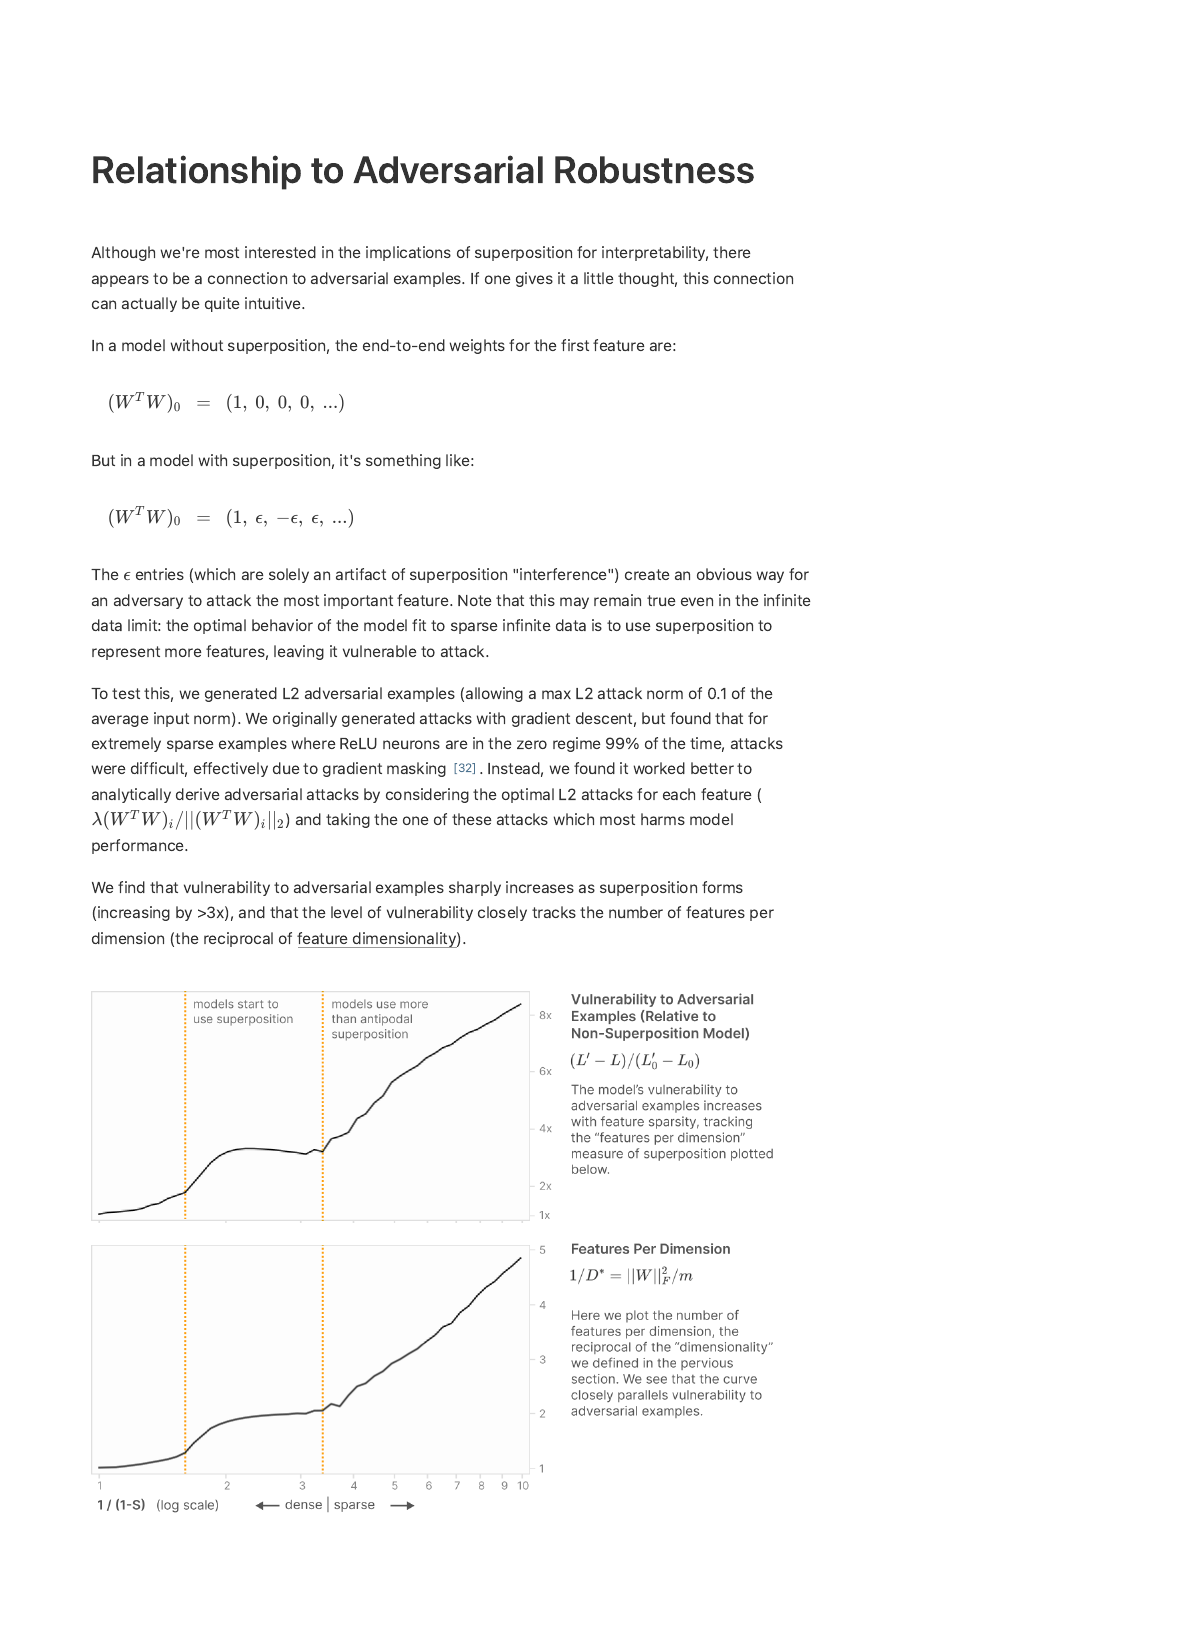
作者报告:叠加形成后,对抗脆弱性上升 3 倍以上,而且与"每个维度塞了多少特征"强相关。这把两个原本分开的现象——polysemanticity 和对抗脆弱性——连到了同一个机制上,也给对抗训练提供了新抓手。
最弱的一环:干预只发生在玩具里
诚实地说,这篇论文的局限也很清楚:所有干预都发生在玩具模型里。真实网络上只做了定性对照——ImageNet CNN 深层更多 polysemantic、transformer 早期 MLP 层极端 polysemantic,模式吻合,但没有在真实模型上执行"消除叠加"的实验。从机制到工程收益的因果链,在论文内部没有闭合。
它留下的是三条可执行的工程路线:提高特征稀疏度、改造激活函数的干扰行为、利用相关结构做针对性正则。这三条路后来分别被 SAE(稀疏自编码器)、特征工程等一系列后续工作接走了。
一句话记住这篇
特征存在方向上;特征足够稀疏时,m 维空间就能装下远超 m 个特征,靠容忍一点点干扰——这就是 superposition。最该记住的数字是:叠加形成后对抗脆弱性上升 3 倍以上;最该保留的态度是:叠加机制在玩具里被严格证明,在真实网络上还停留在模式吻合。
用可完全控制的 ReLU toy autoencoder,把『特征数超过维度』的 superposition 从假设变成可观测、可解析、可复现的现象——附带相变图、多胞体几何刻画和『叠加中能算 abs』的证据——并把 polysemanticity 从解释障碍重新定位成可研究的机制,留下三条消除叠加的工程路线图。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:真实网络中神经元与可解释特征的一一对应经常失效:大量神经元是 polysemantic(对多个无关输入响应),且特征数似乎远超维度数;受控复现为:在合成稀疏特征 + ReLU autoencoder 中,模型可以把超过隐藏维度 m 的特征存储进 m 维空间,即 superposition。
在哪里观测:真实侧:ImageNet CNN(InceptionV1 深层 polysemantic 神经元比例更高)与 transformer 语言模型早期 MLP 层(神经元极端 polysemantic)(§1 Background & Motivation、§10 Discussion)。受控侧:合成数据 x_i 以概率 S 为 0、否则 uniform[0,1],带重要性 I_i;ReLU output model x'=ReLU(W^T W x + b),特征数 n=20、隐藏维 m=5(§2 Demonstrating Superposition)。
如何量化:受控侧:W^TW 非对角项量化 interference(特征互相泄露);特征嵌入范数 ||W_i|| 判断特征是否被表示;feature dimensionality D_i = ||W_i||² / Σ_j (Ŵ_i·W_j)² 量化每个特征占多少分数维度(§4);神经元堆叠权重图人工判定 monosemantic/polysemantic(§7)。真实侧:polysemanticity 为既有定性观察,真实模型无特征 ground truth,叠加程度不可直接测量(§10 Discussion 明示)。
② 机制假设
假设:特征以『方向』存储在线性表示中(linear representation hypothesis);当特征稀疏时,把超过 m 个的特征方向以『几乎正交但不完全正交』的方式打包进 m 维空间:容忍少量 interference(靠 ReLU 等非线性激活过滤噪声),换取表示更多特征,收益超过代价;小模型据此 noisily simulate 一个更大的稀疏网络(§1、§2 Mathematical Understanding)。
证据:
- 线性模型(无激活)恒只表示 top-m 主成分且解与稀疏度无关;输出端加一个 ReLU 后,同一数据上叠加出现,特征数随稀疏度单调增加(§2 Basic Results)。
- 把 loss 按稀疏模式分解(L = (1−S)^n L_n + … + S^n L_0),S→1 时 1-sparse 项 L_1 主导;L_1 中 feature benefit 与 interference 的权衡退化为球面打包问题(Thomson problem 类比),ReLU 使负 interference 免费(§2 Mathematical Understanding)。
- 2 特征 1 维相变实验:三种候选配置(忽略/叠加 antipodal/专属维度)的闭式 loss 与经验相图一致,理论端确认一阶相变(§3 Superposition as a Phase Change)。
- 特征维度分数聚集于 1/2、2/3、3/4、2/5、3/8,对应 antipodal pair、triangle、tetrahedron、pentagon、square antiprism;高效打包时各特征维度之和 ≈ 嵌入维度(§4 The Geometry of Superposition)。
- 叠加还能承载计算:abs 任务在 n=100 特征、m=40 神经元下于稀疏域以叠加方式实现(§8 Computation in Superposition)。
- 独立复现:Redwood、OpenAI、DeepMind(Tom McGrath)、Marius Hobbhahn 复现核心结果(§12 Comments & Replications)。
备选解释:
- 压缩感知/稀疏恢复:同一数学现象的既有框架;但 toy model 的嵌入矩阵是学出来的、特征带重要性差异、计算被限制为单层线性+非线性(§11 Related Work)。
- 非线性压缩:多层非线性编码也可超维度存储;附录给出构造并比较 MSE,作者认为典型情况下稀疏叠加更高效(Appendix: Nonlinear Compression)。
- polysemanticity 的替代叙事:多个神经元联合消歧、分布式/群体编码(population codes);作者把 decomposability 与 superposition 分开处理(§1、§11)。
- McGrath 的解析发现低稀疏+双高重要性时存在 W1≈W2≈1/√2 的『confused feature』解,说明叠加解空间比论文主体展示的更丰富(§12)。
形式化/toy model:有 toy model + 部分闭式解:ReLU output model x'=ReLU(W^T W x + b),加权 MSE loss L = Σ_x Σ_i I_i (x_i − x'_i)²;loss 按稀疏模式分组后 1-sparse 项可解析化;n=2、m=1 情形由 McGrath 给出完整 loss 面与相边界解析(§12);压缩感知下界给出容量上界 m = Ω(−n(1−S)log(1−S))(Appendix 定理 1–2)。
③ 局部干预
干预对象:特征稀疏度 S 与相对重要性 I(数据分布参数,其余条件固定)
操作:2 特征 1 维:第 2 特征重要性 0.1–10 × 稀疏度 1.0–0.01 扫描;每点训练 10 个模型、平均并丢弃最高 loss 模型;绘制『不学/叠加/专属维度』三态相图并与闭式解对比(§3)。
效果:经验相图与闭式解一致;稀疏度足够高时叠加才出现,最优配置在相边界处不连续跳变;理论端确认一阶相变(§3)。
局部性:单变量扫描的最小干预;相图依赖解析候选配置枚举,作者自述未考虑三特征联合叠加等配置(§3)。
干预对象:隐藏层激活函数(privileged basis)
操作:线性隐藏层 vs ReLU hidden layer 模型 h=ReLU(Wx)、x'=ReLU(W^T h + b);n=10、m=5、I_i=0.75^i,每稀疏度训练 1000 个模型取最低 loss(§7)。
效果:稀疏度升高时神经元从 monosemantic 切换到 polysemantic(两类可同层共存),出现类神经元级相变;特征向基方向对齐,W 直接可解释(§7)。
局部性:只改激活函数;作者坦承该模型会尽量回避 ReLU(给 hidden bias 就线性化、给足够特征就平均模拟 bias),干预的可用区间有限(§7 Limitations)。
干预对象:特征相关性结构(数据生成分布)
操作:构造 correlated/anticorrelated feature sets(m=2 时把权重画成单位圆上的点;6 特征 3 组相关对扫稀疏度)(§4 Non-Uniform Superposition)。
效果:相关特征趋向正交、形成局部几乎正交基;反相关特征趋向 antipodal;极稀疏→极稠密时特征排列从 hexagon 逐渐 collapse 成 PCA 主成分(§4)。
局部性:只改数据分布、不动架构;结论限于 toy 内部,『局部非叠加假设』对真实网络是否成立作者只称『如果成立将很强』(§4)。
干预对象:训练过程(对抗训练)
操作:用解析最优攻击(针对随机特征)做对抗训练,尝试反向消除叠加(§6 Relationship to Adversarial Robustness)。
效果:能降低叠加,但攻击幅度需达输入 L2 范数的 80% 才能完全消除;作者自评『不令人满意』并搁置(§6)。
局部性:单机制干预;攻击为解析近似(梯度下降在 ReLU 零域 99% 时有梯度遮蔽),未尝试更强的对抗攻击(§6)。
干预对象:loss 正则项
操作:对隐藏层激活加 L1 正则 λ||h||_1(§9 Approach 1)。
效果:toy model 中可消除叠加,代价是更高 loss(幅度未量化);对真实网络的推广是推测、未实验(§9)。
局部性:作用于全局激活范数,属于训练期干预,有别于对单一电路/特征的定点干预(§9)。
因果验证:合成数据下特征即 ground truth:学到的 W 可直接与闭式最优配置比对;闭式解(理论 toy model of the toy model)与经验相图交叉验证;Redwood/OpenAI/DeepMind/Hobbhahn 独立复现核心图。局限:整条因果链在 toy model 内部闭合,对真实网络没有任何干预实验;与真实模型的对应只有定性一致性(如 InceptionV1 深层更 polysemantic 与『稀疏度↑→叠加↑』方向一致)(§3、§10、§12)。
④ 工程收益
指标:polysemanticity 的解释与预测
数值:解释 monosemantic/polysemantic 神经元为何共存并随稀疏度相变;预测 InceptionV1 深层更多 polysemantic(高层特征更稀疏)、早期 transformer MLP 层极端 polysemantic
基线:此前 polysemanticity 只有观察描述、无机制模型(§1)
设置:ReLU hidden layer 与 abs 计算模型 vs 真实网络定性对照(§7、§8、§10 Discussion)
指标:对抗脆弱性的机制解释
数值:叠加形成时对抗脆弱性增加 >3×,且与每维特征数紧密相关;预测鲁棒模型性能更低、更可解释
基线:无叠加模型不承受此类 interference 攻击(§6)
设置:解析最优 L2 攻击,max attack norm = 0.1 × 平均输入范数(§6)
指标:启发特征提取方法(稀疏自编码器)
数值:评论区 Sharkey et al. 用单层 L1 稀疏自编码器在 toy ground truth 上几乎完全恢复特征,直接催生后续 SAE 工作线(§12)
基线:叠加时特征方向不可枚举(§9 Approach 2)
设置:toy ground truth 特征 + 稀疏组合数据(§12)
指标:架构理解(MoE)
数值:叠加 ≈ 固定神经元数下把模型『变大』;MoE 把神经元稀疏性折成免费 FLOPs,为 MoE 的优势提供机制解释
基线:以神经元数为硬约束的稠密模型
设置:思想实验/定性论证,无实验(§9 Approach 1)
指标:安全可解释性路线图
数值:『solving superposition』(枚举所有特征)等价于多项解释原语:分解激活空间、语义字典、电路分析;给出三条路线(L1 无叠加模型 / 过完备基稀疏编码 / 混合方案)
基线:无法对特征做全称量词式安全断言(§9)
设置:理论蓝图,无真实模型实验(§9)
代价:toy model 中消除叠加的代价是更高 loss(未量化);真实网络『找过完备基』需要 millions 神经元 × billions token 的超完备分解,是独立的大型工程挑战;解码后存在 surface vs virtual structure(virtual neurons)的额外鸿沟;L1 作用于全局激活,稀疏编码还需要额外确定特征数量(§9)。
可迁移性:作者明示:叠加、monosemantic/polysemantic 共存、与对抗样本的关系较可能泛化;多胞体几何与学习动力学『很可能只属于 toy model』;真实网络侧全部证据为定性吻合,无定量验证(§10 Discussion)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 强(合成体系内):现象与机制在同一 ground-truth 体系内闭环——经验观察、loss 分解推导、闭式解与独立复现互相印证;『真实网络也存在叠加』只是定性外推(polysemanticity 模式吻合),无直接测量。 |
| 机制→干预 | 中—强:机制直接给出可调旋钮(稀疏度、激活函数、相关性结构、正则、对抗训练),干预结果与机制预测一致(相变边界、monosemantic↔polysemantic 切换);但全部干预在 toy 内部,真实模型上的干预方案未执行。 |
| 干预→收益 | 弱(最弱一环):本文没有在真实模型上做『干预→量化收益』的实验;收益侧是蓝图、定性一致性与后续工作的素材,干预与收益之间的因果链在本文内未闭合。 |
| 最弱一环 | intervention_to_gain:从『toy 内调节/消除叠加』到『真实模型的工程收益』没有本文自己的证据;真正的收益由后续工作(稀疏自编码器、Engineering Monosemanticity in Toy Models)补上。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 可表示特征数(叠加存在性) | 稀疏度升高时表示的特征数超过 m 且单调增加;n=20/m=5 时从稠密域(1−S=1.0)的 top-5 增至远超 5;n=80/m=20 时呈同形放大版 | 线性模型恒只表示 top-m 主成分(PCA 类比),解与稀疏度无关 | ReLU output model,n=20、m=5、I_i=0.7^i,扫特征激活概率 1−S:1.0→0.1(§2 Basic Results) |
| 叠加的相变 | 2 特征 1 维下特征在『不学/叠加(antipodal W=[1,−1])/专属维度』三态间切换,经验相图与闭式解一致;理论端确认一阶相变(最优 loss 导数不连续) | 线性模型无相变,始终是 PCA 式最优 | 第 2 特征重要性 0.1–10 × 稀疏度 1.0–0.01;每点 10 个模型平均、丢弃最高 loss(§3 Superposition as a Phase Change) |
| 分数维度几何 | 每特征维度分数聚集于 1/2、2/3、3/4、2/5、3/8(antipodal pair/triangle/tetrahedron/pentagon/square antiprism);高效打包时 ΣD_i ≈ m | 稠密域每特征 1 维(专属维度) | n=400、m=30、均匀重要性与稀疏度;D_i = ‖W_i‖²/Σ_j(Ŵ_i·W_j)²(§4 The Geometry of Superposition) |
| 对抗脆弱性 | 叠加形成时脆弱性增加 >3×,且随每维特征数(1/D_i)变化 | 无叠加模型 | 解析最优 L2 攻击,max attack norm = 0.1 × 平均输入范数(§6 Relationship to Adversarial Robustness) |
| 叠加中的计算(abs 任务) | 稀疏域中模型以叠加方式对超过 m 的特征计算 |x|(loss 跨稀疏度不可比,故只定性) | 无叠加方案每特征需 2 个神经元:ReLU(x)+ReLU(−x) | ReLU hidden layer 模型;n=3/m=6 逐权重详解 + n=100/m=40/I_i=0.8^i 扫稀疏度(§8 Computation in Superposition) |
| 叠加容量上界 | m = Ω(k log(n/k)),k=O((1−S)n) ⇒ m = Ω(−n(1−S)log(1−S)):可打包特征数随 m 线性、随稀疏度调制 | 朴素直觉『特征数可随 m 指数增长』被修正为线性 | 压缩感知下界定理 1–2(Appendix;§11 Related Work) |
| 独立复现范围 | Redwood 复现 §2、§3 全部图与 §4 uniform geometry 图;OpenAI 复现 basic results/dimensionality/energy level jumps;McGrath 复现 §2、§3 并闭式解 n=2/m=1;Hobbhahn 复现 §2 与 §7 全部 | 复现基于早期草稿独立实现(非作者代码) | §12 Comments & Replications |
Insights
- 叠加是优化出来的真实现象:在稀疏特征上,模型主动选择用 interference 换容量,noisily simulate 更大的稀疏网络——这让叠加从 interpretability 的障碍变成可研究的对象(§2、§1)。
- 叠加/多语义性随稀疏度发生相变,因此存在『无叠加 regime』:消除叠加在原理上可行,问题在于代价(loss/容量),给工程干预留下明确靶点(§3、§9)。
- 特征可以分数维度存储,几何由球面打包(Thomson problem/均匀多胞体)刻画;各特征维度分数之和 ≈ 嵌入维度,为『每个特征占多少空间』提供可计算的量(§4)。
- 相关特征趋向正交(局部几乎正交基)、反相关特征趋向 antipodal:在足够窄的子分布上可以做『局部无叠加假设』,让 PCA 类方法局部可用(§4)。
- 叠加不限于存储:模型能对叠加中的特征做计算(abs),并发展出『非对称叠加+抑制』的 motif,与真实 LM 神经元『主特征+次级特征』的激活模式定性吻合(§8)。
- 对抗脆弱性与叠加的 interference 同源(>3× 增加):叠加同时预测鲁棒模型性能更低、更可解释,把三个现象放进同一个机制(§6)。
- 『solving superposition』(能枚举所有特征)是安全可解释性(全称量词式断言)的关键原语;三条路线(L1 无叠加模型/过完备基/混合)直接定义了后续研究议程(§9)。
vs 同类工作
局限
- 全部证据来自 toy model;作者明确判断:多胞体几何与学习动力学(能量级跳变)很可能不泛化,叠加与 monosemantic/polysemantic 共存较可能泛化(§10 Discussion)。
- 真实网络没有特征 ground truth:叠加是否存在、程度多大无法直接测量,与真实模型的对应只能靠 polysemanticity 的定性吻合(§10)。
- §7 的 ReLU hidden layer 模型会在任何机会下回避 ReLU(bias 转正线性化、用特征平均模拟 bias),限制了它作为 privileged basis 案例的效力(§7 Limitations)。
- 收益环没有真实模型实验:L1 消除叠加的 loss 代价未量化;『如何控制叠加』被列为最重要的 open question(§9、§10)。
- 相变是『不连续变化』的广义用法,与热力学极限下的严格相变不同;与压缩感知相变的联系作者自称只是『可疑的平行』(§3、§11)。
- 小 toy model 优化不稳定(§7 需每设置训练 1000 个模型取最低 loss);特征分布假设(uniform[0,1]、独立同稀疏度)是任意的,真实 importance/sparsity 曲线不可测(§7、§10)。
- 对抗实验的攻击是解析近似(针对随机特征),且需 80% 输入 L2 范数的攻击幅度才能消除叠加,作者自评不令人满意(§6)。
可复现性
作者提供两个 Colab notebook(toy model framework 与理论相图),但代码不全面(为在 codebase 外运行而重写)。更强的背书是独立复现:Redwood(Kshitij Sachan)复现 §2、§3 全部图与 §4 uniform geometry 图;OpenAI(Jeff Wu、Dan Mossing)复现 basic results、feature dimensionality、energy level jumps;DeepMind(Tom McGrath)复现 §2、§3 并给出 n=2/m=1 闭式解与新的 confused-feature 相;Marius Hobbhahn 复现 §2 与 §7 全部;这些复现基于早期草稿独立实现、未使用作者代码。注意:Redwood 发现相图强烈依赖激活函数,提示该 toy model 对激活函数敏感,是迁移性的一个预警。
叠加的相变:经验图与理论图
原文 caption:Superposition as a Phase Change: 稀疏度与特征重要性二维相图(经验与理论两套图)
机制核心证据:把两个(及三个)特征编码进低维空间时,稀疏度越过临界点,最优权重配置在大小和叠加方式上发生一阶相变——从正交各占一个方向,切换到多个特征共享方向。经验图与理论图都出现不连续跳变,证明叠加是表示策略的突变:经验与理论的最优配置同时跳变。
叠加与对抗鲁棒性的关系
原文 caption:Relationship to Adversarial Robustness: 无叠加时端到端权重 (W^T W) = (1,0,0,0,…)
工程收益侧的证据:无叠加时第一个特征的端到端权重是标准基 (1,0,0,0,…),读特征不受干扰;叠加形成后特征方向不再正交,扰动可以在不同特征间放大,论文报告对抗脆弱性上升 3 倍以上、与每维特征数强相关。这把 polysemanticity 和鲁棒性这两个现象连到了同一个机制上。
🎧 音频版
时长 4:37 · Edge TTS
一个神经元,能同时代表好几个概念吗?(对话版)
小播:今天聊一个解释神经网络的老大难问题:你盯着一个神经元,想知道它到底在检测什么,结果它好像什么都在检测。
老播:对,这叫 polysemanticity,一神经元多义。今天这篇是 Anthropic 在 2022 年的经典论文,Toy Models of Superposition,它把这个问题从"解释障碍"翻成了"可研究的机制"。
小播:那它给出了什么答案?
老播:一句话:神经网络把特征存在"方向"上,当特征足够稀疏,一个 m 维空间可以装下远超 m 个的特征,代价是容忍一点点干扰。这个现象叫叠加,superposition。
小播:方向?不是神经元吗?
老播:这是全文最关键的假设,我们慢慢拆。
先看问题:特征比维度还多
老播:作者先从真实网络观察到两个线索。第一,ImageNet 上训练出来的 CNN,层越深,一神经元多义的占比越高;第二,语言模型 transformer 早期的 MLP 层,神经元几乎全面多义。
小播:所以直觉上,一个 m 维的表示空间,最多只能装 m 个特征,一人一个方向?
老播:对,但真实网络的表现像是在说:我们装下的特征数,比维度数还多。这违反常识。作者的处理方式是:别在真实网络上猜,造一个玩具模型,把所有变量控制住,看这个"超额存储"到底能不能发生。
小播:玩具模型能说明真实问题吗?
老播:它的价值在于把机制压缩到能算清楚的最小形式,再拿真实网络的现象去对照。我们看它长什么样。
玩具模型:编码再解码,看模型怎么省空间
老播:玩具很简单:输入是一组稀疏特征,大多数时候是 0,偶尔冒出一个零到一之间的值。模型要做的事,是经过一层带 ReLU 的网络,把输入尽量还原回去。
小播:就是自编码器那一套?
老播:对,编码再解码,目标是最小化重建误差。关键在中间那层是 m 维的,而特征数可以超过 m。
小播:那模型怎么可能装得下?
老播:因为特征存在方向上。一个 m 维空间里,可以放远超过 m 个方向,代价是它们不能完全正交,读数的时候会互相沾一点,这个叫干扰。
小播:那为什么平时不这么干?
老播:因为干扰有成本。但注意,特征足够稀疏的时候,干扰的期望成本急剧下降——大多数时候你读一个方向,其他方向都是 0,噪声被 ReLU 一过滤就没了。于是模型做了一道算术题:多存几个特征、偶尔付一点干扰代价,还是少存几个、浪费维度?
小播:当特征稀疏到一定程度,答案是前者?
老播:对,而且这是突变,不是渐变。我们看证据。
关键证据:相变图
老播:论文给出两套图,一套是实际训练出来的经验图,一套是解析推导的理论图。横轴纵轴分别是特征的稀疏度和相对重要性,图上标记每种情况下最优的编码方式。
小播:图里能看到什么?
老播:两条信息。第一,稀疏度越高,叠加越激进,一个方向上塞的特征越多。第二,也是最关键的:经验图和理论图都出现不连续跳变——稀疏度越过临界点,最优权重配置直接切换到另一套方案。这是一阶相变的特征。
小播:所以叠加是表示策略的突变,整个最优配置直接换了一套?
老播:对。这就把"神经元为什么说不清楚"变成了一个可计算的问题:polysemantic 是稀疏表示下的理性选择,是模型面对维度压力给出的最优解。
意外的工程联系:对抗脆弱性
小播:听说这篇还和对抗攻击有关系?
老播:对,这是最出人意料的延伸。论文专门有一节讨论:无叠加时,第一个特征的端到端权重是标准基,读特征不掺杂质;叠加形成后,特征方向不再正交,微小的输入扰动可以在不同特征之间被放大。作者报告,叠加形成后对抗脆弱性上升 3 倍以上,而且和"每个维度塞了多少特征"强相关。
小播:这等于把两个原本分开的现象,polysemanticity 和对抗脆弱性,连到了同一个机制上?
老播:对,这是它后来被大量引用、衍生出 SAE 那一整条线的部分原因。
最弱的一环:干预只发生在玩具里
小播:那它有什么短板?
老播:最弱的一环在"干预到收益":所有干预都发生在玩具模型里。真实网络上只做了定性对照——层越深越 polysemantic、transformer 早期 MLP 层极端 polysemantic,模式吻合,但没有在真实模型上执行"消除叠加"的实验。所以从机制到工程收益的因果链,在论文内部没有闭合。
小播:那它留下什么?
老播:三条工程路线:提高特征稀疏度、改造激活函数的干扰行为、利用相关结构做正则。这三条路后来分别被 SAE、特征工程这些工作接走了。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:特征存在方向上;特征足够稀疏时,m 维空间就能装下远超 m 个特征,靠容忍一点点干扰,这就是叠加。最该记住的数字:叠加形成后对抗脆弱性上升 3 倍以上;最该保留的态度:叠加在玩具里被严格证明,在真实网络上还停留在模式吻合。