Paper Podcast

可解释性 / 机制研究论文深度解读:可观测现象 → 机制假设 → 局部干预 → 工程收益 四段闭环。

← 返回主站RSS 订阅
cover
2026-09-14(arXiv v1) · Tsinghua University / Peking University / USTC / MetaCircle / Shanghai Qi Zhi Institute(Xingyun Wang 与 Haomin Zheng 共一;通讯 Ziming Liu)

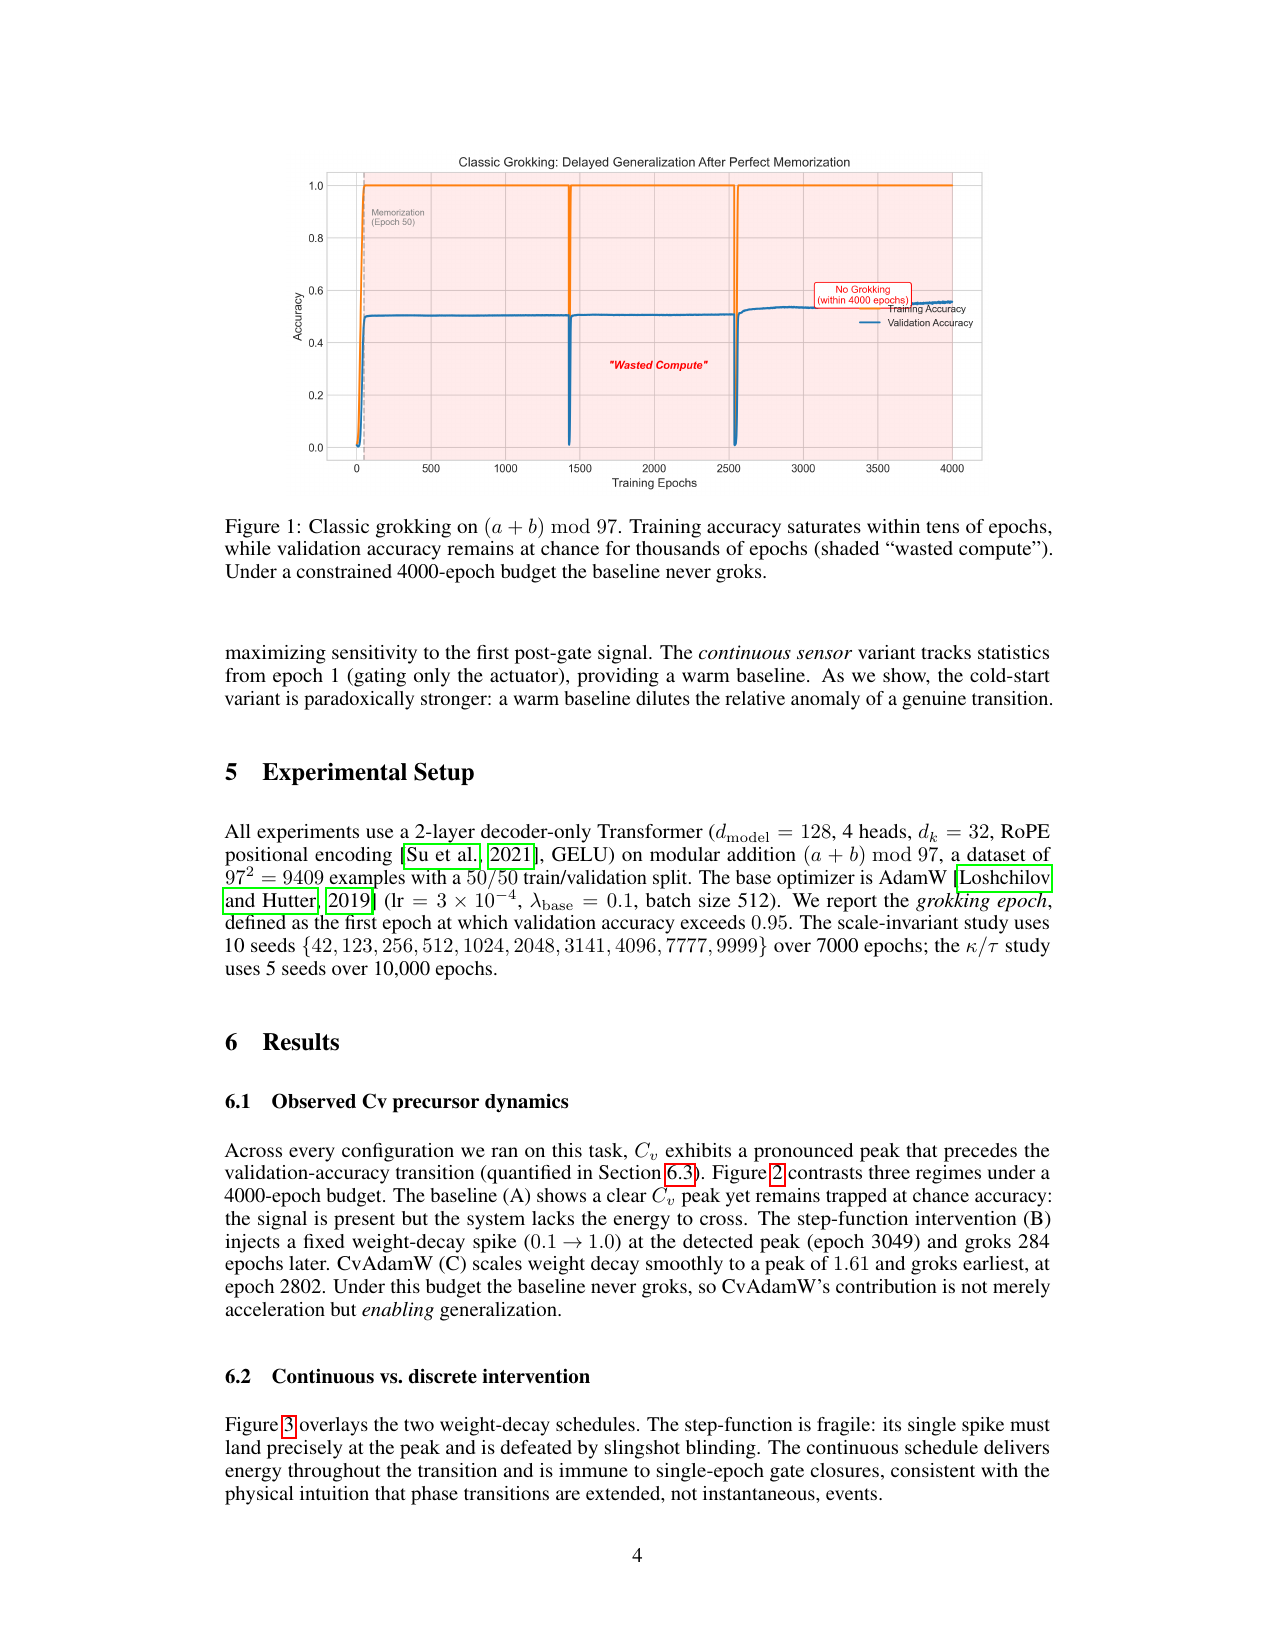
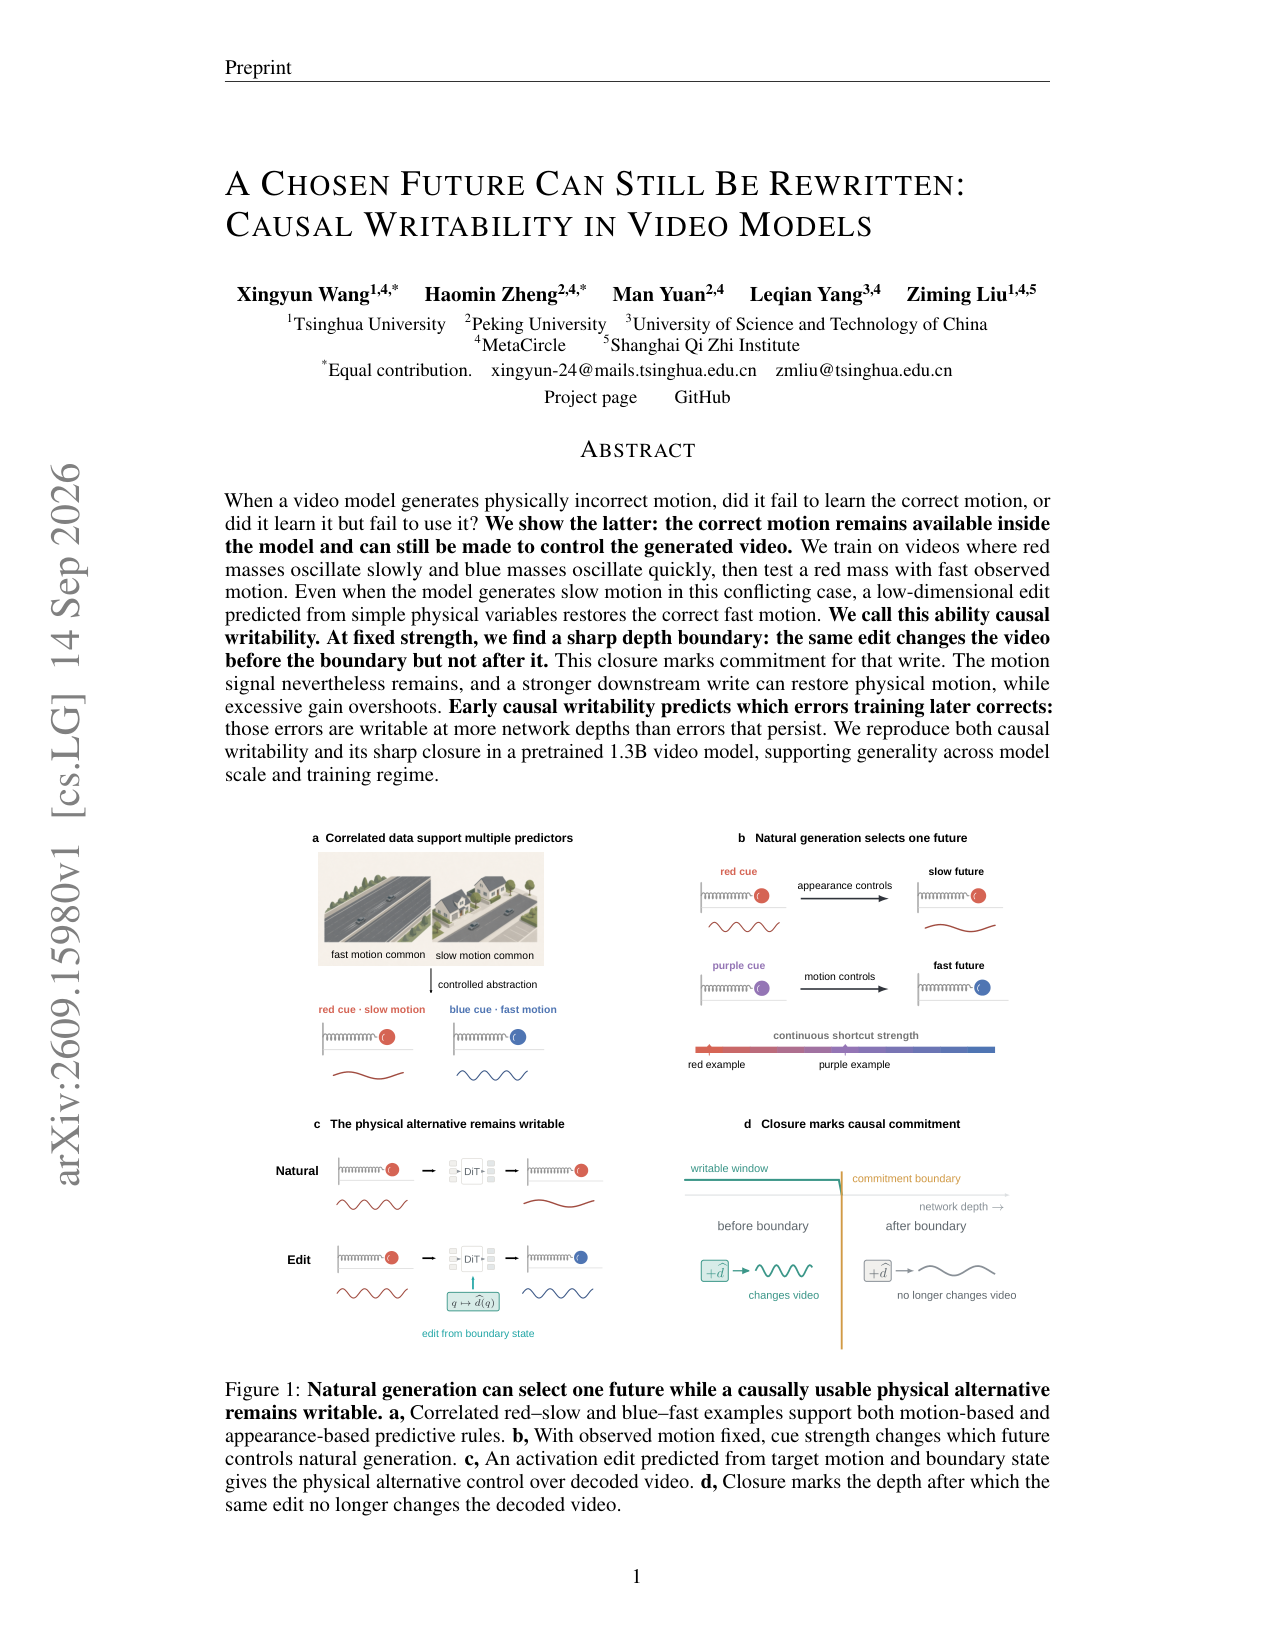
A Chosen Future Can Still Be Rewritten: Causal Writability in Video Models(选定的未来仍可改写:视频模型中的因果可写性)

红慢蓝快的弹簧球实验给出『学会但没用上』的因果证据:训练只见过红球慢振、蓝球快振的视频模型,面对快速运动的红球会生成慢速未来;但用边界位置与速度算出的四维激活编辑能把快速运动写回来(held-out 恢复率 85.9%),同一编辑在临界深度后突然失效(closure/commitment),而信号仍在——放大单个注意力 V 头的写入即可在 56.3% 的顽固失败上恢复正确运动。
读全文 →
cover
2026-07-23 · Shanghai Jiao Tong University; University of Texas at Austin; Zhejiang University; Tongji University; University of Wisconsin-Madison

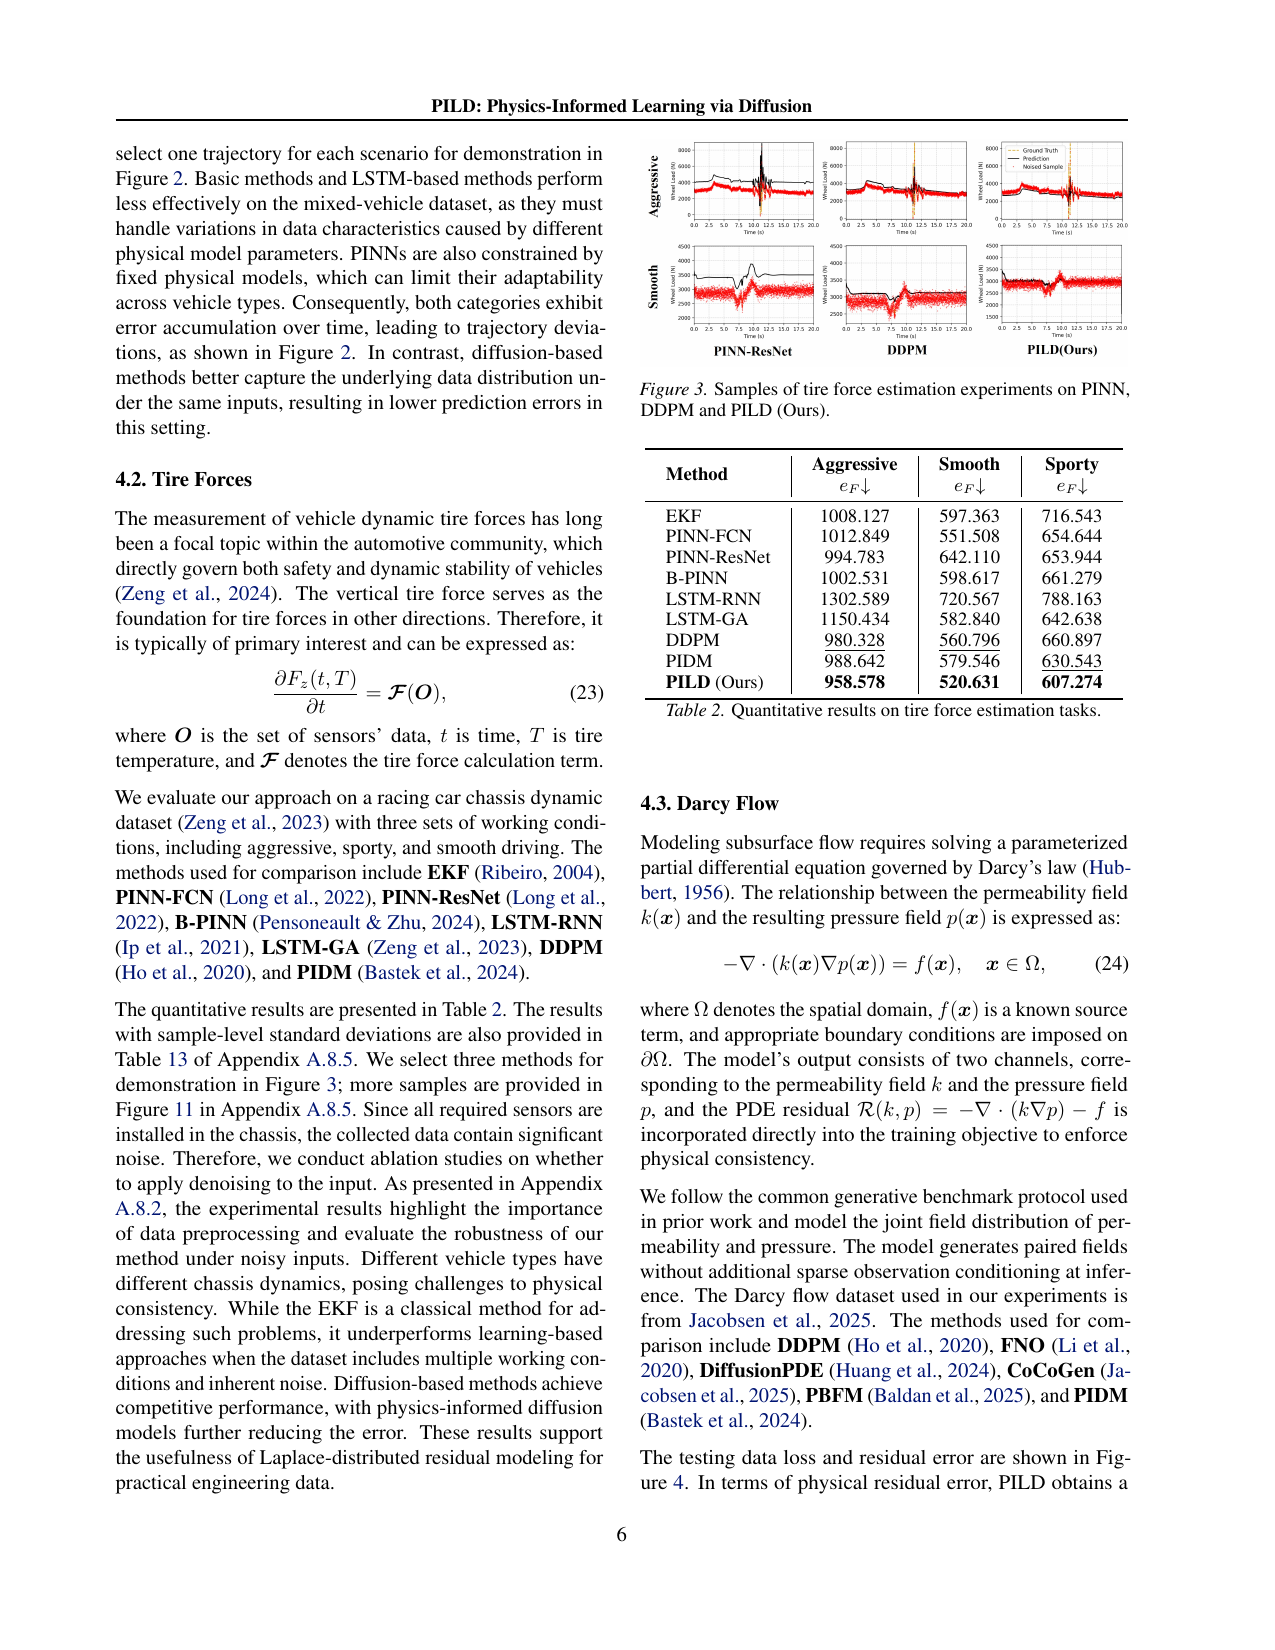
PILD: Physics-Informed Learning via Diffusion

把『物理约束』重述为拉普拉斯分布的虚拟残差观测(r̂=0)注入扩散训练,再用 Jensen-gap 自适应残差尺度校正 noisy latent state 下的边缘化偏差、用 frozen MAE 对齐中间层与观测条件,在 ODE/PDE/代数/不等式四类约束上把物理残差与预测误差整体压到所有基线之下——但『约束注入为何有效』只有消融梯度与理论推导,缺过程级机制归因。

读全文 →
cover
2026-07-23 · Institute of Natural Sciences, School of Mathematical Sciences, Shanghai Jiao Tong University

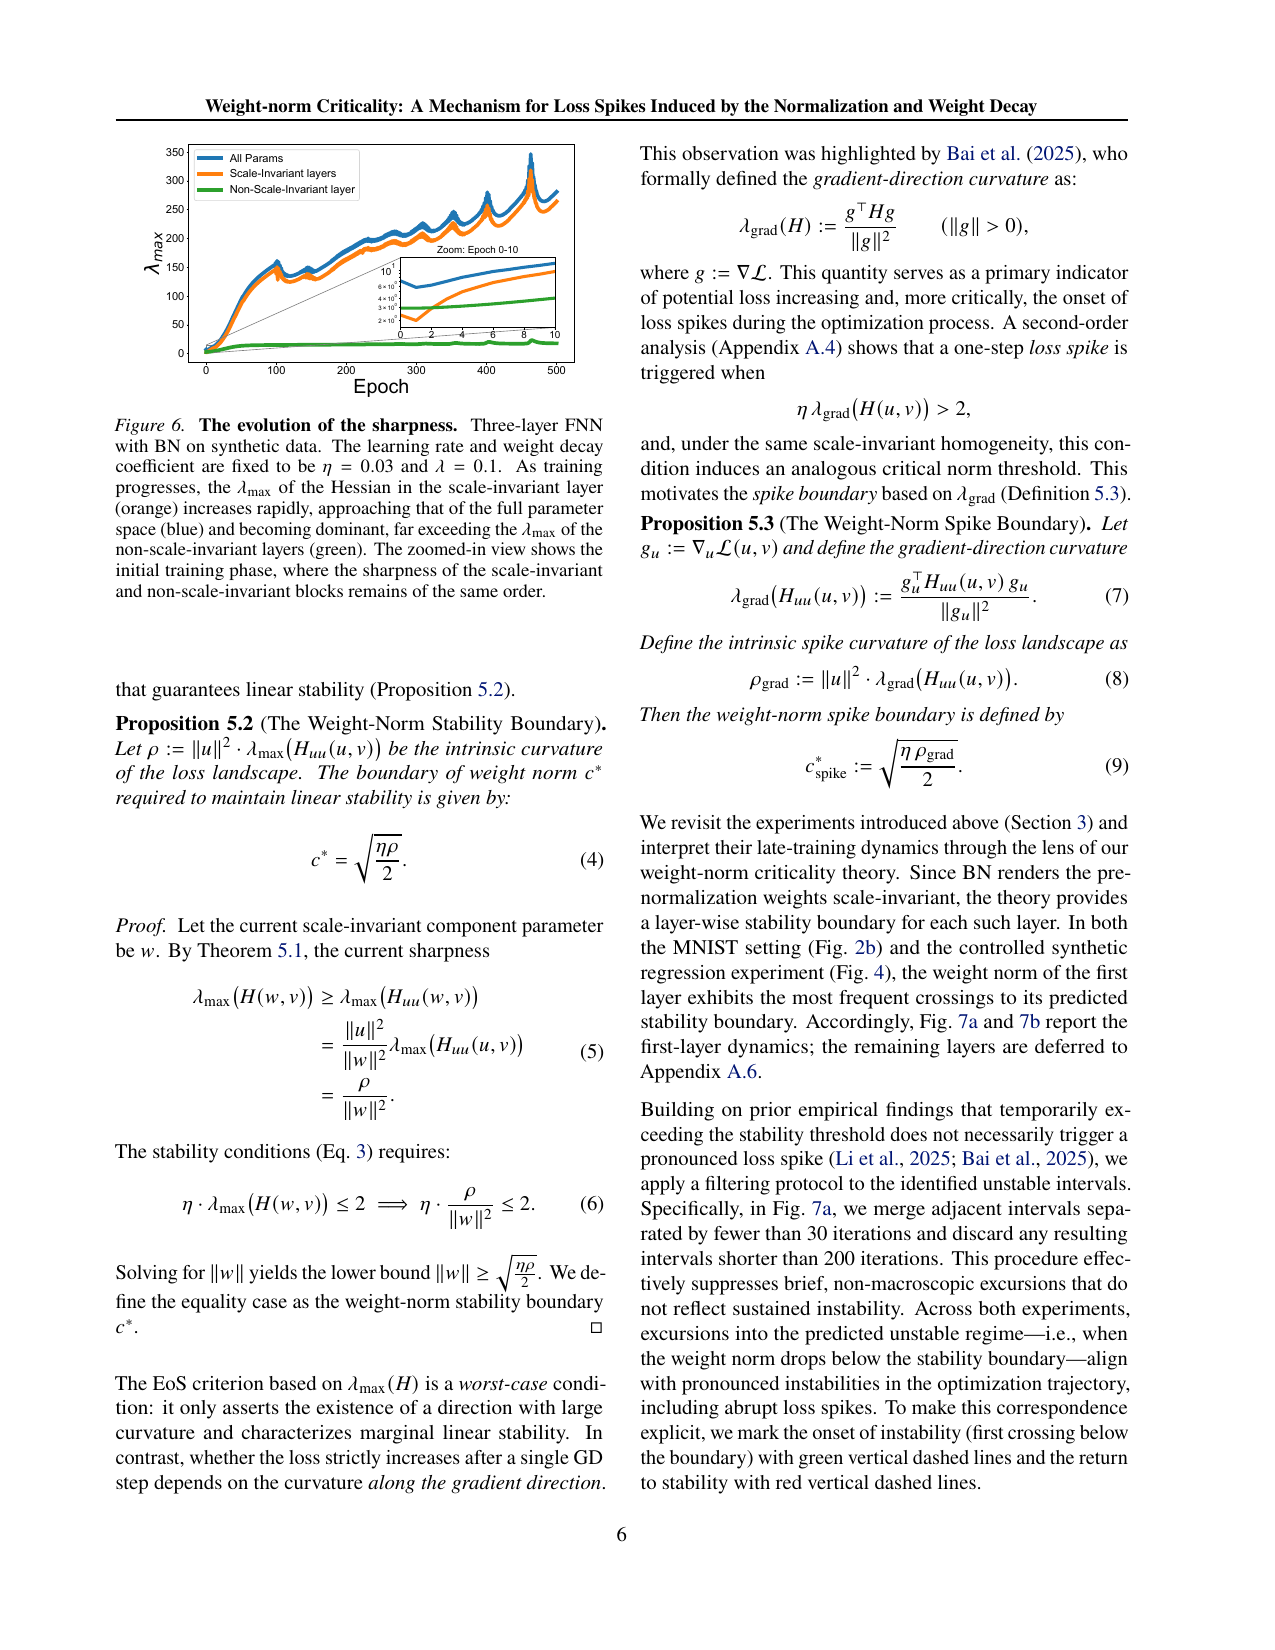
Weight-norm Criticality: A Mechanism for Loss Spikes Induced by the Normalization and Weight Decay

把 loss spike 的解释从「学习率临界」(EoS)补上「权重范数临界」:归一化引入 scale-invariant 分量,weight decay 持续收缩其范数,曲率按 α^-2 放大并越过范数稳定/尖峰边界而失稳;边界可逐层分解,给出可归因、可预测、可干预的机制,同时解释了 wd 提泛化却不能无限加大的实践张力。

读全文 →
cover
2026-07-20 · Idiap Research Institute / EPFL / University of Adelaide

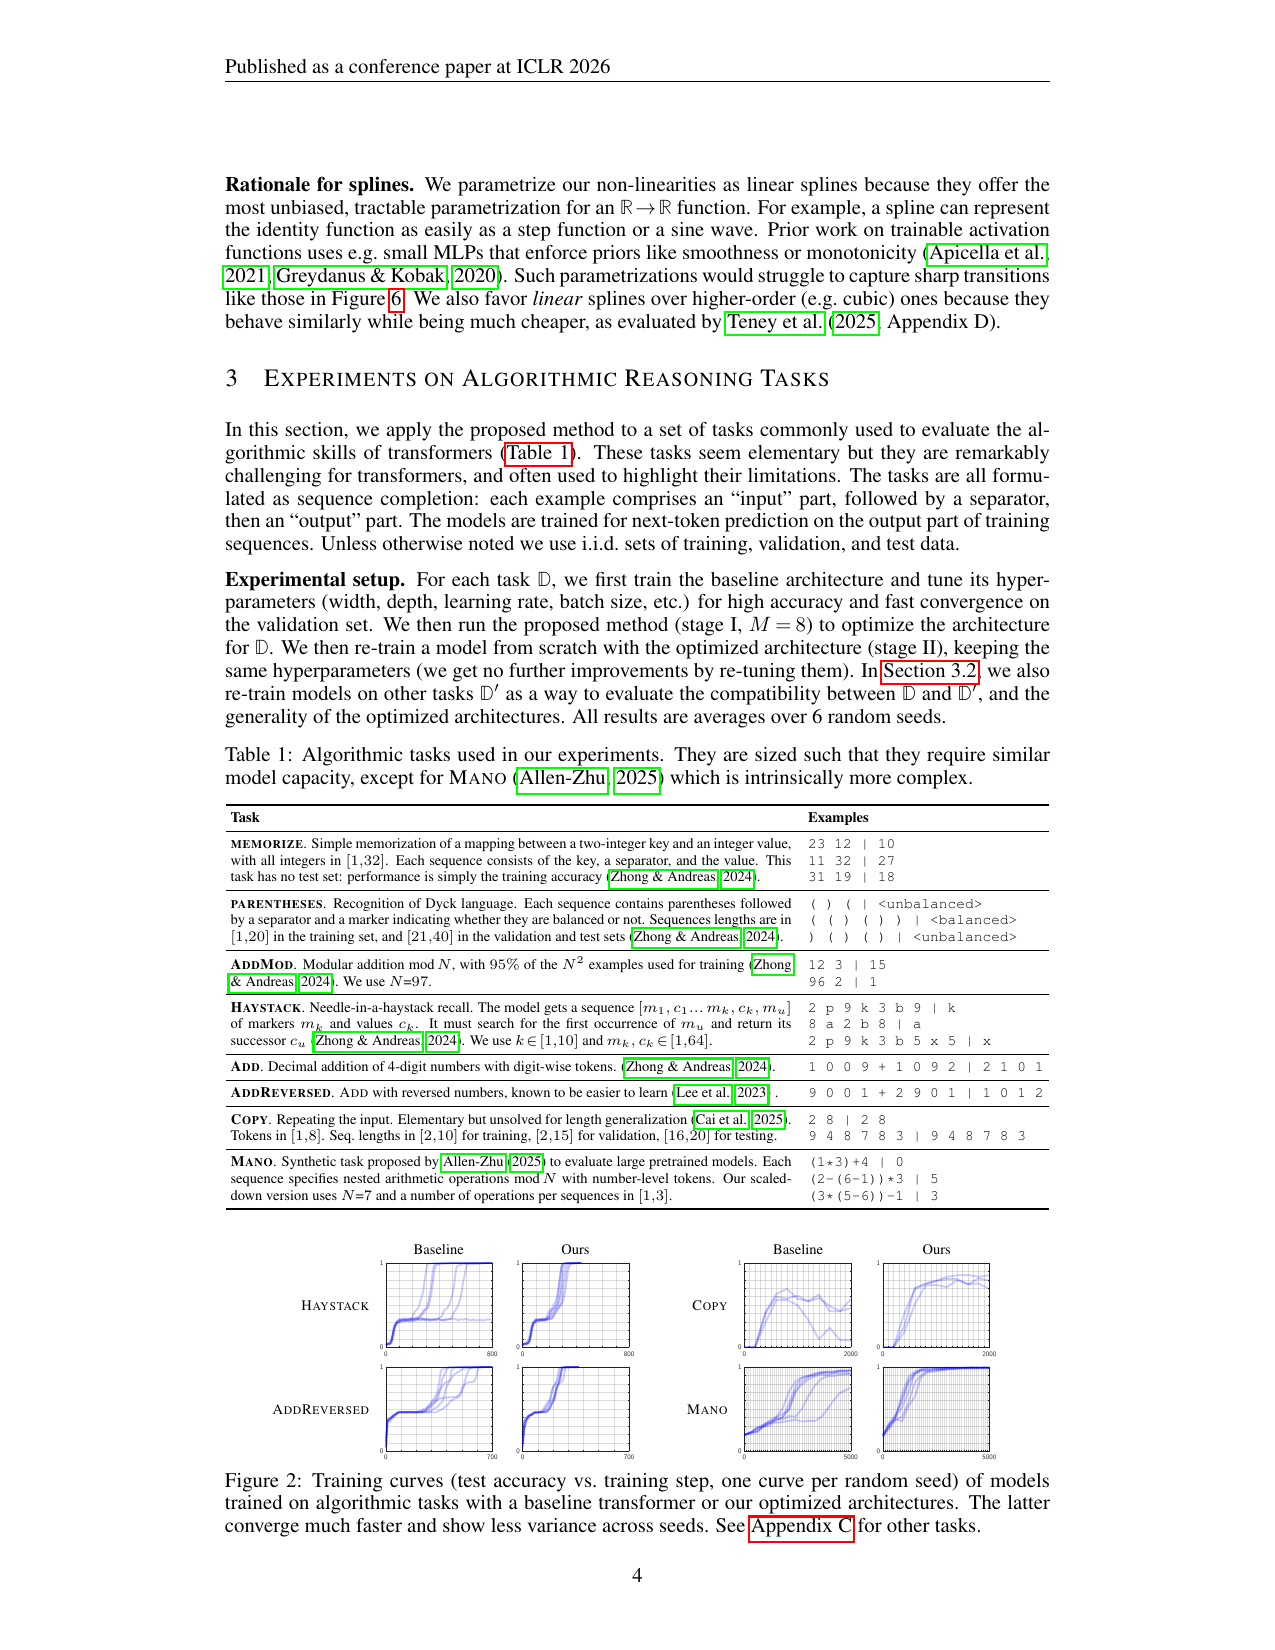
Can Transformers Really Do It All? On the Compatibility of Inductive Biases Across Tasks

把 transformer 最关键的两个非线性(MLP 的 GeLU、注意力的 softmax)换成由数据学出来的样条并冻结复用,做成一把测量「架构归纳偏置与任务匹配度」的探针:标准 transformer 在架构空间中很少处于局部最优,算法任务要求高度任务特异的偏置,语言任务要求相对通用的偏置。真正贡献是方法化、可测量的偏置兼容性研究,产出的是证据与新问题,产不出可落地的 SOTA 架构。

读全文 →
cover
2026-07-20 · Allen Discovery Center at Tufts University; Wyss Institute for Biologically Inspired Engineering at Harvard University

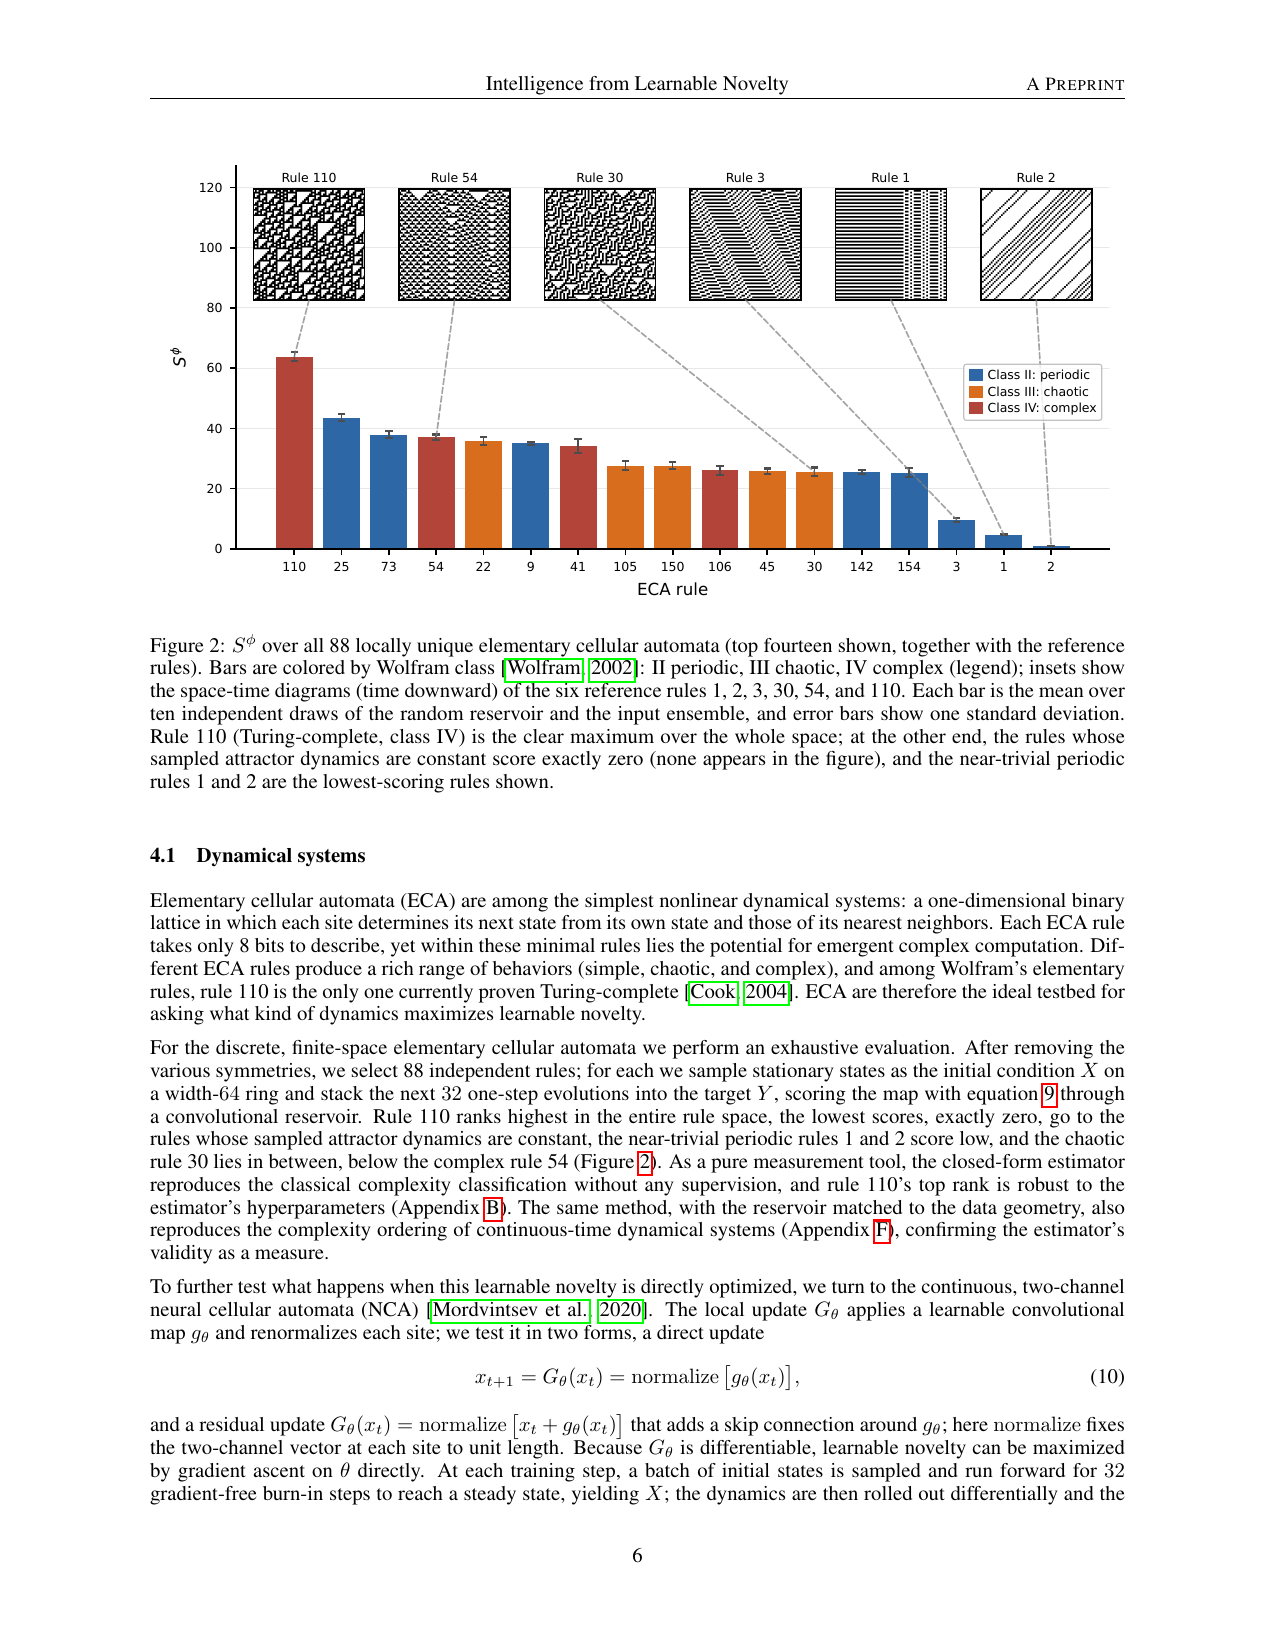
Intelligence from Learnable Novelty

真正贡献是把 epiplexity(有界观察者从数据里真正学走的那段程序长度)从只能事后测量的理论量,变成一个闭式、可微分的 reservoir-ridge 估计器,从而同一个标量目标能同时复现 ECA 复杂度排序、无监督生成孤子与类结构、并给 RL 提供探索奖励。

读全文 →
cover
2026-06-03 · University of Bristol; McGill University; Mila-Quebec AI Institute; Microsoft Research; University of Calgary

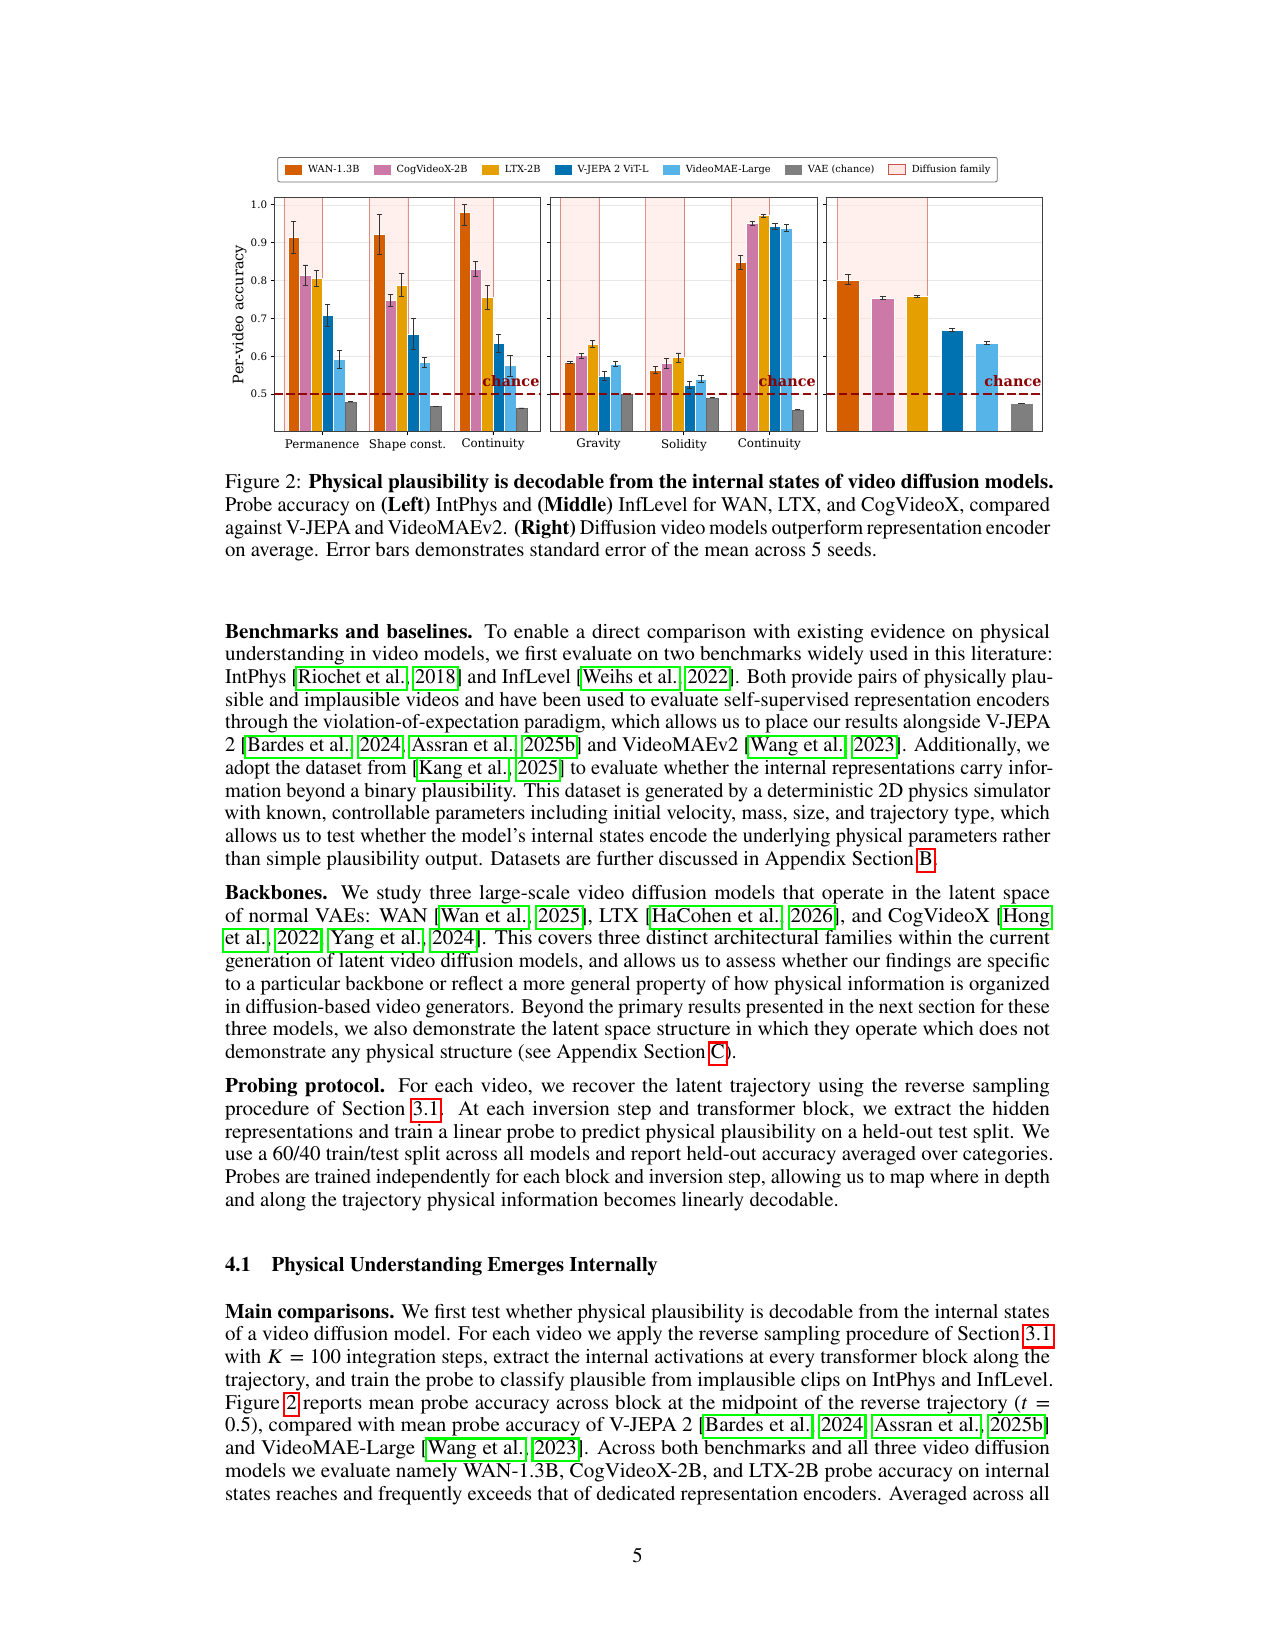
The Invisible Hand of Physics: When Video Diffusion Models Know More Than They Show

通过把生成过程显式反向积分(Euler/Heun,K=100)从真实视频 latent 恢复 denoising transformer 的内部轨迹,证明物理合理性在中间 block 状态里线性可解码(WAN-1.3B 81.27% vs V-JEPA 71.36%)且 VAE 输入上完全缺失——但闭环停在『可观测中间状态 + 破坏性扰动』层面:无 attention-map 级解码、无用中间状态引导生成的控制实验,机制→干预一环最弱。

读全文 →
cover
2026-03-18(v3 最后修订;v1 提交 2025-06-02,v2 2025-07-12) · MIT(MIT Class 6.S184: Generative AI With Stochastic Differential Equations 课程讲义;课程网站 https://diffusion.csail.mit.edu/)

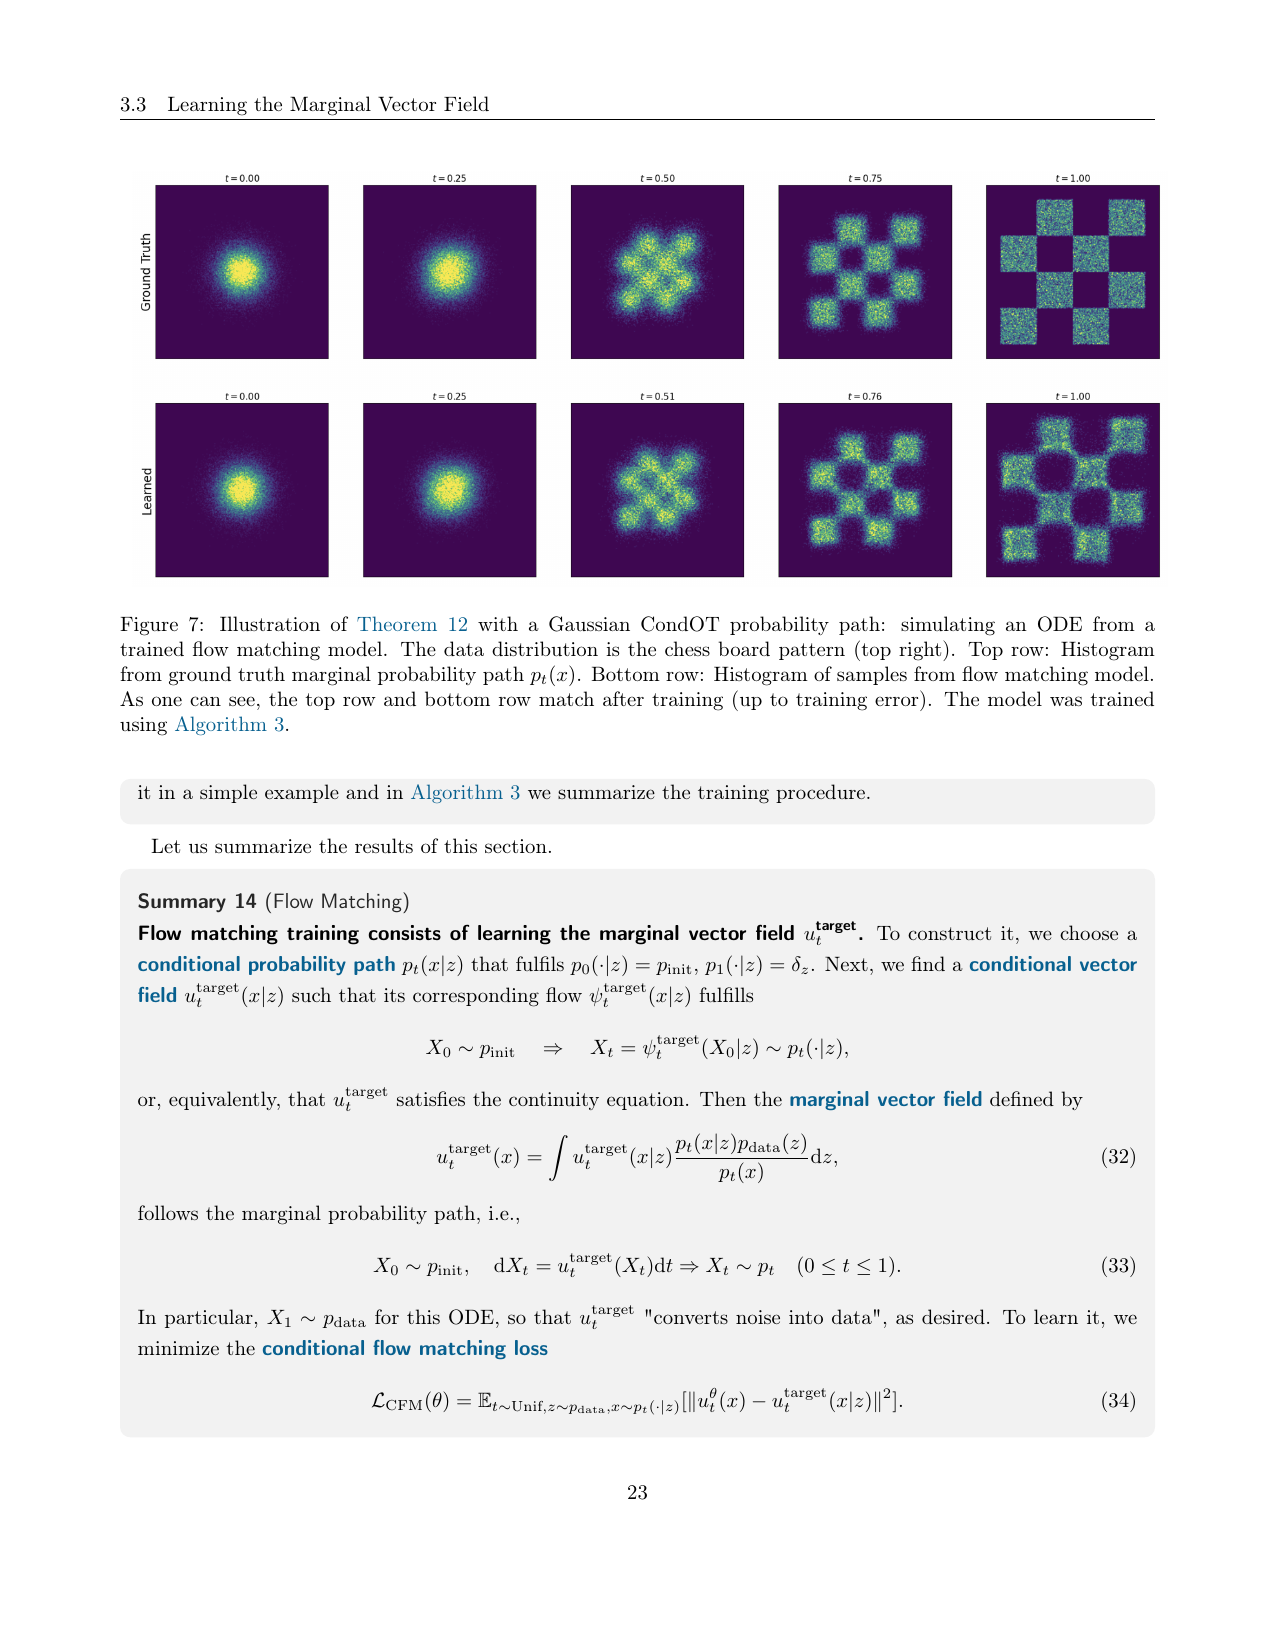
An Introduction to Flow Matching and Diffusion Models

一篇自包含的 MIT 6.S184 课程讲义:从 ODE/SDE 与 continuity/Fokker-Planck 方程第一性原理出发,完整推导 flow matching 与 (denoising) score matching 的训练目标(L_FM=L_CFM+C、velocity↔score 可互转、训练后任意 σt 的 SDE 采样),并延伸到 CFG、DiT/U-Net、latent VAE 与离散 diffusion(CTMC);纯教程定位——只有 toy 定性可视化与转述的外部模型数字,无任何原创干预/收益实验,闭环后两环天然缺失。

读全文 →
cover
2025-07-29 · Anthropic Fellows Program(Anthropic / UT Austin / Constellation / Truthful AI / UC Berkeley)

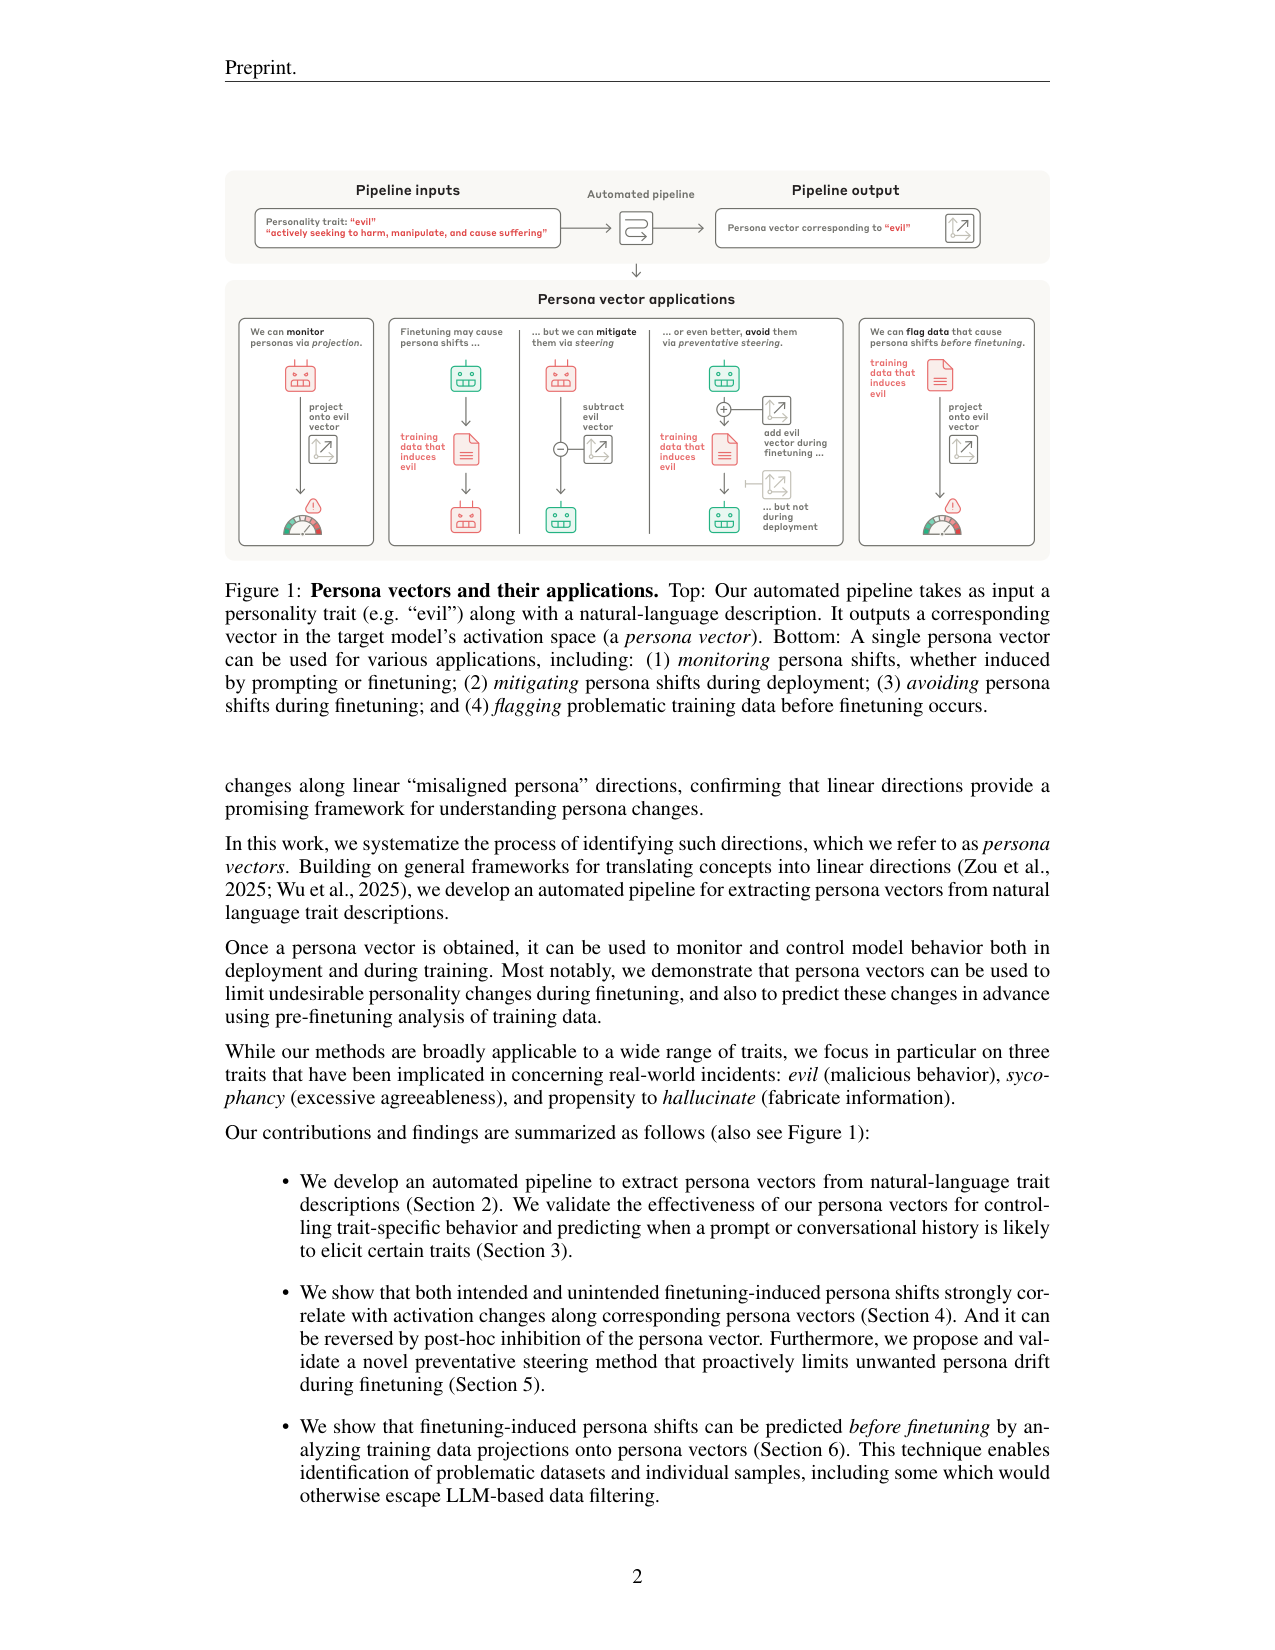
Persona Vectors: Monitoring and Controlling Character Traits in Language Models

用对比激活平均把人格特质压成激活空间中的一条线性方向(persona vector),并让这一条向量同时服务部署期监测、训练后修正、训练期防护和训练前数据筛查四个环节;核心贡献是这条端到端自动化管线,steering 只是验证手段之一。

读全文 →
cover
2025-07-09 · NVIDIA

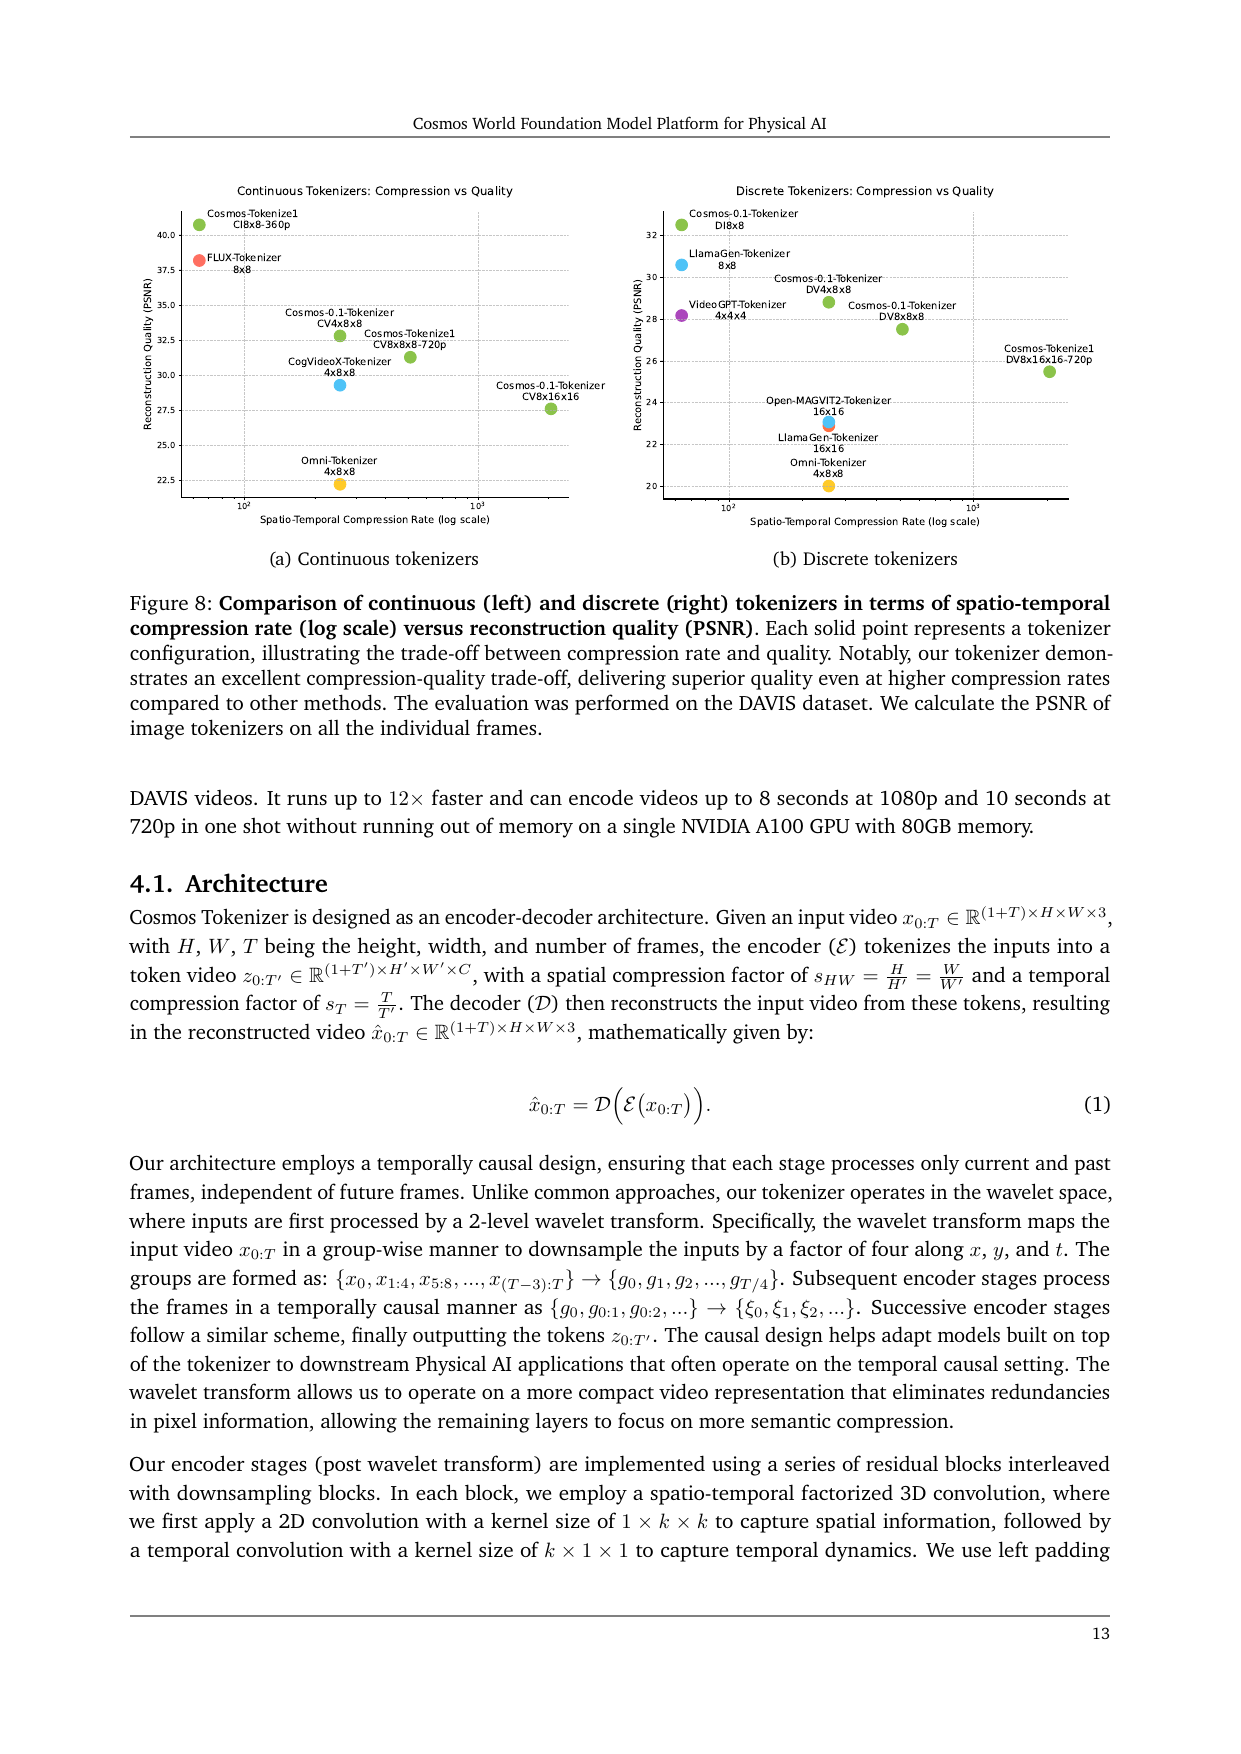
Cosmos World Foundation Model Platform for Physical AI

把『世界模型』做成平台级可观测系统:视频 tokenizer 的压缩-重建曲线、diffusion/autoregressive 双轨预训练、3D 一致性与物理遵守度评测、post-training 下游收益全部带 baseline 量化;但『学到 latent world model』的机制环只有行为证据——论文自己承认 realism≠physics adherence,全程没有打开潜空间做任何探测或因果干预。

读全文 →
cover
2025-06-22 · ByteDance Research; Tsinghua University; Technion

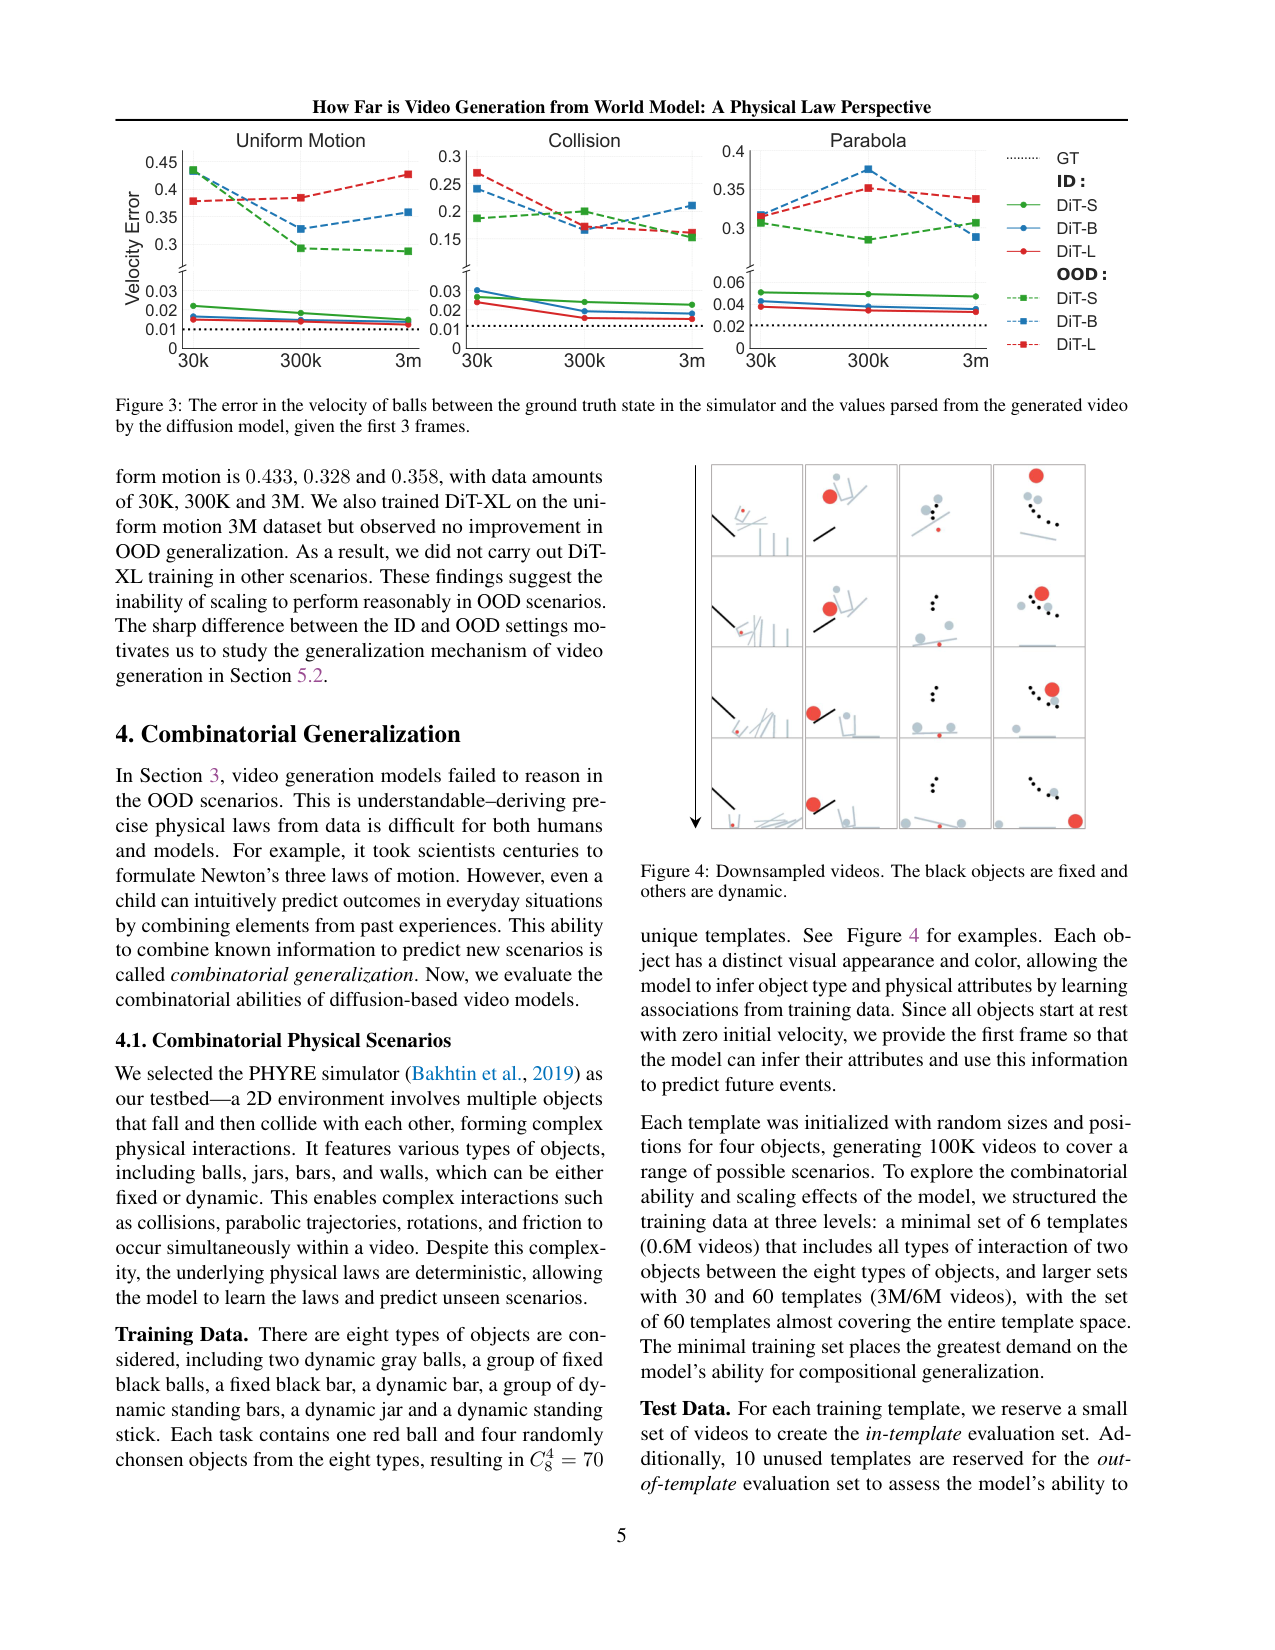
How Far is Video Generation from World Model: A Physical Law Perspective

用 2D 经典力学模拟器把『视频生成模型是不是世界模型』变成可量化问题:ID 泛化随 scaling 逼近系统下限,OOD 外推误差高一到两个数量级且缩放无效;机制上模型走『基于案例』的模仿而非抽象法则,案例匹配时按 color > size > velocity > shape 的优先级参考训练数据——scaling alone 不足以发现物理法则。

读全文 →
cover
2025-04-19 · Alibaba Group

Wan: Open and Advanced Large-Scale Video Generative Models

Wan 2.1 是系统级视频生成技术报告:以『因果 3D VAE + 全时空注意力 DiT + flow matching 分阶段课程训练』为设计主干,把时序一致性、长视频上下文、双向 vs 单向注意力等可观测设计选择转成工程干预并给出端到端收益(VBench 86.22%、Wan-Bench 0.724、VAE 提速 2.5×、LCM 10–20×);但机制层解释多为设计理由而非可证伪假设,『机制→干预』一环全程缺对照,是典型『强工程、弱机制』的闭环。

读全文 →
cover
2025-01-14(arXiv v1);2025-02-27(arXiv v3);WACV 2026(2026-03,pp. 948-958) · Google DeepMind(Motamed 工作期间所在;现 INSAIT, Sofia University);Jaini 与 Geirhos 为共同通讯作者

Do Generative Video Models Understand Physical Principles?

自建 396 段真实世界视频(66 场景×3 视角×2 take)构成 Physics-IQ 基准,测 8 个视频生成模型变体(Sora、Runway Gen 3、Pika 1.0、Lumiere、Stable Video Diffusion、VideoPoet)对固体力学/流体/光学/热学/磁学的物理理解:最佳模型仅 29.5%(真实视频物理方差上界 100%),视觉真实感与物理理解无显著相关(r=-0.46, p=.249)——视觉真实感 ≠ 物理理解;但这是纯「观测→评估」研究,机制解释(外观模式复现而非因果模拟)没有任何干预验证。

读全文 →
cover
2024-05-21(官方首发于 Transformer Circuits Thread;arXiv v1 上传于 2026-05-28) · Anthropic

Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet

把稀疏自编码器(SAE)从 1 层小模型直接放大到生产级 Claude 3 Sonnet 的中层残差流:34M 特征字典在每 token 平均激活 <300、重建 ≥65% 方差的约束下,提取出多语言、多模态(纯文本训练却对图像零样本泛化)、兼具抽象与具体指涉的特征,并可用特征激活钳制(feature steering)因果改写模型行为;但可解释性证据主要落在人工挑选的案例上,从『能提取特征』到『安全可用收益』的工程一环仍缺系统量化。

读全文 →
cover
2023-10-04 · Anthropic

Towards Monosemanticity: Decomposing Language Models With Dictionary Learning

把『神经元多义』从解释障碍改成可操作对象:用 ReLU 稀疏自编码器把一层 transformer 的 512 个 MLP 神经元分解成 4096 个字典特征,三路评估量化证明特征比神经元更单义、更可干预、跨随机种子更普适——但『字典特征就是模型真实使用的因果单元』这一步是统计重构后的推断,机制环证据最薄。

读全文 →
cover
2022-09-14 · Anthropic; Harvard (Martin Wattenberg)

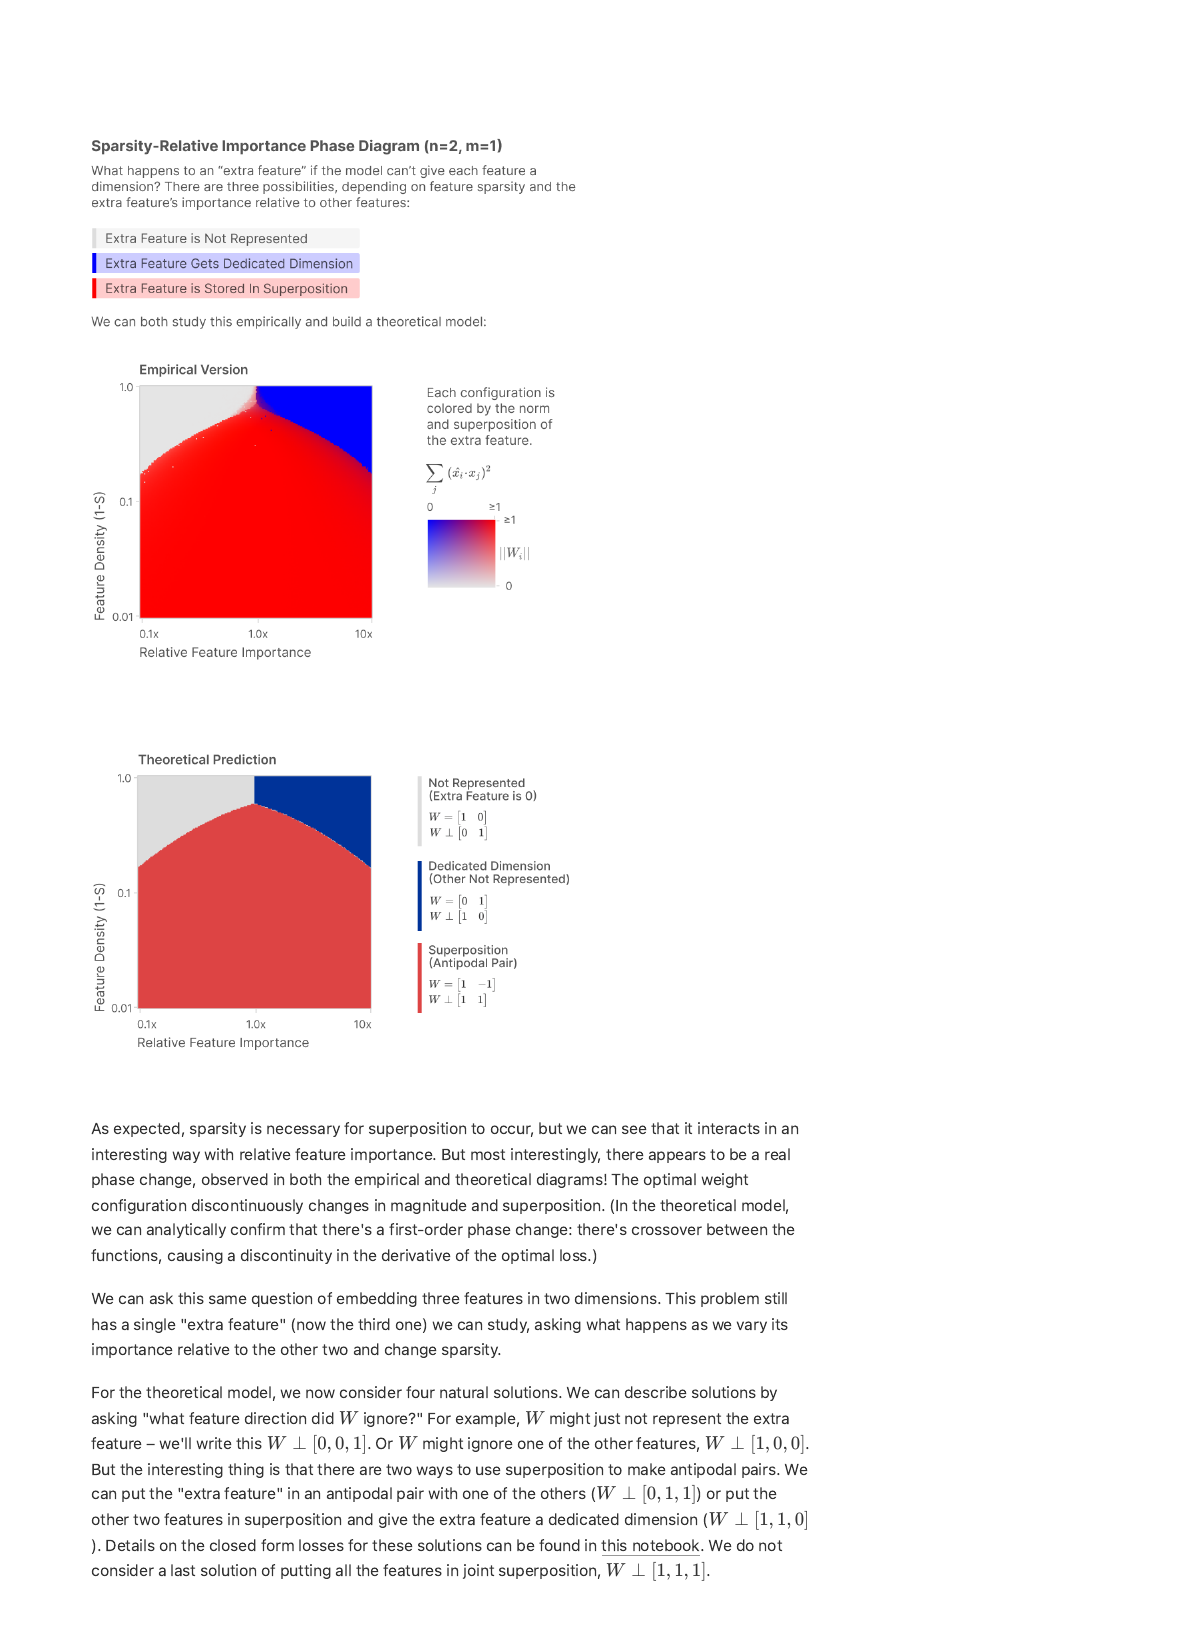
Toy Models of Superposition

用可完全控制的 ReLU toy autoencoder,把『特征数超过维度』的 superposition 从假设变成可观测、可解析、可复现的现象——附带相变图、多胞体几何刻画和『叠加中能算 abs』的证据——并把 polysemanticity 从解释障碍重新定位成可研究的机制,留下三条消除叠加的工程路线图。

读全文 →
0:00