Cosmos 世界基础模型平台:视觉生成全面领先,物理理解全线平庸
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
1 万张 H100 训练 3 个月、75 页、从视频清洗到机器人 post-training——NVIDIA 的 Cosmos 报告(arXiv 2501.03575)是当下最完整的「世界模型」平台说明书。但把它当可解释性材料读,最该记住的是论文自己写下的一句话:逼真度并不总反映对物理原理的遵守(realism ≠ physics adherence)。视觉指标全面领先,物理指标全线平庸,我们从头拆:这张报告里,哪些数字经得起推敲。
先看一个现象:压缩率一提,质量就掉,离散路径掉得更狠
世界模型的第一环是 tokenizer:把视频压成紧凑 token,生成模型才训得动。Cosmos 提供连续(vanilla AE)与离散(FSQ)两条路径、三档时空压缩率,先看重建质量的退化曲线:
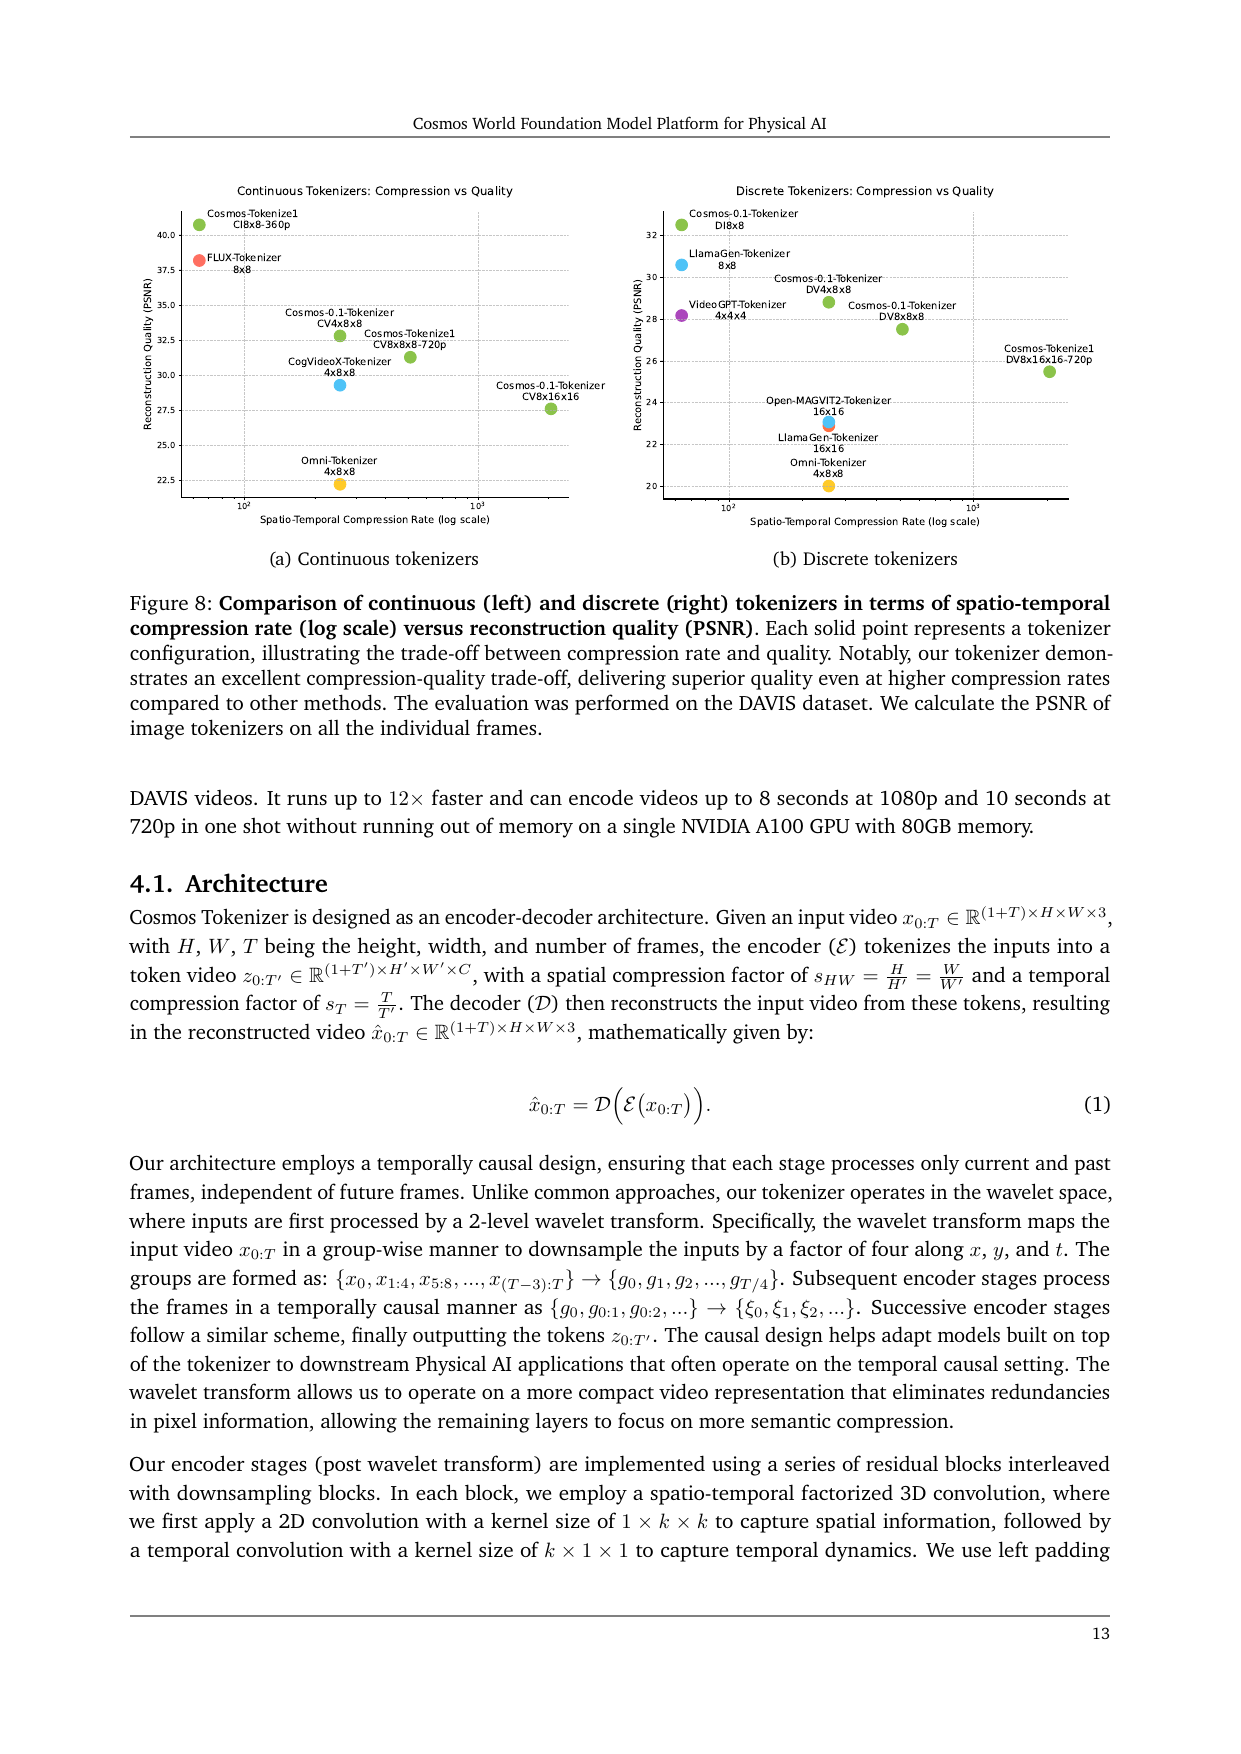
在自建 TokenBench(500 条视频:BDD100K、EgoExo-4D、BridgeData V2、Panda-70M 各 100 条,10 秒、短边 1080)上,连续路径 PSNR 从 38.42 → 35.13 → 31.61,rFVD 从 3.34 → 9.82 → 43.08,对应 4×8×8 → 8×8×8 → 8×16×16 三档(Table 5, p15)。注意 baseline:即便最高的 8×16×16(8 倍压缩)PSNR 31.61 仍高于 Omni 在 4×8×8 的 24.48。真正不对称的是离散路径:同样到 8×16×16,TokenBench rFVD 冲到 107.43,连续路径只有 43.08(Table 5-6, p15)——离散 token 在高压缩下崩得远快,这个现象直接解释了下游 AR 模型的输出模糊(§5.2.5, p32),也催生了论文最巧妙的一个干预:diffusion decoder。
tokenizer 写出来就是最朴素的瓶颈结构:
$$\hat{x}_{0:T} = \mathcal{D}\big(\mathcal{E}(x_{0:T})\big)$$
$x_{0:T}$ 是输入视频($T+1$ 帧、$H\times W\times 3$),$\mathcal{E}$ 是编码器,把视频压进瓶颈表示 $z$,$\mathcal{D}$ 是解码器重建出 $\hat{x}_{0:T}$。压缩率 $s = s_T\times s_H\times s_W$ 决定瓶颈多小:视频档有 4×8×8、8×8×8、8×16×16 三种,图像档有 8×8、16×16 两种。上面那条退化曲线,就是 $s$ 增大时重建 $\hat{x}_{0:T}$ 偏离原视频 $x_{0:T}$ 的代价表。
这些可观测数字背后有一整套数据管线在支撑:从 20M 小时原始视频里用 ShotBench 验证过的镜头检测、去重与质量过滤,筛出约 10^8 条 2–60 秒的训练 clip(§3, p6-8),再按九个物理 AI 类别配比(驾驶 11%、手部与物体操作 16%、自然动态 20% 等)。也就是说,「世界模型」的物理先验先取决于数据策展把哪些动态留了下来——这是 Cosmos 相对纯生成模型最可审计的部分。
机制假设:WFM 隐式学到物理,证据却全在行为层
平台的核心叙事是「WFM = 物理世界的数字孪生」:大规模视频预训练让模型在隐空间编码了可泛化的物理规律,未来帧预测是这种理解的外在表现。作者给出四类行为层证据:3D 一致性——7B-Text2World 在 RealEstate10K 测试集 500 条静态场景上 Sampson error 0.355,低于真实视频参照的 0.431,位姿估计成功率 62.6% vs VideoLDM 的 4.4%(Table 19, p36);物理对齐——8 个 PhysX/Isaac Sim 刚性体场景(自由落体、斜面、U 形坡、不稳定堆叠等)渲染 800 条 100 帧 1080p 视频作真值,33 帧窗口、4 个 seed,9 帧条件下 7B-Video2World 物体级 IoU 0.592、PSNR 21.06(Table 20, p38-39);迁移证据——预训练模型在 DL3DV-10K、Cosmos-1X、Bridge、RDS 上微调后显著优于同数据从零微调的 CamCo、VideoLDM、IRASim(§6);规模效应——AR「对象从下方出现」失败率从 4B 的 15% 降到 12B 的 2%(Table 18, p35)。
但作者自己在结论里拆台(§9, p58):所有 WFM 同样挣扎于物理遵守,更大模型不提升物理对齐——Table 20 里 4B 到 14B 的 IoU 没有单调改善;3D 评测只覆盖静态场景,高分可能来自训练数据分布而非几何推理;未来帧预测可被短时视觉插值这类统计规律模仿,而论文没有打开潜空间做任何探测或干预来排除这种解释。看物理场景 rollout 的目视对比,结论就钉在像素上:
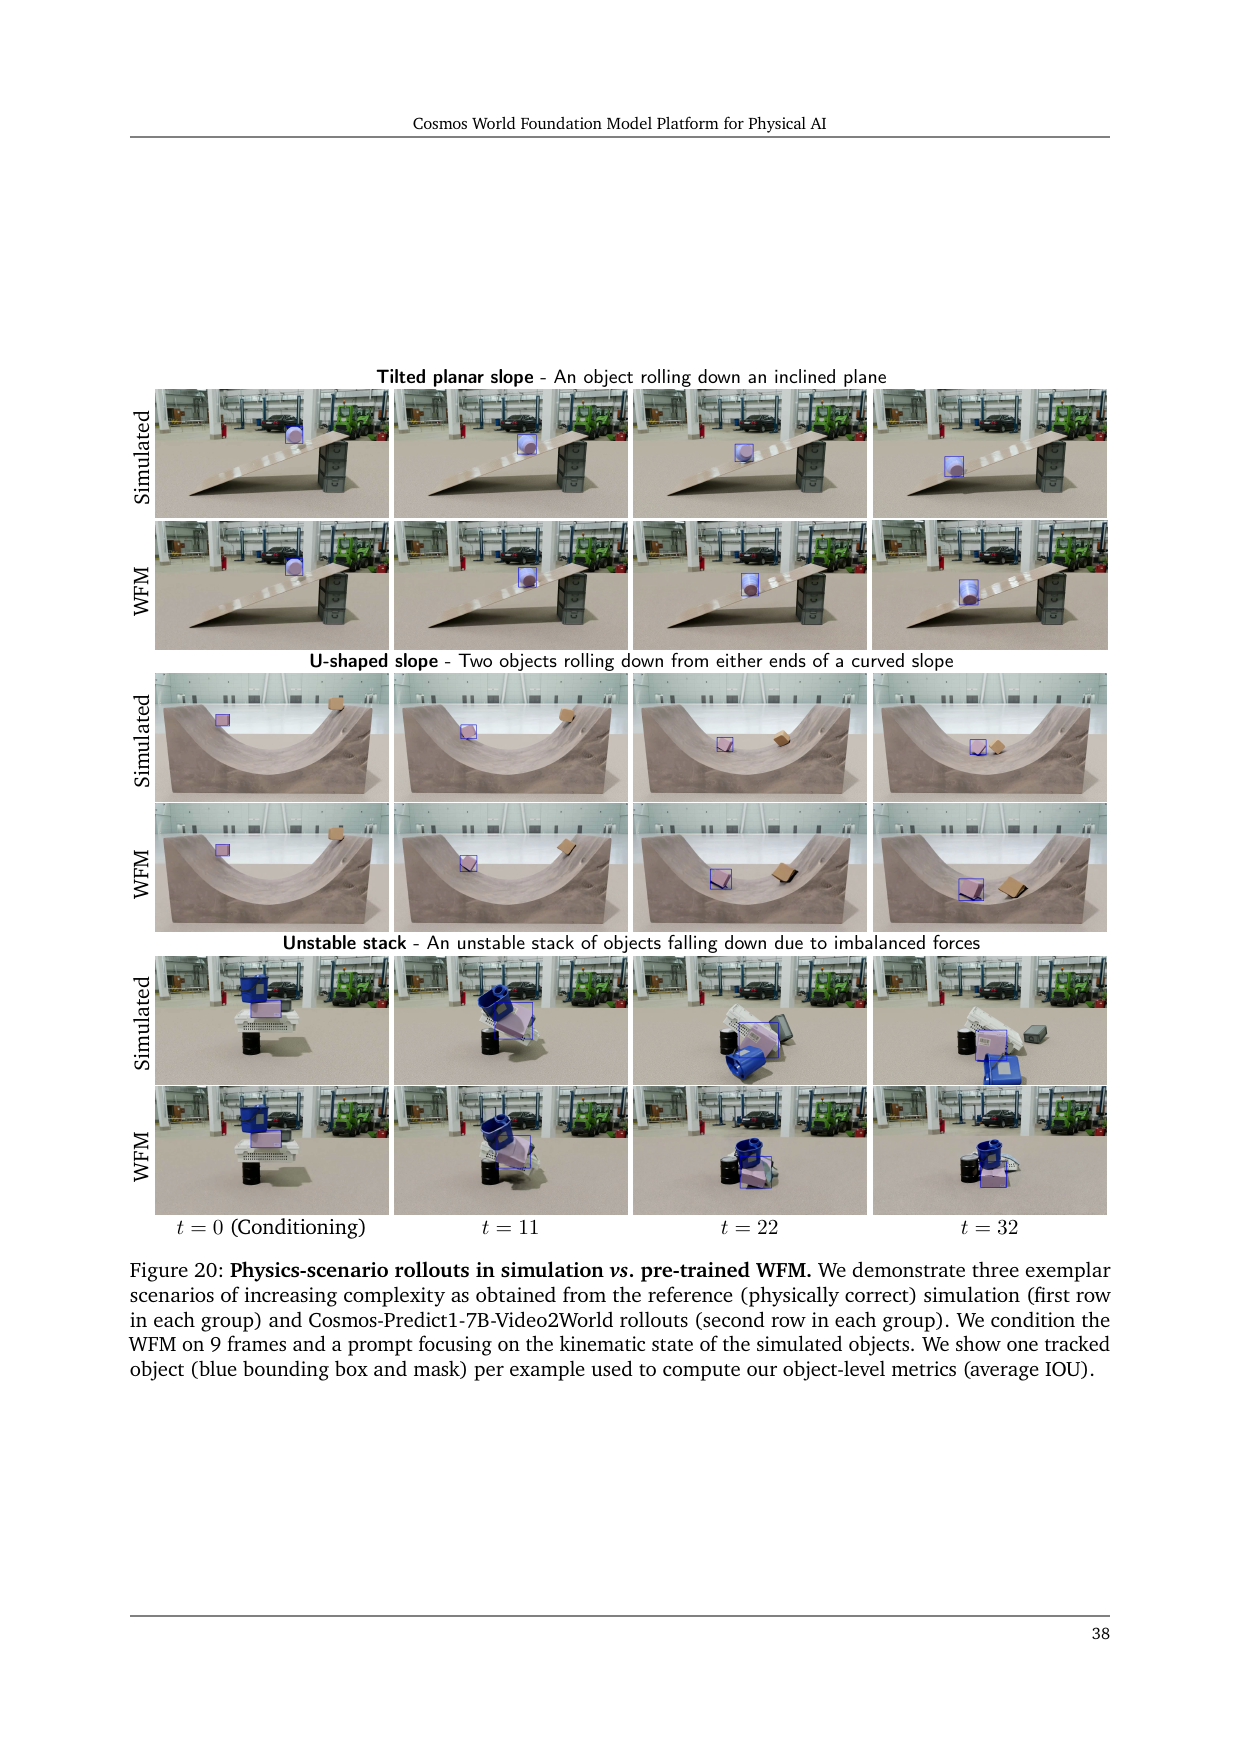
模型能跟上大致的运动方向,但物体位置、形状与真值逐步漂移——画面看起来连贯,物理细节对不上。3D 一致性指标本身也值得展开,Sampson error 是把「几何对不对」变成数字的公式:
$$\epsilon_{\text{samp}} = \frac{1}{N} \sum_{i=1}^{N} \frac{\|\bar{y}_i^{\top} F \bar{x}_i\|^2}{(F\bar{x}_i)_1^2 + (F\bar{x}_i)_2^2 + (F^{\top}\bar{y}_i)_1^2 + (F^{\top}\bar{y}_i)_2^2}$$
逐项看:$\bar{x}_i$、$\bar{y}_i$ 是两帧之间第 $i$ 对点匹配的齐次坐标,$F$ 是由位姿估计得到的基础矩阵;分子 $\bar{y}_i^{\top} F \bar{x}_i$ 度量匹配点偏离极线约束的程度,分母做归一化,$N$ 对匹配平均后数值越小,几何一致性越强。Cosmos 的 0.355 低于真实视频的 0.431,说明静态场景的几何一致性确实强——但这正是论文自己限定范围的结论。
干预:两处机制级干预,其余全是工程
报告里真正「观测到现象 → 定点干预」的闭环只有两个,都在训练动力学里。第一处:diffusion 模型训练早期观察到注意力 logits 不稳定、attention entropy 塌缩(§5.1.2, p20),干预是在所有 self-/cross-attention 的 Q、K 上做 RMSNorm 并加可学习缩放——与之前解读的 Weight-norm Criticality 关注的是同一类归一化稳定性问题。第二处:AR 模型 logits 过大会让梯度范数失控,干预是加 z-loss:$\mathcal{L}_{z\text{-loss}} = \lambda \sum_i z_i^2$,把 logits 往 0 拉,$\lambda = 3\times 10^{-4}$(§5.2.1, p28)。这两处都只有定性陈述、无消融数字,但机制指向明确。
其余是工程干预,挑三个有数字的:AdaLN-LoRA 把 AdaLN 的密集投影低秩分解(rank 256),11B → 7B 参数减少 36% 且全部评测指标保持 parity;Medusa 投机解码 + 低分辨率适配把 4B 吞吐从 444.95 提到 894.67 tokens/s(2.0×,5B 为 3.2×),320×512 下 10.08 frames/s 达到实时(Table 15/17, p30-31);diffusion decoder 用条件去噪把离散 token 的模糊重建修清晰(Fig. 18, p34,无量化指标)。AR 家族那边还有一个与「next-token prediction」对齐的目标,训练时最小化视频 token 序列的负对数似然:
$$\mathcal{L}_{NLL} = -\log P(v_i \mid v_1, v_2, \dots, v_{i-1}; \Theta)$$
$v_i$ 是第 $i$ 个离散视频 token,条件概率 $P$ 由 Transformer decoder(参数 $\Theta$)建模,$\Theta$ 就是 4B/5B/12B/13B 四个规模的 AR 模型。这是与 diffusion 的连续去噪完全不同的第二套生成范式,论文用同一套 tokenizer 家族给两套范式喂数——双轨对照本身就是一个大实验。
post-training 的条件注入同样有干净公式——相机控制用的 Plücker 嵌入:
$$r = (d, m) \in \mathbb{R}^6, \qquad m = c \times d$$
$d$ 是每个 latent 像素的相机单位光线方向,$c$ 是相机中心位置,$m = c \times d$ 是叉积,六维向量 $r$ 与 latent 拼接注入去噪网络(每 8 帧取第 4 帧位姿,§6.1.2, p41)。收益:相机控制位姿成功率 82.0% vs 同数据微调的 CamCo 43.0%(Table 22, p42);机器人动作条件 FVD 190 vs IRASim 593(Table 23, p47);多视角 TSE 0.68 vs VideoLDM 1.24(Table 24, p51)。
收益与最弱一环
把收益和弱点放一起,结论是对称的:收益全在行为层,弱点也全在机制层。工程收益都是带 baseline 的数字——DAVIS 4×8×8 重建 PSNR 35.85 vs CogVideoX 29.29、Omni 22.23(Table 5);tokenizer 推理 34.8 ms/帧 vs CogVideoX 414 ms(Table 9);指令视频预测人工偏好 78.3% vs VideoLDM-Instruction 13.0%(Fig. 24, p46)。
但「机制 → 干预」这一环几乎不存在:从「WFM 隐式学到世界动态」到平台设计之间没有推导链,潜空间从未被打开(全文无 probing、无 latent 干预、无因果扰动),物理遵守度低且没有被任何平台干预改善——IoU 最高 0.592,4B 到 14B 拉不开差距。
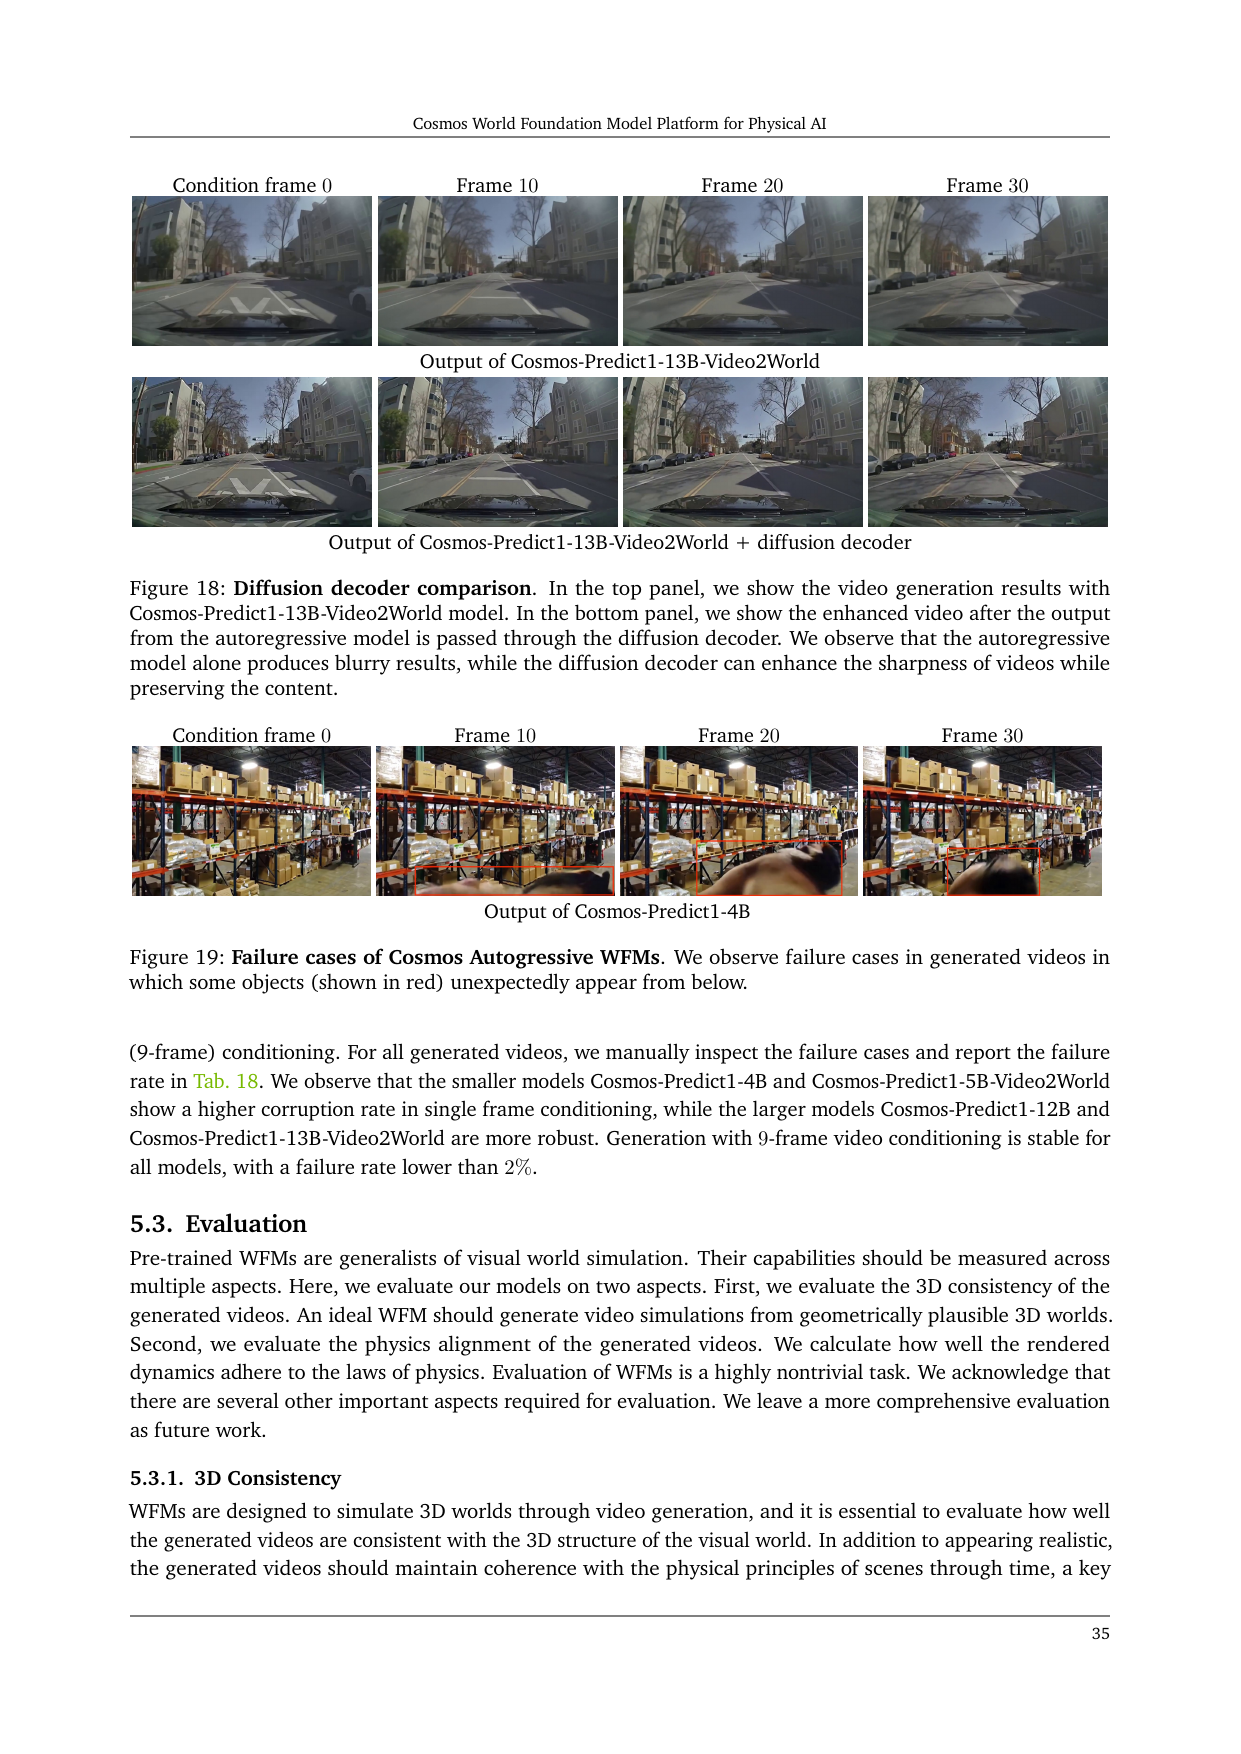
它同时说明规模改善低阶一致性(15% → 2%),而 9 帧条件把全部模型压到 2% 以下——条件帧数比规模更强的杠杆,这是输入上下文长度作为干预的实证。
这套收益的代价也要算清楚:14B 扩散模型参数/梯度/优化器约 280 GB、激活 310 GB,靠 FSDP + context parallelism 才压到单卡可训(§5.1.4, p23-24);实时模式以 320×512 降分辨率换速度,而 AR 推理附加 diffusion decoder 后单卡延迟从 31.04s 涨到 61.49s(Table 16, p31)。另外论文没有用 KV cache(MQA/GQA 明确不用),推理优化靠的是 Medusa 与低分辨率——这一点与常见的 LLM 系 AR 模型不同。综合起来,Cosmos 的定位是:一个可观测、可复现、可迁移的平台,但「学到世界动态」这一句需要打折读。
一句话记住这篇
Cosmos 把「世界模型」做成了带 baseline 的平台:压缩-质量曲线、3D 一致性、物理对齐、下游迁移全部可复现、可比较;但最该记住的是论文自己承认的结论——realism ≠ physics,视觉保真(PSNR 33+、位姿成功率 62.6%)与物理遵守(IoU 最高 0.592)是可分离的两个量,更大模型不提升物理对齐。最该记住的数字:9 帧条件把 AR 失败率压到 2% 以下、把物理对齐 IoU 从 0.332 抬到 0.592——在世界模型里,输入上下文长度本身就是可观测的强干预。
把『世界模型』做成平台级可观测系统:视频 tokenizer 的压缩-重建曲线、diffusion/autoregressive 双轨预训练、3D 一致性与物理遵守度评测、post-training 下游收益全部带 baseline 量化;但『学到 latent world model』的机制环只有行为证据——论文自己承认 realism≠physics adherence,全程没有打开潜空间做任何探测或因果干预。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:三类可观测现象。① 视频 tokenizer 的可观测压缩特性:同一 tokenizer 家族在 4×8×8 → 8×8×8 → 8×16×16 三档压缩率下重建质量系统性退化(TokenBench 上连续系列 PSNR 38.42→35.13→31.61、rFVD 3.34→9.82→43.08,Table 5);离散(FSQ)路径退化远快于连续(AE)路径(DV8×16×16 的 TokenBench rFVD 达 107.43 vs CV8×16×16 的 43.08,Table 5-6),直接导致 AR 模型输出模糊(§5.2.5, p32)。② 训练动力学异常:diffusion WFM 训练早期『注意力 logits 不稳定→attention entropy collapse』(§5.1.2, p20);AR 模型 logits 过大导致梯度范数失控(z-loss 动机,§5.2.1, p28);14B 扩散模型『几乎没有 loss spike 且无非恢复性 spike』(§5.1.3, p22)。③ 世界模型行为层可观测量:3D 一致性(Sampson error、相机位姿估计成功率、新视角合成 PSNR/SSIM/LPIPS)与物理规则遵守度(PhysX+Isaac Sim 8 场景下未来帧预测的像素级 PSNR/SSIM、特征级 DreamSim、物体级 IoU)(§5.3, p35-39)。
在哪里观测:tokenizer 评测在 DAVIS 1080p 与自建 TokenBench(500 条视频:BDD100K / EgoExo-4D / BridgeData V2 / Panda-70M 各 100 条,10 秒、短边 1080,§4.3, p16);WFM 3D 一致性在 RealEstate10K 测试集 500 条静态场景(§5.3.1, p36);物理对齐在 800 条 100 帧 1080p 合成物理视频(8 个 PhysX/Isaac Sim 场景,4 个静态相机视角,33 帧评估窗口,§5.3.2, p37-39);全部 WFM 用 10,000 张 H100 训练 3 个月(§5, p18)。
如何量化:重建质量用 PSNR / SSIM / rFID(图像)/ rFVD(视频)(Table 5-8, p15-16);3D 一致性用 Sampson error + 位姿估计成功率(COLMAP)+ 视角合成 PSNR/SSIM/LPIPS(Table 19, p36);物理对齐用 PSNR/SSIM、DreamSim、SAMURAI 传播的物体 mask IoU,跨帧/跨视频/4 个随机 seed 取均值(Table 20, p38-39);AR『对象从下方出现』失败率用 100 条 Physical AI 输入人工检查(Table 18, p35)。
② 机制假设
假设:大规模视频预训练能让 WFM 隐式学到物理世界的底层动态:WFM 被定位为『物理世界的数字孪生』(digital twin of the physical world,§1, p2),即连续/离散 token 的隐空间中编码了可泛化的物理规律,Video2World 的未来帧预测(pixel space 行为)是这种世界理解的体现;tokenizer 的瓶颈表示是模型『看见世界』的窗口。
证据:
- 3D 一致性:diffusion WFM 的 Sampson error 0.355(7B-Text2World)低于真实视频参照 0.431,位姿估计成功率 62.6%/68.4% vs 真实视频 56.4%、VideoLDM 4.4%(Table 19, p36)——生成视频在几何上比 baseline 更接近 3D 世界。
- 物理对齐:9 帧条件下 diffusion 7B-Video2World 物体级 IoU 0.592、PSNR 21.06(Table 20, p38-39),8 个刚性体场景(自由落体/斜面/多米诺/跷跷板/陀螺仪等)上表现出一定直觉物理。
- 迁移证据:预训练 WFM 在 DL3DV-10K / Cosmos-1X / Bridge / RDS 上微调后显著优于同数据从零微调的 baseline(CamCo、VideoLDM、IRASim,§6, Table 22-25),作者解读为『继承了大量世界先验』(§6.1.3, p42)。
- 规模效应:AR『对象从下方出现』失败率随规模下降(图像条件 4B 15% → 12B 2%,Table 18, p35),被解读为更大模型学到更稳定的物体永久性。
备选解释:
- 论文自认的备选解释:realism ≠ physics adherence——『生成的逼真度并不总反映对物理原理的遵守』(§9, p58);所有 WFM『同样挣扎于物理遵守』,更大模型不提升物理对齐(§5.3.2, p39),说明行为层的视觉保真不构成世界理解的证据。
- 3D 一致性评测只覆盖静态场景(RealEstate10K),高分解力可能来自训练数据分布而非几何/物理推理;作者承认 WFM 评测『高度 nontrivial』且评估体系主观(§9, p58)。
- 『未来帧预测成功』可被短时视觉插值、纹理统计模仿或数据先验解释,无需隐式物理模型;论文没有做任何潜空间探测(无 probing、无 latent 干预、无因果扰动)来排除这类统计性解释。
形式化/toy model:null。论文无 toy model、无潜空间可解释性分析,机制假设停留在行为层定义(WFM=能生成未来观测的生成模型)。全部形式化是工程目标:tokenizer 压缩-重建损失(L1 + VGG-19 感知损失 Eq.2-3、光流损失、Gram 损失、对抗微调,p14-15)、EDM 扩散训练目标(Eq.5-8, p19)、AR 的 NLL 目标(Eq.9, p27)、Plücker 相机条件(Eq.11, p41)与轨迹误差(Eq.12, p41)。
③ 局部干预
干预对象:tokenizer 架构与训练目标(表示瓶颈本身)
操作:因果设计:2 级 Haar wavelet 变换 + 因果时空注意力/卷积;连续 tokenizer 用 vanilla AE(latent 16 维),离散用 FSQ(6 维,(8,8,8,5,5,5),词表 64,000);两阶段训练(L1+VGG 感知 → 光流+Gram+对抗微调);提供 4×8×8 / 8×8×8 / 8×16×16 三档压缩(§4, p11-17)。
效果:4×8×8 下 DAVIS PSNR 35.85(vs CogVideoX 29.29、Omni 22.23);8×16×16(8×更高压缩)TokenBench PSNR 31.61 仍高于 Omni 4×8×8 的 24.48(Table 5, p15);推理 34.8 ms/帧 vs CogVideoX 414 ms(Table 9, p16)。
局部性:干预对象是表示瓶颈本身(编码器/解码器/量化器),属于表征层干预;但是全局重设计的 tokenizer,不是对训练好模型的定点扰动,局部性体现在『压缩率这一可调旋钮』上。
干预对象:diffusion WFM 的注意力层 Q/K
操作:Query-Key RMSNorm(可学习 scale)——直接针对观测到的早期训练 attention logits 不稳定 / entropy collapse(§5.1.2, p20-21)。
效果:训练稳定(作者只给定性陈述,无消融数字)。
局部性:只改注意力计算内的 Q/K 归一化,是机制层最小干预;但没有量化对照来归因收益。
干预对象:DiT 的 AdaLN 密集投影
操作:AdaLN-LoRA(rank 256)低秩分解(§5.1.2, p21)。
效果:11B→7B 参数减少 36%,全部评测指标保持 parity。
局部性:只作用于 AdaLN 层,是结构级参数干预;收益无独立消融。
干预对象:AR 模型的 logits 稳定性
操作:z-loss(λ=3×10⁻⁴,平方 logits 惩罚项)(§5.2.1, p28)。
效果:大规模训练中梯度范数保持健康(定性)。
局部性:只加一个全局正则项,不触碰架构。
干预对象:AR 模型推理路径(而非权重)
操作:Medusa 投机解码头(单层 FFN+SiLU,只解冻最后 2 层+解嵌层)+ 低分辨率适配(DV8×16×16 tokenizer 在 320p 微调,4B 在 320×512 微调)(§5.2.4, p30-31)。
效果:4B 吞吐 444.95→894.67 tokens/s(9 头,2.0×)、5B 303.61→982.77(3.2×)(Table 15, p30);320×512 下 10.08 frames/s,达 10 FPS 实时(Table 17, p31)。
局部性:只加解码头/改推理分辨率,backbone 主权重不动;注意:论文并未使用 KV cache(MQA/GQA 明确不用,KV caching 只在结论里作为 diffusion→causal 蒸馏的未来方向出现,§9, p58)——推理优化的实际手段是 Medusa+低分辨率。
干预对象:AR 输出的离散 token 表征
操作:diffusion decoder(Cosmos-Predict1-7B-Decoder-DV8×16×16ToCV8×8×8-720p):把离散 token 嵌入→2×上采样→与连续噪声输入拼接,条件去噪生成连续 token 再解码(§5.2.5, p32-33)。
效果:修复离散 tokenizer 高压缩造成的模糊,保留内容并增强清晰度(Fig. 18, p34;无量化指标)。
局部性:不动 tokenizer 与 WFM 主干,只在解码侧加条件去噪器——『表征修复』式干预。
干预对象:post-training 的条件注入机制
操作:相机 Plücker 嵌入(6 维 r=(d,m),每 8 帧用第 4 帧,§6.1.2, p41)、动作 embedder MLP(5B 走 cross-attention、7B 加进 timestamp 嵌入,§6.2.2, p45)、view embedding + view-dependent cross-attention + 64 点轨迹条件(§6.3.2, p49)。
效果:相机控制位姿成功率 82.0% vs CamCo 43.0%(Table 22, p42);多视角 TSE 0.68 vs 1.24(Table 24, p51)。
局部性:新模态通过现成条件机制注入,主干预训练权重不变。
因果验证:因果验证全部在行为层:tokenizer 与 SOTA 同设置对照(FLUX/CogVideoX/Omni/VideoGPT/Open-MAGVIT2/LlamaGen,Table 4-9);WFM 与 CamCo/VideoLDM/IRASim 同数据微调对照(§6);物理对齐以 PhysX 仿真相为 ground truth(§5.3.2)。但机制层干预(QK-norm、z-loss、AdaLN-LoRA、Medusa 层选择)大多只有定性陈述或自对照,无组件消融表;对『潜空间是否编码物理』没有任何干预/探测验证——这是闭环最大缺环。
④ 工程收益
指标:视频 tokenizer 重建 PSNR(连续, 4×8×8, DAVIS)
数值:35.85 dB
基线:CogVideoX 29.29 dB、Omni 22.23 dB(同压缩率)
设置:Cosmos-Tokenize1-CV4×8×8-360p, 49 帧, AE, Table 5, p15
指标:视频 tokenizer 重建(离散, 4×8×8, TokenBench)
数值:PSNR 35.74 / SSIM 0.910 / rFVD 19.25
基线:Omni 25.31 / 0.827 / 53.55;VideoGPT 33.66 / 0.914 / 13.85(但压缩更低 4×4×4)
设置:DV4×8×8-360p, FSQ, TokenBench 500 视频, Table 6, p15
指标:压缩-质量退化曲线(连续视频, TokenBench)
数值:PSNR 38.42→35.13→31.61;rFVD 3.34→9.82→43.08(4×8×8→8×8×8→8×16×16)
基线:8×16×16 的 PSNR 31.61 仍 > Omni 4×8×8 的 24.48
设置:Cosmos-Tokenize1 系列, Table 5, p15
指标:图像 tokenizer PSNR(8×8, MS-COCO)
数值:32.79 dB(+8.79 dB)
基线:FLUX-Tokenizer 24.00 dB
设置:CI8×8-360p, 5,000 张 COCO 验证图, Table 7, p16
指标:tokenizer 推理速度
数值:视频 34.8 ms/帧(CV4×8×8, 105M 参数)
基线:CogVideoX 414 ms(216M)、Omni 82.9 ms(54M);整体 2×-12× 更快
设置:单 A100 80GB, Table 9, p16
指标:3D 一致性(预训练 WFM)
数值:Sampson error 0.355、位姿估计成功率 62.6%、视角合成 PSNR 33.02
基线:VideoLDM 0.841 / 4.4% / 26.23;真实视频 0.431 / 56.4% / 35.38
设置:7B-Text2World, RealEstate10K 测试集 500 静态场景, Table 19, p36
指标:物理对齐(9 帧条件)
数值:7B-Video2World PSNR 21.06 / SSIM 0.691 / DreamSim 0.859 / IoU 0.592
基线:1 帧条件 17.34 / 0.538 / 0.836 / 0.332;无外部 baseline(对照 PhysX 真值);14B 9 帧 20.21 / 0.635 / 0.860 / 0.598
设置:8 场景 800 条 100 帧 1080p 合成视频, 33 帧窗口, 4 seeds, Table 20, p38-39
指标:AR 失败率(对象从下方出现)
数值:图像条件:4B 15% / 5B 7% / 12B 2% / 13B 3%
基线:9 帧视频条件全部 <2%(13B 0%)
设置:100 条 Physical AI 输入人工检查, Table 18, p35
指标:Medusa 投机解码吞吐
数值:4B 894.67 / 5B 982.77 tokens/s(9 头)
基线:无 Medusa 444.95 / 303.61(2.0× / 3.2×);forward passes 7680→1812 / 10240→1799
设置:8×H100, 50 条 640×1024 测试视频, BF16, Table 15, p30
指标:实时视频生成
数值:10.08 frames/s(806.61 tokens/s)
基线:640×1024 原分辨率下论文未报实时数字(非实时)
设置:320×512 低分辨率适配+Medusa, 8×H100 80GB, 10-FPS 输入, Table 17, p31
指标:相机控制 post-training
数值:FID 14.30 / FVD 120.49 / 位姿成功率 82.0% / 旋转误差 1.646°
基线:CamCo(同 DL3DV-10K 微调)57.49 / 433.24 / 43.0% / 8.277°
设置:RealEstate10K 500 样本, Table 22, p42
指标:机器人动作条件(Bridge)
数值:7B-ActionCond FVD 190 / PSNR 21.14 / SSIM 0.82
基线:IRASim-Action 593 / 19.13 / 0.64
设置:100 条官方 Bridge 测试 episodes, Table 23, p47
指标:多视角驾驶生成
数值:FID 32.16 / FVD 210.23 / TSE 0.68 / CSE 2.11
基线:VideoLDM-MultiView 60.84 / 884.46 / 1.24 / 6.48;真实视频 TSE 0.69 / CSE 1.71
设置:RDS 数据集, 1,000 样本质量 / 800 样本一致性(4 类轨迹各 200), Table 24, p51
指标:指令视频预测人工偏好
数值:78.3% 整体偏好(7B-Sample-Instruction)
基线:VideoLDM-Instruction 13.0%(8.7% 平局)
设置:Cosmos-1X 数据集, 4 维度人类评估, Fig. 24, p46
代价:训练成本:10,000 张 H100 × 3 个月(§5, p18);14B 扩散模型参数/梯度/优化器 ~280 GB + 激活 310 GB(FSDP 64 → ~4 GB/GPU、CP 8 → ~40 GB/GPU,§5.1.4, p23-24);12B AR 模型 ~192 GB(TP/SP,§5.2.2, p29)。实时模式以分辨率(320×512)换速度;AR 推理附加 diffusion decoder 后延迟显著上升(4B 单卡 31.04s→61.49s,Table 16, p31)。
可迁移性:tokenizer 跨分辨率、跨时长(长度无关推理,§4, p12)与跨域(TokenBench 5 域)泛化已验证;WFM 跨下游任务(相机/机器人/驾驶)迁移是论文主论点(§6, p40-52);但物理对齐不足被自认(§9, p58),机制级可迁移性(潜空间表征能否移植到新任务)无证据。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 弱。可观测现象(压缩退化曲线、3D 一致性、物理对齐、失败率)测量扎实且带 baseline,但『学到物理/世界动态』的机制主张只有行为证据;论文自己承认 realism≠physics、所有模型同样挣扎于物理遵守,且没有做任何潜空间探测来桥接现象与机制。 |
| 机制→干预 | 弱(最弱一环)。QK-norm / z-loss 算得上从训练动力学观测出发的最小干预,但『latent world model』机制假设没有推导出任何可证伪的干预规格;tokenizer、双轨架构、post-training 条件注入全是工程驱动;论文从未对潜空间做扰动/ablation 来验证『物理表征』存在。 |
| 干预→收益 | 中偏强。收益全部有同设置 baseline(CamCo / VideoLDM / IRASim / CogVideoX / FLUX / Omni)与明确 setup;但训练稳定性干预(QK-norm、z-loss、AdaLN-LoRA、loss scaling)无消融数字,部分收益(diffusion decoder 修复、Medusa 保质量)是自对照。 |
| 最弱一环 | mechanism_to_intervention:从『WFM 隐式学到世界动态』到平台设计之间没有机制推导链;潜空间从未被打开验证,物理遵守度低且未被任何平台干预改善——机制环是框架叙事而非可检验命题。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 视频 tokenizer 重建 PSNR(连续, 4×8×8, DAVIS) | 35.85 dB | CogVideoX 29.29 dB;Omni 22.23 dB(同 4×8×8) | Cosmos-Tokenize1-CV4×8×8-360p,49 帧,AE,Table 5, p15 |
| 视频 tokenizer 重建(离散, 4×8×8, TokenBench) | PSNR 35.74 / SSIM 0.910 / rFVD 19.25 | Omni 25.31 / 0.827 / 53.55;VideoGPT 33.66 / 0.914 / 13.85(4×4×4 更低压缩) | DV4×8×8-360p,FSQ 词表 64,000,TokenBench 500 视频,Table 6, p15 |
| 压缩-质量退化曲线(连续视频, TokenBench) | PSNR 38.42→35.13→31.61;rFVD 3.34→9.82→43.08 | 8×16×16(8×更高压缩)PSNR 31.61 仍 > Omni 4×8×8 的 24.48 | 4×8×8→8×8×8→8×16×16,Cosmos-Tokenize1 系列,Table 5, p15 |
| 图像 tokenizer PSNR(8×8, MS-COCO) | 32.79 dB(+8.79 dB) | FLUX-Tokenizer 24.00 dB | CI8×8-360p,5,000 张 COCO 验证图,Table 7, p16 |
| tokenizer 推理速度 | 视频 34.8 ms/帧(CV4×8×8, 105M 参数) | CogVideoX 414 ms(216M)、Omni 82.9 ms(54M);整体 2×-12× 更快 | 单 A100 80GB,Table 9, p16 |
| 3D 一致性(预训练 WFM) | Sampson error 0.355 / 位姿成功率 62.6% / 视角合成 PSNR 33.02 | VideoLDM 0.841 / 4.4% / 26.23;真实视频 0.431 / 56.4% / 35.38 | 7B-Text2World,RealEstate10K 测试集 500 静态场景,Table 19, p36 |
| 物理对齐(9 帧条件) | 7B-Video2World PSNR 21.06 / SSIM 0.691 / DreamSim 0.859 / IoU 0.592 | 1 帧条件 17.34 / 0.538 / 0.836 / 0.332;14B 9 帧 20.21 / 0.635 / 0.860 / 0.598;无外部 baseline | 8 场景 800 条 100 帧 1080p PhysX/Isaac Sim 合成视频,33 帧窗口,4 seeds,Table 20, p38-39 |
| AR 失败率(对象从下方出现) | 图像条件:4B 15% / 5B 7% / 12B 2% / 13B 3% | 9 帧视频条件全部 <2%(13B 0%) | 100 条 Physical AI 输入人工检查,Table 18, p35 |
| Medusa 投机解码吞吐 | 4B 894.67 / 5B 982.77 tokens/s(9 头) | 无 Medusa:444.95 / 303.61(2.0× / 3.2×);forward passes 7680→1812 / 10240→1799 | 8×H100,50 条 640×1024 测试视频,BF16,Table 15, p30 |
| 实时视频生成 | 10.08 frames/s(806.61 tokens/s) | 640×1024 原分辨率论文未报实时数字(非实时) | 320×512 低分辨率适配 + Medusa,8×H100 80GB,10-FPS 输入,Table 17, p31 |
| 相机控制 post-training | FID 14.30 / FVD 120.49 / 位姿成功率 82.0% / 旋转误差 1.646° | CamCo(同 DL3DV-10K 微调)57.49 / 433.24 / 43.0% / 8.277° | RealEstate10K 500 样本,Table 22, p42 |
| 机器人动作条件(Bridge) | 7B-ActionCond FVD 190 / PSNR 21.14 / SSIM 0.82 | IRASim-Action 593 / 19.13 / 0.64 | 100 条官方 Bridge 测试 episodes,Table 23, p47 |
| 多视角驾驶生成 | FID 32.16 / FVD 210.23 / TSE 0.68 / CSE 2.11 | VideoLDM-MultiView 60.84 / 884.46 / 1.24 / 6.48;真实视频 TSE 0.69 / CSE 1.71 | RDS 数据集,1,000 样本质量 / 800 样本一致性(4 类轨迹各 200),Table 24, p51 |
| 指令视频预测人工偏好 | 78.3% 整体偏好(7B-Sample-Instruction) | VideoLDM-Instruction 13.0%(8.7% 平局) | Cosmos-1X 数据集,4 维度人类评估,Fig. 24, p46 |
Insights
- 压缩-质量曲线是平台最『可观测』的窗口:同一 tokenizer 家族在三档压缩率下的 PSNR/rFVD 退化干净可复现,且离散(FSQ)路径在高压缩下损失远大于连续(AE)路径(TokenBench rFVD 107.43 vs 43.08)——这直接解释了 AR 输出模糊,并催生了 diffusion decoder 这个『表征修复』式干预(§4.3 p15-16, §5.2.5 p32)。
- realism ≠ physics 是被数据证实的一次解耦:视觉保真指标(PSNR 33+、位姿成功率 62.6%)远超物理遵守指标(IoU 最高 0.592,所有模型同样挣扎),论文在结论里明确承认『逼真度不总反映物理原理遵守』(§5.3 p36-39, §9 p58)——生成能力与世界理解是可分离的两个量。
- 规模改善的是低级一致性而非高级物理:12B/13B AR 在物理对齐上与 4B/5B 打平甚至更差(Table 20),却显著降低『对象从下方出现』这类永久性失败率(15%→2%,Table 18)——capacity 补的是 object permanence 这类低阶约束。
- 条件帧数是比规模更强的杠杆:9 帧条件把全部 AR 模型失败率压到 <2%(Table 18),并把 7B-V2W 的物理对齐 IoU 从 0.332 抬到 0.592(Table 20)——在世界模型里,输入上下文长度本身就是可观测的强干预。
- 训练动力学是报告里唯一真正闭环的机制故事:观测到 attention entropy collapse → 加 QK-norm;观测到 logits 爆炸/梯度范数失控 → 加 z-loss(λ=3×10⁻⁴)——这两处是『现象→局部干预』的直接映射,其余环节(tokenizer、双轨架构、post-training)都是工程驱动。
- 机制层是框架叙事而非可检验命题:整份 75 页报告没有打开过潜空间——没有 probing、没有 latent 干预、没有因果扰动;『digital twin of the physical world』是定位陈述,唯一的相关证据是行为层评测(且承认不足)。
vs 同类工作
局限
- 零潜空间/内部表征分析:不探测 token/latent 编码了什么、不做 latent 因果干预,『学到世界动态』只有行为证据;对 interpretability 闭环这是最大缺环(全文无 probing/ablation 章节)。
- 物理遵守度弱(论文自认):所有 WFM『equally struggle with physics adherence』,列举 object impermanence、接触动力学不准、instruction following 不一致、重力/光照/流体违反(§5.3.2, p39;§9, p58)。
- 评测面窄:3D 一致性只用 RealEstate10K 静态场景(500 条);物理对齐只有 8 个合成刚性体场景、33 帧窗口;没有 VBench 式通用视频基准(VBench 仅在参考文献);人类评估只在 Cosmos-1X 一个数据集上。
- 关键机制干预无消融数字:QK-norm、z-loss、AdaLN-LoRA、loss scaling、AdamW betas/eps 的收益多为定性陈述,无对照表。
- 无 KV cache / MQA / GQA:AR 模型未用 KV caching,论文只把『双向 diffusion 蒸馏成 causal student 以支持 KV caching』列为未来方向(§5.2.2, p29;§9, p58);实时性靠 320×512 降分辨率换取,上限 10 FPS。
- 数据与算力不可复现:Cosmos-1X、RDS 为内部数据,20M 小时语料不公开;10,000×H100×3 个月训练成本使端到端复现不现实;无 seed 级结果表。
- 数字表述有概数:§4.3 声称『+4 dB PSNR improvement』(p12)是相对 Fig. 8 的概数,表内实际增量依设置从约 +2.1 dB(TokenBench DV4×8×8 vs VideoGPT)到约 +12.8 dB(ImageNet CI8×8 vs FLUX)不等,引用应以表格数字为准。
可复现性
模型 open-weight:Cosmos-Predict1 系列(diffusion 7B/14B Text2World+Video2World;AR 4B/5B/12B/13B)与 Cosmos-Tokenize1 全套经 NVIDIA Open Model License 发布(§1, p3);TokenBench(github.com/NVlabs/TokenBench)与 ShotBench(github.com/NVlabs/ShotBench)公开。完整超参见 Table 11(diffusion, p20)与 Table 14(AR, p29),tokenizer 结构/损失见 §4(p11-17),全部评测协议(DAVIS、TokenBench、RealEstate10K、Bridge、RDS 指标定义)足够详细可复算;Medusa/低分辨率流程含表(Table 15-17, p30-31)。不可复现部分:内部数据(Cosmos-1X ~12,000 episodes、RDS 360 万条 20 秒六视角 clip)、20M 小时语料、10,000 H100×3 个月训练、14B 级推理资源;无 seed 级数字表。取数提醒:无版本号 PDF 链接返回 v3(2025-07-09,75 页),如需 v1(2025-01-07)用 /pdf/2501.03575v1;「KV cache」一词在全文(含 5.2.4 推理优化节)不出现,推理优化的实际手段是 Medusa 投机解码与低分辨率适配。
连续与离散 tokenizer 的压缩率-重建质量曲线(DAVIS)
原文 caption:Comparison of continuous (left) and discrete (right) tokenizers in terms of spatio-temporal compression rate (log scale) versus reconstruction quality (PSNR). Each solid point represents a tokenizer configuration, illustrating the trade-off between compression rate and quality. (caption 由 PDF 文本清理)
这是「可观测现象」环的目视锚点:横轴是时空压缩率(对数刻度)、纵轴是重建 PSNR,每个点是一个 tokenizer 配置。同一家族从 4×8×8 提到 8×16×16(8× 更高压缩)质量系统性下滑,但整条曲线仍压在所有对手上方——对应 Table 5 里 8×16×16 的 PSNR 31.61 仍高于 Omni 4×8×8 的 24.48。读图时看两个信息:压缩与质量确实在交换(瓶颈表示有代价),以及离散路径(右侧)在高压缩下掉得更快,这直接预告了 AR 模型的模糊问题。
AR WFM 的失效案例:物体从画面下方凭空出现
原文 caption:Failure cases of Cosmos Autoregressive WFMs. We observe failure cases in generated videos in which some objects (shown in red) unexpectedly appear from below. (caption 由 PDF 文本清理)
支撑「物理遵守度弱」的典型失效案例:红色标出的物体在没有运动学来源的情况下从画面底部凭空出现(object impermanence)。配合 Table 18 的失败率数字(图像条件 4B 15% → 12B 2%;换成 9 帧视频条件后全部 <2%)一起读,它同时支撑两个论断:模型对物体永久性的掌握随规模提升,且条件帧数比规模更强的杠杆——这是行为层可观测、可量化的失败类别。
物理场景 rollout:仿真真值 vs 预训练 WFM 预测
原文 caption:Physics-scenario rollouts in simulation vs. pre-trained WFM. We demonstrate three exemplar scenarios of increasing complexity as obtained from the reference (physically correct) simulation (first row in each group) and Cosmos-Predict1-7B-Video2World rollouts (second row in each group). (caption 由 PDF 文本清理)
物理对齐评测的核心目视证据:每组上排是 PhysX/Isaac Sim 的真值仿真(斜面滚落、U 形坡、不稳定堆叠),下排是 7B-Video2World 在 9 帧条件 + 运动学 prompt 下的预测,蓝色框是被跟踪物体(用于 IoU 计算)。直观读法是:模型能跟上大致的运动方向,但物体位置、形状与真值逐步漂移——对应 Table 20 里物体级 IoU 最高只有 0.592(7B-Video2World 9 帧条件)。这张图把「realism ≠ physics」这个结论钉在像素上:画面看起来连贯,物理细节对不上。
🎧 音频版
时长 22:11 · Edge TTS
视觉逼真 ≠ 物理正确:NVIDIA Cosmos 报告,自己承认了这一点(对话版)
小播:今天聊 NVIDIA 的 Cosmos 世界模型报告,75 页、1 万张 H100 训练三个月,够重磅了。
老播:够重磅,但听完今天这期,你会记住一个反直觉的结论:这份报告视觉指标全面领先,物理指标全线平庸,而且这是论文自己承认的。
小播:自己承认?技术报告一般不都往好里说吗。
老播:这篇在结论里白纸黑字写了一句:逼真度并不总反映对物理原理的遵守。我们从头拆,先看他们观察到什么。
现象:压缩率一提,质量就掉,离散掉得更狠
老播:世界模型的第一步,是把视频压成 token,模型才训得动。Cosmos 提供两套 tokenizer,一套连续、一套离散,各有三档压缩率。
小播:压缩率越高损失越大,这不意外吧?
老播:意外的是数字。连续路径在自建评测集上,PSNR 从 38.42 一路掉到 31.61,rFVD 从 3.34 涨到 43.08——涨了十三倍。
小播:这是压到 8 倍的时候?
老播:对,8×16×16 这档。更关键的是离散路径:同样压到 8 倍,rFVD 冲到 107,是连续路径的两倍半还多。
小播:所以离散 token 在高压缩下崩得特别快?
老播:对,这个现象直接解释了他们自回归模型的输出为什么模糊。然后他们补了一个干预:加一个 diffusion decoder,把离散 token 重建出来的模糊画面修清晰。
小播:这套数据从哪来的?
老播:从 2000 万小时的原始视频里筛出来的,经过镜头检测、去重、质量过滤,最后留下约一亿条 2 到 60 秒的片段,再按驾驶、操作、自然动态这些物理类别配比。也就是说,模型能学到的物理,先取决于数据策展把哪些动态留了下来。
小播:这个可审计,比一句「学到了物理」实在多了。
机制:所谓「数字孪生」,证据全在行为层
小播:那他们凭什么说模型学到了物理?
老播:三组行为证据。第一组是 3D 一致性:在 RealEstate10K 的 500 条静态场景上,生成视频的几何误差 0.355,比真实视频参照的 0.431 还低;相机位姿估计成功率 62.6%,基线 VideoLDM 只有 4.4%。
小播:生成的东西比真实视频还「3D」?
老播:听上去很猛,但有个限定:全是静态场景。第二组是物理对齐:用 8 个 PhysX 物理仿真场景当真值,让模型预测未来帧,物体级 IoU 最高只有 0.592。
小播:0.355 和 0.431 这种几何误差,怎么体验?
老播:你可以把它想成「画面里的结构有多守规矩」:误差越小,场景里物体的相对位置越经得起从另一个角度看。他们的生成结果在这个指标上甚至好于真实视频——但正如前面说的,这套评测只覆盖了静态场景。
小播:0.592 是什么概念?
老播:物体框平均重叠不到六成,十个物体里至少有四个位置对不上。第三组是规模效应:自回归模型的「物体凭空出现」失败率,从 4B 的 15% 降到 12B 的 2%。
小播:规模越大越稳,这不就是学到了物理?
老播:注意,失败率降的是「物体永久性」这种低阶约束。同一张表里,更大模型没有提升物理对齐——4B 到 14B 的 IoU 拉不开差距。作者原话:所有模型同样挣扎于物理遵守。
干预:真正闭环的只有两处
小播:那有没有从现象到修复的完整闭环?
老播:有,但只有两处,都在训练稳定性上。第一处:扩散模型训练早期注意力分数不稳定、注意力熵塌缩,他们给 Q 和 K 加了归一化。第二处:自回归模型 logits 太大、梯度范数失控,他们加了一个 z-loss,把 logits 往零拉。
小播:这两处有消融数字吗?
老播:没有,只有定性描述。其他干预全是工程:AdaLN 低秩化把参数从 11B 减到 7B,指标不变;Medusa 投机解码把吞吐翻了一倍;相机控制用 Plücker 嵌入,位姿成功率 82%,对比同数据微调的 CamCo 只有 43%。
收益与最弱一环
小播:收益都带 baseline 吗?
老播:带,这是这份报告最扎实的地方:重建 PSNR 35.85,对比 CogVideoX 的 29.29、Omni 的 22.23;指令视频预测人工偏好 78.3%,对比 13%;下游机器人、驾驶任务全面领先。
小播:收益数字这么漂亮,最该警惕什么?
老播:先看迁移:预训练模型在四个下游任务上微调,都显著优于同数据从零训练的基线——相机控制位姿成功率 82% 对 43%,机器人动作 FVD 190 对 593,多视角一致性误差 0.68 对 1.24。这个「先预训练再微调」的优势是真的。
小播:那最弱的一环在哪?
老播:机制到干预这一环几乎是空的。他们说模型隐式学到了世界动态,但整份报告没有打开过潜空间——没有探测、没有扰动、没有因果实验。「数字孪生」是一句定位,一个可检验的命题都算不上。
小播:所以这模型到底怎么用?
老播:当工具用没问题,当「世界理解」的证据要打折。报告里最亮的一个干预是条件帧数:从 1 帧换成 9 帧条件,物理对齐 IoU 从 0.332 抬到 0.592,自回归失败率全部压到 2% 以下。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:Cosmos 把世界模型做成了带 baseline 的可观测平台,但最该记住的是论文自己承认的:视觉逼真和物理正确是两回事——位姿成功率 62.6% 和物理 IoU 0.592,一个像学霸,一个勉强及格。
小播:最该记住的数字是哪个?
老播:9 帧条件,IoU 从 0.332 到 0.592,失败率降到 2% 以下——条件帧数比模型规模更能干预物理表现。读这篇报告,带着「行为层强、机制层空」这个判断去读。