视频生成离世界模型有多远?一篇把「物理」变成可测量问题的论文
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
Sora 出来之后,大家反复问一个问题:视频生成模型算不算世界模型?它看懂物理了吗?这个问题难回答,因为真实视频里的「物理」没有标签。字节跳动、清华和 Technion 团队的这篇 ICML 2025 论文(arXiv 2411.02385)换了个做法:用 2D 经典力学模拟器生成一批物理规则已知的视频,把「懂物理」变成可以量化的误差。结论一句话:模型在训练分布内(ID)几乎完美,一旦测试条件超出分布(OOD),误差暴涨一两个数量级,加数据、加参数都无效——它更像一个「照着最近训练案例模仿」的检索器,没有抽象出物理法则。我们从头拆。
先看现象:ID 内接近满分,OOD 直接崩盘
作者用 Box2D 搭了三个确定性的物理任务:匀速直线运动、两球完全弹性碰撞、抛物线运动。每个任务采样 30K 到 3M 段视频,用 DiT 系列模型(从 22.5M 参数的 DiT-S 到 456M 参数的 DiT-XL)训练,条件给前 3 帧,生成 32 帧。
测试分两种:ID 在训练区间内采样,OOD 把速度、半径推到训练区间之外。 结果分化非常干净。
- ID:匀速任务上,DiT-L 配 3M 数据,速度误差 0.012,逼近真值视频解析出的系统下限 0.010;DiT-S 配 30K 数据是 0.022。误差随数据和模型规模稳步下降。
这是全篇最核心的否定结果:scaling 能压平 ID 误差,压不动 OOD 误差。数据量成倍地涨,模型一路加到 456M 参数,OOD 外推纹丝不动。图 3 一张图说清这件事。
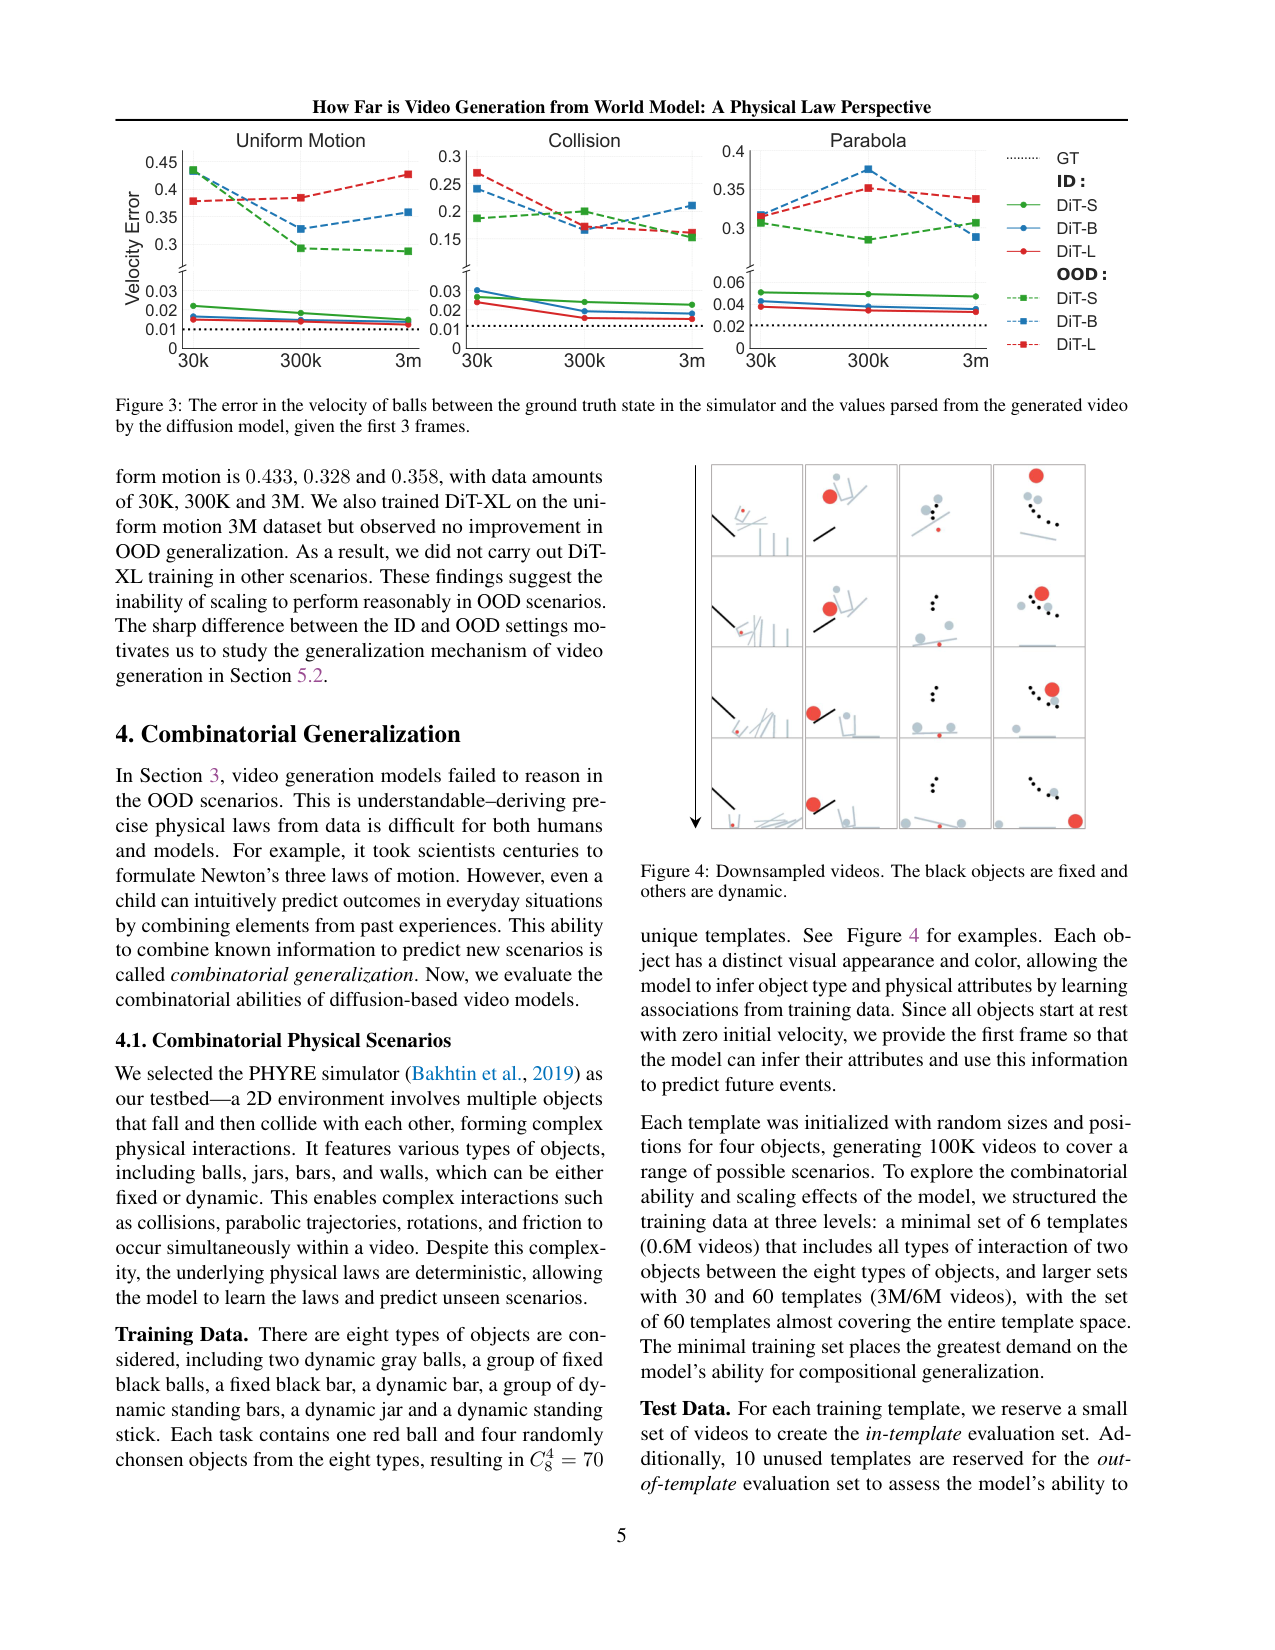
读图对比左右两列的高度差:左边 ID 稳步下降贴住系统下限,右边 OOD 高一到两个数量级还在随机跳动。这是「scaling alone 不足以发现物理法则」的直接证据。
核心概念:先把「物理一致」写成式子
为了让「模型懂不懂物理」可以讨论,论文先立了一个框架。视频生成模型的任务是:给定条件帧 $I_{1..c}$,生成后面的帧。把它拆成两步——先在 latent 空间里按动力学推进隐状态 $z$,再把 $z$ 渲染成像素:
$$z_{t+1} \approx z_t + \delta F(z_t), \quad I_t = R(z_t)$$
逐项看:$z_t$ 是第 t 帧的隐状态,$F$ 是隐空间里的动力学函数(物理法则就藏在它里面),$\delta$ 是时间步长,$R$ 是渲染器。生成模型要做的,等价于学一个 $F$,让它推出的 $z_{t+1}$ 和真实物理推进对上。
「对上」怎么度量?三个任务的物理都是解析的,真值速度 $v_t$ 可以直接算出来。再从生成视频的像素里按颜色提取球心位置、差分得到生成速度 $\hat{v}_t$,定义速度误差:
$$e = \frac{1}{N|T|}\sum_{i=1}^{N}\sum_{t\in T}\left|v_t^{(i)} - \hat{v}_t^{(i)}\right|$$
逐项看:$N$ 是测试视频数,$T$ 是帧集合,$v_t^{(i)}$ 是第 i 段视频第 t 帧的解析速度,$\hat{v}_t^{(i)}$ 是模型生成视频里对应的速度。这个 $e$ 就是「模型预测的物理」和「真实物理」的平均绝对偏差;它小到接近真值视频自身的解析误差(GT 下限),就算物理过关。训练目标本身还是标准的自回归式:最小化条件帧之后所有帧的负对数似然 $-\log p_\theta(I_{c+1..L}|I_{1..c})$——模型从未被要求显式预测物理量,误差全是从像素里逼出来的。
机制:模型在「模仿最近案例」,没有在「推理物理法则」
现象成立后,论文要回答:为什么 ID 行、OOD 不行?他们提出 case-based 泛化假说:给定条件帧,模型先找训练集里最接近的样本照着模仿,模仿时对不同属性给的权重不同。三个受控实验钉死这条链。
实验一:速度缺失区间。 训练集故意缺掉中间速度段 [1.25, 3.75]。如果模型懂「匀速」,条件帧给中间速度,它应该继续匀速;结果生成速度偏向训练区间的两端——它在匹配最近的训练案例,没有在按惯性定律外推。把缺口收窄,模型又恢复正确内插。
实验二:水平翻转。 训练里加入反向运动的视频后,低速球可能在条件帧后突然掉头——模型把反向训练视频当成了最接近的匹配,出现违反物理的转向。
实验三:成对优先级。 训练只有「红球 + 蓝方块」这种组合,测试给蓝球,蓝球在条件帧后立刻变成蓝方块——模型按颜色做案例匹配,形状被忽略。1,400 个测试例无一例外,最终排序钉死为:
$$\text{color} > \text{size} > \text{velocity} > \text{shape}$$
这条优先级解释了开放视频模型常见的翻车:物体形状保持不住、颜色却能稳住——颜色是检索时权重最高的属性,形状最不被尊重。
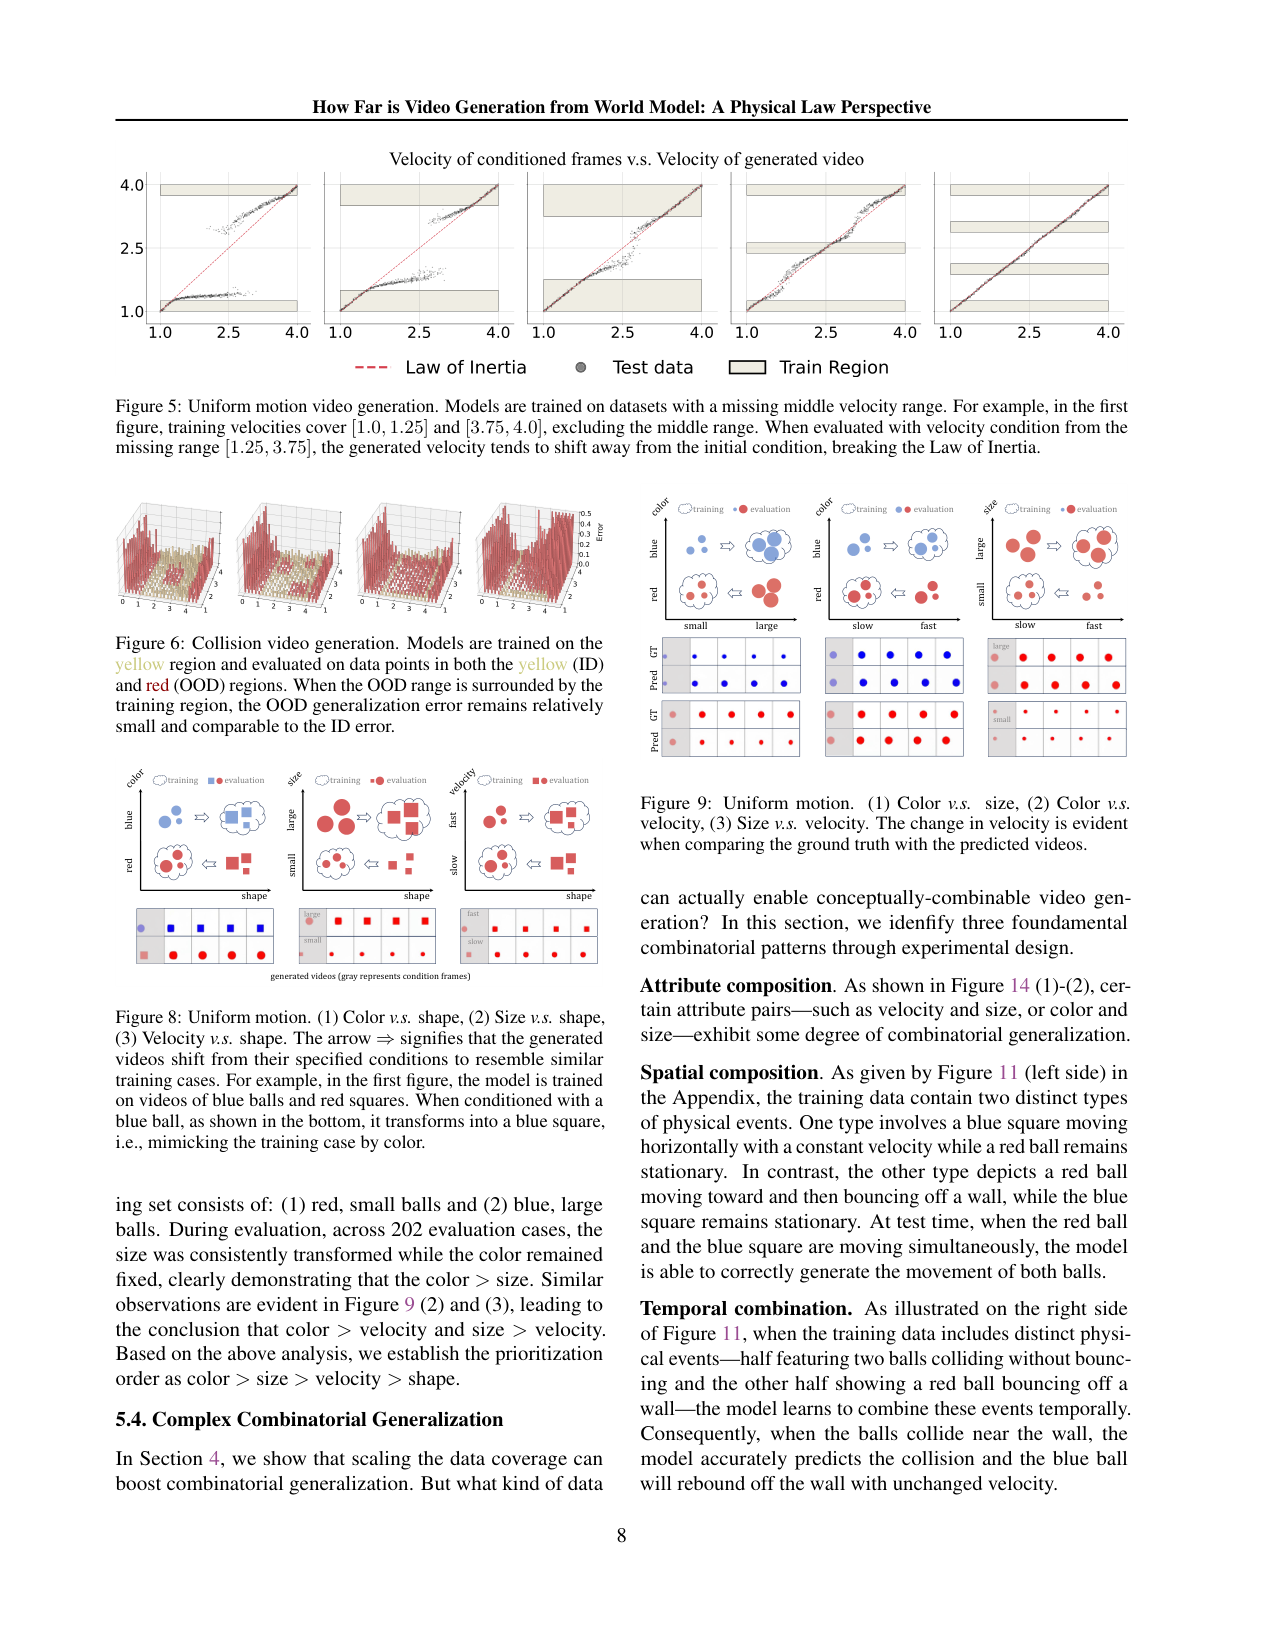
读图看条件帧到生成帧的属性跳变方向:箭头表示生成结果从指定条件滑向最近的训练案例,三列实验分别钉死了 shape 是最低优先级。
干预:动数据覆盖,比动数据总量更有效
如果机制是 case-based 检索,干预旋钮就该在「训练分布长什么样」上。作者确实从这里拿到了全篇最正面的收益。
干预一:扩大组合覆盖。 组合泛化场景用 PHYRE 的 8 类物体选 4 个,共 $C(8,4)=70$ 种模板。训练从 6 个模板(0.6M 视频)扩到 30、60 个模板(3M、6M 视频),模型、分辨率、训练步数都不变;10 名评估者判定 100 条保留模板视频,out-of-template 的 abnormal rate 从 67% 降到 18%、再降到 10%(DiT-XL)。模型规模同样重要:DiT-B 用同样 60 个模板只能到 24%。同样的数据量,把组合覆盖铺开,组合能力明显变好。
干预二:补回缺失区间。 只改训练分布的形状(把缺失的速度段补回一部分),不增加数据总量,模型从失败的外推转成正确的内插。
干预三:换 VAE。 把自研 (2+1)D-VAE 换成开源 CogVideo VAE,重跑优先级实验,排序 color > size > velocity > shape 不变——排除优先级是自研编码器的偶然产物。
三个干预都是单一变量对照,结果与「case-based 检索 + 数据覆盖决定可组合性」一致;如果模型真学到了抽象法则,OOD 应该随缩放改善,实际没有——这从反面又排除了一次法则假说。
代价与边界:这套结论现在能推多远
要诚实地说,边界非常清楚:
1. 全是 2D 简化场景。几何形状、纯色背景、一两个物体、Box2D 模拟,和真实视频的纹理、遮挡、非刚体、连续高维空间差距很大,向真实世界外推要谨慎。
2. OOD 只有诊断、没有方案。论文证明了「缩放无效」,但没有给出物理感知正则、显式状态这类干预路径——这一环是全文最弱的地方。
3. 机制证据是行为层的。case-based 检索和优先级排序来自生成结果的推断,没有激活、注意力这些模型内部证据,解释不了「为什么按这个顺序检索」。
4. 视觉表示有信息瓶颈。穿缝场景里,球和缝隙的尺寸差只有像素级时,纯视觉判断不了能不能穿过,模型给出视觉合理但物理错误的结果。
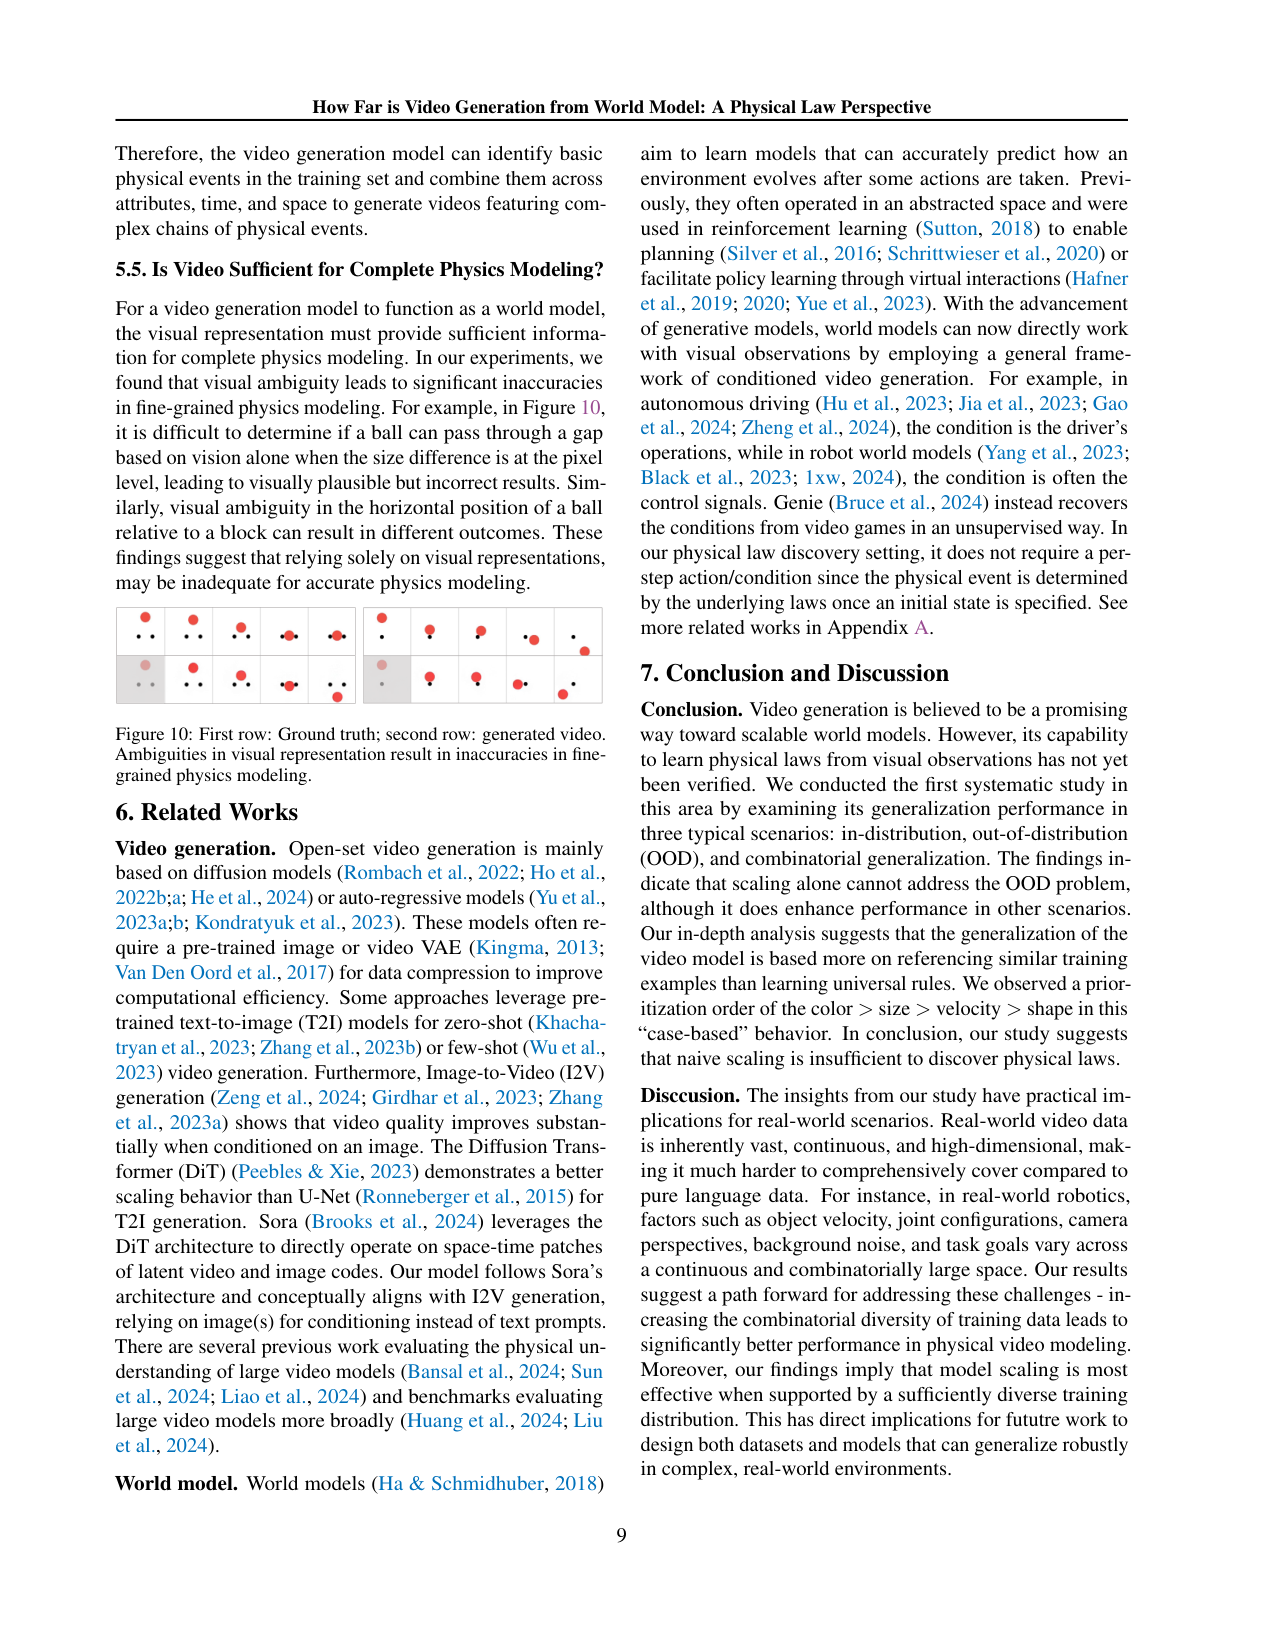
读图对比上下两行:从同样的像素出发,真值和生成给出不同结论——这支撑了「视觉表示不足以支撑精细物理建模」的边界判断。
一句话记住这篇
把「视频生成是不是世界模型」变成可量化问题之后,答案是:ID 内逼近系统下限(0.012 vs 0.010),OOD 外推误差高 35 倍且缩放无效(0.427);模型走 case-based 模仿(优先级 color > size > velocity > shape),扩大数据覆盖(abnormal 67% → 10%)比单纯加数据更有效。最该记住的保留态度:结论在 2D 简化场景里被严格验证,OOD 失败仍没有干预方案——把它当诊断,别当终局。
用 2D 经典力学模拟器把『视频生成模型是不是世界模型』变成可量化问题:ID 泛化随 scaling 逼近系统下限,OOD 外推误差高一到两个数量级且缩放无效;机制上模型走『基于案例』的模仿而非抽象法则,案例匹配时按 color > size > velocity > shape 的优先级参考训练数据——scaling alone 不足以发现物理法则。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:视频生成模型在训练分布内(ID)近乎完美预测物体运动,但测试条件一旦超出训练范围(OOD),速度预测误差比 ID 高一个数量级以上;增大数据量(30K→3M)和模型规模(22.5M→310M/456M)几乎不改善甚至随机波动 OOD 误差。
在哪里观测:自建 Box2D 2D 模拟器生成三组确定性物理任务:匀速直线运动、两球完全弹性碰撞、抛物线运动;每个任务 2–4 个自由度(初始速度/半径/质量),ID 区间内均匀采样 30K/300K/3M 视频;DiT-S/B/L/XL(22.5M/89.5M/310M/456M)在 32 张 A100、batch 256 上训练 100K steps;前 3 帧作条件,32 帧 128×128;OOD 测试在半径/速度超出训练范围处采样(约 2.4K–4.8K 例,六档 OOD 组合)。
如何量化:从生成视频像素按颜色提取球心位置,差分得速度,定义速度误差 e = (1/N|T|)ΣΣ|v_t − v̂_t|(v_t 为解析速度、v̂_t 为模拟器真值);以 Groundtruth 视频解析误差作为系统下限(匀速任务 GT≈0.010)。
② 机制假设
假设:视频生成模型没有抽象出通用物理法则,而是『基于案例』(case-based)泛化:给定条件帧,检索最接近的训练样本并模仿;检索时对不同属性赋予不同权重,形成 color > size > velocity > shape 的优先级。
证据:
- 速度缺失区间实验(Fig.5):训练集故意缺中间速度段 [1.25,3.75],条件帧给中间速度时,生成速度偏向训练区间两端——模型在『模仿最近案例』而非按惯性定律匀速运动;区间缺口收窄后转为正确插值。
- 水平翻转实验(Fig.7):训练加入反向运动(Set-2 w. flip)后,低速球可能在条件帧后突然反向——模型把反向训练视频当成了最接近匹配,出现违反物理的掉头。
- 成对优先级实验(Fig.8/9,1,400 测试例无例外):训练只有『红球+蓝方块』,测试给蓝球时,蓝球在条件帧后立即变成蓝方块——模型按颜色而非形状做案例匹配;完整排序 color > size > velocity > shape。
- 替换 VAE(CogVideo VAE,Fig.12/附录 D.1)重跑优先级实验,排序不变——排除自研 VAE 的偶然性。
备选解释:
- 数据记忆假说被组合泛化结果部分反驳:模型确实能在未见过的模板组合(60 模板外 10 个)上组合已知物理事件,说明存在一定程度的组合能力;因此『纯记忆』与『纯法则抽象』都不成立,case-based 检索+组合是中间态。
形式化/toy model:论文给出物理一致性框架:latent 动力学 z_{t+1} ≈ z_t + δF(z_t)、渲染 I_t = R(z_t),训练目标 −log pθ(I_{c+1..L}|I_{1..c});case-based 检索与优先级排序为行为层规律,未给出检索距离度量的内部形式化。
③ 局部干预
干预对象:训练数据组合覆盖(模板空间)
操作:把组合泛化训练集从 6 个模板(0.6M 视频)扩到 30/60 个模板(3M/6M 视频),覆盖 C(8,4)=70 种模板空间
效果:out-of-template 人工 abnormal rate 从 67% 降到 18%、再降到 10%
局部性:只动数据覆盖,模型(DiT-XL)、分辨率、训练步数不变
干预对象:训练数据缺失区间
操作:把缺失的速度区间逐步收窄或补回一部分,不增加数据总量
效果:模型从失败的外推转为成功的内插,OOD 预测误差显著下降
局部性:仅修改训练分布形状,验证『插值 vs 外推』通道
干预对象:视频 VAE 编码器
操作:把自研 (2+1)D-VAE 换成开源 CogVideo VAE,冻结 VAE 只训扩散部分
效果:优先级排序 color > size > velocity > shape 保持一致
局部性:替换感知压缩模块,验证优先级不是自研 VAE 的产物
因果验证:三个干预都做『单一变量』对照:组合覆盖只变模板数、缺失区间只变分布形状、VAE 替换只变编码器;结果与『case-based 检索 + 数据覆盖决定可组合性』的机制预测一致,且与『法则抽象』预测相悖(若真学到法则,OOD 外推应随缩放改善,实际没有)。
④ 工程收益
指标:out-of-template 人工 abnormal rate(组合泛化)
数值:67% → 10%(DiT-XL,6→60 模板)
基线:6 模板(0.6M 视频)时 67% 异常
设置:PHYRE 2D 场景,8 类物体选 4 个(70 模板),DiT-XL 256×256 32 帧,64 张 A100 训练 1000K steps;10 名评估者判 100 条保留模板视频
指标:out-of-template 人工 abnormal rate(模型规模对照)
数值:24%(DiT-B,60 模板)
基线:10%(DiT-XL,60 模板)
设置:同 60 模板数据,模型从 XL 缩到 B——模型容量同样重要
指标:ID 速度误差(匀速任务)
数值:0.012(DiT-L,3M 数据)
基线:Groundtruth 系统下限 0.010;DiT-S 30K 时为 0.022
设置:32 帧 128×128,前 3 帧条件,Box2D 匀速运动
指标:OOD 速度误差(匀速任务)
数值:0.427(DiT-L,3M 数据)
基线:同配置 ID 误差 0.012;30K/300K/3M 下误差随机波动无下降趋势
设置:速度/半径超出训练区间采样,与 ID 同模型同数据量
代价:收益只落在组合泛化这一档:OOD 外推仍是失败模式,scaling + 组合覆盖都救不了;像素级视觉表示存在信息瓶颈(Fig.10 穿缝歧义),纯视觉建模有下限;组合评估依赖人工判定,成本高且主观。
可迁移性:作者在附录对开源预训练模型(CogVideo、Stable Video Diffusion)做了部分验证:优先级排序稳健;但 ID/OOD 缩放结论未在真实大规模预训练模型上复测,向真实世界(纹理、遮挡、非刚体、连续高维空间)外推需谨慎。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中—强:现象(ID 好/OOD 差、缩放无效)有三任务×三数据量×三模型规模的系统证据;case-based 机制有缺失区间、翻转、成对优先级等受控实验支撑;但『case-based 检索』是行为层推断,没有模型内部的检索过程证据。 |
| 机制→干预 | 中(最弱一环):从机制推出的可干预旋钮(数据覆盖、分布形状)干预结果与预测一致;但优先级排序为何是 color > size > velocity > shape 没有机制层解释(未探测检索距离度量的构成),且对 OOD 失败没有提出可落地的干预方案。 |
| 干预→收益 | 中:组合多样性能把 abnormal 从 67% 压到 10%(有系统数据),模型容量也证实重要;但收益边界清楚——只对组合泛化有效,OOD 外推仍无解。 |
| 最弱一环 | 机制→干预:case-based 与优先级排序停留在行为规律层面,缺乏『模型内部为什么这么检索』的机制证据;论文对 OOD 失败只给出诊断(scaling 不够),未给出干预路径。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ID 速度误差(匀速运动) | 0.012(DiT-L 3M)→ 逼近 GT 系统下限 0.010 | DiT-S 30K 时 0.022 | Box2D 匀速运动,32 帧 128×128,前 3 帧条件,A100×32 训练 100K steps |
| OOD 速度误差(匀速运动) | 0.427(DiT-L 3M),约为 ID 的 35 倍 | 同配置 ID 0.012;30K/300K/3M 下误差随机波动(0.433/0.328/0.358) | 半径/速度超出训练区间;六档 OOD 组合(仅 r、仅 v、r&v、双球等) |
| 组合泛化 abnormal rate | 67% → 18% → 10%(DiT-XL,6/30/60 模板) | DiT-B 60 模板时 24% | PHYRE 8 类物体选 4(C(8,4)=70 模板),10 模板保留做测试,10 名评估者判 100 条视频 |
| 属性优先级排序 | color > size > velocity > shape | 1,400 个成对测试例无例外;CogVideo VAE 下排序不变 | 成对属性消融:训练只含两种属性组合,测试其余两种;逐对比较 color/size/velocity/shape |
Insights
- scaling 的收益有边界:把 ID 误差压到系统下限(0.012 vs 0.010)容易,OOD 误差(0.427)却与数据/模型规模无关——视频生成模型在 ID 上是模仿器,在 OOD 上不是物理学家。
- case-based 泛化 + 优先级排序(color>size>velocity>shape)解释了开放视频模型在形状保持/物体一致性上的翻车:模型按颜色优先检索训练案例,形状是最不被尊重的属性。
- 组合泛化是『中间地带』:数据覆盖组合空间(6→60 模板)比纯数据量更有效,对机器人/自动驾驶的数据策略有直接启示——多样性优先于总量。
- 纯视觉世界模型有信息下限:像素级歧义(能否穿过缝隙、遮挡位置)意味着仅靠视觉表示无法做精细物理建模(Fig.10)。
vs 同类工作
局限
- 实验全部在 2D 简化场景(几何形状、纯色背景、1–2 物体、Box2D 模拟),与现实视频的纹理/遮挡/非刚体/连续高维空间差距大,结论外推需谨慎。
- 模型全部从零训练、数据为模拟视频;对 Sora 等大规模预训练模型的物理理解上限,本文只验证了优先级排序(CogVideo/SVD),未验证 ID/OOD 缩放结论。
- case-based 机制与优先级排序是行为层观察,没有激活/注意力等模型内部证据解释『为什么按这个顺序检索』。
- 组合泛化评估依赖 10 名评估者的人工判定(100 条视频),主观且样本小;像素级指标(SSIM/PSNR/LPIPS)与物理正确性弱相关(6 模板时 PSNR 反而最高)。
- 对 OOD 失败没有提出改进方案(物理感知正则、符号约束、世界模型显式状态等),停留在诊断与数据策略建议。
可复现性
正文与附录给出完整数据生成(Box2D、ID/OOD 采样网格、六档 OOD 组合)、模型(DiT 尺寸表、VAE 冻结、RoPE 3D、mask 条件)、训练(A100×32/64、batch 256、100K/1000K steps)与评估(像素解析速度、FVD/SSIM/PSNR/LPIPS、人工 abnormal 协议)细节;项目页 phyworld.github.io 提供可视化;未在正文提供完整开源代码仓库链接。
ID 与 OOD 速度误差随数据/模型规模的变化(匀速/碰撞/抛物线)
原文 caption:The error in the velocity of balls between the ground truth state in the simulator and the values parsed from the generated video by the diffusion model, given the first 3 frames.
全篇最核心的否定结果:三行分别对应匀速、碰撞、抛物线三个任务,左列是 ID 误差、右列是 OOD 误差。ID 侧随数据量(30K→3M)和模型(DiT-S/B/L)增大稳步下降并贴近 GT 系统下限;OOD 侧不仅高一到两个数量级,而且随缩放随机波动、没有改善趋势。读图时对比左右两列的高度差,这是『scaling alone 不足以发现物理法则』的直接证据。
成对优先级实验:color > shape、size > shape、velocity > shape
原文 caption:Uniform motion. (1) Color v.s. shape, (2) Size v.s. shape, (3) Velocity v.s. shape. The arrow ⇒ signifies that the generated videos shift from their specified conditions to resemble similar training cases.
case-based 泛化的机制证据:训练只含『红球+蓝方块』等组合,测试时给蓝球,蓝球在条件帧后立刻变成蓝方块(按颜色匹配);同理红方块变红球。1,400 例无例外,说明模型做案例匹配时颜色优先于形状;三列分别钉死 shape 是最低优先级。读图看条件帧与生成帧的属性跳变方向,箭头表示从条件偏移到训练案例的方向。
视觉歧义导致精细物理建模出错(穿缝场景)
原文 caption:First row: Ground truth; second row: generated video. Ambiguities in visual representation result in inaccuracies in fine-grained physics modeling.
纯视觉世界模型的信息瓶颈:球与缝隙的尺寸差只有像素级时,仅凭视觉无法判断球能否穿过,模型给出视觉上合理但物理上错误的结果(球被卡住或穿过)。读图对比上下两行(真值 vs 生成),理解为什么论文认为视觉表示不足以支撑完整物理建模——这支撑了『需要显式状态或符号信息』的边界结论。
视频生成模型,到底懂不懂物理?(对话版)
小播:今天想聊一个特别火的话题——视频生成模型到底算不算世界模型?它真的懂物理吗?
老播:这篇 ICML 2025 的论文叫《How Far is Video Generation from World Model》,作者来自字节跳动、清华和 Technion。他们做了件很聪明的事:用 2D 经典力学模拟器,生成物理规则完全已知的视频,把「懂不懂物理」变成一个可以量化的误差。结论先说:模型在训练分布内几乎满分,一旦超出分布,误差暴涨一两个数量级,加数据、加参数都救不回来。
小播:等等,「超出分布」是什么意思?
老播:就是测试条件和训练条件不一样。比如训练里球的速度都在某个区间内,测试却给区间外的速度。我们先把实验设置讲清楚。
先看现象:ID 接近满分,OOD 直接崩
老播:他们用 Box2D 搭了三个任务:匀速直线运动、两球完全弹性碰撞、抛物线运动。训练数据从 3 万段到 300 万段不等,模型是 DiT 系列,小的 22.5M 参数,大的 456M 参数。给前 3 帧,生成 32 帧。
小播:结果呢?
老播:训练分布内,也就是 ID,表现非常好。匀速任务上,DiT-L 配 300 万段数据,速度误差是 0.012,逼近真值视频自身的解析误差 0.010,到系统下限了。但测试分布外,也就是 OOD,同样的模型和数据,误差跳到 0.427,是 ID 的 35 倍。
小播:35 倍?差距这么大。
老播:而且最要命的是,数据从 3 万涨到 300 万,误差随机波动,300 万的时候反而比 30 万还高;模型加到 456M 参数,也没有改善。这就是全篇最核心的否定结果:scaling 能压平分布内的误差,压不动分布外的误差。
小播:所以它看起来像是「背题」,没有在「解题」?
老播:这个说法很接近了,但论文给了一个更精确的机制解释:case-based 泛化。
机制:照着最近的训练案例模仿
老播:case-based 泛化的意思是:给定条件帧,模型先到训练集里找最接近的样本,照着模仿;模仿的时候,对不同属性的重视程度还不一样。
小播:这个「照着模仿」,有实验证据吗?
老播:有三个。第一个是速度缺失区间实验:训练集故意缺掉中间速度段,条件帧给中间速度,如果模型懂匀速定律,它应该继续匀速走;结果生成速度偏向训练区间的两端——它在匹配最近的训练案例,没有在按惯性定律外推。把缺口收窄,它又能正确内插了。
小播:这确实像是模仿,而不是在推理。
老播:第二个实验更有意思,水平翻转:训练里加入反向运动的视频之后,低速球可能在条件帧后突然掉头,模型把反向视频当成了最接近的匹配。第三个是成对优先级实验:训练只有「红球加蓝方块」,测试给蓝球,蓝球在条件帧后立刻变成蓝方块——按颜色匹配,形状被忽略。
小播:所以它优先看颜色,不看形状?
老播:对,1,400 个测试例无一例外,排序是颜色大于大小、大于速度、大于形状。这个排序还解释了开放视频模型常见的翻车:物体形状保不住,颜色却能稳住。他们后来把自研的 VAE 换成开源的 CogVideo VAE,排序不变,说明这不是编码器的偶然产物。
小播:那这个机制能被干预吗?总得有点正面的收获吧。
干预:动数据覆盖,比动数据总量更有效
老播:有,这篇最正面的收益在组合泛化上。他们用 PHYRE 场景,8 类物体选 4 个,一共 70 种模板组合。训练从 6 个模板扩到 30 个、再到 60 个,模型和训练步数都不变,10 名评估者判定 100 条视频。
小播:效果呢?
老播:out-of-template 的 abnormal rate 从 67% 降到 18%,再降到 10%。模型规模也重要,同样的 60 个模板,小一号的 DiT-B 只有 24%。所以结论是:同样的数据量,把组合覆盖铺开,比单纯加数据更有效。
小播:这个对做数据策略的人很有用。那这套结论能直接用到真实视频上吗?
老播:要泼一盆冷水,论文自己也很诚实。第一,实验全在 2D 简化场景,几何形状、纯色背景,和真实视频的纹理、遮挡差距很大。第二,OOD 失败只有诊断、没有方案,论文证明了缩放无效,但没给出物理感知正则、显式状态这类干预路径,这是最弱的一环。第三,case-based 检索和优先级排序是行为层的推断,没有模型内部的证据。
小播:还有别的边界吗?
老播:还有一个很有意思的点:穿缝场景里,球和缝隙的尺寸差只有像素级,纯视觉判断不了能不能穿过,模型给出视觉合理但物理错误的结果。这说明纯视觉世界模型存在信息下限,可能需要显式状态或符号信息。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:把「视频生成是不是世界模型」变成可量化问题之后,答案是:分布内逼近系统下限,分布外误差高 35 倍且缩放无效;模型走的是「照着最近案例模仿」的路,优先级是颜色大于大小、大于速度、大于形状;扩大数据覆盖能把组合泛化的异常率从 67% 压到 10%。
小播:那最该保留的怀疑是什么?
老播:结论全在 2D 简化场景里验证,OOD 失败还没有干预方案——把它当诊断,别当终局。