PILD:把物理约束写成一条「残差为零」的拉普拉斯虚拟观测
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。来源:arXiv:2601.21284v2(34 页,2026-07-23),上海交大 / UT Austin / 浙大 / 同济 / UW-Madison 合作。
先看一个现象:扩散模型生成的样本很漂亮,但纯数据驱动的模型不守物理定律。车辆跟踪任务里,DDPM 的预测轨迹随时间累积误差、逐渐偏离真值;等离子体预测任务里,DDPM 的密度误差是 0.122±0.020(×10¹⁹),温度误差 1.766±0.284(eV),都明显高于任何显式注入物理约束的方法。这篇论文(PILD)的主张很直接:把「物理约束」重述为一条拉普拉斯分布的虚拟残差观测 r̂=0,注入扩散训练目标,再配一个 Jensen-gap 感知的自适应残差尺度,在 ODE/PDE/代数/不等式四类约束、四个基准上把物理残差与预测误差压到所有基线之下。要理解为什么这么改有用,得从「精确的物理目标为什么算不出来」讲起。
先看现象:数据驱动扩散模型为什么「越界」
论文用四个基准加一个 toy 把现象钉住,全部使用任务专用 DiT backbone(Tables 6-9):
- 车辆跟踪(Ackerman ODE 一步转移模型,Wang et al. 2025b 驾驶数据,downtown/rural 两工况,增量式预测):DDPM 的轨迹误差随时间累积、偏离真值(Figure 2),位置误差 9.653m,是 PILD 的 4.796m 的两倍。
一个取数提醒:论文里所有 ± 值都是单模型评估的样本级标准差(Table 12 注释明确),不是多随机种子统计,这是后面讨论证据强度时的前提。
机制假设:约束即似然,偏差即方差
核心构造是把「残差为零」建模为一个虚拟观测。设 $R(x_0)$ 是物理残差算子(Darcy 任务里取 $R(k,p)=-\nabla\cdot(k\nabla p)-f$),则虚拟观测的似然是:
$$q_R(\hat r \mid x_0) = \mathrm{Laplace}\!\left(\hat r;\ R(x_0),\ b_t I\right),\qquad \hat r = 0$$
其中 $b_t$ 是残差尺度(与扩散噪声强度成比例),$x_0$ 是干净状态。选拉普拉斯分布的理由有三个:重尾对离群点鲁棒、惩罚等价于 ℓ1 形式、梯度 log-凹好优化(A.3)。这一步把「外挂正则」升级成了与数据似然统一进同一个变分目标的概率观测。
但精确的物理目标要对后验 clean-state 做 log-边缘化,在带噪的 latent state 下产生两类近似缺口。论文用二阶累积量展开把缺口写了出来(A.2.3):
$$L^{\mathrm{true}}_{\mathrm{phys}}(t) \approx \frac{\mu_t}{b_t} - \frac{\sigma_t^2}{2\, b_t^2}, \qquad \Delta_t \approx \frac{\sigma_t^2}{2\, b_t^2}$$
这里 $\mu_t = \mathbb{E}[\|R(x_0)\|_1 \mid x_t, O]$ 是条件残差均值,$\sigma_t^2$ 是条件残差方差,$\Delta_t$ 就是 log-边缘化的 Jensen 型偏差——它由「残差的条件方差」主导,噪声越大、偏差越大。第一类缺口是后验代表点缺口 $R(\mathbb{E}[x_0]) \neq \mathbb{E}[R(x_0)]$,用两步 DDIM 估计的 $x_0^{\ast}$ 缓解(训练与推理共用同一套两步反推)。第二类缺口对应自适应残差尺度:
$$\tilde b_t = b_t + \frac{\bar\sigma_t^2}{2\,(\bar\mu_t + \varepsilon)}$$
其中 $\bar\mu_t,\bar\sigma_t^2$ 是 minibatch 残差矩经 EMA(动量 $\rho\in[0,1)$)稳定后的估计,$\varepsilon$ 是数值稳定常数。这个式子的意思是:条件残差方差越大,就把残差尺度放得越大,吸收掉二阶偏差,同时保持残差惩罚的正形式。物理损失最终写成 $L_{\mathrm{phys}}(t) = \frac{1}{\tilde b_t}\|R(x_0^{\ast})\|_1$,叠加到扩散损失上(λ_t 是 Min-SNR 权重)。条件任务还加一项 physics-conditional alignment:frozen MAE 编码观测 $O$ 得目标 $u_O$,中间 DiT 层的池化表示 $z^{(l)}$ 与它做 stop-gradient 余弦对齐($\lambda_{\mathrm{align}}=0.01$)。理论一致性由附录命题保证:若目标数据满足 $R(x_0)=0$,扩展的 score-matching 目标不改变最优分数场,物理项只是把采样钉在物理流形上。
验证:同 backbone 消融逐级单调
机制给完,论文用同 backbone 消融把链条钉住(Table 4,plasma 密度误差 / tire eF 三工况平均):DiT only 0.122/734.007 → +Gaussian 残差 0.102/723.252 → +Laplace(无 Jensen)0.088/713.044 → +Laplace(有 Jensen)0.081/702.430 → +Alignment alone 0.083/719.795 → Full model 0.074/695.494。每一步都在两个任务上同向改进,说明收益来自三个组件的叠加。注意两个细节:Laplace 与 Jensen 校正各自贡献约 0.01 的密度误差改进,而 alignment 单独加反而略差(0.083 劣于 0.081),只有与概率残差组合才最优。
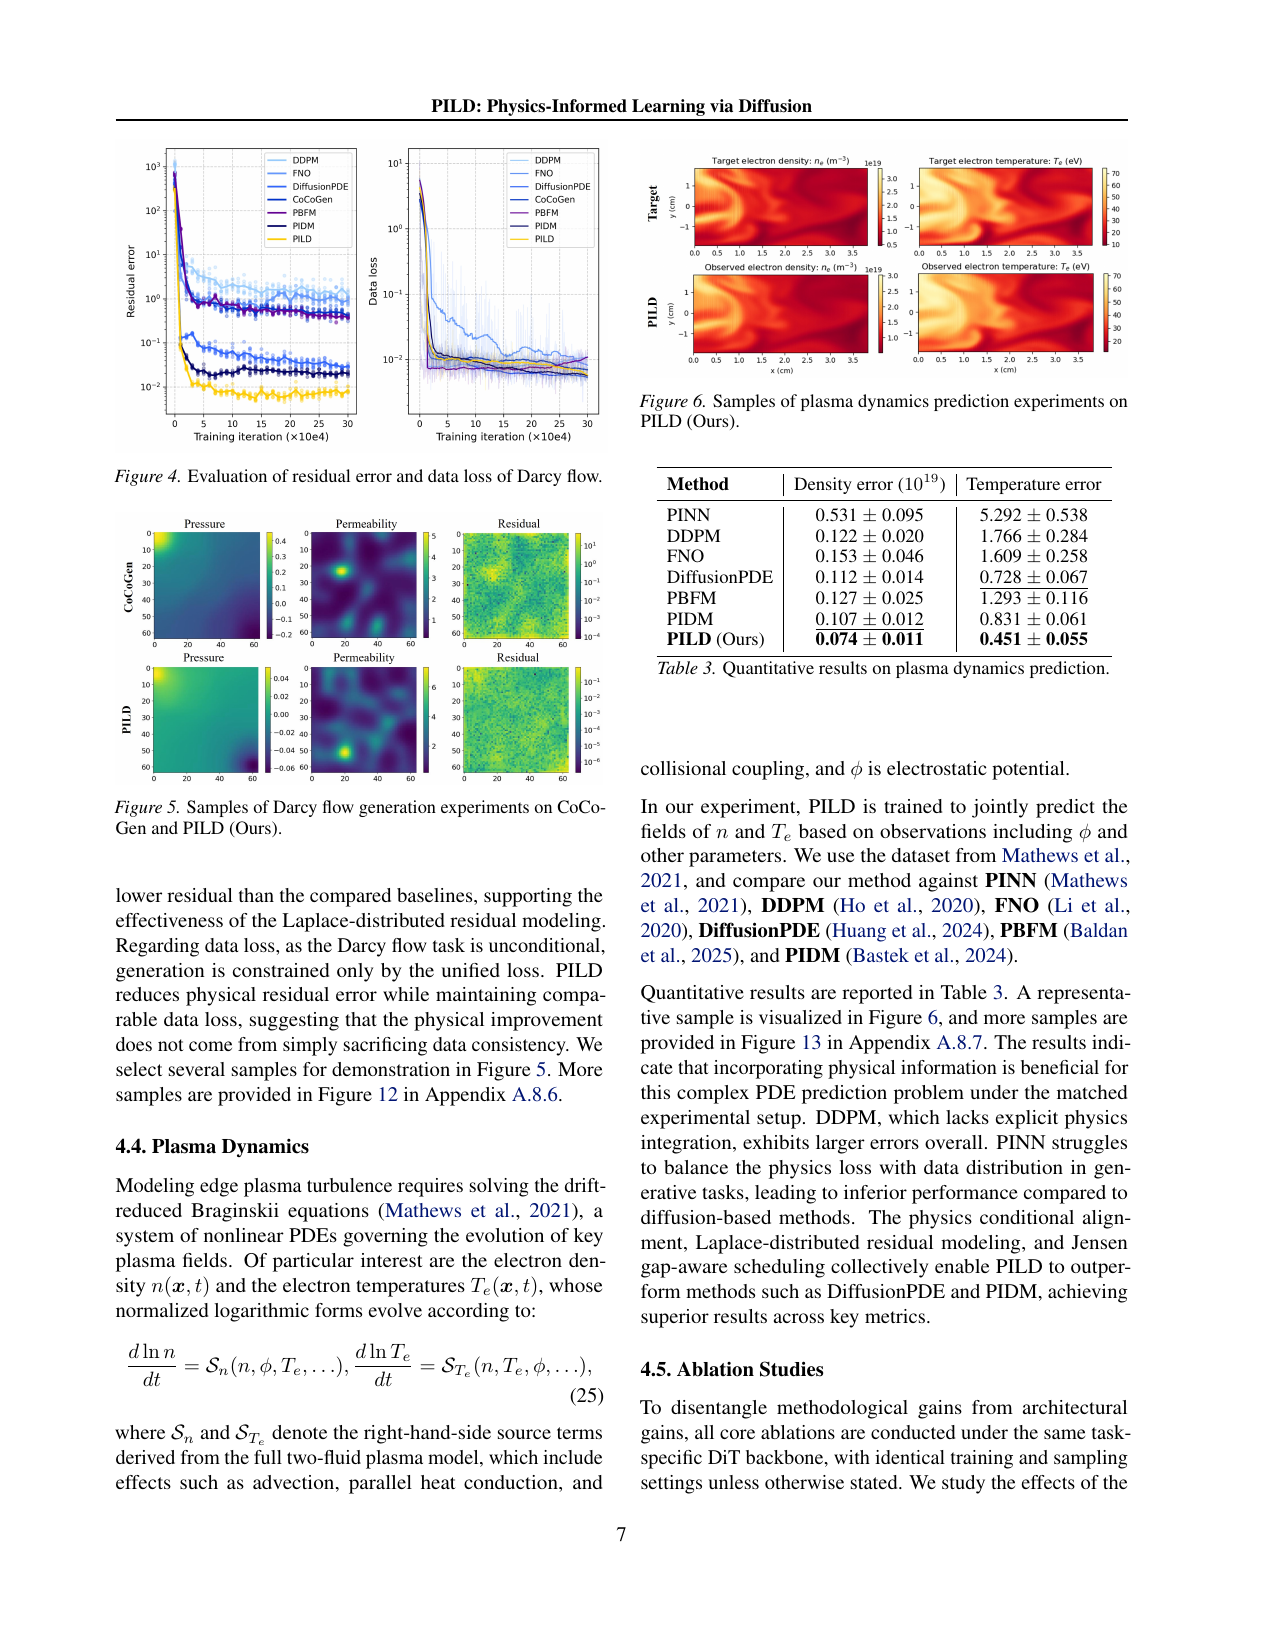
Figure 4 是收益环的核心证据:在无条件生成 k/p 联合场的 Darcy 任务(64×64 网格,$-\nabla\cdot(k\nabla p)=f$)上,PILD 把物理残差压到全部基线之下,同时 data loss 与其他方法基本持平——物理改进来自约束注入,而不是牺牲数据一致性。读图时左右两组柱分开看:左边残差越低越好,PILD 最低;右边数据损失越平越好,PILD 没有掉队。
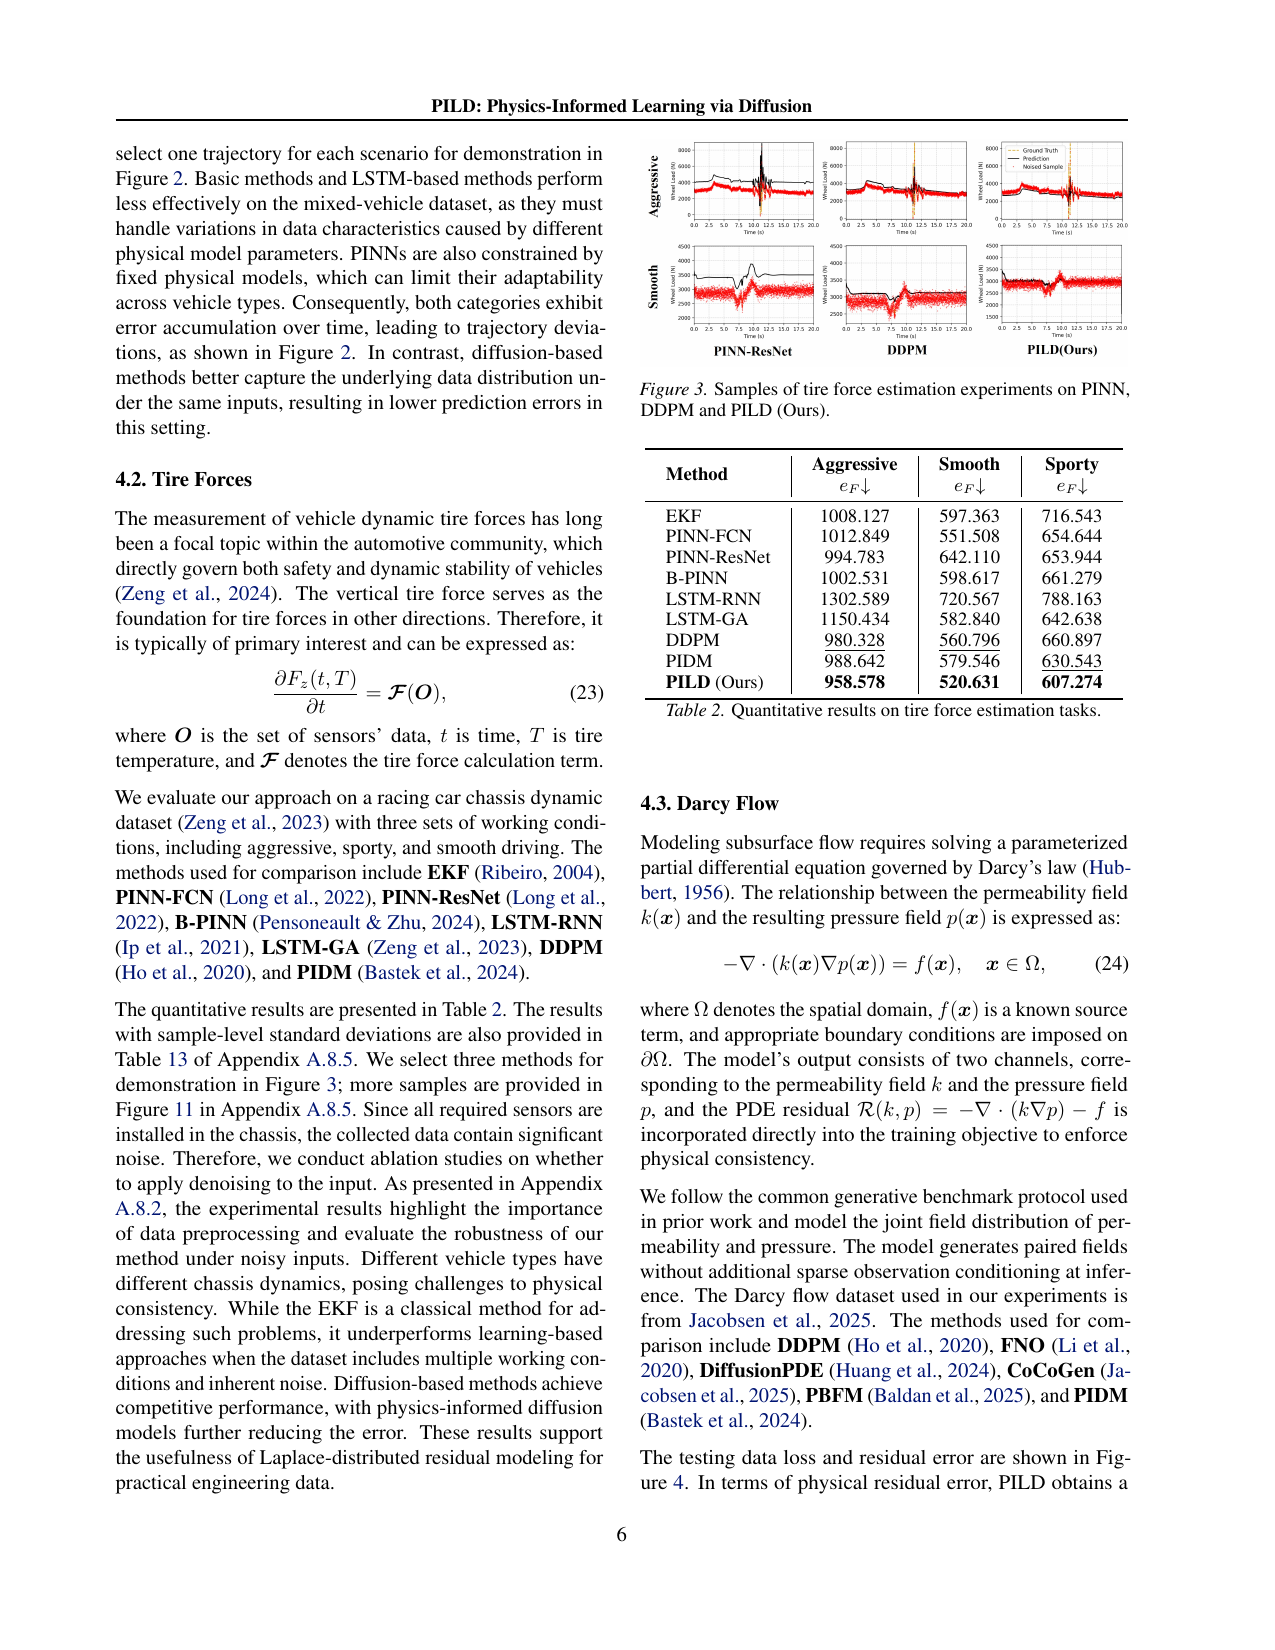
Figure 2 把「现象→收益」放进同一张图:增量式轨迹预测中,纯数据驱动的 DDPM 越推越偏,注入物理约束的 PILD 始终贴近真值轨迹。定量上 PILD 三项误差(位置/航向/速度)全面低于最佳基线 DDPM:downtown 4.796/5.391/3.048 vs 9.653/6.109/4.317,rural 3.562/5.837/3.033 vs 4.697/7.138/4.936(Table 1,EKF 基线为 6.602/6.930/5.476 与 6.179/6.241/5.512)。
收益与代价:四任务全优,但证据强度有限
- plasma:PILD 密度误差 0.074±0.011、温度误差 0.451±0.055,对照 PIDM 0.107±0.012 / 0.831±0.061、DiffusionPDE 0.728±0.067(温度)、DDPM 0.122±0.020 / 1.766±0.284(Table 3)。
诚实的代价有四点。第一,Jensen gap 只被缓解、没有被严格消除:二阶展开截断了三阶累积量项(A.2.3),论文在 §5 自认这是 future work。第二,主表对比是系统级而非受控:PIDM/DiffusionPDE 用 U-Net、PILD 用 DiT(A.8.1),Table 1-3 的增益混合了架构差异;同 backbone 消融(Table 4)的组件差异小、无显著性检验、无多 seed。第三,无代码、无数据链接、无 seed 级统计,「为什么约束注入有效」缺过程级归因——论文没有报告 $\tilde b_t$/$\sigma_t^2$ 的训练动力学,没有隔离验证自适应尺度、Laplace 重尾、DDIM 代表点各自的因果贡献,这是闭环里最弱的一环。第四,框架前提是训练数据在概率意义上符合物理定律,数据系统性违背物理时框架会失效。
一句话记住这篇
物理约束可以写成一条「残差为零」的拉普拉斯虚拟观测:精确目标算不了,就用自适应尺度 $\tilde b_t = b_t + \bar\sigma_t^2/(2(\bar\mu_t+\varepsilon))$ 吸收 log-边缘化的 Jensen 偏差,条件残差方差越大、尺度放得越大。结果是在同一 backbone 下把 plasma 密度误差从 0.122(DiT only)压到 0.074,四个基准的残差与预测误差全面最优,推理 0.08s 反而快于 DDPM 的 4.5s。最该记住的保留态度是:消融梯度单调、方向一致,但 Jensen gap 只是被缓解,缺机制级归因与多 seed 统计——「为什么有效」这一环还没有被真正闭合。
把『物理约束』重述为拉普拉斯分布的虚拟残差观测(r̂=0)注入扩散训练,再用 Jensen-gap 自适应残差尺度校正 noisy latent state 下的边缘化偏差、用 frozen MAE 对齐中间层与观测条件,在 ODE/PDE/代数/不等式四类约束上把物理残差与预测误差整体压到所有基线之下——但『约束注入为何有效』只有消融梯度与理论推导,缺过程级机制归因。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
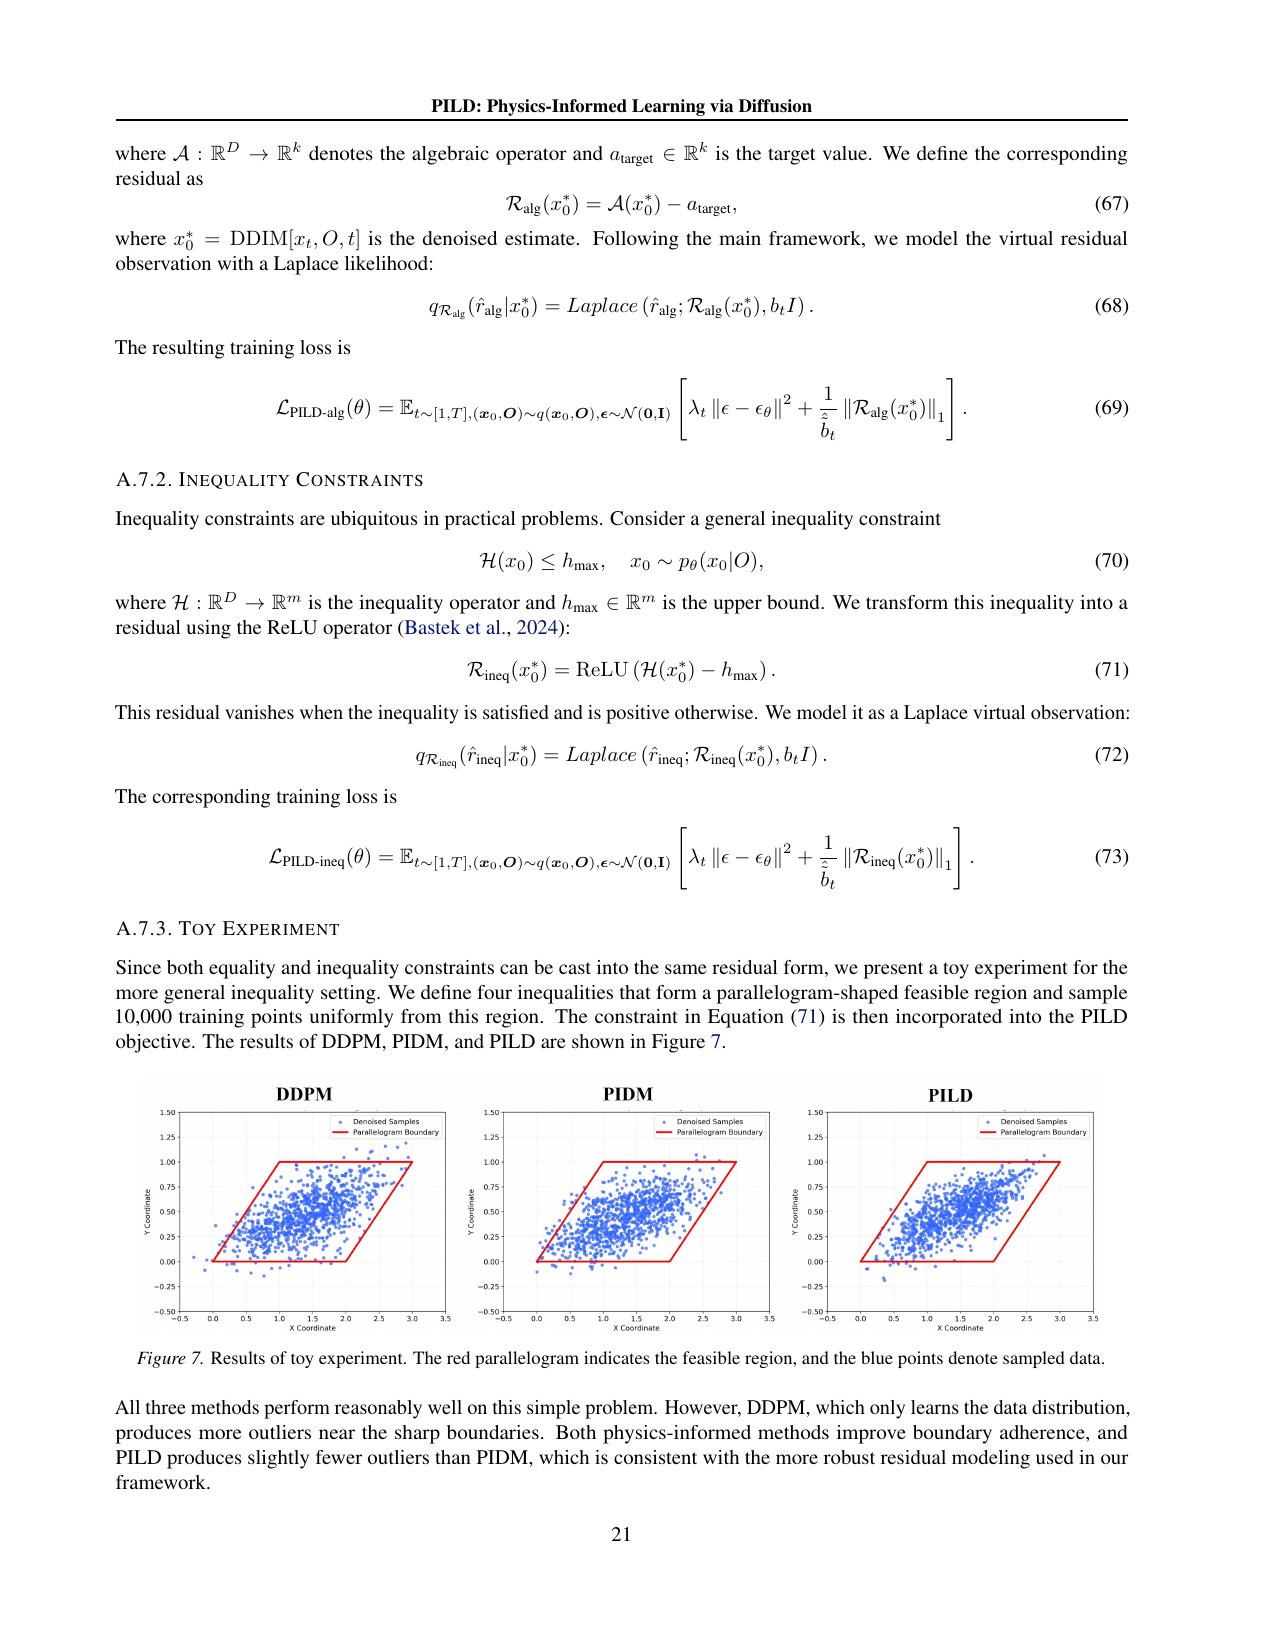
观测到什么:纯数据驱动的扩散生成模型(DDPM/DiT)生成的样本不遵守物理定律:预测误差与物理残差明显高于任何显式注入物理约束的方法。量化证据:plasma 任务 DDPM 密度误差 0.122±0.020、温度误差 1.766±0.284(Table 3, p7);tire force 任务纯 DiT(DDPM only) 三工况平均 eF=734.007(Table 4, p8);tracking 任务 DDPM 轨迹误差累积、偏离真值(Figure 2, p6);toy experiment 中只学数据分布的 DDPM 在可行域(平行四边形)边界产生明显更多离群点(A.7.3 Figure 7, p21)。
在哪里观测:4 个基准 + 1 个 toy,全部使用任务专用 DiT backbone(Tables 6-9, p18-19):(1) 车辆跟踪——Ackerman ODE 一步转移模型(Eq 22),Wang et al. 2025b 驾驶数据集,downtown/rural 两种工况,增量式轨迹预测;(2) 轮胎力估计——赛车底盘数据(Zeng et al. 2023),∂Fz/∂t=F(O) 模型(Eq 23),aggressive/smooth/sporty 三工况,含显著传感器噪声;(3) Darcy flow——无条件生成 k、p 联合场,−∇·(k∇p)=f(Eq 24),Jacobsen et al. 2025 数据集,64×64 网格;(4) plasma dynamics——drift-reduced Braginskii PDE(Eq 25),Mathews et al. 2021 数据集,由 φ 等观测条件联合预测电子密度 n 与温度 Te。
如何量化:物理残差算子 R(x):Darcy 用 R(k,p)=−∇·(k∇p)−f 直接进训练目标(p6-7);任务误差指标——plasma 密度误差(×10¹⁹ 单位)与温度误差(eV),tire 为轮胎载荷偏差 eF(N,三工况平均),tracking 为 ex&y(m)/eψ(deg)/evx(km/h)三项;toy 用可行域边界离群点数(定性,无定量数字)。所有 ± 值均为单模型评估的样本级标准差(Table 12 注释明确:± across evaluated trajectories or generated samples in a single trained-model evaluation, p25),非多 seed 统计。
② 机制假设
假设:物理约束可以被概率化地注入扩散训练:把『残差为零』建模为一个虚拟观测 r̂=0,其似然 qR(r̂|x0)=Laplace(r̂; R(x0), btI)(Eq 2, p3),残差惩罚因此获得『重尾鲁棒 + ℓ1 形式 + log-凹梯度』的概率解释(A.3, p16)。但在 noisy latent states 下,精确物理目标 Ltrue_phys(t)=−log E[exp(−‖R(x0)‖₁/bt)|xt,O](Eq 7, p3)需要对后验 clean-state 做 log-边缘化,产生两类近似缺口:后验代表点缺口 R(E[x0])≠E[R(x0)](Eq 5, p3,用两步 DDIM 估计 x*_0 缓解),以及二阶累积量展开导出的 Jensen 型偏差 Δt≈σt²/(2bt²)(Eq 9-10, p3),后者用 Jensen-gap 感知的自适应残差尺度 b̃t=bt+σ̄t²/(2(μ̄t+ε)) 吸收(Eq 11/14, p3-4)。条件任务另加 physics-conditional alignment:frozen MAE 编码观测 O 得目标 uO,中间 DiT 层池化表示 z(l) 与其余弦对齐(Eq 17-20, p4),保持去噪过程中间表征与观测条件一致。
证据:
- 理论一致性:命题(A.2.2, p14)——若目标数据满足 R(x0)=0,扩展的 score-matching 目标(Eq 42)不改变最优分数场,求解逆 SDE 仍生成 q(x0),物理项只是把采样钉在物理流形上。
- 推导自洽:二阶累积量展开得到 Ltrue_phys ≈ μt/bt − σt²/(2bt²)(Eq 51-52, A.2.3, p14-15),证明偏差由条件残差方差 σt² 主导,这是自适应尺度的直接动机。
- 近似合理性:KL(q, pθ) 在前 2k iterations 降超 3 个数量级(5.210e+01 → 3.446e-03),100k 时 3.103e-04(Table 5, p17),支撑『用 q 的轨迹近似 pθ 轨迹』的推导前提。
- 消融梯度(同 backbone):+Laplace w/ Jensen (0.081 / 702.430) < +Laplace w/o Jensen (0.088 / 713.044) < +Gaussian (0.102 / 723.252) < DiT only (0.122 / 734.007)(density error / tire eF,Table 4, p8),Laplace 与 Jensen 校正各自带来单调改进。
备选解释:
- 增益可能主要来自『任何显式物理惩罚』而非概率化/Jensen 校正:Table 4 里 w/o Jensen 相对 Gaussian 已改进(0.088 vs 0.102),Jensen 校正的边际增益很小(0.081 vs 0.088;702 vs 713),且无显著性检验/多 seed,无法排除训练噪声。
- 系统级对比混合了架构差异:主表(Table 1-3)中 PIDM 是 U-Net 实现、PILD 是 DiT(A.8.1, p22),部分增益可能来自 backbone 而非方法本身;作者仅靠同 backbone 消融补救。
- 对齐机制单独加反而劣于 +Laplace w/ Jensen(0.083/719.795 vs 0.081/702.430,Table 4, p8),『对齐是必要条件』的机制地位存疑,更可能是组合效应。
- Laplace 优于 Gaussian 的解释(重尾鲁棒、ℓ1 形式,A.3, p16)是论点式论证,没有在控制方差/尺度下做统计验证。
形式化/toy model:虚拟残差观测:r̂=0,qR(r̂|x0)=Laplace(r̂; R(x0), btI),bt=Bt/c(Eq 2/6, p3);精确物理负对数似然 Ltrue_phys(t)=−log E_{x0~pθ(·|xt,O)}[exp(−‖R(x0)‖₁/bt)](Eq 7, p3);二阶展开 ≈ μt/bt − σt²/(2bt²),偏差 Δt≈σt²/(2bt²),其中 St=‖R(x0)‖₁、μt=E[St|xt,O]、σt²=Var(St|xt,O)(Eq 8-10, p3);minibatch 插件统计 μ̂t、σ̂t²(Eq 12-13, p4)经 EMA μ̄t=ρμ̄t+(1−ρ)μ̂t、σ̄t²=ρσ̄t²+(1−ρ)σ̂t²(Eq 57-58, p15)得有效尺度 b̃t=bt+σ̄t²/(2(μ̄t+ε))(Eq 14/59, p4/p15);训练损失 Lbase=E_{t,(x0,O),ϵ}[λt‖ϵ−ϵθ‖² + (1/b̃t)‖R(x*_0)‖₁],x*_0=DDIM[xt,O,t] 两步估计(Eq 16/65, p4/p17,λt 为 Min-SNR 权重);条件对齐 Lalign=1−⟨z(l), sg[uO]⟩/(‖z(l)‖‖sg[uO]‖),uO=fMAE(O),LPILD=Lbase+λalign·Lalign(Eq 17-21, p4);代数约束 Ralg=A(x*_0)−atarget(Eq 67, p20)、不等式约束 Rineq=ReLU(H(x*_0)−hmax)(Eq 71, p21)以同一 Laplace 似然框架接入。
③ 局部干预
干预对象:扩散训练目标中的物理项:从固定/时间步耦合惩罚改为 Laplace 虚拟残差观测 + Jensen-gap 自适应尺度
操作:Lphys=(1/b̃t)‖R(x*_0)‖₁,b̃t=bt+σ̄t²/(2(μ̄t+ε)) 由 timestep-wise minibatch 残差矩经 EMA(ρ∈[0,1))稳定后计算(Eq 12-16, p3-4);DDIM 两步估计 x*_0 提供 clean-state 代表点(Eq 5, p3;A.5, p17)。
效果:4 个基准的物理残差与预测误差全部降至最低:plasma 密度误差 0.074 vs PIDM 0.107(Table 3, p7);tire 三工况全胜 DDPM/PIDM(Table 2, p6);tracking 三项误差全面低于最佳基线 DDPM(Table 1, p5);Darcy 残差低于全部基线且 data loss 持平(Figure 4, p7)。
局部性:只改训练损失的物理项,扩散 backbone、噪声调度、采样过程不变;但 b̃t 依赖全局 minibatch 统计(非逐样本局部量),且 Laplace 假设 R 的残差统计是重尾的,对非 ℓ1 适配的算子需重映射。
干预对象:条件任务中间 DiT 层表征(层索引 l 按任务配置,Tables 6-9 的 Alignment layer S)
操作:池化 H(l) 经轻量投影头 gφ 得 z(l),与 frozen MAE 编码器输出的 uO=fMAE(O) 做 stop-gradient 余弦对齐:Lalign=1−⟨z(l), sg[uO]⟩/(‖z(l)‖‖sg[uO]‖),λalign=0.01(Eq 17-21, p4)。
效果:单独加入无稳定增益(0.083/719.795,甚至劣于 +Laplace w/ Jensen 的 0.081/702.430),与概率残差公式组合后全模型最优(0.074/695.494)(Table 4, p8)——是协同组件而非独立收益源。
局部性:只在单一中间层注入、MAE 编码器 frozen 防目标漂移(A.5, p19);仅条件任务(tracking/tire/plasma)使用,无条件任务 Darcy 不适用。
干预对象:clean-state 代表点估计:训练残差评估与最终生成共用两步 DDIM 反推
操作:x*_0=DDIM[xt,O,t](训练)与 xT→x1→x0 两步采样(推理,Algorithm 1, p20),缓解 R(E[x0])≠E[R(x0)] 的后验代表点缺口(Eq 5, p3)。
效果:训练时残差评估与推理都只需 2 步反推;推理时间 0.08s,反而低于 DDPM 的 4.5s(Table 11, p23)。
局部性:网络与采样流程内部改动,不改变目标定义;代价是 x*_0 仍是近似代表点而非严格后验样本(论文自认,p3)。
因果验证:同 backbone 逐步消融(Table 4, p8):DiT(DDPM only) → +Gaussian → +Laplace w/o Jensen → +Laplace w/ Jensen → +Alignment alone → Full model,在 plasma(density error)与 tire(eF 三工况平均)两个任务上方向一致:0.122→0.102→0.088→0.081→0.083→0.074 与 734.007→723.252→713.044→702.430→719.795→695.494;另做扩散步数 20/50/100 消融(0.095/0.089/0.074,820.793/702.538/695.494)。局限:无显著性检验、无多 seed、无 b̃t/σt² 训练动力学报告,『Laplace+Jensen+alignment 各自贡献多少』只能靠趋势方向判断,alignment 单独无效使该组件因果归属含糊。
④ 工程收益
指标:plasma 密度误差(×10¹⁹)
数值:0.074±0.011(PILD)
基线:最佳基线 PIDM 0.107±0.012(DDPM 0.122±0.020,-39%)
设置:drift-reduced Braginskii,Mathews et al. 2021 数据集,Table 3, p7
指标:plasma 温度误差(eV)
数值:0.451±0.055(PILD)
基线:最佳基线 DiffusionPDE 0.728±0.067(PIDM 0.831±0.061,-46%)
设置:同上,Table 3, p7
指标:tire force eF(N,三工况)
数值:958.578 / 520.631 / 607.274(PILD)
基线:DDPM 980.328/560.796/660.897,PIDM 988.642/579.546/630.543
设置:Zeng et al. 2023 赛车底盘数据,Table 2, p6
指标:tracking 误差(ex&y/eψ/evx)
数值:downtown 4.796/5.391/3.048;rural 3.562/5.837/3.033(PILD)
基线:最佳基线 DDPM 9.653/6.109/4.317;4.697/7.138/4.936
设置:Wang et al. 2025b 数据集,增量轨迹预测,Table 1, p5
指标:Darcy flow 物理残差
数值:低于全部基线,data loss 与基线持平(Figure 4 曲线,无表格数值)
基线:CoCoGen/PBFM/PIDM/DiffusionPDE/FNO/DDPM
设置:无条件生成 k/p 联合场,Jacobsen et al. 2025 数据集,Figure 4, p7
指标:完整模型 vs 纯 DiT(同 backbone)
数值:density 0.074 vs 0.122(-39%);tire eF 695.494 vs 734.007(-5.2%)
基线:DiT(DDPM only) 基线
设置:Table 4, p8
代价:训练开销高于纯扩散:tracking PILD 35min / 2.6G 显存 vs DDPM 22min / 2.1G(Table 11, p23);Darcy 与 PIDM 持平(8h / 3.2G);推理反更低(0.08s vs DDPM 4.5s,两步 DDIM)。工程附加成本:每个条件任务需单独自监督预训练 MAE 编码器(mask ratio 0.5/0.75)并冻结;λalign=0.01、物理惩罚强度 c(0.005/0.0001/0.001/0.00001)每任务手调。
可迁移性:方法声明覆盖四类约束:ODE(Ackerman Eq 22)、PDE(Darcy Eq 24、Braginskii Eq 25)、代数方程(A.7.1 Eq 66-69, p20)、不等式约束(A.7.2 Eq 70-73, p21 + toy 平行四边形可行域实验 Figure 7, p21);但实证仅 4 任务 + 1 个无定量数字的 toy,无大规模/多 seed/跨领域验证,可迁移性只能说『框架级成立、数字级未证』。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中。现象刻画跨 4 个工程/科学基准一致,机制有理论推导(一致性命题 A.2.2 + 二阶累积量展开 A.2.3)与过程证据(KL 快速收敛 Table 5),『Laplace+Jensen 优于固定尺度』有消融梯度支撑;但『残差似然确实在训练中把 pθ 重定向到物理流形』从未被直接测量(无训练中残差/概率质量轨迹),现象-机制连接靠结果反推。 |
| 机制→干预 | 中偏弱(最弱一环)。从『Jensen 偏差 Δt≈σt²/2bt² 存在』到『b̃t 校正带来最终收益』之间缺过程级归因:论文未报告 b̃t/σt² 的训练动力学、未消融 EMA/ε/两步 DDIM 估计、未单独验证 Laplace 重尾假设(A.3 为论点式论证);约束注入为何有效只有端到端数字与推导,没有机制层面的归因实验。 |
| 干预→收益 | 中。同 backbone 消融方向一致且跨两任务复现,扩散步数消融单调;但边际差异小(density 0.081 vs 0.088)、无显著性检验/多 seed、± 为样本级标准差,alignment 单独无效(0.083/719.795 反劣于 0.081/702.430),收益-干预链条只有方向性证据。 |
| 最弱一环 | mechanism_to_intervention:『约束以概率残差形式注入为何有效』缺少机制归因——自适应尺度、Laplace 重尾、DDIM 代表点各自的因果贡献没有被隔离验证,需要补 b̃t 动力学分析与组件级对照才能把『推导合理』升级为『机制确证』。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| plasma 密度误差(×10¹⁹) | 0.074±0.011 | PIDM 0.107±0.012;DDPM 0.122±0.020;PINN 0.531±0.095 | drift-reduced Braginskii 预测,Table 3, p7 |
| plasma 温度误差(eV) | 0.451±0.055 | DiffusionPDE 0.728±0.067;PIDM 0.831±0.061;DDPM 1.766±0.284 | 同上,Table 3, p7 |
| tire force eF(N) | 958.578(aggressive)/ 520.631(smooth)/ 607.274(sporty) | DDPM 980.328/560.796/660.897;PIDM 988.642/579.546/630.543;基线中最佳 DDPM | 三工况,Table 2, p6 |
| tracking 三项误差(ex&y/eψ/evx) | downtown 4.796/5.391/3.048;rural 3.562/5.837/3.033 | 最佳基线 DDPM:9.653/6.109/4.317;4.697/7.138/4.936(EKF 6.602/6.930/5.476;6.179/6.241/5.512) | Table 1, p5 |
| 同 backbone 消融(density / tire eF) | Full 0.074 / 695.494;Laplace w/ Jensen 0.081 / 702.430;Laplace w/o Jensen 0.088 / 713.044;Gaussian 0.102 / 723.252;DiT only 0.122 / 734.007;Alignment alone 0.083 / 719.795 | DiT(DDPM only) 基线 | Table 4, p8 |
| KL(q, pθ) | 100k iterations 时 3.103e-04(初始 5.210e+01,2k 后 3.446e-03) | 无基线(近似合理性证据) | Table 5, p17 |
| 训练/推理成本 | tracking 训练 35min、推理 0.08s、2.6G;Darcy 训练 8h、推理 0.18s、3.2G | DDPM tracking 22min / 4.5s / 2.1G;PIDM Darcy 8h / 0.19s / 3.2G | Table 11, p23 |
Insights
- 把物理约束重述为『虚拟残差观测 + 概率似然』:残差惩罚不再是外挂正则,而是与数据似然统一进同一个变分目标;一致性命题保证理想情形下目标分布不被改变,物理项只负责把采样钉在物理流形上(A.2.2, p14)。
- Jensen 偏差是方法论的第二贡献点:log-边缘化偏差由条件残差方差主导(Δt≈σt²/2bt²),自适应尺度 b̃t=bt+σ̄t²/(2(μ̄t+ε)) 在保持正残差惩罚形式的同时吸收二阶项——这是与 PIDM 固定/时间步耦合尺度的本质区别(Eq 9-14, p3-4)。
- Laplace 比 Gaussian 更适配真实噪声工程数据:重尾 + ℓ1 形式使其对离群点鲁棒,消融与 A.8.2 噪声输入实验(PILD 原噪输入 775.914 仍优于 PIDM 828.933 与 PINN-ResNet 957.683)一致(Table 4, p8;Table 10, p23)。
- 对齐正则单独无效、与概率残差组合才有效(0.083/719.795 vs full 0.074/695.494,Table 4, p8):说明条件是协同组件而非独立收益源,也提示『条件一致性』需要与『物理似然』共享梯度通道才能起作用。
- 两步 DDIM 一石二鸟:训练残差评估与推理生成共用 2 步反推,物理约束不增加推理成本(0.08s 反快于 DDPM 4.5s,Table 11, p23),同时把后验代表点缺口压到工程可接受水平。
- KL(q, pθ) 过程监测作为方法自洽性的在线证据:前 2k iterations 下降超 3 个数量级,支撑『用已知前向过程 q 近似 pθ 轨迹』这一推导前提(Table 5, p17)。
vs 同类工作
局限
- Jensen gap 只被缓解、未被严格消除:A.2.3 的二阶累积量展开截断了三阶项(κ3 项,Eq 51, p15),论文在 §5(p8)自认这是 future work。
- 主表对比是系统级而非受控:PIDM/DiffusionPDE 用 U-Net、PILD 用 DiT(A.8.1, p22),Table 1-3 的增益混合了架构差异;同 backbone 消融(Table 4)差异幅度小且无显著性检验、无多 seed。
- 无代码、无数据链接、无 seed 级统计:± 值全部是单模型的样本级标准差(Table 12 注释, p25),训练随机性完全未报告。
- 框架前提是训练数据在概率意义上符合物理定律(§3.1, p3):若数据系统性地违背物理,分布本身就会误导学习;系统识别明确被排除在范围外。
- 对齐机制增加工程复杂度:每条件任务需独立自监督预训练 frozen MAE 编码器(mask ratio 0.5/0.75,A.5, p19),且单独加入无稳定收益。
- toy experiment(代数/不等式约束的展示)只有定性结论与 Figure 7,无任何定量数字;四类约束中代数/不等式仅在该 toy 上验证。
可复现性
超参全表公开(Tables 6-9, p18-19):每任务专用 DiT(hidden 256/384/256/512,blocks 6/10/8/12,heads 8/12/8/16,patch 4/8/4×4/4×4),diffusion timesteps=100,batch 8/32/8/32,iterations 1e4/5e5/3e5/5e5,lr 1e-3/1e-5/1e-4/1e-5,物理惩罚强度 c=0.005/0.0001/0.001/0.00001,λalign=0.01(Darcy 无对齐),cosine β schedule(tracking/tire β1=1e-4, βT=0.03;Darcy/plasma 1e-6, 1e-2)。算法细节:EMA 动量 ρ∈[0,1)(Eq 57-58, p15)、两步 DDIM(Algorithm 1, p20)、MAE 预训练后 frozen(mask 0.5/0.75)、基于验证损失的 early stopping。数据源均公开(Wang et al. 2025b、Zeng et al. 2023、Jacobsen et al. 2025、Mathews et al. 2021),但论文与 arXiv 页面均未提供代码或数据链接,正文仅称部分基线(LSTM-RNN、B-PINN、DDPM、PIDM)使用开源实现(A.8.1, p22);无多 seed/显著性报告。34 pages / 13 figures / 14 tables,arXiv:2601.21284v2(v1 2026-01-29,v2 2026-07-23)。
车辆跟踪任务:纯数据驱动 DDPM 轨迹误差累积、PILD 跟随真值
原文 caption:Experiment results on tracking tasks. (caption 由 PDF 文本清理;主文:Trajectory prediction is performed incrementally, where each predicted point is fed into the next step, to evaluate error accumulation over time)
「现象→收益」一图两用的核心证据:同一驾驶数据集(downtown/rural 两工况)上增量式轨迹预测,纯数据驱动的 DDPM 预测误差随时间累积、轨迹偏离真值,而注入物理约束的 PILD 始终贴近真值轨迹。定量上 PILD 三项误差(位置/航向/速度)全面低于最佳基线 DDPM(如 downtown 4.796 vs 9.653)。读图看曲线的分离程度——越往后推,DDPM 偏得越远,PILD 不漂。
Darcy flow:PILD 物理残差最低,同时 data loss 与基线持平
原文 caption:Evaluation of residual error and data loss of Darcy flow. (caption 由 PDF 文本清理)
工程收益环的核心证据:无条件生成 k/p 联合场的 Darcy 任务(64×64 网格,−∇·(k∇p)=f)上,PILD 把物理残差压到全部基线之下,同时 data loss 与其他方法基本持平——证明物理改进来自约束注入而非牺牲数据一致性。读图时两组柱状图分开看:左边残差越低越好(PILD 最低),右边数据损失越平越好(PILD 没有掉队)。
toy 实验:可行域(红色平行四边形)边界离群点,DDPM 最多、PILD 最少
原文 caption:Results of toy experiment. The red parallelogram indicates the feasible region, and the blue points denote sampled data. (caption 由 PDF 文本清理)
框架可泛化性的支撑证据:用四条不等式围出平行四边形可行域、均匀采样 1 万点训练,代数/不等式约束以同一个 Laplace 虚拟残差框架接入。DDPM 只在数据分布层面学习,在尖锐边界附近产生明显更多离群点;PILD 比 PIDM 更贴近边界。读图看蓝色点相对红色区域的渗出量,渗出越少说明残差似然把采样钉在物理流形上的效果越好。
🎧 音频版
时长 17:38 · Edge TTS
扩散模型不守物理定律怎么办?(对话版)
小播:今天聊一篇把物理定律塞进扩散模型的论文,叫 PILD,标题有点长——Physics-Informed Learning via Diffusion。扩散模型我们聊过不少,这篇有什么新鲜事?
老播:新鲜在它的切入角度。大家早就发现,纯数据驱动的扩散模型生成东西很漂亮,但在工程和科学场景里它会「越界」:预测的车辆轨迹越推越偏,等离子体的密度误差高得离谱。以前的解法是给训练目标加一个物理惩罚项,这篇论文说,慢着,我们把「残差为零」当成一条虚拟观测写进概率框架里,效果更好。先给结论:在四个基准上,PILD 把物理残差和预测误差压到了所有基线之下,推理还更快。
小播:先说现象吧,纯数据驱动到底差在哪?
老播:车辆跟踪任务最直观。增量式预测,一个点一个点往未来推,DDPM 的轨迹越推越偏,位置误差 9.6 米,大概一辆公交车那么长;PILD 的误差 4.8 米,一辆轿车。等离子体任务更夸张:DDPM 的密度误差 0.122,温度误差 1.77 电子伏特;而最好的物理注入方法只有 0.107 和 0.73。四个基准加一个 toy 实验,现象是同一个:只学数据分布的扩散模型,物理上站不住。
小播:那怎么把物理塞进去?直接加个惩罚项不行吗?
老播:能加,但作者选了一条更概率化的路。他们把「残差为零」建模成一个虚拟观测:算一下生成样本的物理残差,理想情况下它应该等于零,于是让这个零观测服从拉普拉斯分布,尺度跟扩散噪声挂钩。选拉普拉斯有三个理由:重尾,对传感器离群点鲁棒;惩罚是 ℓ1 形式;梯度好优化。
小播:这跟直接加惩罚项有什么区别?
老播:区别在数学上更干净,但代价是精确目标算不出来。因为训练时拿到的是带噪样本,你得在「干净样本的后验分布」上做对数边缘化,这个期望没闭式解。论文用二阶展开把它摊开:真实目标约等于残差均值除以尺度,减去一个修正项——残差方差除以两倍尺度平方。这个修正项就是 Jensen 偏差,它由条件残差方差主导:噪声越大,偏差越大。
小播:那怎么办?硬算算不了,展开又有偏差?
老播:两步走。第一步,干净状态的代表点用两步 DDIM 反推出来,训练和推理共用同一套操作,不增加额外成本。第二步,把残差尺度做成自适应的:在基础尺度上,加上「残差方差除以两倍的残差均值」这一项。残差越不确定,尺度放得越大,正好吸收掉那个二阶偏差,同时保持惩罚的符号。这就是论文说的 Jensen-gap-aware 自适应残差尺度。
小播:这么改,会不会把原本学好的数据分布搞坏?
老播:框架层面不会。附录里有个一致性命题:如果训练数据本身满足物理定律,把残差似然加进目标,最优的分数场保持不变——物理项只是把采样「钉」在物理流形上,该学的分布照样学。而且这套构造是模块化的:代数方程、不等式约束都能写成同样的残差形式。toy 实验里四条不等式围出一个平行四边形可行域,DDPM 在边界上渗出不少离群点,PILD 基本都收在界内。
小播:自适应尺度是核心创新?
老播:是核心之一。之前的方法,比如 PIDM,用固定尺度或者只跟时间步挂钩的尺度,没处理「残差本身有多不确定」这件事。PILD 把这一项显式建模了。条件任务还有第三个组件:用一个冻结的 MAE 编码器把观测条件编码成目标,让 DiT 中间层的表示和它做余弦对齐,保证去噪过程中间表征一直记得观测条件。
小播:效果呢?数字说话。
老播:同 backbone 消融,一个组件一个组件加,梯度非常干净:纯 DiT 密度误差 0.122,加高斯残差 0.102,换拉普拉斯 0.088,加 Jensen 校正 0.081,加对齐 0.083,全量模型 0.074。轮胎力那边同样单调:从 734 一路降到 695。注意对齐单独加反而略差,只有跟概率残差组合才最优——它是协同组件。
小播:四成多的误差降幅,代价是什么?
老播:训练贵一点:tracking 训练 35 分钟,DDPM 只要 22 分钟。但推理反而更便宜:PILD 出一次预测 0.08 秒,DDPM 要 4.5 秒——物理约束没有拖慢采样,因为训练和生成共用两步 DDIM。噪声场景也扛得住:不去噪的原噪输入上,PILD 的轮胎力误差 775.9,比 PIDM 的 828.9 和 PINN 的 957.7 都低。另外,物理改进没有拿数据一致性来换:Darcy 任务上 PILD 的物理残差最低,同时 data loss 和其他方法基本持平——它不是把残差压下去就丢了数据。
小播:那最弱的一环在哪?
老播:作者自己也承认两件事。第一,Jensen 偏差只是被缓解,没有被严格消除——二阶展开把三阶项截断了,论文把它列为 future work。第二,主表的对比混了架构:PIDM 用 U-Net,PILD 用 DiT,部分增益可能来自架构;同 backbone 的消融差异又小,没有显著性检验,也没有多随机种子,所有 ± 都是单模型评估的样本级标准差。更关键的是,「约束以概率残差形式注入为什么有效」缺过程级归因——论文没有报告残差尺度在训练里怎么变,没有把自适应尺度、拉普拉斯、DDIM 代表点各自的贡献隔离出来验证。
小播:也就是说,方向对,证据是方向性的?
老播:对,这是最准确的总结。消融梯度单调、跨任务复现、推理零额外成本,方向性证据很扎实;但「为什么有效」这一环还没有被真正闭合。读这篇的时候,把「工程收益」和「机制确证」分开看。
小播:最后用一句话收个尾?
老播:一句话:物理约束可以写成一条「残差为零」的拉普拉斯虚拟观测,残差越不确定,自适应尺度放得越大,把边缘化偏差吸收掉——同一 backbone 下密度误差从 0.122 压到 0.074,推理 0.08 秒反而比 DDPM 快。最该记住的数字是 0.074:四成多的误差降幅,来自一个能算的、能解释的、代价几乎为零的训练目标改动。