视觉真实 ≠ 物理理解:396 段真实世界视频,测出最佳视频生成模型只有 29.5 分
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个令人不安的现象:Sora 生成的视频,连 Gemini 1.5 Pro 都常常分不出真假;可把它放进一场物理考试里,它只拿了 10 分。这篇 WACV 2026 论文(arXiv 2501.09038)自建了一个叫 Physics-IQ 的基准:396 段真实拍摄的视频、覆盖固体力学/流体/光学/热学/磁学五类物理原则,测了 8 个视频生成模型变体(Sora、Runway Gen 3、Pika 1.0、Lumiere、Stable Video Diffusion、VideoPoet)。结果一句话:最佳模型 VideoPoet (multiframe) 也只拿到 29.5 分,而真实世界的物理方差上界是 100 分;而且视觉真实感和物理理解之间没有显著相关(r=-0.46, p=.249)。生成得越像真的,跟懂不懂物理,是两码事。
这个结论的争论背景有两派。乐观派沿 Feynman 的「不能创造,即不能理解」:模型被训练去预测视频的下一帧,就像语言模型预测下一个 token,成功的预测意味着理解。反驳派则指出因果问题:被动「观看」无法对世界做干预,模型分不清相关与因果;而且生成模型经验的是数字世界,只要复现训练数据里的常见模式就能骗过观众。Physics-IQ 想用可量化的方式给这场辩论一个中间答案。
先看考试设计:真实世界、OOD 场景、可计算的物理方差上界
之前的物理评测大多用合成数据(Physion、CRAFT、IntPhys、VideoPhy 等),存在真实-合成分布偏移。Physics-IQ 反过来:66 个真实拍摄的 OOD 场景——橡皮鸭插进多米诺链、台球撞球、壶铃砸纸杯——这类场景训练分布里几乎不可能出现,只能靠对物理的理解求解。每个场景拍 3 个视角(左/中/右)、每个视角拍 2 遍(take 1/take 2,Sony Alpha a6400、30 FPS、3840×2160、静态机位),共 396 段、每段 8 秒。8 秒切成 3 秒条件段 + 5 秒真值续篇;条件段的最后一帧是人工挑的 switch frame,比如多米诺场景取「首牌刚倾倒、还没碰到第二张」的瞬间,保证预测必须靠物理。
评测协议的核心是四个指标,分别回答「在哪发生、何时何地发生、发生多少、怎么发生」。位置指标是空间 IoU,比较真实与生成视频的运动掩膜 $M$:
$$\text{Spatial-IoU} = \frac{|M_{\text{real}} \cap M_{\text{gen}}|}{|M_{\text{real}} \cup M_{\text{gen}}|}$$
这里 $M_{\text{real}}$、$M_{\text{gen}}$ 分别是基于真实/生成视频的二值运动图(背景差分得到,h×w 空间掩膜),IoU 就是交集比并集,衡量动作发生的位置对不对。要连「何时」一起考,就把掩膜按帧比较再对时间平均:
$$\text{Spatiotemporal-IoU} = \frac{1}{T}\sum_t \frac{|M_{\text{real},t} \cap M_{\text{gen},t}|}{|M_{\text{real},t} \cup M_{\text{gen},t}|}$$
$M_{t}$ 是第 $t$ 帧的 h×w×t 二值运动掩膜切片,$T$ 是总帧数——这一项惩罚「位置对了但时机错了」。再加一个加权空间 IoU(按时间加权平均动作量,区分来回摆的钟摆和滚过去的球),以及像素级 MSE(惩罚外观与交互的偏差)。四项加总(MSE 取负号)就是 Physics-IQ 总分,并归一化到「物理方差 = 100%」:同一个场景的 take 1 和 take 2 互相比,能得多少分,就是真实世界物理随机性的上界。
现象:全体模型大幅落后上界
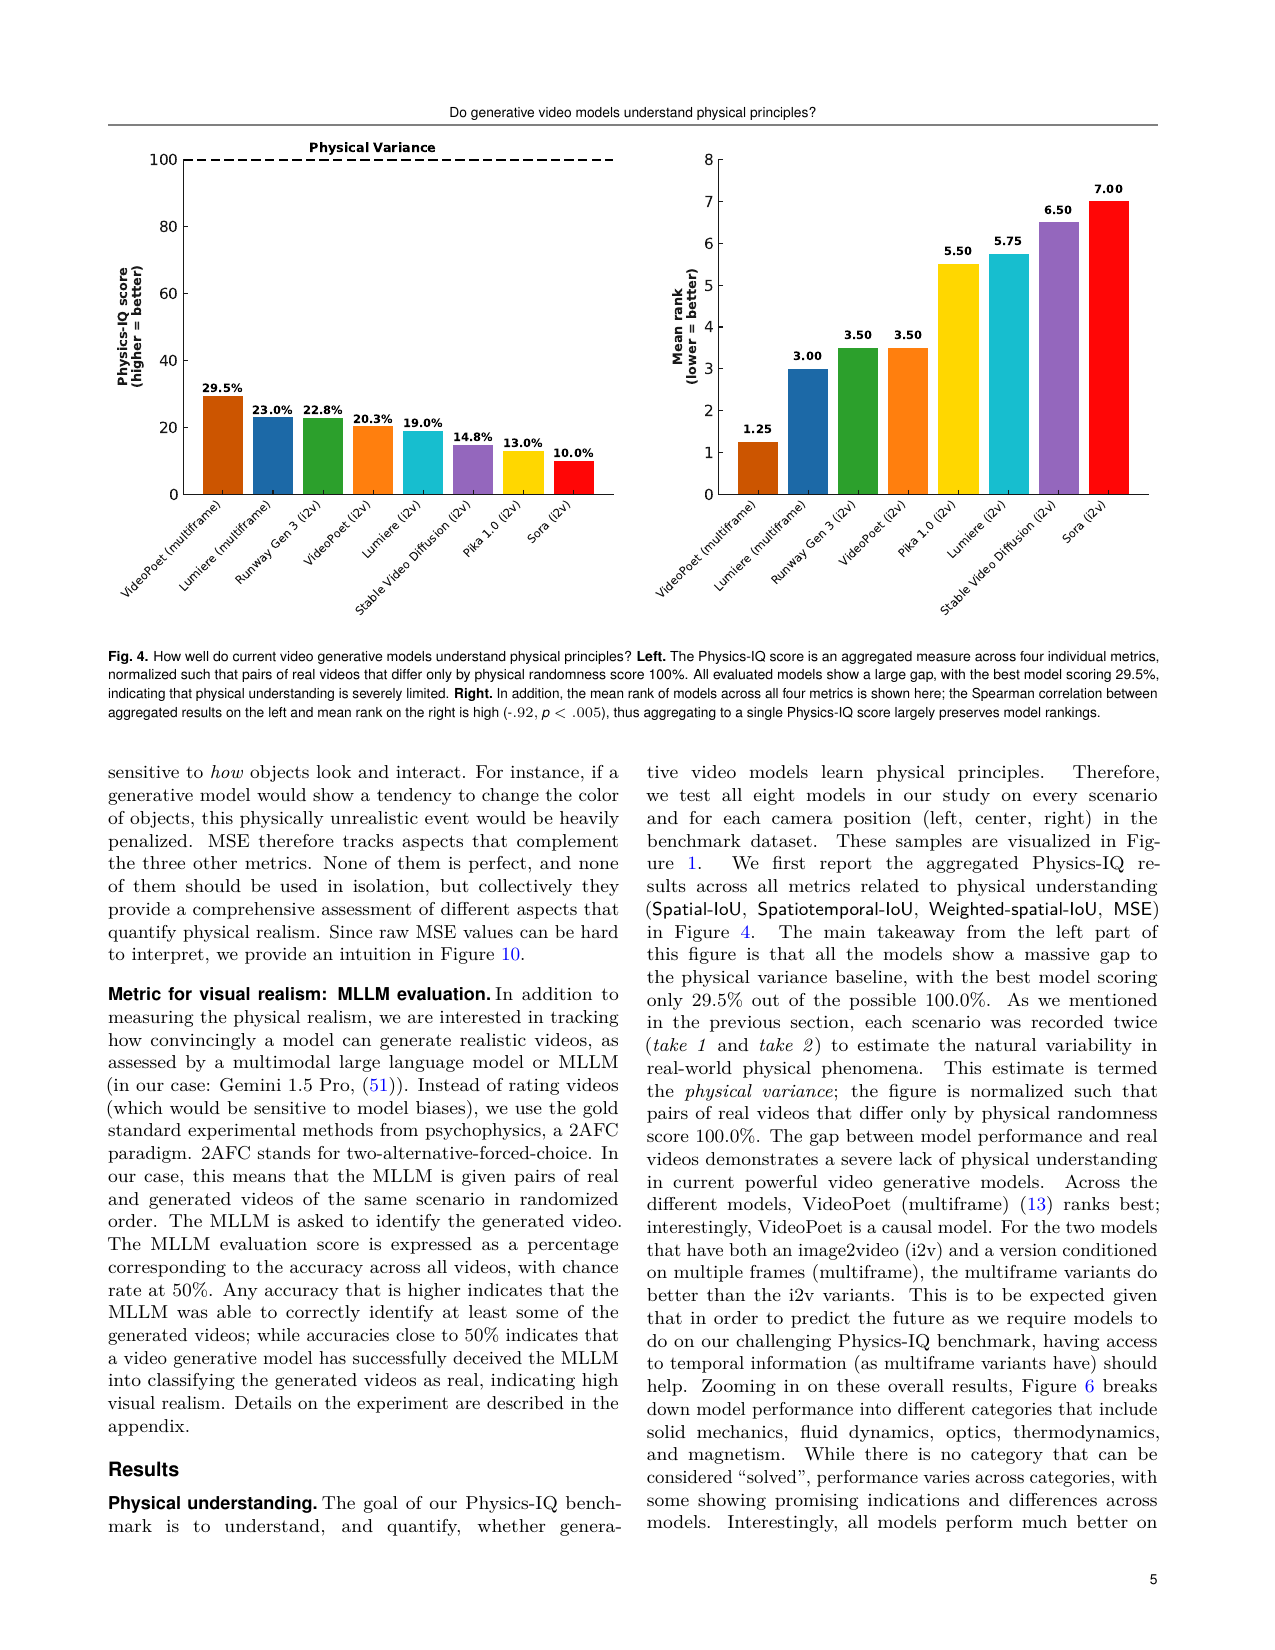
Figure 4 是全篇的核心负结果:最好的 VideoPoet (multiframe) 29.5%,之后是 Lumiere (multiframe) 23.0%、Runway Gen 3 22.8%,Sora 垫底 10.0%——没有一类模型摸到 100 分上界的零头。结论对指标选择不敏感:连最宽松的 Spatial IoU(只问动作发生在哪),模型最好也只有 0.204,而真实视频之间是 0.678,差距超过 3 倍;要问「何时、多少、怎么发生」的指标差距更大。物理理解在所有被测模型上都是严重受限的,这是第一条重复出现的主线结论。
关键证据:真实感与物理理解无显著相关
论文用视觉真实感做了第二套测量:让 Gemini 1.5 Pro 做二选一(2AFC),从「真实 vs 生成」视频对里指出哪段是生成的,50% 是 chance——越接近 50%,说明越难识破、越真实。
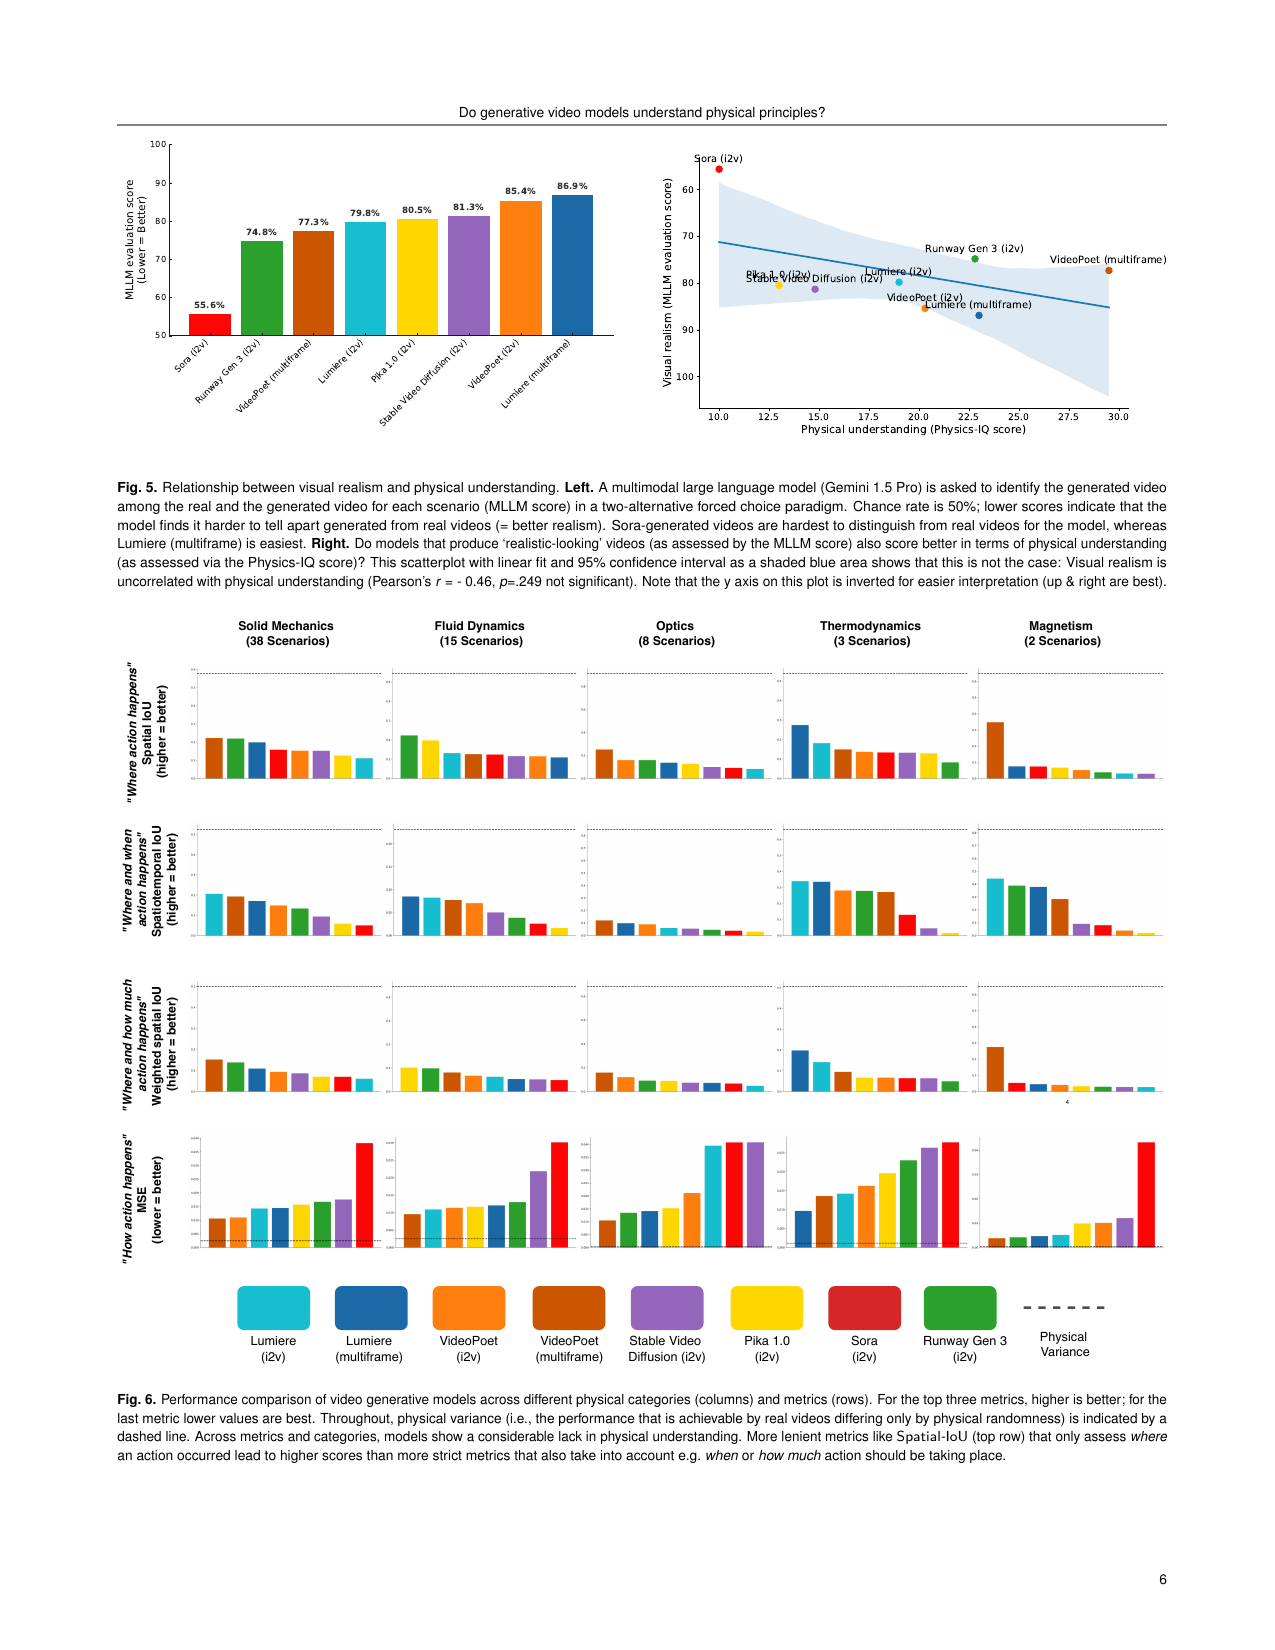
Figure 5 右边这张散点图是全文最锋利的一张:横轴物理理解、纵轴视觉真实感(倒置,越靠上越真实),8 个点毫无趋势,Pearson r = -0.46、p = .249,统计上不显著。两个极端点把结论钉死:最会骗人的 Sora(MLLM 55.6%,最接近 chance)物理垫底(10.0%);最容易被识破的 Lumiere (multiframe)(86.9%)物理反而排第二(23.0%)。视觉真实感与物理理解是两条可分离的能力轴——这是第二条主线结论,后面机制段会解释为什么可以分离。
机制:外观模式复现,与因果模拟是两条路
论文给出的机制解释是 shortcut learning:模型只需在像素分布上「像真实视频」,就能骗过 MLLM 和观众,它的生成是训练数据里常见模式的复制,而不是对物理因果的模拟。三个定性证据支撑这条机制。最著名的是火柴入水案例:Runway Gen 3 在火柴火焰触水的瞬间,凭空生成一根蜡烛并被点燃——每一帧都高清写实,但时序上物理不可能,这叫「物从无中生有」(object-into-existence)幻觉,且模型幻觉出的是与场景一致的物体(火柴→蜡烛),说明它在调取场景记忆补齐内容。第二个是训练分布先验外泄:Lumiere 把红台球桌生成成绿的,暴露了「常见台球桌是绿色」的统计偏好。第三个:Sora 频繁插入转场剪辑,说明其训练范式优化的是「像艺术视频」,跟物理模拟无关。机制段读完要记住的重点:这些案例都指向「复制模式」而非「模拟因果」——但注意,这个机制解释只有相关性证据,后面是最弱一环。
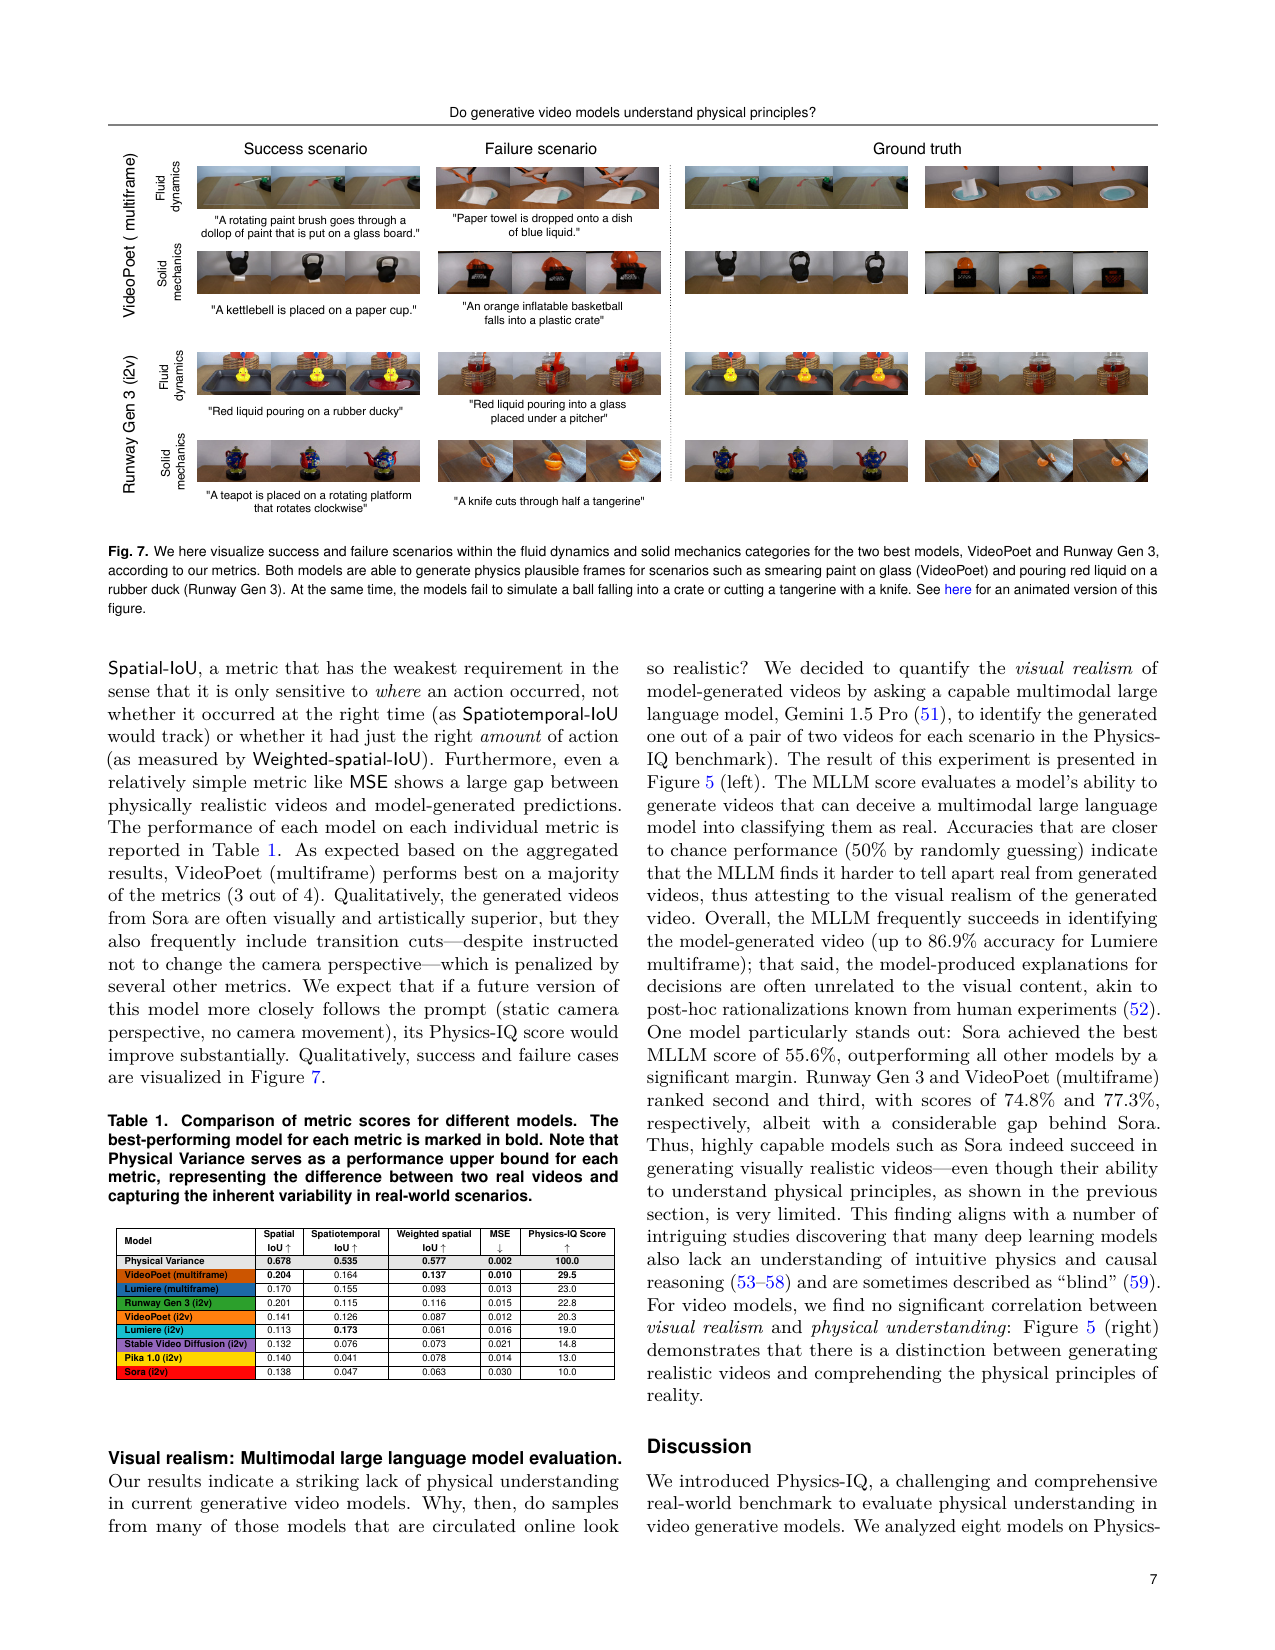
Figure 7 展示了能力边界:左列是成功案例(VideoPoet 在玻璃上抹油漆、Runway 往橡皮鸭倒红液——流体铺展这类训练常见模式),右列是失败案例(球落进板条箱、刀切橘子——需要接触力与碰撞推理的固体力学)。模型擅长复现「像」的动作模式,在需要因果推理的地方出错。
收益:基准本身 + 一个「同构」信号
这篇的工程收益主要是资产本身:数据、指标、代码全部开源,可复算。除此之外有一个值得注意的模式:同一产品的多帧(multiframe)变体全面优于单帧(i2v)变体——VideoPoet 29.5 vs 20.3,Lumiere 23.0 vs 19.0;而全场最佳 VideoPoet 恰是因果(自回归)模型。作者的解读是:当「预测下一帧」的训练目标与评测范式同构时表现最好——评估严格度也印证了这一点:越宽松的指标分数越高,单一宽松指标会高估能力,物理理解评估必须按需求严格度分级。
代价与边界:最弱一环在「机制无因果验证」
论文自己没声称做机制验证,这是必须说清的最弱一环:shortcut/外观记忆的解释,只由 n=8 的相关性(r=-0.46, p=.249)加定性案例支撑,没有任何模型内部干预、训练分布操纵或对照实验。此外有四个现实限制。其一,Sora/Runway/Pika 是闭源 API,采样 seed、采样次数、模型版本都不可控,跨模型对比可能混入 API 行为差异。其二,评估协议刻意保守:惩罚物体幻觉、镜头运动、转场切换,Sora 因频繁转场被多指标扣分,作者自认若 Sora 遵守静态机位提示、分数会大幅提升——保守设计避免误报,但会低估个别模型。其三,MSE 等像素指标同样惩罚外观偏差,「不理解物理」和「预测困难」没有分离。其四,人类研究只有 5 名被试、25 个场景,相邻排位的排序不可靠。
一句话记住这篇
视觉真实感与物理理解是两条独立的轴:最会骗过 MLLM 的 Sora(真实感 55.6%)物理垫底(10.0%),最易识破的 Lumiere multiframe(86.9%)物理反而第二(23.0%)。最该记住的数字是:真实世界物理方差上界 100 分,最佳模型只有 29.5 分,连最宽松的指标也只有真实视频的 1/3;最该记住的保留是:这篇是「观测→评估」研究,机制解释(复制模式而非模拟物理)还没有任何干预验证。
自建 396 段真实世界视频(66 场景×3 视角×2 take)构成 Physics-IQ 基准,测 8 个视频生成模型变体(Sora、Runway Gen 3、Pika 1.0、Lumiere、Stable Video Diffusion、VideoPoet)对固体力学/流体/光学/热学/磁学的物理理解:最佳模型仅 29.5%(真实视频物理方差上界 100%),视觉真实感与物理理解无显著相关(r=-0.46, p=.249)——视觉真实感 ≠ 物理理解;但这是纯「观测→评估」研究,机制解释(外观模式复现而非因果模拟)没有任何干预验证。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:被测现象:视频生成模型对真实世界物理原则的『理解』,操作化为预测物理事件续篇的能力。物理任务集覆盖 5 类原则——固体力学(38 场景,如多米诺链中断、壶铃/纸片砸枕头、球落板条箱、刀切橘子、链式反应)、流体动力学(15 场景,如玻璃板上油漆涂抹、往橡皮鸭倒红液、纸巾落蓝液)、光学(8 场景,阴影/反射)、热学(3 场景,如火柴入水熄焰)、磁学(2 场景);共 66 个真实拍摄的 OOD 场景(如橡皮鸭插入多米诺链、台球撞球),只能靠对物理的理解求解、无法靠复现训练模式解决。
在哪里观测:自建 Physics-IQ 数据集:396 段真实视频 = 66 场景 × 3 视角(左/中/右)× 2 take;每段 8 秒、30 FPS、3840×2160(16:9),Sony Alpha a6400 + 16-50mm 镜头、静态机位拍摄;每个场景按 3 秒条件段 + 5 秒真值续篇切分,条件段末帧为人工挑选的 switch frame(如多米诺首牌刚倾倒、尚未接触第二牌的时刻)。评测对象:8 个模型变体(6 个产品)——VideoPoet(i2v + multiframe)、Lumiere(i2v + multiframe)、Runway Gen 3(i2v)、Pika 1.0(i2v)、Stable Video Diffusion(i2v)、Sora(i2v)。
如何量化:四个指标(§2.5):Spatial IoU(动作发生在哪)、Spatiotemporal IoU(何时何地发生)、Weighted-spatial IoU(何处发生 + 多少动作,基于背景差分的 h×w×t 二值运动掩膜)、MSE(动作如何发生,像素保真);四者加总(MSE 取负号)得到 Physics-IQ score,并归一化到『物理方差 = 100%』——每个场景拍两遍 take 1/take 2 估计真实世界物理随机性上界。另用视觉真实感指标:Gemini 1.5 Pro 2AFC(50% 为 chance,越低越真实)+ 两项人类配对研究(5 名 PhD 被试、25 场景)。结果:最佳模型 VideoPoet (multiframe) 仅 29.5%,Sora 仅 10.0%,全部大幅落后于 100.0% 的物理方差上界(Fig 4,p952-953;Table 1,p954)。
② 机制假设
假设:视觉真实感来自训练数据中的外观模式复现(shortcut learning / 记忆),与因果物理模拟是两条可分离的能力轴:模型只需在像素分布上像真实视频,就能骗过 MLLM 与观众,却无法预测物理事件的续篇。配套论述(§1,p948):预测式训练对应 Feynman 式『不能创造即不能理解』的乐观论点,而因果性反驳认为被动『观看』无法干预世界,因而无法区分相关与因果;生成式模型经验的是数字世界而非具身世界,其输出只是对训练数据常见模式的复制。定性机制证据:『物从无中生有』幻觉(object-into-existence)与训练分布先验外泄(如 Lumiere 把红台球桌变绿、Sora 插转场剪辑)表明模型在回忆场景一致的内容而非模拟物理。
证据:
- 8 个模型变体上 Physics-IQ 与 MLLM 真实感得分无显著相关:Pearson r = -0.46,p = .249(n=8)(Fig 5 右,p954)。
- 解耦的直接例证:Sora 真实感最强(MLLM 2AFC 55.6%,最接近 chance)却在 Physics-IQ 垫底(10.0%);Lumiere (multiframe) 真实感最弱(86.9% 最易识别)却是 Physics-IQ 第二(23.0%)(§3.3 p954-955;Table 1 p954)。
- 定性失败案例:火柴入水场景中 Runway Gen 3 在火焰触水的瞬间凭空生成一根蜡烛并被点燃,逐帧写实但时序物理不可能;更强模型(Runway、Sora)的幻觉内容常与场景一致(火柴→蜡烛),提示部分是场景记忆而非因果模拟(§4,p955)。
- 训练先验外泄:prototyping 中 Lumiere 一生成就把红台球桌变绿(常见绿色台球桌先验);Sora 频繁插入转场剪辑(§4,p955)。
- 部分成功案例(VideoPoet 模拟玻璃上油漆涂抹、Runway 往橡皮鸭倒红液,Fig 6,p954)说明从纯观察习得某些物理原则可能,但普遍失败说明主流机制仍是模式复现而非物理模拟(§4,p955-956)。
备选解释:
- 评估协议假象:模型可能具备部分物理知识,但 5 秒长程预测、像素级 MSE 的严苛性、以及闭源 API 的采样/后处理不可控,使分数被系统性低估——作者承认 Physics-IQ 刻意保守、惩罚转场与镜头运动,Sora 若严格遵循『静态机位』提示其分数会大幅提升(§3.1 p954;§4 p955)。
- 条件设定混杂:i2v vs multiframe、文本条件有无、FPS 8-30、分辨率 128×128-1280×768 各异(Supp Table 2),跨模型对比混入输入模态差异;作者自己也预期 multiframe 理应占优(§3.1,p953)。
- 指标代理性:四个指标只量化运动掩膜/像素相似,不直接测量任何物理定律;MLLM 的判定文本解释常与视觉证据无关,且对 Sora 识别失败尤甚——『真实感』本身是测量工具的弱点(§4,p955)。
- 能力不是二元的:按原理分解(Supp Fig 12)显示没有一类被『解决』但性能随类别浮动,物理理解可能是分场景、分原理的部分能力,而非整体缺失。
- 采样/规模解释:论文自身把『纯 scaling 是否足够』列为开放问题,未来模型可能靠更大数据与推理时采样改善——即当前负结果可能反映规模不足而非原理性上限(§4,p955-956)。
形式化/toy model:无定量 toy model。形式化是论证性表述(§1,p948-949):把『视觉真实感』与『物理理解』定义为两条可分离的能力轴,分别用 MLLM 2AFC 准确率(p952-953 §2.6)与四指标聚合的 Physics-IQ score(§2.5,p951-953)度量,再检验二者相关(r=-0.46, p=.249)。机制语言借自 shortcut learning(§1,p948,引 Geirhos 2020 等)与因果/具身认知论证(被动观察无法区分相关与因果),未给出可证伪的定量机制模型。
③ 局部干预
干预环缺失(null)——如实标注,不硬凑。
因果验证:无。论文未对模型做任何干预实验:没有改变物理场景参数观察生成变化的受控对照,没有训练数据/权重/条件层面的操纵,没有内部探针。唯一的『准干预』在基准设计层面——构造 OOD 场景(橡皮鸭插入多米诺链、壶铃 vs 纸片砸枕头)强迫模型脱离训练分布,但这是数据集构建而非对模型的因果操纵,不能把观测到的失败归因于某个具体机制。论文对『复制模式 vs 真正理解』的 pro/con 论证(§1,p948-949)以论述形式呈现,无对照实验。
④ 工程收益
测量画像而非模型改进:给出 8 个模型变体的完整物理理解排序(Physics-IQ 10.0-29.5:VideoPoet mf > Lumiere mf > Runway Gen 3 > VideoPoet i2v > Lumiere i2v > SVD > Pika > Sora;Table 1,p954)与真实感排序(MLLM 55.6-86.9%,Fig 5 左,p954),并证明二者解耦(r=-0.46)。产出三个可操作结论:① 视觉真实感不能当作物理理解的代理指标;② multiframe/causal 模型(VideoPoet)显著优于 i2v,时域条件是关键增益来源(§3.1,p953-954);③ 宽松指标(Spatial IoU)高估能力,评估需按『位置/时机/程度/保真』分级(Supp Fig 12;§4,p955)。
代价:拍摄 396 段真实视频(三视角、双 take、4K 30FPS);逐场景人工挑选 switch frame;对每个模型变体预处理匹配 FPS/分辨率并做 API 推理;Gemini 1.5 Pro 2AFC 评估 + 两项人类研究(5 名 PhD 被试、25 场景、每人 40/20 对);指标实现(背景差分运动掩膜 + IoU/MSE)与 Supp 伪代码。成本主体是一次性数据采集与黑盒 API 推理,评估管线本身轻量。
可迁移性:高(作为基准):数据与代码开源(physics-iq.github.io / github.com/google-deepmind/physics-IQ-benchmark),评估协议(3 秒条件 + 5 秒续篇 + 四指标 + 物理方差归一化)与模型无关、可对后续模型即插即用追踪进步;指标基于静态机位假设,不适用于相机运动视频。局限:闭源 API 模型(Sora/Runway/Pika)不可复现;评测时点锁定在 2024 年模型代际。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中偏弱:观测层严谨(真实视频、双 take 物理方差上界、人类研究校准指标、完整指标公式),但机制证据全部是跨模型相关(n=8)与定性失败案例,没有任何对照实验隔离『外观记忆/模式复现』与『评估协议假象』『长程预测误差』等备选解释。 |
| 机制→干预 | 缺失(最弱一环):从『真实感≠理解』的观测结论到『模型靠外观记忆而非因果模拟』的机制断言之间,没有任何干预步骤——论文不操纵模型、不扰动场景参数、不做训练分布对照,机制主张完全靠论证与相关支撑。 |
| 干预→收益 | 缺失/不适用:本研究没有『干预→工程增益』闭环——产出是测量基准与负结果诊断,而非模型改进;可迁移物是开源基准与评估协议,不涉及干预收益。 |
| 最弱一环 | mechanism_to_intervention:整篇是「观测→评估」研究,闭环在『观测→机制』之后即断——没有任何一环节的因果操纵,机制解释无法区分于评估协议假象、规模不足、长程预测误差等备选解释。要补这一环需要:对同一模型做场景参数扰动(如改变初始条件看生成变化)、训练数据/条件消融、或与合成数据上可验证的物理学习对照。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| Physics-IQ score(最佳模型) | 29.5%(VideoPoet multiframe,8 变体中最高) | 真实视频物理方差上界 = 100.0%;最差 Sora (i2v) = 10.0% | 66 场景×3 视角×8 模型变体;四指标聚合后按物理方差归一化;§3.1 Fig 4(p952-953)、Table 1(p954) |
| 各模型 Physics-IQ score 排名 | VideoPoet mf 29.5 / Lumiere mf 23.0 / Runway Gen 3 22.8 / VideoPoet i2v 20.3 / Lumiere i2v 19.0 / SVD 14.8 / Pika 13.0 / Sora 10.0 | 物理方差 100.0;multiframe 均优于同产品 i2v(VideoPoet 29.5 vs 20.3;Lumiere 23.0 vs 19.0) | Table 1(p954) |
| 视觉真实感 vs 物理理解相关性 | Pearson r = -0.46,p = .249(n=8,不显著) | 零相关假设无法拒绝;真实感最高(55.6%)的 Sora 反而 Physics-IQ 垫底 | MLLM 2AFC 得分 vs Physics-IQ 散点 + 线性拟合(95% CI,y 轴倒置);Fig 5 右(p954) |
| MLLM 2AFC 真实感得分(识别生成视频的准确率,chance = 50%) | Sora 55.6%(最接近 chance);Lumiere (multiframe) 86.9%(最易识别) | 其余:VideoPoet mf 77.3%、Runway Gen 3 74.8%、Lumiere i2v 79.8%、Pika 80.5%、SVD 81.3%、VideoPoet i2v 85.4% | Gemini 1.5 Pro,每场景真实-生成成对 2AFC,随机化顺序;§3.3(p954-955)、Fig 5 左(p954) |
| 人类研究 1(真实 vs 模型,选更物理合理者) | 模型被选比例 0-8%:Runway Gen 3 (Rank 3) 2/25 = 8%,VideoPoet i2v (Rank 4) 1/25 = 4%,其余 6 变体 0/25 | 人类压倒性偏好真实视频;与 Physics-IQ 排名大体一致 | 25 随机场景、5 名 PhD 被试、每人 40 对;全视频高斯模糊去除分辨率偏置;§3.2(p954) |
| 人类研究 2(模型 vs 模型,按 Physics-IQ rank 配对 1v8/2v7/3v6/4v5) | Runway vs SVD 22-3(88% 一致);VideoPoet mf vs Sora 19-6(76%);Lumiere mf vs Pika 16-9(64%) | 唯一例外:VideoPoet i2v(Rank 4, 20.3)vs Lumiere i2v(Rank 5, 19.0)偏好低排位者 15-10(仅 40% 与排名一致) | 每人 20 对;§3.2(p954) |
| 单指标差距(Spatial IoU / MSE) | 最佳 Spatial IoU 0.204(VideoPoet mf)vs 物理方差 0.678;最佳 MSE 0.010(VideoPoet mf)vs 物理方差 0.002 | 全部模型、全部指标均大幅落后物理方差上界;Sora MSE 0.030 最差 | Table 1(p954) |
| Physics-IQ 排名 vs 四指标平均 rank 一致性 | Spearman r = -0.92,p < .005 | 聚合为单一 Physics-IQ score 基本保留模型排名(mean rank:VideoPoet mf 1.25 ... Sora 7.00) | arXiv v3 Fig 4 右(p5);8 模型变体 |
| 数据集规模与场景分布 | 396 视频 = 66 场景 × 3 视角 × 2 take;8 秒/段、30 FPS、3840×2160、静态机位 | 场景分布:Solid Mechanics 38 / Fluid Dynamics 15 / Optics 8 / Thermodynamics 3 / Magnetism 2(共 66) | §2.1(p949);Supp Fig 12 |
Insights
- 视觉真实感 ≠ 物理理解,且是定量结论而非口号:8 个模型变体上两者无显著相关(r=-0.46, p=.249);最强『骗子』Sora(MLLM 55.6%)物理最弱(10.0),最易识破的 Lumiere (multiframe)(86.9%)物理反而第二(23.0)。
- 物理理解普遍严重受限:最佳模型仅 29.5%,距 100.0% 的物理方差上界有一倍以上差距;连最宽松的 Spatial IoU(0.204 vs 0.678)都不到真实视频的 1/3——结论对指标选择不敏感。
- 时域条件与因果自回归是真实增益来源:同一产品 multiframe 变体全面优于 i2v(VideoPoet 29.5 vs 20.3;Lumiere 23.0 vs 19.0),最佳模型恰是因果(自回归)模型 VideoPoet——「预测下一帧」的训练目标与评估范式同构时表现最好。
- 『物从无中生有』幻觉是机制的窗口:Runway Gen 3 在火柴入水时凭空生成蜡烛并点燃,逐帧写实但时序不可能;更强的模型幻觉出与场景一致的物体(火柴→蜡烛),说明模型在调取场景记忆补齐内容,而非模拟因果链。
- 训练分布先验会直接外泄进生成:Lumiere 把红台球桌变绿、Sora 频繁插入转场剪辑——这是『复制常见模式』而非『模拟物理』的直接指纹,也是 shortcut 机制最有说服力的定性证据。
- 评估严格度决定结论:宽松指标(Spatial IoU,只问位置)上模型明显好于要求时机/程度的指标(Spatiotemporal/Weighted IoU),物理理解评估必须按需求严格度分级,单一宽松指标会高估能力。
vs 同类工作
局限
- 机制无因果验证(最根本):shortcut/外观记忆解释仅由 n=8 的相关性与定性案例支撑,无模型内部干预、无训练分布操纵、无对照实验;论文也未声称做了。
- 黑盒 API 评估混杂:Sora/Runway/Pika 为闭源 API,采样 seed、采样次数、推理后处理不可控,模型版本与评估时点未锁定(2024 年代际),跨模型对比可能混入 API 行为差异。
- 评估协议刻意保守且有已知偏置:Physics-IQ 惩罚物体幻觉、镜头运动、转场切换;Sora 因频繁转场被多指标扣分,作者自认若 Sora 遵守『静态机位』提示分数会大幅提升——保守设计有利于避免误报,但可能低估个别模型。
- 指标只是代理:四指标不直接量化任何物理定律;MLLM 判定依据常与视觉证据无关(文本解释经常出错)且对 Sora 识别失败尤甚;论文明确警告不应单独解读任何指标。
- 场景分布偏斜:固体力学 38/66 场景,磁学仅 2、热学仅 3;按原理分解(Supp Fig 12)无类别被『解决』,但小类的统计功效有限,跨原理比较需谨慎。
- 『不理解』与『预测困难』未分离:像素级 MSE 等指标同样惩罚外观偏差,生成正确运动但外观不一致会被计为失败,可能低估物理正确性;作者以『每帧都高质量但时序不可能』(Runway 蜡烛)作为反证,但未做系统分离。
- 人类研究功效有限:5 名被试、25 场景、每对 20-40 次比较;对相邻排位的判别(40% 一致)说明分数相近的模型间排序并不可靠。
可复现性
数据与代码开源:项目页 https://physics-iq.github.io/(WACV 匿名版为 anonphysicsiq.github.io),代码 https://github.com/google-deepmind/physics-IQ-benchmark(arXiv 版链接,physics-IQ-benchmark 大小写不一致;WACV 版称代码在补充材料中)。Supp 给出完整复现材料:模型规格表(Supp Table 2:FPS 8-30、分辨率 128×128-1280×768、文本/单帧/多帧条件矩阵)、全部 66 场景 switch frame 图(Supp Fig 11)、MLLM 2AFC prompt 原文、FPS 线性插值与背景差分运动掩膜伪代码(Supp Algorithm 1-2)、人类研究协议(5 名被试、25 场景、40/20 对)。指标公式完整(§2.5,p951-953),Table 1(p954)给出全部模型 × 指标数值,可直接重算 Physics-IQ 排名。不可完全复现点:Sora/Runway/Pika 闭源 API(版本与采样不可控)、Gemini 1.5 Pro 行为随版本漂移、真实拍摄环境细节仅示意图(Supp Fig 7-8)、按物理原理分解仅有图形无逐格数值(Supp Fig 12)。arXiv v1(2025-01-14)与 WACV 版标题略有出入,正文数字一致;arXiv v3(2025-02-27)含 Fig 4 右面板 mean rank(Spearman -0.92, p<.005),WACV 版不含。
8 个视频生成模型在 Physics-IQ 上集体大幅落后物理方差上界
原文 caption:Fig. 4. How well do current video generative models understand physical principles? Left. The Physics-IQ score is an aggregated measure across four individual metrics, normalized such that pairs of real videos that differ only by physical randomness score 100%. All evaluated models show a large gap, with the best model scoring 29.5%, indicating that physical understanding is severely limited. Right. The mean rank of models across all four metrics; the Spearman correlation between aggregated results on the left and mean rank on the right is high (-.92, p<.005).
全篇核心负结果:8 个模型变体(VideoPoet/Lumiere 的 i2v 与 multiframe、Runway Gen 3、Pika 1.0、Stable Video Diffusion、Sora)的 Physics-IQ 总分全部集中在 10.0%–29.5%,而真实视频两遍拍摄(take 1 vs take 2)定义的物理方差上界是 100%。读图看两个锚点:最左侧绿色虚线是『真实世界的物理随机性』,模型柱状图都只到它的零头——视觉生成能力和物理理解之间存在约 3 倍以上的差距。
视觉真实感与物理理解无显著相关
原文 caption:Fig. 5. Relationship between visual realism and physical understanding. Left. A multimodal LLM (Gemini 1.5 Pro) is asked to identify the generated video among the real and the generated video for each scenario (MLLM score) in a two-alternative forced choice paradigm. Chance rate is 50%; lower scores indicate that the model finds it harder to tell apart generated from real videos (= better realism). Sora-generated videos are hardest to distinguish from real videos, whereas Lumiere (multiframe) is easiest. Right. This scatterplot with linear fit and 95% confidence interval shows that this is not the case: Visual realism is uncorrelated with physical understanding (Pearson's r=-0.46, p=.249 not significant).
全篇最重要的论断图:横轴是物理理解(Physics-IQ),纵轴是视觉真实感(MLLM 2AFC 得分,y 轴倒置,越靠上越真实),散点+线性拟合显示两者无显著相关(r=-0.46,p=.249)。读图要抓两个极端点:最会骗过 MLLM 的 Sora(真实感 55.6% 最接近 chance)物理垫底(10.0%);最容易被识破的 Lumiere multiframe(86.9%)物理反而排第二(23.0%)——这就是『视觉真实感 ≠ 物理理解』的定量证据。
成功与失败场景:能抹油漆、倒红液,但接不住球、切不开橘子
原文 caption:Fig. 7. We here visualize success and failure scenarios within the fluid dynamics and solid mechanics categories for the two best models, VideoPoet and Runway Gen 3, according to our metrics. Both models are able to generate physics plausible frames for scenarios such as smearing paint on glass (VideoPoet) and pouring red liquid on a rubber duck (Runway Gen 3). At the same time, the models fail to simulate a ball falling into a crate or cutting a tangerine with a knife.
定性证据面板:左列是能生成的物理合理续篇(VideoPoet 抹油漆、Runway 往橡皮鸭倒红液),右列是失败案例(球落进板条箱、刀切橘子)。读图对照每格 caption 与生成结果:模型擅长『流体铺展』这类训练集中常见的像素模式,却在需要接触力、碰撞、切割的固体力学上出错——把『复制外观模式』与『模拟物理因果』的能力边界画得很直观。
🎧 音频版
时长 15:11 · Edge TTS
视频生成模型懂物理吗?最会骗人的 Sora 只拿了 10 分(对话版)
小播:今天聊一个特别适合当谈资的话题:视频生成模型,到底懂不懂物理?
老播:这篇论文直接给了一组数字,你听完会记住:他们自建了 396 段真实世界视频的物理考试,测了 Sora、Runway、Pika 这些主流模型,结果最佳模型只拿了 29.5 分,满分线是真实世界的 100 分;而 Sora,那个生成视频以假乱真的 Sora,只拿了 10 分垫底。
小播:啊?Sora 生成的东西不是很像真的吗?
老播:这就是最反直觉的地方:视觉真实感和物理理解之间没有显著相关。这篇论文把这两个东西拆开了——模型能骗过你和它懂物理,是两条独立的能力。我们从头拆这场考试是怎么设计的。
小播:先说考试题吧,怎么出题才能考出物理理解?
老播:他们自己拍。66 个真实场景,全是训练数据里几乎不可能出现的怪场景:橡皮鸭插进多米诺链、壶铃砸纸杯、台球撞球。每个场景三个视角、拍两遍,一共 396 段视频。每段 8 秒,前 3 秒给模型当条件,让它预测后 5 秒。
小播:那怎么保证它没在背答案?怎么确认它是真懂物理?
老播:关键在断点。比如多米诺场景,条件段停在首牌刚倾倒、还没碰到第二张的那个瞬间——模型必须推理出碰撞会怎么传导。橡皮鸭插在链中间,它还得知道链条会在鸭子那里断掉。这种题背不出来。
小播:评分呢?总不能肉眼打分吧。
老播:四个指标,分别考:动作发生在哪、何时何地发生、发生多少、怎么发生。最简单的一项只问位置,模型最好也才 0.204 分,而真实视频自己之间是 0.678,差三倍以上。越要考「时机、程度、方式」,模型掉得越狠。
小播:那综合下来,最高分是谁?
老播:VideoPoet 的多帧版本,29.5 分。第二名是 Lumiere 多帧,23 分。Sora 垫底,10 分。记住这条主线:所有模型都离 100 分上界差一大截,物理理解整体严重受限。
小播:那视觉真实感呢?Sora 不是最会骗人吗?
老播:他们让 Gemini 1.5 Pro 做二选一,从真实和生成视频里挑出哪段是生成的,50% 是瞎猜水平。Sora 是 55.6%,几乎骗过了 Gemini,真实感全场第一。可它的物理分是全场倒数第一,10 分。
小播:最像真的,物理最差?
老播:对。反过来的例子也有:最容易被识破的 Lumiere 多帧,真实感 86.9%,物理分反而排第二。所以整篇最核心的结论就是:生成得越像真的,跟懂不懂物理,是两码事。这句话有数据撑腰:r 等于负 0.46,p 等于 0.249,统计上不显著相关。
小播:那模型到底是靠什么蒙混过关的?
老播:作者的机制解释叫 shortcut,走捷径:模型只需要在像素分布上复现训练数据里的常见模式。有个特别典型的例子,火柴放进水里,火焰触水的瞬间,Runway 凭空生出一根蜡烛还点着了——每一帧都高清写实,但时序上物理不可能。
小播:凭空变出蜡烛?
老播:对,这叫「物从无中生有」的幻觉。而且注意细节:它变出的是蜡烛,跟火柴同场景的东西,说明模型在调取场景记忆补齐内容,在做「看起来连贯」的拼接,在做「因果模拟」。还有证据:Lumiere 把红台球桌生成成绿的,暴露了训练数据里绿台球桌更常见;Sora 老插转场剪辑,说明它被训练成「像艺术视频」。
小播:那这套基准本身,除了打脸,还有什么用处?
老播:用处很大。数据、指标、代码全部开源,以后任何新模型出来,都能直接拿这套题考一遍,分数可复算。物理理解从此有了统一的度量衡。
小播:那看模型的分项成绩,有没有能抄作业的规律?
老播:有一个很清楚的规律:同一产品,多帧版本全面赢单帧版本,VideoPoet 从 20.3 涨到 29.5,Lumiere 从 19.0 涨到 23.0。给的条件越多、时间信息越足,表现越好。这跟直觉一致——预测未来的时候,知道过去几秒发生了什么,总比只看一帧强。
小播:还有别的吗?
老播:还有一个信号:全场最佳的 VideoPoet 恰好是因果自回归模型,就是那种逐帧往后推的架构。当「预测下一帧」的训练目标和考试方式同构的时候,成绩最好。另外分项看,模型擅长流体铺展这类训练里常见的模式,比如抹油漆、倒红液;一考接触力、碰撞、切割,就露馅了。
小播:那有没有模型表现出一点物理直觉?
老播:有,而且有个信号很有意思:同一产品,多帧版本全面赢单帧版本,VideoPoet 从 20.3 涨到 29.5。而全场最佳的视频生成模型,恰好是因果自回归模型。也就是说,当「预测下一帧」的训练目标跟考试方式同构的时候,表现最好。模型擅长流体铺展这类常见模式,比如抹油漆、倒红液;一考接触力、碰撞、切割,就露馅了。
小播:听起来基准很有用,但这篇论文自己承认的最弱一环是什么?
老播:最弱的一环在机制解释上。作者说模型是「复制模式」,但这个解释只有 8 个模型的相关性数据加几个定性案例撑着,没有任何模型内部的干预实验,没有操纵训练分布,没有对照实验。另外三个现实限制:Sora、Runway、Pika 都是闭源 API,采样细节不可控;评分规则刻意严格,惩罚幻觉和转场,作者自认 Sora 如果遵守静态机位、分数会大幅提升;还有像素级误差会把「不懂物理」和「预测困难」混在一起。
小播:所以怎么总结这篇?
老播:一句话:视觉真实感不等于物理理解,最会骗人的 Sora 物理垫底,只有 10 分。最该记住的数字是 29.5 对 100——最佳模型离真实世界的物理方差上界,还差一大截。
小播:那照这篇的意思,模型看再多视频也懂不了物理?
老播:作者留了个开放问题:到底是继续堆数据和算力,还是得让模型真的去跟世界互动?论文的态度是,先把「懂没懂」量化清楚,这个基准就是干这个的。至少现在,别把「生成得像真的」当成「它懂了」。