Flow Matching 与扩散模型:把「噪声变数据」拆成一条可训练的微分方程
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。来源:MIT 6.S184 课程讲义(Peter Holderrieth、Ezra Erives),arXiv:2506.02070v3(84 页,2026-03-18)。
为什么一张图能从纯噪声里长出来?Stable Diffusion 3、Movie Gen 这些模型的答案可以压缩成一句话:先定义一条从噪声分布 $\mathcal{N}(0,I_d)$ 走向数据分布的「概率路径」,再训练一个神经网络去拟合路径上每个位置的运动方向。MIT 这门课(6.S184,课程网站 diffusion.csail.mit.edu)的讲义把这件事从头推导了一遍,给出一个贯穿全篇的结论:flow matching 与扩散模型是同一套「概率路径 + 向量场」框架的两种参数化,条件训练目标与边际目标只差一个常数,velocity 与 score 可以解析互转。
先看一个现象:训练一个 flow matching 模型,只需要反复执行三行操作——采样一个数据点 $z$、采样一个时间 $t\sim U[0,1]$、加一点高斯噪声,然后让网络预测「去噪方向」并做均方误差回归(Algorithm 3)。训练过程从不模拟任何 ODE 轨迹(simulation-free),代价极低。但训练完之后,从纯噪声出发沿学到的向量场积分,采样直方图就和真实数据分布逐时间步对齐。要回答「这么简单的回归为什么能学会整个分布」,得先引入一个概念:概率路径。
核心概念:概率路径与条件向量场
概率路径 $p_t$ 描述「t 时刻的样本服从什么分布」:$t=0$ 时是纯噪声 $p_{\mathrm{init}}=\mathcal{N}(0,I_d)$,$t=1$ 时是数据 $p_{\mathrm{data}}$。最常用的 Gaussian 条件路径,给每个数据点 $z$ 一条从噪声到 $z$ 的插值:
$$p_t(x \mid z) = \mathcal{N}\!\left(\alpha_t z,\ \beta_t^2 I_d\right), \qquad x = \alpha_t z + \beta_t \varepsilon$$
这里的 $\alpha_t$、$\beta_t$ 是噪声调度(noise scheduler),单调且满足 $\alpha_0=\beta_1=0$、$\alpha_1=\beta_0=1$,保证 $t=0$ 落在纯噪声、$t=1$ 落在数据点 $z$ 上;$\varepsilon\sim\mathcal{N}(0,I_d)$ 是标准高斯噪声。采样式可以这样读:$t$ 越接近 1,$\alpha_t$ 越大、$\beta_t$ 越小,样本越像数据;$t$ 越接近 0 越像噪声。
有了路径,还需要知道「粒子该往哪走」。对 Gaussian 路径,条件向量场可以解析求出来(对 flow $\psi_t = \alpha_t z + \beta_t x$ 求时间导数):
$u_t^{\mathrm{target}}(x \mid z) = \left(\dot\alpha_t - \frac{\alpha_t \dot\beta_t}{\beta_t}\right) z + \frac{\dot\beta_t}{\beta_t}\, x$
其中 $\dot\alpha_t,\dot\beta_t$ 是调度的导数,$z$ 是目标数据点,$x$ 是当前带噪样本。它回答的问题是:给定「目标是 $z$」,$t$ 时刻位于 $x$ 的粒子应该朝哪个方向移动。注意条件场只依赖单个已知的 $z$——这是后面一切化简的起点。
关键来了:marginalization trick
生成时 $z$ 是未知的,我们需要的是能输运整个分布 $p_{\mathrm{init}}\to p_{\mathrm{data}}$ 的边际向量场 $u_t^{\mathrm{target}}(x)$。直接定义它要除以边际密度 $p_t(x)$,而那个积分不可算。Theorem 9(marginalization trick)绕开了这一点:边际向量场等于条件向量场的后验加权平均——
$$u_t^{\mathrm{target}}(x) = \int u_t^{\mathrm{target}}(x \mid z)\ \frac{p_t(x\mid z)\, p_{\mathrm{data}}(z)}{p_t(x)}\ dz$$
被积函数中的分式,正是「给定带噪样本 $x$,它来自数据点 $z$」的后验。所以这个式子可以理解为:把每个候选数据点的走向,按置信度加权求和。continuity equation(Theorem 11)给出充要条件:只要 $\partial_t p_t = -\mathrm{div}(p_t u_t^{\mathrm{target}})$,沿该场流动的粒子分布就严格等于 $p_t$。关键点在于:$p_t(x)$ 只出现在后验权重里,训练时可以用期望估计,全程不必显式计算边际密度。
训练目标:L_FM = L_CFM + C
接下来是整篇讲义最实用的结论(Theorem 12):不可实现的边际目标 $\mathcal{L}_{\mathrm{FM}}$ 与解析可算的条件目标 $\mathcal{L}_{\mathrm{CFM}}$ 梯度相同,只差一个与参数 $\theta$ 无关的常数——
$$\mathcal{L}_{\mathrm{FM}}(\theta) = \mathcal{L}_{\mathrm{CFM}}(\theta) + C$$
所以最小化 $\mathcal{L}_{\mathrm{CFM}}$ 等价于拟合真实边际向量场:在无限表达能力假设下,最优解 $\theta^{\ast}$ 处有 $u_t^{\theta^{\ast}} = u_t^{\mathrm{target}}$,采样终点 $X_1$ 近似服从 $p_{\mathrm{data}}$。取最常用的 CondOT 路径 $\alpha_t=t,\ \beta_t=1-t$,损失进一步化简成一行最小二乘:
$\mathcal{L}_{\mathrm{CFM}} = \mathbb{E}_{t\sim U[0,1],\, z\sim p_{\mathrm{data}},\, \varepsilon\sim\mathcal{N}(0,I_d)} \left\| u_t^\theta\!\left(tz + (1-t)\varepsilon\right) - (z - \varepsilon) \right\|^2$
逐项看:输入 $tz+(1-t)\varepsilon$ 是「随时间线性插值的带噪样本」,回归目标 $z-\varepsilon$ 是「样本减噪声」——网络要学的是从带噪样本指向干净方向的速度。训练后只需用 Euler 法(Algorithm 1)从噪声积分到 $t=1$ 即可采样。
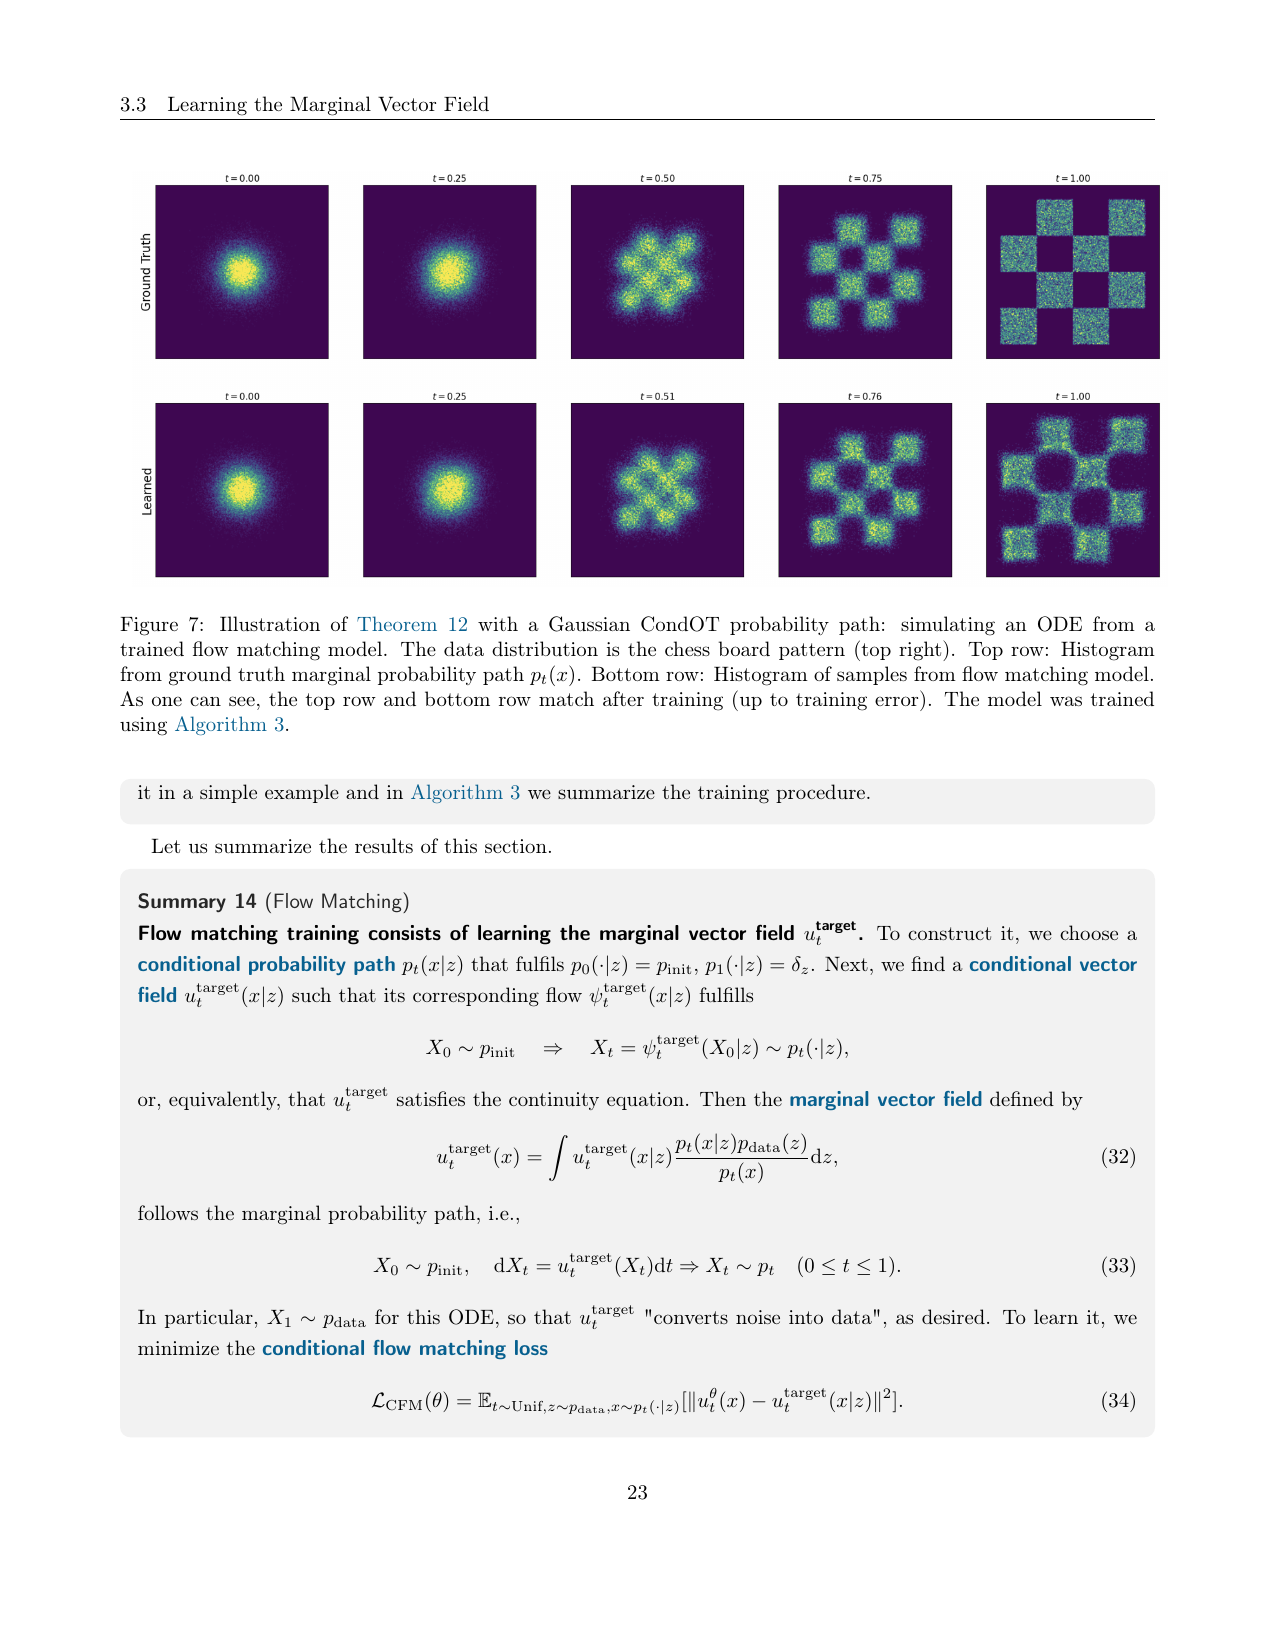
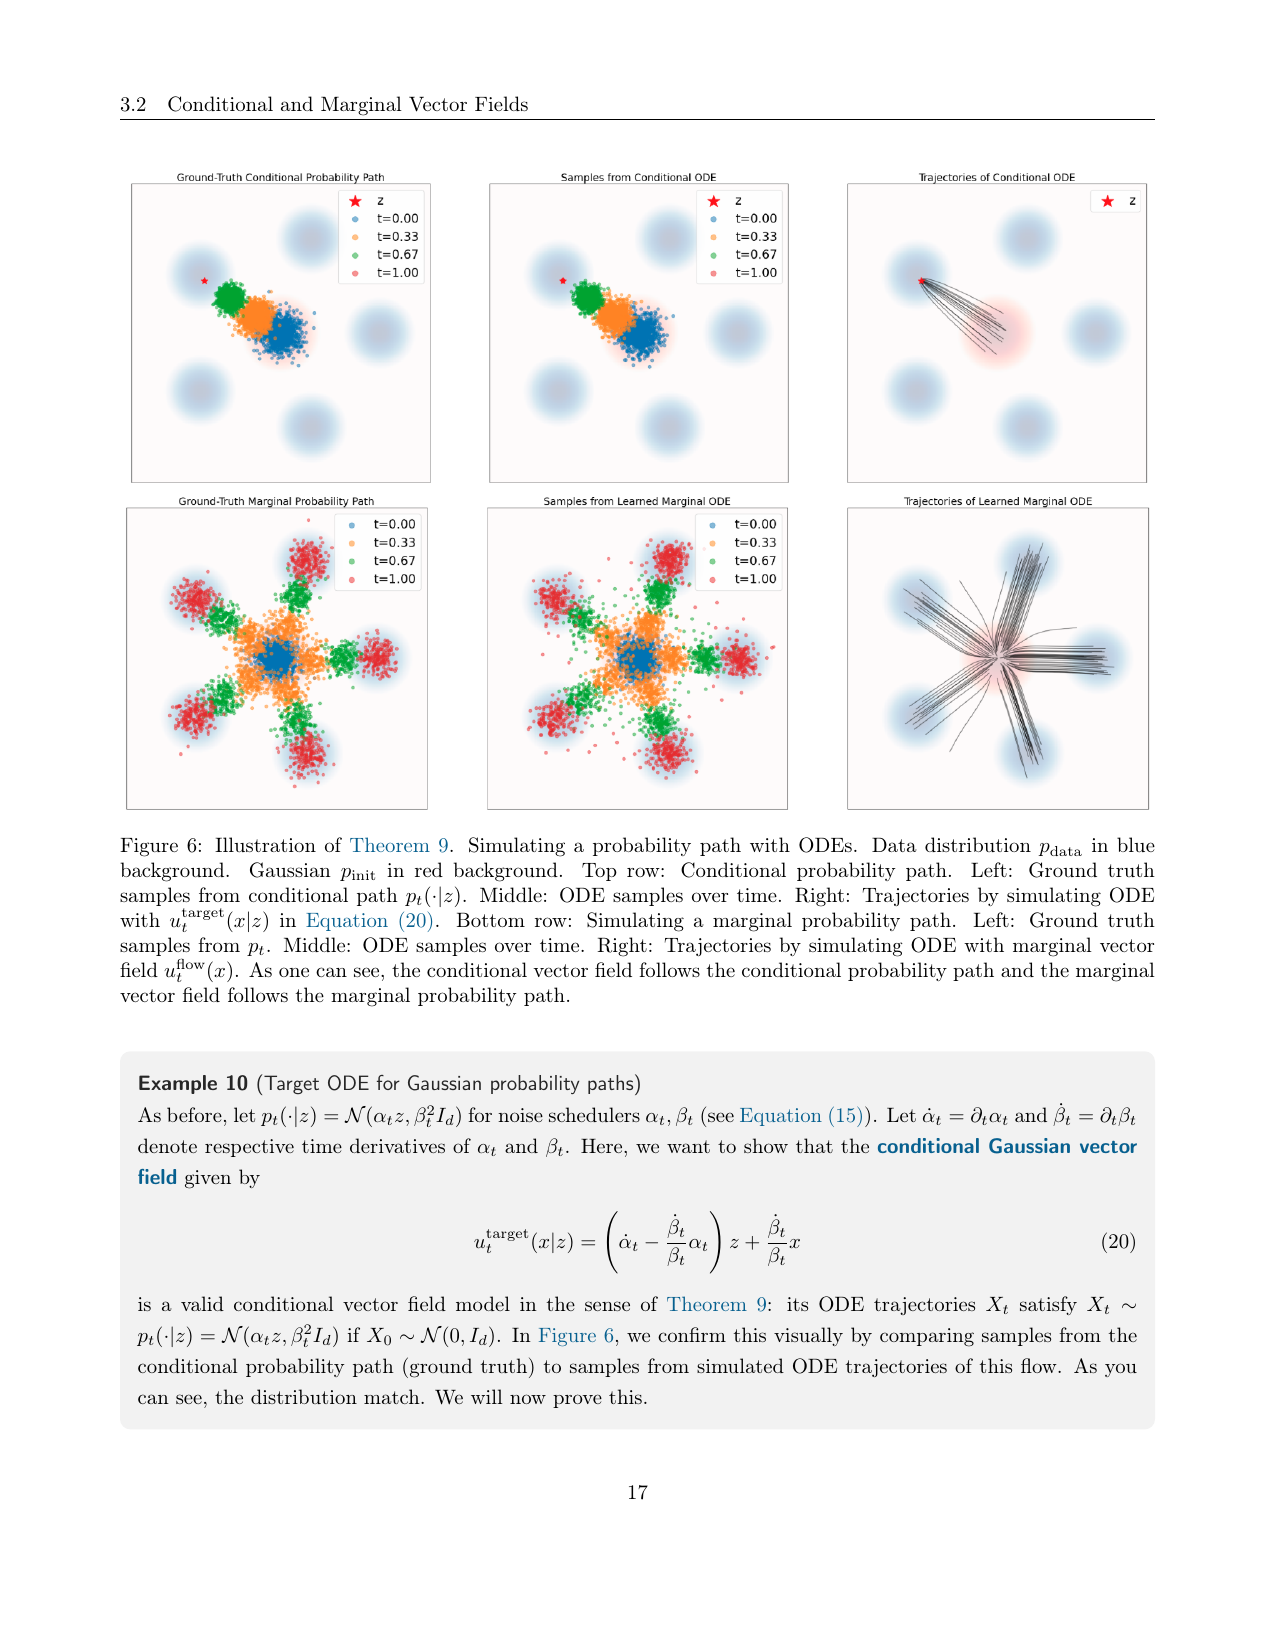
Figure 7 是这张卡的核心证据:下排是训练后模型从噪声积分得到的直方图,上排是 ground-truth 边际路径 $p_t$,两者只在训练误差级别有差异——「条件回归等价于边际输运」从定理落到了可复现演示。大规模印证是转述的:Stable Diffusion 3 用同一 CFM 目标加 MM-DiT 架构(8B 参数、50 步 Euler、CFG $w\in[2.0,5.0]$),Movie Gen Video 用 CFM 加 CondOT(30B 参数、时间 autoencoder 8×)。同一个公式在不同尺度上被反复使用,这正是教程要解释的现象。机制的图解在 Figure 6:分别用 ODE 模拟条件场与边际场,采样分布都与左列的 ground-truth 直方图重合,说明「先定条件场、把边际化搬进期望」的构造确实把 $\mathcal{N}(0,I_d)$ 输运到了 $p_{\mathrm{data}}$。
同一机制的第二面:score 与 SDE 采样
flow matching 学「速度场」$u$,扩散模型学「分数」$\nabla\log p_t$——这是同一机制的两种参数化。Gaussian 路径下二者可解析互转(Proposition 1):
$$u_t^{\mathrm{target}}(x) = a_t\, \nabla\log p_t(x) + b_t\, x, \qquad a_t = \frac{\beta_t^2 \dot\alpha_t}{\alpha_t} - \dot\beta_t \beta_t,\quad b_t = \frac{\dot\alpha_t}{\alpha_t}$$
学出任何一个,另一个可以代公式换出来,还能再参数化为 denoiser $D_t(x)=\mathbb{E}[z\mid x]$。训练侧同样有 $\mathcal{L}_{\mathrm{SM}} = \mathcal{L}_{\mathrm{CSM}} + C$(Theorem 22),DDPM 的噪声预测目标就是它的重参数化。由此得到的工程收益:训练时可以不指定噪声强度 $\sigma_t$,训练后按需选择采样器——确定性 ODE 或任意噪声强度的 SDE 共享同一个网络。Theorem 17 保证加噪不改变边际:只要写成 $dX_t = [u_t^{\mathrm{target}}(X_t) + \frac{\sigma_t^2}{2}\nabla\log p_t(X_t)]dt + \sigma_t dW_t$,$X_t$ 的边际分布仍然是 $p_t$(由 Fokker-Planck 方程 Theorem 19 证明)。所谓「最优 $\sigma_t$」是训练与模拟误差的产物,理论上是自由参数(p28 脚注 2)。
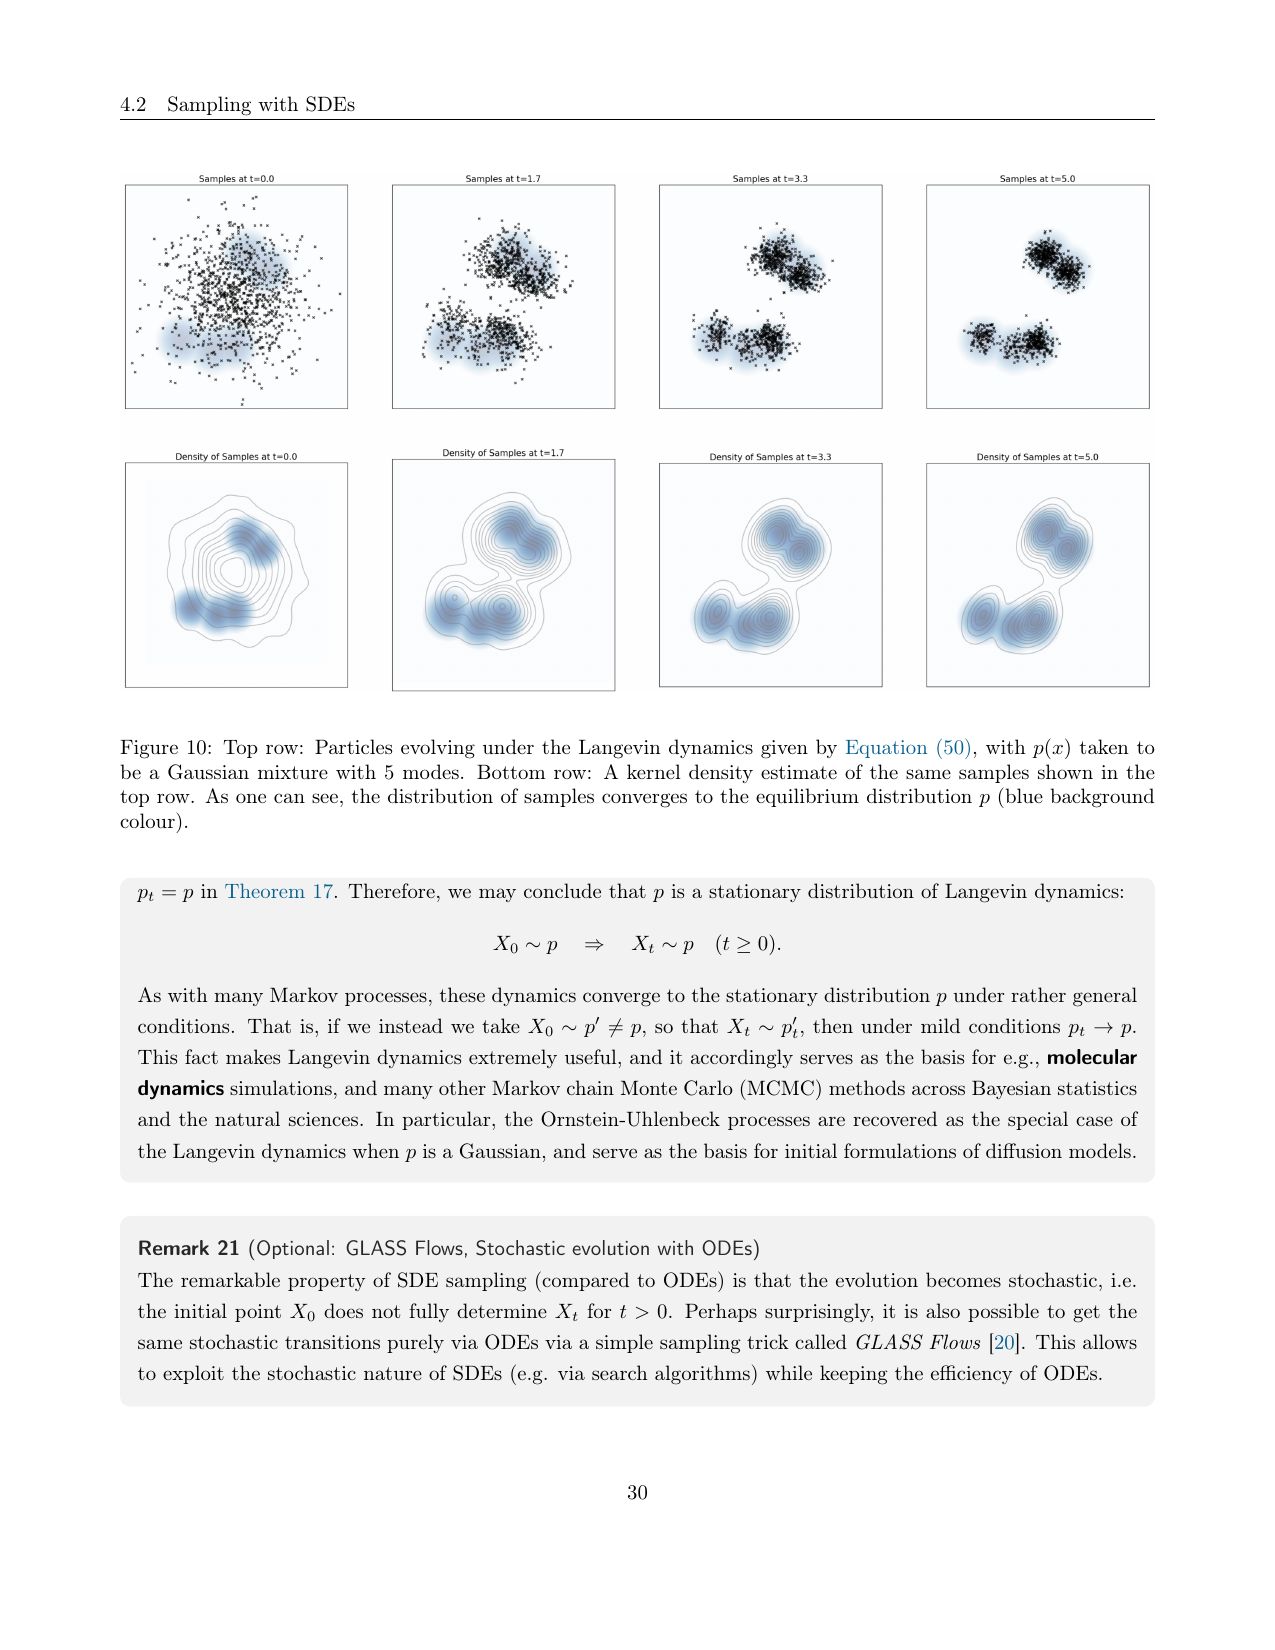
Figure 10 展示这套机制超出生成场景的一面:取常数路径 $p_t = p$,SDE 退化为 Langevin 动力学,粒子演化后收敛到平衡分布 $p$(5-mode 高斯混合)——同一族方程同时覆盖生成式建模与 MCMC 采样,这是「continuity/Fokker-Planck 统一透镜」论点的可视化依据。
工程配方与理论边界
工程层需要两个补充。其一是 classifier-free guidance(CFG):采样时用 $\tilde{u}_t(x\mid y) = (1-w)\, u_t^{\mathrm{target}}(x\mid\varnothing) + w\, u_t^{\mathrm{target}}(x\mid y)$ 放大条件信号,训练时以概率 $\eta$ 把标签丢弃成 $\varnothing$,让一个网络同时扮演条件与无条件两个角色(Algorithm 5)。注意 $w>1$ 时 $\tilde{u} \neq u^{\mathrm{target}}$,所以 CFG 是启发式而非推导结论,论文用「几乎所有 AI 生成图像都重度使用 CFG $w\ge 4$」的经验事实支撑它(p39)。其二是离散数据:v3 新增的 CTMC 离散 diffusion 把 rate matrix 对应向量场、Kolmogorov Forward Equation 对应 continuity equation(Theorem 36),masked diffusion LM 就是这个配方,SOTA 离散扩散 Llada2.0(100B 参数)据引用在使用它(p65)。
诚实的边界有两条。第一,泛化性限制是构造性的:denoising diffusion 只适用于 Gaussian 初值与 Gaussian 路径,flow matching 允许任意 $p_{\mathrm{init}}\to p_{\mathrm{data}}$(Appendix E),「Gaussian 限制」是实现约束。第二,本教程的闭环后两环天然缺失:没有任何干预或消融实验,最接近干预的 CFG 被作者自标为启发式;没有定量基准(无 FID/IS、无 loss 曲线、无基准表),全部图片是定性可视化或转述外部数字,SD3 与 Movie Gen 的 8B/30B 参数、50 步 Euler 等设置都来自外部技术报告。定理的 minimizer 结论还依赖无限表达能力假设(Theorem 12/22),toy 演示未公开网络规模、超参与训练步数,「match up to training error」是目视结论。
一句话记住这篇
flow matching 与扩散模型共享同一条机制链:先定条件概率路径,再按后验加权得到边际向量场,最小二乘回归($\mathcal{L}_{\mathrm{FM}}=\mathcal{L}_{\mathrm{CFM}}+C$)等价于拟合该场,采样终点 $X_1$ 逼近 $p_{\mathrm{data}}$;velocity 与 score 可解析互转,训练后 ODE 与任意噪声 SDE 共享同一网络。最该记住的保留态度是:这套推导在小 toy 上被严格验证、被 SD3/Movie Gen 等大规模使用,但教程本身无实验,CFG 的 $w$ 与工业收益数字都是经验证据。
一篇自包含的 MIT 6.S184 课程讲义:从 ODE/SDE 与 continuity/Fokker-Planck 方程第一性原理出发,完整推导 flow matching 与 (denoising) score matching 的训练目标(L_FM=L_CFM+C、velocity↔score 可互转、训练后任意 σt 的 SDE 采样),并延伸到 CFG、DiT/U-Net、latent VAE 与离散 diffusion(CTMC);纯教程定位——只有 toy 定性可视化与转述的外部模型数字,无任何原创干预/收益实验,闭环后两环天然缺失。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:扩散/flow matching 模型生成过程的可观测数学结构:从 p_init=N(0,Id) 到 p_data 的插值/加噪概率路径 p_t(采样式 x=αt z+βt ε,Eq 15-16, p15-16)、解析形式的训练目标(条件向量场 u_t^target(x|z) 与条件 score ∇log p_t(x|z),Eq 20/40, p17/25)、训练后模型沿 ODE/SDE 的生成轨迹(Algorithm 1/2, p9/13),以及采样分布与 ground-truth 边际路径 p_t 的一致性(Fig 7, p23)。
在哪里观测:连续数据生成(图像/视频/分子,表示为 z∈Rd,§1.3, p4-6;文本作为离散数据在 v3 扩展至 §7 的 CTMC 离散 diffusion);教程自带示例设置:2D chessboard toy 分布(Fig 5/7/19, p15/23/60)、5-mode 高斯混合 Langevin 平衡(Fig 10, p30)、MNIST 手写数字 CFG(Fig 13, p39)、128×128 ImageNet 类条件生成(Fig 11 转述自 [18], p35/39)。
如何量化:教程的『测量』= 解析推导 + 定性可视化,无任何定量指标:目标场/score 由解析公式给出(Eq 17-20, p16-17;Eq 38-42, p25-26),训练后模拟 ODE/SDE 并将采样直方图与 ground-truth p_t 对比(Fig 7『the top row and bottom row match after training (up to training error)』, p23;Fig 10 KDE 收敛, p30);全文无 FID/IS/PP 等指标、无 loss 曲线、无基准表。
② 机制假设
假设:为什么 flow matching / score matching 目标能学到数据分布:存在一个把 p_init 输运到 p_data 的输运场——边际向量场 u_t^target(Theorem 9, Eq 17-19, p16);对解析可得的条件向量场做后验加权平均即得边际向量场(marginalization trick),continuity equation 是『向量场↔概率路径』匹配的充要条件(Theorem 11, Eq 23, p19);加 score 项 σt²/2·∇log p_t 的 SDE 保持同一边际路径(Theorem 17, Eq 44-45, p27,由 Fokker-Planck 方程 Theorem 19, Eq 49, p29 证明);训练侧,不可积的边际目标被条件目标无偏替代——L_FM=L_CFM+C、L_SM=L_CSM+C(Theorem 12/22, p20/31),故最小化 L_CFM/L_CSM 等价于拟合 u_t^target/∇log p_t,采样终点 X1 近似服从 p_data(Theorem 12『minimizer θ* 处 u_θ*_t=u_t^target』, p20;Theorem 22『s_θ*_t=∇log p_t』, p31)。
证据:
- 完整定理-证明链:Theorem 9(p16)→ Theorem 11(p19)→ Theorem 12(p20)→ Theorem 17(p27)→ Theorem 19(p29)→ Theorem 22(p31)→ Proposition 1(p26),全部在文内给出证明;continuity equation 与 Fokker-Planck 另有自含证明(Appendix B / Theorem 41, p72-76)。
- toy 定性验证:Fig 6(p17)条件/边际 ODE 轨迹与 ground-truth p_t 分布一致;Fig 7(p23)训练后 flow matching 采样直方图与 p_t 匹配(『up to training error』);Fig 10(p30)Langevin 收敛到 5-mode 高斯混合平衡分布;Fig 9(p27)SDE 采样保持边际 p_t。
- 外部大规模印证(转述,非本教程实验):Stable Diffusion 3 用同一 CFM 目标 + MM-DiT(8B 参数、50 步 Euler、CFG w∈[2.0,5.0],§6.3.1, p52);Movie Gen Video 用 CFM + CondOT(30B 参数、temporal AE 8×,§6.3.2, p53);离散侧 SOTA(引 [4] Llada2.0, 100B)用 §7 的 CTMC 配方(p65)。
- 文献等价性论证:离散时间 DDPM 的 ELBO 在连续时间下变为等式(Appendix E, p82);forward process / time-reversal 是 Gaussian 概率路径的等价构造(p82-83)——『如何构造训练目标』存在多种等价方案,教程用 Fokker-Planck 路径统一之。
备选解释:
- forward process 视角(Eq 146, Appendix E, p82-83):先加噪再反转;教程论证其被迫限制为仿射向量场 u_t^forw(x)=a_t x 才能得到闭式条件分布,且『前向过程』训练中从不真正模拟(p83)。
- 时间反转构造(Anderson [2], Eq 147-148, p83):训练目标可经时间反转 SDE 得到,是 Proposition 1 目标在倒置时间约定下的特例;教程指出其非必要且常次优(probability flow ODE 通常更好,引 [23,28], p83)。
- 离散时间 DDPM([41,42,17], p82):Markov 链 + ELBO 下界;连续时间下 ELBO 变紧,与 SDE 视角『并非根本不同』(p82)。
- score 与 velocity 不是两个机制而是同一机制的两个参数化:Gaussian 路径下可解析互转(Proposition 1, Eq 41-42, p26),且都可再参数化为 posterior mean / denoiser D_t(x)=E[z|x](Remark 16, Eq 43, p26)——备选参数化被证明等价而非排除。
- 离散侧:rate matrix 是向量场的类比、Kolmogorov Forward Equation 是 continuity equation 的离散类比(Proposition 2, p61)、离散 marginalization trick(Theorem 36, p61)与连续版同构;Generator Matching 框架 [19] 进一步统一二者(Remark 40, p66)。
形式化/toy model:教程核心推导(§3-4,v3 编号;全部方程可在对应页码找到): 1. 概率路径:p_t(·|z) 满足 p_0=p_init、p_1=δz(Eq 11, p14);Gaussian 路径 p_t(·|z)=N(αt z, βt²Id),调度 α0=β1=0、α1=β0=1(Eq 15, p15);采样 x=αt z+βt ε(Eq 16, p16)。 2. 条件向量场(Gaussian):u_t^target(x|z)=(α̇t−αt β̇t/βt)z+(β̇t/βt)x(Eq 20, p17),由 flow ψ_t^target(x|z)=αt z+βt x 求导得到(Eq 21, p17)。 3. 边际化 trick:u_t^target(x)=∫u_t^target(x|z)·p_t(x|z)p_data(z)/p_t(x) dz(Eq 17-18, p16;Theorem 9, p16);continuity equation ∂t p_t=−div(p_t u_t^target)(Eq 23, Theorem 11, p19)。 4. SDE 扩展:dX_t=[u_t^target(X_t)+σt²/2·∇log p_t(X_t)]dt+σt dW_t(Eq 44, Theorem 17, p27);Gaussian score ∇log p_t(x|z)=−(x−αt z)/βt²(Eq 40, p25);Langevin 特例(Eq 50, Remark 20, p29)。 5. Flow matching 目标:L_CFM=E‖uθt(x)−u_t^target(x|z)‖²(Eq 26, p20),L_FM=L_CFM+C(Theorem 12, p20);Gaussian 化简为 E‖uθt(αt z+βt ε)−(α̇t z+β̇t ε)‖²(Eq 31, Example 13, p22);CondOT αt=t、βt=1−t:L=E‖uθt(tz+(1−t)ε)−(z−ε)‖²(Algorithm 3, p22)。 6. Score matching 目标:L_CSM=E‖sθt(x)−∇log p_t(x|z)‖²(Eq 54, p32),L_SM=L_CSM+C(Theorem 22, p31);Gaussian 化简 E‖sθt(αt z+βt ε)+ε/βt‖²(Example 23, p31);DDPM 重参数化 εθt=−βt sθt、丢弃 1/βt²(p31;Algorithm 4, p32)。 7. velocity↔score 转换(probability flow ODE):u_t^target(x)=a_t·∇log p_t(x)+b_t·x,a_t=βt²α̇t/αt−β̇tβt、b_t=α̇t/αt(Proposition 1, Eq 41-42, p26);训练后可用任意 σt≥0 构造 SDE 采样(Eq 55-56, p33);denoiser D_t(x)=(βt u_t^target(x)−β̇t x)/(α̇t βt−αt β̇t)(Remark 16, Eq 43, p26)。 8. CFG:ũ_t(x|y)=(1−w)u_t^target(x|∅)+w·u_t^target(x|y)(Eq 65, Summary 27, p38);训练时以概率 η 丢弃标签 y→∅(Algorithm 5, p38);w≠1 时 ũ≠u^target,为启发式(p37/39)。 9. 时间采样:所有训练算法取 t∼Unif[0,1](Algorithms 3/4/5, p22/32/38);logit-normal 等非均匀时间采样/损失加权不在本教程范围内(属 companion guide [26],教程未覆盖)。 10. 离散扩散对应式:rate matrix 定义与条件(Eq 84-86, p55)、factorized mixture path(Example 35, p59)、KFE(Proposition 2, p61)、离散 marginalization(Theorem 36, p61)、masked diffusion LM 目标(Algorithm 8, p65)。
③ 局部干预
干预环缺失(null)——如实标注,不硬凑。
④ 工程收益
收益环缺失(null)——如实标注,不硬凑。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 强(对教程而言)。现象→机制是教程的主干:从『生成轨迹与训练目标的数学结构』到『为何这些目标能学到 p_data』有完整演绎证明链(Theorem 9/11/12/17/19/22 + Proposition 1 全部在文内证明,Appendix B 另附 FP 证明,p72-76),toy 可视化(Fig 6/7/9/10)提供定性佐证;但证据类型是『数学等价+定性演示』,教程不做量化实验,且 minimizer 等价结论依赖无限表达能力等理想假设(Theorem 12/22, p20/31)。 |
| 机制→干预 | 缺。教程无任何局部干预/扰动实验(无权重/激活/数据扰动、无消融、无 mechanism probing);最接近『干预』的是推理时 CFG 的 w>1 放大,但被明确标注为启发式、非从机制推出的可证伪命题(p37/39)。 |
| 干预→收益 | 缺。无干预故无干预→收益证据;文中 SD3/Movie Gen 的规模与采样设置(8B/30B 参数、50 步 Euler、CFG w∈[2.0,5.0])全部转述自外部技术报告 [14]/[33](§6.3, p52-53),非本教程实验。 |
| 最弱一环 | 缺:local_intervention 与 engineering_gain 两环整体缺失(教程无干预实验、无收益实验),mechanism_to_intervention 与 intervention_to_gain 随之为空——这是 tutorial 的固有缺口,也是整个闭环最弱之处;phenomenon_to_mechanism 证据链再完整,闭环也无法闭合。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| marginal 与 conditional flow matching 目标等价 | L_FM(θ)=L_CFM(θ)+C(梯度相同;minimizer θ* 处 u_θ*_t=u_t^target,假定无限表达能力) | 离散时间 DDPM 的 ELBO 只是下界;连续时间下 Theorem 12/22 是等式而非下界 | Theorem 12, p20;Appendix E, p82 |
| score matching 与 denoising score matching 等价 | L_SM(θ)=L_CSM(θ)+C;minimizer θ* 处 s_θ*_t=∇log p_t;Gaussian 路径下化简为噪声预测 E‖sθt(αt z+βt ε)+ε/βt‖² | βt≈0 时 1/βt² 数值不稳定;DDPM 丢弃常数并重参数化 εθt=−βt sθt 得 L_DDPM=E‖εθt(αt z+βt ε)−ε‖² | Theorem 22, Example 23, p31;Algorithm 4, p32 |
| velocity↔score 转换(probability flow ODE) | u_t^target(x)=a_t·∇log p_t(x)+b_t·x(a_t=βt²α̇t/αt−β̇tβt, b_t=α̇t/αt);学一个即得另一个;还可再参数化为 posterior mean / denoiser D_t(x)=E[z|x] | 训练后任意 σt≥0 的 SDE 采样(Eq 55-56)与确定性 ODE 采样共享同一概率路径 | Proposition 1, Remark 16, p26;Summary 24, p32-33 |
| SDE 扩展保持边际概率路径 | dX_t=[u_t^target(X_t)+σt²/2·∇log p_t(X_t)]dt+σt dW_t ⇒ X_t∼p_t(σt 可训练后任意选取;最优 σt 是误差产物,p28 脚注 2) | Langevin 静态路径特例退化为 MCMC;GLASS flows 为另一扩展(Remark 21, p30) | Theorem 17, Eq 44-45, p27;Theorem 19 (Fokker-Planck), p29;Remark 20, p29 |
| CondOT 目标化简与 toy 演示 | αt=t、βt=1−t ⇒ L_CFM=E‖uθt(tz+(1−t)ε)−(z−ε)‖²;训练后 ODE 采样直方图与 ground-truth p_t 匹配(目视结论) | 一般 Gaussian 路径目标 E‖uθt(αt z+βt ε)−(α̇t z+β̇t ε)‖²;无任何定量指标对比 | Example 13, Algorithm 3, p22-23;Fig 7, p23 |
| 离散扩散(CTMC)与连续 flow matching 同构 | rate matrix 类比向量场、KFE 类比 continuity equation、离散 marginalization trick(Theorem 36)成立;factorized mixture path 上得到 masked diffusion LM 训练目标(token-wise NLL) | 状态空间 |S|=V^d 指数增长,必须 factorized(稀疏)约束;SOTA 离散 diffusion(Llada2.0, 100B,引 [4])使用该配方 | §7, p54-66;Theorem 33, p56;Theorem 36/Proposition 2, p61;Algorithm 8, p65;Remark 40, p66 |
Insights
- marginalization trick 是 flow matching 可规模化的支点:条件目标解析可得(Eq 20, p17),边际目标 ∫u_t^target(x|z)·后验 dz 的期望可以在期望内部计算(Theorem 9/12 的证明核心, p16/20),从而完全绕开不可积的边际密度 p_t(x)——『先定条件场、再把边际化搬进期望』这一顺序是整套算法的关键结构。
- 『学什么』可以在训练后决定:L_FM=L_CFM、L_SM=L_CSM 且 Gaussian 路径下 velocity/score/denoiser 三参数化可解析互转(Proposition 1, Remark 16, p26),同一个网络可以按需选 ODE 或任意 σt 的 SDE 采样(Eq 55-56, p33)——训练目标与采样器解耦。
- continuity equation 与 Fokker-Planck 方程是统一透镜:flow(Theorem 11, p19)、SDE 扩展(Theorem 17, p27)、Langevin MCMC(Remark 20, p29)都是同一方程族的实例;forward process 与 time-reversal 只是等价实现(Appendix E, p82-83),probability flow ODE 反而常更优(引 [23,28], p83)。
- 加噪项不改变边际:σt dW_t 的注入对边际 p_t 无影响(Theorem 17, p27),这是『随机采样与确定性采样共享同一训练模型』的数学原因;『最优 σt』的存在是训练/模拟误差的产物而非理论需求(p28 脚注 2)。
- 泛化性边界被精确画出:flow matching / stochastic interpolants 允许任意 p_init→p_data 与任意概率路径,denoising diffusion 只适用于 Gaussian 初值与 Gaussian 路径(Appendix E, p83-84)——『Gaussian 限制』不是实现细节而是构造性约束。
- CFG 是经验启发式而非推导结论:w>1 时 ũ≠u^target(p37),其合理性靠『几乎所有 AI 生成图像都重度使用 CFG w≥4』的经验事实支撑(p39);∅ 标签技巧让单网络同时近似条件与无条件目标,是『一个模型两个角色』的工程巧思(p38)。
- 离散与连续共享同一套原理:rate matrix↔向量场、KFE↔continuity equation、marginalization trick 两侧同构(Theorem 36, p61),Generator Matching 框架 [19] 将它们统一为『马尔可夫过程的生成式学习』(Remark 40, p66)——教程本身即隐含了这种可移植性论证。
vs 同类工作
局限
- 教程定位为教学讲义(MIT 6.S184 课程笔记),无原创实验:所有图均为定性可视化(Fig 5-20)或转述外部工作(Fig 11 来自 [18]),全文无 FID/IS/PP 等定量指标、无基准表、无 loss 曲线。
- toy 演示的可复现信息不足:chessboard(d=2)、5-mode 高斯混合、MNIST 图示均未给出网络规模、超参、训练步数与 seed,『match up to training error』(Fig 7, p23)是目视结论;严格复现需依赖课程 labs(网站 diffusion.csail.mit.edu,Remark 1, p3)。
- 理论结论依赖理想化假设:Theorem 12/22 的 minimizer 结论假定无限表达能力参数化(p20/31);SDE 解的存在唯一性(Theorem 5, p12)与随机积分不展开(引 [29]);Fokker-Planck 充分性依赖抛物型 PDE 解的唯一性(Appendix B, p76)。
- 数值部分只覆盖一阶方法:Euler(Algorithm 1, p9)与 Euler-Maruyama(Algorithm 2, p13),Heun 仅提及(p8);采样步数、σt 调优等实践细节留给 labs。
- 等价性结论有明确边界:velocity/score/denoiser 互转的分母项(α̇t βt−αt β̇t,Eq 43, p26)在退化调度下未讨论;DDPM 丢弃 1/βt² 在 βt≈0 处数值不稳(p31);CFG 的 w 无理论指导值,是经验超参(p39)。
- v3 新增内容同样无实验支撑:VAE/β-VAE(§6.2, p46-51)与 CTMC 离散 diffusion(§7, p54-66)给出算法与推导,但 masked diffusion LM 等均为配方描述,效果数据全部转述(如 Llada2.0 引 [4], p65)。
可复现性
教程给出全部 8 个算法的完整伪代码:Euler 采样(Algorithm 1, p9)、Euler-Maruyama(Algorithm 2, p13)、flow matching 训练(Algorithm 3, p22)、score matching 训练(Algorithm 4, p32)、CFG 训练(Algorithm 5, p38)、β-VAE(Algorithm 6, p51)、CTMC 采样/训练(Algorithm 7/8, p58/65),配合解析目标公式(Eq 20/26/31/40/54 等)与全部定理证明(continuity equation 与 Fokker-Planck 的自含证明在 Appendix B, p72-76),理论上可按图实现 toy 示例;教程不含代码与数据集,配套 lecture recordings 与 labs(含 MNIST lab three, Fig 13, p39)在课程网站 https://diffusion.csail.mit.edu/(Remark 1, p3);定量数字无法独立核验(教程无定量结果,SD3/Movie Gen 数字转述 [14]/[33]);版本说明:本卡基于最新版 arXiv:2506.02070v3(2026-03-18,84 页;v1 2025-06-02、v2 2025-07-12 为 56 页旧结构,v3 重排章节并新增 §6.2 VAE 与 §7 离散 diffusion),逐 section 核对的是 v3 的 §1-§8 与 Appendix A-E。
训练后的 flow matching 模型用 ODE 采样,直方图与 ground-truth 边际路径对齐(chessboard toy)
原文 caption:Illustration of Theorem 12 with a Gaussian CondOT probability path: simulating an ODE from a trained flow matching model. The data distribution is the chess board pattern (top right). Top row: Histogram from ground truth marginal probability path p_t(x). Bottom row: Histogram of samples from flow matching model. As one can see, the top row and bottom row match after training (up to training error). The model was trained using Algorithm 3. (caption 由 PDF 文本清理)
这是全篇最关键的一张图,验证「现象→机制→收益」里训练目标这一环:用 Algorithm 3 的最小二乘条件目标(CondOT,α_t=t、β_t=1−t)训练后,从噪声积分 ODE 得到的采样直方图(下排)与 ground-truth 边际路径 p_t(上排)逐时间步对齐,只有训练误差级别的差异。读图时对照上下两排同一时刻 t 的分布形状,形状重合说明 L_CFM 确实拟合了边际向量场、采样 X_1 逼近 p_data。
ODE 模拟条件/边际向量场的轨迹与 ground-truth 概率路径一致(Theorem 9 插图)
原文 caption:Illustration of Theorem 9. Simulating a probability path with ODEs. Data distribution p_data in blue background. Gaussian p_init in red background. Top row: Conditional probability path. Left: Ground truth samples from conditional path p_t(·|z). Middle: ODE samples over time. Right: Trajectories by simulating ODE with u_t^target(x|z). Bottom row: Simulating a marginal probability path. (caption 由 PDF 文本清理)
机制假设的核心证据:marginalization trick(Theorem 9)的图解。上排展示条件向量场 u_t^target(x|z) 的 ODE 轨迹复现条件概率路径,下排展示按后验加权平均得到的边际向量场 u_t^target(x) 的 ODE 轨迹复现边际路径 p_t——两排的 ODE 采样分布都与左列的 ground-truth 直方图一致,说明「先定条件场、再把边际化搬进期望」的构造确实输运 N(0,I_d) 到 p_data。
Langevin 动力学(静态路径特例)收敛到 5-mode 高斯混合平衡分布
原文 caption:Top row: Particles evolving under the Langevin dynamics given by Equation (50), with p(x) taken to be a Gaussian mixture with 5 modes. Bottom row: A kernel density estimate of the same samples shown in the top row. As one can see, the distribution of samples converges to the equilibrium distribution p (blue background colour). (caption 由 PDF 文本清理)
SDE 机制环的定性佐证:当概率路径取常数(p_t=p)时,Theorem 17 的 SDE 退化为 Langevin 动力学,粒子随时间演化后,KDE 密度(下排)收敛到目标平衡分布 p(蓝色背景)。这张图说明 flow/SDE 框架不限于生成任务——同一套 Fokker-Planck 机制覆盖 MCMC 采样,是教程『统一透镜』论点的可视化依据。
🎧 音频版
时长 17:44 · Edge TTS
扩散模型和 flow matching,到底是不是一套东西?(对话版)
小播:今天聊一篇生成模型方向的 MIT 课程讲义,标题叫《An Introduction to Flow Matching and Diffusion Models》。网上讲生成模型的教程那么多,这份有什么特别的?
老播:特别在它把一件事讲透了:扩散模型和 flow matching,其实是同一套框架的两种写法。Stable Diffusion 3、Movie Gen 这些我们天天听说的模型,底层用的都是这套东西。今天你只要记住一条主线就够了——先给每个数据点定一条从噪声走到它的路,再按概率把所有路加权,训练一个网络去学这个「加权方向」;生成的时候,从噪声出发沿着学到的方向一路积分到底。
小播:开头有点抽象,能不能先给结论?
老播:行,三十秒结论:训练 flow matching,代码里就三行——抽一个数据点、抽一个时间、加一点噪声,让网络做最小二乘回归。训练过程完全不模拟生成,论文里叫 simulation-free,一个 batch 跑起来就是普通回归的价钱。但训练完之后,从纯噪声出发一步一步推,推出来的分布和真实数据几乎一样。这份讲义回答的就是:为什么这么简单的回归,能学会整个分布。
小播:那总得有个解释吧,为什么?
老播:解释从一个概念开始:概率路径。想象时间从 0 走到 1,t 等于 0 的时候样本是纯噪声,t 等于 1 的时候样本是真实数据。给每个数据点单独看,它有一条自己的插值路:中间时刻的样本,就是「数据乘一个系数,加噪声乘一个系数」。这条路上的运动方向可以直接算出来,公式是现成的,不用学。
小播:那到底要学的是什么?
老播:要学的是「边际向量场」——把全体数据点的路合在一起,整个分布该往哪个方向流。难点在这:直接定义它,要除以一个算不出来的积分。讲义的关键一步叫 marginalization trick:边际向量场,等于条件向量场的后验加权平均。通俗说,就是先问「这个带噪样本最像从哪个数据点来的」,再按这个置信度把各个方向加权求和。这一步把不可算的目标变得可算。
小播:训练目标呢?我听说 flow matching 的损失函数特别简单?
老播:对,这是全篇最实用的一条结论:真实的边际目标,和解析可算的条件目标,只差一个常数。最小化后者,就等价于拟合前者。取最常用的 CondOT 路径,损失变成一行均方误差——输入是「噪声和数据按时间插值」,回归目标是「样本减噪声」。训练后从噪声出发,用欧拉法积分到终点,就是一张图。
小播:空口无凭,讲义里有验证吗?
老播:有,一个棋盘格 toy。模型训练完,从噪声积分采样,采样直方图和真实的中间时刻分布逐时间步对齐,只有训练误差级别的差别。注意是每个中间时刻都对得上,说明网络学的确实是一条能输运整个分布的路。再看工业侧:Stable Diffusion 3 用同一个目标加 MM-DiT 架构,八十亿参数,五十步欧拉采样,CFG 权重取 2 到 5;Movie Gen 视频模型三百亿参数,用 CondOT 路径。同一个公式,从小 toy 到大模型,被反复使用。
小播:八十亿、三百亿,这个量级能说明什么?
老播:说明这套理论被工业界反复验证过。八十亿参数比现在主流大语言模型小一个量级,但已经能生成高质量图像;Movie Gen 三百亿参数直接做视频。而且这套机制还有个工程自由度:训练时可以不确定采样器的噪声强度,训练完再选——想要确定性,就积分 ODE;想要多样性,就加噪声跑 SDE,同一个网络两边通用。数学保证是:加噪声这一项,不改变样本的边际分布。
小播:那除了生成,这套机制还能干别的吗?
老播:能,讲义里有个彩蛋:把概率路径设成恒定不动,SDE 就退化成 Langevin 动力学,粒子照样收敛到目标分布,讲义用五峰高斯混合演示了这个过程。同一族方程同时覆盖生成式建模和 MCMC 采样,数学工具是通用的。
小播:听起来很完美,有没有短板?
老播:短板必须说,这是这份讲义最弱的一环:它没有任何实验。所有图,要么是 toy 上的定性演示,要么转述外部模型的数字——SD3 和 Movie Gen 的参数、步数都来自技术报告,讲义自己没有基准表,没有 FID,没有 loss 曲线。唯一接近「干预」的 CFG 引导,论文自己写明是启发式:w 取多少没有理论指导,靠的是「几乎所有 AI 生成图都用 CFG、且权重不小于 4」这个经验事实。
小播:也就是说,推导很扎实,但证据链少了两环?
老播:对,机制这一环它做到了极致,从第一性原理把定理一个个证给你看;但「干预」和「收益」这两环,讲义里是空的。读它的时候,把「推导严密的教程」和「有实验的论文」分开看,别把转述的数字当成它自己的实验结果。
小播:最后用一句话收个尾?
老播:一句话:扩散模型和 flow matching 是一套框架——先定条件路径,按后验加权得到边际向量场,最小二乘回归等价于拟合这个场,采样终点就是数据分布。最该记住的数字是五十:SD3 用五十步欧拉采样就能从噪声生成一张图,而训练它的损失,就一行均方误差。