The Invisible Hand of Physics:视频扩散模型「知道」的物理,比它们展示出来的多
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个反常识的组合:视频扩散模型生成的视频常常违反物理——物体穿过板条箱、东西凭空冒出来,输出侧的评测(Kang et al. 2025、Huberman et al. 2026)早就证明它们无法外推基本力学。可这篇论文(arXiv 2606.05328)却在对 WAN、CogVideoX、LTX 三个扩散模型的内部状态做完探测后给出相反的结论:物理合理性在 transformer 的中间 block 状态里是线性可解码的,准确率甚至超过专门做表征学习的 V-JEPA。模型输出端不兑现物理,内部却在编码物理——这就是标题说的 "know more than they show"。
这个信号有一个干净到近乎苛刻的对照:模型输入侧的 VAE latent 上,探针只有 chance(48–53%)。也就是说,物理信息不在输入里,是 diffusion transformer 自己在计算中构建出来的,而它的训练目标既不是预测式的、也完全没有物理感知。物理表征作为生成计算的副产物涌现,这是本片的第一个核心结论,也是它与 V-JEPA 那类「物理从预测式训练里涌现」(Garrido et al. 2025)最根本的区别。后面我们会看到,这条结论在三个架构、两个基准上都被重复验证。
先看方法:怎么拿到「看不见」的内部轨迹
要回答「扩散模型内部有没有物理结构」,先要解决一个访问问题:扩散模型从不暴露真实视频对应的 latent 轨迹。这篇的做法是把采样过程显式倒过来跑。flow matching 模型学的是一个时变速度场 $v_\theta$,生成就是沿下面的常微分方程(ODE)从噪声积分到数据:
$$\frac{d\mathbf{Z}_t}{dt} = v_\theta(\mathbf{Z}_t, t), \quad t \in [0,1]$$
这里 $\mathbf{Z}_t$ 是 t 时刻的 latent,$v_\theta$ 是学到的速度场,积分方向是从 $t=0$(纯噪声)到 $t=1$(干净视频)。精确的逆采样是隐式 Euler——未知量出现在方程两边,每步都要迭代求解,成本是正采样的一个数量级。作者的关键简化是:用显式 Euler/Heun 近似,在已知端点处求速度:
$$\mathbf{Z}_{t_k} = \mathbf{Z}_{t_{k+1}} - \Delta t \cdot v_\theta(\mathbf{Z}_{t_{k+1}}, t_{k+1})$$
逐项看:$\mathbf{Z}_{t_{k+1}}$ 是当前已知的更「干净」的 latent,$\Delta t$ 是步长,$v_\theta$ 在已知端点取值,一步网络前向就能回退一步。显式反向的代价是引入近似误差,论文在附录 A 给出全局误差界:
$$\|\mathbf{e}_0\| \le M h \frac{e^{L} - 1}{L} + O(h^2)$$
其中 $h$ 是步长,$L$ 是速度场的 Lipschitz 常数,$M$ 与速度场沿自身流的变化率有关——整流流(rectified flow)训练会让 $M$ 很小。误差随 $h$ 线性消失,重建一致性实验(把恢复的噪声再正向采样,能还原原视频)支持这条轨迹是「视频保真」的。有了这条管线,对任意真实视频都能恢复完整轨迹,逐 block、逐 denoising step 提取 hidden states(mean-pooled over tokens)训练线性探针,60/40 划分、seed 42,每 block×每 step 独立训练。K=100 步、取 t=0.5(第 50 步)为默认探测点,CFG=1.0、256×256、WAN/CogVideoX 81 帧、LTX 97 帧。
现象:中间状态的物理信号,压过了表征编码器
实验用的基准是 IntPhys(物体恒存/形状一致/连续性)和 InfLevel(重力/固体性/连续性),模型是三个架构族:WAN-1.3B(30 blocks,hidden 1536)、CogVideoX-2B(30 blocks,1920)、LTX-2B(28 blocks,2048)。
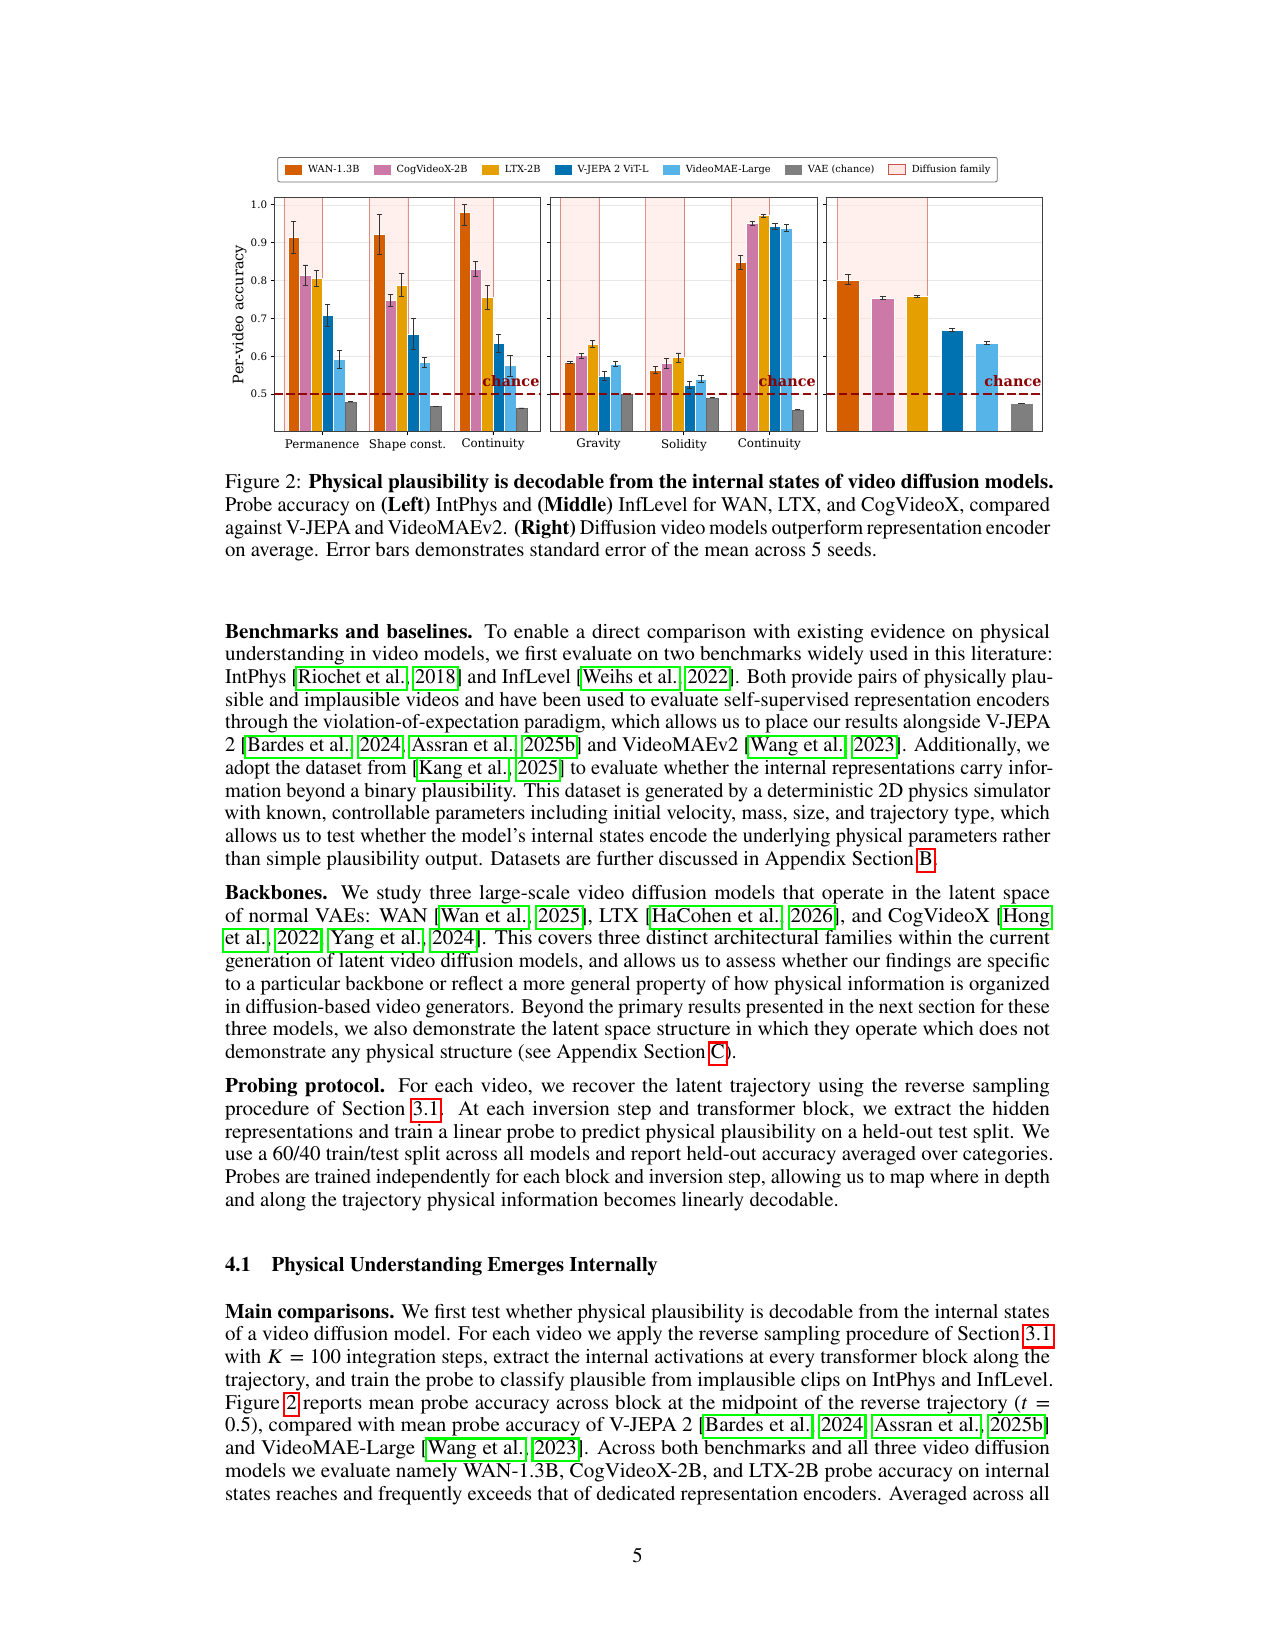
Figure 2 是第一个核心结论的证据:per-video 协议下(每段视频独立分类,比二选一更难),三个扩散模型在 IntPhys+InfLevel 的类别平均准确率全部超过 V-JEPA-2 ViT-L(71.36%)和 VideoMAE-Large,其中 WAN-1.3B 达到 81.27%;pairwise 协议(二选一)同样全面领先。图中 VAE(chance)那根横线是全场最重要的参照:输入 latent 上探针只有 48–53%,信号是从 transformer 内部才出现的。记住这个数字组合:输入 chance、中间状态 81.27%、baseline 71.36%——物理信息是 diffusion 计算自己长出来的。
信号在哪:整条轨迹都有,中间深度最强
第二个问题是位置:信号是只在某个噪声水平、某几层出现,还是组织在整个去噪过程中?Figure 4 的深度×噪声网格给出了答案。
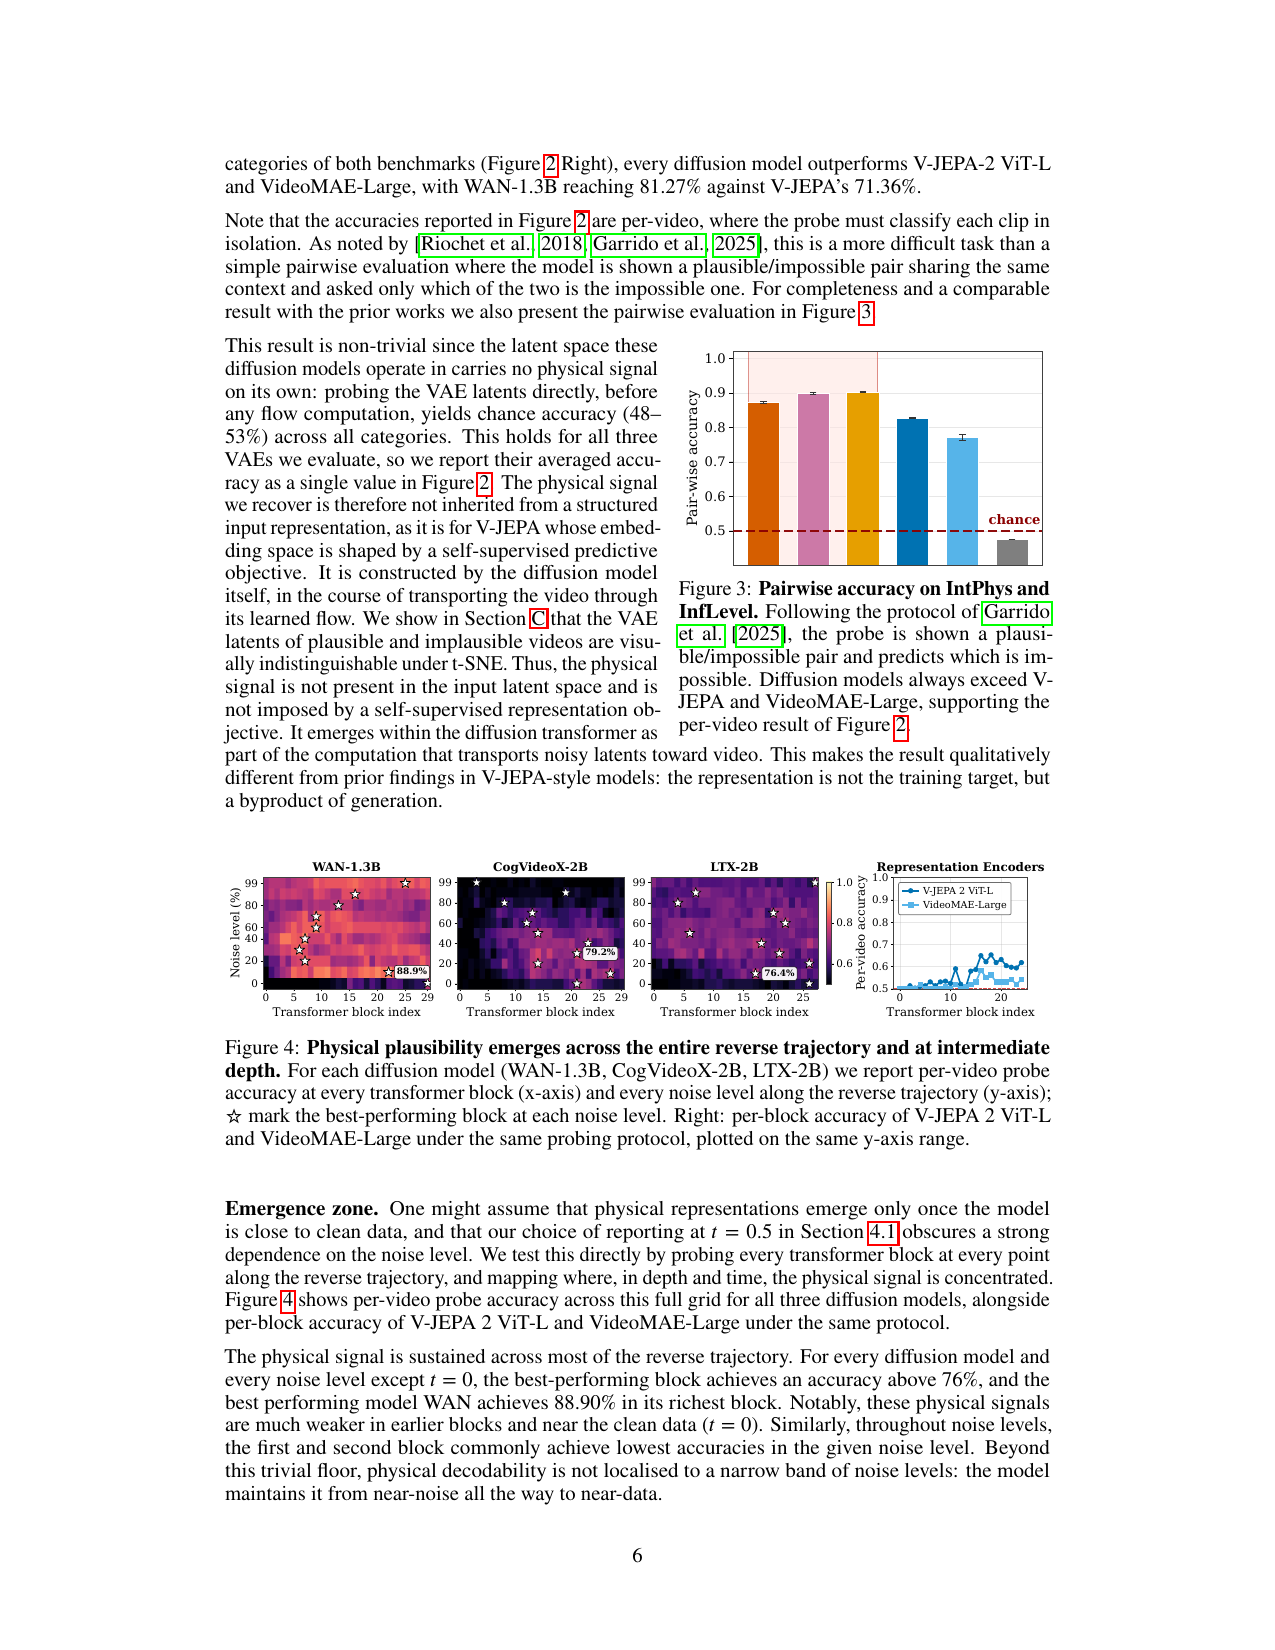
读这张图看两件事:横着看深度,WAN 和 CogVideoX 的最佳 block 集中在中间 1/3(blocks 15–25),LTX 稍晚,这跟 Joseph et al. 2026 在 V-JEPA 上报告的 emergence zone 一致——跨训练目标、跨架构的共性;竖着看噪声,除 t=0(接近干净数据)外,每个噪声水平的 best block 都超过 76%,WAN 峰值 88.90%。物理信号贯穿几乎整条反演轨迹、在中间层最强,这是「物理活在 ODE 轨迹里」的第一份证据。配套的定量解码把结论推得更远:在 Kang et al. 2025 的受控抛物线数据上,用 t=0.5 的单 block 做线性回归,初始位置 $x_0$ 三个模型 R²=1.00,初始速度 $v_0$ WAN 0.88、CogVideoX 和 LTX 0.99,与 V-JEPA/VideoMAE 打平——内部状态承载的不只是二元「合不合理」,而是具体的物理参数。
物理活在流里:重建保真 ≠ 物理解码成功
最考验结论的对照组是步数扫描。把反向采样步数 K 从 100 减到 20:
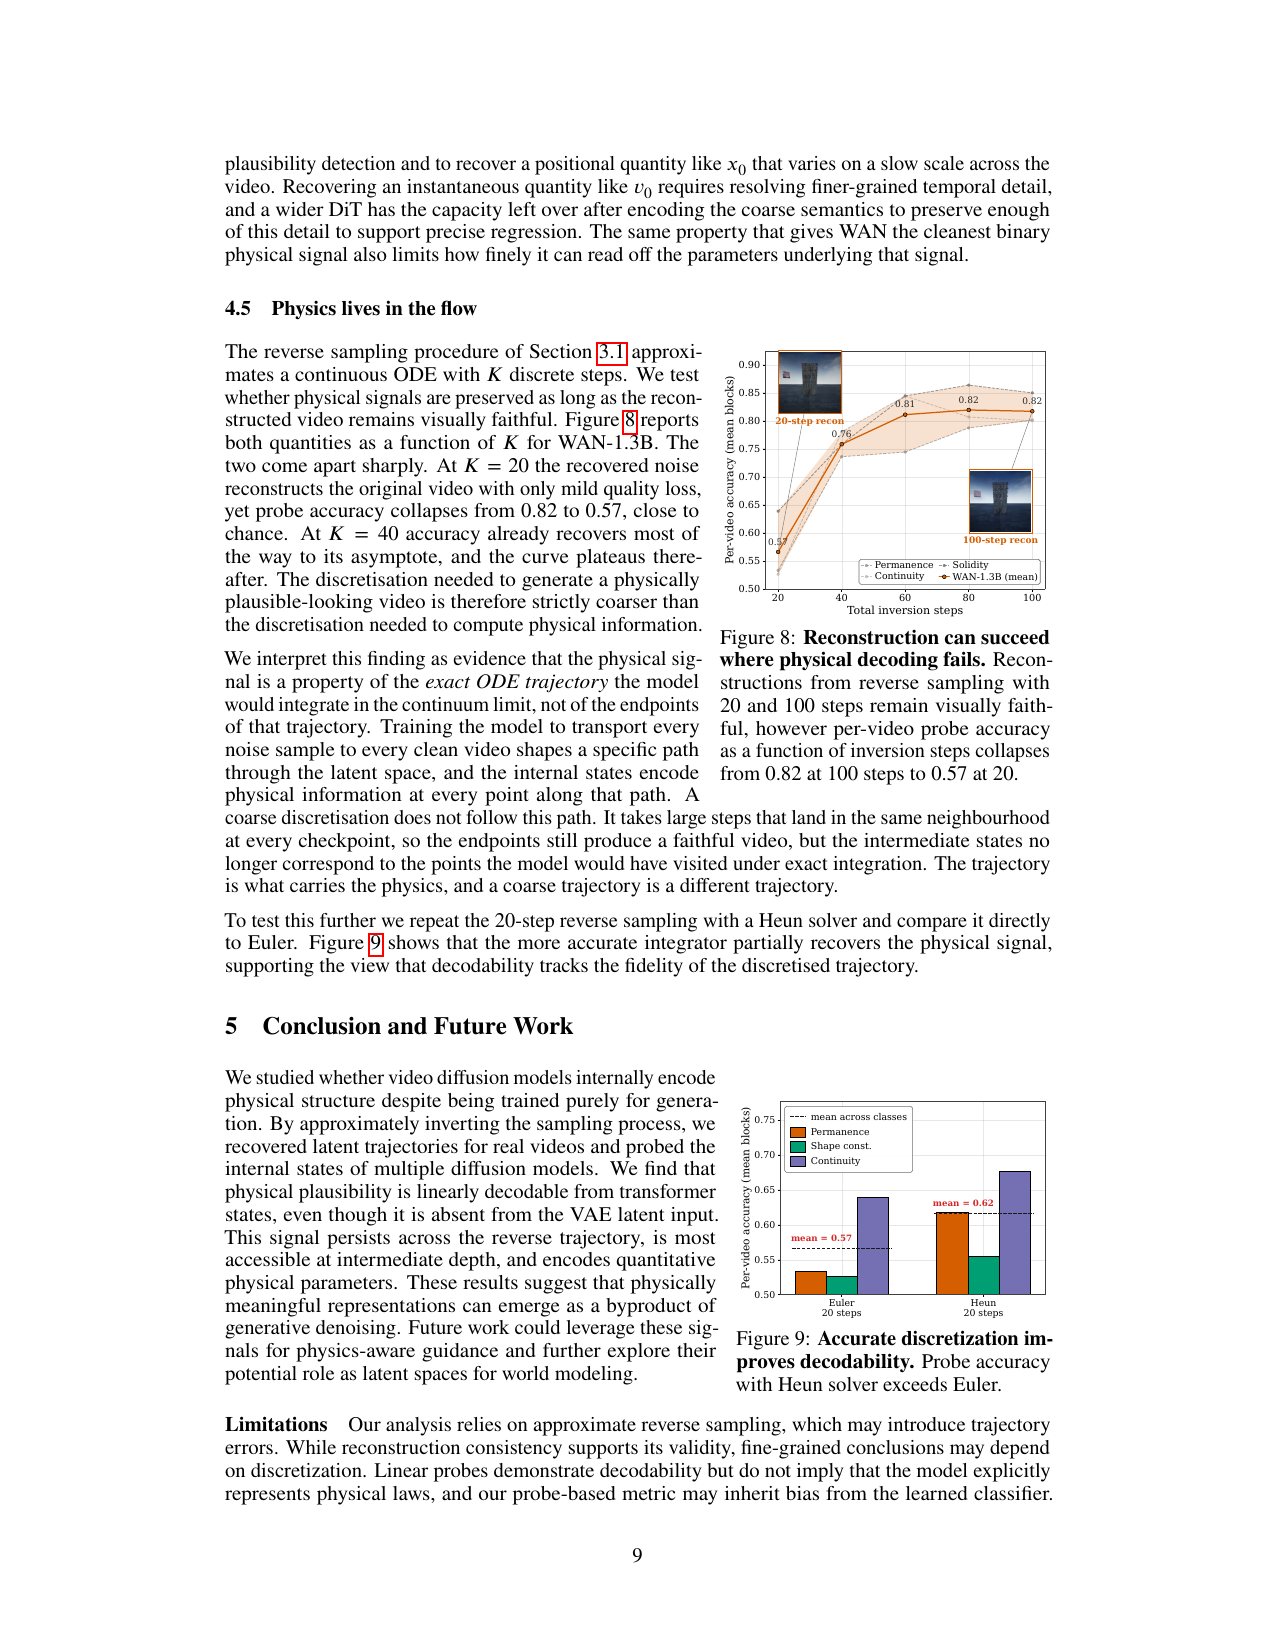
Figure 8 展示了两条曲线彻底分离:K=20 时重建视频只有轻微质量损失、依然视觉保真,可探针准确率从 0.82 崩到 0.57(接近 chance);K=40 恢复大半,之后进入平台;换用精度更高的 Heun 积分器,20 步从 Euler 的 0.57 回升到 0.62。结论是:产生「看起来物理合理」的视频,需要的离散化精度,远低于计算物理信息需要的精度。端点保住了,中间状态却偏离了模型本来会走的路径——物理信息是连续 ODE 轨迹的属性,粗轨迹就是另一条轨迹。这是第二个核心结论,它把「信号在 transformer 内部」升级成「信号在去噪流里」。
干预:可读层 ≠ 因果层
探测回答「哪里读得出来」,干预回答「哪里真正起作用」。作者对每个 block 输出加标度高斯噪声 $\hat{\mathbf{h}} = \mathbf{h} + \alpha\, \sigma(\mathbf{h}) \odot \boldsymbol{\varepsilon}$(α=0.5,σ(h) 是 per-token 标准差),从同一噪声 latent 重新生成视频、再反向采样、用 step-50 探针打分,测 probe-surprise 位移 Δb。WAN 上把 30 个 block 全扫了一遍(180 个场景):扰动最敏感的是早期层(blocks 0–8,峰值在 3–5),CogVideoX 早期主导、中段下降、后期部分恢复,LTX 呈双峰。关键反差:探针最可读的中间层(15–25)并不是扰动最敏感层。两条定位拼起来是一幅完整画面:物理结构早期注入、逐层变换、到中间层才线性可读。
代价与边界:最弱一环在「机制 → 干预」
要泼冷水的地方作者自己写得很清楚。第一,整个研究主体是相关性证据,机制假设(denoising 计算副产物)没有推出可证伪的干预规格——实际干预是通用破坏性加噪,不能回答「改哪个方向会改变哪条物理律」,论文也没展示「改中间状态→把物理上不合理的生成改合理」的控制实验,physics-aware guidance 只列在 future work。第二,Δb 的读出与信号定义同源(同一个探针家族),干预收益可能继承探针自身偏差。第三,摘要和 §3 声称可访问 attention maps,但全部实验实际探测的是 block hidden states,attention-map 级解码并未实现。第四,显式反向有 O(h²) 局部误差,细粒度结论依赖离散化。第五,探针可解码表示存在可利用的低层统计线索,等价于「显式表征物理定律」的证据;WAN 最小(hidden 1536)反而准确率最高,作者用「窄模型被迫优先编码粗粒度时空语义、宽模型的信号被纹理维度稀释」解释,自己也承认三个架构的差异不止 hidden dimension,这条只是 suggestive。
一句话记住这篇
视频扩散模型的物理理解,是一种「藏在中间、两头不见」的生成副产物:VAE 输入是 chance(48–53%),输出端可以违反物理,但去噪轨迹的中间状态全程线性可读——WAN-1.3B 达 81.27%,超过 V-JEPA-2 的 71.36%,峰值 88.90%,而且物理信息活在 ODE 轨迹里,不在端点上。最该记住的态度:这套「显式反向采样 + 逐 block 探测」把真实视频变成可探测管线,是实打实的工程贡献;但机制→干预一环最弱,从「中间状态可解码」到「用中间状态控制生成」之间,还缺一场真正的因果实验。
通过把生成过程显式反向积分(Euler/Heun,K=100)从真实视频 latent 恢复 denoising transformer 的内部轨迹,证明物理合理性在中间 block 状态里线性可解码(WAN-1.3B 81.27% vs V-JEPA 71.36%)且 VAE 输入上完全缺失——但闭环停在『可观测中间状态 + 破坏性扰动』层面:无 attention-map 级解码、无用中间状态引导生成的控制实验,机制→干预一环最弱。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:两类可观测现象:一是物理合理性的线性可解码信号——per-video 协议下 WAN-1.3B 在 IntPhys+InfLevel 全类别平均 81.27% 准确率,超过 V-JEPA-2 ViT-L(71.36%)与 VideoMAE-Large;二是定量物理变量解码——Kang et al. 2025 抛物线运动子集上初始位置 x0 三模型 R²=1.00、初始速度 v0 R²=0.88-0.99。配套的『负观测』同样关键:VAE latent 输入上探针只有 chance(48-53%)、t-SNE 两色完全混合(App C),说明信号不在输入里(§4.1 p5-6;§4.4 p8-9)。
在哪里观测:三个 latent video diffusion 模型的中间 block 状态:WAN-1.3B(30 blocks,hidden 1536)、CogVideoX-2B(30 blocks,1920)、LTX-2B(28 blocks,2048),沿『真实视频 latent → 反向采样恢复的噪声轨迹』(K=100 Euler/Heun,t=0.5 即 step 50,CFG=1.0,256×256,WAN/CogVideoX 81 帧、LTX 97 帧)逐 block 提取(§3.1 p3-4;App E p15)。数据:IntPhys(permanence/shape const./continuity)、InfLevel(gravity/solidity/continuity)、Kang et al. 2025 受控物理数据(§4 p4-5;App B p13-14)。注意:摘要与 §3 声称可访问 attention maps,但全部实验的实际探测对象是 block 输出 hidden states(mean-pooled over tokens),论文没有做任何 attention-map 级解码。
如何量化:每个 block × 每个 denoising step 独立训练线性探针:60/40 train/validation split(seed 42,40% 验证),mean-pooled 特征,线性分类器 50 epochs(Adam lr=1e-3,batch 4,交叉熵),报告 held-out 准确率与 pairwise 协议(Fig 3);x0/v0 用 t=0.5 单 block 线性回归(§4.4);probe-surprise 用 ψ_s(V)=logit_implausible−logit_plausible(Eq. 6)与 Δb(Eq. 7);判别探针方向 Δw=w(1)−w(0)(Eq. 13,App D)。结果:除 t=0 外每个噪声水平 best block >76%,WAN 峰值 88.90%,best blocks 集中在 WAN/CogVideoX 第 15–25 块(中间 1/3)、LTX 稍晚(§4.1 p6-7;Fig 4)。
② 机制假设
假设:物理表征是 denoising 计算的副产物:flow-matching 的 velocity field 把每个噪声样本输运到每个干净视频,塑造了 latent space 里的一条具体路径;为完成『噪声→干净视频』的输运,transformer 在路径的每一点都需要组织时空语义结构,于是物理信息被隐式编码在中间状态里,即使训练目标既非预测式也非物理感知(§1 p1-2;§5 p9)。信号是连续 ODE 轨迹的属性而非端点属性(§4.5 p9)。
证据:
- VAE 输入对照:直接探测三模型 VAE latents 全部是 chance(48-53%),t-SNE 下两色完全混合(§4.1 p6;App C Fig 12-13),排除『信号从结构化输入继承』,定位到 transformer 内部。
- 跨模型跨基准:三个架构族(WAN/CogVideoX/LTX)× 两基准平均,每个 diffusion 模型都超过 V-JEPA-2 ViT-L(71.36%)与 VideoMAE-Large,per-video 与 pairwise(Fig 3)两个协议一致(§4.1 p5-6)。
- 轨迹组织证据:信号在几乎整条 reverse trajectory 上持续(除 t=0 外每噪声水平 best block >76%),在中间深度最强(blocks 15–25 / LTX 稍晚),与 Joseph et al. 2026 在 V-JEPA 上的 emergence zone 一致;probe 判别权重幅度呈同样结构(App D Fig 14),排除单一探针/单一噪声水平的人为现象(§4.1 p6-7;Fig 4)。
- 定量解码:x0 R²=1.00(三模型)、v0 R²=0.88-0.99,达到表征编码器水平——内部状态承载的不只是二元 plausibility 而是具体初始条件(§4.4 p8-9;Fig 6)。
- 轨迹保真度解耦:K=20 时重建仍视觉保真但探针准确率从 0.82 崩到 0.57(近 chance),K=40 恢复大半,Heun 20 步(0.62)部分恢复——可解码性跟踪离散化轨迹对连续流的忠实度而非输出质量,支持『物理活在流里』(§4.5 p9;Fig 8-9)。
- 因果敏感结构:对 WAN 30 blocks 逐一加噪(α=0.5,180 scenes)产生结构化 Δb 分布(早期层 blocks 0–8 最强、峰值 3–5),且因果敏感层(早期)≠ 线性可读层(中间),提示物理结构早期注入、逐层传播、中间层才线性可读(§4.2 p7;Fig 5)。
备选解释:
- 统计模式匹配:模型可能只是复现训练分布中的运动模式而非编码定律——作者在引言引 Kang et al. 2025 / Huberman et al. 2026 承认生成输出在 OOD 下无法外推基本力学,本文的内部信号与输出失败并存,两者关系未解(§1 p1)。
- 线性可解码 ≠ 显式表征:探针可能利用与 plausibility 相关的低层统计线索(如纹理/边缘统计),不代表模型显式表示『重力、动量守恒』等定律(§5 Limitations p9-10)。
- 度量循环偏差:probe-surprise 的读出与被扰动对象同源于同一批训练好的线性探针,干预收益可能继承探针自身偏差(§5 p9-10)。
- 反向采样近似:显式反向(Eq. 4)相对隐式精确逆(Eq. 3)有 O(h²) 局部误差,轨迹误差可能影响细粒度结论(§5 p9;App A p12)。
- 容量稀释解释只是 suggestive:三个架构的差异不止 hidden dimension(1536/1920/2048),『宽模型稀释而非缺失』的解读作者自称不确定(§4.3 p7-8)。
形式化/toy model:无独立 toy model/合成机制。形式化由四块组成:(a) 显式反向采样误差界——假设 vθ C¹ 且 L-Lipschitz,局部误差 −h²·(Dvθ/Dt)+O(h³)(Eq. 10),全局误差 ‖e0‖ ≤ M·h·(e^L−1)/L + O(h²)(Eq. 12,App A p12);(b) 干预公式 ĥ=h+α·σ(h)⊙ε,ε∼N(0,I)(Eq. 5);(c) probe-surprise ψ_s=logit_implausible−logit_plausible 与 Δb=ψ̄(Vb)−ψ̄(Vbase)(Eq. 6-7);(d) 判别探针方向 Δw=w(1)−w(0)(Eq. 13)。这些都是度量定义,不是从机制推出的可证伪模型。
③ 局部干预
干预对象:denoising transformer 的单个 block 输出 hidden states(WAN 全部 30 blocks 逐一干预;CogVideoX/LTX 同法逐 block,见 Fig 5)
操作:生成阶段在每次 denoising step 对目标 block 输出加标度高斯噪声 ĥ=h+α·σ(h)⊙ε,α=0.5,σ(h) 为 per-token feature std(使 α 跨深度可比);从同一恢复的 noise latent 生成基线视频,再对每个被干预 block 重新生成并 re-invert,用 step-50 线性探针打分得到 Δb(§3.2 p4;Eq. 5-7;App E p16)。
效果:WAN:早期层(blocks 0–8)Δb 最强(峰值 3–5),中后层仍有非零影响,分布较宽;CogVideoX:早期主导、中间下降、后期部分恢复;LTX:双峰(早期+晚期强,中间弱)。关键反差:探针最可读的中间层(blocks 15–25)并不是扰动最敏感层——物理结构在早期建立、逐层变换、中间层才线性可读(§4.2 p7;Fig 5)。
局部性:block 粒度(架构级定位):一次只扰动一个 block、其余 29 个保持,扰动在整条 denoising 轨迹的每个 step 施加;这是破坏性加噪而非对假设机制的靶向操纵,没有 per-head/per-token/circuit 级定位。
因果验证:配对设计:每个被干预视频与同一 noise latent 的未干预基线比较 Δb(Eq. 7),WAN 全扫描 30 blocks × 180 plausible scenes(§4.2 p7)。三点削弱:(1) 读出与信号定义同源——Δb 通过训练好的线性探针家族度量,探针自身偏差可能被算作因果效应;(2) 干预是通用噪声扰动,不是从机制假设推出的可证伪操纵,不能回答『改哪个方向会改变哪条物理律』;(3) 作者明言结果是相关性的,干预只提供部分因果证据,不能确立机制性/人类可解释的物理定律编码(§5 p9-10)。论文没有展示通过修改中间状态把物理上不合理的生成变成合理(或反之)的控制实验。
④ 工程收益
指标:per-video plausibility 探针准确率(IntPhys+InfLevel 类别平均)
数值:81.27%(WAN-1.3B,best block 于 t=0.5)
基线:V-JEPA-2 ViT-L 71.36%;VideoMAE-Large 更低(Fig 2 Right);VAE latent chance 48-53%
设置:K=100 反向采样、block hidden states mean-pooled、线性探针、60/40 split seed 42;§4.1 p6、Fig 2
指标:pairwise plausibility 准确率(Garrido et al. 2025 协议)
数值:三个 diffusion 模型全部超过 V-JEPA-2 与 VideoMAE-Large(具体数值仅在图中)
基线:V-JEPA-2 ViT-L 与 VideoMAE-Large 同协议
设置:Fig 3 p6
指标:定量物理变量回归 R²(Kang et al. 2025 抛物线子集,t=0.5 单 block)
数值:x0:WAN/CogVideoX/LTX 均 R²=1.00;v0:WAN 0.88、CogVideoX 0.99、LTX 0.99
基线:V-JEPA-2 ViT-L 与 VideoMAE-Large:x0=1.00、v0=1.00
设置:§4.4 p8-9;Fig 6
指标:深度×噪声网格峰值准确率(每 block × 每 denoising step 独立探针)
数值:除 t=0 外每个噪声水平 best block >76%;WAN 峰值 88.90%(中间深度)
基线:同协议下 V-JEPA/VideoMAE per-block 曲线(Fig 4 右)
设置:§4.1 p6;Fig 4
指标:轨迹保真度 vs 物理可解码性(K 扫描,WAN-1.3B)
数值:100 步 0.82 → 20 步 0.57(近 chance);40 步已恢复大半;Heun 20 步 0.62 > Euler 20 步 0.57
基线:20 步与 100 步反向采样重建视频均视觉保真
设置:§4.5 p9;Fig 8-9
代价:反向采样每次网络前向与正向采样同量级(K=100 步);需在每 block×每 step 提取并保存激活;探针按 block×step 独立训练(50 epochs Adam lr=1e-3 batch 4);干预实验对每个 block 要重新生成+重新反转+重新打分(WAN 30 blocks×180 scenes,单 NVIDIA GH200/96GB per job)。论文未给端到端时间/预算数字(App E p16)。
可迁移性:跨架构结论强:3 个不同架构族(WAN-1.3B/CogVideoX-2B/LTX-2B)× 2 基准 + 1 个受控物理数据集,探针一致工作,中间深度 emergence 与 V-JEPA 阵营一致。但工程收益止步于『可探测/可读数』:无文本条件(CFG=1.0)以外验证、无下游控制实验(physics-aware guidance 明确列为 future work,§5 p9)、无世界模型/规划等下游任务收益;也没有与其他特征(如 attention maps、cross-attention 特征)的对比。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中偏强。现象层扎实:多模型多基准 + VAE 输入 chance 对照 + K 扫描/Heun 对照把『信号在 transformer 内部、活在 ODE 轨迹里』立住;但线性可解码性不承诺显式表征,探针度量存在同源偏差,整体仍是相关性证据(§5 p9-10)。 |
| 机制→干预 | 弱(最弱一环)。『denoising 隐式编码物理』没有推导出具体的可证伪干预规格:实际干预是通用破坏性加噪(α=0.5),不是对假设机制的靶向操纵,也没有『改中间状态→改变生成物理』的控制实验;Δb 又用同一探针家族读出,机制身份与干预读出纠缠。 |
| 干预→收益 | 中偏弱。干预的收益是诊断性的(定位因果敏感层、揭示可读层≠因果层),没有转化为工程控制收益(无引导生成、无物理性提升实验);WAN 有 30×180 全扫描,CogVideoX/LTX 只有模式描述;pairwise 数值与部分图内数字未入正文。 |
| 最弱一环 | mechanism_to_intervention:从『物理信息编码在中间状态』到『扰动 block 证明因果责任』之间没有机制推导,干预是破坏性噪声而非靶向操纵,且读出与信号定义同源——这是闭环里最需要补证据的地方。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| per-video plausibility 探针准确率(类别平均) | 81.27%(WAN-1.3B) | V-JEPA-2 ViT-L 71.36%;VideoMAE-Large 更低;VAE latent chance 48-53% | IntPhys+InfLevel,K=100 反向采样、t=0.5、线性探针、60/40 split seed 42;§4.1 p6、Fig 2 |
| pairwise plausibility 准确率 | 三 diffusion 模型均超过 V-JEPA 与 VideoMAE(具体值见图) | V-JEPA-2 ViT-L、VideoMAE-Large(Garrido 2025 协议) | Fig 3 p6 |
| x0/v0 回归 R² | x0 三模型均 1.00;v0:WAN 0.88、CogVideoX 0.99、LTX 0.99 | V-JEPA/VideoMAE:x0=1.00、v0=1.00 | Kang 2025 抛物线子集,t=0.5 单 block;§4.4 p8-9、Fig 6 |
| 深度×噪声网格峰值 | WAN 88.90%;每噪声水平(除 t=0)best block >76% | V-JEPA/VideoMAE 同协议 per-block 曲线 | Fig 4 p6 |
| 轨迹保真度扫描(K) | 0.82(100 步)→ 0.57(20 步);40 步恢复大半;Heun 20 步 0.62 | 20/100 步重建均视觉保真 | WAN-1.3B;§4.5 p9、Fig 8-9 |
| 因果敏感 block(Δb,IntPhys) | WAN 早期层最强(blocks 0–8、峰值 3–5)且分布宽;CogVideoX 早期主导+后期恢复;LTX 双峰 | 可读层(中间 blocks 15–25)≠ 因果敏感层(早期) | 30 blocks × 180 scenes、α=0.5、step-50 探针;§4.2 p7、Fig 5 |
| 中间深度 emergence zone | WAN/CogVideoX best blocks 15–25(中间 1/3)、LTX 稍晚 | 与 Joseph et al. 2026(V-JEPA)emergence zone 一致(Fig 4 右复现) | Fig 4 p6-7 |
Insights
- 物理表征可以是生成副产物:输入是重建性 VAE latent(探针 chance、t-SNE 混合)、训练目标无预测/物理感知,物理可解码性却在 denoising transformer 内部出现——把『涌现物理』从表征学习阵营扩展到生成阵营(§4.1 p6)。
- 信号活在 ODE 轨迹里而非端点上:K=20 重建保真但解码崩盘、Heun 部分恢复,可解码性与输出保真度解耦——物理信息是连续流的路径属性(§4.5 p9)。
- 可读层 ≠ 因果层:中间层线性可读、早期层扰动最敏感,两个定位互补成『早期注入→深层变换→中间可读』的完整画面(§4.1-4.2 p6-7)。
- 压缩提高可解码性:WAN(最小、hidden 1536)反而准确率最高,解释为窄 DiT 被迫优先编码粗粒度时空语义、物理信号在宽模型中被纹理维度稀释——暗示物理信号是隐空间的低维结构(§4.3 p7-8)。
- 反向采样把『真实视频→模型内部状态』变成可探测管线:显式 Euler/Heun 以近似正向采样成本恢复轨迹,局部误差 O(h²)、全局误差 O(h)——方法本身是本次最大的工程贡献(App A p12)。
- 探测网格(block×noise)与 probe 判别权重结构一致(App D Fig 14),说明中间深度信号不是单一探针或单一噪声水平的伪影(§4.1 p6-7)。
vs 同类工作
局限
- 探针可解码 ≠ 显式表征:论文自认不证明模型在机制性/人类可解释层面编码物理定律(§5 p9-10)。
- 度量循环:probe-surprise 干预的读出与被扰动对象同源于同一探针家族,probe 可能继承学习分类器偏差(§5 p9-10)。
- 相关性:整体结果相关,干预只提供部分因果证据(§5 p10)。
- 反向采样近似:显式反向有 O(h²) 局部误差,细粒度结论依赖离散化(§5 p9;App A p12)。
- attention maps 缺席:摘要/§3 声明访问中间状态与 attention maps,但全部实验只探测 block hidden states,attention-map 级解码未实现。
- 无控制闭环:physics-aware guidance 只是 future work,没有展示用中间状态引导或修正生成输出的实验(§5 p9)。
- 细节不完整:pairwise 数值与部分网格数字(76.4/79.2/88.9)只在图中;CogVideoX/LTX 干预仅模式描述;三架构差异不止 hidden dimension(§4.3 自认 suggestive)。
可复现性
代码公开:https://github.com/ParsaEsmati/videodiffusionphysics(摘要内链接)。完整复现超参在 App E:反向采样 K=100(默认)、Euler/Heun、CFG scale 1.0、step 50(t=0.5)、256×256、WAN/CogVideoX 81 帧、LTX 97 帧;WAN 30 blocks hidden 1536、CogVideoX 30 blocks 1920、LTX 28 blocks 2048;探针 60/40 split(seed 42,40% validation)、block 输出 mean-pooled、线性分类器 50 epochs Adam lr=1e-3 batch 4;干预 α=0.5、step-50 探针、WAN 180 plausible scenes 全 block 扫描;硬件单 NVIDIA GH200(96GB)/job(App E p15-16)。数据集:IntPhys/InfLevel validation splits 与 Kang et al. 2025 抛物线子集。取数提醒:arXiv 单版本 v1(cs.GR);无表格化的逐类别数字(多在图内);无第三方复现记录。
物理合理性从扩散模型内部状态里线性可解码
原文 caption:Figure 2: Physical plausibility is decodable from the internal states of video diffusion models. Probe accuracy on (Left) IntPhys and (Middle) InfLevel for WAN, LTX, and CogVideoX, compared against V-JEPA and VideoMAE v2. (Right) Diffusion video models outperform representation encoders on average. Error bars demonstrate standard error of the mean across 5 seeds.
全篇头号结论:对 WAN/CogVideoX/LTX 三个扩散模型的中间 block 状态训练线性探针,per-video 物理合理性准确率(IntPhys+InfLevel 类别平均)每个模型都超过专用表征编码器 V-JEPA-2 ViT-L(71.36%)与 VideoMAE-Large;右侧柱状图显示 WAN-1.3B 达 81.27%。同时标注 VAE latent 输入上探针只有 chance(48–53%)——读图要抓住这组对照:信号不在输入 latent 里,是 diffusion transformer 自己在计算中构建出来的。
物理信号沿整条反演轨迹持续、在中间深度最强
原文 caption:Figure 4: Physical plausibility emerges across the entire reverse trajectory and at intermediate depth. For each diffusion model (WAN-1.3B, CogVideoX-2B, LTX-2B) we report per-video probe accuracy at every transformer block (x-axis) and every noise level along the reverse trajectory (y-axis); star marks the best-performing block at each noise level. Right: per-block accuracy of V-JEPA 2 ViT-L and VideoMAE-Large under the same probing protocol.
证明『信号在哪里』的深度×噪声网格:除 t=0(接近干净数据)外,每个噪声水平上 best block 准确率都超过 76%,WAN 峰值 88.90%;best blocks 集中在中间 1/3 深度(WAN/CogVideoX 的 blocks 15–25,LTX 稍晚),与右侧 V-JEPA 的 emergence zone 一致。读图看两个维度:物理信息贯穿几乎整条去噪轨迹(不是只在端点),并且线性可读性在中间层最强——这是『物理活在 ODE 轨迹里』的第一份证据。
重建保真但物理解码崩盘:物理信号是轨迹属性
原文 caption:Figure 8: Reconstruction can succeed where physical decoding fails. Reconstructions from reverse sampling with 20 and 100 steps remain visually faithful, however per-video probe accuracy as a function of inversion steps collapses from 0.82 at 100 steps to 0.57 at 20.
支撑『物理活在流里』的解耦实验:把反演步数 K 从 100 减到 20,重建视频仍然视觉保真,但探针准确率从 0.82 崩到 0.57(接近 chance);K=40 已恢复大半。读图看两条曲线的背离:端点的像素质量保住了,中间状态却不再落在模型本来会经过的轨迹上——说明物理信息是连续 ODE 轨迹的属性,可解码性跟踪的是离散化轨迹对流的忠实度,与输出质量无关。
🎧 音频版
时长 17:41 · Edge TTS
视频扩散模型「知道」的物理,比它们展示出来的多(对话版)
小播:今天聊一篇特别反直觉的论文——视频扩散模型生成的东西常常违反物理,可它们的内部状态里,居然藏着能读出来的物理信号。
老播:对,这篇叫 The Invisible Hand of Physics。一句话给你结论:模型的输出端不兑现物理,但把采样过程倒着跑一遍,在中间层状态上做线性探测,物理合理性准确率能到 81.27%,超过专门学表征的 V-JEPA 的 71.36%。模型输入里啥都没有,信号是它在去噪计算里自己长出来的。
小播:等一下,输入里没有,是什么意思?
老播:这些模型吃的是 VAE 的 latent,就是压缩后的视频编码。直接在 VAE 输入上做探测,准确率只有 48% 到 53%,跟瞎猜一样。可一旦进入 transformer 的中间层,信号就冒出来了。
小播:那输出端呢?不是说生成违反物理吗?
老播:对,输出端经常违反物理,球穿过板条箱、东西凭空出现。所以这篇的核心观点就是:物理信息藏在中间状态里,两头都看不见。我们从头拆——先看他们是怎么把内部状态挖出来的。
小播:扩散模型又不给你看真实视频对应的内部状态,怎么挖?
老播:他们想到一招:把采样过程显式倒过来跑。扩散模型的生成,本质是沿着一个学到的速度场,从噪声积分到干净视频。作者从干净视频出发,沿着同一个速度场往回积分,一步一步退回噪声,中间每个 block 的状态就都拿到了。
小播:往回积,不会积歪吗?
老播:理论上精确的反演每步都要迭代求解,成本高一整个数量级。他们用显式近似,每一步只算一次网络前向,代价是引入误差。他们证明了误差随步长线性消失,而且把恢复的噪声再正向生成一遍,能还原原视频,说明这条路是靠谱的。
小播:好,那拿到中间状态之后,看到了什么?
老播:三个模型一起看:WAN-1.3B、CogVideoX-2B、LTX-2B。在 IntPhys 和 InfLevel 两个物理合理性基准上,对每个 block 的中间状态训练线性探针,三个模型的准确率全部超过 V-JEPA 和 VideoMAE,WAN 最好,81.27%。记住这个数字组合:输入 chance,中间状态 81.27%,baseline 是 71.36%。
小播:那信号是只在某一层、某一步出现,还是到处都有?
老播:这是第二个有意思的发现。他们把每个 block 和每个去噪步都扫了一遍:除了接近干净数据的最后一步,其他所有噪声水平上,最佳层的准确率都超过 76%,WAN 峰值到 88.9%。而且最佳层集中在中间三分之一深度,这跟之前 V-JEPA 上发现的 emergence zone 一致。
小播:也就是说,跨模型、跨训练目标,物理信号都长在中间层?
老播:对。还不止二元判断。用受控的抛物线数据做线性回归,模型内部状态能读出初始位置,三个模型都是满分拟合;初始速度也能读出,0.88 到 0.99。里面装着具体的物理参数——初始位置、初始速度,都能从状态里读出来。
小播:那怎么证明信号真的活在去噪过程里,而不是输出端的副产品?
老播:他们做了一个特别干净的对照:把反向采样的步数从 100 减到 20。这时候重建的视频照样保真,看着没啥区别,可探针准确率从 0.82 崩到 0.57,接近瞎猜。换更高精度的积分器,又能捞回来一点。
小播:视频长一样,物理信号却没了?
老播:对,这就是关键:产生「看起来合理」的视频,需要的精度,比算出物理信息需要的精度低得多。端点保住了,但中间状态偏离了模型本来该走的轨迹。所以物理信息是轨迹的属性,粗轨迹就是另一条轨迹。
小播:那知道信号在哪之后,有没有做干预实验?
老播:做了,而且有个反直觉的结果。他们往每个 block 的输出上加噪声,看哪个位置最影响生成视频的物理合理性。结果最敏感的是早期层,不是最可读的中间层。
小播:读得出来的地方,跟真正起作用的地方还不一样?
老播:不一样。探针最可读的是中间层,扰动最敏感的却是早期层。作者的解读是:物理结构在早期就建立起来,一层层变换,到中间层才变成线性可读的形式。
小播:那这套方法,现在能直接用吗?
老播:这里得泼盆冷水,这也是作者自己承认的最弱一环。整个研究主体是相关性证据:干预只是往 block 上加噪声,没有做到「改中间状态就把不合理的生成改成合理」,物理引导的生成只列在 future work。而且干预效果的读出,跟信号定义用的是同一批探针,可能互相串味。另外论文说能访问 attention maps,实际实验只做了 block 状态,attention 级解码并没做。
小播:所以它的价值更多是探测框架本身?
老播:对,这份贡献很实在:显式反向采样把「真实视频→模型内部状态」变成了可探测的管线,跨架构跨基准都成立。它告诉你扩散模型里确实长出了物理结构,也告诉你从哪里读、哪一层在起作用。但从「可解码」到「能控制」,中间还缺一场真正的因果实验。
小播:最后用一句话收个尾?
老播:视频扩散模型的物理知识,是藏在中间、两头不见的生成副产物:VAE 输入是瞎猜水平,输出端可以违反物理,但去噪轨迹的中间状态全程可读,WAN 做到 81.27%,超过 V-JEPA 的 71.36%。最该记住的数字是 81.27% 对 71.36%,最该记住的保留是:物理活在流里,而且机制到干预这一环,还得补课。