红球明明在快速运动,视频模型却生成慢速未来——它是没学会,还是学会了没用上?
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先把这个贯穿全篇的例子摆上桌。训练一个视频模型,只给它看两类弹簧振子视频:红球慢速振荡(角频率 ω ∈ [2.2, 3.0] rad/s)和蓝球快速振荡(ω ∈ [5.2, 6.4] rad/s),各 1024 条,颜色与频率完美绑定,训练集里不存在任何冲突组合。测试时,给它看一个快速运动的红球——这个组合训练里从未出现。结果模型生成的未来是慢速振荡:颜色这条统计捷径压过了它眼前看到的运动。
问题来了:它到底没学会「快速运动」,还是学会了、只是生成时没用上?光看生成视频无法区分这两种失败。这篇 arXiv 2609.15980(2026-09-14,Xingyun Wang、Haomin Zheng 共一,Ziming Liu 通讯,清华/北大/USTC/MetaCircle)给出的回答是后者,而且证据是因果级的:不用重新训练,只用红球在边界帧的位置和速度算出一个四维激活编辑,加进模型中间层,生成的视频就恢复成快速运动。他们把这种能力命名为因果可写性(causal writability),并进一步量出这条写入在网络深度上的「末班车」:越过某个临界深度,同样的编辑突然失效;但信号还在,到下游把单个注意力 V 头的写入放大,正确运动又能被找回来。
实验台:一个能把两种失败拆开的弹簧球
为什么这件事以前测不出来?因为真实视频里外观、场景、物体身份和运动很少独立变化——高速公路场景里车普遍快,居民区里车普遍慢,场景外观在统计上可以代理速度。训练数据无法区分「按运动外推」和「按外观代理」这两条规则,这叫预测欠定(predictive underspecification)。要让两条规则给出不同答案,必须制造冲突。
Spring 任务就是这个冲突制造机。模型是 488M 参数的 latent flow-matching Transformer:30 个双向 DiT block、hidden 1152、FFN 4608、9 个 128 维注意力头,配冻结的 Wan2.1 VAE。每段视频 128×128、20fps、129 帧,前 65 帧是条件、后 64 帧让模型生成;VAE 把视频压成 33 个 latent 帧、2112 个 token(1088 条件 + 1024 目标)。另设两种历史条件:Long 保留全部 65 帧真实运动,Short 只露最后 8 帧运动(前 57 帧换成固定背景),用来调节「运动证据」的多少。
评估全程在完全解码的像素视频上做,不用任何 MLLM 当裁判:一个确定性检测器逐帧跟踪球的中心,再对轨迹拟合谐波 $x(t) = a\cos(\hat{\omega}t) + b\sin(\hat{\omega}t) + c$。$\hat{\omega}$ 落在观测运动所属的训练带内记 physics-following,落在颜色关联的对立带内记 shortcut。这套评估器配了严格有效性门槛(检出 ≥90% 帧、RMSE ≤ 0.035 等),后面所有数字都从它出来。
现象:颜色与运动在抢方向盘,且颜色只做「选带」
第一个实验固定真实运动和生成种子,把球的颜色从红到蓝扫 11 档色相。
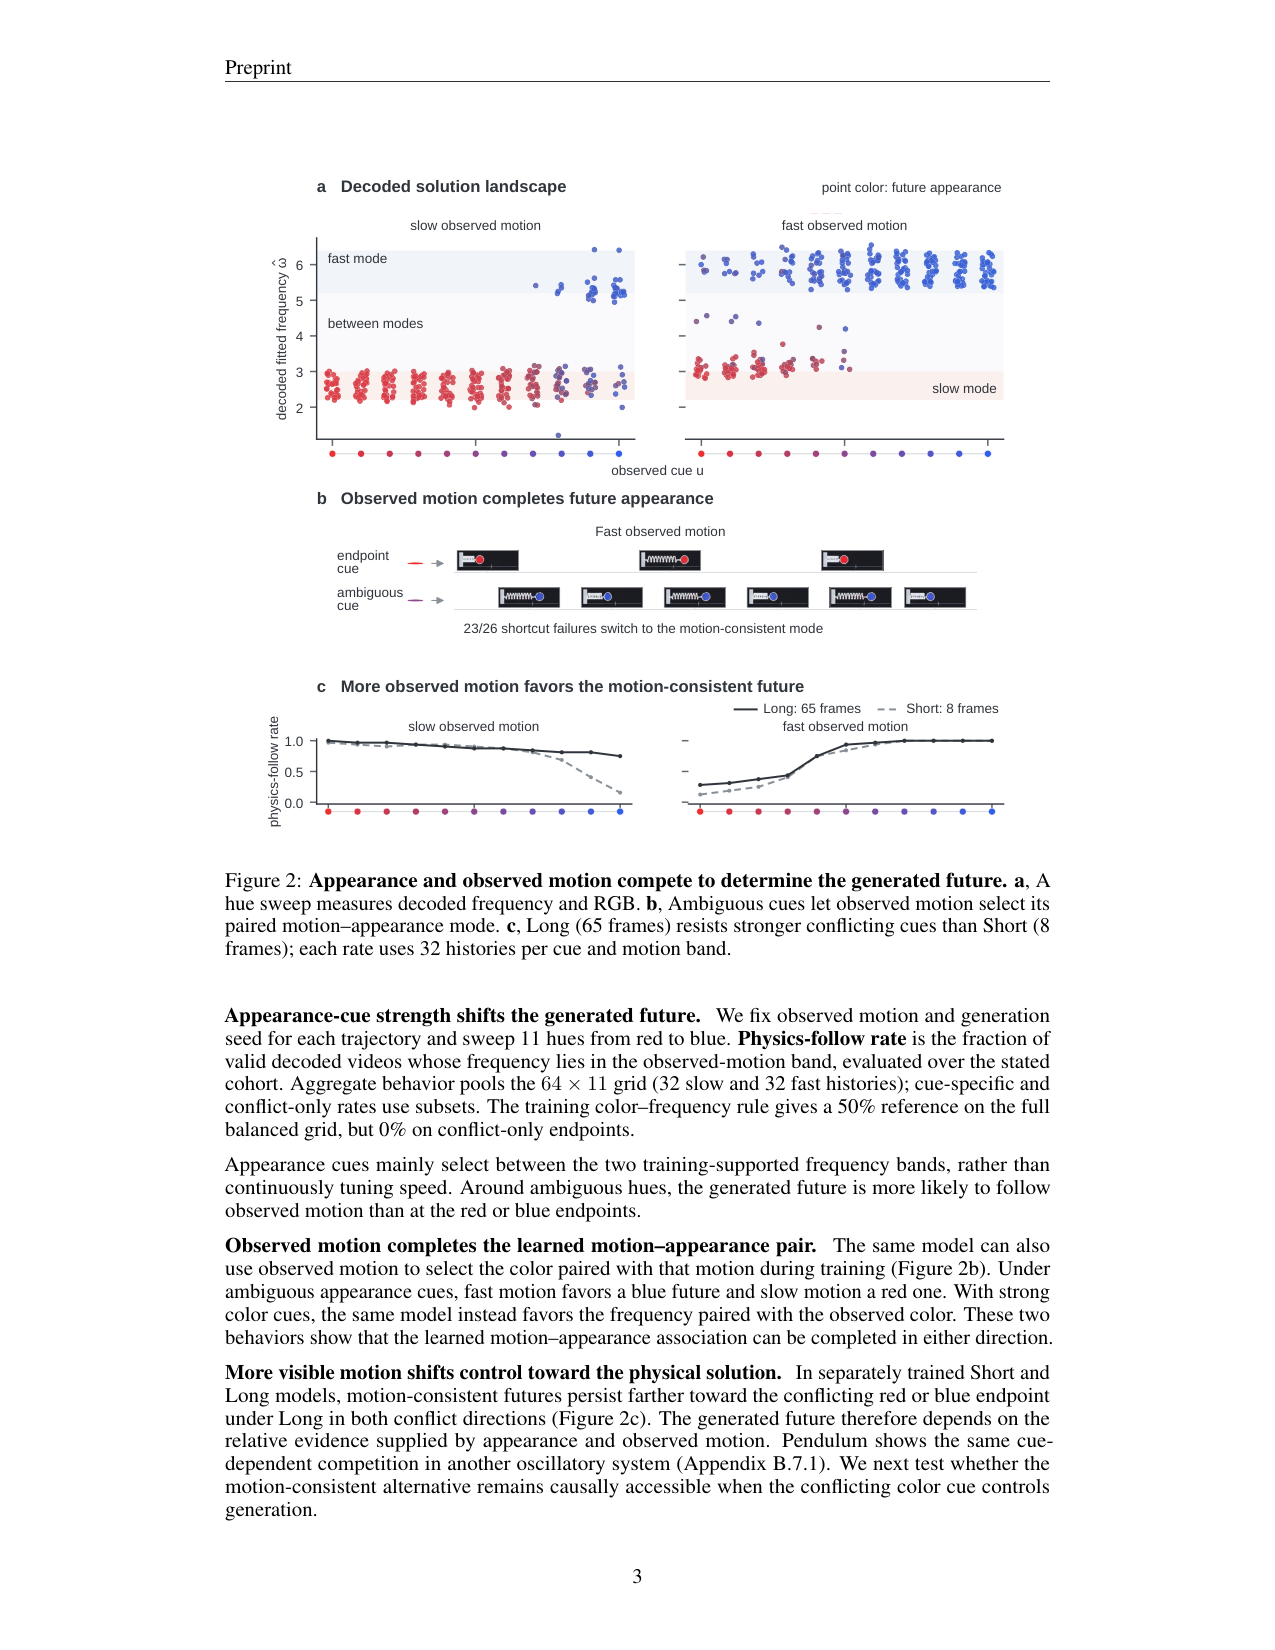
Figure 2a 的地貌图是全文现象的浓缩:横轴是输入色相,纵轴是解码频率,点的颜色是生成未来的实测 RGB。关键读数有三个。其一,频率主要落在慢、快两个训练支持带之一——颜色做的是在两个模式之间「选带」,几乎不产生中间的折中频率。其二,在强冲突端点(快速运动 + 纯红),physics-follow rate 掉到 0% 参考线:颜色完胜。其三,把颜色调到模糊的紫色,方向盘易主:26 条 shortcut 失败里有 23 条切回运动一致模式。更妙的是反向补全(Figure 2b):模糊颜色下,快速运动会把未来外观引向蓝、慢速引向红——学到的运动-外观关联可以双向完形。
这说明红蓝球例子里生成的慢速未来,是颜色线索在证据不足时赢下了竞争,而非模型手里没有快速运动这个选项。Long/Short 对比(Figure 2c)补上另一块拼图:可见运动越多,模型越能顶住冲突颜色。证据的相对强弱决定谁控制生成——这为后面的「可写性窗口」埋下伏笔。
干预:一个由位置与速度算出的四维写入
现象清楚了,现在做因果检验。核心构造是严格 aligned–conflict 配对:同一条物理轨迹、同一个边界状态(最后一帧观测的位置 x* 与速度 v*)、同一个生成种子,只改球的颜色。aligned 输入用训练配对的颜色(快速配蓝),模型跟着物理走;conflict 输入用对立颜色(快速配红),模型走 shortcut。两个 rollout 都合法,唯一差别是颜色。
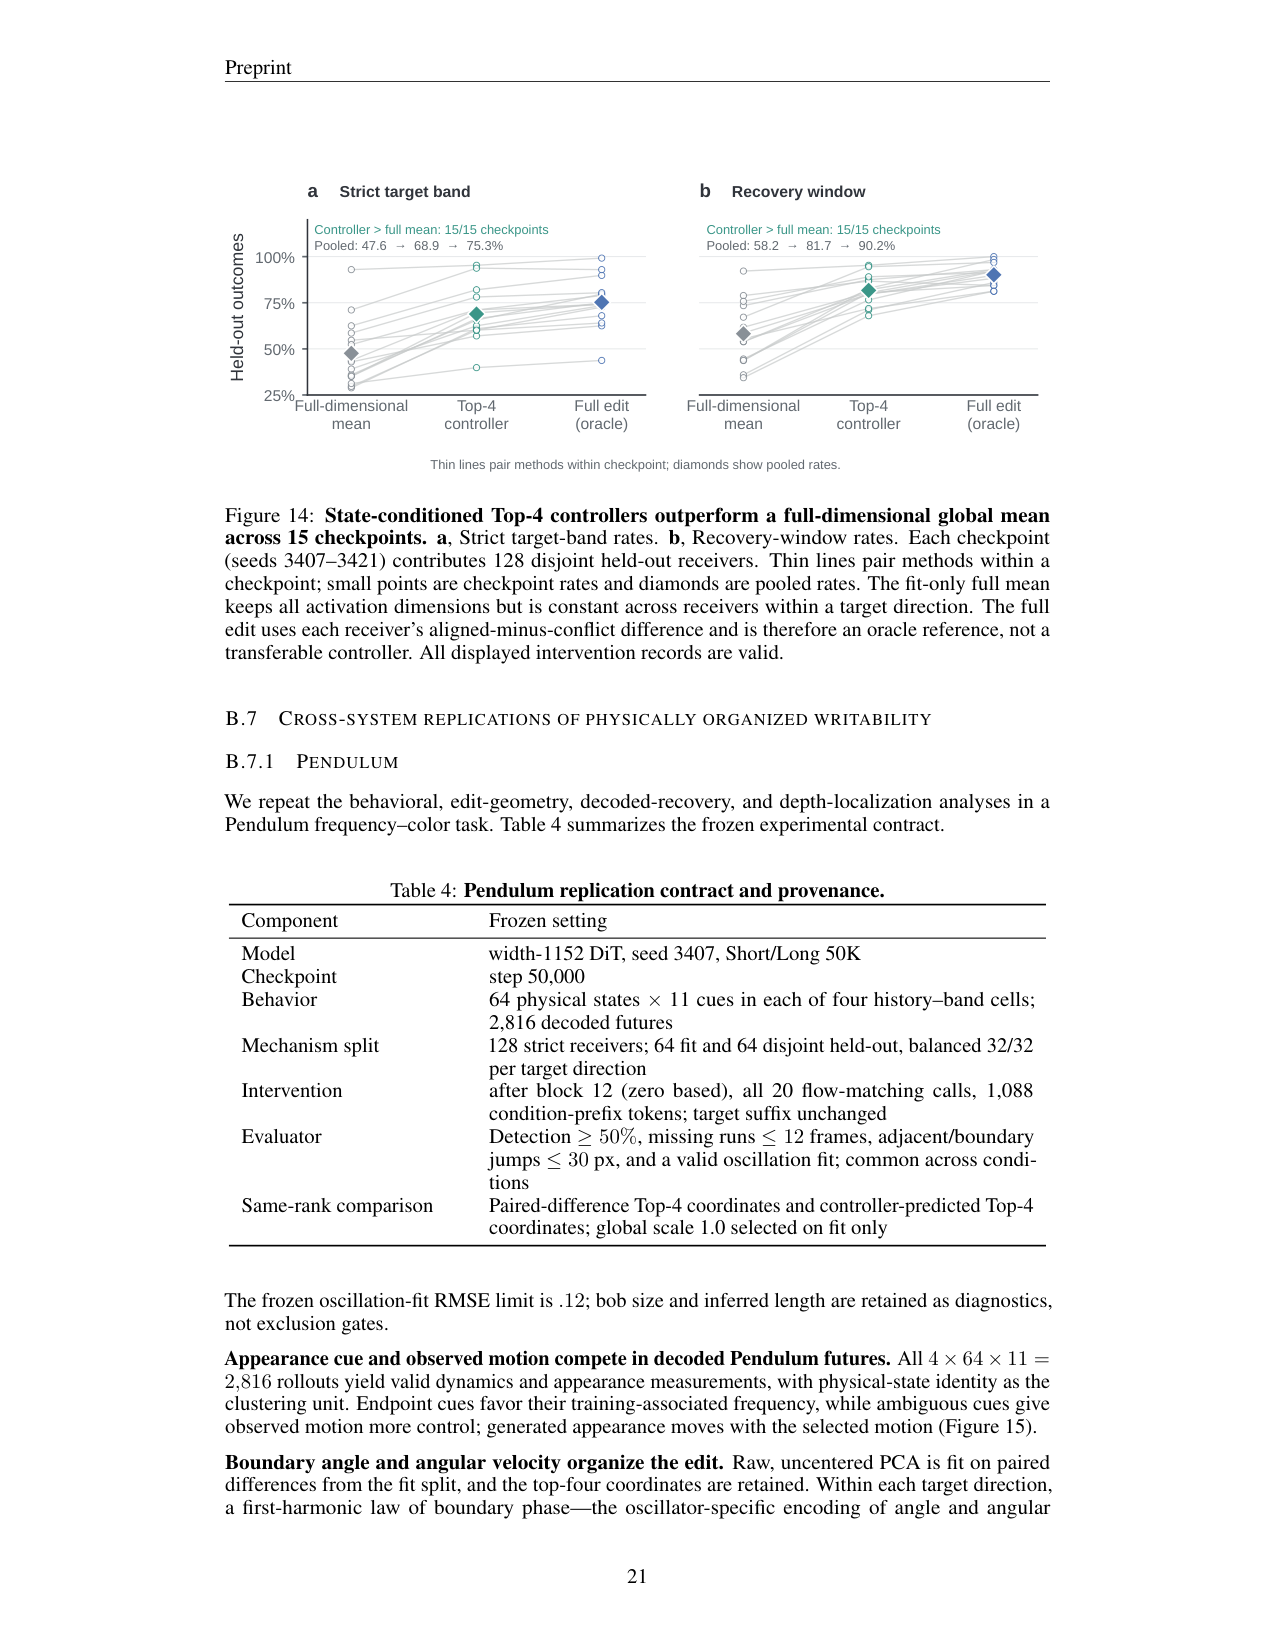
记 $h_{A,i}$、$h_{C,i}$ 为某 DiT block 之后观测帧 token 的状态,定义全差分编辑 $d_i = h_{A,i} - h_{C,i}$。把它加到 conflict run 的观测帧状态上(只动 1088 个条件 token,目标 token 不碰),解码未来就被改向快速(Figure 3a)。效果用归一化频率恢复来量:
$$R_\omega = \frac{\hat{\omega}_{\text{edit}} - \hat{\omega}_C}{\hat{\omega}_A - \hat{\omega}_C}$$
$\hat{\omega}_C$ 是 conflict 自然生成的频率,$\hat{\omega}_A$ 是 aligned 的频率,所以 $R_\omega = 0$ 表示没改变,$R_\omega = 1$ 表示完全恢复到 aligned 水平。这个归一化让不同轨迹、不同方向的编辑可以放在同一把尺上。
全差分编辑要读 aligned 的激活,这在真实场景里拿不到。论文的三步递进把它变成可执行的工具。第一步,降维:对配对差分做 uncentered PCA,只保留前 4 个坐标,held-out 写入 87.8% 落在 $.75 < R_\omega < 1.25$ 窗口内,对照全差分的 92.4%——效果几乎全在四维子空间里。第二步,找组织:这 4 个坐标随边界相位排成光滑的环(Figure 3b)。对谐振运动 $x = A\cos\theta$、$v = -A\omega\sin\theta$,定义边界相位
$$\theta^* = \mathrm{atan2}\left(-v^*/\omega_{\text{true}},\; x^*\right)$$
$\cos\theta^*$ 类位置、$\sin\theta^*$ 类速度(频率归一后)。也就是说,写入向量的形状由「球在边界时刻位于哪、动多快」决定。第三步,控制器:按目标方向分别拟合一阶谐波映射
$$\hat{z}_{1:4}(\theta^*) = \beta_0 + \beta_c\cos\theta^* + \beta_s\sin\theta^*$$
它把 held-out 坐标预测 $R^2$ 从仅方向模型的 .51–.60 提到 .83–.88(Figure 12 的消融显示:方向只定下 PC1 的粗平移,PC2–PC4 的状态变化必须靠这条相位律)。对一条全新的视频,冻结控制器从边界位置/速度加目标方向直接算出 4 个坐标,经冻结 PCA 基重建激活编辑——六组 run–方向里 85.9% 的合成写入落在恢复窗内(Figure 3c)。全程不读 aligned 视频、不读 aligned 激活,更不重新训练权重。
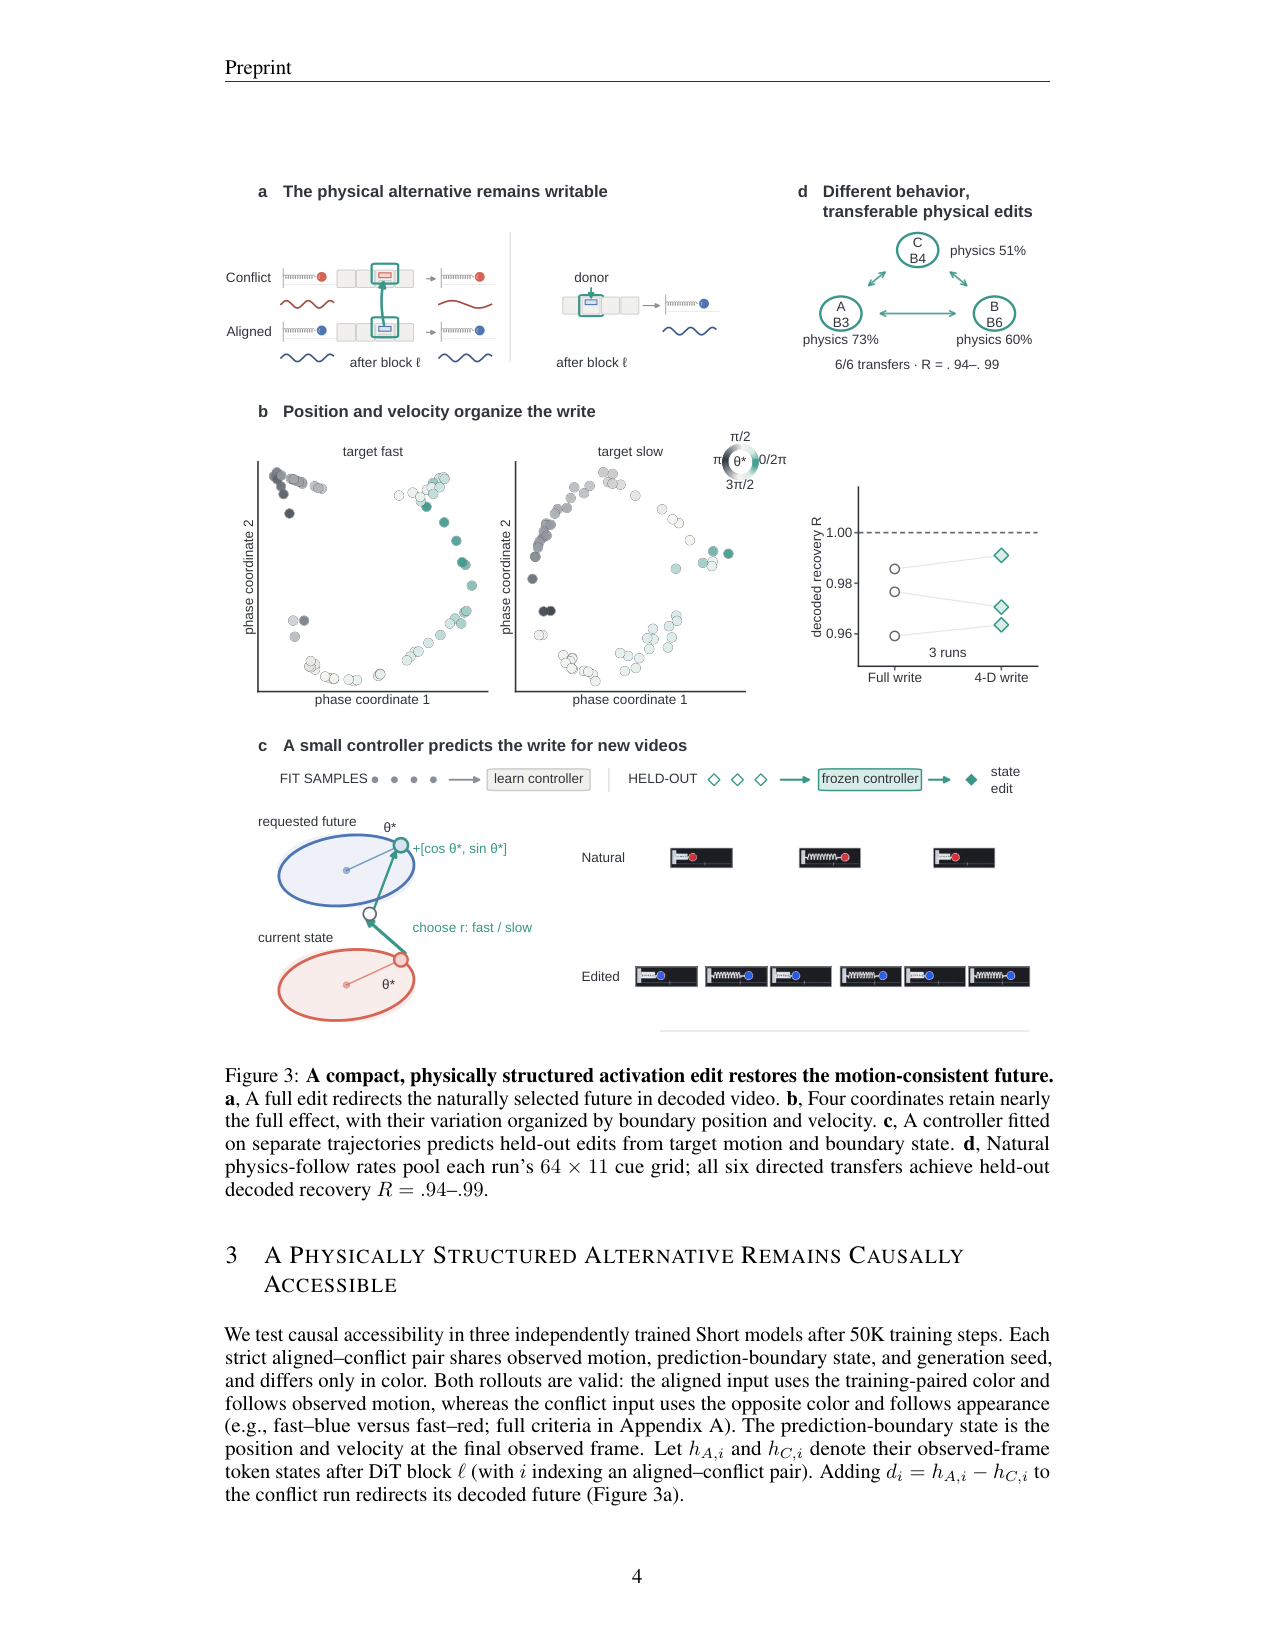
两个对照把这个结果钉得更牢。Figure 14:换用「保留全部激活维、但对每条新视频恒定」的全维均值写入,严格目标带率只有 47.6%,而状态条件四维控制器 68.9%,且在 15/15 个 checkpoint 上全胜——低维加状态条件赢过高维无状态,说明有效信息真的按物理状态组织。Figure 3d / Figure 27:三个同架构同配置、仅种子不同的模型,自然 physics-follow 率相差 22 个百分点(51%/60%/73%),行为差异巨大;但一个 scale 加四维正交映射就能把控制器预测的编辑在六个有向模型对之间转移,held-out 解码恢复全部落在 R = .94–.99,而方向内打乱轨迹的零假设只有 .066–.152(p < 0.00005)。行为不同,不代表内部的物理解不同;差异在下游怎么用这个共享解——这句话在后面注意力一节会变成具体组件。
深度扫描:写入有一班「末班车」
编辑有效,接下来的问题是:在多深之前有效?论文把同一个固定强度的编辑依次注入 31 个位点(第 0 个 block 前 + 每个 block 后),定义
$$W_\omega(\ell) = \Pr_i\left[\text{valid} \;\wedge\; .75 < R_\omega^i(\ell) < 1.25\right], \qquad D_\omega = \sum_{\ell} W_\omega(\ell)$$
$W_\omega(\ell)$ 是严格失败中在第 $\ell$ 层仍可被改写的比例,$D_\omega$ 是 31 个位点里可写位点的期望数——同一条写入能深入网络多远,被变成一个可计数的量。
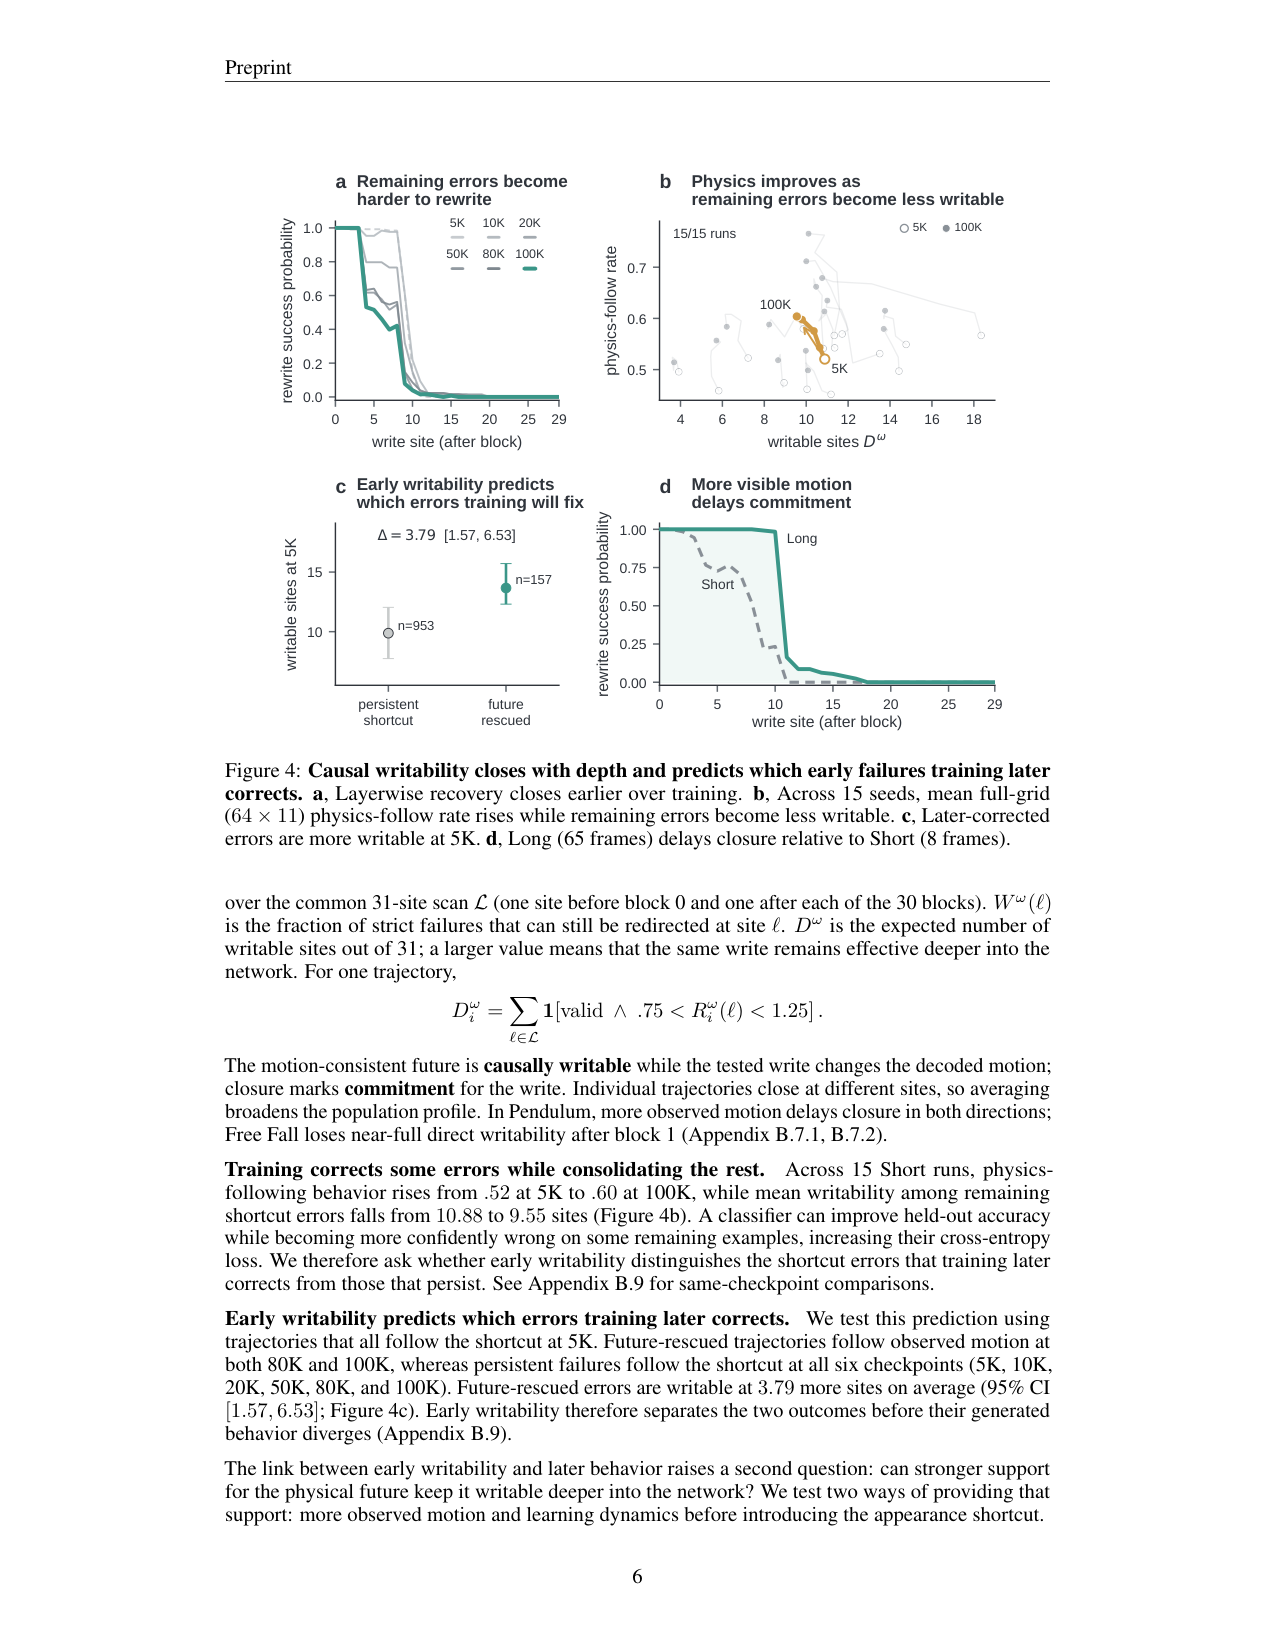
结果是一条尖锐的边界:同一编辑在边界前改变视频、边界后几乎完全失效,过渡发生在 1–2 个相邻 block 内。论文把这个关闭点称为 closure,它标记这条写入的 commitment(承诺点):越过它,观测帧的信息已经来不及进入未来帧的 token。三个 Short run 的操作边界在 B3/B6/B6,Long 在 B16/B8/B10(Table 6)——更多可见运动把末班车推迟了最多 13 层(Figure 4d)。
训练动力学给出更有应用价值的读数。15 个独立 run 从 5K 训到 100K:整体 physics-follow 率从 .52 涨到 .60,而剩余错误的平均可写位点从 10.88 降到 9.55(Figure 4b)——训练一边修好一部分错误,一边把修不动的错误焊得更死。焊死的过程可以直接观测:Figure 23 冻结那批在全部 6 个 checkpoint 都是严格失败的同一批轨迹,13/15 个 run 的 $D_\omega$ 仍在下降(Δ = −0.62,CI [−1.48, −0.11]),排除了「失败集合换了人」的样本组成解释。最锋利的是 Figure 4c:在 5K 时刻全是 shortcut 失败的轨迹里,后来(80K、100K)被训练救回的 157 条,比 953 条顽固失败平均多 3.79 个可写位点(95% CI [1.57, 6.53])。在生成行为还没有任何分化之前,可写性已经把这个错误会被修好还是焊死分开了——这是一个可操作的训练监控信号。
迁移到预训练大模型:先学运动,再学颜色
这套结论会不会只是从头训练的小玩具的特产?论文把同一个红慢蓝快任务搬到预训练 Wan 1.3B 视频 DiT 上,并顺手测了一个课程干预:Direct 路径直接学偏置任务;Neutral-first 路径先在 2048 条灰色弹簧视频上学 10K 步(同样的快慢运动,但颜色不携带频率信息),再喂同样的红慢蓝快数据,两条路径的数据顺序与随机流严格对齐。
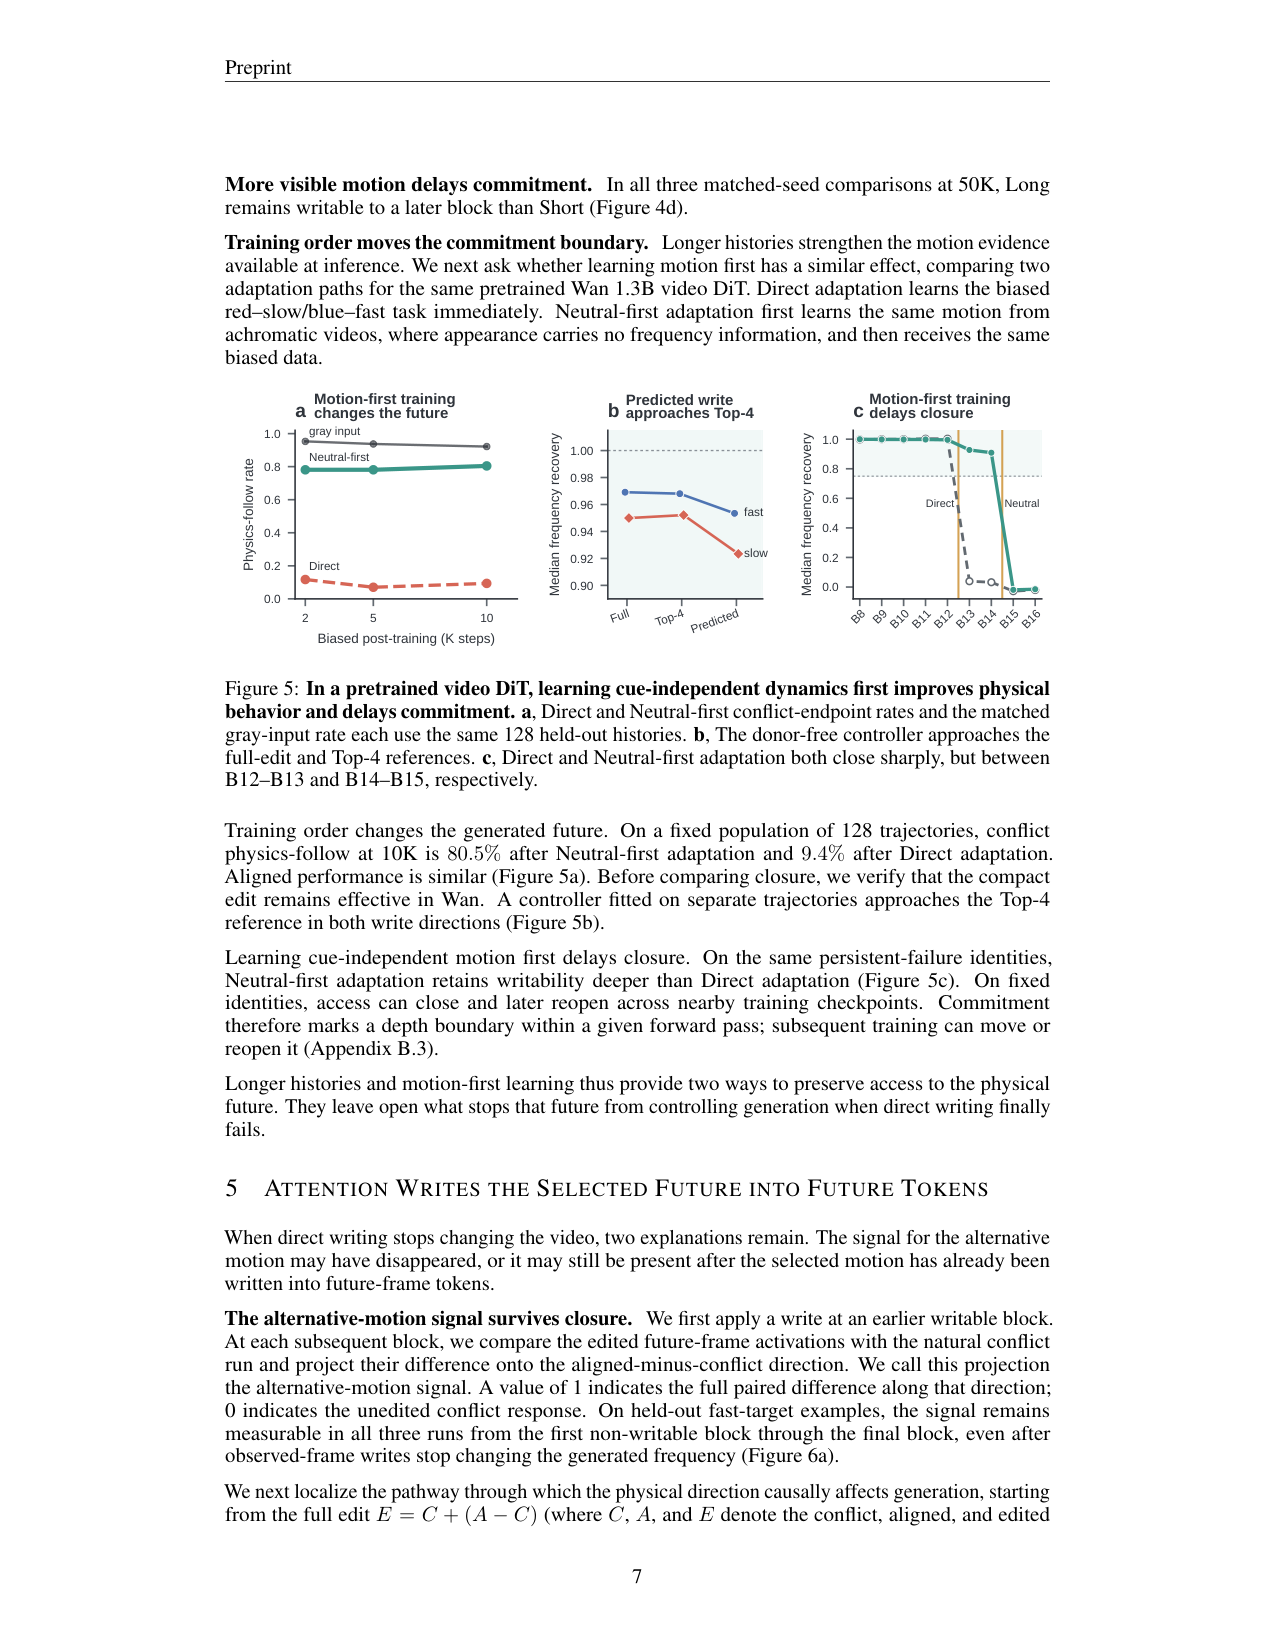
Figure 5a 的差异是数量级的:10K 步偏置训练后,冲突端点 physics-follow 率 Neutral-first 80.5%、Direct 仅 9.4%,而 aligned 表现两边相近(~94–96%),灰色输入约 96% 作为上界参照。Figure 9 显示三件套在 Wan 里完整复现:held-out 坐标相位组织($R^2$ = .97/.93)、donor-free 控制器中位恢复 .953/.923 逼近 top-4 天花板 .968/.952、以及固定身份队列上单 block 级尖锐塌缩——Direct 在 B12–B13 之间关闭,Neutral-first 在 B14–B15。先学无偏见的动力学,把末班车又往后推了两层。
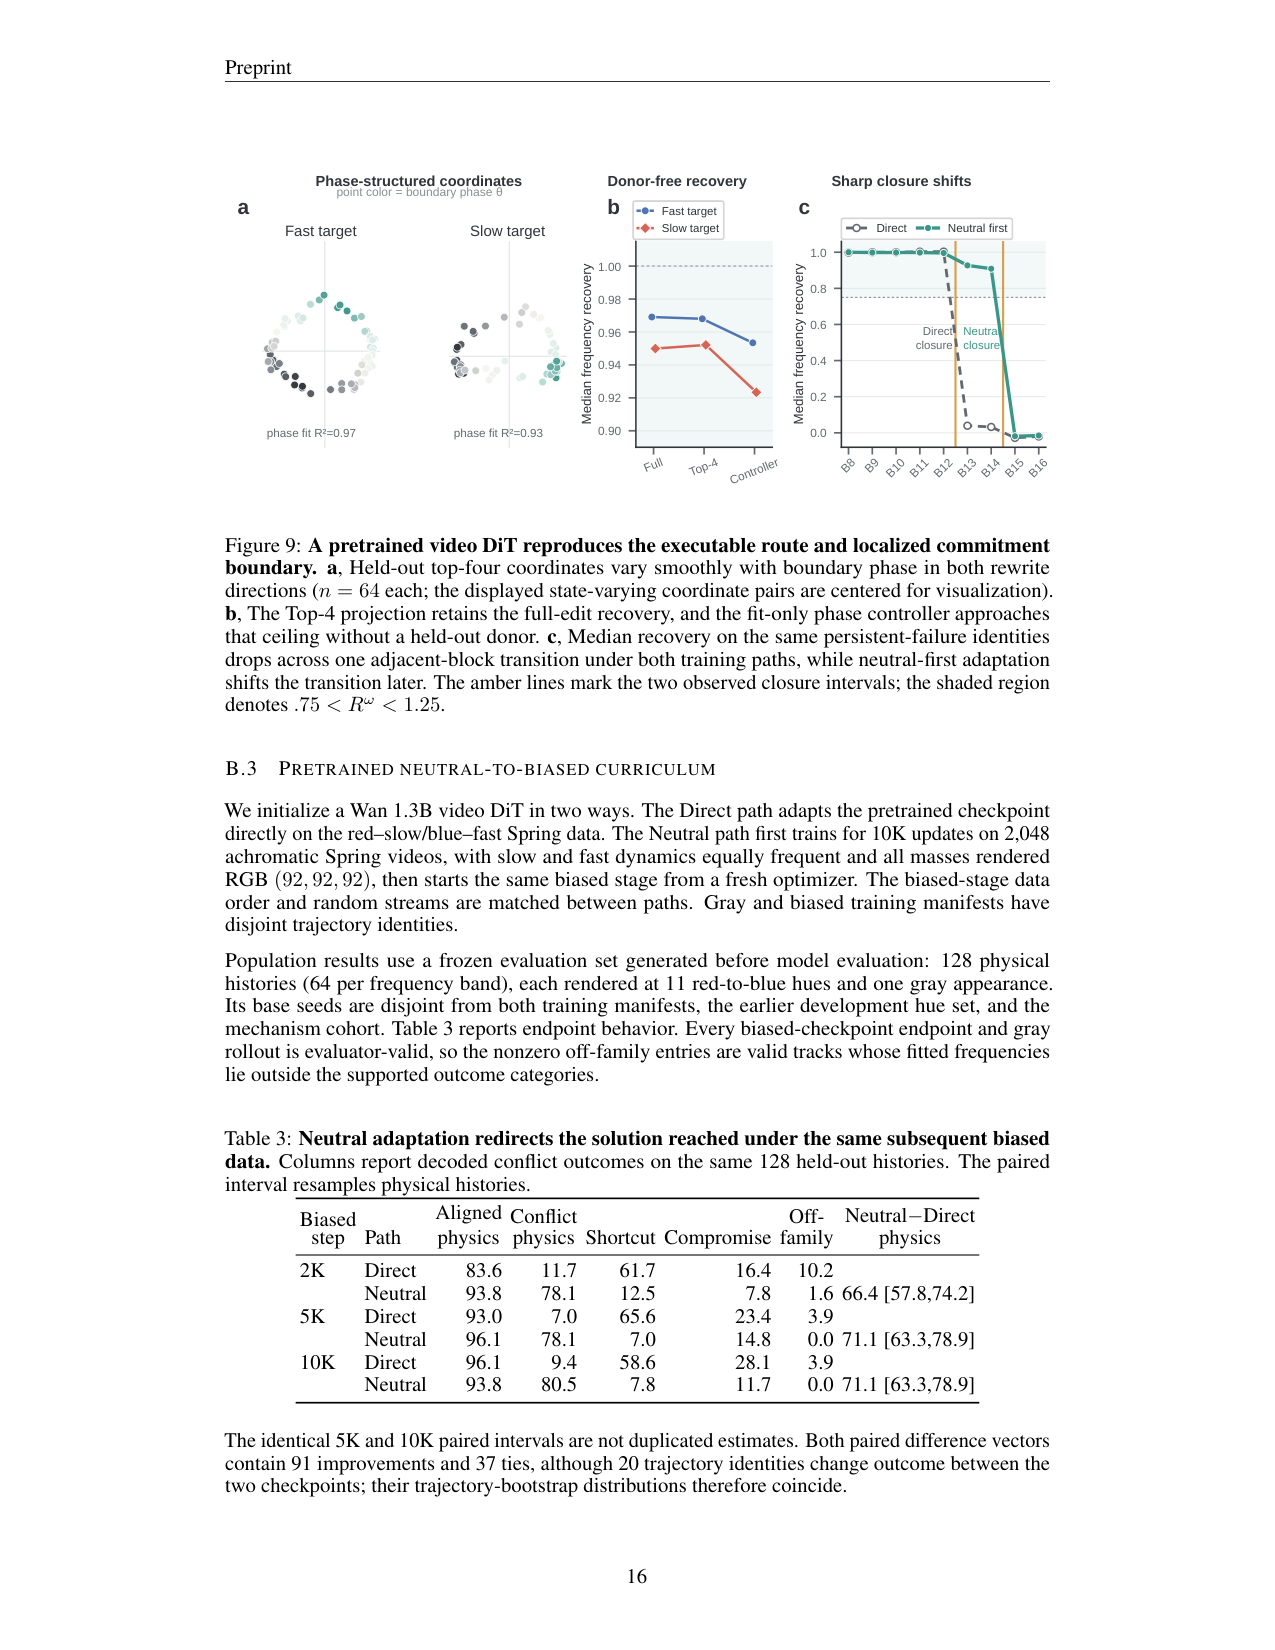
另一个值得记住的细节:在固定身份的轨迹上,B13/B14 的可写性会在相邻 checkpoint 之间关闭又重开(B12 始终可写、B15 始终关闭)。commitment 是一次前向计算里的深度边界,后续训练可以移动甚至重开它——它是 checkpoint 局部的计算性质,不是不可逆的「吸收态」。
机制:信号没丢,是注意力没把它写进未来
closure 之后,两种解释还在竞争:备选运动的信号已经从网络里消失,或者信号还在、只是选定的未来已经被写进未来帧 token。Figure 6a 直接区分了它们:先在早期可写层做一次写入,然后逐 block 测量编辑引发的未来帧激活差在 aligned−conflict 方向上的投影。这个「备选运动信号」从第一个不可写 block 一直到最后一个 block 都可测。closure 关掉的控制权,不是信息。
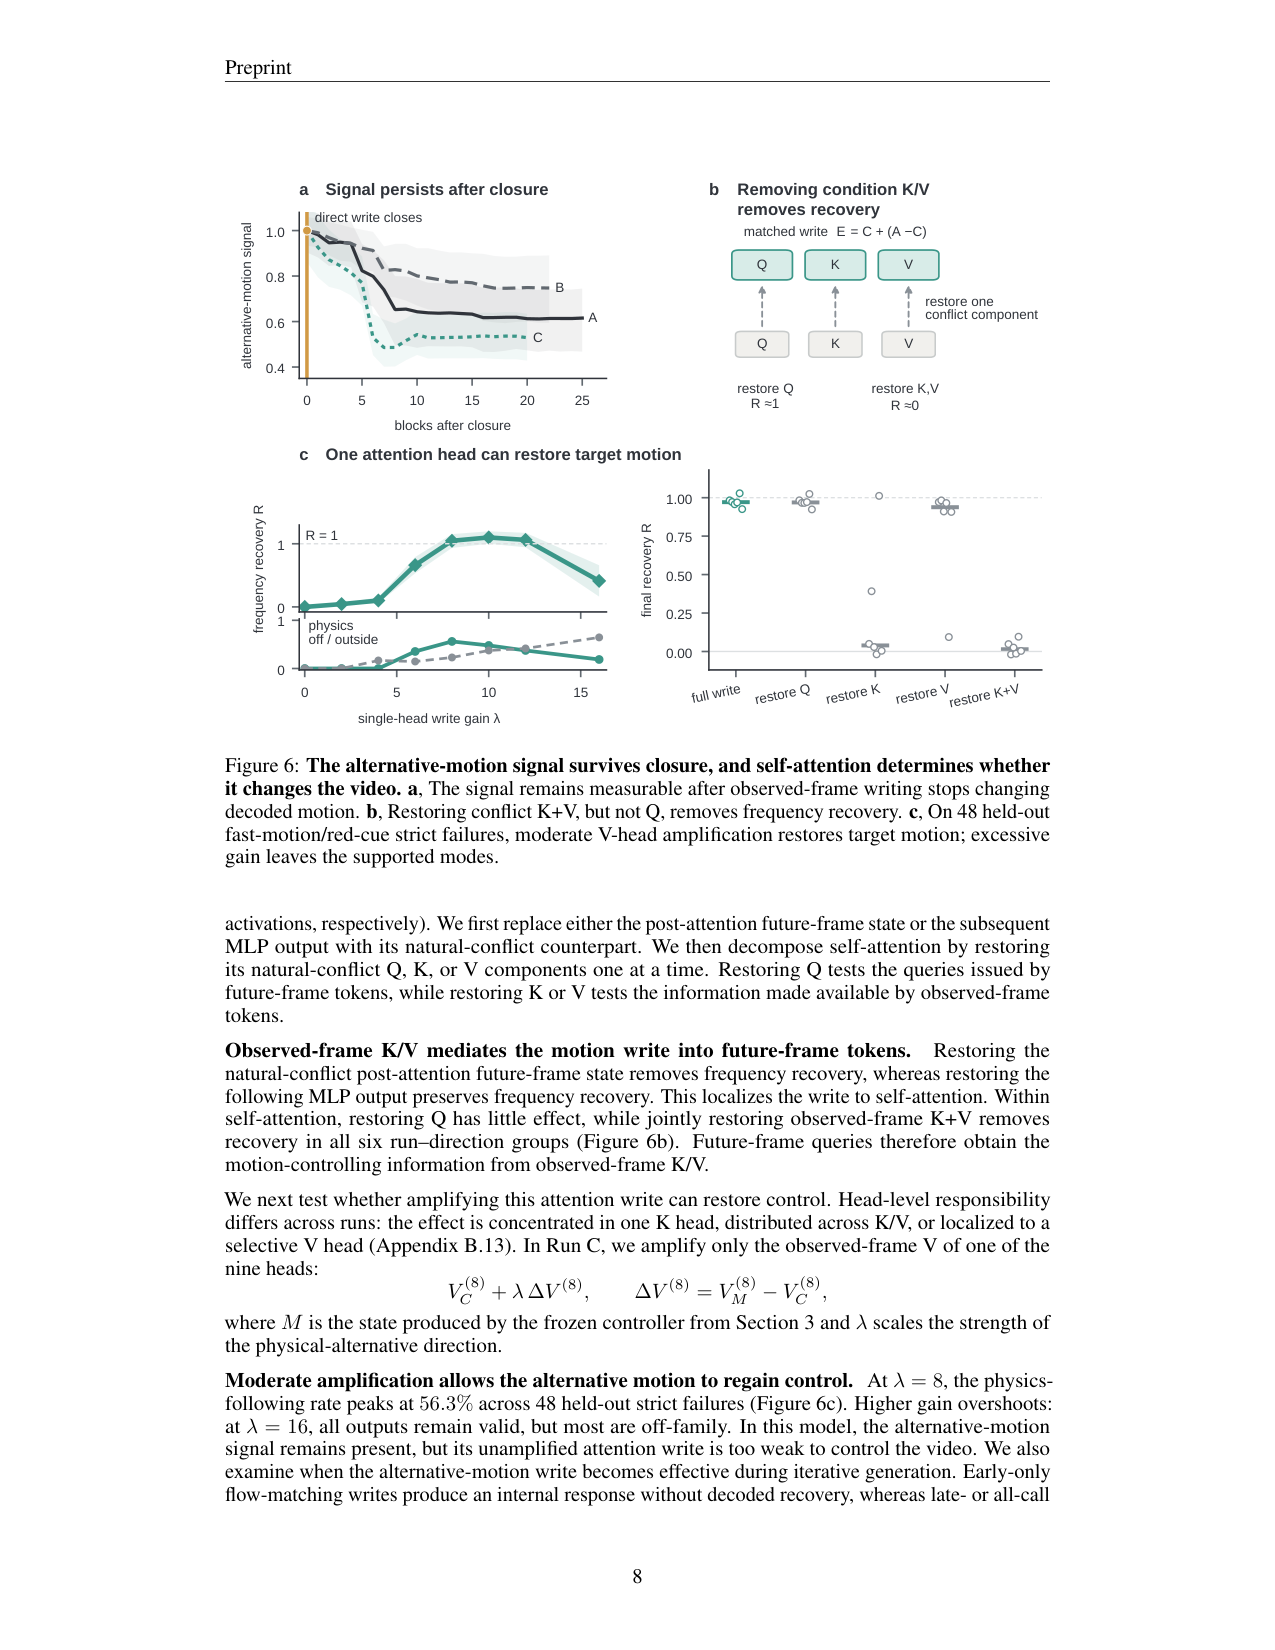
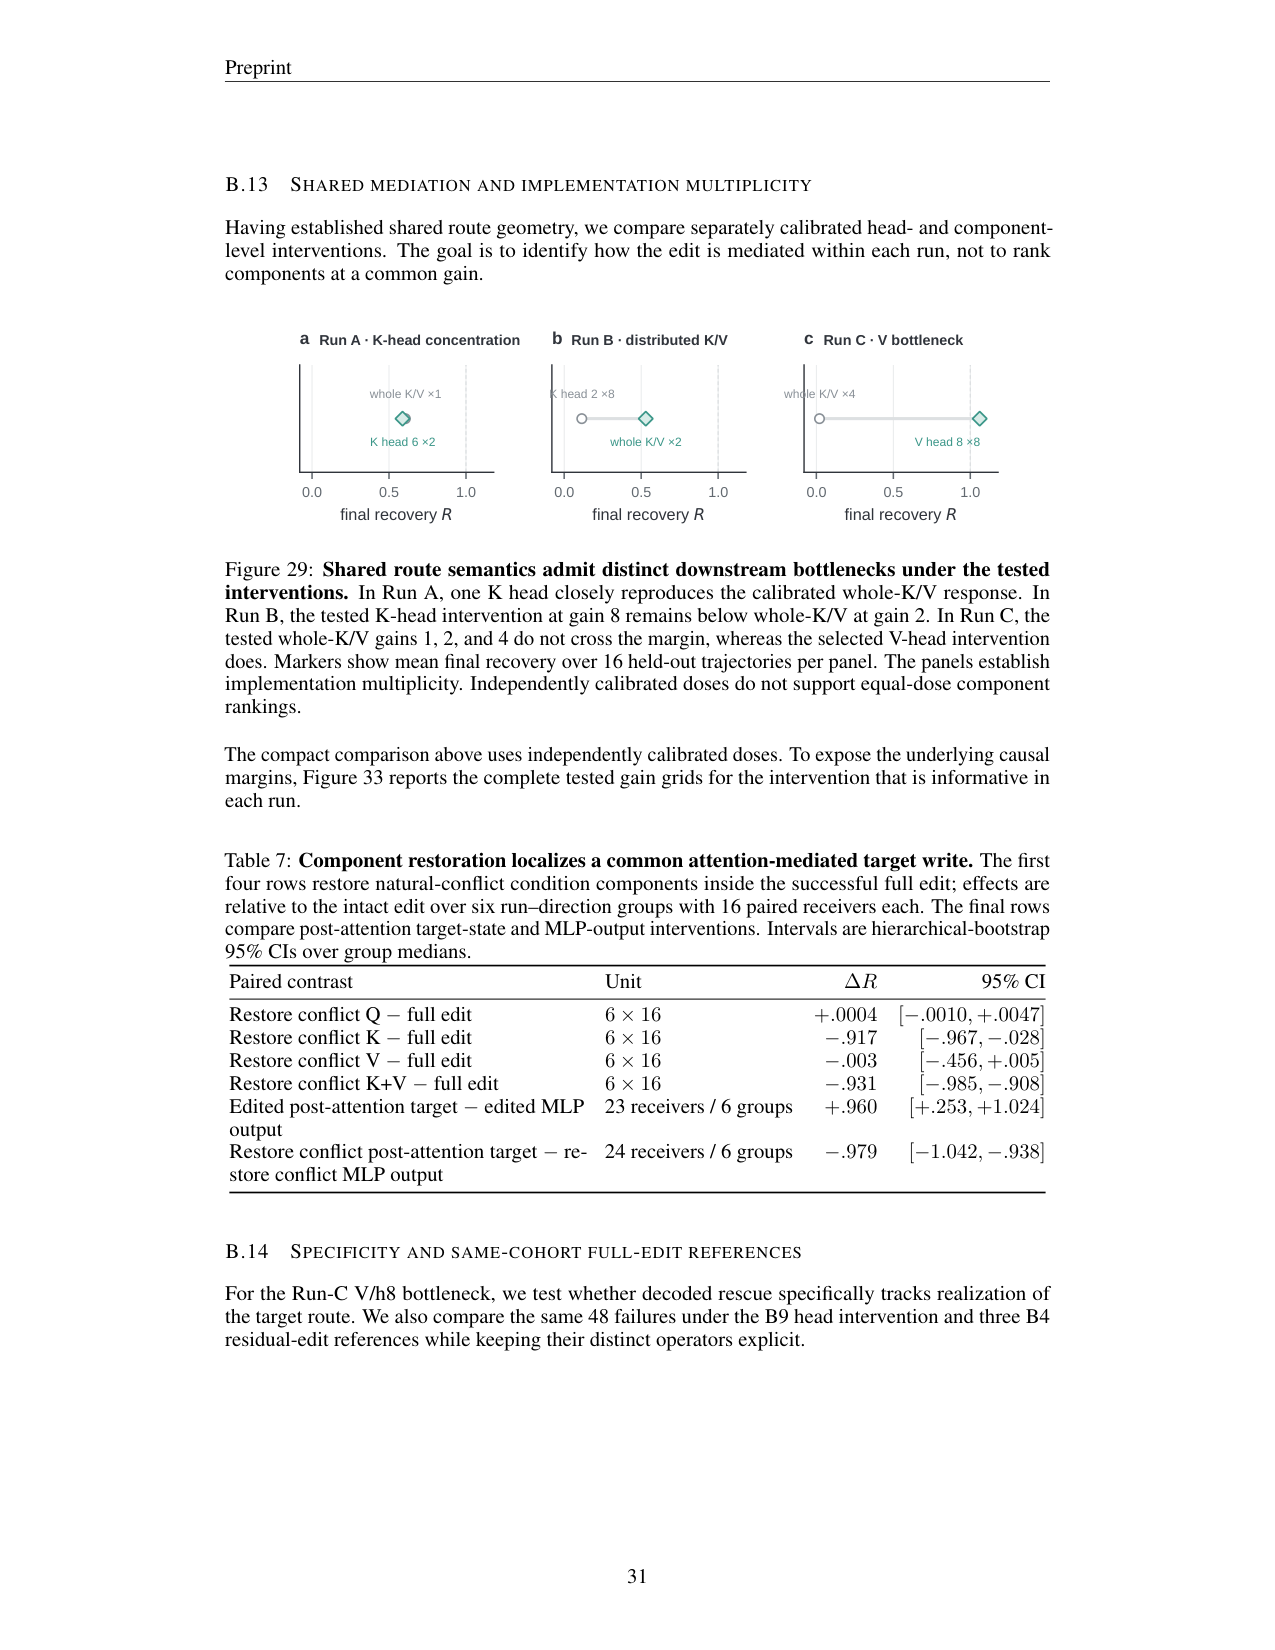
那控制权在谁手里?组件还原实验:在一个本来成功的全编辑里,逐个把自然冲突的 Q、K、V 还原回去。还原 Q 几乎无影响(ΔR = +.0004);联合还原观测帧的 K+V 把恢复彻底抹掉(ΔR = −.931,CI [−.985, −.908])。再把 post-attention 的未来帧状态换成冲突版,恢复消失;换 MLP 输出则不影响。结论落在自注意力上:未来帧的 query 从观测帧的 K/V 里读取运动控制信息,写入未来 token 的这一步决定哪个未来兑现。
最后一步是把这条通路拧大。三个 run 的责任组件各不相同:Run A 集中在一个 K 头,Run B 分散在 K/V,Run C 落在一个选择性 V 头(Figure 29,论文诚实地标注这是「实现多样性」,各 run 的增益独立标定,不做同剂量排名)。在 Run C,只放大 9 个头中第 8 个 V 头的观测帧写入:
$$V_C^{(8)} + \lambda\,\Delta V^{(8)}, \qquad \Delta V^{(8)} = V_M^{(8)} - V_C^{(8)}$$
$M$ 是前文冻结控制器产生的状态,$\lambda$ 缩放物理备选方向的强度。$\lambda = 8$ 时,48 条 held-out 顽固失败的 physics-follow 率从 0% 升到 56.3%(Figure 6c),与同批失败上 B4 残差全编辑参考的 50.0% 相当;$\lambda = 16$ 时全部输出仍有效,但多数越出两个支持带——增益有窗口,拧过头就 overshoot。两个对照排除「只是激活变大」:route 对齐投影与解码救活相关(Spearman ρ = 0.39,shuffle p = 0.0067),且在控制响应范数后依然显著,范数本身的偏相关近零(Figure 30)。写入还有时间维度:同样的编辑只在 flow-matching 早段调用注入,内部有响应但解码不恢复;晚段或全程注入才救得回来(Figure 31)。
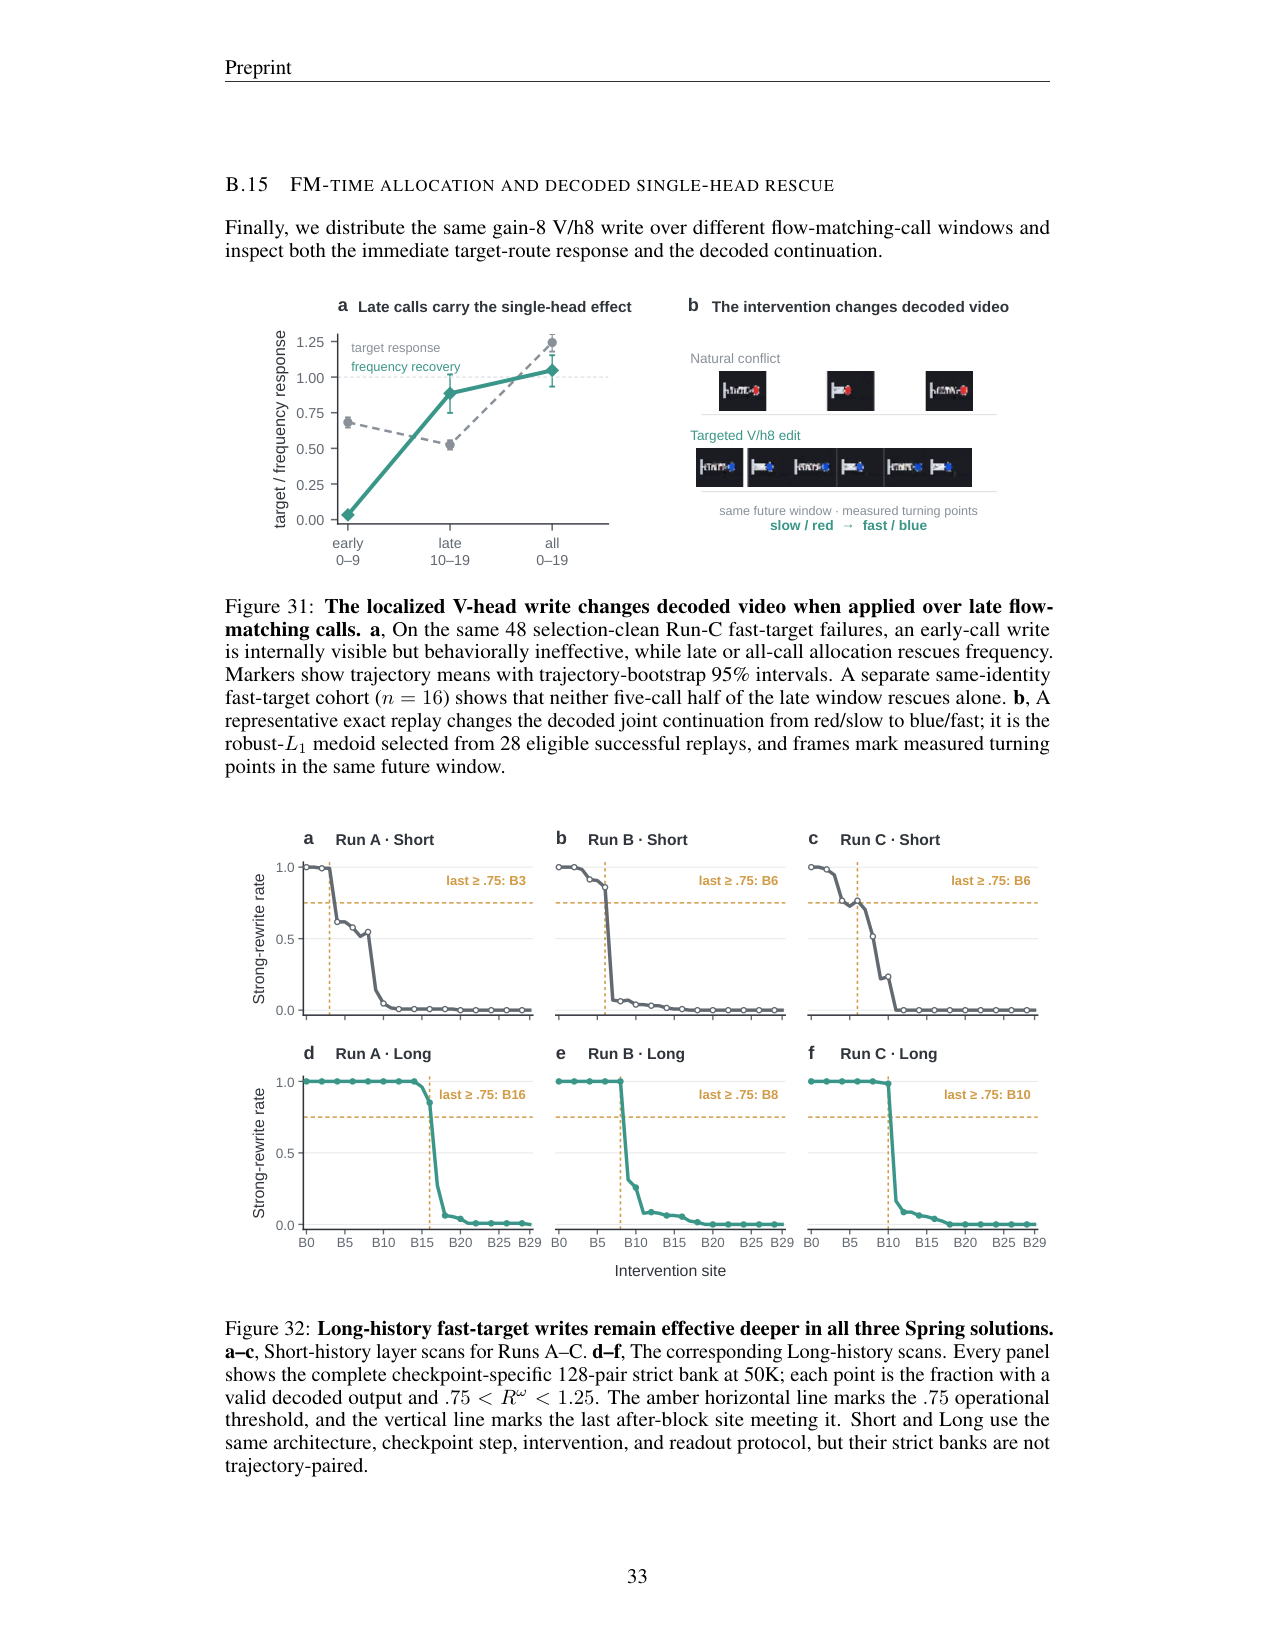
注意 Figure 31b 的细节:被救回的视频里球从红色变成蓝色——编辑沿训练耦合的外观-动力学模式行动,改运动会连带改外观。这不是一个颜色-动力学解耦的纯净物理通道,也是全文最该被记住的限制之一。
收益、代价与最弱一环
把闭环走完。可观测现象是红蓝球冲突下的 shortcut 生成;机制假设是「学会但没用上 + 注意力写入决定兑现」;干预是边界状态算出的低维写入与下游 V 头增益;收益则是一组带 baseline 的硬数字:donor-free 控制器 85.9% 在窗(top-4 oracle 87.8%)、跨模型 6/6 转移 R = .94–.99、早期可写性 +3.79 位点预测训练命运、Wan 课程干预 80.5% vs 9.4%、单 V 头 56.3% 救回顽固失败。系统外推也有初步证据:单摆复现相位组织与 Long 延迟 closure(两个方向 +10.53/+8.05 位点),自由落体里指定重力的 [1, g] 控制器中位恢复 .967(61/64 成功),虽然它的直接可写性在 block 1 后就基本消失。
代价同样清楚:干预是推理期激活编辑,需要 fit split 上的统计;编辑连带外观;增益有窗口;closure 结论绑定所测编辑强度与 checkpoint;每个 run 的责任头不同。最弱一环在收益的外部效度:从受控弹簧到自然视频世界模型的距离没有测量——自然出现的 shortcut 是否也有同样的 point of no return,论文明确说开放。不过就算只把它当训练监控工具(5K 时刻量一遍可写性,就知道哪些错误会被训练修好、哪些会被焊死)和课程设计依据(先学动力学再引入外观偏见,80.5% vs 9.4%),这套东西的工程含义已经立住了。
一句话记住这篇
快速运动的红球被生成成慢速,不代表模型没学会快速运动:用边界位置与速度算出的四维写入能把它改回来;这条写入有一班深度上的末班车(closure/commitment),错过之后信号仍在,把单个注意力 V 头的写入放大,56.3% 的顽固失败重新服从物理。 最该记住的数字是 +3.79(5K 时分开「会被训练修好的错误」与「焊死的错误」的可写位点差);最该记住的保留是:编辑沿耦合模式行动(改运动会连带改颜色),且自然视频里的 shortcut 是否有同样的末班车,还没人知道。
红慢蓝快的弹簧球实验给出『学会但没用上』的因果证据:训练只见过红球慢振、蓝球快振的视频模型,面对快速运动的红球会生成慢速未来;但用边界位置与速度算出的四维激活编辑能把快速运动写回来(held-out 恢复率 85.9%),同一编辑在临界深度后突然失效(closure/commitment),而信号仍在——放大单个注意力 V 头的写入即可在 56.3% 的顽固失败上恢复正确运动。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:预测欠定(predictive underspecification)导致的可观测分流:训练数据中颜色与频率绑定(红↔慢 ω∈U[2.2,3.0] rad/s、蓝↔快 ω∈U[5.2,6.4] rad/s,各 1024 条、无冲突组合),测试时固定真实运动、只改颜色(11 档红→蓝色相扫描),同一物理历史会随颜色线索强弱在两个训练支持的频率带之间切换——强冲突端点(快历史+红色)上 physics-follow rate 掉到 0% 参考线,中间紫色(ambiguous cue)档反而跟随观测运动;外观主要做『选带』而非连续调速。反向补全同样成立:模糊颜色下快速运动会把未来外观引向蓝色。可见运动越多(Long 65 帧 vs Short 8 帧),抗冲突颜色能力越强。
在哪里观测:Spring 受控弹簧-振子任务:488M 参数 latent flow-matching DiT(30 个双向 block、hidden 1152、FFN 4608、9 头×128 维、1×2×2 patch),冻结 Wan2.1 VAE;128×128、20fps、129 帧视频(0–64 帧条件、65–128 帧生成;33 latent 帧 = 17 条件帧 1088 token + 16 目标帧 1024 token);三个独立训练种子(Run A/B/C,seed 3407/3408/3409)的 Short 50K checkpoint 为主,15 个种子做纵向训练动力学;另在 Pendulum(另一振子)、Free Fall(非振荡重力)与预训练 Wan 1.3B 视频 DiT 上复制。
如何量化:全解码视频评估(不用 MLLM 判断):确定性检测器逐帧跟踪质量块中心(检出≥90% 帧、缺失≤3 帧、跳变≤12px 等有效性门槛),对像素位移拟合 x(t)=a cos(ω̂t)+b sin(ω̂t)+c(1601 点频率网格,RMSE≤0.035 保留);ω̂ 落入历史一致带记 physics-following、落入颜色关联的对立带记 shortcut、落入两带之间记 compromise。行为网格 = 64 物理历史 × 11 色相(同 history 的 11 个变体是重复测量而非独立样本)。干预效果用归一化频率恢复 R_ω=(ω̂_edit−ω̂_C)/(ω̂_A−ω̂_C),0=自然冲突频率、1=对应 aligned 频率;可写性用 W_ω(ℓ)=严格失败中在第 ℓ 位点仍满足 .75 假设:正确运动仍然存在于模型内部、只是没控制自然生成:颜色与运动两条预测规则在训练分布上无法区分,生成时被选中的未来由颜色线索接管,但运动一致的备选未来仍躺在一个低维、按物理状态组织的激活子空间里;随着前向计算推进,观测帧信息被逐步写进未来帧 token(经自注意力 K/V),越过某个临界深度后同一写入来得太迟——closure 标记的是该写入的承诺点(commitment),是失控点而非信息丢失点(类比 Kalman 可观测 vs 可控)。 证据: 备选解释: 形式化/toy model:三个轻量形式化:(1) 恢复度 R_ω=(ω̂_edit−ω̂_C)/(ω̂_A−ω̂_C) 把每次干预归一到『自然冲突→aligned』区间;(2) 边界相位 θ*=atan2(−v*/ω_true, x*) 来自谐振解 x=A cosθ、v=−Aω sinθ,cosθ* 类位置、sinθ* 类速度;控制器为逐目标方向的一阶谐波映射 ẑ_{1:4}(θ*)=β0+βc cosθ*+βs sinθ*,经冻结 PCA 基重建激活编辑;(3) 可写性 W_ω(ℓ)=Pr_i[valid∧.75 干预对象:激活(观测帧 1,088 个 condition token 在某 block 后的残差状态) 操作:三种算子:(a) 替换 h_C←h_A(layer localization);(b) 加全差分/投影/转移/预测编辑 h_C←h_C+d̃(route 分析),d=h_A−h_C;(c) Run C 的 B9 注意力第 8 V 头增益 V_C+λΔV。所有干预只动 condition 前缀、目标后缀在注入时不改,每次前向的 20 次 flow-matching 调用各命中一次(除显式声明的 FM 窗口实验)。 效果:全差分把冲突 run 的解码未来改向运动一致模式;top-4 保留近乎全部效果(87.8% vs 92.4% 在窗);预测控制器 85.9% 在窗;单 V 头 λ=8 在 48 条顽固失败上 56.3% physics-follow。 局部性:极强:单一注入位点(31 选 1)、只改 2,112 token 中的 1,088 个条件 token、top-4 低维坐标或 9 头中的 1 个 V 头;编辑由边界位置/速度(或指定重力 g)算出,不重新训练任何权重。 干预对象:训练过程(学习顺序/证据量,间接移动可写边界) 操作:(a) 可见运动从 8 帧加到 65 帧(Short→Long);(b) Wan 1.3B 先在 2,048 条灰色无色彩偏置的弹簧视频上学 10K 步(Neutral-first),再喂同样的红慢蓝快数据,对照 Direct 直接学偏置任务。 效果:Long 把操作边界推后 +13/+2/+4 个 block(Run A/B/C);Neutral-first 把冲突端点 physics-follow 从 9.4% 拉到 80.5%(10K,128 条 held-out 历史),并把 closure 从 B12–B13 推到 B14–B15。 局部性:数据/课程层面,不动架构与优化器;biased 阶段数据顺序与随机流在两路径间对齐。 因果验证:严格 aligned–conflict 配对是同轨迹、同边界状态 (x*,v*)、同生成种子的反事实对,只有质量块颜色不同,且两 rollout 均有效(aligned 落在真实带、conflict 落在对立 shortcut 带、|ω̂_A−ω̂_C|≥2.0);共享 256 轨迹库(128 快目标+128 慢目标,fit/held-out 各 128 按方向平衡)。所有投影/系数/模型选择都只在 fit split 上定(fit-only)再评 held-out。组件还原(逐个把自然冲突 Q/K/V、post-attention 状态、MLP 输出还原进成功编辑)定位因果通路;shuffle 零假设(20,000 次)检验跨 run 几何;route 投影 vs 响应范数的偏相关排除『只是激活变大』;固定身份队列追踪 closure 在相邻 checkpoint 间的关闭与重开。 指标:held-out 解码频率恢复(donor-free 控制器) 数值:85.9% 合成写入落在 .75 基线:top-4 oracle 87.8%、全差分 oracle 92.4%;仅方向模型坐标 R² .51–.60 → 控制器 .83–.88 设置:3 个 Short 50K run × 2 改写方向;128 fit / 128 held-out 严格配对;§3 Fig 3c(p4)、Fig 12(p19) 指标:跨模型编辑转移(6 个有向 run 对) 数值:held-out 解码恢复 R=.94–.99,6/6 成功 基线:方向内 shuffle 坐标 R² 均值 .066–.152(matched .955–.997);各 run 自然 physics-follow 相差 22 个百分点(51%/60%/73%) 设置:scale+4D 正交映射在独立轨迹上 fit,128 held-out 物理身份;§3 Fig 3d、B.11 Fig 27 指标:训练命运的早期预测 数值:5K 时刻将被训练救回的错误比顽固错误多 3.79 个可写位点(95%CI [1.57,6.53]) 基线:顽固失败 n=953、将被救回 n=157(全部为 5K 时刻的 shortcut 失败;救回=80K 与 100K 都转 physics) 设置:15 个 Short run 纵向 5K–100K;6 种可写性定义与控制误差严重度/边界状态后稳健(Fig 4c、Fig 24) 指标:预训练 Wan 1.3B 的学习顺序收益 数值:冲突端点 physics-follow 80.5%(Neutral-first)vs 9.4%(Direct),10K biased 步 基线:aligned 表现相近(93.8% vs 96.1%);灰色输入 ~96%;配对差 71.1pp,CI [63.3,78.9] 设置:128 条 held-out 历史 × 端点色相;Neutral 先 10K 灰色课程;Table 3、Fig 5a(p7) 指标:单 V 头下游放大(Run C) 数值:λ=8 时 56.3% physics-follow、mean R=1.05 基线:未编辑冲突 0%;B4 残差全编辑参考 50.0%、top-4 41.7%、fit-only 状态编辑 43.8%(操作位点不同,描述性对比) 设置:48 条 held-out 快目标/红线索严格失败,B9 注意力 V head 8,全部 20 次 FM 调用;Fig 6c、Table 8(p8/p32) 代价:干预是推理期的激活编辑,需先跑一次自然生成拿到配对/拟合统计(或事后测量冲突频率与相位的事后控制器);编辑沿训练耦合的外观-动力学模式行动——slow→fast 会把未来颜色一起拉向蓝色,目前没有颜色-动力学解耦的子空间;增益有窗口,λ=16 即 overshoot 越出支持带;closure 针对所测编辑/位点/checkpoint,且逐 run 的责任头不同(K 头集中/分散 K/V/单 V 头三种实现);Free Fall 的直接可写性在 block 1 后基本消失,下游放大路线在该系统未验证。 可迁移性:同一 Spring 架构内:跨 3 个种子转移 6/6(R=.94–.99),跨同一 run 的 6 个 checkpoint 的 matched 坐标兼容中位 .796–.966(Fig 28)。跨系统:Pendulum 复现相位组织(held-out 相位面 R² .985/.975、预测编辑中位 .917 vs top-4 .926)与 Long 延迟 closure(两个方向 +10.53/+8.05 位点);Free Fall 复现紧致可写坐标([1,g_target] 控制器中位 R_g=.967、61/64 重力拟合成功)与早期 closure。跨规模/训练体制:预训练 Wan 1.3B 复现可执行编辑(donor-free 中位 .953/.923 vs top-4 .968/.952)与尖锐 closure。未验证:自然出现的 shortcut(非合成绑定)、文本条件大模型、颜色-动力学解耦写入。② 机制假设
③ 局部干预
④ 工程收益
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| top-4 低维编辑保留率 | 87.8% held-out 写入落在 .75<R_ω<1.25 | 全差分编辑 92.4%(同窗口);随机/无结构基线不适用(方向仅模型坐标 R² .51–.60) | 3 个 Short 50K run × 2 方向共 6 组;uncentered PCA fit 于 128 对、held-out 128 对;§3 Fig 3b(p4) |
| donor-free 控制器解码恢复 | 85.9% 在恢复窗;中位 R_ω .910–1.012 | top-4 oracle 87.8%;全维均值控制器严格带率 47.6% vs 控制器 68.9%(15/15 checkpoint 全胜) | 边界相位 θ*+目标方向 → 一阶谐波 → 4 坐标 → 冻结 PCA 基;不读 held-out aligned 激活;Fig 3c、Fig 14(p21) |
| 跨 run 转移 | 6/6 有向对 held-out R=.94–.99 | shuffle 零假设坐标 R² .066–.152(p<0.00005);三 run 自然 physics-follow 51%/60%/73% | scale+4D 正交映射,128 fit / 128 held-out 物理身份;Fig 3d(p4)、Fig 27(p30) |
| closure 深度边界(操作阈值 .75) | Short B3/B6/B6,Long B16/B8/B10(Run A/B/C) | 同一 checkpoint 内从 ~100% 改写到 ~0 的过渡发生在 1–2 个相邻 block 内;Wan Direct B12–B13 vs Neutral B14–B15 | 31 位点扫描、各 run 自身 128 对严格库、50K checkpoint;Table 6(p27)、Fig 4d(p6)、Fig 5c(p7) |
| 早期可写性预测训练命运 | Δ=+3.79 位点(95%CI [1.57,6.53]) | 顽固 n=953 vs 将被救回 n=157;15/15 run 中 13 个固定身份顽固错误 D_ω 随训练下降(Δ=−0.62,CI [−1.48,−0.11]) | 15 个 Short run、6 checkpoint(5K–100K)纵向;Fig 4c(p6)、Fig 23(p27) |
| Wan 1.3B 学习顺序 | 冲突 physics-follow 80.5% vs 9.4%;closure 推迟 2 个 block | Direct adaptation 同数据同步数;灰色输入 ~96%;aligned 两边 ~94–96% 相近 | 128 条 held-out 历史端点色相,10K biased 步;Table 3(p16)、Fig 5a/c(p7) |
| 注意力 K/V 因果定位 | 还原冲突 K+V:ΔR=−.931(CI [−.985,−.908]);还原 Q:+.0004 | 完整编辑=1.0 参考;还原 post-attention 未来状态 −.979、还原 MLP 输出不影响 | 6 run–方向组 × 16 配对 receiver,层次 bootstrap;Fig 6b(p8)、Table 7(p31) |
| 单 V 头增益(Run C) | λ=8 → 56.3% physics-follow、mean R=1.05;λ=16 全部有效但多数 off-family | 未编辑 0%;同 48 失败上 B4 全编辑 50.0%(操作不同,描述性);route 投影 ρ=0.39(shuffle p=0.0067) | 48 条 held-out 快目标/红线索严格失败,B9 V head 8,全 20 次 FM 调用;Fig 6c(p8)、Table 8(p32)、Fig 30(p32) |
Insights
- 『没学会』和『学会没用上』在生成结果上不可区分,但在因果上可区分:同一个快速红球输入,自然生成走颜色 shortcut 出慢速,而边界状态算出的 4 维写入能把快速未来拉回来——acquisition 与 control 是两条轴,对应控制论里可观测与可控的区分(论文引 Kalman 1960)。
- 写入有『末班车』:观测帧信息经自注意力逐步搬进未来 token,固定强度编辑存在 1–2 个 block 宽的尖锐 closure;commitment 是对该写入的承诺点,后续训练可以移动或重开它(固定身份上 B13/B14 会关闭又重开),所以它是 checkpoint 局部的计算性质而非吸收态。
- 同样的物理解、不同的下游使用:三个同配置种子的自然 physics-follow 差 22 个百分点,却共享可转移的编辑几何(6/6 有向转移 R=.94–.99,matched R² .955–.997 vs shuffle .066–.152)——行为差异来自下游怎么用这个共享解,且每个 run 的实现瓶颈不同(K 头集中/分散 K/V/单 V 头)。
- 训练只修一部分错误、同时把剩下的焊死:15 个 run 上 physics-follow 从 .52 涨到 .60,而剩余错误的可写位点从 10.88 降到 9.55;5K 时刻多 3.79 个可写位点就能显著预测该错误会被训练救回——早期可写性是可操作的训练监控信号。
- 两条『给物理未来撑腰』的途径都有效:推理侧加可见运动(Long 边界 +13/+2/+4 block)、数据侧先学无颜色偏见的动力学(Wan 冲突 physics 80.5% vs 9.4%,closure 推后 2 block);编辑要趁早、证据要给足。
vs 同类工作
局限
- 合成受控系统(论文自承):弹簧/单摆/自由落体允许精确反事实配对与定量解码评估,但自然视频里 shortcut 与物理的耦合更复杂;自然出现的 shortcut 是否有同样的 point of no return 仍开放(§6)。
- 编辑沿耦合模式行动(论文自承 + 可读出的关键限制):slow→fast 写入会同时把未来颜色拉向蓝——写入的是训练耦合的『联合未来模式』,没有颜色-动力学解耦的纯净物理通道;Free Fall 里编辑同样连带外观。离『只改物理量、不动外观』的精准控制还有距离。
- closure 结论的条件性(论文自承):边界针对所测固定强度编辑、31 个位点与具体 checkpoint;逐轨迹边界不同使群体曲线展宽;逐 run 责任组件不同(K 头集中/分散/单 V 头),没有跨 run 统一的『哪个头』答案。
- 横向读写差距:spring 主体分析只覆盖两个训练支持的频率带,事中控制器不能可靠指定两带之间的 unsupported 频率(Fig 13 明示);Free Fall 在 block 1 后即失去近乎全部直接可写性,且下游放大路线未在该系统验证。
- Wan 复制样本量有限:closure 对比在同一批 17 条 slow-target 顽固失败上做;事件中心分析(Fig 11)用富集 shortcut 倾向的库,不估计总体失败率;固定身份的关闭-重开现象是探索性结果(11 条身份)。
- probing 依赖检测器:所有结论建立在确定性像素检测+谐波拟合的评估器上,虽然比 MLLM 判断可靠,但 ω̂ 拟合本身有 RMSE 门槛与有效性强约束,边界情形(compromise 带、off-family)的归类会影响 rate 的细粒度读数。
可复现性
论文承诺开源:训练/评估代码、配置、数据生成器、随机种子、checkpoint 元数据与哈希、冻结评估 manifest、冻结 aligned–conflict 配对身份与输入帧、figure builder 与审计脚本;release 脚本可重跑证据检查、核验出处、重建机制图并编译文稿(Reproducibility Statement, p9-10)。项目页 https://xingyun-24.github.io/causal-writability/ 已放出论文、代码与视频。关键超参(Table 1):AdamW lr 2e-4、batch 32、wd 0.01、ConstantLR、无 EMA;20 次 flow-matching 调用、scheduler shift 5.0;主机制分析用 50K checkpoint、纵向 15 run 到 100K。
总览:相关数据支持多条预测规则;自然生成选定一个未来;物理备选仍可写;closure 标记承诺
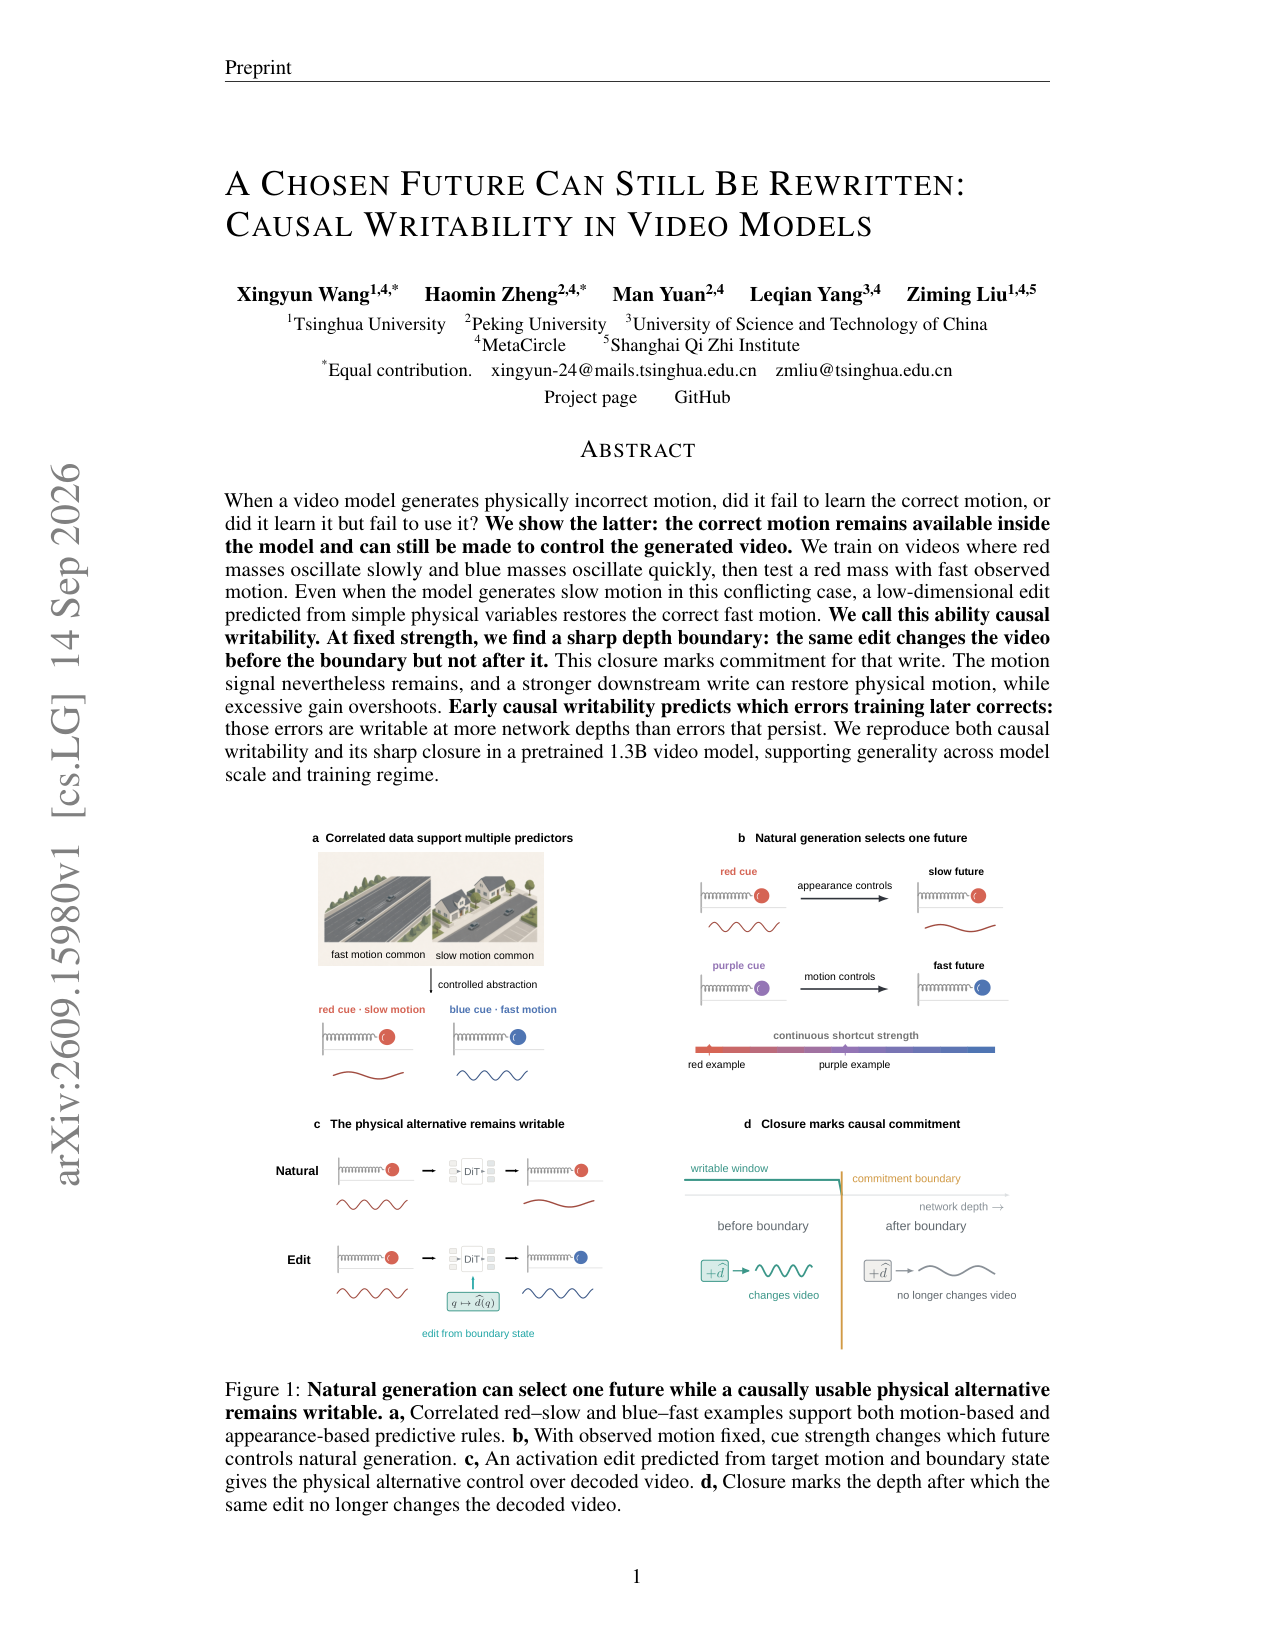
原文 caption:Figure 1: Natural generation can select one future while a causally usable physical alternative remains writable. a, Correlated red–slow and blue–fast examples support both motion-based and appearance-based predictive rules. b, With observed motion fixed, cue strength changes which future controls natural generation. c, An activation edit predicted from target motion and boundary state gives the physical alternative control over decoded video. d, Closure marks the depth after which the same edit no longer changes the decoded video.
全篇叙事的一张图:(a) 红慢蓝快的相关数据同时支持『按运动外推』和『按颜色代理』两条规则;(b) 固定观测运动扫颜色线索,自然生成的未来在慢速/快速两个模式间易主(紫色模糊线索时运动接管);(c) 由目标运动+边界状态预测的激活编辑让物理备选获得控制权;(d) closure——越过某深度后同一编辑不再改变解码视频。读法:把『红球快动却生成慢速』这一个例子从现象到干预到深度边界串成一线。
外观线索与观测运动竞争生成未来的控制权
原文 caption:Figure 2: Appearance and observed motion compete to determine the generated future. a, A hue sweep measures decoded frequency and RGB. b, Ambiguous cues let observed motion select its paired motion–appearance mode. c, Long (65 frames) resists stronger conflicting cues than Short (8 frames); each rate uses 32 histories per cue and motion band.
现象层的核心证据。(a) 解码解空间地貌:固定真实运动、11 档色相从红扫到蓝,解码频率主要落在两个训练支持带之一——颜色做的是『选带』而非连续调速,点的颜色是生成未来的实测 RGB;(b) 模糊(紫)线索下观测运动反向补全:快历史走出蓝色未来、慢历史走出红色未来,运动-外观关联可以双向完形;(c) Long(65 帧可见运动)在两个冲突方向上都比 Short(8 帧)更抗冲突端点。23/26 的 shortcut 失败在紫色线索下切回运动一致模式。
紧致、物理结构化的激活编辑恢复运动一致未来
原文 caption:Figure 3: A compact, physically structured activation edit restores the motion-consistent future. a, A full edit redirects the naturally selected future in decoded video. b, Four coordinates retain nearly the full effect, with their variation organized by boundary position and velocity. c, A controller fitted on separate trajectories predicts held-out edits from target motion and boundary state. d, Natural physics-follow rates pool each run's 64 × 11 cue grid; all six directed transfers achieve held-out decoded recovery R = .94–.99.
方法层核心。(a) 严格配对:冲突 run(红+快观测→慢生成)加上 aligned−conflict 差分后改出快未来;(b) top-4 PCA 坐标在快/慢两个改写方向上分别排成随边界相位 θ* 有序的光滑环——位置与速度组织了写入;右小图显示 4 维写入的解码恢复逼近全写入(87.8% vs 92.4%);(c) 小控制器流程:fit 轨迹上学 [cos θ*, sin θ*]+方向 → 4 坐标的映射,held-out 上冻结使用,85.9% 在窗;(d) 三个 run 自然行为差 22pp(51/60/73%),但 6 个有向转移全部 R=.94–.99——行为不同、物理编辑几何共享。
因果可写性随深度关闭,并预测哪些错误会被训练修好
原文 caption:Figure 4: Causal writability closes with depth and predicts which early failures training later corrects. a, Layerwise recovery closes earlier over training. b, Across 15 seeds, mean full-grid (64 × 11) physics-follow rate rises while remaining errors become less writable. c, Later-corrected errors are more writable at 5K. d, Long (65 frames) delays closure relative to Short (8 frames).
深度边界 + 训练动力学。(a) 5K→100K 逐位点改写成功率:训练越久,剩余错误的可写剖面越早塌缩;(b) 15 个 run 的轨迹:physics-follow 从 .52 涨到 .60 的同时剩余错误可写位点从 10.88 降到 9.55——训练一边修错一边把修不动的焊死;(c) 将被救回的 157 条错误在 5K 时比 953 条顽固错误多 3.79 个可写位点(CI [1.57,6.53])——行为分化之前,可写性已经分出两种命运;(d) Long 的可写剖面明显深于 Short,更多可见运动推迟 commitment。
预训练 Wan 1.3B:先学无线索动力学改善物理行为并推迟承诺
原文 caption:Figure 5: In a pretrained video DiT, learning cue-independent dynamics first improves physical behavior and delays commitment. a, Direct and Neutral-first conflict-endpoint rates and the matched gray-input rate each use the same 128 held-out histories. b, The donor-free controller approaches the full-edit and Top-4 references. c, Direct and Neutral-first adaptation both close sharply, but between B12–B13 and B14–B15, respectively.
跨规模复制 + 课程干预。(a) 同一个 Wan 1.3B,Direct 直接学红慢蓝快后冲突端点 physics-follow 只有 9.4%,Neutral-first(先 10K 灰色视频学同样运动)达 80.5%,灰色输入 ~96% 为上界参照;(b) donor-free 控制器在 Wan 里中位恢复 .953/.923,逼近 top-4 的 .968/.952——紧致编辑在 1.3B 预训练模型里同样可执行;(c) 两条路径都尖锐关闭,但 Neutral 的边界从 B12–B13 推到 B14–B15:学习顺序移动承诺点。
备选运动信号在 closure 后存活;自注意力决定它能否改变视频
原文 caption:Figure 6: The alternative-motion signal survives closure, and self-attention determines whether it changes the video. a, The signal remains measurable after observed-frame writing stops changing decoded motion. b, Restoring conflict K+V, but not Q, removes frequency recovery. c, On 48 held-out fast-motion/red-cue strict failures, moderate V-head amplification restores target motion; excessive gain leaves the supported modes.
机制定位的三连证据。(a) closure(黄线)之后,编辑引发的 future-frame 响应在 aligned−conflict 方向上的投影仍持续到最后一层——信息没丢,是失去了控制;(b) 组件还原:把冲突 K+V 还原进成功编辑,恢复归零;还原 Q 无影响——未来帧 query 是从观测帧 K/V 拿到运动控制信息的;(c) Run C 单 V 头(9 头之第 8)增益扫描:λ=8 时 48 条顽固失败 56.3% 转 physics、mean R=1.05;λ=16 全有效但多数越带——信号在,只是未放大的注意力写入太弱。
预训练视频 DiT 复现可执行路线与局部化承诺边界
原文 caption:Figure 9: A pretrained video DiT reproduces the executable route and localized commitment boundary. a, Held-out top-four coordinates vary smoothly with boundary phase in both rewrite directions. b, The Top-4 projection retains the full-edit recovery, and the fit-only phase controller approaches that ceiling without a held-out donor. c, Median recovery on the same persistent-failure identities drops across one adjacent-block transition under both training paths, while neutral-first adaptation shifts the transition later.
Wan 1.3B 复制主文三件套:相位面 R²=.97/.93 的 held-out 坐标组织、donor-free 控制器逼近 top-4 天花板、以及在固定身份队列上 Direct(B12–B13)与 Neutral(B14–B15)各自的单 block 级尖锐塌缩。说明『学会/用上』的区分与尖锐 closure 不限于从头训练的小模型。
控制器消融:需要按目标方向分别的边界相位律
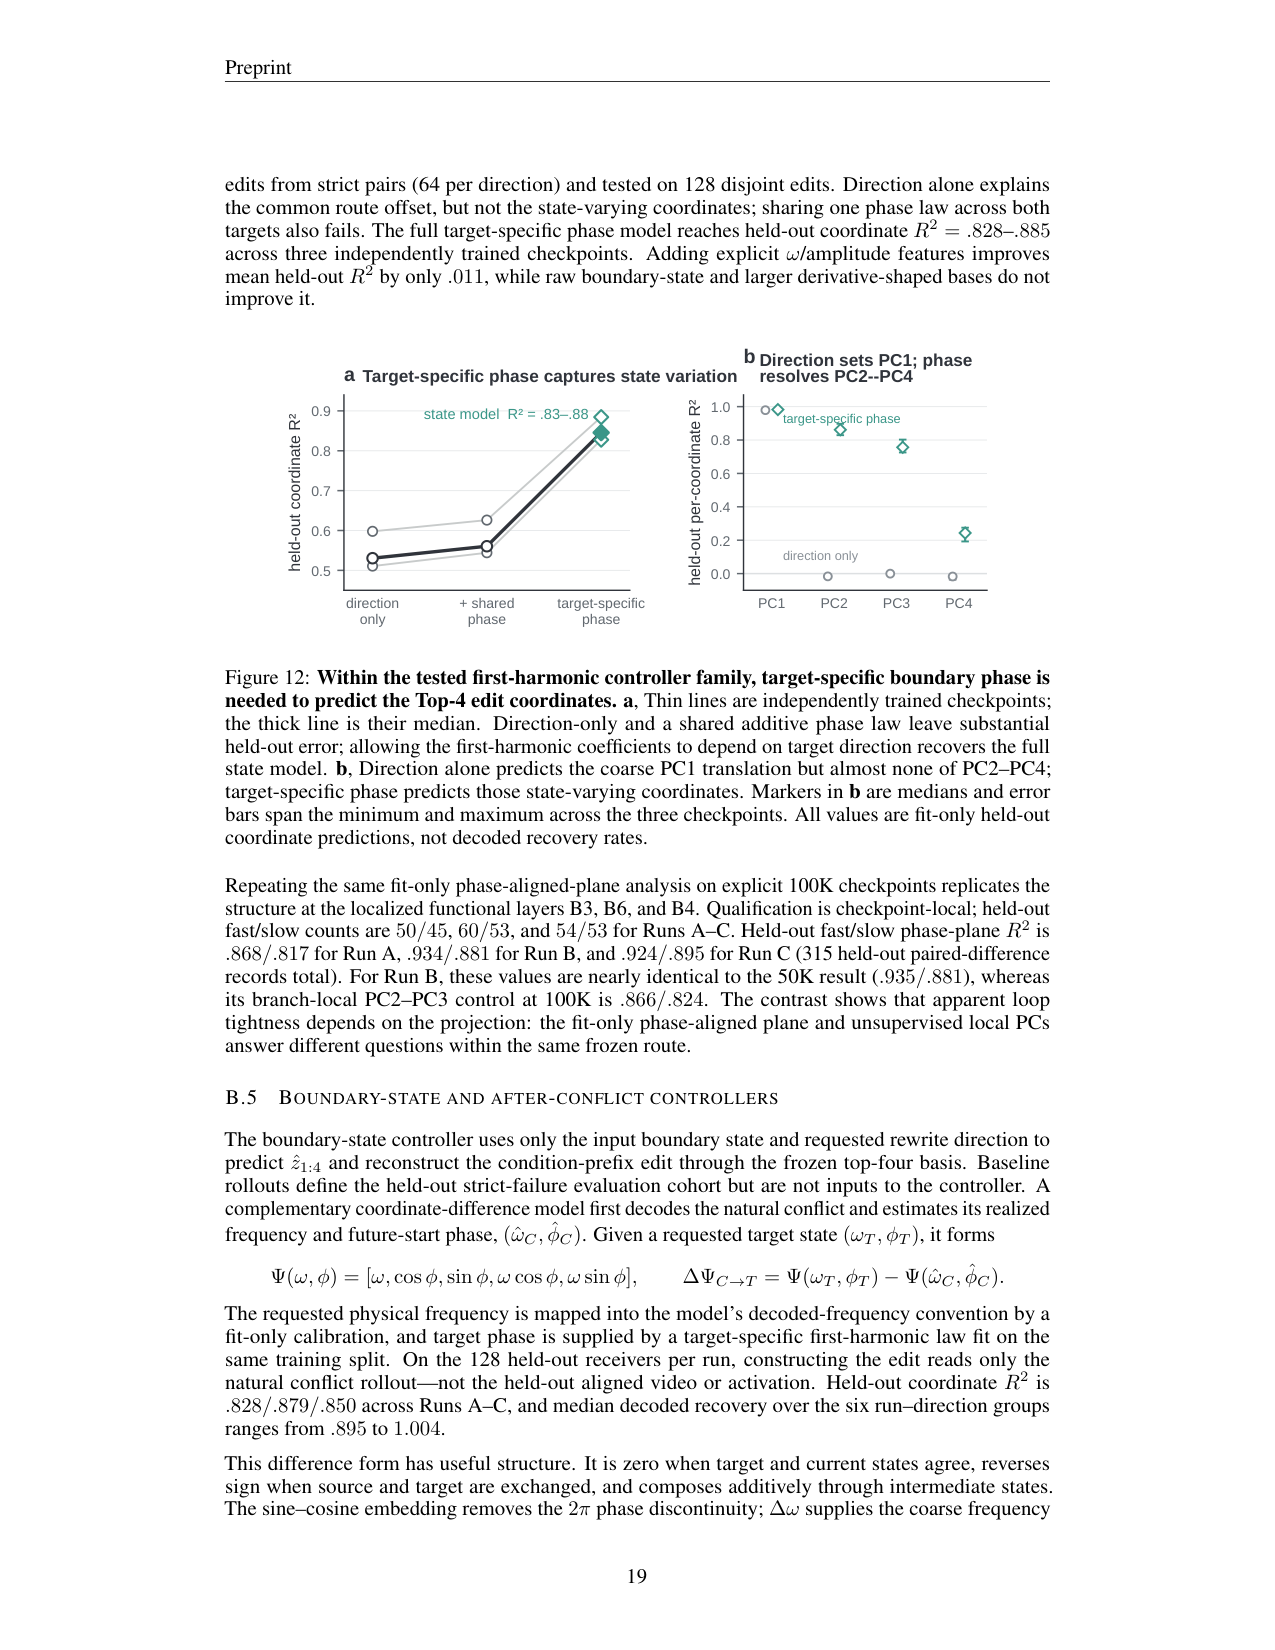
原文 caption:Figure 12: Within the tested first-harmonic controller family, target-specific boundary phase is needed to predict the Top-4 edit coordinates. a, Direction-only and a shared additive phase law leave substantial held-out error; allowing the first-harmonic coefficients to depend on target direction recovers the full state model. b, Direction alone predicts the coarse PC1 translation but almost none of PC2–PC4; target-specific phase predicts those state-varying coordinates.
控制器为什么长这样:仅方向只能解释 PC1 的整体平移(R² .51–.60),PC2–PC4 的状态变化必须靠按目标方向分开的一阶谐波相位律(R² .83–.88);显式加 ω/振幅特征只再提 .011。支撑『写入由边界位置与速度组织』的论断,同时划出边界:在这个谐波族内相位是充分统计量。
状态条件 top-4 控制器在 15 个 checkpoint 上全胜全维均值
原文 caption:Figure 14: State-conditioned Top-4 controllers outperform a full-dimensional global mean across 15 checkpoints. a, Strict target-band rates. b, Recovery-window rates. Each checkpoint contributes 128 disjoint held-out receivers. The full edit uses each receiver's aligned-minus-conflict difference and is therefore an oracle reference.
排除『大空间均值就够』:保留全部激活维但对 receiver 恒定的全维均值,严格带率 47.6%、恢复窗 58.2%;状态条件 top-4 控制器 68.9%/81.7%,且 15/15 checkpoint 全胜;oracle 全编辑 75.3%/90.2% 是上界。低维+状态条件优于高维+无状态,说明有效信息真的按物理状态组织。
将被训练救回的错误在同一早期 checkpoint 已实现更多目标写入
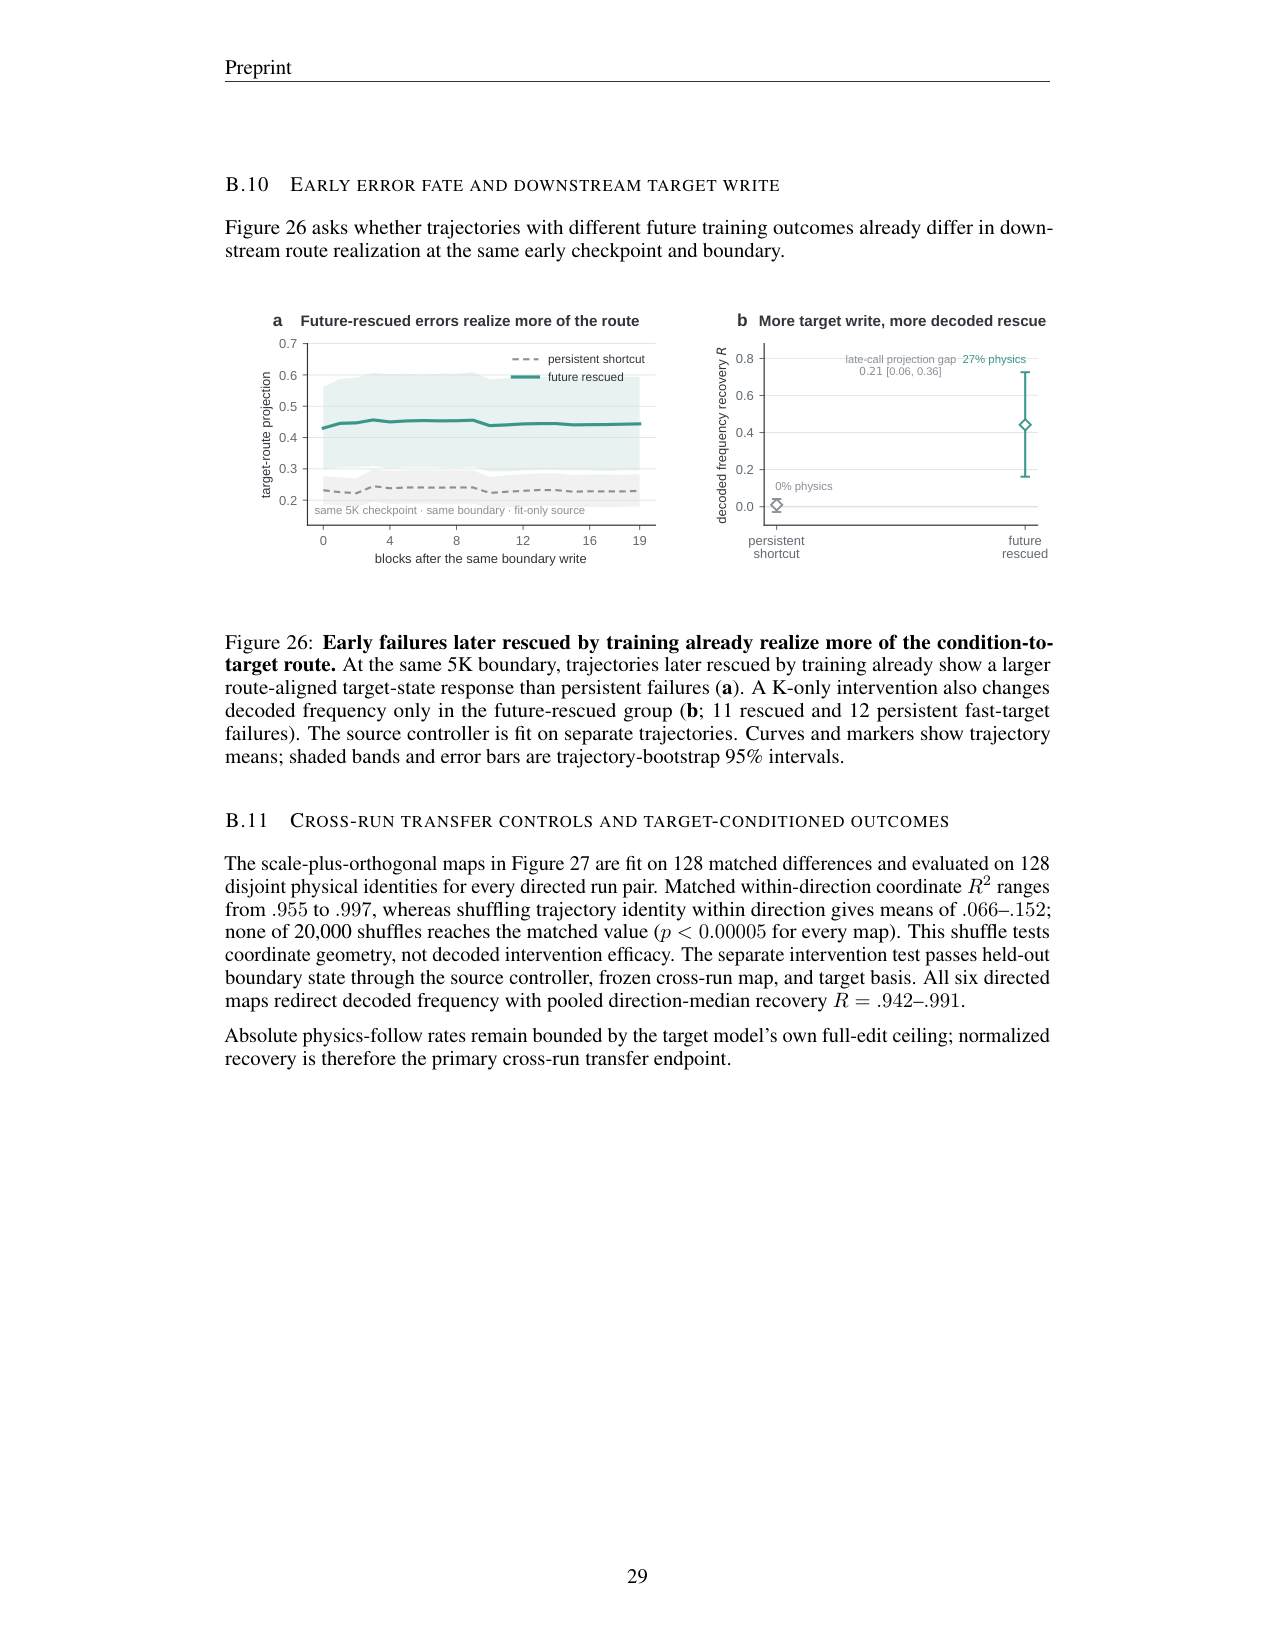
原文 caption:Figure 26: Early failures later rescued by training already realize more of the condition-to-target route. At the same 5K boundary, trajectories later rescued by training already show a larger route-aligned target-state response than persistent failures. A K-only intervention also changes decoded frequency only in the future-rescued group.
把 Fig 4c 的相关性往机制方向推进一步:同一 5K 边界写入后,将被救回组在后续 block 的 route 对齐目标态响应持续更高(late-call 投影差 0.21,CI [0.06,0.36]);只做 K 写入只在被救回组改变解码频率(27% vs 0% physics)。可写性差异背后是可测的下游目标写入差异。
内部几何跨独立训练模型转移
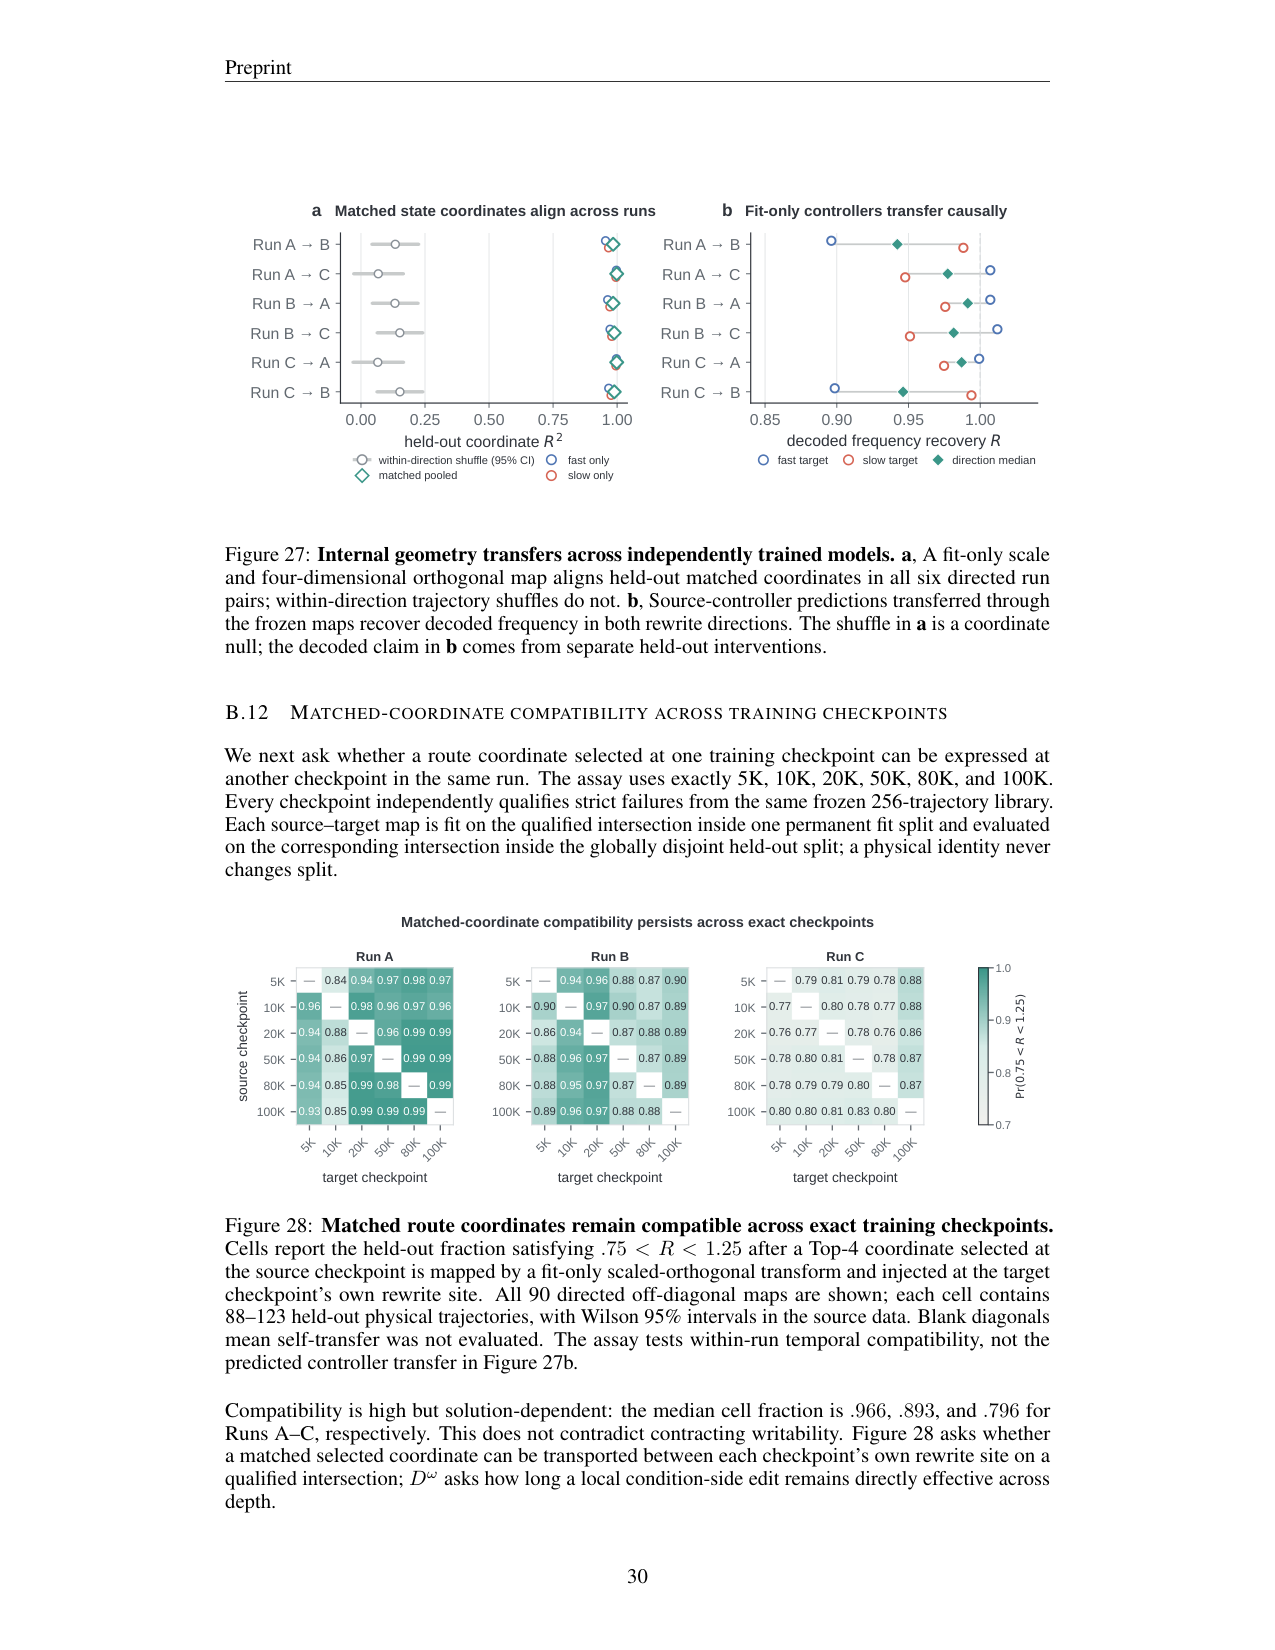
原文 caption:Figure 27: Internal geometry transfers across independently trained models. a, A fit-only scale and four-dimensional orthogonal map aligns held-out matched coordinates in all six directed run pairs; within-direction trajectory shuffles do not. b, Source-controller predictions transferred through the frozen maps recover decoded frequency in both rewrite directions.
跨模型共享的证据强度:(a) 6 个有向 run 对的 matched 坐标 R² .955–.997,20,000 次 shuffle 无一达到(p<0.00005)——对齐的是真实状态几何;(b) 冻结映射 + 源控制器的预测编辑在目标 run 上真实改视频,两个方向的方向中位 R=.942–.991。配合三 run 自然行为差 22pp,钉死『共享物理解、差异在下游使用』。
共享路线语义下,不同 run 的下游瓶颈组件不同
原文 caption:Figure 29: Shared route semantics admit distinct downstream bottlenecks under the tested interventions. In Run A, one K head closely reproduces the calibrated whole-K/V response. In Run B, the tested K-head intervention at gain 8 remains below whole-K/V at gain 2. In Run C, the tested whole-K/V gains do not cross the margin, whereas the selected V-head intervention does.
实现多样性(implementation multiplicity):Run A 单 K 头(head 6 ×2)复现整体 K/V 响应;Run B 效果分散在 K/V;Run C 只有被选中的 V 头(head 8 ×8)能越过边际。三 run 共享 route 几何却各有瓶颈——诚实呈现『没有统一的哪个头』,也解释了为什么主文 V 头结论限定在 Run C。
局部化 V 头写入在晚段 flow-matching 调用上改变解码视频
原文 caption:Figure 31: The localized V-head write changes decoded video when applied over late flow-matching calls. a, An early-call write is internally visible but behaviorally ineffective, while late or all-call allocation rescues frequency. b, A representative exact replay changes the decoded joint continuation from red/slow to blue/fast.
写入的时间维度:同样 λ=8 的 V/h8 编辑,只在 0–9 次早段调用写入时内部响应可见但解码不恢复,晚段(10–19)或全程调用才救回频率——有效控制取决于写入在迭代去噪中的时间分配,不只是网络位置。(b) 同窗口真实解码帧序列:红/慢自然未来被改成蓝/快,编辑同时改写了耦合的外观。
红球在快速运动,模型却生成慢速未来——它是没学会,还是学会了没用上?(对话版)
小播:今天聊一篇视频模型可解释性的新论文。我先描述一个画面:一个视频模型,训练时只见过红球慢慢振荡、蓝球快速振荡。现在给它看一个快速运动的红球,你猜它生成什么?
老播:它生成慢速运动。这就是这篇论文的出发点。颜色这条统计捷径,盖过了模型眼前实际看到的运动。
小播:那这不就是没学会吗?训练数据里快速运动总是跟蓝色绑在一起,它没见过快速的红球啊。
老播:这就是全篇要拆开的问题:它是没学会快速运动,还是学会了、但生成时没用上?单看生成结果,这两种失败长得一模一样。论文给出的答案是后者,而且用的是因果证据:不重新训练,只用球在边界帧的位置和速度算出一个四维的激活编辑,加进模型中间层,生成的视频就恢复成快速运动了。
小播:等会等会,「算出一个编辑」是什么意思?怎么算的?
老播:我们从头拆。先看他们怎么把这个问题变成可测量的实验。
先看实验台:弹簧球和反事实配对
老播:模型是一个 488M 参数的 flow-matching 视频 Transformer,30 个 DiT block,配一个冻结的 Wan2.1 VAE。每段视频 129 帧,前 65 帧给它看,后 64 帧让它生成。训练数据 2048 条:1024 条红球慢振,频率在每秒 2.2 到 3.0 弧度;1024 条蓝球快振,每秒 5.2 到 6.4 弧度。颜色和频率完美绑定,没有任何冲突组合。
小播:测试的时候呢?
老播:固定真实运动,只改颜色。一条快速运动的轨迹,给它配红色——这就是冲突输入,模型走捷径,生成慢速;配蓝色——这叫 aligned 输入,模型跟着物理走,生成快速。两条轨迹的物理参数、边界状态、生成种子全都一样,只有颜色不同。这叫反事实配对,是后面所有因果结论的地基。
小播:那怎么判定生成的到底是快是慢?让人看吗?
老播:不看人,也不看大模型。他们在完全解码的像素视频上,用一个确定性检测器逐帧跟踪球心,然后拟合谐波,读出频率。频率落在观测运动那个带里,算服从物理;落在颜色关联的对立带里,算走捷径。全部数字都从这套评估器出来。
现象:颜色和运动在抢方向盘
小播:好,现在先做现象实验。他们扫了颜色?
老播:对,固定运动和种子,把球的颜色从红到蓝扫 11 档。结果频率主要落在慢、快两个训练支持带之一——颜色做的是在两个模式之间「选带」,几乎不产生中间频率。强冲突端点,快速运动配纯红,服从物理的比例是 0%,颜色完胜。
小播:那如果把颜色调成紫色,红不红蓝不蓝呢?
老播:问得好,这是最有意思的一档。颜色一模糊,运动就接管了:26 条原本走捷径的失败里,23 条切回运动一致的模式。而且还有反向操作:模糊颜色下,快速运动会把生成的球引向蓝色,慢速引向红色。也就是说,模型学到的「运动-外观」关联是可以双向完形的——它手里明明有快速运动这个选项。
小播:所以生成慢速,只是颜色在证据不足的时候赢了竞争?
老播:对。还有一个佐证:可见运动给得越多,模型越抗冲突颜色。他们训了两种条件,Long 看全部 65 帧运动,Short 只看最后 8 帧,Long 在两个冲突方向上都更能顶住。证据强弱决定谁控制生成,这是现象层的完整画面。
干预:一个由位置和速度算出的四维写入
小播:现在到核心了。那个「编辑」到底是怎么构造的?
老播:分三步。第一步,拿 aligned 和 conflict 两条 rollout 在中间某个 block 之后的观测帧激活,做差,得到一个差分向量。把这个差加回 conflict run,只加在 1088 个条件 token 上,未来 token 一个都不碰——解码视频就从慢速改成快速。
小播:但这要拿到 aligned 的激活,等于要一个「正确答案」的 donor,实际场景哪有这个?
老播:对,所以第二步是问:这个差分向量有没有结构?答案是有,而且结构非常漂亮。对一堆配对差分做 PCA,前 4 个坐标就保留了几乎全部效果:held-out 写入 87.8% 落在恢复窗口里,全差分是 92.4%。更关键的是,这 4 个坐标随边界相位排成光滑的环。
小播:边界相位是什么?
老播:就是最后一帧观测时刻,球的位置和速度合成的一个角度。谐振运动里,位置正比于 cos、速度正比于 sin,所以这个相位角的余弦分量像位置、正弦分量像速度。写入向量的形状,由「球在边界时刻在哪、动多快」决定。
小播:那第三步就顺了:不用 donor,直接由边界状态把写入算出来。
老播:对。他们拟合了一个很小的控制器:输入边界相位加目标方向,经过一个一阶谐波映射,输出那 4 个坐标,再经冻结的 PCA 基重建激活编辑。held-out 视频上,85.9% 的合成写入落在恢复窗口内。不读任何 aligned 信息,不重新训练权重。
小播:85.9% 听着不错,但有没有对照说明「四维加状态」是必要的?
老播:有。他们换了一个保留全部激活维度、但对每条新视频都一样的均值写入,严格带率 47.6%;状态条件四维控制器 68.9%,而且在全部 15 个 checkpoint 上都赢。低维加状态条件,赢过高维无状态——有效信息确实是按物理状态组织的。
小播:我还想知道,换几个随机种子重训,这套东西还在吗?
老播:在,而且这是全文我最喜欢的结果之一。三个同配置、不同种子的模型,自然行为差很多:服从物理的比例分别是 51%、60%、73%,差了 22 个百分点。但是,用一个缩放加四维正交映射,编辑可以在六个有向模型对之间转移,held-out 恢复全部在 0.94 到 0.99。打乱轨迹的零假设只有 0.07 到 0.15,p 值小于十万分之五。
小播:这三个模型行为差那么多,内部的物理写法却是一样的?
老播:对,这句话值得重复:自然行为不同,不代表内部的物理解不同,差异在下游怎么用这个共享解。记住这句话,后面注意力一节它会变成具体的组件。
深度扫描:写入有一班末班车
小播:好,现在问深度的问题:这个写入在多深之前有效?
老播:他们把同一个固定强度的编辑,挨个注入 31 个位点,从第 0 个 block 之前到最后一个 block 之后。结果是一条尖锐的边界:边界之前,编辑改变视频;边界之后,同样的编辑几乎完全失效,过渡只有一到两个 block 宽。他们把这个关闭点叫 closure,它标记这条写入的承诺点——越过它,观测帧的信息已经来不及被写进未来帧了。
小播:为什么会来不及?
老播:因为随着前向计算推进,自注意力不断把观测帧的信息搬进未来帧的 token。搬完之前,你改观测帧还能影响未来;搬完之后,未来已经定型,再改观测帧就晚了。所以 closure 是「这条写入的末班车」。
小播:那证据给得足,末班车是不是就晚一点?
老播:对,Long 模型的边界比 Short 晚,三个种子里最多晚了 13 层。这是第一种推迟末班车的办法:多给可见运动。第二种办法在学习顺序,后面讲 Wan 的时候会说。
小播:训练过程会改变这班车吗?
老播:会,而且方向很有意思。15 个独立 run 从 5 千步训到 10 万步:整体服从物理的比例从 0.52 涨到 0.60,但剩余错误的平均可写位点从 10.88 降到 9.55。也就是说,训练一边修好一部分错误,一边把修不好的错误焊得更死。
小播:「焊死」有直接证据吗?会不会只是后期失败集合换了一批难样本?
老播:他们冻结了那批在全部 6 个 checkpoint 都是失败的同一批轨迹,15 个 run 里 13 个的可写性照样下降,排除了样本组成的解释。最锋利的数字是这个:在 5 千步时全是捷径失败的轨迹里,后来被训练救回的 157 条,比 953 条顽固失败平均多 3.79 个可写位点,置信区间 1.57 到 6.53。
小播:也就是说,在生成行为还看不出任何差别的时候,可写性已经预告了这个错误的命运?
老播:对,这是全文最有工程含义的一个结果:训练早期量一遍可写性,你就知道哪些错误会被训练修好,哪些会被焊死。这是一个可操作的训练监控信号。
搬到大模型:先学运动,再学颜色
小播:这些结论会不会只是小玩具模型上的特产?
老播:他们把同样的红慢蓝快任务搬到预训练的 Wan 1.3B 视频 DiT 上,还顺手测了一个课程干预。一条路径直接学偏置任务;另一条先学 1 万步灰色弹簧视频——同样的快慢运动,但颜色不带频率信息——然后再喂同样的红慢蓝快数据。
小播:结果差多少?
老播:1 万步偏置训练后,冲突端点服从物理的比例:先学灰色运动的路径 80.5%,直接学的只有 9.4%。aligned 表现两边相近,都在九成以上。先学无偏见的动力学,模型面对冲突颜色时几乎不走捷径。
小播:那三件套——低维结构、控制器、尖锐边界——在大模型里都还在?
老播:都在。held-out 坐标随相位组织,R 方 0.97 和 0.93;donor-free 控制器中位恢复 0.953 和 0.923,逼近 top-4 天花板的 0.968 和 0.952;closure 照样尖锐,直接学在 B12 到 B13 之间关闭,先学运动的路径推迟到 B14 到 B15。学习顺序把末班车又推后了两层。
小播:那错过末班车就永远没救了吗?
老播:也不是。在固定身份的轨迹上,B13、B14 的可写性会在相邻 checkpoint 之间关闭又重开。承诺点是单次前向里的计算性质,后续训练可以移动甚至重开它——它不是不可逆的。
机制:信号没丢,是注意力没写进去
小播:closure 之后,那个快速运动的信号还在不在网络里?
老播:在,这是 Figure 6a 直接测出来的。先在早期可写层做写入,然后逐 block 追踪编辑在未来帧激活里引发的响应,投影到 aligned 减 conflict 的方向上。这个备选运动信号,从第一个不可写 block 一直到最后一个 block 都可测。closure 关掉的是控制权,信息本身还在。
小播:那控制权在谁手里?
老播:组件还原实验来定位。在一个本来成功的编辑里,逐个把自然冲突的 Q、K、V 还原回去:还原 Q,几乎没影响;联合还原观测帧的 K 加 V,恢复彻底消失,ΔR 是负 0.931。再往下,把自注意力之后的未来帧状态换成冲突版,恢复消失;换 MLP 输出,没影响。
小播:所以结论落在自注意力:未来帧的 query,从观测帧的 K/V 里读取运动控制信息。
老播:对,写入未来 token 的这一步,决定哪个未来兑现。那最后一步自然就是:把这条通路拧大。三个模型的责任组件不一样:Run A 集中在一个 K 头,Run B 分散在 K/V,Run C 落在一个选择性 V 头上。在 Run C,他们只放大 9 个头里第 8 个 V 头的观测帧写入。
小播:放大多少?
老播:λ 等于 8 的时候,48 条顽固失败里 56.3% 转向物理,平均恢复超过 1;作为参照,同一批失败上残差全编辑的参考是 50%。λ 拧到 16,全部输出仍然合法,但大多数越出了两个支持带——增益有窗口,拧过头就冲出去。
小播:会不会只是激活变大了而已?
老播:他们排掉了:route 方向的投影和解码救活相关,斯皮尔曼相关 0.39,shuffle 检验 p 值 0.0067;控制响应范数之后仍然显著,范数本身的偏相关接近零。还有一个时间维度:同样的编辑只在去噪早段注入,内部有反应但视频不变;晚段或全程注入才救得回来。
小播:我注意到一个细节,你说救回的视频里球变成蓝色了?
老播:对,这是全文最该记住的限制之一:编辑沿着训练耦合的外观-动力学模式走,改运动会连带改颜色。它写入的是「联合未来模式」,还不是一个颜色-动力学解耦的纯净物理通道。
收益、代价和最弱一环
小播:最后把闭环走完。这套东西的收益和代价怎么算?
老播:收益是一组带基线的硬数字:donor-free 控制器 85.9% 在恢复窗,top-4 oracle 是 87.8%;跨模型六个有向对全部转移成功,恢复 0.94 到 0.99;早期可写性多 3.79 个位点,预测训练命运;Wan 的课程干预,80.5% 对 9.4%;单 V 头放大,56.3% 顽固失败救回。系统外推也有初步证据:单摆复现了相位组织和长历史延迟 closure,自由落体里指定重力的控制器中位恢复 0.967。
小播:代价呢?
老播:干预是推理期的激活编辑,要先在拟合集上学统计;编辑连带外观;增益有窗口;closure 绑定所测的编辑强度和 checkpoint;每个模型的责任头不同,没有「统一是哪个头」的答案。
小播:如果让你诚实评一下这个闭环,最弱的是哪一环?
老播:从干预到收益的外部效度。现象到机制、机制到干预,这两段证据都很强——反事实配对、全解码评估、组件级还原,链条完整。但从受控弹簧到自然视频里的世界模型,距离没有测量:自然出现的捷径是不是也有同样的末班车,论文自己说开放。不过就算只看眼前,它作为训练监控工具和课程设计依据,工程含义已经立住了。
小播:好,最后用一句话收尾。
老播:快速运动的红球被生成成慢速,不代表模型没学会快速运动:用边界位置和速度算出的四维写入能把它改回来;这条写入在深度上有一班末班车,错过之后信号仍在,把单个注意力 V 头的写入放大,超过一半的顽固失败重新服从物理。记住两个数字:3.79——早期可写性分开「会被修好的错误」和「会被焊死的错误」;还有 0.94 到 0.99——不同行为的模型之间,物理编辑几乎无损转移。也记住那个保留:改运动会连带改颜色,自然视频里的捷径有没有同样的末班车,还没人知道。