Thermodynamic Weight Decay:把 grokking 当相变,用注意力「比热」在线加热
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
训练精度早就 100%,泛化却要等几千个 epoch 才突然出现——grokking 这个怪现象让无数实验白烧算力。这篇 2026 年 7 月的单作者预印本(arXiv 2607.20552,代码公开)给它换了一副眼镜:把 grokking 看成热力学相变,用注意力 logits 的方差当「比热」探针,检测到网络逼近相变就自动加大 weight decay 给系统「加热」,把 4000 epoch 预算内永远不 grok 的基线,压到 2802 epoch 就 grok。先记住这个数字,下面从头拆。
现象:Cv 峰可靠地先于泛化跃迁,但给不出倒计时
grokking 的标准画像(Power et al. 2022 最早刻画):在 (a+b) mod 97 这类算法任务上,训练精度几十个 epoch 就饱和,验证精度在 chance 水平停几千个 epoch,然后突然跳到接近完美。
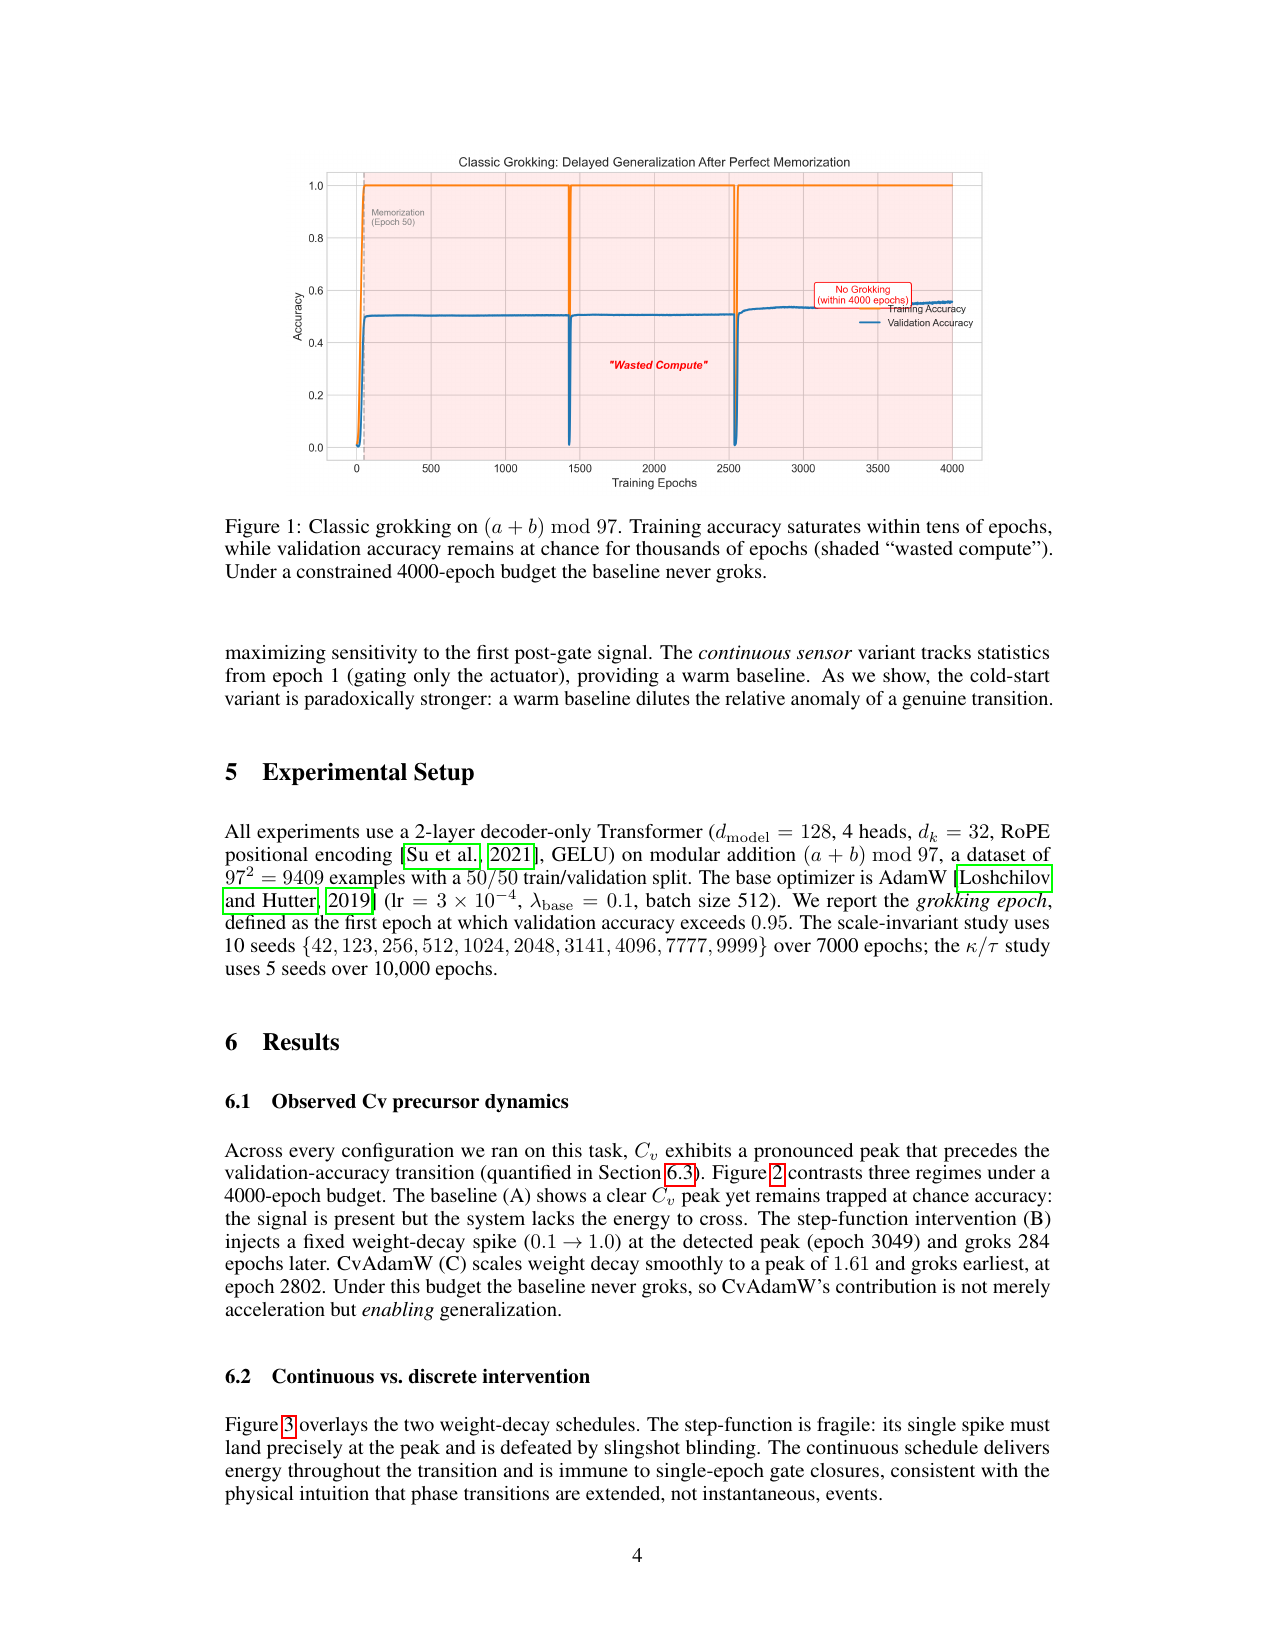
论文的观测增量是:逐 epoch 计算注意力 logits 的方差,把它当作比热 $C_v$。在全部 10 个随机种子(seed)里,$C_v$ 的峰都出现在泛化跃迁之前,平均领先 2400 epoch(std 974,中位 2396)。设置是:2 层 decoder-only Transformer(d_model=128、4 heads、d_k=32、RoPE、GELU),AdamW(lr=3e-4、λbase=0.1、batch 512),(a+b) mod 97 共 9409 个样本、50/50 划分,grokking epoch 定义为验证精度首次超过 0.95。要泼的冷水在第二个数字:$C_v$ 峰出现的时机与 grokking epoch 几乎零相关(Pearson r=-0.099, p=0.79;Spearman r=0.055, p=0.88)。也就是说,它是可靠的定性前置信号(「要变盘了」),给不出定量倒计时(「还剩多久」)。这个区分决定了下文所有设计:信号只配当触发器。
机制:softmax 是 Boltzmann 分布,logits 方差是比热
机制假设完全借自 Kim 2026 的热力学同构。先给预期:注意力 softmax 的数学形式和统计力学的 Boltzmann 分布同构,于是温度、能级、比热这些概念都能落到 attention 上可计算。单个 query 对 n 个 key 的注意力权重是:
$$p_i = \frac{\exp(z_i / \sqrt{d_k})}{\sum_{j=1}^{n} \exp(z_j / \sqrt{d_k})}, \qquad z_i = (QK^{\top})_i$$
$z_i$ 是第 $i$ 个 key 的注意力 logit,$\sqrt{d_k}$ 是缩放因子。对照 Boltzmann 分布 $p_i = e^{-E_i/T}/Z$:logit 的负值当能级 $E_i$,$1/\sqrt{d_k}$ 当逆温度 $\beta$,分母当配分函数 $Z$。统计力学里比热 $C_v = \mathrm{Var}(E)/T^2$ 在相变处发散,于是可计算的「比热」就是缩放后 logits 的方差:
$$C_v = \mathrm{Var}\!\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)$$
$QK^{\top}$ 是 query 与 key 的内积矩阵,除以 $\sqrt{d_k}$ 后取方差,逐 epoch 得到一个标量。如果 grokking 是相变,网络就该用 $C_v$ 的尖峰「宣布」自己逼近相边界——这正是 10/10 seed 观测到的现象。
干预的执行器是 weight decay。同一套同构给出温度-范数关系:
$$T_{\mathrm{eff}} \propto \frac{\sqrt{d_k}}{\|W\|_2}$$
$\|W\|_2$ 是权重矩阵的谱范数,weight decay 持续压小它,等效温度被推高——加大 weight decay 等于加热。传统解释里 weight decay 是「把模型从尖锐的记忆化极小值推向平坦的泛化盆」(Liu et al. 2023、Nanda et al. 2023 的相关工作),这里被重述成有物理意义的执行器,同一个旋钮,两种语言。作者也承认:记忆化在尖锐极小值、泛化在平坦盆的旧叙事,不借助热力学语言也成立——同构的增量在于给出一个可计算的在线探针,机制身份本身仍需单独验证。
干预:CvAdamW,只动一个旋钮
CvAdamW 是 AdamW 的 drop-in 替代:优化器主体零改动,只把 weight decay 系数从固定常数改成逐 epoch 的在线函数。先给预期,规则一句话:$C_v$ 的动量一旦超过噪声底,weight decay 就按比例放大,峰过去后回落。形式上:
$$\delta_t = C_v(t) - C_v(t-1), \qquad \mu_t = \alpha \mu_{t-1} + (1-\alpha)\,\delta_t$$
$$\lambda_t = \lambda_{\mathrm{base}} + \kappa \cdot \max(0,\ \mu_t - \tau)$$
$\delta_t$ 是 $C_v$ 的逐 epoch 变化,$\mu_t$ 是它的 EMA 动量(α=0.9,等效 10 epoch 窗口),τ 是噪声底,κ 是放大系数,$\lambda_{\mathrm{base}}=0.1$ 是基线 weight decay。系统平时就是标准 AdamW,只有 $C_v$ 持续爬升时 $\lambda_t$ 才被按比例抬高。
这套设计是一次次翻车改出来的,三个失败模式各对应一个组件:初始化噪声——无门控时所有检测器都在 epoch 16 乱触发(随机初始化的混沌 attention 被误认成相变),加记忆门(train_acc ≥ 0.99 才激活)修复;小批微纹波——epoch 240 的单点向上毛刺让离散触发器浪费掉一次注入,α=0.9 的 EMA 负责吸收;slingshot 盲区——结构重组时训练精度瞬时跌破 0.99,门在 $C_v$ 峰顶恰好关闭,离散触发器瞎掉,连续比例响应靠提前积累的动量免疫。连续优于离散,是全文的方法论主线。
去掉任务相关阈值是第二步:把 $\delta_t$ 当随机变量做 EMA 均值/方差估计,转成 z-score,只留通用阈值 2σ:
$$\lambda_t = \lambda_{\mathrm{base}} + \max(0,\ Z_t - 2.0), \qquad Z_t = \frac{\delta_t - \mu^z_t}{\sqrt{\sigma^{z\,2}_t + \epsilon}}$$
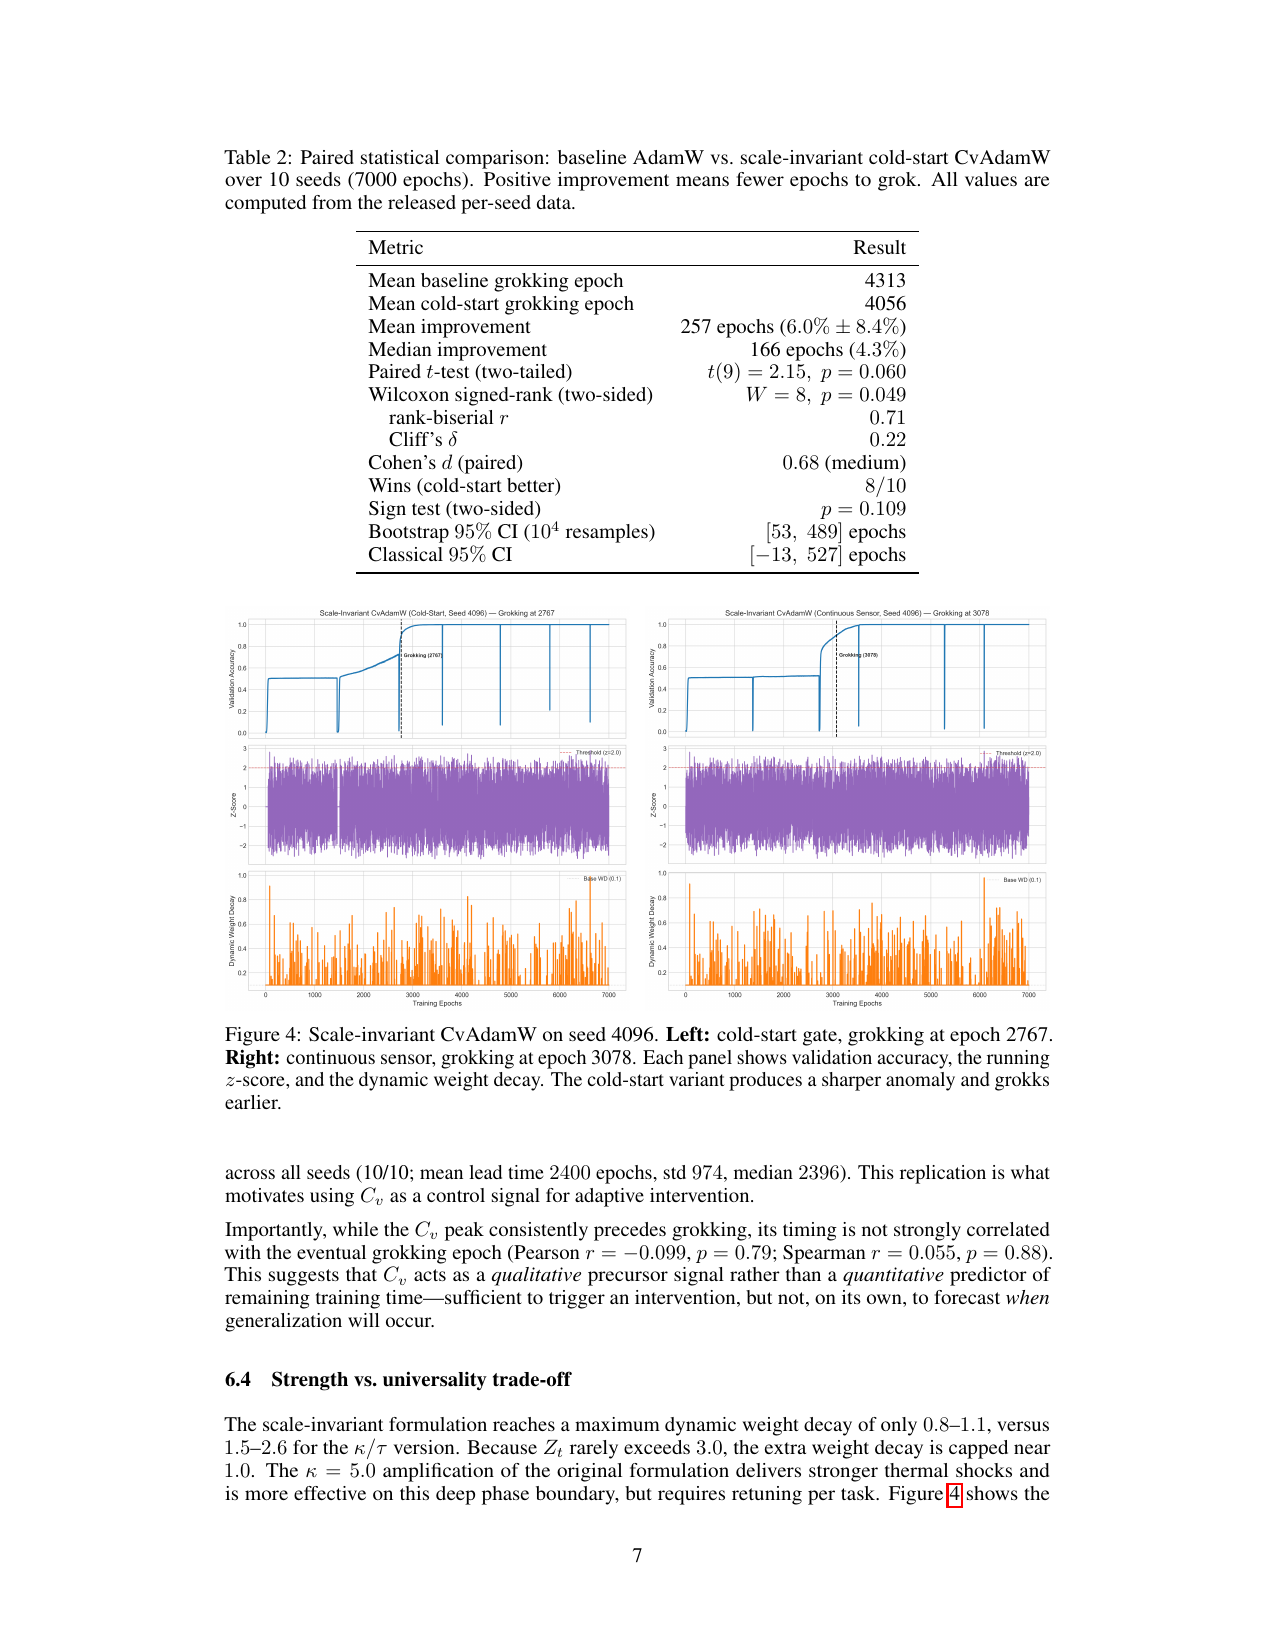
门后冷启动(cold-start,统计量从门开才开始积累)反直觉地强于从 epoch 1 就跟踪的 continuous sensor:热基线稀释了真实异常的相对强度,冷启动的 z-score 更尖锐、grok 更早。两组实验预算不同:κ/τ 版跑 10,000 epoch(5 seeds),scale-invariant 版跑 7000 epoch(10 seeds);动态 weight decay 的峰值,scale-invariant 版约 0.8–1.1,κ/τ 版约 1.5–2.6(示例运行峰值 1.61),对照基线固定 0.1。
收益:从不 grok 到 2802,但统计在打架
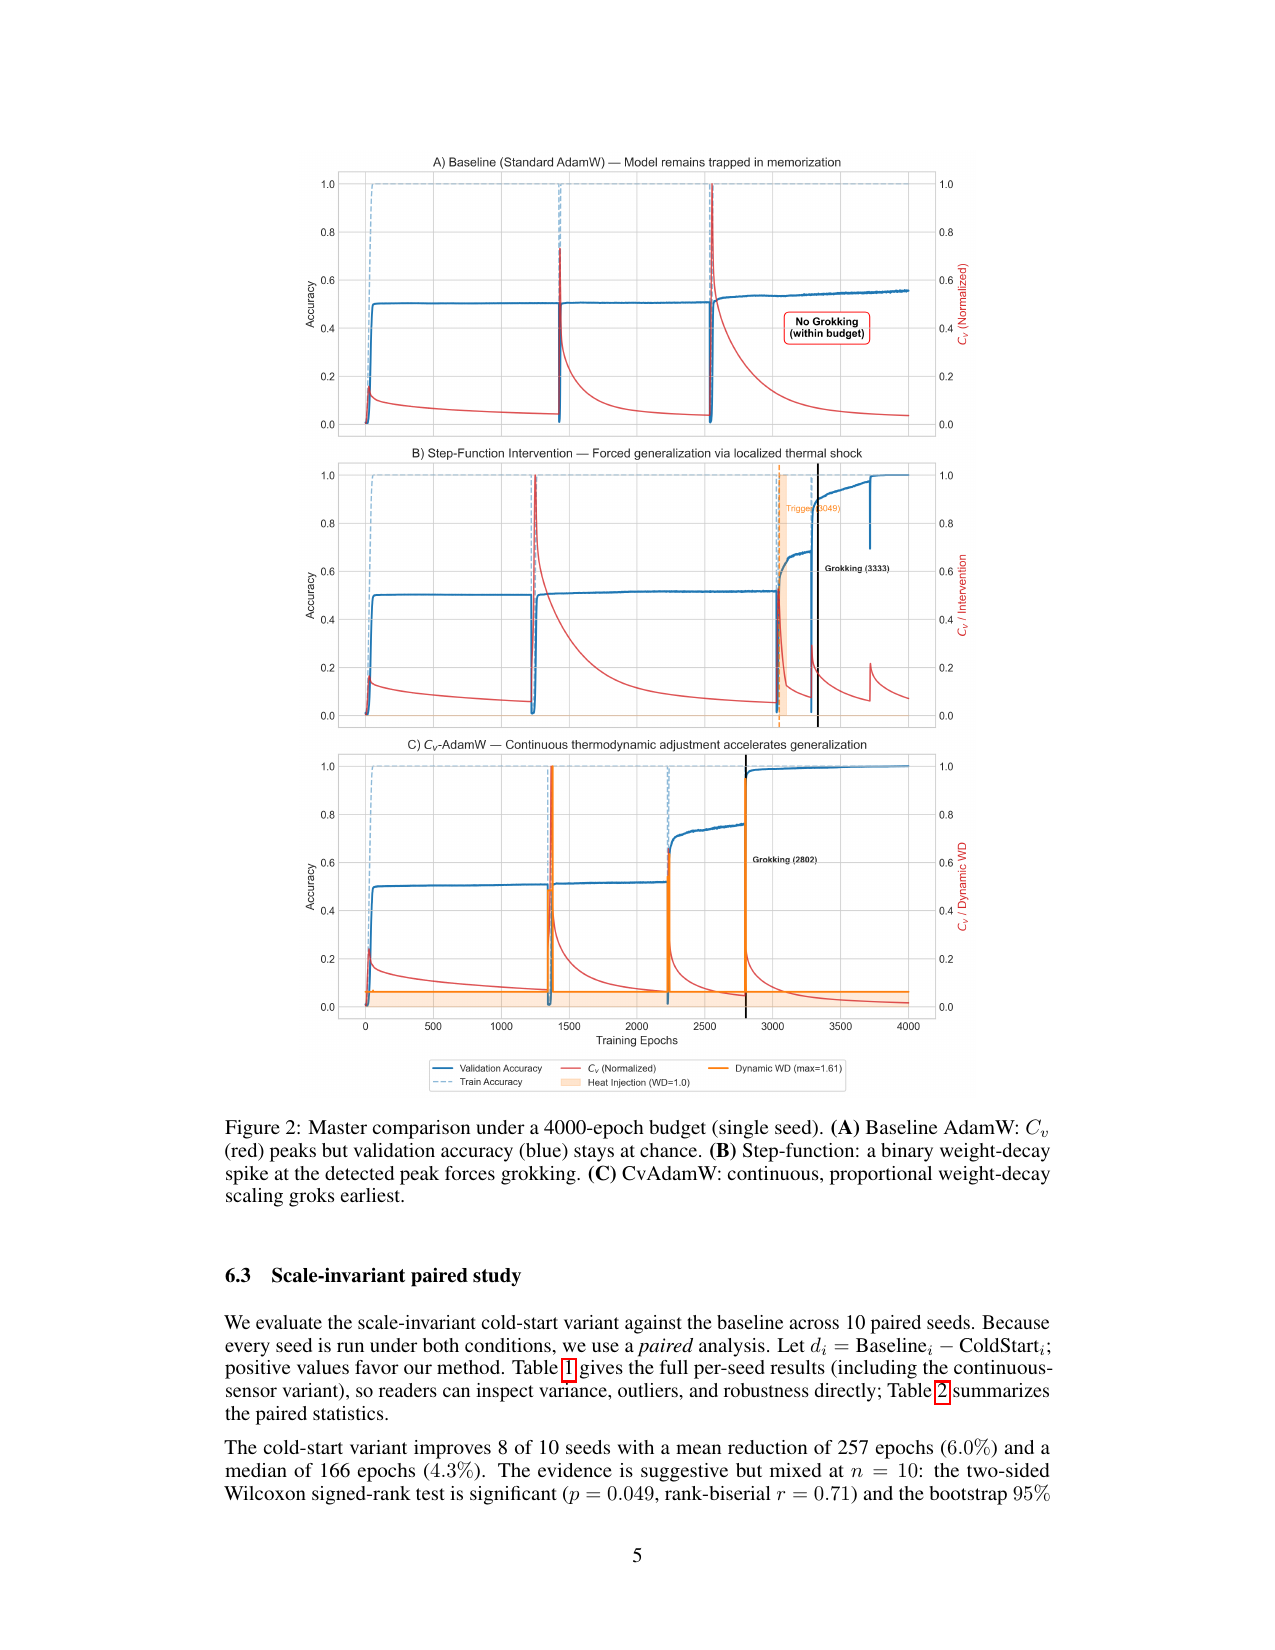
旗舰结果(4000 epoch 预算,单 seed):基线 AdamW 永远不 grok;step-function 对照在检测到峰后(epoch 3049)注入一次 0.1→1.0 的 weight decay 尖峰,284 epoch 后 grok(约 3333);CvAdamW 按比例连续加热,2802 epoch grok。这个结果的性质值得单独强调:在 4000 epoch 预算下,CvAdamW 的贡献是「使能」而不止加速——基线完不成任务,加热把任务从不可能变成可能;到了 10-seed 配对里任务本来能完成时,它只带来温和加速(6%)。两种场景,一种解锁,一种提速。
scale-invariant 变体的 10-seed 配对(7000 epoch 预算)更诚实:cold-start 平均 4056 epoch vs 基线 4313,快 257 epoch(6.0%),中位快 166(4.3%),8/10 seed 更快;Wilcoxon 符号秩检验 p=0.049、bootstrap 95% CI [53,489]、Cohen's d=0.68 支持有效,但配对 t 检验 p=0.060、sign test p=0.109 不显著——n=10 下统计检验互相打架,论文把全部结果并列摆出,没有挑好看的说。
最弱一环:机制归属没有隔离
收益端最该泼冷水的是机制归属:从「$C_v$ 是相变前置信号」到「按 $C_v$ 放大 weight decay 能加速」,中间没有 schedule 对照把「$C_v$ 信号起作用」和「更早/更多 weight decay 有帮助」分开,也没有 gate/EMA 组件消融;「加热→翻越相边界」是类比驱动的设计,论文自己把对照列为 future work。加上单任务单架构((a+b) mod 97 + 2 层小 Transformer)、没有与 attention entropy、weight norm、gradient norm、loss derivative 等既有 progress measure 做 head-to-head 对比、语言/视觉模型上 emergence 更渐进、前置信号可能更难检测——这套「相变诊断 + 热注入」目前是干净但脆弱的单点证据。
一句话记住这篇
grokking 有前置信号:注意力 logits 的方差(比热 $C_v$)在 10/10 个 seed 里先于泛化跃迁,平均早 2400 epoch,但给不出倒计时;按信号比例放大 weight decay(CvAdamW)能让 4000 epoch 内永不 grok 的基线在 2802 epoch grok。最该记住的数字是 2802 vs 永不,最该保留的态度是:信号能当触发器,机制归属还没隔离,跨任务泛化要等下一组实验。
把注意力 logits 方差当作比热 Cv 的在线探针,用动态 weight decay 在 grokking 相变边界前注入能量,把『grokking 加速』从离线诊断变成在线控制——但全部证据只落在 modular arithmetic 单任务上,机制归属仍未被隔离验证。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:两类可观测现象:一是 grokking 本身——训练精度几十个 epoch 内饱和,验证精度停留在 chance 长达数千 epoch 后突然跃迁;二是论文发现的关键前置信号——注意力 logits 的方差(定义为比热 Cv)在泛化跃迁之前出现明显峰值。
在哪里观测:modular addition (a+b) mod 97,9409 个样本、50/50 train/validation 划分;2 层 decoder-only Transformer(d_model=128,4 heads,d_k=32,RoPE,GELU),AdamW(lr=3e-4,λbase=0.1,batch 512)。
如何量化:Cv = Var(QK^T / √d_k) 逐 epoch 计算;grokking epoch 定义为验证精度首次超过 0.95 的 epoch;在记忆门(train_acc ≥ 0.99)之后定位 EMA 平滑 Cv 的峰值 epoch,计算与 grokking epoch 的 lead time。结果:10/10 seeds 中 Cv 峰先于 grokking,平均 lead time 2400 epochs(std 974,中位 2396);但峰值时机与 grokking epoch 几乎不相关(Pearson r=-0.099, p=0.79;Spearman r=0.055, p=0.88)——是定性前置信号,不是定量预报器(§6.3, p6-7)。
② 机制假设
假设:grokking 是注意力『信息气体』的热力学相变:softmax 即 Boltzmann 分布、1/√d_k 即逆温度、logits 即能级,因此 logits 方差充当比热 Cv;比热在相变处发散,Cv 的峰值就是网络在宣布自己逼近相边界。weight decay 是执行器:Teff ∝ √d_k / ‖W‖₂,增大 weight decay 缩小范数即『加热』,帮助系统从记忆化的亚稳态翻越到泛化的平坦盆(§2.1-2.2, p2)。
证据:
- 在全部 10 个 seed 的基线轨迹上,Cv 峰都先于 grokking 出现(平均领先 2400 epochs),复现了 Kim 2026 的相变预测(§6.3, p6-7)。
- Cv 峰不预测 grokking 时机,与『相变是定性事件而非可定时事件』的表述自洽(§6.3, p7)。
- 干预实验的外部一致:在 Cv 峰处注入能量(step-function 或 CvAdamW)都能让基线无法 grok 的设置成功 grok(§6.1, p4-5)。
备选解释:
- Cv 峰可能只是注意力置信度/方差的一般性变化,未必是『比热』或『相变』的特异性量;论文未与 attention entropy、weight norm、gradient norm、loss derivative 等既有 progress measure 做 head-to-head 对比(§7 Limitations, p8)。
- 传统解释:记忆化对应 sharp 高曲率极小值、泛化在平坦盆,weight decay 提供范数压力使其逃逸——该叙事不需要热力学语言也能成立(§2.2, p2)。
- Cv 峰与 grokking 时机零相关,提示该信号可能是相变的伴生现象而非驱动因素(§6.3, p7)。
形式化/toy model:无独立 toy model。形式化全部借用 Kim 2026 的同构映射:pi = exp(-Ei/T)/Z、β=1/√d_k、Cv=Var(E)/T²,落成可直接计算的 Cv=Var(QK^T/√d_k)(Eq. 1-2, §2.1, p2),以及 Teff ∝ √d_k/‖W‖₂ 的温度-范数关系(Eq. 3, §2.2, p2)。
③ 局部干预
干预对象:AdamW 的 weight decay 系数 λ(逐 epoch 调节,其余优化器状态不变)
操作:CvAdamW:用 EMA(α=0.9,等效 10-epoch 窗口)平滑 Cv 一阶差分得到动量 μ_t,按 λ_t = λbase + κ·max(0, μ_t - τ) 比例放大 λ;配记忆门(train_acc ≥ 0.99 才激活)与 scale-invariant z-score 变体 λ_t = λbase + max(0, Z_t - 2.0)。z-score 变体分 cold-start(门开后才开始积累统计量)与 continuous sensor 两种(§3-4, p3-4)。
效果:4000-epoch 预算下基线永远不 grok,CvAdamW(κ/τ 版)在 epoch 2802 grok;step-function 对照(检测到峰后在 epoch 3049 注入 0.1→1.0 的一次性 weight decay 尖峰)在 284 epochs 后 grok(约 epoch 3333),连续比例版最早(§6.1-6.2, p4-5)。
局部性:只动一个全局标量(weight decay 系数),优化器主体零改动、drop-in 替换;但这是全局标量而非 per-module/per-circuit 定位,『局部性』体现在旋钮最小化而非作用范围。
因果验证:10-seed 配对设计(每 seed 同基线同跑):8/10 seeds 改进,但统计上只能算『暗示性』——Wilcoxon 符号秩检验显著(W=8, p=0.049, rank-biserial r=0.71),bootstrap 95% CI [53,489] 排除 0,而配对 t 检验(p=0.060)、sign test(p=0.109)与经典 CI [-13,527] 不显著,论文如实并列而非挑选(Table 2, p7)。三个失败模式作为负对照记录(无门时 epoch 16 全部误触发;单 epoch 噪声在 epoch 240 误触发;slingshot 让门在 Cv 峰处恰好关闭)。论文明确把『区分信号起作用 vs 只是更多 weight decay 起作用』的 schedule 对照列为 future work——即干预收益尚未被隔离归因到 Cv 信号本身(§7, p8-9)。
④ 工程收益
指标:grokking epoch(验证精度首次 > 0.95)
数值:2802(CvAdamW κ/τ 版,单 seed)
基线:同一 4000-epoch 预算下 AdamW 基线在 4000 epochs 内从未 grok(信号在但能量不足)
设置:(a+b) mod 97,2 层 Transformer,lr=3e-4,λbase=0.1,batch 512,4000-epoch 预算(§6.1, Figure 2, p4-5)
指标:grokking epoch(scale-invariant cold-start,10 seeds 配对均值)
数值:4056(改进 -257 epochs / 6.0% ± 8.4%;中位改进 166 / 4.3%)
基线:基线均值 4313(std 776)
设置:同一任务,10 seeds,7000-epoch 预算(§6.3, Table 1-2, p6-7)
指标:改进种子数与效应量
数值:8/10 seeds 改进;Cohen's d=0.68(中等);最大单项收益 +1023 epochs(seed 3141)、+781(seed 2048)
基线:2 个回归 seed(123、1024)分别 -140、-120 epochs,小于最大收益
设置:10-seed 配对(§6.3, Table 1, p6)
指标:Cv 前置信号 lead time
数值:平均 2400 epochs(std 974,中位 2396),10/10 seeds 峰先于 grokking
基线:grokking epoch 与 Cv 峰时机相关性 ~0(Pearson r=-0.099, p=0.79)
设置:基线轨迹、记忆门之后 EMA 平滑 Cv 峰(§6.3, p6-7)
代价:需要逐 epoch 在线访问注意力 logits 并计算方差(一次额外统计开销,量级轻微但非零);κ/τ 版含两个任务相关常数(τ 阈值、κ 放大系数,κ=5.0),跨任务需重调;scale-invariant 版换取通用性的代价是更弱的最大注入(动态 λ 峰值 0.8-1.1 vs κ/τ 的 1.5-2.6,因 Z_t 极少超过 3.0),在深相边界上效果更弱;zthresh=2.0 按构造任务无关,但论文承认在差异很大的问题上可能仍需适配(§6.4, p7-8)。
可迁移性:未验证。全部结果局限于单一任务 (a+b) mod 97 与小型 2 层 Transformer;未测语言/视觉模型;未测其他模 p 与乘/减运算;未与其他 progress measure 对比,不能声称 Cv 是最优信号而只是『可用』信号(§7 Limitations, p8)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中。现象(Cv 峰先于 grokking,10/10 seeds,单任务)复现扎实,但机制身份完全依赖外部 Kim 2026 同构,且未与其他 progress measure 对照;Cv 峰与 grokking 时机零相关,削弱『Cv 是相变驱动量』的解读。 |
| 机制→干预 | 弱(最弱一环)。『加热→翻越相边界』是类比驱动的设计,不是从机制推出的可证伪命题;干预里起作用的是 Cv 信号还是『更早/更多 weight decay』尚未隔离——论文自己把该对照列为 future work。 |
| 干预→收益 | 中偏弱。配对统计在 n=10 下测试互相打架(Wilcoxon 与 bootstrap 显著,t 检验与 sign test 不显著);旗舰结果(2802 vs 从不 grok)是单 seed;无 gate/EMA 组件消融。 |
| 最弱一环 | mechanism_to_intervention:从『Cv 是相变前置信号』到『按 Cv 动量放大 weight decay 就能加速』这一步既没有被机制推导支撑,也没有被因果对照隔离,是整个闭环最需要补证据的地方。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| grokking epoch(4000-epoch 预算) | 2802(CvAdamW κ/τ) | AdamW 基线 4000 epochs 内不 grok;step-function 对照约 3333(峰处注入后 284 epochs) | (a+b) mod 97,单 seed,§6.1 Figure 2 |
| 平均 grokking epoch(10 seeds 配对) | 4056(cold-start) | 4313(基线,-257 epochs / 6.0%;中位 -166 / 4.3%) | 7000-epoch 预算,§6.3 Table 1-2 |
| 配对统计显著性 | Wilcoxon W=8, p=0.049;bootstrap 95% CI [53,489];Cohen's d=0.68;8/10 seeds | 配对 t 检验 p=0.060、sign test p=0.109、经典 CI [-13,527] 不显著 | 10 seeds,§6.3 Table 2 |
| Cv 峰领先于 grokking | 10/10 seeds,平均 lead 2400 epochs(std 974,中位 2396) | Cv 峰时机与 grokking epoch 相关 ~0(r=-0.099, p=0.79) | 基线轨迹,EMA 平滑后取峰,§6.3 |
| 动态 weight decay 峰值 | scale-invariant 0.8-1.1;κ/τ 1.5-2.6(示例运行峰值 1.61) | 基线固定 λ=0.1 | §6.4, Figure 2 |
| 失败模式定位 | 3 个(epoch 16 初始化噪声;epoch 240 微纹波;slingshot 盲区) | 全部由记忆门 / EMA(α=0.9) / 连续比例响应修复 | §3.2, p3 |
Insights
- Cv 是定性前置信号而非定量预报器:它可靠地『先于』 grokking 出现(10/10),但峰值时机与 grokking epoch 零相关——这决定它只适合当触发器,不适合当 ETA 估计器。
- 连续比例响应优于一次性触发:slingshot 效应会在 Cv 峰处临时拉低 train_acc 关闭门控,离散触发器恰好错过峰值;动量已提前积累的连续调节器天然免疫这类时序误差。
- cold-start 反直觉地强于 continuous sensor:从 epoch 1 累计的统计量稀释了真实异常的相对强度,门后冷启动的 z-score 更尖锐、grok 更早。
- 把三个失败模式当作贡献本身:每次失败直接对应一个设计元素(记忆门、EMA 吸收器、连续比例缩放),是『负结果驱动设计』的清晰示例。
- weight decay 被重新表述为一个有物理意义的执行器(Teff ∝ √d_k/‖W‖₂),同一个旋钮从『防过拟合的正则项』变成『可在线调制的热注入』。
vs 同类工作
局限
- 单任务单架构:只有 (a+b) mod 97 + 小型 2 层 Transformer,grokking 在该任务上异常干净,作者明确不声称泛化(§7, p8)。
- 无语言/视觉模型证据:GPT 式语言模型与 ViT 上 emergence 更渐进,前置信号可能更难检测(§7, p8)。
- 未与其他 progress measure head-to-head:无法声称 Cv 是最优信号,只能说是可用信号;与 attention entropy、weight norm、gradient norm、loss derivative 的对比被列为最重要的 next experiment(§7, p8-9)。
- 统计功效不足:n=10 下测试互相打架,2/10 seeds 回归,论文如实并列所有检验结果(§7, p8)。
- 机制归属未隔离:没有 schedule 对照区分『Cv 信号起作用』与『更多 weight decay 有帮助』,也没有 gate/EMA 组件消融(§7, p8-9)。
- 阈值可移植性未验证:zthresh=2.0 按构造任务无关,但作者承认在差异很大的问题上可能需要适配(§7, p8)。
可复现性
论文给出完整超参与逐 seed 数据:d_model=128、4 heads、d_k=32、RoPE、GELU、lr=3e-4、λbase=0.1、batch 512、EMA α=0.9、记忆门 0.99、zthresh=2.0、κ=5.0;Table 1 列出 10 seeds 三条件(基线/cold-start/continuous)完整 grokking epoch,Table 2 给出全部配对检验统计量,可直接重算。代码与数据公开:https://github.com/baymaxbyte/cbo_core(Python 仓库,存在且 2026-06-30 有更新),论文自称附全量失败日志。注意:arXiv 无版本号 PDF 链接 (/pdf/2607.20552) 曾返回错误论文,需用版本化链接 /pdf/2607.20552v1;单作者独立研究、无第三方复现。
grokking 经典现象:(a+b) mod 97 上训练饱和、验证长期停在 chance
原文 caption:Figure 1: Classic grokking on (a+b) mod 97. Training accuracy saturates within tens of epochs, while validation accuracy remains at chance for thousands of epochs (shaded “wasted compute”). Under a constrained 4000-epoch budget the baseline never groks.
「现象」环的基线证据:训练精度几十个 epoch 内饱和,验证精度停在 chance 上千个 epoch 后才跃迁,阴影区就是被浪费的计算;在 4000 epoch 预算内基线永远不 grok。读图注意两条曲线的剪刀差与阴影区间。
三种策略对照(4000 epoch 预算):基线卡死 / step 注入 / CvAdamW 最早 grok
原文 caption:Figure 2: Master comparison under a 4000-epoch budget (single seed). (A) Baseline AdamW: Cv (red) peaks but validation accuracy (blue) stays at chance. (B) Step-function: a binary weight-decay spike at the detected peak forces grokking. (C) CvAdamW: continuous, proportional weight-decay scaling groks earliest.
「干预→收益」环的核心证据:同样的 Cv 信号三种用法三种结局——基线看到峰但没有能量过不去;在峰处打一次 weight decay 尖峰(step)能 grok 但更晚;CvAdamW 按信号比例连续加热最早(epoch 2802)。读图对比三张子图蓝线(验证精度)的跃迁时刻。
scale-invariant z-score 变体(seed 4096):cold-start 更尖锐、更早 grok
原文 caption:Figure 4: Scale-invariant CvAdamW on seed 4096. Left: cold-start gate, grokking at epoch 2767. Right: continuous sensor, grokking at epoch 3078. Each panel shows validation accuracy, the running z-score, and the dynamic weight decay. The cold-start variant produces a sharper anomaly and groks earlier.
支撑证据:去掉任务相关阈值后,z-score 检测(只留 2σ 通用阈值)仍然有效;门开后冷启动(左)统计量更尖锐、grok 更早(2767 vs 3078)。读图看 z-score 尖峰与动态 weight decay 抬升的同步。
🎧 音频版
时长 11:45 · Edge TTS
Thermodynamic Weight Decay:grokking 的「比热」信号,能不能拿来在线加热(对话版)
小播:今天聊一个训练圈的老问题:grokking。模型训练精度早就 100% 了,验证精度却像睡着了一样,几千个 epoch 不动,然后突然一步登天。
老播:先给结论。这篇叫 Thermodynamic Weight Decay,单作者预印本,2026 年 7 月挂的 arXiv。它把 grokking 当成热力学相变,用「注意力 logits 的方差」当比热探针,检测到网络要变盘了,就自动加大 weight decay 给系统加热。结果:4000 epoch 预算内永远不 grok 的基线,被它压到 2802 epoch 就 grok。最该记住的保留意见:只在一个任务上验证,而且说不清到底是信号起作用,还是单纯 weight decay 加多了。
小播:等等,先补课——grokking 到底长什么样?
老播:一个特别干净的例子:(a+b) mod 97,就是算模 97 的加法。9409 个样本,一半训练一半验证。训练精度几十个 epoch 就接近 100%,但验证精度在瞎猜的水平上停了几千个 epoch,然后突然跳到 95% 以上。中间那段就是白烧的算力。
小播:几千个 epoch,那怎么知道它到底会不会醒来?
老播:这正是这篇的观测增量。他们把注意力 logits 的方差当成「比热」,逐 epoch 算。在 10 个随机种子里,全部 10 个,这个方差峰都出现在泛化跃迁之前,平均早 2400 个 epoch。换算成体验:如果 1 个 epoch 是 1 分钟,等于变盘前 40 小时就有信号。
小播:那不是可以拿它当倒计时?
老播:不行,这里有个关键转折:峰出现的时间,和 grokking 真正发生的时间,几乎零相关。也就是说,它只能告诉你「要变盘了」,告诉不了你「还剩多久」。所以作者只敢拿它当触发器,不敢当预报器。这个区分,后面所有设计都围着它转。
小播:那「比热」这个说法哪来的?总得有理论依据吧。
老播:借的,来自 Kim 2026 的一个形式化同构。注意力权重算的是 softmax:p_i 等于 e 的 z_i 除以根号 d_k 次方,再归一化。统计力学里,Boltzmann 分布长一个样:e 的负能级除以温度。所以 logit 当能级,根号 d_k 分之一当逆温度,整个 softmax 就是 Boltzmann 分布。统计力学里比热在相变处发散,于是 logits 的方差就当比热,峰就是网络在喊「我要相变了」。这套映射里,weight decay 也有新身份:它压小权重范数,等效温度就升高——加大 weight decay 等于加热。
小播:所以检测到峰,就加热,就能推它一把?
老播:对,这就是他们做的优化器,CvAdamW。一句话:C_v 的动量超过噪声底,weight decay 就按比例放大,峰过去就回落。优化器主体一点没动,只把 weight decay 系数从固定常数改成在线动态的,drop-in 替换。
小播:这么简单的改动,一次就成了?
老播:没有,作者把翻车过程全写出来了,这是这篇最诚实的部分。三个失败模式,各对应一个设计:第一个,不设防时所有检测器在 epoch 16 就乱触发,把随机初始化的混沌当成相变——加记忆门,训练精度过 99% 才激活;第二个,epoch 240 一个单点毛刺就让离散触发器浪费一次注入——用指数移动平均吸收噪声;第三个最阴,叫 slingshot:结构重组时训练精度会瞬时跌破门槛,门在峰顶正好关上,离散触发器直接瞎掉——所以改成连续比例响应,峰还没到,动量已经积累好了。
小播:那阈值呢?不同任务 C_v 的尺度不一样吧。
老播:他们把变化量转成 z-score,阈值只用通用的 2σ,去掉任务相关参数。这里还有个反直觉的发现:门开后冷启动的统计量,比从 epoch 1 就跟踪的更尖锐、grok 更早——因为长期积累的基线把真实异常的相对强度稀释了。
小播:好,数字呢?到底快了多少?
老播:先说旗舰:4000 epoch 预算,基线永远不 grok;在峰处打一次 weight decay 尖峰的 step 对照,约 3333 epoch grok;连续加热的 CvAdamW,2802。再看 10 个 seed 配对:平均从 4313 压到 4056,快 257 个 epoch,6%;8 个 seed 更快。但这里要诚实:10 个样本下统计检验互相打架,Wilcoxon 显著、bootstrap 区间不含零,配对 t 检验又不显著。作者把所有结果并列摆出来,没有挑好看的说。
小播:所以它是让「不可能的变成可能」?
老播:对,这个区别很关键。4000 epoch 预算下,基线永远完不成,加热把任务从不可能变成可能,这是解锁;到了 10 个 seed 配对里,任务本来能完成,它就只给温和的加速,平均快 6%,这是提速。论文的定位就是:前者是它最值钱的地方,后者要等更多证据。
小播:那最弱的一环在哪?
老播:机制归属。从「C_v 是相变前置信号」到「按 C_v 放大 weight decay 能加速」,中间没有对照实验把两件事分开:到底是信号起作用,还是「更早、更多地加 weight decay」本来就帮忙?作者自己把这个对照列为 future work。再加上只测了模加法一个任务、没和 attention entropy 这些老牌 progress measure 比过、语言模型和视觉模型上 emergence 更平滑、可能更难测——这套「相变诊断加热注入」,现在是干净但脆弱的单点证据。
小播:一句话总结?
老播:grokking 有前置信号:注意力 logits 的方差,10 个 seed 全部先于泛化跃迁,平均早 2400 个 epoch,但它只配当触发器;按信号比例加热,能把永不 grok 的基线压到 2802。最该记住的态度:信号真实,机制归属还没隔离,跨任务泛化等下一组实验。