把 GeLU 和 softmax 换成学出来的样条:一只测「架构与任务匹配度」的探针
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:同一个 GPT-2 风格的 transformer,只换掉两个非线性组件——MLP 里的 GeLU、注意力里的 softmax——再从头训练,8 个基础算法任务(加法、括号匹配、COPY 等)上的表现全面变好:收敛快 2–3 倍、跨随机种子的方差消失、MANO 从「拟合训练集但测试不完美」变成接近完美、COPY 在未见长度上的失败也被明显缓解。但反过来说,换下来的偏置几乎不能跨任务复用:为 ADD 优化出的架构搬到 COPY 上,效果比标准 transformer 还差。这篇 ICLR 2026 论文(arXiv 2607.17624)的结论是:标准 transformer 在架构空间里很少是局部最优——算法任务要求高度任务特异的偏置,语言任务只要求相对通用的偏置。得出这个结论靠一把可测量的探针,我们从头拆。
背景:为什么非线性形状能代表「归纳偏置」
要理解这篇论文,得先引入一个概念:inductive bias(归纳偏置)——学习算法对函数空间的先验,即在无数个都能拟合训练数据的函数里,架构天然更偏爱哪一类。Transformer 与线性模型的差别几乎全集中在少数非线性操作上。论文的工作假设是:归纳偏置主要由这些非线性的具体函数形状决定(沿用 Mingard et al. 2019 与 Teney et al. 2024/2025 的 simplicity bias 谱系),标准形状(GeLU、softmax)偏爱低复杂度、平滑的目标函数,与算法性、需要系统性组合的任务错配,与自然语言的统计结构更匹配。
于是他们把非线性本身变成可优化的对象。MLP 层写成:
$$x \leftarrow W'\,\phi(Wx + b) + b'$$
这里 $x$ 是激活向量,$W, b$ 与 $W', b'$ 是可学习的权重与偏置,$\phi: \mathbb{R} \to \mathbb{R}$ 是逐元素非线性——基线里是 GeLU,本文里是一个可学习的一维线性样条。选样条的理由是「无偏」:它表达恒等、阶跃、正弦都同样容易。注意力一侧做类似的事,把 softmax 核换成可学习的核:
$$K(Q_i, K_j) = \phi'(Q_i)^\top \phi'(K_j)$$
$Q_i$ 是第 $i$ 个位置的 query,$K_j$ 是第 $j$ 个位置的 key,$\phi'$ 是另一个样条,先把 query/key 逐元素过一遍,再求内积作为相似度。样条本身是分段线性插值:
$$\phi(x) = \theta_k + \frac{\theta_{k+1}-\theta_k}{\tau_{k+1}-\tau_k}(x-\tau_k), \quad x \in [\tau_k,\tau_{k+1}]$$
$\tau_k$ 是均匀铺在区间上的节点(实验里通常 122 个点铺在 $[-20, 20]$),$\theta_k$ 是节点处的函数值,即要学的参数。
关键来了:训练分两阶段。stage I 在 held-out 数据上优化样条形状与权重——用 M 个不同 seed 的并行模型共享同一组样条,防止权重与形状共适应;stage II 冻结样条、当作预调好的超参数,用标准训练从零重训,还能搬到别的数据集上复用(mix-and-match)。学出来的样条,就是「这个任务需要的偏置」的实物证据。
现象:换掉两个非线性,差距大到吓人
实验设置:8 个算法 toy task 全部按 next-token 序列补全训练,基线是 GPT-2 风格 decoder-only transformer,超参(含学习率)在每任务上调到最大稳定值;优化架构在 stage II 用相同超参从零重训,结果按 6 个随机种子平均。
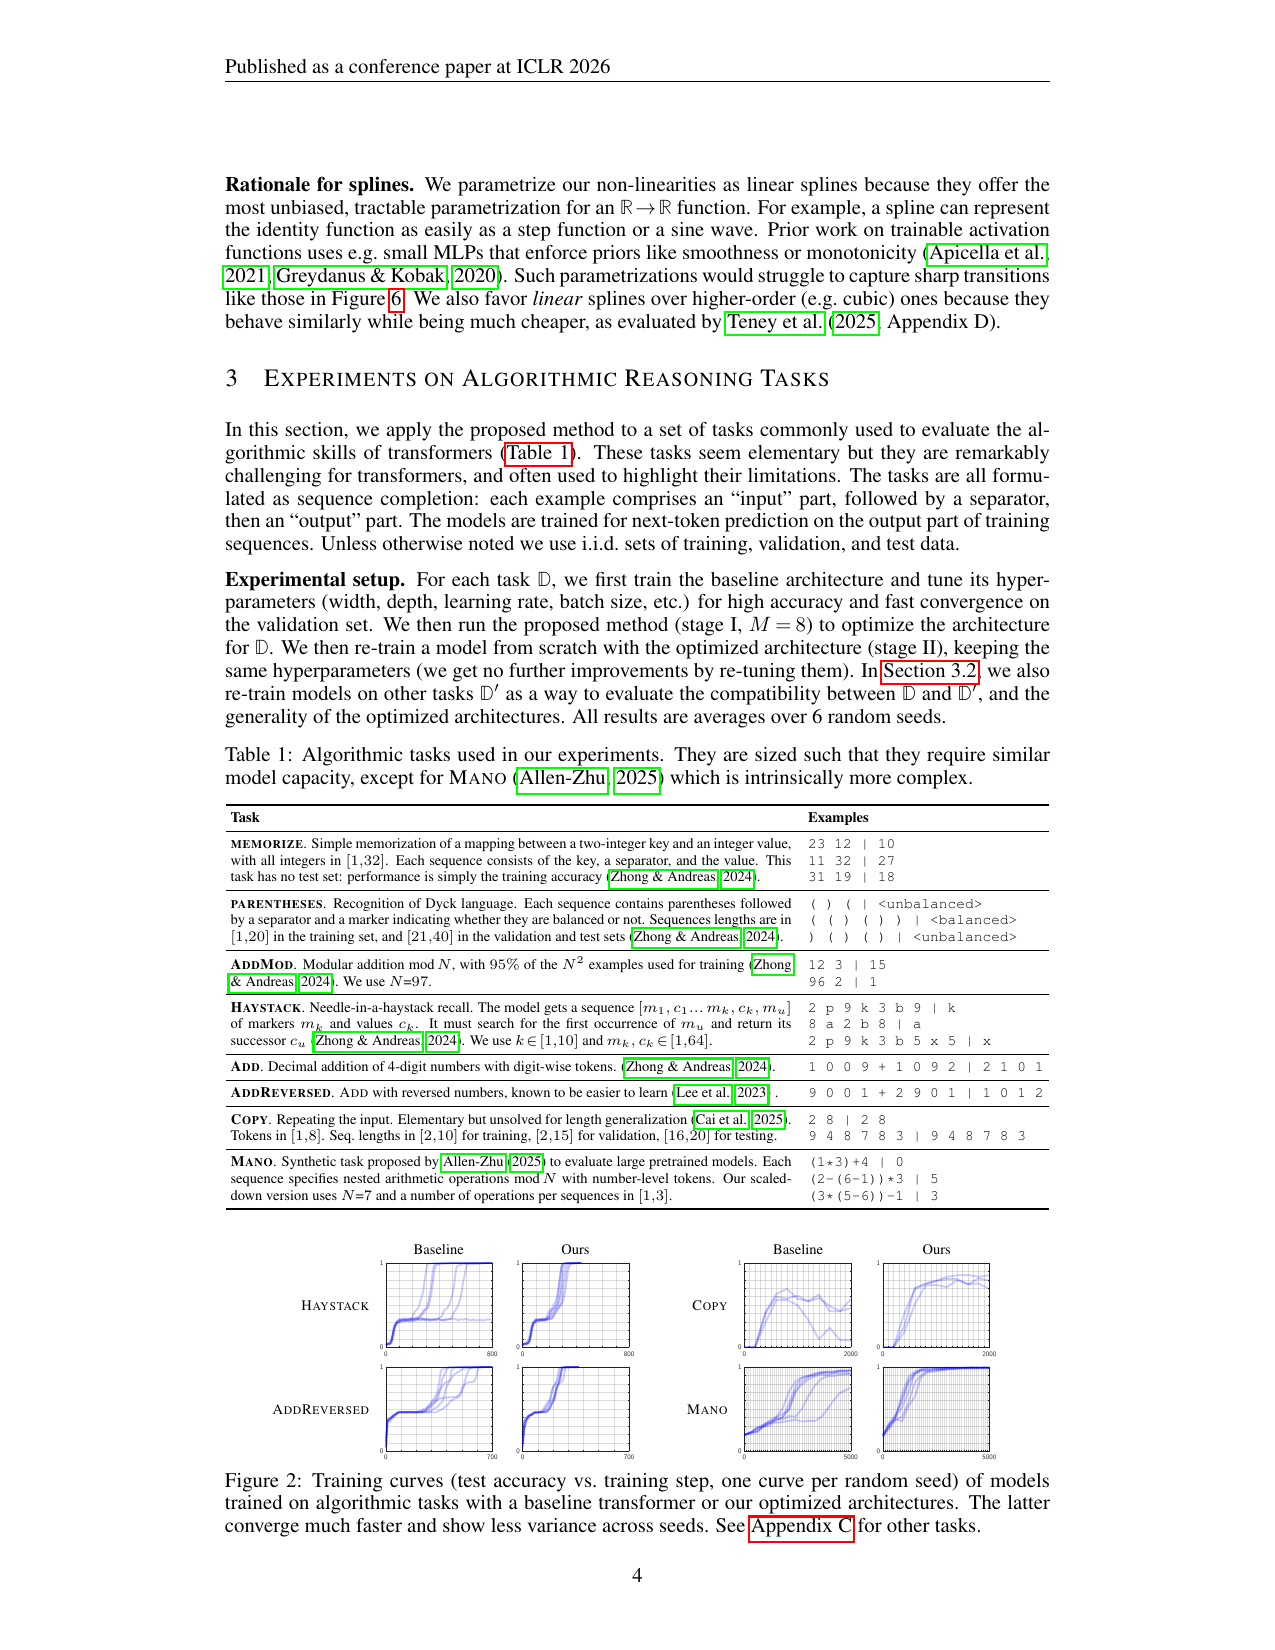
Figure 2 是「可观测现象」环的核心证据:同一设置下优化架构收敛明显更快——ADD、MANO 快 2–3 倍;基线的多根种子曲线散得很开,优化架构几乎重合。还有两类更隐蔽的失败:MANO 上基线能拟合训练集但测试精度上不去;COPY 在未见长度(>10)上准确率≈0,配合 Alibi 位置编码再做长度相关优化,能继续提升到长度 30。一句话:同一套超参只改两个非线性,标准 transformer 离自己的潜力差得远。
机制:形状随任务而变,细节是功能
如果「形状即偏置」成立,不同任务学出的形状应当彼此不同,图 6 直接展示这一点:
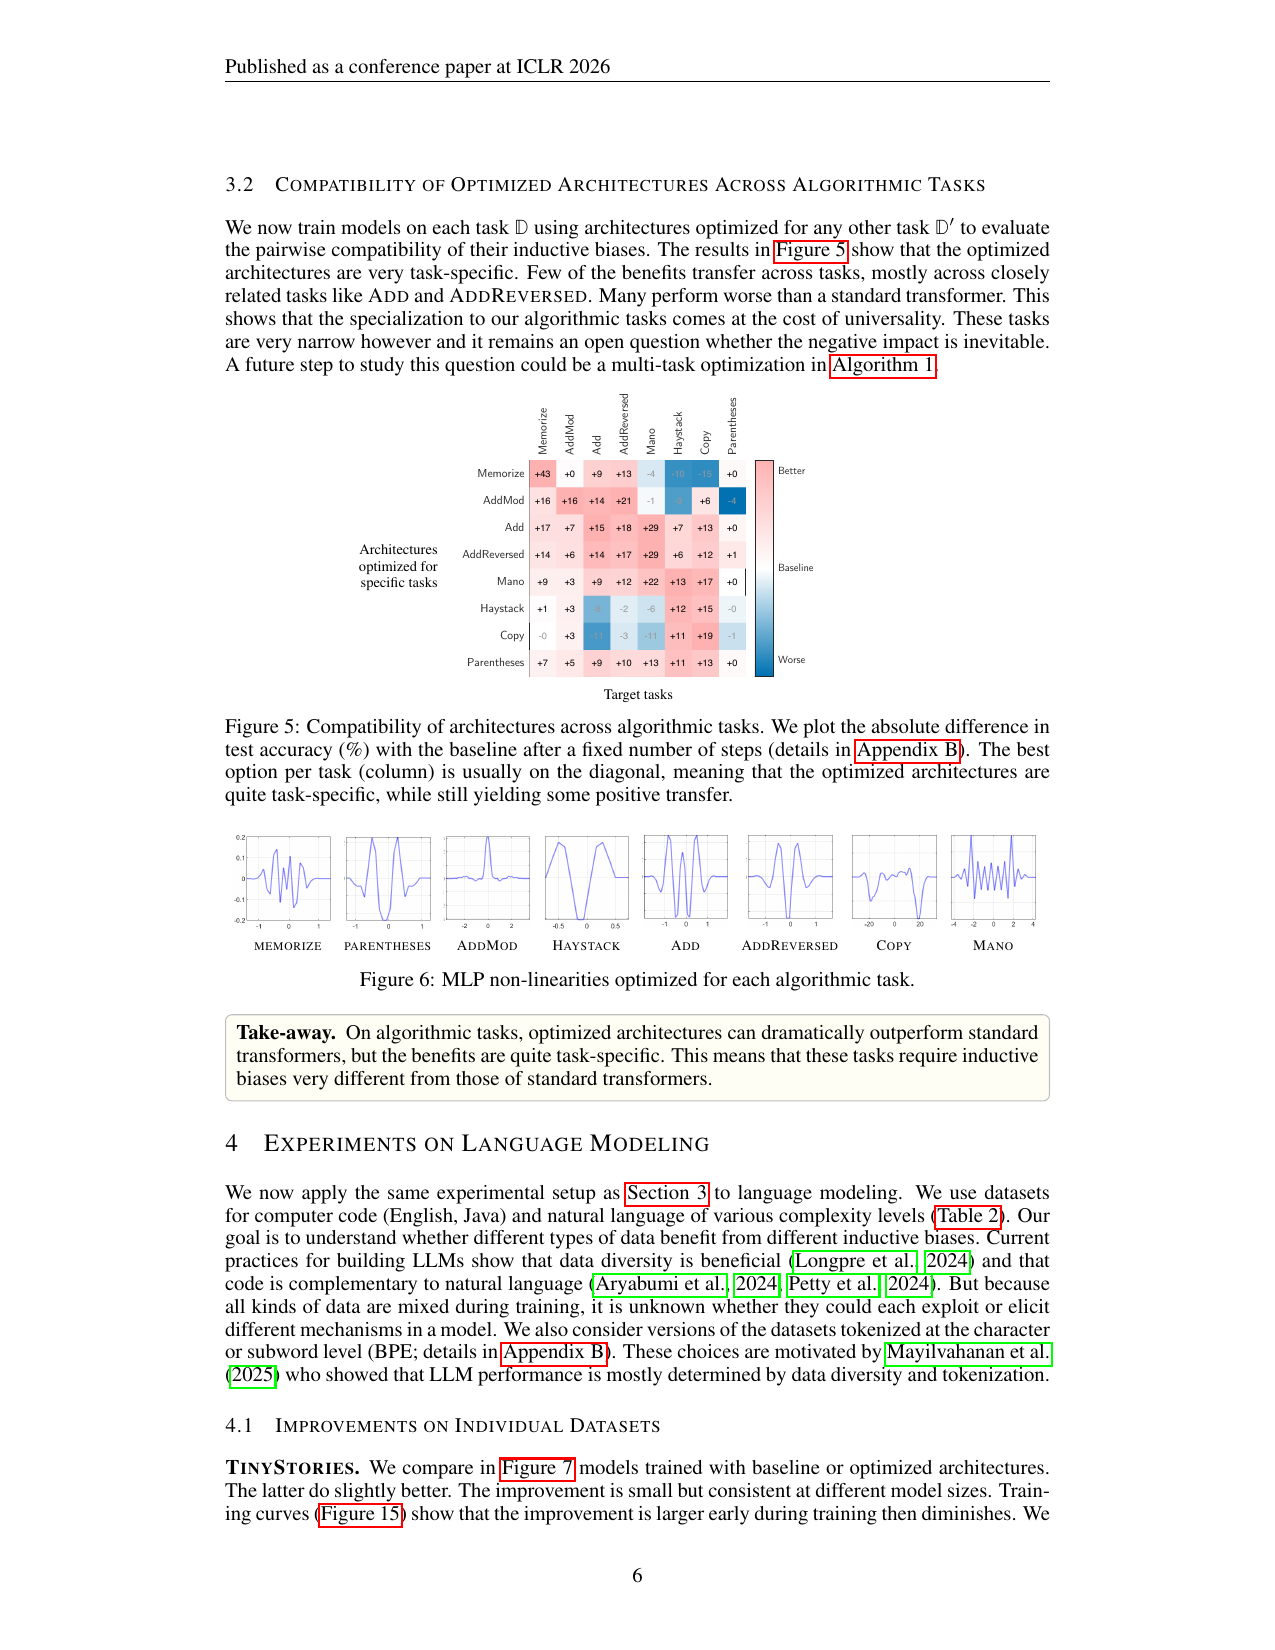
8 个任务并排,形状差异巨大,普遍带尖锐过渡——这正是选线性样条的原因,带平滑/单调先验的参数化表达不了这种突变。而语言任务上学出的形状是另一种:近似正弦小波(图 7 右)。形状随任务结构变化,是机制假设的第一个直接证据。
第二个证据是「细节是功能」:把 TinyStories 学出的小波形状做对称化「清理」,8 个尺寸配置里几乎全部变差(差 −0.1~−0.4 pp);用低阶多项式近似也系统性更差(n=3 时验证困惑度 4.79 vs 样条 4.64)。这说明起作用的是波形的微观细节——讨论激活函数时只分「ReLU 还是 GeLU」的家族层面可能不够,形状级别的偏置差异是实打实的。
兼容性:算法任务的特异,语言的通用
论文最有信息量的实验是跨任务复用:用为任务 D 学出的架构去训练任务 D′,测偏置兼容性。
Figure 5 的 8×8 矩阵里,行是为某任务优化的架构、列是目标任务,数值是固定步数后相对基线的测试准确率差(pp)。对角处处最优(MEMORIZE +43、COPY +19),离对角多处为负——COPY 架构搬到 ADD 上 −11 pp,正迁移只出现在 ADD↔ADDREVERSED 等近邻任务。算法任务的偏置高度任务特异,这是「单一架构同时最优所有能力」假设的反例,论文把它对齐到 no-free-lunch 定理。
语言侧是另一幅图景:
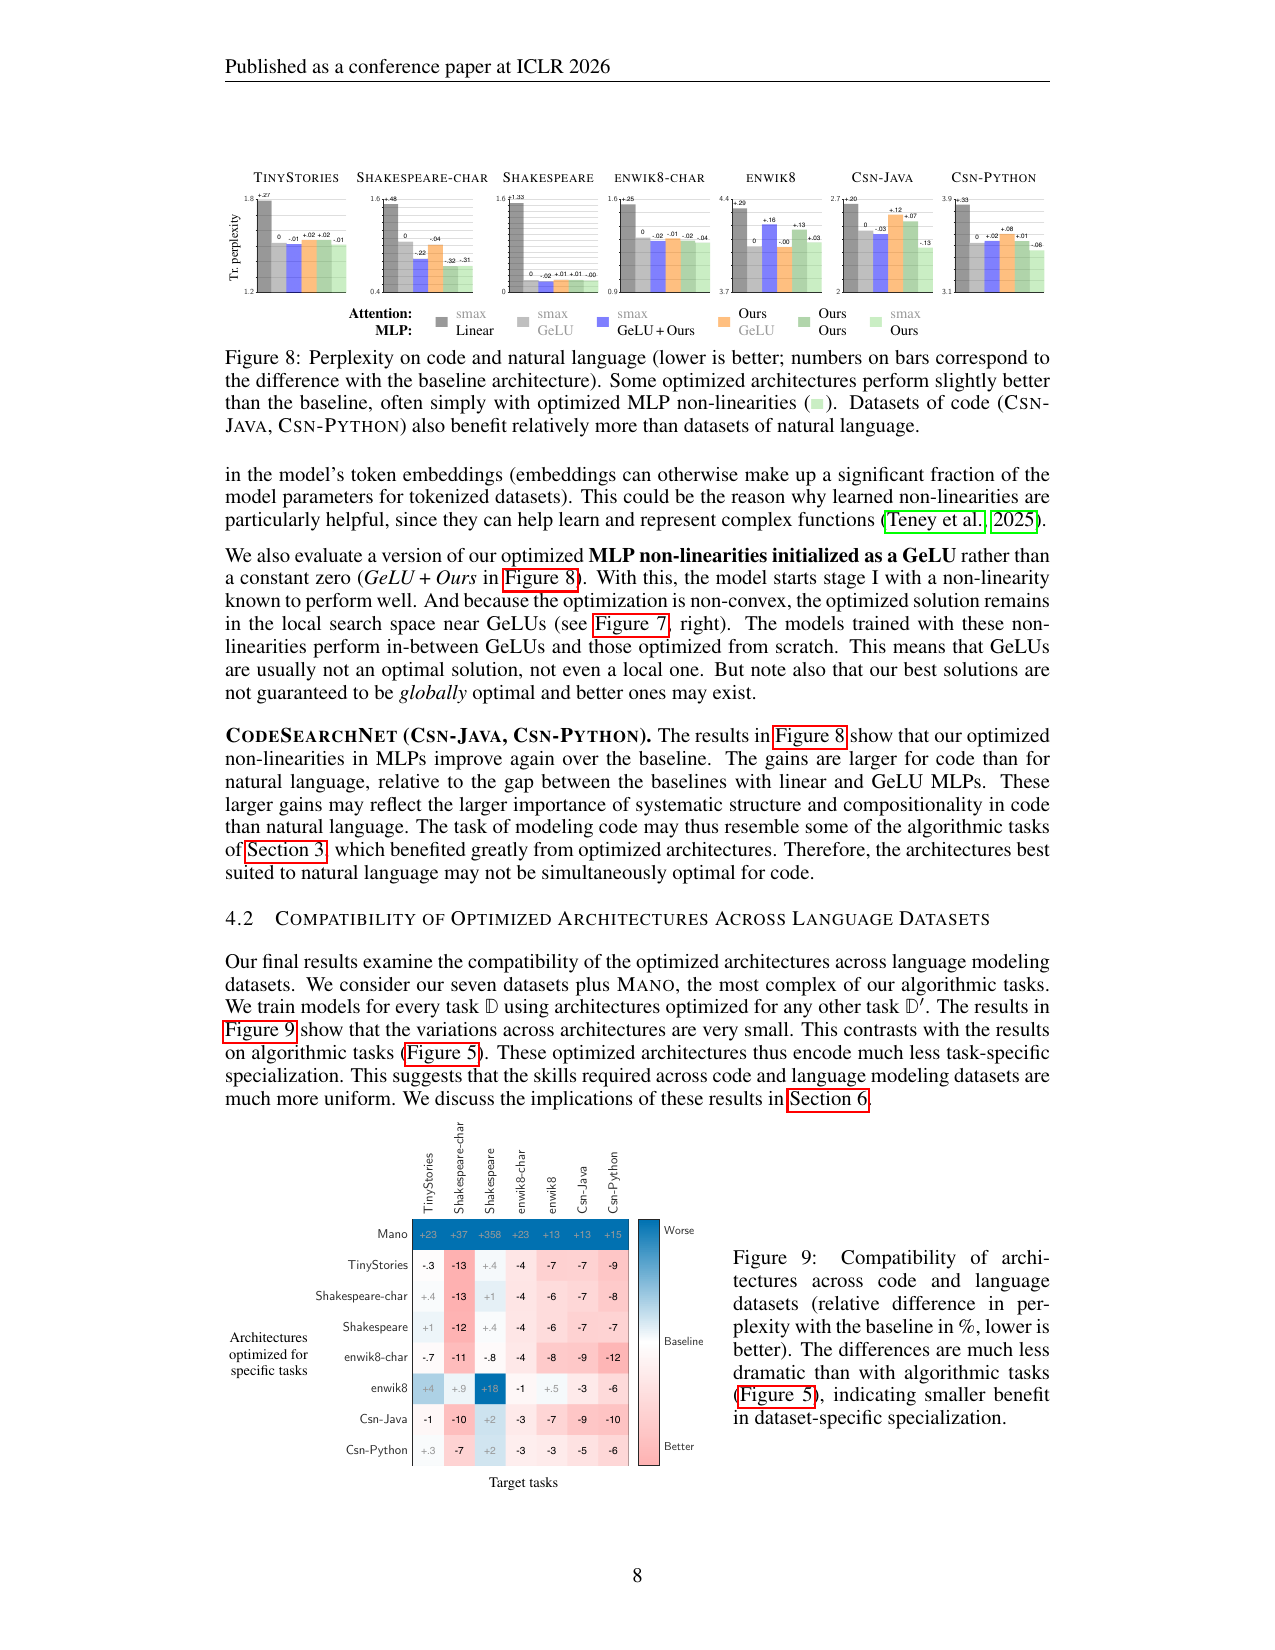
语言数据集间的相对困惑度差多在几个百分点内,跨字符级/BPE 两种 tokenization 都能迁移。收益小但一致:TinyStories 验证 token 准确率 64.4 vs 63.7(+0.7 pp),FineWeb 上 12 层验证损失 3.68 vs 3.72(基线 GeLU/ReLU)。例外是 MANO 架构迁到 TinyStories 显著变差(相对困惑度 +358%)。语言任务只需要相对通用的偏置,标准 transformer 在语言上更接近局部最优;算法任务则差得远。 这个双重结论在开头、机制段和这里各出现一次,是全篇的记忆锚点。
代价与边界:探针好用,落地产不了
要诚实地说,这篇的价值是测量工具,产出的是证据与新问题。三条限制:原始样条在较大模型上明显更慢(FineWeb 12 层 81,720 秒 vs ReLU 28,020 秒,表 6);注意力侧收益小(替换 softmax 大多不赢,作者解释为 softmax 接近局部最优),干预空间在注意力一端受限;机制证据是行为级的——论文没有打开「学到的样条如何实现算法」的黑箱,也没有形式化「何种形状对应何种算法能力」。论文自承语言侧的改进「实际用途上不直接可用」。工程出口存在:学到的样条可用 18 阶多项式近似,压到接近 ReLU 的速度并保住大部分收益。
一句话记住这篇
标准 transformer 在架构空间里很少是局部最优:算法任务上换掉两个非线性就能快 2–3 倍,但偏置高度任务特异、几乎不可迁移;语言任务上收益小但一致、跨数据集通用。 最该记住的是那张 8×8 兼容性矩阵——对角最优、离对角为负,它把「架构偏置与任务的匹配度」变成了一张可以测量的表。
把 transformer 最关键的两个非线性(MLP 的 GeLU、注意力的 softmax)换成由数据学出来的样条并冻结复用,做成一把测量「架构归纳偏置与任务匹配度」的探针:标准 transformer 在架构空间中很少处于局部最优,算法任务要求高度任务特异的偏置,语言任务要求相对通用的偏置。真正贡献是方法化、可测量的偏置兼容性研究,产出的是证据与新问题,产不出可落地的 SOTA 架构。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:标准 GPT-2 风格 transformer 在 8 个基础算法任务上明显低于自身潜力:收敛慢(ADD/MANO 比优化架构慢 2–3× 到达同等精度)、跨随机种子方差大、部分任务拟合训练集但测试精度不完美(MANO)、COPY 在未见长度上完全失败;把 GeLU/softmax 换成数据优化的非线性后,相同超参下这些问题显著缓解。语言建模上也能得到一致但更小的改进。结论层面:标准 transformer 在架构空间中罕见局部最优。
在哪里观测:8 个算法 toy task(MEMORIZE、PARENTHESES、ADDMOD、HAYSTACK、ADD、ADDREVERSED、COPY、MANO,数据改编自 Zhong & Andreas 2024 与 Allen-Zhu 2025)和语言建模数据集(TinyStories、Shakespeare、enwik8、CodeSearchNet-Java/Python、FineWeb),均按 next-token 序列补全设置(§3、§4、附录 E)。
如何量化:token-wise 测试准确率(COPY 用序列级准确率)、训练曲线到收敛的步数、6 seeds 的准确率方差、固定步数后的相对准确率差(跨任务矩阵,各任务步数不同,见附录 B 列表)、语言任务的验证困惑度与 token 准确率、语言跨任务矩阵的相对困惑度变化 %(图 9)。
② 机制假设
假设:transformers 的归纳偏置主要由少数非线性组件(MLP 的 GeLU、注意力相似度的 softmax)的具体函数形状决定;标准形状偏袒低复杂度、平滑的目标函数(simplicity bias 谱系,借 Mingard et al. 2019 与 Teney et al. 2024/2025),与算法性、需要系统性组合的任务错配,与自然语言的统计结构更匹配。因此把非线性形状本身当作可优化对象,能得到与任务匹配的偏置;不同任务的最优偏置彼此不同,标准 transformer 自然很少是局部最优。
证据:
- 任务特异形状:不同算法任务学出的 MLP 非线性形状差异巨大,含尖锐过渡(图 6),与语言任务上近似正弦小波的形状(图 7 右)形成对比,偏置形状随任务结构变化。
- 细节是功能的:对 TinyStories 学出的非线性做对称化「清理」后,8 个尺寸配置中几乎全部变差(图 12,差 -0.1~-0.4 pp);低阶多项式近似系统性更差(表 7:n=3 为 4.79 vs spline 4.64),说明起作用的是波形的微观细节。
- 收益归因于 MLP 非线性:只优化 MLP 与同时优化 MLP+注意力结果相近,注意力一侧收益小(附录 C,图 10);TinyStories 上 11 种文献替代方案(Linear、ReLU、ReLU²、TanH、Sinc、Gaussian、GLU/Swish、多项式注意力 P1/P3、NormSoftmax、Adaptive softmax)无一超过学到的 spline(表 3,2 层宽 256)。
- 偏置可移植性随任务类型呈结构:算法任务间交叉矩阵对角最优、迁移少(图 5);语言数据集间差异小(图 9),偏置与任务类型相关而随机。
备选解释:
- 收益可能部分来自优化动力学而非偏置本身(spline 更好优化、更好训练);论文用两阶段+冻结+从零重训、M=1 vs M=6 对照(表 5)缓解,但未完全排除。
- 跨任务差异也可能是任务难度或样本量的副产物(MANO 明显更复杂),论文只做定性讨论。
- 注意力侧结论相反:替换 softmax 收益小、作者解释为 softmax 接近局部最优(§4.1),说明「非线性形状决定偏置」在注意力一侧被削弱,机制并非全域一致。
- 更宽的备选解释:性能差异可由数据多样性与 tokenization 主导(引 Mayilvahanan et al. 2025),架构只起次要作用。
形式化/toy model:无针对机制本身的 toy model 或形式化:论文借用 prior work 的 simplicity bias 理论作为解释框架(激活函数决定简单性偏置),但未形式化「何种 spline 形状对应何种算法能力」,也没有表征级分析。
③ 局部干预
干预对象:MLP 层非线性(GeLU)与注意力相似度函数(softmax 核)
操作:替换为可学习的一维线性样条:MLP 逐元素激活 φ_θMLP,注意力核 K(Q,K)=φ_θA(Q)ᵀφ_θA(K)。stage I 用 held-out 20% 数据 + 双 loss + M=8(算法)/M=3(语言)个并行模型优化 spline keypoints 与权重,防止共适应;stage II 冻结 spline,用标准训练从零重训,并可在其他数据集 D′ 上复用(mix-and-match)。
效果:算法任务收敛快 2–3×、跨种子方差基本消除、MANO 达接近完美测试精度、COPY 长度泛化在 Alibi 之上继续提升;语言任务上小幅但一致的提升。
局部性:局部性强:只改两个非线性组件,注意力结构、位置编码、优化器、超参、数据全部不变;stage II 中 spline 被冻结、被视为预调超参而非模型容量(§2 脚注 2)。
干预对象:位置编码(仅长度泛化实验)
操作:在 Alibi 架构上用双 loss 机制:权重在序列长度 2–10 上优化、非线性在 2–15 上优化,迫使架构捕获长度泛化偏置。
效果:COPY 上比 Alibi 单独使用更高的准确率,收益延伸到更长序列(测至 30)。
局部性:叠加在既有 Alibi 组件上,只改变非线性训练时的长度分布。
因果验证:控制变量较充分:基线在每任务上把超参调到最大稳定 LR;stage II 用相同超参从零重训;算法任务 6 seeds 平均;「GeLU+Ours」(从 GeLU 初始化)结果介于 GeLU 与从零优化之间,排除任意可学习函数都行的解释;对称化消融(图 12)、多项式近似消融(表 7)、M=1 vs M=6(表 5)、只换 MLP vs 只换注意力(图 10)提供直接对照。
④ 工程收益
指标:学习速度
数值:快 2–3×
基线:标准 transformer(LR 已调至最大稳定值)
设置:ADD 与 MANO,训练曲线测试精度 vs 步数,6 seeds(§3.1,图 2,p4)
指标:测试精度/泛化
数值:从「拟合训练集但测试不完美」到接近完美
基线:标准 transformer
设置:MANO(N=7、每序列 1–3 ops),6 seeds(§3.1,图 2)
指标:长度泛化
数值:从 ≈0 到在 Alibi 之上继续提升(OOD 测至长度 30)
基线:基线完全失败;Alibi 部分解决
设置:COPY:训练长 2–10、验证 2–15、OOD 测试至 30,序列级准确率(§3.1,图 3)
指标:种子稳定性
数值:方差大幅下降,部分任务从大方差到基本消除
基线:标准 transformer
设置:HAYSTACK/COPY/ADDREVERSED/MANO 等,每任务 6 seeds 训练曲线(图 2、图 10)
指标:小容量效率
数值:同参数下保持更高精度(宽度 4–128 区间)
基线:标准 transformer
设置:PARENTHESES/MEMORIZE/ADDREVERSED/HAYSTACK/ADD 宽度扫描(§3.1,图 4)
指标:语言建模精度
数值:TinyStories 验证 token 准确率 +0.7 pp(64.4 vs 63.7)、训练困惑度 1.57 vs 1.58;1–4 层 × 宽 128–1024 上 +0.1~+2.4 pp
基线:GeLU 基线(线性 MLP 为 59.9)
设置:2 层宽 256(表 3);全尺寸扫描(§4.1,图 7)
指标:更大规模验证损失
数值:4 层 3.82 vs 3.87,12 层 3.68 vs 3.72
基线:GeLU 与 ReLU(两者接近)
设置:FineWeb + NanoGPT Speedrun 基线的单卡改编,2–12 层、约 91–162M 参数,3 seeds 平均(表 6,附录 E)
指标:计算成本回收
数值:多项式近似(n=18)12 层训练 29,100s vs 28,020s,验证损失 3.69 vs 3.68
基线:ReLU;精确 spline 为 81,720s
设置:FineWeb 同一代码库(表 6、附录 F)
代价:原始 spline 在较大模型上明显更慢(FineWeb 8 层 8,520s vs ReLU 3,120s;12 层 81,720s vs 28,020s,表 6);stage I 需多模型并行与 held-out 数据,开销额外;语言任务改进小,论文明确说这些改进「实际用途上不直接可用」(§1),主要价值是作为测量证据。
可迁移性:算法任务之间差:8×8 交叉矩阵对角最优(如 MEMORIZE +43 pp、COPY +19 pp,固定步数口径),多处离对角为负(Copy 架构在 ADD 上 -11 pp),仅 ADD↔ADDREVERSED 等近邻任务正迁移(§3.2,图 5)。语言数据集之间好:相对困惑度差异多在几个百分点内,跨 char/BPE 两种 tokenization 均可迁移;例外是 MANO 架构迁到语言任务显著变差(TinyStories 相对困惑度 +358%)(§4.2,图 9)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中。现象测量扎实(训练曲线、方差、交叉矩阵、固定步数口径),机制证据以行为消融为主(形状随任务而异、细节重要、14 种替代方案全输),但没有打开「学到的 spline 如何实现算法」的黑箱,没有形式化,也没有表征级证据。 |
| 机制→干预 | 中强。干预目标就是机制所指的组件(非线性),「只换 GeLU 就拿到大部分收益」是最直接的局部归因;但推导链较宽,更宽泛的「任何可学习函数都能更好」假设也能导出同样干预;注意力侧与机制不一致(换 softmax 收益小,作者解释为 softmax 接近局部最优)。 |
| 干预→收益 | 算法任务强:控制严格(相同超参、从零重训、6 seeds、基线 LR 调满)。语言任务弱但一致:差距小(准确率零点几个 pp、验证损失 0.03–0.05),论文自己也标注「实际不直接可用」;工程收益真实但属于测量副产物,并非论文目标。 |
| 最弱一环 | phenomenon→mechanism:从「换非线性有效」推进到「非线性形状即偏置、形状差异即机制」之间缺少机制层面的直接证据与形式化。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 算法任务收敛速度 | 快 2–3× | 标准 transformer(LR 已调满) | ADD、MANO,6 seeds(§3.1,图 2,p4) |
| MANO 测试精度 | 从拟合训练集但测试不完美到接近完美 | 标准 transformer | N=7、1–3 ops,6 seeds(§3.1,图 2) |
| COPY 长度泛化(序列级准确率) | 从 ≈0 提升到 Alibi 之上、OOD 测至长度 30 | 基线失败;Alibi 部分解决 | 训练 2–10、验证 2–15、测试至 30(§3.1,图 3) |
| 算法任务跨架构迁移(固定步数后准确率差 pp) | 对角最优,如 MEMORIZE +43、COPY +19;离对角多处为负(Copy 架构在 ADD 上 -11) | 标准 transformer | 8×8 矩阵,各任务固定步数 150–3000(§3.2,图 5,附录 B) |
| TinyStories 语言建模 | 验证准确率 64.4 vs 63.7(+0.7 pp),训练困惑度 1.57 vs 1.58 | GeLU;Linear 59.9 | 2 层、宽 256(表 3);全尺寸 +0.1~+2.4 pp(图 7) |
| FineWeb 验证损失(NanoGPT Speedrun 基线上) | 4 层 3.82 vs 3.87;8 层 3.72 vs 3.72/3.78;12 层 3.68 vs 3.72 | GeLU、ReLU | 2–12 层、约 91–162M 参数、3 seeds(表 6,附录 E) |
| 语言数据集间架构迁移(相对困惑度差) | 多数在几个百分点内;MANO 架构迁到 TinyStories 为 +358% | 标准 transformer | 7 语言数据集 + MANO 交叉矩阵(§4.2,图 9) |
Insights
- 把非线性当「可测量的先验」:两阶段 + 冻结 + 跨任务复用把归纳偏置兼容性变成可量化矩阵,算法任务强任务特异(图 5)、语言任务弱任务特异(图 9),给「哪些能力可以共享一个架构」提供了实验入口。
- 标准 transformer 对语言比对算法任务更接近局部最优:语言上改进小而一致、跨数据集迁移好;算法上改进大但几乎不可迁移。两条证据指向同一结论:单一架构同时最优所有能力难以成立(§6 的 no-free-lunch 对齐)。
- 非线性的微观形状承载功能:类小波外形相似、细节不同就掉性能(图 12、表 7),解释 transformer 时看激活函数家族(ReLU/GeLU/GLU 层面)可能不够,形状级别的偏置差异是实打实的。
- 参数化的偏置性本身是方法学发现:同一函数族用 spline 参数化可学,直接优化多项式系数则完全失败(附录 F),「先验的无偏性」(spline 对应最均匀先验)是训练动力学层面的真实变量。
- 工程上给出可行出口:学到的 spline 可用 n=18 多项式近似压缩到接近 ReLU 速度并保住大部分收益(表 6),缓解「探针架构不可落地」的质疑。
vs 同类工作
局限
- 规模小:语言实验远小于 SOTA LLM,作者自述更大规模下效果可能消失或变化(§6 Limitations)。
- 搜索空间受限:GLU 式乘法交互与复杂注意力(如 Tropical attention)无法在公式化内表示(§6)。
- 机制证据间接:无表征分析或形式化说明 spline 如何实现算法,偏置错配主要靠行为结果与 prior 理论支撑。
- 注意力侧干预收益小(替换 softmax 大多不赢,§4.1),方法的干预空间在注意力一端受限。
- 跨任务矩阵用固定步数而非收敛终值比较(附录 B 列出各任务步数),是工程近似公平性口径;部分任务基线已饱和到完美精度,信息有限。
- 未做多任务联合优化(§3.2 列为 future work),负迁移是否必然没有回答。
- 语言改进实际不直接可用(作者自述):原始 spline 昂贵、收益小。
可复现性
数据:算法任务基于 Zhong & Andreas (2024) 的 random_transformers 生成代码(预生成、训练/验证/测试严格不相交,测试集 1e3 条);MANO 按 Allen-Zhu (2025) 重实现并缩小(N=7、每序列 1–3 ops、1e5 训练样本);语言数据用 TinyStories、Shakespeare、enwik8(Yong 2025 clean 版)、CodeSearchNet、FineWeb。方法:Algorithm 1 完整给出两阶段/双 loss/M 并行模型流程;表 4 给出全部超参(层数、宽度、步数、LR、M、spline 范围与间距);spline 精确实现(Listing 1)与多项式近似(Listing 2)代码内嵌在附录。统计口径:算法任务 6 seeds 平均,FineWeb 3 seeds(表 6)。官方代码:https://github.com/idiap/lm-afs(§6 结尾)。
算法任务的训练曲线:基线 vs 优化架构
原文 caption:Training curves (test accuracy vs. training step, one curve per random seed) of models trained on algorithmic tasks with a baseline transformer or our optimized architectures. The latter converge much faster and show less variance across seeds.
「可观测现象」环的核心证据:在相同超参、相同数据、6 个随机种子下,只把 GeLU/softmax 换成学出的样条,ADD/MANO 等任务收敛快 2–3 倍,基线的多根种子曲线散得很开而优化架构几乎重合。读图看两个东西:到达同等精度需要的步数,以及种子之间的散度——两者都说明标准 transformer 离自身潜力差得远。
算法任务间的架构兼容性矩阵(8×8)
原文 caption:Compatibility of architectures across algorithmic tasks. We plot the absolute difference in test accuracy (%) with the baseline after a fixed number of steps. The best option per task (column) is usually on the diagonal, meaning that the optimized architectures are quite task-specific, while still yielding some positive transfer.
「偏置兼容性」环的核心证据:8×8 矩阵的行是为某任务优化的架构、列是目标任务,数值是固定步数后相对基线的测试准确率差(pp)。对角处处最优(MEMORIZE +43、COPY +19),离对角多处为负(COPY 架构在 ADD 上 −11),正迁移只出现在 ADD↔ADDREVERSED 等近邻任务——算法任务要求高度任务特异的偏置,是「单一架构同时最优所有能力」假设的反例。
每个算法任务各自学出的 MLP 非线性形状
原文 caption:MLP non-linearities optimized for each algorithmic task.
「机制假设」环的证据:8 个算法任务并排展示学出的 MLP 非线性形状,差异巨大且普遍带尖锐过渡(这是选线性样条的原因,带平滑/单调先验的参数化表达不了突变);与语言任务上近似正弦小波的形状(图 7 右)形成对照,支持「偏置形状随任务结构变化」的机制假设。
代码与语言数据集间的架构兼容性矩阵
原文 caption:Compatibility of architectures across code and language datasets (relative difference in perplexity with the baseline in %, lower is better). The differences are much less dramatic than with algorithmic tasks, indicating smaller benefit in dataset-specific specialization.
语言侧的对照证据:跨 7 个语言/代码数据集(含 char 与 BPE 两种 tokenization)的相对困惑度差多在几个百分点内,与算法任务矩阵的剧烈对角化形成对比,支持「语言任务偏置更通用、标准 transformer 在语言上更接近局部最优」;例外是 MANO 架构迁到 TinyStories 显著变差(相对困惑度 +358%)。
🎧 音频版
时长 15:07 · Edge TTS
Transformer 能通吃所有任务吗?(对话版)
小播:今天聊一篇 ICLR 2026 的论文,标题问了一个很扎心的问题:Transformer 真的什么都能干吗?
老播:这篇的答案很具体:标准 transformer 在大多数任务上都没「到位」。作者做了一件事——把 transformer 里两个最关键的激活函数,MLP 的 GeLU 和注意力的 softmax,换成由数据学出来的样条。只改这两个地方,8 个算法小任务全面变好:收敛快 2 到 3 倍,跨随机种子的方差消失,连以前几乎失败的 COPY 长度泛化都被明显缓解。
小播:等一下,只换两个激活函数?参数、数据、超参都不动?
老播:都不动。stage II 里样条是冻结的,从零重训,超参和基线一模一样,6 个种子平均。所以差距只能来自架构本身。但反过来说,这些学出来的偏置几乎不能跨任务用:为加法优化的架构拿去学 COPY,比标准 transformer 还差。算法任务要的是高度任务特异的偏置,语言任务只要相对通用的偏置——这是全篇的主线结论,后面还会重复。
现象:同一套超参,差距大到吓人
老播:他们做了 8 个算法 toy task,全部按序列补全训练,基线的学习率已经调到最大稳定值,标准到不能再标准。结果只换掉两个非线性之后:ADD 和 MANO 上收敛快 2 到 3 倍;原来 6 个随机种子的曲线散得很开,现在几乎重合。
小播:曲线散得很开说明什么?
老播:同一个配置跑 6 遍,结果大不一样——这说明任务和架构的偏置不匹配,学成什么样要看运气。还有更隐蔽的:MANO 上基线能把训练集吃下去,测试精度却上不去;COPY 在超过训练长度的序列上准确率几乎为零。这些都是「架构没到位」的症状,把两个非线性一换,症状就消失。
机制:非线性形状就是偏置
小播:为什么换两个函数,效果能这么大?
老播:先引入一个概念,叫归纳偏置:架构偏爱哪一类函数,在能拟合数据的函数里挑谁。论文的工作假设是,transformer 的偏置主要由少数非线性组件的具体形状决定。MLP 层就是权重、非线性、权重:输入经过 W 和 b,过一个逐元素的 φ,再乘 W'。基线里 φ 是 GeLU,他们换成一维线性样条——122 个控制点铺在负 20 到正 20 之间,学每个点的函数值,段与段之间线性插值。
小播:所以样条想长成什么样就长成什么样?
老播:对,它没有平滑、单调这类先验,能表达尖角。注意力那边同理:原来 softmax 算相似度,他们换成把 query 和 key 各自过一遍样条再求内积。关键证据是图 6:8 个算法任务学出来的形状完全不一样,普遍带尖锐过渡;而语言任务学出来的是近似正弦的小波。形状随任务变,这是机制的第一个证据。
小播:那形状的细节重要吗?长得像不就行?
老播:这是全篇最狠的一个消融。他们把 TinyStories 学出的小波做对称化「清理」,8 个尺寸配置里几乎全部变差;用低阶多项式近似也系统性更差。波形长得像没用,微观细节才是功能。这等于说,研究激活函数不能只看家族,ReLU、GeLU、GLU 之下的形状差异是实打实的。
兼容性:算法任务的特异,语言的通用
老播:接下来是信息量最大的实验:把为任务 A 学出来的架构,拿去训练任务 B,测兼容性。8×8 的矩阵里,对角线上几乎处处最好——MEMORIZE 的架构在自己任务上比基线高 43 个百分点,COPY 高 19 个;但离对角很多是负数,COPY 架构搬到 ADD 上反而低 11 个点。
小播:也就是说,算法任务的偏置基本不能共享?
老播:对,只有 ADD 和 ADDREVERSED 这种近邻任务能互相迁移,这直接挑战「一个架构通吃所有能力」的说法。语言那边是另一幅图景:多个语言和代码数据集之间,相对困惑度差大多在几个百分点以内,跨字符级和 BPE 两种 tokenization 都能迁移;例外是 MANO 架构搬过去会崩,TinyStories 上相对困惑度涨 358%。
小播:语言任务的偏置更通用,收益也小一些?
老播:对,TinyStories 上验证准确率 64.4 对 63.7,FineWeb 12 层验证损失 3.68 对 3.72,提升小但一致。所以主线结论是:算法任务上标准 transformer 离局部最优差得远,语言上只差一点点。开头说过一遍,这里再说一遍,收尾还会重复。
收益与最弱一环
小播:那这方法能直接用到我自己的模型上吗?
老播:这里要泼冷水,这也是论文自己承认的边界。第一,原始样条很慢:FineWeb 12 层要 81,720 秒,ReLU 只要 28,020 秒,贵将近三倍。第二,注意力那边收益很小,换 softmax 大多不赢,作者解释是 softmax 已经接近局部最优——说明「形状决定偏置」在注意力一侧被削弱。第三,证据是行为级的:论文没有打开「学到的样条到底怎么实现算法」的黑箱,也没有形式化。论文自己说,语言上的改进实际用不上。
小播:所以它更像测量工具,产结论,产不出 SOTA 架构?
老播:对,但它有工程出口:学到的样条能用 18 阶多项式近似,压到接近 ReLU 的速度,还保住大部分收益。记住这三点,你读它的时候就知道该在哪个位置保留怀疑。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:标准 transformer 在架构空间里很少是局部最优——算法任务上,换掉两个非线性就快 2 到 3 倍,但偏置高度特异、几乎不可迁移;语言任务上,收益小但一致、跨数据集通用。最该记住的画面是那张 8×8 兼容性矩阵:对角最优,离对角为负。
小播:架构和任务匹不匹配,原来是能测的。
老播:对,这就是这篇最大的价值:把「归纳偏置」从玄学变成一张可以测量的表。