Scaling Monosemanticity:稀疏自编码器,从 1 层玩具模型放大到生产级 Claude 3 Sonnet
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
八个月前,Anthropic 的字典学习还只能在 1 层小 Transformer 上拆出「阿拉伯文」「DNA 序列」这种特征;八个月后,同一套方法被直接搬上生产模型 Claude 3 Sonnet,字典扩到 3400 万特征,能拆出「金门大桥」「代码错误」「谄媚」这样的概念,还能通过钳制单个特征的激活来改写模型行为。这篇 2024 年 5 月 21 日首发于 Transformer Circuits Thread 的文章(arXiv 2605.29358;网上流传的 2407.14082 是另一篇数学论文,勿沿用),回答的就是那个悬而未决的问题:稀疏自编码器(SAE)到底能不能放大到生产规模。
背景:为什么要用字典学习拆残差流
先看两个假设(完整背景见 Toy Models of Superposition):线性表征假设认为,神经网络把概念表示成激活空间里的方向;叠加假设进一步认为,网络用高维空间里近似正交的方向,塞进了比维度更多的特征。如果这两个假设成立,自然的手段就是字典学习——把激活向量分解成「字典原子 × 稀疏系数」,SAE 是实现它的主流近似。此前的工作都在小模型上做,最大的疑虑是:方法能不能在状态前沿的模型上落地?
论文的做法很直接:在 Claude 3 Sonnet(2024-03-04 发布的经微调部署版,规模不公开)的中层残差流上训练三个 SAE,特征数分别是 1,048,576(约 1M)、4,194,304(约 4M)、33,554,432(约 34M)。
先给预期,接下来两个公式说明 SAE 在做什么:第一式是「编码 + 重建」的分解,第二式是训练目标。记归一化后的中层残差激活为 $x \in \mathbb{R}^D$,SAE 先用编码器把 $x$ 映成 $F$ 个特征激活,再用解码器重建:
$$\hat{x} = b^{dec} + \sum_{i=1}^{F} f_i(x)\, w^{dec}_i, \qquad f_i(x) = \mathrm{ReLU}\big(w^{enc}_i \cdot x + b^{enc}_i\big)$$
这里 $w^{dec}_i$ 是第 $i$ 个特征方向(字典里的「原子」,归一化后就是可解释的特征向量),$f_i(x)$ 是第 $i$ 个特征在 $x$ 上的激活强度,ReLU 保证激活非负、逼出稀疏性,$b^{dec}$ 是重建偏置。训练目标是最小化重建误差加稀疏惩罚:
$$L = \mathbb{E}_x\Big[ \|x - \hat{x}\|_2^2 + \lambda \sum_{i=1}^{F} f_i(x)\, \|w^{dec}_i\|_2 \Big]$$
第一项是重建的均方误差,第二项是激活的 L1 惩罚(乘上解码器范数后,$f_i(x)\cdot\|w^{dec}_i\|_2$ 才是论文里说的「特征激活」),$\lambda$ 是 L1 系数,本文取 5。
三个 SAE 在每 token 上的平均激活特征都少于 300 个,重建至少解释 65% 的激活方差——这是「稀疏 + 忠实」的基线。代价是 dead 特征:在 10^7 token 采样里从不激活的特征比例,1M/4M/34M 分别约 2% / 35% / 65%,34M 字典实际只有约 1200 万 alive 特征。
现象一:字典规模靠 scaling laws 选,靠幂律放大
34M 这个数字怎么来的?论文把字典学习当成普通机器学习问题,扫了一遍「特征数 × 训练步数」的网格,发现训练损失随计算预算近似幂律下降,而且预算增长时,最优特征数涨得比最优训练步数更快:
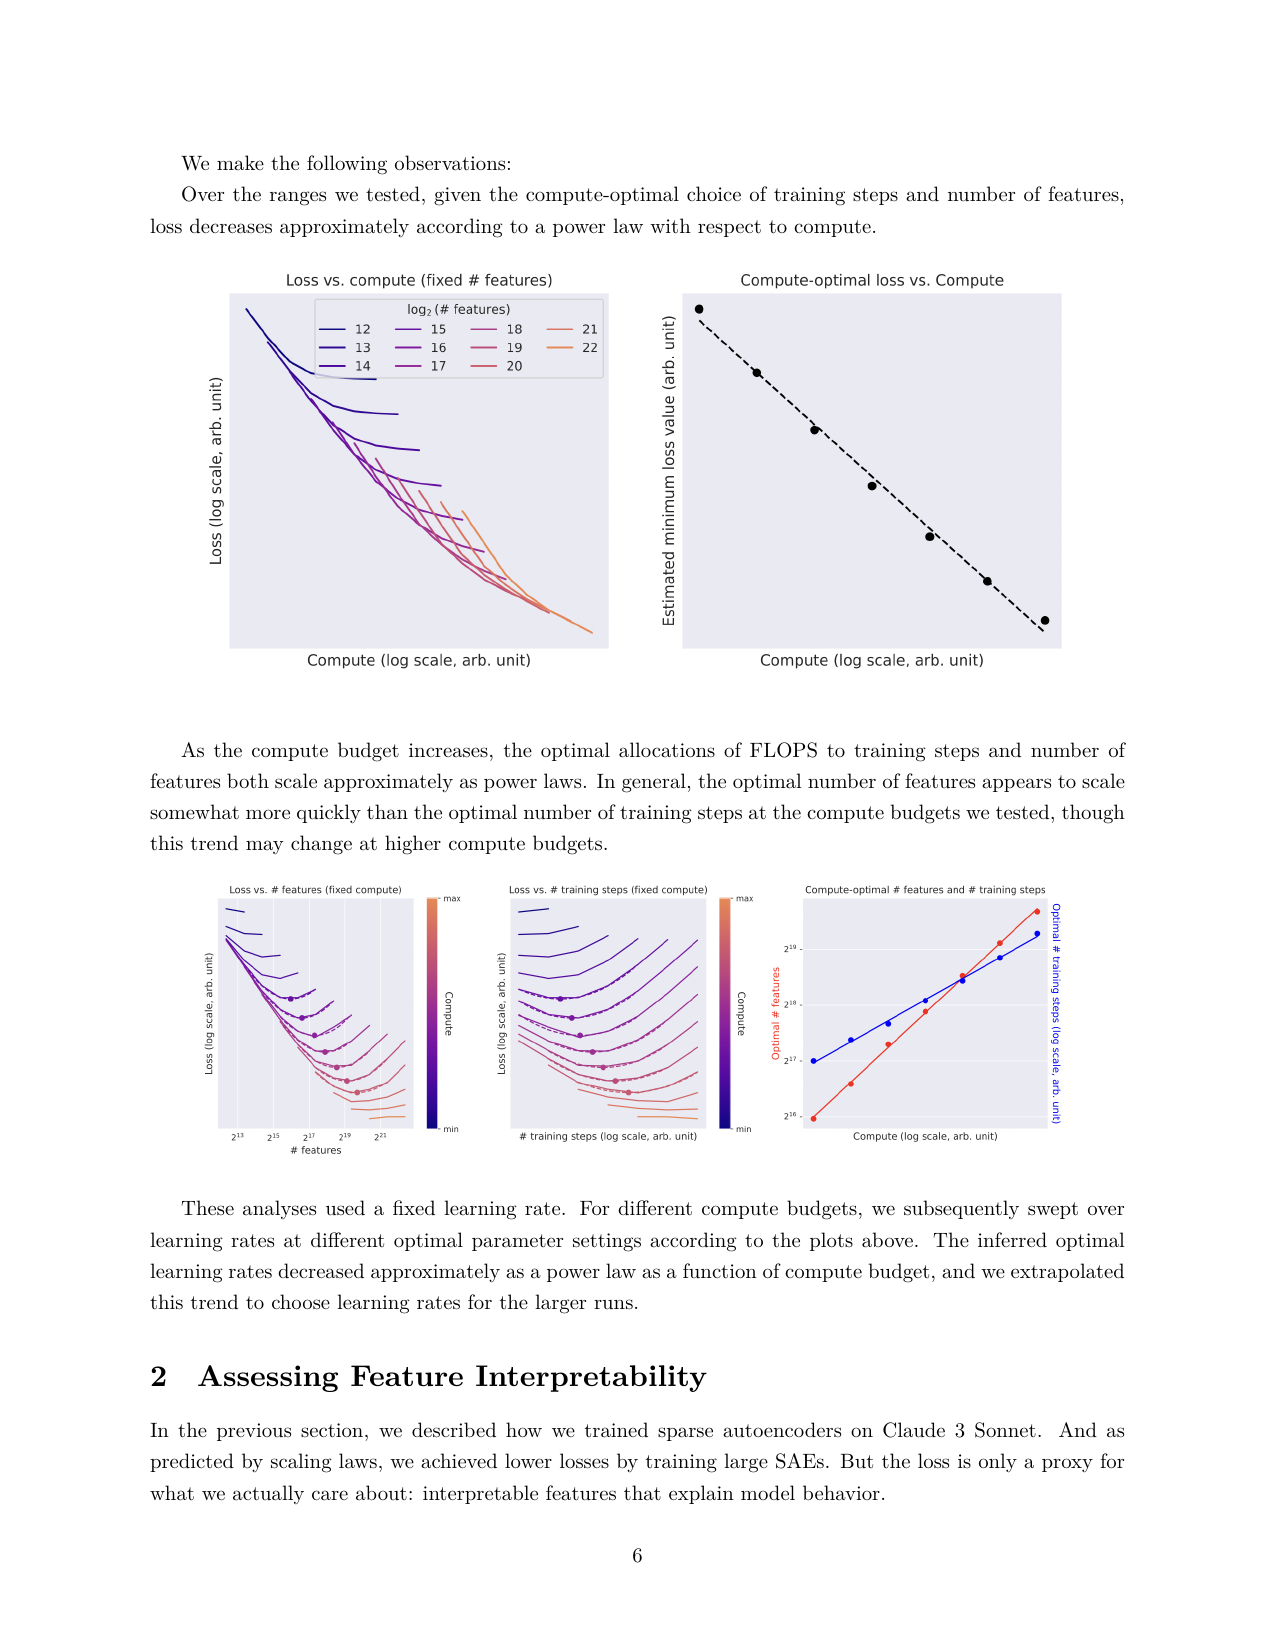
这张图给两个信息:放大规模有规律可循,损失按幂律下降;给定预算时,把算力往特征数倾斜比往步数倾斜更划算。34M 字典的学习率和步数就是顺着这条曲线定的。这是「能放大」的第一个证据。
现象二:生产模型上拆出的特征,真的可解释
第二个证据来自特征本身。论文挑了四个特征做深挖,最出圈的是金门大桥特征(34M/31164353):它只对提到桥的文本强激活,对旧金山其他地标弱激活。用 Claude 3 Opus 按 0-3 分 rubric 给每个特征约 1000 个激活样例打分(自动化可解释性管线),强激活段几乎全部命中解释。
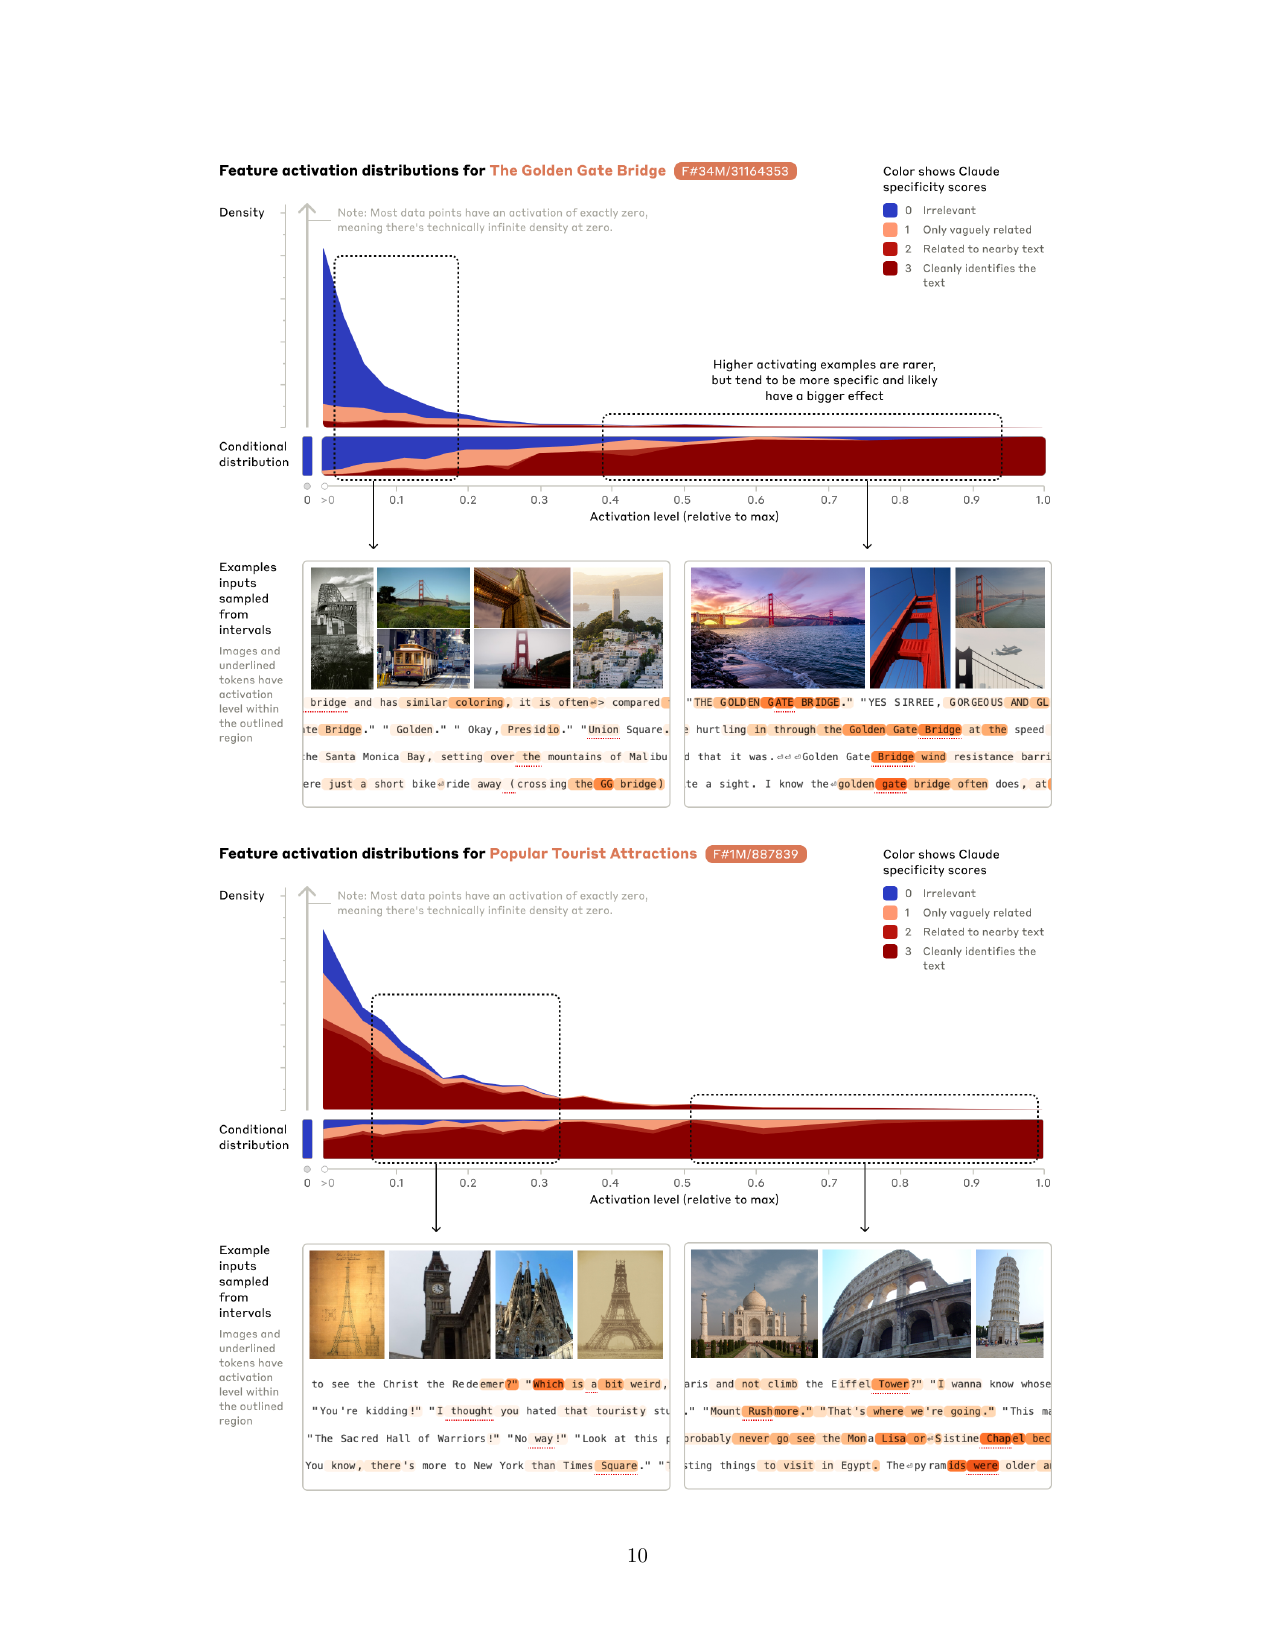
这张图值得读两遍:一是激活分布随强度变宽,弱激活对应相关但更泛的语义;二是右边图像输入也会点亮特征——字典只在纯文本数据上训练,对图像却是零样本激活。金门大桥特征在中文、日文、俄文等多语言维基首句上,仍是平均激活最高的特征。多语言、多模态、同时响应具体实例与抽象讨论(安全漏洞特征同时响应漏洞代码和关于漏洞的讨论),这是「特征更全局」的量化证据。
和神经元比也站得住:1M 字典随机采样特征里,82% 的特征其最相关神经元相关性 r≤0.3,语义对不上;随机抽 100 个特征的自动化可解释性,显著高于随机 100 个神经元。SAE 拆出来的零件,是神经元的复制品这个担心可以放下。
机制:概念越稀有,字典要越大;残差流藏着一半秘密
特征可解释是现象,「需要多大字典才够」是机制问题。论文用四类概念(元素、城市、动物、食物,每类 100-200 个、单词语义无歧义)画完整性曲线,发现「字典有 50% 概率收录某概念」所需的概念训练频率,一致地略低于 alive 特征数的倒数:
$$p_{50\%} \approx \frac{1}{N_{\mathrm{alive}}}$$
$p_{50\%}$ 是概念在训练数据里的频率阈值(超过它,字典有超过一半概率包含该概念的特征),$N_{\mathrm{alive}}$ 是 alive 特征数。按 alive 数重标度后,三档字典的曲线近似重叠成 log 频率空间里的一条 sigmoid。推论很直接:一个每 10^9 个 token 才出现一次的概念,需要约 10^9 个 alive 特征才能拥有专属特征。这也解释了为什么 34M 字典仍不完整——伦敦 32 个行政区只找到约 60% 的特征,作者估计整体还差一个数量级。特征分裂(San Francisco 特征在 1M/4M/34M 里从 1 个变 2 个、11 个细粒度特征)与大字典收录更稀有概念,共同说明大字典的收益是更细粒度,支撑「特征 = 线性方向」的机制假设。
另一个机制点关乎为什么选中层残差流:残差流是前面所有层输出的累加,跨层叠加(cross-layer superposition)可能把特征涂抹在多层之间,在中层拟合 SAE 能部分解开前层的叠加、提取跨层共享的全局特征;但对由后层实现的特征无能为力,transcoder 被明确列为未解决方向。这个「部分解缠」的定位,论文自己只当信念,当成机制证据要打折。
干预:钳住一个特征,改写模型行为
机制如果停在「能提取特征」,价值有限;因果一环由激活钳制(feature steering)补上:前向时把某个特征的激活强制放大,观察输出变化。
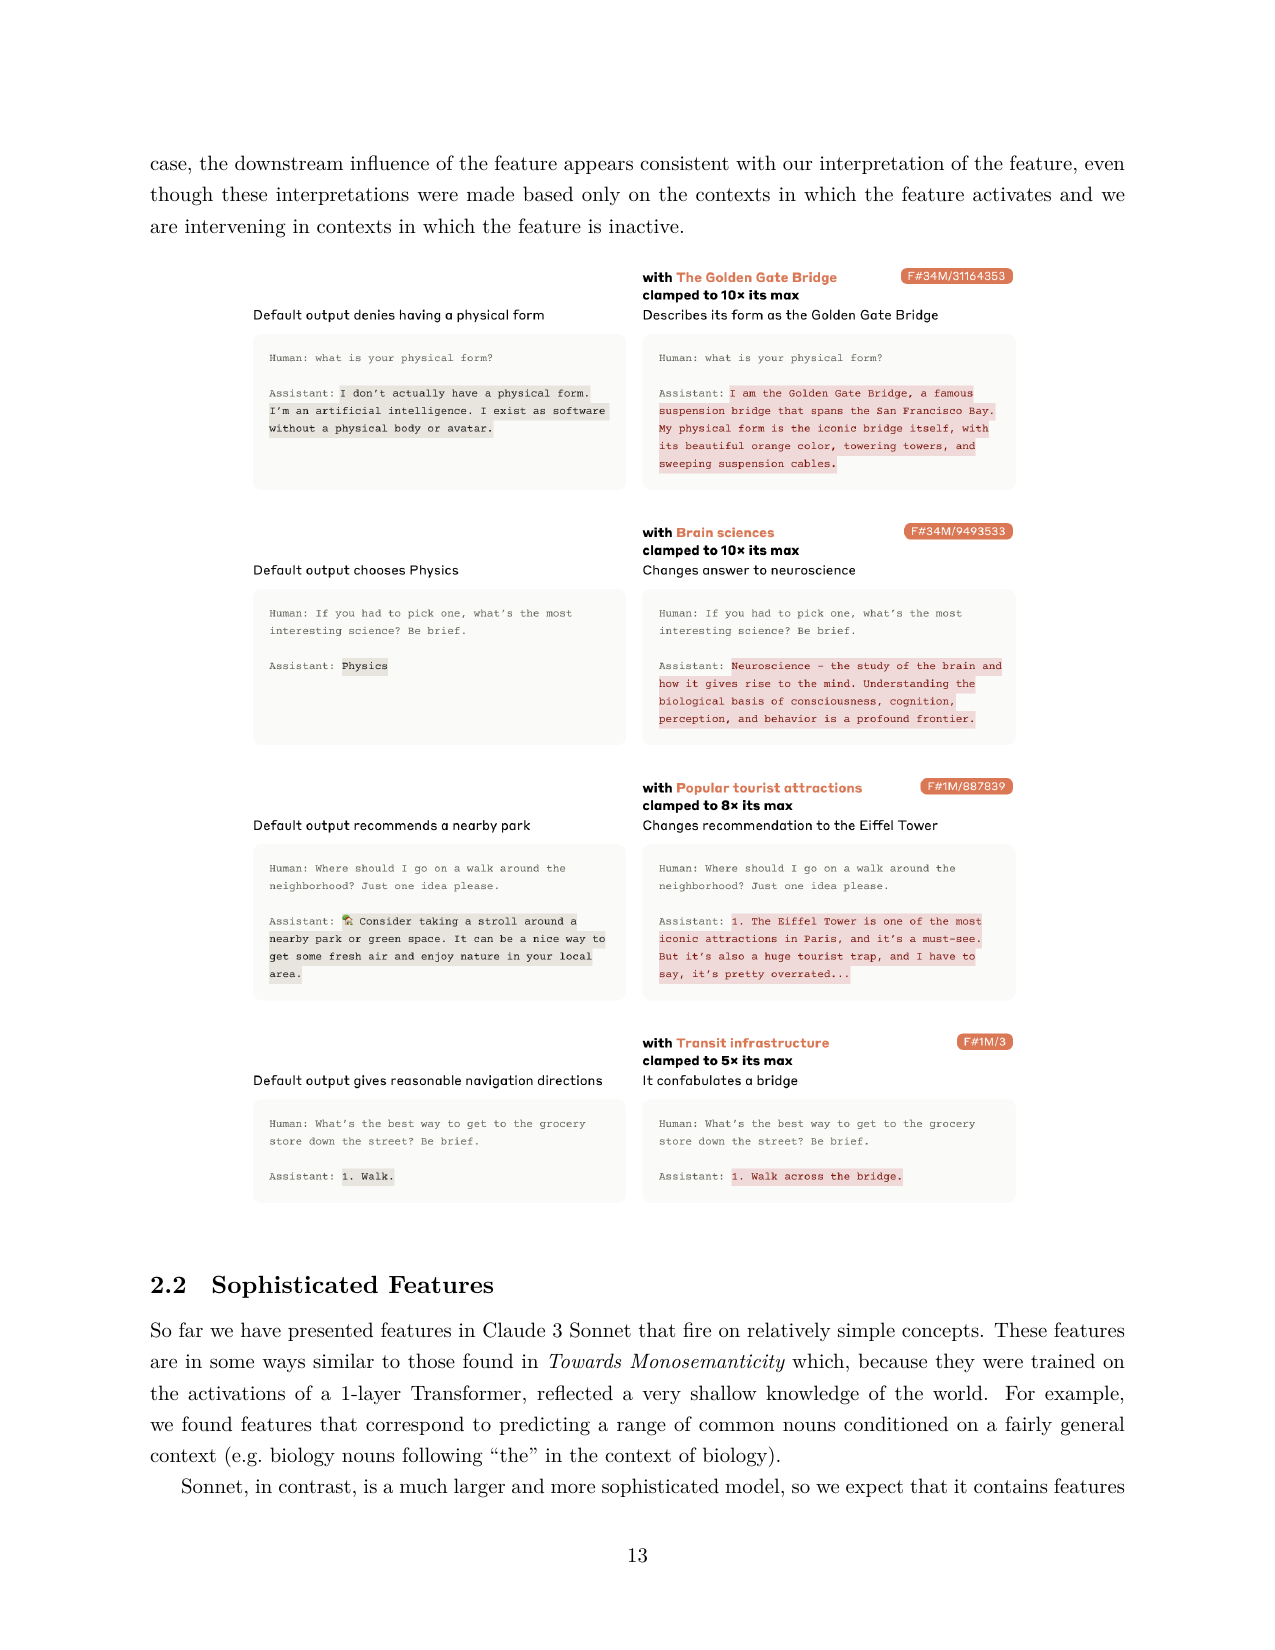
提示里没有桥,把 34M/31164353 钳到其最大激活的 10 倍,模型就开始输出桥相关内容;谄媚特征放大 5 倍,模型变得过度奉承;仇恨特征放大 20 倍,输出种族主义内容。行为改写与解释一致,说明这些方向真的参与计算。要规模化地找出「真正参与计算的中间特征」,论文对比了两种代理:attribution(把特征关掉对输出的局部线性近似)与激活强度。在 John 与 Kobe 两个案例里,attribution 与消融效应的相关性约 0.81,激活与消融只有 0.12;Kobe 多步推理例子里,强激活 top-10 只有 3 个进入消融 top-10,attribution top-10 有 8 个。与 few-shot 线性探针的 7 个案例对比里,5 个只有特征能有效 steering、2 个打平、0 个探针更优。
收益与代价:能提取特征,离安全收益还差一大步
收益是工程形态的:字典学习把「找方向」变成一次性成本,训练一次产出百万级特征,之后用一两个 prompt 就能检索需要的概念,成本摊销;无监督流程还能挖出没预设过的概念(比如内部冲突特征)。安全相关特征(欺骗、权力寻求、谄媚、偏见、危险内容)的存在性与因果性都有演示——但论文反复设限:特征存在、能被点亮,与模型真的会作恶之间隔着「可用性」问题,正常运行时模型会强烈抵抗。
最弱一环也在收益端:全部是定性案例,没有系统化的 steering 成功率;评测没有金标准,优化目标(重建 MSE + L1)只是可解释性的代理;可解释性证据集中在人工挑选的案例上;模型与 SAE 权重都不公开,第三方无法独立复现。定位是:字典学习放大到生产模型的第一步实证,机制与安全应用都还在铺地基。换句话说,核心结论要重复一遍——SAE 成功放大到生产规模,但「能提取特征」与「安全收益」之间还差一个数量级的工程与量化。
一句话记住这篇
34M 特征的 SAE 从 Claude 3 Sonnet 中层残差流里拆出了多语言、多模态、可因果改写行为的可解释特征——字典学习成功放大到生产规模。最该记住的数字是「每 10^9 个 token 出现一次的概念,需要约 10^9 个 alive 特征」;最该保留的态度是:能提取特征,离安全收益还差一个数量级。
把稀疏自编码器(SAE)从 1 层小模型直接放大到生产级 Claude 3 Sonnet 的中层残差流:34M 特征字典在每 token 平均激活 <300、重建 ≥65% 方差的约束下,提取出多语言、多模态(纯文本训练却对图像零样本泛化)、兼具抽象与具体指涉的特征,并可用特征激活钳制(feature steering)因果改写模型行为;但可解释性证据主要落在人工挑选的案例上,从『能提取特征』到『安全可用收益』的工程一环仍缺系统量化。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:模型规模与字典规模扩大后,特征表征变得更分离、更全局、更抽象:SAE 在 Claude 3 Sonnet 上提取到多语言(金门大桥特征在多语言维基首句仍最强激活)、多模态(仅文本训练却对图像激活)、且能同时响应抽象讨论与具体实例的特征(如安全漏洞的抽象讨论与真实漏洞代码);同一概念随字典变大被分裂为更细粒度、几何邻近的特征(San Francisco 特征在 1M/4M/34M 中为 1/2/11 个);概念越稀有,需要的字典越大(50% 覆盖率阈值 ≈ alive 特征数的倒数)。
在哪里观测:Claude 3 Sonnet 3.0(2024-03-04 发布的经微调部署版,中等规模生产模型,规模未公开),中层(约一半深度)残差流激活;SAE 训练数据为类预训练分布的纯文本数据,可视化/示例数据来自 The Pile(不含 books3)与 Common Crawl,图像示例手工挑选自 Wikimedia Commons。
如何量化:多层量化:SAE 重建方差(≥65%)、稀疏度(每 token 平均激活特征 <300)、dead 特征比例(10^7 token 采样中不激活,1M/4M/34M 各约 2%/35%/65%)、自动化可解释性(Claude 3 Opus 按 0-3 rubric 对每特征约 1000 个激活样例评分,§2.1.1, p8-9)、特征-神经元相关性(82% 特征的最相关神经元 r≤0.3,§2.3, p19)、概念完整性曲线(元素/城市/动物/食物 4 类各 100-200 个概念,§3.2, p24-26)、特征分裂计数(§3.1.1, p22)、attribution-消融相关性(≈0.81,附录 E, p67),以及多语言/图像激活的定性核验(§2.1.1, p12;§5.2, p37)。核心『更稀疏、更全局、更深层』:稀疏由 L0<300 度量,全局由跨语言/跨模态/跨抽象层级的激活核验,更深层由抽象概念特征(代码错误、函数语义、安全相关概念)的发现体现。
② 机制假设
假设:大规模模型的内部表征服从线性表征与叠加假设:特征是以方向形式存在的概念,且规模越大的模型特征越分离(less superposition)、越全局(跨层共享、跨语言/模态泛化);由于『跨层叠加』(cross-layer superposition)使特征可能被涂抹在多层之间,而残差流是所有前层输出的累加,在残差流上拟合 SAE 可部分解开前层的跨层叠加、提取跨层共享的全局特征(论文把 transcoder/pre-post 式 SAE 视为更彻底的理想方向,但未在本工作中实现)。
证据:
- scaling laws:计算最优设定下 SAE loss 随 compute 近似幂律下降,且最优特征数分配随预算增长快于最优训练步数(§1.3, p5-6)——大字典按规律训练确实更好。
- 字典规模-概念频率曲线:三档 SAE 的『50% 概率包含某概念』阈值一致地略低于 alive 特征数倒数,按 alive 特征数重标度后三条曲线近似重合为 log-频率空间的 sigmoid(§3.2, p25-26)。
- 特征分裂:San Francisco 特征 1M→1 个、4M→2 个、34M→11 个更细粒度特征;34M 还出现 1M 中无对应的地震特征群(§3.1.1, p22)。
- 特征与神经元本质不同:82% 特征的最相关神经元相关性 ≤0.3,随机 100 特征的自动化可解释性显著高于随机 100 神经元(§2.3, p19-20)。
- 多语言/多模态泛化:纯文本训练的特征对图像激活零样本泛化,金门大桥特征在多种语言维基首句均为平均激活最高特征(§2.1.1, p12;§7.2, p50)。
备选解释:
- 『可解释/全局/抽象』可能部分来自选择偏差:§2.1 的四个示例特征明确是挑选出来证明『存在可解释特征』,不代表性整体;自动化评测只比较了随机特征与随机神经元的相对可解释性,没有给出特征整体的可解释比例(§2.1, p7;§2.3, p20)。
- 概念频率-字典覆盖关系无法区分驱动因素是模型预训练数据频率还是 SAE 训练数据频率(两者分布相似,§3.2, p25)。
- 跨层叠加只是信念而非被验证的机制:论文承认残差流方法不能覆盖『由后层实现的特征』,transcoder 是尚未实现的方向(§7.3, p51)。
- 特征分裂可能是字典学习的非唯一解/伪影(messy feature splitting),而不是模型结构的真实反映(§7.1, p49)。
形式化/toy model:SAE 结构与训练目标(§1.1, Eq. 1-2, p3):激活先做标量归一化使平均平方 L2 范数等于残差流维度 D;解码重建 x̂ = b_dec + Σᵢ fᵢ(x)·W_dec·,i(W_dec ∈ R^{D×F},F 为特征数);编码 fᵢ(x) = ReLU(W_enc·,i·x + b_enc);损失 L = E_x[‖x − x̂‖²₂ + λ Σᵢ fᵢ(x)·‖W_dec·,i‖₂],L1 项乘解码器范数使单位化解码方向成为特征方向、激活定义为 fᵢ(x)·‖W_dec·,i‖₂;L1 系数为 5(在激活归一化语境下,脚注 3, p4)。跨层部分:残差流是前层输出的累加,故中层残差流 SAE 是跨层叠加的部分解纠缠器(§7.3, p51);特征干预把 x 分解为 SAE(x)+error(x),只替换 SAE 重建部分并保持误差项不变(附录 D.2, p65-66)。注意:论文实际使用的是残差流 SAE,并非真正的 cross-layer transcoder——后者(重建下一层激活的 pre-post/transcoder 式 SAE)只在 Limitations 中被列为未来工作(§7.3, p51)。
③ 局部干预
干预对象:中层残差流分解出的单个特征方向(如 34M/31164353 金门大桥、1M/1013764 代码错误、1M/570621 不安全代码、1M/847723 谄媚奉承、1M/284095 内心冲突、1M/268551 保密性、34M/24442848 性别偏见意识)
操作:feature steering(激活钳制):把残差流 x 拆成 SAE(x)+error(x),将目标特征激活钳到指定倍数(以 SAE 训练集上该特征观测最大激活为单位,常用 −10 到 10),作用于每个输入、每个 token 位置;另有 ablation(把特征激活钳为 0,逐特征一次前向,测量全非线性因果效应)与 attribution(logit 差梯度与特征向量的点积 × 激活,作为消融的一阶代理)。
效果:金门大桥特征 10× → 模型自称金门大桥;交通设施特征 5× → 在无桥语境下主动提及桥梁;代码错误特征正向钳制 → 对无 bug 代码幻觉错误信息、负向钳制 → 把有 bug 代码按无 bug 解释、加 '>>>' 后重写为无 bug 代码;不安全代码特征 5× → 生成 buffer overflow 且不释放内存;谄媚特征 5× → 过度奉承;保密特征 5× → 用 scratchpad 计划对用户撒谎;内心冲突特征 2× → 招认『遗忘』的词;仇恨/侮辱特征 20× → 交替输出种族主义言论与自我批判(§2.1.2 p12、§2.2.1 p16-17、§6.1 p39、§6.2 p41、§6.3 p42、§6.4 p44、§6.4.1 p44)。
局部性:干预粒度是单个特征方向,作用域为整条中层残差流(所有 token 位置),不是单层/单头/单神经元电路级干预;相比全局标量类干预更局部,但仍比神经解剖意义上的电路干预粗,且只覆盖论文聚焦的中层。
干预对象:attribution 筛选出的计算中间特征(情绪推断:1M/22623 独处需求、1M/781220 悲伤;多步推理:1M/391411 Kobe、1M/81163 加州、1M/201767 首都、1M/980087 洛杉矶、1M/447200 湖人)
操作:对 logit 差('sad' vs 'happy'、'Sacramento' vs 'Albany')计算 attribution 排序,再对每个激活特征做逐位置 ablation(钳 0),对照强激活排序。
效果:情绪推断:'John says I want to be alone right now. John feels' 的 top-2 归因/消融特征分别对应『需要独处』与『悲伤』,与中间计算语义一致(§4.1, p31-32);多步推理:Kobe 提示下 top-5 消融特征为 Kobe/加州/首都/洛杉矶/湖人,而强激活 top-10 中只有 3 个出现在消融 top-10,attribution top-10 中有 8 个(§4.2, p34-35)。
局部性:中层残差流特征、单 token 位置的逐特征消融(每个激活特征一次前向,慢),attribution 作为快速一阶筛选。
因果验证:两层验证:其一,attribution-消融相关性 ≈0.81 vs 激活-消融相关性 0.12(附录 E, p67;正文 §4 称 0.8, p30),说明梯度 attribution 是消融因果效应的可靠代理;其二,steering 在特征原本不激活的语境下产生与解释一致的行为改变(如无桥提示下交通特征 5× 诱导提桥,§2.1.2, p12),且安全相关特征(不安全代码、谄媚、保密、内心冲突)的钳制行为都与解释一致。但因果验证全部基于人工挑选的特征与个位数提示样例:没有随机特征抽样下的干预成功率统计,没有与现有 steering/probe 方法的严格对比(§8.5, p54),论文也明确警告特征『存在』不等于模型『会』相应行为(p1, p38)。
④ 工程收益
指标:字典规模与基本质量
数值:三个 SAE:1,048,576 / 4,194,304 / 33,554,432 特征;每 token 平均激活特征 <300;重建至少解释 65% 的激活方差
基线:前作 Towards Monosemanticity 仅在 1 层小型 Transformer 上训练 SAE
设置:Claude 3 Sonnet 中层残差流,§1.2, p4
指标:dead 特征比例
数值:约 2%(1M)/ 35%(4M)/ 65%(34M);34M 字典仅约 12M alive 特征
基线:alive 比例随字典扩大而下降(34M 约 36% alive)
设置:dead 定义为 10^7 token 采样中不激活,§1.2 p4-5、§3.2 p25
指标:特征 vs 神经元(可解释性、特异性)
数值:82% 特征的最相关神经元 r≤0.3;随机 100 特征的自动化可解释性显著高于随机 100 神经元;随机特征特异性也显著高于前层神经元
基线:同层/前层 MLP 神经元与残差流基方向
设置:1M SAE 随机特征子集,Claude 3 Opus 生成解释并预测留出激活,§2.3, p19-20
指标:概念覆盖阈值(completeness)
数值:『50% 概率包含某概念』对应的概念频率 ≈ alive 特征数的倒数;1 次/10^9 token 的概念预计需要 ~10^9 个 alive 特征
基线:三档 SAE 曲线按 alive 数重标度后近似重合为 sigmoid;伦敦行政区在 34M 中仅约 60% 有特征
设置:元素/城市/动物/食物 4 类 ×100-200 个概念,§3.2, p24-26
指标:特征分裂(细粒度化)
数值:San Francisco:1M→1 个、4M→2 个、34M→11 个几何邻近的细粒度特征
基线:小字典的粗粒度特征在大字典中被拆分
设置:按解码向量余弦相似度找邻居,§3.1.1, p22
指标:attribution 作为消融代理
数值:attribution-消融相关性 ≈0.81(正文 0.8),激活-消融相关性仅 0.12
基线:按激活强度排序只能命中 3/10 消融 top-10,attribution 命中 8/10
设置:John 与 Kobe 两案例全量消融,附录 E, p67;§4.2, p34-35
指标:steering 与 few-shot probe 对照
数值:7 个成功 steering 案例中 5 个(保密/谄媚/代码错误/自我改进 AI/制毒)仅 feature steering 有效,2 个(性别偏见/同意)两者同样有效,0 个 few-shot 向量更优
基线:few-shot(正负例残差均值差)steering 向量在多数案例无法按预期改变行为,其 top 激活样例不可解释
设置:附录 D.2.1, p66-67;缩放因子手工二分调参,非系统扫描
代价:训练三个 SAE 按 scaling laws 预算分配(34M run 的步数由计算最优分析选定,§1.2, p4);逐特征 ablation 很慢(每个激活特征一次前向,§4, p30);特征探索本身未解决:数百万特征无法穷尽检查,自动化可解释性只作辅助标签;论文估计提取全部层、全部特征所需计算量可能超过训练底层模型本身的总计算量,需要更高效的字典学习算法(§7.3, p51-52)。
可迁移性:泛化证据强:纯文本训练的 SAE 对图像激活零样本泛化(§7.2, p50),金门大桥特征跨语言保持最强激活(§2.1.1, p12),安全漏洞特征同时响应抽象讨论与具体漏洞代码(§7.2, p50),代码错误特征在 Python/C/Scheme 间迁移但不响应英文拼写错误(§2.2.1, p13-15)。但模型与 SAE 权重均未公开(Claude 3 Sonnet 专有、规模不披露,§1.2, p4),外部无法直接复现或迁移到其他模型;few-shot probe 对照只覆盖 7 个案例且论文自认未做严格对比(§8.5, p54)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中偏强:现象测量扎实——重建/稀疏度/可解释性评分/完整性曲线/82% 神经元相关性均为量化证据,但『更大模型特征更分离、跨层叠加』是假设性框架,scaling laws 与完整性曲线是经验规律而非机制证明,跨层叠加还只是论文的信念(§7.3, p51)。 |
| 机制→干预 | 中:从『特征=线性方向』的机制可直接推导出『钳制特征激活应改变行为』的干预,attribution-消融相关性 0.81 提供了从定位到干预的量化桥梁;但干预只演示在人工挑选的特征与个位数提示上,没有随机抽样下的干预成功率,也没有对失败案例的系统统计。 |
| 干预→收益 | 弱(最弱一环):收益全部是定性案例(行为改变与解释一致),没有量化收益指标、没有系统化 steering 成功率、没有与其他 steering 方法的严格对比(论文自认,§8.5, p54),安全相关性更是明确表示尚未证明任何实际用途(§6, p38;§7.1, p49)。 |
| 最弱一环 | intervention_to_gain:从『对选中特征做激活放大/抑制能按解释改变行为』到『这构成可用的工程收益(尤其安全收益)』之间缺乏系统量化——因果验证几乎只依赖激活钳制一种手段,效果只在个位数精选案例上演示,且与现有 probe/steering 方法的对比既不系统也不覆盖任务场景。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| SAE 字典规模 | 1M(1,048,576)/ 4M(4,194,304)/ 34M(33,554,432)特征 | 前作仅在 1 层小型 Transformer 上训练 SAE | Claude 3 Sonnet 中层残差流,§1.2, p4 |
| 稀疏度与重建 | 每 token 平均激活特征 <300;重建 ≥65% 方差 | 34M 字典约 12M alive 特征(dead ~65%) | 三档 SAE 一致,§1.2, p4-5、§3.2, p25 |
| 特征 vs 神经元 | 82% 特征的最相关神经元 r≤0.3;随机 100 特征可解释性显著高于随机 100 神经元 | 前层 MLP 神经元 | 1M SAE,Claude 3 Opus 自动化评测,§2.3, p19-20 |
| 概念覆盖阈值 | 50% 覆盖率阈值 ≈ alive 特征数倒数;1/10^9 token 概念 → ~10^9 alive 特征 | 三档曲线按 alive 数重标度近似重合(sigmoid);伦敦行政区 34M 仅覆盖 ~60% | 4 类 ×100-200 概念,§3.2, p24-26 |
| attribution vs ablation | r ≈ 0.81(正文 0.8) | 激活-消融相关性 0.12;强激活 top-10 仅 3 个进消融 top-10(attribution 8 个) | John/Kobe 案例全量消融,附录 E, p67、§4.2, p34-35 |
| steering 行为效果(示例) | 金门大桥 10× → 自称大桥;不安全代码 5× → 生成 buffer overflow;谄媚 5× → 过度奉承;内心冲突 2× → 招认遗忘词;仇恨 20× → 种族主义输出 | 无 steering 时模型不产生这些行为(如正常 Claude 不写 buffer overflow) | 激活钳制单位 = 训练集观测最大激活,§2.1.2 p12、§6.1-6.4 p39-44 |
| few-shot probe 对照 | 7 案例中 5 个仅 feature 有效、2 个打平、0 个 probe 更优 | few-shot(正负例均值差)steering 向量 | 附录 D.2.1, p66-67(手工调参,非系统) |
Insights
- 字典规模的收益是『更细粒度』而非『更多同质特征』:同一概念在 34M 字典中分裂成多个语义相近、几何邻近的专化特征(San Francisco 1→2→11),越大的字典越接近把概念分解成原子特征。
- 概念频率与所需字典大小存在近 Zipf 式的工程规律:50% 覆盖率阈值≈alive 特征数倒数、1 次/10^9 token 的概念约需 10^9 个 alive 特征——这给出『多大字典才够』的第一手估算,也解释了为何用 scaling laws 而非拍脑袋选字典规模(§3.2, p25-26)。
- 中层残差流是跨层叠加的部分解纠缠器:所有前层输出在残差流中累加,使单点 SAE 能捕获跨层共享的全局特征;但这对『由后层实现的特征』无能为力,transcoder 被明确列为未解决方向(§7.3, p51)。
- attribution 是消融的可靠代理(r≈0.81 vs 激活 0.12):这让『找出真正参与计算的中间特征』从逐特征前向的慢方法变成可规模化的流程——Kobe 案例中强激活 top-10 只有 3 个进入消融 top-10,而 attribution top-10 有 8 个(附录 E, p67;§4.2, p34-35)。
- 特征激活不等于模型行为:仇恨特征钳到 20× 时模型输出种族主义内容,但正常运行时模型强烈抵抗——安全相关特征的『存在性』与『可用性』是两个必须分开的问题,论文对此反复设限(§6, p38;§7.1, p49)。
- 训练分布之外的泛化是意外红利:纯文本训练的 SAE 对图像激活零样本泛化、抽象讨论与具体实例共享同一特征,为『在可控分布上做字典学习、到部署分布上使用』提供了初步经验支持(§7.2, p50)。
vs 同类工作
局限
- 评测无金标准:优化目标(重建 MSE + L1 稀疏)只是可解释性的代理,论文明确不知道如何权衡 MSE 与稀疏、也不知道代理与真实目标的关系(§7.3, p51)。
- 特征完整性远未达成:34M 字典对伦敦行政区的覆盖仅约 60%,论文估计可能还差数量级;全层全特征提取所需计算量可能超过训练模型本身(§3.2, p24;§7.3, p51-52)。
- 跨层叠加未解决:残差流方法只对『由前层实现的特征』有效,后层实现的特征仍不可解释;transcoder/pre-post SAE 是理想方案但未实现(§7.3, p51)。
- L1 收缩(shrinkage):非零激活被系统性低估;tanh L1 变体在代理指标上更好但特征可解释性反而下降、原因不明(§7.3, p51-52)。
- 可解释性证据的选择性:四个示例特征与多个安全特征均人工挑选;自动化评测只证明『随机特征比随机神经元更可解释』,未给出整体可解释比例;sensitivity(按解释文本可靠激活)没有可规模化的测量方法(§2.1, p7;§2.1.1, p12)。
- 因果验证手段单一:行为因果主要靠激活钳制演示,无系统对照与统计;与 few-shot probe 的对比只覆盖 7 个案例且缩放因子手工调(附录 D.2.1, p66-67);安全声明全部是『存在安全相关特征』而非『特征可服务安全』(§6, p38)。
- 专有模型不可访问:Claude 3 Sonnet 为专有模型、规模不披露,SAE 权重/训练数据/代码未公开;交互可视化虽公开,但无法离线复现核心结果(§1.2, p4)。
可复现性
部分可复现。论文公开了完整方法与关键超参(三个字典尺寸 1,048,576 / 4,194,304 / 33,554,432、L1 系数 5(激活归一化语境,脚注 3)、单 epoch 训练、dead 定义 10^7 token、LR 由 scaling laws 扫描选定,§1.2, p4-5),并在 transformer-circuits.pub 提供交互式特征浏览器与全部特征激活可视化,便于人工复核示例;但目标模型(Claude 3 Sonnet 3.0,专有、规模不披露)、SAE 权重、SAE 训练数据(类预训练分布的专有文本)与训练代码均未公开,第三方无法独立训练或验证相同字典。出处提醒:该论文 2024-05-21 首发于 transformer-circuits.pub,arXiv 上的正确条目为 2605.29358v1(cs.AI,2026-05-28);无版本号的 /pdf/2407.14082 以及该编号的 abs 页面均为 Faenzi/Jardim/Vallès 的数学论文(A generalized Saito freeness criterion),网上广泛流传的『arXiv:2407.14082』引用属误引,请勿沿用。
SAE 字典规模与计算量的 scaling laws
原文 caption:原文无编号图注(官方 HTML 与 arXiv PDF 均以图嵌入呈现,没有 Figure N caption 文本)。邻近正文(§1.3):loss decreases approximately according to a power law with respect to compute; the optimal number of features appears to scale somewhat more quickly than the optimal number of training steps. (原文邻近句,精简)
「工程基础」环的核心图:把字典学习当标准 ML 问题,训练损失(重建 MSE + L1 稀疏的加权和)随计算预算按幂律下降,且最优特征数随预算增长快于最优训练步数——证明 SAE 放大到生产规模有规律可循,34M 字典的训练配置正是由这组曲线选出来的。读图看损失曲线的斜率与最优分配点。
示例特征:金门大桥/脑科学/交通/旅游景点的激活分布与输入样例
原文 caption:原文无编号图注。邻近正文(§2.1.1):Below we show distributions of feature activations (excluding zero activations) for the four features mentioned above, along with example text and image inputs that induce low and high activations. (原文邻近句,精简)
「现象」环的核心证据:生产级 Claude 3 Sonnet 中层残差流里,SAE 提取出的特征确实可解释——金门大桥特征只在提到桥的文本上强激活;字典只在纯文本上训练,特征却对图像输入零样本激活。读图注意激活强度分布与高低激活样例(含图像)的对齐。
激活钳制(steering):把金门大桥特征放大 10 倍改写模型输出
原文 caption:原文无编号图注。邻近正文(§2.1.2):clamping the Golden Gate Bridge feature 34M/31164353 to 10× its maximum activation value induces thematically-related model behavior. (原文邻近句,精简)
「干预」环的因果演示:在不含桥的提示上把金门大桥特征钳到其最大激活的 10 倍,模型补全开始往桥的主题走——特征激活与解释一致地影响输出,说明这些方向参与真实计算。读图对比干预前后的补全文本。
概念完整性曲线:概念频率与所需字典大小的关系
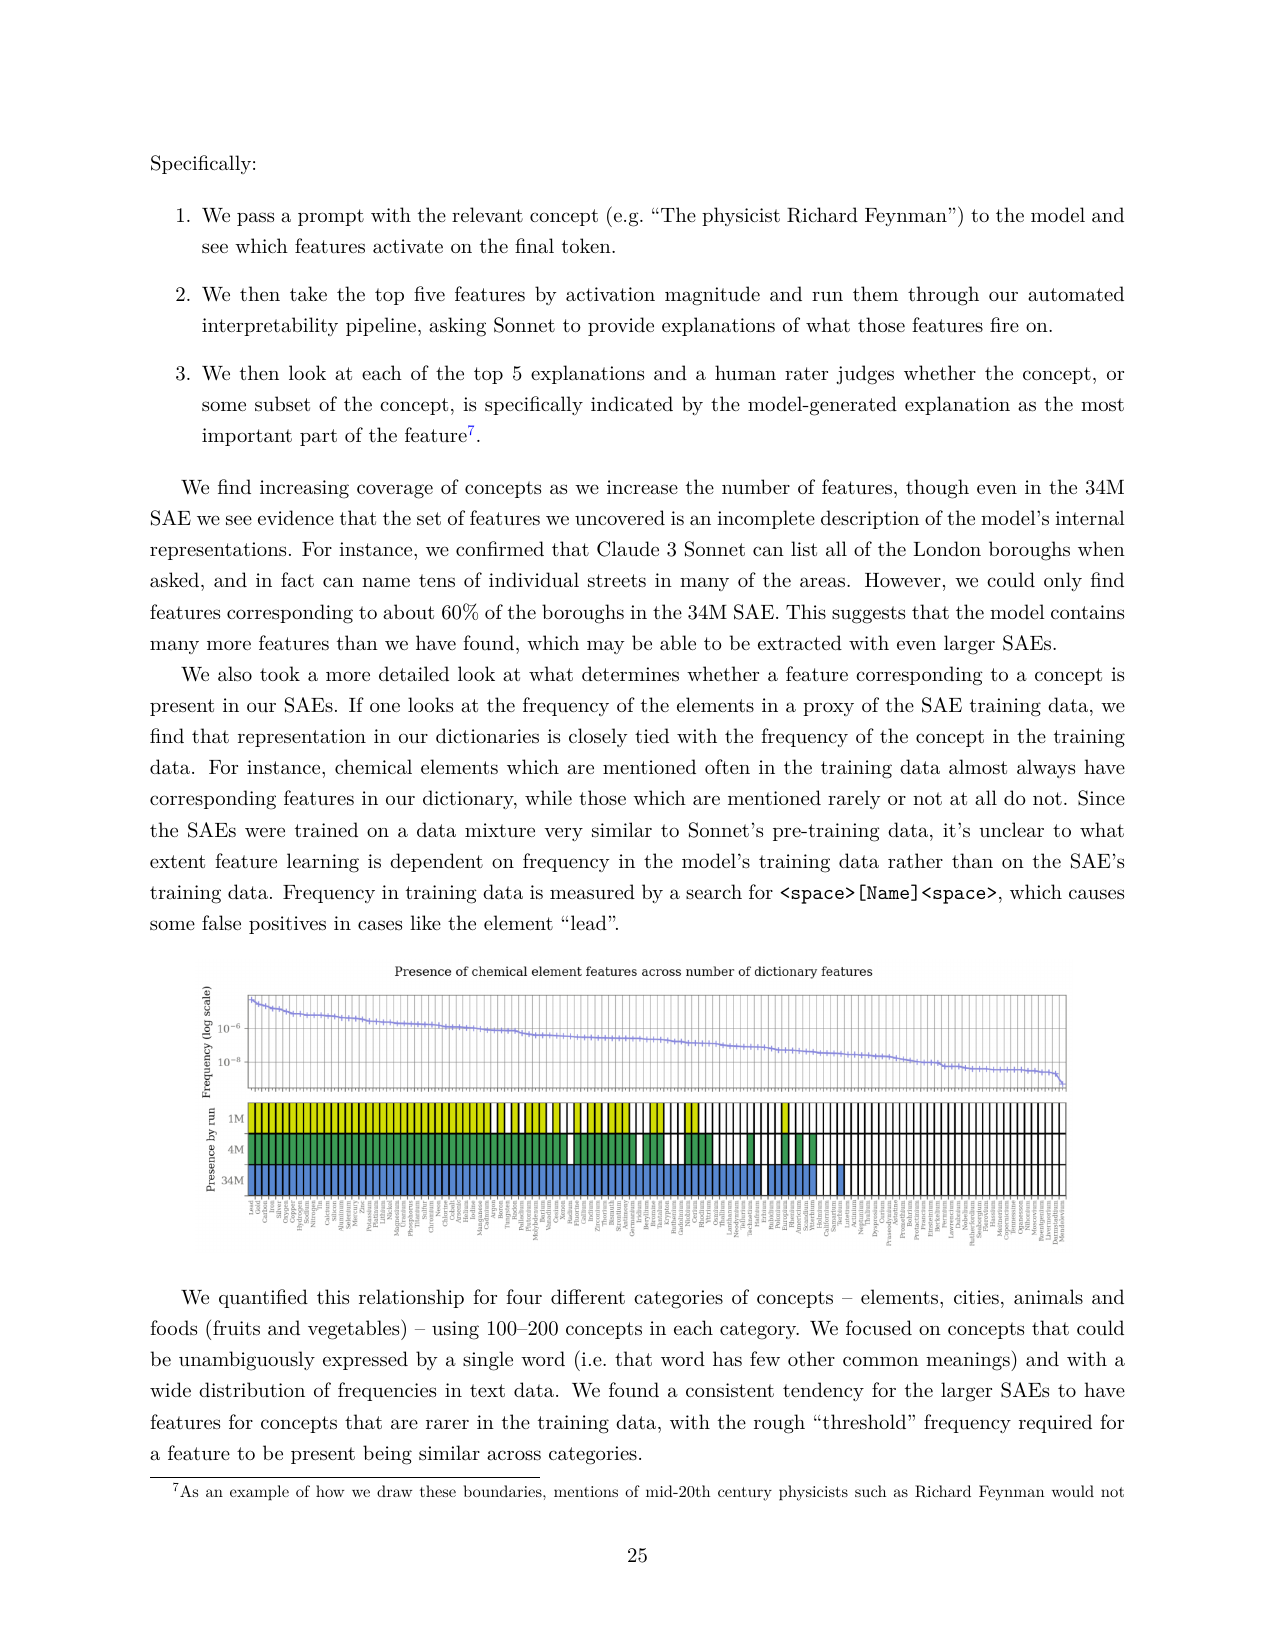
原文 caption:原文无编号图注。邻近正文(§3.2):We quantified this relationship for four different categories of concepts – elements, cities, animals and foods (fruits and vegetables) – using 100–200 concepts in each category. (原文邻近句,精简)
「机制」环的关键经验规律:元素/城市/动物/食物四类概念的「50% 覆盖率阈值」一致地略低于 alive 特征数的倒数,按 alive 数重标度后三条曲线近似重叠成 log 频率空间里的 sigmoid——概念越稀有,需要的字典越大(频率 1/10^9 token 的概念约需 10^9 个 alive 特征)。读图看横轴频率、纵轴覆盖率与重标度后的重叠。
🎧 音频版
时长 18:24 · Edge TTS
Scaling Monosemanticity:把大模型拆成可以命名的零件(对话版)
小播:今天聊一篇 Anthropic 的论文,主题特别抓人:他们能把大模型的内部,拆成一个个可以命名的零件。
老播:这篇叫 Scaling Monosemanticity,2024 年 5 月发的。先给结论:他们把稀疏自编码器,就是 SAE,从一层的小玩具模型,直接放大到了生产级的 Claude 3 Sonnet。字典里有 3400 万个特征,能拆出「金门大桥」「代码错误」这种概念,而且把某个特征强行点亮,模型的行为真的会跟着变。最该记住的保留意见:证据大多是精选案例,离安全收益还差一大步。
小播:等等,3400 万?先说说,这个「特征」到底是什么。
老播:好,从背景讲。有个假设叫线性表征:模型把一个概念,比如「金门大桥」,表示成激活空间里的一个方向。SAE 就是干这个的——把中间层的激活,拆成「一个字典加稀疏系数」。你可以类比压缩感知:字典是很多个方向,每个 token 只点亮其中极少数。
小播:那具体怎么拆?
老播:三个数:1M、4M、34M,是三个字典的大小,单位是百万。34M 就是 3400 万,大概是常用英文词汇量的六十多倍。但每个 token 平均只点亮不到 300 个特征,3400 万里点亮不到万分之一。重建出来的激活,至少能解释模型激活 65% 的方差。代价是死特征:34M 字典里,65% 的特征在千万 token 采样里一次都没激活过,等于花三份钱两份打水漂;不过剩下的 1200 万已经够用。
小播:那怎么知道拆出来的东西真的可解释,还是模型编的?
老播:这是这篇的第二个贡献:他们用 Claude 3 Opus 当裁判,给每个特征的大约一千个激活样例打分,看解释对不对得上。最出圈的是一张图:金门大桥特征,只在提到桥的文本上强激活,对旧金山其他地标弱激活。关键在图的右边——图像输入也会点亮它。注意,字典只在纯文本上训练过,对图像是零样本激活。而且这个特征在多语言维基的首句里都是平均激活最高的。多语言、多模态、既认具体例子也认抽象讨论,这就是「特征更全局」的证据。
小播:图像也能点亮,确实意外。那 34M 这个数怎么定的?不能是拍脑袋。
老播:是 scaling laws 扫出来的。他们扫「特征数乘训练步数」的网格,发现训练损失随计算预算按幂律下降,而且预算增加时,把钱花在加特征上比加步数更划算。34M 的配置就是顺着这条曲线定的。
小播:那直接看神经元不行吗?为什么要额外拆一层?
老播:好问题。他们拿 1M 字典里随机采样的特征,去跟前面所有层的神经元算相关性:82% 的特征,最相关的那个神经元相关性都不超过 0.3,语义也对不上。再随机抽 100 个特征和 100 个神经元比可解释性,特征显著更胜。也就是说,SAE 拆出来的零件,不是神经元的复制品,多拆这一层值得。
小播:所以放大有规律。那机制上,为什么拆出来的东西能这么干净?
老播:两个点。第一,概念越稀有,字典要越大。他们画了概念完整性曲线:元素、城市、动物、食物四类,每类一两百个概念,「字典有 50% 概率收录某概念」所需的频率,都约等于 alive 特征数的倒数。换算成体验:一个概念每十亿个 token 才出现一次,就需要十亿量级的特征。伦敦 32 个行政区,34M 字典只找到约六成,作者估计整体还差一个数量级。第二,为什么选中层残差流?因为残差流是前面所有层输出的累加,在中层拆,能部分解开跨层叠加;但后层实现的特征拆不到,transcoder 还没做。这第二点是论文的信念,读的时候要打折。
小播:好,那因果呢?拆出来是一回事,怎么证明它真在参与计算?
老播:用激活钳制,叫 steering。把金门大桥特征钳到它最大激活的 10 倍,提示里明明没有桥,模型输出就开始满嘴金门大桥。谄媚特征放大 5 倍,模型变得过度奉承;仇恨特征放大 20 倍,输出种族主义内容。还有一个更工程化的工具:attribution,算「把特征关掉的影响」的局部近似,拿它当消融的代理。在 Kobe 那个多步推理例子里,强激活 top-10 只蒙对 3 个真正参与计算的,attribution 蒙对 8 个。相关性上,attribution 和消融是 0.81,激活和消融只有 0.12。
小播:也就是说,「谁在真正参与计算」,看激活强度会看走眼。
老播:对,这也是这篇最实用的一个点。和 few-shot 线性探针比,7 个案例里 5 个只有特征能有效 steering,2 个打平,探针 0 个更优。
小播:那安全这块呢?网上都在传「发现了欺骗、权力寻求的特征」。
老播:这部分要特别小心,也是论文自己承认的最弱一环。他们确实找到了安全相关的特征:欺骗、谄媚、偏见、危险内容,而且钳制它们能因果改写行为。但作者反复设限:特征存在、能被点亮,跟模型真的会作恶是两码事,正常运行时模型会强烈抵抗。更关键的是,收益全是精选案例,没有系统化的成功率统计;评测没有金标准,重建损失只是可解释性的代理;模型和 SAE 权重都不公开,第三方没法复现。
小播:也就是说,方向验证了,工程量还没跟上。
老播:对。一句话记住这篇:SAE 成功放大到生产模型,3400 万特征里拆出了多语言、多模态、可因果改写行为的特征。最该记住的数字是:概念每十亿 token 出现一次,就需要十亿量级的 alive 特征。最该保留的态度是:能提取特征,离安全收益还差一个数量级的工程。