Towards Monosemanticity:把「多义神经元」拆成字典特征,让单义性变得可以测量
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:神经网络里最自然的计算单元——神经元——偏偏最不适合人类理解。论文里这个只有一层的 transformer,有一个神经元同时响应学术引用、英语对话、HTTP 请求和韩语文本;视觉模型 Inception v1 里,单个神经元同时响应猫脸和车头。这种「一个神经元对应多个不相关概念」的现象叫多义性(polysemanticity),它让「按神经元理解网络」这条路基本走不通。
Anthropic 这篇 Transformer Circuits 报告(2023-10-04,transformer-circuits.pub)给出的解法是:把基本单元从神经元换成「字典特征」。他们用稀疏自编码器(SAE)把一层 transformer 的 512 个 MLP 神经元分解成 4096 个特征(主分析 run A/1),用三路量化证明这些特征比神经元更单义、更可干预、跨随机种子更普适。这是后来整个 SAE 研究路线的起点。
核心主张一句话:多义性挡不住理解——字典学习可以把神经元的多义拆开成更单义的单元。我们从头拆。
先看现象:神经元是多义的,而且这可能来自 superposition
多义性背后有一个更深的假设:superposition(叠加)。模型要表示的特征数量远超神经元数量,于是把每个特征存成神经元空间里的一条方向,神经元只是多个方向的混合。如果特征在数据里稀疏,低维的神经元激活仍然可以无歧义地恢复出高维的稀疏编码——这正是压缩感知的逻辑,Toy Models of Superposition 那篇已经在 toy 模型上验证过这条路线。
关键推论:既然特征藏在方向的混合里,想找它们就得用过完备基。论文把目标写成分解式:
$$x^j \approx b + \sum_i f_i(x^j)\, d_i$$
先给预期:这个式子要说的是「激活向量可以被拆成一组方向的加权和」。逐项看:$x^j$ 是第 $j$ 个数据点的 MLP 激活向量(512 维),$d_i$ 是第 $i$ 个特征的单位方向,$f_i(x^j)$ 是该特征在这次激活里的强度(激活值),$b$ 是偏置。特征数量远大于神经元数(最多 256 倍),这就是「过完备」——正因为过完备,恢复才需要稀疏性这个前提。
作者还论证了为什么不能靠改架构解决:cross-entropy 训练下,即使不存在 superposition,模型也倾向于多义表示(论文给出 toy 论证),SoLU、1-hot 激活这类「架构级稀疏」路线因此被放弃。所以只能在训练后做分解。
方法:稀疏自编码器,用 L1 惩罚逼出稀疏
要找这样的过完备分解,论文用稀疏自编码器(SAE):编码器把激活压成稀疏特征向量,解码器再把特征重建回激活,训练目标
$$\mathcal{L} = \underbrace{\big\| x - W_d f(x) \big\|_2^2}_{\text{重建}} + \lambda \big\| f(x) \big\|_1$$
逐项看:$x$ 是输入激活;$f(x) = \text{ReLU}(W_e (x - b_d) + b_e)$ 是编码器输出,即特征激活向量;$W_d$ 是解码器,它的列就是特征方向 $d_i$;第一项 MSE 要求重建尽量准,第二项 L1 惩罚逼特征稀疏,$\lambda$ 控制稀疏强度(主 run 用 0.01)。设置:字典宽度从 512(1×)到 131,072(256×),在 8 亿个 MLP 激活上训练(Adam,batch 8192,100 万步);被研究的模型是单层 transformer(残差流 128、MLP 512、ReLU,The Pile 100B tokens)。主分析聚焦 A/1:4096 个特征、8× 扩展。
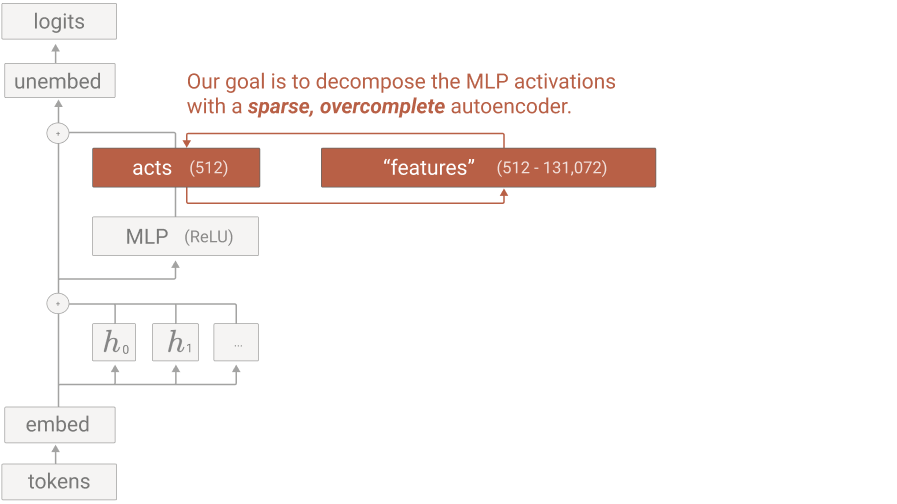
这张图把「模型 + 分解器」的整体设置画在一张表里:左边是被拆的模型,右边是 SAE,重点看「过完备」——字典宽度是神经元数的 1 到 256 倍,靠稀疏性才能恢复。
验证:深挖四个特征,特征真的在推动行为
机制验证靠四个深挖的特征:阿拉伯语(A/1/3450)、DNA(A/1/2937)、base64(A/1/2357)、希伯来语(A/1/416)。每一步都按「假设 → 验证 → 证明」展开:
- 假设:特征激活与对应的计算代理相关(比如「文本是否阿拉伯语」的检测器)。实测 Pearson 相关:阿拉伯语 0.74、DNA 0.8、base64 0.38、希伯来语 0.55(40M token 上)。阿拉伯语特征有个漂亮细节:
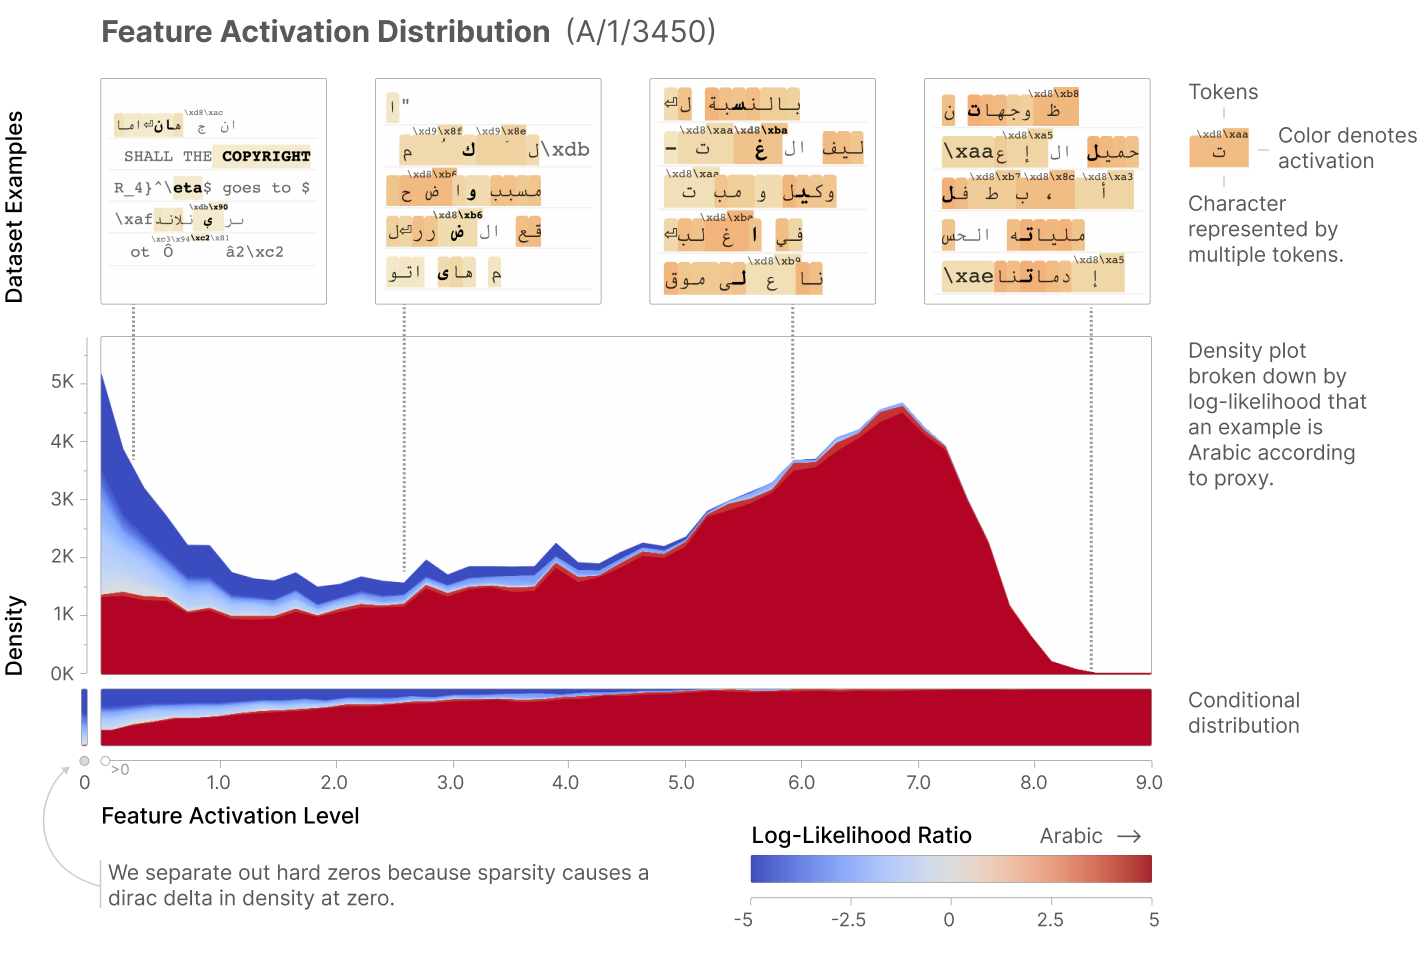
激活值从低到高分区看,token 属于阿拉伯语的占比从 25% 一路涨到 98%——特征越强越专一,整个激活谱系都自洽。
- 证明:光有相关不够,还要证明特征在推动行为。消融实验:把 A/1/3450 的激活人为置零,模型对阿拉伯语 token 的预测变差,对标点等共享符号的预测反而变好;pinned sampling:把特征钉在最大值采样,模型开始生成阿拉伯语。两个因果操作与「阿拉伯语特征」的解释完全自洽。
- 排除备选:特征有没有可能只是某颗「幸运的神经元」?检查系数:阿拉伯语特征在神经元基里最大的三个系数全是负的,有 27 个神经元的系数超过 0.1;与之最相关的神经元(A/neurons/489)响应的是各种非英语语言的混合,阿拉伯语只占一小条。这个特征横跨几十个神经元,正是 superposition 的典型形态。
广度:典型特征也可解释,还能跨模型复现
深挖特征毕竟是挑出来的,论文用三路评估证明「典型特征」也可解释:人工打分(0–14 分 rubric,在激活谱系上均匀采样;中位数:神经元 0 分、特征 12 分)、Claude 2 预测激活的相关、logit 权重 50/50 分类准确率(特征 74% vs 神经元 58%)。随机权重对照:把模型权重打乱再跑同样的分解,特征退化成 span、file、.、nature 这类琐碎的单 token 特征——多 token 可解释性来自模型学到的结构,不是数据统计本身。
普适性也能量化:同一超参、另一随机种子的模型 B/1 上,A/1 特征的最近特征中位激活相关 0.72,神经元只有 0.46;四个深挖特征跨模型相关 0.85–0.92。还有 feature splitting:base64 在 512 特征宽度的 A/0 里是 1 个特征,到 4096 的 A/1 里分裂成 3 个(字母、数字、编码 ASCII 文本)——「正确的特征数量」可能没有定义,不同宽度是同一对象的不同分辨率。另一个现象是 token-in-context 特征:A/4 里有上百个「the」的上下文特征,数学散文里的 the、机器学习语境里的 the 各算一个,作者论证这是模型用更锐利的局部预测换组合式表示的局部编码,可能是真实机制而并非字典伪迹。
收益与边界:解释力回到模型身上,最弱一环在「因果性」
工程收益:用重建激活替换 MLP 激活后,A/1 还原了 79% 的 log-likelihood——大部分机制被解释,但还有 21% 没覆盖(作者承认 ablated-MLP 基线让这个数字偏高);4096 个特征里有 168 个死特征、292 个超低密度特征(激活率低于百万分之一)。论文自承找不到一个满意的「自编码器是否工作」的指标:total information 与可解释性不相关,最后只能靠人工检查、密度直方图、重建损失和玩具模型组合判断——这也是整个领域至今的痛点。整条证据链最弱的一环是「机制→干预」:SAE 是从激活统计里重建出来的字典,字典特征是否就是模型实际使用的因果单元,论文没有直接检验——作者明确采取 agnostic 立场,21% 的损失贡献未覆盖,local vs compositional code 的歧义也没解决。Neel Nanda 的外部复现支持结果可复现(解码器权重在神经元基里 92% 稠密、encoder/decoder 中位余弦相似度 0.5),但同样没有回答因果性问题。
一句话记住这篇
多义神经元背后的信息藏在方向的混合里:用稀疏自编码器把 512 个神经元拆成 4096 个字典特征,特征比神经元更单义(人工中位 12 分 vs 0 分)、更可干预(消融与钉住采样因果自洽)、跨随机种子更普适(中位相关 0.72 vs 0.46),并还原了 79% 的 MLP 预测。最该记住的保留态度:字典特征是有效的描述单位,但「模型真的在用这些特征做计算」这一步还没有被直接证明——它是统计重构,因果地位悬而未决。
把『神经元多义』从解释障碍改成可操作对象:用 ReLU 稀疏自编码器把一层 transformer 的 512 个 MLP 神经元分解成 4096 个字典特征,三路评估量化证明特征比神经元更单义、更可干预、跨随机种子更普适——但『字典特征就是模型真实使用的因果单元』这一步是统计重构后的推断,机制环证据最薄。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:多义神经元(polysemanticity):单个神经元对互不相关的输入混合响应(例:本模型一个神经元同时响应学术引用、英语对话、HTTP 请求与韩语文本,§Introduction);与之关联的假设性现象 superposition(激活超分布):模型用远超神经元数量的稀疏『特征』存储信息,特征方向构成过完备基(§Problem Setup/Superposition Hypothesis)。
在哪里观测:一层 transformer(1 attention block + 1 MLP block,残差流 128、MLP 512、ReLU,The Pile 100B tokens,Adam 训练,§The (one-layer) model we're studying);同一超参不同随机种子的 A/B 两个模型做普适性对照;SAE 在 8B 个 MLP 激活向量上训练(总数据集 10B 向量,40M 上下文×250 token,batch 8192,1M 步),宽度 512–131,072(1×–256×),主分析运行 A/1=4096 特征、L1=0.01(§Sparse Autoencoder Setup + 附录 Autoencoder Dataset and Basic Training)。
如何量化:论文实际用量化指标:(a) 特征密度=特征非零激活的 token 占比,取对数画直方图(典型 1e-3–1e-6;A/16 直方图双峰:左峰~1e-7 ultralow density、右峰~1e-5 high density,§附录 Feature Density Histograms);(b) 平均 L0(非零特征数,仅诊断指标、目标<10–20,不进 loss,§附录 Hyperparameter Selection);(c) 字典重建 MSE 与重建后替换 MLP 激活的 log-likelihood 还原率(A/1 还原 79%,§Global Analysis/How much of the model does our interpretation explain?);(d) 特征激活与计算代理的相关(Pearson,40M tokens:Arabic 0.74、DNA 0.8、base64 0.38、Hebrew 0.55,§Detailed Investigations);(e) 可解释性评分(人工 rubric 0–14;Claude 2 预测激活的 Spearman、logit 权重 50/50 分类准确率,§Global Analysis)。
② 机制假设
假设:多义神经元源于 superposition:模型把远超神经元数量的稀疏特征以方向形式存储在激活空间中,特征激活稀疏使得从低维投影恢复高维稀疏编码(压缩感知)成为可能;论文同时论证,即使不存在 superposition,cross-entropy 训练也会偏好多义表示,因此架构级稀疏路线(SoLU、1-hot 激活)不可行,只能在训练后做字典分解(§Problem Setup、§Why not architectural approaches)。
证据:
- 存在性证明:4 个深挖特征(Arabic A/1/3450、DNA A/1/2937、base64 A/1/2357、Hebrew A/1/416)对计算代理高度特异/敏感,消融与 pinned sampling 的下游效应与解释自洽,且不与任何单个神经元对应(§Detailed Investigations)。
- 普适性:A/1 特征在 B/1(另一随机种子模型)中的最近特征中位激活相关 0.72,而神经元之间只有 0.46;4 个深挖特征跨模型相关 0.85–0.92(§Phenomenology/Universality)。
- 几何:UMAP 中特征方向按语义聚簇(base64、Arabic 等),且随字典宽度增大出现 feature splitting(base64 1→3→多),与『真特征以相似方向簇存在于紧致 superposition』的图景一致(§Feature Splitting)。
- 随机权重对照:打乱权重矩阵的模型上,字典特征退化为琐碎的单 token 特征(span、file、.、nature),非单 token 特征无法给出解释,说明 A/1 的多 token 可解释性来自模型学到的结构而非数据统计本身(§Global Analysis/Do features tell us about the model or the data?)。
- 形式化 toy 论证:单神经元+四互斥特征(A/B/C/D)的 cross-entropy 例子里,多义表示 loss=ln2≈0.7,单义表示 loss=(3/4)ln3≈0.8,证明多义性在无 superposition 时也会被偏好(§Why not architectural approaches)。
备选解释:
- 特征只是事后(post-hoc)描述而非模型真实计算单元:论文明确取 agnostic 立场,仅以普适性作为『特征在单模型之外存在』的间接证据(§Problem Setup、§Discussion)。
- local vs compositional code:『the in physics』这类 token-in-context 特征可能只是 L1 正则把模型推向过局部编码的产物,而非模型真实机制;论文论证模型确实可能用局部编码换取更锐利的预测,但未排除前一解释(§Discussion: Are Token in Context Features Real?)。
- 可解释性可能只来自数据分布:随机权重对照部分排除该解释——单 token 簇确实是数据驱动,多 token 簇则是模型结构驱动(§Global Analysis)。
- 特征并非完全单义:低激活区间可解释性下降、logit 权重存在近似各向同性的 interference 部分,说明字典特征可能残留多义(§Global Analysis Caveats、§Detailed Investigations/Universality)。
形式化/toy model:ReLU 稀疏自编码器(本论文没有 Gated 结构、没有 aux 损失项,两者是后续 Scaling Monosemanticity 的扩展;L0 只作诊断指标、不进 loss)。设输入输出维 n、字典维 m,W_e∈R^{m×n}、W_d∈R^{n×m}(列单位范数)、偏置 b_e、b_d,则 x̄=x−b_d,f=ReLU(W_e x̄+b_e),x̂=W_d f+b_d,损失 L=(1/|X|)Σ_{x∈X}‖x−x̂‖₂²+λ‖f‖₁(MSE 按元素平均、L1 为和,λ 为 L1 系数;§附录 Autoencoder Architecture)。pre-encoder bias 与 b_d 绑定(初值取数据集 geometric median),死神经元在步 25k/50k/75k/100k 重采样(§附录 Neuron Resampling)。给定过完备字典求稀疏激活的精确形式是 NP-hard 压缩感知,SAE 是其 amortized 线性近似(§Using Sparse Autoencoders)。
③ 局部干预
干预对象:单个字典特征在 MLP 激活中的分量 f_i(x)·d_i(4096 个字典方向中的单个方向,比神经元更细粒度)
操作:全上下文特征消融:跑模型到 MLP 层,用 SAE 把激活分解为特征,从激活中减去 f_i(x)d_i,完成前向,逐 token 记录 log-likelihood 变化(§附录 Feature Ablations)。
效果:Arabic 特征消融使阿拉伯文 token 预测变差、仅对共享标点(如句号)有帮助;DNA 特征消融伤害 5'- 前缀后 DNA 串的预测;消融效应幅度随激活水平增大(§Detailed Investigations)。
局部性:单特征级干预(一个字典方向),作用限于 SAE 可重建的子空间——论文自认 21% 的 MLP 损失贡献未被重建覆盖(§Global Analysis)。
干预对象:单个特征的激活值(pinning)
操作:固定数字前缀 1,2,…,10,把 A/1/3450 设为其观测最大值后采样;base64 特征同理(§Detailed Investigations/Feature Downstream Effect、Summary of Results)。
效果:模型从数字前缀转向生成阿拉伯文文本;激活 base64 特征使模型生成 base64 文本——特征激活能转向生成(steering)。
局部性:只改动一个特征激活标量,其余激活与权重不变。
干预对象:特征在 unembedding 上的 logit 权重(logit lens 类验证,观测性而非干预)
操作:读取每个特征对下一 token logits 的线性贡献(logit weights),与激活侧解释交叉验证(§Global Analysis/Do features tell us about the model or the data?)。
效果:Arabic/Hebrew/base64 特征的 top logit tokens 与解释一致并形成独立模式;PLOSOne 特征(A/1/3949)只对 '.' 有高权重,其余 logit 权重近各向同性干扰——干扰权重可解释为 superposition 的产物(§Phenomenology/Universality)。
局部性:不改变模型,只做读出的归因分析。
因果验证:三层交叉:(1) 消融与 pinned sampling 在同一特征上给出方向一致的因果效应(§Detailed Investigations);(2) 跨模型复现——B/1 中对应特征(相关 0.85–0.92)的消融效应一致(§Detailed Investigations/Universality);(3) 随机权重对照排除『可解释性只来自数据』(§Global Analysis)。未做:特征间组合干预、SAE 重建误差与干预效应的对照(干预在重建后的激活上进行,作者未量化重建误差对结论的贡献)。
④ 工程收益
指标:可解释性(人工 rubric,0–14,>8 视为可解释)
数值:特征激活区间中位 12;神经元中位 0(多数神经元连假设都给不出)
基线:同一模型的 512 个神经元
设置:盲评者 Adam Jermyn,412 个特征激活区间、162 个特征+神经元,按激活谱 11 个区间均匀采样(§Global Analysis/Manual Human Analysis)
指标:自动化可解释性:Claude 2 预测激活的 Spearman 相关
数值:特征中位 0.58(mean 0.53,failures 0/3676)
设置:49 个解释示例(10 个 top 区间+每区间 2 个+5 随机+10 换上下文),60 个 9-token 测试示例共 540 预测/特征,解释与测试数据严格分离(§Global Analysis/Automated Interpretability – Activations 图)
指标:logit 权重解释预测准确率(50/50 top-positive vs random token)
数值:74%(特征平均)
设置:Claude 2 判断未见过的 logit token 是否应被特征上调(§Global Analysis/Automated Interpretability – Logit Weights)
指标:MLP log-likelihood 损失贡献还原率
数值:A/1(4096 特征)79%;131,072 特征、L1=0.004 的运行 94.5%
设置:用 SAE 输出替换 MLP 激活在训练集上测损失;作者自认 ablated-MLP 基线使百分比偏高(§Global Analysis/How much of the model does our interpretation explain?);注意正文 A/5 标签与公开 runs 表不一致,见 reproducibility
指标:稀疏性(特征密度与 L0)
数值:特征密度典型 1e-3–1e-6;L0 目标<10–20;A/1 中 168/4096 死特征、292/4096 ultralow density(<1e-6)
设置:100M token 子集统计;特征密度=非零激活 token 占比(§Global Analysis、§附录 Feature Density Histograms、Importance Scoring)
指标:普适性(跨随机种子模型最近单元的中位激活相关)
数值:0.72(A/1 特征↔B/1 特征);4 个深挖特征 0.85–0.92
设置:A/1 与 B/1 全部特征两两比对,40,960,000 tokens 上的激活 Pearson 相关(§Phenomenology/Universality)
指标:特征特异性(激活与计算代理的 Pearson 相关)
数值:Arabic 0.74;DNA 0.8;base64 0.38;Hebrew 0.55
设置:log-likelihood-ratio 代理(Unicode 块/[ATCG]/[a-zA-Z0-9+/]),40M tokens,激活阈值 0(§Detailed Investigations)
指标:特征≠神经元
数值:Arabic 特征在神经元基中 3 个最大系数全为负、27 个神经元 |coeff|≥0.1;Hebrew 最相关神经元 corr=0.1、base64 最相关 corr=0.18
设置:~40M 示例上的激活相关 + 字典系数分析(§Detailed Investigations/The feature is not a neuron)
代价:SAE 训练计算量大:8B 激活向量、1M 步(§附录);宽字典有死特征与 ultralow density 伪迹(A/1 中 168+292 个),需要 resampling 且有 loss 尖峰/发散风险(§附录 Neuron Resampling);L1 系数需随字典宽度重扫(0.001–0.01);论文承认没有可靠的『字典是否工作』指标(total information 与可解释性不相关),最终依赖人工检查(§How can we tell if the autoencoder is working?);naive 自动化解释模拟 100k 特征×4096-token 上下文成本约 $12,500–25,000(§Global Analysis);作者未提供 SAE 设计修改的严格消融(§附录 Advice)。
可迁移性:论文只在一层 transformer 上演示,作者明言该模型 logit 对特征激活近似线性,是线性表示假设最有利的情形,多层推广不在本文实验内(§The (one-layer) model we're studying);外部复现:Neel Nanda 在开源 1 层 GELU 语言模型上复现核心结果并公开教程/代码(§Comments & Replications);多层证据来自引用的 Cunningham et al. 与 Smith 的工作,非本文;跨数据集有限:部分特征反映 Pile 特有统计(PLOSOne 特征:0.02% token 激活,至少 1/10,000 token 是 PLoS 引用缩写,§Phenomenology/Universality)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中偏强:多义神经元与稀疏过完备分解在同一小模型上被多路量化(密度直方图、L0、重建还原率、代理相关、三路可解释性评估),随机权重对照把『数据统计』与『模型结构』分开;但 superposition 本身未被直接观测,是从字典学习成功反推的。 |
| 机制→干预 | 弱(最弱一环):从『模型用 superposition 存特征』到『SAE 的 4096 个字典方向就是可干预的真特征』之间没有直接检验——SAE 是统计重建(21% MLP 损失贡献未覆盖),特征可能是事后描述而非模型实际使用的因果单元,作者自认 agnostic;local vs compositional code 的歧义未解决,正确特征数量可能无定义。 |
| 干预→收益 | 中偏强:消融/pinned sampling 在深挖特征上给出与解释一致的因果效应且跨模型复现;但深挖特征是挑选的,全局分析不保证每个特征都可干预,且干预在重建激活上进行、未对照重建误差的影响。 |
| 最弱一环 | mechanism_to_intervention:字典特征是否真因果、是否只是统计重构没有被直接检验。要补这一环需要:SAE 重建误差与干预效应的对照、跨字典/跨层一致性检验、与某种真特征 ground truth 的比对(如 toy model 或更严格的下游行为预测),这些在论文内均缺失。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 人工可解释性评分(rubric 0–14) | 特征区间中位 12 | 神经元中位 0 | 412 区间/162 单元,激活谱均匀采样,§Global Analysis/Manual Human Analysis |
| Claude 2 激活预测 Spearman | 特征中位 0.58(mean 0.53) | 神经元中位 0.2;随机=0 | 540 预测/特征,§Global Analysis(Automated Interpretability – Activation 图) |
| logit 权重解释准确率 | 74%(特征) | 58%(神经元);随机=50% | 50/50 top-positive vs random token,§Global Analysis |
| MLP loss 还原率 | 79%(A/1, 4096 特征);94.5%(131,072 特征, L1=0.004) | zero-ablate MLP=0 | SAE 输出替换 MLP 激活,§Global Analysis |
| 普适性(中位激活相关) | 0.72(特征) | 0.46(神经元) | A/1↔B/1,40.96M tokens,§Phenomenology/Universality |
| 特征特异性(Pearson) | Arabic 0.74 / DNA 0.8 / base64 0.38 / Hebrew 0.55 | Arabic 占训练 token 0.13% 但占特征激活 token 81% | 40M tokens,计算代理,§Detailed Investigations |
| 稀疏性 | 密度典型 1e-3–1e-6;L0 目标<10–20;A/1 中 168 dead + 292 ultralow | 随机样本上特征 88% 激活为零 vs 神经元 54% | 100M token 子集,§Global Analysis + 附录 |
| 特征≠神经元 | Hebrew/ base64 最相关神经元 corr=0.1/0.18;Arabic 27 个 |coeff|≥0.1 | 最相关神经元为语言混合检测器 | ~40M 示例激活相关,§Detailed Investigations |
Insights
- 字典特征是比神经元更可用的分析单元:人工、Claude 激活预测、logit 权重三路评估一致给出特征显著优于神经元(12 vs 0;0.58 vs 0.2;74% vs 58%),且特征跨随机种子比神经元更相似(0.72 vs 0.46)。
- polysemanticity 被重新定位为需要事后处理的工程问题:cross-entropy 训练即使在无 superposition 时也偏好多义表示(ln2≈0.7 < (3/4)ln3≈0.8),SoLU/1-hot 等架构路线因此被放弃(§Why not architectural approaches)。
- feature splitting 提供多分辨率视图:base64 从 A/0 的 1 个特征分裂为 A/1 的 3 个(字母/数字/编码 ASCII 文本),『正确的特征数量』可能无定义,不同宽度字典是同一对象的不同分辨率(§Feature Splitting)。
- token-in-context 特征(A/4 中有上百个『the』上下文特征)指向局部编码:模型用更锐利的局部预测换取组合式表示,作者论证这可能是模型真实机制而非字典伪迹(§Discussion)。
- 随机权重对照区分数据与模型:打乱权重的模型上字典只学到琐碎单 token 特征,多 token 可解释性来自模型学到的结构(§Global Analysis)。
- 『如何识别好特征』仍是开放问题:total information 指标与可解释性不相关,最终靠人工检查+密度直方图+重建损失+玩具模型组合判断(§How can we tell if the autoencoder is working?)。
vs 同类工作
局限
- 只测一层 transformer(残差流 128/MLP 512),logit 对特征激活近似线性是该模型独有优势,多层推广在论文内没有实验(§The (one-layer) model we're studying)。
- 深挖特征是挑选的(作者自认 cherry-picked);全局随机样本可能低估重要特征的可解释性(§Global Analysis Caveats)。
- 79% 的 MLP loss 还原意味着 21% 未被解释,且作者自认 ablated-MLP 基线使该百分比偏高;特征在低激活区间可能残留多义(§Global Analysis)。
- SAE 设计选择(pre-encoder bias、untied decoder、resampling)没有严格消融,只有直觉与轶事证据(§附录 Advice for Training Sparse Autoencoders)。
- ultralow density 簇是训练伪迹而非模型属性(A/1 中 292/4096),来源未解;另有 168 个死特征(§Global Analysis、§附录 Feature Density Histograms)。
- 特征的『真实性』悬而未决:作者取 agnostic 立场,local vs compositional code 未分辨,『正确特征数量』可能无定义(§Discussion)。
- 部分发现是 Pile 特有的:PLOSOne 引用缩写占 1/10,000 token,这类特征不能跨数据集迁移(§Phenomenology/Universality)。
可复现性
全文、全部 90 个字典的特征可视化、数据集示例与消融效果在 transformer-circuits.pub 公开可交互浏览(source_url);超参数完整公开:模型为 The Pile 100B tokens、Adam、残差流 128、MLP 512、ReLU;SAE 用 Kaiming Uniform 初始化、batch 8192、1M 步、8B/10B 激活向量、L1 系数∈{0.01,0.008,0.006,0.004,0.001}、字典宽度 512–131,072、W_d 列单位范数、pre-encoder bias 取 geometric median、resampling 于步 25k/50k/75k/100k 且 dead 定义为前 12,500 步未激活(§附录)。外部复现:Neel Nanda 公开复现代码与教程,在开源 1 层 GELU 模型上复现,另报解码器权重在神经元基中 92% 稠密、encoder/decoder 中位余弦相似度 0.5(§Comments & Replications)。两个注意点:① 本论文无官方 arXiv 条目,题目给定的 arXiv:2406.04092 实际是另一篇论文(Towards bit threads in general gravitational spacetimes,JHEP 2024),请以 transformer-circuits.pub 链接为准;② 正文称 131,072 特征、L1=0.004 的运行为 A/5,但公开 runs 表中 L1=0.01 的 131,072 运行是 A/5,L1=0.004 的 131,072 运行标为 A/23,正文标签与 runs 表不一致。
单层 Transformer + 稀疏自编码器:512 个 MLP 神经元分解成 512–131,072 个字典特征
原文 caption:We aim to take its MLP activations – the activations we can't avoid needing to decompose – and decompose them into 'features'. 配表:Transformer(1 个 Attention Block + 1 个 MLP Block/ReLU,MLP 512 维,The Pile 100B tokens)与 Sparse Autoencoder(ReLU encoder + Linear decoder,字典宽度 512 (1×) 到 131,072 (256×),8B 个 MLP 激活样本,loss = L2 重建 + L1 稀疏惩罚)。(caption 由网页提取)
全篇方法总览:左侧是被研究的单层 Transformer(残差流 128、MLP 512、ReLU,在 The Pile 100B token 上训练),右侧是稀疏自编码器——用比神经元多得多的字典方向(最多 256 倍)去重建 MLP 激活,L1 惩罚逼出稀疏。读图关键是「过完备 + 稀疏」这对组合:特征数超过神经元数,靠稀疏性才可能从低维投影恢复高维编码(压缩感知)。
A/1/3450 特征在不同激活强度区间的激活-行为关系
原文 caption:Feature activation interval analysis of the Arabic script feature A/1/3450: the fraction of tokens belonging to Arabic script increases significantly by feature activity level, from 25% when the feature is barely active to 98% when the feature activation is above 5.(caption 由网页提取)
具体特征示例:横轴把特征激活分成若干区间,纵轴显示该区间里 token 属于阿拉伯语的占比——从刚激活时的 25% 涨到高激活时的 98%,特征「越强越专一」。这张图演示了论文的核心主张:字典特征比神经元更单义,且激活谱系上各区间都自洽;配合消融(减掉该特征后阿拉伯语 token 预测变差)和 pinned sampling(钉住最大值后模型开始生成阿拉伯语),构成特征确实在推动行为的因果证据。
🎧 音频版
时长 18:21 · Edge TTS
给多义神经元做「字典分解」(对话版)
小播:今天聊一篇可解释性领域绕不开的论文,Anthropic 的 Transformer Circuits 报告。先给个结论?
老播:结论一句话:神经元的「多义」能拆。他们用稀疏自编码器,把一层 transformer 的 512 个神经元拆成了 4096 个特征,拆出来的特征比神经元更单义、更能干预、换一个随机种子还能复现。这是后来整个 SAE 路线的起点。
小播:等等,先解释一下「多义神经元」是什么意思。
老播:就是一颗神经元对一堆不相关的输入都起反应。论文里那个单层模型,有一颗神经元同时响应学术引用、英语对话、HTTP 请求和韩语文本。你没法说清楚这颗神经元在干什么,因为它同时干四件事。
小播:为什么会这样?
老播:他们的假设叫 superposition,叠加。模型要存的特征比神经元多得多,于是不搞「一个神经元一个特征」,而是把每个特征存成神经元空间里的一条方向,一颗神经元是很多方向的混合。这和 Toy Models of Superposition 那篇的结论一脉相承。
小播:既然知道是叠加,为什么不直接改架构,让模型别叠加?
老播:试过了,走不通。他们之前在 Toy Models 里就试过 SoLU 这类鼓励稀疏的激活函数,结果发现 cross-entropy 训练下,模型天生就偏好多义表示——就算没有叠加,它也倾向于让一颗神经元同时干好几件事。所以只能在训练之后把叠加拆开。
小播:那怎么把方向拆出来?
老播:用字典学习,具体实现是稀疏自编码器。输入是激活,先压成一个稀疏的特征向量,再重建回激活。训练目标两个:重建要准,同时逼特征稀疏。关键设计是过完备:特征数量比神经元数多,主分析里 512 个神经元拆成 4096 个特征,相当于每个神经元平均拆成 8 个更专一的单元;最大的一档直接拆到 13 万个。
小播:特征比神经元还多,这不是更难懂了吗?
老播:恰恰相反。神经元是「一个顶好几个」的混合体,特征是「一个只管一件事」的单义单元。拆出来的特征里有专门响应阿拉伯语的、专门响应 DNA 序列的、专门响应 base64 的。换做神经元,你根本找不到这种干净的对应。
小播:怎么证明这些特征是真的在起作用,而不是事后贴标签?
老播:这是这篇论文最扎实的地方,三步走。第一步是相关:阿拉伯语特征的激活和「文本是不是阿拉伯语」的检测器相关 0.74,DNA 是 0.8。第二步是消融:把阿拉伯语特征的激活人为清零,模型对阿拉伯语 token 的预测就变差;反过来把它钉在最大值,模型就开始生成阿拉伯语。第三步是排除巧合:这个特征横跨几十颗神经元,最相关的那颗神经元其实是各种语言的混合,所以它没有偷偷复用某颗现成的「阿拉伯语神经元」。
小播:有没有可能这些可解释性来自数据本身,而不是模型?
老播:他们做了个对照:把模型权重打乱,再跑同样的分解,特征立刻退化成 span、file、句号这种琐碎的单 token 特征,谁也解释不出什么。说明多 token 的可解释性来自模型学到的结构,数据统计本身给不出来。
小播:那这是挑出来的特例,还是普遍现象?
老播:他们做了三路评估回答这个问题。人工打分:神经元中位数 0 分,基本看不出在干什么;特征中位数 12 分,解释又自信又具体。让 Claude 猜 logit 权重,特征 74% 准确,神经元 58%。再换一个随机种子重训一个模型,特征的中位相关 0.72,神经元只有 0.46。还有更细的:base64 特征在粗字典里是一个,在细字典里裂成三个,字母、数字、编码 ASCII 文本各管一摊。
小播:听起来很完整,那这篇论文有什么短板?
老播:短板在最硬的那一环:因果。自编码器是从激活统计里重建出来的字典,特征解释得很好,但模型是不是真的「用这些特征做计算」?论文没有直接证明,作者自己也说这是统计重构,还留了 21% 的预测没还原。另外研究对象只是单层模型,多层推广在论文里没有实验。
小播:所以正确的态度是?
老播:把它当一套好用的分析工具,别当最终答案。论文给了 79% 的还原率、可复现的特征、一套完整的验证方法,但「字典特征就是模型真正的计算单元」这一步还悬着。Neel Nanda 后来用开源模型复现了大部分结果,验证了工具性,没验证因果性。
小播:这篇论文为什么后来这么重要?
老播:因为它把「单义性」从口号变成了可测量的东西:可解释性打分、消融因果、跨种子复现,这三件套后来成了整个 SAE 领域的标准动作。今天你看到的 GPT-4 可解释性研究、各种开源 SAE 工具,源头都能追到这篇。
小播:最后用一句话总结?
老播:神经元是多义的混合体,稀疏自编码器能把 512 个神经元拆成 4096 个更单义的特征——更可解释、更可干预、跨随机种子可复现,还原了 79% 的预测。最该记住的数字:神经元人工可解释性中位 0 分,特征 12 分。最该记住的保留态度:特征好不好用已经证明,模型是不是真正在用它们,还没有。