Weight-norm Criticality:训练 loss 尖峰,除了学习率还有一条「权重范数」通道
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
训练 loss 曲线上那些突然冒出来的尖峰,长期被归因于学习率开得太大——这是 Edge of Stability(EoS)那条线的解释:学习率乘上曲率超过 2,优化就站不稳了。上海交大团队的这篇新论文(arXiv 2607.21005)补上了另一条独立通道:哪怕学习率完全不动,只要网络里有归一化层,weight decay 本身就足以把训练推到失稳边缘。他们把这套机制叫 weight-norm criticality(权重范数临界)。
这条通道的好处是可控:它把「spike 是玄学」变成「spike 可以归因、可以预测、可以干预」。我们从头拆。
先看现象:wd 越大,尖峰越勤
作者在四档规模递增的设置里观察到了同一个现象:把 weight decay 调大,loss spike 来得更频繁、更剧烈;但把网络里的归一化层去掉,同样的 weight decay 几乎不诱发尖峰。
- 最大的设置:187M 参数、16 层 16 头的 LLaMA 风格 Transformer,在 1000 亿 token 语料上预训练 1 个 epoch(AdamW,wd∈{0, 0.5, 1}):wd=0 平滑,wd=0.5/1 频繁 spike。
「不稳定」用 Hessian 的最大特征值 λmax(也叫 sharpness,锐度)来量化。MNIST 探针上,wd 从 0 加到 0.03,训练终点 λmax 从 15 一路涨到 28、383、3863。记住这个数字:稳定性是这么一点点被抽走的。
核心概念:scale invariance,为什么归一化是关键
要解释这条通道,得先引入一个概念:scale invariance(缩放不变性)。设归一化层前面有一组权重 $u$,如果把它整体放大或缩小一个因子 $\alpha$,损失几乎不变,这组权重就是 scale-invariant 的。写成式子:
$$L(\alpha u, v) = L(u, v)$$
这里的 $L$ 是损失函数,$v$ 是其他所有权重,$\alpha > 0$ 是任意缩放因子。为什么成立?因为 BatchNorm/LayerNorm 会把激活重新归一化,前层权重放大缩小被抵消了,对最终输出和 loss 基本无感。
关键的分工出现了:loss 对这组权重的「大小」无感,但 weight decay 对大小有强烈的意见——它专门惩罚权重范数,于是 $u$ 的范数 $\|u\|$ 被一点一点压小。这是第一条腿。
关键公式:曲率按 α⁻² 放大
先给预期:接下来的式子要回答「权重范数变小,为什么会导致训练失稳」。直觉是——损失对权重缩放不敏感,但损失曲面在权重方向上的曲率是敏感的,而且范数越小、曲面越陡。
论文的核心定理(定理 5.1)给出一个下界:
$$\lambda_{\max}\big(H(\alpha u, v)\big) \ge \alpha^{-2}\,\lambda_{\max}\big(H_{uu}(u, v)\big)$$
逐项看:$H$ 是完整 Hessian 矩阵(损失对所有权重的二阶导数),$H_{uu}$ 是只属于 $u$ 那一块的 Hessian 块;$\lambda_{\max}$ 取最大特征值,衡量损失曲面在当前位置最陡的方向有多陡。
这个式子在说:当 scale-invariant 分量的范数被 weight decay 缩到原来的 $\alpha$ 倍时,曲率的下界按 $\alpha^{-2}$ 放大——范数减半,曲率变四倍;范数缩到十分之一,曲率涨一百倍。推导用的是 Hessian 块缩放恒等式加 Cauchy interlacing 定理,附录 A.5 有完整证明。
顺着这条逻辑,作者给出两个可计算的失稳边界:
$$\eta\,\lambda_{\max} \le 2 \quad\text{(线性稳定边界,对应 EoS 型尖峰)}$$
$$c^{\ast} = \sqrt{\eta\,\rho / 2},\quad \rho = \|u\|^2 \lambda_{\max}(H_{uu}) \quad\text{(范数跌破它就失稳)}$$
这里 $\eta$ 是学习率,$\rho$ 是「范数平方 × 块曲率」的合成量;$c^{\ast}$ 是范数的临界值。第一层权重范数一旦跌破 $c^{\ast}$,稳定条件被破坏,尖峰就会出现——而且这个边界可以逐层算,每层只要自己参数块的 Hessian,失稳可以归因到具体某一层。
验证:受控实验直接对上 α⁻²
机制给完,论文用两个关键实验把链条钉死。第一个是受控缩放实验:固定其他所有参数,只把 scale-invariant 分量缩放到 $\alpha$,实测 λmax 的轨迹与 $\alpha^{-2}\lambda_{\max}(H_{uu})$ 的下界完全一致(FNN 和 ResNet-50 都验证)。第二个是训练全程追踪 λmax:
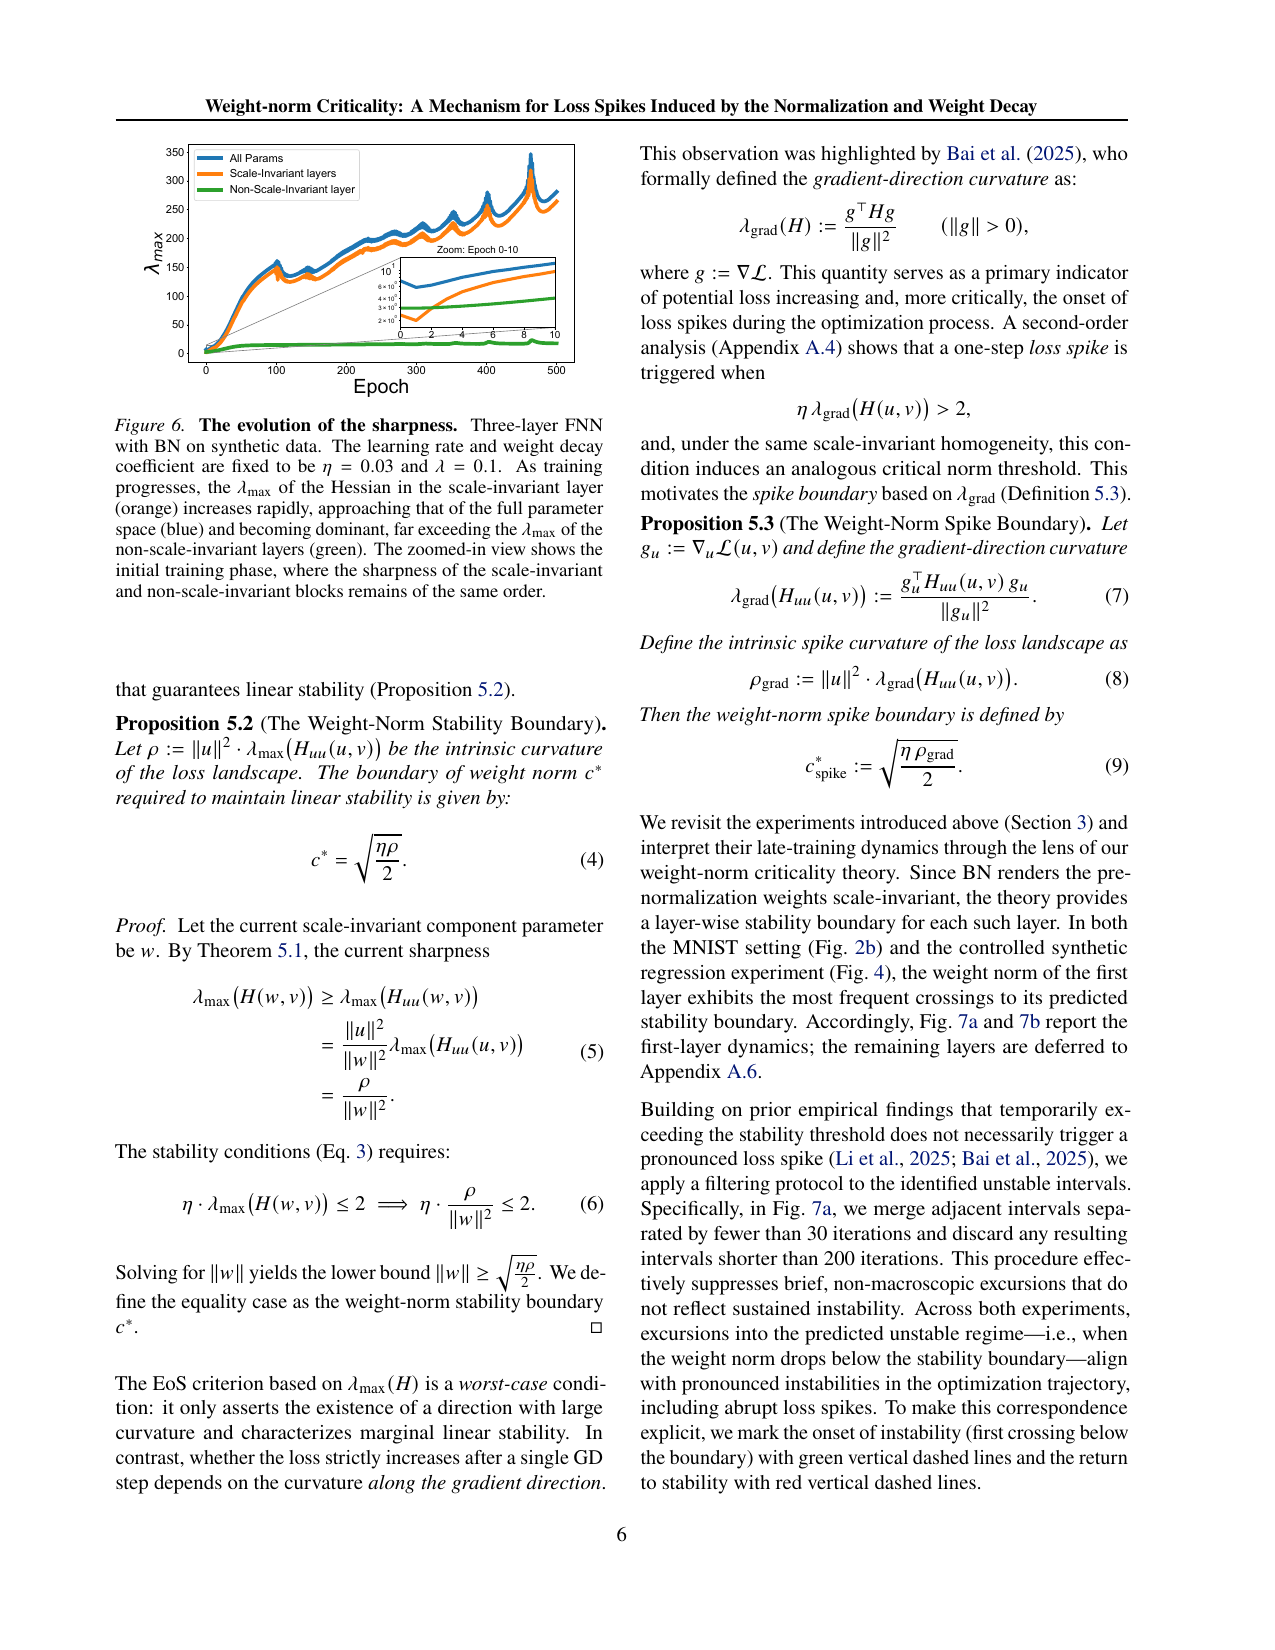
Figure 6 是「可观测现象」这一环的核心证据:训练中 loss spike 出现的时刻,λmax 同步演化并越过临界边界——说明尖峰来自权重范数与曲率耦合的临界行为,学习率只是另一条独立的触发通道。注意 spike 时刻和 sharpness 峰值的对齐,这是全篇最关键的目视证据。
干预:把 weight decay 从关键位置挪走
机制明确之后,干预就非常轻:对 scale-invariant 的那部分权重关掉 weight decay,或者只把 weight decay 施加在不受缩放影响的层上,其他设置一律不动。
在 187M 的大模型上,只对 MLP 块关闭 weight decay:训练末尾 loss 从 2.720 降到 2.548,spike 明显减少(Fig.9)。在小网络上有更干净的对照:
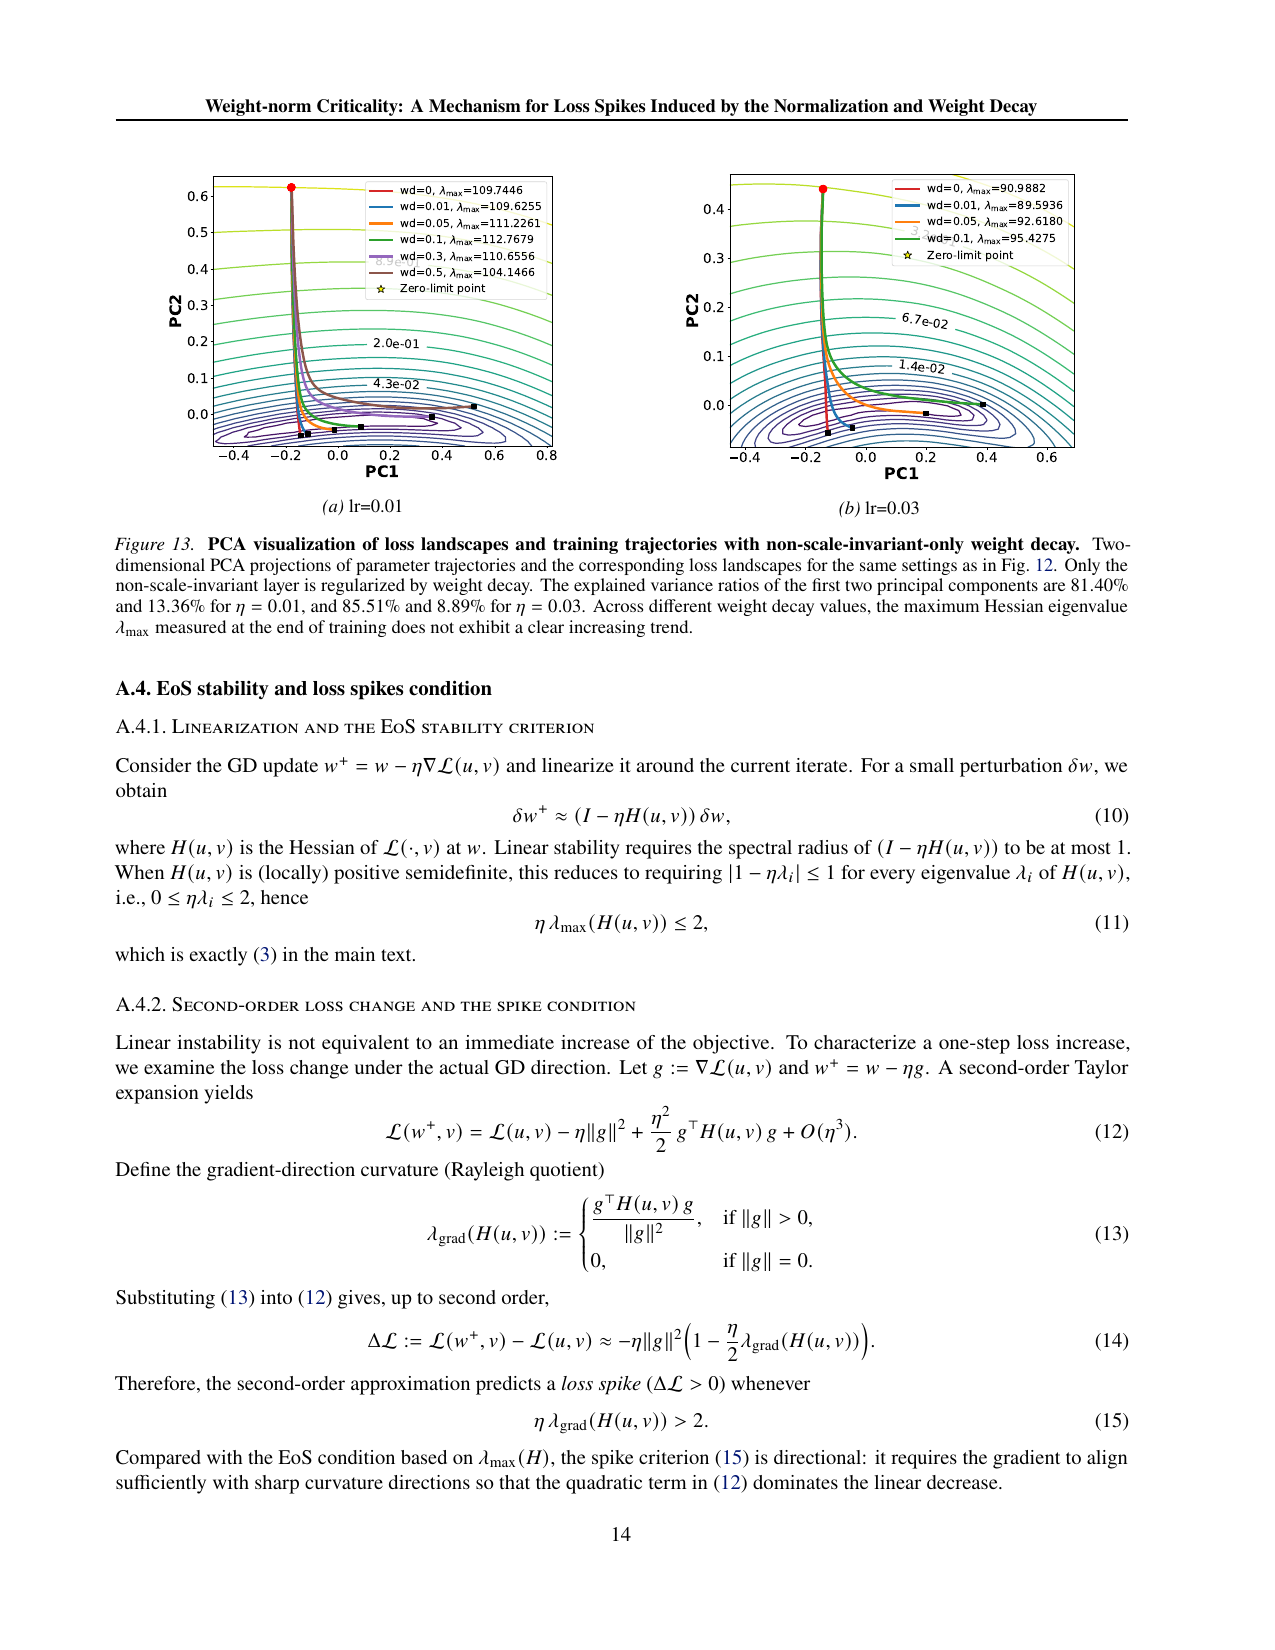
Figure 13 展示:当 weight decay 只加在非 scale-invariant 的输出层(fc-out)时,终点 λmax 稳定在 90–113 左右、没有单调暴涨的趋势;对照全量 wd 的 91→113→205→281 一路攀升(Fig.4b)。同样的 wd 总量,换个施加位置,稳定性完全不同——这就是「可归因」的工程价值。
代价与边界:这套理论现在能直接用吗
要诚实地说,这里有三条现实限制:
1. 大模型上的干预位置是经验定位的。在 187M Transformer 上,作者选择关 MLP 的 wd 是依据「MLP 特征向量占比」这类启发式,没有真的在大模型上算 $c^{\ast}$。论文自承:把整套理论直接套到深层 Transformer 还有实质困难。
2. 算边界很贵。每层的 $\rho$ 需要 Hessian 顶层特征值或梯度方向曲率,187M+ 规模成本高,论文没给高效近似。
3. 证据强度有限。大部分结论是单次运行、图线呈现,没有多随机种子统计,spike 频次没有数字统计。
所以它的定位是:一个可解释、可归因、可干预的机制框架——小网络里被严格验证,大模型上是强启发。
一句话记住这篇
loss spike 有两条路:学习率太大(EoS),或者归一化层权重范数被 weight decay 抽干——loss 对缩放无感,曲率却按 $\alpha^{-2}$ 放大,范数跌破临界值 $c^{\ast}$,训练就失稳。最该记住的数字是:范数缩到十分之一,曲率涨一百倍;最该保留的态度是:边界在小网络上成立,在大模型上还需要更多工作。
把 loss spike 的解释从「学习率临界」(EoS)补上「权重范数临界」:归一化引入 scale-invariant 分量,weight decay 持续收缩其范数,曲率按 α^-2 放大并越过范数稳定/尖峰边界而失稳;边界可逐层分解,给出可归因、可预测、可干预的机制,同时解释了 wd 提泛化却不能无限加大的实践张力。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:训练 loss 在个别 step 突然上升的 loss spike;增大 weight decay 系数后 spike 更频繁、更剧烈,且只在含归一化层(BN/LN)的网络中出现——同样的 wd 对无归一化网络几乎不诱发 spike。
在哪里观测:四个规模递增的设置:(1) 187M 参数、16 层 16 头 LLaMA 风格 Transformer 在 100B-token 语料上预训练 1 epoch(AdamW,wd∈{0,0.5,1},Fig.1a,§3);(2) ResNet-50 在 CIFAR-100(SGD,lr=0.003,wd∈{0,0.001,0.01},Fig.1b,§3);(3) 4 层×512 宽 FNN,Linear→Norm→Tanh 隐藏块,BN/LN 可选,MNIST(SGD,lr=0.003,wd∈{0,0.001,0.01,0.03},Fig.2,§3);(4) 3 层 FNN+BN/LN 在合成回归 y=x1+2x2(全批量 GD,lr∈{0.01,0.03},Fig.4a,§3)。
如何量化:训练 loss 轨迹(对数坐标)定性比对 spike 频率;Hessian 最大特征值 λmax(训练终点,Fig.3/4b);scale-invariant 层权重范数 ‖W1‖ 对预测边界 c*_spike 的穿越区间(Fig.7);顶层 Hessian 特征向量的模块分解占比(Fig.8)。正文未给出 spike 频次的数值统计,以图线呈现为主。
② 机制假设
假设:归一化(BN/LN)使前层权重具有正 scale invariance(L(αu,v)=L(u,v)):loss 对权重整体缩放不敏感,但局部曲率不敏感。weight decay 持续收缩 scale-invariant 分量范数 ‖u‖,Hessian 的 uu 块按 α^-2 放大(定理 5.1),λmax 随 ‖u‖→0 快速增长;一旦越过 EoS 型线性稳定边界(ηλmax≤2,命题 5.2)或梯度方向尖峰边界(ηλ_grad>2,命题 5.3),优化动力学失稳,出现 loss spike——即「权重范数临界」weight-norm criticality。
证据:
- 定理 5.1:在 L(αu,v)=L(u,v) 下 λmax(H(αu,v)) ≥ α^-2·λmax(H_uu(u,v)),证明基于 Hessian 块缩放恒等式加 Cauchy interlacing(§5.1,附录 A.5)。
- 受控缩放实验:固定其他参数、仅把 scale-invariant 分量缩放到 α,实测 λmax 轨迹与 α^-2·λmax(H_uu) 下界一致(FNN 与 ResNet-50,Fig.5,§5.1)。
- 训练中 λmax 演化:scale-invariant 块的 λmax 随训练快速上升,中后期主导全局 λmax(Fig.6,§5.1)。
- wd 增大 → 收敛点沿 PCA 主方向朝「zero-limit 点」(scale-invariant 参数置零)移动,终点 λmax 单调增大:MNIST 15→28→383→3863,合成回归 91→113→205→281(Fig.3/4b,§4)。
- 第一层范数 ‖W1‖ 跌破预测边界 c*_spike 的持续区间与 loss spike 时间对齐(Fig.7a/b,§5.2;逐层结果 Fig.14,附录 A.6)。
- 对照实验:无归一化 FNN 在相同 wd 下无 spike(Fig.2a);wd 只加在非 scale-invariant 层时 λmax 不增长、无 spike(附录 A.3,Fig.12/13)。
备选解释:
- 学习率临界 / Edge of Stability(ηλmax>2):本工作把它作为基底判据保留,新增的路径是「范数收缩→曲率放大→被动越过该判据」;论文定位为互补视角。
- Adam 自适应机制(Bai et al. 2025 的 β2/二阶矩滞后):可独立诱发 spike,但本论文用纯 SGD/全批量 GD 也复现 spike,说明该机制无法覆盖 wd 路径。
- 数据/坏 batch 假说(Chowdhery et al. 2023):无法解释合成任务(固定全批量、无坏 batch)下的 spike。
- 全局 scale-invariant 网络的 ill-conditioned(Li & Arora 2019):本文扩展为只需局部 scale-invariant 分量,覆盖含非 scale-invariant 层的实用网络(§2)。
形式化/toy model:有完整形式化:定理 5.1(曲率爆炸下界)、命题 5.2(范数稳定边界 c*=√(ηρ/2),ρ=‖u‖²·λmax(H_uu))、命题 5.3(梯度方向尖峰边界 c*_spike=√(ηρ_grad/2)),以及逐层边界分解——每个 scale-invariant 分量只需自己参数块的 Hessian;附录 A.4 用二阶泰勒展开导出单步 spike 条件 ηλ_grad>2。
③ 局部干预
干预对象:Transformer 中尺度不变分量所在的 MLP 模块(LayerNorm 前权重)
操作:对 MLP 参数关闭 weight decay,其余模块保持原 wd 不变;187M Transformer 上 wd=3 全量 vs wd=3 除 MLP,合成 3x→x 任务同理(Fig.8b/9,§6.2)
效果:MLP 对顶层 Hessian 特征向量的贡献不再随训练单调增长;loss spike 数量大幅减少,训练 loss 曲线末段约 2.548(对照约 2.720,Fig.9 纵轴刻度量级)
局部性:只改 MLP 参数的 wd,网络结构与其余模块超参全部不动
干预对象:非 scale-invariant 层(fc-out)
操作:把 weight decay 只施加于 fc-out,不施加于 scale-invariant 层 fc1/fc2(附录 A.3,Fig.12/13)
效果:终点 λmax 不随 wd 单调增长(约 90–113 区间波动,对照全量 wd 时 91→281);即使 lr=0.03、wd 高达 0.5 也不出现 loss spike
局部性:只改 wd 的作用对象,不动网络结构与优化器
干预对象:scale-invariant 层权重范数(监控型干预,不改训练)
操作:逐层计算 c*_spike 边界并监控 ‖W‖ 穿越(Fig.7/14)
效果:把失稳归因到具体层(实验中第一层主导、穿越先于 spike),具备失稳预警与归因能力
局部性:零训练改动,只加在线计算
因果验证:三条证据链:(1) 机制层——受控参数缩放直接验证 α^-2 曲率下界(Fig.5);(2) 预测层——‖W1‖ 跌破 c*_spike 的持续区间与 spike 时间对齐(Fig.7,绿色虚线=首次跌破、红色=恢复),并配过滤协议(间隔<30 步合并、<200 步丢弃);(3) 干预层——只对非 scale-invariant 层加 wd(附录 A.3)或对 MLP 关 wd(Fig.8b/9)均消除 spike,方向与机制预测一致。注意:LLM 设置未计算理论边界,MLP 干预由顶层特征向量分解经验驱动,由机制公式直接导出的边界验证只在小 FNN 上完成。
④ 工程收益
指标:训练 loss(曲线末段)
数值:约 2.548
基线:全量 wd=3 时约 2.720
设置:187M 参数、16 层 16 头 LLaMA 风格 Transformer,100B-token 语料预训练 1 epoch,AdamW(lr warmup 至 1e-3 再衰减至 1e-4),仅对 MLP 关闭 wd(Fig.9,§6.2)
指标:loss spike 频率
数值:大幅减少(图线呈现,无数值统计)
基线:全量 wd=3 时频繁且剧烈的 spike
设置:同上 187M Transformer;合成 3x→x 任务(4 层单头 Transformer,d_model=400)对 MLP 关 wd 后 spike 显著减少(Fig.8b/9,§6.2)
指标:终点 λmax(sharpness)
数值:约 90–113 波动,无随 wd 单调增长
基线:全量 wd 时 91→281(wd=0→0.1)
设置:3 层 FNN+BN 合成回归,lr=0.01/0.03,wd 只施加于 fc-out(附录 A.3,Fig.12/13)
指标:失稳归因/预警
数值:可定位到具体层(第一层主导),边界穿越先于 spike
基线:无(定性结果)
设置:MNIST FNN+BN 与合成回归的逐层边界分析(Fig.7/14,§5.2,附录 A.6)
代价:需计算 Hessian 顶层特征值或梯度方向曲率(每层 ρ / ρ_grad),187M+ 规模上成本高,论文未给高效近似方案;边界预测依赖 ad hoc 过滤协议(30/200 步阈值);监控收益无定量评估(命中率/误报率未知)。
可迁移性:适用于任何含 scale-invariant 分量(BN/LN 前权重等)的网络,不要求全局 scale invariance;已在 FNN+BN/LN、ResNet-50+BN、Transformer(合成任务与 187M 预训练)验证。作者在 §7 承认深度 Transformer 上直接套用理论工具面临实质困难;对无归一化架构不适用;对非 wd 成因的 spike(Adam 自适应、数据异常)不覆盖。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中强:wd→λmax 增长有系统数据(Fig.3/4/5/6)且受控缩放验证 α^-2 下界;但「终点 λmax 随 wd 增大」与「训练中途 spike」的连接主要靠 Fig.7 目视对齐,spike 频次无数值统计、无多 seed 重复。 |
| 机制→干预 | 中:小 FNN 上「只对非 scale-invariant 层加 wd」由机制直接推导且验证成立;但旗舰 LLM 设置的干预(MLP 关 wd)由顶层特征向量分解经验驱动,论文未在 LLM 上计算 c*_spike 边界,机制→干预的推导链条在该设置下松散。 |
| 干预→收益 | 中:干预与对照差异方向一致、幅度明显(loss 约 2.548 vs 2.720、spike 消失),但为单次运行无统计重复,收益仅限训练稳定性/训练 loss,未评估测试泛化;监控类收益无定量指标。 |
| 最弱一环 | mechanism_to_intervention——LLM/Transformer 场景下干预选择依赖经验定位(MLP 特征向量占比),未直接使用理论边界;论文自述对复杂模型直接套用理论有实质困难(§7)。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| 终点 λmax(MNIST FNN+BN) | 15 → 28 → 383 → 3863 | wd=0 时 λmax=15 | 4 层×512 宽 FNN+BN,MNIST,SGD lr=0.003,wd∈{0,0.001,0.01,0.03},Fig.3(§4) |
| 终点 λmax(合成回归 FNN+BN) | 91 → 113 → 205 → 281 | wd=0 时 λmax=91 | 3 层 FNN+BN,y=x1+2x2,全批量 GD lr=0.03,wd∈{0,0.01,0.05,0.1},Fig.4b(§4) |
| 曲率放大(受控缩放 α^-2 下界验证) | α=0.2 时 λmax 约 1.5e3(FNN)/ 约 6e4(ResNet-50),且不低于 α^-2·λmax(H_uu) | α=1 时 λmax 约 1e2–1e3 量级 | 固定非 scale-invariant 参数、仅缩放 scale-invariant 分量;FNN η=0.03(Fig.5a),ResNet-50/CIFAR-100 η=0.002(Fig.5b,§5.1) |
| 训练 loss(187M Transformer) | 约 2.548(曲线末段) | 全量 wd=3 时约 2.720 | 16 层 16 头 187M LLaMA 风格 Transformer,100B-token 预训练 1 epoch,AdamW,仅 MLP 关 wd(Fig.9,§6.2) |
| spike 频率 | wd 增大→spike 更频繁;对 MLP 关 wd→spike 显著减少 | wd=0 无 spike(Fig.1a);全量 wd=3 时频繁 spike(Fig.9) | 187M Transformer(Fig.1a/9,§3/§6.2)与 ResNet-50/CIFAR-100(Fig.1b,§3) |
| 非 scale-invariant-only wd 的终点 λmax | 约 90–113,无单调趋势 | 全量 wd 时 91→281 | 3 层 FNN+BN 合成回归,wd 仅施加于 fc-out,lr=0.01/0.03,Fig.13(附录 A.3) |
Insights
- loss spike 的归因可以从「学习率临界」补上「权重范数临界」:同一学习率下,wd 通过压缩 scale-invariant 层范数把网络被动推过稳定边界,spike 不必是优化器或数据的问题。
- 范数收缩与曲率放大是 α^-2 的关系(定理 5.1),因此 wd 与稳定性之间是边界型关系:wd 存在「不能越过」的临界强度,这解释了 wd 提升泛化却不能无限加大的实践张力。
- 临界边界可逐层分解,只依赖该层参数的 Hessian 块,把「网络级失稳」归因为「组件级」,实验中第一层主导——具备监控/归因工具的形态。
- 机制不要求全局 scale invariance,只要网络含归一化等 scale-invariant 分量即可成立,ResNet/Transformer 等实用网络都满足。
- 干预方式可移植:对 scale-invariant 分量关 wd(或把 wd 导向非 scale-invariant 层)即可在其他设置不变的前提下消除 wd 型 spike,为「正则强度上限」提供机制依据。
vs 同类工作
局限
- 深度 Transformer 上直接计算/应用理论边界面临实质困难(§7);LLM 实验只验证了定性趋势与启发式干预,未在 187M 模型上验证 c*_spike 预测。
- spike 频次、λmax 曲线等关键证据多为图线呈现,正文无数值统计与多 seed 重复;187M/100B-token 实验为单次运行。
- 边界预测的过滤协议(间隔<30 步合并、<200 步丢弃)为 ad hoc 设定;预测作为「分类器」的命中率/误报率未评估。
- 计算边界需要 Hessian 顶层特征值/梯度方向曲率,大规模下成本高,论文未提供高效近似算法。
- loss spike 与泛化的关系未研究,作者也承认 spike 偶尔可能与更好测试表现共存,收益仅限训练稳定性。
- 正文未给 Fig.7a(MNIST)的超参,附录 A.6 的逐层 MNIST 分析用 η=0.005、λ=0.01,与 §3 扫描设置 η=0.003 不一致;ResNet-50 学习率在 A.1.2(0.003)与 Fig.5b 说明(0.002)不一致,均为论文内未解释的细节出入。
- ResNet 残差连接破坏严格逐层 scale invariance,§5.1 只缩放 Conv→BN 权重,理论对该架构近似成立。
可复现性
附录 A.1 给出全部架构、优化器、超参与合成任务定义(3x→x、y=x1+2x2),小规模实验(MNIST、合成回归、3x→x)可按描述复现;未提供代码仓库链接与随机种子,正文为单次运行;187M/100B-token 预训练实验算力成本高,复现门槛高。
训练中锐度(sharpness λmax)的演化
原文 caption:The evolution of the sharpness. Three-layer FNN with BN on synthetic data. The learning rate and weight decay coefficients are fixed to η=0.03 and λ=0.1. (caption 由 PDF 文本清理)
这是「可观测现象」环的核心证据:训练中 loss spike 出现时,λmax(参数空间的锐度/曲率)同步演化并越过临界边界,说明尖峰来自权重范数与曲率耦合的临界行为,学习率只是另一条独立的触发通道。读图时注意 spike 时刻与 sharpness 峰值的对齐。
仅含非 scale-invariant 权重衰减时损失景观与训练轨迹的 PCA 可视化
原文 caption:PCA visualization of loss landscapes and training trajectories with non-scale-invariant-only weight decay. (caption 由 PDF 文本清理)
对照组实验:当权重衰减只作用于非 scale-invariant 分量时,损失景观和训练轨迹不再出现论文描述的临界失稳形态。这排除了「衰减本身」作为解释,把机制定位到 scale-invariant 分量的范数收缩上,是机制假设环的支撑证据。
🎧 音频版
时长 6:16 · Edge TTS
训练 loss 上的尖峰,到底哪来的?(对话版)
小播:今天聊一篇训练相关的新论文,主题特别实用——训练 loss 曲线上的那些尖峰,到底哪来的?
老播:这篇叫 Weight-norm Criticality,上个月刚挂在 arXiv 上。很多人遇到 loss spike,第一反应是学习率开太大了。但这篇论文说的是另一条路:哪怕学习率完全不动,只要网络里有归一化层,weight decay 本身就足以把训练推到失稳边缘,尖峰就冒出来了。
小播:等等,weight decay 不是用来防过拟合的吗,它也能惹事?
老播:它平时确实在防过拟合,但在这篇的机制里,它同时在干另一件事:不断压小归一化层前面那组权重的范数。压到一定程度,训练的稳定性就绷不住了,于是出现尖峰。
小播:那这个"一定程度",能提前算出来吗?
老播:能,这正是这篇论文的核心贡献:它给了一条可以计算的边界。我们从头讲,先看他们观察到的现象。
先看现象:wd 越大,尖峰越勤
老播:他们做了四档规模递增的实验。最小的是一组合成数据,三层小网络,只做 y 等于 x1 加两倍的 x2 这种简单回归;最大的是 187M 参数的、LLaMA 风格的大模型,在 1000 亿 token 的语料上预训练。
小播:规模差这么多,现象是同一个吗?
老播:同一个:把 weight decay 调大,尖峰就来得更频繁、更剧烈。最关键的对照是:把网络里的归一化层去掉,同样的 weight decay 几乎不诱发尖峰。也就是说,spike 不是 weight decay 单独造成的,是"归一化加 weight decay"这个组合造成的。
小播:那怎么量化"越来越不稳定"?总得有个数吧。
老播:有。他们盯住 Hessian 的最大特征值,记作 λmax,它衡量损失曲面在当前位置有多陡。在 MNIST 的小实验里,weight decay 从 0 一路加到 0.03,训练结束时的 λmax 从 15 涨到 28、383、最后 3863。
小播:等一下,3863 对 15,涨了 250 多倍?
老播:对,这就是"稳定性一点点被抽走"的过程。记住这个数字,后面解释为什么它会爆炸。
中间机制:为什么曲率会爆炸
老播:要解释这个,得先引入一个概念,叫 scale invariance,缩放不变性。假设有一组权重 u,如果把它整体放大或缩小,损失函数几乎不变,那这组权重就是 scale invariant 的。
小播:归一化层前面的权重就是这样?
老播:对。BatchNorm 或 LayerNorm 会把激活重新缩放,所以前面的权重放大缩小,对最终输出影响很小,loss 基本不变。这就是第一条腿。第二条腿是 weight decay,它专门惩罚权重的大范数,于是这组权重的范数被一点点压小。
小播:范数变小怎么了?
老播:关键来了。损失对权重缩放不敏感,但对曲率是敏感的。论文用一条定理证明:当权重范数缩小到原来的 α 倍,局部曲率会被放大到 α 的平方分之一那么多。范数减半,曲率变四倍;范数缩到十分之一,曲率涨一百倍。曲率一旦涨过界,训练就不稳了。
小播:所以范数越小,曲面越陡,直到陡到站不住?
老播:对。他们把这个"站不住的边界"也写成了公式:学习率乘以最大曲率,超过 2,线性稳定性就保不住了,这是尖峰出现的第一道坎。他们还做了受控实验直接验证:只把权重缩小到原来的 0.2 倍,其他全不动,曲率实测值就和理论的"平方反比放大"对上了,ResNet-50 上直接放大到六万量级。
小播:所以尖峰不是玄学,是曲率真的爆了。那知道机制之后,能干预吗?
局部干预:把 weight decay 从关键位置挪走
老播:能,而且干预很轻。思路就一句话:对 scale invariant 的那部分权重关掉 weight decay,或者干脆把 weight decay 只施加在不受缩放影响的层上。其他设置一律不动。
小播:效果呢?
老播:在 187M 的大模型上,只对 MLP 块关闭 weight decay,训练末尾的 loss 从 2.720 降到 2.548,尖峰明显减少。这和你调学习率是两条独立的修法——它修的是"范数被抽干"这条通道。
小播:那这套方法能直接用在我自己的大模型上吗?
老播:这里要泼一盆冷水,这也是论文自己承认的最弱一环:在小网络上,"该关哪一层的 weight decay"可以由理论边界直接算出来;但在 187M 的大模型上,干预位置是凭经验定位的,没有真的用理论边界去算。论文说,把整套理论直接套到深层 Transformer 上,还有实质困难。
小播:也就是说,方向很对,但离"一键诊断"还有距离?
老播:对,而且还有两个现实代价:算这个边界需要 Hessian 的最大特征值,大规模下成本很高,论文没给高效近似;另外大部分证据是单次运行,没有多随机种子重复,尖峰频率也没有数字统计,只能看图。所以它的价值在于给了一个可解释、可归因的机制框架。
收尾:一句话记住这篇
小播:那最后用一句话总结?
老播:loss spike 除了"学习率开太大"这条老路,还有一条新路:归一化层让权重对缩放无感,weight decay 却不断压小它的范数,曲率按范数平方的反比放大,直到越过稳定边界,尖峰就出现了。最该记住的数字是:范数缩到十分之一,曲率涨一百倍。
小播:而最该记住的保留态度是:这套边界在小网络上被严格验证了,在大模型上还需要更多工作。
老播:没错。这篇论文值得读,但读的时候带着这个判断去读。