把「可学的新奇」从理论量变成可优化目标:一个闭式估计器同时驱动复杂度、聚类与探索
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
先看一个现象:两条经典的「智能」目标函数,各有各的著名翻车现场。最大化惊奇的新奇搜索会被「噪声电视」钉死——屏幕每帧独立随机,永远不可预测、永远新奇,但什么都学不到;最小化惊奇的自由能智能体会缩进「暗室」——一切都可预测,所以什么都不做。这篇来自 Tufts/Harvard 的预印本(arXiv 2607.18433)认为两个失败是同一个原因:两种目标都把「学得走的新奇」和「学不走的新奇」当成同一个量。解药是只优化「学得走」的那部分——learnable novelty(可学新奇,即 Finzi et al. 2026 的 epiplexity)——并把它从只能事后测量的理论量,变成一个闭式、可微分的估计器。同一个标量,作为度量复现了 ECA 复杂度分类(rule 110 排第一);作为目标,让元胞自动机长出孤子、让 MNIST 编码无监督按数字聚类;作为奖励,给 RL 提供 9/10 任务不崩的探索。我们从头拆。
核心概念:总惊奇要拆成两半
先引入一个概念:prequential description length(前馈描述长度)。一个有界计算能力的观察者逐项接收数据流,每来一个数据点先预测、再为预测误差支付「惊奇」、然后更新模型。把全程的惊奇累加,就是这个流在这个计算约束下的最小描述长度。它按 MDL 拆成两半:
$$L(Y|X) = \min_{M \in \mathcal{M}}\left[\, |M| - \log p(Y|X,M) \,\right] \approx |M^*| + R$$
第一项 $|M^*|$ 是最优模型的程序长度——观察者真正从数据里学走的结构,即 epiplexity($=S_\phi$);第二项 $R$ 是任何模型都压不掉的残差。这里 $Y$ 是要预测的目标,$X$ 是已知输入,$\mathcal{M}$ 是观察者能力范围内的模型集合,$p(Y|X,M)$ 是模型 $M$ 给数据的概率。
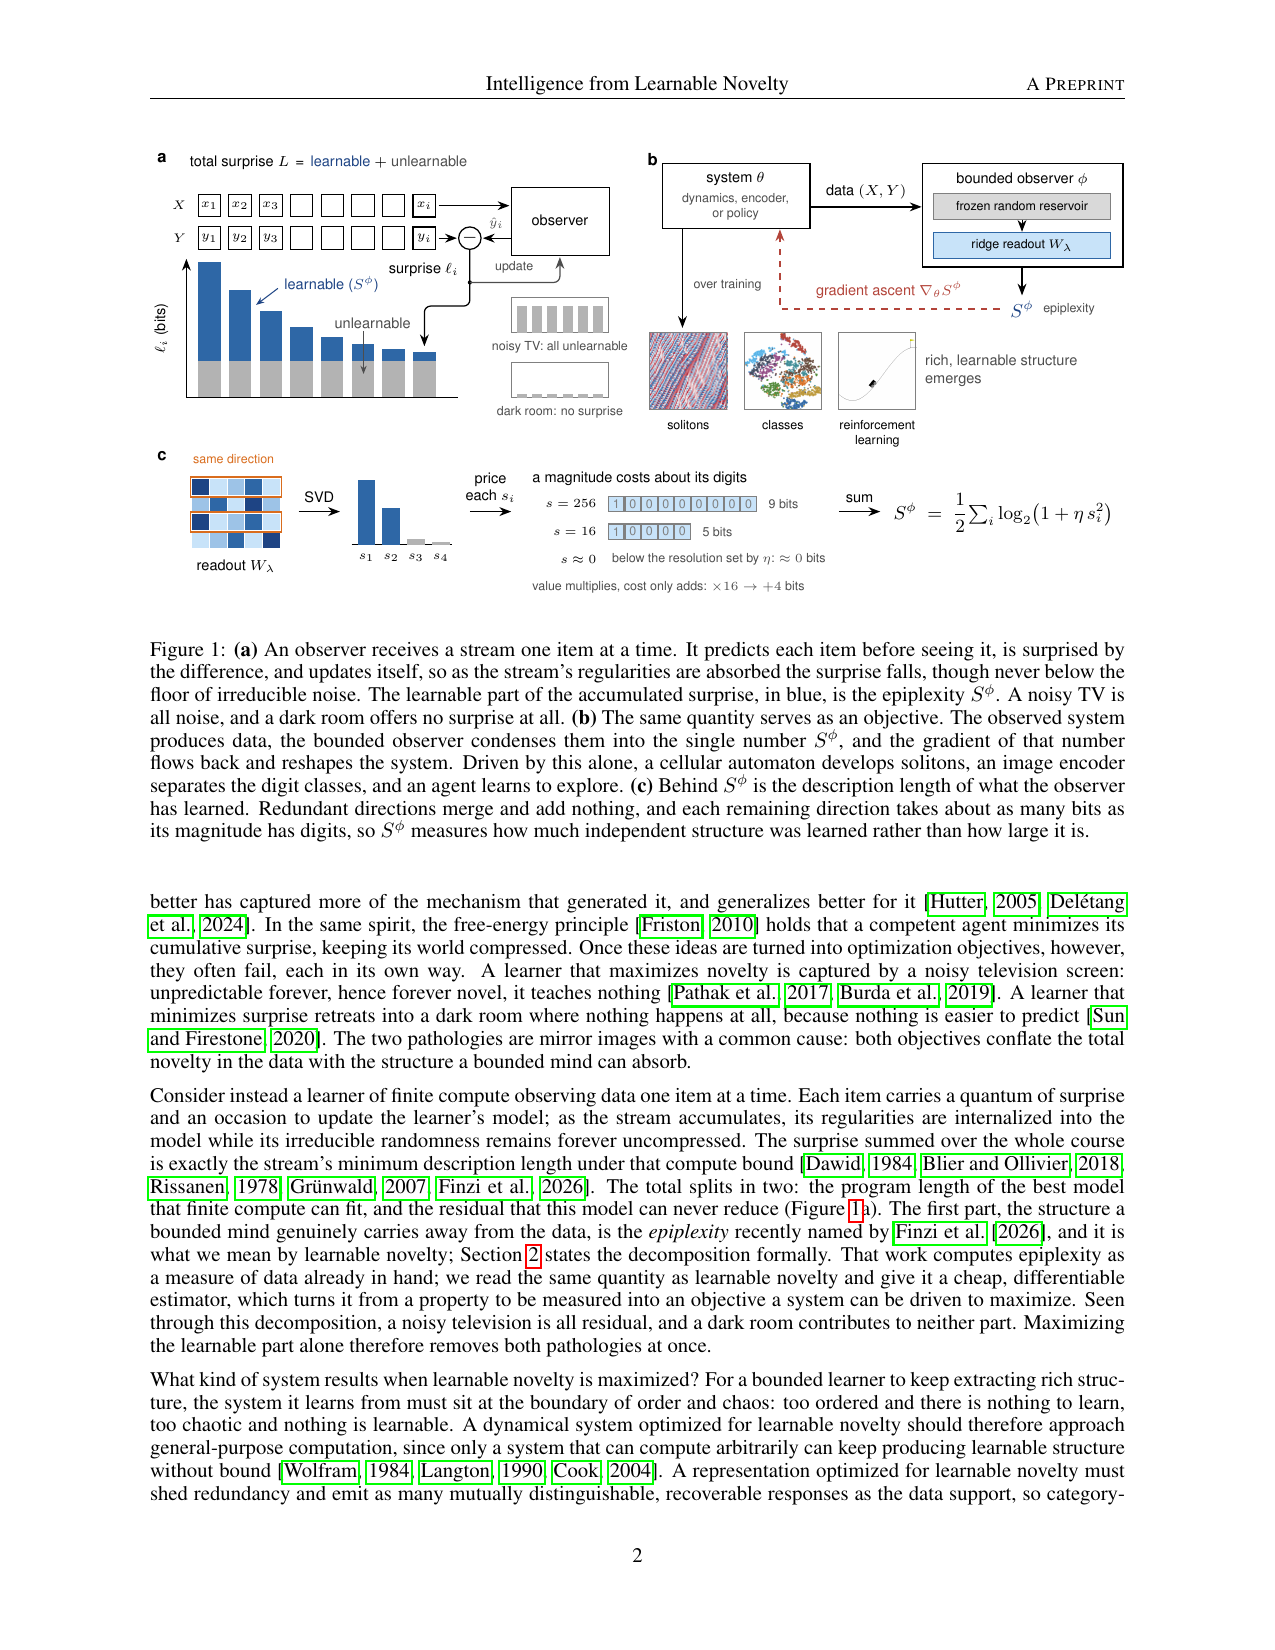
关键来了:novelty search 最大化的是总和 $L$,被残差主导,于是被噪声电视拖走;自由能原理最小化总和 $L$,把可学结构一起压掉,于是缩进暗室。噪声电视对 $|M^*|$ 贡献为零,暗室对两段贡献都≈0。**两个病态的共同解药:只看 $|M^*|$。**
关键公式:闭式、可微的 S_φ 估计器
原本求 epiplexity 要对每个系统完整训练一个模型(Finzi et al. 2026),又贵又不可导——当度量可以,当目标不行。论文的关键工程动作是:把「有界学习器」实例化成一个固定随机 reservoir(随机非线性特征映射)+ 线性 readout。此时最优模型有闭式解(ridge 回归),$S_\phi$ 也随之闭式:
$$S_\phi(Y|X) = \frac{1}{2}\sum_{i}\log_2\!\left(1 + \eta\, s_i(W_\lambda)^2\right), \quad W_\lambda = (\tilde{H}^\top \tilde{H} + \lambda I)^{-1}\tilde{H}^\top \tilde{Y}$$
逐项看:$\tilde{H}$ 是输入过 reservoir 后的特征矩阵(逐列标准化),$\tilde{Y}$ 是目标(中心化并按固定精度 $u_Y$ 缩放),$W_\lambda$ 是 ridge 解出的最优 readout,$s_i(W_\lambda)$ 是它的奇异值,$\eta$ 是分辨率参数,$\lambda$ 是 ridge 系数。这个 log-det 形式就是描述长度:每个非零奇异值方向贡献约 $\frac{1}{2}\log_2(1+\eta s^2)$ bit,冗余方向合并后不再加钱,值放大只加对数成本。$S_\phi$ 度量的是「观察者学走了多少独立结构」,与结构的大小无关。 数值上用可微 QR 求解代替正规方程保稳定;论文用精确 MDL 求解器做对照,88 条 ECA 上 Spearman ρ=0.997——ridge 只改变提取的 bit 数,不改变排序。
验证一:作为度量,无监督复现 ECA 复杂度分类
实验设置:88 条局部唯一的一维元胞自动机(width-64 环、每规则 512 个初始样本、τ=32 目标窗口),用同一个卷积 reservoir 打分,全程不需要任何监督标签:
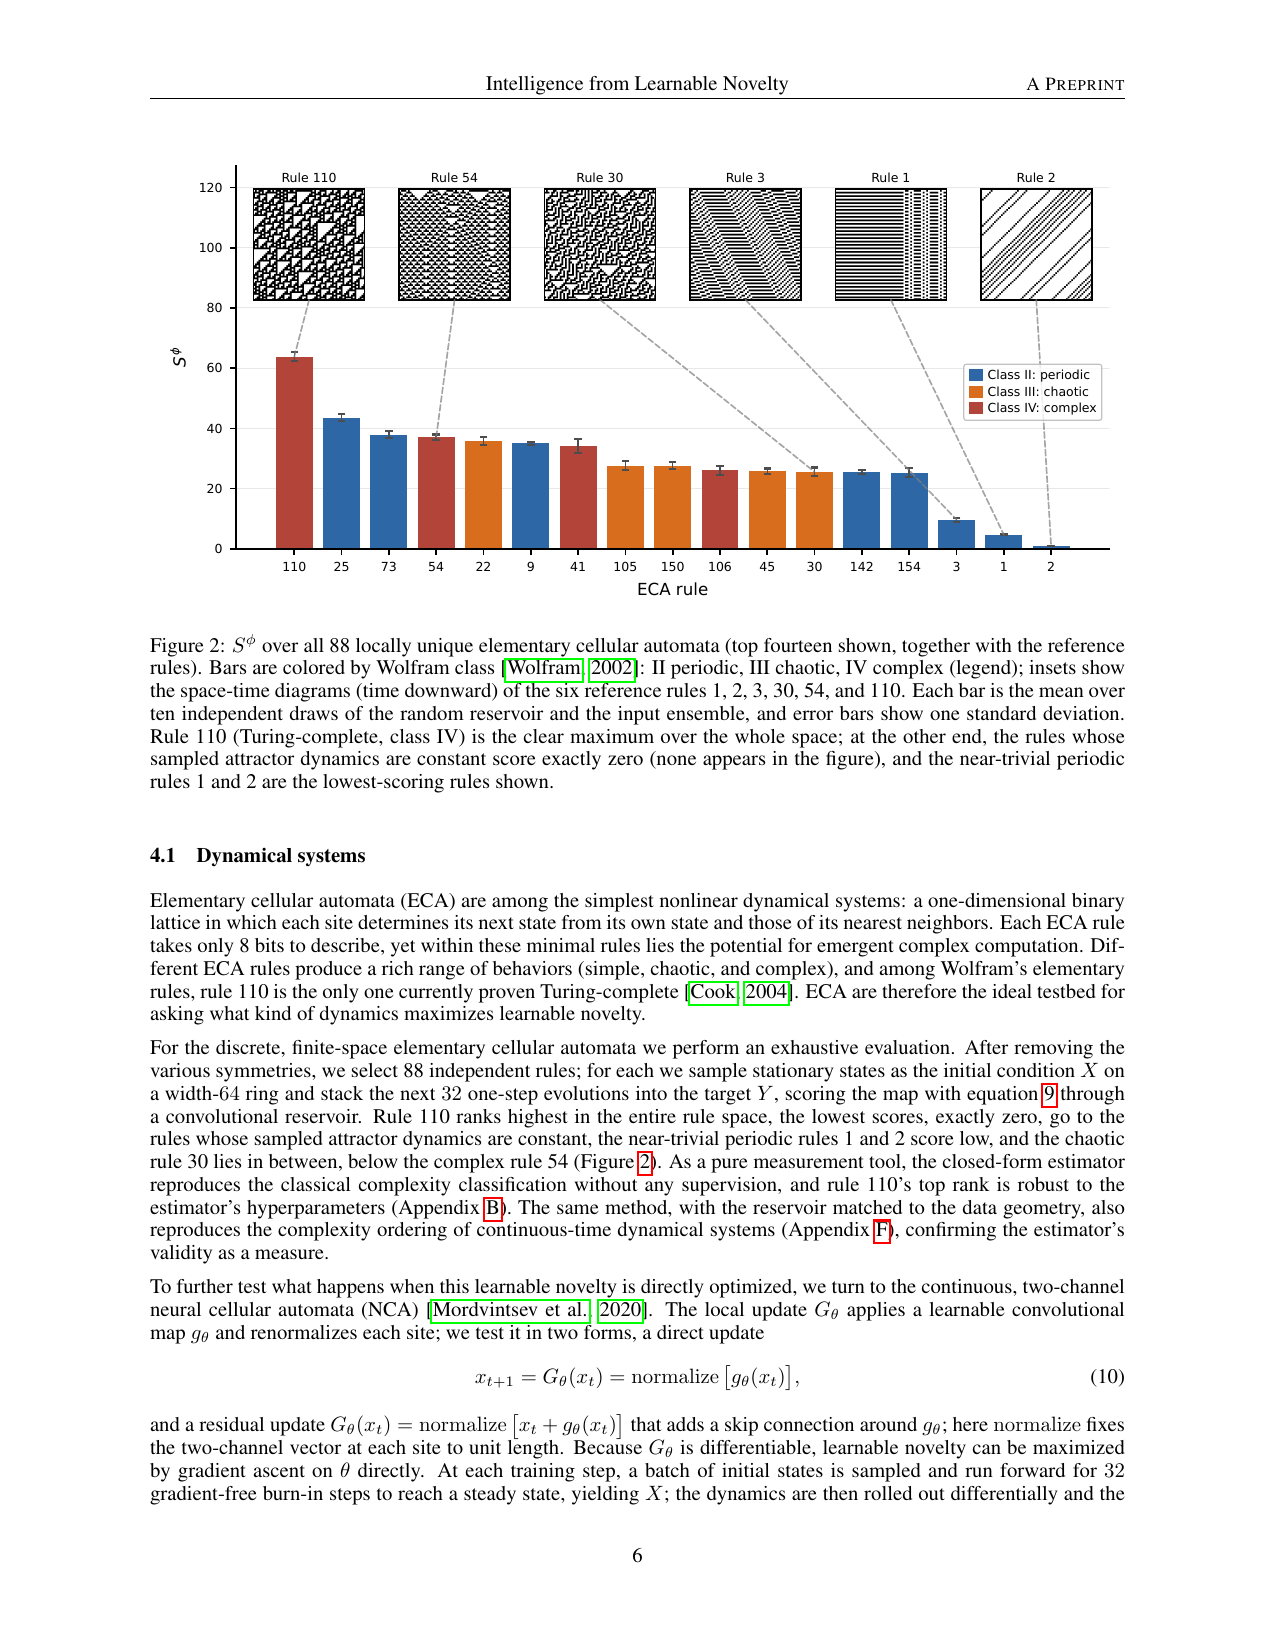
Figure 2 是「可学结构」这个核心量的最强外部验证:图灵完备的 rule 110 排第 1(比 runner-up 高 24.7 bits;精确 MDL 下 38.7 bits),常数吸引子规则得 0,复杂类 rule 54 高于混沌类 rule 30(gap 10.9±1.0 bits)。几十年的 Wolfram 复杂度分类被一个闭式标量无监督复现,且对 7 维超参扫描稳健。这里有个诚实的限定:所谓复杂度排序是「特定有界观察者」的属性——reservoir 感受野半径超过 2 时 rule 30/54 的顺序会反转,规则 110 则在两种 regime 都居首。
验证二:作为目标,长出孤子、聚出类别
同一把尺子当目标用:1D NCA(神经元胞自动机)的局部规则直接对 $S_\phi$ 做梯度上升(τ=8、2000 步)。
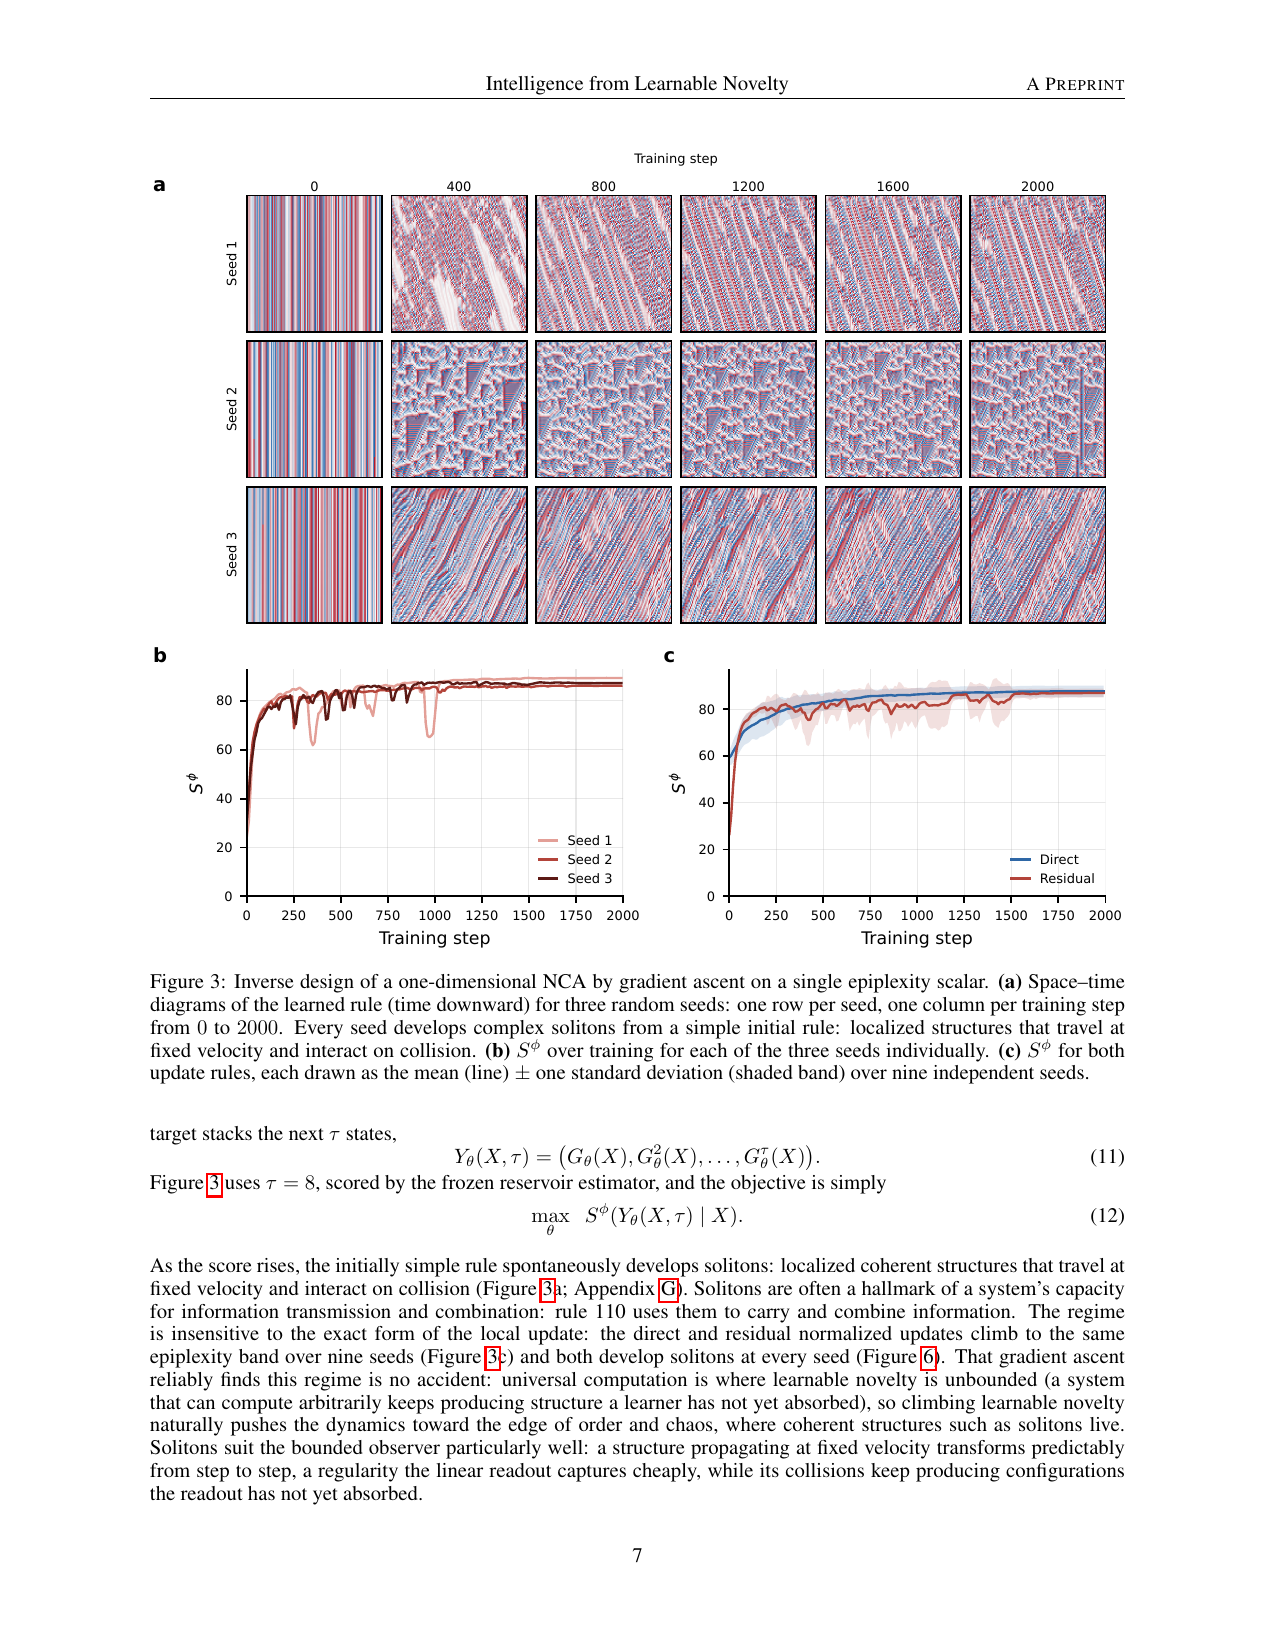
Figure 3 展示:初始简单规则自发长出以固定速度运动、碰撞后相互作用的孤子——rule 110 正是用孤子携带和组合信息;direct/residual 两种更新、9 个种子全部出现,$S_\phi$ 升到 86–89 后平台化。梯度为什么把系统推向那里:通用计算处可学新奇无界,序-混沌边界就是 $S_\phi$ 的鞍脊。技术上用 pre-activation normalization 把 reservoir 钉在边缘混沌(χ≈1),否则落入有序相(χ≈0.55)损失表达力。
表示学习上,64 维单位范数编码只以最大化 $S_\phi$ 训练,标签从不进入训练:
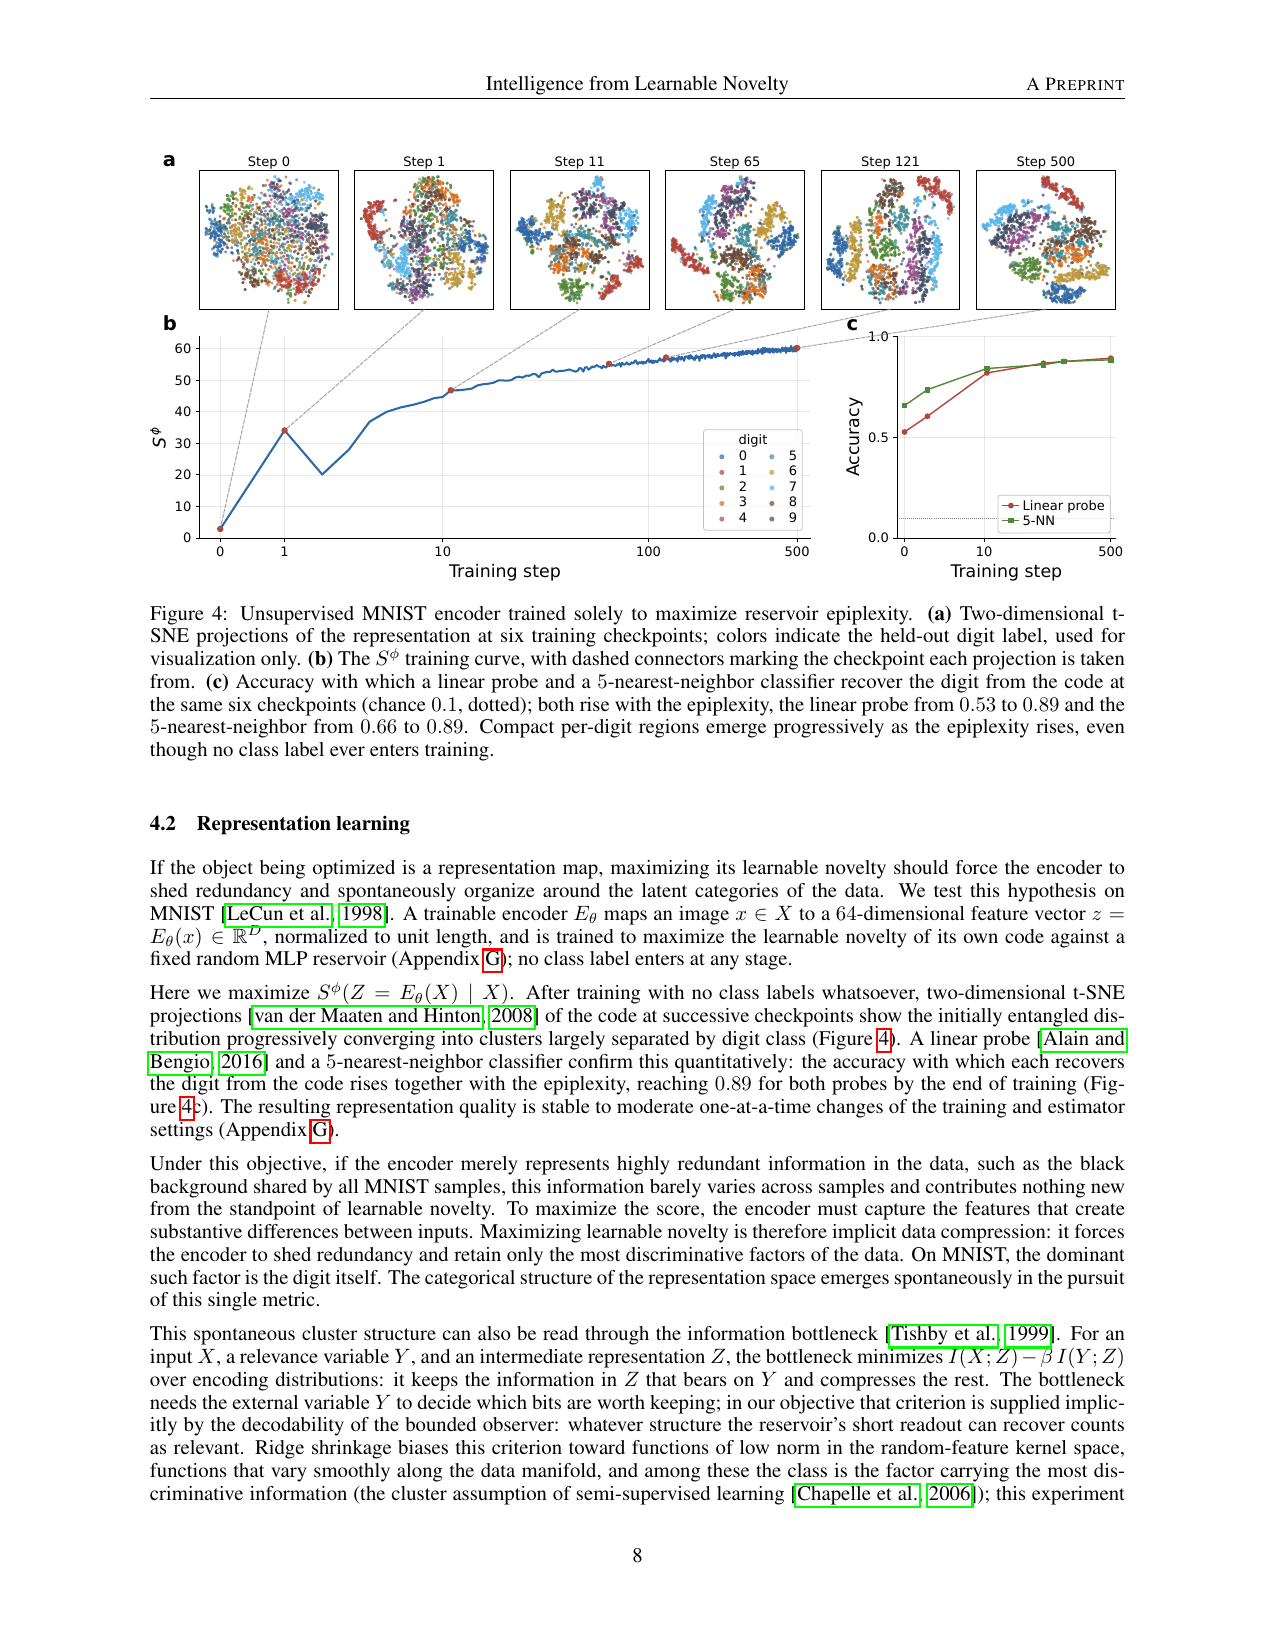
Figure 4 是关键验证:t-SNE 上编码从纠缠到逐步按数字分开,线性探针 0.53→0.89、5-NN 0.66→0.89(chance 0.1)。类别是「可学性最大」的因子,冗余信息(如黑色背景)几乎不变、贡献≈0——最大化 $S_\phi$ 就是隐式压缩,表示被推向去冗余聚类。注意评估用了标签探针(只度量、不进训练),且 λ≤0.3 或 η≤0.1 时探针掉到 0.5 以下,结果依赖选择性 readout。
验证三:作为奖励,给 RL 补上探索
RL 上梯度不能穿过环境,就把同一个闭式分数当内在奖励交给 PPO:$r_t = r_t^{\text{task}} + \beta\,(S_\phi^t - S_\phi^{t-1})$,β 按环境标定。10 个环境、600k 步、10 seeds:9/10 任务不低于纯任务奖励基线、0 崩溃(最差 Walker2d −4%);Acrobot 跨 seed 标准差从 166 掉到 2,PointMaze 从 77 掉到 22;状态模长对照在 Hopper、LunarLander 上崩溃(LunarLander 169→−171),说明收益来自「能被压缩的状态」,而追大状态则一环境一命。
代价与边界:最弱一环在干预→收益
要诚实地说:闭环里最弱的是 intervention→gain。RL 多处均值提升落在误差棒重叠区间(HalfCheetah 362±201→393±260),MNIST 聚类用标签探针评估,NCA 孤子是定性判据,也没有与 RND/ICM 的数值对比。机制本身有完整形式化支撑,但「可学/不可学分解」很大程度是定义性的,没有实验直接操纵分解本身来证伪。另外两个结构性限制:reservoir 冻结、观察者不成长,结构超出其可读范围就看不见,$S_\phi$ 会饱和;epiplexity-only 也不是任务求解器——Acrobot 上它会回避结束 episode 的目标,任务方向仍由外部奖励锚定。
一句话记住这篇
把惊奇拆成「学得走」和「学不走」两半,只追前者。最该记住的实验是那张 ECA 排序图:一个闭式、无监督的标量让图灵完备的 rule 110 排第一;最该记住的保留态度是:排序和收益都依赖观察者的构造——这是「系统-有界观察者」关系的属性,而非系统的绝对属性。
真正贡献是把 epiplexity(有界观察者从数据里真正学走的那段程序长度)从只能事后测量的理论量,变成一个闭式、可微分的 reservoir-ridge 估计器,从而同一个标量目标能同时复现 ECA 复杂度排序、无监督生成孤子与类结构、并给 RL 提供探索奖励。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:两条经典智能目标函数的镜像失败:最大化惊奇的 novelty search / 好奇智能体会被「噪声电视」捕获(每帧独立随机=永远新奇=学不到任何东西),最小化惊奇的自由能智能体会退进「暗室」(一切都可预测=什么都不做)。论文同时在三条线上复现/重建更老的现象:ECA 的 Wolfram 复杂度分类(rule 110 唯一被证明图灵完备、应排最高)、无监督表示会自发按类别聚类、稀疏奖励环境里任务回报不足以驱动探索。
在哪里观测:noisy-TV 与 dark-room 现象引自既有文献(Pathak et al. 2017, Burda et al. 2019; Sun & Firestone 2020);本论文重建现象的设置在:88 条局部唯一 ECA(width-64 环、每规则 512 初始样本、1000 步 burn-in、τ=32 目标窗口、10 次 reservoir+数据重抽)、1D NCA(width 64、τ=8、2000 步)、MNIST(64 维单位范数编码、500 步)、10 个 RL 环境(PPO、600k 步)。
如何量化:ECA 用闭式估计器 S_phi(bit)排序并对照 Wolfram 类(Fig.2);MNIST 用线性探针与 5-NN 从编码恢复数字的准确率(chance 0.1,Fig.4c);NCA 用时空图目视孤子 + S_phi 训练曲线(Fig.3);RL 用 100 集评估的任务回报,10 seeds 报 mean±std(Table 1)。
② 机制假设
假设:前馈总惊奇(prequential description length)L 按 MDL 拆成「可学部分 |M*|(=epiplexity, Finzi et al. 2026)」与「不可学残差」;novelty search 最大化的是总和、被残差主导,FEP 最小化总和、把可学结构一起压掉,两者失败于同一个原因:把两种惊奇当成一个量。真正值得最大化的是 |M*| 本身;把 |M*| 当目标,会把动力学推向序-混沌边界(通用计算处可学新奇无界)、把表示推向去冗余聚类(类别是可学性最大的因子)、把智能体推向保持未来丰富而非终止。
证据:
- 形式化:Eq.1-4 给出 MDL 分解,S_phi(Y|X)=|M*_phi|,噪声电视贡献全在残差、暗室对两段都贡献≈0(§2)
- 作为 measure:88 条 ECA 里 rule 110 排第 1(runner-up 之上边际 24.7 bits;精确 MDL 下 38.7 bits),常数吸引子规则得 0,复杂类 rule 54 高于混沌类 rule 30(gap 10.9±1.0 bits)(Fig.2, §4.1, App.D)
- 作为 objective:1D NCA 梯度上升后从简单规则长出可碰撞孤子,S_phi 升到 86-89、约 1500 步平台化,direct/residual 两种更新 9 seeds 全部出现(Fig.3, Fig.6, §G.1)
- MNIST 无标签训练下编码自发按数字聚类,线性探针 0.53→0.89、5-NN 0.66→0.89(Fig.4c, §4.2)
- RL 上作为 intrinsic reward 9/10 任务不差于任务奖励、0 崩溃(Table 1, §4.3)
- 理论区分:与 Schmidhuber 压缩进度不同——压缩进度奖励描述长度下降速率,长期会被暗室收割,learnable novelty 对暗室贡献≈0,天然堵死该路线(§5)
备选解释:
- 状态模长对照(∥ot∥² 归一化状态模长作同样标定的 bonus):HalfCheetah 上提升比 epiplexity 更多,但 Hopper、LunarLander 上崩溃(169→-171),说明收益不是「追大状态」的副产品(Table 1, §4.3)
- 预测误差好奇(ICM/RND):需要内层训练一个预测器、可被环境噪声困住;learnable novelty 免掉内层训练且对噪声免疫——但论文只做概念对比,没有数值对比(§4.3)
- 观测者相对性:reservoir 感受野半径>2 时 rule 30/54 排序反转(-14.6±1.0 bits),说明所谓复杂度排序是「特定有界观察者」的属性,不是系统绝对属性(App.B)
- MNIST 的类结构评估用了标签(线性探针/5-NN 需要标签度量,只是不进训练);λ≤0.3 或 η≤0.1 时探针准确率掉到 0.5 以下,说明结果依赖选择性 readout(§4.2, §G.2)
形式化/toy model:有完整形式化:Eq.1-4 的 MDL/前馈编码分解;Eq.5-9 的闭式 ridge 估计器 S_phi=(1/2)log2 det(I+η W_lambda W_lambda^T);App.C 用矩阵 t 边缘化导出 log-det 描述长度(ridge 对应固定精度、log-det 对应被积掉的精度);App.D 的精确 MDL 求解器(majorize-minimize,与 ridge 在 88 条规则上 Spearman ρ=0.997);Eq.13 的序-混沌序参量 χ(pre-activation normalization 把 reservoir 钉在 χ≈1,plain reservoir 只有 0.55-0.75)。
③ 局部干预
干预对象:epiplexity 的求值器(Finzi et al. 2026 对每个系统训一个 NN)
操作:换成固定随机 reservoir + 线性 ridge readout:W_lambda=(H̃^T H̃+λI)^{-1}H̃^T Ỹ,闭式、确定、可微,数值上用可微 QR 解而非正规方程(§3, App.E)
效果:S_phi 从「每系统一次完整训练的度量」变成可直接反传的标量目标;与精确 MDL 在排序上几乎一致(ρ=0.997),代价是只捕获随机特征上线性可读的浅层结构
局部性:只替换「怎么算 S_phi」,下游系统(NCA/编码器/策略)架构一概不动
干预对象:1D NCA 的局部更新 G_theta
操作:对 θ 做单标量 S_phi(Y_theta(X,τ=8)|X) 的梯度上升;burn-in 后加 σ=0.1 高斯扰动避免固定点给出零梯度(§4.1, Table 4)
效果:从简单规则长出孤子(S_phi 0→86-89,约 1500 步平台);9 seeds 全部出现,直接/残差两种更新形式都出现,学到的是与格宽无关的局部规则
局部性:只改目标函数;更新形式(direct/residual)与架构保持原样,两个变体结果一致说明孤子不是某一种更新形式的伪影
干预对象:MNIST 编码器 E_theta(64 维单位范数编码)
操作:只最大化自身编码对固定随机 MLP reservoir(width 2048)的可学新奇度 S_phi(Z|X),任何标签不进训练;用 λ=3、η=30 收紧 readout(§4.2, Table 3)
效果:编码自发按 10 个数字类聚类,线性探针与 5-NN 都到 0.89;学习率/批大小/编码维数/reservoir 深度扫描下探针保持 0.80-0.90
局部性:无监督目标替换监督/自监督目标,网络与数据不动;结果在 λ=3、η=30 邻域稳定,但 λ≤0.3 或 η≤0.1 失效(<0.5)
干预对象:PPO 智能体的奖励信号
操作:加入 intrinsic bonus:r_t = r_task + β(S_t^ϕ − S_{t−1}^ϕ),即轨迹 epiplexity 的增量;β 按「整集 bonus 贡献 ≈ 0.1× 随机策略任务回报尺度」逐环境标定(§4.3, §H.1)
效果:9/10 任务不差于任务奖励、0 崩溃;稀疏奖励任务上把所有 seed 都变成稳定求解;reservoir 宽度 32 保证只奖励「可被小观察者压缩」的结构化运动而非混沌
局部性:单标量奖励项;策略、环境、训练器全部不动;对照项(状态模长 bonus)用同一标定流程
因果验证:状态模长对照证明不是「追大状态」(magnitude 在 3 个任务掉到基线以下、2 个任务崩溃,epiplexity 只在 Walker2d 掉 4%);epiplexity-only 组证明驱动本身存在且独立于任务(Walker2d 上比任务奖励还高 327 vs 296,Acrobot 上会回避结束 episode 的目标);ECA 排序做 7 维单变量超参扫描(η/λ/τ/depth/kernel/channels/N)证明 rule 110 的榜首在多数配置下稳健;精确 MDL 对照(880 次成对求解、ρ=0.997)证明 ridge 近似忠实;无扰动消融证明梯度信号确实来自可学结构(固定点给出零梯度);直接/残差两种更新 + 9 seeds 证明孤子涌现不是更新形式或单 seed 的偶然。
④ 工程收益
指标:ECA 复杂度排序:rule 110 排名
数值:#1/88(runner-up 之上边际 24.7 bits,精确 MDL 下 38.7 bits)
基线:Wolfram 分类 + Cook 的图灵完备性证明;runner-up 规则第 2 名
设置:88 条局部唯一 ECA、width-64 环、512 样本/规则、τ=32、10 次 reservoir+数据重抽(§4.1 Fig.2, App.D Fig.8, p.5/16-20)
指标:MNIST 无监督聚类质量(线性探针 / 5-NN 准确率)
数值:0.53→0.89 / 0.66→0.89(结束均为 0.89)
基线:chance 0.1;训练起点探针 0.53
设置:64 维单位范数编码、无标签、500 步、reservoir width 2048、λ=3、η=30(Fig.4c, p.7, §G.2)
指标:1D NCA 从简单规则长出孤子
数值:S_phi 终值 86-89(约 1500 步平台);direct/residual 两种更新 9 seeds 全部长出可碰撞孤子
基线:初始简单规则(S_phi 从低位爬升)
设置:width-64 1D NCA、τ=8、2000 步、每步 2048 初始状态批、AdamW lr 1e-4(Fig.3, Fig.6, §G.1, p.6-7/21)
指标:RL 任务回报(100 集评估、10 seeds mean±std)
数值:9/10 任务不差于基线、0 崩溃;Hopper 1879±325→2192±270;LunarLander 169±74→208±25(+23%);Acrobot −167±166→−83±2(跨 seed 标准差 166→2);PointMaze 229±77→256±22(标准差 77→22);最差 Walker2d 296±45→285±41(−4%)
基线:纯任务奖励 PPO;状态模长对照在 Hopper/LunarLander 崩溃(LunarLander 169→−171)
设置:10 个环境、PPO、8 并行环境、600k 步、10 seeds、100 集评估、β 按 0.1×随机策略回报尺度标定(Table 1, §4.3, §H, p.8-9/22-24)
指标:连续时间系统复杂度排序
数值:Lorenz 46 > Rössler 25 > Thomas 17 > 线性系统 6.9-8.4
基线:混沌 vs 线性的定性分类
设置:512 样本/系统、8 次 reservoir 重抽、MLP reservoir width 64 λ=0.1(Fig.9, §F.1, p.20-21)
指标:ridge 估计器与精确 MDL 的一致性
数值:ECA 88 规则 Spearman ρ=0.997、同一 top-14 集合、最大排名变化仅 rule 41(第2→第13);NCA 轨迹 Pearson r=0.996
基线:App.D 的精确 MDL 最小化解(880+99 次成对求解)
设置:同一 reservoir 与数据、精确目标直接最小化对比(Fig.8, App.D, p.19-20)
代价:闭式 ridge 解 + SVD 使每次求值便宜且可微(数值上必须用 QR 而非正规方程保持条件数与梯度);在线逐 step 场景用 Sherman-Morrison rank-1 更新把每步降到 O(m²);仍要按实验场景调超参(Table 3 里四套配置的 λ/η/width 各不相同,RL 还逐任务标定 β 与窗口 τ∈[8,48]);reservoir 必须做 pre-activation normalization 才能保持 χ≈1,否则落入有序相(χ≈0.55)损失表达力(App.A.3, Fig.5)。
可迁移性:同一个估计器横跨三种用途(measure/objective/reward)与四类数据几何(1D CA、连续流、图像、RL 观测),ECA 排序在 7 维超参扫描中大部分保持 rule 110 榜首、MNIST 在 4 个训练超参上稳定在 0.80-0.90;但观测者相对性意味着排序与收益依赖 reservoir 构造(感受野>半径 2 时 30/54 反转),MNIST 需要足够选择性的 readout(λ≤0.3/η≤0.1 时 <0.5),RL 的 β/τ 逐环境标定,跨环境直接搬参数不可行。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中等偏强:现象(noisy TV / dark room)来自既有文献,机制有完整 MDL 形式化并同时解释两个极端;S_phi 无监督复现几十年的 ECA 复杂度分类是机制核心量(可学结构)的强外部验证。但没有实验直接操纵「可学/不可学分解」本身来证伪,机制在很大程度是定义性的。 |
| 机制→干预 | 强:估计器设计由定义推导而来(reservoir 是定义允许的任意 bounded learner 的一个实例,readout 最优有闭式解),并有精确 MDL 对照(ρ=0.997)与边缘混沌分析(χ≈1)兜底;ridge 近似被证明不改变排序而只改变提取的 bit 数。 |
| 干预→收益 | 中等:每个收益都有对照/消融/鲁棒性扫描(模长对照、epiplexity-only、直接/残差、7 维超参扫描、无扰动消融),但 RL 多处均值提升落在误差棒重叠区间(HalfCheetah 362±201→393±260 等)、MNIST 聚类用标签探针评估、NCA 孤子为定性判据,且没有与 RND/ICM 的数值对比。 |
| 最弱一环 | intervention_to_gain |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| ECA rule 110 排名 | #1/88,边际 24.7 bits(精确 MDL 下 38.7 bits) | Wolfram class IV / Cook 图灵完备;runner-up 第 2 名 | 88 规则、width-64、512 样本、τ=32、10 draws(Fig.2/8, §4.1/App.D) |
| MNIST 探针准确率 | 线性探针 0.53→0.89,5-NN 0.66→0.89 | chance 0.1 | 64 维编码、无标签、500 步、λ=3、η=30(Fig.4c, §4.2) |
| NCA 孤子涌现 | S_phi 86-89、9 seeds 全出现 | 初始简单规则 | width-64 1D NCA、τ=8、2000 步、direct/residual 各 9 seeds(Fig.3/6, §G.1) |
| RL 回报 | 9/10 提升、0 崩溃、最差 −4%;Hopper +313、LunarLander +23%、Acrobot 跨 seed std 166→2 | PPO 任务奖励;模长对照 2 任务崩溃(LunarLander 169→−171) | 10 envs、600k 步、10 seeds、100 集评估(Table 1, §4.3) |
| 连续系统排序 | Lorenz 46 > Rössler 25 > Thomas 17 > 线性 6.9-8.4 | 混沌/线性定性分类 | 512 样本、8 draws、MLP reservoir(Fig.9, §F.1) |
| 估计器保真度 | ρ=0.997(ECA)/ r=0.996(NCA) | 精确 MDL 最小化解 | 880+99 次成对求解(Fig.8, App.D) |
Insights
- 惊奇必须按可学/不可学拆开:noisy TV 与 dark room 是对称的失败,因为两个目标都在优化总和 L;只看 |M*| 后两个病态同时消失(§2)
- epiplexity 从度量变成目标的关键工程动作是 reservoir:闭式 ridge readout 让纯理论量可微可优化,一个标量同时驱动复杂度生成、表示聚类与探索(§3)
- 复杂度/表示质量/适应性是「系统-有界观察者」关系的属性,不是系统绝对属性:rule 30/54 排序随观察者感受野反转,rule 110 在两种 regime 都居首(App.B)
- 序-混沌边缘是自动涌现的:通用计算处可学新奇无界,梯度自然把系统推向那里;技术上用 pre-activation normalization 把 reservoir 钉在 χ≈1(§4.1, App.A.3)
- 与预测误差好奇的工程差异:无需内层训练预测器,bounded observer 固定、闭式求解,且对噪声免疫——奖励的是「能被压缩的状态」而非「预测不了的状态」(§4.3)
- MNIST 类结构是隐式压缩的结果:信息瓶颈中的「相关变量」由 reservoir 的可解性代替,λ=3 收紧 readout 才迫使编码器保留最可区分的因子(§4.2, §G.2)
vs 同类工作
局限
- observer 不成长:frozen reservoir 固定了可学边界,只能看到随机特征上线性可读的浅层结构;系统把 observer 读满后 S_phi 饱和——论文自述 limitation 1(§5)
- RL 中 learnable novelty 只是 bonus,任务方向仍由外部奖励锚定;epiplexity-only 不是任务求解器,Acrobot 上会回避结束 episode 的目标(§4.3)
- 排序是观测者相对的:reservoir 感受野超过半径 2 时 rule 30/54 顺序反转;MNIST 需要 λ=3、η=30 附近的选择性 readout,λ≤0.3 或 η≤0.1 时探针掉到 0.5 以下(App.B, §G.2)
- RL 的 9/10 里多处均值差在误差棒重叠范围(HalfCheetah 362±201→393±260、BipedalWalker 125±74→151±49),论文未提供与 RND/ICM 的数值对比
- 实验环境几乎全是有限游戏;对无限游戏里「避免终止」条件如何起作用没有测量——论文自述 limitation 2(§5)
可复现性
附录很完整:Table 2-4 给出 ECA/MNIST/NCA/RL 全部采样与优化设置,App.B/G 给出单变量超参鲁棒性扫描,App.D/E 给出精确 MDL 与数值稳定的可微 QR 解法,App.F.2 给出在线 O(m²) 递归求解;论文页脚提供代码仓库 https://github.com/Zhangyanbo/learnable-novelty。残留不确定性:RL 的 β/τ 逐环境标定、reservoir 权重随机性只报 mean±std(10 seeds / 10 draws),无代码运行验证记录。
框架图:观察者、前馈惊奇与 MDL 分解(S_phi 的三种用途)
原文 caption:(a) An observer receives a stream one item at a time. It predicts each item before seeing it, is surprised by the difference, and updates itself... The learnable part of the accumulated surprise, in blue, is the epiplexity S_phi. A noisy TV is all noise, and a dark room offers no surprise at all. (b) The same quantity serves as an objective... (c) Behind S_phi is the description length of what the observer has learned.
全篇机制的总览图:把累计惊奇拆成「可学部分(蓝色,epiplexity S_phi)」与「不可学残差」,noisy TV 的惊奇全在残差、dark room 两段都≈0;同一个 S_phi 既能当度量、又能当目标(梯度回传重塑系统)还能当 RL 奖励,并展示 log-det 描述长度与冗余方向合并的直觉。读图先看 (a) 的分解,再看 (b) 的三个出口。
88 条 ECA 的 S_phi 排序:rule 110 居首
原文 caption:S_phi over all 88 locally unique elementary cellular automata (top fourteen shown, together with the reference rules). Bars are colored by Wolfram class: II periodic, III chaotic, IV complex. Rule 110 (Turing-complete, class IV) is the clear maximum over the whole space; at the other end, the rules whose sampled attractor dynamics are constant score exactly zero.
「S_phi 作为度量」环的核心证据:无监督、只用闭式估计器对 88 条局部唯一 ECA 排序,图灵完备的 rule 110 排第 1(runner-up 之上边际 24.7 bits),常数吸引子规则得 0,复杂类 rule 54 高于混沌类 rule 30(gap 10.9±1.0 bits),复现了几十年的 Wolfram 复杂度分类。读图看柱高的跨类分布:有序→复杂→混沌的分层与 Wolfram 类吻合。
1D NCA 梯度上升长出可碰撞孤子
原文 caption:Inverse design of a one-dimensional NCA by gradient ascent on a single epiplexity scalar. (a) Space-time diagrams of the learned rule for three random seeds: one row per seed, one column per training step from 0 to 2000. Every seed develops complex solitons from a simple initial rule. (b) S_phi over training for each seed. (c) S_phi for both update rules over nine seeds.
「S_phi 作为目标」环的核心证据:1D NCA 的局部规则只以最大化 S_phi 为目标做梯度上升(τ=8、2000 步),初始简单规则自发长出以固定速度运动、碰撞后相互作用的孤子——rule 110 正是用孤子携带和组合信息;direct/residual 两种更新、9 seeds 全部出现(S_phi 升到 86–89 后平台化)。读图看时空图中孤子的出现与 (c) 的 9-seed 曲线重合度。
MNIST 无标签编码:表示自发按数字聚类
原文 caption:Unsupervised MNIST encoder trained solely to maximize reservoir epiplexity. (a) Two-dimensional t-SNE projections of the representation at six training checkpoints. (b) The S_phi training curve. (c) Accuracy with which a linear probe and a 5-nearest-neighbor classifier recover the digit from the code (chance 0.1); both rise with the epiplexity, the linear probe from 0.53 to 0.89 and the 5-NN from 0.66 to 0.89.
「表示去冗余聚类」预测的证据:64 维单位范数编码只以最大化 S_phi 训练、标签从不进入训练,t-SNE 上编码从纠缠到逐步按数字分开,线性探针 0.53→0.89、5-NN 0.66→0.89(chance 0.1)。读图看 (a) 六个检查点的聚类演化与 (c) 探针精度随 S_phi 同步上升——类别就是可学性最大的因子。
🎧 音频版
时长 11:13 · Edge TTS
噪声电视和暗室,为什么都学不会?(对话版)
小播:今天聊一篇挺有野心的预印本,作者是 Tufts 和哈佛的 Zhang 与 Levin,标题叫《Intelligence from Learnable Novelty》。核心问题就一个:智能的目标函数,到底该优化什么?
老播:这篇从一个老难题切入:最大化惊奇的智能体会被「噪声电视」钉住——画面每帧独立随机,永远新奇,但什么都学不到;反过来,最小化惊奇的自由能智能体会缩进「暗室」——一切都可预测,干脆什么都不做。作者说这两个失败是同一个原因:都把「学得走的新奇」和「学不走的新奇」混成了一个数。解药是只追学得走的那部分,他们叫 learnable novelty。他们还给了闭式、可微分的估计器,同一个数,拿来测复杂度、当目标、当奖励都行。
小播:一个数能同时干三件事?先讲机制再验证吧。
老播:好,我们从头拆:先看现象,再讲机制,最后看它最弱的一环。
现象:两个镜像的翻车
老播:噪声电视和暗室,一个太乱,一个太静。噪声电视每帧都是独立随机噪声,预测器永远学不会,但每次预测都失败,所以「惊奇」永远满格,追求新奇就被它钉死。暗室正好相反,一切都可以预测,惊奇为零,追求最小惊奇的智能体就缩进去不动。
小播:两个失败方向相反,为什么说原因是同一个?
老播:因为两个目标都在优化「总惊奇」这一个量,而这个量能拆成两半:观察者真正学走的程序长度,加上永远压不掉的残差。噪声电视的惊奇全在残差,暗室两半都接近于零。只看学得走的那一半,两个病态同时消失。这就是论文的机制主张。
机制:一个闭式估计器
小播:那「学得走的惊奇」怎么算?听起来得训练模型?
老播:原来的做法确实要:对每个系统完整训练一个模型,再量它学走了多少,又贵又没法求导。这篇的关键动作,是把「有界学习器」换成固定随机 reservoir 加线性 readout。reservoir 就是一堆随机非线性特征,readout 只有一层线性层,最优解是闭式的 ridge 回归,所以整个估计器可微、可求导。
小播:然后呢?
老播:学走的量变成一个 log-det 公式:把 readout 的每个奇异值方向换算成 bit 数加起来。冗余方向合并后不加钱,值放大只加对数成本。这个数度量的是「学走了多少独立结构」,跟结构多大无关。他们又和精确 MDL 求解器对照:88 条元胞自动机上相关系数 0.997,排序几乎不变,说明 ridge 近似是忠实的。
验证:度量、目标、奖励
老播:第一站,当度量。88 条局部唯一的一维元胞自动机,同一个 reservoir 无监督打分:图灵完备的 rule 110 排第一,比第二名高 24.7 bits;常数吸引子规则得 0;复杂类 rule 54 排在混沌类 rule 30 前面。几十年的 Wolfram 复杂度分类,被一个标量无监督复现。
小播:这是硬验证。当目标呢?
老播:1D 元胞自动机的规则直接对 S_phi 做梯度上升,2000 步之后,初始的简单规则自己长出了孤子——就是那种以固定速度移动、撞上还会相互作用的结构,rule 110 正是靠孤子做计算的。9 个随机种子全部出现。另一个实验:MNIST 的编码器,没有标签、只最大化 S_phi,64 维编码自动按数字聚成团,线性探针准确率从 0.53 爬到 0.89。
小播:这有点像「类别本来就是数据里最可学的那层结构」。
老播:对,最大化可学新奇就是隐式压缩:冗余信息贡献接近零,编码只好留下最可区分的因子。
小播:那 RL 上呢?当奖励能干活吗?
老播:梯度穿不过环境,就把同一个分数当内在奖励加给 PPO。10 个环境、60 万步:9 个不差于纯任务奖励,一个也没崩,最差的 Walker2d 只掉 4%。Acrobot 原来跨种子结果差到没谱,标准差 166,加上这个奖励变成 2,它补的正是稀疏奖励缺的探索。
收益与最弱一环
小播:听起来三线全通,最弱的一环在哪?
老播:在「干预到收益」这一段,作者自己的自评也是这个。第一,RL 好几个任务的均值提升落在误差棒重叠区间,比如 HalfCheetah 从 362 正负 201 到 393 正负 260,统计上不够硬。第二,MNIST 聚类用了标签探针评估——标签只是不进训练,还是出现了。第三,没有和 RND、ICM 这些经典好奇方法的数值对比。另外两个结构性问题:reservoir 冻结,观察者不成长,超出它可读范围的结构看不见,分数会饱和;纯 learnable novelty 也不是任务求解器,Acrobot 上它会故意不结束游戏,方向还得靠外部奖励锚定。
小播:所以它更像一个统一的测量框架?
老播:对,价值在于把三件通常分开的事——复杂度生成、抽象聚类、探索——归到同一个可微分的量上。记住三个数字:rule 110 比第二名高 24.7 bits;MNIST 探针从 0.53 到 0.89;RL 十个任务零崩溃。也记住一个保留:排序和收益都依赖观察者,换个感受野,rule 30 和 54 的顺序就会反转。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:把惊奇拆成「学得走」和「学不走」两半,只追前者——一个闭式、无监督、可微分的标量,让 rule 110 排第一、让编码自己聚出类别、让智能体自己探索;它的边界也明确:观察者是谁,答案就属于谁。
小播:机制统一,边界诚实,这期就到这。
老播:对,读到这篇,带着这两个判断去读。