Wan 2.1:VBench 86.22% 压过 Sora 的开源视频模型,强在工程、弱在机制
> 量子位技术拆解 · 公式前后都给你直觉。完整结构化数据见「速查」tab。
2025 年初,阿里开源的 Wan 2.1(arXiv 2503.20314,60 页)在公开 VBench 榜上拿 86.22%,压过 Sora 的 84.28%,还顺手把 1.3B 小模型做到 8.19 GB 显存可跑。这份报告值得读的地方,在于它示范了一套系统级的工程范式:每一个大设计都对应一个可观测的训练/推理现象,但几乎没有一个被机制化检验——因果 3D VAE、全时空注意力 DiT、flow matching 课程训练、滑动窗口、缓存、量化,链条完整,机制层缺席。我们从头拆。
先看现象:注意力成本、chunk 边界、采样步冗余
视频生成的第一个工程瓶颈是注意力开销。Wan 的主干是 DiT,序列长度来自 VAE 的时空压缩:一个 $(1+T)\times H\times W\times 3$ 的视频,被压成 $[1+T/4,\, H/8,\, W/8,\, 16]$ 的 latent,再经 patchify(3D 卷积核 $(1,2,2)$)展成 token 序列。论文给的 DiT 成本模型是:
$$C = L\big(\alpha b s h^2 + \beta b s^2 h\big)$$
$L$ 是层数,$b$ 是 micro-batch,$s$ 是序列长度,$h$ 是隐层维度;$\alpha$ 项对应线性层(随 $s$ 线性),$\beta$ 项对应注意力(随 $s^2$ 二次增长),非因果注意力下 $\beta$ 前向取 4、反向取 8。代入实际规模:序列到 1M token 时,注意力占端到端训练时间高达 95%(§4.3.1, p15)。这个数字解释了报告里几乎每一个设计选择——为什么 VAE 要压缩、为什么要缓存、为什么要滑动窗口。
第二个可观测现象在 VAE 的推理路径:逐 chunk 编码/解码长视频时,若 chunk 之间不维持特征缓存,chunk 边界会失去时序连续性(§4.1.3, p11-12);因果卷积核为 3 时只需缓存前一个 chunk 末尾 2 帧、2× 时序下采样时缓存 1 帧,就能保证任意长度视频的稳定推理。第三个现象在采样侧:同一 DiT block 内不同采样步的 attention 输出高度相似,CFG 采样后期条件/无条件输出也相似(§4.4.2, p18)——这是后面 diffusion cache 1.62× 加速的直接依据。第四个现象偏负例:TensorRT 量化会引入可测量的闪烁与时序不连贯(§5.6.3, p44),而 flicker 本身没有直接量化指标,只有像素级稳定性这类 proxy(§4.6, p20-21)。
数据侧还有一组容易漏掉的观测。预训练阶段,抖动镜头、静态访谈类视频、低质运动数据会被系统剔除或降采样,因为作者发现它们损害运动生成质量(§3.1, p6);合成图像污染小于 10% 就会显著降性能,因此专门训练分类器过滤「污染」图——数据管线直接砍掉约 50% 的初始数据。caption 侧,自家模型用 slow-fast 编码(每 4 帧保原始分辨率、其余帧做全局池化)把 VideoMME 无字幕准确率从 67.6% 抬到 69.1%(§3.3.3, p9),整体 F1 与 Gemini 1.5 Pro 相当。这些负例与工程观测,比正向叙事更接近可检验的「现象」——合成污染、量化退化、因果注意力不适配,都是可以被复现的取舍。
机制假设:五条设计理由,没有一条被当假说检验
报告给的是五条设计理由,没有一条被当作可证伪机制检验:时序因果性——未来帧不影响过去帧是真实连贯视频的关键,所以 VAE 用 3D 因果卷积 + RMSNorm(替换 GroupNorm)保因果(§4.1, p10);双向注意力适合扩散——decoder-only 因果注意力不适配扩散文本条件注入,所以文本编码器选双向的 umT5(观察承自 HunyuanVideo,§4.7.2, p25);局部时序依赖——时序依赖局限在有限窗口,所以 Streamer 用滑动窗口就能维持连续性(§5.6.2, p42);跨步注意力冗余——不同采样步输出相似,所以可以缓存复用(§4.4.2, p18);深度优于 AdaLN 参数量——同参数下加深层数比加大 AdaLN 更有效(§4.7.2, p24)。
支持证据大多是工程收益而非机制验证:feature cache 让任意长视频不出现边界断裂;umT5 在 T2I 上 FID 43.01,优于 Qwen-VL-7B 末层特征的 43.72(但略差于其倒数第二层的 42.91,Table 6, p25);Streamer 在 8 张 A100 上以 8 FPS 实时生成 15 分钟视频(Fig. 30, p42);diffusion cache 带来 1.62×;四种 AdaLN 配置里 Full-shared-AdaLN-1.5B(35 层)训练 loss 最低,胜过参数更多的 Non-shared-AdaLN-1.7B(30 层,Fig. 16, p24)。注意这最后一条是全报告最接近「消融」的实验——但只到训练 loss 级。
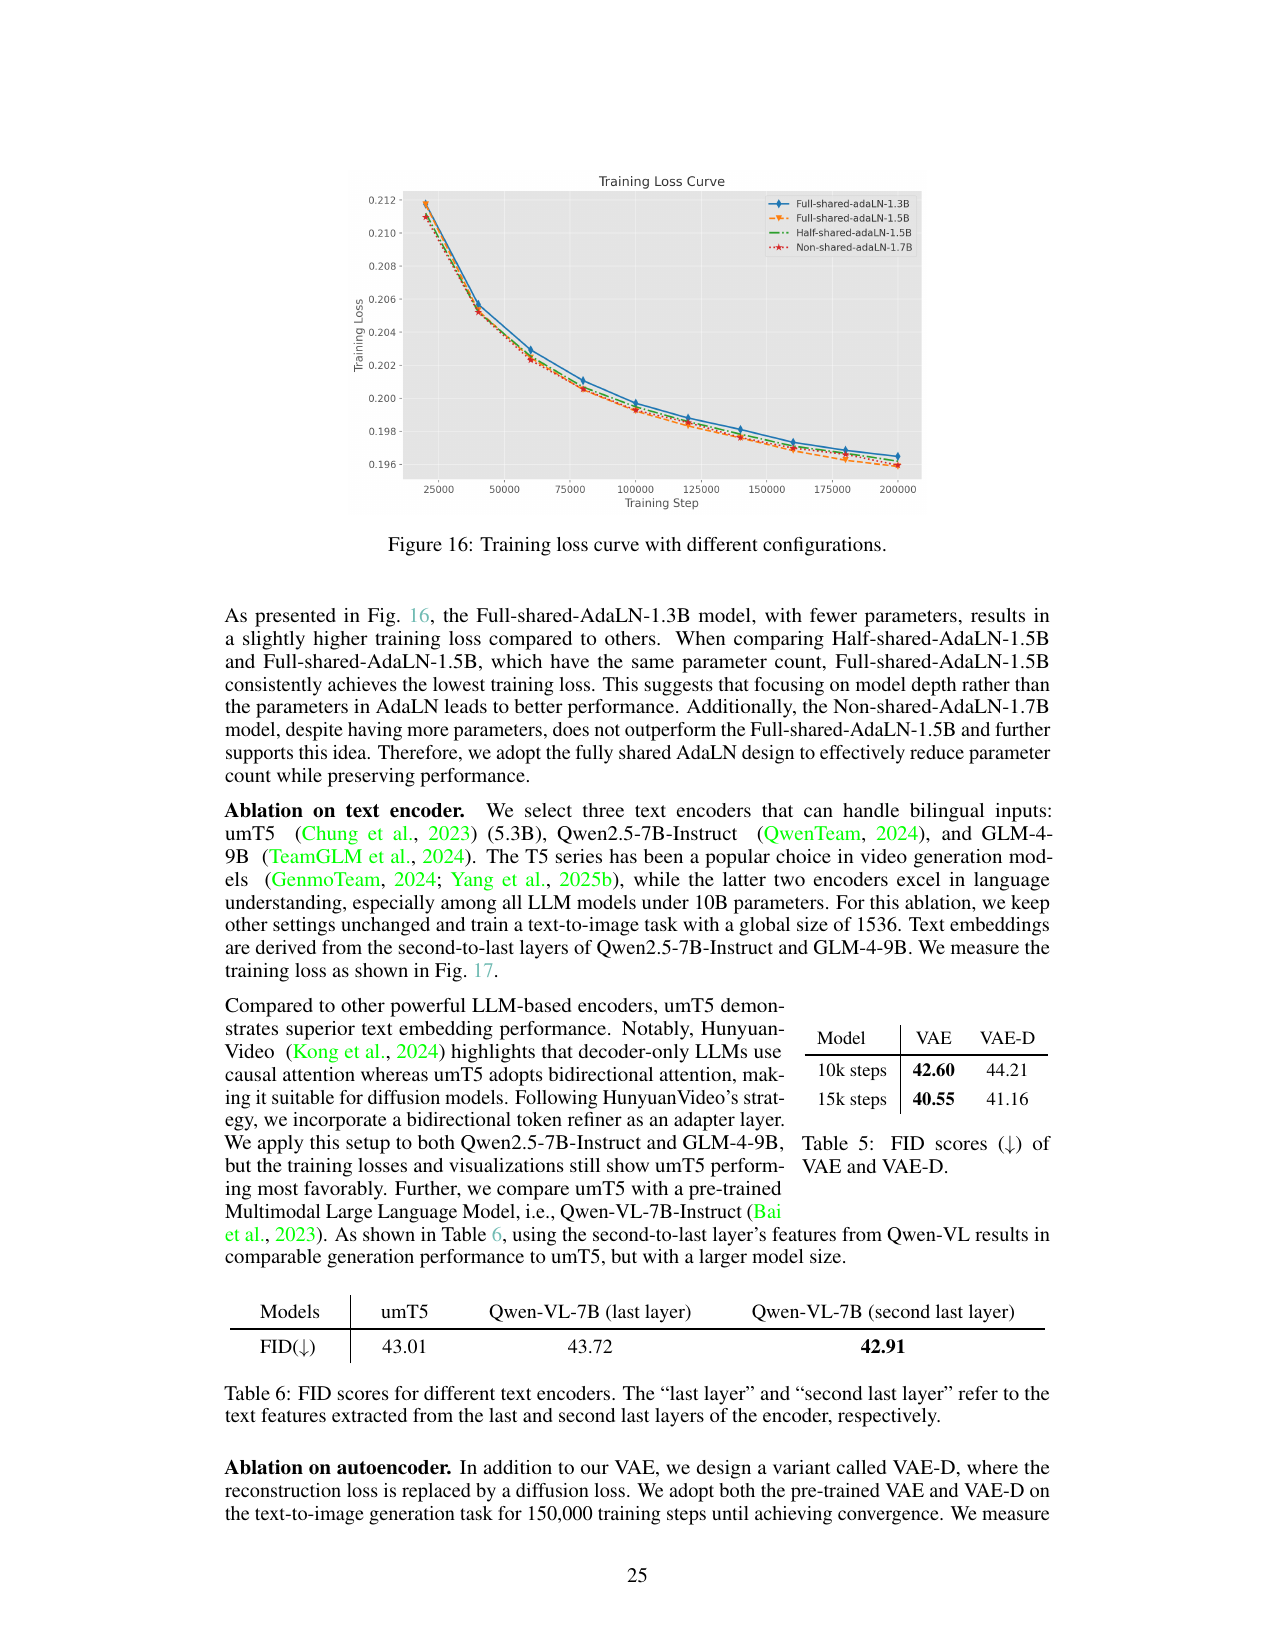
备选解释在报告里基本没被隔离:时序一致性收益没有「因果 vs 双向」的 VAE/注意力 A/B 消融,因果性可能只是压缩率或训练便利的副产品;双向注意力的优势可能来自 umT5 的预训练规模而非注意力方向(作者没做同规模同预训练的方向对照);端到端 SOTA 可能主要由数据规模(数十亿图文、O(1) 万亿 token)与课程训练驱动;Streamer 窗口大小 $w = T$ 的选择没有消融。换句话说,机制→干预这一环在这份报告里是缺席的,而不是薄弱。
干预与形式化:flow matching 课程 + 组件级手术
机制缺席不耽误工程。训练侧的形式化是 flow matching(Rectified Flow 线性插值 + logit-normal 采样 $t$ + MSE 速度损失):
$$x_t = t\,x_1 + (1-t)\,x_0, \qquad v_t = \frac{dx_t}{dt} = x_1 - x_0$$
$$\mathcal{L} = \mathbb{E}_{x_0, x_1, c_{txt}, t}\big[\|u(x_t, c_{txt}, t; \theta) - v_t\|^2\big]$$
$x_1$ 是真实视频 latent,$x_0 \sim \mathcal{N}(0, I)$ 是噪声,$t\in[0,1]$ 按 logit-normal 分布采样,$x_t$ 是两者的线性插值;$v_t = x_1 - x_0$ 是插值路径的匀速速度场,模型 $u(\cdot; \theta)$ 学的是预测这个速度,$c_{txt}$ 是 umT5 的 512 token 文本嵌入。训练分四阶段课程:先 256px 的 T2I 预训练对齐语义与几何,再 192px/16fps/5 秒视频与图联合,然后 480px、720px 逐级上分辨率(§4.2.2, p14-15)——这样避开「高分辨率 + 长时序联合训练」导致的吞吐骤降与梯度方差尖峰。
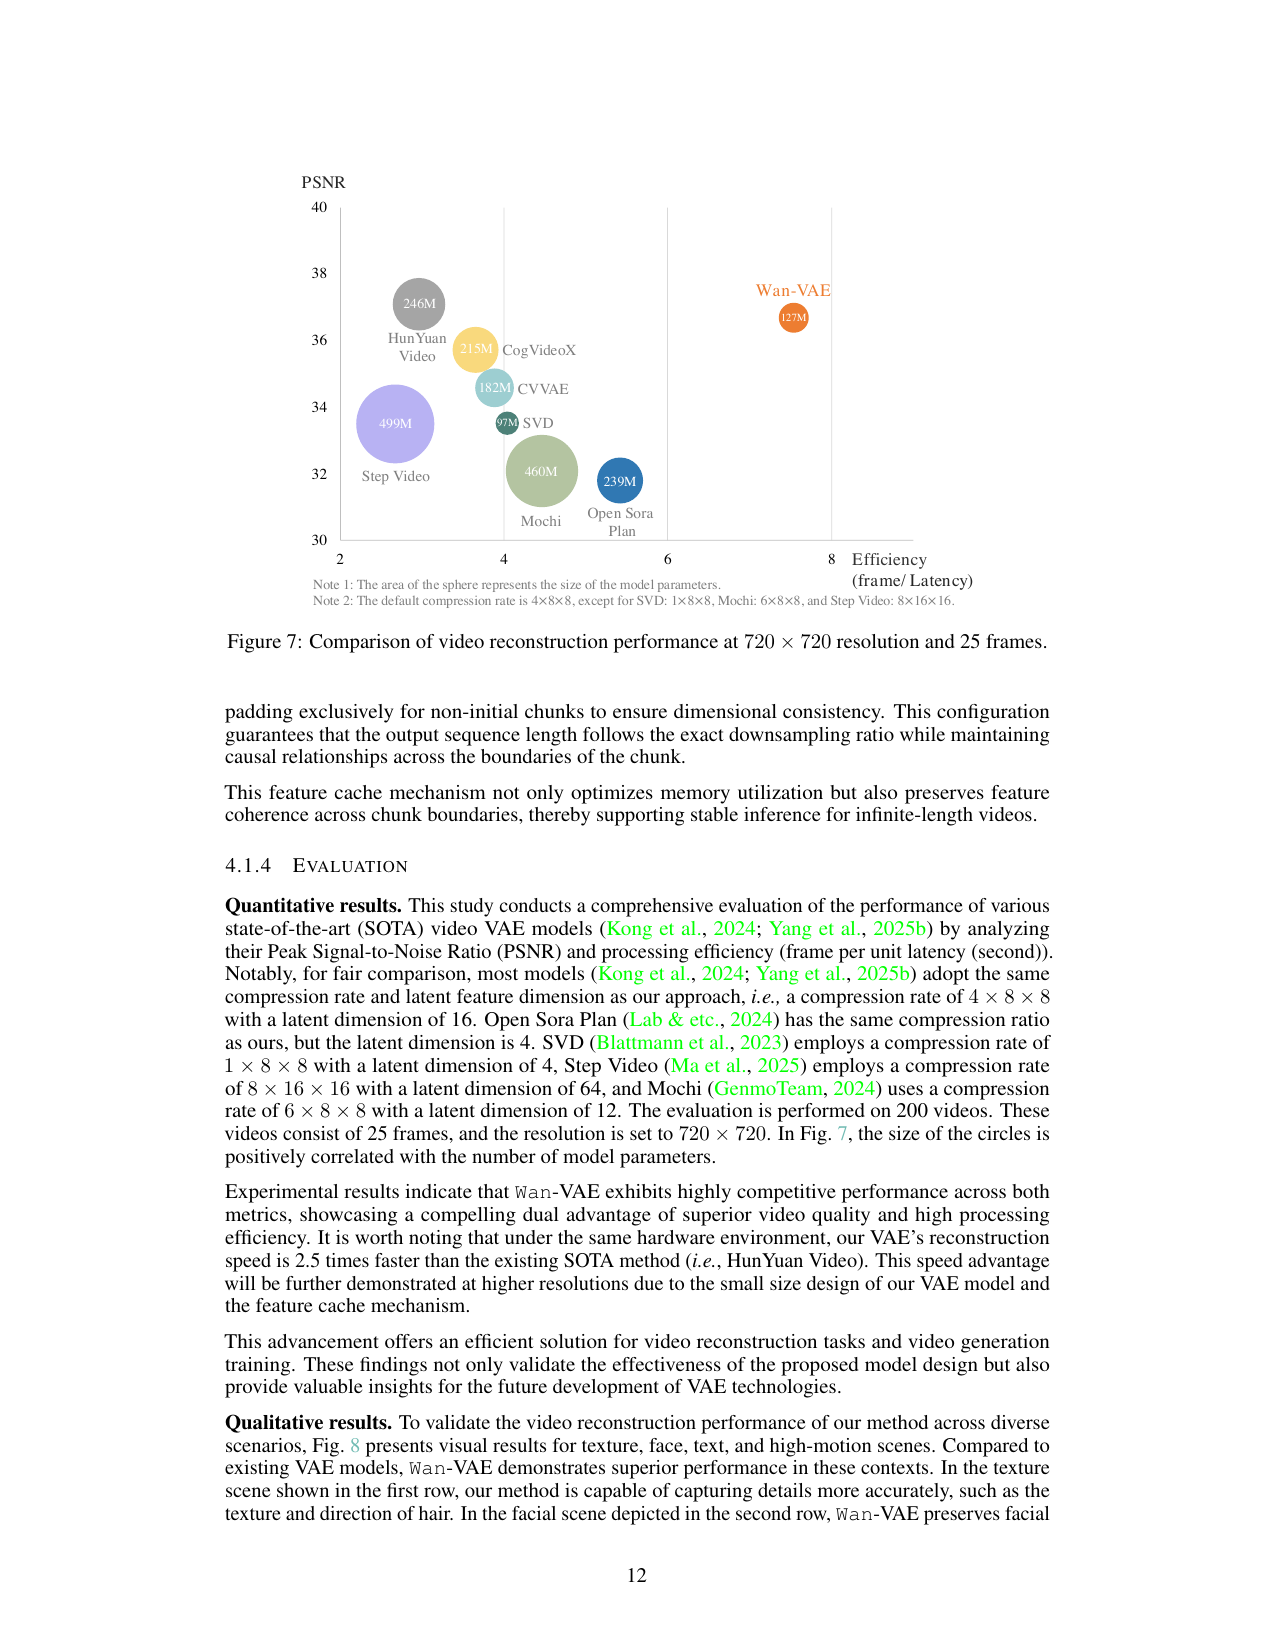
组件级干预选四个有数字的。Wan-VAE(127M 参数):3D 因果卷积 + 时序下采样 + feature cache,200 个 720×720/25 帧视频上 PSNR≈38 全场最高、效率约 6 frame/latency,重建速度 2.5× HunyuanVideo(Fig. 7, p12):
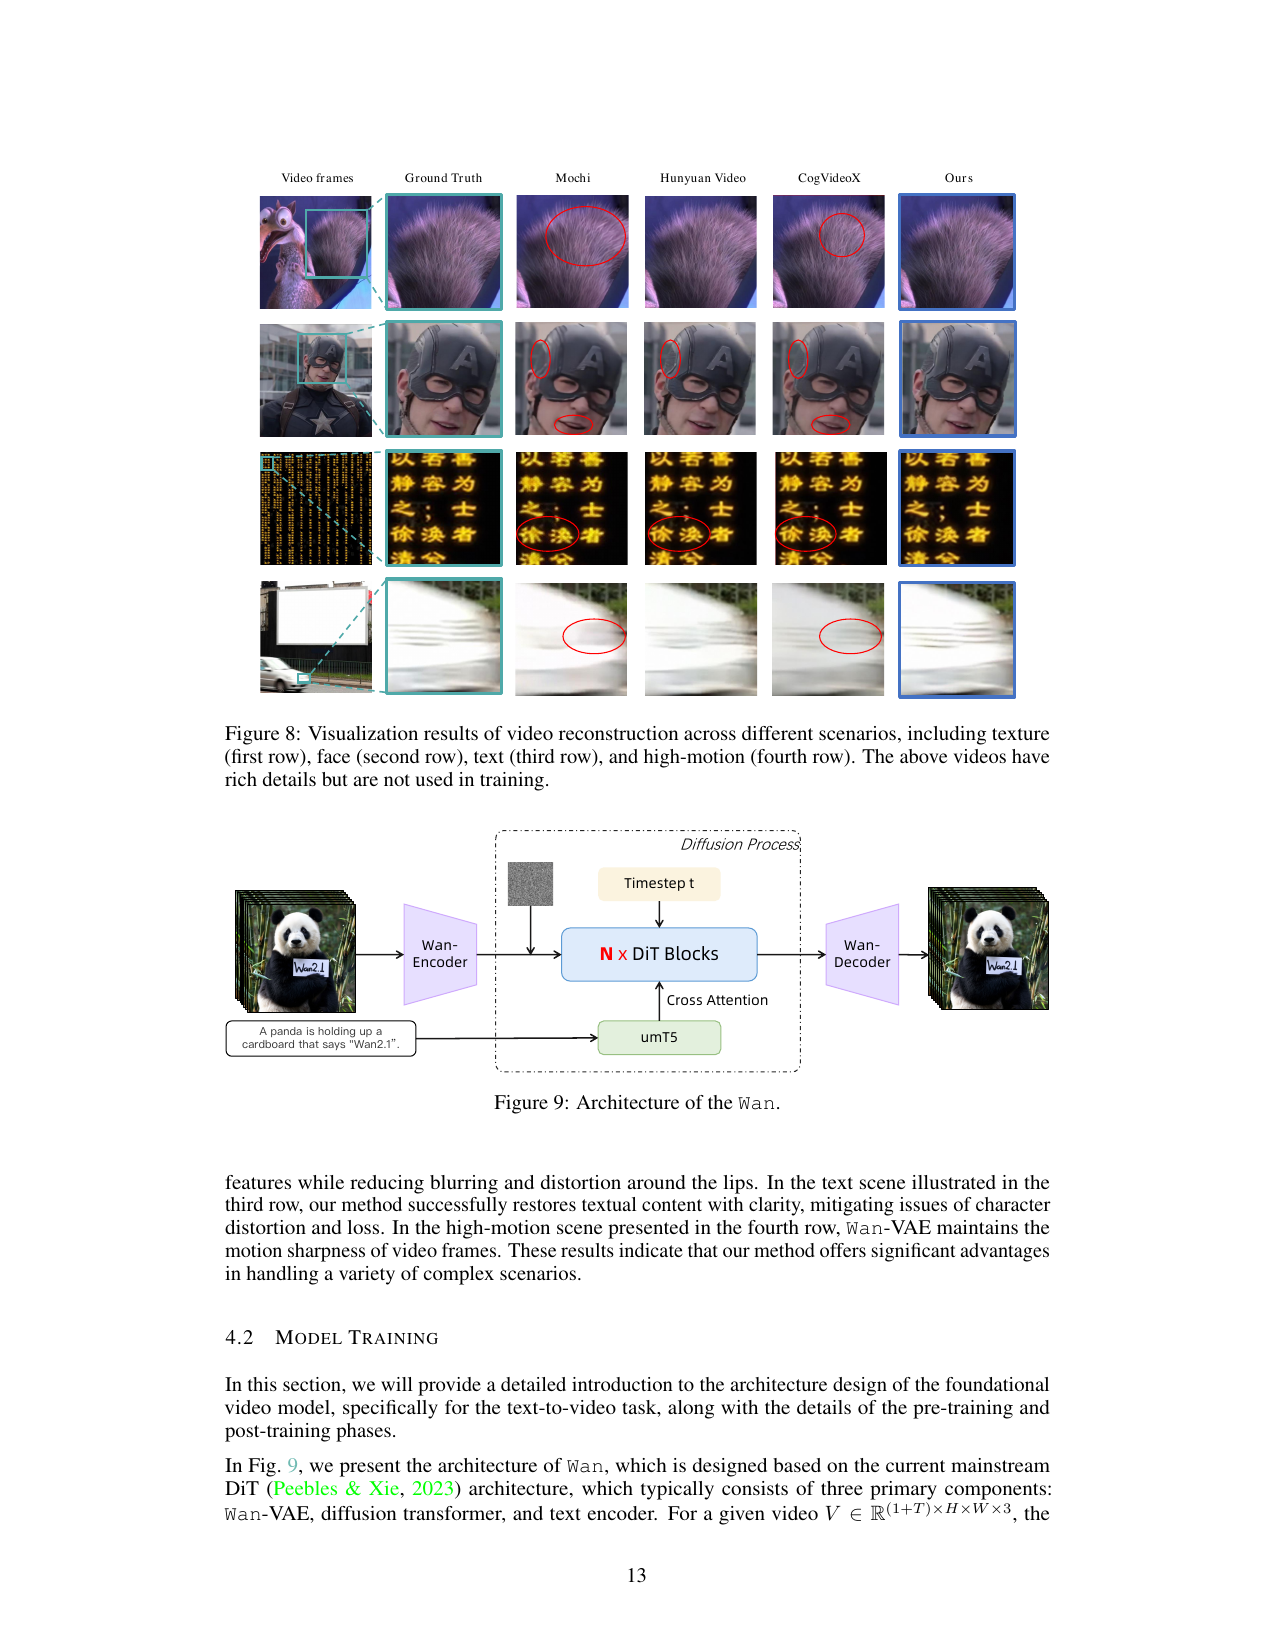
DiT 主干:全时空自注意力(非分窗、非 U-ViT——U-ViT 只是 related work 里 Mochi 的主干)+ 交叉注意力注入 umT5 + 共享时间嵌入 MLP(各 block 只学 bias,参数 −25%)。推理优化:diffusion cache 1.62×、FP8 GEMM 1.13×、8-bit FlashAttention 1.27×(H20 上 95% MFU,混合 int8/FP8 + FP32 跨块累加,FA3 原生 FP8 在视频上质量明显退化)。Streamer + LCM 蒸馏:滑动去噪窗口 + 缓存 token 以噪声 0 重注入 + 4 步一致性模型,10–20× 加速、8–16 FPS 渲染,单张 4090(int8 + TensorRT)8 FPS、演示 20 FPS(§5.6.3, p44)。整条主干的架构图就是 Figure 9——它是全文所有干预的挂载点:
收益与最弱一环
端到端收益全部带外部基线:VBench 86.22%(visual 86.67 / semantic 84.44)vs Sora 84.28%、MiniMax 83.41%、Hunyuan 83.24%(Table 4, p23);自建 Wan-Bench 加权分 0.724 vs Sora 0.700(每模型 1,035 样本、5,000+ 对人工偏好加权,Table 2, p21);700+ 任务人工评测里 overall ranking 对 Runway 胜率 67.6%(Table 3, p23)。1.3B 小模型 VBench 83.96% 也超过 Hunyuan 与 Kling,显存只要 8.19 GB。但归因边界报告自己也守不住:VBench 数字是自报口径,Wan-Bench 是自建评测,数据与算力规模不披露,端到端分数无法分离到任何一个单一设计。
另有几个自对照值得记录:VAE 比 VAE-D(重建 loss 换扩散 loss)在 T2I 上 FID 全面更低(15k 步 40.55 vs 41.16,Table 5, p25);推理期用 Qwen2.5-Plus 把用户 prompt 改写成训练 caption 的分布(加细节不改语义、补自然动作、按「风格→内容摘要→细节」结构),在 Wan-Bench 上有提升但报告没给具体增益数字(§4.5, p19-20)。
最弱一环是机制到干预的推导链:报告从不宣称机制,干预全部来自工程观察复用(HunyuanVideo 的双向注意力观察、DiT 主流范式、流匹配框架),因果性、窗口依赖、跨步冗余三条假设都没有对照实验隔离;消融只到 1.3B 模型的训练 loss/FID 级(AdaLN 四种配置、文本编码器三选一、VAE vs VAE-D),无 seed 方差、无显著性检验。这是一份诚实的工程报告:收益数字可信,机制叙事空缺——读它时把「设计理由」和「已验证因果」分开记账。
一句话记住这篇
Wan 2.1 是「可观测设计选择 → 工程干预」的样板:注意力成本(1M token 占训练 95%)、chunk 边界断裂、跨步注意力冗余、量化闪烁,每个现象都有对应干预(因果 VAE + feature cache、全时空 DiT、diffusion cache、混合精度),端到端 VBench 86.22% 压过 Sora 的 84.28%;但机制假设一条都没有被当作可证伪命题检验,最弱一环是「机制→干预」的缺席。最该记住的数字:因果卷积核为 3 时,跨 chunk 只需缓存前 2 帧,就能支持无限长视频稳定推理——时序一致性的工程化,往往只需要一个很小的状态。
Wan 2.1 是系统级视频生成技术报告:以『因果 3D VAE + 全时空注意力 DiT + flow matching 分阶段课程训练』为设计主干,把时序一致性、长视频上下文、双向 vs 单向注意力等可观测设计选择转成工程干预并给出端到端收益(VBench 86.22%、Wan-Bench 0.724、VAE 提速 2.5×、LCM 10–20×);但机制层解释多为设计理由而非可证伪假设,『机制→干预』一环全程缺对照,是典型『强工程、弱机制』的闭环。
闭环(Observation → Mechanism → Intervention → Gain)
① 可观测现象
观测到什么:三类可观测现象:(1) 时序类——『未来帧不应影响过去帧』被作者视为生成真实连贯视频的关键约束(§4.1, p10);传统 DiT 受注意力长时序开销限制只能生成几秒视频(§5.6.2, p40);TensorRT 量化在部分情况引入可测量的不稳定——闪烁(flickering)与时序不连贯(§5.6.3, p44);VAE 长视频逐 chunk 编码/解码时若不在 chunk 间维持特征缓存,会在 chunk 边界失去时序连续性(§4.1.3, p11-12)。(2) 注意力方向类——decoder-only LLM 的因果注意力作为扩散文本编码器表现不佳,双向注意力的 umT5 收敛更快、组合性更好(§4.7.2, p25,观察承自 HunyuanVideo);同一 DiT block 内不同采样步的 attention 输出高度相似、采样后期条件/无条件输出相似(§4.4.2, p18)。(3) 数据/训练动态类——高分辨率+长时序联合训练导致吞吐骤降与梯度方差尖峰(§4.2.2, p14);抖动镜头、静态视频、低质运动数据损害运动生成质量(§3.1, p6);合成图像污染 <10% 即显著降性能(§3.1, p6);I2V 首帧与内容差异大时模型难以学到稳定的图生视频(§5.1.2, p27)。
在哪里观测:贯穿 T2V/I2V/编辑/个性化/实时/音频共 8 个任务;核心设置:Wan-VAE(127M 参数,4×8×8 时空压缩,latent C=16,§4.1.1, p10)、Wan 1.3B/14B DiT、umT5 文本编码器;评测在自建 Wan-Bench(每模型 1,035 样本)、公开 VBench、200 个 720×720/25 帧重建集、700+ 人工评测任务上进行(§4.6-4.7, p20-23)。
如何量化:现象大多以『设计动机+定性描述』呈现,量化集中在端到端指标:Wan-Bench 14 维自动评分 + 5,000+ 对人工偏好加权(§4.6, p21);VBench 16 维公开榜(Table 4, p23);VAE 用 PSNR×效率散点(200 视频,Fig 7, p12);caption 模型用 CAPability 协议 F1(10 维 × 1,000 视频,Fig 4, p9);实时性用 FPS(Fig 30/31, p42)。注意:flicker/时序一致性等关键现象本身没有直接量化指标,只有『像素级稳定性』(静态区帧间差)等 proxy(§4.6, p20-21)。
② 机制假设
假设:报告给的是设计理由而非可证伪机制假设,主要五条:(1) 时序因果性——未来帧不影响过去帧是生成真实连贯视频的关键,故 VAE 采用 3D 因果卷积 + RMSNorm(替换 GroupNorm)保证因果性(§4.1, p10;§4.1.1, p10);(2) 双向注意力适合扩散——decoder-only 因果注意力不适合扩散文本条件注入,双向 umT5 的组合性与收敛更优(§4.7.2, p25,观察承自 HunyuanVideo 并复用其 bidirectional token refiner 策略);(3) 局部时序依赖假设——时序依赖局限在有限时间窗口内,故 Streamer 用滑动窗口即可维持视频连续性(§5.6.2, p42);(4) 跨步注意力冗余——不同采样步 attention 输出相似 + CFG 后期条件/无条件输出相似,故可缓存复用(§4.4.2, p18);(5) 深度优于 AdaLN 参数量——同参数下加深层数比加大 AdaLN 更有效(§4.7.2, p24)。
证据:
- 因果性设计的工程收益:RMSNorm + feature cache 使任意长视频 chunk 推理不产生边界断裂、支持无限长稳定推理(§4.1.3, p11-12);VAE 重建速度 2.5× HunyuanVideo(§4.1.4, p12)。
- 双向注意力:umT5 在 T2I 任务 FID 43.01,优于 Qwen-VL-7B 末层 43.72(但次于其倒数第二层 42.91);给 Qwen2.5/GLM-4 加双向 token refiner 适配层后训练损失与可视化仍不如 umT5(§4.7.2, Table 6, p25)。
- 滑动窗口:Streamer 在 8 A100 上实时 8 FPS 生成 15 分钟视频(Fig 30, p42);单 4090 + int8/TensorRT 演示 20 FPS(Fig 31, p42)。
- 跨步冗余:diffusion cache 给 14B T2V 带来 1.62× 推理加速(§4.4.2, p18)。
- 深度>参数:Full-shared-AdaLN-1.5B(35 层)训练 loss 最低,胜过参数更多的 Non-shared-AdaLN-1.7B(30 层)(Fig 16, p24)。
备选解释:
- 时序一致性/生成质量收益未隔离到因果设计:无『因果 vs 双向』VAE 或注意力的 A/B 消融,因果性可能只是压缩率/训练便利的副产品(§4.7.2 仅做 VAE vs VAE-D 损失项消融)。
- 双向注意力优势可能来自 umT5 的预训练质量/规模而非注意力方向本身——作者未做同规模同预训练下的方向对照,『双向适合扩散』是借来的假设。
- 端到端 SOTA 收益可能主要由数据规模(数十亿图文、O(1) 万亿 token)与课程训练驱动,而非任何单个设计选择;且评测部分为自建(Wan-Bench)或自报(VBench 口径),有选择性风险(§4.6, p20-21)。
- Streamer 的『局部窗口依赖』假设未被检验:窗口大小 w=T 的选择无消融,也不清楚窗口外信息被截断的代价。
形式化/toy model:工程层形式化存在:flow matching 目标 xt = tx1 + (1−t)x0、vt = x1 − x0、MSE 速度损失(Eq. 1-3, §4.2.2, p14);DiT 计算成本模型 L(αbsh² + βbs²h),非因果注意力 β=4(前向)/8(反向),1M token 时 attention 占训练时间高达 95%(§4.3.1, p15)。机制层形式化(如因果注意力如何产生时序一致性的理论刻画、窗口大小的信息论依据、双向注意力为何利于扩散)不存在——标 null。
③ 局部干预
干预对象:Wan-VAE(图 5-6)
操作:3D 因果卷积 + 时序 2× 下采样;GroupNorm→RMSNorm(『保时序因果性』);首帧仅空间压缩(沿用 MagViT-v2);空间上采样层输入通道减半(推理内存 −33%);feature cache(chunk 化推理:1+T/4 个 chunk、每 chunk ≤4 帧,因果卷积核 3 时缓存前 chunk 末 2 帧、2× 时序下采样时缓存 1 帧,初始 chunk 零填充);127M 参数;三阶段训练:2D 图像 VAE→inflate 为 3D 因果 VAE→128×128/5 帧低分辨率训练→高质量微调 + 3D 判别器 GAN loss(损失 L1×3 + KL×3e-6 + LPIPS×3)(§4.1.1-4.1.2, p10-11)
效果:200 视频 720×720/25 帧评测中 PSNR≈38 为全场最高、效率约 6 frame/latency(Fig 7, p12);重建速度 2.5× HunyuanVideo(§4.1.4, p12);支持任意长视频稳定推理(§4.1.3, p11)
局部性:干预严格限定在 VAE 内部,DiT 完全不变;因果性与长视频能力以『架构约束』层面注入,属组件级而非机制级定位
干预对象:DiT 主干(§4.2.1, p14)
操作:全时空自注意力(非分窗、非 U-ViT——U-ViT 仅出现在 related work 对 Mochi 的描述里,§2, p5);交叉注意力注入 umT5 条件;共享时间嵌入 MLP(预测 6 个调制参数,各 block 只学 bias,参数 −25%);patchify 3D 卷积核 (1,2,2),序列长 L=(1+T/4)×H/16×W/16
效果:无单独量化(与数据规模、课程训练捆绑在端到端结果里);25% 参数节省有消融旁证(Full-shared-AdaLN 训练 loss 对比,Fig 16, p24)
局部性:全局架构选择,无注意力形式 A/B 消融
干预对象:训练课程与优化(§4.2.2, p14-15)
操作:flow matching(Rectified Flow 线性插值、logit-normal 采样 t、MSE 速度损失)+ 四阶段课程:256px T2I 预训练→(256px 图 + 192px/16fps/5s 视频)→480px→720px;bf16 混合精度、AdamW wd=1e-3、lr=1e-4、按 FID/CLIP Score 平台期降 lr
效果:端到端 SOTA(VBench 86.22% 等),但每阶段增益未单独消融
局部性:训练协议级干预,覆盖全部模块,无法归因到单一设计
干预对象:Streamer 滑动窗口 + LCM 蒸馏(§5.6.2-5.6.3, p40-44)
操作:2w 个 token 的训练序列(w=窗口=扩散步数 T),前 w 个仅 warmup 不计 loss;推理用去噪队列滑动:最左 token 出队缓存、新噪声 token 入队;缓存 token 以噪声 0 重新入队保证窗口间连续性;再以 Latent Consistency Model 蒸馏成 4 步一致性模型
效果:10–20× 推理加速、8–16 FPS 渲染(§5.6.3, p44);8 A100 实时 8 FPS 生成 15 分钟视频(Fig 30, p42);单 4090 int8+TensorRT 8 FPS/演示 20 FPS(§5.6.3, p44;Fig 31, p42)
局部性:从预训练模型微调(主干权重继承);窗口大小 w=T 无消融
干预对象:推理优化(§4.4.2-4.4.3, p18-19;§5.6.3, p44)
操作:diffusion cache(跨步 attention 缓存 + CFG 跨步缓存 + 残差补偿);FP8 GEMM(per-tensor 权重/per-token 激活);8-bit FlashAttention(S=QK^T 用 int8、O=PV 用 FP8、跨块 FP32 累加 + block size 调优);int8(torchao) + TensorRT 量化
效果:diffusion cache 1.62×;FP8 GEMM 1.13×(DiT 模块,相对 BF16 GEMM 2×);8-bit FA 1.27×、H20 上 95% MFU;代价是 TensorRT 引入 flickering/时序不连贯(§5.6.3, p44)
局部性:推理管线级,训练权重不变
干预对象:推理期 prompt 改写(§4.5, p19-20)
操作:Qwen2.5-Plus 按训练 caption 分布改写用户 prompt(加细节不改语义、补自然动作、按『风格→内容摘要→细节』三段式结构),并给每图像/视频配多风格多长度 caption
效果:Wan-Bench 上提升(Table 1 示例;具体增益数字未给)
局部性:纯推理期,模型权重零改动
因果验证:弱。报告以系统级评测 + 少量模块级消融为主:AdaLN 四种配置训练 loss 曲线(Fig 16, p24)、文本编码器三选一(Fig 17 + Table 6, p25)、VAE vs VAE-D 损失项(Table 5, p25)——全部是 1.3B 模型上『训练损失/FID 级』对比,无 seed 方差、无逐干预归因、无因果/双向注意力 A/B、无窗口大小消融;端到端数字(VBench/Wan-Bench/人工评测)无法分离到任何单一设计选择。
④ 工程收益
指标:VBench 总分
数值:86.22%(visual 86.67 / semantic 84.44)
基线:Sora 84.28%、MiniMax-Video-01 83.41%、Hunyuan 83.24%、Gen-3 82.32%、CogVideoX1.5-5B 82.17%、Kling 81.85%;Wan 1.3B 83.96%
设置:Wan 14B(2025-02-24 checkpoint),公开 VBench 榜(Table 4, p23)
指标:Wan-Bench 加权总分
数值:0.724(14B);0.689(1.3B)
基线:Sora 0.700、CN-TopA 0.693、CN-TopB 0.690、Hunyuan 0.673、Mochi 0.639
设置:每模型 1,035 样本、Wan-Bench prompts;14 维自动评分 + 5,000+ 对人工偏好加权(Table 2, p21;§4.6-4.7.1, p21-22)
指标:人工评测 T2V 胜率
数值:overall ranking:vs Runway 67.6%、vs CN-TopC 48.9%、vs CN-TopA 44.0%、vs CN-TopB 44.0%;matching:vs Runway 69.1%;visual quality:vs Runway 48.1%
基线:逐对对比中 Wan 14B 胜出比例;总轮数 overall 5,560 / visual 5,710 / motion 5,785 / matching 5,578
设置:700+ 任务、20+ 标注者、4 维度(Table 3, p23)
指标:VAE 重建 PSNR 与速度
数值:PSNR≈38(对比模型中最高);重建速度 2.5× HunyuanVideo
基线:HunyuanVideo(215M)PSNR≈36.5;Mochi、CogVideoX、CVVAE、SVD、StepVideo、Open Sora Plan 均更低;同压缩率 4×8×8 + latent 16 对齐
设置:200 视频、25 帧、720×720(Fig 7, p12;§4.1.4, p12)
指标:推理加速
数值:diffusion cache 1.62×;8-bit FlashAttention 1.27×、H20 上 95% MFU;FP8 GEMM 1.13×(DiT 模块)
基线:无缓存 BF16 基线;FA3 原生 FP8 在视频上质量明显退化(改用混合 int8/FP8 + FP32 跨块累加)
设置:Wan 14B T2V(§4.4.2, p18;§4.4.3, p18-19)
指标:实时生成 FPS
数值:8–16 FPS(LCM+Streamer);单 4090 int8+TensorRT 8 FPS;演示 20 FPS
基线:原始 50 步扩散需数分钟生成数秒视频;LCM 蒸馏 10–20×
设置:8 A100 生成 15 分钟视频(Fig 30, p42);单 RTX 4090(Fig 31, p42;§5.6.3, p44)
指标:文本编码器 FID(T2I)
数值:umT5(5.3B)43.01
基线:Qwen-VL-7B 末层 43.72、倒数第二层 42.91(略优);Qwen2.5-7B / GLM-4-9B 训练 loss 更高
设置:T2I 任务、global size 1536(Table 6, p25;Fig 17, p25)
指标:VAE vs VAE-D(FID↓)
数值:15k 步 40.55 vs 41.16;10k 步 42.60 vs 44.21
基线:VAE-D(重建 loss 换扩散 loss)全面更差
设置:T2I 任务 150k 步(Table 5, p25)
指标:caption 模型(F1)
数值:10 维整体与 Gemini 1.5 Pro 相当;slow-fast 编码使 VideoMME 无字幕 67.6→69.1
基线:Gemini 1.5 Pro 密集 caption
设置:CAPability 协议、每维 1,000 视频(Fig 4, p9;§3.3.3, p9)
指标:视频个性化 ArcFace 相似度
数值:0.5526
基线:CN-TopA 0.5655(略高)、CN-TopB 0.5197、CN-TopC 0.4998
设置:Table 8, p37
指标:规模/成本事实
数值:DiT 占训练计算 >85%;1M token 序列时 attention 占端到端训练时间 ≤95%;激活内存 >8TB(micro-batch 1);14B 未优化单卡推理约 30 分钟/视频;1.3B 仅需 8.19GB VRAM
基线:标准 LLM 激活系数 γ≈34 vs DiT γ>60
设置:§4.3.1, p15;§6, p47;Abstract, p1
代价:训练/推理成本仍是主要代价:14B 未优化单卡约 30 分钟/视频(§6, p47);TensorRT 量化以 flickering/时序不连贯为代价(§5.6.3, p44);评测依赖自建 Wan-Bench 与内部数据,跨机构可比性有限(§4.6, p20-21);训练数据内部版权+公开混合、算力规模不披露,『训练复现』成本未知。
可迁移性:未系统验证:报告为单机构系统报告,8 个下游任务全部基于同一基础模型族;机制级结论(因果性、双向注意力、窗口依赖假设)未迁移到其他架构/数据规模验证;正向条件是代码与全部权重开源(github.com/Wan-Video/Wan2.1),第三方可复现评测与微调(Abstract, p1;§6, p48)。
闭环自评
| 环节 | 强度 |
|---|---|
| 现象→机制 | 中偏弱。现象记录丰富且系统(flicker、长视频限制、chunk 边界断裂、双向 vs 单向注意力差异、跨步注意力相似性、合成图污染阈值),但多数停留在定性描述+设计动机,只有 caption slow-fast(VideoMME 67.6→69.1)与注意力缓存(1.62×)等少数现象有直接量化;『因果性关键』『窗口依赖』等机制断言基本未测。 |
| 机制→干预 | 弱(最弱一环)。报告从不宣称机制,干预设计来自工程经验与观察复用(HunyuanVideo 的双向注意力观察、DiT 系主流范式、流匹配框架),没有任何『从机制假设推出干预』的可证伪链条;因果性带来时序一致、窗口内依赖假设、跨步注意力冗余三条都没有对照实验隔离——机制→干预在整份报告里是缺席的,而非薄弱。 |
| 干预→收益 | 中。端到端收益强且有外部基线(VBench 86.22% vs Sora 84.28%、Wan-Bench 0.724 vs Sora 0.700、人工胜率),但多个数字来自自建评测/自报榜单;消融只到模块级训练 loss(AdaLN/编码器/VAE-D),无逐干预归因、无 seed 方差、无显著性检验。 |
| 最弱一环 | mechanism_to_intervention:Wan 是系统级技术报告,闭环中『机制假设』与『机制→干预』两环近乎缺席——干预直接由工程观察驱动,缺少任何可证伪的机制链条,如实标注为整份报告的最弱一环。 |
问题
要解决什么:
为什么 prior work 不够:
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| VBench 总分 | 86.22%(visual 86.67 / semantic 84.44) | Sora 84.28%、MiniMax 83.41%、Hunyuan 83.24%、Gen-3 82.32%、CogVideoX1.5-5B 82.17%、Kling 81.85%;Wan 1.3B 83.96% 亦超 Hunyuan/Kling/CogVideoX | Wan 14B (2025-02-24);Table 4, p23 |
| Wan-Bench 加权总分 | 0.724(14B) | Sora 0.700、CN-TopA 0.693、CN-TopB 0.690、Wan 1.3B 0.689、Hunyuan 0.673、Mochi 0.639 | 1,035 样本/模型、Wan-Bench prompts、5,000+ 对人工偏好加权;Table 2, p21 |
| 人工评测 T2V 胜率(overall ranking) | vs Runway 67.6%、CN-TopC 48.9%、CN-TopA 44.0%、CN-TopB 44.0% | matching 维度 vs Runway 69.1%;visual quality vs Runway 48.1% | 700+ 任务、20+ 标注者、4 维度;Table 3, p23 |
| VAE 重建 PSNR 与速度 | PSNR≈38(全场最高);速度 2.5× HunyuanVideo | HunyuanVideo 215M PSNR≈36.5;同压缩率 4×8×8+latent 16 对齐;Mochi/CogVideoX/CVVAE/SVD/StepVideo/Open Sora Plan 均更低 | 200 视频、25 帧、720×720;Fig 7, p12;§4.1.4, p12 |
| 推理加速 | diffusion cache 1.62×;8-bit FlashAttention 1.27×;FP8 GEMM 1.13×(DiT) | 无缓存 BF16 基线;FA3 原生 FP8 质量明显退化 | Wan 14B T2V;§4.4.2, p18;§4.4.3, p18-19 |
| 实时生成 | 8–16 FPS(LCM+Streamer,10–20× 加速);单 4090 int8+TensorRT 8 FPS;演示 20 FPS | 原始 50 步扩散数分钟/数秒视频 | 8 A100 生成 15 分钟视频(Fig 30, p42);RTX 4090(Fig 31, p42;§5.6.3, p44) |
| 文本编码器 FID | umT5 43.01 | Qwen-VL-7B 末层 43.72、倒数第二层 42.91(仅此处略优);Qwen2.5-7B/GLM-4-9B 训练 loss 更高 | T2I、1536 global size;Table 6 + Fig 17, p25 |
Insights
- 这是一份『可观测设计选择→工程干预』的系统报告样板:每个大设计(因果 VAE、全时空注意力、flow matching 课程、滑动窗口、缓存、量化)都对应一个可观测的训练/推理现象,但几乎没有一条被机制化检验——解释层是最薄一环。
- 时序一致性的工程化路径是三维的:数据侧(剔除抖动/静态/低质运动视频,§3.1, p6;SigLIP 过滤首帧-内容失配,§5.1.2, p27)、架构侧(因果卷积+feature cache 保 chunk 边界连贯,§4.1.3, p11)、推理侧(Streamer 缓存 token 以噪声 0 重注入保窗口间连贯,§5.6.2, p43;TensorRT 误差导致的 flicker 被明确承认,§5.6.3, p44)——同一现象在三个层面都有干预,但 flicker 本身没有任何直接指标。
- 双向 vs 单向注意力的可观测差异只在文本编码器被记录(umT5 双向 vs decoder-only 因果,§4.7.2, p25),且观察承自 HunyuanVideo;报告未做同规模同预训练的方向对照,『双向适合扩散』仍是借来的假设。
- U-ViT 只是 related work 中 Mochi 的主干(§2, p5);Wan 主干是带全时空自注意力的普通 DiT(§1, p3;§4.2.1, p14)——不要把本报告误读成 U-ViT 系架构报告。
- 收益归因边界诚实但未被打破:数据 O(1) 万亿 token、数十亿图文、课程训练与架构选择完全捆绑,『某个设计贡献了多少』无从分离;报告用公开榜(VBench)对冲自建评测(Wan-Bench)的偏向,但 VBench 数字同样是自报。
- 负例比正例更接近机制可观测:合成图污染 <10% 即有害(§3.1, p6)、FA3 原生 FP8 在视频上质量退化(§4.4.3, p18)、TensorRT 量化引入 flicker(§5.6.3, p44)、decoder-only 因果注意力不适配扩散(§4.7.2, p25)——这四条『观测→设计取舍』链条比任何正向叙事都更完整。
vs 同类工作
局限
- 机制层全部缺环:无因果/双向注意力消融、无 VAE 因果性消融、无 Streamer 窗口大小消融;『因果性关键』『窗口依赖假设』均未可证伪化。
- 评测偏向:Wan-Bench 为自建(含人工偏好加权),VBench 结果自报;人工评测样本(700+ 任务、20+ 标注者)相对模型规模偏小;无统计显著性、无 seed 方差报告。
- 关键数字缺少复现细节:8.19GB VRAM、2.5×、1.62×、10–20× 等的硬件/精度/步数/缓存策略未完整披露;VAE PSNR≈38 只以散点图呈现(Fig 7, p12),无数值表。
- 训练数据与算力不披露(『internal copyrighted sources』、数十亿图文、O(1) 万亿 token、GPU 规模未知),可复现性主要靠开源权重而非训练流程。
- 作者自述限制:大运动场景细节保真仍差、14B 未优化推理约 30 分钟/视频、特定领域(教育/医疗)能力不足(§6, p47);音频生成不含人声(§5.7, p47)。
- 部分下游任务评估为纯定性:编辑(§5.2.3, p35)、音频(§5.7.2, p47)、T2I(§5.3, p35)无量化证据;个性化 ArcFace 还低于 CN-TopA(0.5526 vs 0.5655,Table 8, p37)。
可复现性
代码与全部模型权重开源:https://github.com/Wan-Video/Wan2.1(Abstract, p1;§6, p48)。VAE/DiT 架构、训练超参(bf16、AdamW wd=1e-3、lr=1e-4、flow matching 方程 Eq.1-3、logit-normal 采样)、课程阶段(256px T2I→192/480/720px)均有文字级描述(§4.1-4.2, p10-15),可在开源权重上复现评测与下游微调;但训练数据(内部版权+公开混合、数十亿图文、O(1) 万亿 token)与算力不披露,Wan-Bench 的具体 prompt 集与打分模型未全部发布,人工评测协议无细节,『从零复现训练』不可行、『复现评测/微调』可行。注意:arXiv 显示 62 位作者('Team Wan and 61 other authors'),正文 §7 按名字母序列出;本文档基于 v2(2025-04-19),与 v1(2025-03-26)为同版式,数字以 v2 为准。
VAE 重建质量(PSNR)× 效率散点(720×720 / 25 帧)
原文 caption:Comparison of video reconstruction performance at 720×720 resolution and 25 frames. The area of each sphere represents the size of the model parameters. (caption 由 PDF 文本清理)
VAE 设计的核心收益图:纵轴重建 PSNR、横轴效率(帧/延迟),圆点面积对应参数量,全部模型对齐 4×8×8 压缩率 + latent 16(SVD/Mochi/StepVideo 除外,见原图注)。Wan-VAE(127M 参数)落在右上角:PSNR≈38 全场最高、效率约 6 frame/latency,比 HunyuanVideo(215M)快 2.5×——证明「3D 因果 + 小模型 + feature cache」这套干预在质量与速度上同时成立,是「工程干预→可量化收益」里最干净的一处。
Wan 整体架构:Wan-VAE + DiT + umT5
原文 caption:Architecture of the Wan. (caption 由 PDF 文本清理)
全文架构主张的目视锚点:输入视频经 Wan-VAE 编码为 latent,3D patchify 后进入 N× DiT block(全时空自注意力 + umT5 交叉注意力 + 时间步条件调制),再经 VAE 解码回像素。读图确认三件事:主干是 diffusion transformer 而非 U-ViT 分窗结构;文本条件走 umT5 交叉注意力;时间步与文本通过调制注入——后续所有干预(feature cache、diffusion cache、Streamer、量化)都挂在这条主干上。
四种 AdaLN 配置的训练 loss 曲线
原文 caption:Training loss curve with different configurations. (caption 由 PDF 文本清理)
全报告为数不多的真消融:四种 AdaLN 配置(Full-shared-1.3B / Half-shared-1.5B / Full-shared 加深 1.5B / Non-shared-1.7B)在同一 T2I 预训练设置(20 万步、global batch 1536)下的训练 loss。Full-shared-AdaLN-1.5B(35 层)收敛最低,胜过参数更多的 Non-shared-AdaLN-1.7B(30 层)——支撑「同参数下加深层数比加大 AdaLN 更有效」这一设计理由;但证据停在训练 loss 级,没有下游任务归因,也说明报告机制层验证的边界在哪。
🎧 音频版
时长 19:38 · Edge TTS
VBench 86.22% 压过 Sora 的开源视频模型,强在工程、弱在机制(对话版)
小播:今天聊一篇视频生成圈很热的技术报告——阿里的 Wan 2.1,全开源。
老播:先给结论:它在公开榜 VBench 上拿了 86.22%,压过 Sora 的 84.28%;它最强的点,是示范了一套系统级的工程范式——每个大设计都对应一个可观测现象,却没有一个被机制化检验。
小播:意思是工程很强、机制很弱?
老播:对,这是整份报告的底色。我们从头拆,先看它观察到哪些现象。
现象:注意力太贵、边界会断、采样步在偷懒
老播:第一个现象是成本。视频生成的主干是 DiT,注意力开销随序列长度平方增长。论文算了一笔账:序列到 1M token 时,注意力占训练时间的 95%。
小播:95%?那其他模块基本等于白跑。
老播:对,这个数字解释了报告里几乎所有设计——为什么要拼命压缩视频、为什么要缓存、为什么要滑动窗口。第二个现象在解码路径:长视频逐块处理时,块与块之间不维持缓存,画面就会在边界断裂。
小播:这个他们怎么修的?
老播:很轻:因果卷积的核是 3,只要缓存前一个块的末尾 2 帧,就能保证任意长度视频稳定连贯。第三个现象在采样侧:同一个 block 里,不同采样步的注意力输出高度相似,所以缓存复用,推理直接快 1.62 倍。
小播:还有个现象值得提:TensorRT 量化会带来闪烁,他们自己承认了。
老播:对,这是负例,但它比正例更接近「可检验的现象」——合成图污染不到 10% 就有害、FP8 注意力原生实现会退化、量化引入闪烁,这些才是真观测。
机制:五条设计理由,没有一条被当假说检验
小播:那机制层呢?
老播:报告给了五条设计理由,但没有一条做了对照实验。第一,时序因果性:未来帧不该影响过去帧,所以 VAE 用因果卷积加 RMSNorm。第二,双向注意力适合扩散:所以文本编码器选 umT5 而不是 decoder-only 的模型。
小播:这两条听起来都挺合理啊。
老播:合理不等于验证过。因果性的收益没有「因果对双向」的 A/B 消融;双向注意力的优势可能来自 umT5 的预训练规模,而不是注意力方向——作者没做同规模的方向对照。第三条局部窗口依赖:假设时序依赖只在一个窗口内,Streamer 才敢用滑动窗口生成无限长视频,但窗口大小本身没有消融。第四条跨步冗余和第五条深度优于 AdaLN 参数量,同样只到工程证据。
小播:那「深度优于 AdaLN」这个总该有实验吧?
老播:有,这是全报告最接近消融的一个:四种配置比训练 loss,35 层的全共享 AdaLN 模型收敛最好,胜过参数更多的 30 层模型。但证据只到训练 loss,没有下游任务归因。
干预:因果 VAE 加课程训练,把工程做满
小播:机制缺席,那工程上做了什么?
老播:先说 VAE:127M 参数的小模型,3D 因果卷积加特征缓存,200 个视频上 PSNR 约 38,全场最高,重建速度是 HunyuanVideo 的 2.5 倍。模型小一半还快两倍半,这是整份报告最干净的一处收益。
小播:训练侧呢?
老播:用 flow matching:真实视频和纯噪声之间做线性插值,模型学插值路径上的速度。配合四阶段课程——先 256 分辨率的文生图,再 192 的视频,然后 480、720 逐级上——绕开高分辨率加长时序联合训练导致的吞吐骤降。
小播:推理侧怎么做到实时的?
老播:两条路。一条是 Streamer:滑动去噪窗口,生成完最左边的 token 就出队缓存,新的噪声 token 入队,缓存 token 以噪声 0 重新注入保证衔接,配 LCM 蒸馏成 4 步,10 到 20 倍加速,8 张 A100 能 8 帧每秒实时生成 15 分钟视频。
小播:那这个 VAE 具体怎么个设计?
老播:输入视频压成四分之一时间、八分之一空间,通道扩到 16,第一帧只做空间压缩——这样图片和视频能在同一个 latent 空间里共用一套生成模型。特征缓存就是顺着这个因果结构做的:块与块之间只传递那 2 帧的边界状态。
小播:单卡呢?
老播:单张 4090,int8 加 TensorRT 量化,8 帧每秒,演示跑到 20 帧。代价就是前面说的:量化会引入闪烁。
收益与最弱一环
小播:端到端收益都带基线吗?
老播:带:VBench 86.22%,对比 Sora 84.28%、MiniMax 83.41%;自建 Wan-Bench 0.724,对比 Sora 0.700;700 多个任务的人工评测里,总体排名对 Runway 胜率 67.6%。1.3B 小模型也有 83.96%,显存只要 8.19 GB,普通显卡能跑。
小播:看起来没有短板啊?
老播:有三点要打折:VBench 数字是自报口径,Wan-Bench 是自建评测;训练数据规模不披露,端到端分数没法归因到任何单一设计;机制层最弱的一环——从「为什么这样设计」到「这样设计确实有效」之间的对照,整份报告几乎没做。
小播:所以读这份报告的正确姿势是?
老播:把「设计理由」和「已验证因果」分开记账。收益数字可信,机制叙事空缺,它是一份诚实但工程导向的报告。
收尾:一句话记住这篇
小播:最后用一句话总结?
老播:Wan 2.1 用一套「观测到现象就上工程干预」的打法,把 VBench 做到 86.22%、压过 Sora 的 84.28%,因果 VAE、缓存、滑动窗口环环相扣;但它把机制假设全部留在了「设计理由」层面,最弱一环是机制到干预的推导链。
小播:最该记住的数字是哪个?
老播:因果卷积核是 3,跨块只需缓存前 2 帧,就能无限长稳定生成——时序一致性的工程化,往往只需要一个很小的状态。带着「强工程、弱机制」这个判断去读,收益和局限都清楚了。