ADAS:让 meta agent 用代码「造」agent
> 量子位技术拆解 · 先给主张再给机制。完整结构化数据见「速查」tab。
先看一个判断:机器学习的历史反复上演同一件事——手工设计的工件最终被学出来的替代。HOG 特征被 CNN 学出的特征替代,网络架构被 NAS 搜出来。那 agent 呢?CoT、Self-Reflection、Toolformer 这些 building block 和它们的组合方式,现在全是人设计的。ADAS(Automated Design of Agentic Systems,ICLR 2025)把这个主张推到 agent 上:agent 设计本身应该是一个优化问题,而搜索空间应该用代码。
核心概念:ADAS 三件套
论文先把 ADAS 形式化成一个优化过程,三个组件(Figure 2):
1. 搜索空间:能表示哪些 agent。PromptBreeder 只变异 prompt,workflow 固定;DyLAN 只优化节点连接,工具固定——它们的空间天然覆盖不了新结构。
2. 搜索算法:怎么探索空间。RL(GPT-Swarm)、FM 迭代生成(PromptBreeder)都是选项。
3. 评估函数:怎么评价候选,比如验证集准确率。
ADAS 的主张是:用代码当搜索空间。agent 被定义成一个 forward(task) → answer 函数,跑在一个不到 100 行的框架里(框架提供 FM 查询、prompt 格式化、ARC 代码求解等基础函数)。代码是 Turing-complete 的,所以理论上任何 prompt、工具、workflow 组合都表示得了;FM 又擅长写代码,搜索可以直接吃模型的编码先验;还能搭建在 LangChain 这类人类成果之上。
代码空间还有一个现实优势:它能直接站在人类成果上。论文指出,搜索可以建立在 LangChain 这类开源 agent 框架之上,把 RAG、搜索工具等现有 building block 当基础函数用——搜索发现的是「怎么组合」而非「从零造轮子」。而 graph/network 类搜索空间没有这个继承性,每次都要重新设计表示。这也解释了为什么 FM 做这个搜索特别合适:编码任务占 FM 训练数据的很大一块,让它们改 agent 代码,比让它们改一张图结构高效得多。
机制:Meta Agent Search
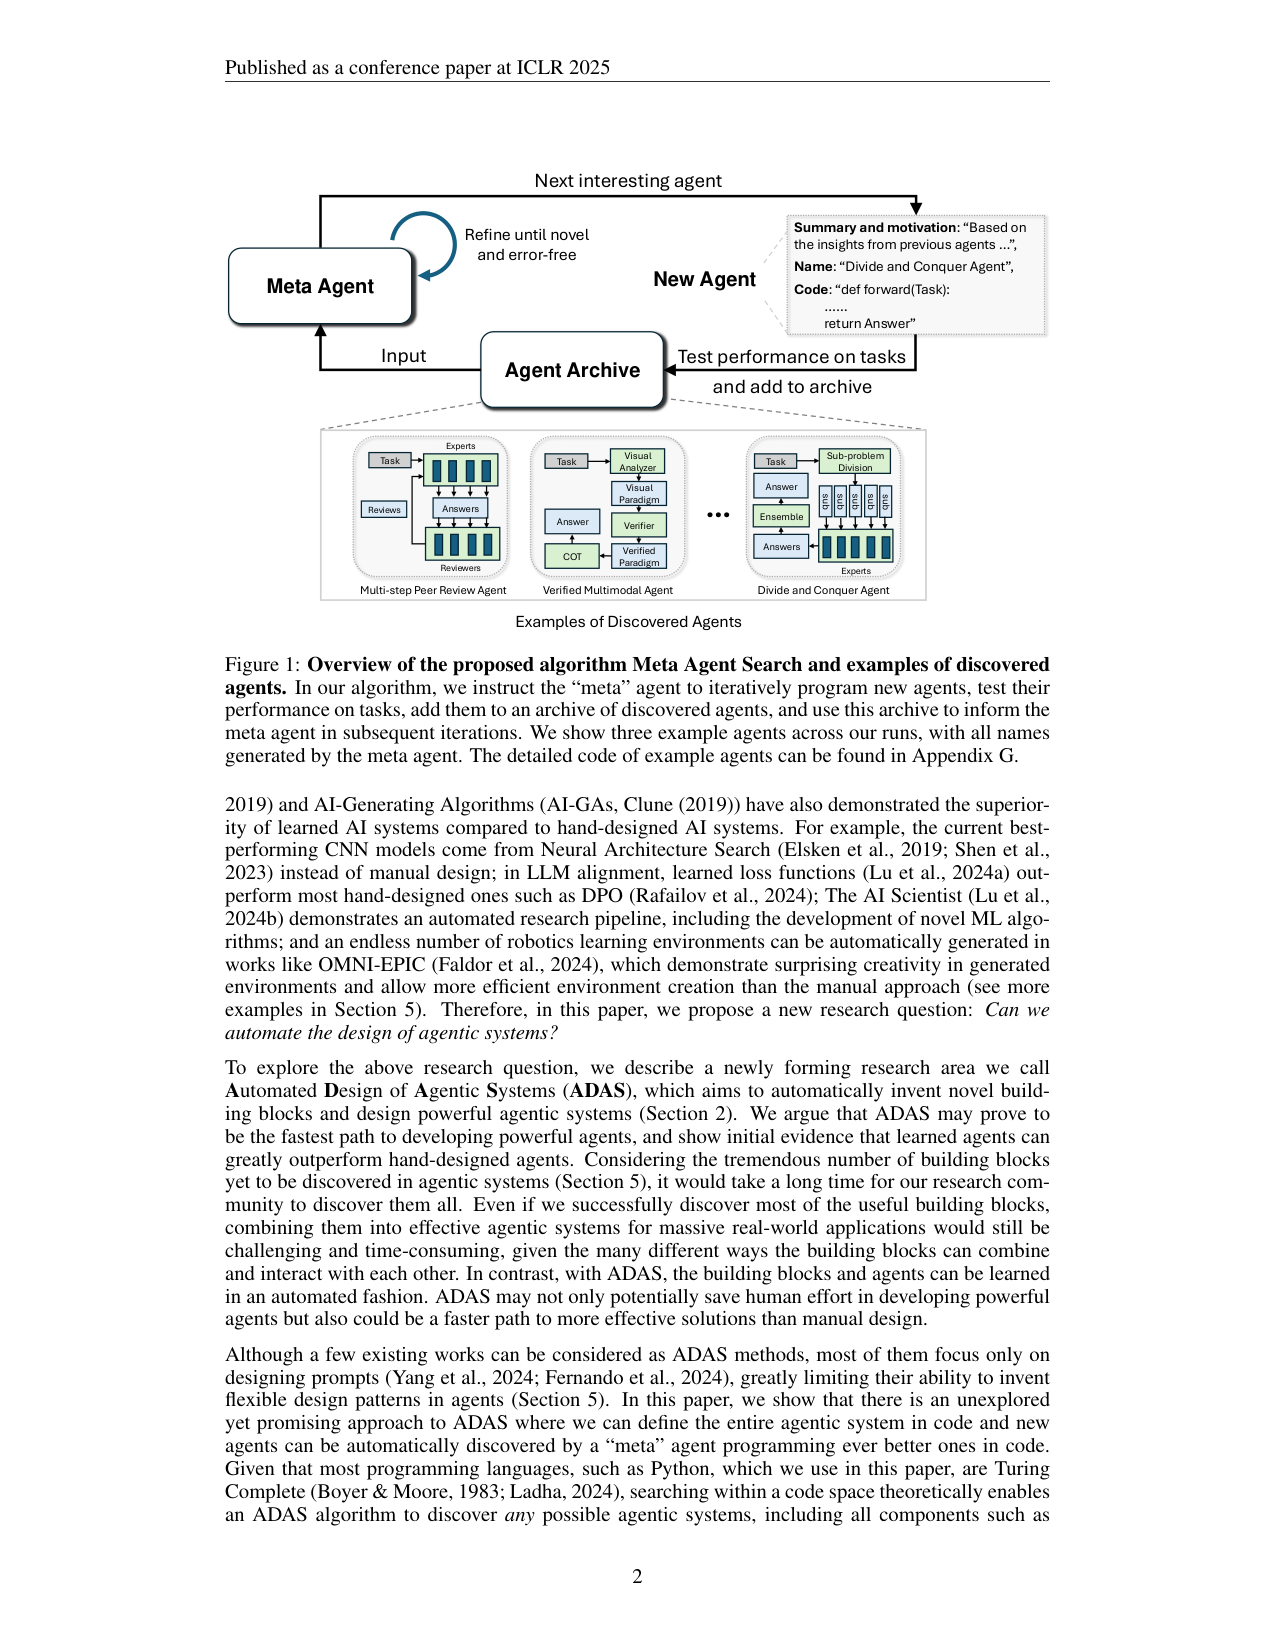
算法叫 Meta Agent Search,四步循环(Figure 1):
1. 用基础 agent(CoT、Self-Refine)初始化 archive。
2. meta agent(GPT-4)读 archive,先写一段高层设计描述,再把它实现成代码。
3. 做两轮 self-refine 检查新意(novelty),然后评估(GPT-3.5 执行,验证集准确率)。
4. 成功的 agent 进 archive,成为后续迭代的 stepping stone。
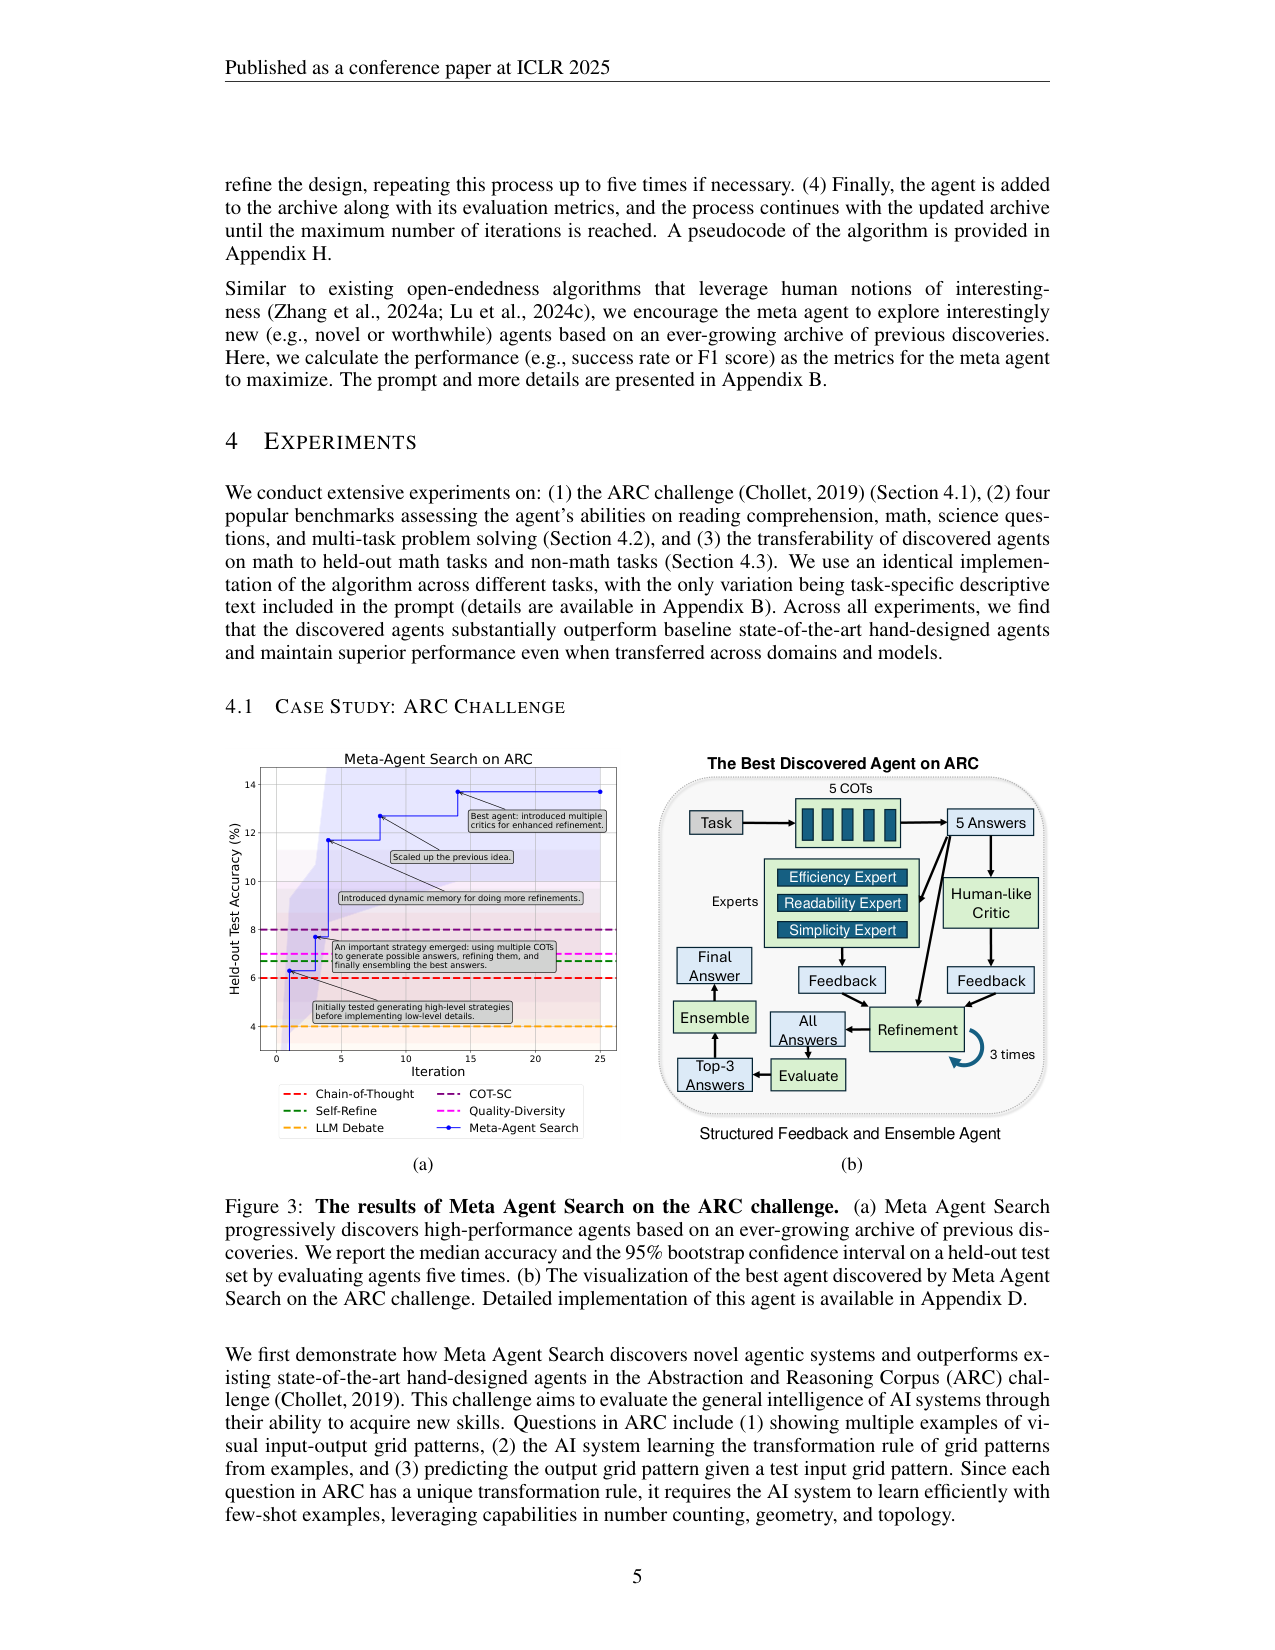
关键在 archive 的累积效应:iteration 3 冒出一个「多个 CoT 生成答案→修正→集成」的模式,成为后续设计的核心台阶;最终在 ARC 上胜出的复杂反馈机制,是 iteration 5(多样化反馈)、11(专家评估效率/简洁性)、12(模拟人类反馈)三个点子组合的产物——单个点子出现时不亮眼,被后面复用后才开花。这就是论文说的 open-endedness。
关键结果:全域领先 + 强迁移
- 阅读理解(DROP):F1 79.4±0.8,最佳手工 Role Assignment 65.8±0.9,OPRO 69.1——+13.6。
setup 一致性值得强调:所有 baseline 用同一框架实现,meta 用 GPT-4、执行统一用 GPT-3.5,避免「搜索器比执行器强」的混淆。
局限:成本、新意检查、安全
1. 计算贵:每个候选验证集 5 次采样、30 迭代、多 baseline;用 GPT-3.5 降本,但搜出的设计在强模型上是否仍最优未验证。
2. 新意检查脆弱:novelty 靠 meta agent 两轮自评,无客观度量;论文没报告 archive 里低质量候选的比例,搜索稳定性(多 seed)证据单薄。
3. 安全边界:生成代码容器化隔离执行 + 人工检查,作者自承模型能力或对齐缺陷下代码仍可能有害(§6)。
4. 适用域:知识密集型任务(GPQA)提升有限——agent 结构优化不能替代知识本身。
一句话记住这篇
ADAS 把 agent 设计变成代码空间里的优化:meta agent 编程、archive 累积、stepping stones 组合。最该记住的数字是:DROP F1 79.4 对 65.8、MGSM 53.4 对 39.0,跨域迁移 GSM8K +25.9%;最该记住的机制是——archive 让低收益点子成为高收益结构的台阶,这是它与单点 prompt 优化的本质区别。
提出 ADAS 研究领域 + Meta Agent Search:meta agent(GPT-4)在 <100 行代码框架里反复编程新 agent(forward 函数),archive 累积前序发现当 stepping stones;DROP F1 79.4 对最佳手工 65.8、MGSM 53.4 对 39.0,且发现的 agent 跨域跨模型迁移仍领先(GSM8K +25.9%、ARC 跨模型近 50%)。
问题
要解决什么:agent 系统的 building blocks(CoT、self-reflection、tool use)与组合方式靠人设计,领域特化手工调参成本高;ADAS 提出把 agent 设计本身当优化问题——搜索空间、搜索算法、评估函数三件套,并用代码作为搜索空间证明「自动设计 agent」可行。
为什么 prior work 不够:PromptBreeder/OPRO 只变异 prompt 文本、workflow 固定;DyLAN/GPT-Swarm 只优化节点连接、工具与组件固定;AgentOptimizer 只学工具;AutoFlow 用自创语言限制表达——现有搜索空间都覆盖不了「全新 building block + 全新组合」。
进化循环(搜索空间 → 算子 → 评估 → 选择)
搜索空间(什么被进化):agent 代码:forward(task)→answer 函数,在 <100 行的基础框架内(提供 FM 查询、prompt 格式化、ARC 代码求解等基础函数);Turing-complete,理论上可表示任意 prompt/工具/workflow 组合;框架基础函数只读。
变异/提案算子:
- meta agent(GPT-4)基于 archive 生成高层设计描述后编程实现新 agent
- 两轮 self-refine 新意检查(novelty):先自评再自改
- archive 增长:评估通过的 agent 存档,成为后续迭代的 stepping stones
- 设计模式跨迭代组合(类似 LLM crossover):iteration 5/11/12 的点子最终拼成复杂反馈机制
评估方式:每域独立搜索 + 验证/测试集准确率(5 次采样取中位数 ± 95% bootstrap CI):ARC(60 题样本、25 迭代)、DROP、MGSM、MMLU、GPQA(30 迭代);meta 用 GPT-4、候选与 baseline 用 GPT-3.5 评估以降低成本。
选择与归档:archive 持续累积,无淘汰、无 fitness 门槛硬规则(『足够有趣/成功的才加入』由 meta agent 判断);转移实验取 top-3 agent。论文未定义显式多样性控制——靠 meta agent 的两轮 novelty 自评把关。
自我改进程度:L1:FM 固定(GPT-4 编程、GPT-3.5 执行),agent 设计(workflow+prompt+工具组合)自进化;meta 编程规程、框架、archive 机制全部手工设计。
输入 / 输出
输入
| 名称 | 类型 | 说明 |
|---|
输出
| 名称 | 类型 | 说明 |
|---|
数据集
| 数据 | 规模 | 备注 |
|---|
架构(摘要)
主干与结构
backbone:
参数:
类型:
→ 详见 Architecture tab。
关键结果
| 指标 | 值 | 最强 baseline | setup |
|---|---|---|---|
| DROP(阅读理解)F1 | 79.4 ± 0.8 | 最佳手工 Role Assignment 65.8 ± 0.9;OPRO 69.1 ± 0.9 | Table 1(p7),meta 用 GPT-4、执行用 GPT-3.5,5 次采样中位数 ± 95% CI |
| MGSM(多语数学)准确率 | 53.4 ± 3.5 | 最佳手工 LLM-Debate 39.0 ± 3.4;OPRO 30.6 ± 3.2 | Table 1(p7),同上 setup |
| MMLU / GPQA | 69.6 ± 3.2 / 34.6 ± 3.2 | OPRO 67.6 / 32.9 | Table 1(p7);Science/Multi-task 提升小,论文归因 FM 知识不足 |
| 跨域迁移(MGSM 搜的 agent → GSM8K / GSM-Hard) | 相对最佳 baseline +25.9% / +13.2% | 各域最佳手工 agent | abstract + p3;MGSM 上 top agent(Dynamic Role-Playing Architecture)转 GSM8K 69.5±3.2、GSM-Hard 70.4±0.9(Table 2,p8) |
| ARC 跨模型迁移 | top-3 agent 从 GPT-3.5 迁到其它 FM,接近 50% 准确率且持续优于手工 baseline | 手工 agent(COT/COT-SC/Self-Refine/LLM-Debate/QD)跨模型迁移 | Table 3(p8);ARC 60 题样本、25 迭代搜索 |
| 搜索机制观察(ARC) | iteration 3 出现 multi-CoT-refine-ensemble 模式;最终反馈机制由 iteration 5/11/12 的点子组合而成 | 无(过程观察) | Fig.3a(p5)——archive 让早期低收益的点子成为后期高收益结构的 stepping stones |
Insights
- 代码是完整的 agent 搜索空间:prompt/workflow/工具组合都能表示,还能直接复用 LangChain 等人类成果,且 FM 编码先验让搜索高效——这是 graph/network 搜索空间给不了的(§2)。
- 开放性来自 archive:多 COT 修正再集成的模式在 iteration 3 出现并成为关键 stepping stone,复杂反馈机制是 iteration 5/11/12 三个点子的组合——类似进化中的 crossover(§4.1)。
- 提升幅度与任务性质挂钩:FM 知识足够的阅读/数学域收益大(+13.6/+14.4),知识不足的 GPQA 受限——agent 结构优化补不了知识缺口(§4.2)。
- 跨域跨模型迁移强:MGSM 发现的模式在 GSM8K/GSM-Hard 上 +25.9%/+13.2%,说明学的是可复用设计模式而非任务特化(§4.3)。
vs 同类工作
- vs PromptBreeder/OPRO(prompt 级):只变异 prompt 文本、workflow 固定;Meta Agent Search 搜索整个 agent 代码,所有域都超 OPRO(Table 1)。
- vs DyLAN/GPT-Swarm(graph 级):只优化节点连接,工具与组件固定;ADAS 能发现全新 building blocks(Multi-step Peer Review、Verified Multimodal)。
- vs AgentOptimizer/AutoFlow/Agent-Symbolic-Learning:部分覆盖组件或用受限语言;代码空间的 ADAS 理论上全覆盖,且能搭建在开源 agent 框架之上。
局限
- 计算昂贵:每个候选要在验证集上跑 5 次采样,30 迭代 × 多 baseline,成本高;用 GPT-3.5 评估降本,但搜出的设计未必在更强模型上最优。
- 新意检查脆弱:novelty 靠 meta agent 两轮 self-refine 自评,无客观度量,可能放过重复或误杀有用变异;论文未报告 archive 中低质量候选的比例。
- 安全边界:生成代码在容器化隔离环境执行 + 人工检查,但作者自承『model-generated code could still act destructively due to limitations in model capability or alignment』(§6)。
- 知识边界:Science/Multi-task 域提升小(论文归因 FM 知识不足),说明 agent 结构优化有适用域。
- 搜索稳定性未验证:论文以单次搜索过程观察为主(Fig.3a 是单条轨迹),多 seed 重复与失败模式分析缺失。
可复现性
- code:https://github.com/ShengranHu/ADAS
- notes:框架代码与 prompt 在附录 C/D;baseline 与 meta agent 用同一框架实现保证公平;ARC 网格用字符串表示、代码求解。
ADAS / Meta Agent Search 架构:archive 进化循环
Mermaid 数据流
flowchart TD
    ARCH["Agent Archive\n(基线:CoT / Self-Refine…\n+ 历次发现的 agent)"]
    MA["Meta Agent(GPT-4)"]
    MA -->|"1. 读 archive 形成高层设计描述"| DESC["设计描述\n(总结前代 insights)"]
    DESC -->|"2. 实现为代码"| CODE["forward(task) → answer\n(<100 行框架内)"]
    CODE -->|"3. 两轮 self-refine 新意检查"| NOV{"novel?\n(meta agent 自评)"}
    NOV -- "否" --> MA
    NOV -- "是" --> EVAL["评估\n(GPT-3.5 执行,\n验证/测试集 5 次采样)"]
    EVAL -->|"性能达标/足够有趣"| ARCH
    EVAL -->|"失败"| MA
    ARCH -->|"stepping stones\n(迭代 3 的 multi-CoT-ensemble 等)"| MA
    TASKS["任务域\nARC / DROP / MGSM / MMLU / GPQA"] --> EVAL
组件详解
- Meta Agent(元层设计器):GPT-4,负责「读 archive → 写设计描述 → 实现代码」。prompt 里给 archive 摘要与前代 insights,让它产出「基于前代洞见的新 agent」。它只产出代码(含名字与一句话描述),不直接解任务。
设计要点
1. 代码空间的完备性:Turing-complete 表示覆盖 prompt/工具/workflow 全部组合,且能站在 LangChain 等人类框架上起步。
2. Archive 即开放性:无淘汰、无 fitness 门槛,靠累积与复用形成 open-ended 搜索;论文观察到 iteration 5/11/12 的低收益点子最终拼成 ARC 最优 agent 的反馈机制。
3. 公平评估协议:baseline 与候选用同一框架、同一执行模型(GPT-3.5),隔离「设计质量」与「模型能力」两个变量。
4. 安全隔离:所有生成代码在容器化沙箱执行 + 人工检查;这是自动化代码生成类工作的标准防线。
Meta Agent Search 总览 + 发现的 agent 示例
原文 caption:Overview of the proposed algorithm Meta Agent Search and examples of discovered agents. The meta agent iteratively programs new agents, tests their performance on tasks, adds them to an archive of discovered agents, and programs increasingly interesting agents.
展示机制与产物:meta agent 读 archive、写新 agent 代码(含名字与设计描述)、测试后归档;右侧是三个发现的设计——Multi-step Peer Review、Verified Multimodal、Divide and Conquer。读法:看「Next interesting agent」与 archive 的循环,以及发现的 agent 结构差异。为什么重要:它证明「自动设计能产出全新结构」而不只是调 prompt,是全文主张的视觉浓缩,站点封面。
ADAS 三件套:搜索空间 / 搜索算法 / 评估函数
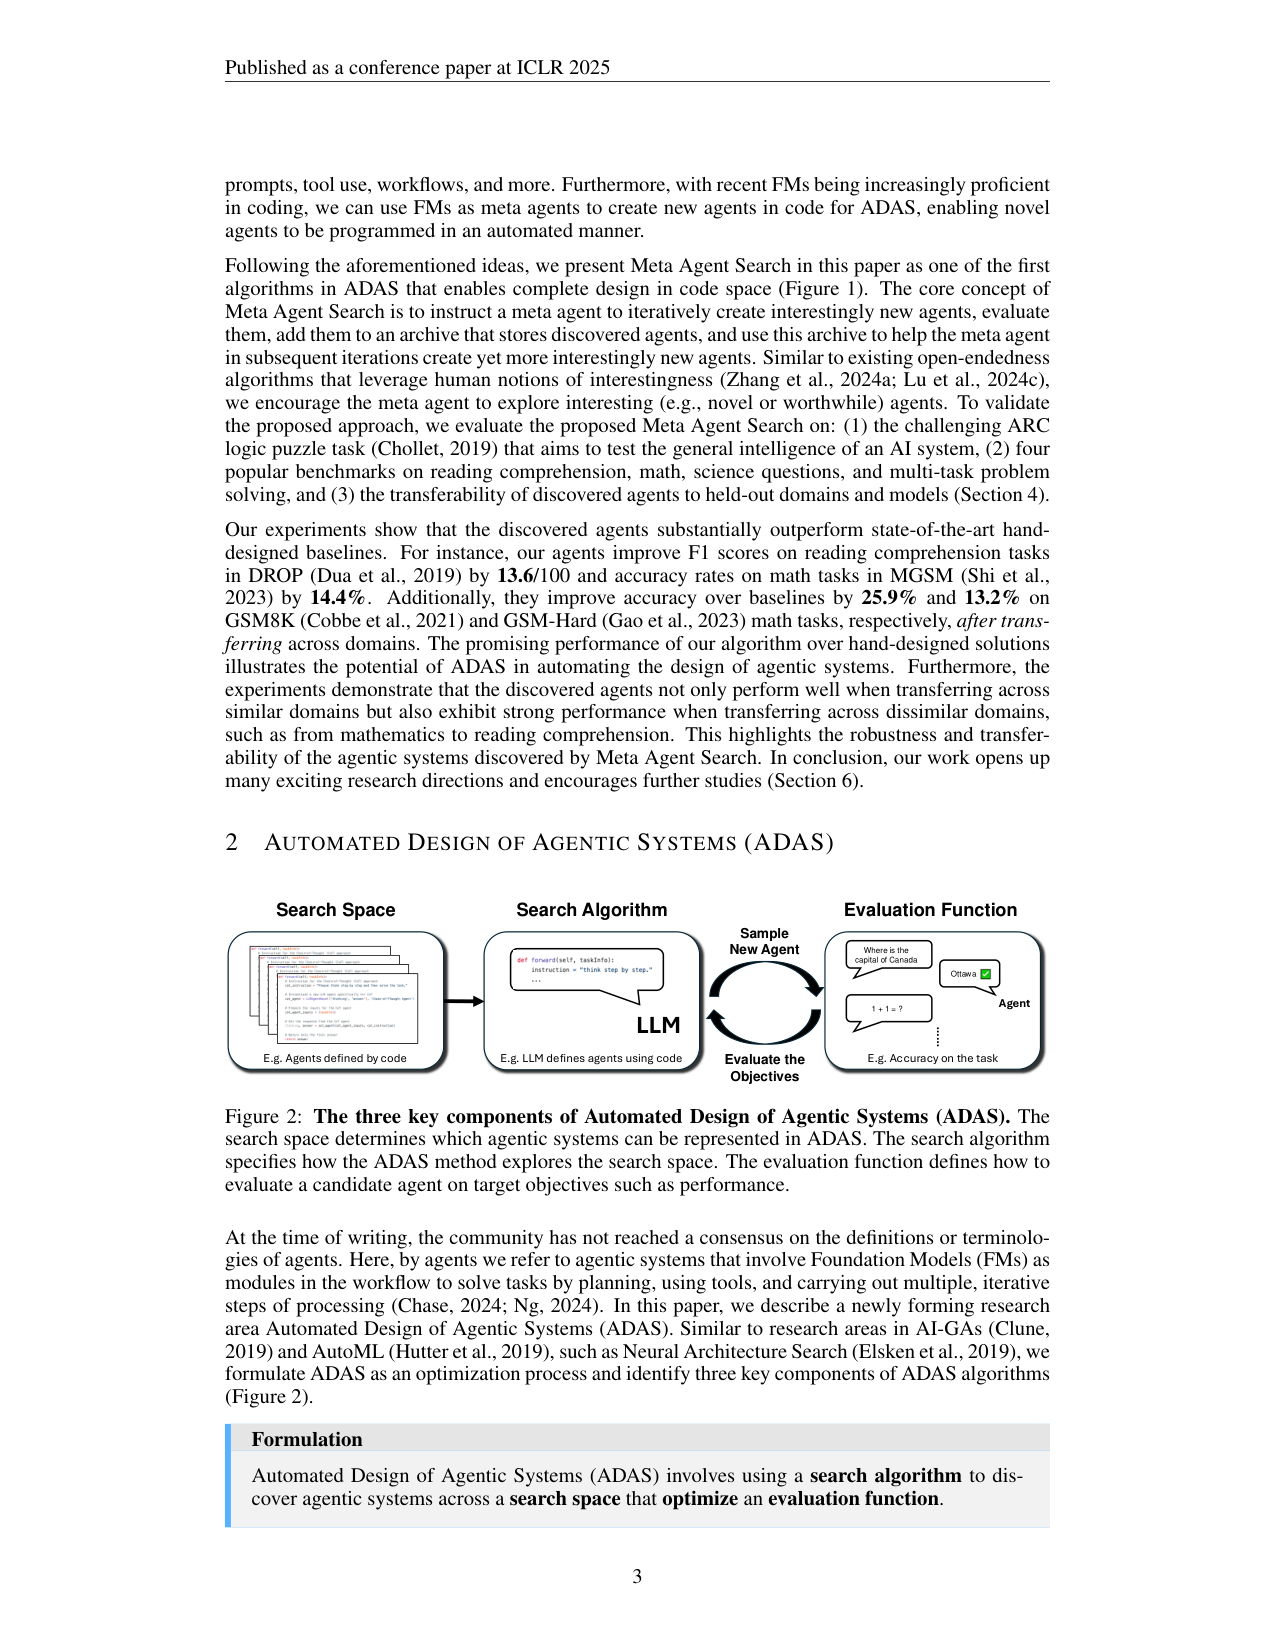
原文 caption:The three key components of Automated Design of Agentic Systems (ADAS). The search space determines which agentic systems can be represented; the search algorithm specifies how the method explores the space; the evaluation function defines how to evaluate a candidate agent.
展示 ADAS 的形式化定义:搜索空间(代码定义的 agent)、搜索算法(LLM 用代码定义 agent)、评估函数(任务准确率)。读法:看三者的输入输出箭头与示例问题流。为什么重要:它把 ADAS 定位成 AutoML/NAS 的 agent 版,为后续所有『自动设计 agent』工作提供了公共坐标系。
ARC 上的渐进发现:archive stepping stones 与最优 agent
原文 caption:The results of Meta Agent Search on the ARC challenge. (a) Meta Agent Search progressively discovers high-performance agents based on an ever-growing archive. (b) The visualization of the best agent discovered on ARC.
证明「开放性搜索逐步突破」:面板 a 展示随迭代准确率爬升、关键突破标注在文本框(iteration 3 的 multi-CoT-refine-ensemble 成为核心 stepping stone);面板 b 展示最终 agent 的复杂反馈结构(由 iteration 5/11/12 的三个点子组合而成)。读法:看爬升曲线与标注的突破点。为什么重要:它演示了进化式组合——单点改进不显眼,但被后续迭代复用后开花结果,这是 open-endedness 的核心机制证据。
让一个 meta agent 用代码批量「造」agent(对话版)
小播:今天聊一篇 ICLR 2025 的论文,想法特别大胆:agent 这种系统,能不能让 AI 自己设计?
老播:这篇叫 ADAS,作者是 UBC 的 Jeff Clune 团队。一句话结论:让一个 meta agent 用代码反复编程新 agent,存进一个不断长大的档案库,前代设计当台阶用。在阅读理解和数学上,发现的 agent 比最好的人工设计高 13 到 14 个点,而且换到别的任务、别的模型,依然领先。
小播:等等,agent 设计不是人很擅长的事吗?
老播:人确实在做,但机器学习的历史反复上演一件事:手工设计的工件,最后都被学出来的替代了。视觉特征从 HOG 变成 CNN 学出来的,网络架构变成 NAS 搜出来的。这篇说:轮到 agent 了。
三件套:搜索空间、算法、评估
小播:那「自动设计 agent」怎么定义?
老播:论文先立了个框架,三件套:搜索空间,就是能表示哪些 agent;搜索算法,怎么探索;评估函数,怎么打分。现有方法都缺一块——PromptBreeder 只改 prompt,workflow 固定;GPT-Swarm 只调节点连接,工具固定。它们永远发现不了新结构。
小播:那 ADAS 用什么当搜索空间?
老播:代码。agent 被定义成一个 forward 函数,输入任务、输出答案,跑在一个不到 100 行的框架里。代码是图灵完备的,任何 prompt、工具、workflow 的组合都表示得了。而且模型本来就擅长写代码,搜索能直接吃这个先验。
Meta Agent Search:四个步骤
小播:搜索怎么跑?
老播:四步循环。第一步,用一个档案库起步,里面先放 CoT、Self-Refine 这些基础 agent。第二步,meta agent 读档案库,先写一段高层设计描述,再实现成代码。第三步,做两轮自我反思检查新意,然后评估——执行统一用 GPT-3.5,避免「搜索器比执行器强」的混淆。第四步,达标的进档案库,成为后面的台阶。
小播:档案库为什么关键?
老播:这是开放性搜索的核心。举个具体例子:在 ARC 逻辑谜题上,第 3 轮迭代冒出一个「多个 CoT 生成答案、修正、再集成」的模式,成了后面所有设计的台阶。最后胜出的那个复杂反馈机制,是第 5 轮、第 11 轮、第 12 轮三个点子的组合——单个点子出现时不亮眼,被后面复用才开花。
小播:所以是进化式的组合?
老播:对,记住这个记忆锚点:它有点像遗传算法的交叉,只不过交叉的单元是「agent 设计理念」,由 meta agent 用语言完成。
数字:阅读、数学、迁移
小播:给硬数字。
老播:阅读理解 DROP,F1 79.4,最好的手工设计 Role Assignment 是 65.8,prompt 优化器 OPRO 是 69.1——高出 13.6。数学 MGSM,53.4,最好的手工 LLM-Debate 是 39.0——高出 14.4。多任务和科学题提升小一些:MMLU 69.6 对 67.6,GPQA 34.6 对 32.9。
小播:为什么科学题提升小?
老播:论文的解释很诚实:GPQA 这种研究生级科学题,模型本身的知识不够,再好的 agent 结构也补不了知识缺口。结构优化在「模型会做但容易做错」的任务上最值钱——比如阅读里的幻觉、数学里的计算错误。
小播:迁移呢?
老播:先记一个记忆锚点:它搜出来的是可复用的设计模式,可以跨任务、跨模型迁移——换个任务、换个模型照样领先,这是它和普通 prompt 优化的本质区别。
老播:跨域迁移:在 MGSM 数学域搜出的 agent 转到 GSM8K,相对最佳 baseline 提升 25.9%,转到 GSM-Hard 提升 13.2%。跨模型迁移:ARC 上 top-3 agent 从 GPT-3.5 迁到别的模型,接近 50% 的准确率,还是压着手工设计。
泼冷水:成本、新意、安全
小播:它有什么短板?
老播:四个。第一,贵:每个候选要在验证集上跑 5 次采样,30 轮迭代再乘上多个 baseline,成本很高,所以执行只能用便宜的 GPT-3.5——那搜出的设计在强模型上是否最优,没人验证过。
小播:第二?
老播:新意检查太主观。novelty 靠 meta agent 自己两轮反思来判断,没有客观度量——可能放过重复设计,也可能误杀有用的变异。论文也没报告档案库里有多少低质量候选。
小播:第三和第四?
老播:安全:生成代码在隔离沙箱里执行,还要人工检查,但作者自己承认,模型能力或对齐有缺陷时,代码仍可能造成破坏。还有适用域:知识密集型任务上提升有限,结构优化替代不了知识。
收尾
小播:最后用一句话总结?
老播:ADAS 把 agent 设计变成代码空间里的优化:meta agent 编程、档案库累积、设计理念跨迭代组合。最该记住的数字是:DROP F1 79.4 对 65.8,MGSM 53.4 对 39.0,跨域迁移 GSM8K 提升 25.9%。
小播:而最该记住的机制是:档案库让低收益的点子成为高收益结构的台阶。
老播:没错。这篇是「自动设计 agent」这条线的开山之作,它提出的三件套框架,后面 AFlow、Meta-Harness 都在用。读它之前记住那句历史规律:手工设计的工件,迟早被学出来的替代。