Paper Podcast

harness 工程与自进化智能体深度解读:搜索空间 → 变异算子 → 评估 → 选择 → 自我改进。

← 返回主站RSS 订阅
cover harness-evolution
2026-07-04 · Lil'Log

Harness Engineering for Self-Improvement(综述)

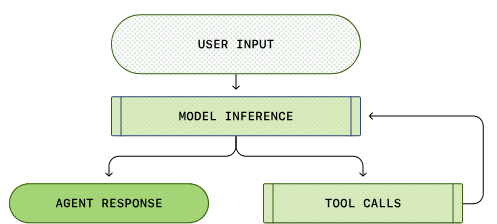
把「harness(决定存什么/取什么/呈现什么的代码系统)本身当优化目标」的综述:按进化对象从 prompt→结构化上下文→workflow→harness 代码→优化器代码分层,给出 L0–L2 自我改进分级;用 STOP/Self-Harness/AHE/DGM/SIA 等实证说明模型能改进机制,但效果取决于基座能力、可观测性与评测质量。
读全文 →
harness engineeringself-improvementrecursive self-improvement
cover harness-evolution
2026-06-08 · Shanghai Artificial Intelligence Laboratory

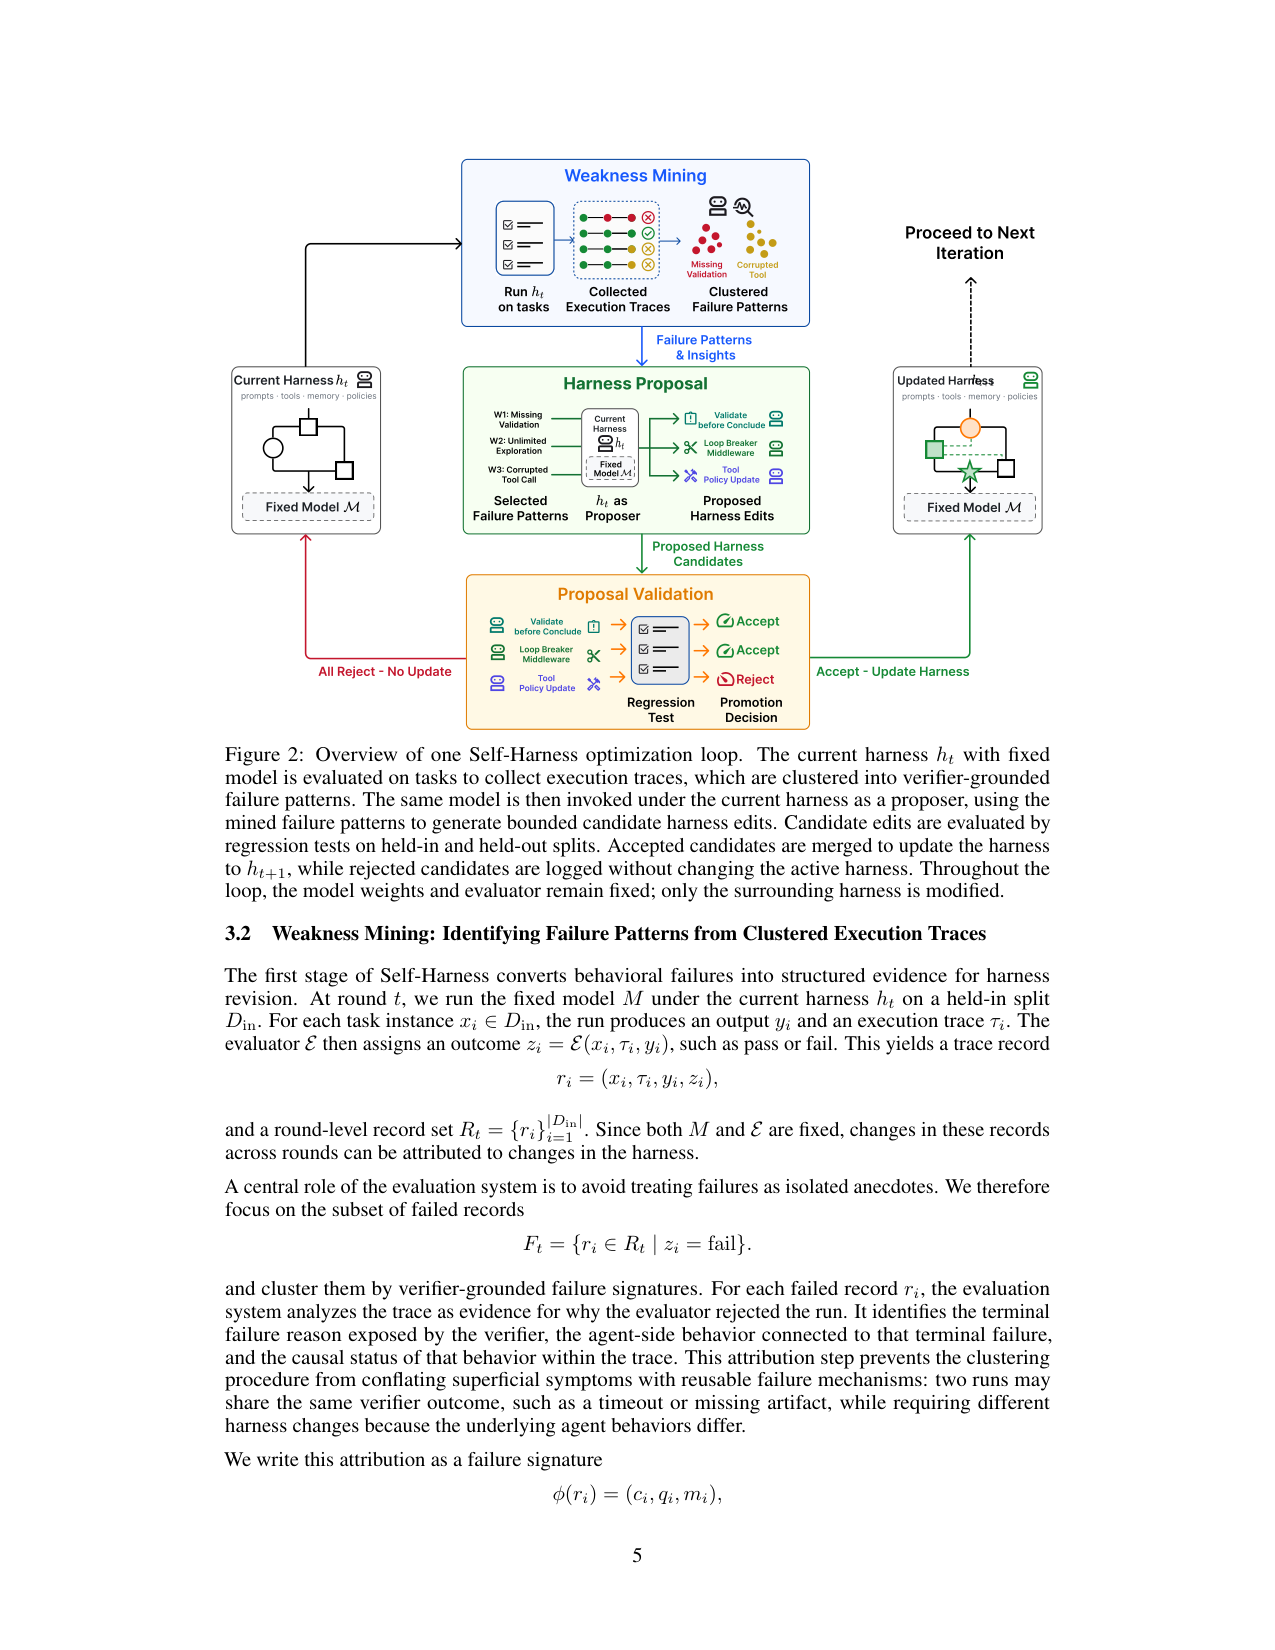
Self-Harness: Harnesses That Improve Themselves

Self-Harness 让被固定模型自己完成三阶段循环——weakness mining(按 verifier-grounded 失败签名聚类执行轨迹)→ 有界 harness 提案 → held-in/held-out 双 split 回归验证通过才接受——在 Terminal-Bench-2.0 的 64 任务子集上,MiniMax M2.5 / Qwen3.5-35B-A3B / GLM-5 的 held-out pass 分别从 40.5% / 23.8% / 42.9% 升到 61.9% / 38.1% / 57.1%,模型权重、工具、评估器全程不变。

读全文 →
harness evolutionself-improving agentregression testing
cover verifiable-reasoning
2026-05-29 · Huawei Foundation Model Department / CUHK

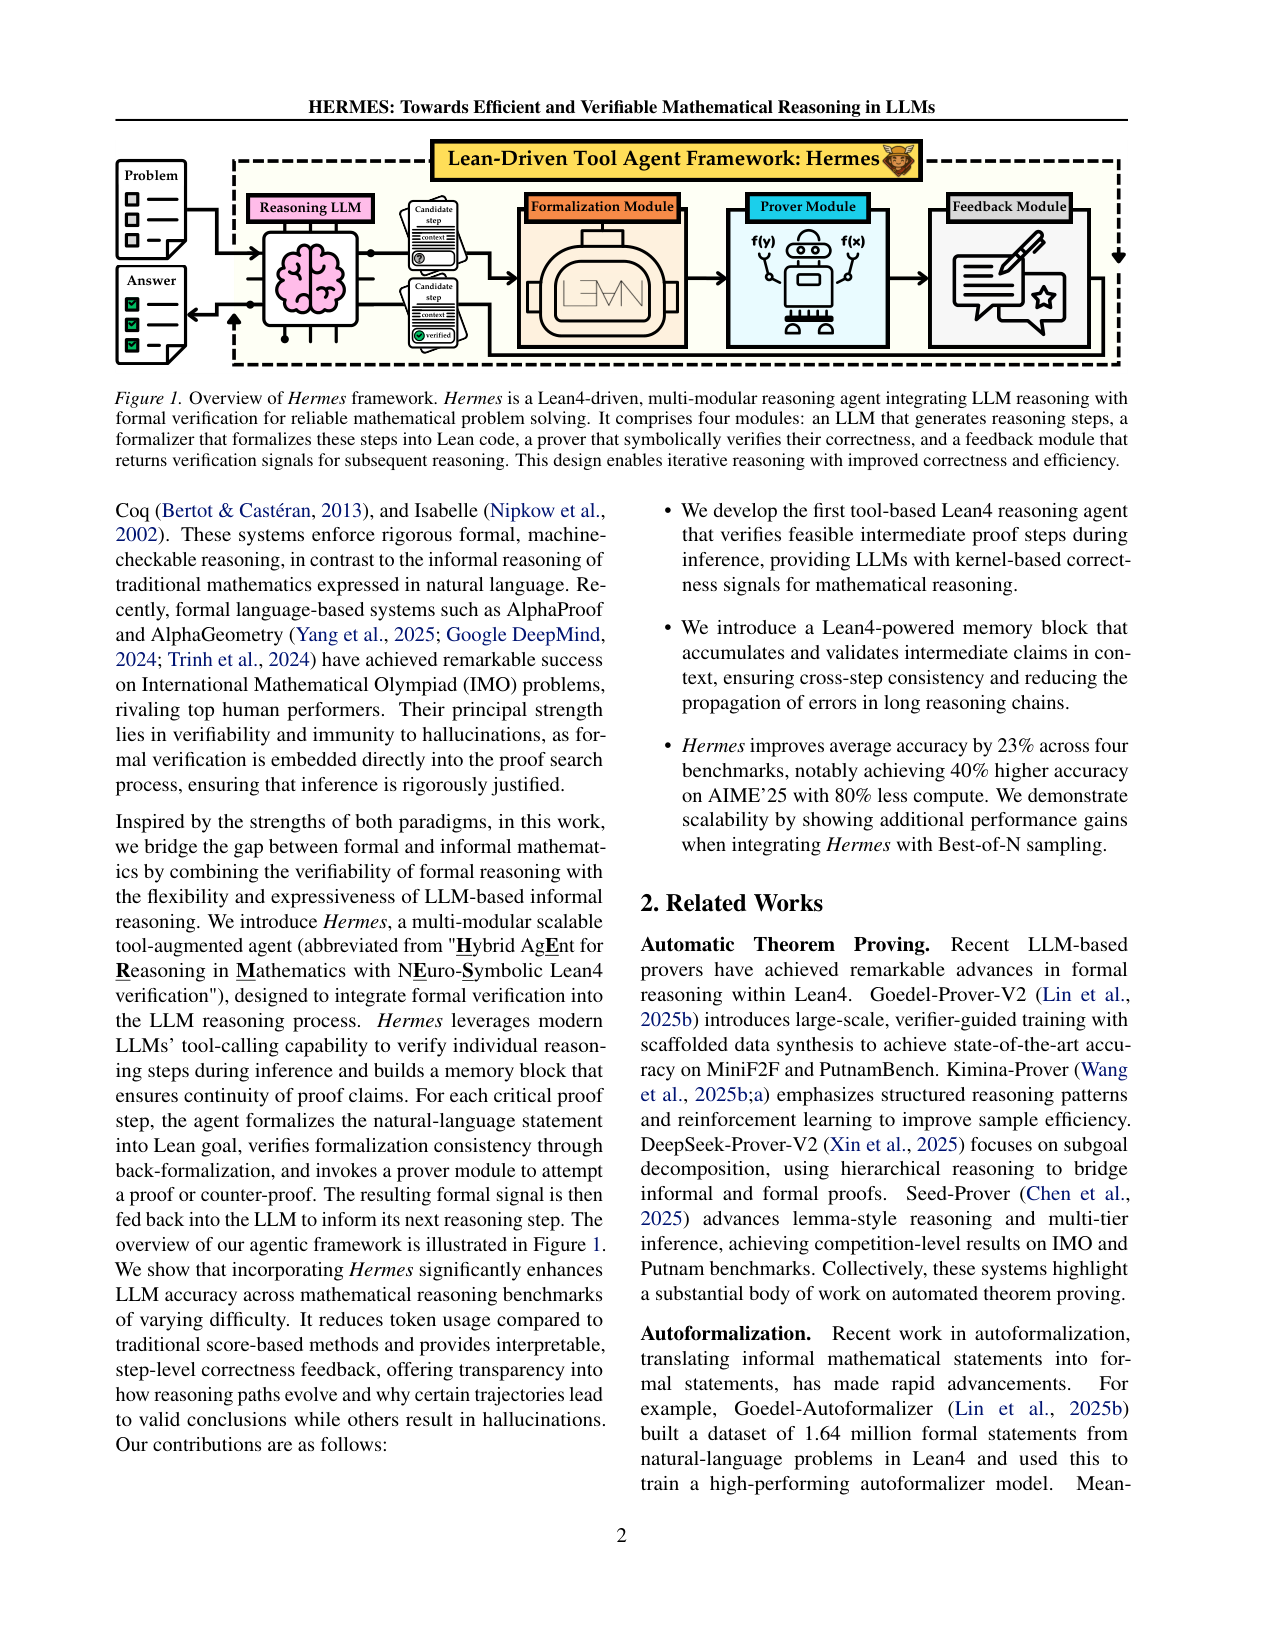
HERMES: Towards Efficient and Verifiable Mathematical Reasoning in LLMs

把 Lean4 形式验证接进数学推理的中间步骤:HERMES 对关键推理步骤做「自动形式化→证明/反证→反馈」并用已验证断言记忆库防漂移;AIME'25 上 DeepSeek-V3.2 从 50.0% 提到 70.0%(相对 +40%),每题总 FLOPs 比 reward-based Best-of-5 少约 80%。

读全文 →
verifiable-reasoningLean4formal verification
cover self-improving-agent
2026-05-28 · Penn State / UC Santa Cruz / Amazon / Emory / UIUC / Northeastern

Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents

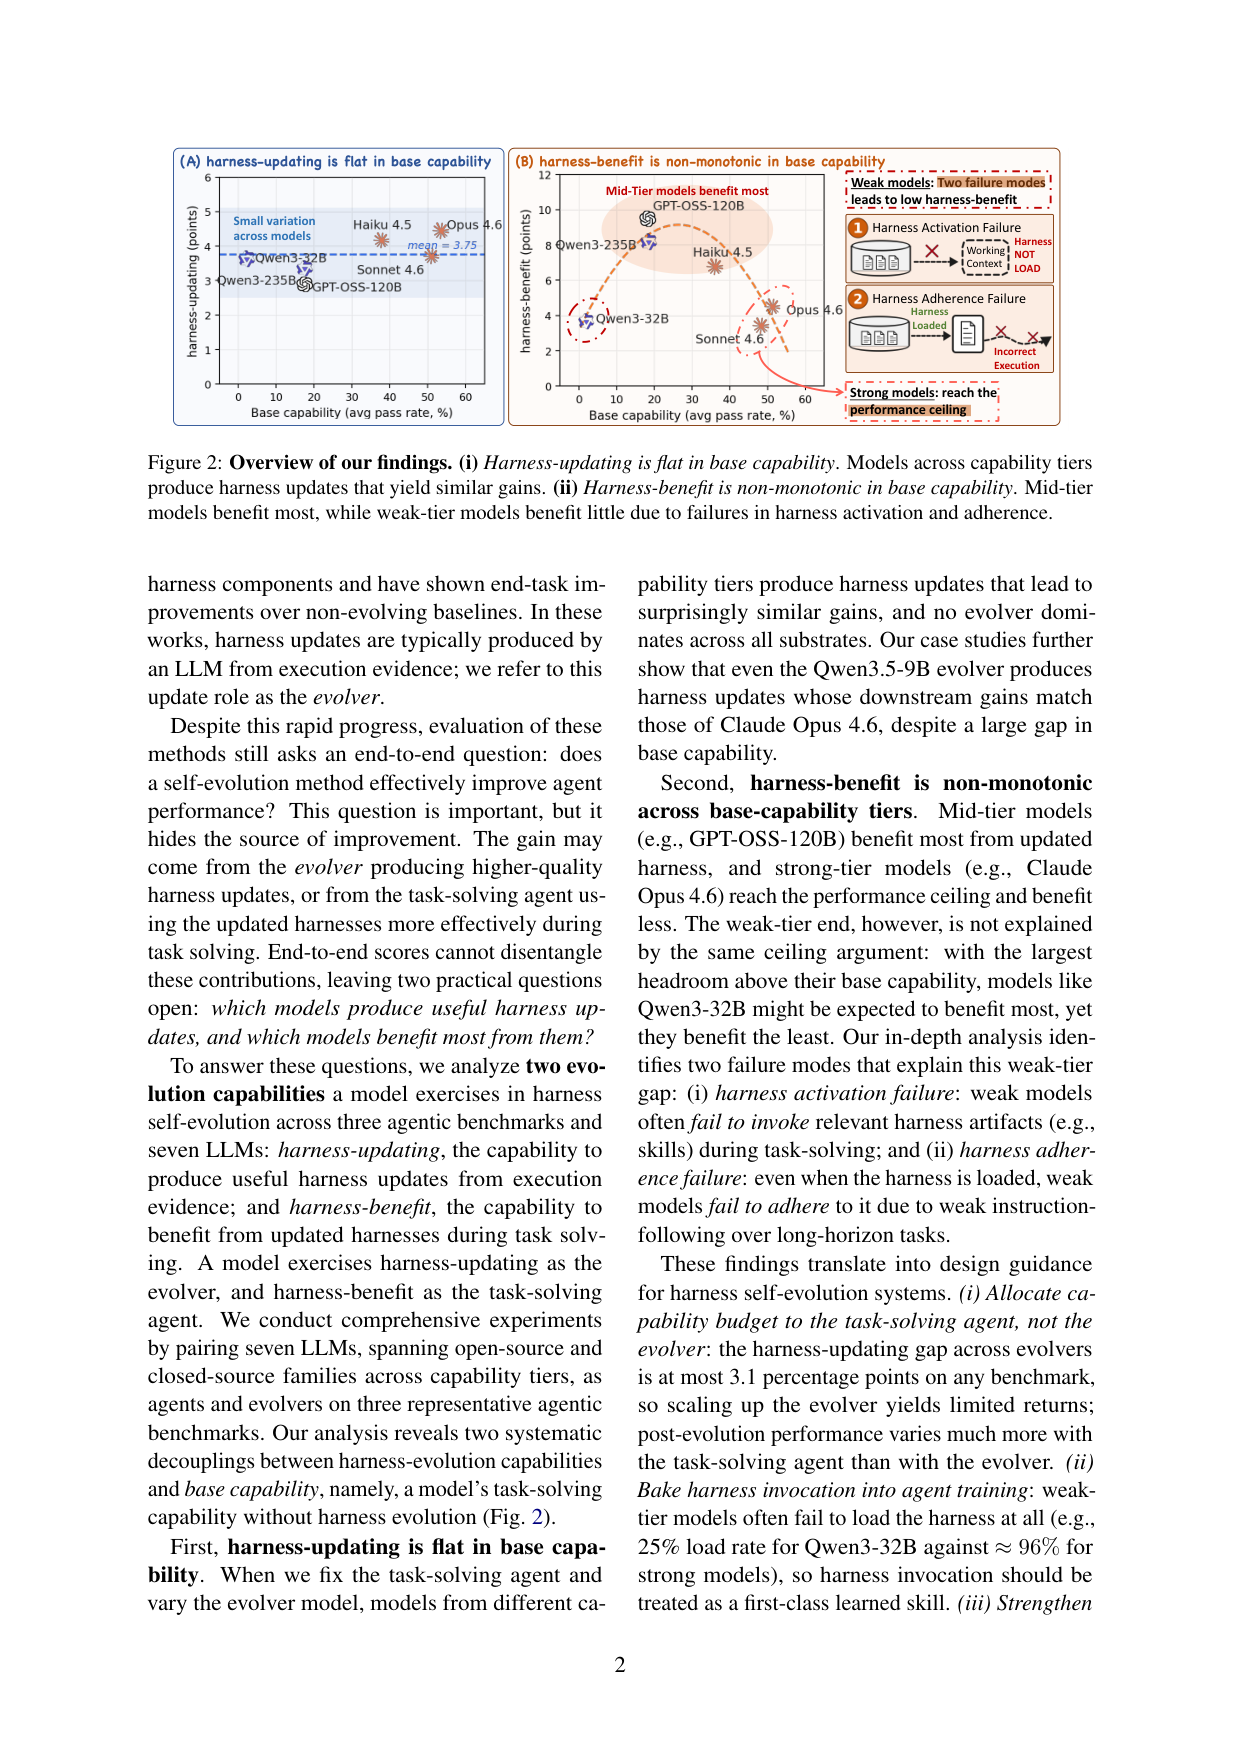
这篇把 harness 自我进化拆成两个独立能力轴:evolver 侧的 harness-updating(产出有用更新的能力)与执行 agent 侧的 harness-benefit(从更新 harness 获益的能力)。跨 7 个模型 × 3 个 benchmark 的交叉配对显示:9B 的 Qwen3.5-9B 写出的 skill 与 Claude Opus 4.6 程序同构、收益相当(最好/最差 evolver 差距 ≤3.1pp),但 harness-benefit 随基座能力非单调——SWE 上中档 Qwen3-235B 获益 19.3pp,弱模型 Qwen3-32B 只有 4.4pp、强模型 Opus 4.6 只有 2.6pp——瓶颈在执行 agent 的 harness 加载率与长程指令遵循。

读全文 →
harness evolutioncapability analysisself-evolving agent
cover self-improving-agent
2026-05-28 · Hexo Labs / University of Oxford

SIA: Self Improving AI with Harness & Weight Updates

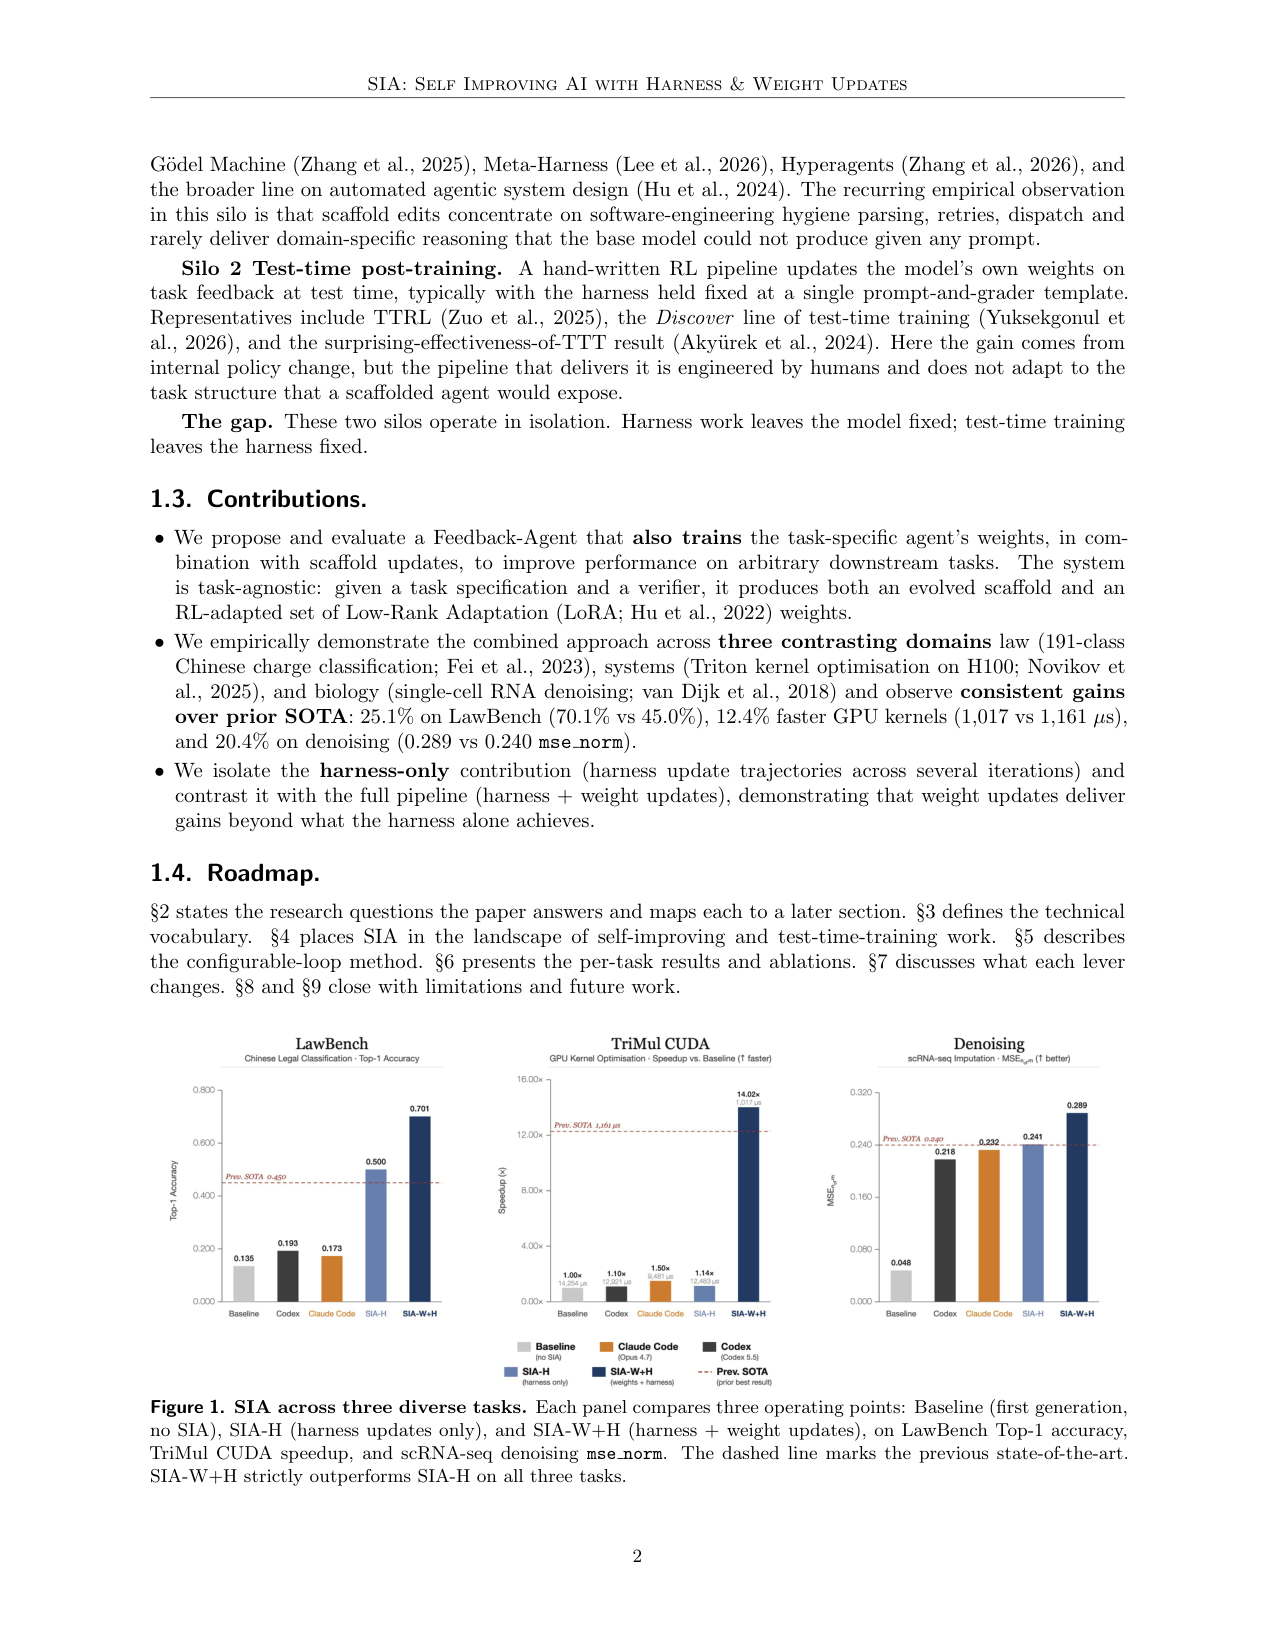
SIA 是首个在同一闭环里同时进化 harness 与权重的自改进系统:Meta-Agent 生成初始 scaffold,Task-Specific Agent 执行,Feedback-Agent 看轨迹后每步选择『改 harness』还是『用 RL 更新 LoRA 权重』。在三个领域(LawBench top-1 70.1% vs 前 SOTA 45.0%、TriMul 1,017µs vs 1,161µs、scRNA denoising 0.289 vs 0.240)双杠杆都超过 harness-only,但作者自己承认证据是 provisional:RL 算法选择是按观察模式描述的、完整处理 defer 到 v2。

读全文 →
self-improving agenttest-time trainingharness engineering
cover harness-evolution
2026-05-23 · Tsinghua University / AgiBot

DemoEvolve: Overcoming Sparse Feedback in Agentic Harness Evolution with Demonstrations

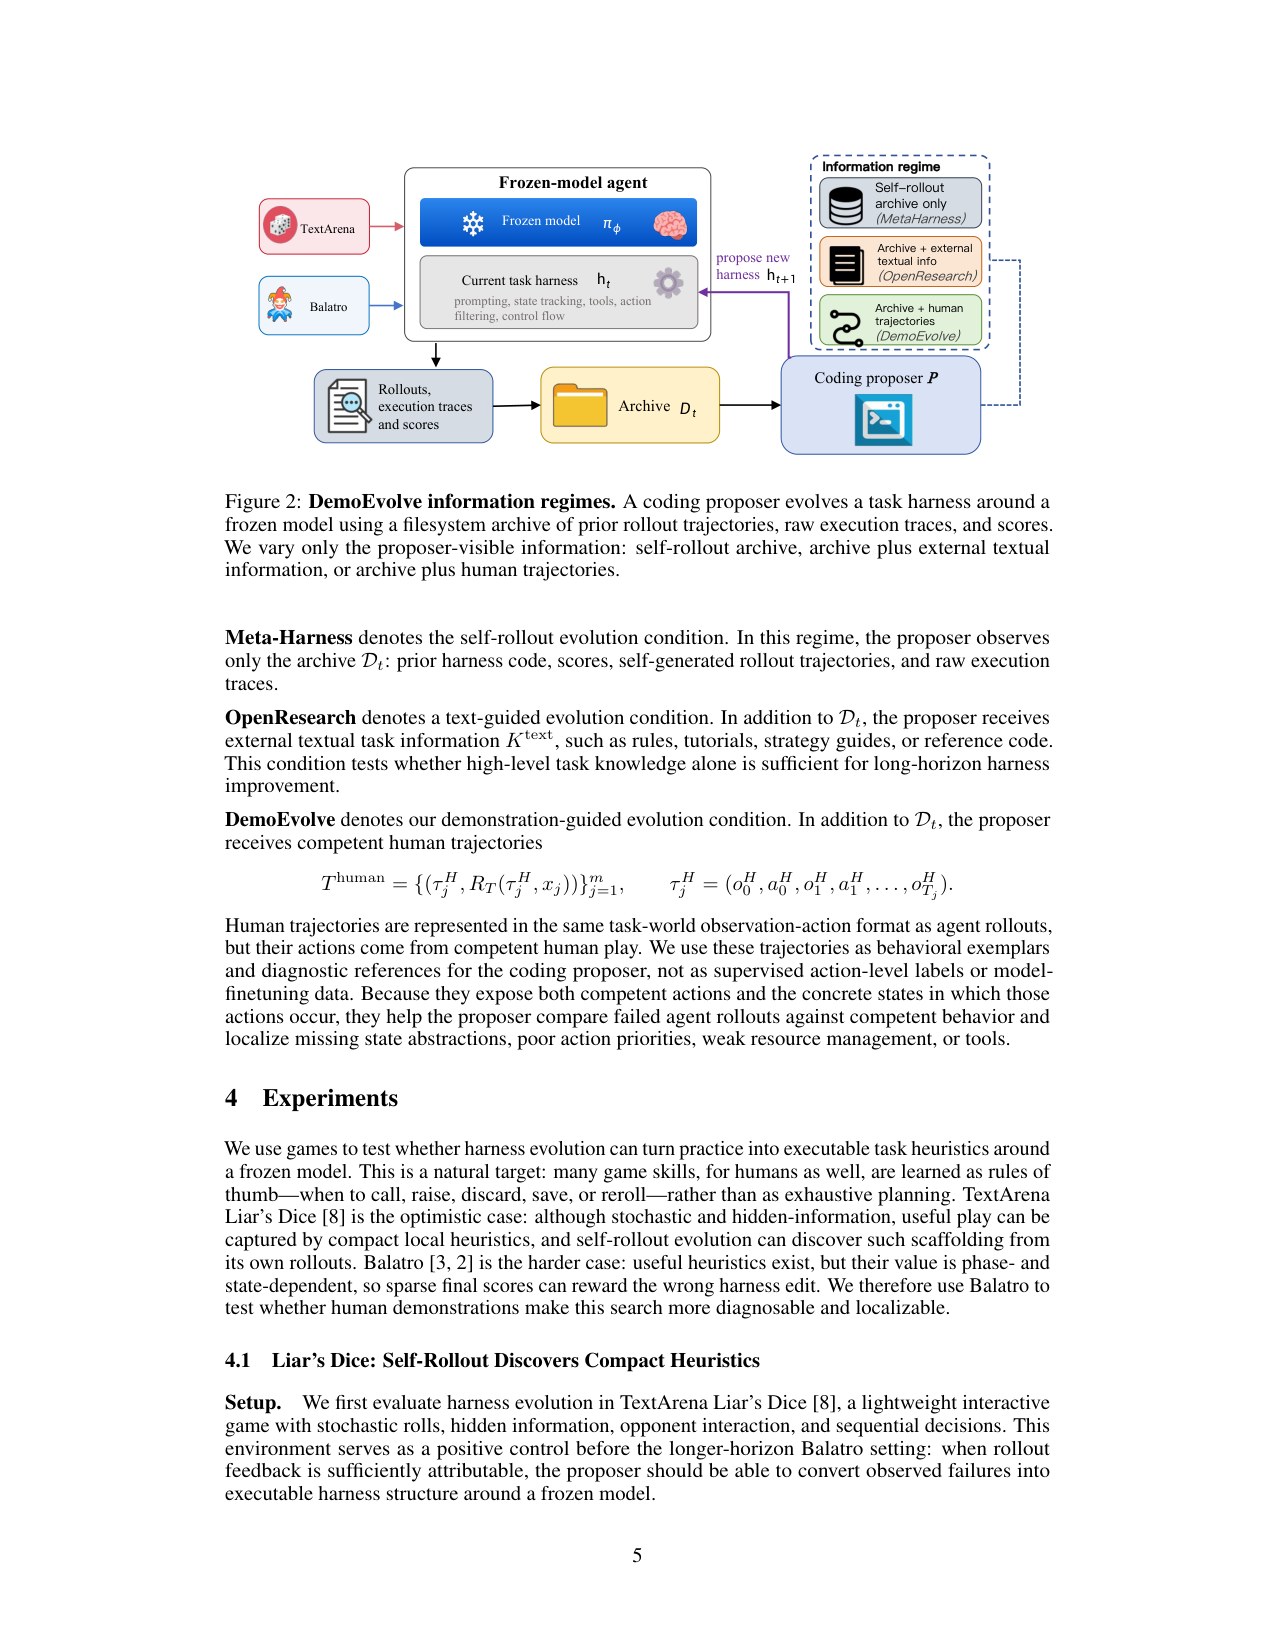
DemoEvolve 在自 rollout 存档之外把人类专家轨迹作为 proposer 的 harness 级诊断/编辑参考经验:Liar's Dice 上自 rollout 进化本来就有效(held-out 0.392→0.800),但 Balatro 这类长时程随机环境里稀疏反馈会误导搜索——Meta-Harness 的 ID 增益不迁移、且被选中编辑的 hook 因实现错误从未触发;加入人类示范后完成率 12/15 vs Meta-Harness 的 6/15,OOD 也提升(20.00 vs 16.33)。

读全文 →
harness evolutiondemonstrationssparse feedback
cover harness-evolution
2026-05-18 · Fudan University / Peking University / Shanghai Qiji Zhifeng

Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses

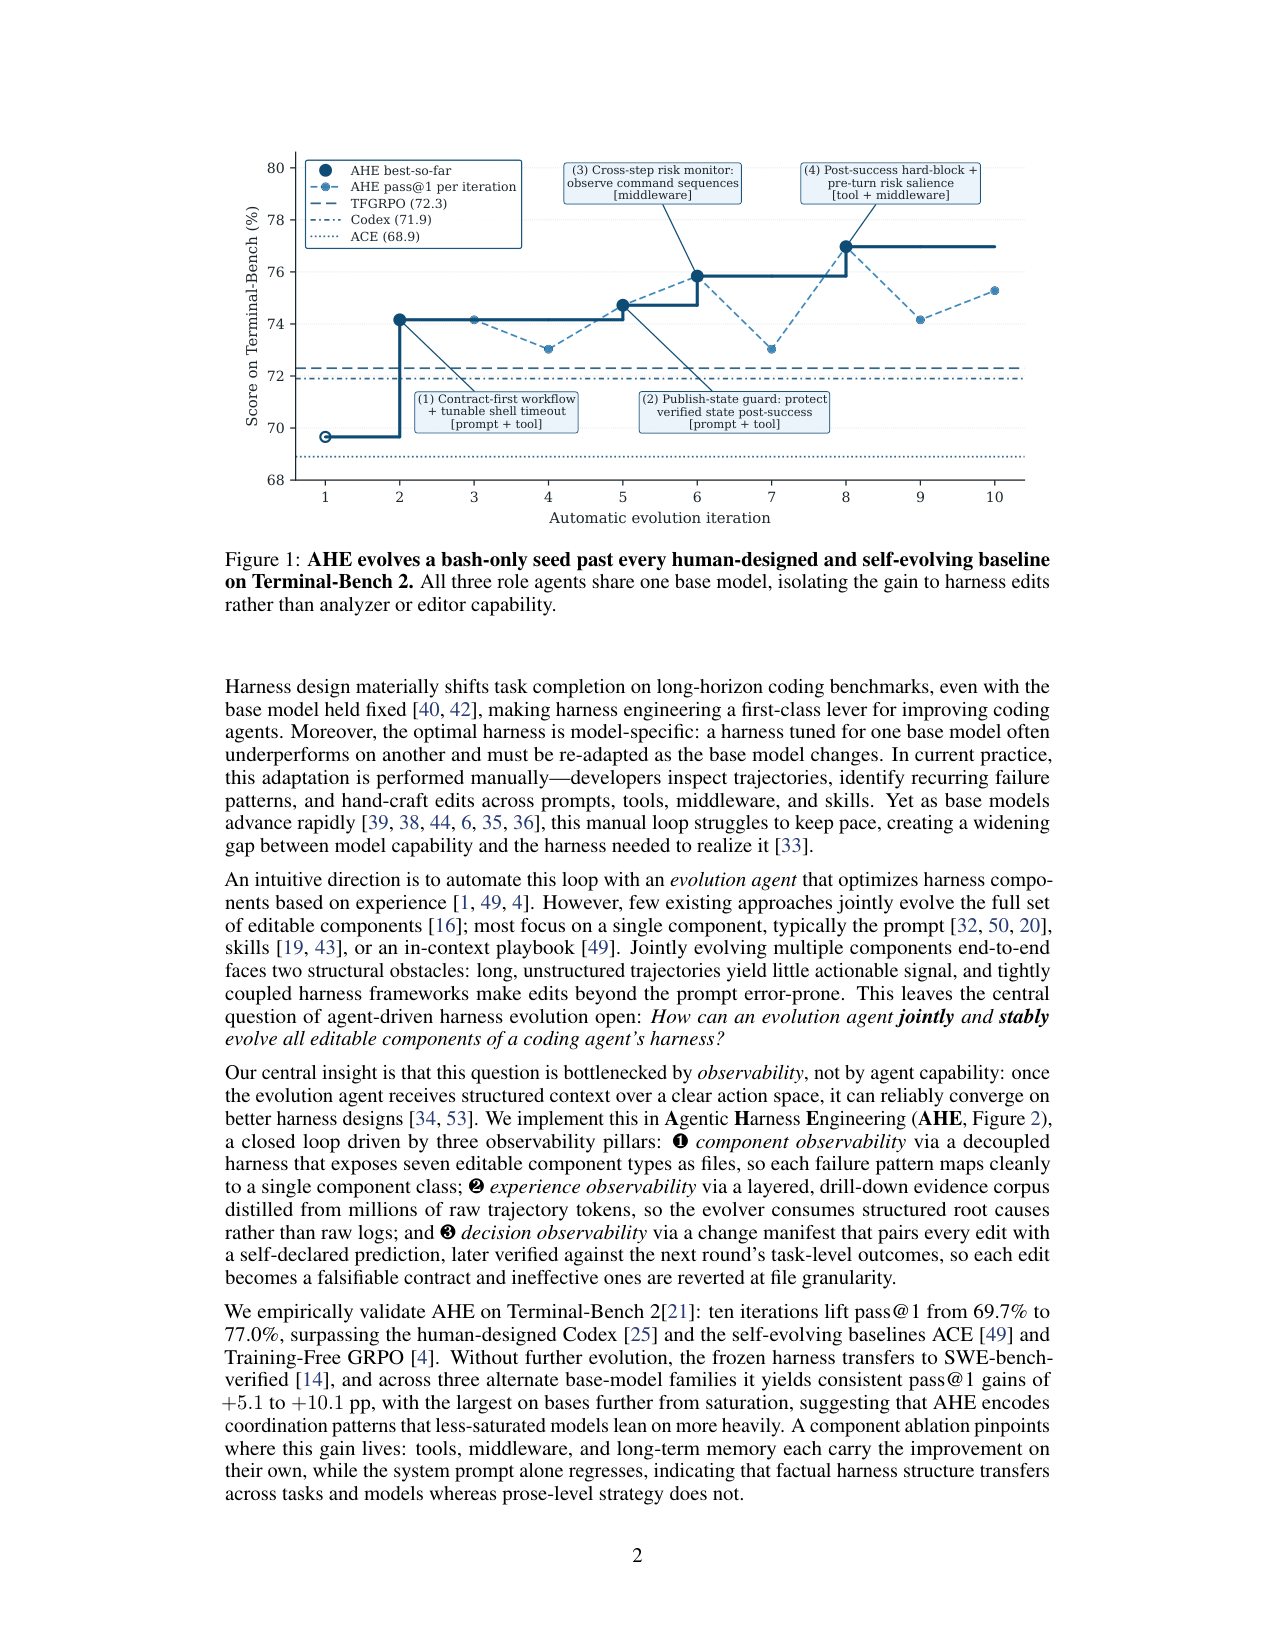
AHE 把 harness 进化拆成三大可观测性支柱——组件(7 类组件文件化)、经验(约 10M token 轨迹蒸馏成可下钻证据语料)、决策(每个编辑配自我声明的可证伪预测、下一轮验证后文件级回滚)——10 轮迭代在 Terminal-Bench 2 上把 pass@1 从 69.7% 推到 77.0%,超过 Codex(71.9%)、ACE(68.9%)与 TF-GRPO(72.3%),冻结后的 harness 迁移到 SWE-bench-verified 与三个跨族基座仍为正收益。

读全文 →
harness evolutionobservabilitycoding agent
cover harness-evolution
2026-05-11 · Princeton University / ARISE Foundation / Google DeepMind

Continual Harness: Online Adaptation for Self-Improving Foundation Agents

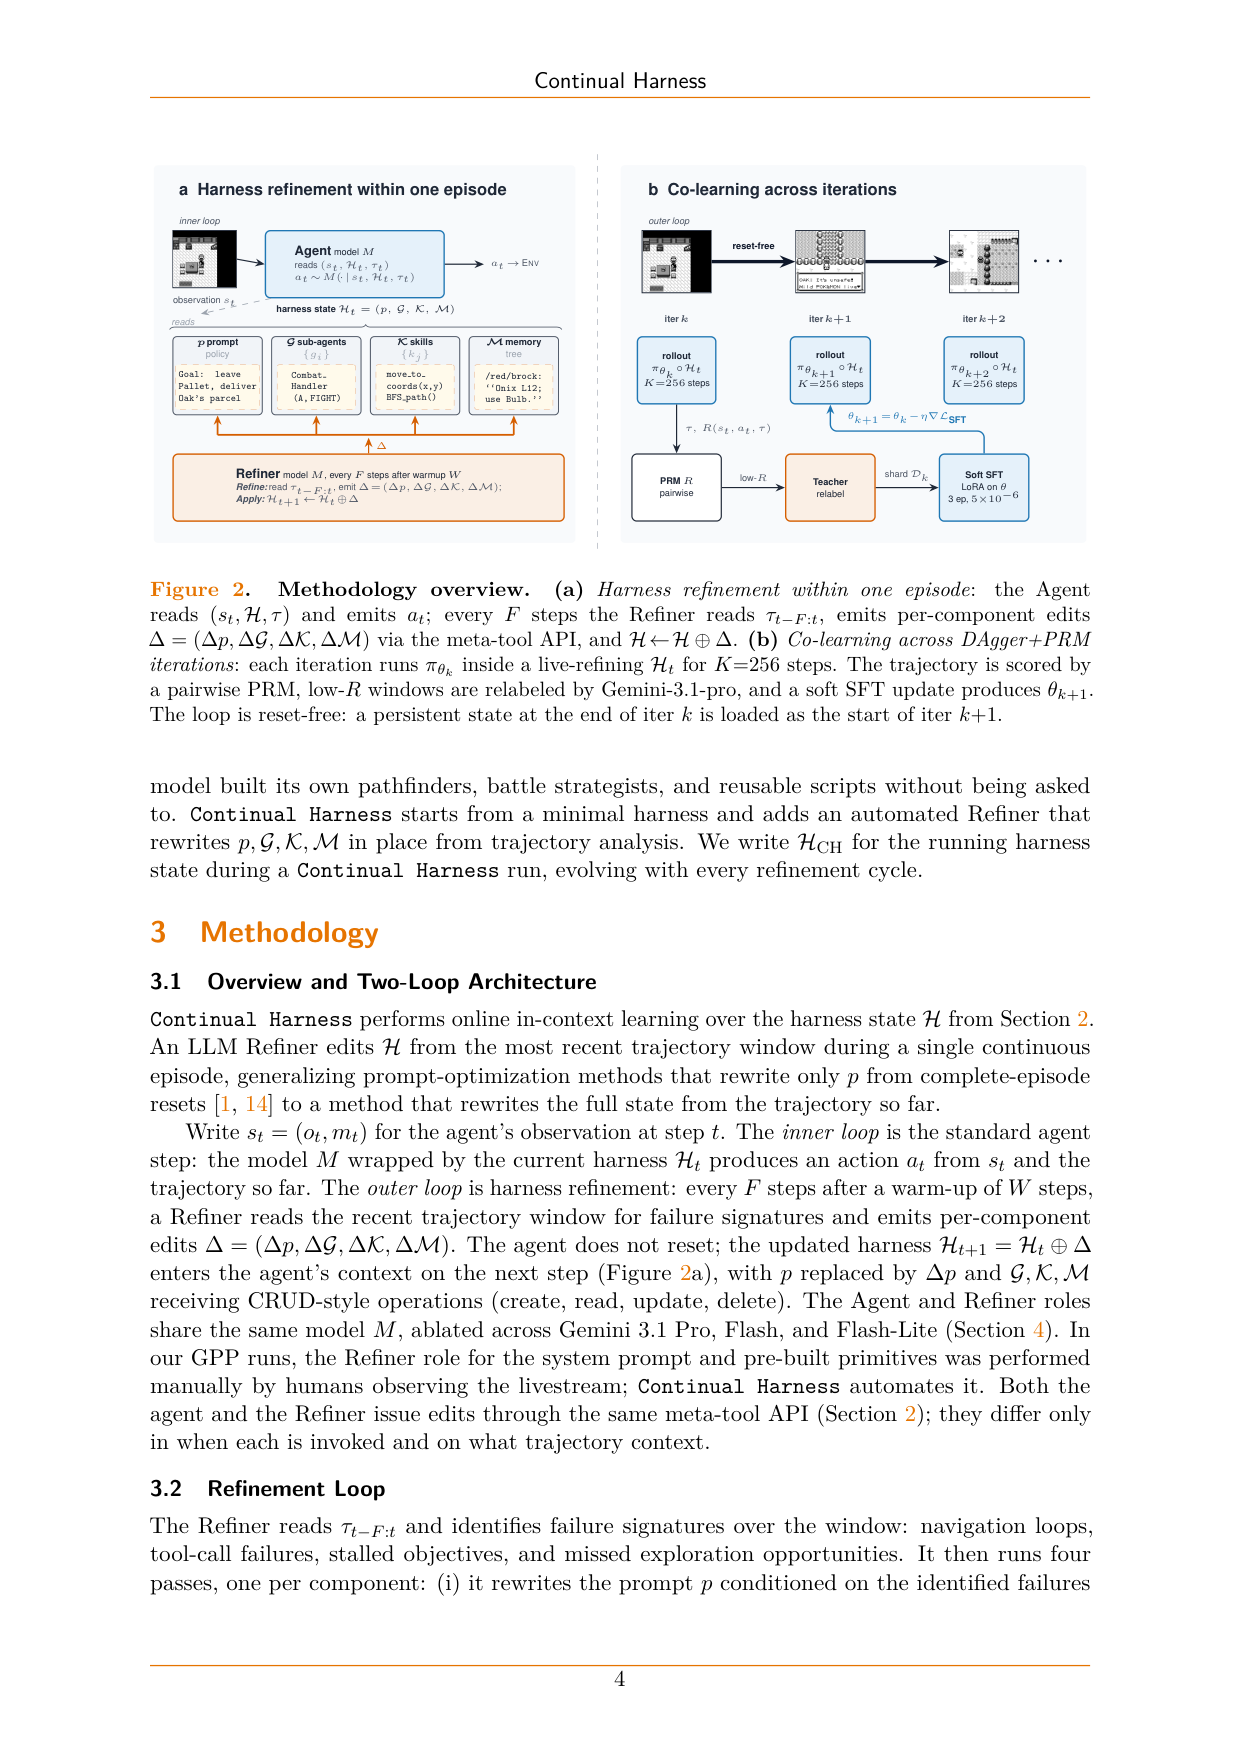
Continual Harness 把 Gemini Plays Pokémon(GPP)里的人类人工打磨 harness 循环自动化成 reset-free 的在线自改进:agent 与 Refiner 交替,Refiner 每隔 F 步对 prompt/子 agent/技能/记忆做 CRUD 编辑。在 Pokémon Red/Emerald 上,Gemini 3.1 Pro 从零自举达到 100% 里程碑、成本约 $130 vs 最小 harness 的 $215(约 −40%),收复大部分与专家 harness 的差距;再用 DAgger+PRM+前沿教师重标注实现『harness 与权重共学』,让开源 Gemma-4 在 Red 上跨训练迭代持续推进里程碑。

读全文 →
harness evolutionreset-freeembodied agent
cover harness-evolution
2026-03-30 · Stanford University / KRAFTON / MIT

Meta-Harness: End-to-End Optimization of Model Harnesses

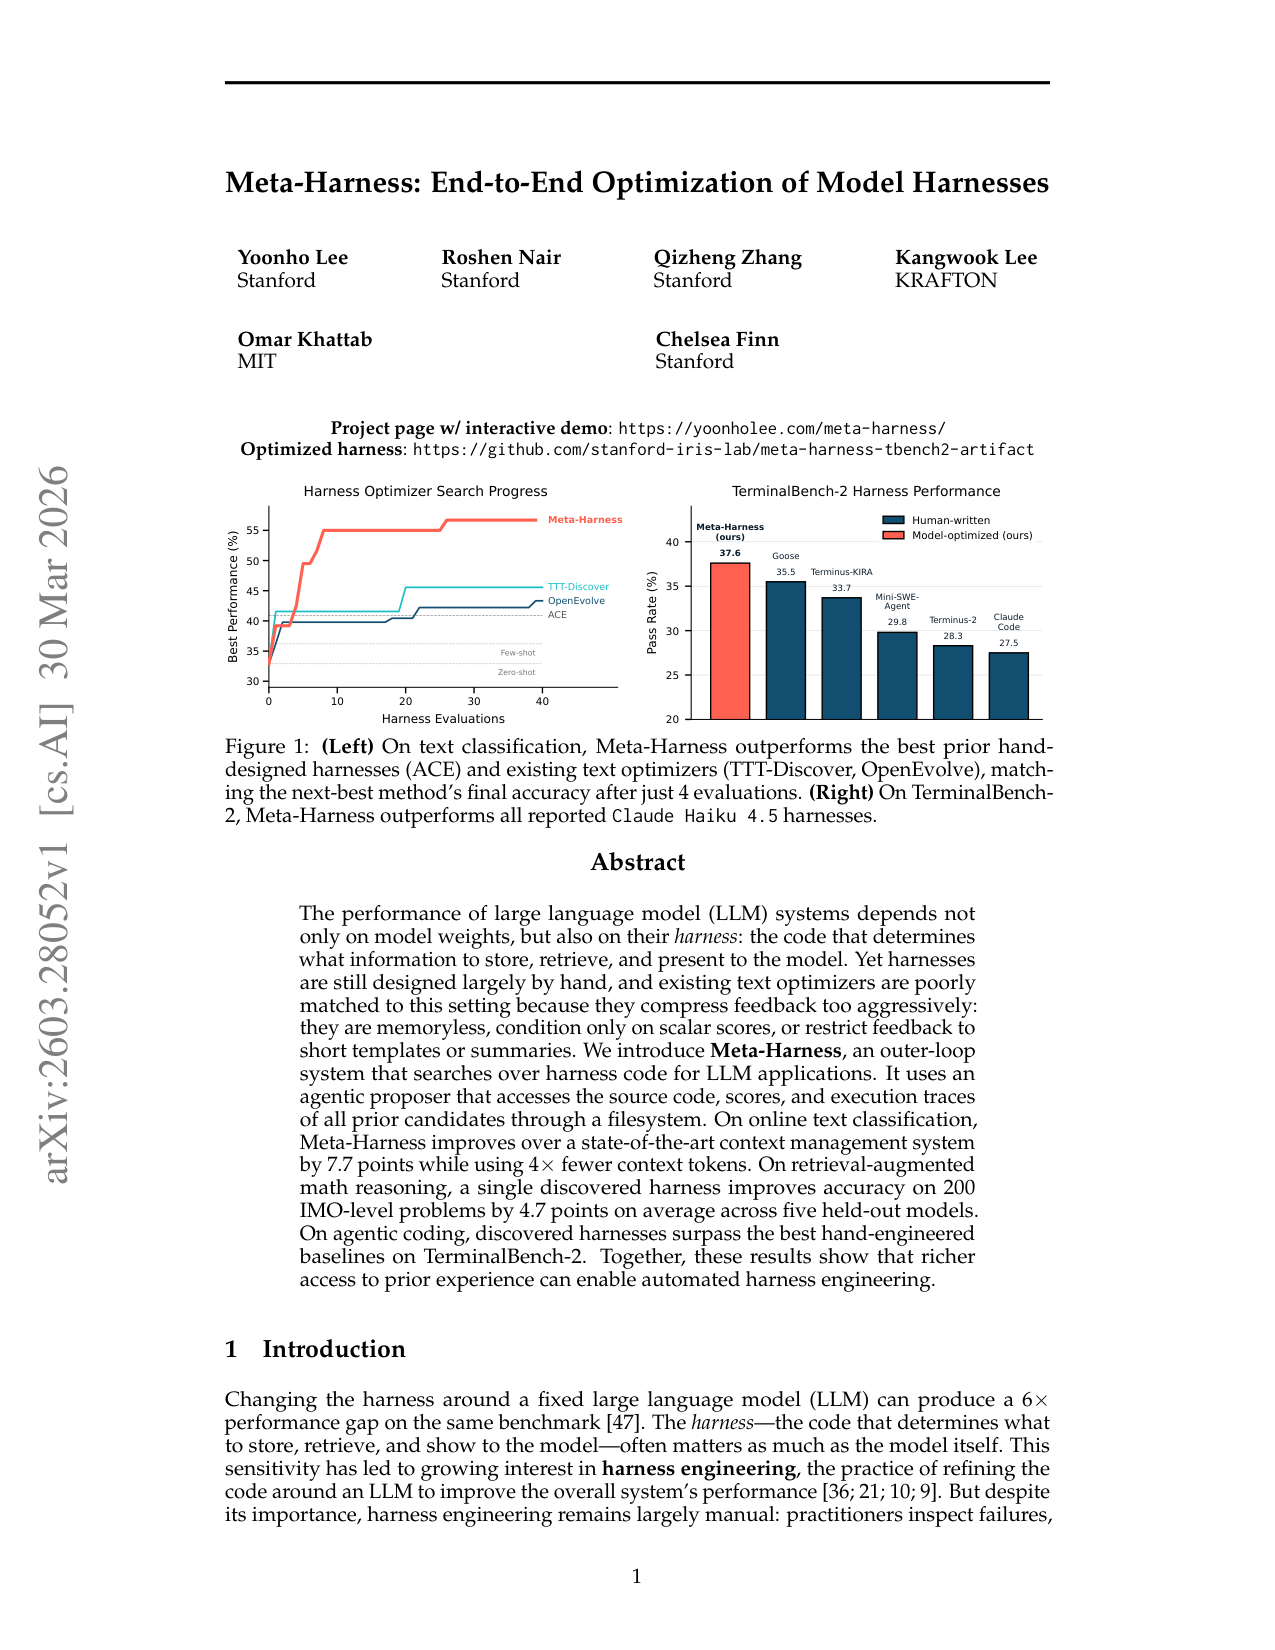
把「决定存什么/取什么/呈现什么」的 harness 代码本身当优化对象:coding-agent proposer 通过文件系统访问所有先例的源码、分数与执行轨迹来提案新 harness,产出 Pareto 前沿候选;在线文本分类比 ACE 高 7.7 个点且上下文 token 少 4×,数学检索 harness 跨 5 个未见模型平均 +4.7 点,TerminalBench-2 超越全部已报告的人类设计 harness。

读全文 →
harness-evolutionharness engineeringcode-space search
cover context-engineering
2026-03-29 · Stanford University / SambaNova Systems / UC Berkeley

Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models

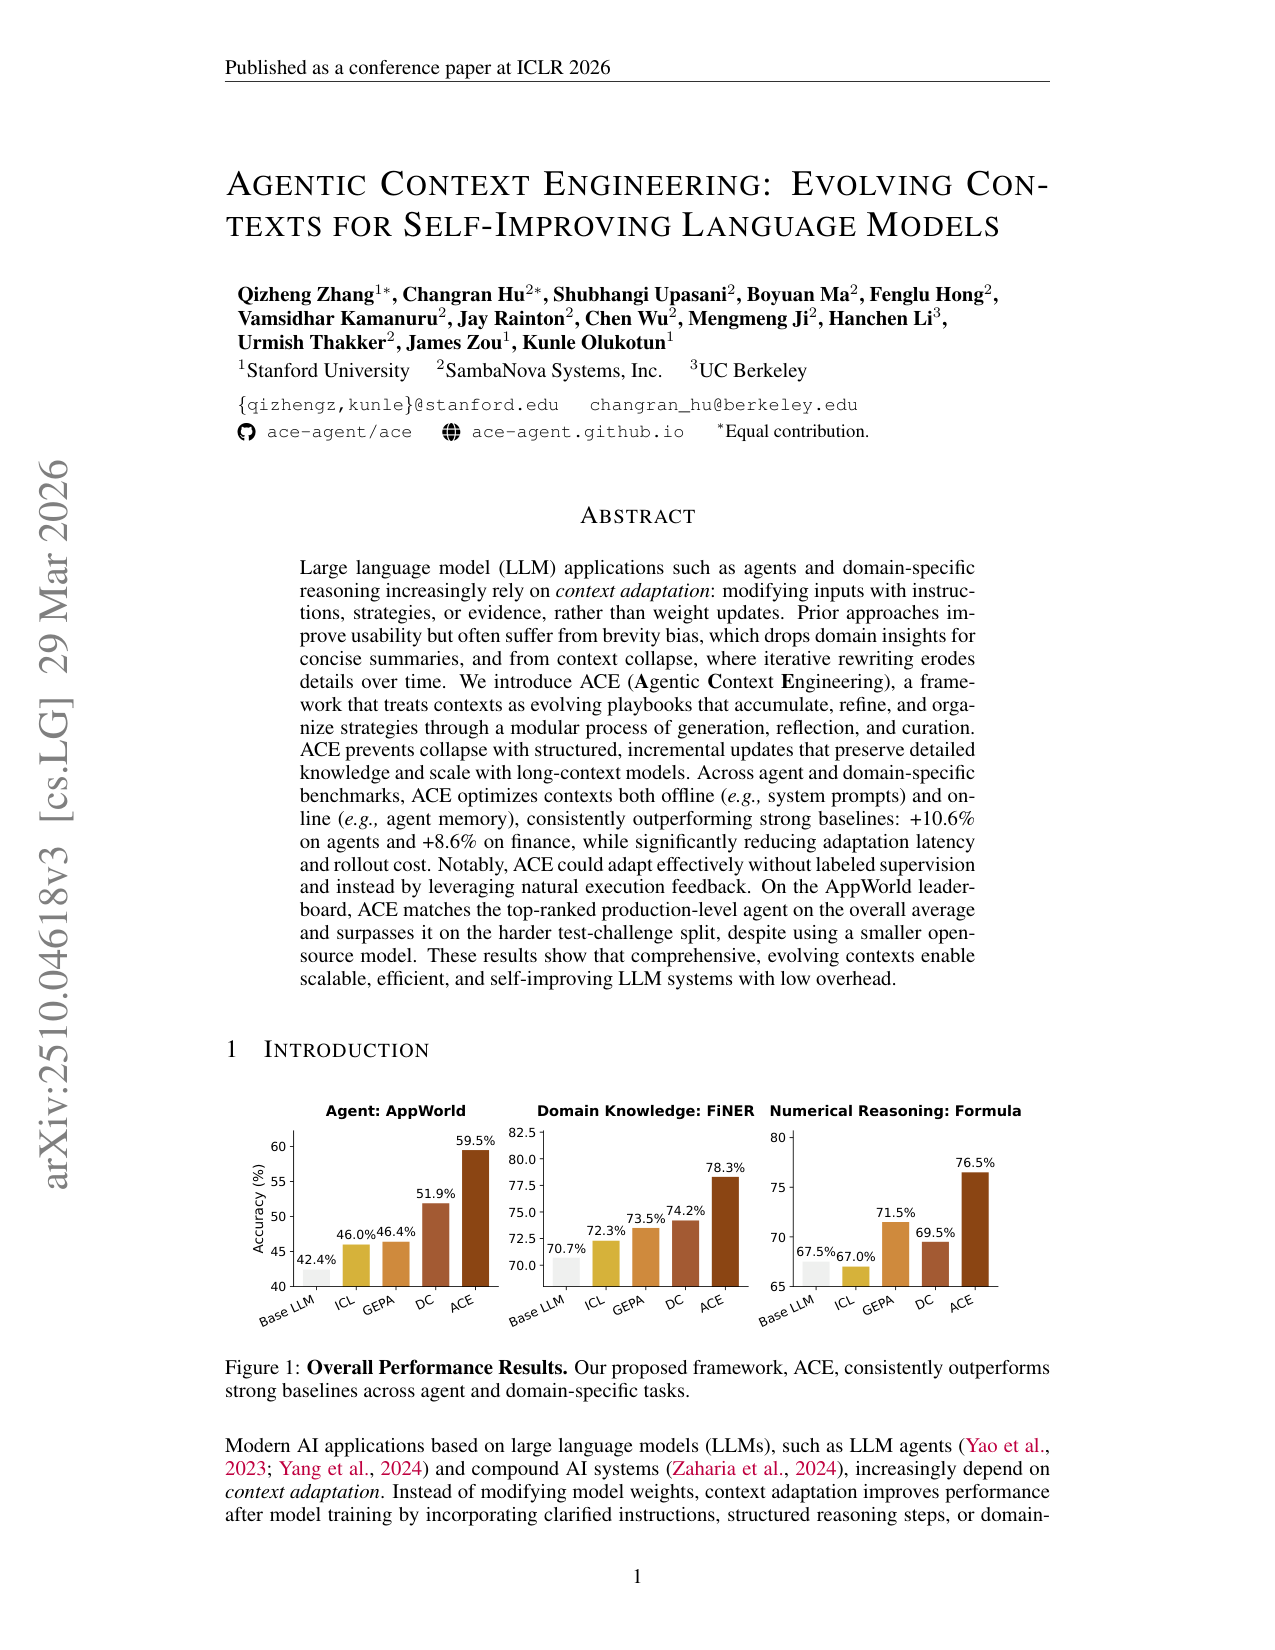
把上下文当「进化中的 playbook」:Generator/Reflector/Curator 三组件产出带 identifier 的结构化条目,用增量 delta 更新替代整体重写,治好 brevity bias 与 context collapse;AppWorld 上 ReAct+ACE 59.5% 对 base 42.4%,FiNER +7.6 个点、Formula +9.0 个点,离线适应延迟比 GEPA 省 82.3%。

读全文 →
context-engineeringself-improving agentplaybook
cover harness-evolution
2026-03-19 · University of British Columbia / Vector Institute / Meta FAIR

HyperAgents

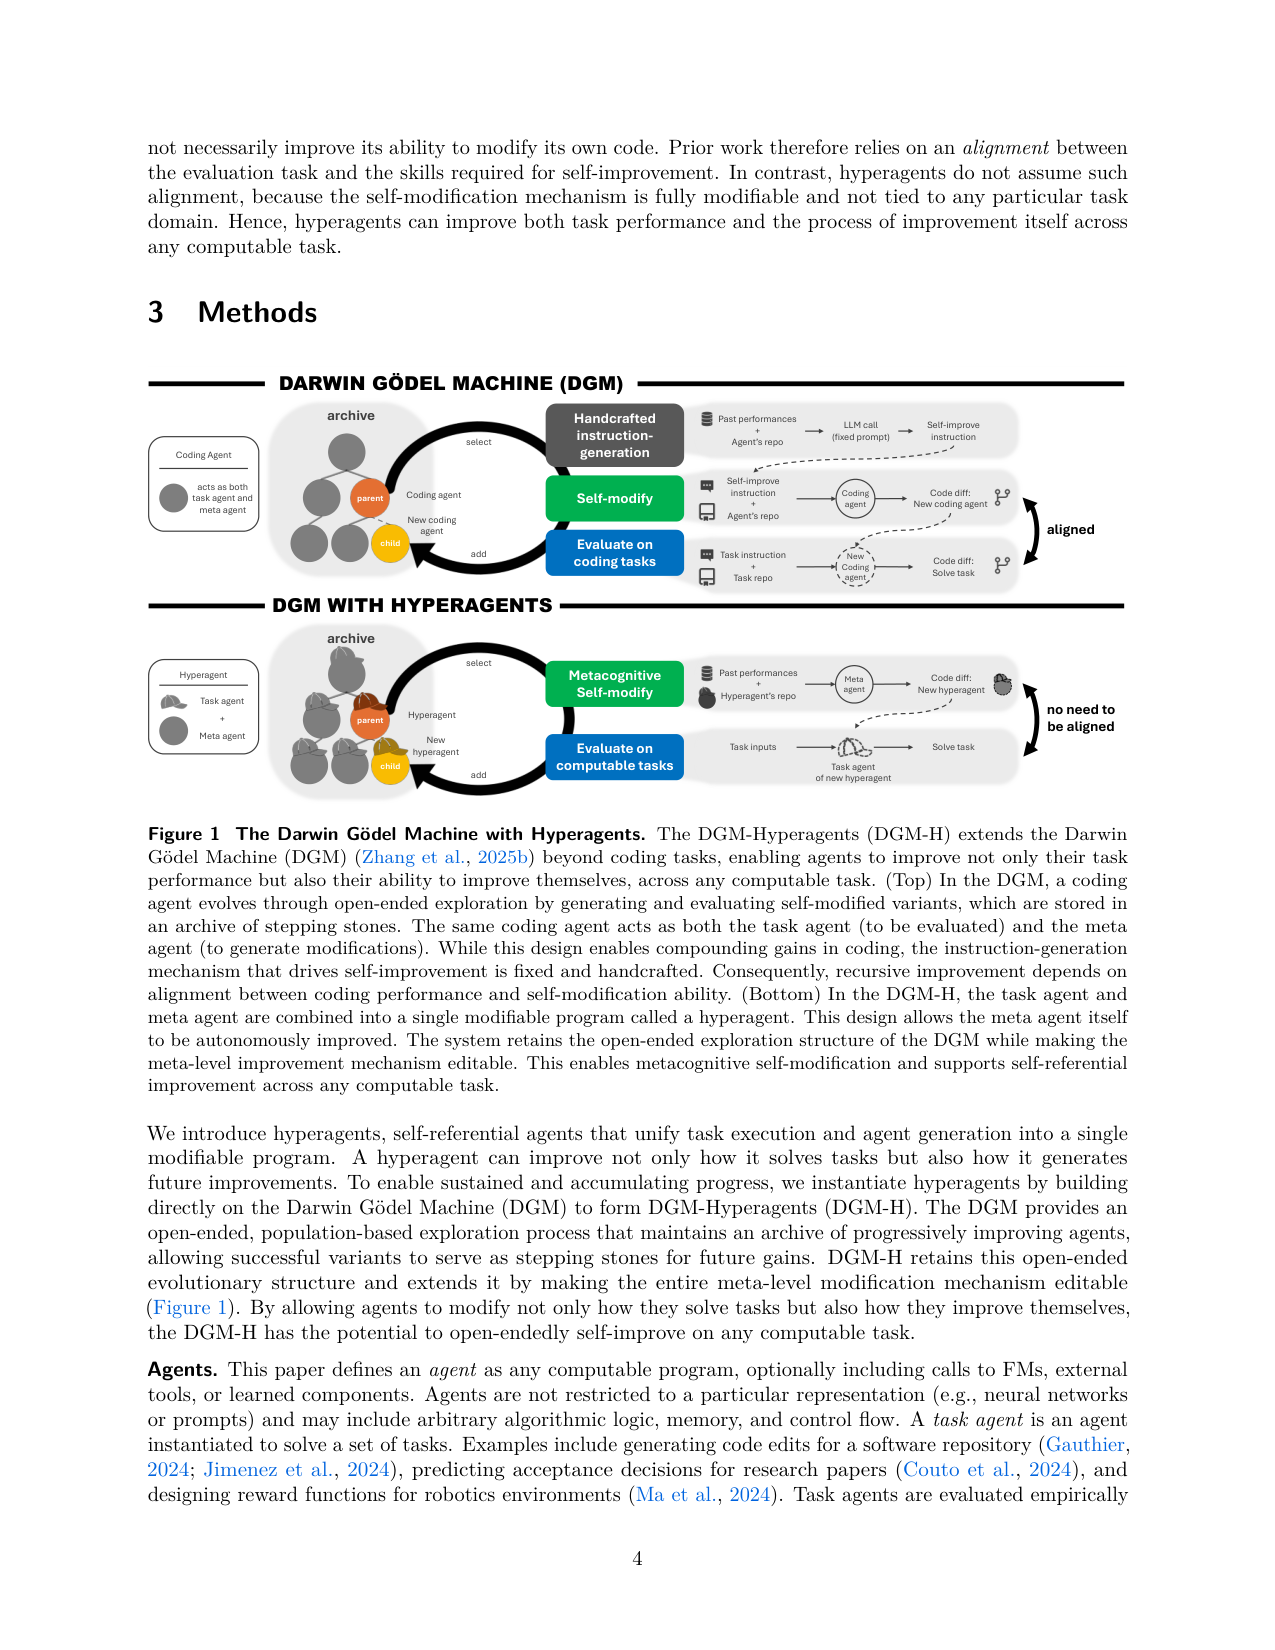
把 task agent 与 meta agent 合成单个可编辑程序(hyperagent),让「生成未来改进的机制」本身也可被编辑:在编码、论文评审、机器人奖励设计、IMO 级数学评分四个领域持续改进(论文评审测试集 0.0→0.710、奖励设计 0.060→0.372),并证明元层改进(持久记忆、性能追踪)可跨领域转移、跨 run 累积。

读全文 →
self-referential agentsmeta agentopen-ended evolution
cover context-engineering
2026-02-11 · Peking University(State Key Laboratory of General AI)

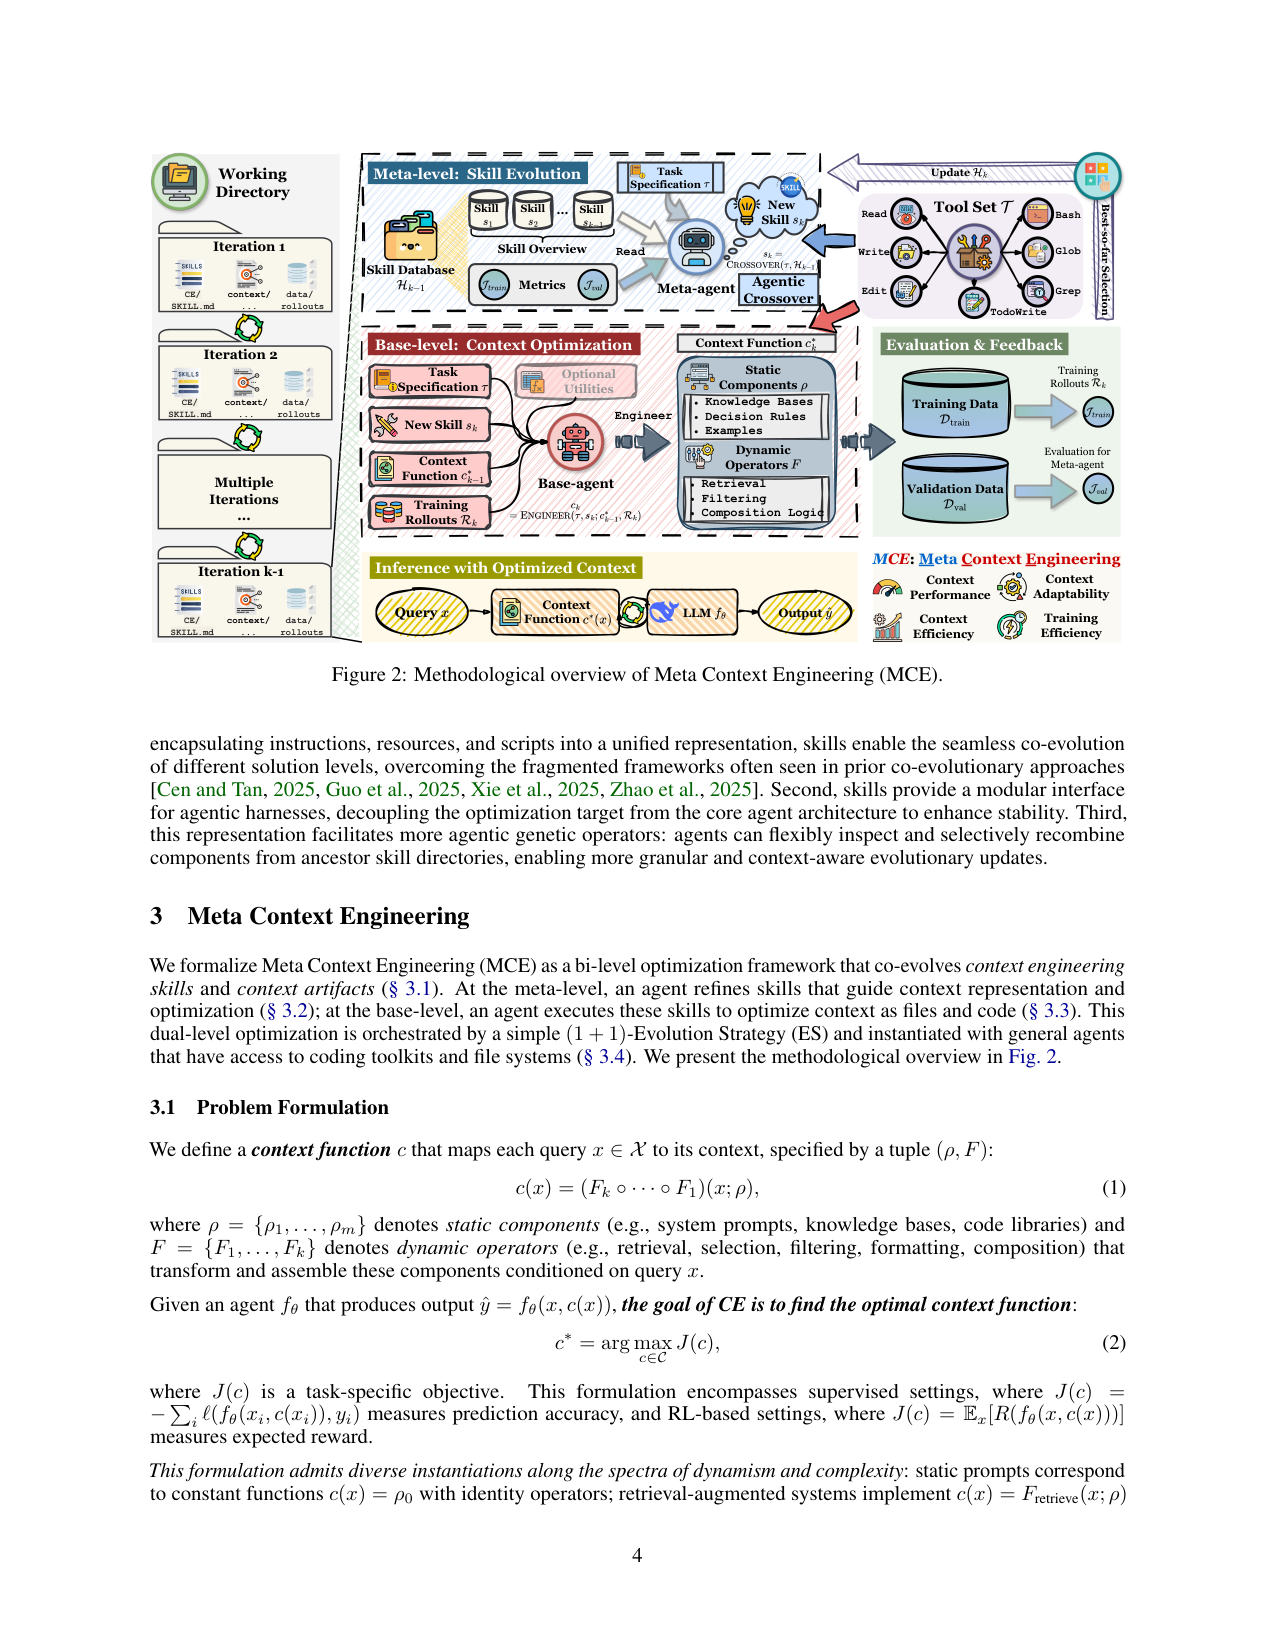
Meta Context Engineering via Agentic Skill Evolution

机制与内容分离的双层上下文优化:meta 层用 agentic crossover 进化「怎么管上下文」的 skill,base 层按 skill 把上下文当文件与代码优化;五个域相对 SOTA agentic CE 方法平均 +16.9%(范围 5.6–53.8%),FiNER 训练比 ACE 快 13.6×,上下文长度按任务自适应(1.5K–86K token)。

读全文 →
context-engineeringskill evolutionbi-level optimization
cover evolutionary-search
2025-11-28 · University of Washington / Microsoft

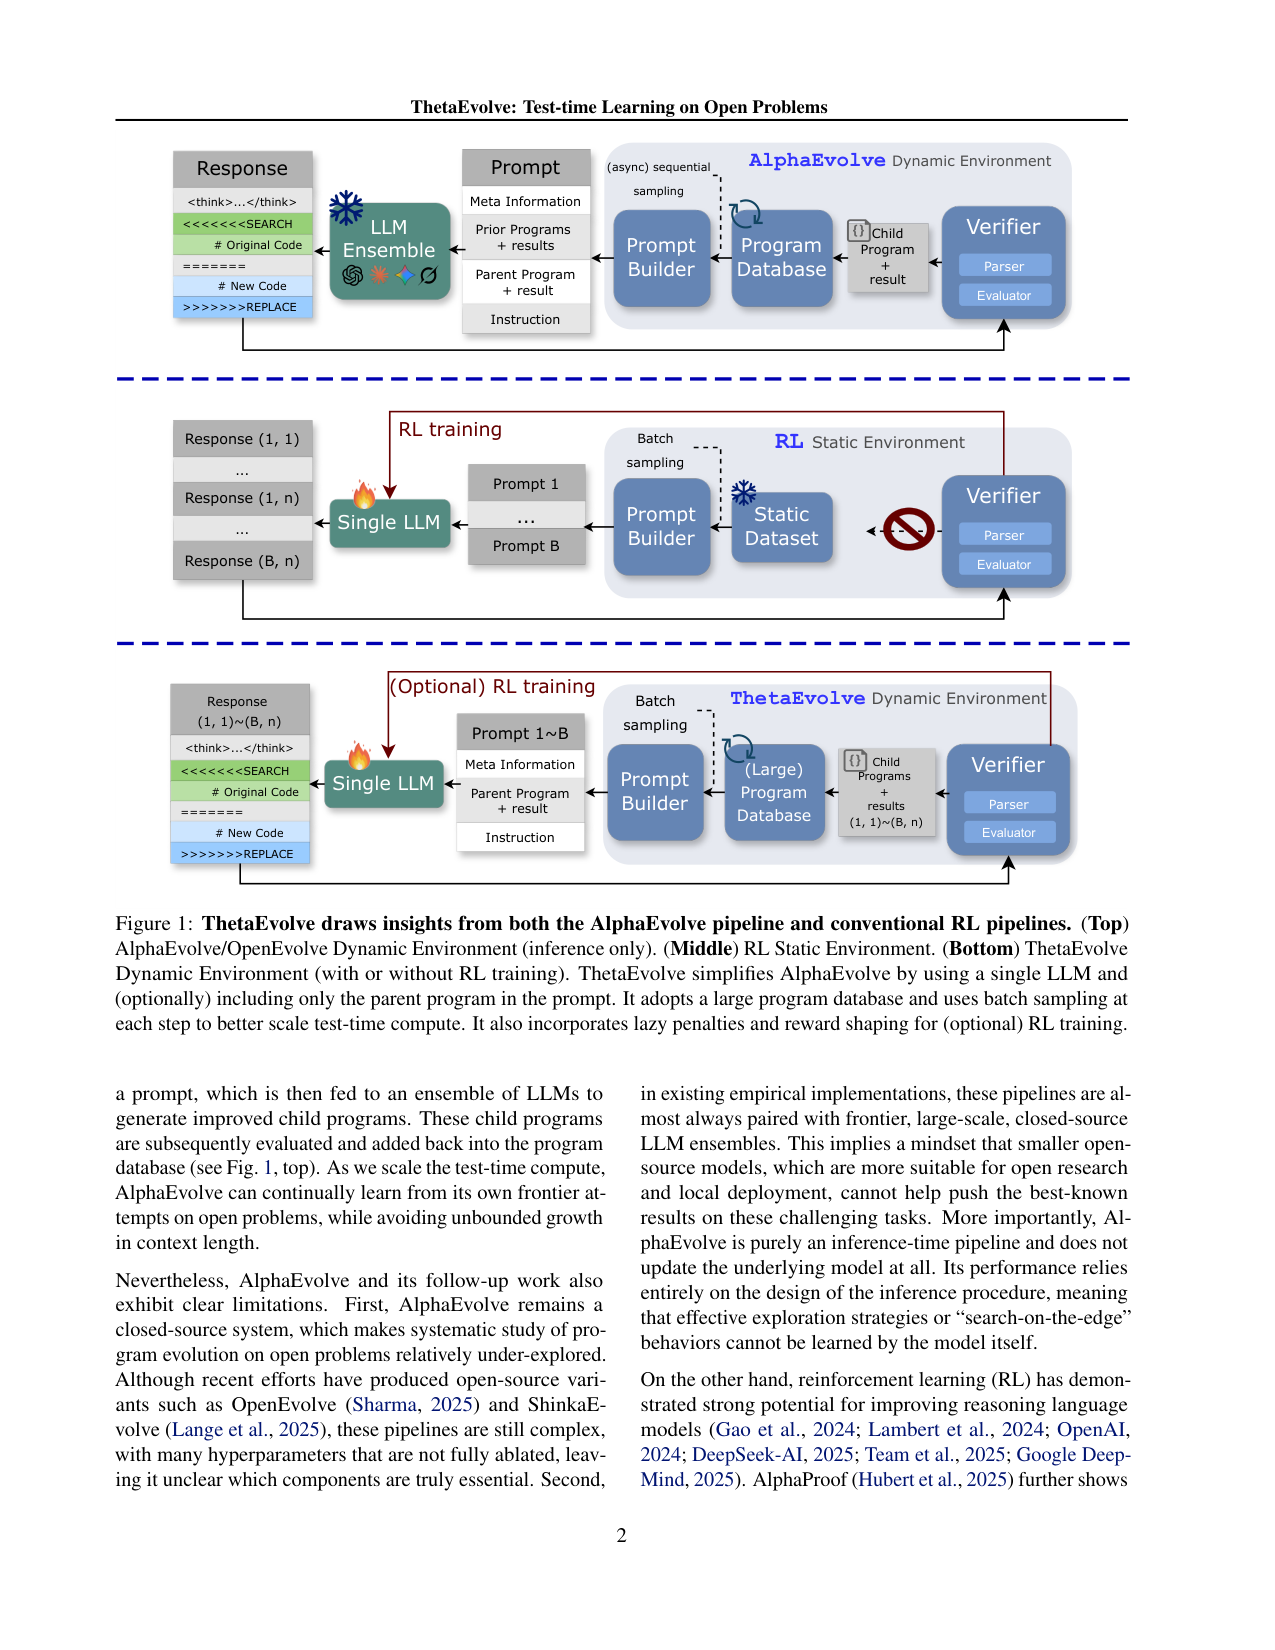
ThetaEvolve: Test-time Learning on Open Problems

用单个开源 8B 模型(DeepSeek-R1-0528-Qwen3-8B)加大规模程序数据库(population 10000)把 AlphaEvolve 简化成可扩展的 test-time 学习系统,并首次让 8B 模型刷新 AlphaEvolve 列出的两个开放问题上界(circle packing 2.63598308 vs AlphaEvolve 2.63586276;FACI 1.503133 vs 1.503164),RL 训练的 checkpoint 还学到了可迁移的「进化能力」。

读全文 →
test-time learningevolutionary searchRL
cover evolutionary-search
2025-09-17 · Sakana AI

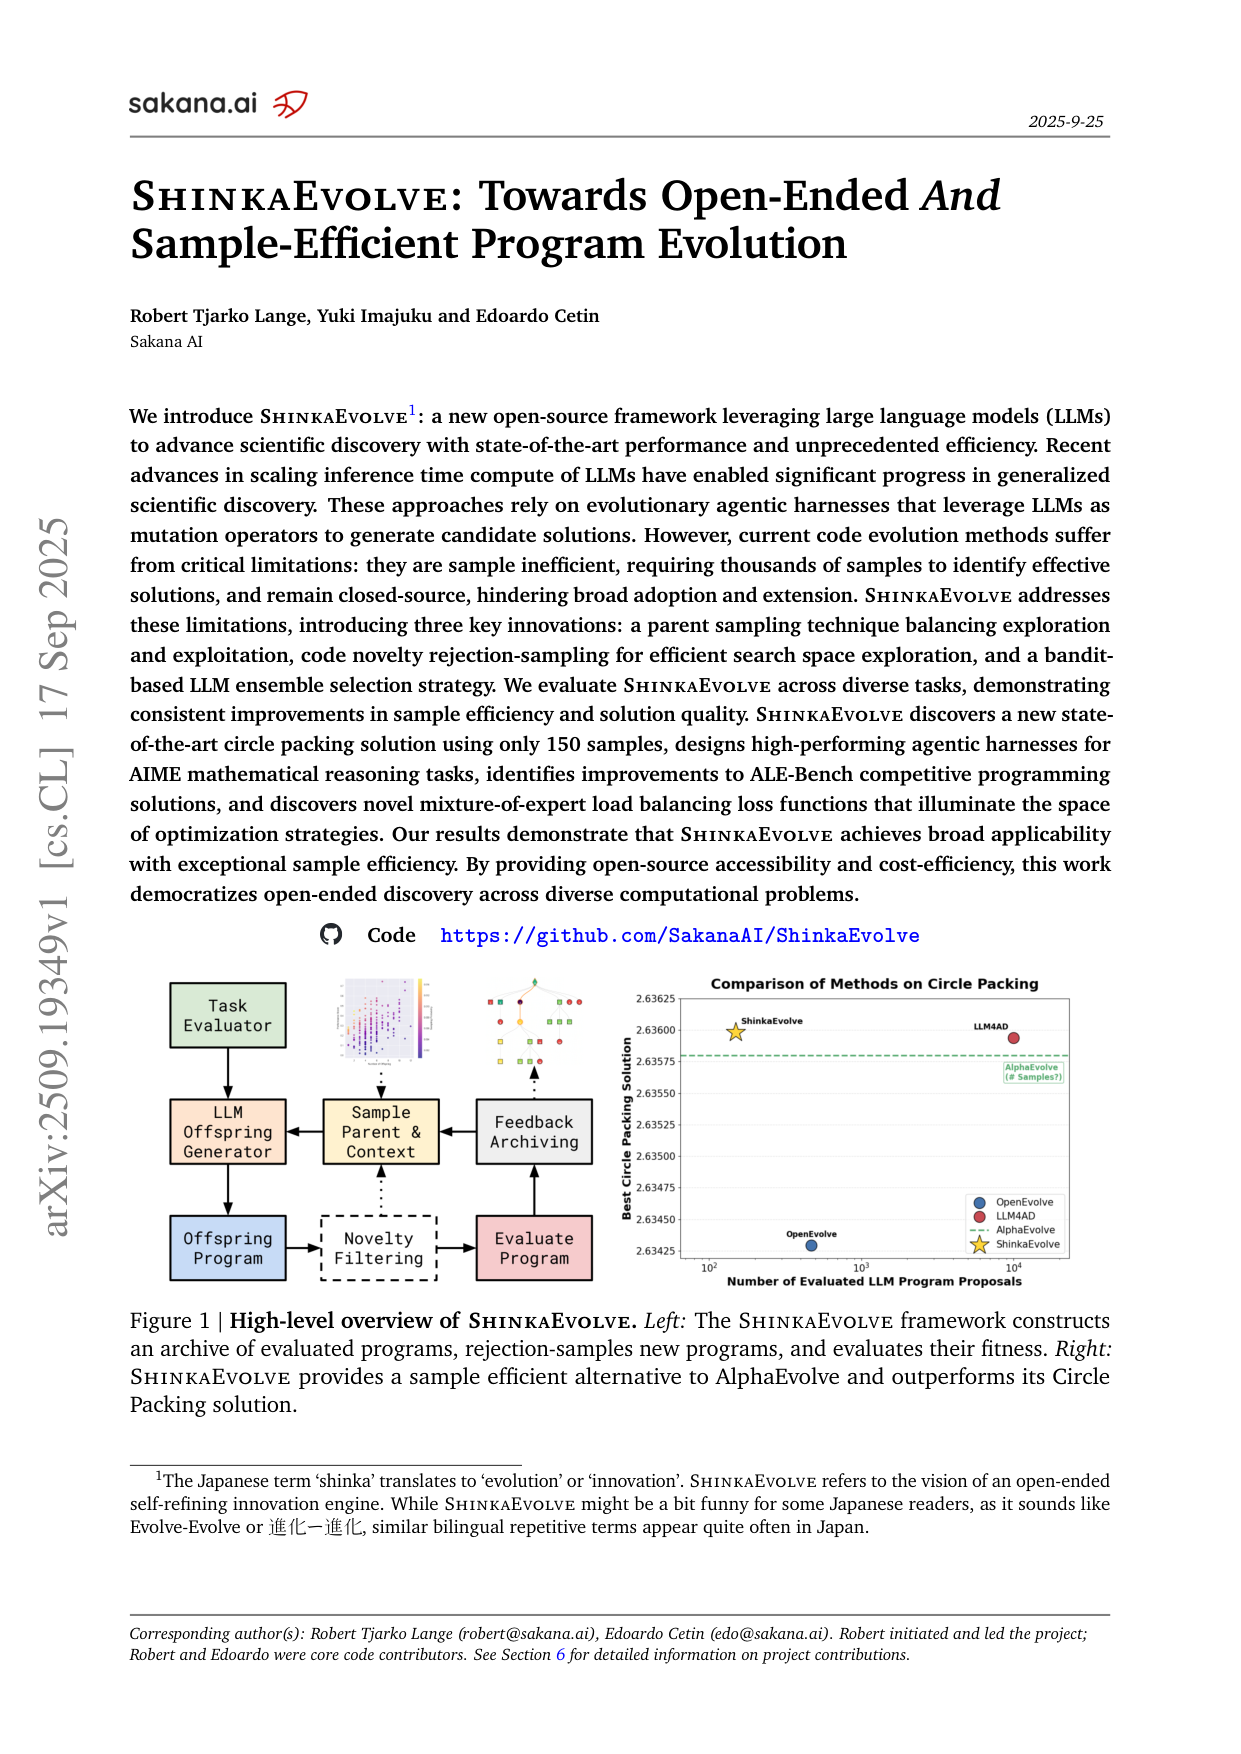
ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution

三个采样效率组件——按性能与子代数平衡的 parent sampling、embedding 余弦相似度的 code-novelty 拒绝采样、UCB1 选择 LLM 加 meta-scratchpad 沉淀成功模式——让 ShinkaEvolve 只用约 150 次程序评估就发现新的 circle packing SOTA(26 圆半径和 2.6359831,超越 AlphaEvolve 的 2.635),并进化出 AIME agent scaffold 与 MoE 负载均衡损失。

读全文 →
program evolutionsample efficiencynovelty rejection sampling
cover evolutionary-search
2025-07-25 · UC Berkeley / Stanford / BespokeLabs.ai / Notre Dame / Databricks / MIT

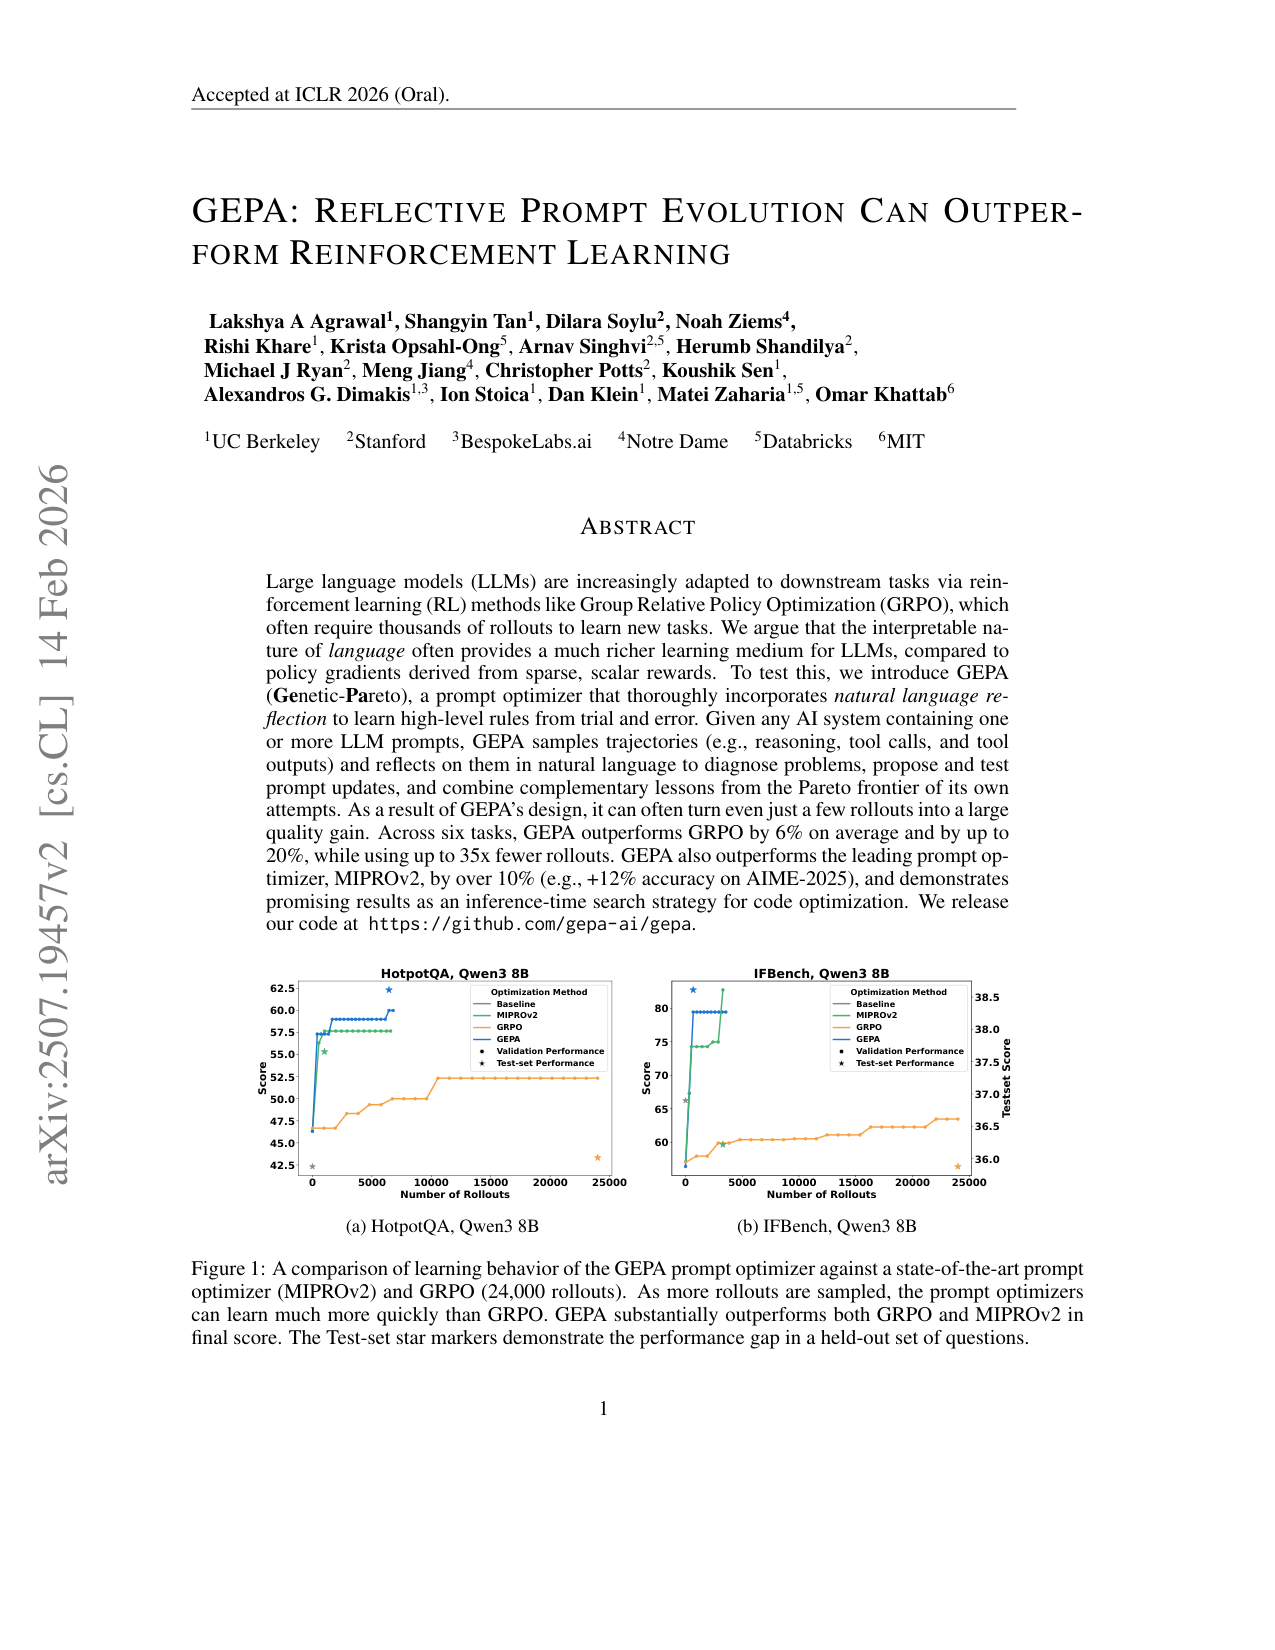
GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning

把每一次 rollout 变成自然语言学习信号:GEPA 用轨迹与评估文本(编译器报错、rubric 失败)驱动反思式变异,用 Pareto 前沿按实例选择候选,在 Qwen3 8B 上以最多 35 倍更少的 rollout 超过 GRPO(HotpotQA 62.33 vs 43.33;IFBench 用 678 次 rollout 达 38.61% vs GRPO 用 24,000 次达 35.88%)。

读全文 →
reflective prompt optimizationPareto searchsample efficiency
cover evolutionary-search
2025-06-16 · Google DeepMind

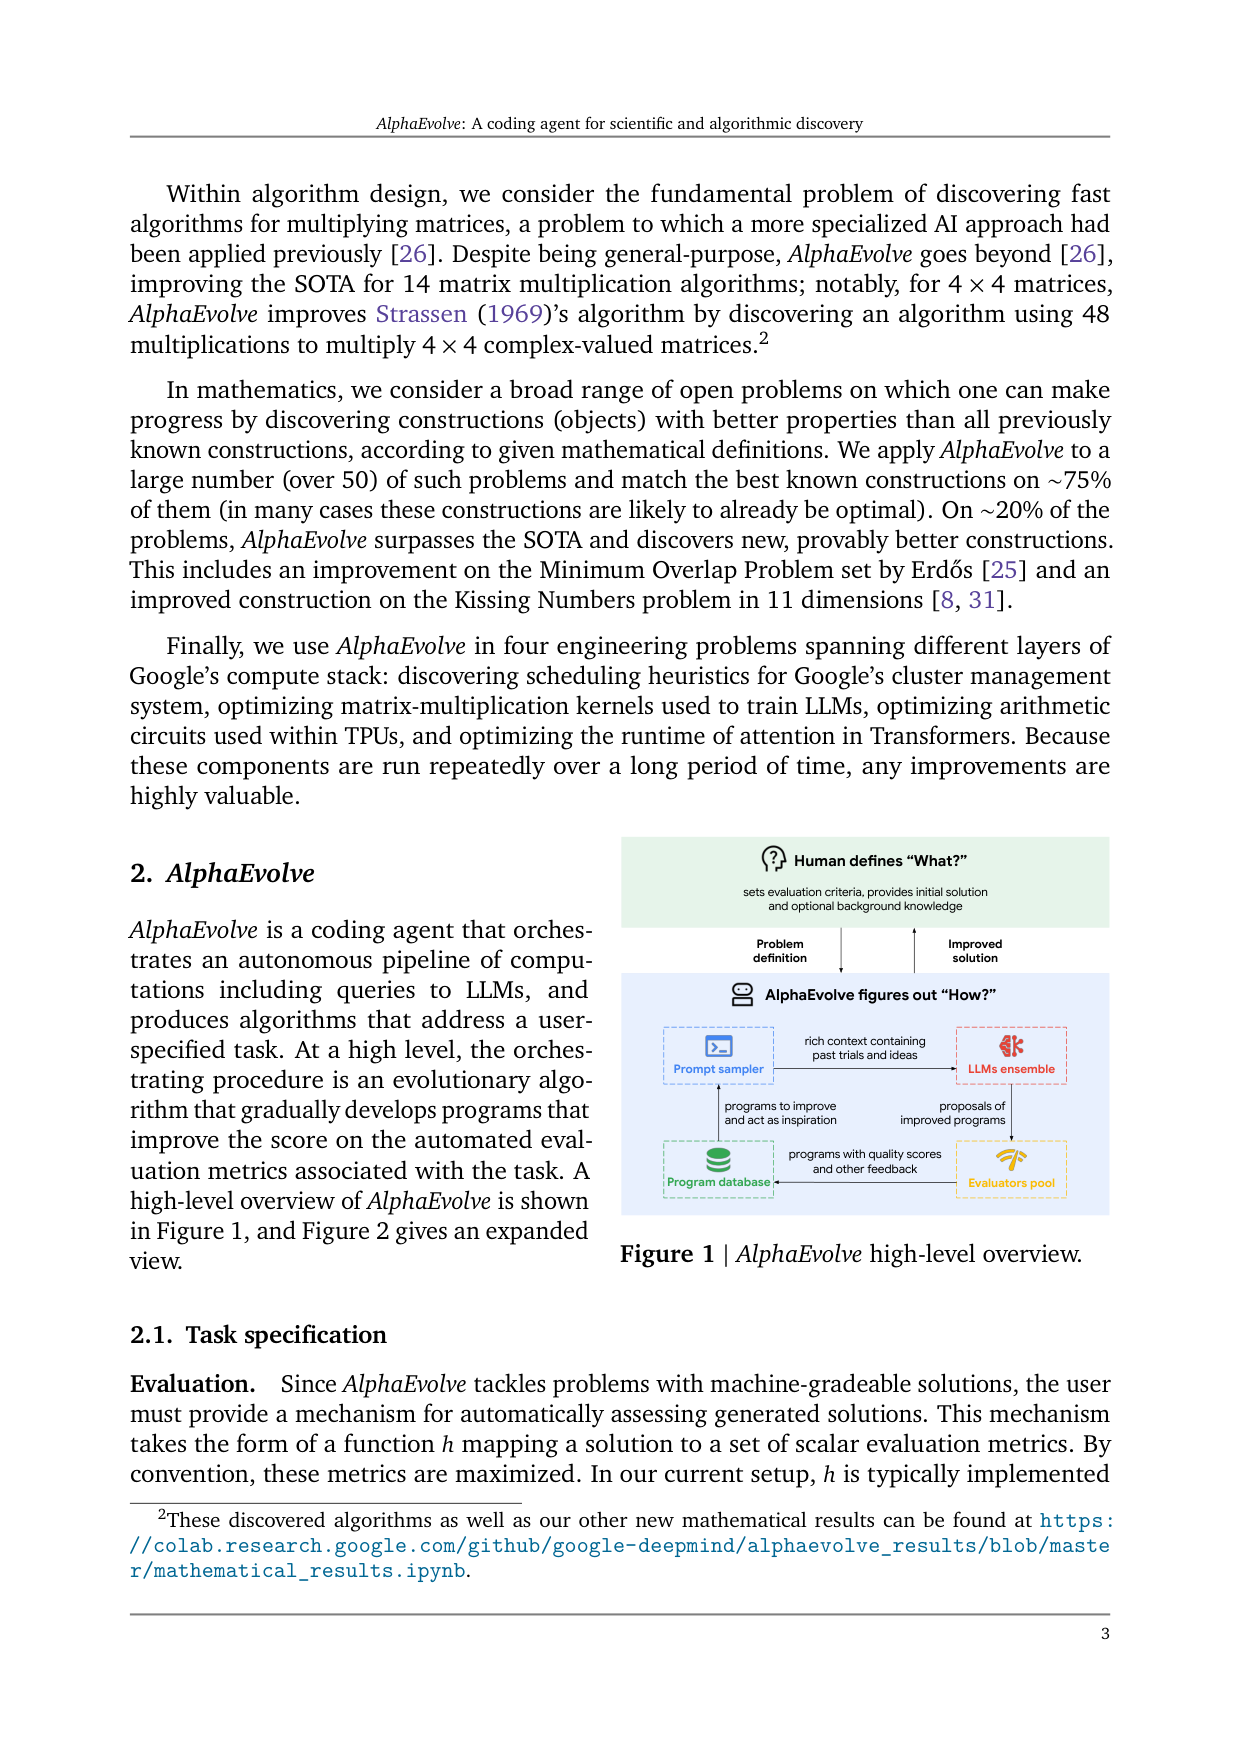
AlphaEvolve: A coding agent for scientific and algorithmic discovery

把「要改进的程序」用 # EVOLVE-BLOCK 标进代码,让 LLM 生成 diff 进化整个代码库、由自动评估器把关:在矩阵乘法上首次改进 Strassen 的 4×4 复矩阵算法(49→48 次标量乘法,56 年来的首个改进),并在 50+ 个数学开放问题上约 75% 打平已知最优、约 20% 超越 SOTA。

读全文 →
evolutionary program searchcode superoptimizationmatrix multiplication
cover harness-evolution
2025-05-29 · University of British Columbia / Vector Institute / Sakana AI

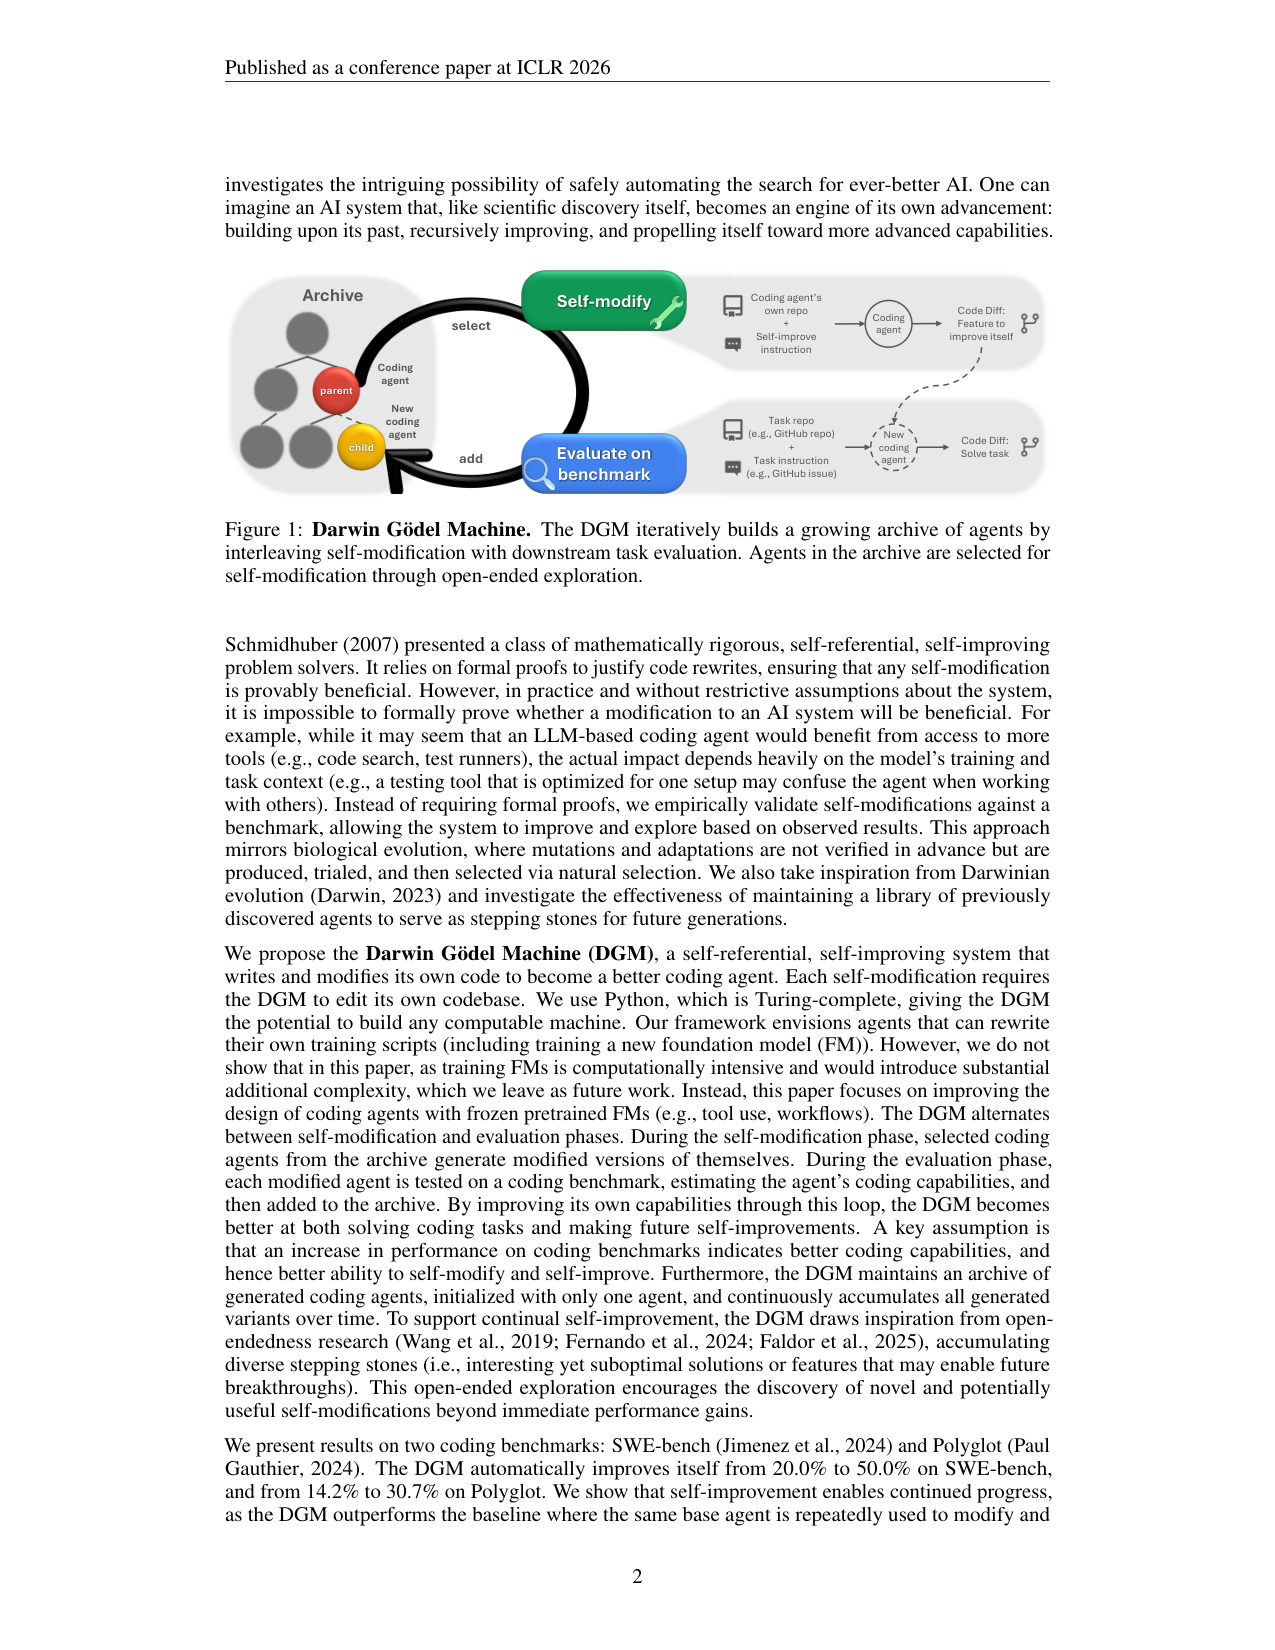
Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents

固定模型权重,让 coding agent 用 bash + editor 两个工具编辑自己的 harness 代码库:按「性能/孩子数」概率选 parent、把每个变体归档进开放探索树,80 次迭代内 SWE-bench Verified 从 20.0% 涨到 50.0%、Polyglot 从 14.2% 涨到 30.7%,且收益跨模型、跨 benchmark、跨语言迁移。

读全文 →
self-improving agentsopen-ended evolutionharness evolution
cover workflow-design
2025-04-15 · DeepWisdom / HKUST(GZ) / Renmin University of China / Nanjing University / Fudan / KAUST / Université de Montréal

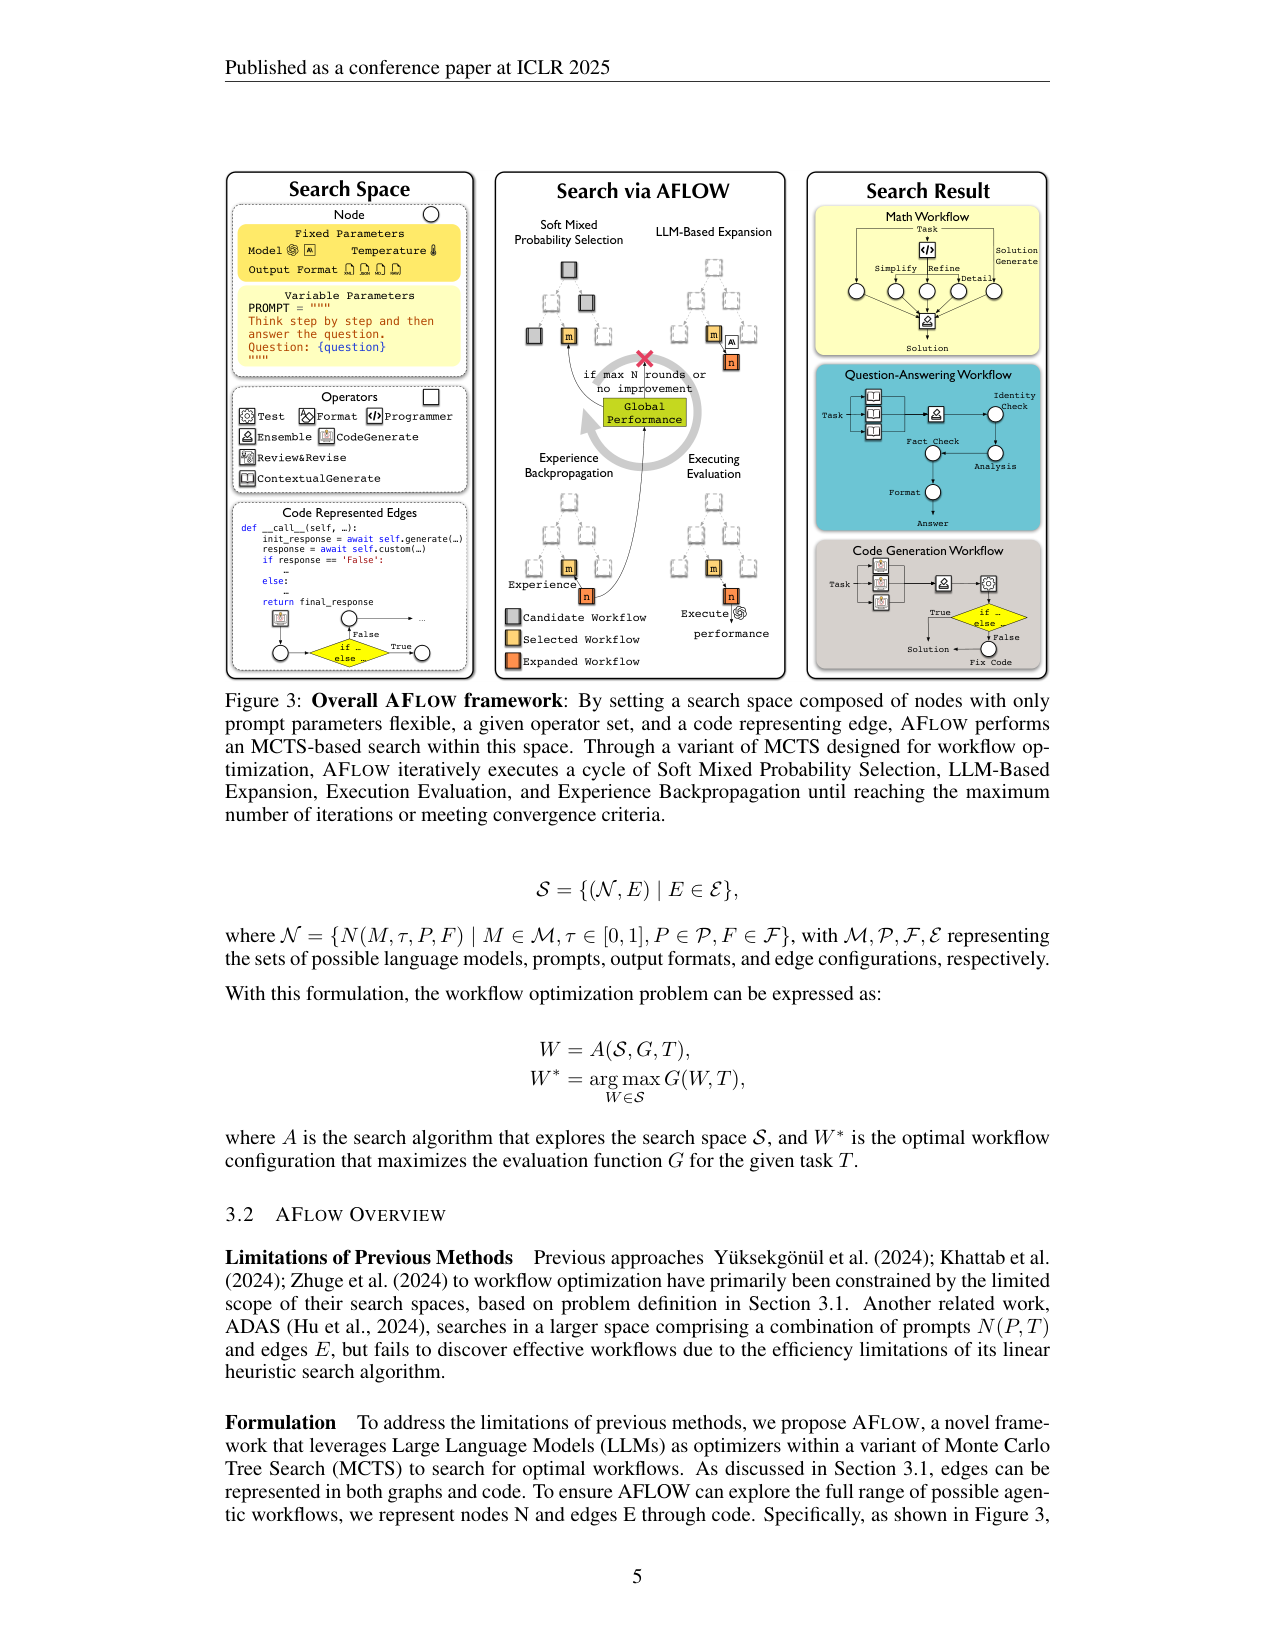
AFLOW: Automating Agentic Workflow Generation

agentic workflow 用代码表示 + MCTS 优化(Soft Mixed 选择→LLM 扩展→执行评估→经验回填):6 个 benchmark 平均 80.3%(GPT-4o-mini 执行),超最佳手工方法 +5.7%、超 ADAS +19.5%;小模型+搜出的 workflow 以 GPT-4o 约 4.55% 的成本打平甚至超过它(HumanEval)。

读全文 →
workflow-designMCTScode-represented workflow
cover workflow-design
2025-03-02 · University of British Columbia / Vector Institute / Canada CIFAR AI Chair

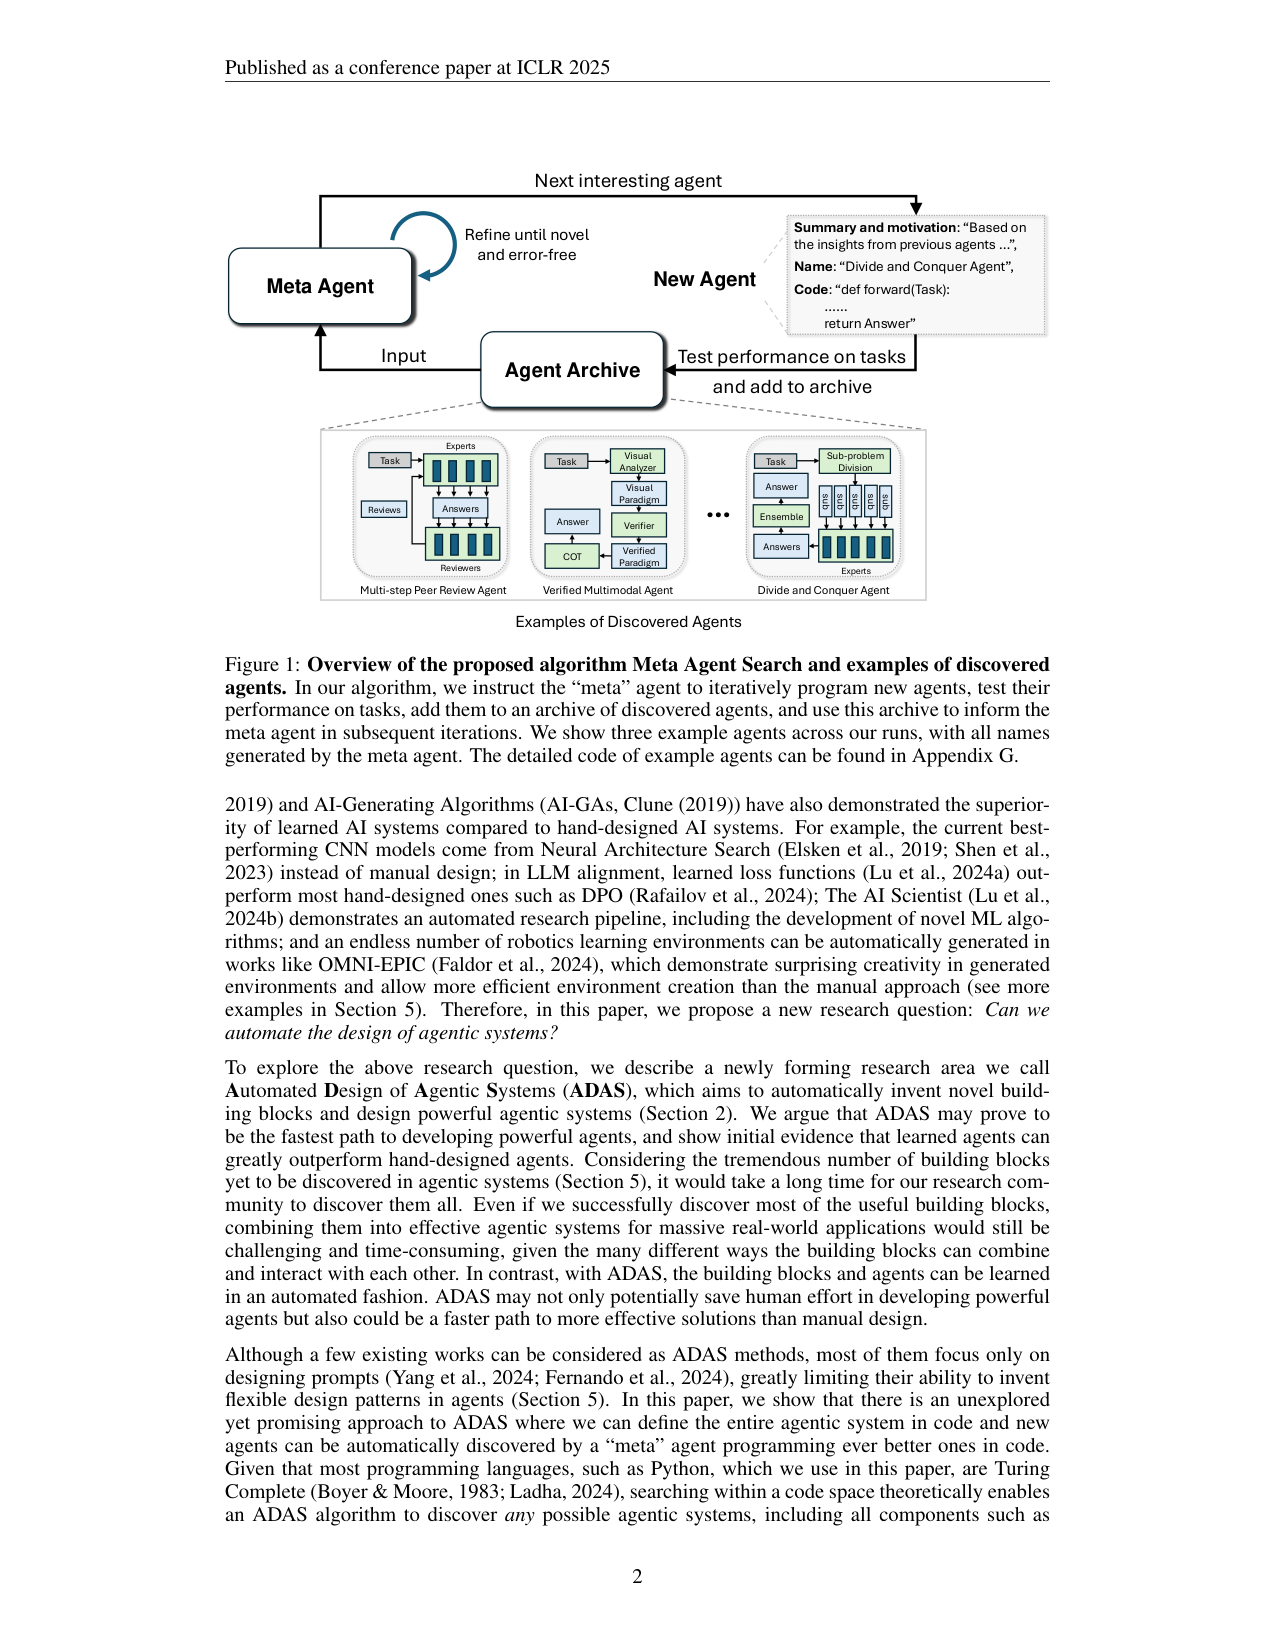
Automated Design of Agentic Systems

提出 ADAS 研究领域 + Meta Agent Search:meta agent(GPT-4)在 <100 行代码框架里反复编程新 agent(forward 函数),archive 累积前序发现当 stepping stones;DROP F1 79.4 对最佳手工 65.8、MGSM 53.4 对 39.0,且发现的 agent 跨域跨模型迁移仍领先(GSM8K +25.9%、ARC 跨模型近 50%)。

读全文 →
workflow-designmeta agentcode search
cover self-improving-agent
2024-08-16 · Stanford University / Microsoft Research / OpenAI

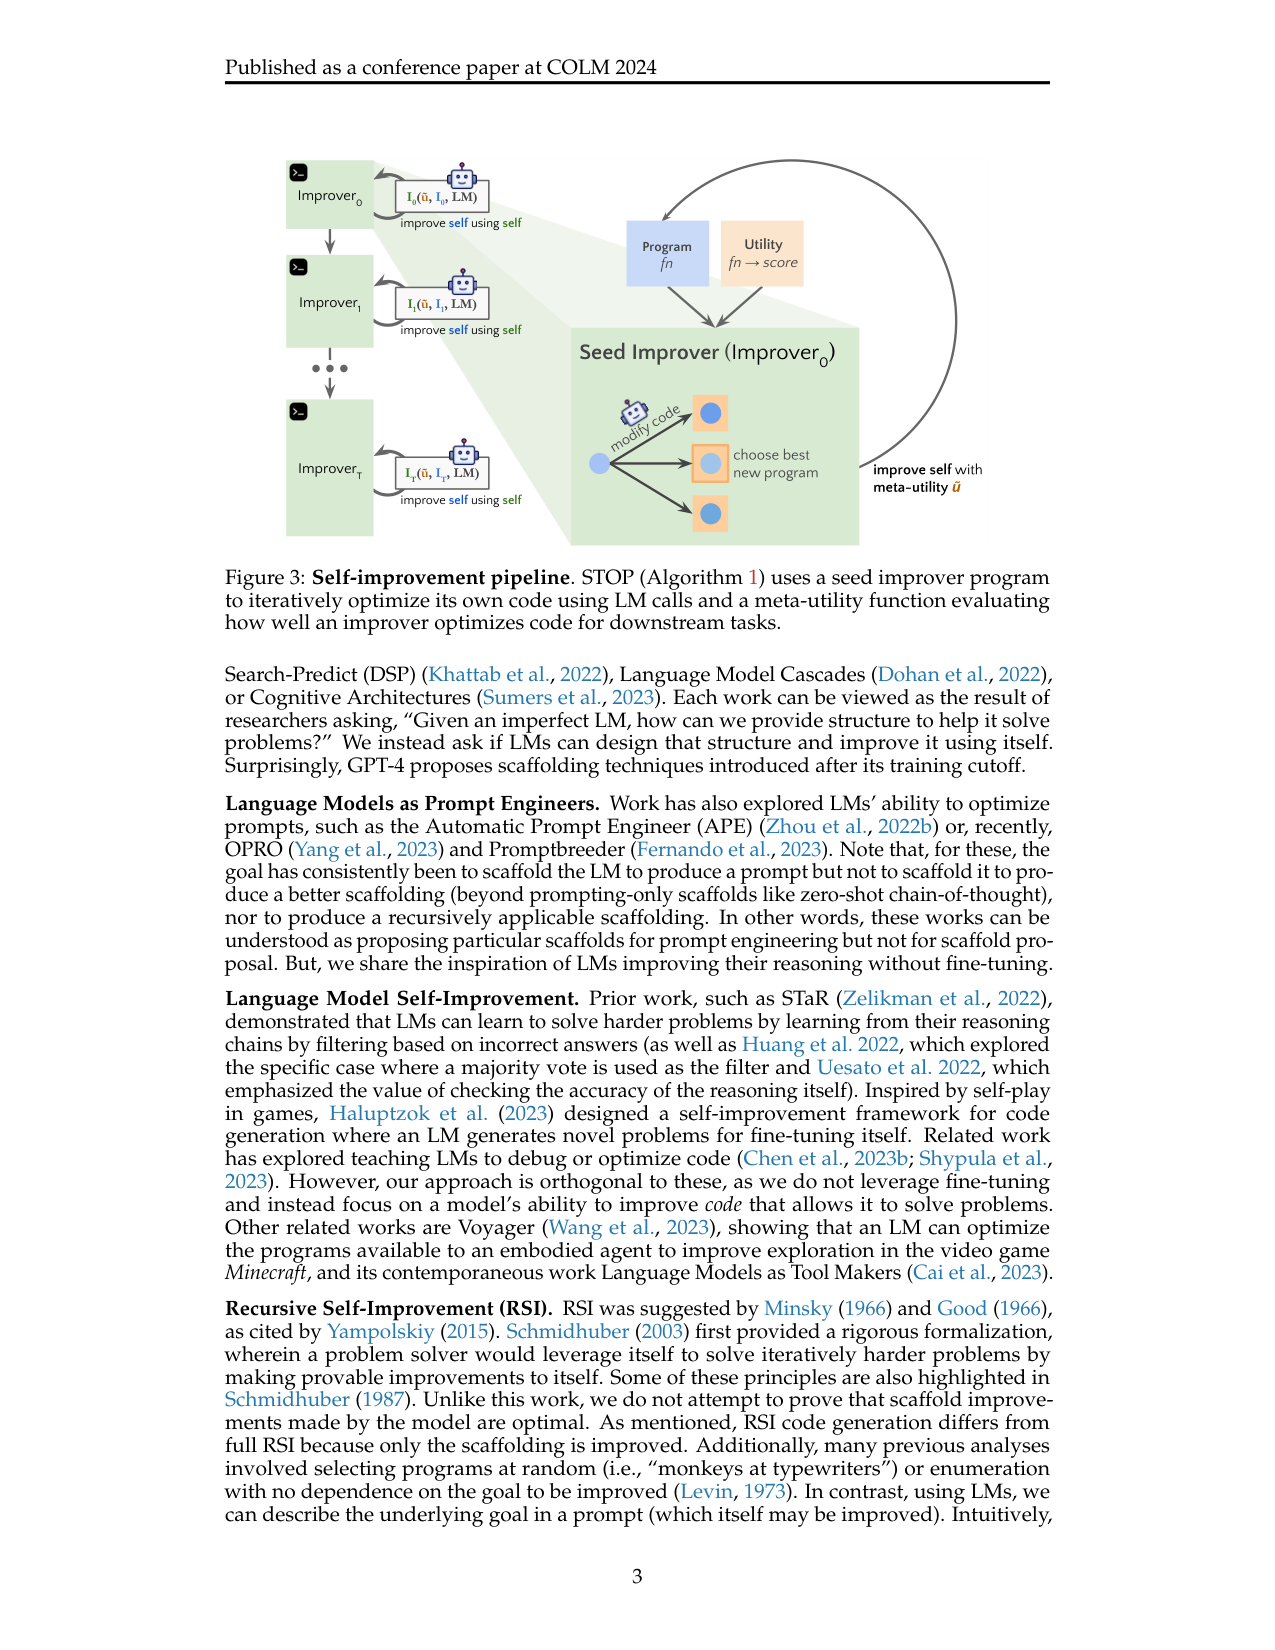
Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation

STOP 把「改进器(improver)程序本身」当作优化对象:种子 improver 借助 GPT-4 递归改进自己(I_t = I_{t-1}(û, I_{t-1}, L)),在多个下游算法任务上稳定提升,并自主提出遗传算法、模拟退火、beam search 等改进策略;模型权重全程不变,处在 L1 自我改进层级(非完整 RSI)。

读全文 →
recursive self-improvementscaffoldingmeta-optimization
cover evolutionary-search
2023-09-28 · Google DeepMind

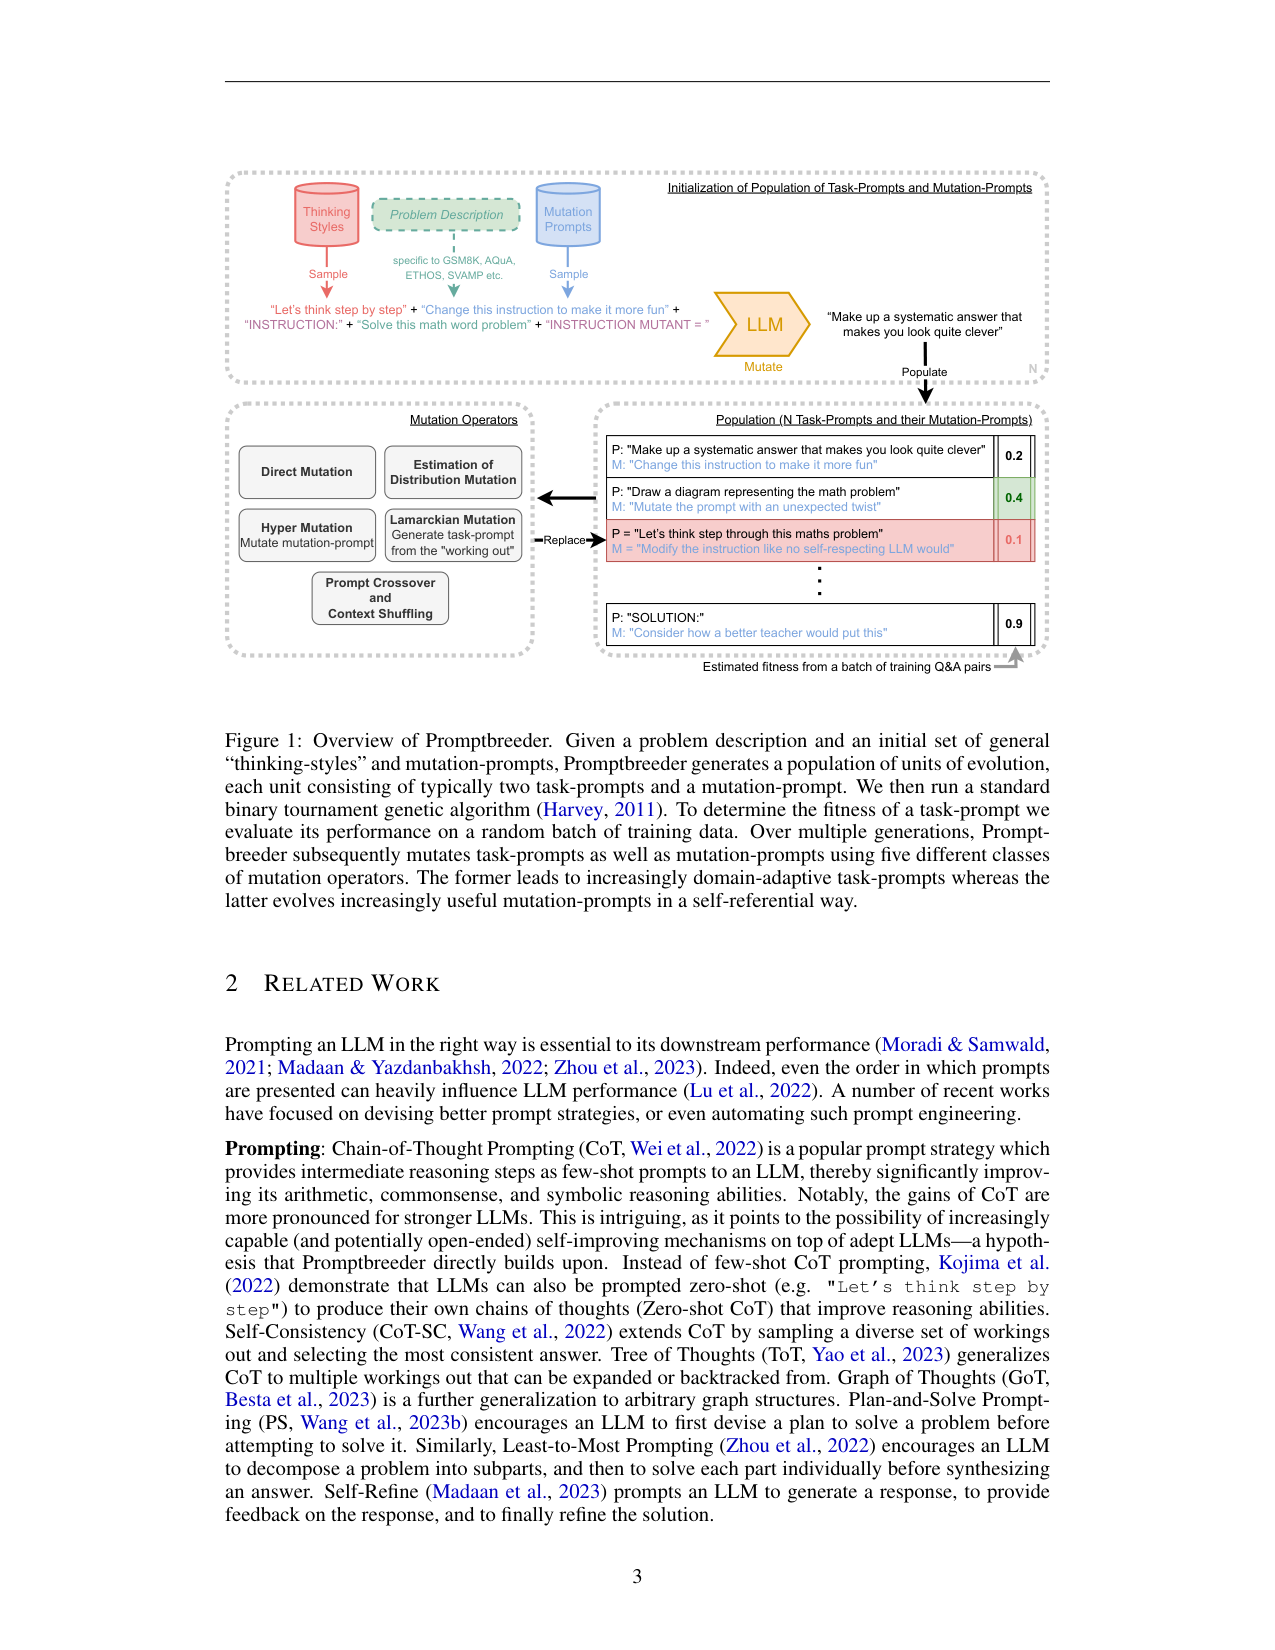
Promptbreeder: Self-Referential Self-Improvement via Prompt Evolution

把「改进 prompt 的 prompt」也放进进化循环:Promptbreeder 用 LLM 当变异算子,同时进化 task-prompt 与 mutation-prompt,在 8 个算术/常识推理 benchmark 上以冻结的 PaLM 2-L 权重超过手写 CoT 与 Plan-and-Solve(GSM8K 零样本 83.9% vs PS+ 的 60.5%),并在 ETHOS 上进化出 89% 的两段式提示(对照手写提示 80%)。

读全文 →
prompt evolutionself-referentialevolutionary algorithm
0:00